Lec 9 part2 · Lec 10 · control hazard 해결(PC+4 예측·delay slot)과 BTB·2-bit branch predictor
정밀 정리 · 검증 2026-09-24 17:40
1개요
1.1Q&A: forwarding logic 에 use_rs 조건이 없는 이유, load-use stall 과 다른 register 안전성.
1.2Lec 9 후반: PC+4 예측(86%), MEM 판정 3 bubble IPC 0.70 → EX 0.78 → ID 0.88, ID 비교기 forwarding, JALR 은 EX.
1.3MIPS branch delay slot 과 compiler 의 slot 채우기(a/b/c), 현대 ISA 는 대부분 미사용.
1.4Lec 10: Oracle BTB(IPC 0.89) → hash·tag BTB → 1-bit BHT(IPC 0.94) → 2-bit saturating·hysteresis counter (p1~17 까지 진행).
2섹션별 정리 상황·문제 → 원인 → 해결
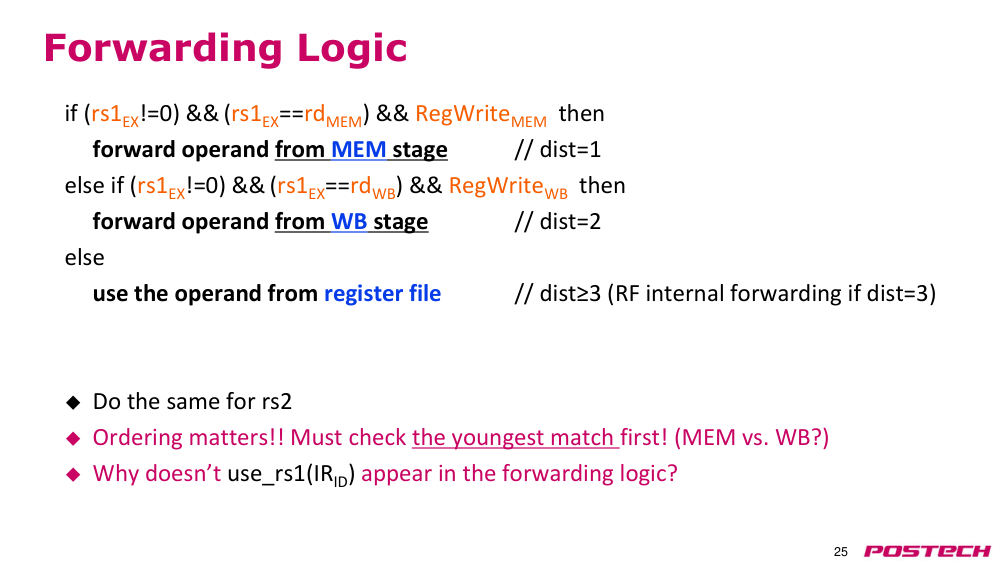
2.13:14–9:00Q&A 1: forwarding logic 에 use_rs1 조건이 없는 이유
상황·문제ALU 입력 앞 mux 에 EX/MEM·MEM/WB 값을 추가하는 forwarding logic 에 왜 use_rs1(IR) 조건을 쓰지 않나?
원인forwarding logic 은 rs1/rs2 자리에 무엇을 넣을지만 정한다. 뒤의 mux 가 PC·immediate 를 고르면 그 값은 어차피 쓰이지 않는다.
해결쓰지 않을 operand 는 어느 값이 forward 돼도 결과에 영향 없음 → 조건 불필요 (stall 은 잘못 멈추면 손해라 use_rs 가 필요).
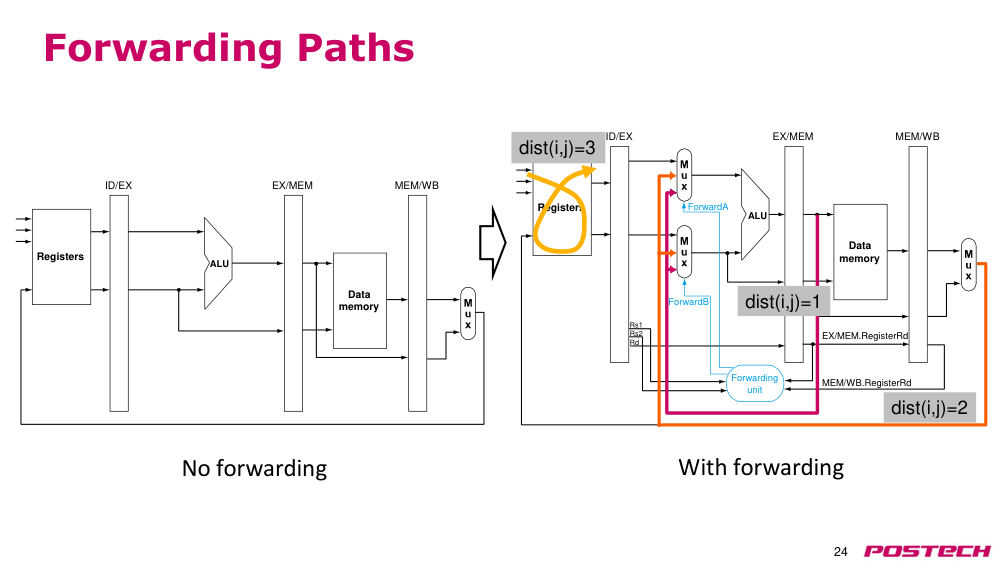
- forwarding mux 는 register file 값 대신 pipeline register 값을 고르는 것
- immediate·PC 를 쓰는 instruction 은 forwarding 선택과 무관
2.29:00–15:25Q&A 2: load-use stall 뒤 다른 register(x5)도 안전한가
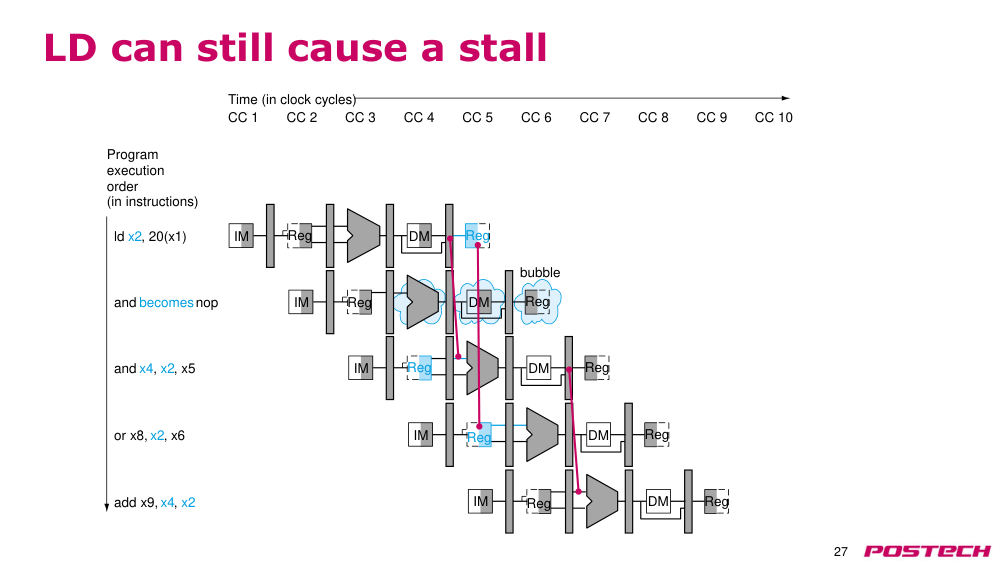
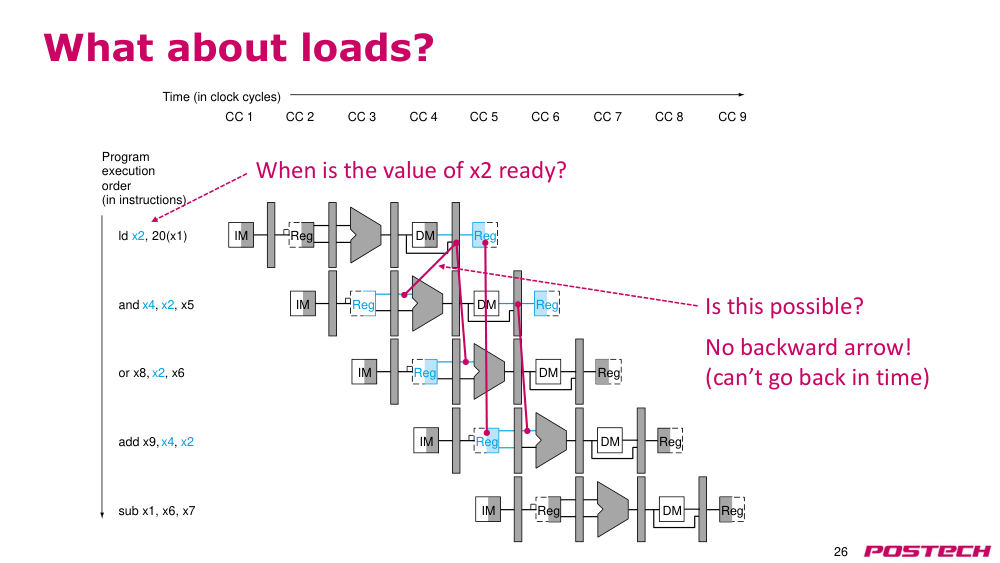
상황·문제add x5 … / or … / ld x2, 20 / and x4, x2, x5 에서 ld 때문에 stall 할 때 x5 가 update 전 값을 읽지 않을지 질문.
원인stall 이 우선: forwarding 여부와 상관없이 ld–and 사이 bubble 1개가 반드시 들어간다.
해결and 가 ID 에서 읽을 때쯤 x5 를 쓴 add 는 이미 writeback 을 마쳐 register file 에 값이 있으므로 문제없음. 이후 출석 확인.
- stall 조건 검사가 forwarding 보다 먼저
- dist 가 3 이상이면 register file 에서 바로 읽음
2.315:40–20:10control hazard 복습과 PC+4 예측
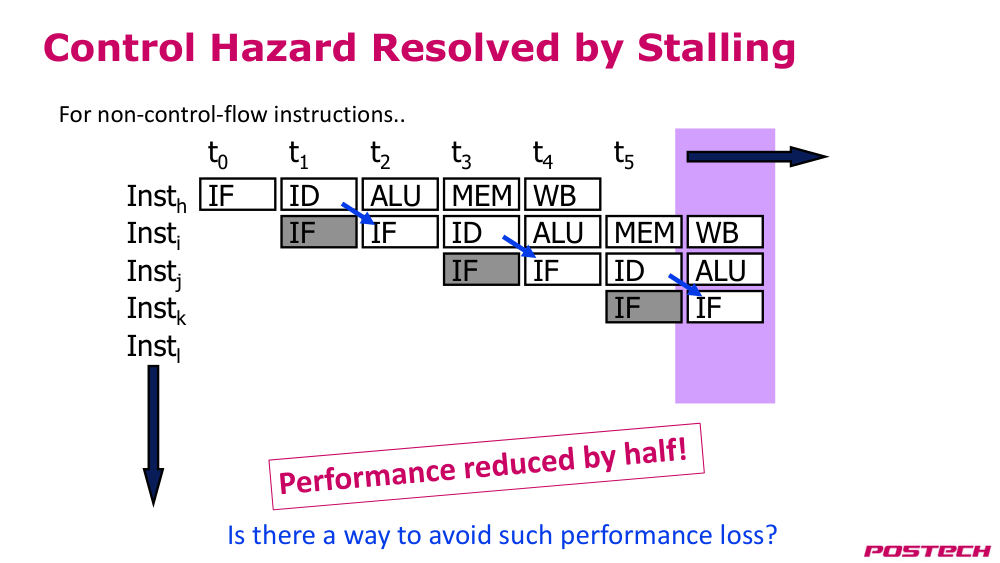
상황·문제fetch 직후 다음 PC 를 알아야 하는데 decode 전에는 PC+4 인지 branch/jump target 인지 모른다.
원인ID 끝까지 기다리면 격 cycle 에 fetch → 성능 절반.
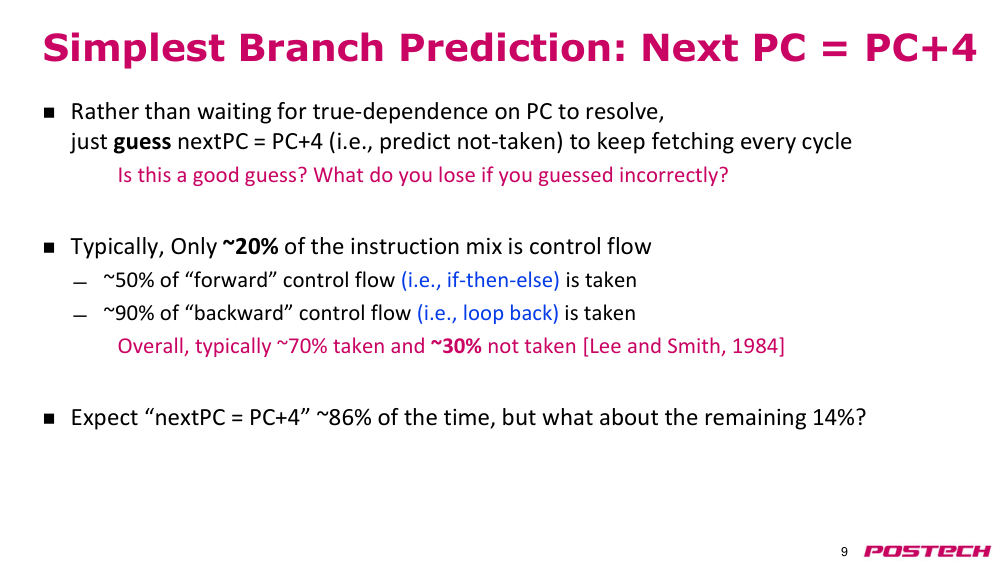
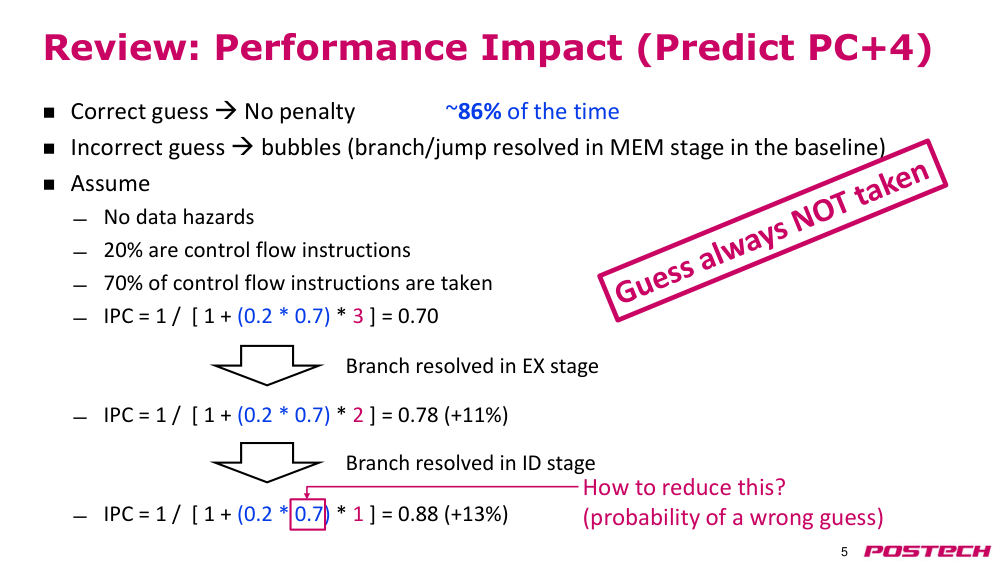
해결nextPC = PC+4 로 예측하고 틀리면 flush. control flow 20%, 그중 70% taken → 86% 정답, 14% 오답.
- forward branch 50%, backward branch 90% taken
- control flow 중 30% not taken = 전체 6% 도 PC+4 로 맞음
2.3.r.1Branch predictor (Wikipedia) ↗ · static/dynamic 예측, 2-bit saturating counter, two-level, gshare, tournament 개요
2.420:10–25:00branch 결과를 언제 아나: MEM 단계와 flush
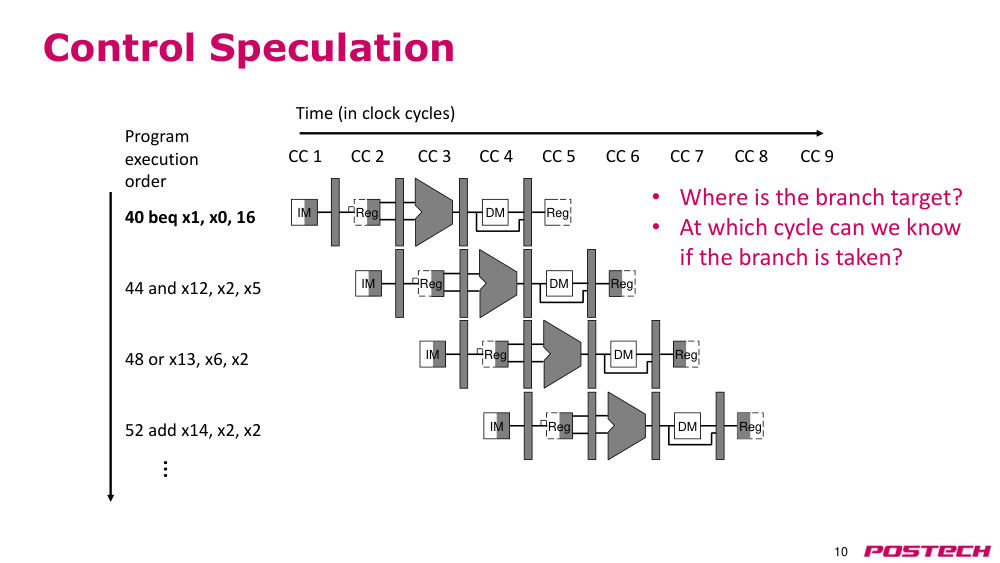
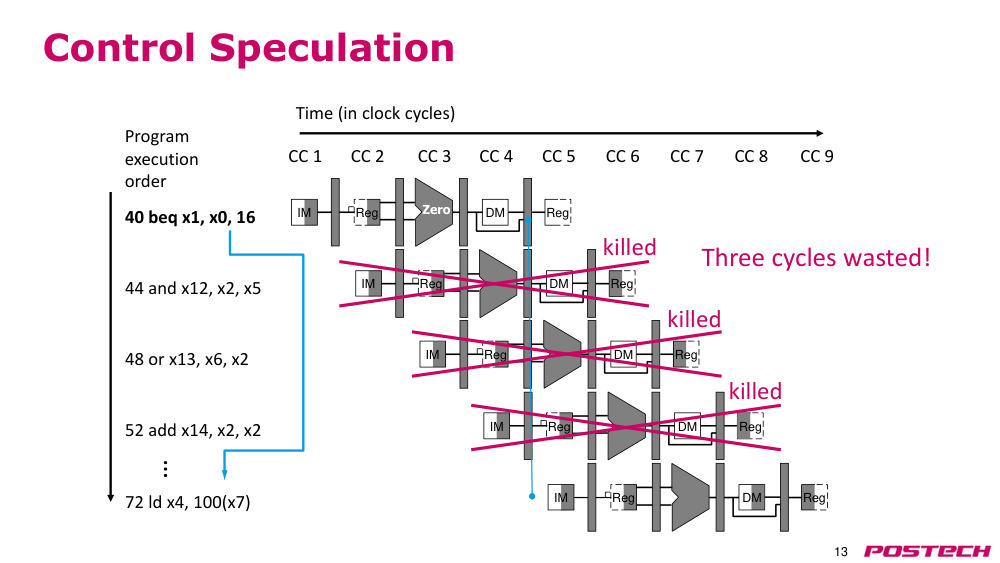
상황·문제40 beq x1, x0, 16 의 target 72 (imm 은 bit 1부터라 shift 1 → 32) 는 언제 확정되는가?
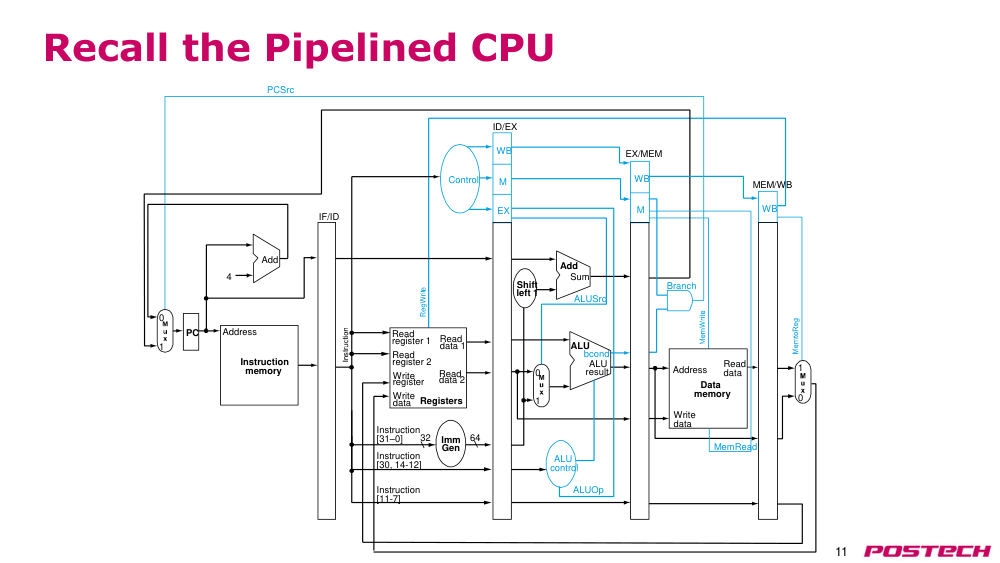
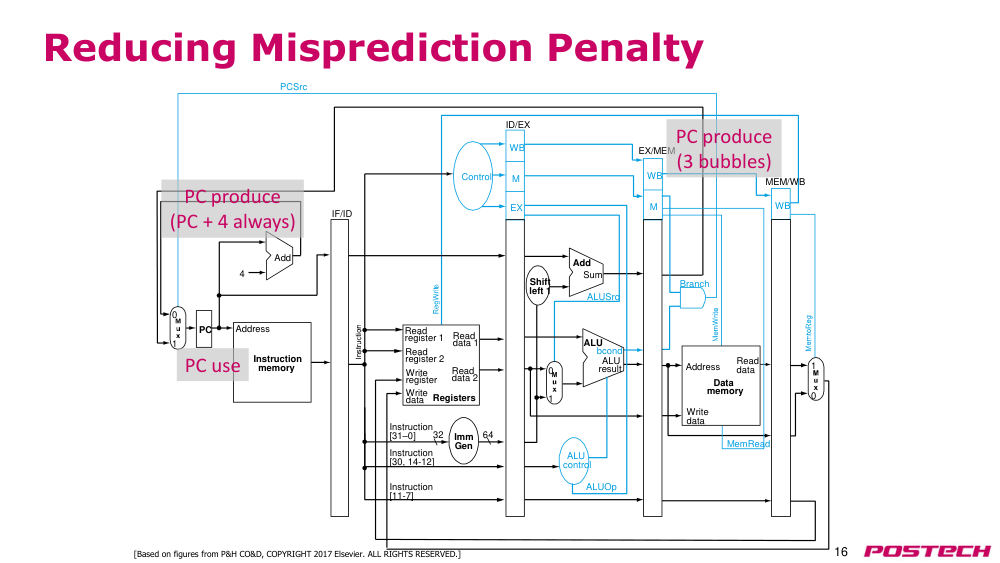
원인현재 pipeline 은 MEM 단계에서 PC+4 와 target 중 PC 를 고름 → 그 사이 IF·ID·EX 의 3개 instruction 이 잘못된 경로.
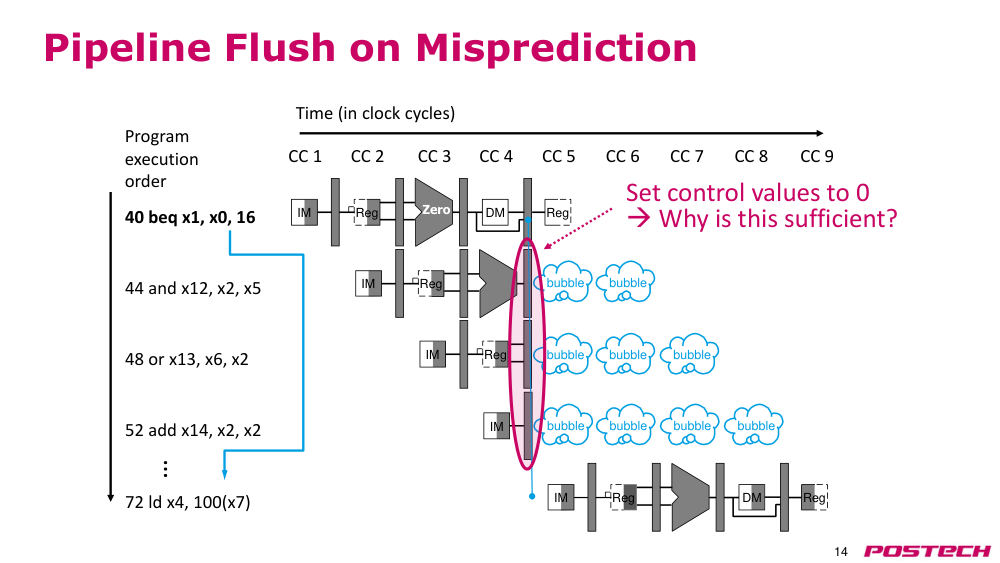
해결3개를 flush: pipeline register 의 control 값을 0 으로 해 bubble 로. register writeback·memory write 만 막으면 programmer visible state 가 안 바뀐다.
- misprediction 한 번에 3 cycle 낭비
- control 0 으로 충분한 이유: state 변경 지점은 RF write 와 memory write 뿐
2.525:00–27:20PC+4 예측의 성능: IPC 0.70
상황·문제86% 정답이어도 오답마다 bubble 3개.
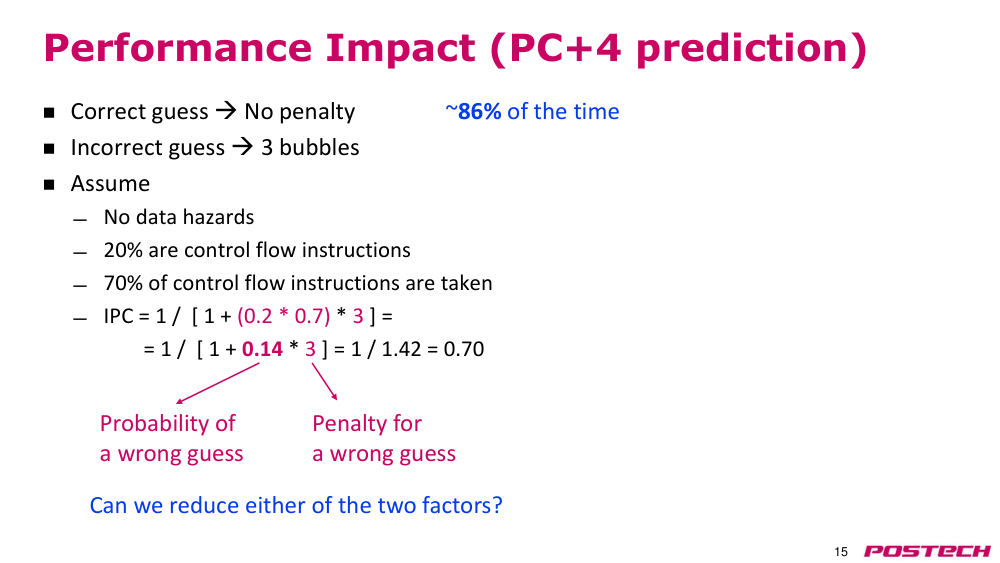
원인IPC = 1/[1+(0.2*0.7)*3] = 0.70, ideal 1 대비 30% 저하.
해결줄일 수 있는 두 인자: 오답 확률(더 나은 예측) 또는 penalty(3). penalty 부터 다룬다.
- 가정: data hazard 없음, 20% control flow, 70% taken
2.627:20–31:40misprediction penalty 줄이기: EX·ID 단계 판정
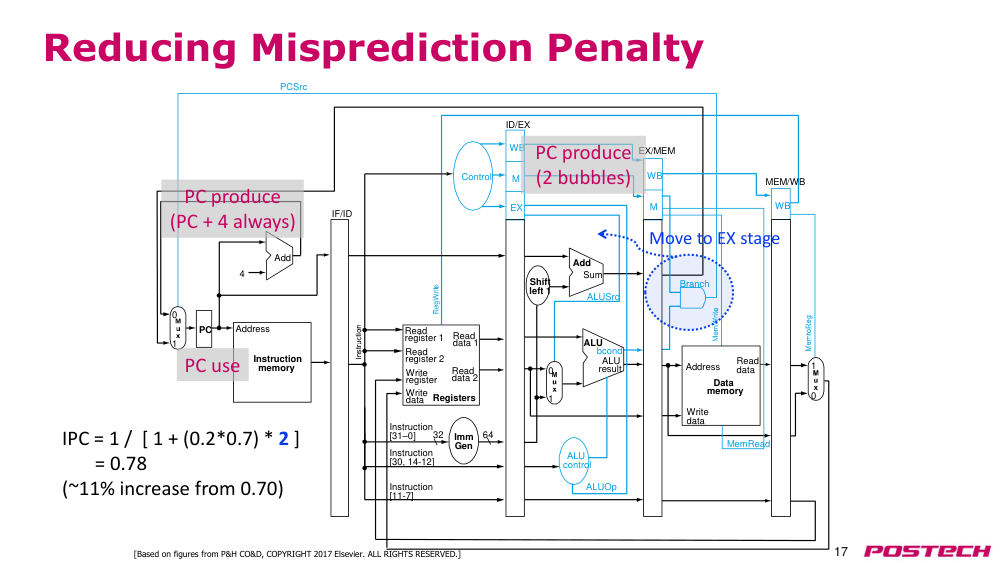
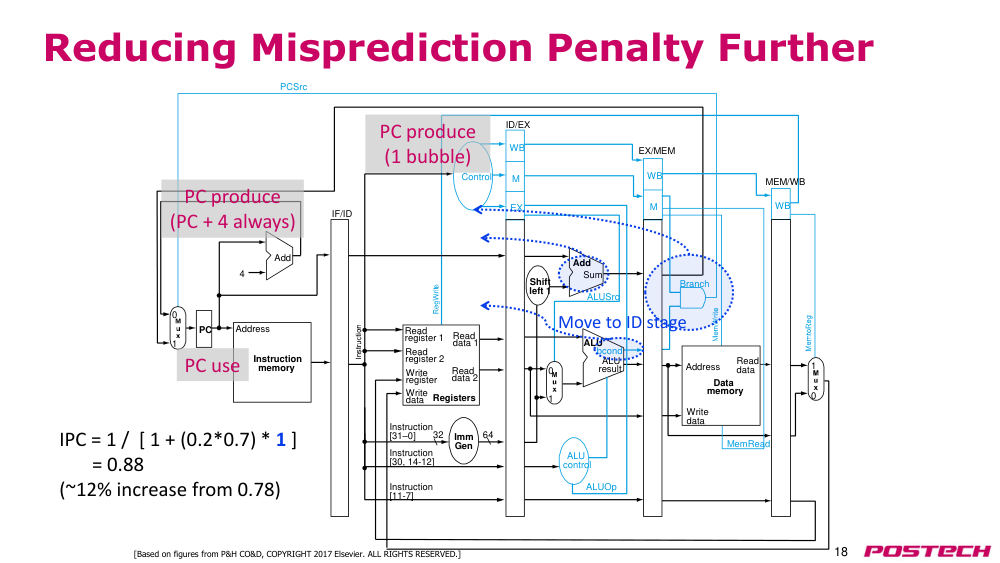
상황·문제branch target(adder)과 조건(ALU)은 이미 EX 에서 나오는데 AND gate 가 MEM 에 있어 penalty 3.
원인판정 위치가 늦을수록 잘못 fetch 한 instruction 이 많다.
해결AND 를 EX 로 → 2 bubble, IPC 0.78(+11%). target adder 와 비교기를 ID 로 → 1 bubble, IPC 0.88(+12%). ID 비교기는 full ALU 가 아닌 =, <, ≤ 비교라 저렴.
- EX 판정 IPC 0.78
- ID 판정 IPC 0.88
2.6.r.1Classic RISC pipeline (Wikipedia) ↗ · 5-stage pipeline 의 control hazard·branch delay slot·forwarding
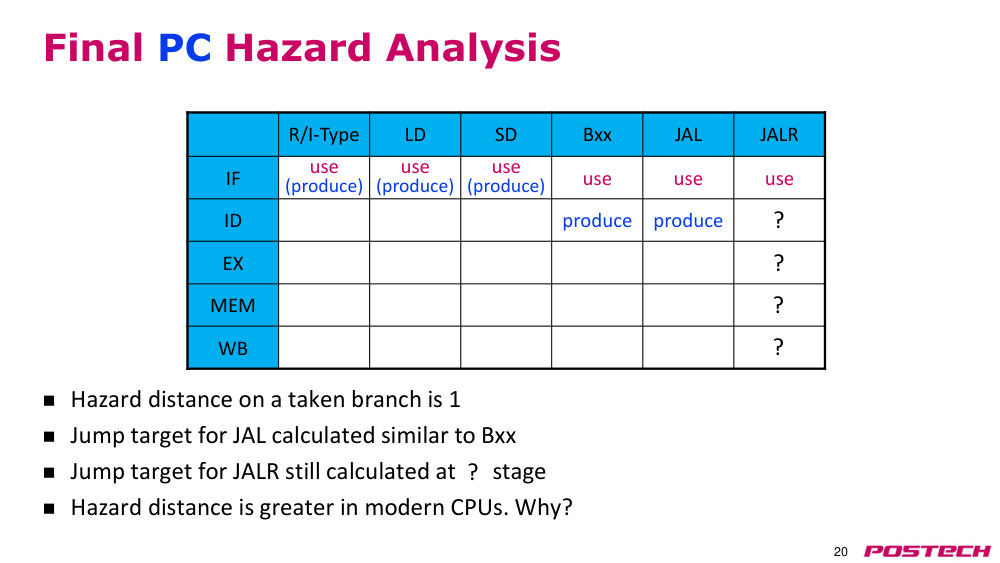
2.731:40–37:30ID 판정의 추가 고려와 최종 hazard 표
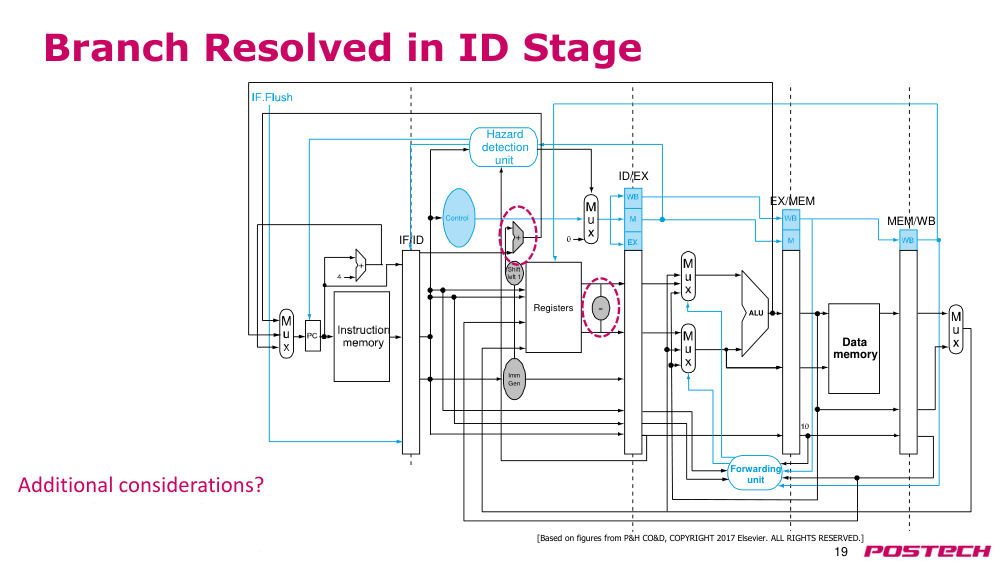
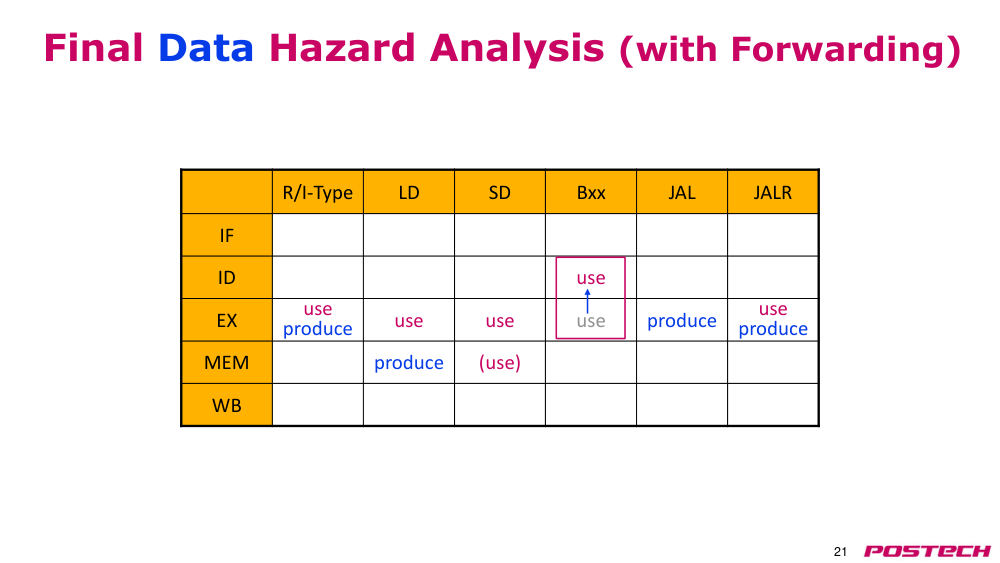
상황·문제ID 의 비교기는 register file 값만 쓰는데 operand 가 EX·MEM·WB 의 instruction 에 의존하면?
원인branch 가 register 를 EX 가 아닌 ID 에서 use 하게 되어 기존 forwarding path 로는 부족.
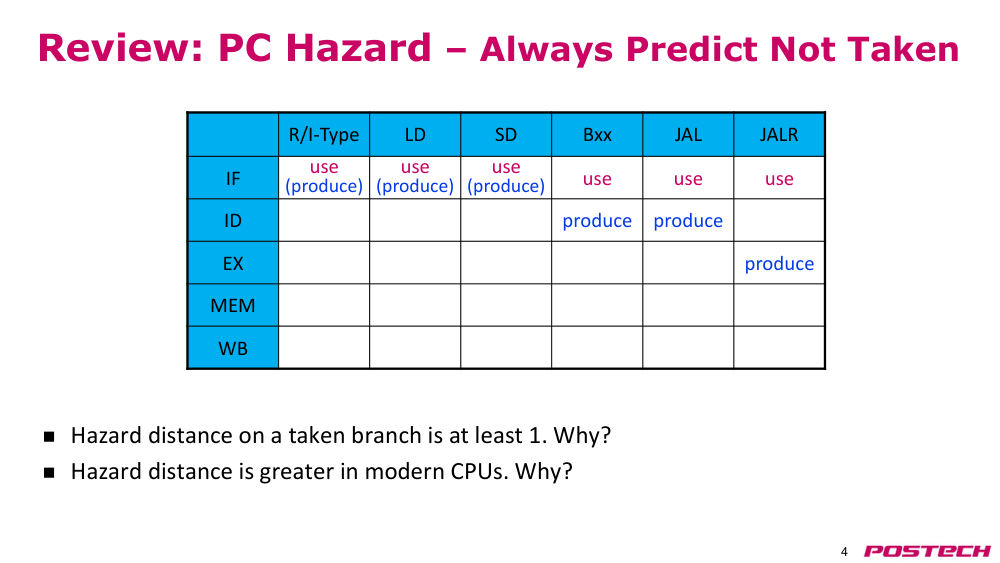
해결비교기로 가는 bypass path 추가, 불가능하면 stall. 최종: Bxx·JAL 은 ID, JALR 은 register+ALU 가 필요해 EX 에서 target produce. 10~20 stage 현대 CPU 는 hazard distance 가 더 크다.
- JALR target = EX (퀴즈 정답)
- taken branch hazard distance 1
2.7.r.1Classic RISC pipeline (Wikipedia) ↗ · 5-stage pipeline 의 control hazard·branch delay slot·forwarding
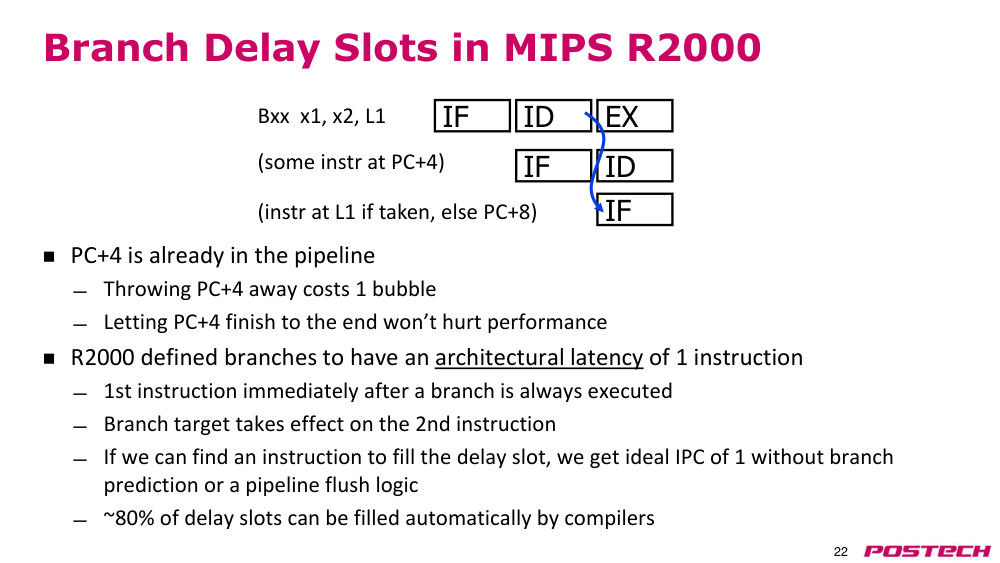
2.837:30–43:10MIPS R2000 branch delay slot
상황·문제ID 판정으로도 misprediction 시 1 instruction 이 flush 된다.
원인branch 의 architectural latency 를 1 instruction 으로 정의하면 바로 뒤 instruction 은 결과와 무관하게 항상 실행.
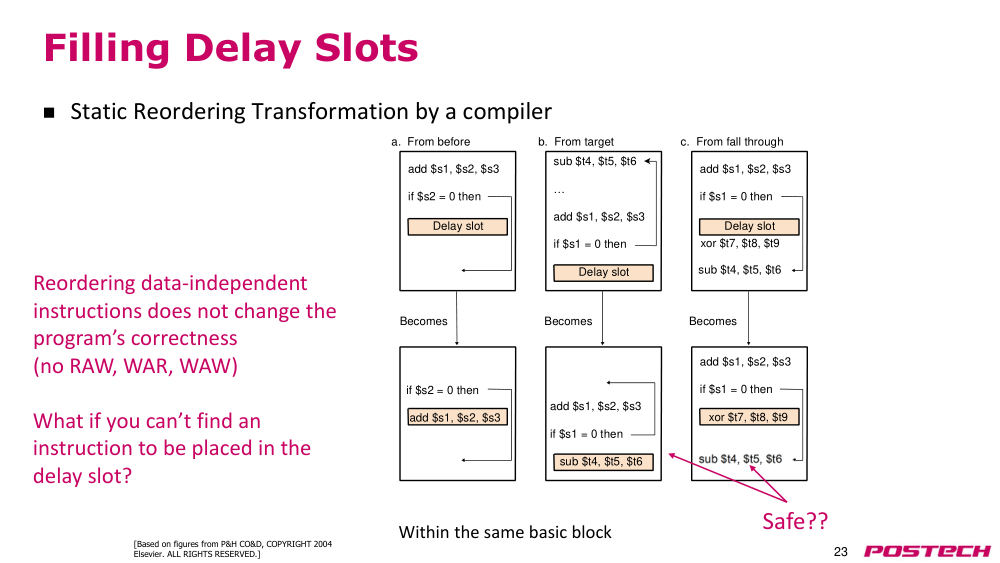
해결compiler 가 slot 을 채움(~80% 자동): a. branch 앞에서, b. target 에서, c. fall-through 에서 가져옴. b·c 는 항상 실행돼도 같은 state 인지 확인해야 안전.
- load delay slot 과 같은 발상
- 같은 basic block 에서 고르면 correctness 영향 없음
2.943:10–47:20Q&A 3: delay slot 의미와 한계
상황·문제b·c 방식이 state 를 바꾸지 않나, a 에서 slot 의 add 는 왜 항상 실행되나 질문.
원인slot 의 instruction 은 branch 결과와 무관하게 항상 실행되도록 ISA semantics 가 정의. a 는 원래도 항상 실행되던 것이라 동일, b·c 는 원래 조건부였으므로 결과가 달라질 수 있다.
해결채울 것이 없으면 no-op → code size 증가. 예측을 잘 하면 불필요해 현재 대부분의 architecture 는 delay slot 을 쓰지 않는다.
- delay slot = architecture 에 microarchitecture 가 노출된 예
2.1047:20–49:25Lecture 10 시작: 복습
상황·문제branch prediction 을 다루기 전 PC hazard 와 PC+4 예측을 복습.
원인PC+4 는 86% 정답, 오답 시 bubble.
해결penalty 를 1 로 줄여 IPC 0.7 → 0.88. 남은 것은 오답 확률.
- always not taken 예측과 동일
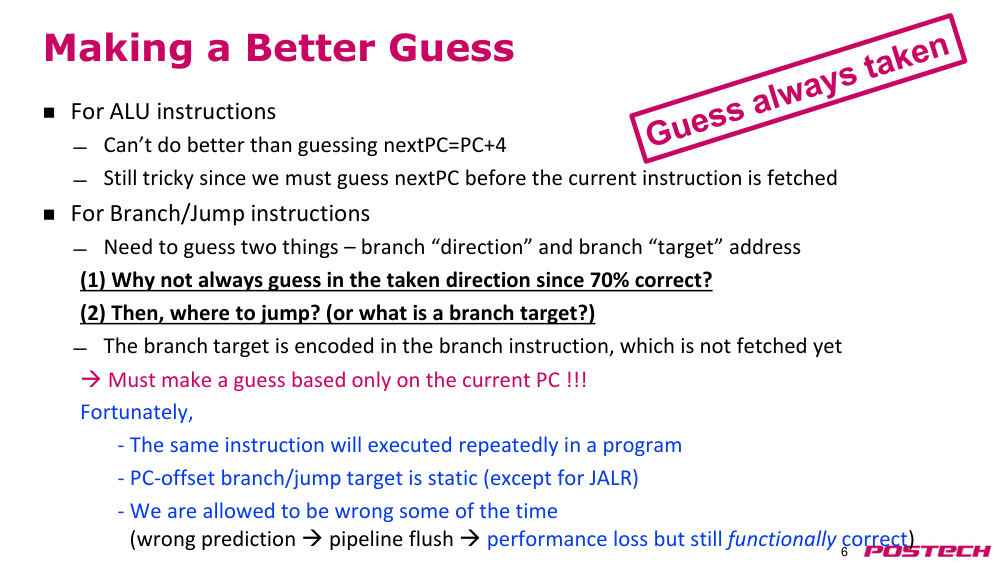
2.1149:25–55:13더 나은 추측: direction 과 target
상황·문제fetch 전에는 PC 만 안다: ALU 인지 branch 인지도, taken 여부도, target 도 모름.
원인target 은 아직 fetch 안 한 instruction 에 encode 되어 있어 처음 보는 instruction 은 거의 추측 불가.
해결같은 instruction 이 반복 실행(예: browser 10분 사용)되고 PC-offset target 은 static → history 를 기억. JALR 은 register 값이 바뀌어 불가. 틀려도 flush 로 correctness 유지.
- always taken 이면 70% 정답이지만 target 을 알아야 함
2.11.r.1Branch predictor (Wikipedia) ↗ · static/dynamic 예측, 2-bit saturating counter, two-level, gshare, tournament 개요
2.1255:13–58:00Oracle BTB
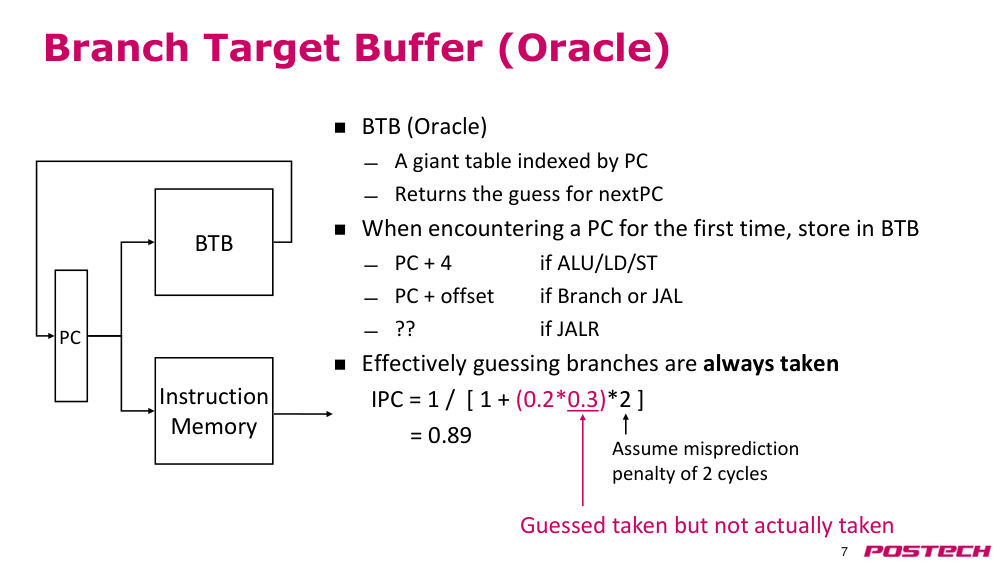
상황·문제PC 로 index 하는 이상적 BTB 에 처음 실행 때 next PC 저장(ALU/LD/ST: PC+4, branch/JAL: PC+offset).
원인JALR 은 target 이 변해 BTB 로 처리 불가(일단 제외).
해결사실상 always taken, penalty 2 가정 시 IPC = 1/[1+(0.2*0.3)*2] = 0.89 로 PC+4 방식보다 개선.
- BTB = branch target buffer
2.1358:00–1:05:00현실의 BTB: hash, collision, tag
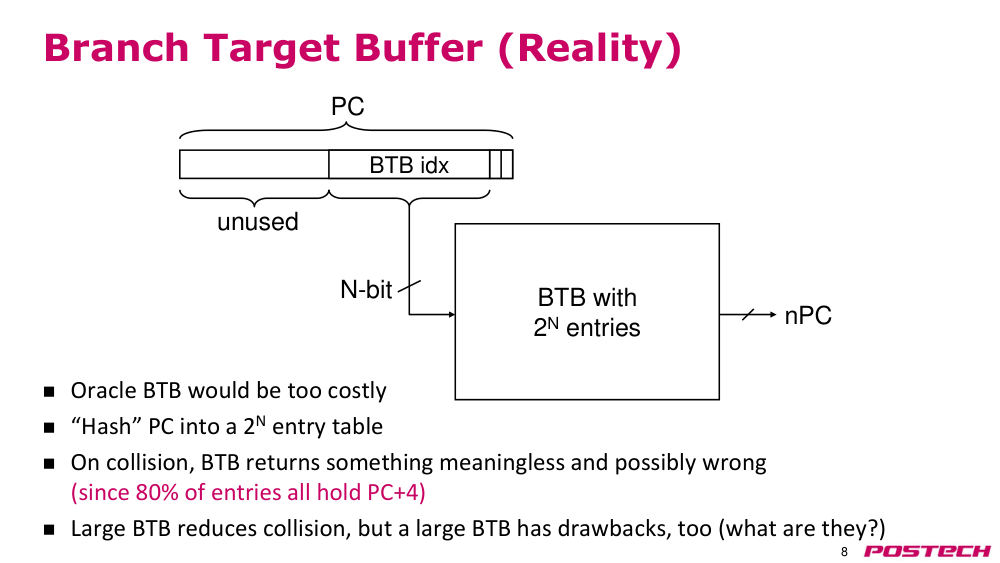
상황·문제64-bit PC 전체로 index 하는 table 은 너무 크다.
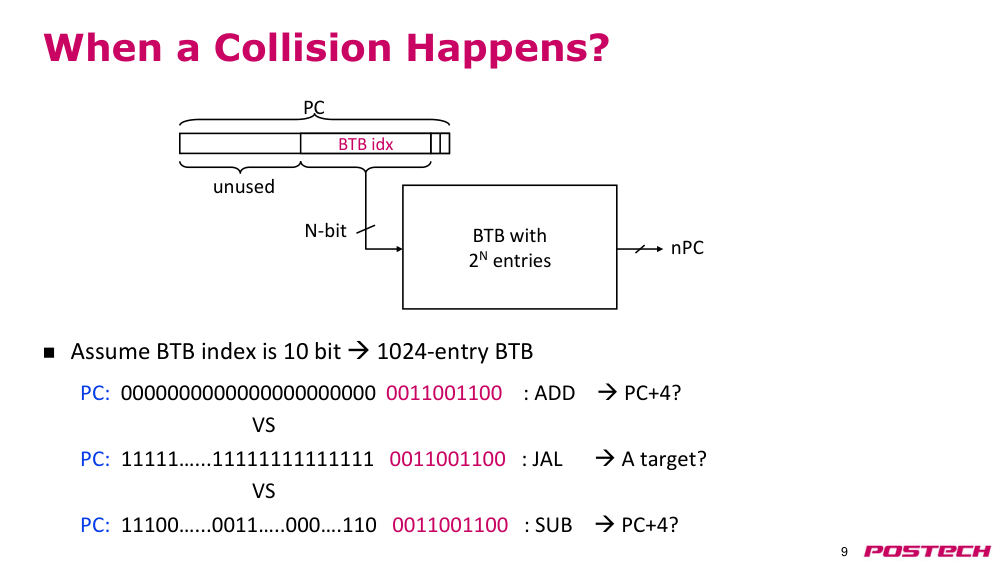
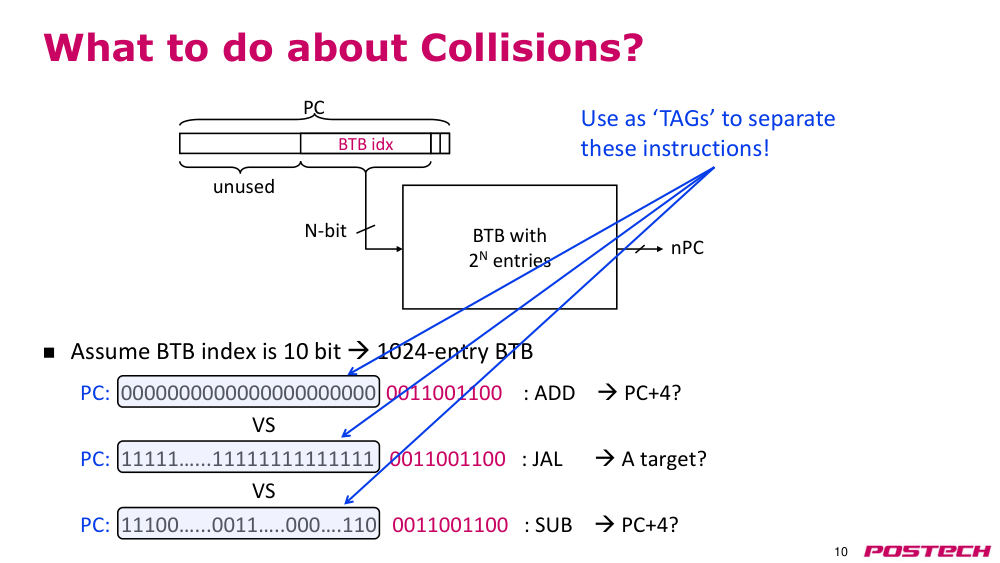
원인PC 의 N bit 만 hash 해 2^N entry 로 줄이면 collision (예: 하위 10 bit 가 같은 ADD·JAL·SUB). 큰 BTB 는 area 와 lookup latency 가 커짐.
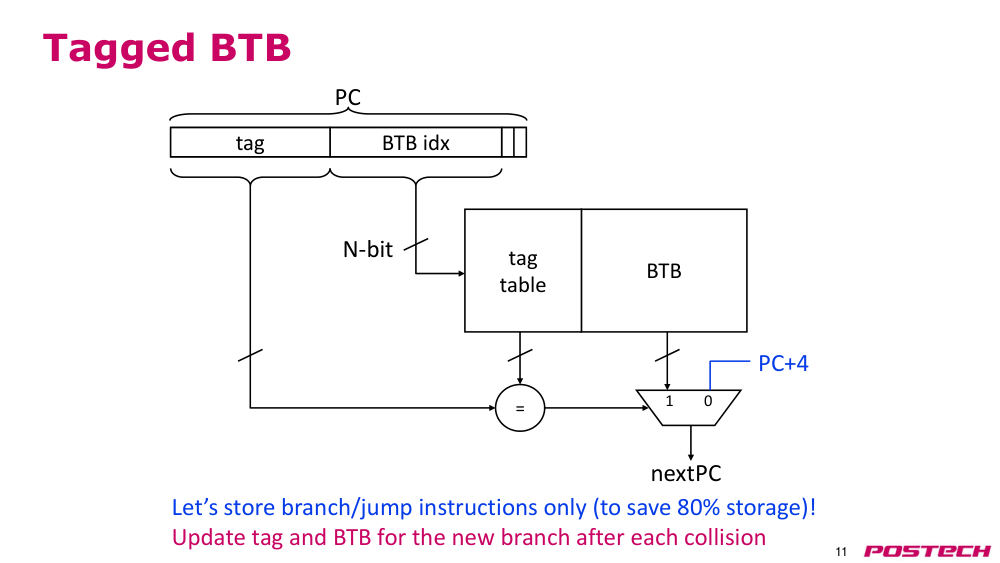
해결남은 상위 bit 를 tag 로 저장해 비교, 불일치면 PC+4. branch/jump 만 저장해 공간 절약(80% 는 PC+4), mismatch 시 tag·target 갱신.
- tag miss → PC+4
- non-branch 는 BTB entry 불필요
2.141:05:00–1:10:30direction 예측: 직전 결과 재사용과 1-bit BHT
상황·문제always taken/not taken 으로는 70% 를 넘을 수 없다 (target 은 BTB 가 담당).
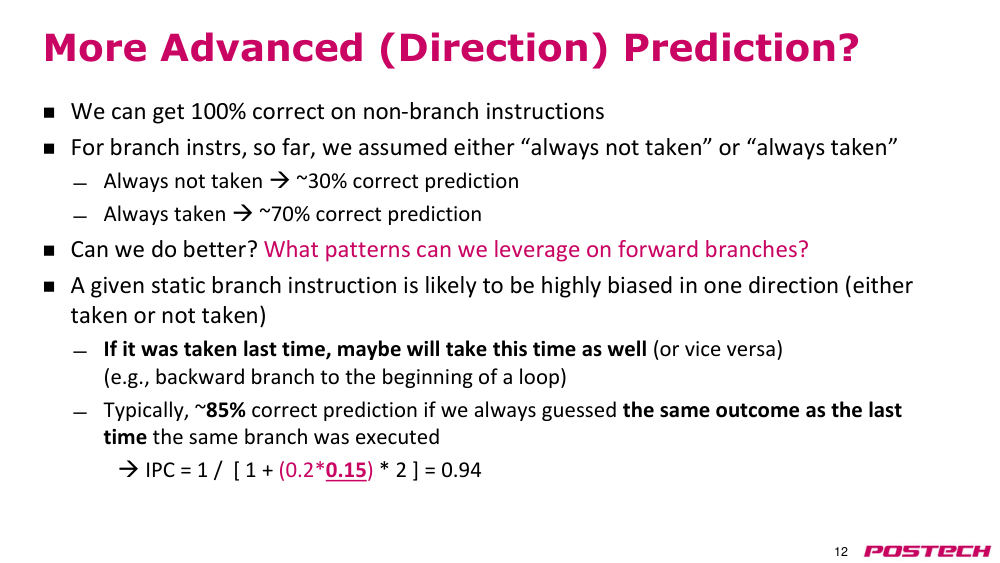
원인static branch 는 한 방향으로 강하게 편향(if 문, loop 끝 backward branch).
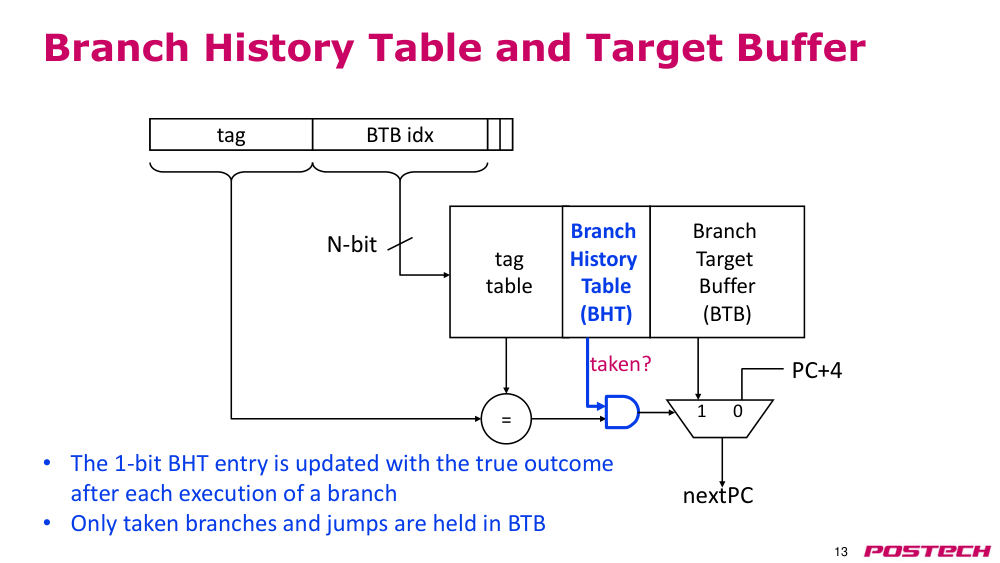
해결직전과 같은 결과로 추측 → 강의는 '80%' 라 말하고 오답 15% 로 IPC 0.94 계산 (슬라이드 ~85%). BTB 에 1-bit BHT 추가: taken 이면 BTB target, 아니면 PC+4.
- IPC 0.94 = ideal 대비 6% 저하
2.14.r.1Branch predictor (Wikipedia) ↗ · static/dynamic 예측, 2-bit saturating counter, two-level, gshare, tournament 개요
2.151:10:30–1:14:001-bit predictor 의 약점
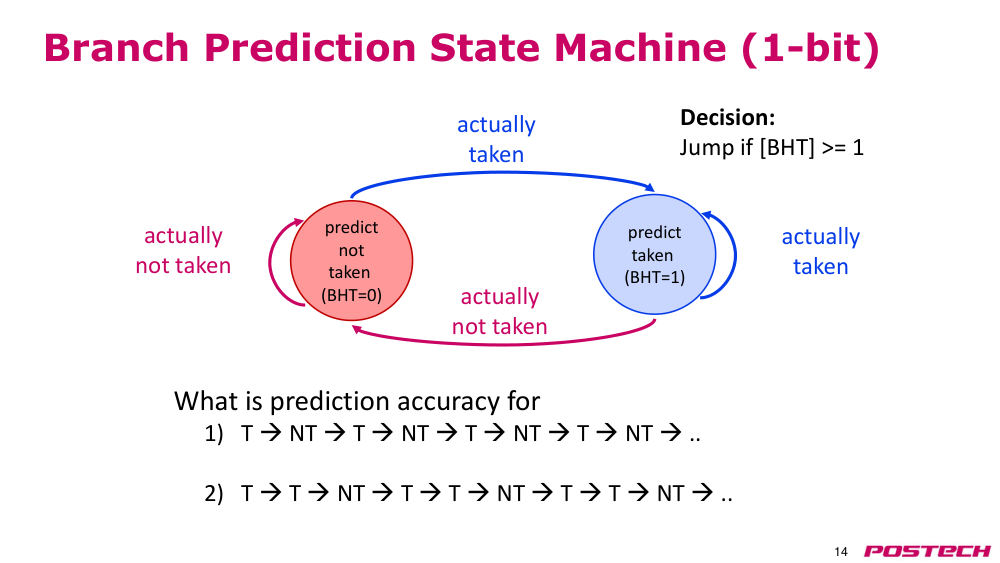
상황·문제1-bit BHT 는 predict taken/not taken 2 state machine.
원인T,NT 교대 패턴은 매번 틀리고, T,T,NT 반복은 1/3 만 맞음 — always taken 보다 나쁨.
해결bit 를 늘려 한 번의 예외로 방향을 바꾸지 않게 해야 한다.
- 단일 bit 는 예외 한 번에 두 번 틀림
2.15.r.1Branch predictor (Wikipedia) ↗ · static/dynamic 예측, 2-bit saturating counter, two-level, gshare, tournament 개요
2.161:14:00–1:19:302-bit saturating counter 와 hysteresis counter
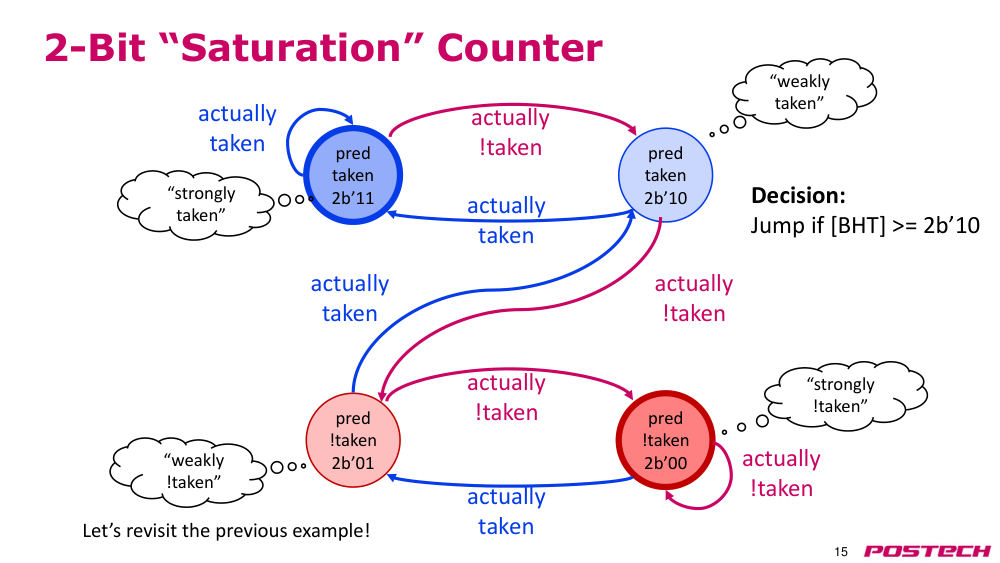
상황·문제더 나은 direction 예측을 위해 2-bit state 사용.
원인saturating: strongly/weakly taken·not taken 4 state, MSB 로 예측. 앞 두 패턴의 taken 을 모두 맞힌다.
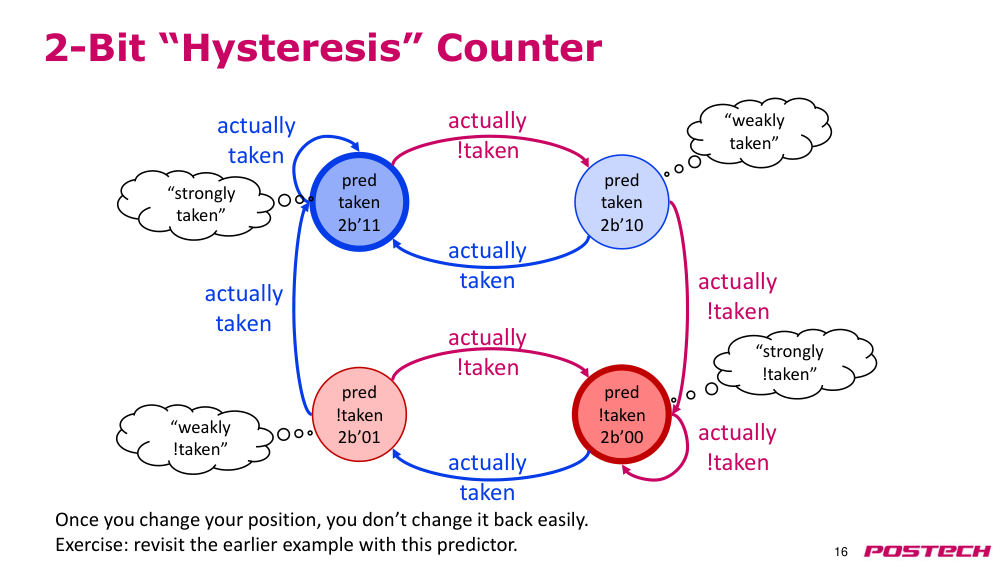
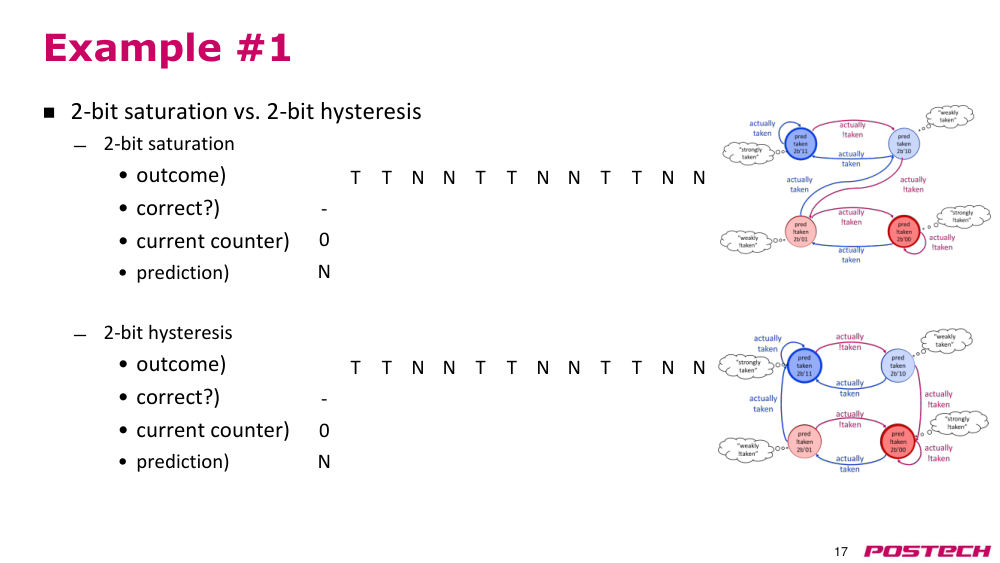
해결hysteresis: weak 에서 틀리면 반대쪽 strong 으로 가 두 weak state 사이 진동을 막아 not taken 은 맞힌다. Example #1 은 PDF 로 직접 풀기(과제).
- Jump if [BHT] >= 2b'10
- 패턴에 따라 더 나은 counter 가 다름
2.16.r.1Branch predictor (Wikipedia) ↗ · static/dynamic 예측, 2-bit saturating counter, two-level, gshare, tournament 개요
3핵심 개념
3.1branch target buffer(BTB, 분기 타깃 버퍼)
PC 로 index 해 next PC(target)를 돌려주는 table. 상위 PC bit 를 tag 로 저장해 collision 구분.
3.2branch history table(BHT, 분기 이력 테이블)
branch 별 직전 결과(1-bit) 또는 2-bit counter. taken 예측 시 BTB target 사용.
3.2.r.1Branch predictor (Wikipedia) ↗ · static/dynamic 예측, 2-bit saturating counter, two-level, gshare, tournament 개요
3.32-bit saturating counter(2비트 포화 카운터)
00~11 네 state, MSB 가 1 이면 taken 예측. 한 번의 예외로 방향을 바꾸지 않음.
3.3.r.1Branch predictor (Wikipedia) ↗ · static/dynamic 예측, 2-bit saturating counter, two-level, gshare, tournament 개요
3.4hysteresis counter(히스테리시스 카운터)
weak state 에서 틀리면 반대쪽 strong 으로 이동, 방향을 쉽게 되돌리지 않는다.
3.5branch delay slot(분기 지연 슬롯)
branch 바로 뒤 instruction 은 결과와 무관하게 항상 실행되도록 정의 (MIPS R2000).
3.6pipeline flush(파이프라인 플러시)
잘못 fetch 한 instruction 의 control 을 0 으로 해 bubble 로 바꿈.
3.7misprediction penalty(예측 오류 페널티)
MEM 판정 3, EX 판정 2, ID 판정 1 bubble. IPC 0.70 / 0.78 / 0.88.
4스스로 확인
4.1PC+4 예측이 86% 맞는 근거는?
답
control flow 20% 중 30% not taken(6%) + non-control 80% = 86%.
4.2MEM 판정에서 misprediction 시 bubble 수와 IPC 는?
답
3개, IPC = 1/[1+(0.2*0.7)*3] = 0.70.
4.3branch 판정을 ID 로 옮길 때 추가로 필요한 것은?
답
비교기로 가는 forwarding path, 불가능하면 stall.
4.4JALR target 은 어느 단계에서 나오나?
답
EX. register 값 + immediate 를 ALU 로 계산해야 하므로.
4.5flush 할 때 control 값을 0 으로만 해도 되는 이유는?
답
state 를 바꾸는 곳은 register writeback 과 memory write 뿐이라서.
4.6BTB 에 tag 를 두는 이유는?
답
하위 index bit 가 같은 다른 instruction 의 collision 을 구분하려고. 불일치면 PC+4.
4.7T,NT 교대 패턴에서 1-bit predictor 의 정답률은?
답
0%. 매번 직전과 반대 결과가 나온다.
5참고 자료
5.1Branch predictor (Wikipedia) ↗ · static/dynamic 예측, 2-bit saturating counter, two-level, gshare, tournament 개요
5.4Classic RISC pipeline (Wikipedia) ↗ · 5-stage pipeline 의 control hazard·branch delay slot·forwarding
5.5Kessler, The Alpha 21264 Microprocessor (IEEE Micro 1999) PDF, UPenn CIS501 ↗ · 슬라이드 p26 그림(Fig 4)의 원 논문, tournament predictor 구조
5.6HPS Branch Prediction Publications (UT Austin, Patt group) ↗ · Yeh & Patt ISCA 1993 two-level predictor 논문 목록·원문 링크