이 자료를 쓰는 강의: 45 Lec 10 · control hazard 해결(PC+4 예측·delay slot)과 BTB·2-bit branch predictor · 46 2-bit predictor 예제, global history·two-level·tournament predictor 와 return address stack
Lec10-pipelined-CPU-branchpredict (updated)
한국어판 강의자료 · 36쪽
p.1CSED311 컴퓨터구조 – 강의 10
파이프라인 CPU – branch prediction(분기 예측)
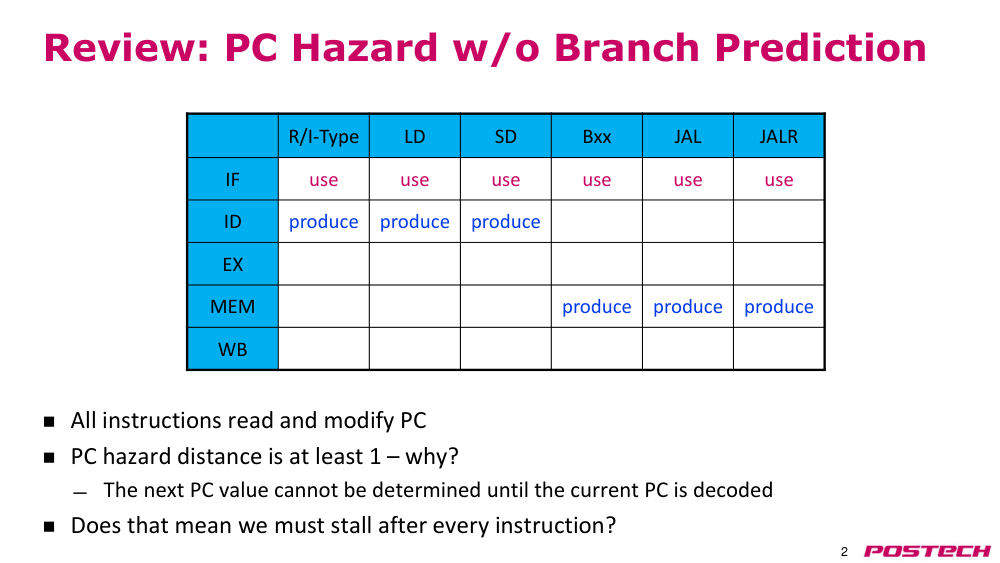
p.2리뷰: branch prediction(분기 예측) 없이 PC hazard(PC 해저드)
- 모든 명령어가 PC를 읽고 수정한다
- PC hazard distance(PC 해저드 거리)는 최소 1 이상이다 – 왜?
- NextPC(다음 PC) 값은 현재 PC가 디코딩된 후에야 결정될 수 있다
- 이것이 매 명령어마다 stall(스톨)해야 한다는 의미인가?
- R/i-type(I형)
- LD
- SD
- Bxx
- JAL
- JALR
- IF
- use
- use
- use
- use
- use
- use
- ID
- produce
- produce
- produce
- EX
- MEM
- produce
- produce
- produce
- WB
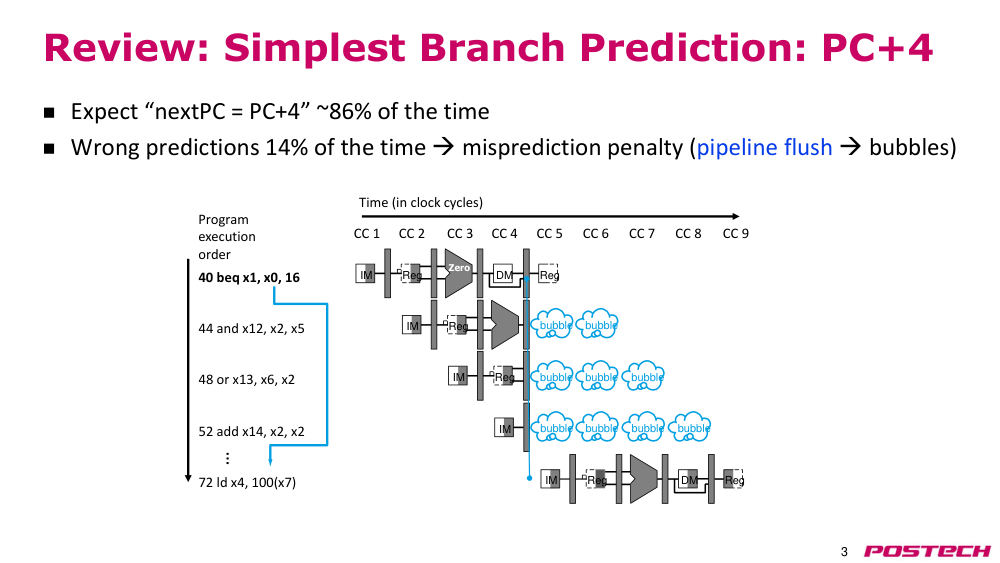
p.3리뷰: 가장 간단한 branch prediction(분기 예측): PC+4
- NextPC(다음 PC) = PC+4 라고 예측하는 것이 약 86%의 경우에 성립한다
- 예측 오류는 14%의 경우 발생 → 예측 오류 페널티 (파이프라인 플러시 → 버블)
- 프로그램 execute(실행) 순서
- 40 beq x1, x0, 16
- 44 and x12, x2, x5
- 48 or x13, x6, x2
- 52 add x14, x2, x2
- 72 ld x4, 100(x7)
- …
- 레지스터
- 시간 (클럭 사이클 기준)
- CC 1
- CC 2
- CC 3
- CC 4
- CC 5
- CC 6
- CC 7
- CC 8
- CC 9
- IM
- DM
- Reg
- Reg
- IM
- Reg
- IM
- IM
- DM
- Reg
- Reg
- bubble(버블)
- bubble(버블)
- bubble(버블)
- bubble(버블)
- bubble(버블)
- bubble(버블)
- bubble(버블)
- bubble(버블)
- bubble(버블)
- IM
- Zero
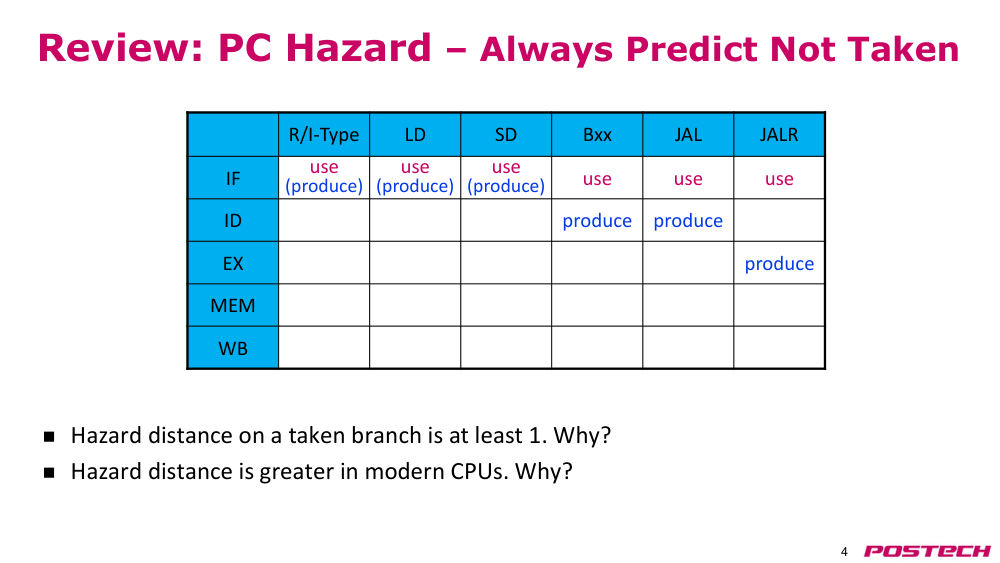
p.4리뷰: PC hazard(PC 해저드) – 항상 not taken(미취함) 예측
- taken(취함) 분기에서의 hazard distance(해저드 거리)는 최소 1 이상이다. 왜?
- 현대 CPU에서는 hazard distance(해저드 거리)가 더 크다. 왜?
- R/i-type(I형)
- LD
- SD
- Bxx
- JAL
- JALR
- IF
- use
- (생산)
- use
- (생산)
- use
- (생산)
- use
- use
- use
- ID
- 생산
- 생산
- EX
- 생산
- MEM
- WB
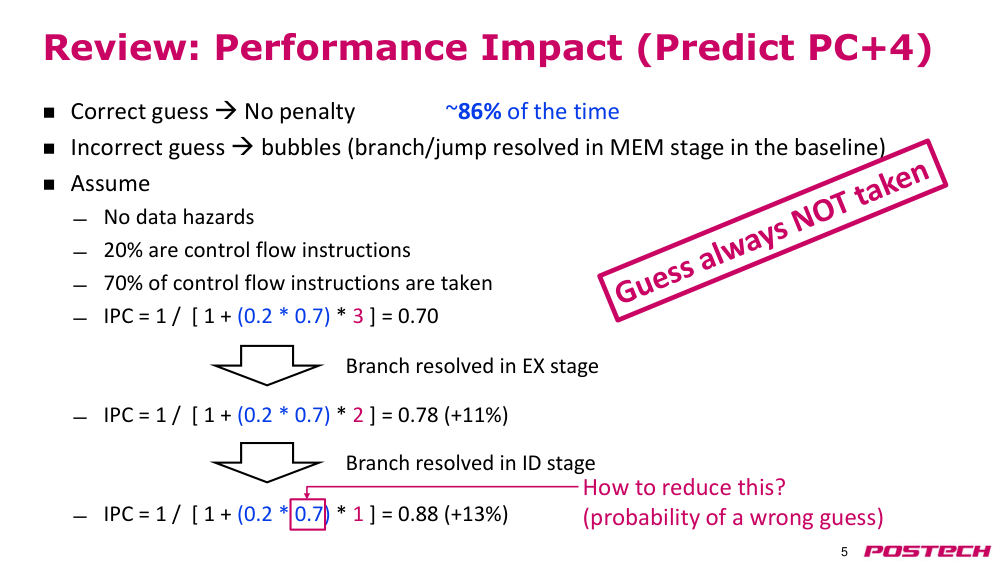
p.5리뷰: 성능 영향 (PC+4 예측)
- 정확한 예측 → 페널티 없음
- 약 86%의 경우
- 오류 예측 → 버블 (기준 파이프라인에서 분기/점프는 MEM 스테이지에서 해석됨)
- 가정
- 데이터 위험 없음
- 20%는 control flow instruction(제어 흐름 명령어)
- control flow instruction(제어 흐름 명령어)의 70%는 taken(취함)
- IPC = 1 / [1 + (0.2 * 0.7) * 3] = 0.70
- IPC = 1 / [1 + (0.2 * 0.7) * 2] = 0.78 (+11%)
- IPC = 1 / [1 + (0.2 * 0.7) * 1] = 0.88 (+13%)
- branch resolution(분기 해석)이 EX 스테이지에서 이루어짐
- branch resolution(분기 해석)이 ID 스테이지에서 이루어짐
- 이를 줄이려면?
- (오류 예측 확률 감소)
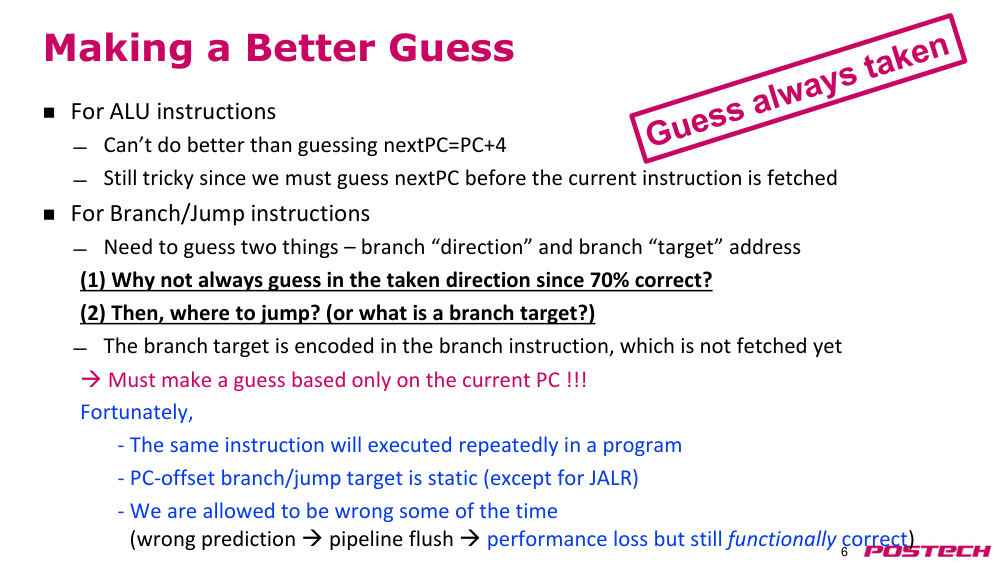
p.6더 나은 예측을 하기 위해
- ALU 명령어의 경우
- PC+4 예측보다 더 나은 예측은 불가능하다
- 현재 명령어가 가져와지기 전에 NextPC(다음 PC)를 예측해야 하므로 여전히 어려움
- 분기/점프 명령어의 경우
- 두 가지를 예측해야 한다 – branch direction(분기 방향)과 branch target address(분기 타겟 주소)
- (1) 왜 70%가 정확하므로 항상 taken(취함) 방향으로 예측하지 않는가?
- (2) 그러면 어디로 점프할까? (또는 branch target(분기 타겟)은 무엇인가?)
- branch target(분기 타겟)은 분기 명령어에 인코딩되어 있으며, 아직 가져와지지 않았다
- → 현재 PC만을 기반으로 예측해야 한다!
- 행운스럽게도
- - 같은 명령어는 프로그램에서 반복적으로 execute(실행)된다
- - PC offset(PC 오프셋) 분기/점프 타겟은 정적이다 (JALR 제외)
- - 일부 오류는 허용된다
- (오류 예측 → pipeline flush(파이프라인 플러시) → 성능 저하지만 기능적으로 정확함)
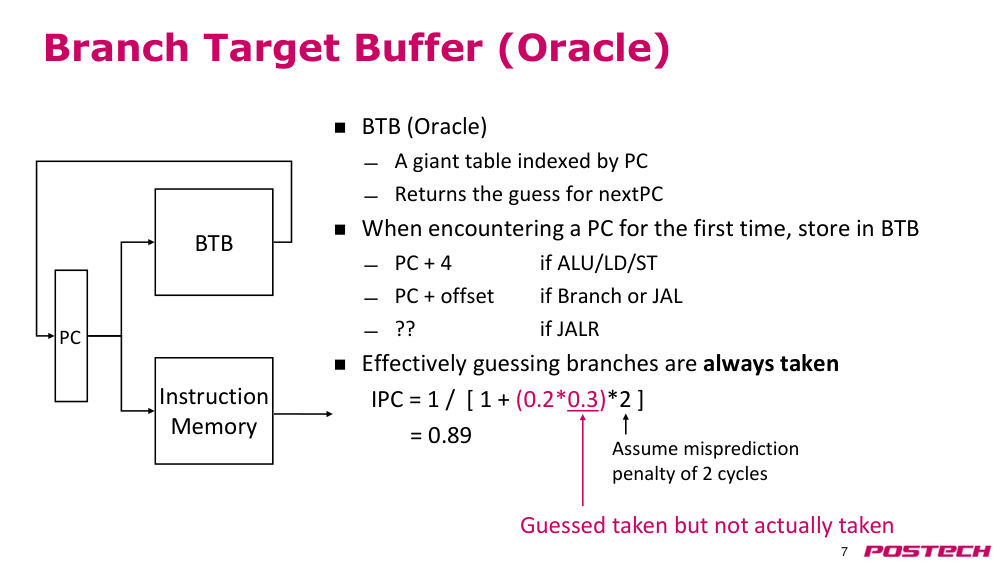
p.7branch target(분기 타겟) 버퍼 (Oracle)
- BTB (Oracle): PC를 인덱스로 사용하는 거대한 테이블
- NextPC(다음 PC)에 대한 추측을 반환
- 처음 만난 PC를 발견하면 BTB에 저장
- ALU/LD/ST인 경우: PC + 4
- 분기 또는 JAL인 경우: PC + 오프셋
- JALR인 경우: ??
- 실제로는 항상 taken(취함)으로 추측하는 것과 유사
- IPC = 1 / [1 + (0.2 * 0.3) * 2] = 0.89
- misprediction penalty(예측 오류 페널티)가 2 사이클이라고 가정
- 추측은 taken(취함)으로 예측했지만 실제로는 not taken(미취함)
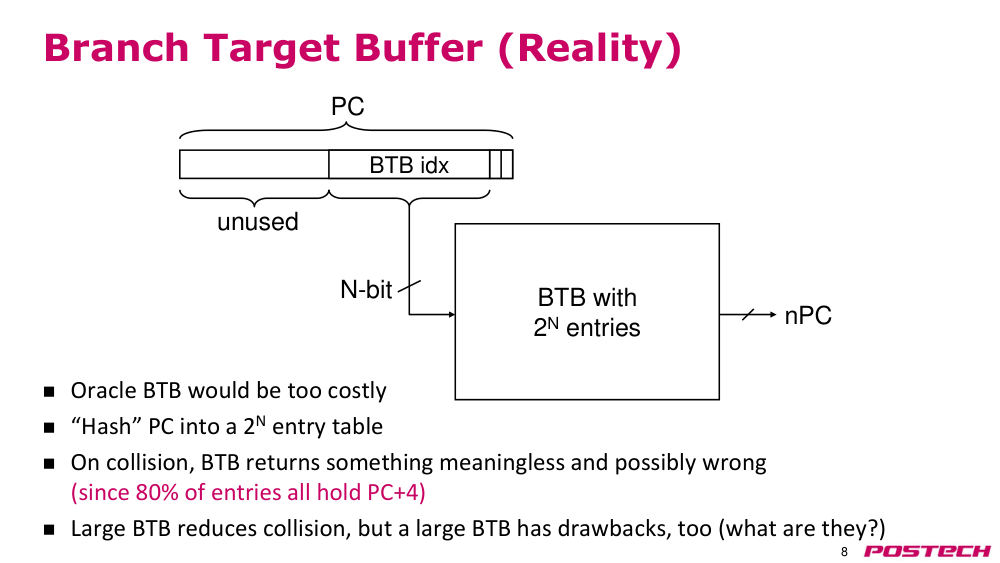
p.8branch target(분기 타겟) 버퍼 (현실)
- Oracle BTB는 너무 비쌀 수 있음
- PC를 2N개 항목의 테이블로 hash(해시)
- collision(충돌) 시, BTB는 의미 없고 오류가 날 수 있는 값을 반환 (80% 항목이 PC+4를 보유하기 때문)
- 큰 BTB는 collision(충돌)을 줄이지만, 큰 BTB에도 단점이 있음 (무엇인가?)
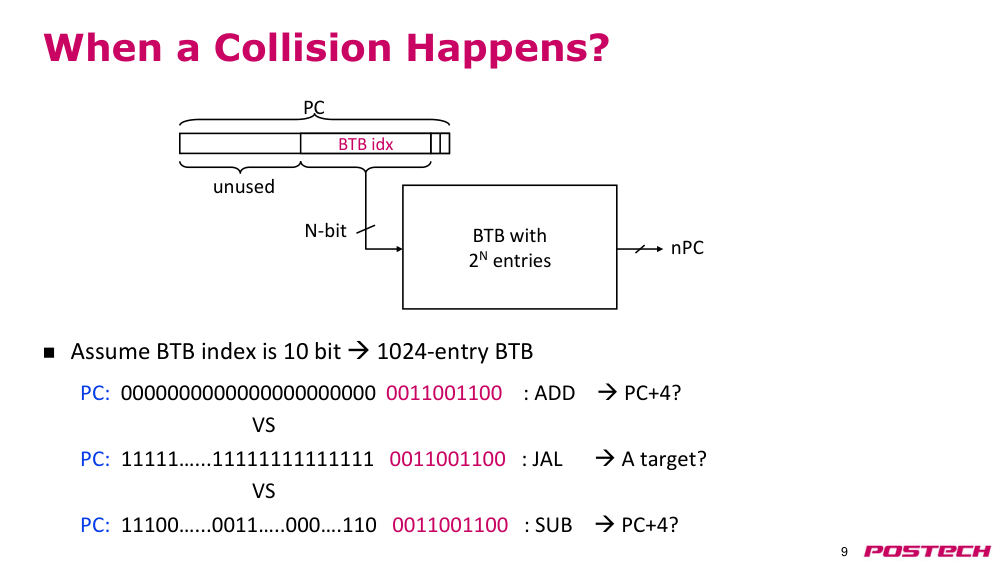
p.9collision(충돌)이 발생할 때
- BTB 인덱스가 10비트라고 가정 → 1024개 항목의 BTB
- PC: 0000000000000000000000 0011001100 → ADD: PC+4?
- VS
- PC: 11111…...11111111111111 0011001100 → JAL: 타겟?
- VS
- PC: 11100…...0011…..000….110 0011001100 → SUB: PC+4?
- BTB with 2N entries
- BTB idx
- PC
- unused
- N-bit
- nPC
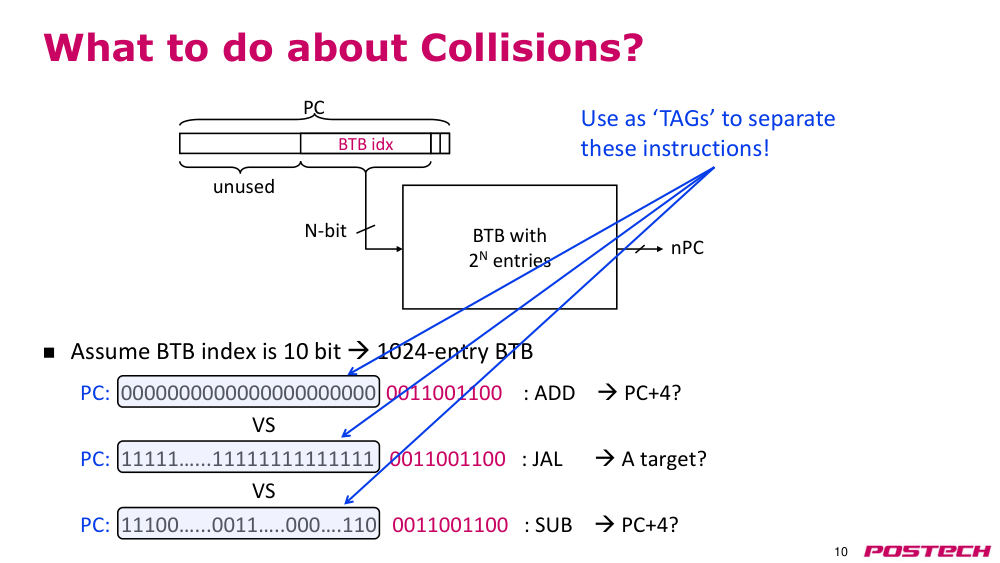
p.10collision(충돌)에 대응하는 방법
- BTB 인덱스가 10비트라고 가정 → 1024개 항목의 BTB
- PC: 0000000000000000000000 0011001100 → ADD: PC+4?
- VS
- PC: 11111…...11111111111111 0011001100 → JAL: 타겟?
- VS
- PC: 11100…...0011…..000….110 0011001100 → SUB: PC+4?
- BTB with 2N entries
- BTB idx
- PC
- unused
- N-bit
- nPC
- 이 명령어들을 구분하기 위해 'tag(태그)'로 사용
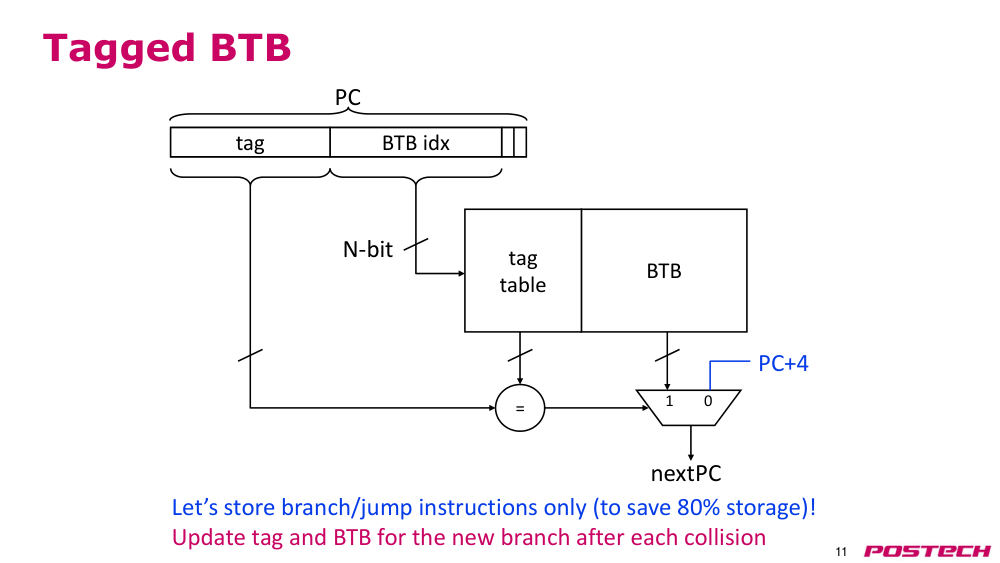
p.11tag(태그)가 있는 BTB
- 분기/점프 명령어만 저장 (80% 저장 공간 절약)
- 각 collision(충돌) 후 새로운 분기의 tag(태그)와 BTB 업데이트
- BTB
- BTB idx
- tag
- table
- 1 0
- PC+4
- nextPC
- =
- tag
- PC
- N-bit
p.12더 고급(방향) 예측?
- 비분기 명령어에 대해 100% 정확도를 얻을 수 있음
- 분기 명령어에 대해 지금까지는 항상 'not taken(미취함)' 또는 'taken(취함)'으로 가정
- 항상 not taken(미취함) → 약 30% 정확도
- 항상 taken(취함) → 약 70% 정확도
- 더 나은 예측은 가능한가? 전방 분기에서 어떤 패턴을 활용할 수 있는가?
- 특정 static branch(정적 분기) 명령어는 한 방향으로 매우 편향될 가능성이 높음 (taken(취함) 또는 not taken(미취함))
- 지난번에 taken(취함)이었다면, 이번에도 taken(취함)일 가능성이 높음 (또는 반대)
- (예: 루프의 시작점으로 되돌아가는 역방향 분기)
- 같은 분기를 이전에 execute(실행)했을 때의 결과와 동일한 결과를 항상 추측하면 일반적으로 약 85% 정확도
- → IPC = 1 / [1 + (0.2 * 0.15) * 2] = 0.94
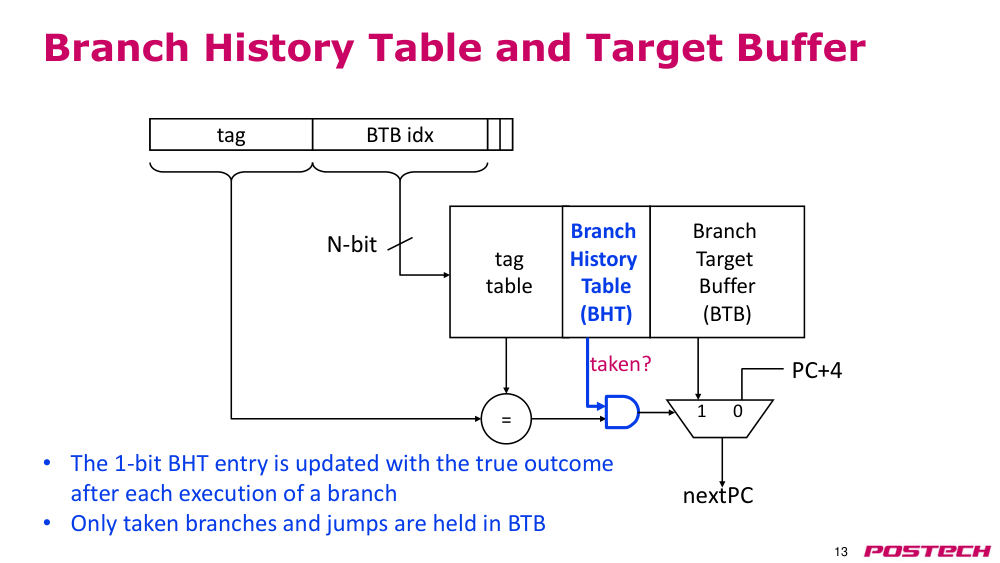
p.13branch history table (BHT)(분기 이력 테이블)과 타겟 버퍼
- branch target(분기 타겟) 버퍼 (BTB)
- BTB 인덱스
- N비트 tag(태그) 테이블
- 1 0
- PC+4
- nextPC =
- • 1비트 BHT 항목은 분기 명령어 execute(실행) 후 실제 결과로 갱신됨
- • BTB에는 단지 taken(취함) 분기와 점프만 저장됨
- tag(태그)
- 분기 이력 테이블 (BHT)
- taken(취함)?
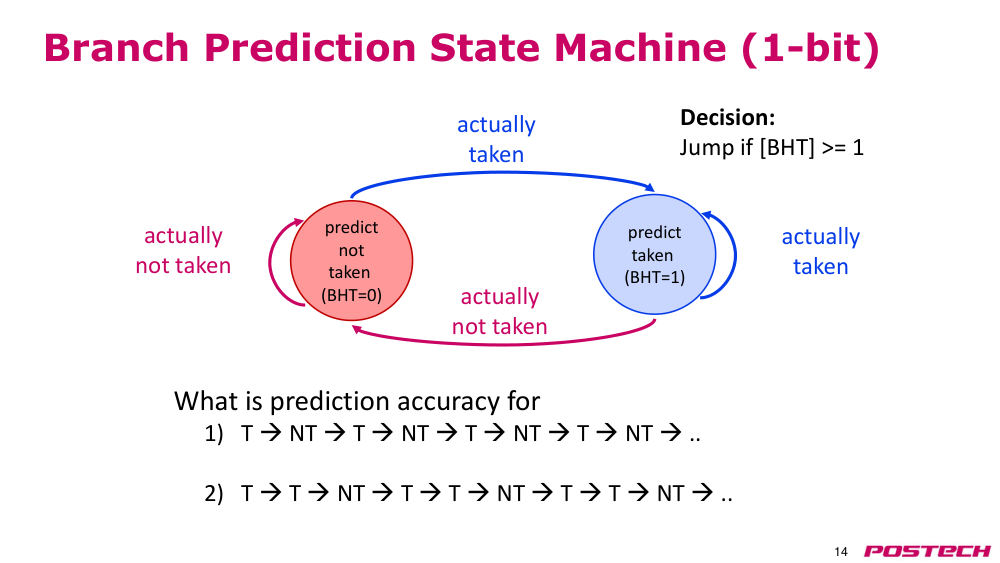
p.141비트 branch prediction(분기 예측) state machine(상태 기계)
- 예측: taken(취함) (BHT=1)
- 예측: not taken(미취함) (BHT=0)
- 실제로 not taken(미취함)
- 실제로 taken(취함)
- 실제로 taken(취함)
- 실제로 not taken(미취함)
- 1) T → NT → T → NT → T → NT → T → NT → …에 대한 prediction accuracy(예측 정확도)는?
- 2) T → T → NT → T → T → NT → T → T → NT → …에 대한 prediction accuracy(예측 정확도)는?
- 결정: [BHT] >= 1이면 점프
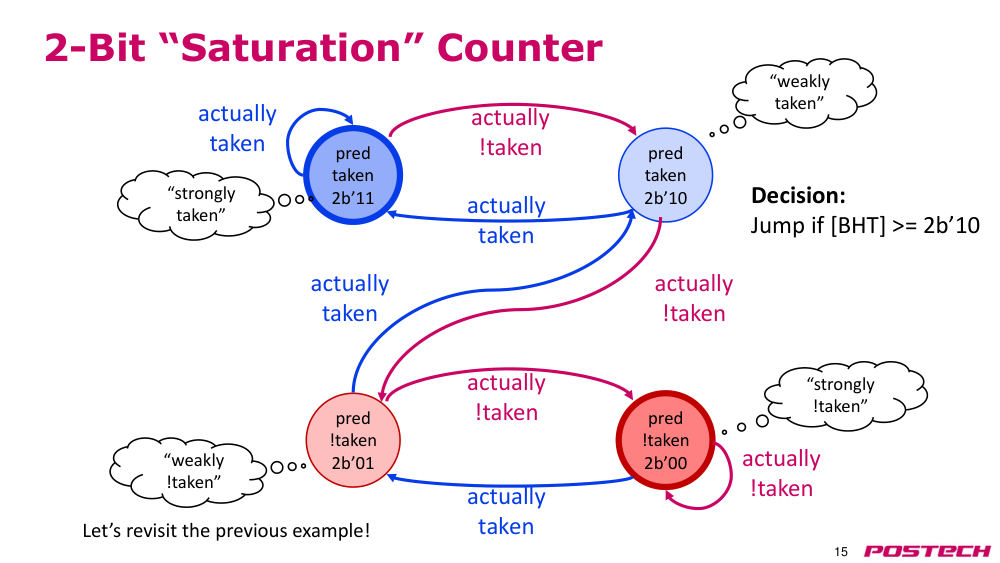
p.152비트 '포화' 카운터
- 예측: taken(취함)
- 2b’11
- 예측: taken(취함)
- 2b’10
- 예측: not taken(미취함)
- 2b’01
- 예측: not taken(미취함)
- 2b’00
- 실제로 taken(취함)
- 실제로 taken(취함)
- 실제로 not taken(미취함)
- 실제로 not taken(미취함)
- 실제로 not taken(미취함)
- 실제로 not taken(미취함)
- 실제로 taken(취함)
- 실제로 taken(취함)
- 결정: [BHT] >= 2b’10이면 점프
- 강하게 taken(취함)
- 약하게 taken(취함)
- 약하게 not taken(미취함)
- 강하게 not taken(미취함)
- 이전 예제를 다시 살펴보자!
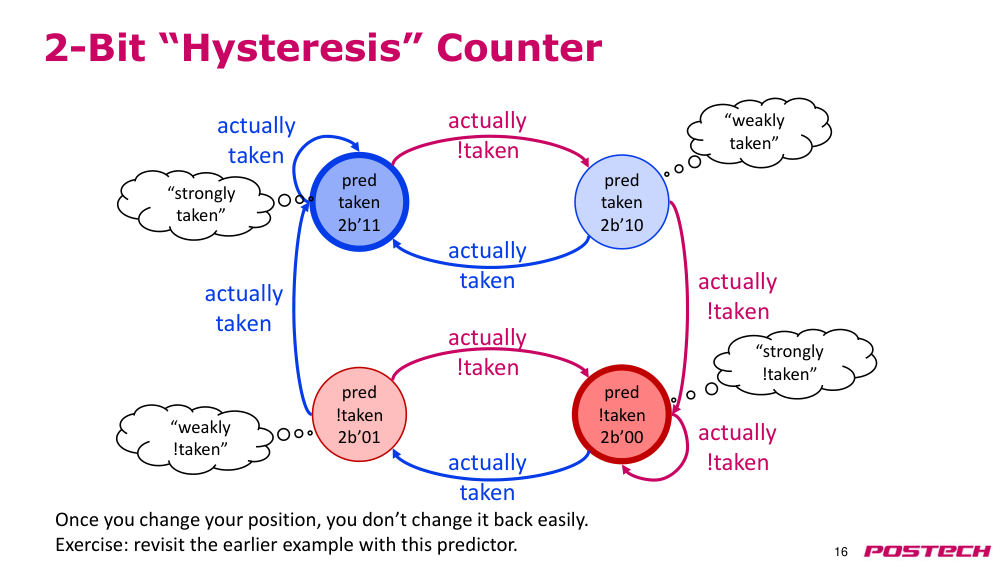
p.162비트 '히스테리시스' 카운터
- 예측: taken(취함)
- 2b’11
- 예측: taken(취함)
- 2b’10
- 예측: not taken(미취함)
- 2b’01
- 예측: not taken(미취함)
- 2b’00
- 실제로 taken(취함)
- 실제로 taken(취함)
- 실제로 not taken(미취함)
- 실제로 not taken(미취함)
- 실제로 not taken(미취함)
- 실제로 not taken(미취함)
- 실제로 taken(취함)
- 실제로 taken(취함)
- 약하게 taken(취함)
- 강하게 taken(취함)
- 약하게 not taken(미취함)
- 강하게 not taken(미취함)
- 한 번 상태를 바꾸면 쉽게 되돌리지 않는다.
- 연습: 이 예측기로 이전 예제를 다시 검토해보기
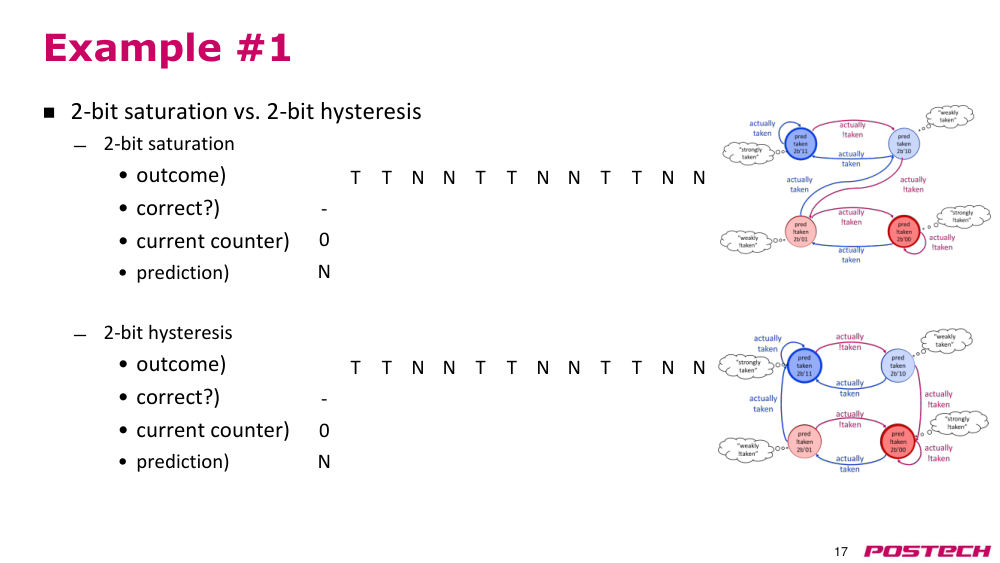
p.17예제 #1
- 2비트 포화 vs. 2비트 히스테리시스
- 2비트 포화
- • 결과)
- • 올바르게 예측되었는가?)
- • 현재 카운터)
- • 예측)
- 2비트 히스테리시스
- • 결과)
- • 올바르게 예측되었는가?)
- • 현재 카운터)
- • 예측)
- T
- X
- 1
- N
- T
- X
- 2
- T
- N
- X
- 1
- N
- N
- O
- 0
- N
- T
- X
- 1
- N
- T
- X
- 2
- T
- N
- X
- 1
- N
- N
- O
- 0
- N
- T
- X
- 1
- N
- T
- X
- 2
- T
- N
- X
- 1
- N
- N
- O
- 0
- N
- T
- X
- 1
- N
- T
- X
- 3
- T
- N
- X
- 2
- T
- N
- X
- 0
- N
- T
- X
- 1
- N
- T
- X
- 3
- T
- N
- X
- 2
- T
- N
- X
- 0
- N
- T
- X
- 1
- N
- T
- X
- 3
- T
- N
- X
- 2
- T
- N
- X
- 0
- N
- -
- 0
- N
- -
- 0
- N
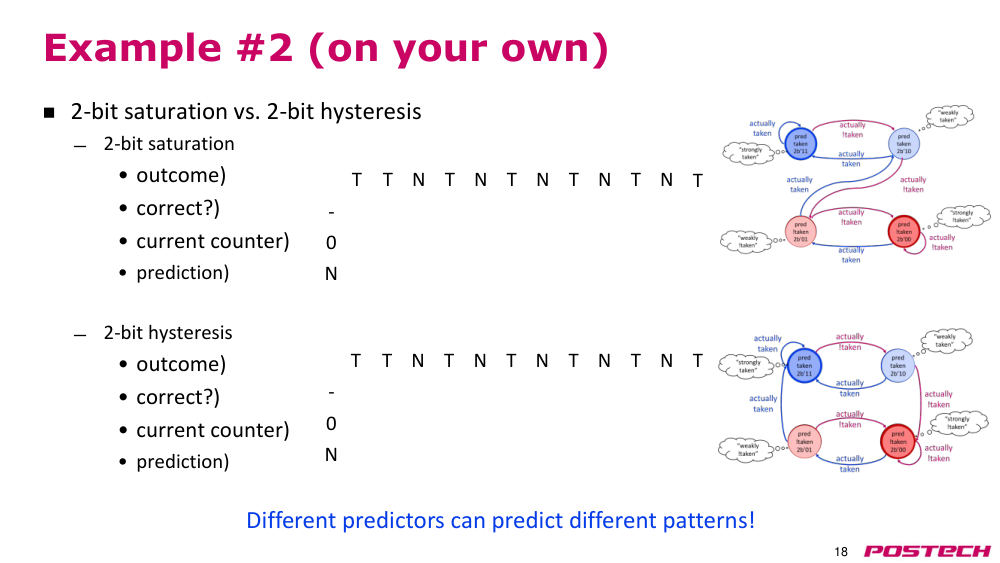
p.18예제 #2 (자신으로 해보기)
- 2비트 포화 vs. 2비트 히스테리시스
- 2비트 포화
- • 결과)
- • 올바르게 예측되었는가?)
- • 현재 카운터)
- • 예측)
- 2비트 히스테리시스
- • 결과)
- • 올바르게 예측되었는가?)
- • 현재 카운터)
- • 예측)
- T
- X
- 1
- N
- T
- X
- 2
- T
- N
- X
- 1
- N
- T
- X
- 2
- T
- N
- X
- 1
- N
- T
- X
- 2
- T
- N
- X
- 1
- N
- T
- X
- 2
- T
- N
- X
- 1
- N
- T
- X
- 2
- T
- T
- X
- 1
- N
- T
- X
- 3
- T
- N
- X
- 2
- T
- T
- O
- 3
- T
- N
- X
- 2
- T
- T
- O
- 3
- T
- N
- X
- 2
- T
- T
- O
- 3
- T
- N
- X
- 2
- T
- T
- O
- 3
- T
- N
- X
- 2
- T
- T
- O
- 3
- T
- 다른 예측기들은 서로 다른 패턴을 예측할 수 있다!
- -
- 0
- N
- -
- 0
- N
p.19state machine(상태 기계) 기반 예측기
- 2비트 예측기는 90% 이상의 정확도를 달성할 수 있음
- IPC = 1 / [1 + (0.20 * 0.10) * 2] = 0.96
- 합리적인 2비트 예측기는 거의 동일한 성능을 보임
- 주로 반복적으로 같은 행동을 하는 분기들에 주목함 (>80%)
- • 1비트 및 2비트 예측기는 동일한 효과를 가짐
- 가끔 한 번씩 반대 방향으로 execute(실행)되는 경우 (5~10%)
- • 1-bit predictor(1비트 예측기): 2번의 예측 오류
- • 2비트 예측기: 1번의 예측 오류
- 기타 사례 (<10%)
- • 일부는 더 고급 예측기로 포착 가능
- Amdahl's law(암다울의 법칙)은 이에 대해 무엇을 말하는가?
- 그러나 현대 프로세서는 고급 예측기를 사용한다. 왜일까?
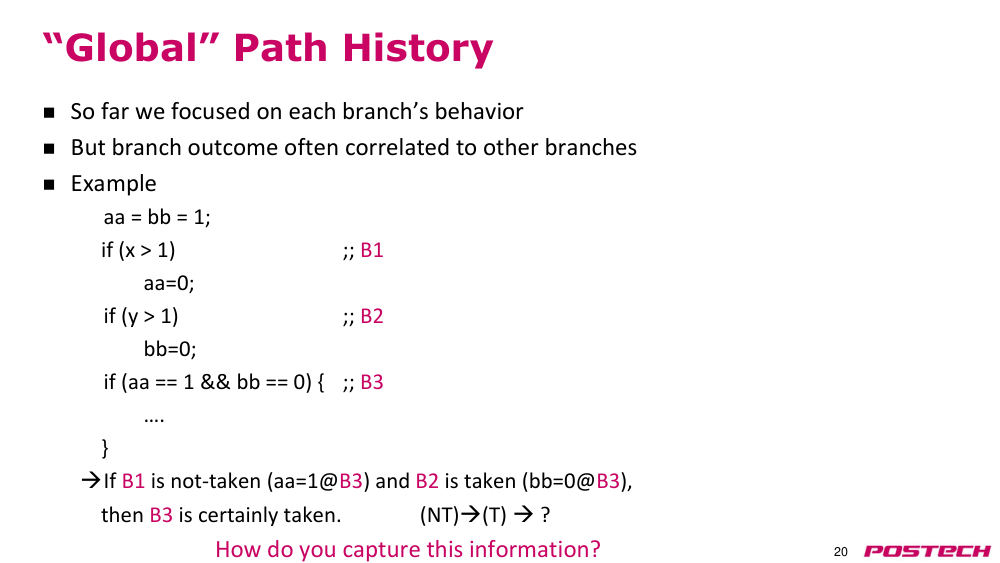
p.20global path history(전역 경로 이력)
- 이전까지는 각 분기의 행동에 집중해 왔음
- 하지만 branch outcome(분기 결과)는 다른 분기들과 종종 상관관계 있음
- 예시
- aa = bb = 1;
- if (x > 1)
- ;; B1
- aa=0;
- if (y > 1)
- ;; B2
- bb=0;
- if (aa == 1 && bb == 0) {
- ;; B3
- ...
- }
- → B1이 not taken(미취함, aa=1@B3)이고 B2가 taken(취함, bb=0@B3)라면, B3는 확실히 taken(취함). (NT)→(T)→?
- 이 정보를 어떻게 포착할 수 있을까?
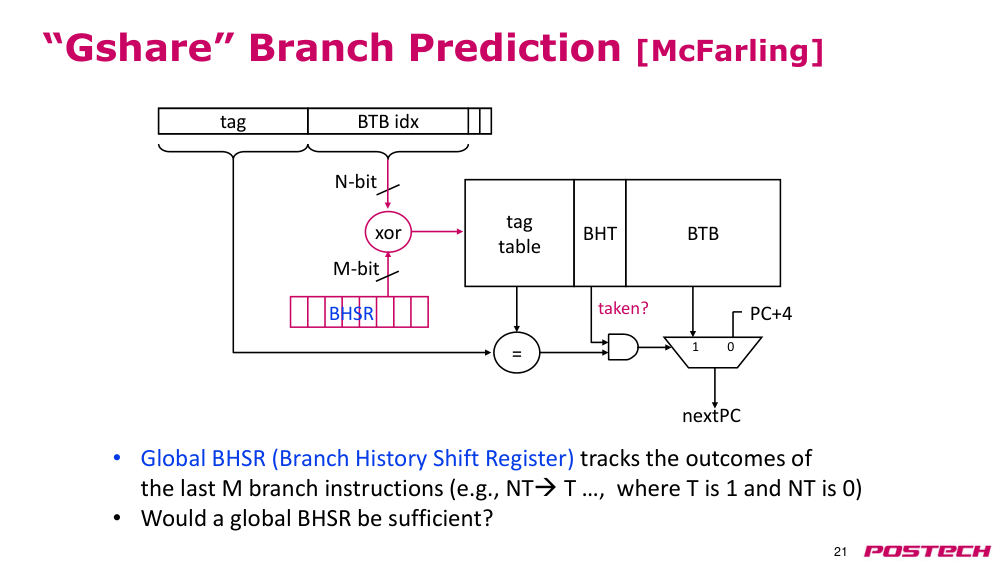
p.21"Gshare" branch prediction(분기 예측) [McFarling]
- global BHSR(분기 이력 시프트 레지스터)는 최근 M개의 분기 명령어 결과를 추적함 (예: NT→T …, 여기서 T는 1, NT는 0)
- 글로벌 BHSR만으로 충분할까?
- BTB
- BTB idx
- N-bit
- tag
- table
- 1 0
- PC+4
- nextPC
- =
- tag
- BHT
- taken?
- xor
- M-bit
- BHSR
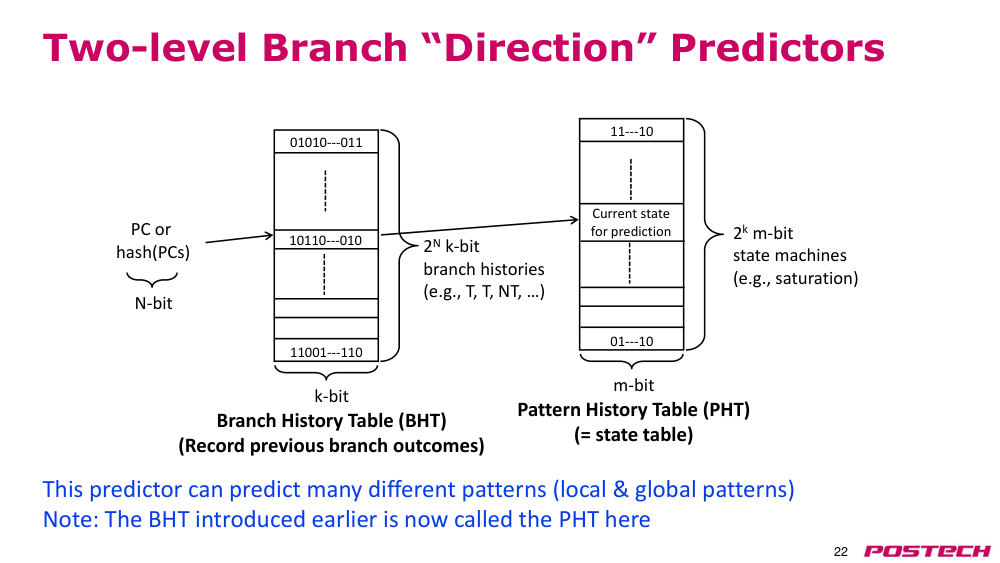
p.22이중 레벨 분기 "방향" 예측기
- 이 예측기는 다양한 패턴(로컬 및 글로벌 패턴)을 예측할 수 있음
- 참고: 이전에 소개된 BHT는 이제 여기서 PHT로 불림
- PC 또는
- hash(PCs)
- N-bit
- 2N k-bit
- 분기 이력
- (예: T, T, NT, …)
- k-bit
- 분기 이력 테이블 (BHT)
- (이전 branch outcome(분기 결과) 기록)
- 10110---010
- 01010---011
- 11001---110
- 2k m-bit
- state machine(상태 기계)
- (예: 포화)
- m-bit
- 패턴 이력 테이블 (PHT)
- (= 상태 테이블)
- 현재 예측을 위한 상태
- 11---10
- 01---10
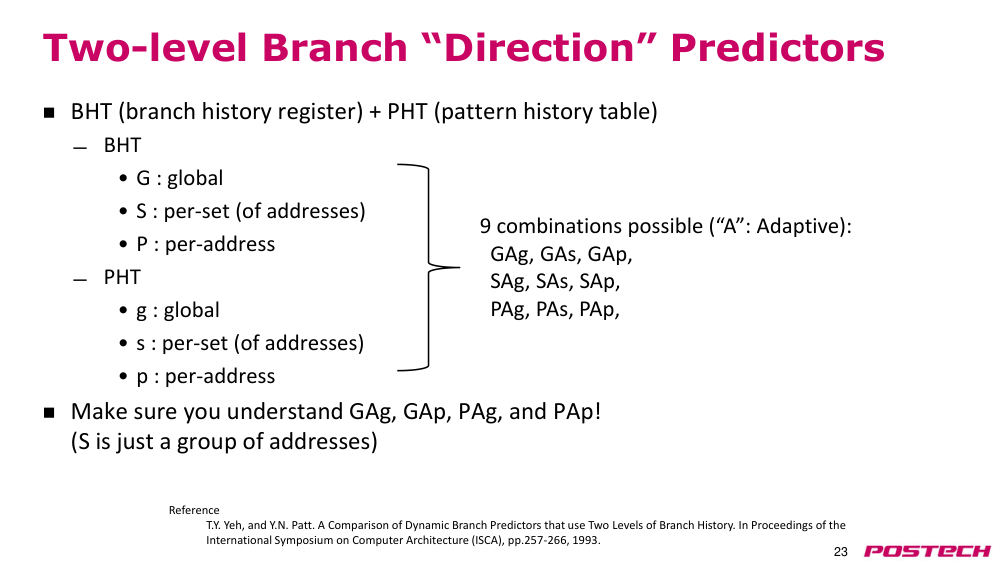
p.23이중 레벨 분기 "방향" 예측기
- BHT(분기 이력 레지스터) + PHT(패턴 이력 테이블)
- BHT
- • G: 글로벌
- • S: 주소 그룹별 (세트)
- • P: 주소별
- PHT
- • g: 글로벌
- • s: 주소 그룹별 (세트)
- • p: 주소별
- GAg, GAp, PAg, PAp를 이해해야 함!
- (S는 주소 그룹을 의미함)
- 9가지 조합 가능 ("A": 적응형):
- GAg, GAs, GAp,
- SAg, SAs, SAp,
- PAg, PAs, PAp,
- 참고
- T.Y. Yeh, and Y.N. Patt. A Comparison of Dynamic Branch Predictors that use Two Levels of Branch History. In Proceedings of the International Symposium on Computer Architecture (ISCA), pp.257-266, 1993.
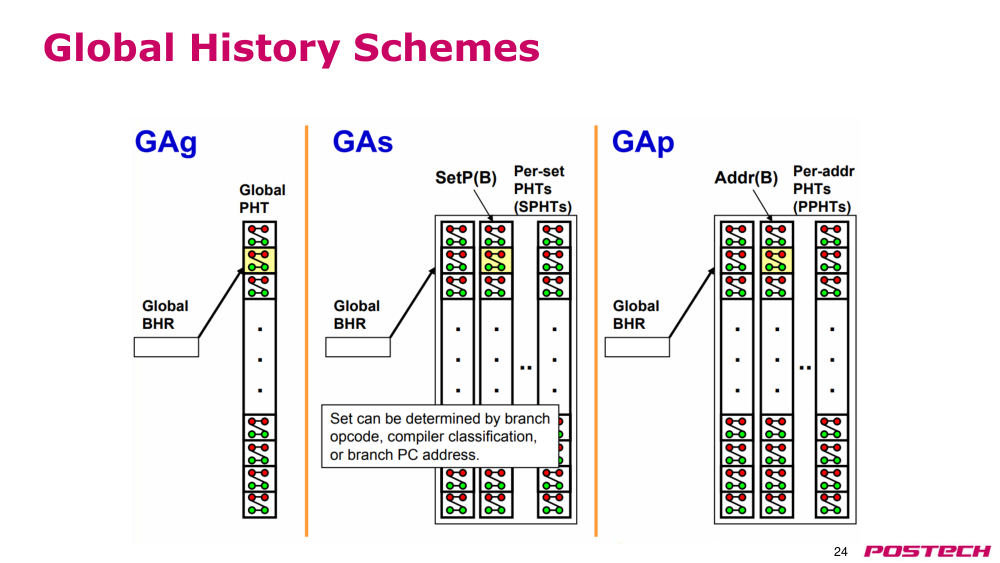
p.24global history(전역 이력) 방식
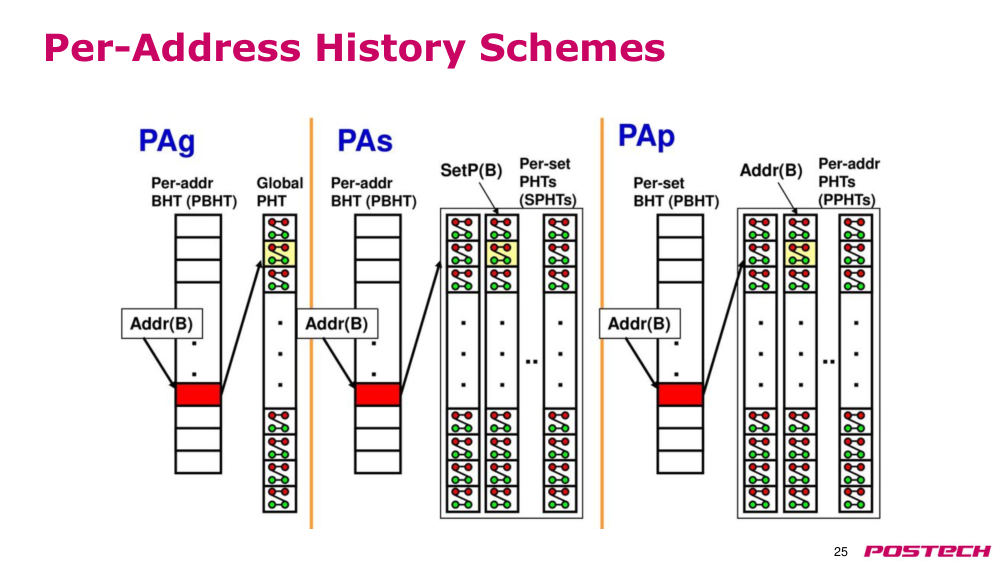
p.25Per-Address history(주소별 이력) 방식
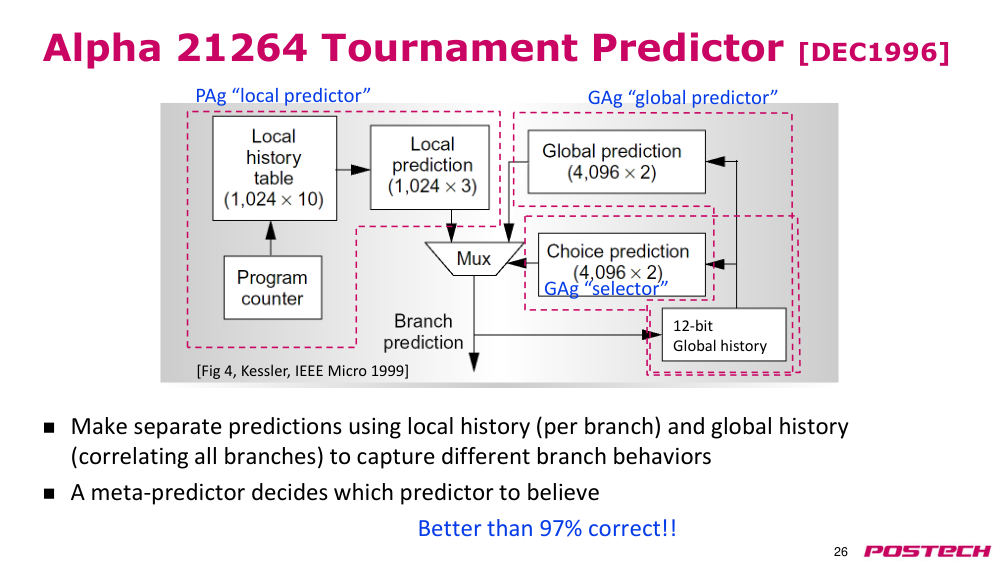
p.26Alpha 21264 tournament predictor(토너먼트 예측기) [DEC1996]
- 로컬 이력(각 분기별)과 전역 이력(모든 분기 간 상관관계)를 사용하여 별도의 예측을 수행하여 다양한 분기 행동을 포착한다
- meta-predictor(메타 예측기)가 어느 예측기를 신뢰할지 결정한다
- 97% 이상 정확함!!
- [그림 4, Kessler, IEEE Micro 1999]
- 12비트 global history(전역 이력)
- PAg: "로컬 예측기"
- GAg: "글로벌 예측기"
- GAg: "선택기"
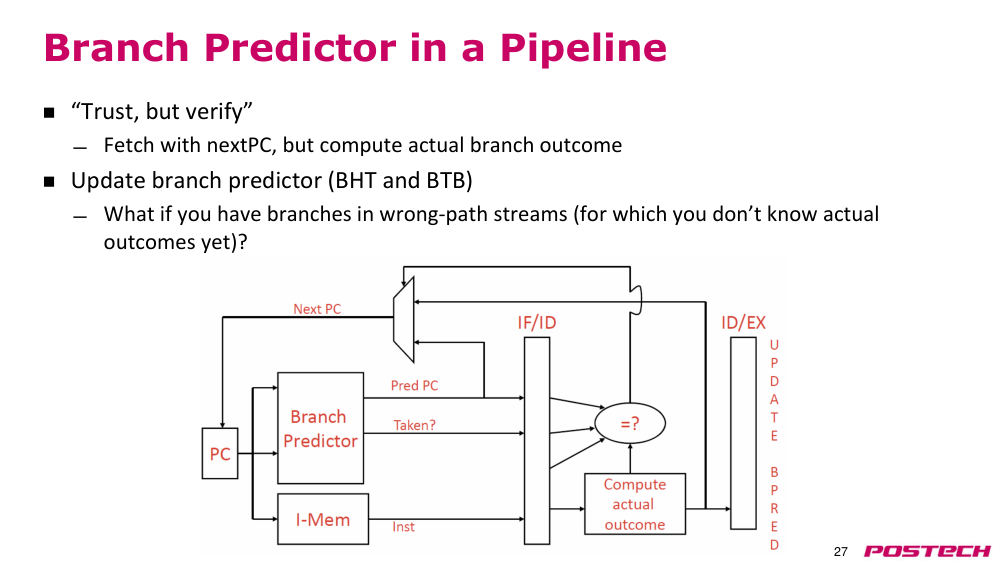
p.27파이프라인 내 branch prediction(분기 예측)기
- "trust, but verify(신뢰하되 검증하라)" – NextPC(다음 PC)로 가져오기 하지만 실제 branch outcome(분기 결과) 계산
- branch prediction(분기 예측)기(BHT 및 BTB) 업데이트
- 만약 잘못된 경로 스트림에 branch(분기)가 존재할 경우(아직 실제 결과를 알 수 없음) 어떻게 할 것인가?
p.28return address stack (RAS)(반환 주소 스택)
- 레지스터 간접 점프(JALR 등)의 타겟은 지역성(locality)이 거의 없음
- 이력 기반 예측기는 작동하지 않는다. 왜냐하면?
- 그러나 간단한 "스택"은 function call(함수 호출)과 반환의 사용 패턴을 매우 잘 포착할 수 있음
- 반환 주소 스택(RAS)
- 링크 명령어(JAL 등)가 execute(실행)될 때 반환 주소를 스택에 푸시한다. 왜냐하면 호출을 할 때 어디로 돌아올지 이미 알고 있기 때문이다
- 반환 명령어(JALR 등)의 PC를 만나면 스택의 최상단을 팝하여 NextPC(다음 PC)를 예측할 수 있다
- RAS와 BTB 중 언제 어느 것을 따를 것인가?
- return address stack (RAS)(반환 주소 스택)이 오버플로우할 경우 어떻게 할 것인가?
p.29speculative execution(추측 실행) 요약
- 각 control flow instruction(제어 흐름 명령어)는 파이프라인을 따라 예측된 NextPC(다음 PC)를 가져가야 한다
- 명령어의 제어 흐름 결과가 알려질 때(=branch resolution(분기 해석) 시점), 예측된 NextPC(다음 PC)를 검증한다
- 만약 NextPC(다음 PC)가 올바르게 예측되었을 경우
- BHT 업데이트(=예측 상태 로직 → 예측 강화)
- 추가로 할 일 없음
- 만약 NextPC(다음 PC)가 잘못 예측되었을 경우
- BHT 및/또는 BTB 업데이트
- 파이프라인 내 "더 어린" 명령어 모두 플러시
- 정확한 타겟에서 다시 가져오기 시작
- 5단계 RISC-V와 같은 in-order pipeline(순서 유지 파이프라인)에서는 비교적 쉬움. 그러나 깊은 파이프라인, superscalar(슈퍼스칼라), Out-of-Order execution(순서 외 실행) 파이프라인(예: Intel i7)에서는 매우 어려워질 수 있음
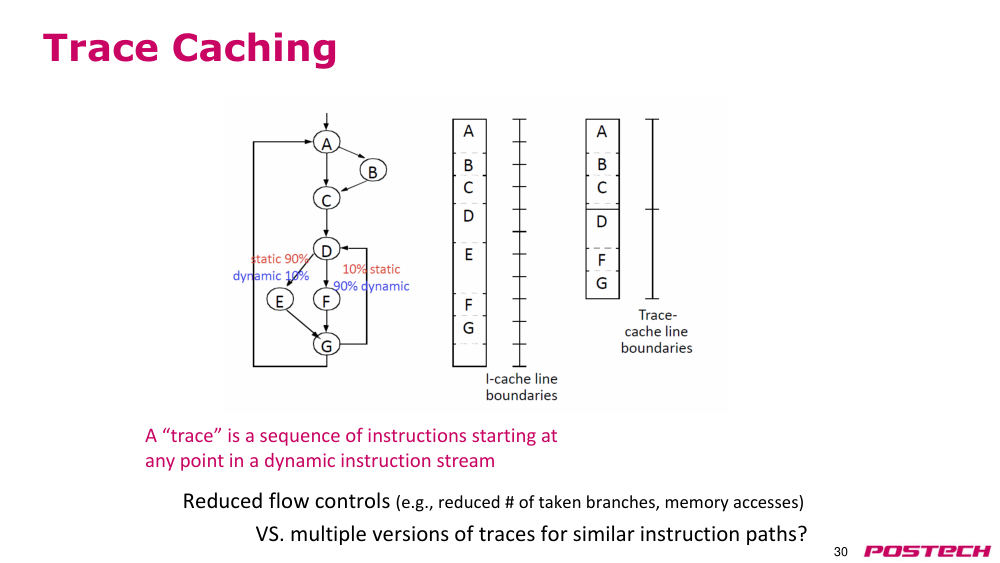
p.30트레이스 캐싱
- 제어 흐름 감소(예: taken(취함) 분기 수, memory access(메모리 접근) 수 감소)
- 유사한 명령어 경로에 대해 여러 버전의 트레이스를 사용하는 것과 비교
- "트레이스"는 동적 명령어 스트림의 어느 지점에서 시작하는 명령어 시퀀스이다
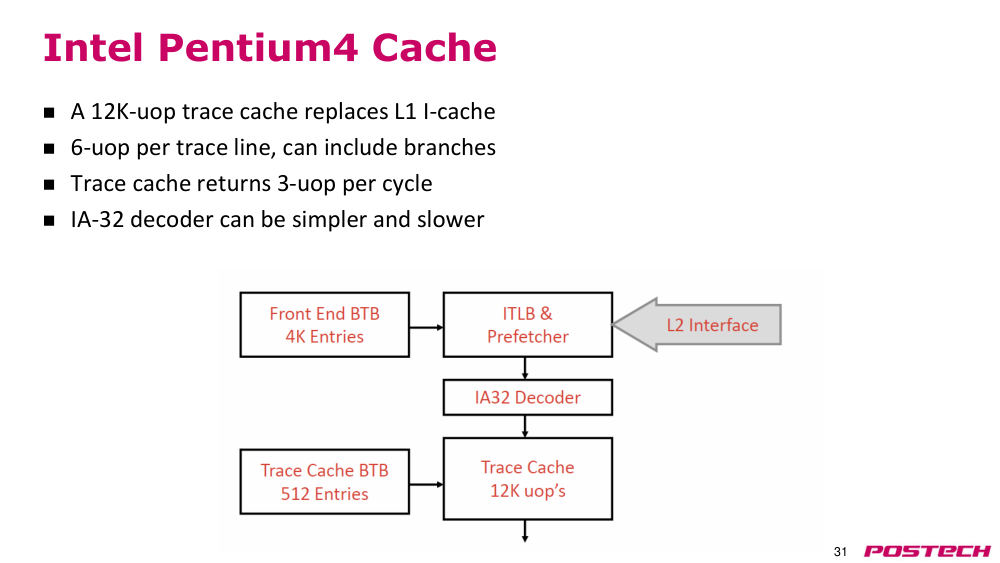
p.31Intel Pentium4 Cache
- 12K-uop 트레이스 캐시가 L1 I-캐시를 대체한다
- 트레이스 라인당 6-uop, 분기 포함 가능
- 트레이스 캐시는 사이클당 3-uop를 반환한다
- IA-32 디코더는 더 간단하고 느릴 수 있다
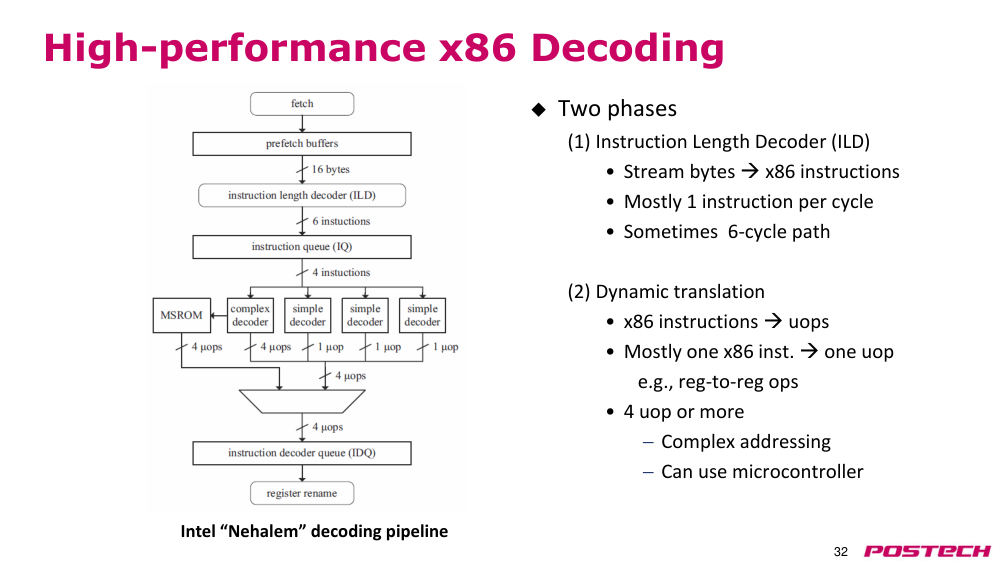
p.32고성능 x86 디코딩
- 두 단계
- (1) 명령어 길이 디코더 (ILD)
- • 스트림 바이트 → x86 명령어
- • 대부분 사이클당 1개의 명령어
- • 때때로 6사이클 경로
- (2) 동적 번역
- • x86 명령어 → uop
- • 대부분 1개의 x86 명령어 → 1개의 uop
- 예: 레지스터-레지스터 연산
- • 4개 이상의 uop
- − 복잡한 주소 지정
- − microcode(마이크로코드) 사용 가능
- Intel "Nehalem" decoding pipeline
p.33predicated execution(프레디케이션 실행): if-conversion(If 변환)
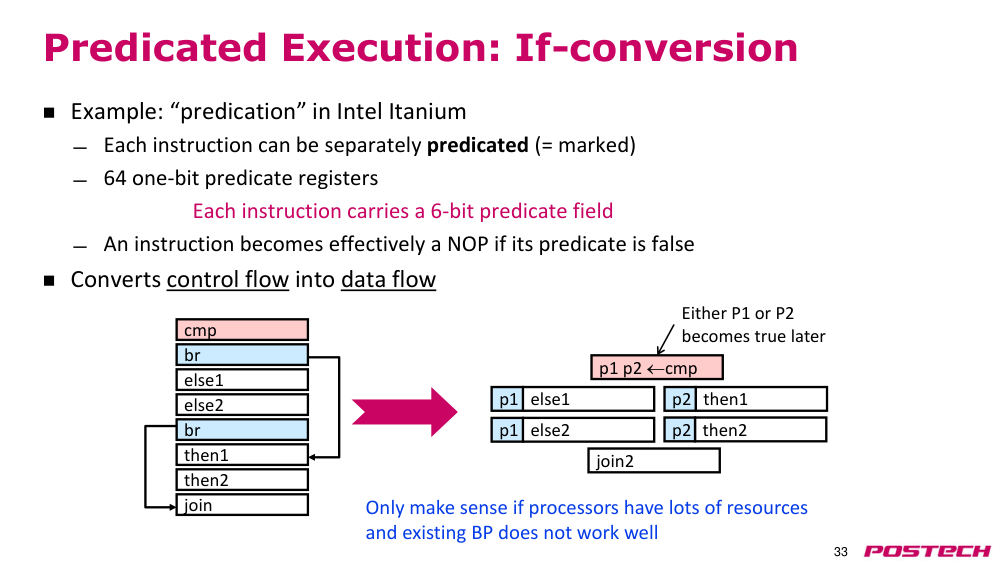
- 예: Intel Itanium의 predication(프레디케이션)
- 각 명령어에 별도의 predicate(프레디케이트)를 지정할 수 있음(= 표시)
- 64개의 1비트 predicate register(프레디케이트 레지스터)
- 각 명령어는 6비트 predicate field(프레디케이트 필드)를 포함
- predicate(프레디케이트)가 false이면 명령어는 실제로 NOP와 동일하게 작동
- 제어 흐름을 데이터 흐름으로 변환
- cmp
- br
- else1
- else2
- br
- then1
- then2
- join
- p1 p2 ← cmp
- join2
- else1
- p1
- else2
- p1
- then2
- p2
- then1
- p2
- P1 또는 P2 중 하나는 나중에 참이 된다
- 프로세서가 많은 자원을 가지며 기존의 BP가 잘 작동하지 않을 때만 의미 있음
p.34소프트웨어가 branch prediction(분기 예측)에 관여하기
- static branch(정적 분기) '힌트'는 모든 분기와 함께 인코딩될 수 있음
- taken(취함) vs. not taken(미취함)
- 동적 BP 하드웨어에 엔트리 할당 여부 결정
- 소프트웨어와 하드웨어는 BP 하드웨어를 공동으로 제어할 수 있음
- Intel Itanium은 실제 분기 전에 상태를 설정할 수 있는 'brp'(분기 예측) 명령어를 제공
- TAR (타겟 주소 레지스터)
- 작은, 완전히 연관형 BTB
- 전적으로 prepare-to-branch instruction(분기 준비 명령어)에 의해 제어됨
- TAR에서의 히트는 모든 다른 예측을 무시한다
p.35branch prediction(분기 예측): 핵심 요약
- 현재 PC를 기반으로 NextPC(다음 PC)를 결정하는 방법
- 정확한 정보(나중에 제공됨)를 기다리는 것은 stall(스톨)을 유발함
- 쉬운 부분
- 같은 PC는 항상 같은 명령어를 가리킴
- (자기 수정 코드 제외)
- 비제어 흐름 명령어의 경우 NextPC는 항상 PC+4
- PC offset(PC 오프셋) 제어 흐름(예: Bxx 및 JAL)의 타겟은 항상 동일함
- 타겟 테이블을 유지하면 거의 100% 정확하게 처리 가능
- 그렇지 않은 부분
- taken(취함) 여부 결정은 정적이지 않음
- • 역방향 분기의 90%는 taken(취함) (루프)
- • 전방 분기의 50%는 taken(취함) (If-then-else)
- 특정 분기는 거의 항상 동일한 방식으로 반복됨
p.36질문?
- 공지사항
- - 읽기: P&H (RISC-V ed.) Ch 4.9-4.15
- - 논문 읽기(선택사항): "Dynamic Branch Prediction with Perceptrons", Jimenez and Lin, HPCA’01
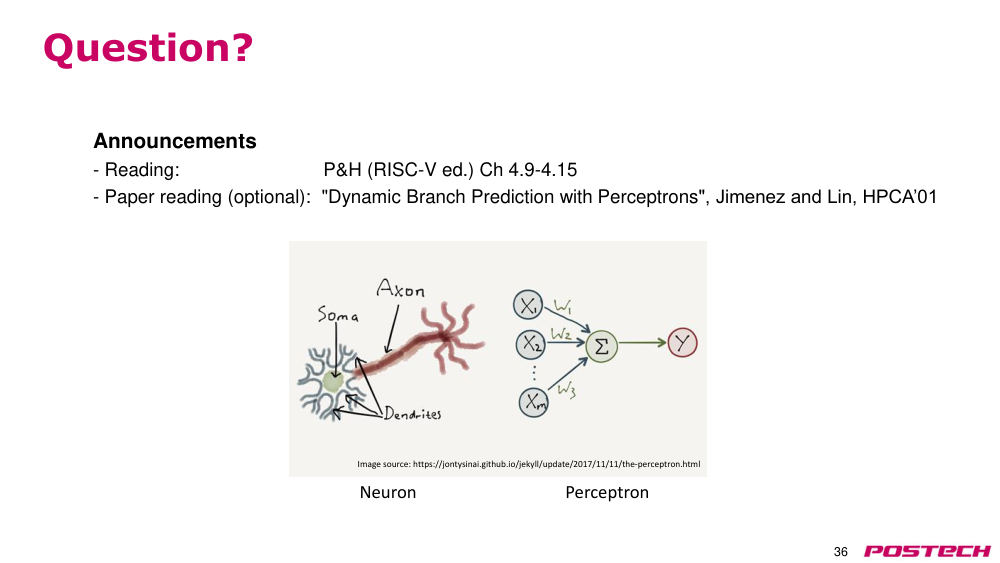
- 뉴런
- Perceptron(퍼셉트론)
- 이미지 출처: https://jontysinai.github.io/jekyll/update/2017/11/11/the-perceptron.html