이 자료를 쓰는 강의: 43 Lec 8 · pipelined control 과 data hazard·stall · 44 Lec 9 · data forwarding·load-use stall 과 control hazard 도입
Lec8-pipelined-CPU-datahaz
한국어판 강의자료 · 37쪽
p.1CSED311 컴퓨터구조 – 강의 8
p.2instruction pipelining(명령어 파이프라인)의 현실
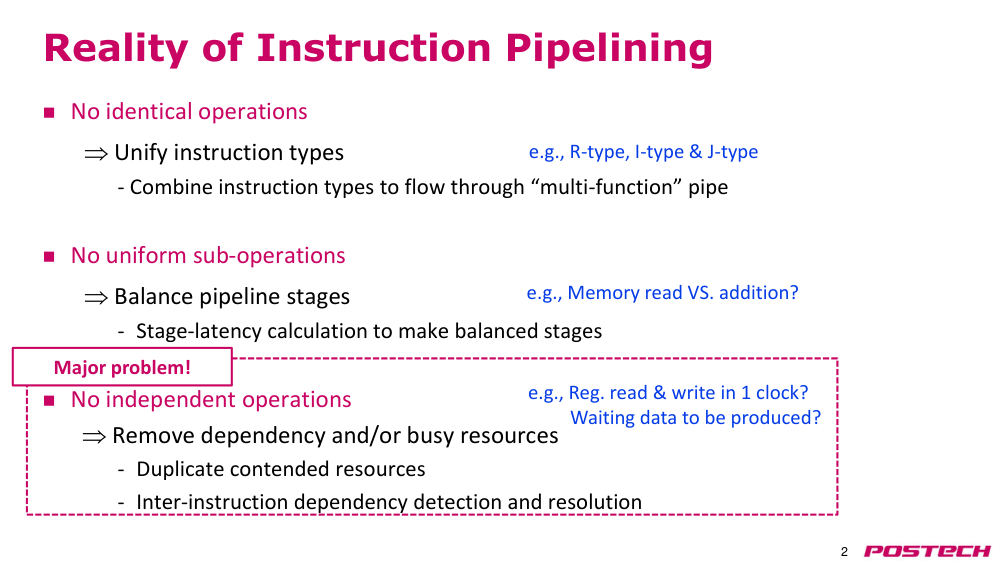
- 동일한 연산 없음
- → 명령어 유형 통합
- - 다양한 기능을 가진 파이프를 통해 명령어 흐름 통합
- 서브 연산이 일관되지 않음
- → pipeline stages(파이프라인 단계) 균형화
- - stage-latency calculation(단계 지연 계산)을 통해 balanced stages(균형 잡힌 단계) 구현
- 독립적인 연산 없음
- → 의존성 제거 및/또는 사용 중인 자원 제거
- - 경쟁하는 자원 복제
- - inter-instruction dependency detection(명령어 간 의존성 탐지) 및 해결
- 예: r-type(R형), i-type(I형), j-type(J형)
- 예: memory read(메모리 읽기) vs. addition(덧셈)?
- 예: 1 클럭 내 register read(레지스터 읽기) 및 쓰기?
- 생산 대기 중인 데이터?
- 주요 문제!
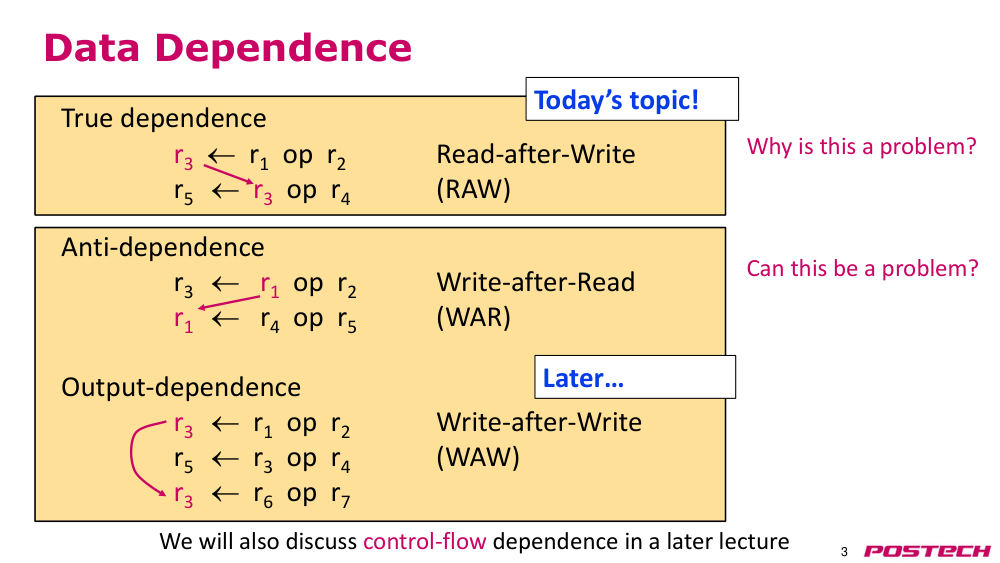
p.3오늘의 주제! data dependence(데이터 의존성)
- true dependence(진정한 의존성)
- r3 ← r1 op r2
- 쓰기 후 읽기 (Read-after-Write, RAW)
- r5 ← r3 op r4
- anti-dependence(반의존성)
- r3 ← r1 op r2
- 읽기 후 쓰기 (Write-after-Read, WAR)
- r1 ← r4 op r5
- output-dependence(출력 의존성)
- r3 ← r1 op r2
- 쓰기 후 쓰기 (Write-after-Write, WAW)
- r5 ← r3 op r4
- r3 ← r6 op r7
- 나중 강의에서 control-flow dependence(제어 흐름 의존성)도 다룰 예정
- 왜 문제가 되는가?
- 이 문제는 실제로 문제가 될 수 있는가?
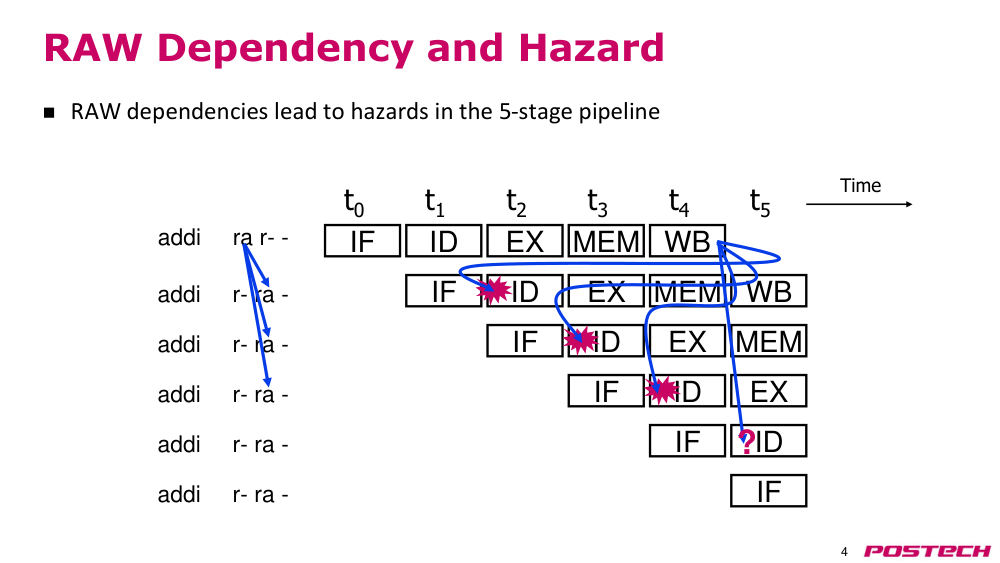
p.4RAW 의존성과 해저드
- RAW 의존성은 5단계 파이프라인에서 해저드를 유발함
- MEM
- WB
- IF
- ID
- IF
- EX
- ID
- MEM
- EX
- WB
- addi ra r- -
- addi r- ra -
- MEM
- IF
- ID
- EX
- IF
- ID
- EX
- IF
- ID
- IF
- addi r- ra -
- addi r- ra -
- addi r- ra -
- addi r- ra -
- t0
- t1
- t2
- t3
- t4
- t5
- 시간
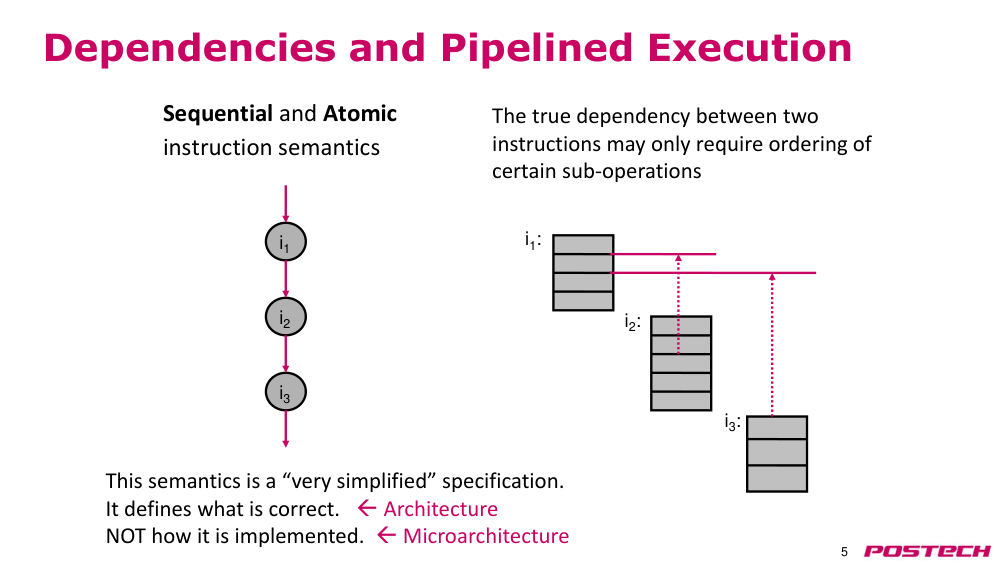
p.5의존성과 파이프라인 실행
- 순차적이고 원자적인 명령어 의미
- i1
- i2
- i3
- 이 의미는 '매우 단순화된' 사양임.
- 정확한 동작을 정의함. ← 아키텍처
- 구현 방식을 정의하지 않음. ← microarchitecture(마이크로아키텍처)
- i1:
- i2:
- i3:
- 두 명령어 사이의 true dependence(진정한 의존성)은 특정 서브 연산의 순서만 요구할 수 있음
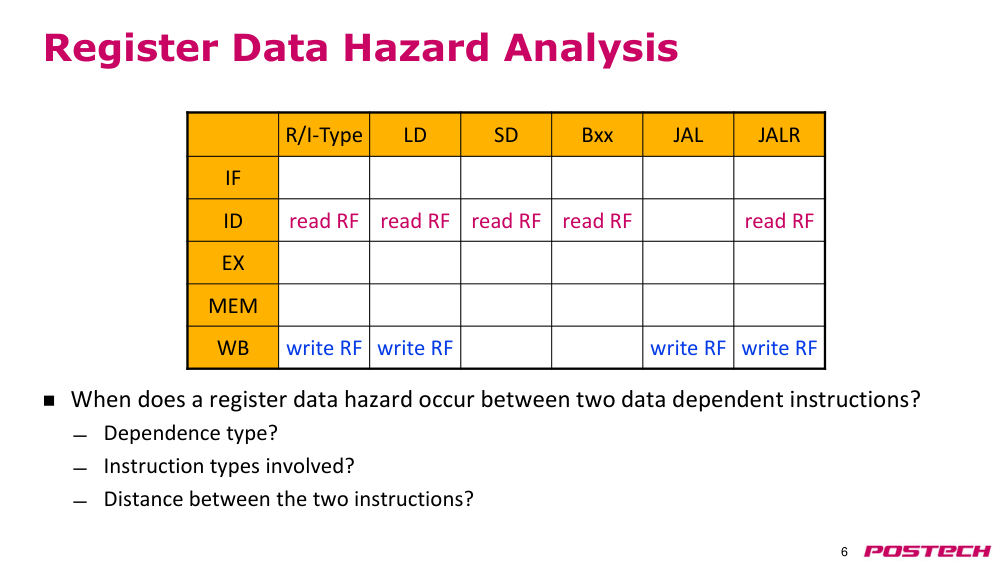
p.6register data hazard analysis(레지스터 데이터 해저드 분석)
- 두 data dependence(데이터 의존성) 명령어 사이에 레지스터 data hazard(데이터 해저드)가 발생하는 조건은?
- 의존성 유형?
- 관련된 명령어 유형?
- 두 명령어 사이의 거리?
- R/i-type(I형)
- LD
- SD
- Bxx
- JAL
- JALR
- IF
- ID
- read RF
- read RF
- read RF
- read RF
- read RF
- EX
- MEM
- WB
- write RF
- write RF
- write RF
- write RF
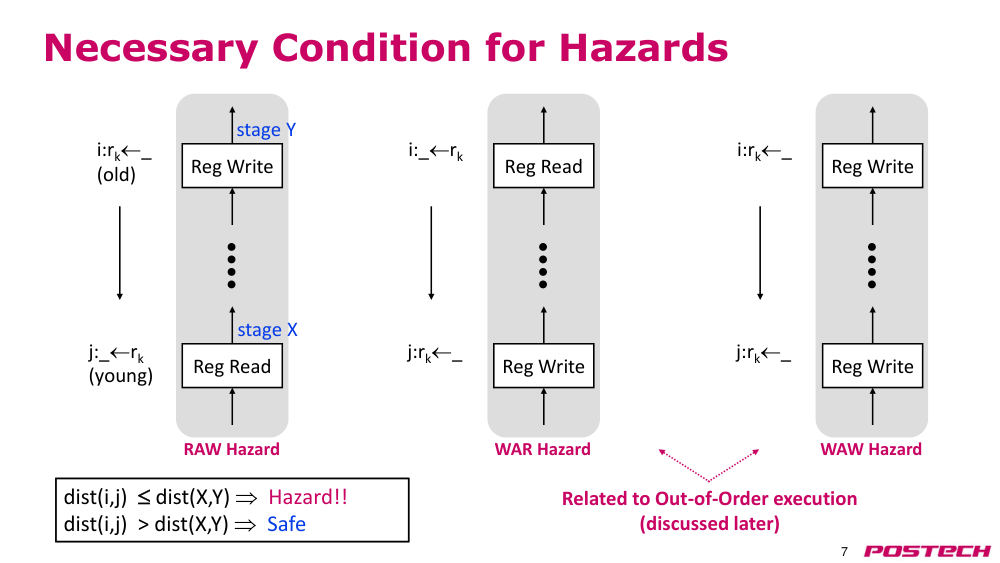
p.7necessary condition for hazards(해저드의 필수 조건)
- i: rk ← _ (old)
- j: _ ← rk (young)
- register write(레지스터 쓰기)
- register read(레지스터 읽기)
- 단계 Y
- 단계 X
- dist(i,j) ≤ dist(X,Y) ⇒ ??
- dist(i,j) > dist(X,Y) ⇒ ??
- RAW hazard(RAW 해저드)
- i: _ ← rk
- j: rk ← _
- register read(레지스터 읽기)
- register write(레지스터 쓰기)
- WAR hazard(WAR 해저드)
- i: rk ← _
- j: rk ← _
- register write(레지스터 쓰기)
- register write(레지스터 쓰기)
- WAW hazard(WAW 해저드)
- dist(i,j) ≤ dist(X,Y) ⇒ 해저드!!
- dist(i,j) > dist(X,Y) ⇒ 안전
- out-of-order execution(비순차 실행)과 관련됨 (나중에 논의)
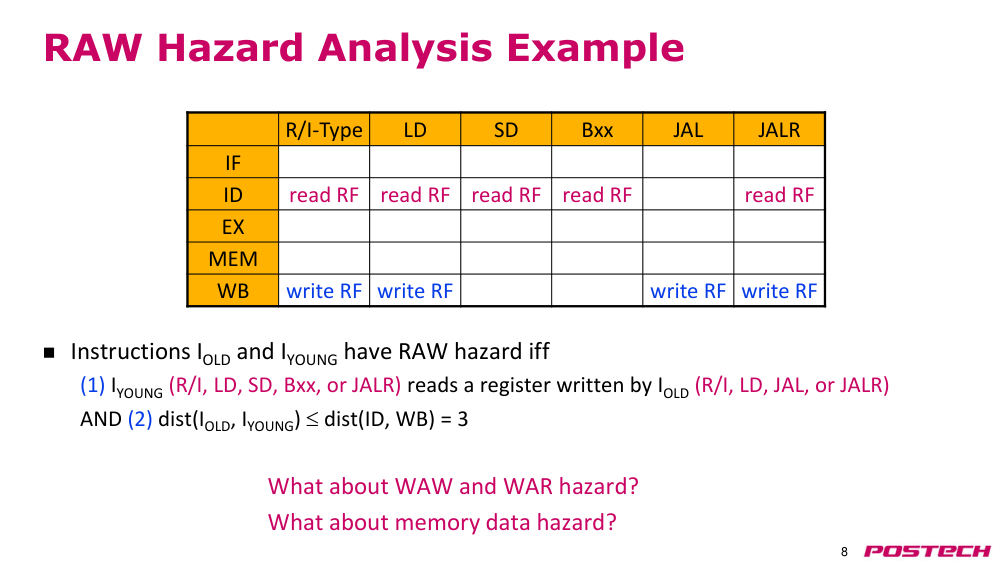
p.8RAW hazard(RAW 해저드) 분석 예제
- 명령어 IOLD와 IYOUNG이 RAW hazard(RAW 해저드)를 가질 조건은 다음과 같다:
- (1) IYOUNG (R/I, LD, SD, Bxx, 또는 JALR)이 IOLD (R/I, LD, JAL, 또는 JALR)이 쓰는 레지스터를 읽는다
- AND (2) dist(IOLD, IYOUNG) ≤ dist(ID, WB) = 3
- WAW 및 WAR hazard(WAW 및 WAR 해저드)에 대해서는?
- memory data hazard(메모리 데이터 해저드)에 대해서는?
- R/i-type(I형)
- LD
- SD
- Bxx
- JAL
- JALR
- IF
- ID
- registers(레지스터 파일) 읽기
- registers(레지스터 파일) 읽기
- registers(레지스터 파일) 읽기
- registers(레지스터 파일) 읽기
- registers(레지스터 파일) 읽기
- EX
- MEM
- WB
- registers(레지스터 파일) 쓰기
- registers(레지스터 파일) 쓰기
- registers(레지스터 파일) 쓰기
- registers(레지스터 파일) 쓰기
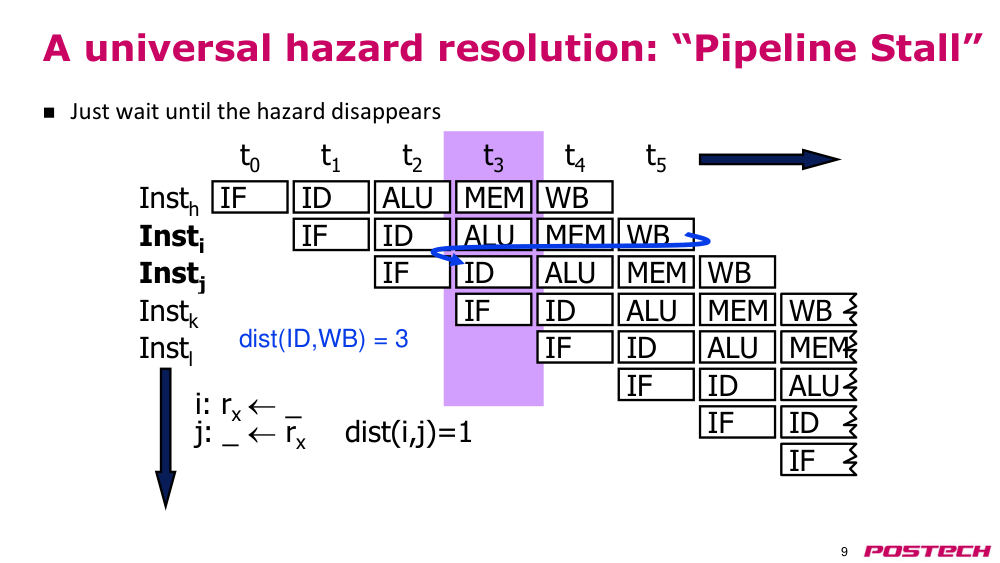
p.9pipeline stall(파이프라인 스톨): universal hazard resolution(일반 해저드 해결)
- 해저드가 사라질 때까지 기다리기만 하면 된다.
- dist(ID, WB) = 3
- t0
- t1
- t2
- t3
- t4
- t5
- Insti
- Instj
- Instk
- Instl
- Insth
- i: rx ← _
- j: _ ← rx
- dist(i,j) = 1
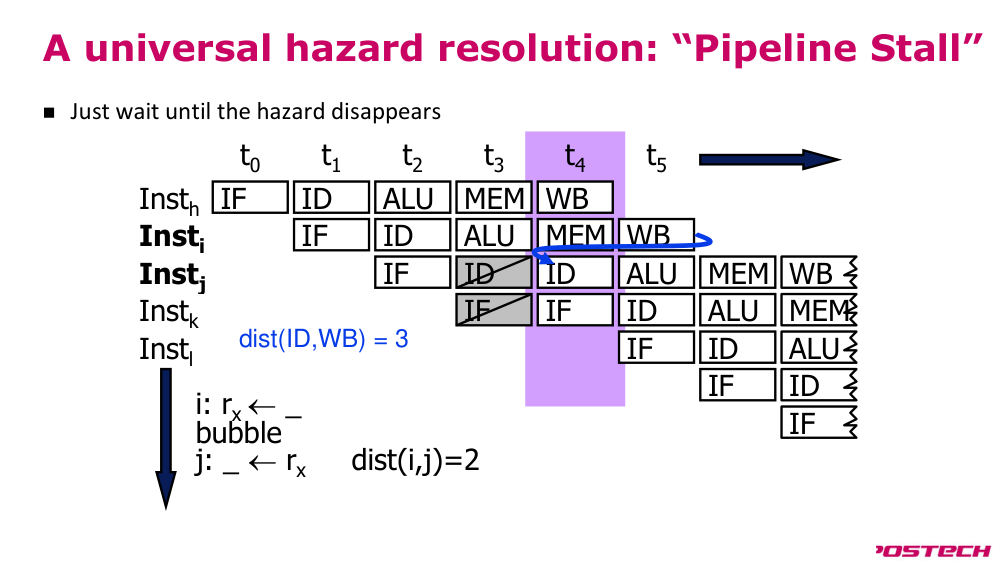
p.10pipeline stall(파이프라인 스톨): universal hazard resolution(일반 해저드 해결)
- 해저드가 사라질 때까지 기다리기만 하면 된다.
- dist(ID, WB) = 3
- t0
- t1
- t2
- t3
- t4
- t5
- Insti
- Instj
- Instk
- Instl
- Insth
- i: rx ← _
- bubble
- j: _ ← rx
- dist(i,j) = 2
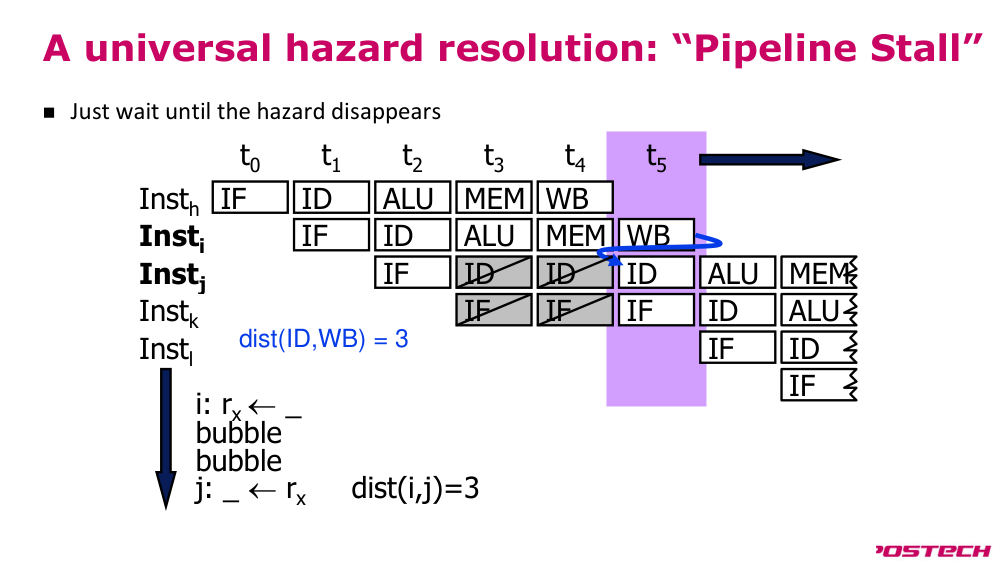
p.11pipeline stall(파이프라인 스톨): universal hazard resolution(일반 해저드 해결)
- 해저드가 사라질 때까지 기다리기만 하면 된다.
- dist(ID, WB) = 3
- t0
- t1
- t2
- t3
- t4
- t5
- Insti
- Instj
- Instk
- Instl
- Insth
- i: rx ← _
- bubble
- bubble
- j: _ ← rx
- dist(i,j) = 3
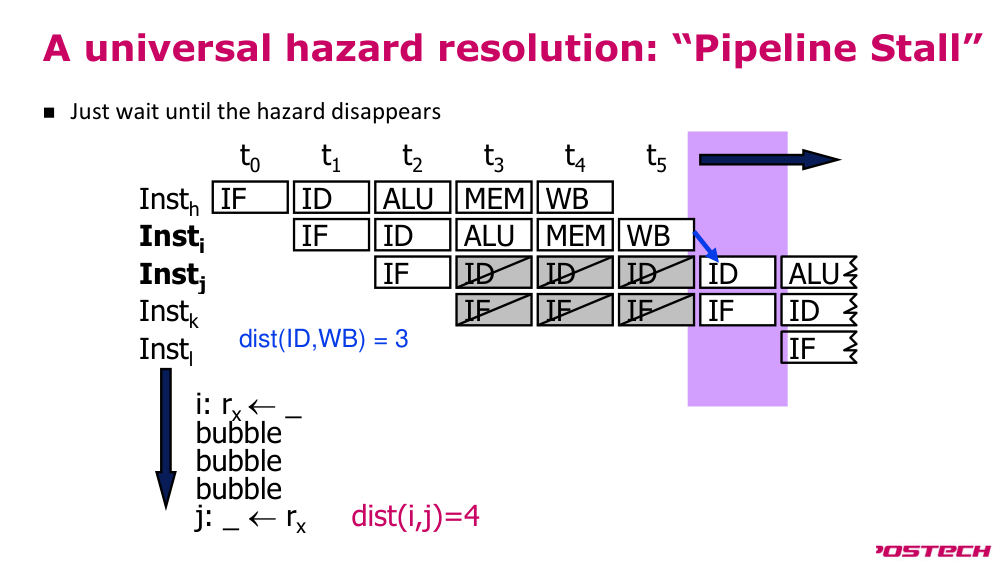
p.12pipeline stall(파이프라인 스톨): universal hazard resolution(일반 해저드 해결)
- 해저드가 사라질 때까지 기다리기만 하면 된다.
- dist(ID, WB) = 3
- t0
- t1
- t2
- t3
- t4
- t5
- Insti
- Instj
- Instk
- Instl
- Insth
- i: rx ← _
- bubble
- bubble
- bubble
- j: _ ← rx
- dist(i,j) = 4
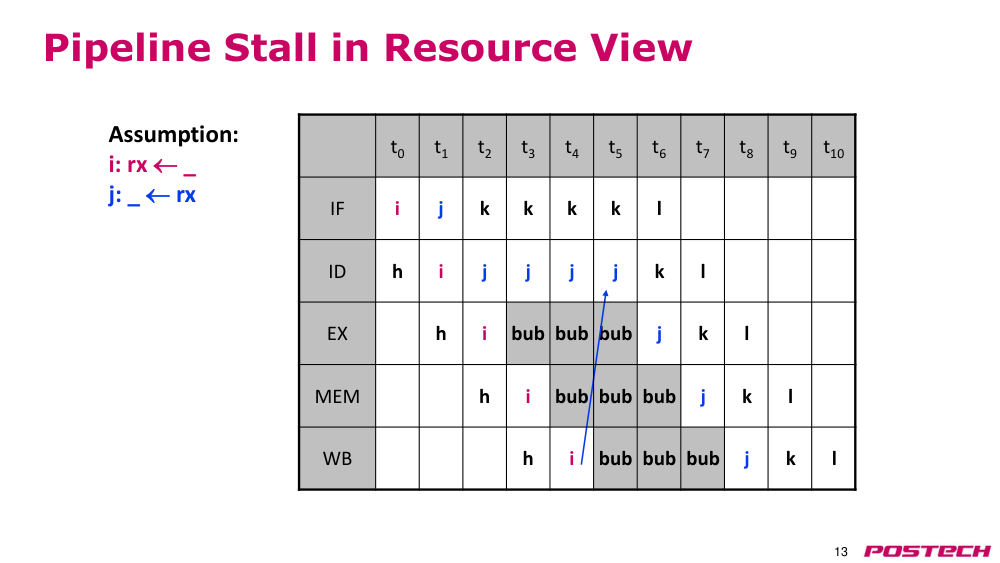
p.13pipeline stall in resource view(자원 관점에서의 파이프라인 스톨)
- 가정:
- i: rx ← _
- j: _ ← rx
- t0
- t1
- t2
- t3
- t4
- t5
- t6
- t7
- t8
- t9
- t10
- IF
- i
- j
- k
- ID
- h
- i
- j
- EX
- h
- i
- MEM
- h
- WB
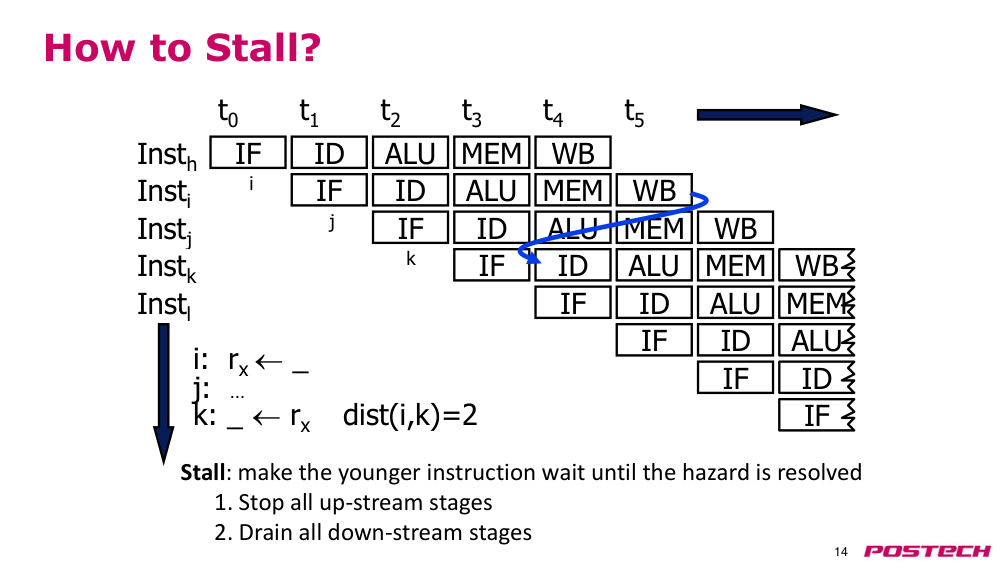
p.14how to stall?(스톨하는 방법?)
- stall(스톨): 젊은 명령어가 해저드가 해결될 때까지 기다리게 함
- 1. 상류 단계 모두 정지
- 2. 하류 단계 모두 drain(드레인)
- IF
- WB
- IF
- ID
- ALU
- MEM
- IF
- ID
- ALU
- MEM
- IF
- ID
- ALU
- MEM
- IF
- ID
- ALU
- t0
- t1
- t2
- t3
- t4
- t5
- IF
- ID
- MEM
- IF
- ID
- ALU
- IF
- ID
- Insti
- Instj
- Instk
- Instl
- WB
- WB
- i: rx ← _
- j: …
- k: _ ← rx
- dist(i,k)=2
- i
- j
- Insth
- WB
- MEM
- ALU
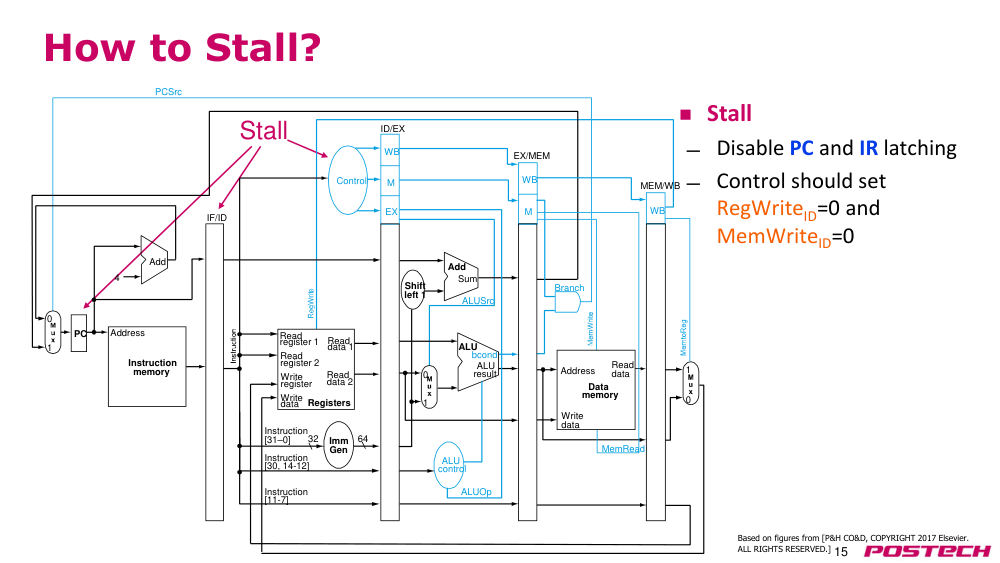
p.15how to stall?(스톨하는 방법?)
- stall(스톨)
- PC 및 IR latching(IR 래칭) 비활성화
- control signals(제어 신호)가 설정해야 할 사항:
- RegWriteID = 0
- MemWriteID = 0
- WB
- M
- EX
- WB
- M
- WB
- PCSrc
- MemRead
- Add
- Address
- Instruction memory
- Address
- Write data
- Read data
- Data memory
- Add
- Sum
- ALU
- ALU result
- bcond
- Shift left 1
- PC
- 4
- ID/EX
- IF/ID
- EX/MEM
- MEM/WB
- ALUOp
- ALUSrc
- Branch
- Control
- 0
- 1
- 0
- 1
- 1
- 0
- Read register 1
- Read register 2
- Write register
- Write data
- Instruction [31–0]
- Instruction [11-7]
- Instruction [30, 14-12]
- Read data 1
- Read data 2
- Registers
- Imm Gen
- 32
- 64
- ALU control
p.16언제 stall(스톨)할까?
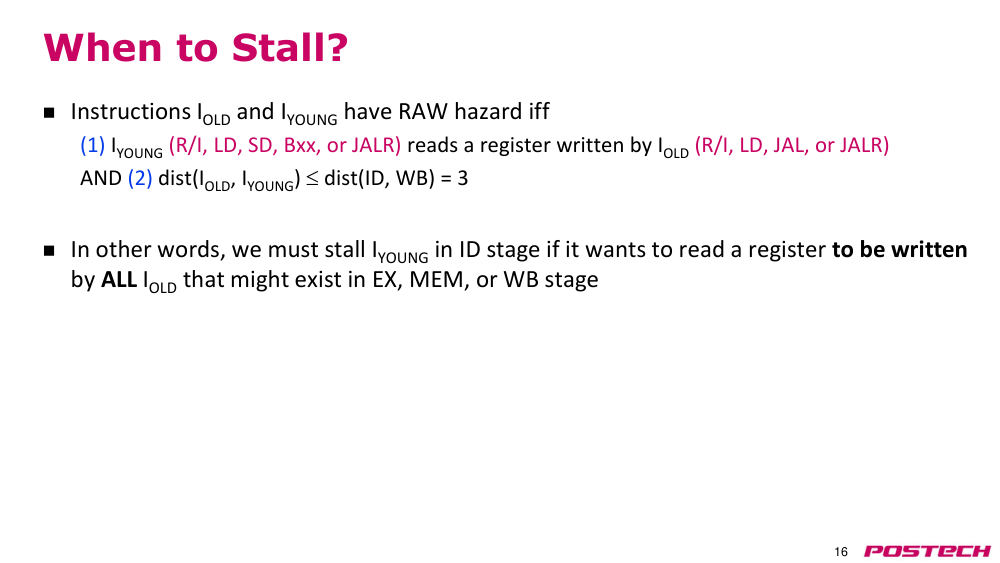
- 명령어 IOLD과 IYOUNG이 RAW hazard(RAW 해저드)를 가질 조건은 다음과 같음:
- (1) IYOUNG (R/I, LD, SD, Bxx, 또는 JALR)가 IOLD (R/I, LD, JAL, 또는 JALR)가 쓰는 레지스터를 읽는 경우
- AND
- (2) dist(IOLD, IYOUNG) ≤ dist(ID, WB) = 3
- 즉, 만약 IYOUNG이 EX, MEM, 또는 WB 단계에 존재할 수 있는 모든 IOLD가 쓰는 레지스터를 읽으려 한다면, ID 단계에서 IYOUNG을 stall(스톨)해야 함
p.17stall condition(스톨 조건)
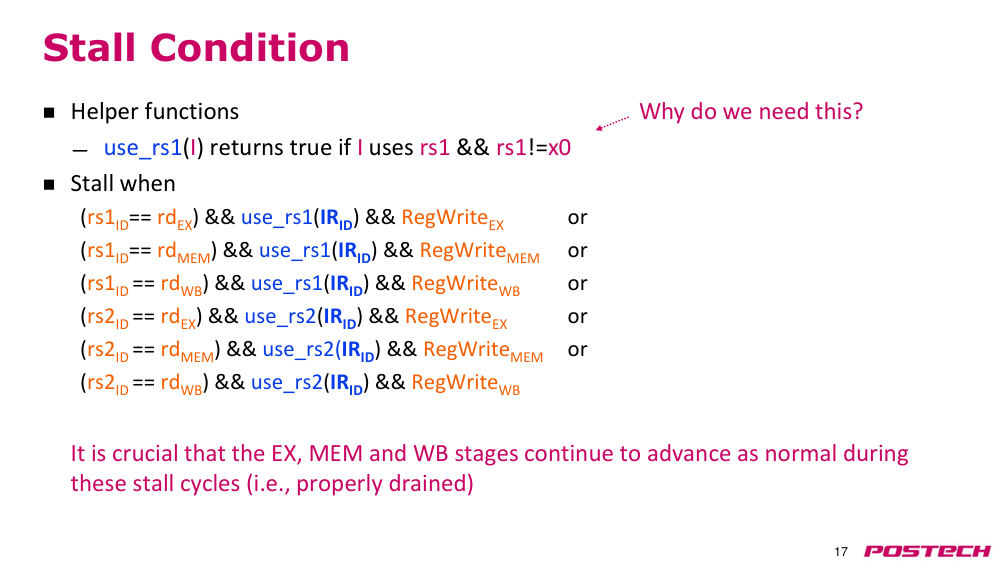
- helper functions(보조 함수):
- use_rs1(I)는 I가 rs1을 사용하고, rs1 ≠ x0인 경우에 참을 반환
- stall condition(스톨 조건):
- (rs1ID == rdEX) && use_rs1(IRID) && RegWriteEX
- 또는
- (rs1ID == rdMEM) && use_rs1(IRID) && RegWriteMEM
- 또는
- (rs1ID == rdWB) && use_rs1(IRID) && RegWriteWB
- 또는
- (rs2ID == rdEX) && use_rs2(IRID) && RegWriteEX
- 또는
- (rs2ID == rdMEM) && use_rs2(IRID) && RegWriteMEM
- 또는
- (rs2ID == rdWB) && use_rs2(IRID) && RegWriteWB
- 이러한 stall cycles(스톨 사이클) 동안 EX, MEM, WB 단계는 정상적으로 진행되어야 함 (즉, 올바르게 drain(드레인)되어야 함)
- 왜 이런 조건이 필요한가?
p.18예제 어셈블리 코드
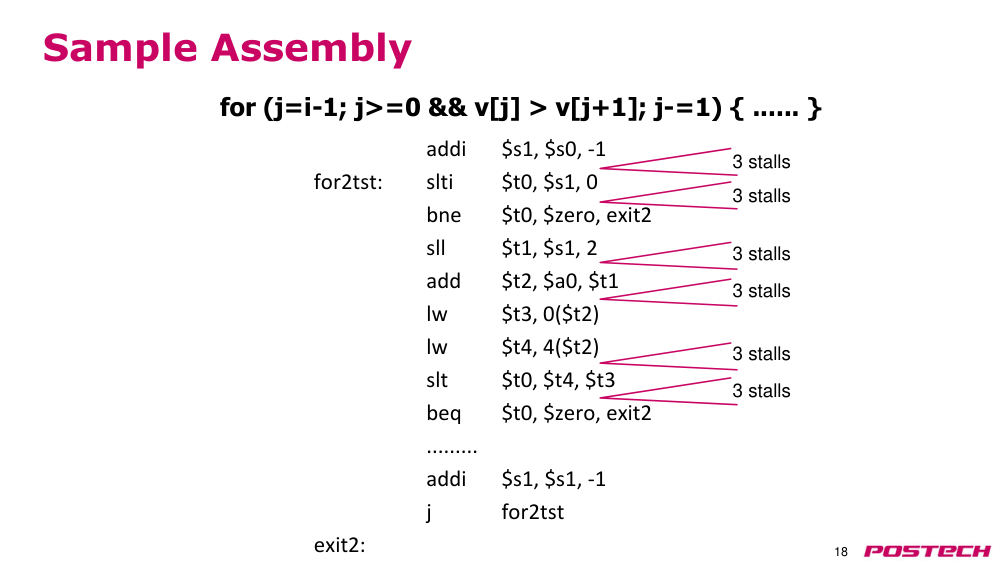
- addi $s1, $s0, -1
- for2tst:
- slti $t0, $s1, 0
- bne $t0, $zero, exit2
- sll $t1, $s1, 2
- add $t2, $a0, $t1
- lw $t3, 0($t2)
- lw $t4, 4($t2)
- slt $t0, $t4, $t3
- beq $t0, $zero, exit2
- .........
- addi $s1, $s1, -1
- j for2tst
- exit2:
- 3 stalls(스톨)
- 3 stalls(스톨)
- 3 stalls(스톨)
- 3 stalls(스톨)
- 3 stalls(스톨)
- 3 stalls(스톨)
- for (j=i-1; j>=0 && v[j] > v[j+1]; j-=1) { ...... }
p.19stall(스톨)이 성능에 미치는 영향
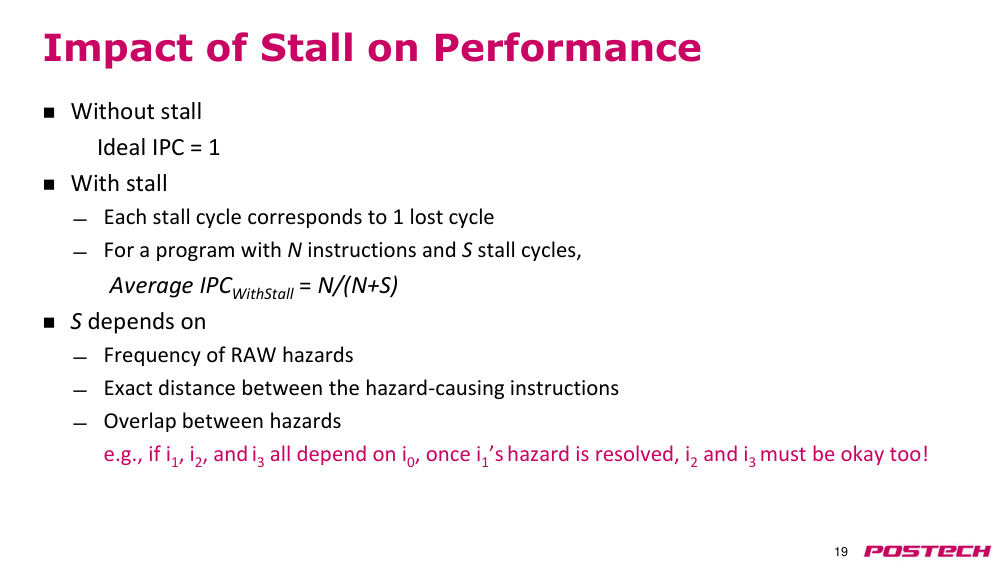
- stall(스톨) 없이
- 이상적인 IPC = 1
- stall(스톨) 있음
- 각 stall cycles(스톨 사이클)은 1개의 손실 사이클에 해당
- N개의 명령어와 S개의 stall cycles(스톨 사이클)을 가진 프로그램에 대해
- 평균 IPCWithStall = N/(N+S)
- S는 다음에 따라 달라짐
- RAW hazard(RAW 해저드)의 빈도
- 해저드를 일으키는 명령어 사이의 정확한 거리
- overlap between hazards(해저드 간 겹침)
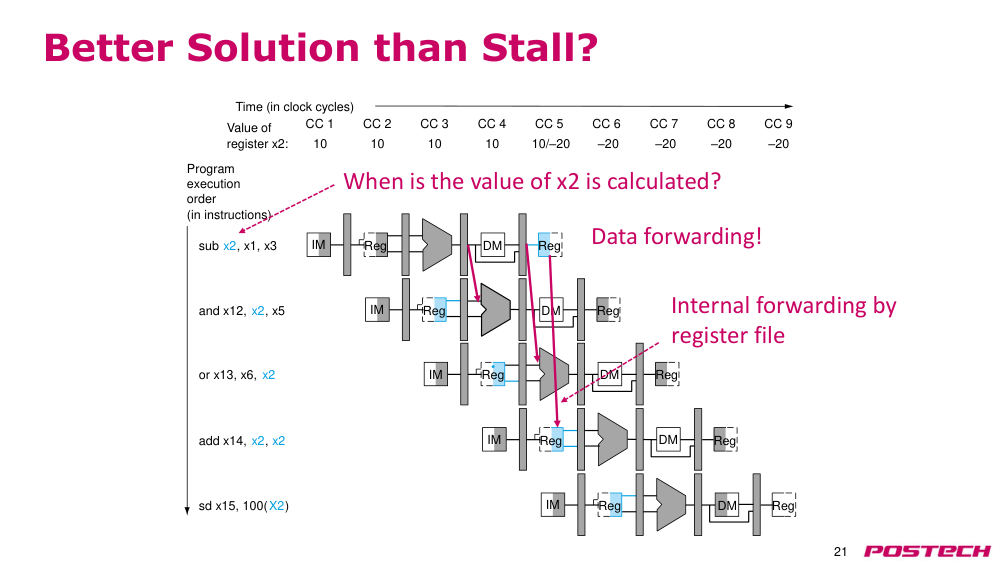
p.20stall(스톨)보다 더 나은 해결책?
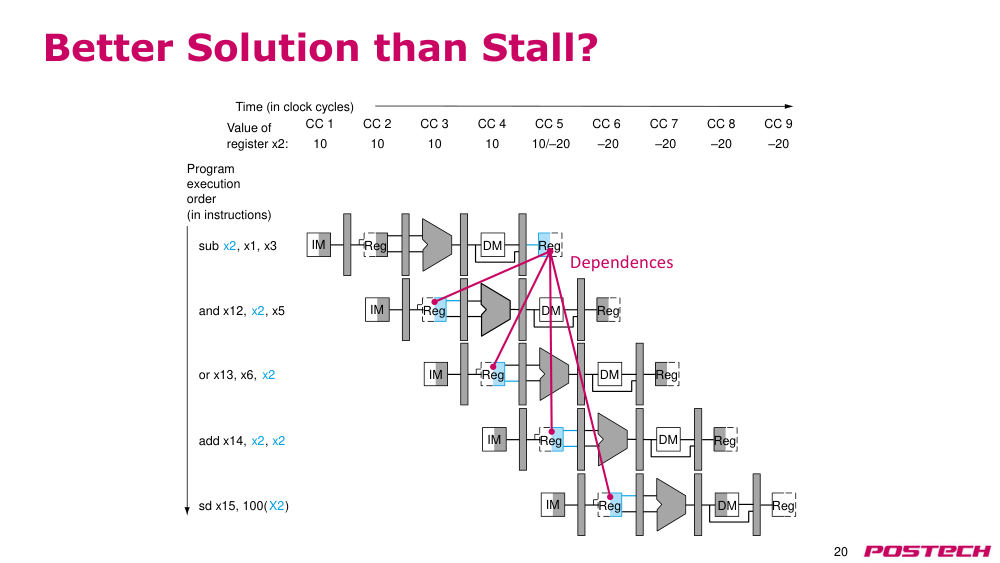
- 프로그램 실행 순서 (명령어 기준)
- sub x2, x1, x3
- and x12, x2, x5
- or x13, x6, x2
- add x14, x2, x2
- sd x15, 100(X2)
- 시간 (클럭 사이클 기준)
- CC 1
- CC 2
- CC 3
- CC 4
- CC 5
- CC 6
- CC 7
- CC 8
- CC 9
- instruction memory(명령어 메모리)
- data memory(데이터 메모리)
- 레지스터
- 레지스터
- instruction memory(명령어 메모리)
- data memory(데이터 메모리)
- 레지스터
- 레지스터
- instruction memory(명령어 메모리)
- data memory(데이터 메모리)
- 레지스터
- 레지스터
- instruction memory(명령어 메모리)
- data memory(데이터 메모리)
- 레지스터
- 레지스터
- instruction memory(명령어 메모리)
- data memory(데이터 메모리)
- 레지스터
- 레지스터
- 레지스터 x2의 값:
- 10/–20
- –20
- –20
- –20
- –20
- 의존성
p.21stall(스톨)보다 더 나은 해결책?
- 프로그램 실행 순서 (명령어 기준)
- sub x2, x1, x3
- and x12, x2, x5
- or x13, x6, x2
- add x14, x2, x2
- sd x15, 100(X2)
- 시간 (클럭 사이클 기준)
- CC 1
- CC 2
- CC 3
- CC 4
- CC 5
- CC 6
- CC 7
- CC 8
- CC 9
- instruction memory(명령어 메모리)
- data memory(데이터 메모리)
- 레지스터
- 레지스터
- instruction memory(명령어 메모리)
- data memory(데이터 메모리)
- 레지스터
- 레지스터
- instruction memory(명령어 메모리)
- data memory(데이터 메모리)
- 레지스터
- 레지스터
- instruction memory(명령어 메모리)
- data memory(데이터 메모리)
- 레지스터
- 레지스터
- instruction memory(명령어 메모리)
- data memory(데이터 메모리)
- 레지스터
- 레지스터
- 레지스터 x2의 값:
- 10/–20
- –20
- –20
- –20
- –20
- x2의 값은 언제 계산되는가?
- data forwarding(데이터 포워딩)!
- registers(레지스터 파일) 내부의 포워딩
p.22데이터 포워딩 (=레지스터 바이패싱)
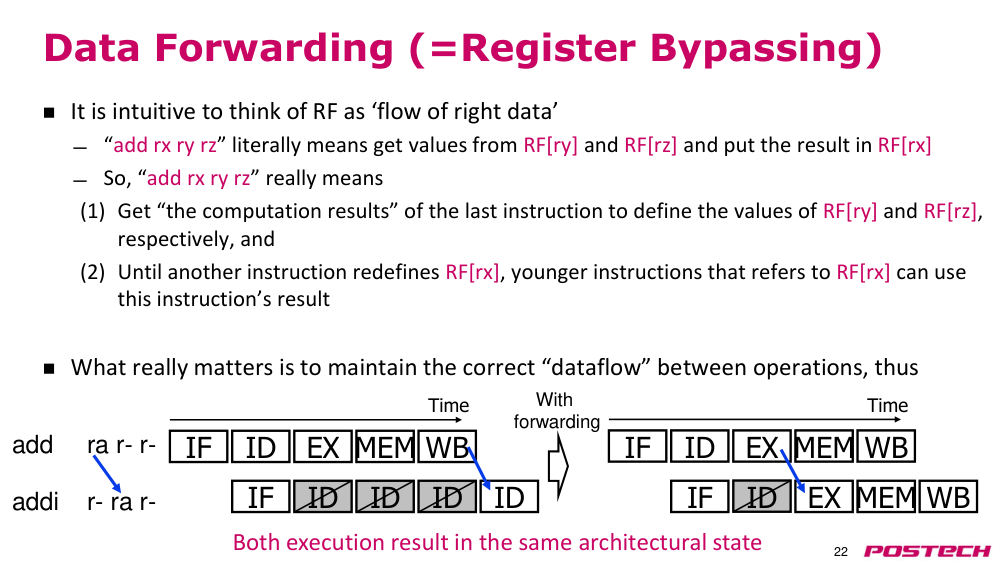
- 레지스터 파일(RF)을 '정확한 데이터의 흐름'으로 이해하는 것이 직관적이다
- "add rx ry rz"는 실제로 RF[ry]와 RF[rz]의 값을 가져와 결과를 RF[rx]에 넣는다는 의미이다
- 따라서 "add rx ry rz"는 실제로 다음과 같은 의미를 가진다
- (1) RF[ry]와 RF[rz]의 값을 정의한 마지막 명령어의 계산 결과를 각각 가져오고,
- (2) 다른 명령어가 RF[rx]를 다시 정의하기 전까지, RF[rx]를 참조하는 젊은 명령어들은 이 명령어의 결과를 사용할 수 있다
- 실제로 중요한 것은 연산 간의 올바른 '데이터 흐름'을 유지하는 것이다
- add ra r- r-
- addi r- ra r-
- ID
- ID
- ID
- IF
- ID
- WB
- IF
- ID
- EX MEM
- 시간
- 두 실행 모두 동일한 아키텍처 상태를 생성함
- ID
- WB
- IF
- ID
- EX MEM
- 시간
- MEM
- IF
- EX
- WB
- 포워딩 있음
p.23포워딩을 통한 RAW hazard(RAW 해저드) 해결
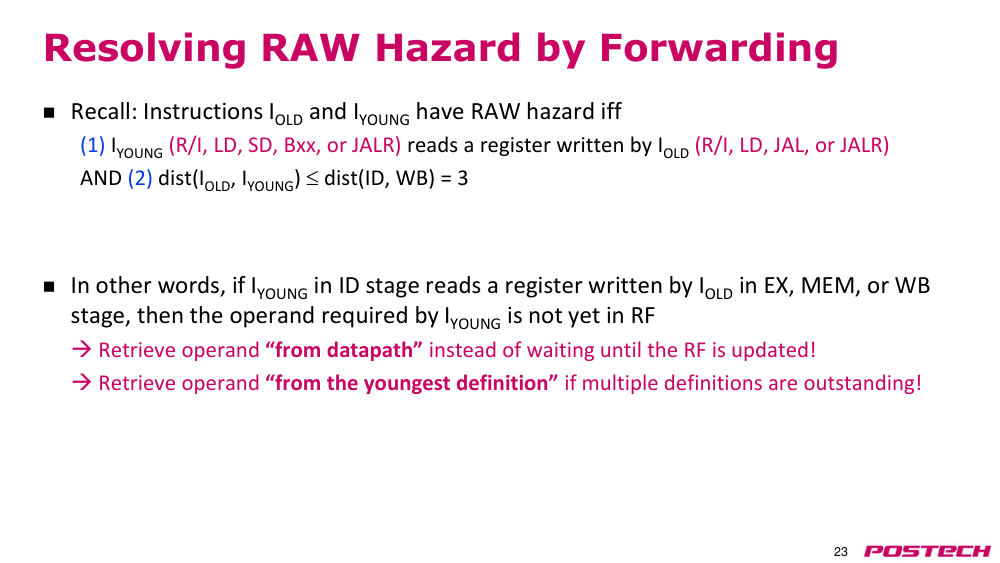
- 다음 조건을 만족할 때, IOLD와 IYOUNG은 RAW hazard(RAW 해저드)를 가짐을 기억하자
- (1) IYOUNG (R/I, LD, SD, Bxx, 또는 JALR)가 IOLD (R/I, LD, JAL, 또는 JALR)가 쓰는 레지스터를 읽는다
- AND (2) dist(IOLD, IYOUNG) ≤ dist(ID, WB) = 3
- 즉, IYOUNG이 ID 단계에서 IOLD이 EX, MEM, 또는 WB 단계에서 쓰는 레지스터를 읽는다면, IYOUNG이 필요한 피연산자가 아직 RF에 존재하지 않는다
- → RF가 업데이트되기까지 기다리지 않고, 'datapath(데이터패스)'에서 피연산자를 가져오라!
- → 여러 정의가 동시에 진행 중이라면, '가장 젊은 정의'로부터 피연산자를 가져오라!
p.24forwarding paths(포워딩 경로)
- data memory(데이터 메모리)
- 레지스터
- ALU(산술논리장치)
- ALU(산술논리장치)
- ID/EX
- 포워딩 없음
- 포워딩 있음
- EX/MEM
- MEM/WB
- data memory(데이터 메모리)
- 레지스터
- ID/EX
- EX/MEM
- MEM/WB
- forwarding unit(포워딩 유닛)
- EX/MEM.RegisterRd
- MEM/WB.RegisterRd
- Rs1
- Rs2
- Rd
- ForwardB
- ForwardA
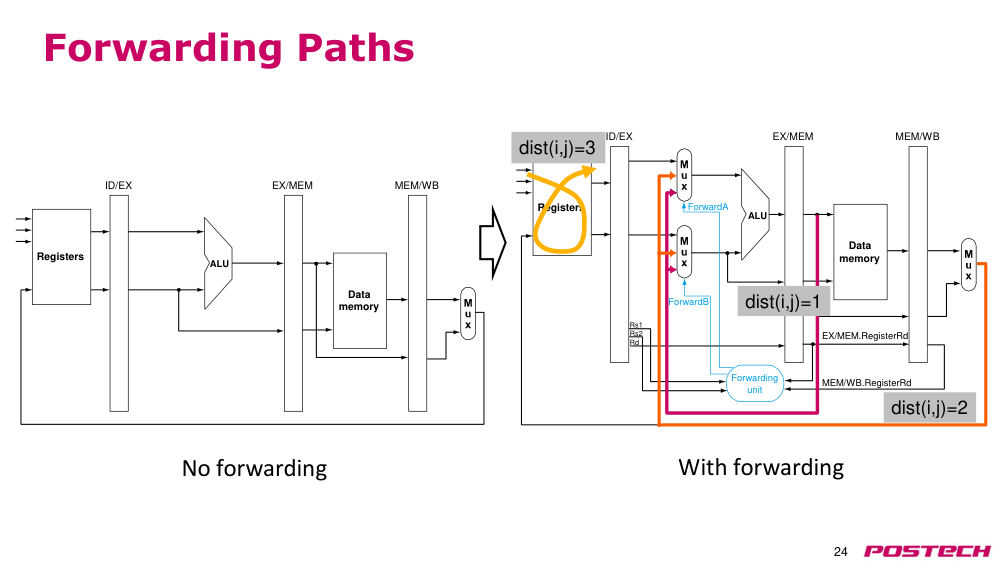
- dist(i,j)=3
- dist(i,j)=1
- dist(i,j)=2
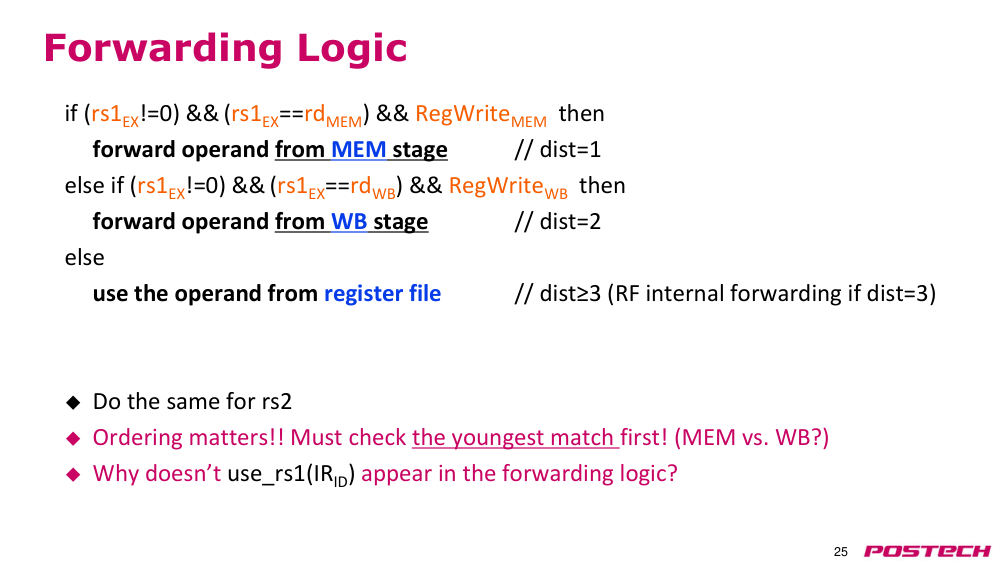
p.25포워딩 논리
- if (rs1EX != 0) && (rs1EX == rdMEM) && RegWriteMEM then
- 포워딩: MEM 단계에서 피연산자 전달
- // 거리 = 1
- else if (rs1EX != 0) && (rs1EX == rdWB) && RegWriteWB then
- 포워딩: WB 단계에서 피연산자 전달
- // 거리 = 2
- else
- registers(레지스터 파일)에서 피연산자 사용
- // 거리 ≥ 3 (거리 = 3인 경우 registers(레지스터 파일) 내부 포워딩)
- • rs2에 대해서도 동일한 처리 수행
- • 순서가 중요하다! 가장 최신의 매칭을 먼저 확인해야 한다! (MEM vs. WB?)
- • 왜 use_rs1(IRID)가 포워딩 논리에 나타나지 않는가?
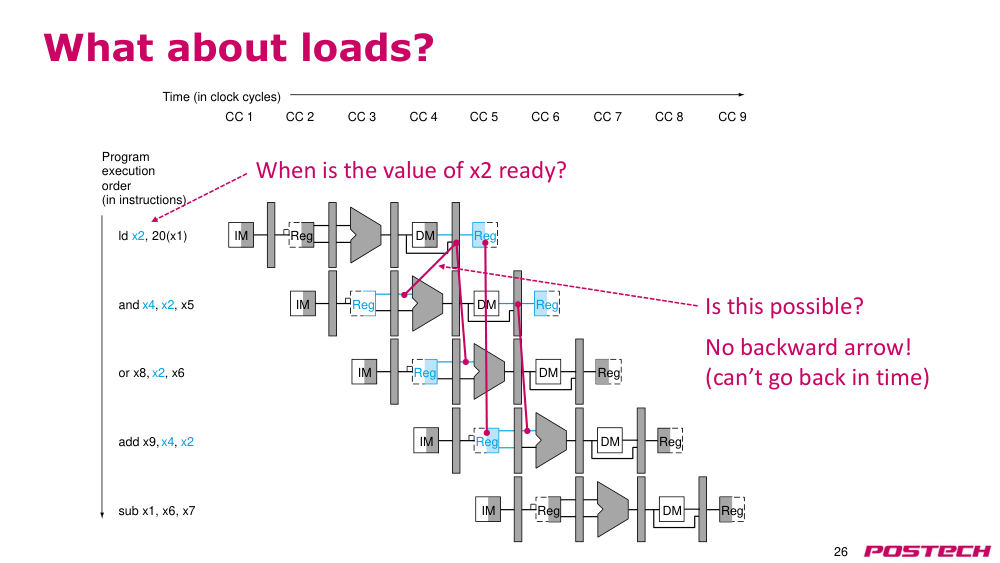
p.26LW(로드 명령어)의 경우는 어떨까?
- 프로그램 실행 순서 (명령어 기준)
- ld x2, 20(x1)
- and x4, x2, x5
- or x8, x2, x6
- add x9, x4, x2
- sub x1, x6, x7
- 시간 (클럭 사이클 기준)
- CC 1
- CC 2
- CC 3
- CC 4
- CC 5
- CC 6
- CC 7
- CC 8
- CC 9
- IM
- DM
- Reg
- Reg
- IM
- DM
- Reg
- Reg
- IM
- DM
- Reg
- Reg
- IM
- DM
- Reg
- Reg
- IM
- DM
- Reg
- Reg
- 이 가능한가?
- x2의 값은 언제 준비되는가?
- 역방향 화살표 없음!
- (시간을 거슬러 올라갈 수 없다)
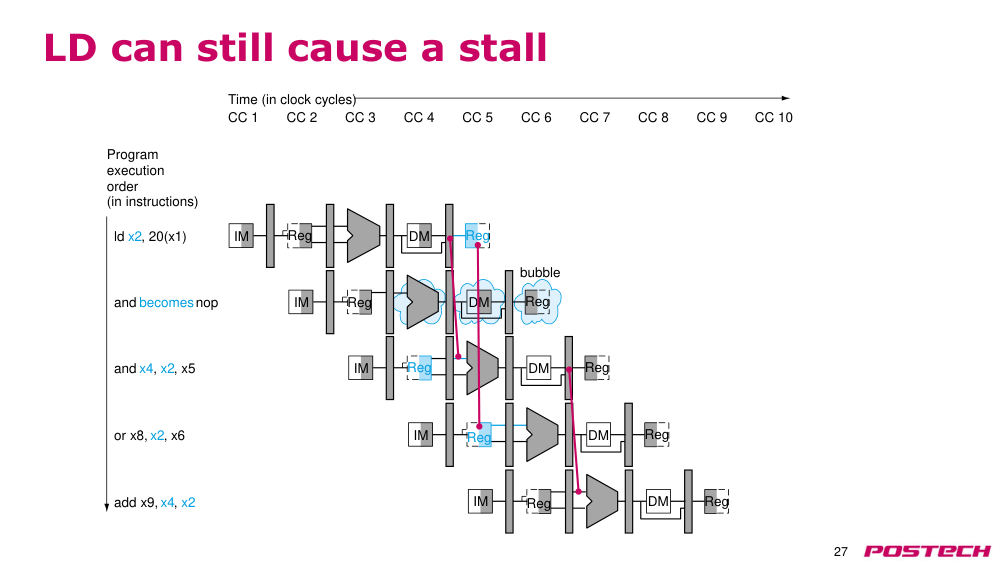
p.27LW(로드 명령어)는 여전히 stall(스톨)을 유발할 수 있다
- bubble(버블)
- 프로그램 실행 순서 (명령어 기준)
- ld x2, 20(x1)
- and는 nop으로 변환됨
- and x4, x2, x5
- or x8, x2, x6
- add x9, x4, x2
- 시간 (클럭 사이클 기준)
- CC 1
- CC 2
- CC 3
- CC 4
- CC 5
- CC 6
- CC 7
- CC 8
- CC 9
- CC 10
- IM
- DM
- Reg
- Reg
- IM
- DM
- Reg
- Reg
- IM
- DM
- Reg
- Reg
- IM
- DM
- Reg
- Reg
- IM
- DM
- Reg
- Reg
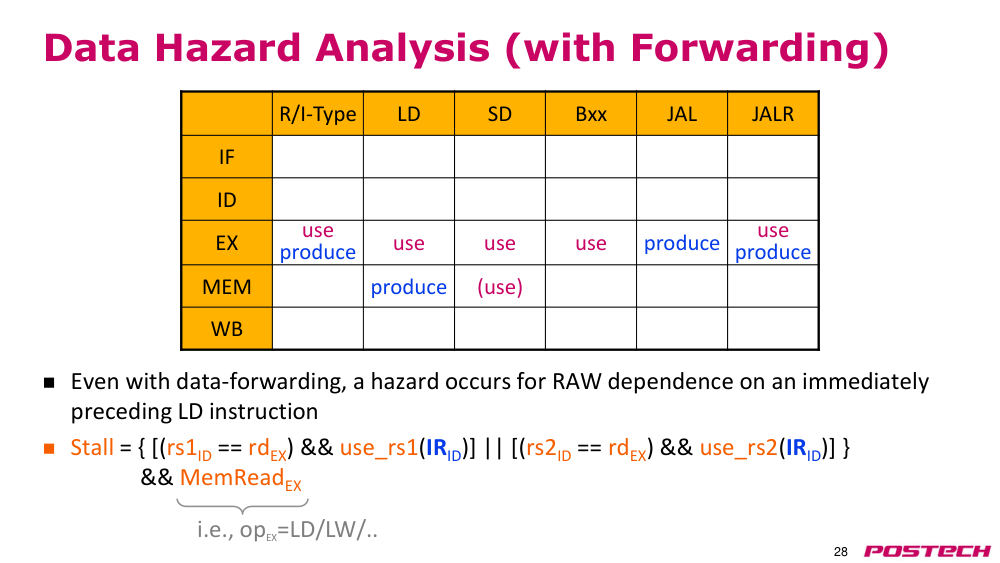
p.28포워딩을 통한 data hazard(데이터 해저드) 분석
- 포워딩이 있더라도, 바로 이전의 LD 명령어에 대한 RAW 의존성에서는 해저드가 발생한다.
- stall(스톨) = { [(rs1ID == rdEX) && use_rs1(IRID)] || [(rs2ID == rdEX) && use_rs2(IRID)] } && MemReadEX
- R/i-type(I형)
- LD
- SD
- Bxx
- JAL
- JALR
- IF
- ID
- EX
- use
- produce
- use
- use
- use
- produce
- use
- produce
- MEM
- produce
- (use)
- WB
- 즉, opEX = LD / LW / ...
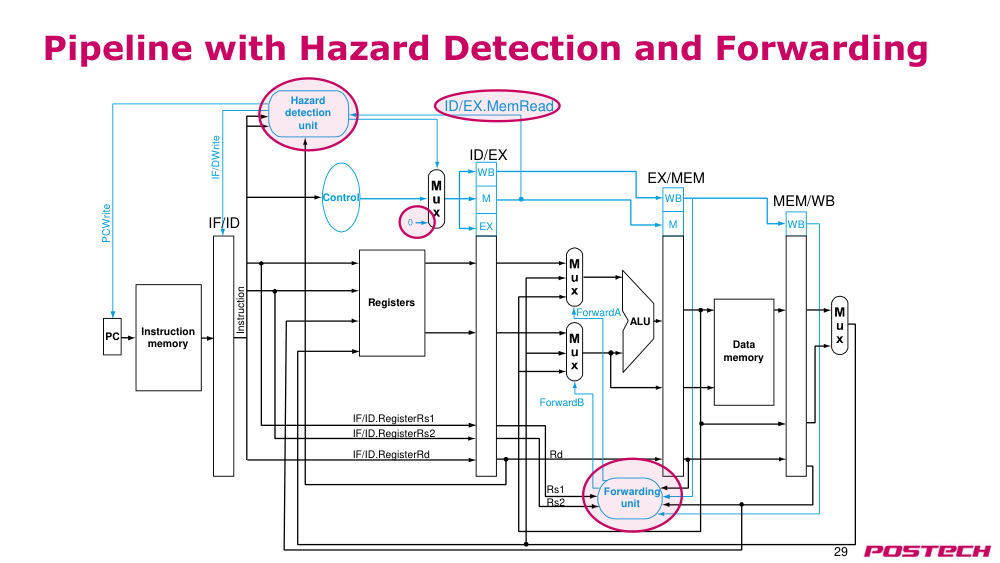
p.29해저드 탐지 및 포워딩을 갖춘 파이프라인
- M
- WB
- WB
- data memory(데이터 메모리)
- instruction memory(명령어 메모리)
- ALU
- ID/EX
- EX/MEM
- MEM/WB
- forwarding unit(포워딩 유닛)
- PC
- 제어
- EX
- M
- WB
- IF/ID
- hazard detection unit(해저드 탐지 유닛)
- ID/EX.MemRead
- IF/ID.RegisterRs1
- 명령어
- IF/ID.RegisterRs2
- IF/ID.RegisterRd
- PCWrite
- IF/DWrite
- 레지스터
- Rd
- Rs1
- Rs2
- ForwardA
- ForwardB
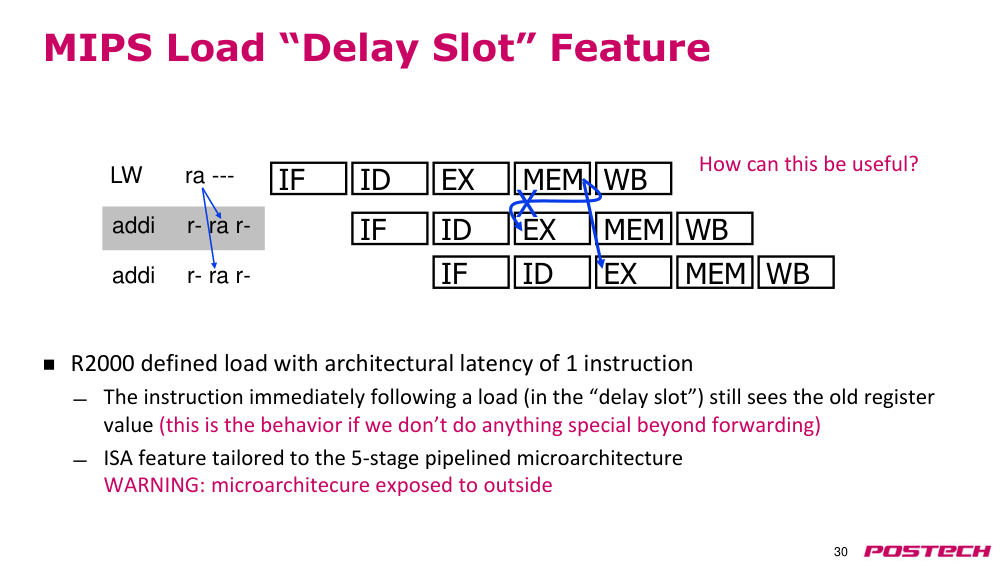
p.30MIPS 로드 'delay slot(지연 슬롯)' 기능
- R2000는 LW(로드 명령어)의 architectural latency(아키텍처적 지연)을 1개 명령어로 정의함
- LW(로드 명령어) 바로 뒤에 오는 명령어 (지연 슬롯 내의 명령어)는 여전히 이전 레지스터 값을 보게 된다 (포워딩만으로는 이와 같은 동작이 발생함)
- 5단계 파이프라인 microarchitecture(마이크로아키텍처)에 맞춰 설계된 ISA 기능
- 경고: microarchitecture(마이크로아키텍처)가 외부에 노출됨
- MEM
- WB
- IF
- ID
- IF
- EX
- ID
- MEM
- EX
- WB
- LW
- ra ---
- addi
- r- ra r-
- MEM
- IF
- ID
- EX
- WB
- addi
- r- ra r-
- 이 기능은 어떻게 유용할 수 있는가?
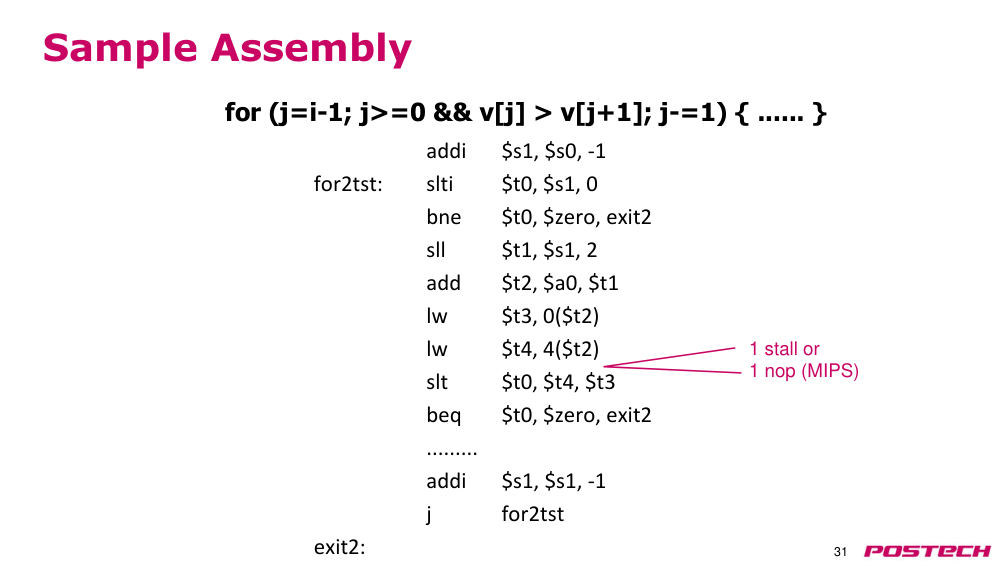
p.31예제 어셈블리 코드
- addi $s1, $s0, -1
- for2tst:
- slti $t0, $s1, 0
- bne $t0, $zero, exit2
- sll $t1, $s1, 2
- add $t2, $a0, $t1
- lw $t3, 0($t2)
- lw $t4, 4($t2)
- slt $t0, $t4, $t3
- beq $t0, $zero, exit2
- ........
- addi $s1, $s1, -1
- j for2tst
- exit2:
- for (j=i-1; j>=0 && v[j] > v[j+1]; j-=1) { ...... }
- 1 stall(스톨) 또는 1 nop (MIPS)
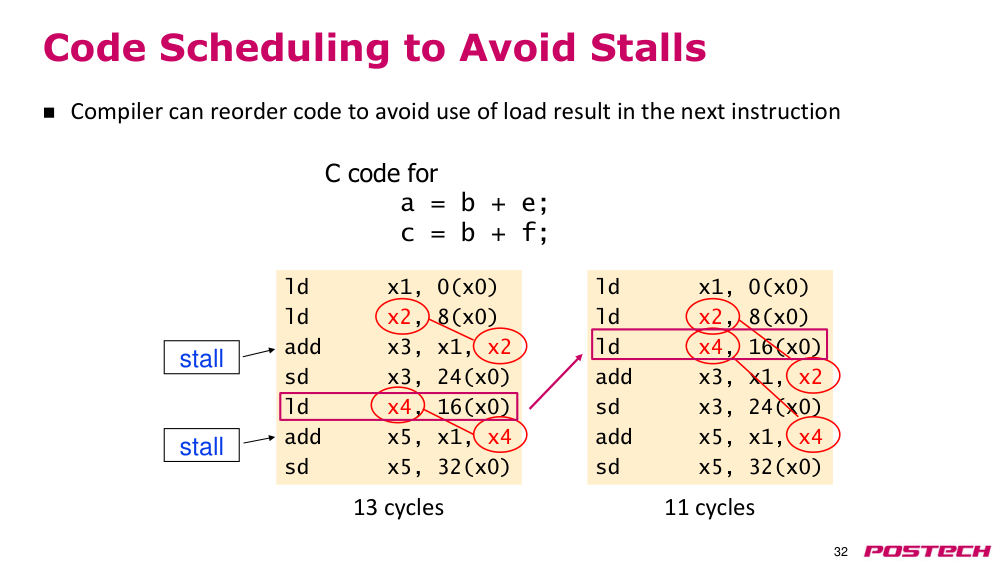
p.32stall(스톨)을 피하기 위한 code scheduling(코드 스케줄링)
- 컴파일러는 다음 명령어에서 로드 결과를 사용하는 것을 피하기 위해 코드를 재정렬할 수 있음
- ld x1, 0(x0)
- ld x2, 8(x0)
- add x3, x1, x2
- sd x3, 24(x0)
- ld x4, 16(x0)
- add x5, x1, x4
- sd x5, 32(x0)
- stall
- stall
- ld x1, 0(x0)
- ld x2, 8(x0)
- ld x4, 16(x0)
- add x3, x1, x2
- sd x3, 24(x0)
- add x5, x1, x4
- sd x5, 32(x0)
- 11 사이클
- 13 사이클
- C 코드: a = b + e; c = b + f;
p.33용어 정의
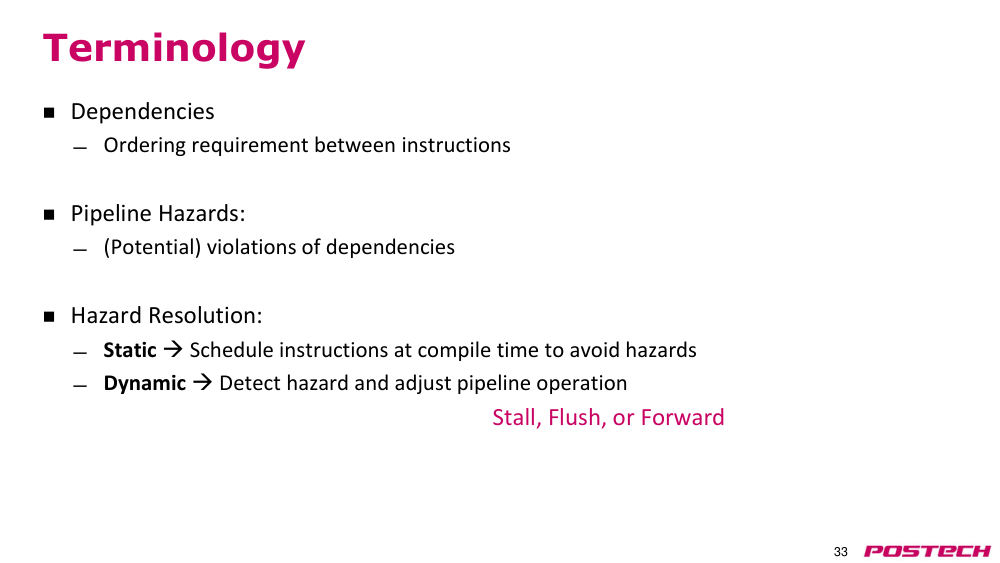
- 의존성: 명령어 간의 순서 요구 조건
- 파이프라인 해저드: 의존성의 (잠재적) 위반
- hazard resolution(해저드 해결):
- 정적 → 컴파일 시점에 명령어를 스케줄링하여 해저드를 피함
- 동적 → 해저드를 탐지하고 파이프라인 동작을 조정함
- stall(스톨), 플러시, 또는 포워딩
p.34왜 매우 깊은 파이프라인을 사용하지 않는가?
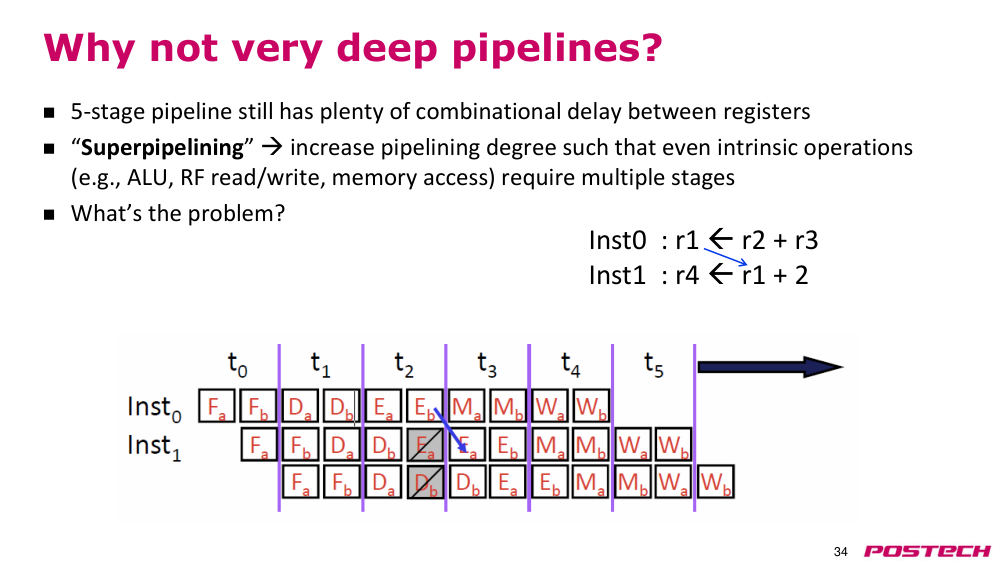
- 5단계 파이프라인은 여전히 레지스터 사이에 많은 조합 논리 지연을 가짐
- ‘슈퍼파이프라인화’ → pipeline stages(파이프라인 단계) 수를 늘려서 내재적 연산(예: ALU, RF 읽기/쓰기, 메모리 접근)도 여러 단계를 필요로 함
- 문제는 무엇인가?
- Inst0: r1 ← r2 + r3
- Inst1: r4 ← r1 + 2
p.35인텔 P4의 슈퍼파이프라인화된 정수 ALU
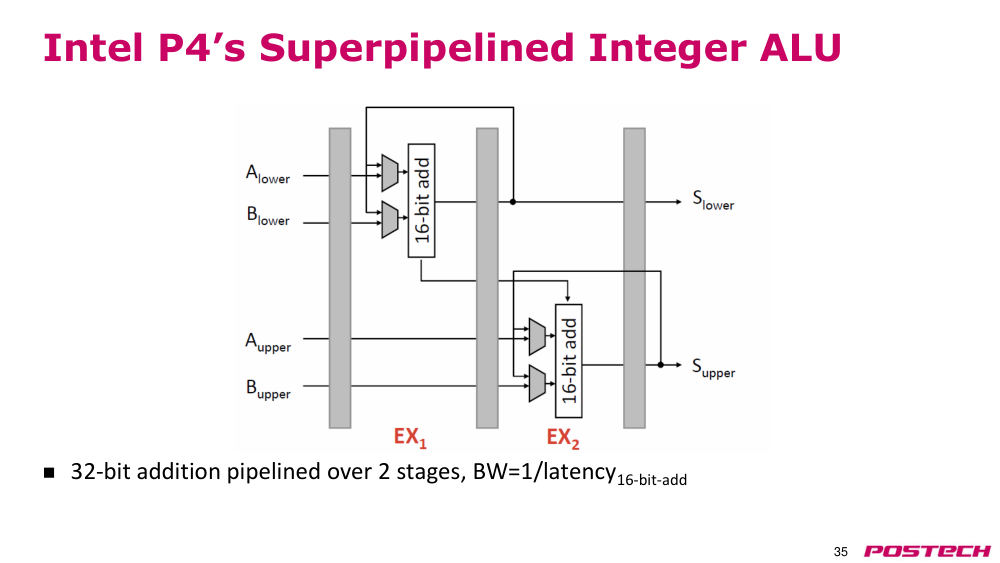
- 32비트 addition(덧셈)은 2단계 파이프라인으로 처리되며, 대역폭 = 1 / 지연 시간 16비트 add(덧셈)
p.36슈퍼파이프라인화가 실제로 불가능하다면?
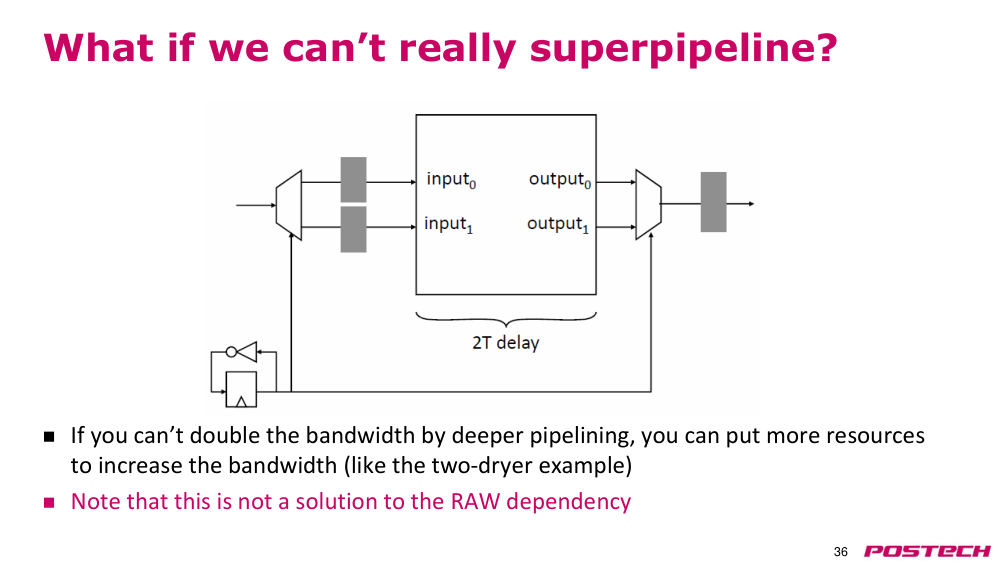
- 더 깊은 파이프라인화로 대역폭을 두 배로 늘릴 수 없다면, 더 많은 자원을 추가하여 대역폭을 늘릴 수 있음 (예: 두 대의 건조기 예시)
- 참고: 이는 RAW 의존성의 해결책이 아님
p.37질문?
- 질문?
- 공지사항
- - 읽기: P&H (RISC-V ed.) Ch 4.8