이 자료를 쓰는 강의: 44 Lec 9 · data forwarding·load-use stall 과 control hazard 도입 · 45 Lec 10 · control hazard 해결(PC+4 예측·delay slot)과 BTB·2-bit branch predictor
Lec9-pipelined-CPU-controlhaz
한국어판 강의자료 · 25쪽
p.1pipelined CPU(파이프라인 CPU) – control hazard(제어 위험)
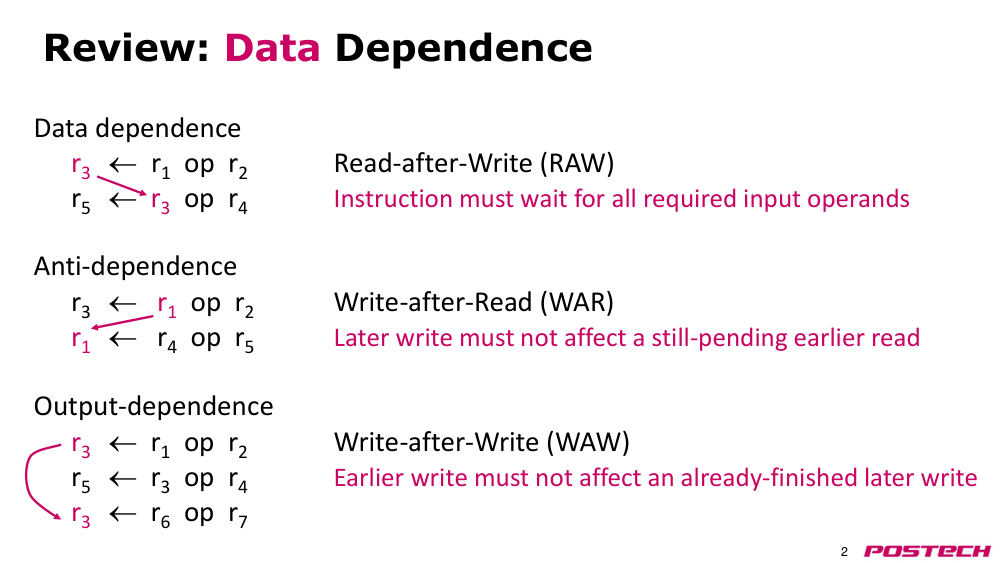
p.2리뷰: data dependence(데이터 의존성)
- data dependence(데이터 의존성)
- r3 ← r1 op r2
- 쓰기 후 읽기 (RAW)
- r5 ← r3 op r4
- 명령어는 모든 필요한 입력 operand(피연산자)가 준비될 때까지 기다려야 함
- anti-dependence(반의존성)
- r3 ← r1 op r2
- 읽기 후 쓰기 (WAR)
- r1 ← r4 op r5
- 나중에 쓰는 연산은 아직 미완료된 이전의 읽기 연산에 영향을 주면 안 됨
- output-dependence(출력 의존성)
- r3 ← r1 op r2
- 쓰기 후 쓰기 (WAW)
- r5 ← r3 op r4
- 이전에 쓰는 연산은 이미 완료된 나중의 쓰기 연산에 영향을 주면 안 됨
- r3 ← r6 op r7
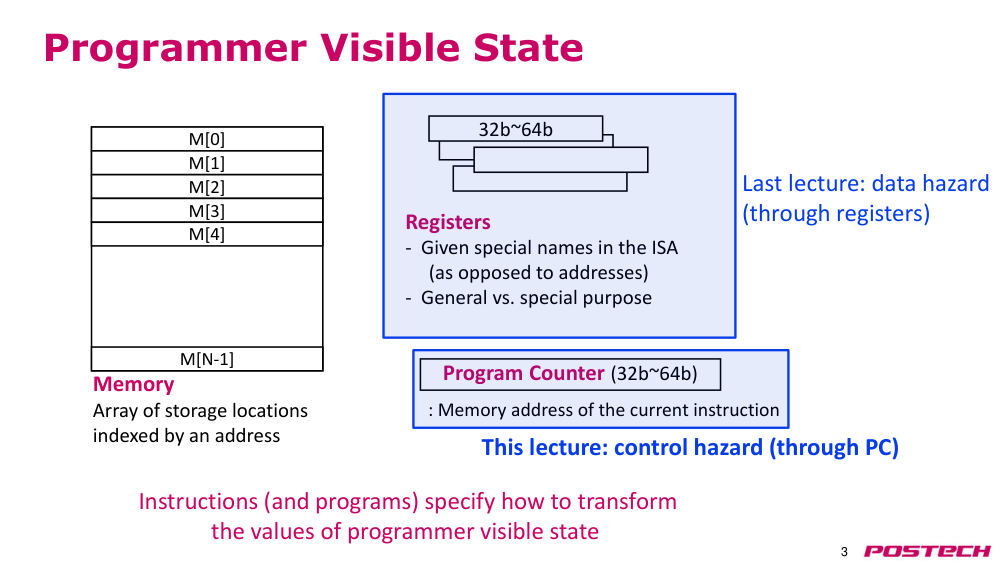
p.3programmer visible state(프로그래머 가시 상태)
- M[0]
- M[1]
- M[2]
- M[3]
- M[4]
- M[N-1]
- memory(메모리)
- 주소로 인덱싱된 저장 위치의 배열
- 프로그램 카운터 (32b~64b)
- : 현재 명령어의 memory(메모리) 주소
- 명령어(및 프로그램)는 programmer visible state(프로그래머 가시 상태)의 값들을 어떻게 변환할지 지정함
- 32b~64b
- registers(레지스터)
- - ISA에서 특별한 이름을 가짐 (주소와는 다름)
- - 범용 vs. 특수 목적
- 이전 강의: 데이터 위험 (레지스터를 통해)
- 이번 강의: 제어 위험 (PC를 통해)
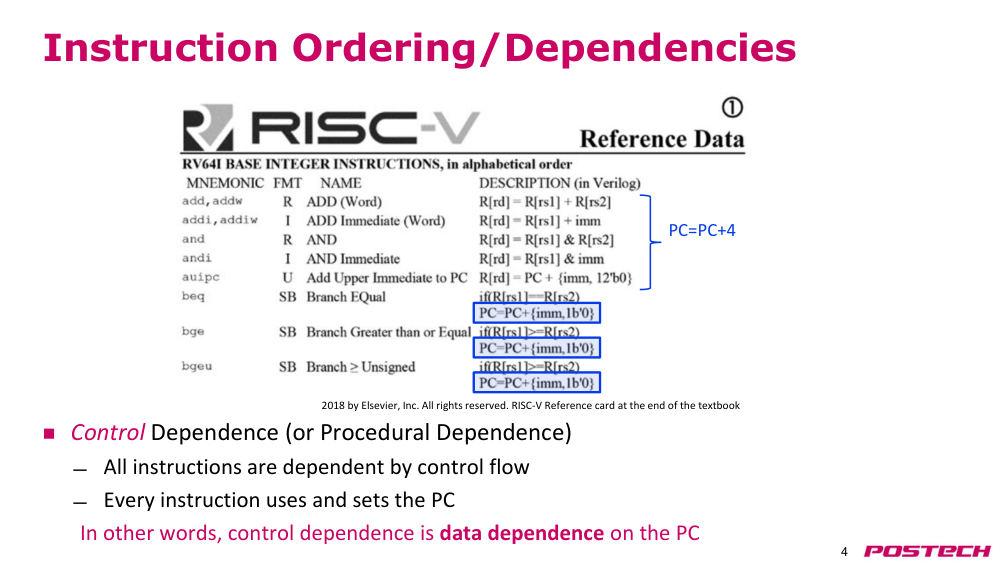
p.4명령어 순서/의존성
- 제어 의존성 (또는 절차적 의존성)
- 모든 명령어는 제어 흐름에 의해 의존함
- 모든 명령어는 PC를 사용하고 설정함
- 즉, control dependence(제어 의존성)은 PC에 대한 data dependence(데이터 의존성)임
- 2018 by Elsevier, Inc. All rights reserved. RISC-V Reference card at the end of the textbook
- PC = PC+4
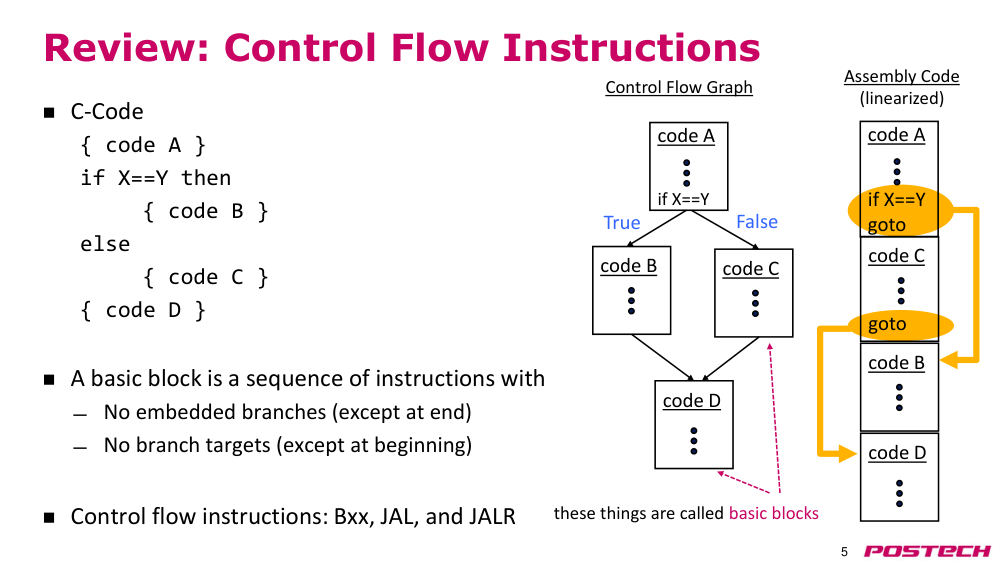
p.5리뷰: control flow instructions(제어 흐름 명령어)
- C-코드
- { code A }
- if X==Y then
- { code B }
- else
- { code C }
- { code D }
- basic block(기본 블록)은 다음과 같은 특성을 가짐:
- 임베디드 분기 없음 (끝에만 가능)
- branch target(분기 대상) 없음 (시작에만 가능)
- control flow instructions(제어 흐름 명령어): bxx, JAL, JALR
- code A
- if X==Y
- code B
- code C
- code D
- 제어 흐름 그래프
- True
- False
- 어셈블리 코드 (선형화된 형태)
- code A
- if X==Y
- goto
- code C
- goto
- code B
- code D
- 이러한 것들은 basic block(기본 블록)이라고 불림
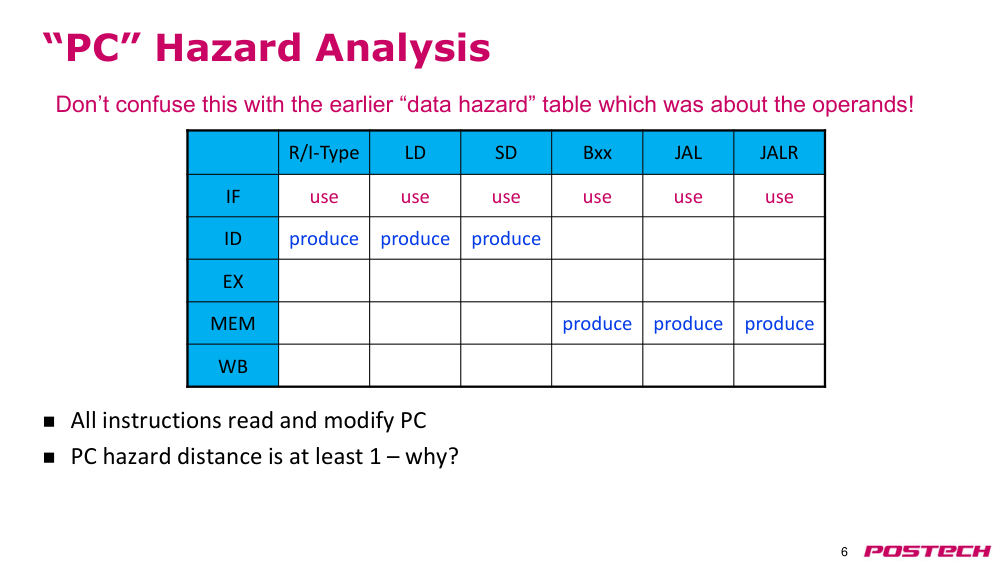
p.6"PC" 위험 분석
- 모든 명령어는 PC를 읽고 수정함
- PC hazard distance(PC 위험 거리)는 최소 1 이상 – 왜냐하면?
- 현재 PC가 디코딩되기 전까지 다음 PC 값은 결정될 수 없음
- R/I-Type
- LD
- SD
- Bxx
- JAL
- JALR
- IF
- use
- use
- use
- use
- use
- use
- ID
- produce
- produce
- produce
- EX
- MEM
- produce
- produce
- produce
- WB
- 이전의 데이터 위험 표와 혼동하지 말 것! 이 표는 operand(피연산자)에 관한 것이 아님
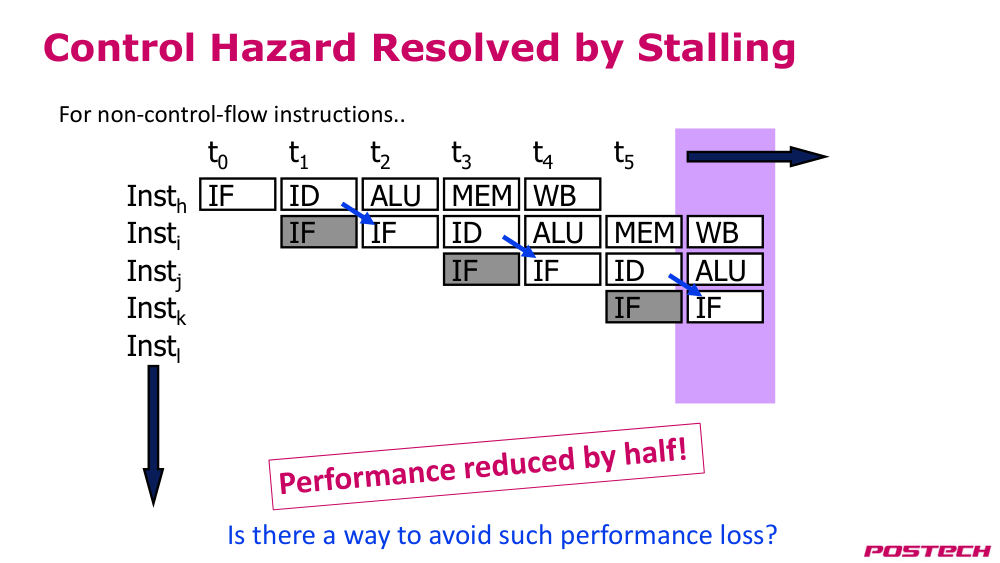
p.7stalling(스톨링)으로 control hazard(제어 위험) 해결
- non-control-flow instructions(비제어 흐름 명령어)에 대해...
- 이러한 성능 손실을 피할 수 있는 방법이 있을까?
p.8다음 PC 예측
p.9가장 간단한 branch prediction(분기 예측): next PC = PC+4(다음 PC = PC+4)
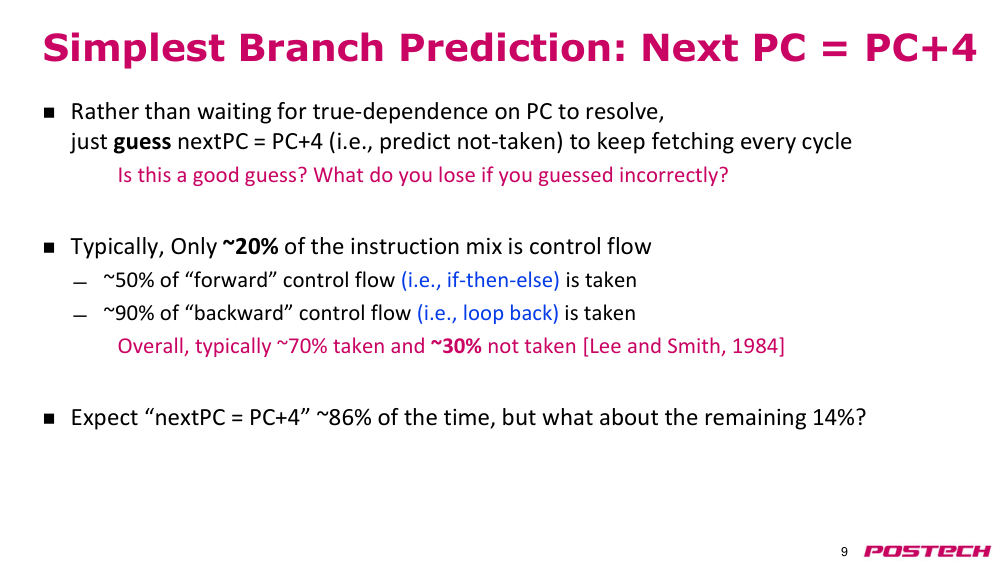
- PC에 대한 true-dependence(진의존성)이 해결되기를 기다리지 않고, 단순히 nextPC = PC+4 (즉, not-taken(미실행) 예측)로 추측하여 매 사이클마다 계속 가져오기
- 이 추측은 좋은가? 잘못 추측했을 경우 무엇을 잃게 되는가?
- 일반적으로 명령어 혼합에서 제어 흐름은 약 20% 정도
- 전진 제어 흐름(예: if-then-else)의 약 50%는 분기가 수행됨
- 역방향 제어 흐름(예: 루프 백)의 약 90%는 분기가 수행됨
- 전반적으로 일반적으로 약 70%는 분기 수행되고, 약 30%는 미실행 [Lee and Smith, 1984]
- next PC = PC+4(다음 PC = PC+4)를 약 86%의 시간 동안 기대할 수 있지만, 나머지 14%는 어떻게 되는가?
p.10control speculation(제어 추측)
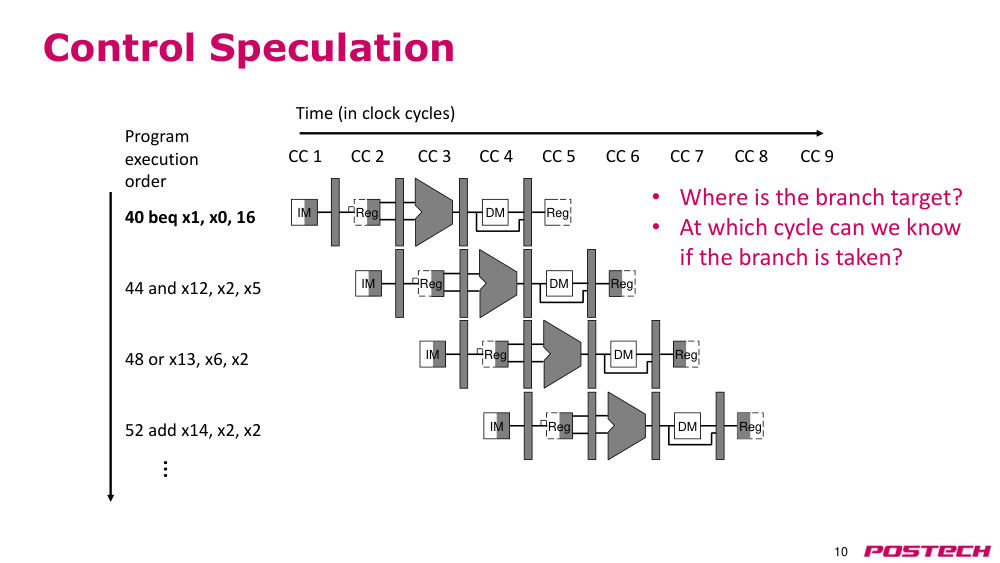
- 프로그램 실행 순서
- 40 beq x1, x0, 16
- 시간 (클럭 사이클 기준)
- CC 1
- CC 2
- CC 3
- CC 4
- CC 5
- CC 6
- CC 7
- CC 8
- CC 9
- IM
- DM
- Reg
- Reg
- 44 and x12, x2, x5
- IM
- DM
- Reg
- Reg
- Reg
- 48 or x13, x6, x2
- IM
- DM
- Reg
- 52 add x14, x2, x2
- IM
- DM
- Reg
- Reg
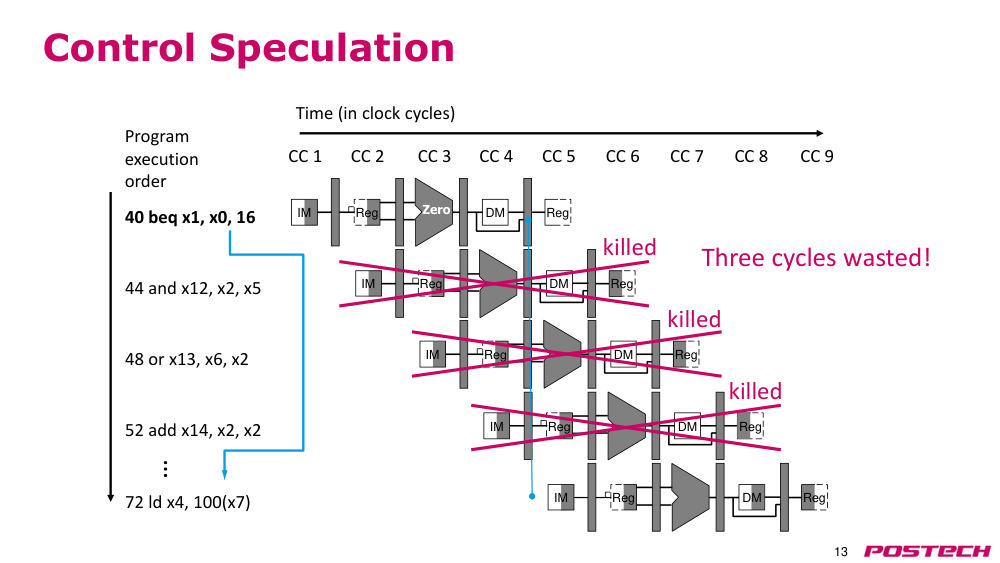
- • branch target(분기 대상)은 어디에 있는가?
- • 분기가 실행되는지 알 수 있는 시점은 언제인가?
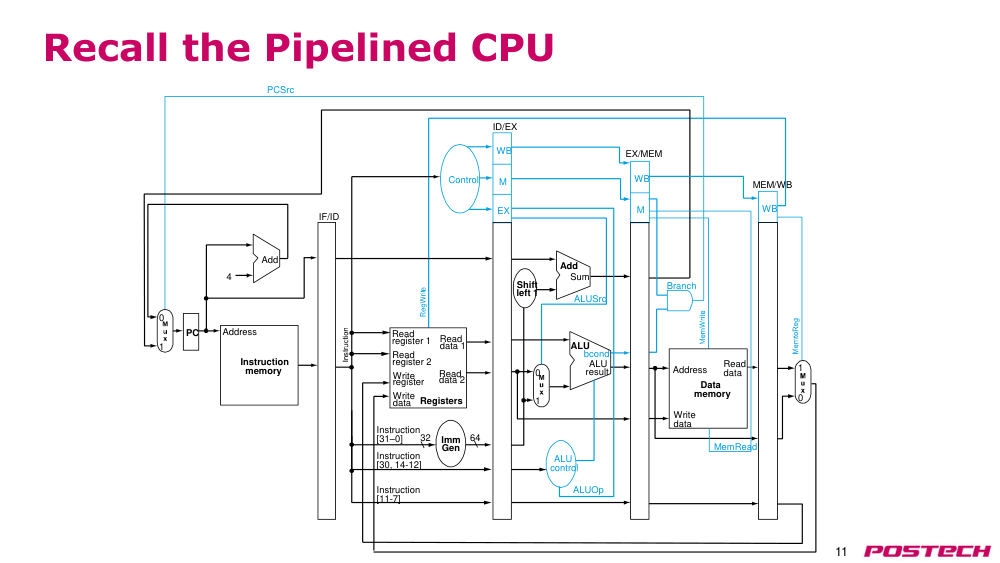
p.11pipelined CPU(파이프라인 CPU) 다시 보기
- WB
- M
- EX
- WB
- M
- WB
- PCSrc
- MemRead
- Add
- Address
- Instruction memory
- Address
- Write data
- Read data
- Data memory
- Add
- Sum
- ALU
- ALU result
- bcond
- Shift left 1
- PC
- 4
- ID/EX
- IF/ID
- EX/MEM
- MEM/WB
- ALUOp
- ALUSrc
- Branch
- Control
- 0
- 1
- 0
- 1
- 1
- 0
- Read register 1
- Read register 2
- Write register
- Write data
- Instruction [31–0]
- Instruction [11-7]
- Instruction [30, 14-12]
- Read data 1
- Read data 2
- Registers
- Imm Gen
- 32
- 64
- ALU control
p.12control speculation(제어 추측)
- Reg
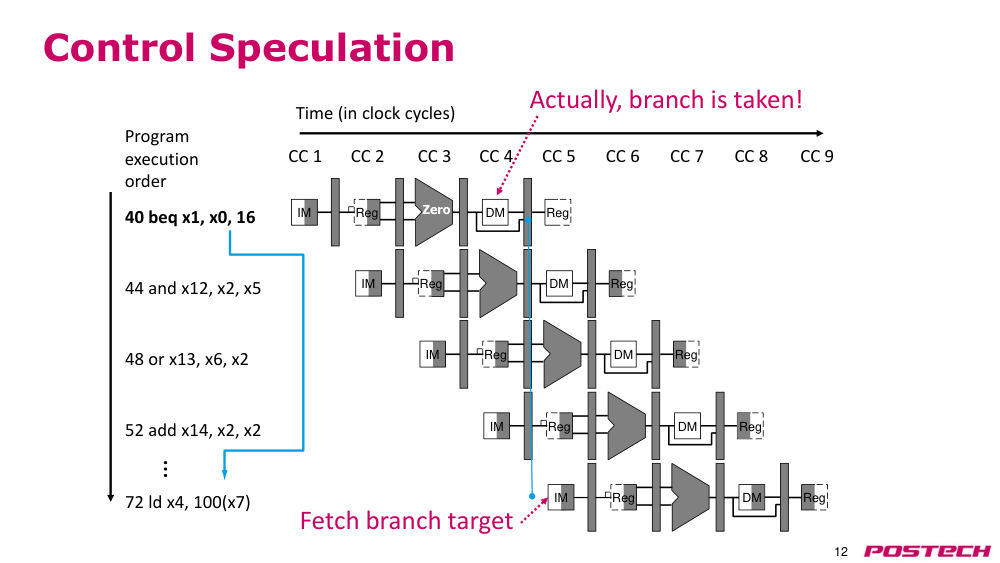
- 프로그램 실행 순서
- 40 beq x1, x0, 16
- 44 and x12, x2, x5
- 48 or x13, x6, x2
- 52 add x14, x2, x2
- 72 ld x4, 100(x7)
- 시간 (클럭 사이클 기준)
- CC 1
- CC 2
- CC 3
- CC 4
- CC 5
- CC 6
- CC 7
- CC 8
- CC 9
- IM
- DM
- Reg
- Reg
- IM
- DM
- Reg
- Reg
- IM
- DM
- Reg
- IM
- DM
- Reg
- Reg
- DM
- Reg
- Reg
- ...
- 실제로 분기가 수행됨!
- Zero
- branch target(분기 대상) 가져오기
- IM
p.13control speculation(제어 추측)
- 프로그램 실행 순서
- 40 beq x1, x0, 16
- 44 and x12, x2, x5
- 48 or x13, x6, x2
- 52 add x14, x2, x2
- 72 ld x4, 100(x7)
- 시간 (클럭 사이클 단위)
- CC 1
- CC 2
- CC 3
- CC 4
- CC 5
- CC 6
- CC 7
- CC 8
- CC 9
- IM
- DM
- Reg
- Reg
- IM
- DM
- Reg
- Reg
- IM
- DM
- Reg
- IM
- DM
- Reg
- Reg
- …
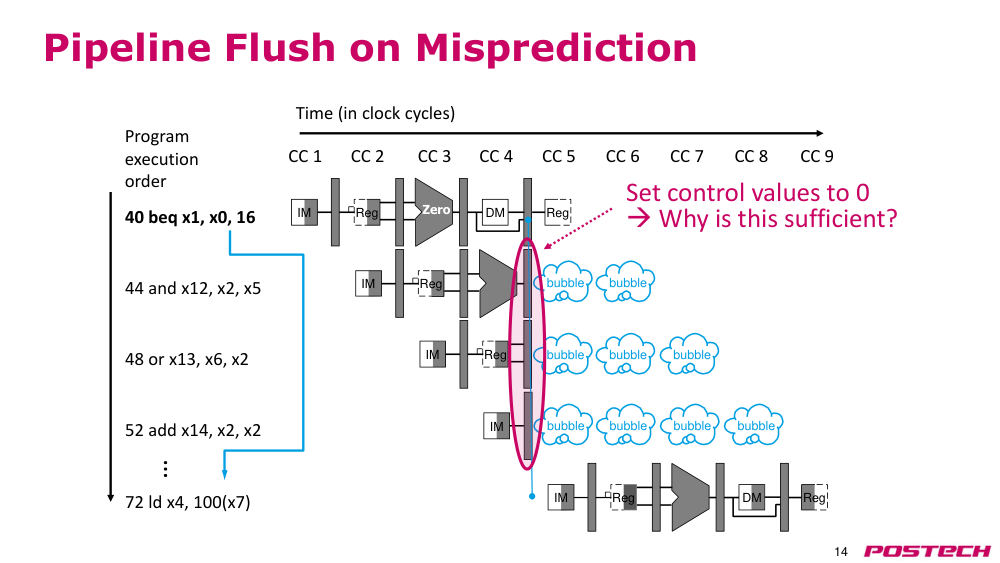
- killed(무효화됨)
- killed(무효화됨)
- killed(무효화됨)
- 0
- 세 사이클 낭비됨!
- IM
p.14예측 오류 시 pipeline flush(파이프라인 플러시)
- 프로그램 실행 순서
- 40 beq x1, x0, 16
- 44 and x12, x2, x5
- 48 or x13, x6, x2
- 52 add x14, x2, x2
- 72 ld x4, 100(x7)
- 시간 (클럭 사이클 단위)
- CC 1
- CC 2
- CC 3
- CC 4
- CC 5
- CC 6
- CC 7
- CC 8
- CC 9
- IM
- DM
- Reg
- Reg
- IM
- Reg
- IM
- IM
- DM
- Reg
- Reg
- …
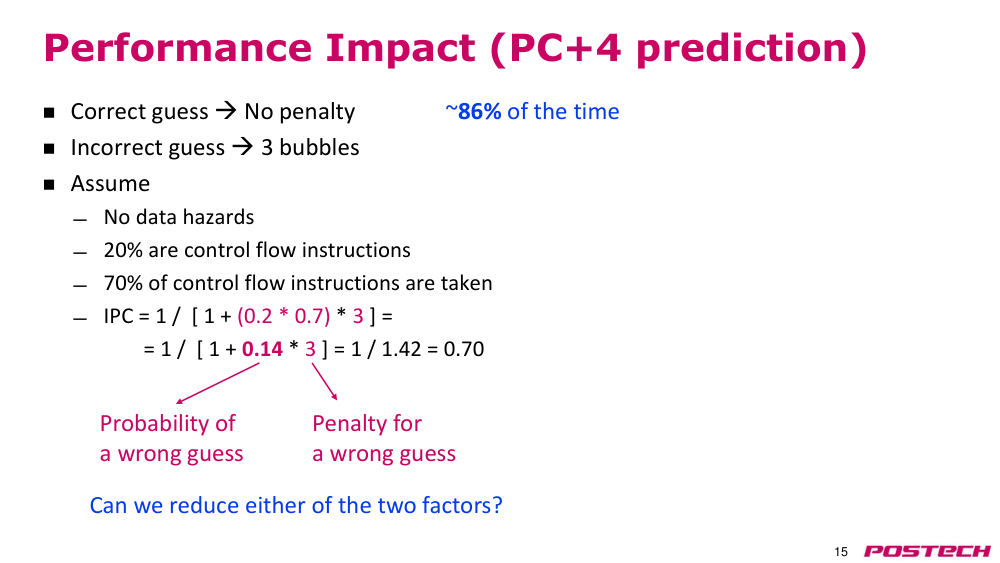
- bubble(버블)
- bubble(버블)
- bubble(버블)
- bubble(버블)
- bubble(버블)
- bubble(버블)
- bubble(버블)
- bubble(버블)
- bubble(버블)
- 제어 값 0으로 설정
- → 왜 이것이 충분한가?
p.15성능 영향 (PC+4 예측)
- 정확한 예측 → 페널티 없음
- ~86%의 시간 동안
- misprediction(예측 오류) → 3개의 bubble(버블)
- 가정
- 데이터 위험 없음
- 20%는 control flow instructions(제어 흐름 명령어)
- control flow instructions(제어 흐름 명령어)의 70%는 분기 수행됨
- IPC = 1 / [ 1 + (0.2 * 0.7) * 3 ] =
- = 1 / [ 1 + 0.14 * 3 ] = 1 / 1.42 = 0.70
- misprediction(예측 오류)에 대한 페널티
- misprediction(예측 오류)의 확률
- 두 요소 중 하나를 줄일 수 있을까?
p.16misprediction penalty(예측 오류 페널티) 감소
- WB
- M
- EX
- WB
- M
- WB
- PCSrc
- MemRead
- Add
- Address
- Instruction memory
- Address
- Write data
- Read data
- Data memory
- Add
- Sum
- ALU
- ALU result
- bcond
- Shift left 1
- PC
- 4
- ID/EX
- IF/ID
- EX/MEM
- MEM/WB
- ALUOp
- ALUSrc
- Branch
- Control
- 0
- 1
- 0
- 1
- 1
- 0
- Read register 1
- Read register 2
- Write register
- Write data
- Instruction [31–0]
- Instruction [11-7]
- Instruction [30, 14-12]
- Read data 1
- Read data 2
- Registers
- Imm Gen
- 32
- 64
- ALU control
- misprediction penalty(예측 오류 페널티) 감소
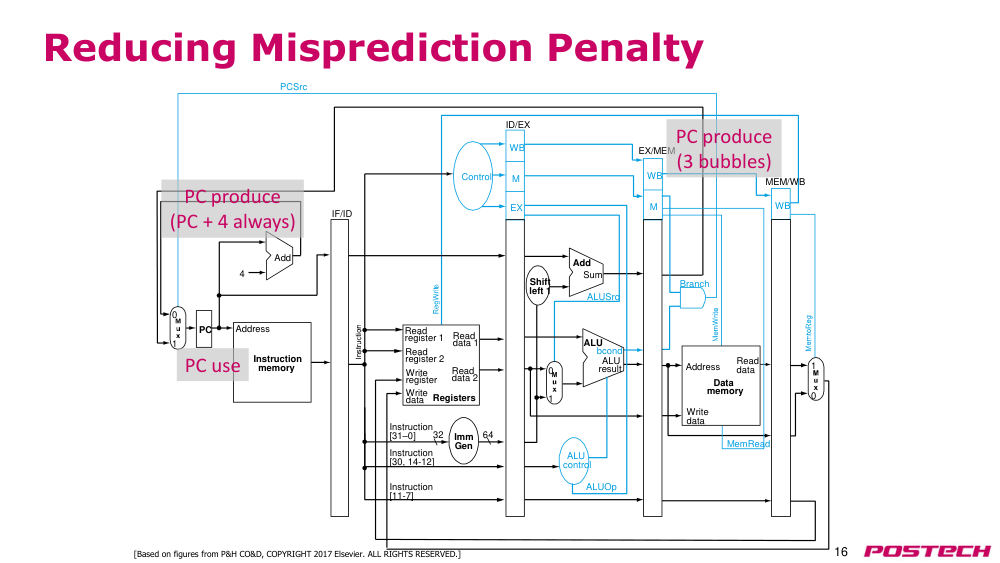
- PC 사용
- PC 생성 (PC + 4 항상)
- PC 생성 (3개의 버블)
- [P&H CO&D의 그림 기반, COPYRIGHT 2017 Elsevier. ALL RIGHTS RESERVED.]
p.17misprediction penalty(예측 오류 페널티) 감소
- WB
- M
- EX
- WB
- M
- WB
- PCSrc
- MemRead
- Add
- Address
- Instruction memory
- Address
- Write data
- Read data
- Data memory
- Add
- Sum
- ALU
- ALU result
- bcond
- Shift left 1
- PC
- 4
- ID/EX
- IF/ID
- EX/MEM
- MEM/WB
- ALUOp
- ALUSrc
- Branch
- Control
- 0
- 1
- 0
- 1
- 1
- 0
- Read register 1
- Read register 2
- Write register
- Write data
- Instruction [31–0]
- Instruction [11-7]
- Instruction [30, 14-12]
- Read data 1
- Read data 2
- Registers
- Imm Gen
- 32
- 64
- ALU control
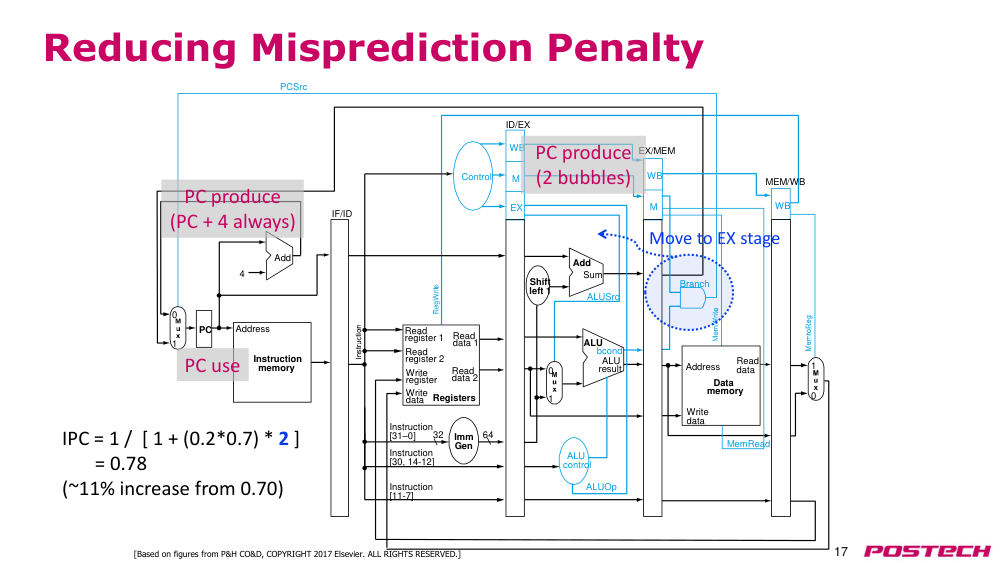
- misprediction penalty(예측 오류 페널티) 감소
- PC 생성 (2개의 버블)
- [P&H CO&D의 그림 기반, COPYRIGHT 2017 Elsevier. ALL RIGHTS RESERVED.]
- IPC = 1 / [ 1 + (0.2*0.7) * 2 ]
- = 0.78
- (0.70에서 약 11% 증가)
- EX 단계로 이동
- PC 사용
- PC 생성 (PC + 4 항상)
p.18misprediction penalty(예측 오류 페널티) 추가 감소
- WB
- M
- EX
- WB
- M
- WB
- PCSrc
- MemRead
- Add
- Address
- Instruction memory
- Address
- Write data
- Read data
- Data memory
- Add
- Sum
- ALU
- ALU result
- bcond
- Shift left 1
- PC
- 4
- ID/EX
- IF/ID
- EX/MEM
- MEM/WB
- ALUOp
- ALUSrc
- Branch
- Control
- 0
- 1
- 0
- 1
- 1
- 0
- Read register 1
- Read register 2
- Write register
- Write data
- Instruction [31–0]
- Instruction [11-7]
- Instruction [30, 14-12]
- Read data 1
- Read data 2
- Registers
- Imm Gen
- 32
- 64
- ALU control
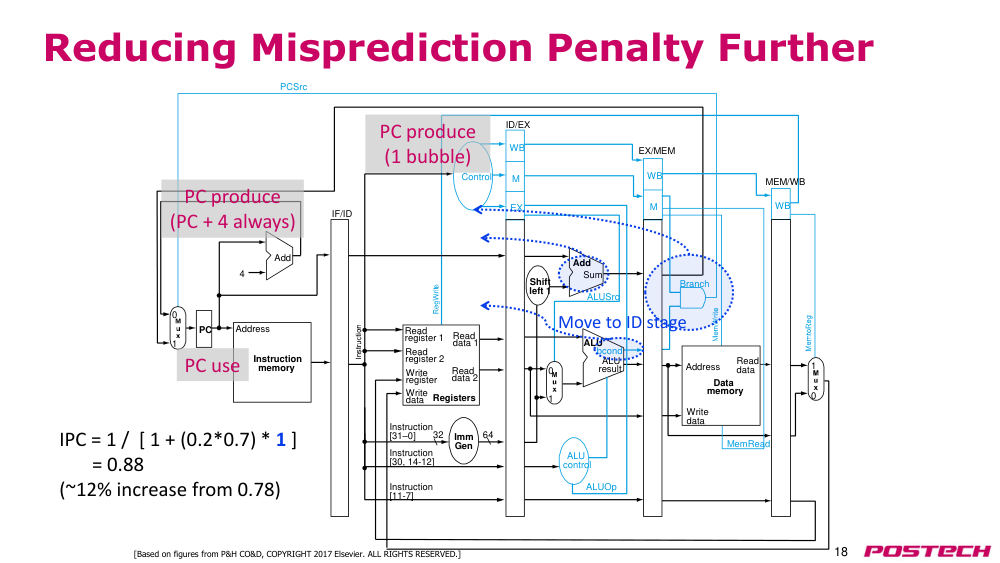
- misprediction penalty(예측 오류 페널티) 추가 감소
- PC 생성 (1개의 버블)
- [P&H CO&D의 그림 기반, COPYRIGHT 2017 Elsevier. ALL RIGHTS RESERVED.]
- PC 사용
- PC 생성 (PC + 4 항상)
- ID 단계로 이동
- IPC = 1 / [ 1 + (0.2*0.7) * 1 ]
- = 0.88
- (0.78에서 약 12% 증가)
p.19branch resolved in ID stage(ID 단계에서 분기 해결)
- 데이터 memory(메모리)
- registers(레지스터)
- ALU
- ID/EX
- EX/MEM
- MEM/WB
- forwarding unit(포워딩 유닛)
- 제어
- IF/ID
- hazard detection unit(위험 탐지 유닛)
- +
- +
- Imm Gen
- 시프트 왼쪽 1
- =
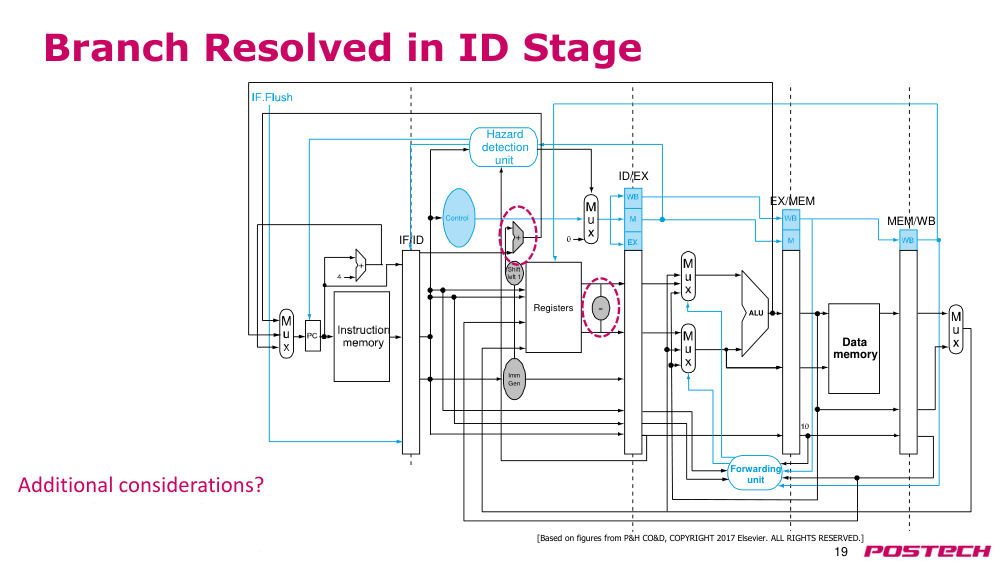
- 추가 고려사항? (힌트: 데이터 위험)
- - ID 단계에서 비교에 대한 데이터 포워딩
- - 위 포워딩이 불가능할 경우 stalling(스톨링)
p.20최종 PC 위험 분석
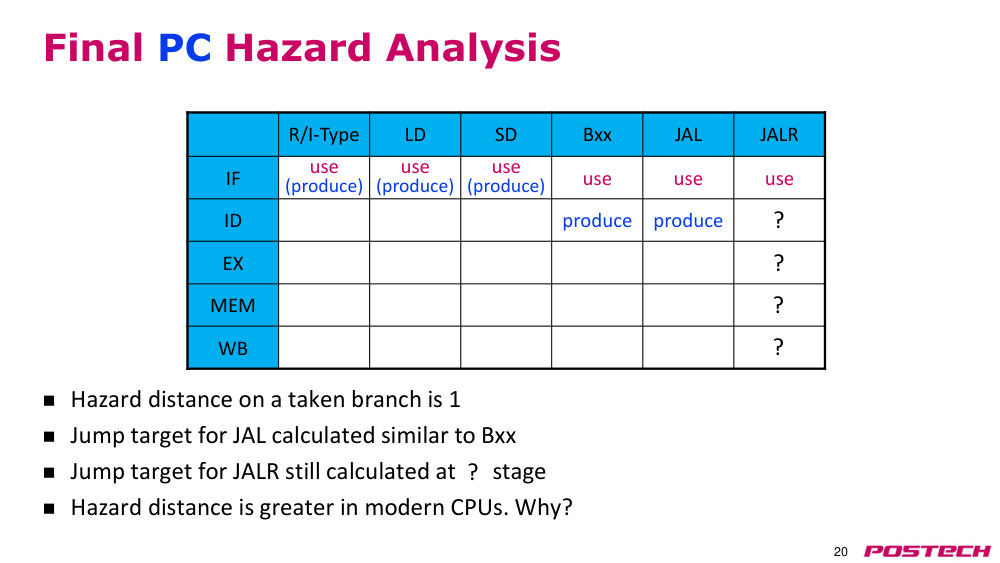
- taken branch(수행된 분기)의 위험 거리는 1이다.
- JAL의 jump target(점프 대상)은 Bxx와 유사하게 계산된다.
- JALR의 jump target(점프 대상)은 여전히 EX 단계에서 계산된다.
- 현대 CPU에서는 위험 거리가 더 크다. 왜일까?
- R/I형
- LD
- SD
- Bxx
- JAL
- JALR
- IF
- 사용 (생산)
- 사용 (생산)
- 사용 (생산)
- 사용
- 사용
- 사용
- ID
- 생산
- 생산
- EX
- 생산
- MEM
- WB
- ?
- ?
- ?
- ?
- ?
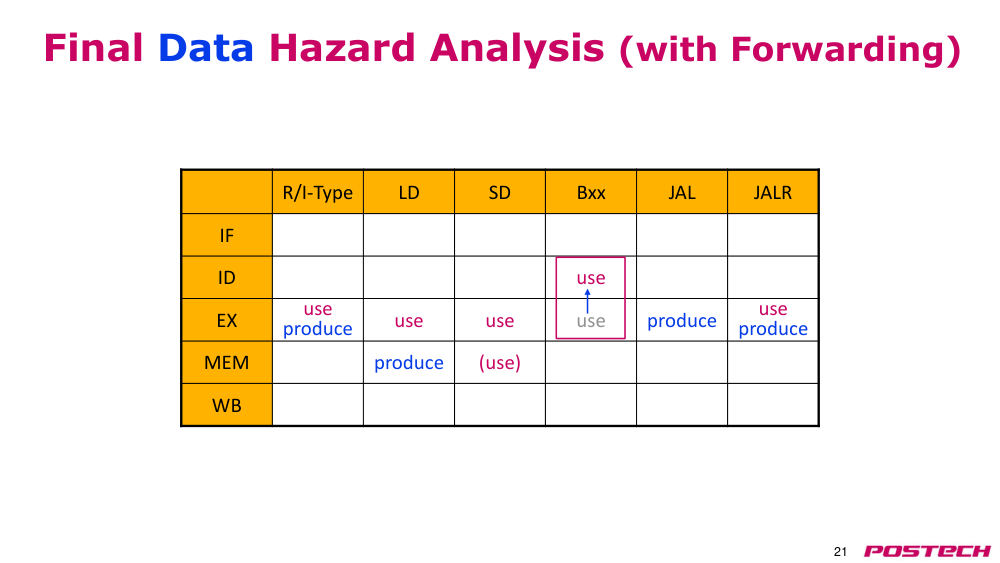
p.21포워딩을 사용한 최종 데이터 위험 분석
- R/I형
- LD
- SD
- Bxx
- JAL
- JALR
- IF
- ID
- 사용
- EX
- 사용
- 생산
- 사용
- 사용
- 사용
- 생산
- 사용
- 생산
- MEM
- 생산
- (사용)
- WB
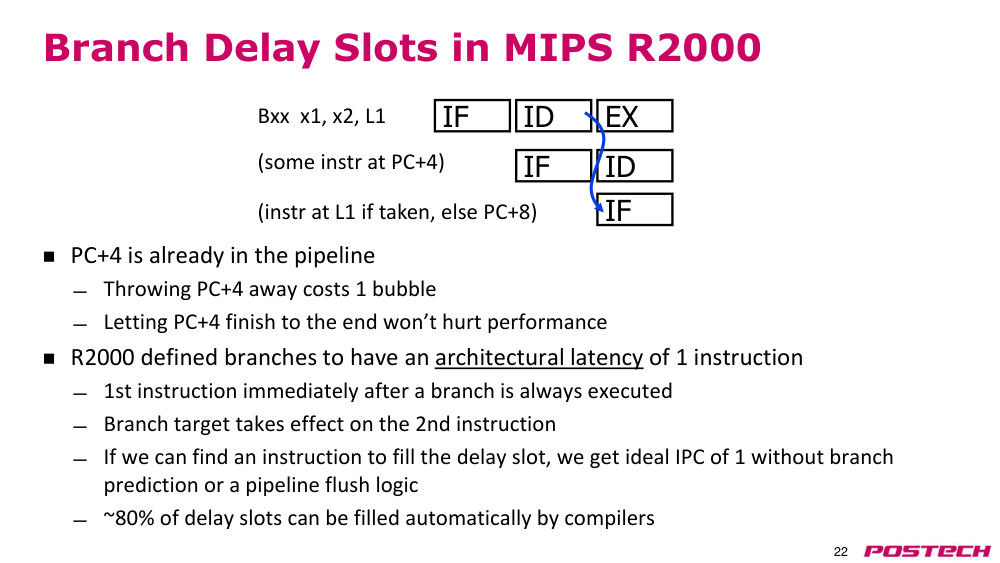
p.22MIPS R2000의 branch delay slot(분기 지연 슬롯)
- PC+4는 이미 파이프라인에 존재한다.
- PC+4를 버리면 1개의 bubble(버블)이 발생한다.
- PC+4를 끝까지 실행하게 하면 성능에 해롭지 않다.
- R2000은 분기의 architectural latency(아키텍처적 지연)을 1개의 명령어로 정의했다.
- 분기 다음에 오는 1번째 명령어는 항상 실행된다.
- branch target(분기 대상)은 2번째 명령어에서 적용된다.
- 지연 슬롯에 명령어를 채울 수 있다면, branch prediction(분기 예측)이나 pipeline flush(파이프라인 플러시) 논리를 사용하지 않고도 이상적인 IPC 1을 달성할 수 있다.
- compiler(컴파일러)에 의해 약 80%의 지연 슬롯이 자동으로 채워진다.
- Bxx x1, x2, L1
- ID
- IF
- (PC+4에 있는 어떤 명령어)
- IF
- EX
- ID
- IF
- (L1에 있는 명령어, 취소되지 않았을 경우, 아니면 PC+8)
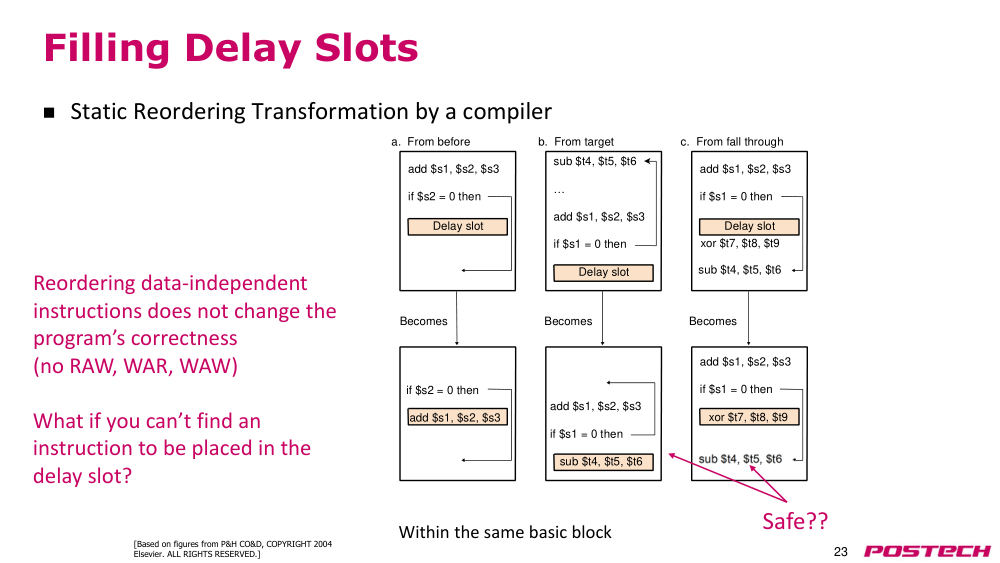
p.23지연 슬롯 채우기
- compiler(컴파일러)에 의한 static reordering transformation(정적 재정렬 변환)
- a. 분기 전 상태
- b. branch target(분기 대상) 상태
- c. 순차 실행 경로 상태
- sub $t4, $t5, $t6
- ...
- add $s1, $s2, $s3
- if $s1 = 0 then
- add $s1, $s2, $s3
- if $s1 = 0 then
- add $s1, $s2, $s3
- if $s1 = 0 then
- sub $t4, $t5, $t6
- add $s1, $s2, $s3
- if $s1 = 0 then
- sub $t4, $t5, $t6
- add $s1, $s2, $s3
- if $s2 = 0 then
- 변환됨
- 변환됨
- 변환됨
- 지연 슬롯
- 지연 슬롯
- 지연 슬롯
- sub $t4, $t5, $t6
- if $s2 = 0 then
- add $s1, $s2, $s3
- 같은 basic block(기본 블록) 내에서
- 안전한가?
- data-independent instructions(데이터에 독립적인 명령어)를 재정렬해도 프로그램의 정확성은 변하지 않는다.
- (RAW, WAR, WAW 없음)
- 지연 슬롯에 넣을 명령어를 찾을 수 없다면?
- xor $t7, $t8, $t9
- xor $t7, $t8, $t9
p.24다음 강의: 더 나은 예측 만들기
- 현재 PC
- branch history(분기 이력)
p.25질문?
- 질문?
- 공지사항
- - 읽기: P&H (RISC-V ed.) Ch 4.9