Lec 22 part2 & 23 · TPU 성능(roofline)·TPUv2/v3 와 메모리 장치(SRAM·DRAM·DDR)
정밀 정리 · 검증 2026-09-25 01:20
1개요
1.1L22 후반: roofline model 로 TPUv1 성능 분석(DDR3 memory-bound), GPU·CPU 비교에서 8-bit 정수와 7 ms response time 제약.
1.2TPUv2/v3: training 용 ML supercomputer, bfloat16·128×128 MMU, HBM, 2D torus interconnect, 1,024 chip scaling 과 co-design.
1.3DSA 교훈: 실제로 중요한 workload(MLP·LSTM)에 집중, compute·network·storage 균형(Amdahl).
1.4L23: SRAM 6T cell·read 순서, DRAM 1T1C·destructive read·refresh, row buffer·bank·DIMM, access 과정·latency, DDR·burst (p16 까지).
2섹션별 정리 상황·문제 → 원인 → 해결
2.12:23–4:00지난 시간 복습: TPU 구조·ISA
상황·문제L22 후반 이어서. Google TPU 는 data center 의 deep learning 가속용.
원인systolic array 기반 matrix multiply unit 은 data 를 한 번 가져와 여러 번 재사용 → CPU core 보다 효율적.
해결block diagram(MMU + 전용 buffer + 기타 functional unit, 자체 DRAM, PCIe 로 host 연결)과 CISC 형 ISA 를 다시 짚음.
- ISA 는 target application(deep learning) 기능에 맞춘 CISC style
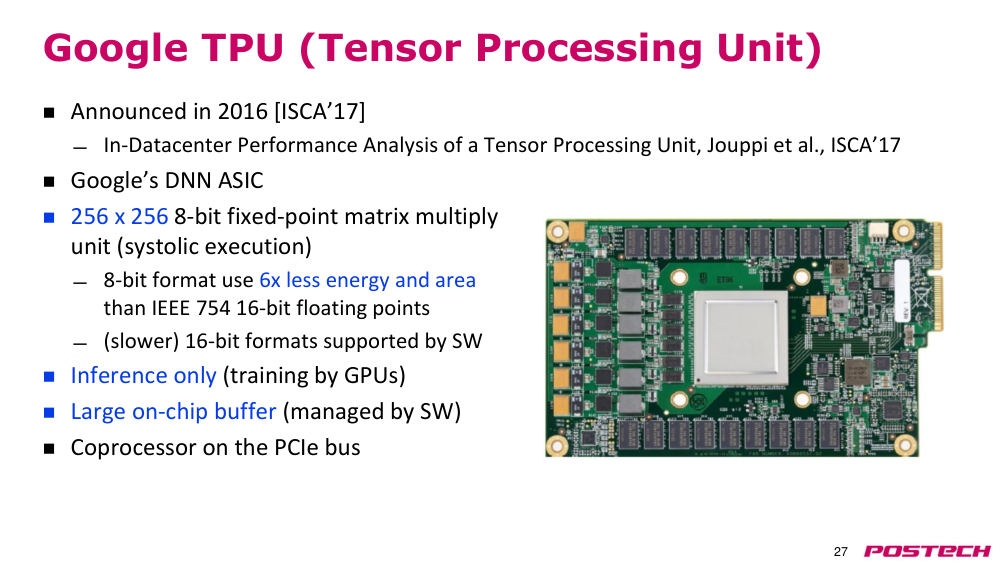
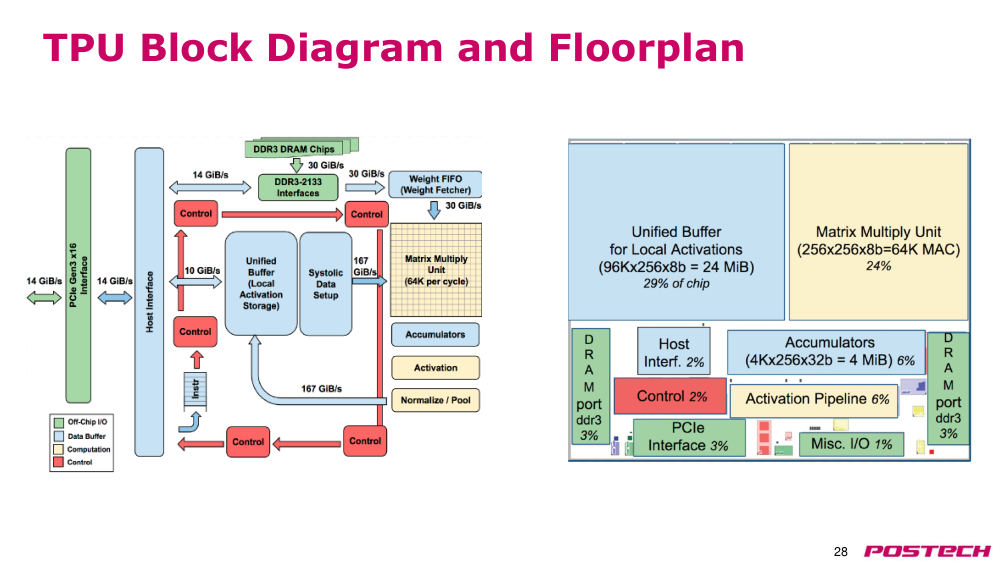
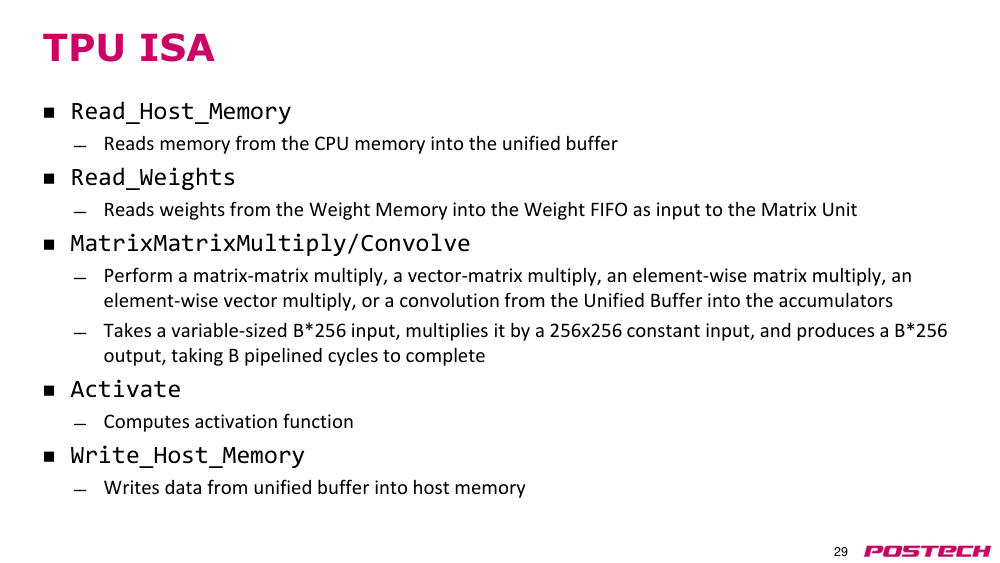
2.1.r.1Google Cloud Blog: An in-depth look at Google's first TPU ↗ · 256x256 MXU, 8-bit quantization, CISC 명령, MLP0 7 ms latency 한도
2.24:04–12:36roofline model 개념: 판서 예제
상황·문제TPU 성능을 CPU·GPU 와 비교하려면 arithmetic intensity 별 성능 상한을 보는 도구가 필요.
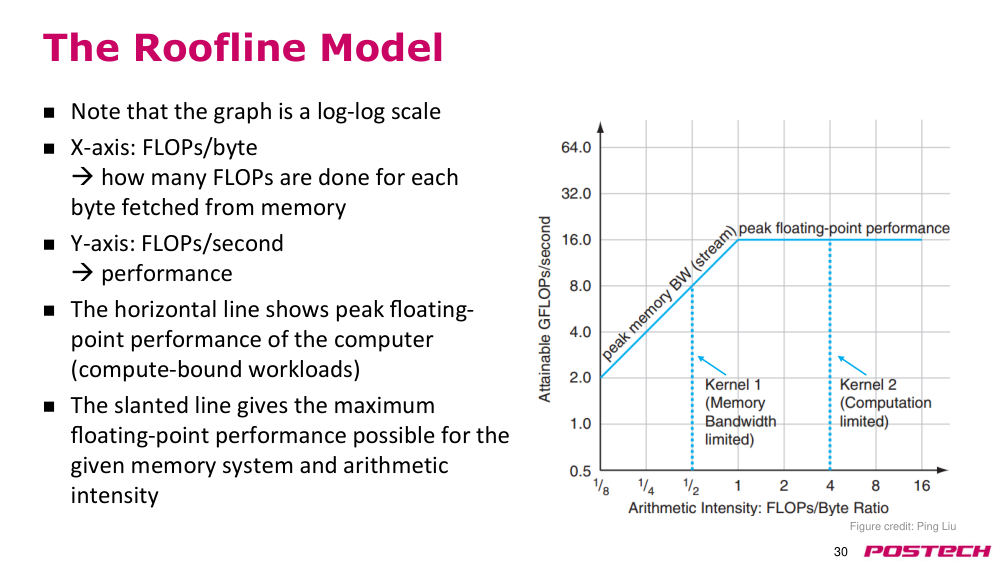
원인예: memory 16 B/s, processor 128 B/s(= 32 FLOPs/s, FP 4 byte). 가져온 data 를 1번 쓰면 16 B/s, 2번 32 B/s, 3번 48 B/s 로 memory bus 가 병목.
해결재사용을 늘리면 8번에서 processor peak 128 B/s 에 도달, 그 이상은 늘지 않음. 기울어진 선 + 수평선이 지붕 모양이라 roofline.
- peak 아래 구간은 memory system 이 성능을 결정
- 예제 processor 는 일부러 아주 느리게 잡은 것
2.2.r.1Wikipedia: Roofline model ↗ · arithmetic intensity(FLOPs/byte), memory-bound vs compute-bound 정의
2.312:36–17:43roofline 읽는 법과 TPU roofline
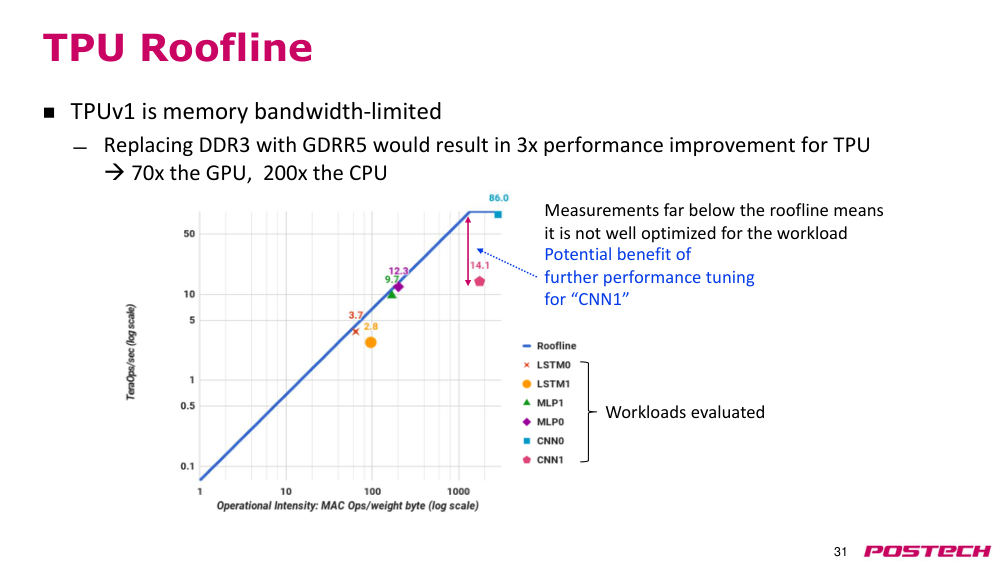
상황·문제x축 FLOPs/byte(log), y축 throughput(log). 수평선 = peak, 기울어진 선 = memory bandwidth 한계.
원인TPUv1 은 DDR3 를 써서 대부분의 arithmetic intensity 구간에서 memory bandwidth-bound. 대부분 workload 는 roofline 근처, LSTM1·CNN1 은 아래(다른 병목).
해결DDR3 → GDDR5 면 3배 향상 → GPU 의 70배, CPU 의 200배. DDR3 는 초기 설계 기간 단축 때문이었고 후속 세대는 더 높은 bandwidth memory 사용.
- memory bandwidth bound region vs compute bound region
- roofline 아래 점 = 실제 성능이 다른 병목으로 더 낮음
2.3.r.1Wikipedia: Roofline model ↗ · arithmetic intensity(FLOPs/byte), memory-bound vs compute-bound 정의
2.3.r.2Jouppi et al., In-Datacenter Performance Analysis of a Tensor Processing Unit (ISCA'17, arXiv) ↗ · TPUv1 원 논문: K80 GPU·Haswell CPU 대비 평균 15~30배
2.417:43–23:27GPU·CPU 와 비교: 8-bit 정수와 response time 제약
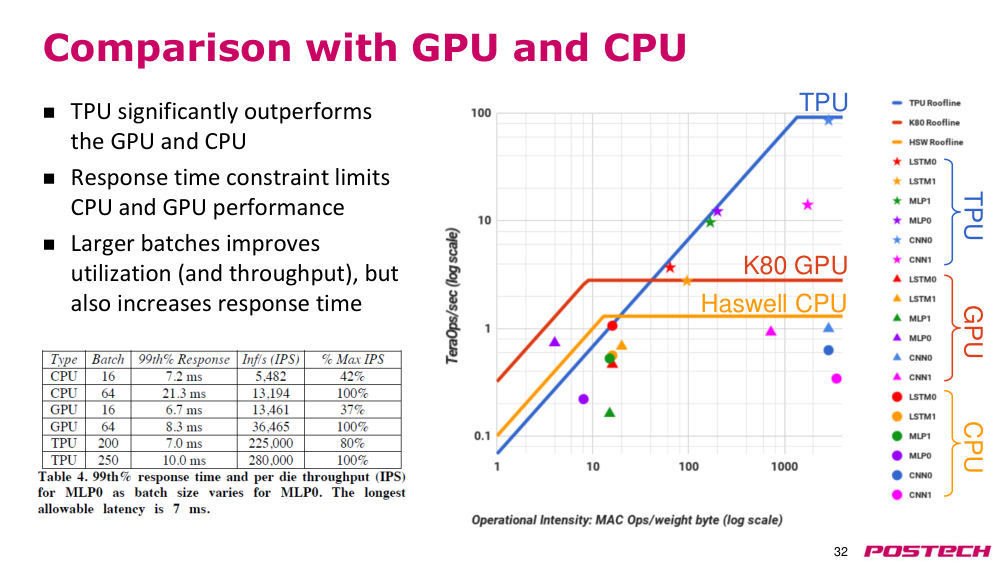
상황·문제별 = TPU, 삼각형 = GPU, 원 = CPU, 같은 색 = 같은 workload. y축 차이로 비교.
원인TPU 우위 이유: 1) 8-bit integer 로 특화해 산술 유닛이 훨씬 많음 2) inference 의 response time 제약(7 ms) 이 CPU·GPU 의 batch 크기를 제한.
해결batch 를 키우면 utilization·throughput 이 오르지만 response time 도 증가. TPU 는 batch 200 에서도 7 ms 를 지킴.
- CNN0: 교수 추정 GPU 는 CPU 의 약 4배, TPU 는 약 80배
- GPU·CPU 는 compute peak 에 묶이는 구간에서 TPU 는 memory bandwidth 에 묶임
2.4.r.1Google Cloud Blog: An in-depth look at Google's first TPU ↗ · 256x256 MXU, 8-bit quantization, CISC 명령, MLP0 7 ms latency 한도
2.4.r.2Jouppi et al., In-Datacenter Performance Analysis of a Tensor Processing Unit (ISCA'17, arXiv) ↗ · TPUv1 원 논문: K80 GPU·Haswell CPU 대비 평균 15~30배
2.523:27–27:36TPU 와 DSA 설계 지침, CNN 과대 집중 문제
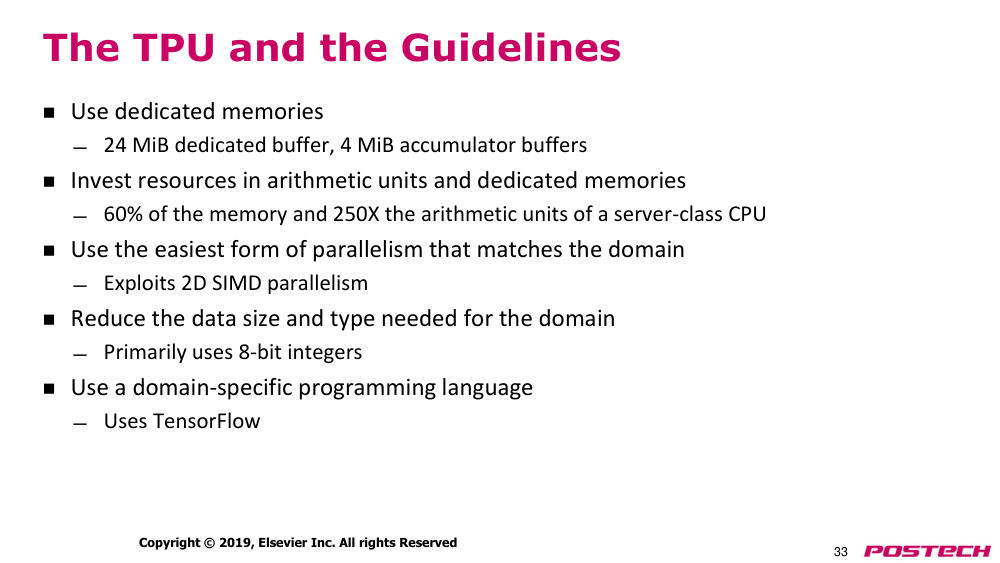
상황·문제L22 의 DSA 지침을 TPU 에 적용해 복습.
원인전용 memory(24 MiB buffer, 4 MiB accumulator), 서버 CPU 대비 memory 60%·산술 유닛 250배, 2D SIMD, 8-bit 정수, TensorFlow.
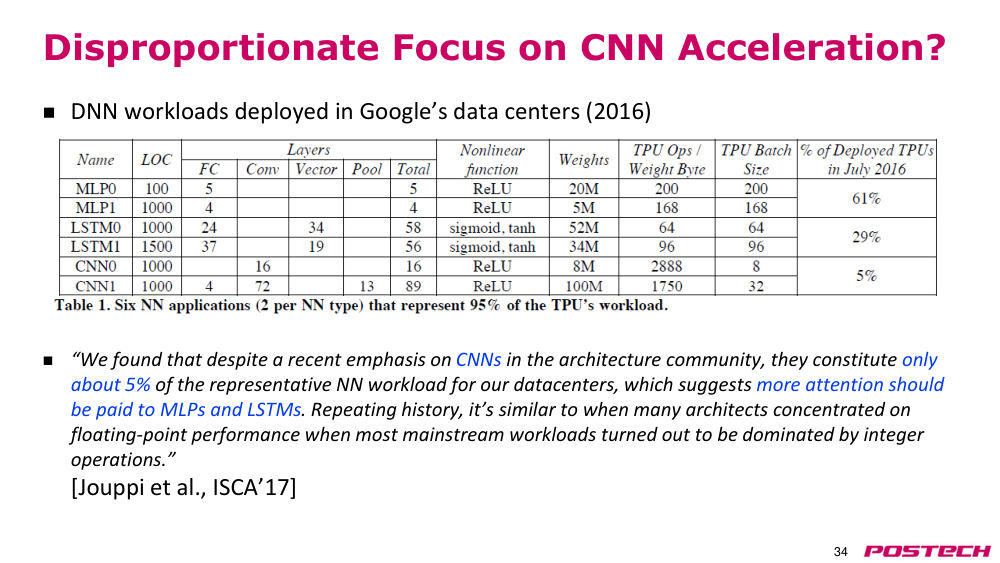
해결Google data center 의 DNN 은 MLP·LSTM 이 대부분, CNN 은 약 5% 인데 학계는 CNN 가속 논문이 훨씬 많음 → 흥미로워 보이는 것보다 실제로 중요한 application 에 집중.
- CNN 이 ImageNet competition 으로 deep learning 의 poster child 였던 탓이라는 교수 추측
2.5.r.1Jouppi et al., In-Datacenter Performance Analysis of a Tensor Processing Unit (ISCA'17, arXiv) ↗ · TPUv1 원 논문: K80 GPU·Haswell CPU 대비 평균 15~30배
2.627:36–30:00TPUv2·v3 동기: ML supercomputer
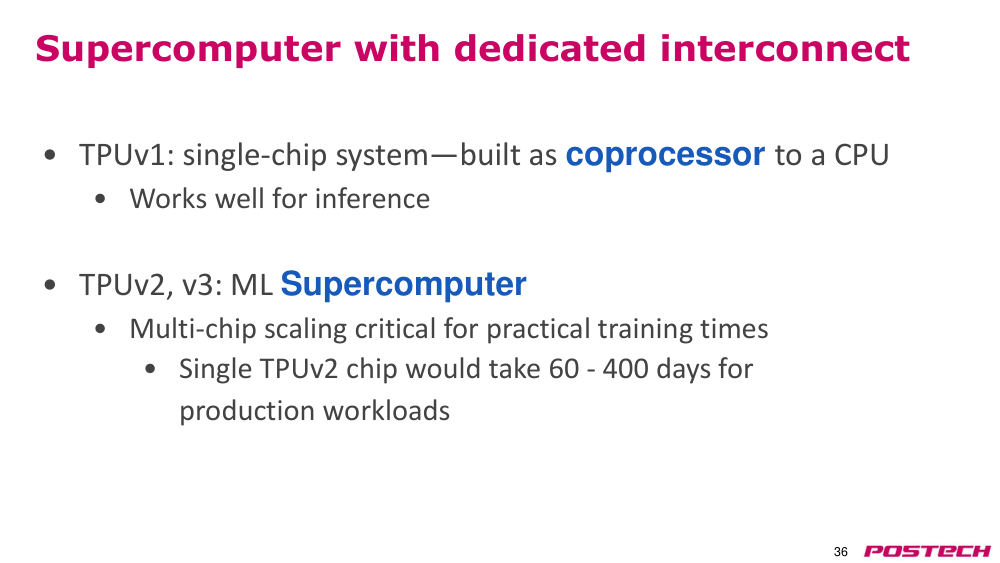
상황·문제TPUv1 은 PCIe 로 붙은 CPU coprocessor 단일 chip, inference 에는 충분.
원인training 은 dataset 을 반복 통과시키며 backpropagation 으로 parameter 갱신 → 단일 TPUv2 chip 으로는 production workload 에 60~400일.
해결여러 TPU 를 interconnect 로 묶는 multi-chip scaling 으로 training 시간 단축 (ML supercomputer). 최신은 TPUv4 지만 자료 없음.
2.730:00–38:05TPU core 의 MMU: bfloat16 과 128×128 선택
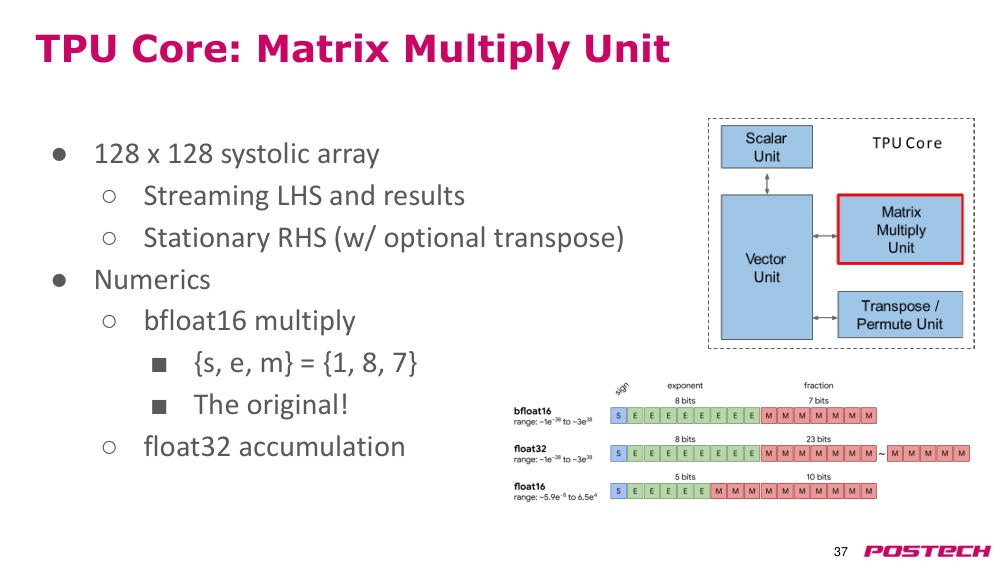
상황·문제기본 구조는 TPUv1 과 같이 MMU 중심, vector·scalar·transpose unit 을 추가. MMU 는 128×128 systolic array.
원인float32 = sign 1·exponent 8·fraction 23, FP16 = exponent 5·fraction 10 → dynamic range 가 좁아 training 에 불리. bfloat16 은 exponent 8 유지, fraction 축소.
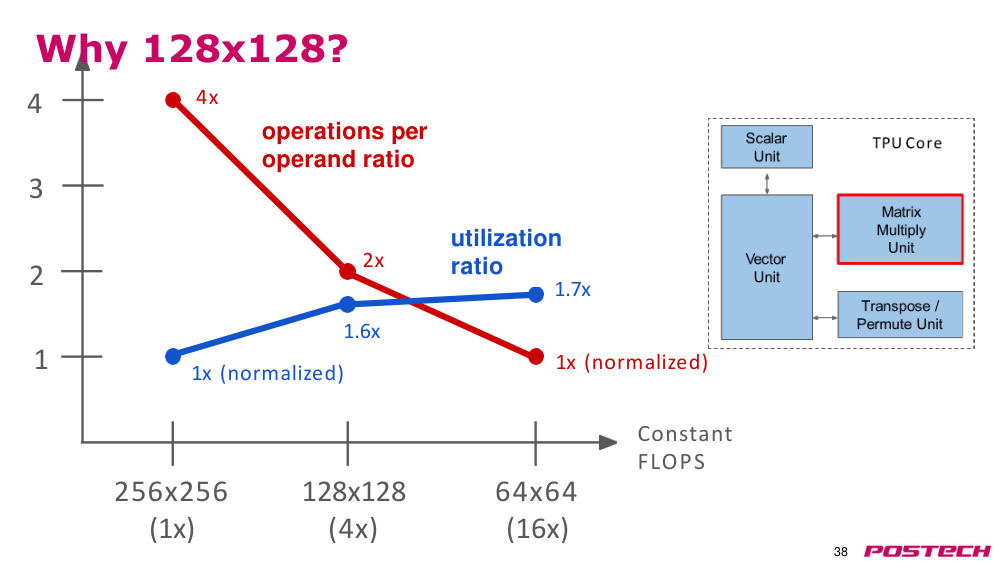
해결곱셈(비쌈)은 bfloat16, 누산(덧셈만)은 float32. 256×256 은 bfloat16 로는 비싸고 utilization 이 낮음, 64×64 는 utilization 1.6x→1.7x 로 소폭 개선뿐 operand reuse 가 절반 → 128×128 이 sweet spot.
- B 는 Google Brain 에서 유래
- systolic array 한 변 PE 수 = operand 재사용 횟수 (64 → 128 이면 2배)
2.838:05–43:04TPUv2 core unit, memory system, interconnect
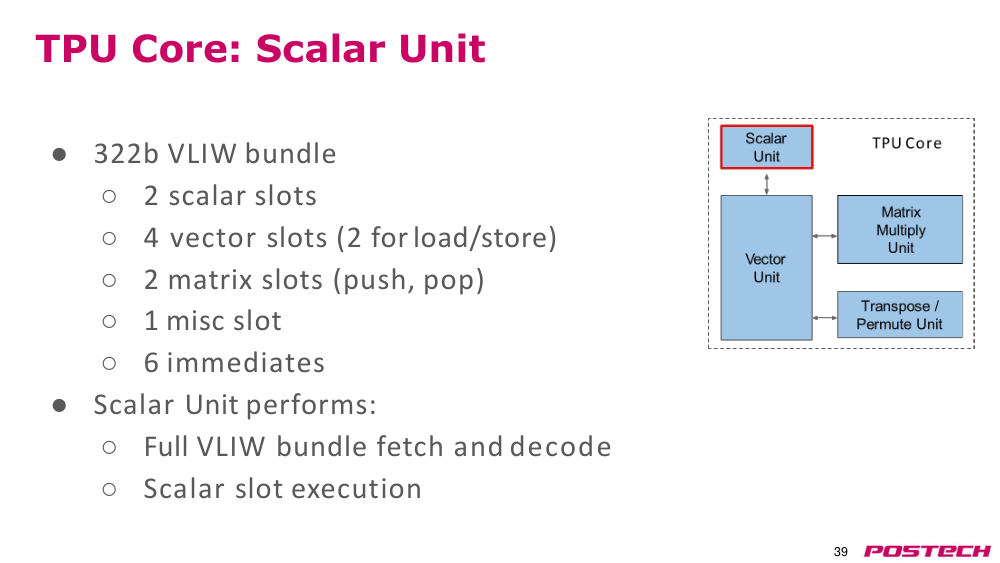
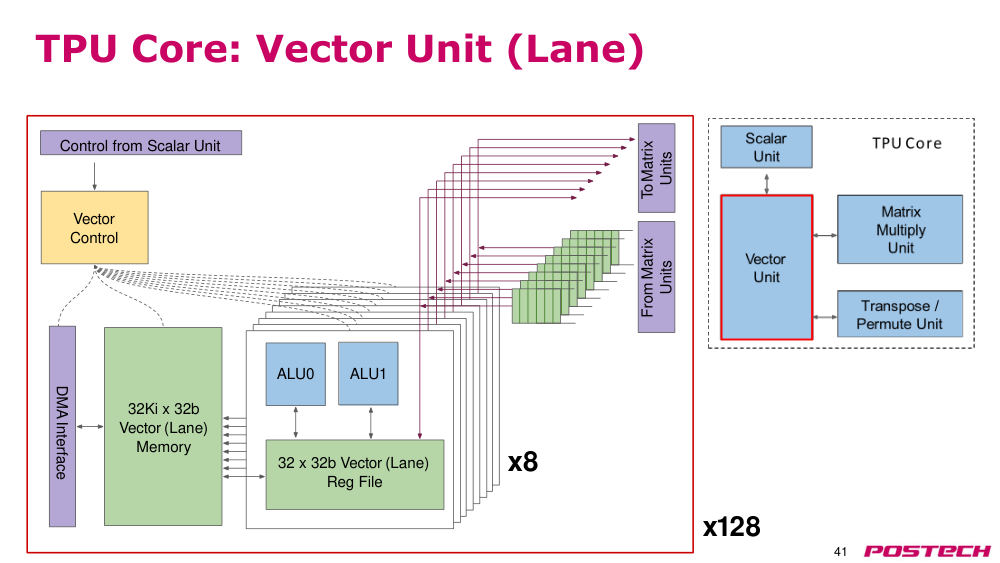
상황·문제scalar unit(세부 생략), vector unit, transpose·reduction·permute unit 이 MMU 를 보조.
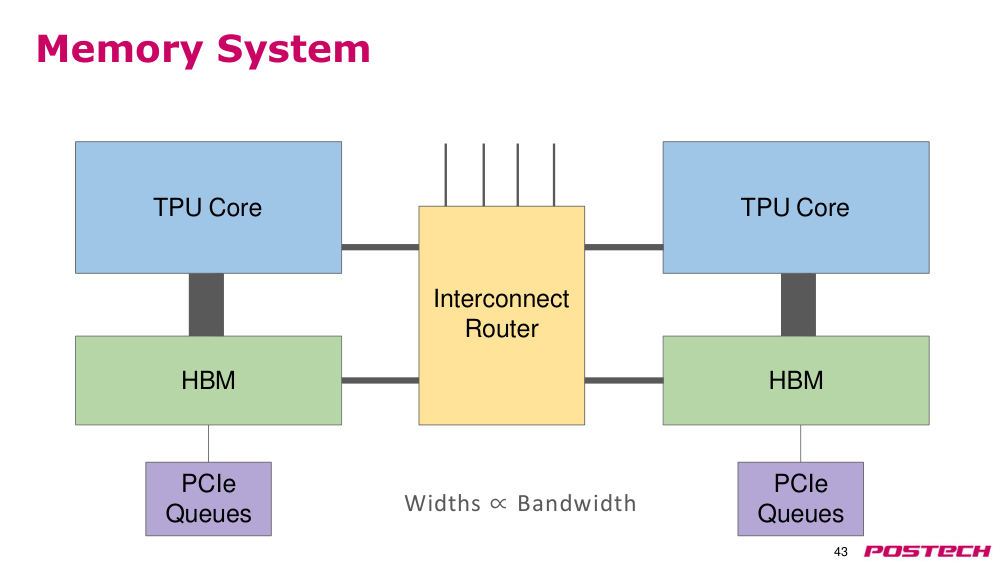
원인TPUv2 chip = TPU core 2개. DDR3 대신 HBM 으로 memory bandwidth 병목 회피, 그림 폭 ∝ bandwidth (PCIe 보다 HBM·interconnect 가 훨씬 넓음).
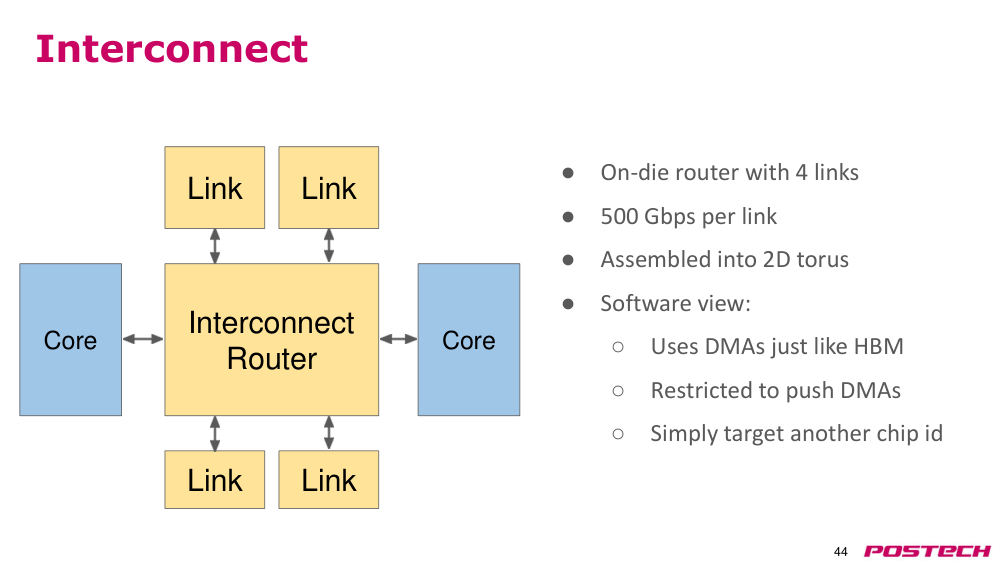
해결on-die router 에 link 4개(link 당 500 Gbps), 2D torus 구성. SW 는 HBM 처럼 DMA 로 다른 chip id 의 HBM 에 push.
- push DMA 제한의 의미는 교수도 확실치 않다며 원 발표 영상 참고를 권함
- HBM 은 다음 강의에서 자세히
2.943:04–46:18TPUv2 floorplan·요약, TPUv3 과 supercomputer
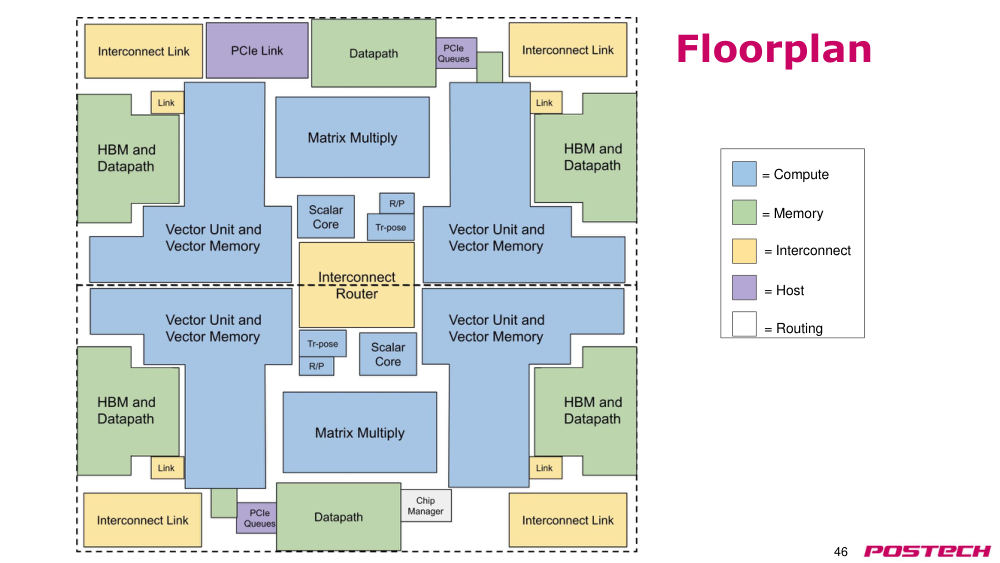
상황·문제TPUv2 floorplan 은 MMU·vector unit·vector memory·HBM/PCIe datapath·router 가 대부분.
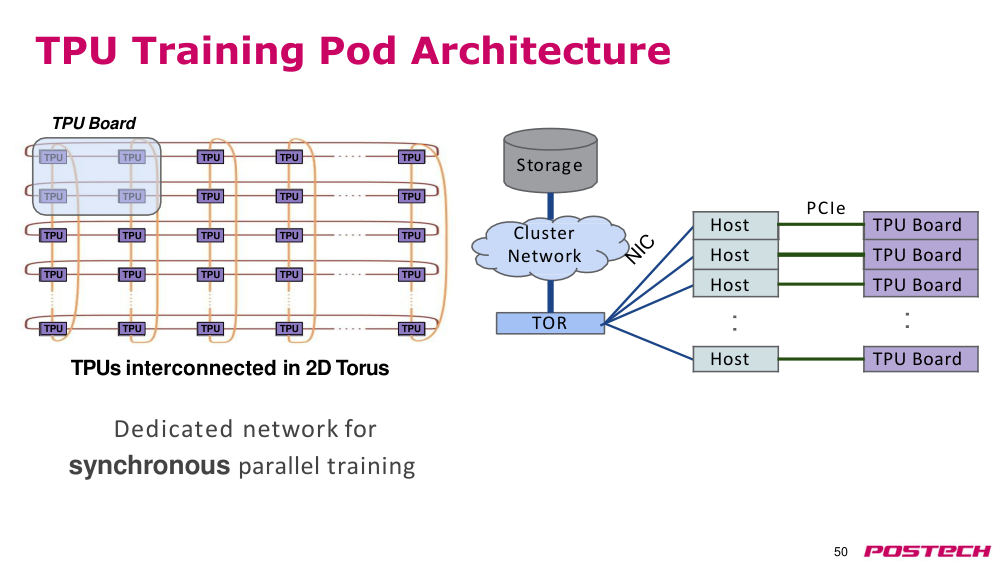
원인TPUv2 board 는 chip 4개, 공랭. board 들을 TPU 전용 network(2D torus)로 연결, host 는 PCIe 로 접근.
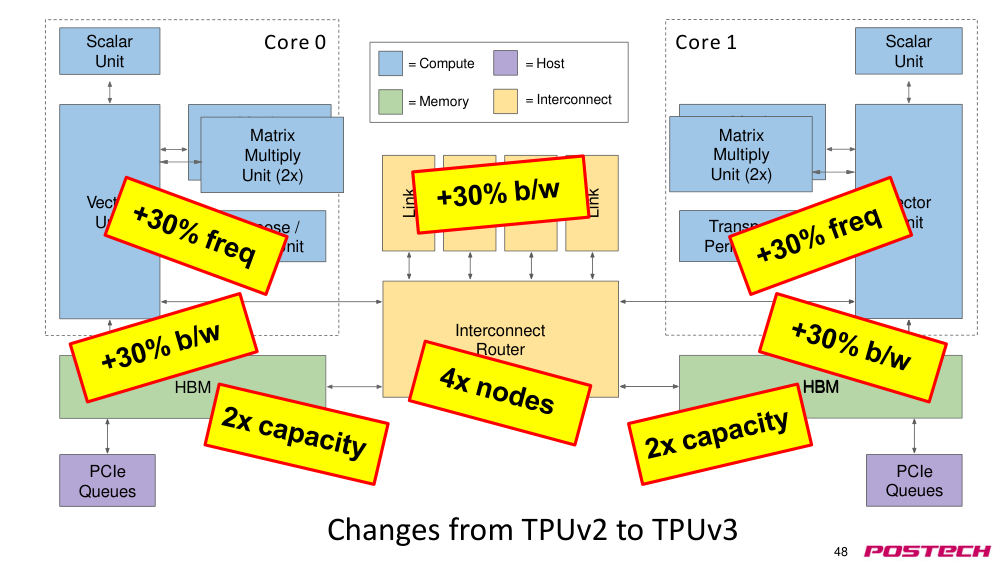
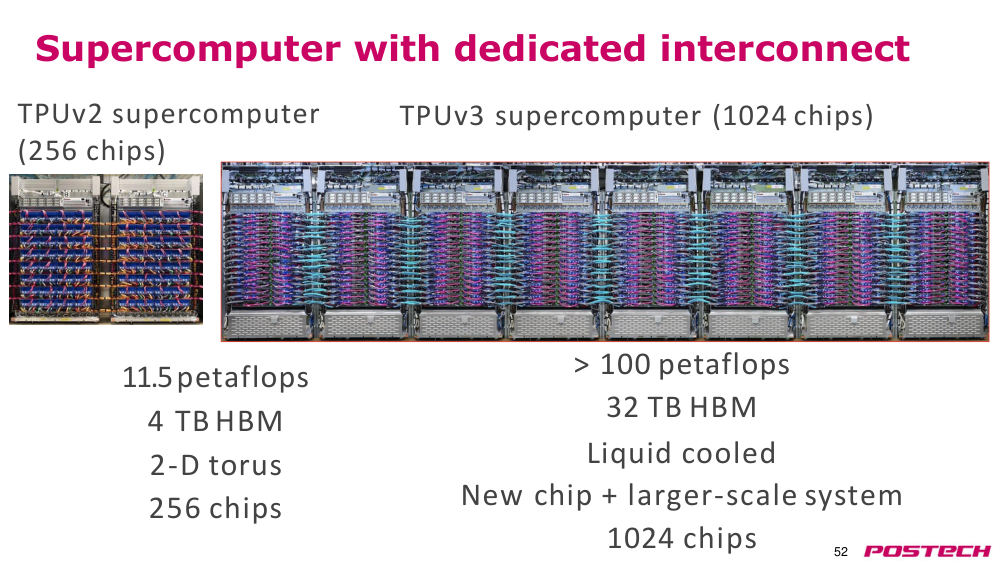
해결TPUv3: MMU 2→4, HBM 용량 2배(교수: 이전 8 GB per HBM), bandwidth 향상, liquid cooling. v2 는 256 chip, v3 는 1,024 chip·100+ petaflops·HBM 32 TB.
- TPUv4 는 발표됐지만 세부 비공개(강의 시점)
2.1046:18–48:41TPUv3 scaling 과 algorithm·SW·HW co-design
상황·문제chip 수를 늘릴 때 speedup 이 비례하는지 production workload 로 측정.
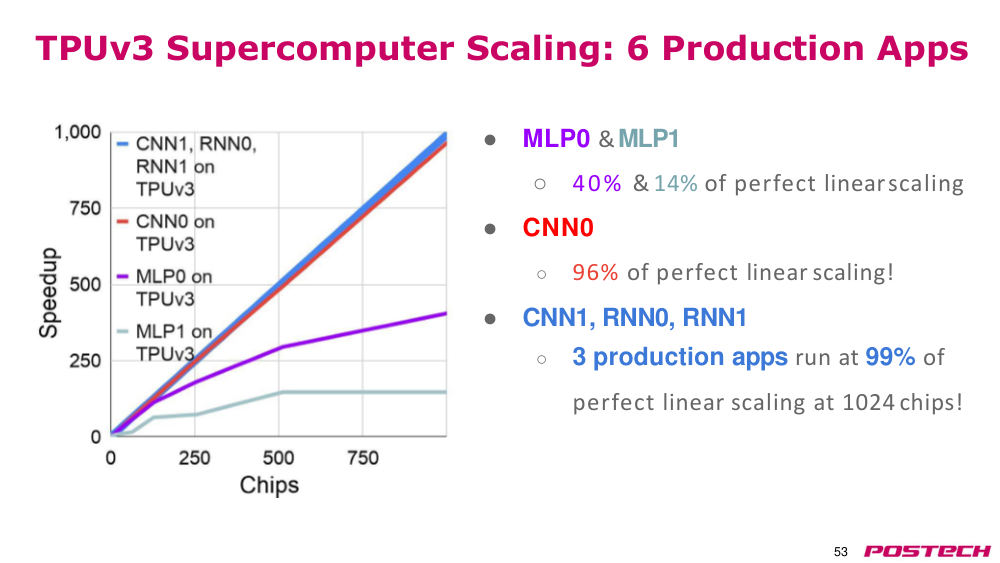
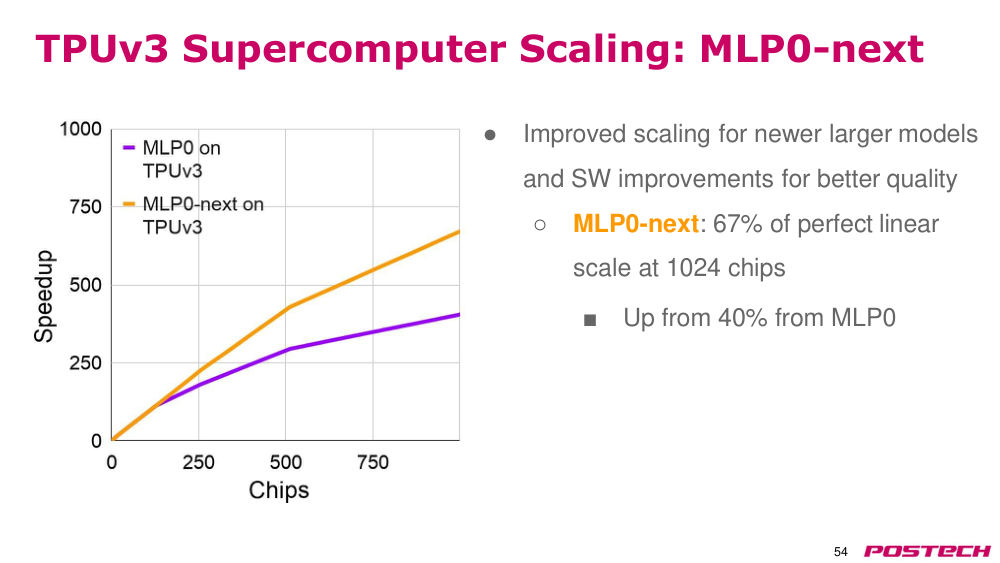
원인CNN0·CNN1·RNN0·RNN1 은 1,024 chip 에서 perfect linear 의 96~99%, MLP0·MLP1 은 40%·14%. MLP 는 memory bound 라 TPU 간 통신 bandwidth 가 병목.
해결새 model MLP0-next 로 67% 까지 개선 → DSA 는 hardware 에 맞춰 algorithm·software 를 함께 설계(co-design)해야 함.
2.1148:41–51:02AI chip 생태계와 큰 그림
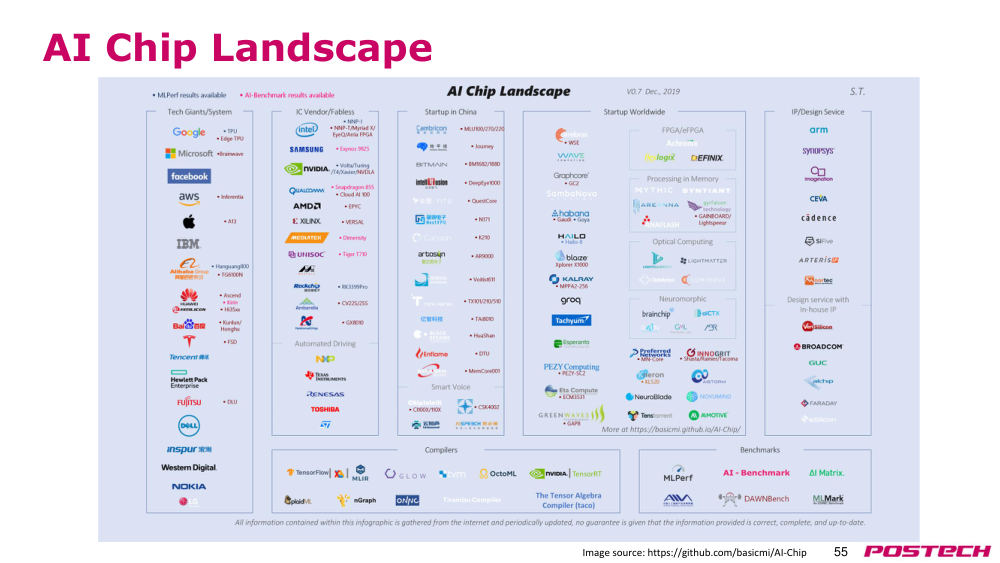
상황·문제Google 외에도 Microsoft·Facebook·AWS·Apple(neural engine), 자율주행 업체, compiler·benchmark 업체가 AI chip 경쟁.
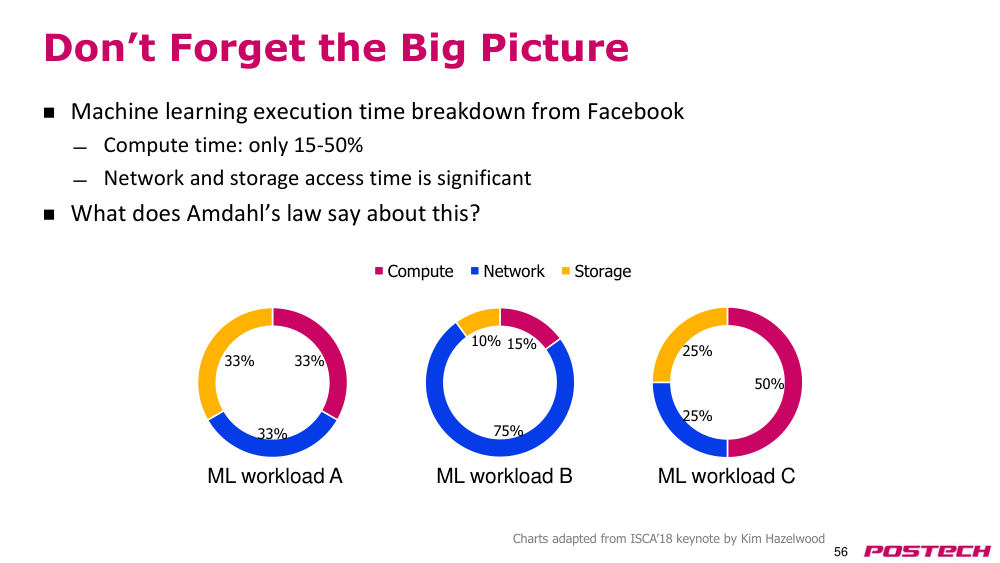
원인Facebook ML workload 한 예: network 75%, compute 15% → compute 만 가속해도 이득이 작음.
해결workload 마다 비율이 다르므로 compute·network·storage 를 균형 있게 설계해야 성능·cost efficiency 확보.
2.1251:02–52:46질문·출석 체크
상황·문제TPU 질문 받음(없음), Zoom 이름에 학번 넣어 출석 체크.
2.1352:46–1:01:33L23 메모리 장치 시작: SRAM
상황·문제지금까지 memory 는 추상적으로 봄(cache, on-chip SRAM). main memory 인 DRAM 세부는 아직. 중간에 L22·L23 강의자료 업로드 안내.
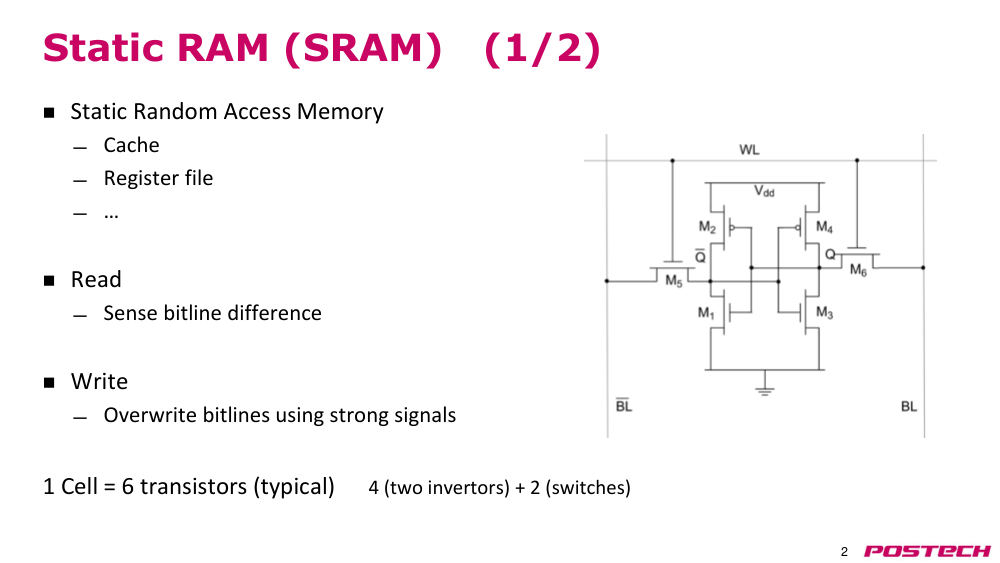
원인SRAM 은 값이 static(refresh 불필요), 짧은 latency 라 cache·register file 용. cell = 보통 6T(inverter 저장 4 + access 2), word line 1개 + bit line 2개(BL, BL_bar).
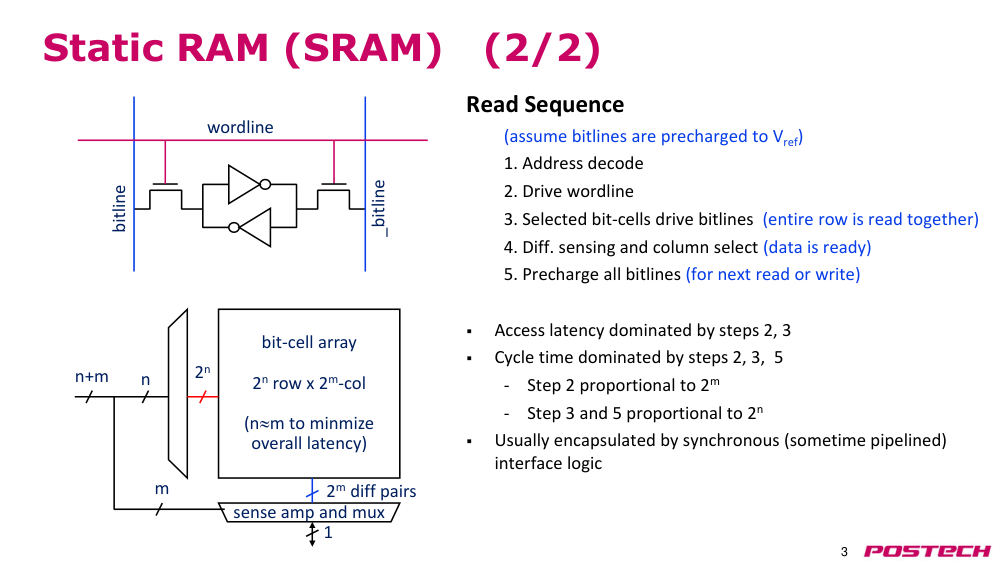
해결read: address decode → word line 구동 → cell 이 bit line 구동 → 차이 sensing·column mux → precharge. write: bit line 을 원하는 값으로 강하게 구동.
- address n+m bit: n 은 row, m 은 row 안 column 선택
- word line·bit line 길이는 cell 수에 비례, 구동·precharge 가 latency 대부분
- cache 에서는 synchronous·pipelined interface 로 감춰짐
2.13.r.1Wikipedia: Static random-access memory ↗ · 6T cell, word line 이 access transistor 를 켜고 bit line 으로 read/write
2.141:01:33–1:05:36DRAM cell: 1T1C, destructive read, refresh
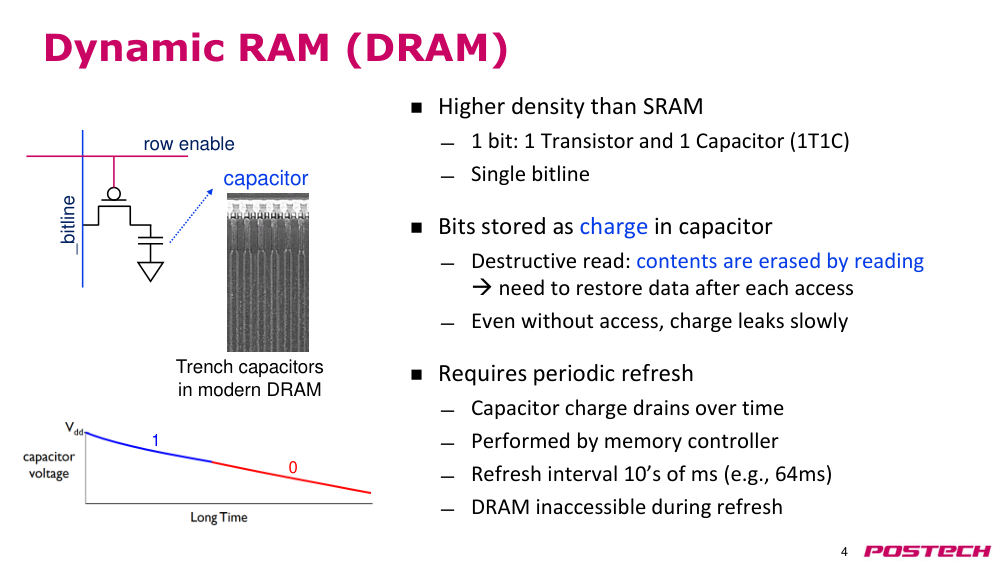
상황·문제DRAM 은 capacitor 의 charge 로 bit 저장(charge 있음 = 1). 세로로 긴 trench capacitor 로 면적당 cell 수 증가.
원인1T1C·bit line 1개라 SRAM 보다 밀도 높음. 그러나 읽으면 charge 가 빠져 값이 사라지고(destructive read), 가만히 둬도 charge 가 leak.
해결access 후 값을 restore, 주기적으로 refresh(수십 ms, 예 64 ms 마다 전체). refresh 중엔 다른 data 접근 불가.
2.14.r.1Wikipedia: Dynamic random-access memory ↗ · 1T1C cell, destructive read, refresh, row/column·sense amplifier
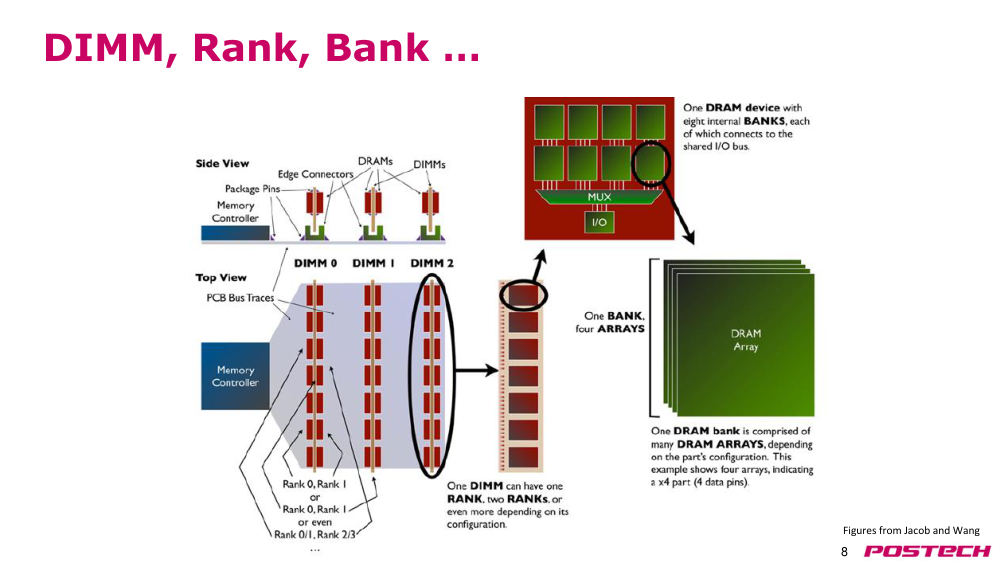
2.151:05:36–1:11:00DRAM array 구성: row buffer, bank, DIMM
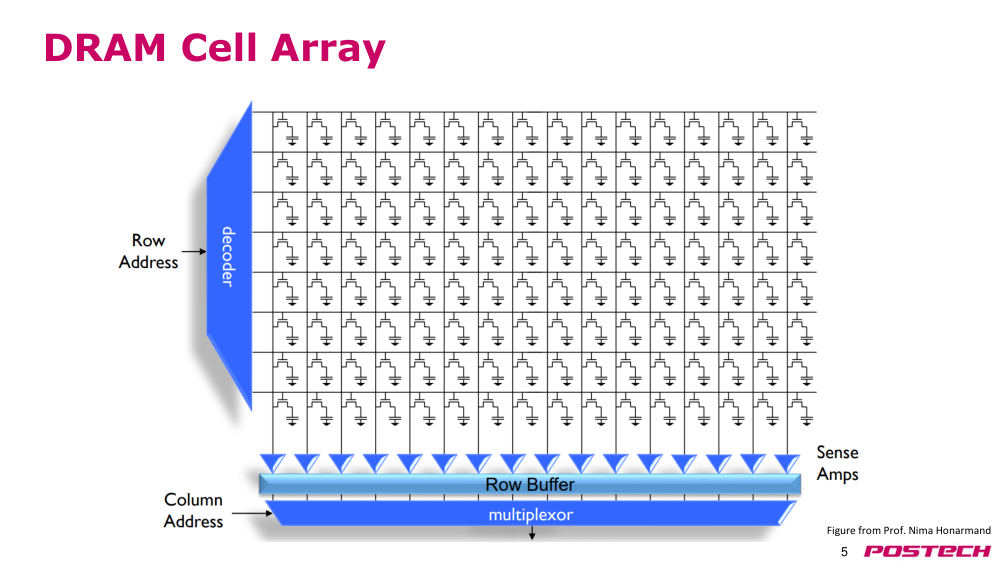
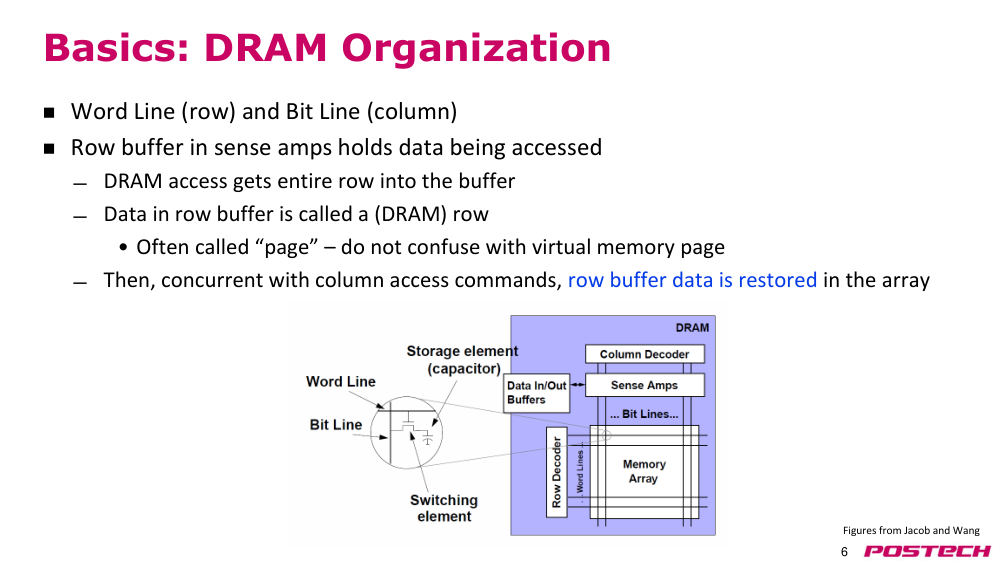
상황·문제row decoder 가 word line 을 구동하면 row 전체가 row buffer(= sense amp)로, column address 로 mux 에서 선택.
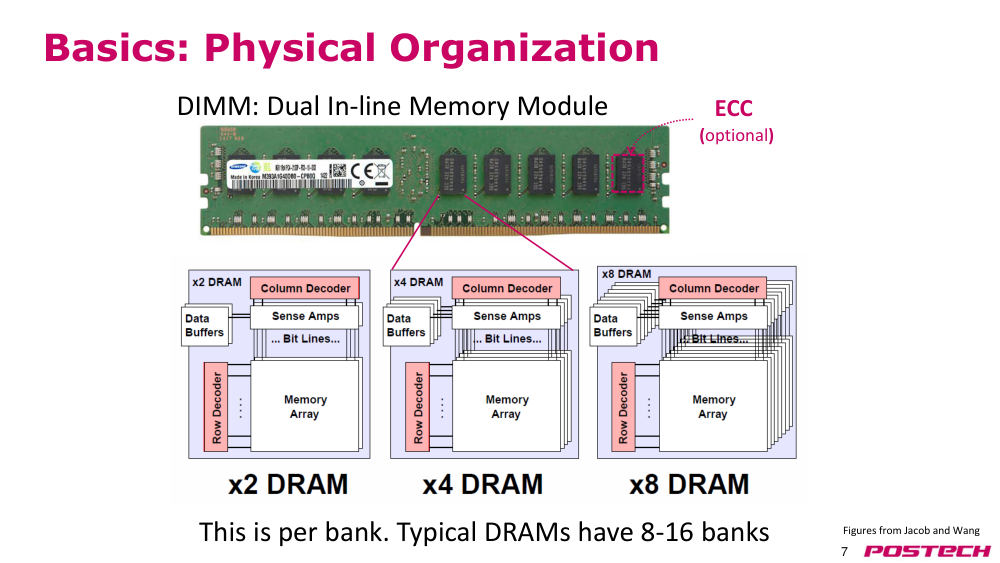
원인DRAM row 를 page 라고도 부르지만 virtual memory page 와 무관. row buffer 접근 중 cell 로 data restore. mux 하나는 1 bit 만 → ×4·×8 이면 array 4·8개.
해결DIMM: ×8 chip 8개로 64-bit bus, 서버는 ECC chip 추가해 72-bit. array 묶음이 bank, chip 에 여러 bank, DIMM 여러 개가 memory controller 에 연결.
- desktop DRAM 은 보통 ECC 없음
- typical DRAM 은 bank 8~16개(슬라이드)
2.161:11:00–1:14:10DRAM access 과정과 latency 구성
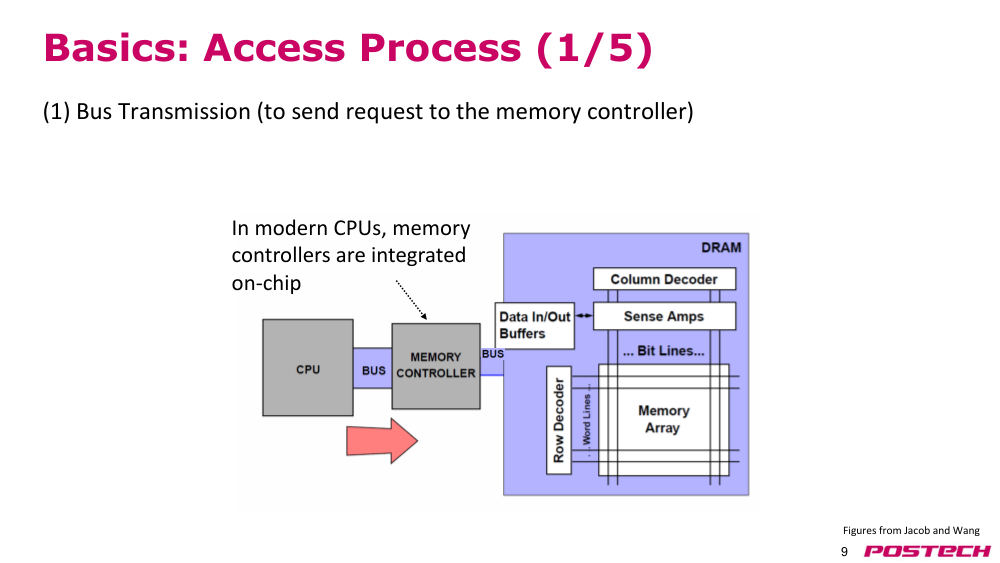
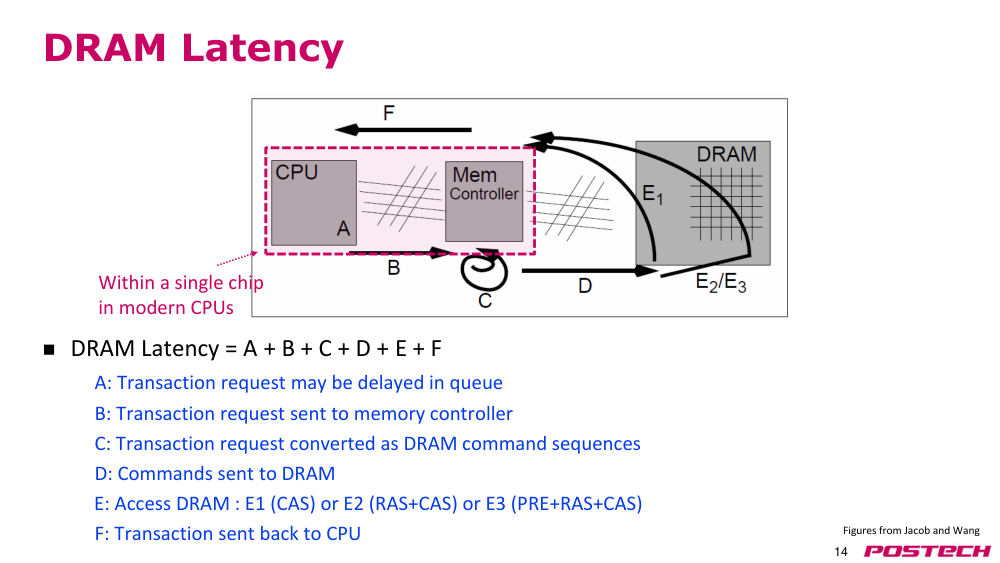
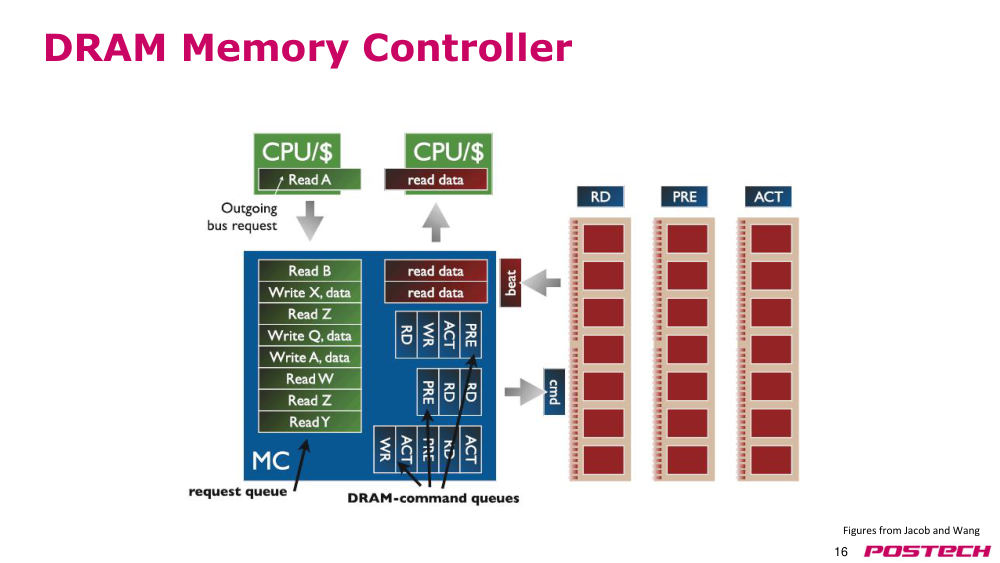
상황·문제CPU 요청 → on-chip memory controller → DRAM command.
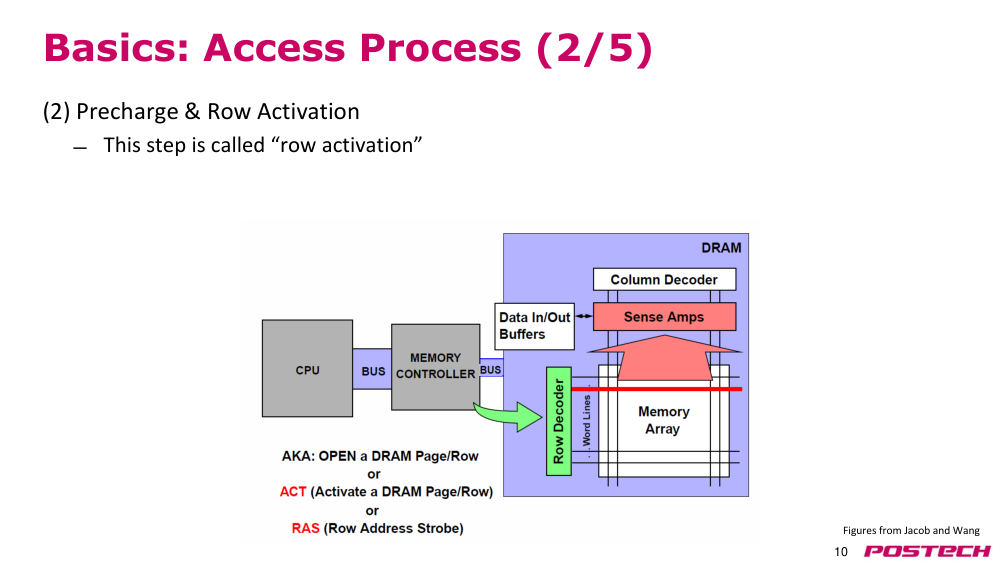
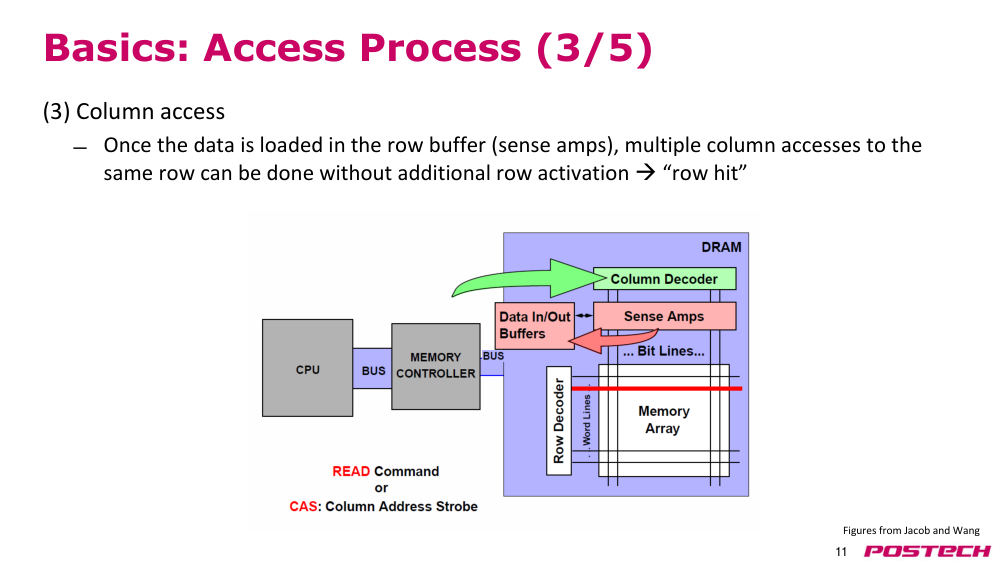
원인precharge(bit line 전압 준비) → row activation(row 를 sense amp 로) → column access → data 를 controller 로 → CPU 로 응답.
해결latency = queue 지연 + controller 전송 + command 변환 + bus 전송 + DRAM access(row 상태에 따라 CAS / RAS+CAS / PRE+RAS+CAS) + 응답 전송. row 가 이미 열려 있으면 column access 만.
- 같은 row 에 여러 column access 는 activation 없이 → row hit
2.16.r.1Wikipedia: Dynamic random-access memory ↗ · 1T1C cell, destructive read, refresh, row/column·sense amplifier
2.171:14:10–1:15:20두 번째 출석 체크
상황·문제앞 출석은 무효, 이번 것이 유효하다고 공지(출석 후 나가는 학생 때문).
2.181:15:20–1:18:35DDR interface 와 burst
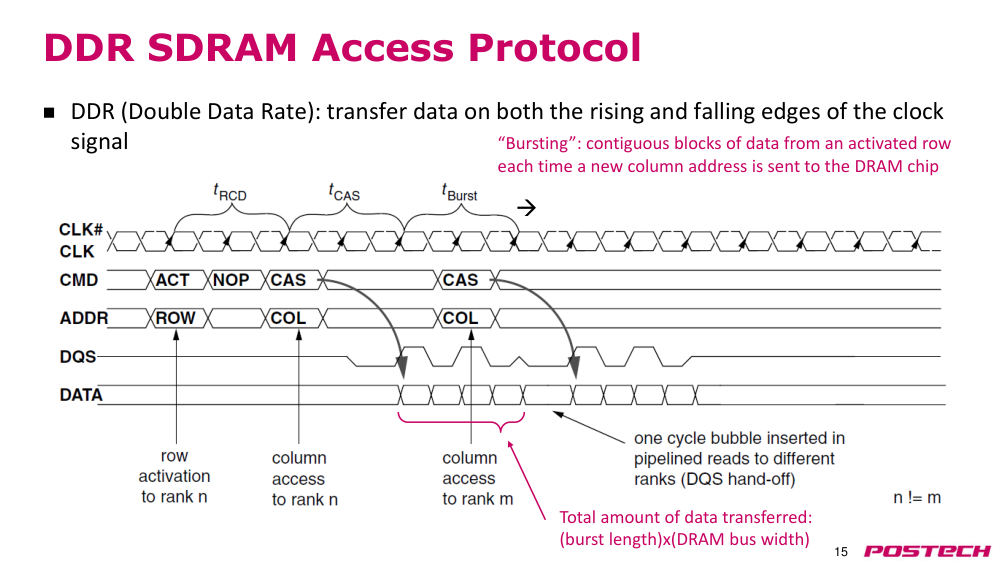
상황·문제현대 DRAM 은 DDR(double data rate) interface.
원인clock 의 rising·falling edge(CLK·CLK# 교차) 양쪽에서 전송 → cycle 당 wire 하나에 2 bit. command·address 는 DDR 아님.
해결column access 한 번에 여러 data 를 연속 전송(burst, 예 burst length 4) → DRAM 을 더 효율적으로 사용. 나머지는 다음 강의.
- 전송량 = burst length × DRAM bus width(슬라이드)
3핵심 개념
3.1roofline model(루프라인 모델)
arithmetic intensity 별 성능 상한. 기울어진 선 = memory bandwidth, 수평선 = compute peak.
3.1.r.1Wikipedia: Roofline model ↗ · arithmetic intensity(FLOPs/byte), memory-bound vs compute-bound 정의
3.2arithmetic intensity(산술 밀도)
memory 에서 가져온 byte 당 수행하는 FLOPs. 재사용이 많을수록 큼.
3.2.r.1Wikipedia: Roofline model ↗ · arithmetic intensity(FLOPs/byte), memory-bound vs compute-bound 정의
3.3response time constraint(응답 시간 제약)
inference 요청을 7 ms 안에 처리해야 해 CPU·GPU 는 큰 batch 불가.
3.3.r.1Google Cloud Blog: An in-depth look at Google's first TPU ↗ · 256x256 MXU, 8-bit quantization, CISC 명령, MLP0 7 ms latency 한도
3.4bfloat16
sign 1·exponent 8·fraction 7. float32 와 같은 dynamic range, 정밀도 축소. Google Brain 제안.
3.52D torus(2차원 토러스)
ring 의 2차원 판. TPU 간 link 4개로 구성.
3.6co-design(공동 설계)
hardware 에 맞게 algorithm·software 를 함께 설계. MLP0-next 가 40%→67% scaling.
3.7SRAM 6T cell
inverter 2개(4T) + access transistor 2개, word line 1·bit line 2.
3.7.r.1Wikipedia: Static random-access memory ↗ · 6T cell, word line 이 access transistor 를 켜고 bit line 으로 read/write
3.8destructive read(파괴적 읽기)
DRAM 은 읽으면 capacitor charge 가 빠져 값이 사라짐 → restore 필요.
3.8.r.1Wikipedia: Dynamic random-access memory ↗ · 1T1C cell, destructive read, refresh, row/column·sense amplifier
3.9refresh(리프레시)
leak 되는 charge 를 주기적으로 복구. 예 64 ms, refresh 중 접근 불가.
3.10row buffer(로우 버퍼) / sense amplifier
activation 된 row 전체를 보유. 같은 row 재접근은 row hit.
3.10.r.1Wikipedia: Dynamic random-access memory ↗ · 1T1C cell, destructive read, refresh, row/column·sense amplifier
3.11bank(뱅크)
chip 안 독립 array 묶음. DRAM 은 보통 8~16개.
3.12DDR(double data rate)
clock rising·falling edge 양쪽에서 data 전송, cycle 당 wire 당 2 bit.
4스스로 확인
4.1memory 16 B/s, processor 128 B/s 일 때 가져온 data 를 한 번만 쓰면 성능은?
답
16 B/s. memory bus 가 병목. 8번 재사용해야 peak 128 B/s.
4.2TPUv1 이 대부분 구간에서 memory-bound 인 이유와 개선 추정치는?
답
DDR3 사용(설계 기간 단축). GDDR5 면 3배 → GPU 의 70배, CPU 의 200배.
4.3CPU·GPU 가 batch 를 키우지 못한 이유는?
답
inference response time 한도 7 ms. batch 를 키우면 throughput 은 오르지만 response time 도 증가.
4.4bfloat16 이 FP16 보다 training 에 유리한 이유는?
답
exponent 8 bit 로 float32 와 같은 dynamic range. training 은 넓은 범위의 수를 다룸.
4.5128×128 MMU 를 고른 이유는?
답
256×256 은 비싸고 utilization 이 낮음, 64×64 는 utilization 소폭 향상뿐 operand reuse 가 절반.
4.6MLP0·MLP1 의 1,024 chip scaling 이 나빴던 이유는?
답
memory bound 라 TPU 간 통신 bandwidth 가 병목. MLP0-next 로 67% 까지 개선.
4.7DRAM 이 refresh 와 restore 를 둘 다 필요로 하는 이유는?
답
읽으면 charge 가 빠지고(destructive read), 읽지 않아도 charge 가 leak.
4.8DRAM access 에서 E1·E2·E3 의 차이는?
답
row 상태: 이미 열림(CAS), 닫힘·precharge 됨(RAS+CAS), 다른 row 열림(PRE+RAS+CAS).
5참고 자료
5.1Jouppi et al., In-Datacenter Performance Analysis of a Tensor Processing Unit (ISCA'17, arXiv) ↗ · TPUv1 원 논문: K80 GPU·Haswell CPU 대비 평균 15~30배
5.2Google Cloud Blog: An in-depth look at Google's first TPU ↗ · 256x256 MXU, 8-bit quantization, CISC 명령, MLP0 7 ms latency 한도
5.5Wikipedia: Dynamic random-access memory ↗ · 1T1C cell, destructive read, refresh, row/column·sense amplifier
5.6Wikipedia: Static random-access memory ↗ · 6T cell, word line 이 access transistor 를 켜고 bit line 으로 read/write