이 자료를 쓰는 강의: 61 TPU 성능(roofline)·TPUv2/v3 와 메모리 장치(SRAM·DRAM·DDR) · 62 memory controller·HBM·PIM·새 memory 와 storage(flash·SSD·RAID)
Lec23-MemoryDevice (updated)
한국어판 강의자료 · 30쪽
p.1CSED311 컴퓨터구조 – 강의 23
메모리 장치
p.2정적 랜덤 액세스 메모리 (SRAM) (1/2)
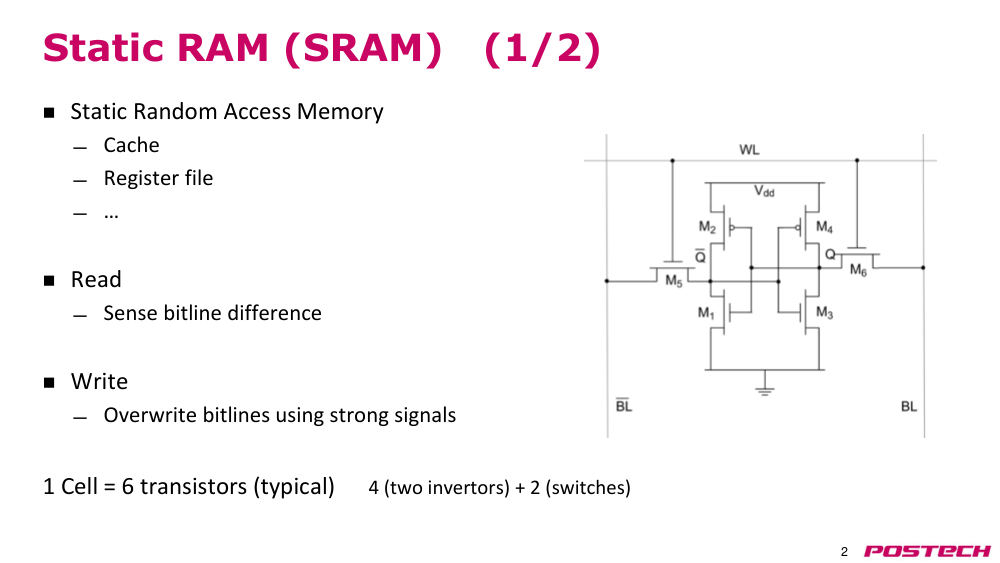
- static RAM (SRAM)(정적 랜덤 액세스 메모리)
- cache(캐시)
- register file(레지스터 파일)
- …
- 읽기
- bitline(비트라인) 차이를 감지
- 쓰기
- 강한 신호로 bitline(비트라인) 덮어쓰기
- 1 셀 = 6 트랜지스터 (보통)
- 4 (두 개의 인버터) + 2 (스위치)
p.3정적 랜덤 액세스 메모리 (SRAM) (2/2)
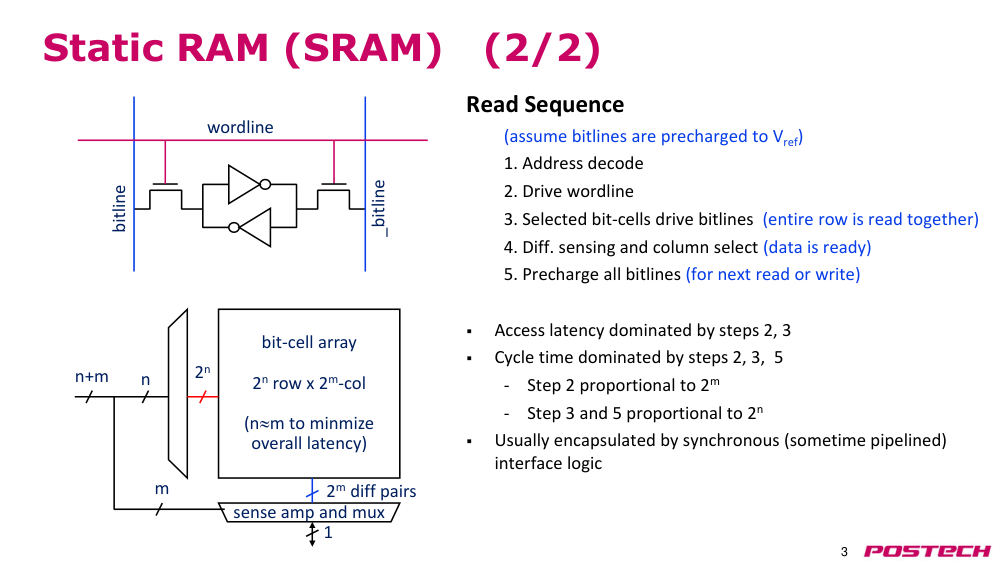
- 비트 셀 어레이
- 2n 행 × 2m 열
- (n ≈ m은 전체 지연 시간 최소화를 위해)
- sense amplifier(센스 증폭기) 및 멀티플렉서
- 2m 차동 쌍
- 2n
- n
- m
- 1
- wordline(월라인)
- bitline(비트라인)
- bitline(비트라인)
- n+m
- 읽기 순서
- (비트라인이 Vref로 precharge(프리차지)된 것으로 가정)
- 1. address decode(주소 디코딩)
- 2. wordline(월라인) 드라이브
- 3. 선택된 비트 셀이 bitline(비트라인)을 드라이브 (전체 행이 동시에 읽힘)
- 4. 차동 감지 및 컬럼 선택 (데이터 준비 완료)
- 5. 모든 bitline(비트라인) 프리차지 (다음 읽기 또는 쓰기용)
- • access latency(접근 지연 시간)은 단계 2, 3에 의해 주로 결정됨
- • cycle time(사이클 시간)은 단계 2, 3, 5에 의해 주로 결정됨
- • 단계 2는 2m에 비례함
- • 단계 3 및 5는 2n에 비례함
- • 일반적으로 동기식 (때로 파이프라인화된) 인터페이스 논리로 캡슐화됨
p.4동적 랜덤 액세스 메모리 (DRAM)
- SRAM보다 높은 밀도
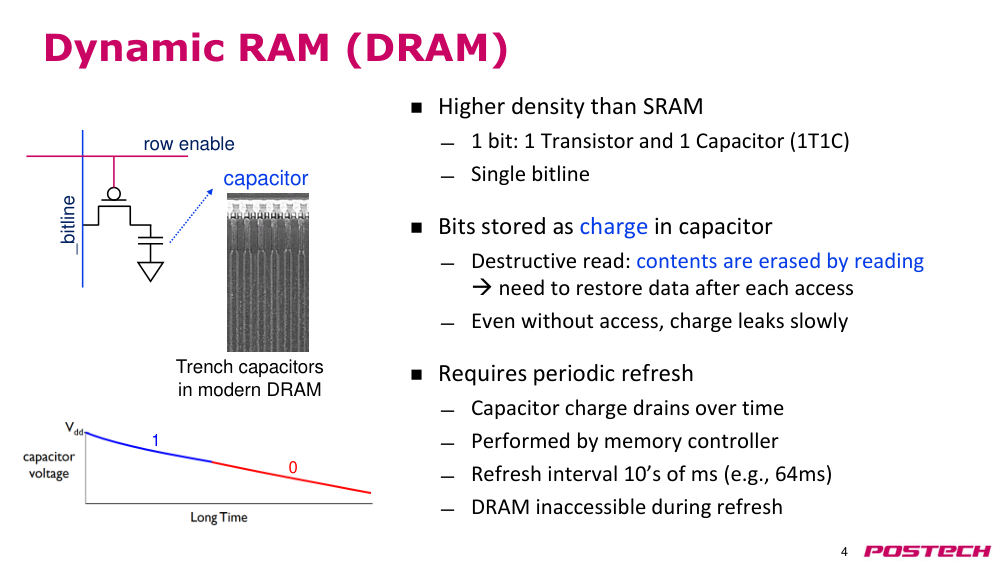
- 1 비트: 1 트랜지스터 + 1 커패시터 (1T1C)
- 단일 bitline(비트라인)
- 비트는 커패시터에 저장된 전하로 표현됨
- destructive read(파괴적 읽기): 읽기 시 내용이 소멸됨
- → 각 액세스 후 데이터 복원 필요
- 접근 없이도 전하가 천천히 누출됨
- 주기적인 리프레시 필요
- 커패시터 전하가 시간이 지남에 따라 소멸됨
- 메모리 컨트롤러가 수행함
- refresh interval(리프레시 간격): 수십 ms (예: 64ms)
- 리프레시 중에는 DRAM 접근 불가능
- row enable(로우 인에이블)
- bitline(비트라인)
- trench capacitor(트렌치 커패시터)
- 현대 DRAM에서 사용됨
- 1
- 0
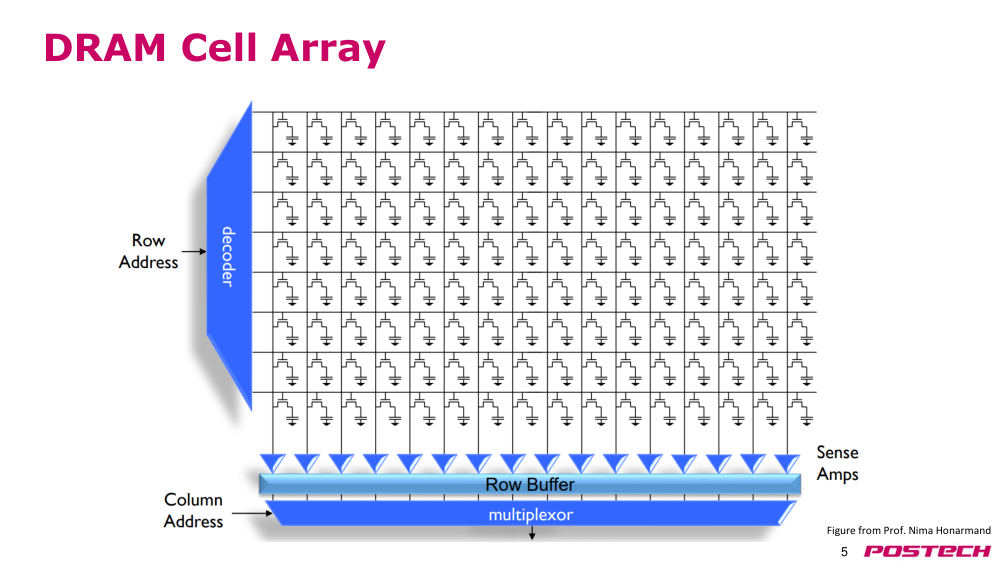
p.5DRAM 셀 어레이
- 프로프. Nima Honarmand의 그림에서 인용
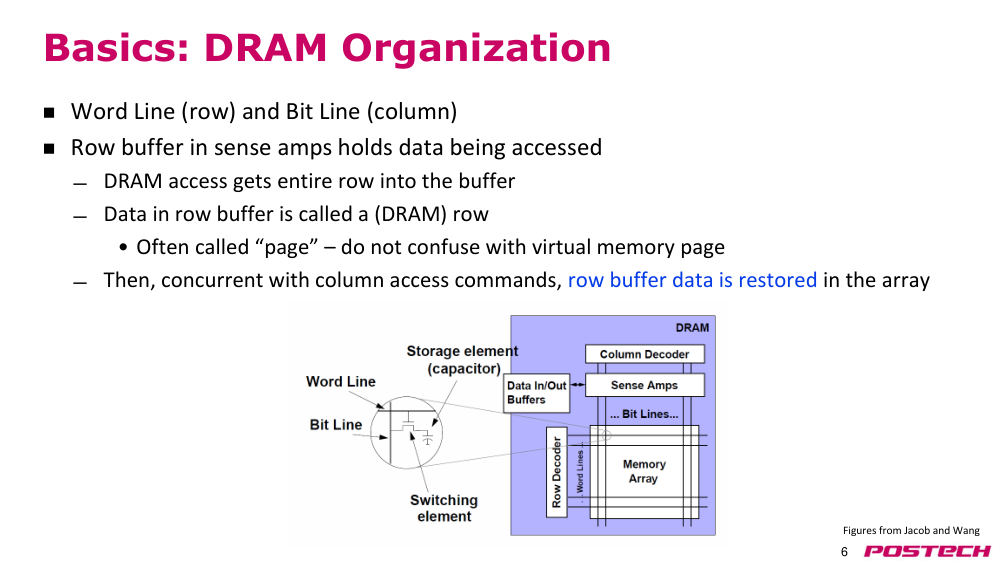
p.6기초: DRAM 구성
- 월라인(행)과 비트라인(열)
- sense amplifier(센스 증폭기) 내 row buffer(로우 버퍼)는 접근 중인 데이터를 보유함
- DRAM 액세스 시 전체 행이 버퍼로 로드됨
- row buffer(로우 버퍼)에 있는 데이터를 (DRAM) 행이라 부름
- 종종 '페이지'라고 불림 – 가상 메모리 페이지와 혼동하지 말 것
- 그 후, column access(컬럼 액세스) 명령과 병렬로 row buffer(로우 버퍼) 데이터가 어레이에 복원됨
- Jacob 및 Wang의 그림에서 인용
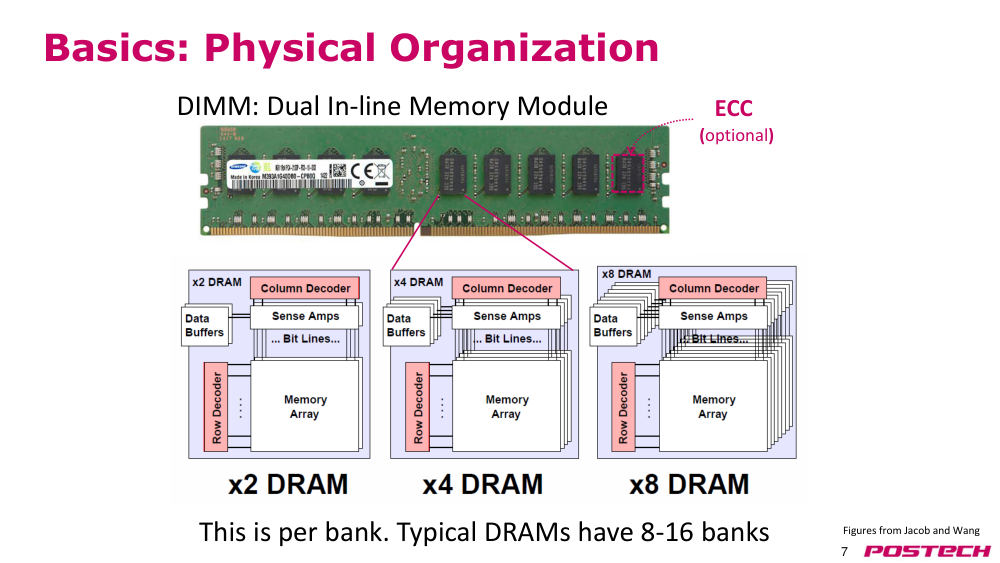
p.7기초: 물리적 구성
- 이것은 bank(뱅크) 단위입니다. 일반적인 DRAM은 8~16개의 뱅크를 가집니다.
- ECC (옵션)
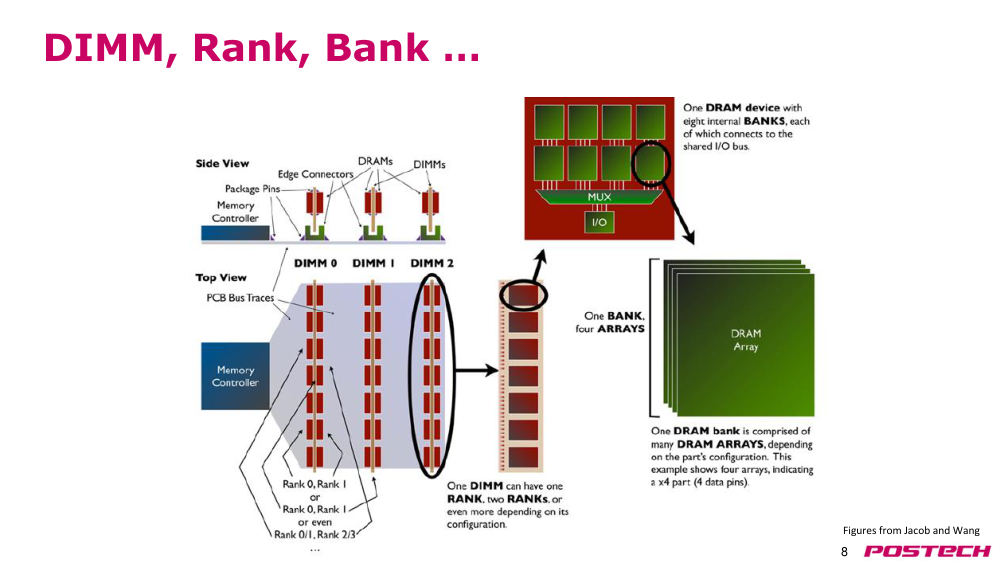
p.8DIMM, rank(랭크), bank(뱅크) …
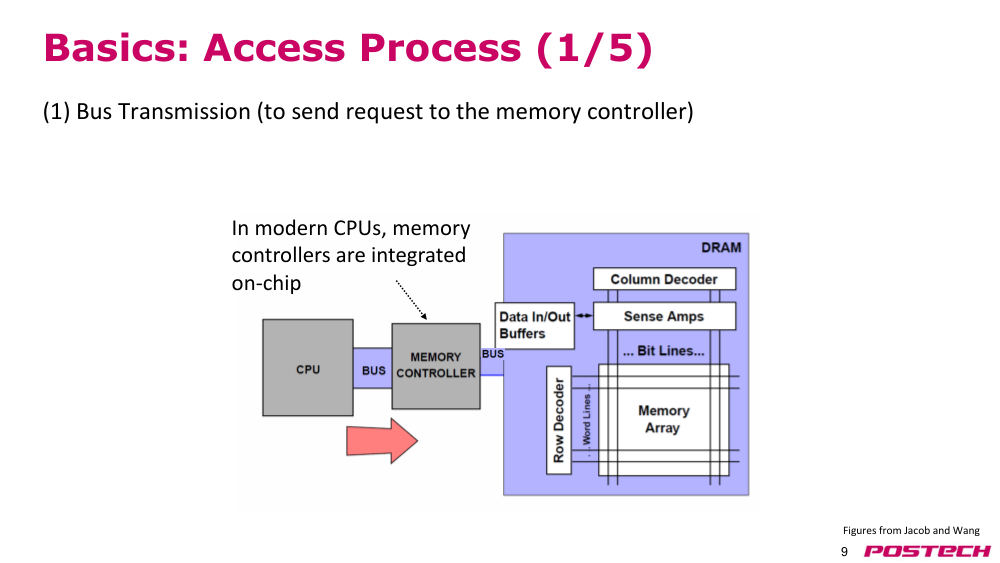
p.9기초: 액세스 프로세스 (1/5)
- (1) 버스 전송 (메모리 컨트롤러에 요청을 전송하기 위해)
- 현대 CPU에서는 메모리 컨트롤러가 온칩에 통합되어 있습니다.
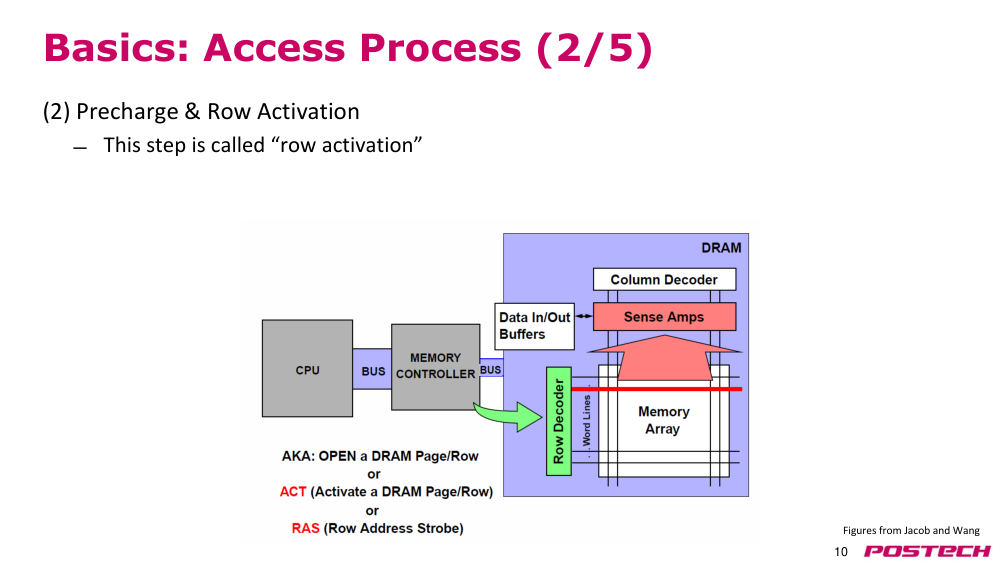
p.10기초: 액세스 프로세스 (2/5)
- (2) precharge(프리차지) 및 row activation(로우 활성화)
- 이 단계는 'row activation(로우 활성화)'라고 불립니다.
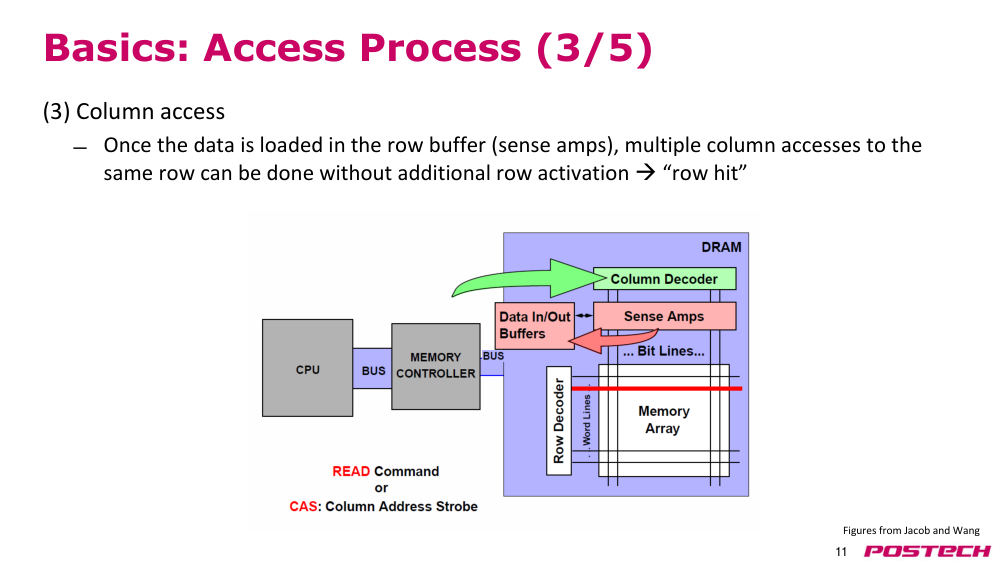
p.11기초: 액세스 프로세스 (3/5)
- (3) column access(컬럼 액세스)
- 데이터가 로우 버퍼(센스 증폭기)에 로드된 후, 동일한 로우에 대한 여러 번의 column access(컬럼 액세스)는 추가적인 row activation(로우 활성화) 없이 수행될 수 있음 → '로우 히트'
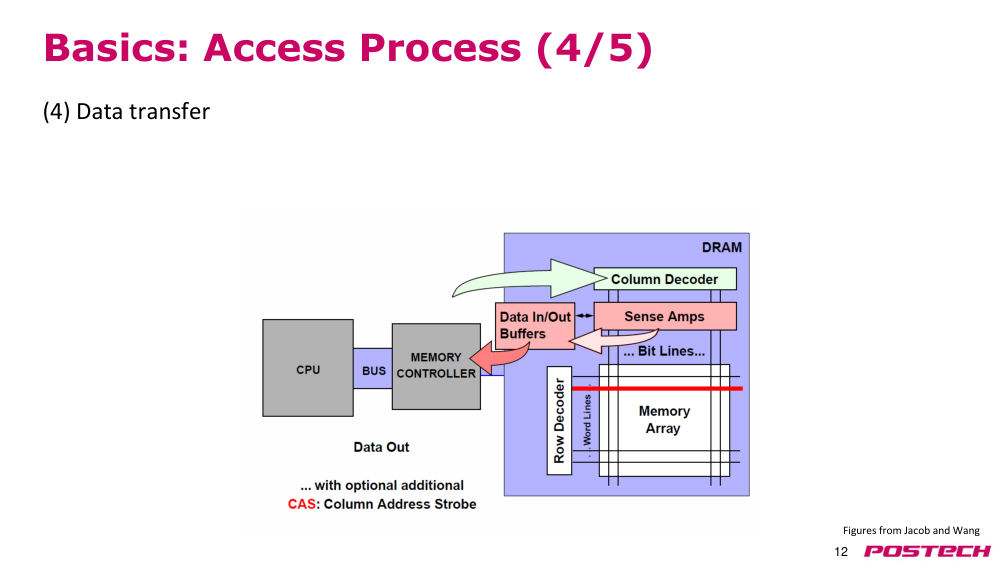
p.12기초: 액세스 프로세스 (4/5)
- (4) data transfer(데이터 전송)
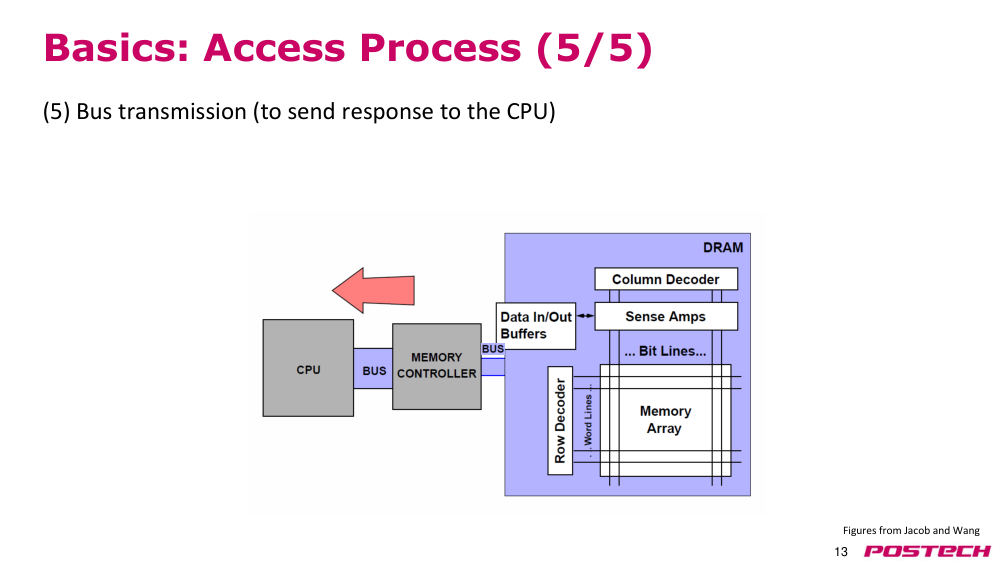
p.13기초: 액세스 프로세스 (5/5)
- (5) 버스 전송 (응답을 CPU로 전송하기 위해)
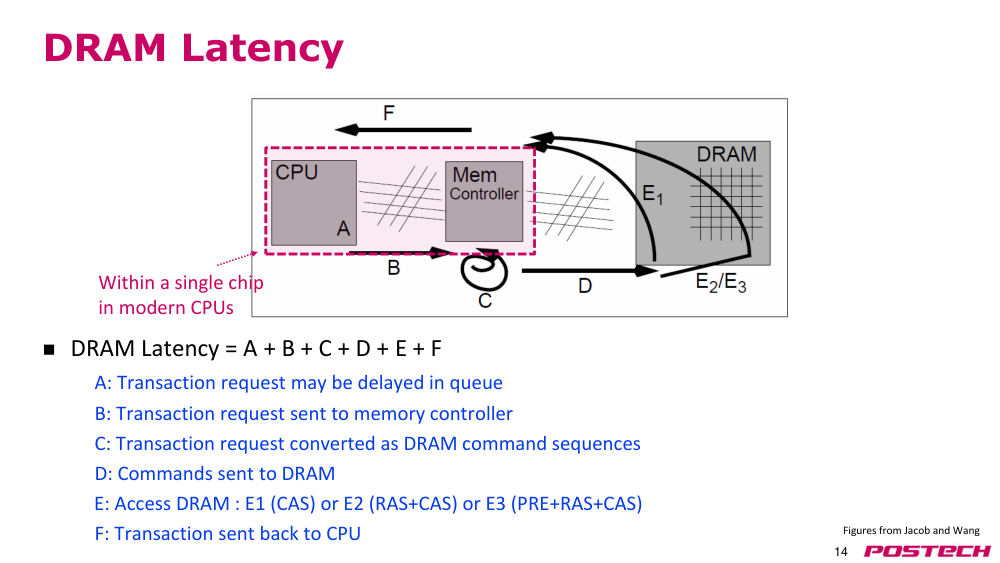
p.14DRAM access latency(접근 지연 시간)
- DRAM access latency(접근 지연 시간) = A + B + C + D + E + F
- A: 트랜잭션 요청이 큐에서 지연될 수 있음
- B: 트랜잭션 요청이 메모리 컨트롤러로 전송됨
- C: 트랜잭션 요청이 DRAM 명령 시퀀스로 변환됨
- D: 명령이 DRAM로 전송됨
- E: DRAM에 액세스: E1 (CAS) 또는 E2 (RAS+CAS) 또는 E3 (PRE+RAS+CAS)
- F: 트랜잭션 응답이 CPU로 전송됨
- 단일 칩 내부
- 현대 CPU에서
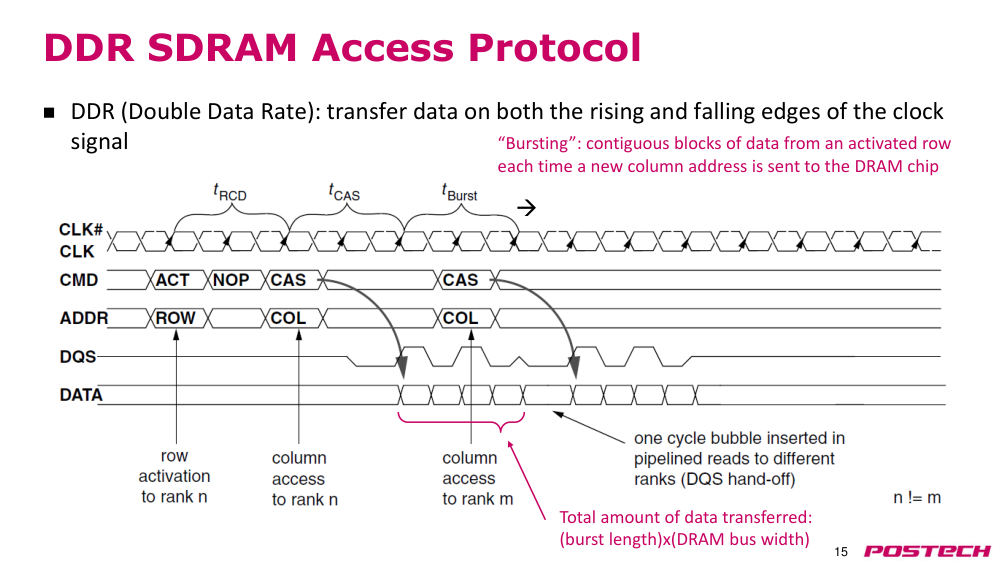
p.15DDR SDRAM 액세스 프로토콜
- DDR (더블 데이터 레이트): 클럭 신호의 오르는 에지와 내림 에지 양쪽에서 data transfer(데이터 전송)
- → 버스트 전송 (Bursting): 활성화된 로우에서 연속적인 데이터 블록
- 각각 새로운 컬럼 주소가 DRAM 칩에 전송될 때마다
- 전송되는 데이터 총량: (버스트 길이) × (DRAM 버스 폭)
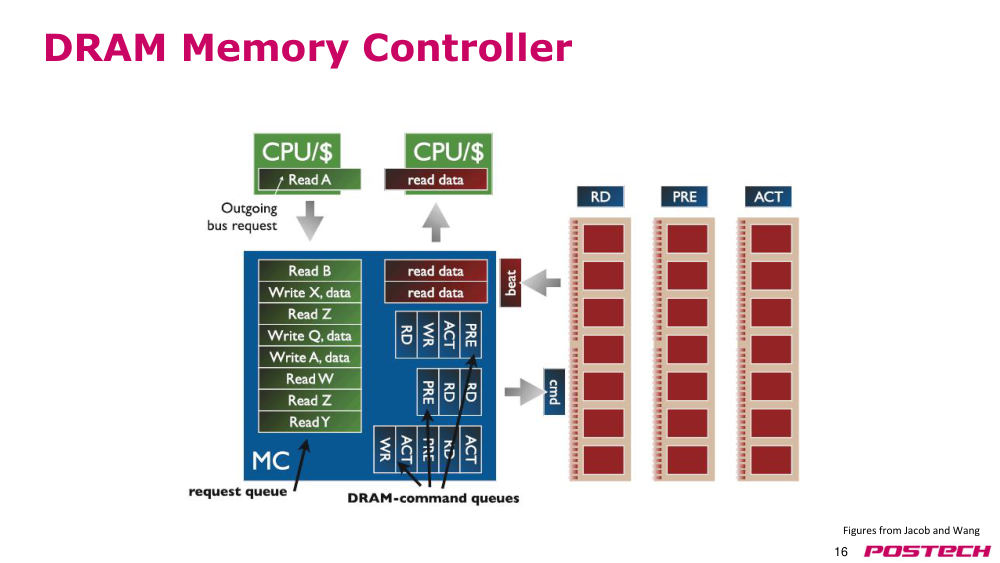
p.16DRAM 메모리 컨트롤러
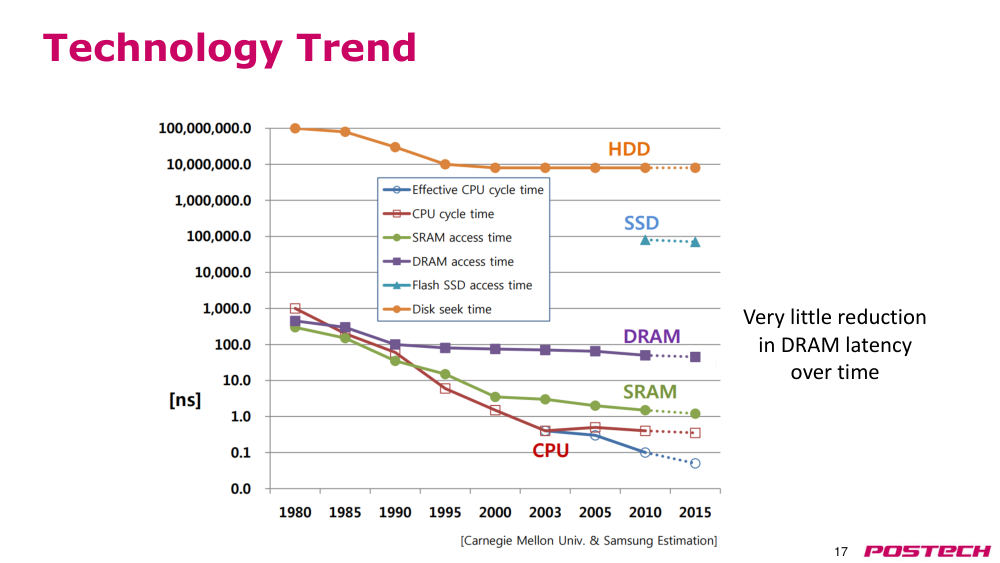
p.17기술 트렌드
- DRAM access latency(접근 지연 시간)의 감소는 매우 미미함
- 시간이 지남에 따라
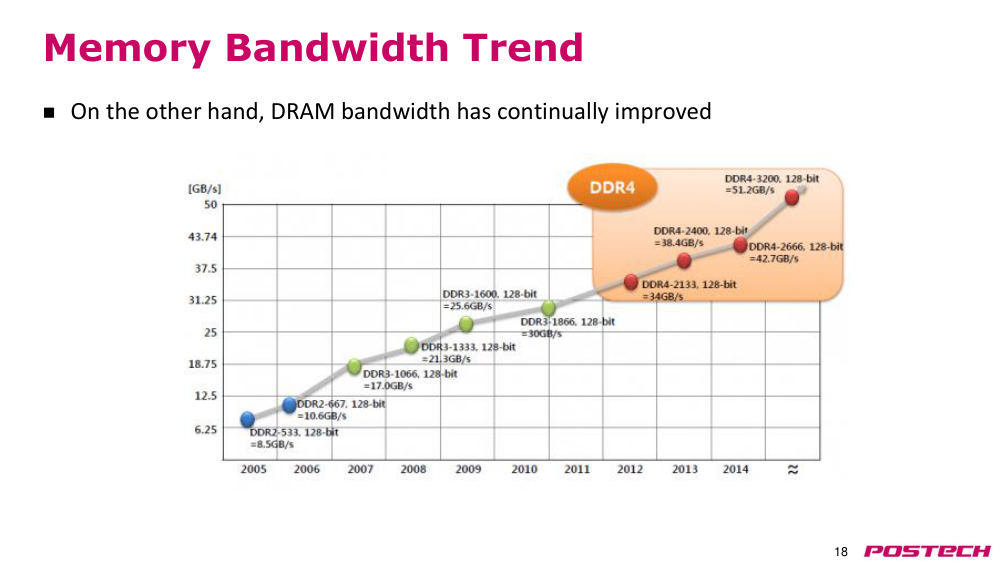
p.18memory bandwidth(메모리 대역폭) 트렌드
- 반면, DRAM 대역폭은 지속적으로 향상됨
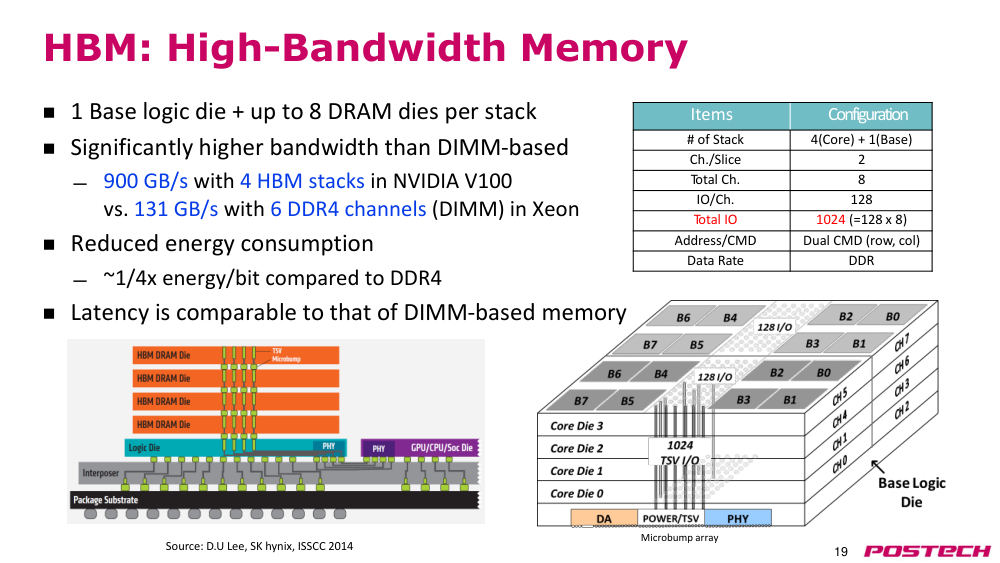
p.19HBM: 고대역폭 메모리
- base logic die(베이스 로직 다이) 1개 + 스택당 최대 8개의 DRAM 다이
- DIMM 기반 메모리보다 훨씬 높은 대역폭
- NVIDIA V100에서 4개의 HBM 스택 사용 시 900 GB/s vs. Xeon에서 6개의 DDR4 채널(DIMM) 사용 시 131 GB/s
- 에너지 소비 감소
- ~DDR4 대비 1/4x 에너지/비트
- access latency(접근 지연 시간)은 DIMM 기반 메모리와 유사
- 출처: D.U. Lee, SK 하이닉스, ISSCC 2014
- 항목
- 구성
- # of Stack
- 4(Core) + 1(Base)
- Ch./Slice
- 2
- Total Ch.
- 8
- IO/Ch.
- 128
- Total IO
- 1024 (=128 x 8)
- Address/CMD
- Dual CMD (row, col)
- Data Rate
- DDR
- microbump array(마이크로범프 배열)
p.20지속 중이거나 미래의 혁신
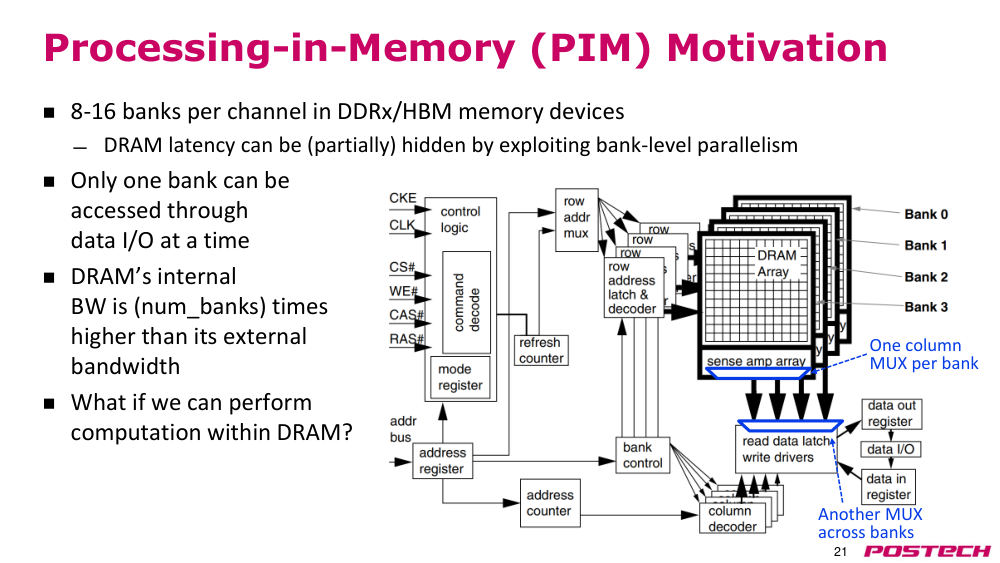
p.21메모리 내 처리(PIM)의 동기
- DDRx/HBM 메모리 장치에서 채널당 8-16개의 bank(뱅크)
- bank-level parallelism(뱅크 수준 병렬성)을 활용하여 DRAM의 지연 시간을 (부분적으로) 숨길 수 있음
- 단, 데이터 I/O를 통해 동시에 접근할 수 있는 bank(뱅크)는 하나뿐임
- DRAM의 internal bandwidth(내부 대역폭)은 external bandwidth(외부 대역폭)의 (num_banks)배에 달함
- 만약 DRAM 내부에서 계산을 수행할 수 있다면?
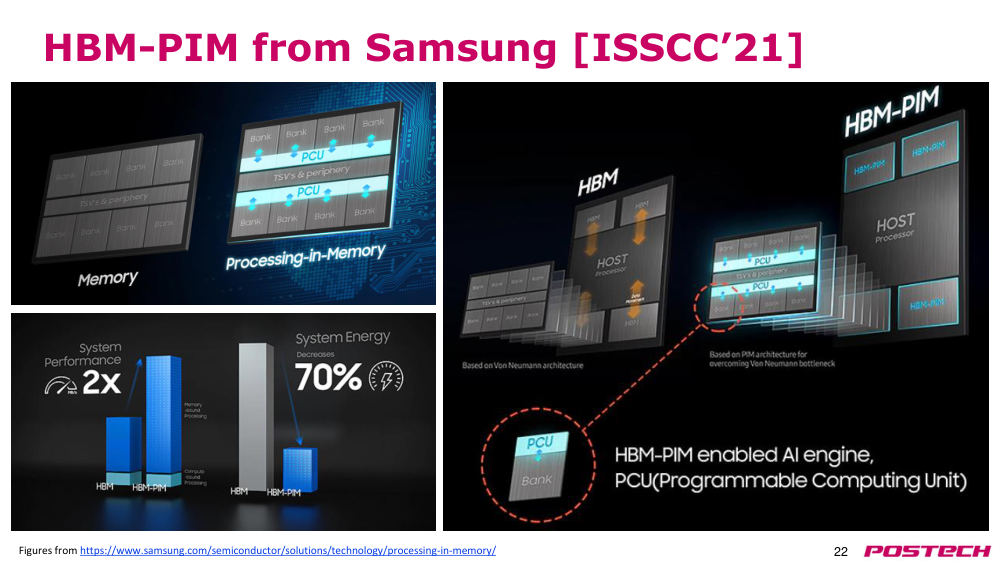
p.22삼성의 HBM-PIM [ISSCC’21]
- 이미지 출처: https://www.samsung.com/semiconductor/solutions/technology/processing-in-memory/
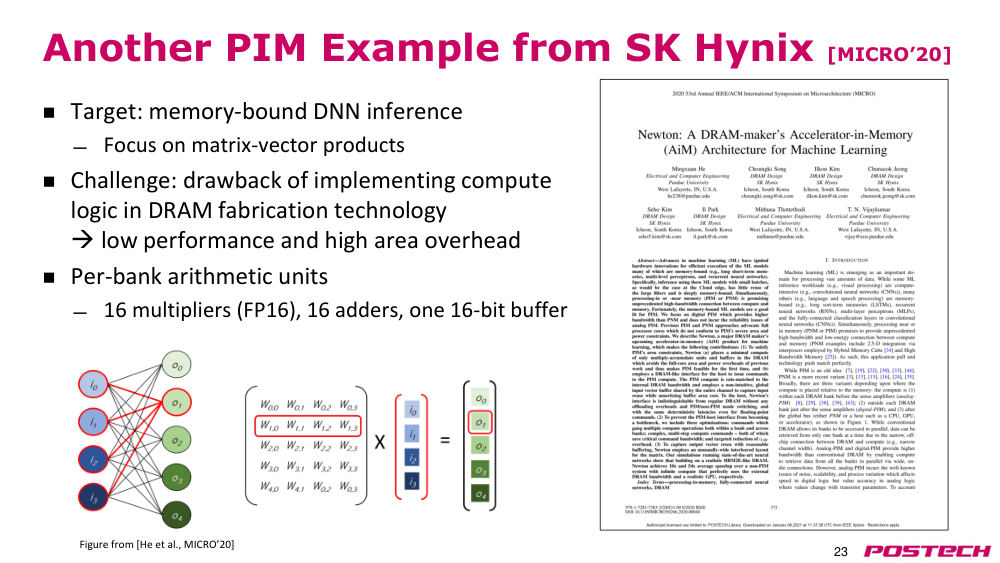
p.23SK 하이닉스의 또 다른 PIM 예시 [MICRO’20]
- 목표: memory-bound workload(메모리 제약 워크로드)인 DNN 추론
- matrix-vector product(행렬-벡터 곱)에 초점
- 도전 과제: DRAM 제조 기술에 계산 논리를 구현할 경우의 단점
- → 낮은 성능 및 높은 면적 오버헤드
- bank(뱅크)별 산술 단위
- 16개의 곱셈기(FP16), 16개의 가산기, 16비트 버퍼 1개
- 이미지 출처: [He et al., MICRO’20]
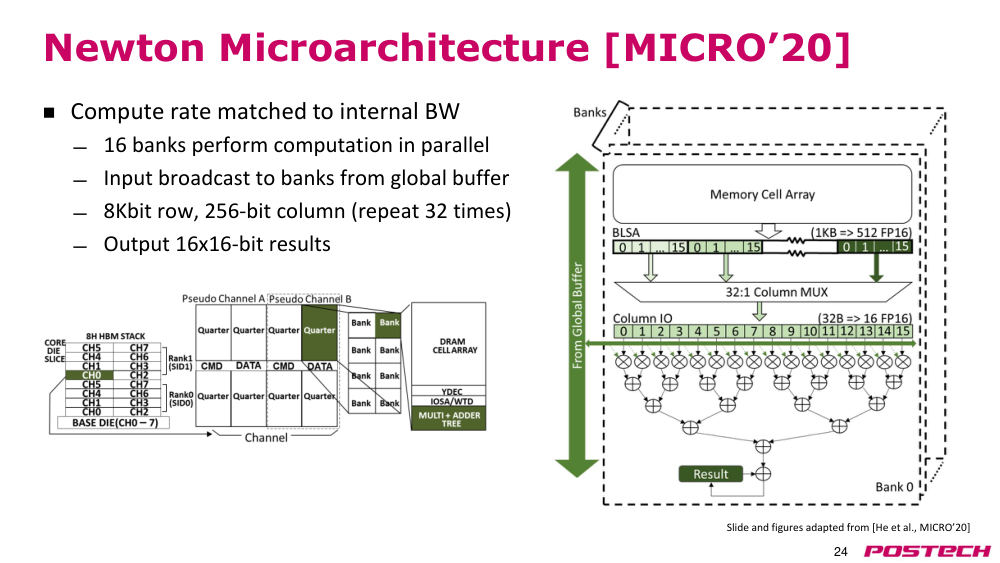
p.24뉴턴 마이크로아키텍처 [MICRO’20]
- compute rate(계산 속도)를 internal bandwidth(내부 대역폭)에 맞춤
- 16개의 bank(뱅크)가 병렬로 계산 수행
- 입력은 global buffer(글로벌 버퍼)에서 bank(뱅크)로 브로드캐스트
- 8K비트 로우, 256비트 컬럼 (32회 반복)
- 출력: 16x16비트 결과
- 슬라이드 및 그림은 [He et al., MICRO’20]에서 수정
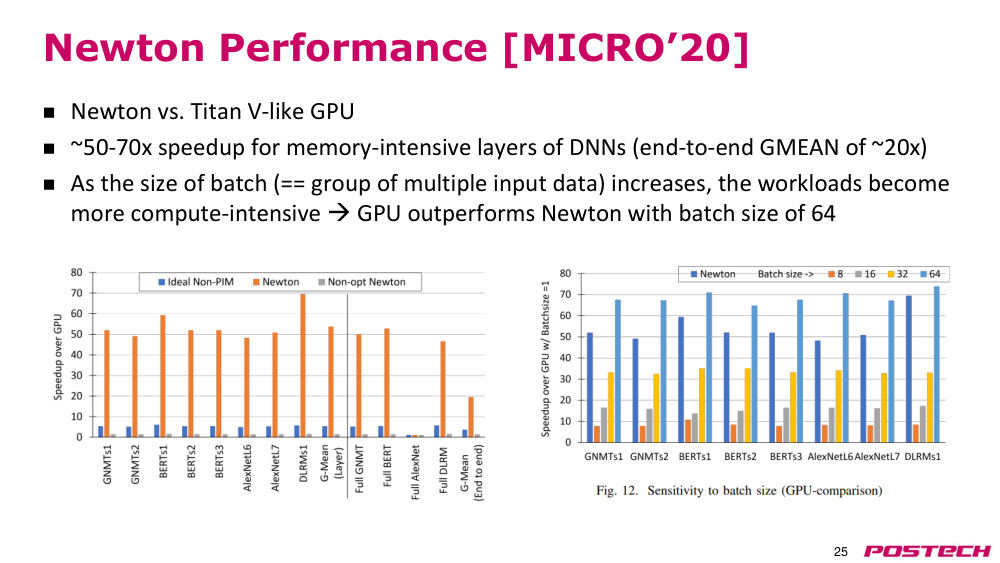
p.25뉴턴 성능 [MICRO’20]
- 뉴턴 vs. 타이탄 V 유사 GPU
- ~50-70배의 속도 향상 (DNN의 메모리 집약적 레이어에서, end-to-end GMEAN(종단 간 GMEAN) ~20배)
- 배치 크기(==여러 입력 데이터의 그룹)가 증가할수록 워크로드가 더 계산 집약적으로 변함 → 배치 크기 64에서 GPU가 뉴턴을 능가함
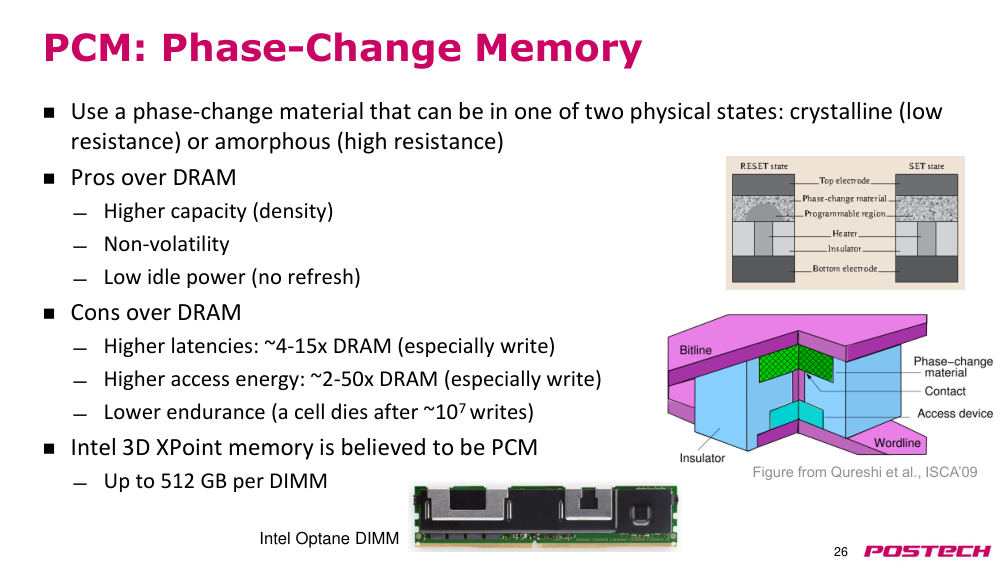
p.26PCM: 상변화 메모리
- 결정 상태(저저항) 또는 비정질 상태(고저항) 중 하나의 물리적 상태를 가질 수 있는 상변화 물질 사용
- DRAM 대비 장점:
- - 더 높은 용량(밀도)
- - 비휘발성
- - 리프레시가 필요 없음 → 저대기 전력
- DRAM 대비 단점:
- - 더 높은 지연 시간: ~4-15배 DRAM (특히 쓰기 시)
- - 더 높은 액세스 에너지: ~2-50배 DRAM (특히 쓰기 시)
- - 낮은 내구성 (셀은 약 10⁷회 쓰기 후 고장)
- Intel 3D XPoint 메모리는 PCM으로 여겨짐
- DIMM당 최대 512 GB
- Intel Optane DIMM
- 그림 출처: Qureshi 등, ISCA’09
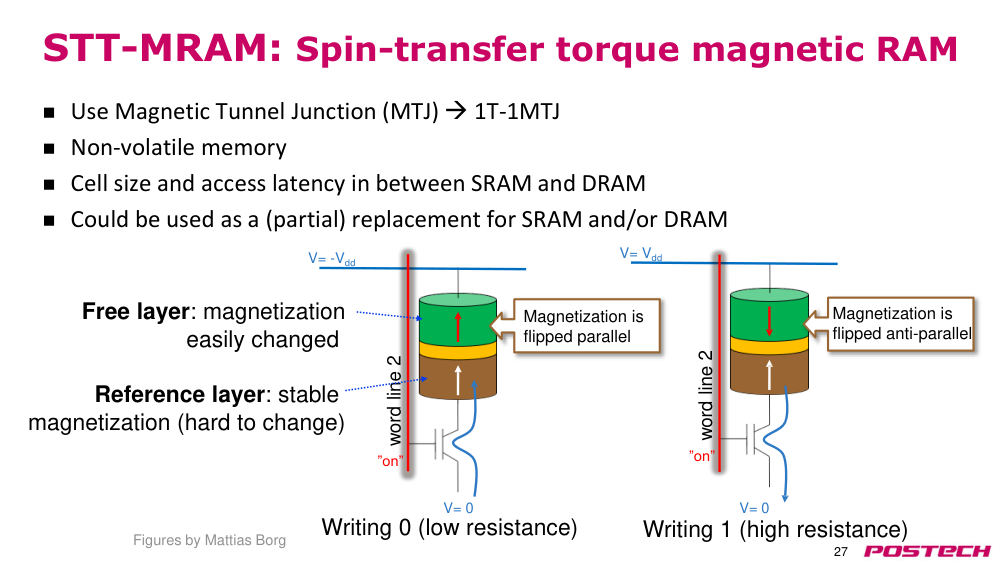
p.27STT-MRAM: spin-transfer torque magnetic RAM(스핀 전달 토크 자기 RAM)
- 자기 터널 접합(MTJ) 사용 → 1T-1MTJ
- non-volatile memory(비휘발성 메모리)
- 셀 크기 및 액세스 지연 시간은 SRAM과 DRAM 사이
- SRAM 및/또는 DRAM의 (부분적) 대체로 사용 가능
- wordline(월라인) 2: "on" → V = Vdd, V = 0 → 자화 방향이 평행으로 전환
- 자유층: 자화가 쉽게 변경됨
- 참고층: 안정된 자화(변경하기 어려움)
- wordline(월라인) 2: "on" → V = -Vdd, V = 0 → 자화 방향이 반평행으로 전환
- 0 쓰기 (저저항)
- 1 쓰기 (고저항)
- 그림 출처: Mattias Borg
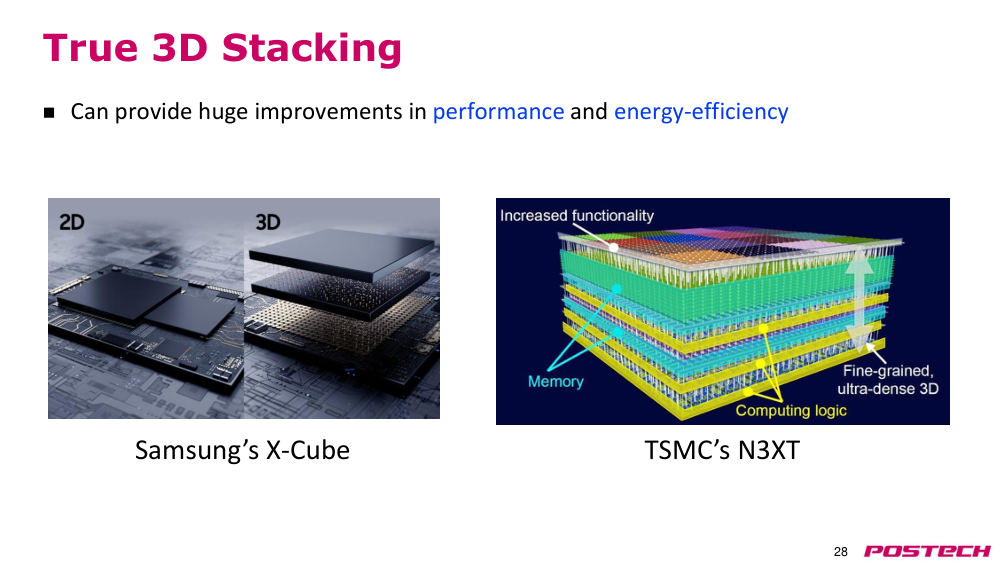
p.28true 3D stacking(진정한 3차원 적층)
- 매우 큰 성능 및 energy efficiency(에너지 효율성) 향상 가능
- 삼성의 X-Cube
- TSMC의 N3XT
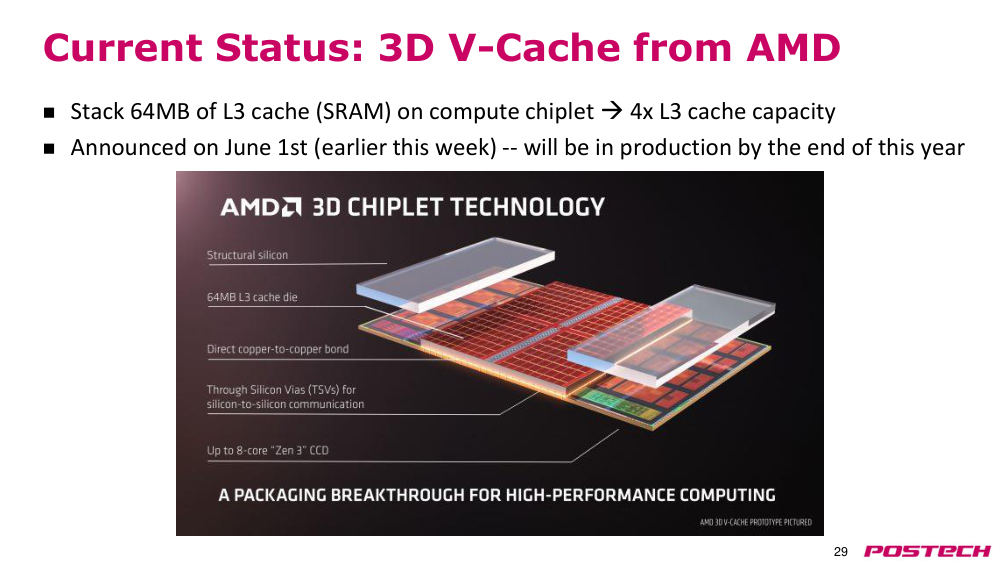
p.29현재 상태: AMD의 3D V-Cache(3차원 V-캐시)
- compute chiplet(컴퓨트 칩렛) 위에 64MB의 L3 캐시(SRAM) 적층 → L3 캐시 용량 4배 증가
- 6월 1일 발표 (이번 주 초) → 올해 말까지 생산 예정
p.30질문?