이 자료를 쓰는 강의: 60 CUDA 예제·warp divergence 와 domain-specific accelerator(DNN·systolic array·TPU) · 61 TPU 성능(roofline)·TPUv2/v3 와 메모리 장치(SRAM·DRAM·DDR)
Lec22-Domain-specific accelerator (updated)
한국어판 강의자료 · 57쪽
p.1Domain-Specific accelerator(도메인 특화 가속기)
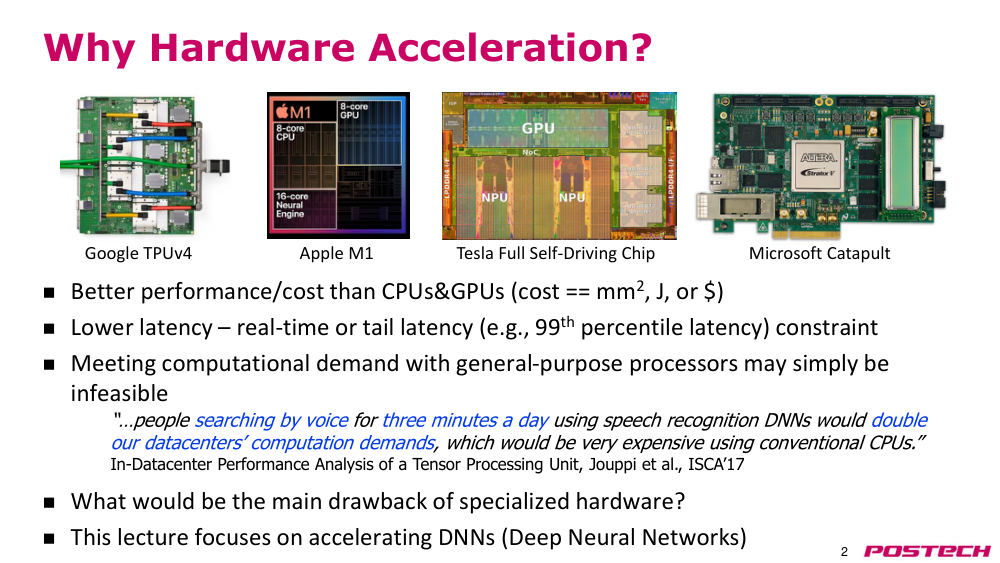
p.2hardware acceleration(하드웨어 가속)의 이유
- CPU 및 GPU보다 더 나은 성능/비용 (비용 == mm², J, 또는 $)
- 낮은 지연 시간 – 실시간 또는 꼬리 지연 시간(예: 99번째 백분위 지연 시간) 제약
- 일반 목적 프로세서로 computational demand(계산 요구량)을 충족하는 것은 단순히 불가능할 수 있음
- 전용 하드웨어의 주요 단점은 무엇인가?
- 이 강의는 심층 신경망(DNN) 가속에 초점을 맞춘다
- Apple A12X
- Tesla Full Self-Driving Chip
- Microsoft Catapult
- ‘사람들이 음성 인식 DNN을 사용해 하루에 3분 동안 검색할 경우, 데이터센터의 computational demand(계산 요구량)이 두 배로 증가할 것이며, 이는 기존 CPU로는 매우 비쌀 것이다.’
- Tensor 처리 유닛의 데이터센터 내 성능 분석, Jouppi 등, ISCA’17
- Google TPUv4
- Apple M1
p.3deep neural network (DNN)(심층 신경망) 소개
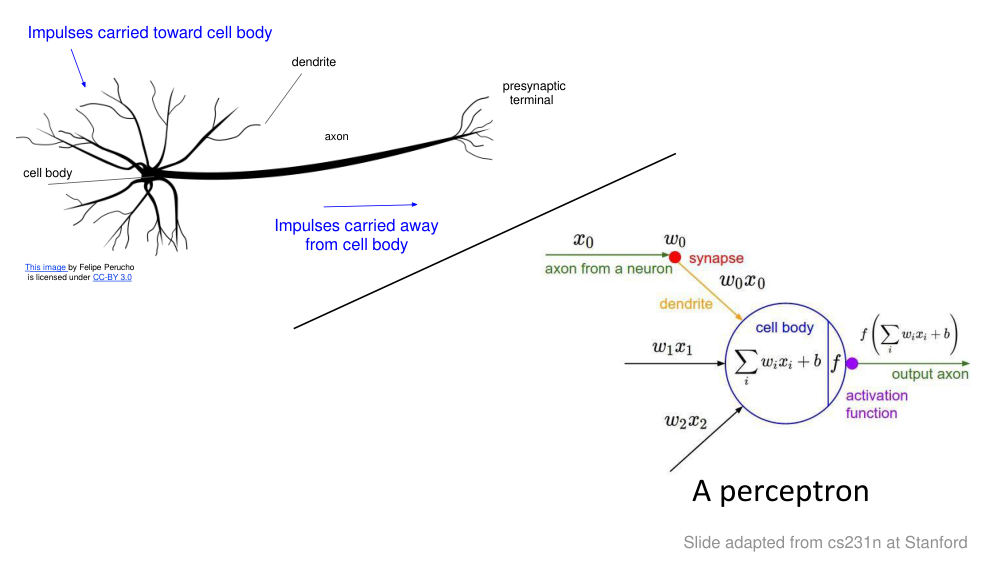
p.4perceptron(퍼셉트론)
- 세포체에서 멀어지는 자극
- 이 이미지는 Felipe Perucho가 제공함
- 세포체로 향하는 자극
- 수상
- presynaptic terminal(시냅스전 종말)
- 축삭
- 세포체
- T
- CC-BY 3.0 라이선스
- Stanford의 cs231n에서 수정됨
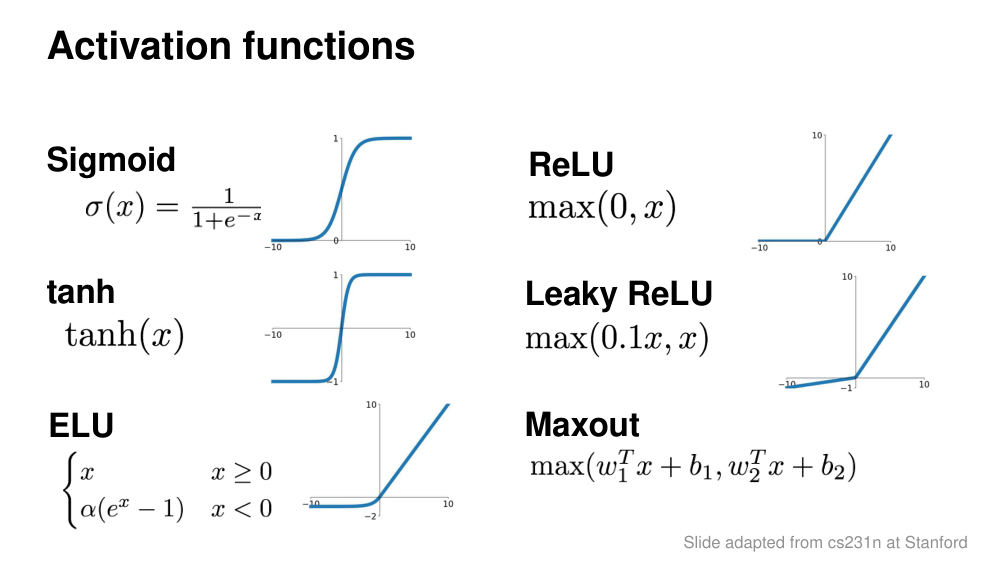
p.5activation function(활성화 함수)
- sigmoid(시그모이드)
- tanh(하이퍼볼릭 탄젠트)
- ReLU(렐루)
- leaky ReLU(리키 렐루)
- maxout(맥스아웃)
- ELU(엘루)
- Slide adapted from cs231n at Stanford
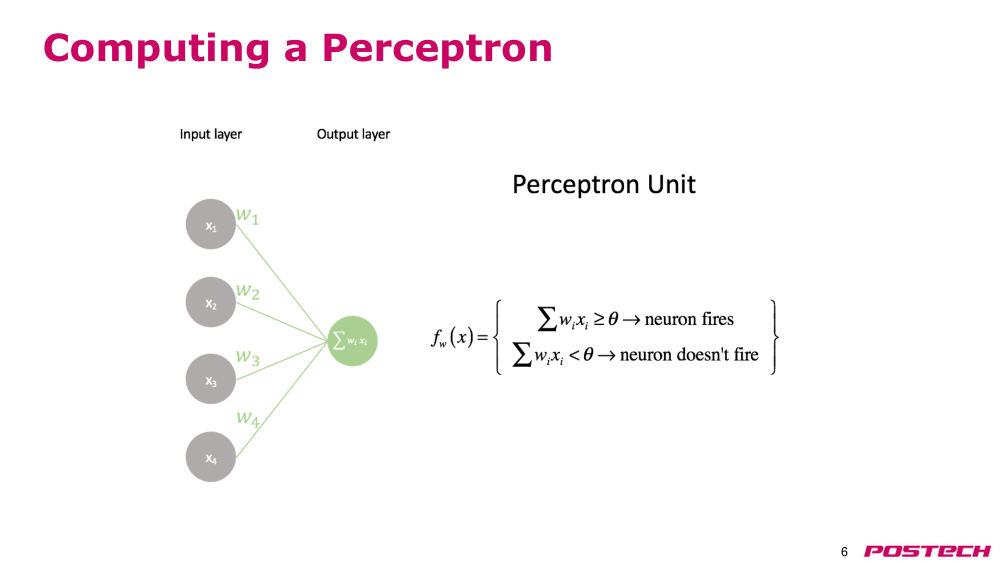
p.6perceptron(퍼셉트론) 계산
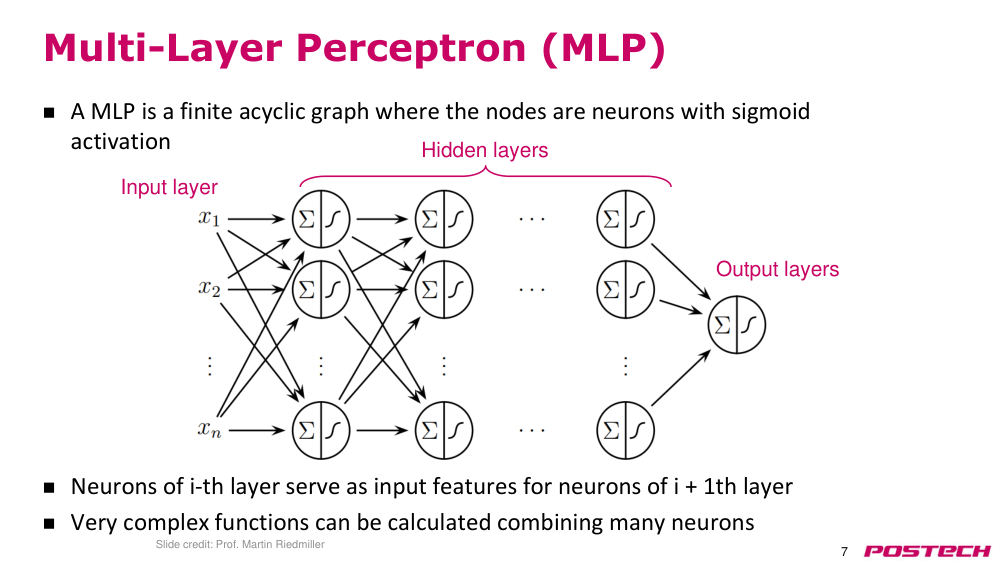
p.7다층 퍼셉트론 (MLP)
- - MLP는 노드가 sigmoid(시그모이드) activation function(활성화 함수)를 가진 신경망인 유한한 비순환 그래프이다.
- - i번째 층의 neuron(뉴런)은 i+1번째 층의 neuron(뉴런)에 입력 특징으로 사용된다.
- - 많은 신경망을 결합함으로써 매우 복잡한 함수를 계산할 수 있다.
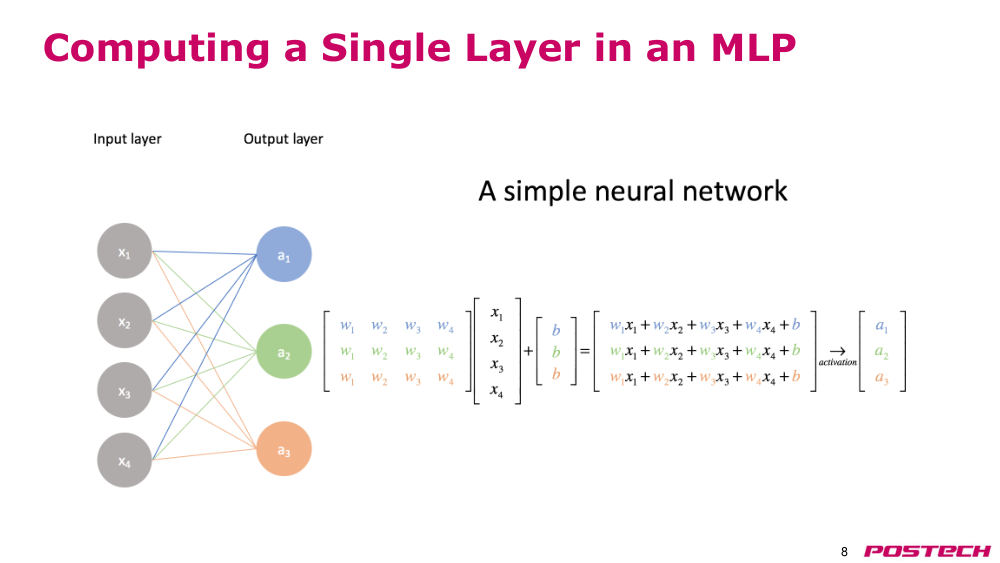
p.8MLP에서 단일 층 계산
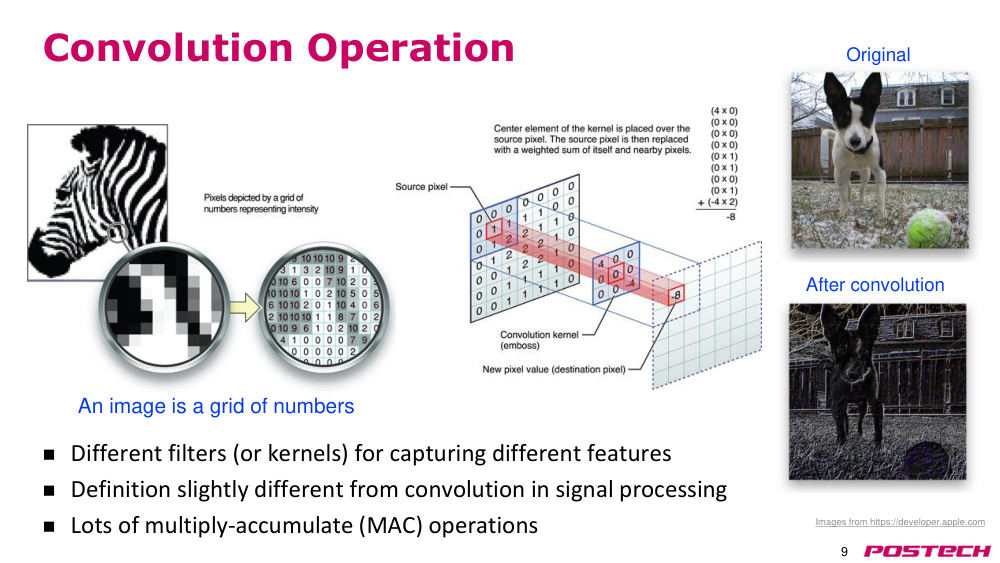
p.9convolution operation(컨볼루션 연산)
- - 다양한 특징을 포착하기 위해 서로 다른 필터(또는 커널) 사용
- - 신호 처리에서의 컨볼루션과 정의가 약간 다름
- - 많은 곱셈-누산(MAC) 연산 수행
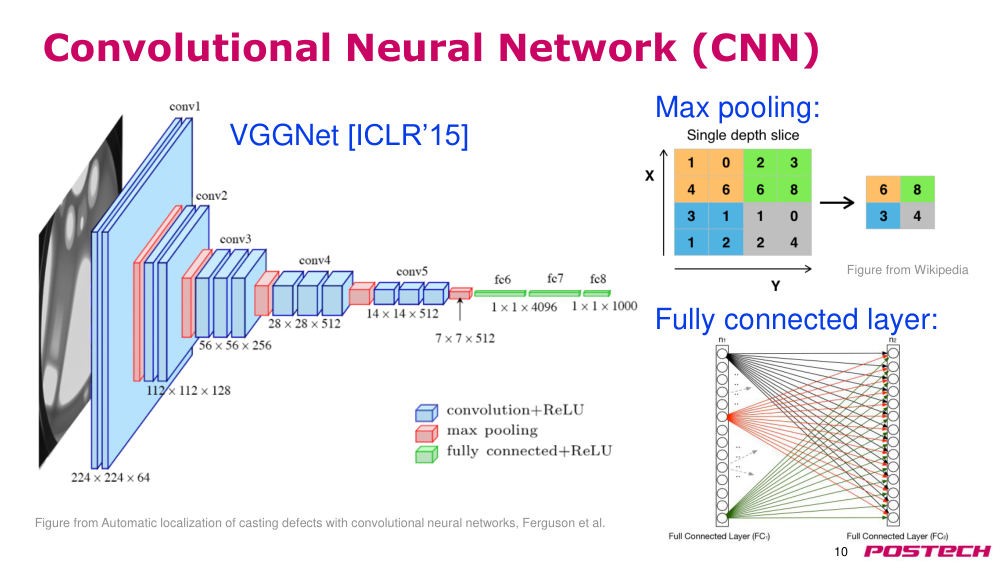
p.10컨볼루션 신경망 (CNN)
- - max pooling(맥스 풀링):
- - fully connected layer(완전 연결층):
- - VGGNet(VGG넷) [ICLR’15]
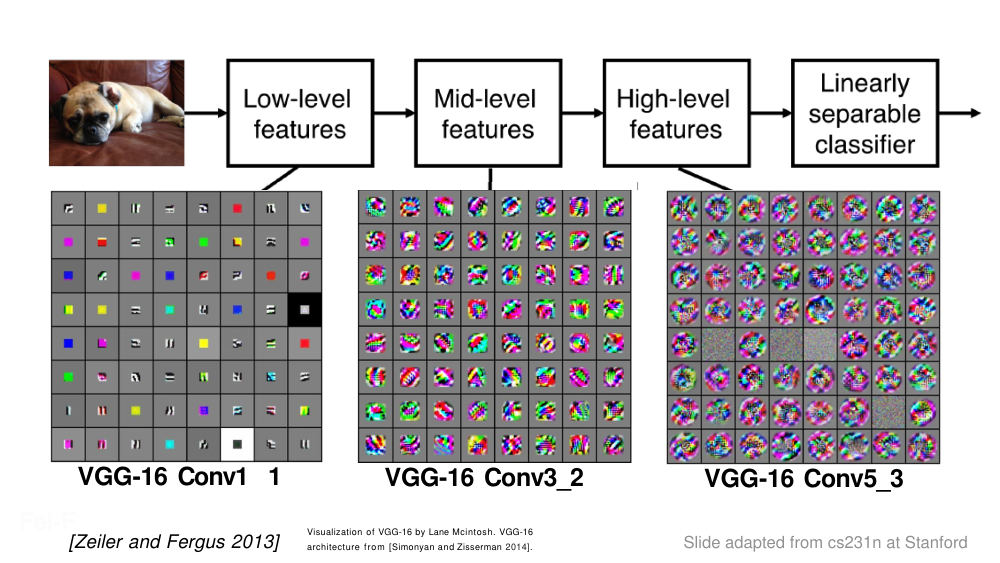
p.11Lane Mcintosh가 시각화한 VGG-16
- - VGG-16 아키텍처는 [Simonyan and Zisserman 2014]에서 가져옴.
- - [Zeiler and Fergus 2013]
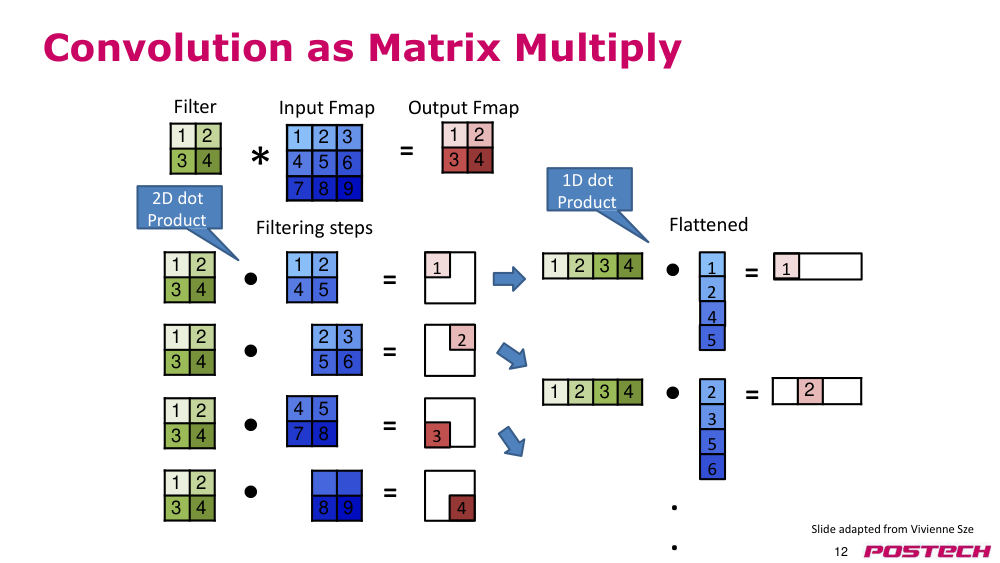
p.12컨볼루션을 matrix multiply(행렬 곱셈)으로
- - filter(필터)
- - 입력 특징 맵
- - 출력 특징 맵
- - *
- - =
- - ●
- - =
- - 2
- - ●
- - =
- - 3
- - 4
- - 3
- - 5
- - 6
- - .
- - .
- - ●
- - =
- - 1
- - filtering(필터링) 단계
- - 2D 내적
- - 1
- - 2
- - 4
- - 5
- - ●
- - =
- - 1
- - 평탄화된 1D 내적
- - 1 2
- - 4 5
- - 2 3
- - 5 6
- - 1 2
- - 3 4
- - 4 5
- - 7 8
- - 1 2
- - 3 4
- - 8 9
- - 1 2 3 4
- - 2
- - 1 2
- - 3 4
- - 1 2
- - 3 4
- - 1 2
- - 3 4
- - 1 2
- - 3 4
- - ●
- - =
- - 2
- - 1
- - 2 3
- - 4
- - 5 6
- - 7 8 9
- - ●
- - 1 2 3 4
- - =
- - 슬라이드는 Vivienne Sze의 자료에서 수정됨
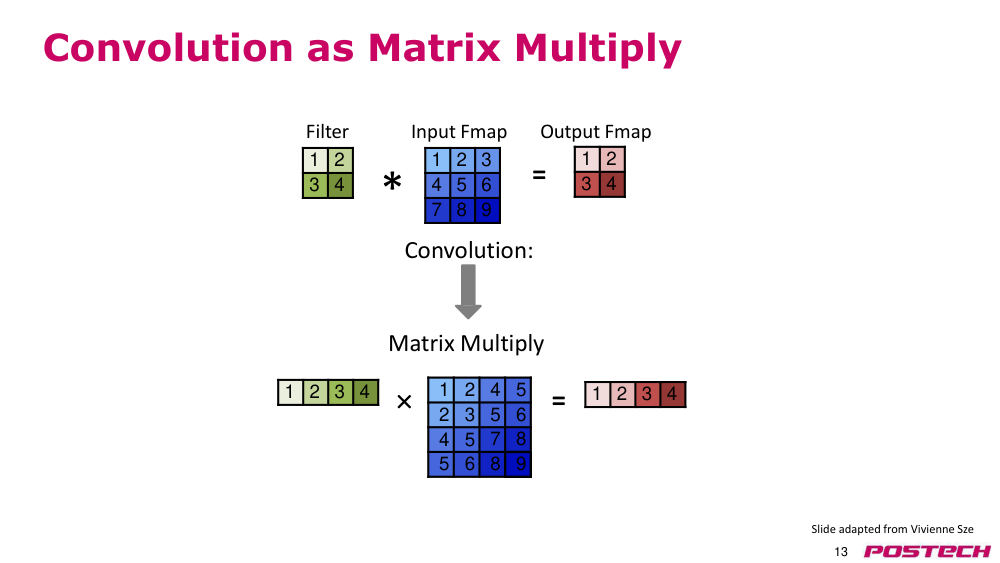
p.13컨볼루션을 matrix multiply(행렬 곱셈)으로
- filter(필터)
- 입력 특성 맵
- 출력 특성 맵
- *
- =
- 1 2 3
- 4 5 6
- 7 8 9
- 1 2
- 3 4
- 1 2
- 3 4
- 1 2 3 4
- 1 2 3 4
- 1
- 2
- 4
- 5
- 2
- 3
- 5
- 6
- 4
- 5
- 7
- 8
- 5
- 6
- 8
- 9
- 컨볼루션:
- matrix multiply(행렬 곱셈)
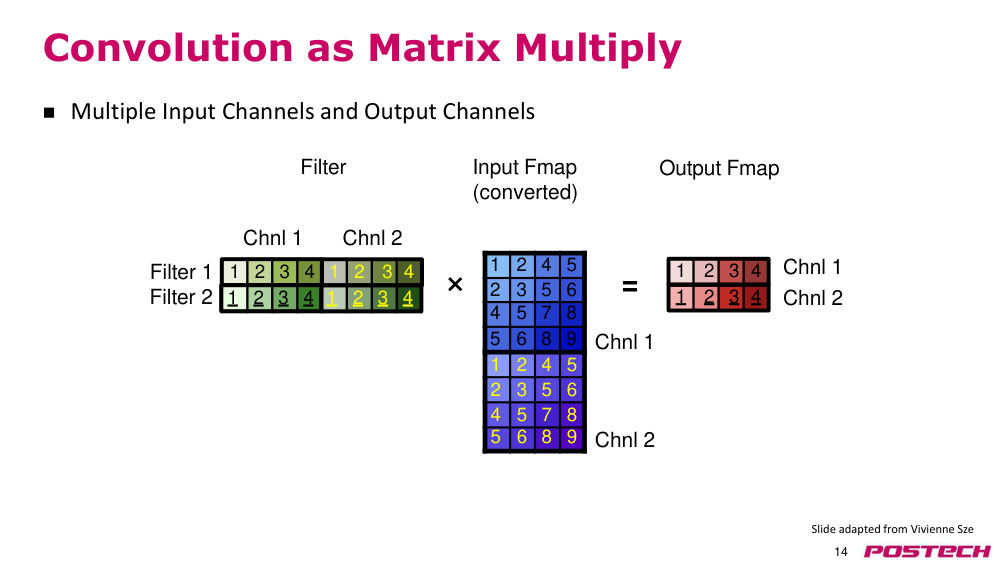
p.14여러 입력 채널과 출력 채널
- 컨볼루션을 matrix multiply(행렬 곱셈)으로
- =
- 채널 1
- 채널 2
- filter(필터) 1
- filter(필터) 2
- 채널 1
- 채널 2
- 채널 1
- 채널 2
- 입력 특성 맵
- 출력 특성 맵
- (변환된)
- filter(필터)
- 1 2 4 5
- 2 3 5 6
- 4 5 7 8
- 5 6 8 9
- 1 2 4 5
- 2 3 5 6
- 4 5 7 8
- 5 6 8 9
- 1 2 3 4
- 1 2 3 4
- 1 2 3 4 1 2
- 3 4
- 1 2 3 4 1
- 2 3 4
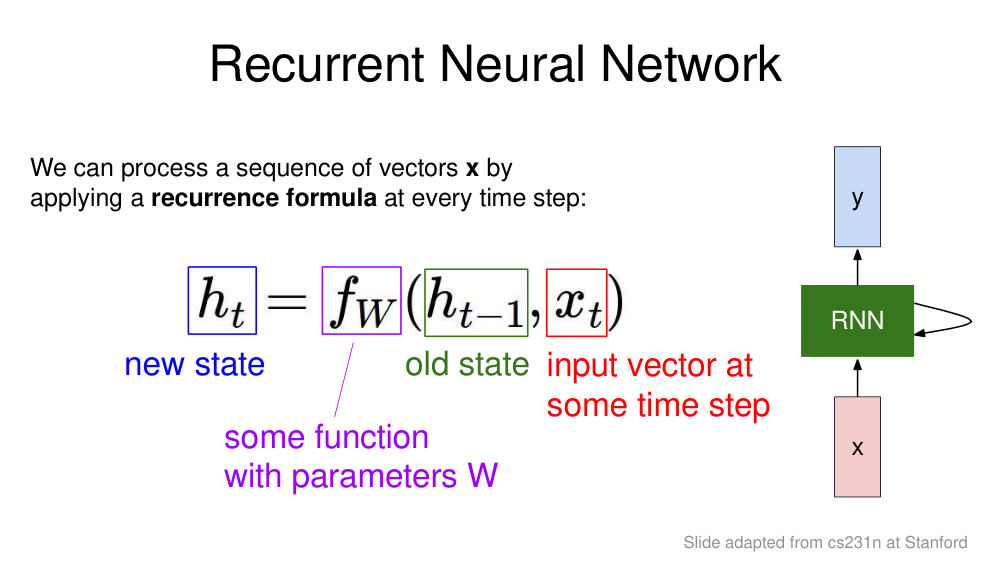
p.15순환 신경망
- 벡터 시퀀스 x를 처리할 수 있음
- 각 시간 단계에서 재귀 공식을 적용함:
- 새로운 상태
- 이전 상태
- 일정 시간 단계의 입력 벡터
- 매개변수 W를 가진 함수
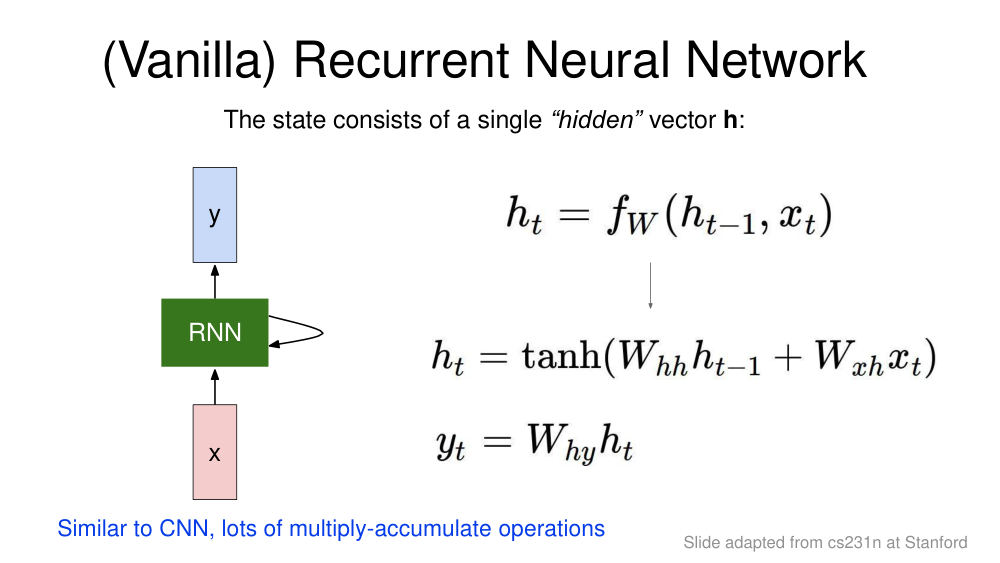
p.16(보통의) 순환 신경망
- 상태는 단일 '은닉' 벡터 h로 구성됨
- CNN과 유사하게, 많은 Multiply-Accumulate (MAC)(곱셈-누산 연산) 수행
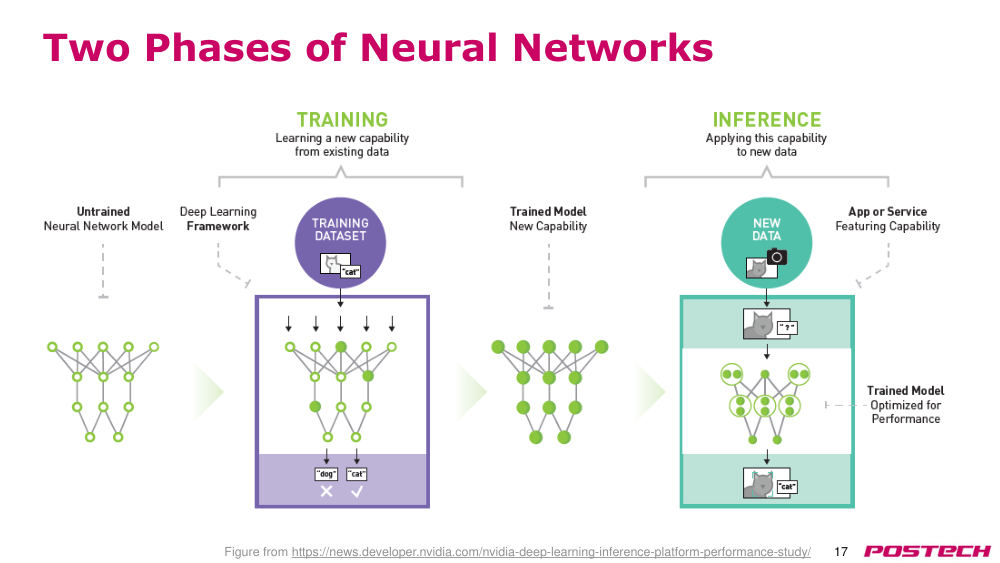
p.17신경망의 두 단계
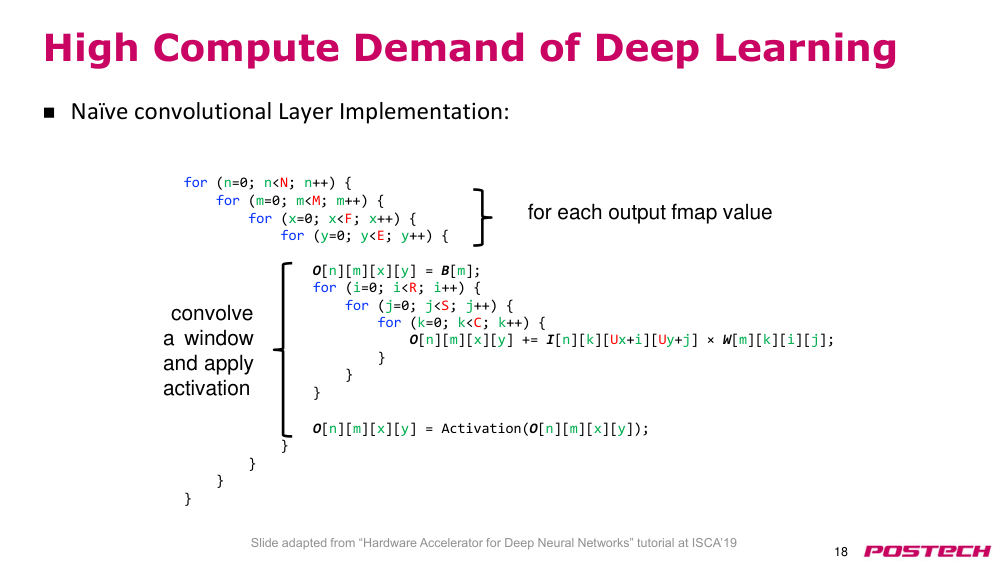
p.18심층 학습의 높은 computational demand(계산 요구량)
- 비효율적인 컨볼루션 계층 구현:
- for (n=0; n<N; n++) {
- for (m=0; m<M; m++) {
- for (x=0; x<F; x++) {
- for (y=0; y<E; y++) {
- O[n][m][x][y] = B[m];
- for (i=0; i<R; i++) {
- for (j=0; j<S; j++) {
- for (k=0; k<C; k++) {
- O[n][m][x][y] += I[n][k][Ux+i][Uy+j] × W[m][k][i][j];
- }
- }
- }
- O[n][m][x][y] = Activation(O[n][m][x][y]);
- }
- }
- }
- }
- 각 출력 특성 맵 값에 대해
- 윈도우를 컨볼루션하고
- activation(활성화)을 적용함
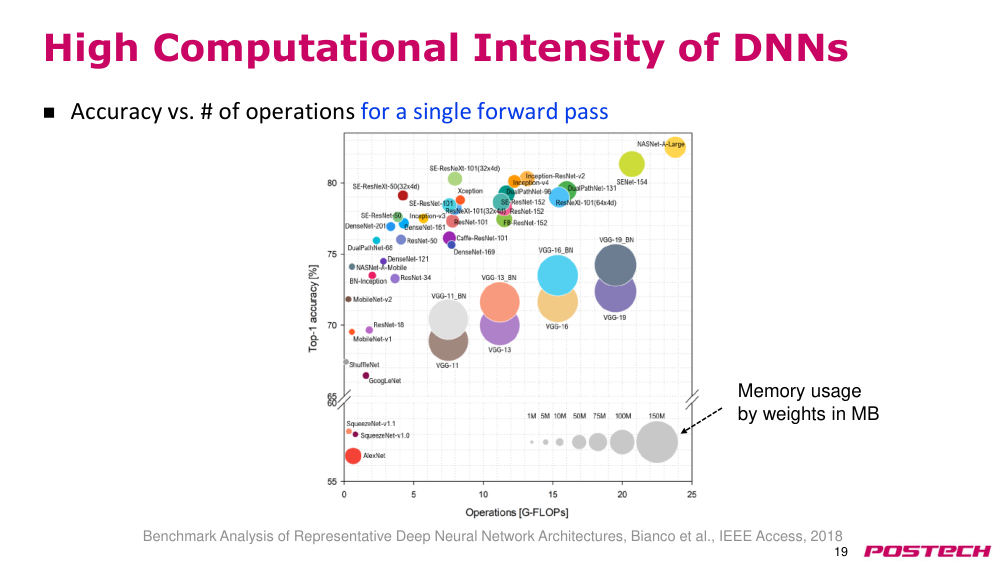
p.19deep neural network (DNN)(심층 신경망)의 높은 계산 밀도
- 한 번의 전방 전파에 대한 정확도 대 연산 수
- 대표적인 deep neural network (DNN)(심층 신경망) 아키텍처의 벤치마크 분석, Bianco 등, IEEE Access, 2018
- 가중치에 의한 메모리 사용량 (MB)
p.20hardware accelerator(하드웨어 가속기)
p.21systolic array(시스톨릭 어레이)
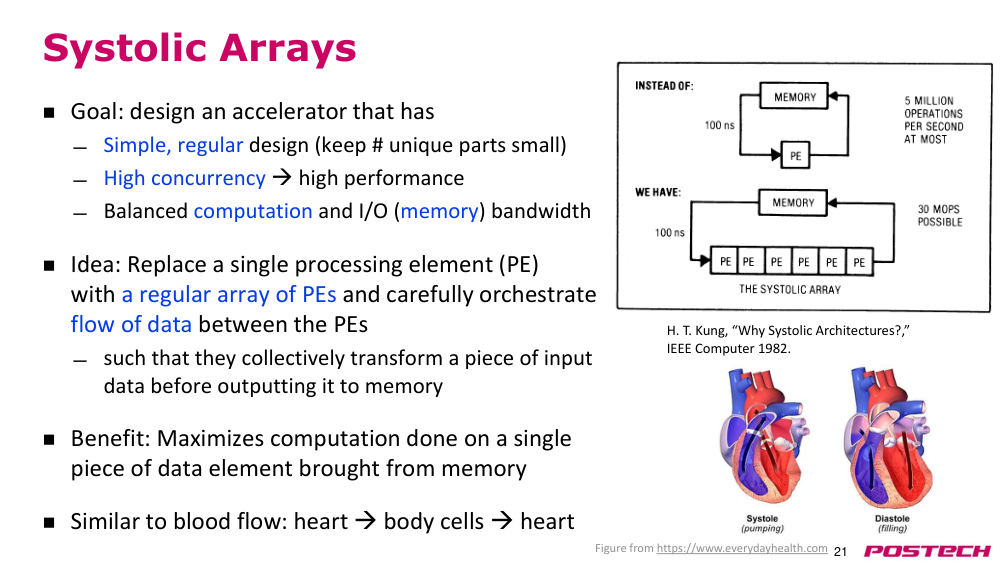
- 목표: 다음을 갖춘 가속기를 설계하기
- 간단하고 정규화된 설계 (고유한 부품 수를 작게 유지)
- high concurrency(고병렬성) → 높은 성능
- 계산과 I/O(메모리) 대역폭의 균형
- 아이디어: 단일 processing element(처리 요소, PE) 대신 정규적인 PE 배열을 사용하고, PE 간의 data flow(데이터 흐름)을 정교하게 조율하여
- 입력 데이터 조각을 수집하여 메모리로 출력하기 전에 공동으로 변환
- 장점: 메모리에서 한 번 가져온 데이터 요소에 대해 수행되는 계산을 최대화
- 혈액 순환과 유사: 심장 → 신체 세포 → 심장
- H. T. Kung, “Why Systolic Architectures?,” IEEE Computer 1982.
- 그림 출처: https://www.everydayhealth.com
p.22systolic array(시스톨릭 어레이)
- 장점
- memory bandwidth(메모리 대역폭)의 더 나은 활용
- high concurrency(고병렬성)
- 정규화된 설계 (데이터 흐름 및 control flow(제어 흐름) 모두)
- 단점
- irregular parallelism(비정규 병렬성)의 활용이 좋지 않음
- 특화됨 → 일반적으로 적용되지 않음 (계산이 PE의 기능/구조에 맞아야 함)
- 참고:
- pipelining(파이프라이닝)과 다름: 비선형 어레이 구조, 다방향 data flow(데이터 흐름), 각 PE는 (작은) 로컬 명령어 및 데이터 메모리를 가질 수 있음
- SIMD와 다름: 각 PE가 서로 다른 작업을 수행할 수 있음
p.23systolic array(시스톨릭 어레이)를 통한 matrix multiply(행렬 곱셈) 가속
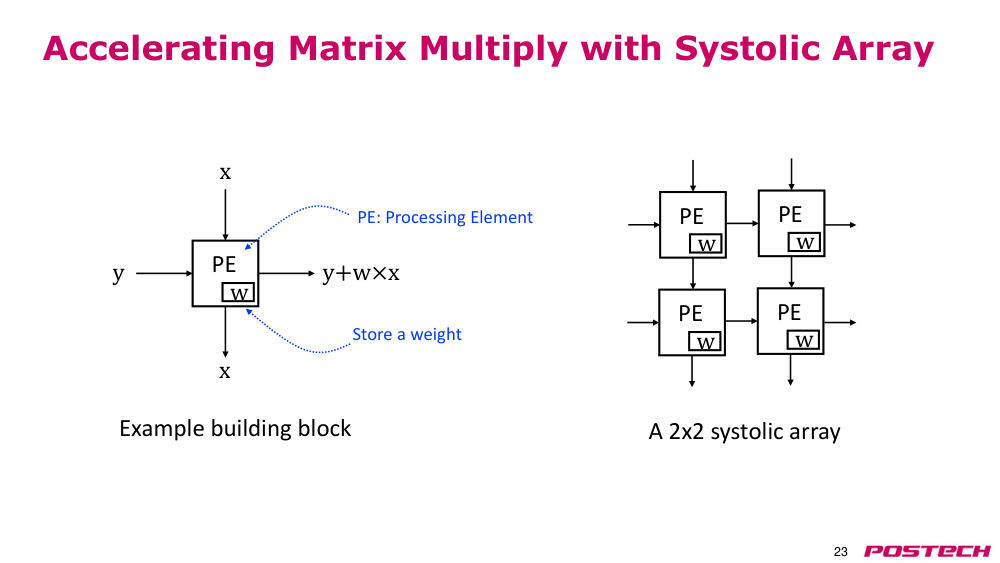
- 가중치 저장
- y + w × x
- w
- PE
- y
- PE: processing element(처리 요소)
- w
- PE
- w
- PE
- w
- PE
- w
- PE
- 예시 빌딩 블록
- 2x2 systolic array(시스톨릭 어레이)
p.24systolic array(시스톨릭 어레이) 예제
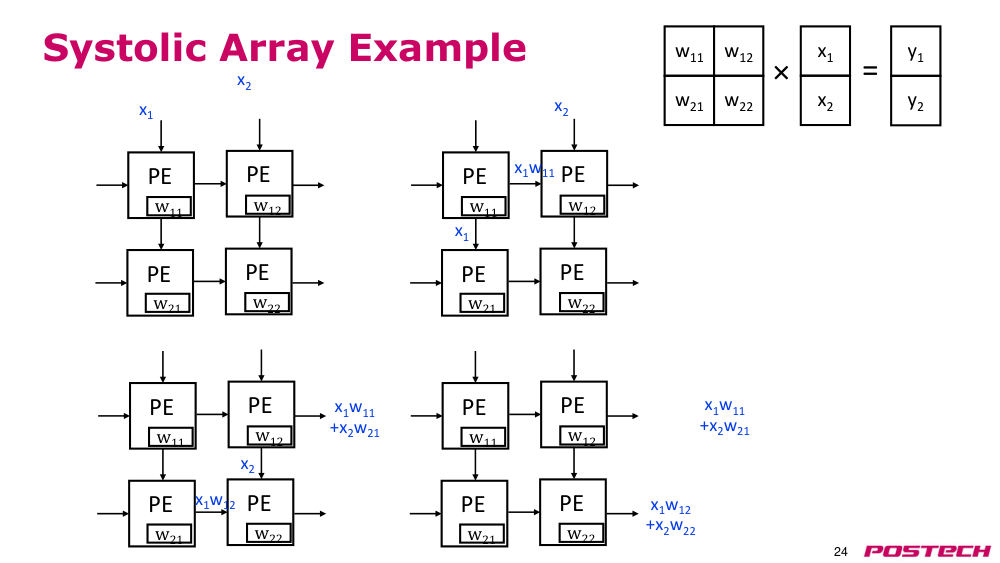
- x1
- x2
- w11
- w21
- w12
- w22
- y1
- y2
- ×
- =
- w11
- PE
- PE
- PE
- PE
- w21
- w12
- w22
- x1
- x2
- w11
- PE
- PE
- PE
- PE
- w21
- w12
- w22
- x2
- x1
- x1w11
- x1w11
- +x2w21
- w11
- PE
- PE
- PE
- PE
- w21
- w12
- w22
- x2
- x1w12
- x1w11
- +x2w21
- w11
- PE
- PE
- PE
- PE
- w21
- w12
- w22
- x1w12
- +x2w22
p.25도메인 특화 가속기(DSA)를 위한 지침
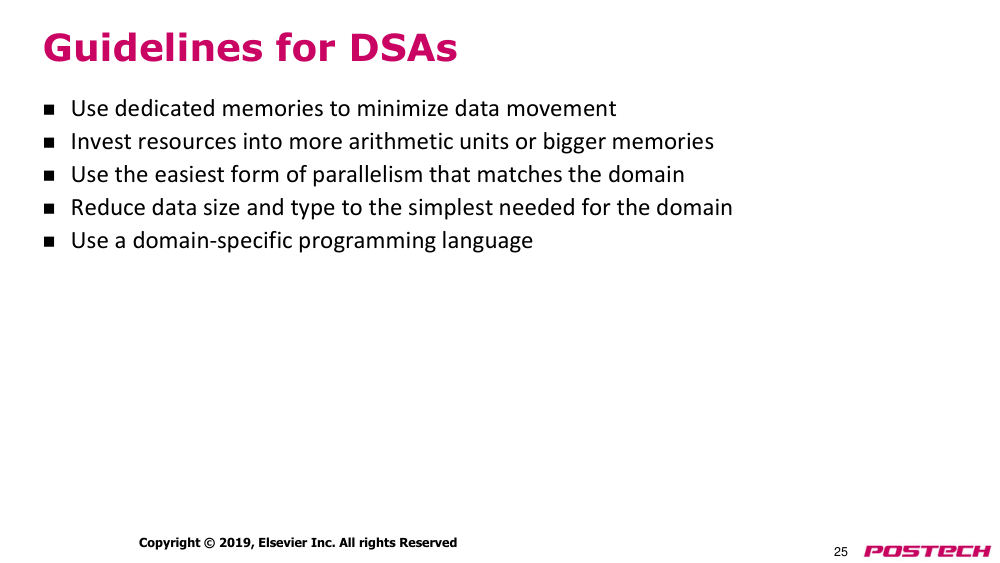
- 전용 메모리를 사용하여 data movement(데이터 이동)을 최소화한다.
- 더 많은 산술 유닛이나 더 큰 메모리를 확보하기 위해 자원을 투자한다.
- 도메인에 맞는 가장 간단한 형태의 병렬성을 사용한다.
- 도메인에 필요한 최소한의 데이터 크기와 형식으로 줄인다.
- Domain-Specific programming language(도메인 특화 프로그래밍 언어)를 사용한다.
p.26Google TPU (텐서 처리 유닛)
p.27Google TPU (텐서 처리 유닛)
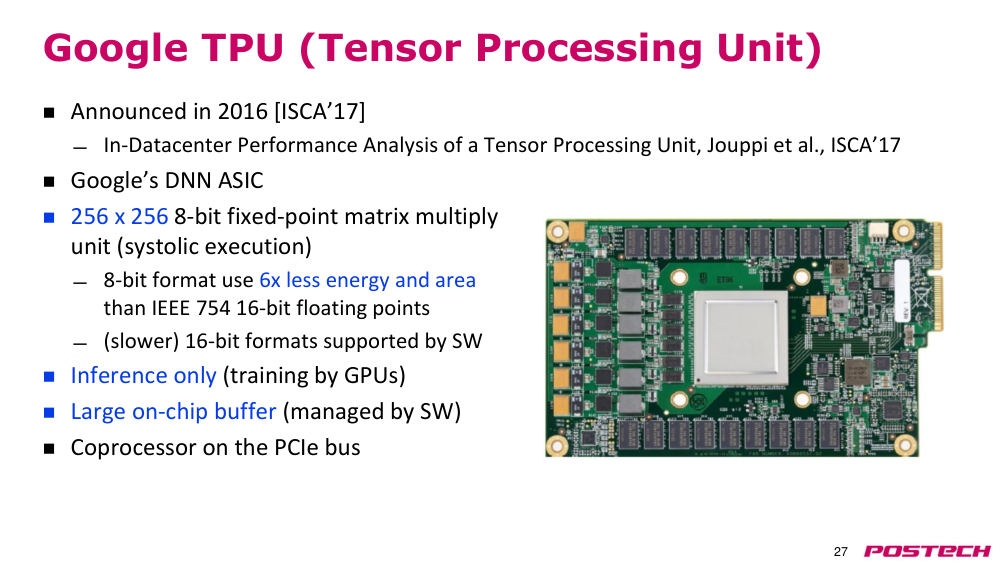
- 2016년 발표 [ISCA’17]
- In-Datacenter Performance Analysis of a Tensor Processing Unit, Jouppi 등, ISCA’17
- Google의 심층 신경망(Deep Neural Network, DNN) ASIC
- 256 x 256 8비트 고정소수점 matrix multiply(행렬 곱셈) 유닛 (시스톨릭 실행)
- 8비트 형식은 IEEE 754 16비트 부동소수점보다 에너지와 면적을 6배 적게 사용
- (더 느림) 소프트웨어에서 16비트 형식도 지원
- 추론 전용 (학습은 GPU로 수행)
- 큰 온칩 버퍼 (소프트웨어가 관리)
- PCIe 버스의 코프로세서
p.28TPU 블록 다이어그램 및 floorplan(플로어플랜)
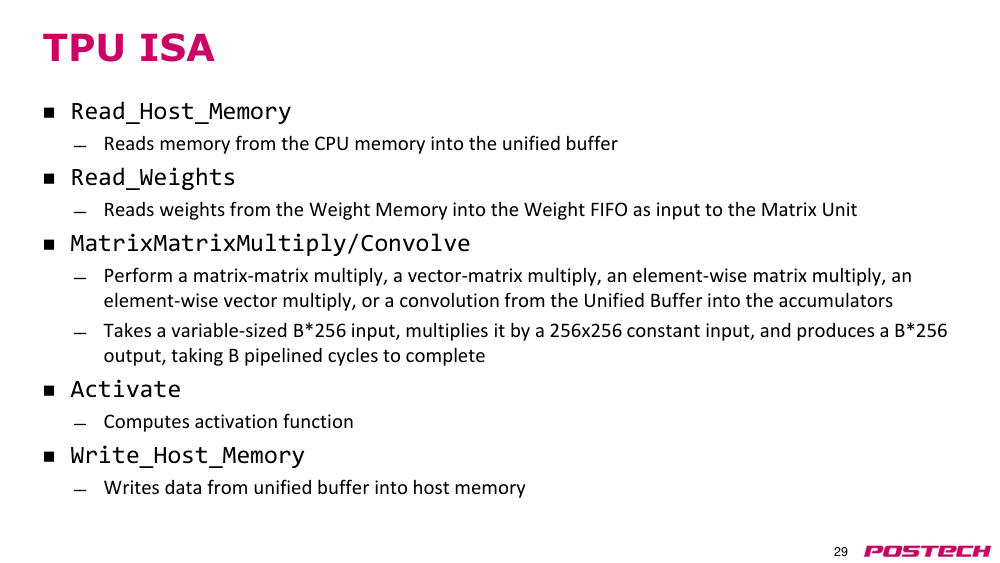
p.29TPU 명령어 세트 아키텍처(ISA)
- Read_Host_Memory
- CPU 메모리에서 데이터를 unified buffer(통합 버퍼)로 읽는다.
- Read_Weights
- weight memory(가중치 메모리)에서 가중치를 읽어 행렬 유닛의 가중치 FIFO로 전달한다.
- MatrixMatrixMultiply/Convolve
- unified buffer(통합 버퍼)에서 accumulator(누산기)로 matrix-matrix multiply(행렬-행렬 곱셈), vector-matrix multiply(벡터-행렬 곱셈), element-wise matrix multiply(요소별 행렬 곱셈), element-wise vector multiply(요소별 벡터 곱셈) 또는 convolution(컨볼루션)을 수행한다.
- 변수 크기의 B*256 입력을 256x256 상수 입력과 곱하고, B*256 출력을 생성하며, B개의 파이프라인 사이클을 소요한다.
- Activate
- activation function(활성화 함수)를 계산한다.
- Write_Host_Memory
- unified buffer(통합 버퍼)에서 데이터를 호스트 메모리로 쓴다.
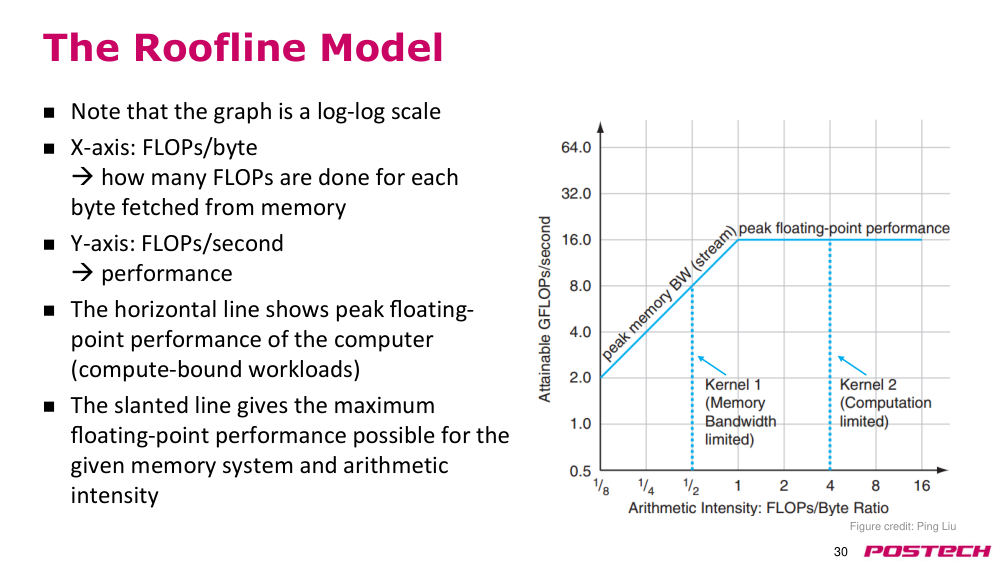
p.30roofline model(루프라인 모델)
- 그림은 로그-로그 스케일임을 주의
- X축: FLOPs/byte
- → 메모리에서 가져온 각 바이트당 수행되는 FLOPs 수
- Y축: FLOPs/second(FLOPs/초)
- → 성능
- 수평선은 컴퓨터의 최대 Floating-Point performance(부동소수점 성능)을 나타냄 (계산 중심 작업)
- 기울어진 선은 주어진 메모리 시스템과 arithmetic intensity(산술 밀도)에 대해 가능한 최대 Floating-Point performance(부동소수점 성능)을 제공함
- 그림 출처: Ping Liu
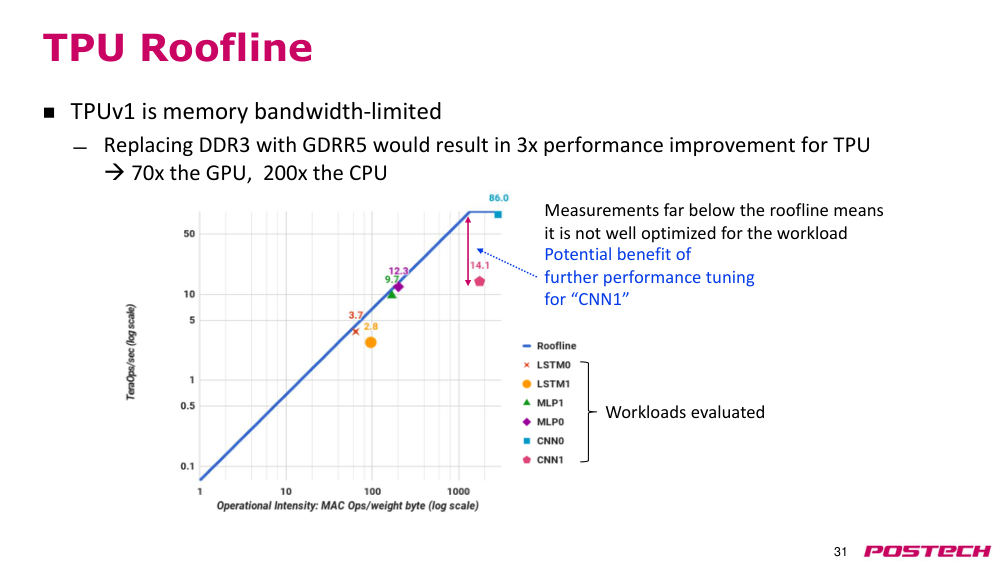
p.31TPU 루프라인
- TPUv1은 memory bandwidth(메모리 대역폭) 제한 상태이다.
- DDR3를 GDDR5로 교체하면 TPU의 성능이 3배 향상된다.
- → GPU의 70배, CPU의 200배 성능 향상
- ‘CNN1’에 대한 추가 성능 최적화의 잠재적 이점
- 루프라인 아래 측정된 성능은 워크로드에 대해 잘 최적화되지 않았음을 의미한다.
- 평가된 워크로드
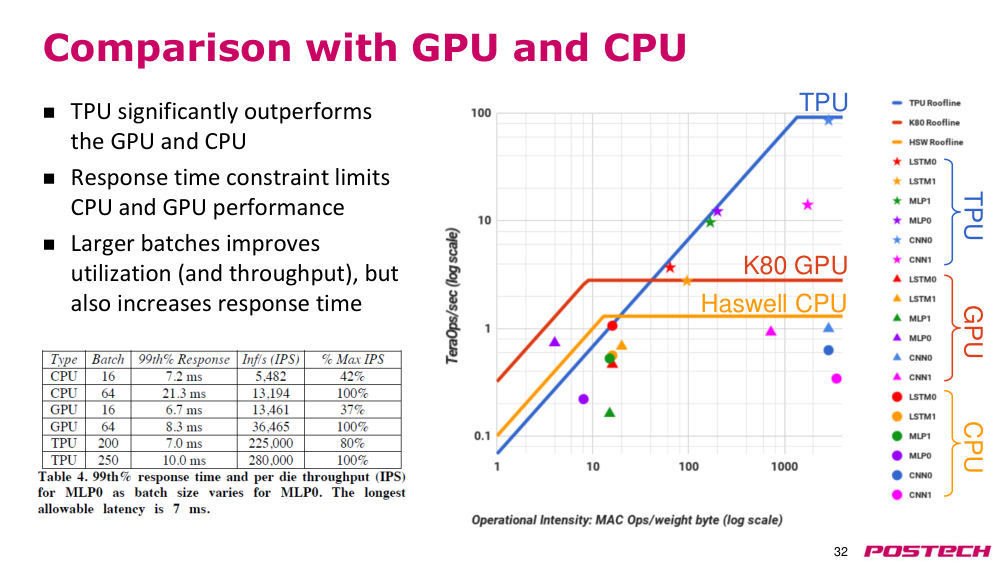
p.32GPU 및 CPU와의 비교
- TPU는 GPU와 CPU를 크게 능가한다.
- response time(응답 시간) 제약이 CPU와 GPU의 성능을 제한한다.
- 더 큰 batch size(배치 크기)는 활용도(및 처리량)를 향상시키지만, response time(응답 시간)도 증가시킨다.
- TPU
- K80 GPU
- Haswell CPU
- TPU
- GPU
- CPU
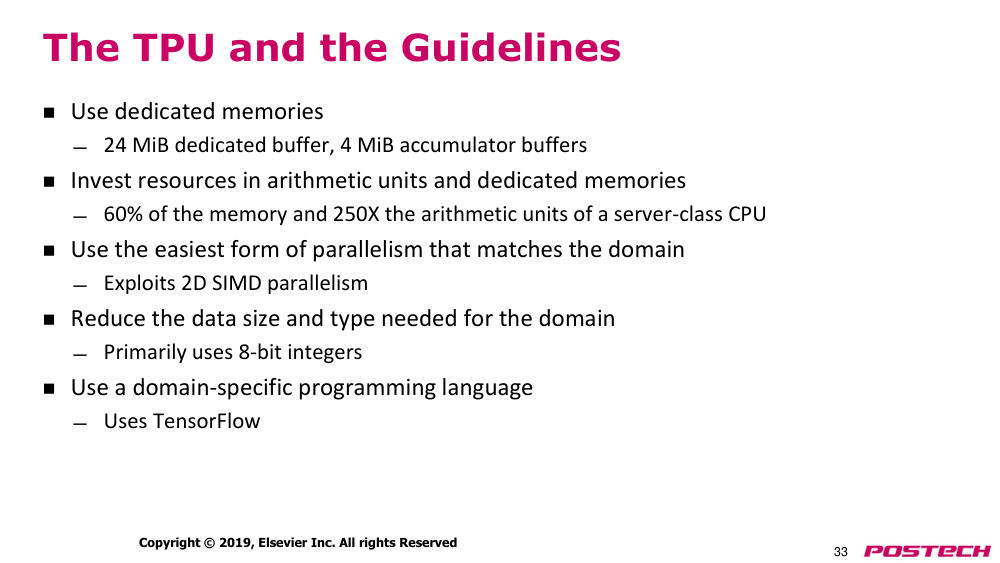
p.33TPU와 지침
- 전용 메모리를 사용하라.
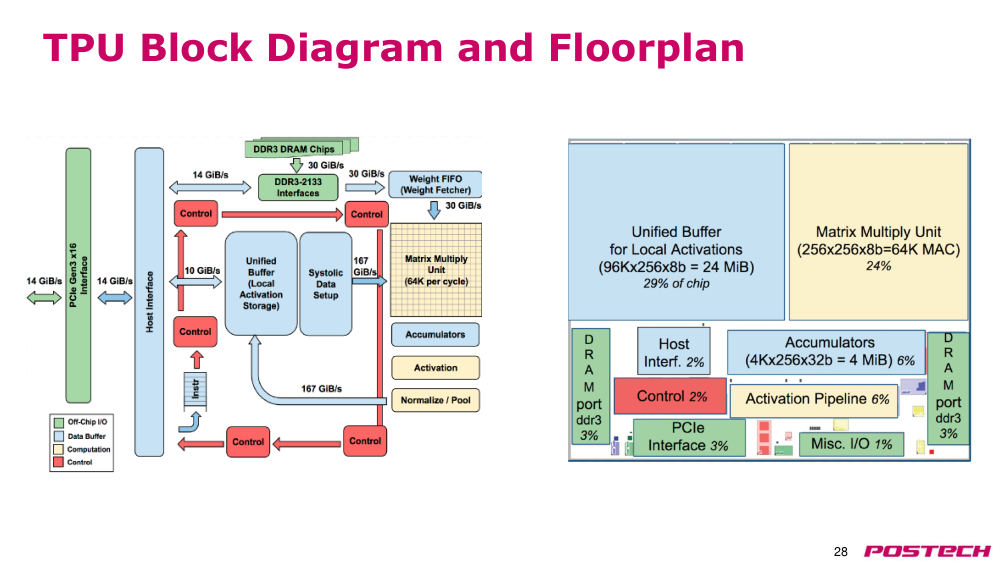
- 24 MiB 전용 버퍼, 4 MiB accumulator(누산기) 버퍼
- 산술 유닛과 전용 메모리에 자원을 투자하라.
- 서버급 CPU보다 메모리의 60%, 산술 유닛은 250배
- 도메인에 맞는 가장 쉬운 병렬성 형태를 사용하라.
- 2D SIMD 병렬성 활용
- 도메인에 필요한 데이터 크기와 형식을 줄여라.
- 주로 8비트 정수 사용
- Domain-Specific programming language(도메인 특화 프로그래밍 언어)를 사용하라.
- TensorFlow 사용
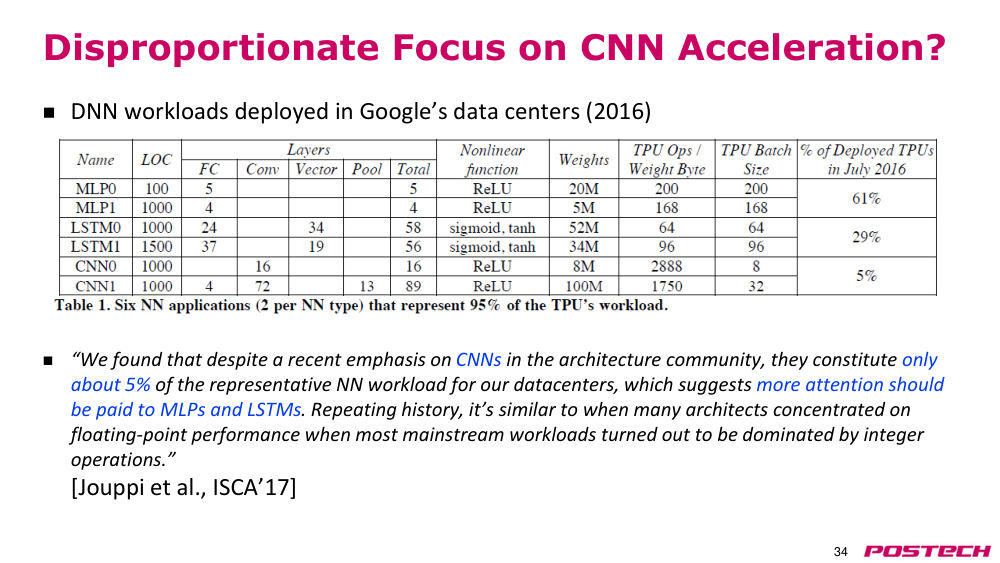
p.34convolutional neural network (CNN)(컨볼루션 신경망) 가속에 대한 과도한 집중?
- Google 데이터센터에 배포된 DNN 워크로드 (2016)
- ‘최근 아키텍처 커뮤니티에서 CNN에 대한 강조에도 불구하고, 이는 데이터센터의 대표적 신경망 워크로드의 약 5%에 불과하다. 이는 MLP와 LSTM에 더 많은 주의를 기울여야 함을 시사한다. 과거와 유사하게, 대부분의 메인스트림 워크로드가 integer operations(정수 연산)에 의해 지배됨에도 불구하고, 많은 아키텍트들이 Floating-Point performance(부동소수점 성능)에 집중했던 것과 같다.’
- [Jouppi 등, ISCA’17]
p.35Google TPU v2 및 v3
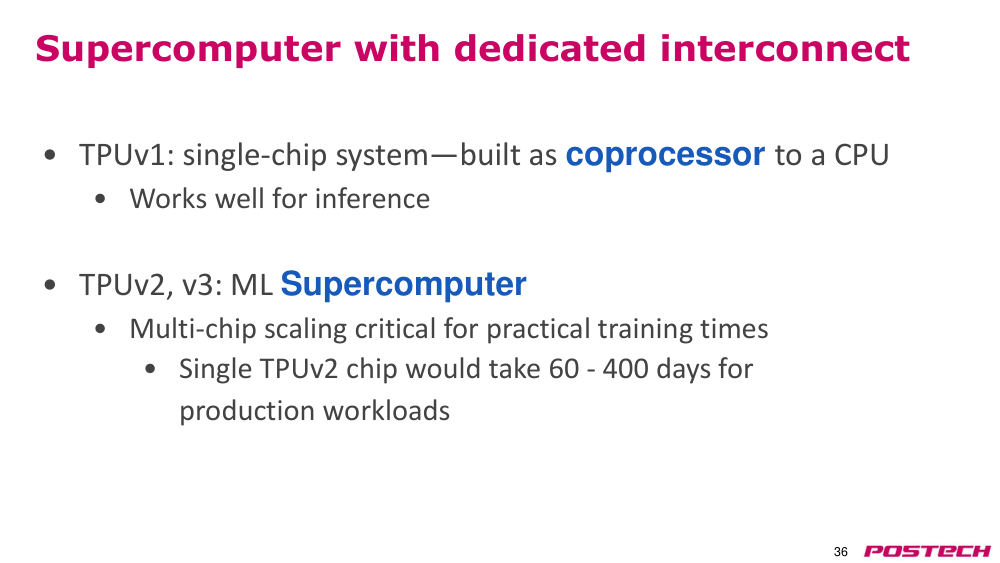
p.36전용 interconnect(인터커넥트)를 갖춘 supercomputer(슈퍼컴퓨터)
- TPUv1: 단일 칩 시스템 — CPU의 보조 처리기로 구현
- 추론에 잘 맞음
- TPUv2, v3: ML supercomputer(머신러닝 슈퍼컴퓨터)
- Multi-Chip scaling(다중 칩 스케일링)은 실용적인 학습 시간을 위해 필수적이다.
- 단일 TPUv2 칩은 production workload(생산용 워크로드)에 대해 60~400일이 소요된다.
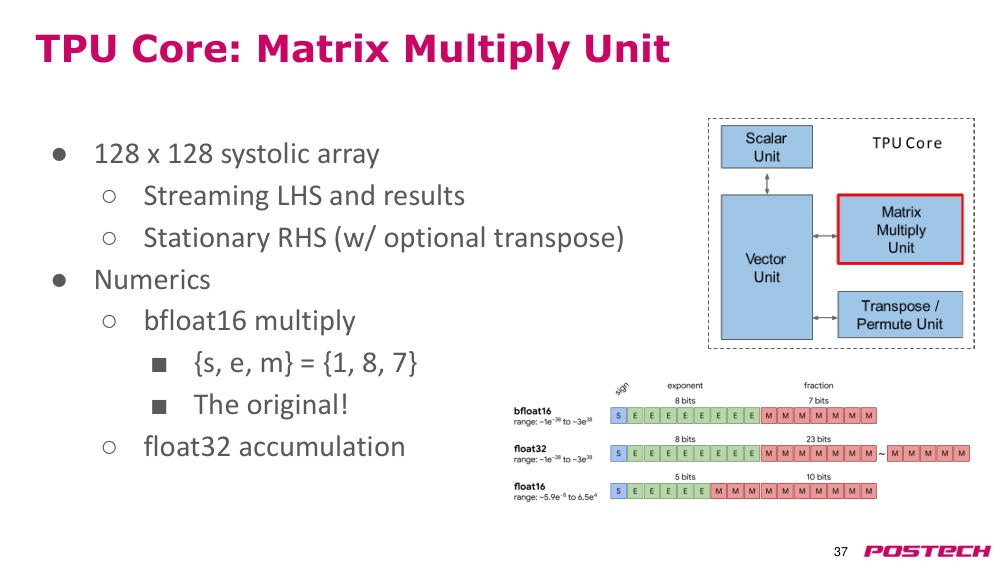
p.37TPU 코어: matrix multiply(행렬 곱셈) 단위
- ● 128 x 128 systolic array(시스톨릭 어레이)
- ○ 스트리밍 왼쪽 항 (streaming LHS) 및 결과
- ○ 정지된 오른쪽 항 (stationary RHS) (선택적 전치 가능)
- ● 수치 표현 (numerics)
- ○ bfloat16 곱셈
- ■ {s, e, m} = {1, 8, 7}
- ■ 원래 형태!
- ○ float32 누산
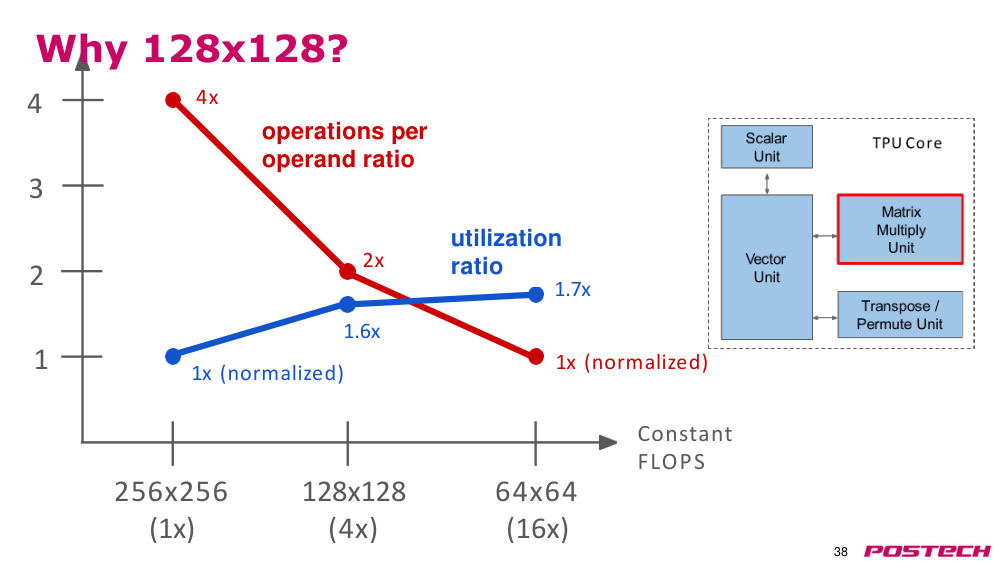
p.38왜 128x128인가?
- 256x256 (1x)
- 128x128 (4x)
- 64x64 (16x)
- 1
- 2
- 3
- 4
- 연산/피연산자 비율
- 1x (정규화)
- 2x
- 4x
- 1x (정규화)
- 1.6x
- 이용률 비율
- 1.7x
- 왜 128x128인가?
- 일정한 FLOPs
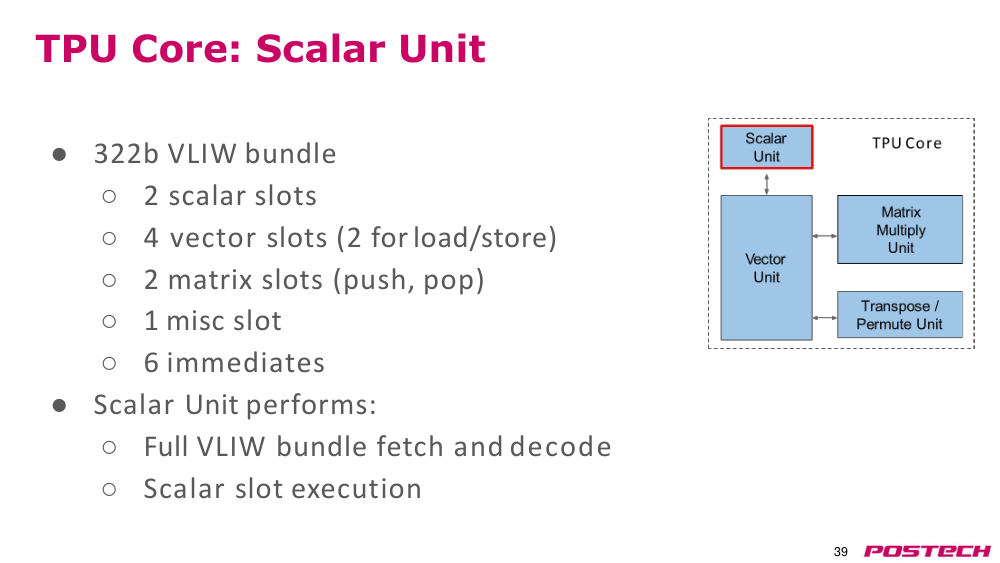
p.39TPU 코어: scalar unit(스칼라 유닛)
- ● 322b VLIW bundle(VLIW 번들)
- ○ 2개의 스칼라 슬롯
- ○ 4개의 벡터 슬롯 (2개는 로드/스토어용)
- ○ 2개의 행렬 슬롯 (푸시, 팝)
- ○ 1개의 기타 슬롯
- ○ 6개의 immediate(즉시값)
- ● scalar unit(스칼라 유닛)이 수행하는 작업:
- ○ 전체 VLIW bundle(VLIW 번들) 가져오기 및 디코딩
- ○ 스칼라 슬롯 실행
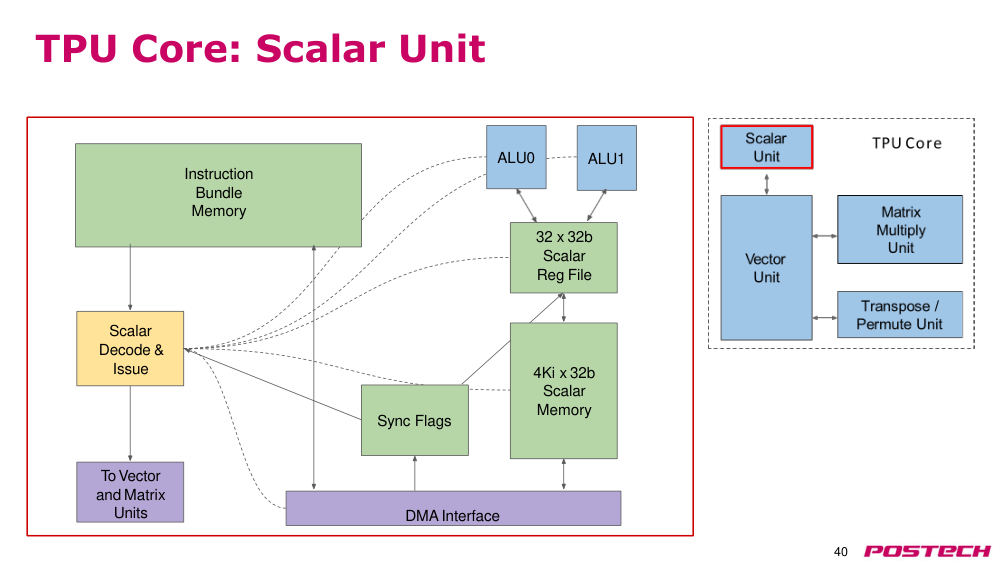
p.40TPU 코어: scalar unit(스칼라 유닛)
- 스칼라 디코딩 및 발행
- DMA interface(DMA 인터페이스)
- TPU 코어: scalar unit(스칼라 유닛)
- 명령어 번들
- 메모리
- 32 x 32b scalar register file(스칼라 레지스터 파일)
- ALU0
- ALU1
- sync flags(동기화 플래그)
- 벡터 및 행렬 유닛으로
- 4Ki x 32b 스칼라 메모리
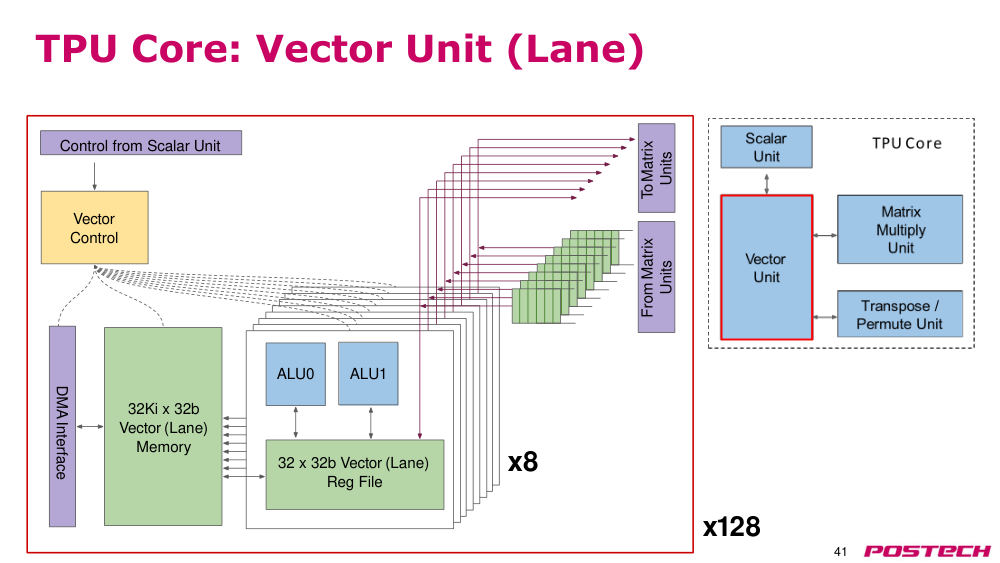
p.41TPU 코어: 벡터 유닛 (레인)
- 32 x 32b 벡터 (레인) 레지스터 파일
- 벡터 제어
- scalar unit(스칼라 유닛)에서 오는 제어
- 32Ki x 32b 벡터 (레인) 메모리
- DMA interface(DMA 인터페이스)
- 행렬 유닛으로
- 행렬 유닛에서
- x8
- x128
- ALU0
- ALU1
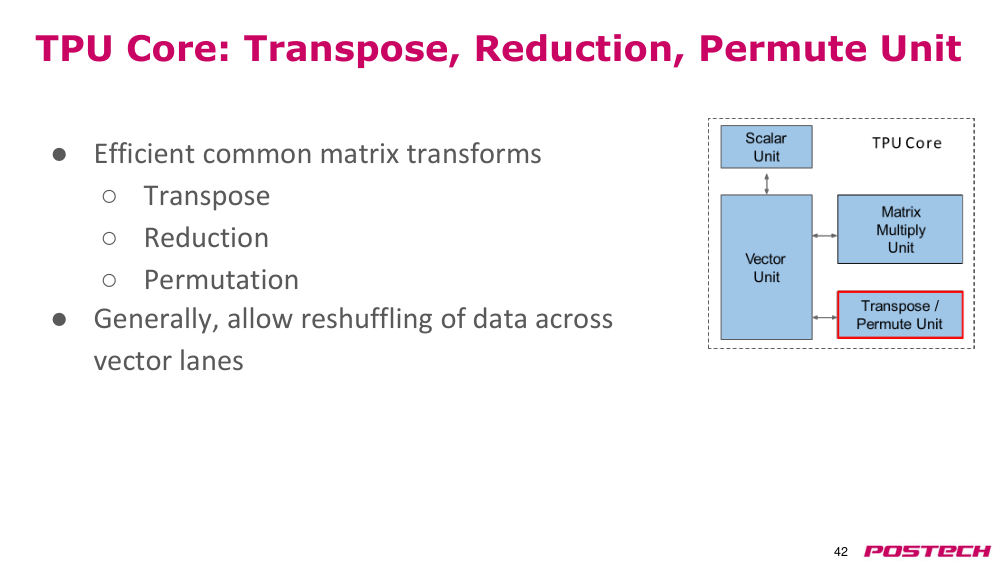
p.42TPU 코어: transpose(전치), reduction(리덕션), permute unit(순서 변경 유닛)
- ● 효율적인 일반적인 행렬 변환
- ○ transpose(전치)
- ○ reduction(리덕션)
- ○ permutation(순열)
- ● 일반적으로 벡터 lane(레인) 간 데이터 재정렬을 허용
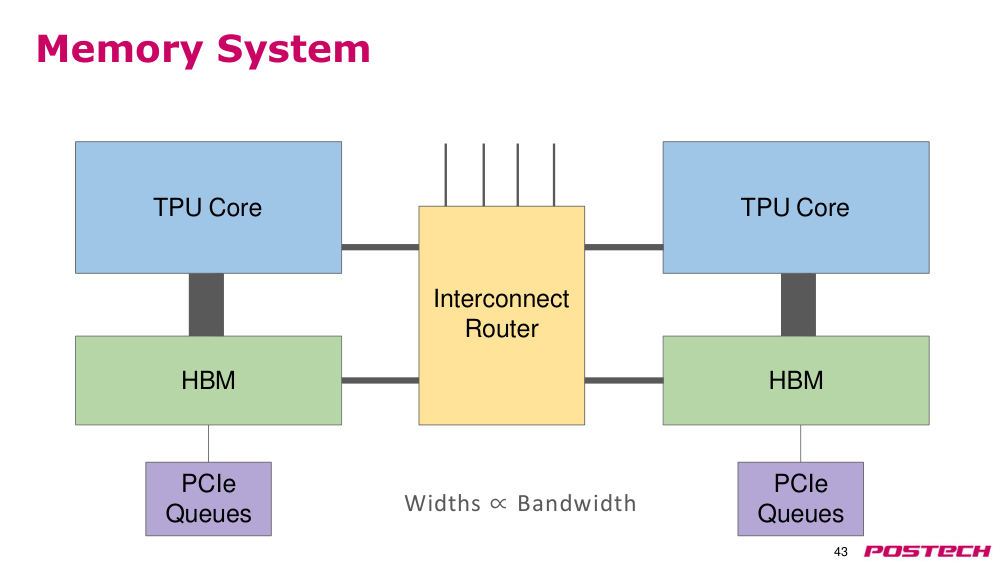
p.43메모리 시스템
- HBM
- TPU 코어
- interconnect router(인터커넥트 라우터)
- HBM
- TPU 코어
- PCIe
- 큐
- PCIe
- 큐
- 폭 ∝ 대역폭
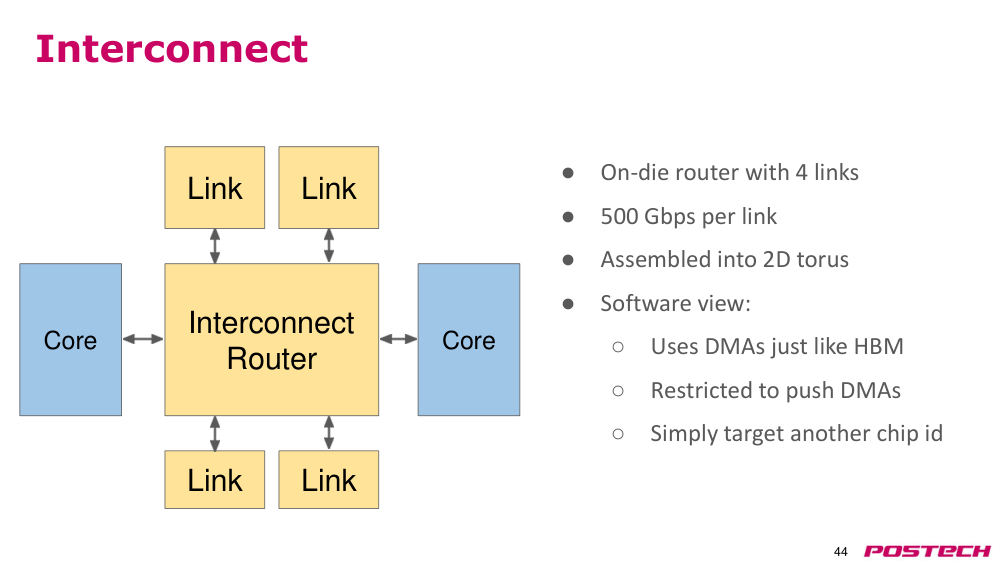
p.44인터커넥트
- 온다이 라우터에 4개의 링크 포함
- 링크당 500 Gbps
- 2D torus(2차원 토러스)로 조립
- software view(소프트웨어 뷰):
- ○ HBM과 마찬가지로 DMA 사용
- ○ push DMA(푸시 DMA)에 제한됨
- ○ 단순히 다른 칩 ID를 대상으로 함
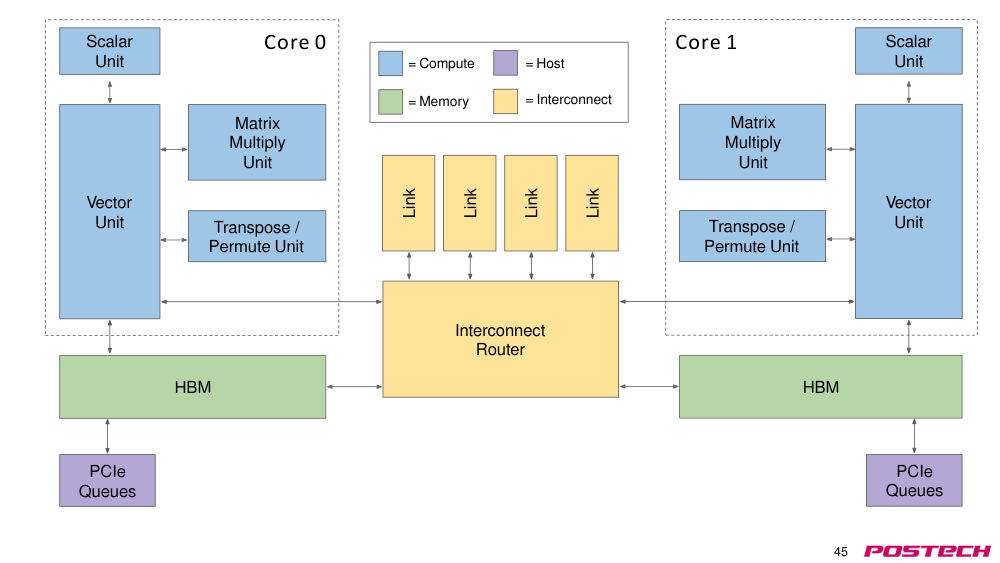
p.45matrix multiply(행렬 곱셈) 유닛
- vector unit(벡터 유닛)
- 전치/permute unit(순서 변경 유닛)
- HBM
- PCIe
- 큐
- interconnect router(인터커넥트 라우터)
- scalar unit(스칼라 유닛)
- 링크
- 링크
- 링크
- 링크
- 코어 1
- matrix multiply(행렬 곱셈) 유닛
- vector unit(벡터 유닛)
- 전치/permute unit(순서 변경 유닛)
- HBM
- scalar unit(스칼라 유닛)
- PCIe
- 큐
- = 계산
- = 메모리
- = 호스트
- = 인터커넥트
- 코어 0
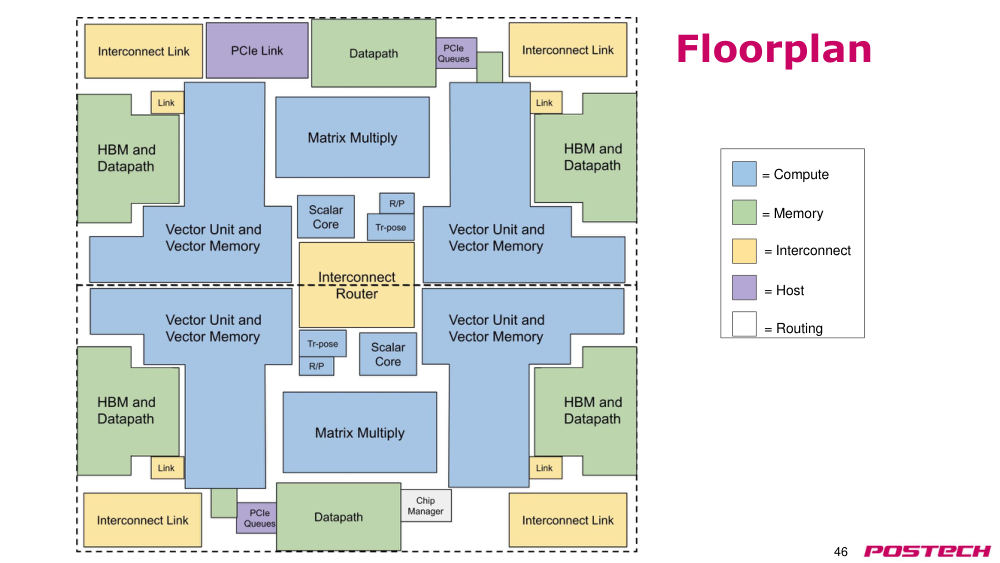
p.46플로어플랜
- = 계산
- = 메모리
- = 인터커넥트
- = 호스트
- = 라우팅
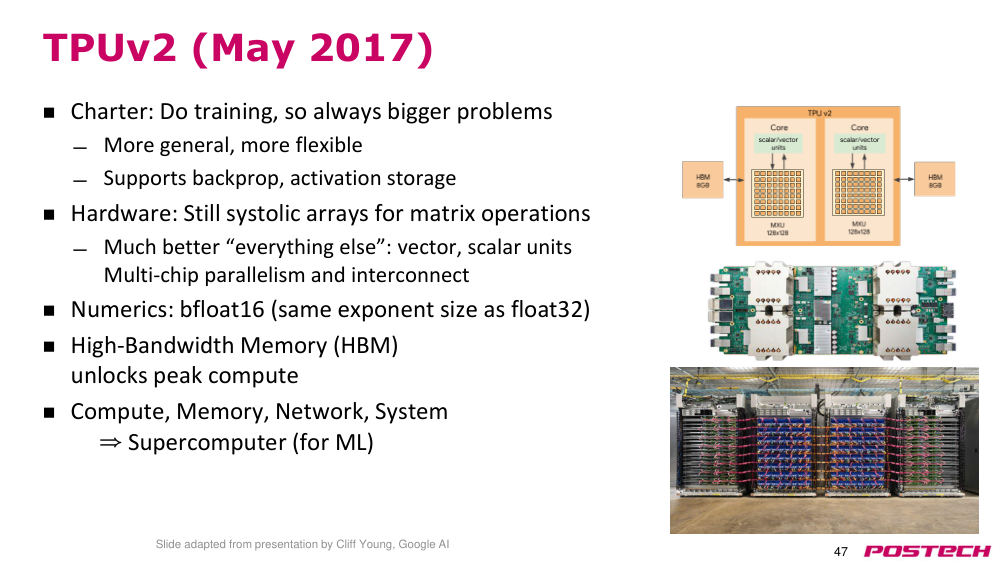
p.47TPUv2 (2017년 5월)
- 목표: 학습 수행, 항상 더 큰 문제 해결
- 더 일반적이고 더 유연함
- 역전파 및 activation(활성화) 저장 지원
- 하드웨어: 여전히 행렬 연산에 대해 systolic array(시스톨릭 어레이) 사용
- 다른 모든 부분(벡터, 스칼라 유닛) 훨씬 개선됨
- 다중 칩 병렬성 및 인터커넥트
- numerics(수치 표현): bfloat16 (float32와 동일한 지수 크기)
- 고대역폭 메모리(HBM)가 최대 계산 성능을 해제
- 계산, 메모리, 네트워크, 시스템 ⇒ ML supercomputer(머신러닝 슈퍼컴퓨터)
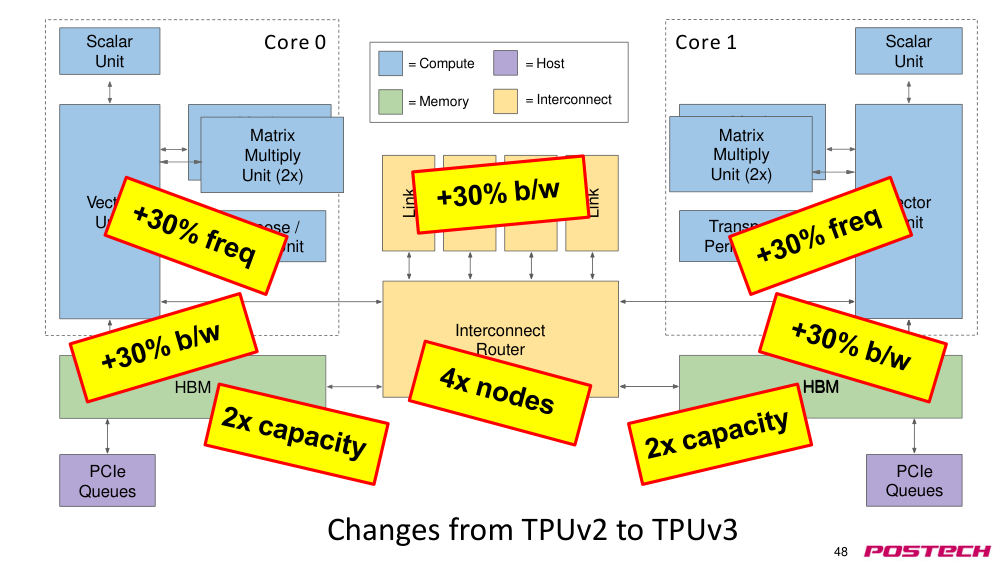
p.48TPUv2에서 TPUv3로의 변경
- matrix multiply(행렬 곱셈) 유닛
- vector unit(벡터 유닛)
- 전치/permute unit(순서 변경 유닛)
- HBM
- PCIe
- 큐
- interconnect router(인터커넥트 라우터)
- scalar unit(스칼라 유닛)
- 링크
- 링크
- 링크
- 링크
- 코어 1
- matrix multiply(행렬 곱셈) 유닛
- vector unit(벡터 유닛)
- 전치/permute unit(순서 변경 유닛)
- HBM
- scalar unit(스칼라 유닛)
- PCIe
- 큐
- = 계산
- = 메모리
- = 호스트
- = 인터커넥트
- 코어 0
- matrix multiply(행렬 곱셈) 유닛 (2x)
- matrix multiply(행렬 곱셈) 유닛 (2x)
- HBM
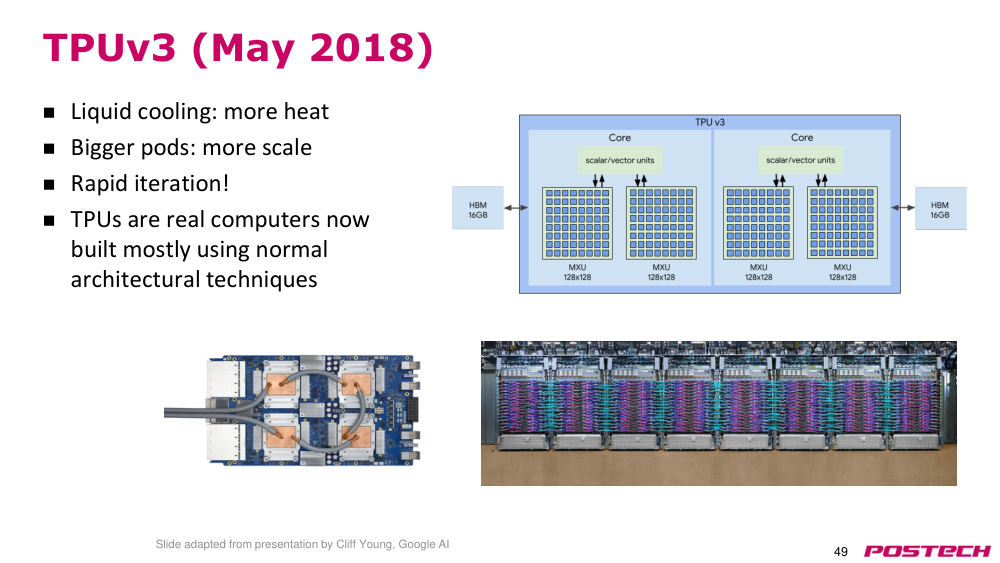
p.49TPUv3 (2018년 5월)
- 액체 냉각: 더 많은 열 발생
- 더 큰 팟: 더 큰 규모
- 빠른 반복 개발!
- TPU는 이제 진정한 컴퓨터가 되었음
- 대부분 일반적인 아키텍처 기법을 사용하여 설계됨
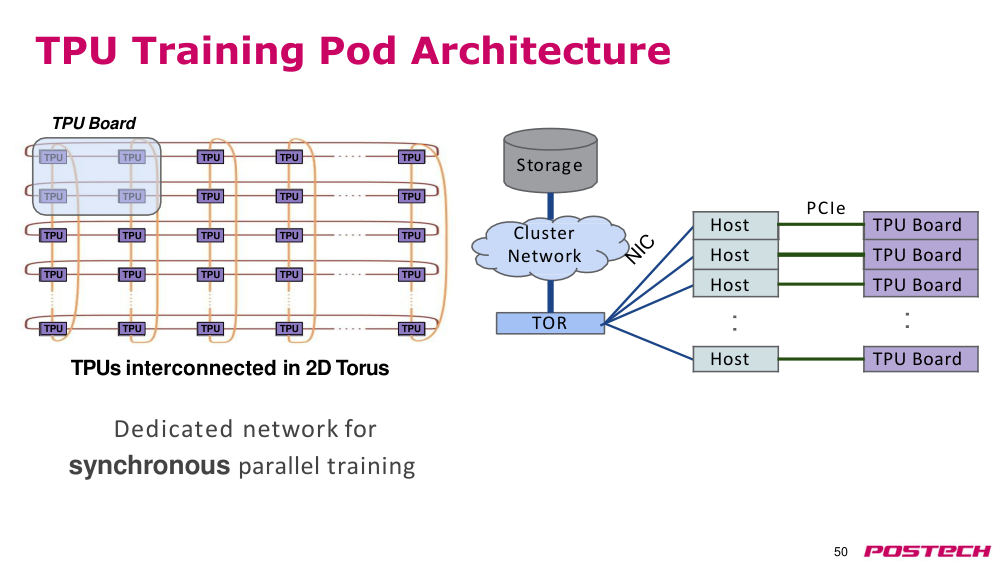
p.50TPU Training Pod 아키텍처
- TPU는 2차원 토러스(2D torus)로 연결됨
- 동기화 병렬 훈련을 위한 전용 네트워크
- PCIe
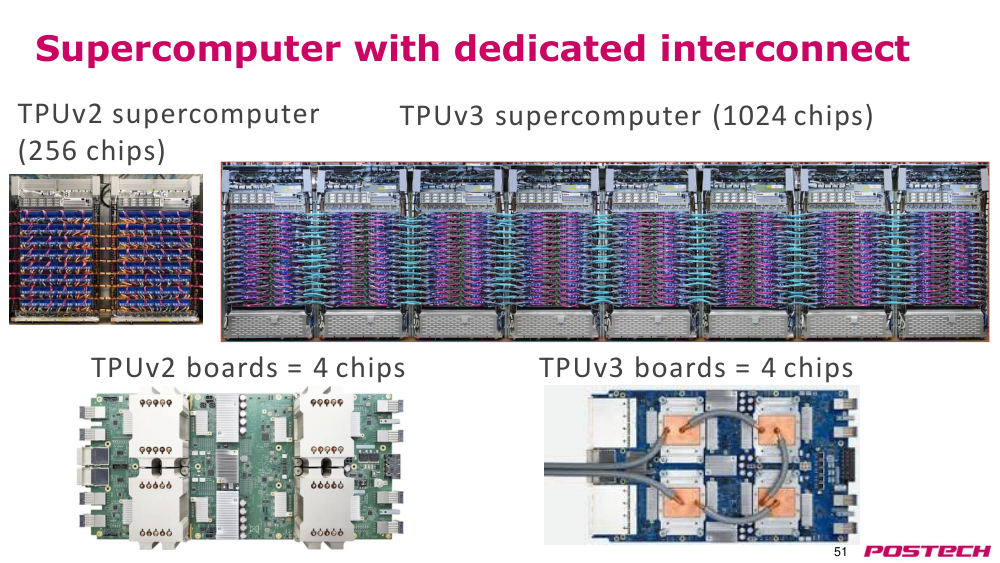
p.51TPUv3 보드 = 4개 칩
- TPUv2 보드 = 4개 칩
- 전용 interconnect(인터커넥트)를 갖춘 supercomputer(슈퍼컴퓨터)
- TPUv2 supercomputer(슈퍼컴퓨터) (256개 칩)
- TPUv3 supercomputer(슈퍼컴퓨터) (1024개 칩)
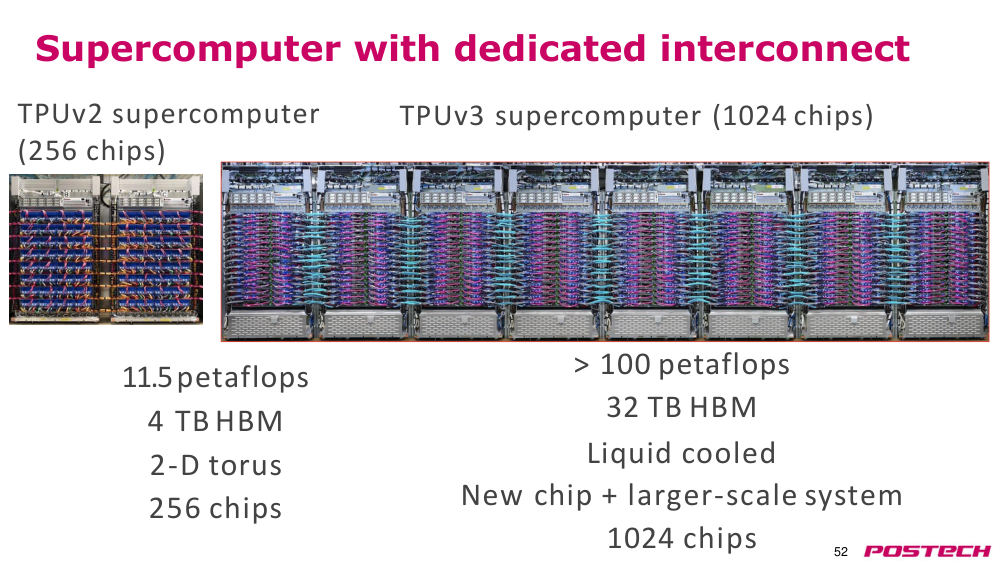
p.52TPUv2 및 TPUv3 supercomputer(슈퍼컴퓨터) 사양
- 11.5 페타플롭스
- 4 TB HBM
- 2D torus(2차원 토러스)
- 256개 칩
- > 100 페타플롭스
- 32 TB HBM
- 액체 냉각
- 새로운 칩 + 더 큰 규모의 시스템
- 1024개 칩
- 전용 interconnect(인터커넥트)를 갖춘 supercomputer(슈퍼컴퓨터)
- TPUv2 supercomputer(슈퍼컴퓨터) (256개 칩)
- TPUv3 supercomputer(슈퍼컴퓨터) (1024개 칩)
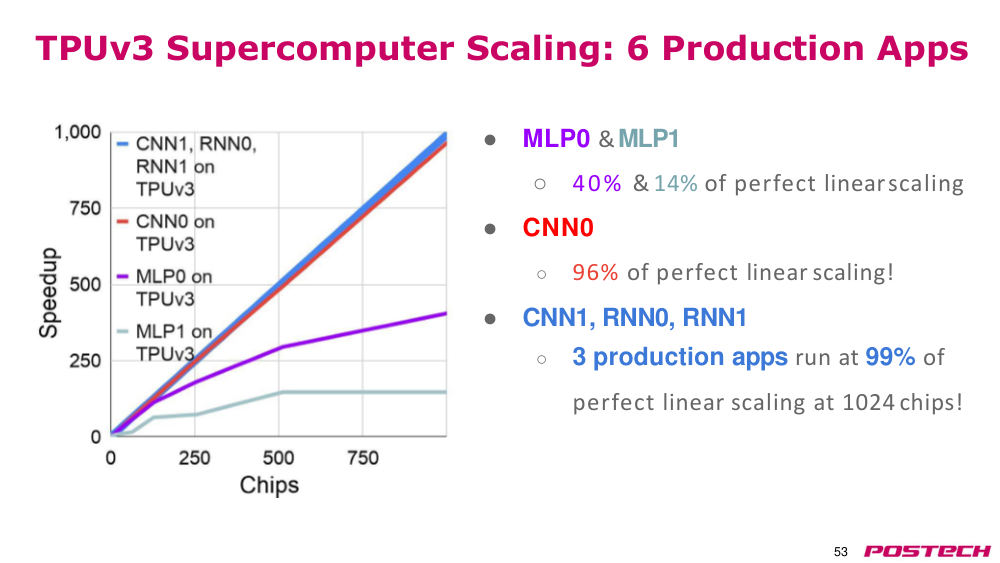
p.53TPUv3 supercomputer(슈퍼컴퓨터) 스케일링: 6개 생산용 앱
- MLP0 & MLP1
- ○ 40% 및 14%의 이상적 선형 스케일링
- CNN0
- ○ 이상적 선형 스케일링의 96%!
- CNN1, RNN0, RNN1
- ○ 1024개 칩에서 3개의 생산용 앱이 이상적 선형 스케일링의 99%를 달성함!
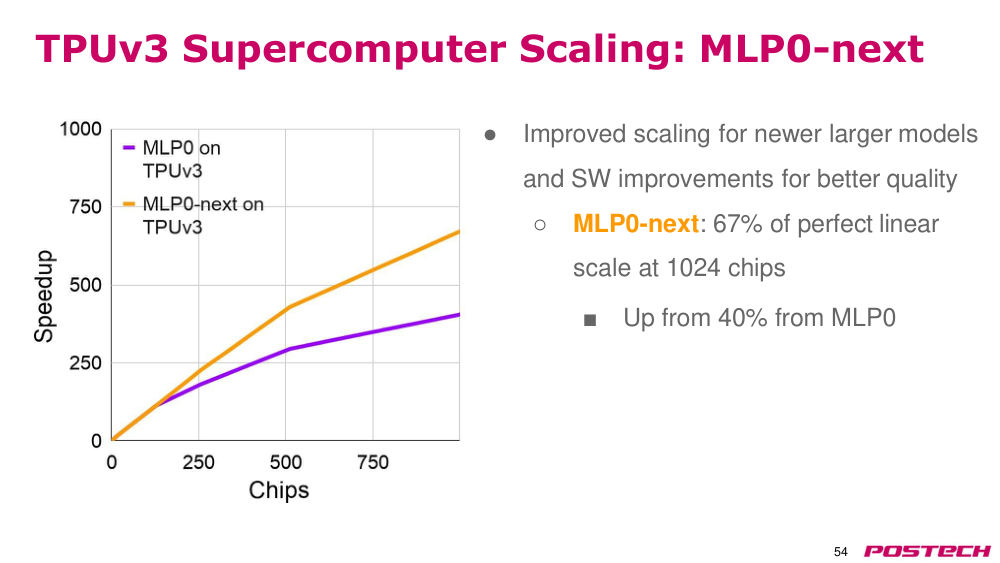
p.54TPUv3 supercomputer(슈퍼컴퓨터) 스케일링: MLP0-next
- 더 큰 모델 및 소프트웨어 개선으로 인한 개선된 스케일링
- MLP0-next: 1024개 칩에서 이상적 선형 스케일링의 67%
- ■ MLP0의 40%에서 상승
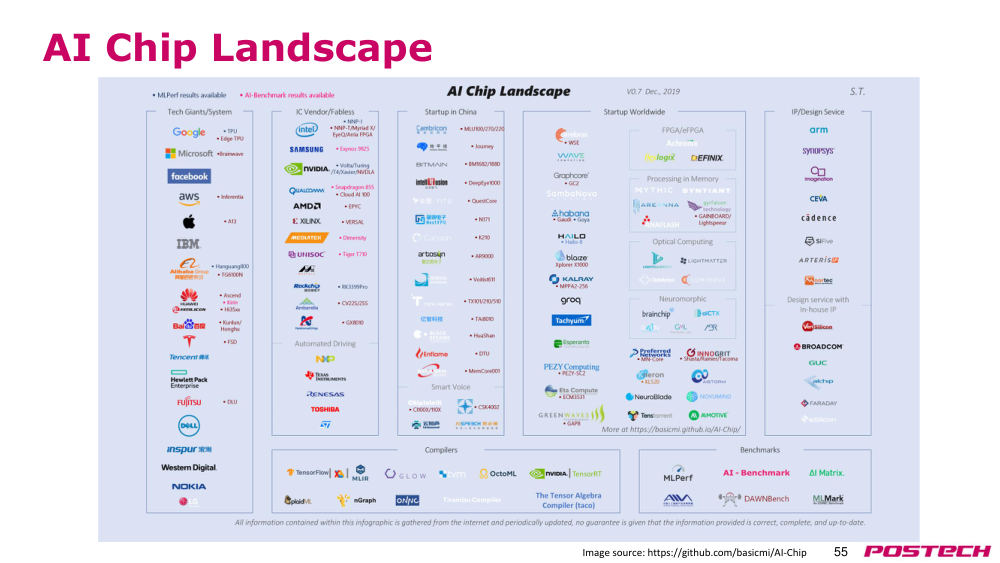
p.55AI 칩 생태계
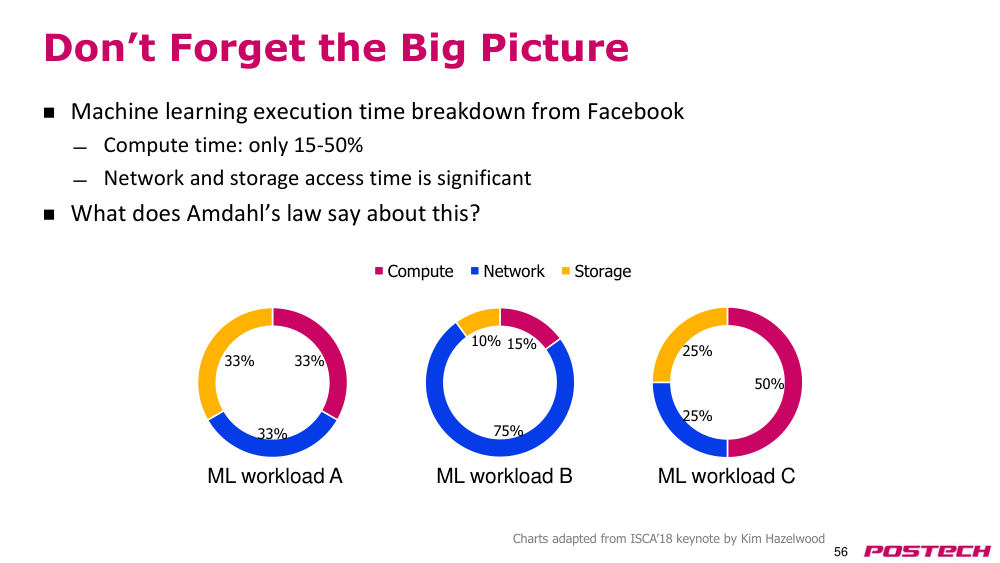
p.56큰 그림을 잊지 마세요
- 머신러닝 실행 시간 분포(Facebook 기준)
- 계산 시간: 단지 15-50%
- 네트워크 및 저장소 접근 시간이 상당히 큼
- Amdahl's law(암달의 법칙)은 이에 대해 무엇을 말하는가?
- Kim Hazelwood의 ISCA’18 기조 강연 자료를 바탕으로 수정
p.57질문?
- Google의 TPU에 대한 발표를 보기: https://youtu.be/4bGoGjTRT9U?t=101