Lec 19 & 20 · bus 동작(arbitration, sync/async protocol, 성능, error detection) 과 parallel architecture 도입(Amdahl, Flynn, array vs vector)
정밀 정리 · 검증 2026-09-24 23:17
1개요
1.1L19 후반: 공유 bus 의 master/slave/arbiter, REQ/GNT, synchronous read/write 와 bus turnaround, IRDY/TRDY 기반 asynchronous·burst transaction.
1.2bus 성능(arbitration·transaction latency, peak bandwidth N·f 와 burst 상각), PCIe·SATA·SAS 등 실제 interface, parity/ECC/CRC, split-transaction bus.
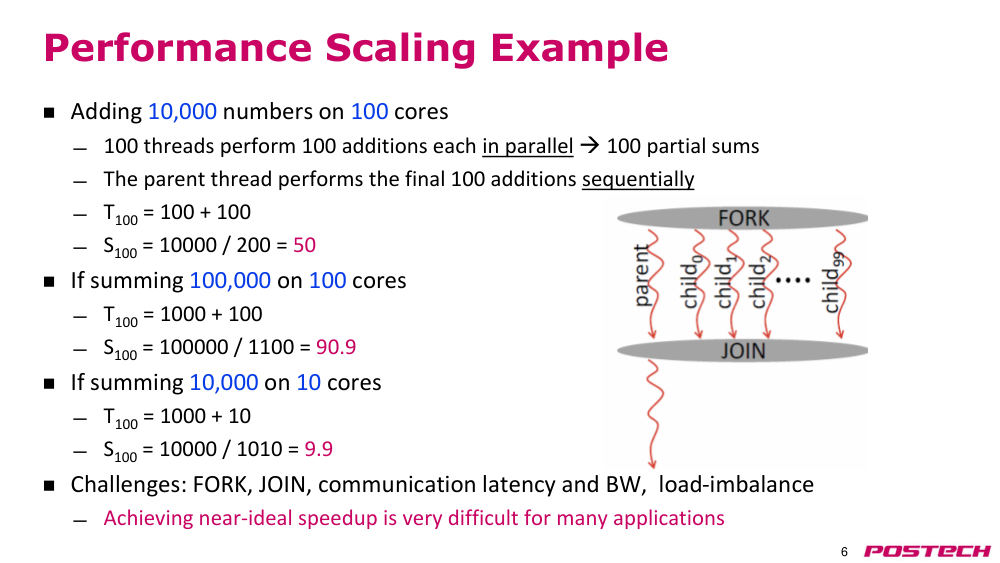
1.3L20 도입: Dennard scaling 종료로 frequency 정체 → parallel architecture. Amdahl's law 와 100 core 합산 예(S=50).
1.4Flynn's taxonomy 로 SIMD 를 위치시키고 array processor(space) 와 vector processor(time) 의 차이·tradeoff 까지. L20 p11 이후는 다음 강의.
2섹션별 정리 상황·문제 → 원인 → 해결
2.10:54–6:40bus 기본 개념: broadcast medium 과 protocol
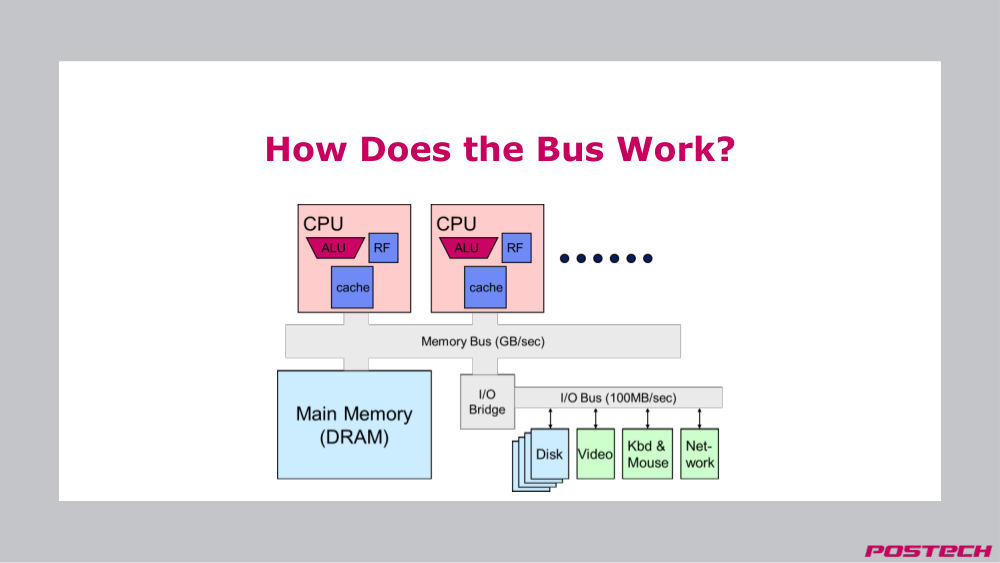
상황·문제여러 CPU·memory·I/O device 가 하나의 bus 를 공유. 여러 device 가 동시에 보내려 하면 누가 보낼지 정해야 함.
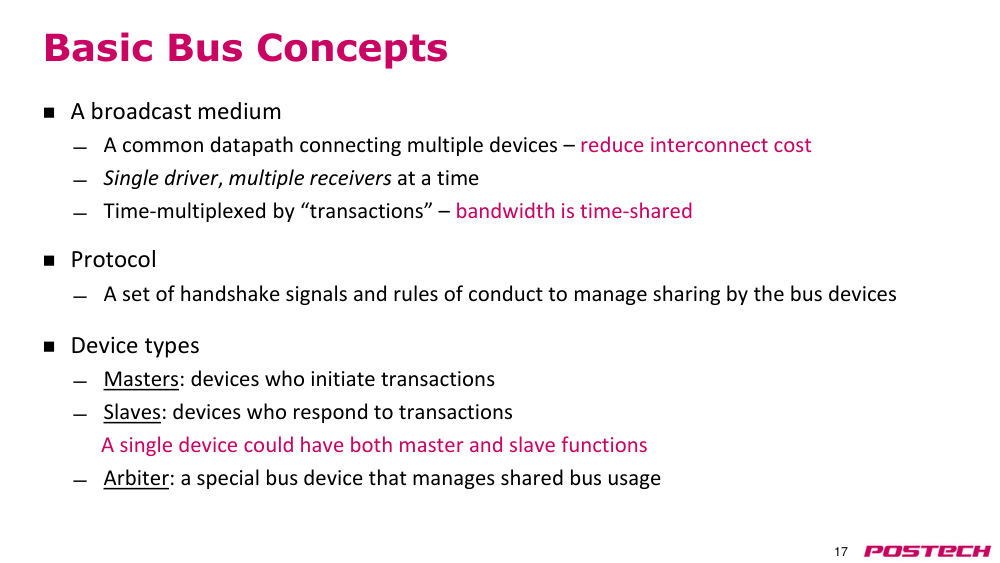
원인bus 는 single driver·multiple receiver 의 broadcast medium. 한 번에 하나만 drive 가능.
해결transaction 단위 time-multiplexing, 모든 device 가 지키는 protocol, master·slave·arbiter 역할 구분.
- point-to-point 보다 wire 가 적어 cost 낮음
- device 당 bandwidth ≈ bus bandwidth / device 수
- arbiter 가 누가 언제 bus 를 쓸지 결정
2.1.r.2Wikipedia: Arbiter (electronics) ↗ · multi-master bus 에서 bus arbiter 가 bus cycle 마다 master 선택
2.26:43–12:10bus transaction 단계와 signal·구성
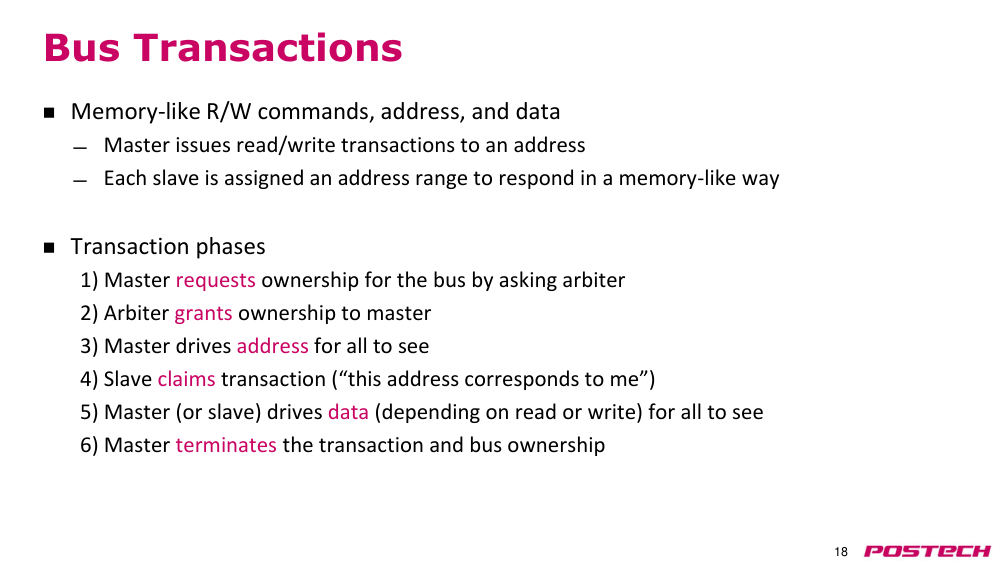
상황·문제master 가 read/write 를 특정 address 에 보내고 해당 slave 가 memory 처럼 응답해야 함.
원인bus 소유권이 하나뿐이라 arbitration 을 거친 뒤에만 address·data 를 drive 가능.
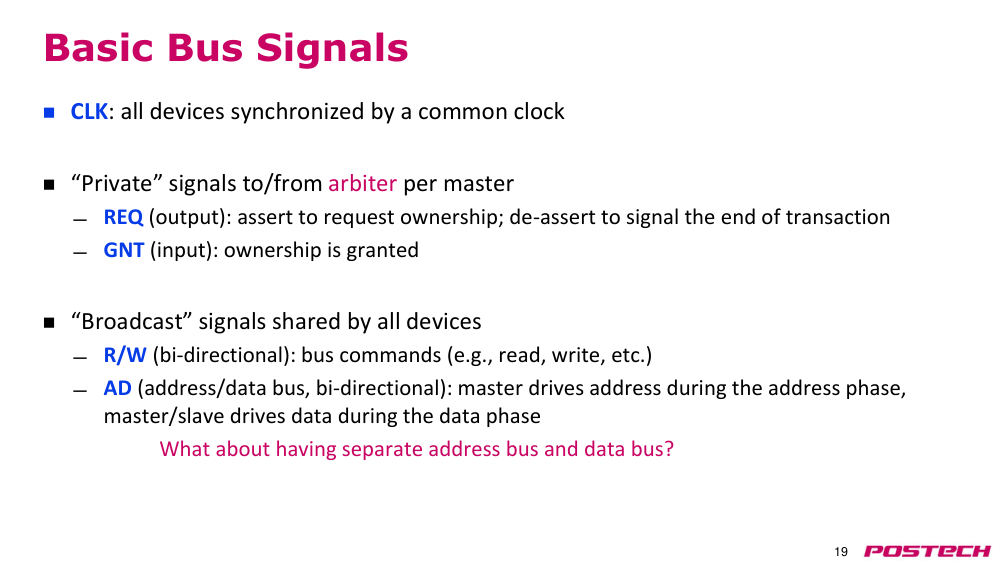
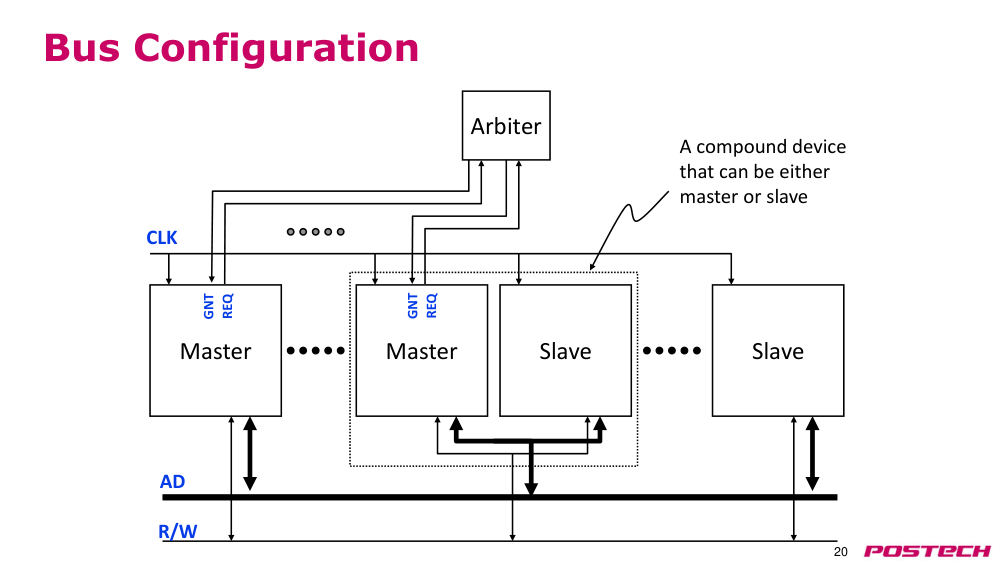
해결REQ → GNT → address drive → slave claim → data drive → 종료·반납. signal: CLK, master 별 REQ/GNT, 공유 R/W·AD.
- REQ 는 transaction 끝을 알릴 때 de-assert
- AD 공유 bus 는 address·data 를 순서대로 보내 느림 → 분리하면 성능 향상
- slave 는 REQ/GNT wire 가 없음
2.2.r.1Wikipedia: Arbiter (electronics) ↗ · multi-master bus 에서 bus arbiter 가 bus cycle 마다 master 선택
2.312:11–16:40synchronous read·write transaction
상황·문제모든 신호를 clock rising edge 에서 sample 하는 synchronous bus 에서 read/write 의 timing.
원인request 와 response 사이 latency 가 protocol 로 미리 정해져 있음. read 는 driver 가 master→slave 로 바뀜.
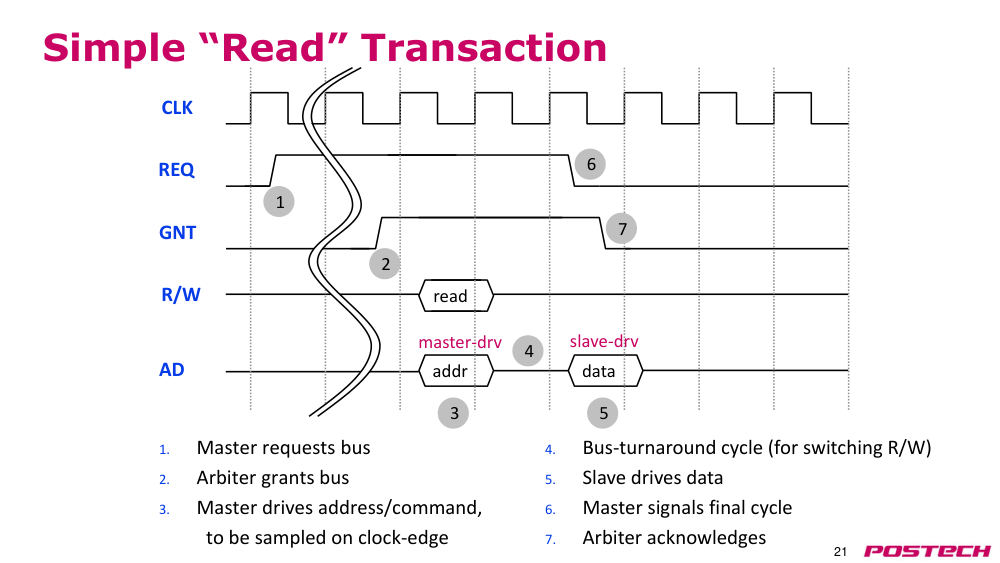
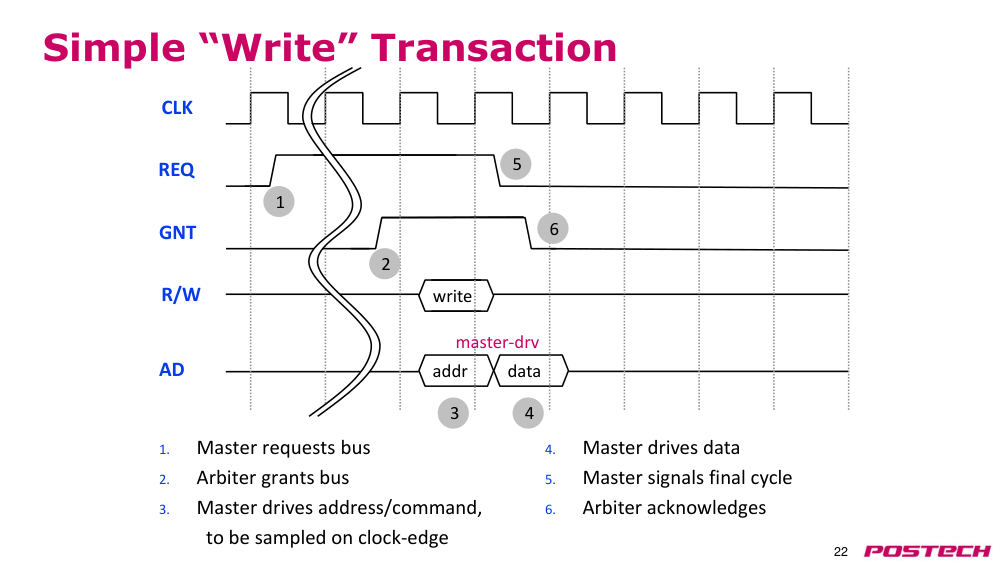
해결read 는 address 와 data 사이 1 cycle bus turnaround 필요, write 는 master 가 연달아 drive 해 turnaround 없음.
- bus turnaround: reader/writer 가 바뀔 때 전기적 이유로 1 cycle 낭비
- 두 master 가 REQ 를 올려도 GNT 는 하나에만
2.416:41–18:51(행정) Zoom 영상 지연·출석 확인
상황·문제Zoom 영상·음성 지연 문제로 출석 확인 후 지연이 있는 학생은 녹화본을 보도록 안내.
2.518:52–21:30asynchronous bus protocol (IRDY/TRDY)
상황·문제synchronous protocol 은 event timing 이 고정돼 있어 느린 device 와 빠른 device 가 bus 를 공유하면 문제.
원인모든 device 가 정해진 cycle 안에 반응해야 하기 때문.
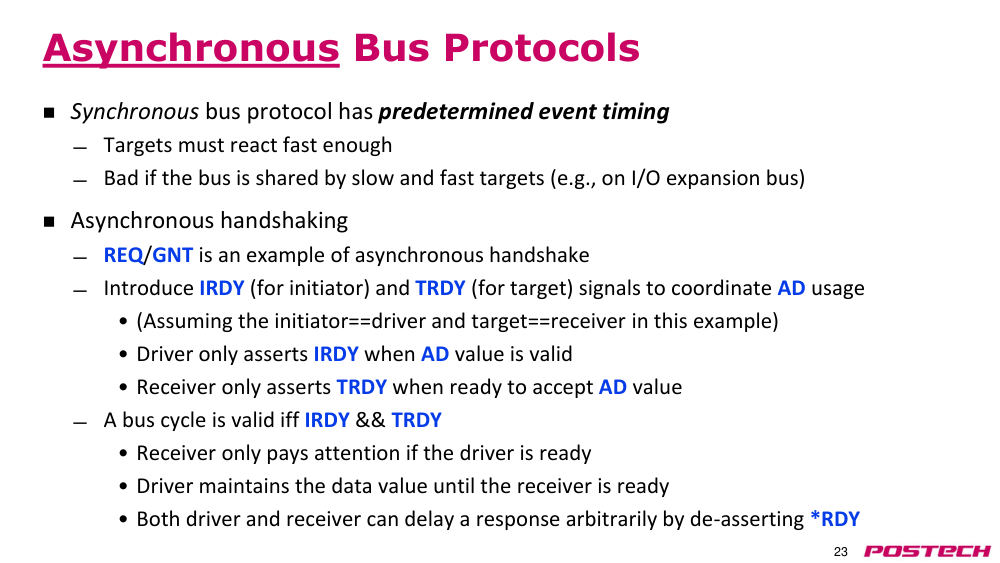
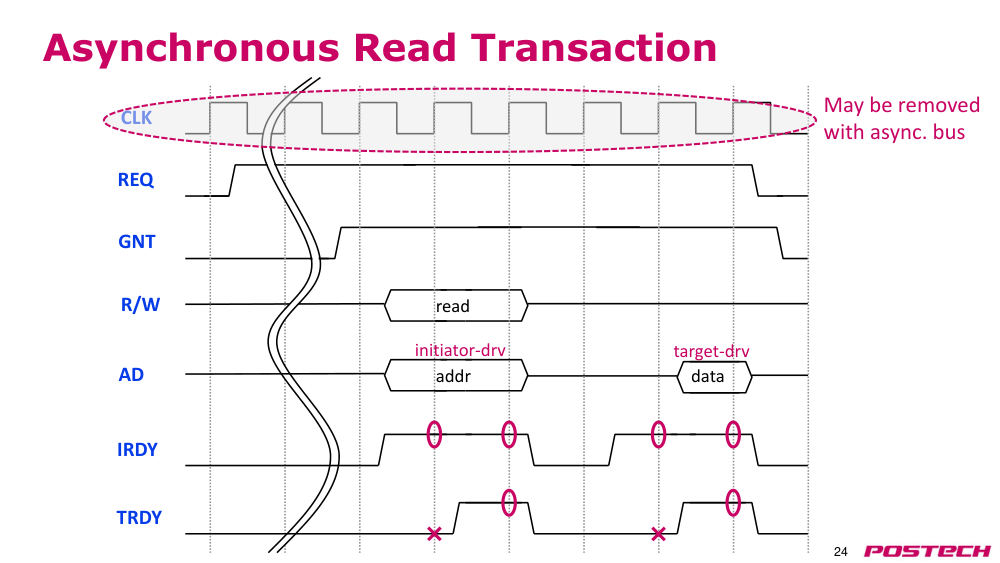
해결IRDY(initiator 의 값 유효)·TRDY(target 준비) handshake. 둘 다 assert 일 때만 bus cycle 유효, 준비 안 되면 같은 값 유지.
- 예시 가정: initiator = driver, target = receiver
- REQ/GNT 도 asynchronous handshake 의 예
2.621:31–26:05asynchronous read 와 burst read
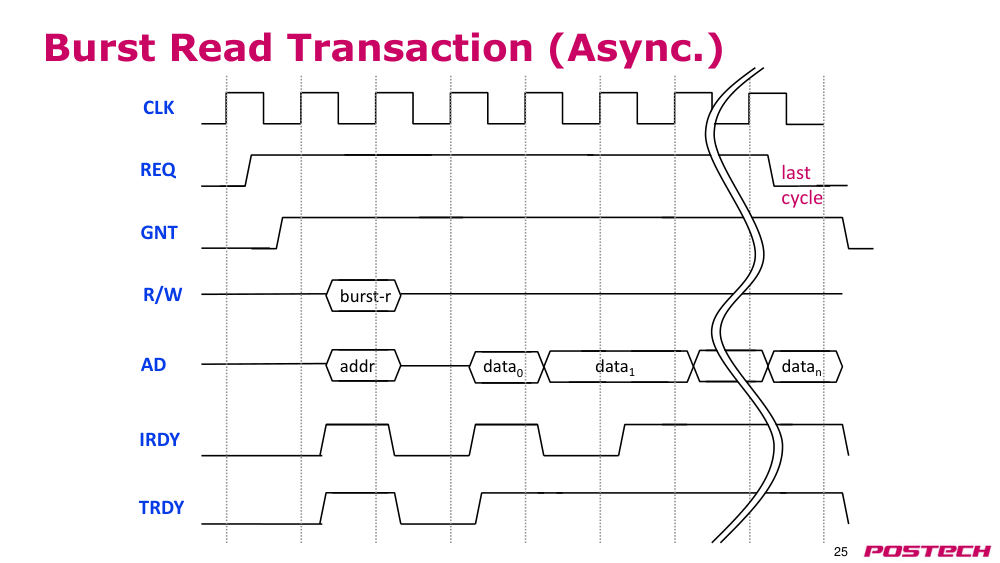
상황·문제clock 없는 async bus 에서 read 한 건과 여러 data 를 읽는 burst 가 어떻게 진행되는지.
원인target 이나 initiator 중 한쪽이 준비되지 않으면 전송이 성립하지 않음.
해결준비되지 않은 동안 driver 가 같은 값 유지. burst 는 한 command 로 data0~datan 을 연속 전송.
- CLK 은 async bus 에서 제거 가능(구현에 따라 유지)
- burst 중 initiator 가 IRDY 를 내리면 target 이 같은 data 유지
2.726:06–31:49bus 성능: latency 와 bandwidth
상황·문제bus 는 data 전송 전 여러 단계를 거쳐 latency·bandwidth overhead 가 있음.
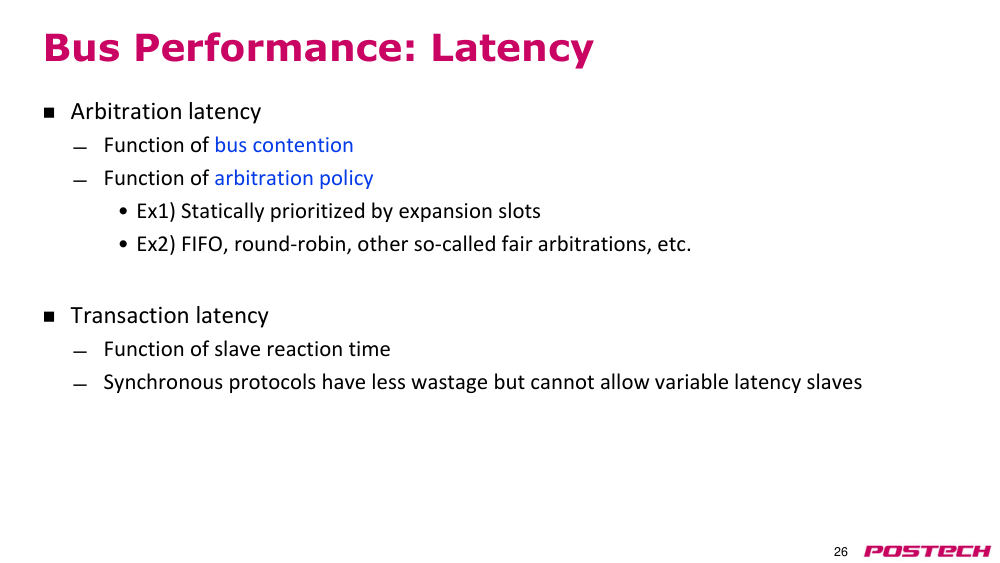
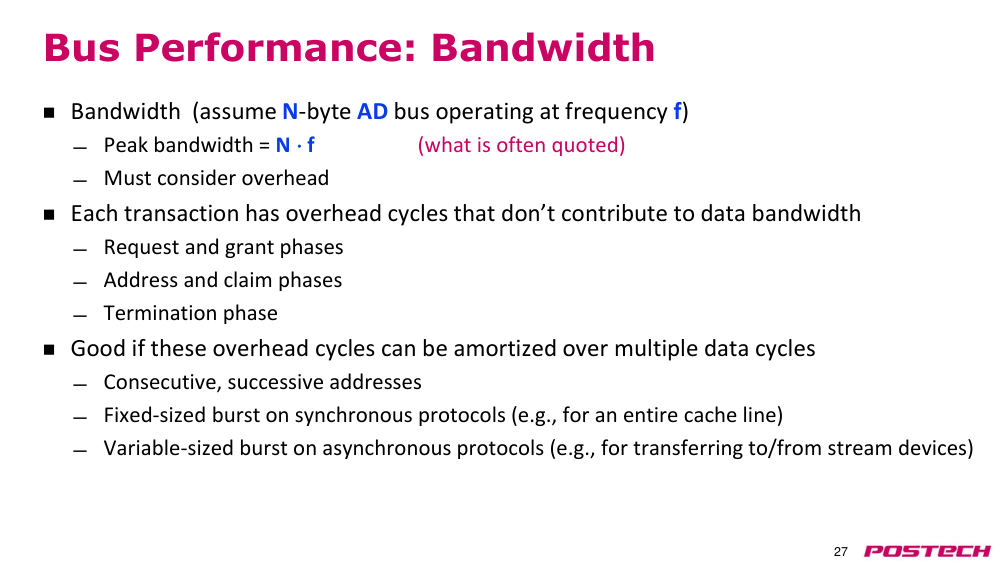
원인arbitration latency(contention·policy), transaction latency(slave 반응·protocol), arbitration·turnaround 등 data 없는 cycle.
해결peak bandwidth N·f 는 상한일 뿐. burst 로 overhead 를 여러 data cycle 에 상각(sync: fixed-size cache line, async: variable-size).
- arbitration policy: static priority, FIFO·round-robin, fairness-aware
- synchronous 는 낭비 적지만 variable-latency slave 불가 → 느린 slave 는 async
- burst 길이 N 이 클수록 overhead 비중 감소
2.7.r.1Wikipedia: Arbiter (electronics) ↗ · multi-master bus 에서 bus arbiter 가 bus cycle 마다 master 선택
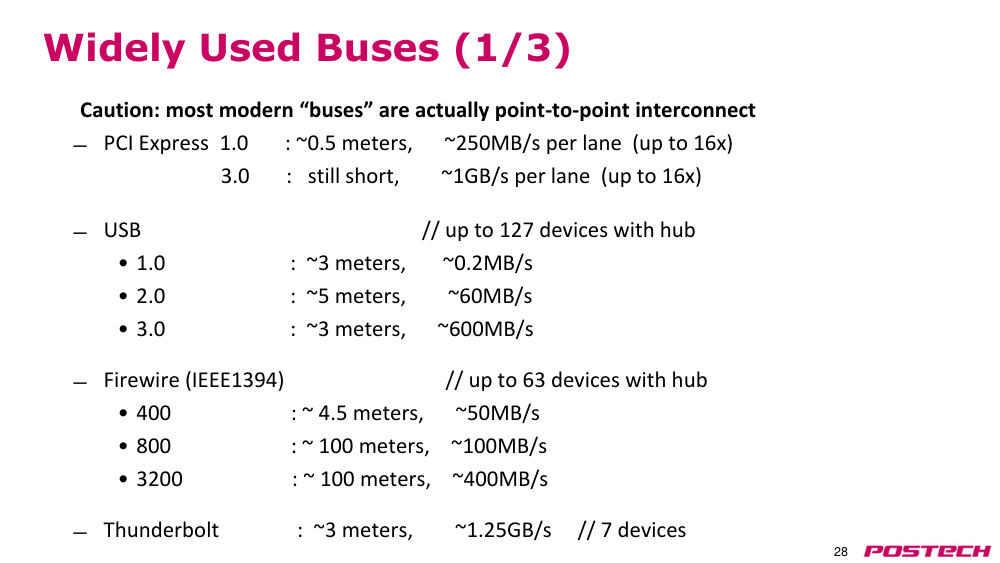
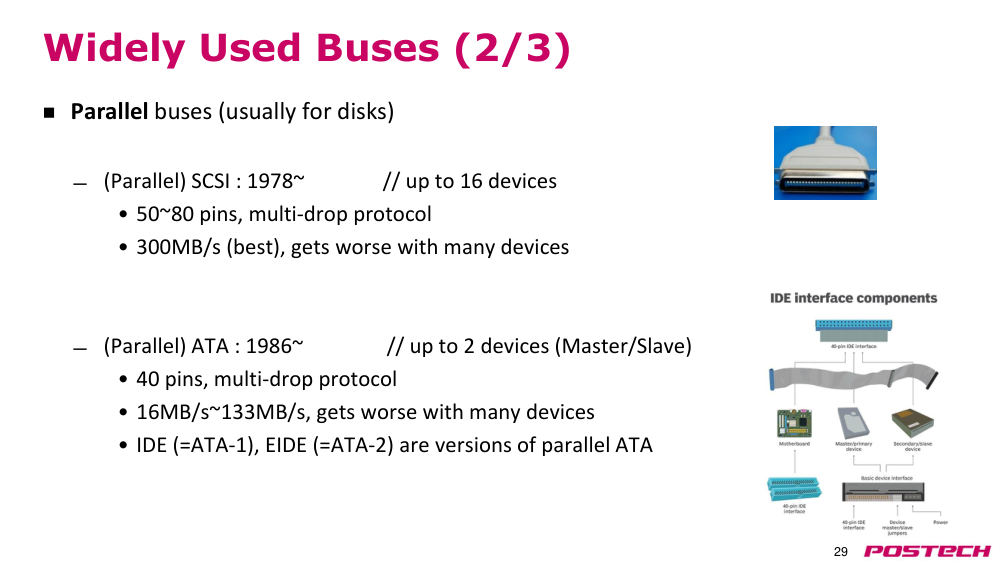
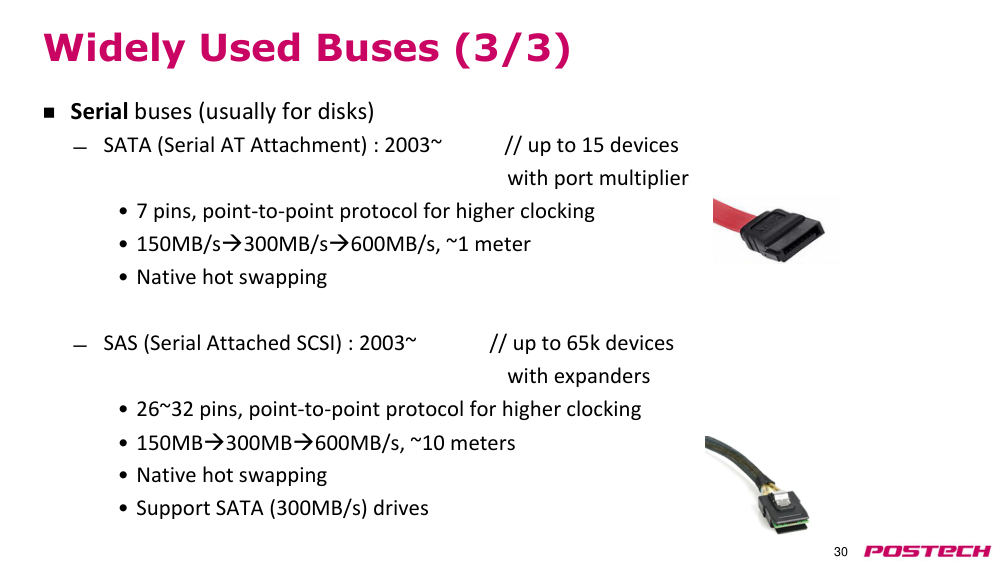
2.831:50–36:23널리 쓰이는 bus: PCIe·USB·ATA·SATA·SAS
상황·문제실제 system 의 I/O interface 사례.
원인고성능 I/O 는 physical bus 대신 point-to-point interconnect 를 쓰면서 이름만 'bus'.
해결PCIe(graphic card), USB·Thunderbolt, 예전 parallel SCSI/ATA(multi-drop) → SATA(point-to-point), SAS(server, hot swap).
- ATA: primary/secondary 두 device 중 하나만 전송
- SAS 는 native hot swapping 으로 서버 가동 중 drive 교체
2.936:24–41:05bus error detection: parity, ECC, CRC
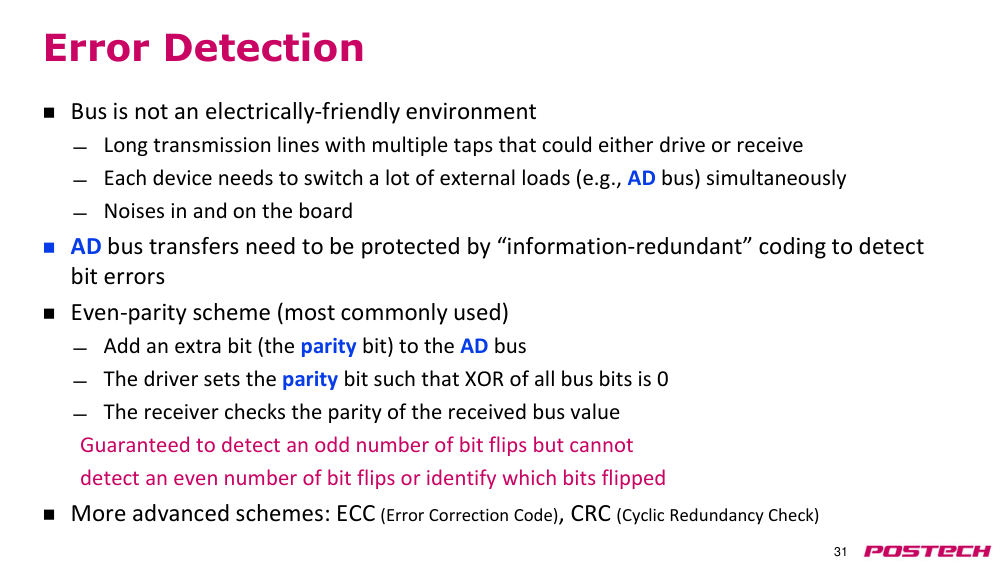
상황·문제여러 device 가 긴 wire 를 공유하고 noise 가 있어 bus 에서 bit error 발생.
원인bus 는 electrically-friendly 환경이 아님.
해결even parity bit 로 XOR 검사 → 오류면 retry. 짝수 개 flip 은 못 잡음 → ECC(1-bit 정정·2-bit 탐지), CRC(PCIe·storage).
- parity 는 홀수 개 bit flip 만 탐지
- server 는 memory·cache 를 ECC 로 보호, 2-bit 오류는 OS 가 application 에 통보
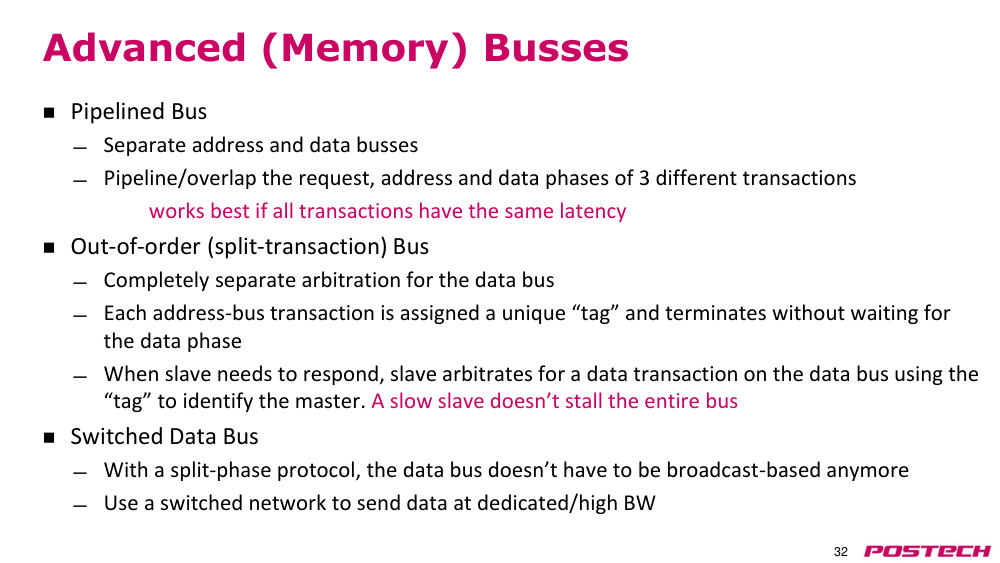
2.1041:06–44:49advanced bus: pipelined, split-transaction, switched
상황·문제arbitration·command overhead 와 느린 device 응답이 bus 성능을 떨어뜨림.
원인한 transaction 이 끝날 때까지 bus 가 묶이고 응답 순서가 요청 순서에 묶임.
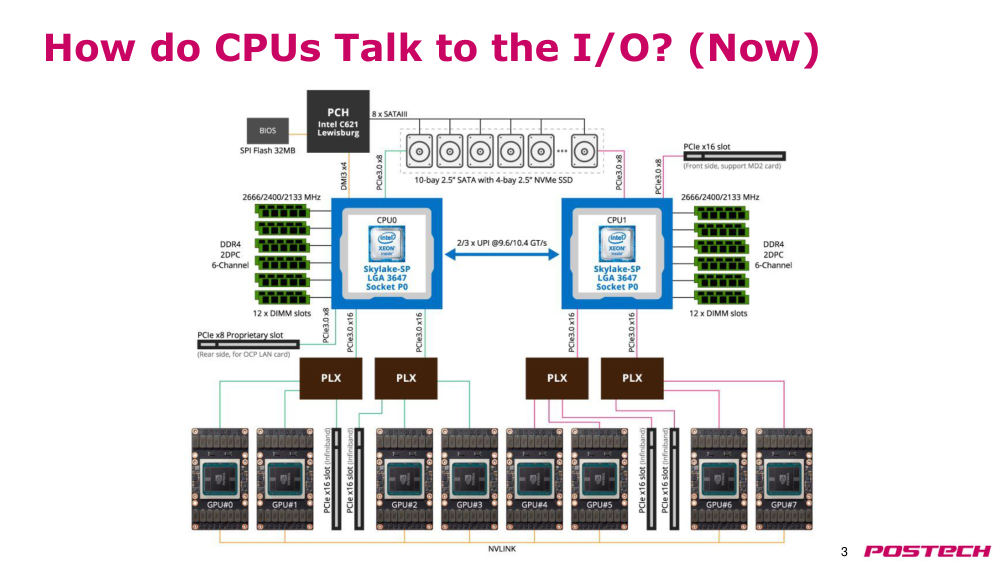
해결address/data bus 분리·pipeline, out-of-order(split-transaction) 응답, 나아가 switched point-to-point interconnect.
- 요청 A,B,C 에 응답이 C,A,B 순으로 와도 됨 (hard drive head 위치 예)
- 고성능 machine 의 switch 구조(p3 그림) 가 그 예
2.1144:50–47:01Q&A: clock 없는 bus 의 turnaround 보장
상황·문제학생 질문: async bus 에 clock 이 없는데 bus turnaround time 을 어떻게 강제하나.
원인bus 에 공통 clock 이 없어도 각 device 는 내부 clock 을 가짐.
해결device 가 자신의 internal clock 으로 필요한 cycle 수만큼 기다려 turnaround 를 보장.
2.1247:02–55:14parallel architecture 동기: 성능·power 추세
상황·문제Moore's law 로 transistor 는 계속 늘지만 single-thread 성능 향상은 2000년대부터 크게 둔화.
원인Dennard scaling 이 끝나 power 가 급증 → frequency 를 더 못 올림. 성능이 높을수록 watts/performance 도 악화.
해결늘어난 transistor 로 core 를 복제해 DLP·TLP 를 활용하는 parallel processing.
- Moore's law 는 성능에 대해 말하지 않음
- single thread 만 있는 application 은 multi-core 이득 없음
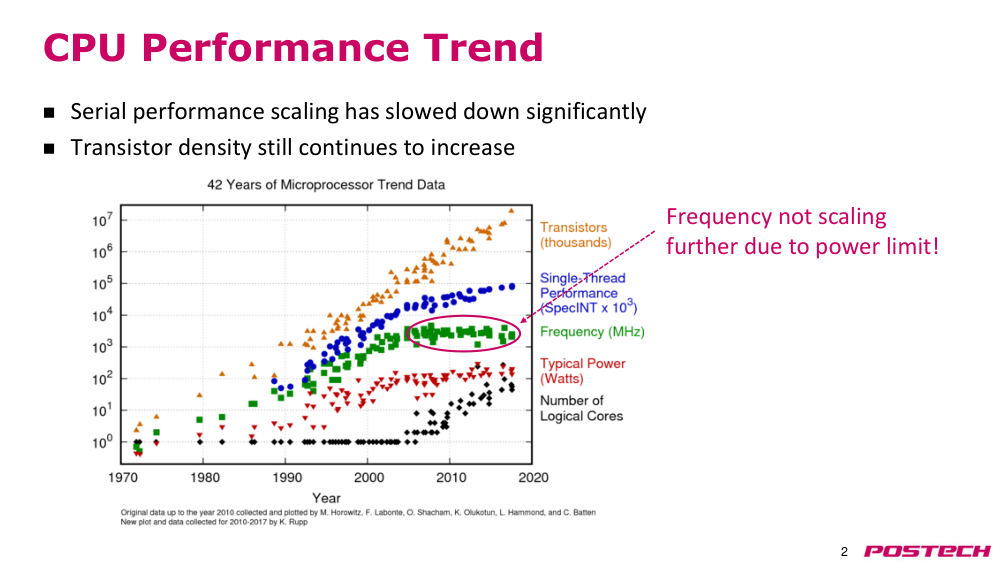
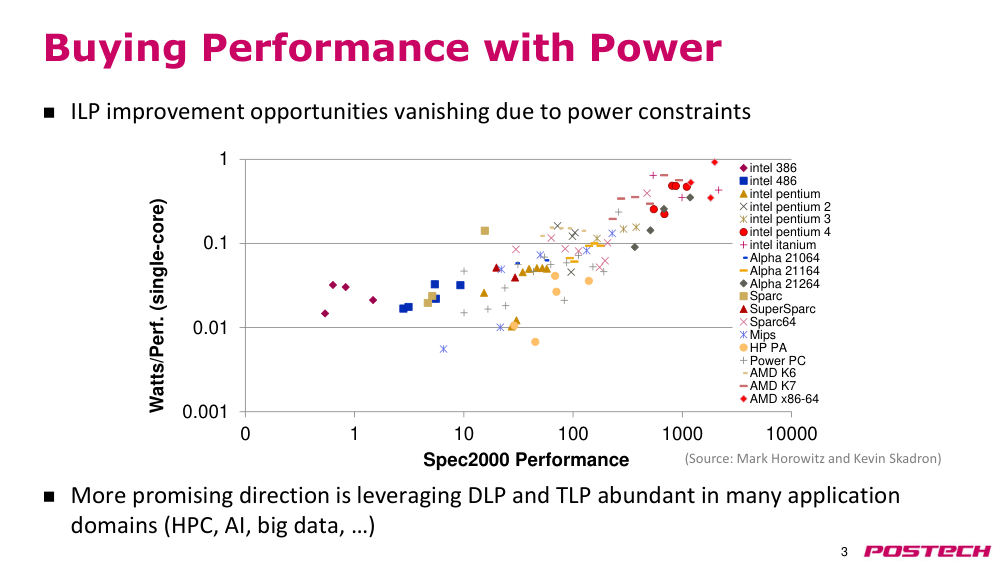
2.12.r.3Karl Rupp: microprocessor-trend-data (GitHub) ↗ · p2 '42 Years of Microprocessor Trend Data' 원 데이터
2.1355:15–1:02:39speedup 과 Amdahl's law, scaling 예제
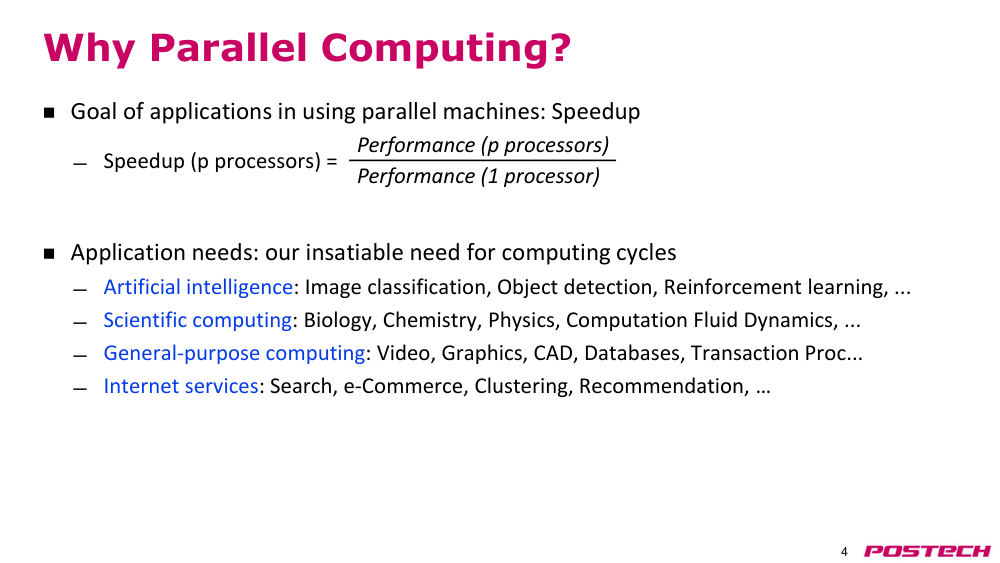
상황·문제p 개 processor 로 이상적으로 p 배 speedup 을 기대.
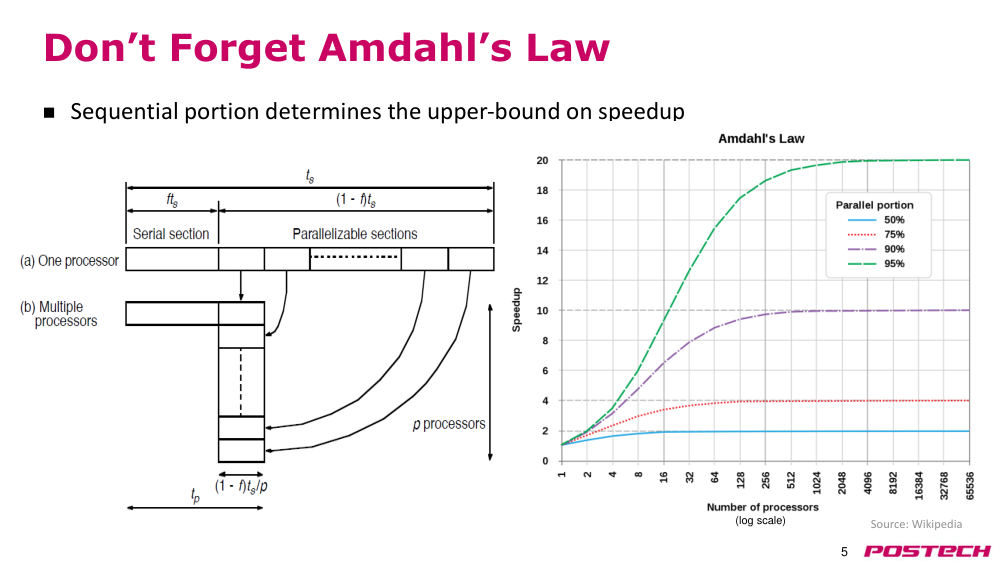
원인serial 부분은 병렬화되지 않음(Amdahl). 여기에 fork/join, 통신, load imbalance overhead 추가.
해결목표 성능을 현실적으로 잡고 parallel 부분 비중을 키움. 10,000개 합 100 core 예: S=50, 100,000개면 90.9.
- parallel portion 50% → 최대 2배, 90% → 최대 10배
- 64K processor 로 10배를 노리는 것은 좋지 않음
- near-ideal speedup 은 많은 application 에서 매우 어려움
2.141:02:40–1:07:51Flynn's taxonomy 와 SIMD processing
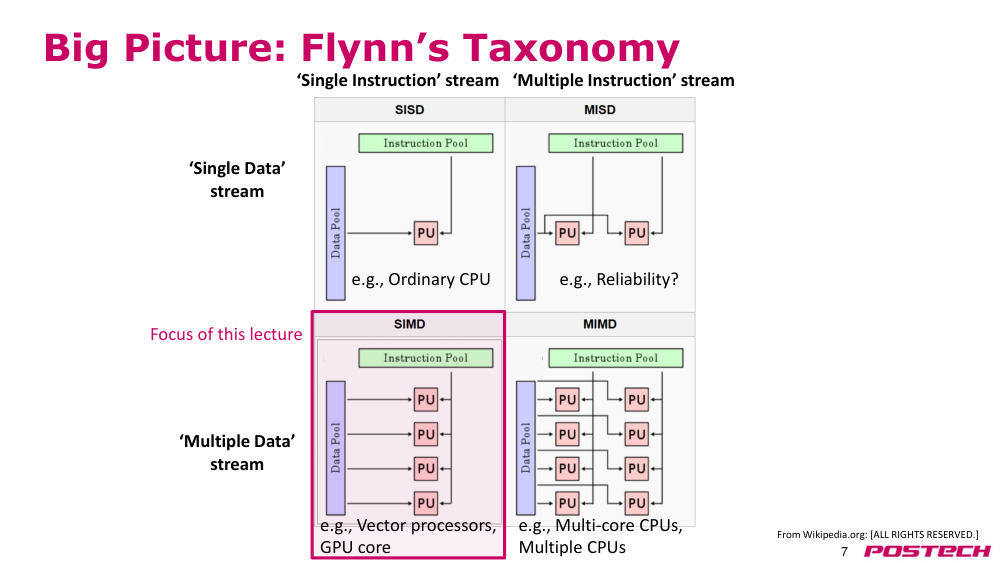
상황·문제parallel processing 방식을 분류하는 틀 필요.
원인instruction stream 과 data stream 이 각각 single/multiple.
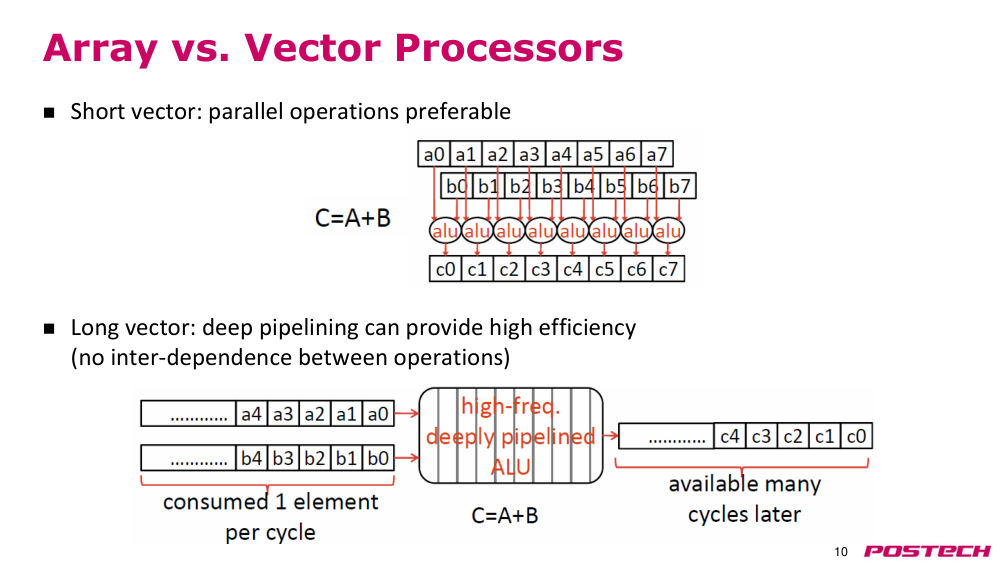
해결SISD(일반 CPU), SIMD(vector·GPU, 이 강의 초점), MISD(reliability?), MIMD(multi-core). SIMD 는 space(array) 또는 time(vector) 으로 처리.
- MISD: 같은 data 에 두 PU → 하나가 고장나도 동작
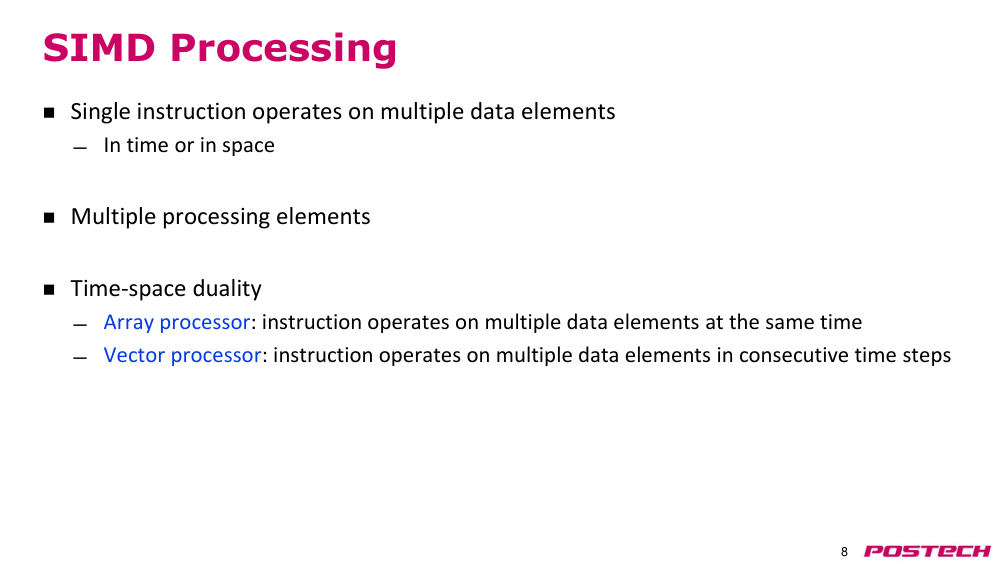
- array processor = 같은 시각 여러 PE, vector processor = 한 unit 이 연속 time step
2.151:07:52–1:14:23array processor vs vector processor
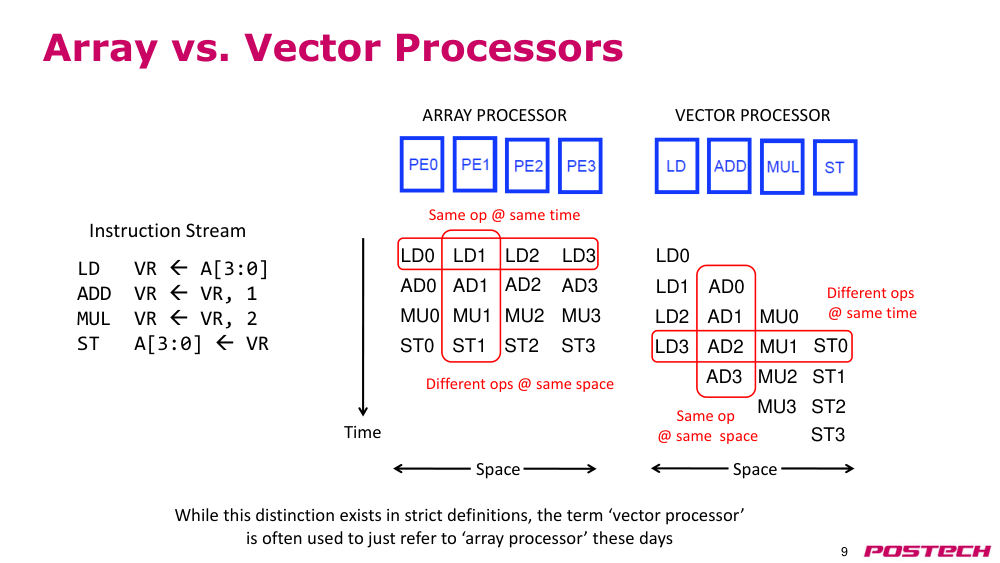
상황·문제같은 SIMD 라도 PE 를 공간에 복제할지 한 unit 을 시간에 걸쳐 쓸지 선택.
원인array 는 PE 마다 모든 연산 가능, vector 는 unit 마다 전용 연산(load/add/mul/store)으로 다른 연산이 동시에 흐름.
해결짧은 vector 는 array(1 cycle vs 8 cycle), 긴 vector(예 1024) 는 고주파 deeply pipelined ALU 의 vector 가 효율적. 다음 시간에 계속.
- array: space 축 같은 연산, time 축 다른 연산
- 흔히 array processor 도 vector processor 라 부름
3핵심 개념
3.1arbiter(중재기)
여러 master 의 REQ 중 하나에 GNT 를 줘 bus 소유권을 결정. policy: static priority, FIFO·round-robin 등.
3.1.r.1Wikipedia: Arbiter (electronics) ↗ · multi-master bus 에서 bus arbiter 가 bus cycle 마다 master 선택
3.2bus turnaround(버스 턴어라운드)
bus 를 drive 하는 device 가 바뀔 때 전기적 이유로 필요한 idle cycle. read 에는 있고 write 에는 없음.
3.3IRDY/TRDY handshake
initiator 는 값이 유효할 때 IRDY, target 은 받을 준비가 되면 TRDY. 둘 다 assert 일 때만 전송 성립.
3.4burst transfer(버스트 전송)
한 번의 arbitration·command 로 여러 data 를 연속 전송해 overhead 상각.
3.5peak bandwidth(최대 대역폭)
N-byte bus × 주파수 f. overhead cycle 때문에 실제 관측 bandwidth 는 더 낮음.
3.6even parity(짝수 패리티)
1의 개수가 짝수가 되도록 parity bit 설정. 홀수 개 bit flip 만 탐지.
3.7split-transaction bus(분할 트랜잭션 버스)
요청과 응답을 별도 transaction 으로 나눠 응답이 out-of-order 로 와도 됨. 느린 slave 가 bus 를 멈추지 않음.
3.8Dennard scaling(데나드 스케일링)
transistor 가 작아지면 power density 일정 → 2000년대에 끝나 frequency 향상 정체.
3.9Amdahl's law(암달의 법칙)
serial 부분이 speedup 상한 결정. parallel 50% → 최대 2배, 90% → 최대 10배.
3.10Flynn's taxonomy(플린의 분류)
instruction/data stream 의 single/multiple 조합으로 SISD·SIMD·MISD·MIMD.
3.11array processor vs vector processor
array: 여러 PE 가 같은 시각 같은 연산(space). vector: 전용 unit 이 element 를 연속 time step 으로 pipeline 처리.
4스스로 확인
4.1synchronous read 에는 bus turnaround cycle 이 있고 write 에는 없는 이유는?
답
read 는 address 는 master, data 는 slave 가 drive 해 driver 가 바뀜. write 는 master 가 둘 다 drive.
4.2asynchronous bus 에서 bus cycle 이 유효한 조건은?
답
IRDY && TRDY. 한쪽이 준비되지 않으면 driver 가 같은 값을 유지.
4.3peak bandwidth N·f 가 실제 bandwidth 보다 큰 이유와 완화 방법은?
답
arbitration·command·turnaround·종료 cycle 은 data 를 나르지 않음. burst 로 여러 data cycle 에 상각.
4.4even parity 로 탐지할 수 없는 오류는?
답
짝수 개 bit flip. 어느 bit 가 바뀌었는지도 알 수 없음.
4.5parallel portion 이 90% 일 때 processor 를 무한히 늘리면 최대 speedup 은?
답
10배 (1 / 0.1).
4.610,000개 수를 100 core 로 더할 때 speedup 이 50 인 이유는?
답
병렬 100 cycle + 부분합 100개를 순차로 더하는 100 cycle = 200 → 10000/200.
4.7짧은 vector 와 긴 vector 에서 array/vector processor 중 유리한 쪽은?
답
짧으면 array(ALU 여러 개로 한 번에), 길면 deeply pipelined ALU 의 vector processor.