이 자료를 쓰는 강의: 56 sequential consistency 와 relaxed model · I/O(port register, memory-mapped I/O, DMA, polling/interrupt) · 57 bus 동작(arbitration, sync/async protocol, 성능, error detection) 과 parallel architecture 도입(Amdahl, Flynn, array vs vector)
Lec19-IO
한국어판 강의자료 · 33쪽
p.1CSED311 컴퓨터구조 – 강의 19
- 입출력 및 bus(버스)
- 김광선
- 컴퓨터공학과
- POSTECH
- 면책 조항: 슬라이드 일부는 Carnegie Mellon University, University of Michigan, Purdue University, University of Pennsylvania, University of Wisconsin의 교수진 Austin, Brehob, Falsafi, Hill, Hoe, Lipasti, Martin, Roth, Shen, Smith, Sohi, Tyson, Vijaykumar, Mutlu, Wenisch가 개발함
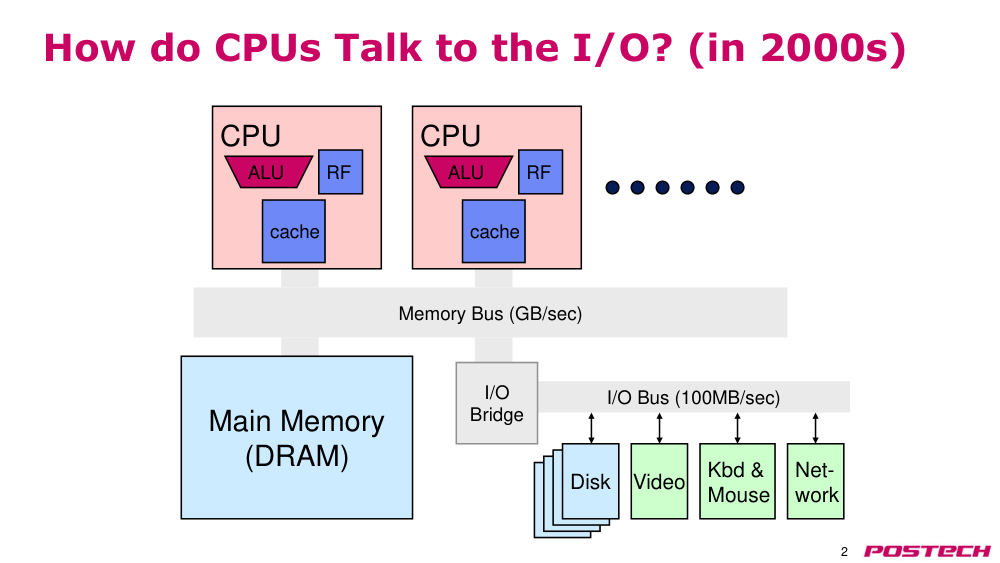
p.22
- disk(디스크)
- disk(디스크)
- disk(디스크)
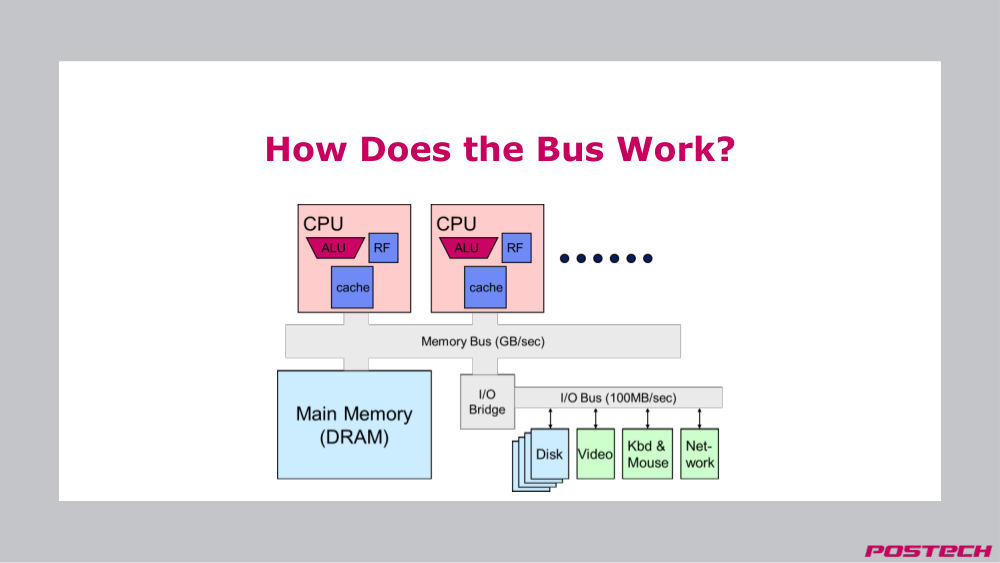
- 입출력 버스 (100MB/sec)
- 2000년대의 CPU가 입출력 장치와 어떻게 소통하는가?
- CPU(중앙처리장치)
- ALU(산술논리장치)
- RF(레지스터 파일)
- cache(캐시)
- 메모리 버스 (GB/sec)
- 주기억장치 (DRAM)
- I/O bridge(입출력 브리지)
- disk(디스크)
- kbd & mouse(키보드 및 마우스)
- CPU(중앙처리장치)
- ALU(산술논리장치)
- RF(레지스터 파일)
- cache(캐시)
- network(네트워크)
- video(비디오)
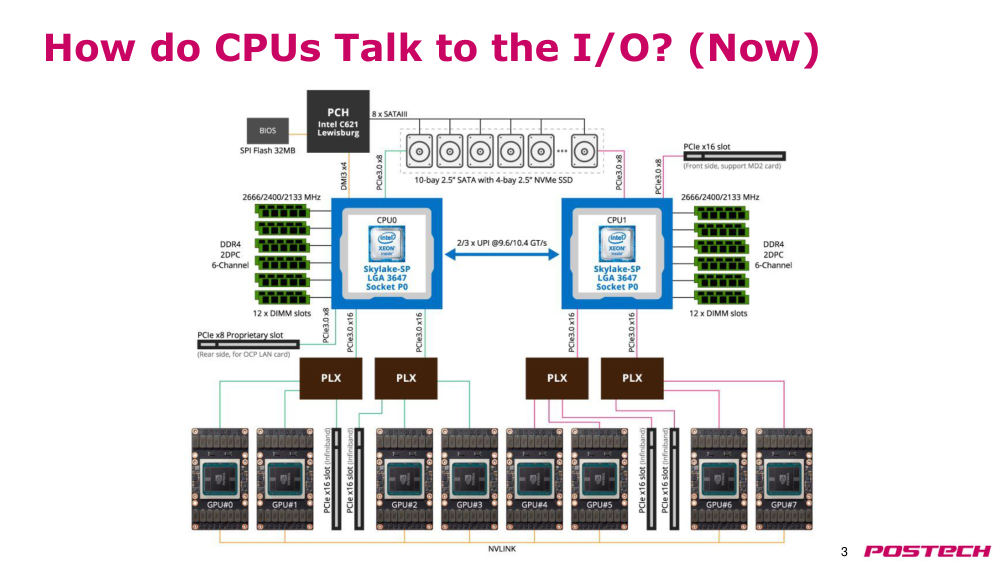
p.33
- 현재의 CPU가 입출력 장치와 어떻게 소통하는가?
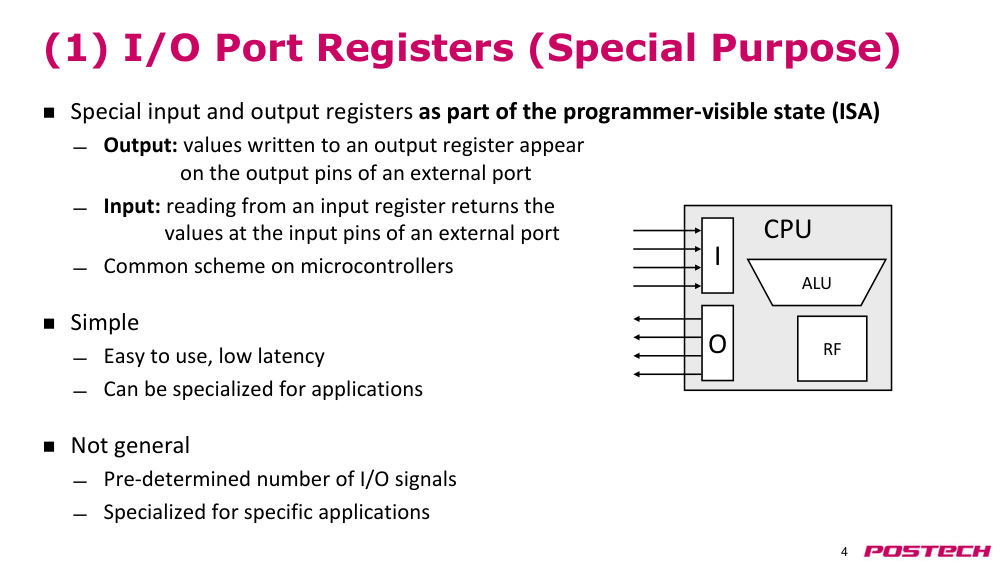
p.44
- (1) 입출력 포트 레지스터 (특수 목적)
- 프로그래머가 직접 접근할 수 있는 상태(ISA)의 일부로 특수 입력/출력 레지스터
- 출력: 출력 레지스터에 쓰는 값은 외부 포트의 출력 핀에 나타남
- 입력: 입력 레지스터를 읽으면 외부 포트의 입력 핀 값이 반환됨
- 마이크로컨트롤러에서 흔한 방식
- 간단함
- 사용이 쉬우며 지연 시간이 낮음
- 응용 프로그램에 특화될 수 있음
- 일반적이지 않음
- 사전에 결정된 입출력 신호 수
- 특정 응용 프로그램에 특화됨
- CPU(중앙처리장치)
- ALU(산술논리장치)
- RF(레지스터 파일)
- 입출력
p.55
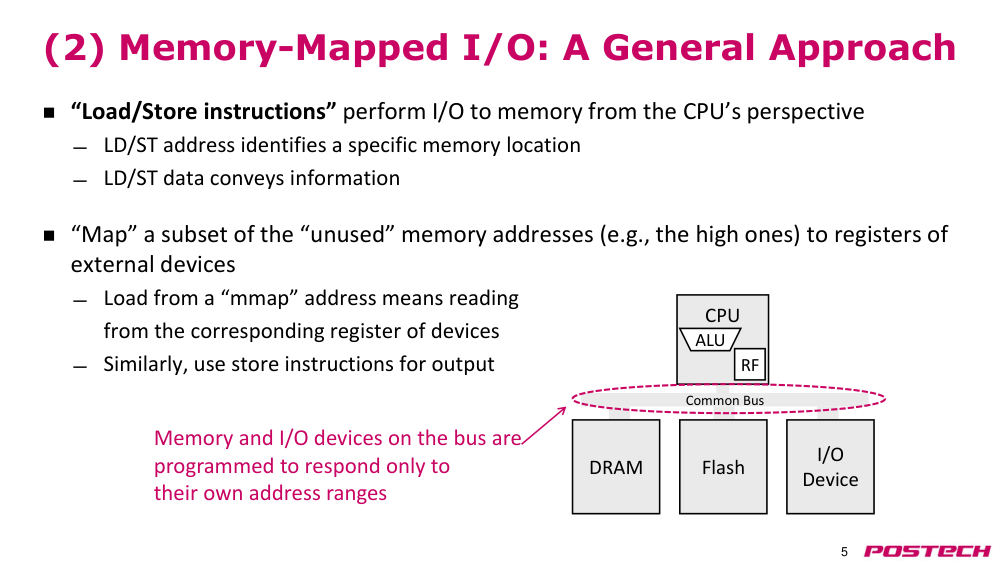
- (2) Memory-Mapped I/O(메모리 매핑 입출력): 일반적인 접근 방식
- CPU 관점에서 ‘Load/Store instructions(로드/스토어 명령어)’가 메모리로 입출력을 수행함
- 로드/스토어 주소는 특정 메모리 위치를 식별함
- 로드/스토어 데이터는 정보를 전달함
- ‘사용되지 않는’ 메모리 주소의 일부(예: 높은 주소)를 외부 장치의 레지스터에 매핑함
- ‘mmap’ 주소에서의 로드는 장치의 해당 레지스터에서 읽는 것과 동일함
- 비슷하게, 출력에는 스토어 명령어 사용
- CPU(중앙처리장치)
- ALU(산술논리장치)
- RF(레지스터 파일)
- DRAM(동적 랜덤 액세스 메모리)
- 플래시
- 입출력 장치
- 공통 bus(버스)
- bus(버스) 상의 메모리 및 입출력 장치는 자신의 address range(주소 범위)에만 반응하도록 프로그래밍됨
p.66
- mmap 입출력: idempotency(멱등성) 및 cache problem(캐시 문제)
- 일반적으로 메모리 로드/스토어 의미는 idempotency(멱등성)을 가짐
- 기억해보자, 메모리 의미는 M[A] 위치를 ‘읽을 때’ 이전에 M[A]에 ‘쓰기’한 마지막 값을 반환해야 함
- → M[A]에 쓰는 것이 한 번 vs. 10번일 때의 효과는?
- → M[A]를 여러 번 읽는 경우의 효과는?
- 그러나 mmap 로드/스토어는 종종 부수적인 효과를 가짐
- mmap 로드/스토어의 수신자는 메모리처럼 동작하지 않을 수 있음
- 장치 레지스터를 읽거나 쓰는 동작이 다른 상태 변화를 유도할 수 있음
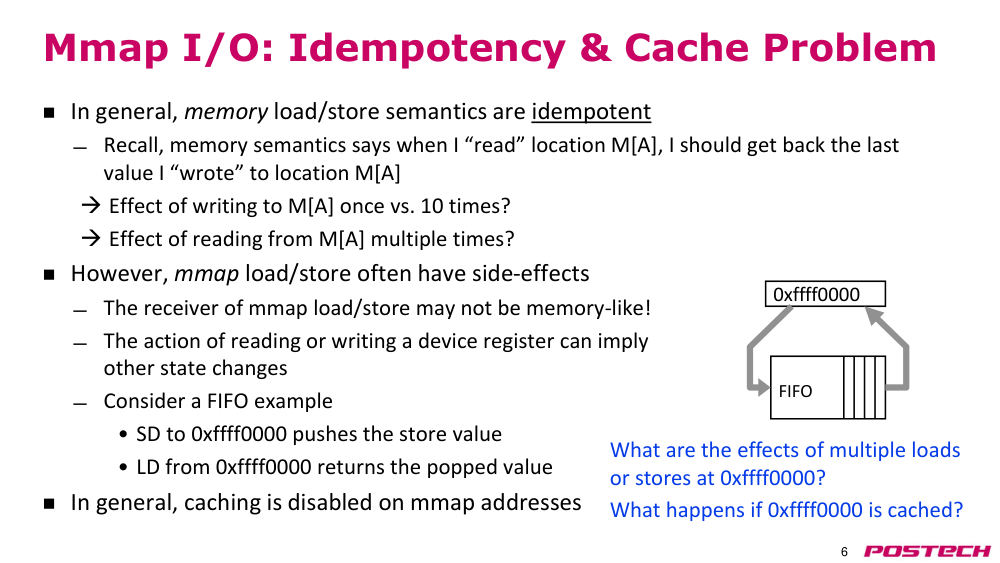
- FIFO 예시를 고려해보자
- • 0xffff0000에 SD를 하면 스토어 값이 푸시됨
- • 0xffff0000에서 LD를 하면 팝된 값이 반환됨
- 일반적으로 mmap 주소에서는 cache(캐시)가 비활성화됨
- FIFO(선입선출 큐)
- 0xffff0000
- 0xffff0000이 cache(캐시)에 저장된다면 어떻게 되는가?
- 0xffff0000에서 여러 번의 로드 또는 스토어가 발생할 때의 영향은?
p.7직접 메모리 접근 (DMA)
- mmap 입출력은 느리며 많은 CPU 사이클을 소모할 수 있음
- SSD에서 대량의 데이터를 메모리로 로드하는 경우를 고려해보자
- 왜 I/O 장치가 메모리를 직접 접근하게 하지 않는가?
- DMA 장치에 대한 명령어:
- “0x54100 위치에서 시작하여 1024 KB를 읽기(또는 쓰기)”
- CPU는 디바이스 레지스터에 mmap 쓰기를 사용하여 명령어를 발행
- DMA transfer(DMA 전송)이 완료되었는지 어떻게 알 수 있는가?
- DMA engine(DMA 엔진)에 대한 명령어:
- “원본 블록(즉, 기준 주소 및 크기)을 대상 블록으로 복사”
- 원본 및 대상 영역은 메모리 또는 mmap된 영역일 수 있음
- 흥미로운 점: cache(캐시)와의 상호작용은?
p.8Write-Back cache(쓰기-백 캐시)와 DMA
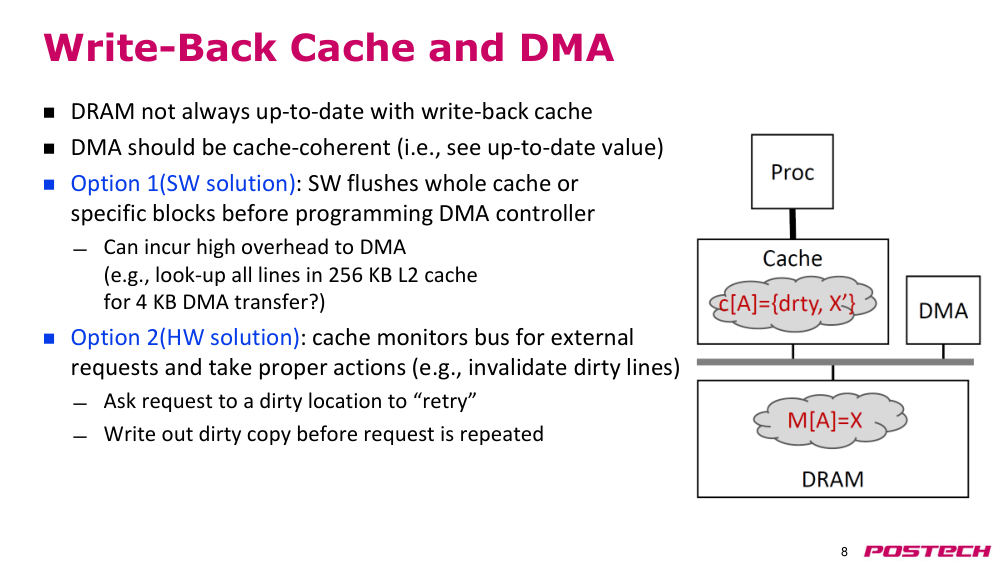
- DRAM은 항상 Write-Back cache(쓰기-백 캐시)와 일치하지 않을 수 있음
- DMA는 캐시 일관성(Cache-Coherent)이어야 함 (즉, 최신 값을 볼 수 있어야 함)
- 옵션 1(소프트웨어 해결책): DMA 컨트롤러를 프로그래밍하기 전에 전체 cache(캐시) 또는 특정 블록을 플러시
- DMA에 높은 오버헤드를 초래할 수 있음
- (예: 4 KB DMA transfer(DMA 전송)을 위해 256 KB L2 cache(캐시)의 모든 라인을 검색해야 하는 경우)
- 옵션 2(하드웨어 해결책): cache(캐시)가 외부 REQ(요청)을 모니터링하고 적절한 조치를 취함 (예: dirty line(더티 라인) 무효화)
- dirty location(더티 위치)에 대한 REQ(요청)은 “재시도”를 요구함
- REQ(요청)이 반복되기 전에 더러운 복사본을 쓰기
p.9DMA: 가상 메모리 문제
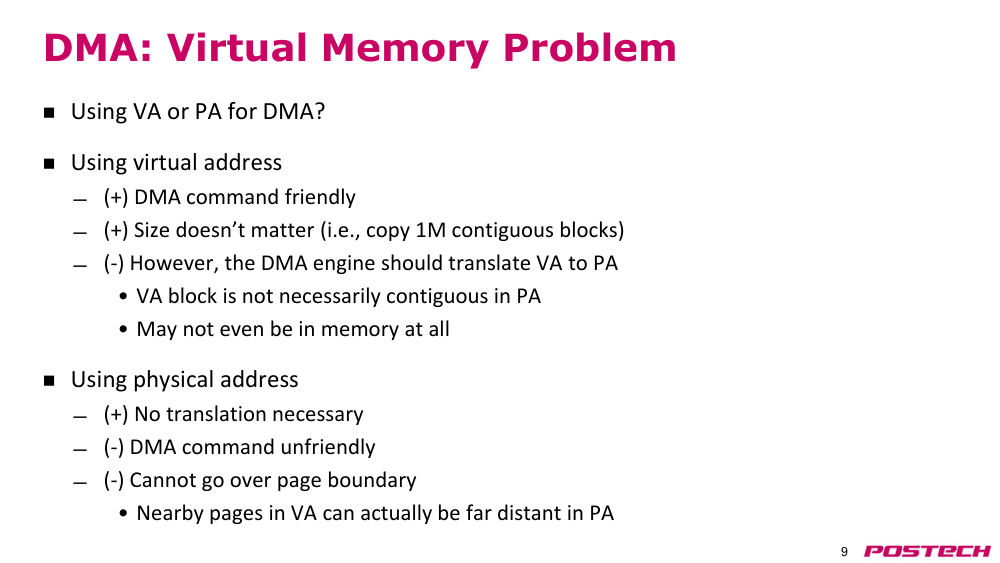
- DMA에 가상 주소(VA) 또는 물리 주소(PA)를 사용할 것인가?
- virtual address (VA)(가상 주소) 사용:
- ✓ DMA 명령어에 친화적
- ✓ 크기의 제약이 없음 (예: 1M 개의 연속 블록 복사 가능)
- ✗ 그러나 DMA engine(DMA 엔진)이 VA를 PA로 변환해야 함
- • VA 블록은 반드시 PA에서 연속적이지 않음
- • 메모리에 존재하지 않을 수도 있음
- physical address (PA)(물리 주소) 사용:
- ✓ 변환 과정이 필요 없음
- ✗ DMA 명령어에 친화적이지 않음
- ✗ 페이지 경계를 넘을 수 없음
- • VA에서 가까운 페이지는 PA에서는 멀리 떨어져 있을 수 있음
p.10DMA: 가상 메모리 문제
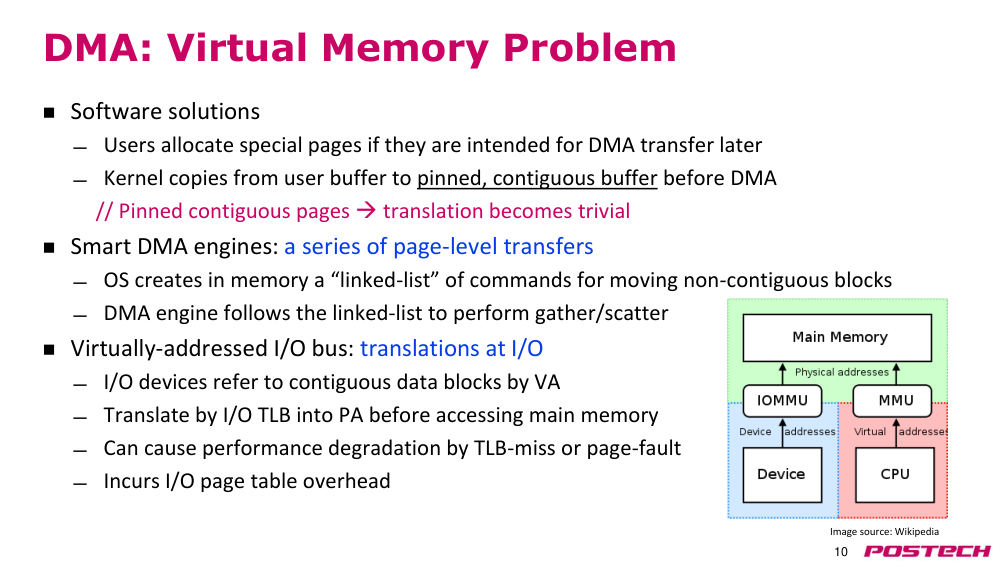
- 소프트웨어 해결책:
- 향후 DMA transfer(DMA 전송)을 위해 특수 페이지를 할당함
- 커널은 사용자 버퍼에서 고정된 contiguous buffer(연속 버퍼)로 복사한 후 DMA 수행
- // 고정된 연속 페이지 → 변환 과정이 간단해짐
- 스마트 DMA engine(DMA 엔진): 페이지 단위 전송 시리즈
- OS는 비연속 블록을 이동하기 위한 ‘Linked-List of commands(명령어 연결 리스트)’를 메모리에 생성
- DMA engine(DMA 엔진)은 연결 리스트를 따라가며 집합/분산(Gather/Scatter) 수행
- Virtually-Addressed I/O bus(가상 주소 기반 입출력 버스): I/O에서 변환 수행
- I/O 장치는 VA로 연속 데이터 블록을 참조
- 메인 메모리에 접근하기 전에 I/O TLB로 PA로 변환
- TLB 미스 또는 page fault(페이지 폴트)로 인해 성능 저하 가능성 있음
- I/O 페이지 테이블 오버헤드 발생
p.11I/O 장치를 언제 서비스해야 하는가?
p.12패키지 배달 비유
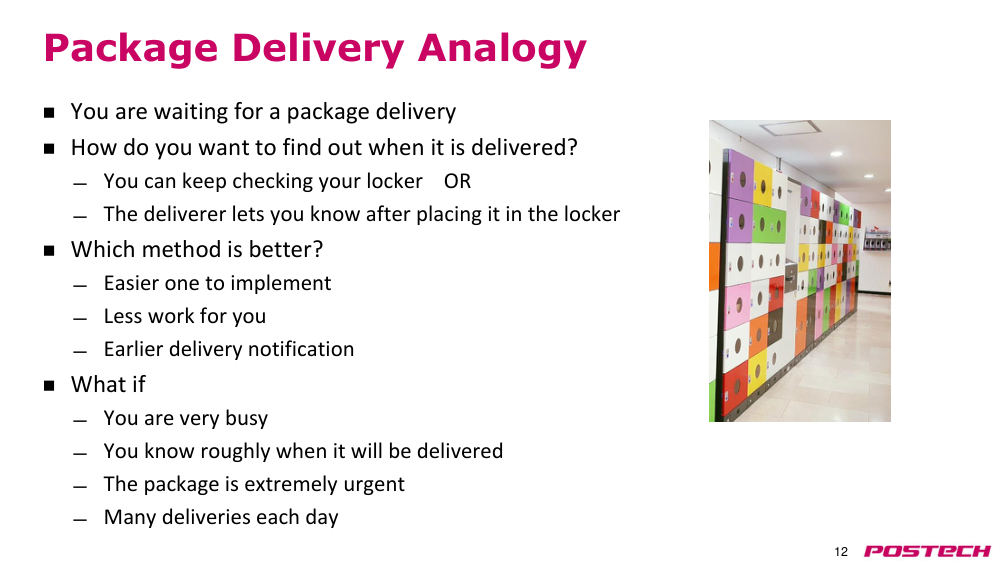
- 당신은 패키지 배달을 기다리고 있다
- 배달이 완료되었을 때 어떻게 알 수 있을까?
- 당신은 계속 락커를 확인할 수 있음 OR
- 배달자가 락커에 패키지를 넣은 후 당신에게 알림을 줄 수 있음
- 어떤 방법이 더 나은가?
- 구현이 더 쉬움
- 당신이 해야 할 일이 적음
- 배달 알림이 빠름
- 만약 다음과 같은 상황이라면?
- 당신이 매우 바쁨
- 대략 언제 도착할지 알고 있음
- 패키지가 매우 긴급함
- 하루에 여러 건의 배달이 있음
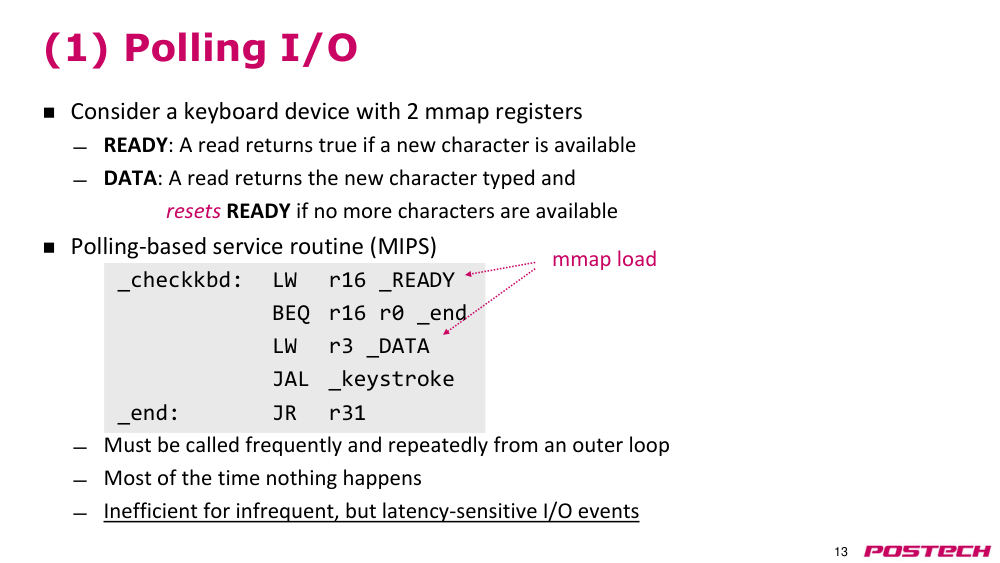
p.13polling I/O(폴링 기반 입출력)
- 키보드 장치가 2개의 mmap 레지스터를 가진다고 가정하자.
- READY: 새로운 문자가 사용 가능한 경우 읽기 연산이 true를 반환한다.
- DATA: 새로운 문자를 반환하며, 더 이상 문자가 없으면 READY를 재설정한다.
- 폴링 기반 서비스 루틴 (MIPS)
- _checkkbd:
- LW r16 _READY
- BEQ r16 r0 _end
- LW r3 _DATA
- JAL _keystroke
- _end:
- JR r31
- 외부 루프에서 자주 반복 호출되어야 한다.
- 대부분의 시간 동안 아무 일도 일어나지 않는다.
- 희귀하지만 지연 민감한 입출력 이벤트에 비효율적이다.
- mmap 로드
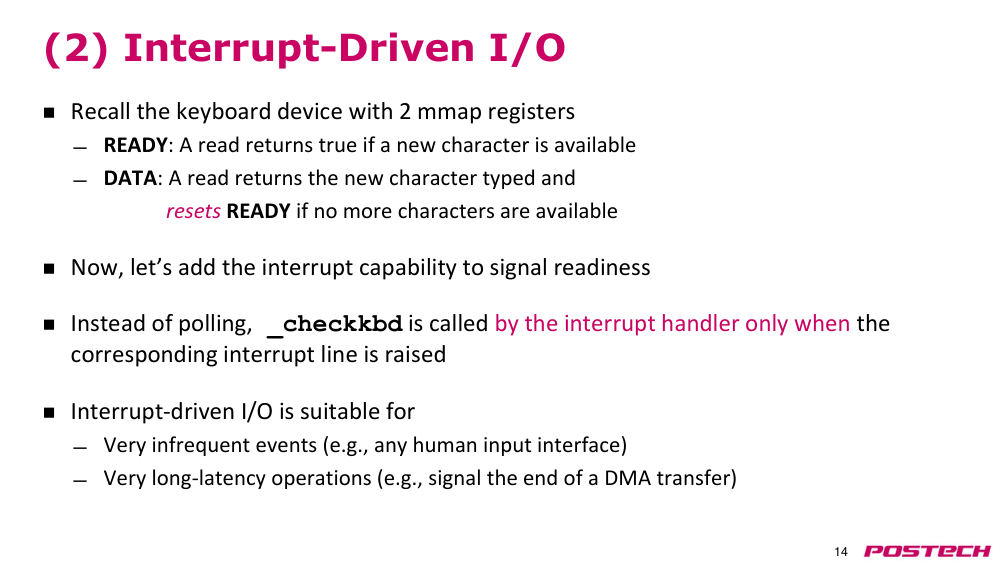
p.14Interrupt-Driven I/O(인터럽트 기반 입출력)
- 키보드 장치가 2개의 mmap 레지스터를 가진다고 recall하자.
- READY: 새로운 문자가 사용 가능한 경우 읽기 연산이 true를 반환한다.
- DATA: 새로운 문자를 반환하며, 더 이상 문자가 없으면 READY를 재설정한다.
- 이제 준비 상태를 알리기 위해 인터럽트 기능을 추가한다.
- 폴링 대신, _checkkbd는 해당 인터럽트 라인이 활성화되었을 때만 interrupt handler(인터럽트 핸들러)에 의해 호출된다.
- Interrupt-Driven I/O(인터럽트 기반 입출력)은 다음에 적합하다:
- 매우 희귀한 이벤트 (예: 사용자 입력 인터페이스)
- 매우 긴 지연을 가지는 작업 (예: DMA transfer(DMA 전송) 완료 신호)
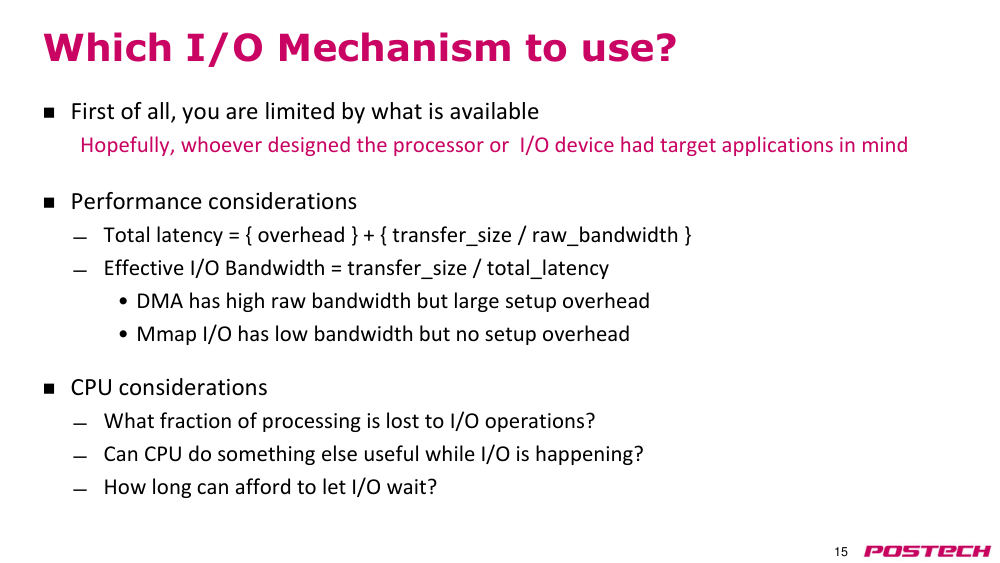
p.15어떤 입출력 메커니즘을 사용할 것인가?
- 먼저 사용 가능한 것에 제한된다.
- 프로세서나 입출력 장치를 설계한 사람이 타겟 애플리케이션을 고려했기를 바란다.
- 성능 고려사항:
- total latency(전체 지연 시간) = { 오버헤드 } + { 전송 크기 / raw bandwidth(원시 대역폭) }
- effective I/O bandwidth(실제 입출력 대역폭) = 전송 크기 / total latency(전체 지연 시간)
- DMA는 높은 raw bandwidth(원시 대역폭)을 가지지만 큰 setup overhead(설정 오버헤드)를 가진다.
- mmap 입출력은 낮은 대역폭을 가지지만 setup overhead(설정 오버헤드)가 없다.
- CPU 고려사항:
- 처리량의 몇 퍼센트가 입출력 작업에 소모되는가?
- 입출력이 진행되는 동안 CPU는 다른 유용한 일을 할 수 있는가?
- 입출력이 얼마나 오래 기다릴 수 있는가?
p.16bus(버스)는 어떻게 작동하는가?
p.17기본 bus(버스) 개념
- broadcast medium(브로드캐스트 매체):
- 여러 장치를 연결하는 공통 datapath(데이터 경로) – interconnect cost(인터커넥트 비용) 절감
- 한 번에 하나의 드라이버, 여러 수신기
- ‘transaction(트랜잭션)’으로 Time-Multiplexed(시간 분할 다중화) – 대역폭은 시간 공유
- protocol(프로토콜):
- bus(버스) 장치들이 공유를 관리하기 위해 사용하는 handshake signals(핸드셰이크 신호)와 규칙의 집합
- 장치 유형:
- master(마스터): transaction(트랜잭션)을 시작하는 장치
- slave(슬레이브): transaction(트랜잭션)에 응답하는 장치
- 단일 장치는 master(마스터) 및 slave(슬레이브) 기능을 모두 가질 수 있다.
- arbiter(중재기): 공유 bus(버스) 사용을 관리하는 특수 버스 장치
p.18bus(버스) transaction(트랜잭션)
- 메모리와 유사한 R/W(읽기/쓰기) 명령어, 주소, 데이터:
- master(마스터)는 주소에 대해 읽기/write transaction(쓰기 트랜잭션)을 발행한다.
- 각 slave(슬레이브)는 메모리와 유사하게 응답할 address range(주소 범위)를 할당받는다.
- transaction(트랜잭션) 단계:
- 1) master(마스터)는 arbiter(중재기)에 bus(버스) 소유권 REQ(요청)
- 2) arbiter(중재기)는 master(마스터)에게 소유권 GNT(허가)
- 3) master(마스터)는 모든 장치가 볼 수 있도록 주소를 드라이브
- 4) slave(슬레이브)가 transaction(트랜잭션)을 주장함 ("이 주소는 나와 관련 있음")
- 5) 마스터(또는 슬레이브)가 읽기 또는 쓰기 여부에 따라 데이터를 드라이브하여 모든 장치가 볼 수 있도록 함
- 6) master(마스터)가 transaction(트랜잭션)과 bus(버스) 소유권을 종료
p.19기본 bus(버스) 신호
- CLK: 모든 장치가 공통 클럭에 의해 동기화됨
- master(마스터)별로 arbiter(중재기)와의 '개별' 신호
- REQ (출력): 소유권을 요청할 때 활성화; transaction(트랜잭션) 종료를 알리기 위해 비활성화
- GNT (입력): 소유권이 부여됨
- 모든 장치가 공유하는 '방송' 신호
- R/W (양방향): bus(버스) 명령어 (예: 읽기, 쓰기 등)
- AD (주소/데이터 bus(버스), 양방향): master(마스터)가 주소 단계 동안 주소를 드라이브하고, 데이터 단계 동안 마스터/slave(슬레이브)가 데이터를 드라이브함
- 주소 bus(버스)와 데이터 버스를 별도로 두는 것은 어떻게 되는가?
p.20bus(버스) 구성
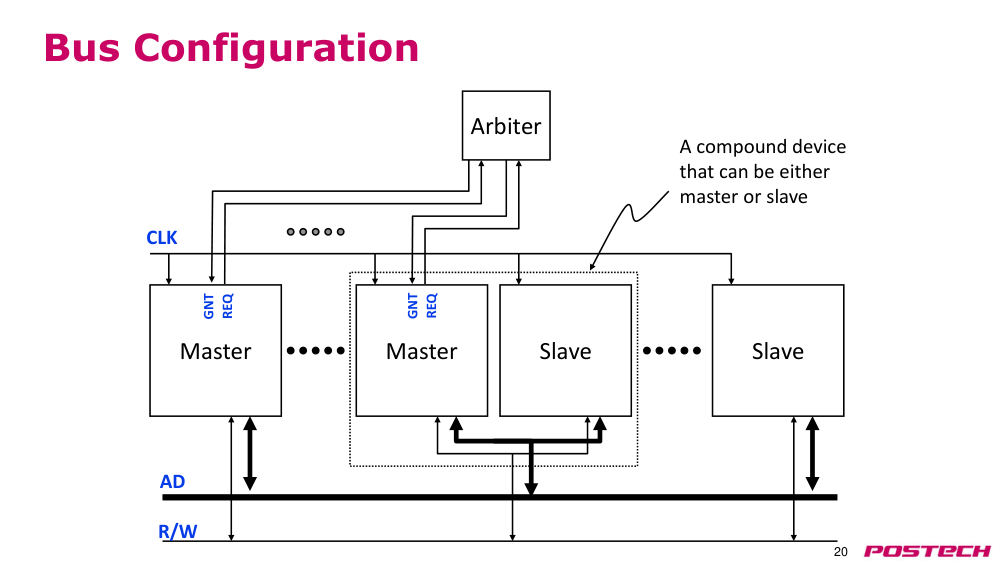
- master(마스터)
- arbiter(중재기)
- master(마스터)
- slave(슬레이브)
- slave(슬레이브)
- REQ
- GNT
- REQ
- GNT
- AD
- R/W
- 복합 장치 (마스터이거나 slave(슬레이브)일 수 있음)
- CLK
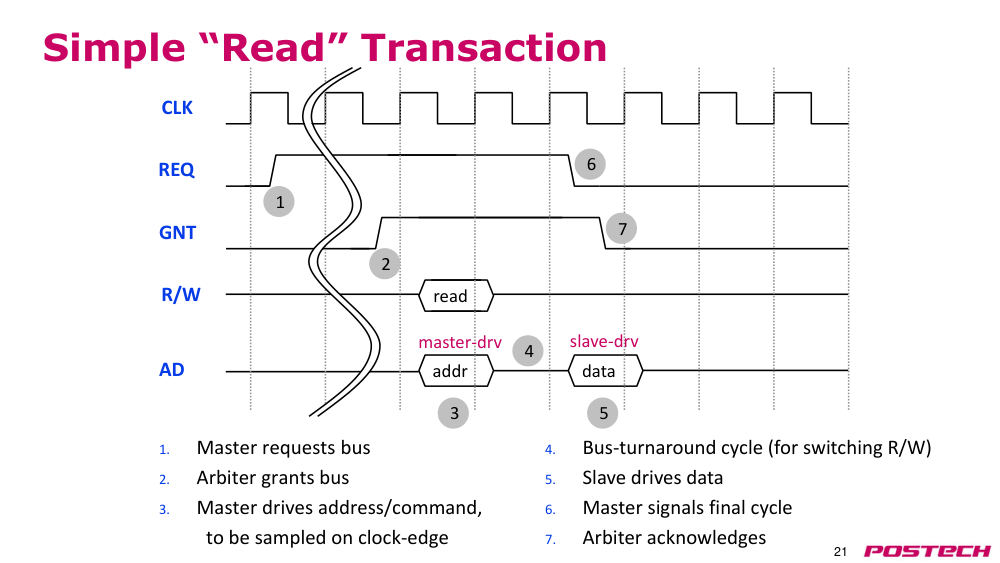
p.21간단한 '읽기' transaction(트랜잭션)
- CLK
- addr
- data
- read
- REQ
- GNT
- R/W
- AD
- 1
- 2
- 3
- 4
- 5
- 6
- 4. bus turnaround cycle(버스 턴어라운드 사이클) (R/W 전환을 위한)
- 5. slave(슬레이브)가 데이터를 드라이브함
- 6. master(마스터)가 마지막 사이클을 신호로 보냄
- 7. arbiter(중재기)가 확인함
- 7
- master-drv
- slave-drv
- 1. master(마스터)가 bus(버스) REQ(요청)
- 2. arbiter(중재기)가 bus(버스) GNT(허가)
- 3. master(마스터)가 주소/명령어를 드라이브하며, CLK(클럭) 엣지에서 샘플링됨
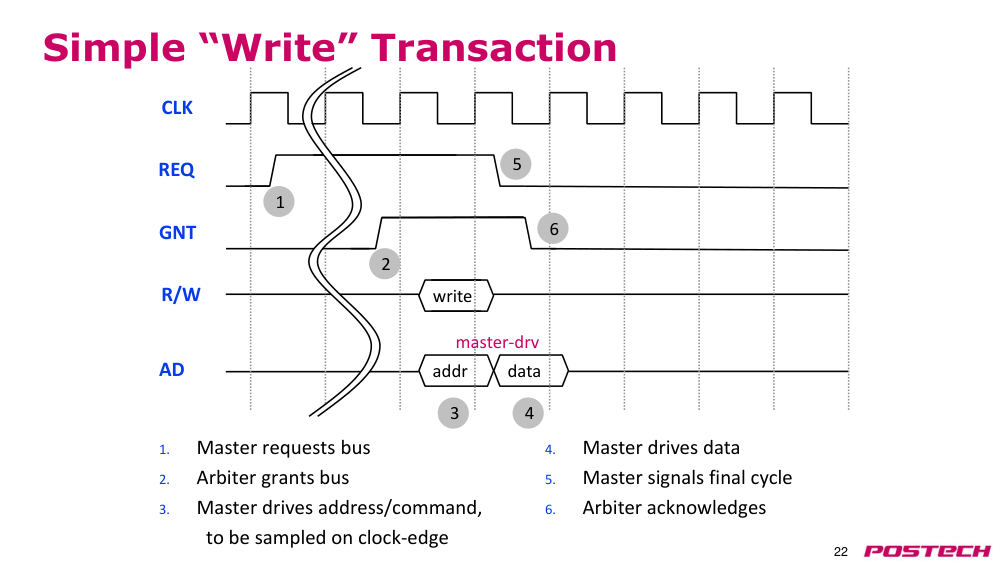
p.22간단한 '쓰기' transaction(트랜잭션)
- CLK
- addr
- data
- write
- REQ
- GNT
- R/W
- AD
- 1
- 2
- 3
- 4
- 5
- 4. master(마스터)가 데이터를 드라이브함
- 5. master(마스터)가 마지막 사이클을 신호로 보냄
- 6. arbiter(중재기)가 확인함
- 6
- master-drv
- 1. master(마스터)가 bus(버스) REQ(요청)
- 2. arbiter(중재기)가 bus(버스) GNT(허가)
- 3. master(마스터)가 주소/명령어를 드라이브하며, CLK(클럭) 엣지에서 샘플링됨
p.23비동기 bus(버스) protocol(프로토콜)
- 동기 bus(버스) protocol(프로토콜)은 미리 정해진 이벤트 타이밍을 가짐
- 타겟은 충분히 빠르게 반응해야 함
- bus(버스)가 느린 장치와 빠른 장치를 공유할 경우 좋지 않음 (예: I/O 확장 버스)
- asynchronous handshaking(비동기 핸드셰이크)
- REQ/GNT는 asynchronous handshaking(비동기 핸드셰이크)의 예시임
- AD 사용을 조율하기 위해 IRDY (이니시에이터용) 및 TRDY (타겟용) 신호 도입
- • (이 예시에서는 이니시에이터 == 드라이버, 타겟 == 수신기로 가정)
- • 드라이버는 AD 값이 유효할 때만 IRDY를 활성화함
- • 수신기는 AD 값을 수락할 준비가 되었을 때만 TRDY를 활성화함
- • bus(버스) 사이클이 유효하려면 IRDY && TRDY가 모두 참이어야 함
- • 수신기는 드라이버가 준비되었을 때만 주의를 기울임
- • 드라이버는 수신기가 준비될 때까지 데이터 값을 유지함
- • 드라이버와 수신기 모두 *RDY를 비활성화함으로써 응답을 임의로 지연시킬 수 있음
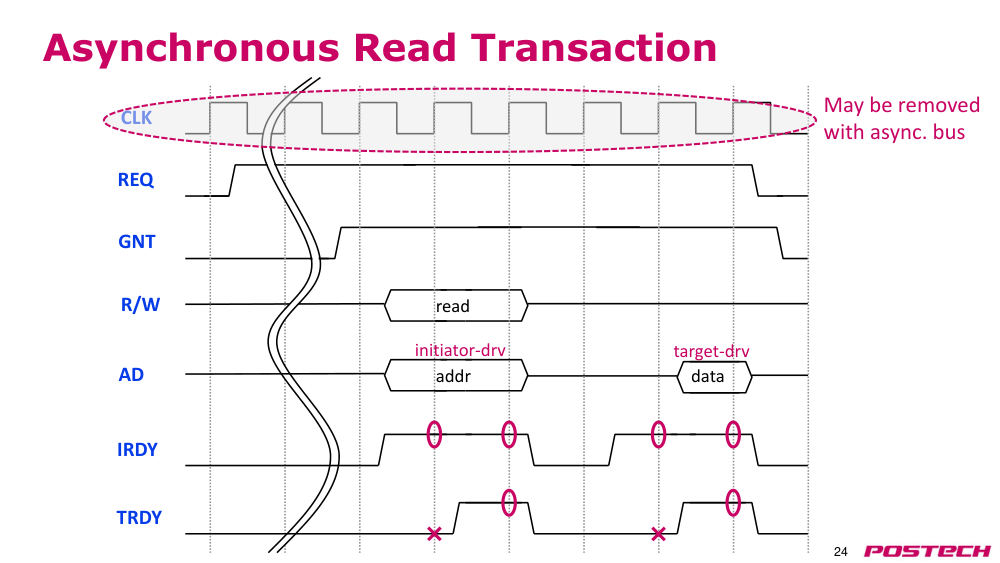
p.24비동기 read transaction(읽기 트랜잭션)
- CLK
- read
- REQ
- GNT
- R/W
- AD
- data
- IRDY
- TRDY
- addr
- initiator-drv
- target-drv
- 비동기 bus(버스)를 사용하면 제거 가능
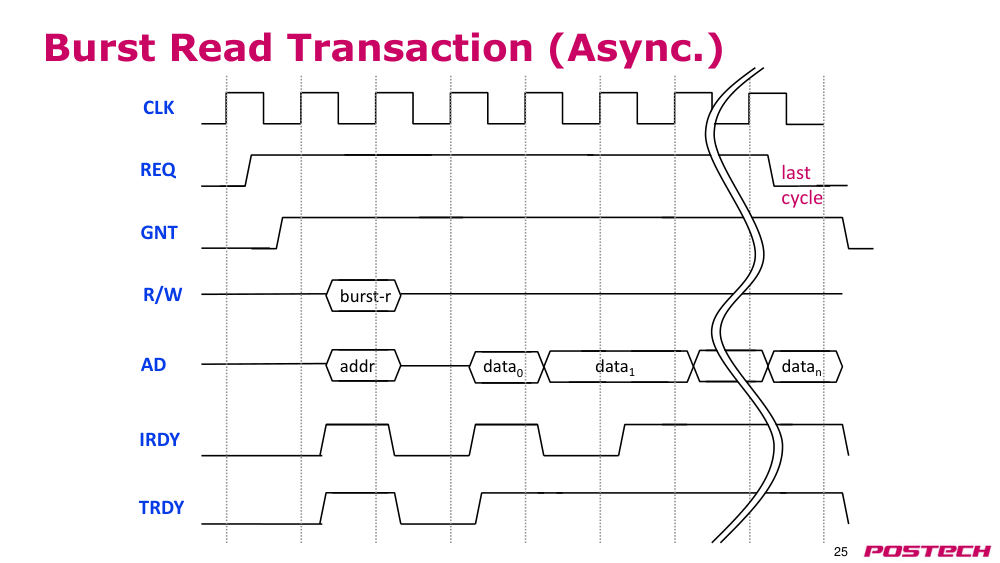
p.25burst read transaction(버스트 읽기 트랜잭션) (비동기)
- CLK
- burst-r
- REQ
- GNT
- R/W
- AD
- data0
- IRDY
- TRDY
- addr
- data1
- last
- cycle
- datan
p.26bus(버스) 성능: 지연 시간
- arbitration latency(중재 지연 시간)
- bus(버스) 경합의 함수
- arbitration policy(중재 정책)의 함수
- 예1) 확장 슬롯에 의해 정적 우선순위 부여
- 예2) FIFO, 라운드 로빈, 기타 '공정한' arbitration(중재) 방식 등
- transaction latency(트랜잭션 지연 시간)
- slave(슬레이브) 반응 시간의 함수
- synchronous protocol(동기 프로토콜)은 낭비가 적지만, 변동 지연 시간을 가진 slave(슬레이브)를 허용하지 못한다
p.27bus(버스) 성능: 대역폭
- 대역폭 (N바이트 AD bus(버스)가 주파수 f로 동작한다고 가정)
- peak bandwidth(최대 대역폭) = N · f
- (흔히 인용되는 값)
- 오버헤드를 고려해야 함
- 각 transaction(트랜잭션)은 데이터 대역폭에 기여하지 않는 overhead cycles(오버헤드 사이클)을 가짐
- REQ(요청) 및 GNT(허가) 단계
- 주소 및 REQ(요청) 단계
- 종료 단계
- 이 overhead cycles(오버헤드 사이클)이 여러 데이터 사이클에 걸쳐 amortized(상각된)다면 좋음
- 연속적인 주소, 순차적 주소
- synchronous protocol(동기 프로토콜)에서 고정 크기의 burst(버스트) (예: cache(캐시) 라인 전체)
- asynchronous protocol(비동기 프로토콜)에서 가변 크기의 burst(버스트) (예: 스트림 장치 간 전송)
p.28일반적으로 사용되는 버스 (1/3)
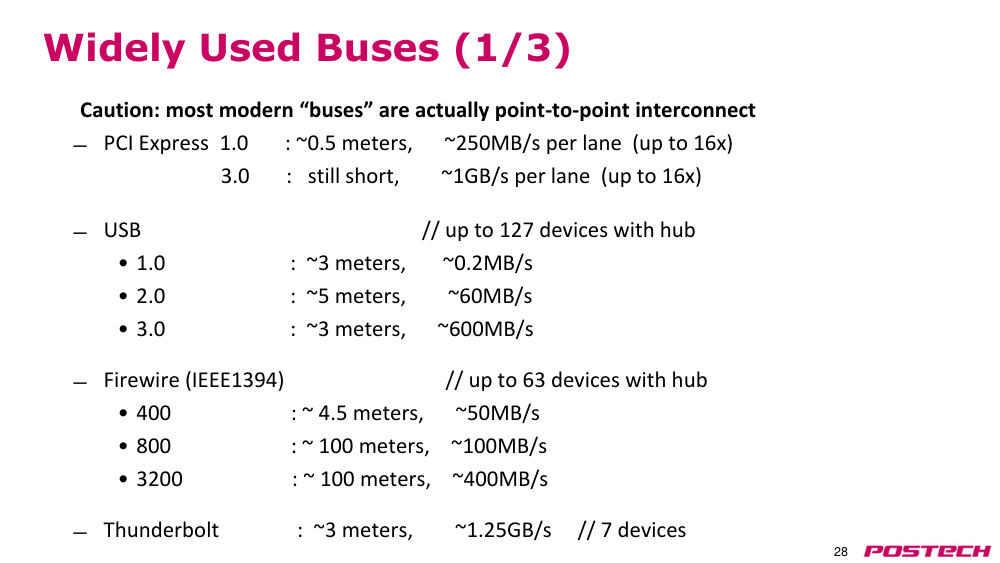
- 주의: 대부분의 현대 'bus(버스)'는 실제로는 포인트 투 포인트 인터커넥트이다
- PCI Express 1.0 : ~0.5 미터, ~250MB/s per lane (최대 16x)
- 3.0 : 여전히 짧음, ~1GB/s per lane (최대 16x)
- USB // 허브를 통해 최대 127개 장치
- 1.0 : ~3 미터, ~0.2MB/s
- 2.0 : ~5 미터, ~60MB/s
- 3.0 : ~3 미터, ~600MB/s
- FireWire (IEEE 1394) // 허브를 통해 최대 63개 장치
- 400 : ~ 4.5 미터, ~50MB/s
- 800 : ~ 100 미터, ~100MB/s
- 3200 : ~ 100 미터, ~400MB/s
- Thunderbolt : ~3 미터, ~1.25GB/s // 7개 장치
p.29일반적으로 사용되는 버스 (2/3)
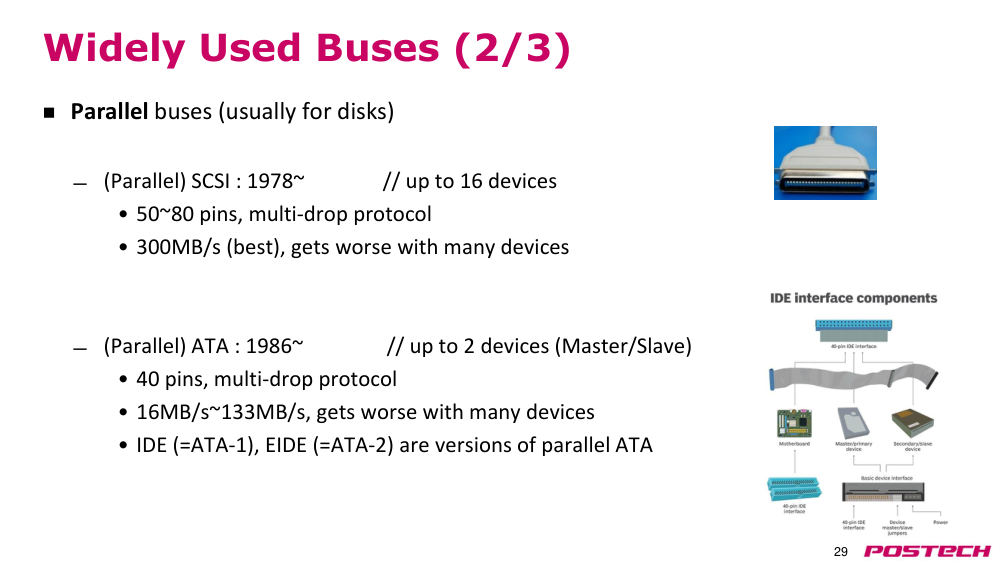
- 병렬 버스 (일반적으로 disk(디스크)용)
- (병렬) SCSI : 1978~ // 최대 16개 장치
- 50~80핀, 멀티드롭 protocol(프로토콜)
- 최고 300MB/s, 장치가 많을수록 성능 저하
- (병렬) ATA : 1986~ // 최대 2개 장치 (마스터/슬레이브)
- 40핀, 멀티드롭 protocol(프로토콜)
- 16MB/s~133MB/s, 장치가 많을수록 성능 저하
- IDE (=ATA-1), EIDE (=ATA-2)는 병렬 ATA의 버전
p.30일반적으로 사용되는 버스 (3/3)
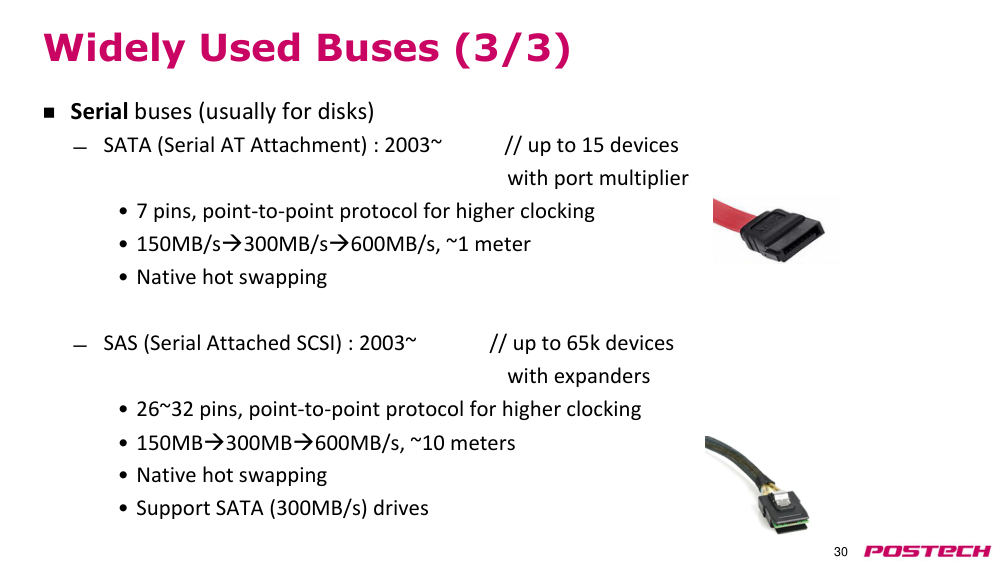
- 시리얼 버스 (일반적으로 disk(디스크)용)
- SATA (Serial AT Attachment) : 2003~ // 최대 15개 장치
- 포트 멀티플라이어와 함께
- 7핀, 더 높은 CLK(클럭)을 위한 포인트 투 포인트 protocol(프로토콜)
- 150MB/s → 300MB/s → 600MB/s, ~1미터
- 네이티브 핫스왑
- SAS (Serial Attached SCSI) : 2003~ // 최대 65,000개 장치
- 익스팬더와 함께
- 26~32핀, 더 높은 CLK(클럭)을 위한 포인트 투 포인트 protocol(프로토콜)
- 150MB → 300MB → 600MB/s, ~10미터
- 네이티브 핫스왑
- SATA (300MB/s) 드라이브 지원
p.31오류 탐지
- bus(버스)는 전기적으로 친화적인 환경이 아님
- 긴 전송선과 여러 개의 탭으로 인해, 각 장치는 동시에 많은 외부 부하(예: AD 버스)를 스위칭해야 함
- 보드 내부 및 보드 위에 노이즈 존재
- AD bus(버스) 전송은 비트 오류를 탐지하기 위해 '정보 중복' 코드로 보호되어야 함
- 짝수 패리티 방식(가장 흔히 사용됨)
- AD bus(버스)에 추가 비트(패리티 비트)를 추가함
- 드라이버는 모든 bus(버스) 비트의 XOR 결과가 0이 되도록 패리티 비트를 설정함
- 수신 측은 수신된 bus(버스) 값의 패리티를 확인함
- 홀수 개의 비트 전환이 반드시 탐지되지만, 짝수 개의 비트 전환이나 어떤 비트가 전환되었는지 식별할 수 없음
- 보다 고급 방식: ECC(오류 수정 코드), CRC(순환 중복 검사)
p.32고급(메모리) bus(버스)
- 파이프라인 bus(버스)
- 주소 bus(버스)와 데이터 버스를 별도로 분리함
- 3개의 서로 다른 transaction(트랜잭션)의 REQ(요청), 주소, 데이터 단계를 파이프라인/오버랩함
- 모든 transaction(트랜잭션)이 동일한 지연 시간을 가질 경우 가장 효과적임
- out-of-order(비순차) bus(버스) (split-transaction(분할 트랜잭션))
- data bus(데이터 버스)에 대한 arbitration(중재)를 완전히 별도로 처리함
- 각 주소 bus(버스) transaction(트랜잭션)은 고유한 '태그'를 부여받으며, 데이터 단계를 기다리지 않고 종료됨
- slave(슬레이브)가 응답이 필요할 때, '태그'를 사용하여 data bus(데이터 버스)에서 data transaction(데이터 트랜잭션)을 중재하여 REQ(요청)함. 느린 슬레이브가 전체 버스를 정지시키지 않음
- switched data bus(스위치드 데이터 버스)
- split-phase protocol(분할 단계 프로토콜)을 사용하면, 데이터 bus(버스)가 더 이상 방송 기반일 필요 없음
- switched network(스위치드 네트워크)를 사용하여 전용/고대역폭으로 데이터 전송 가능
p.33질문?