이 자료를 쓰는 강의: 57 bus 동작(arbitration, sync/async protocol, 성능, error detection) 과 parallel architecture 도입(Amdahl, Flynn, array vs vector) · 58 vector processor (벡터 프로세서) 구조와 memory
Lec20-ParallelArchitectures (updated)
한국어판 강의자료 · 41쪽
p.1
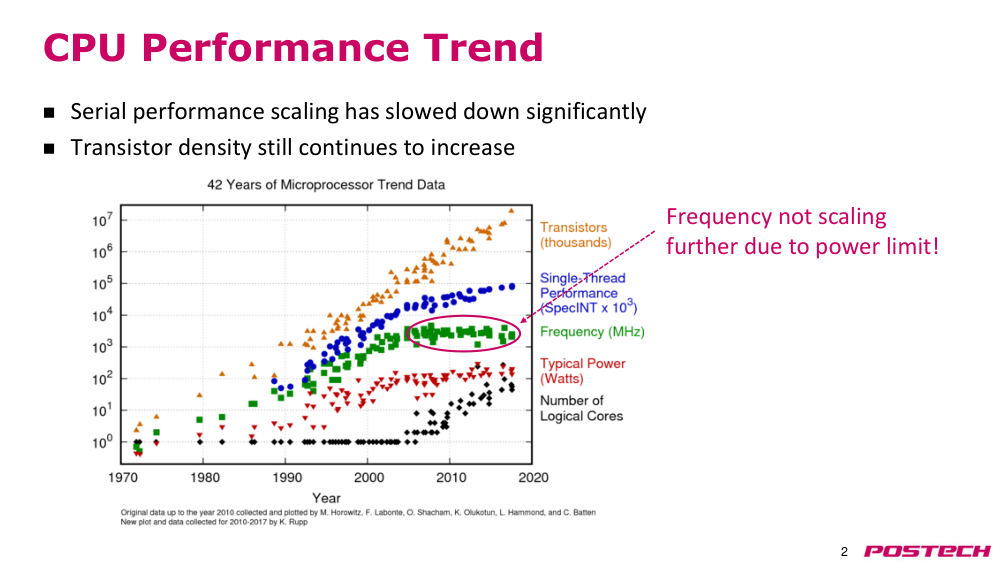
p.2CPU performance trend(CPU 성능 추세)
- serial performance scaling(순차 성능 스케일링)은 크게 둔화됨
- transistor density(트랜지스터 밀도)는 여전히 증가 중
- power limit(전력 한계)로 인해 frequency scaling(주파수 스케일링) 더 이상 불가능!
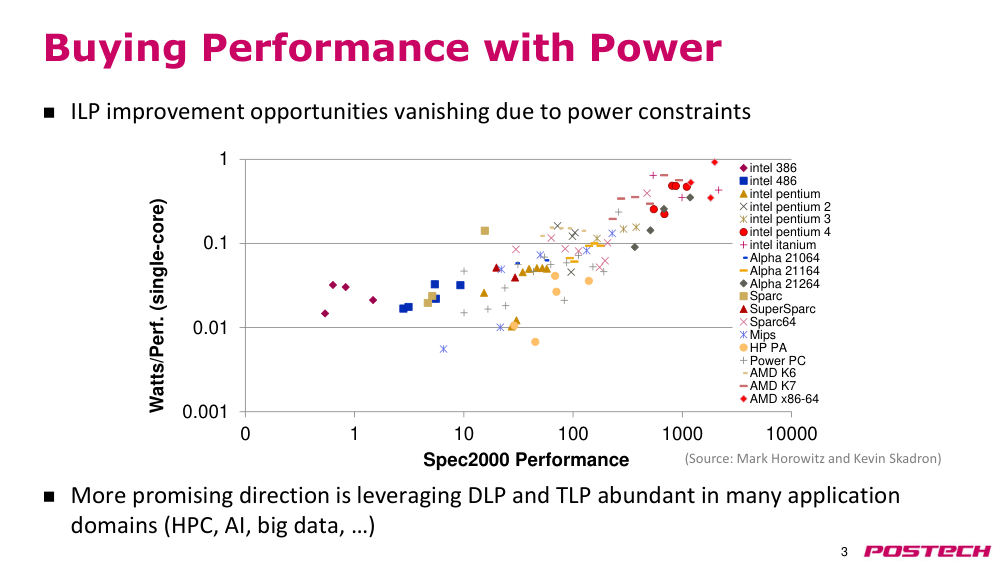
p.3전력으로 성능 구매하기
- 전력 제약으로 인해 ILP 향상 기회는 사라지고 있음
- 더 유망한 방향은 HPC, AI, 빅데이터 등 많은 응용 분야에서 풍부한 DLP와 TLP 활용하기 (출처: Mark Horowitz and Kevin Skadron)
- 0.001
- 0.01
- 0.1
- 1
- 0
- 1
- 10
- 100
- 1000
- 10000
- 와트/성능 (싱글코어)
- Spec2000 성능
- intel 386
- intel 486
- intel pentium
- intel pentium 2
- intel pentium 3
- intel pentium 4
- intel itanium
- Alpha 21064
- Alpha 21164
- Alpha 21264
- Sparc
- SuperSparc
- Sparc64
- Mips
- HP PA
- Power PC
- AMD K6
- AMD K7
- AMD x86-64
p.4왜 병렬 컴퓨팅인가?
- 병렬 머신을 사용하는 응용 프로그램의 목표: speedup(속도 향상)
- 속도 향상 (p개의 프로세서) = 성능 (p개 프로세서) / 성능 (1개 프로세서)
- 응용 프로그램의 필요성: 컴퓨팅 사이클에 대한 끝없는 욕구
- 인공지능: 이미지 분류, 객체 탐지, 강화 학습 등
- 과학 계산: 생물학, 화학, 물리학, 유체역학 계산 등
- 일반 목적 컴퓨팅: 영상, 그래픽스, CAD, 데이터베이스, 거래 처리 등
- 인터넷 서비스: 검색, 전자상거래, 클러스터링, 추천 등
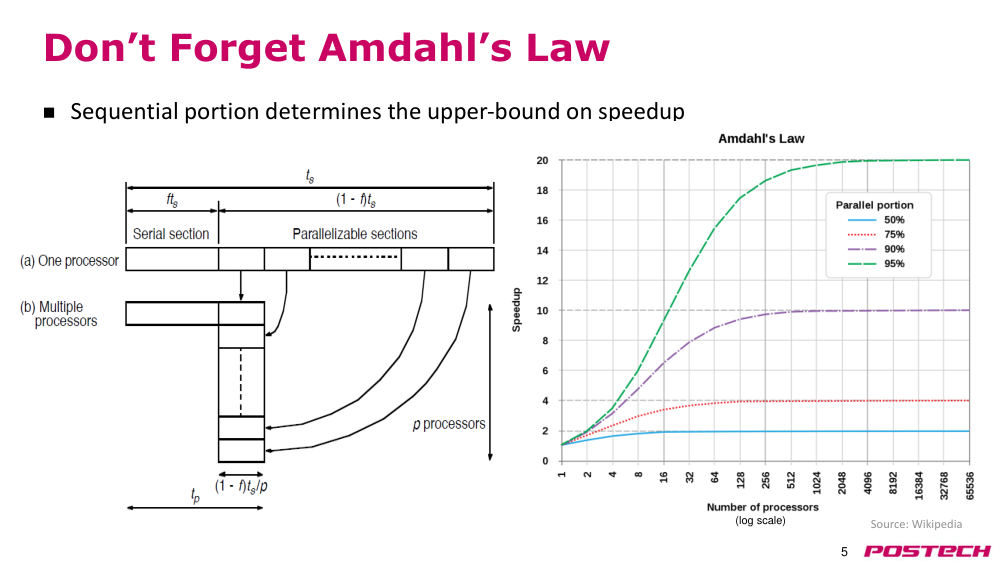
p.5Amdahl's law(암다울의 법칙)을 잊지 마라
- 순차 부분이 speedup(속도 향상)의 상한선을 결정함
- 출처: Wikipedia (로그 스케일)
p.6성능 스케일링 예제
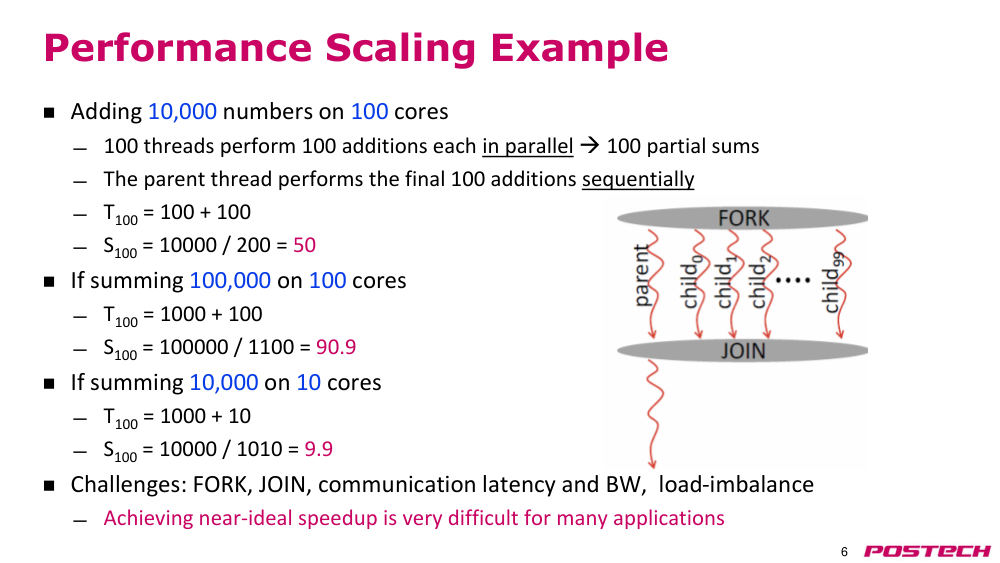
- 100코어에서 10,000개의 수를 더하기
- 100개 스레드가 병렬로 각각 100번의 덧셈 수행 → 100개의 부분합
- 부모 스레드가 최종 100번의 덧셈을 순차적으로 수행
- T100 = 100 + 100
- S100 = 10000 / 200 = 50
- 100,000개를 100코어에서 더하기
- T100 = 1000 + 100
- S100 = 100000 / 1100 = 90.9
- 10,000개를 10코어에서 더하기
- T100 = 1000 + 10
- S100 = 10000 / 1010 = 9.9
- 도전 과제: FORK, JOIN, communication latency(통신 지연) 및 bandwidth(대역폭), load-imbalance(로드 불균형)
- 많은 응용 프로그램에서 이상적인 speedup(속도 향상) 달성은 매우 어렵다
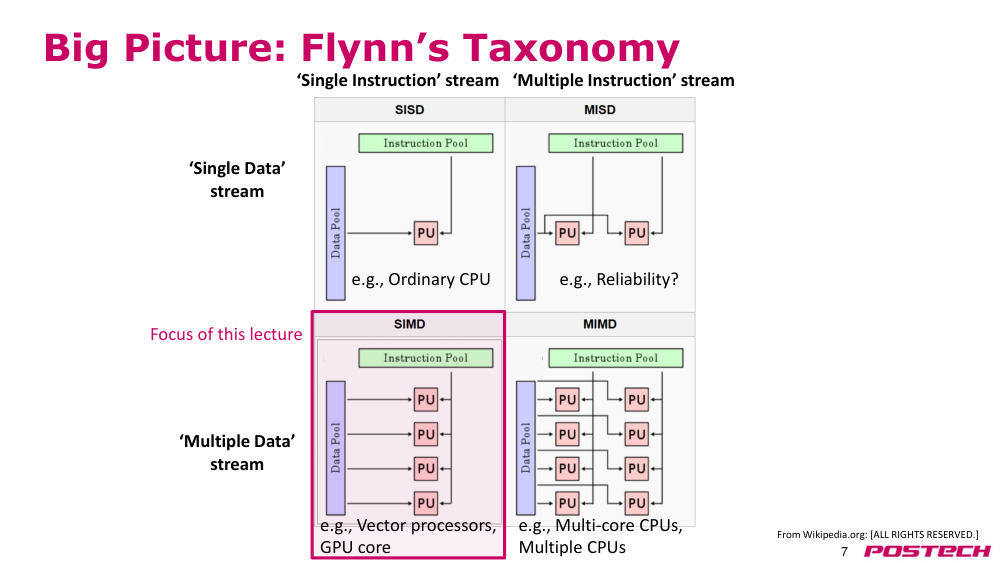
p.7전체 그림: Flynn's taxonomy(플린의 분류법)
- Wikipedia.org에서 인용: [모든 권리 보유.]
- 예: 일반 CPU
- 예: 신뢰성?
- 예: vector processor(벡터 프로세서), GPU 코어
- 예: 멀티코어 CPU, 다수의 CPU
- ‘단일 명령’ 스트림 ‘다중 명령’ 스트림
- ‘단일 데이터’ 스트림
- ‘다중 데이터’ 스트림
- 이 강의의 초점
p.8SIMD 처리
- 단일 명령이 다수의 데이터 요소에 작동함 — 시간 또는 공간에서
- 다수의 처리 요소
- time-space duality(시간-공간 이중성)
- array processor(어레이 프로세서): 명령이 동시에 다수의 데이터 요소에 작동함
- vector processor(벡터 프로세서): 명령이 연속적인 시간 단계에서 다수의 데이터 요소에 작동함
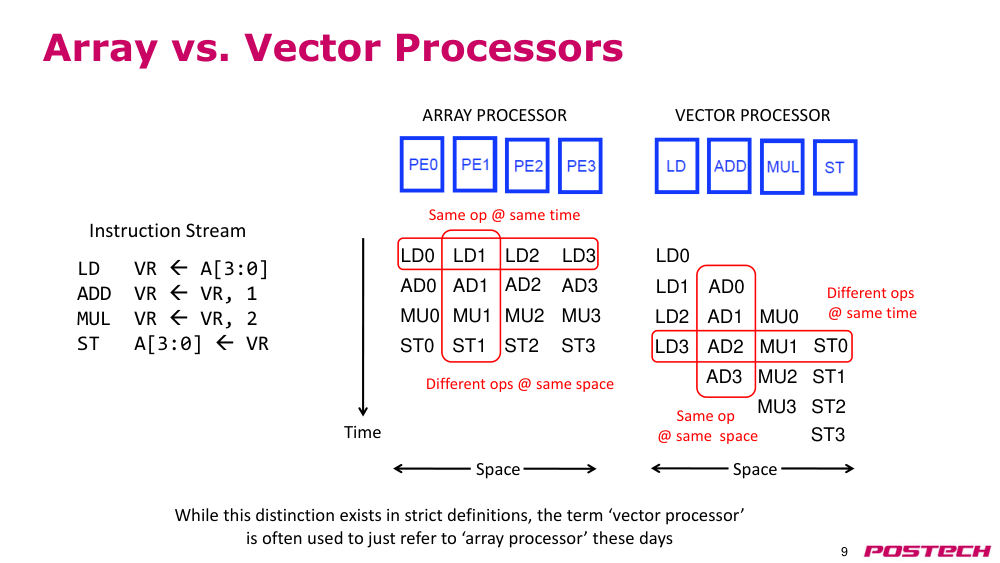
p.9array processor(어레이 프로세서) vs. vector processor(벡터 프로세서)
- array processor(어레이 프로세서)
- vector processor(벡터 프로세서)
- LD VR A[3:0]
- ADD VR VR, 1
- MUL VR VR, 2
- ST A[3:0] VR
- 명령 스트림
- 시간
- LD0
- LD1
- LD2
- LD3
- AD0
- AD1
- AD2
- AD3
- MU0
- MU1
- MU2
- MU3
- ST0
- ST1
- ST2
- ST3
- LD0
- LD1
- AD0
- LD2
- AD1
- MU0
- LD3
- AD2
- MU1
- ST0
- AD3
- MU2
- ST1
- MU3
- ST2
- ST3
- 공간
- 공간
- 동일한 연산 @ 동일한 시간
- 다른 연산 @ 동일한 공간
- 다른 연산 @ 동일한 시간
- 동일한 연산 @ 동일한 공간
- 이 구분은 엄격한 정의에서는 존재하지만, 오늘날에는 'vector processor(벡터 프로세서)'라는 용어가 종종 'array processor(어레이 프로세서)'를 가리키는 데 사용됨
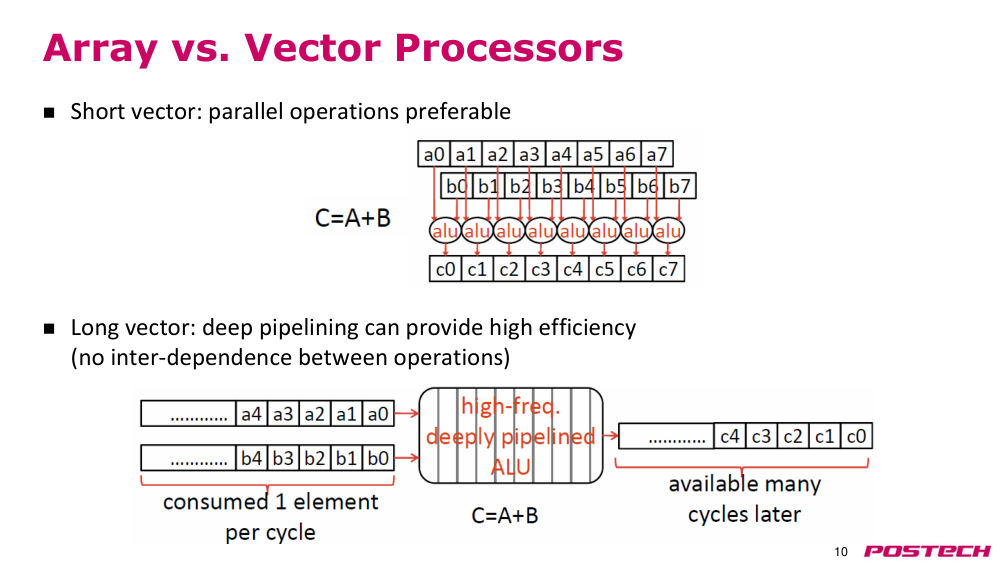
p.10array processor(어레이 프로세서) vs. vector processor(벡터 프로세서)
- 짧은 벡터: 병렬 연산이 선호됨
- 긴 벡터: deep pipeline(심층 파이프라인)을 통해 높은 효율성 제공 가능 (연산 간 의존성 없음)
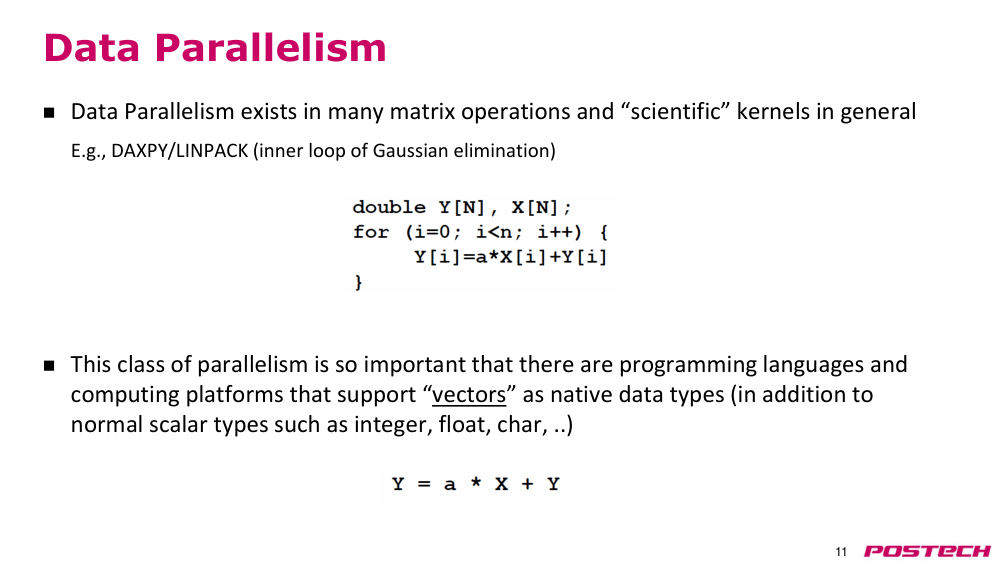
p.11DLP(데이터 병렬성)
- DLP(데이터 병렬성)은 많은 행렬 연산과 일반적으로 'scientific kernels(과학적 핵심 알고리즘)'에서 존재함
- 예: DAXPY/LINPACK (가우스 소거법의 내부 루프)
- 이 병렬성 유형은 너무 중요하여, 프로그래밍 언어와 컴퓨팅 플랫폼 중에는 '벡터'를 기본 데이터 타입으로 지원하는 경우가 있음 (정수, 실수, 문자 등 일반 스칼라 타입 외에)
p.12vector processor(벡터 프로세서)
p.13vector processor(벡터 프로세서)의 장점
- 벡터 내부에 의존성이 없음
- pipelining(파이프라인화) 및 병렬화가 매우 효과적임
- 매우 심층적인 파이프라인을 가질 수 있음. 의존성이 없음!
- 각 명령어가 많은 작업을 생성함
- instruction fetch bandwidth(명령어 가져오기 대역폭) 요구를 줄일 수 있음
- 벡터를 레지스터/캐시/메모리로 prefetching(프리패치)하기 쉬움
- 매우 regular memory access pattern(규칙적인 메모리 접근 패턴)
- 루프를 명시적으로 코드로 작성할 필요 없음
- 명령어 시퀀스에 분기 수가 적음
p.14vector processor(벡터 프로세서)의 단점
- 병렬성이 규칙적인 경우(데이터/SIMD 병렬성)에만 효과적임
- 벡터 연산
- 병렬성이 불규칙할 경우 매우 비효율적임
- memory bandwidth(메모리 대역폭)는 쉽게 bottleneck(병목)이 될 수 있음. 특히 다음 경우에 해당함
- 1. 계산/메모리 연산 균형이 유지되지 않을 때
- 2. 데이터가 memory bank(메모리 뱅크)에 적절히 매핑되지 않을 때
p.15vector registers(벡터 레지스터)
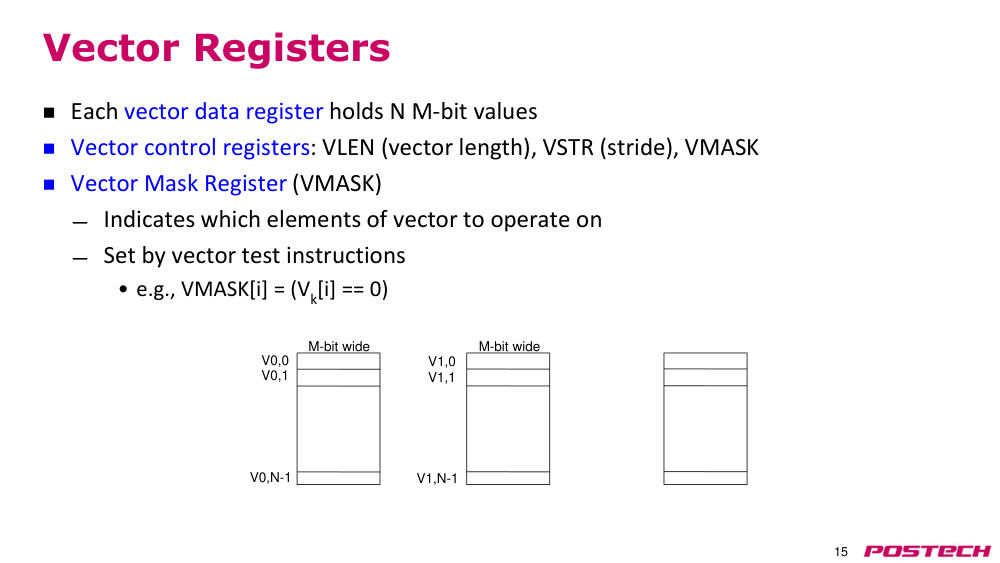
- 각 벡터 데이터 레지스터는 N개의 M비트 값 저장
- vector control registers(벡터 제어 레지스터): VLEN(벡터 길이), VSTR(스트라이드), VMASK
- 벡터 마스크 레지스터(VMASK)
- 벡터의 어떤 요소를 연산할지 나타냄
- 벡터 테스트 명령어로 설정됨
- • 예: VMASK[i] = (Vk[i] == 0)
- V0,0
- V0,1
- V0,N-1
- V1,0
- V1,1
- V1,N-1
- M비트 폭
- M비트 폭
p.16vector functional units(벡터 기능 유닛)
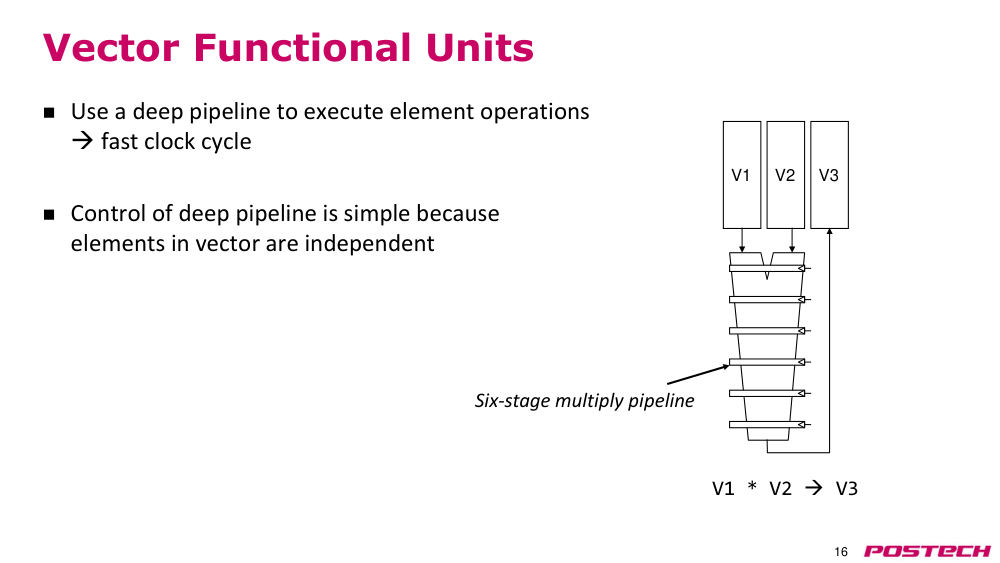
- 요소 연산을 수행하기 위해 deep pipeline(심층 파이프라인) 사용
- 빠른 클럭 주기
- deep pipeline(심층 파이프라인)의 제어가 간단함
- 벡터 내 요소들이 서로 독립적이기 때문임
- 6단계 곱셈 파이프라인
- V1
- V2
- V3
- V1 * V2 → V3
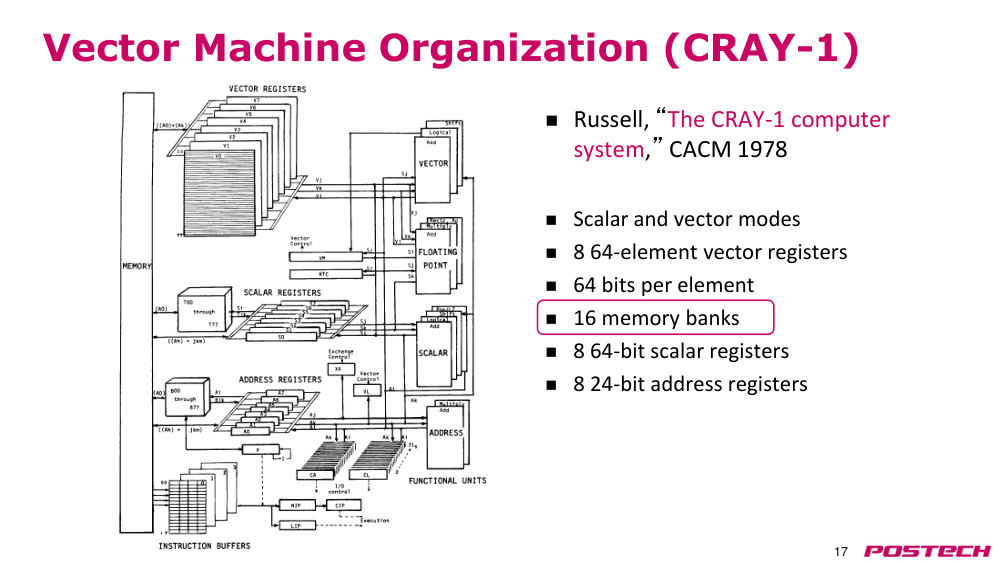
p.17벡터 머신 구성 (CRAY-1)
- Russell, “The CRAY-1 computer system,” CACM 1978
- 스칼라 및 벡터 모드
- 8개의 64요소 vector registers(벡터 레지스터)
- 요소당 64비트
- 16개의 memory bank(메모리 뱅크)
- 8개의 64비트 스칼라 레지스터
- 8개의 24비트 주소 레지스터
p.18vector processor(벡터 프로세서) 예시 (RISC-V)
- 예: RISC-V에 대한 벡터 확장
- v0부터 v31까지: 32개 × 64요소 레지스터, (64비트 요소)
- vector length (VLEN)(벡터 길이), stride (VSTR)(스트라이드) 등을 지정하기 위한 추가 레지스터
- 벡터 명령어
- • fld.v, fsd.v: 벡터 로드/스토어
- • fadd.d.v: 더블 정밀도 벡터 덧셈
- • fadd.d.vs: 스칼라를 더블 정밀도 벡터의 각 요소에 더함
p.19예: DAXPY (Y = a × X + Y)
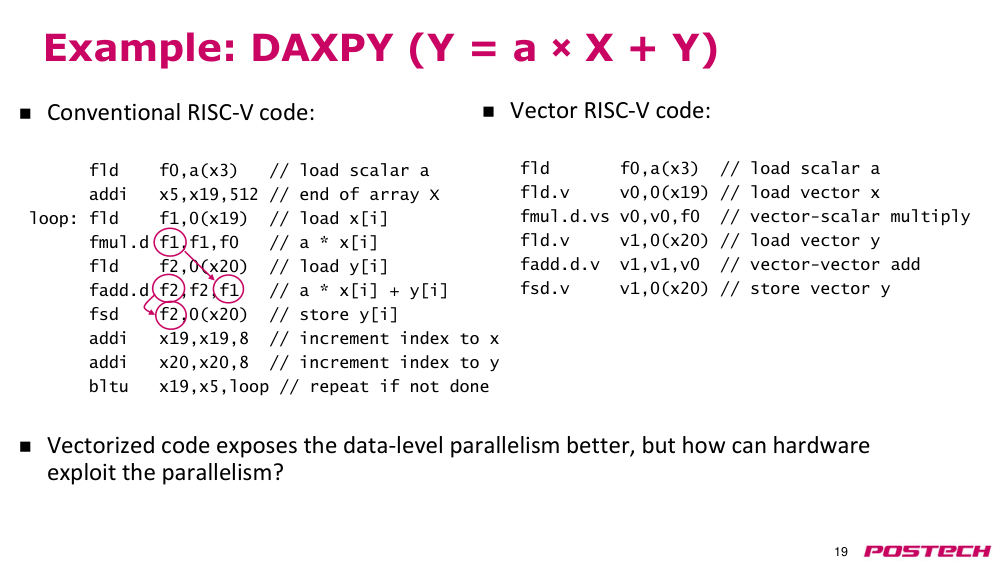
- 기존 RISC-V 코드:
- fld f0,a(x3) // 스칼라 a 로드
- addi x5,x19,512 // 배열 X의 끝
- loop: fld f1,0(x19) // x[i] 로드
- fmul.d f1,f1,f0 // a * x[i]
- fld f2,0(x20) // y[i] 로드
- fadd.d f2,f2,f1 // a * x[i] + y[i]
- fsd f2,0(x20) // y[i] 저장
- addi x19,x19,8 // x 인덱스 증가
- addi x20,x20,8 // y 인덱스 증가
- bltu x19,x5,loop // 완료되지 않았으면 반복
- 벡터화된 코드는 데이터 수준 병렬성을 더 잘 드러내지만, 하드웨어는 어떻게 이 병렬성을 활용할 수 있을까?
- 벡터 RISC-V 코드:
- fld f0,a(x3) // 스칼라 a 로드
- fld.v v0,0(x19) // 벡터 x 로드
- fmul.d.vs v0,v0,f0 // 벡터-스칼라 곱
- fld.v v1,0(x20) // 벡터 y 로드
- fadd.d.v v1,v1,v0 // 벡터-벡터 덧셈
- fsd.v v1,0(x20) // 벡터 y 저장
p.20벡터 메모리 로드/저장
- 다수의 요소를 로드/저장해야 함
- 요소들은 일정한 거리(스트라이드)로 분리되어 있음 — 현재는 stride (VSTR)(스트라이드) = 1로 가정
- 한 사이클에 하나의 요소를 로드할 수 있다면, 연속적인 사이클에 요소들을 로드할 수 있음
- 1요소/사이클의 처리량을 유지할 수 있음
- 문제: 메모리 접근에 1사이클 이상이 걸리는 경우 어떻게 해야 하는가?
- 해결책: 메모리를 bank(뱅크)로 나누고, 요소들을 bank(뱅크) 간에 interleaving(인터리빙)
p.21memory banking(메모리 뱅킹)
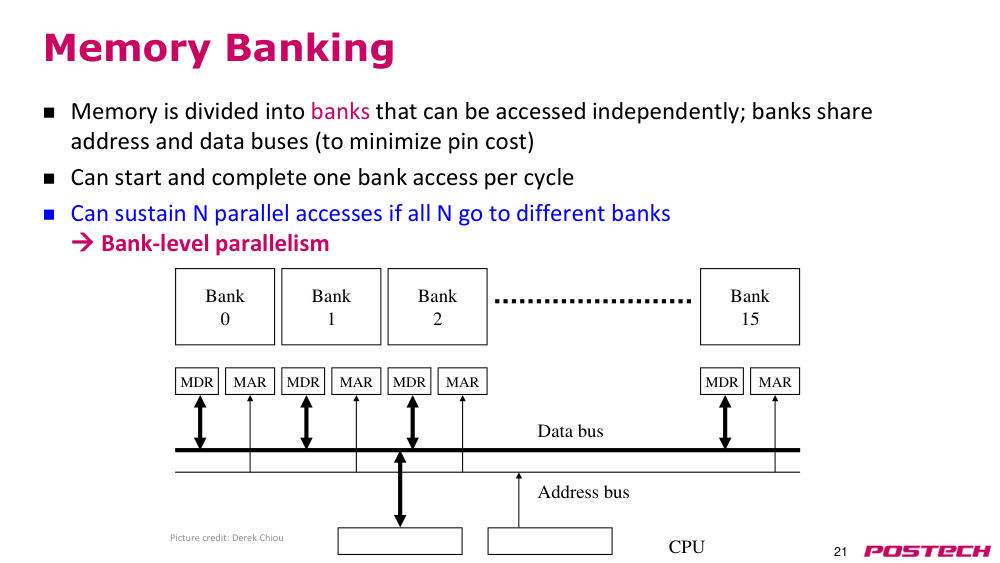
- 메모리는 독립적으로 접근 가능한 bank(뱅크)로 나뉨; bank(뱅크)들은 주소 및 데이터 버스를 공유 (핀 수를 최소화하기 위해)
- 한 사이클에 하나의 bank(뱅크) 접근을 시작하고 완료할 수 있음
- 모든 N개의 bank(뱅크)가 서로 다른 bank(뱅크)에 접근하면 N개의 병렬 접근을 유지할 수 있음
- → bank-level parallelism(뱅크 수준 병렬성)
- 그림 설명: CPU에서 주소 버스와 데이터 버스를 통해 여러 bank(뱅크)에 접근하는 구조. 각 bank(뱅크)는 MDR과 MAR을 가짐. bank(뱅크) 0~15까지 존재함. 사진 출처: Derek Chiou
p.22bank-level parallelism(뱅크 수준 병렬성) 예시
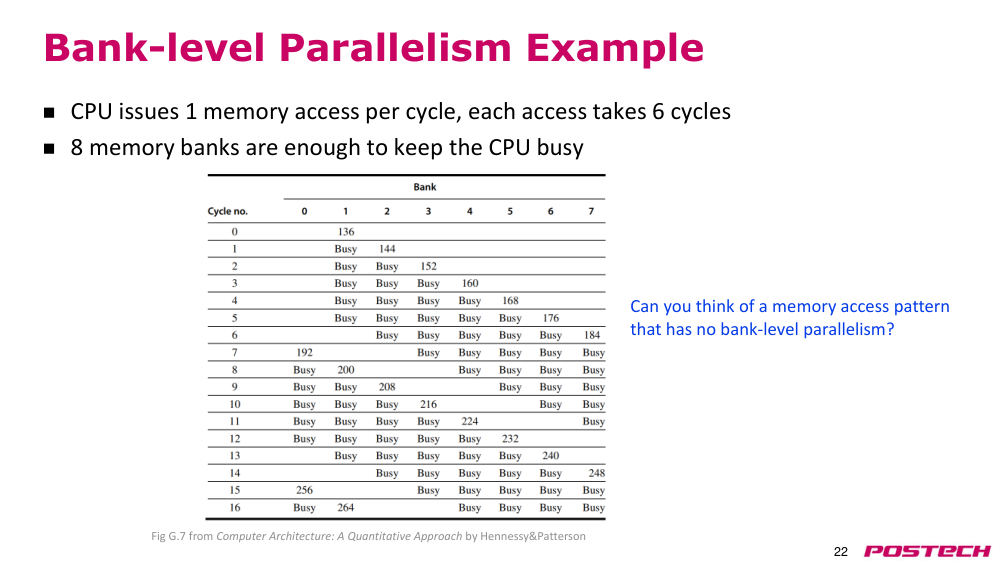
- CPU는 한 사이클에 하나의 메모리 접근을 요청하며, 각 접근은 6사이클 소요
- 8개의 memory bank(메모리 뱅크)만으로도 CPU를 항상 바쁘게 유지할 수 있음
- 그림 G.7 출처: Hennessy & Patterson, Computer Architecture: A Quantitative Approach
- 문제: bank-level parallelism(뱅크 수준 병렬성)이 없는 메모리 접근 패턴은 무엇인가?
p.23벡터 메모리 시스템
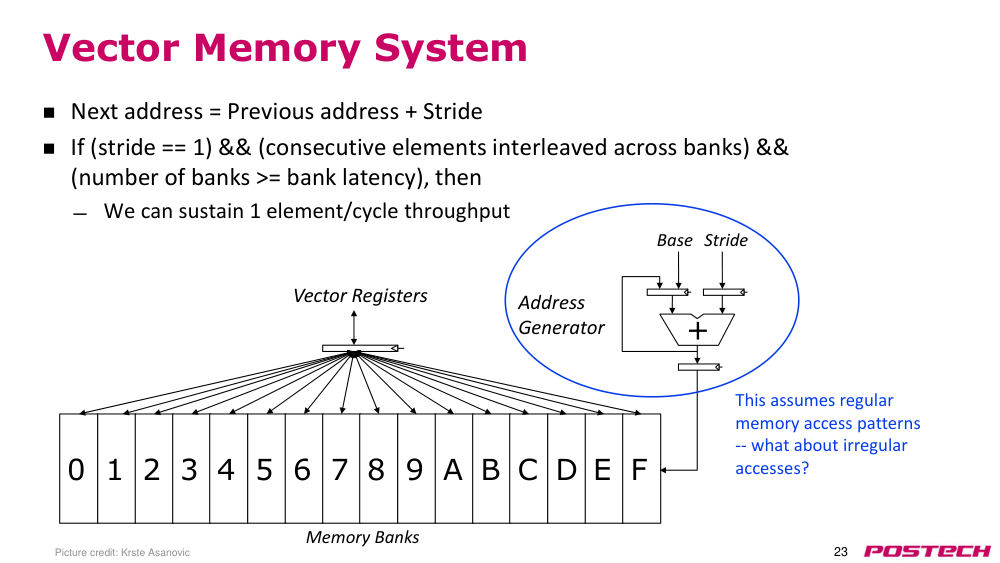
- 다음 주소 = 이전 주소 + stride (VSTR)(스트라이드)
- 만약 (스트라이드 == 1) && (연속된 요소들이 bank(뱅크) 간에 interleaving(인터리빙)됨) && (bank(뱅크) 수 >= bank(뱅크) 지연 시간)이라면
- 1요소/사이클의 처리량을 유지할 수 있음
- 그림 설명: 베이스 주소와 stride (VSTR)(스트라이드)를 기반으로 address generator(주소 생성기)에서 다음 주소를 계산. vector registers(벡터 레지스터)와 memory bank(메모리 뱅크) 간의 연결 구조. regular memory access pattern(규칙적인 메모리 접근 패턴)을 가정함 — irregular access(불규칙한 접근)은 어떻게 처리할까?
- 사진 출처: Krste Asanovic
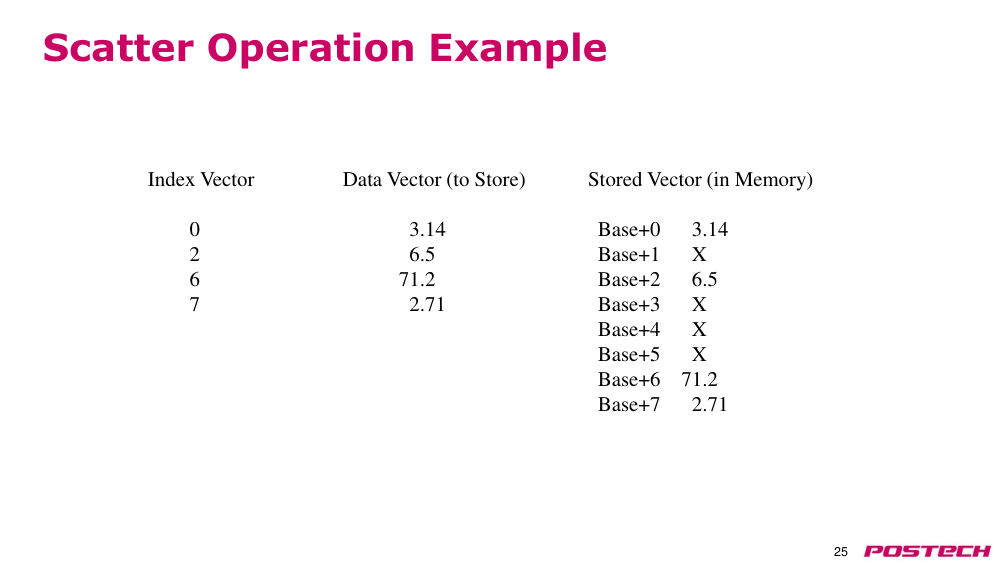
p.24불규칙 접근을 위한 gather(개더)/scatter(스캐터)
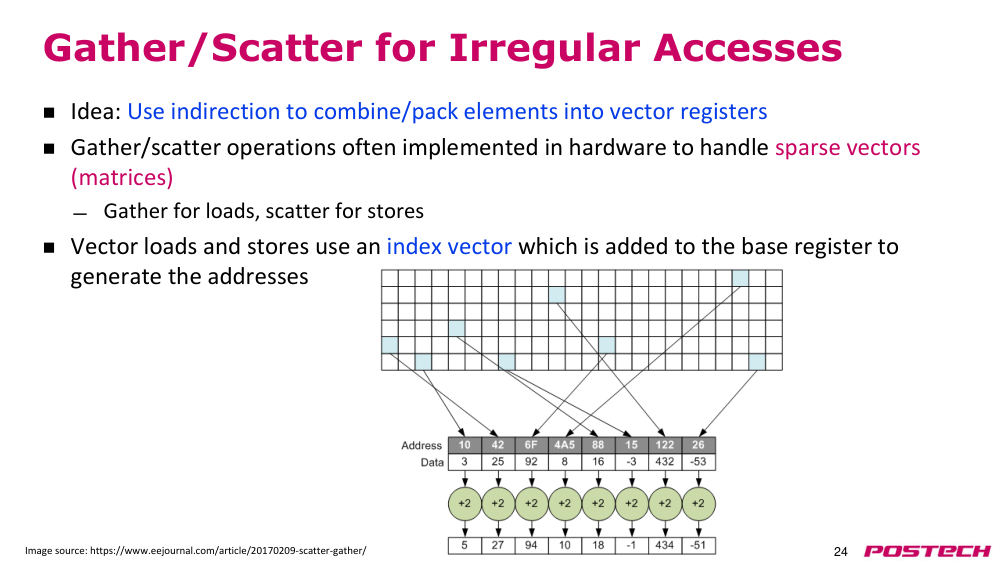
- 아이디어: 간접 주소를 사용하여 요소들을 vector registers(벡터 레지스터)에 결합하거나 패킹
- gather(개더)/scatter operation(스캐터 연산)은 희소 벡터(행렬)를 처리하기 위해 하드웨어로 구현되는 경우가 많음
- 로드에는 gather(개더), 저장에는 scatter(스캐터) 사용
- 벡터 로드/저장은 base register(베이스 레지스터)에 index vector(인덱스 벡터)를 더하여 주소를 생성함
- 이미지 출처: https://www.eejournal.com/article/20170209-scatter-gather/
p.25scatter operation(스캐터 연산) 예제
- index vector(인덱스 벡터)
- 데이터 벡터 (저장할 값)
- 메모리에 저장된 벡터
p.26gather(개더)/scatter(스캐터) 코드 예제
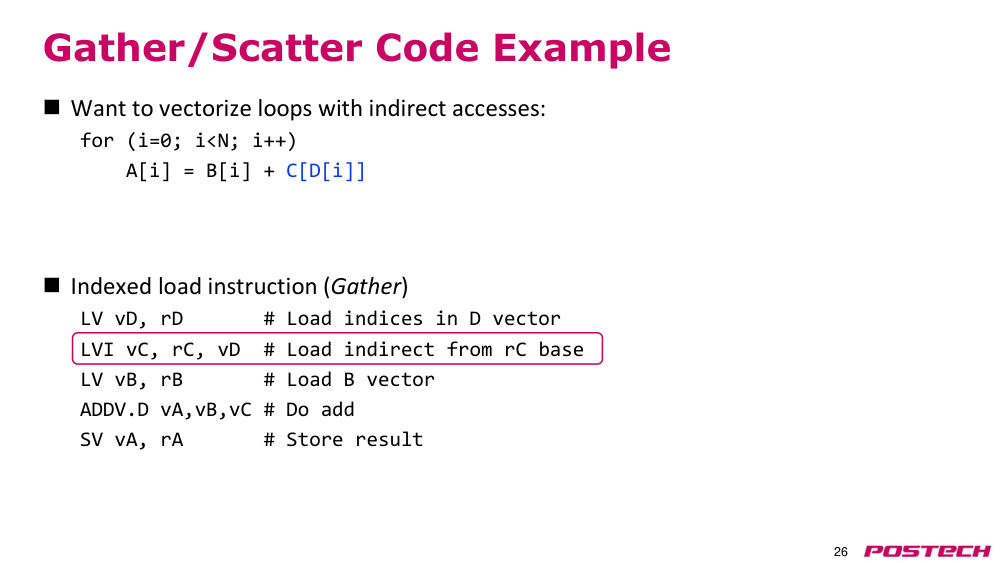
- 간접 접근을 포함한 루프를 벡터화하고자 함:
- for (i=0; i<N; i++)
- A[i] = B[i] + C[D[i]]
- indexed load instruction(인덱스 로드 명령어) (gather(개더))
- LV vD, rD
- # D 벡터에 인덱스 로드
- LVI vC, rC, vD
- # rC 기준에서 간접 로드
- LV vB, rB
- # B 벡터 로드
- ADDV.D vA,vB,vC
- # 덧셈 수행
- SV vA, rA
- # 결과 저장
p.27DAXPY 예제 다시 보기
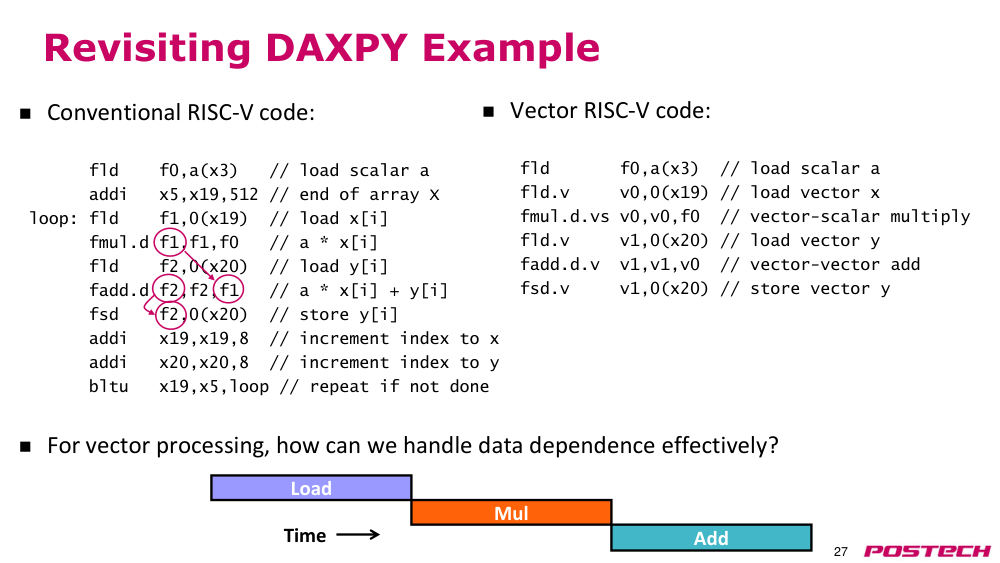
- 기존 RISC-V 코드:
- fld f0,a(x3) // 스칼라 a 로드
- addi x5,x19,512 // 배열 X의 끝
- loop: fld f1,0(x19) // x[i] 로드
- fmul.d f1,f1,f0 // a * x[i]
- fld f2,0(x20) // y[i] 로드
- fadd.d f2,f2,f1 // a * x[i] + y[i]
- fsd f2,0(x20) // y[i] 저장
- addi x19,x19,8 // x 인덱스 증가
- addi x20,x20,8 // y 인덱스 증가
- bltu x19,x5,loop // 완료되지 않았으면 반복
- 벡터 처리를 위해 데이터 의존성을 효과적으로 다루는 방법은?
- 벡터 RISC-V 코드:
- fld f0,a(x3) // 스칼라 a 로드
- fld.v v0,0(x19) // 벡터 x 로드
- fmul.d.vs v0,v0,f0 // 벡터-스칼라 곱
- fld.v v1,0(x20) // 벡터 y 로드
- fadd.d.v v1,v1,v0 // 벡터-벡터 덧셈
- fsd.v v1,0(x20) // 벡터 y 저장
- 로드
- 곱
- 덧셈
- 시간
p.28vector chaining(벡터 체이닝)
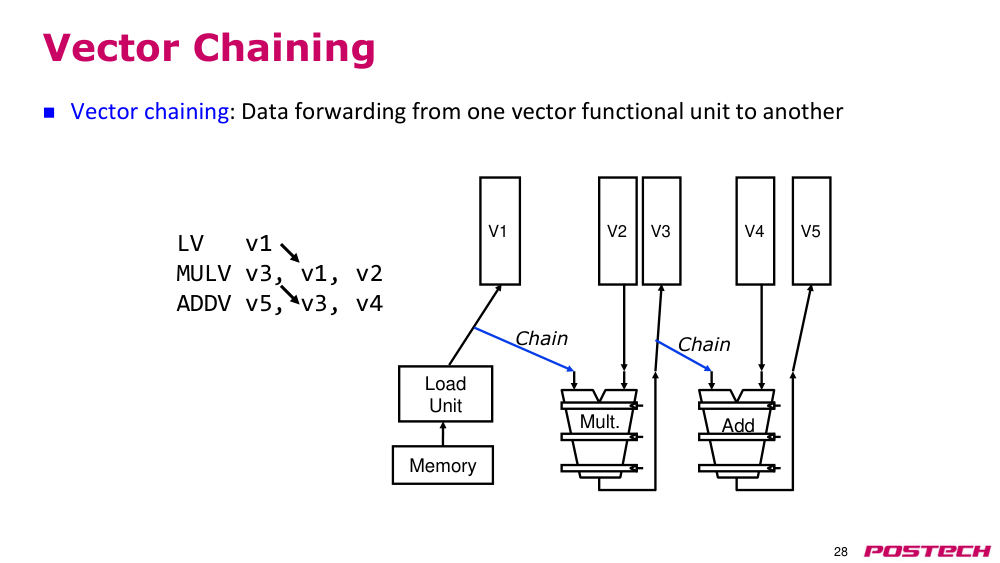
- vector chaining(벡터 체이닝): 하나의 vector functional units(벡터 기능 유닛)에서 다른 유닛으로 data forwarding(데이터 포워딩)
- LV v1
- MULV v3, v1, v2
- ADDV v5, v3, v4
- 메모리
- V1
- 로드 유닛
- 곱셈
- V2
- V3
- 체이닝
- 덧셈
- V4
- V5
- 체이닝
p.29vector chaining(벡터 체이닝)의 장점
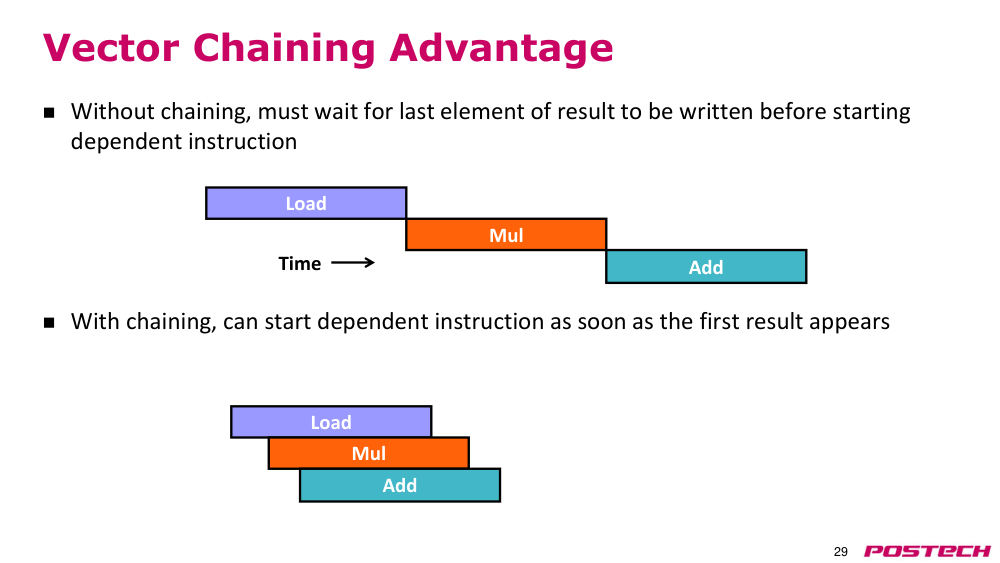
- 체이닝 없이, 결과의 마지막 요소가 저장된 후에야 의존 명령어를 시작할 수 있음
- 체이닝 있으면, 첫 번째 결과가 나타나는 즉시 의존 명령어를 시작할 수 있음
- 로드
- 곱
- 덧셈
- 로드
- 곱
- 덧셈
- 시간
p.30질문
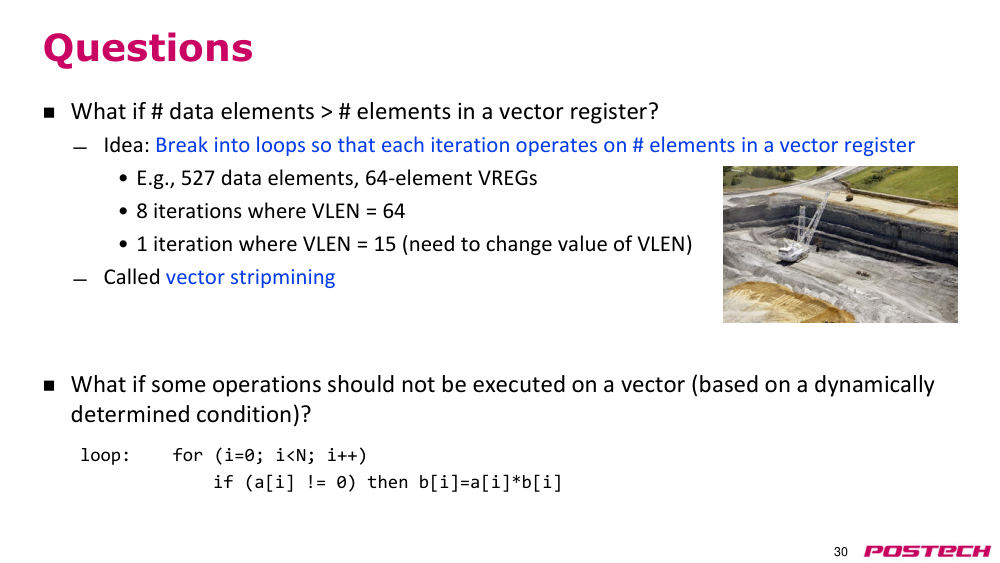
- vector registers(벡터 레지스터)에 있는 요소 수보다 데이터 요소 수가 많을 경우?
- 아이디어: vector registers(벡터 레지스터)에 들어갈 수 있는 요소 수만큼 루프를 나누기
- 예: 527개의 데이터 요소, 64요소 VREG
- 8번의 반복에서 VLEN = 64
- 1번의 반복에서 VLEN = 15 (VLEN 값 변경 필요)
- 이를 vector stripmining(벡터 스트립마이닝)이라 함
- 벡터 연산 중 일부가 동적으로 결정된 조건에 따라 실행되어서는 안 될 경우?
- loop: for (i=0; i<N; i++)
- if (a[i] != 0) then b[i]=a[i]*b[i]
p.31루프 내 조건부 연산
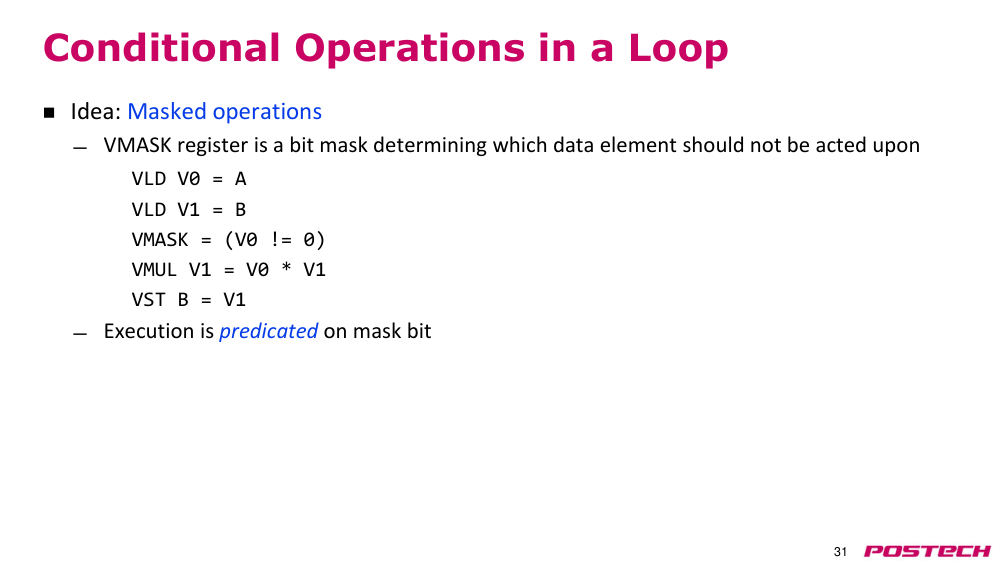
- 아이디어: masked operations(마스크 연산)
- VMASK 레지스터는 어떤 데이터 요소에 대해 연산을 수행하지 않을지를 결정하는 비트 마스크
- VLD V0 = A
- VLD V1 = B
- VMASK = (V0 != 0)
- VMUL V1 = V0 * V1
- VST B = V1
- 실행은 마스크 비트에 따라 predicated(프레디케이션됨)
p.32마스킹을 사용한 다른 예시
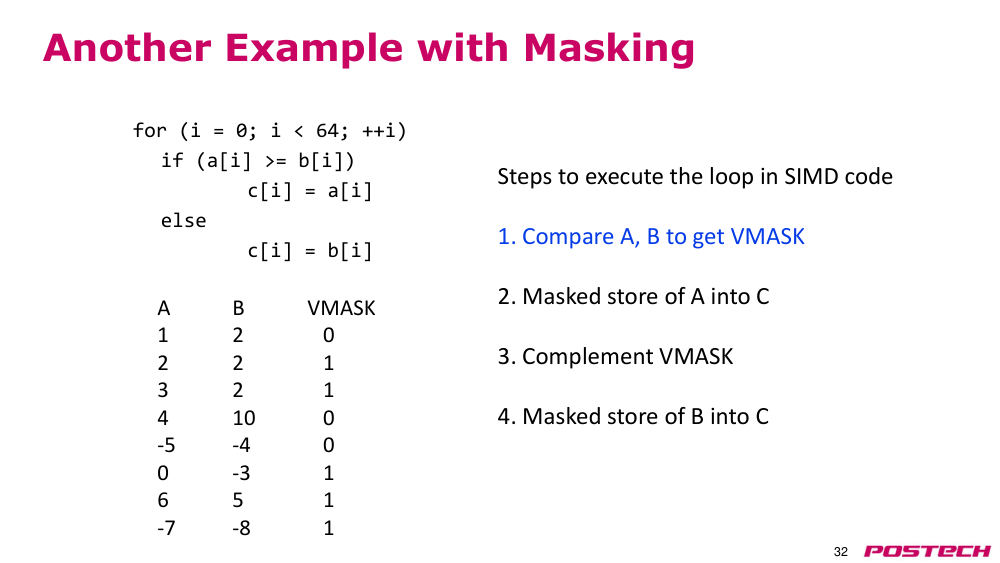
- for (i = 0; i < 64; ++i)
- if (a[i] >= b[i])
- c[i] = a[i]
- else
- c[i] = b[i]
- A
- B
- VMASK
- 1
- 2
- 0
- 2
- 2
- 1
- 3
- 2
- 1
- 4
- 10
- 0
- -5
- -4
- 0
- 0
- -3
- 1
- 6
- 5
- 1
- -7
- -8
- 1
- 루프를 SIMD 코드로 실행하는 단계
- 1. A와 B를 비교하여 VMASK 생성
- 2. A를 C에 masked operations(마스크 연산)으로 저장
- 3. VMASK를 보완
- 4. B를 C에 masked operations(마스크 연산)으로 저장
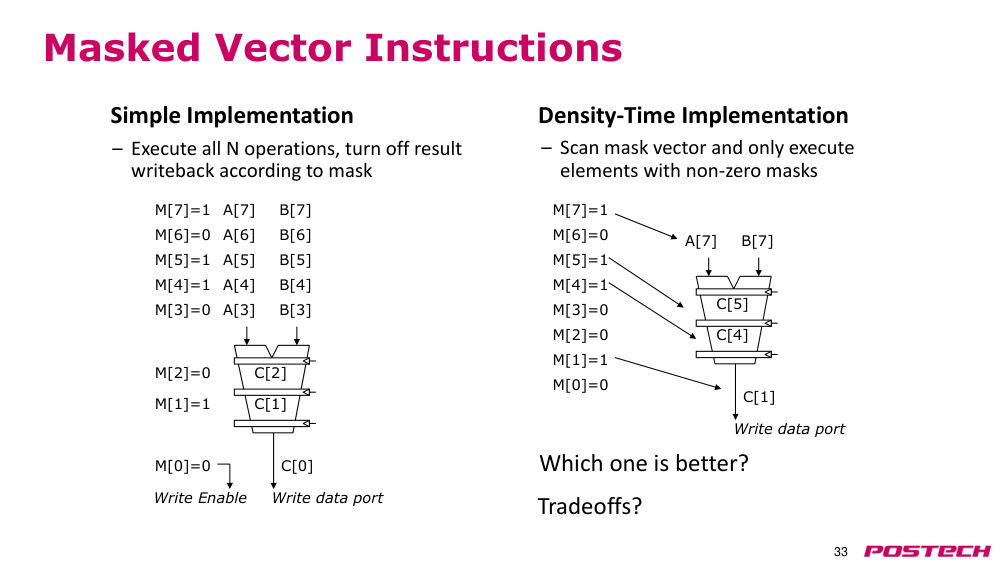
p.33마스크 벡터 명령어
- 어느 쪽이 더 나은가?
- 상충 요소는?
- C[1]
- C[2]
- C[0]
- A[3]
- B[3]
- A[4]
- B[4]
- A[5]
- B[5]
- A[6]
- B[6]
- M[3]=0
- M[4]=1
- M[5]=1
- M[6]=0
- M[2]=0
- M[1]=1
- M[0]=0
- Write data port
- Write Enable
- A[7]
- B[7]
- M[7]=1
- 간단한 구현
- – N개의 모든 연산을 수행하고, 마스크에 따라 결과 쓰기 비활성화
- C[4]
- C[5]
- C[1]
- Write data port
- A[7]
- B[7]
- M[3]=0
- M[4]=1
- M[5]=1
- M[6]=0
- M[2]=0
- M[1]=1
- M[0]=0
- M[7]=1
- 밀도-시간 구현
- – 마스크 벡터를 스캔하고, 비제로 마스크를 가진 요소만 실행
p.34다른 몇 가지 문제점
- stride (VSTR)(스트라이드)와 banking(뱅킹)
- 서로 상대적으로 소수이면서, bank(뱅크) 접근 지연을 커버할 만큼 충분한 bank(뱅크)가 있다면, 1요소/사이클의 처리 속도를 유지할 수 있음
- 행렬의 저장 방식
- 행 우선: 행 내 연속된 요소가 메모리에서 연속적으로 배치됨
- 열 우선: 열 내 연속된 요소가 메모리에서 연속적으로 배치됨
- 행과 열에 접근할 때 stride (VSTR)(스트라이드)를 변경해야 함
p.35행렬 곱셈
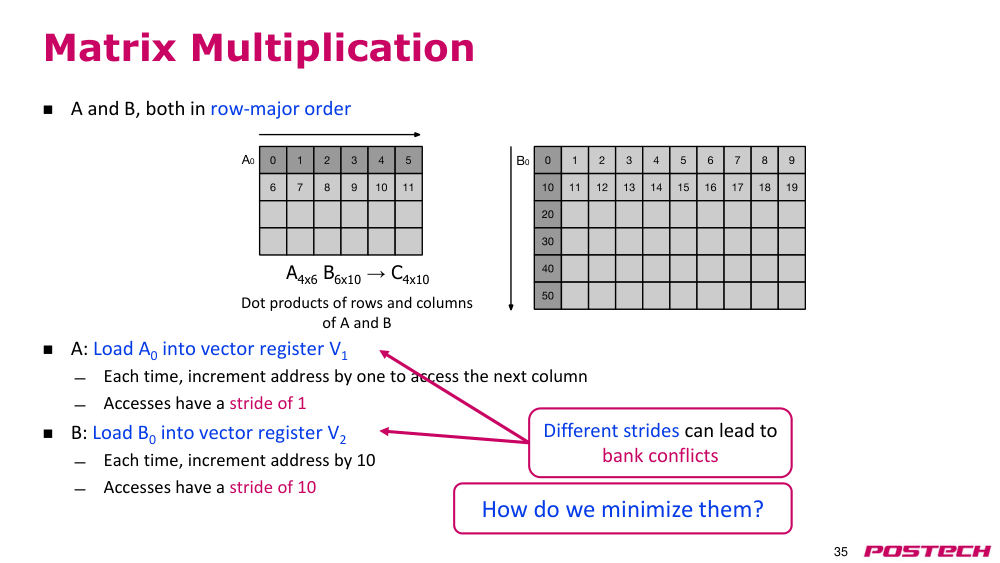
- A와 B는 모두 행 우선 순서로 저장됨
- A: A0를 vector registers(벡터 레지스터) V1에 로드
- 각각 다음 열에 접근하기 위해 주소를 1씩 증가
- 접근 시 stride (VSTR)(스트라이드)는 1
- B: B0를 vector registers(벡터 레지스터) V2에 로드
- 각각 주소를 10씩 증가
- 접근 시 stride (VSTR)(스트라이드)는 10
- A4x6 B6x10 → C4x10
- A와 B의 행과 열의 내적
- 다른 stride (VSTR)(스트라이드)는 bank conflict(뱅크 충돌)를 유발할 수 있음
- 어떻게 이를 최소화할 수 있는가?
p.36bank conflict(뱅크 충돌) 최소화
- 더 많은 bank(뱅크) 사용
- 접근 패턴에 맞는 더 나은 데이터 레이아웃
- 항상 가능할까?
- 주소를 bank(뱅크)에 매핑하는 방식 개선
- 예: 무작위 매핑
- Rau, “Pseudo-randomly interleaved memory,” ISCA 1991.
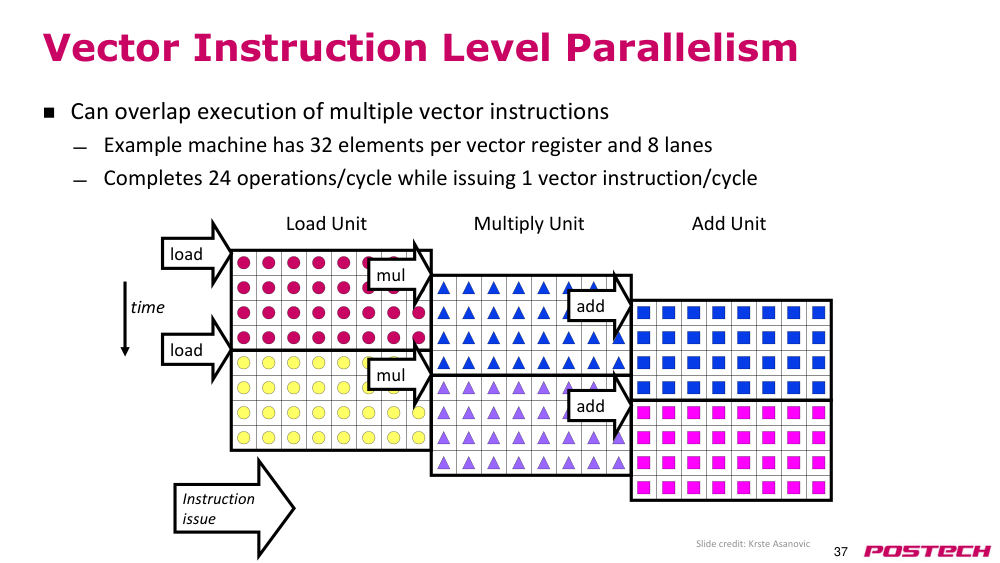
p.37벡터 명령어 수준 병렬성
- 다수의 벡터 명령어 실행을 겹쳐 수행할 수 있음
- 예: vector registers(벡터 레지스터)당 32개의 요소와 8개의 레인을 가진 머신
- 사이클당 1개의 벡터 명령어를 발행하면서, 사이클당 24개의 연산을 완료함
- 로드 유닛
- 곱셈 유닛
- 덧셈 유닛
- 시간
- 명령어 발행
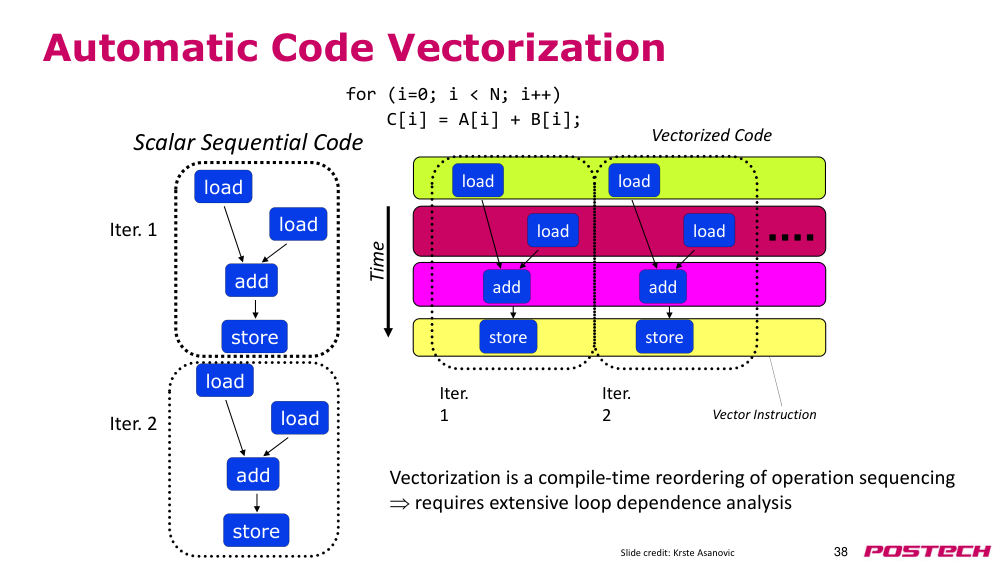
p.38자동 코드 벡터화
- for (i=0; i < N; i++)
- C[i] = A[i] + B[i];
- 로드
- 로드
- 덧셈
- 스토어
- 로드
- 로드
- 덧셈
- 스토어
- 반복 1
- 반복 2
- 스칼라 순차 코드
- 벡터화는 컴파일 시점에서 연산 순서를 재정렬하는 것
- → 광범위한 루프 의존성 분석 필요
- 벡터 명령어
- 로드
- 로드
- 덧셈
- 스토어
- 로드
- 로드
- 덧셈
- 스토어
- 반복 1
- 반복 2
- 벡터화된 코드
- 시간
p.39벡터/SIMD 처리 요약
- 벡터/SIMD 머신은 규칙적인 데이터 수준 병렬성을 효과적으로 활용함
- 많은 데이터 요소에 동일한 연산 수행
- 성능 향상, 설계 단순화 (벡터 내 의존성 없음)
- 성능 향상은 코드의 벡터화 가능성에 제한됨
- 스칼라 연산이 벡터 머신 성능을 제한함
- Amdahl's law(암다울의 법칙)을 기억할 것
- CRAY-1은 당시 가장 빠른 스칼라 머신이기도 했음!
- 기존 많은 ISA는 (벡터 유사) SIMD 연산을 포함함
- Intel MMX/SSEn/AVX, PowerPC AltiVec, Arm Neon/SVE
p.40병렬 시스템의 다양한 형태
- 작업 분배
- 병렬성의 세분화: 작업이 얼마나 세밀하게 나뉘는가 (전체 프로그램에서 비트까지)
- 규칙성: 동질적 vs. 비동질적 노드
- 로드 밸런싱: 정적 vs. 동적
- 통신
- 메시지 전달 vs. 공유 메모리
- • 복수의 OS와 다른 애플리케이션 vs. 하나의 OS와 스레드
- 통신의 세분화: 단어에서 페이지까지
- 인터커넥트 및 인터페이스 설계/성능
- • 토폴로지, 라우팅, 흐름 제어 등
- 대부분의 실제 설계는 여러 프로그래밍 및 구현 패러다임을 결합함
p.41질문?
- 공지사항
- - 교재 읽기: P&H Ch 6.1 – 6.5