Lec 17 part 3 & Lec 18 · coherence 성능 문제 마무리, synchronization(lock, atomic RMW, LR/SC) · memory consistency 도입
정밀 정리 · 검증 2026-09-24 22:40
1개요
1.1Lec17 마지막: coherence protocol 의 deadlock·livelock·starvation 예와 shared memory 요약.
1.2Lec18: process/thread, fork·pthread, data race 와 critical section, lock 을 위한 atomic RMW(Test&Set, Fetch&Add, Swap, Compare&Swap).
1.3lock 성능(traffic·latency·fairness·scalability)과 개선(backoff, test and test&set, LL/SC), RISC-V lr.d/sc.d 예제.
1.4memory consistency 도입: coherence 와 구분, Dekker 유래 예에서 store buffer 로 (0,0) 발생. SC 는 다음 시간.
2섹션별 정리 상황·문제 → 원인 → 해결
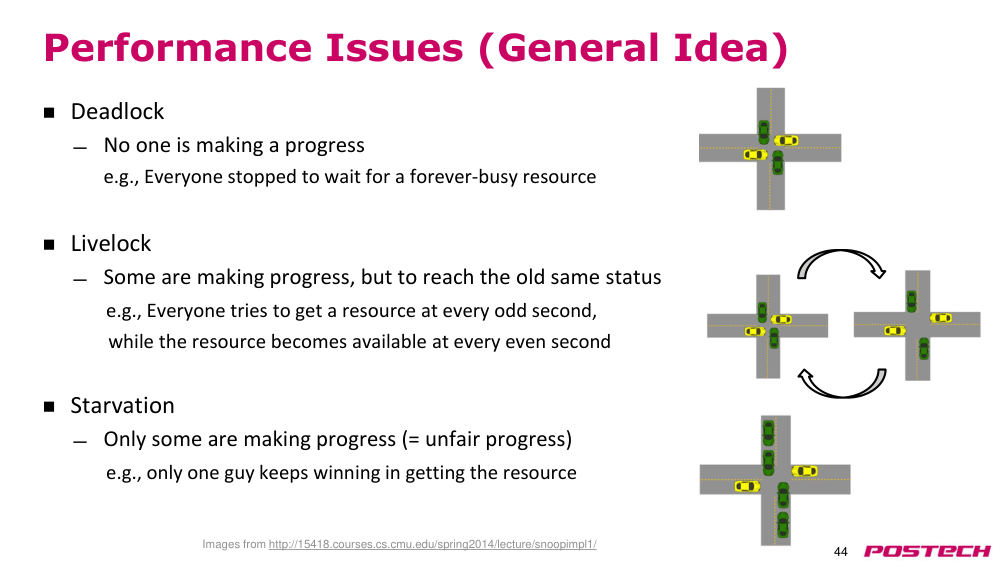
2.12:17–6:05Performance issue 일반: deadlock·livelock·starvation
상황·문제coherence protocol 의 마지막 주제인 performance issue. 공유 resource(교차로) 비유로 세 가지 진행 실패를 정의.
원인deadlock: 서로 막아 아무도 진행 못 함. livelock: 모두 후진·재진입을 반복해 두 상태 사이만 오감. starvation: 세로 차선만 계속 통과.
해결shared resource 설계 시 세 경우 모두 피해야 함.
- deadlock = no progress, livelock = 활동은 있으나 같은 상태 반복
- starvation = 일부만 progress(불공정)
2.26:05–10:43Cache coherence 의 deadlock·livelock·starvation 예와 요약
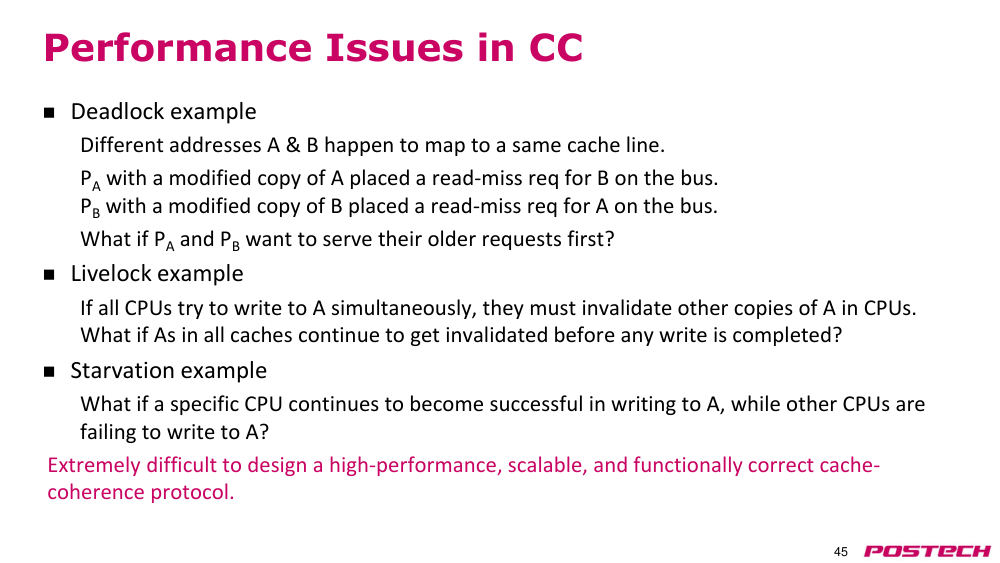
상황·문제같은 문제가 coherence protocol 에서도 생김.
원인A·B 가 같은 cache line: PA(A 를 M)가 B read-miss, PB(B 를 M)가 A read-miss, 서로 자기 요청 먼저면 deadlock. 모두 A 에 write 하면 read-exclusive 로 서로 invalidate 반복 → livelock. 한 CPU 만 계속 성공 → starvation.
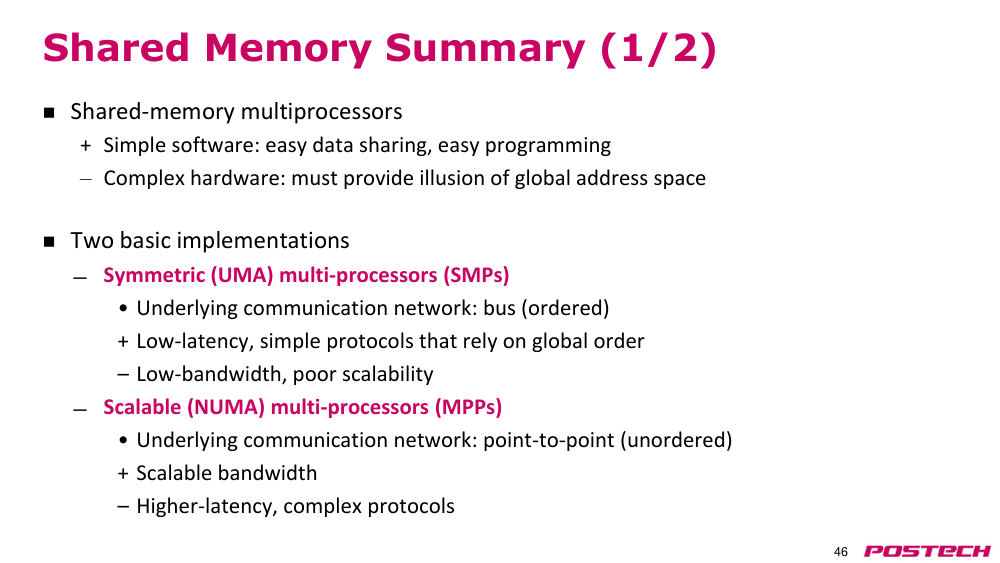
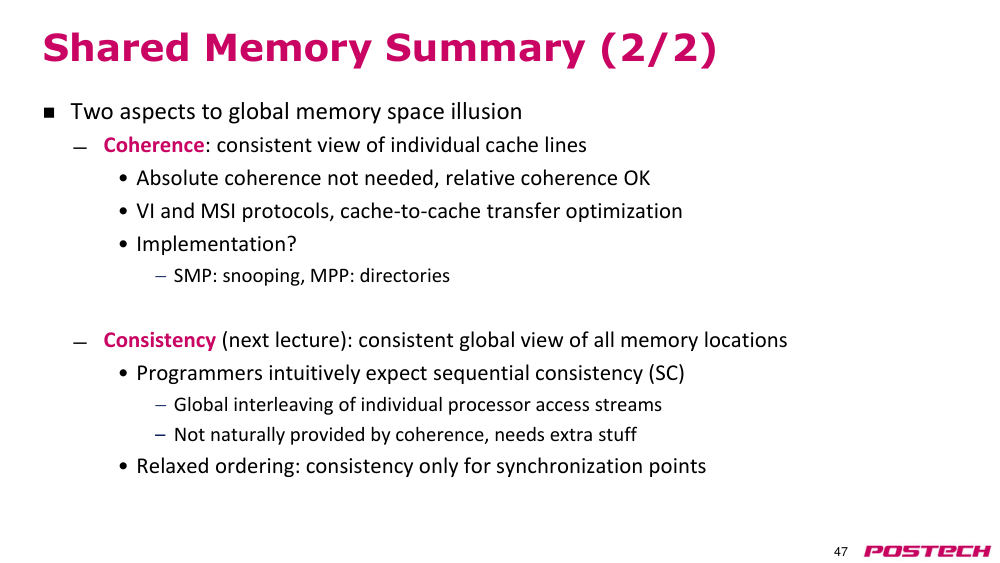
해결실제 application 에서 성능 문제가 안 되게 설계해야 하나 고성능·확장성·정확성을 모두 갖추기 매우 어려움. 이어 shared memory 요약(p46·47)을 보여 주고 synchronization 으로 넘어감.
- 현재 쓰는 CPU 에도 발견 안 된 coherence protocol bug 가 있을 수 있음(강사)
- 요약 slide 는 "직접 보라"며 넘어감
2.310:43–15:30Synchronization 배경: multithreading, process vs thread
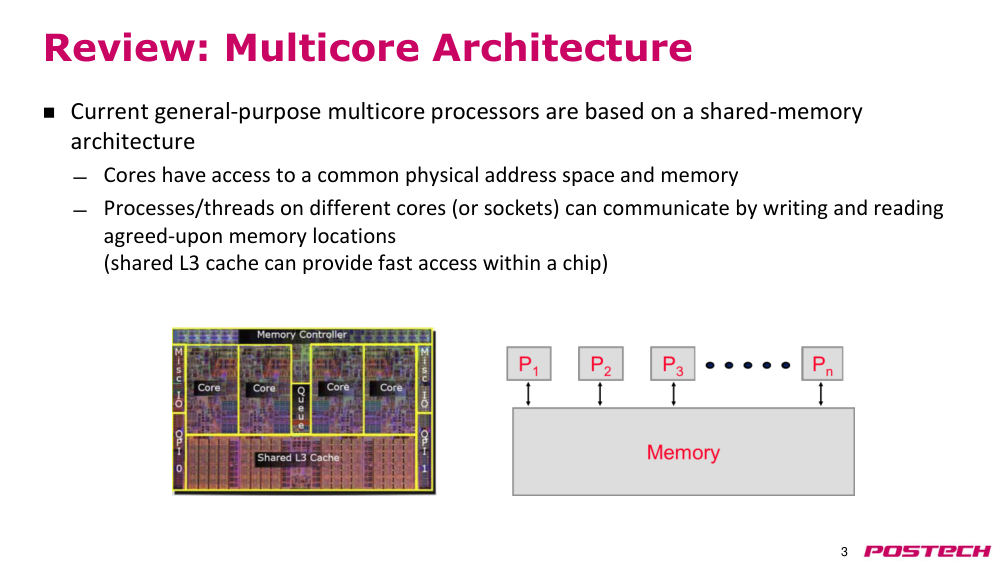
상황·문제Lecture 18 시작. multicore 는 하나의 global physical address space 를 공유.
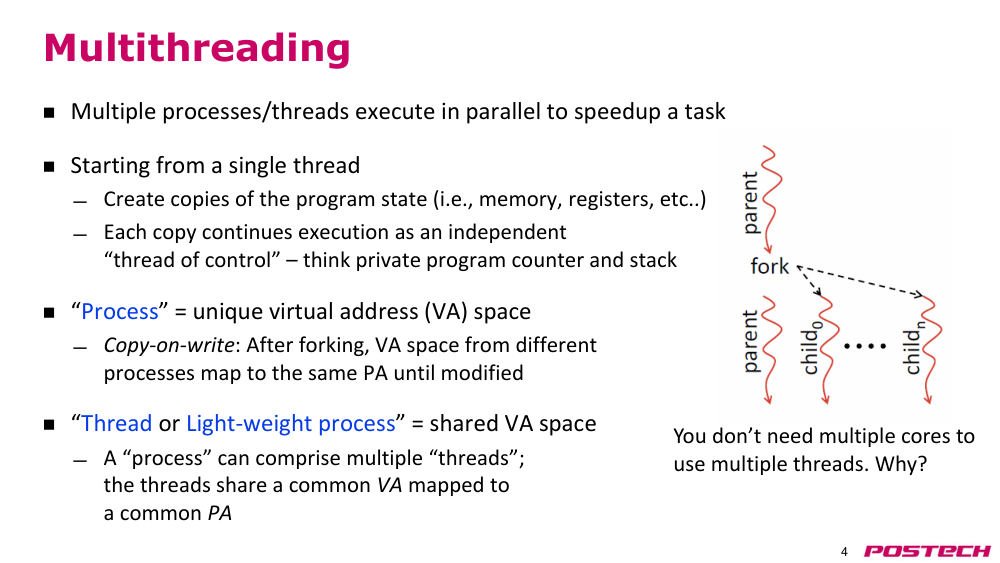
원인여러 process/thread 가 동시에 실행되어 task 가속. 모두 single thread 에서 fork/spawn 으로 시작.
해결process 는 각자 virtual address space(fork 직후 같은 data, write 시 copy-on-write), thread 는 VA 공유. 둘 다 자기 PC·stack(thread of control).
- process = 별도 VA space, thread(light-weight process) = 공유 VA space
- fork 직후 같은 data·code, write 하면 copy 생성(자세한 것은 OS 과목)
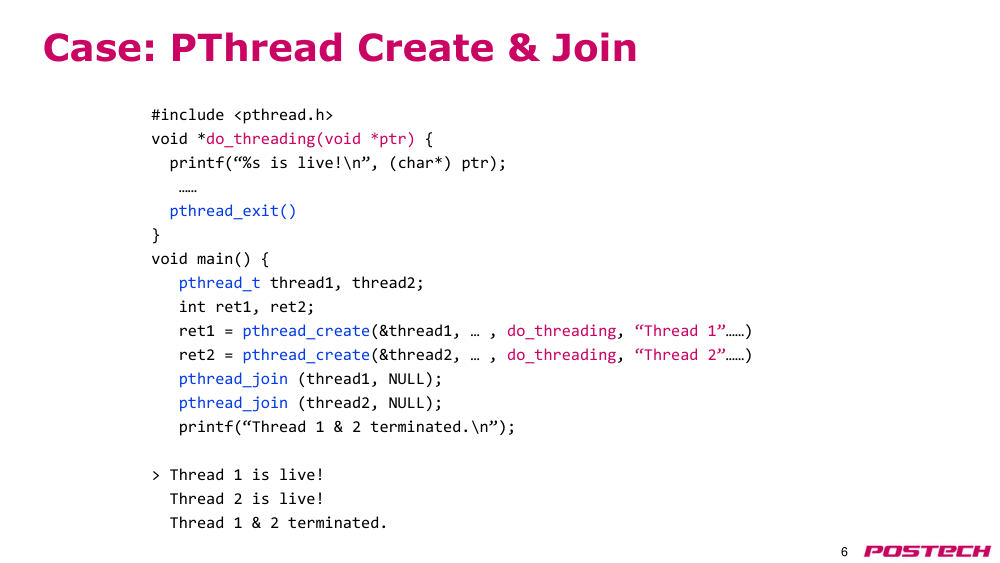
2.415:30–18:28fork() 와 pthread create/join
상황·문제process 와 thread 를 실제로 만드는 방법.
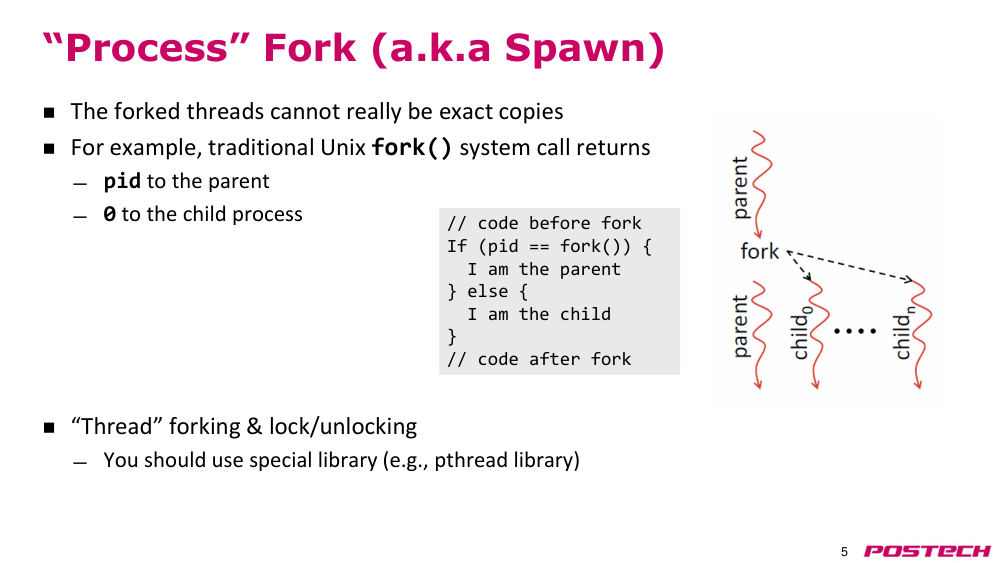
원인fork() 를 부르면 기존 process 와 새 process 두 개가 되고 반환값으로 구분(child 는 0).
해결thread 는 pthread library: pthread_create 로 생성된 thread 가 지정 함수 실행, pthread_join 으로 pthread_exit 까지 대기 → 이후 parent thread 하나만 남음.
- child 에 fork 반환값 0
- pthread_join 은 해당 thread 가 pthread_exit 할 때까지 대기
2.518:28–21:25영상·음성 지연 확인과 출석 확인
상황·문제영상·음성 지연 여부 확인(1~10 판서 test) 후 출석 확인. 문제 있으면 나중에 녹화본으로 보라고 안내.
2.621:25–28:13Data race, critical section, lock
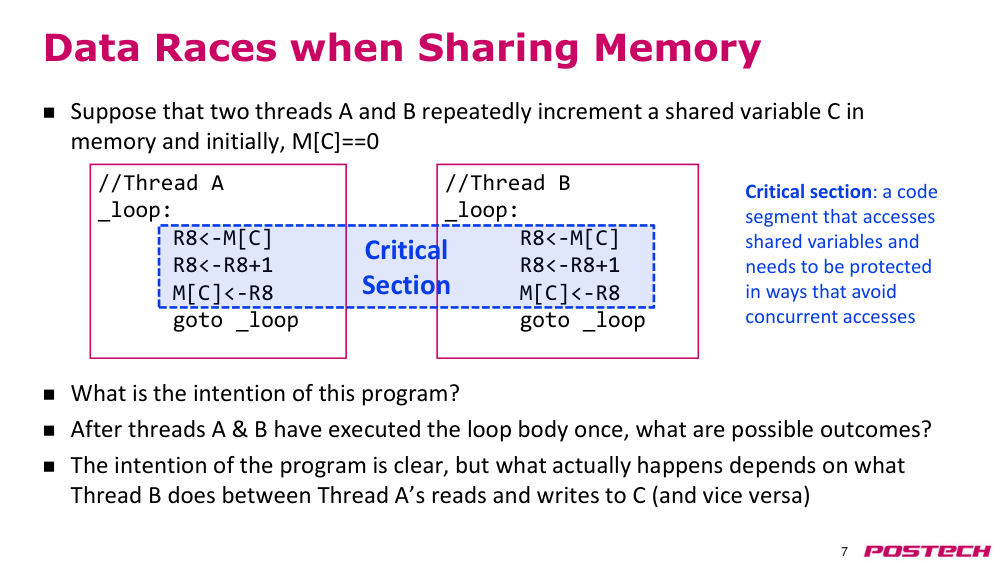
상황·문제thread A·B 가 shared C 를 load→+1→store 로 한 번씩 증가. 의도한 결과는 2.
원인둘 다 먼저 load 하면 둘 다 0 을 읽고 1 을 써서 결과 1(학생 답).
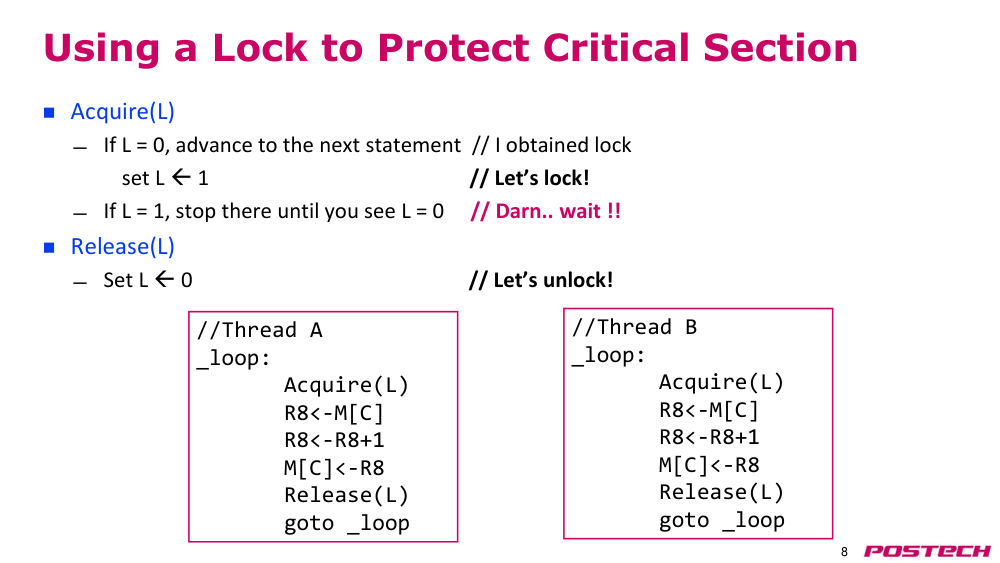
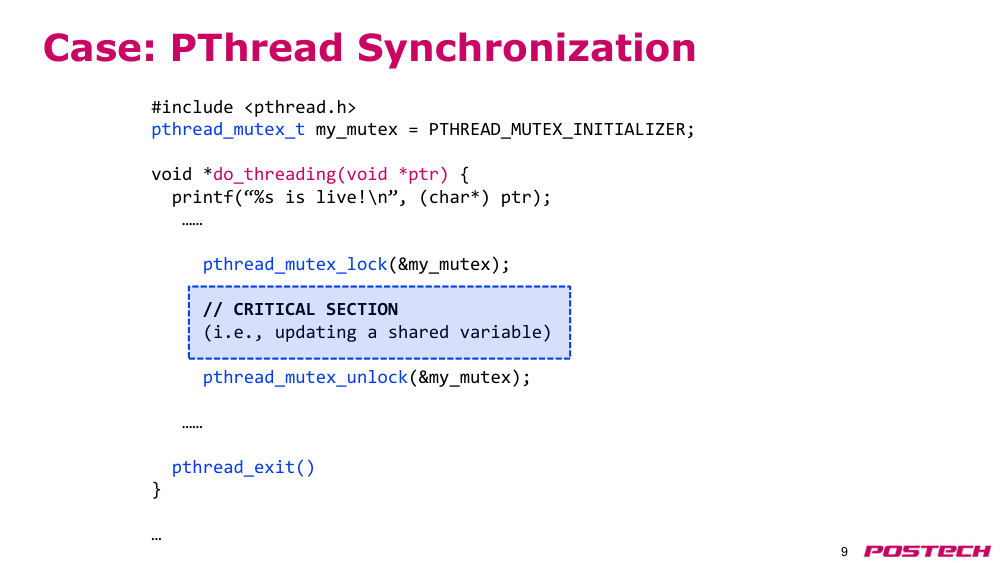
해결shared variable 에 접근하는 critical section 은 한 thread 만 들어가게 lock 으로 보호: Acquire(L)(L==0 이면 1 로 set, 아니면 대기) / Release(L)(0 을 씀). pthread 에서는 pthread_mutex_lock/unlock.
- critical section = shared variable 에 접근하는 code 구간
- L==1 이면 lock 을 얻을 때까지 반복 확인(질문 답변)
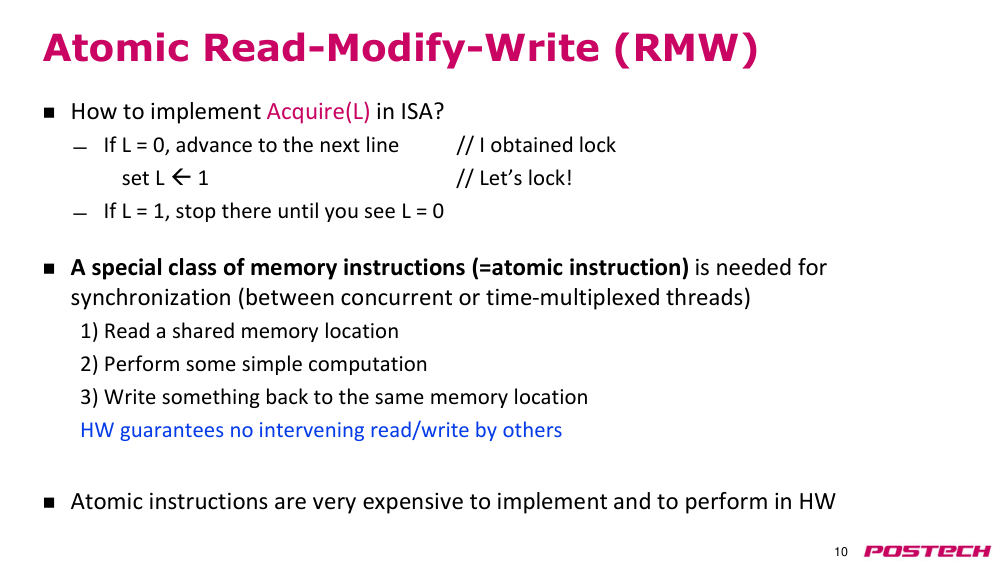
2.728:13–33:05Atomic read-modify-write 가 필요한 이유
상황·문제SW lock 을 HW 에서 가능하게 해야 함.
원인일반 load 로 L 을 읽고 검사한 뒤 store 로 1 을 쓰면 그 사이 다른 thread 도 0 을 보고 1 을 쓸 수 있음.
해결read → 간단한 계산 → 같은 위치 write 를 한 instruction 으로 하고, HW 가 다른 thread 의 중간 read/write 가 없음을 보장하는 atomic instruction. RISC-V 로는 2~3 개일 일을 한 번에 해서 구현 비용이 큼.
- atomic = lock 값을 update 하는 동안 다른 thread 가 수정 불가
- 질문 답변: lock 을 못 얻으면 L 을 계속 반복 확인
2.833:05–37:22Atomic RMW instruction 종류
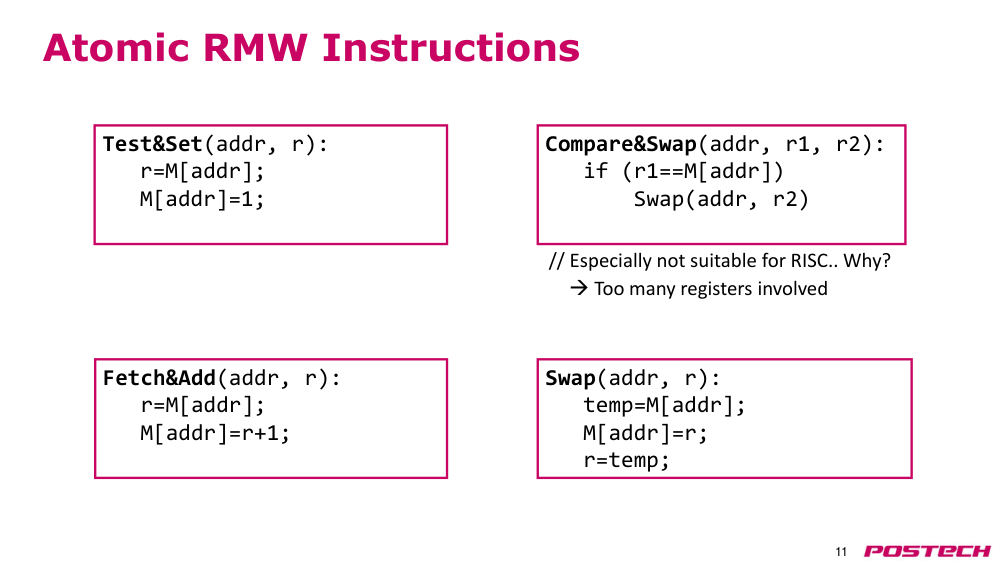
상황·문제architecture 마다 여러 변형의 atomic RMW 지원.
원인Test&Set: M[addr]→r, M[addr]=1. Fetch&Add: r+1 을 씀. Swap: 교환. Compare&Swap: r1==M[addr] 이면 r2 와 swap.
해결Compare&Swap 은 한 instruction 에 register operand 가 많아(주소 포함 3개) instruction 을 단순하게 하려는 RISC 에 맞지 않음(다른 것이 맞다는 뜻은 아님).
- Compare&Swap 은 RISC 에 특히 부적합: too many registers
2.937:22–41:09Test&Set·Compare&Swap 으로 acquire/release 구현
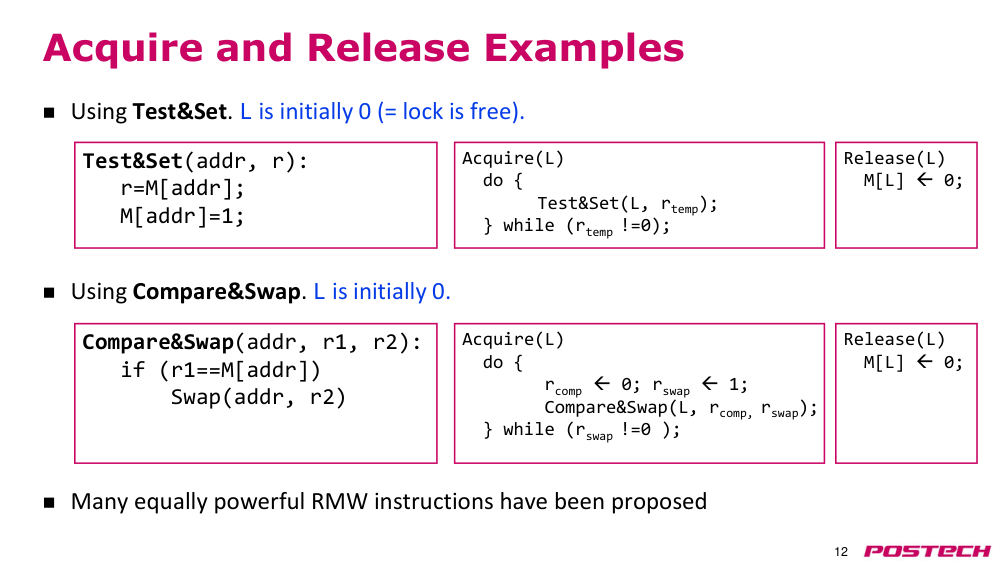
상황·문제slide 의 Test&Set(...) 는 함수가 아니라 instruction 의 동작 설명.
원인Test&Set 을 loop 에서 실행: 결과 register 가 0 이면 획득, 1 이면 이미 잡힌 것(1 에 1 을 써서 변화 없음)이라 반복.
해결Compare&Swap: rcomp=0, rswap=1 로 두고 성공하면 rswap=0·L=1, 실패하면 rswap=1 이라 반복. release 는 둘 다 L 에 0 을 쓰는 일반 store.
- release 는 특수 instruction 불필요
2.1041:09–48:25Lock 구현 고려사항: traffic, latency, fairness, scalability
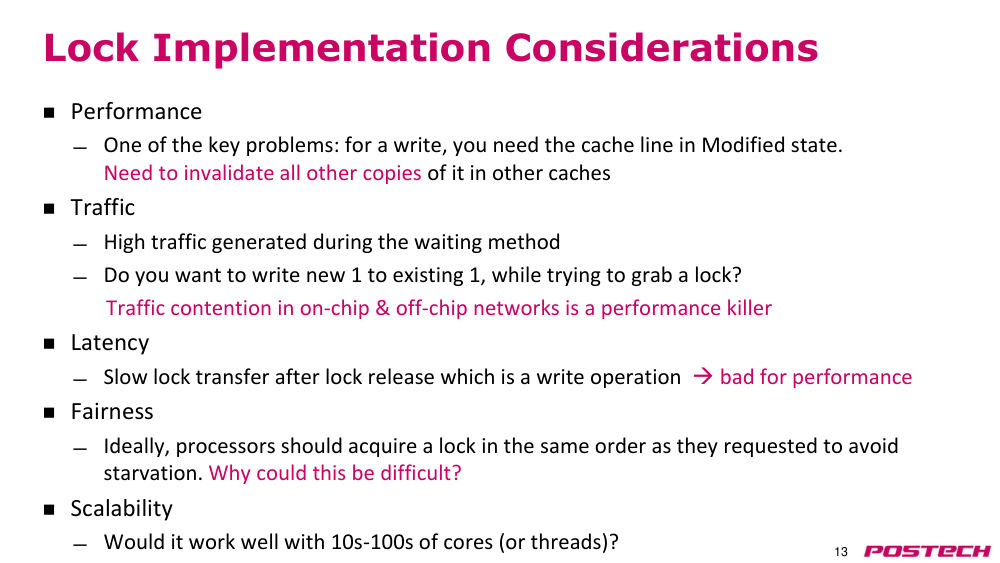
상황·문제atomic instruction 에 따라 성능·복잡도가 다름.
원인lock 에 write 하려면 line 이 M 상태여야 해 다른 core copy invalidate. 1 에 1 을 써도 request/response traffic 이 생겨 lock 과 무관한 core traffic 도 방해. release 가 느리면 보통 critical path 가 아닌 write 가 critical path 가 됨.
해결fairness: bus 는 broadcast 라 모두 동시에 보지만 mesh 같은 point-to-point 에서는 가까운 core 가 빨리 접근 → topology·network 우선순위가 영향. 수십~수백 core 로 확장되는 lock 필요.
- 효과 없는 write(1→1) 도 invalidation·traffic 유발
- fairness 가 어려운 이유: interconnect topology(학생 답 queue 외)
2.1148:25–51:40성능 개선: backoff, test-and-test&set, LL/SC
상황·문제lock contention 과 traffic 을 줄이는 방법.
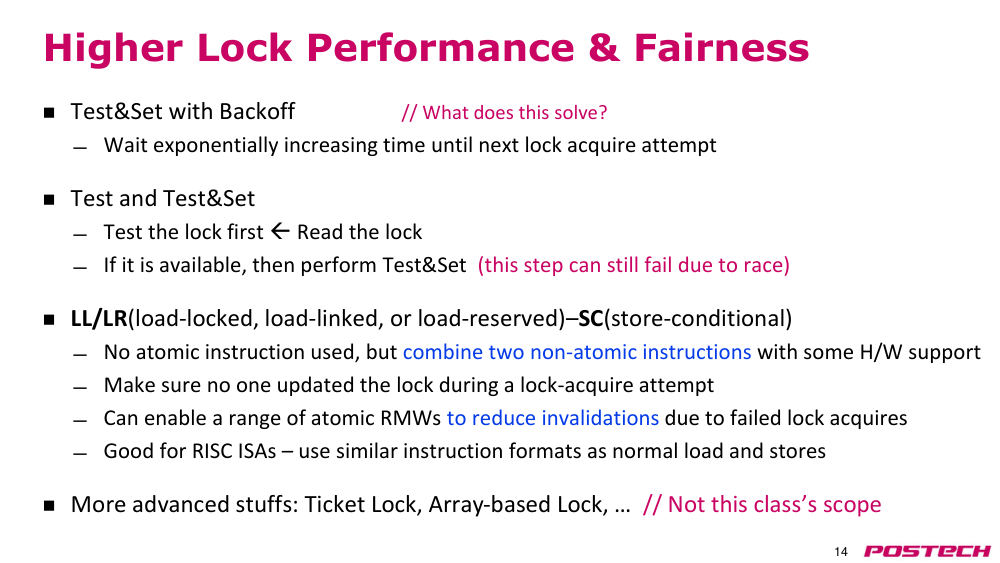
원인backoff: 실패 후 2, 4, 8, 16 cycle 로 지수 증가 대기 → contention·traffic·invalidation 감소. test and test&set: 먼저 read 해서 0 일 때만 test&set → write 감소.
해결LL(load-locked/reserved)–SC(store-conditional) 쌍: 두 non-atomic instruction 으로 acquire 중 아무도 lock 을 update 안 했음을 확인. lock 이 잡혀 있으면 LL 만 실행해 write traffic 감소. 일반 load/store 형식이라 RISC 에 적합.
- LL/SC 는 CISC 식 복잡 atomic instruction 대신 RISC 에 적합
2.11.r.2Wikipedia: Test and test-and-set ↗ · 먼저 읽어 보고 test-and-set, contended lock 의 coherence traffic 감소
2.1251:40–55:36RISC-V lr.d / sc.d
상황·문제RISC-V 가 지원하는 LR/SC.
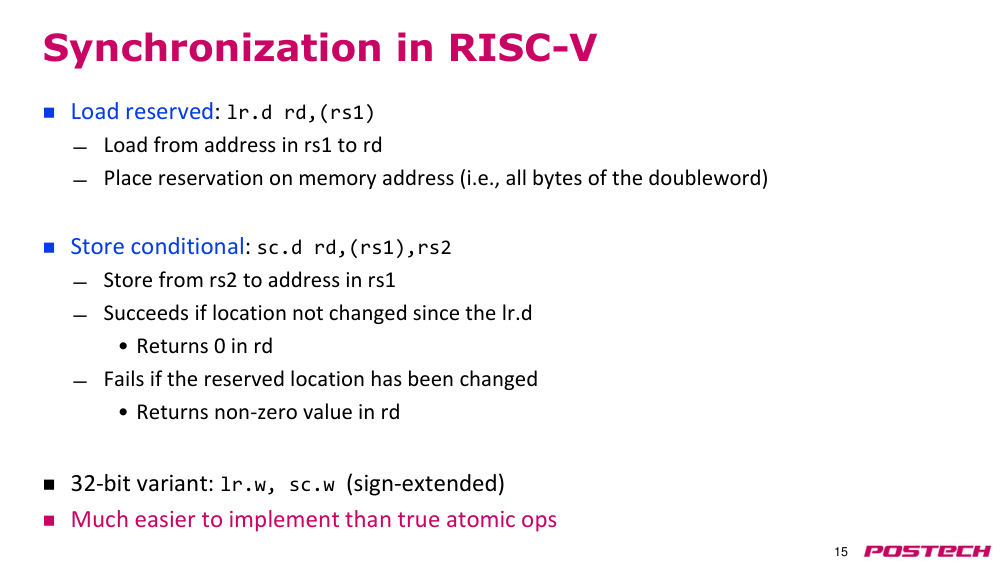
원인lr.d rd,(rs1): 일반 load + 그 doubleword 에 reservation. sc.d rd,(rs1),rs2: store 에는 없던 destination rd 가 있음.
해결lr.d 이후 위치가 안 바뀌었으면 rd=0(성공, 획득), 바뀌었으면 rd=nonzero. 32-bit 는 lr.w/sc.w. 강의는 "store 는 어쨌든 수행"이라 했으나 spec 은 실패 시 memory 에 쓰지 않음.
- rd==0 이면 성공 → critical section 진입
- spec: "If the SC.W fails, the instruction does not write to memory"
2.1355:36–58:41RISC-V LR/SC 예: atomic swap 과 lock
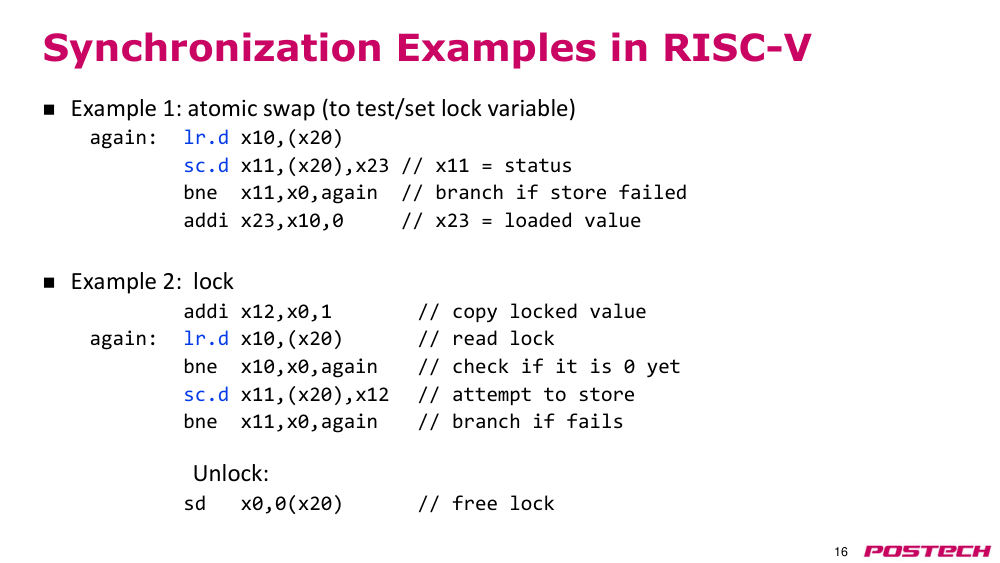
상황·문제LR/SC 로 atomic swap 과 lock 구현.
원인swap: lr.d x10,(x20) → sc.d x11,(x20),x23 → x11≠0 이면 again → addi x23,x10,0 로 x23 과 M[x20] 교환.
해결lock: x12=1, lr.d 로 lock 을 읽어 0 이 아니면 again, 0 이면 sc.d 로 1 을 쓰고 x11≠0 이면 again, 성공하면 critical section. unlock 은 sd x0,0(x20).
- x0 과 비교해 sc 성공 여부 판단
2.1458:41–1:03:46질의응답: reservation 구현, lr immediate, sc 쓰기
상황·문제학생 질문 세 개에 답변.
원인reservation: dirty bit 는 load 만으로 set 되므로 부적합, 별도 structure 에 예약 주소를 두고 update 가 오면 match 표시. lr 에 immediate 가 없는 이유는 강사도 확답 못 하고 spec 확인 권유.
해결sc 가 조건과 무관하게 쓰는 것은 문제 없나 → lock 을 잘 설계하면 test&set 처럼 문제 안 됨(강사). 단 RISC-V spec 은 실패한 SC 가 memory 에 쓰지 않음.
- lr immediate 질문은 강의에서 미해결
2.151:03:46–1:08:06Coherence vs consistency
상황·문제synchronization 구현은 consistency model 에 따라 달라지므로 먼저 구분.
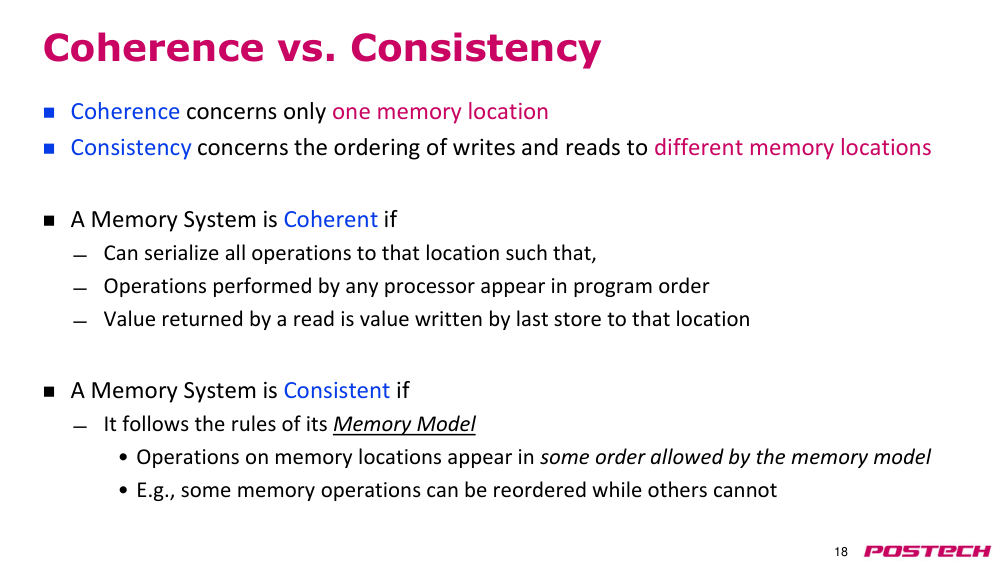
원인coherence: 한 memory 위치, 같은 위치 접근은 program order 로 serialize, read 는 last store 값. consistency: 서로 다른 위치에 대한 read/write 의 허용 순서.
해결memory model 규칙을 따르면 consistent. 예: 어떤 model 은 read 재정렬은 허용하고 store 는 불허. coherence protocol 과 무관.
- coherence = one location, consistency = different locations
2.161:08:06–1:17:30Dekker 유래 예: (0,0) 결과와 store buffer
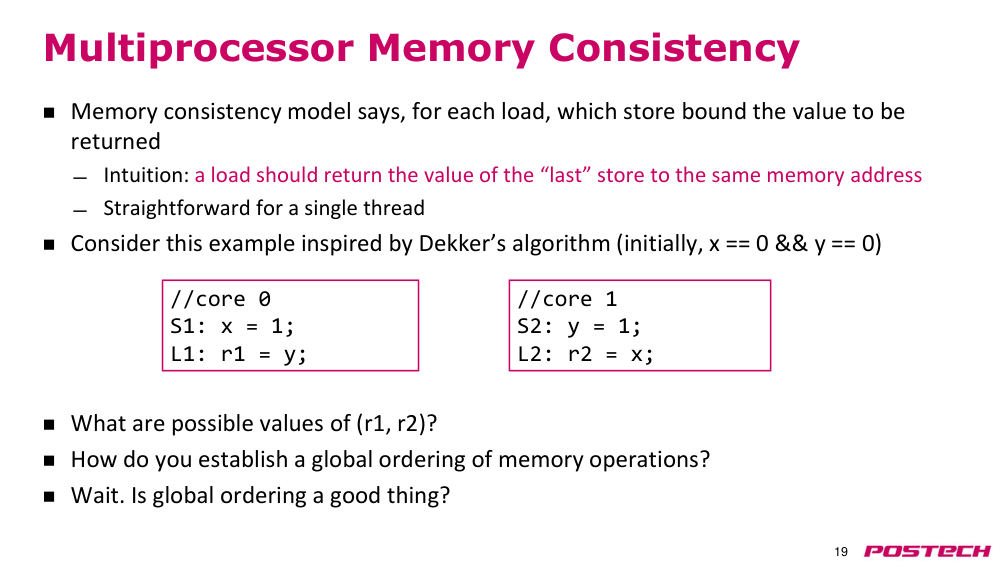
상황·문제core0: x=1; r1=y / core1: y=1; r2=x (초기 0). 가능한 (r1,r2)?
원인(1,1), (0,1), (1,0) 은 interleaving 으로 설명. (0,0) 은 불가능해 보이지만 실제 machine 에서 나옴. OoO 가 아니어도, coherence 가 있어도 core 와 cache 사이 store buffer 에 x=1, y=1 이 있는 동안 load 가 먼저 cache 를 읽으면 발생.
해결memory consistency model 이 어떤 reordering 을 허용하는지 정함. global ordering 은 직관적이지만 store buffer 같은 구조를 못 씀 → 좋은가 나쁜가?
- store buffer 가 store→load 순서를 다른 core 에게 깨뜨림(학생 LSQ 답)
- 어떤 model 은 (0,0) 을 금지, 어떤 model 은 허용
2.16.r.1James Bornholt: Memory Consistency Models: A Tutorial ↗ · store buffer(TSO) 로 SC 가 금지한 00 결과가 나오는 설명 (슬라이드 p27 추천, 옛 utexas 주소는 여기로 301)
2.16.r.2Wikipedia: Memory ordering ↗ · multiprocessor 의 runtime reordering 과 memory barrier (슬라이드 p23 인용)
2.171:17:30–1:18:36예고: sequential consistency, 종료
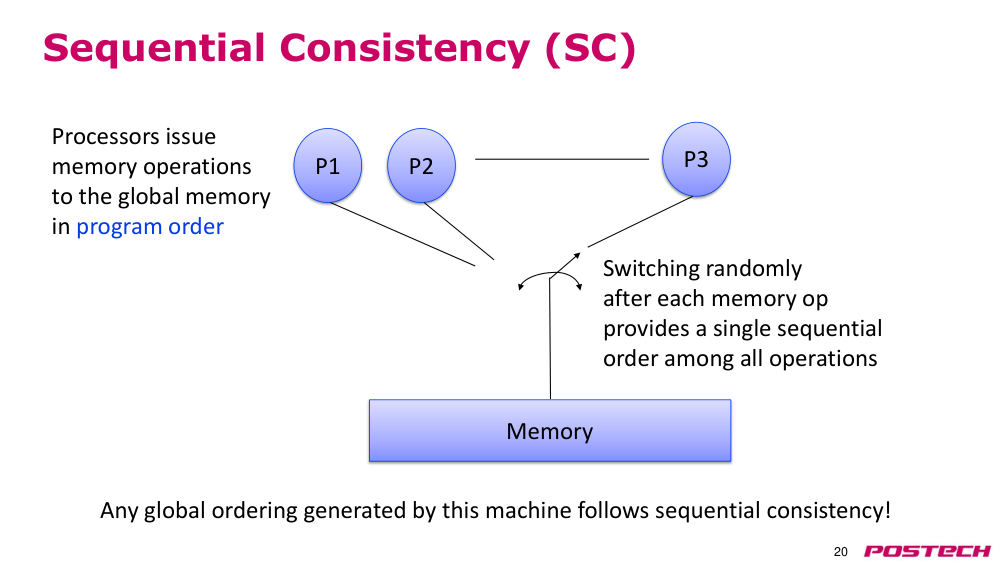
상황·문제다음 시간에 직관적이지만 성능 비용이 있는 sequential consistency 를 다룸. 질문 없으면 종료.
3핵심 개념
3.1livelock(라이브락)
활동은 있으나 같은 상태를 반복해 진행 못 함. 예: 모든 CPU 가 A 에 write 하며 서로 invalidate.
3.2critical section(임계 구역)
shared variable 에 접근해 동시 접근을 막아야 하는 code 구간. lock 으로 보호.
3.3atomic RMW(원자적 read-modify-write)
read·계산·write 를 한 instruction 으로, 중간 개입 없음을 HW 가 보장.
3.4Test&Set
M[addr] 를 r 로 읽고 M[addr]=1. r==0 이면 lock 획득.
3.5Compare&Swap
r1==M[addr] 이면 r2 와 swap. register operand 가 많아 RISC 에 부적합.
3.6exponential backoff(지수 백오프)
lock 실패 후 대기 시간을 2,4,8,16 cycle 로 늘려 contention 감소.
3.7test and test&set
먼저 일반 read 로 0 인지 보고 0 일 때만 test&set → write·invalidation 감소.
3.7.r.1Wikipedia: Test and test-and-set ↗ · 먼저 읽어 보고 test-and-set, contended lock 의 coherence traffic 감소
3.8LR/SC(load-reserved / store-conditional)
lr 로 reservation, 그 사이 update 가 없으면 sc 성공(rd=0). RISC-V lr.d/sc.d, lr.w/sc.w.
3.9memory consistency(메모리 일관성)
서로 다른 위치에 대한 read/write 가 어떤 순서로 보일 수 있는지 정하는 규칙(memory model).
3.10store buffer(스토어 버퍼)
store 를 queue 에 두고 load 가 추월. 다른 core 가 store 를 늦게 봐 (0,0) 같은 결과 가능.
3.10.r.1James Bornholt: Memory Consistency Models: A Tutorial ↗ · store buffer(TSO) 로 SC 가 금지한 00 결과가 나오는 설명 (슬라이드 p27 추천, 옛 utexas 주소는 여기로 301)
4스스로 확인
4.1두 thread 가 C(=0)를 한 번씩 증가시킬 때 결과가 1 이 되는 경우는?
답
둘 다 먼저 load 해서 0 을 읽고 각각 1 을 store.
4.2일반 load/검사/store 로 Acquire 를 만들면 왜 안 되나?
답
load 와 store 사이에 다른 thread 도 0 을 보고 1 을 써 둘 다 진입.
4.3Test&Set lock 에서 이미 잡힌 lock 에 다시 1 을 쓰면 무엇이 문제인가?
답
값은 안 바뀌어도 line 을 M 으로 가져와 다른 copy 를 invalidate, traffic 유발.
4.4test and test&set 이 traffic 을 줄이는 이유는?
답
lock 이 1 이면 read 만 반복하고 write(test&set)를 하지 않음.
4.5sc.d x11,(x20),x12 후 x11 이 nonzero 면?
답
lr.d 이후 reservation 위치가 바뀌어 실패, again 으로 재시도.
4.6x=1; r1=y / y=1; r2=x 에서 (0,0) 이 in-order core 에서도 나오는 이유는?
답
store 가 store buffer 에 있는 동안 load 가 cache 에서 먼저 0 을 읽음.
5참고 자료
5.2Wikipedia: Memory ordering ↗ · multiprocessor 의 runtime reordering 과 memory barrier (슬라이드 p23 인용)
5.3James Bornholt: Memory Consistency Models: A Tutorial ↗ · store buffer(TSO) 로 SC 가 금지한 00 결과가 나오는 설명 (슬라이드 p27 추천, 옛 utexas 주소는 여기로 301)
5.5Lamport 1979: How to Make a Multiprocessor Computer That Correctly Executes Multiprocess Programs ↗ · SC 원 논문 (IEEE TC 1979)