이 자료를 쓰는 강의: 55 coherence 성능 문제 마무리, synchronization(lock, atomic RMW, LR/SC) · memory consistency 도입 · 56 sequential consistency 와 relaxed model · I/O(port register, memory-mapped I/O, DMA, polling/interrupt)
Lec18-Synchronization
한국어판 강의자료 · 30쪽
p.1CSED311 컴퓨터구조 – 강의 18
synchronization(동기화) 및 consistency(일관성)
p.2동기화
p.33. 복습: multicore architecture(다중코어 아키텍처)
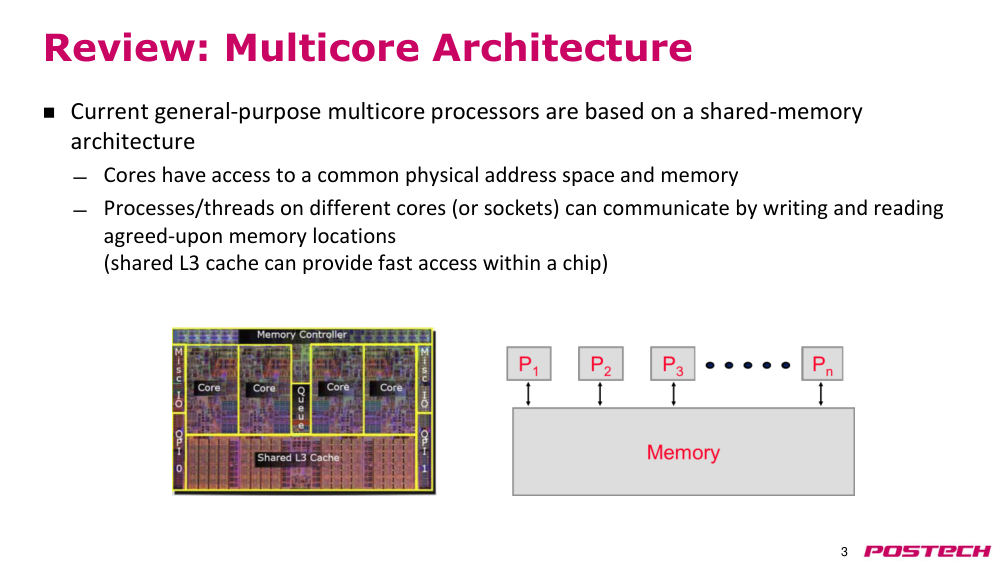
- 현재 일반 목적의 다중코어 프로세서는 shared-memory architecture(공유 메모리 아키텍처) 기반이다.
- 코어들은 공통의 physical address space(물리 주소 공간)과 메모리에 접근할 수 있다.
- 다른 코어(또는 소켓)에 있는 프로세스/thread(스레드)는 합의된 메모리 위치에 쓰고 읽음으로써 통신할 수 있다.
- (공유 L3 캐시는 칩 내에서 빠른 접근을 제공할 수 있다)
p.44. 멀티스레딩
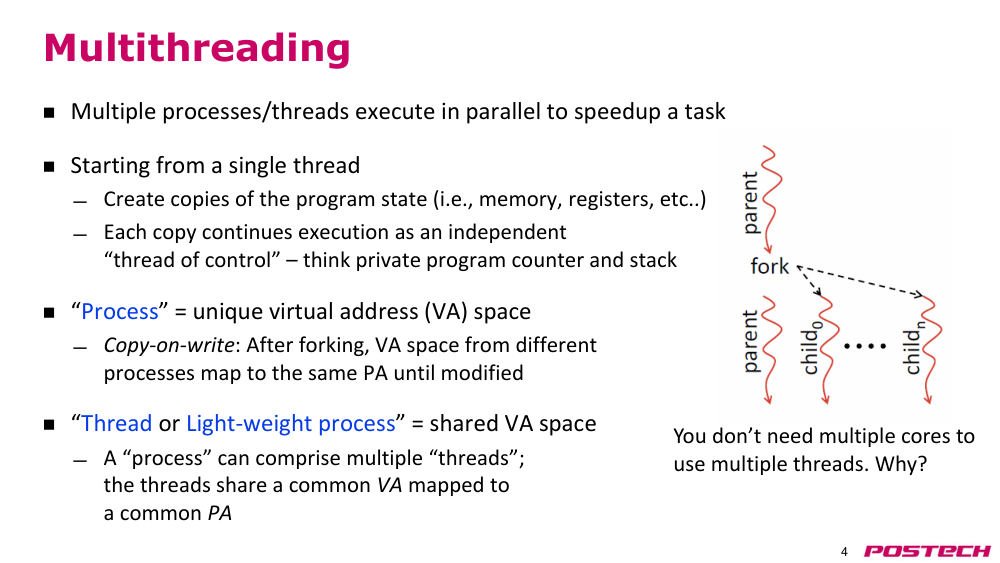
- 여러 개의 프로세스/thread(스레드)가 병렬로 실행되어 작업을 가속화한다.
- 단일 thread(스레드)에서 시작하여
- 프로그램 상태(예: 메모리, 레지스터 등)의 사본을 생성한다.
- 각 사본은 독립적인 '제어 흐름'으로 실행된다 – 개인적인 program counter(프로그램 카운터)와 stack(스택)을 생각해보라.
- "프로세스" = 고유한 virtual address space(가상 주소 공간)
- copy-on-write(쓰기 시 복사): fork(포크) 후, 서로 다른 프로세스의 virtual address space(가상 주소 공간)은 수정될 때까지 동일한 물리 주소로 매핑된다.
- "thread(스레드) 또는 light-weight process(경량 프로세스)" = 공유 virtual address space(가상 주소 공간)
- 한 '프로세스'는 여러 'thread(스레드)'를 포함할 수 있으며, 스레드들은 공통의 virtual address space(가상 주소 공간)을 공유하며, 이는 공통의 물리 주소로 매핑된다.
- 다중 코어가 필요하지 않다. 왜일까?
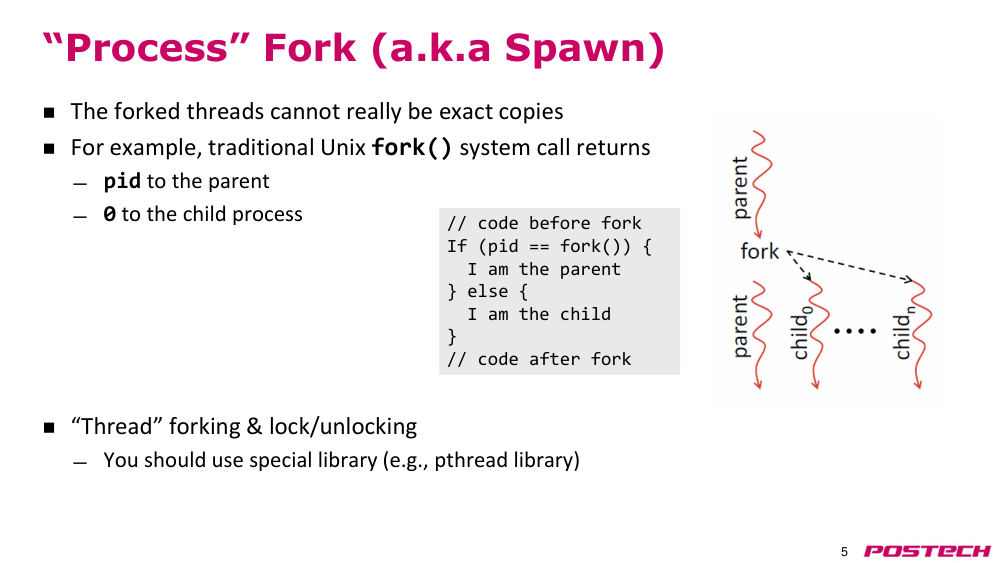
p.55. "프로세스" fork(포크) (또는 spawn(스폰))
- fork(포크)된 thread(스레드)는 실제로 정확한 사본이 될 수 없다.
- 예를 들어, 전통적인 Unix fork() 시스템 호출은
- 부모에게 pid를 반환한다.
- 자식 프로세스에게 0을 반환한다.
- "thread(스레드)" fork(포크) 및 락/언락
- 특수 라이브러리(예: pthread 라이브러리)를 사용해야 한다.
- // fork(포크) 전 코드
- If (pid == fork()) {
- I am the parent
- } else {
- I am the child
- }
- // fork(포크) 후 코드
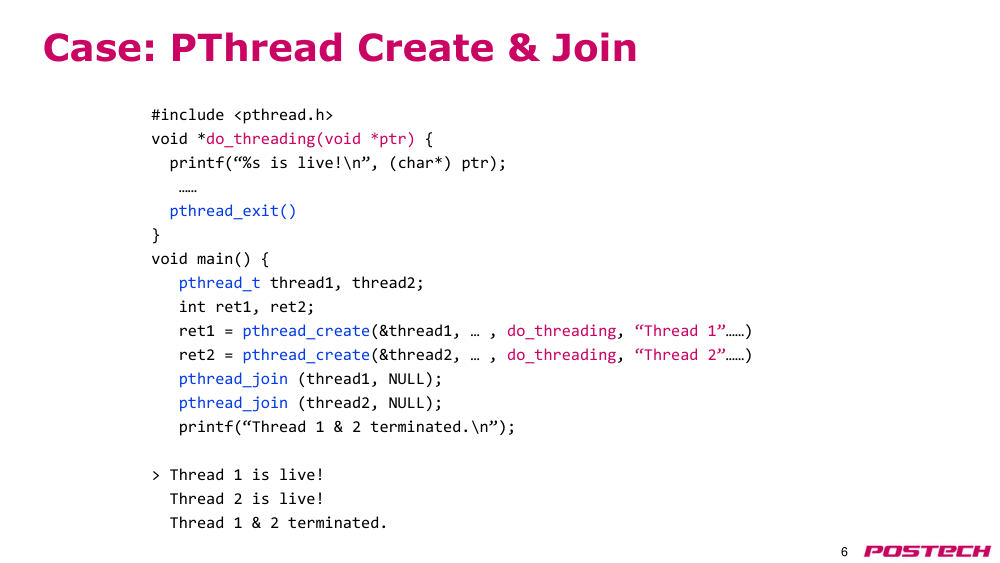
p.66. 사례: PThread 생성 및 조인
- #include <pthread.h>
- void *do_threading(void *ptr) {
- printf("%s is live!\n", (char*) ptr);
- ……
- pthread_exit()
- }
- void main() {
- pthread_t thread1, thread2;
- int ret1, ret2;
- ret1 = pthread_create(&thread1, … , do_threading, "Thread 1"……)
- ret2 = pthread_create(&thread2, … , do_threading, "Thread 2"……)
- pthread_join (thread1, NULL);
- pthread_join (thread2, NULL);
- printf("Thread 1 & 2 terminated.\n");
- }
- > Thread 1 is live!
- Thread 2 is live!
- Thread 1 & 2 terminated.
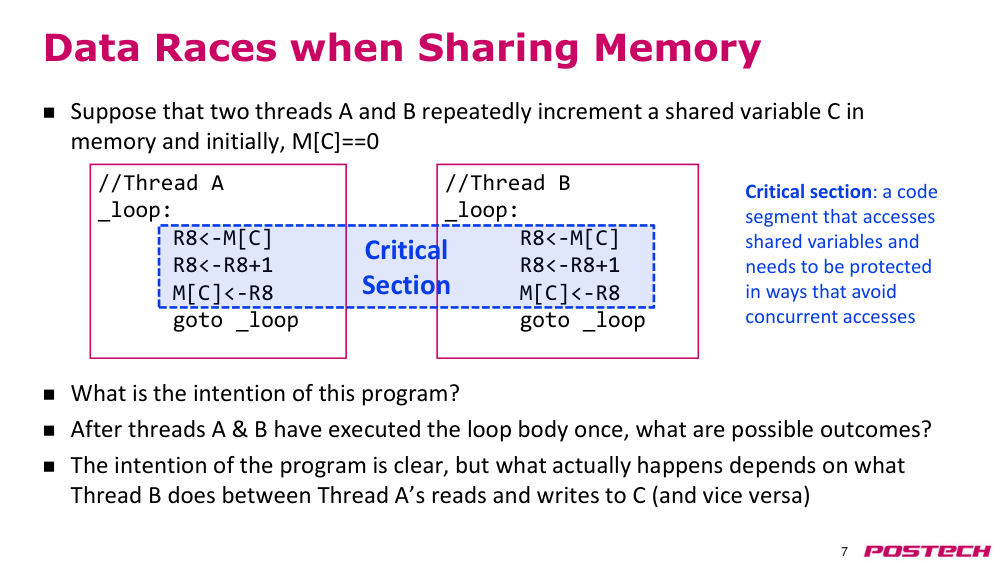
p.7메모리 공유 시 data race(데이터 레이스)
- 두 thread(스레드) A와 B가 메모리에 있는 shared variable(공유 변수) C를 반복적으로 증가시킨다고 가정하고, 초기에 M[C] == 0이라고 하자.
- 이 프로그램의 의도는 무엇인가?
- thread(스레드) A와 B가 루프 본문을 한 번 실행한 후 가능한 결과는 무엇인가?
- 프로그램의 의도는 명확하지만, 실제로 발생하는 결과는 thread(스레드) A가 C에 대한 읽기와 쓰기 사이에 스레드 B가 어떤 작업을 하는지에 따라 달라진다.
- // thread(스레드) A
- _loop:
- R8 <- M[C]
- R8 <- R8 + 1
- M[C] <- R8
- goto _loop
- // thread(스레드) B
- _loop:
- R8 <- M[C]
- R8 <- R8 + 1
- M[C] <- R8
- goto _loop
- critical section(임계 구역): shared variable(공유 변수)에 접근하는 코드 세그먼트이며, 동시 접근을 방지하기 위해 보호되어야 한다.
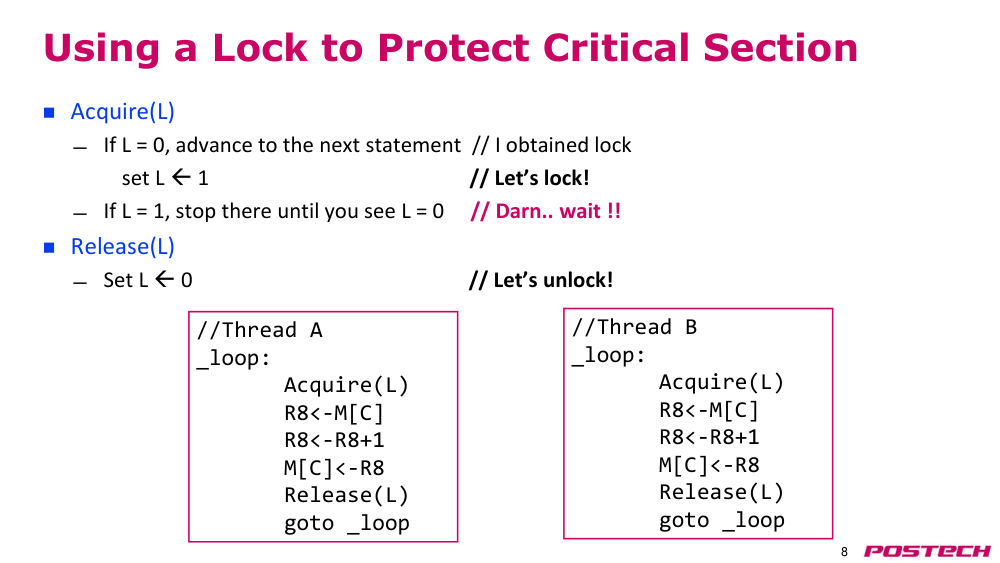
p.8critical section(임계 구역) 보호를 위한 락 사용
- Acquire(L)
- If L == 0, 다음 문장으로 진행 // 락을 획득함
- set L <- 1 // 락을 걸자!
- If L == 1, L == 0을 볼 때까지 기다림 // 아, 기다려야 하네!
- Release(L)
- set L <- 0 // 락을 해제하자!
- // thread(스레드) A
- _loop:
- Acquire(L)
- R8 <- M[C]
- R8 <- R8 + 1
- M[C] <- R8
- Release(L)
- goto _loop
- // thread(스레드) B
- _loop:
- Acquire(L)
- R8 <- M[C]
- R8 <- R8 + 1
- M[C] <- R8
- Release(L)
- goto _loop
p.9사례: PThread 동기화
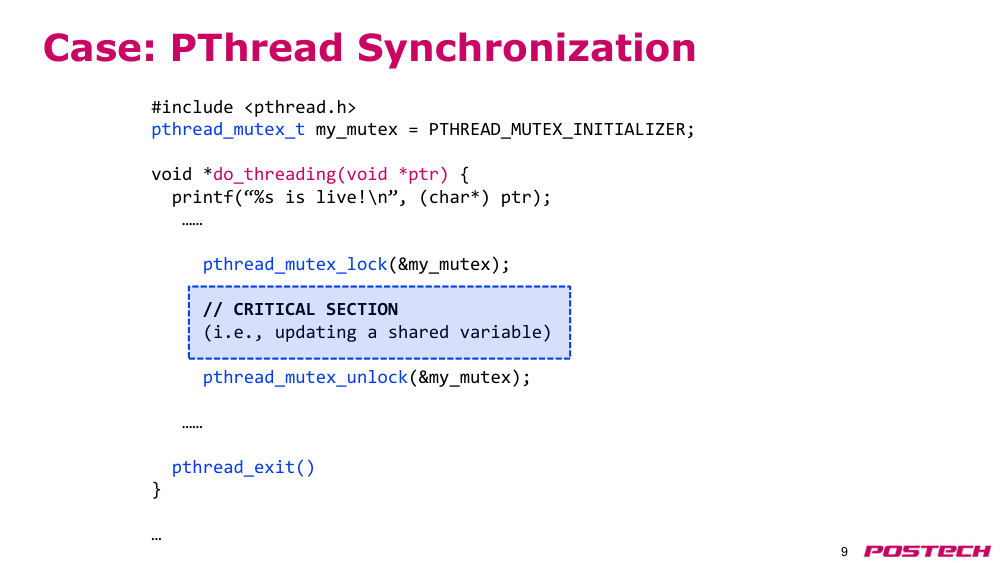
- #include <pthread.h>
- pthread_mutex_t my_mutex = PTHREAD_MUTEX_INITIALIZER;
- void *do_threading(void *ptr) {
- printf("%s is live!\n", (char*) ptr);
- ……
- pthread_mutex_lock(&my_mutex);
- // critical section(임계 구역)
- // (예: shared variable(공유 변수) 업데이트)
- pthread_mutex_unlock(&my_mutex);
- ……
- pthread_exit();
- }
p.10원자적 읽기-수정-쓰기 (RMW)
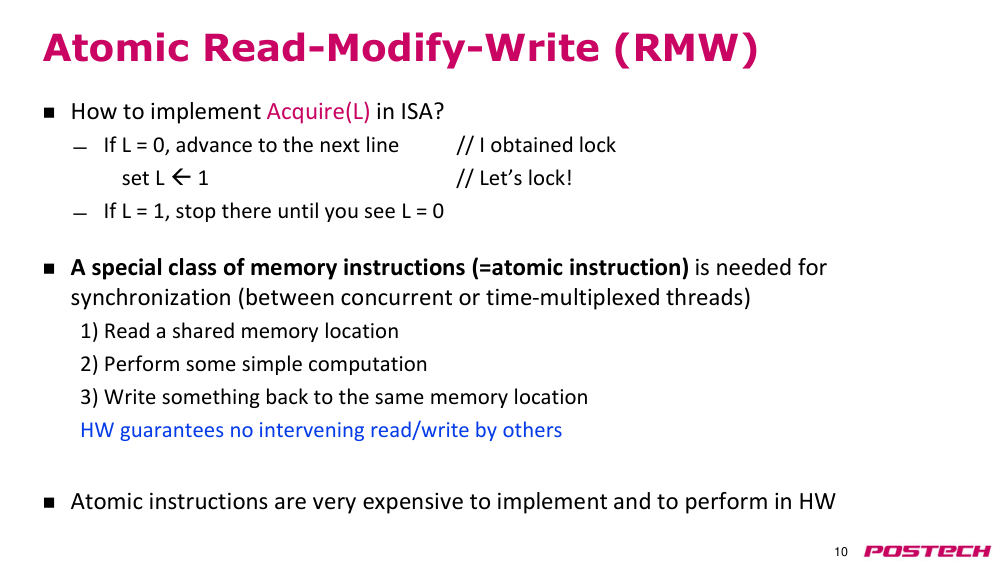
- Acquire(L)을 ISA에서 어떻게 구현할 수 있는가?
- If L == 0, 다음 줄로 진행 // 락을 획득함
- set L <- 1 // 락을 걸자!
- If L == 1, L == 0을 볼 때까지 기다림
- 동시 실행 또는 시간 분할된 thread(스레드) 간의 동기화를 위해 특수한 종류의 메모리 명령어(=원자적 명령어)가 필요하다.
- 1) 공유 메모리 위치를 읽기
- 2) 간단한 계산 수행
- 3) 동일한 메모리 위치에 결과 쓰기
- 하드웨어는 다른 thread(스레드)가 중간에 읽기/쓰기를 수행하지 못하도록 보장한다.
- atomic instruction(원자적 명령어)는 하드웨어에서 구현하고 수행하는 데 매우 비용이 크다.
p.11atomic RMW instructions(원자적 RMW 명령어)
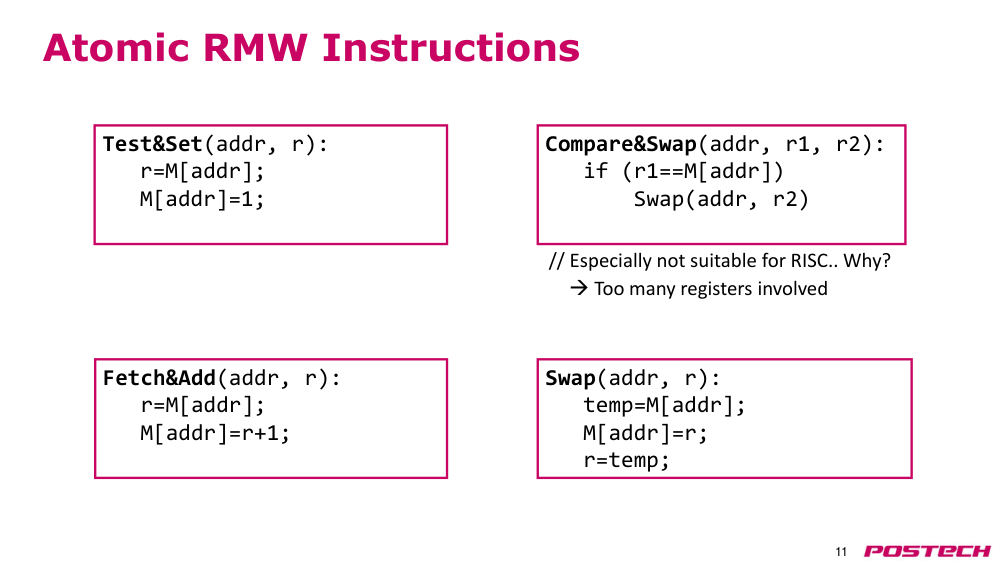
- Swap(addr, r):
- temp = M[addr];
- M[addr] = r;
- r = temp;
- Fetch&Add(addr, r):
- r = M[addr];
- M[addr] = r + 1;
- Test&Set(addr, r):
- r = M[addr];
- M[addr] = 1;
- Compare&Swap(addr, r1, r2):
- if (r1 == M[addr])
- Swap(addr, r2);
- // 특히 RISC에 적합하지 않은 이유?
- → 너무 많은 레지스터가 필요하다.
p.12acquire/release(획득/해제) 예시
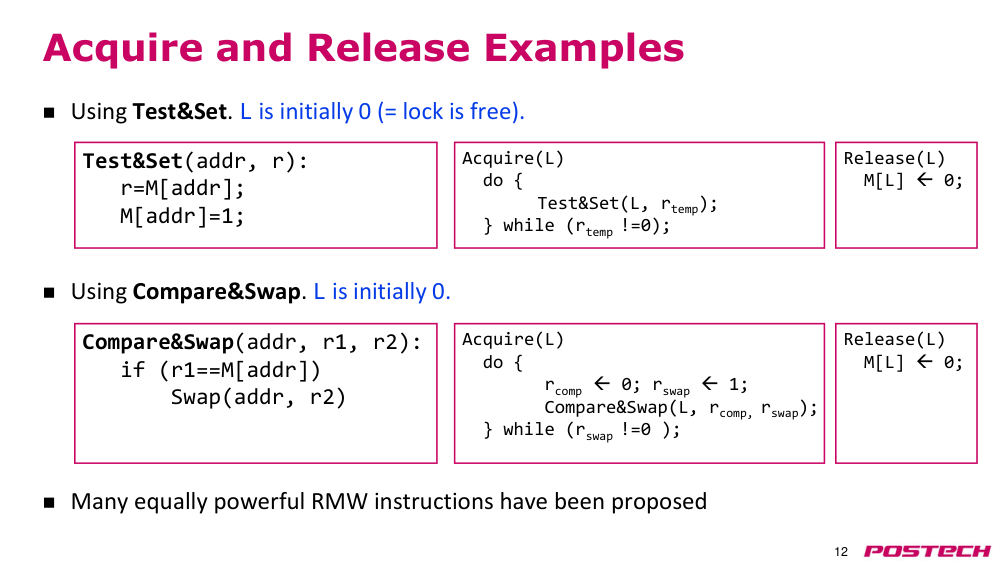
- Test&Set을 사용. L은 초기에 0 (= 락이 해제됨).
- Compare&Swap을 사용. L은 초기에 0.
- 많은 동등한 강력한 RMW 명령어들이 제안됨.
- Acquire(L)
- do {
- Test&Set(L, rtemp);
- } while (rtemp != 0);
- Release(L)
- M[L] <- 0;
- Test&Set(addr, r):
- r = M[addr];
- M[addr] = 1;
- Acquire(L)
- do {
- rcomp <- 0; rswap <- 1;
- Compare&Swap(L, rcomp, rswap);
- } while (rswap != 0);
- Release(L)
- M[L] <- 0;
- Compare&Swap(addr, r1, r2):
- if (r1 == M[addr])
- Swap(addr, r2)
p.13락 구현 고려 사항
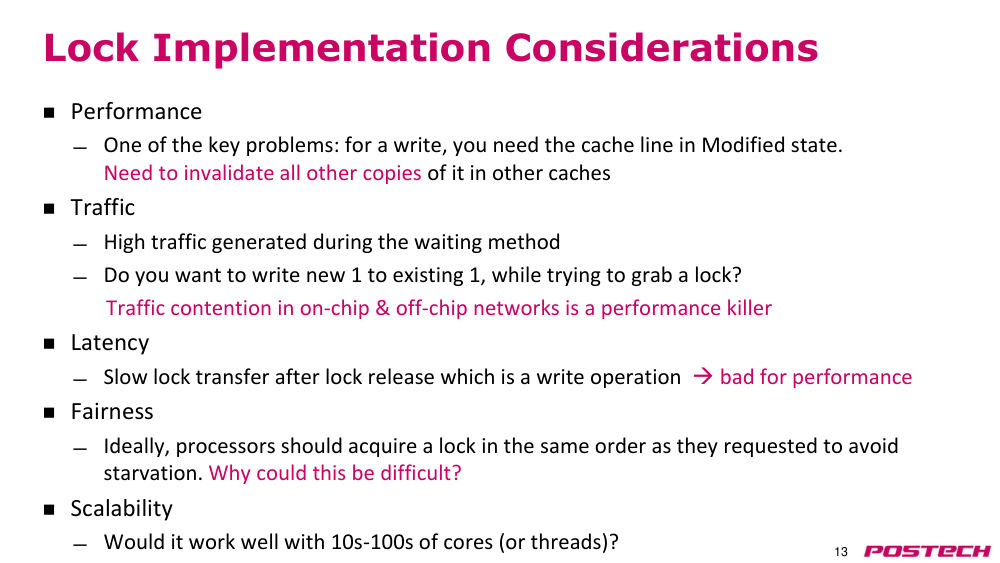
- 성능
- 핵심 문제 중 하나: 쓰기 작업을 수행하려면 cache line(캐시 라인)이 Modified state(수정 상태)여야 한다.
- 다른 캐시에 존재하는 해당 cache line(캐시 라인)의 모든 복사본을 invalidation(무효화)해야 한다.
- 트래픽
- 대기 메서드 동안 높은 트래픽이 발생한다.
- 락을 획득하려는 도중 기존의 1에 새로운 1을 쓰고 싶은가?
- 온칩 및 오프칩 네트워크에서의 traffic contention(트래픽 경쟁)은 성능을 저하시킨다.
- latency(지연)
- release(락 해제) 후 락 전달이 느리다. 이는 쓰기 작업이므로 성능에 악영향을 준다.
- fairness(공정성)
- 이상적으로는 프로세서들이 락을 요청한 순서와 동일한 순서로 획득해야 하며, 이는 starvation(기아)을 방지하기 위함이다.
- 왜 이 조건이 어려울 수 있는가?
- scalability(확장성)
- 10개에서 100개의 코어(또는 스레드)와 함께 잘 작동할 수 있는가?
p.14더 높은 락 성능과 fairness(공정성)
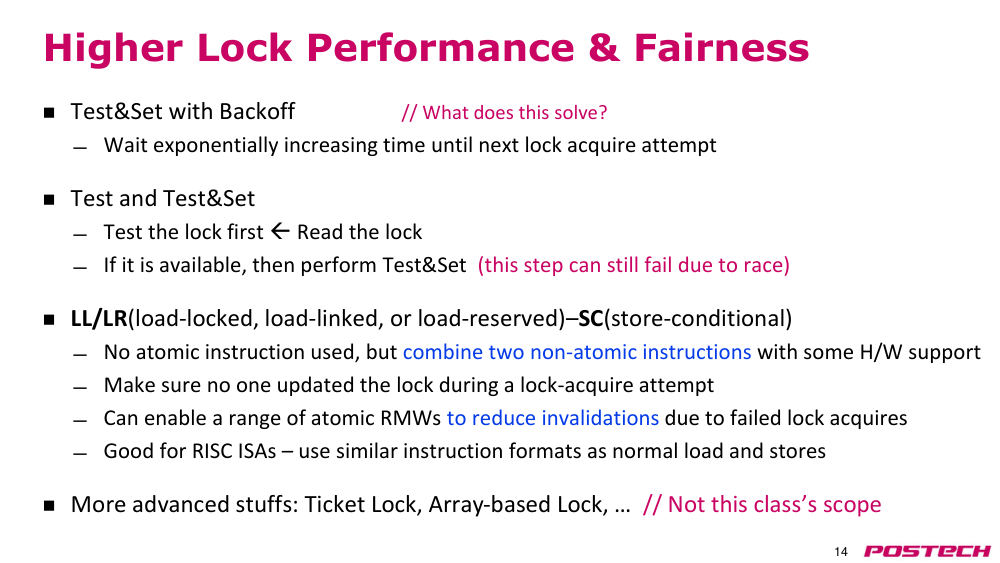
- backoff(백오프)를 사용한 Test&Set(테스트 앤 세트)
- // 이는 무엇을 해결하는가?
- 다음 acquire(락 획득) 시도까지 지수적으로 증가하는 시간을 기다린다.
- test and Test&Set(테스트 앤 테스트 앤 세트)
- 먼저 락을 테스트한다. → 락을 읽는다.
- 만약 락이 사용 가능하다면, Test&Set(테스트 앤 세트)를 수행한다. (이 단계에서도 race condition(경쟁 조건)으로 인해 실패할 수 있음)
- LL/LR(load-locked(잠금 로드), load-linked(연결 로드), 또는 load-reserved(예약 로드))–SC(store-conditional(조건부 저장))
- atomic instruction(원자적 명령어)를 사용하지 않지만, hardware support(하드웨어 지원)을 받는 두 개의 non-atomic instructions(비원자적 명령어)를 조합한다.
- acquire(락 획득) 시도 중 누군가 락을 수정하지 않았는지 확인한다.
- 실패한 acquire(락 획득)으로 인한 invalidation(무효화)를 줄이기 위해 다양한 원자적 RMW를 가능하게 한다.
- RISC-V ISA에 적합함. 일반적인 load(로드)와 store(스토어)와 유사한 명령어 형식 사용.
- 보다 고급 기법들: ticket lock(티켓 락), array-based lock(배열 기반 락) 등 // 본 수업 범위 외
p.15RISC-V에서의 동기화
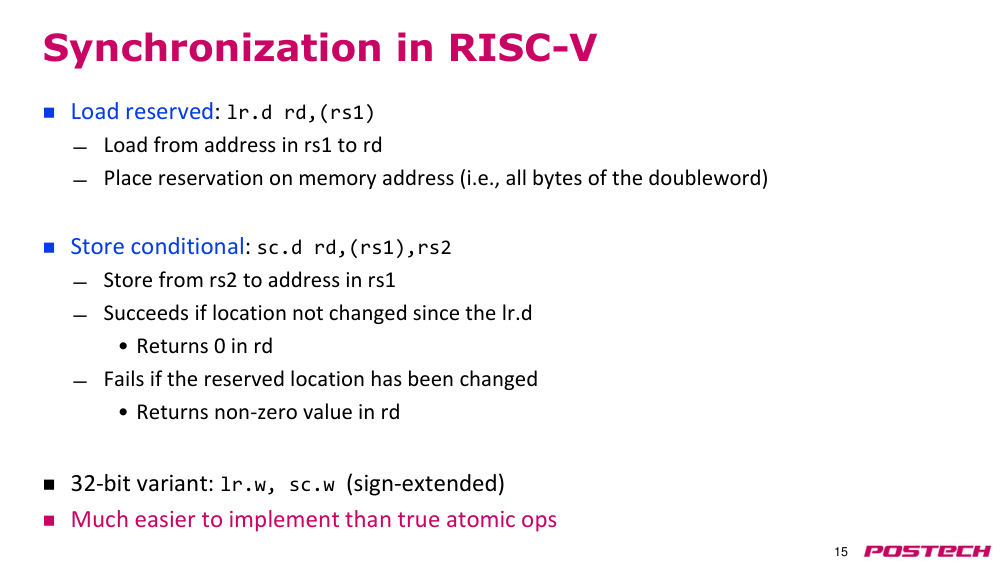
- Load-Reserved(로드 예약): lr.d rd,(rs1)
- rs1에 있는 주소에서 rd로 load(로드)한다.
- 메모리 주소에 reservation(예약)을 설정한다. (즉, doubleword(더블워드)의 모든 바이트에 대해)
- store-conditional(조건부 저장): sc.d rd,(rs1),rs2
- rs2에서 rs1에 있는 주소로 store(스토어)한다.
- lr.d 이후 해당 위치가 변경되지 않았다면 성공한다.
- • rd에 0을 반환한다.
- reservation(예약)된 위치가 변경되었으면 실패한다.
- • rd에 0이 아닌 값을 반환한다.
- 32비트 버전: lr.w, sc.w (부호 확장)
- 진정한 원자적 연산보다 훨씬 쉽게 구현할 수 있다.
p.16RISC-V에서의 동기화 예제
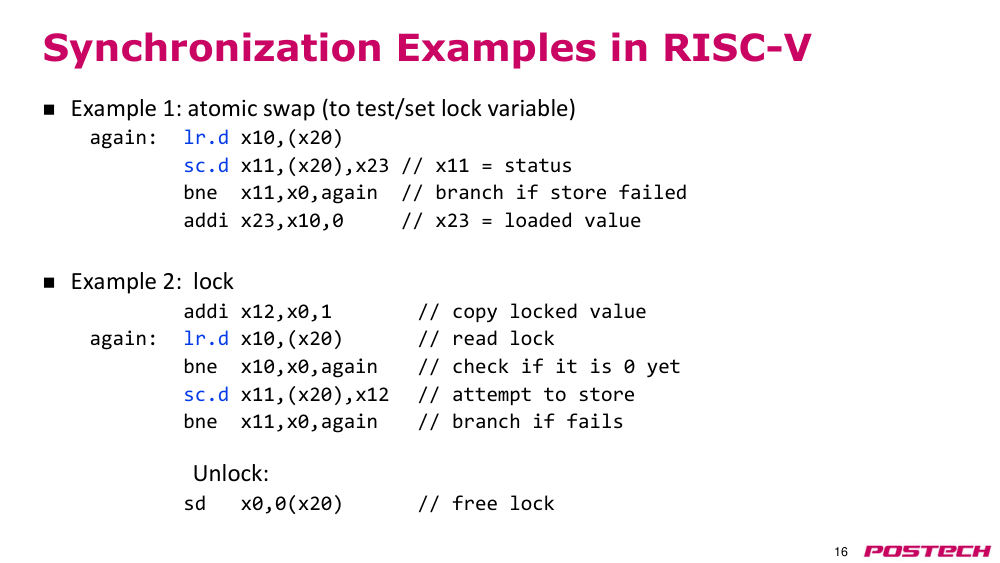
- 예제 1: 원자적 스왑 (락 변수 테스트/설정용)
- again:
- lr.d x10,(x20)
- sc.d x11,(x20),x23 // x11 = 상태
- bne x11,x0,again // store(스토어) 실패 시 분기
- addi x23,x10,0 // x23 = load(로드)된 값
- 예제 2: 락
- addi x12,x0,1 // 락된 값 복사
- again:
- lr.d x10,(x20) // 락 읽기
- bne x10,x0,again // 아직 0인지 확인
- sc.d x11,(x20),x12 // 저장 시도
- bne x11,x0,again // 실패 시 분기
- Unlock:
- sd x0,0(x20) // release(락 해제)
p.17memory consistency(메모리 일관성)
p.18cache coherence(캐시 일관성)와 memory consistency(메모리 일관성)
- cache coherence(캐시 일관성)은 오직 하나의 메모리 위치에만 관련된다.
- memory consistency(메모리 일관성)은 서로 다른 메모리 위치에 대한 쓰기와 읽기의 순서에 관련된다.
- 메모리 시스템이 coherent(캐시 일관성 유지)인 경우:
- 해당 위치에 대한 모든 연산을 시리얼화할 수 있으며,
- 어떤 프로세서가 수행한 연산은 프로그램 순서대로 나타난다.
- 읽기 연산이 반환하는 값은 해당 위치에 마지막으로 쓰인 값이다.
- 메모리 시스템이 consistent(일관성 유지)인 경우:
- 그 memory model(메모리 모델)의 규칙을 따르는 것이다.
- • 메모리 위치에 대한 연산은 memory model(메모리 모델)이 허용하는 어떤 순서로도 나타날 수 있다.
- • 예: 일부 메모리 연산은 reordering(재정렬)될 수 있지만, 다른 일부는 불가능하다.
p.19다중프로세서 memory consistency(메모리 일관성)
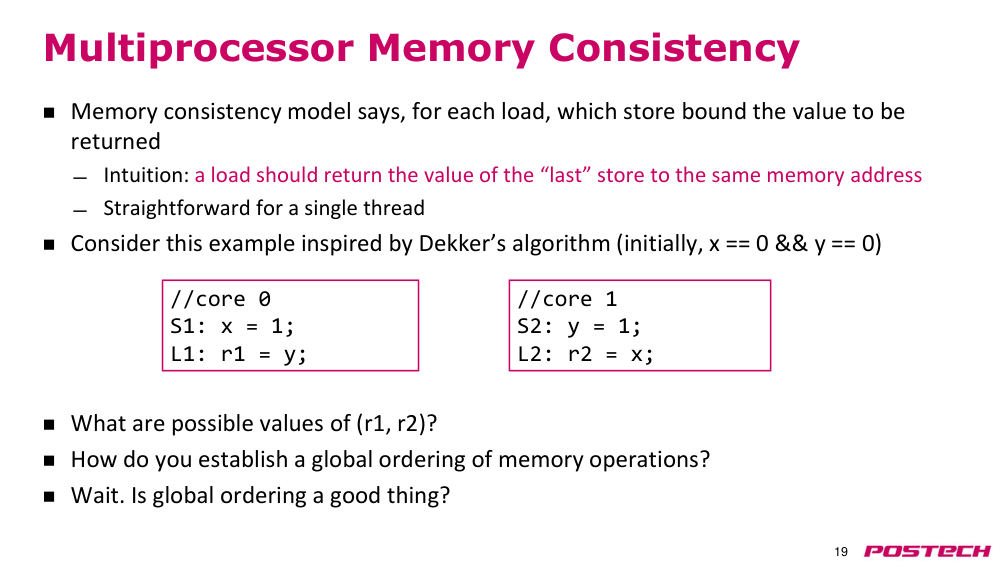
- memory consistency model(메모리 일관성 모델)은 각 load(로드)에 대해 반환될 값이 어떤 store(스토어)에 의해 결정되는지를 정의한다.
- 직관적으로, load(로드)는 동일한 메모리 주소에 대해 "마지막"으로 수행된 store(스토어)의 값을 반환해야 한다.
- 단일 thread(스레드)에서는 직관적으로 명확하다.
- 다음은 Dekker’s algorithm을 영감으로 삼은 예제이다 (초기 상태: x == 0 && y == 0).
- 가능한 (r1, r2) 값은 무엇인가?
- 메모리 연산들에 대한 global ordering(전역 순서)를 어떻게 설정할 수 있는가?
- 잠깐. global ordering(전역 순서)는 좋은 것인가?
p.20sequential consistency(SC, 순차 일관성)
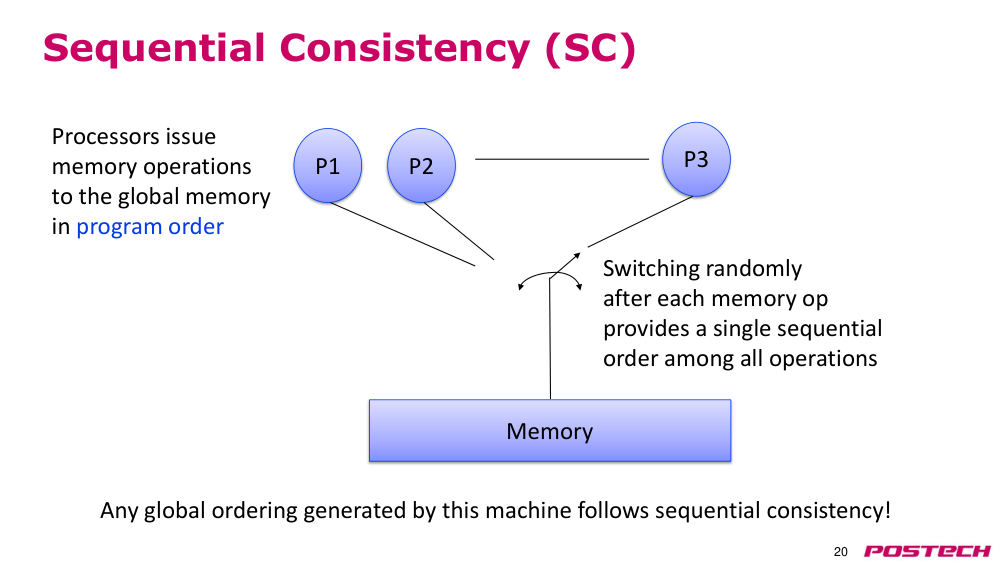
- 각 메모리 연산 후 무작위로 스위칭하면, 모든 연산들에 대해 단일한 순차적 순서를 제공한다.
- 프로세서는 프로그램 순서에 따라 글로벌 메모리에 메모리 연산을 발생시킨다.
- P1
- P2
- P3
- Memory
- 이 기계가 생성하는 어떤 global ordering(전역 순서)도 sequential consistency(SC, 순차 일관성)을 따른다!
p.21sequential consistency(SC, 순차 일관성)를 위한 충분 조건
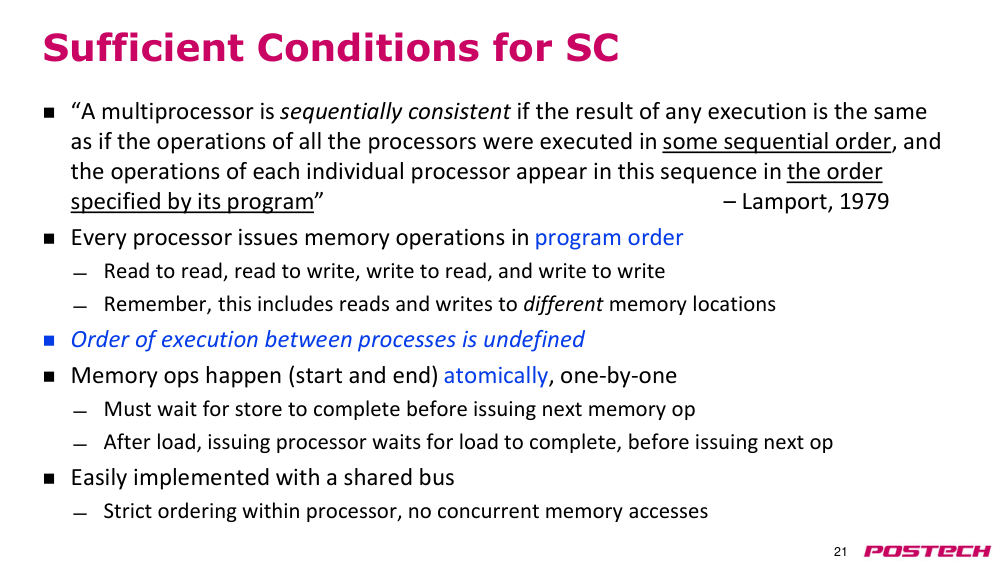
- "다중프로세서가 sequential consistency(SC, 순차 일관성)을 갖는다는 것은, 모든 프로세서의 연산이 어떤 순차적 순서로 실행되었을 때의 결과와 동일한 결과를 얻는다는 뜻이다. 또한 각 개별 프로세서의 연산은 그 프로그램에서 지정한 순서로 이 순서에 나타나야 한다."
- – Lamport, 1979
- 모든 프로세서는 프로그램 순서에 따라 메모리 연산을 발생시킨다.
- 읽기-읽기, 읽기-쓰기, 쓰기-읽기, 쓰기-쓰기 순서를 포함한다.
- 이것은 서로 다른 메모리 위치에 대한 읽기와 쓰기 연산도 포함된다.
- 프로세스 간 실행 순서는 정의되지 않는다.
- 메모리 연산은 원자적으로 하나씩 시작되고 완료된다.
- 다음 메모리 연산을 발생시키기 전에 store(스토어)가 완료되기를 기다려야 한다.
- load(로드) 이후, 발행 프로세서는 다음 연산을 발생시키기 전에 로드가 완료되기를 기다린다.
- 공유 버스를 사용하면 쉽게 구현할 수 있다.
- 프로세서 내부에서는 엄격한 순서가 유지되며, 동시 메모리 접근은 없음
p.22sequential consistency(SC, 순차 일관성) [Lamport]
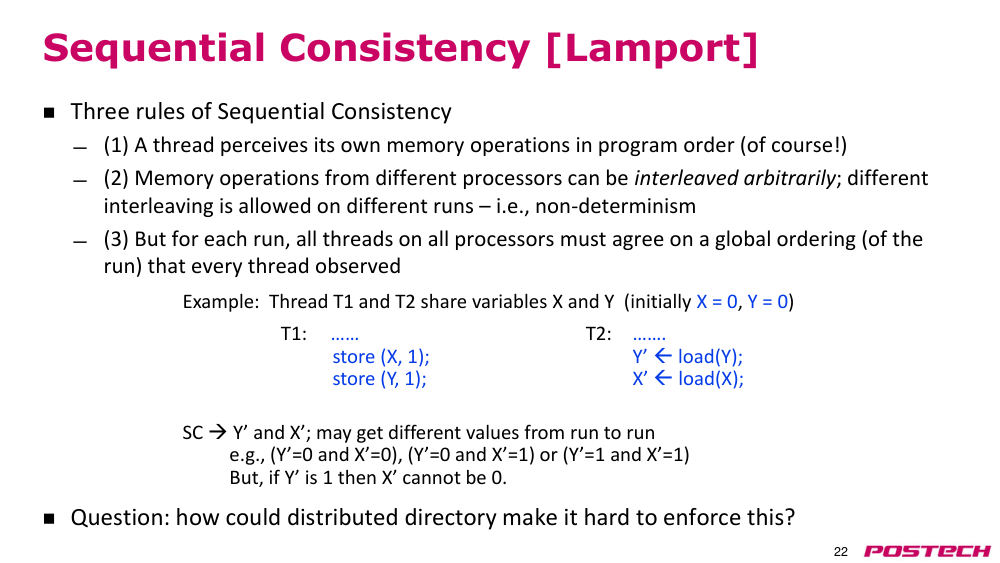
- sequential consistency(SC, 순차 일관성)의 세 가지 규칙:
- (1) thread(스레드)는 자신의 메모리 연산을 프로그램 순서로 인식한다 (물론!).
- (2) 서로 다른 프로세서의 메모리 연산은 임의로 교차될 수 있으며, 서로 다른 실행에서 다른 교차가 허용된다 — 즉, 비결정성.
- (3) 그러나 각 실행에 대해, 모든 프로세서의 모든 thread(스레드)는 그 실행에 대해 동일한 global ordering(전역 순서)를 동의해야 하며, 모든 스레드가 그 순서를 관찰해야 한다.
- 질문: 분산 디렉터리 구조는 이 규칙을 지키는 데 어떻게 어려움을 줄 수 있는가?
- 예시: thread(스레드) T1과 T2가 변수 X와 Y를 공유한다 (초기값: X = 0, Y = 0)
- T1: ……
- T2: ……
- store (X, 1);
- Y’ load(Y);
- store (Y, 1);
- X’ load(X);
- SC → Y’와 X’는 실행마다 다른 값을 가질 수 있다.
- 예: (Y’=0 and X’=0), (Y’=0 and X’=1), 또는 (Y’=1 and X’=1)
- 그러나 Y’가 1이라면 X’는 0이 될 수 없다.
p.23sequential consistency(SC, 순차 일관성) 예제
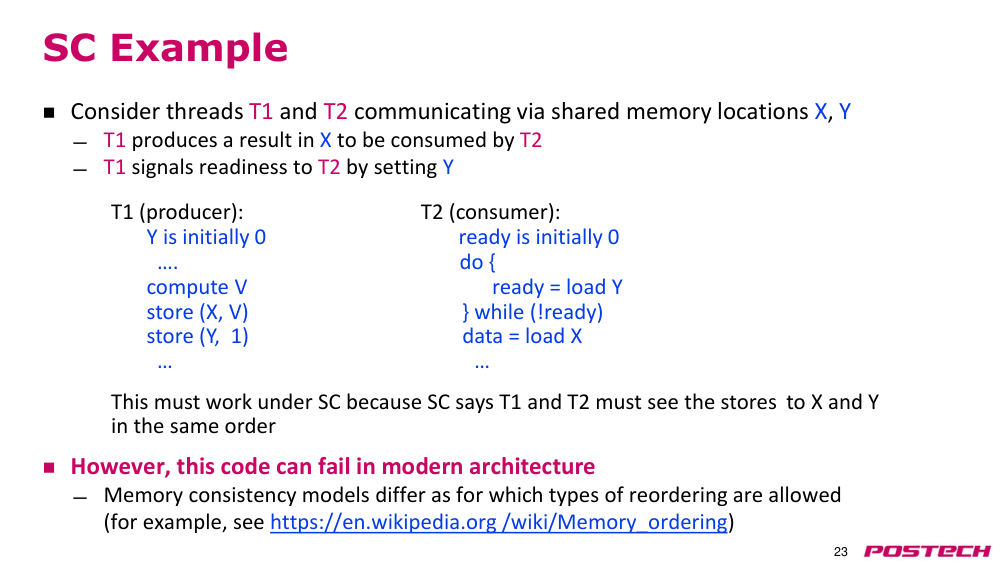
- thread(스레드) T1과 T2가 공유 메모리 위치 X, Y를 통해 통신한다고 가정하자.
- T1은 X에 결과를 저장하여 T2가 소비하도록 한다.
- T1은 Y를 설정하여 T2에게 준비 상태를 알린다.
- 그러나 이 코드는 현대 아키텍처에서는 실패할 수 있다.
- memory consistency model(메모리 일관성 모델)은 어떤 종류의 reordering(재정렬)이 허용되는지를 다르게 정의한다.
- (예: https://en.wikipedia.org/wiki/Memory_ordering 참조)
- T1 (생산자):
- Y는 초기에 0
- …
- compute V
- store (X, V)
- store (Y, 1)
- …
- T2 (소비자):
- ready는 초기에 0
- do {
- ready = load Y
- } while (!ready)
- data = load X
- …
- SC 하에서는 이 코드가 작동해야 한다. 왜냐하면 SC는 T1과 T2가 X와 Y에 대한 store(스토어)를 동일한 순서로 보아야 한다고 정의하기 때문이다.
p.24Dekker’s algorithm
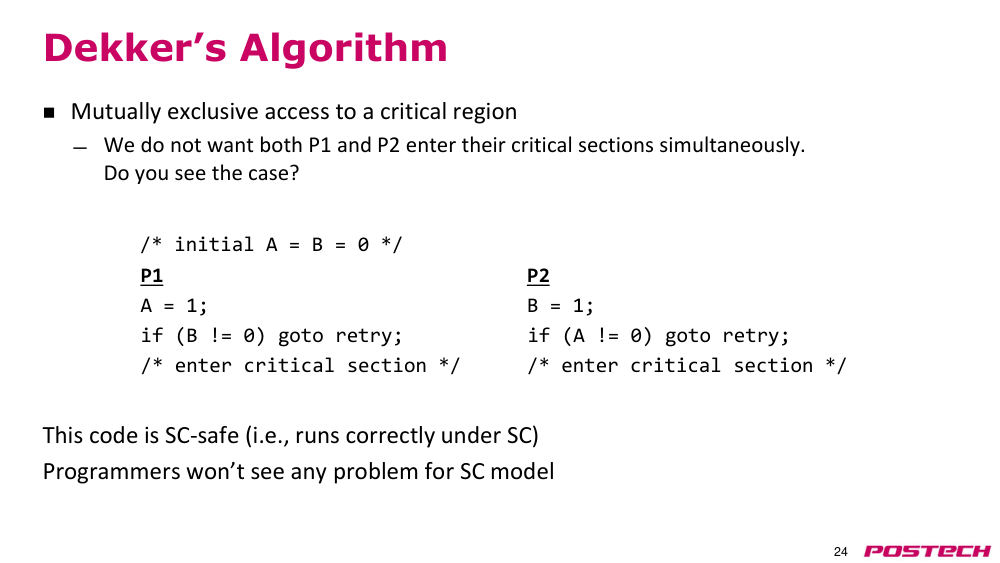
- critical section(임계 구역)에 대한 mutual exclusion(상호 배제) 접근.
- P1과 P2가 동시에 critical section(임계 구역)에 들어가는 것을 원하지 않는다.
- 어떤 경우가 문제인가?
- /* 초기값 A = B = 0 */
- P1
- P2
- A = 1;
- B = 1;
- if (B != 0) goto retry;
- if (A != 0) goto retry;
- /* critical section(임계 구역) 진입 */
- /* critical section(임계 구역) 진입 */
- 이 코드는 SC 안전하다 (즉, SC 모델 하에서 올바르게 동작한다).
- 프로그래머는 SC 모델에서는 문제를 보지 못한다.
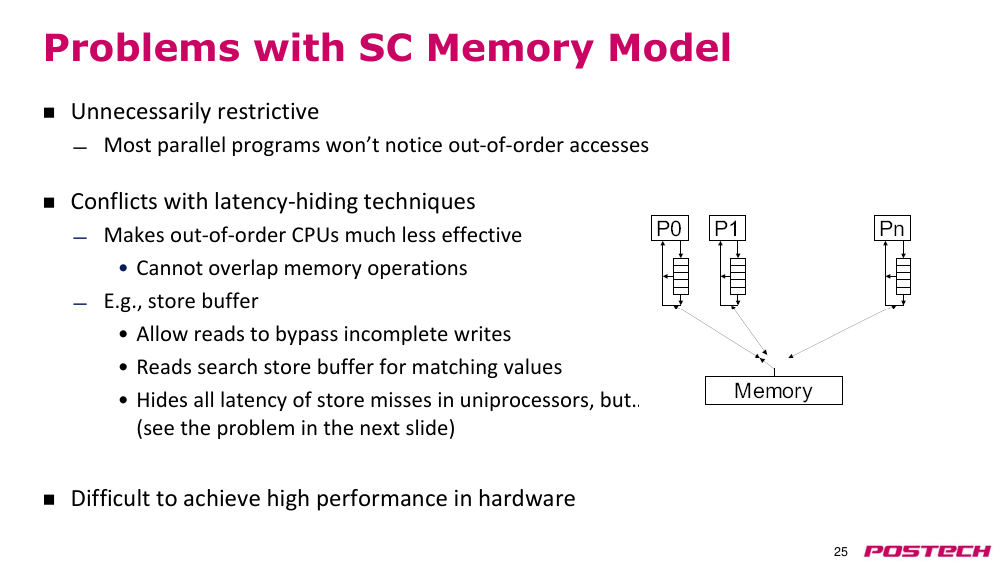
p.25sequential consistency(SC, 순차 일관성) memory model(메모리 모델)의 문제점
- 불필요하게 제한적
- 대부분의 병렬 프로그램은 순서가 바뀐 접근을 느끼지 못함
- latency(지연) 숨김 기법과 충돌
- out-of-order CPU(비순차 CPU)의 효과를 크게 떨어뜨림
- 메모리 연산을 겹치게 할 수 없음
- 예: store buffer(스토어 버퍼)
- 읽기 연산이 완료되지 않은 쓰기 연산을 건너뛸 수 있음
- 읽기 연산은 store buffer(스토어 버퍼)에서 일치하는 값을 검색함
- 일반적인 단일 프로세서에서는 store miss(스토어 미스)의 모든 latency(지연)을 숨길 수 있지만…
- 다음 슬라이드에서 문제점을 확인할 수 있음
- 하드웨어에서 높은 성능을 달성하기 어렵다
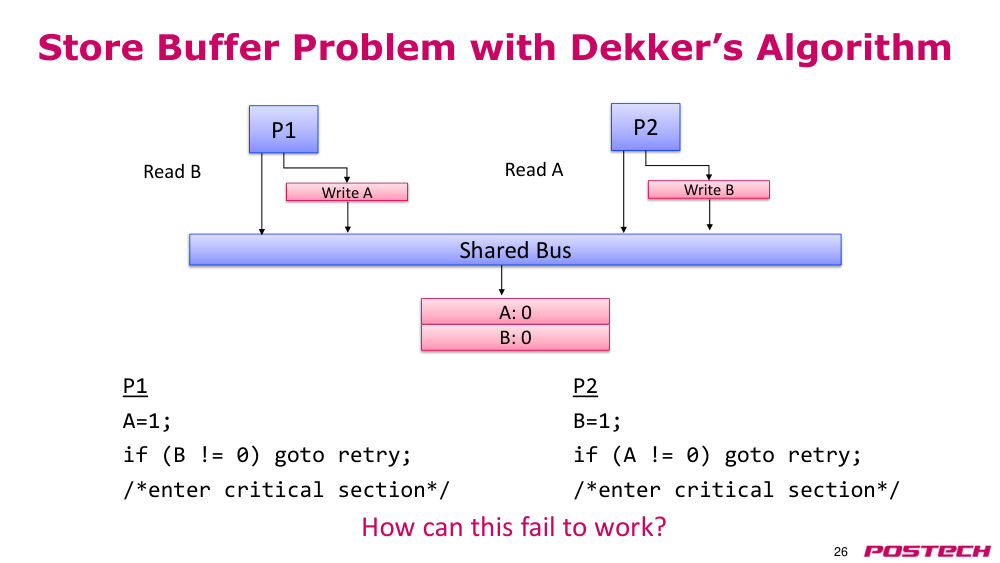
p.26Dekker’s algorithm에서의 store buffer(스토어 버퍼) 문제
- 공유 버스
- P1
- Write A
- Read B
- P2
- Write B
- Read A
- A: 0
- B: 0
- P1
- P2
- A=1;
- B=1;
- if (B != 0) goto retry;
- if (A != 0) goto retry;
- /*critical section(임계 구역) 진입*/
- /*critical section(임계 구역) 진입*/
- 이 코드가 작동하지 않는 이유는 무엇인가?
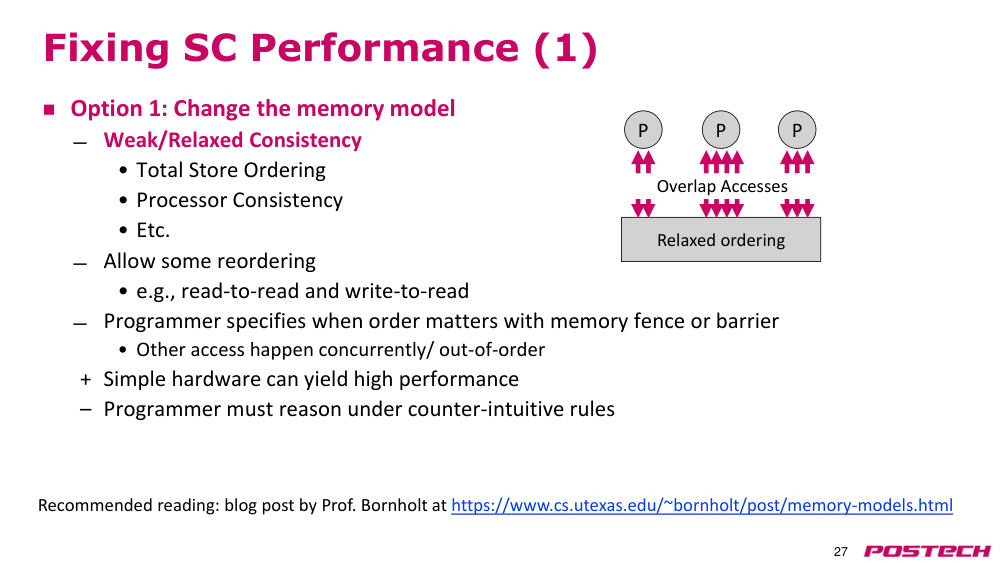
p.27sequential consistency(SC, 순차 일관성) 성능 개선 (1)
- 옵션 1: memory model(메모리 모델) 변경
- weak/relaxed consistency(약한/완화된 일관성)
- • TSO(Total Store Order)
- • processor consistency(프로세서 일관성)
- • 기타
- 일부 reordering(재정렬) 허용
- • 예: 읽기-읽기 및 쓰기-읽기
- 프로그램이 순서가 중요한 경우 memory fence(메모리 펜스) 또는 barrier(배리어)로 지정
- • 다른 접근은 동시 또는 out-of-order(비순차적으로) 수행됨
- + 간단한 하드웨어로도 높은 성능을 얻을 수 있음
- – 프로그래머는 직관적이지 않은 규칙을 기반으로 추론해야 함
- P
- relaxed ordering(완화된 순서)
- P
- P
- 접근 겹치기
- 추천 독서: Prof. Bornholt의 블로그 포스트 https://www.cs.utexas.edu/~bornholt/post/memory-models.html
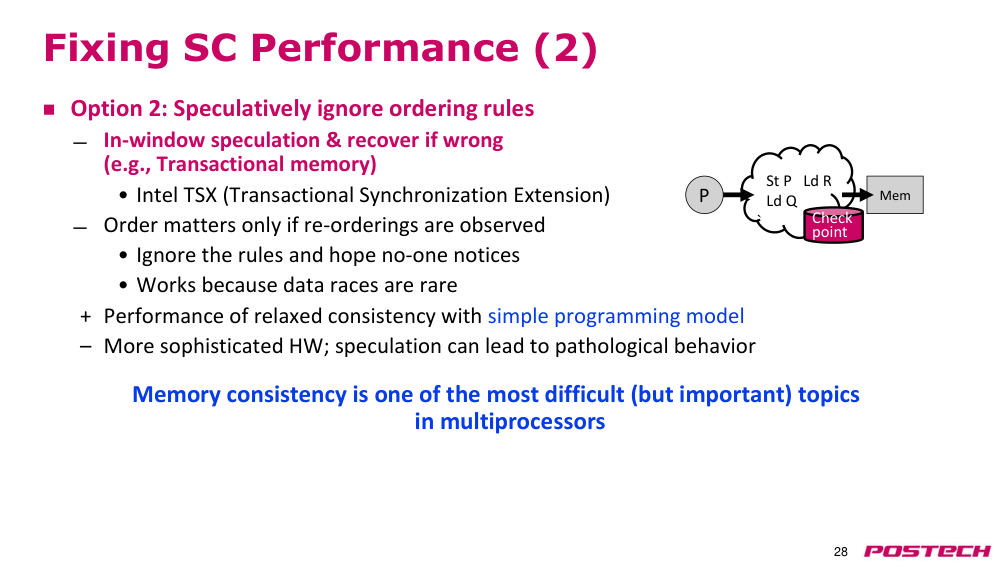
p.28sequential consistency(SC, 순차 일관성) 성능 개선 (2)
- 옵션 2: 순서 규칙을 speculatively(추측적으로) 무시하기
- in-window speculation(윈도우 내 추측 실행) 및 잘못된 경우 복구
- (예: transactional memory(트랜잭셔널 메모리))
- • Intel TSX (Transactional Synchronization Extension)
- 순서가 중요한 경우는 reordering(재정렬)이 관찰되었을 때만 해당
- • 규칙을 무시하고 누군가 눈치채지 않기를 기대
- • data race(데이터 레이스)가 드물기 때문에 작동함
- + relaxed consistency(완화된 일관성)의 성능과 간단한 프로그래밍 모델을 동시에 달성
- – 더 복잡한 하드웨어 필요; speculation(추측)은 비정상적인 동작을 유도할 수 있음
- memory consistency(메모리 일관성)은 멀티프로세서에서 가장 어려운(그러나 중요한) 주제 중 하나임
- St P Ld R
- Ld Q
- Check
- point
- P
p.29memory consistency(메모리 일관성)에 대한 의견
- memory consistency(메모리 일관성)은 아키텍처와 프로그래머 간의 합의임
- HW: 당신의 load(로드)가 이 store(스토어)를 보게 될 것임을 허용할 것임
- SW: 위 약속을 기반으로 코드를 작성할 것임
- • simple consistency(단순한 일관성) = 프로그래밍이 쉬움 = 낮은 성능
- • advanced consistency(고급 일관성) = 프로그래밍이 어려움 = 높은 성능
- memory consistency model(메모리 일관성 모델)은 다음과 같은 주요 이유 중 하나임
- • 병렬 아키텍처를 구축하기 어렵게 만듦
- • 많은 프로그래머가 좋은 병렬 코드를 작성하지 못함
- 대부분의 프로그래머는 sequential consistency(SC, 순차 일관성)만 알고 있거나, sequential consistency(순차 일관성)만 다룰 수 있음
p.30질문?
- 공지사항
- - 교재 읽기: P&H Ch 2.11