이 자료를 쓰는 강의: 53 TLB·virtual cache·VIPT 와 cache coherence 도입 · 54 snooping protocol(VI·MI·MSI·MESI) 과 directory-based coherence · 55 coherence 성능 문제 마무리, synchronization(lock, atomic RMW, LR/SC) · memory consistency 도입
Lec17-CacheCoherence (updated)
한국어판 강의자료 · 48쪽
p.1CSED311 컴퓨터구조 – 강의 17
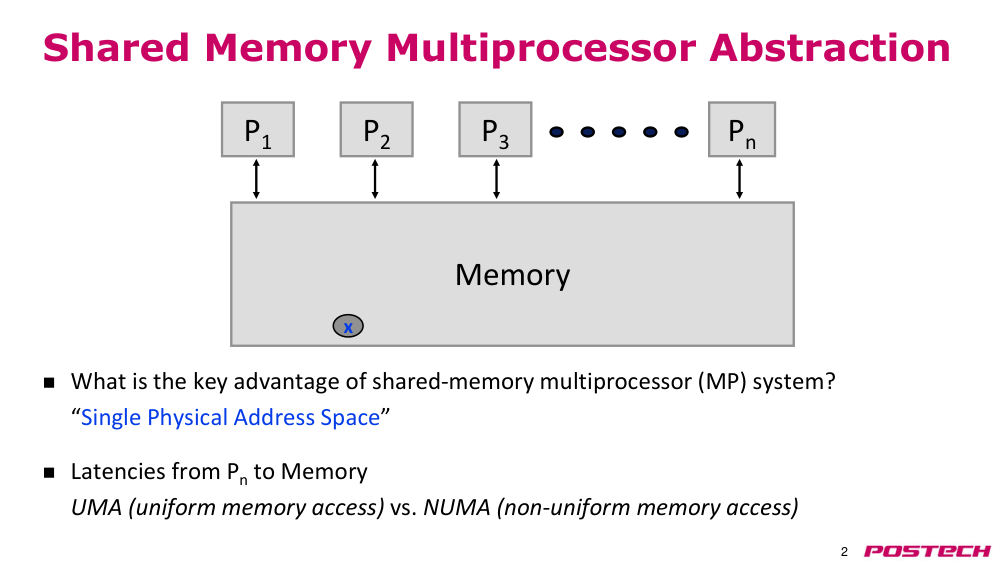
p.2shared memory multiprocessor(공유 메모리 다중처리 시스템)의 추상화
- 공유 메모리 다중처리 시스템(MP)의 핵심 장점은 무엇인가?
- “single physical address space(단일 물리적 주소 공간)”
- Pn에서 메모리까지의 지연 시간
- UMA(균일 메모리 접근) vs. NUMA(비균일 메모리 접근)
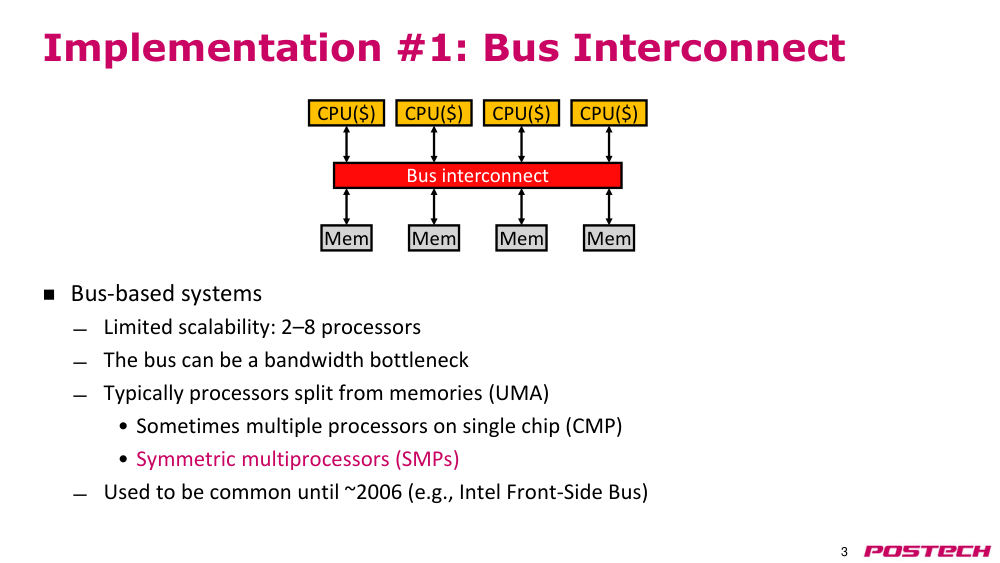
p.3구현 #1: bus interconnect(버스 인터커넥트)
- 버스 기반 시스템
- scalability(확장성) 제한: 2–8개의 프로세서
- 버스는 bandwidth bottleneck(대역폭 병목)이 될 수 있음
- 일반적으로 프로세서와 메모리를 분리함 (UMA)
- 때때로 단일 칩에 다수의 프로세서가 존재함 (CMP)
- 대칭 다중처리기(SMPs)
- 2006년까지 일반적이었음 (예: Intel Front-Side Bus)
- CPU($)
- Mem
- CPU($)
- Mem
- CPU($)
- Mem
- CPU($)
- Mem
- bus interconnect(버스 인터커넥트)
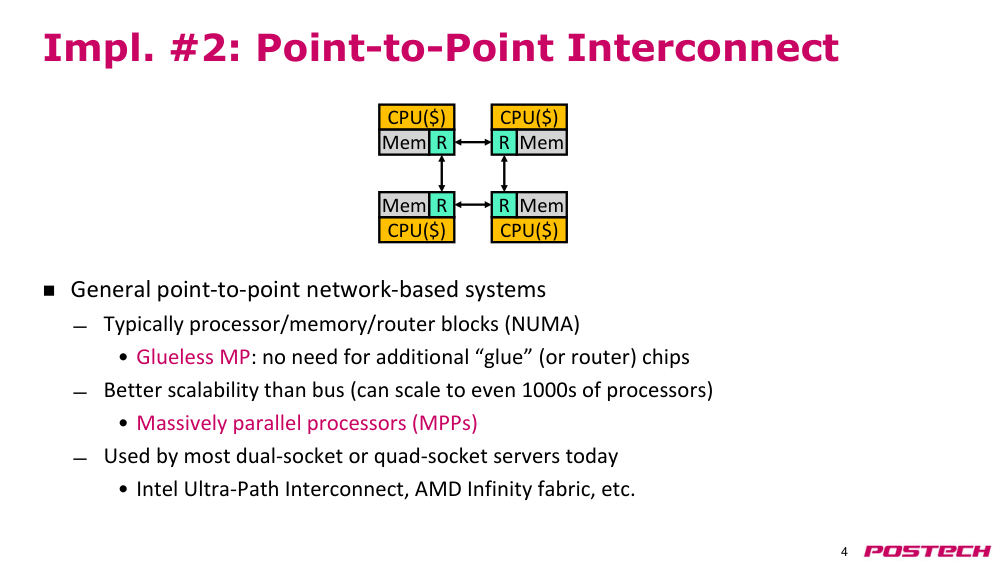
p.4구현 #2: Point-to-Point interconnect(포인트투포인트 인터커넥트)
- 일반적인 포인트투포인트 네트워크 기반 시스템
- 일반적으로 프로세서/메모리/라우터 블록 (NUMA)
- glueless MP(글루리스 다중처리기): 추가적인 '글루'(또는 라우터) 칩이 필요 없음
- 버스보다 더 나은 확장성 (수천 개의 프로세서까지 확장 가능)
- 대규모 병렬 처리기(MPPs)
- 오늘날 대부분의 듀얼 소켓 또는 쿼드 소켓 서버에서 사용됨
- Intel Ultra-Path Interconnect, AMD Infinity Fabric 등
- CPU($)
- Mem R
- CPU($)
- Mem R
- CPU($)
- Mem
- R
- CPU($)
- Mem
- R
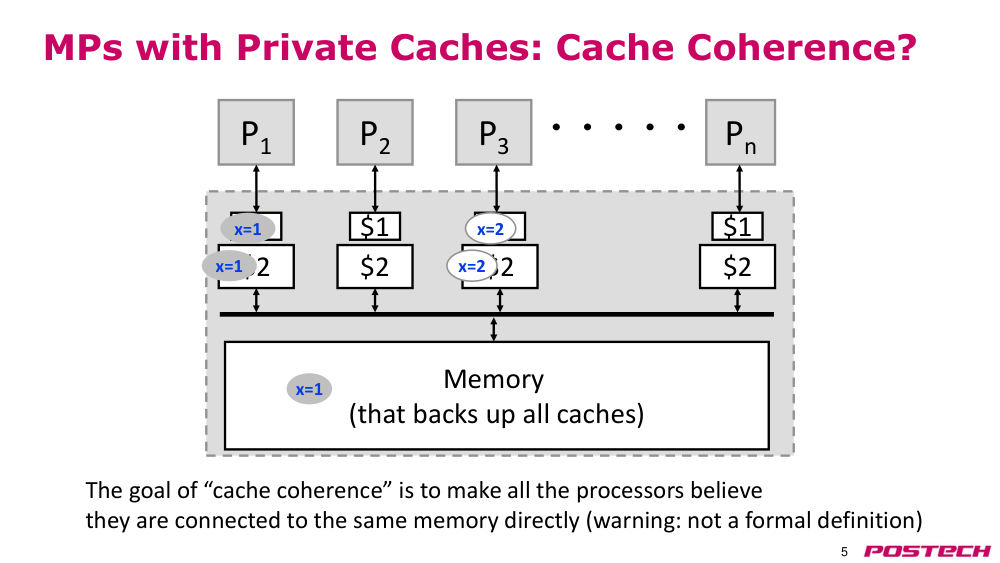
p.5private caches(개별 캐시)를 가진 다중처리기: cache coherence(캐시 일관성)?
- ‘cache coherence(캐시 일관성)’의 목표는 모든 프로세서가 마치 직접 동일한 메모리에 연결되어 있는 것처럼 느끼게 하는 것 (경고: 공식적인 정의는 아님)
- P1
- P2
- P3
- Pn
- $1
- $2
- 메모리 (모든 캐시를 백업함)
- $1
- $2
- $1
- $2
- $1
- $2
- x=1
- x=1
- x=1
- x=1
- x=1
- x=2
- x=2
p.6cache coherence(캐시 일관성)의 극단적인 해결책
- #1. 공유 변수의 캐시 사용 금지
- #2. 여러 복사본을 허용하되, 언제나 모든 복사본이 동일한 값을 가지도록 보장
- 한 복사본의 업데이트는 메모리와 모든 캐시 내의 모든 복사본에 보여져야 함
- 따라서 동시에 여러 읽기자와 쓰기자가 존재할 수 있음
- #3. 한 메모리 위치에 대해 단 하나의 복사본만 허용
- 위치 X가 한 캐시에 캐시되어 있다면, 메모리나 다른 캐시에는 유효하지 않음
- 다른 프로세서는 위치 X를 소유하고 있는 프로세서를 찾아야 하며, 읽기 또는 쓰기 전에 ownership(소유권)을 인수해야 함
- 따라서 한 위치당 하나의 읽기자/쓰기자만 가능
- 각 접근 방식의 단점은 무엇인가?
- cache coherence protocol(캐시 일관성 프로토콜)은 캐시 간에 특정 정책을 시행하기 위한 ‘규칙’이다
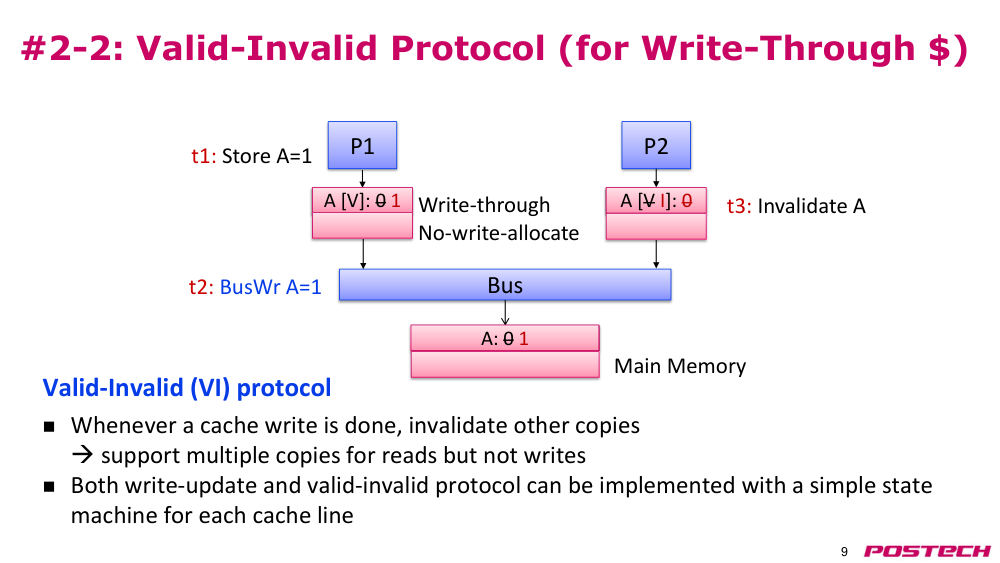
p.7#2. "다중 동일 복사본" 프로토콜
- cache line(캐시 라인)은 유효 또는 invalid state(무효 상태)일 수 있음
- Write-Through(쓰기-스루) 및 쓰기-무할당(Write-No-Allocate) 방식 기반
- 읽기 시 캐시는 read transaction(읽기 트랜잭션)을 발생시킴
- cache line(캐시 라인)이 수정될 때마다 메모리로 write transaction(쓰기 트랜잭션)을 발생시킴
- 라인이 eviction(축출)될 때 Write-Back(쓰기-백)을 수행할 필요 없음
- 다수의 읽기자(Reader)를 허용하나, 버스로 Write-Through(쓰기-스루)해야 함
- 모든 캐시는 다른 캐시의 write transaction(쓰기 트랜잭션)을 snooping(스누핑)함
- 쓰기가 현재 캐시된 위치로 가는지 확인함
- 엄청난 bus traffic(버스 트래픽)과 태그 대역폭(tag bandwidth) 발생 (보통 캐시 접근의 15%는 store operation(스토어 연산)임)
- 쓰기가 캐시된 위치로 가는 경우:
- (1) 기존 값을 새 snooping(스누핑)된 값으로 덮어씀 (=쓰기-업데이트 프로토콜)
- 또는 (2) 기존 값을 삭제함 (=유효-무효 프로토콜)
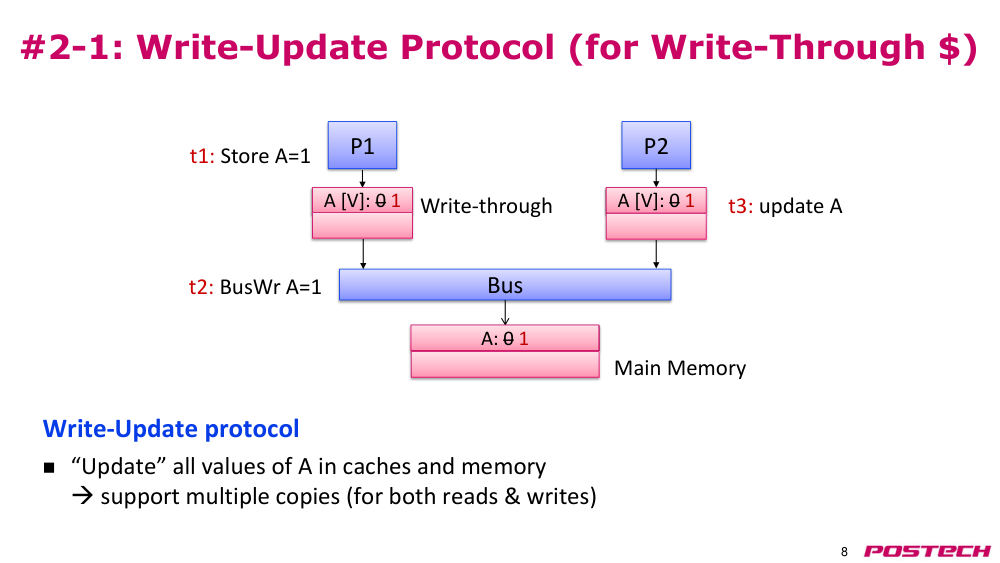
p.8#2-1: 쓰기-업데이트 프로토콜 (쓰기-스루 $)
- Write-Update protocol(쓰기-업데이트 프로토콜)
- A의 모든 값들을 캐시와 메모리에서 "업데이트"함
- → 읽기 및 쓰기 모두에 대해 다중 복사본을 지원함
- 버스
- P1
- t1: Store A=1
- P2
- A: 0
- A [V]: 0
- A [V]: 0
- 메인 메모리
- Write-Through(쓰기-스루)
- t2: BusWr A=1
- t3: update A
- A [V]: 0 1
- A: 0 1
- A [V]: 0 1
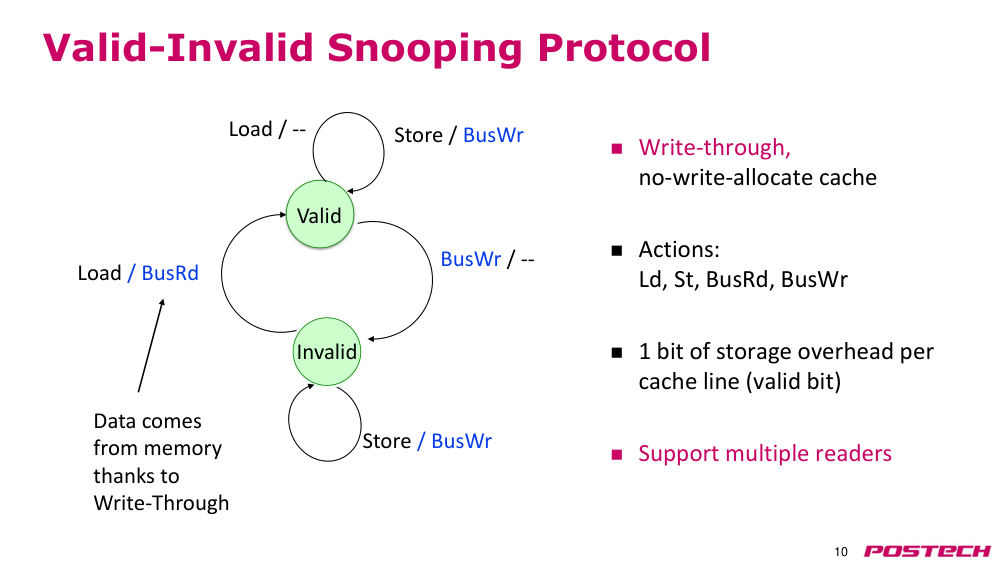
p.9#2-2: 유효-무효 프로토콜 (쓰기-스루 $)
- 유효-무효(VI) 프로토콜
- 캐시 쓰기 수행 시 다른 복사본을 invalidation(무효화)함
- → 읽기에는 다중 복사본을 지원하나, 쓰기에는 지원하지 않음
- 쓰기-업데이트 및 Valid-Invalid protocol(유효-무효 프로토콜)은 각 cache line(캐시 라인)에 대한 간단한 상태 기계로 구현 가능함
- 버스
- P1
- t1: Store A=1
- P2
- A: 0
- A [V]: 0
- A [V]: 0
- 메인 메모리
- Write-Through(쓰기-스루)
- No-write-allocate
- t2: BusWr A=1
- t3: Invalidate A
- A [V I]: 0
- A: 0 1
- A [V]: 0 1
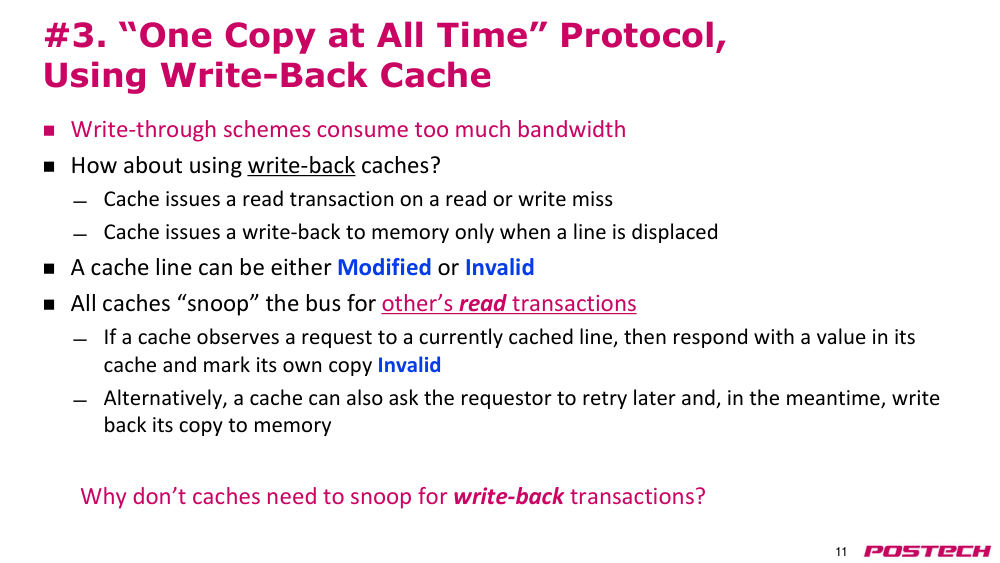
p.10유효-무효 snooping(스누핑) 프로토콜
- Write-Through(쓰기-스루), Write-No-Allocate(쓰기-무할당) 캐시
- 작업: Ld, St, BusRd, BusWr
- cache line(캐시 라인)당 1비트의 저장 공간 오버헤드(유효 비트)
- 다수의 읽기자를 지원함
- Store / BusWr
- Valid
- BusWr / --
- Invalid
- Load / BusRd
- Load / --
- Store / BusWr
- 데이터는 Write-Through(쓰기-스루) 덕분에 메모리에서 옴
p.11#3. "모든 시점에 하나의 복사본만" 프로토콜, Write-Back cache(쓰기-백 캐시) 사용
- Write-Through(쓰기-스루) 방식은 너무 많은 대역폭을 소비함
- Write-Back cache(쓰기-백 캐시)를 사용하는 것은 어떨까?
- 읽기 또는 write miss(쓰기 미스) 시 캐시는 read transaction(읽기 트랜잭션)을 발생시킴
- 라인이 eviction(축출)될 때만 메모리로 Write-Back(쓰기-백)을 수행함
- cache line(캐시 라인)은 수정 상태(Modified) 또는 무효 상태(Invalid)일 수 있음
- 모든 캐시는 다른 캐시의 read transaction(읽기 트랜잭션)을 snooping(스누핑)함
- 캐시가 현재 캐시된 라인에 대한 요청을 관찰하면, 자신의 캐시에 있는 값을 응답하고 자신의 복사본을 invalidation(무효화)함
- 또는 요청자를 나중에 재시도(retry)하도록 요청하고, 그 동안 자신의 복사본을 Write-Back to memory(메모리로 쓰기-백)할 수 있음
- 왜 캐시는 Write-Back(쓰기-백) transaction(트랜잭션)을 snooping(스누핑)할 필요가 없나요?
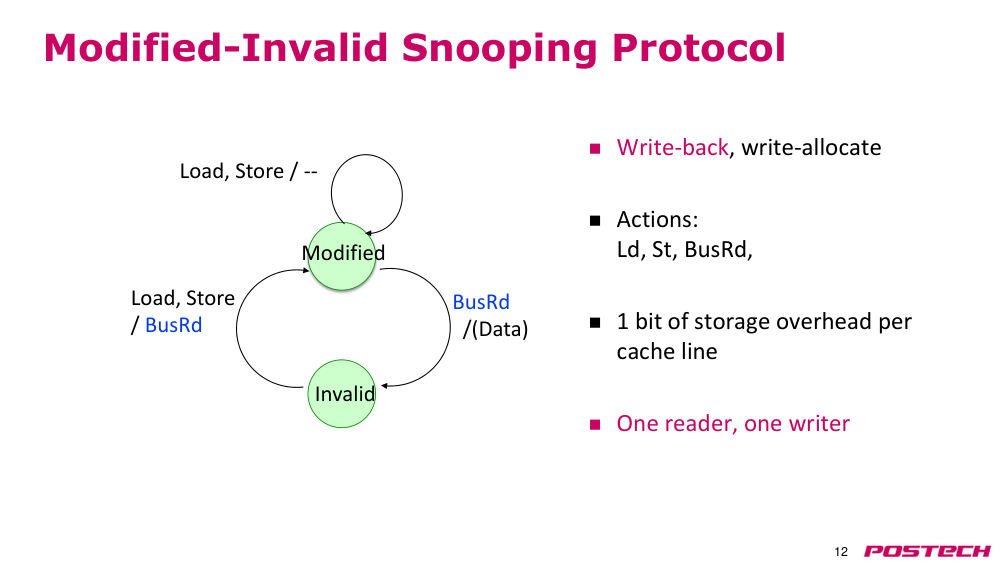
p.12수정-무효 snooping(스누핑) 프로토콜
- Write-Back(쓰기-백), 쓰기-할당(Write-allocate)
- 작업: Ld, St, BusRd
- cache line(캐시 라인)당 1비트의 저장 공간 오버헤드
- 한 명의 읽기자, 한 명의 쓰기자
- Modified
- BusRd
- / (Data)
- Invalid
- Load, Store / BusRd
- Load, Store / --
p.13Write-Back cache(쓰기-백 캐시)를 사용한 '다중 복사본' 프로토콜은 어떨까?
- 핵심 아이디어: '서로 배타적' 상태와 '공유' 상태를 구분한다.
- 서로 배타적 – '소유자'가 캐시 블록의 유일한 복사본을 가지고 있으며, 자유롭게 수정할 수 있다.
- 공유 – 여러 독자가 가능하지만, ownership(소유권)을 확보하지 않으면 쓸 수 없다.
- (1) read miss(읽기 미스) 시 어떤 캐시(있을 경우)가 소유자인지 찾아야 한다.
- (2) 최종적으로 메모리에 업데이트하여 쓰기 연산이 손실되지 않도록 해야 한다.
p.14버스 기반 시스템을 위한 cache coherence protocol(캐시 일관성 프로토콜)
- 버스는 broadcast medium(방송 매체)이며, 버스 'snooping(스누핑)'을 통해 모든 캐시가 다른 캐시가 무엇을 하려는지 확인할 수 있다.
- 캐시는 다른 캐시의 bus transaction(버스 트랜잭션)에 intervention(개입)할 수도 있다 (예: 다른 캐시에게 transaction(트랜잭션)을 나중에 retry(재시도)하도록 요청하거나, 메모리 대신 응답할 수 있다).
- 일반적인 상태 비트 외에도, 각 cache line(캐시 라인)과 함께 추가 정보(즉, cache coherence(캐시 일관성) 상태)를 기록한다.
- 예시:
- 무효: cache line(캐시 라인)이 유효한 데이터를 가지고 있지 않다.
- 공유: 유효한 라인이나, 다른 캐시가 복사본을 가질 수 있다 (보통 메모리와 동일하고 변경되지 않았다).
- 수정: cache line(캐시 라인)이 가져온 이후 쓰기 연산을 수행하여 변경되었다.
- 독점: 유효한 라인이며 메모리와 동일하지만, 다른 캐시는 복사본을 가지지 않는다.
- → 이 상태는 언제 유용할까?
p.15MSI 및 MESI cache coherence(캐시 일관성) 상태
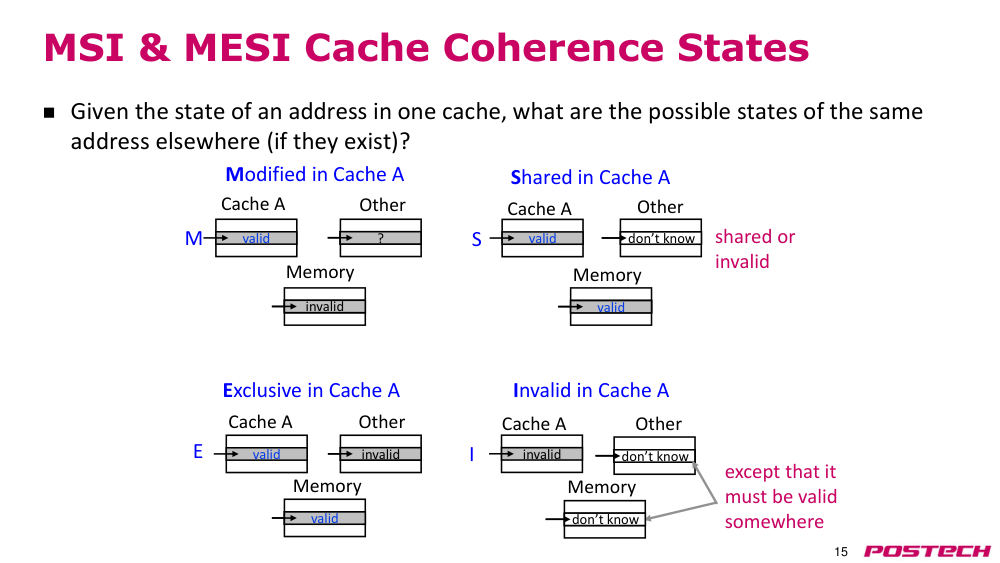
- 한 캐시에서 주소의 상태가 주어졌을 때, 다른 캐시에서 동일한 주소의 가능한 상태는 무엇인가요 (존재할 경우)?
- 캐시 A가 modified state(수정 상태)일 때:
- 다른 캐시: 알 수 없음
- 메모리: 무효
- 캐시 A가 exclusive state(독점 상태)일 때:
- 다른 캐시: 무효
- 메모리: 유효
- 캐시 A가 shared state(공유 상태)일 때:
- 다른 캐시: 공유 또는 무효
- 메모리: 유효
- 캐시 A가 invalid state(무효 상태)일 때:
- 다른 캐시: 알 수 없음
- 메모리: 알 수 없음
- 메모리 상태: 알 수 없음
- 다른 캐시 상태: 알 수 없음
- 다른 캐시 상태: 알 수 없음
- 단, 어딘가에는 반드시 유효해야 한다.
p.16MSI 및 MESI protocol(MESI 프로토콜)
- 단일 쓰기자/다중 읽기자 사용에 대한 효율적인 정책이다.
- 여러 개의 읽기 전용 복사본(모두 동일) 허용 (공유)
- 단일 쓰기 가능한 복사본만 허용 (독점, 수정)
- bus transaction(버스 트랜잭션) 수를 줄인다.
- Write-Back(쓰기-백) 방식 기반
- read miss(읽기 미스) 시 읽기 전용 복사본을 위한 read transaction(읽기 트랜잭션)을 발생시킨다.
- write miss(쓰기 미스) 시 독점 복사본을 위한 'Read-With-Intent-to-Modify(수정을 의도한 읽기)'를 발생시킨다.
- 읽기 전용 복사본에 write hit(쓰기 히트) 시 다른 캐시에 대해 invalidation transaction(무효화 트랜잭션)을 발생시킨다.
- 독점 상태(즉, 클린 또는 수정되지 않은) 라인을 eviction(축출)할 때는 아무런 조치를 취하지 않는다.
- modified state(수정 상태) 라인을 eviction(축출)할 때는 dirty(더티) 값을 Write-Back to memory(메모리로 쓰기-백)한다.
- 모든 캐시는 다른 캐시의 read transaction(읽기 트랜잭션), 'Read-With-Intent-to-Modify(수정을 의도한 읽기)', invalidation transaction(무효화 트랜잭션)을 버스에서 snooping(스누핑)한다.
p.17수정-공유-무효(MSI) 프로토콜
- 각 캐시에서 블록당 3가지 상태를 추적한다.
- 무효: 캐시가 복사본을 가지고 있지 않다.
- 공유: 캐시가 읽기 전용 복사본을 가지고 있다; 클린 (즉, 메모리와 동일하다).
- 다른 캐시가 이 복사본을 가질 수도 있다.
- 수정: 캐시가 쓰기 가능한 'dirty(더티)' 복사본을 가지고 있다.
- dirty(더티) = 메모리가 최신 상태가 아님.
- 다른 캐시는 이 복사본을 가지지 않는다.
- 프로세서에서 수행할 수 있는 세 가지 동작:
- 로드, 스토어, eviction(축출)
- 버스에서 발생하는 다섯 가지 메시지:
- BusRd, BusRdX, BusInv, BusWB, BusReply
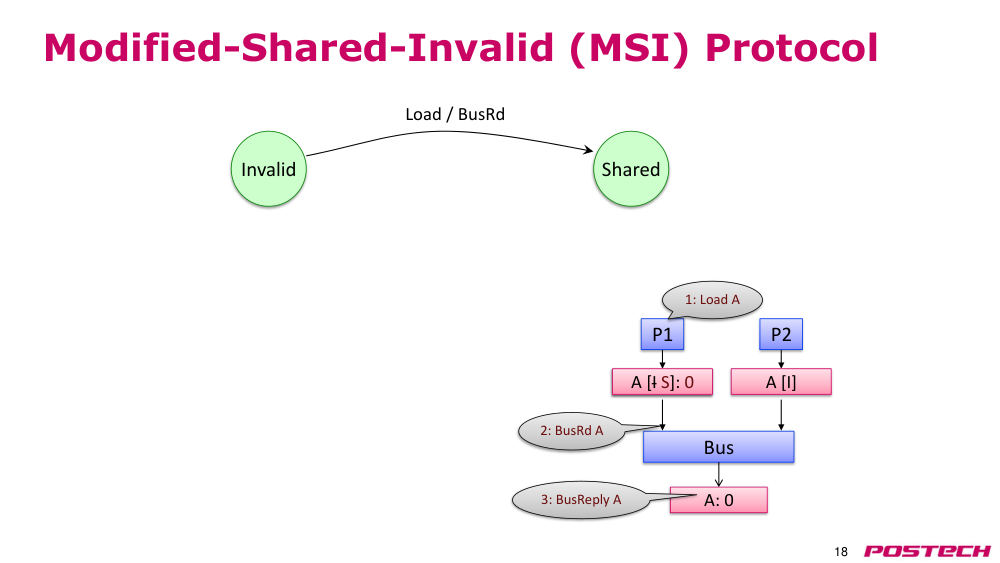
p.18수정-공유-무효(MSI) 프로토콜
- 무효
- 로드 / BusRd
- 공유
- 버스
- A [I]
- A: 0
- P2
- A [I]
- P1
- 1: Load A
- 2: BusRd A
- 3: BusReply A
- A [I S]: 0
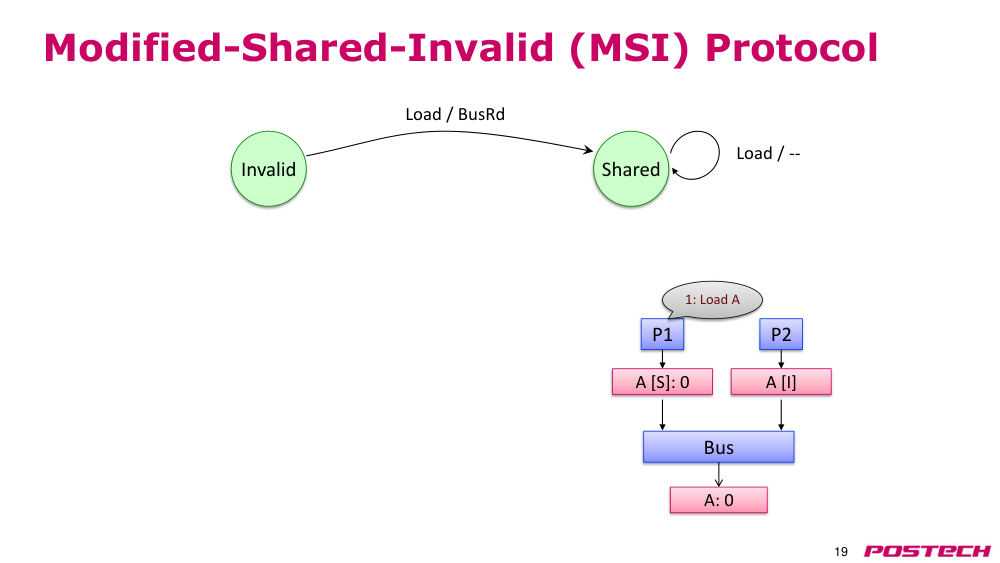
p.19수정-공유-무효(MSI) 프로토콜
- Load / BusRd
- Load / --
- Bus
- A [I]
- A: 0
- P2
- A [S]: 0
- P1
- 1: Load A
- Invalid
- Shared
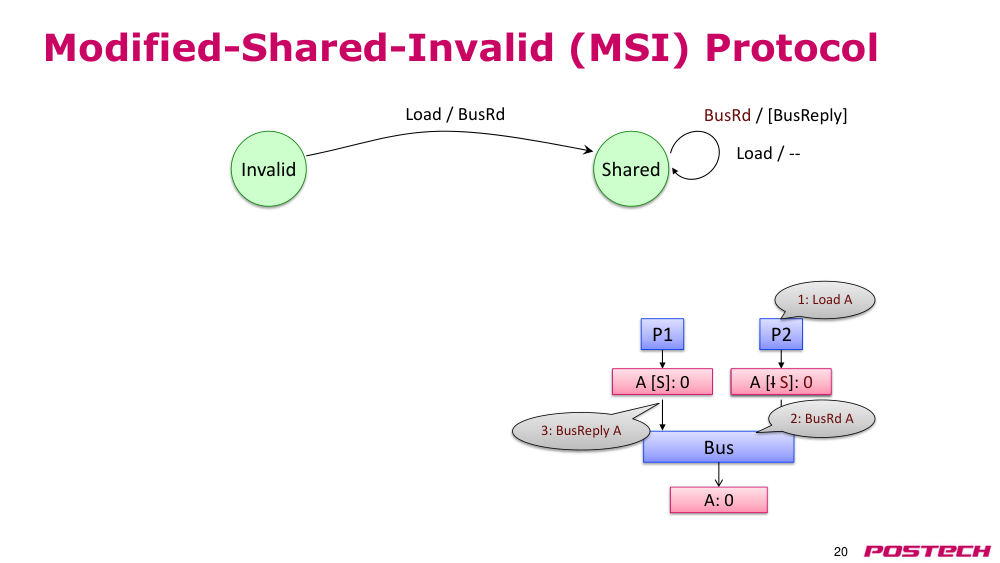
p.20수정-공유-무효(MSI) 프로토콜
- Load / BusRd
- Load / --
- BusRd / [BusReply]
- Bus
- A [I]
- A: 0
- P2
- A [S]: 0
- P1
- 1: Load A
- 2: BusRd A
- 3: BusReply A
- A [I S]: 0
- Invalid
- Shared
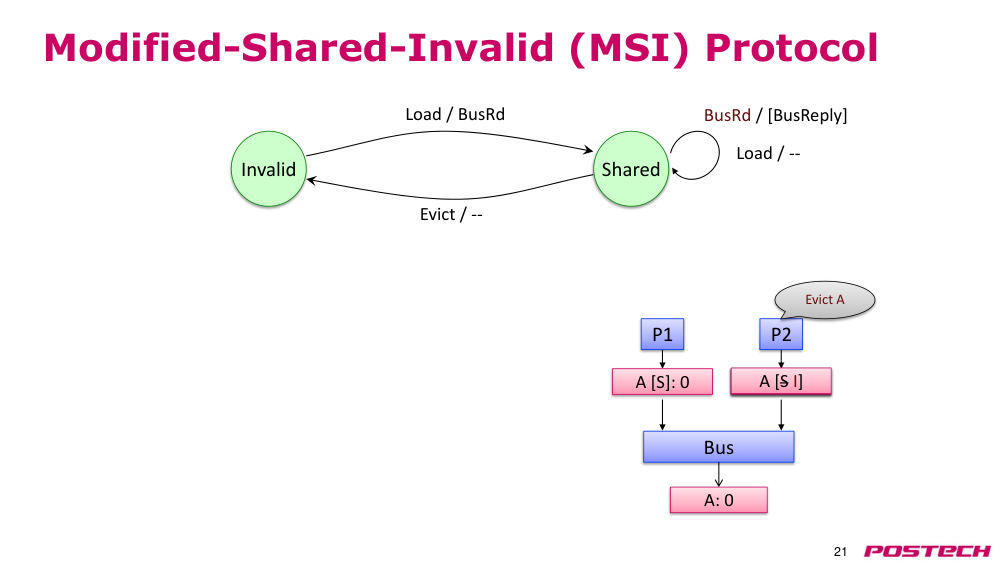
p.21수정-공유-무효(MSI) 프로토콜
- Load / BusRd
- Load / --
- BusRd / [BusReply]
- Evict / --
- Bus
- A [I]
- A: 0
- P2
- A [S]: 0
- P1
- A [S]: 0
- A [S I]
- Evict A
- Invalid
- Shared
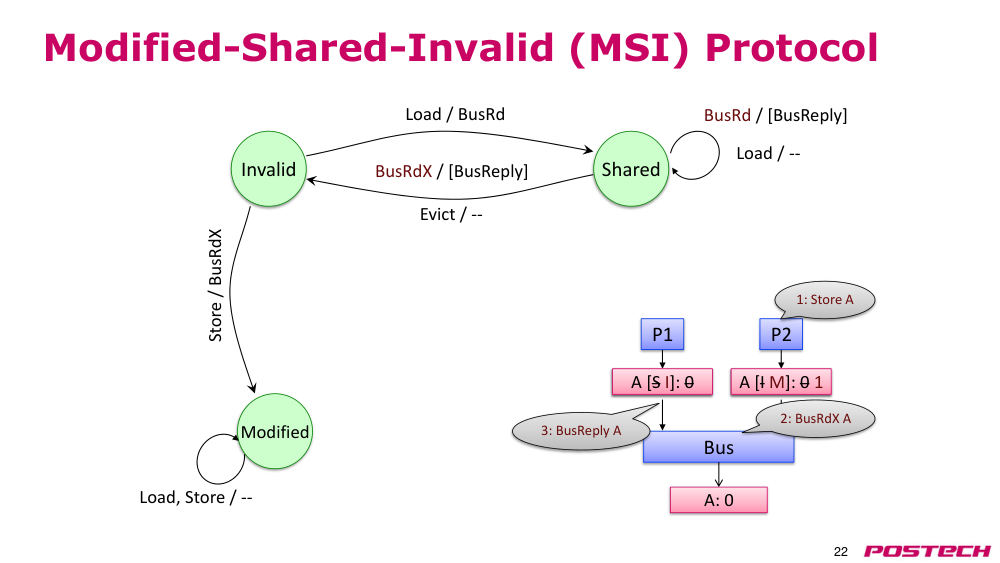
p.22수정-공유-무효(MSI) 프로토콜
- A [S]: 0
- Modified-Shared-Invalid (MSI) Protocol
- Store / BusRdX
- Load / BusRd
- Load / --
- BusRd / [BusReply]
- Modified
- Evict / --
- BusRdX / [BusReply]
- Bus
- A [I]
- A: 0
- P2
- A [S I]: 0
- P1
- 1: Store A
- 2: BusRdX A
- 3: BusReply A
- A [I M]: 0 1
- Load, Store / --
- Invalid
- Shared
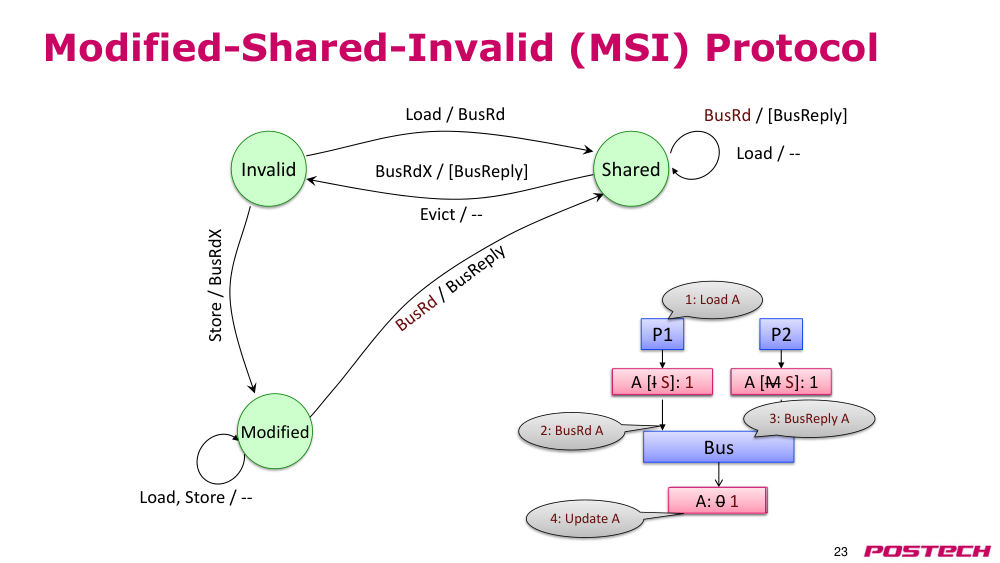
p.23수정-공유-무효(MSI) 프로토콜
- Modified-Shared-Invalid (MSI) Protocol
- Store / BusRdX
- Load / BusRd
- Load / --
- BusRd / [BusReply]
- Evict / --
- Load, Store / --
- BusRdX / [BusReply]
- Bus
- A [M]: 1
- A: 0
- P2
- A [I]
- P1
- 1: Load A
- 2: BusRd A
- 3: BusReply A
- A [I S]: 1
- A [M S]: 1
- A: 0 1
- 4: Update A
- Invalid
- Shared
- Modified
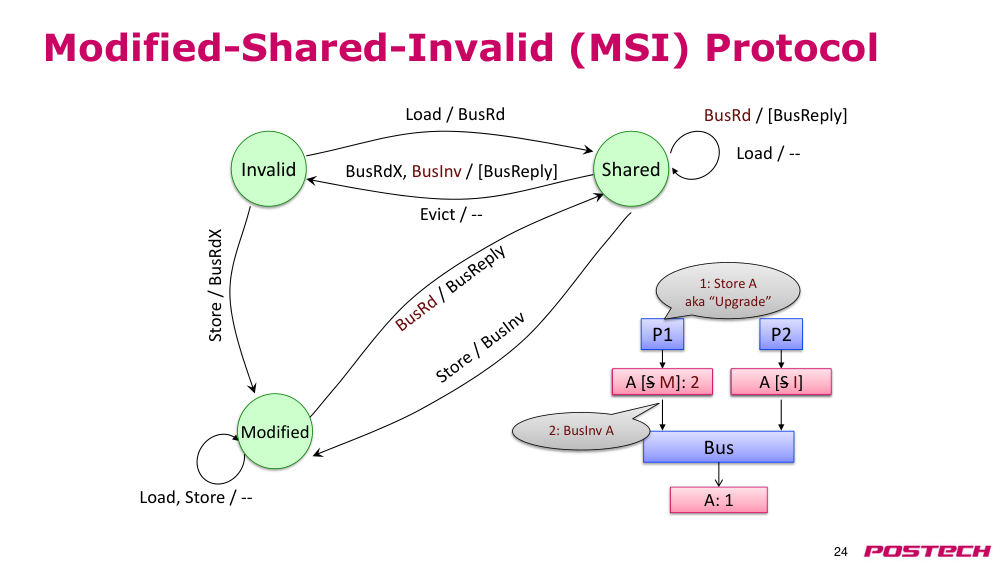
p.24수정-공유-무효(MSI) 프로토콜
- Modified-Shared-Invalid (MSI) Protocol
- Store / BusRdX
- Load / BusRd
- Load / --
- BusRd / [BusReply]
- Evict / --
- Load, Store / --
- Bus
- A [S]: 1
- A: 1
- P2
- A [S]: 1
- P1
- 1: Store A
- aka “Upgrade”
- 2: BusInv A
- A [S M]: 2
- A [S I]
- BusRdX / [BusReply]
- BusRdX, BusInv / [BusReply]
- Invalid
- Shared
- Modified
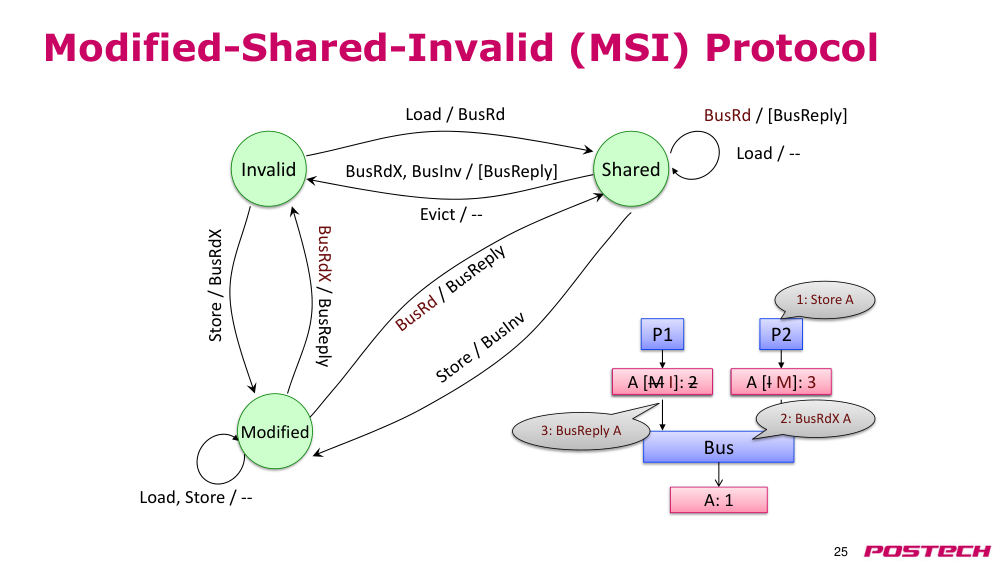
p.25수정-공유-무효(MSI) 프로토콜
- 스토어 / BusRdX(버스 읽기-수정)
- 로드 / BusRd(버스 읽기)
- 로드 / --
- BusRd(버스 읽기) / [BusReply(버스 응답)]
- BusRdX(버스 읽기-수정) / BusReply(버스 응답)
- eviction(축출) / --
- 로드, 스토어 / --
- BusRdX(버스 읽기-수정), BusInv(버스 무효화) / [BusReply(버스 응답)]
- 버스
- P1: A [I]
- A: 1
- P2: A [M]: 2
- 1: 스토어 A
- 2: BusRdX(버스 읽기-수정) A
- 3: BusReply(버스 응답) A
- A [M I]: 2
- A [I M]: 3
- 무효
- 공유
- 수정
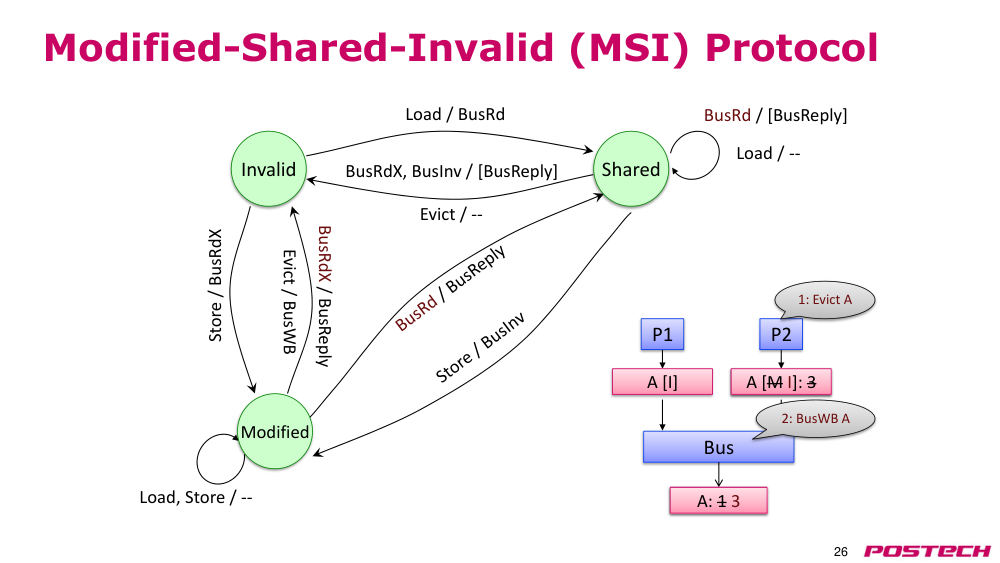
p.26수정-공유-무효(MSI) 프로토콜
- 스토어 / BusRdX(버스 읽기-수정)
- 로드 / BusRd(버스 읽기)
- 로드 / --
- BusRd(버스 읽기) / [BusReply(버스 응답)]
- BusRdX(버스 읽기-수정) / BusReply(버스 응답)
- eviction(축출) / --
- eviction(축출) / BusWB(버스 쓰기-백)
- 로드, 스토어 / --
- BusRdX(버스 읽기-수정), BusInv(버스 무효화) / [BusReply(버스 응답)]
- 버스
- P1: A [M]: 3
- A: 1
- P2: A [I]
- 1: eviction(축출) A
- 2: BusWB(버스 쓰기-백) A
- A [M I]: 3
- A: 1 3
- 무효
- 공유
- 수정
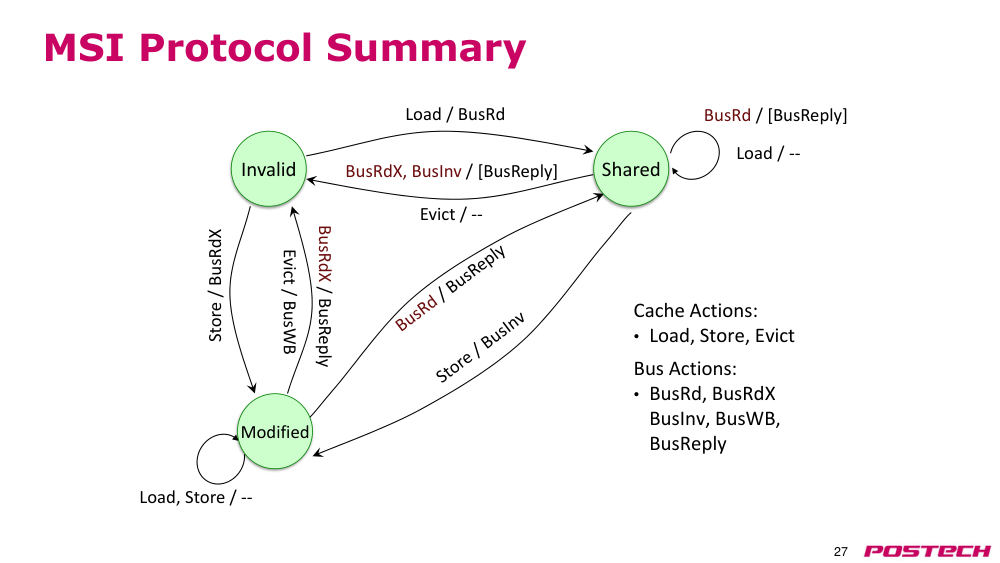
p.27MSI protocol(MSI 프로토콜) 요약
- 스토어 / BusRdX(버스 읽기-수정)
- 로드 / BusRd(버스 읽기)
- 로드 / --
- BusRd(버스 읽기) / [BusReply(버스 응답)]
- 캐시 동작:
- • 로드, 스토어, eviction(축출)
- 버스 동작:
- • BusRd(버스 읽기), BusRdX(버스 읽기-수정)
- • BusInv(버스 무효화), BusWB(버스 쓰기-백)
- • BusReply(버스 응답)
- BusRdX(버스 읽기-수정) / BusReply(버스 응답)
- eviction(축출) / --
- eviction(축출) / BusWB(버스 쓰기-백)
- 로드, 스토어 / --
- BusRdX(버스 읽기-수정), BusInv(버스 무효화) / [BusReply(버스 응답)]
- 무효
- 공유
- 수정
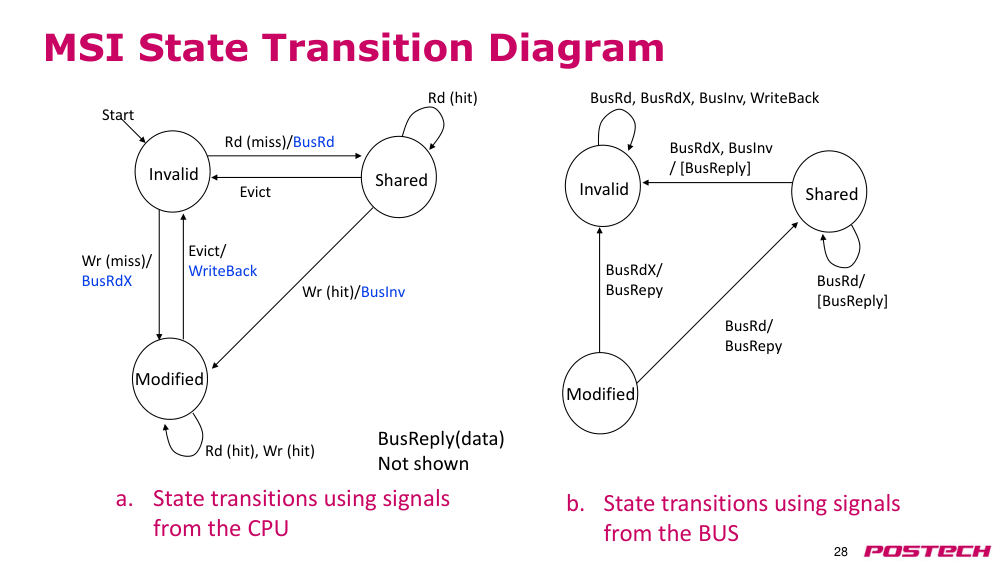
p.28MSI state transition(상태 전이) 다이어그램
- 무효
- 공유
- 수정
- 로드(미스)/BusRd(버스 읽기)
- 로드(히트)
- 쓰기(히트)/BusInv(버스 무효화)
- 로드(히트), 쓰기(히트)
- eviction(축출)
- eviction(축출)/Write-Back(쓰기-백)
- 쓰기(미스)/BusRdX(버스 읽기-수정)
- 시작
- 무효
- 공유
- 수정
- BusRd(버스 읽기)/[BusReply(버스 응답)]
- BusRd(버스 읽기)/BusReply(버스 응답)
- BusRdX(버스 읽기-수정), BusInv(버스 무효화)/[BusReply(버스 응답)]
- BusRdX(버스 읽기-수정)/BusReply(버스 응답)
- BusRd(버스 읽기), BusRdX(버스 읽기-수정), BusInv(버스 무효화), Write-Back(쓰기-백)
- 버스 응답(data)
- 표시되지 않음
- a. CPU로부터의 신호를 사용한 state transition(상태 전이)
- b. 버스로부터의 신호를 사용한 state transition(상태 전이)
p.29MESI protocol(MESI 프로토콜, Illinois Protocol)
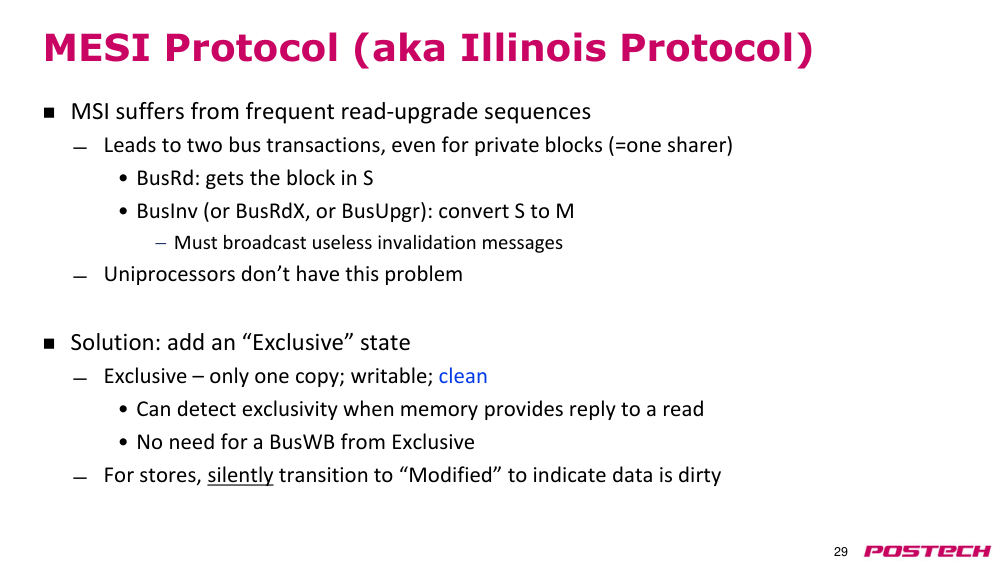
- MSI는 자주 발생하는 읽기-upgrade(업그레이드) 시퀀스로 인해 문제 발생
- private caches(개별 캐시) 라인(=한 명의 공유자)에도 불구하고 두 번의 bus transaction(버스 트랜잭션) 필요
- • BusRd(버스 읽기): 블록을 shared state(공유 상태)로 가져옴
- • 버스 무효화(또는 BusRdX(버스 읽기-수정), 또는 버스 업그레이드): shared state(공유 상태)를 modified state(수정 상태)로 전환
- • 불필요한 invalidation(무효화) 메시지 방송
- 단일 처리기 시스템에서는 이 문제가 없음
- 해결책: '독점' 상태 추가
- exclusive state(독점 상태) – 하나의 복사본만 존재; 쓰기 가능; 클린 상태
- • 메모리가 읽기 요청에 응답할 때 독점성 감지 가능
- • exclusive state(독점 상태)에서 BusWB(버스 쓰기-백) 필요 없음
- • 스토어 시, 조용히 '수정' 상태로 전이하여 데이터가 dirty(더티)임을 나타냄
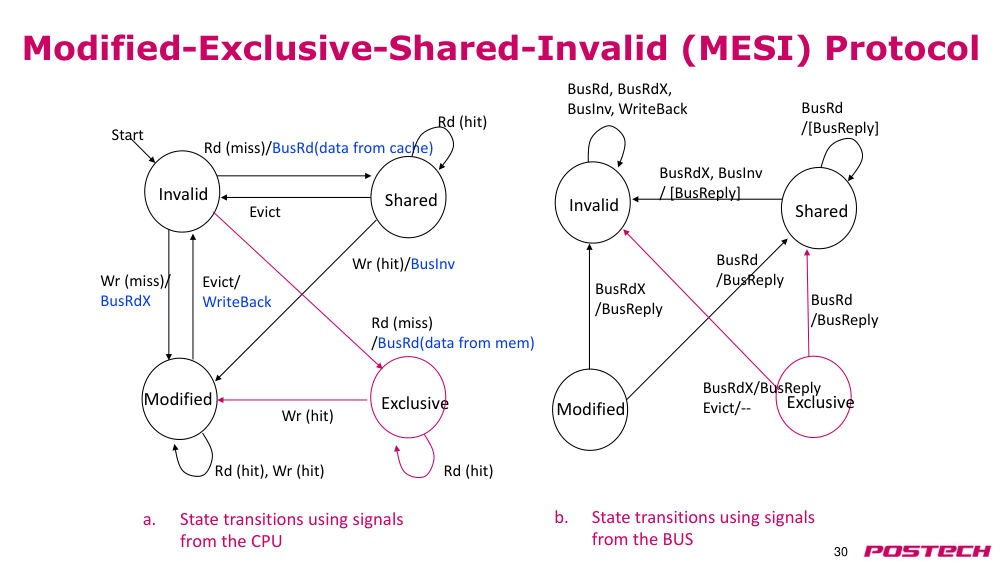
p.30수정-독점-공유-무효(MESI) 프로토콜
- 무효
- 공유
- 수정
- 로드(미스)/버스 읽기(캐시에서 데이터)
- 로드(히트)
- 쓰기(히트)/BusInv(버스 무효화)
- 로드(히트), 쓰기(히트)
- eviction(축출)
- eviction(축출)/Write-Back(쓰기-백)
- 쓰기(미스)/BusRdX(버스 읽기-수정)
- 시작
- 무효
- 공유
- 수정
- BusRd(버스 읽기)/[BusReply(버스 응답)]
- BusRd(버스 읽기)/BusReply(버스 응답)
- BusRdX(버스 읽기-수정)/BusReply(버스 응답)
- BusRd(버스 읽기), BusRdX(버스 읽기-수정), BusInv(버스 무효화), Write-Back(쓰기-백)
- a. CPU로부터의 신호를 사용한 state transition(상태 전이)
- b. 버스로부터의 신호를 사용한 state transition(상태 전이)
- BusRdX(버스 읽기-수정), BusInv(버스 무효화)/[BusReply(버스 응답)]
- 독점
- 로드(미스)/버스 읽기(메모리에서 데이터)
- 쓰기(히트)/로드(히트)
- 독점
- BusRdX(버스 읽기-수정)/BusReply(버스 응답)
- eviction(축출)/--
- BusRd(버스 읽기)/BusReply(버스 응답)
p.31스누피 버스의 구현
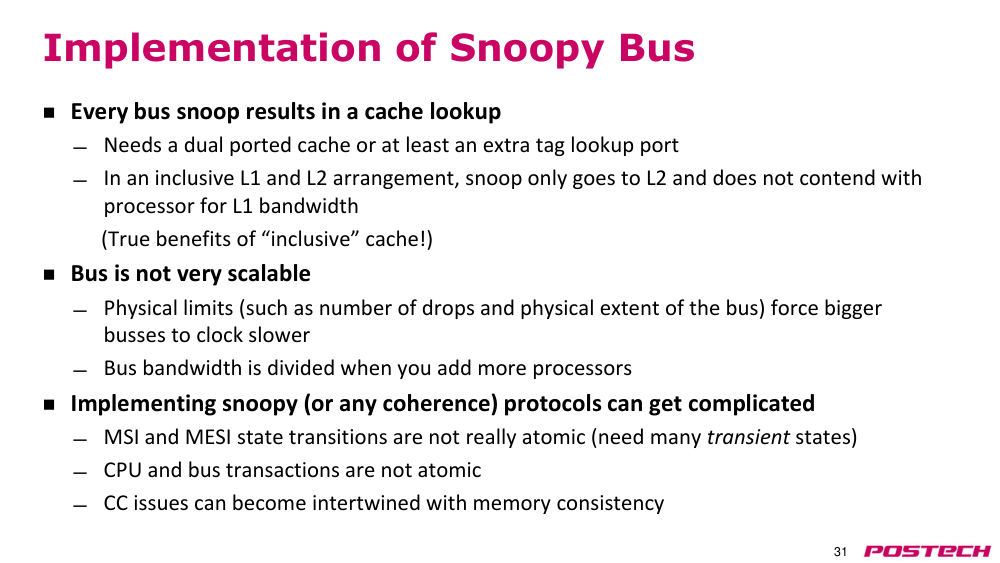
- 각 버스 snooping(스누핑)은 캐시 검색을 수반한다.
- 이를 위해 이중 포트 캐시 또는 최소한 추가 태그 검색 포트가 필요하다.
- 포함형 L1 및 L2 구성에서는 snooping(스누핑)이 L2로만 이루어지며, 프로세서가 L1 대역폭을 사용하는 것과 경쟁하지 않는다.
- inclusive cache(포함형 캐시)의 진정한 이점!
- 버스는 scalability(확장성) 면에서 별로 좋지 않다.
- 물리적 한계(예: 버스에 연결 가능한 드롭 수 및 버스의 물리적 크기)로 인해 더 큰 버스는 더 낮은 클럭 속도로 작동해야 한다.
- 프로세서를 추가할수록 버스 대역폭이 분할된다.
- 스누핑(또는 어떤 일관성 프로토콜이라도)을 구현하는 것은 복잡해질 수 있다.
- MSI 및 MESI state transition(상태 전이)는 실제로 원자적이지 않다(여러 중간 상태가 필요하다).
- CPU 및 bus transaction(버스 트랜잭션)은 원자적이지 않다.
- CC 문제는 memory consistency(메모리 일관성)과 얽힐 수 있다.
p.32확장 가능한 cache coherence(캐시 일관성)
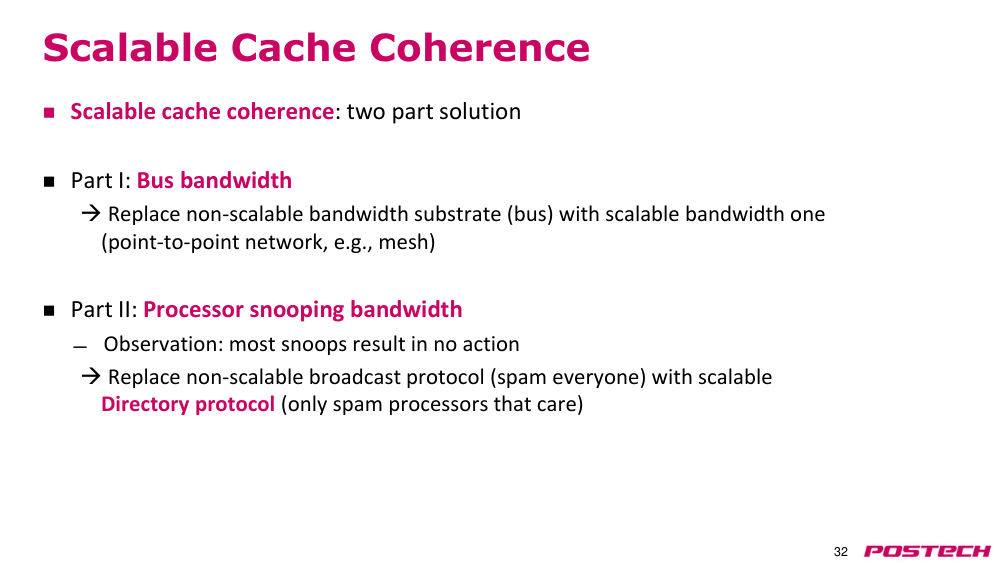
- 확장 가능한 cache coherence(캐시 일관성): 두 가지 구성 요소로 해결
- 제1부: 버스 대역폭
- → 비확장성 대역폭 기반(버스)을 확장 가능한 대역폭 기반(예: 메시 구조의 포인트투포인트 네트워크)으로 교체한다.
- 제2부: 프로세서 snooping(스누핑) 대역폭
- 관찰: 대부분의 snooping(스누핑)은 아무런 동작도 하지 않는다.
- → 비확장성 방송 프로토콜(모든 사람에게 방송)을 확장 가능한 디렉터리 프로토콜(관심 있는 프로세서만 방송)로 교체한다.
p.33디렉터리 기반 cache coherence protocol(캐시 일관성 프로토콜)
- 아이디어: 논리적으로 중심화된 디렉터리가 각 캐시 블록의 사본이 어디에 있는지 추적한다. 캐시는 일관성을 보장하기 위해 이 디렉터리를 참조한다.
- 비방송형 일관성 프로토콜을 위한 디렉터리
- 메모리를 확장하여 캐싱 정보를 추적한다.
- 각 물리적 cache line(캐시 라인)에 대해 디렉터리는 다음을 기록한다:
- • 소유자: 수정 상태(M 상태) 또는 독점 상태(E 상태)의 사본을 가진 프로세서
- • 공유자: 클린 상태(S 상태) 사본을 가진 프로세서 – 각 프로세서에 대해 1비트
- 프로세서는 디렉터리에 일관성 이벤트를 전송한다. 예를 들어, 해당 디렉터리 항목에 대해:
- • 읽기 시: 캐시 비트를 설정하고 데이터 공급을 준비한다.
- • 쓰기 시: 블록을 가진 모든 캐시를 invalidation(무효화)하고 비트를 재설정한다.
- 장점: 확장 가능 (일관성 트래픽 감소)
- 단점: 추가 저장 공간 오버헤드, 지연 증가 ($ → 디렉터리 → 메모리.)
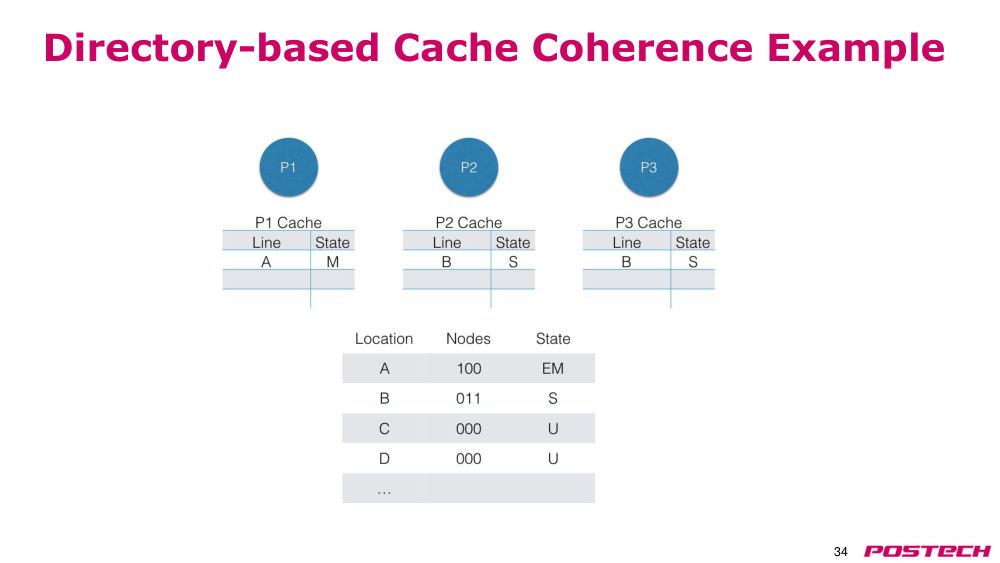
p.34디렉터리 기반 cache coherence(캐시 일관성) 예시
p.35중앙 집중형 디렉터리
- 단일 디렉터리는 모든 노드의 캐시 태그 사본을 포함한다.
- 장점:
- • invalidation(무효화)/업데이트를 사본을 가진 노드들만에게 전송한다.
- • 중앙 시리얼라이제이션 지점: memory consistency(메모리 일관성) 확보가 쉽다 (버스와 마찬가지로…)
- 문제:
- • 분산형 디렉터리보다 scalability(확장성)이 낮다 (수천 개의 노드에서 오는 트래픽을 상상해 보라…)
- • 디렉터리 크기/구조는 노드 수에 따라 변한다.
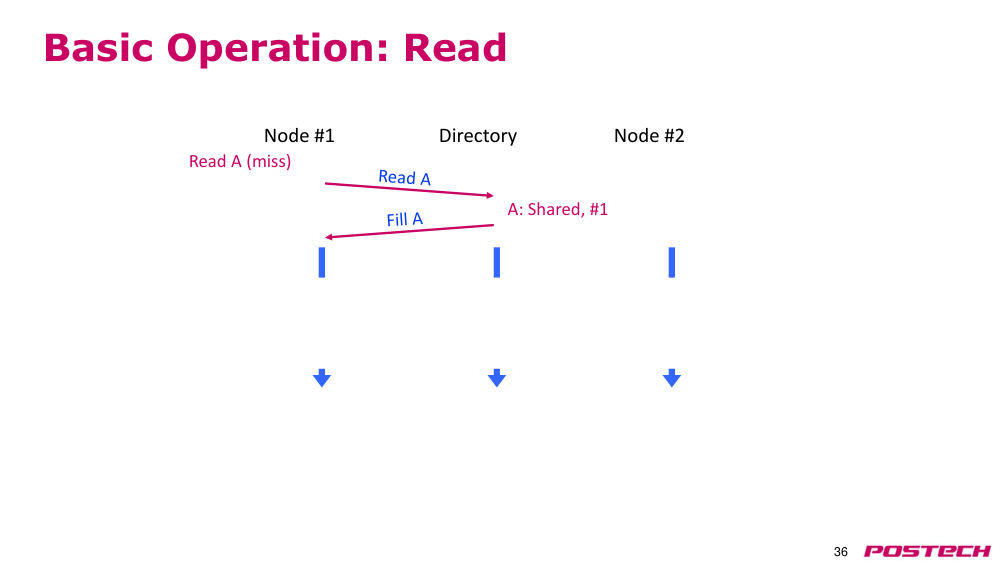
p.36기본 동작: 읽기
- 읽기 A (미스)
- 노드 #1
- 디렉터리
- 노드 #2
- A: 공유, #1
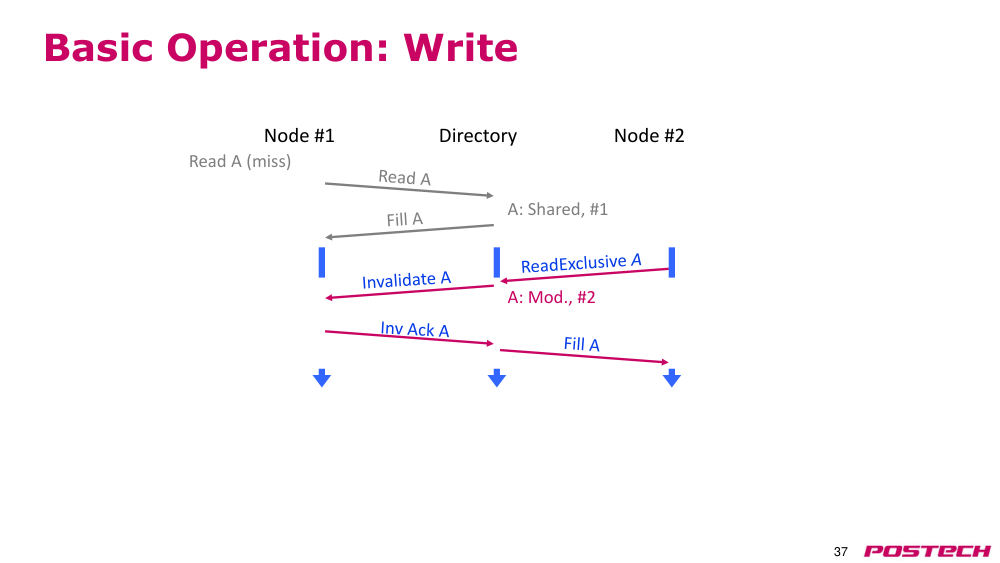
p.37기본 동작: 쓰기
- 읽기 A (미스)
- 노드 #1
- 디렉터리
- 노드 #2
- A: 공유, #1
- A: 수정, #2
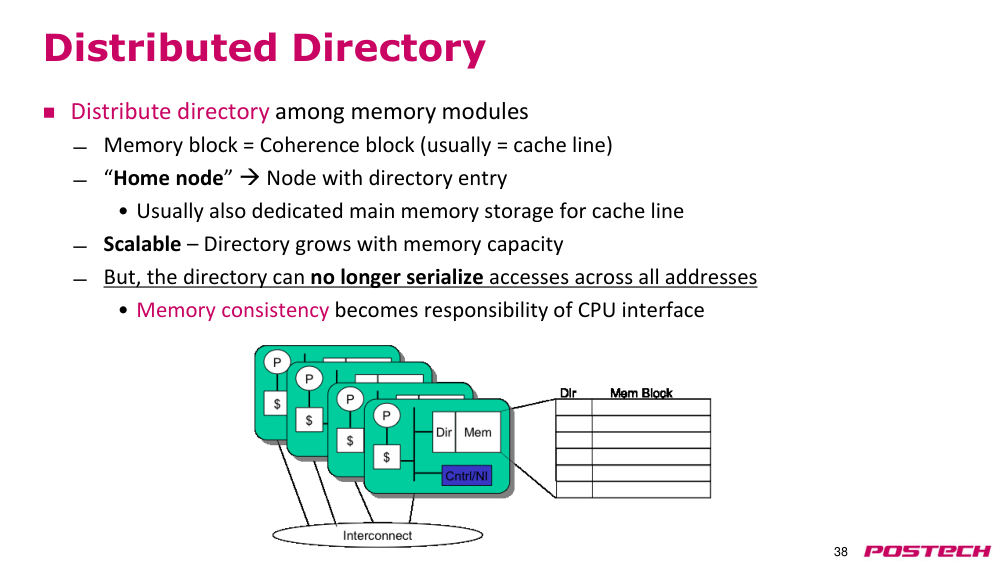
p.38분산 디렉터리
- 디렉터리를 메모리 모듈들 사이에 분산
- 메모리 블록 = cache coherence(캐시 일관성) 블록 (보통 = 캐시 라인)
- "홈 노드" → 디렉터리 항목이 있는 노드
- 보통 cache line(캐시 라인)을 위한 전용 주요 메모리 저장소도 있음
- scalability(확장성) 있음 – 디렉터리 크기가 메모리 용량에 따라 증가
- 하지만 이제 모든 주소를 통한 접근을 시리얼화할 수 없음
- memory consistency(메모리 일관성)은 CPU 인터페이스의 책임이 됨
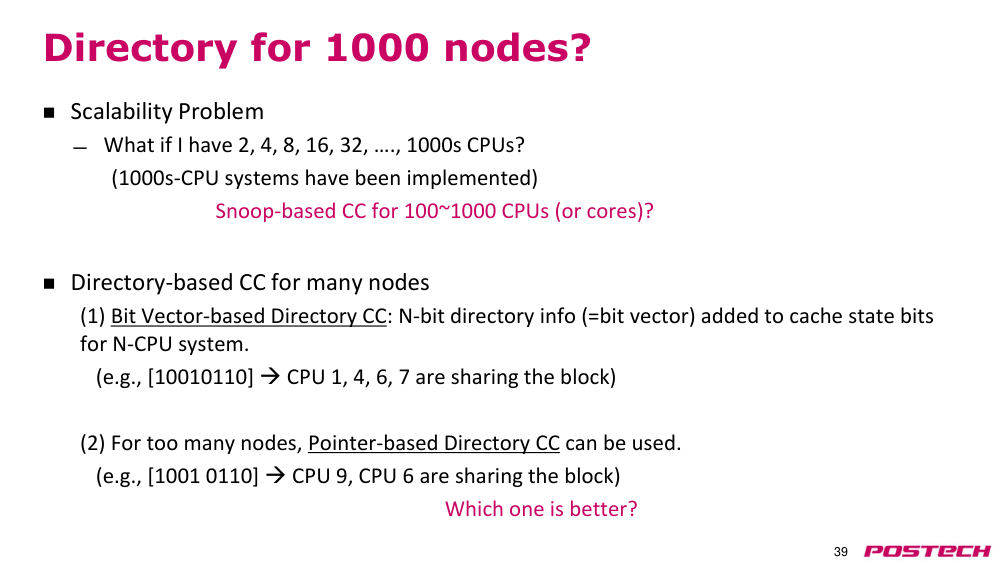
p.391000개 노드용 디렉터리?
- scalability(확장성) 문제
- 만약 2, 4, 8, 16, 32, …, 수천 개의 CPU를 가진다면?
- (수천 개 CPU 시스템은 이미 구현됨)
- 100~1000개 CPU(또는 코어)에 대해 snooping(스누핑) 기반 cache coherence(캐시 일관성)?
- 많은 노드에 대해 디렉터리 기반 cache coherence(캐시 일관성) 사용
- (1) 비트 벡터 기반 디렉터리 cache coherence(캐시 일관성): N개 CPU 시스템에 대해 N비트 디렉터리 정보(=비트 벡터)를 캐시 상태 비트에 추가
- (예: [10010110] → CPU 1, 4, 6, 7이 블록을 공유함)
- (2) 노드 수가 너무 많을 경우 포인터 기반 디렉터리 cache coherence(캐시 일관성) 사용 가능
- (예: [1001 0110] → CPU 9, CPU 6이 블록을 공유함)
- 어느 쪽이 더 나은가?
p.40디렉터리 프로토콜 설계: 용어 정의
- 로컬 노드 (L)
- 우리가 관심 있는 transaction(트랜잭션)을 시작하는 노드
- 홈 노드 (H)
- 주소의 메모리 위치와 디렉터리 항목이 존재하는 노드
- 원격 노드 (R)
- transaction(트랜잭션)에 참여하는 다른 모든 노드
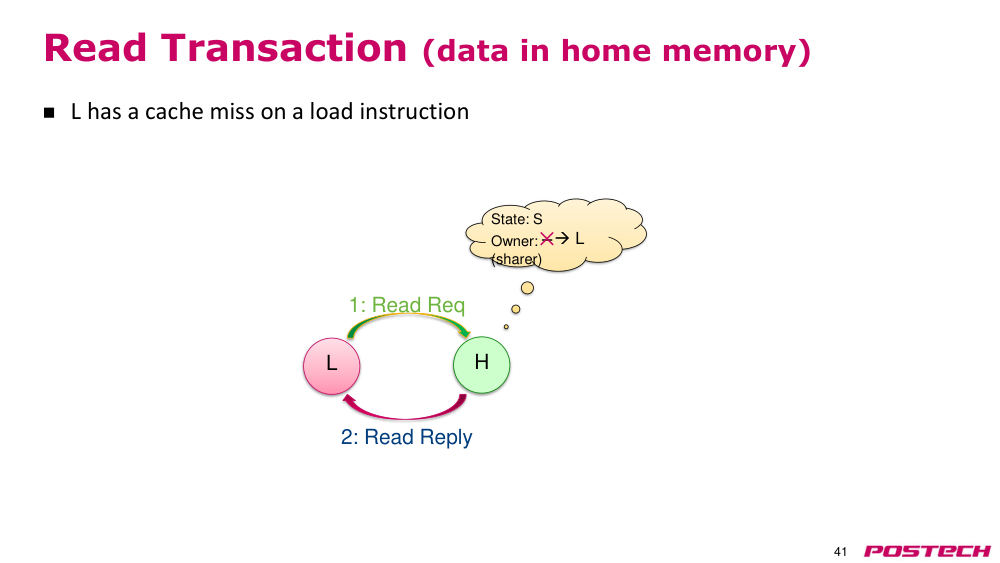
p.41홈 메모리에 데이터가 있는 read transaction(읽기 트랜잭션)
- L은 로드 명령어에서 cache miss(캐시 미스) 발생
- L
- 1: 읽기 요청
- 2: 읽기 응답
- 상태: S
- 소유자: –
- (공유자)
- → L
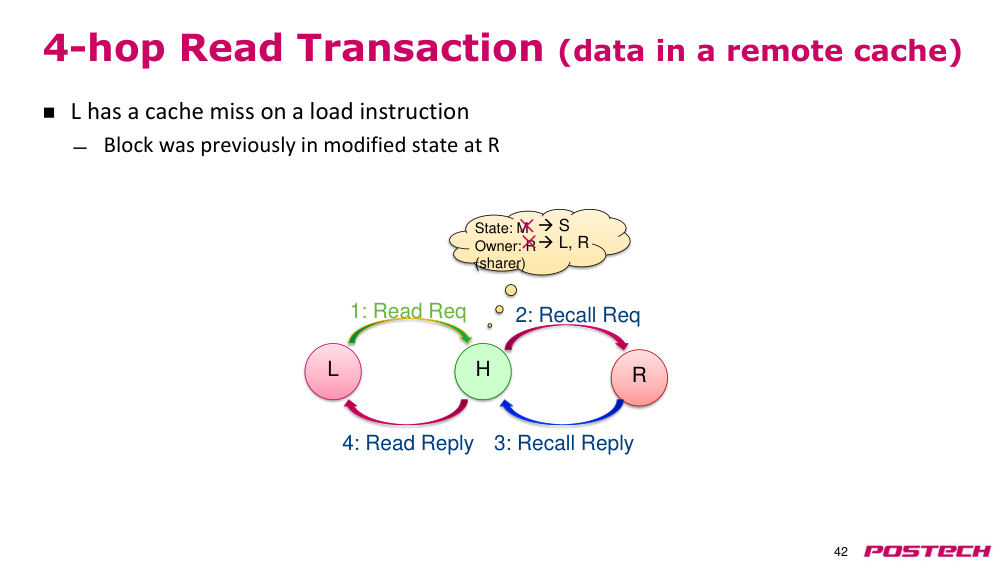
p.424-hop read transaction(4-홉 읽기 트랜잭션) (데이터가 원격 캐시에 있음)
- L은 로드 명령어에서 cache miss(캐시 미스) 발생
- 블록은 이전에 R에서 modified state(수정 상태)였음
- L
- H
- 1: 읽기 요청
- 4: 읽기 응답
- R
- 2: Recall Req(리콜 요청)
- 3: Recall Reply(리콜 응답)
- 상태: M
- 소유자: R
- (공유자)
- → S
- → L, R
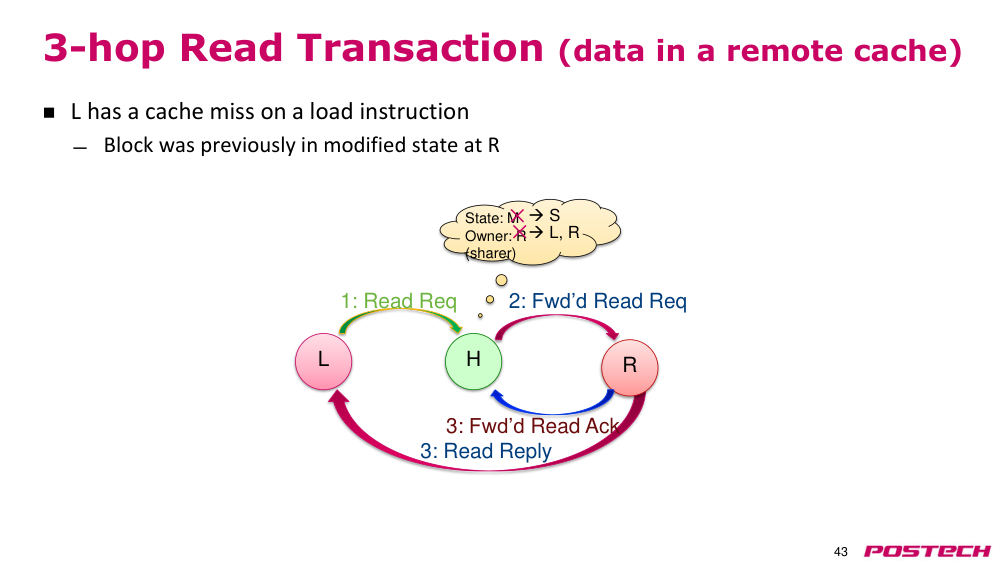
p.433-hop read transaction(3-홉 읽기 트랜잭션) (데이터가 원격 캐시에 있음)
- L은 로드 명령어에 대해 cache miss(캐시 미스) 발생
- 블록은 이전에 R에서 수정 상태(M)였음
- 1: 읽기 요청
- 3: 읽기 응답
- R
- 2: 전달된 읽기 요청
- 3: 전달된 읽기 승인
- 상태: M
- 소유자: R (공유자)
- →S
- →L, R
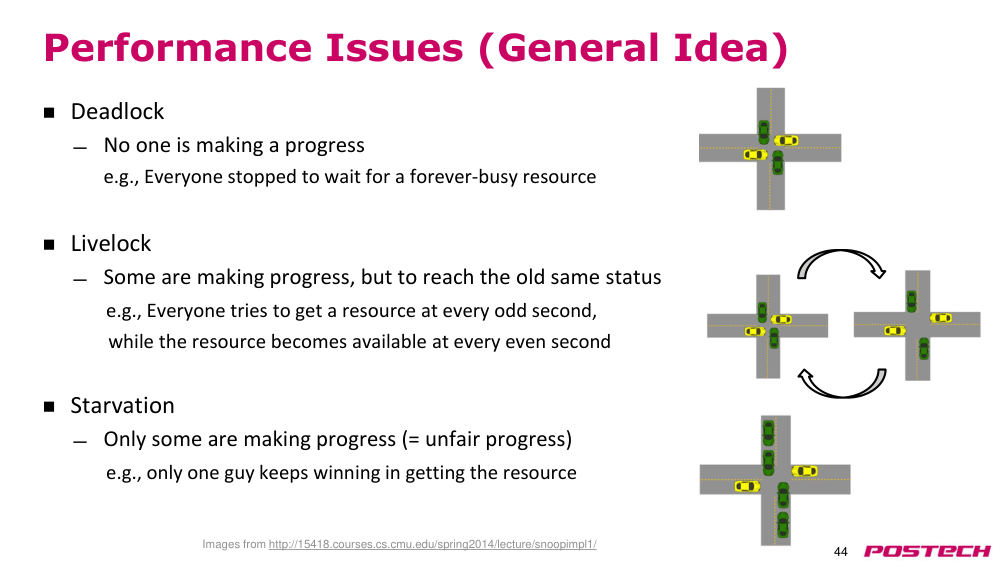
p.44성능 문제 (일반적인 아이디어)
- 데드락
- 누구도 진전이 없음
- 예: 모든 프로세스가 영원히 사용 중인 자원을 기다림
- 라이브락
- 일부는 진전이 있지만, 이전 상태로 돌아감
- 예: 모든 프로세스가 홀수 초마다 자원을 요청하고, 자원은 짝수 초에만 사용 가능함
- starvation(기아)
- 일부만 진전됨 (= 불공정한 진전)
- 예: 한 명의 프로세스만 자원을 계속 획득함
- 이미지 출처: http://15418.courses.cs.cmu.edu/spring2014/lecture/snoopimpl1/
p.45cache coherence(캐시 일관성)에서의 성능 문제
- 데드락 예시
- 다른 주소 A와 B가 동일한 cache line(캐시 라인)에 매핑되는 경우
- A의 수정 복사본이 있는 PA가 B에 대한 read miss(읽기 미스) 요청을 버스에 전송
- B의 수정 복사본이 있는 PB가 A에 대한 read miss(읽기 미스) 요청을 버스에 전송
- 만약 PA와 PB가 오래된 요청을 먼저 처리하고자 한다면?
- 라이브락 예시
- 모든 CPU가 동시에 A에 쓰기 시도 시, 다른 CPU의 A 복사본을 invalidation(무효화)해야 함
- 만약 모든 캐시의 A가 쓰기 완료 전에 계속 invalidation(무효화)된다면?
- starvation(기아) 예시
- 특정 CPU가 A에 쓰기 성공을 계속 반복하는 동안, 다른 CPU는 A에 쓰기 실패
- 고성능, scalability(확장성), 기능적으로 올바른 cache coherence protocol(캐시 일관성 프로토콜) 설계는 매우 어렵다
p.46공유 메모리 요약 (1/2)
- shared memory multiprocessor(공유 메모리 다중처리 시스템)
- + 간단한 소프트웨어: 데이터 공유가 쉬움, 프로그래밍이 쉬움
- – 복잡한 하드웨어: 전역 주소 공간의 환상 제공 필요
- 두 가지 기본 구현 방식
- 대칭 (UMA) 다중처리기 (SMPs)
- • 기반 통신 네트워크: 버스 (순서 있는)
- + 낮은 지연, 전역 순서에 의존하는 간단한 프로토콜
- – 낮은 대역폭, 나쁜 scalability(확장성)
- 확장 가능한 (NUMA) 다중처리기 (MPPs)
- • 기반 통신 네트워크: 포인트투포인트 (순서 없는)
- + 확장 가능한 대역폭
- – 높은 지연, 복잡한 프로토콜
p.47공유 메모리 요약 (2/2)
- 전역 메모리 공간 환상의 두 가지 측면
- coherence(일관성): private caches(개별 캐시) 라인에 대한 일관된 시각
- • absolute coherence(절대적 일관성)는 필요 없으며, relative coherence(상대적 일관성)만으로도 충분함
- • 유효-무효(VI) 및 MSI protocol(MSI 프로토콜), 캐시 간 전송 최적화
- • 구현 방법?
- - SMP: snooping(스누핑), MPP: 디렉터리
- memory consistency(메모리 일관성) (다음 강의)
- • 모든 메모리 위치에 대한 일관된 전역 시각
- • 프로그래머는 직관적으로 sequential consistency(순차적 일관성, SC)를 기대함
- - 각 프로세서의 접근 스트림이 전역적으로 교차됨
- - cache coherence(캐시 일관성)에 의해 자연스럽게 제공되지 않으며, 추가적인 기능 필요
- • relaxed ordering(느슨한 순서): 동기화 지점에서만 일관성 보장
p.48질문?
- 공지사항
- - 교재 읽기: P&H Ch 5.10
- - 논문 읽기: "The Directory-Based Cache Coherence Protocol for the DASH Multiprocessor", Lenoski, Laudon, and Gharachorloo, ISCA’90