Lec 15 part 2 & Lec 16 · segment·paging·page table 구조와 TLB
정밀 정리 · 검증 2026-09-24 20:46
1개요
1.1base and bound 의 한계(fragmentation, 부분 공유 불가)에서 segment, 다시 고정 크기 page 로 발전하는 흐름.
1.2demand paging 을 cache 와 비교(miss penalty 크고 miss rate 낮아 SW 처리 가능), page table·page fault 처리 복습.
1.3page table 크기 문제(64bit 에서 2^52 entry)를 hierarchical·hashed(inverted) page table 로 해결.
1.4Lecture 16 시작: translation 을 빠르게 하는 TLB 의 구조와 설계(split·multi-level, associativity).
2섹션별 정리 상황·문제 → 원인 → 해결
2.17:05–10:12recap: base and bound 와 privilege level
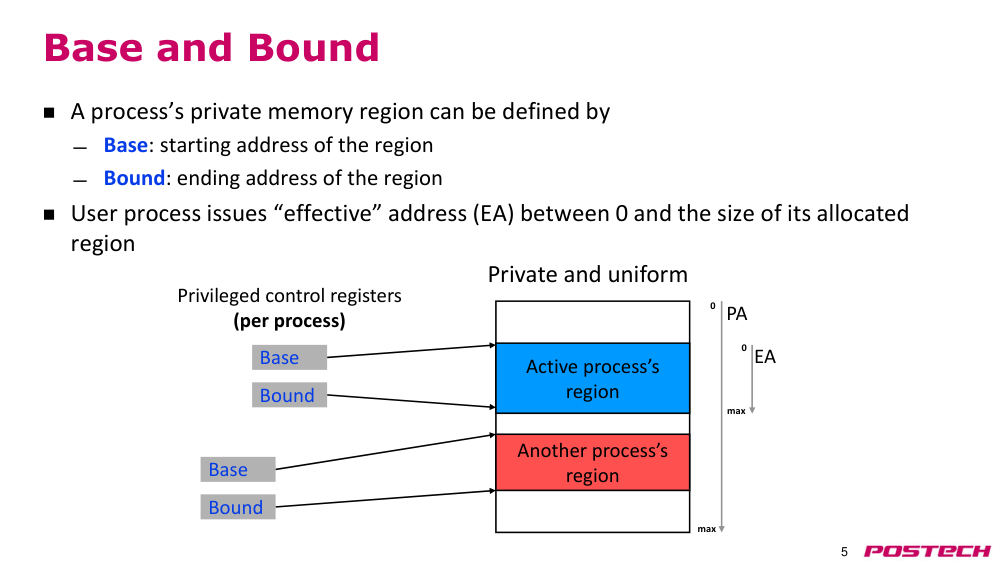
상황·문제한 machine 의 여러 process 에 서로 다른 memory 공간을 주는 가장 단순한 방법이 base and bound.
원인process 가 base·bound register 를 직접 고치면 다른 process 영역을 침범할 수 있다.
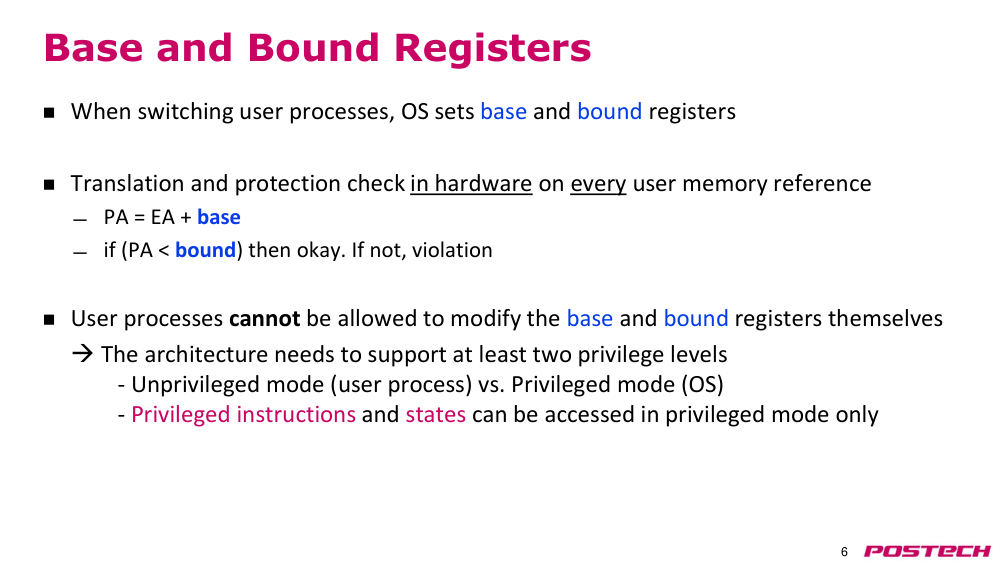
해결PA = EA + base, PA < bound 면 valid 아니면 violation. base·bound 는 OS 만 privileged mode 의 특수 instruction 으로 수정.
- process 마다 base register·bound register 한 쌍
- user(unprivileged) vs OS(privileged) 최소 두 privilege level 필요
2.210:12–14:01base and bound 의 한계와 segment
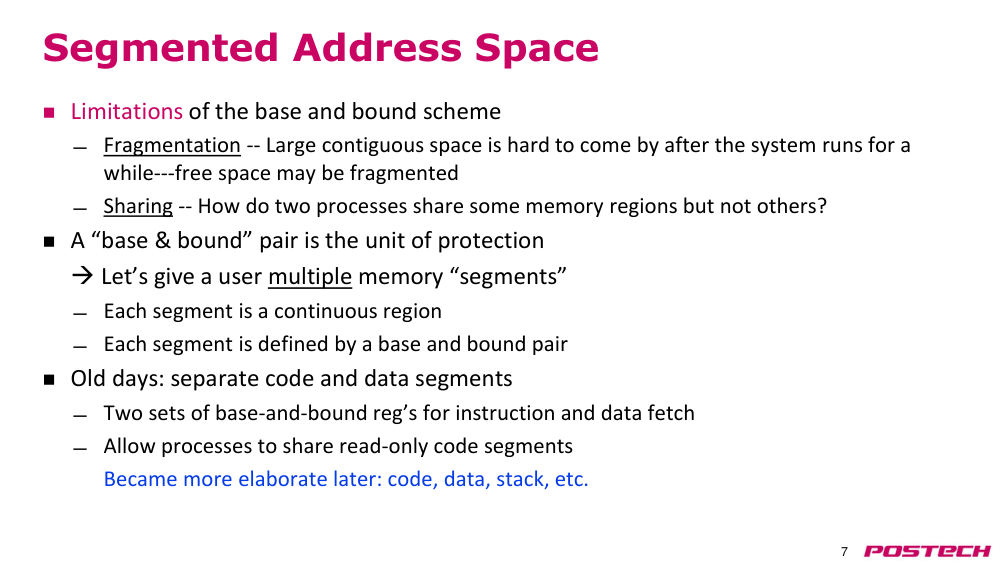
상황·문제process 를 오래 돌리면 physical space 가 fragment 되어, 전체 free 공간이 충분해도 연속 공간을 못 찾는다.
원인영역이 하나뿐이라 일부만 공유(sharing)할 방법도 없다: 전부 공유하거나 전혀 안 하거나.
해결process 에 여러 segment(각각 base·bound 를 가진 연속 영역)를 준다. 옛날엔 code/data 두 개, 이후 code·data·stack 등.
- code segment 만 공유하면 같은 프로그램 두 instance 가 code 는 공유, data·stack 은 따로
- segment 단위로 공유 범위 지정
2.314:01–16:44segment 기반 address translation
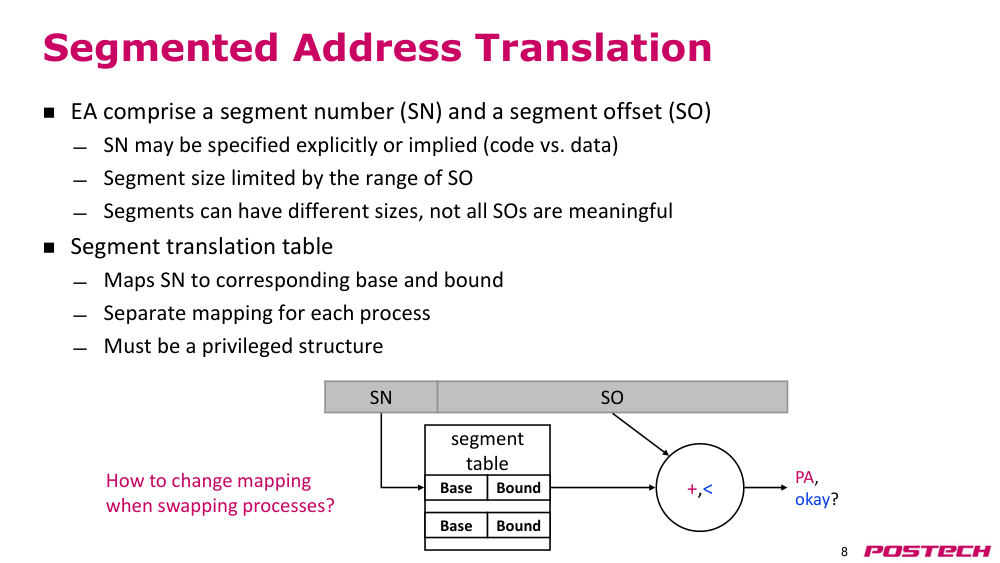
상황·문제EA 로 어느 segment 인지와 그 안의 위치를 알아내야 한다.
원인segment 마다 크기가 달라 base·bound 를 segment 별로 찾아야 한다.
해결EA 상위 bit = segment number(SN) 로 segment table 을 index 해 base·bound 를 얻고, offset+base < bound 검사. context switch 때 OS 가 table 시작 주소 register 만 바꾼다.
- segment table 은 process 별·privileged 구조
- table 시작 위치를 가리키는 register 를 바꾸는 방식이 많은 architecture 에서 쓰임
2.416:44–18:29segment 별 protection bit
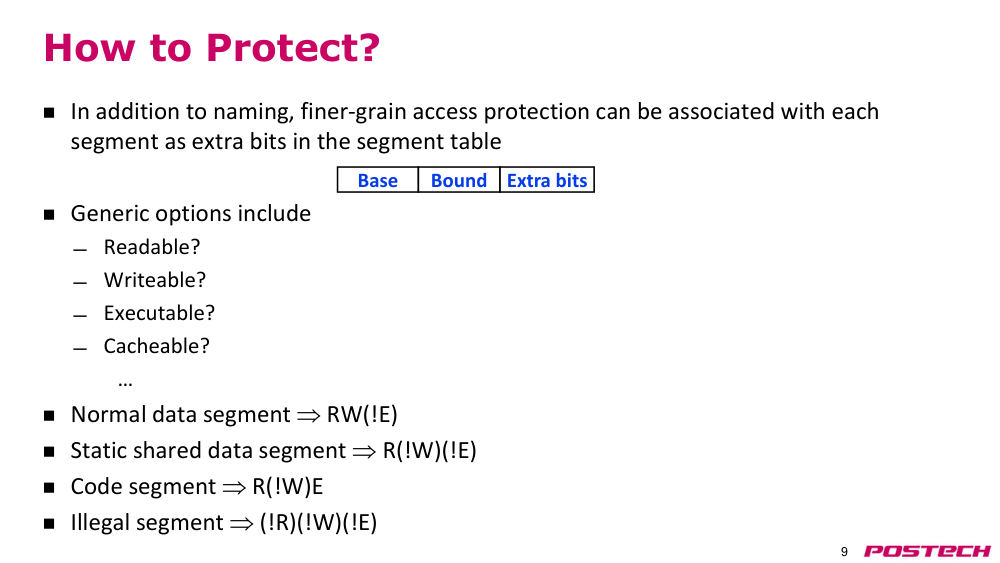
상황·문제segment 용도(data, 공유 data, code)에 따라 허용할 access 가 다르다.
원인base·bound 만으로는 read/write/execute 구분이 없다.
해결segment table entry 에 readable·writable·executable·cacheable 등 extra bit. data=RW!E, 읽기전용 공유 data=R!W!E, code=R!WE, 셋 다 없으면 invalid.
- (!R)(!W)(!E) entry 는 illegal(invalid) segment 로 간주
2.518:29–21:35page 기반 address space
상황·문제segment 도 크기가 제각각이라 fragmentation 이 남는다.
원인가변 크기 영역을 연속으로 할당해야 하기 때문.
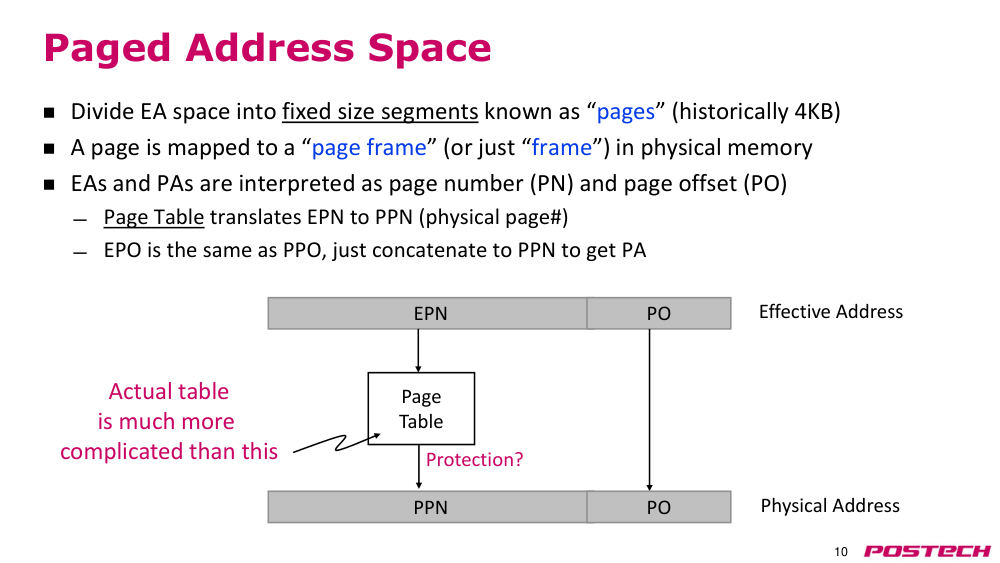
해결address space 를 같은 크기 page(역사적으로 4KB)로 나눈다. EA = page number + offset, page table 이 EPN→PPN, offset 은 그대로 사용.
- page(effective 공간) 는 page frame(physical 위치)에 매핑
- 개념상 모든 EA 의 PPN 을 주는 하나의 큰 table
2.621:35–27:53external vs internal fragmentation, large page (퀴즈)
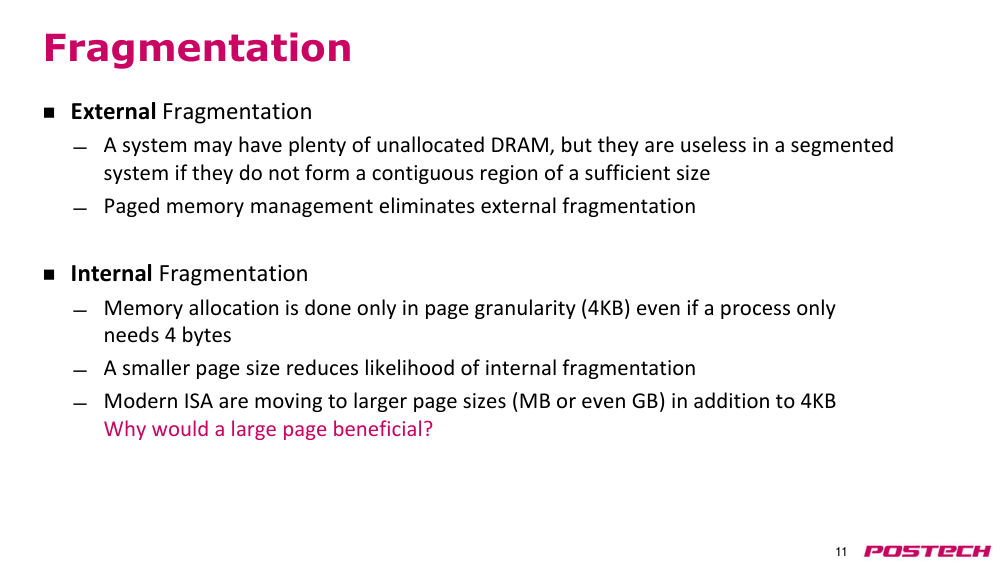
상황·문제paging 은 external fragmentation(연속 free 공간 부족)을 없애지만 internal fragmentation 이 생긴다.
원인할당이 page 단위(4KB)라 4 byte 만 필요해도 4KB 할당. 1GB page 로 900MB 쓰면 ~100MB 낭비.
해결보통 작은 할당이 드물어 큰 문제 아님. 현대 ISA 는 MB·GB page 도 지원: page table entry 수가 줄어 translation 이 쉬워진다(TLB 에서 더 설명).
- free 공간이 모두 page 크기의 배수라 external fragmentation 제거
- 900MB 를 4KB page 로 = 900/4×2^10 개 PTE, 1GB page 면 1 개
- 퀴즈 정답 credit: 박태규
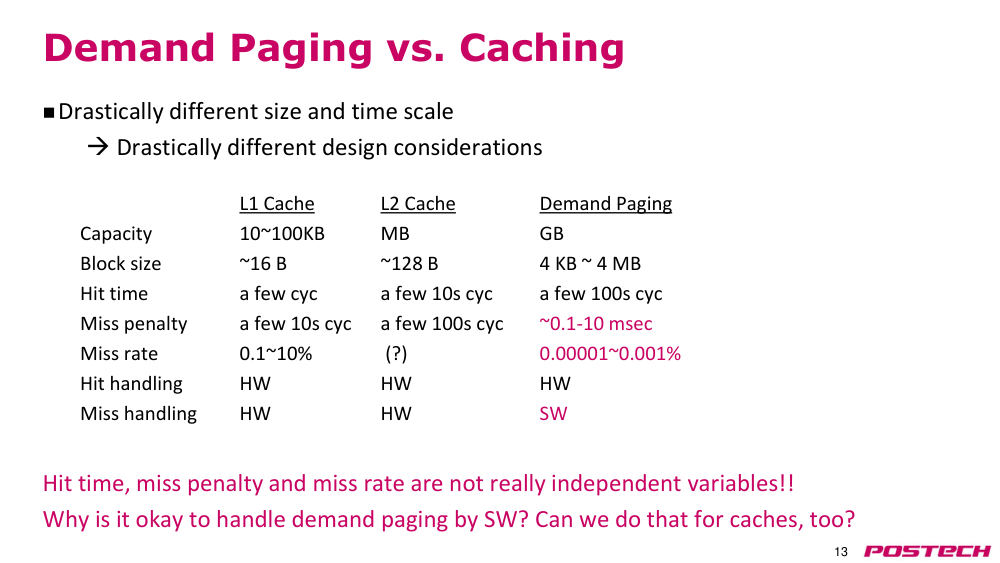
2.727:53–34:18demand paging 과 cache 비교
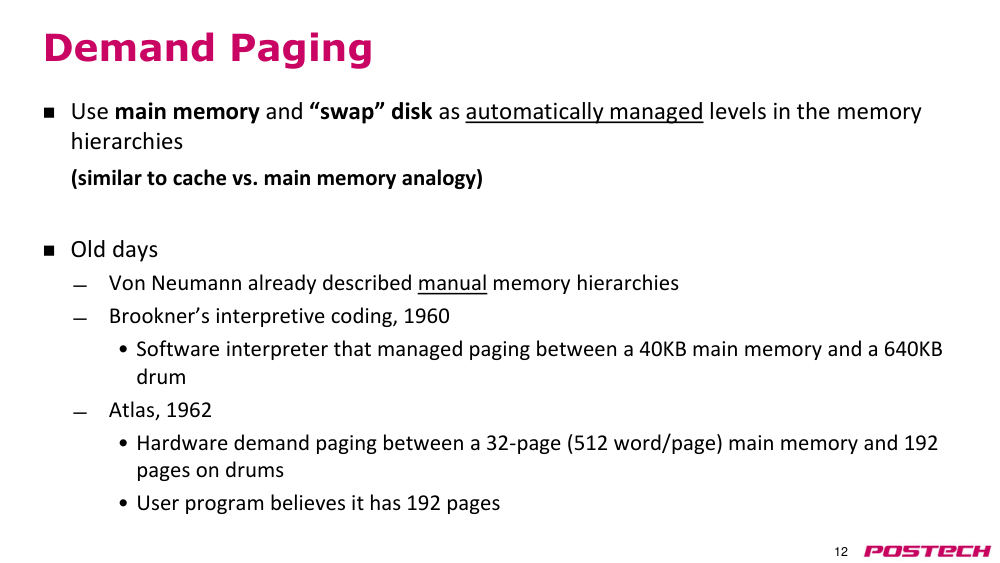
상황·문제모든 process 의 virtual address space 합은 physical memory 보다 훨씬 크지만 큰 공간의 illusion 을 줘야 한다.
원인main memory 에 다 못 두는 page 가 생긴다.
해결disk 에 두고 필요할 때 main memory 로 가져오며 덜 쓰는 page 를 evict(OS 가 자동). 60년대 drum 부터 같은 원리.
- cache 대비 miss penalty 는 훨씬 크고(disk) miss rate 는 훨씬 낮다
- miss 가 드물어 SW(OS) 처리가 허용되지만 cache miss 를 SW 로 처리하면 수백 cycle 보다 훨씬 오래 걸려 불가
- miss rate 가 높으면 main memory 를 늘려야 함
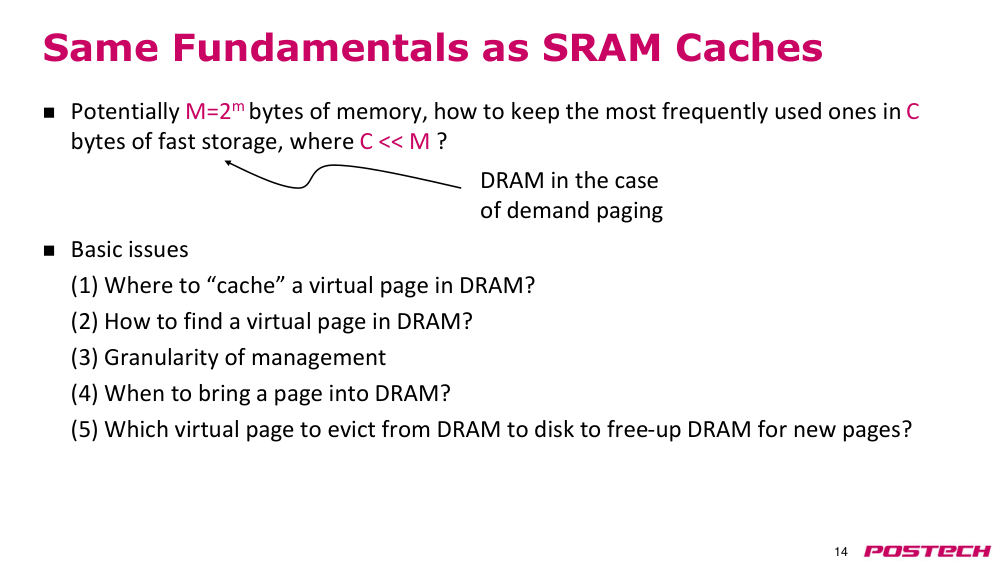
2.834:18–39:17SRAM cache 와 같은 원리, EA·VA·PA 용어, page 공유 (퀴즈)
상황·문제main memory 와 disk 사이에서도 cache 와 같은 질문(어디 둘지, 찾기, 단위, 언제 가져올지, 무엇을 evict)에 답해야 한다.
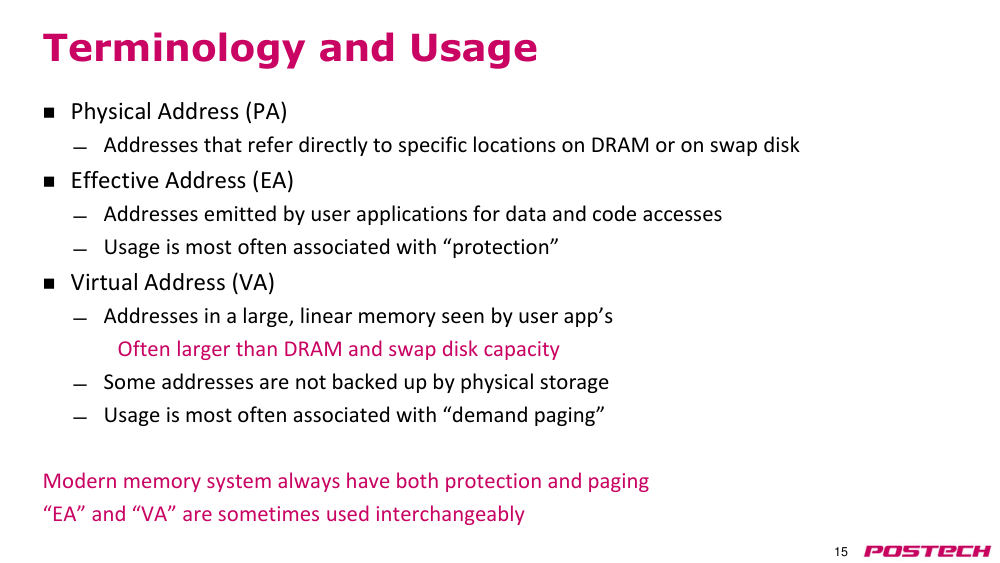
원인EA·VA·PA 용어가 섞여 쓰여 혼동된다.
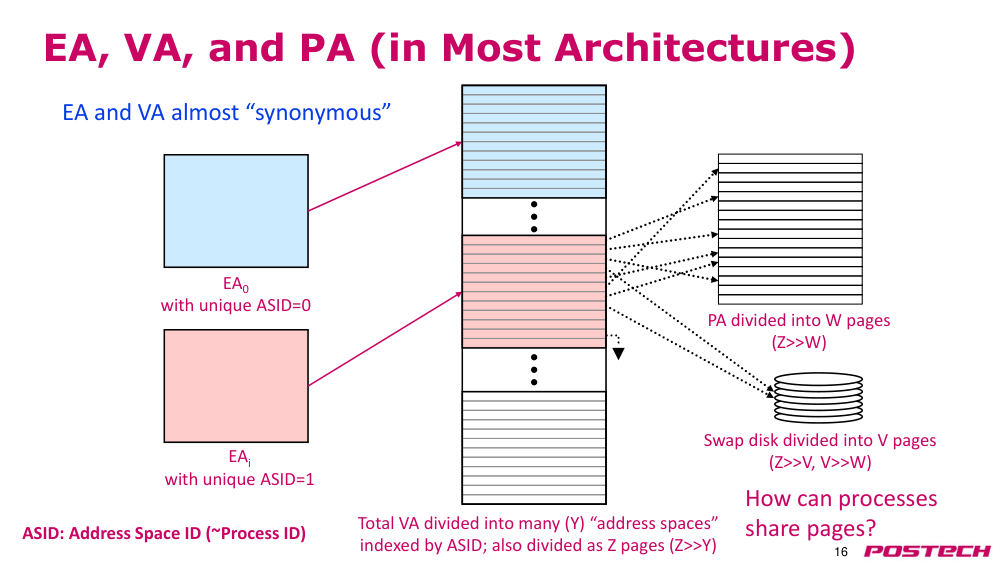
해결PA = DRAM/swap disk 위치, EA = program 이 만든 주소(protection 쪽), VA = demand paging 쪽 용어, 흔히 같은 뜻. 같은 VA 는 PID(ASID)로 구분.
- page 공유: 두 process 의 page table 이 같은 page frame 을 가리키게 한다 (credit: 김정진)
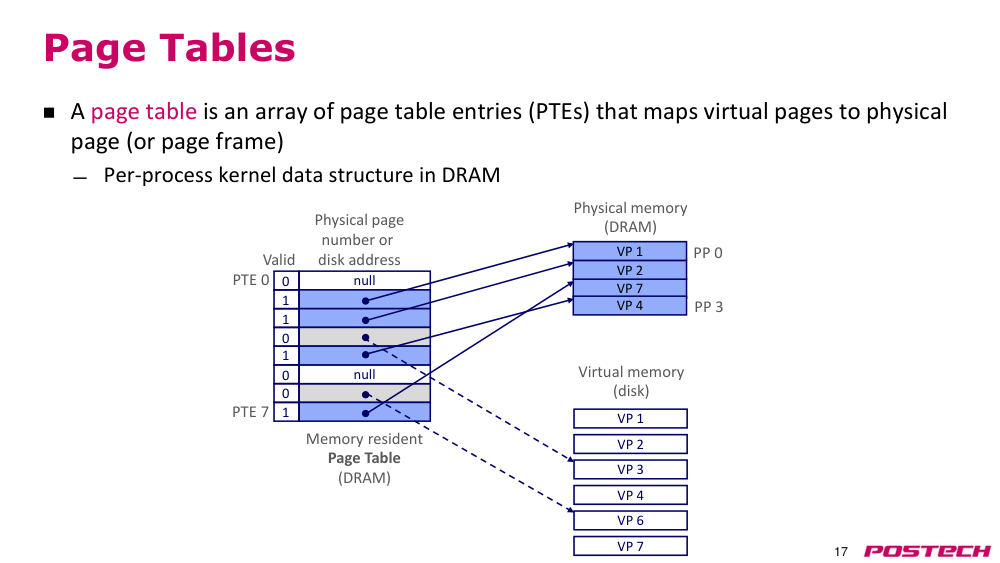
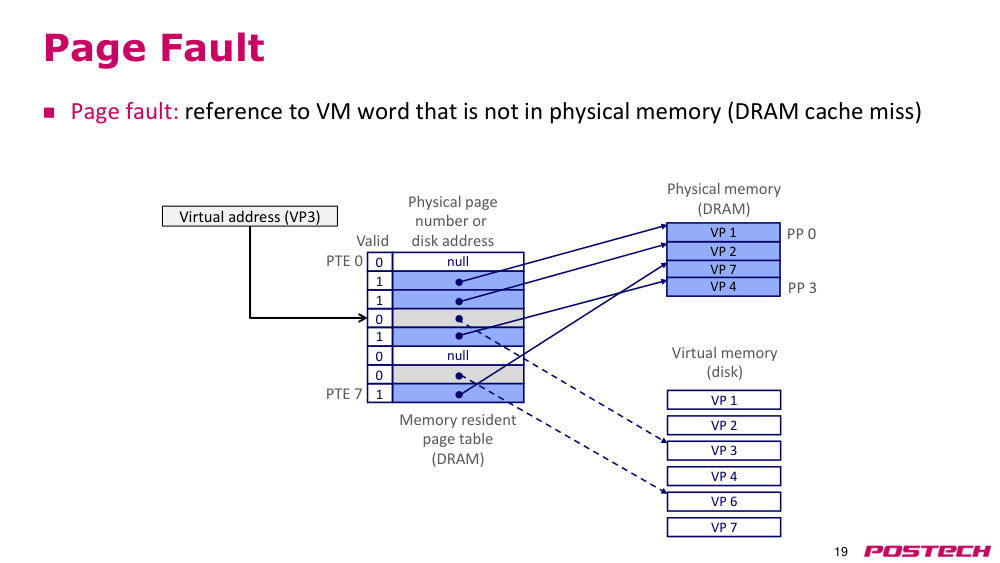
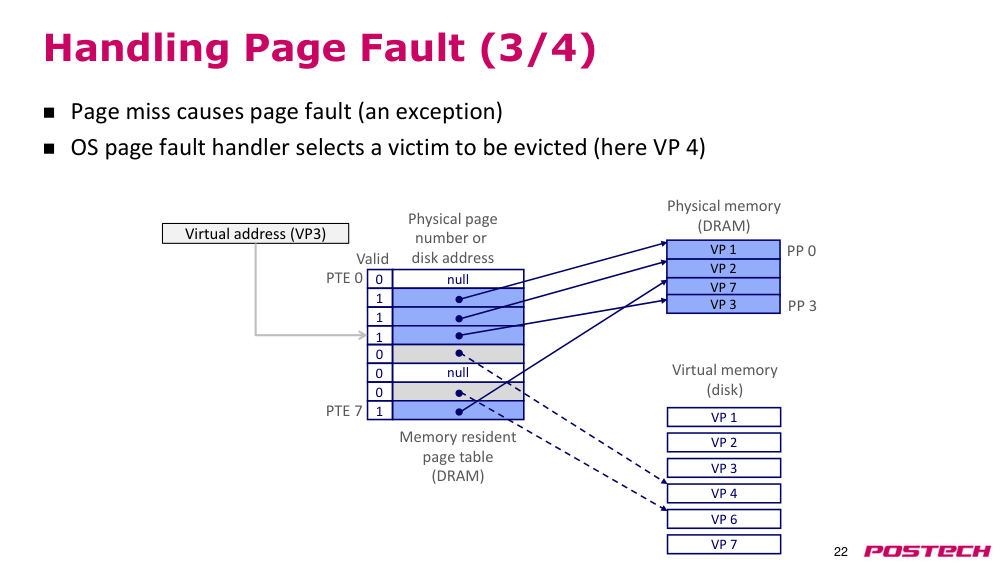
2.939:17–43:48page table, page hit, page fault 처리
상황·문제VA 접근 시 page 가 memory 에 있는지 disk 에 있는지, 유효한지 알아야 한다.
원인page table 은 PTE 배열이고 그림의 'valid' bit 는 사실 memory/disk 여부(x86 의 present bit), 진짜 invalid 는 주소가 null 인 entry.
해결hit 이면 DRAM 에서 접근. miss(page fault)면 victim page 를 evict 하고 disk 에서 올린 뒤 PTE 갱신 후 access 재개. invalid entry 접근은 segmentation fault.
- 강의자가 그림의 valid bit 표기가 헷갈린다고 정정
- prerequisite 과목에서 배운 내용이라 빠르게 진행
2.1043:48–55:38page table 의 크기·속도 문제와 HW walk (퀴즈)
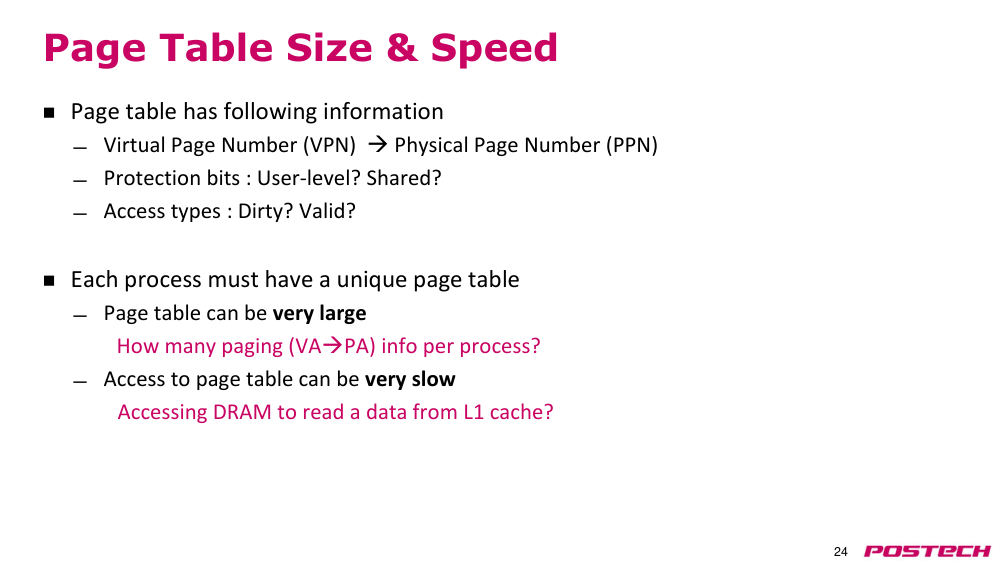
상황·문제PTE 에는 PPN, protection bit(user? shared? RWX), valid·present·dirty 가 필요하다. dirty 면 evict 때 disk 에 write back.
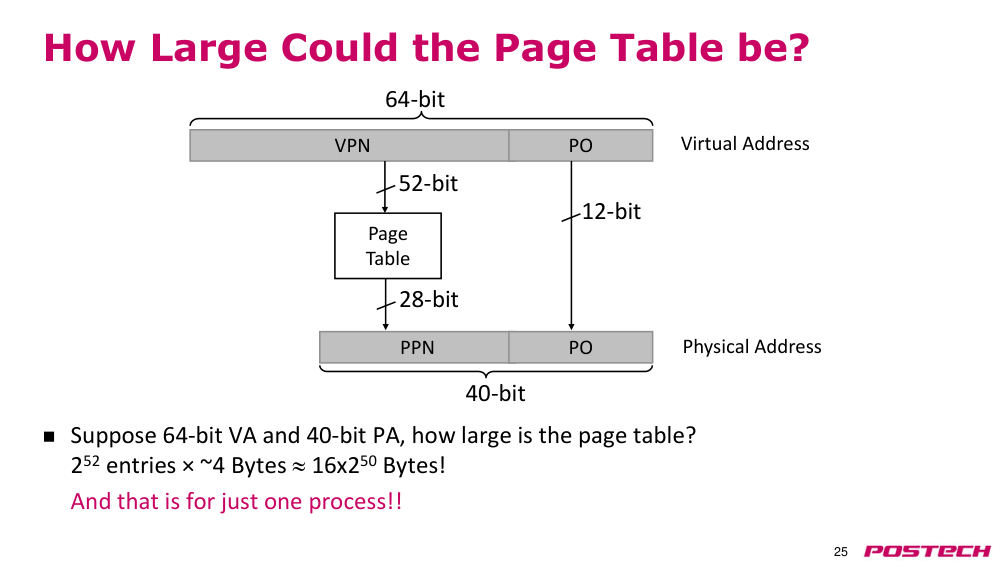
원인64bit VA, 4KB page 면 VPN 52bit, PA 40bit → PPN 28bit, 2^52×4B = 16×2^50 byte, process 하나당. 또 매 access 마다 DRAM 의 table 을 읽으면 cache 가 무의미.
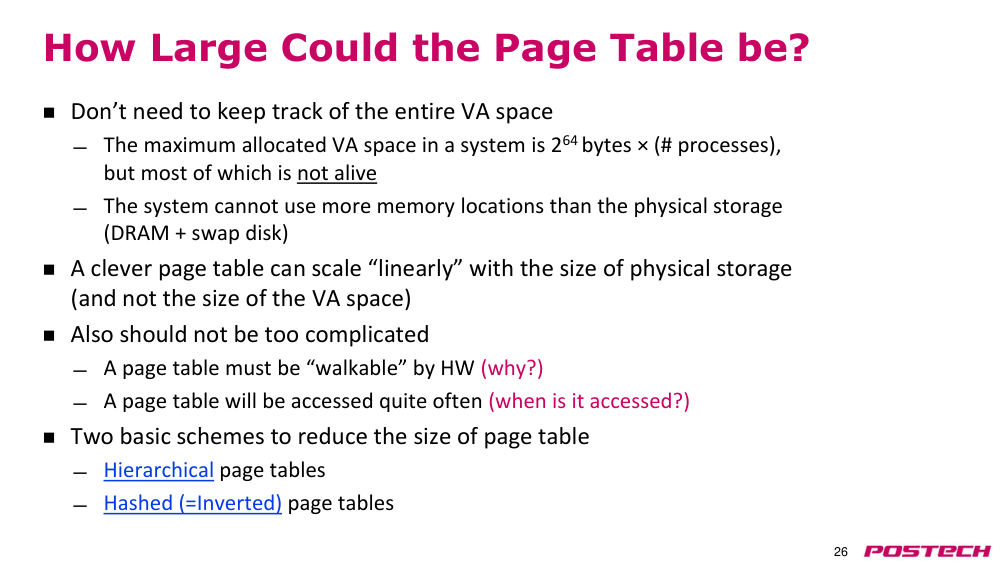
해결대부분 VA 는 쓰이지 않으므로 사용량에 비례하는 compact table 이 필요. 자주 walk 하므로 HW 가 walk 할 만큼 단순해야 한다.
- SW walk 는 instruction 실행 외에 exception 처럼 pipeline flush·context switch 비용이 크다
- 고성능 machine 은 HW walk. TLB miss 시에도 table 접근
2.1155:38–1:03:44hierarchical(multi-level) page table 과 best/worst case
상황·문제단일 거대 table 대신 작게 나눈 table 로 unused 영역을 없애고 싶다.
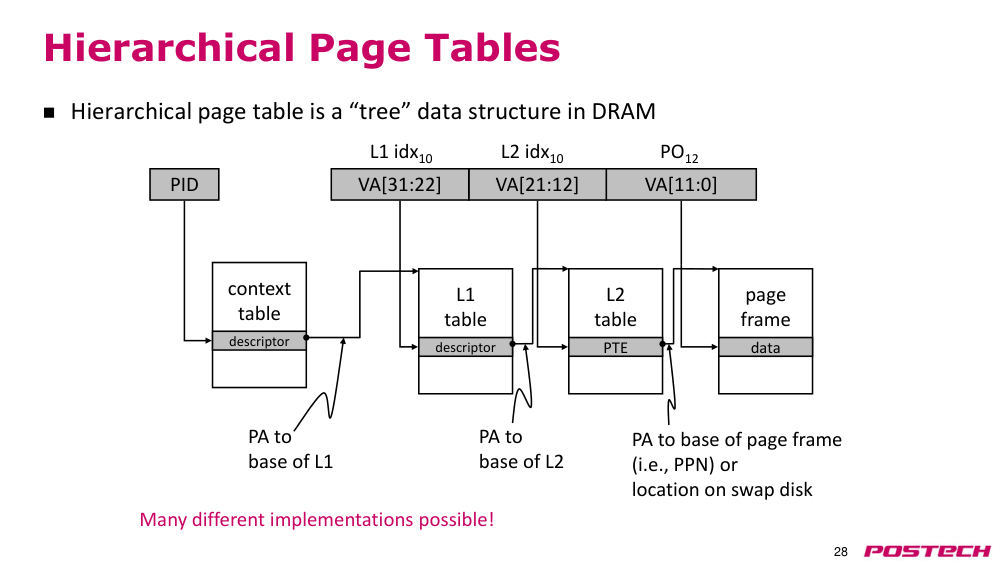
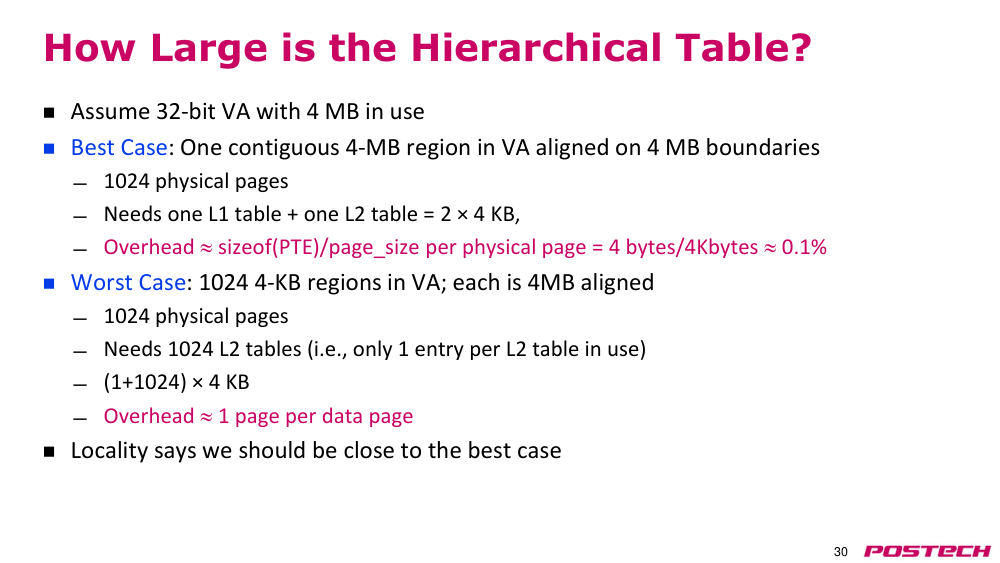
원인32bit VA 를 L1 index 10bit, L2 index 10bit, offset 12bit 로 나누면 table 은 각 1024 entry.
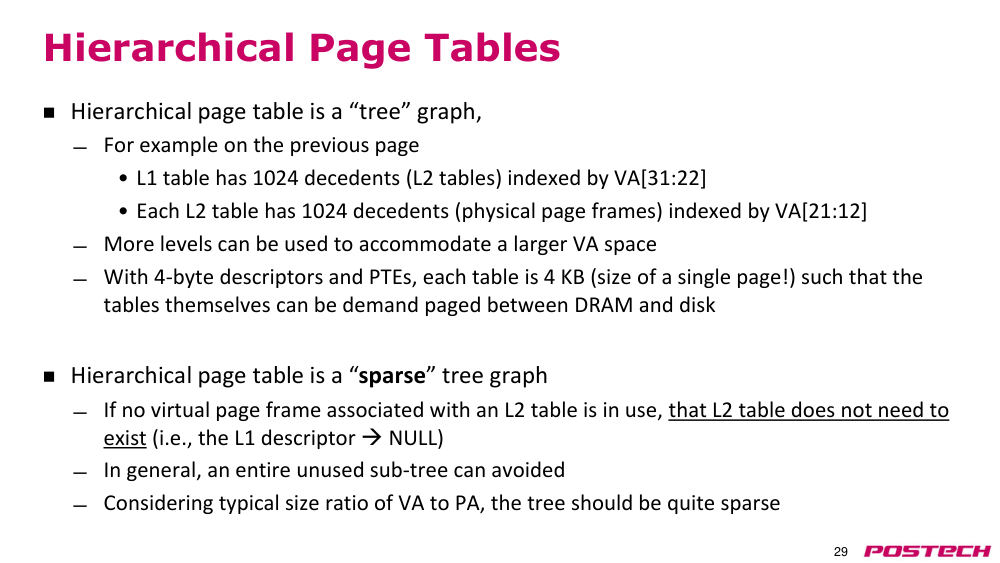
해결L1 entry 가 L2 table base 를 가리키고, 안 쓰는 L2 table 은 만들지 않는다(sparse tree). 4B×1024 = 4KB 라 table 자체도 page frame 에 두고 demand paging 가능.
- 4MB 사용 시 best: L1+L2 하나씩(연속 4MB)
- worst: L2 table 당 PTE 하나만 valid → L2 1024 개
- locality 때문에 보통 best 에 가깝다 (4MB array 는 L2 하나~둘)
2.121:03:44–1:10:16hashed(inverted) page table
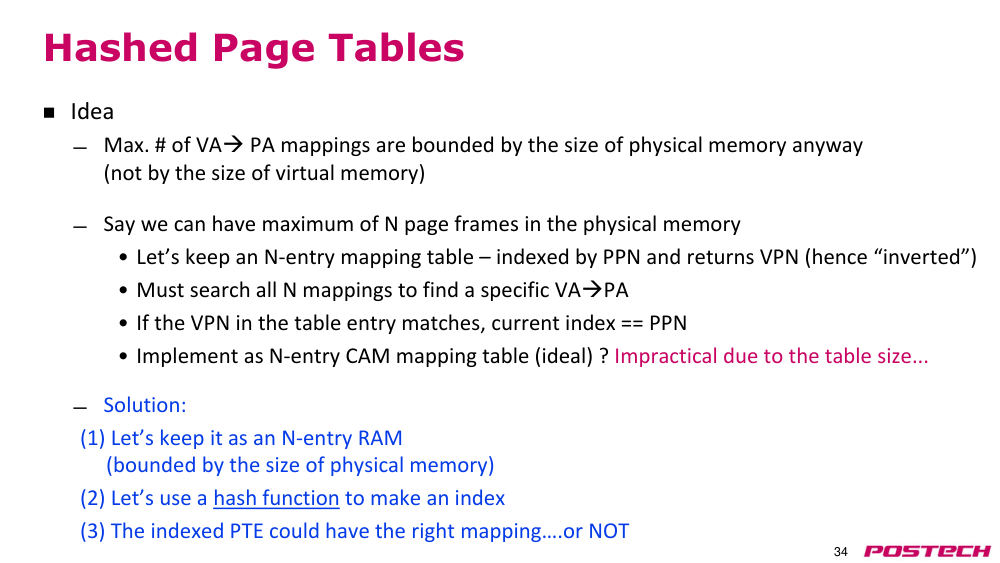
상황·문제VA→PA mapping 의 최대 수는 physical memory 크기로 제한되므로 frame 수만큼만 entry 를 두고 싶다.
원인inverted table 은 PPN 을 넣어 VPN 을 얻는 구조라, 가진 VPN 으로 찾으려면 N 개 entry 전부 검색해야 한다.
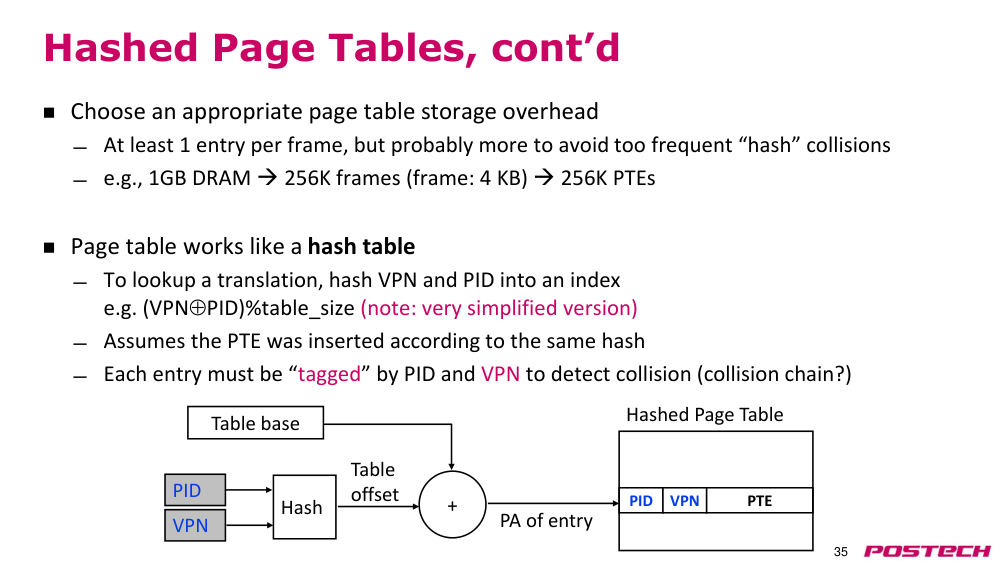
해결(VPN, PID)를 hash 해 index 를 얻고 base register 에 더해 entry 위치를 구함. entry 의 PID·VPN tag 로 일치 확인, collision 은 별도 처리.
- collision 을 줄이려 safety factor 2~3: 1GB 용 256K frame 대신 512K entry 등
- index 가 곧 PPN
2.131:10:16–1:15:18VM part 1 마무리, 질의응답(한국어): VA 와 inverted page table
상황·문제Jacob & Mudge 논문 읽기 권장 후 질문을 받음. 학생이 VA/PA 방향을 반대로 이해한 질문.
원인program 의 pointer·array 주소, load instruction 의 주소는 모두 VA. DRAM 접근에는 PA 가 필요.
해결page table 은 VPN→PPN, inverted 는 반대라 전체를 봐야 하므로 hash 로 page frame 위치를 정한다. disk 에서 page 를 올릴 때도 hash 로 frame 을 정하고 기존 것을 evict.
- p10 그림에 LD x6, x7(0x123) 예시를 판서하며 설명
2.13.r.1Jacob & Mudge, Virtual Memory: Issues of Implementation (IEEE Computer 1998) ↗ · 강의가 읽기를 권한 논문, VM 설계 공간 정리
2.141:15:18–1:18:42Lecture 16: TLB 도입
상황·문제매 memory access 마다 VA→PA translation 이 필요하다.
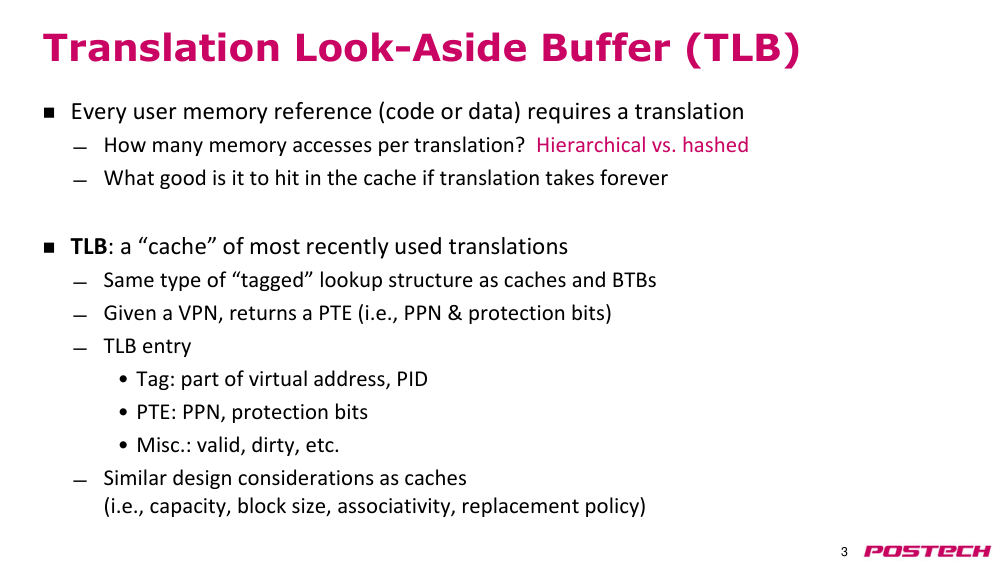
원인page table 도 memory 에 있어 translation 에 memory access 가 필요하고, multi-level 이면 load 하나에 여러 번 access.
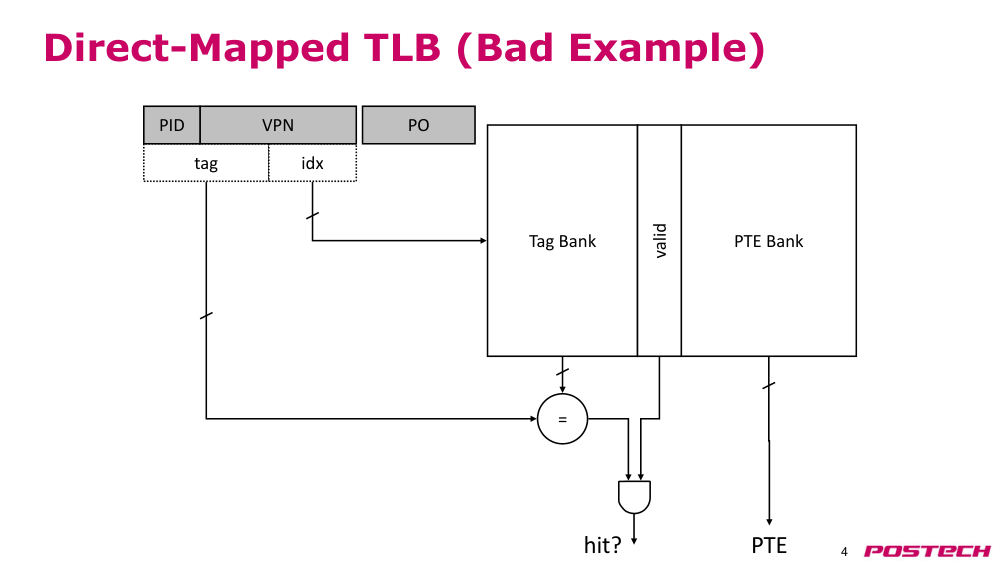
해결최근 쓴 PTE 를 cache 하는 TLB(Translation Look-aside Buffer). tag 로 VPN(+PID) 비교, data 는 PTE(PPN·protection bit), valid·dirty bit 등.
- cache·BTB 와 같은 tagged lookup 구조
- capacity·block size·associativity·replacement 등 cache 와 같은 설계 고려
2.14.r.2OSTEP Ch.19 Paging: Faster Translations (TLBs) ↗ · TLB 동작·HW vs SW-managed miss·ASID 를 교재 수준으로
2.151:18:42–1:23:27direct-mapped TLB 예와 TLB 설계
상황·문제TLB 를 cache 처럼 설계할 때 크기·block size·associativity 를 정해야 한다.
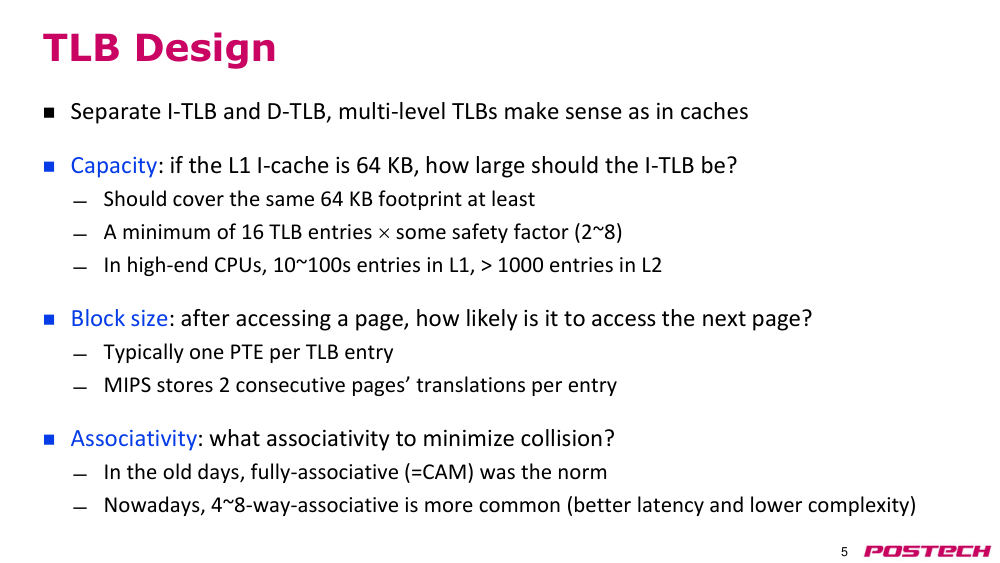
원인L1 TLB 는 L1 cache 가 담는 page 를 커버해야 한다: 64KB I-cache = 16 page → 최소 16 entry, line 이 더 많은 page 에서 올 수 있어 여유 필요.
해결PID+VPN 일부로 index·tag 비교(direct-mapped). split I/D TLB, L1/L2 TLB. 보통 TLB entry 당 PTE 1개(MIPS 는 2개), 옛날 fully-associative 에서 L1 4~8 way 로.
- 고성능 CPU: L1 TLB 수십~수백 entry, L2 는 훨씬 많음
- TLB 이야기는 다음 강의에서 계속
3핵심 개념
3.1segment(세그먼트)
base·bound 로 정의되는 연속 영역. process 마다 여러 개, segment table 로 SN→base·bound.
3.2external fragmentation(외부 단편화)
free 공간은 충분하지만 연속되지 않아 할당 못 함. paging 이 제거.
3.3internal fragmentation(내부 단편화)
page 단위 할당으로 page 안에 남는 낭비. 4 byte 에 4KB.
3.4large page(huge page)
MB·GB page. internal fragmentation 은 늘지만 PTE 수가 줄어 translation 이 쉬워짐.
3.6hierarchical page table(계층적 페이지 테이블)
L1 index→L2 table→PTE 의 sparse tree. 안 쓰는 L2 table 생략, table 도 page 크기.
3.7hashed(inverted) page table
frame 수만큼 entry, (VPN,PID) hash 로 index, index 가 PPN. PID·VPN tag 로 확인.
3.8TLB(Translation Look-aside Buffer)
최근 PTE 만 cache 하는 tagged 구조. VPN(+PID) 입력, PTE 출력.
4스스로 확인
4.1base and bound 방식의 두 한계는?
답
fragmentation 으로 연속 공간 확보가 어렵고, 일부 영역만 공유할 수 없다.
4.2large page 의 장점과 단점은?
답
PTE 수가 줄어 translation(TLB) 이 쉬워진다. 대신 internal fragmentation 이 커진다.
4.3demand paging miss 는 SW 로 처리해도 되는데 cache miss 는 왜 안 되나?
답
page miss 는 드물고 penalty 가 이미 disk 급이라 SW 비용이 묻힌다. cache miss 를 SW 로 하면 수백 cycle 보다 훨씬 느려진다.
4.464bit VA, 4KB page, 40bit PA 에서 flat page table 크기는?
답
2^52 entry × 4B = 16×2^50 byte, process 하나당.
4.532bit VA 에서 4MB 사용 시 2-level table 의 best/worst?
답
best L1+L2 = 8KB, worst L1 + L2 1024 개 ≈ 4MB.
4.6page table walk 를 SW 로 하면 추가 비용은?
답
exception 처럼 pipeline flush 와 user↔OS context switch 비용이 든다.
4.764KB L1 I-cache 를 커버하려면 L1 I-TLB entry 는 최소 몇 개?
답
4KB page 기준 16 개. line 이 더 많은 page 에서 올 수 있어 여유를 둔다.
5참고 자료
5.5Jacob & Mudge, Virtual Memory: Issues of Implementation (IEEE Computer 1998) ↗ · 강의가 읽기를 권한 논문, VM 설계 공간 정리