이 자료를 쓰는 강의: 51 non-blocking cache·write policy·multi-level cache 와 virtual memory 도입 · 52 segment·paging·page table 구조와 TLB
Lec15-VM I
한국어판 강의자료 · 36쪽
p.1CSED311 컴퓨터구조 – 강의 15
- virtual memory(가상 메모리) I
- 김광선
- 컴퓨터공학과
- POSTECH
- 면책 조항: 슬라이드는 Carnegie Mellon University, University of Michigan, Purdue University, University of Pennsylvania, University of Wisconsin의 교수진 Austin, Brehob, Falsafi, Hill, Hoe, Lipasti, Martin, Roth, Shen, Smith, Sohi, Tyson, Vijaykumar, Mutlu, Wenisch의 일부 자료를 바탕으로 개발됨
p.2현대 virtual memory(가상 메모리)의 두 가지 구성 요소
- 다중 작업 시스템에서 가상 메모리(Virtual Memory, VM)는 각 프로세스에게 큰, 개인용, 균일한 메모리의 착각을 제공한다.
- 제1부: 이름 지정과 보호
- 각 프로세스는 구멍이 없는 큰 연속된 메모리 segment(세그먼트)를 보게 된다 ("가상" address space(주소 공간)은 사용 가능한 물리적 저장소보다 훨씬 크다).
- 각 프로세스의 메모리 공간은 개인용이므로, 다른 프로세스의 접근으로부터 보호된다.
- 제2부: 요청 기반 페이지링(Demand Paging)
- 보조 저장소(disk(디스크)의 swap space(스왑 공간))의 용량
- 주 저장소(DRAM)의 속도
p.3기구: address translation(주소 변환)
- 가상 메모리(Virtual Memory)는 보호와 demand paging(요청 기반 페이지링)을 동일한 하드웨어 기구인 주소 변환(Address Translation)을 통해 구현한다.
- 사용자 프로세스는 "효과 주소"(Effective Address, EA)를 사용하여 동작한다.
- 하드웨어는 모든 메모리 참조 시 EA를 PA(물리 주소)로 변환한다.
- 프로세스가 이름 지을 수 있는 물리적 위치(DRAM 및/또는 스왑 디스크)를 제어한다.
- 물리적 백업 저장소(DRAM 대신 스왑 디스크)의 dynamic relocation(동적 재배치)를 허용한다.
- OS는 address translation(주소 변환) 하드웨어와 정책을 제어한다.
- 특권 운영: 사용자로부터 보호됨
p.4메모리 보호의 진화
- 초기 기계들은 보호와 address translation(주소 변환)의 개념이 없었다.
- 단일 프로세스, 단일 사용자이므로 필요 없음
- → 자동으로 "개인용이고 균일한" (그러나 매우 크지 않음)
- 프로그램은 physical address (PA)(물리 주소)를 직접 사용함
- → 다중 작업 보호 필요 없음
- 다중 작업 101
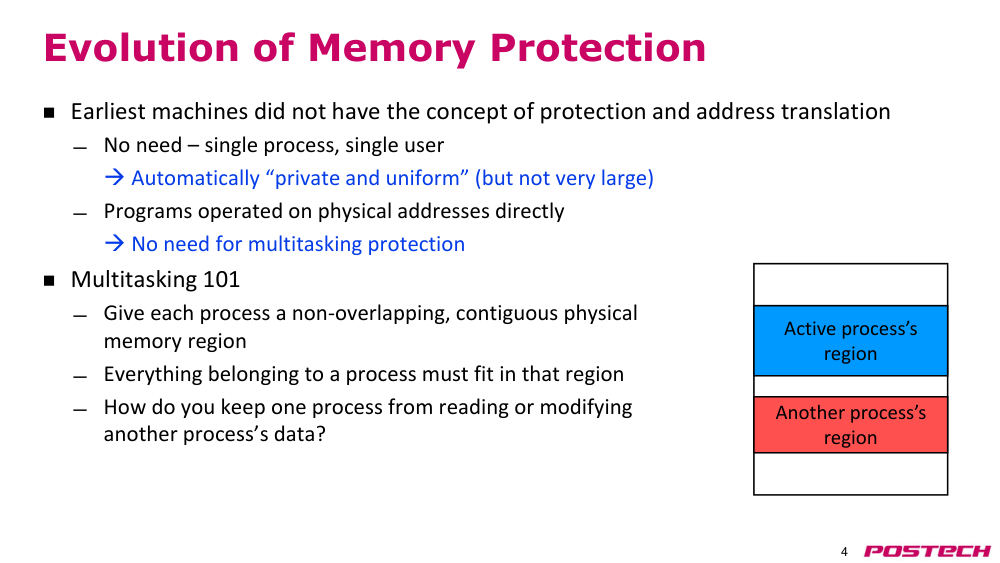
- 각 프로세스에게 겹치지 않는 연속된 physical memory(물리 메모리) 영역을 제공한다.
- 프로세스에 속하는 모든 것이 그 영역에 맞아야 한다.
- 한 프로세스가 다른 프로세스의 데이터를 읽거나 수정하는 것을 어떻게 막을 수 있는가?
- 활성 프로세스의 영역
- 다른 프로세스의 영역
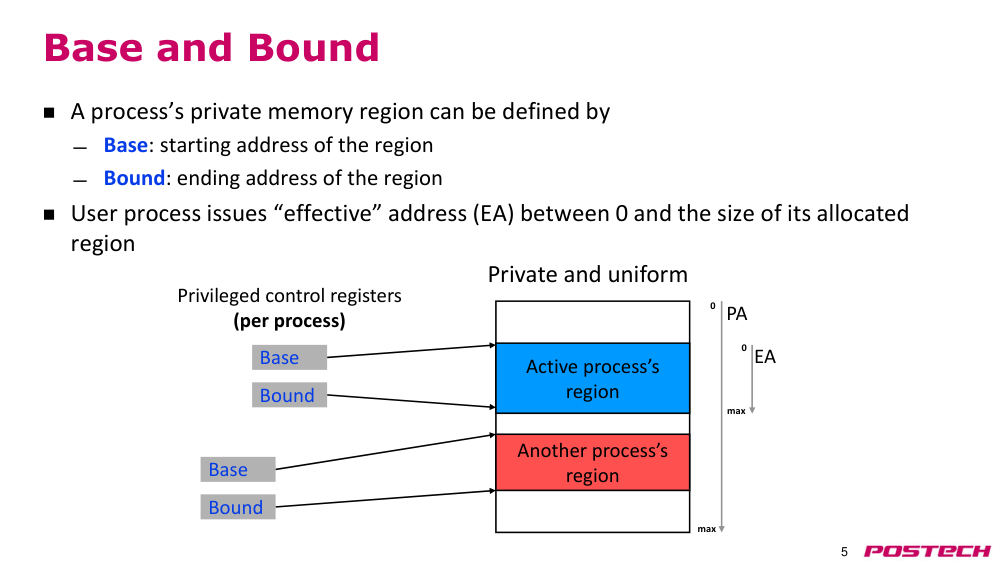
p.5베이스와 바운드
- 프로세스의 개인 메모리 영역은 다음과 같이 정의될 수 있다.
- 베이스: 영역의 시작 주소
- 바운드: 영역의 끝 주소
- 사용자 프로세스는 할당된 영역 크기 내에서 0부터 최대값까지의 "효과 주소"(EA)를 발행한다.
- 활성 프로세스의 영역
- 다른 프로세스의 영역
- 베이스
- 바운드
- 특권 제어 레지스터 (프로세스별)
- PA
- EA
- 최대값
- 0
- 0
- 최대값
- 베이스
- 바운드
- 개인용이고 균일한
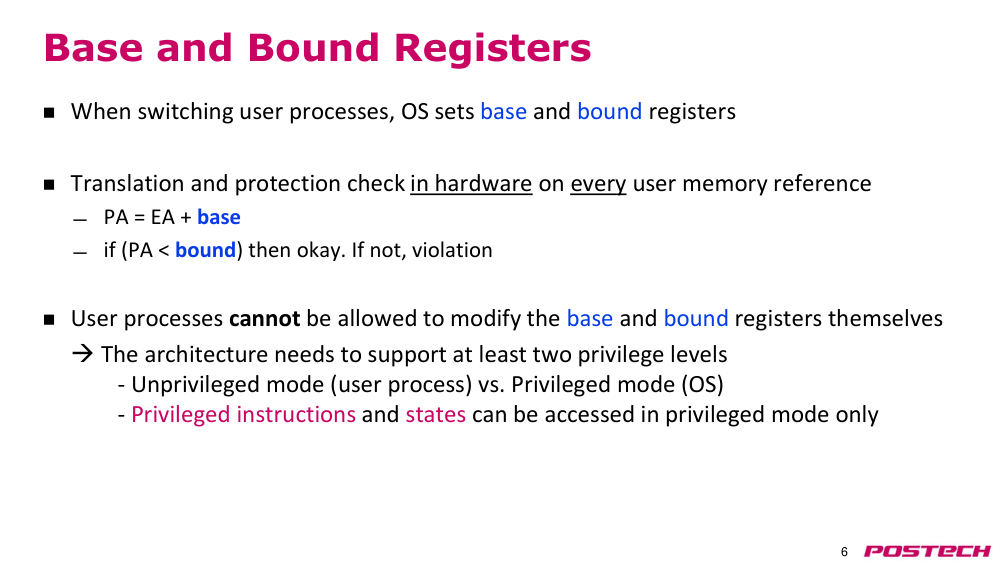
p.6베이스 및 bound register(바운드 레지스터)
- 사용자 프로세스를 전환할 때 OS는 베이스 및 bound register(바운드 레지스터)를 설정한다.
- 모든 사용자 메모리 참조 시 하드웨어에서 변환 및 보호 검사를 수행한다.
- PA = EA + 베이스
- 만약 (PA < 바운드)이면 허용. 그렇지 않으면 위반
- 사용자 프로세스가 베이스 및 bound register(바운드 레지스터)를 직접 수정하는 것을 허용해서는 안 된다.
- → 아키텍처는 최소한 두 가지 특권 수준을 지원해야 한다.
- - unprivileged mode(비특권 모드)(사용자 프로세스) 대 privileged mode(특권 모드)(OS)
- - privileged instruction(특권 명령어) 및 상태는 privileged mode(특권 모드)에서만 접근 가능
p.7segment(세그먼트) 기반 address space(주소 공간)
- 베이스 및 바운드 방식의 한계
- fragmentation(단편화) – 시스템이 일정 시간 동안 실행된 후에는 큰 연속 공간을 확보하기 어려움 – 사용 가능한 공간이 단편화될 수 있음
- 공유 – 두 프로세스가 일부 메모리 영역만 공유하고 다른 부분은 공유하지 않도록 할 수 있는가?
- 베이스 & 바운드 쌍은 보호의 단위임
- → 사용자에게 여러 개의 메모리 'segment(세그먼트)'를 제공하자
- 각 segment(세그먼트)는 연속된 영역임
- 각 segment(세그먼트)는 베이스 및 바운드 쌍으로 정의됨
- 과거에는 코드와 데이터 segment(세그먼트)를 별도로 분리함
- 명령어 및 데이터 참조에 대해 각각 별도의 베이스-bound register(바운드 레지스터) 사용
- 읽기 전용 코드 segment(세그먼트)를 공유할 수 있음
- 나중에는 더 복잡해짐: 코드, 데이터, 스택 등
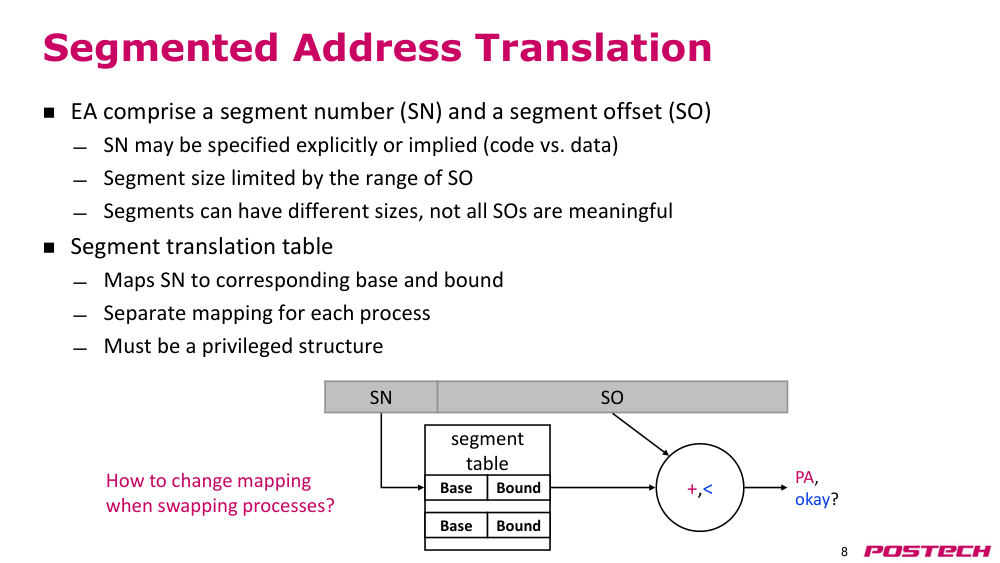
p.8segment(세그먼트) 기반 address translation(주소 변환)
- 효과 주소(EA)는 segment(세그먼트) 번호(SN)와 세그먼트 오프셋(SO)으로 구성됨
- SN은 명시적으로 지정되거나 암시적으로 지정될 수 있음 (코드 vs. 데이터)
- segment(세그먼트) 크기는 SO의 범위에 의해 제한됨
- segment(세그먼트)는 서로 다른 크기를 가질 수 있으며, 모든 SO가 의미 있는 것은 아님
- segment(세그먼트) 변환 테이블
- SN을 해당 베이스 및 바운드로 매핑함
- 각 프로세스에 대해 별도의 매핑이 필요함
- 특권 구조여야 함
- 프로세스 전환 시 매핑을 어떻게 변경할 것인가?
p.9보호는 어떻게 할까?
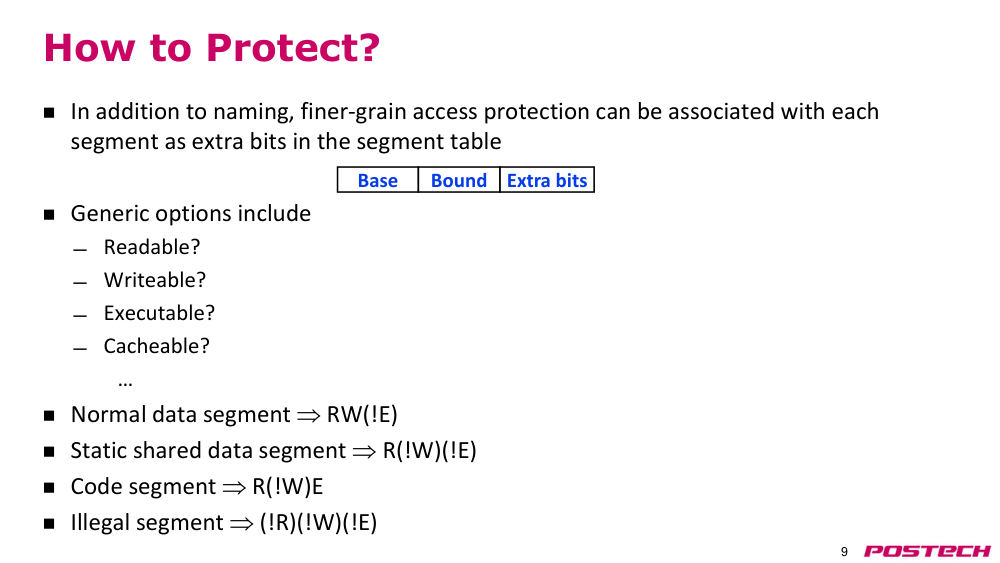
- 이름 외에도, segment table(세그먼트 테이블)에 각 segment(세그먼트)에 대해 더 세밀한 접근 보호를 추가 비트로 부여할 수 있음
- 일반적인 옵션 포함
- 읽기 가능?
- 쓰기 가능?
- 실행 가능?
- 캐시 가능?
- …
- 일반적인 데이터 segment(세그먼트) → R W (!E)
- 정적 공유 데이터 segment(세그먼트) → R (!W) (!E)
- 코드 segment(세그먼트) → R (!W) E
- 불법 segment(세그먼트) → (!R) (!W) (!E)
p.10페이지 기반 address space(주소 공간)
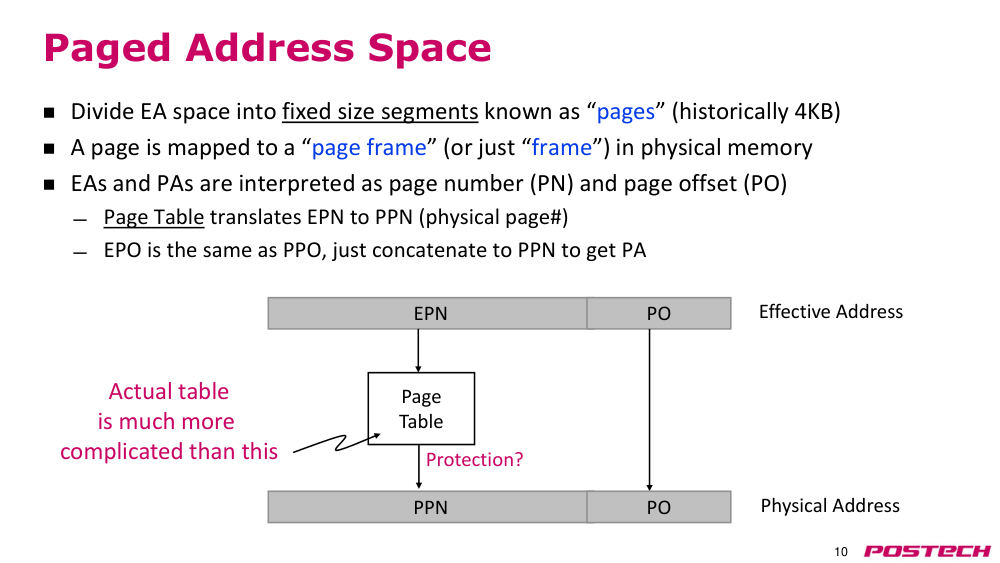
- effective address(EA)(효과 주소) 공간을 고정된 크기의 page(페이지)로 나누며, 이를 page(페이지)라고 함 (역사적으로 4KB)
- 페이지는 physical memory(물리 메모리) 내의 'page frame(페이지 프레임)' (또는 단순히 '프레임')에 매핑됨
- 효과 주소(EA)와 물리 주소(PA)는 페이지 번호(PN)와 페이지 오프셋(PO)으로 해석됨
- page table(페이지 테이블)은 EPN을 PPN(물리 페이지 번호)로 변환함
- EPO는 PPO와 동일하며, PPN과 연결하여 PA를 생성함
- 실제 page table(페이지 테이블)은 이보다 훨씬 복잡함
p.11fragmentation(단편화)
- external fragmentation(외부 단편화)
- 시스템은 충분한 미할당 DRAM을 보유하고 있지만, segment(세그먼트) 기반 시스템에서는 충분한 크기의 연속 영역이 형성되지 않으면 유용하지 않음
- 페이지 기반 메모리 관리는 external fragmentation(외부 단편화)을 제거한다
- internal fragmentation(내부 단편화)
- 메모리 할당은 페이지 단위(4KB)로만 이루어지며, 프로세스가 4바이트만 필요하더라도 마찬가지임
- 작은 페이지 크기는 internal fragmentation(내부 단편화)의 가능성을 줄임
- 현대의 ISA는 4KB 외에도 더 큰 페이지 크기(1MB 또는 1GB)를 사용 중임
- 왜 큰 페이지가 유리할까?
p.12demand paging(요청 기반 페이지링)
- 메인 메모리와 '스왑' 디스크를 memory hierarchy(메모리 계층)에서 자동으로 관리되는 레벨로 사용함
- (캐시 vs. 메인 메모리와 유사한 비유)
- 과거의 사례
- Von Neumann은 이미 수동 memory hierarchy(메모리 계층)을 설명함
- Brookner의 해석적 코드, 1960
- • 40KB 메인 메모리와 640KB 드럼 사이에서 페이지링을 관리하는 소프트웨어 인터프리터
- Atlas, 1962
- • 32 page(페이지)(page(페이지)당 512 word(워드)) 메인 메모리와 드럼에 192 page(페이지) 사이의 하드웨어 기반 demand paging(요청 기반 페이지링)
- • 사용자 프로그램은 192페이지를 가진 것으로 인식함
p.13demand paging(요청 기반 페이지링) vs. 캐시
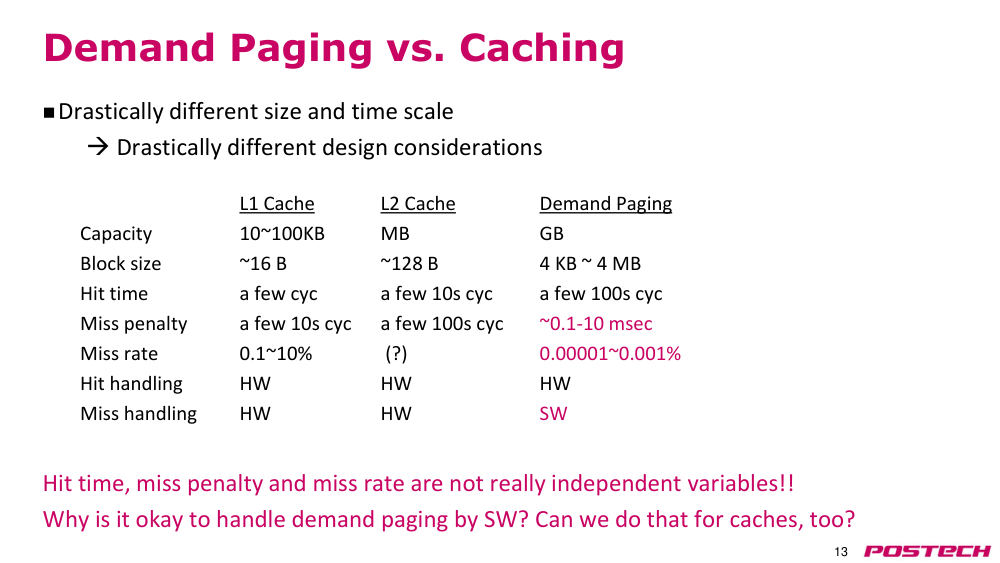
- 매우 다른 크기와 시간 척도
- → 매우 다른 설계 고려사항
- L1 캐시: 용량 10~100KB, 블록 크기 ~16B, hit time(히트 시간) 몇 사이클, miss penalty(미스 패널티) 몇 10 사이클, miss rate(미스 비율) 0.1~10%
- L2 캐시: 용량 MB, 블록 크기 ~128B, hit time(히트 시간) 몇 10 사이클, miss penalty(미스 패널티) 몇 100 사이클, 미스 비율 (?)
- demand paging(요청 기반 페이지링): 용량 GB, 블록 크기 4 KB ~ 4 MB, hit time(히트 시간) 몇 100 사이클, miss penalty(미스 패널티) ~0.1-10 msec, miss rate(미스 비율) 0.00001~0.001%
- 히트 처리: 하드웨어
- 미스 처리: 하드웨어 (L1, L2 캐시), 소프트웨어 (요청 기반 페이지링)
- hit time(히트 시간), miss penalty(미스 패널티), miss rate(미스 비율)은 사실상 독립 변수가 아니다!
- 왜 demand paging(요청 기반 페이지링)은 소프트웨어로 처리해도 되는가? 캐시에도 같은 방식을 적용할 수 있는가?
p.14SRAM 캐시와 동일한 기본 원리
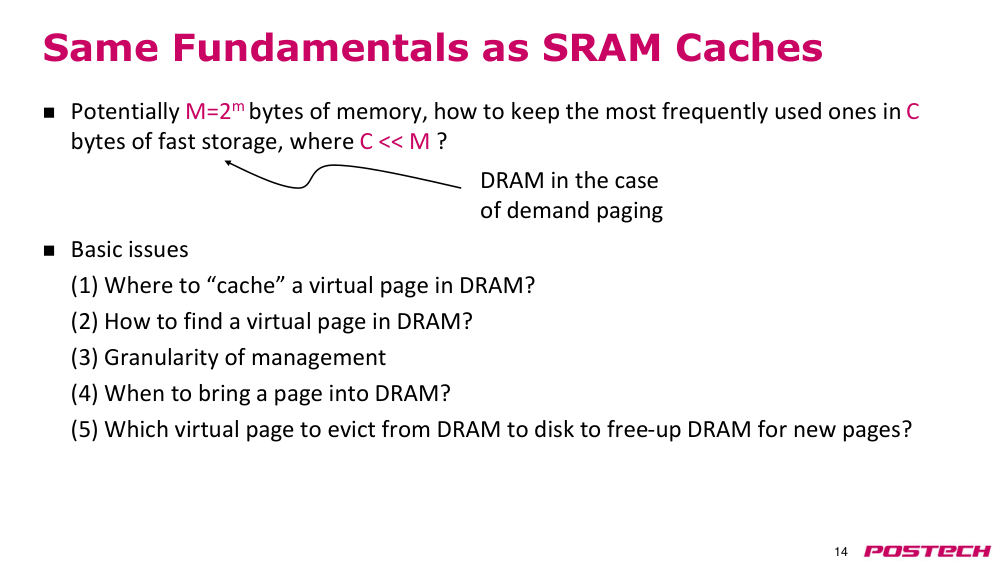
- 가능한 메모리 크기 M = 2^m bytes, 빠른 저장소 C bytes (C << M)에 자주 사용되는 데이터를 유지하려면?
- 기본적인 문제들
- (1) DRAM에 가상 페이지를 어디에 '캐시'할 것인가?
- (2) DRAM에 가상 페이지를 어떻게 찾을 것인가?
- (3) granularity of management(관리의 세분성)
- (4) 언제 페이지를 DRAM으로 불러올 것인가?
- (5) DRAM에서 디스크로 eviction(제거)할 가상 페이지는 무엇인가? (새 페이지를 위한 DRAM 공간 확보를 위해)
p.15용어 및 사용법
- 물리 주소 (PA): DRAM 또는 swap disk(스왑 디스크)의 특정 위치를 직접 참조하는 주소
- 효과 주소 (EA): 사용자 애플리케이션이 데이터 및 코드 접근을 위해 생성하는 주소
- 사용법은 주로 '보호'와 관련됨
- 가상 주소 (VA): 사용자 애플리케이션이 보는 큰 선형 메모리 공간의 주소
- 일반적으로 DRAM 및 swap disk(스왑 디스크) 용량보다 큼
- 일부 주소는 물리적 저장소에 의해 백업되지 않음
- 사용법은 주로 'demand paging(요청 기반 페이지링)'과 관련됨
- 현대 메모리 시스템은 항상 보호와 페이지링을 모두 지원함
- "EA"와 "VA"는 종종 서로 교환 가능하게 사용됨
p.16swap disk(스왑 디스크)를 V개의 페이지로 나누기
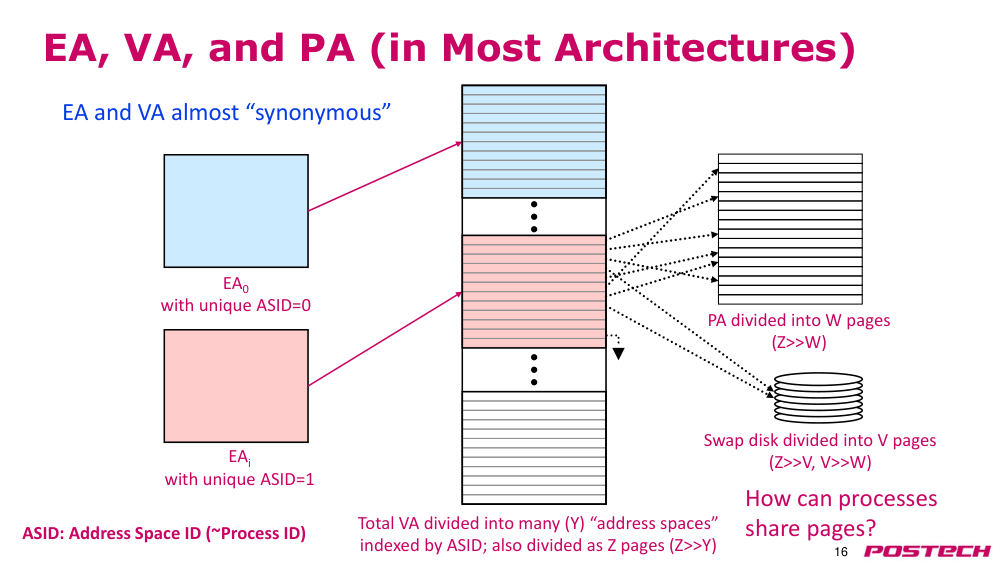
- swap disk(스왑 디스크)는 V개의 페이지로 나뉘며 (Z >> V, V >> W)
- 물리 주소 (PA)는 W개의 페이지로 나뉘며 (Z >> W)
- EA, VA, PA (대부분의 아키텍처에서)
- 전체 virtual address (VA)(가상 주소) 공간은 Y개의 "address space(주소 공간)"으로 나뉘며, ASID로 인덱싱됨. 또한 Z개의 페이지로 나뉨 (Z >> Y)
- ASID = 0인 EA0
- ASID = 1인 EAi
- EA와 VA는 거의 "동의어"와 같음
- 프로세스 간 페이지 공유는 어떻게 가능한가?
- ASID: address space(주소 공간) ID (~프로세스 ID)
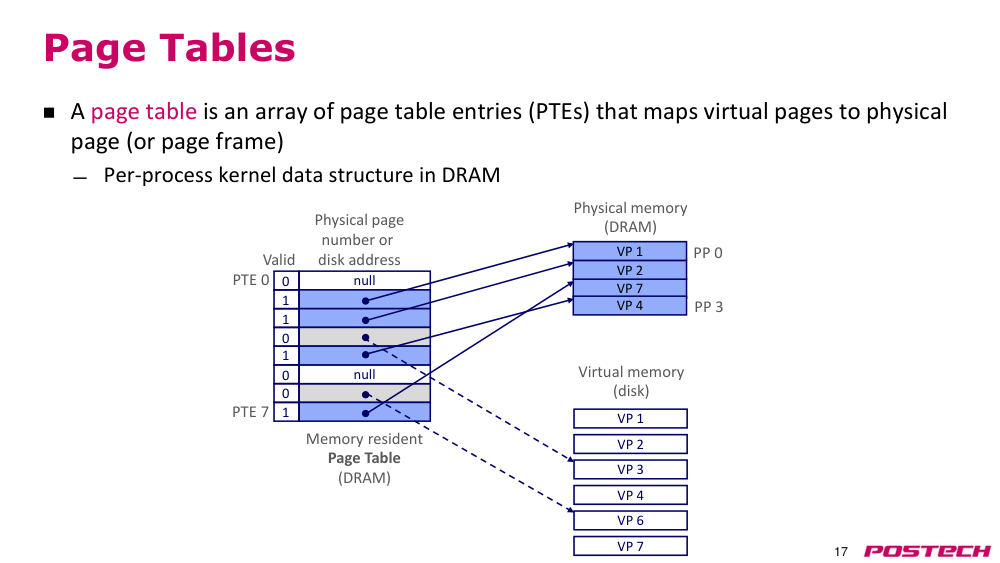
p.17page table(페이지 테이블)
- page table(페이지 테이블)은 가상 페이지를 물리 페이지(또는 페이지 프레임)로 매핑하는 페이지 테이블 항목(PTE)의 배열이다
- DRAM 내의 프로세스별 커널 데이터 구조
- memory resident(메모리 내에 존재하는) 페이지 테이블 (DRAM)
- 물리 메모리 (DRAM)
- 가상 페이지 번호 (VP) 7, 4, 2, 1, 6, 3
- valid bit(유효 비트): 0 또는 1
- physical page number (PPN)(물리 페이지 번호) 또는 디스크 주소
- PTE 0, PTE 7
- 물리 페이지 번호 (PP) 0, 3
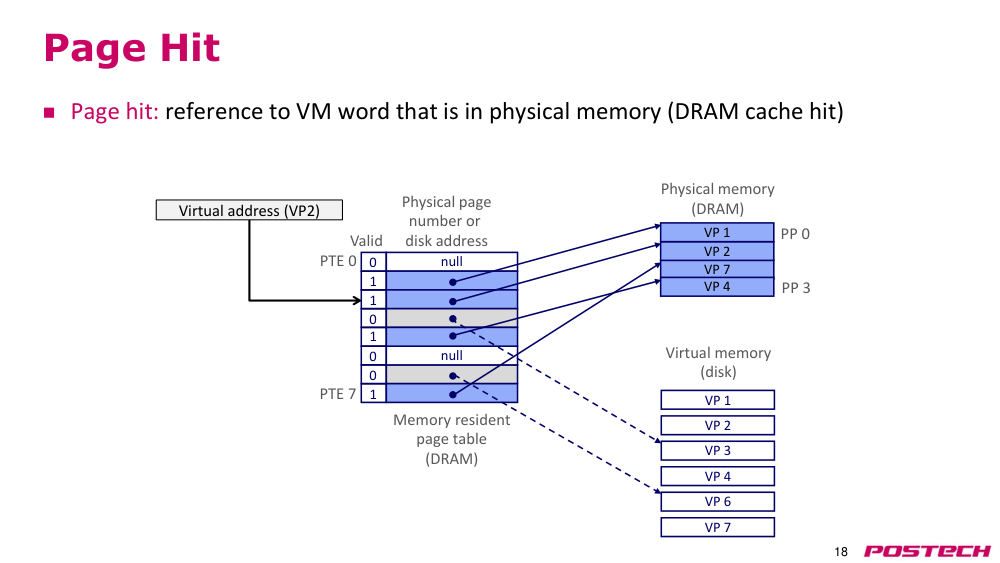
p.18page hit(페이지 히트)
- page hit(페이지 히트): 물리 메모리(DRAM)에 존재하는 virtual memory(가상 메모리) 단어에 대한 참조 (DRAM 캐시 히트)
- memory resident(메모리 내에 존재하는) 페이지 테이블 (DRAM)
- 물리 메모리 (DRAM)
- 가상 페이지 번호 (VP) 7, 4, 2, 1, 6, 3
- valid bit(유효 비트): 0 또는 1
- physical page number (PPN)(물리 페이지 번호) 또는 디스크 주소
- PTE 0, PTE 7
- 물리 페이지 번호 (PP) 0, 3
- 가상 주소 (VP2)
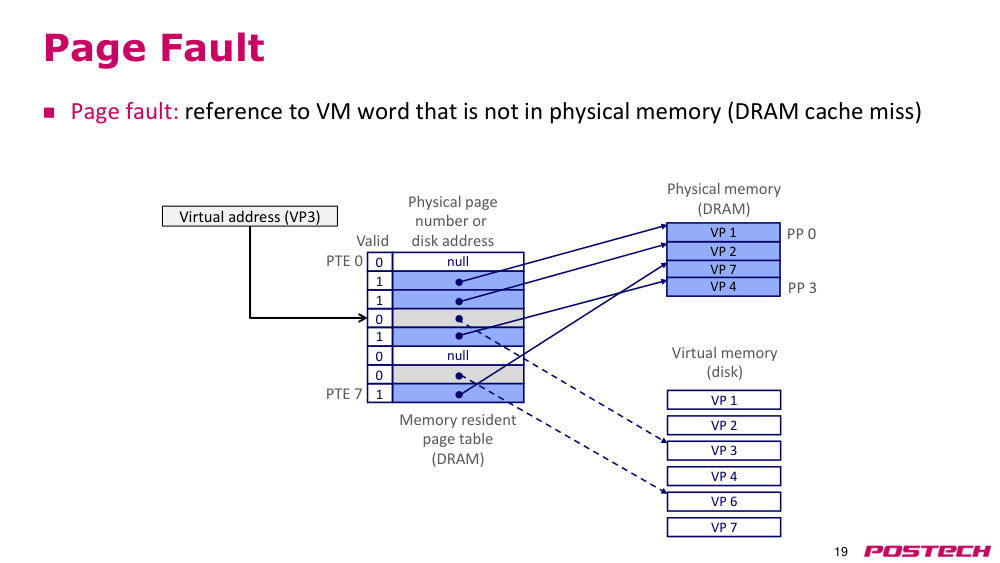
p.19page fault(페이지 폴트)
- page fault(페이지 폴트): 물리 메모리(DRAM 캐시 미스)에 없는 virtual memory(가상 메모리) 단어에 대한 참조
- memory resident(메모리 내에 존재하는) 페이지 테이블 (DRAM)
- 물리 메모리 (DRAM)
- 가상 메모리 (디스크)
- 가상 페이지 번호 (VP 7)
- 가상 페이지 번호 (VP 4)
- valid bit(유효 비트): 0, 1, 0, 1, 0, 1, 0, 1
- physical page number (PPN)(물리 페이지 번호) 또는 디스크 주소
- page table(페이지 테이블) 항목 (PTE 0)
- page table(페이지 테이블) 항목 (PTE 7)
- 물리 페이지 번호 (PP 0)
- 가상 페이지 번호 (VP 2)
- 가상 페이지 번호 (VP 1)
- 물리 페이지 번호 (PP 3)
- 가상 페이지 번호 (VP 1)
- 가상 페이지 번호 (VP 2)
- 가상 페이지 번호 (VP 4)
- 가상 페이지 번호 (VP 6)
- 가상 페이지 번호 (VP 7)
- 가상 페이지 번호 (VP 3)
- 가상 주소 (VP3)
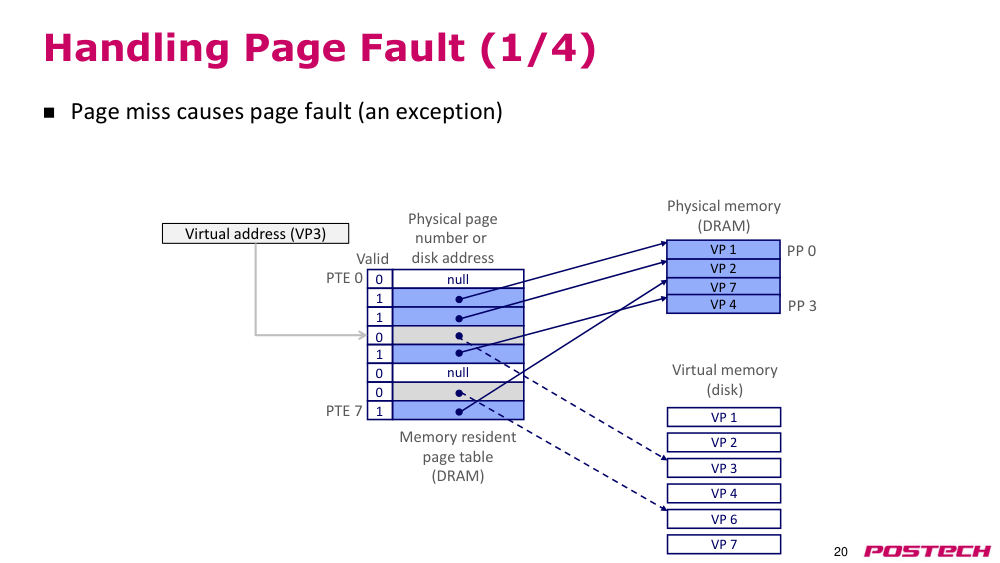
p.20page fault(페이지 폴트) 처리 (1/4)
- page miss(페이지 미스)는 page fault(페이지 폴트)(예외)을 유발함
- memory resident(메모리 내에 존재하는) 페이지 테이블 (DRAM)
- 물리 메모리 (DRAM)
- 가상 메모리 (디스크)
- 가상 페이지 번호 (VP 7)
- 가상 페이지 번호 (VP 4)
- valid bit(유효 비트): 0, 1, 0, 1, 0, 1, 0, 1
- physical page number (PPN)(물리 페이지 번호) 또는 디스크 주소
- page table(페이지 테이블) 항목 (PTE 0)
- page table(페이지 테이블) 항목 (PTE 7)
- 물리 페이지 번호 (PP 0)
- 가상 페이지 번호 (VP 2)
- 가상 페이지 번호 (VP 1)
- 물리 페이지 번호 (PP 3)
- 가상 페이지 번호 (VP 1)
- 가상 페이지 번호 (VP 2)
- 가상 페이지 번호 (VP 4)
- 가상 페이지 번호 (VP 6)
- 가상 페이지 번호 (VP 7)
- 가상 페이지 번호 (VP 3)
- 가상 주소 (VP3)
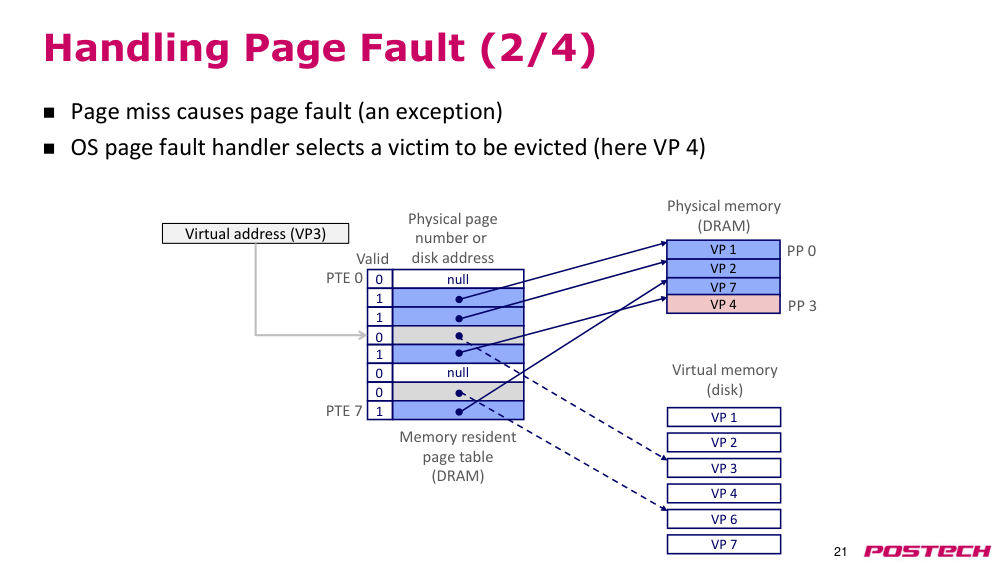
p.21page fault(페이지 폴트) 처리 (2/4)
- page miss(페이지 미스)는 page fault(페이지 폴트)(예외)을 유발함
- OS page fault handler(페이지 폴트 핸들러)는 eviction(제거)될 victim page(희생 페이지)를 선택함 (여기서는 VP 4)
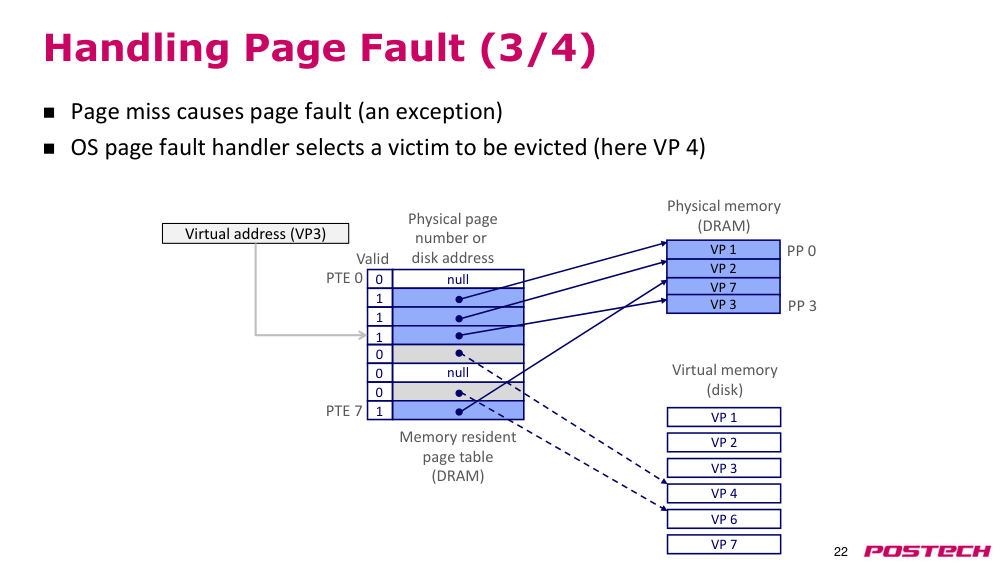
p.22page fault(페이지 폴트) 처리 (3/4)
- page miss(페이지 미스)는 page fault(페이지 폴트)(예외)을 유발함
- OS page fault handler(페이지 폴트 핸들러)는 eviction(제거)될 victim page(희생 페이지)를 선택함 (여기서는 VP 4)
- eviction(제거)된 페이지의 valid bit(유효 비트)는 0으로 설정됨
- 새로운 페이지의 valid bit(유효 비트)는 1로 설정됨
- 새로운 페이지의 physical page number (PPN)(물리 페이지 번호)는 PP 3으로 설정됨
- page table entry (PTE)(페이지 테이블 항목)의 physical page number (PPN)(물리 페이지 번호) 또는 디스크 주소가 업데이트됨
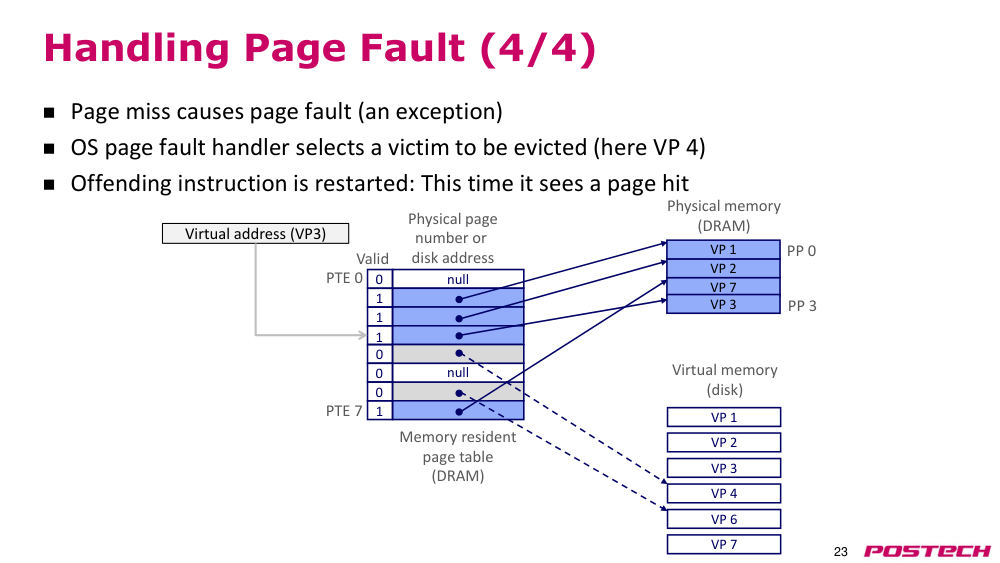
p.23page fault(페이지 폴트) 처리 (4/4)
- page miss(페이지 미스)는 page fault(페이지 폴트)(예외)을 유발함
- OS page fault handler(페이지 폴트 핸들러)는 eviction(제거)될 victim page(희생 페이지)를 선택함 (여기서는 VP 4)
- 오류 명령어는 재시작됨: 이번에는 page hit(페이지 히트)를 확인함
p.24page table(페이지 테이블) 크기 및 속도
- page table(페이지 테이블)에는 다음 정보가 포함됨:
- 가상 페이지 번호 (VPN) → 물리 페이지 번호 (PPN)
- protection bits(보호 비트): 사용자 수준? 공유?
- access types(접근 유형): dirty bit(더티 비트)? valid bit(유효 비트)?
- 각 프로세스는 고유한 page table(페이지 테이블)을 가져야 함
- page table(페이지 테이블)은 매우 클 수 있음
- 각 프로세스당 몇 개의 페이지 변환(VA→PA) 정보가 필요한가?
- page table(페이지 테이블)에 접근하는 것은 매우 느릴 수 있음
- L1 캐시에서 데이터를 읽기 위해 DRAM에 접근하는 것과 같은 문제
p.25page table(페이지 테이블)은 얼마나 클 수 있을까?
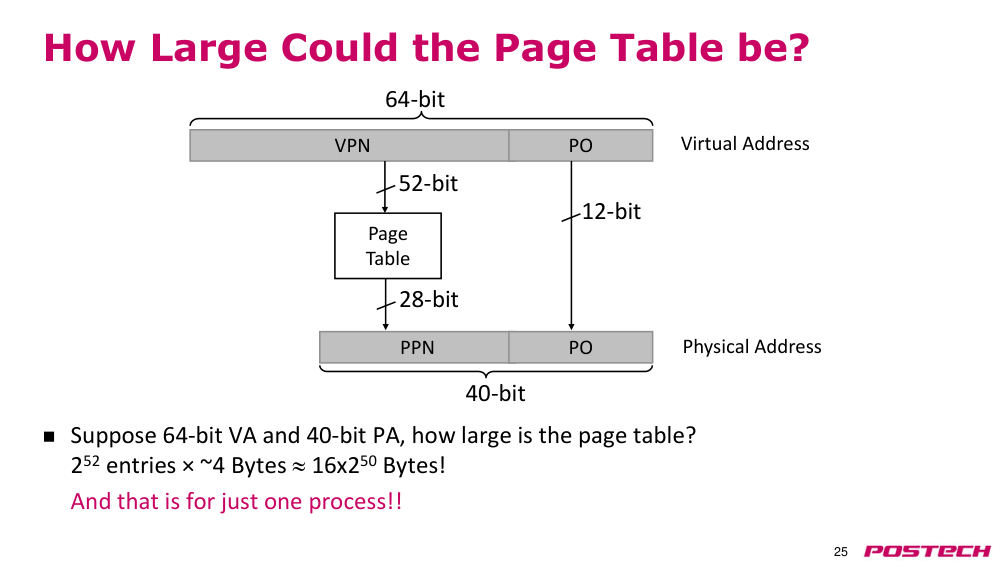
- 64비트 가상 주소(VA)와 40비트 물리 주소(PA)를 가정할 때, page table(페이지 테이블)의 크기는 얼마인가?
- 2^52개 항목 × 약 4 bytes(바이트) ≈ 16×2^50 bytes(바이트)!
- 그것도 단일 프로세스에 대한 것일 뿐이다!!
- virtual address (VA)(가상 주소): 64비트
- 페이지 오프셋(PO): 12비트
- 가상 페이지 번호(VPN): 52비트
- physical address (PA)(물리 주소): 40비트
- 물리 페이지 번호(PPN): 28비트
p.26page table(페이지 테이블)은 얼마나 클 수 있을까?
- 전체 virtual address (VA)(가상 주소) 공간을 추적할 필요는 없다.
- 시스템에서 할당된 최대 virtual address(VA)(가상 주소) 공간은 2^64 bytes(바이트) × (프로세스 수)이지만, 그 중 대부분은 활성화되어 있지 않다.
- 시스템은 물리 저장소(DRAM + 스왑 디스크)보다 더 많은 메모리 위치를 사용할 수 없다.
- 현명한 page table(페이지 테이블)은 물리 저장소 크기(가상 address space(주소 공간) 크기와는 무관하게)에 따라 "선형적으로" 확장될 수 있다.
- 또한 너무 복잡해서는 안 된다.
- page table(페이지 테이블)은 하드웨어에 의해 "걷기"(walkable) 가능해야 한다. (왜?)
- page table(페이지 테이블)은 자주 접근된다. (언제 접근되는가?)
- page table(페이지 테이블) 크기를 줄이기 위한 두 가지 기본 방식:
- hierarchical page table(계층적 페이지 테이블)
- 해시(=역행) page table(페이지 테이블)
p.27page table(페이지 테이블) 크기를 줄이는 방법?
- hierarchical page table(계층적 페이지 테이블)
- multi-level page table(다단계 페이지 테이블)
p.28hierarchical page table(계층적 페이지 테이블)
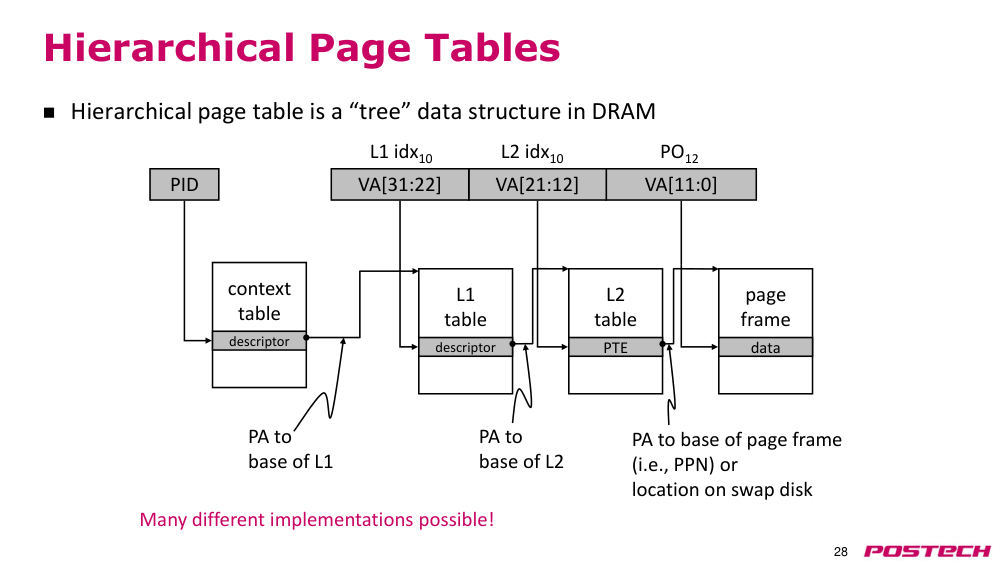
- hierarchical page table(계층적 페이지 테이블)은 DRAM 내의 "트리" 데이터 구조이다.
- 가상 주소(VA)의 비트 범위:
- VA[11:0] → 페이지 오프셋(PO)
- VA[21:12] → L2 테이블 인덱스
- VA[31:22] → L1 테이블 인덱스
- L1 테이블 디스크립터 → L2 테이블의 기준 주소
- L2 테이블 디스크립터 → page frame(페이지 프레임)의 기준 주소 (즉, PPN) 또는 swap disk(스왑 디스크)의 위치
- 데이터는 page frame(페이지 프레임)에 저장됨
- PID 및 컨텍스트 테이블 디스크립터도 존재할 수 있음
- 다양한 구현 방식이 가능하다!
- L1 인덱스: 10비트
- L2 인덱스: 10비트
- page offset (PO)(페이지 오프셋): 12비트
p.29hierarchical page table(계층적 페이지 테이블)
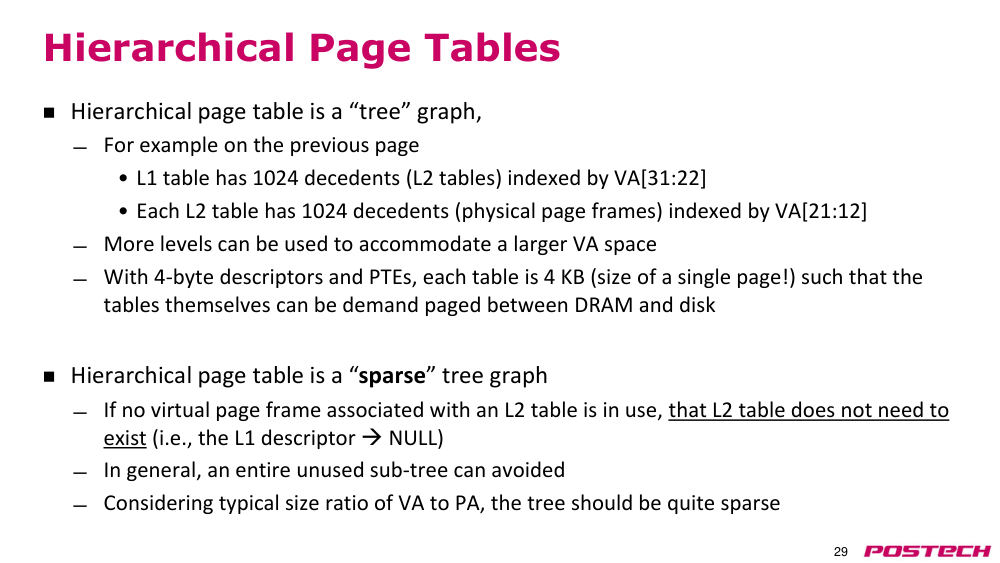
- hierarchical page table(계층적 페이지 테이블)은 "트리" 그래프 구조이다.
- 예를 들어 이전 페이지의 예시에서:
- • L1 테이블은 VA[31:22]로 인덱싱되는 1024개의 하위 노드(L2 테이블)를 가진다.
- • 각 L2 테이블은 VA[21:12]로 인덱싱되는 1024개의 하위 노드(물리 페이지 프레임)를 가진다.
- 더 큰 virtual address (VA)(가상 주소) 공간을 수용하기 위해 더 많은 레벨을 사용할 수 있다.
- 4바이트 디스크립터와 PTE를 사용할 경우, 각 테이블은 4KB(단일 페이지 크기)이며, 이 테이블들 자체도 DRAM과 디스크 사이에서 demand paging(요청 기반 페이지링)이 가능하다.
- hierarchical page table(계층적 페이지 테이블)은 "희소한" 트리 그래프이다.
- • L2 테이블과 연결된 가상 page frame(페이지 프레임)이 사용 중이지 않으면, 그 L2 테이블은 존재할 필요가 없다 (즉, L1 디스크립터 → NULL).
- 일반적으로 사용되지 않는 하위 트리 전체를 회피할 수 있다.
- virtual address (VA)(가상 주소) 공간과 physical address (PA)(물리 주소) 공간의 일반적인 크기 비율을 고려하면, 트리는 매우 희소해야 한다.
p.30계층적 테이블의 크기는 얼마나 되는가?
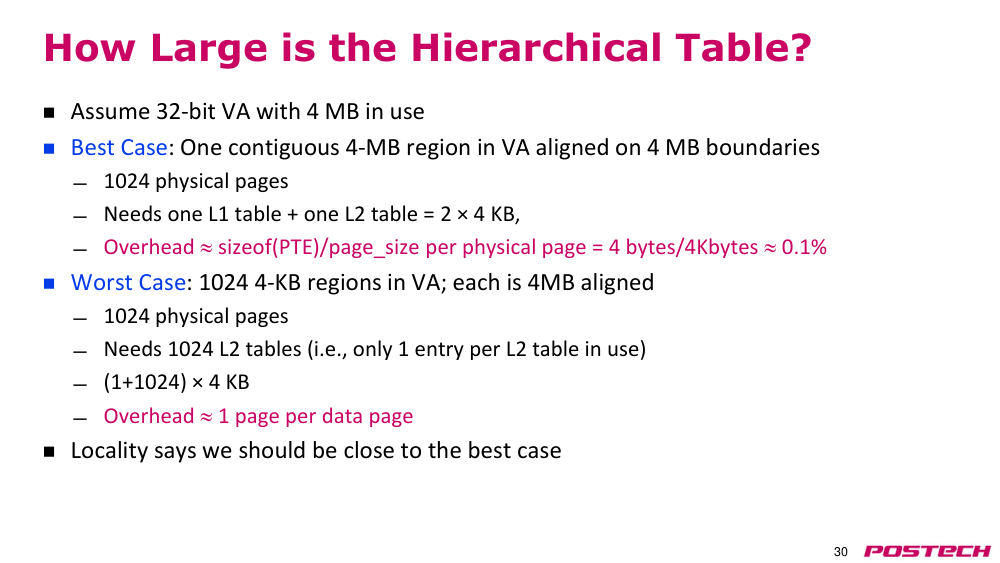
- 32비트 가상 주소(VA)를 가정하고, 4MB가 사용 중이라고 가정한다.
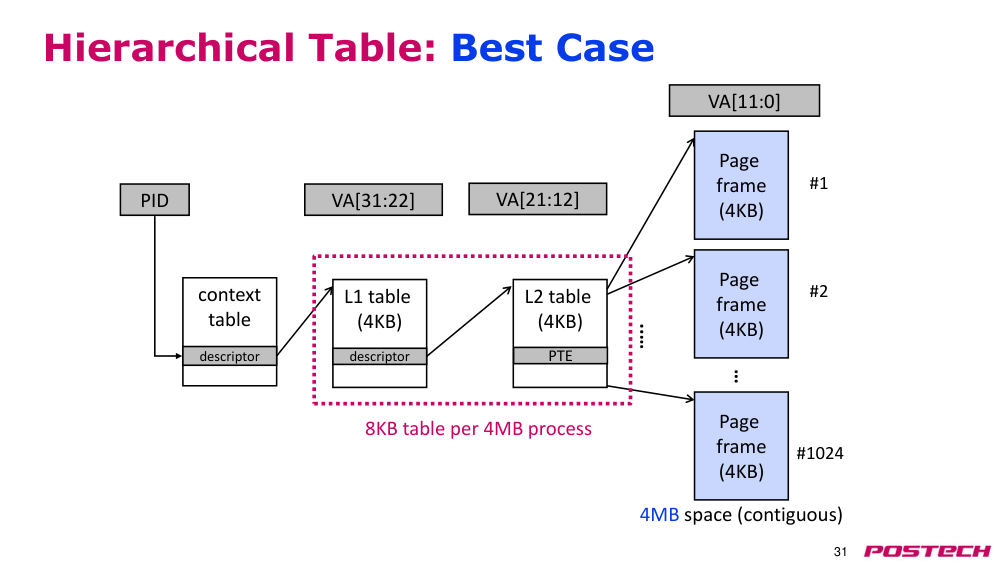
- 최선의 경우: virtual address (VA)(가상 주소) 공간 내에서 4MB 크기의 연속 영역이 4MB 경계에 맞춰져 있다.
- • 1024개의 물리 페이지
- • L1 테이블 1개 + L2 테이블 1개 필요 → 2 × 4KB
- • 오버헤드 ≈ PTE 크기 / 페이지 크기 = 4바이트 / 4KB ≈ 0.1%
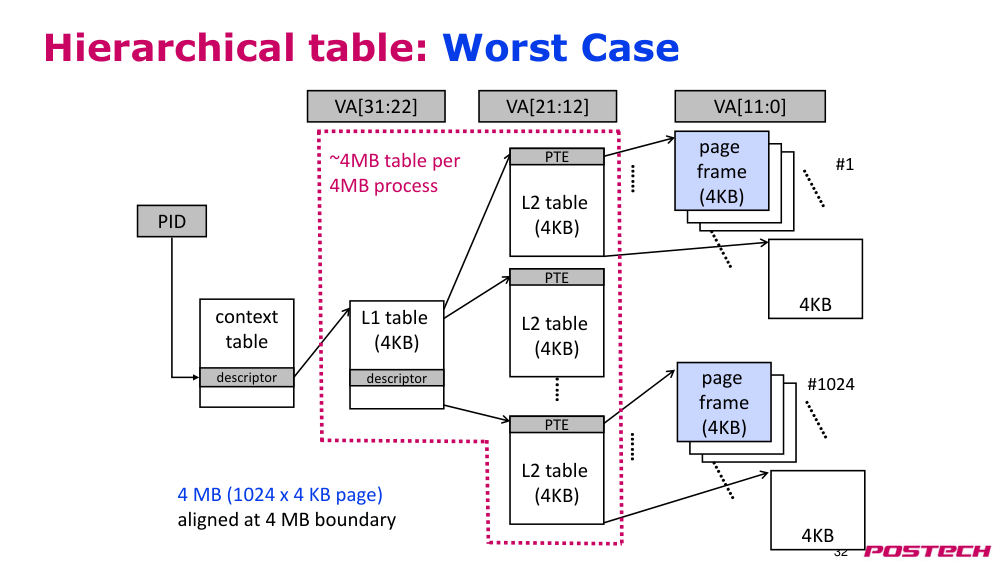
- 최악의 경우: virtual address (VA)(가상 주소) 공간 내에서 1024개의 4KB 영역이 각각 4MB 경계에 맞춰져 있다.
- • 1024개의 물리 페이지
- • L2 테이블 1024개 필요 (각 L2 테이블에 하나의 항목만 사용됨)
- • (1 + 1024) × 4KB
- • 오버헤드 ≈ 데이터 페이지당 1페이지
- 국소성에 따르면, 최선의 경우에 가까워야 한다.
p.31계층적 테이블: 최선의 경우
- VA[11:0]
- VA[21:12]
- VA[31:22]
- L1 테이블 (4KB) 디스크립터
- L2 테이블 (4KB) PTE
- 페이지 프레임 (4KB)
- PID 컨텍스트 테이블 디스크립터
- ...
- 페이지 프레임 (4KB)
- 페이지 프레임 (4KB)
- ...
- #1
- #2
- #1024
- 4MB 프로세스당 8KB 테이블
- 연속적인 4MB 공간
p.32계층적 테이블: 최악의 경우
- VA[11:0]
- VA[21:12]
- VA[31:22]
- L1 테이블 (4KB) 디스크립터
- PID 컨텍스트 테이블 디스크립터
- ...
- #1
- 4MB (1024 x 4KB 페이지) – 4MB 경계에 정렬됨
- L2 테이블 (4KB)
- 4KB 페이지 프레임 (4KB)
- #1024
- 4KB 페이지 프레임 (4KB)
- ……
- PTE
- L2 테이블 (4KB)
- PTE
- L2 테이블 (4KB)
- PTE
- 약 4MB 테이블 per 4MB 프로세스
p.33page table(페이지 테이블) 크기를 줄이는 방법?
- hashed page table(해시 페이지 테이블) (a.k.a. inverted page table(역행 페이지 테이블))
p.34hashed page table(해시 페이지 테이블)
- Idea
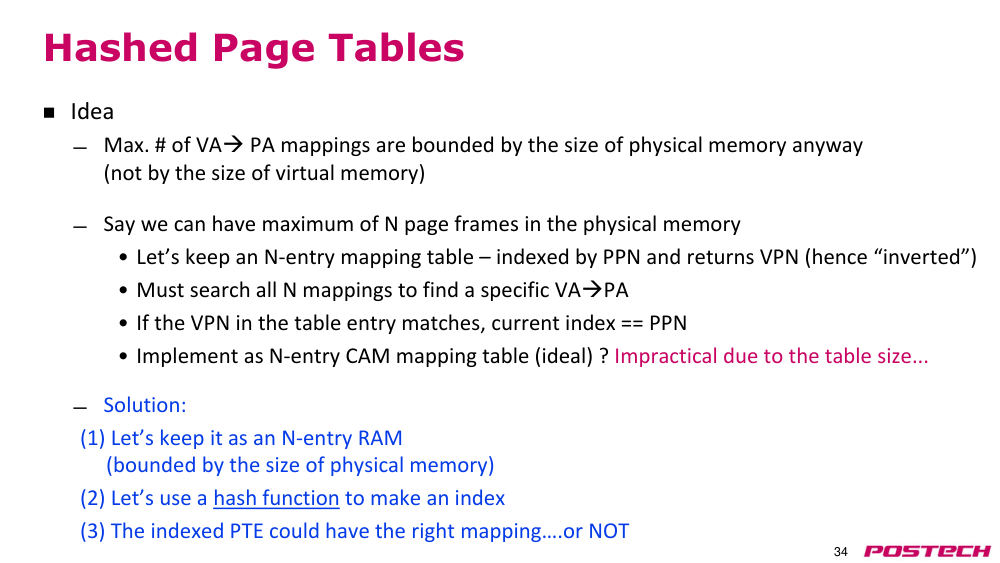
- virtual address (VA)(가상 주소) → physical address (PA)(물리 주소) 매핑의 최대 수는 physical memory(물리 메모리) 크기에 의해 제한된다 (가상 메모리 크기에 의해 제한되지 않음)
- physical memory(물리 메모리)에 최대 N개의 page frame(페이지 프레임)을 가질 수 있다고 가정하자
- • N개 항목의 매핑 테이블을 유지하자 – PPN으로 인덱싱하고 VPN을 반환한다 (따라서 '역행'이라 함)
- • 특정 VA → PA를 찾기 위해 N개의 매핑을 모두 검색해야 한다
- • 테이블 항목의 VPN이 일치하면 현재 인덱스 == PPN
- • N개 항목의 CAM 매핑 테이블로 구현 (이상적)? 테이블 크기 때문에 비현실적...
- 해결책:
- (1) N개 항목의 RAM으로 유지 (물리 메모리 크기에 의해 제한됨)
- (2) 해시 함수를 사용하여 인덱스 생성
- (3) 인덱싱된 PTE는 올바른 매핑일 수도 있고, 아닐 수도 있음
p.35hashed page table(해시 페이지 테이블), 계속
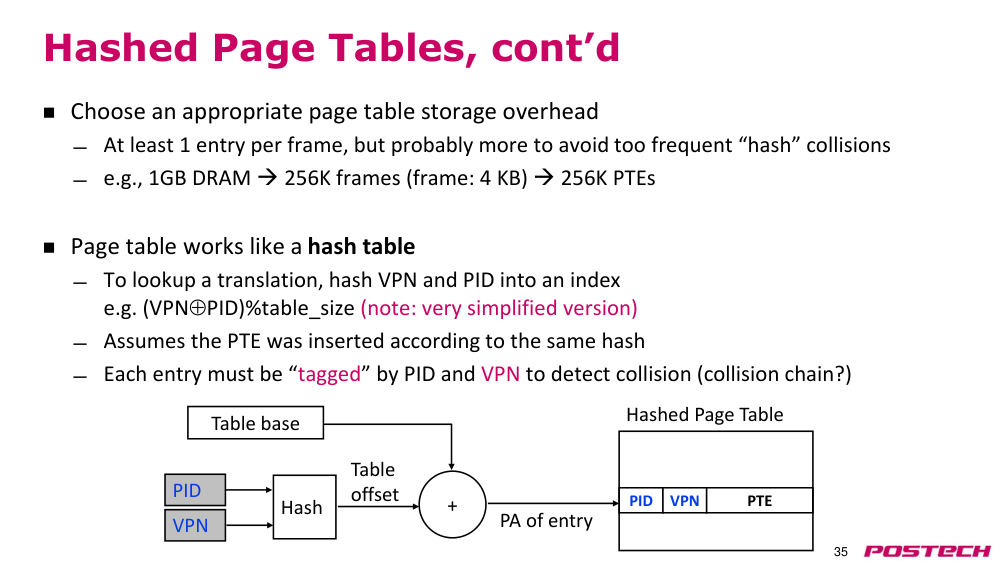
- 적절한 page table(페이지 테이블) 저장소 오버헤드 선택
- 최소한 프레임당 1개의 항목은 필요하지만, 해시 충돌이 너무 자주 발생하지 않도록 더 많은 항목이 필요할 수 있음
- 예: 1GB DRAM → 256K 프레임 (프레임 크기: 4KB) → 256K PTEs
- page table(페이지 테이블)은 해시 테이블과 유사하게 작동
- 변환을 검색하려면 VPN과 PID를 해시하여 인덱스 생성
- 예: (VPN ⊕ PID) % table_size (매우 단순화된 버전)
- PTE가 동일한 해시 방식으로 삽입되었다고 가정
- 각 항목은 충돌을 탐지하기 위해 PID와 VPN으로 태그되어야 함 (충돌 체인?)
- VPN
- PID
- 테이블 베이스
- 해시
- 테이블 오프셋
- +
- 엔트리의 PA
- PID
- VPN
- PTE
- hashed page table(해시 페이지 테이블)
p.36질문?
- 공지사항
- - 교재 읽기: P&H Ch 5.7
- - 논문 읽기: “Virtual Memory: Issues of Implementation”, B. L Jacob and T. N. Mudge., IEEE Computer, 1998