Lec16-VM II
한국어판 강의자료 · 22쪽
p.1
p.2page table(페이지 테이블) 접근 지연을 줄이기 위한 방법
- address translation latency(주소 번역 지연)을 줄이기 위해
- 변환 색인 버퍼(TLB) 사용
p.33 변환 색인 버퍼(TLB)
- 모든 사용자 메모리 참조(코드 또는 데이터)는 번역이 필요함
- 번역에 필요한 메모리 접근 횟수는? 계층적 vs. 해시
- 번역이 무척 오래 걸린다면 캐시에서 히트해도 소용없음
- TLB: 최근에 사용된 번역의 '캐시'
- 캐시와 BTB와 유사한 '태그' 기반 검색 구조
- 가상 페이지 번호(VPN)를 입력하면 page table(페이지 테이블) 엔트리(PTE)를 반환함 (즉, 물리 페이지 번호(PPN) 및 보호 비트)
- TLB 엔트리
- • 태그: virtual address (VA)(가상 주소)의 일부, 프로세스 ID(PID)
- • PTE: PPN, 보호 비트
- • 기타: 유효(valid), dirty bit(더티 비트) 등
- 캐시와 유사한 설계 고려사항
- (즉, capacity(용량), block size(블록 크기), associativity(연관성), replacement policy(교체 정책))
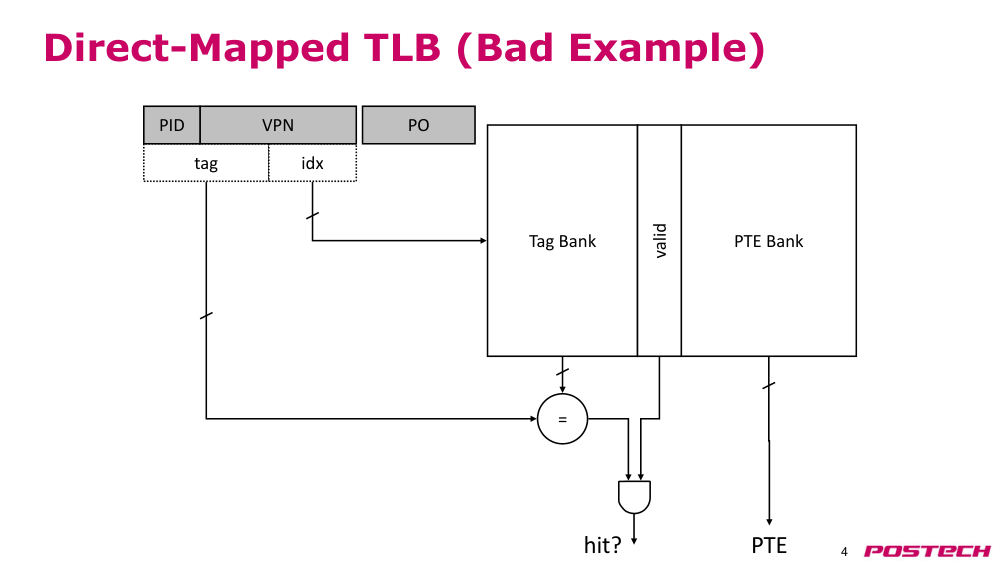
p.44 직접 매핑 TLB (나쁜 예시)
- PTE bank(뱅크)
- 태그
- 인덱스
- PTE
- =
- tag bank(태그 뱅크)
- 히트?
- 유효
- 가상 페이지 번호(VPN)
- 페이지 오프셋(PO)
- 프로세스 ID(PID)
p.55 TLB 설계
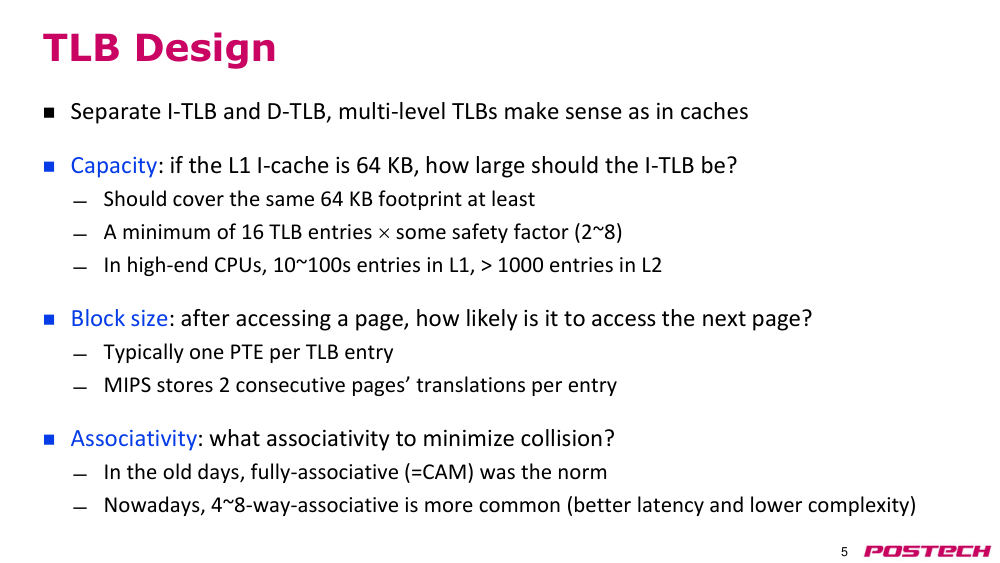
- I-TLB와 D-TLB를 분리하거나, multi-level TLB(다단계 TLB)를 사용하는 것이 캐시와 마찬가지로 타당함
- capacity(용량): L1 코드 캐시가 64 KB라면, I-TLB는 얼마나 커야 하는가?
- 적어도 64 KB의 영역을 커버해야 함
- 최소 16개의 TLB 엔트리 × safety factor(안전 계수)(2~8)
- 고성능 CPU에서는 L1에 10~100개 이상, L2에 1000개 이상의 엔트리 사용
- block size(블록 크기): 한 페이지에 접근한 후 다음 페이지를 접근할 가능성은 얼마나 높은가?
- 보통 TLB 엔트리당 1개의 PTE
- MIPS는 한 엔트리당 2개의 연속된 페이지 번역을 저장
- associativity(연관성): 충돌을 최소화하기 위해 어떤 연관성을 사용할 것인가?
- 과거에는 완전 연관성(CAM)이 일반적이었음
- 현재는 4~8방향 associativity(연관성)이 더 흔함 (더 낮은 지연과 낮은 복잡성)
p.66 TLB miss(TLB 미스) 발생 시
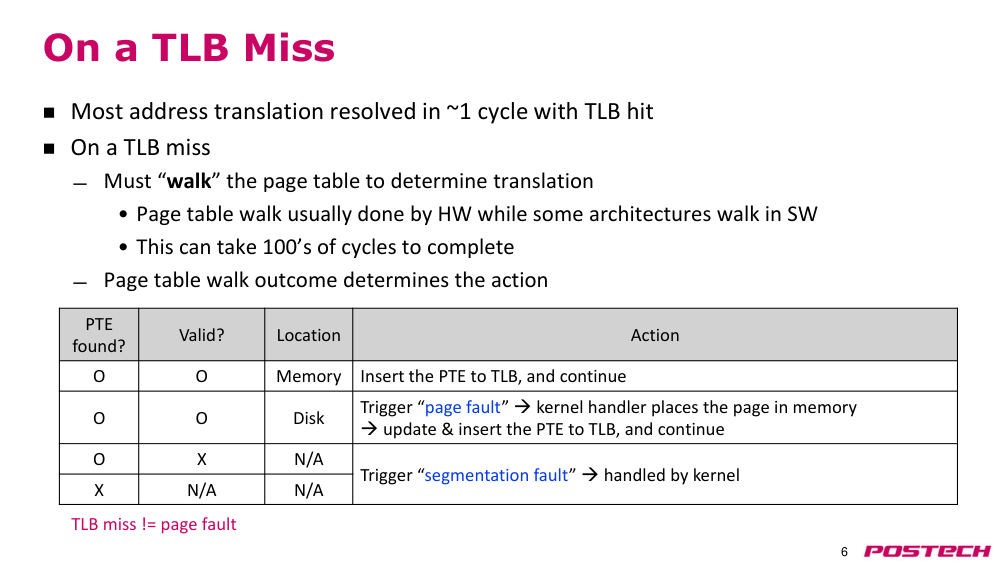
- TLB hit(TLB 히트) 시 대부분의 address translation(주소 번역)이 약 1 사이클 내에 완료됨
- TLB miss(TLB 미스) 발생 시
- page table(페이지 테이블)을 '워크'하여 번역을 결정해야 함
- • page table walk(페이지 테이블 워크)는 일반적으로 하드웨어(HW)에서 수행되며, 일부 아키텍처는 소프트웨어(SW)에서 수행함
- • 이 과정은 수백 사이클이 소요될 수 있음
- page table walk(페이지 테이블 워크) 결과에 따라 다음 동작 결정됨
- PTE 존재 여부?
- 유효 여부?
- 위치
- 행동
- O
- O
- main memory(주기억장치)
- PTE를 TLB에 삽입하고 계속 실행
- O
- O
- 디스크
- page fault(페이지 폴트) 발생 → 커널 핸들러가 페이지를 main memory(주기억장치)에 로드 → PTE 업데이트 및 TLB에 삽입 후 계속 실행
- O
- X
- N/A
- segmentation fault(세그멘테이션 폴트) 발생 → 커널에서 처리
- X
- N/A
- N/A
- TLB miss(TLB 미스) ≠ page fault(페이지 폴트)
p.7virtual address (VA)(가상 주소)에서 physical address (PA)(물리 주소)로의 변환
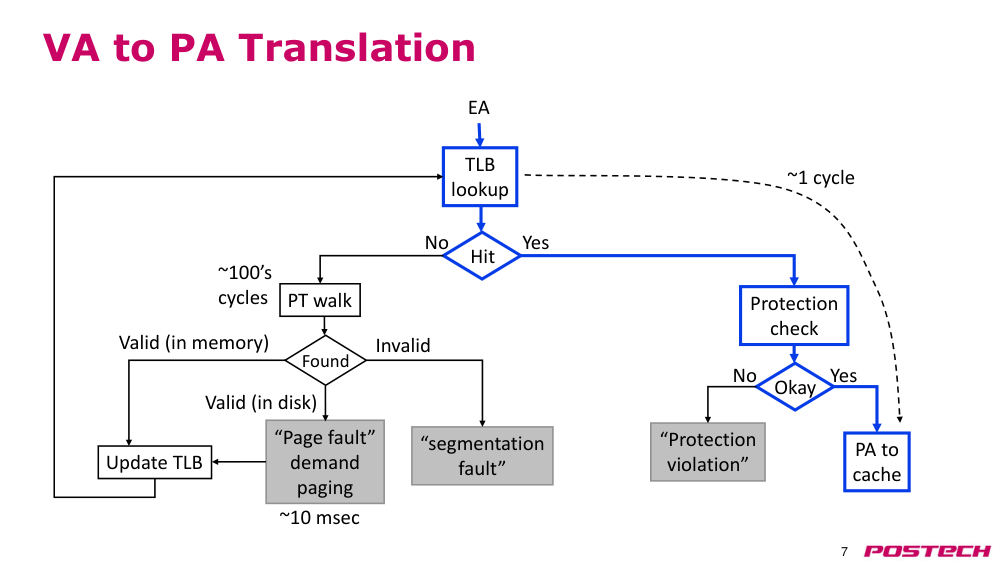
- 효과 주소 (EA)
- TLB 조회
- page table walk(페이지 테이블 워크)
- TLB 업데이트
- segmentation fault(세그멘테이션 폴트)
- 보호 검사
- 물리 주소 (PA) → 캐시
- 아니요
- 예
- protection violation(보호 위반)
- ~1 사이클
- ~100의 사이클
- ~10ms
- 히트
- 발견됨
- 무효
- 유효 (기억장치 내)
- 허용됨
- 아니요
- 예
- page fault(페이지 폴트)
- demand paging(요구 페이징)
- 유효 (디스크 내)
p.8하드웨어 또는 software-managed TLB(소프트웨어 관리 TLB)?
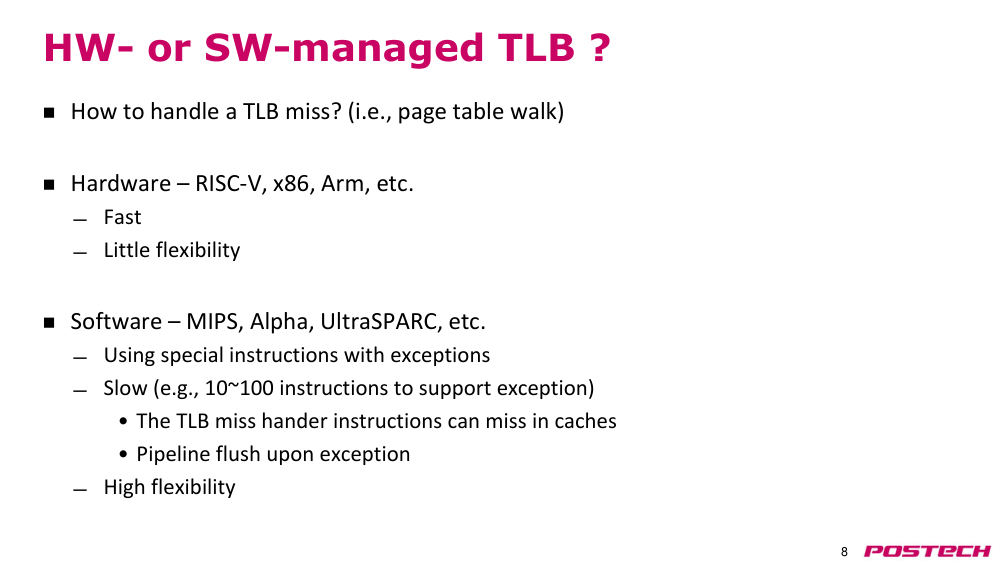
- TLB miss(TLB 미스)를 어떻게 처리할까? (즉, page table(페이지 테이블) 워크)
- 하드웨어 – RISC-V, x86, Arm 등
- 빠름
- 유연성 낮음
- 소프트웨어 – MIPS, Alpha, UltraSPARC 등
- 특수 명령어와 예외를 사용
- 느림 (예: 예외를 지원하기 위해 10~100개의 명령어 필요)
- TLB miss(TLB 미스) 핸들러 명령어도 캐시에서 미스 가능
- 예외 발생 시 파이프라인 flush(플러시)
- 높은 유연성
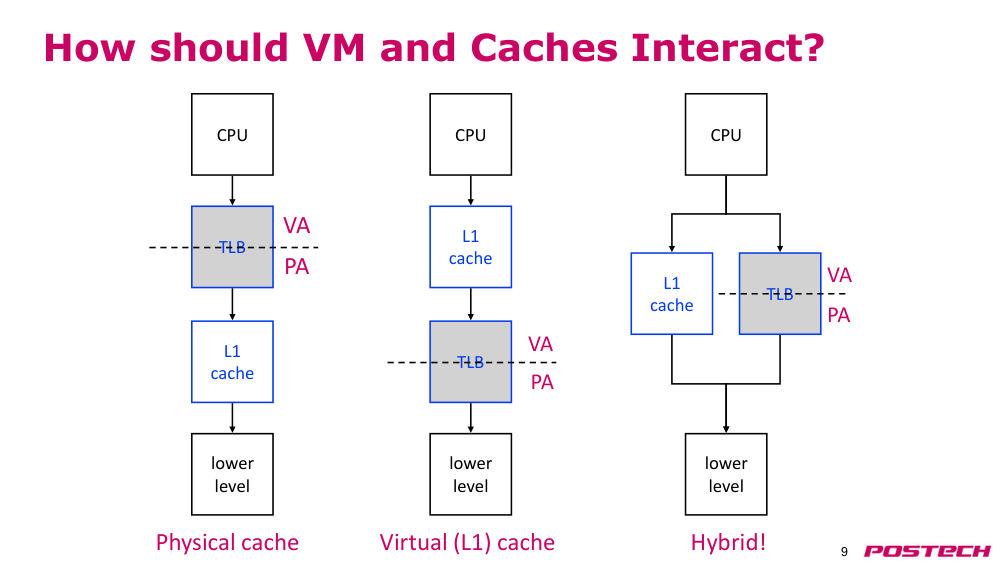
p.9virtual memory(가상 메모리)와 캐시는 어떻게 상호작용해야 할까?
- CPU
- TLB
- L1 cache(L1 캐시)
- 하위 레벨
- physical cache(물리 캐시)
- CPU
- L1 cache(L1 캐시)
- TLB
- 하위 레벨
- 가상 캐시 (L1)
- 가상 주소 (VA)
- 물리 주소 (PA)
- CPU
- L1 cache(L1 캐시)
- TLB
- 하위 레벨
- 하이브리드!
- 가상 주소 (VA)
- 물리 주소 (PA)
- 가상 주소 (VA)
- 물리 주소 (PA)
p.10L1 cache(L1 캐시)를 가상으로 사용할 수 있을까?
- TLB가 있더라도 여전히 address translation(주소 번역)에 시간이 소요됨
- 단순한 구현에서는 최선의 경우 메모리 접근 시간은 TLB hit(TLB 히트) 시간 + L1 cache(L1 캐시) hit time(히트 시간)
- 왜 캐시에 virtual address (VA)(가상 주소)로 접근하고, DRAM에 캐시 미스 시에만 번역하지 않을까?
- TLB hit(TLB 히트) 시간 >> L1 cache(L1 캐시) hit time(히트 시간)이라면 의미 있음
- SUN SPARC의 virtual cache(가상 캐시), 약 1990년대
- die 크기가 충분히 커져 L1 cache(L1 캐시) 통합 가능
- MMU와 TLB 여전히 별도 칩에 존재
- CPU 속도가 빨라져 외부 SRAM 접근이 너무 느림
- 그러나 이러한 조건은 더 이상 성립하지 않음
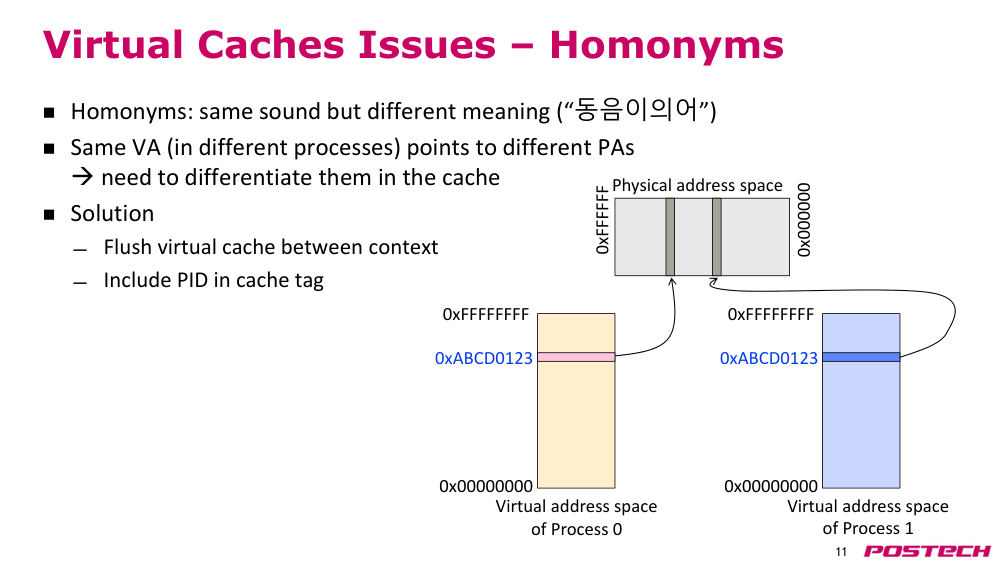
p.11virtual cache(가상 캐시)의 문제점 – homonyms(동음이의어)
- homonyms(동음이의어): 같은 발음이지만 다른 의미 ("동음이의어")
- 다른 프로세스에서 동일한 가상 주소(VA)가 서로 다른 물리 주소(PA)를 가리킴
- → 캐시에서 이를 구분해야 함
- 해결책
- context switch(컨텍스트 전환) 시 virtual cache(가상 캐시) flush(플러시)
- cache tag(캐시 태그)에 프로세스 ID(PID) 포함
- 0xABCD0123
- 0xFFFFFFFF
- 0x00000000
- 0xABCD0123
- 0xFFFFFFFF
- 0x00000000
- 프로세스 0의 virtual address (VA)(가상 주소) 공간
- 프로세스 1의 virtual address (VA)(가상 주소) 공간
- 0x000000
- 0xFFFFFF
- physical address (PA)(물리 주소) 공간
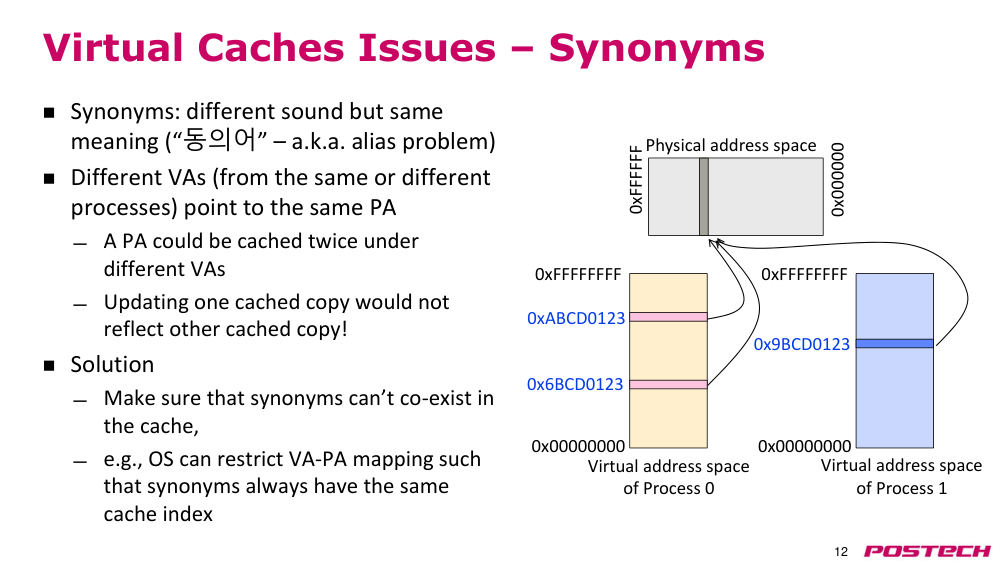
p.12virtual cache(가상 캐시)의 문제점 – synonyms(동의어)
- synonyms(동의어): 다른 발음이지만 같은 의미 ("동의어" – 별칭 문제)
- 같은 또는 다른 프로세스에서 다른 가상 주소(VA)가 동일한 물리 주소(PA)를 가리킴
- → 동일한 PA가 서로 다른 VA로 캐시에 두 번 저장될 수 있음
- 한 캐시 복사본을 업데이트해도 다른 복사본에는 반영되지 않음!
- 해결책
- synonyms(동의어)가 캐시에 동시에 존재하지 않도록 보장
- 예: OS가 VA-PA 매핑을 제한하여 synonyms(동의어)가 항상 동일한 cache index(캐시 인덱스)를 갖도록 함
- 0xABCD0123
- 0xFFFFFFFF
- 0x00000000
- 0x9BCD0123
- 0xFFFFFFFF
- 0x00000000
- 프로세스 0의 virtual address (VA)(가상 주소) 공간
- 프로세스 1의 virtual address (VA)(가상 주소) 공간
- 0x000000
- 0xFFFFFF
- physical address (PA)(물리 주소) 공간
- 0x6BCD0123
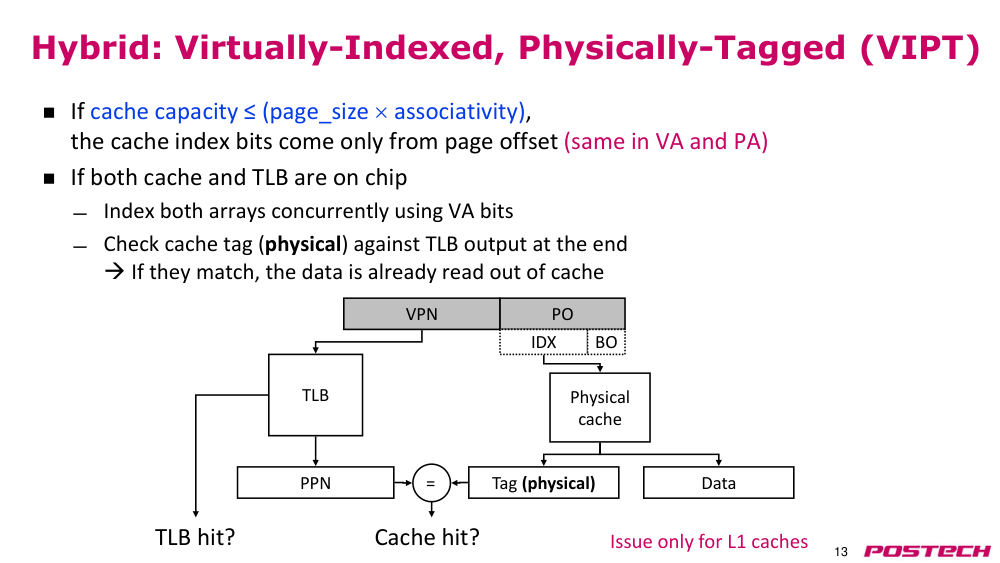
p.13하이브리드: 가상 인덱싱, 물리 태그 (VIPT)
- 캐시 capacity(용량) ≤ (페이지 크기 × 연관성)인 경우, cache index(캐시 인덱스) 비트는 page offset (PO)(페이지 오프셋)에서만 나옴 (VA와 PA에서 동일)
- 캐시와 TLB가 모두 칩 내부에 있다면, VA 비트를 사용하여 두 배열을 동시에 인덱싱
- 마지막에 캐시 태그(물리적)를 TLB 출력과 비교
- → 일치하면 데이터는 이미 캐시에서 읽혀짐
- 가상 페이지 번호 (VPN)
- 페이지 오프셋 (PO)
- 변환 색인 버퍼 (TLB)
- 물리 페이지 번호 (PPN)
- 캐시 인덱스 (IDX)
- 블록 오프셋 (BO)
- physical cache(물리 캐시)
- 태그 (물리적)
- 데이터
- 캐시 히트?
- TLB hit(TLB 히트)?
- ※ L1 cache(L1 캐시)에만 해당
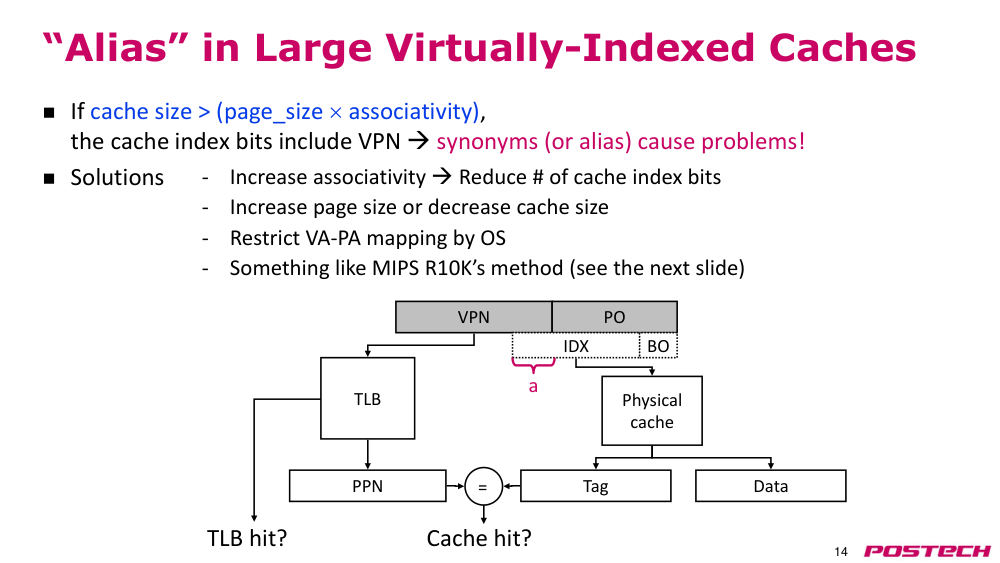
p.14큰 가상 인덱싱 캐시에서의 '별칭' 문제
- 캐시 크기가 (페이지 크기 × 연관성)보다 큰 경우, cache index(캐시 인덱스) 비트에 VPN이 포함됨 → 동의어(또는 별칭)로 인해 문제가 발생!
- 해결 방법:
- 가상 페이지 번호 (VPN)
- 페이지 오프셋 (PO)
- 변환 색인 버퍼 (TLB)
- 물리 페이지 번호 (PPN)
- 캐시 인덱스 (IDX)
- 블록 오프셋 (BO)
- physical cache(물리 캐시)
- 태그
- 데이터
- 캐시 히트?
- TLB hit(TLB 히트)?
- a
- associativity(연관성) 증가 → cache index(캐시 인덱스) 비트 수 감소
- 페이지 크기 증가 또는 캐시 크기 감소
- OS가 VA-PA 매핑을 제한
- MIPS R10K 방식과 유사한 방법 사용 (다음 슬라이드 참조)
p.15MIPS R10000의 가상 인덱싱 캐시
- 32 KB, 2-way(2-웨이) 가상 인덱싱 L1 캐시 (16B 블록) → 인덱스에 10비트, block offset(블록 오프셋)에 4비트 필요
- page offset (PO)(페이지 오프셋)은 12비트이므로, 인덱스의 2비트는 VPN[1:0]에 해당
- 직접 매핑 물리 L2 cache(L2 캐시) → L2는 L1을 포함함
- VPN[1:0]은 L2의 '태그'에 추가됨
- 두 가상 주소(VA와 VB)가 VPN[1:0]만 다를 경우, 동일한 물리 주소(PA)로 매핑됨
- VA가 먼저 접근되어 L1 및 L2에 블록 할당됨
- VB가 참조될 때 발생하는 일:
- 1. VB는 L1에서 다른 블록을 인덱싱하고 미스 발생
- 2. VB는 PA로 번역되어 L2에서 VA와 동일한 블록에 접근
- 3. 태그 비교 실패 (VPNVA[1:0] ≠ VPNVB[1:0])
- 4. L2는 L1에 synonym(동의어)인 VA가 캐시된 것을 감지
- → VB가 L1에 다시 채워지기 전에 VA의 엔트리 eviction(축출)
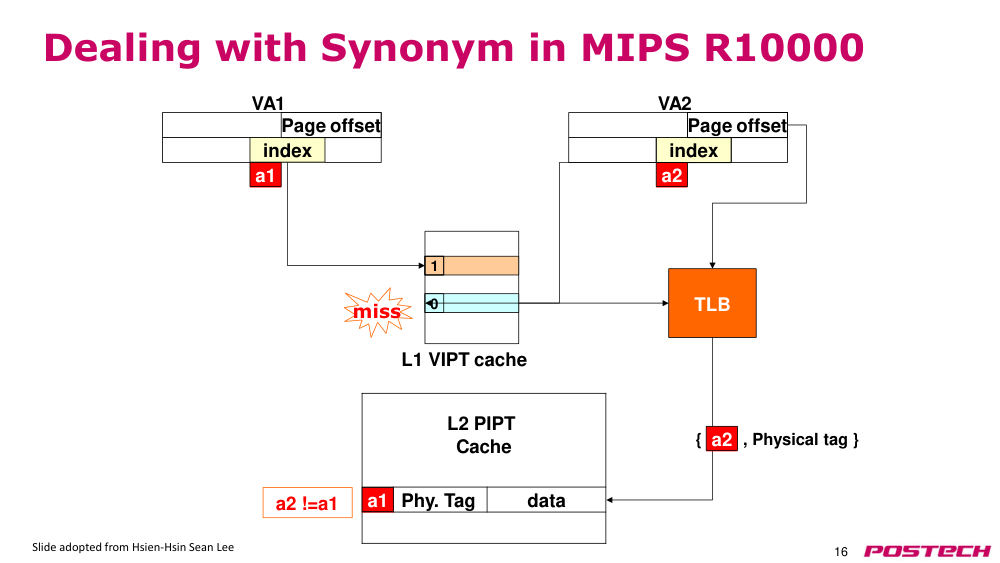
p.16MIPS R10000에서의 synonyms(동의어) 처리
- L2 PIPT 캐시
- a1 물리 태그
- 데이터
- 인덱스
- a1
- page offset (PO)(페이지 오프셋)
- 인덱스
- a2
- page offset (PO)(페이지 오프셋)
- VA1
- VA2
- 1
- 0
- 변환 색인 버퍼 (TLB)
- 미스
- { , 물리 태그 }
- a2
- a2 ≠ a1
- L1 VIPT 캐시
- a1
- 슬라이드 출처: Hsien-Hsin Sean Lee
p.17사례 연구: Intel x86의 virtual memory(가상 메모리)
p.18Intel x86
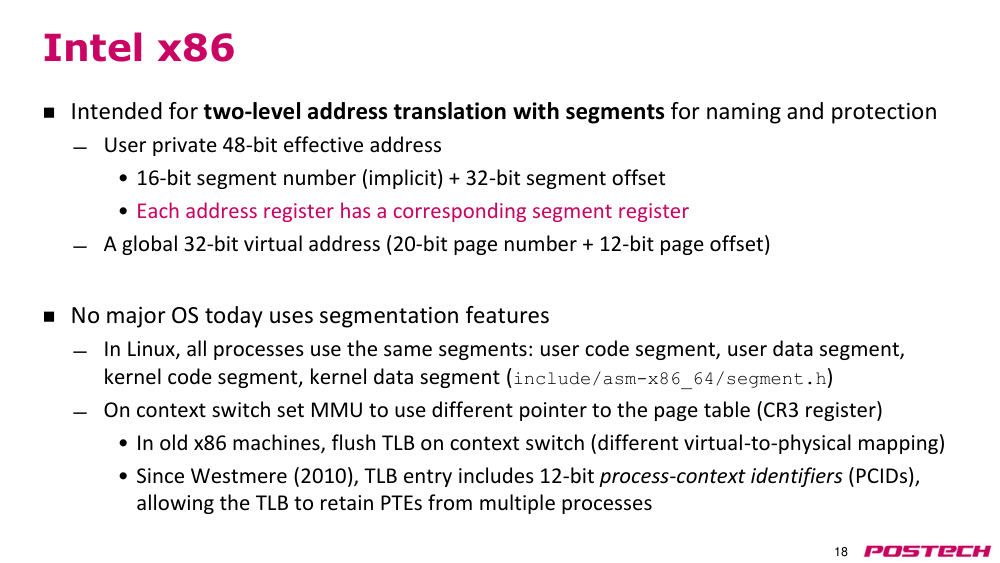
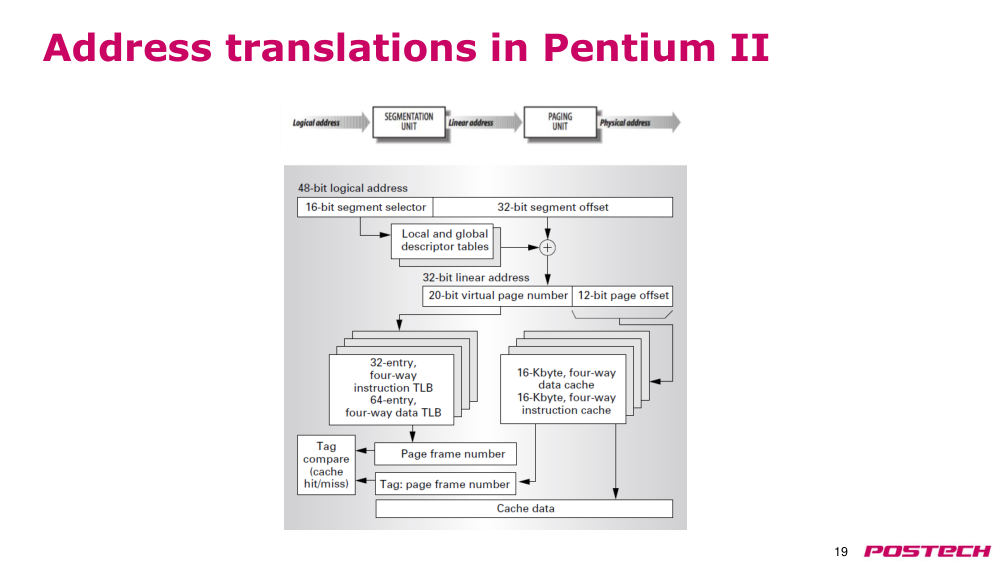
- 두 단계 address translation(주소 번역)과 세그먼트를 사용한 이름 지정 및 보호를 위한 설계
- 사용자 전용 48비트 효과 주소 (EA)
- • 16비트 세그먼트 번호(암시적) + 32비트 세그먼트 오프셋
- • 각 주소 레지스터는 해당 세그먼트 레지스터를 가짐
- 글로벌 32비트 가상 주소 (20비트 virtual page number (VPN)(가상 페이지 번호) + 12비트 페이지 오프셋)
- 현재 주요 OS는 세그먼트 기능을 사용하지 않음
- Linux에서는 모든 프로세스가 동일한 세그먼트 사용: 사용자 코드 세그먼트, 사용자 데이터 세그먼트, 커널 코드 세그먼트, 커널 데이터 세그먼트 (include/asm-x86_64/segment.h)
- context switch(컨텍스트 전환) 시 MMU가 page table(페이지 테이블)에 대한 다른 포인터를 사용하도록 설정 (CR3 레지스터)
- 구형 x86 기계에서는 context switch(컨텍스트 전환) 시 TLB 플러시 (다른 가상-물리 매핑)
- Westmere (2010년 이후)부터는 TLB 엔트리에 12비트 프로세스 컨텍스트 식별자 (PCID) 포함 → 여러 프로세스의 PTE를 TLB가 유지 가능
p.19Pentium II의 address translation(주소 번역)
p.20Core i7 page table(페이지 테이블) 번역
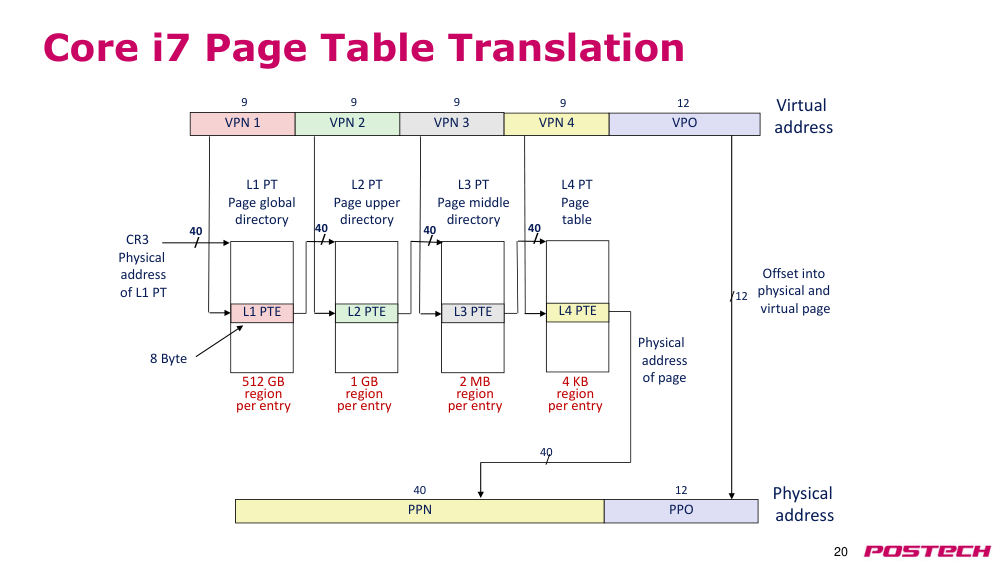
- CR3 register(CR3 레지스터): page global directory(페이지 전역 디렉터리)의 physical address (PA)(물리 주소)
- 가상 주소 (VA): 36비트
- 가상 페이지 번호 (VPN) 1 ~ 4: 각각 9비트
- 페이지 오프셋 (PO): 12비트
- 물리 페이지 번호 (PPN): 40비트
- 물리 페이지 오프셋 (PPO): 12비트
- L1 페이지 테이블 (L1 PT): page global directory(페이지 전역 디렉터리)
- L2 페이지 테이블 (L2 PT): page upper directory(페이지 상위 디렉터리)
- L3 페이지 테이블 (L3 PT): page middle directory(페이지 중간 디렉터리)
- L4 페이지 테이블 (L4 PT): 페이지 테이블
- 각 page table(페이지 테이블) 엔트리 (PTE): 8바이트
- 각 엔트리의 크기: 512GB, 1GB, 2MB, 4KB 지역을 나타냄
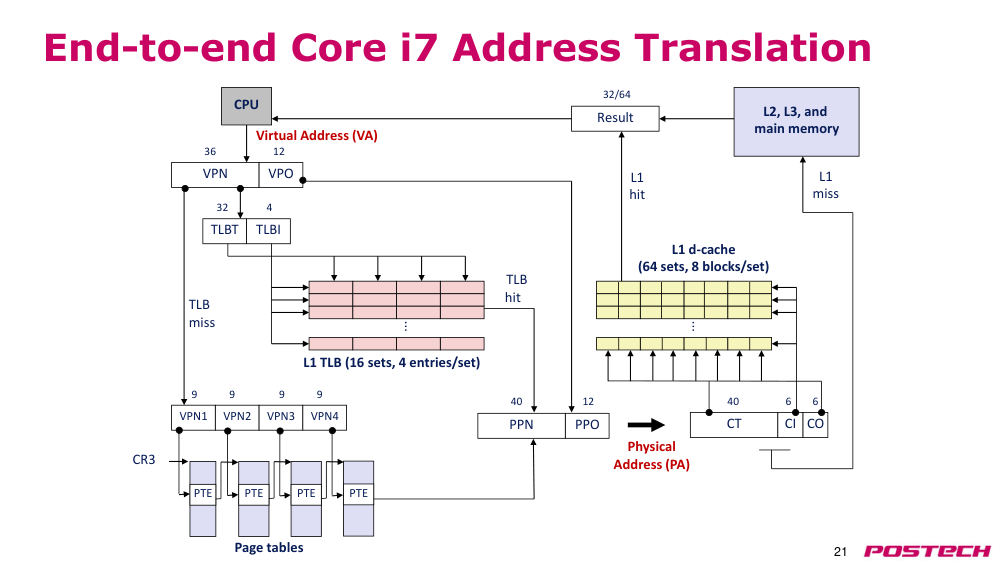
p.21Core i7 address translation(주소 번역)의 종단 간 흐름
- CPU에서 가상 주소 (VA) 입력: 36비트 VPN + 12비트 VPO
- L1 TLB (16세트, 세트당 4개 엔트리): TLB 인덱스 (TLBI) = 4비트, TLB 태그 (TLBT) = 32비트
- TLB hit(TLB 히트): TLB에서 PPN을 바로 가져옴
- TLB miss(TLB 미스): page table walk(페이지 테이블 워크) 수행
- page table walk(페이지 테이블 워크)를 통해 PTE를 검색하여 PPN과 PPO 추출
- 물리 주소 (PA): 40비트 PPN + 12비트 PPO
- L1 데이터 캐시 (64세트, 세트당 8블록): 캐시 인덱스 (CI) = 6비트, 캐시 태그 (CT) = 40비트, 블록 오프셋 (CO) = 6비트
- L1 cache(L1 캐시) 히트: 데이터를 바로 가져옴
- L1 cache(L1 캐시) 미스: L2, L3, main memory(주기억장치)로 접근
- 가상 주소 (VA) → 가상 페이지 번호 (VPN) 1~4 → 물리 주소 (PA)로의 변환 흐름 완료
p.22질문?
- 공지사항:
- - 교재 읽기: P&H Ch 5.5 – 5.6, 5.11, 5.18