Lec 3 part2 · Lec 4 · RISC-V jump·calling convention 과 performance 측정
정밀 정리 · 검증 2026-09-24 14:23
1개요
1.1Lec3 나머지: JAL/JALR 과 immediate sign bit 위치, x86 가변 길이 encoding·micro-op, caller/callee-saved register 와 calling convention, memory usage convention.
1.2Lec4 전반: 성능 정의(항공기 예), latency vs throughput(Snowmobile), wall-clock time·clock, IPC/CPI/MIPS 와 iron law, FLOPS 의 함정, energy trade-off.
1.3relative performance 는 'faster than'·speedup 으로만 표현하고, Amdahl's law 로 common case 를 빠르게 하라는 원칙으로 마무리.
1.4L03 p34-39(linking)는 CSED211 복습 과제, L04 p19-30(평균·benchmark)은 다음 강의로 넘어감.
2섹션별 정리 상황·문제 → 원인 → 해결
2.11:01–10:25JAL(jump and link, J-type)와 immediate bit 재배열
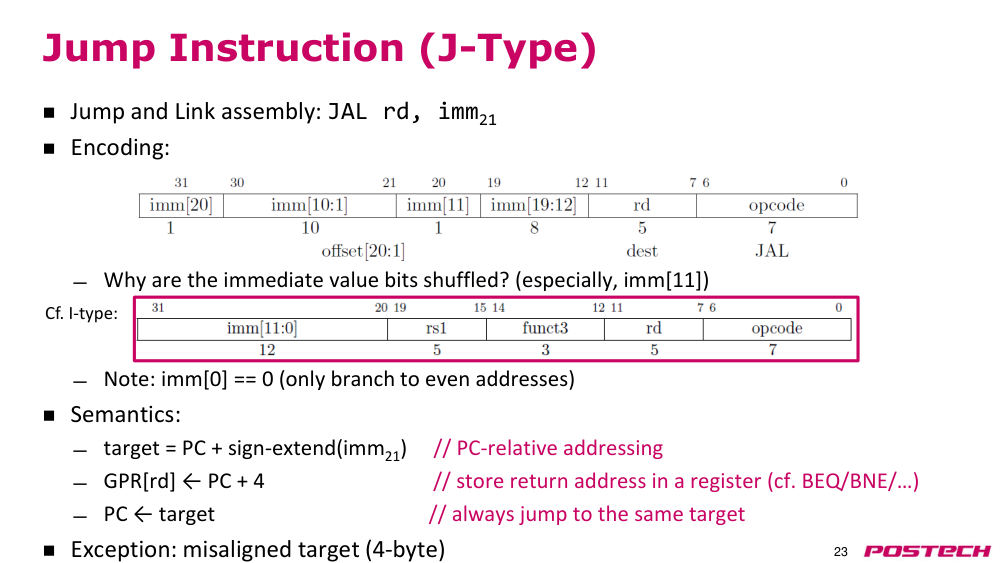
상황·문제지난 시간 branch 에 이어 unconditional jump 인 JAL 을 본다. JAL 은 immediate bit 가 섞여 있고 imm[11] 이 I-type 과 다른 위치에 있다. 왜 그런가?
원인모든 형식에서 명령어 MSB(bit 31)를 immediate 의 MSB(sign bit)로 고정하려고 imm[20] 을 bit 31 에 두고 imm[11] 을 옮겼다.
해결sign extension 에 쓸 bit 위치가 형식과 무관하게 같아 microarchitecture 설계가 단순해진다. target = PC + sext(imm), rd ← PC+4, imm[0]=0 이라 짝수 주소로만 점프, misaligned target 은 exception.
- link = 돌아올 위치(PC+4)를 rd 에 저장, function call 에 사용
- 명령어 MSB 는 항상 immediate 의 sign bit
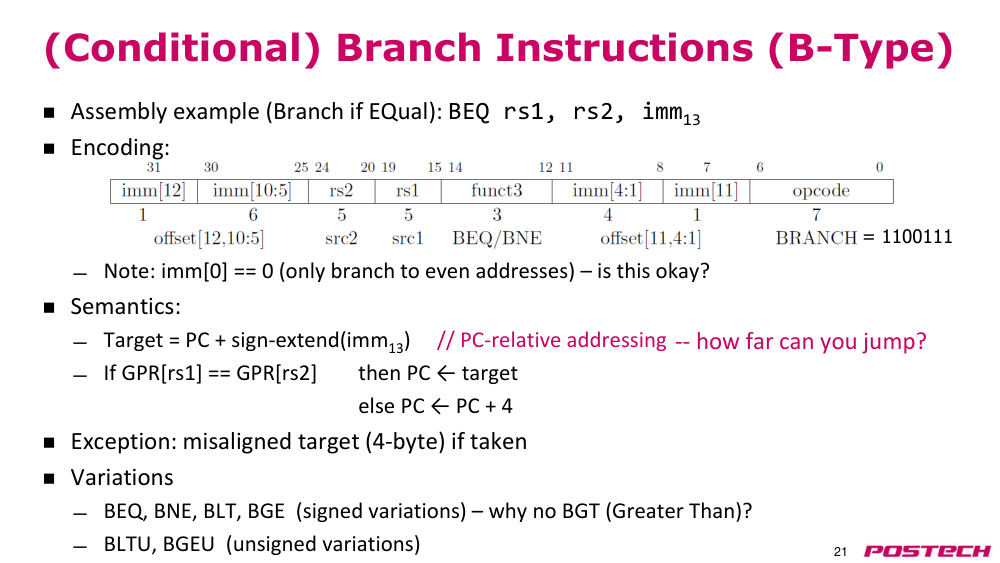
- 강의 시작 직후 branch 슬라이드(p21)를 잠깐 띄우고 넘어감
2.1.r.1riscv-isa-manual (GitHub) ↗ · JAL/JALR encoding·semantics 원문 (unprivileged ISA manual source)
2.210:25–12:40JALR(jump and link register, I-type)
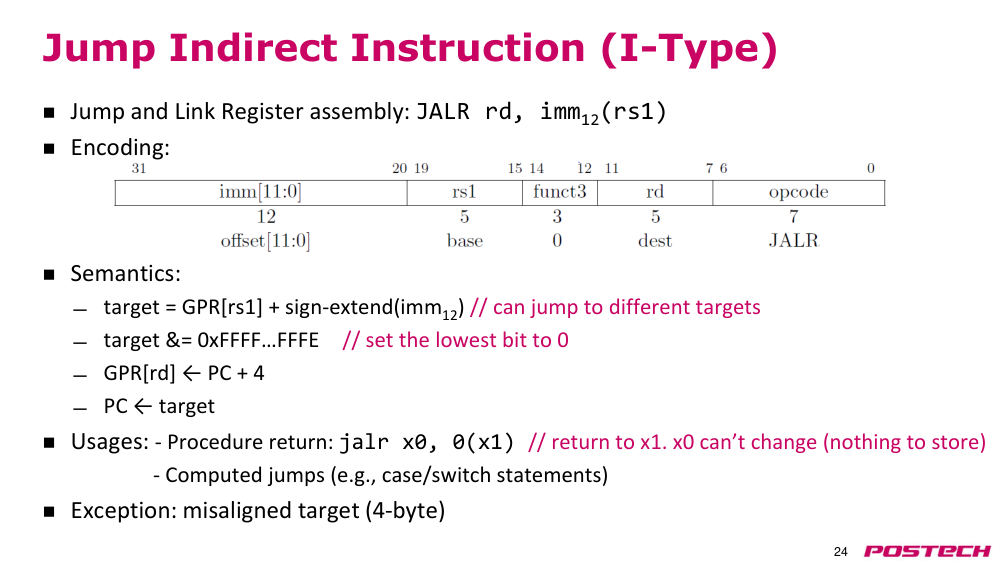
상황·문제PC 가 아니라 register 값을 기준으로 점프해야 하는 경우(함수 return, switch 문)는 어떻게 하나?
원인JAL 의 target 은 PC-relative 라 호출 위치로 되돌아가거나 계산된 주소로 가는 jump 를 표현할 수 없다.
해결JALR rd, imm12(rs1): target = GPR[rs1] + sext(imm12), 최하위 bit 를 0 으로. rd ← PC+4. return 은 jalr x0, 0(x1), case/switch 는 rs1 값을 바꿔 여러 target 으로 점프.
- immediate 가 12 bit 로 짧고 rs1·funct3 필드가 있음
- x1 에 caller 위치를 두면 return 에 쓸 수 있음
2.2.r.1riscv-isa-manual (GitHub) ↗ · JAL/JALR encoding·semantics 원문 (unprivileged ISA manual source)
2.312:40–15:24RISC-V 형식 요약 vs x86 가변 길이 encoding, micro-op
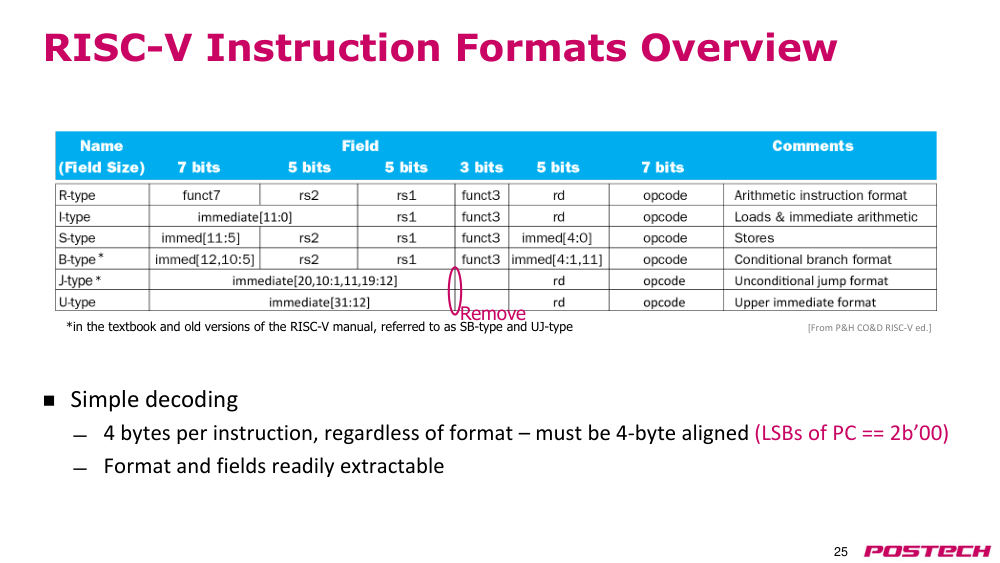
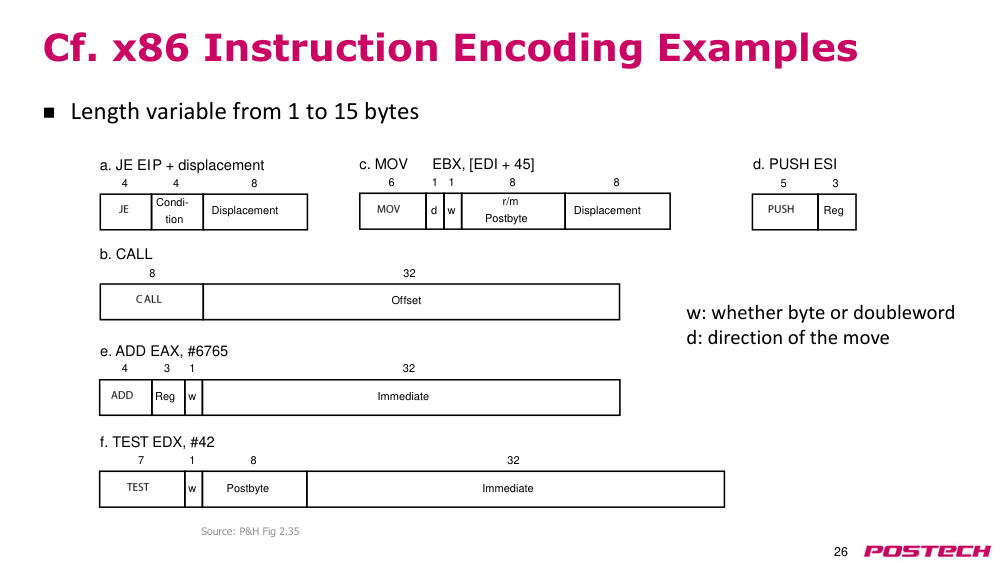
상황·문제RISC-V 는 4 byte 고정 형식인데 CISC 인 x86 은 명령 길이가 1~15 byte 로 다르고 encoding 도 명령마다 크게 다르다.
원인x86 은 decoding 이 복잡해 같은 명령을 반복 decode 하는 부담이 크다.
해결현대 x86 CPU 는 명령을 단순한 micro-op 으로 번역해 CPU 안에 두고 반복 사용해 decode overhead 를 피한다 (2강 뒤에 자세히).
- RISC-V: 4-byte 고정, 필드 위치 일정
- x86: 1~15 byte, programmer 에게 micro-op 은 보이지 않음
2.3.r.1x86 and amd64 instruction reference (felixcloutier.com) ↗ · Intel SDM 에서 추출한 x86 명령 reference (가변 길이 encoding 비교)
2.3.r.2Micro-operation (Wikipedia) ↗ · 복잡한 x86 명령을 micro-op 으로 decode, decoded micro-op cache(trace cache)
2.415:24–21:12caller-/callee-saved register 와 calling convention
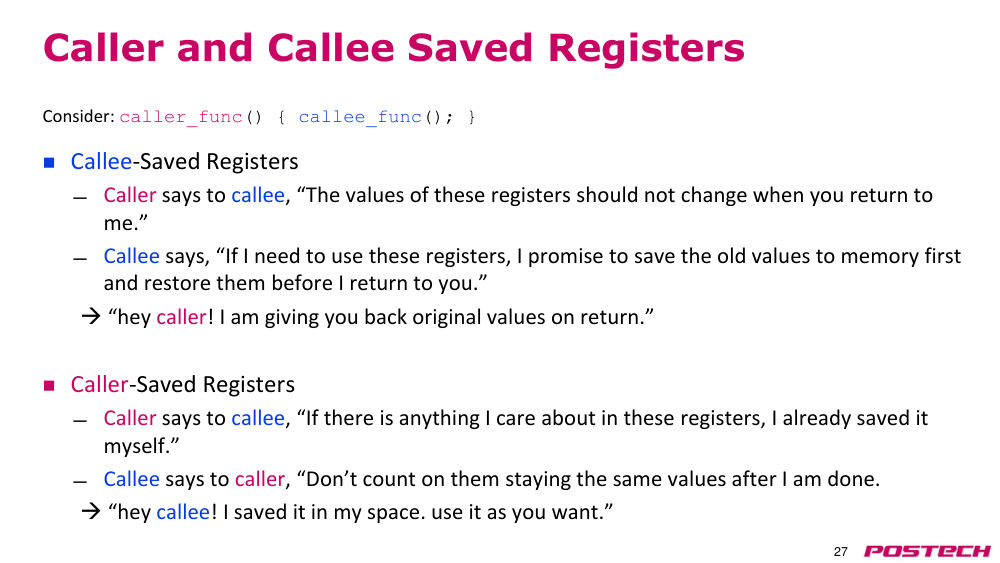
상황·문제callee 함수를 assembly 로 짤 때 아무 register 나 쓰면 caller 가 나중에 쓸 값을 망가뜨린다. 어떤 register 가 안전한가?
원인caller 와 callee 가 같은 register file 을 공유하므로 누가 어떤 register 를 보존할지 약속이 필요하다.
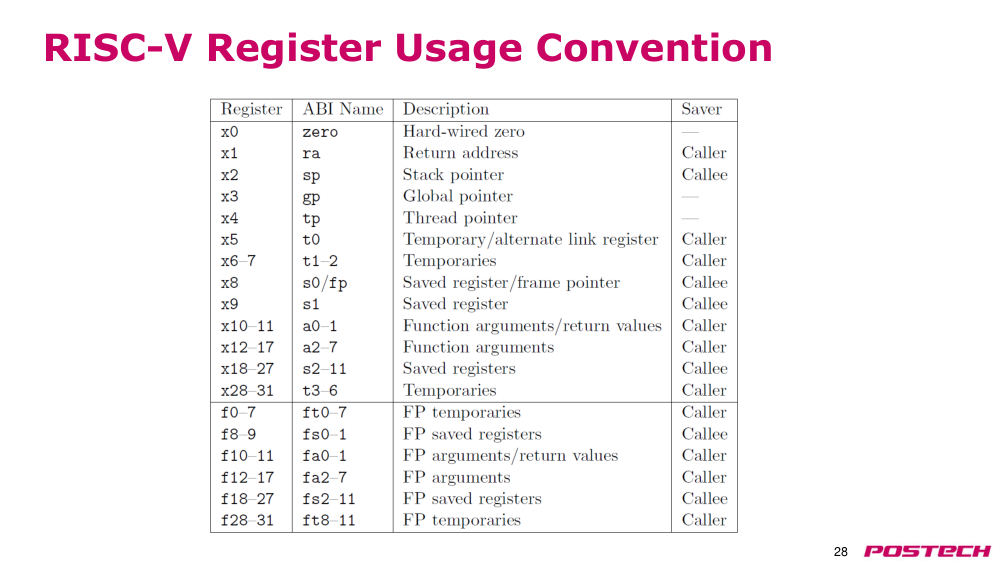
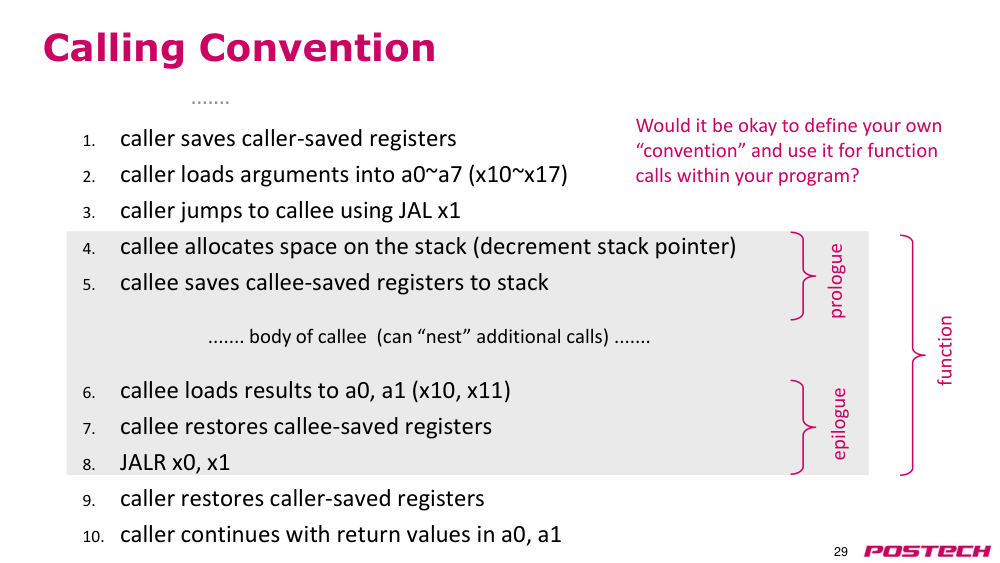
해결callee-saved: 쓰려면 stack 에 저장 후 return 전 복원. caller-saved: caller 가 미리 저장했으니 callee 가 자유롭게 사용. 절차: 인수 a0-a7(x10-x17) → JAL x1 → callee stack 할당·저장 → 결과 a0, a1 → 복원 → JALR x0, x1.
- a0~a7 = x10~x17, return address = x1
- prologue: stack pointer 감소, callee-saved 저장 / epilogue: 복원 후 return
2.4.r.1RISC-V ELF psABI (riscv-non-isa) ↗ · register ABI 이름(ra, sp, a0-a7, s0-s11, t0-t6)과 caller/callee-saved 규약
2.521:12–25:45Q&A: JAL 이 JALR 로 대체 가능한가, rd 로 x0 대신 다른 register?
상황·문제채팅 질문 두 개: JALR 만 있으면 JAL 이 필요 없지 않나? return 의 JALR rd 로 x0 대신 다른 register 를 써도 되나?
원인JAL 을 흉내 내려면 PC 값이 register 에 있어야 하는데 PC 를 register 에 저장하는 명령은 없다 (jump 의 side effect 로만 저장). return 시 PC+4 는 필요 없어 x0 에 버린다.
해결강사 답: JAL 은 중복이 아니라 둘 다 필요. 다른 register 를 rd 로 써도 동작은 하지만 불필요하고, caller 에게 쓸데없는 정보를 넘겨 security 측면에서 좋지 않을 수 있다.
- rd = x0 → 결과를 버림
2.625:45–29:20memory usage convention, addressing 요약, RISC-V 정리·읽기 과제
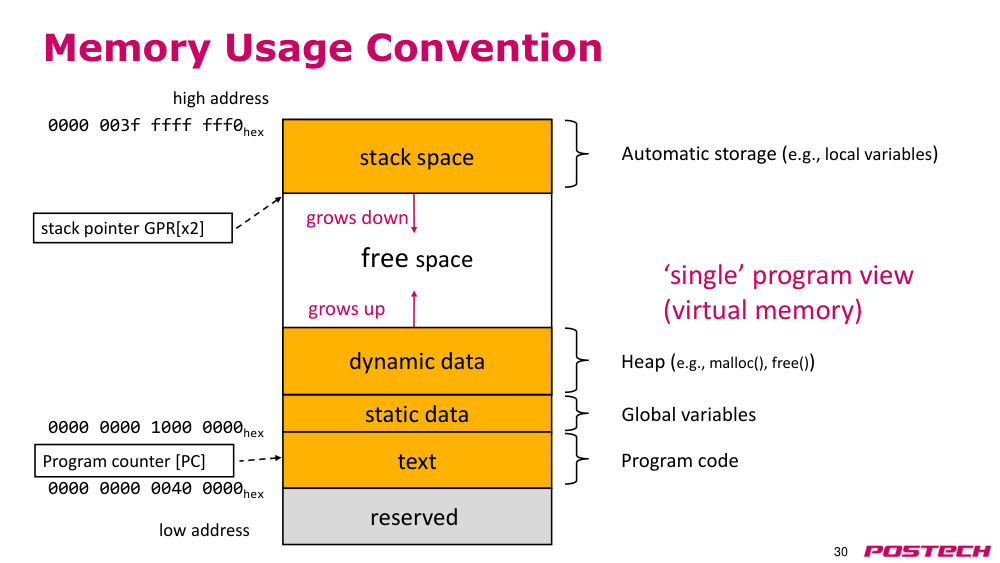
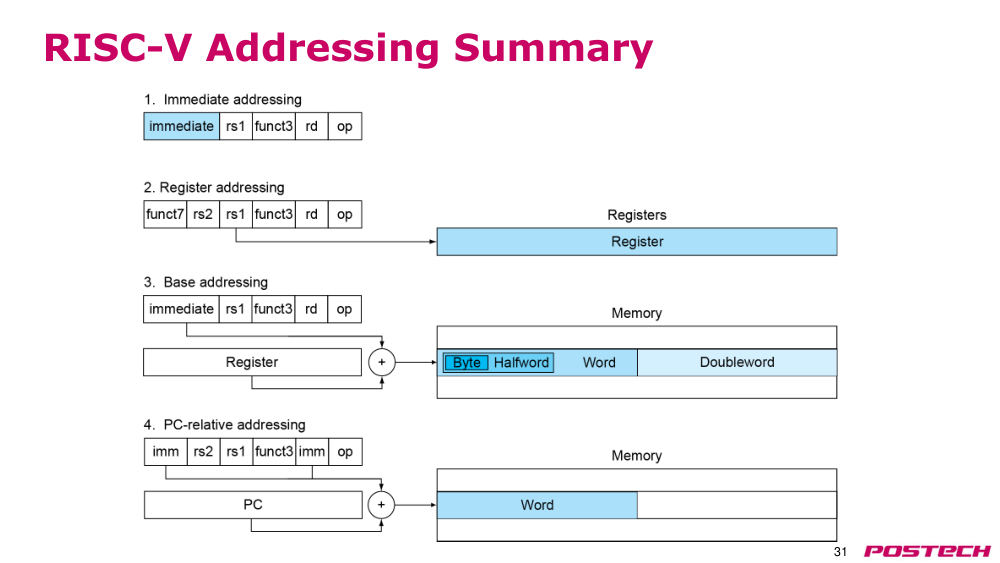
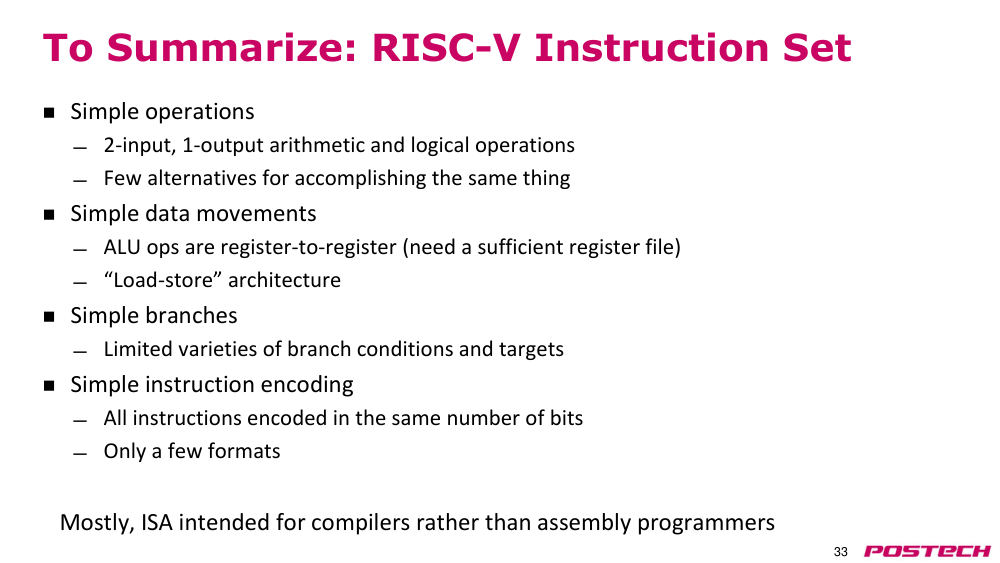
상황·문제RISC-V program 은 address space 를 어떻게 나눠 쓰나? 남은 ISA 내용은?
원인stack 은 위에서 아래로, heap(malloc/free)은 아래에서 위로 자라 가운데 free space 를 유연하게 나눈다. text 는 0x0040_0000, static data 는 0x1000_0000 부터, 가장 낮은 영역은 reserved.
해결이는 단일 program 의 virtual address space 이고, 여러 program 은 virtual memory 로 서로 다른 physical 위치에 map 된다. 설계 목표는 simplicity. p34-39(linking)는 CSED211 내용이라 복습 과제로. 읽기 P&H Ch 1.6-1.12.
- stack 은 downward, heap 은 upward
- privileged mode·exception·virtual memory 등은 다루지 않음
2.6.r.1RISC-V Ratified Specifications (RISC-V International) ↗ · unprivileged·privileged ISA manual 공식 배포 페이지
2.729:20–31:57Lec4 시작: performance 를 어떻게 정의하나 (항공기 예)
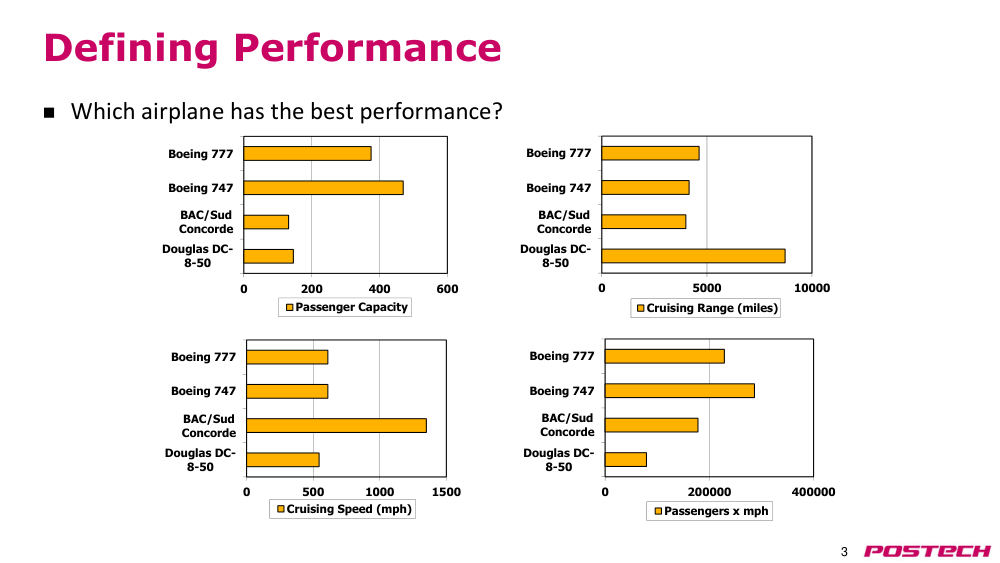
상황·문제네 항공기 중 어느 것이 '최고'인가?
원인passenger capacity 는 Boeing 747, 항속 거리는 Douglas DC-8, cruising speed 는 Concorde 가 최고라 기준마다 답이 다르다. capacity × speed 같은 조합 지표도 가능.
해결무엇이 중요한지에 따라 비교 기준이 정해진다. computer system 에서는 주로 latency 와 throughput 을 쓴다.
- 747 은 항속 거리에서 777 보다도 짧음
2.831:57–39:10latency(지연 시간) vs throughput(처리량)
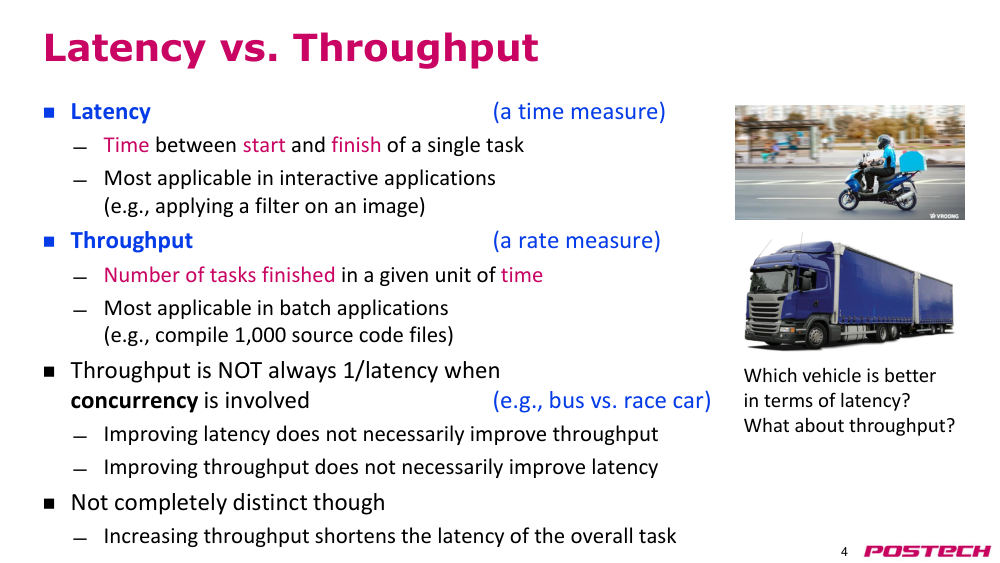
상황·문제latency 는 작업 하나의 시작~끝 시간(interactive, 예: 사진 filter), throughput 은 단위 시간당 끝낸 작업 수(batch, 예: 1,000개 source 파일 compile).
원인compiler A 0.5 s/파일, B 0.1 s/파일이면 1,000개에 500 s vs 100 s, 2 vs 10 files/s 로 짧은 latency 가 높은 throughput. 그러나 concurrency 가 있으면 둘은 직접 관계가 없다.
해결bus(50명) vs race car, truck vs motorcycle: latency 가 나빠도 throughput 은 좋을 수 있다. truck 적재량을 늘리고 속도가 80% 가 되면 throughput 은 늘고 latency 는 나빠진다. 비교 시 어떤 지표인지 주의.
- throughput 향상 ≠ latency 향상
- 그래도 많은 경우 throughput 향상은 전체 작업 시간을 줄인다
2.939:10–43:20예: AWS Snowmobile
상황·문제exabyte 급 data 를 cloud data center 로 옮겨야 한다. internet 전송은 너무 오래 걸린다.
원인트럭 container 에 storage 를 싣고 fiber 로 복사한 뒤 data center 까지 운전하면 latency 는 나쁘지만 throughput 이 매우 높다.
해결10 Gbps 전용선으로 26년 걸릴 전송을 Snowmobile 로 6개월에 끝낸다고 강의에서 소개.
- file 하나의 latency 는 최악이지만 전체 시간은 크게 단축
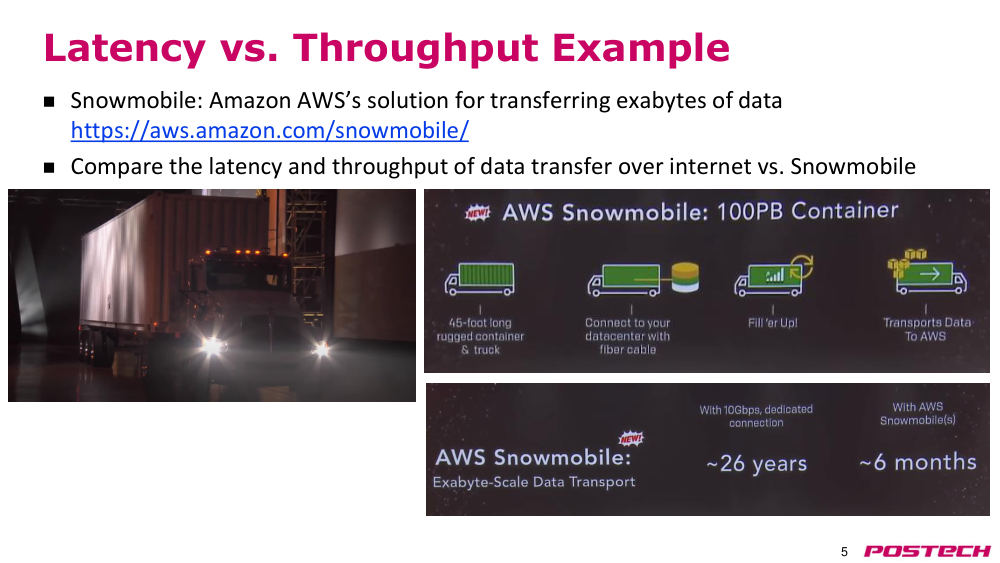
2.9.r.1Sneakernet (Wikipedia) ↗ · AWS Snowmobile(2016, 트럭 1대 100 PB) 과 물리 운송의 high latency·high bandwidth
2.1043:20–47:40It is all about time: Unix time 명령, clock cycle
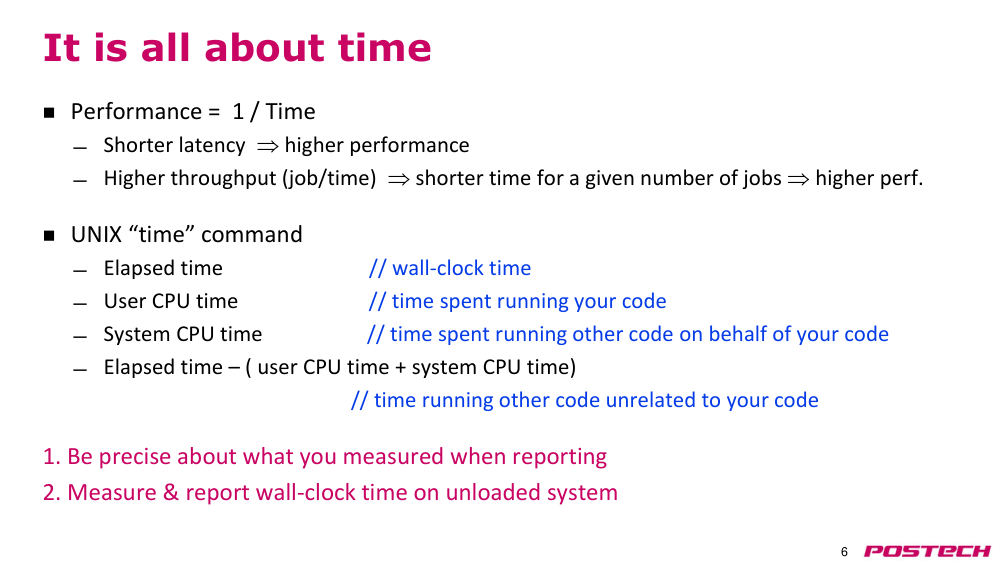
상황·문제latency 든 throughput 이든 결국 시간이 성능이다 (performance = 1/time). 시간을 어떻게 재나?
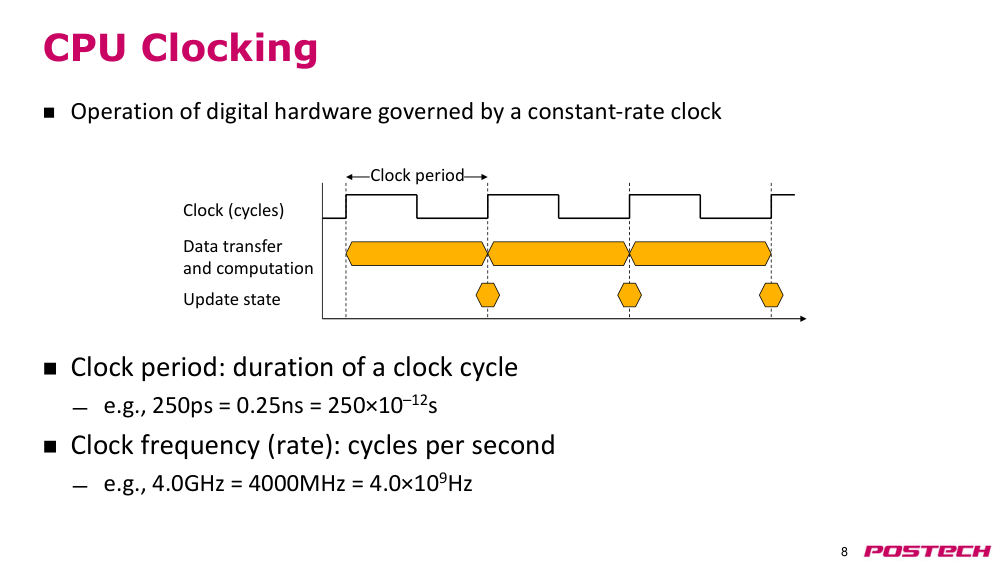
원인Unix time 의 real(wall-clock)에는 내 code 외 다른 code 실행 시간도 들어가고 user/sys 로 나뉜다. digital system 은 clock edge 마다 state(memory element)를 갱신한다.
해결무엇을 쟀는지 정확히 밝히고 unloaded system 에서 wall-clock time 을 잰다. clock period(예 250 ps) 와 clock frequency(예 4.0 GHz = 4×10^9 cycles/s)는 역수.
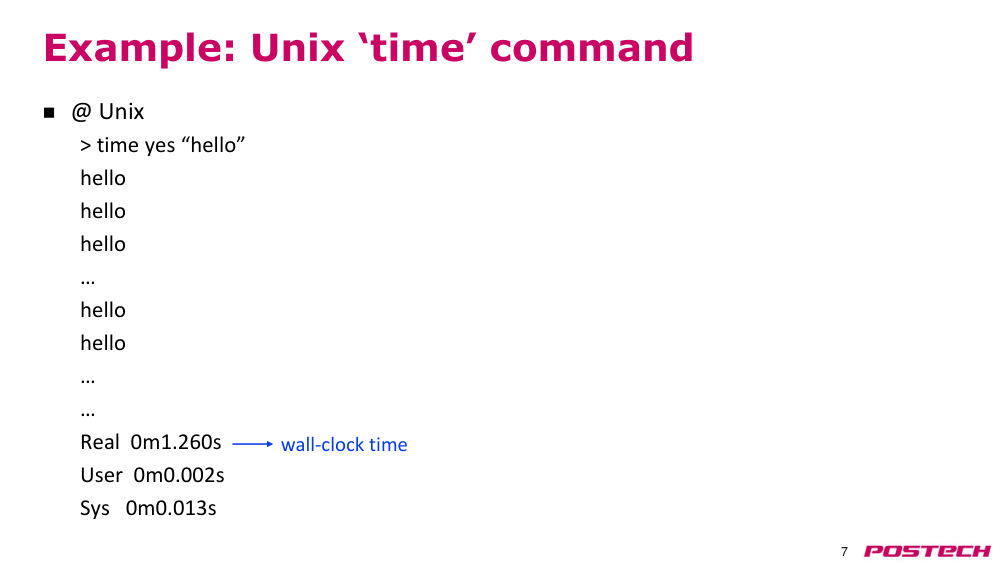
- time yes "hello" 예: real 1.260 s, user 0.002 s, sys 0.013 s
- clock cycle 이 CPU 성능 시간 측정의 기본 단위
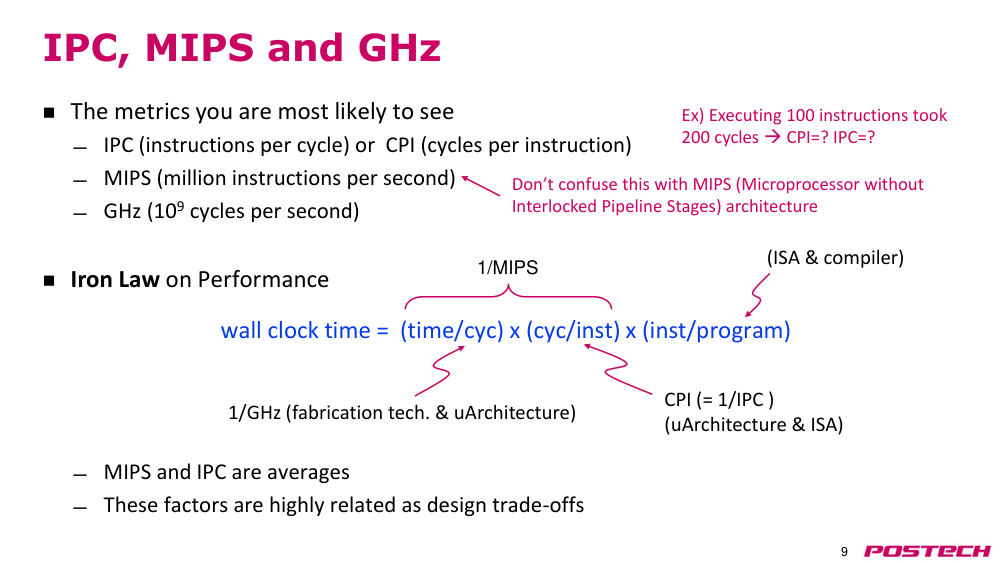
2.1147:40–54:50IPC·CPI·MIPS·GHz 와 iron law of performance
상황·문제CPU 성능 지표로 IPC(inst/cycle), CPI(=1/IPC), MIPS(million inst/s), GHz 를 흔히 본다. 이들은 wall-clock time 과 어떻게 연결되나?
원인wall-clock time = (time/cycle) × (cycles/inst) × (inst/program). time/cycle 은 fabrication 기술·microarchitecture, CPI 는 microarchitecture·ISA, inst 수는 ISA·compiler(·programmer)가 정한다.
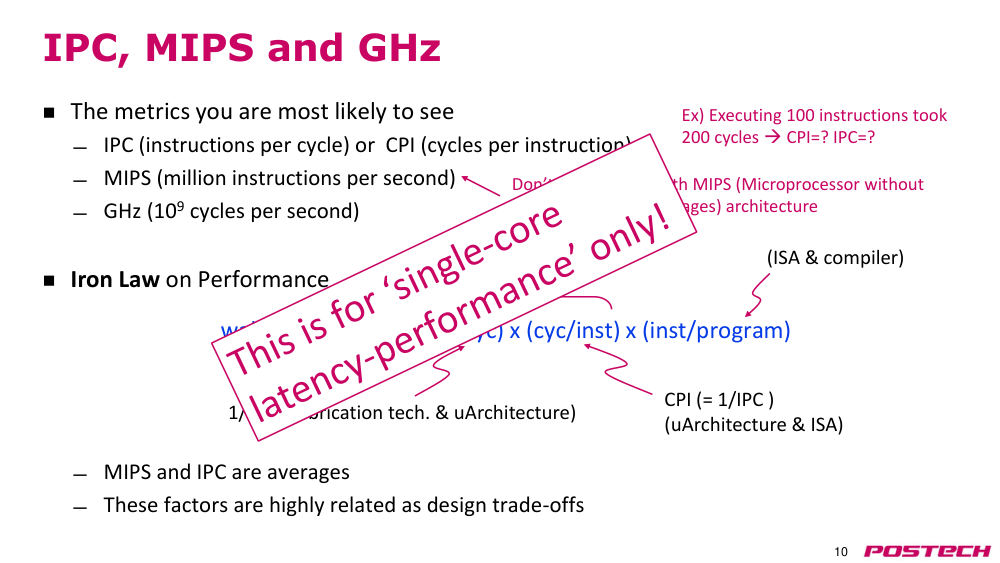
해결예: 100 inst 를 200 cycle → IPC 0.5, CPI 2. 세 요소는 design trade-off (CISC: inst 수↓ CPI↑). 모두 평균값이며 single-core latency 성능에만 성립 (lock 등 multi-core 는 예외).
- MIPS 지표 ≠ MIPS architecture (Microprocessor without Interlocked Pipeline Stages)
- cycle 에 많은 일을 넣으면 cycle 이 길어짐
2.11.r.1Iron law of processor performance (Wikipedia) ↗ · time/program = inst/program × cycles/inst × time/cycle
2.11.r.2Cycles per instruction (Wikipedia) ↗ · CPI 정의와 execution time = CPI × instruction count × clock time
2.1254:50–59:20FLOPS 지표의 함정
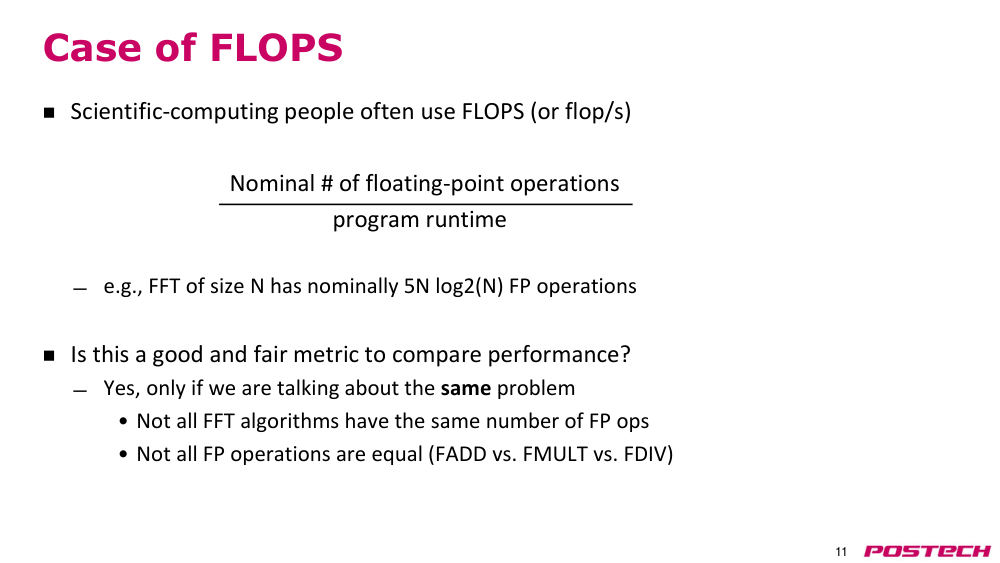
상황·문제과학 계산·deep learning 에서는 FLOPS(nominal FP op 수 / program runtime)를 쓴다. integer 연산이면 OPS(GPU 의 TOPS).
원인FADD·FMULT·FDIV 는 비용이 다른데(곱셈·나눗셈이 더 오래 걸림) FLOPS 는 모두 같은 개수로 센다. FFT 알고리즘마다 FP op 수도 다르다.
해결같은 문제(같은 연산 구성)를 비교할 때만 공정한 지표. 다른 algorithm·system 비교에는 부적절.
- 크기 N 의 FFT 는 nominal 5N log2(N) FP ops
- FFT = Fast Fourier Transform (채팅 질문)
2.1359:20–1:02:50다차원 비교: 실행 시간과 energy
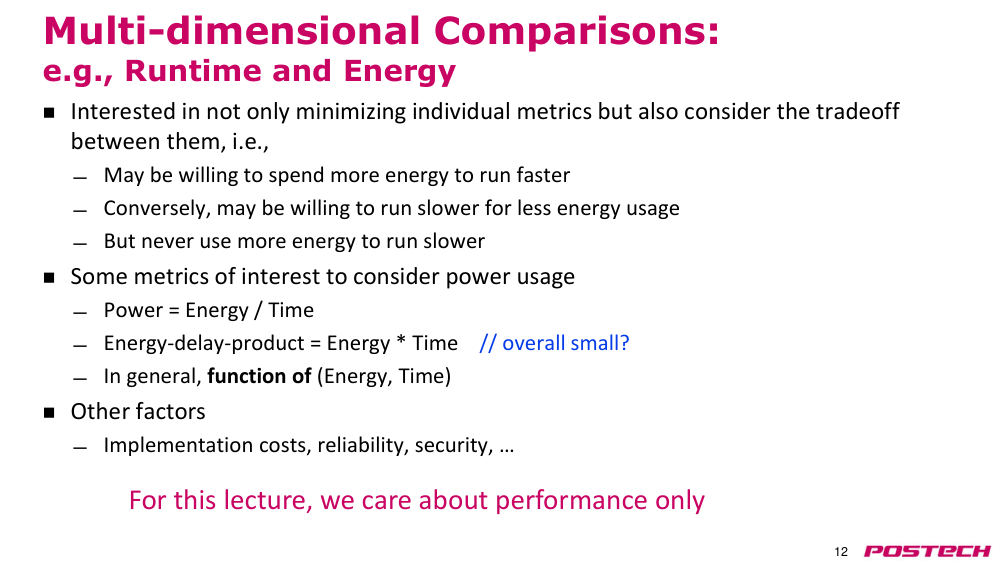
상황·문제mobile 기기에서는 성능뿐 아니라 배터리 지속 시간도 중요하다. 10배 빠르지만 2시간만 가는 smartphone 은 좋은 선택이 아닐 수 있다.
원인energy 와 time 사이에 trade-off 가 있다. 더 쓰고 빠르게, 덜 쓰고 느리게(battery saving mode)는 가능하지만 더 쓰고 느리게는 절대 안 된다.
해결power = energy/time, energy-delay product(EDP) = energy × time (작을수록 좋음). cost·reliability·security 도 있지만 이 강의는 성능만 다룬다.
2.141:02:50–1:09:35relative performance 표현과 speedup
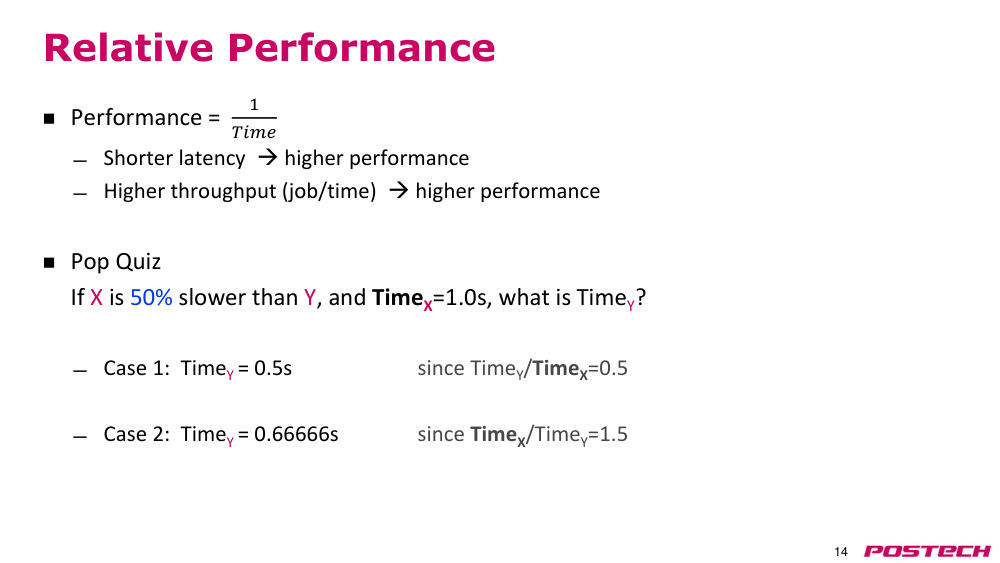
상황·문제여러 program 의 성능을 요약·비교해야 한다. 'X 가 Y 보다 50% 느리고 TimeX=1 s' 이면 TimeY 는 0.5 s 인가 0.67 s 인가?
원인'slower than' 은 일상 언어와 기술 용어가 어긋나 두 해석이 모두 가능하다.
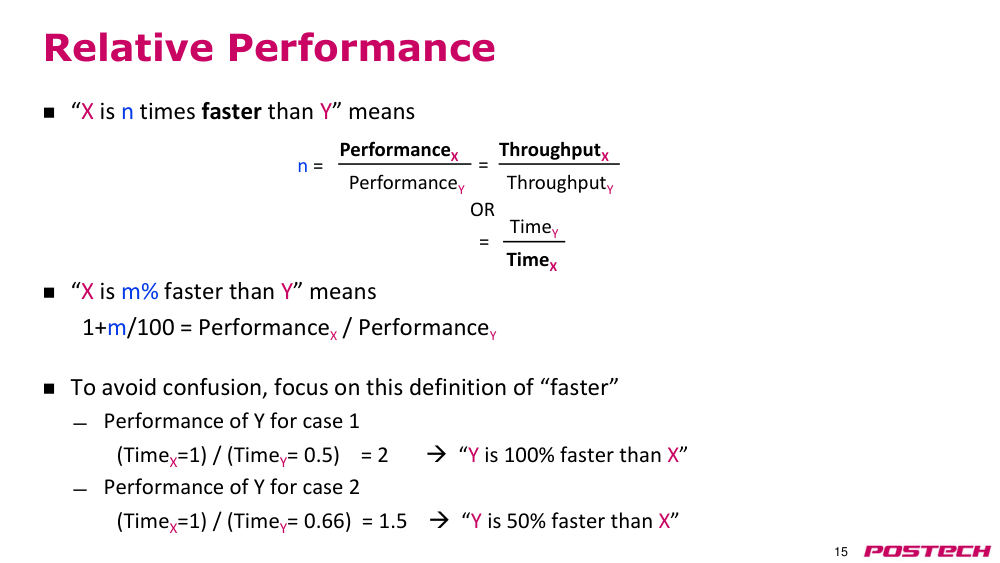
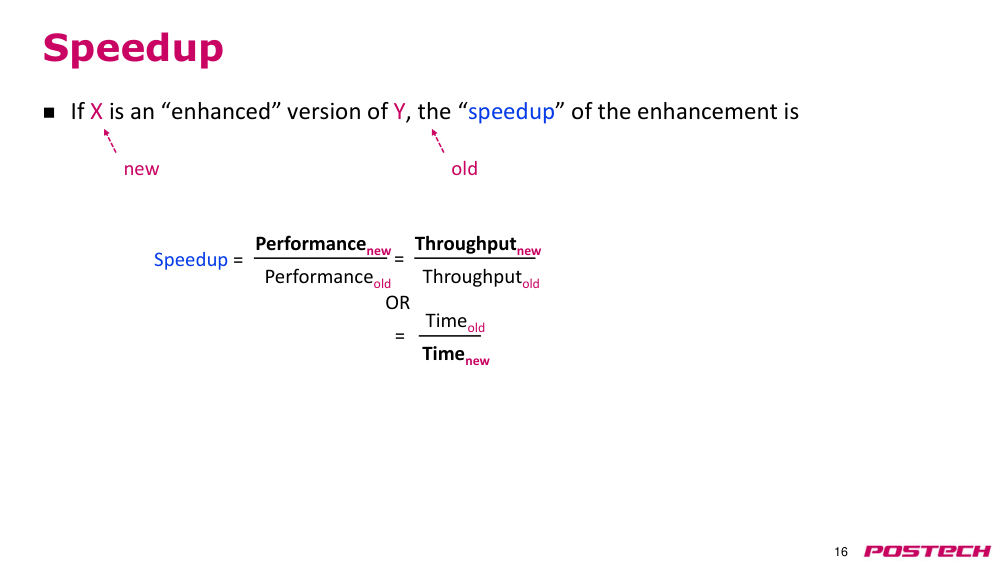
해결항상 'faster than' 만 쓴다. X 가 n배 빠름 = Perf_X/Perf_Y = n = Time_Y/Time_X, m% 빠름 = 1+m/100. 0.5 s 면 'Y 가 100% 빠름', 0.67 s 면 '50% 빠름'. speedup = relative performance.
- performance = 1/execution time
- 2배 빠름 → speedup 2, 20% 빠름 → 1.2
2.151:09:35–1:14:30Amdahl's law(암달의 법칙): make the common case fast
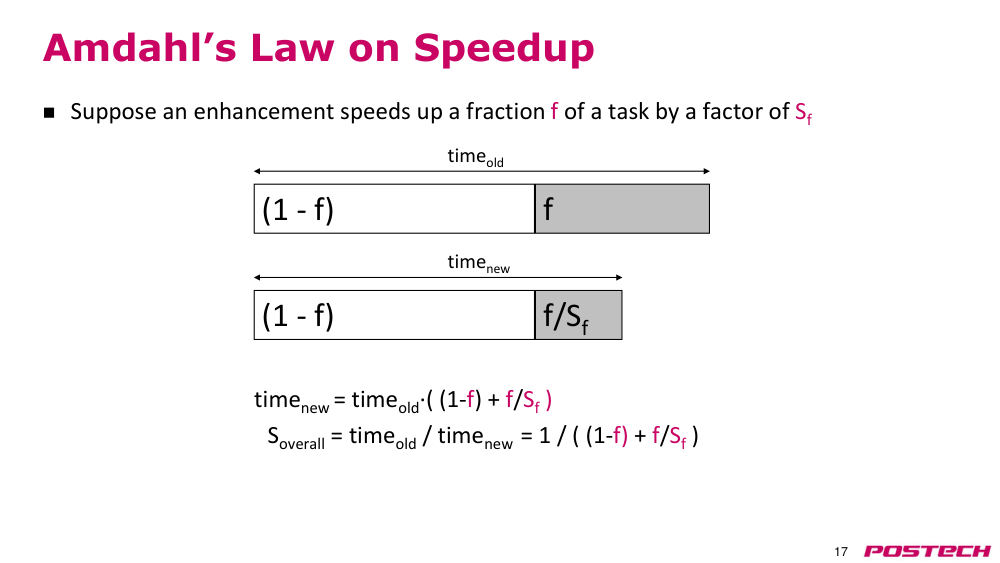
상황·문제program 의 일부 fraction f 만 Sf 배 빠르게 하면 전체는 얼마나 빨라지나?
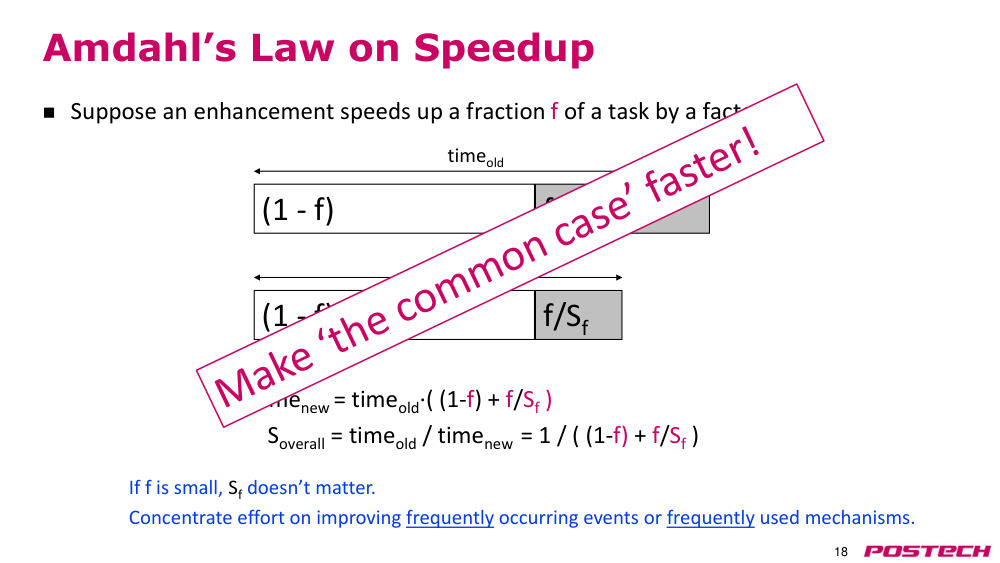
원인time_new = time_old × ((1-f) + f/Sf), S_overall = 1/((1-f) + f/Sf). 바뀌지 않는 (1-f) 부분이 상한을 정한다.
해결f 가 작으면 Sf 가 1000 이든 무한대든 효과가 거의 없다. 자주 일어나는 event·자주 쓰는 mechanism(common case)에 노력을 집중. 남은 부분은 다음 강의에서.
- 공부에도 적용: 전체 영향이 큰 부분에 집중
3핵심 개념
3.1JAL(jump and link)
target = PC + sext(imm21), rd ← PC+4. function call 에 사용.
3.1.r.1riscv-isa-manual (GitHub) ↗ · JAL/JALR encoding·semantics 원문 (unprivileged ISA manual source)
3.2sign bit 위치 고정
모든 형식에서 명령어 bit 31 = immediate MSB. sign extension hardware 단순화.
3.3JALR(jump and link register)
target = GPR[rs1] + sext(imm12), LSB 0. return(jalr x0, 0(x1))·switch 문.
3.3.r.1riscv-isa-manual (GitHub) ↗ · JAL/JALR encoding·semantics 원문 (unprivileged ISA manual source)
3.4micro-op(마이크로 연산)
x86 복잡 명령을 CPU 내부 단순 명령으로 번역·재사용해 decode 부담을 줄임.
3.4.r.1Micro-operation (Wikipedia) ↗ · 복잡한 x86 명령을 micro-op 으로 decode, decoded micro-op cache(trace cache)
3.5callee-saved / caller-saved register
callee-saved 는 callee 가 저장·복원, caller-saved 는 caller 가 미리 저장.
3.6calling convention(호출 규약)
인수 a0-a7(x10-x17), JAL x1 호출, 결과 a0/a1, JALR x0, x1 return.
3.6.r.1RISC-V ELF psABI (riscv-non-isa) ↗ · register ABI 이름(ra, sp, a0-a7, s0-s11, t0-t6)과 caller/callee-saved 규약
3.7latency(지연 시간)
단일 작업의 시작~끝 시간. interactive 응용에 적합.
3.8throughput(처리량)
단위 시간당 끝낸 작업 수. batch 응용에 적합. latency 와 직접 관계 없을 수 있음.
3.9wall-clock time
Unix time 의 real. unloaded system 에서 재야 함.
3.10IPC / CPI
IPC = inst/cycle, CPI = 1/IPC. 100 inst 200 cycle → CPI 2.
3.10.r.1Cycles per instruction (Wikipedia) ↗ · CPI 정의와 execution time = CPI × instruction count × clock time
3.11iron law of performance(성능의 철칙)
time = time/cycle × cycles/inst × inst/program. single-core latency 성능에만.
3.11.r.1Iron law of processor performance (Wikipedia) ↗ · time/program = inst/program × cycles/inst × time/cycle
3.12FLOPS
FP op 수 / runtime. 같은 문제 비교에만 공정 (FADD·FMULT·FDIV 비용 차이).
3.13energy-delay product(EDP)
energy × time. energy 와 성능을 한 지표로, 작을수록 좋음.
3.14speedup(속도 향상)
Perf_new/Perf_old = Time_old/Time_new. 'faster than' 표현만 사용.
3.15Amdahl's law(암달의 법칙)
S = 1/((1-f) + f/Sf). common case 를 빠르게.
4스스로 확인
4.1JAL 에서 imm[11] 을 I-type 과 다른 자리에 둔 이유는?
답
명령어 MSB(bit 31)를 모든 형식에서 immediate sign bit 로 고정하려고 imm[20] 을 거기 두었기 때문. sign extension 이 단순해진다.
4.2함수에서 caller 로 돌아가는 명령은?
답
jalr x0, 0(x1). x1 의 return address 로 점프하고 PC+4 는 x0 에 버린다.
4.3JALR 만으로 JAL 을 대신할 수 없는 이유는?
답
JAL 을 흉내 내려면 PC 가 register 에 있어야 하는데 PC 를 register 에 저장하는 명령이 따로 없다.
4.4callee 가 callee-saved register 를 쓰려면?
답
stack 에 공간을 잡아 원래 값을 저장하고, return 전에 복원한다.
4.5compiler A 0.5 s/파일, B 0.1 s/파일일 때 throughput 은?
답
A 2 files/s, B 10 files/s. 이 경우엔 짧은 latency 가 높은 throughput 이지만 concurrency 가 있으면 성립하지 않는다.
4.6100 inst 를 200 cycle 에 실행하면 IPC·CPI 는?
답
IPC 0.5, CPI 2.
4.7TimeX = 1 s, TimeY = 0.5 s 일 때 올바른 표현은?
답
Y 가 X 보다 100% 빠르다 (speedup 2). 'slower than' 은 쓰지 않는다.
4.8f = 0.1 을 무한히 빠르게 하면 전체 speedup 은?
답
1/(1-0.1) ≈ 1.11배가 상한. common case 를 빠르게 해야 한다.
5참고 자료
5.2RISC-V ELF psABI (riscv-non-isa) ↗ · register ABI 이름(ra, sp, a0-a7, s0-s11, t0-t6)과 caller/callee-saved 규약
5.3Iron law of processor performance (Wikipedia) ↗ · time/program = inst/program × cycles/inst × time/cycle