이 자료를 쓰는 강의: 39 Lec 4 · RISC-V jump·calling convention 과 performance 측정 · 40 Lec 5 · 성능 요약(평균·SPEC)과 single-cycle CPU datapath
Lec4-Performance
한국어판 강의자료 · 30쪽
p.1CSED311 컴퓨터구조 – 강의 4
p.2컴퓨터의 성능을 어떻게 측정할까?
- "당신의 컴퓨터는 얼마나 빠른가요?"
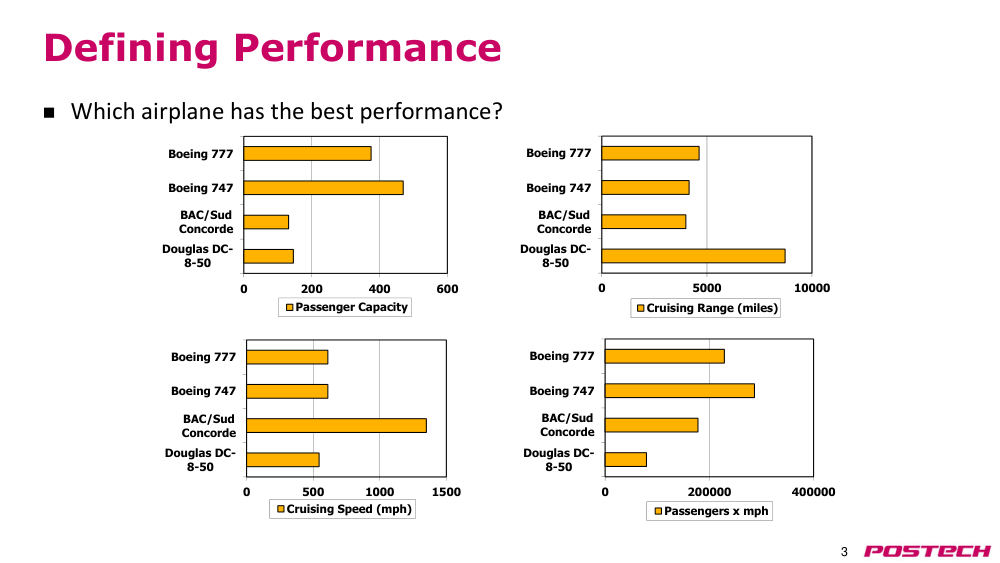
p.3성능 정의하기
- • 어떤 항공기의 성능이 가장 우수한가?
- Passenger Capacity (탑승객 수)
- Cruising Range (비행 거리, 마일)
- Cruising Speed (비행 속도, mph)
- Passengers x mph (탑승객 수 × mph)
p.4latency(지연 시간) vs. throughput(처리량)
- • 지연 시간 (latency)
- - 시간 측정 (시간 단위)
- - 단일 작업의 시작과 종료 사이의 시간
- - 인터랙티브 응용 프로그램에 가장 적합 (예: 이미지에 필터 적용)
- • 처리량 (throughput)
- - 주어진 시간 단위 내에 완료된 작업 수
- - 배치 처리 응용 프로그램에 가장 적합 (예: 소스 코드 파일 1,000개 컴파일)
- • 동시성(concurrency)이 있을 경우 throughput(처리량)은 항상 1/latency(지연 시간)이 아님
- - (예: 버스 vs. 레이스카)
- • latency(지연 시간) enhancement(개선)은 throughput(처리량) 개선을 보장하지 않음
- • throughput(처리량) enhancement(개선)은 latency(지연 시간) 개선을 보장하지 않음
- • 그러나 완전히 별개는 아님
- - throughput(처리량) 증가 시 전체 작업의 latency(지연 시간)이 단축됨
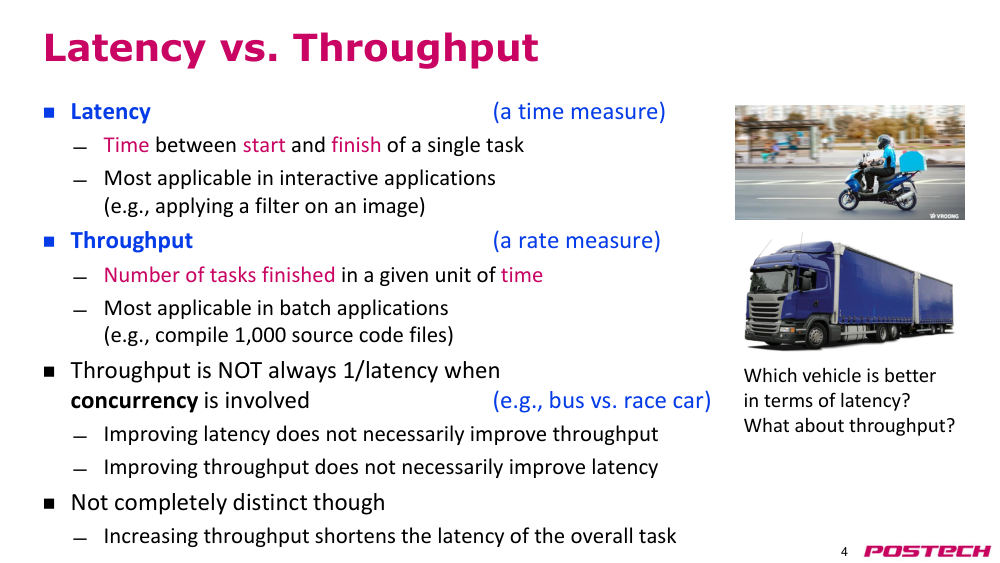
- • latency(지연 시간) 측면에서 더 좋은 차량은 무엇인가?
- • throughput(처리량) 측면에서 더 좋은 차량은 무엇인가?
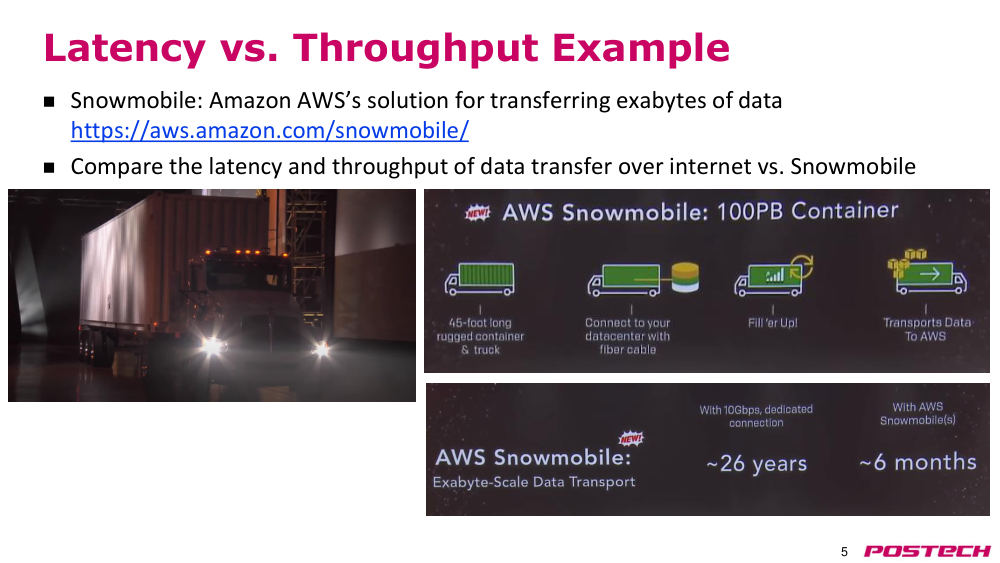
p.5latency(지연 시간) vs. throughput(처리량) 예시
- • 스노모빌: 아마존 AWS의 엑사바이트 단위 데이터 전송 솔루션
- - https://aws.amazon.com/snowmobile/
- • 인터넷을 통한 데이터 전송과 스노모빌의 latency(지연 시간) 및 throughput(처리량) 비교
p.6모든 것은 시간에 관한 것이다
- • 성능 = 1 / 시간
- - 짧은 latency(지연 시간) ⇒ 높은 성능
- - 높은 처리량(job/시간) ⇒ 주어진 작업 수에 대한 시간 단축 ⇒ 높은 성능
- • UNIX "time" 명령어
- - 경과 시간 (wall-clock time)
- - 사용자 CPU 시간 (당신의 코드 실행에 소요된 시간)
- - 시스템 CPU 시간 (당신의 코드를 대신하여 실행된 다른 코드에 소요된 시간)
- - 경과 시간 – (사용자 CPU 시간 + 시스템 CPU 시간)
- - 당신의 코드와 무관한 다른 코드 execution time(실행 시간)
- • 1. 성능 보고 시 측정한 내용을 명확히 하라
- • 2. 부하가 없는 시스템에서 wall-clock time(월클록 시간)을 측정하고 보고하라
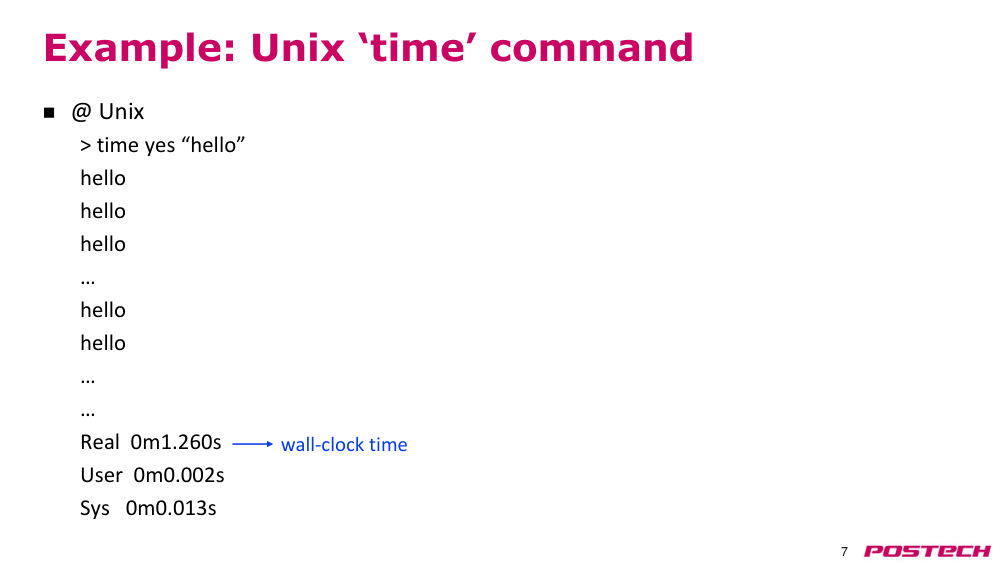
p.7예시: Unix 'time' 명령어
- @ Unix
- > time yes "hello"
- hello
- hello
- hello
- ...
- hello
- hello
- ...
- ...
- Real 0m1.260s
- User 0m0.002s
- Sys 0m0.013s
- wall-clock time(월클록 시간)
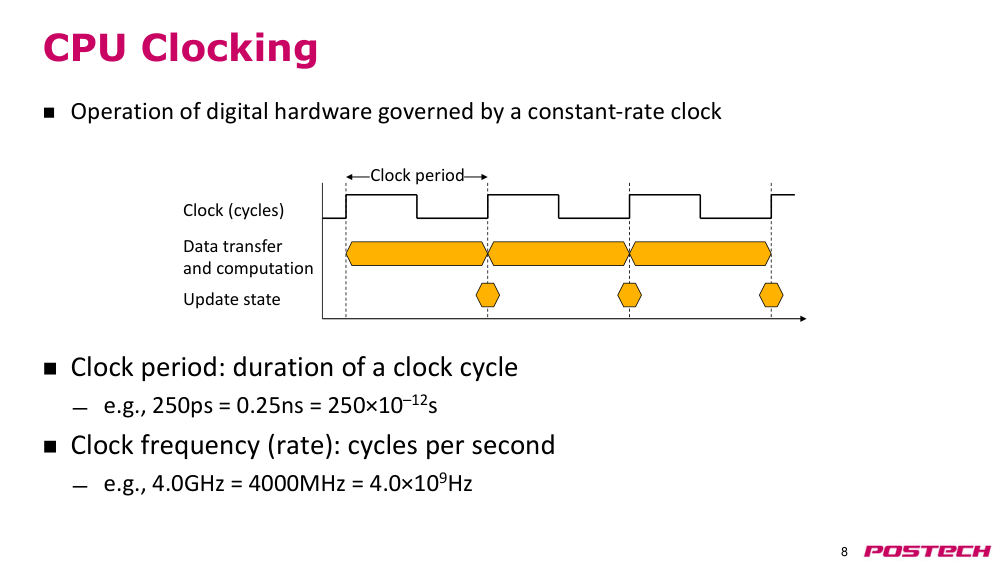
p.8CPU 클럭
- 디지털 하드웨어의 동작은 일정 주기의 클럭에 의해 제어됨
- clock period(클럭 주기): 클럭 cycle(사이클)의 지속 시간
- 예: 250ps = 0.25ns = 250×10⁻¹²s
- 클럭 주파수(속도): 초당 cycle(사이클) 수
- 예: 4.0GHz = 4000MHz = 4.0×10⁹Hz
- 클럭 (사이클)
- 데이터 전송 및 계산
- 상태 갱신
- clock period(클럭 주기)
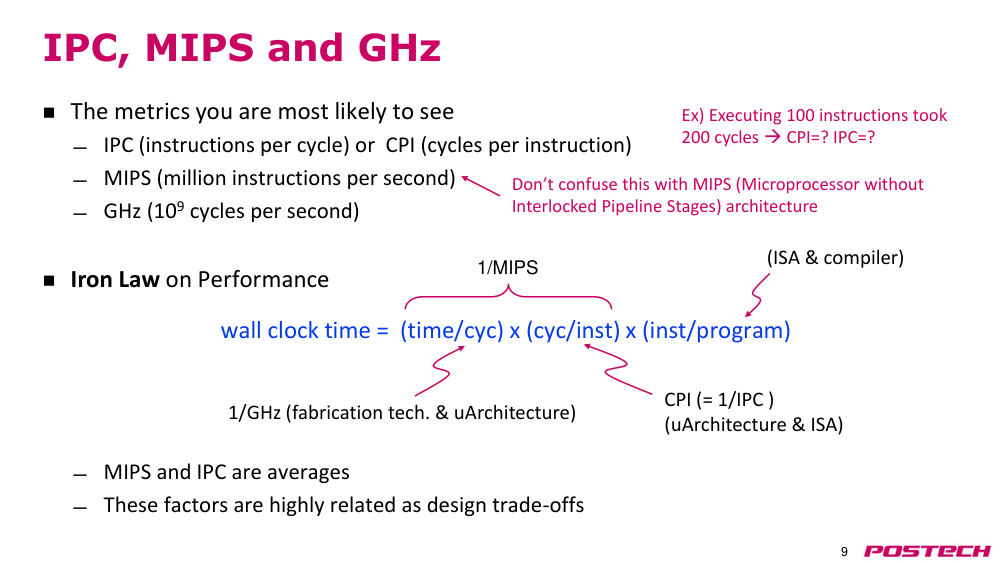
p.9IPC, MIPS 및 GHz
- 가장 흔히 볼 수 있는 지표
- IPC (cycle(사이클)당 instruction(지시어) 수) 또는 CPI (instruction(지시어)당 cycle(사이클) 수)
- MIPS (1초당 백만 지시어)
- GHz (10⁹ cycle(사이클) per 초)
- iron law on performance(성능의 철칙)
- wall-clock time(월클록 시간) = (시간/사이클) × (사이클/지시어) × (지시어/프로그램)
- MIPS와 IPC는 평균값임
- 이 요소들은 설계 상의 트레이드오프로서 매우 밀접하게 관련됨
- 1/GHz (제조 기술 및 마이크로아키텍처)
- 1/MIPS
- CPI (= 1/IPC) (마이크로아키텍처 및 instruction(지시어) 세트 아키텍처)
- ISA(지시어 세트 아키텍처) 및 compiler(컴파일러)
- MIPS (Microprocessor without Interlocked Pipeline Stages) 아키텍처와 혼동하지 마라
- 예) 100개의 instruction(지시어)를 실행하는 데 200개의 cycle(사이클)이 소요됨 → CPI=? IPC=?
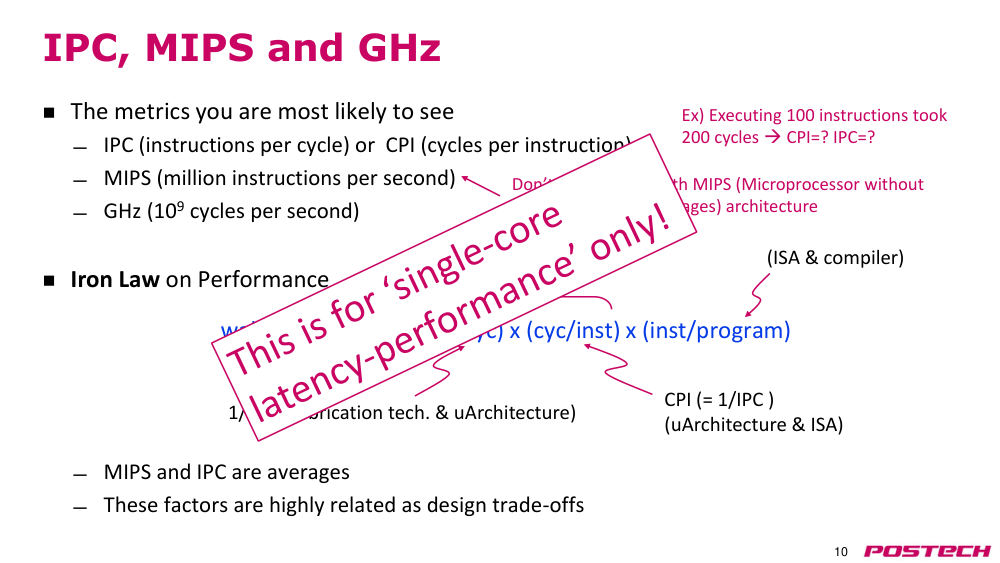
p.10IPC, MIPS 및 GHz
- 가장 흔히 볼 수 있는 지표
- IPC (cycle(사이클)당 instruction(지시어) 수) 또는 CPI (instruction(지시어)당 cycle(사이클) 수)
- MIPS (1초당 백만 지시어)
- GHz (10⁹ cycle(사이클) per 초)
- iron law on performance(성능의 철칙)
- wall-clock time(월클록 시간) = (시간/사이클) × (사이클/지시어) × (지시어/프로그램)
- MIPS와 IPC는 평균값임
- 이 요소들은 설계 상의 트레이드오프로서 매우 밀접하게 관련됨
- 1/GHz (제조 기술 및 마이크로아키텍처)
- 1/MIPS
- CPI (= 1/IPC) (마이크로아키텍처 및 instruction(지시어) 세트 아키텍처)
- ISA(지시어 세트 아키텍처) 및 compiler(컴파일러)
- MIPS (Microprocessor without Interlocked Pipeline Stages) 아키텍처와 혼동하지 마라
- 예) 100개의 instruction(지시어)를 실행하는 데 200개의 cycle(사이클)이 소요됨 → CPI=? IPC=?
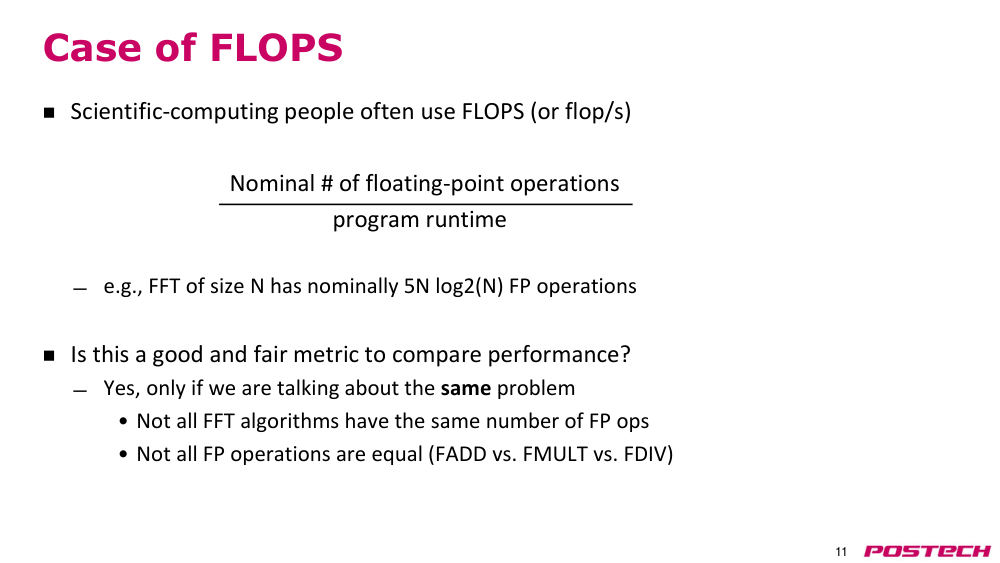
p.11FLOPS의 사례
- 과학 계산 분야에서는 종종 FLOPS (또는 flop/s)를 사용함
- 명목상의 floating-point operation(부동소수점 연산) 수
- 프로그램 execution time(실행 시간)
- 예: 크기 N의 FFT는 명목상 5N log₂(N)개의 floating-point operation(부동소수점 연산)을 가짐
- 이 지표가 성능 비교에 적절하고 공정한가?
- 동일한 문제에 대해 이야기할 경우에만 그렇다
- 모든 FFT 알고리즘의 floating-point operation(부동소수점 연산) 수가 동일하지 않음
- 모든 floating-point operation(부동소수점 연산)이 동일하지 않음 (FADD vs. FMULT vs. FDIV)
p.12다차원적 비교: 예를 들어 execution time(실행 시간)과 에너지
- 개별 지표를 최소화하는 것 외에도, 이들 사이의 트레이드오프를 고려해야 함
- 더 많은 에너지를 소비해 더 빠르게 실행하는 것에 수용 가능
- 반대로, 더 적은 에너지 사용을 위해 더 느리게 실행하는 것에 수용 가능
- 그러나 더 느리게 실행하기 위해 더 많은 에너지를 소비하는 것은 절대 불가능
- 에너지 사용을 고려할 때 관심 있는 지표들
- power(전력) = 에너지 / 시간
- energy-delay-product(에너지-지연 곱) = 에너지 × 시간 // 전반적으로 작을수록 좋음
- 일반적으로 (에너지, 시간)의 함수
- 기타 요소들
- 구현 비용, 신뢰성, 보안 등
- 이 강의에서는 성능만 고려함
p.13성능을 요약하고 비교하는 방법?
- 컴퓨터 A는 컴퓨터 B보다 얼마나 빠른가?
- 여러 프로그램에 대한 하나의 성능 수치는 어떻게 도출할 수 있는가?
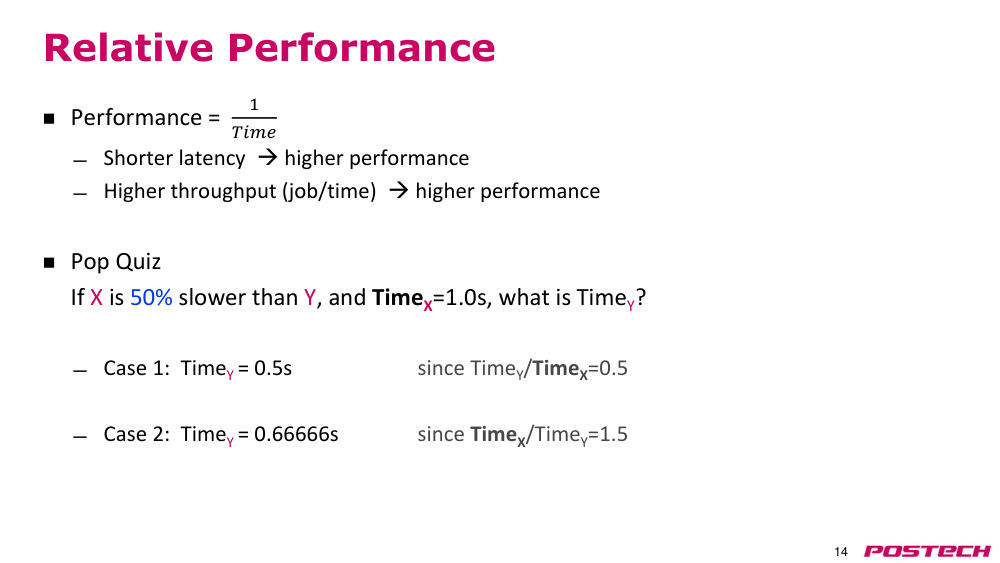
p.14relative performance(상대 성능)
- 성능 = 1 / execution time(실행 시간)
- 짧은 latency(지연 시간) → 높은 성능
- 높은 처리량(작업/시간) → 높은 성능
- 팝 퀴즈: X는 Y보다 50% 느리다. TimeX = 1.0s일 때, TimeY는 얼마인가?
- 사례 1: TimeY = 0.5s (TimeY / TimeX = 0.5)
- 사례 2: TimeY = 0.66666s (TimeX / TimeY = 1.5)
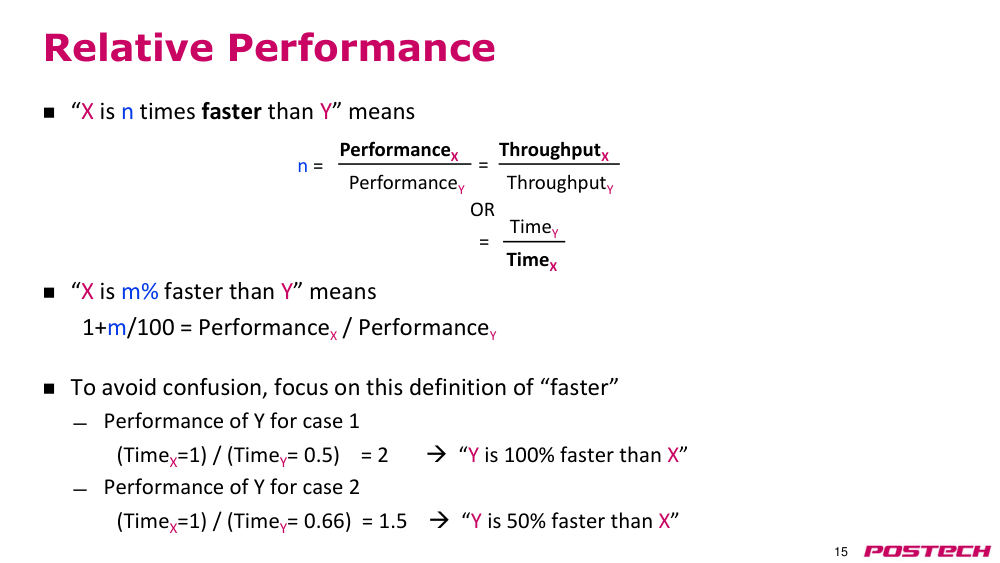
p.15relative performance(상대 성능)
- X는 Y보다 n배 빠르다 → PerformanceX / PerformanceY = n
- X는 Y보다 m% 빠르다 → 1 + m/100 = PerformanceX / PerformanceY
- 혼란을 피하기 위해 ‘빠르다’의 정의에 집중하자
- 사례 1에서 Y의 성능: TimeX=1일 때, TimeY=0.5 → 성능비 = 2 → ‘Y는 X보다 100% 빠르다’
- 사례 2에서 Y의 성능: TimeX=1일 때, TimeY=0.66 → 성능비 = 1.5 → ‘Y는 X보다 50% 빠르다’
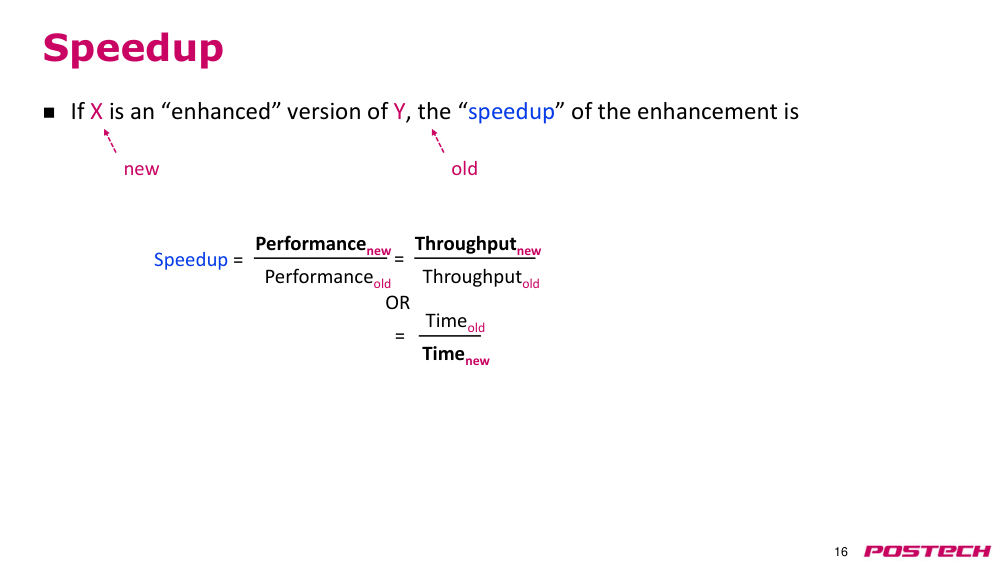
p.16speedup(속도 향상)
- X가 Y의 ‘enhancement(개선)된’ 버전이라면, 개선의 ‘speedup(속도 향상)’은 다음과 같다.
- Speedup = 성능new / 성능old = throughput(처리량)new / 처리량old = Timeold / Timenew
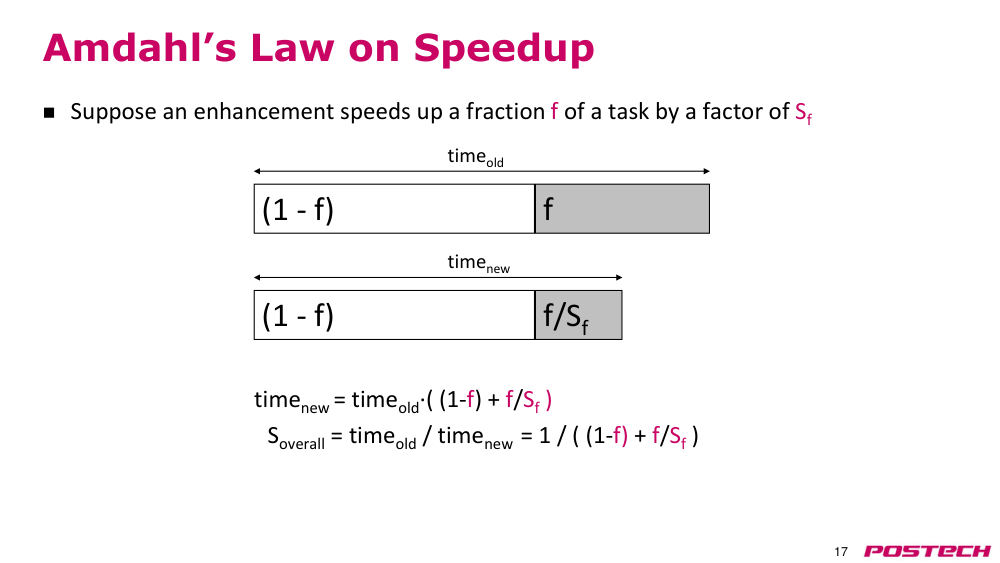
p.17Amdahl's law(암다할의 법칙): speedup(속도 향상)
- enhancement(개선)이 작업의 비율 f를 요인 Sf만큼 빠르게 한다고 가정하자.
- timenew = timeold · ((1 - f) + f / Sf)
- Soverall = timeold / timenew = 1 / ((1 - f) + f / Sf)
- (1 - f) × timeold
- (1 - f) × timenew
- f / Sf
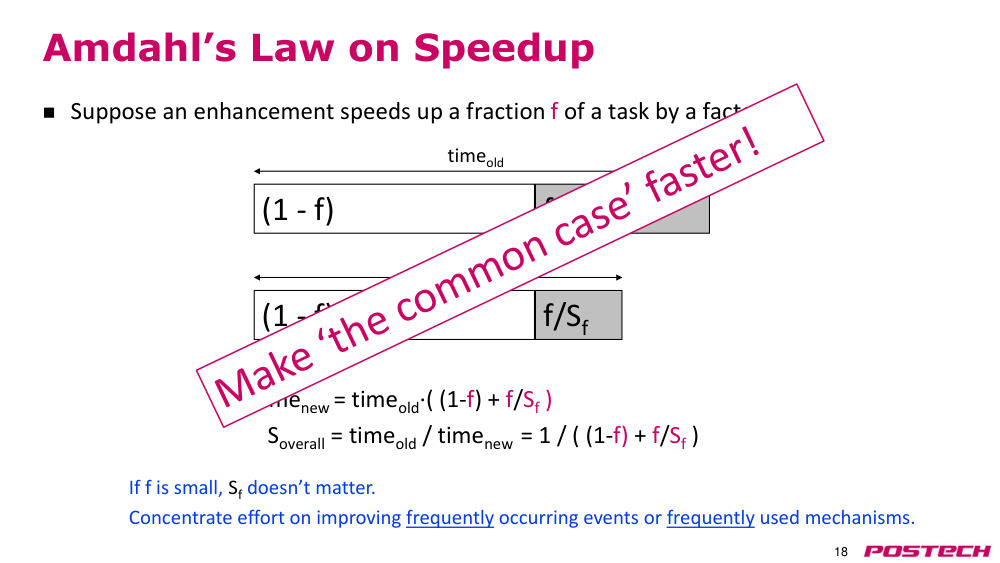
p.18Amdahl's law(암다할의 법칙): speedup(속도 향상)
- enhancement(개선)이 작업의 비율 f를 요인 Sf만큼 빠르게 한다고 가정하자.
- timenew = timeold · ((1 - f) + f / Sf)
- Soverall = timeold / timenew = 1 / ((1 - f) + f / Sf)
- (1 - f) × timeold
- (1 - f) × timenew
- f / Sf
- f가 작으면 Sf는 중요하지 않다. 자주 발생하는 사건이나 자주 사용되는 메커니즘을 enhancement(개선)하는 데 집중하라.
p.19성능 요약
- 두 컴퓨터 X와 Y를 비교할 때, X와 Y의 relative performance(상대 성능)은 X와 Y가 수행하도록 요청된 작업에 크게 의존한다.
- X는 응용 프로그램 A에서 Y보다 m% 빠를 수 있다.
- X는 응용 프로그램 B에서 Y보다 n% 빠를 수 있다 (여기서 m ≠ n).
- Y는 응용 프로그램 C에서 X보다 k% 빠를 수 있다.
- 어느 컴퓨터가 더 빠른가, 그리고 얼마나 빠른가?
- 이는 당신이 관심 있는 응용 프로그램에 달려 있다.
- 여러 응용 프로그램이 있다면, 각각의 상대적 중요성이 중요하다.
- 성능 비교를 하나의 수치적 측정값으로 요약하는 방법은 여러 가지가 있다.
- 어떤 방법은 정확히 당신의 목적에 의미 있을 수도 있다.
- 하지만 언제 어떤 방법을 써야 할지 알아야 한다.
- 의심스럽다면, 전체적인 이야기를 제시하라.
p.20arithmetic mean(산술 평균)
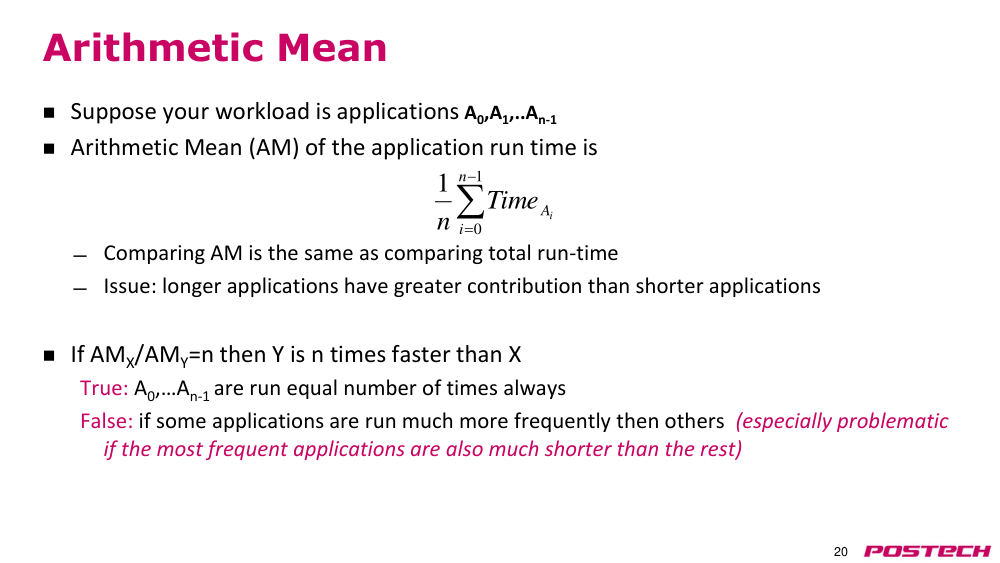
- workload(작업 부하)가 응용 프로그램 A0, A1, ... An-1로 구성되어 있다고 가정하자.
- 응용 프로그램 execution time(실행 시간)의 산술 평균(AM)은 다음과 같다.
- arithmetic mean(산술 평균)을 비교하는 것은 총 execution time(실행 시간)을 비교하는 것과 같다.
- 문제점: 더 긴 응용 프로그램이 더 큰 기여를 한다.
- 만약 AMX / AMY = n이면, Y는 X보다 n배 빠르다.
- 참: A0, ... An-1는 항상 동일한 횟수로 실행된다.
- 거짓: 일부 응용 프로그램이 다른 것보다 훨씬 자주 실행되는 경우 (특히 가장 자주 실행되는 응용 프로그램이 나머지보다 훨씬 짧은 경우에 특히 문제가 된다).
p.21weighted arithmetic mean(가중 산술 평균)
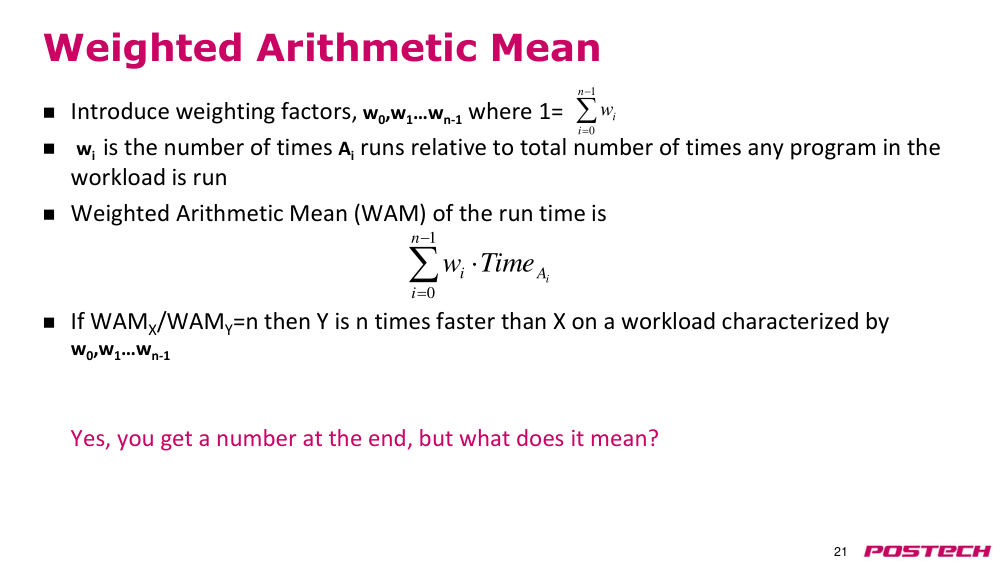
- weighting factor(가중치 요소) w₀, w₁, …, wₙ₋₁를 도입한다. 여기서 Σwᵢ = 1이다.
- wᵢ는 작업 부하(workload) 내에서 프로그램 Aᵢ가 실행되는 횟수를 전체 실행 횟수에 대한 fraction (f)(비율)로 나타낸다.
- execution time(실행 시간)의 가중 산술 평균(WAM)은 다음과 같다.
- 만약 WAMX / WAMY = n이라면, 가중치 w₀, w₁, …, wₙ₋₁로 특성화된 workload(작업 부하)에서 Y는 X보다 n배 빠르다.
- 네, 결과로 숫자가 나온다. 하지만 그 숫자는 무엇을 의미하는가?
p.22geometric mean(기하 평균)
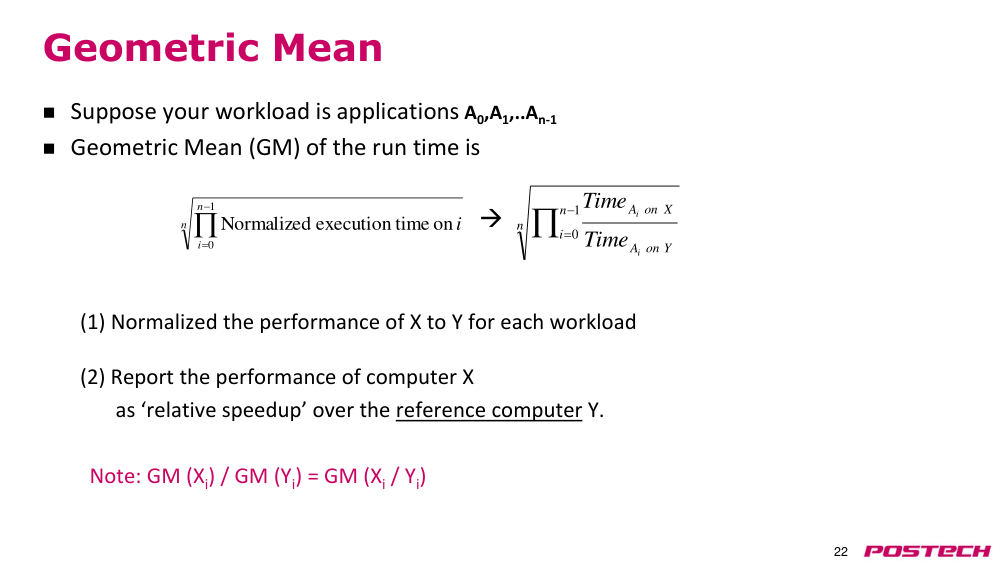
- workload(작업 부하)가 응용 프로그램 A0, A1, .. An-1로 구성되어 있다고 가정하자.
- 기하 평균(GM)은 execution time(실행 시간)에 대해 다음과 같다.
- → (1) 각 workload(작업 부하)에 대해 컴퓨터 X의 성능을 컴퓨터 Y에 대해 normalization(정규화)한다.
- → (2) 컴퓨터 X의 성능을 reference computer(기준 컴퓨터) Y에 대한 '상대 speedup(속도 향상)'으로 보고한다.
- 참고: GM(Xi) / GM(Yi) = GM(Xi / Yi)
p.23기하 평균 (계속)
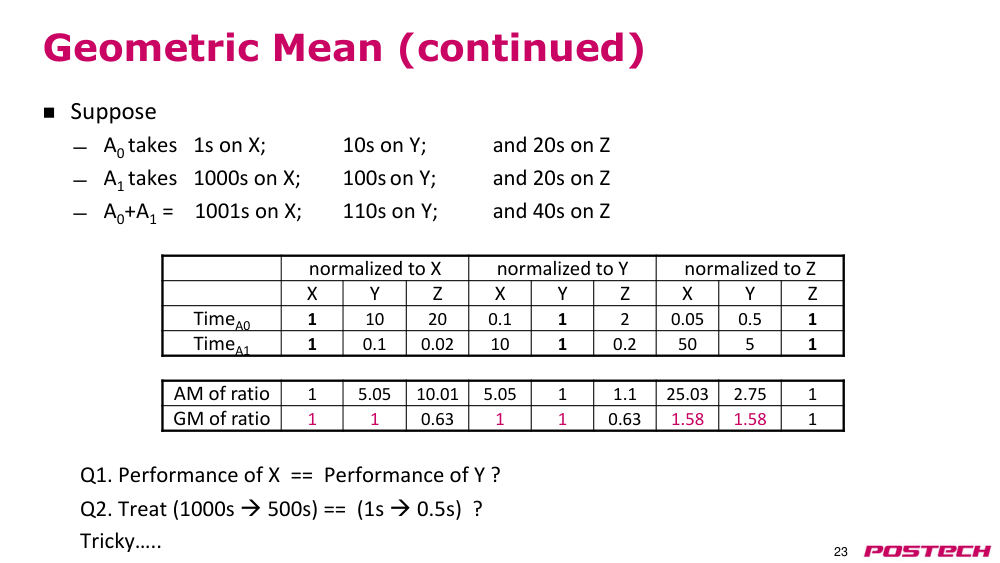
- - A0는 X에서 1초, Y에서 10초, Z에서 20초 소요
- - A1은 X에서 1000초, Y에서 100초, Z에서 20초 소요
- - A0 + A1은 X에서 1001초, Y에서 110초, Z에서 40초 소요
- 질문 1: X의 성능 == Y의 성능인가?
- 질문 2: (1000초 → 500초)의 enhancement(개선) == (1초 → 0.5초)의 개선인가?
- 매우 주의 깊게 살펴봐야 함
- X 기준 normalization(정규화)
- Y 기준 normalization(정규화)
- Z 기준 normalization(정규화)
- A0 execution time(실행 시간)
- 1
- 10
- 20
- 0.1
- 1
- 2
- 0.05
- 0.5
- 1
- A1 execution time(실행 시간)
- 1
- 0.1
- 0.02
- 10
- 1
- 0.2
- 50
- 5
- 1
- fraction (f)(비율)의 arithmetic mean(산술 평균)
- 1
- 5.05
- 10.01
- 5.05
- 1
- 1.1
- 25.03
- 2.75
- 1
- fraction (f)(비율)의 geometric mean(기하 평균)
- 1
- 1
- 0.63
- 1
- 1
- 0.63
- 1.58
- 1.58
- 1
p.24harmonic mean(조화 평균)
- "율"(예: 처리량)의 arithmetic mean(산술 평균)을 취하면 안 된다.
- 예: 처음 10km는 30km/h, 다음 10km는 90km/h일 때, 평균 속도는 (30 + 90)/2 = 60km/h가 아니다!
- 평균 속도를 계산하려면
- 1. 전체적으로 전개하기
- 평균 속도 = 총 거리 / 총 시간 = 20 / (10/30 + 10/90) = 45km/h
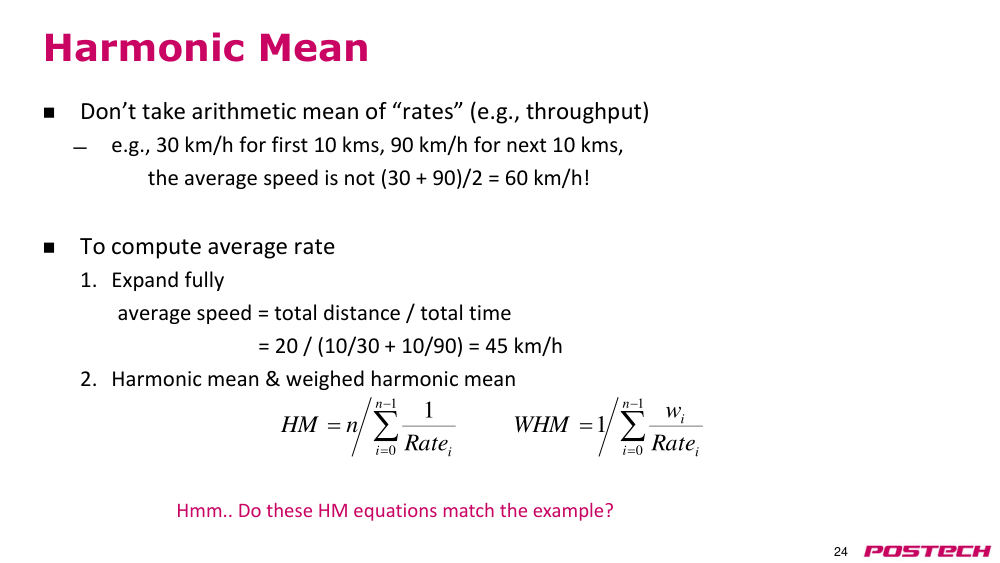
- 2. harmonic mean(조화 평균) 및 가중 조화 평균
- HM = n / \sum_{i=0}^{n-1} \frac{1}{Rate_i}
- WHM = 1 / \sum_{i=0}^{n-1} \frac{w_i}{Rate_i}
- 이 harmonic mean(조화 평균) 식들이 예시와 일치하는가?
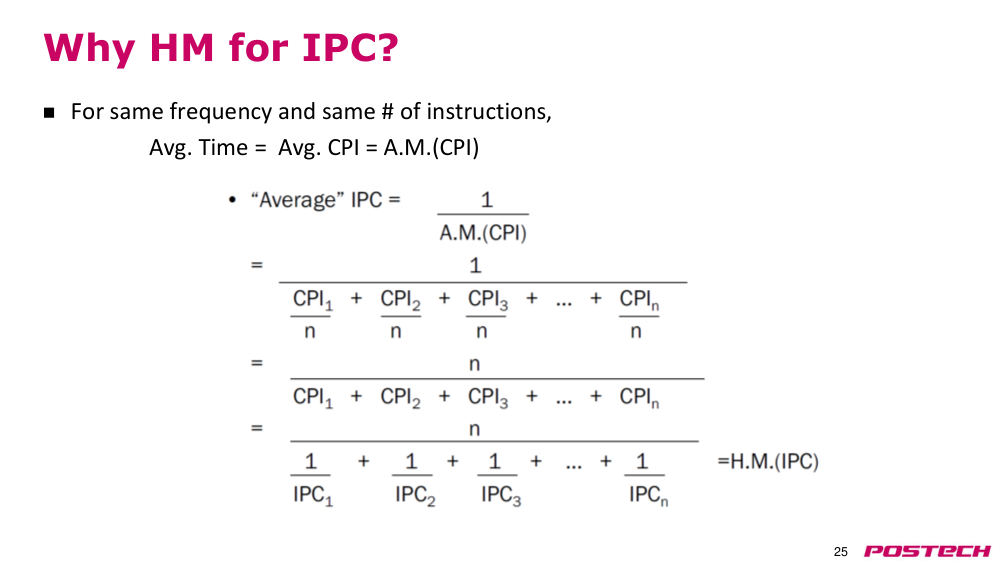
p.25IPC에 대해 왜 harmonic mean(조화 평균)을 사용하는가?
- 같은 clock frequency(클럭 주파수)와 같은 instruction(지시어) 수를 가진 경우, 평균 시간 = 평균 CPI = CPI의 산술 평균(A.M.)
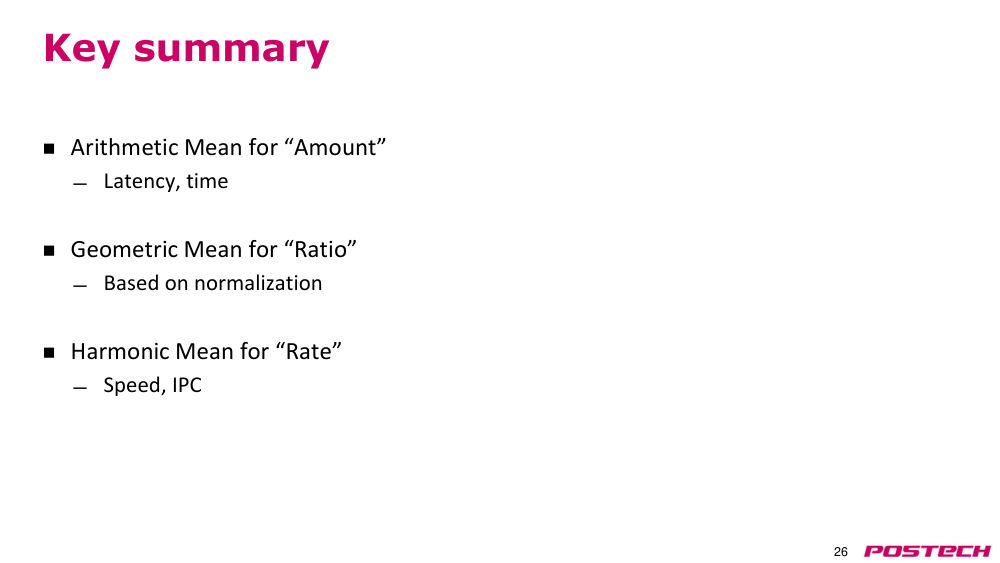
p.26핵심 요약
- ‘양’에 대해 arithmetic mean(산술 평균) 사용 — latency(지연 시간), 시간
- ‘fraction (f)(비율)’에 대해 geometric mean(기하 평균) 사용 — normalization(정규화) 기반
- ‘율’에 대해 harmonic mean(조화 평균) 사용 — 속도, IPC
p.27standard benchmarks(표준 벤치마크)
- 왜 standard benchmarks(표준 벤치마크)가 필요한가? — 각자가 관심 있는 응용 프로그램이 다르며, 성능의 다양한 측면에 관심이 있음 — 연구하고자 하는 시스템에 대해 당신의 응용 프로그램이 사용할 수 없을 수 있음
- SPEC 벤치마크 (www.spec.org) — 표준 성능 평가 기구 — multi-industry committee(다중 산업 위원회)가 선정한 '현실적인', 일반 목적의 public-domain applications(공공 도메인 응용 프로그램) 세트 — 사용 패턴과 기술 변화를 반영하기 위해 몇 년마다 업데이트됨 — 객관성과 predictive power(예측 능력)의 느낌 — 모두가 완벽하지 않다는 것을 알고 있지만, 적어도 모두가 같은 규칙을 따라 플레이하거나 속임수를 쓰는 것
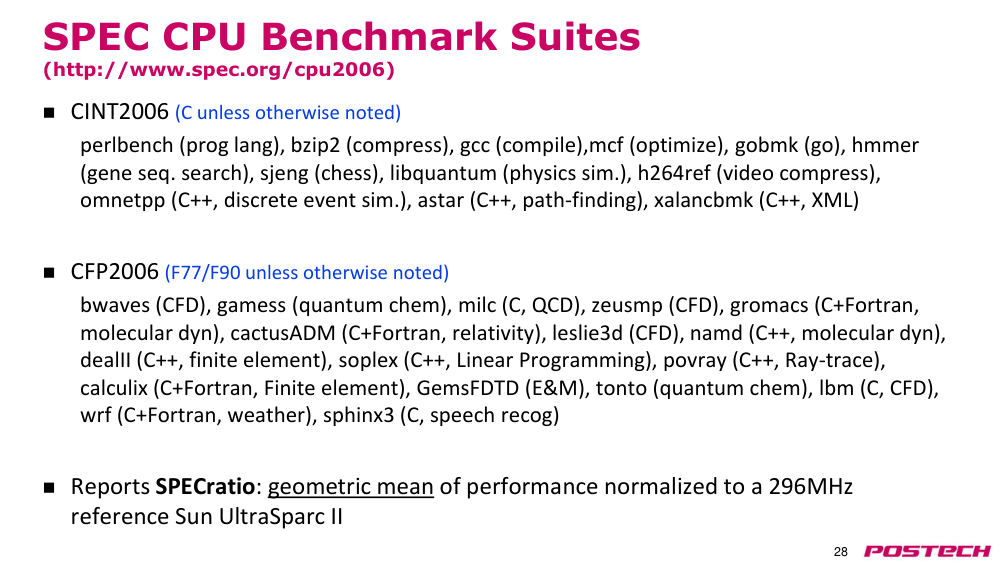
p.28SPEC CPU benchmark suites(SPEC CPU 벤치마크 세트)
- CINT2006 (기타 표기 없을 경우 C) — perlbench (프로그래밍 언어), bzip2 (압축), gcc (컴파일), mcf (최적화), gobmk (고), hmmer (유전자 서열 검색), sjeng (체스), libquantum (물리 시뮬레이션), h264ref (비디오 압축), omnetpp (C++, 이산 사건 시뮬레이션), astar (C++, 경로 탐색), xalancbmk (C++, XML)
- CFP2006 (기타 표기 없을 경우 F77/F90) — bwaves (CFD), gamess (양자 화학), milc (C, QCD), zeusmp (CFD), gromacs (C+Fortran, 분자 역학), cactusADM (C+Fortran, 상대성 이론), leslie3d (CFD), namd (C++, 분자 역학), dealII (C++, 유한 요소), soplex (C++, 선형 프로그래밍), povray (C++, 레이 트레이싱), calculix (C+Fortran, 유한 요소), GemsFDTD (전자기학), tonto (양자 화학), lbm (C, CFD), wrf (C+Fortran, 날씨 예보), sphinx3 (C, 음성 인식)
- SPECratio 보고: 296MHz 기준 Sun UltraSparc II에 대해 성능을 normalization(정규화)한 후의 geometric mean(기하 평균)
p.29성능 요약
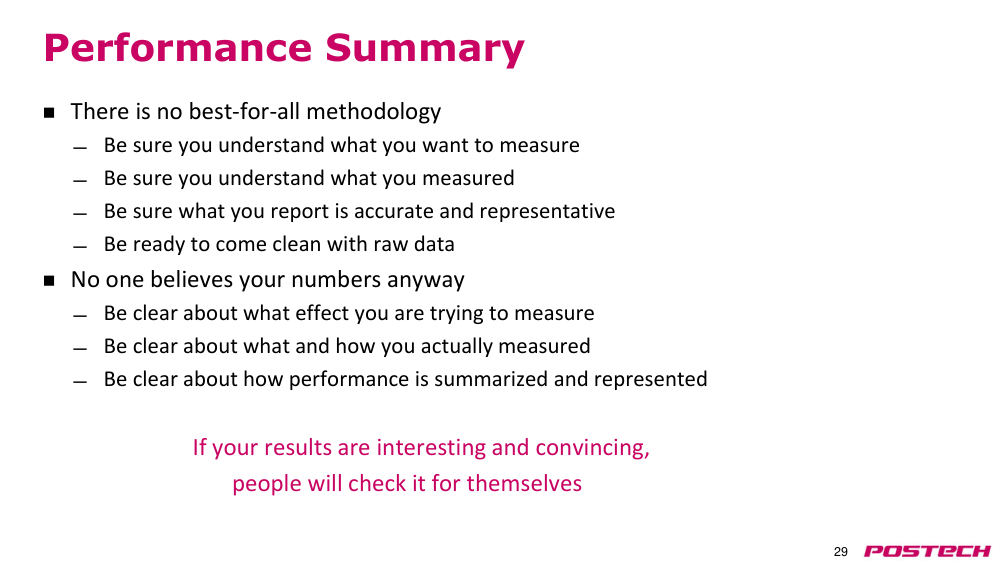
- 모든 상황에 최적의 방법론은 존재하지 않음 — 무엇을 측정하고자 하는지 이해해야 함 — 무엇을 측정했는지 이해해야 함 — 보고하는 내용이 정확하고 대표적인지 확인해야 함 — 원시 데이터(raw data)를 공개할 준비가 되어 있어야 함
- 아무도 당신의 수치를 믿지 않을 것이다 — 어떤 영향을 측정하려는지 명확히 해야 함 — 실제로 어떻게 측정했는지 명확히 해야 함 — 성능이 어떻게 요약되고 표현되었는지 명확히 해야 함 — 만약 결과가 흥미롭고 설득력 있다면, 사람들은 스스로 확인할 것이다
p.30질문?
- 공지사항
- - 읽기: P&H Ch 4.1 – 4.4