이 자료를 쓰는 강의: 38 Instruction set architecture(명령어 집합 아키텍처) II: RISC-V · 39 Lec 4 · RISC-V jump·calling convention 과 performance 측정
Lec3-ISA II (updated)
한국어판 강의자료 · 40쪽
p.1CSED311 컴퓨터구조 – 강의 3
p.2리뷰
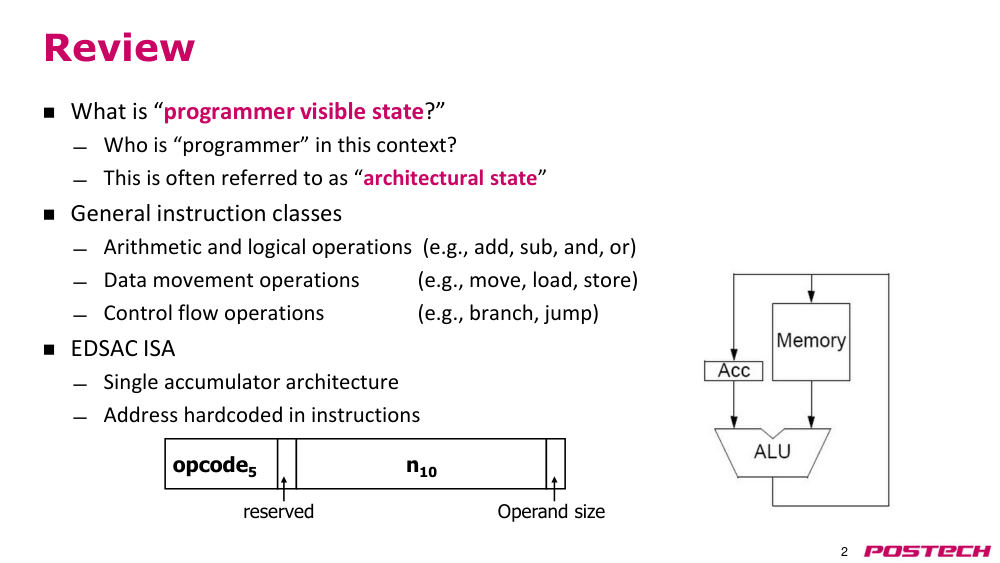
- "programmer visible state(프로그래머가 보는 상태)"란 무엇인가?
- 이 맥락에서 "프로그래머"는 누구인가?
- 이것은 종종 "architectural state(아키텍처 상태)"라고도 불린다
- 일반적인 명령어 클래스
- 산술 및 논리 연산 (예: add, sub, and, or)
- 데이터 이동 연산 (예: move, load, store)
- 제어 흐름 연산 (예: branch, jump)
- EDSAC ISA(EDSAC 명령어 집합 아키텍처)
- single accumulator architecture(단일 누산기 아키텍처)
- 주소는 명령어에 하드코딩되어 있음
- opcode(오퍼레이션 코드)5
- n10
- reserved(예약됨)
- operand size(피연산자 크기)
p.3리뷰: instruction set architecture (ISA)(명령어 집합 아키텍처) – 컴퓨터의 언어
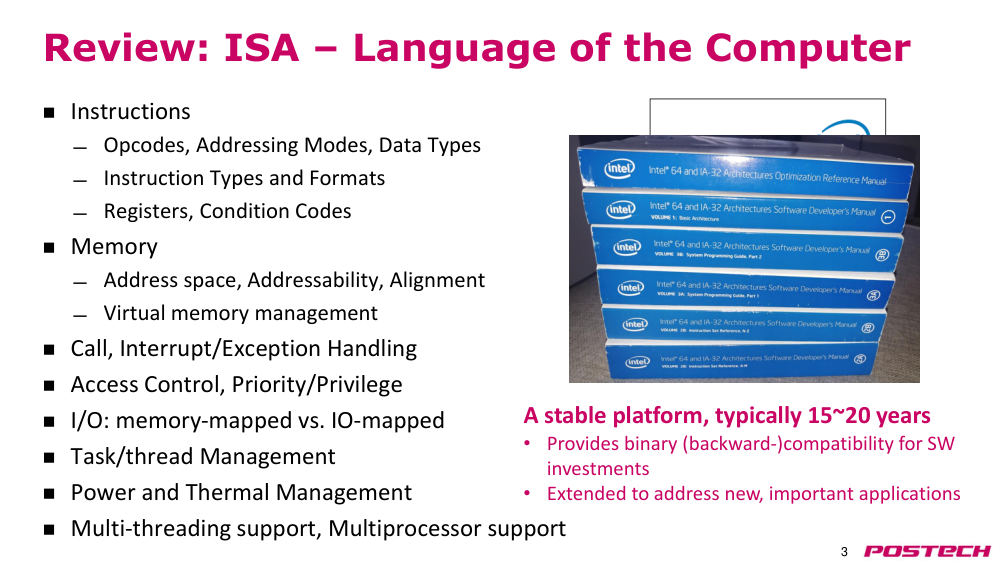
- 명령어
- opcode(오퍼레이션 코드), addressing modes(주소 지정 방식), data types(데이터 유형)
- instruction types and formats(명령어 유형 및 형식)
- registers(레지스터), condition codes(조건 코드)
- memory(메모리)
- address space(주소 공간), addressability(주소 가능성), alignment(정렬)
- virtual memory management(가상 메모리 관리)
- call handling(호출 처리), Interrupt/Exception handling(인터럽트/예외 처리)
- access control(접근 제어), Priority/Privilege(우선순위/권한)
- I/O(입출력): Memory-Mapped I/O(메모리 매핑된 입출력) vs. I/O-Mapped I/O(입출력 매핑된 입출력)
- Task/Thread management(작업/스레드 관리)
- power and thermal management(전력 및 열 관리)
- multi-threading support(다중 스레딩 지원), multiprocessor support(다중 프로세서 지원)
- 안정적인 플랫폼, 일반적으로 15~20년
- 소프트웨어 투자에 대한 바이너리(역방향) 호환성 제공
- 새로운 중요한 응용 프로그램을 해결하기 위해 확장됨
p.4RISC-V 개요
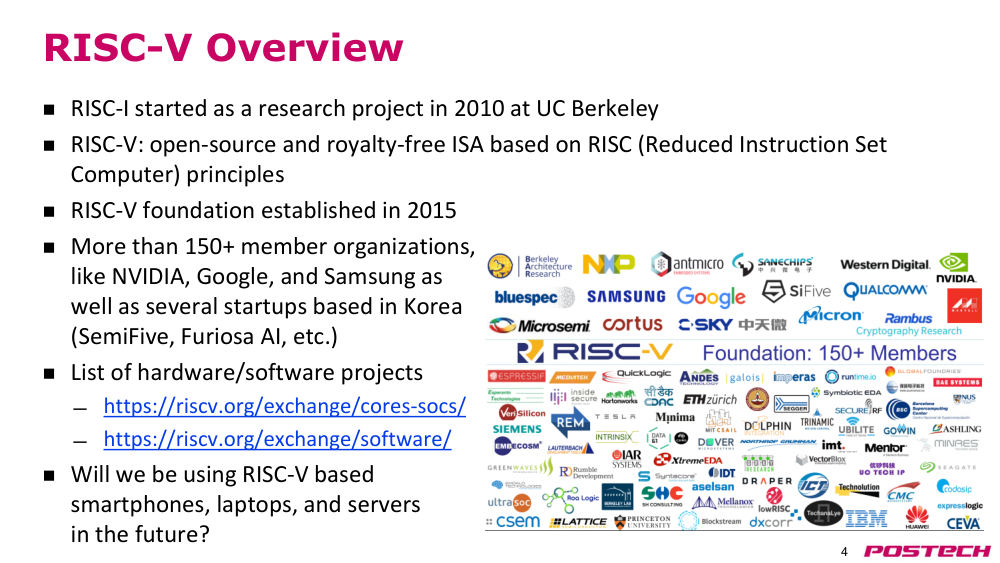
- RISC-I는 2010년 UC 버클리에서 연구 프로젝트로 시작됨
- RISC-V: RISC(단순 명령어 집합 컴퓨터) 원칙에 기반한 open-source(오픈소스) 및 royalty-free(로열티 없음) instruction set architecture (ISA)(명령어 집합 아키텍처)
- RISC-V foundation(RISC-V 재단)은 2015년 설립됨
- 150개 이상의 회원 기관 보유
- NVIDIA, Google, 삼성 등과 함께 한국 기반 스타트업(SemiFive, Furiosa AI 등) 포함
- 하드웨어/소프트웨어 프로젝트 목록
- https://riscv.org/exchange/cores-socs/
- https://riscv.org/exchange/software/
- 미래에 RISC-V 기반 스마트폰, 노트북, 서버를 사용하게 될까?
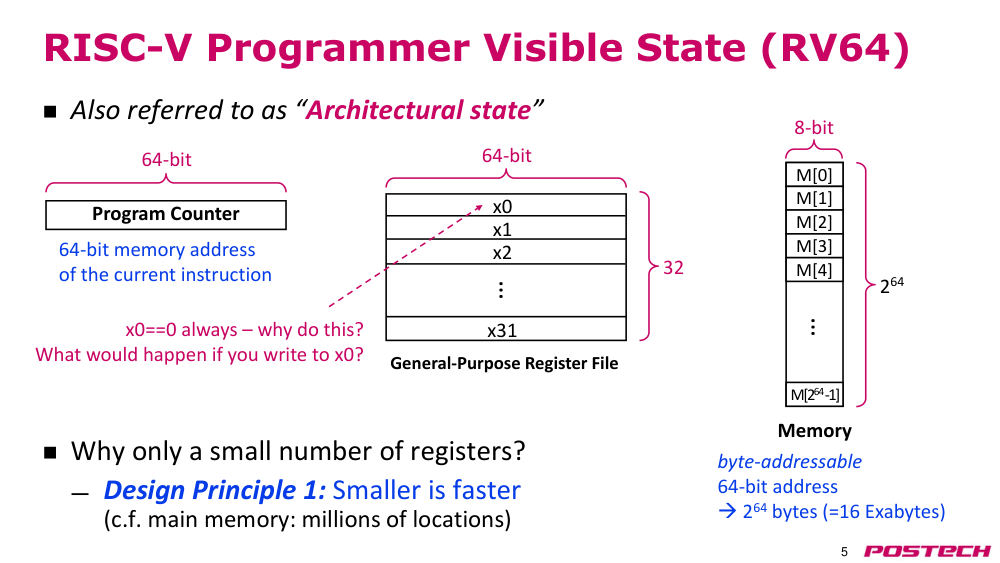
p.5RISC-V 프로그래머가 보는 상태 (RV64)
- "architectural state(아키텍처 상태)"라고도 함
- 왜 registers(레지스터) 수가 적은가?
- design principle 1: smaller is faster(설계 원칙 1: 작을수록 빠르다)
- (예: 메인 memory(메모리): 수백만 개의 위치)
- memory(메모리)
- program counter (PC)(프로그램 카운터)
- M[0]
- M[1]
- M[2]
- M[3]
- M[4]
- M[264 -1]
- …
- x0
- x1
- x2
- …
- x31
- x0는 항상 0이다 – 왜 이렇게 하는가?
- x0에 쓰면 어떻게 되는가?
- 64비트
- 64비트
- 8비트
- 현재 명령어의 64비트 memory(메모리) 주소
- byte-addressable(바이트 주소 가능)
- 64비트 주소
- → 264 바이트 (=16 엑사바이트)
- General-Purpose register file(일반 목적 registers(레지스터) 파일)
- 32
- 264
p.6데이터 형식
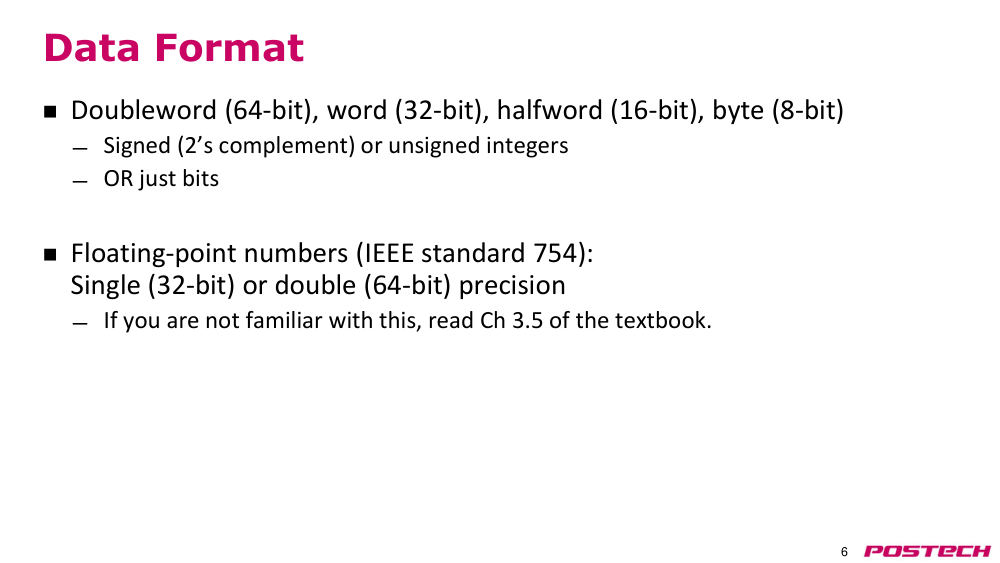
- doubleword(더블워드) (64비트), word(워드) (32비트), halfword(하프워드) (16비트), byte(바이트) (8비트)
- 부호 있는 (2의 보수) 또는 unsigned integers(부호 없는 정수)
- 또는 단순히 비트
- 부동소수점 수 (IEEE 754 표준): 단정밀도 (32비트) 또는 이중 정밀도 (64비트)
- 이에 익숙하지 않다면 교재 3.5장을 읽어보라.
p.7연습: instruction representation(명령어 표현)
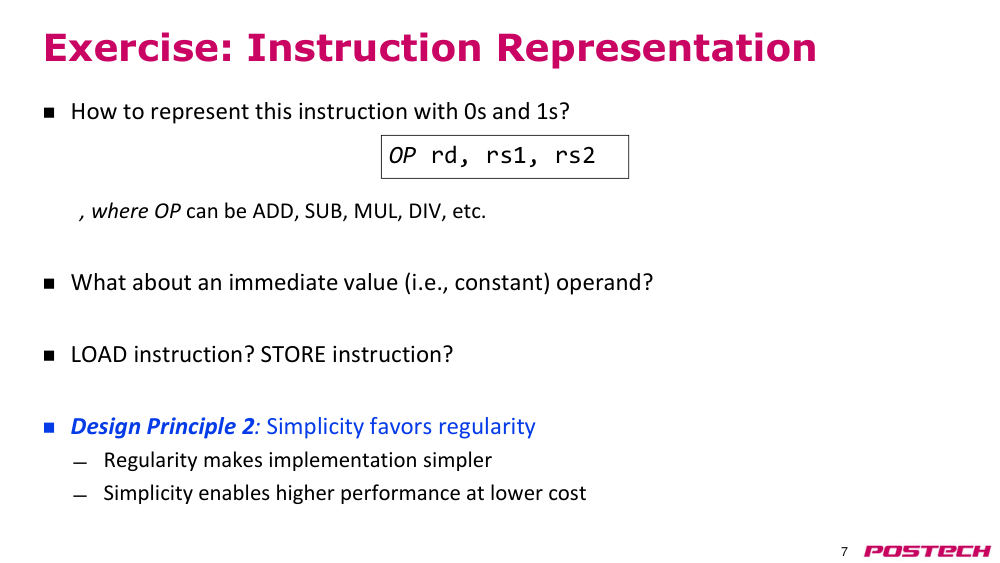
- 0과 1로 이 명령어를 어떻게 표현할 수 있을까?
- OP rd, rs1, rs2
- (OP는 ADD, SUB, MUL, DIV 등이 될 수 있음)
- immediate value(즉시 값) operand(피연산자), 즉 상수에 대해서는 어떻게 할까?
- load instruction(로드 명령어)? store instruction(스토어 명령어)?
- design principle 2: simplicity favors regularity(설계 원칙 2: 단순성이 규칙성을 선호한다)
- 규칙성은 구현을 더 간단하게 만든다
- 단순성은 낮은 비용으로 더 높은 성능을 가능하게 한다
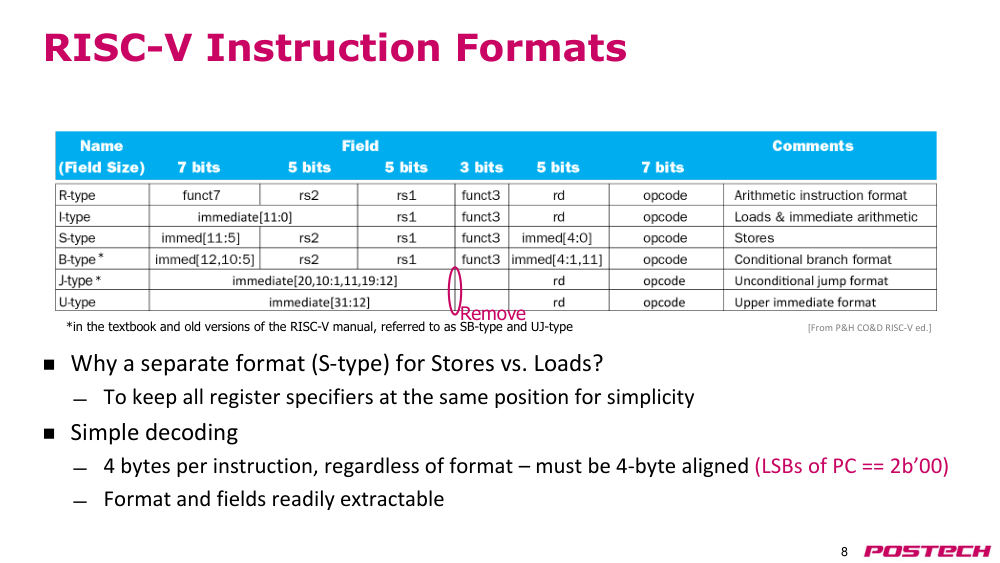
p.8RISC-V 명령어 형식
- 로드와 스토어에 대해 별도의 형식(S형)을 사용하는 이유는 무엇인가?
- 모든 registers(레지스터) 지정자를 단순화를 위해 동일한 위치에 두기 위해
- 간단한 디코딩
- 각 명령어는 4바이트이며, 형식에 관계없이 항상 4-byte aligned(4바이트 정렬)되어야 함 (PC의 하위 2비트 == 2b’00)
- 형식과 필드는 쉽게 추출 가능하다
- [P&H CO&D RISC-V ed.에서 발췌]
- *교재 및 RISC-V 매뉴얼의 오래된 버전에서는 SB형과 UJ형으로 불림*
- *제거*
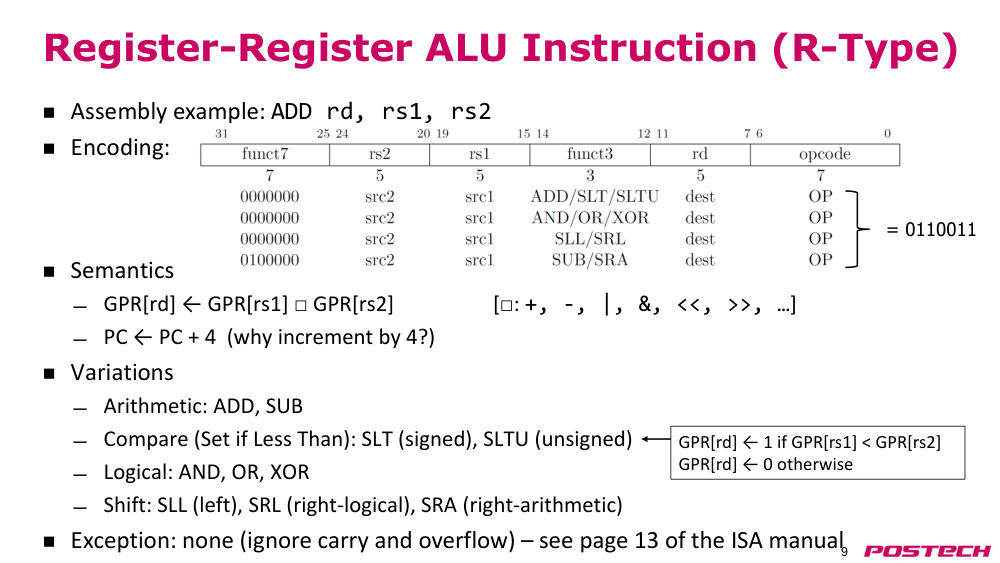
p.9registers(레지스터)-레지스터 ALU 명령어 (R형)
- 어셈블리 예시: ADD rd, rs1, rs2
- 인코딩:
- 의미:
- GPR[rd] ← GPR[rs1] □ GPR[rs2]
- [□: +, -, |, &, <<, >>, …]
- PC ← PC + 4 (왜 4만큼 증가시키는가?)
- 변형:
- 산술: ADD, SUB
- 비교(작은 경우 설정): SLT (부호 있는), SLTU (부호 없는)
- 논리: AND, OR, XOR
- 시프트: SLL (왼쪽), SRL (오른쪽 논리), SRA (오른쪽 산술)
- 예외: 없음 (캐리와 오버플로우 무시) – ISA 매뉴얼 13페이지 참조
- = 0110011
- GPR[rd] ← 1 if GPR[rs1] < GPR[rs2]
- GPR[rd] ← 0 otherwise
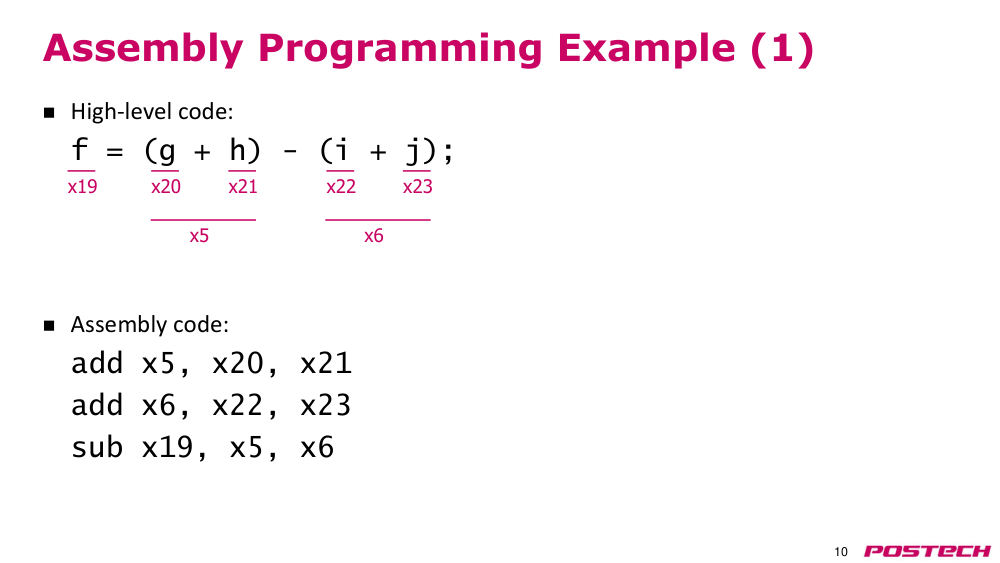
p.10어셈블리 프로그래밍 예제 (1)
- 고수준 코드:
- f = (g + h) - (i + j);
- 어셈블리 코드:
- add x5, x20, x21
- add x6, x22, x23
- sub x19, x5, x6
- x19
- x20
- x21
- x22
- x23
- x5
- x6
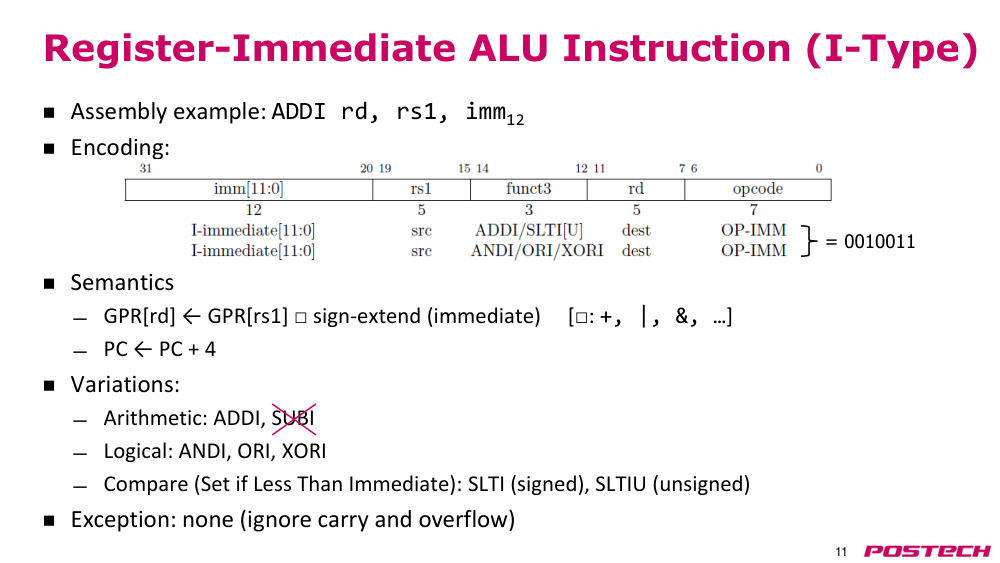
p.11registers(레지스터)-즉시 ALU 명령어 (I형)
- 어셈블리 예시: ADDI rd, rs1, imm12
- 인코딩:
- 의미:
- GPR[rd] ← GPR[rs1] □ sign-extend(immediate)
- [□: +, |, &, …]
- PC ← PC + 4
- 변형:
- 산술: ADDI, SUBI
- 논리: ANDI, ORI, XORI
- compare (set if less than immediate)(즉시값보다 작으면 설정): SLTI (부호 있는), SLTIU (부호 없는)
- 예외: 없음 (캐리와 오버플로우 무시)
- = 0010011
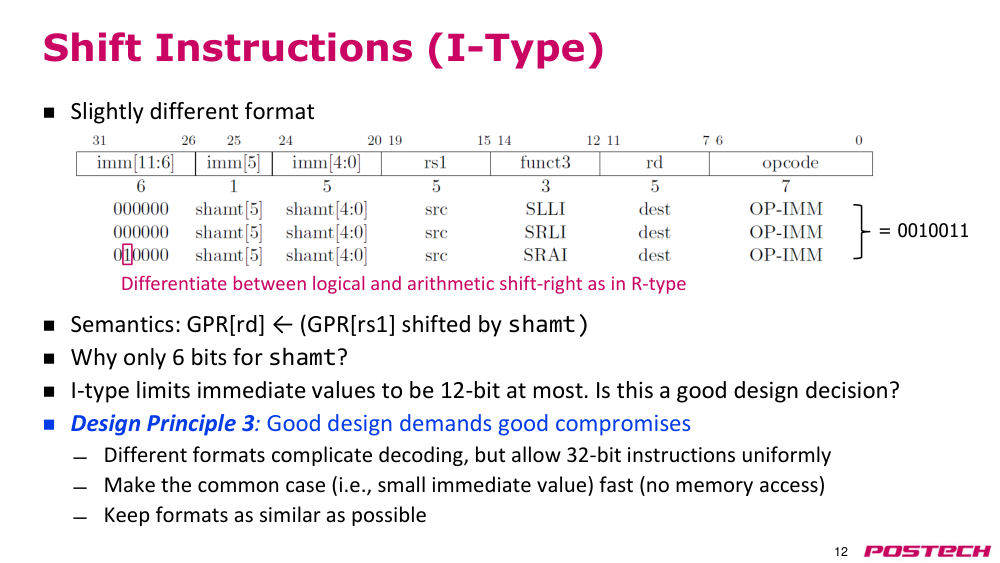
p.12시프트 명령어 (I형)
- 약간 다른 형식
- 의미: GPR[rd] ← (GPR[rs1]을 shamt만큼 시프트한 값)
- 왜 shamt에 6비트만 사용하는가?
- I형은 immediate value(즉시 값)을 최대 12비트로 제한한다. 이는 좋은 설계 결정인가?
- design principle 3: good design demands good compromises(설계 원칙 3: 좋은 설계는 좋은 타협을 요구한다)
- 다른 형식은 디코딩을 복잡하게 하지만, 32비트 명령어를 일관되게 유지할 수 있다
- 보통의 경우(작은 즉시 값)를 빠르게 처리한다(메모리 접근 없이)
- 형식을 가능한 한 유사하게 유지한다
- = 0010011
- R형과 마찬가지로 논리적 및 산술적 오른쪽 시프트를 구분한다
p.13큰 상수에 대한 고려
- 대부분의 상수는 작다
- 12비트 immediate value(즉시 값)만으로 충분하다
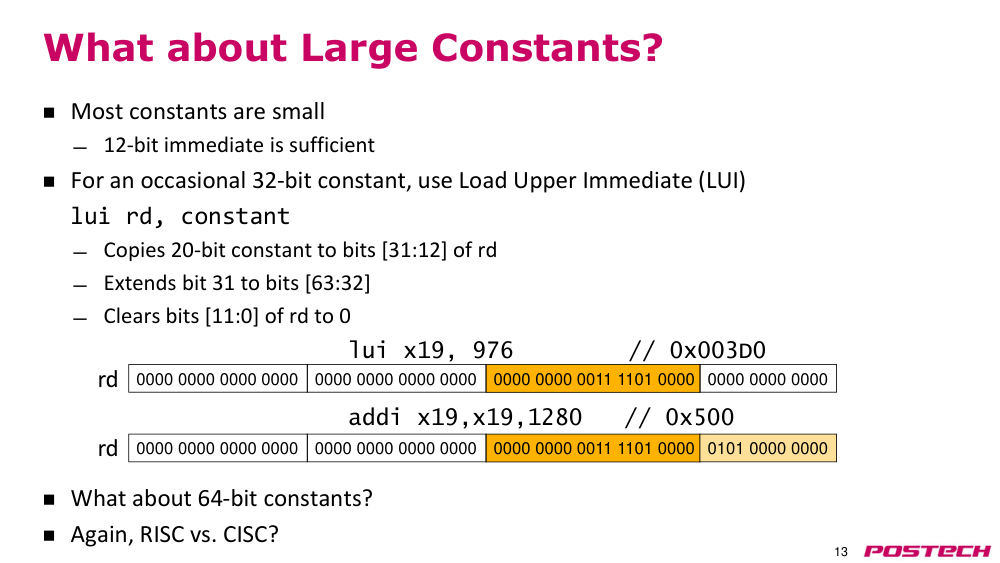
- 드물게 32비트 상수를 사용할 경우, load upper immediate(상위 즉시값 로드, LUI) 명령어를 사용한다
- lui rd, constant
- 20비트 상수를 rd의 비트 [31:12]에 복사한다
- 비트 31을 비트 [63:32]까지 확장한다
- rd의 비트 [11:0]을 0으로 지운다
- 64비트 상수는 어떻게 처리할까?
- 다시 한 번, RISC와 CISC의 차이?
- 0000 0000 0011 1101 0000
- 0000 0000 0000 0000
- lui x19, 976
- // 0x003D0
- addi x19, x19, 1280
- // 0x500
- 0000 0000 0000 0000
- 0000 0000 0000 0000
- 0000 0000 0011 1101 0000
- 0000 0000 0000 0000
- 0000 0000 0000 0000
- 0101 0000 0000
- rd
- rd
p.14RISC-V: Load-Store architecture(로드-스토어 아키텍처)
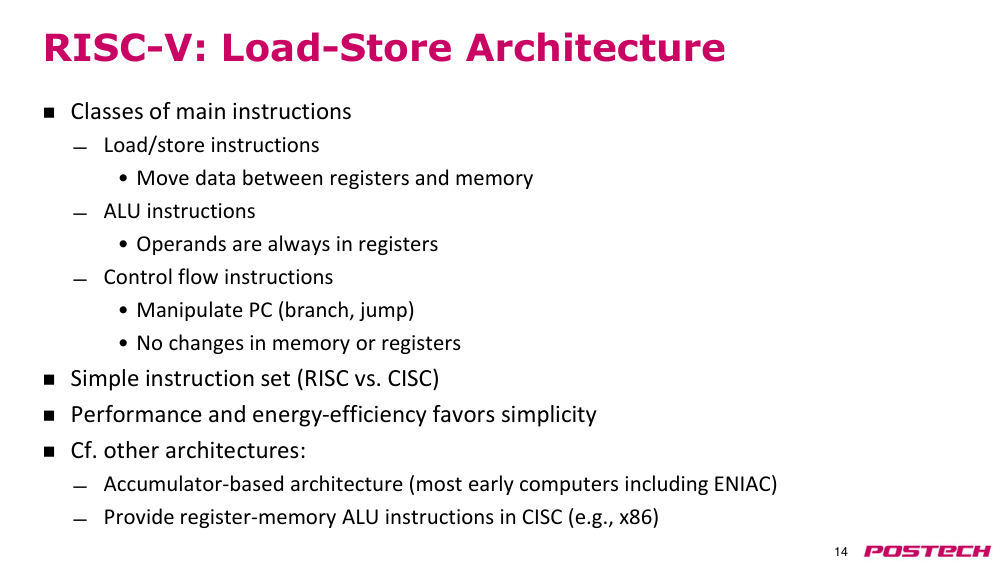
- 주요 명령어의 종류:
- load/store instruction(로드/스토어 명령어)
- • registers(레지스터)와 memory(메모리) 사이의 데이터 이동
- ALU instructions(ALU 명령어)
- • 연산의 피연산자는 항상 registers(레지스터)에 있다
- 제어 흐름 명령어
- • 프로그램 카운터(PC)를 조작한다(브랜치, 점프)
- • memory(메모리)나 registers(레지스터)의 내용은 변경되지 않는다
- 간단한 명령어 집합(RISC 대 CISC)
- 성능과 에너지 효율성은 단순성에 유리하다
- 다른 아키텍처와 비교:
- 누산기 기반 아키텍처(ENIAC 포함한 대부분의 초기 컴퓨터)
- CISC에서는 registers(레지스터)-memory(메모리) ALU instructions(ALU 명령어) 제공(예: x86)
p.15로드 명령어 (I형)
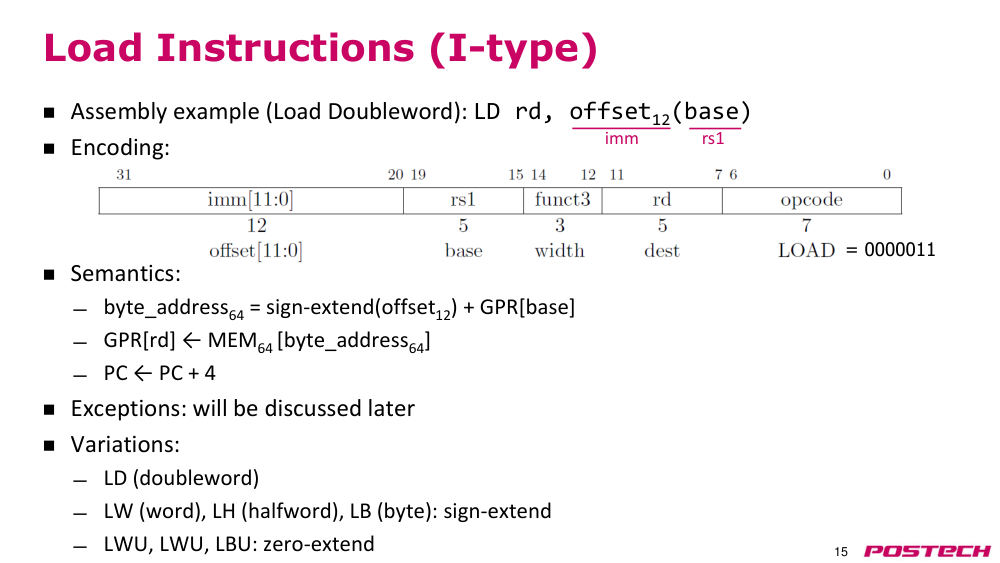
- 어셈블리 예제(더블워드 로드): LD rd, offset12(base)
- 인코딩:
- 의미:
- byte_address64 = sign‐extend(offset12) + GPR[base]
- GPR[rd] ← MEM64 [byte_address64]
- PC ← PC + 4
- 예외: 나중에 논의할 예정
- 변형:
- LD (더블워드)
- LW (word(워드)), LH (halfword(하프워드)), LB (byte(바이트)): sign-extend(부호 확장)
- LWU, LHU, LBU: zero-extend(0으로 확장)
- rs1
- imm
- = 0000011
p.16big endian(빅엔디안) vs. little endian(리틀엔디안) (1부, 제4장, 글리버 여행기)
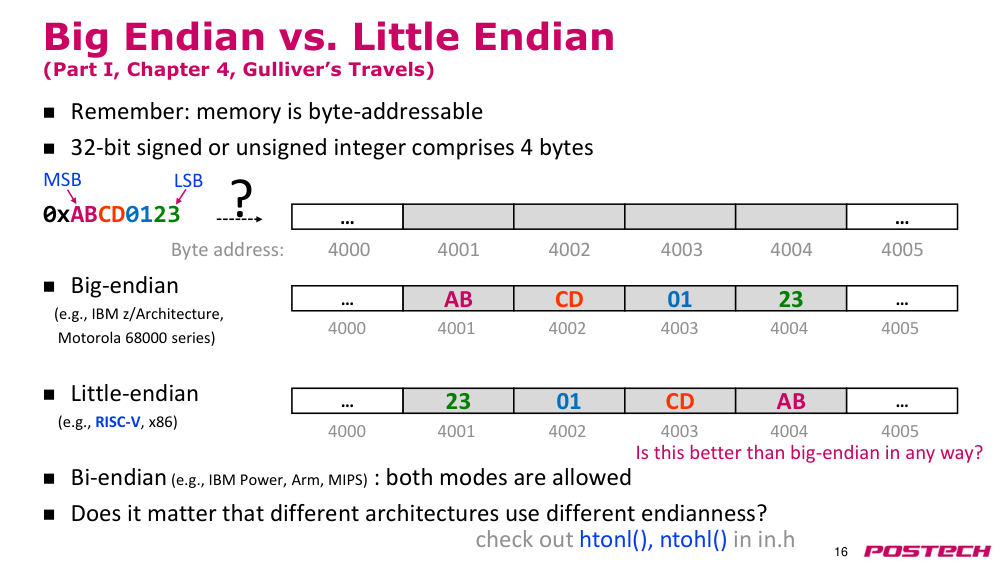
- 기억할 것: memory(메모리)는 byte-addressable(바이트 주소 가능)하다
- 32비트 signed (2’s complement)(부호 있는) 또는 unsigned integers(부호 없는 정수)는 4바이트로 구성된다
- big endian(빅엔디안)
- (예: IBM z/Architecture, Motorola 68000 시리즈)
- little endian(리틀엔디안)
- (예: RISC-V, x86)
- bi-endian(바이엔디안) (예: IBM Power, Arm, MIPS): 두 모드 모두 허용
- 다른 아키텍처가 서로 다른 엔디안을 사용한다는 것이 문제인가?
- in.h에서 htonl(), ntohl() 확인하기
- LSB
- MSB
- 0xABCD0123
- AB
- CD
- 01
- 23
- 4001
- 4002
- 4003
- 4004
- ...
- ...
- 4000
- 4005
- 23
- 01
- CD
- AB
- 4001
- 4002
- 4003
- 4004
- ...
- ...
- 4000
- 4005
- 4001
- 4002
- 4003
- 4004
- ...
- ...
- 4000
- 4005
- ?
- byte(바이트) 주소:
- big endian(빅엔디안)보다 더 나은 점이 있을까?
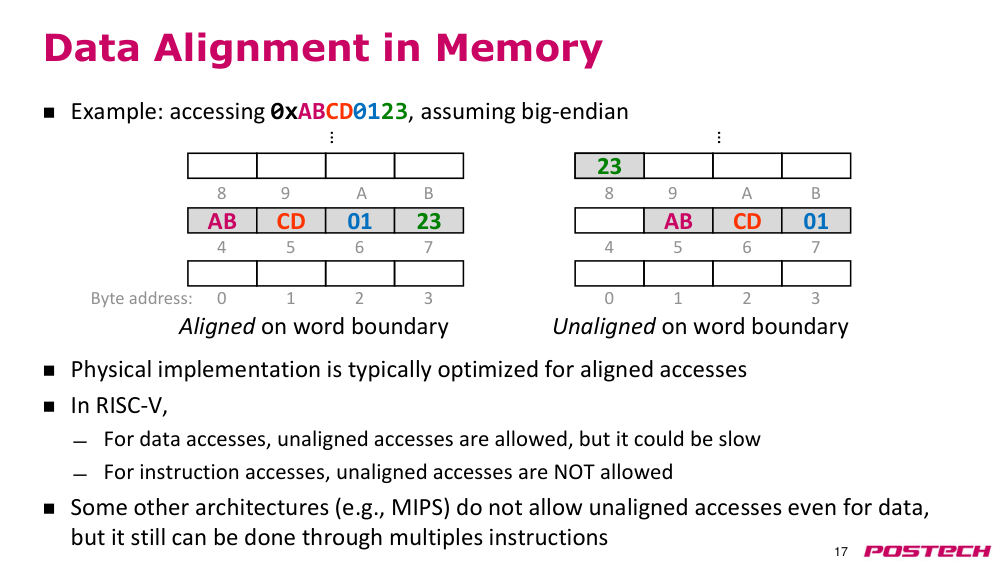
p.17memory(메모리) 내 data alignment(데이터 정렬)
- 예: 0xABCD0123에 접근, big endian(빅엔디안) 가정
- 물리적 구현은 일반적으로 aligned access(정렬된 접근)에 최적화되어 있다
- RISC-V에서는:
- • 데이터 접근 시, 비정렬 접근은 허용되지만 느릴 수 있다
- • 명령어 접근 시, 비정렬 접근은 허용되지 않는다
- 일부 다른 아키텍처(MIPS 등)는 데이터에 대해서도 비정렬 접근을 허용하지 않지만, 여러 명령어를 통해 구현 가능하다
- 0
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- AB
- CD
- 01
- 23
- 8
- 9
- A
- B
- byte(바이트) 주소:
- ...
- word(워드) 경계에 alignment(정렬)됨
- 0
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- AB
- CD
- 01
- 23
- 8
- 9
- A
- B
- ...
- word(워드) 경계에 비정렬됨
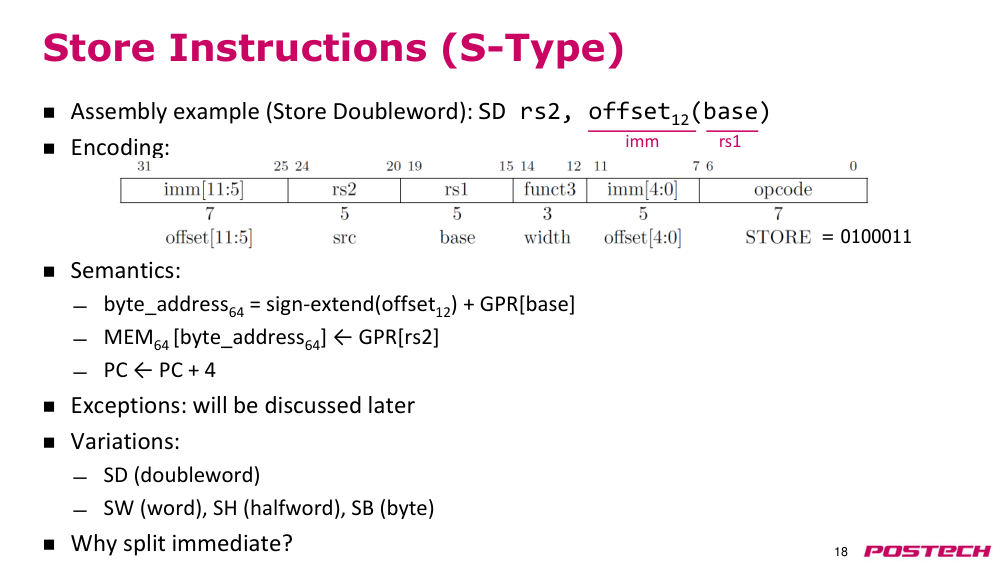
p.18스토어 명령어 (S형)
- 어셈블리 예제(더블워드 스토어): SD rs2, offset12(base)
- 인코딩:
- 의미:
- byte_address64 = sign‐extend(offset12) + GPR[base]
- MEM64 [byte_address64] ← GPR[rs2]
- PC ← PC + 4
- 예외: 나중에 논의할 예정
- 변형:
- SD (더블워드)
- SW (word(워드)), SH (halfword(하프워드)), SB (byte(바이트))
- 왜 immediate value(즉시 값)을 분리하는가?
- rs1
- imm
- = 0100011
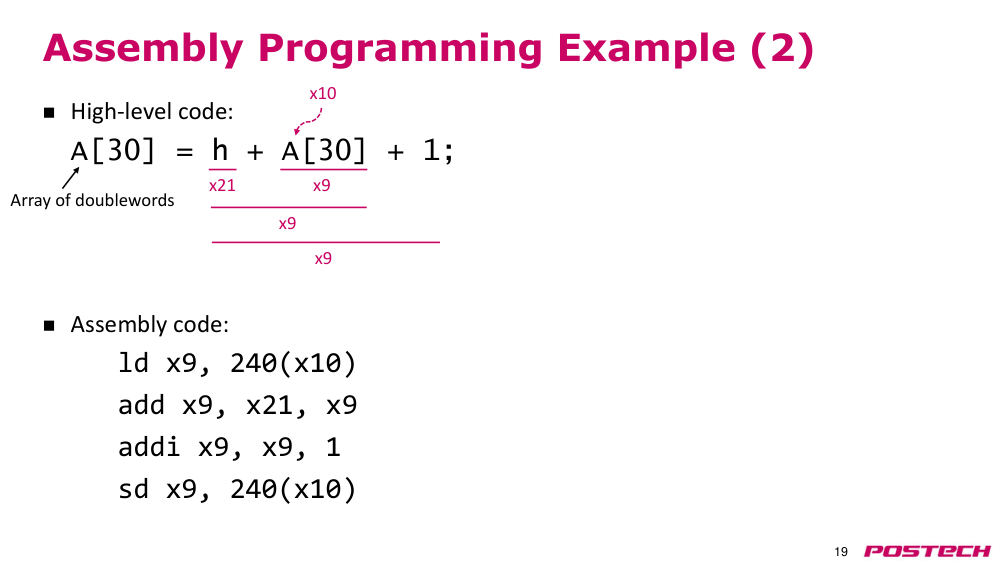
p.19어셈블리 프로그래밍 예제 (2)
- 고수준 코드:
- A[30] = h + A[30] + 1;
- 어셈블리 코드:
- ld x9, 240(x10)
- add x9, x21, x9
- addi x9, x9, 1
- sd x9, 240(x10)
- x21
- x10
- x9
- x9
- x9
- doubleword(더블워드) 배열
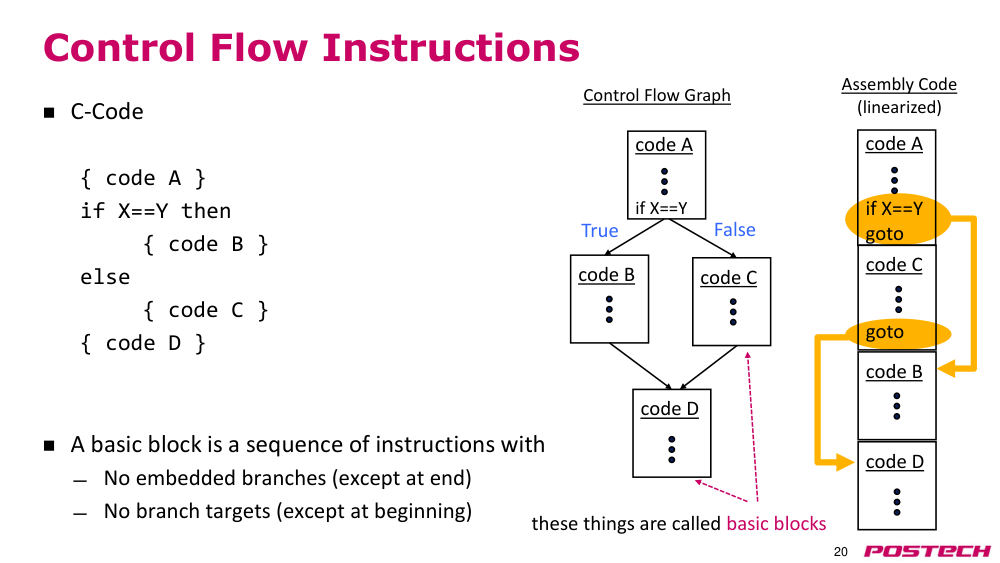
p.20제어 흐름 명령어
- C-코드
- { code A }
- if X==Y then
- { code B }
- else
- { code C }
- { code D}
- basic block(기본 블록)은 다음 조건을 만족하는 명령어 시퀀스이다:
- • 중간에 임의의 브랜치가 없음 (끝을 제외하고)
- • 중간에 branch target(브랜치 타깃)이 없음 (시작을 제외하고)
- control flow graph(제어 흐름 그래프)
- True
- False
- 어셈블리 코드 (선형화된 형태)
- code A
- if X==Y
- goto
- code C
- goto
- code B
- code D
- 이러한 구조들은 basic block(기본 블록)이라고 불린다
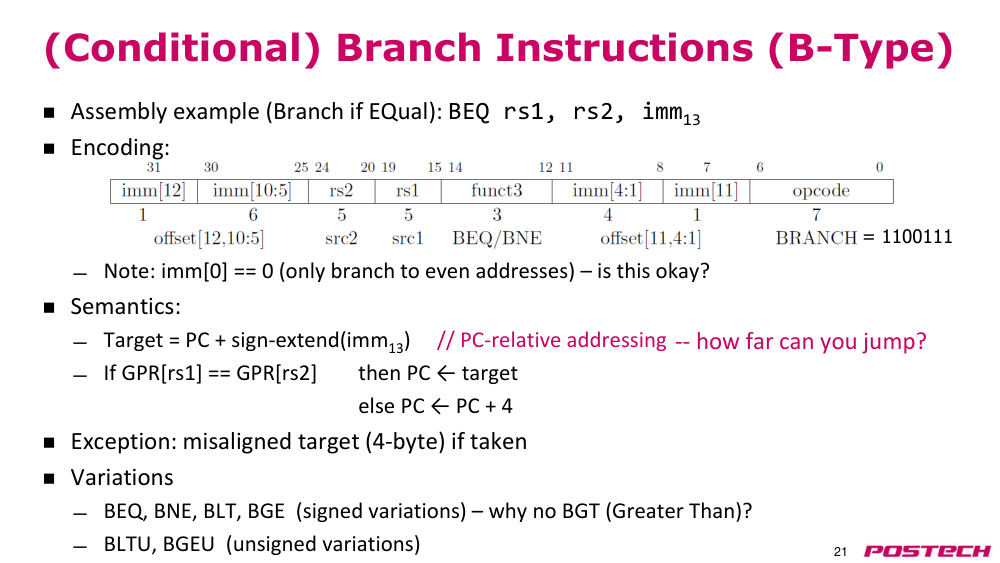
p.21(조건부) 브랜치 명령어 (B형)
- 어셈블리 예제 (같을 때 브랜치): BEQ rs1, rs2, imm13
- 인코딩:
- Note: imm[0] == 0 (단지 짝수 주소로 브랜치 가능) – 이는 괜찮은가?
- 의미:
- Target = PC + sign-extend(imm13) // PC-relative addressing(PC 상대 주소 지정)
- If GPR[rs1] == GPR[rs2]
- then PC ← target
- else PC ← PC + 4
- 예외: 브랜치가 수행된 경우 misaligned target(비정렬 타깃) (4바이트)
- 변형:
- BEQ, BNE, BLT, BGE (부호 있는 변형) – 왜 BGT (greater than(보다 큼))는 없나?
- BLTU, BGEU (부호 없는 변형)
- = 1100111
- -- 얼마나 멀리 점프할 수 있는가?
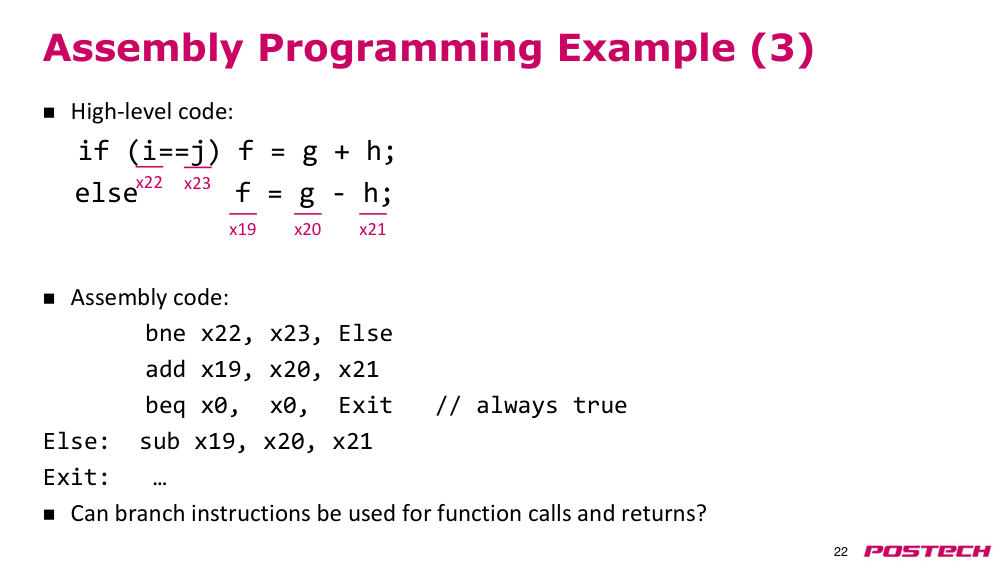
p.22어셈블리 프로그래밍 예제 (3)
- 고수준 코드:
- if (i==j) f = g + h;
- else f = g - h;
- 어셈블리 코드:
- bne x22, x23, Else
- add x19, x20, x21
- beq x0, x0, Exit // 항상 참
- Else: sub x19, x20, x21
- Exit: …
- 브랜치 명령어는 함수 호출과 반환에 사용될 수 있는가?
- x22
- x23
- x19
- x20
- x21
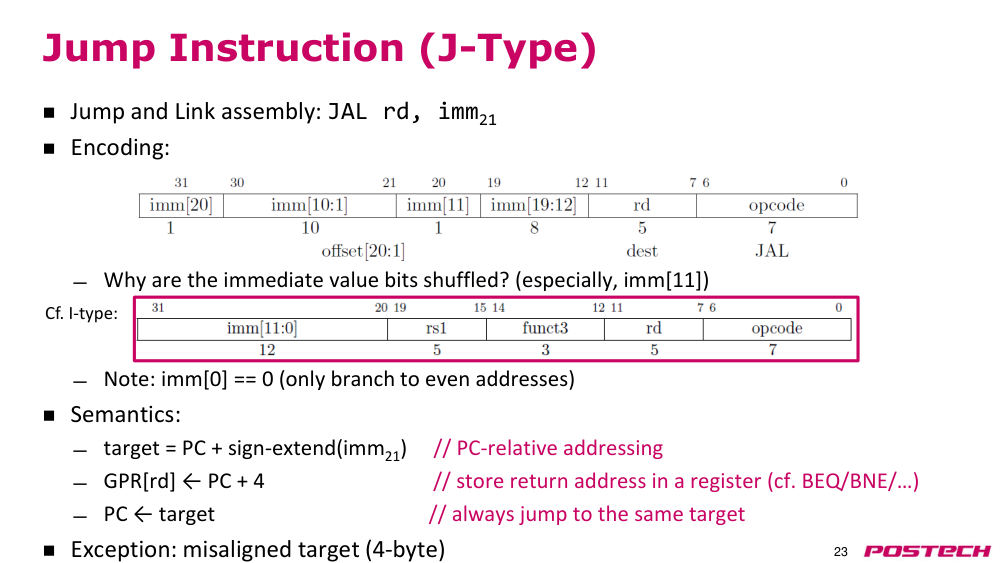
p.23점프 명령어 (J형)
- jump and link(점프 및 링크) 어셈블리: JAL rd, imm21
- 인코딩:
- 왜 immediate value(즉시 값) 비트들이 재배열되는가? (특히 imm[11])
- Note: imm[0] == 0 (단지 짝수 주소로 점프 가능)
- 의미:
- target = PC + sign-extend(imm21) // PC-relative addressing(PC 상대 주소 지정)
- GPR[rd] ← PC + 4 // return address(반환 주소)를 registers(레지스터)에 저장 (BEQ/BNE 등과 비교)
- PC ← target // 항상 같은 target(타깃)으로 점프
- 예외: misaligned target(비정렬 타깃) (4바이트)
- I형과 비교:
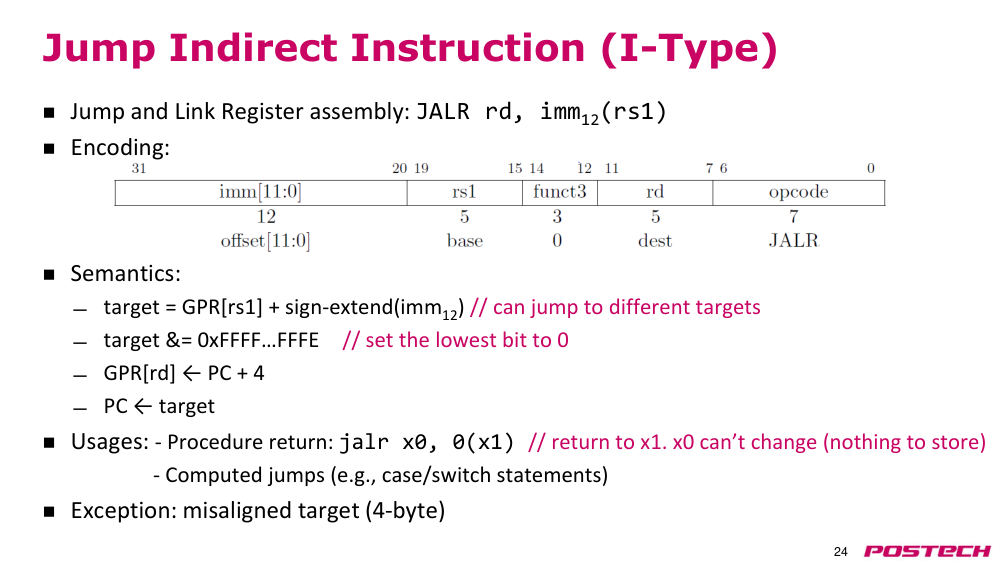
p.24jump indirect instruction(간접 점프 명령어) (I형)
- jump and link register(레지스터 점프 및 링크) 어셈블리: JALR rd, imm12(rs1)
- 인코딩:
- 의미:
- target = GPR[rs1] + sign-extend(imm12) // 다른 target(타깃)으로 점프 가능
- target &= 0xFFFF…FFFE // 최하위 비트를 0으로 설정
- GPR[rd] ← PC + 4
- PC ← target
- 사용 사례:
- - 프로시저 반환: jalr x0, 0(x1) // x1로 반환. x0는 변경 불가 (저장할 것이 없음)
- - 계산된 점프 (예: case/switch 문장)
- 예외: misaligned target(비정렬 타깃) (4바이트)
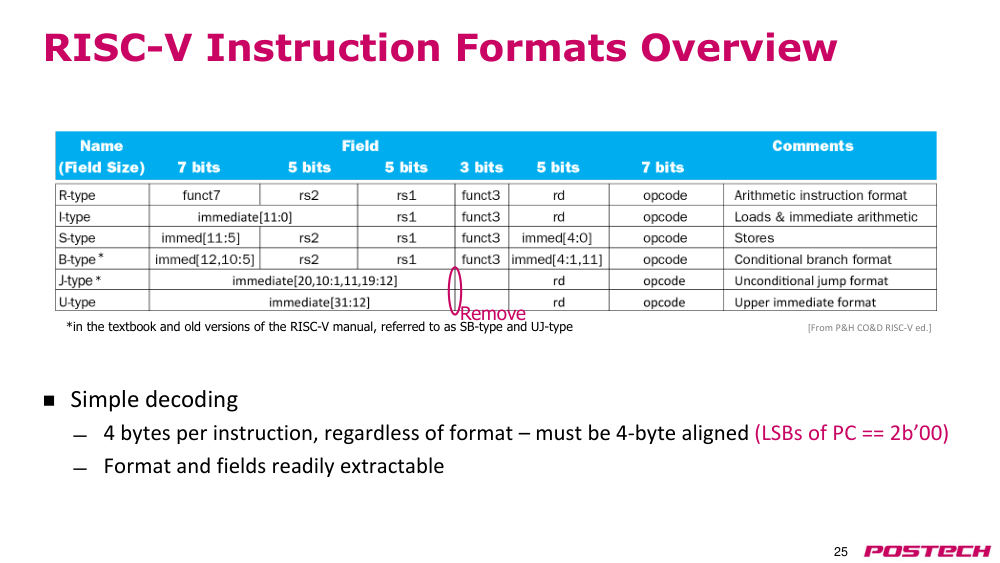
p.25RISC-V 명령어 형식 개요
- 간단한 디코딩
- 명령어당 4바이트, 형식에 관계없이 항상 4-byte aligned(4바이트 정렬) 필요 (PC의 하위 2비트 == 2b’00)
- 형식과 필드는 쉽게 추출 가능
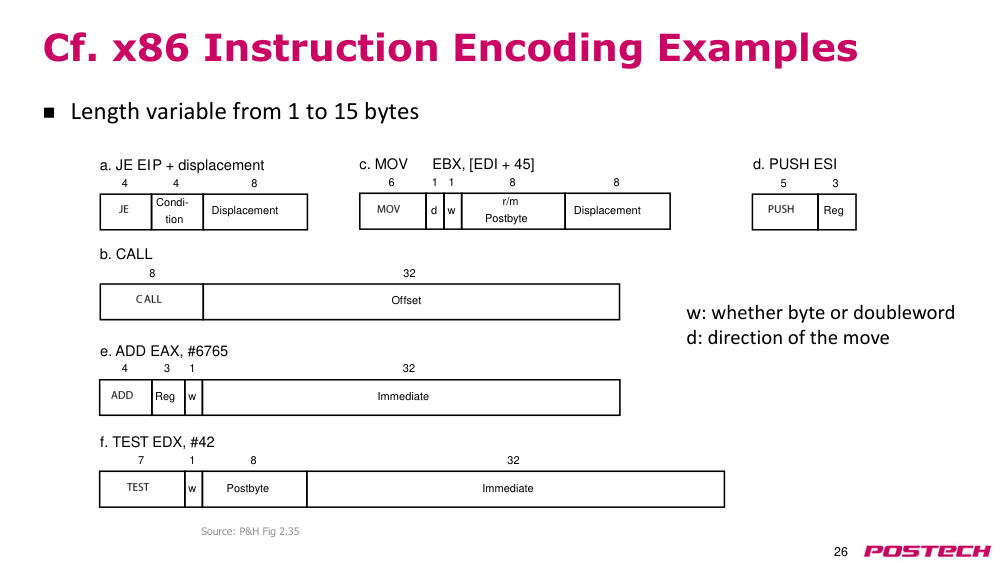
p.26비교: x86 instruction encoding(명령어 인코딩) 예시
- 길이가 1에서 15바이트까지 변동 가능
- a. JE EIP + displacement
- b. CALL
- c. MOV EBX, [EDI + 45]
- d. PUSH ESI
- e. ADD EAX, #6765
- f. TEST EDX, #42
- immediate value(즉시 값)
- postbyte(포스트바이트)
- TEST
- ADD
- PUSH
- MOV
- CALL
- JE
- w: byte(바이트) 또는 doubleword(더블워드) 여부
- d: 이동 방향
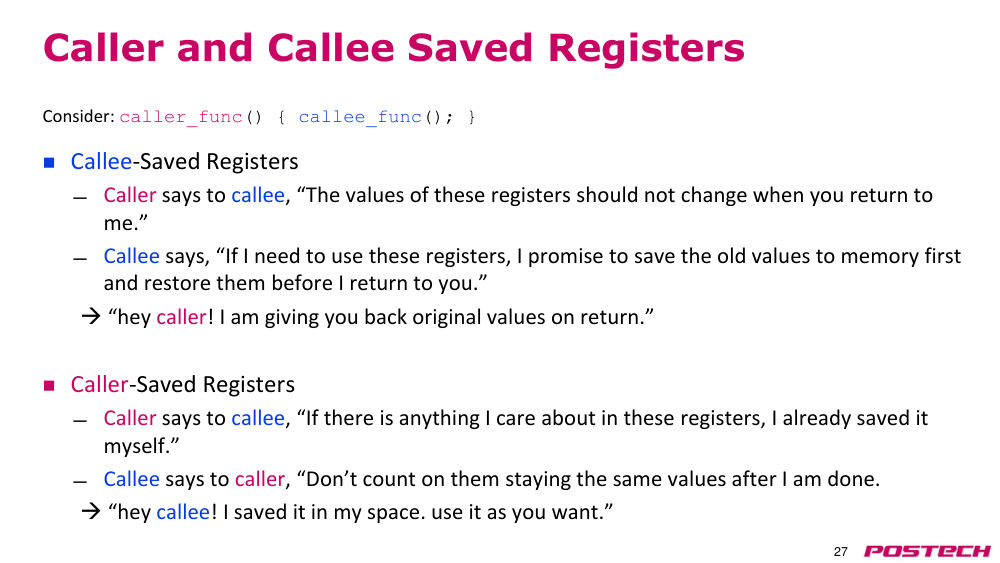
p.27호출자 및 Callee-Saved registers(피호출자 저장 레지스터)
- Callee-Saved registers(피호출자 저장 레지스터)
- 호출자는 피호출자에게 말함: "이 registers(레지스터)의 값은 나에게 돌아올 때 변하지 않아야 한다."
- 피호출자는 호출자에게 말함: "이 registers(레지스터)를 사용해야 한다면, 먼저 이전 값을 memory(메모리)에 저장하고 반환하기 전에 복원할 것이다."
- → "여보세요 호출자! 반환 시 원래 값들을 돌려드릴게요."
- Caller-Saved registers(호출자 저장 레지스터)
- 호출자는 피호출자에게 말함: "이 registers(레지스터)에 내가 관심 있는 내용이 있다면, 이미 스스로 저장해두었어요."
- 피호출자는 호출자에게 말함: "나한테 끝난 후에도 그 값이 그대로 유지되리라 기대하지 마세요."
- → "여보세요 피호출자! 내가 공간에 저장해두었으니, 마음껏 사용하세요."
- 고려사항: caller_func() { callee_func(); }
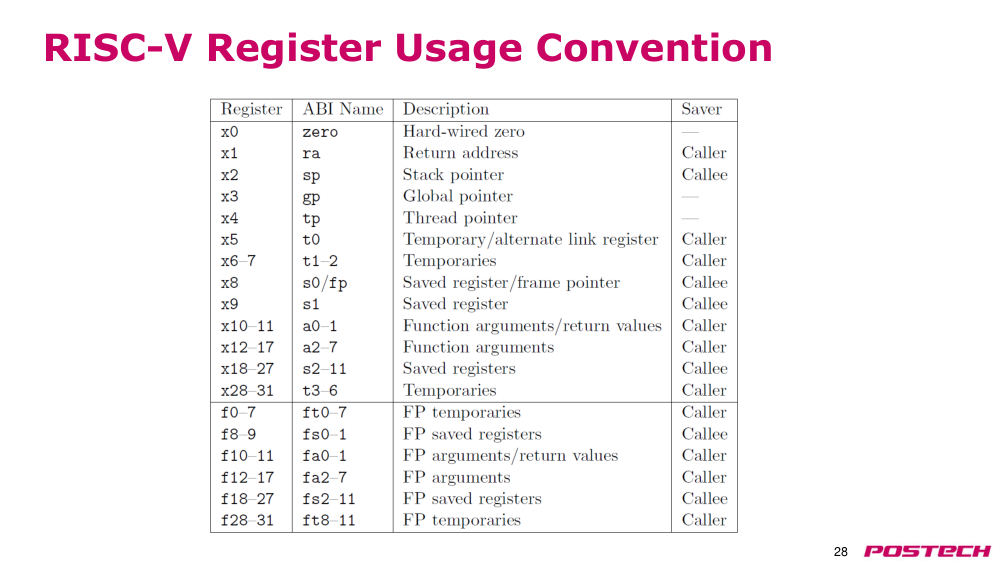
p.28RISC-V registers(레지스터) 사용 관례
p.29호출 관례
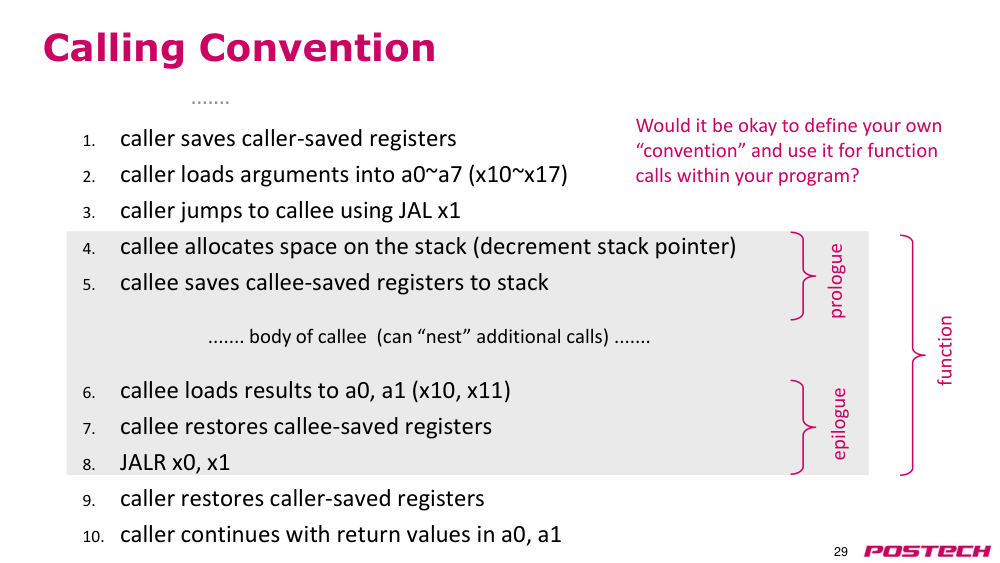
- 호출자가 Caller-Saved registers(호출자 저장 레지스터)를 저장한다
- 호출자가 인수를 a0~a7 (x10~x17)에 로드한다
- 호출자가 JAL x1을 사용하여 피호출자로 점프한다
- 피호출자가 스택에 공간을 할당한다 (스택 포인터 감소)
- 피호출자가 Callee-Saved registers(피호출자 저장 레지스터)를 스택에 저장한다
- 피호출자가 결과를 a0, a1 (x10, x11)에 로드한다
- 피호출자가 Callee-Saved registers(피호출자 저장 레지스터)를 복원한다
- JALR x0, x1
- 호출자가 Caller-Saved registers(호출자 저장 레지스터)를 복원한다
- 호출자가 a0, a1에 있는 반환 값으로 계속 execution(실행)한다
- ....... 피호출자의 본문 (추가 호출을 중첩할 수 있음) .......
- prologue(프롤로그)
- epilogue(에필로그)
- ....... 함수
- 자신만의 "관례"를 정의하고 프로그램 내 함수 호출에 사용해도 괜찮을까?
p.30memory(메모리) 사용 관례
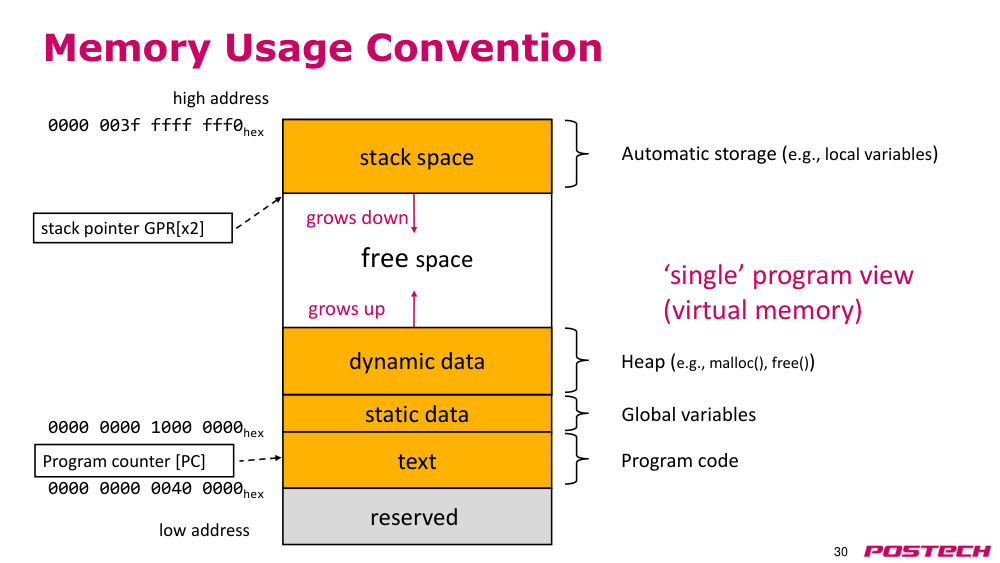
- 정적 데이터
- 텍스트
- 예약 공간
- 자유 공간
- 스택 공간
- 동적 데이터
- 스택은 아래로 성장
- 힙은 위로 성장
- 낮은 주소
- 높은 주소
- 프로그램 코드
- 스택 포인터 GPR[x2]
- "단일" 프로그램 뷰 (가상 메모리)
- 힙 (예: malloc(), free())
- 프로그램 카운터 [PC]
- 전역 변수
- 자동 저장 (예: 지역 변수)
- 0000 003f ffff fff0hex
- 0000 0000 0040 0000hex
- 0000 0000 1000 0000hex
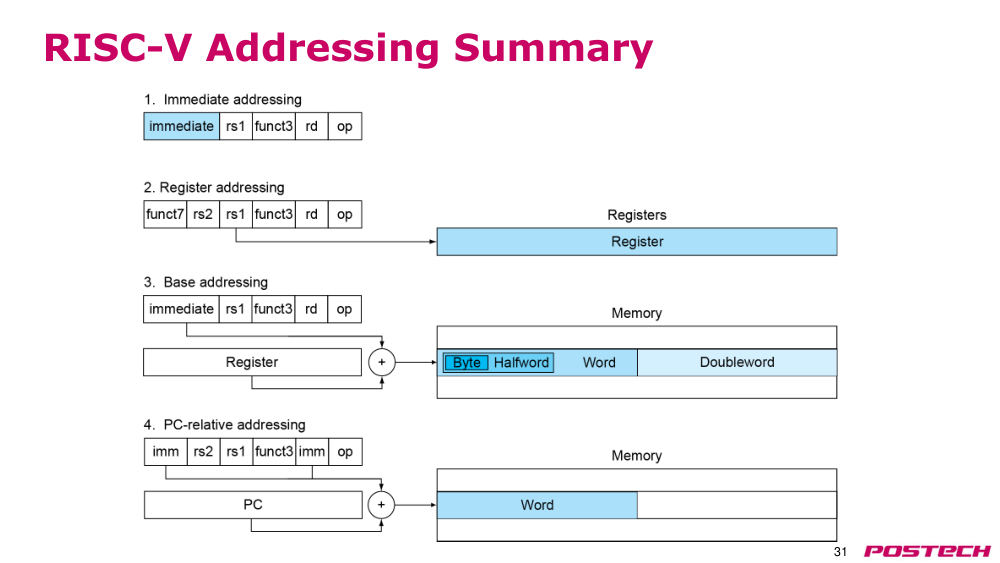
p.31RISC-V 주소 지정 요약
p.32우리가 다루지 않은 내용
- • privileged modes(특권 모드) • user mode(사용자 모드) vs. supervisor mode(슈퍼바이저 모드)
- • exception handling(예외 처리) • supervisor handling routine(슈퍼바이저 처리 루틴)으로 trap(트랩)한 후 복귀
- • 가상 메모리 (Virtual Memory) • 각 사용자는 2⁶⁴ byte(바이트)의 개인적, 대용량, 선형적이고 빠른 메모리를 가짐?
- • 부동소수점 명령어 (Floating-Point Instructions) • 관심이 있다면 instruction set architecture (ISA)(명령어 집합 아키텍처) 설명서를 참조
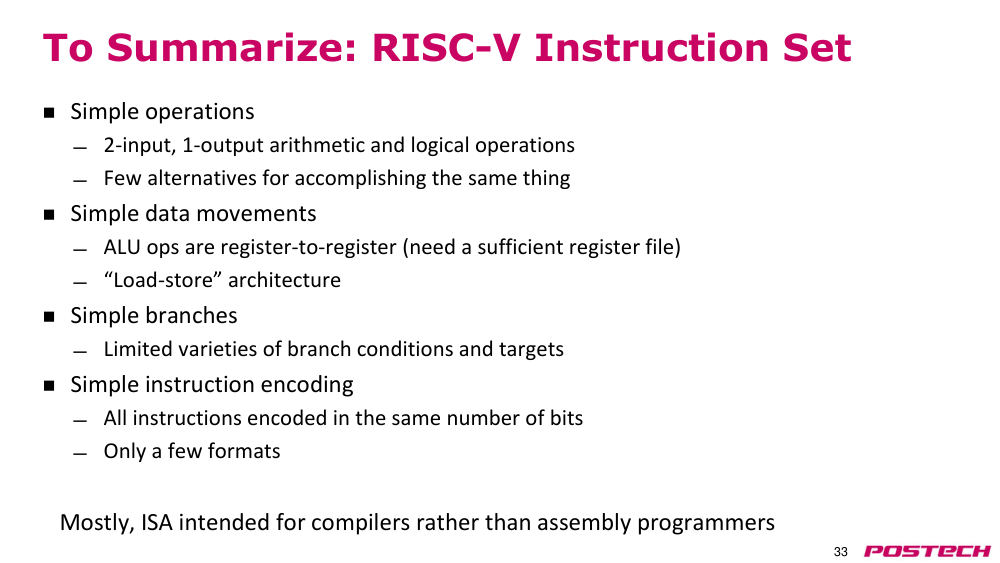
p.33요약: RISC-V 명령어 집합
- • 간단한 연산 • 2입력, 1출력 arithmetic and logical operations(산술 및 논리 연산) • 동일한 작업을 수행하기 위한 선택지가 적음
- • 간단한 데이터 이동 • ALU 연산은 registers(레지스터)-레지스터 형식 (충분한 레지스터 파일 필요) • "로드-스토어" 아키텍처
- • 간단한 브랜치 • 브랜치 조건과 타겟의 종류가 제한됨
- • 간단한 instruction encoding(명령어 인코딩) • 모든 명령어는 동일한 비트 수로 인코딩됨 • 형식이 몇 가지뿐임 • 주로 컴파일러를 위한 것이며, 어셈블리 프로그래머를 위한 것은 아님
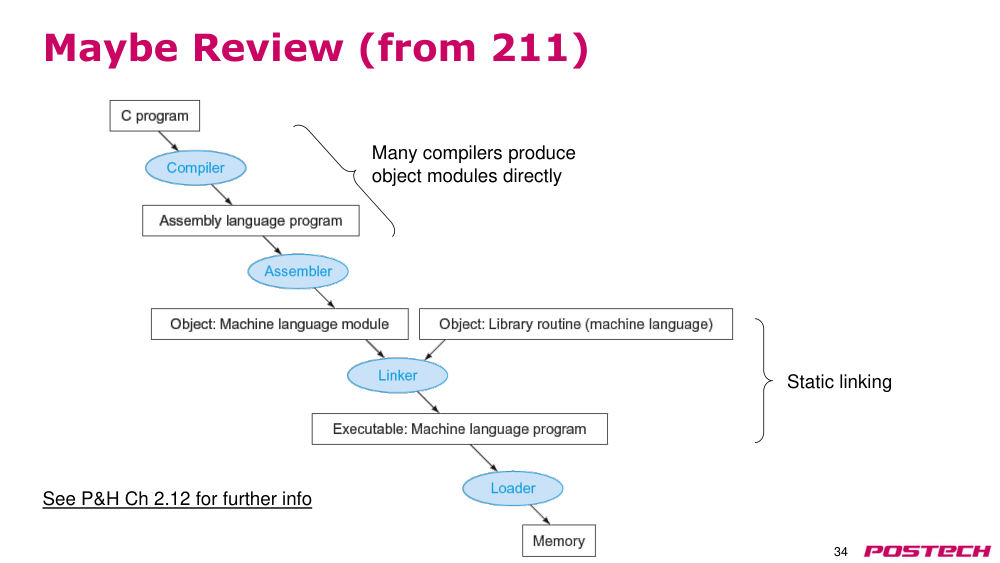
p.34다시 살펴보기 (211에서)
- P&H Ch 2.12에서 추가 정보 확인 가능
- 많은 컴파일러는 직접 객체 모듈을 생성함 • 정적 링킹 (Static linking)
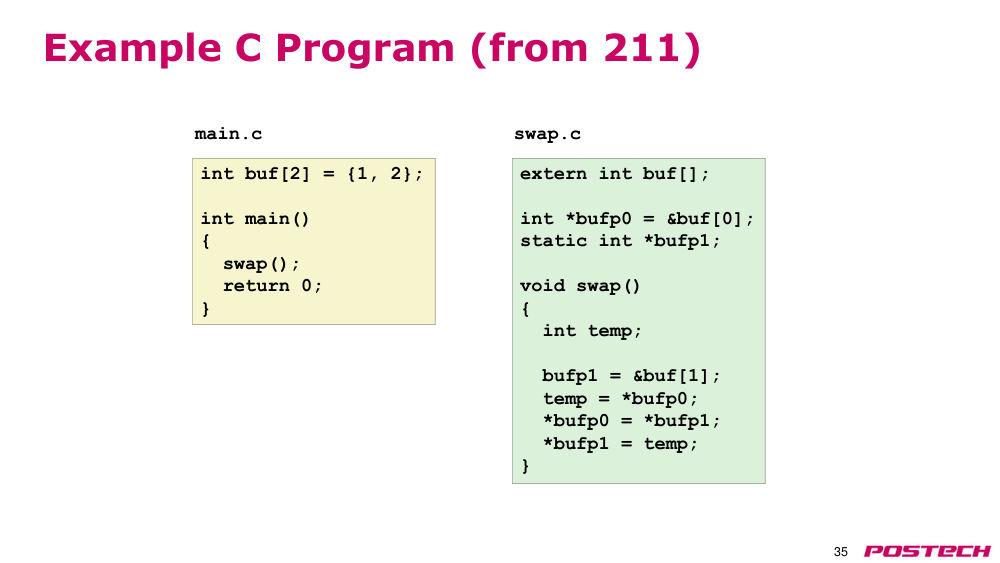
p.35예제 C 프로그램 (211에서)
- int buf[2] = {1, 2}; int main() { swap(); return 0; }
- main.c
- extern int buf[]; int *bufp0 = &buf[0]; static int *bufp1; void swap() { int temp; bufp1 = &buf[1]; temp = *bufp0; *bufp0 = *bufp1; *bufp1 = temp; }
- swap.c
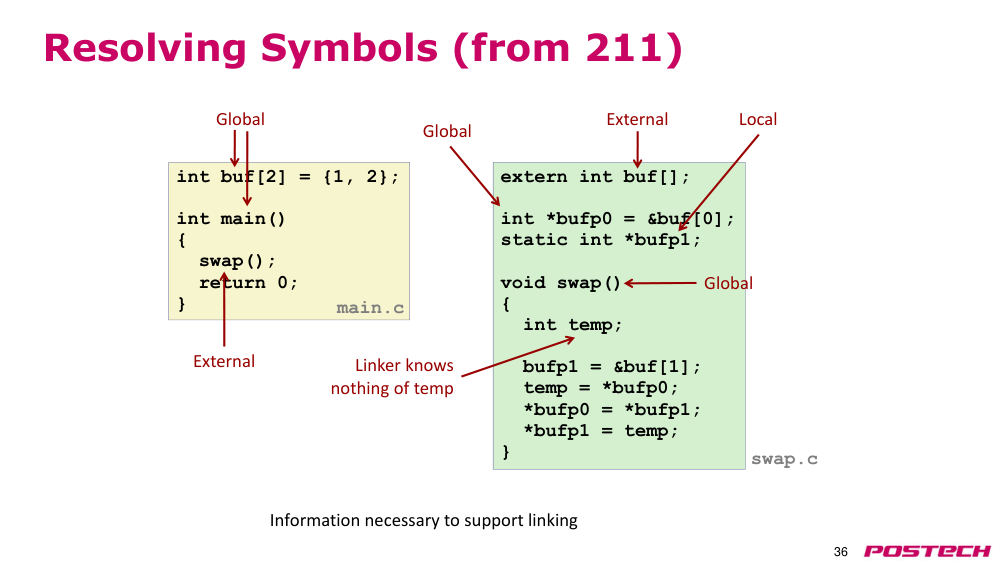
p.36심볼 해결 (211에서)
- int buf[2] = {1, 2}; int main() { swap(); return 0; }
- main.c
- extern int buf[]; int *bufp0 = &buf[0]; static int *bufp1; void swap() { int temp; bufp1 = &buf[1]; temp = *bufp0; *bufp0 = *bufp1; *bufp1 = temp; }
- swap.c
- 전역 외부 외부 로컬 전역 링커는 temp에 대해 아무것도 모름 전역
- 링킹을 지원하기 위한 정보
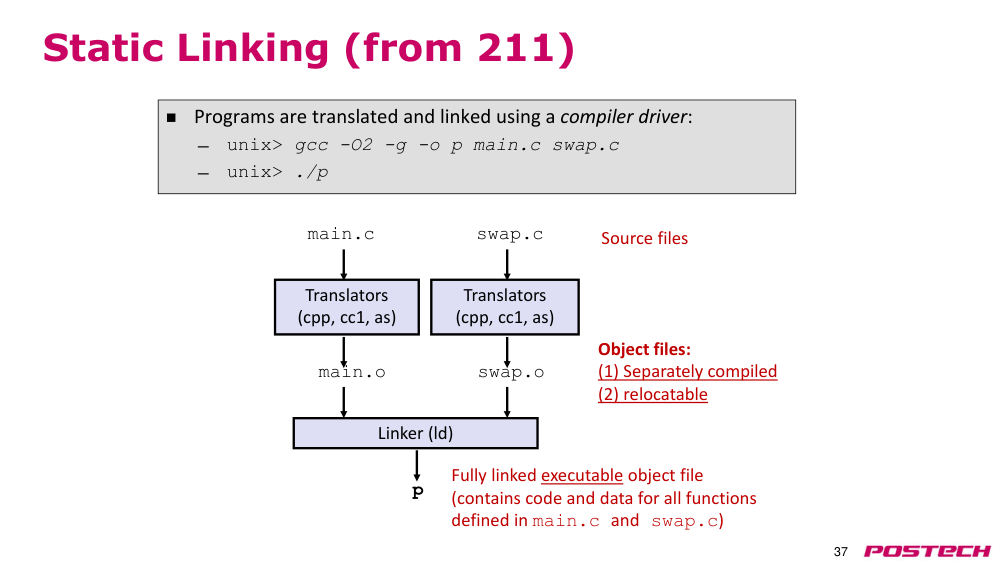
p.37정적 링킹 (211에서 발췌)
- 프로그램은 컴파일러 드라이버를 사용하여 번역되고 연결된다:
- unix> gcc -O2 -g -o p main.c swap.c
- unix> ./p
- 링커 (ld)
- 번역기 (cpp, cc1, as)
- main.c
- main.o
- 번역기 (cpp, cc1, as)
- swap.c
- swap.o
- p
- 소스 파일
- 객체 파일:
- (1) 별도로 컴파일됨
- (2) 재배치 가능
- fully linked executable object file(완전히 링크된 실행 가능한 객체 파일)
- (main.c 및 swap.c에 정의된 모든 함수에 대한 코드와 데이터 포함)
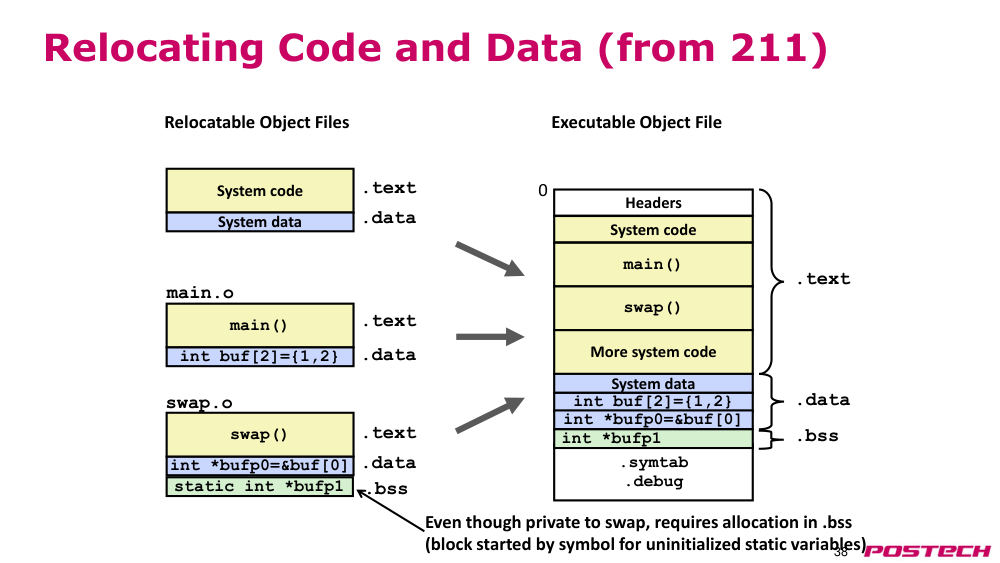
p.38코드와 데이터의 재배치 (211에서 발췌)
- main()
- main.o
- int *bufp0=&buf[0]
- swap()
- swap.o
- int buf[2]={1,2}
- 헤더
- main()
- swap()
- 0
- 시스템 코드
- int *bufp0=&buf[0]
- int buf[2]={1,2}
- 시스템 데이터
- 더 많은 시스템 코드
- 시스템 데이터
- 재배치 가능한 객체 파일
- executable object file(실행 가능한 객체 파일)
- .text
- .text
- .data
- .text
- .data
- .text
- .data
- .symtab
- .debug
- .data
- int *bufp1
- .bss
- 시스템 코드
- static int *bufp1
- .bss
- swap 내부에서만 사용되지만 .bss에 할당 필요
- (초기화되지 않은 정적 변수를 위한 심볼로 시작되는 블록)
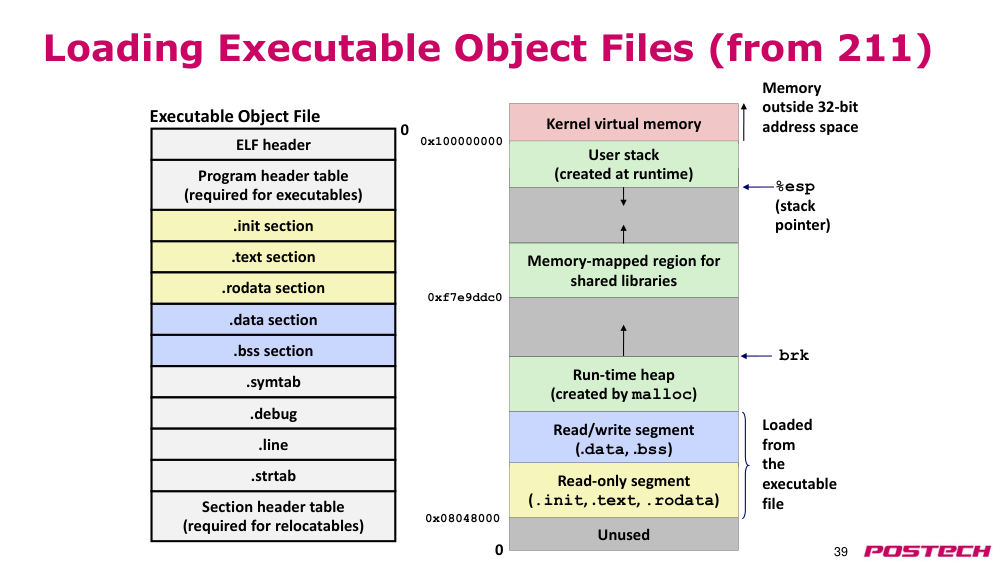
p.39executable object file(실행 가능한 객체 파일)의 로딩 (211에서 발췌)
- ELF 헤더
- 프로그램 헤더 테이블
- (실행 가능 파일에 필요)
- .text 섹션
- .data 섹션
- .bss 섹션
- .symtab
- .debug
- 섹션 헤더 테이블
- (재배치 가능 파일에 필요)
- 0
- executable object file(실행 가능한 객체 파일)
- 커널 가상 memory(메모리)
- 공유 라이브러리용 memory(메모리) 매핑 영역
- 런타임 힙
- (malloc에 의해 생성됨)
- 사용자 스택
- (런타임에 생성됨)
- 사용되지 않는 영역
- 0
- %esp
- (스택 포인터)
- 32비트 address space(주소 공간) 외부 memory(메모리)
- brk
- 0x100000000
- 0x08048000
- 0xf7e9ddc0
- 읽기/쓰기 세그먼트 (.data, .bss)
- 읽기 전용 세그먼트 (.init, .text, .rodata)
- executable file(실행 가능 파일)에서 로드됨
- .rodata 섹션
- .line 섹션
- .init 섹션
- .strtab 섹션
p.40질문?
- 유용한 자료:
- - RISC-V 사용자 레벨 ISA 사양: https://content.riscv.org/wp-content/uploads/2017/05/riscv-spec-v2.2.pdf
- - RISC-V privileged ISA specification(특권 ISA 명세): https://content.riscv.org/wp-content/uploads/2017/05/riscv-privileged-v1.10.pdf
- 공지사항:
- - 읽기: P&H Ch 1.6-1.12
- 선택적으로, Ch 3 (CSED211 수강하지 않은 경우 특히 권장)