Lec 23 · Release consistency·multi-copy atomicity 와 Synchronization(동기화)
정밀 정리 · 검증 2026-09-24 07:47
1개요
1.122강에서 미룬 release consistency(RC): acquire/release 의미, eager RC·lazy RC 구현
1.2multi-copy-atomic vs non-multi-copy-atomic model, language memory model·DRF 로 마무리
1.3Synchronization: load/store 만의 mutual exclusion(deadlock·livelock) → Dekker's algorithm
1.4atomic RMW(amoswap) lock, relaxed model 의 fence 와 RISC-V AMO aq/rl 비교
1.5non-blocking synchronization 과 Compare&Swap, ABA problem·double CAS (LR/SC 는 다음 강의)
2섹션별 정리 상황·문제 → 원인 → 해결
2.10:22–4:45복습: relaxed model·TSO 와 fence
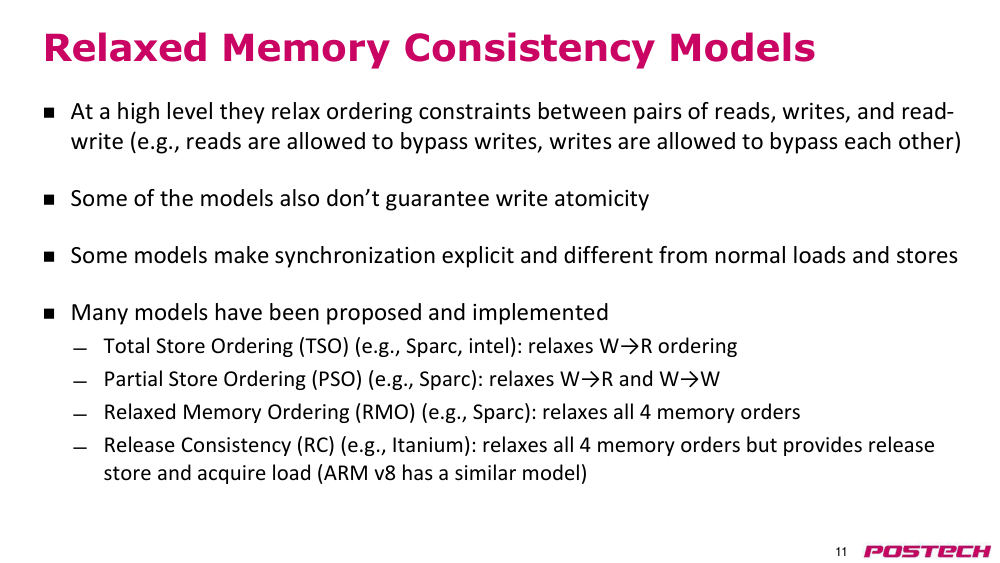
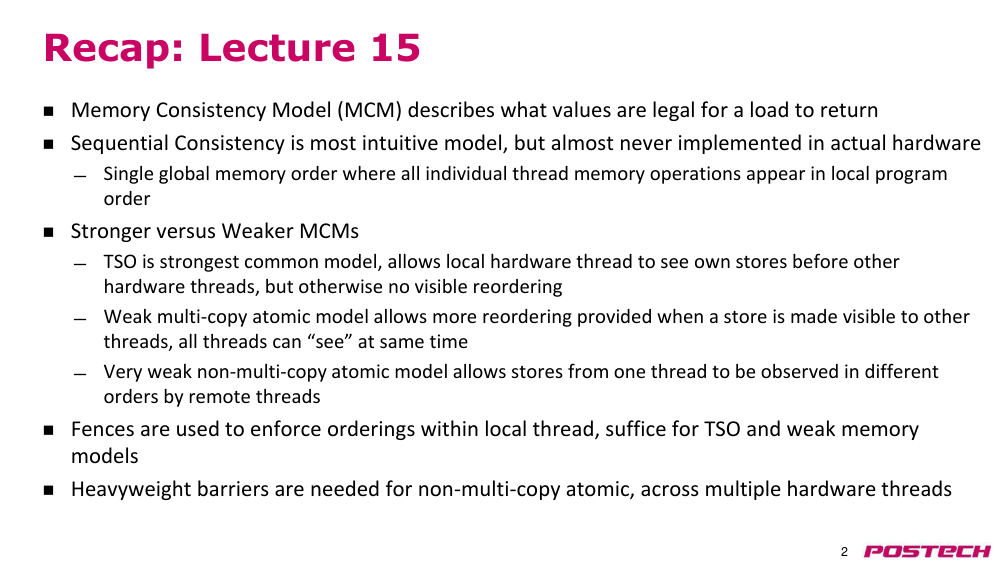
상황·문제SC 는 모든 memory access 를 program order 로 강제해 성능이 낮다 → relaxed memory consistency model(완화된 메모리 일관성 모델) 복습
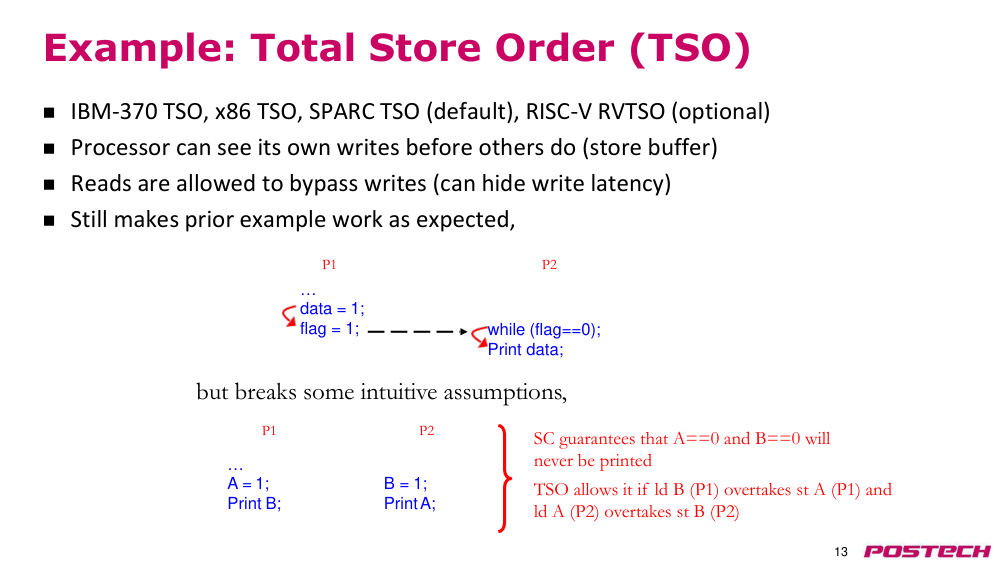
원인TSO(Total Store Order) 는 read 가 write 를 bypass 하도록 허용, W→W·R→R 순서는 유지
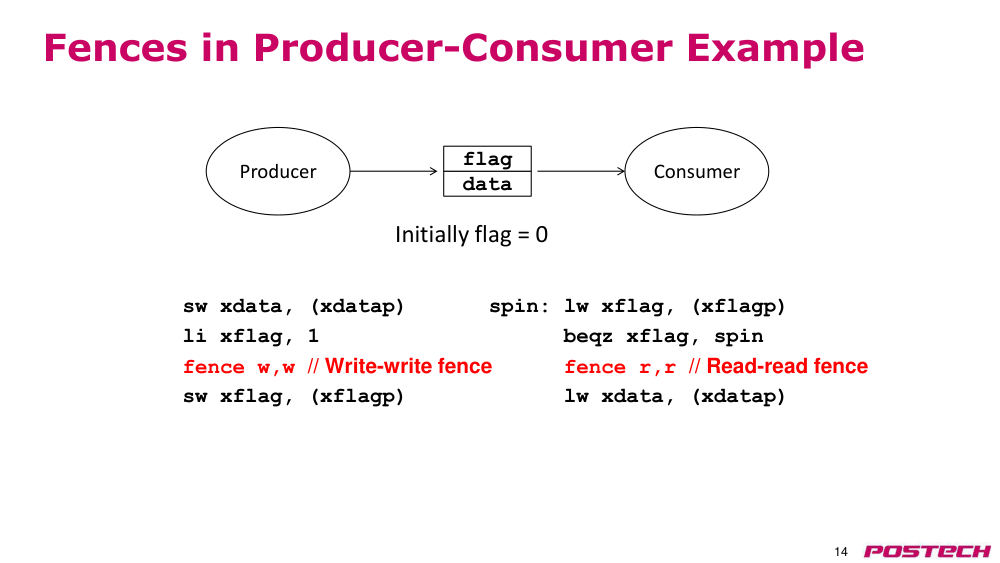
해결model 이 보장하지 않는 순서는 fence 로 강제: producer 는 data store 와 flag store 사이 fence w,w, consumer 는 flag load 와 data load 사이 fence r,r
- TSO: read 가 앞선 write 를 앞지를 수 있음 (store buffer)
- fence 앞의 연산이 fence 뒤 연산보다 먼저 완료되도록 강제
2.1.r.1Wikipedia: Memory ordering ↗ · architecture 별 허용 reordering 표 (x86 은 store 뒤 load 만, SPARC TSO/PSO/RMO)
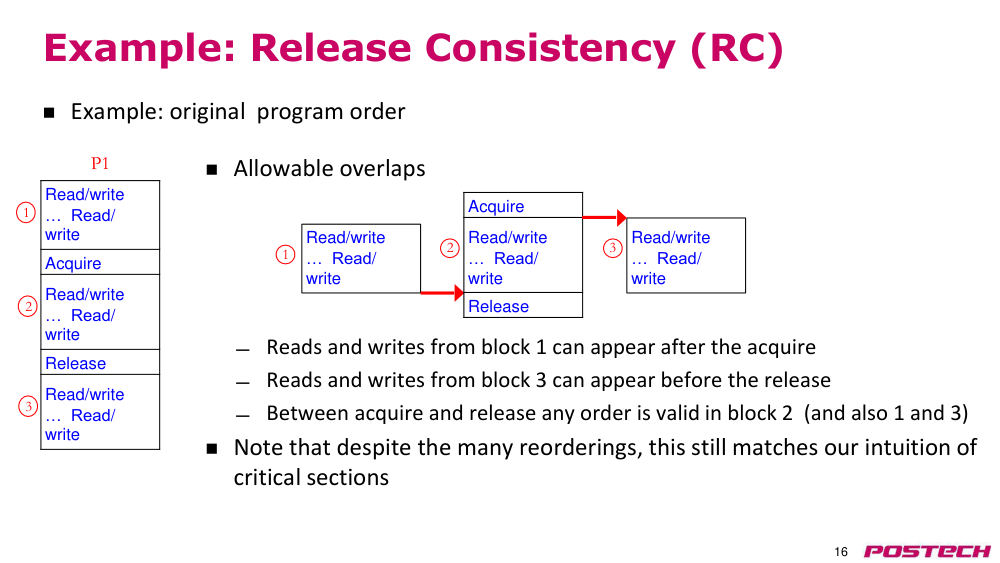
2.24:45–10:19Release consistency(RC) 정의와 허용 overlap
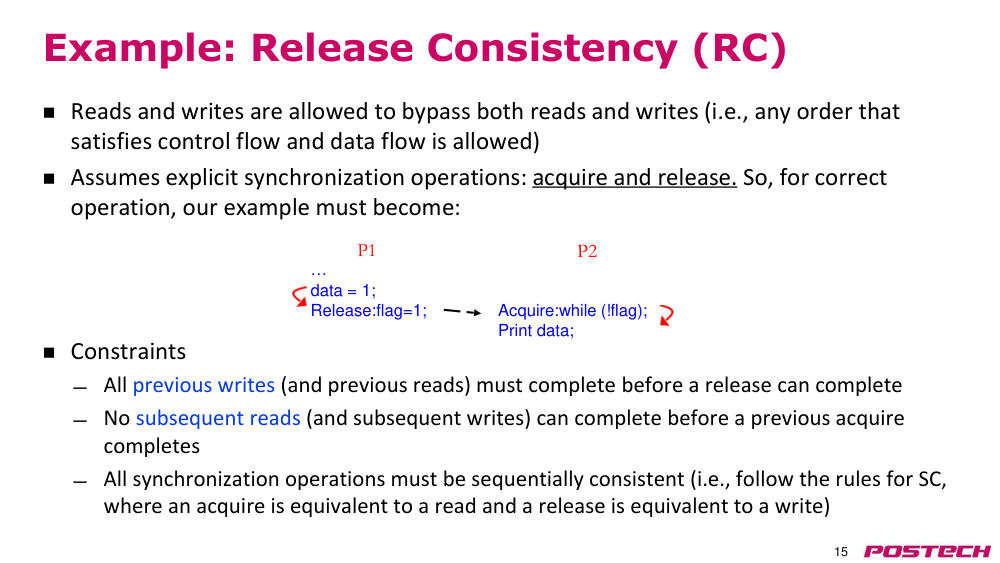
상황·문제RC: control·data dependence 만 지키면 read·write 가 read·write 를 모두 bypass 가능 (TSO 보다 약함)
원인순서가 필요한 곳을 hardware 가 모름 → programmer 가 acquire·release 로 표시해야 함
해결release: 앞선 write 가 모두 완료돼야 release 완료. acquire: 뒤 read 는 acquire 뒤에 실행. acquire(=read)·release(=write) 끼리는 SC
- block 1 은 acquire 뒤로, block 3 은 release 앞으로 이동 가능
- 많은 reorder 를 허용해도 critical section 직관과 일치
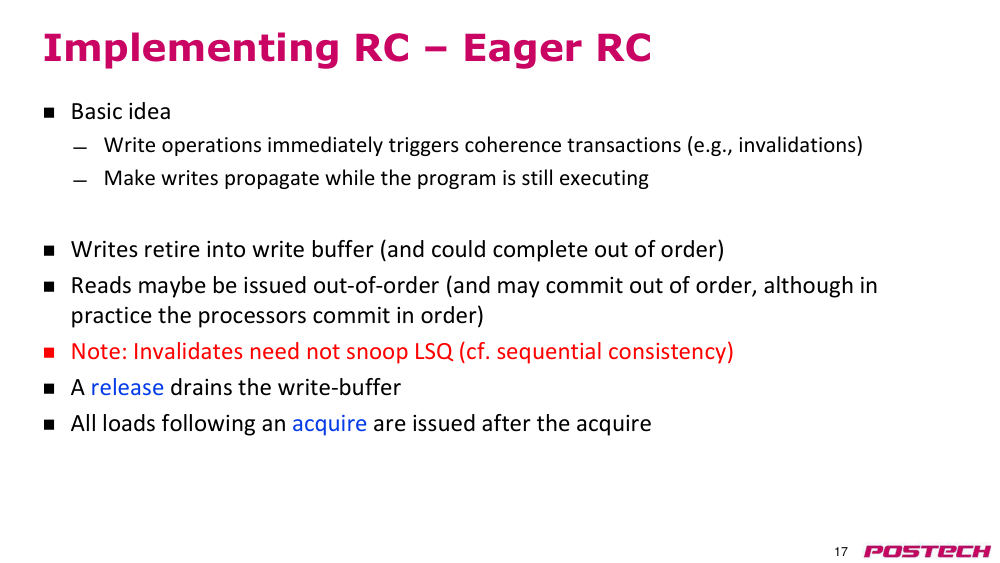
2.310:19–14:32RC 구현 1: eager RC
상황·문제RC 를 hardware 로 어떻게 구현할지: write 를 가능한 빨리 전파하는 방식
원인write 마다 즉시 coherence transaction(invalidation) 발생 → 같은 위치를 여러 번 쓰면 transaction 이 많아짐
해결write 는 write buffer 에서 out-of-order 완료, release 때 write buffer drain, acquire 뒤 load 는 acquire 뒤 issue. invalidation 이 LSQ 를 snoop 할 필요 없음(SC 와 차이)
- read 는 out-of-order issue 가능 (실제로는 in-order commit)
- SC 와 달리 LSQ snoop 불필요
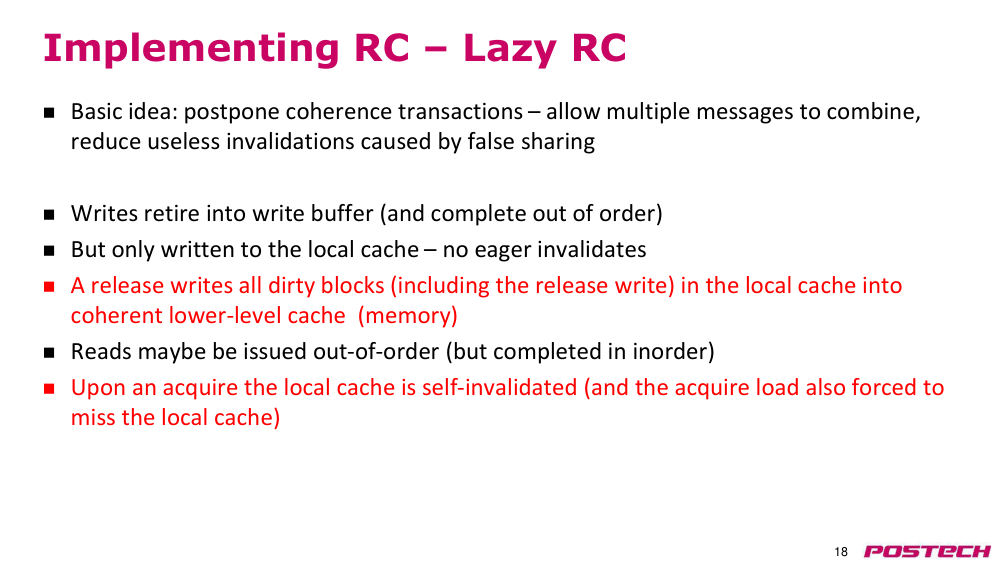
2.414:32–21:01RC 구현 2: lazy RC 와 local/shared 추적
상황·문제eager RC 의 coherence transaction overhead 를 줄이고 싶다
원인write 마다 invalidation 을 보내면 여러 write 를 결합할 수 없음
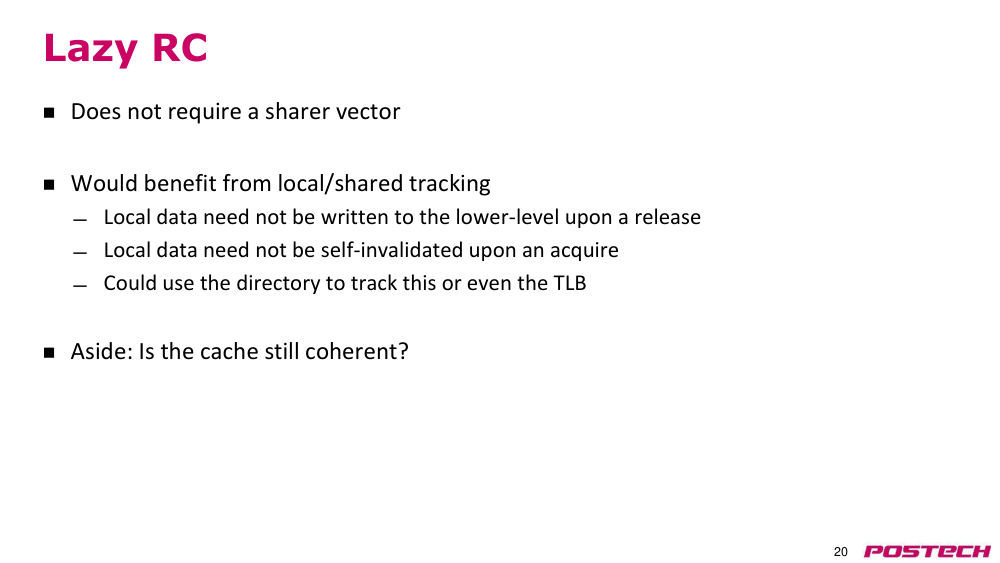
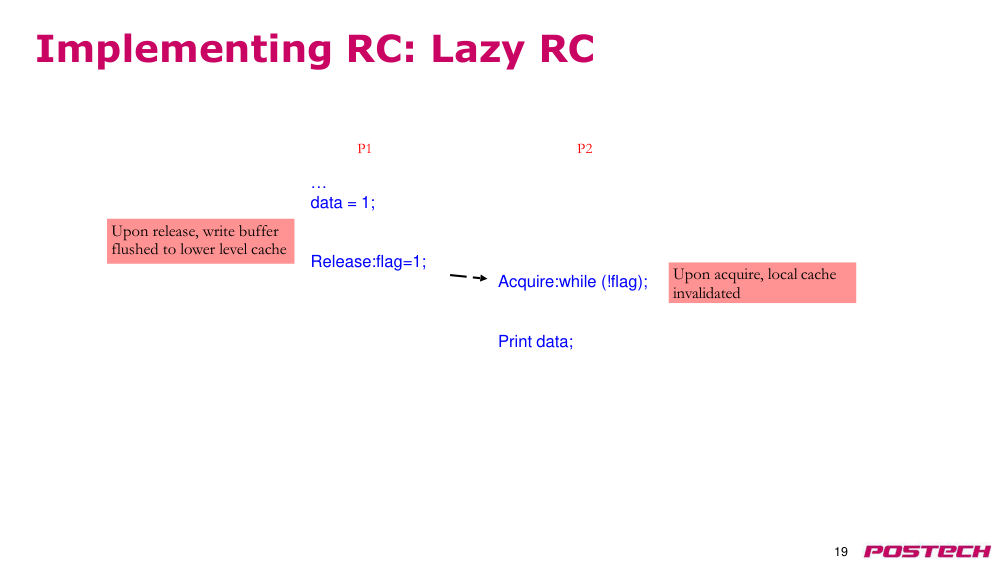
해결write 는 local cache 에만 기록(invalidation 없음), release 때 dirty block 을 lower-level cache 로 flush, acquire 때 local cache self-invalidation. local/shared 를 추적하면 local line 은 flush·invalidate 생략
- cache 전체 self-invalidation 은 비쌈 → shared line 만 선택적으로 invalidate
- coherent 하지 않은 것처럼 보이나 acquire/release 를 제대로 넣으면 올바르게 동작
2.521:01–29:48Multi-copy-atomic vs non-multi-copy-atomic
상황·문제여러 processor 가 같은 위치의 copy 를 가질 때 write 가 모두에게 같은 순서로 보이는가
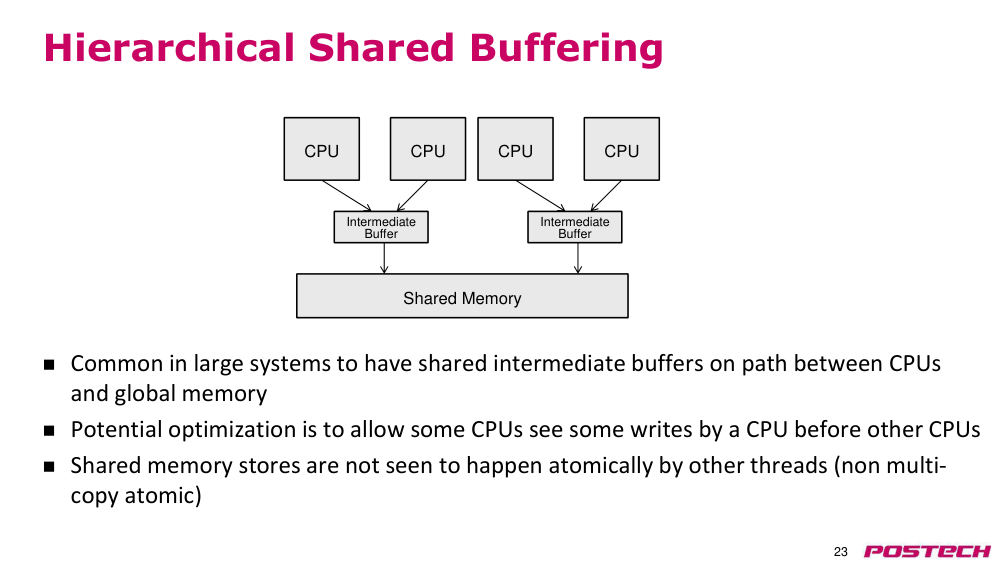
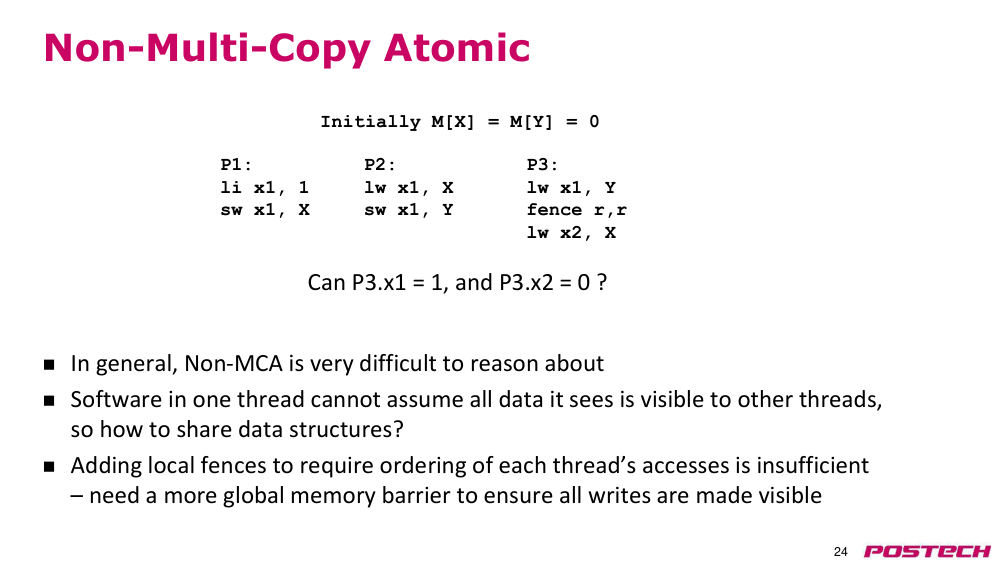
원인hierarchical shared buffer: 같은 buffer 를 공유하는 processor 가 write 를 먼저 봄 → store 가 atomic 하게 보이지 않음(non-MCA)
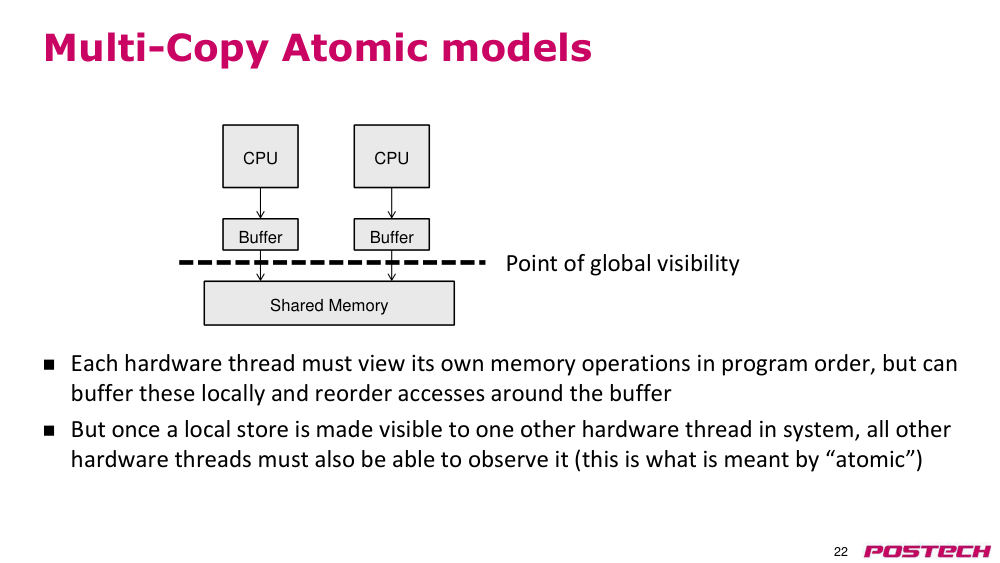
해결MCA: global visibility 지점을 넘은 write 는 모든 thread 가 관측. non-MCA 는 local fence 로 부족하고 더 global 한 memory barrier 필요
- P1 X=1, P2 X→Y 복사, P3 Y 읽고 fence r,r 후 X: non-MCA 에선 P3.x1=1·x2=0 가능
- non-MCA 는 구현은 쉽지만 programmer 가 추론하기 매우 어려움
2.5.r.1Wikipedia: Memory ordering ↗ · architecture 별 허용 reordering 표 (x86 은 store 뒤 load 만, SPARC TSO/PSO/RMO)
2.5.r.2Wikipedia: Consistency model ↗ · coherence(한 위치) vs consistency(여러 위치), SC·TSO·PSO·release consistency
2.629:48–32:55Final notes: 여러 model 지원·language memory model·출석 확인
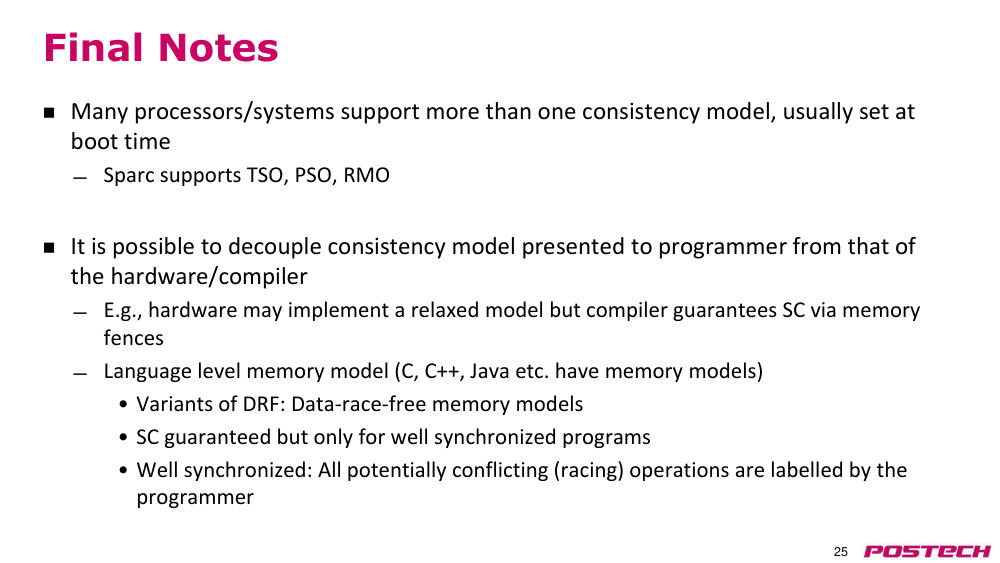
상황·문제hardware 가 제공하는 model 과 programmer 가 보는 model 을 분리할 수 있음
원인hardware 가 relaxed 여도 compiler 가 fence 를 넣으면 SC 를 제공할 수 있음
해결C/C++/Java 등 language-level model, DRF(data-race-free): 잘 synchronize 된 program 에 SC 보장 → 다음 주제 synchronization 으로 연결. 이후 출석(손들기) 확인
- SPARC 는 TSO·PSO·RMO 지원, 보통 boot 시 선택 (강의에선 'good time' 으로 들림)
2.6.r.1Sorin·Hill·Wood, A Primer on Memory Consistency and Cache Coherence (1st ed., UCLA 강의 사본) ↗ · Ch.4 TSO·fence, Ch.5 relaxed(XC)·release consistency
2.6.r.2Hennessy & Patterson, Computer Architecture: A Quantitative Approach 6th ed. (Elsevier) ↗ · 추천 독서 교재 (ca_L15: 5.6-5.7, ca_L16: 5.5)
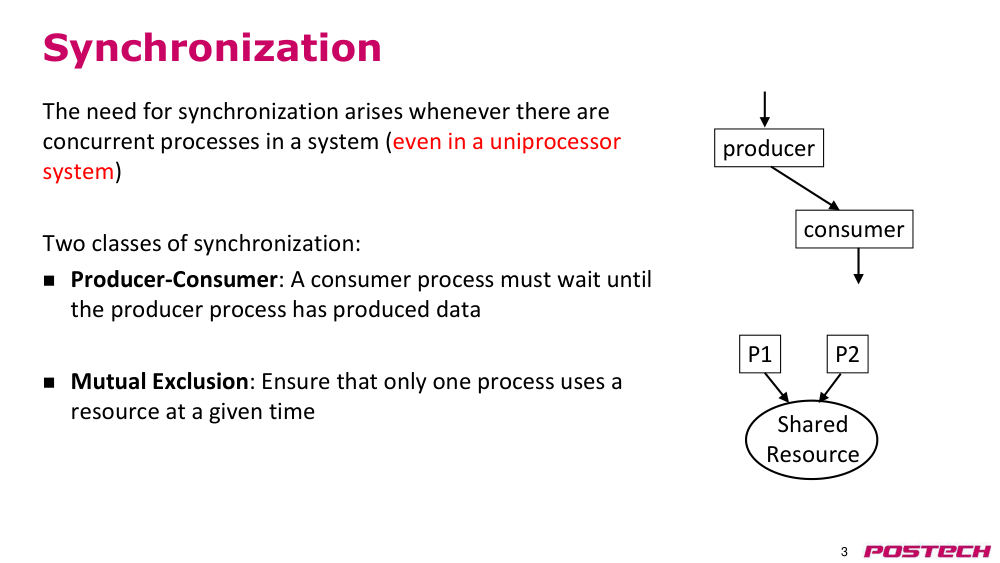
2.732:55–37:57Synchronization 도입: producer-consumer 와 mutual exclusion
상황·문제concurrent process 가 memory 의 data 를 공유하면 synchronization 이 필요 (uniprocessor 에서도)
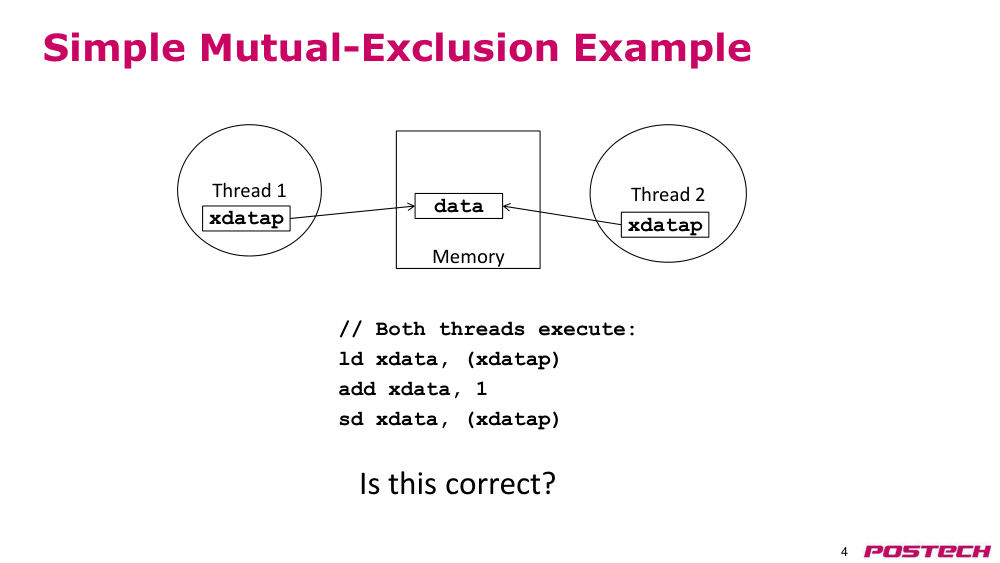
원인두 thread 가 ld→add 1→sd 를 동시에 하면 둘 다 1 을 읽어 2 를 씀 (기대값 3)
해결producer-consumer 와 mutual exclusion(상호 배제) 두 유형, 올바른 동기화 필요
- Lecture 15 recap 슬라이드 제시
- ld/add/sd 가 atomic 하지 않아 update 유실
2.7.r.1Wikipedia: Mutual exclusion ↗ · critical section·deadlock·starvation, Dekker 등 software 해법 목록
2.837:57–41:40load/store 만으로 mutual exclusion: deadlock·livelock·starvation
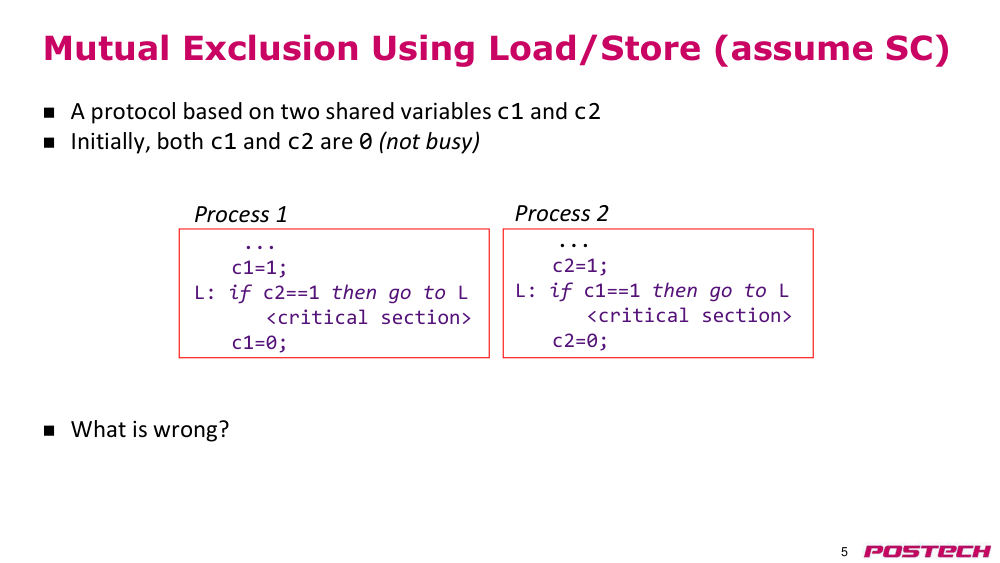
상황·문제SC 가정, 공유 변수 c1·c2 로 critical section 진입 의사를 표시
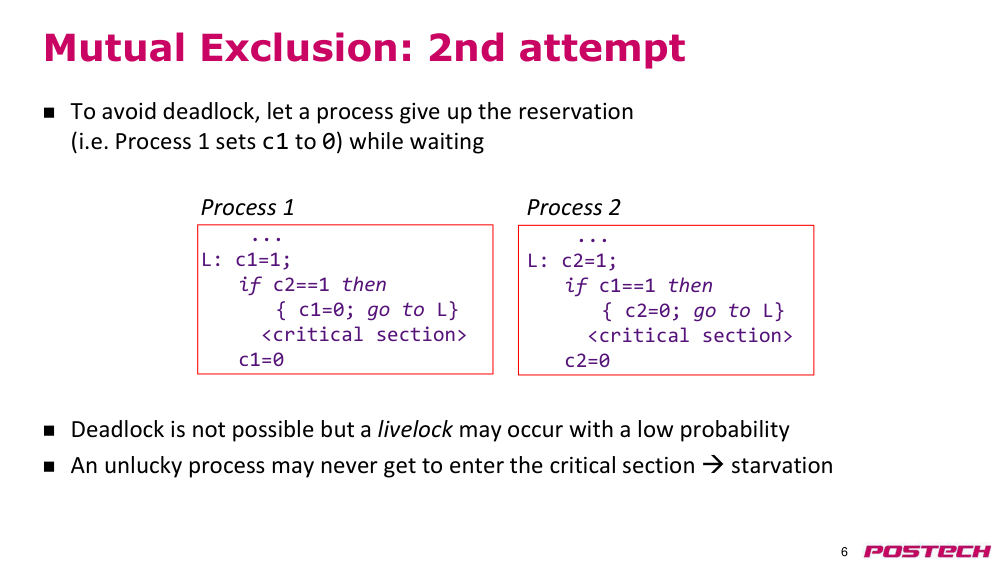
원인1차: 둘 다 c=1 이면 서로 spin 하며 deadlock. 2차: 대기 시 c 를 0 으로 되돌리면 deadlock 은 없지만 동시 실행 시 livelock, 운 나쁜 process 는 starvation
해결turn 변수를 추가한 Dekker 방식으로 해결 (다음 섹션)
- deadlock: 둘 다 loop 에서 못 나옴
- livelock: 둘 다 set/clear 를 반복하며 진입 못 함
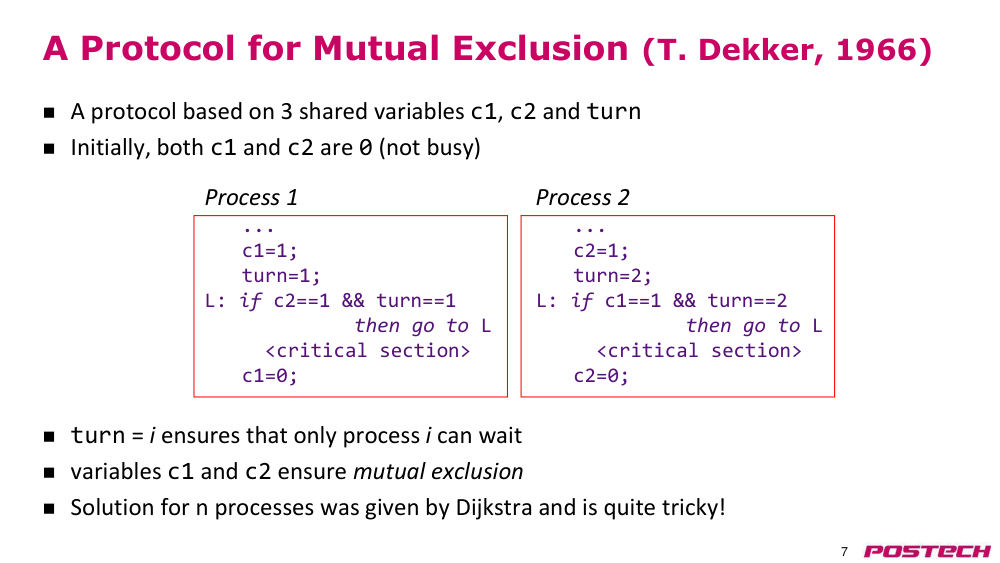
2.941:40–45:56Dekker's algorithm
상황·문제c1·c2 만으로는 livelock·unfairness 가 남음
원인누가 기다릴지 정하는 정보가 없음
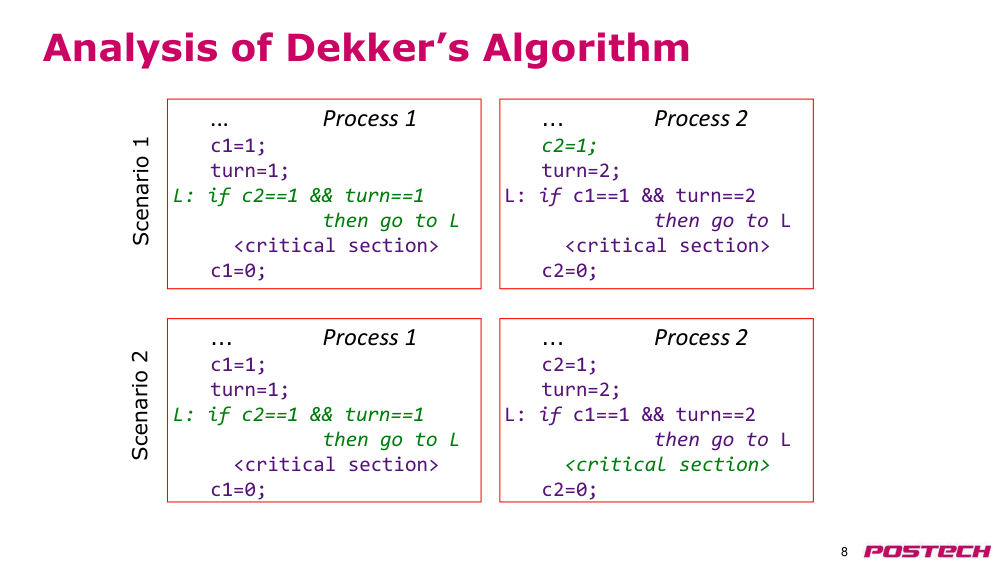
해결turn 변수 추가: c_i=1, turn=i 후 상대 c 가 1 이고 turn==i 면 대기. 늦게 turn 을 쓴 쪽이 대기해 livelock 없이 교대 진입
- 슬라이드: T. Dekker 1966 (강의에선 '1960s'), n-process 해법은 Dijkstra
- scenario 1·2 로 두 interleaving 분석
2.9.r.1Wikipedia: Dekker's algorithm ↗ · c1·c2(want)+turn 으로 두 process 상호배제, store buffer CPU 에선 barrier 필요
2.9.r.2Wikipedia: Mutual exclusion ↗ · critical section·deadlock·starvation, Dekker 등 software 해법 목록
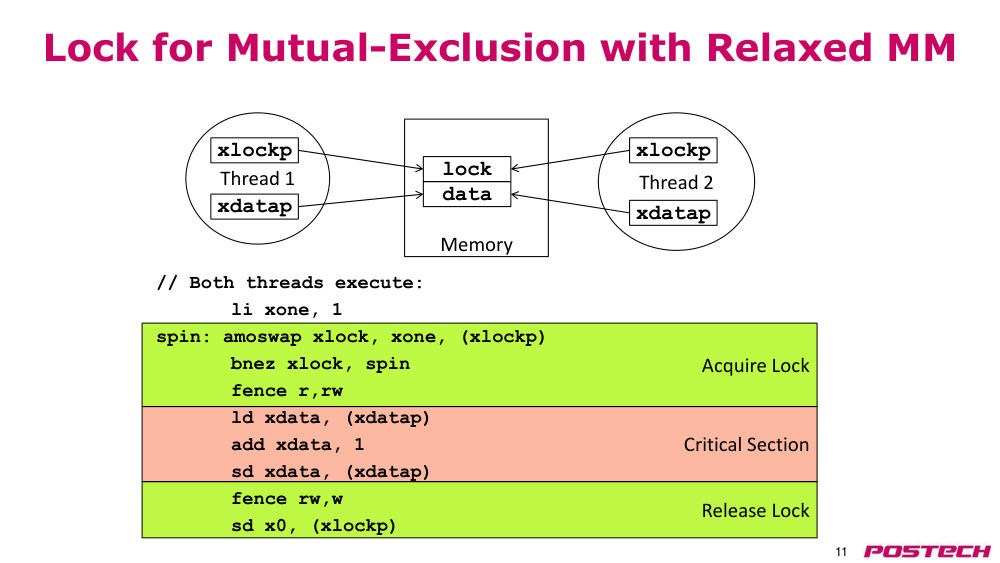
2.1045:56–51:10Atomic RMW 명령어와 amoswap lock
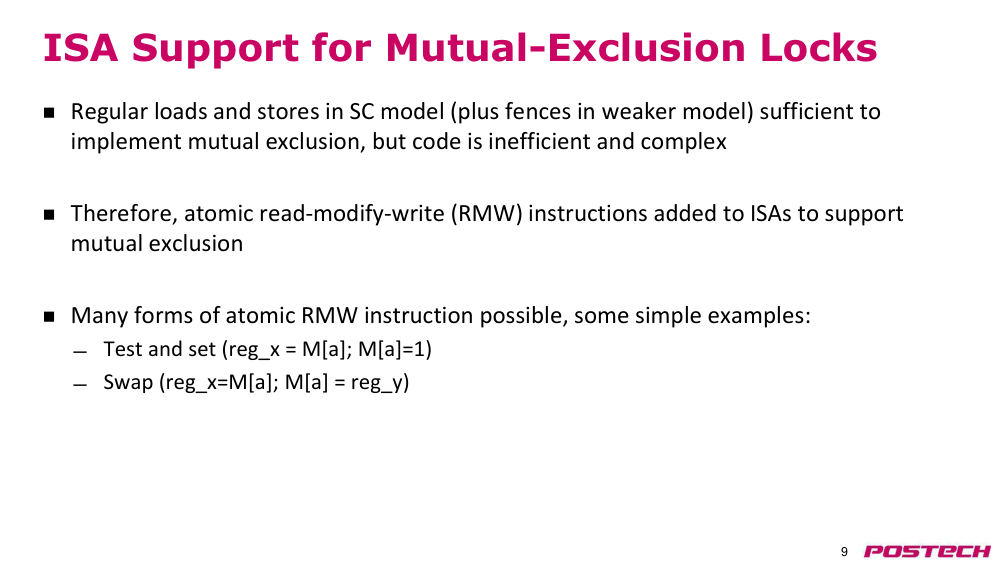
상황·문제load/store 로도 SC 에선 mutual exclusion 가능하나 weak model 에선 fence 가 필요해 코드가 비효율적·복잡
원인읽기와 쓰기 사이에 다른 thread 가 끼어들 수 있음
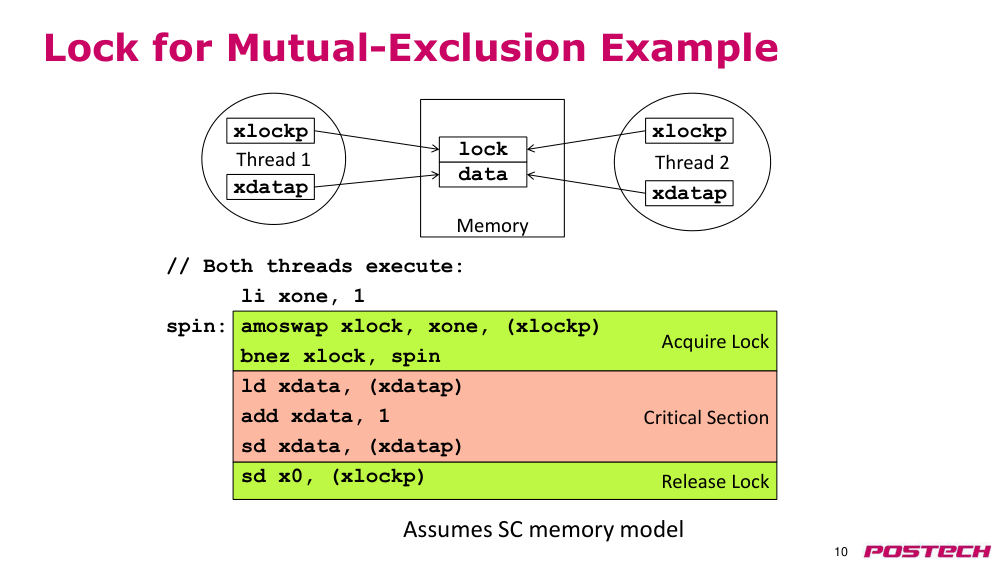
해결atomic read-modify-write(RMW) 명령어 추가: test-and-set, swap. amoswap 으로 lock 에 1 을 쓰고 old 값이 0 이면 진입, 끝나면 sd x0 로 해제
- test-and-set: reg=M[a]; M[a]=1
- swap: reg_x=M[a]; M[a]=reg_y
2.1151:10–55:46Relaxed model 의 lock: fence 와 RISC-V AMO aq/rl
상황·문제relaxed model 에선 lock 획득 전에 shared data 를 건드리거나 해제 뒤에 write 가 완료될 수 있음
원인amoswap 자체는 주변 load/store 와 순서를 보장하지 않음
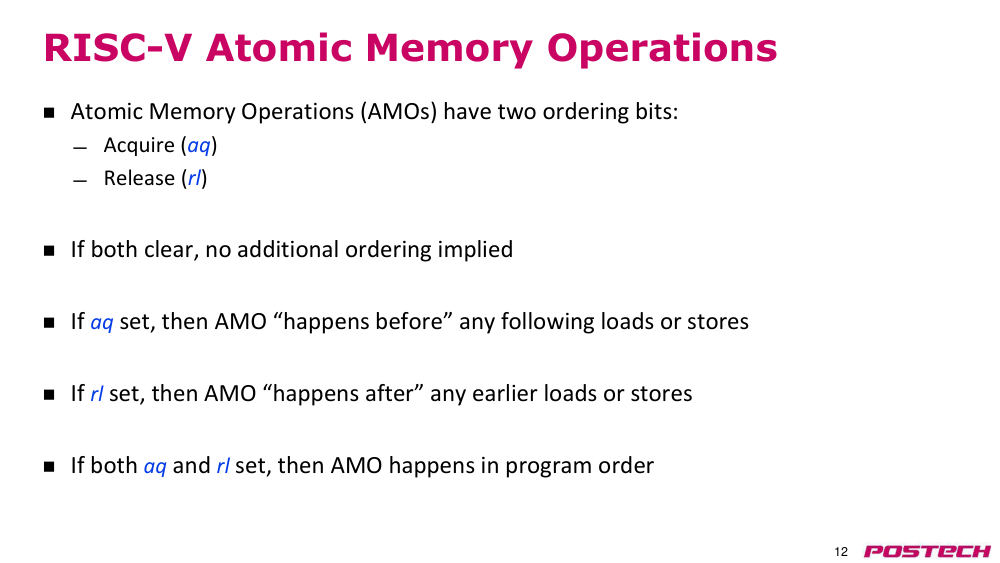
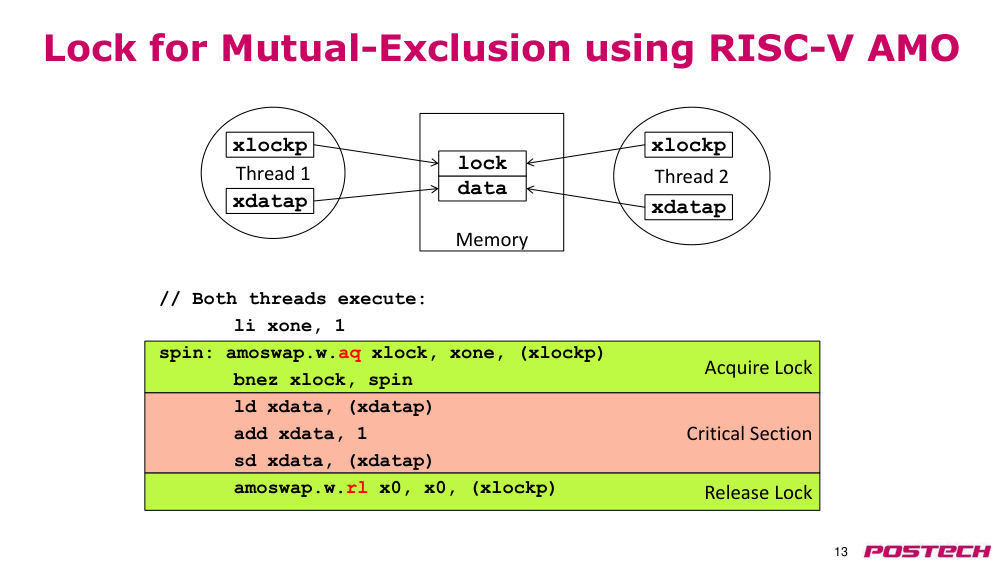
해결획득 뒤 fence r,rw, 해제 앞 fence rw,w. 또는 RISC-V AMO 의 aq bit(뒤 연산보다 먼저)·rl bit(앞 연산 뒤에) → amoswap.w.aq / amoswap.w.rl 로 fence 제거
- aq·rl 둘 다 clear: 추가 순서 없음, 둘 다 set: program order
- aq=RC 의 acquire, rl=release 와 대응
2.11.r.1RISC-V ISA Manual (Unprivileged): "A" Extension ↗ · AMO 의 aq/rl bit 의미, constrained LR/SC loop 의 forward progress 규칙
2.1255:46–1:00:19FENCE vs AMO.aq/rl
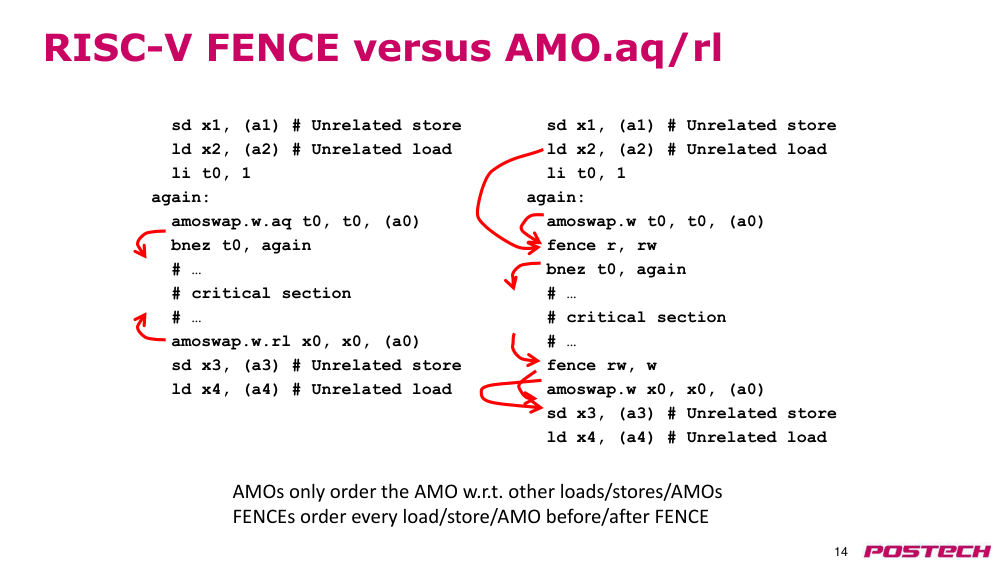
상황·문제fence 와 aq/rl AMO 는 같은 일을 하는 것처럼 보임
원인fence 는 fence 앞뒤 모든 load/store 를 순서화, AMO 는 AMO 자신과 다른 연산 사이만 순서화
해결aq/rl 버전: critical section 앞 unrelated load 가 AMO 뒤로, 뒤 unrelated store 가 release AMO 앞으로 이동 가능. fence 버전은 이 reorder 불가 → fence 가 더 강함
- AMOs only order the AMO w.r.t. other loads/stores/AMOs
- FENCEs order every load/store/AMO before/after FENCE
2.12.r.1RISC-V ISA Manual (Unprivileged): "A" Extension ↗ · AMO 의 aq/rl bit 의미, constrained LR/SC loop 의 forward progress 규칙
2.131:00:19–1:08:01Non-blocking synchronization: Compare&Swap
상황·문제lock 을 잡은 software thread 가 de-schedule 되면 다른 thread 가 critical section 에서 진전 못 함
원인lock 기반 동기화는 lock 보유자에 의존
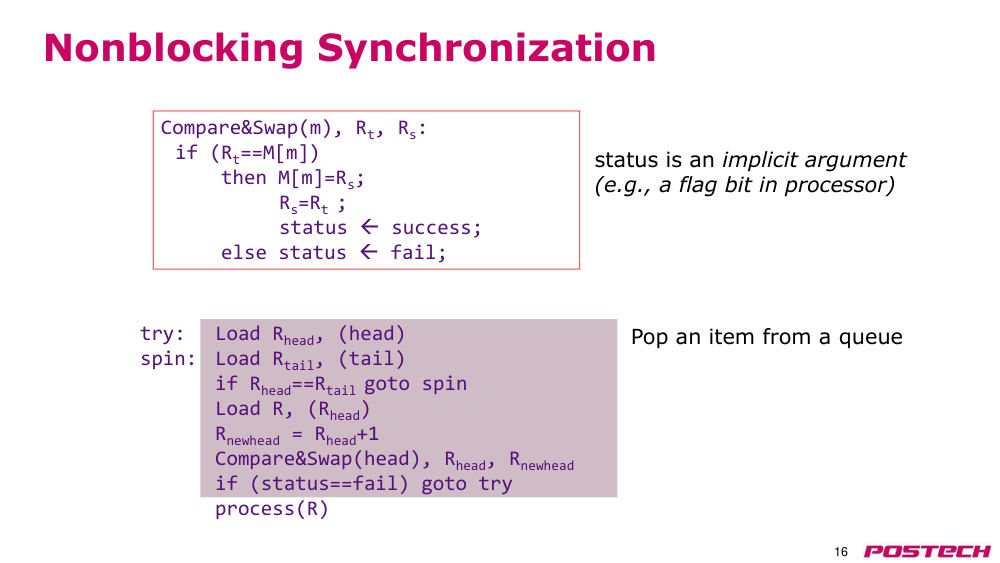
해결lock 없이 atomic 하게: Compare&Swap(m),Rt,Rs — M[m]==Rt 면 M[m]=Rs, status(implicit flag)=success. queue pop: head 를 읽고 Rhead+1 로 CAS, 실패면 retry
- status 는 processor flag bit 같은 implicit argument
- head·tail pointer 가 memory 에 있고 head==tail 이면 empty (판서 설명)
2.13.r.1Wikipedia: Non-blocking algorithm ↗ · lock 보유 thread 가 선점돼도 다른 thread 가 진전하는 non-blocking 동기화
2.141:08:01–1:15:45CAS 의 문제: 복잡성·ABA, double CAS, LR/SC 예고와 Q&A
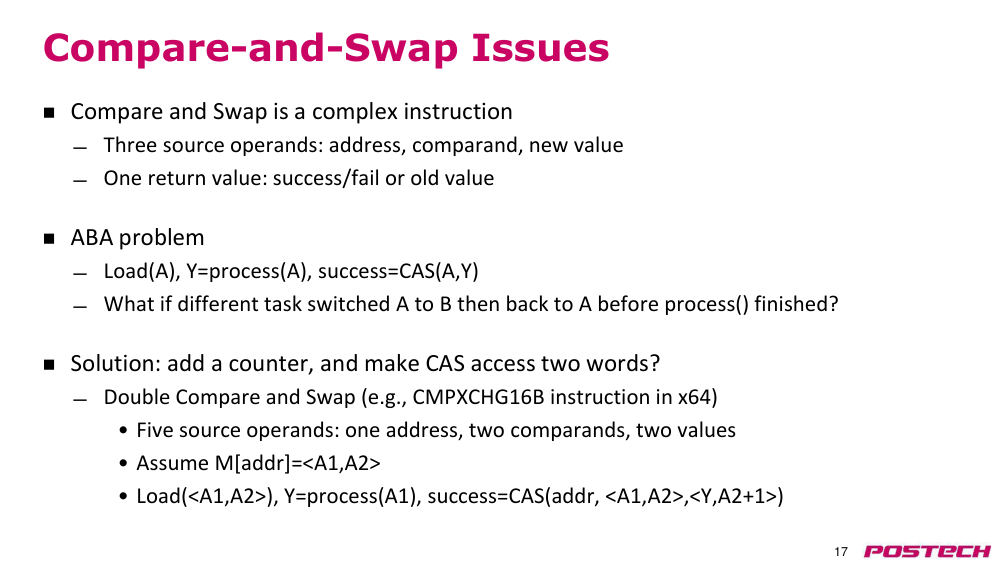
상황·문제CAS 는 source operand 3개(address·comparand·new value)+return 값 → RISC ISA 에 부적합, 구현 비용 큼
원인ABA problem: 값만 비교하므로 다른 task 가 A→B→A 로 바꿔도 CAS 성공
해결counter 를 붙인 double compare-and-swap(x64 CMPXCHG16B, operand 5개) → 더 복잡. RISC 에 맞는 LR/SC 는 다음 강의
- Q: CAS 가 starvation 을 일으킬 수 있나? → 강의자 즉답 보류, 다음 강의에서 답하기로
- LR/SC 슬라이드는 잠깐만 표시
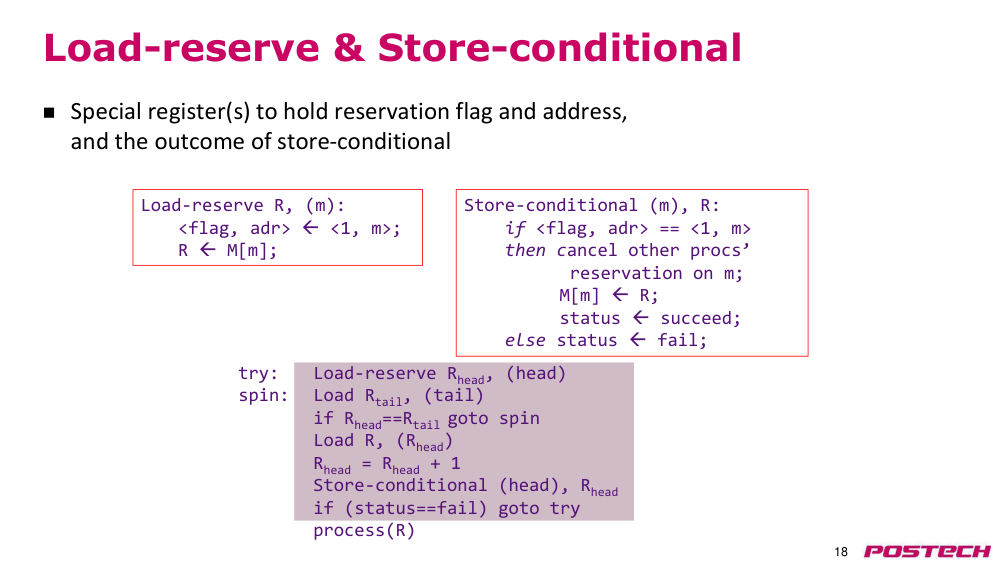
2.14.r.3Wikipedia: Load-link/store-conditional ↗ · LL/SC 는 값이 복원돼도 갱신을 감지(ABA 없음), RISC-V lr/sc 진전 보장
3핵심 개념
3.1Release consistency(RC, 릴리즈 일관성)
acquire/release 로 표시된 synchronization 만 SC, 나머지 read·write 는 자유롭게 reorder
3.2Eager RC / Lazy RC
eager: write 즉시 invalidation, release 때 write buffer drain. lazy: local cache 에만 쓰고 release 때 flush, acquire 때 self-invalidate
3.3Multi-copy atomicity(MCA, 다중 사본 원자성)
한 thread 에 보인 store 는 모든 thread 에 보임 → 모두 같은 write 순서 관측
3.3.r.1Wikipedia: Memory ordering ↗ · architecture 별 허용 reordering 표 (x86 은 store 뒤 load 만, SPARC TSO/PSO/RMO)
3.4DRF(data-race-free) memory model
conflicting 연산을 label 해 잘 synchronize 된 program 에 SC 보장
3.5Deadlock / Livelock / Starvation
deadlock: 서로 기다려 정지, livelock: 상태는 변하나 진전 없음, starvation: 특정 process 만 계속 진입 못 함
3.6Dekker's algorithm(데커 알고리즘)
c1·c2·turn 으로 load/store 만으로 두 process 상호배제 (SC 가정)
3.6.r.1Wikipedia: Dekker's algorithm ↗ · c1·c2(want)+turn 으로 두 process 상호배제, store buffer CPU 에선 barrier 필요
3.7Atomic RMW (test-and-set, swap, amoswap)
read-modify-write 를 atomic 하게 수행, spin lock 구현
3.8AMO aq/rl bit
aq: AMO 가 뒤 연산보다 먼저, rl: 앞 연산 뒤에. fence 보다 약함(AMO 자신만 순서화)
3.8.r.1RISC-V ISA Manual (Unprivileged): "A" Extension ↗ · AMO 의 aq/rl bit 의미, constrained LR/SC loop 의 forward progress 규칙
3.9Compare-and-swap(CAS)
M[m]==Rt 면 Rs 로 교체, status 반환. lock 없는 non-blocking 동기화
3.9.r.2Wikipedia: Non-blocking algorithm ↗ · lock 보유 thread 가 선점돼도 다른 thread 가 진전하는 non-blocking 동기화
3.10ABA problem
값만 비교하는 CAS 가 A→B→A 변경을 감지 못함, counter+double CAS 로 완화
4스스로 확인
4.1RC 에서 acquire 앞의 read/write 는 acquire 뒤로 이동할 수 있는가?
답
가능. acquire 는 뒤 연산만 제약, release 는 앞 write 만 제약
4.2lazy RC 에서 acquire 때 local cache 를 self-invalidate 하는 이유는?
답
다른 core 의 write 가 invalidation 없이 lower level 에만 있으므로 stale line 을 버려야 함
4.3non-MCA 예제에서 P3 의 fence r,r 로 x2=0 을 막지 못하는 이유는?
답
Y=1 이 P3 에 전파됐어도 X=1 이 아직 P3 에 전파되지 않을 수 있음 (local fence 는 자기 순서만)
4.4c1·c2 만 쓰는 2번째 시도의 문제는?
답
deadlock 은 없지만 동시 set/clear 반복으로 livelock, starvation 가능
4.5amoswap.w.aq/rl 과 fence r,rw/fence rw,w 의 차이는?
답
AMO 는 자신과 주변 연산만 순서화해 unrelated load/store 의 이동을 허용, fence 는 앞뒤 모든 연산 순서화
4.6ABA problem 은 무엇이고 double CAS 는 어떻게 막는가?
답
값이 A→B→A 로 돌아오면 CAS 성공. counter 를 함께 비교해 중간 변경을 감지
5참고 자료
5.1Hennessy & Patterson, Computer Architecture: A Quantitative Approach 6th ed. (Elsevier) ↗ · 추천 독서 교재 (ca_L15: 5.6-5.7, ca_L16: 5.5)
5.2Sorin·Hill·Wood, A Primer on Memory Consistency and Cache Coherence (1st ed., UCLA 강의 사본) ↗ · Ch.4 TSO·fence, Ch.5 relaxed(XC)·release consistency
5.4Wikipedia: Memory ordering ↗ · architecture 별 허용 reordering 표 (x86 은 store 뒤 load 만, SPARC TSO/PSO/RMO)
5.5Wikipedia: Consistency model ↗ · coherence(한 위치) vs consistency(여러 위치), SC·TSO·PSO·release consistency
5.7Wikipedia: Dekker's algorithm ↗ · c1·c2(want)+turn 으로 두 process 상호배제, store buffer CPU 에선 barrier 필요
5.11RISC-V ISA Manual (Unprivileged): "A" Extension ↗ · AMO 의 aq/rl bit 의미, constrained LR/SC loop 의 forward progress 규칙