이 자료를 쓰는 강의: 23 Release consistency·multi-copy atomicity 와 Synchronization(동기화) · 24 LR/SC·Transactional memory 와 I/O·Warehouse-scale computing
Lec16 - Synch
한국어판 강의자료 · 23쪽
p.1CSED503 고급 컴퓨터 구조 – 강의 16
p.2복습: 강의 15
- 메모리 일관성 모델(MCM)은 로드가 반환할 수 있는 값이 무엇인지 설명한다.
- sequential consistency(순차 일관성)은 가장 직관적인 모델이지만, 실제 하드웨어에서는 거의 구현되지 않는다.
- 단일 전역 메모리 순서로, 모든 개별 스레드의 메모리 연산이 로컬 프로그램 순서에 따라 나타난다.
- 강력한 MCM과 약한 MCM의 비교:
- TSO는 일반적으로 가장 강력한 모델로, 로컬 하드웨어 스레드가 다른 하드웨어 스레드보다 자신의 스토어를 먼저 볼 수 있지만, 그 외에는 가시적인 재정렬이 허용되지 않는다.
- weak multi-copy atomic model(약한 다중 복사 원자 모델)은 스토어가 다른 스레드에 가시화될 때, 모든 스레드가 동시에 "보게" 되는 조건 하에 더 많은 재정렬을 허용한다.
- very weak non-multi-copy atomic model(매우 약한 비다중 복사 원자 모델)은 한 스레드의 스토어가 원격 스레드에 서로 다른 순서로 관찰될 수 있다.
- fences(펜스)는 로컬 스레드 내에서 순서를 강제하기 위해 사용되며, TSO와 약한 메모리 모델에 충분하다.
- 비다중 복사 원자 모델에서는 다수의 하드웨어 스레드 간에 synchronization(동기화)를 위해 heavyweight barriers(무거운 장벽)이 필요하다.
p.3synchronization(동기화)
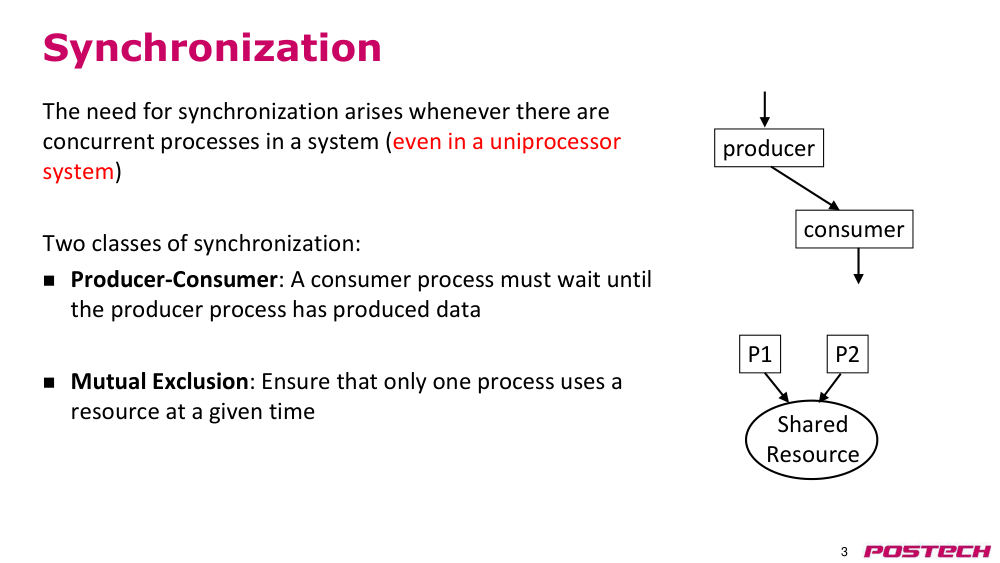
- synchronization(동기화)의 필요성은 시스템 내에서 동시 실행 프로세스가 존재할 때 발생한다 (단일 프로세서 시스템에서도 마찬가지이다).
- synchronization(동기화)의 두 가지 유형:
- Producer-Consumer(생산자-소비자): 소비자 프로세스는 생산자 프로세스가 데이터를 생성할 때까지 기다려야 한다.
- mutual exclusion(상호 배제): 주어진 시점에 자원을 하나의 프로세스만 사용하도록 보장한다.
- 공유 자원
- P1
- P2
p.4간단한 mutual exclusion(상호 배제) 예제
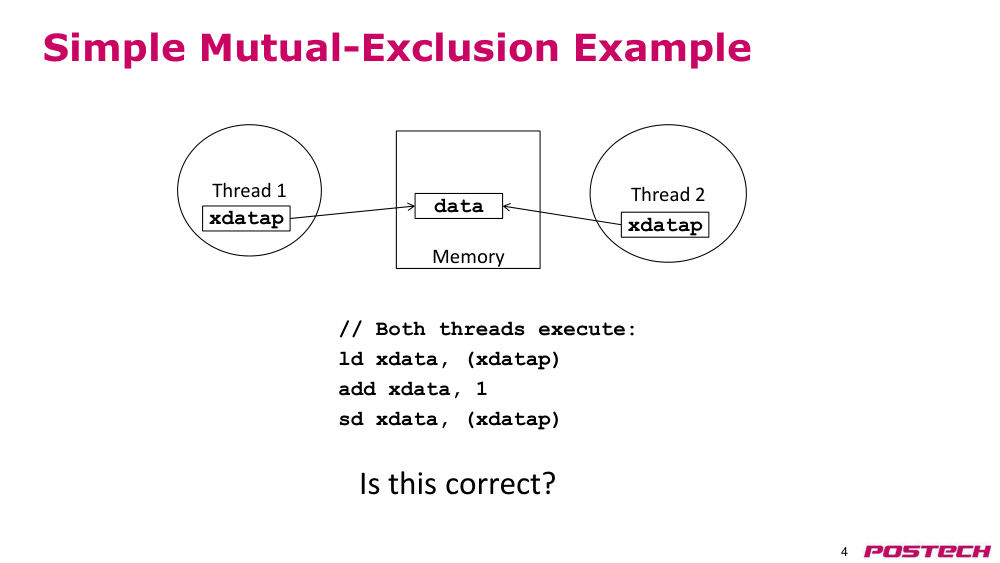
- 메모리
- // 두 스레드 모두 실행:
- ld xdata, (xdatap)
- add xdata, 1
- sd xdata, (xdatap)
- data
- Thread 1
- Thread 2
- 이 코드는 올바른가?
- xdatap
- xdatap
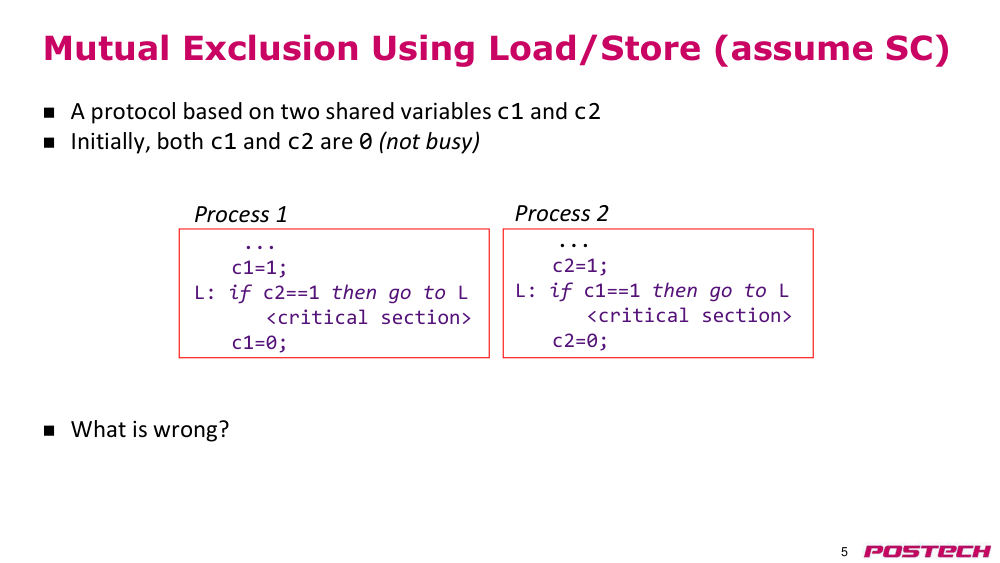
p.5로드/스토어를 이용한 상호 배제 (순차 일관성 가정)
- 두 개의 공유 변수 c1과 c2를 기반으로 한 프로토콜.
- 초기값: c1과 c2 모두 0 (비사용 상태).
- 문제점은 무엇인가?
- 프로세스 1
- ...
- c1=1;
- L: if c2==1 then go to L
- <critical section(임계 구역)>
- c1=0;
- 프로세스 2
- ...
- c2=1;
- L: if c1==1 then go to L
- <critical section(임계 구역)>
- c2=0;
- deadlock(데드락)!
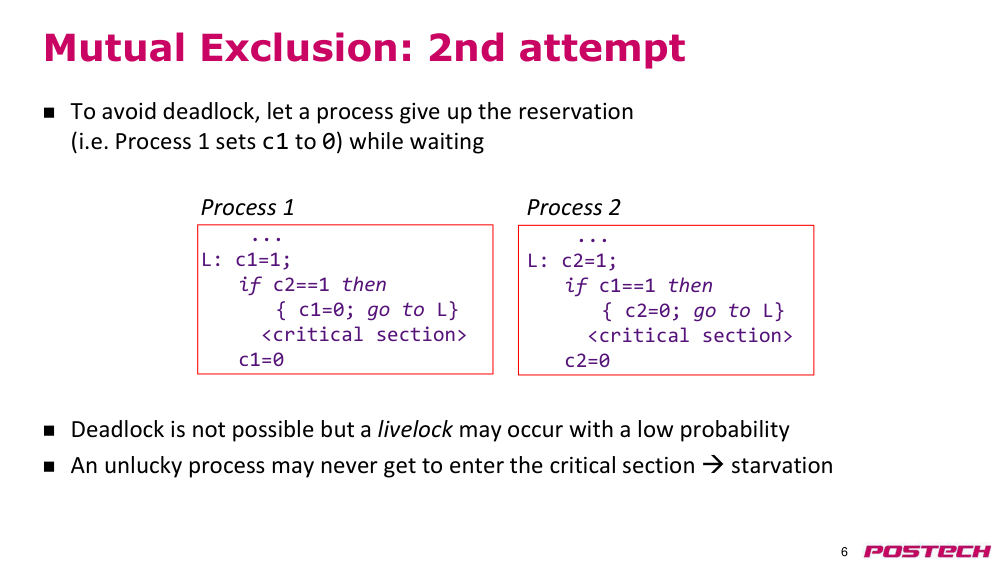
p.6mutual exclusion(상호 배제): 2번째 시도
- deadlock(데드락)을 피하기 위해, 프로세스가 대기 중일 때 reservation(예약)을 포기한다 (예: 프로세스 1이 c1을 0으로 설정).
- deadlock(데드락)은 발생하지 않지만, 낮은 확률로 livelock(라이브락)이 발생할 수 있다.
- 운이 나쁜 프로세스는 critical section(임계 구역)에 들어가지 못할 수 있다 → starvation(기아).
- 프로세스 1
- ...
- L: c1=1;
- if c2==1 then
- { c1=0; go to L}
- <critical section(임계 구역)>
- c1=0
- 프로세스 2
- ...
- L: c2=1;
- if c1==1 then
- { c2=0; go to L}
- <critical section(임계 구역)>
- c2=0
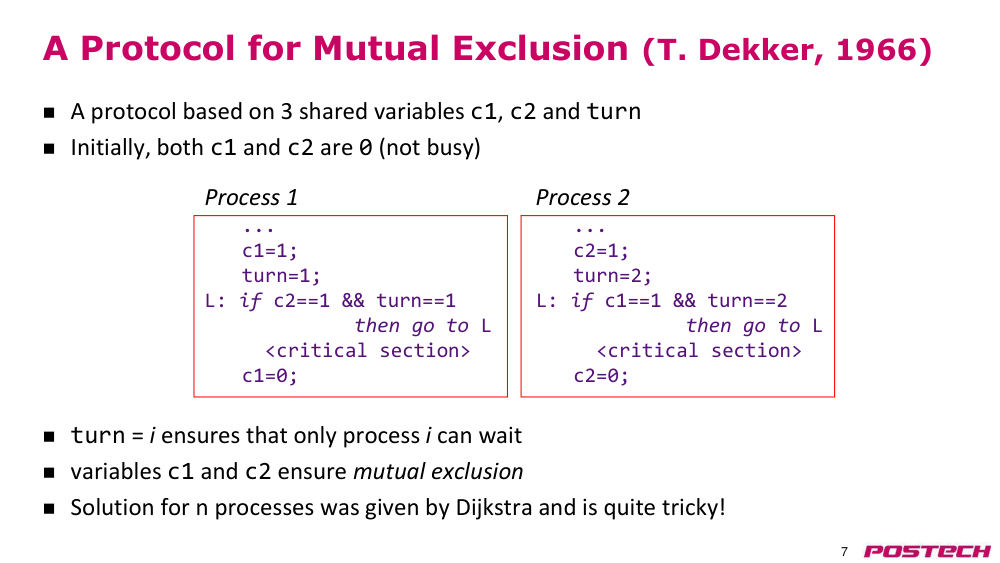
p.7mutual exclusion(상호 배제)를 위한 프로토콜 (T. 데커, 1966)
- 3개의 공유 변수 c1, c2, turn을 기반으로 한 프로토콜
- 초기 상태: c1과 c2는 모두 0 (비사용 중)
- turn = i는 오직 프로세스 i만 대기할 수 있음을 보장
- 변수 c1과 c2는 mutual exclusion(상호 배제)를 보장
- n개 프로세스에 대한 해법은 디크스트라가 제시했으며, 매우 복잡하다!
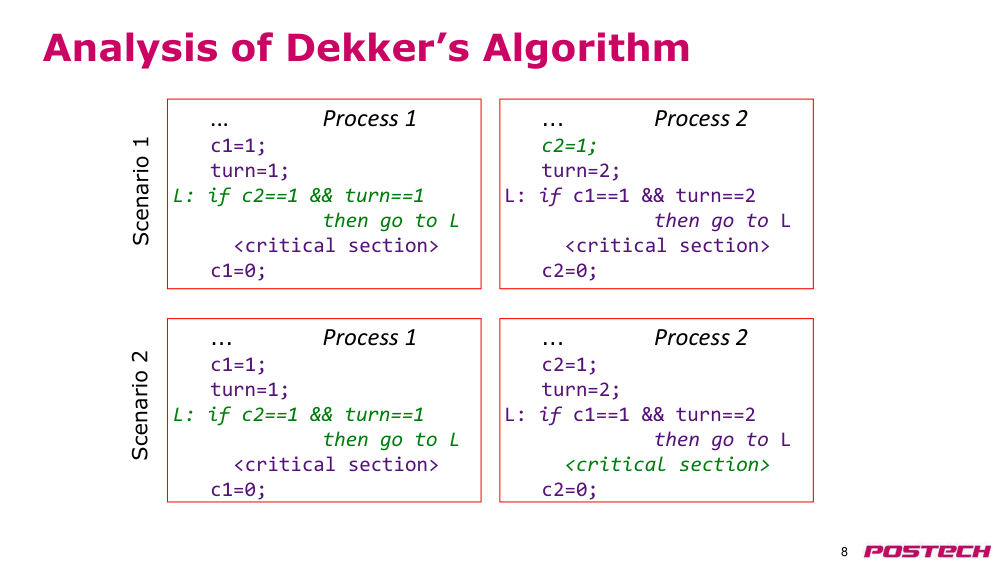
p.8dekker’s algorithm(데커 알고리즘) 분석
- 프로세스 1
- c1 = 1;
- turn = 1;
- L: if c2 == 1 && turn == 1 then go to L
- <critical section(임계 구역)>
- c1 = 0;
- 프로세스 2
- c2 = 1;
- turn = 2;
- L: if c1 == 1 && turn == 2 then go to L
- <critical section(임계 구역)>
- c2 = 0;
- 시나리오 1
- 프로세스 1
- c1 = 1;
- turn = 1;
- L: if c2 == 1 && turn == 1 then go to L
- <critical section(임계 구역)>
- c1 = 0;
- 프로세스 2
- c2 = 1;
- turn = 2;
- L: if c1 == 1 && turn == 2 then go to L
- <critical section(임계 구역)>
- c2 = 0;
- 시나리오 2
p.9mutual exclusion(상호 배제) 락을 위한 ISA 지원
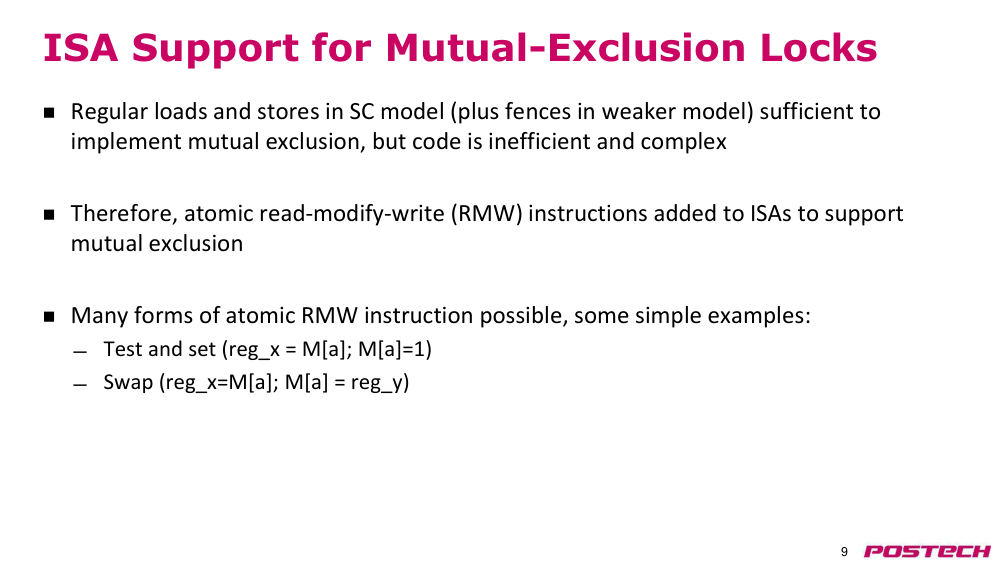
- 순차 일관성(MCM) 모델에서의 일반적인 로드와 스토어(약한 모델에서는 fences(펜스) 포함)만으로도 mutual exclusion(상호 배제)를 구현할 수 있으나, 코드가 비효율적이고 복잡하다
- 따라서 mutual exclusion(상호 배제)를 지원하기 위해 원자적 읽기-수정-쓰기(RMW) 명령어가 ISA에 추가됨
- 원자적 RMW 명령어는 여러 형태가 가능하며, 간단한 예시들:
- 테스트 및 세트 (reg_x = M[a]; M[a] = 1)
- 스왑 (reg_x = M[a]; M[a] = reg_y)
p.10mutual exclusion(상호 배제) 예제를 위한 락
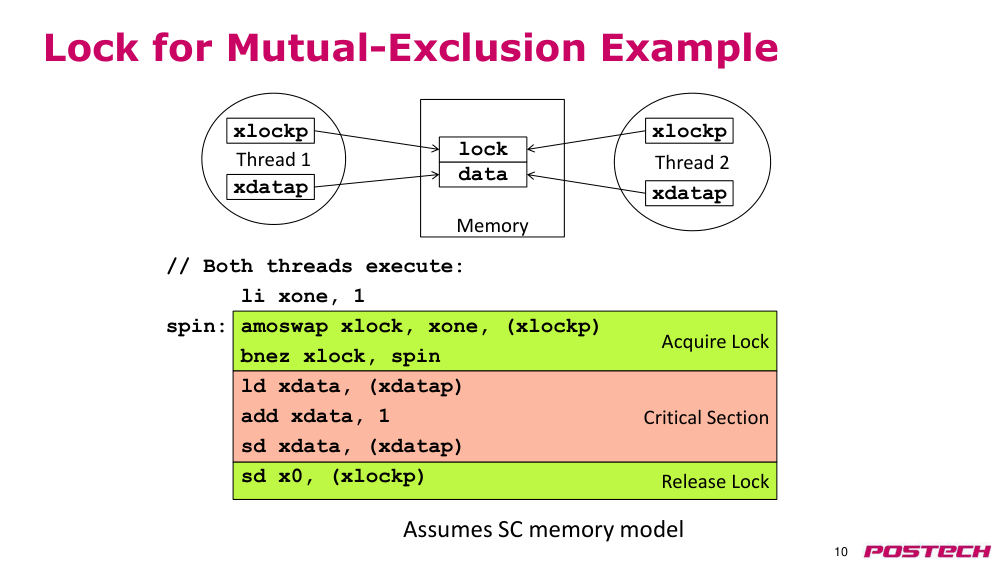
- // 두 스레드 모두 실행:
- li xone, 1
- spin: amoswap xlock, xone, (xlockp)
- bnez xlock, spin
- ld xdata, (xdatap)
- add xdata, 1
- sd xdata, (xdatap)
- sd x0, (xlockp)
- data
- Thread 1
- Thread 2
- xdatap
- xdatap
- lock
- xlockp
- xlockp
- 순차 일관성(MCM) 모델을 가정
p.11완화된 메모리 모델에서의 mutual exclusion(상호 배제) 락
- release lock(락 해제)
- acquire lock(락 획득)
- critical section(임계 구역)
- memory(메모리)
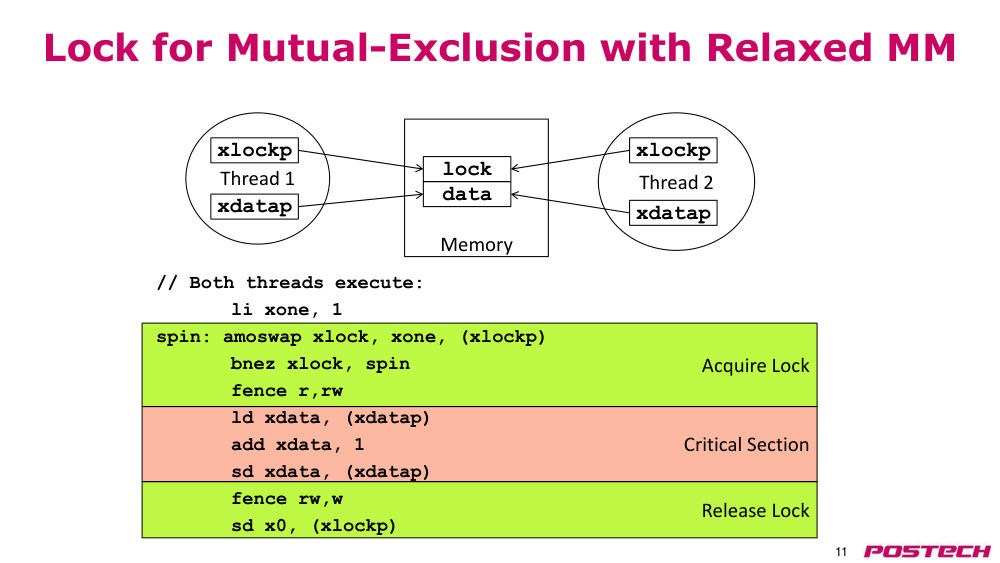
- // 두 스레드 모두 실행:
- li xone, 1
- spin: amoswap xlock, xone, (xlockp)
- bnez xlock, spin
- fence r,rw
- ld xdata, (xdatap)
- add xdata, 1
- sd xdata, (xdatap)
- fence rw,w
- sd x0, (xlockp)
- data
- Thread 1
- Thread 2
- xdatap
- xdatap
- lock
- xlockp
- xlockp
p.12RISC-V atomic memory operations (AMOs)(RISC-V 원자 메모리 연산)
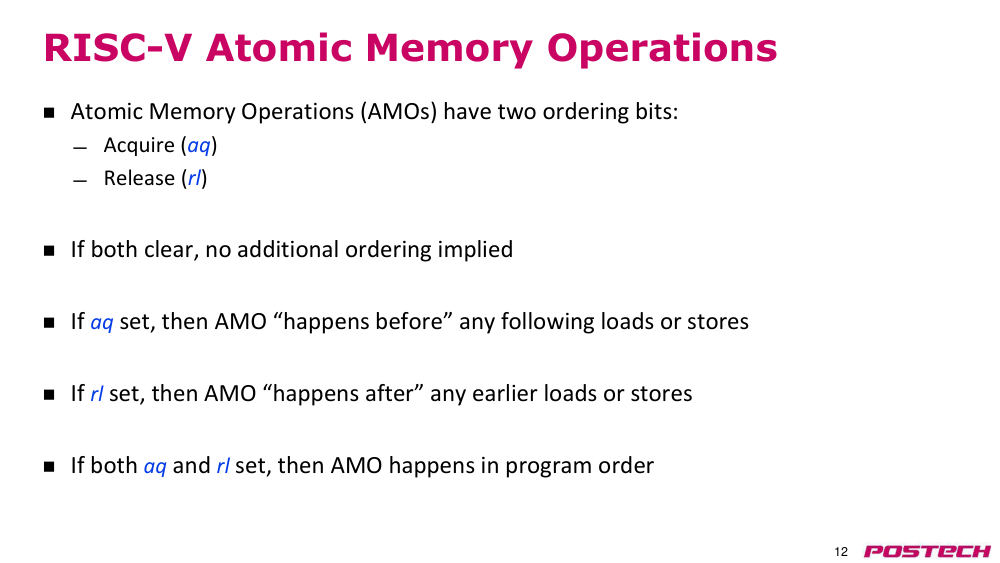
- 원자 메모리 연산(AMOs)은 두 개의 순서 지정 비트를 가짐:
- acquire(획득) (aq)
- release(해제) (rl)
- 둘 다 clear인 경우, 추가적인 순서 보장 없음
- aq가 설정되면, AMO는 이후의 모든 로드나 스토어보다 "이전에 발생"함
- rl이 설정되면, AMO는 이전의 모든 로드나 스토어보다 "이후에 발생"함
- aq와 rl 둘 다 설정되면, AMO는 프로그램 순서에 따라 발생
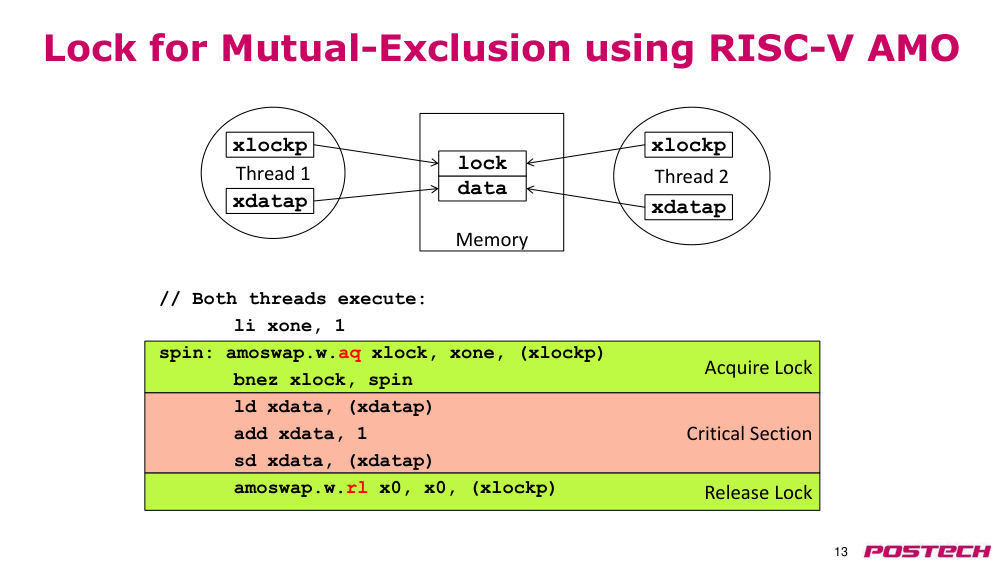
p.13RISC-V AMO를 사용한 mutual exclusion(상호 배제)를 위한 락
- data
- Thread 1
- Thread 2
- xdatap
- xdatap
- lock
- xlockp
- xlockp
- release lock(락 해제)
- acquire lock(락 획득)
- critical section(임계 구역)
- // 두 스레드 모두 실행:
- li xone, 1
- spin: amoswap.w.aq xlock, xone, (xlockp)
- bnez xlock, spin
- ld xdata, (xdatap)
- add xdata, 1
- sd xdata, (xdatap)
- amoswap.w.rl x0, x0, (xlockp)
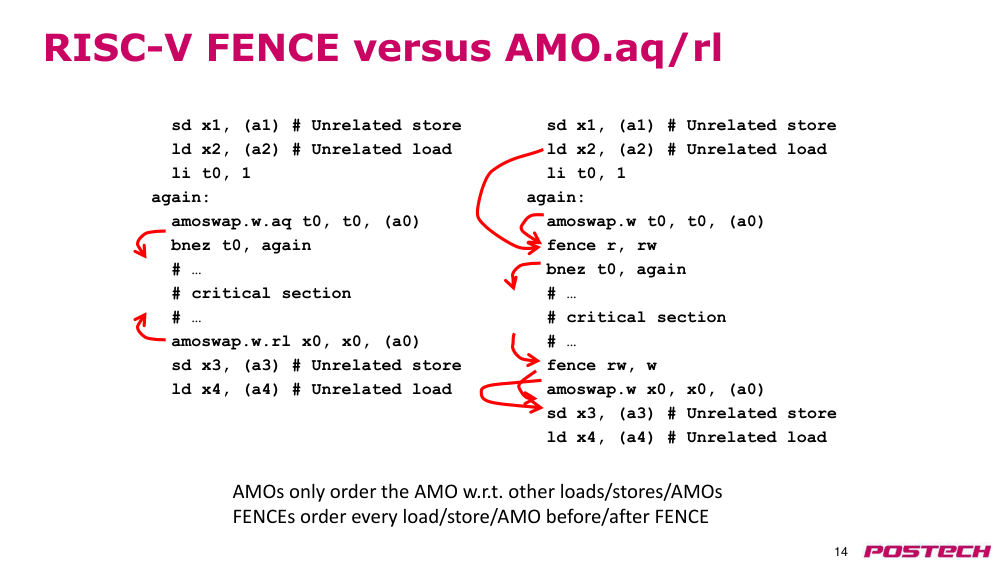
p.14RISC-V FENCE와 AMO.aq/rl 비교
- sd x1, (a1) # 관련 없는 저장
- ld x2, (a2) # 관련 없는 로드
- li t0, 1
- again:
- amoswap.w.aq t0, t0, (a0)
- bnez t0, again
- # …
- # critical section(임계 구역)
- # …
- amoswap.w.rl x0, x0, (a0)
- sd x3, (a3) # 관련 없는 저장
- ld x4, (a4) # 관련 없는 로드
- sd x1, (a1) # 관련 없는 저장
- ld x2, (a2) # 관련 없는 로드
- li t0, 1
- again:
- amoswap.w t0, t0, (a0)
- fence r, rw
- bnez t0, again
- # …
- # critical section(임계 구역)
- # …
- fence rw, w
- amoswap.w x0, x0, (a0)
- sd x3, (a3) # 관련 없는 저장
- ld x4, (a4) # 관련 없는 로드
- AMOs는 다른 로드/저장/AMOs와의 순서만 보장한다
- FENCE는 FENCE 전후의 모든 로드/저장/AMO를 순서화한다
p.15락 없이 critical section(임계 구역) 실행
- 소프트웨어 스레드가 락을 획득한 후 스케줄링되지 않으면, 다른 스레드는 critical section(임계 구역) 내에서 진전을 이루지 못한다
- “비차단” synchronization(동기화)는 락을 획득하지 않고도 critical section(임계 구역)을 원자적으로 실행할 수 있도록 한다
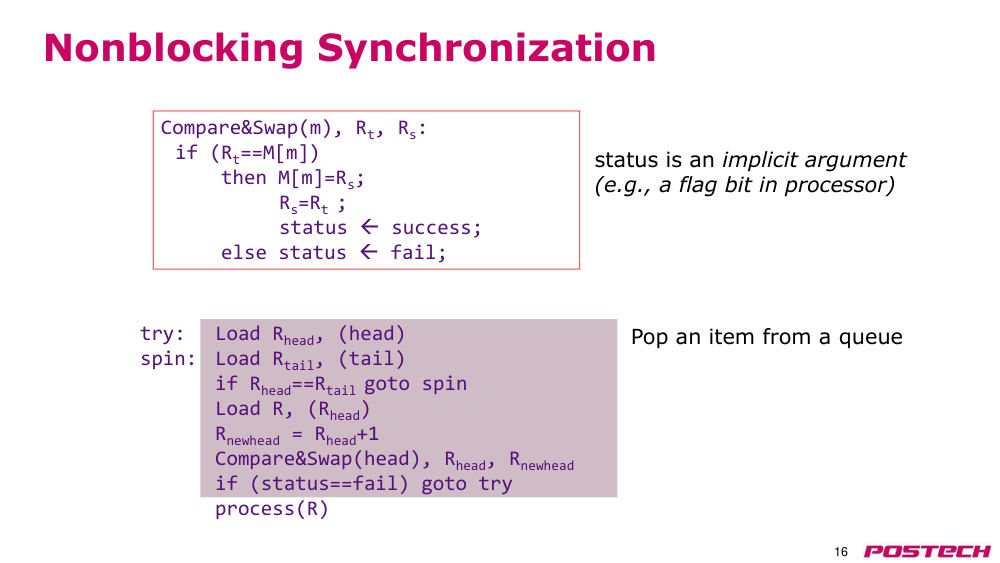
p.16non-blocking synchronization(비차단 동기화)
- Compare&Swap(m), Rt, Rs:
- if (Rt==M[m])
- then M[m]=Rs;
- Rs=Rt ;
- status success;
- else status fail;
- try: Load Rhead, (head)
- spin:
- Load Rtail, (tail)
- if Rhead==Rtail goto spin
- Load R, (Rhead)
- Rnewhead = Rhead+1
- Compare&Swap(head), Rhead, Rnewhead
- if (status==fail) goto try
- process(R)
- status는 암시적 인자이다
- (예: 프로세서의 플래그 비트)
p.17Compare&Swap(비교 및 스왑)의 문제점
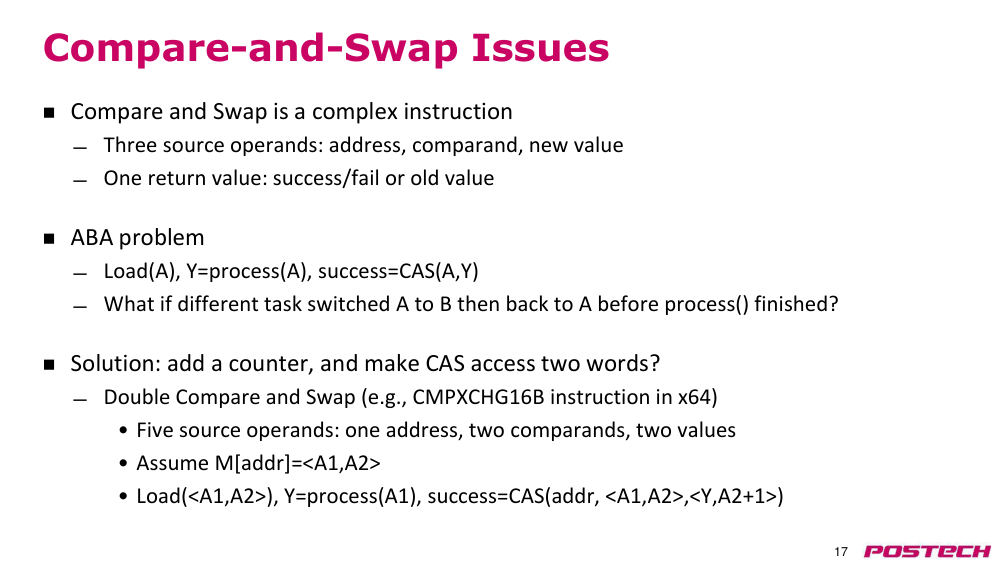
- Compare&Swap(비교 및 스왑)은 복잡한 명령어이다
- 세 개의 소스 오퍼랜드: 주소, 비교 값, 새로운 값
- 한 개의 반환 값: 성공/실패 또는 이전 값
- ABA problem(ABA 문제)
- Load(A), Y=process(A), success=CAS(A,Y)
- process()가 완료되기 전에 다른 작업이 A를 B로 변경했다가 다시 A로 되돌렸다면?
- 해결책: 카운터 추가, CAS가 두 단어에 접근하도록 하기?
- 이중 비교 및 스왑 (예: x64의 CMPXCHG16B 명령어)
- 다섯 개의 소스 오퍼랜드: 하나의 주소, 두 개의 비교 값, 두 개의 값
- M[addr]=<A1,A2>라고 가정
- Load(<A1,A2>), Y=process(A1), success=CAS(addr, <A1,A2>,<Y,A2+1>)
p.18load-reserve(로드-예약) 및 store-conditional(스토어-조건부)
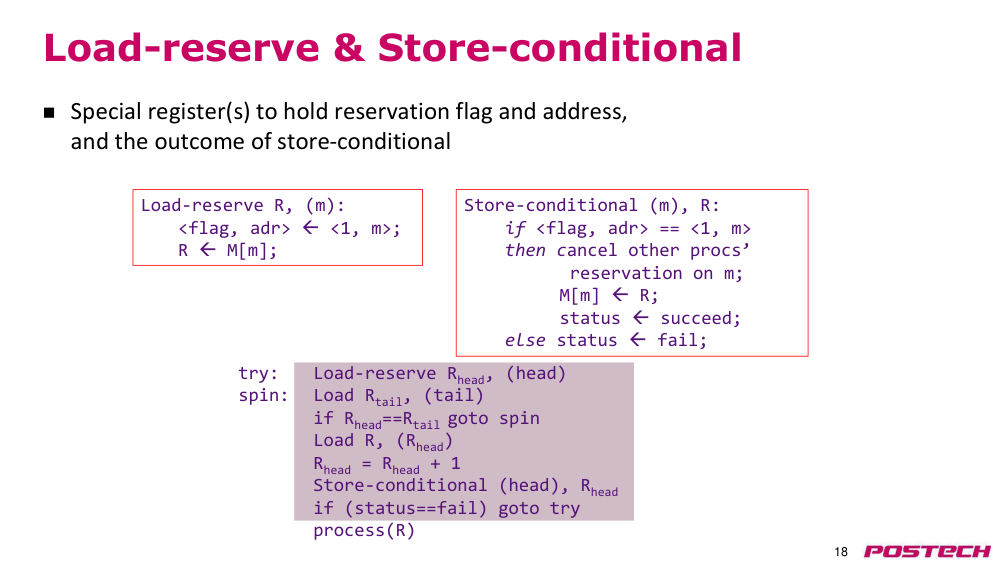
- reservation flag(예약 플래그)와 주소를 저장하는 특수 레지스터
- store-conditional(스토어-조건부)의 결과를 저장
- try: Load-reserve Rhead, (head)
- spin:
- Load Rtail, (tail)
- if Rhead==Rtail goto spin
- Load R, (Rhead)
- Rhead = Rhead + 1
- Store-conditional (head), Rhead
- if (status==fail) goto try
- process(R)
- Load-reserve R, (m):
- <flag, adr> <1, m>;
- R M[m];
- Store-conditional (m), R:
- if <flag, adr> == <1, m>
- then cancel other procs’
- reservation on m;
- M[m] R;
- status succeed;
- else status fail;
p.19MESI caches(MESI 캐시)를 사용한 load-reserve(로드-예약)/store-conditional(스토어-조건부)
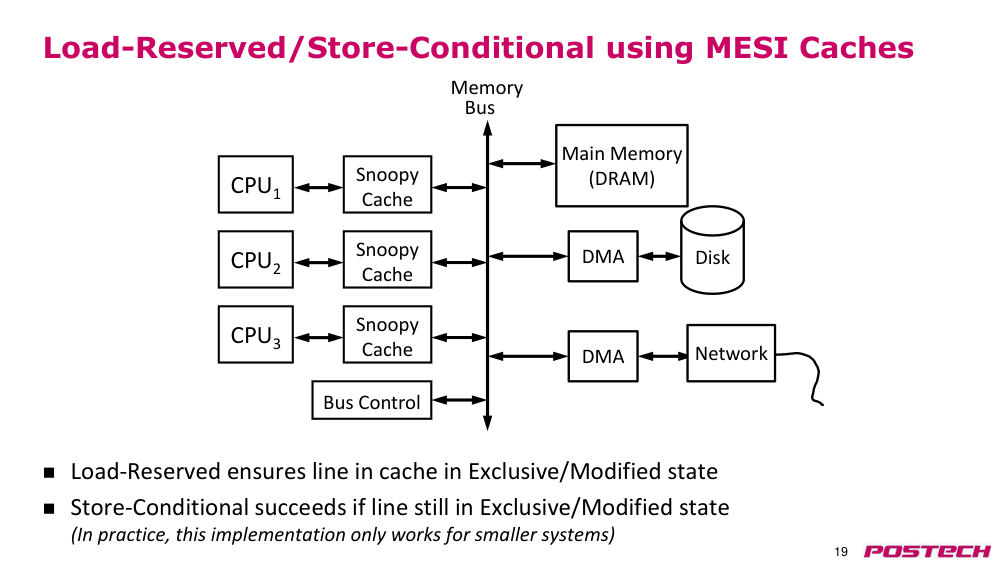
- load-reserve(로드-예약)은 캐시 라인을 독점/수정 상태로 유지함을 보장함
- store-conditional(스토어-조건부)는 라인이 여전히 독점/수정 상태에 있을 경우에만 성공함
- (실제로는 이 구현은 작은 시스템에서만 작동함)
p.20LR/SC의 문제점
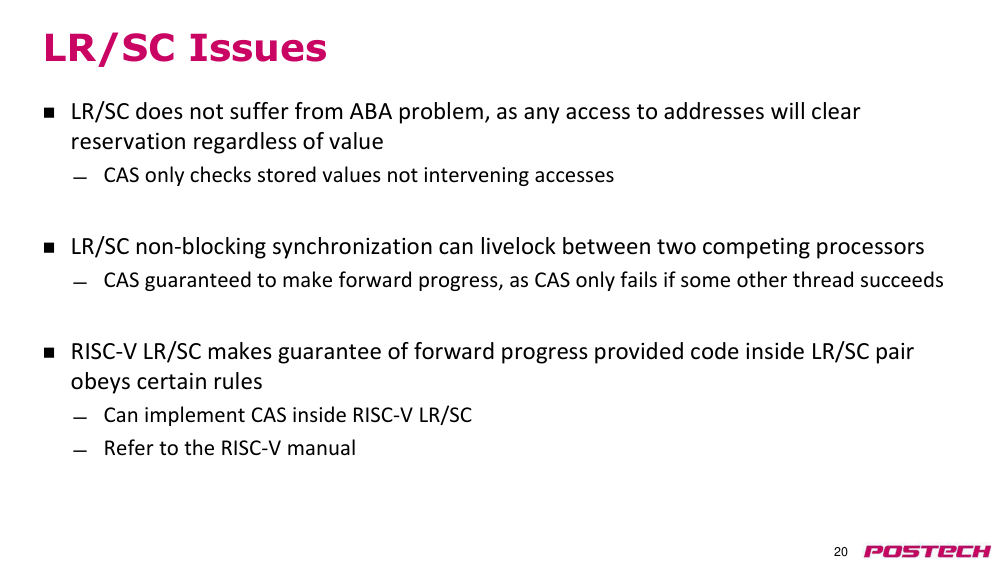
- LR/SC는 ABA problem(ABA 문제)에 영향을 받지 않음. 왜냐하면 주소에 대한 어떤 접근이라도 reservation(예약)을 해제하기 때문임 (값과 무관함)
- CAS는 중간 접근을 확인하지 않고 저장된 값을만 확인함
- LR/SC를 이용한 non-blocking synchronization(비차단 동기화)는 두 개의 경쟁하는 프로세서 사이에서 livelock(라이브락)이 발생할 수 있음
- CAS는 다른 스레드가 성공할 경우에만 실패하므로 forward progress(진전 보장)을 보장함
- RISC-V의 LR/SC는 LR/SC 쌍 내부의 코드가 특정 규칙을 따를 경우 forward progress(진전 보장)을 보장함
- RISC-V LR/SC 내부에서 CAS를 구현할 수 있음
- RISC-V 매뉴얼 참조
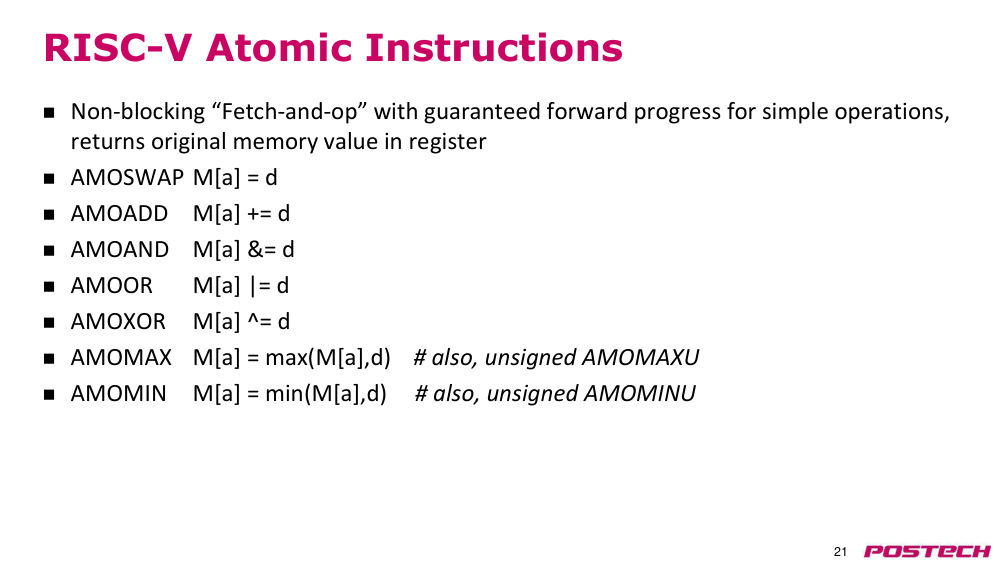
p.21RISC-V 원자 명령어
- 간단한 연산에 대해 forward progress(진전 보장)을 보장하는 비차단 'fetch-and-op(가져오기-연산)'
- 원래 메모리 값을 레지스터에 반환함
- AMOSWAP M[a] = d
- AMOADD M[a] += d
- AMOAND M[a] &= d
- AMOOR M[a] |= d
- AMOXOR M[a] ^= d
- AMOMAX M[a] = max(M[a], d) # 또한 부호 없는 AMOMAXU
- AMOMIN M[a] = min(M[a], d) # 또한 부호 없는 AMOMINU
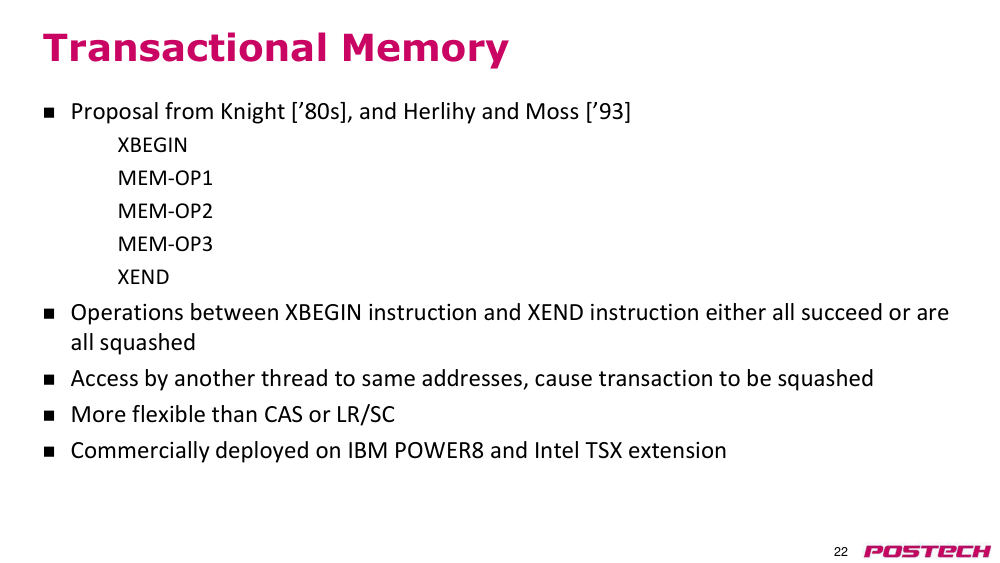
p.22transactional memory(트랜잭션 메모리)
- Knight [80년대] 및 Herlihy와 Moss [93년]의 제안
- XBEGIN
- MEM-OP1
- MEM-OP2
- MEM-OP3
- XEND
- XBEGIN 명령어와 XEND 명령어 사이의 연산은 모두 성공하거나 모두 취소됨
- 다른 스레드가 동일한 주소에 접근하면 트랜잭션이 취소됨
- CAS나 LR/SC보다 더 유연함
- IBM POWER8 및 Intel TSX 확장에서 상용 배포됨
p.23질문?
- 추천 독서:
- 교재의 5.5장