이 자료를 쓰는 강의: 22 VIPT·alias 방지·hashed page table·VM 역사, Memory Consistency(SC·TSO·fence) · 23 Release consistency·multi-copy atomicity 와 Synchronization(동기화)
Lec15 - MemoryConsistency
한국어판 강의자료 · 26쪽
p.1CSED503 고급 컴퓨터 구조 – 강의 15
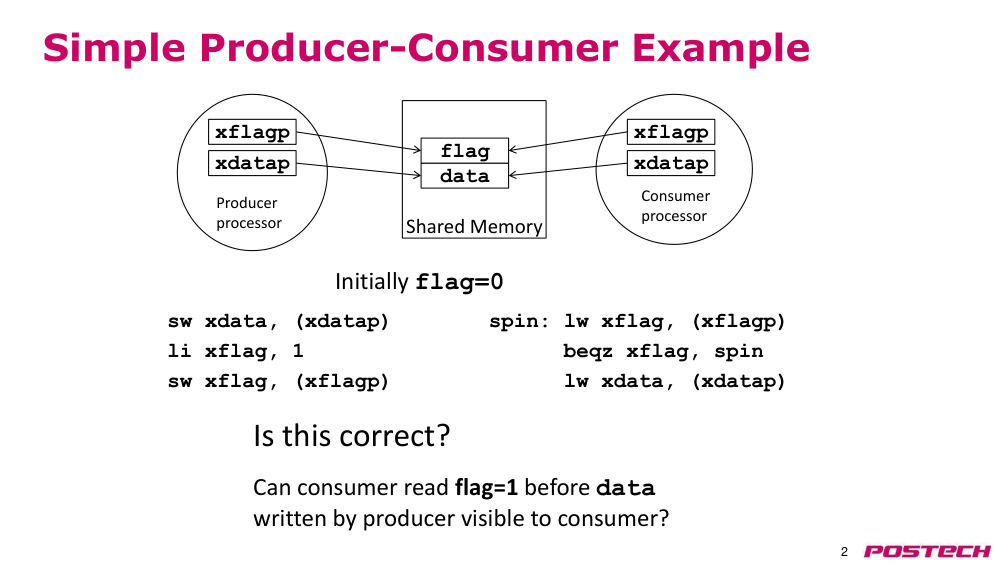
p.2간단한 생산자-소비자 예제
- shared memory(공유 메모리)
- sw xdata, (xdatap)
- li xflag, 1
- sw xflag, (xflagp)
- spin: lw xflag, (xflagp)
- beqz xflag, spin
- lw xdata, (xdatap)
- data
- flag
- 이 코드는 올바른가?
- xflagp
- xdatap
- xflagp
- xdatap
- 초기 flag = 0
- 생산자 processor(프로세서)
- 소비자 processor(프로세서)
- 소비자가 생산자가 쓴 데이터가 가시되기 전에 flag = 1을 읽을 수 있는가?
p.3메모리 일관성
- cache coherence(캐시 일관성):
- 최종적인 쓰기 전파 보장
- 동일한 위치에 대한 모든 쓰기의 단일 순서 보장
- 메모리 일관성:
- 다른 메모리 위치에 대한 로드와 스토어의 순서 지정
- 일명 memory consistency models(메모리 일관성 모델)로 정의됨
- 이것은 하드웨어, 컴파일러, 프로그래머 사이의 '계약'이다
- 즉, 하드웨어와 컴파일러는 모델에서 지정된 순서를 위반하지 않는다
- 즉, 프로그래머는 모델보다 더 엄격한 순서를 가정하지 않는다
- 하드웨어/컴파일러는 모델이 제공하는 순서보다 더 엄격한 순서를 강제할 수 있도록 '안전망' 메커니즘을 제공한다
- 쓰기 전파 시점에 대한 보장 없음
- 동일한 메모리 위치에 대해
- Write-Atomicity(쓰기 원자성)에 대한 보장 없음
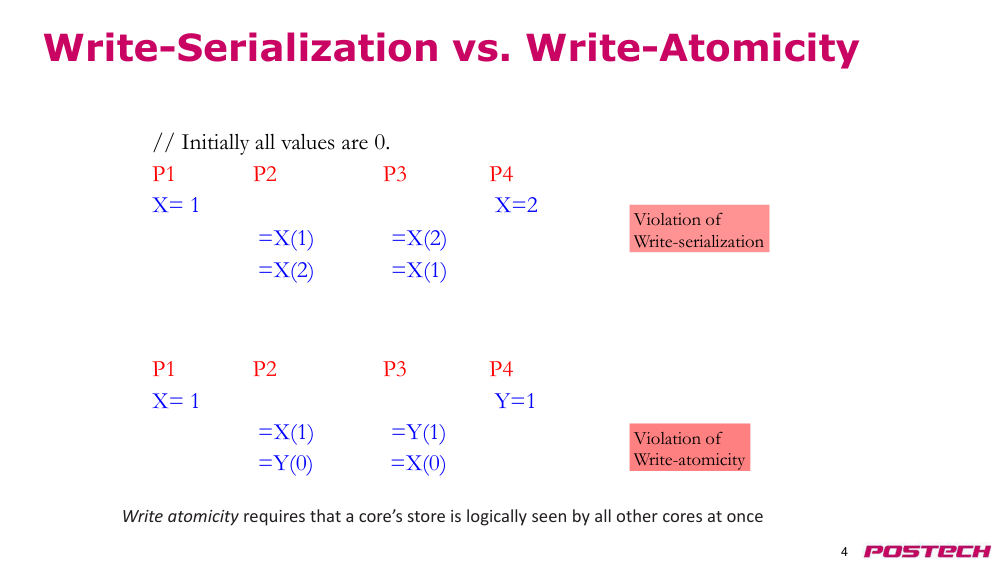
p.4Write-Serialization(쓰기 순서화) vs. Write-Atomicity(쓰기 원자성)
- // 초기 모든 값은 0이다.
- P1
- P2
- P3
- X= 1
- P4
- X=2
- =X(1)
- =X(2)
- =X(2)
- =X(1)
- P1
- X= 1
- P2
- P3
- P4
- Y=1
- =X(1)
- =Y(0)
- =Y(1)
- =X(0)
- Write-Serialization(쓰기 순서화) 위반
- Write-Atomicity(쓰기 원자성) 위반
- Write-Atomicity(쓰기 원자성)은 코어의 스토어가 모든 다른 코어에 동시에 논리적으로 보여져야 함을 요구한다
p.5순차 일관성 (SC)
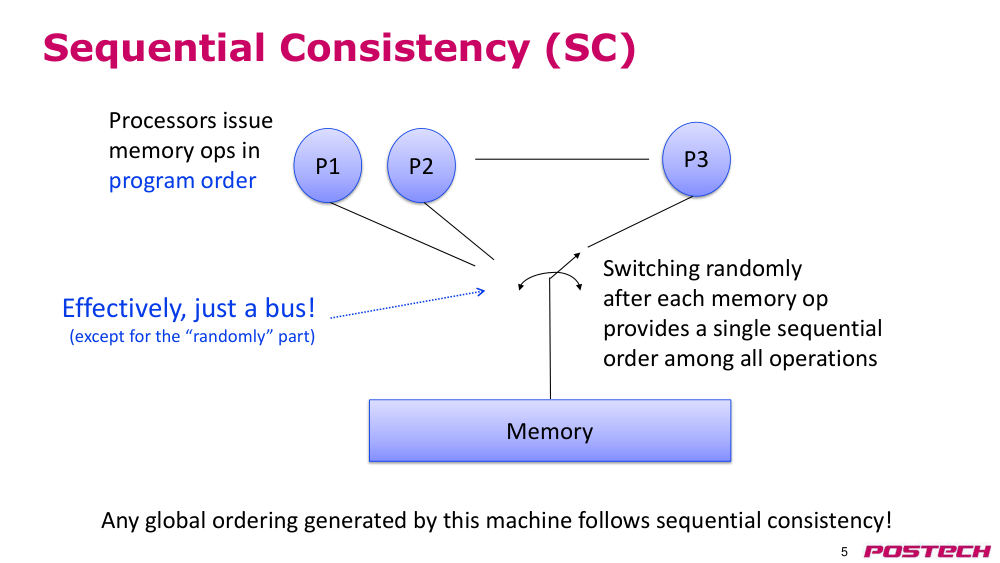
- 각 memory operation(메모리 연산) 후 무작위로 스위칭
- 모든 연산들 사이에 단일 순차 순서 제공
- processor(프로세서)는 program order(프로그램 순서)에 따라 memory operation(메모리 연산)을 발행
- P1
- P2
- P3
- 메모리
- 이 기계가 생성하는 어떤 global ordering(전역 순서)도 sequential consistency (SC)(순차 일관성)을 따른다!
- 실제로, 단지 bus(버스)일 뿐이다!
- (무작위 부분을 제외하고)
p.6sufficient conditions for SC(SC를 위한 충분 조건)
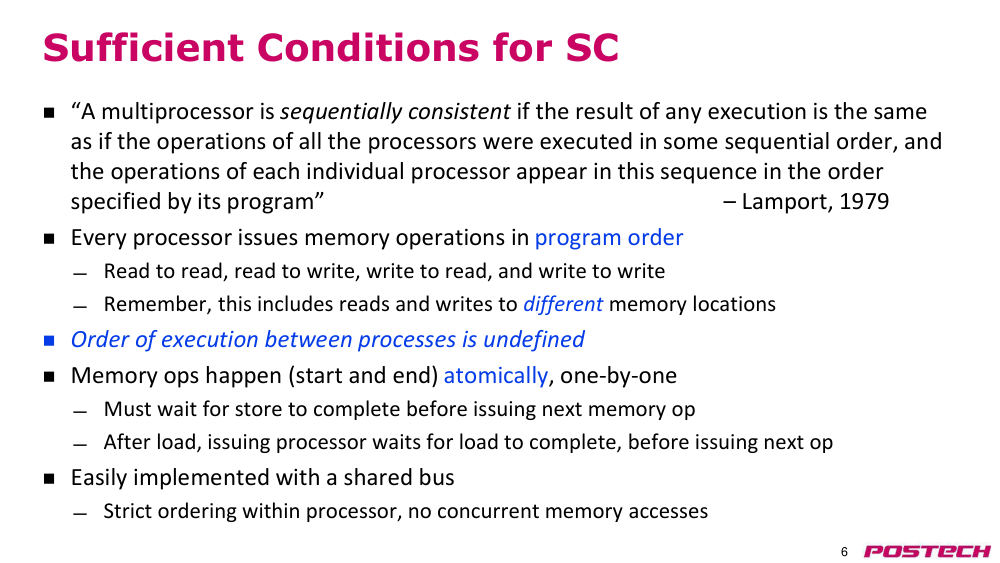
- ‘다중 processor(프로세서)가 어떤 실행 결과도, 모든 프로세서의 연산이 어떤 순차 순서로 실행된 것처럼 보이는 경우와 동일하다면, 그 프로세서는 sequential consistency (SC)(순차 일관성)을 갖는다. 또한 각 개별 프로세서의 연산은 그 프로그램에서 지정된 순서대로 이 순서에 나타난다.’
- – Lamport, 1979
- 모든 processor(프로세서)는 program order(프로그램 순서)에 따라 memory operation(메모리 연산)을 발행한다
- 읽기-읽기, 읽기-쓰기, 쓰기-읽기, 쓰기-쓰기
- 이것은 서로 다른 메모리 위치에 대한 읽기와 쓰기 포함됨을 기억하라
- 프로세스 간 실행 순서는 정의되지 않음
- memory operation(메모리 연산)은 원자적으로 하나씩 시작되고 끝난다
- 다음 memory operation(메모리 연산)을 발행하기 전에 스토어가 완료되기를 기다려야 함
- 로드 이후, 발행 processor(프로세서)는 다음 연산을 발행하기 전에 로드가 완료되기를 기다려야 함
- 공유 bus(버스)를 사용하면 쉽게 구현 가능하다
- processor(프로세서) 내부에서는 엄격한 순서, 동시 메모리 접근 없음
p.7간단한 생산자-소비자 예제
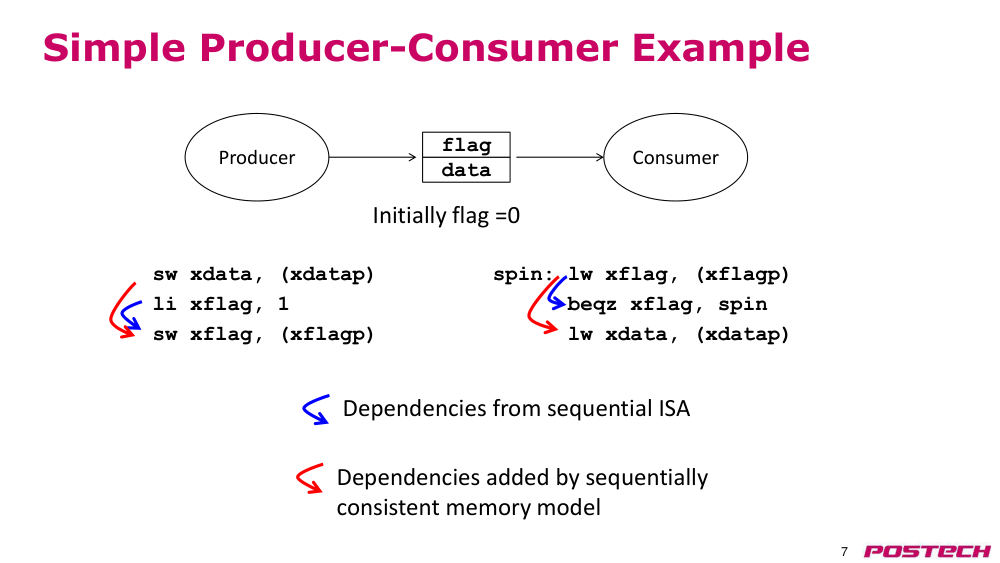
- sw xdata, (xdatap)
- li xflag, 1
- sw xflag, (xflagp)
- spin: lw xflag, (xflagp)
- beqz xflag, spin
- lw xdata, (xdatap)
- data
- flag
- Producer
- Consumer
- 초기 상태: flag = 0
- 순차적 ISA에서의 dependency(의존성)
- sequential consistency (SC)(순차 일관성) memory model(메모리 모델)이 추가하는 dependency(의존성)
p.8SC 구현 최적화
- non-binding prefetches(비결합 프리패치)
- 순서 외로 캐시 라인을 S 또는 M 상태로 가져오기 (또는 병렬로), 하지만 데이터를 레지스터에 넣거나 캐시 라인 데이터를 변경하지 않음
- memory consistency models(메모리 일관성 모델) 관점에서 실제로는 no-op임
- program order(프로그램 순서)에 따라 완료되는 로드/스토어
- speculation(추측 실행)을 이용한 최적화 (W → R, R → R에 대해)
- 후속 읽기는 더 일찍 발행될 수 있음
- 하지만 memory operation(메모리 연산)은 program order(프로그램 순서)에 따라 완료됨
- 로드가 실행되기 전에 invalidation(무효화) 메시지가 수신되면, speculation(추측 실행)이 취소되고 (후속) 로드부터 replay(재실행)됨
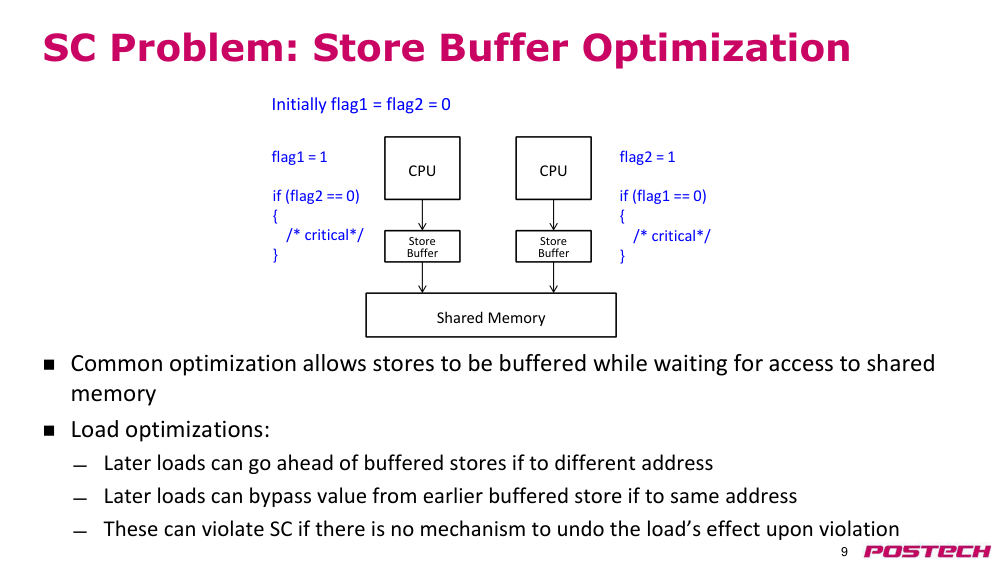
p.9SC 문제: store buffer(스토어 버퍼) 최적화
- 공통적인 최적화: shared memory(공유 메모리)에 접근할 때까지 스토어를 버퍼에 보관할 수 있음
- 로드 최적화:
- 다른 주소에 대한 후속 로드는 버퍼링된 스토어보다 앞서 갈 수 있음
- 같은 주소에 대한 후속 로드는 이전 버퍼링된 스토어의 값을 건너뛸 수 있음
- 이러한 동작은 위반 시 로드의 영향을 되돌릴 수 있는 메커니즘이 없으면 SC를 위반할 수 있음
- CPU
- Store Buffer
- Shared Memory
- CPU
- Store Buffer
- flag1 = 1
- if (flag2 == 0)
- {
- /* critical section(임계 구역) */
- }
- flag2 = 1
- if (flag1 == 0)
- {
- /* critical section(임계 구역) */
- }
- 초기 상태: flag1 = flag2 = 0
p.10대부분의 실제 머신은 SC가 아님
- 단 few개의 상용 ISA만이 SC를 요구함 (예: MIPS R10000)
- x86, ARM, RISC-V 모두 SC가 아님
- 원래 아키텍처 설계자는 최적화된 메모리 시스템을 가진 단일 processor(프로세서)를 개발함 (예: 스토어 버퍼)
- 단일 processor(프로세서)를 연결해 멀티프로세서를 만들었을 때, 결과적으로 생성된 시스템은 SC가 아님
- SC를 요구하면 단순한 머신은 느려지거나, 성능을 유지하기 위해 복잡한 하드웨어를 추가해야 함
- 아키텍처 설계자, 언어 설계자, 애플리케이션 개발자는 약한 메모리 동작을 설명하기 위해 노력함
- 결과적으로 보다 적은 보장을 제공하는 '약한' memory model(메모리 모델)이 등장함
p.11완화된 memory consistency models(메모리 일관성 모델)
- 고수준에서 읽기-읽기, 쓰기-쓰기, 읽기-쓰기 쌍 간의 순서 제약을 완화함 (예: 읽기가 쓰기를 건너뛸 수 있음, 쓰기가 서로를 건너뛸 수 있음)
- 일부 모델은 Write-Atomicity(쓰기 원자성)도 보장하지 않음
- 일부 모델은 synchronization(동기화)를 명시적으로 하고, 일반적인 로드/스토어와 구분함
- 많은 모델이 제안되고 구현됨
- TSO(Total Store Order) (예: Sparc, Intel): W→R 순서 완화
- PSO(Partial Store Order) (예: Sparc): W→R 및 W→W 완화
- RMO(Relaxed Memory Order) (예: Sparc): 모든 4가지 메모리 순서 완화
- release consistency(해제 일관성) (RC) (예: Itanium): 모든 4가지 메모리 순서 완화, 하지만 release store(해제 스토어)와 acquire load(획득 로드) 제공 (ARM v8는 유사 모델 보유)
p.12완화된 memory consistency models(메모리 일관성 모델)
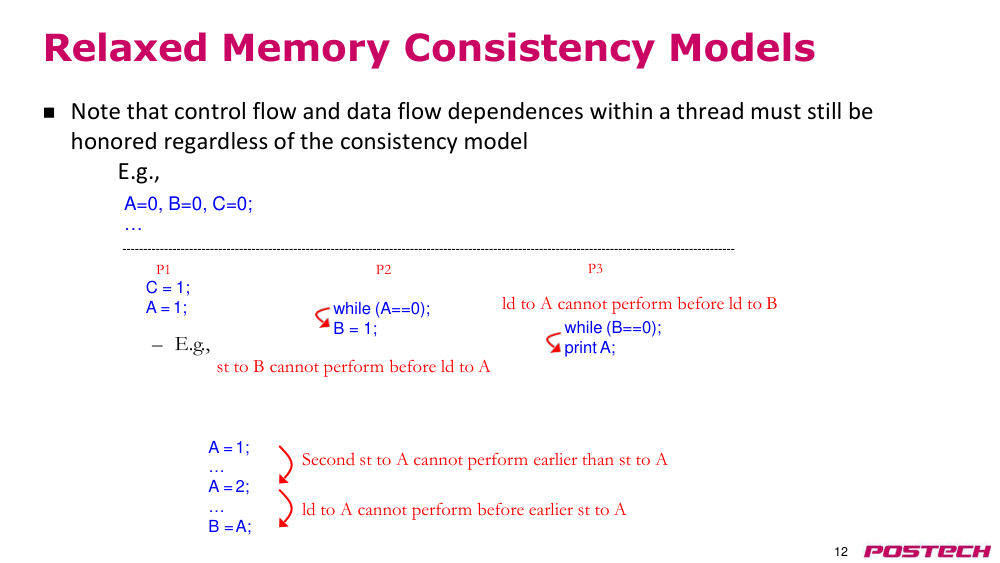
- 단일 thread(스레드) 내의 control flow dependence(제어 흐름 의존성)과 data flow dependence(데이터 흐름 의존성)은 memory consistency models(메모리 일관성 모델)과 무관하게 여전히 지켜져야 함
- 예:
- A=0, B=0, C=0;
- ...
- C = 1;
- A = 1;
- while (A==0);
- B = 1;
- st to B는 ld to A보다 앞서 수행될 수 없음
- ld to A는 ld to B보다 앞서 수행될 수 없음
- while (B==0);
- print A;
- A = 1;
- ...
- A = 2;
- ...
- B = A;
- 두 번째 st to A는 이전 st to A보다 앞서 수행될 수 없음
- ld to A는 이전 st to A보다 앞서 수행될 수 없음
- P1
- P2
- P3
p.13예: TSO(Total Store Order)
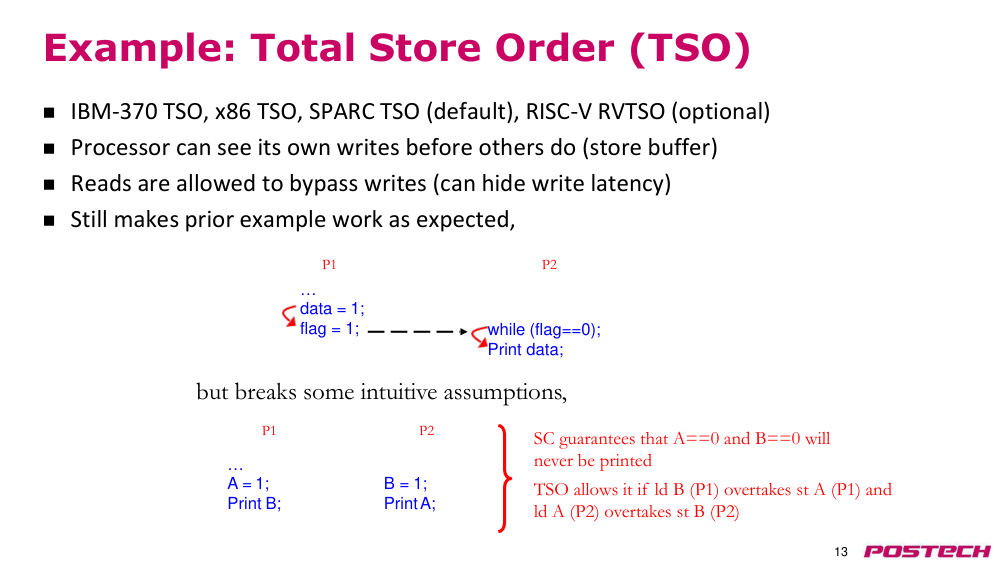
- IBM-370 TSO, x86 TSO, SPARC TSO (기본값), RISC-V RVTSO (선택 사항)
- processor(프로세서)는 다른 프로세서보다 자신의 쓰기 내용을 먼저 볼 수 있음 (스토어 버퍼)
- 읽기 연산은 쓰기 연산을 건너뛸 수 있음 (쓰기 지연을 숨길 수 있음)
- 이전 예제는 여전히 예상대로 작동하지만, 일부 직관적인 가정은 깨짐
- data = 1;
- flag = 1;
- while (flag==0);
- Print data;
- P1
- P2
- …
- A = 1;
- Print B;
- B = 1;
- Print A;
- P1
- P2
- 순차 일관성(SC)은 A==0 및 B==0이 절대 출력되지 않음을 보장함
- TSO는 ld B (P1)가 st A (P1)를 앞질러서, ld A (P2)가 st B (P2)를 앞질러면 허용함
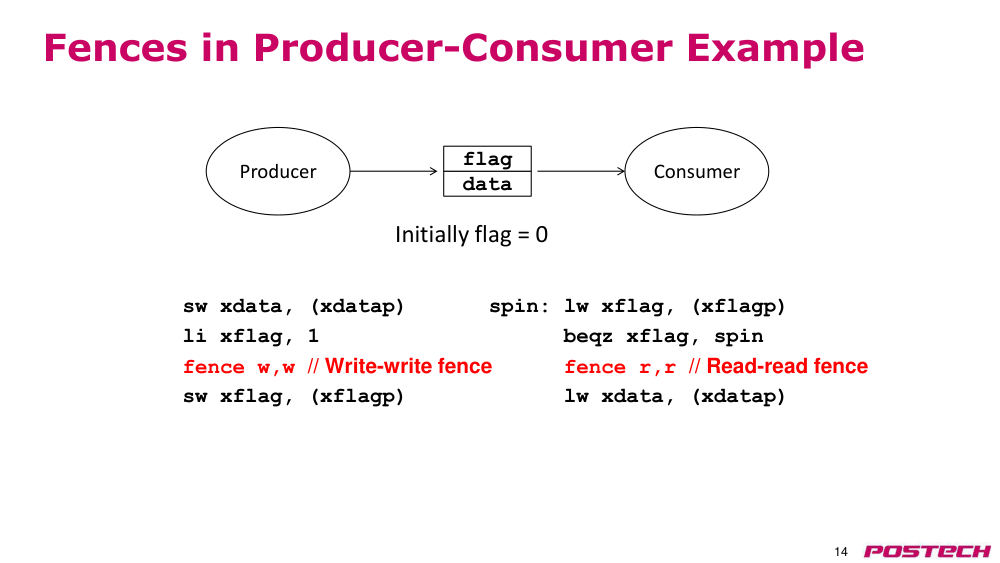
p.14생산자-소비자 예제에서의 fences(펜스)
- data
- flag
- Producer
- Consumer
- 초기 flag = 0
- sw xdata, (xdatap)
- li xflag, 1
- fence w,w // Write-Write fence(쓰기-쓰기 펜스)
- sw xflag, (xflagp)
- spin: lw xflag, (xflagp)
- beqz xflag, spin
- fence r,r // Read-Read fence(읽기-읽기 펜스)
- lw xdata, (xdatap)
p.15예: release consistency(해제 일관성) (RC)
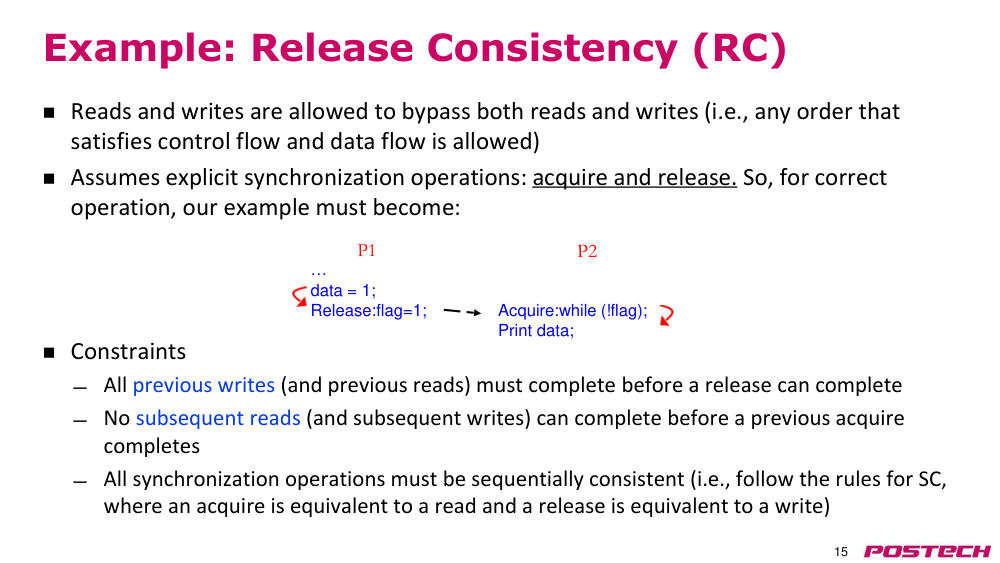
- 읽기 및 쓰기 연산은 읽기와 쓰기 모두를 건너뛸 수 있음 (즉, control flow dependence(제어 흐름 의존성)과 data flow dependence(데이터 흐름 의존성)을 만족하는 모든 순서가 허용됨)
- 명시적인 synchronization(동기화) 연산인 acquire(획득)과 release(해제)를 가정함. 따라서 올바른 동작을 위해 예제는 다음과 같이 변경되어야 함
- 제약 조건
- release(해제)가 완료되기 전까지 이전의 모든 쓰기(및 이전의 읽기)가 완료되어야 함
- 이전의 acquire(획득)이 완료되기 전까지 이후의 읽기(및 이후의 쓰기)는 완료될 수 없음
- 모든 synchronization(동기화) 연산은 순차 일관성(SC)을 따라야 함 (즉, acquire(획득)은 읽기와 동일하고, release(해제)는 쓰기와 동일함)
- data = 1;
- Release: flag = 1;
- Acquire: while (!flag);
- Print data;
- P1
- P2
- …
p.16예: release consistency(해제 일관성) (RC)
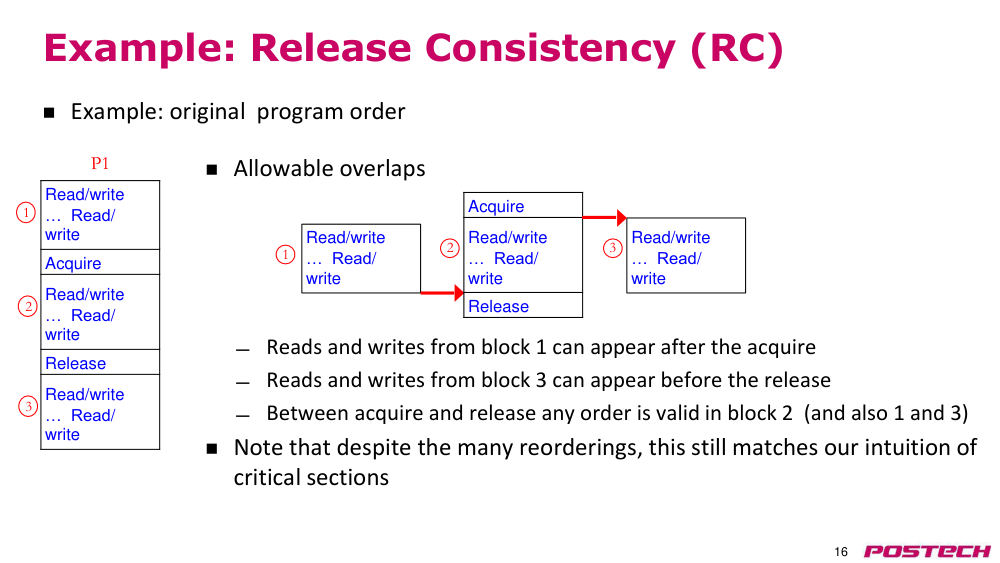
- 예: 원래 program order(프로그램 순서)
- Read/write
- … Read/write
- Acquire
- Read/write
- … Read/write
- Release
- Read/write
- … Read/write
- P1
- 1
- 2
- 3
- Read/write
- … Read/write
- 1
- 2
- Read/write
- … Read/write
- 3
- Acquire
- Read/write
- … Read/write
- Release
- 허용되는 겹침
- 블록 1의 읽기/쓰기 연산은 acquire(획득) 이후에 나타날 수 있음
- 블록 3의 읽기/쓰기 연산은 release(해제) 이전에 나타날 수 있음
- acquire(획득)과 release(해제) 사이에서는 블록 2(또는 블록 1과 3 포함)에서 어떤 순서도 유효함
- 다양한 재정렬에도 불구하고, 이는 여전히 critical section(임계 구역)에 대한 우리의 직관과 일치함
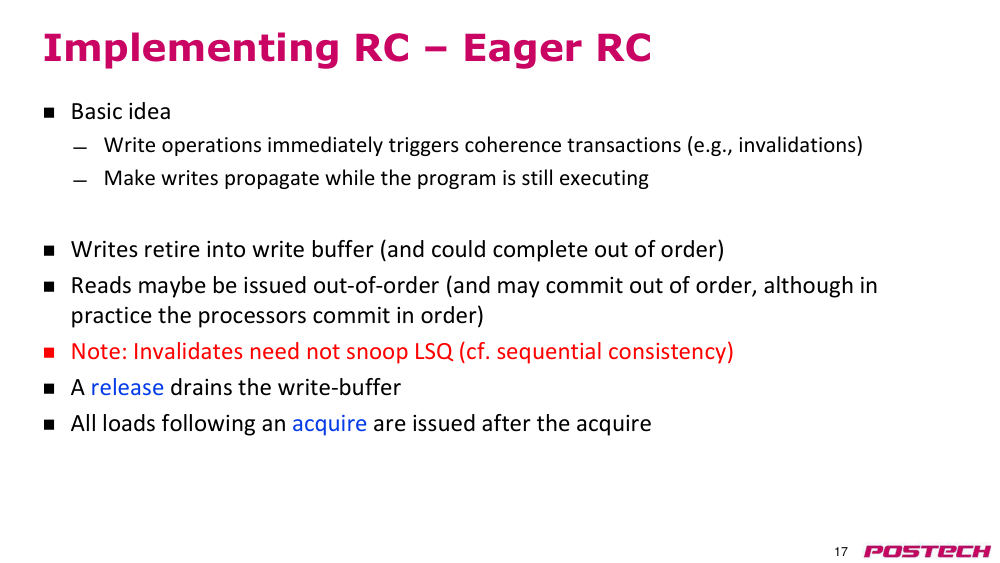
p.17RC 구현 – eager RC(즉각적 RC)
- 기본 아이디어
- 쓰기 연산이 즉시 coherence transaction(코히어런스 트랜잭션)(예: 무효화)를 트리거함
- 프로그램 실행 중에 쓰기 내용이 전파됨
- 쓰기 연산은 쓰기 버퍼에 도달하고, 순서 외로 완료될 수 있음
- 읽기 연산은 순서 외로 발행될 수 있음 (실제로는 처리는 순서대로 이루어짐)
- 참고: invalidation(무효화)는 LSQ를 snoop(스누프)할 필요 없음 (순차 일관성과 비교)
- release(해제)는 쓰기 버퍼를 플러시함
- acquire(획득) 이후의 모든 로드는 acquire(획득) 이후에 발행됨
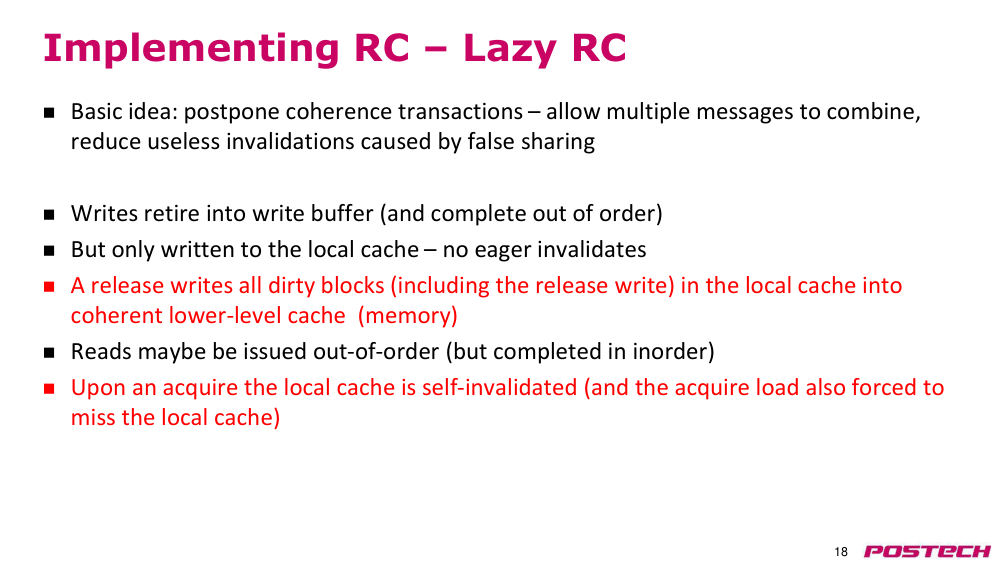
p.18RC 구현 – lazy RC(지연적 RC)
- 기본 아이디어: coherence transaction(코히어런스 트랜잭션)를 지연 – 여러 메시지를 결합하여, false sharing(거짓 공유)로 인한 무의미한 invalidation(무효화)를 줄임
- 쓰기 연산은 쓰기 버퍼에 도달하고, 순서 외로 완료됨
- 하지만 local cache(로컬 캐시)에만 기록됨 – 즉각적인 invalidation(무효화) 없음
- release(해제)는 local cache(로컬 캐시)에 있는 모든 dirty block(더티 블록)(release write(해제 쓰기) 포함)을 coherent lower-level cache(코히어런트 하위 레벨 캐시)(메모리)에 쓰기
- 읽기 연산은 순서 외로 발행될 수 있음 (하지만 순서대로 완료됨)
- acquire(획득)이 발생하면 local cache(로컬 캐시)가 Self-Invalidation(자기 무효화)됨 (또한 acquire load(획득 로드)는 로컬 캐시에서 미스하도록 강제됨)
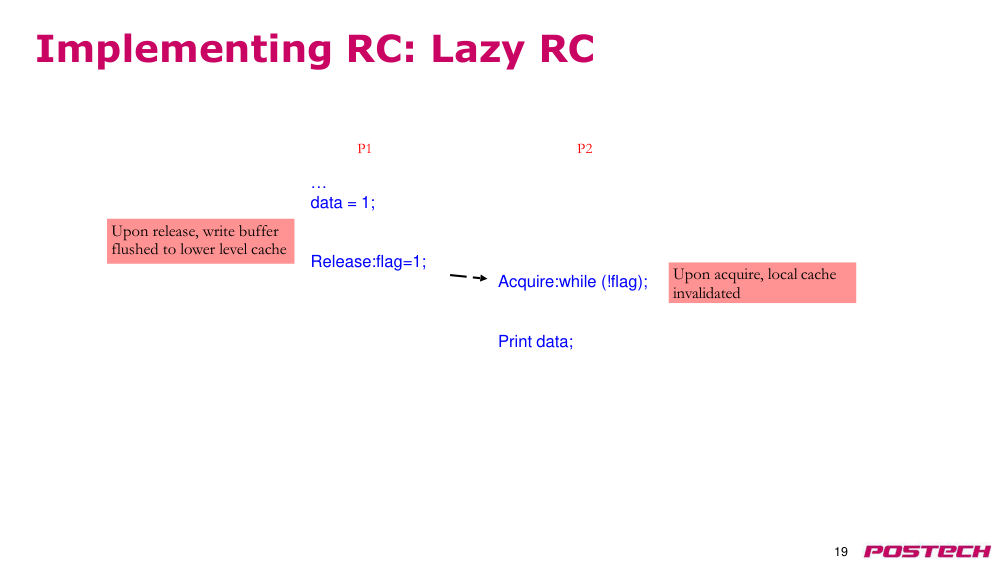
p.19release consistency(해제 일관성) 구현: lazy RC(지연적 RC)
- data = 1;
- Release: flag = 1;
- Acquire: while (!flag);
- Print data;
- P1
- P2
- release(해제) 시, store buffer(스토어 버퍼)는 Lower-Level cache(하위 레벨 캐시)로 플러시됨
- acquire(획득) 시, local cache(로컬 캐시)가 invalidation(무효화)됨
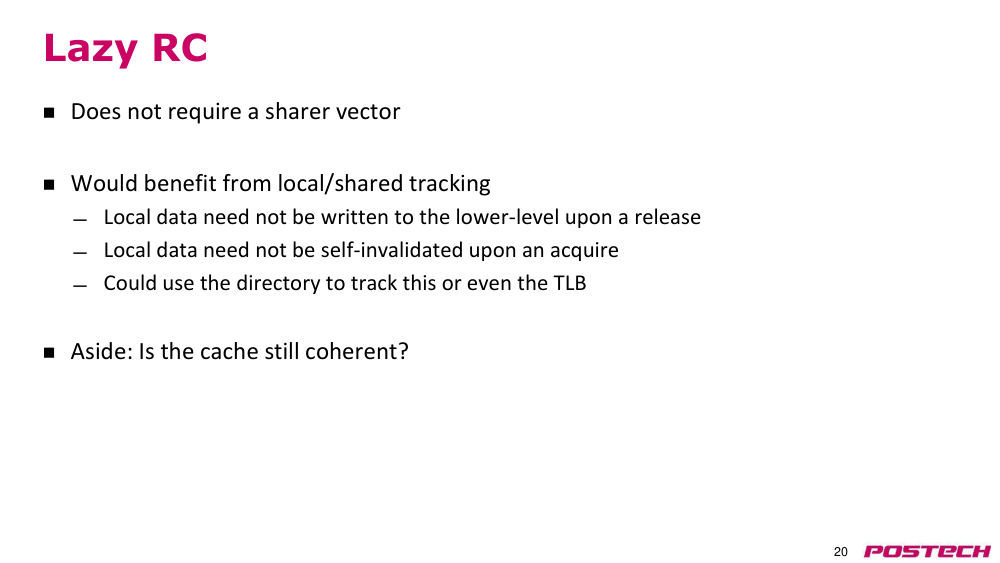
p.20lazy RC(지연적 RC)
- sharer vector(공유자 벡터)를 필요로 하지 않음
- 로컬/공유 추적을 활용하면 유리함
- release(해제) 시, 로컬 데이터는 하위 레벨에 쓰일 필요 없음
- acquire(획득) 시, 로컬 데이터는 Self-Invalidation(자기 무효화)할 필요 없음
- directory(디렉터리) 또는 TLB를 사용해 이를 추적할 수 있음
- 보너스: 캐시는 여전히 일관성 있는가?
p.21Multi-Copy-Atomic(다중 사본 원자성) vs. Non-Multi-Copy-Atomic(비다중 사본 원자성)
- 약한, Multi-Copy-Atomic(다중 사본 원자성) memory model(메모리 모델)
- 모든 processor(프로세서)는 다른 프로세서의 쓰기를 동일한 순서로 보게 됨
- 개선된 ARM v8 memory model(메모리 모델), RISC-V RVWMO, RISC-V의 기본 weak memory model(약한 메모리 모델)
- 약한, Non-Multi-Copy-Atomic(비다중 사본 원자성) memory model(메모리 모델)
- processor(프로세서)는 다른 프로세서의 쓰기를 서로 다른 순서로 볼 수 있음
- ARM v7, 원래 ARM v8, IBM POWER, Digital Alpha (매우 약한 MCM)
- 최근 합의: 이러한 모델은 일반 목적 processor(프로세서)에는 너무 약하다
p.22Multi-Copy-Atomic(다중 사본 원자성) 모델
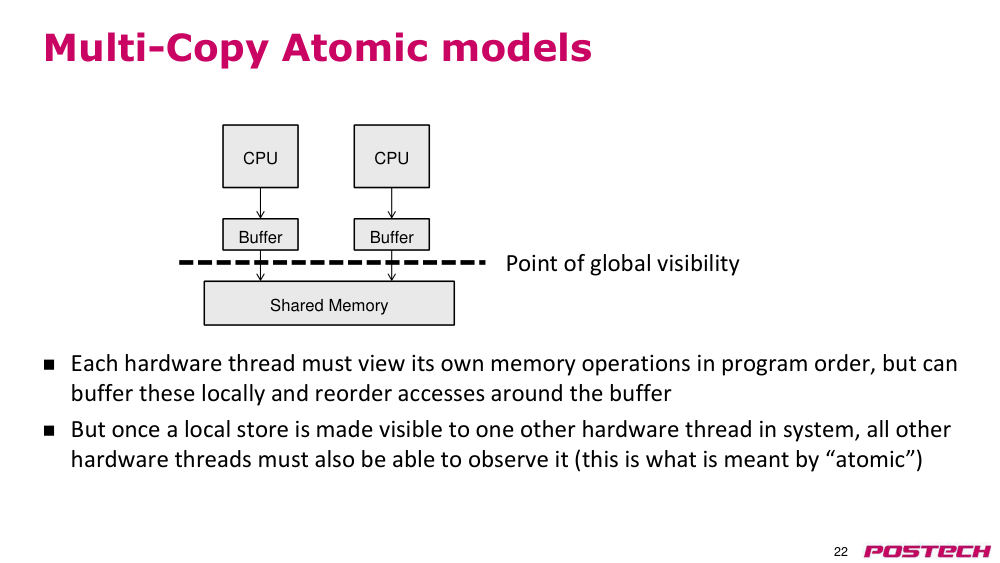
- 각 하드웨어 thread(스레드)는 자신의 memory operation(메모리 연산)을 program order(프로그램 순서)로 보아야 하지만, 이를 로컬로 버퍼링하고 버퍼 주변의 접근을 재정렬할 수 있음
- 하지만 한 하드웨어 thread(스레드)에게 로컬 스토어가 가시화된 순간, 시스템 내 모든 다른 하드웨어 스레드도 그 스토어를 관찰할 수 있어야 함 (이것이 ‘원자적’이란 의미)
p.23hierarchical shared buffering(계층적 공유 버퍼링)
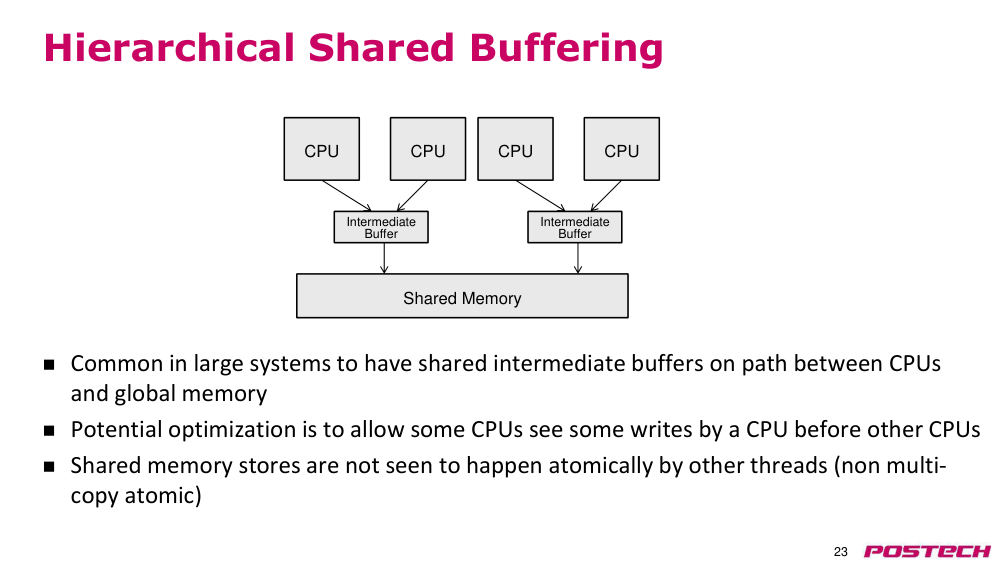
- 대규모 시스템에서는 processor(프로세서)와 전역 메모리 사이에 공유 중간 버퍼를 두는 것이 일반적임
- 잠재적 최적화: 일부 processor(프로세서)가 다른 프로세서의 쓰기를 다른 프로세서보다 먼저 볼 수 있도록 허용함
- shared memory(공유 메모리) 스토어는 다른 thread(스레드)에게 원자적으로 발생한 것으로 보이지 않음 (비다중 사본 원자성)
p.24Non-Multi-Copy-Atomic(비다중 사본 원자성)
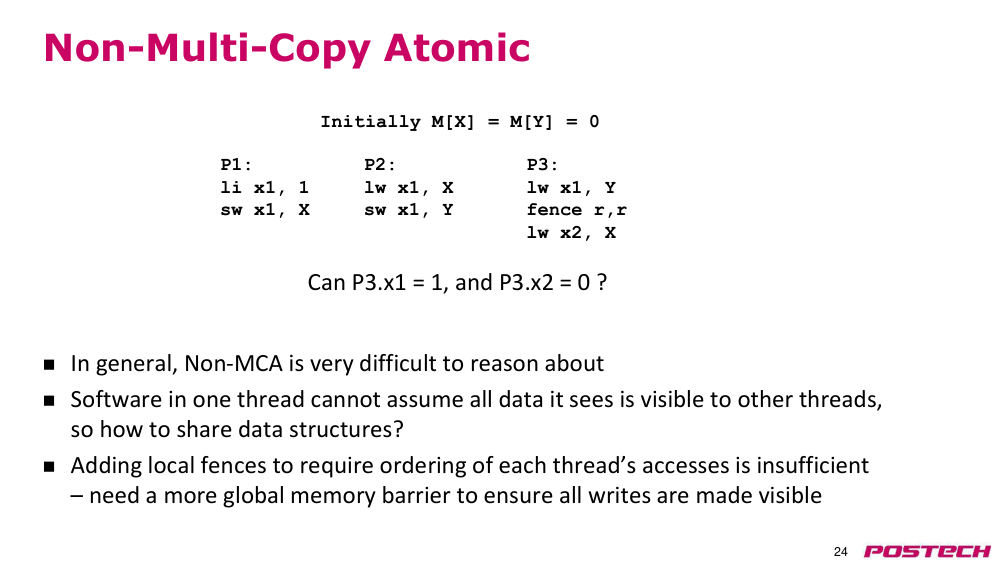
- 일반적으로 비다중 사본 원자성(MCA)은 이해하기 매우 어렵다
- 한 thread(스레드)의 소프트웨어는 자신이 보는 모든 데이터가 다른 스레드에게도 가시적이라고 가정할 수 없으므로, 데이터 구조를 어떻게 공유할 수 있는가?
- 각 thread(스레드)의 접근 순서를 보장하기 위해 로컬 fences(펜스)를 추가하는 것은 부족함 – 모든 쓰기가 가시화되도록 보장하기 위해 더 전역적인 메모리 장벽이 필요함
- 초기 M[X] = M[Y] = 0
- P1:
- li x1, 1
- sw x1, X
- P2:
- lw x1, X
- sw x1, Y
- P3.x1 = 1이고, P3.x2 = 0일 수 있는가?
- P3:
- lw x1, Y
- fence r,r
- lw x2, X
p.25최종 참고사항
- 많은 processor(프로세서)/시스템은 하나 이상의 일관성 모델을 지원하며, 일반적으로 부팅 시에 설정된다.
- Sparc는 TSO, PSO, RMO를 지원한다.
- 프로그래머에게 제시되는 일관성 모델과 하드웨어/컴파일러의 실제 일관성 모델을 분리하는 것이 가능하다.
- 예: 하드웨어는 완화된 모델을 구현할 수 있지만, 컴파일러가 메모리 fences(펜스)를 통해 순차 일관성(SC)을 보장한다.
- 언어 수준의 메모리 모델 (C, C++, Java 등은 메모리 모델을 가진다)
- DRF의 변형: 데이터 레이스 없는 memory model(메모리 모델)
- SC는 보장되지만, 잘 synchronization(동기화)된 프로그램에 한해
- 잘 synchronization(동기화)된 프로그램: 잠재적으로 충돌하는(경쟁하는) 모든 연산이 프로그래머에 의해 레이블링되어 있다.
p.26질문?
- 추천 독서:
- 교재의 5.6 – 5.7 장