Lec 23 part2 & 24 · memory controller·HBM·PIM·새 memory 와 storage(flash·SSD·RAID)
정밀 정리 · 검증 2026-09-25 01:48
1개요
1.1앞 6분: 중간·기말 비중을 20%·35% 로 확정하는 한국어 공지.
1.2L23 후반: memory controller scheduling, DRAM latency 정체·bandwidth 증가, HBM(TSV·interposer·1024 IO).
1.3새 방향: PIM(Samsung HBM-PIM, SK hynix Newton 과 batch 한계), PCM·STT-MRAM, 3D stacking·AMD 3D V-Cache.
1.4L24 storage: flash cell(floating gate·Vt), NAND/NOR, MLC, wear leveling·garbage collection·FTL·SSD, RAID 0~6. 과목 마지막 강의.
2섹션별 정리 상황·문제 → 원인 → 해결
2.10:26–7:31행정: 중간·기말 비중 조정과 시험 방식
상황·문제중간·기말 비중을 처음 25%·30% 에서 18%·37% 로 제안했으나 중간 비중이 너무 낮다는 의견을 받아 20%·35% 로 확정. 시험은 중간고사와 같은 방식(monitor 사용), 세부 공지는 오늘 중.
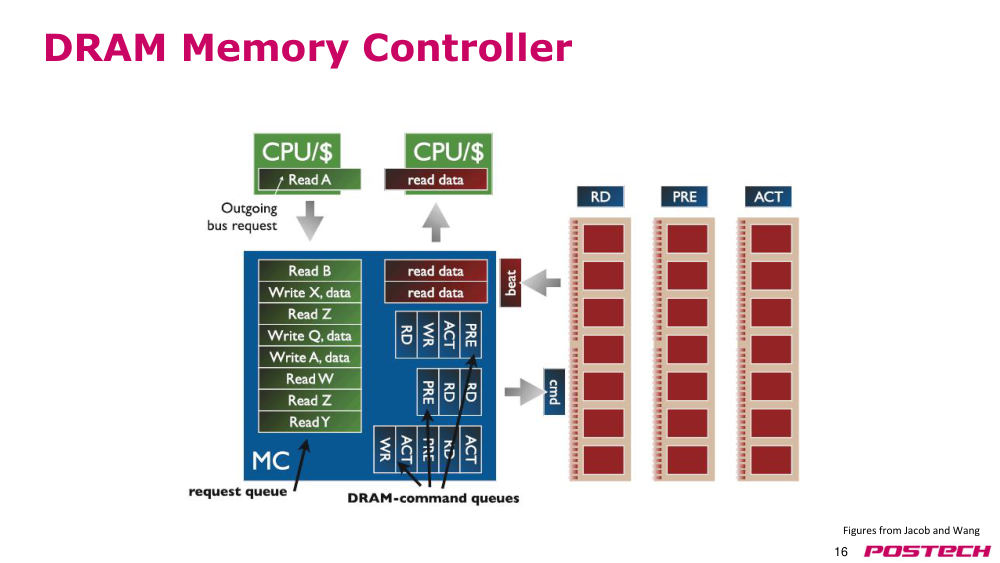
2.27:31–11:29DRAM memory controller 와 request scheduling
상황·문제CPU core 가 DRAM 에 접근하려면 memory controller(MC) 가 필요. memory system 에는 여러 단계의 parallelism(bank 등)이 있음.
원인MC 는 모든 DRAM device 의 bank 별 상태를 기억해야 하고, 요청을 DRAM timing 에 맞는 lower-level command 로 바꿔 발행해야 함.
해결요청 우선순위 조정: row buffer 에 이미 열린 row 를 쓰는 요청은 column address 만으로 빨리 처리되므로 먼저 처리. memory scheduling 자체가 연구 분야.
- command buffer 설계(bank 별 queue 등)는 구현마다 다름
- row buffer = sense amp 에 있는 row 전체 data
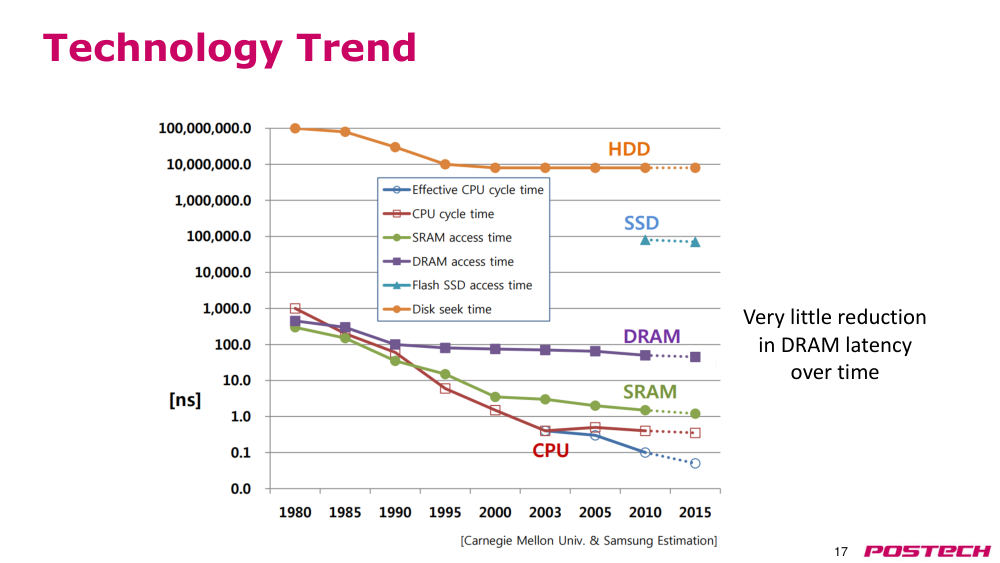
2.311:29–14:19기술 추세: DRAM latency 정체, bandwidth 증가
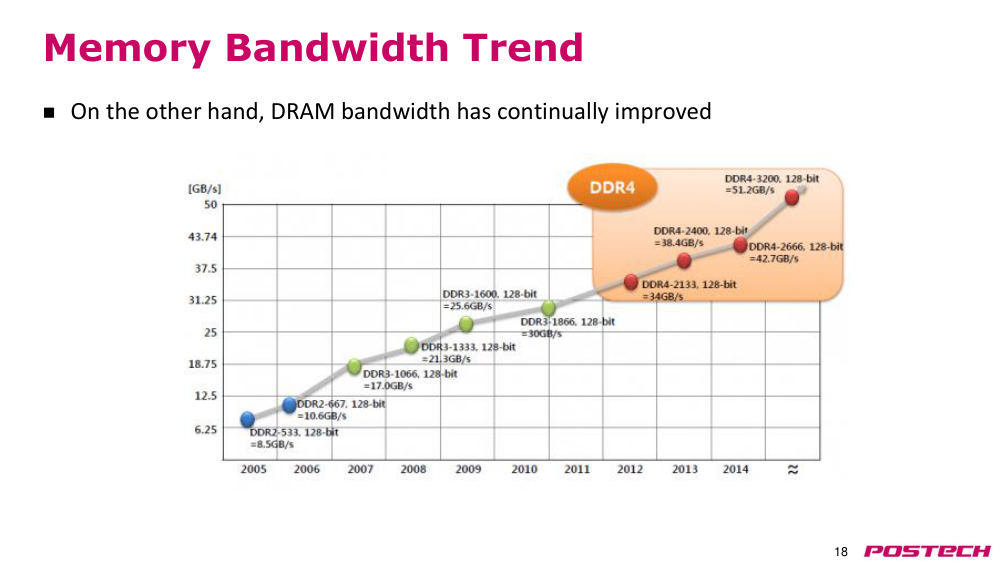
상황·문제1980~2015 latency 그래프: CPU cycle time·SRAM access time 은 크게 줄었지만 DRAM access latency 는 90년대 중반 이후 거의 그대로.
원인DRAM 은 density 와 speed 가 trade-off (cell 을 키우면 빨라지지만 밀도 감소). 시장 수요는 더 큰 용량이고 더 빠른 DRAM 수요는 적음.
해결대신 bandwidth 는 꾸준히 증가: core 수·CPU 성능 증가에 맞춰 instruction·data bandwidth 를 공급해야 하기 때문 (DDR2-533 8.5GB/s → DDR4-3200 51.2GB/s).
- DRAM 은 capacity 에 최적화
- 그래프의 CPU 선은 clock (강의자 추정)
2.414:19–21:35HBM: 3D stacked high bandwidth memory
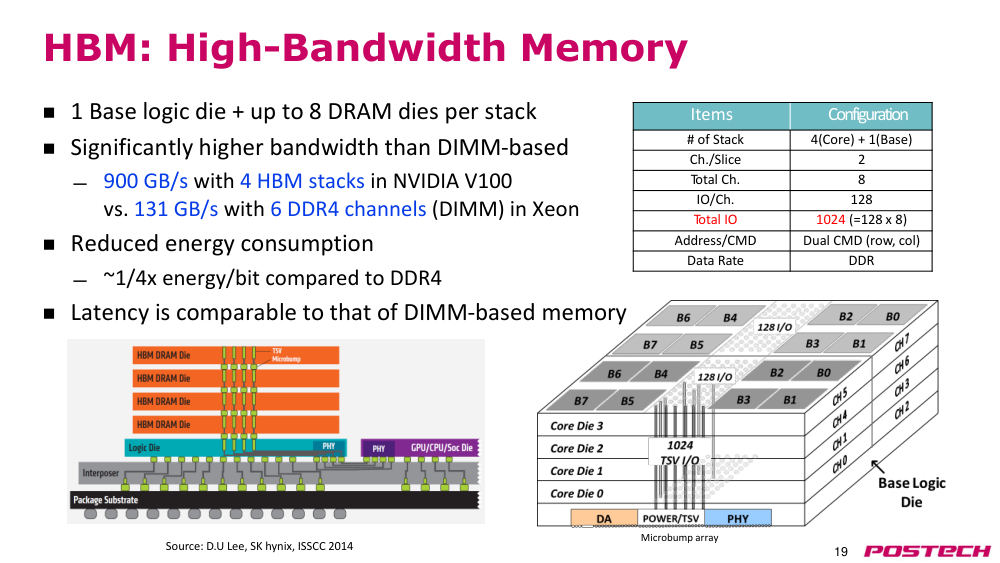
상황·문제GPU 처럼 bandwidth 요구가 큰 processor 는 DDR 로 부족 → GDDR 사용, 그것도 부족해 HBM 으로 이동.
원인package 밖 pin 은 크고 수가 제한됨. DRAM die 하나로는 용량도 부족.
해결interposer 로 작은 pin·가는 wire 를 많이 연결하고, DRAM die 를 쌓아 TSV(through-silicon via)로 전원·data·command 연결. die 당 channel 2개 × 128 IO, 8 channel = 1024 IO (DIMM 64).
- V100 HBM 900 GB/s vs 같은 시기 Xeon 131 GB/s
- wire 가 짧아 energy/bit 가 DDR4 의 약 1/4, latency 개선은 없음
- 1145~1228초 Wi-Fi 재접속으로 잠시 중단
2.4.r.1Wikipedia: High Bandwidth Memory ↗ · DRAM die 적층 + base die, TSV·microbump, die 당 128-bit channel 2개 = 1024-bit, silicon interposer
2.4.r.2Wikipedia: Three-dimensional integrated circuit ↗ · die 적층·TSV, memory-on-logic, 넓은 bus 와 에너지 절감
2.521:35–25:15PIM 동기와 Samsung HBM-PIM
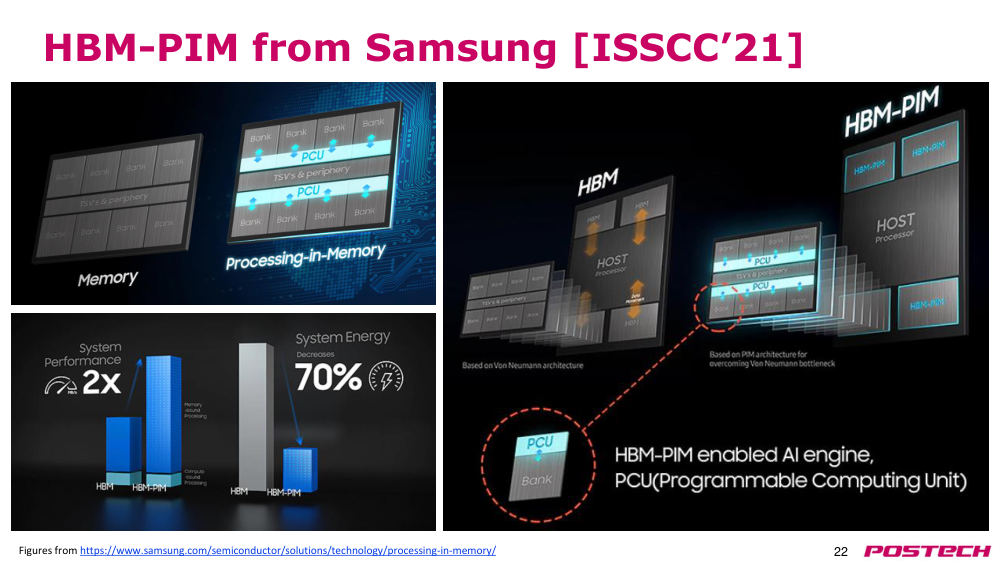
상황·문제현재 memory 의 약점을 보완하는 혁신 중 하나로 PIM(processing in memory) 소개.
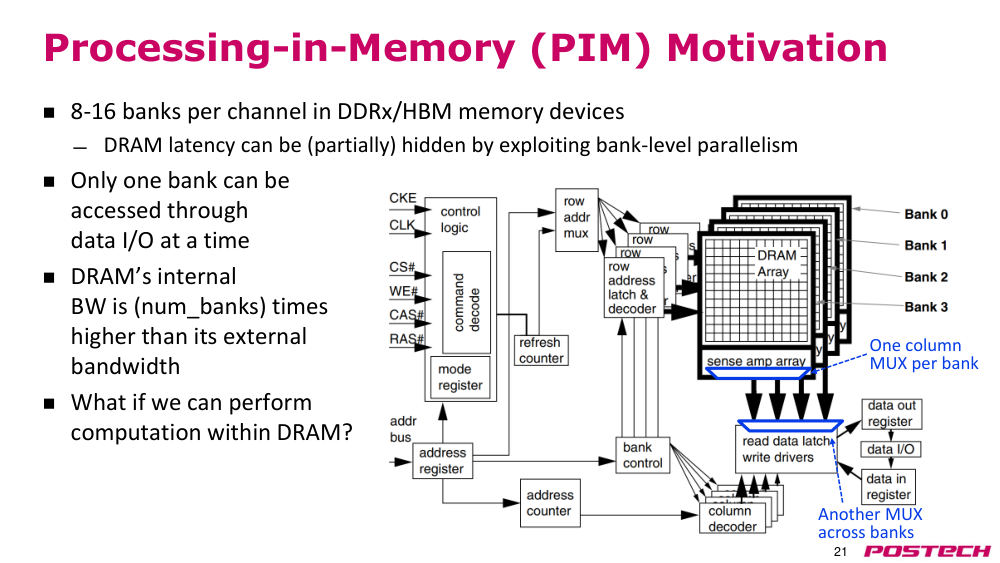
원인DRAM 안 bank 들은 병렬 동작하고 bank 마다 row buffer 가 있지만, pin 수가 제한돼 external bus 로는 한 번에 bank 하나만 전송.
해결각 row buffer 옆에 compute logic 을 두고 bank 병렬로 처리하면 bank-level internal bandwidth 활용. Samsung HBM-PIM: memory-bound application 에서 최대 2배 성능, data 를 host 로 옮기지 않아 에너지 절감.
- internal bandwidth = external 의 (num_banks)배
- HBM-PIM 은 '올해 초' 발표 (강의 시점 기준)
2.5.r.1Wikipedia: In-memory processing ↗ · processing-near-memory / processing-using-memory 개념 (특정 제품 설명은 없음)
2.625:15–31:55SK hynix Newton: DNN 용 DRAM PIM 구조
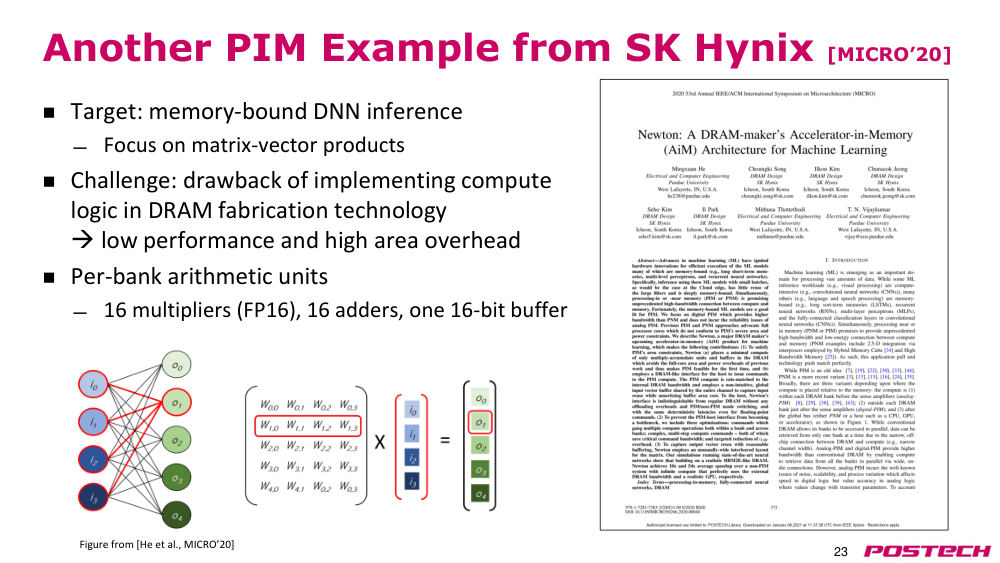
상황·문제Newton(MICRO'20) 목표: memory-bound DNN inference, FC layer 의 input vector × weight matrix. 기존에는 weight 전체를 DRAM 에서 processor 로 읽어야 함.
원인DRAM 공정은 capacitor density 에 최적화 → logic 을 만들면 느리고 면적이 큼. compute logic 을 많이 넣을 수 없음.
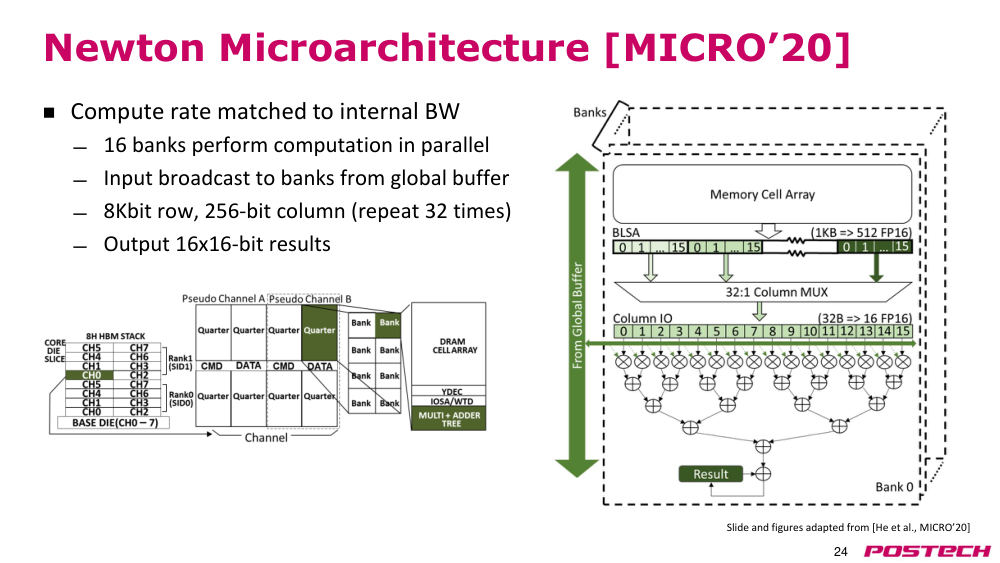
해결bank 당 FP16 multiplier 16·adder 16·16-bit buffer 1개. 한 operand 는 column IO, 다른 하나는 공유 global buffer. 8Kbit row 를 256-bit 씩 32번, 16 bank 병렬.
- layer 출력을 다음 layer 입력으로 바로 사용 가능
- compute rate 를 bank internal bandwidth 에 맞춤
2.6.r.1Wikipedia: In-memory processing ↗ · processing-near-memory / processing-using-memory 개념 (특정 제품 설명은 없음)
2.731:55–36:06Newton 성능과 batch 크기의 한계
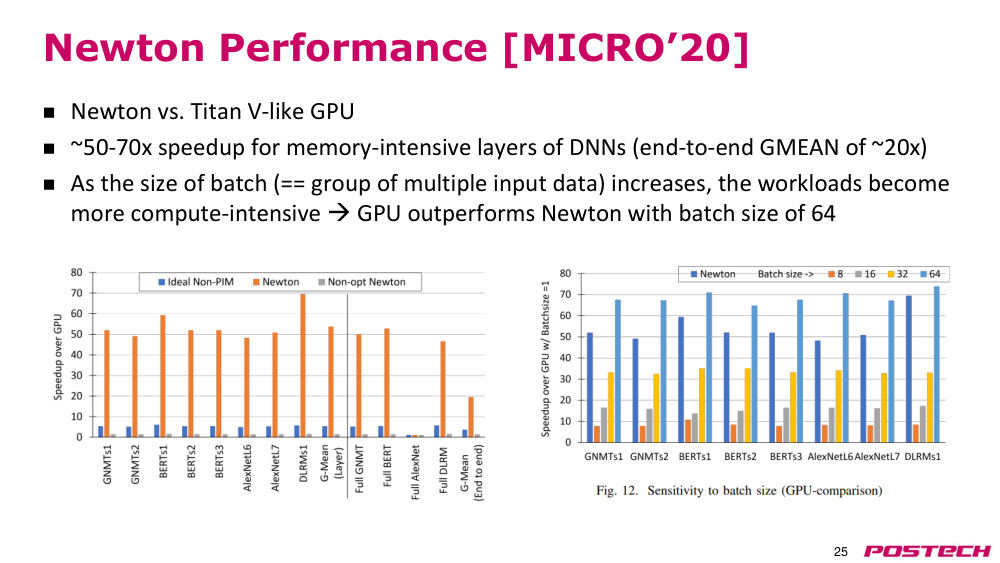
상황·문제Titan V-like GPU 대비 layer 별 50~70배, end-to-end geometric mean 약 20배. AlexNet(CNN) 은 이득 작음.
원인이 성능은 입력 1개(batch 1) 기준. batch 가 크면 weight 를 한 번 읽어 여러 입력에 재사용 → 읽기 비용이 분산돼 compute-intensive 가 됨.
해결batch 8·16 에서는 GPU 가 Newton 보다 못하지만 batch 64 에서는 GPU 가 앞섬. PIM 은 사실상 matrix-vector 곱에 유리, 그래도 small-batch inference 는 많은 응용에서 중요.
- batch 1 = memory bound, 큰 batch = compute bound
2.836:06–42:55새 memory device: PCM 과 STT-MRAM
상황·문제DRAM 은 capacitor 의 charge 로 bit 저장. 다른 저장 원리의 memory 소개.
원인PCM: phase-change material 을 가열해 상태(crystalline/amorphous)를 바꾸고 전류 세기로 판별. STT-MRAM: 고정층 위 free layer 자화를 전류 방향으로 바꿈, 같은 방향이면 전류가 잘 흐름.
해결PCM: 고용량·비휘발·refresh 없음(낮은 idle power) vs 느린 access(특히 write)·높은 access energy·낮은 endurance, Intel Optane DIMM. STT-MRAM(1T-1MTJ): 비휘발, 밀도·latency 가 SRAM 과 DRAM 사이 → 더 조밀한 last-level cache 후보.
- PCM 가열 시 어느 상태가 되는지는 강의자가 기억 안 난다고 함
- slide: PCM latency ~4-15배, energy ~2-50배, ~10^7 write
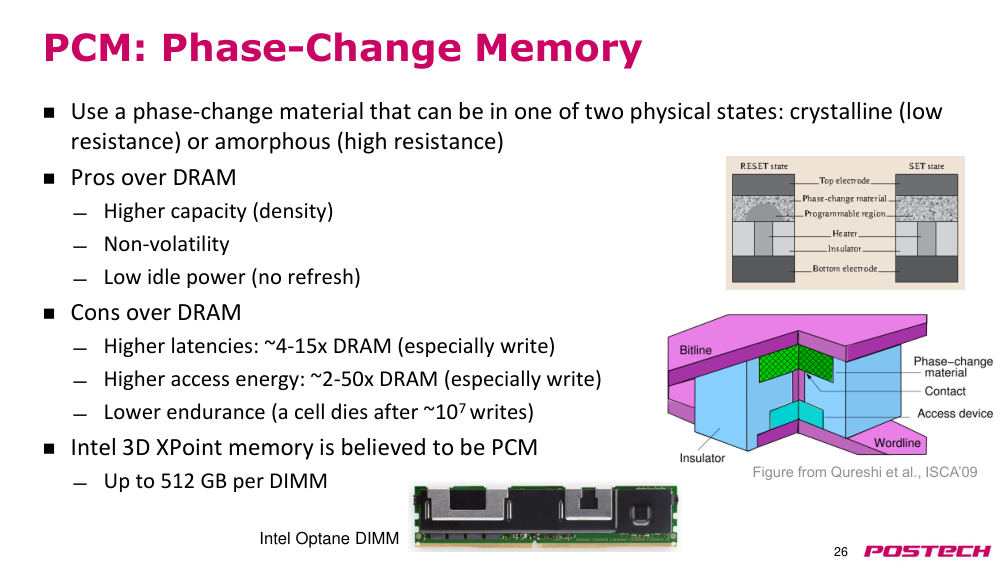
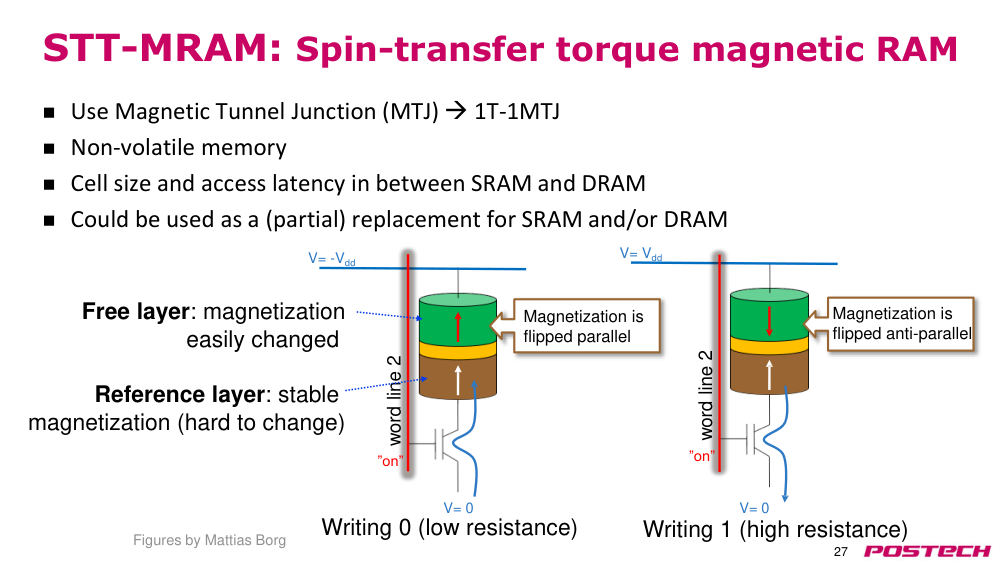
2.8.r.1Wikipedia: Phase-change memory ↗ · crystalline(저저항)/amorphous(고저항), 가열로 상태 전환, 비휘발, 3D XPoint
2.8.r.3Wikipedia: Magnetic tunnel junction ↗ · parallel = 저저항, antiparallel = 고저항, spin-transfer torque 전환
2.942:55–46:53true 3D stacking 과 AMD 3D V-Cache
상황·문제HBM 은 DRAM 끼리만 적층하고 processor 와는 적층하지 않음.
원인processor 위에 memory 를 쌓으면 bandwidth 증가·energy 감소 가능. 단 DRAM 은 온도가 오르면 charge 가 빨리 새어 refresh 주기를 줄여야 해 적층이 어려움.
해결Samsung X-Cube(연구 단계), TSMC N3XT(compute·memory 층 다중 적층). AMD 3D V-Cache: compute die 위에 SRAM 적층해 L3 용량 4배, 연말 생산·내년 초 제품 예상.
- V-Cache 는 '그저께' 발표 (강의 시점)
- 2748~2813초: 질문 대기·출석 확인, 수정 slide 를 PLMS 에 업로드 예정
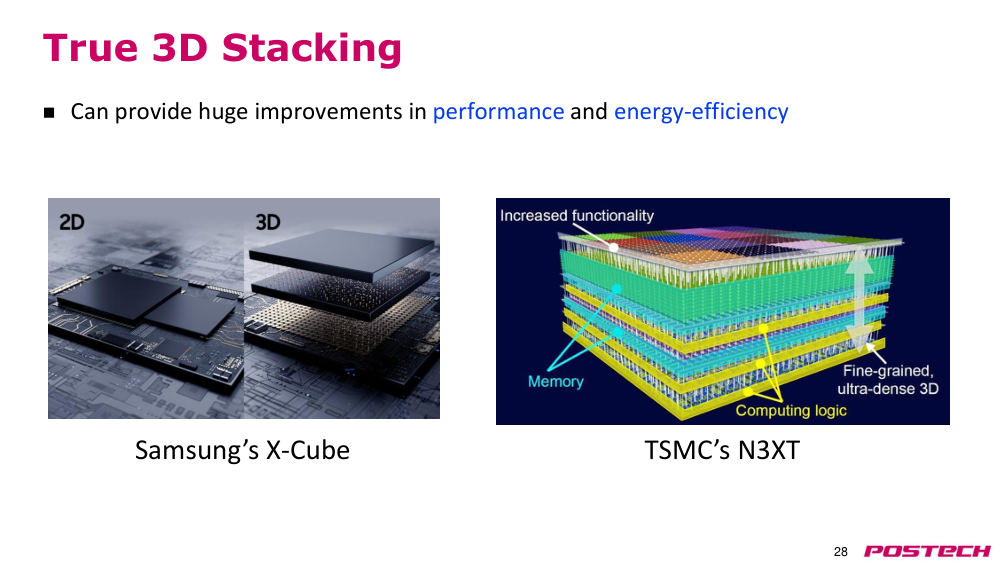
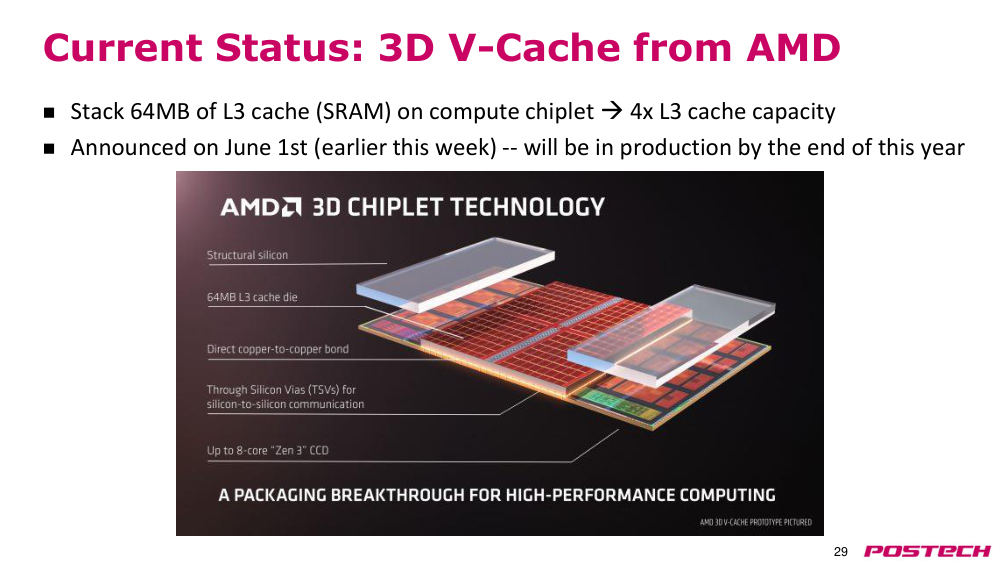
2.9.r.1Wikipedia: Three-dimensional integrated circuit ↗ · die 적층·TSV, memory-on-logic, 넓은 bus 와 에너지 절감
2.1046:53–53:05L24 storage 도입: flash cell 의 원리
상황·문제storage 없는 computer 는 쓸모없음. hard drive 는 선수과목에서 배웠으니 flash memory 와 RAID 를 다룸.
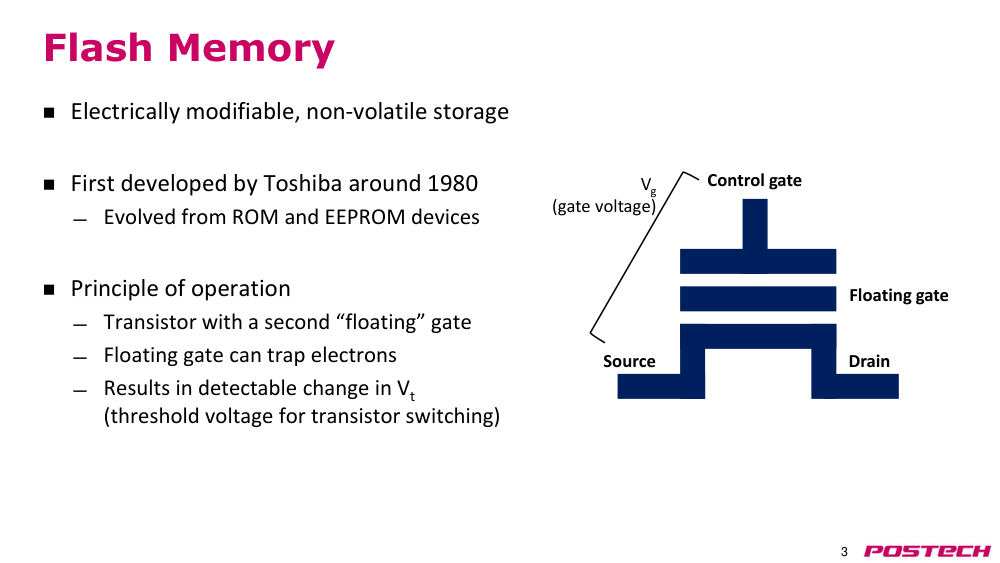
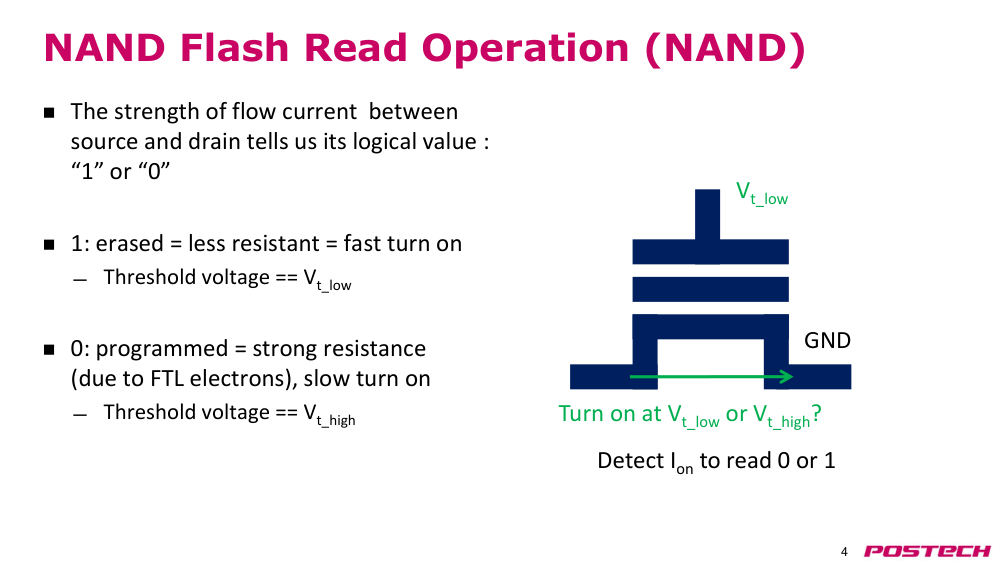
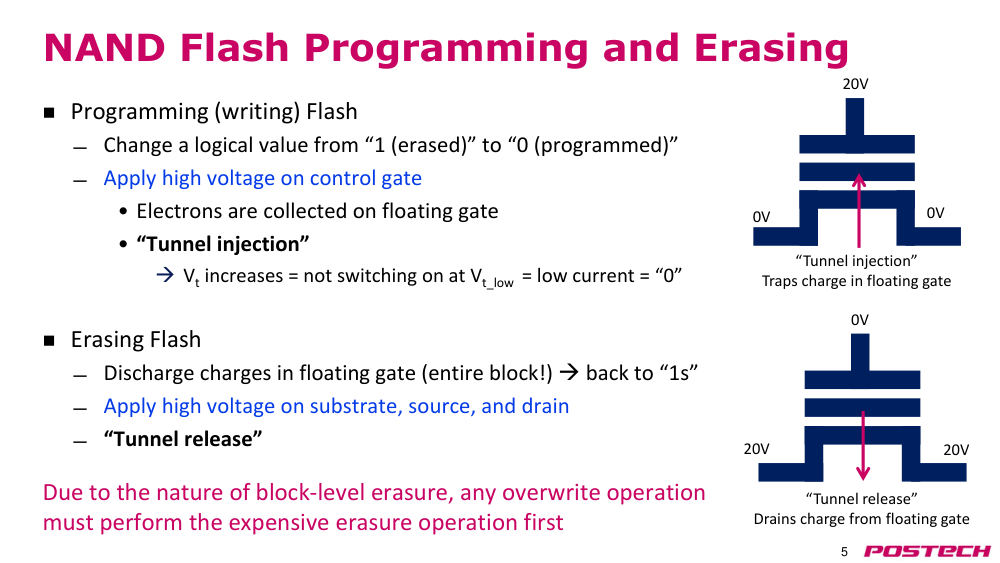
원인flash cell = floating gate 가 있는 transistor. floating gate 에 전자가 있으면 threshold voltage 가 Vt_high, 없으면 Vt_low.
해결전류로 Vt 를 판별: 전자 없음 = 1(초기값), 있음 = 0. program(1→0): gate 고전압으로 전자 주입. erase: 반대로 전자를 빼냄.
- Toshiba 가 80년대 초 개발, EEPROM 에서 발전
- transistor 는 Vg > Vt 이면 닫힌 switch
2.10.r.1Wikipedia: Flash memory ↗ · floating-gate transistor·Vt, NAND/NOR 구조, block 단위 erase, 1980 Toshiba(Masuoka)
2.1153:05–58:22block 단위 erase 와 NAND flash 구조
상황·문제flash 의 한계: erase 는 block(많은 cell 묶음) 단위로만 가능, 0→1 로 바꾸려면 block 전체 erase.
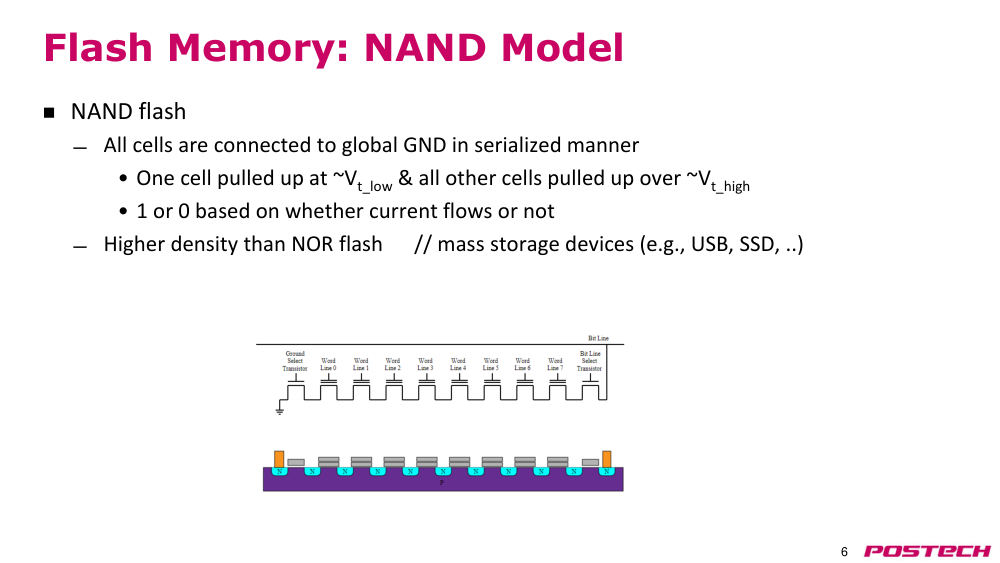
원인NAND: cell 이 직렬 연결. 읽을 cell 외에는 Vt_high 를 걸어 모두 도통시키고, 읽을 cell 에 Vt_low 를 걸어 전류 유무로 0/1 판별.
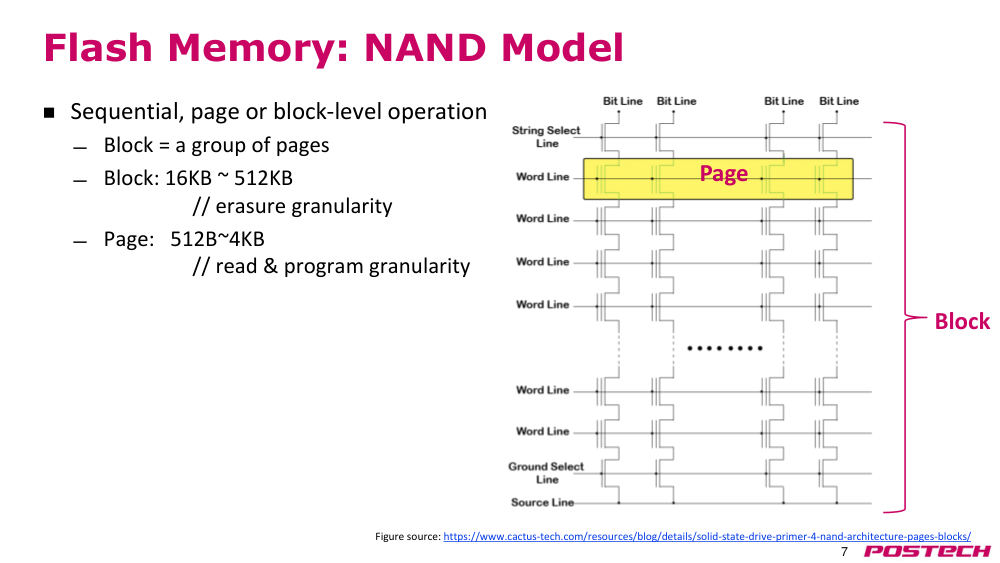
해결같은 word line 을 공유하는 cell = page(512B~4KB, read·program 단위), 여러 column 을 묶은 block(16KB~512KB, erase 단위). NOR 보다 고밀도.
- erase 때 select line 에 low 라고 했다가 high voltage 로 정정
2.11.r.1Wikipedia: Flash memory ↗ · floating-gate transistor·Vt, NAND/NOR 구조, block 단위 erase, 1980 Toshiba(Masuoka)
2.11.r.2Cactus Technologies: SSD primer 4 – NAND architecture (pages, blocks) ↗ · slide p7 그림 출처. string·page(같은 word line)·block 구조
2.1258:22–1:01:45NOR flash 와 NAND·NOR 비교
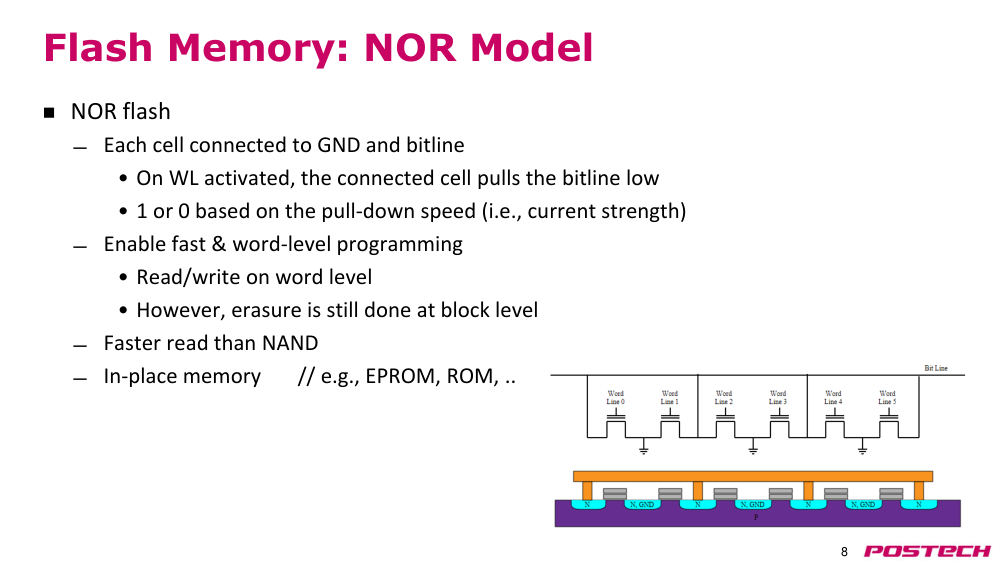
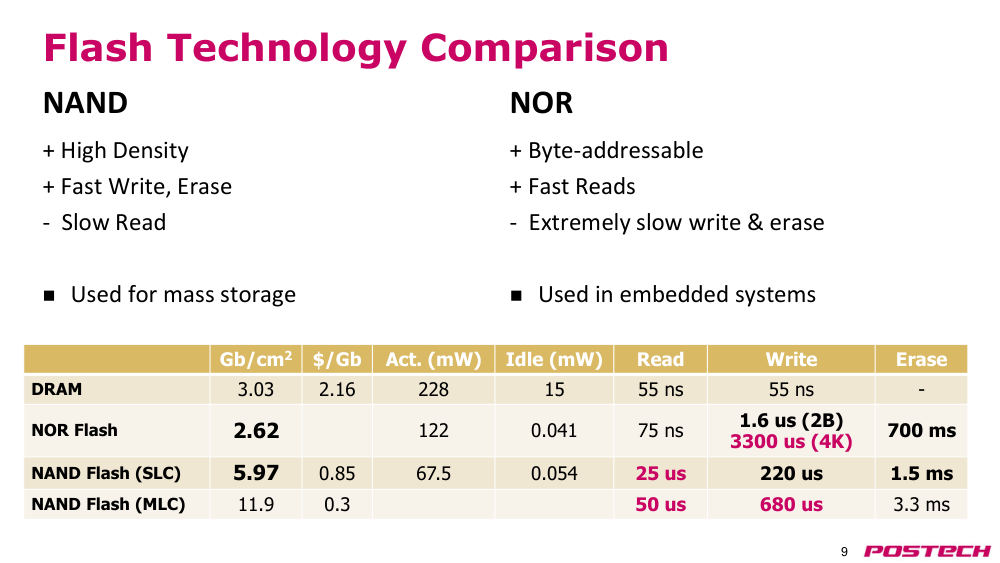
상황·문제NOR: 각 transistor 가 bit line 과 GND 에 연결, 전류가 transistor 하나만 지나 read 가 빠름.
원인page 단위 program(1→0)은 가능하지만 erase(0→1)는 block 단위. 더 작은 단위로 read 가능하지만 연결 overhead 로 밀도가 낮음.
해결NOR 는 small ROM 같은 in-place memory·embedded 용, NAND 는 고밀도 storage 용. 밀도는 NOR 가 DRAM 보다 낮고 NAND 는 DRAM 보다 훨씬 높음, erase 시간은 NOR 가 훨씬 김.
- slide 표: read DRAM 55 ns, NOR 75 ns, NAND SLC 25 us
- erase: NOR 700 ms, NAND SLC 1.5 ms
2.12.r.1Wikipedia: Flash memory ↗ · floating-gate transistor·Vt, NAND/NOR 구조, block 단위 erase, 1980 Toshiba(Masuoka)
2.131:01:45–1:04:17MLC·TLC·QLC 와 flash 의 문제: wear·read disturbance
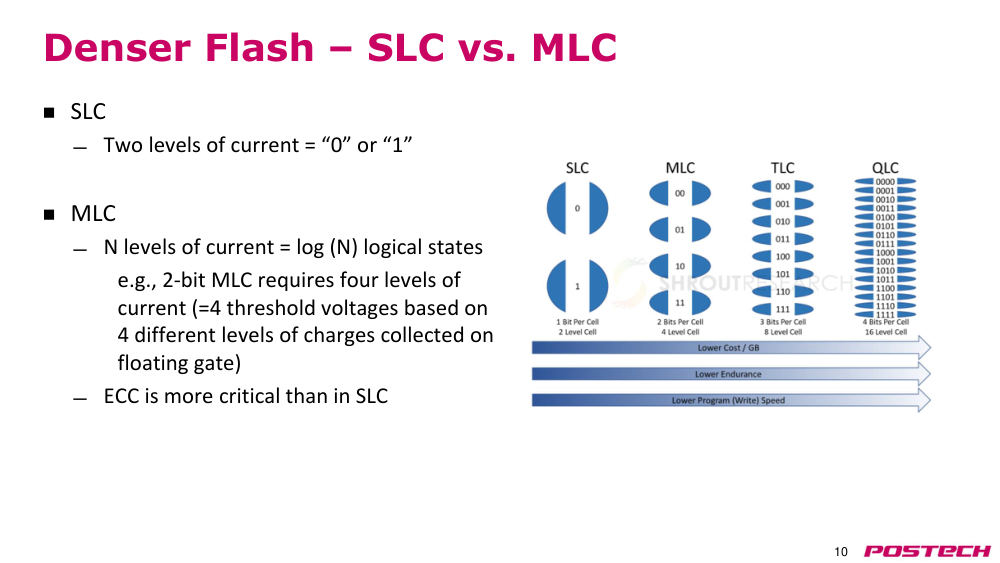
상황·문제Vt level 을 여러 개 두면 cell 당 여러 bit: 4 level = 2 bit, 8 = 3 bit, 16 = 4 bit.
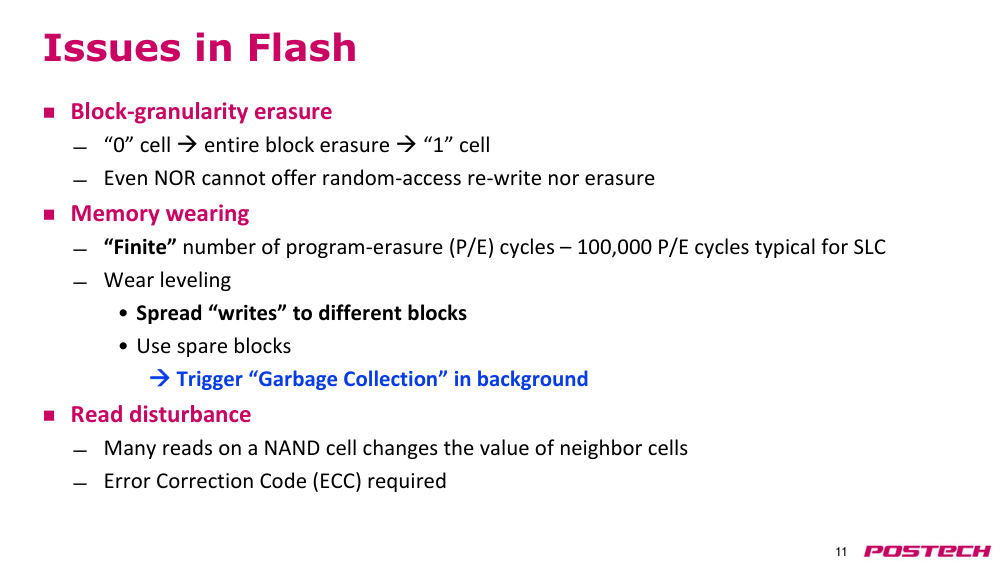
원인level 이 많을수록 전류 감지가 어려워 잘못 읽을 수 있음. program/erase 횟수도 제한(강의 발화: 10^6, slide: SLC 100,000). 같은 NAND cell 을 많이 읽으면 이웃 cell 값이 바뀜.
해결ECC 사용. write 를 여러 block 에 고르게 분산하는 wear leveling, 이를 위해 garbage collection.
- block 단위 erase 라 DRAM 보다 제어 단위가 거침
2.141:04:17–1:07:43garbage collection, FTL, SSD 구성
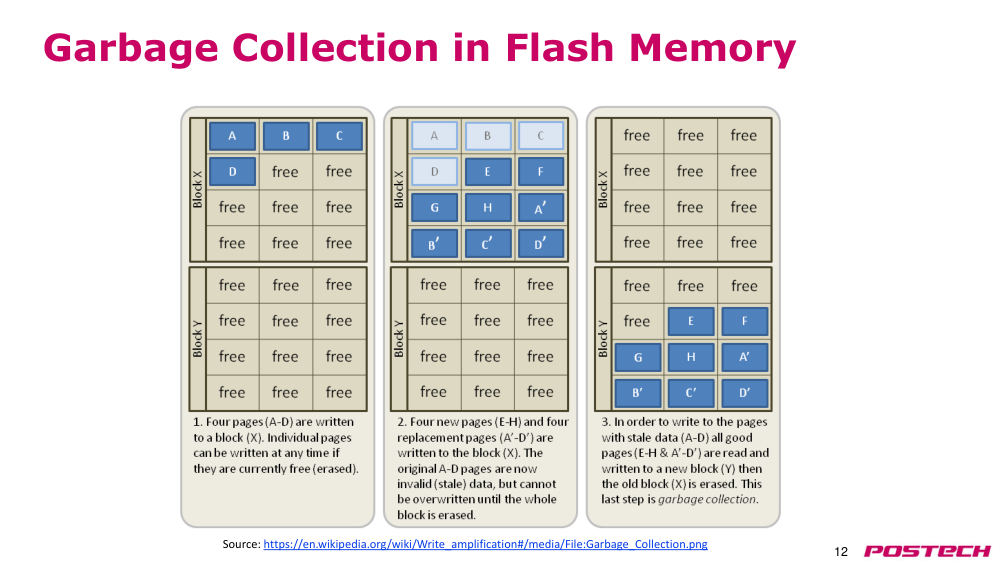
상황·문제이미 program 된 page 는 수정 불가 → 수정본을 다른 free page 에 쓰고 원래 page 는 사용 불가(garbage).
원인block 을 다시 쓰려면 전체 erase 가 필요한데 유효 data 가 섞여 있음. data 위치가 page → page → 다른 block 으로 계속 바뀜.
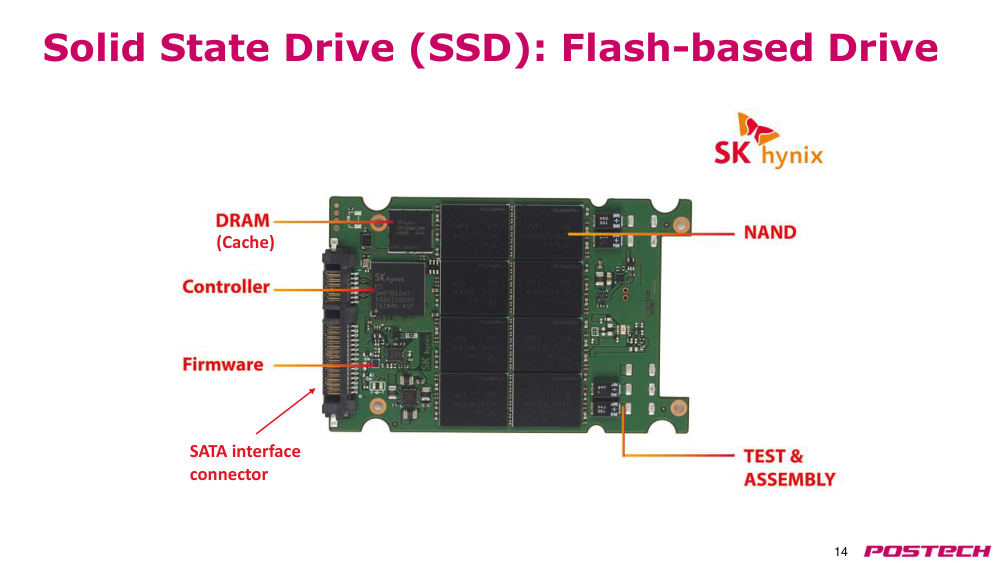
해결유효 data 를 다른 block 으로 옮기고 block 을 erase(garbage collection). logical→physical 주소 변환은 FTL 이 담당. SSD controller(ARM·RISC-V embedded core) 가 metadata 를 DRAM 에 두고 DRAM 은 cache 역할도.
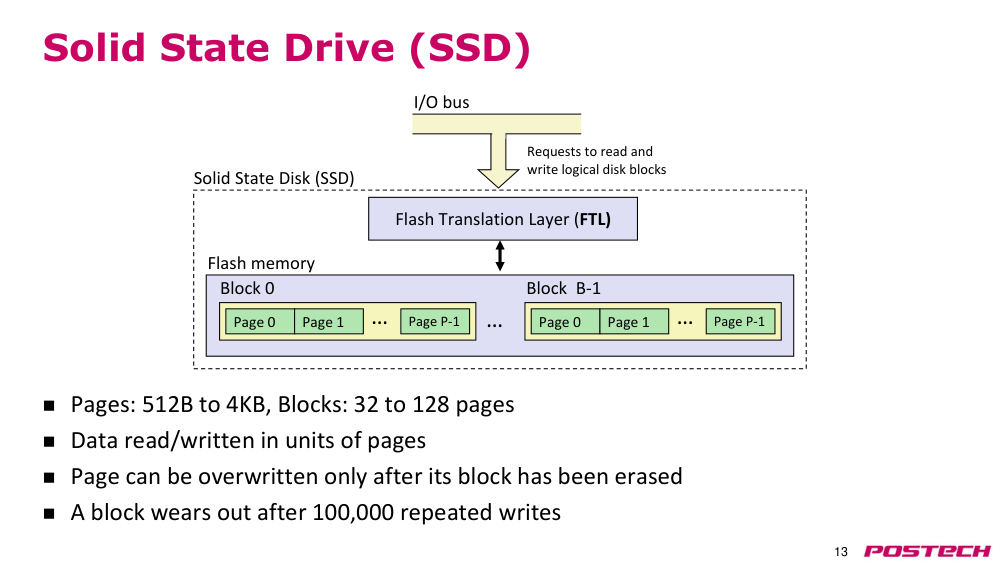
2.14.r.1Wikipedia: Write amplification ↗ · slide p12 그림 출처. garbage collection, FTL 의 logical→physical mapping
2.14.r.3Wikipedia: Solid-state drive ↗ · controller(embedded processor)·DRAM cache·NAND·FTL mapping table
2.151:07:43–1:13:38RAID 0~6
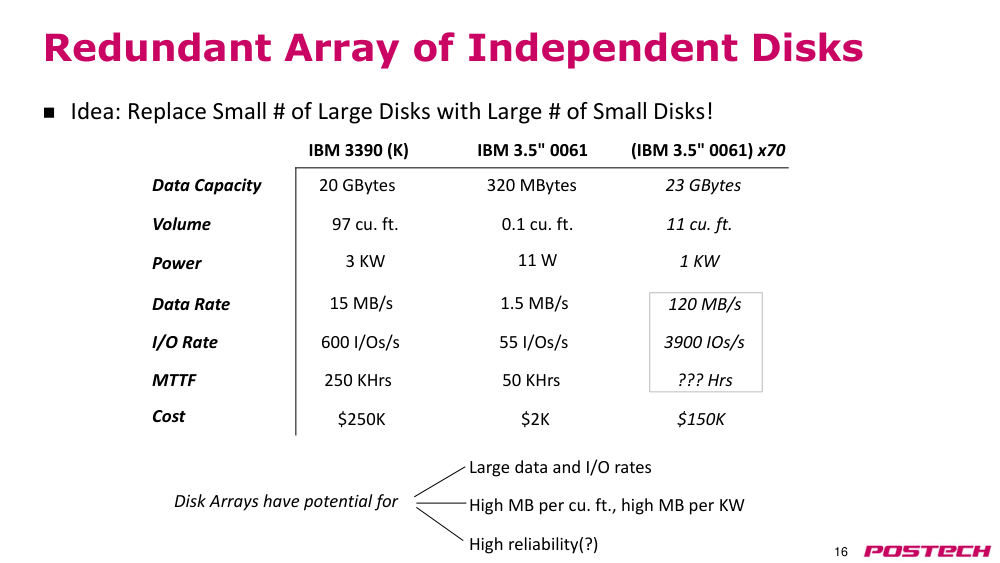
상황·문제대용량 disk 는 용량 대비 가격이 훨씬 비쌈. 값싼 disk 70개로 23 GB 를 $150K 에, 병렬 접근으로 bandwidth·throughput 증가, 전력 감소.
원인disk 가 많아지면 하나만 고장나도 data 손실 (RAID 0: block striping). mirroring(RAID 1)은 용량 절반 낭비.
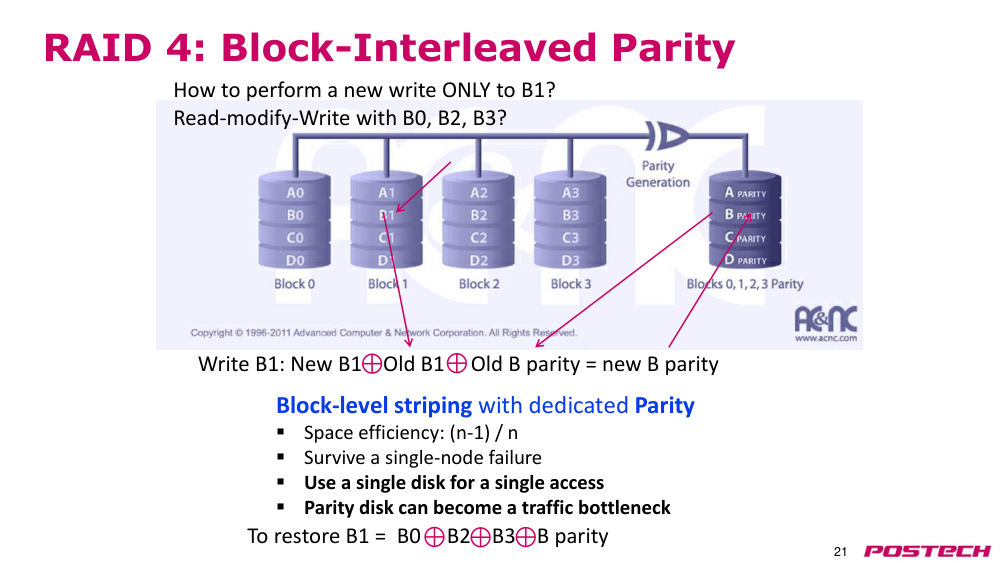
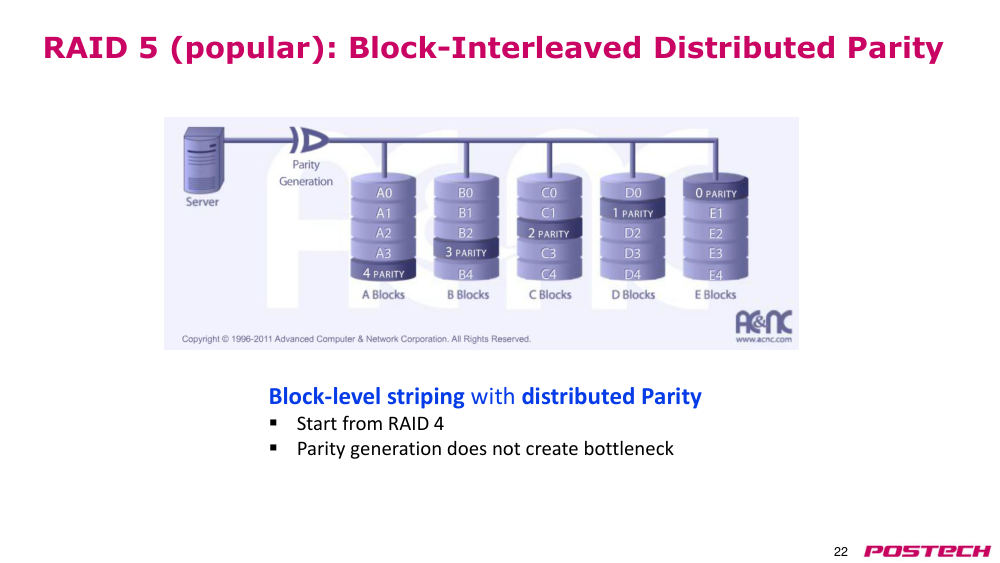
해결RAID 2: bit striping + Hamming ECC(4 data 에 3 ECC disk), 모든 disk 접근. RAID 3: byte striping + parity disk 1개. RAID 4: block striping 으로 disk 하나만 접근, parity disk 가 bottleneck. RAID 5: parity 분산. RAID 6: parity 2배로 disk 2개 고장 복구.
- RAID 는 David Patterson 1988 연구
2.15.r.2Patterson, Gibson, Katz: A Case for Redundant Arrays of Inexpensive Disks (RAID), UCB TR 1987 ↗ · RAID 원 논문(SIGMOD'88) 의 tech report, 5개 RAID level 제안
2.161:13:38–1:14:45행정: 과목 마무리
상황·문제이 강의로 과목 종료. 기말 시험 기술 문제는 미리 알리고, 질문은 MS Teams 에 올려 토론.
3핵심 개념
3.1memory controller(메모리 컨트롤러)
CPU 요청을 bank 상태·timing 에 맞는 DRAM command 로 바꿔 발행, row buffer hit 요청을 먼저 처리하는 등 scheduling.
3.2HBM(High Bandwidth Memory)
DRAM die 를 TSV 로 적층하고 interposer 로 processor 와 1024 IO 연결. V100 900 GB/s, energy/bit ~1/4.
3.2.r.1Wikipedia: High Bandwidth Memory ↗ · DRAM die 적층 + base die, TSV·microbump, die 당 128-bit channel 2개 = 1024-bit, silicon interposer
3.3TSV(through-silicon via)
적층된 die 를 수직으로 관통하는 wire. 전원·data·command 를 위 die 까지 연결.
3.3.r.1Wikipedia: High Bandwidth Memory ↗ · DRAM die 적층 + base die, TSV·microbump, die 당 128-bit channel 2개 = 1024-bit, silicon interposer
3.3.r.2Wikipedia: Three-dimensional integrated circuit ↗ · die 적층·TSV, memory-on-logic, 넓은 bus 와 에너지 절감
3.4PIM(processing in memory, 메모리 내 처리)
bank 의 row buffer 옆에서 계산해 external bus 보다 (num_banks)배 큰 internal bandwidth 활용.
3.4.r.1Wikipedia: In-memory processing ↗ · processing-near-memory / processing-using-memory 개념 (특정 제품 설명은 없음)
3.5Newton(SK hynix)
bank 당 FP16 multiplier·adder 16개로 matrix-vector 곱. batch 1 에서 GPU 대비 GMEAN ~20배, batch 64 에서는 GPU 우세.
3.6PCM(phase-change memory, 상변화 메모리)
crystalline/amorphous 저항 차로 저장. 비휘발·고밀도, 느린 write·낮은 endurance.
3.6.r.1Wikipedia: Phase-change memory ↗ · crystalline(저저항)/amorphous(고저항), 가열로 상태 전환, 비휘발, 3D XPoint
3.7STT-MRAM / MTJ
free layer 자화 방향으로 저항이 달라짐(parallel 저저항). 1T-1MTJ, SRAM 과 DRAM 사이 성능.
3.7.r.2Wikipedia: Magnetic tunnel junction ↗ · parallel = 저저항, antiparallel = 고저항, spin-transfer torque 전환
3.83D V-Cache
AMD 가 compute die 위에 SRAM 64MB L3 를 적층해 L3 4배.
3.8.r.1Wikipedia: Three-dimensional integrated circuit ↗ · die 적층·TSV, memory-on-logic, 넓은 bus 와 에너지 절감
3.9floating gate(플로팅 게이트)
전자를 가두면 threshold voltage 가 Vt_high 로 올라감: 전자 있음 0, 없음 1.
3.9.r.1Wikipedia: Flash memory ↗ · floating-gate transistor·Vt, NAND/NOR 구조, block 단위 erase, 1980 Toshiba(Masuoka)
3.10NAND vs NOR flash
NAND: 직렬 연결·고밀도·storage. NOR: bit line 직결·빠른 read·ROM·embedded.
3.10.r.1Wikipedia: Flash memory ↗ · floating-gate transistor·Vt, NAND/NOR 구조, block 단위 erase, 1980 Toshiba(Masuoka)
3.11MLC / TLC / QLC
Vt level 4·8·16개로 cell 당 2·3·4 bit, 감지 오류가 늘어 ECC 필요.
3.12wear leveling(웨어 레벨링)
P/E cycle 한계 때문에 write 를 모든 block 에 고르게 분산.
3.13garbage collection(가비지 컬렉션)
stale page 가 섞인 block 의 유효 data 를 옮기고 block 전체 erase.
3.13.r.1Wikipedia: Write amplification ↗ · slide p12 그림 출처. garbage collection, FTL 의 logical→physical mapping
3.14FTL(Flash Translation Layer)
SSD 의 logical block 주소를 실제 flash block·page 주소로 변환.
3.15RAID(Redundant Array of Independent Disks)
값싼 disk 여러 개로 용량·bandwidth 확보, striping·mirroring·parity 로 신뢰성. level 0~6.
3.15.r.2Patterson, Gibson, Katz: A Case for Redundant Arrays of Inexpensive Disks (RAID), UCB TR 1987 ↗ · RAID 원 논문(SIGMOD'88) 의 tech report, 5개 RAID level 제안
4스스로 확인
4.1memory controller 가 같은 queue 안에서 어떤 요청을 먼저 처리하면 유리한가?
답
이미 row buffer 에 열린 row 를 쓰는 요청. activation 없이 column address 만으로 처리돼 빠름.
4.2DRAM latency 가 수십 년간 거의 줄지 않은 이유는?
답
latency 를 줄이려면 cell 을 키워 density 를 희생해야 하는데 시장 수요는 용량 쪽이라 DRAM 은 capacity 에 최적화됨.
4.3HBM 이 DIMM 보다 bandwidth 가 큰 이유는?
답
interposer 로 작은 pin·가는 wire 를 많이 연결: 8 channel × 128 = 1024 IO (DIMM 은 64).
4.4DRAM 안에서 계산하면 bandwidth 가 늘어나는 근거는?
답
external I/O 는 한 번에 bank 하나만 전송하지만 bank 들은 병렬 동작 → internal bandwidth 가 (num_banks)배.
4.5batch 64 에서 GPU 가 Newton 을 앞서는 이유는?
답
weight 를 한 번 읽어 64개 입력에 재사용 → load 비용이 분산되어 compute-intensive 가 되기 때문.
4.6NAND flash 에서 한 cell 을 읽는 방법은?
답
나머지 cell 에 Vt_high 이상을 걸어 도통시키고 대상 cell 에 Vt_low 를 걸어 전류가 흐르면 1, 안 흐르면 0.
4.7flash 에서 garbage collection 과 FTL 이 필요한 이유는?
답
page 를 제자리에서 고칠 수 없어(block 단위 erase) 수정본을 다른 page 에 씀 → 유효 data 이동·block erase, 바뀐 위치는 FTL 이 logical→physical 로 변환.
4.8RAID 4 의 bottleneck 과 RAID 5 의 해결책은?
답
모든 write 가 전용 parity disk 를 거침 → parity 를 여러 disk 에 분산(distributed parity).
5참고 자료
5.1Wikipedia: High Bandwidth Memory ↗ · DRAM die 적층 + base die, TSV·microbump, die 당 128-bit channel 2개 = 1024-bit, silicon interposer
5.2Wikipedia: In-memory processing ↗ · processing-near-memory / processing-using-memory 개념 (특정 제품 설명은 없음)
5.3Wikipedia: Flash memory ↗ · floating-gate transistor·Vt, NAND/NOR 구조, block 단위 erase, 1980 Toshiba(Masuoka)
5.4Wikipedia: Write amplification ↗ · slide p12 그림 출처. garbage collection, FTL 의 logical→physical mapping
5.6Patterson, Gibson, Katz: A Case for Redundant Arrays of Inexpensive Disks (RAID), UCB TR 1987 ↗ · RAID 원 논문(SIGMOD'88) 의 tech report, 5개 RAID level 제안