Lec24-Storage
한국어판 강의자료 · 24쪽
p.1
p.2flash memory(플래시 메모리)
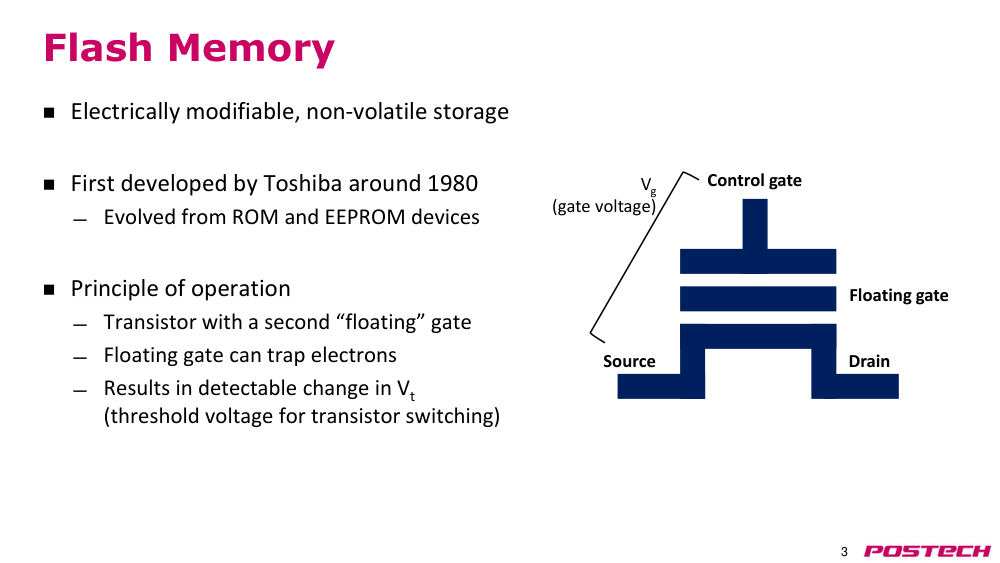
p.3flash memory(플래시 메모리)
- electrically modifiable(전기적으로 수정 가능한) non-volatile storage(비휘발성 저장소)
- 1980년대 초 Toshiba에서 처음 개발됨
- ROM 및 EEPROM 장치에서 진화함
- 작동 원리:
- 두 번째 'floating gate(플로팅 게이트)'를 가진 트랜지스터
- floating gate(플로팅 게이트)는 전자를 포획할 수 있음
- 트랜지스터 스위칭을 위한 임계 전압(Vt)의 감지 가능한 변화를 유도함
- control gate(컨트롤 게이트)
- floating gate(플로팅 게이트)
- source(소스)
- drain(드레인)
- Vg (게이트 전압)
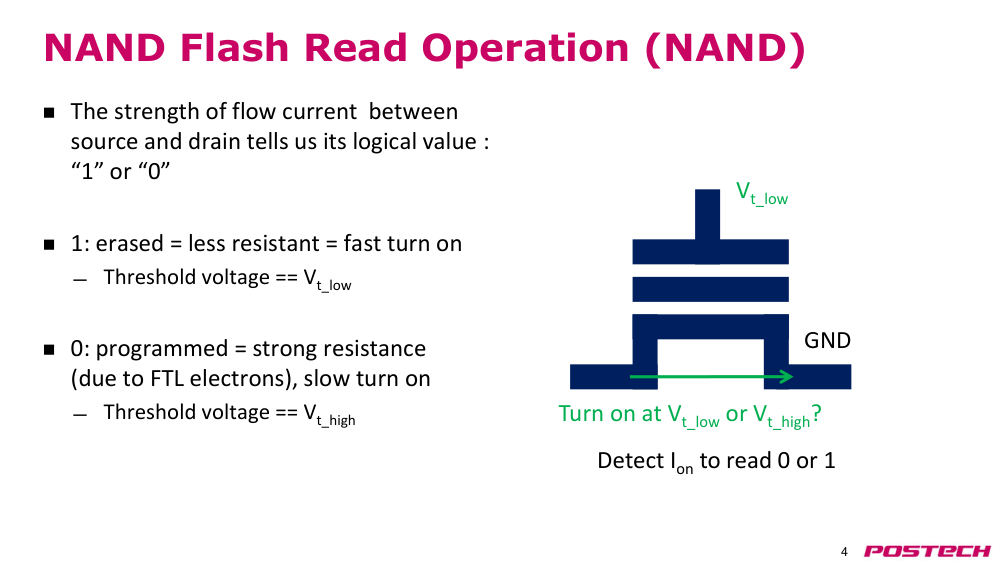
p.4NAND flash(NAND 플래시) 읽기 작업 (NAND)
- source(소스)와 drain(드레인) 사이의 전류 흐름 강도를 통해 논리적 값 '1' 또는 '0'을 알 수 있음
- 1: erased state(지워진 상태) = 저저항 = 빠른 전환
- 임계 전압 == Vt_low
- 0: programmed state(프로그래밍된 상태) = 높은 저항 (플로팅 게이트 전자로 인해), 느린 전환
- 임계 전압 == Vt_high
- Vt_low
- 0 또는 1을 읽기 위해 전류 감지
- GND
- Vt_low 또는 Vt_high에서 전원 켜기?
p.5NAND flash(NAND 플래시) 프로그래밍 및 지우기
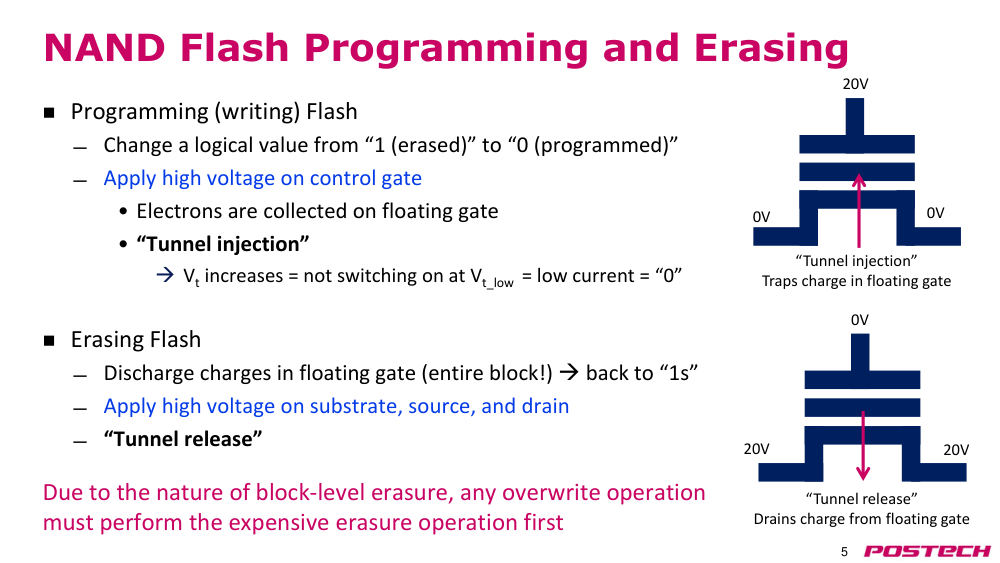
- 플래시 프로그래밍(쓰기)
- 논리적 값 '1(지워진 상태)'에서 '0(프로그래밍된 상태)'로 변경
- control gate(컨트롤 게이트)에 고전압을 인가
- • 전자가 floating gate(플로팅 게이트)에 모임
- • 'tunnel injection(터널 주입)'
- → Vt 증가 = Vt_low에서 스위칭되지 않음 = 저전류 = '0'
- 플래시 지우기
- floating gate(플로팅 게이트)의 전하를 방전 (전체 block(블록)!) → 다시 '1'로 복귀
- 기판, source(소스), drain(드레인)에 고전압 인가
- • 'tunnel release(터널 방출)'
- block-granularity erasure(블록 단위 지우기)의 특성으로 인해, 어떤 오버라이트 작업도 먼저 비용이 큰 지우기 작업을 수행해야 함
- 0V
- 'tunnel release(터널 방출)'
- drain(드레인)에서 floating gate(플로팅 게이트)의 전하 방출
- 20V
- 20V
- 20V
- 'tunnel injection(터널 주입)'
- floating gate(플로팅 게이트)에 전하 포획
- 0V
- 0V
p.6flash memory(플래시 메모리): NAND 모델
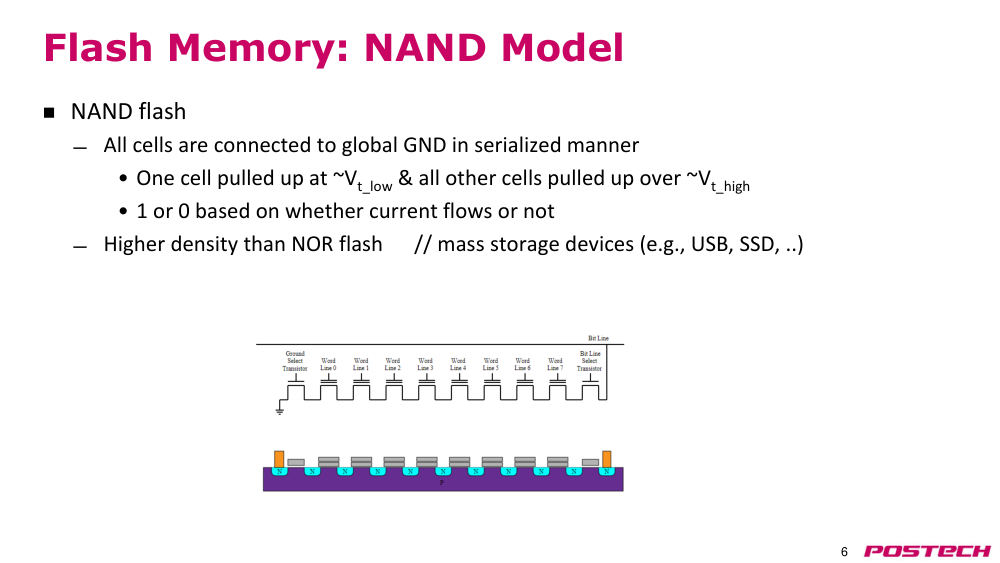
- NAND flash(NAND 플래시)
- 모든 셀이 직렬로 전역 GND에 연결됨
- • 하나의 셀은 약 Vt_low에서 올라가고, 다른 모든 셀은 약 Vt_high 이상으로 올라감
- • 전류가 흐르는지 여부에 따라 1 또는 0 결정
- NOR flash(NOR 플래시)보다 더 높은 밀도
- → 대용량 저장 장치 (예: USB, SSD 등)
p.7flash memory(플래시 메모리): NAND 모델
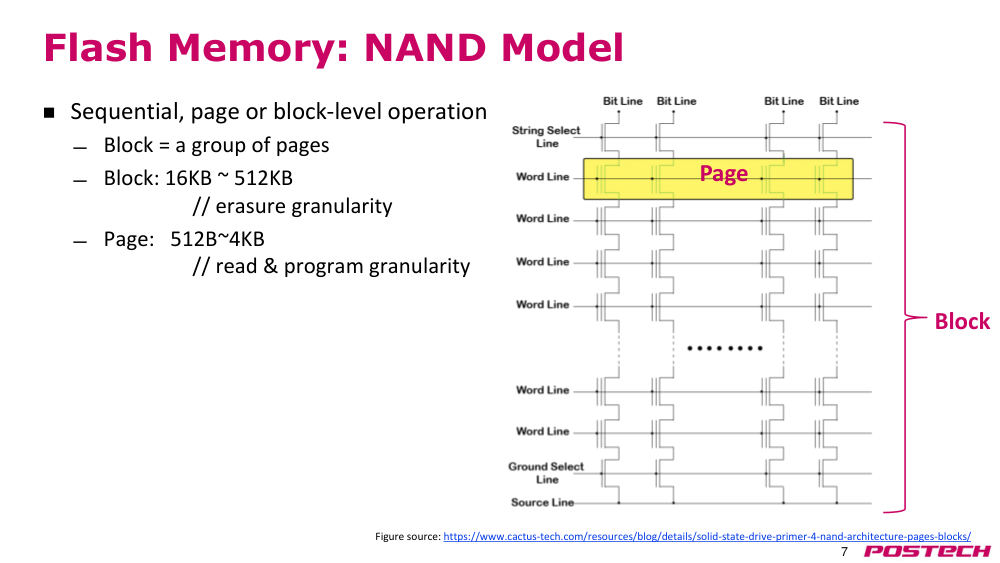
- 순차적, page(페이지) 또는 block-level operation(블록 단위 작업)
- block(블록) = page(페이지)의 그룹
- block(블록): 16KB ~ 512KB // erasure granularity(지우기 단위)
- page(페이지): 512B ~ 4KB // read & program granularity(읽기 및 프로그래밍 단위)
- 그림 출처: https://www.cactus-tech.com/resources/blog/details/solid-state-drive-primer-4-nand-architecture-pages-blocks/
p.8flash memory(플래시 메모리): NOR 모델
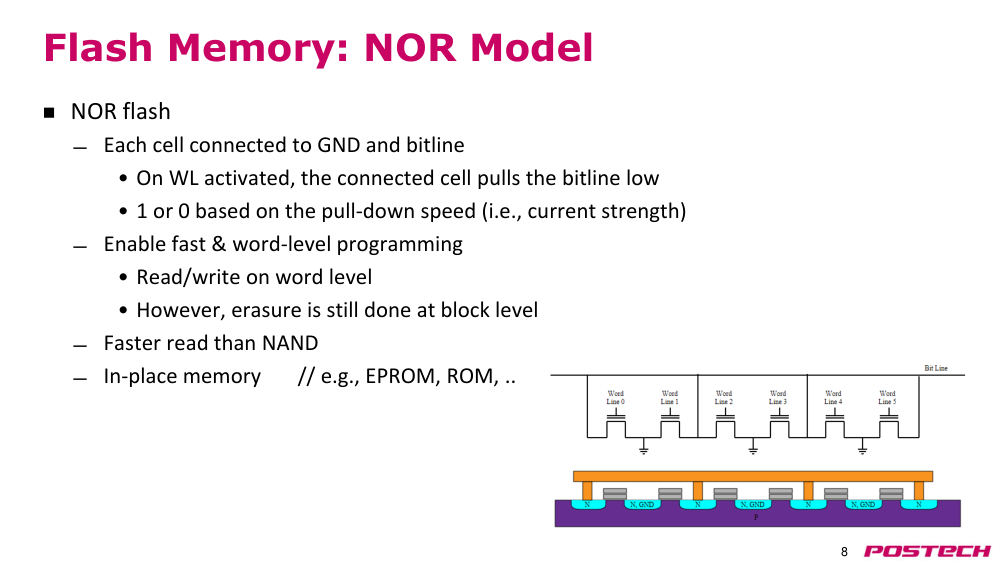
- NOR flash(NOR 플래시)
- 각 셀은 GND와 비트라인에 연결됨
- WL이 활성화되면, 연결된 셀이 비트라인을 낮춤
- 풀다운 속도(즉, 전류 강도)에 따라 1 또는 0 결정
- 빠른 워드 단위 프로그래밍 가능
- 워드 단위 읽기/쓰기 가능
- 그러나 지우기는 여전히 block(블록) 단위로 수행됨
- NAND보다 빠른 읽기 속도
- in-place memory(인플레이스 메모리) // 예: EPROM, ROM, ..
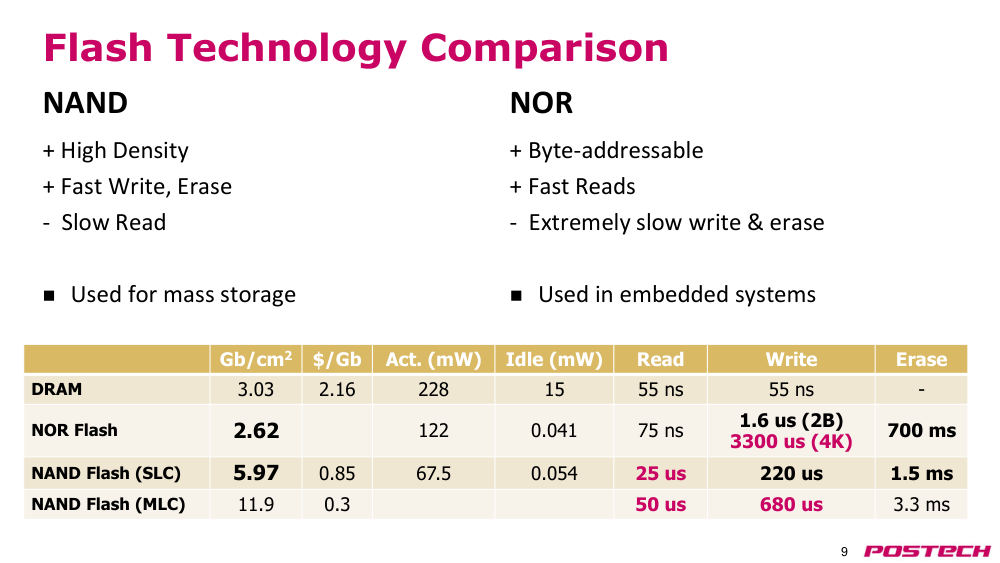
p.9NAND flash(NAND 플래시) 기술 비교
- + 고밀도
- + 빠른 쓰기, 지우기
- - 느린 읽기
- → 대량 저장소에 사용됨
- + byte-addressable(바이트 주소 지정 가능)
- + 빠른 읽기
- - 매우 느린 쓰기 및 지우기
- → 임베디드 시스템에 사용됨
- Gb/cm²
- $/Gb
- Act. (mW)
- Idle (mW)
- Read
- Write
- Erase
- DRAM
- 3.03
- 2.16
- 228
- 15
- 55 ns
- 55 ns
- -
- NOR Flash
- 2.62
- 122
- 0.041
- 75 ns
- 1.6 us (2B)
- 3300 us (4K)
- 700 ms
- NAND Flash (SLC)
- 5.97
- 0.85
- 67.5
- 0.054
- 25 us
- 220 us
- 1.5 ms
- NAND Flash (MLC)
- 11.9
- 0.3
- 50 us
- 680 us
- 3.3 ms
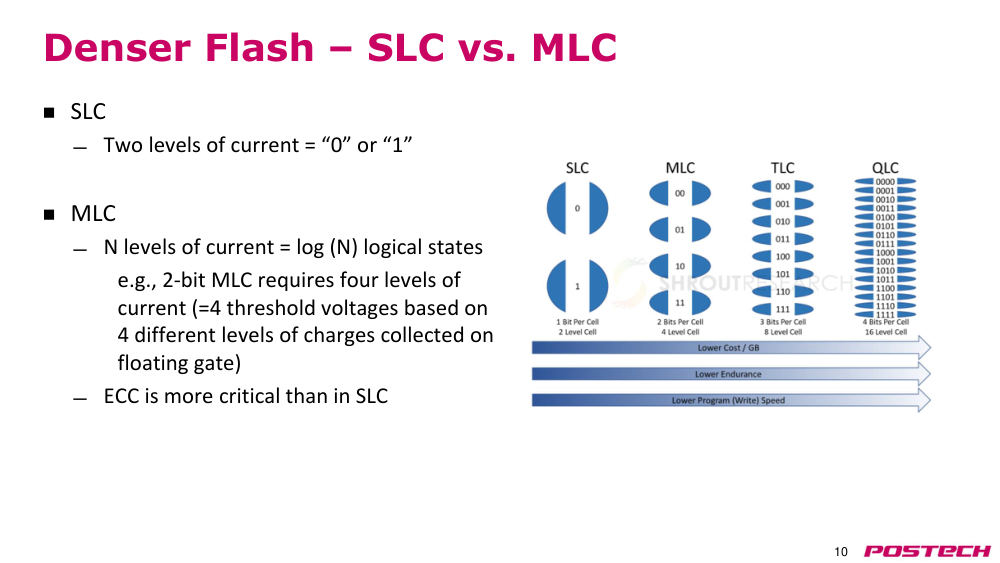
p.10더 밀도 높은 플래시 – SLC vs. MLC
- SLC
- 전류의 두 수준 = '0' 또는 '1'
- MLC
- N개의 전류 수준 = log(N) 논리 상태
- 예: 2비트 MLC는 전류의 네 수준 필요 (= floating gate(플로팅 게이트)에 수집된 4개의 서로 다른 전하 수준에 기반한 4개의 임계 전압)
- ECC는 SLC보다 더 중요함
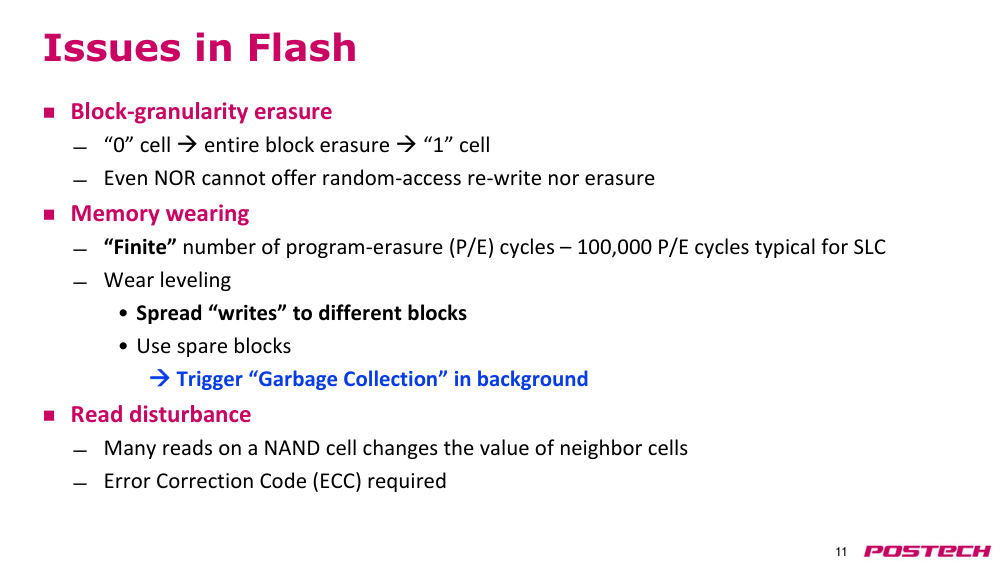
p.11flash memory(플래시 메모리)의 문제점
- block-granularity erasure(블록 단위 지우기)
- '0' 셀 → 전체 block(블록) 지우기 → '1' 셀
- NOR도 랜덤 액세스 재쓰기 또는 지우기를 지원하지 않음
- 메모리 마모
- 프로그램-지우기(P/E) 사이클 수가 '유한'함 – SLC의 경우 일반적으로 100,000 P/E cycles (Program/Erase cycles)(P/E 사이클)
- wear leveling(웨어 레벨링)
- • 쓰기를 다른 block(블록)에 분산
- • spare blocks(예비 블록) 사용
- → 백그라운드에서 'garbage collection(가비지 컬렉션)' 트리거
- read disturbance(읽기 교란)
- NAND 셀에 많은 읽기가 수행되면 인접 셀의 값이 변경됨
- 오류 정정 코드(ECC) 필요
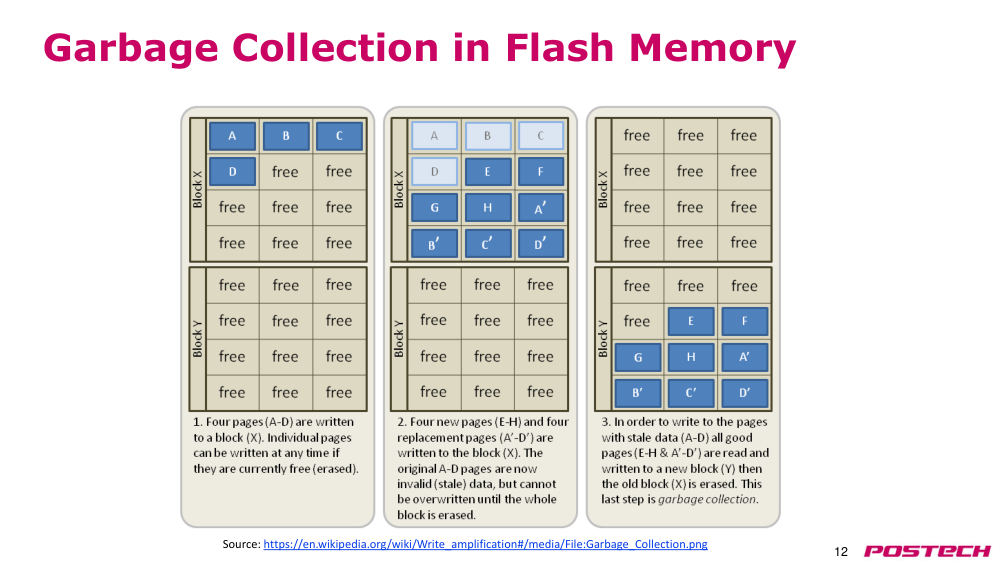
p.12flash memory(플래시 메모리)의 garbage collection(가비지 컬렉션)
- 출처: https://en.wikipedia.org/wiki/Write_amplification#/media/File:Garbage_Collection.png
p.13솔리드 스테이트 드라이브 (SSD)
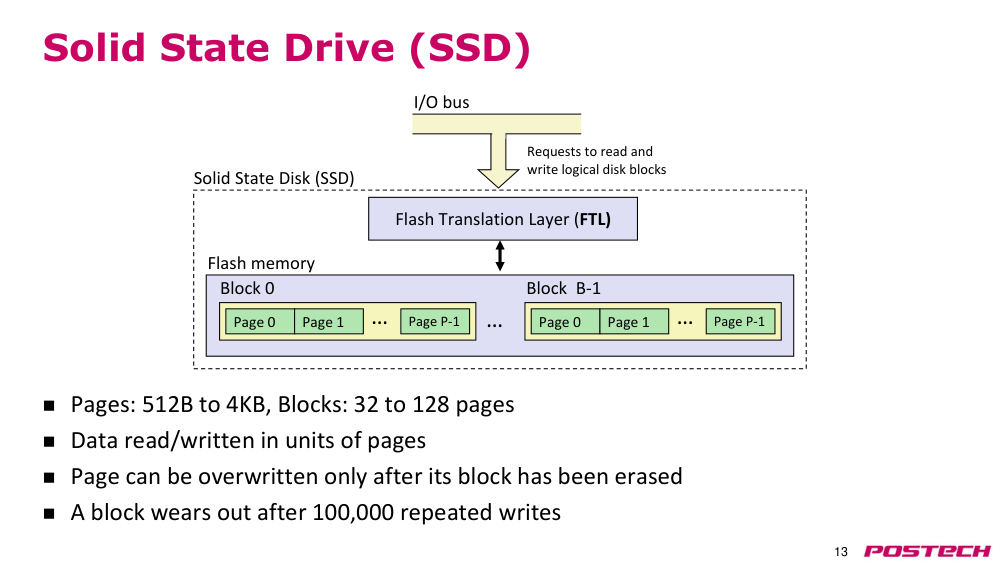
- page(페이지): 512B에서 4KB, block(블록): 32에서 128페이지
- 데이터는 page(페이지) 단위로 읽거나 쓰임
- page(페이지)는 block(블록)이 지워진 후에만 덮어쓸 수 있음
- block(블록)은 100,000회 반복 쓰기 후에 마모됨
- 플래시 변환 레이어 (FTL)
- I/O 버스
- page(페이지) 0
- page(페이지) 1
- page(페이지) P-1
- ...
- block(블록) 0
- ...
- page(페이지) 0
- page(페이지) 1
- page(페이지) P-1
- ...
- block(블록) B-1
- flash memory(플래시 메모리)
- 솔리드 스테이트 디스크 (SSD)
- 논리 디스크 block(블록) 읽기 및 쓰기 요청
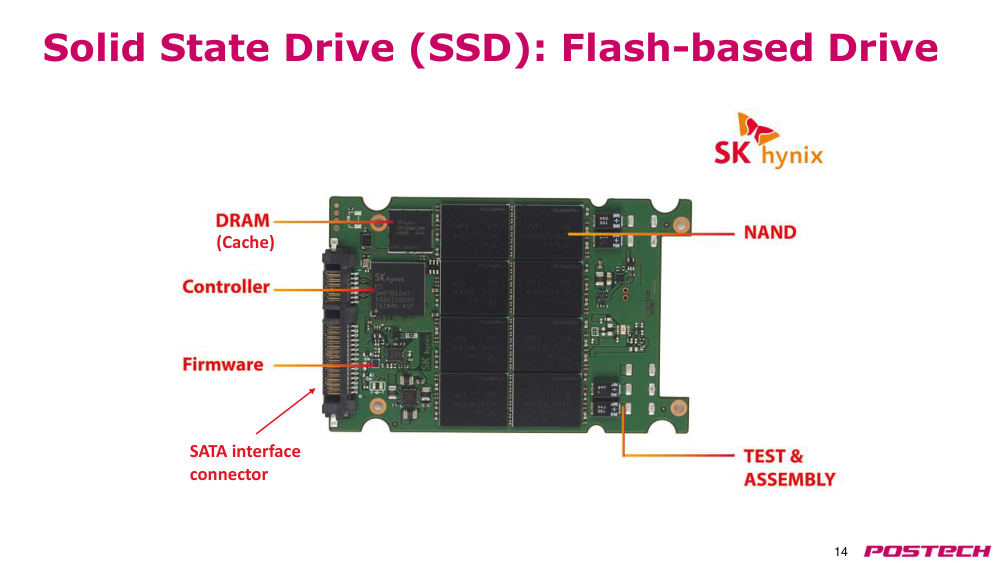
p.14솔리드 스테이트 드라이브 (SSD): 플래시 기반 드라이브
- SATA interface(SATA 인터페이스) 커넥터
- (캐시)
p.15hard drive(하드 드라이브)가 고장났을 경우?
- redundant array of independent disks(독립 디스크의 중복 배열) (RAID)
- (David Patterson의 대표적 연구, 1988년)
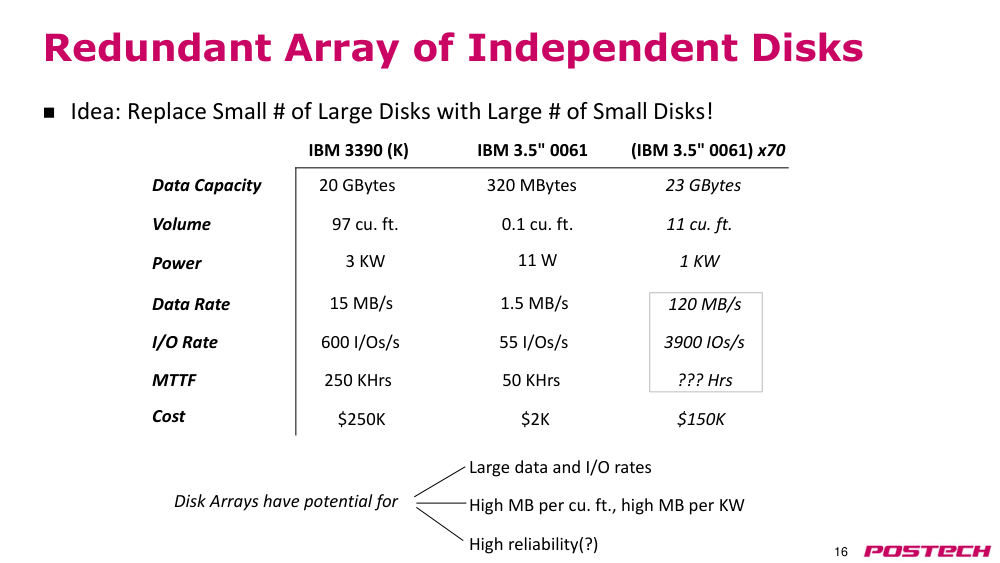
p.16redundant array of independent disks (RAID)(독립 디스크의 중복 배열)
- 아이디어: 소수의 대형 디스크를 다수의 소형 디스크로 대체하라!
- 데이터 용량
- 볼륨
- 전력
- data rate(데이터 전송 속도)
- I/O rate(입출력 속도)
- MTTF
- IBM 3390 (K)
- IBM 3.5" 0061 (IBM 3.5" 0061) ×70
- 20 GBytes
- 320 MBytes
- 23 GBytes
- 97 cu. ft.
- 3 KW
- 15 MB/s
- 600 I/Os/s
- 250 KHrs
- $250K
- 0.1 cu. ft.
- 11 W
- 1.5 MB/s
- 55 I/Os/s
- 50 KHrs
- $2K
- 11 cu. ft.
- 1 KW
- 120 MB/s
- 3900 I/Os/s
- ??? Hrs
- $150K
- 디스크 어레이의 잠재력:
- 대용량 데이터 및 높은 I/O rate(입출력 속도)
- 단위 부피당 고용량, 단위 전력당 고용량
- 높은 신뢰성(?)
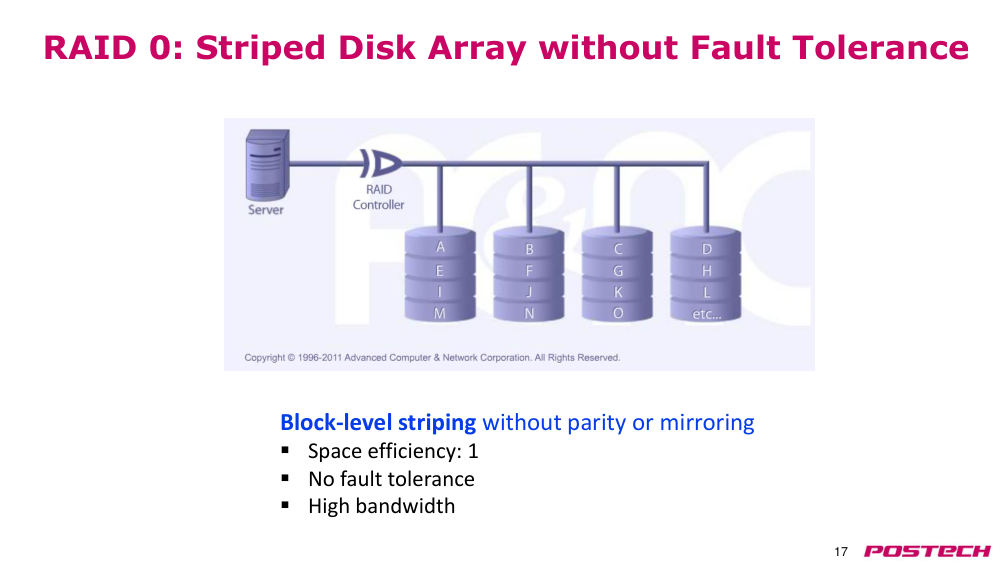
p.17parity(패리티) 또는 mirroring(미러링) 없이 block-level striping(블록 단위 스트라이핑)
- space efficiency(공간 효율성): 1
- fault tolerance(장애 내성) 없음
- 높은 대역폭
- RAID 0: fault tolerance(장애 내성) 없는 스트라이핑 디스크 어레이
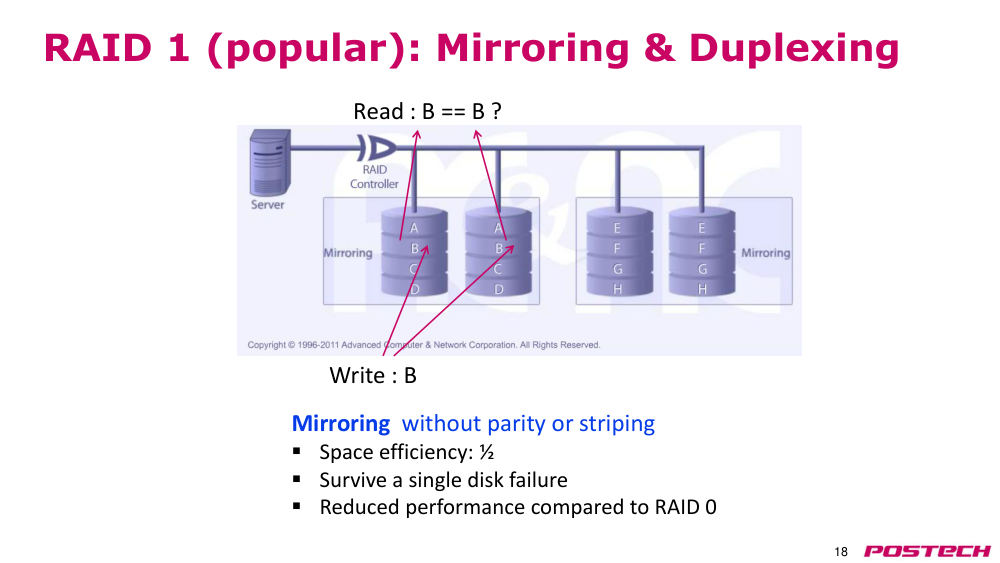
p.18parity(패리티) 또는 스트라이핑 없이 mirroring(미러링)
- space efficiency(공간 효율성): ½
- 단일 디스크 고장에 견딤
- RAID 0에 비해 성능 저하
- RAID 1(대중적): mirroring(미러링) 및 듀플렉싱
- 읽기: B == B ?
- 쓰기: B
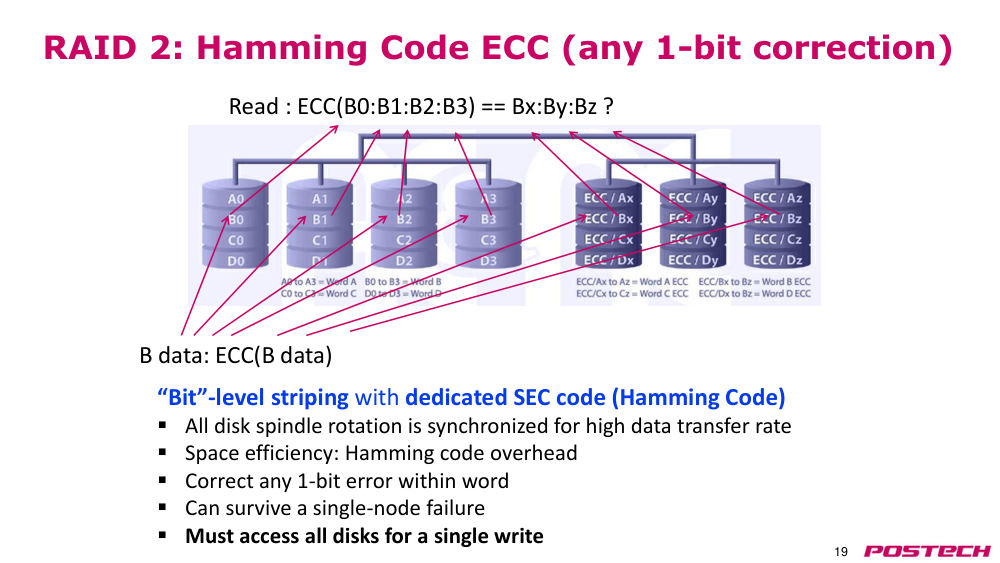
p.19bit-level striping(비트 단위 스트라이핑)과 전용 SEC code(단일 오류 정정 코드) (Hamming code(해밍 코드))
- 모든 디스크 spindle(스핀들)의 회전이 동기화되어 고속 data rate(데이터 전송 속도)를 제공한다.
- space efficiency(공간 효율성): Hamming code(해밍 코드) 오버헤드
- 워드 내에서 1비트 오류를 수정할 수 있다.
- 단일 노드 장애를 견딜 수 있다.
- 단일 쓰기 작업을 수행하려면 모든 디스크에 접근해야 한다.
- B 데이터: ECC(B 데이터)
- RAID 2: Hamming code(해밍 코드) ECC (1비트 수정 가능)
- 읽기: ECC(B0:B1:B2:B3) == Bx:By:Bz ?
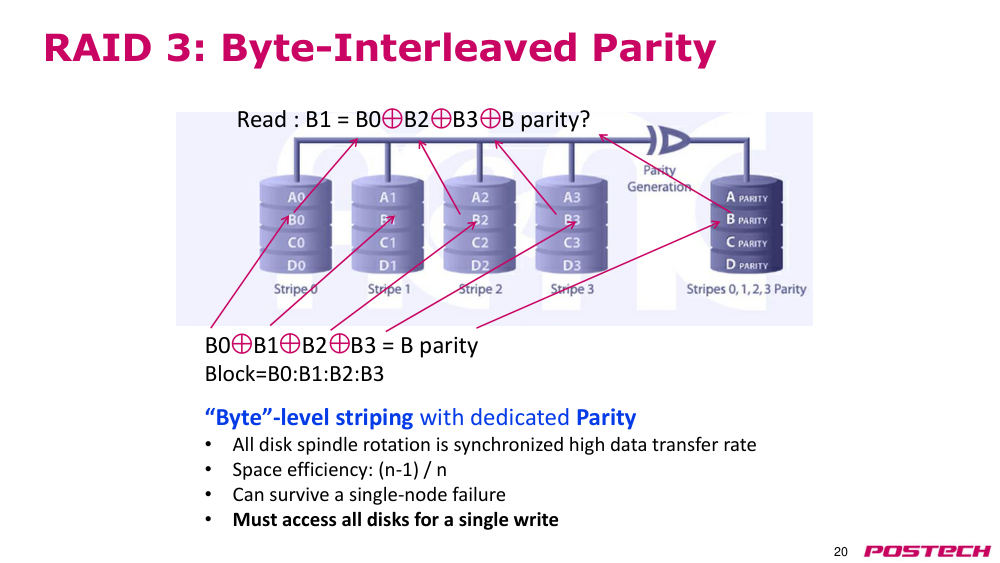
p.20byte-level striping(바이트 단위 스트라이핑)과 전용 parity(패리티)
- 모든 디스크 spindle(스핀들)의 회전이 동기화되어 고속 data rate(데이터 전송 속도)를 제공한다.
- space efficiency(공간 효율성): (n-1) / n
- 단일 노드 장애를 견딜 수 있다.
- 단일 쓰기 작업을 수행하려면 모든 디스크에 접근해야 한다.
- RAID 3: 바이트 인터리브 parity(패리티)
- B0 B1 B2 B3 = B parity(패리티)
- block(블록) = B0:B1:B2:B3
- 읽기: B1 = B0 B2 B3 B parity(패리티) ?
p.21RAID 4: block(블록) 인터리브 parity(패리티)
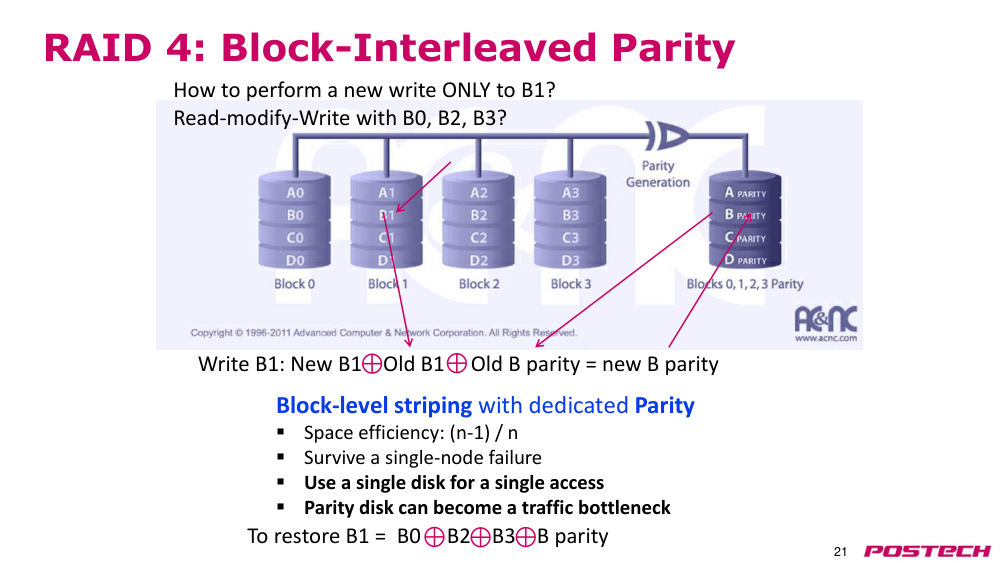
- block-level striping(블록 단위 스트라이핑)과 전용 parity(패리티)
- space efficiency(공간 효율성): (n-1) / n
- 단일 노드 장애를 견딜 수 있다.
- 단일 접근 시 단일 디스크를 사용한다.
- parity(패리티) 디스크는 traffic bottleneck(트래픽 병목)이 될 수 있다.
- B1 쓰기: 새로운 B1 이전 B1 이전 B parity(패리티) = 새로운 B 패리티
- B1 복원: B0 B2 B3 B parity(패리티)
- B1에만 새로운 쓰기를 수행하려면 어떻게 해야 하는가?
- B0, B2, B3와 함께 read-modify-write(읽기-수정-쓰기) 수행?
p.22RAID 5 (인기 있음): block(블록) 인터리브 distributed parity(분산 패리티)
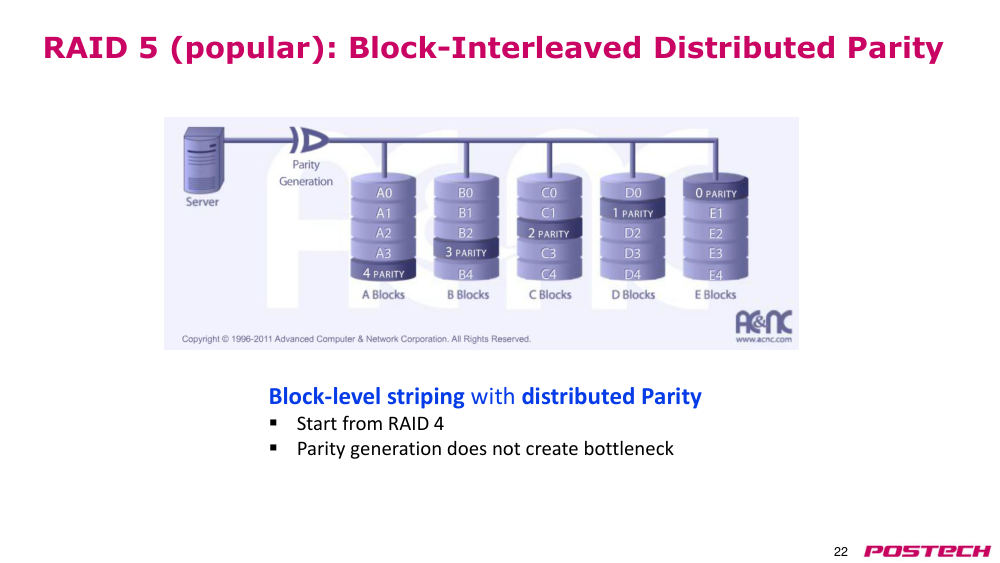
- block-level striping(블록 단위 스트라이핑)과 distributed parity(분산 패리티)
- RAID 4에서 시작한다.
- parity(패리티) 생성이 bottleneck(병목)을 일으키지 않는다.
p.23RAID 6: 두 개의 독립된 parity(패리티) 방식을 가진 독립 데이터 디스크
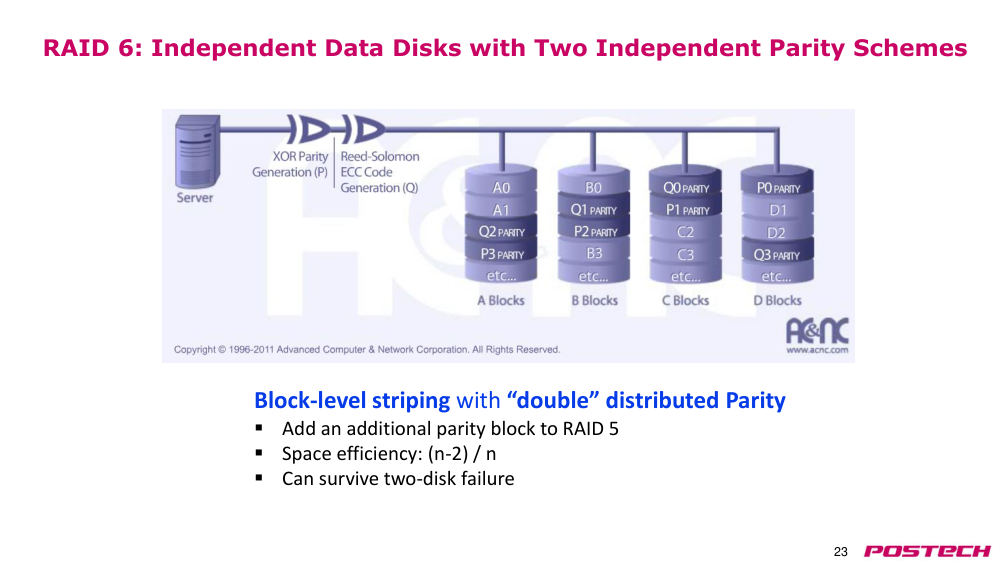
- block-level striping(블록 단위 스트라이핑)과 "이중" distributed parity(분산 패리티)
- RAID 5에 추가 parity(패리티) block(블록)을 더한다.
- space efficiency(공간 효율성): (n-2) / n
- 두 디스크 장애를 견딜 수 있다.
p.24질문?