Lec 18 part 2 & Lec 19 · sequential consistency 와 relaxed model · I/O(port register, memory-mapped I/O, DMA, polling/interrupt)
정밀 정리 · 검증 2026-09-24 22:47
1개요
1.1Lec18 후반: sequential consistency 정의(Lamport)와 예제, store buffer·OoO 와의 충돌(Dekker).
1.2SC 개선: relaxed model(TSO, ARM)+fence, transactional memory(Intel TSX). consistency = HW 와 SW 의 약속.
1.3Lec19: CPU-I/O 연결(UMA→NUMA, PCIe, NVLink), I/O port register, memory-mapped I/O(idempotency, cache bypass).
1.4DMA 와 cache coherence, VA/PA 문제(pinned buffer, gather/scatter, IOMMU), polling vs interrupt, mechanism 선택. bus 는 다음 강의.
2섹션별 정리 상황·문제 → 원인 → 해결
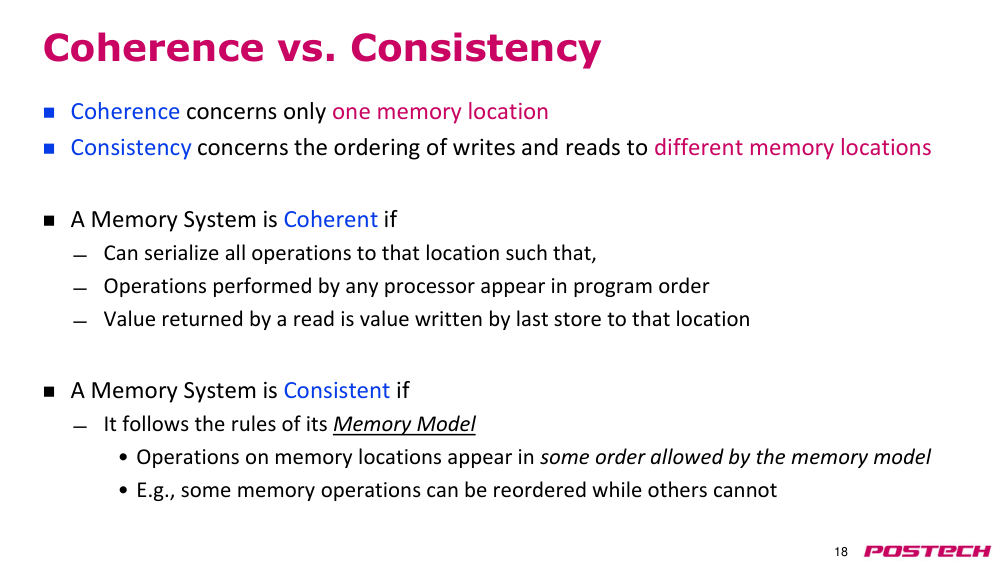
2.10:49–2:40복습: coherence 와 consistency 의 차이
상황·문제55강에서 시작한 memory consistency 를 이어감. coherence 와 무엇이 다른지 다시 정리.
원인coherence 는 한 memory 위치에 여러 processor 가 접근할 때 어떤 값을 봐야 하는가의 문제.
해결consistency 는 여러 위치에 대한 접근의 유효한 ordering 문제. 이번에는 가장 기본 model 인 sequential consistency 를 다룸.
- coherence = single location, consistency = multiple locations 의 ordering
2.22:40–8:42sequential consistency(순차 일관성) 의 정의와 충분 조건
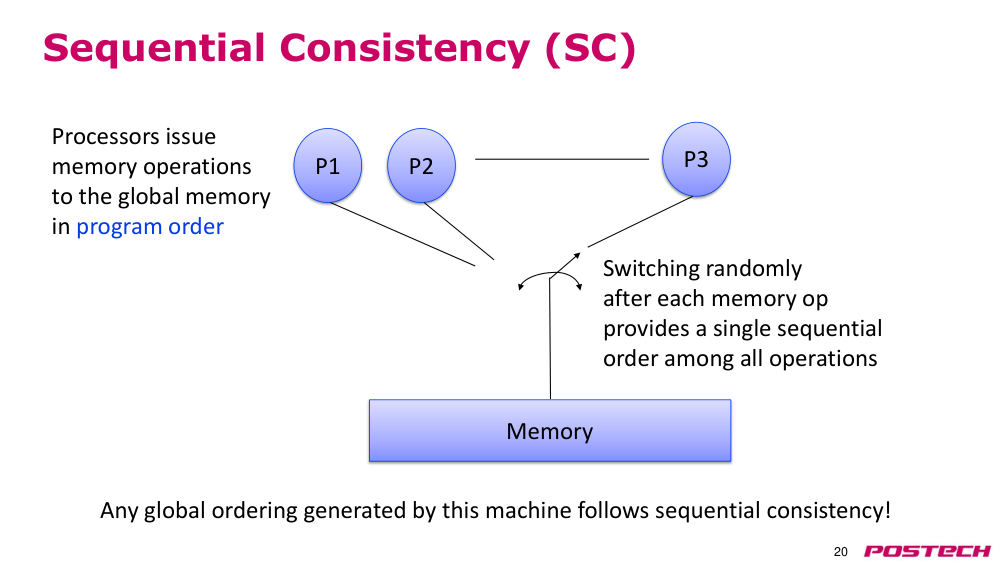
상황·문제여러 processor 가 하나의 shared physical memory 에 read/write 를 낼 때, 모두가 같은 순서를 보게 하는 model.
원인switch 가 한 번에 한 processor 만 memory 에 연결하고 연산마다 임의로 바뀜 → 하나의 global ordering. 각 processor 는 program order 로 memory 연산을 냄.
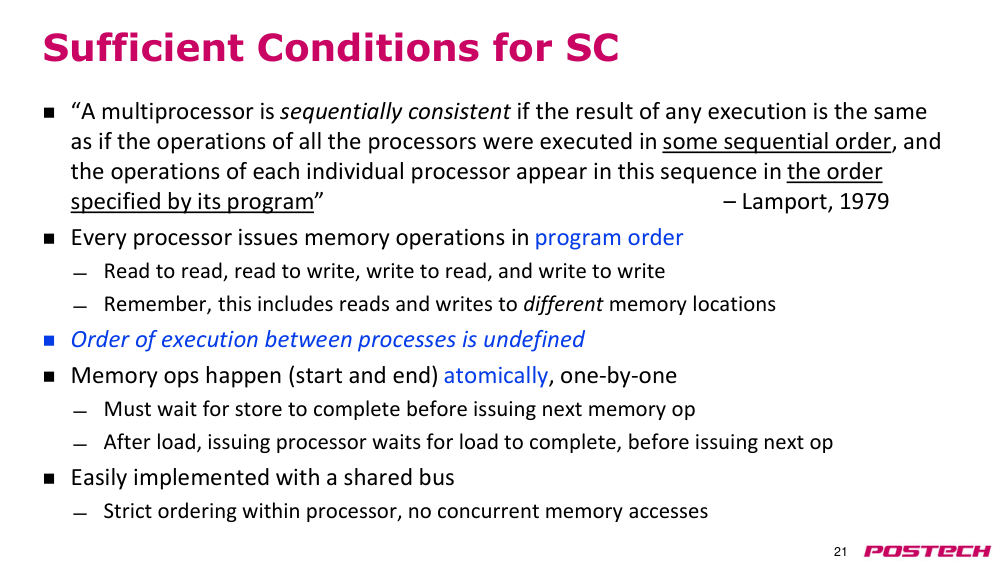
해결Lamport 정의: 어떤 sequential order 와 같은 결과 + 각 processor 는 program order. 충분 조건: 다른 위치 포함 모든 R/W program order, store·load 완료 후 다음 memory 연산. shared bus 로 쉽게 구현.
- SC 두 조건: 모두가 보는 단일 global order, processor 내부는 program order
- processor 간 순서는 정의되지 않음(비결정)
- ALU instruction 은 해당 없음, memory 접근만 대상
2.2.r.2Lamport 1979: How to Make a Multiprocessor Computer That Correctly Executes Multiprocess Programs ↗ · SC 원 논문 (IEEE TC 1979)
2.38:42–14:52SC 예제: 허용되는 interleaving 과 producer-consumer
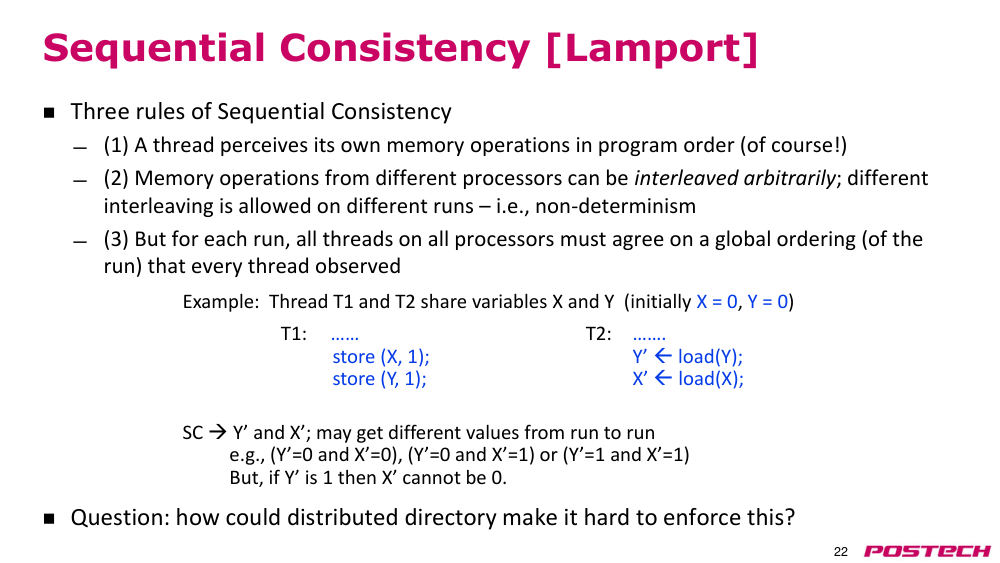
상황·문제SC 에서 어떤 실행 순서가 가능하고 어떤 결과가 불가능한지 예제로 확인.
원인T1: store X,1; store Y,1 / T2: load Y; load X. 1,3,4,2 등은 가능하지만 program order 를 어기는 2,1,3,4 는 불가 → Y'=1 이면 X'=0 불가.
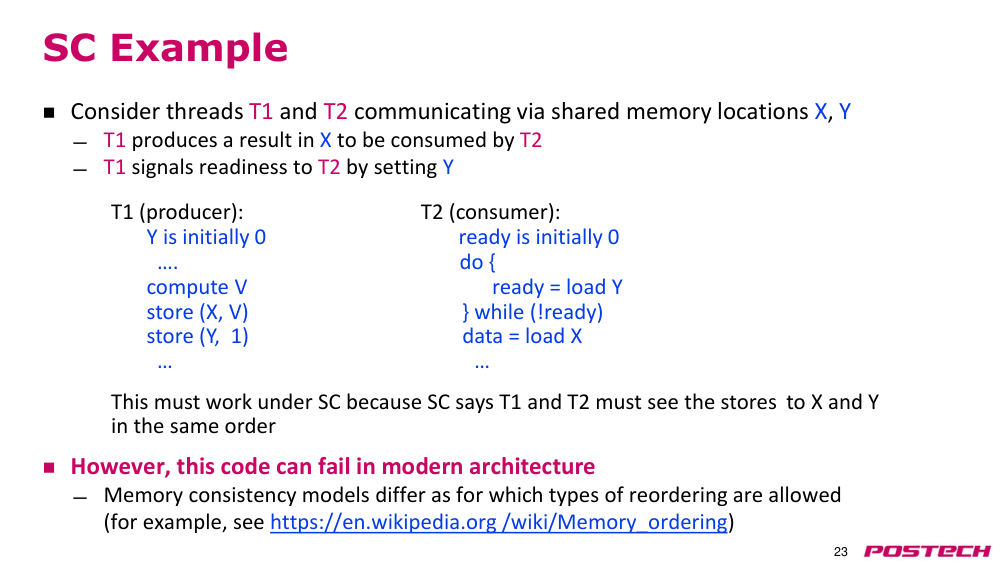
해결producer 가 X 에 V 를 쓰고 Y=1 로 알리면 SC 에서는 consumer 가 Y=1 을 본 뒤 X=V 를 읽음. 하지만 많은 현대 architecture 는 SC 가 아니라 이 code 가 실패할 수 있음.
- Y' 는 flag, X 는 data: SC 에서는 flag 를 보면 data 도 준비됨
- 질문: distributed directory 가 SC 를 왜 어렵게 하나(과제로 남김)
2.3.r.2Wikipedia: Memory ordering ↗ · architecture 별 허용 reordering 표: x86 은 store→load 만, ARMv7 은 전부 허용
2.414:52–21:16SC 의 문제: 제한적이고 store buffer 와 충돌
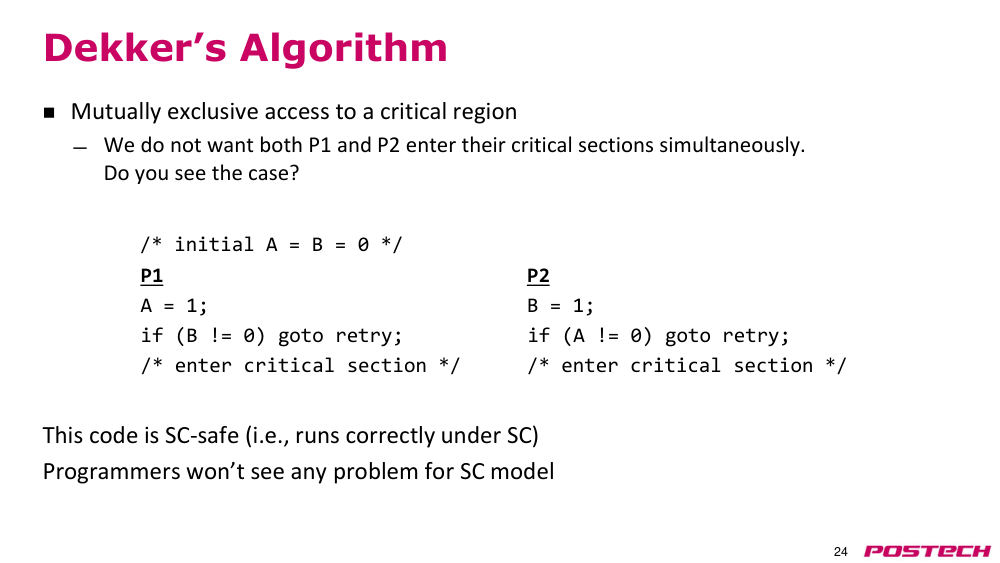
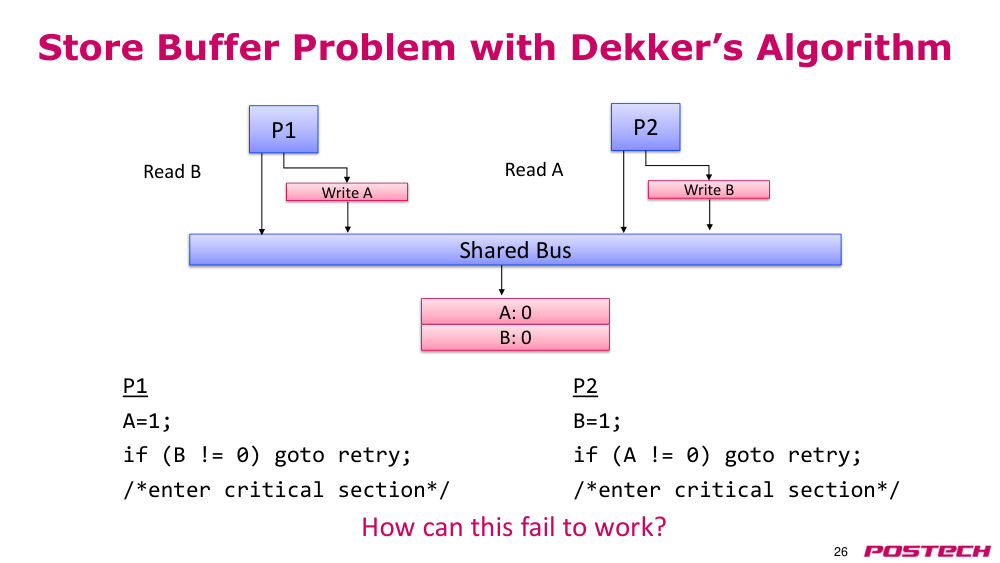
상황·문제Dekker 예는 SC 에서는 안전하지만 현대 CPU 에서는 깨질 수 있음. 왜 현대 architecture 는 SC 를 쓰지 않나.
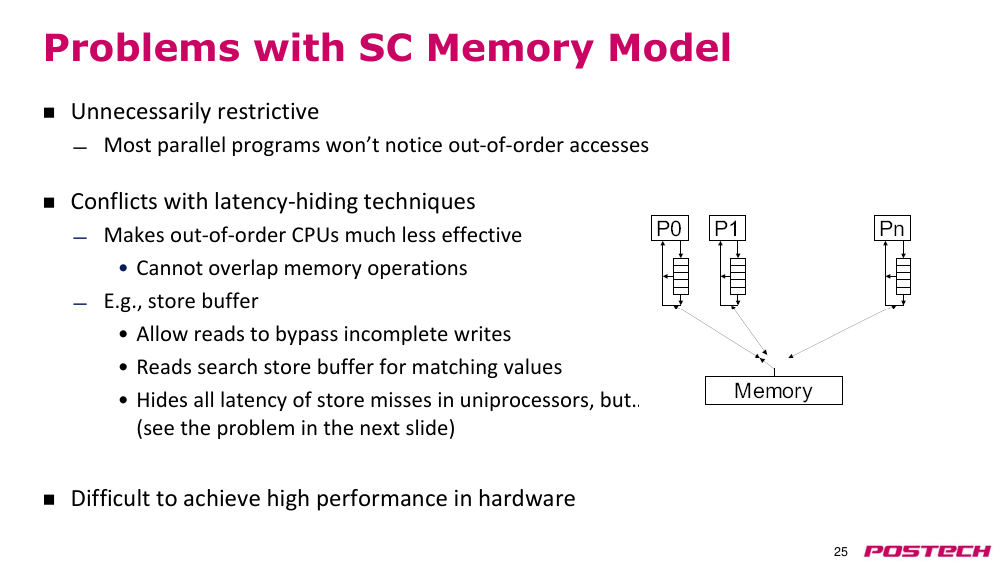
원인불필요하게 제한적: private data 나 shared data 의 다른 부분에선 reordering 이 문제 안 됨. store buffer 에 store 를 둔 채 load 가 먼저 나가면 다른 processor 에는 load→store 순서로 보임. OoO core 도 reorder.
해결Dekker: P1 A=1, P2 B=1 이 store buffer 에 남아 둘 다 memory 의 0 을 읽고 둘 다 critical section 진입. store buffer 를 빼면 성능 손해 → SC 가 아닌 model 이 필요.
- store buffer 는 SC 를 깨뜨림
- SC 로는 고성능 HW 가 어려움
2.4.r.2James Bornholt: Memory Consistency Models: A Tutorial ↗ · store buffer(TSO) 로 SC 가 금지한 00 결과가 나오는 설명과 fence (슬라이드 p27 추천)
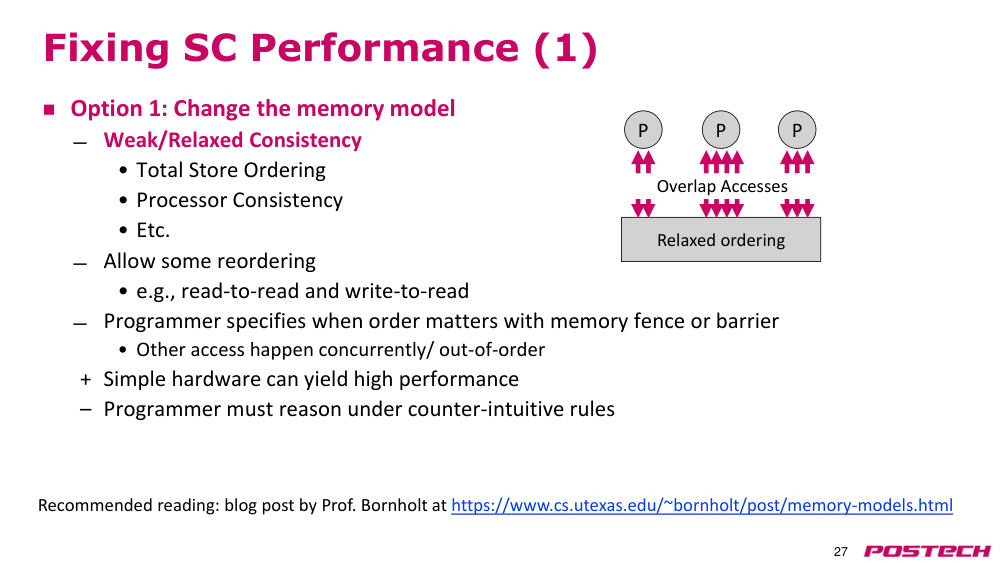
2.521:16–25:08Option 1: relaxed consistency 와 memory fence
상황·문제SC 는 고성능 machine 에 부적합. 첫 대안은 memory model 자체를 바꾸는 것.
원인weak/relaxed model 은 memory 접근 제약을 줄임. x86 은 TSO, ARM 은 더 weak. 같은 TSO 라도 x86 과 SPARC 은 세부가 다름.
해결일부 reordering 허용, 순서가 중요한 곳은 programmer 가 fence/barrier 삽입. HW 성능은 좋아지지만 programmer 가 여러 경우를 추론해야 해 multi-thread programming 이 어려움.
- 주의: 강의에서는 TSO 가 load 끼리 reorder 를 허용하는 예를 들었으나, x86(TSO) 은 load-load reorder 를 허용하지 않고 store→load 만 허용(Wikipedia Memory ordering 표)
- store 끼리 순서는 TSO 에서 유지
2.5.r.1Wikipedia: Memory ordering ↗ · architecture 별 허용 reordering 표: x86 은 store→load 만, ARMv7 은 전부 허용
2.5.r.2James Bornholt: Memory Consistency Models: A Tutorial ↗ · store buffer(TSO) 로 SC 가 금지한 00 결과가 나오는 설명과 fence (슬라이드 p27 추천)
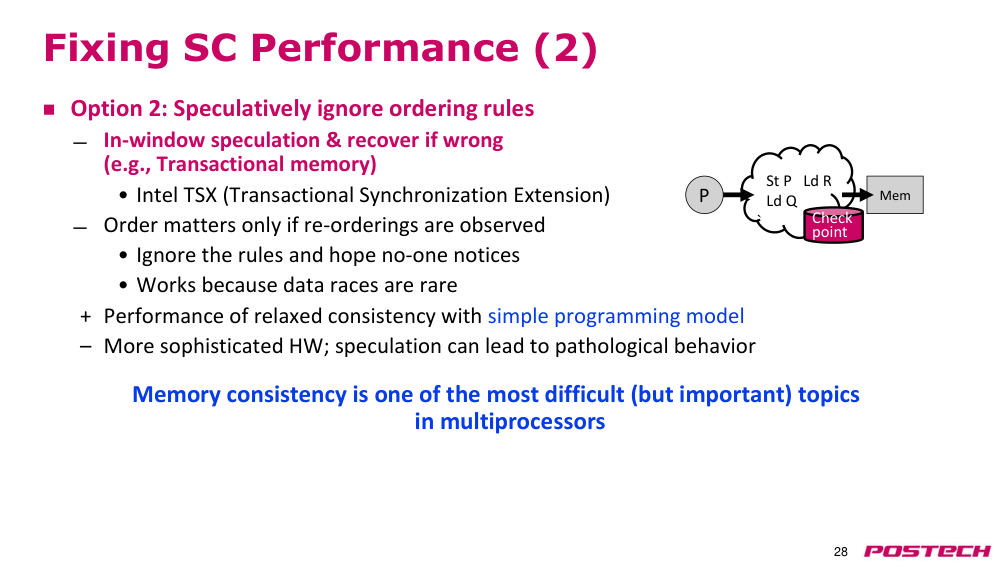
2.625:08–29:05Option 2: transactional memory, consistency 정리
상황·문제programmer 부담 없이 relaxed 성능을 얻는 두 번째 대안.
원인규칙을 무시하고 실행하되, reordering 이 다른 processor 에 관찰될 때만 문제.
해결transactional memory: 문제를 감지하면 이전 checkpoint 로 복구(예: Intel TSX). programming 은 쉬워지고 HW/SW 는 복잡해짐. consistency 는 architecture 와 programmer 의 약속.
- memory consistency 는 multiprocessor 에서 가장 어려운 주제 중 하나
- simple consistency = 쉬운 programming·낮은 성능
2.6.r.2Wikipedia: Transactional Synchronization Extensions ↗ · x86 HW transactional memory, 이후 여러 세대에서 비활성화됨
2.729:05–34:00Lec 19 도입: CPU 와 I/O 의 연결 구조
상황·문제processor·memory 만 다뤘고 I/O device 가 CPU 와 어떻게 통신하는지는 아직.
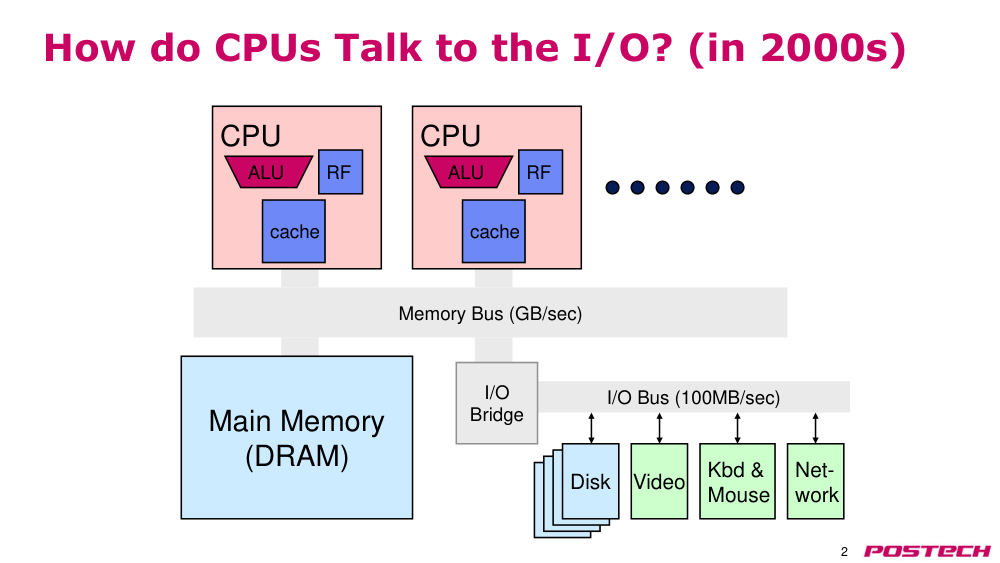
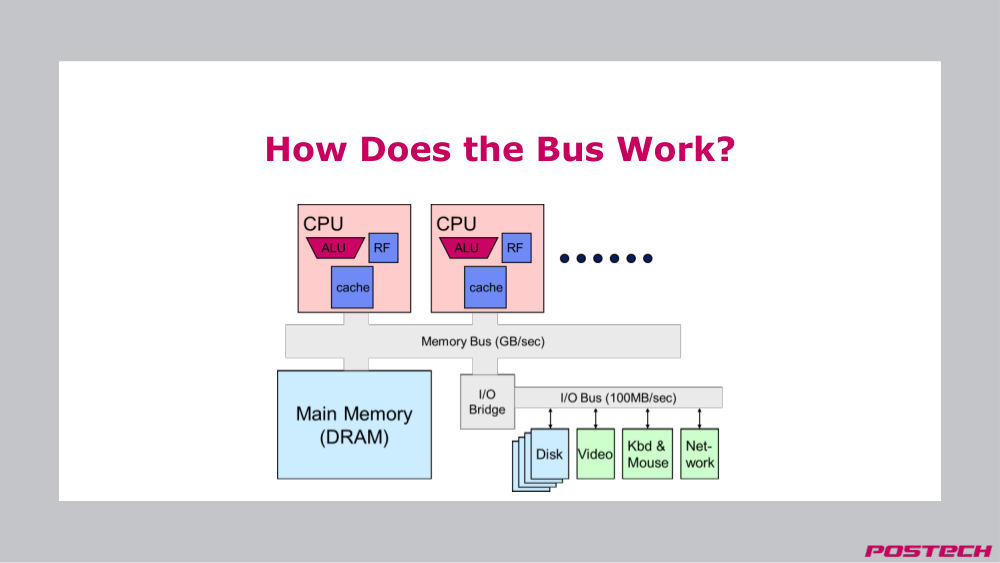
원인2000년대: memory bus 에 memory controller 와 I/O bridge, I/O bridge 의 I/O bus 에 disk·video·keyboard 등. 모든 CPU 가 같은 memory latency(UMA).
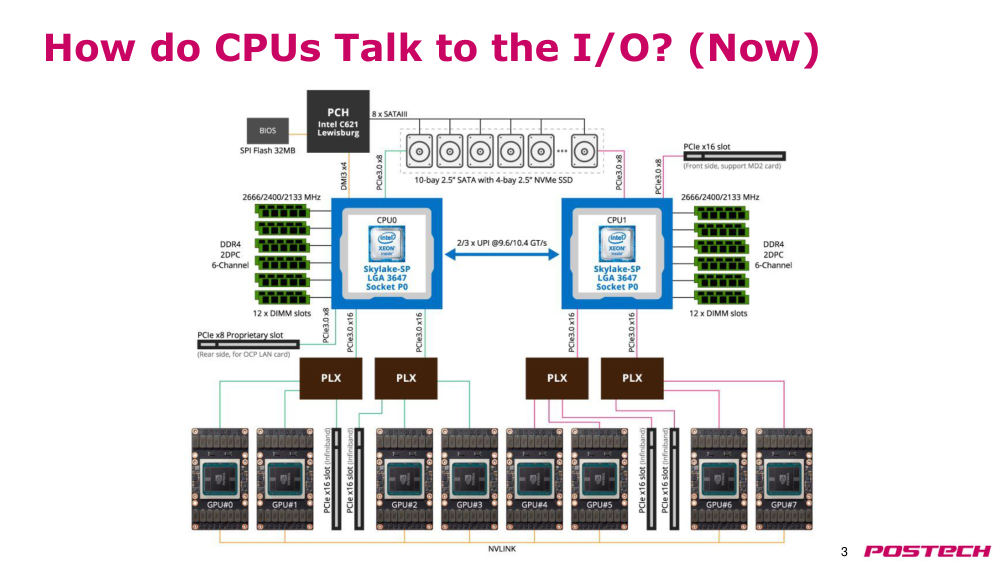
해결현재: CPU socket 끼리 빠른 link, 각 CPU 에 local memory(NUMA). GPU 등은 PCIe(실제는 point-to-point, switch 필요), GPU 끼리는 NVLink.
- 주의: 강의의 'Unified Memory Access' 는 일반 용어로 Uniform Memory Access(UMA)
- PCIe 는 bus 라 부르지만 point-to-point interconnect
2.834:00–36:46(1) I/O port register
상황·문제CPU 가 I/O device 에 접근하는 가장 단순한 방법.
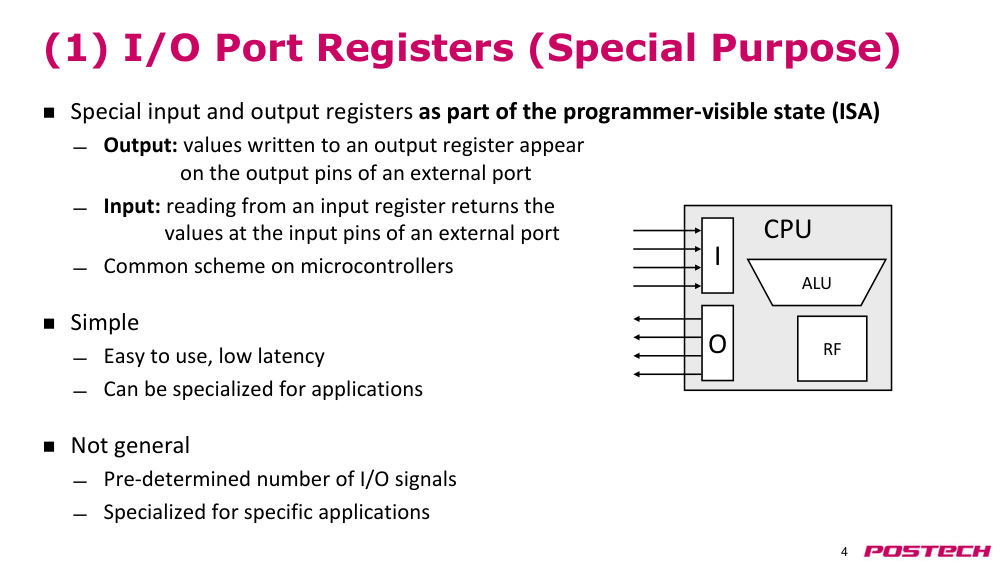
원인CPU 에 input/output 전용 register 를 두고 전용 in/out instruction 으로 접근. output register 에 쓰면 외부 port 로, input register 를 읽으면 device 값.
해결embedded·microcontroller 에서 흔함: 단순, low latency, 용도 특화. 단 register·instruction 이 programmer-visible state 에 추가되고 수십 개 device 로 확장 어려움.
- general purpose 가 아님: I/O 신호 수가 미리 정해짐
2.8.r.1Wikipedia: Memory-mapped I/O and port-mapped I/O ↗ · port-mapped(in/out instruction) 와 memory-mapped I/O 비교
2.936:46–42:08(2) memory-mapped I/O 와 idempotency·cache 문제
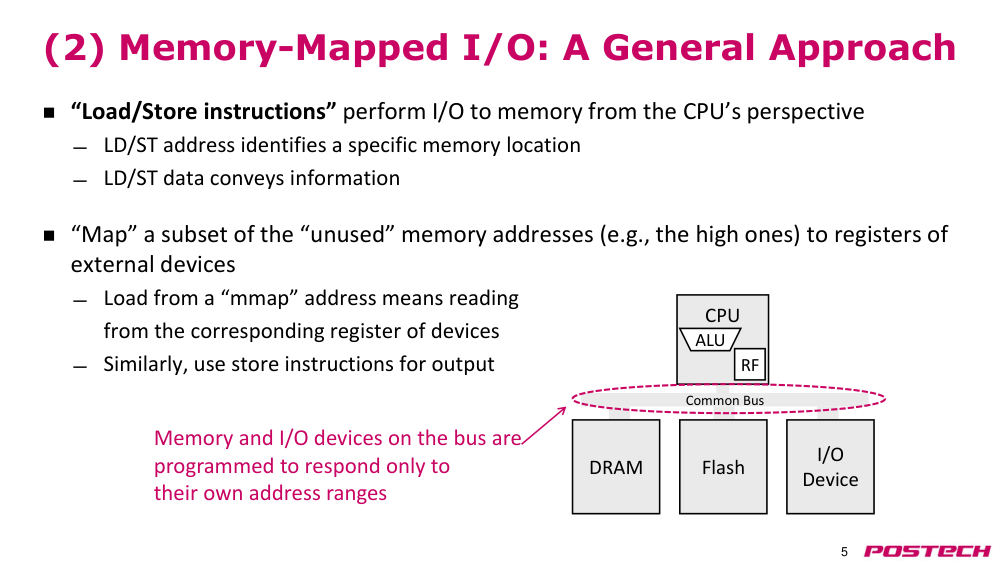
상황·문제더 일반적인 방법: 일반 load/store 로 I/O.
원인특정 address 를 device register 에 mapping, 그 address 의 load/store 는 memory 가 아니라 device 와 통신. device 는 address 가 자기 범위인지 보고 응답.
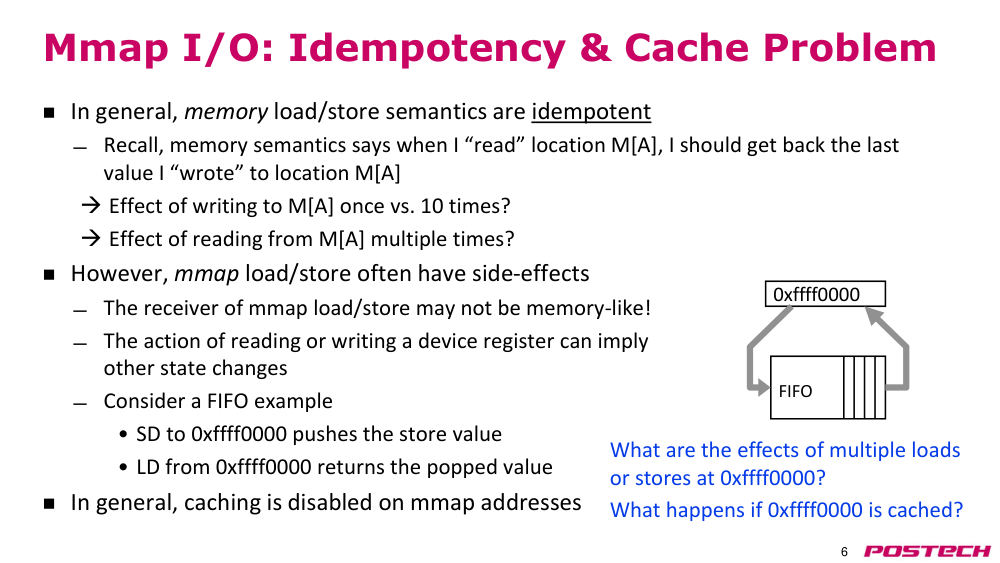
해결일반 memory 는 idempotent 이지만 mmap 은 아님(FIFO: load=pop, store=push, 반복하면 여러 entry). write 가 cache 에 머물면 안 되므로 mmap address 는 cache bypass.
- 주의: 강의는 virtual/physical 중 어느 address 가 mapping 되는지 확답하지 않음(구현에 따라)
- Q&A(3476초~): idempotence 는 ISA 가 정의하지 않음, device driver 작성자가 고려
2.9.r.1Wikipedia: Memory-mapped I/O and port-mapped I/O ↗ · port-mapped(in/out instruction) 와 memory-mapped I/O 비교
2.1042:08–49:12(3) DMA 와 write-back cache
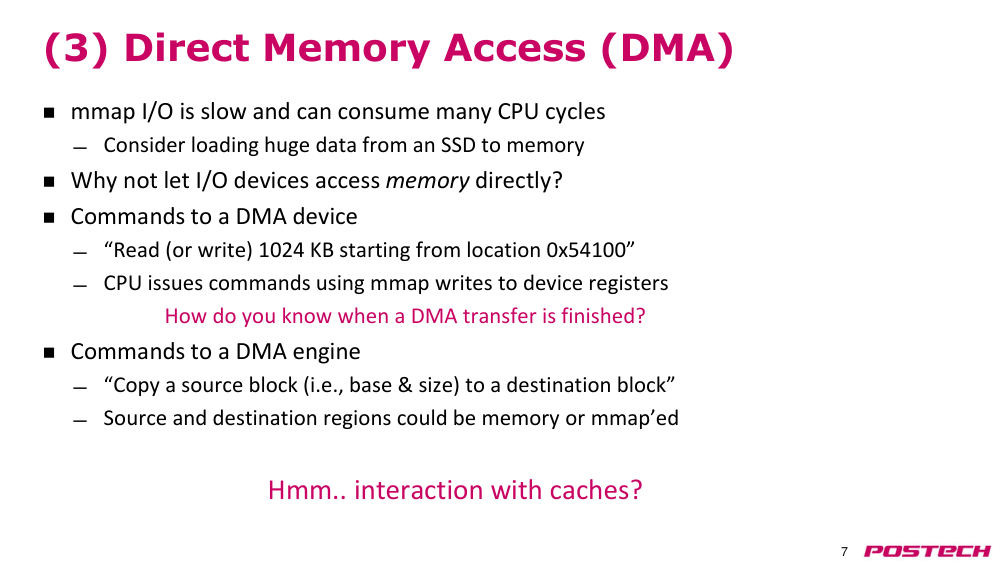
상황·문제mmap I/O 는 대량 data 에 load/store 를 반복해 CPU cycle 소모.
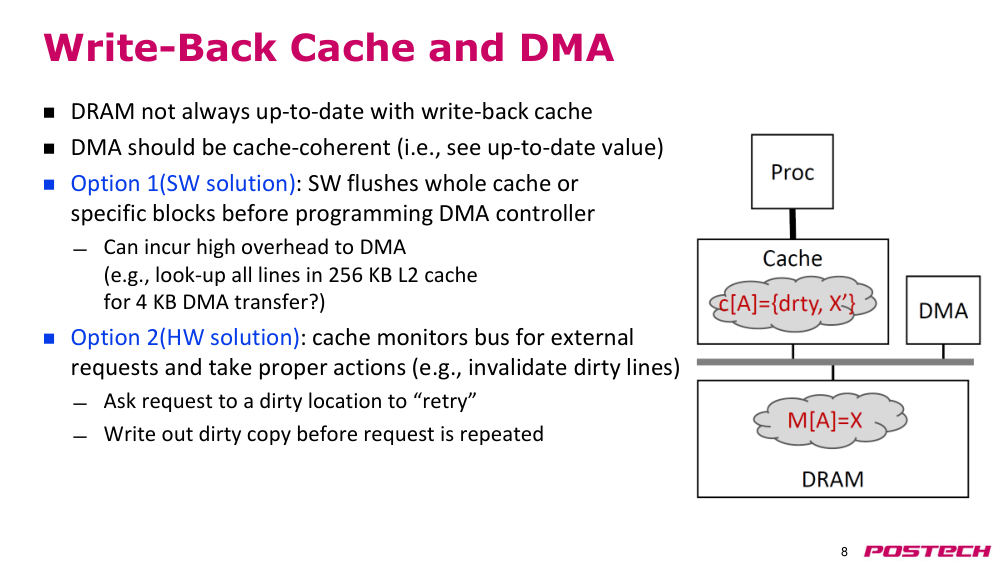
원인DMA: device(또는 CPU 내 DMA engine)에 'source 에서 이만큼을 destination 으로' 명령 하나만 mmap write 로 주고 CPU 는 다른 일. 하지만 최신 data 가 cache 에 있을 수 있음.
해결SW: DMA 전에 cache 또는 해당 영역 flush(4 KB DMA 에 전체 flush 는 유용한 data 손실·tag 검색 overhead). HW: cache 가 외부 request 를 감시해 dirty line 이면 retry 시키고 그 사이 write back.
- 완료 통지 방법은 뒤(interrupt)에서
- HW 방식은 upfront invalidation overhead 가 없음
2.1149:12–57:56DMA 와 virtual memory: VA 냐 PA 냐
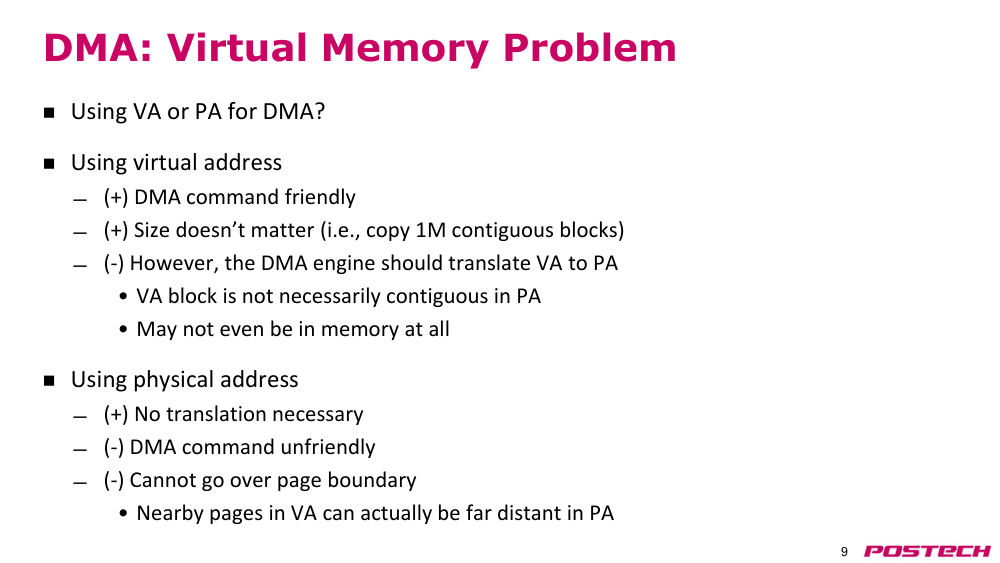
상황·문제DMA 가 virtual address 와 physical address 중 무엇을 쓸지.
원인VA: 명령이 쉽고 큰 연속 영역 가능, 하지만 누군가 변환해야 하고 page 가 disk 에 있으면 page fault 처리. PA: 변환 없음, 하지만 비연속 영역은 여러 작은 transfer 로 쪼개야 함.
해결① SW: pinned contiguous buffer 로 복사 후 PA DMA(성능 예측 가능). ② smart DMA engine: command linked list 로 gather/scatter. ③ IOMMU·IOTLB 로 device 쪽에서 변환(Intel·AMD 고성능 CPU, device memory 보호 기능도).
- IOMMU 는 upfront overhead 는 없지만 page fault·IOTLB miss 로 DMA 성능 예측이 어려움
- pin = OS 가 page 를 swap out 하지 않게 함
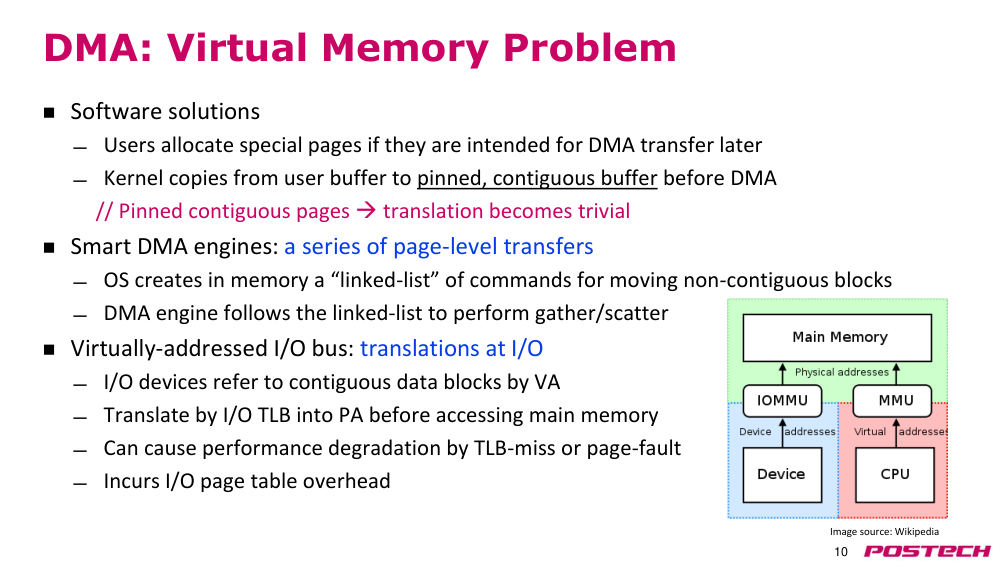
2.11.r.1Wikipedia: Input–output memory management unit ↗ · device address → physical address 변환, DMA 보호, VT-d / AMD-Vi
2.1257:56–1:00:17질의응답·출석
상황·문제idempotence 질문 답변(ISA 가 정의하지 않음, device 내부 동작 문제라 driver 작성자가 주의) 후 채팅 출석 확인.
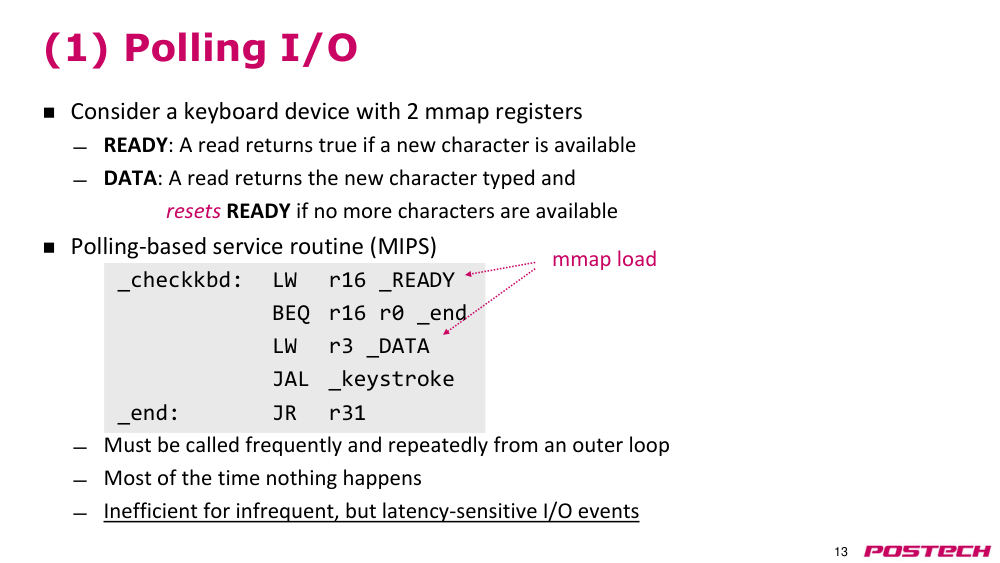
2.131:00:17–1:06:56언제 I/O 를 서비스하나: polling
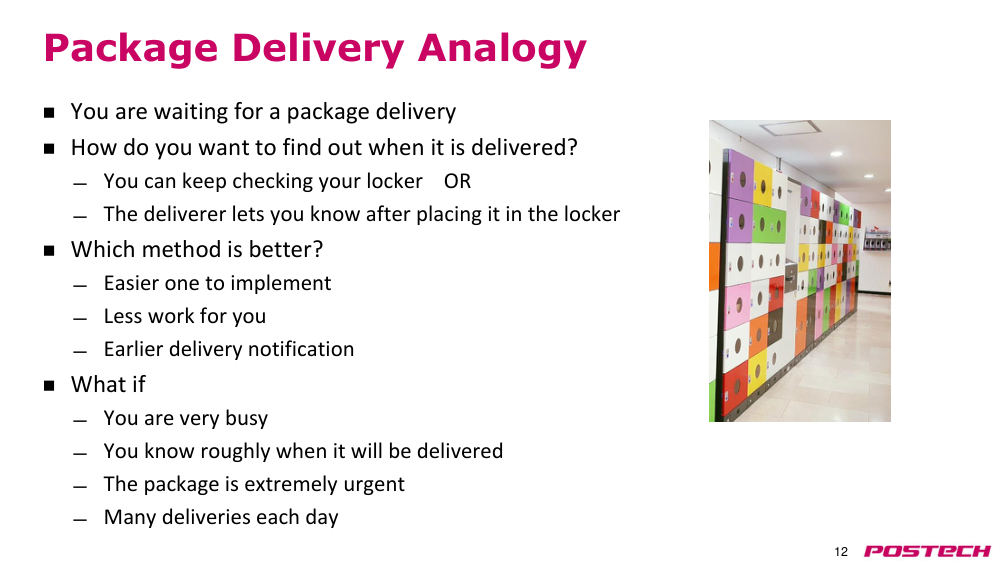
상황·문제어떻게 통신하는지 다음엔 언제(예: DMA 완료 통지). 택배 locker 비유: 계속 확인 vs 알림.
원인polling: keyboard READY·DATA mmap register 를 읽는 routine 을 outer loop 에서 계속 호출. CPU 에겐 keystroke 가 백만 번 확인에 한 번 수준이라 대부분 헛수고.
해결event 가 드물면 시간 낭비, 대신 latency-sensitive 하면 빨리 확인 가능.
- 택배 비유: 구현 복잡도·확인 비용·알림 속도와 상황(바쁨 등)에 따라 선택
2.141:06:56–1:09:02interrupt-driven I/O
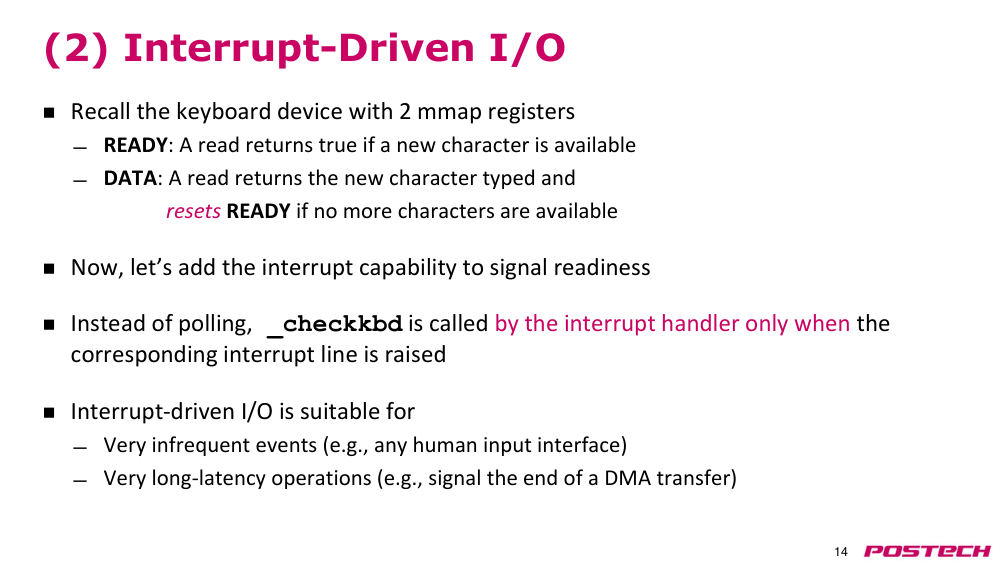
상황·문제polling 의 반복 확인 비용을 없애고 싶음.
원인READY 와 별도로 준비 신호선을 두고, 신호가 올라가면 interrupt handler 가 자동 호출.
해결사람 입력 같은 드문 event, DMA 처럼 긴 latency 작업 완료 통지에 적합.
- handler 가 불릴 때는 data 가 준비된 상태
2.151:09:02–1:14:54어떤 I/O mechanism 을 쓸까, bus 예고
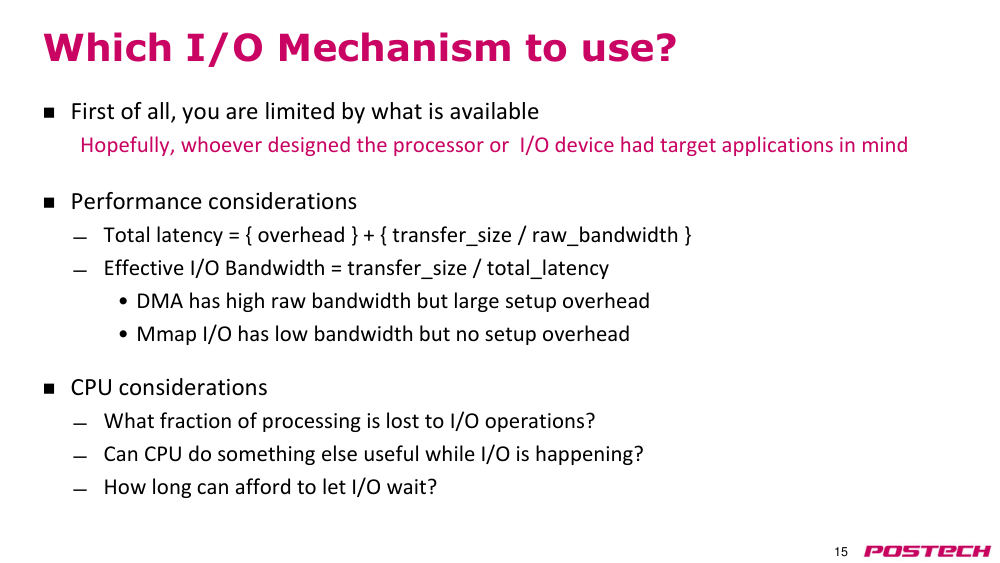
상황·문제architect 가 I/O mechanism 을 고를 때 기준.
원인total latency = one-time overhead + size/raw bandwidth. DMA 는 overhead 크고 raw bandwidth 높음, mmap I/O 는 overhead 작지만 instruction 마다 전송해 bandwidth 낮고 CPU 가 묶임.
해결CPU 가 할 다른 일이 많거나 I/O 가 급하지 않으면 초기 overhead 가 있어도 장기적으로 효율적인 방식. bus 동작(p16~)은 다음 강의로 미루고 종료.
- effective I/O bandwidth = size / total latency
- bus: 여러 agent 중 한 번에 하나만 전송하는 방법은 다음 시간
3핵심 개념
3.1sequential consistency(순차 일관성)
모든 processor 가 같은 단일 global order 를 보고, 각 processor 연산은 program order 로 나타남.
3.1.r.2Lamport 1979: How to Make a Multiprocessor Computer That Correctly Executes Multiprocess Programs ↗ · SC 원 논문 (IEEE TC 1979)
3.2store buffer(스토어 버퍼)
store 를 buffer 에 두고 load 가 먼저 나가게 해 latency 를 숨김. 다른 processor 에는 순서가 바뀌어 보여 SC 위반.
3.2.r.1James Bornholt: Memory Consistency Models: A Tutorial ↗ · store buffer(TSO) 로 SC 가 금지한 00 결과가 나오는 설명과 fence (슬라이드 p27 추천)
3.3TSO(Total Store Order)
x86 의 relaxed model. store 뒤 load 의 reorder(store buffer)만 허용, store 끼리는 순서 유지.
3.3.r.1Wikipedia: Memory ordering ↗ · architecture 별 허용 reordering 표: x86 은 store→load 만, ARMv7 은 전부 허용
3.4memory fence/barrier(메모리 펜스)
그 앞뒤 memory 연산의 reordering 을 막는 instruction. relaxed model 에서 programmer 가 삽입.
3.4.r.1James Bornholt: Memory Consistency Models: A Tutorial ↗ · store buffer(TSO) 로 SC 가 금지한 00 결과가 나오는 설명과 fence (슬라이드 p27 추천)
3.5transactional memory(트랜잭셔널 메모리)
규칙 무시하고 실행 후 충돌 감지 시 checkpoint 로 되돌림. 예: Intel TSX.
3.5.r.2Wikipedia: Transactional Synchronization Extensions ↗ · x86 HW transactional memory, 이후 여러 세대에서 비활성화됨
3.6NUMA(Non-Uniform Memory Access)
각 CPU 에 local memory, remote memory 는 다른 CPU 를 거쳐 느림.
3.7memory-mapped I/O(메모리 매핑 입출력)
device register 를 address 에 mapping 해 일반 load/store 로 I/O. cache 는 bypass.
3.7.r.1Wikipedia: Memory-mapped I/O and port-mapped I/O ↗ · port-mapped(in/out instruction) 와 memory-mapped I/O 비교
3.8idempotent(멱등)
여러 번 해도 한 번과 같은 효과. 일반 memory 는 그렇고 mmap FIFO 는 아님.
3.9DMA(Direct Memory Access)
명령 하나로 device/DMA engine 이 대량 data 를 memory 와 직접 전송, CPU 는 다른 일.
3.10IOMMU / IOTLB
device 가 쓰는 virtual address 를 physical 로 변환하는 MMU. device 의 memory 접근 보호도 제공.
3.10.r.1Wikipedia: Input–output memory management unit ↗ · device address → physical address 변환, DMA 보호, VT-d / AMD-Vi
3.11gather/scatter(모으기/흩뿌리기)
gather: 여러 위치에서 읽음, scatter: 여러 위치에 씀. smart DMA engine 이 linked list 로 수행.
3.12polling(폴링) vs interrupt(인터럽트)
polling 은 상태를 반복 확인(드문 event 엔 낭비), interrupt 는 device 가 신호를 올려 handler 호출.
4스스로 확인
4.1SC 에서 T1: X=1; Y=1 / T2: load Y; load X 일 때 불가능한 결과는?
답
Y'=1, X'=0. T2 가 Y=1 을 봤다면 program order 상 X=1 이 먼저 전역 순서에 있음.
4.2store buffer 가 Dekker 알고리즘을 깨뜨리는 과정은?
답
A=1, B=1 이 각 store buffer 에 남은 채 load B, load A 가 memory 의 0 을 읽어 둘 다 진입.
4.3relaxed model 에서 programmer 가 순서를 보장하는 방법과 대가는?
답
memory fence/barrier 삽입. 여러 경우를 추론해야 해 programming 이 어려워짐.
4.4mmap address 를 cache 하면 안 되는 이유는?
답
write 가 cache 에만 머물러 device 에 닿지 않고, 반복 load/store 의 side effect(FIFO push/pop)도 달라짐.
4.5DMA 가 cache coherent 해야 하는 이유와 두 해법은?
답
write-back cache 의 dirty data 가 DRAM 보다 최신. SW flush 또는 HW 가 외부 request 감시·retry·write back.
4.6DMA 에 physical address 를 쓸 때의 문제와 SW 해법은?
답
VA 상 연속 영역이 PA 에선 흩어져 여러 transfer 로 쪼개야 함. pinned contiguous buffer 로 복사 후 DMA.
4.7polling 이 interrupt 보다 나은 경우는?
답
event 가 자주 오거나 latency-sensitive 해서 바로 확인해야 할 때.
5참고 자료
5.1James Bornholt: Memory Consistency Models: A Tutorial ↗ · store buffer(TSO) 로 SC 가 금지한 00 결과가 나오는 설명과 fence (슬라이드 p27 추천)
5.5Wikipedia: Input–output memory management unit ↗ · device address → physical address 변환, DMA 보호, VT-d / AMD-Vi
5.6Wikipedia: Memory-mapped I/O and port-mapped I/O ↗ · port-mapped(in/out instruction) 와 memory-mapped I/O 비교