Lec 16 part 2 & Lec 17 · TLB·virtual cache·VIPT 와 cache coherence 도입
정밀 정리 · 검증 2026-09-24 21:18
1개요
1.1TLB miss 처리(page table walk 결과별 page fault·segmentation fault)와 HW vs SW-managed TLB.
1.2L1 cache 와 TLB 배치: physical·virtual·hybrid. virtual cache 의 homonym·synonym 문제와 해결.
1.3VIPT 조건(cache ≤ page_size × associativity), 큰 cache 의 alias 해결(MIPS R10000), Intel x86·Core i7 사례.
1.4Lecture 17 시작: shared memory MP(UMA/NUMA, bus vs point-to-point), private cache 의 coherence 문제와 극단적 해법 3가지.
2섹션별 정리 상황·문제 → 원인 → 해결
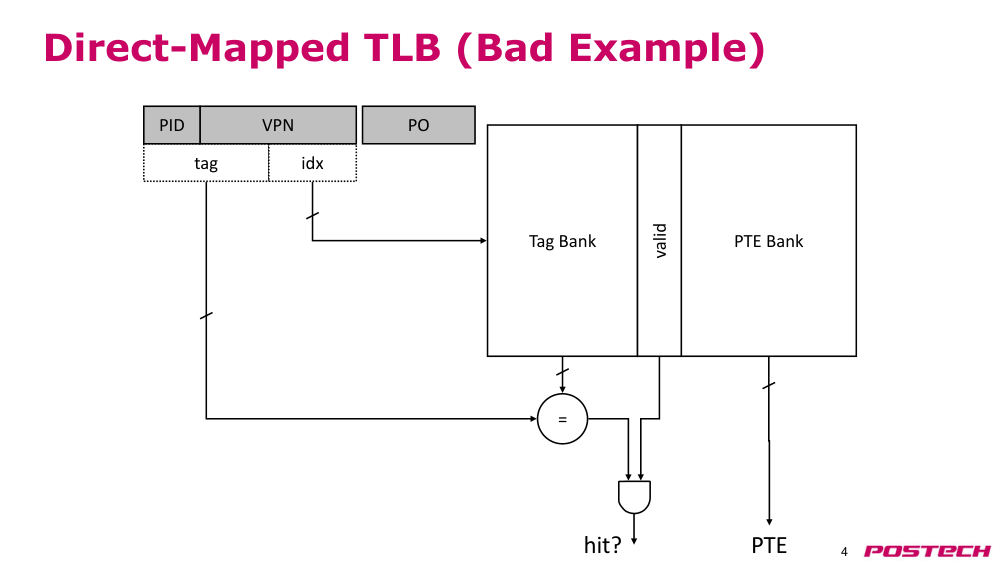
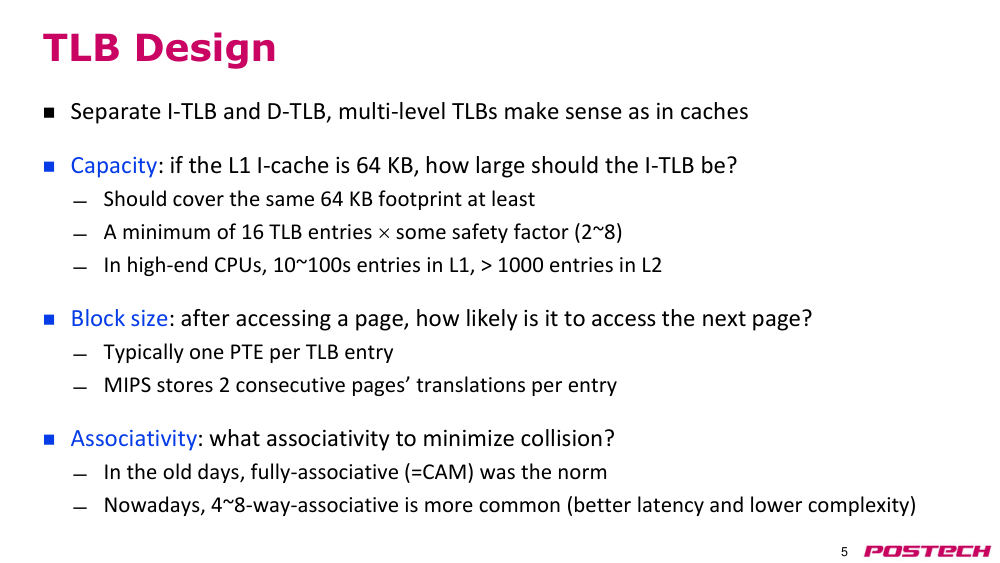
2.10:33–1:30recap: TLB 는 PTE 만 cache
상황·문제지난 시간에 배운 TLB 복습: page table entry(PTE) 만 cache 하는 cache.
원인TLB 도 cache 이므로 capacity·block size·associativity 를 정해야 한다.
해결다음으로 TLB 가 실제로 어떻게 쓰이는지(miss 처리, cache 와의 관계) 로 진행.
- TLB = page table entry 만 cache
- 설계 고려: 충분한 capacity, 적절한 block size·associativity
2.21:30–8:17TLB miss 와 page table walk 결과별 동작
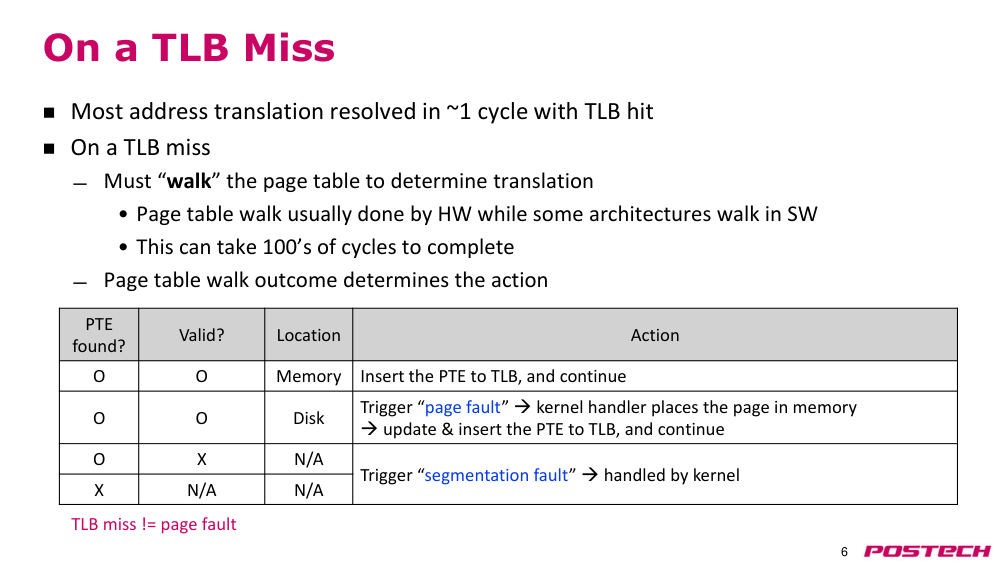
상황·문제모든 program address 는 virtual address 라 physical memory 접근 전에 translation 필요. TLB hit 면 짧은 latency.
원인TLB miss 면 page table 을 walk 해야 하고, multi-level page table 은 PTE 하나 찾는 데 memory access 여러 번 → 수백 cycle.
해결walk 결과: valid·memory 면 PTE 를 TLB 에 넣고 계속, disk 면 page fault(kernel 이 page load), invalid 또는 L2/L3 table 자체가 없으면 segmentation fault.
- page table walk 는 대부분 HW, 일부 옛 architecture 는 SW
- page fault 는 I/O·page table 접근 권한이 필요해 kernel 이 처리
- 상위 table 이 없어 PTE 를 못 찾는 경우도 invalid access → segmentation fault
- TLB miss ≠ page fault
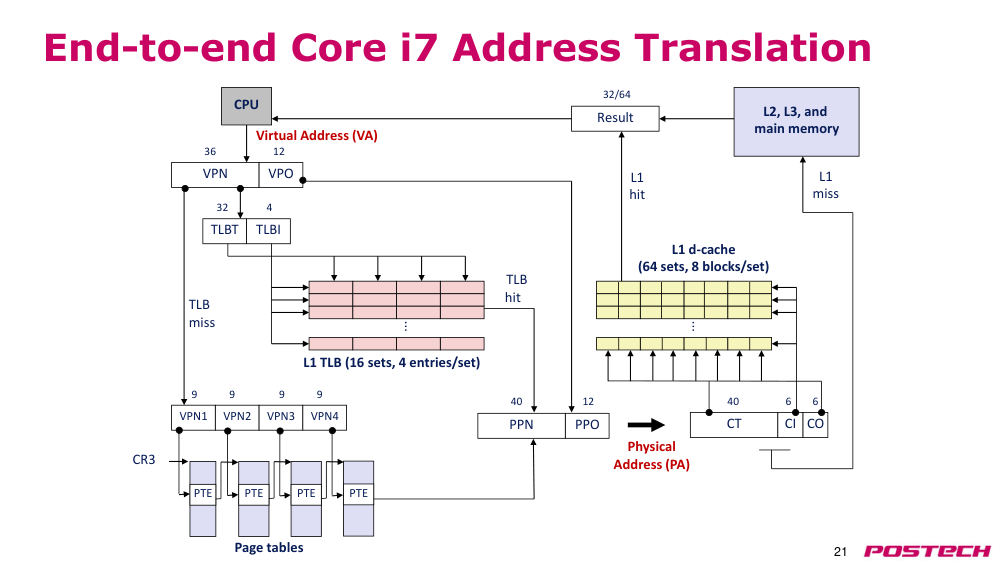
2.38:17–10:36VA→PA translation 전체 흐름
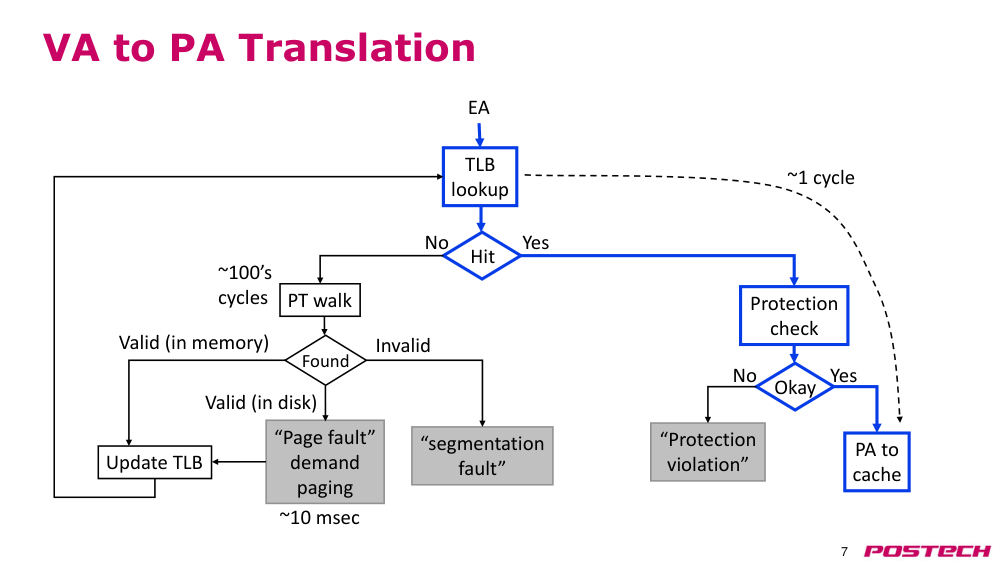
상황·문제TLB lookup 결과와 page 위치에 따라 경로가 갈린다.
원인hit 여도 protection check(read/write/execute) 를 통과해야 하고, miss 면 PT walk 결과에 따라 지연이 크게 다르다.
해결hit+check 통과 → PA 로 cache 접근, 위반 → protection violation(process kill). miss → walk 후 TLB update / disk 면 page fault 후 재개 / invalid 면 segmentation fault.
- TLB lookup ~1 cycle, PT walk ~100's cycles, page fault ~10 msec(slide)
- protection violation 은 허용되지 않은 종류의 access
2.410:36–12:30HW vs software-managed TLB
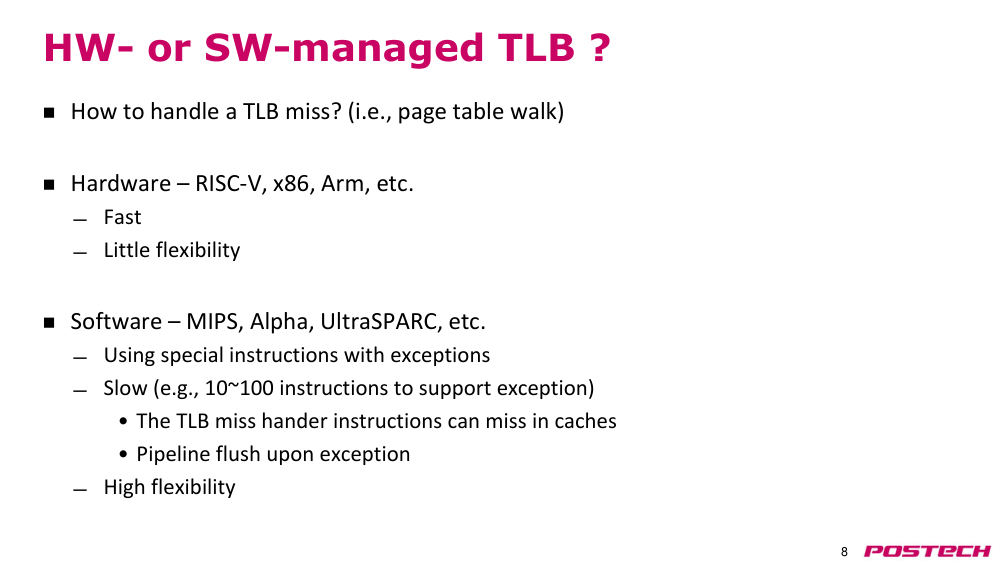
상황·문제TLB miss 시 page table walk 를 누가 할지 선택.
원인SW 방식은 handler instruction 을 fetch·실행해야 하고(10~100 instruction), handler 도 cache miss 가능, pipeline flush 필요.
해결요즘 널리 쓰이는 architecture 는 빠른 HW walk(유연성은 낮음). SW 방식은 유연하지만 느려 요즘은 인기 없음.
- HW: RISC-V, x86, Arm / SW: MIPS, Alpha, UltraSPARC(slide)
- handler fetch 에 수십~수백 cycle
2.512:30–16:03VM 과 L1 cache 의 배치 3가지
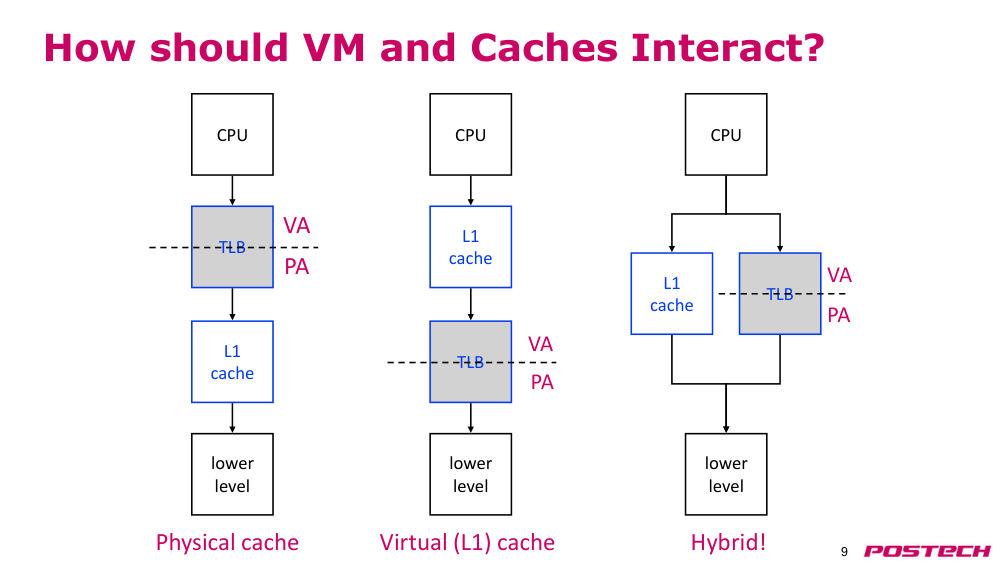
상황·문제translation 된 PA 로 cache 에 접근해야 하는데, 순서를 어떻게 둘지가 문제.
원인naive physical cache 는 L1 접근마다 TLB translation(몇 cycle) 이 먼저 → instruction fetch 가 매 cycle 이라 성능 저하 큼.
해결대안 1: virtual L1 cache(VA 로 L1 접근, miss 때 TLB). 대안 2(요즘 주류): hybrid — L1 과 TLB 를 동시에 접근하고 PA 는 tag 비교에 사용.
- physical cache: TLB → L1
- virtual cache: L1 → (miss 시) TLB
- hybrid: L1·TLB 병렬, L1 miss 시점엔 이미 PA 확보
2.616:03–19:15virtual L1 cache 의 동기: SUN SPARC
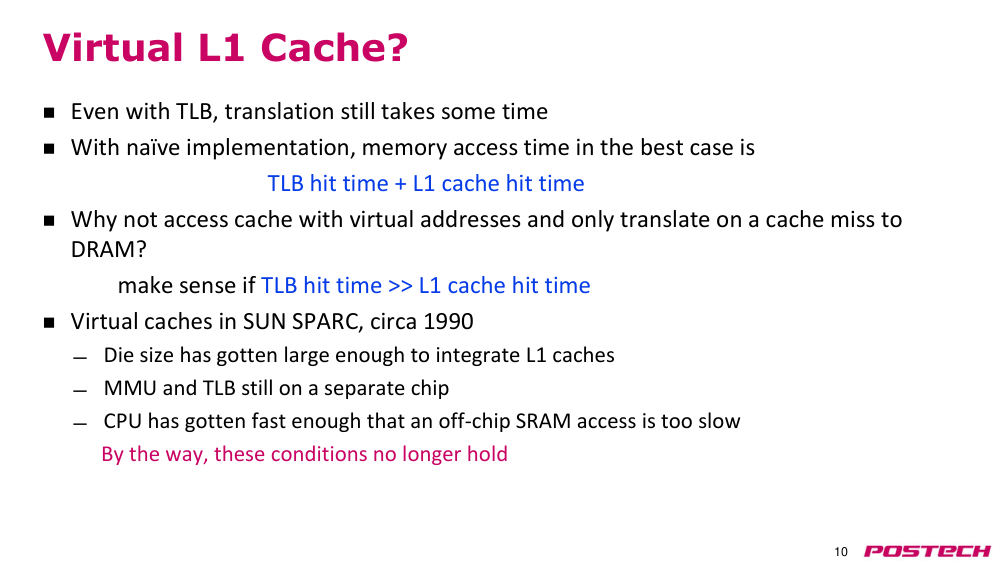
상황·문제physical cache 는 항상 TLB hit time 을 추가로 낸다.
원인virtual cache 는 TLB hit time ≫ L1 hit time 일 때 의미. 1990년경 SPARC 는 L1 을 CPU die 에 넣었지만 MMU·TLB 는 별도 chip 이었다.
해결그래서 VA 로 L1 을 접근하고 miss 때만 off-chip TLB 로 translate. 지금은 TLB·L2·L3(·L4) 까지 on-chip 이라 조건이 성립하지 않음.
- 그 이전 architecture 는 L1 도 off-chip SRAM
- TLB hit time 이 작아도 매 L1 access 마다 몇 cycle 추가는 나쁨
2.719:15–22:03virtual cache 문제 1: homonym
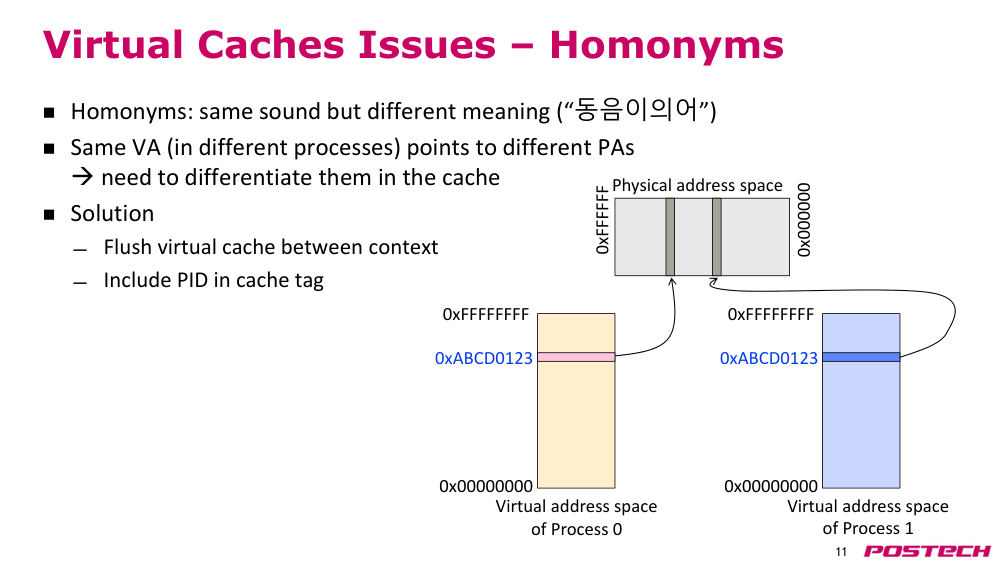
상황·문제같은 VA 가 process 마다 다른 PA 로 mapping 된다(homonym, 동음이의어).
원인VA 로만 cache 를 찾으면 두 process 의 line 을 구분 못 해, hit 이어도 다른 PA 의 data 를 읽을 수 있다.
해결context switch 때 virtual cache 전체 flush, 또는 cache tag 에 PID 포함. 성능상 PID 방식이 더 낫다.
- process 0·1 의 0xABCD0123 이 서로 다른 PA
- 전체 flush 는 성능상 이상적이지 않음
2.822:03–25:55virtual cache 문제 2: synonym
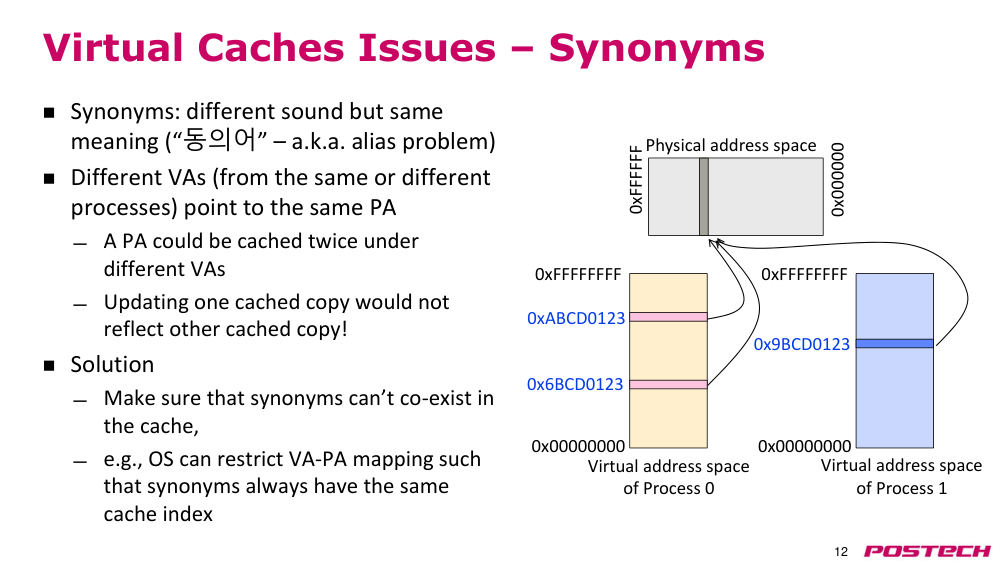
상황·문제서로 다른 VA(같은/다른 address space)가 같은 PA 를 가리킴(synonym, alias). 예: 공유 library code·shared data.
원인같은 PA 가 tag 가 다른 여러 cache line 에 중복 저장 → 한 VA 로 write 하면 다른 copy 는 stale → correctness 문제.
해결synonym 이 cache 에 동시에 없도록: 예) OS 가 VA-PA mapping 을 제한해 synonym 이 항상 같은 cache index 를 갖게. 대신 mapping 유연성 손실.
- homonym 보다 더 복잡한 문제
- 애초에 문제가 없는 설계가 이상적
2.925:55–31:31VIPT: virtually indexed, physically tagged
상황·문제virtual cache 문제를 피하면서 TLB latency 를 숨기고 싶다.
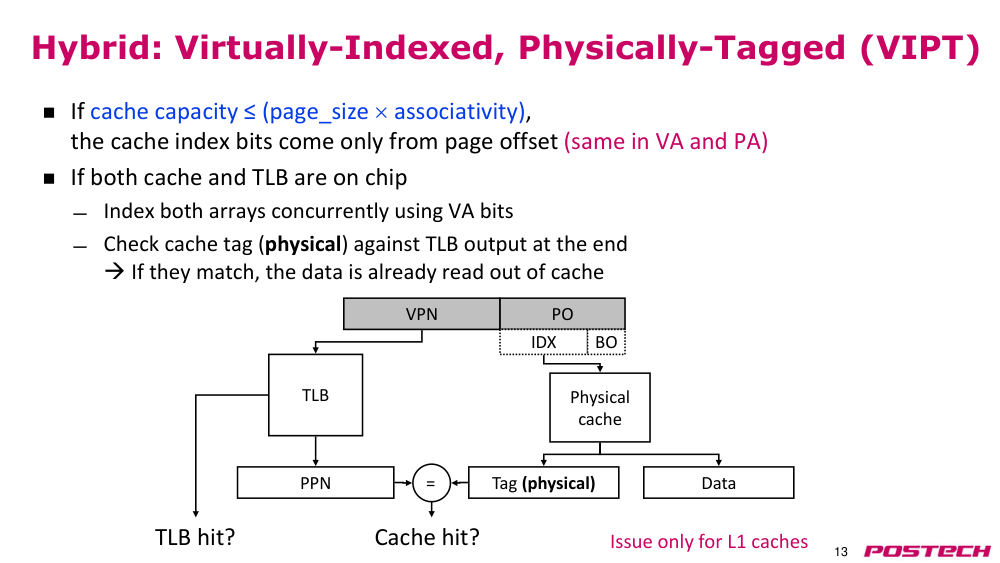
원인cache index 가 page offset 비트에서만 나오면 VA·PA 가 같으므로 translation 전에 cache 를 index 할 수 있다.
해결cache 와 TLB 를 동시에 접근, TLB 의 PPN 으로 physical tag 비교. 조건: cache capacity ≤ page_size × associativity. L2·L3 는 이미 PA 사용.
- 예: 4KB direct-mapped L1 + 4KB page → index 12bit = page offset
- 예: 8KB 2-way(way 당 4KB) 도 12bit index, tag 2개와 비교
- L1 에만 해당하는 문제
2.1031:31–37:51큰 VIPT cache 의 alias 문제와 해결
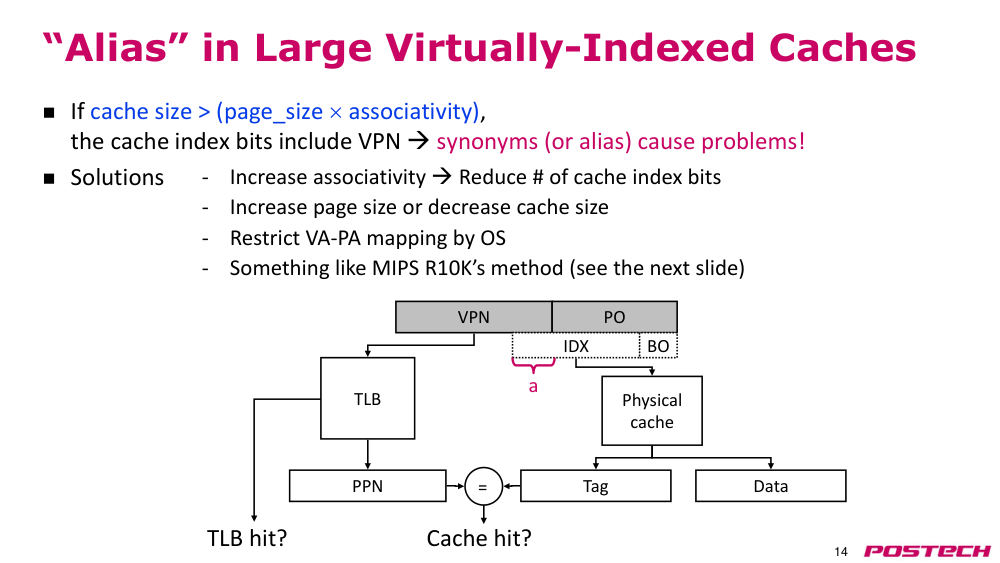
상황·문제cache size > page_size × associativity 면 index 에 translation 이 필요한 VPN bit 가 섞인다.
원인예: 8KB direct-mapped 는 13bit index, page offset 은 12bit → VPN 1bit 가 index. 같은 PA 가 두 line 에 올라가 synonym 재발.
해결해결: OS 가 mapping 제한, 그 bit 를 0·1 두 위치 모두 접근해 tag 비교(둘 다 맞으면 하나 제거), 또는 cache size·associativity·page size 조정(Intel 방식).
- 두 위치 모두 match 면 실제 VPN bit 값 쪽을 남김
- Intel 은 L1 크기·associativity 를 맞춰 문제 회피
2.1137:51–45:15MIPS R10000 의 synonym 처리
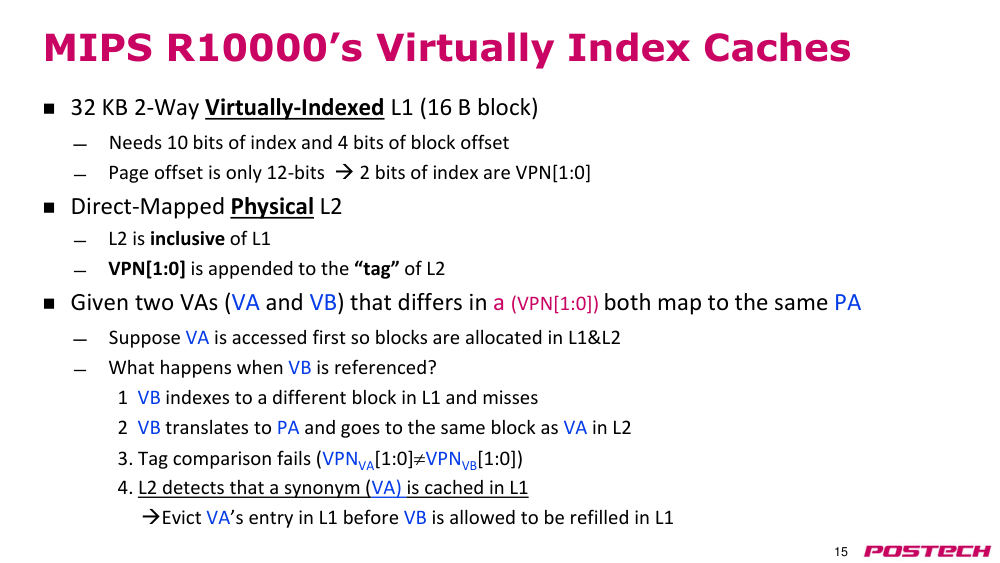
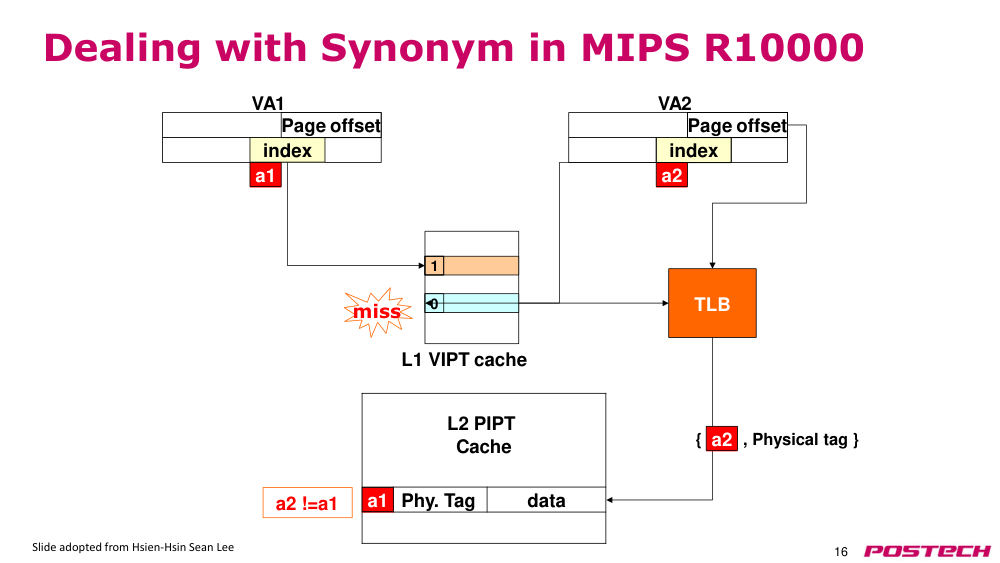
상황·문제R10000 L1: 32KB 2-way → index+offset 14bit, page 4KB 라 offset 12bit → VPN 2bit 가 index 에 사용.
원인VIPT 로 VA2 를 접근하면 VA1 이 cache 한 같은 PA line 과 다른 L1 set 을 index → L1 miss, 같은 data 가 L1 에 두 copy 생길 수 있음.
해결L1 을 포함하는 physical(direct-mapped) L2 의 tag 에 VPN[1:0] 을 추가. L2 hit 인데 a2≠a1 이면 L1 의 a1 line 을 찾아 invalidate, 한 copy 만 유지.
- L2 는 inclusive 라 L1 line 이 반드시 L2 에 있음
- 기본 physical L2 에는 VPN 을 둘 필요가 없지만 synonym 감지를 위해 추가
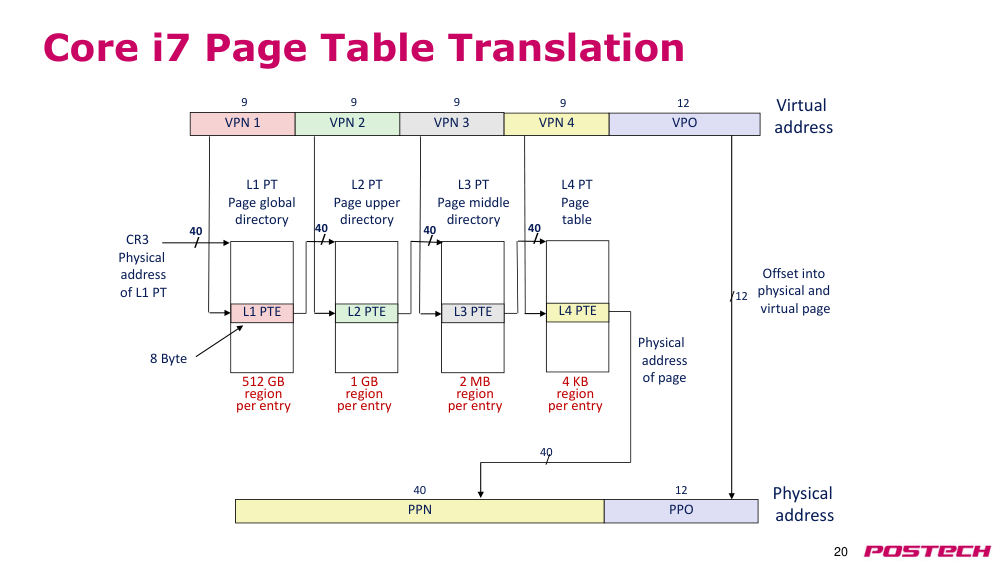
2.1245:15–51:53case study: Intel x86 virtual memory
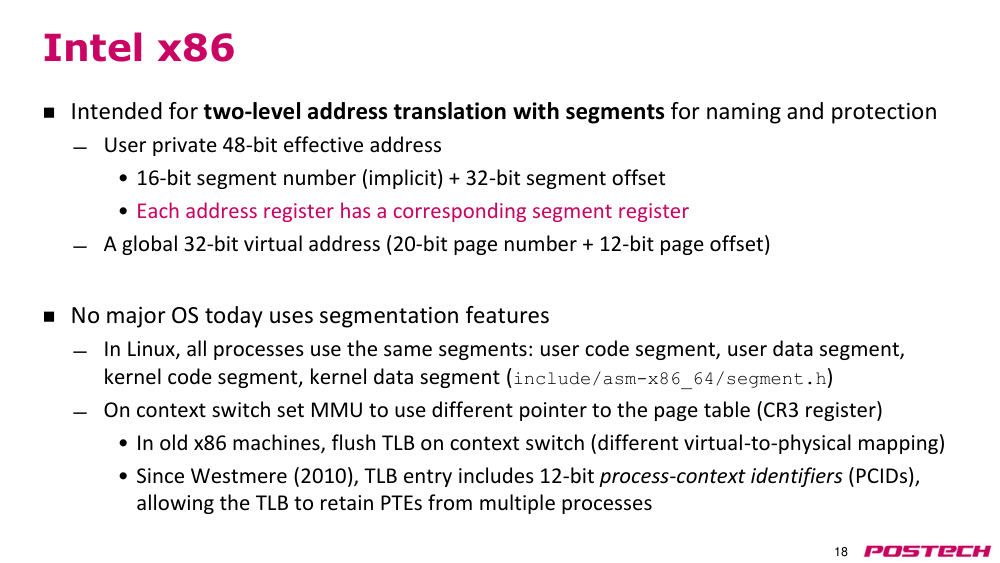
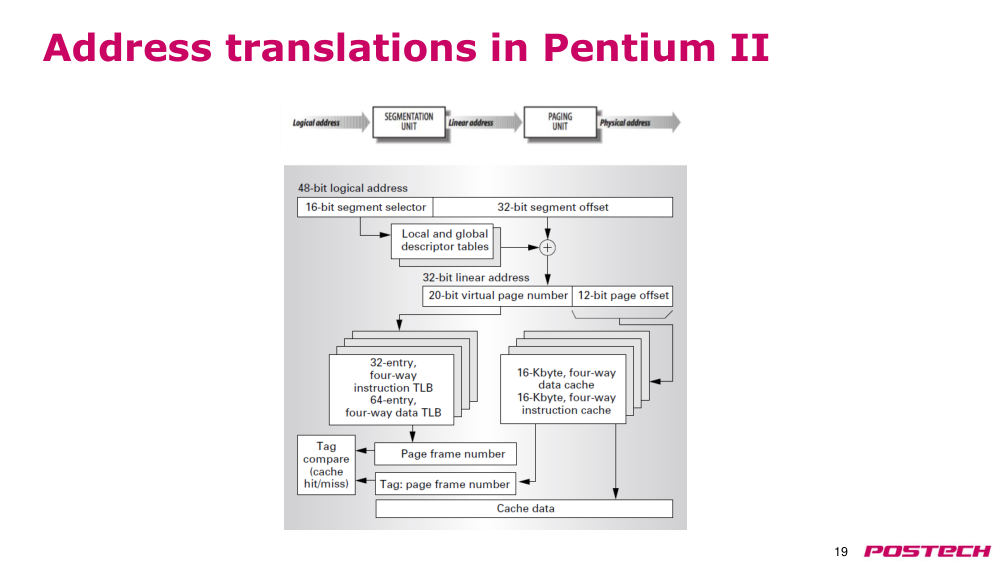
상황·문제x86 은 backward compatibility 때문에 segmentation 을 지원: 48bit EA = 16bit segment 번호 + 32bit offset → 32bit VA(20bit VPN + 12bit offset).
원인요즘 주요 OS 는 segment 를 사실상 안 쓰고(Linux 는 code/data, user/kernel segment 만) paging 에 의존. 옛 x86 은 context switch 때 TLB flush.
해결page table 위치는 privileged register CR3. TLB entry 에 process context identifier(PCID) 를 추가해 context switch 후에도 TLB 유지. Core i7 은 4-level page table, 48bit VA → 40bit PPN, L1 은 12bit 만 쓰는 VIPT 로 synonym 회피.
- 1980년대 x86 program 도 최신 Intel machine 에서 실행 가능
- Pentium II: segment table → 32bit linear → VIPT cache·TLB 병렬
- Core i7 L1 은 cache size·associativity 를 맞춰 synonym 없음
2.1351:53–52:29출석 체크와 Lecture 17 슬라이드 전환
상황·문제quick attendance check 후 cache coherence 슬라이드 로드.
2.1452:29–57:33shared memory multiprocessor 와 bus interconnect
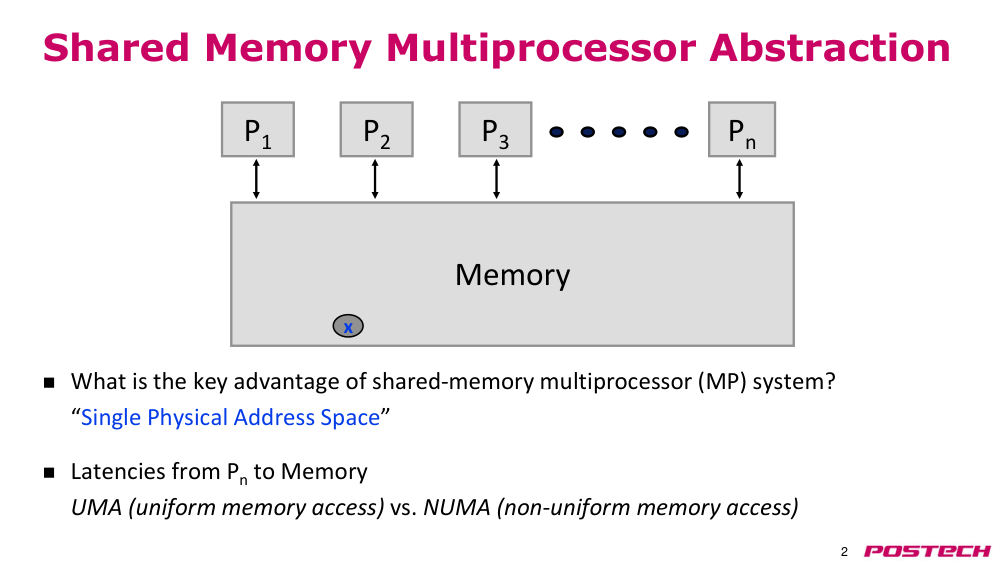
상황·문제cache 주제로 복귀: 여러 processor 가 하나의 physical address space 를 공유(어떤 processor 든 모든 위치 access·modify 가능).
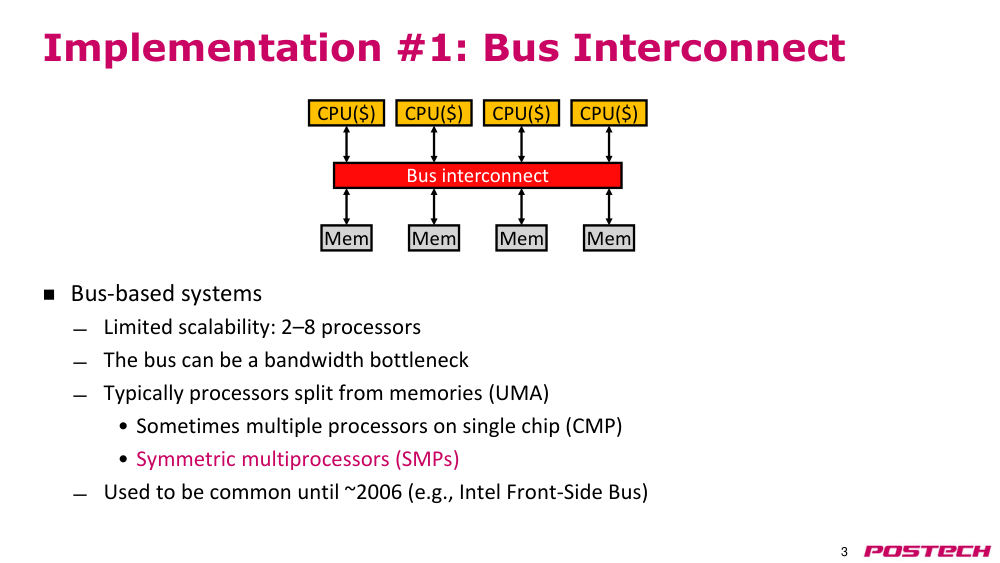
원인구현에 따라 latency 가 균일(UMA)하거나 memory 위치·거리에 따라 다름(NUMA). bus 는 broadcast medium 이라 한 번에 하나만 message 전송 가능.
해결bus 기반 SMP 는 소수 processor 용(2–8개), 위치와 무관하게 latency 동일. 2000년대 중반까지 흔했고 Intel Front-Side Bus 가 예.
- 모든 CPU·memory 가 bus message 를 관찰 가능
- 100개 processor 가 bus 하나 공유 시 병목
- CPU chip 하나에 core 여러 개일 수도(CMP)
2.1557:33–1:01:54point-to-point interconnect (NUMA)
상황·문제bus 의 bandwidth 병목 때문에 point-to-point interconnect 로 이동.
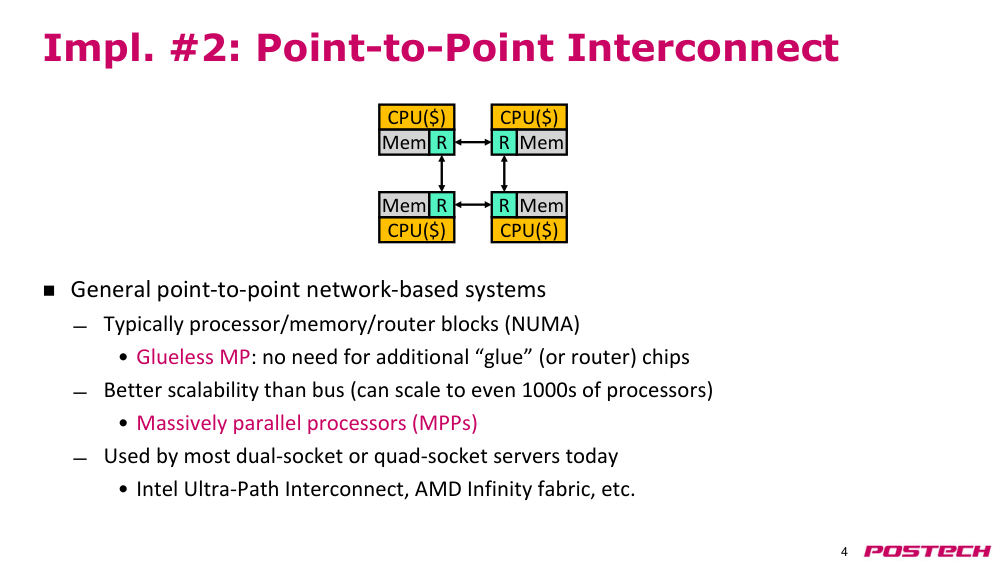
원인processor·router·memory block 을 link 로 연결 → local memory 가 빠르고 여러 hop 거치면 느림(NUMA).
해결router 가 chip 안에 있어 별도 glue chip 불필요(glueless MP). link 가 독립 동작해 통신이 동시에 일어나 수천 processor 까지 확장. 대부분 dual/quad-socket server 가 사용.
- glue(router) chip 을 따로 두는 system 도 있음
- Intel UPI, AMD Infinity Fabric(slide)
- 이 강의 전반부는 bus interconnect 가정
2.161:01:54–1:06:34private cache 와 cache coherence 문제
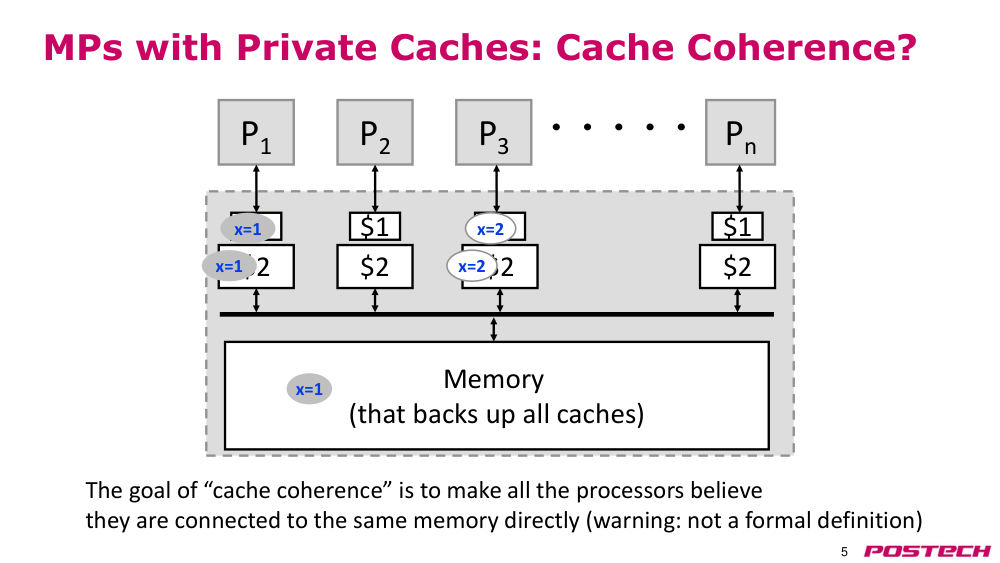
상황·문제shared memory 인데 processor 마다 private cache 가 있음. P1·P3 가 같은 위치(x=1)를 cache.
원인P3 가 x=2 로 update 하면 memory 와 P1 cache 는 old value → 공동 작업(예: sum) 에서 P1 이 최신 값을 못 봄.
해결cache coherence: 모든 processor 가 같은 memory 에 직접 연결된 것처럼, 같은 위치에 대해 항상 최신 data 를 보게 하는 mechanism(비공식 정의).
- coherence = 같은 위치에 대한 update
- memory consistency(나중) = 다른 위치들 간 update·read 순서
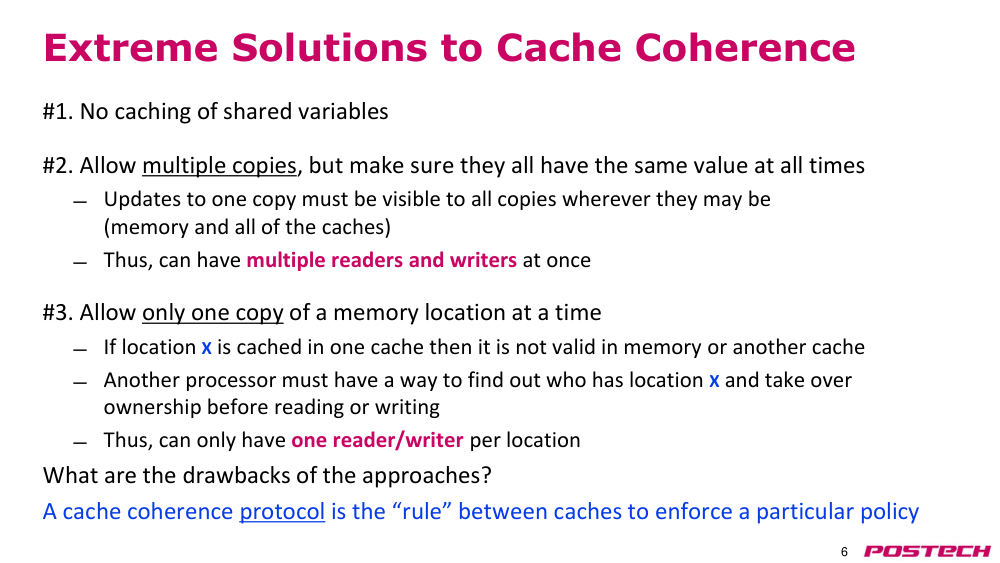
2.171:06:34–1:13:06cache coherence 의 극단적 해법 3가지
상황·문제같은 위치를 여러 processor 가 access 할 때 old value 를 안 보게 할 방법.
원인#1 shared variable 을 cache 안 함 → 성능 나쁨. #2 모든 copy 를 항상 같은 값으로(update broadcast) → 필요 없는 cache 까지 update 해 bus·cache bandwidth 낭비.
해결#3 한 위치에 copy 하나만 → bandwidth 절약, 하지만 누가 가졌는지 찾아야 하고 read-only data 도 여러 copy 불가. 실용적 답은 그 사이: 다음 강의의 cache coherence protocol.
- #2: 다수 reader·writer 동시 허용
- #3: 위치당 reader/writer 하나
- cache coherence protocol = cache 간 policy 를 강제하는 규칙
3핵심 개념
3.1page table walk(페이지 테이블 워크)
TLB miss 시 page table 을 따라가 PTE 를 찾는 과정. multi-level 이면 memory access 여러 번, 수백 cycle.
3.2TLB miss ≠ page fault
TLB miss 는 translation 이 TLB 에 없을 뿐, page fault 는 page 가 disk 에 있어 kernel 이 가져와야 하는 경우.
3.3software-managed TLB(소프트웨어 관리 TLB)
miss 를 exception handler 가 처리. 유연하지만 handler fetch·pipeline flush 로 느림.
3.4virtual cache(가상 캐시)
VA 로 L1 을 접근하고 miss 때만 translate. TLB 가 off-chip 이던 1990년경 SPARC 에서 사용.
3.5homonym(동음이의어)
같은 VA 가 process 마다 다른 PA. 해결: context switch 때 flush 또는 tag 에 PID.
3.6synonym(동의어, alias)
다른 VA 가 같은 PA. virtual cache 에 copy 가 여러 개 생겨 stale data 문제.
3.7VIPT(virtually indexed, physically tagged)
page offset 비트로 cache 를 index 하며 TLB 와 병렬 접근, PPN 으로 tag 비교. cache ≤ page_size × associativity 조건.
3.8PCID(process context identifier)
TLB entry 에 process 식별자를 붙여 context switch 후에도 TLB 유지. CR3 가 page table 위치.
3.9UMA / NUMA
모든 memory 위치 latency 가 같으면 UMA(bus 기반 SMP), 위치·거리에 따라 다르면 NUMA(point-to-point).
3.10glueless MP(글루리스 다중처리기)
router 기능이 CPU chip 에 내장돼 별도 glue(router) chip 없이 point-to-point 로 연결.
3.11cache coherence(캐시 일관성)
여러 private cache 가 같은 위치에 대해 항상 최신 값을 보게 하는 mechanism. 다른 위치 간 순서는 memory consistency.
4스스로 확인
4.1TLB miss 후 page table walk 결과 세 가지와 각 처리는?
답
memory 에 있으면 PTE 를 TLB 에 넣고 계속, disk 면 page fault(kernel 이 page load), invalid·table 없음이면 segmentation fault.
4.2SW-managed TLB 가 느린 이유 두 가지는?
답
handler instruction(10~100개) 을 fetch·실행해야 하고 그것도 cache miss 가능, exception 으로 pipeline flush.
4.3virtual cache 의 homonym 해결책과 더 나은 쪽은?
답
context switch 때 flush 또는 tag 에 PID. flush 는 성능상 나빠 PID 방식이 낫다.
4.44KB page 에서 16KB 4-way L1 은 VIPT 로 synonym 없이 쓸 수 있나?
답
16KB ≤ 4KB × 4 이므로 index 가 page offset 안에 있어 가능.
4.5MIPS R10000 은 VPN[1:0] 을 어디에 두고 무엇을 감지하나?
답
inclusive physical L2 의 tag 에 추가. L2 hit 인데 VPN[1:0] 이 다르면 L1 의 synonym line 을 invalidate.
4.6bus interconnect 가 확장성이 낮은 이유는?
답
broadcast medium 이라 한 번에 하나만 message 전송, processor 가 많으면 bus 가 병목.
4.7극단적 해법 #2(모든 copy 동일 유지) 의 단점은?
답
필요 없는 cache 까지 update 를 전파해 bus·cache bandwidth 를 낭비.