Lec 13 part 2 & Lec 14 · cache 설계(block·associativity·replacement)와 miss 분류·write 문제
정밀 정리 · 검증 2026-09-24 19:48
1개요
1.1tag overhead 를 줄이려 block 을 도입하고, block size 의 장단점(spatial locality vs capacity 낭비·latency·conflict)과 critical word first·sub-blocking 을 다룬다.
1.2direct-mapped 의 conflict 를 줄이려 set-associative·pseudo-associative·fully associative(CAM) cache 와 replacement policy(LRU, pseudo-LRU)를 설명한다.
1.3Lec 14: cache miss 를 cold·capacity·conflict(+coherence)로 분류하고, write 의 tag/data 분리·partial-word write·store buffer 를 다룬다.
1.4Lec 14 p8~27 (MSHR, write policy, multi-level, inclusive/exclusive, reverse engineering)은 이 영상에서 다루지 않았다.
2섹션별 정리 상황·문제 → 원인 → 해결
2.13:34–4:24시작 안내 (업데이트된 slide 게시)
상황·문제강의 직전 업데이트된 slide 를 올렸다는 안내 후, 지난 시간에 이어 cache 설계로 돌아간다.
2.24:24–10:02basic cache parameter 와 Direct-Mapped cache (v1)
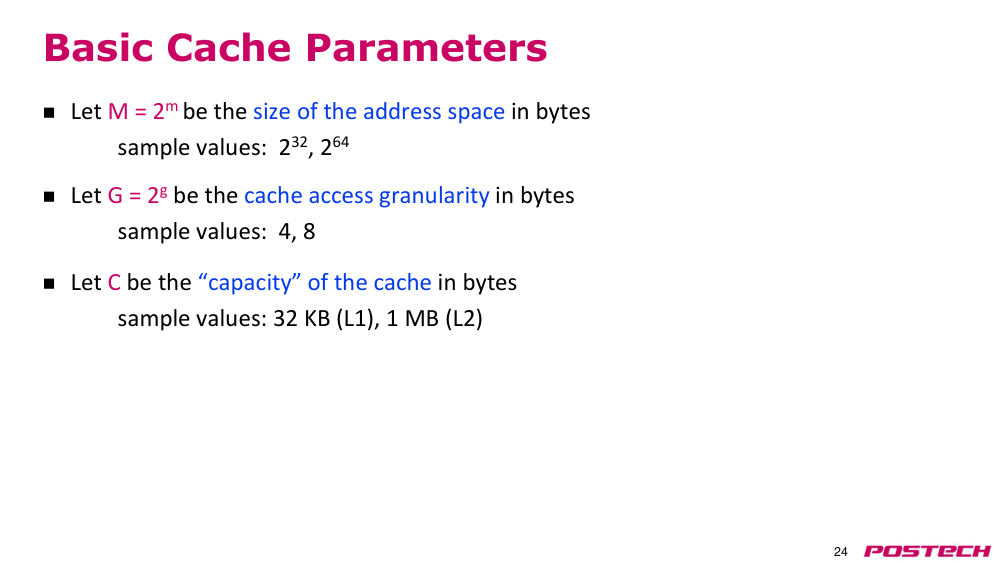
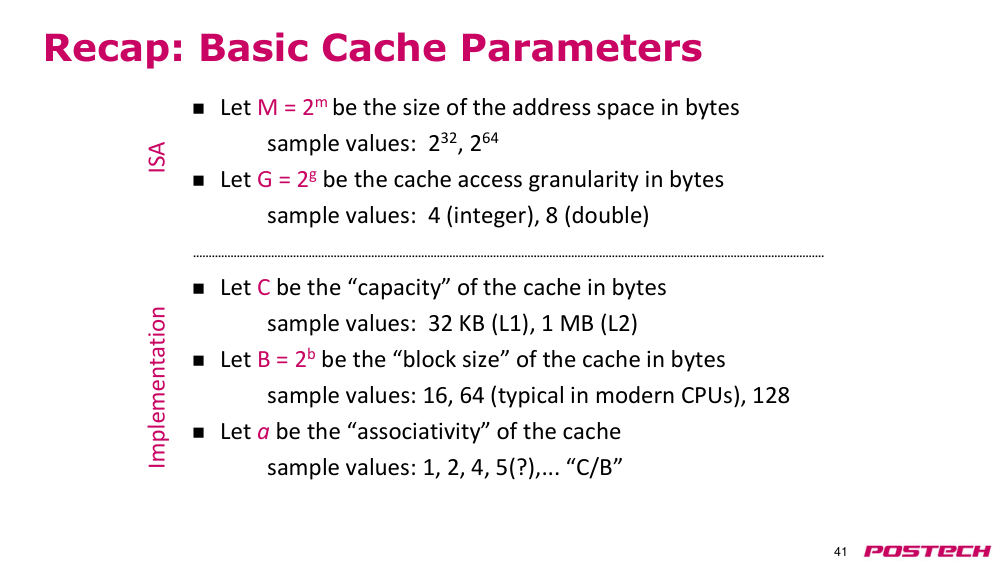
상황·문제M(address space 크기), G(access granularity), C(capacity) 로 cache 를 정의한다. 예: G=4 면 g=2, C=32KB(L1)·1MB(L2).
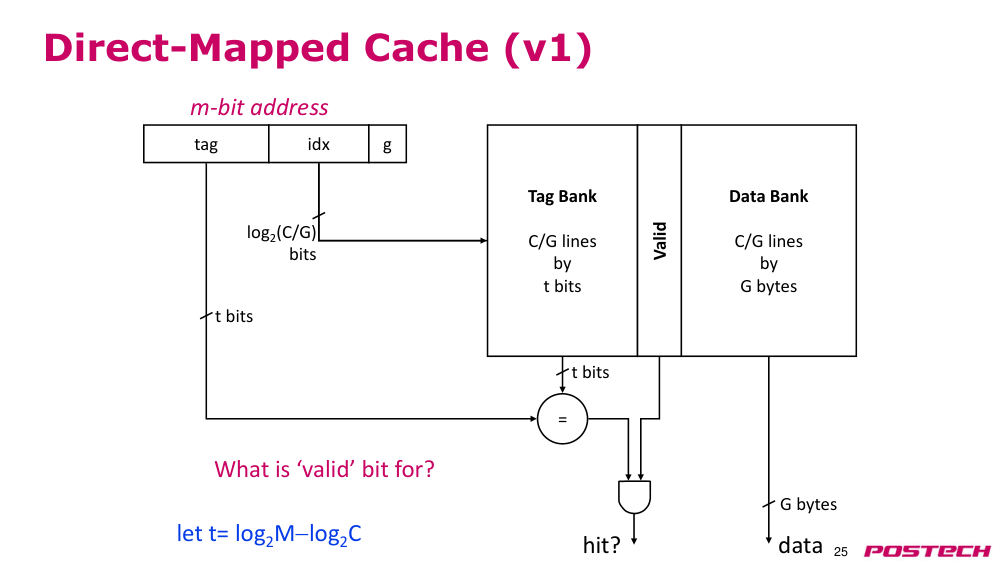
원인address 일부(index)로 줄을 고르면, 윗부분(tag)이 다른 주소도 같은 줄에 온다. 초기화된 0 값이 address 0 과 오인될 수도 있다.
해결tag bank 에 tag 를 저장해 비교하고, valid bit 를 둔다. valid 이고 tag 일치면 hit. branch target buffer(BTB) 와 같은 구조.
- 2¹⁰ entry 면 index 10 bit 필요
- 하위 g bit 는 G byte 안의 위치 (G=4 면 2 bit)
- valid bit: data 를 넣을 때 1 로 설정
2.2.r.1Cache placement policies (Wikipedia) ↗ · direct-mapped/set/fully associative 배치와 tag·index·offset field
2.310:02–17:13tag storage overhead 와 block 도입
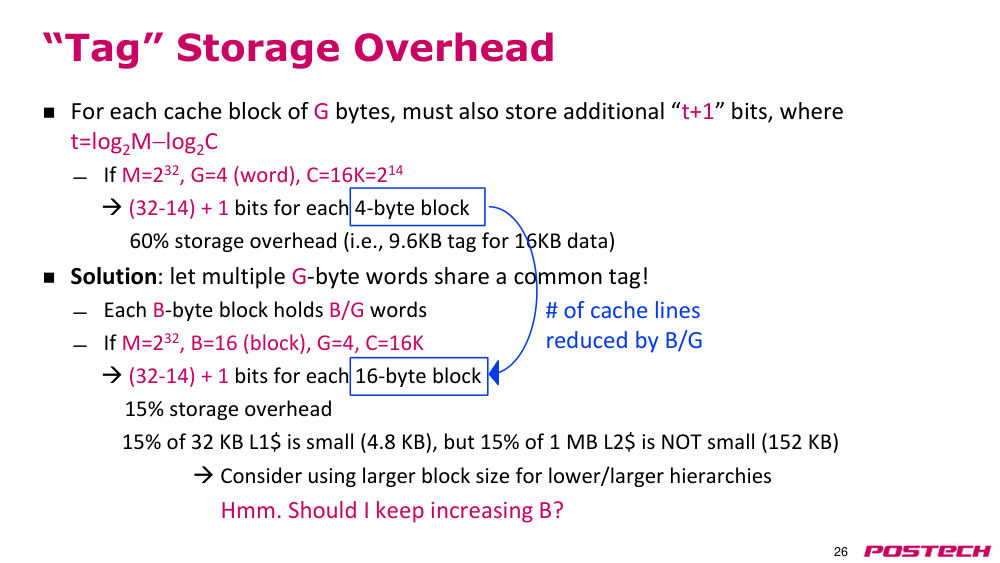
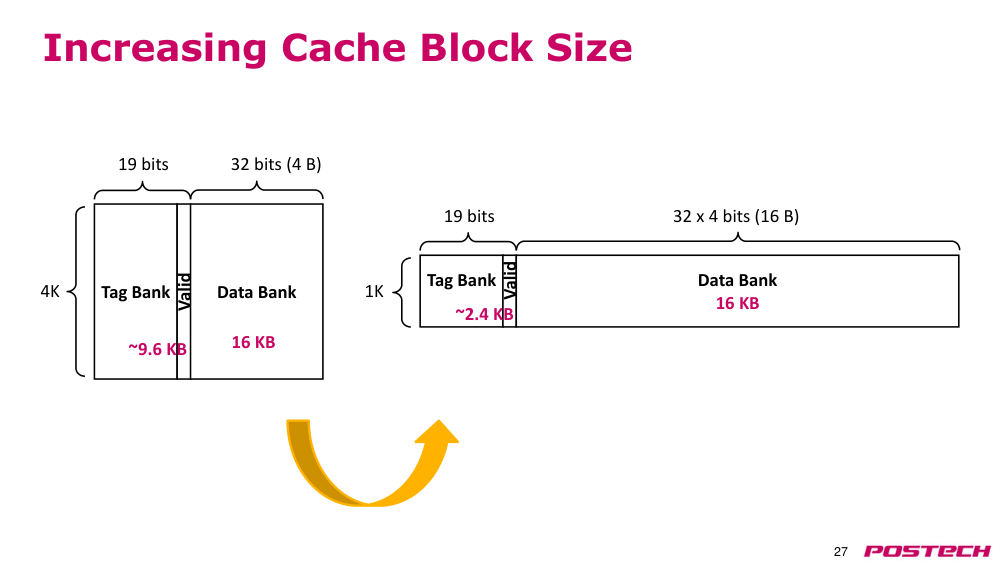
상황·문제G=4, C=16KB, 32-bit address 면 index 12 bit, tag 18 bit + valid 1 = 19 bit 가 32 bit data 마다 붙는다.
원인word 마다 tag 를 두어 9.6KB tag 가 16KB data 에 붙는다 (약 60% overhead).
해결B byte block 이 B/G word 를 공유 tag 로 묶는다. B=16 이면 1K entry × 19 bit ≈ 2.4KB (15%).
- 15% 는 L1 32KB 에서 4.8KB 로 작지만 L2 1MB 에서는 152KB
- 하위 level 에 큰 block 을 고려할 수 있으나 Intel·AMD CPU 는 모든 level 이 64 byte block
- 통상 block 은 32·64 byte, 일부 128 byte
2.3.r.1CPU cache (Wikipedia) ↗ · split L1 I/D, multi-level, inclusive/exclusive, pseudo-associative cache
2.417:13–21:50Direct-Mapped cache (final) 와 block size 의 이점
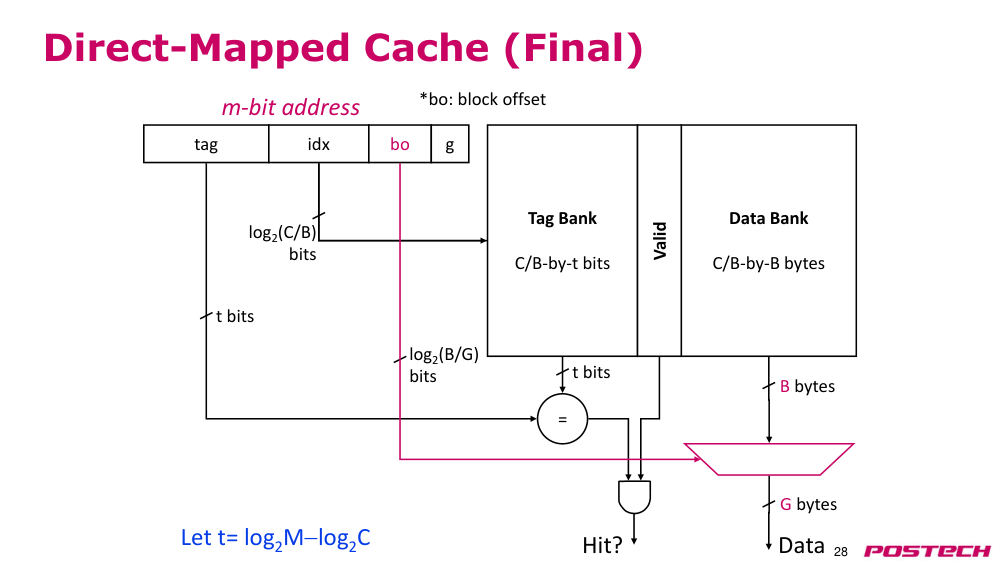
상황·문제block offset bit 가 address 에 추가되고 index 는 짧아진다. block 에서 mux 로 word 를 고른다.
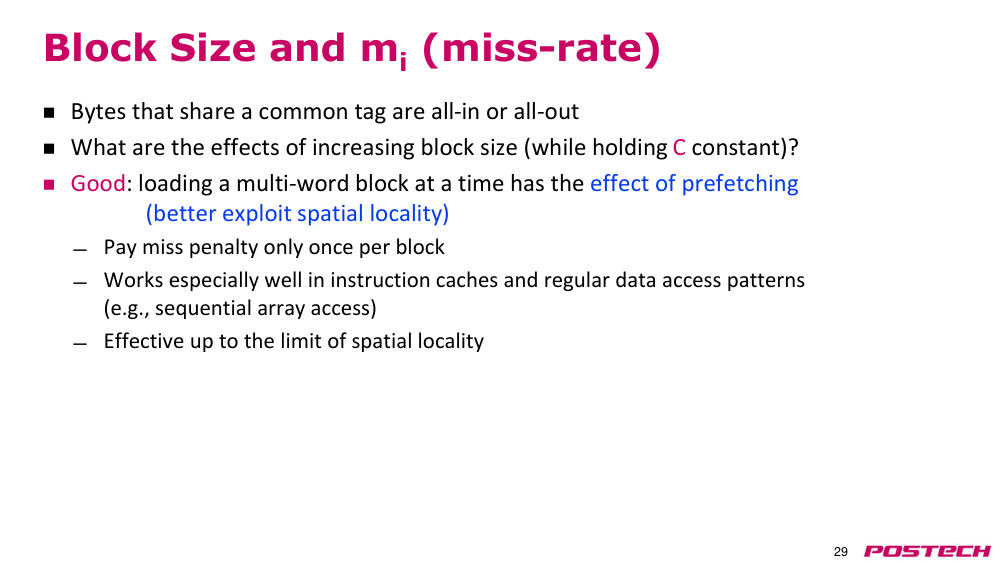
원인tag 를 공유하는 byte 는 all-in/all-out: 한 byte 를 쓰면 block 전체가 들어오고 evict 도 통째로 된다.
해결C 를 고정하고 B 를 키우면 prefetching 효과(spatial locality 활용)로 hit rate 가 오른다. 단, spatial locality 한계까지만.
- 64B block 에서 4B 를 읽으면 나머지도 함께 들어와 이후 hit
- instruction cache·순차 배열 접근에 특히 효과적
- 1KB 처럼 너무 큰 block 은 block 안의 다른 data 를 쓸 확률이 낮다
2.4.r.1Cache placement policies (Wikipedia) ↗ · direct-mapped/set/fully associative 배치와 tag·index·offset field
2.521:50–24:25Test yourself: block offset 을 MSB 에 두면?
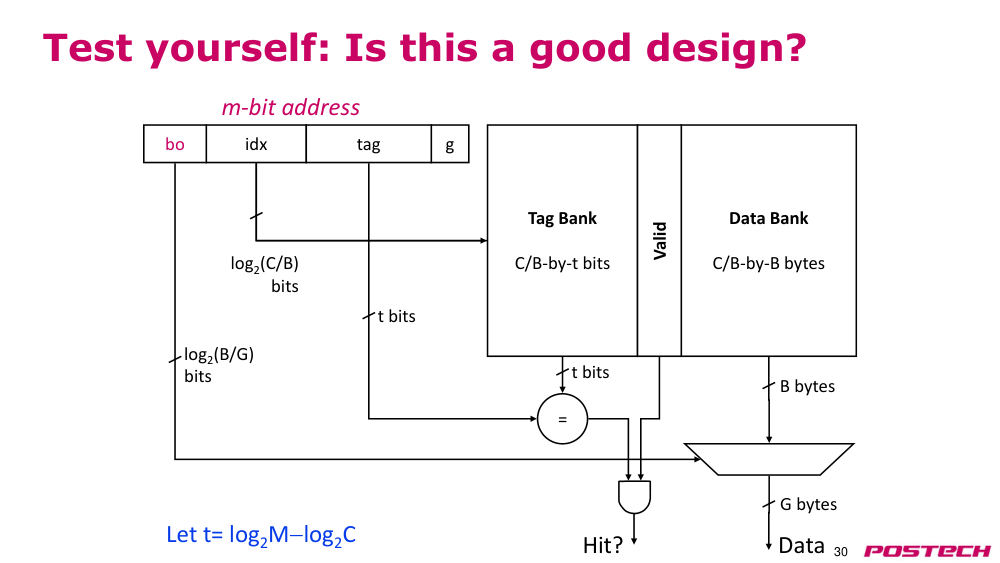
상황·문제bo | idx | tag | g 로 block offset 을 최상위 bit 에서 떼는 설계가 spatial locality 를 살리는지 묻는다.
원인같은 block 에 들어가는 두 주소(예: 100…0 과 000…0)가 address space 에서 멀리 떨어져 있다.
해결가까운 주소가 같은 block 에 모이도록 block offset 은 하위 bit 에 둬야 한다.
- 정답을 말한 학생 2명에게 credit
2.5.r.1Cache placement policies (Wikipedia) ↗ · direct-mapped/set/fully associative 배치와 tag·index·offset field
2.624:25–27:58큰 block 의 단점
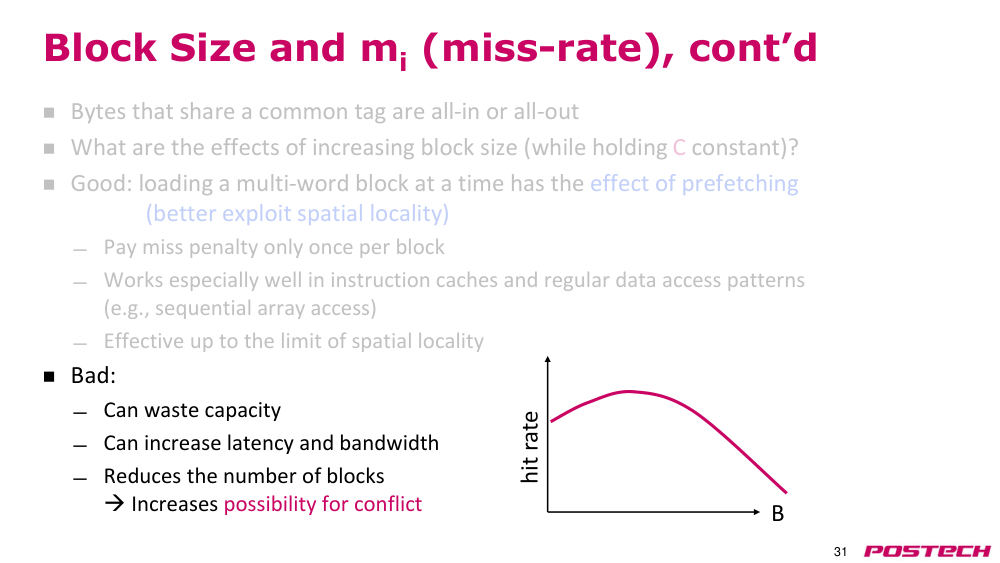
상황·문제block 을 계속 키우면 hit rate 가 오르다가 다시 떨어진다 (p31 그래프).
원인쓰지 않을 data 로 capacity 낭비, 가져오는 latency·bandwidth 증가, C 고정 시 block 수 감소로 conflict 증가.
해결spatial locality 를 살릴 정도의 적당한 block size 를 쓴다.
- 4K entry 대비 4 entry 면 유용한 data 와 충돌할 확률이 훨씬 높다
- 64B block 의 마지막 byte 를 원하면 block 전체 도착까지 기다린다
2.6.r.1CPU cache (Wikipedia) ↗ · split L1 I/D, multi-level, inclusive/exclusive, pseudo-associative cache
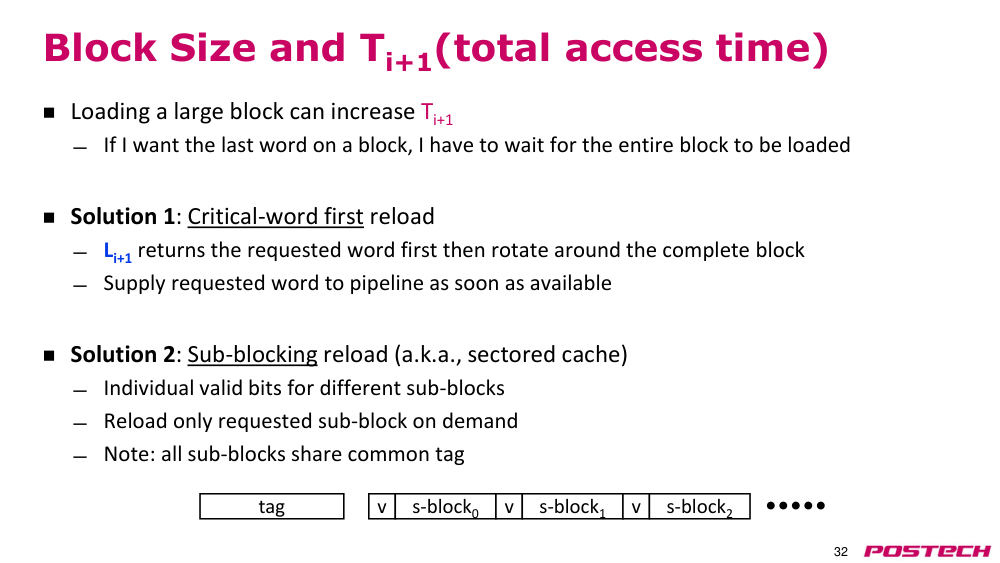
2.727:58–31:17Tᵢ₊₁ 줄이기: critical word first 와 sub-blocking
상황·문제큰 block 을 load 하면 원하는 word 가 늦게 올 수 있어 Tᵢ₊₁ 이 커진다.
원인하위 level 이 block 을 순서대로 보내고, cache 는 block 전체를 가져와야 한다.
해결(1) critical word first: 요청 word 를 먼저 받고 나머지를 이어서. (2) sub-blocking(sectored cache): 요청한 sub-block 만 가져오고 sub-block 마다 valid bit, tag 는 공유.
- 예: 64B block = 16B sub-block × 4
- sub-blocking 은 불필요한 bandwidth 낭비도 줄인다
- 추가 비용은 sub-block 당 valid bit 1 개
2.831:17–34:17Direct-Mapped cache 의 conflict
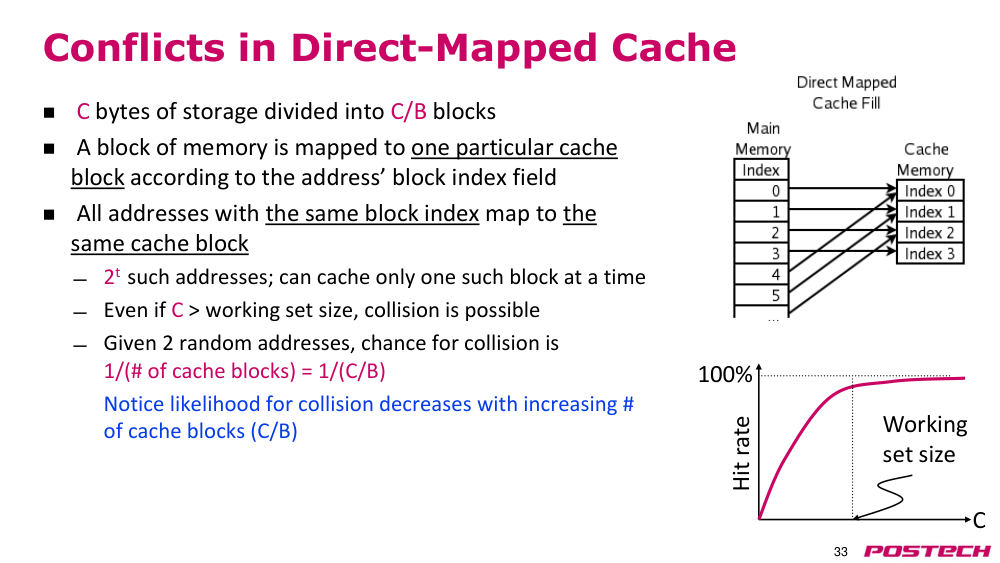
상황·문제C/B 개 block 중 memory block 은 index 로 정해진 한 곳에만 들어간다.
원인tag 만 다른 2ᵗ 개 주소가 한 block 을 두고 경쟁. cache 가 충분히 커도 운 나쁘게 같은 index 면 충돌.
해결임의 두 주소의 충돌 확률은 1/(C/B). block 수가 늘면 줄어든다 → 한 주소를 여러 곳에 둘 수 있게 하자.
- 예: memory 앞 4개 위치가 cache 4줄에, 다음 4개가 다시 같은 4줄에 매핑
- high-performance machine 에는 이상적이지 않다
2.8.r.1Cache placement policies (Wikipedia) ↗ · direct-mapped/set/fully associative 배치와 tag·index·offset field
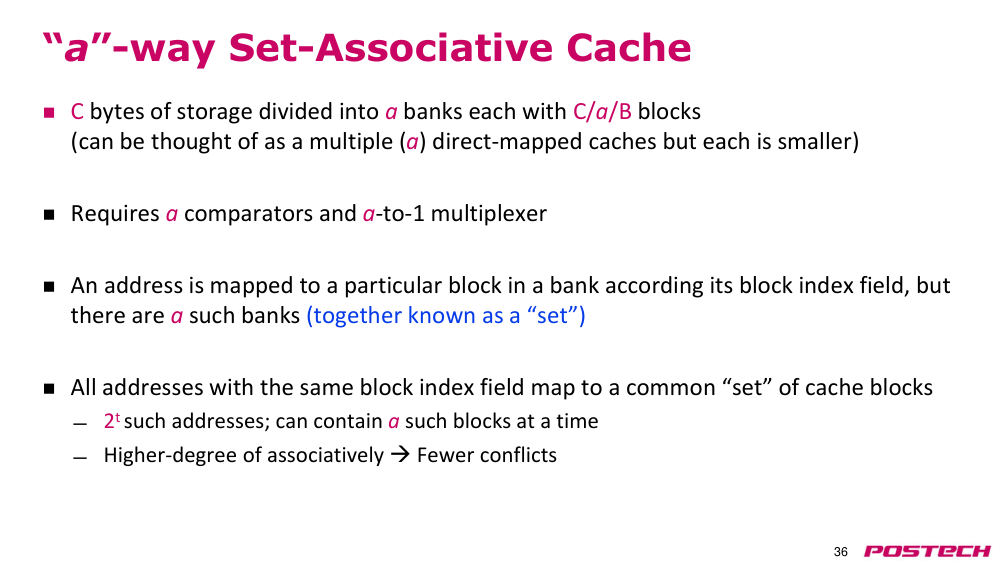
2.934:17–39:49a-way set-associative cache
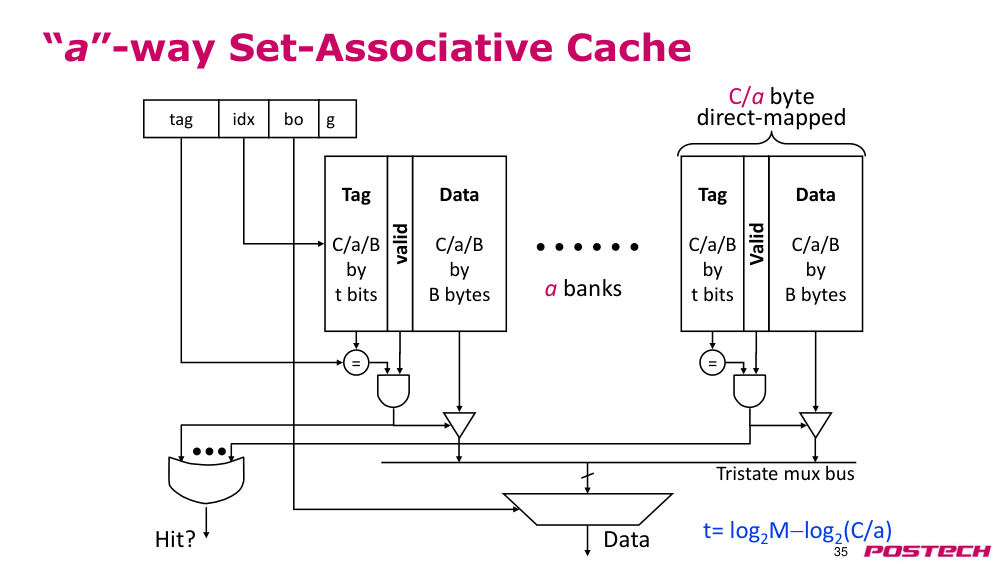
상황·문제data bank 를 a 개의 작은 bank 로 나눠 한 주소가 a 개 bank 중 어디든 들어가게 한다.
원인같은 index 의 두 block 을 동시에 둘 수 있지만, a 개 comparator·AND gate, tristate mux bus, hit 판단용 OR gate 가 추가된다.
해결같은 index 의 block 묶음이 set. circuit 추가로 access latency 는 늘지만 conflict 가 주요 원인이면 miss rate 가 준다.
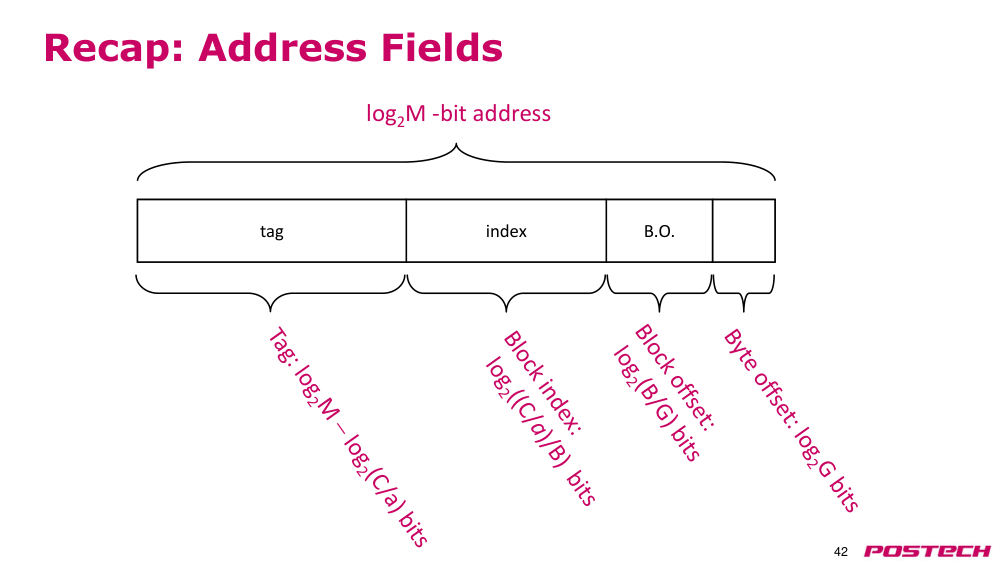
- t = log₂M − log₂(C/a)
- associativity 가 높을수록 conflict 감소
- cache 가 working set 을 담을 만하면 conflict miss 는 적다
2.9.r.1Cache placement policies (Wikipedia) ↗ · direct-mapped/set/fully associative 배치와 tag·index·offset field
2.9.r.2CPU cache (Wikipedia) ↗ · split L1 I/D, multi-level, inclusive/exclusive, pseudo-associative cache
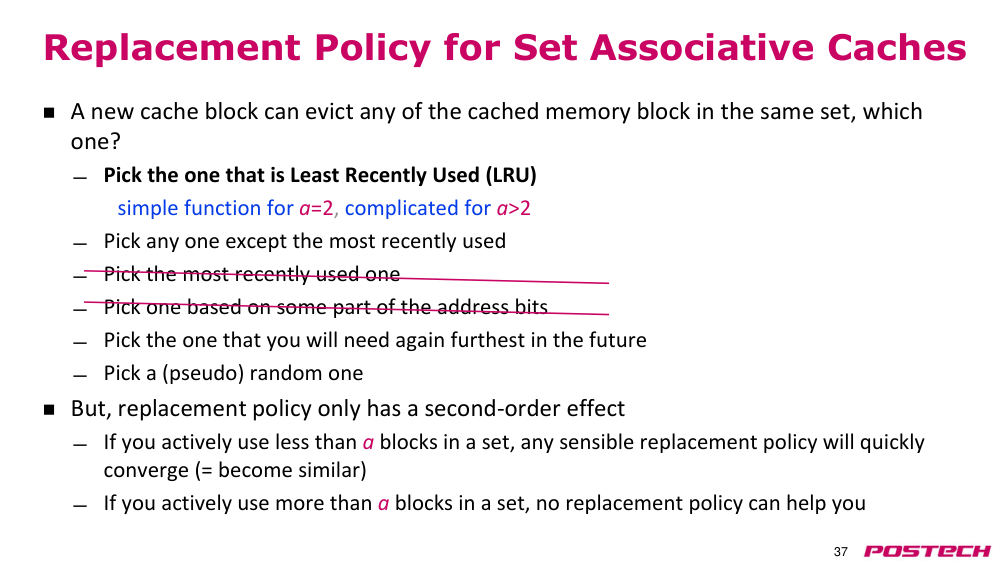
2.1039:49–46:09replacement policy
상황·문제set 에 a 개 block 이 있으면 새 block 을 넣을 때 어느 것을 evict 할지 정해야 한다.
원인가까운 미래에 가장 덜 쓸 block 을 골라야 하는데 LRU 는 a=2 면 간단하지만 a>2 면 구현 비용이 크다.
해결LRU 가 합리적 baseline, 실제로는 pseudo-LRU 로 근사. MRU 제외 아무거나, 가장 늦게 쓸 것 예측, random 도 있다.
- MRU 선택은 한 번 쓰고 다시 안 쓰는 pattern 에서만 의미
- address bit 는 임의적이고 보안상 randomize 되기도 해 쓰지 않는다
- second-order effect: working set 이 cache 에 들어가거나 너무 크면 policy 차이 작음
2.10.r.1Cache replacement policies (Wikipedia) ↗ · LRU, pseudo-LRU, random, Bélády(가장 늦게 다시 쓸 block)
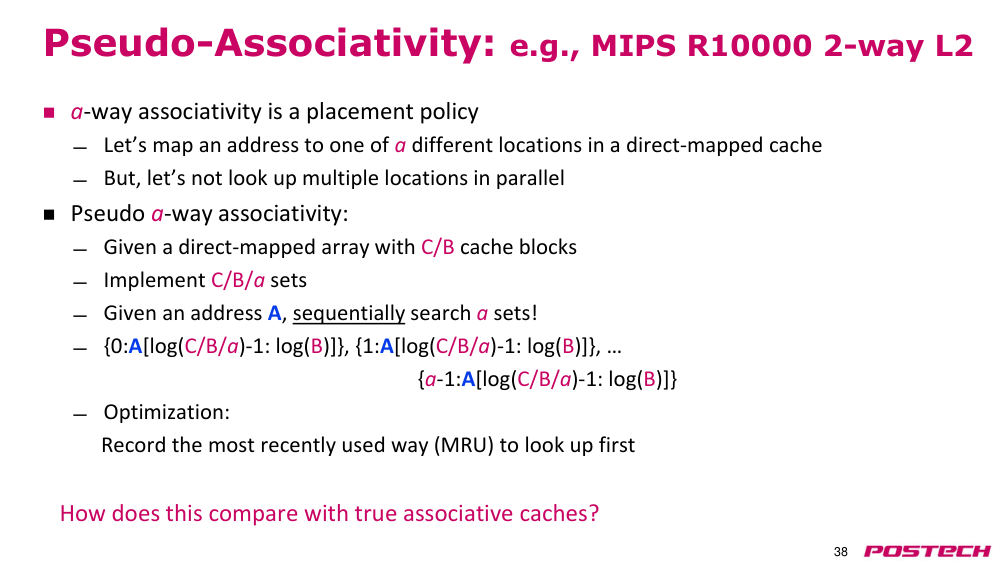
2.1146:09–47:51pseudo-associativity (MIPS R10000 2-way L2)
상황·문제direct-mapped cache 구조를 유지하면서 associative cache 처럼 동작하고 싶다.
원인한 주소가 direct-mapped 배열의 여러 위치로 갈 수 있지만 동시에 볼 수 없어 하나씩 검색한다.
해결most recently used way 같은 예측으로 hit 가능성이 높은 곳을 먼저 본다. 설계는 단순하지만 access time 이 늘어난다.
- miss 면 다음 위치를 이어서 검색
2.11.r.1CPU cache (Wikipedia) ↗ · split L1 I/D, multi-level, inclusive/exclusive, pseudo-associative cache
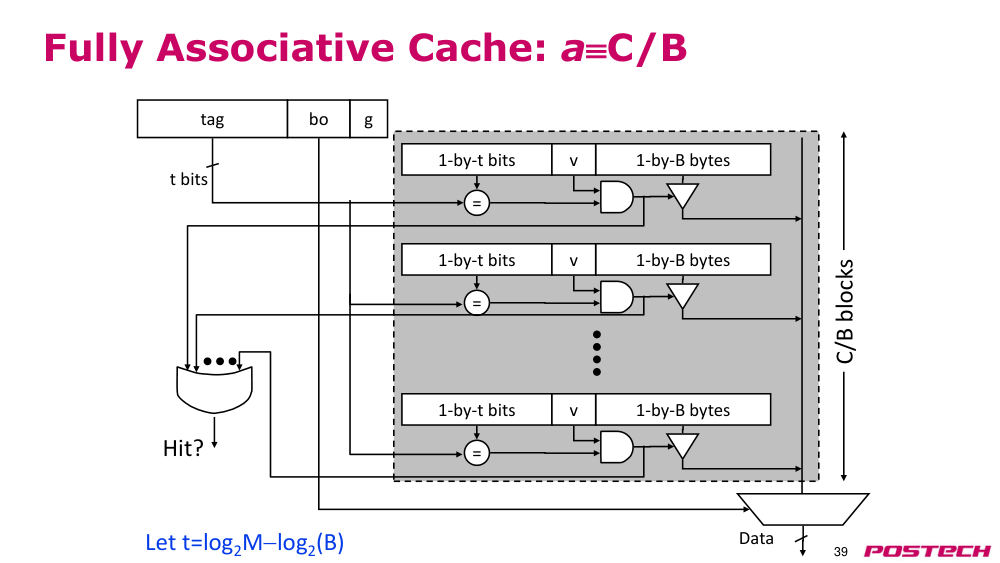
2.1247:51–51:05fully associative cache 와 CAM
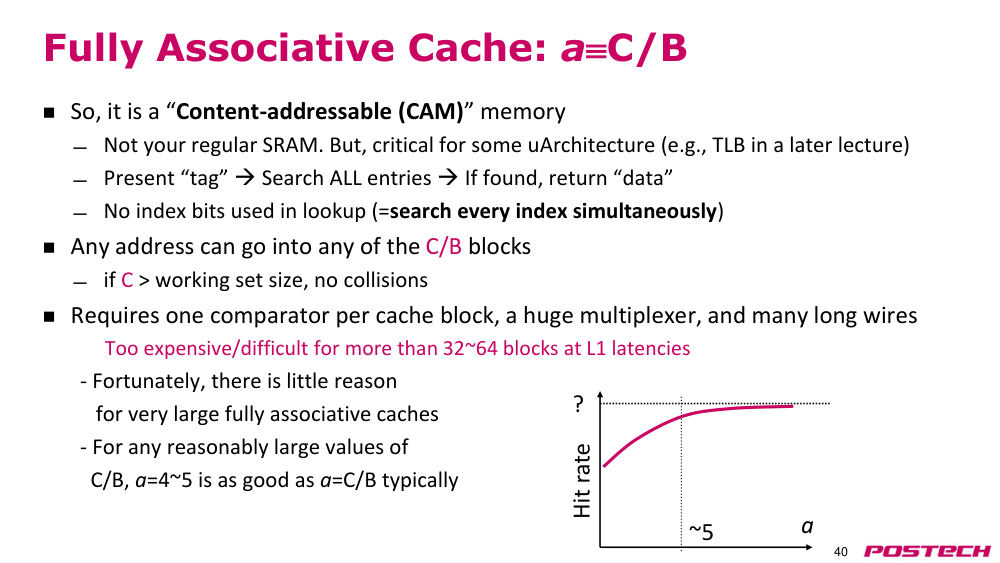
상황·문제associativity 를 set 수 전체(a = C/B)로 늘리면 어떤 block 이든 어디에나 둘 수 있다.
원인block 마다 comparator, 거대한 mux, 긴 배선이 필요해 overhead 가 크다.
해결index 없이 tag 로 전체를 검색하는 content addressable memory(CAM). TLB 처럼 높은 associativity 가 필요한 구조에 쓴다.
- conflict miss 가 없다
- 보통 a=4~5 면 fully associative 와 비슷 → 남는 자원은 capacity 에 투자
2.1351:05–53:30질문·recap·논문 과제 안내
상황·문제선수 과목(시스템 프로그래밍)에서 set/fully associative 를 배웠는지 묻고, p41~42 recap 을 보여준다. Jouppi ISCA'90 논문은 optional, 마감 없음이라고 말함.
2.13.r.1Jouppi, Improving Direct-Mapped Cache Performance ... (ISCA'90) — UPenn CIS 501 사본 ↗ · p43 과제 논문: miss cache, victim cache, stream buffer
2.1453:30–1:00:24cache miss 분류 (Lec 14): cold·capacity·conflict
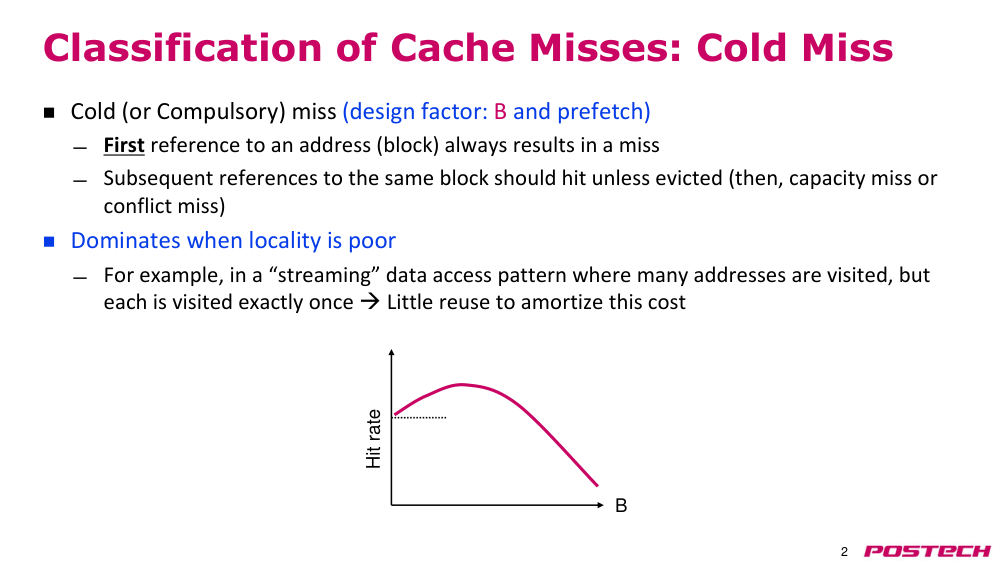
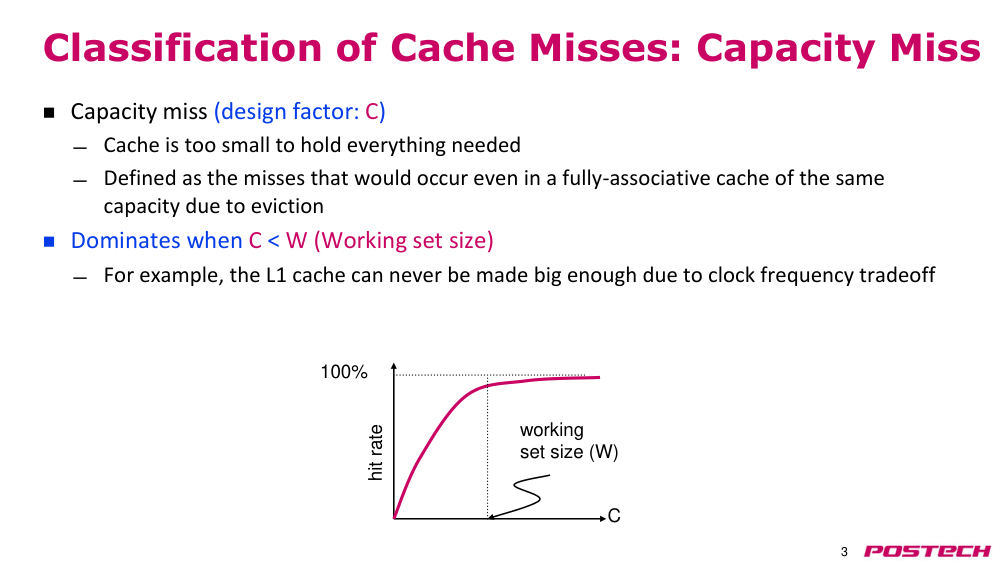
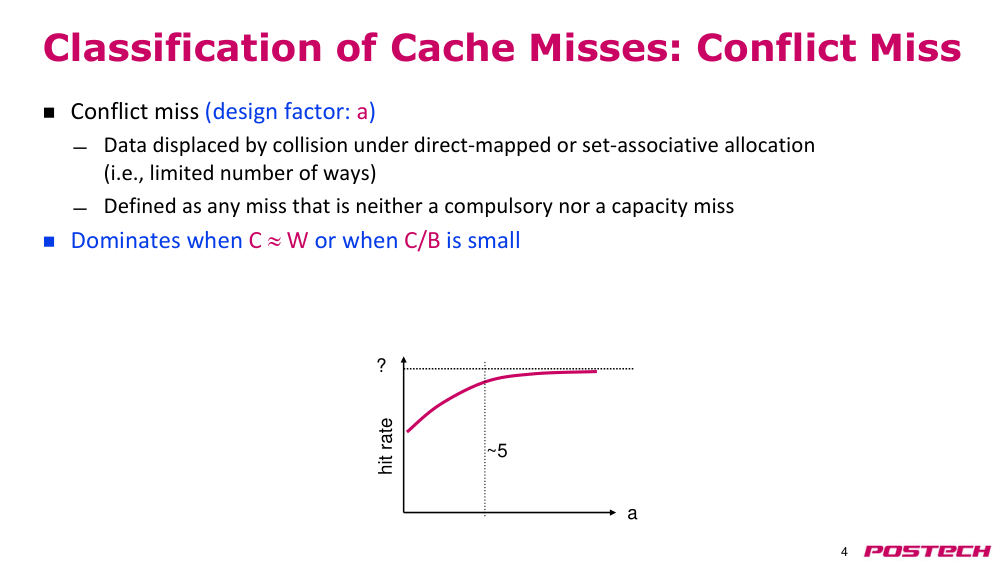
상황·문제cache miss 를 원인별로 cold(compulsory), capacity, conflict 로 나눈다.
원인cold: 처음 참조라 피할 수 없음. capacity: working set > C 라 evict (예: 1K block fully associative 에 2K block working set). conflict: direct-mapped·set-associative 의 제한된 way 때문에 evict.
해결cold 는 큰 B·prefetch 로, capacity 는 C 로, conflict 는 associativity a 로 줄인다. fully associative 에는 conflict miss 가 없다.
- cold miss 는 locality 가 나쁠 때(streaming) 지배적
- B 를 계속 키울 때 늘어나는 miss 는 cold 가 아닌 다른 원인
- conflict: C≈W 이거나 C/B 가 작을 때 지배적
2.14.r.1Cache performance measurement and metric (Wikipedia) ↗ · compulsory·capacity·conflict·coherence miss 정의
2.151:00:24–1:03:10coherence miss 와 capacity vs conflict 질문
상황·문제네 번째 분류 coherence miss(coherence protocol 로 evict 된 block)가 있으나 이후 강의에서 다룬다.
원인질문(한국어): capacity 와 conflict 구분 기준.
해결fully associative 에서도 쫓겨났을 것(용량 부족)이면 capacity, 공간은 남았는데 direct-mapped/set-associative 라서 쫓겨났으면 conflict.
- 쫓겨난 이유로 이름을 붙인다고 생각하면 된다
2.161:03:10–1:06:00block size 와 cold miss 예시
상황·문제8B 원소 A0, A1, A2 … 를 순서대로 읽을 때 block 16B 와 32B 중 어느 쪽이 cold miss 가 많은가.
원인16B 면 2개마다 miss(A0 miss, A1 hit, A2 miss …), 32B 면 4개 중 1번만 miss.
해결block 이 클수록 cold miss 가 준다. B 가 너무 크면 hit rate 가 떨어지는 것은 conflict 때문.
2.16.r.1Cache performance measurement and metric (Wikipedia) ↗ · compulsory·capacity·conflict·coherence miss 정의
2.171:06:00–1:12:05cache write 문제: tag/data 분리와 partial-word write
상황·문제read 는 load·instruction fetch 에 pipeline 이 기다리므로 tag 와 data 를 동시에, 최대한 일찍 접근한다.
원인write 는 뒤따르는 instruction 이 기다리지 않고, miss 면 절대 쓰면 안 되며, miss 처리(block fetch)는 오래 걸린다.
해결write 는 tag 를 먼저 보고 data bank 는 나중에 접근. store 는 word·byte 단위라 block 을 읽어 일부만 고쳐 다시 쓴다(partial-word write). partial-word read 는 필요한 byte 만 고른다.
- write 는 read 와 달리 old data 가 필요 없어 보이지만, cache 관리 방식 때문에 memory 에서 block 을 가져와야 하는 경우가 많다
- 64B block 에 4B store 는 partial update
2.17.r.1Cache (computing) (Wikipedia) ↗ · write-through/write-back, dirty bit, write-allocate/no-write-allocate
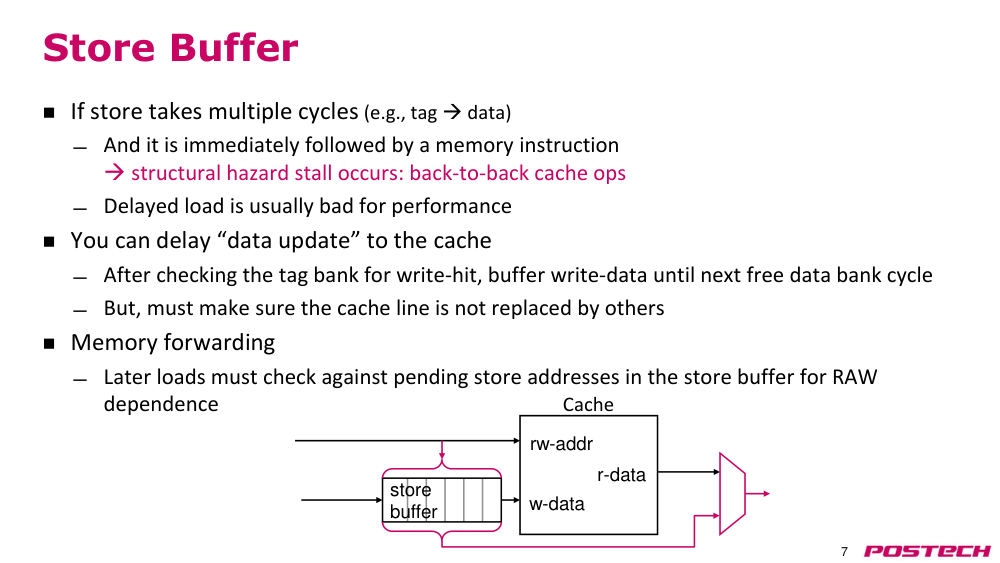
2.181:12:05–1:15:52store buffer
상황·문제store 가 cache 를 여러 cycle(L1 4 cycle~하위 level 수십 cycle) 점유하면 뒤의 load 가 stall 된다 (back-to-back cache op 의 structural hazard).
원인load 결과에 의존하는 instruction 이 있어 load 가 store 보다 성능에 중요하다.
해결write hit 를 store buffer 에 두고 cache 가 한가할 때 drain. 그동안 cache line 이 교체되지 않게 하고, buffer 에 hit 하는 load 는 buffer 의 값을 쓴다(memory forwarding).
- store 와 load 의 criticality 비대칭을 이용
2.18.r.1Write buffer (Wikipedia) ↗ · cache→memory 쓰기를 buffer 에 두고 read 를 먼저 처리 (강의 store buffer 와 같은 발상)
2.18.r.2Memory disambiguation (Wikipedia) ↗ · store queue 를 CAM 으로 검색하는 store-to-load forwarding (RAW)
2.191:15:52–1:19:38마무리·출석, 질문: multi-bank vs sub-blocking
상황·문제채팅 출석 후 질문: set-associative 의 bank 는 bank 마다 tag 가 다르고 conflict 를 줄이려는 것. sub-block 은 한 block 안에서 tag 를 공유하고 valid bit 만 따로 두며 conflict 해결과 무관.
3핵심 개념
3.1valid bit(유효 비트)
entry 에 실제 data 가 있는지 표시. 초기 0 값이 address 0 과 오인되는 것을 막는다.
3.2block(블록) / block offset
B byte 를 하나의 tag 로 관리하는 단위. address 하위 bit(block offset)로 block 안의 word 를 고른다.
3.2.r.1Cache placement policies (Wikipedia) ↗ · direct-mapped/set/fully associative 배치와 tag·index·offset field
3.3critical word first
하위 level 이 요청 word 를 먼저 보내고 나머지 block 을 이어서 보내 대기 시간을 줄인다.
3.4sub-blocking / sectored cache
block 을 sub-block 으로 나눠 요청한 것만 가져온다. sub-block 마다 valid bit, tag 는 공유.
3.5set-associative cache(세트 연관 캐시)
a 개 bank 중 같은 index 의 a 개 block(set) 어디든 둘 수 있다. conflict 감소, comparator·mux 추가.
3.5.r.1Cache placement policies (Wikipedia) ↗ · direct-mapped/set/fully associative 배치와 tag·index·offset field
3.6LRU / pseudo-LRU
가장 오래전에 쓴 block 을 evict. a>2 면 true LRU 는 비싸 pseudo-LRU 로 근사한다.
3.7content addressable memory(CAM)
index 없이 tag(내용)로 전체를 검색하는 memory. fully associative cache·TLB.
3.8cold / capacity / conflict miss
첫 참조 / 용량 부족(fully associative 에서도 발생) / 제한된 way 때문의 evict.
3.8.r.1Cache performance measurement and metric (Wikipedia) ↗ · compulsory·capacity·conflict·coherence miss 정의
3.9coherence miss
cache coherence protocol 로 evict 된 block 의 miss. 이후 강의에서 다룬다.
3.11store buffer(스토어 버퍼)
write 를 buffer 에 두고 cache 가 한가할 때 반영해 load 를 먼저 처리. buffer hit load 는 buffer 값 사용.
3.11.r.1Write buffer (Wikipedia) ↗ · cache→memory 쓰기를 buffer 에 두고 read 를 먼저 처리 (강의 store buffer 와 같은 발상)
3.11.r.2Memory disambiguation (Wikipedia) ↗ · store queue 를 CAM 으로 검색하는 store-to-load forwarding (RAW)
4스스로 확인
4.1G=4, C=16KB, 32-bit address, B=G 일 때 tag overhead 는?
답
index 12 bit, tag 18 bit + valid 1 = 19 bit / 32 bit → 약 9.6KB (60%). B=16 이면 약 2.4KB (15%).
4.2block offset 을 address 최상위 bit 에 두면 왜 나쁜가?
답
같은 block 에 들어가는 주소들이 address space 에서 멀리 떨어져 spatial locality 를 못 살린다.
4.3block size 를 계속 키우면 hit rate 는?
답
spatial locality 로 오르다가, capacity 낭비와 block 수 감소에 따른 conflict 로 다시 떨어진다.
4.4sub-blocking 과 set-associative 의 bank 는 무엇이 다른가?
답
sub-block 은 한 tag 를 공유하고 valid bit 만 따로, bank 는 bank 마다 다른 tag. set-associative 는 conflict 를 줄이려는 것이고 sub-blocking 은 conflict 와 무관.
4.5capacity miss 와 conflict miss 를 어떻게 구분하나?
답
같은 용량의 fully associative cache 에서도 났을 miss 면 capacity, 아니면(way 부족으로 evict) conflict.
4.6write 에서 tag 와 data 를 동시에 접근하지 않는 이유는?
답
miss 면 절대 쓰면 안 되고, write 는 뒤 instruction 이 기다리지 않아 latency 가 덜 중요하다.
5참고 자료
5.1Cache placement policies (Wikipedia) ↗ · direct-mapped/set/fully associative 배치와 tag·index·offset field
5.2CPU cache (Wikipedia) ↗ · split L1 I/D, multi-level, inclusive/exclusive, pseudo-associative cache
5.4Cache performance measurement and metric (Wikipedia) ↗ · compulsory·capacity·conflict·coherence miss 정의
5.5Cache (computing) (Wikipedia) ↗ · write-through/write-back, dirty bit, write-allocate/no-write-allocate
5.6Jouppi, Improving Direct-Mapped Cache Performance ... (ISCA'90) — UPenn CIS 501 사본 ↗ · p43 과제 논문: miss cache, victim cache, stream buffer