이 자료를 쓰는 강의: 49 memory hierarchy(메모리 계층 구조)와 cache(캐시) 기초 · 50 cache 설계(block·associativity·replacement)와 miss 분류·write 문제
Lec13-MemoryHierarchy (updated)
한국어판 강의자료 · 43쪽
p.1CSED311 컴퓨터구조 – 강의 13
- memory hierarchy(메모리 계층 구조) & cache(캐시)
- Gwangsun Kim
- 컴퓨터공학과
- POSTECH
- 면책 조항: 슬라이드는 Carnegie Mellon University, University of Michigan, Purdue University, University of Pennsylvania, University of Wisconsin의 교수진 Austin, Brehob, Falsafi, Hill, Hoe, Lipasti, Martin, Roth, Shen, Smith, Sohi, Tyson, Vijaykumar, Mutlu, Wenisch 등과 공동으로 개발됨
p.22 메모리: ‘이상적’ vs. 현실
- ‘이상적’ 메모리
- 모든 프로그램은 연속적인 2⁶⁴ B 메모리를 보게 된다
- 메모리 어디든 1개의 프로세서 사이클 내에 접근할 수 있다
- 현실에서는…
- 2⁶⁴ B 메모리를 감당할 수 없고, 필요하지도 않다
- 크고 빠른 메모리 기술을 찾을 수 없다
- 해결책: 빠르지만 작은 cache(캐시)와 크고 느린 main memory(주기억장치)로 구성된 ‘마법의’ memory hierarchy(메모리 계층 구조) 만들기
- -- Burks, Goldstein, von Neumann, 1946
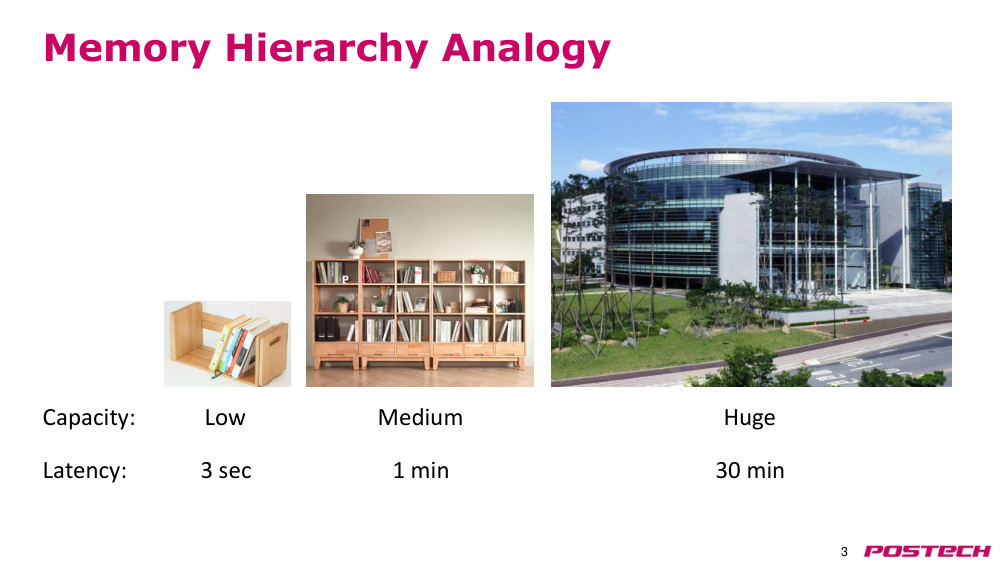
p.33 memory hierarchy(메모리 계층 구조)의 비유
- 용량:
- 낮음
- 3초
- 중간
- 1분
- 거대
- 30분
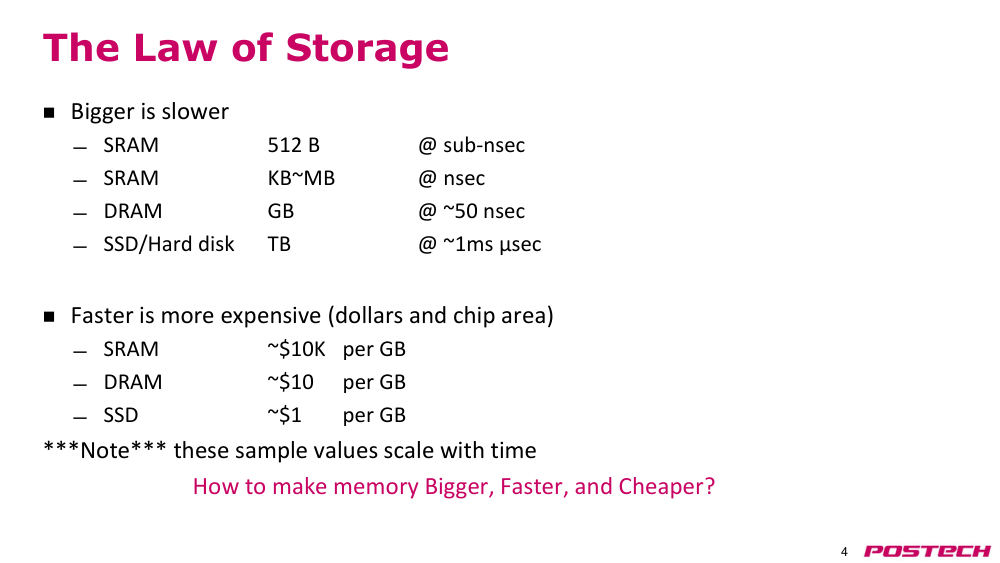
p.44 저장소의 법칙
- 크면 느리다
- SRAM: 512 B @ sub-nsec
- SRAM: KB~MB @ nsec
- DRAM: GB @ ~50 nsec
- SSD/hard disk(하드 디스크): TB @ ~1ms μsec
- 빠르면 더 비싸다 (달러와 칩 면적 측면에서)
- SRAM: 1GB당 약 $10,000
- DRAM: 1GB당 약 $10
- SSD: 1GB당 약 $1
- ***참고*** 이 예시 값은 시간에 따라 비례하여 변화한다
- 메모리를 더 크고, 빠르고, 싸게 만드는 방법은?
p.55 기본 원칙
p.66 지역성
- 최근의 과거는 미래를 예측하는 데 매우 좋은 지표다.
- temporal locality(시간적 지역성): 오늘 학생 식당에서 점심을 먹었다면, 곧 다시 그곳에 갈 가능성이 매우 높다
- spatial locality(공간적 지역성): 학생 식당에서 점심을 먹었다면, Jigok Community Center의 인근 상점에 갈 가능성이 매우 높다
p.7memory locality(메모리 지역성)
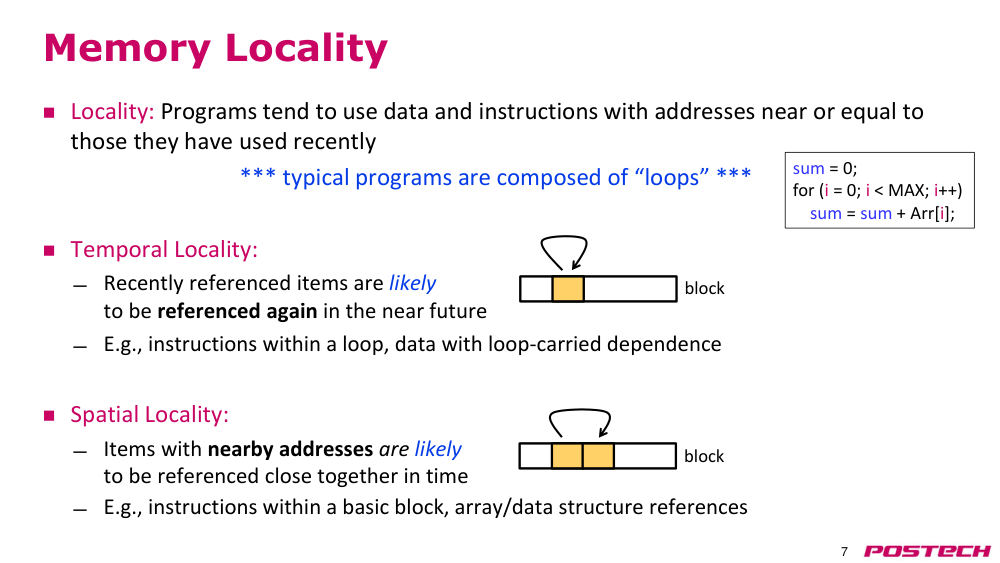
- 지역성: 프로그램은 최근에 사용한 데이터와 명령어의 주소 근처 또는 동일한 주소를 자주 사용한다
- *** 일반적인 프로그램은 '루프'로 구성되어 있다 ***
- temporal locality(시간적 지역성): 최근에 참조한 항목은 곧바로 다시 참조될 가능성이 높다
- 예: 루프 내의 명령어, 루프 전파 의존성을 가진 데이터
- spatial locality(공간적 지역성): 주소가 가까운 항목들은 시간적으로 가까이 참조될 가능성이 높다
- 예: 기본 block(블록) 내의 명령어, 배열/데이터 구조 참조
- block
- block
- sum = 0;
- for (i = 0; i < MAX; i++)
- sum = sum + Arr[i];
p.8cost amortization(비용 분산)
- 총비용 = 일회성 과부하 + 단위당 비용 × N
- 평균 비용 = 총비용 / N
- = (일회성 과부하 / N) + 단위당 비용
- 일회성 과부하가 크더라도, 많은 단위에 걸쳐 비용을 분산할 수 있다면 문제되지 않는다 → 평균 비용 감소
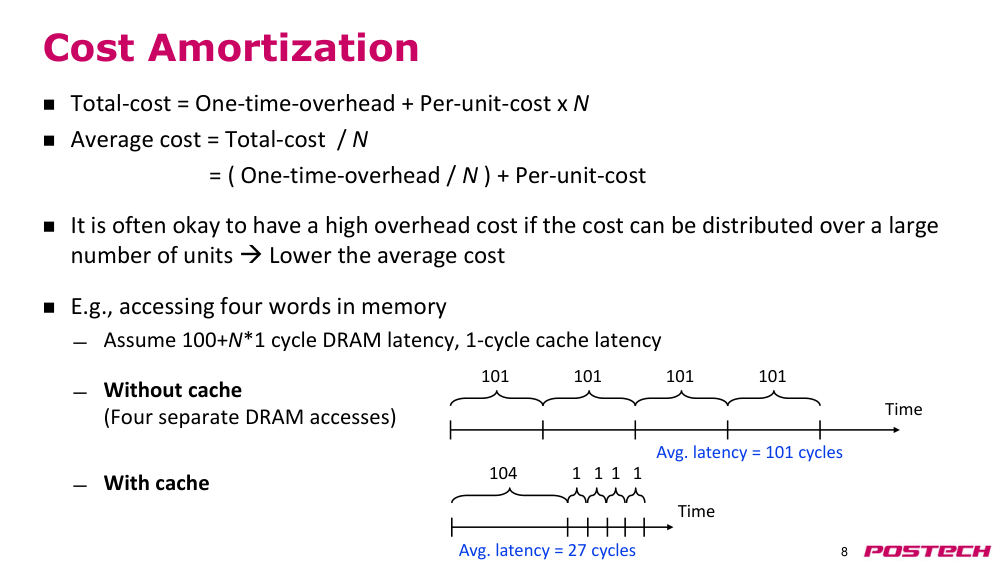
- 예: 메모리에서 네 word(워드)에 접근할 때
- 100 + N×1 사이클 DRAM 지연, 1사이클 cache(캐시) 지연 가정
- cache(캐시) 없음 (네 개의 별도 DRAM 접근)
- 시간: 101, 101, 101, 101
- 평균 latency(지연 시간) = 101 사이클
- cache(캐시) 있음
- 시간: 104, 1, 1, 1, 1
- 평균 latency(지연 시간) = 27 사이클
p.9원칙을 실제에 적용하기
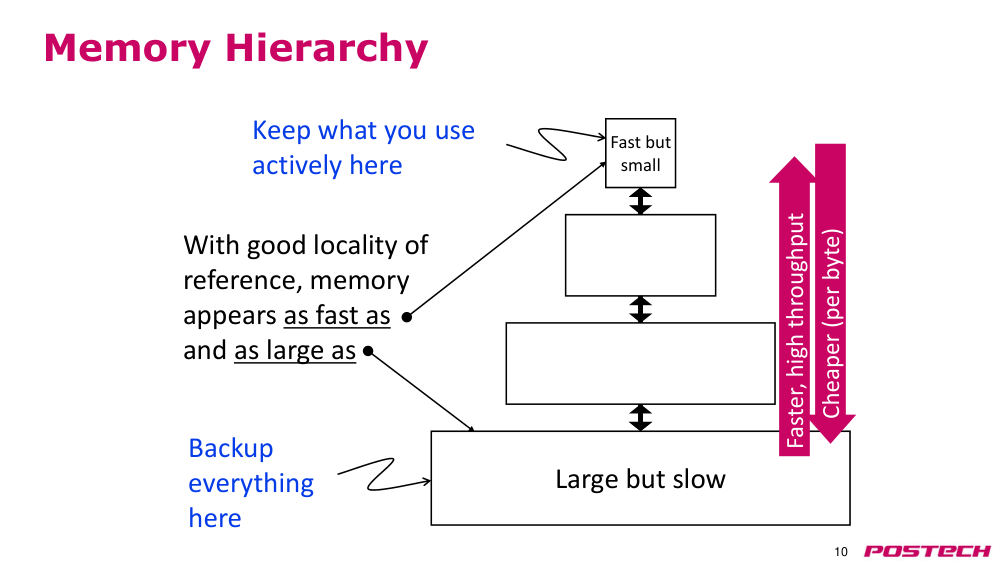
p.10memory hierarchy(메모리 계층 구조)
- 빠르지만 작음
- 크지만 느림
- 자주 사용하는 것을 여기에 유지
- 모든 것을 여기에 백업
- 좋은 참조 지역성이 있다면, 메모리는 빠르고 크게 보인다
- 더 빠른 속도, 높은 throughput(처리량)
- 저렴함 (바이트당)
p.11cache(캐시)
- 영어 정의: 비축물, 무기, 또는 보물 등을 위한 숨겨진 저장 공간
- 컴퓨터 과학 정의: access time(접근 시간)이 짧은 컴퓨터 메모리로, 자주 또는 최근에 사용된 명령어 또는 데이터를 저장하기 위해 사용 (I-cache(캐시) 및 D-캐시)
- 보다 일반적으로는, 특성이 다른 시스템 요소 간의 데이터 전송을 최적화하기 위해 사용 (예: 인터넷 서비스용 cache(캐시) 서버)
p.12memory hierarchy(메모리 계층 구조) 관리
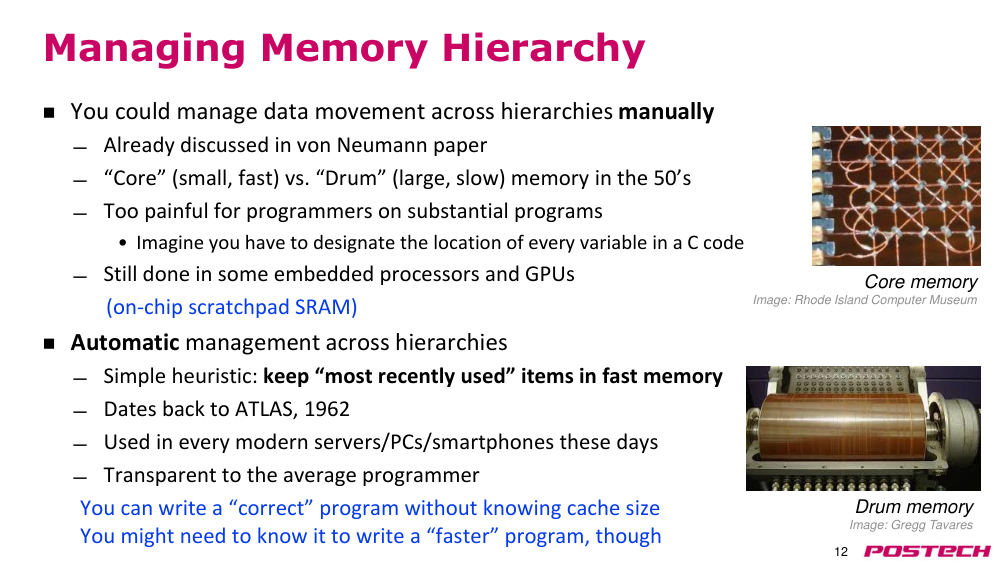
- 계층 간 데이터 이동을 수동으로 관리할 수 있다
- 이미 von Neumann 논문에서 다루어짐
- 1950년대의 '코어'(작고 빠름) vs. '드럼'(크고 느림) 메모리
- 대규모 프로그램에서는 프로그래머에게 너무 고통스럽다
- 예: C 코드에서 모든 변수의 위치를 수동으로 지정해야 한다고 상상해 보라
- 일부 임베디드 프로세서와 GPU에서는 여전히 수행됨 (on-chip scratchpad SRAM(온칩 스크래치패드 SRAM))
- 계층 간 자동 관리
- 간단한 heuristic(휴리스틱): 가장 최근에 사용된 항목을 빠른 메모리에 유지
- 1962년 ATLAS에서 시작됨
- 현재 모든 현대 서버/PC/스마트폰에서 사용됨
- 보통 프로그래머에게 투명함
- cache(캐시) 크기를 몰라도 '정확한' 프로그램을 작성할 수 있음
- 하지만 '더 빠른' 프로그램을 작성하려면 cache(캐시) 크기를 아는 것이 필요할 수 있음
- 드럼 메모리
- 이미지: Gregg Tavares
- 코어 메모리
- 이미지: Rhode Island Computer Museum
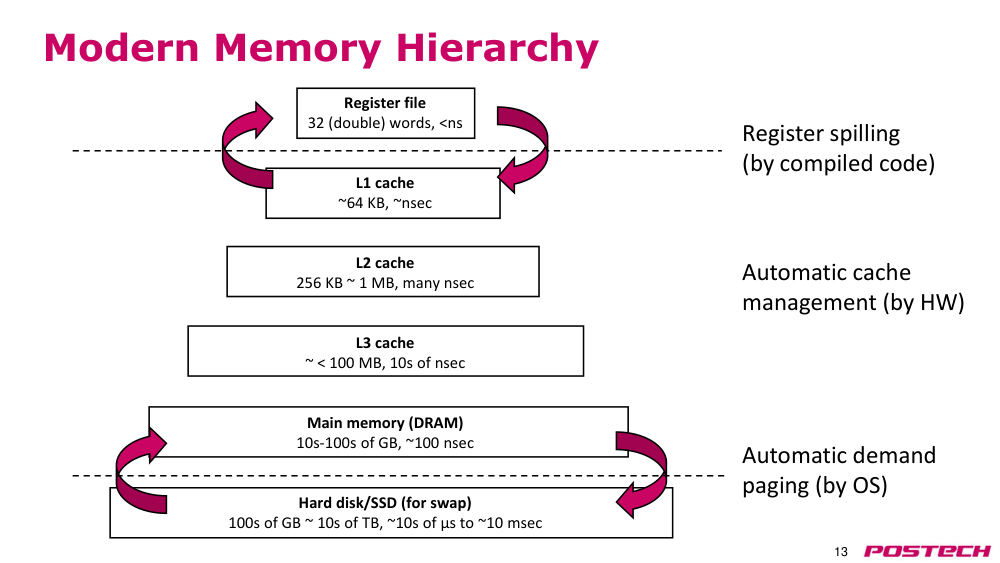
p.13현대의 memory hierarchy(메모리 계층 구조)
- register file(레지스터 파일): 32개(이중) word(워드), <1 ns
- L1 cache(L1 캐시): ~64 KB, ~ns
- L2 cache(L2 캐시): 256 KB ~ 1 MB, 수십 ns
- L3 cache(L3 캐시): ~<100 MB, 10수 ns
- 주기억장치(DRAM): 10s-100s GB, ~100 ns
- hard disk(하드 디스크)/SSD(스왑용): 100s GB ~ 10s TB, ~10s µs ~ ~10 ms
- register spilling(레지스터 스필링)(컴파일된 코드에 의해)
- automatic demand paging(자동 요구 페이징)(OS에 의해)
- 자동 cache(캐시) 관리(HW에 의해)
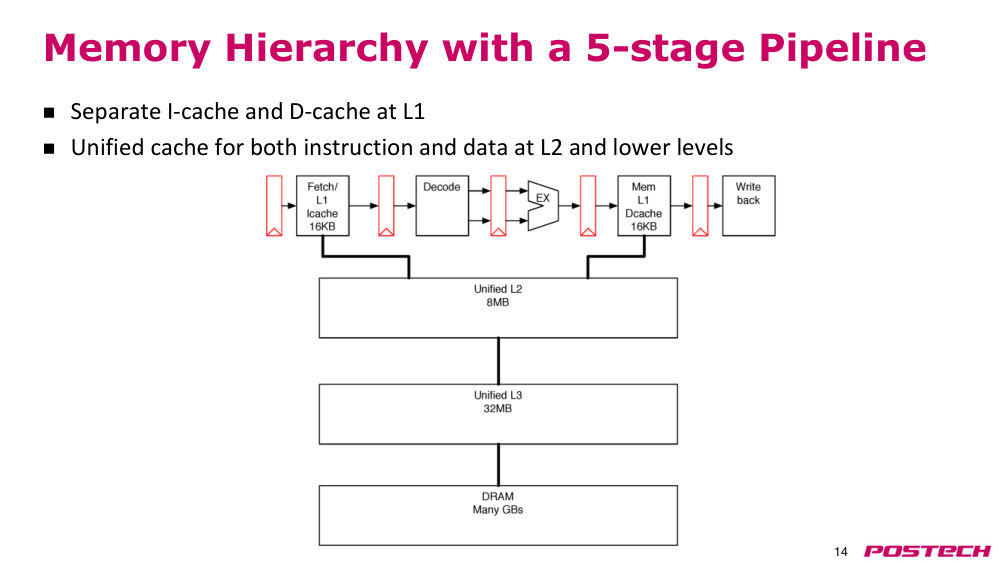
p.145단계 파이프라인을 갖춘 memory hierarchy(메모리 계층 구조)
- L1에서 instruction cache(명령어 캐시)와 data cache(데이터 캐시)를 분리
- L2 및 그 이하 레벨에서 명령어와 데이터 모두에 대해 unified cache(통합 캐시) 사용
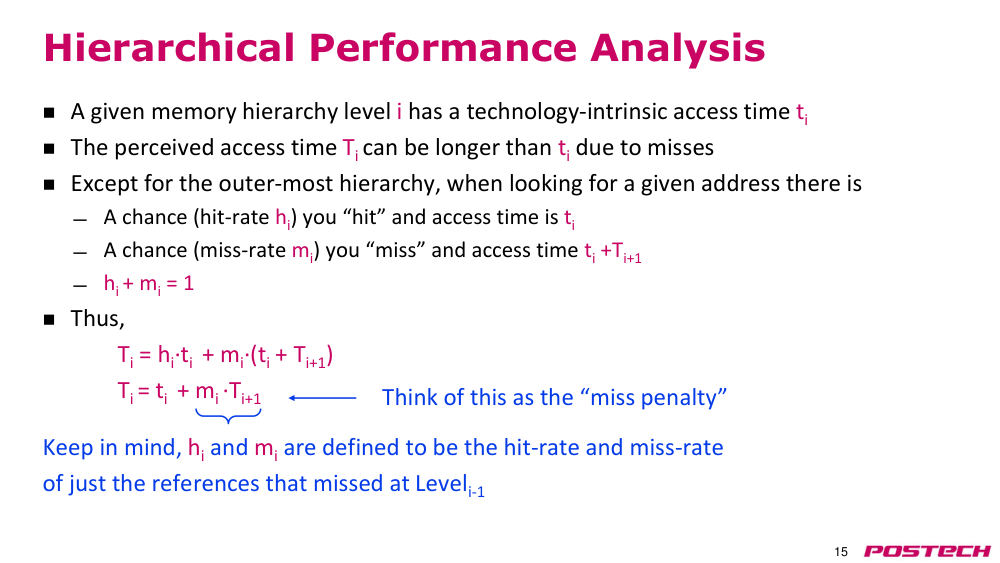
p.15계층적 성능 분석
- memory hierarchy(메모리 계층 구조)의 특정 레벨 i는 기술적 고유 access time(접근 시간) ti를 가짐
- 미스 발생 시 실제 access time(접근 시간) Ti는 ti보다 길 수 있음
- 가장 바깥쪽 계층을 제외하고, 특정 주소를 찾을 때는
- hit rate(히트율) hi로 인해 "히트"하여 access time(접근 시간)이 ti
- miss rate(미스율) mi로 인해 "미스"하여 access time(접근 시간)이 ti + Ti+1
- hi + mi = 1
- 따라서, Ti = hi·ti + mi·(ti + Ti+1)
- Ti = ti + mi ·Ti+1
- 참고: hi와 mi는 Level i-1에서 미스한 참조들에 대한 hit rate(히트율)과 miss rate(미스율)로 정의됨
- 이를 "miss penalty(미스 페널티)"로 생각할 수 있음
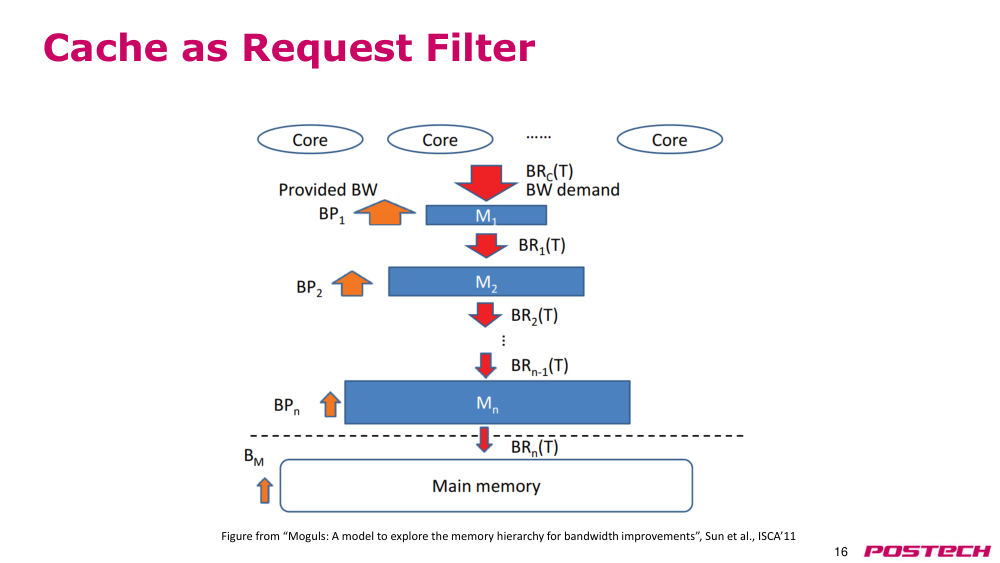
p.16cache(캐시)를 요청 필터로 사용하기
p.17계층 구조 설계의 타협점
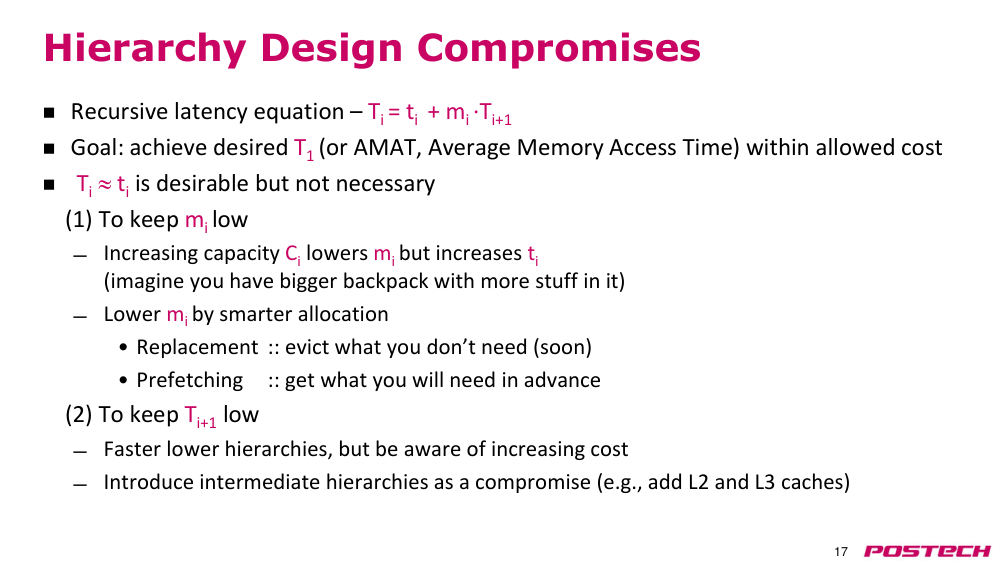
- 재귀적 latency(지연 시간) 방정식: Ti = ti + mi ·Ti+1
- 목표: 허용되는 비용 내에서 원하는 T1(또는 AMAT, 평균 메모리 접근 시간) 달성
- (1) mi를 낮추기 위해
- cache capacity(캐시 용량) Ci를 늘리면 mi는 낮아지지만 ti는 증가함
- (크기가 큰 배낭에 더 많은 물건을 넣는 것과 유사)
- 더 스마트한 할당으로 mi를 낮추기
- • replacement(교체) 정책: 곧 필요하지 않은 것을 eviction(축출)
- • prefetching(프리페치): 앞으로 필요할 것을 미리 가져옴
- (2) Ti+1을 낮추기 위해
- 더 빠른 하위 계층을 도입하지만 비용 증가에 주의
- 중간 계층을 도입하여 타협점 마련(예: L2 및 L3 cache(L3 캐시) 추가)
p.18계층 구조 설계 고려사항
- DRAM(동적 랜덤 액세스 메모리: 대용량 메모리에 사용)
- 용량/비용 최적화
- TDRAM은 주어진 기술 세대에서 타이밍 파라미터에 의해 거의 결정됨
- (DRAM 내부의 지역성에 따라 여전히 변할 수 있음 – 나중에 논의)
- SRAM(정적 랜덤 액세스 메모리: cache(캐시) 및 register file(레지스터 파일)에 사용)
- 최적화 고려사항: 용량, latency(지연 시간), 용량/비용
- 각 cache(캐시) 레벨에 따라 용량과 latency(지연 시간) 사이의 다양한 타협점
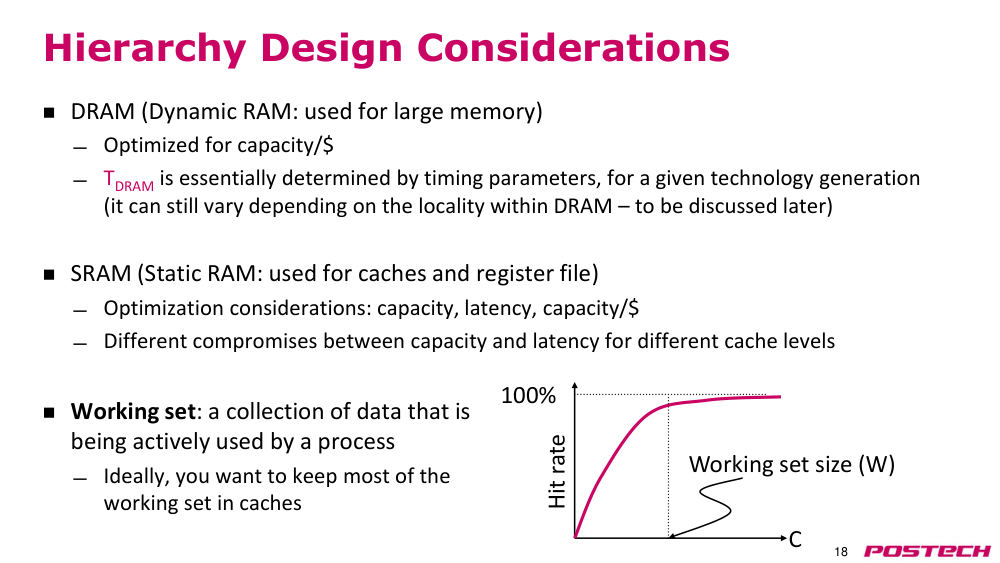
- working set(작업 집합): 프로세스가 현재 활발히 사용 중인 데이터의 집합
- 이상적으로는 working set(작업 집합)의 대부분을 cache(캐시)에 유지하고 싶음
- hit rate(히트율): 100%
- working set(작업 집합) 크기(W)
- cache(캐시) 용량(C)
p.19Intel P4 예시
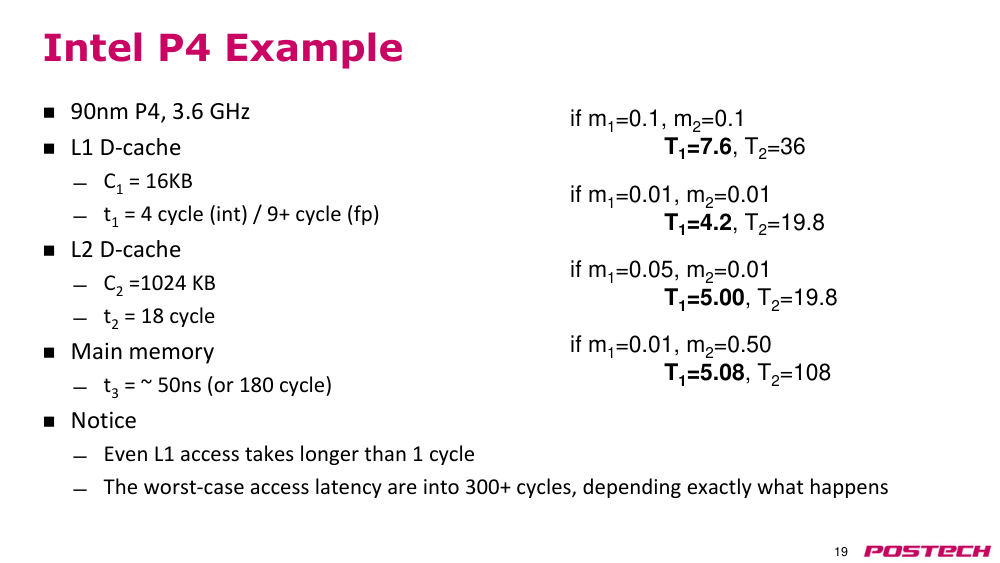
- 90nm P4, 3.6 GHz
- L1 D-cache(L1 데이터 캐시)
- C1 = 16KB
- t1 = 4 사이클 (정수) / 9+ 사이클 (부동소수점)
- L2 D-cache(L2 데이터 캐시)
- C2 = 1024 KB
- t2 = 18 사이클
- main memory(주기억장치)
- t3 = ~50ns (또는 180 사이클)
- 주의사항
- L1 접근도 1 사이클보다 오래 걸림
- 가장 나쁜 경우 접근 latency(지연 시간)은 정확히 무엇이 일어나는지에 따라 300+ 사이클에 이르기도 함
- m1=0.1, m2=0.1 일 때: T1=7.6, T2=36
- m1=0.01, m2=0.01 일 때: T1=4.2, T2=19.8
- m1=0.05, m2=0.01 일 때: T1=5.00, T2=19.8
- m1=0.01, m2=0.50 일 때: T1=5.08, T2=108
p.20cache(캐시) 설계 기본
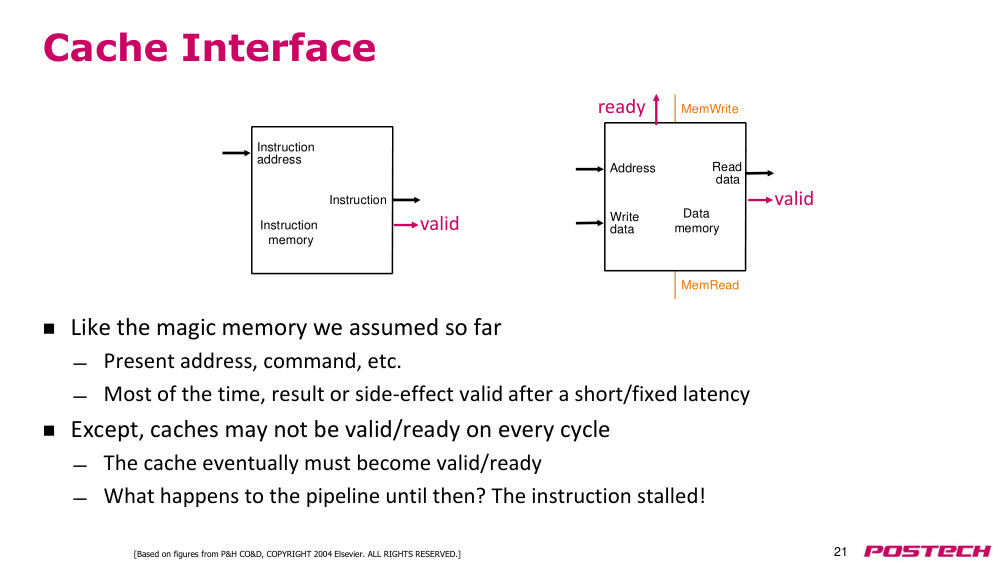
p.21cache(캐시) 인터페이스
- 지금까지 가정한 마법의 메모리처럼 동작
- 주소, 명령어 등 제공
- 대부분의 경우, 짧은/고정된 latency(지연 시간) 후 결과 또는 부수적 효과가 유효함
- 다만, cache(캐시)는 모든 사이클에서 유효/준비 상태가 아닐 수 있음
- cache(캐시)는 결국 유효/준비 상태가 되어야 함
- 그 동안 파이프라인은 어떻게 되는가? 명령어가 정지됨!
- 명령어 메모리
- 명령어 주소
- 명령어 읽기
- 명령어 쓰기
- 데이터 메모리
- 쓰기 데이터
- 읽기 데이터
- 주소
- valid
- valid
- ready
p.22기본 문제
- 가능한 M = 2m바이트의 메모리가 있을 때, C바이트의 빠른 저장소에 자주 사용되는 데이터를 유지해야 함 (C << M)
- 기본적인 문제
- (1) 메모리 위치를 어디에 'cache(캐시)'할 것인가?
- (2) cache(캐시)된 메모리 위치를 어떻게 찾을 것인가?
- (3) 관리의 granularity(세분화 수준): 크고, 작고, 균일한가?
- (4) 언제 메모리 위치를 cache(캐시)로 가져올 것인가?
- (5) 공간을 확보하기 위해 어떤 cache(캐시)된 메모리 위치를 eviction(축출)할 것인가?
- 최적화
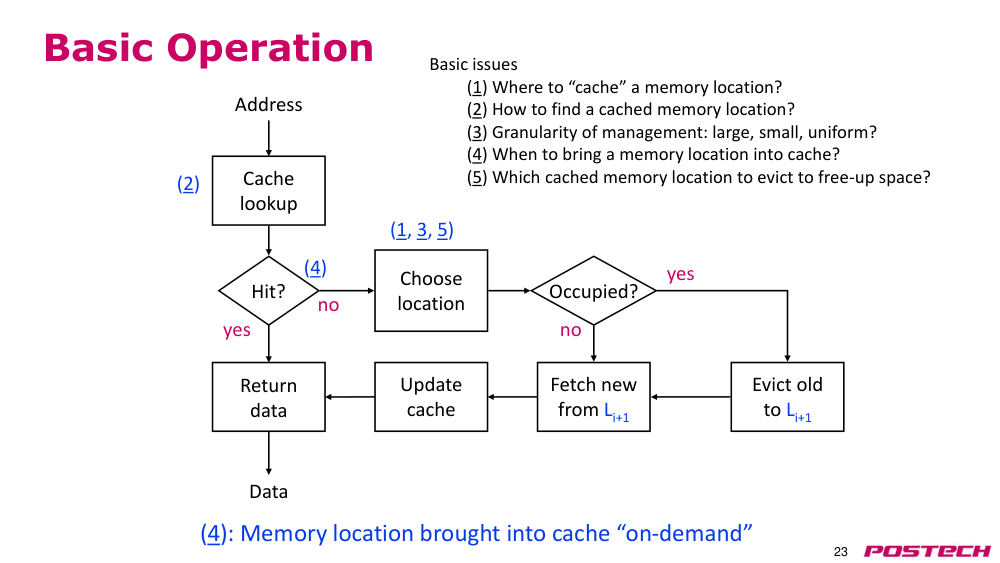
p.23기본 동작
- 히트?
- cache(캐시) 룩업
- 데이터 반환
- 데이터
- 주소
- 위치 선택
- 사용 중인가?
- 예
- 아니오
- 아니오
- Li+1에서 새 데이터 가져오기
- 기존 데이터 eviction(축출)하여 Li+1로 보내기
- 예
- cache(캐시) 업데이트
- (4): 메모리 위치는 'on-demand loading(요청 시 로딩)' 방식으로 cache(캐시)로 가져옴
- (2)
- (1, 3, 5)
- (4)
- 기본적인 문제
- (1) 메모리 위치를 어디에 'cache(캐시)'할 것인가?
- (2) cache(캐시)된 메모리 위치를 어떻게 찾을 것인가?
- (3) 관리의 granularity(세분화 수준): 크고, 작고, 균일한가?
- (4) 언제 메모리 위치를 cache(캐시)로 가져올 것인가?
- (5) 공간을 확보하기 위해 어떤 cache(캐시)된 메모리 위치를 eviction(축출)할 것인가?
p.24기본 cache(캐시) 파라미터
- M = 2m를 address space(주소 공간)의 크기(바이트 단위)로 정의
- 예시 값: 232, 264
- G = 2g를 cache(캐시) 접근의 세분화 수준(바이트 단위)로 정의
- 예시 값: 4, 8
- C를 cache(캐시)의 '용량'(바이트 단위)로 정의
- 예시 값: 32 KB (L1), 1 MB (L2)
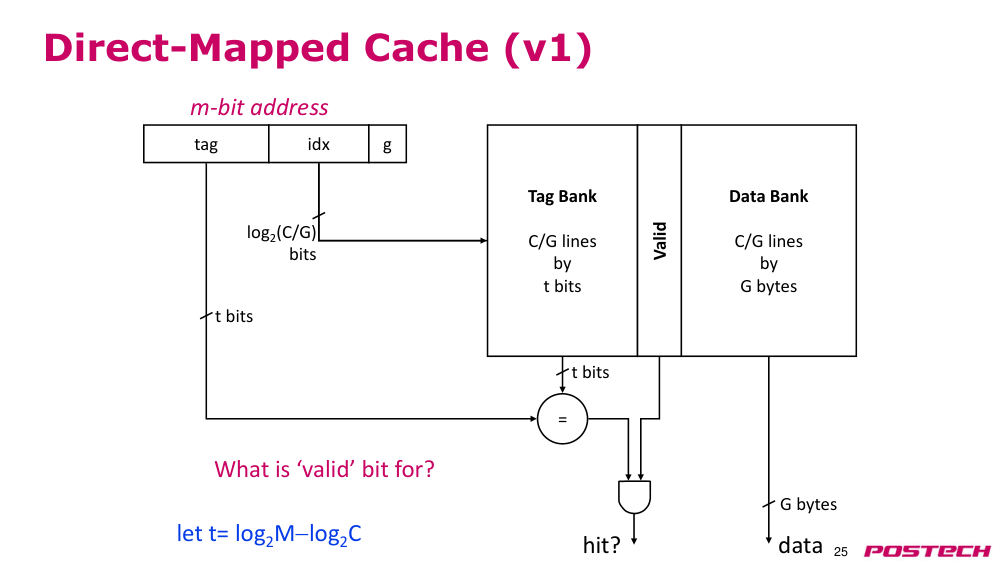
p.25Direct-Mapped cache(직접 매핑 캐시) (v1)
- data bank(데이터 뱅크)
- C/G 라인
- G byte(바이트)
- t = log₂M − log₂C
- tag(태그)
- index(인덱스)
- g
- G byte(바이트)
- 데이터
- tag bank(태그 뱅크)
- C/G 라인
- t 비트
- 히트?
- t 비트
- t 비트
- log₂(C/G) 비트
- valid bit(유효 비트)
- m비트 주소
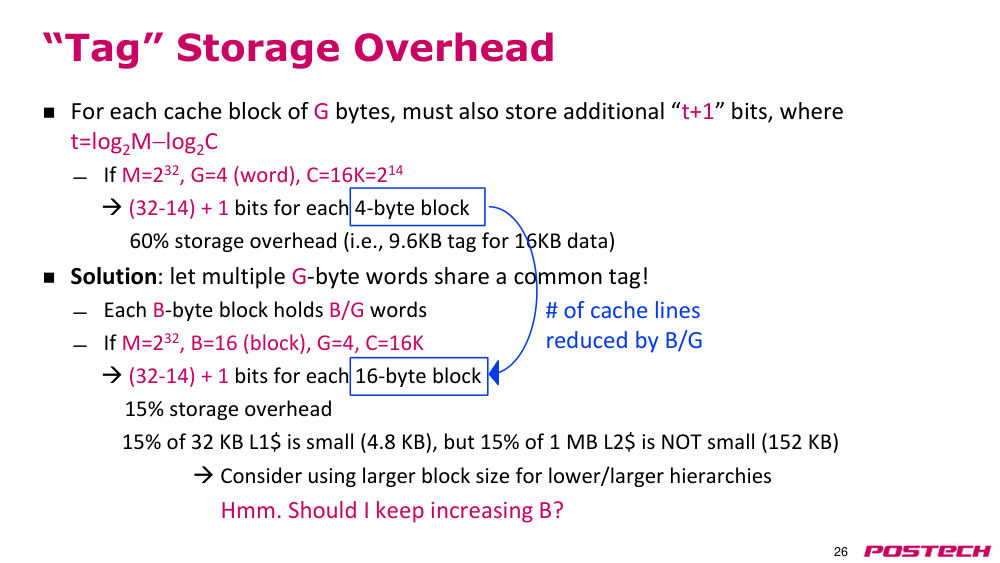
p.26tag storage overhead(태그 저장소 오버헤드)
- 각 G바이트 block(블록)당 t+1 비트의 추가 저장이 필요함 (t = log₂M − log₂C)
- M = 2³², G = 4(워드), C = 16K = 2¹⁴인 경우
- 각 4바이트 block(블록)당 (32−14) + 1 비트
- 저장소 오버헤드 60% (16KB 데이터에 대해 9.6KB 태그)
- 해결책: 여러 G바이트 word(워드)가 공통 tag(태그)를 공유하도록 하기!
- 각 B바이트 block(블록)은 B/G개의 word(워드)를 포함
- M = 2³², B = 16(블록), G = 4, C = 16K인 경우
- 각 16바이트 block(블록)당 (32−14) + 1 비트
- 15% 저장소 오버헤드
- L1 cache(L1 캐시) 32KB의 15%는 작음 (4.8KB), 그러나 L2 cache(L2 캐시) 1MB의 15%는 작지 않음 (152KB)
- 낮은/높은 계층에서 더 큰 block size(블록 크기) 사용 고려
- 이제 B를 계속 늘려야 할까?
- cache line(캐시 라인) 수는 B/G만큼 감소
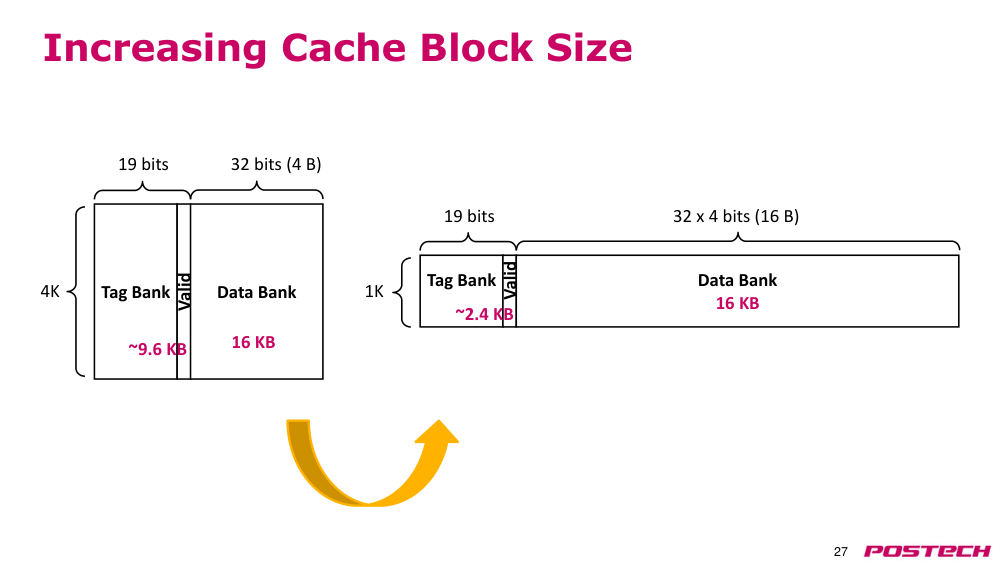
p.27cache(캐시) block size(블록 크기) 증가
- tag bank(태그 뱅크)
- valid bit(유효 비트)
- data bank(데이터 뱅크)
- 32비트 (4B)
- 19비트
- 4K
- tag bank(태그 뱅크)
- valid bit(유효 비트)
- data bank(데이터 뱅크)
- 16KB
- 32 × 4비트 (16B)
- 19비트
- 1K
- ~2.4KB
- 16KB
- ~9.6KB
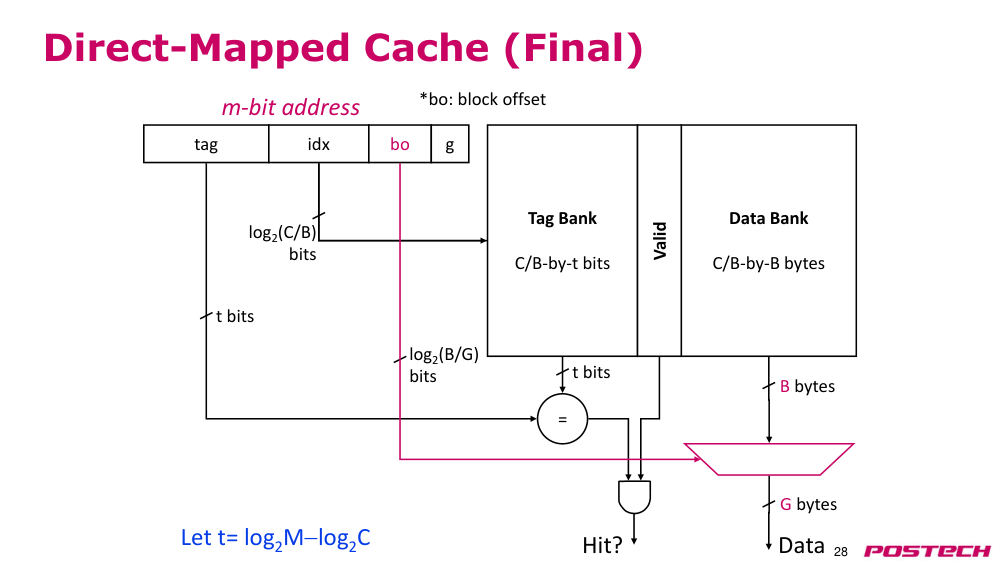
p.28Direct-Mapped cache(직접 매핑 캐시) (최종)
- data bank(데이터 뱅크)
- C/B-by-B byte(바이트)
- t = log₂M − log₂C
- tag(태그)
- index(인덱스)
- block offset(블록 오프셋)
- g
- B byte(바이트)
- G byte(바이트)
- 데이터
- tag bank(태그 뱅크)
- C/B-by-t 비트
- 히트?
- t 비트
- t 비트
- log₂(B/G) 비트
- log₂(C/B) 비트
- valid bit(유효 비트)
- m비트 주소
- *bo: block offset(블록 오프셋)
p.29block size(블록 크기)와 미스율 (miss-rate)
- 공통 tag(태그)를 공유하는 byte(바이트)들은 모두 로드되거나 모두 eviction(축출)됨
- cache capacity(캐시 용량) C를 일정하게 유지하면서 block size(블록 크기)를 증가시키는 효과는?
- 좋은 점: 다중 word(워드) block(블록)을 한 번에 로드하면 prefetching(프리페치) 효과 발생 (공간적 지역성 더 잘 활용)
- block(블록)당 miss penalty(미스 페널티)를 한 번만 지불
- instruction cache(명령어 캐시)와 규칙적인 데이터 접근 패턴(예: 순차 배열 접근)에서 특히 효과적
- spatial locality(공간적 지역성)의 한계까지 유효함
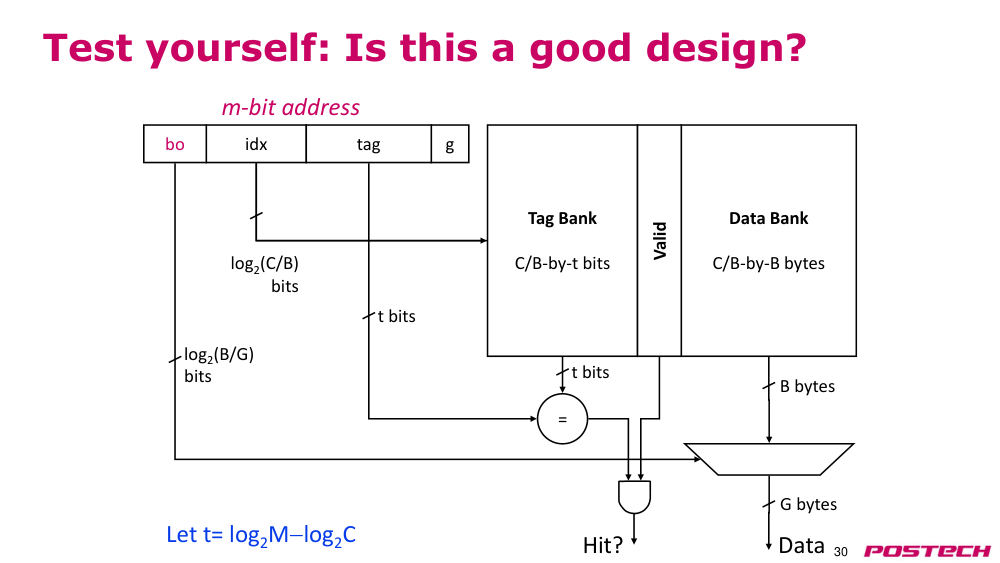
p.30자기 테스트: 이 설계는 좋은가요?
- data bank(데이터 뱅크)
- C/B-by-B byte(바이트)
- t = log₂M − log₂C
- index(인덱스)
- block offset(블록 오프셋)
- g
- B byte(바이트)
- G byte(바이트)
- 데이터
- tag bank(태그 뱅크)
- C/B-by-t 비트
- 히트?
- t 비트
- t 비트
- log₂(B/G) 비트
- log₂(C/B) 비트
- valid bit(유효 비트)
- tag(태그)
- m비트 주소
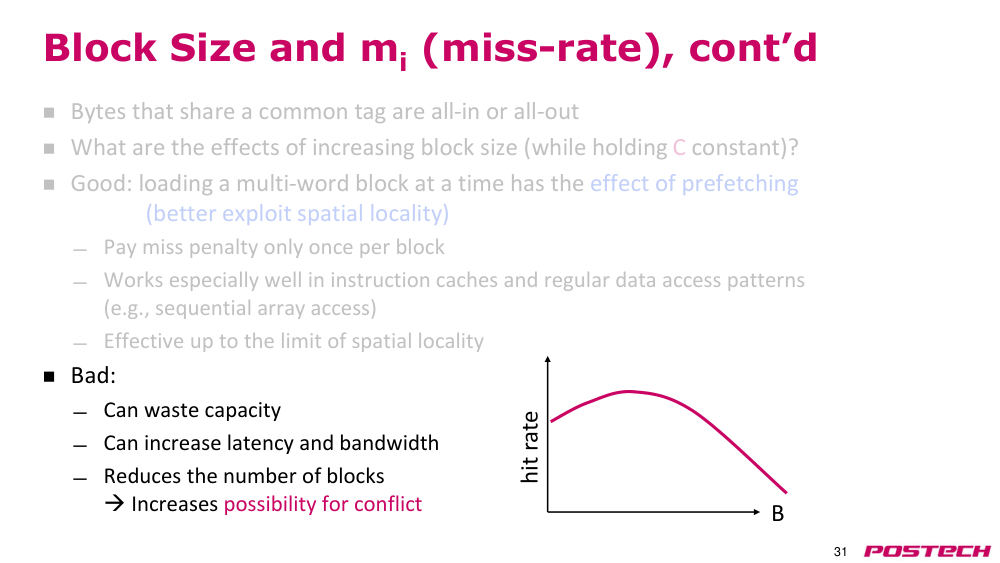
p.31block size(블록 크기)와 miss rate(미스율), 계속
- 공통된 tag(태그)를 공유하는 byte(바이트)들은 모두 로드되거나 모두 eviction(축출)된다.
- block size(블록 크기)를 늘리되 cache capacity(캐시 용량) C는 일정하게 유지할 경우 어떤 영향이 있는가?
- 좋은 점:
- 한 번에 다수의 word(워드) block(블록)을 로드하는 것은 prefetching(프리페치) 효과를 낸다 (공간적 지역성 더 잘 활용)
- block(블록)당 한 번만 miss penalty(미스 페널티)를 지불하면 된다
- instruction cache(명령어 캐시)와 규칙적인 데이터 접근 패턴(예: 순차적 배열 접근)에서 특히 효과적이다
- spatial locality(공간적 지역성)의 한계까지는 효과적이다
- 나쁜 점:
- 용량 낭비가 발생할 수 있다
- latency(지연 시간)과 bandwidth(대역폭)이 증가할 수 있다
- block(블록) 수가 감소한다
- 충돌 가능성 증가
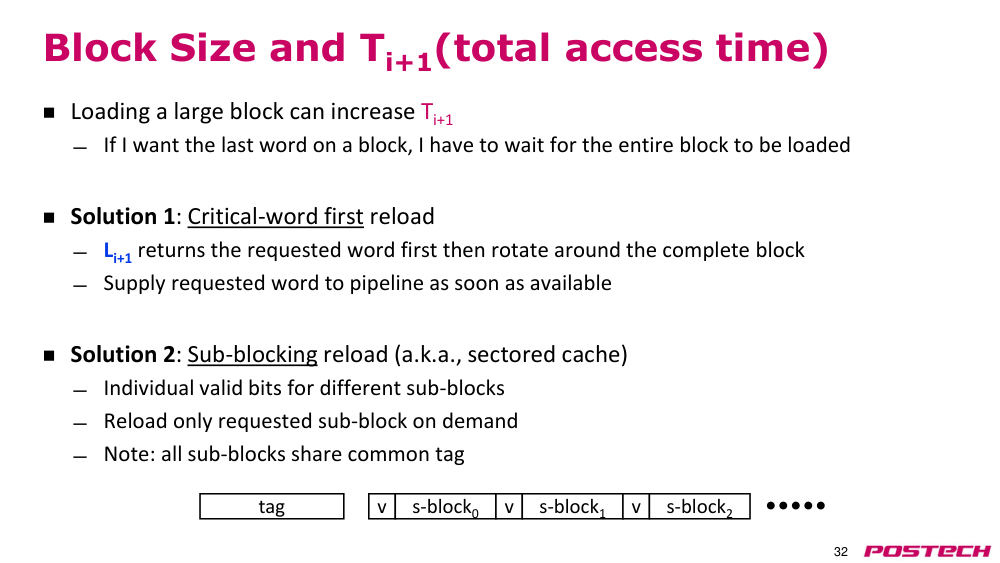
p.32block size(블록 크기)와 Ti+1(전체 접근 시간)
- 큰 block(블록)을 로드하면 Ti+1가 증가할 수 있다
- block(블록)의 마지막 word(워드)를 원할 경우 전체 블록이 로드될 때까지 기다려야 한다
- 해결책 1: critical word first reload(크리티컬 워드 우선 재로드)
- Li+1는 요청된 word(워드)를 먼저 반환한 후 전체 block(블록)을 순환한다
- 요청된 word(워드)가 사용 가능할 때 파이프라인에 공급한다
- 해결책 2: sub-blocking reload(서브 블로킹 재로드) (또는 sectored cache(섹터드 캐시))
- 각 sub-block(서브블록)에 개별 valid bit(유효 비트)가 존재한다
- 요청 시에만 필요한 sub-block(서브블록)만 재로드한다
- 참고: 모든 sub-block(서브블록)은 공통 tag(태그)를 공유한다
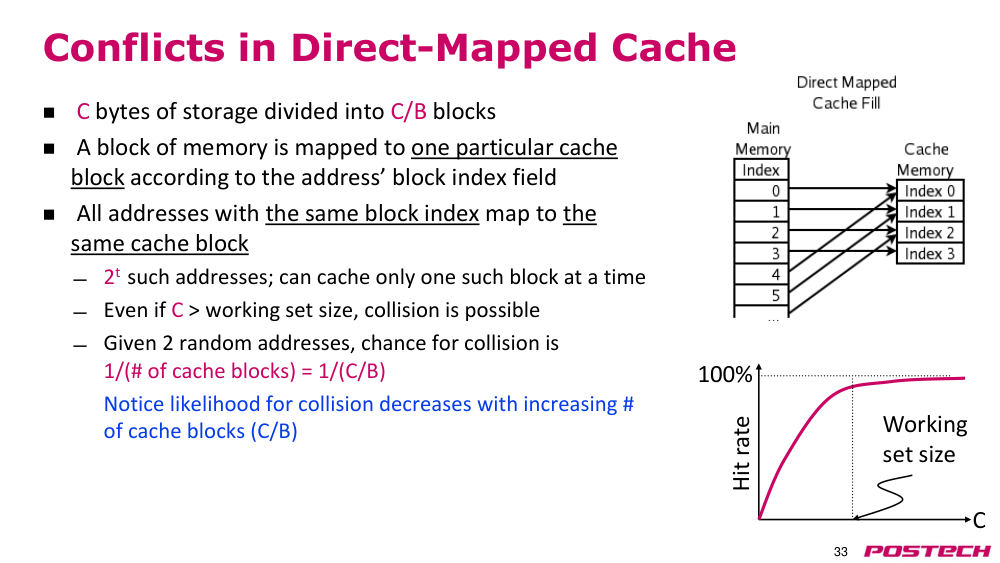
p.33Direct-Mapped cache(직접 매핑 캐시)의 충돌
- C byte(바이트)의 저장 공간이 C/B개의 block(블록)으로 나뉜다
- 메모리의 block(블록)은 주소의 블록 index(인덱스) 필드에 따라 특정 cache(캐시) 블록에 매핑된다
- 같은 block(블록) index(인덱스)를 가진 모든 주소는 동일한 cache(캐시) 블록에 매핑된다
- 2t개의 이러한 주소가 존재하며, 동시에 cache(캐시)할 수 있는 것은 하나의 block(블록)뿐이다
- C가 working set size(작업 집합 크기)보다 크더라도 충돌이 발생할 수 있다
- 2개의 임의 주소가 충돌할 확률은 1/(캐시 block(블록) 수) = 1/(C/B)이다
- cache(캐시) block(블록) 수(C/B)가 증가할수록 충돌 가능성은 감소한다
p.34많은 것이 하나보다 낫다. 여러 개의 Direct-Mapped cache(직접 매핑 캐시)를 함께 사용하는 것은 어떨까?
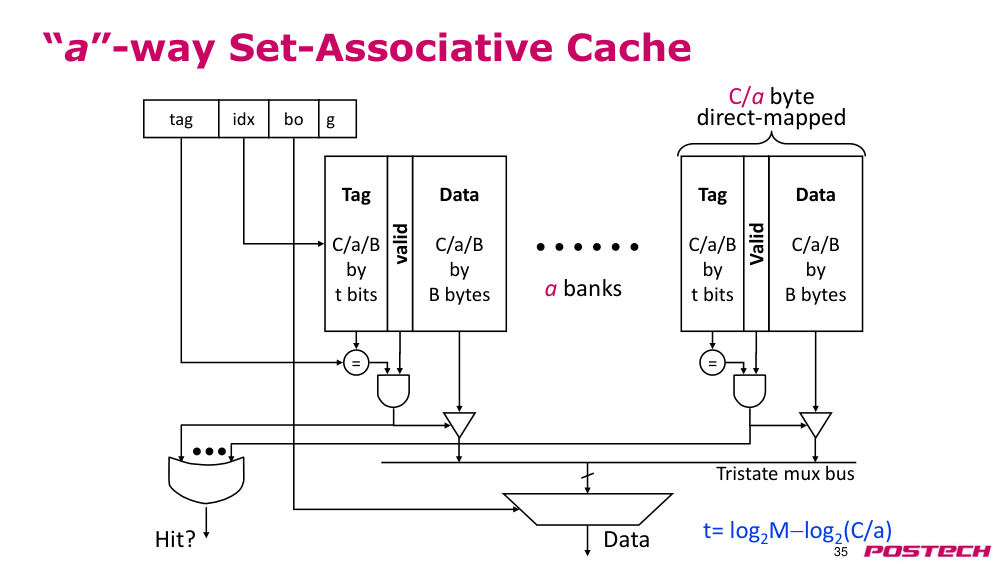
p.35"a"-way Set-Associative cache(세트 연관 캐시)
- 데이터: C/a/B개의 B바이트
- t = log2M − log2(C/a)
- tag(태그)
- index(인덱스)
- block offset(블록 오프셋)
- 데이터 = tag(태그): C/a/B개의 t비트
- 유효
- 데이터: C/a/B개의 B바이트
- tag(태그): C/a/B개의 t비트
- 유효: C/a바이트
- direct-mapped(직접 매핑)
- a개의 bank(뱅크)
- 히트 여부?
- tristate multiplexer bus(트라이스테이트 멀티플렉서 버스)
p.36"a"-way Set-Associative cache(세트 연관 캐시)
- C byte(바이트)의 저장 공간이 각각 C/a/B개의 block(블록)을 가진 a개의 bank(뱅크)로 나뉜다 (a개의 작은 Direct-Mapped cache(직접 매핑 캐시)로 볼 수 있음)
- 비교기 a개와 a:1 멀티플렉서가 필요하다
- 주소는 block(블록) index(인덱스) 필드에 따라 bank(뱅크) 내 특정 블록에 매핑되지만, a개의 bank(뱅크)가 존재한다 (함께 '세트'라고 알려짐)
- 같은 block(블록) index(인덱스) 필드를 가진 모든 주소는 공통된 '세트'의 cache(캐시) 블록에 매핑된다
- 2t개의 이러한 주소가 존재하며, 동시에 a개의 block(블록)을 담을 수 있다
- 연관성 수준이 높을수록 충돌이 줄어든다
p.37Set-Associative cache(세트 연관 캐시)의 cache replacement policy(캐시 교체 정책)
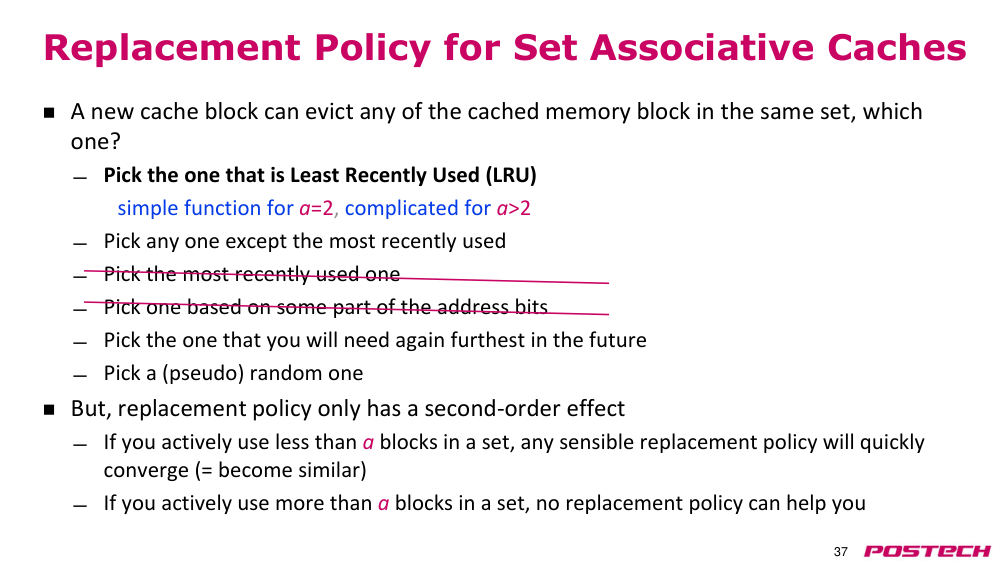
- 새로운 cache(캐시) block(블록)은 동일한 세트 내의 어떤 캐시 메모리 블록을 eviction(축출)할지 결정해야 한다.
- 가장 최근에 사용되지 않은 것(LRU)을 선택한다.
- a=2인 경우 간단한 함수로 구현 가능하지만, a>2인 경우 복잡해진다.
- 가장 최근에 사용된 block(블록)을 제외한 어떤 블록이나 선택한다.
- 가장 최근에 사용된 block(블록)을 선택한다.
- 주소 비트의 일부를 기반으로 block(블록)을 선택한다.
- 앞으로 가장 오래 사용되지 않을 것으로 예상되는 block(블록)을 선택한다.
- 임의의 block(블록)을 선택한다.
- 그러나 cache replacement policy(캐시 교체 정책)은 두 번째 순위의 영향을 미친다.
- 세트 내에서 a개 미만의 block(블록)을 실제로 사용하는 경우, 어떤 합리적인 replacement(교체) 정책이라도 빠르게 수렴(유사해짐)한다.
- 세트 내에서 a개 이상의 block(블록)을 실제로 사용하는 경우, 어떤 replacement(교체) 정책도 도움이 되지 않는다.
p.38pseudo-associativity(의사 연관성): 예, MIPS R10000 2-way L2
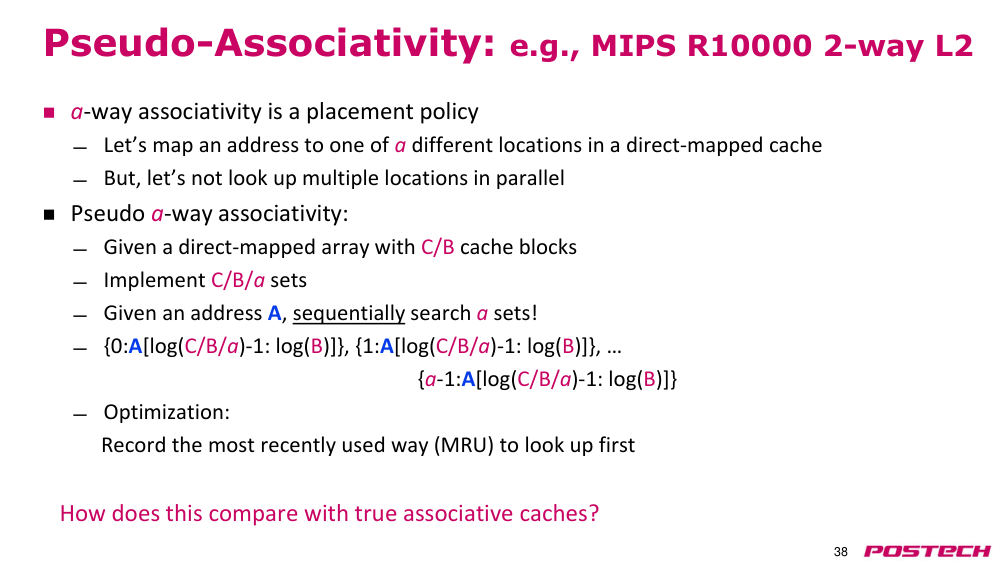
- a-way associativity(a-way 연관성)은 배치 정책이다.
- 주소를 Direct-Mapped cache(직접 매핑 캐시) 내의 a개 다른 위치 중 하나로 매핑한다.
- 그러나 병렬로 여러 위치를 검색하지는 않는다.
- pseudo a-way associativity(의사 a-way 연관성):
- 직접 매핑 배열에 C/B개의 cache(캐시) block(블록)이 있다.
- C/B/a개의 세트를 구현한다.
- 주소 A가 주어졌을 때, 세트를 순차적으로 검색한다!
- {0:A[log(C/B/a)-1: log(B)]}, {1:A[log(C/B/a)-1: log(B)]}, … {a-1:A[log(C/B/a)-1: log(B)]}
- 최적화: most recently used way(MRU)를 기록하여 먼저 검색한다.
- true associative cache(진정한 연관 캐시)와 비교했을 때는 어떻게 다를까?
p.39fully associative cache(완전 연관 캐시): a≡C/B
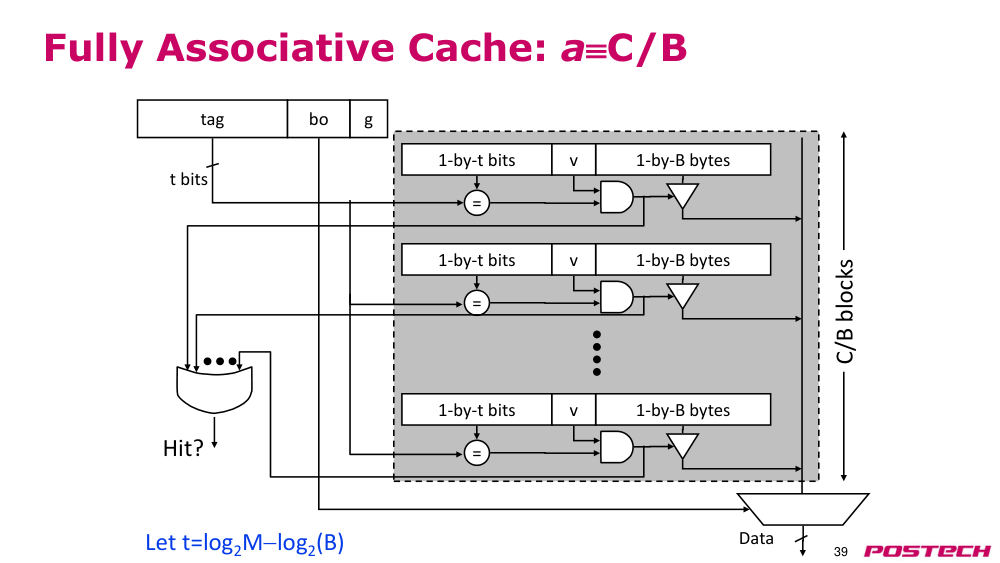
- 1-by-B byte(바이트)
- t = log₂M − log₂(B)
- tag(태그)
- block offset(블록 오프셋)
- 데이터
- 1-by-t 비트
- t 비트
- valid bit(유효 비트)
- 1-by-B byte(바이트)
- 1-by-t 비트
- valid bit(유효 비트)
- 1-by-B byte(바이트)
- 1-by-t 비트
- valid bit(유효 비트)
- C/B block(블록)
- 히트?
p.40fully associative cache(완전 연관 캐시): a≡C/B
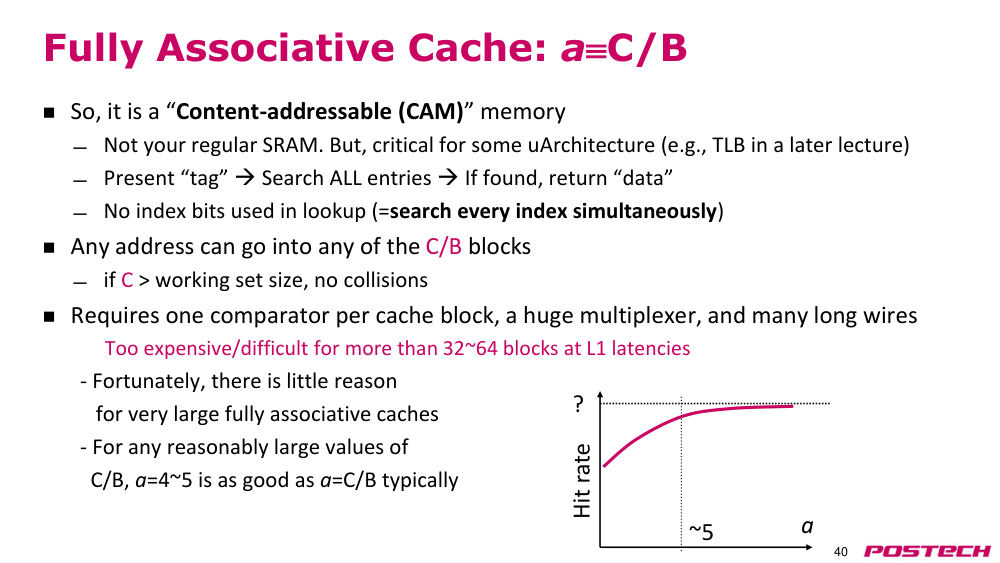
- 따라서 이것은 "content-addressable memory(CAM)(내용 주소 지정 메모리)"이다.
- 일반적인 SRAM이 아니다. 그러나 일부 uArchitecture(마이크로아키텍처)(예: 나중 강의에서 설명할 TLB)에 필수적이다.
- tag(태그)를 제시 → 모든 항목 검색 → 발견되면 데이터 반환
- 검색 시 index(인덱스) 비트를 사용하지 않음(모든 인덱스를 동시에 검색)
- 어떤 주소도 C/B개의 block(블록) 중 어느 곳에나 배치될 수 있다.
- C가 working set size(작업 집합 크기)보다 크면 충돌이 발생하지 않는다.
- cache(캐시) block(블록)당 하나의 비교기, 거대한 멀티플렉서, 그리고 많은 긴 배선이 필요하다.
- L1 latency(지연 시간) 기준으로 32~64개 이상의 block(블록)에 대해 너무 비싸고 어려움.
- 다행히 매우 큰 fully associative cache(완전 연관 캐시)가 필요한 이유는 거의 없다.
- C/B가 합리적으로 큰 값일 경우, 일반적으로 a=4~5는 a=C/B와 비슷한 성능을 낸다.
- hit rate(히트율)
- a
- ~5
p.41요약: 기본 cache(캐시) 파라미터
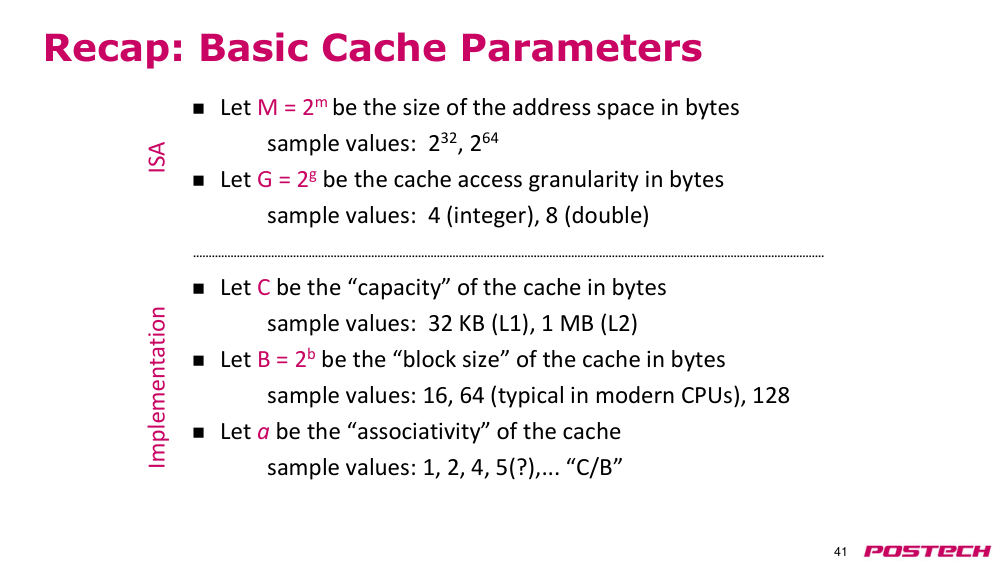
- M = 2ᵐ는 address space(주소 공간)의 크기(바이트 단위)
- 예: 2³², 2⁶⁴
- G = 2ᵍ는 cache(캐시) 접근 세분화 수준(바이트 단위)
- 예: 4(정수), 8(배정밀도)
- C는 cache(캐시) 용량(바이트 단위)
- 예: 32 KB(L1), 1 MB(L2)
- B = 2ᵇ는 cache(캐시) block(블록) 크기(바이트 단위)
- 예: 16, 64(현대 CPU에서 일반적), 128
- a는 cache associativity(캐시 연관성)
- 예: 1, 2, 4, 5(?), ... "C/B"
- ISA
- 구현
p.42요약: 주소 필드
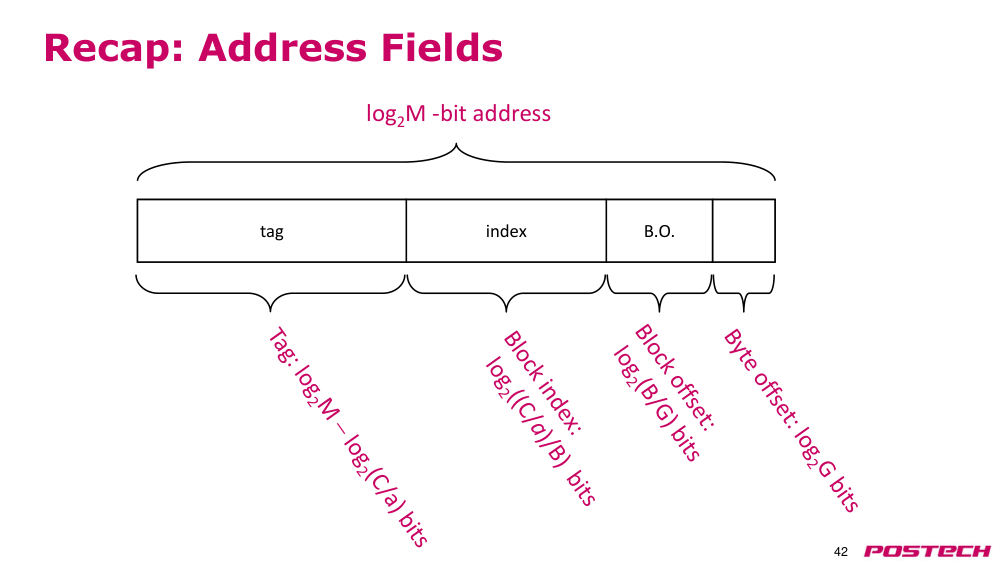
- log₂M비트 주소
- block offset(블록 오프셋)
- index(인덱스)
- tag(태그)
p.43질문?
- 공지사항
- - 교재 읽기: P&H Ch. 5.1 – 5.4
- - 논문 읽기: "Direct-Mapped cache(캐시) 성능 향상을 위한 소형 fully associative cache(완전 연관 캐시) 및 prefetching(프리페치) 버퍼 추가에 관한 연구", N. P. Jouppi, ISCA’90
- - 마감일: 5월 29일 (금) 23:59