이 자료를 쓰는 강의: 50 cache 설계(block·associativity·replacement)와 miss 분류·write 문제 · 51 non-blocking cache·write policy·multi-level cache 와 virtual memory 도입
CSED311 Computer Architecture – Lecture 14
한국어판 강의자료 · 27쪽
p.1CSED311 컴퓨터구조 – 강의 14
- 메모리 계층 및 cache(캐시) II
- Gwangsun Kim
- Department of Computer Science and Engineering
- POSTECH
- 면책 조항: 슬라이드 일부는 Carnegie Mellon University, University of Michigan, Purdue University, University of Pennsylvania, University of Wisconsin의 Austin, Brehob, Falsafi, Hill, Hoe, Lipasti, Martin, Roth, Shen, Smith, Sohi, Tyson, Vijaykumar, Mutlu, Wenisch 교수진이 개발함
p.2cache miss(캐시 미스)의 분류: cold miss(콜드 미스)
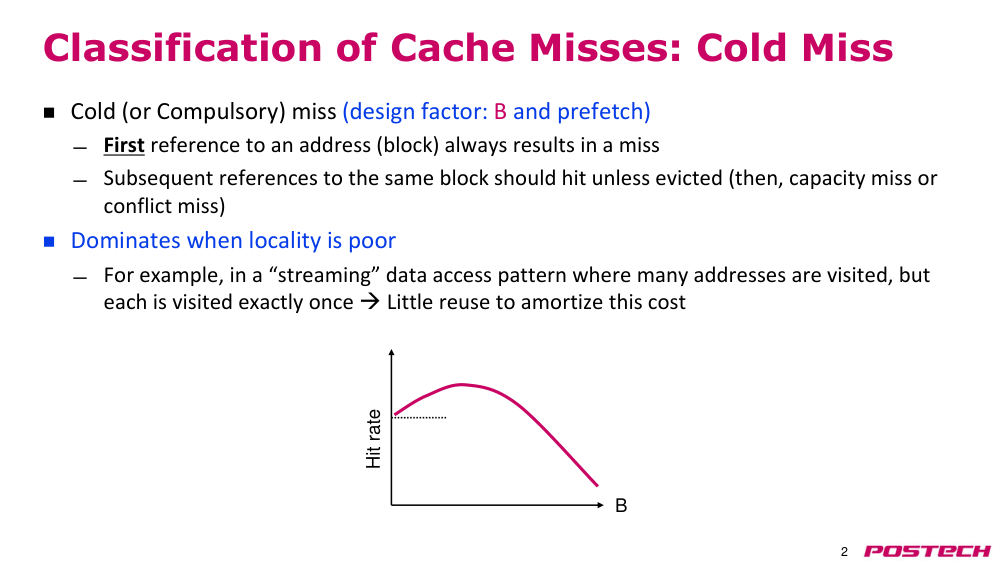
- 콜드(또는 강제) 미스 (설계 요소: block size(블록 크기) B 및 프리패치)
- 주소(블록)에 처음 참조할 때는 항상 미스 발생
- 동일한 블록에 대한 후속 참조는 제거되지 않은 경우 히트가 발생함 (그렇지 않으면 capacity miss(용량 미스) 또는 충돌 미스)
- 지역성이 낮을 때 주로 발생함
- 예: '스트리밍' 데이터 접근 패턴에서 많은 주소를 방문하지만 각 주소는 정확히 한 번만 방문됨 → 이 비용을 분산시킬 만한 재사용이 거의 없음
- hit rate(히트율)
- B
p.3cache miss(캐시 미스)의 분류: capacity miss(용량 미스)
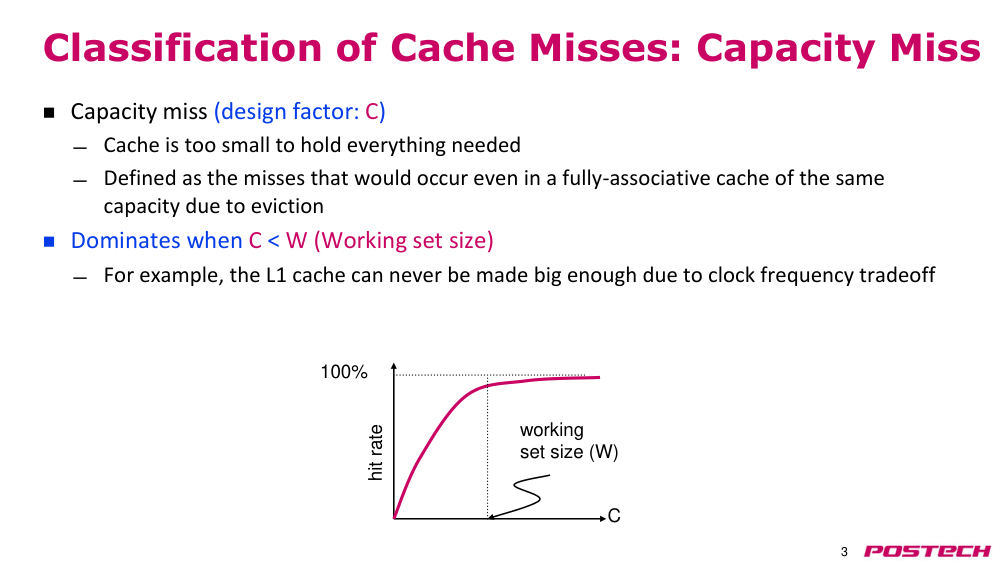
- 용량 미스 (설계 요소: cache(캐시) 크기 C)
- cache(캐시)가 필요한 모든 것을 담기에 너무 작음
- 동일한 용량의 완전 연관 cache(캐시)에서도 발생하는 미스로 정의됨 (제거로 인해 발생)
- C < W(작업 집합 크기)일 때 주로 발생함
- 예: L1 cache(캐시)는 클럭 주파수 트레이드오프로 인해 너무 커질 수 없음
- hit rate(히트율)
- 100%
- 작업 집합 크기 (W)
- C
p.4cache miss(캐시 미스)의 분류: conflict miss(충돌 미스)
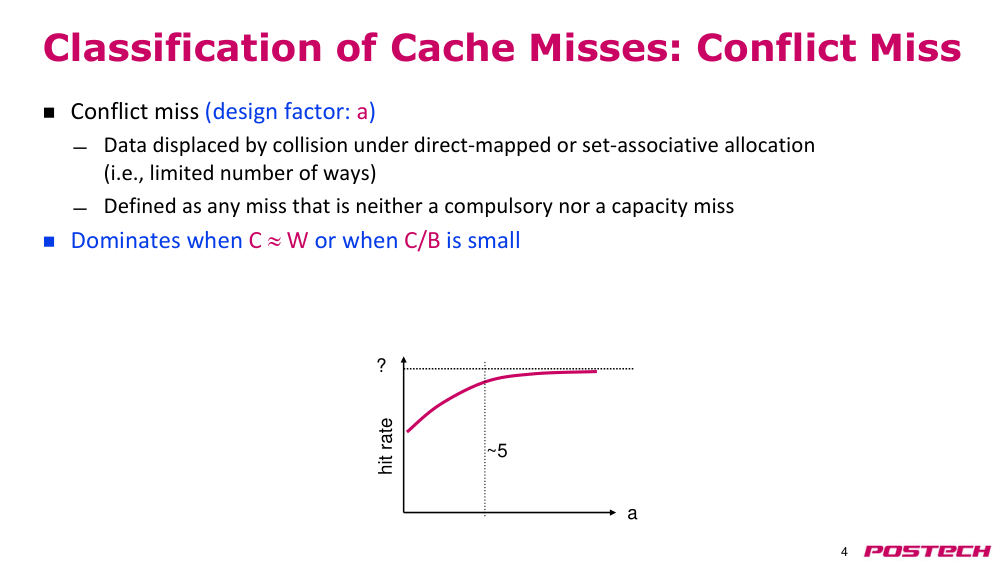
- 충돌 미스 (설계 요소: associativity(연관성) a)
- Direct-Mapped(직접 매핑) 또는 세트 연관 할당에서 충돌로 인해 데이터가 제거됨 (즉, way(웨이)의 수가 제한됨)
- compulsory miss(강제 미스)나 capacity miss(용량 미스)가 아닌 모든 미스로 정의됨
- C ≈ W이거나 C/B가 작을 때 주로 발생함
- hit rate(히트율)
- ?
- a
- ~5
p.5보다 고급적인 문제들
p.6cache(캐시) '쓰기' 문제들
- 현대 CPU에서는 tag bank(태그 뱅크)와 data bank(데이터 뱅크) 접근이 스케줄링에서 분리됨
- 읽기 시, 가능한 한 일찍 tag bank(태그 뱅크)와 data bank(데이터 뱅크)에 동시에 접근해야 함 – 왜?
- • 읽기는 종종 critical path(임계 경로)에 있음
- 쓰기 시, tag bank(태그 뱅크)를 먼저 접근하고 data bank(데이터 뱅크) 접근은 수 사이클 후에 가능함 – 왜?
- • 미스일 때 쓰기하지 않아야 함!
- • 미스 처리는 오랜 시간이 걸릴 수 있음
- 또한 'Partial-Word write(부분 워드 쓰기)' 문제도 있음
- • data bank(데이터 뱅크)를 먼저 읽어 수정되지 않은 바이트를 가져와야 함
- 반대로, 'Partial-Word read(부분 워드 읽기)' 시에는 원하는 바이트만 선택하고 나머지는 무시함
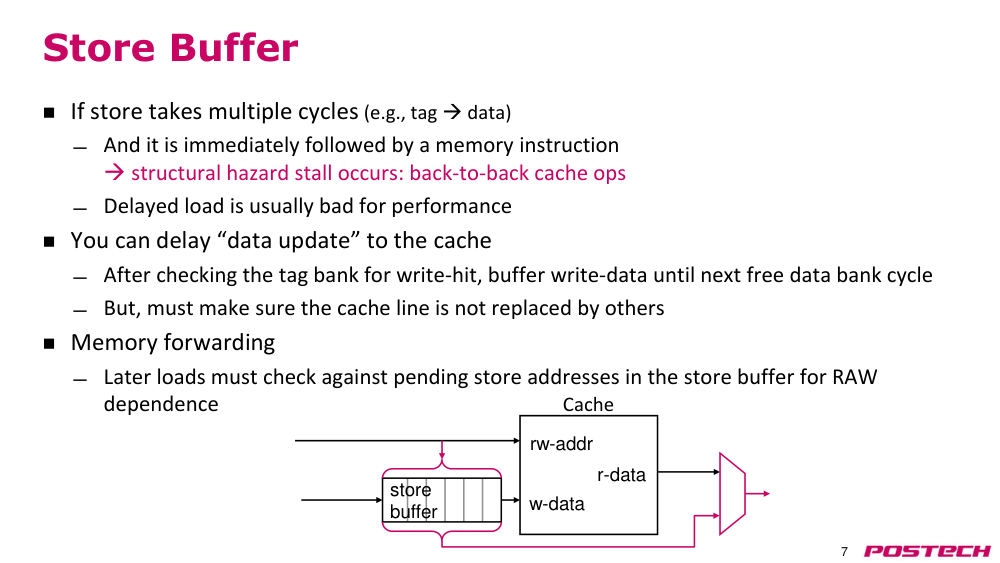
p.7store buffer(스토어 버퍼)
- 스토어가 여러 사이클을 소요하는 경우 (예: tag(태그) → data(데이터))
- 그 다음에 메모리 명령어가 바로 이어질 경우 → structural hazard stall(구조적 해저드 스톨) 발생: 백투백 cache(캐시) 연산
- 지연된 로드는 일반적으로 성능에 좋지 않음
- cache(캐시)에 대한 "데이터 업데이트"를 지연시킬 수 있음
- 쓰기 히트를 확인한 후, 다음에 사용 가능한 data bank(데이터 뱅크) 사이클까지 쓰기 데이터를 버퍼에 보관
- 하지만 cache line(캐시 라인)이 다른 쪽에 의해 교체되지 않도록 보장해야 함
- memory forwarding(메모리 포워딩)
- 나중에 오는 로드는 store buffer(스토어 버퍼)에 있는 보류 중인 스토어 주소를 확인하여 RAW dependence(RAW 종속성)을 검사해야 함
p.8blocking miss(블로킹 미스) 또는 non-blocking miss(비블로킹 미스)?
- CPU는 미스가 해결될 때까지 기다려야 하는가?
- cache miss(캐시 미스)가 처리되는 동안, 다른 주소에 대한 읽기 및 쓰기 연산을 허용해야 하는가?
- 고클럭 레이트의 ILP 프로세서에서는 cache miss(캐시 미스) 동안 너무 많은 명령어 기회를 놓치지 않도록 하는 것이 필수적임
- 하지만 메모리 연산이 순서대로 완료되지 않을 때 순서와 종속성을 신경 써야 함
- in-order pipeline(인오더 파이프라인)에서도 비블로킹 쓰기 미스는 유용할 수 있음
- STORE가 cache(캐시)에 완전히 완료되지 않았다고 해서 파이프라인이 스톨될 필요는 없음
- 하지만 RAW dependence(RAW 종속성) 있는 LOAD의 경우, 스톨하거나 포워딩해야 함
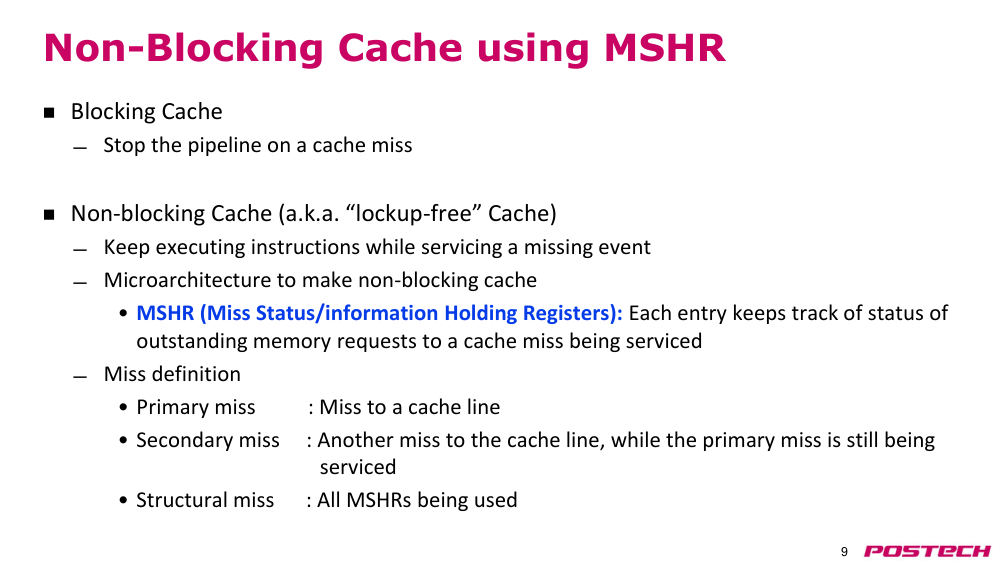
p.9MSHR를 사용한 Non-Blocking cache(비블로킹 캐시)
- blocking cache(블로킹 캐시)
- cache miss(캐시 미스) 발생 시 파이프라인을 멈춤
- 비블로킹 캐시 (또는 "락업 프리" 캐시)
- 미스 이벤트를 처리하는 동안에도 명령어 실행을 계속함
- Non-Blocking cache(비블로킹 캐시)를 구현하기 위한 마이크로아키텍처
- • MSHR (미스 상태/정보 보유 레지스터): 각 항목은 처리 중인 cache miss(캐시 미스)에 대한 미해결 memory request(메모리 요청) 상태를 추적함
- 미스 정의
- • primary miss(주요 미스): cache line(캐시 라인)에 대한 미스
- • secondary miss(보조 미스): primary miss(주요 미스)가 여전히 처리되는 동안 동일한 cache line(캐시 라인)에 대한 또 다른 미스
- • structural miss(구조적 미스): 모든 MSHR가 사용 중일 때 발생
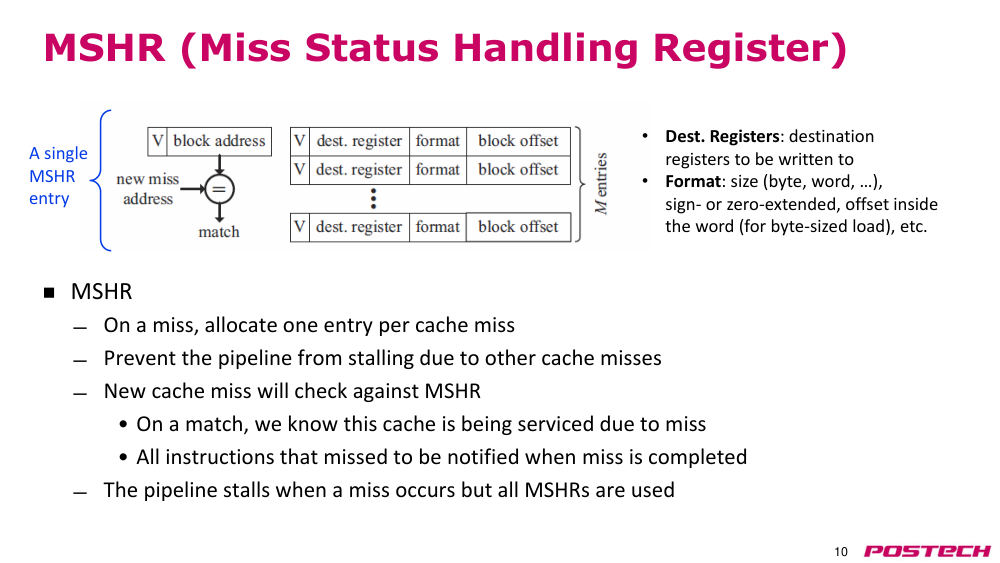
p.10MSHR (미스 상태 처리 레지스터)
- MSHR
- 미스 발생 시, cache miss(캐시 미스)당 하나의 항목을 할당
- 다른 cache miss(캐시 미스)로 인한 파이프라인 스톨을 방지
- 새로운 cache miss(캐시 미스)는 MSHR와 비교
- • 일치하는 경우, 해당 cache(캐시)가 미스로 인해 처리 중임을 알 수 있음
- • 모든 미스가 발생한 명령어는 미스 처리 완료 시 알림을 받음
- 미스가 발생했지만 모든 MSHR가 사용 중인 경우 파이프라인이 스톨됨
- • 목적 레지스터: 쓰여야 할 목적 레지스터
- • 형식: 크기 (바이트, 워드 등), 부호 확장 또는 제로 확장 여부, 워드 내 오프셋 (바이트 크기 로드용 등)
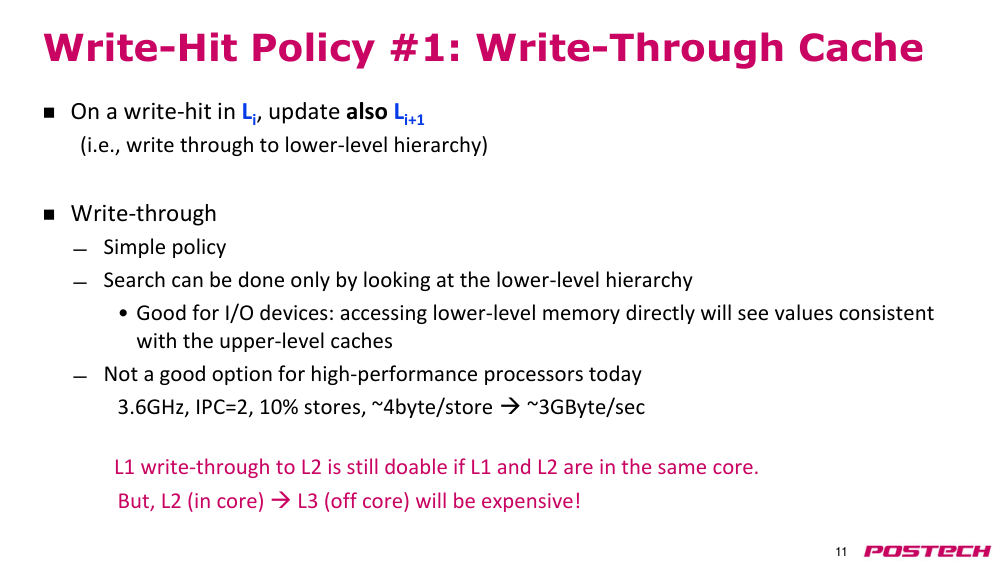
p.11쓰기 히트 정책 #1: Write-Through cache(라이트-쓰로우 캐시)
- Li에서 쓰기 히트 발생 시, Li+1에도 동일하게 업데이트 (즉, 하위 계층으로 쓰기 전파)
- 라이트-쓰로우
- 간단한 정책
- 검색은 하위 계층 계층만 확인해도 가능
- • I/O 장치에 적합: 하위 계층 메모리에 직접 접근하면 상위 cache(캐시)와 일관된 값을 볼 수 있음
- 현재 고성능 프로세서에는 적합하지 않음
- 3.6GHz, IPC=2, 10% 스토어, ~4byte/store → ~3GByte/sec
- L1 라이트-쓰로우 → L2는 동일 코어 내이므로 여전히 가능
- 하지만 L2 (코어 내) → L3 (코어 외)는 비용이 큼!
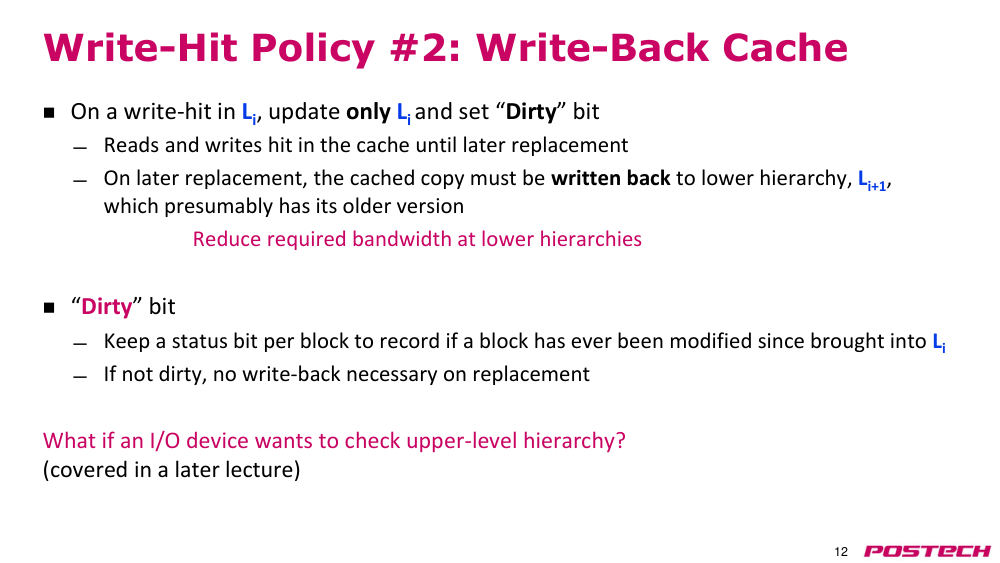
p.12쓰기 히트 정책 #2: Write-Back cache(라이트-백 캐시)
- Li에서 쓰기 히트 발생 시, Li만 업데이트하고 "dirty bit(더티 비트)"를 설정
- 읽기 및 쓰기 연산은 이후 교체될 때까지 cache(캐시)에서 히트됨
- 나중에 교체될 때, cache(캐시)된 복사본을 하위 계층 Li+1에 쓰기 반환해야 함 (여기에는 오래된 버전이 있음)
- 하위 계층에서 요구되는 대역폭을 줄임
- • "dirty bit(더티 비트)"
- 각 블록마다 상태 비트를 유지하여, 블록이 Li에 들어온 이후 수정된 적이 있는지 기록
- 더티가 아니면 교체 시 쓰기 반환 필요 없음
- I/O 장치가 상위 계층을 확인하고 싶다면 어떻게 해야 하는가?
- (나중 강의에서 다룸)
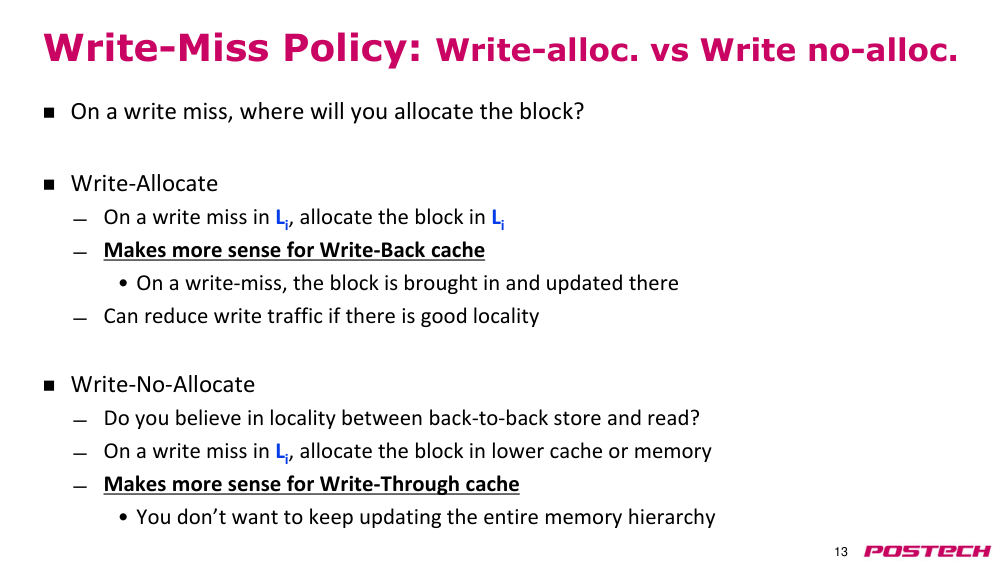
p.13write miss(쓰기 미스) 정책: Write-Allocate(라이트-할당) vs Write-No-Allocate(라이트-노-할당)
- 라이트-할당 (Write-Allocate)
- • cache(캐시) 레벨 Li에서 라이트 미스가 발생할 경우, 블록을 Li에 할당한다.
- • Write-Back cache(라이트-백 캐시)에 더 적합하다.
- • 라이트 미스 시 블록을 가져와서 그곳에서 업데이트한다.
- • 좋은 지역성이 있다면 라이트 트래픽을 줄일 수 있다.
- 라이트-노-할당 (Write-No-Allocate)
- • 연속된 스토어와 리드 사이에 지역성이 있다고 믿는가?
- • cache(캐시) 레벨 Li에서 라이트 미스가 발생할 경우, 더 낮은 캐시 또는 메모리에 블록을 할당한다.
- • Write-Through cache(라이트-쓰로우 캐시)에 더 적합하다.
- • 전체 메모리 계층을 계속 업데이트하고 싶지 않기 때문이다.
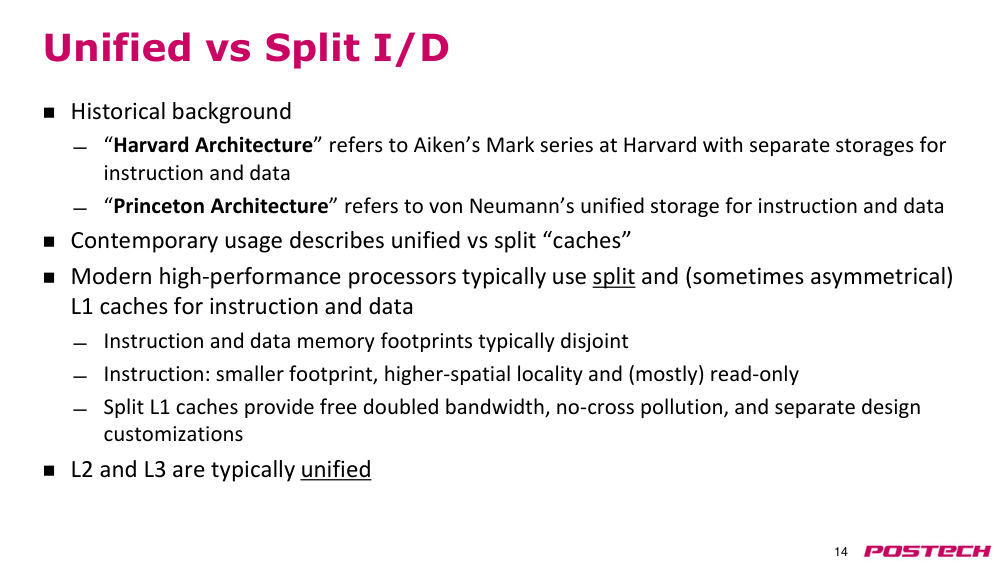
p.14유니파이드 vs 스플릿 I/D
- 역사적 배경
- • Harvard Architecture(하버드 아키텍처)는 Harvard의 Aiken Mark 시리즈에서 명령어와 데이터를 별도 저장소로 구분한 것을 의미한다.
- • Princeton Architecture(프린스턴 아키텍처)는 von Neumann의 명령어와 데이터를 통합 저장소로 관리한 것을 의미한다.
- • 현대적 용어에서는 유니파이드 vs 스플릿 'cache(캐시)'를 설명할 때 사용된다.
- • 현대 고성능 프로세서는 일반적으로 명령어와 데이터용으로 분리된 (때로는 비대칭적인) L1 cache(캐시)를 사용한다.
- • 명령어와 데이터의 메모리 피트프린트는 일반적으로 서로 겹치지 않는다.
- • 명령어: 더 작은 피트프린트, 높은 spatial locality(공간 지역성), 대부분 읽기 전용.
- • 스플릿 L1 cache(캐시)는 bandwidth(대역폭)을 두 배로 늘리고, 교차 오염을 방지하며, 개별 설계 최적화를 가능하게 한다.
- • L2 및 L3는 일반적으로 유니파이드이다.
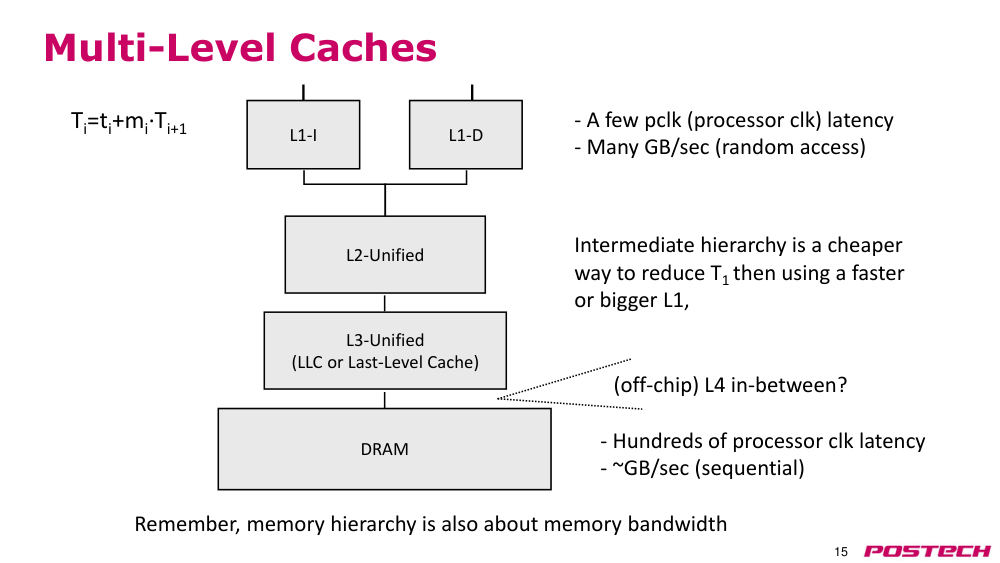
p.15Multi-Level cache(다중 레벨 캐시)
- • 몇 개의 pclk (프로세서 클럭) 지연
- • 수 GB/sec (랜덤 액세스)
- • 수백 개의 프로세서 클럭 지연
- • 약 1 GB/sec (순차적)
- L2-유니파이드
- • 중간 계층은 더 빠르거나 더 큰 L1을 사용하는 것보다 더 저렴한 방식으로 T1을 줄이는 데 사용된다.
- • Ti = ti + mi · Ti+1
- • 메모리 계층은 memory bandwidth(메모리 대역폭)에 대해서도 고려해야 한다.
- L1-I
- L1-D
- DRAM
- L3-유니파이드 (LLC 또는 마지막 레벨 캐시)
- 오프칩 L4는 중간에 존재할 수 있음?
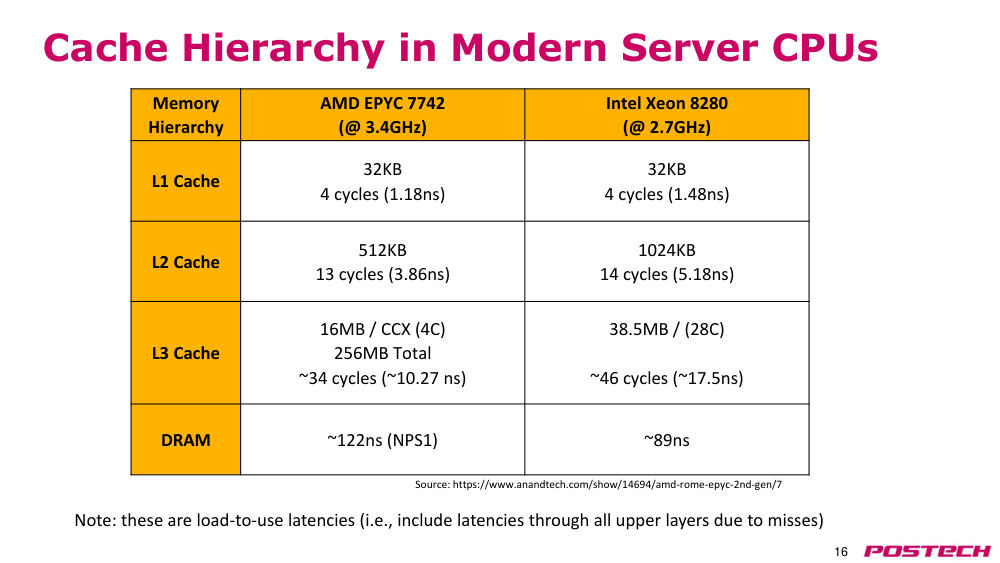
p.16현대 서버 CPU의 cache hierarchy(캐시 계층)
- 메모리 계층
- AMD EPYC 7742 (@ 3.4GHz)
- Intel Xeon 8280 (@ 2.7GHz)
- L1 cache(캐시)
- 32KB
- 4 사이클 (1.18ns)
- 32KB
- 4 사이클 (1.48ns)
- L2 cache(캐시)
- 512KB
- 13 사이클 (3.86ns)
- 1024KB
- 14 사이클 (5.18ns)
- L3 cache(캐시)
- 16MB / CCX (4C)
- 256MB 전체
- ~34 사이클 (~10.27 ns)
- 38.5MB / (28C)
- ~46 사이클 (~17.5ns)
- DRAM
- ~122ns (NPS1)
- ~89ns
- 출처: https://www.anandtech.com/show/14694/amd-rome-epyc-2nd-gen/7
- 참고: 이 값들은 로드-투-유즈 지연(즉, 미스로 인해 모든 상위 레벨을 통과하는 지연 포함)이다.
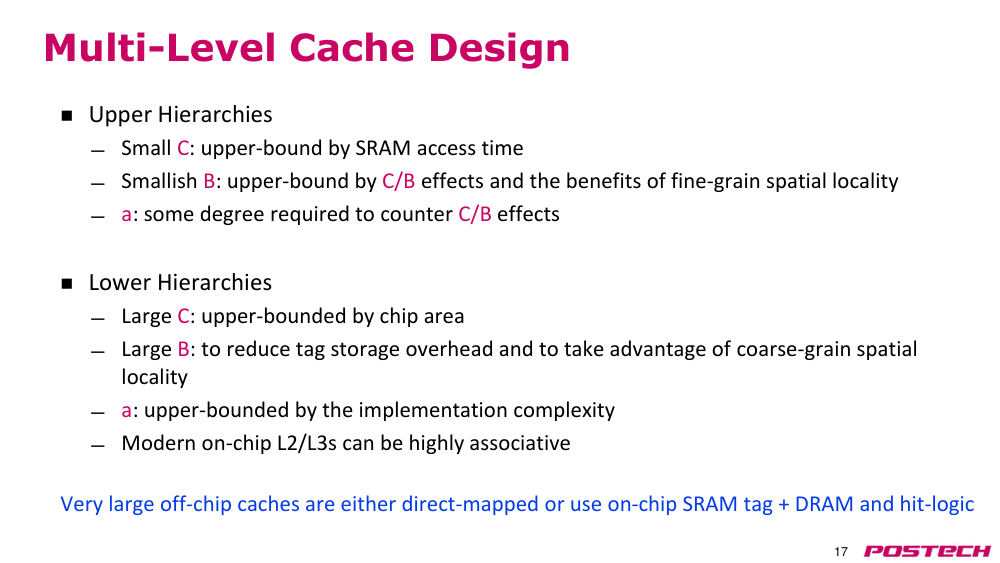
p.17Multi-Level cache(다중 레벨 캐시) 설계
- 상위 계층
- • 작은 C: SRAM 액세스 시간에 의해 상한선을 가진다.
- • 중간 크기의 B: C/B 효과와 세밀한 spatial locality(공간 지역성)의 이점을 고려하여 상한선을 가진다.
- • a: C/B 효과를 상쇄하기 위해 어느 정도 필요하다.
- 하위 계층
- • 큰 C: 칩 면적으로 상한선을 가진다.
- • 큰 B: tag(태그) 저장소 오버헤드를 줄이고, 거시적 spatial locality(공간 지역성)을 활용하기 위해 필요하다.
- • a: 구현 복잡성에 의해 상한선을 가진다.
- • 현대 온칩 L2/L3는 매우 높은 associativity(연관성)을 가질 수 있다.
- • 매우 큰 오프칩 cache(캐시)는 일반적으로 Direct-Mapped(직접 매핑)되거나, 온칩 SRAM tag(태그) + DRAM 및 히트 로직을 사용한다.
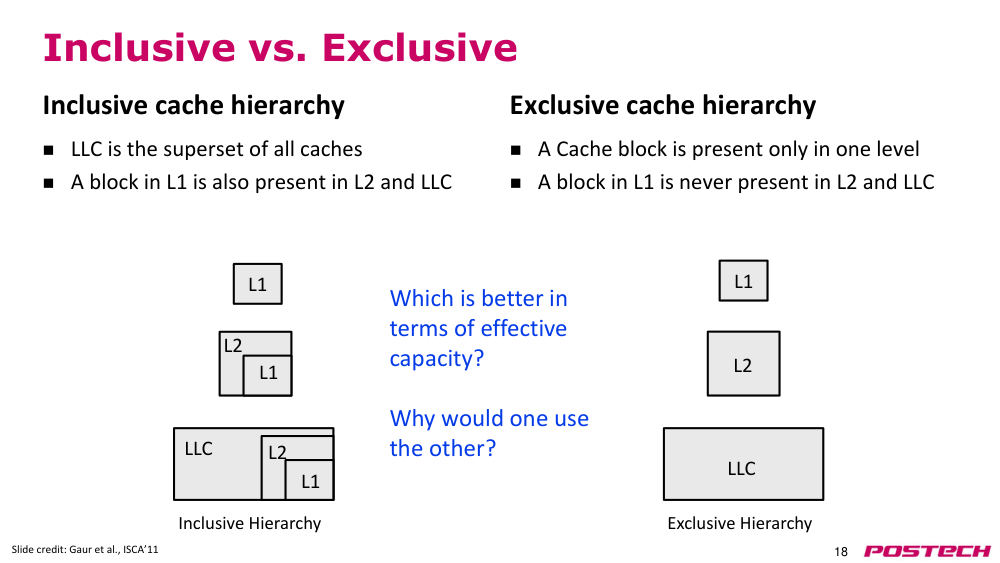
p.18inclusive cache hierarchy(포함형 캐시 계층) vs exclusive cache hierarchy(배타적 캐시 계층)
- inclusive cache hierarchy(포함형 캐시 계층)
- • LLC는 모든 cache(캐시)의 초집합이다.
- • L1에 있는 블록은 L2와 LLC에도 반드시 존재한다.
- exclusive cache hierarchy(배타적 캐시 계층)
- • cache(캐시) 블록은 오직 하나의 레벨에만 존재한다.
- • L1에 있는 블록은 L2와 LLC에 절대 존재하지 않는다.
- LLC
- L1
- L2
- L1
- L1
- LLC
- L2
- inclusive hierarchy(포함형 계층)
- exclusive hierarchy(배타적 계층)
- L1
- L2
- L1
- 슬라이드 출처: Gaur et al., ISCA’11
- 어느 쪽이 효과적인 용량 측면에서 더 좋은가?
- 왜 다른 쪽을 사용할까?
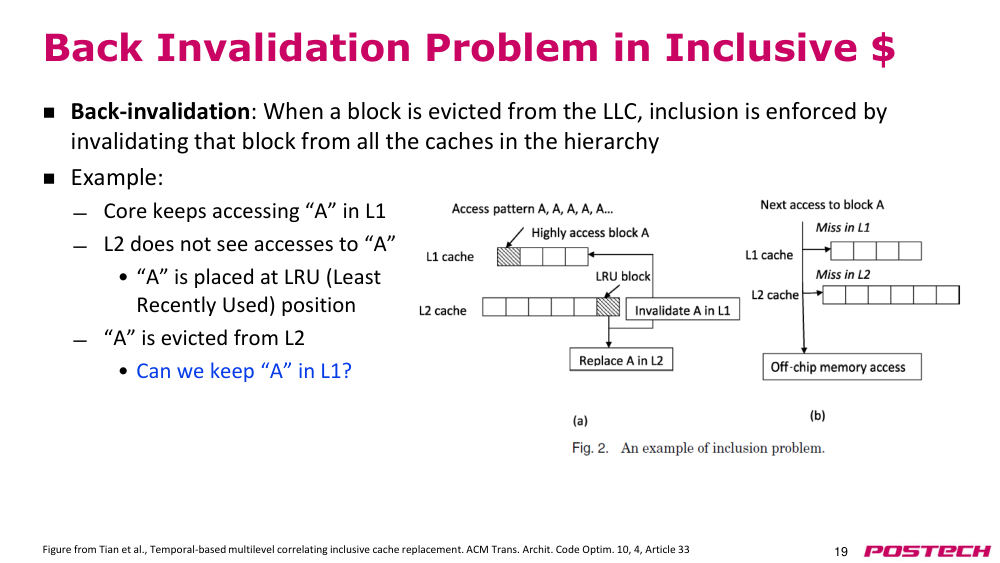
p.19inclusive cache hierarchy(포함형 캐시 계층)에서의 back-invalidation(역방향 무효화) 문제
- back-invalidation(역방향 무효화): last-level cache(최종 레벨 캐시, LLC)에서 블록이 교체될 때, 계층 내 모든 캐시에서 해당 블록을 무효화함으로써 포함성 조건을 유지한다.
- 예시:
- • 코어는 L1에서 "A"에 지속적으로 접근한다.
- • L2는 "A"에 대한 접근을 보지 못한다.
- • "A"는 LRU(최소 최근 사용) 위치에 배치된다.
- • "A"는 L2에서 교체된다.
- • L1에 "A"를 유지할 수 있는가?
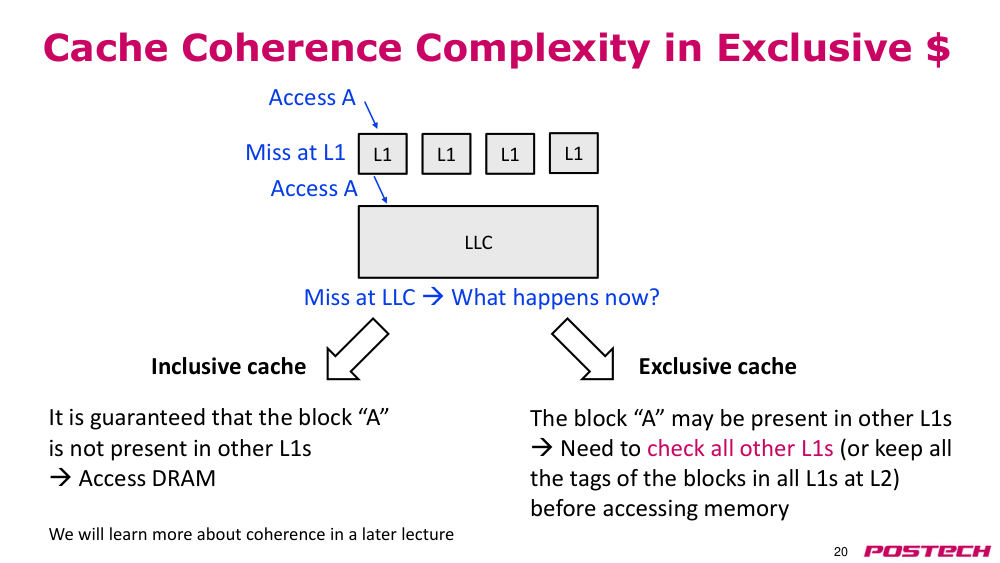
p.20exclusive cache(배타적 캐시)에서의 cache coherence complexity(캐시 일관성 복잡성)
- LLC
- L1
- L1
- L1
- A에 접근
- L1에서 미스 발생
- LLC에서 미스 발생 → 이제 어떻게 되는가?
- A에 접근
- L1
- inclusive cache(포함형 캐시)
- 블록 "A"가 다른 L1에 존재하지 않음을 보장한다.
- → DRAM에 접근
- exclusive cache(배타적 캐시)
- 블록 "A"는 다른 L1에 존재할 수 있다.
- → 메모리에 접근하기 전에 모든 다른 L1을 확인해야 하거나(또는 L2에 모든 L1의 블록 tag(태그)를 유지해야 한다).
- cache coherence(캐시 일관성)에 대해서는 이후 강의에서 더 자세히 배울 것이다.
p.21cache hierarchy(캐시 계층) reverse engineering(역공학)
p.22당신의 컴퓨터에 어떤 cache(캐시)가 있나요?
- 당신의 컴퓨터에 있는 cache(캐시) 구성 정보를 파악하는 것이 가능할까요?
- 왜 사양을 그냥 보지 않을까요?
- • 제조사가 자세한 사양을 제공하지 않을 수 있습니다.
- • CPU 아키텍트로서 칩을 검증하고 싶을 수 있습니다.
- 예시 구성: 용량(C), 연관성(a), 블록 크기(B), 레벨 수 등.
- cache(캐시)는 프로그래머에게 투명해야 합니다.
- • cache(캐시)의 존재 여부는 소프트웨어의 기능적 동작으로 감지되지 않아야 합니다.
- • 그러나 실행 시간 측정 등 타이밍 행동을 통해 cache miss(캐시 미스) 수를 추론함으로써 cache(캐시)의 존재를 알 수 있습니다.
p.23용량 실험 (데이터 cache(캐시)용)
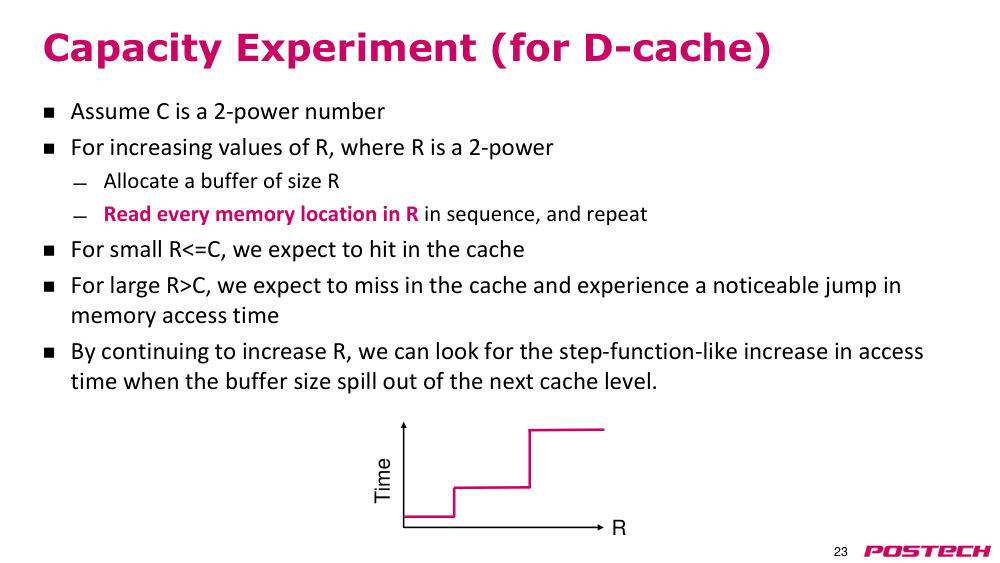
- C가 2의 거듭제곱이라고 가정한다.
- R이 2의 거듭제곱인 증가하는 값에 대해:
- • 크기 R의 버퍼를 할당한다.
- • R 내의 모든 메모리 위치를 순차적으로 읽고 반복한다.
- • 작은 R <= C인 경우, cache hit(캐시 히트)를 기대한다.
- • 큰 R > C인 경우, cache miss(캐시 미스)가 발생하고 메모리 접근 시간에 눈에 띄는 증가가 발생할 것으로 기대한다.
- • R을 계속 증가시키면서, 버퍼 크기가 다음 cache(캐시) 레벨을 넘어서면서 접근 시간이 계단 함수처럼 증가하는 지점을 찾을 수 있다.
- R
- Time
p.24block size(블록 크기) 실험 (용량 C가 알려진 경우)
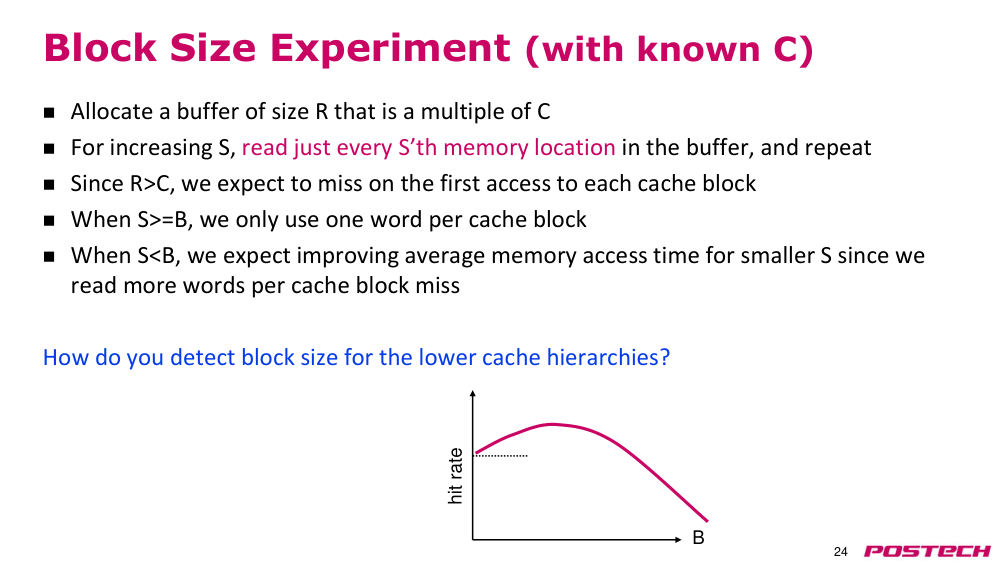
- 크기 R의 버퍼를 할당하며, R은 C의 배수이다.
- 증가하는 S에 대해, 버퍼 내에서 매 S번째 메모리 위치만 읽고 반복한다.
- R > C이므로, 각 cache line(캐시 라인)에 대한 첫 번째 접근에서는 미스가 발생할 것으로 기대한다.
- S >= B이면, 각 cache line(캐시 라인)당 하나의 워드만 사용한다.
- S < B이면, cache line(캐시 라인) 미스 시 더 많은 워드를 읽기 때문에 평균 메모리 접근 시간이 더 나아진다.
- 하위 cache hierarchy(캐시 계층)의 block size(블록 크기)를 어떻게 감지할 수 있나요?
- hit rate(히트율)
- B
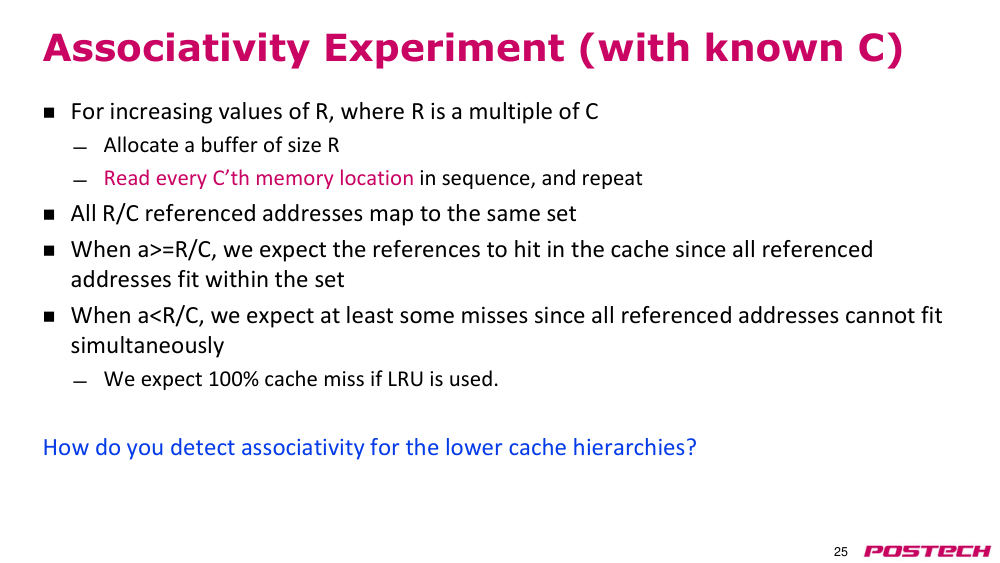
p.25associativity(연관성) 실험 (알려진 C를 사용한 경우)
- R의 증가하는 값에 대해, R은 C의 배수이다.
- 크기 R의 버퍼를 할당한다.
- 순차적으로 C번째 메모리 위치를 읽고 반복한다.
- 모든 R/C 참조 주소는 동일한 세트에 매핑된다.
- a >= R/C이면, 모든 참조 주소가 세트 내에 포함되므로 cache hit(캐시 히트)를 기대할 수 있다.
- a < R/C이면, 모든 참조 주소가 동시에 포함될 수 없으므로 적어도 일부 미스가 발생할 것으로 기대한다.
- LRU가 사용될 경우, cache miss(캐시 미스)율이 100%가 될 것으로 예상된다.
- 하위 cache hierarchy(캐시 계층)의 associativity(연관성)을 어떻게 감지할 수 있는가?
p.26다른 정보는 무엇을 알 수 있을까?
- 라이트-쓰로우 vs. 라이트-백
- Write-Allocate(라이트-할당)
- 유니파이드 vs. 스플릿 설계
- instruction cache(명령어 캐시) C, B, a
- 지연 시간 및 대역폭
- cache replacement policy(캐시 교체 정책)
- …
- Lmbench는 이 목적을 위한 널리 알려진 도구이다.
- "lmbench: Portable Tools for Performance Analysis", McVoy and Staelin, USENIX ATC 1996
- http://lmbench.sourceforge.net/
- 주의: cache(캐시)에 대한 단순한 이해를 기반으로 한 실험은 현대 CPU의 동작을 정확히 예측하지 못할 수 있다. 왜냐하면 가상 메모리, 복잡한 계층 구조, 인덱스 해싱, 프리패치 기능(부분적으로 비활성화 가능)이 있기 때문이다.
- 하지만 여전히 많은 정보를 얻을 수 있다. 시도해 보자!
p.27질문?
- 공지사항
- - 읽기: P&H Ch. 5.8 – 5.9, 5.12 – 5.17