Lec 8 part2 · Lec 9 · data forwarding·load-use stall 과 control hazard 도입
정밀 정리 · 검증 2026-09-24 16:46
1개요
1.1Lec 8 후반: RAW stall 의 성능 손실(IPC=N/(N+S))을 data forwarding(register bypassing)과 forwarding unit 으로 제거.
1.2load-use 는 forwarding 으로도 1 stall → hazard detection unit, MIPS load delay slot, compiler code scheduling 으로 대응.
1.3superpipelining 은 clock 을 올리지만 의존 instruction 사이 bubble 이 늘어 2x speedup 불가.
1.4Lec 9 시작: control dependence = PC 에 대한 data dependence, stall 하면 성능 절반 → PC+4 예측(~86% 정확).
2섹션별 정리 상황·문제 → 원인 → 해결
2.10:30–7:00복습: RAW hazard 와 stall 조건
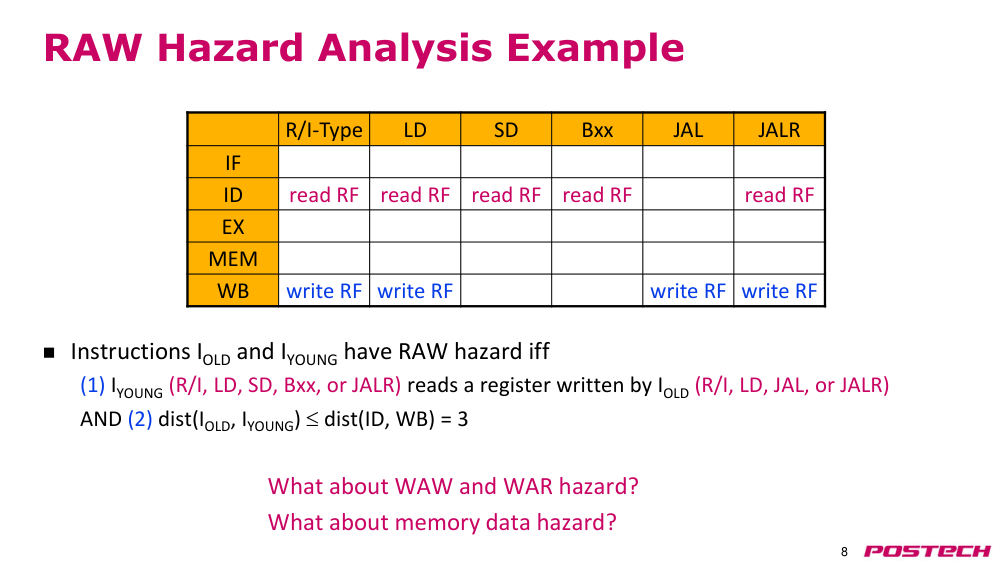
상황·문제younger instruction 이 older instruction 이 쓸 register 를 ID 에서 읽는데 값은 WB 에서야 RF 에 들어간다.
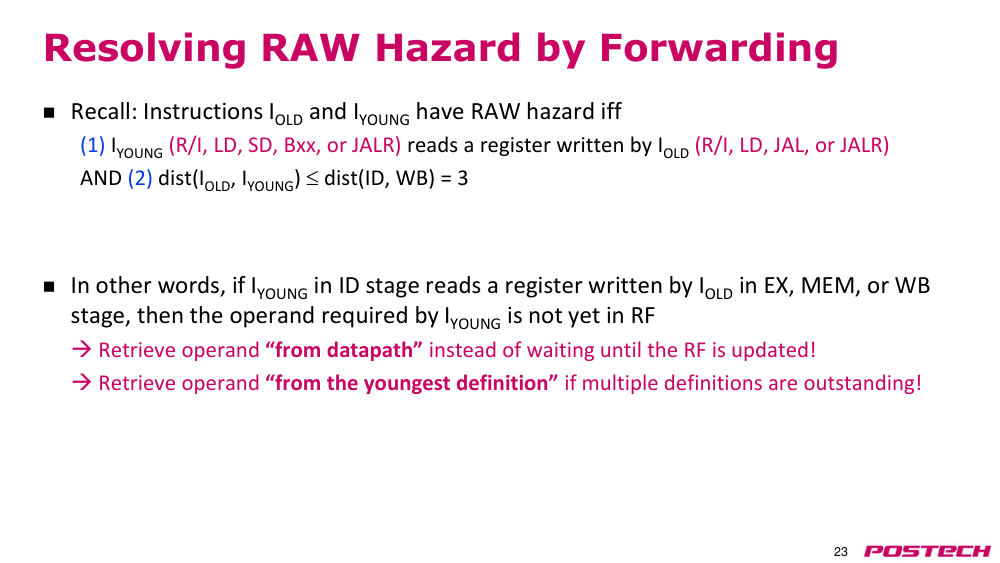
원인use(ID)와 produce(WB) 사이 거리 3. dist(I_OLD, I_YOUNG) ≤ 3 이면 RAW hazard.
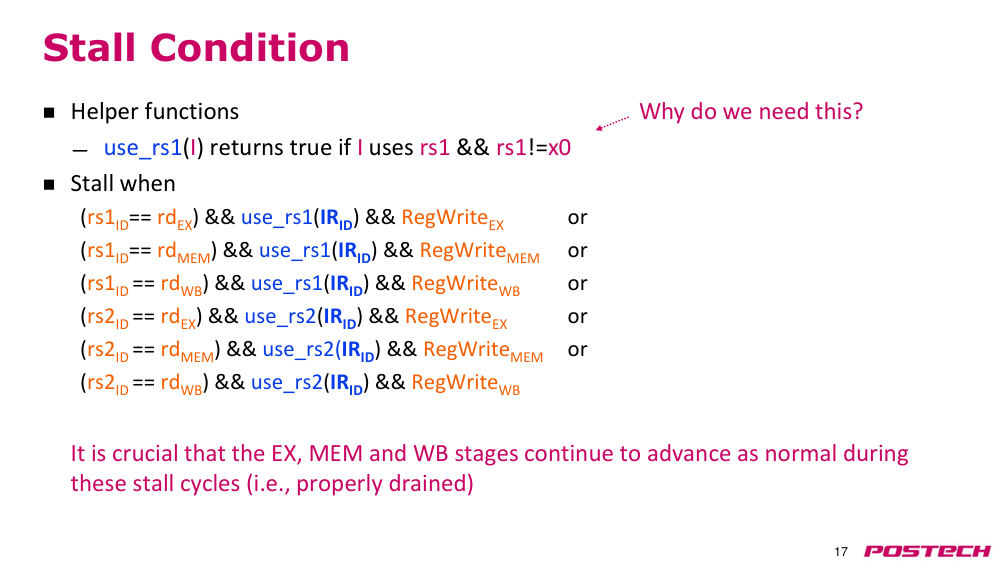
해결stall 조건: rs1/rs2_ID == rd_{EX,MEM,WB} && use_rs(IR_ID) && RegWrite. use_rs 는 rs != x0 확인. ID·IF 는 멈추고 EX·MEM·WB 는 drain.
- x0 는 항상 0 이라 비교에서 제외
- stall 시 뒤 3 stage 는 계속 실행(draining)
2.27:00–11:30stall 이 성능에 주는 영향
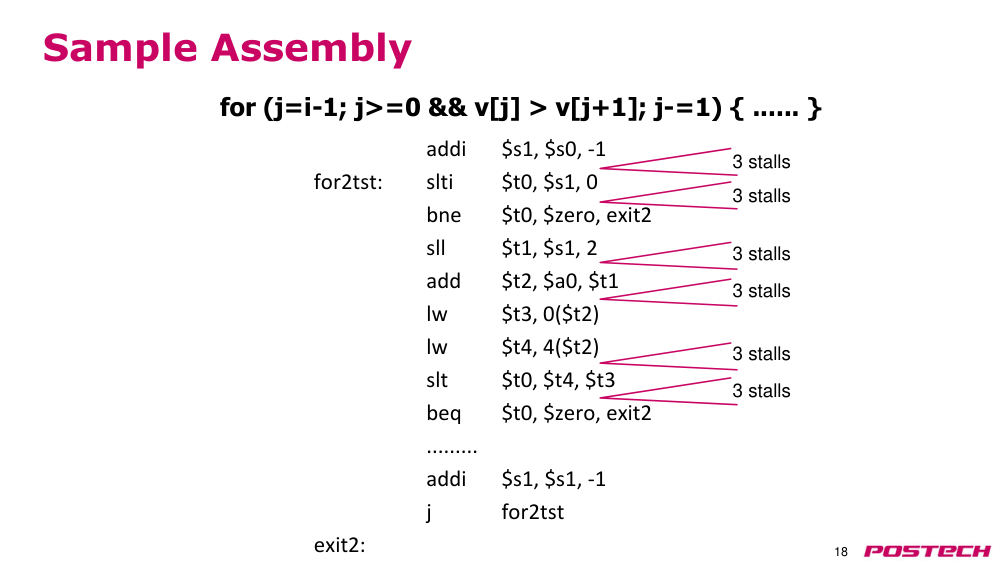
상황·문제sample assembly(for loop)에 RAW dependence 가 많아 stall 이 계속 들어간다.
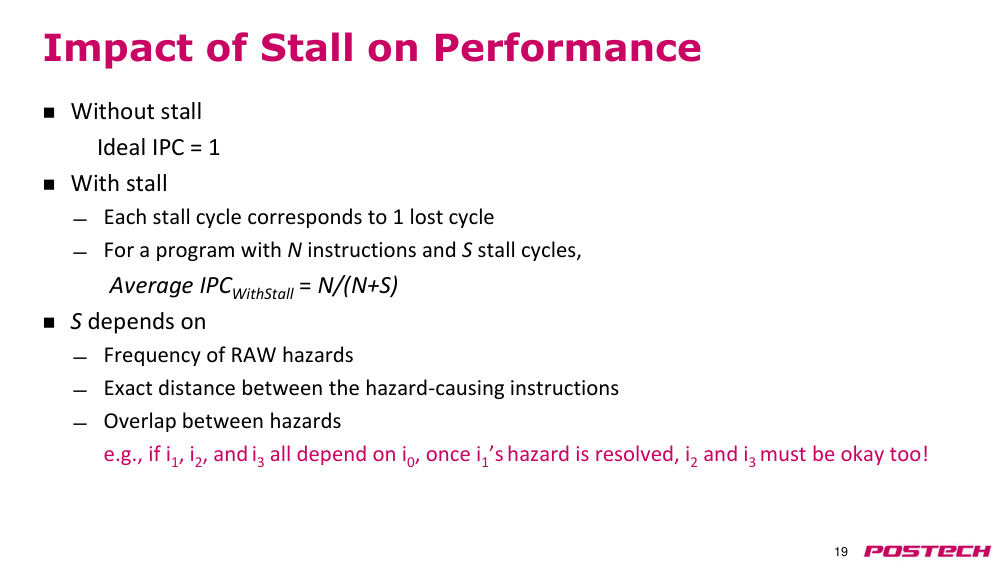
원인stall cycle 하나당 1 cycle 손실. N instructions, S stall cycles 이면 IPC = N/(N+S).
해결S 는 RAW hazard 빈도, hazard 사이 거리, hazard 간 overlap 에 의존. I0 에 I1~I3 가 모두 의존하면 I1 앞 bubble 로 나머지도 해결.
- ideal IPC = 1
- 이렇게 stall 이 많으면 성능이 나빠 → 피할 방법 필요
2.311:30–18:30data forwarding(=register bypassing) 개념
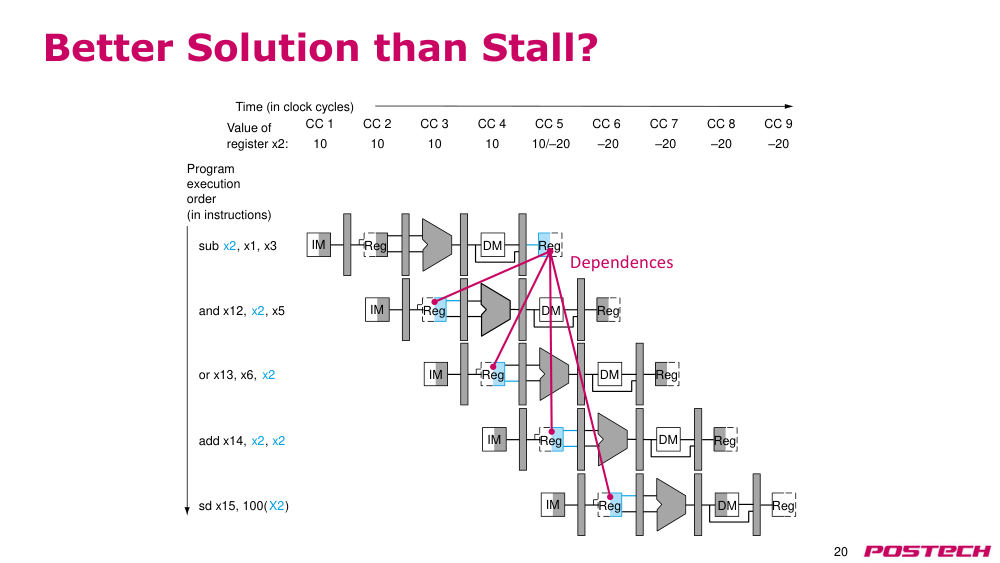
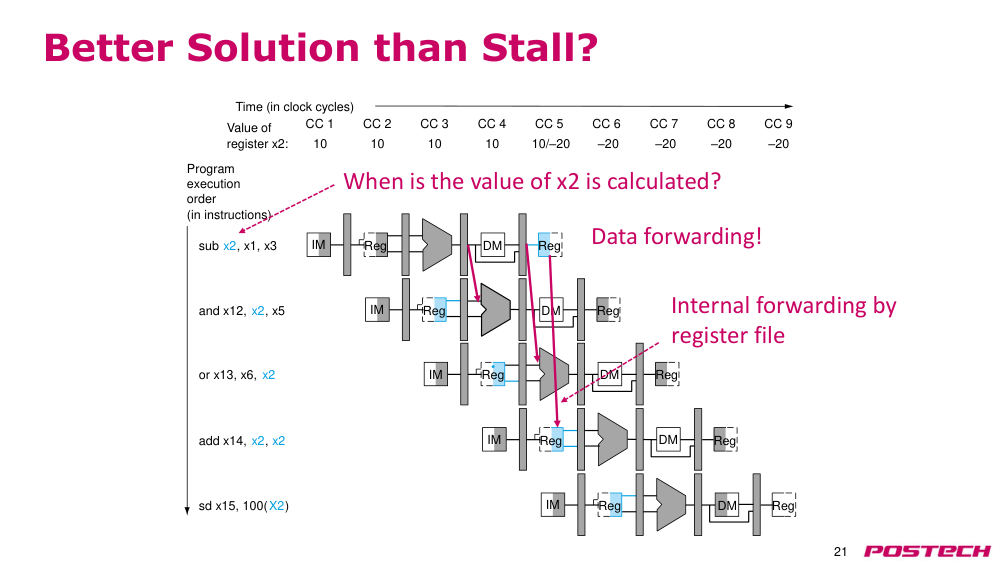
상황·문제sub x2 뒤 and·or·add·sd 가 x2 를 쓰는데 RF 기준으로는 stall 필요.
원인x2 값은 WB 가 아니라 EX 끝(CC 3)에 이미 계산되어 pipeline register 에 있다.
해결EX 결과를 다음 instruction 의 ALU 입력으로 직접 forward. WB 와 같은 cycle 에 읽는 add 는 RF 내부 forwarding. 결과 architectural state 는 stall 과 동일.
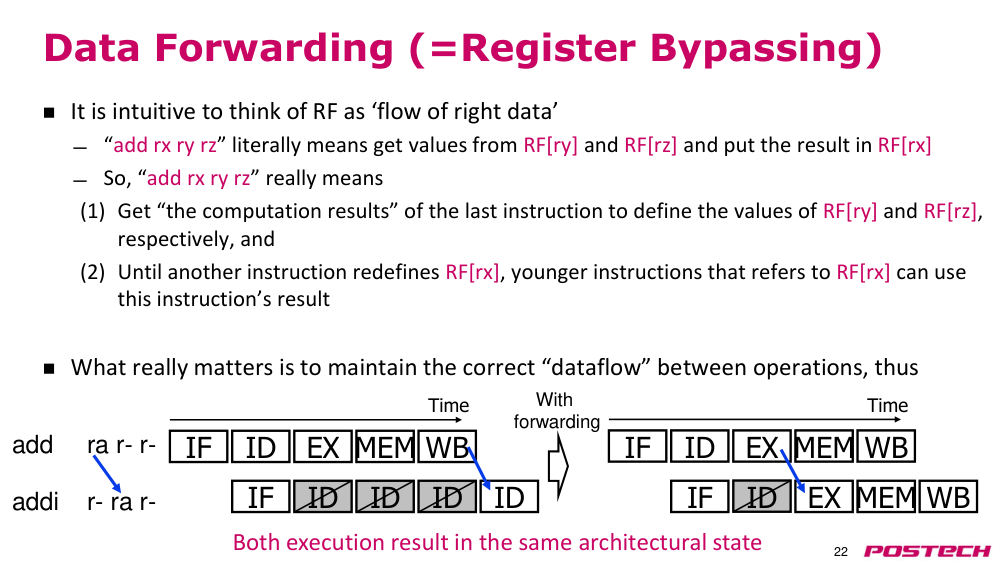
- RF 는 '올바른 data flow' 로 생각: add rx ry rz = ry·rz 를 마지막으로 정의한 instruction 결과를 가져와 rx 에 둔다
- dataflow 만 지키면 실행 방식은 무관
2.3.r.1Operand forwarding (Wikipedia) ↗ · 결과를 register file 을 거치지 않고 다음 instruction 에 넘기는 forwarding
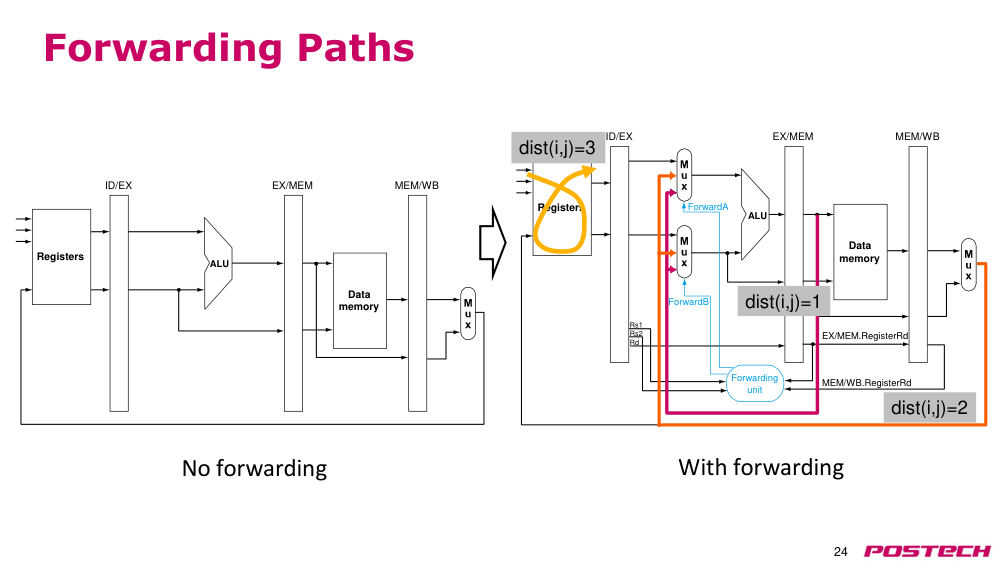
2.418:30–24:00forwarding path 구현
상황·문제RAW hazard 시 필요한 operand 가 아직 RF 에 없다.
원인dist 1 은 EX/MEM, dist 2 는 MEM/WB pipeline register 에 값이 있다. 여러 값이 대기 중이면 가장 young 한 정의가 맞는 값.
해결ALU 두 입력 앞에 3-입력 MUX(RF·EX/MEM·MEM/WB). dist 3 은 RF 내부 forwarding 이라 diagram 에 안 보임.
- retrieve operand from datapath, from the youngest definition
- 중간에 Zoom 지연 문의: 문제 있으면 이메일·채팅으로 알리면 출석 면제
2.4.r.1Classic RISC pipeline (Wikipedia) ↗ · 5-stage pipeline 의 bypassing, load interlock, branch delay slot
2.524:00–27:00forwarding logic (ForwardA/B)
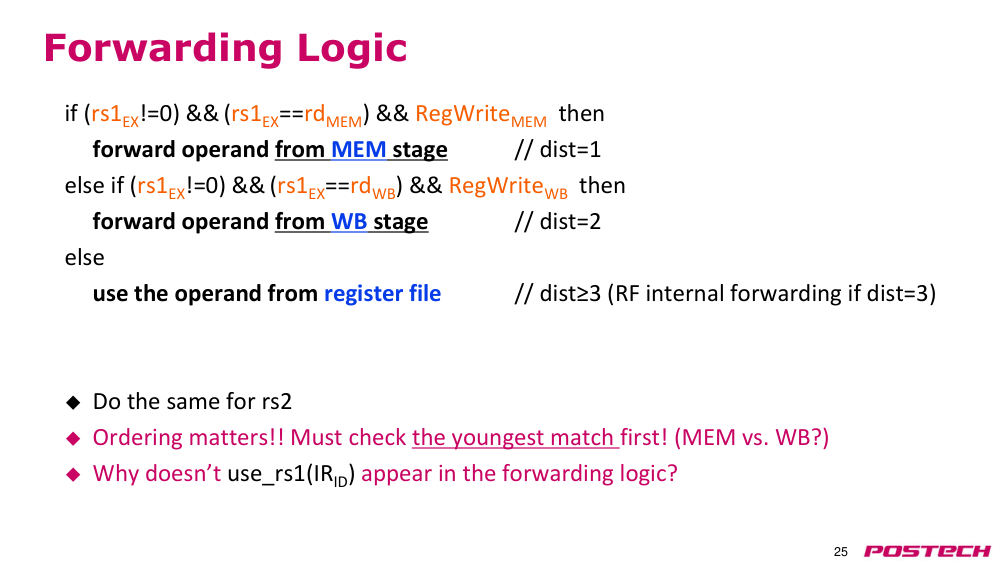
상황·문제MUX select 를 정하는 forwarding unit 이 필요하다.
원인EX 의 rs1/rs2 와 MEM·WB stage 의 rd, RegWrite 를 비교해야 한다.
해결rs1_EX!=0 && rs1_EX==rd_MEM && RegWrite_MEM 이면 MEM 에서(dist 1), 아니면 WB 조건이면 WB 에서(dist 2), 아니면 RF. rs2 도 동일.
- ordering 중요: 더 young 한 MEM match 를 먼저 확인
- forwarding logic 에는 use_rs1 helper 가 없다
2.5.r.1Operand forwarding (Wikipedia) ↗ · 결과를 register file 을 거치지 않고 다음 instruction 에 넘기는 forwarding
2.627:00–30:30load-use hazard: forwarding 으로도 stall
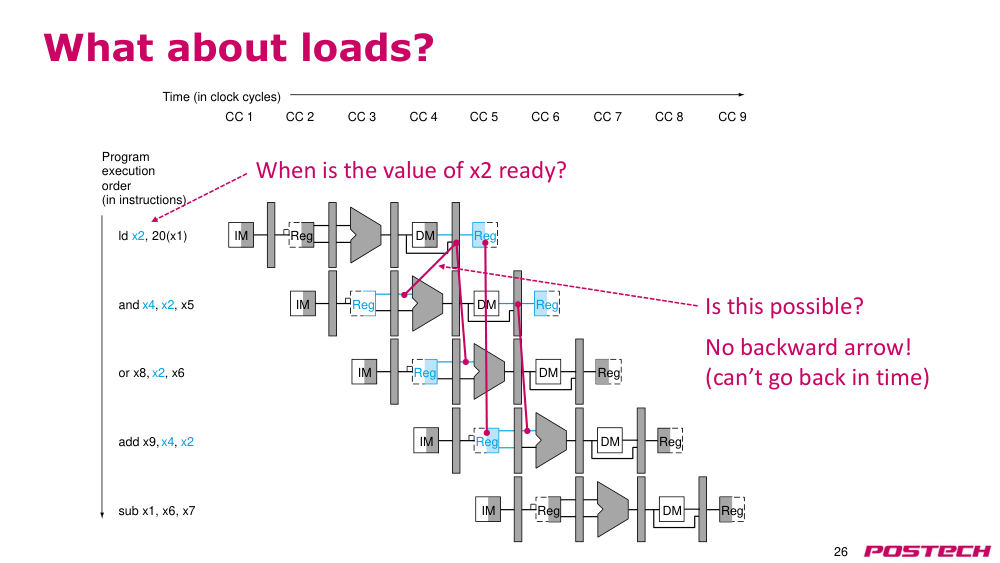
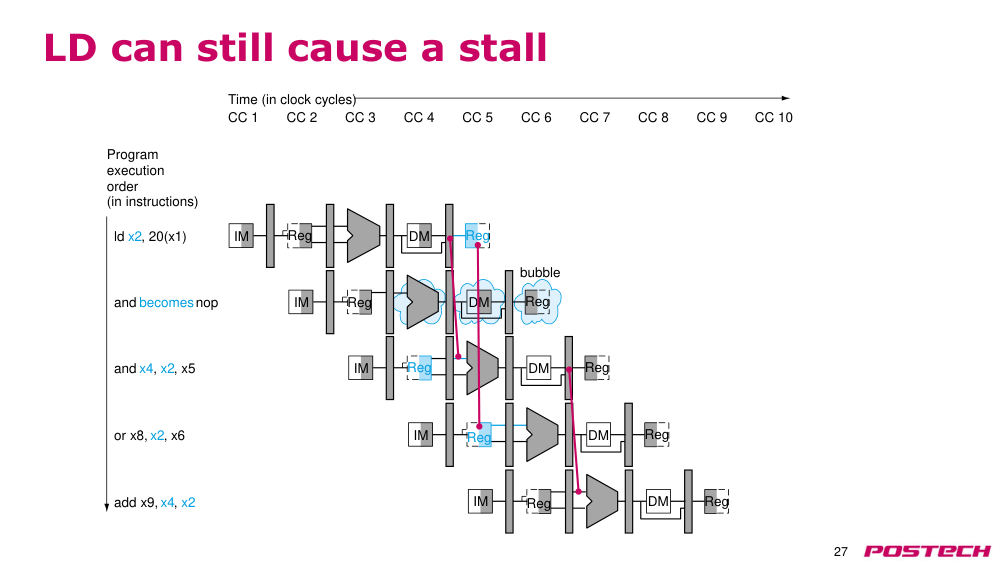
상황·문제ld x2 바로 뒤 and 가 x2 를 사용.
원인load 값은 MEM 끝(CC 5)에 준비되는데 and 는 CC 4 EX 에서 필요 → 시간을 거슬러 forward 불가.
해결and 를 bubble(nop)로 1 cycle stall, 뒤 instruction 도 1 cycle 지연. or 는 forward, add 는 RF 내부 forwarding.
- No backward arrow (can't go back in time)
2.730:30–34:40forwarding 후 data hazard 표와 hazard detection unit
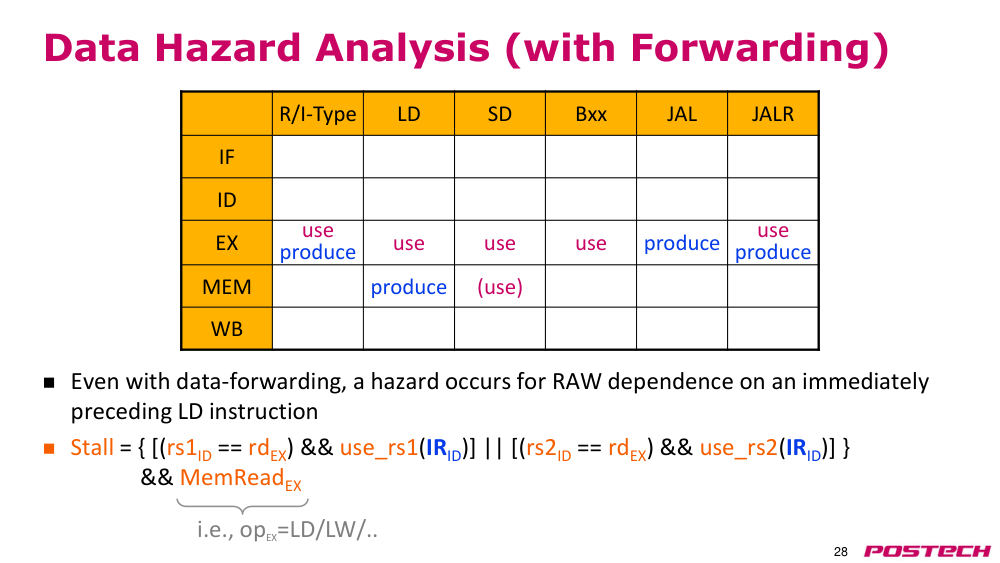
상황·문제forwarding 이후 어느 instruction 이 어느 stage 에서 값을 use/produce 하는지 다시 정리.
원인R/I-type 은 EX 에서 use·produce, LD 는 EX use·MEM produce(MEM 에서 produce 하는 유일한 instruction).
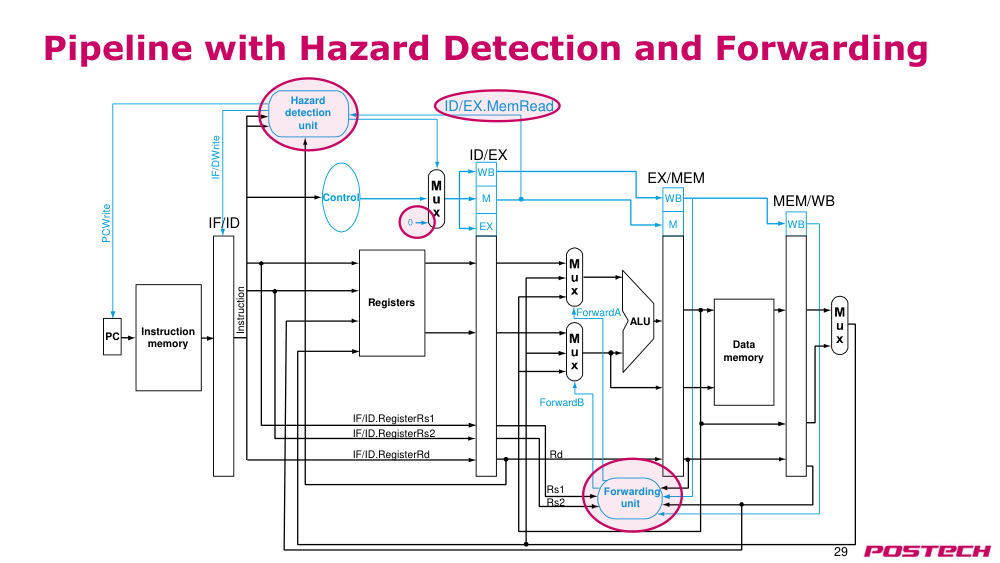
해결Stall = [(rs1_ID==rd_EX && use_rs1) || (rs2_ID==rd_EX && use_rs2)] && MemRead_EX. hazard detection unit 이 PC·IF/ID write 를 막고 control 을 0 으로.
- RAW hazard 가 없으면 여전히 ID 에서 RF read, WB 에서 write
- hazard detection unit + forwarding unit 을 갖춘 pipeline 완성
2.7.r.1Classic RISC pipeline (Wikipedia) ↗ · 5-stage pipeline 의 bypassing, load interlock, branch delay slot
2.834:40–43:30질의응답: forwarding logic 에 use_rs 가 없는 이유
상황·문제use_rs1(IR_ID) 가 forwarding logic 에 왜 없는지 질문.
원인forwarding logic 은 ALU 입력 MUX 선택만 정한다. 해당 operand 를 안 쓰면(예: load 의 두 번째 operand 는 immediate) 무엇을 고르든 무관.
해결stall 조건에서는 안 쓰는 rs2 match 로 불필요한 stall 이 나면 안 되므로 helper 필요. 강의자가 설명이 복잡해졌다며 다음 강의에 슬라이드로 다시 설명 예정. load 관련 추가 질문은 Teams 로.
- 실제 control 은 forwarding logic 외에 immediate 선택 등 다른 control 도 관여(단순화된 diagram)
2.943:30–50:00MIPS load delay slot
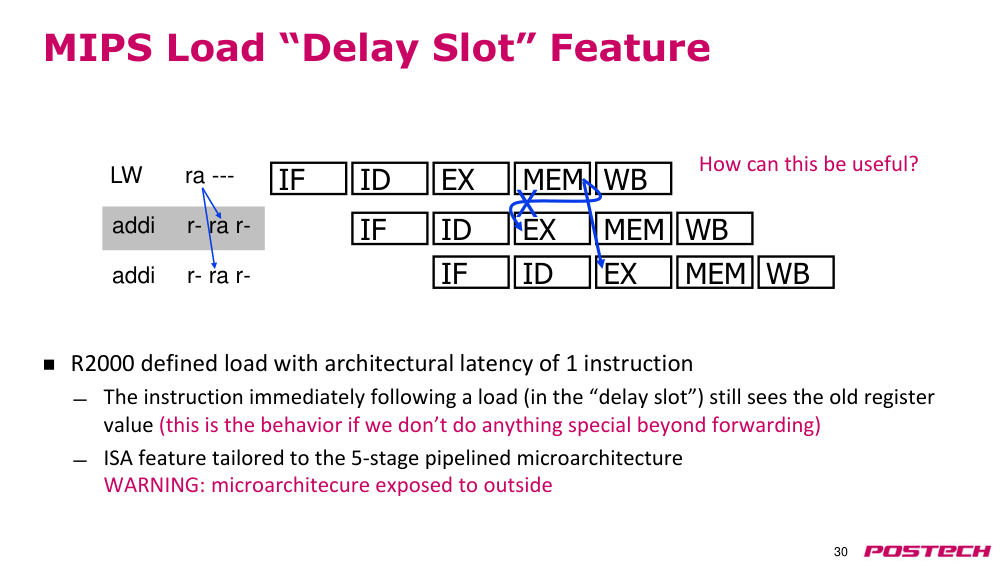
상황·문제MIPS(RISC-V 아님)는 load 바로 뒤 instruction 을 ISA 로 정의해 stall 을 없앤다.
원인R2000 은 load 의 architectural latency 를 1 instruction 으로 정의 → delay slot instruction 은 옛 register 값을 보는 것이 올바른 실행.
해결유용한 instruction 을 slot 에 넣으면 bubble 제거. 단 5-stage microarchitecture 를 ISA 에 노출: 더 깊은 pipeline·out-of-order 에선 무의미, 못 채우면 nop 로 program 만 커짐.
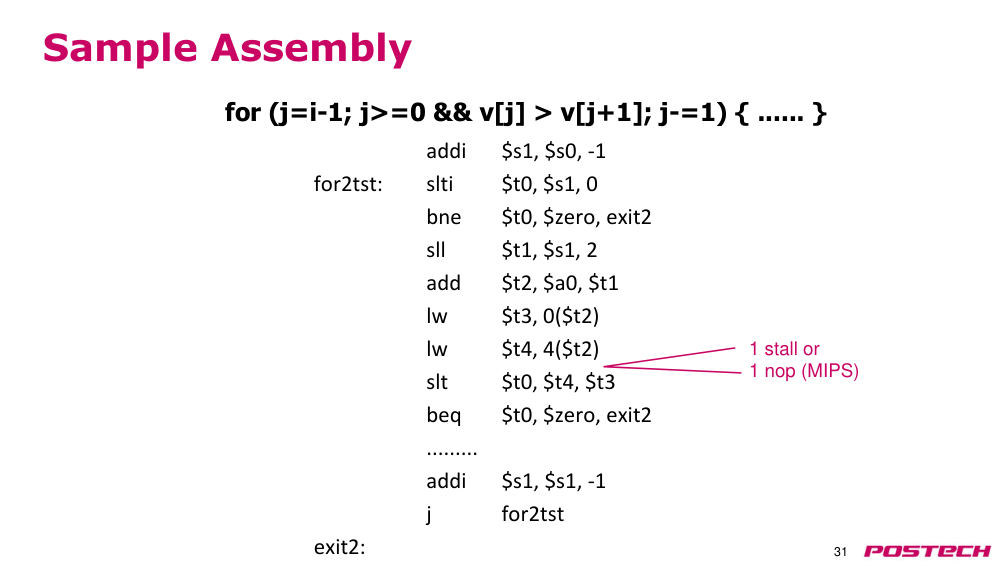
- sample assembly 에서 lw 뒤 slt 는 1 stall 또는 1 nop(MIPS)
- nop 삽입보다 pipeline 안에서 dynamic 하게 bubble 생성이 낫다
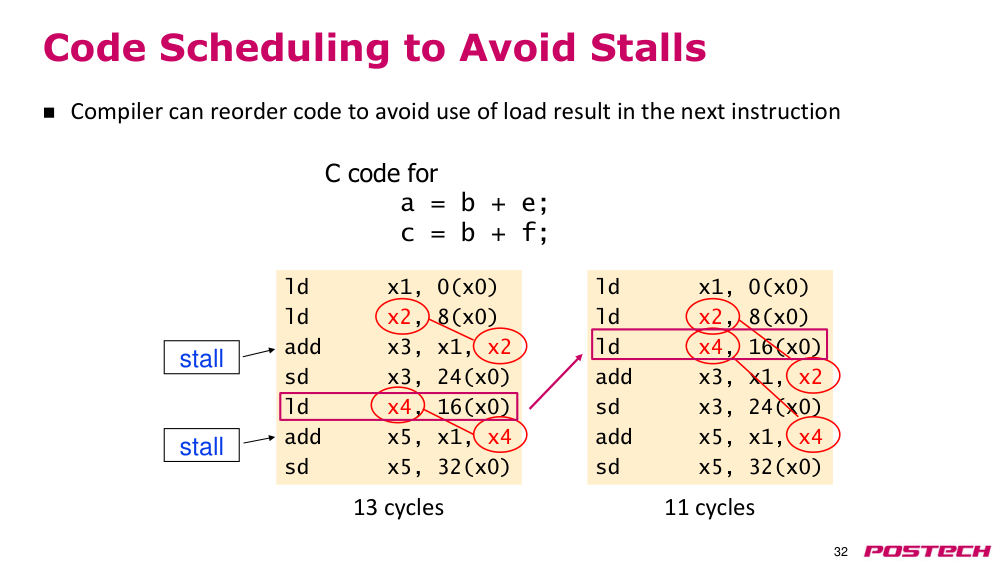
2.1050:00–52:30code scheduling 으로 stall 회피
상황·문제a = b + e; c = b + f; 를 그대로 번역하면 load 직후 사용으로 stall 2개.
원인ld 뒤 바로 add 가 그 값을 사용(distance 1).
해결ld x4 를 위로 옮겨 load 와 사용 사이 distance 를 2 이상으로: 13 cycles → 11 cycles. compiler 나 assembly programmer 가 수행.
- instruction 은 같고 순서만 변경
2.1152:30–58:40superpipelining 과 그 한계
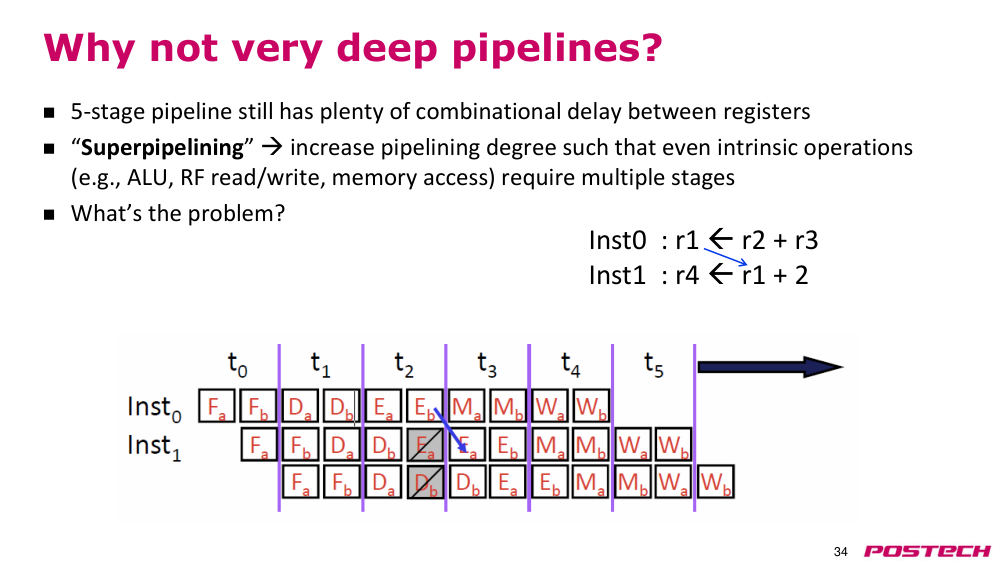
상황·문제5-stage pipeline 도 register 사이 combinational delay 가 커서 stage 를 더 쪼개면 clock 을 높일 수 있다.
원인10-stage(각 stage 2개로 분할)에서 r1 결과는 E_b 끝에 나오는데 의존 instruction 은 E_a 에서 필요 → 5-stage 에 없던 bubble 추가.
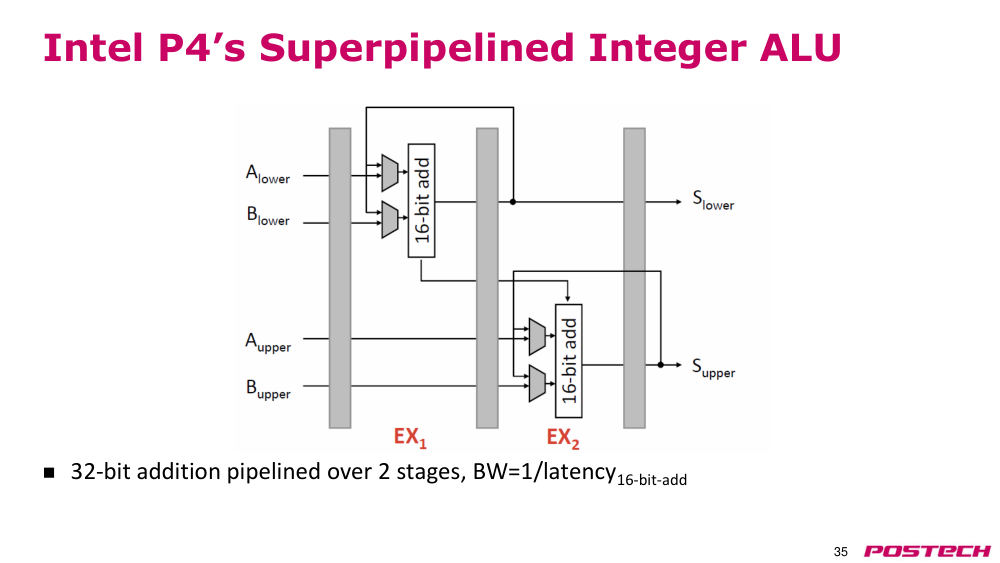
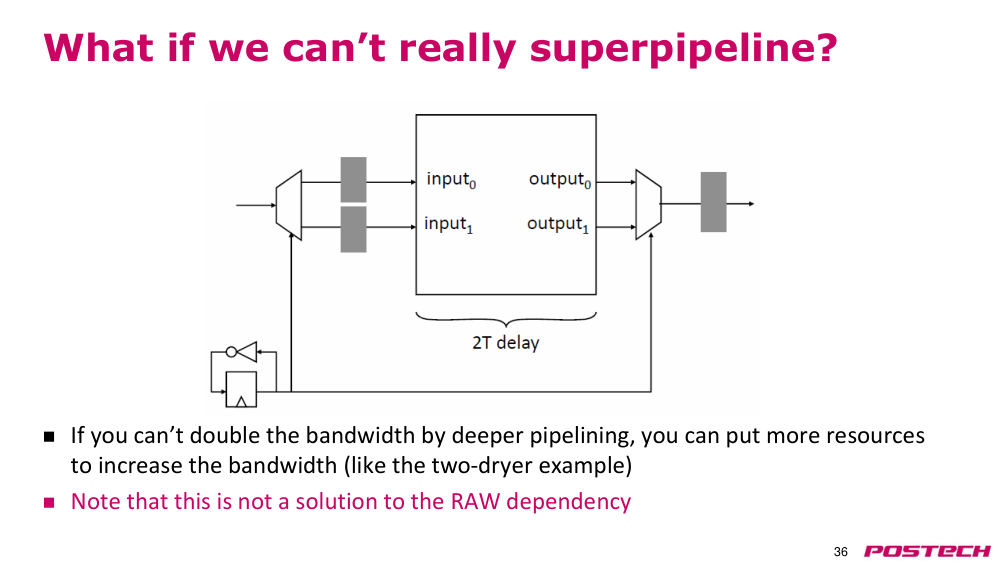
해결2x 깊이로 2x speedup 은 못 얻음. 예: P4 는 32-bit add 를 16-bit add 2 stage 로. 쪼갤 수 없으면 자원을 더 둔다(건조기 2대) — RAW 해결책은 아님.
- latch delay 대비 combinational delay 비율이 클수록 stage 추가가 이득
2.1258:40–1:01:10질의응답: code scheduling 은 누가 하나
상황·문제compiler 가 어떤 CPU 에서 돌지 모르지만 널리 쓰이는 microarchitecture 를 가정해 rescheduling 할 수 있다. CPU 안에서 dynamic 하게 하는 것이 out-of-order core(이후 강의).
2.131:01:10–1:05:30control hazard 도입: PC 를 통한 dependence
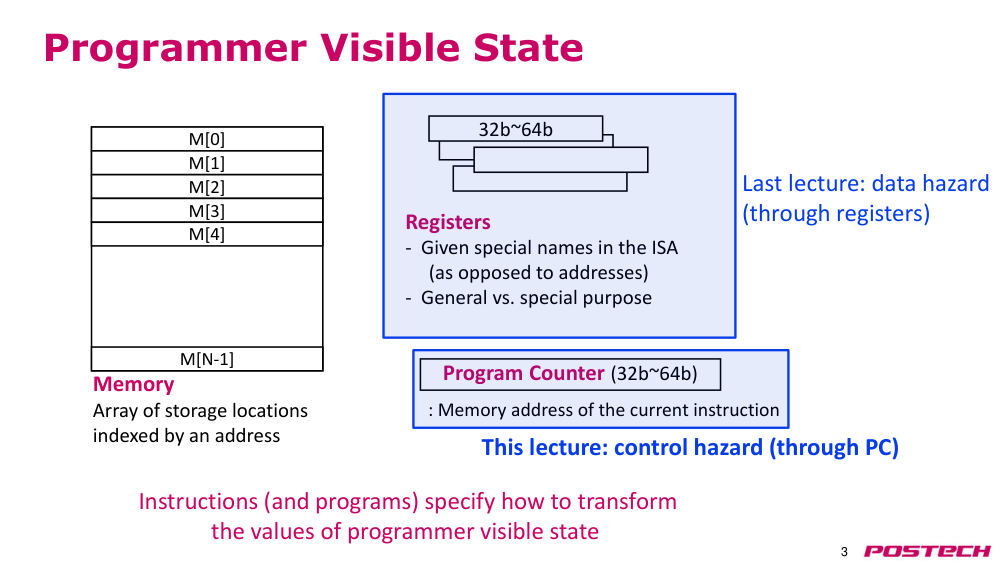
상황·문제data hazard 는 register 를 통한 dependence. programmer visible state 중 memory 는 load·store 가 같은 stage 라 문제없고 PC 는 아직 안 다룸.
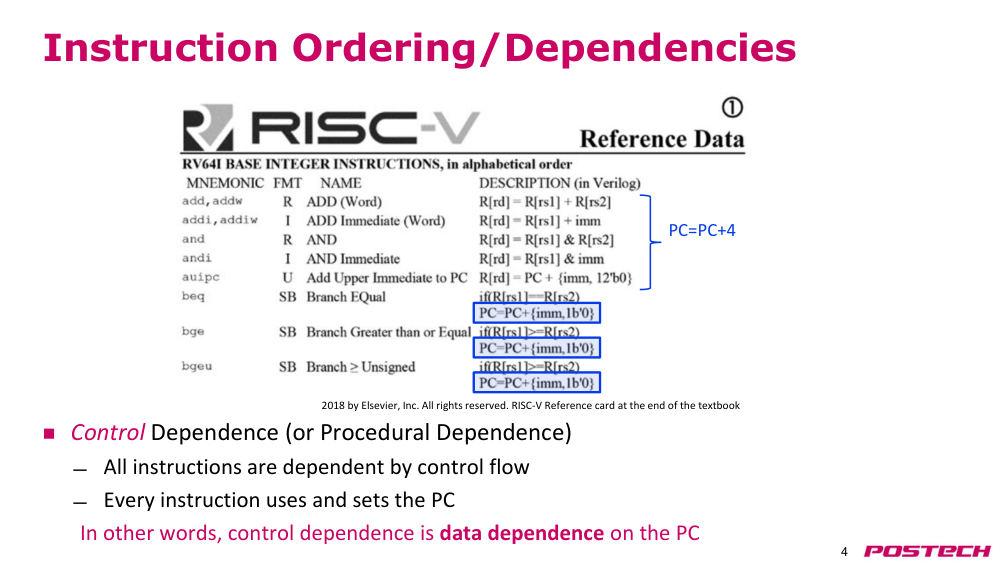
원인모든 instruction 이 PC 를 읽고 수정(PC+4 또는 branch 의 PC+imm). 즉 control dependence 는 PC 에 대한 data dependence.
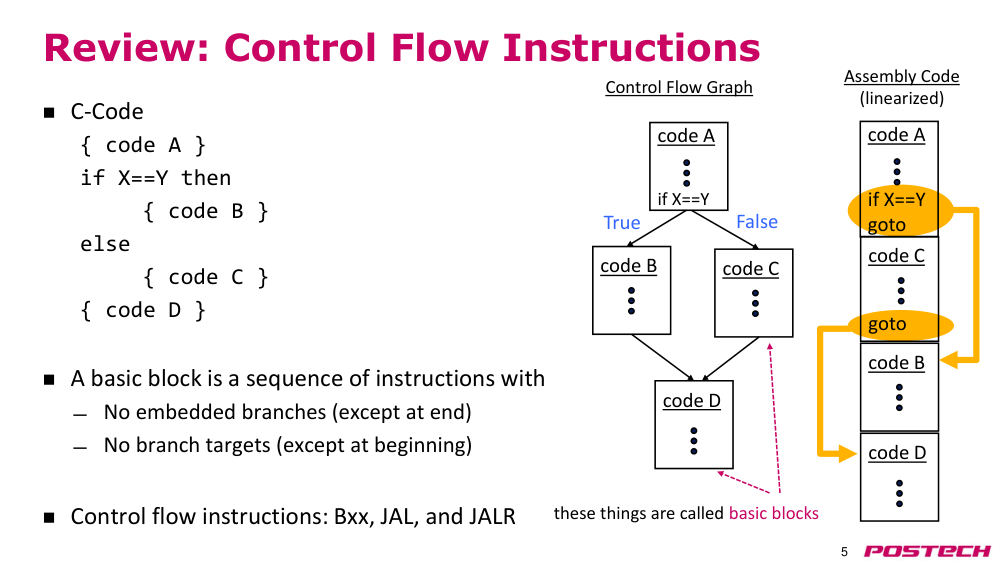
해결C 의 if-else 는 basic block 을 node 로 하는 control flow graph 가 되고, block 안은 PC+4, block 사이는 bxx·JAL·JALR 로 이동.
- RISC-V reference card(교재 끝)에서 각 instruction 의 PC 갱신 확인
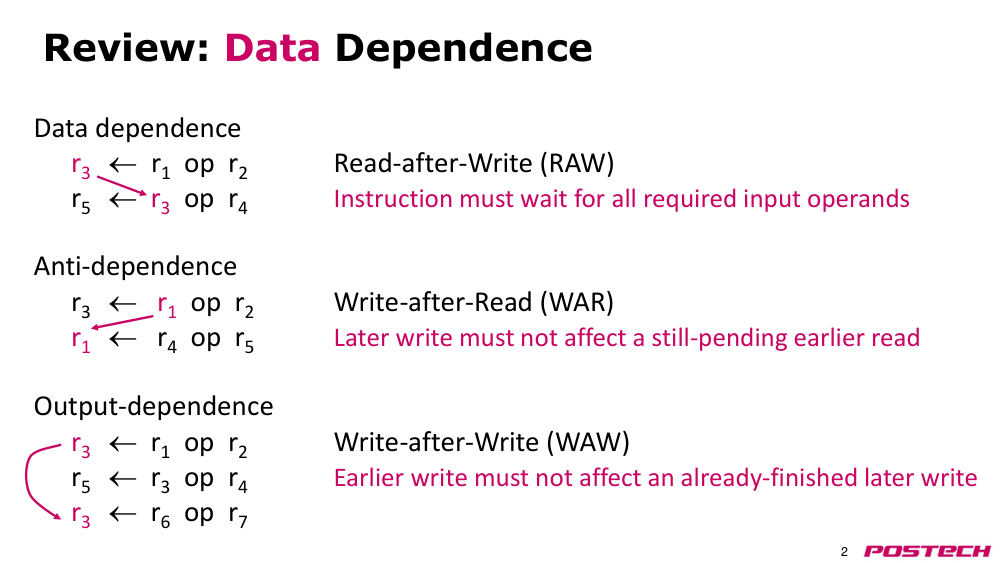
- RAW·WAR·WAW 복습
2.141:05:30–1:12:00PC hazard 분석과 stall 시 성능 절반
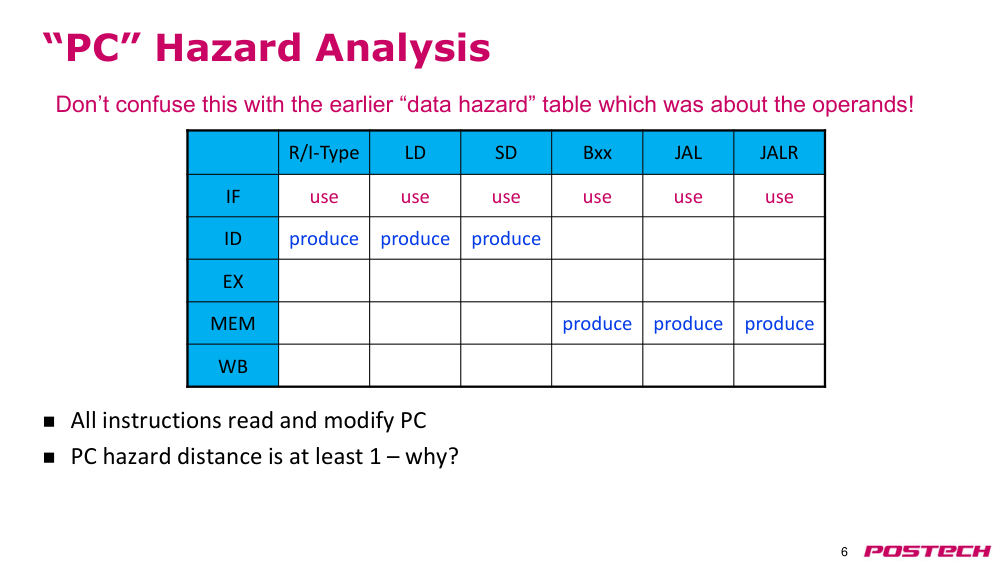
상황·문제모든 instruction 은 IF 에서 PC 를 use, next PC 는 ID(R/I, LD, SD) 또는 MEM(Bxx, JAL, JALR)에서 produce.
원인현재 instruction 을 decode 하기 전엔 PC+4 인지 PC+imm 인지 모른다 → PC hazard distance ≥ 1.
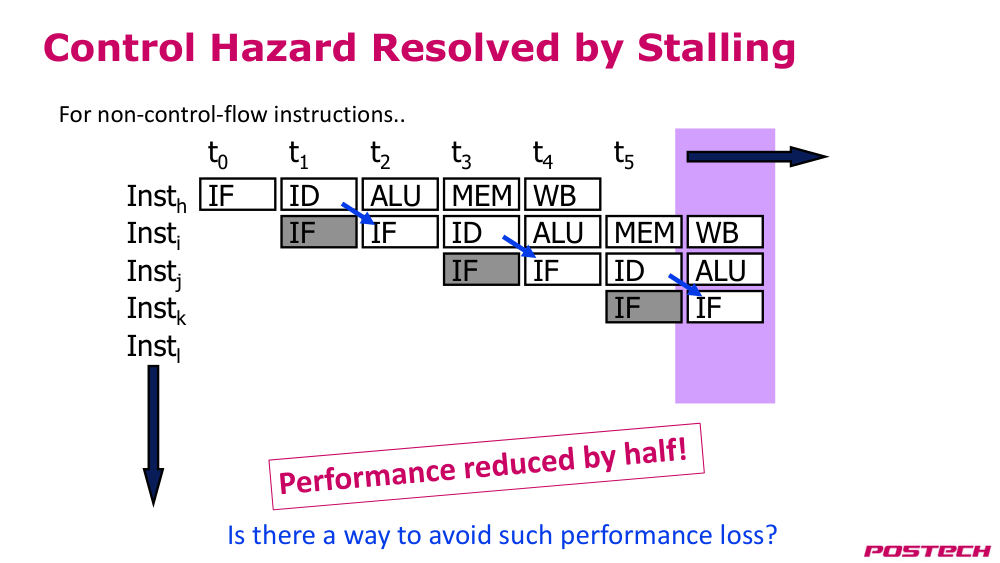
해결stall 로 해결하면 non-control-flow instruction 도 2 cycle 에 하나씩 fetch → 성능 절반. branch 는 더 많은 cycle 낭비.
- data hazard 표와 혼동 금지: 이 표는 operand 가 아닌 PC
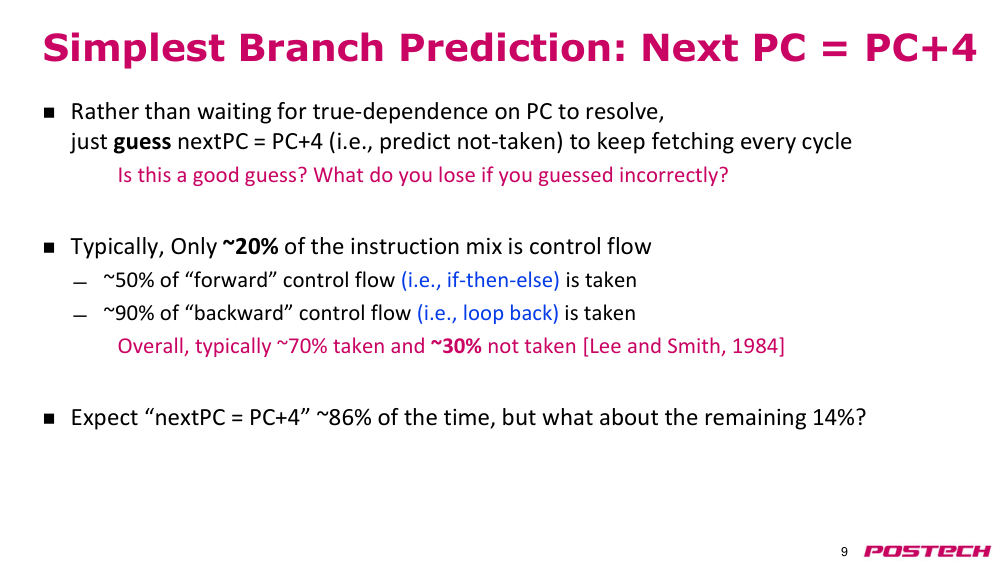
2.151:12:00–1:17:50가장 단순한 branch prediction: next PC = PC+4
상황·문제next PC 를 모르는 동안 fetch 를 계속하려면 예측해야 한다.
원인control flow 는 약 20%, forward 50%·backward(loop) 90% taken → 전체 약 70% taken. 0.2×0.7 = 14% 는 PC+4 가 틀림.
해결PC+4(not-taken)로 예측해 매 cycle fetch, 약 86% 맞음. 틀리면 잘못 fetch 한 instruction 을 flush. 성능 영향 분석은 다음 강의.
- [Lee and Smith, 1984] 통계
- 출석 체크 없음
3핵심 개념
3.1data forwarding(데이터 포워딩) = register bypassing
EX/MEM·MEM/WB pipeline register 의 결과를 RF 를 거치지 않고 ALU 입력으로 넘겨 RAW stall 을 제거.
3.1.r.1Operand forwarding (Wikipedia) ↗ · 결과를 register file 을 거치지 않고 다음 instruction 에 넘기는 forwarding
3.2internal forwarding(RF 내부 포워딩)
같은 cycle 에 RF 에 write 하는 값을 read 하는 instruction 이 바로 받음(dist 3).
3.3forwarding unit(포워딩 유닛)
rs1/rs2_EX 와 rd_MEM·rd_WB, RegWrite 를 비교해 ForwardA/B MUX select 생성. MEM match 우선.
3.4load-use hazard(로드-사용 해저드)
load 값은 MEM 끝에 준비, 바로 다음 instruction 은 EX 에서 필요 → forwarding 으로도 1 cycle stall.
3.5hazard detection unit(해저드 탐지 유닛)
MemRead_EX && rd_EX 가 rs1/rs2_ID 와 같으면 PC·IF/ID write 금지, control 0 으로 bubble.
3.6load delay slot(로드 지연 슬롯)
MIPS R2000 은 load 의 architectural latency 를 1 instruction 으로 정의, 바로 뒤 instruction 은 옛 값을 봄.
3.7code scheduling(코드 스케줄링)
compiler 가 instruction 순서를 바꿔 load 와 사용 사이 거리를 늘려 stall 제거 (13 → 11 cycles).
3.8superpipelining(슈퍼파이프라이닝)
ALU·RF·memory 같은 기본 연산도 여러 stage 로 쪼개 clock 을 높임. 의존 instruction 사이 bubble 증가.
3.9control dependence(제어 의존성)
모든 instruction 이 PC 를 use·set 하므로 PC 에 대한 data dependence.
3.10basic block(기본 블록)
중간에 branch 도 branch target 도 없는 instruction 열. control flow graph 의 node.
3.12branch prediction(분기 예측): PC+4
not-taken 으로 가정하고 계속 fetch. 약 86% 맞고 틀리면 flush.
4스스로 확인
4.1forwarding 이 있을 때 dist 1, 2, 3 의 operand 는 각각 어디서 오나?
답
dist 1 은 EX/MEM(MEM stage), dist 2 는 MEM/WB(WB stage), dist 3 은 RF 내부 forwarding.
4.2forwarding logic 에서 MEM match 를 WB match 보다 먼저 확인하는 이유는?
답
MEM 에 있는 instruction 이 더 young 한 정의이므로 그 값이 최신.
4.3ld x2 바로 뒤 and 가 x2 를 쓰면 왜 stall 이 필요한가?
답
load 값은 CC 5(MEM 끝)에 준비되는데 and 는 CC 4 EX 에서 필요, 시간을 거슬러 forward 불가.
4.4load delay slot 을 ISA 에 두는 것의 단점은?
답
5-stage microarchitecture 를 노출. 깊은 pipeline·out-of-order 에선 무의미하고, 채울 instruction 이 없으면 nop 로 program 만 커짐.
4.5PC+4 예측이 맞는 비율 86% 는 어떻게 나오나?
답
control flow 20% 중 70% taken → 14% 만 틀림. 나머지 80% non-control + 6% not-taken 은 PC+4 가 맞음.
5참고 자료
5.1Computer Organization and Design RISC-V Edition (Elsevier) ↗ · 교재 P&H RISC-V ed. (읽기: Ch 4.8, 4.9)
5.3Classic RISC pipeline (Wikipedia) ↗ · 5-stage pipeline 의 bypassing, load interlock, branch delay slot