Lec 6 part2 · Lec 7 · microcode 마무리와 pipelined CPU 입문
정밀 정리 · 검증 2026-09-24 15:46
1개요
1.1전반부(Lec6 part2): multi-cycle datapath 의 register transfer 를 나열하고 자원 충돌을 피해 instruction 별 RT sequence 를 cycle 단위로 구성.
1.2horizontal/vertical microcode, CISC microcoding(microcode patch·emulation), nanocode·millicode 로 multi-cycle 마무리.
1.3후반부(Lec7): 세탁 비유로 pipelining(latency 동일, throughput 증가), latch delay·cost 모델과 k_opt = √(GT/LS).
1.4RISC-V 를 5 stage 로 나누고 hazard 예고, 불균형 stage 로 4배(이상 5배), pipeline register 와 memory 분리, LD 의 stage 별 동작.
2섹션별 정리 상황·문제 → 원인 → 해결
2.22:05–6:07multi-cycle datapath 의 synchronous register transfer
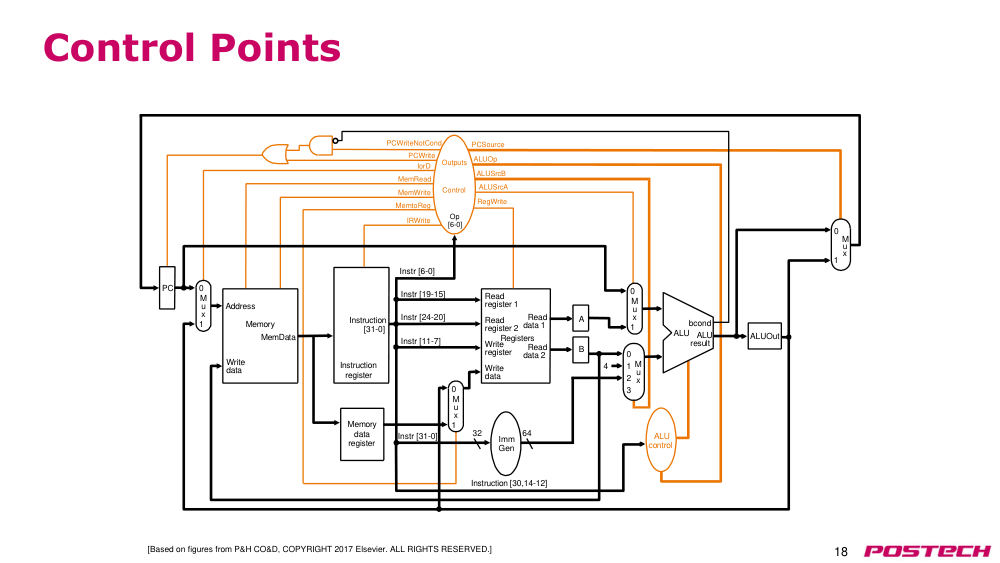
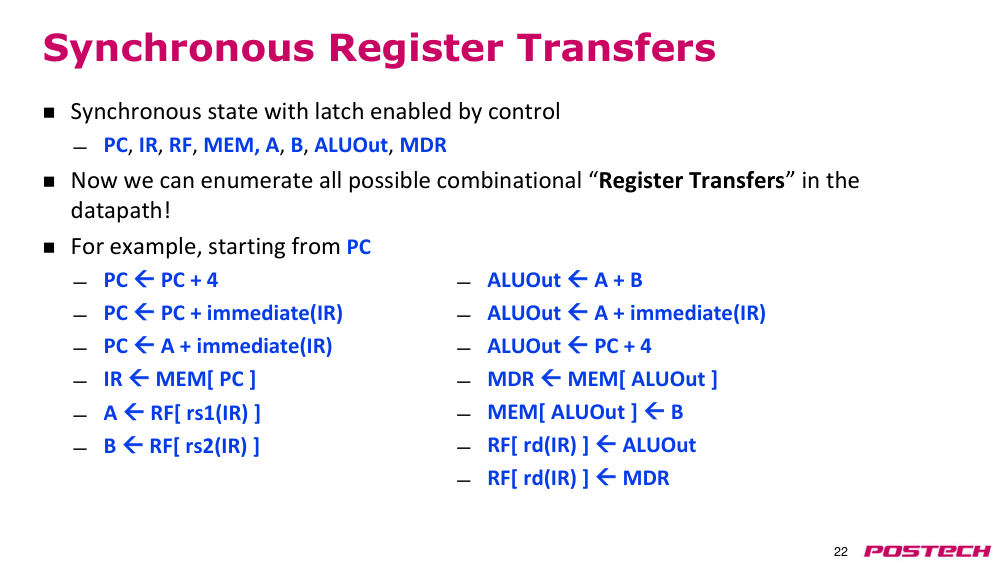
상황·문제지난 시간 multi-cycle datapath·control point 에 이어, 추가한 latch(PC, IR, A, B, ALUOut, MDR)로 가능한 register transfer(RT, 레지스터 전송)를 모두 나열한다.
원인각 cycle 에 combinational logic 이 latch 입력을 정하고 clock rising edge 에서 latch 값이 바뀐다.
해결PC ← PC+4 / PC+imm, IR ← MEM[PC], A·B ← RF, ALUOut ← A+B / A+imm / PC+4, MDR ← MEM[ALUOut], RF[rd] ← ALUOut/MDR 조합으로 RISC-V 전 instruction 구현.
- PC 갱신은 +4, +imm(IR), A+imm(IR) 세 가지
- ALUOut ← PC+4 는 JAL·JALR 의 rd 저장용
- WB 는 ALU 결과 또는 memory 값을 rd 에 기록
2.2.r.1Register-transfer level (Wikipedia) ↗ · register 사이 data 흐름과 그 사이 combinational logic 으로 회로를 기술
2.36:07–11:38RT sequencing: R-type 과 LD, 그리고 RT 충돌
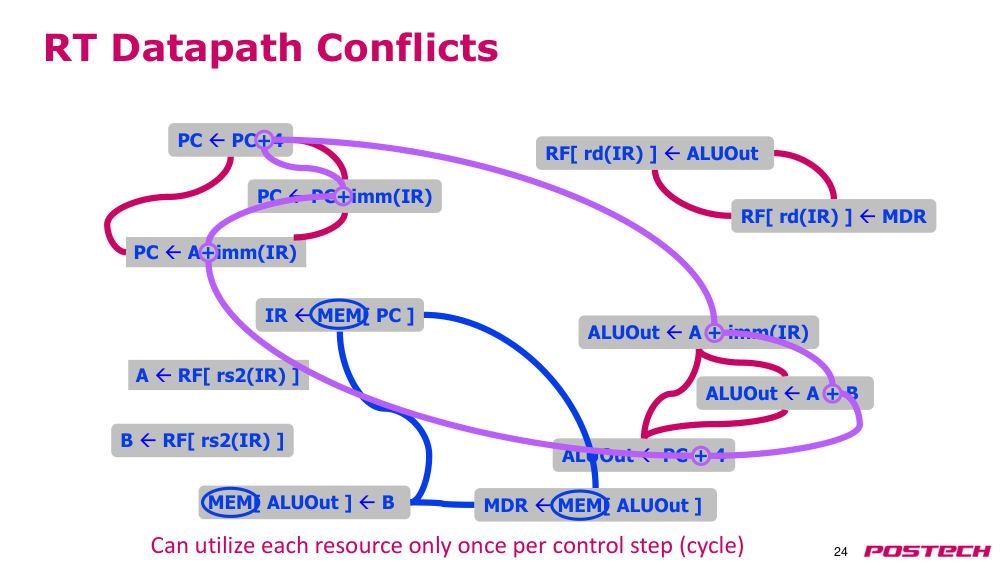
상황·문제instruction 마다 단계별로 어떤 RT 를 쓸지 고르는데, 같은 cycle 에 같은 자원을 쓰는 RT 는 함께 둘 수 없다.
원인PC 를 갱신하는 RT 3개, IR·ALUOut 등 같은 destination latch 를 쓰는 RT, memory 를 쓰는 RT 3개(fetch·load·store), ALU 를 쓰는 RT 는 서로 충돌한다.
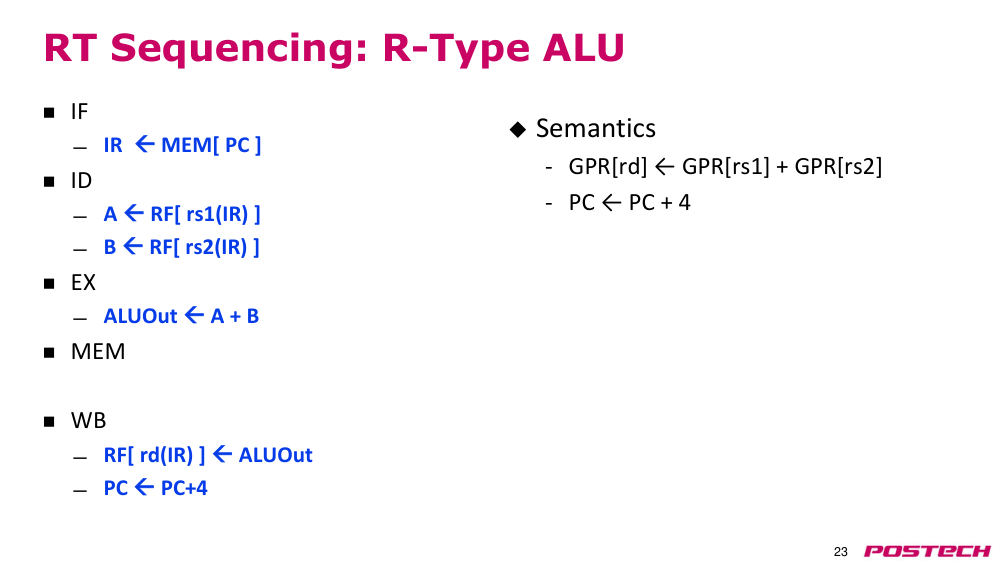
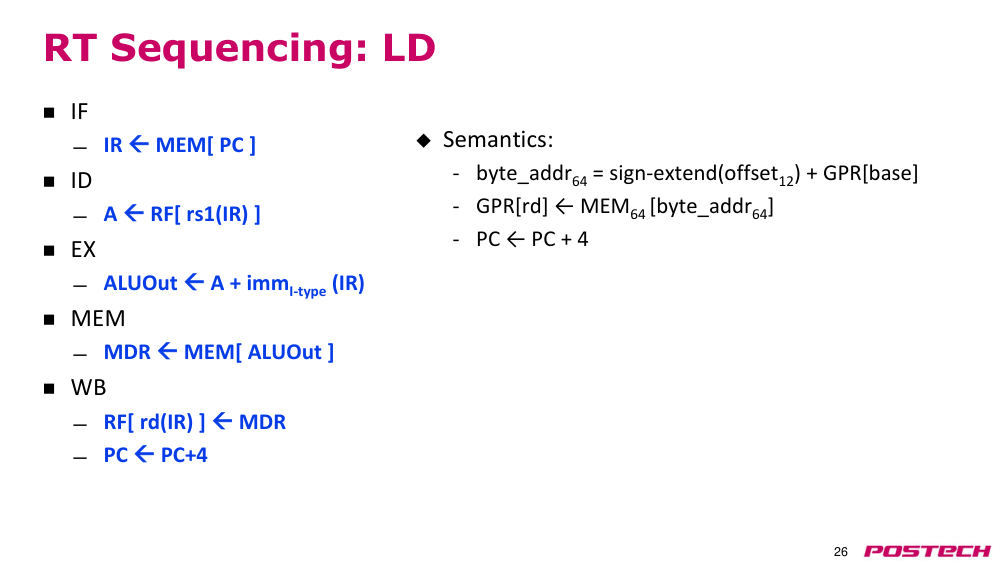
해결충돌하는 RT 를 서로 다른 step(cycle)으로 분리: R-type 은 IF → ID(A,B) → EX(ALUOut ← A+B) → WB(RF[rd] ← ALUOut, PC ← PC+4). LD 는 A+imm → MDR ← MEM[ALUOut] → RF[rd] ← MDR.
- 각 자원·latch 는 control step 당 한 번만 사용
- IR 을 쓰는 RT 는 fetch 다음 cycle 부터
- LD: address 계산 → memory 접근 → rd·PC 갱신
2.3.r.1Register-transfer level (Wikipedia) ↗ · register 사이 data 흐름과 그 사이 combinational logic 으로 회로를 기술
2.411:38–19:39결합된 RT sequencing 과 Q&A
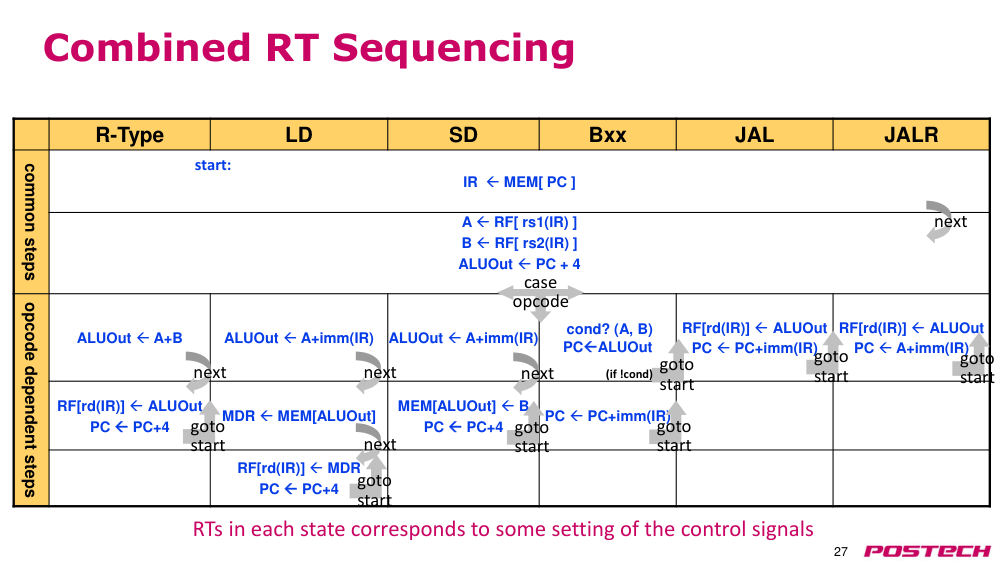
상황·문제모든 instruction 의 RT sequence 를 한 표(각 row = 한 cycle)로 합친다.
원인fetch, decode(A·B read), ALUOut ← PC+4 는 모든 instruction 공통이라 앞 단계에 둔다. 이후 opcode 별로 갈라진다.
해결R-type EX → WB, LD addr → MEM → WB, SD 는 WB 없이 PC 갱신, branch 는 ALU 로 조건 확인 후 PC+4 또는 PC+imm, JAL·JALR 은 PC+4 를 rd 에 저장하고 ALU 로 target 계산.
- 표의 각 row 는 한 cycle (학생 질문)
- branch 는 조건 확인과 target 계산이 모두 ALU 를 써서 한 cycle 에 못 함
- branch 는 not taken 3 cycle, taken 4 cycle 로 latency 가 다름
2.4.r.1Register-transfer level (Wikipedia) ↗ · register 사이 data 흐름과 그 사이 combinational logic 으로 회로를 기술
2.519:39–23:35horizontal·vertical microcode
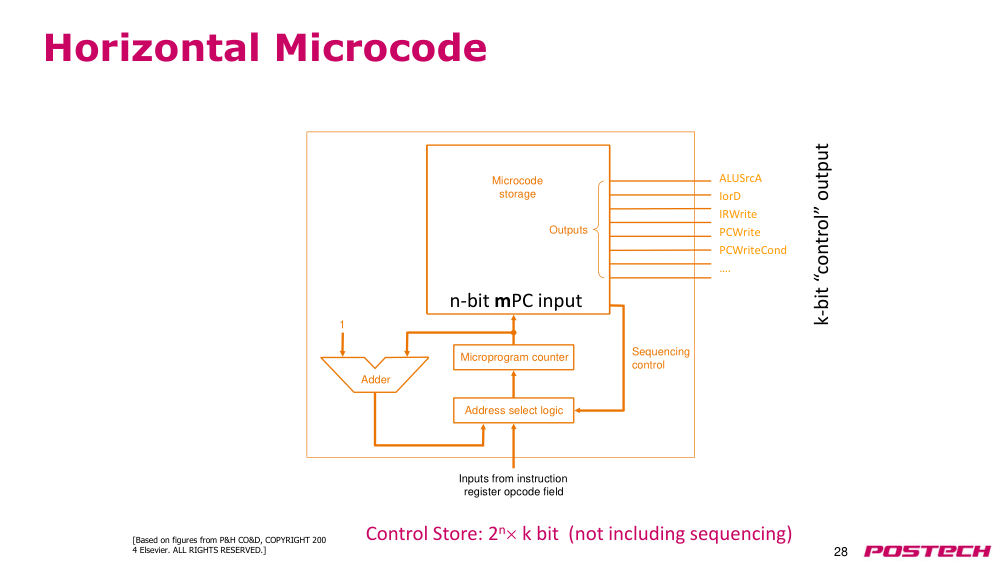
상황·문제앞서 본 microcode controller 는 µPC 로 ROM 을 읽어 각 cycle 의 control signal 을 모두 출력한다.
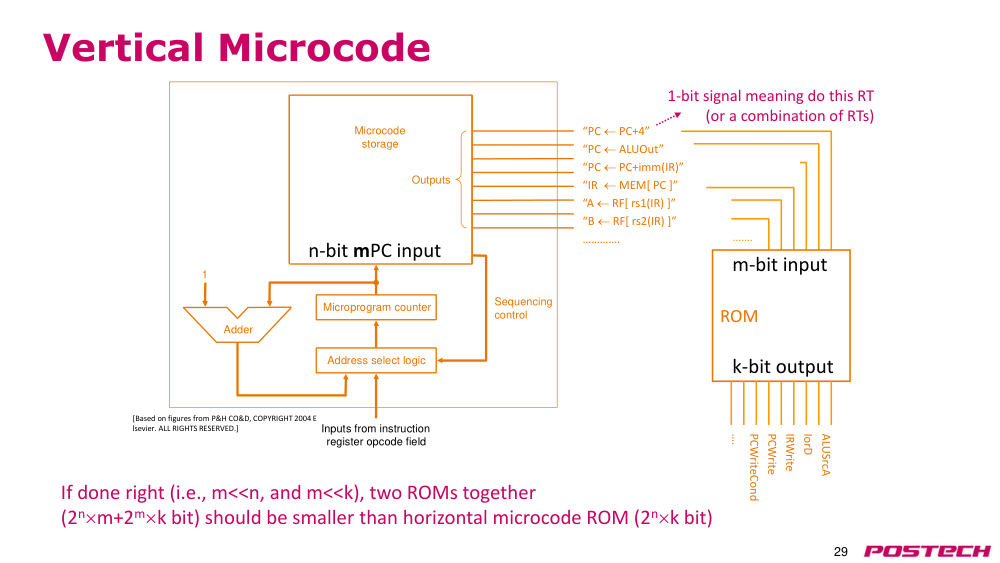
원인control signal 수 k 가 가능한 RT 수 m 보다 훨씬 크면, 한 ROM 이 모든 control 을 출력하는 방식은 비싸다. 여러 instruction 이 같은 RT(PC ← PC+4 등)를 중복으로 가진다.
해결ROM 을 둘로 나눠 첫 ROM 은 어떤 RT 를 할지만 출력, 둘째 ROM 이 그것을 control signal 로 변환 → 전체 cost 감소.
- horizontal: 2^n × k bit control store
- vertical: microinstruction 이 RT 를 encoding, 작은 ROM 두 개
- 가정: control signal 수 ≫ RT 수
2.5.r.1Microcode (Wikipedia) ↗ · horizontal/vertical microcode, Intel·AMD microcode patch, nanocode·millicode
2.623:35–28:15CISC 를 위한 microcoding
상황·문제RISC-V 용으로 만든 datapath 로 polyf(VAX) 같은 복잡한 instruction 도 지원할 수 있는가?
원인ROM 이 충분히 크면 RT 조합으로 임의 instruction 을 sequencing 할 수 있다. 복잡한 경우 loop counter 같은 micro-ISA state 가 추가로 필요하다.
해결출하 후 instruction 추가나 bug fix 를 microcode 갱신으로 처리 (Intel·AMD patch). 단순한 datapath 로 다른 ISA 도 emulation 가능하지만 느려질 수 있다.
- simple datapath 도 Turing machine 처럼 universal
- microcode 수정으로 출하 후 bug fix·instruction 추가
- 다른 ISA emulation 은 느리지만 불가능보다 낫다
2.6.r.1Microcode (Wikipedia) ↗ · horizontal/vertical microcode, Intel·AMD microcode patch, nanocode·millicode
2.728:15–33:49nanocode 와 millicode
상황·문제polyf 같은 복잡한 instruction 을 microcontroller 를 복잡하게 하지 않고 지원하는 방법.
원인micro program 이 너무 길어지거나 FPU 같은 하위 system 을 드물게만 쓰는 경우.
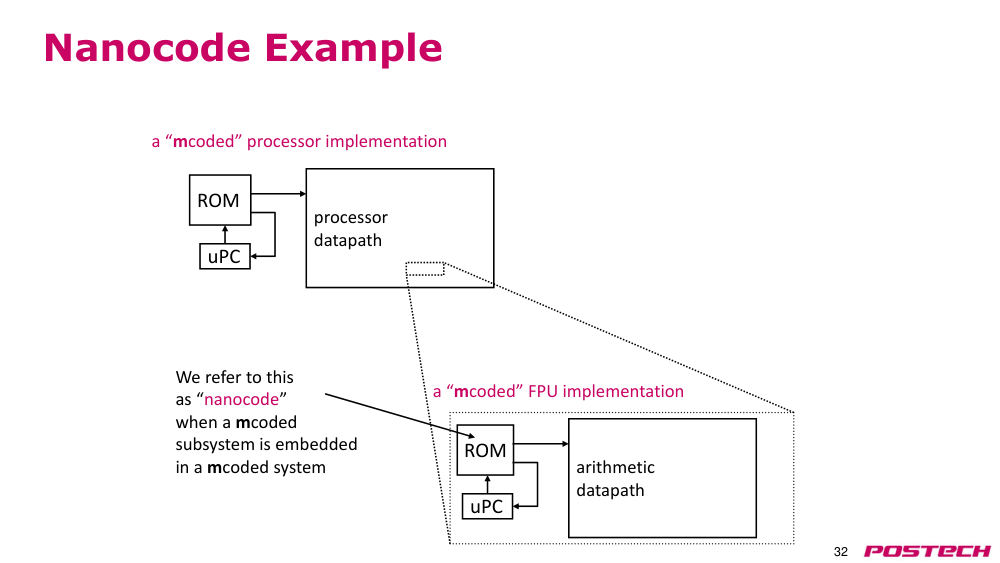
해결nanocode: microcode 아래 단계로, microinstruction 이 FPU 의 nanoprogram 을 호출. millicode: microcode 위 단계로, ISA-level subroutine(add, multiply 등)을 CPU 안에서 호출.
- nanocode = microcoded FPU 같은 microcoded 하위 system
- millicode = CPU 내부 ROM 의 ISA-level subroutine
- 두 경우 모두 microcontroller 변경은 최소 (추상화의 힘)
2.7.r.1Microcode (Wikipedia) ↗ · horizontal/vertical microcode, Intel·AMD microcode patch, nanocode·millicode
2.833:49–38:50multi-cycle 마무리, 출석, Q&A
상황·문제microcontrol 기반 multi-cycle CPU 설계 마무리. 읽기 과제 안내 후 출석 확인, Zoom 이름을 학번+이름으로.
해결Q&A: 지금 datapath 는 최소 요소라 CISC 구현에도 크게 벗어나지 않지만 ISA 마다 최적 datapath 는 다를 수 있다. 함수 return 은 JALR 로 register 값을 PC 에 넣는다 (imm 0).
2.8.r.1Computer Organization and Design RISC-V Edition (Elsevier) ↗ · P&H 교재 (Ch 4.5-4.7 읽기 과제, 세탁 비유 그림 출처)
2.938:50–48:32Lec7 시작: 세탁 비유로 본 pipelining
상황·문제single-cycle 은 가장 느린 instruction 에 맞춰지고, multi-cycle 은 instruction 별 latency 로 돌지만 한 번에 한 instruction 만 처리한다.
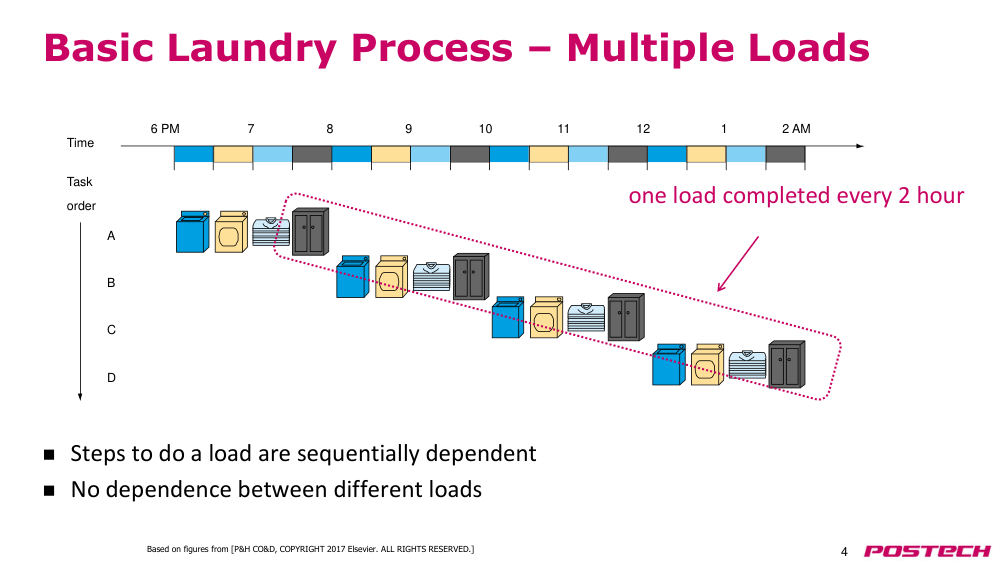
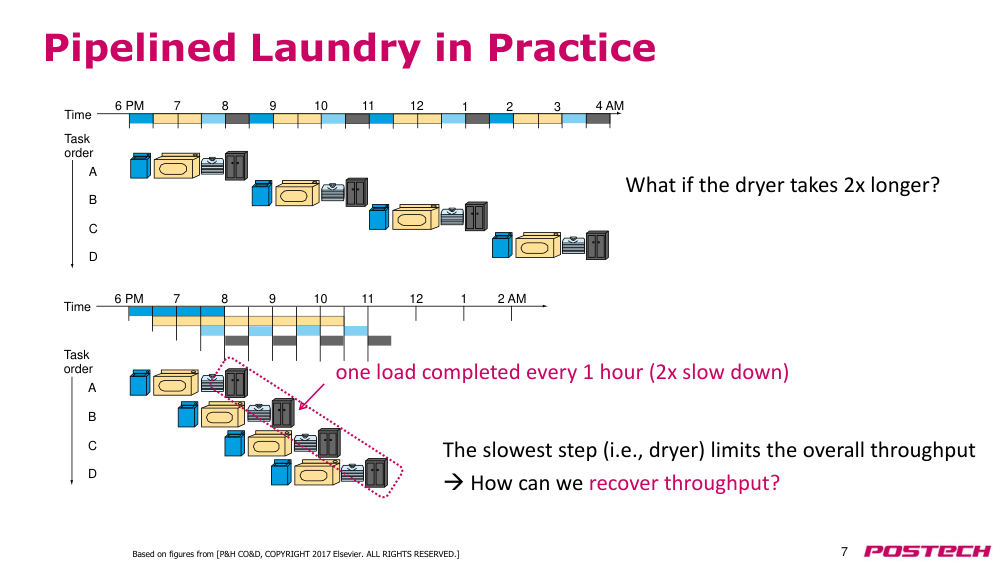
원인한 세탁물의 4단계(각 0.5 h)는 순차 의존이지만 다른 세탁물끼리는 독립이다. 순차 처리하면 4명에 8 h, 건조 중 세탁기가 논다.
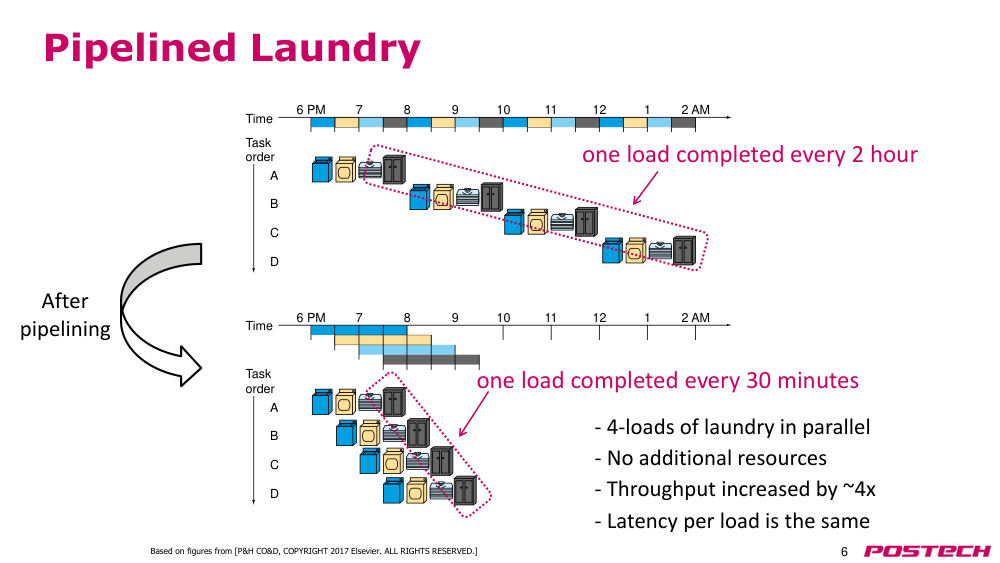
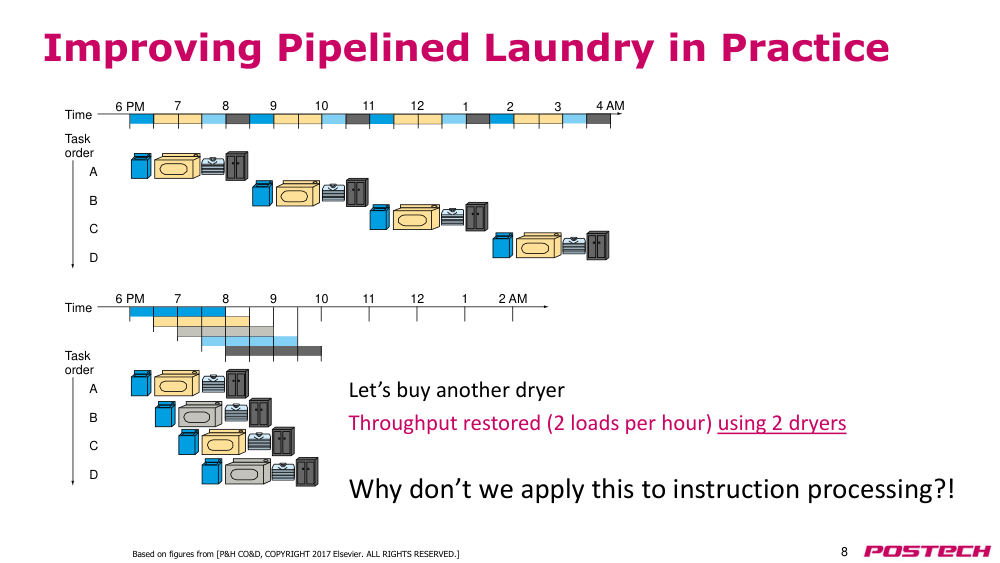
해결pipelining 으로 0.5 h 마다 한 뭉치 완료 → 추가 자원 없이 throughput 4배, 각 latency 2 h 는 동일. 건조기가 2배 느리면 1 h 마다 완료, 건조기 2대로 회복(비용 증가).
- latency 는 그대로, throughput 증가
- 가장 느린 stage 가 throughput 을 제한
- 느린 stage 는 자원 복제로 보완 가능 (비용)
2.9.r.1Pipeline (computing) (Wikipedia) ↗ · latency 는 그대로, throughput 증가, stage 사이 buffer register 비용
2.9.r.2Computer Organization and Design RISC-V Edition (Elsevier) ↗ · P&H 교재 (Ch 4.5-4.7 읽기 과제, 세탁 비유 그림 출처)
2.1048:32–58:24pipeline idealism 과 성능·비용 모델
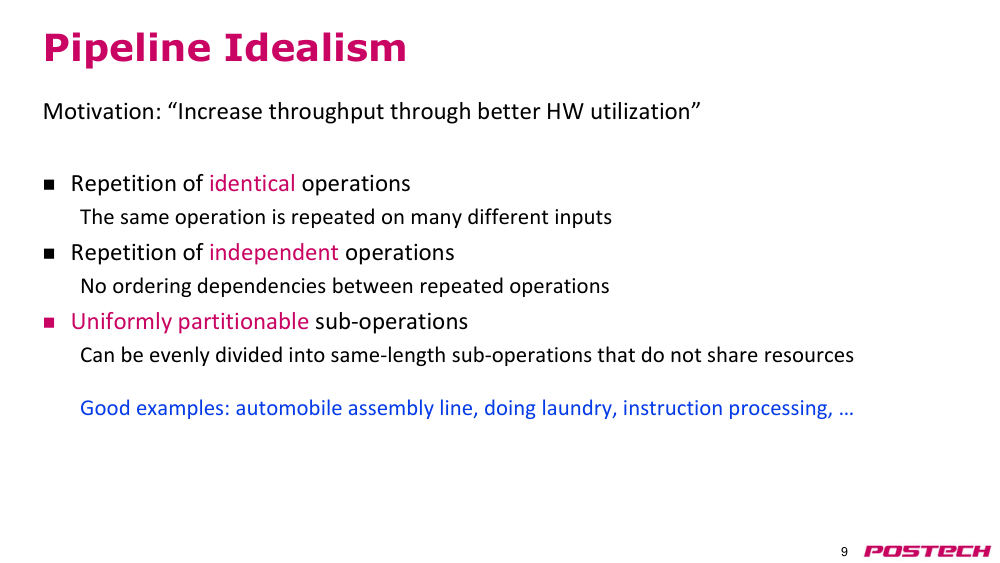
상황·문제세탁 비유를 instruction 처리에 적용: 같은 연산 반복, 독립 연산, 같은 길이로 나눌 수 있는 sub-operation 이 이상적 조건.
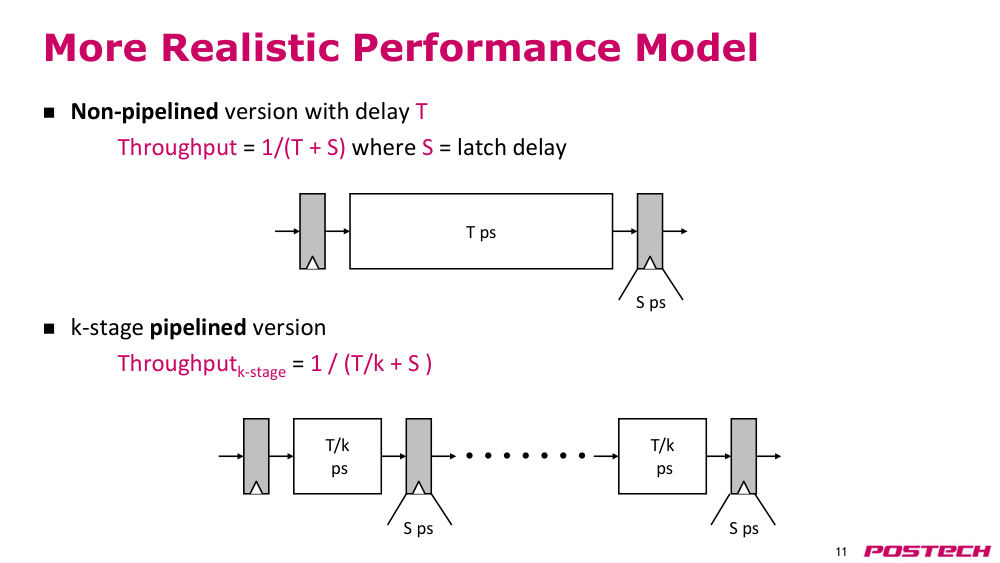
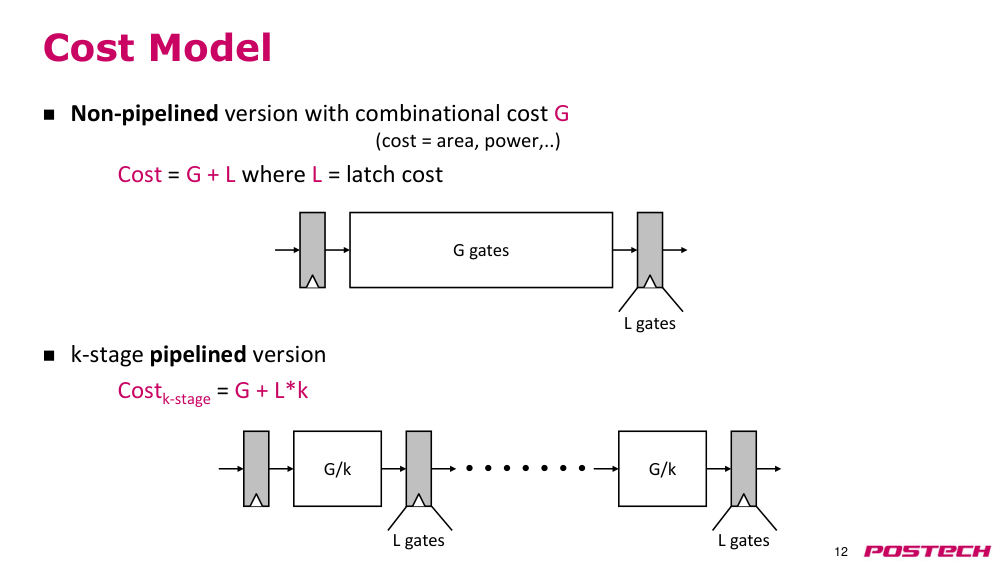
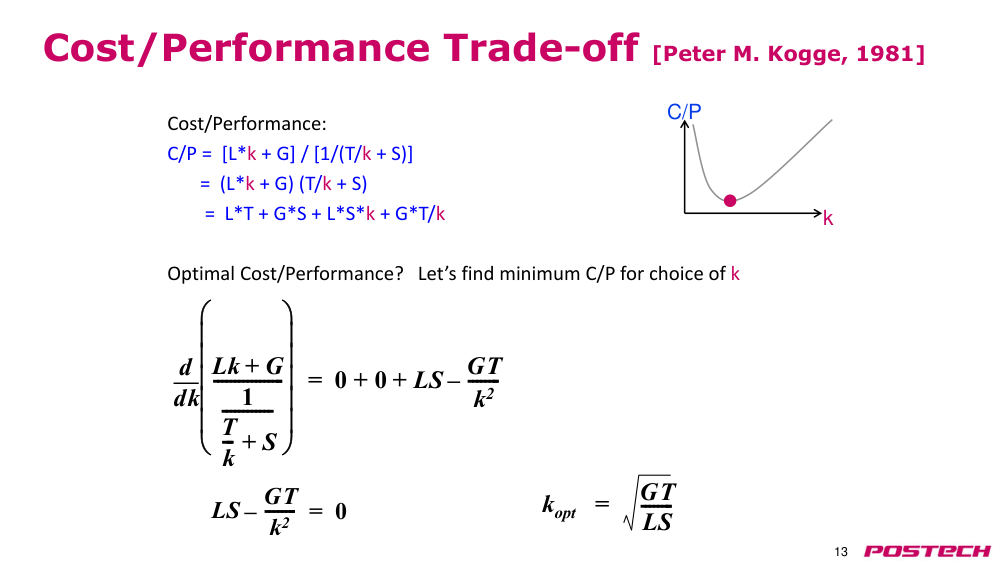
원인combinational logic T ps 를 k stage 로 나누면 이상적 throughput k/T. 실제로는 latch delay S 때문에 1/(T/k + S), cost 는 G + L·k 로 늘어난다.
해결C/P = (L·k + G)(T/k + S) 를 k 로 미분해 0 → k_opt = √(GT/LS). G·T 가 L·S 보다 크면 stage 를 늘리지만, 무작정 늘리면 diminishing return.
- 예: 자동차 조립, 세탁, instruction 처리
- throughput_k = 1/(T/k + S), cost_k = G + L·k
- k_opt = √(GT/LS) (Kogge 1981)
2.10.r.3Flip-flop (electronics) (Wikipedia) ↗ · latch/flip-flop 의 setup time·clock-to-output delay (latch delay S)
2.1158:24–1:03:32RISC-V pipeline: 5 stage 로 나누기와 hazard
상황·문제single-cycle RISC-V datapath 를 어떻게 stage 로 나눌까?
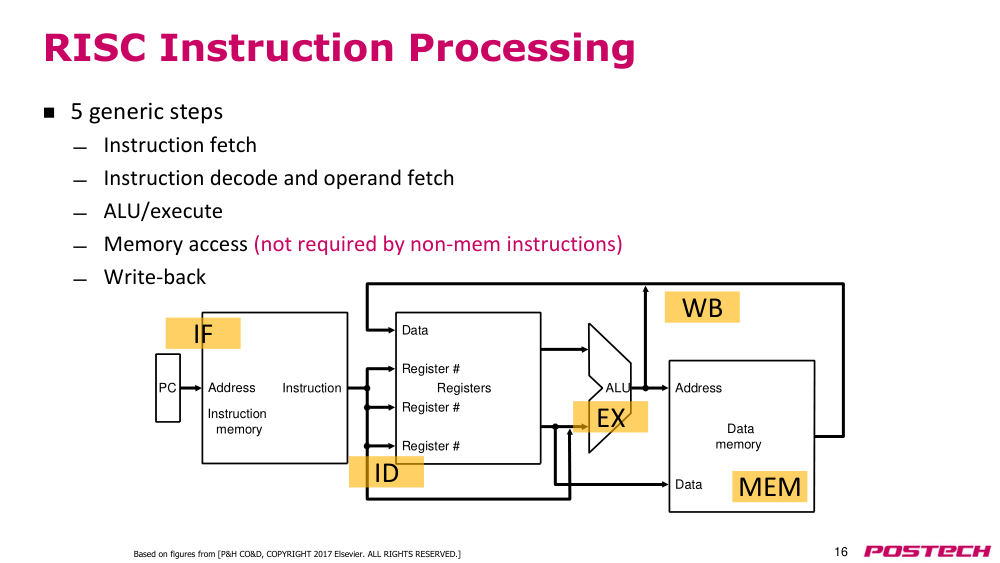
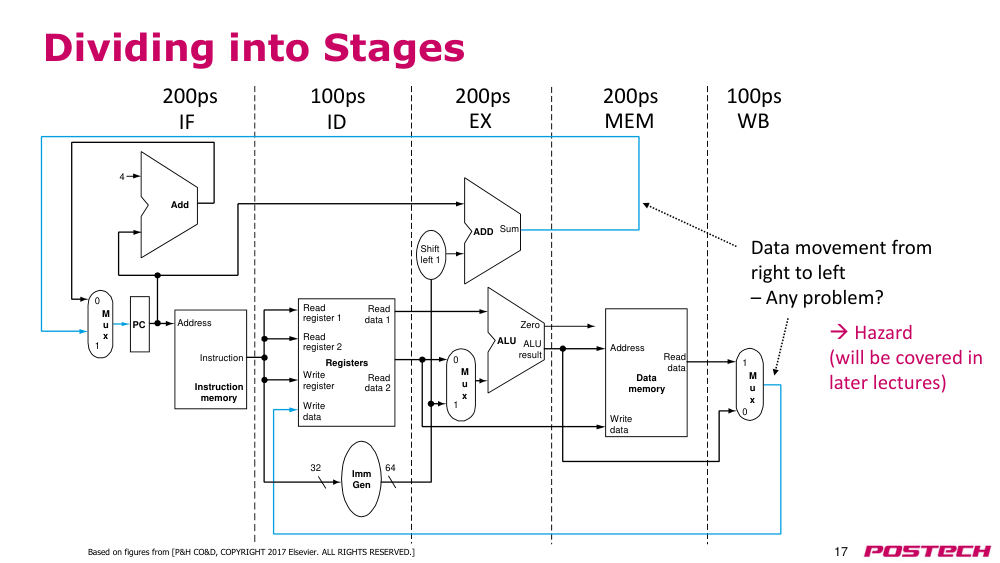
원인instruction 처리는 IF·ID·EX·MEM·WB 5단계라 그대로 5 stage 로 나눈다. 그런데 WB → register file, branch/jump target → PC 는 오른쪽에서 왼쪽으로 흐른다.
해결JAL 의 target 이 계산되기 전에 뒤 instruction 을 어디서 fetch 할지 모르고, 앞 add 의 rd 를 뒤 instruction 이 WB 전에 읽을 수 있다 → hazard. 자세한 내용은 이후 강의.
- IF: instruction memory·PC 갱신, ID: register read·ImmGen
- right-to-left data 이동이 stage 간 의존성을 만든다
- control·data hazard 는 나중 강의에서
2.121:03:32–1:10:35불균형 stage 와 speedup, super pipelining
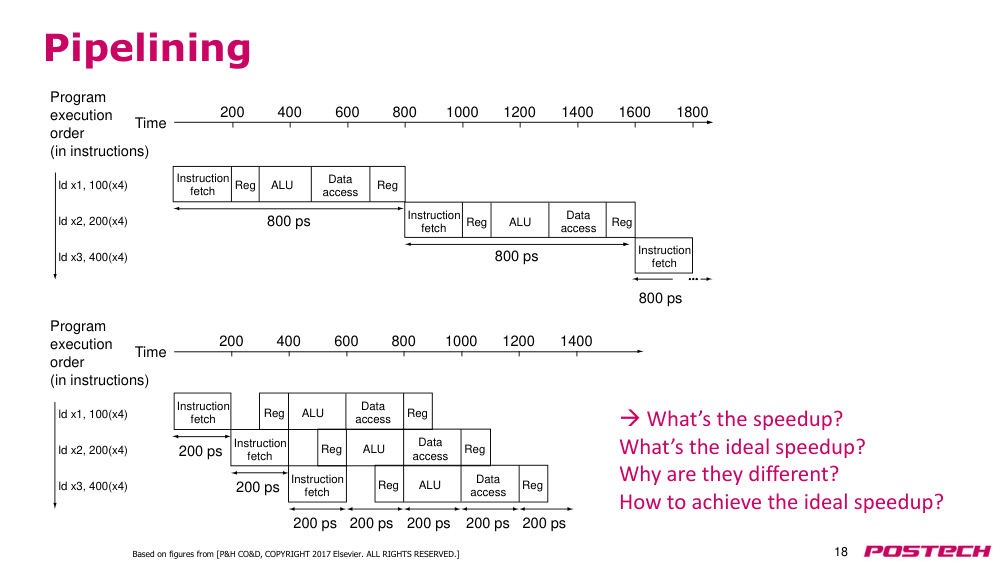
상황·문제stage 마다 시간이 다르다: IF·MEM 200 ps, ALU 200 ps, ID·WB 100 ps.
원인single-cycle 은 instruction 당 800 ps, pipeline 은 가장 느린 stage 200 ps 마다 완료 → 4배. 이상적 speedup 5배에 못 미침.
해결느린 unit(IF, ALU, data memory)을 복제하거나, 느린 stage 를 IF1·IF2, EX1·EX2 처럼 더 쪼갠다. 실제 CPU 는 10~30 stage (super pipelining).
- 800 ps → 200 ps: 4배 (이상 5배)
- 원인: stage latency 불균형
- 해결: 자원 복제 또는 stage 세분화
2.131:10:35–1:14:31pipeline register 와 structural hazard
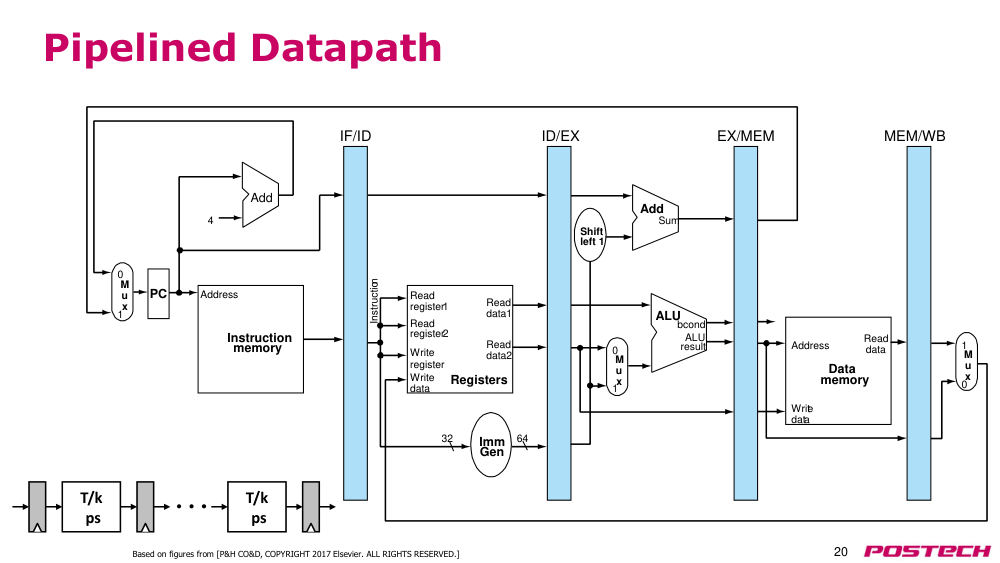
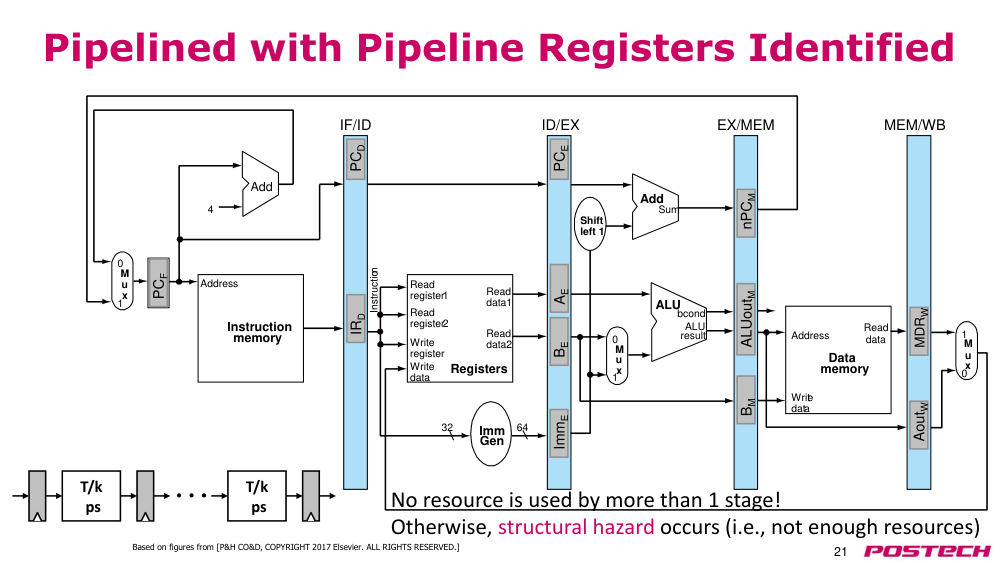
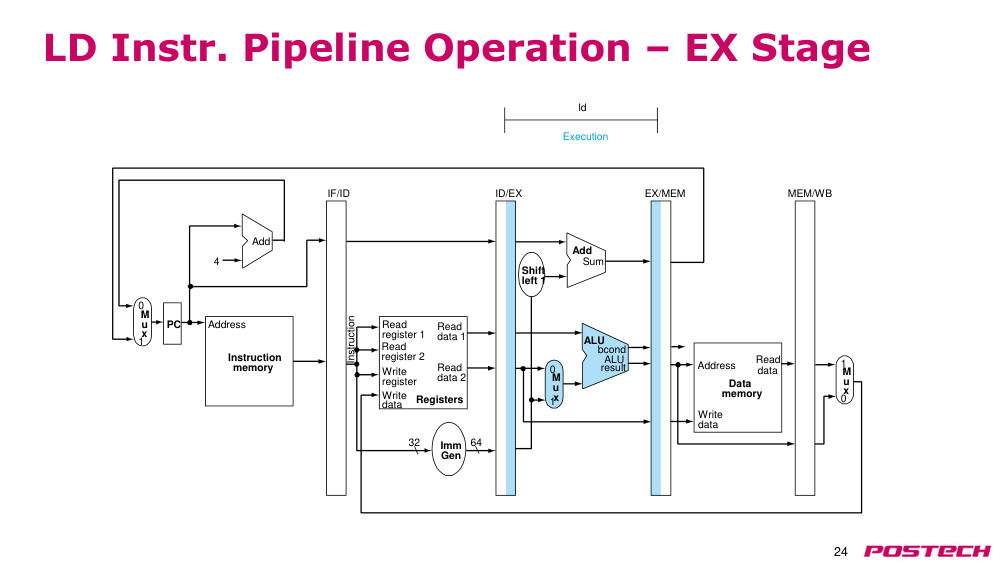
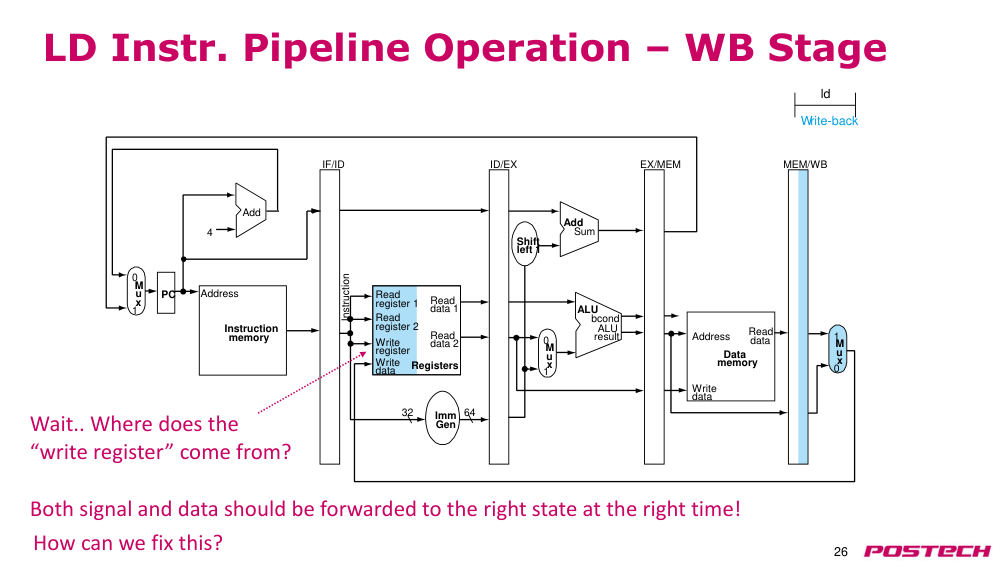
상황·문제큰 combinational logic 을 나눈 자리마다 pipeline register(IF/ID, ID/EX, EX/MEM, MEM/WB)가 필요하다.
원인multi-cycle 에서 추가한 IR, A, B, ALUOut, MDR 에 해당하는 값과 PC 를 stage 마다 보관해야 한다. 한 자원을 두 stage 가 동시에 쓰면 structural hazard.
해결instruction memory 와 data memory 를 다시 분리해 fetch 와 data access 가 같은 cycle 에 가능하게 한다.
- 어떤 자원도 둘 이상의 stage 가 쓰지 않아야 한다
- single memory 면 fetch·data access 충돌 → structural hazard
- B 는 SD 용으로 MEM stage 까지 전달
2.13.r.2Harvard architecture (Wikipedia) ↗ · instruction/data memory 분리 → 같은 cycle 에 fetch 와 data access
2.141:14:31–1:15:47LD 의 pipeline 동작 예와 마무리
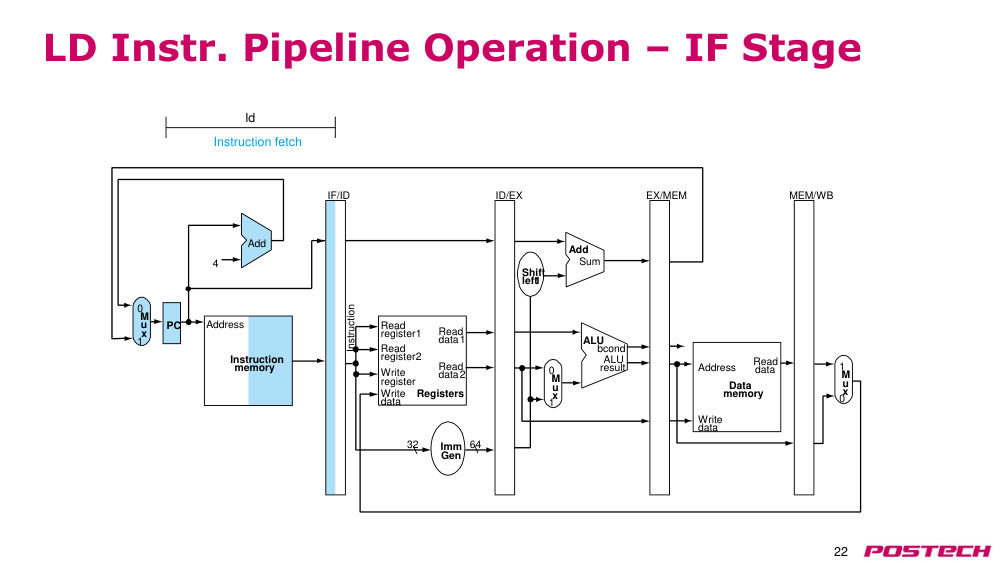
상황·문제LD 하나가 IF(PC+4, fetch) → ID(register read, imm 생성) → EX(address 계산) → MEM(data memory read) → WB(rd 기록)를 지난다.
해결나머지(여러 instruction 동시 진행 등)는 다음 강의에서 계속.
3핵심 개념
3.1register transfer(RT, 레지스터 전송)
한 cycle 에 latch 사이에서 일어나는 전송. 예 ALUOut ← A + B. 같은 자원·latch 를 쓰는 RT 는 같은 cycle 에 못 둔다.
3.1.r.1Register-transfer level (Wikipedia) ↗ · register 사이 data 흐름과 그 사이 combinational logic 으로 회로를 기술
3.2vertical microcode(수직 마이크로코드)
microinstruction 이 RT 를 encoding 하고 두 번째 ROM 이 control signal 로 변환. control 수 ≫ RT 수일 때 cost 감소.
3.2.r.1Microcode (Wikipedia) ↗ · horizontal/vertical microcode, Intel·AMD microcode patch, nanocode·millicode
3.3nanocode / millicode(나노코드 / 밀리코드)
nanocode 는 microcode 아래 하위 system(FPU) 제어, millicode 는 microcode 위 ISA-level subroutine.
3.3.r.1Microcode (Wikipedia) ↗ · horizontal/vertical microcode, Intel·AMD microcode patch, nanocode·millicode
3.4pipelining(파이프라이닝)
처리를 stage 로 나눠 여러 작업을 겹쳐 실행. latency 는 그대로, throughput 증가.
3.4.r.1Pipeline (computing) (Wikipedia) ↗ · latency 는 그대로, throughput 증가, stage 사이 buffer register 비용
3.5latch delay S(래치 지연)
stage 사이 register 의 시간. k stage throughput = 1/(T/k + S) 로 이상치 k/T 를 제한.
3.5.r.1Flip-flop (electronics) (Wikipedia) ↗ · latch/flip-flop 의 setup time·clock-to-output delay (latch delay S)
3.6k_opt = √(GT/LS)
cost/performance (L·k + G)(T/k + S) 를 최소로 하는 stage 수 (Kogge).
3.7hazard(해저드)
pipeline 에서 다음 instruction 을 제때 실행 못 하게 하는 의존·자원 충돌. structural·data·control.
3.8super pipelining(슈퍼 파이프라이닝)
stage 를 더 잘게 나눠 10~30 stage 로 만드는 것.
3.9pipeline register(파이프라인 레지스터)
IF/ID, ID/EX, EX/MEM, MEM/WB. stage 사이 중간 결과와 PC·IR 등을 보관.
4스스로 확인
4.1branch 가 taken 일 때와 not taken 일 때 multi-cycle cycle 수는?
답
not taken 3 cycle, taken 4 cycle. 조건 확인과 target 계산이 모두 ALU 를 써서 한 cycle 에 못 한다.
4.2vertical microcode 가 horizontal 보다 싼 조건은?
답
control signal 수 k 가 가능한 RT 수 m 보다 훨씬 클 때. 첫 ROM 은 RT 만 고르고 둘째 ROM 이 control 로 변환.
4.3세탁 4단계(0.5 h)에서 건조가 1 h 이면 pipeline throughput 은?
답
1 h 마다 한 뭉치 (2배 느려짐). 건조기 2대로 0.5 h 마다로 회복.
4.4stage 800 ps 합계, 가장 느린 stage 200 ps 인 5-stage pipeline 의 speedup 은?
답
800/200 = 4배. 이상적 5배에 못 미치는 이유는 stage 불균형.
4.5pipeline 에서 instruction memory 와 data memory 를 분리하는 이유는?
답
한 instruction 의 fetch 와 다른 instruction 의 data access 가 같은 cycle 에 일어나 single memory 면 structural hazard.
5참고 자료
5.1Computer Organization and Design RISC-V Edition (Elsevier) ↗ · P&H 교재 (Ch 4.5-4.7 읽기 과제, 세탁 비유 그림 출처)
5.5Microcode (Wikipedia) ↗ · horizontal/vertical microcode, Intel·AMD microcode patch, nanocode·millicode