이 자료를 쓰는 강의: 41 Lec 6 · control flow datapath 와 multi-cycle CPU(microcode) · 42 Lec 7 · microcode 마무리와 pipelined CPU 입문
Lec6-multi-cycle-CPU
한국어판 강의자료 · 34쪽
p.1CSED311 컴퓨터구조 – 강의 6
Multi-Cycle CPU(멀티 사이클 CPU)
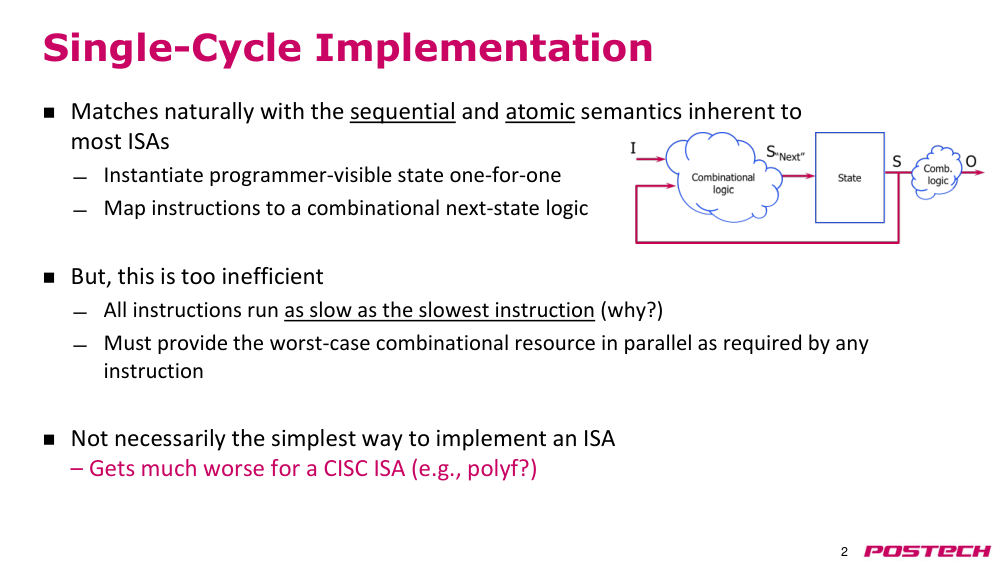
p.2싱글 사이클 구현
- 대부분의 명령어 세트 아키텍처(ISA)에 내재된 순차적이고 원자적인 의미와 자연스럽게 부합한다.
- 프로그래머가 보는 상태(PVS)를 일대일로 구현한다.
- 명령어를 combinational logic(조합 논리)로 구성된 Next-State logic(다음 상태 논리)에 매핑한다.
- 하지만 이는 너무 비효율적이다.
- 모든 명령어는 가장 느린 명령어만큼 느리게 실행된다. (왜?)
- 모든 명령어가 요구하는 최악의 combinational logic(조합 논리) 자원을 병렬로 제공해야 한다.
- 필연적으로 ISA를 구현하는 가장 간단한 방법은 아니다.
- 특히 CISC ISA에서는 더욱 악화된다. (예: polyf?)
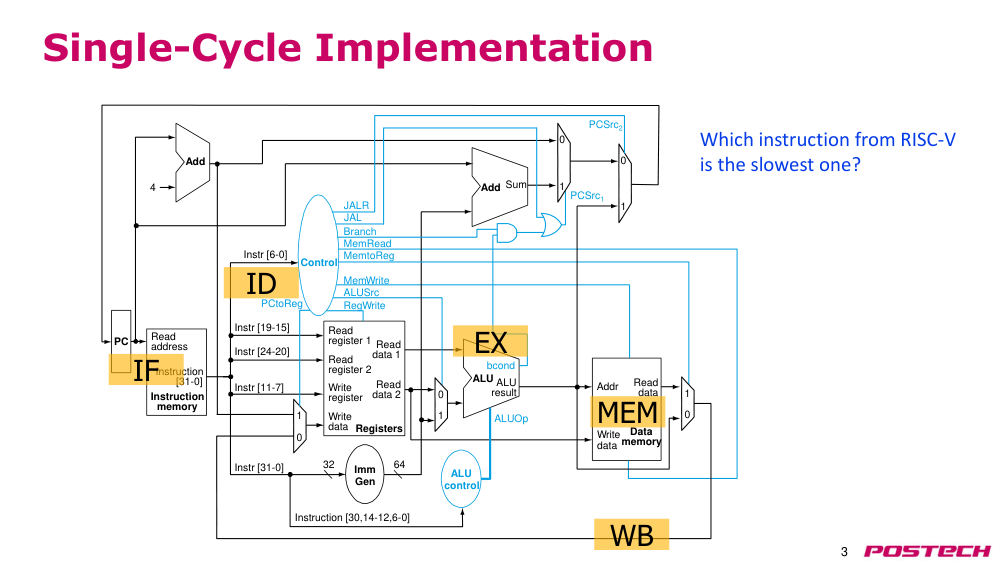
p.3싱글 사이클 구현
- 레지스터 1 읽기
- 데이터 쓰기
- 레지스터
- 산술논리장치( ALU )
- adder(가산기)
- 조건부 branch(브랜치)
- 데이터 1 읽기
- 데이터 2 읽기
- 명령어 [31-0]
- ALU 결과
- adder(가산기) 합
- 주소
- 데이터
- MemRead(메모리 읽기) 데이터
- 4
- 주소 읽기
- instruction memory(명령어 메모리)
- 프로그램 카운터(PC)
- ALU 제어
- branch(브랜치)
- MemRead
- MemtoReg
- ALUOp
- MemWrite
- ALUSrc
- RegWrite
- control unit(제어 유닛)
- 레지스터 2 읽기
- RegWrite(레지스터 쓰기)
- 데이터 쓰기
- ImmGen(이미디어트 생성기)
- 32
- 64
- Instr [19-15]
- Instr [24-20]
- Instr [31-0]
- Instruction [30,14-12,6-0]
- Instr [6-0]
- Instr [11-7]
- 0
- 1
- 1
- 0
- 0
- 1
- 1
- 0
- JAL
- JALR
- 0
- 1
- PCtoReg
- PCSrc1
- PCSrc2
- IF
- ID
- EX
- MEM
- WB
- RISC-V에서 가장 느린 명령어는 무엇인가?
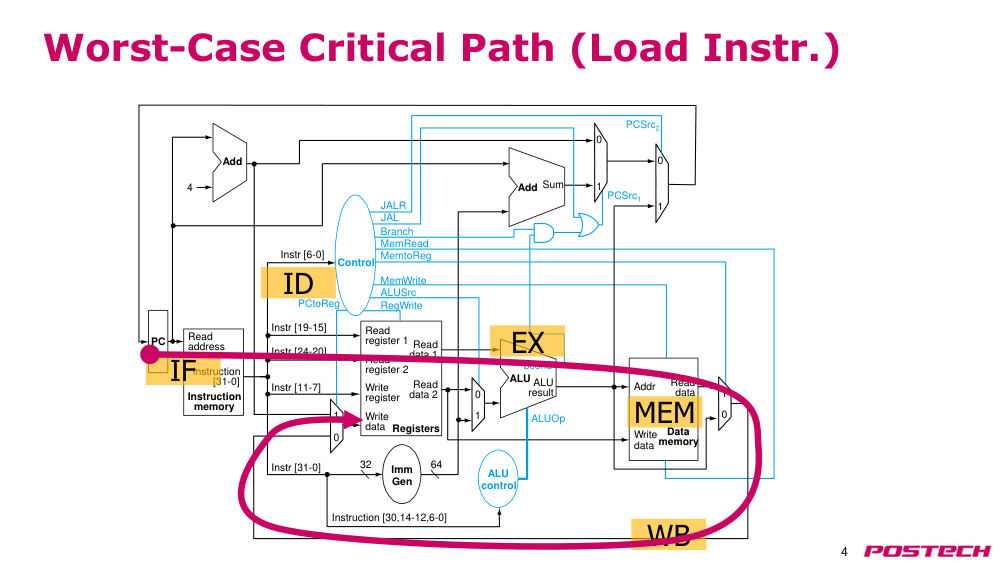
p.4싱글 사이클 구현
- 레지스터 1 읽기
- 데이터 쓰기
- 레지스터
- 산술논리장치( ALU )
- adder(가산기)
- 조건부 branch(브랜치)
- 데이터 1 읽기
- 데이터 2 읽기
- 명령어 [31-0]
- ALU 결과
- adder(가산기) 합
- 주소
- 데이터
- MemRead(메모리 읽기) 데이터
- 4
- 주소 읽기
- instruction memory(명령어 메모리)
- 프로그램 카운터(PC)
- ALU 제어
- branch(브랜치)
- MemRead
- MemtoReg
- ALUOp
- MemWrite
- ALUSrc
- RegWrite
- control unit(제어 유닛)
- 레지스터 2 읽기
- RegWrite(레지스터 쓰기)
- 데이터 쓰기
- ImmGen(이미디어트 생성기)
- 32
- 64
- Instr [19-15]
- Instr [24-20]
- Instr [31-0]
- Instruction [30,14-12,6-0]
- Instr [6-0]
- Instr [11-7]
- 0
- 1
- 1
- 0
- 0
- 1
- 1
- 0
- JAL
- JALR
- 0
- 1
- PCtoReg
- PCSrc1
- PCSrc2
- 최악의 핵심 경로 (로드 명령어)
- IF
- ID
- EX
- MEM
- WB
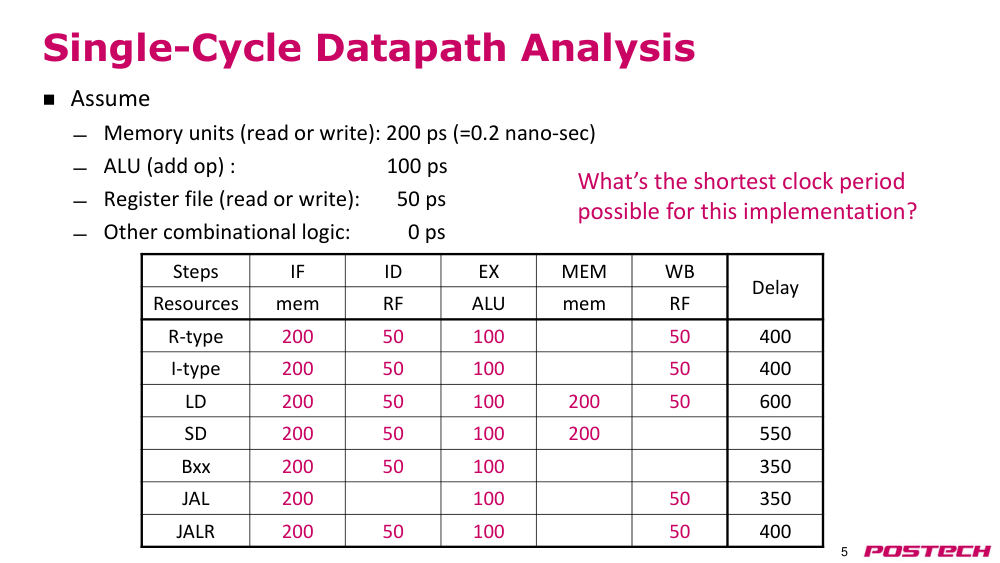
p.5싱글 사이클 datapath(데이터 경로) 분석
- 가정:
- 메모리 단위(읽기 또는 쓰기): 200 ps (=0.2 나노초)
- ALU (덧셈 연산): 100 ps
- 레지스터 파일(읽기 또는 쓰기): 50 ps
- 기타 combinational logic(조합 논리): 0 ps
- 단계
- IF
- ID
- EX
- MEM
- WB
- 지연 시간
- 자원
- mem
- RF
- ALU
- mem
- RF
- R-type
- 200
- 50
- 100
- 50
- 400
- I-type
- 200
- 50
- 100
- 50
- 400
- LD
- 200
- 50
- 100
- 200
- 50
- 600
- SD
- 200
- 50
- 100
- 200
- 550
- Bxx
- 200
- 50
- 100
- 350
- JAL
- 200
- 100
- 50
- 350
- JALR
- 200
- 50
- 100
- 50
- 400
- 이 구현에서 가능한 최단 clock period(클럭 주기)는 얼마인가?
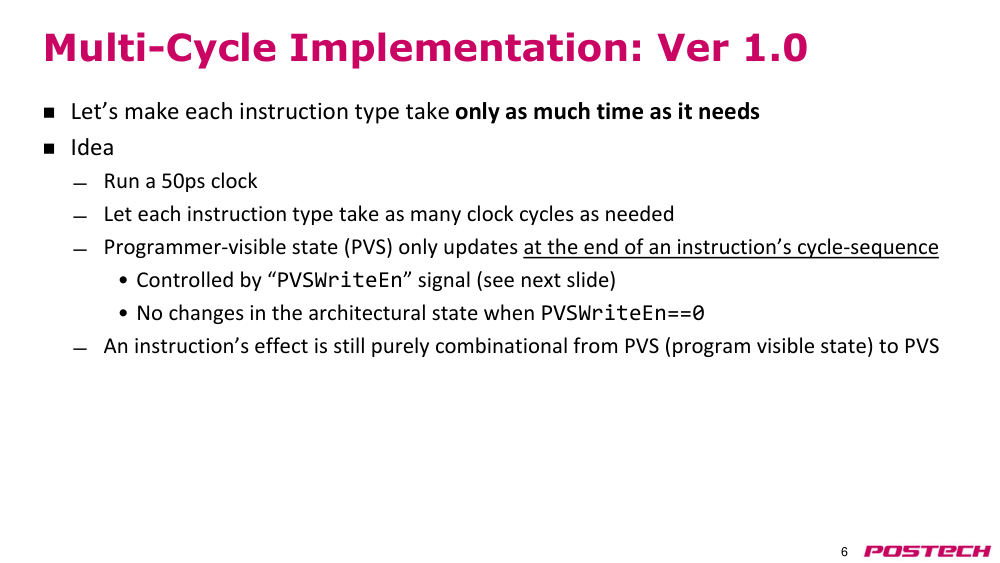
p.6멀티 사이클 구현: 버전 1.0
- 각 명령어 유형이 필요한 만큼의 시간만 사용하도록 하자.
- 아이디어:
- 50ps 클럭을 사용한다.
- 각 명령어 유형이 필요한 만큼의 클럭 사이클을 사용한다.
- 프로그래머가 보는 상태(PVS)는 명령어의 사이클 시퀀스가 끝난 후에만 업데이트된다.
- • "PVSWriteEn" 신호로 제어된다. (다음 슬라이드 참조)
- • PVSWriteEn == 0일 때는 아키텍처 상태에 변화가 없다.
- 명령어의 효과는 여전히 PVS(프로그래머가 보는 상태)에서 PVS로 순수 combinational logic(조합 논리)적이다.
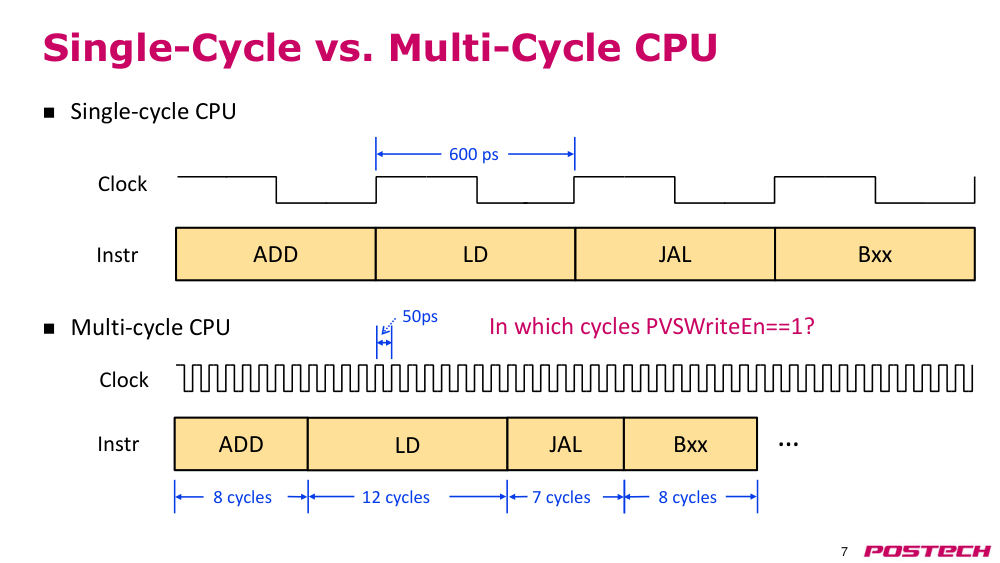
p.7Single-Cycle CPU(싱글 사이클 CPU)와 Multi-Cycle CPU(멀티 사이클 CPU)
- Single-Cycle CPU(싱글 사이클 CPU)
- Multi-Cycle CPU(멀티 사이클 CPU)
- clock period(클럭 주기): 600 ps
- clock period(클럭 주기): 50 ps
- - ADD: 8 사이클
- - LD: 12 사이클
- - JAL: 7 사이클
- - Bxx: 8 사이클
- - ...
- 프로그래머가 보는 상태 쓰기 허용(PVSWriteEn)이 1인 사이클은 언제인가?
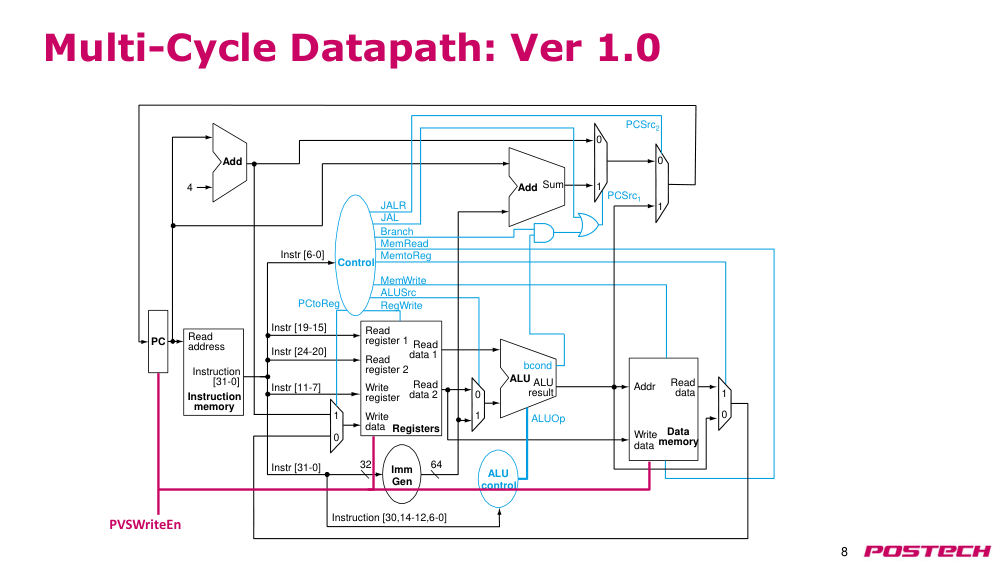
p.8멀티 사이클 datapath(데이터 경로): 버전 1.0
- 레지스터 1 읽기
- 쓰기 데이터
- register file(레지스터 파일)
- 산술논리장치(알루)
- adder(가산기)
- 조건부 branch(브랜치)
- 데이터 1 읽기
- 데이터 2 읽기
- 명령어 [31-0]
- 알루 결과
- adder(가산기) 합
- 주소
- 데이터 메모리
- 데이터 읽기
- 4
- 주소 읽기
- instruction memory(명령어 메모리)
- 프로그램 카운터(PC)
- 알루 제어
- branch(브랜치)
- 메모리 읽기(MemRead)
- 메모리에서 레지스터로 전달(MemtoReg)
- 알루 연산 코드(ALUOp)
- 메모리 쓰기(MemWrite)
- 알루 입력 소스(ALUSrc)
- 레지스터 쓰기(RegWrite)
- control unit(제어 유닛)
- 레지스터 2 읽기
- 쓰기 레지스터
- 쓰기 데이터
- 이미디어트 생성기(ImmGen)
- 32
- 64
- 명령어 [19-15]
- 명령어 [24-20]
- 명령어 [31-0]
- 명령어 [30,14-12,6-0]
- 명령어 [6-0]
- 명령어 [11-7]
- 0
- 1
- 1
- 0
- 0
- 1
- 1
- 0
- JAL
- JALR
- 0
- 1
- PC에서 레지스터로 전달(PCtoReg)
- PC 선택 1(PCSrc1)
- PC 선택 2(PCSrc2)
- 프로그래머가 보는 상태 쓰기 허용(PVSWriteEn)
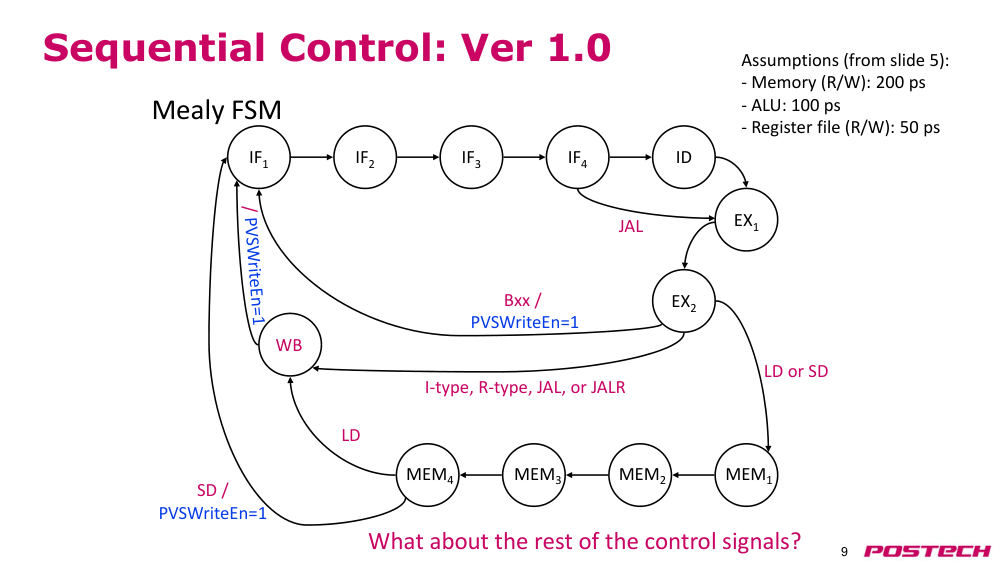
p.9sequential control(순차 제어): 버전 1.0
- IF1
- IF2
- IF3
- IF4
- JAL
- ID
- Bxx / 프로그래머가 보는 상태 쓰기 허용(PVSWriteEn)=1
- LD 또는 SD
- LD
- SD / 프로그래머가 보는 상태 쓰기 허용(PVSWriteEn)=1
- EX2
- EX1
- I형, R형, JAL, 또는 JALR
- WB
- 나머지 control signal(제어 신호)는 어떻게 되는가?
- Mealy FSM(밀리 FSM)
- MEM4
- MEM3
- MEM2
- MEM1
- 가정 (슬라이드 5에서):
- - 메모리(읽기/쓰기): 200 ps
- - 알루: 100 ps
- - 레지스터 파일(읽기/쓰기): 50 ps
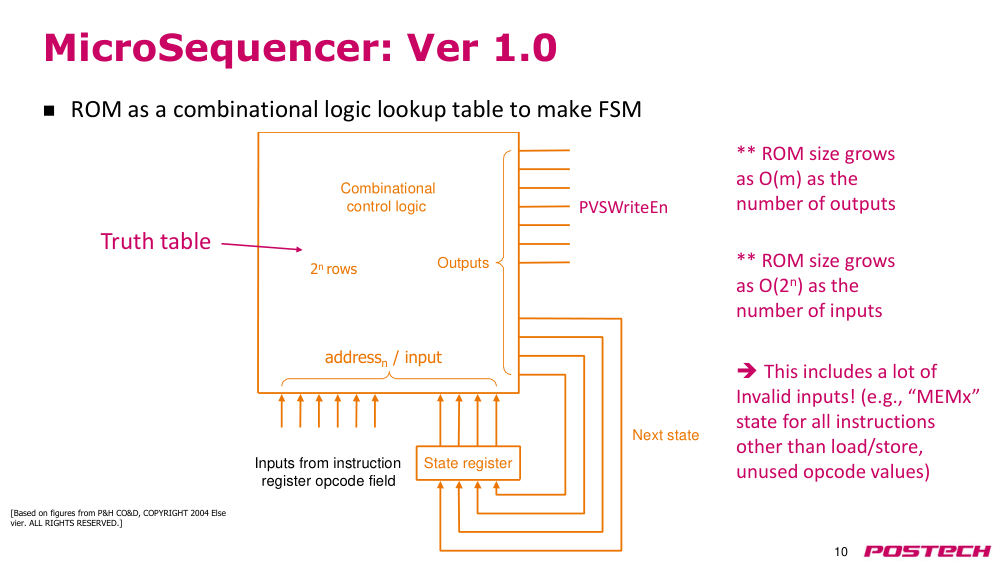
p.10MicroSequencer(마이크로 시퀀서): 버전 1.0
- ROM을 combinational logic(조합 논리) 검색 테이블로 사용하여 FSM 구현
- datapath control outputs(데이터 경로 제어 출력)
- state register(상태 레지스터)
- IR(명령어 레지스터)의 오퍼코드 필드에서 입력
- 출력
- combinational logic(조합 논리) 제어
- 입력
- 다음 상태 주소n / 입력
- 2n행
- 프로그래머가 보는 상태 쓰기 허용(PVSWriteEn)
- truth table(진리표)
- ** ROM size(ROM 크기)는 입력 수에 따라 O(2n)로 증가**
- ** ROM size(ROM 크기)는 출력 수에 따라 O(m)로 증가**
- [P&H CO&D의 그림을 기반으로, COPYRIGHT 2004 Elsevier. ALL RIGHTS RESERVED.]
- → 많은 invalid inputs(무효 입력) 포함! (예: 모든 명령어에 대해 'MEMx' 상태, 사용되지 않는 오퍼코드 값)
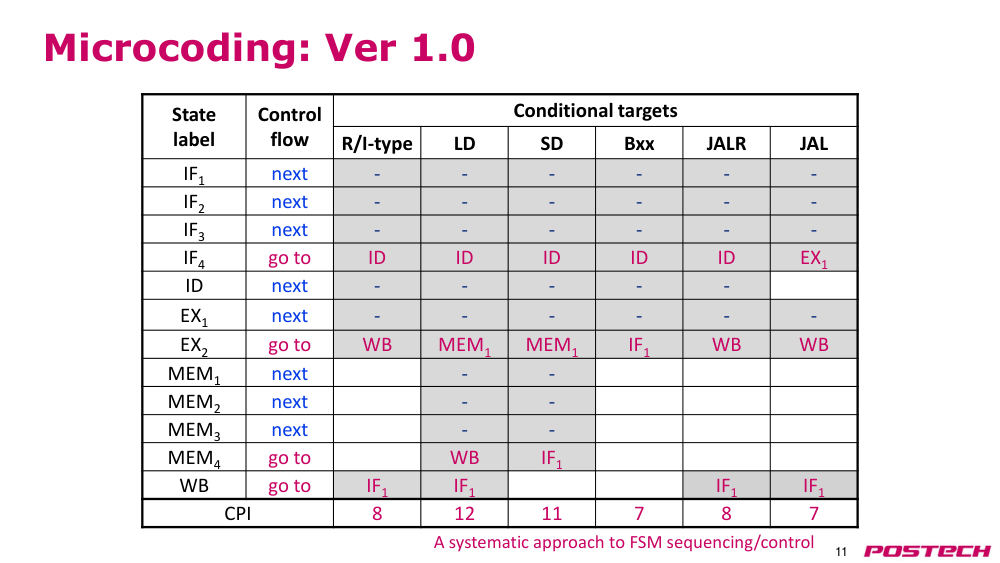
p.11마이크로코딩: 버전 1.0
- 상태 레이블
- control flow(제어 흐름)
- 조건부 대상
- R/I형
- LD
- SD
- Bxx
- JALR
- JAL
- IF1
- next
- -
- -
- -
- -
- -
- IF2
- next
- -
- -
- -
- -
- -
- IF3
- next
- -
- -
- -
- -
- -
- IF4
- go to
- ID
- ID
- ID
- ID
- ID
- EX1
- ID
- next
- -
- -
- -
- -
- -
- EX1
- next
- -
- -
- -
- -
- -
- EX2
- go to
- WB
- MEM1
- MEM1
- IF1
- WB
- WB
- MEM1
- next
- -
- -
- MEM2
- next
- -
- -
- MEM3
- next
- -
- -
- MEM4
- go to
- WB
- IF1
- WB
- go to
- IF1
- IF1
- IF1
- IF1
- CPI
- 8
- 12
- 11
- 7
- 8
- 7
- FSM 시퀀싱/제어에 대한 체계적인 접근 방식
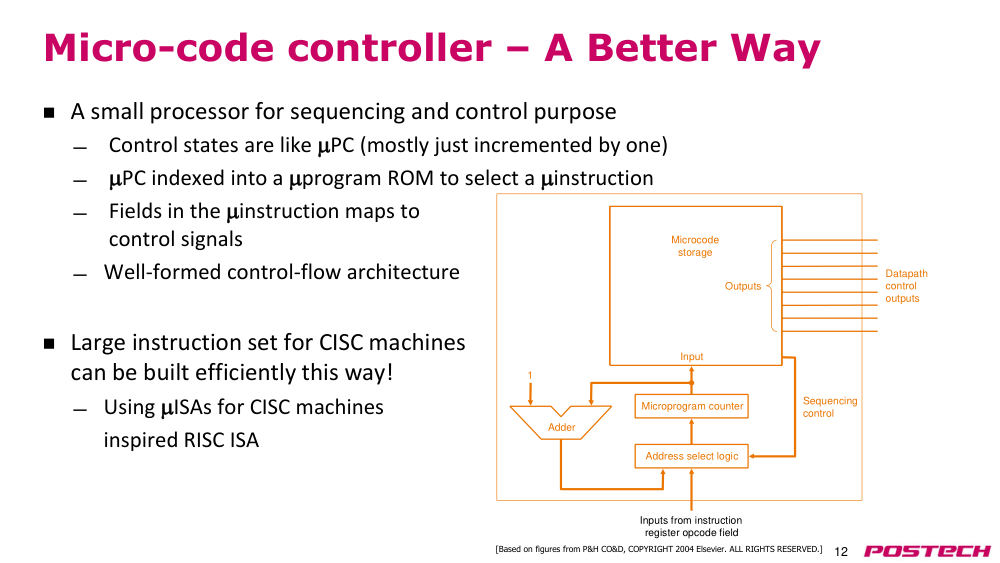
p.12microcode controller(마이크로코드 제어기) – 더 나은 방법
- 시퀀싱 및 제어 목적을 위한 소형 프로세서
- 제어 상태는 mPC와 유사함 (대부분 1씩 증가)
- mPC가 마이크로프로그램 ROM에 인덱스되어 microinstruction(마이크로명령어) 선택
- microinstruction(마이크로명령어)의 필드가 control signal(제어 신호)에 매핑됨
- well-formed Control-Flow architecture(잘 구성된 제어 흐름 아키텍처)
- CISC 기계용 대규모 명령어 세트는 이 방식으로 효율적으로 구축 가능!
- CISC 기계용 mISA 사용은 RISC ISA의 발전에 영감을 줌
- microprogram counter (mPC)(마이크로프로그램 카운터)
- address select logic(주소 선택 논리)
- adder(가산기)
- 1
- 입력
- datapath control outputs(데이터 경로 제어 출력)
- microcode storage(마이크로코드 저장소)
- IR(명령어 레지스터)의 오퍼코드 필드에서 입력
- 출력
- sequencing control(시퀀싱 제어)
- [P&H CO&D의 그림을 기반으로, COPYRIGHT 2004 Elsevier. ALL RIGHTS RESERVED.]
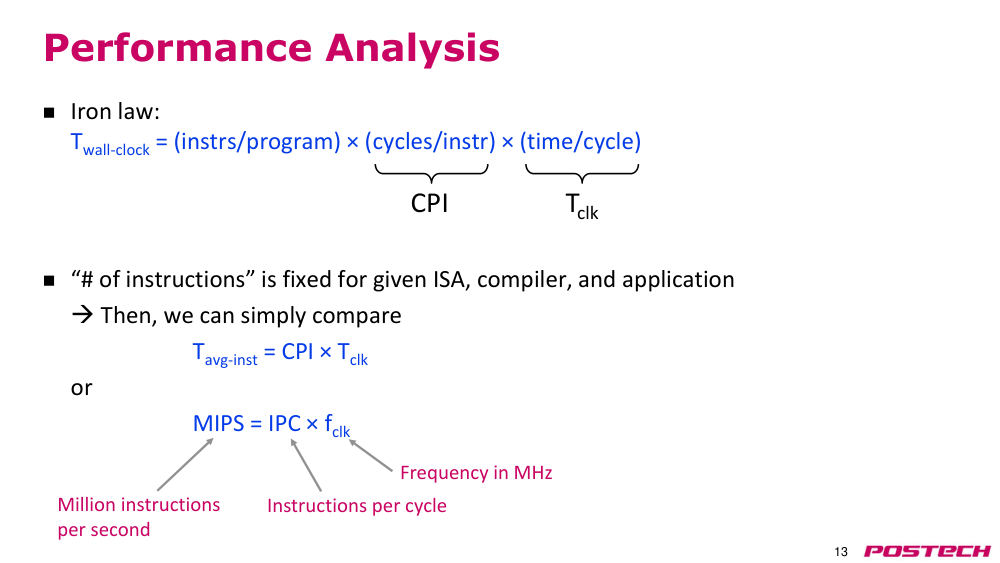
p.13performance analysis(성능 분석)
- iron law(철의 법칙): T_wall-clock = (프로그램당 명령어 수) × (명령어당 사이클 수) × (사이클당 시간)
- ‘명령어 수’는 주어진 명령어 세트 아키텍처(ISA), 컴파일러, 응용 프로그램에 대해 고정됨
- 따라서 간단히 비교할 수 있음: T_avg-inst = CPI × T_clk 또는 MIPS = IPC × f_clk
- 주파수 (MHz)
- CPI(명령어당 사이클 수)
- MIPS(초당 백만 명령어 수)
- CPI
- T_clk
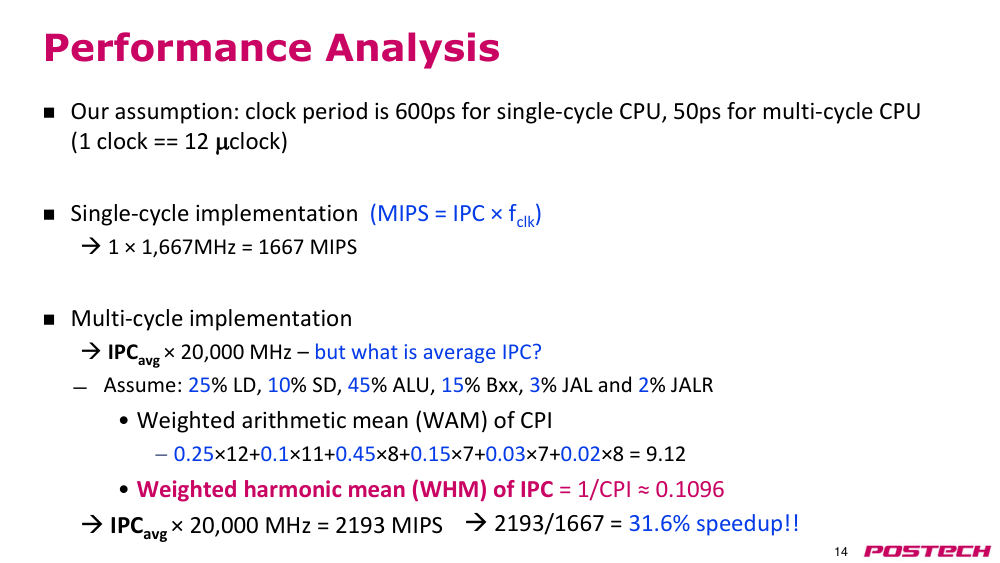
p.14performance analysis(성능 분석)
- 가정: Single-Cycle CPU(싱글 사이클 CPU)의 clock period(클럭 주기)는 600ps, Multi-Cycle CPU(멀티 사이클 CPU)의 클럭 주기는 50ps (1 클럭 == 12 마이크로클럭)
- 싱글 사이클 구현 (MIPS = IPC × f_clk)
- → 1 × 1,667MHz = 1667 MIPS
- 멀티 사이클 구현
- → IPC_avg × 20,000 MHz – 그러나 평균 IPC는 얼마인가?
- 가정: 25% LD, 10% SD, 45% ALU, 15% Bxx, 3% JAL, 2% JALR
- CPI의 가중 산술 평균 (WAM)
- −0.25×12 + 0.1×11 + 0.45×8 + 0.15×7 + 0.03×7 + 0.02×8 = 9.12
- IPC의 가중 조화 평균 (WHM) = 1/CPI ≈ 0.1096
- → IPC_avg × 20,000 MHz = 2193 MIPS
- → 2193 / 1667 = 31.6% speedup(속도 향상)!!
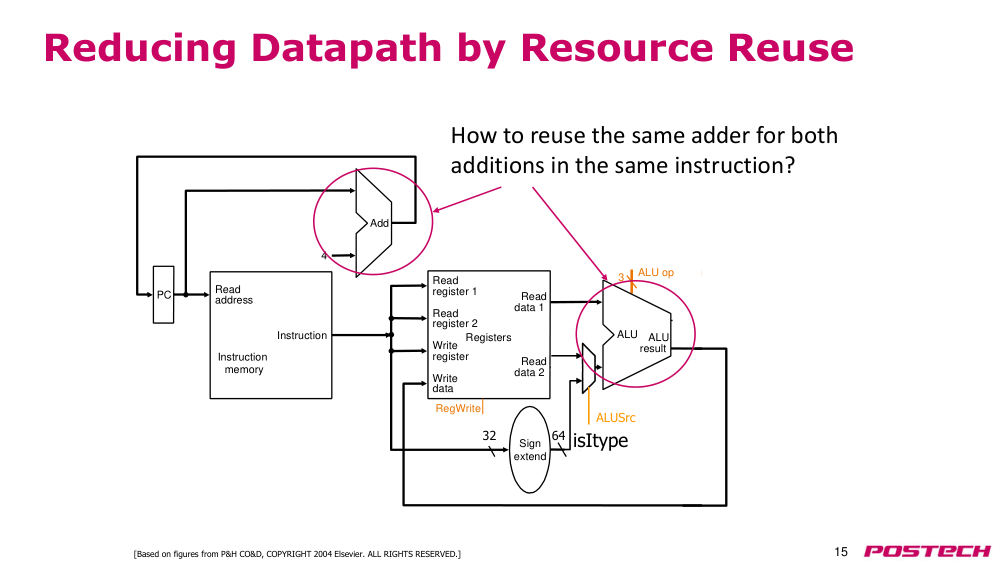
p.15resource reuse(자원 재사용)을 통한 datapath(데이터 경로) 축소
- PC
- instruction memory(명령어 메모리)
- 읽기 주소
- 명령어
- 4
- adder(가산기)
- 16
- 32
- 레지스터
- 쓰기 레지스터
- 읽기 데이터 1
- 읽기 데이터 2
- 읽기 레지스터 1
- 읽기 레지스터 2
- 쓰기 데이터
- sign extend(부호 확장)
- ALU 결과
- zero(영)
- ALU
- RegWrite
- ALUOp(ALU 연산 코드)
- 3
- 이미디어트 타입 여부 (isItype)
- 동일한 명령어 내에서 두 가지 덧셈에 동일한 adder(가산기)를 어떻게 재사용할 수 있는가?
- 32
- 64
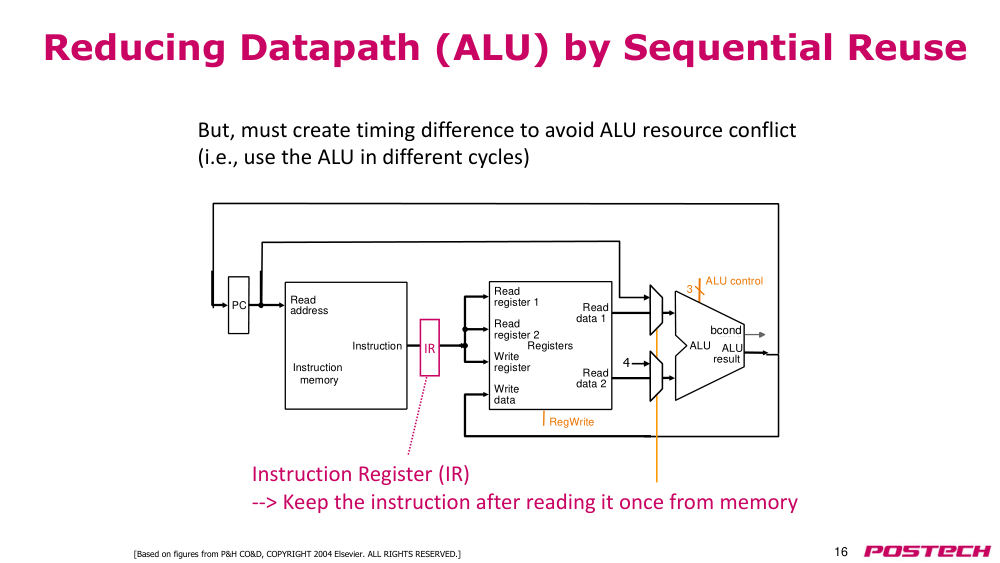
p.16순차 재사용을 통한 데이터 경로(알루) 축소
- PC
- instruction memory(명령어 메모리)
- 읽기 주소
- 명령어
- 4
- adder(가산기)
- 레지스터
- 쓰기 레지스터
- 읽기 데이터 1
- 읽기 데이터 2
- 읽기 레지스터 1
- 읽기 레지스터 2
- 쓰기 데이터
- RegWrite
- ALU 제어
- ALU 결과
- ALU
- zero(영)
- 3
- 4
- IR
- 명령어 레지스터(IR)
- → 메모리에서 한 번 읽은 명령어를 유지
- 하지만 ALU 자원 충돌을 피하기 위해 타이밍 차이를 만들어야 함 (즉, ALU를 다른 사이클에 사용함)
- bcond
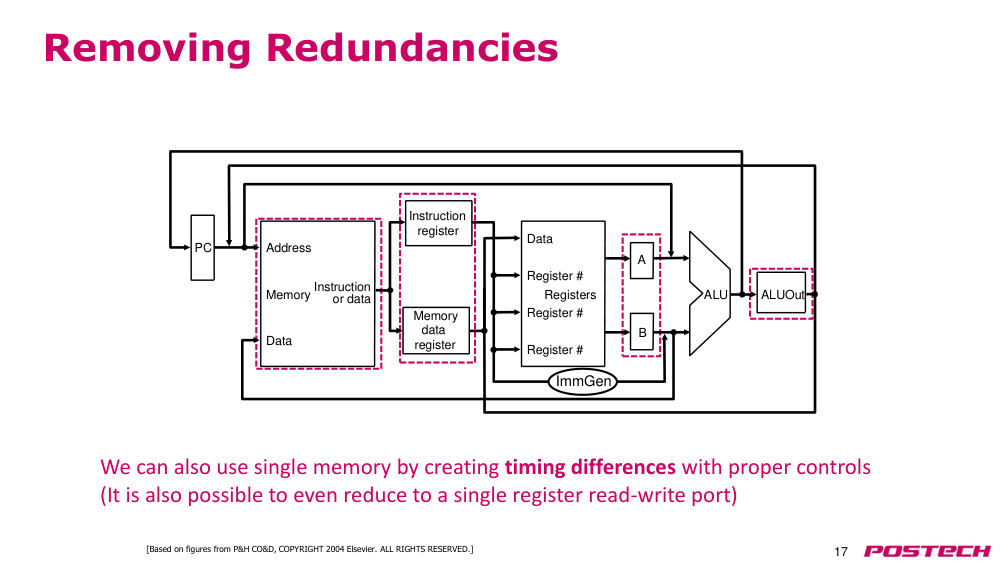
p.17부분적인 중복 제거
- single memory(단일 메모리)를 사용할 수도 있음 (적절한 제어를 통해 타이밍 차이를 만듦)
- 또한 단일 register Read-Write port(레지스터 읽기/쓰기 포트)로까지 줄일 수 있음
- PC
- 메모리
- 주소
- 명령어 또는 데이터
- 데이터
- IR(명령어 레지스터)
- 레지스터
- 레지스터 번호
- 데이터
- 레지스터 번호
- 레지스터 번호
- ALU
- MDR(메모리 데이터 레지스터)
- A
- B
- ALUOut
- ImmGen
p.18제어 포인트
- PC
- Mux
- 0
- 1
- 레지스터
- 쓰기 레지스터
- 쓰기 데이터
- 읽기 데이터 1
- 읽기 데이터 2
- 읽기 레지스터 1
- 읽기 레지스터 2
- Mux
- 0
- 1
- 4
- ImmGen
- 64
- 32
- 명령어 [31-0]
- Instr [11-7]
- IR(명령어 레지스터)
- ALU 제어
- ALU 결과
- ALU
- bcond
- MDR(메모리 데이터 레지스터)
- A
- B
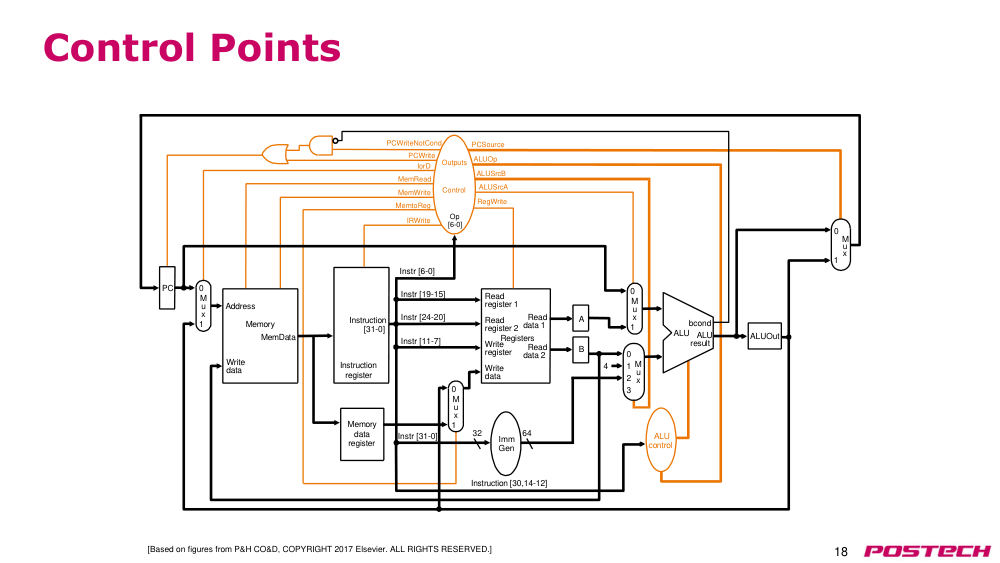
- IorD
- MemRead
- MemWrite
- MemtoReg
- PCWriteNotCond
- PCWrite
- IRWrite
- ALUOp
- ALUSrcB
- ALUSrcA
- PCSource
- RegWrite
- 제어 출력
- Op [6-0]
- 명령어 [30,14-12]
- Mux
- 0
- 1
- 1 Mux
- 0
- 3
- 2
- Mux
- 0
- 1
- ALUOut
- 메모리
- MemData
- 쓰기 데이터
- 주소
- Instr [24-20]
- Instr [19-15]
- Instr [6-0]
- Instr [31-0]
p.19새로운 sequential control(순차 제어) 신호 (1비트)
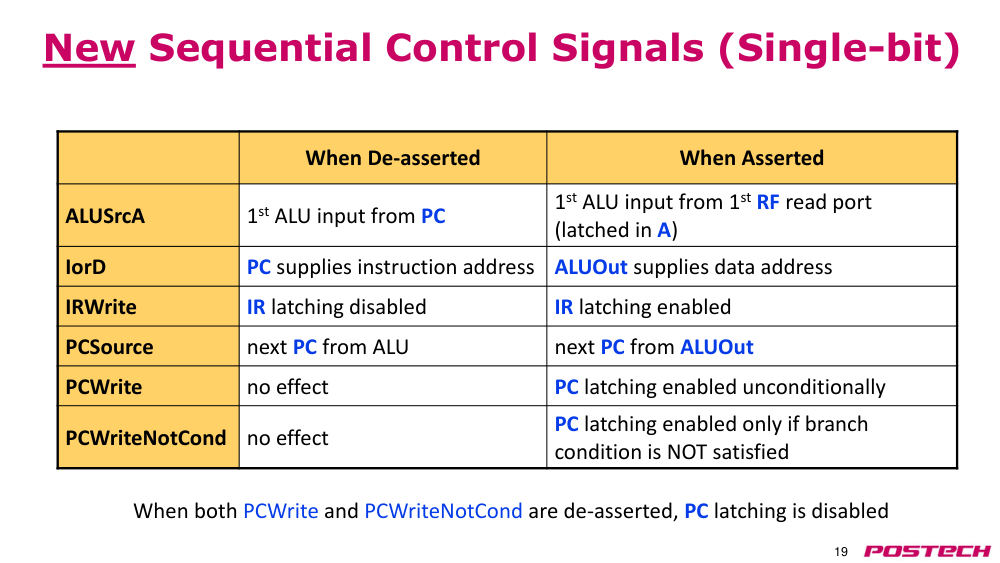
- ALUSrcA가 비활성화될 때: ALU의 1번째 입력은 PC에서 제공
- ALUSrcA가 활성화될 때: ALU의 1번째 입력은 register file(레지스터 파일)의 1번째 읽기 포트에서 제공 (A에 래치됨)
- IorD가 비활성화될 때: PC가 명령어 주소를 제공
- IorD가 활성화될 때: ALUOut가 데이터 주소를 제공
- IRWrite가 비활성화될 때: IR 래치 비활성화
- IRWrite가 활성화될 때: IR 래치 활성화
- PCSource가 비활성화될 때: 다음 PC는 ALU에서 제공
- PCSource가 활성화될 때: 다음 PC는 ALUOut에서 제공
- PCWrite가 비활성화될 때: 효과 없음
- PCWrite가 활성화될 때: PC 래치 조건부 없이 활성화
- PCWriteNotCond가 비활성화될 때: 효과 없음
- PCWriteNotCond가 활성화될 때: branch(브랜치) 조건이 만족되지 않을 경우에만 PC 래치 활성화
- PCWrite와 PCWriteNotCond가 모두 비활성화될 경우, PC 래치 비활성화
p.20새로운 sequential control(순차 제어) 신호 (다중 비트)
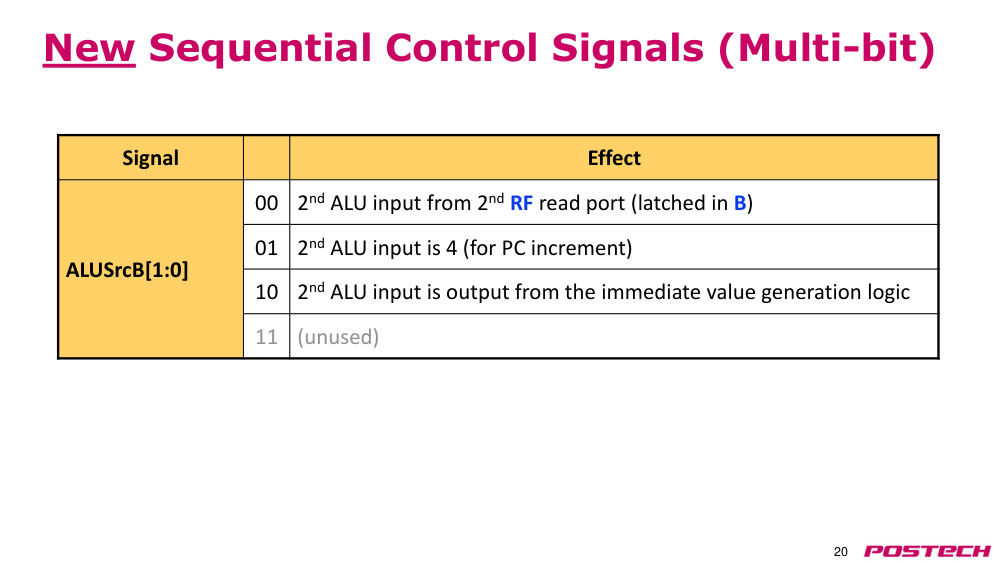
- ALUSrcB[1:0] = 00: ALU의 2번째 입력은 register file(레지스터 파일)의 2번째 읽기 포트에서 제공 (B에 래치됨)
- ALUSrcB[1:0] = 01: ALU의 2번째 입력은 4 (PC 증가용)
- ALUSrcB[1:0] = 10: ALU의 2번째 입력은 ImmGen(이미디어트 생성기)의 출력
- ALUSrcB[1:0] = 11: (사용되지 않음)
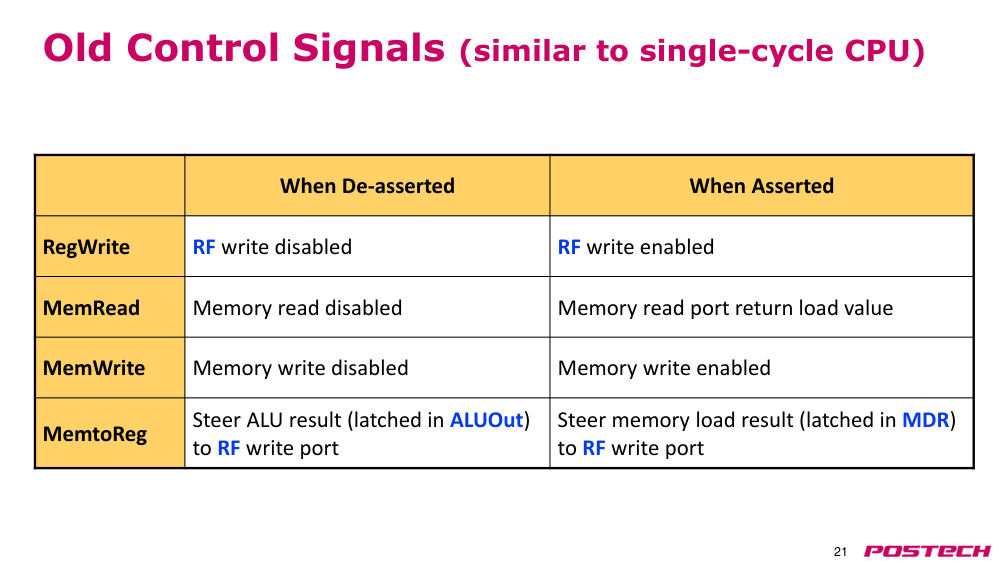
p.21기존 제어 신호 (싱글 사이클 CPU와 유사)
- RegWrite가 비활성화될 때: register file(레지스터 파일) 쓰기 비활성화
- RegWrite가 활성화될 때: register file(레지스터 파일) 쓰기 활성화
- MemRead가 비활성화될 때: 메모리 읽기 비활성화
- MemRead가 활성화될 때: 메모리 읽기 포트에서 로드 값 반환
- MemWrite가 비활성화될 때: 메모리 쓰기 비활성화
- MemWrite가 활성화될 때: 메모리 쓰기 활성화
- MemtoReg가 비활성화될 때: ALU 결과 (래치된 ALUOut)를 register file(레지스터 파일) 쓰기 포트로 전달
- MemtoReg가 활성화될 때: 메모리 로드 결과 (래치된 MDR)를 register file(레지스터 파일) 쓰기 포트로 전달
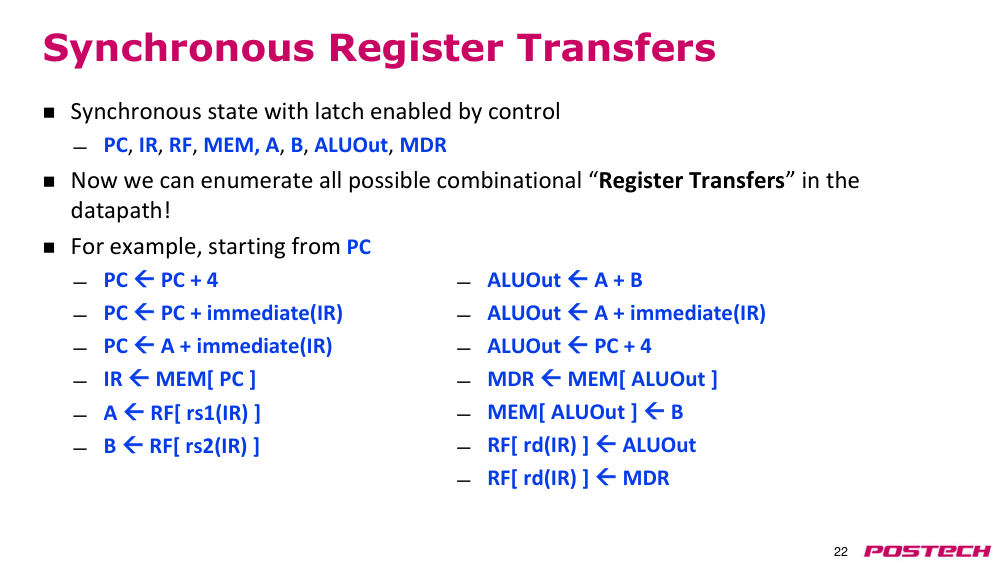
p.22synchronous register transfer(동기식 레지스터 전송)
- control signal(제어 신호)에 의해 래치가 활성화되는 동기 상태: PC, IR, RF, MEM, A, B, ALUOut, MDR
- 이제 datapath(데이터 경로) 내에서 가능한 모든 combinational logic(조합 논리)적 '레지스터 전송(RT)'을 나열할 수 있음!
- 예: PC에서 시작하여
- PC ← PC + 4
- PC ← PC + immediate(IR)
- PC ← A + immediate(IR)
- IR ← MEM[PC]
- A ← RF[rs1(IR)]
- B ← RF[rs2(IR)]
- ALUOut ← A + B
- ALUOut ← A + immediate(IR)
- ALUOut ← PC + 4
- MDR ← MEM[ALUOut]
- MEM[ALUOut] ← B
- RF[rd(IR)] ← ALUOut
- RF[rd(IR)] ← MDR
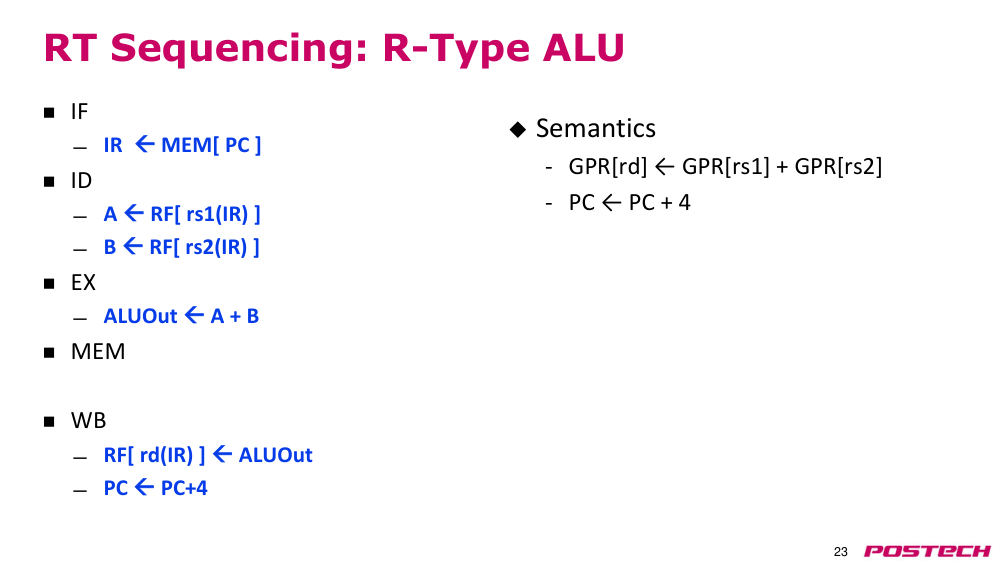
p.23RT 시퀀싱: R형 ALU 명령어
- IF: IR ← MEM[PC]
- ID: A ← RF[rs1(IR)], B ← RF[rs2(IR)]
- EX: ALUOut ← A + B
- MEM: (비어 있음)
- WB: RF[rd(IR)] ← ALUOut
- PC ← PC + 4
- 의미: GPR[rd] ← GPR[rs1] + GPR[rs2], PC ← PC + 4
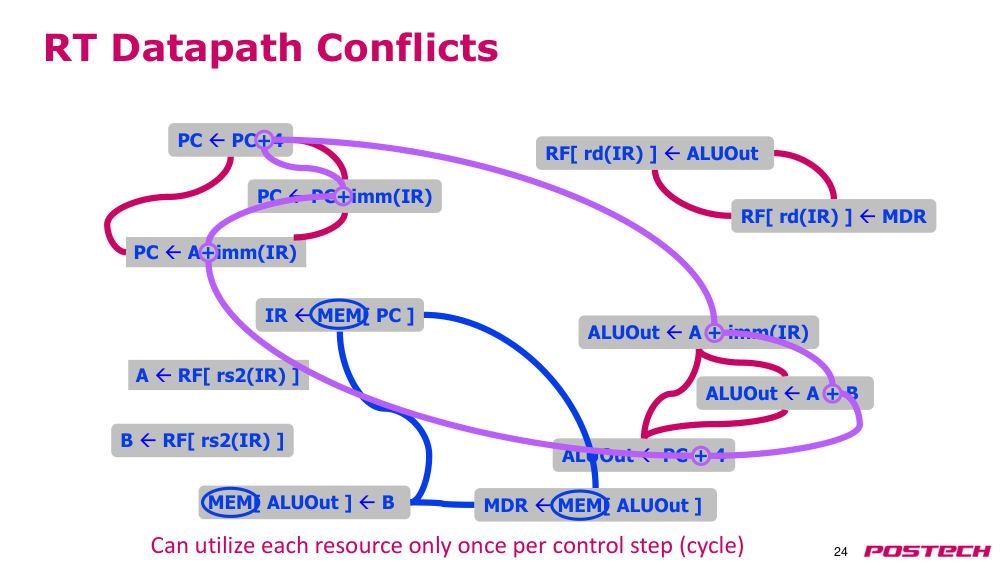
p.24RT datapath(데이터 경로) 충돌
- PC ← PC + 4
- PC ← PC + imm(IR)
- IR ← MEM[PC]
- PC ← A + imm(IR)
- RF[rd(IR)] ← MDR
- RF[rd(IR)] ← ALUOut
- MEM[ALUOut] ← B
- MDR ← MEM[ALUOut]
- ALUOut ← PC + 4
- ALUOut ← A + imm(IR)
- ALUOut ← A + B
- B ← RF[rs2(IR)]
- A ← RF[rs2(IR)]
- 각 제어 단계(사이클)당 각 자원은 한 번만 사용 가능
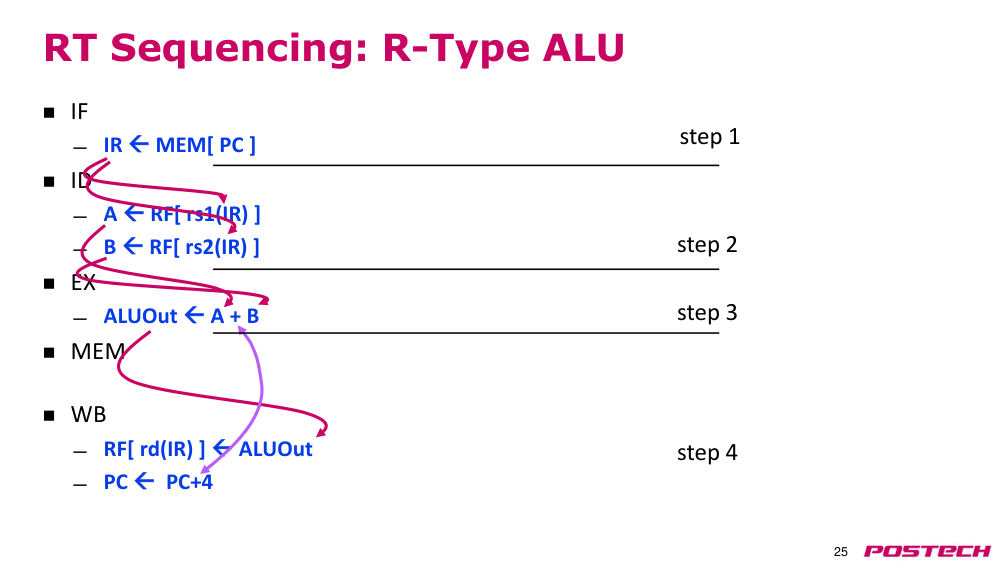
p.25RT 시퀀싱: R-Type ALU
- IF 단계: IR ← instruction memory(명령어 메모리)[PC]
- ID 단계: A ← register file(레지스터 파일)[rs1(IR)]
- B ← register file(레지스터 파일)[rs2(IR)]
- EX 단계: ALUOut ← A + B
- MEM 단계: (비어 있음)
- WB 단계: register file(레지스터 파일)[rd(IR)] ← ALUOut
- PC ← PC + 4
- 단계 1
- 단계 2
- 단계 3
- 단계 4
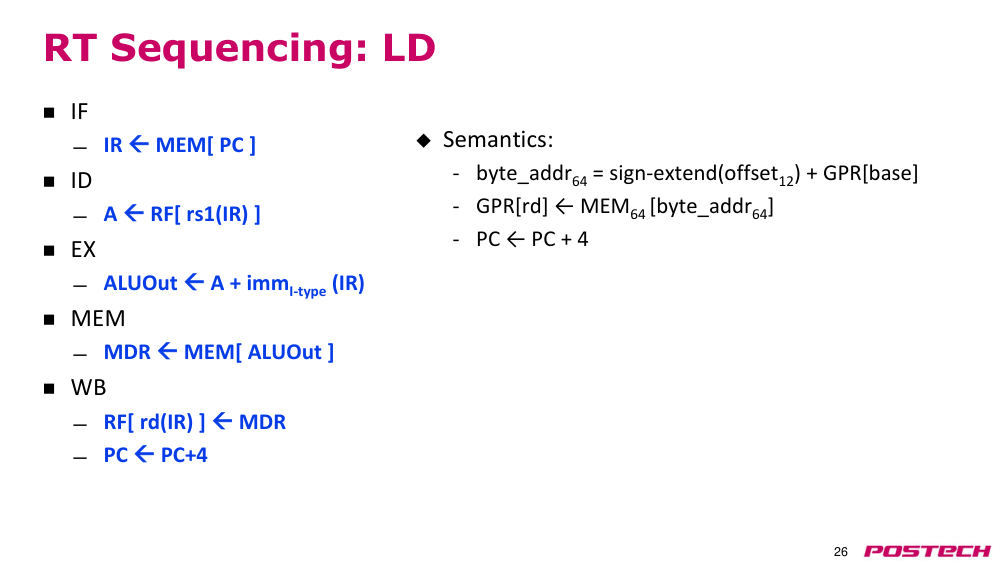
p.26RT 시퀀싱: LD
- IF 단계: IR ← instruction memory(명령어 메모리)[PC]
- ID 단계: A ← register file(레지스터 파일)[rs1(IR)]
- EX 단계: ALUOut ← A + immI-type(IR)
- MEM 단계: MDR ← 메모리[ALUOut]
- WB 단계: register file(레지스터 파일)[rd(IR)] ← MDR
- PC ← PC + 4
- 의미:
- - byte_addr64 = 부호 확장(offset12) + GPR[base]
- - GPR[rd] ← 메모리64[byte_addr64]
- - PC ← PC + 4
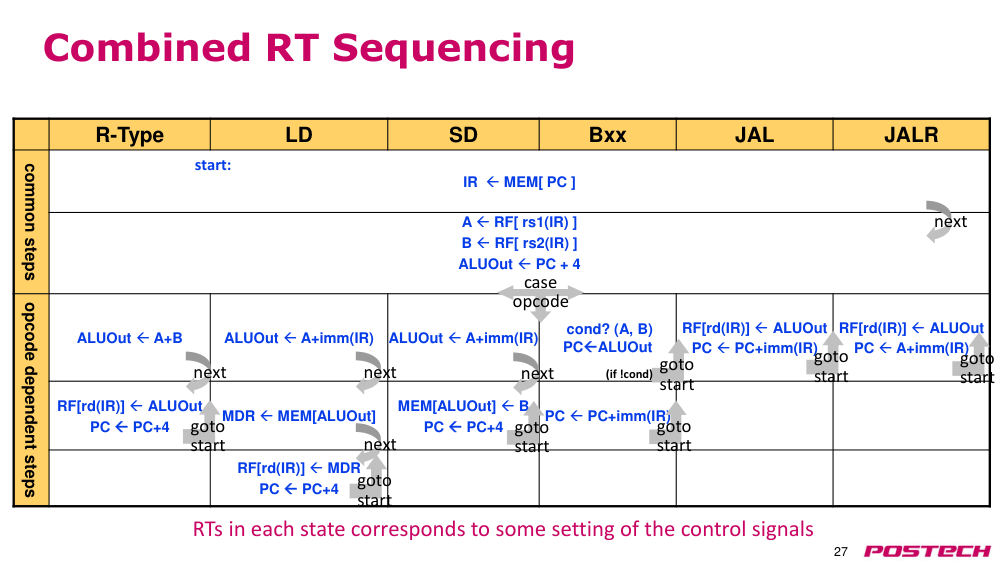
p.27결합된 RT 시퀀싱
- 공통 단계:
- IR ← instruction memory(명령어 메모리)[PC]
- A ← register file(레지스터 파일)[rs1(IR)]
- B ← register file(레지스터 파일)[rs2(IR)]
- ALUOut ← PC + 4
- opcode에 따라 달라지는 단계:
- ALUOut ← A + B
- ALUOut ← A + imm(IR)
- ALUOut ← A + imm(IR)
- 조건? (A, B)
- PC ← ALUOut
- register file(레지스터 파일)[rd(IR)] ← ALUOut
- PC ← PC + imm(IR)
- register file(레지스터 파일)[rd(IR)] ← ALUOut
- PC ← A + imm(IR)
- register file(레지스터 파일)[rd(IR)] ← ALUOut
- PC ← PC + 4
- MDR ← 메모리[ALUOut]
- 메모리[ALUOut] ← B
- PC ← PC + 4
- PC ← PC + imm(IR)
- register file(레지스터 파일)[rd(IR)] ← MDR
- PC ← PC + 4
- 시작:
- 다음
- 다음
- 다음
- 다음
- 다음
- goto
- 시작
- goto
- 시작
- goto
- 시작
- goto
- 시작
- case opcode
- 각 상태의 RT는 control signal(제어 신호)의 특정 설정에 해당함
- goto
- 시작
- goto
- 시작
- (조건이 아닐 경우)
- goto
- 시작
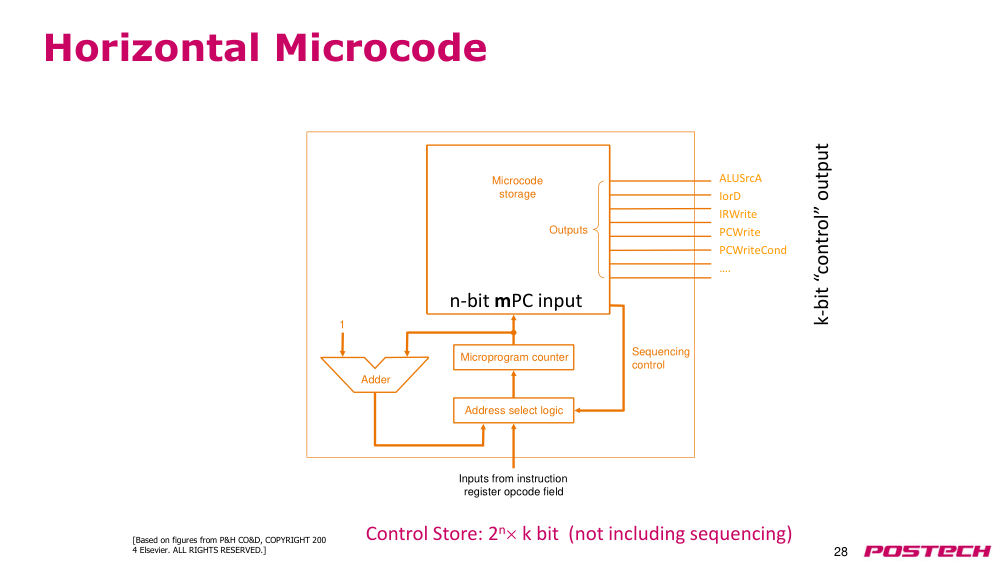
p.28horizontal microcode(수평 마이크로코드)
- microprogram counter (mPC)(마이크로프로그램 카운터)
- address select logic(주소 선택 논리)
- adder(가산기)
- 1
- 입력
- datapath control outputs(데이터 경로 제어 출력)
- microcode storage(마이크로코드 저장소)
- IR(명령어 레지스터) opcode 필드에서 입력
- 출력
- sequencing control(시퀀싱 제어)
- ALUSrcA
- IorD
- IRWrite
- PCWrite
- PCWriteCond
- ...
- n비트 mPC 입력
- k비트 '제어' 출력
- 제어 저장소: 2n × k 비트 (시퀀싱 제외)
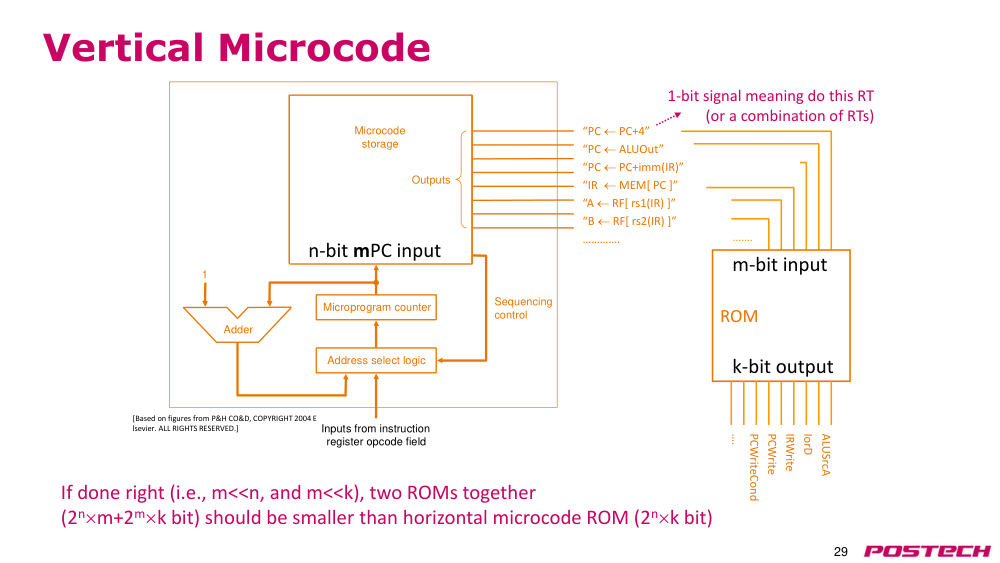
p.29수직 마이크로코드
- microprogram counter (mPC)(마이크로프로그램 카운터)
- address select logic(주소 선택 논리)
- adder(가산기)
- 1
- 입력
- datapath control outputs(데이터 경로 제어 출력)
- microcode storage(마이크로코드 저장소)
- IR(명령어 레지스터) opcode 필드에서 입력
- 출력
- sequencing control(시퀀싱 제어)
- "PC ← PC + 4"
- "PC ← ALUOut"
- "PC ← PC + imm(IR)"
- "IR ← 메모리[PC]"
- "A ← register file(레지스터 파일)[rs1(IR)]"
- "B ← register file(레지스터 파일)[rs2(IR)]"
- ………….
- …….
- ROM
- ALUSrcA
- IorD
- IRWrite
- PCWrite
- PCWriteCond
- ...
- m비트 입력
- k비트 출력
- n비트 mPC 입력
- 1비트 신호: 이 RT를 수행하라 (또는 RT의 조합)
p.30CISC를 위한 마이크로코딩
- microcontroller(마이크로컨트롤러)와 datapath(데이터 경로)를 확장할 수 있을까?
- 내가 아직 생각하지 못한 새로운 명령어를 지원하기 위해
- 예: 복잡한 명령어, 예를 들어 polyf
- 예, 그리고 아마도 더 가능하다.
- 만약 내가 임의의 RISC 명령어를 시퀀싱할 수 있다면, 나는 임의의 'RISC 프로그램'을 마이크로프로그램 시퀀스로 시퀀싱할 수 있다.
- 더 복잡한 microprogram(마이크로프로그램)을 위해 일부 micro-ISA(마이크로 ISA) 상태(예: loop counter(루프 카운터))가 필요할 것이다.
- 더 복잡한 micro-ISA(마이크로 ISA) 기능도 작업을 더 쉽게 한다.
- 마이크로코딩은 매우 단순한 datapath(데이터 경로)로 매우 강력한 계산을 수행할 수 있게 한다.
- Turing machine(튜링 기계)만큼 단순한 datapath(데이터 경로)도 universal(보편적)이다.
- microcode(마이크로코드)는 최소한의 datapath(데이터 경로)를 사용하여 원하는 모든 ISA를 에뮬레이션할 수 있게 한다 (매우 크게 느려짐)
p.31나노코드와 밀리코드
- 나노코드
- 마이크로코드보다 한 단계 낮은 레벨
- 하위 시스템(예: 복잡한 부동소수점 모듈 등)에 대한 마이크로프로그램 제어
- 마이크로제어 datapath(데이터 경로) 내에서 슬레이브 역할을 수행
- 예: polyf 시퀀스는 FPU 내 별도의 나노제어기에서 생성될 수 있음 → 보다 세밀한 코드화 가능
- 밀리코드
- 마이크로코드보다 한 단계 높은 레벨
- ROM에 하드코딩된 명령어 세트 아키텍처(ISA) 수준의 서브루틴
- 복잡한 연산을 처리하기 위해 마이크로제어기가 호출할 수 있음
- 예: MIPS ISA에 polyf를 추가하기 위해, polyf 명령어가 디코딩될 때 마이크로제어기가 호출하는 소프트웨어 루틴으로 구현 가능 → '명령어 에뮬레이션'
- 이 두 경우 모두, polyf 지원을 위해 마이크로제어기를 복잡하게 하지 않음
- 추상화의 힘!!
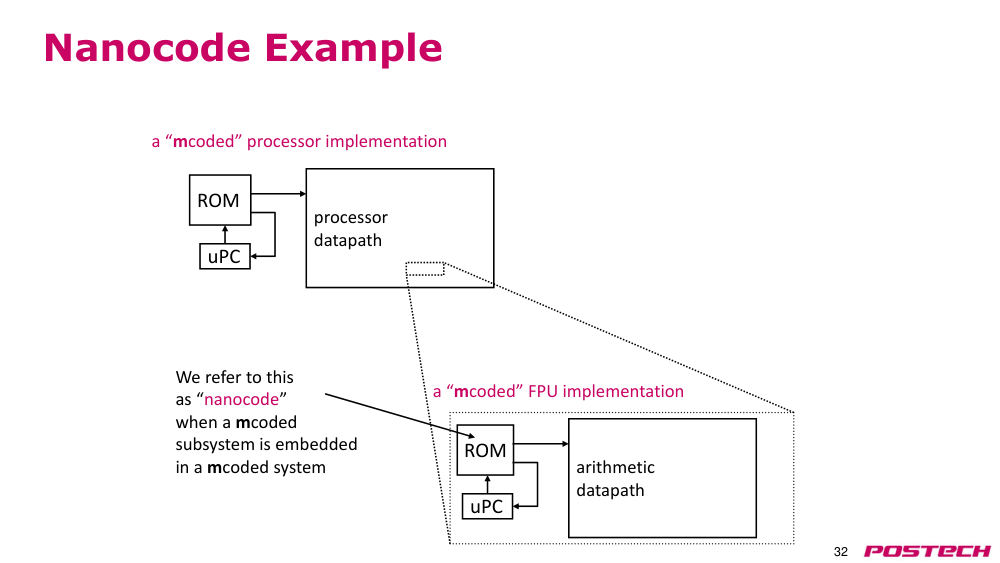
p.32나노코드 예시
- ROM
- uPC
- 산술 datapath(데이터 경로)
- 마이크로코드화된 FPU 구현
- ROM
- uPC
- 프로세서 datapath(데이터 경로)
- 마이크로코드화된 프로세서 구현
- 이 경우를 마이크로코드화된 시스템 내에 마이크로코드화된 하위 시스템이 포함된 경우로 '나노코드'라고 부름
p.33이제 마이크로제어 기반 Multi-Cycle CPU(멀티 사이클 CPU) 설계 방법을 알게 되었습니다
p.34질문?
- 공지사항
- -
- 읽기: P&H (RISC-V ed.) Ch 4.5-4.6