이 자료를 쓰는 강의: 42 Lec 7 · microcode 마무리와 pipelined CPU 입문 · 43 Lec 8 · pipelined control 과 data hazard·stall
Lec7-pipelined-CPU
한국어판 강의자료 · 41쪽
p.1CSED311 컴퓨터구조 – 강의 7
p.2지금까지 배운 내용
- single-cycle implementation(싱글 사이클 구현)의 CPU
- 모든 명령어는 가장 느린 명령어만큼 느리게 실행됨
- multi-cycle implementation(멀티 사이클 구현)의 CPU
- 모든 명령어는 각각의 latency(지연 시간)만큼 실행됨
- 여전히 주어진 시점에 CPU에 하나의 명령어만 존재함
- 오늘의 주제: pipelined CPU(파이프라인 CPU) 구현
- 실제로는 또 다른 multi-cycle implementation(멀티 사이클 구현)이지만, 훨씬 더 나음!
p.3기본 세탁 과정
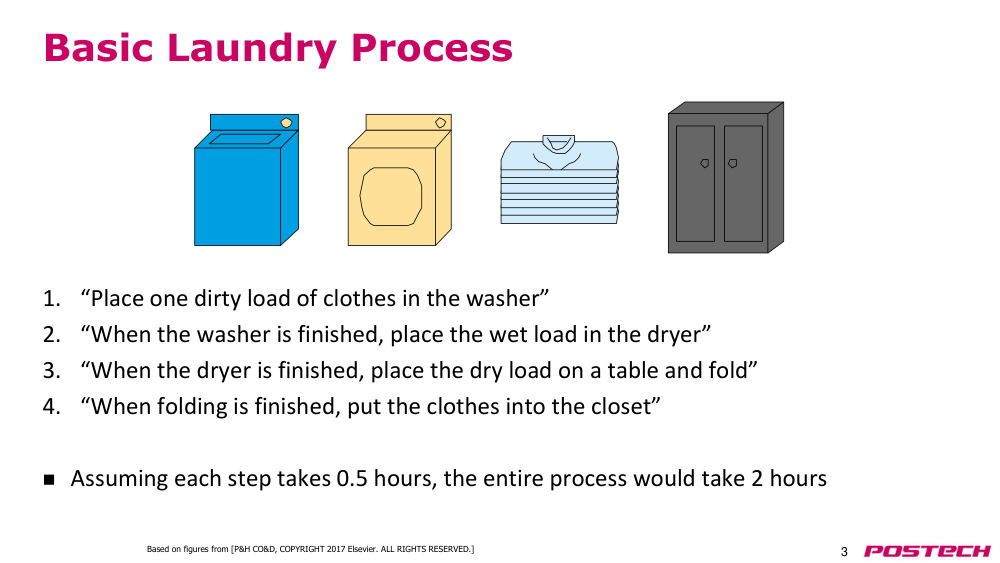
- 1. 오염된 옷 한 뭉치를 세탁기 안에 넣기
- 2. 세탁기가 끝나면 젖은 옷을 건조기로 옮기기
- 3. 건조기가 끝나면 마른 옷을 테이블에 놓고 접기
- 4. 접기가 끝나면 옷을 옷장에 넣기
- 각 단계가 0.5시간 소요될 경우, 전체 과정은 2시간 소요됨
- 출처: [P&H CO&D, COPYRIGHT 2017 Elsevier. ALL RIGHTS RESERVED.]
p.4다수의 세탁물에 대한 기본 세탁 과정
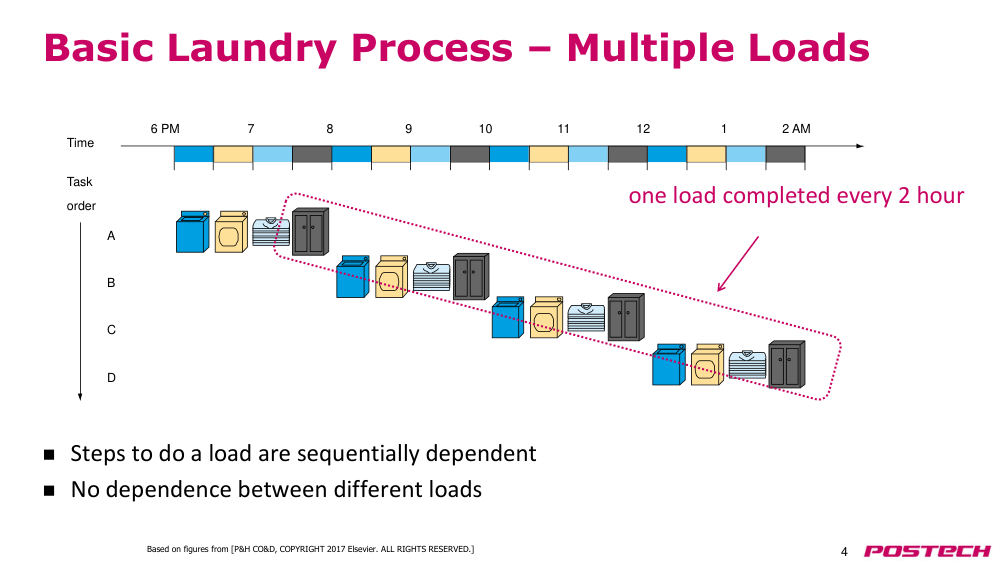
- 한 뭉치의 세탁 과정은 단계 간 순차적 의존성 있음
- 다른 뭉치 사이에는 의존성 없음
- 출처: [P&H CO&D, COPYRIGHT 2017 Elsevier. ALL RIGHTS RESERVED.]
- 시간
- 작업 순서
- A
- B
- C
- D
- 6 PM
- 7
- 8
- 9
- 10
- 11
- 12
- 1
- 2 AM
- 2시간마다 한 뭉치 완료
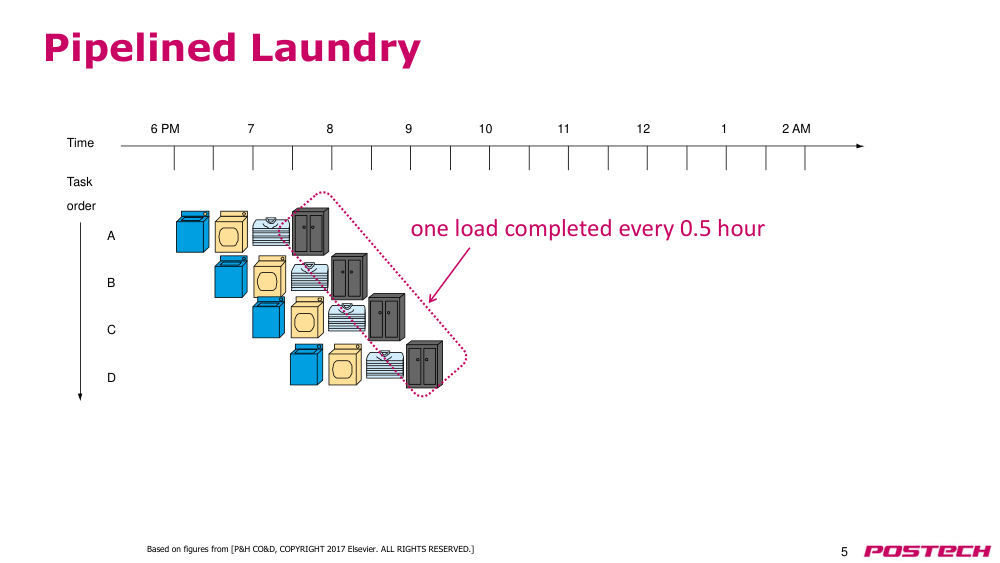
p.5파이프라인 세탁
- 출처: [P&H CO&D, COPYRIGHT 2017 Elsevier. ALL RIGHTS RESERVED.]
- 시간
- 작업 순서
- A
- B
- C
- D
- 6 PM
- 7
- 8
- 9
- 10
- 11
- 12
- 1
- 2 AM
- 0.5시간마다 한 뭉치 완료
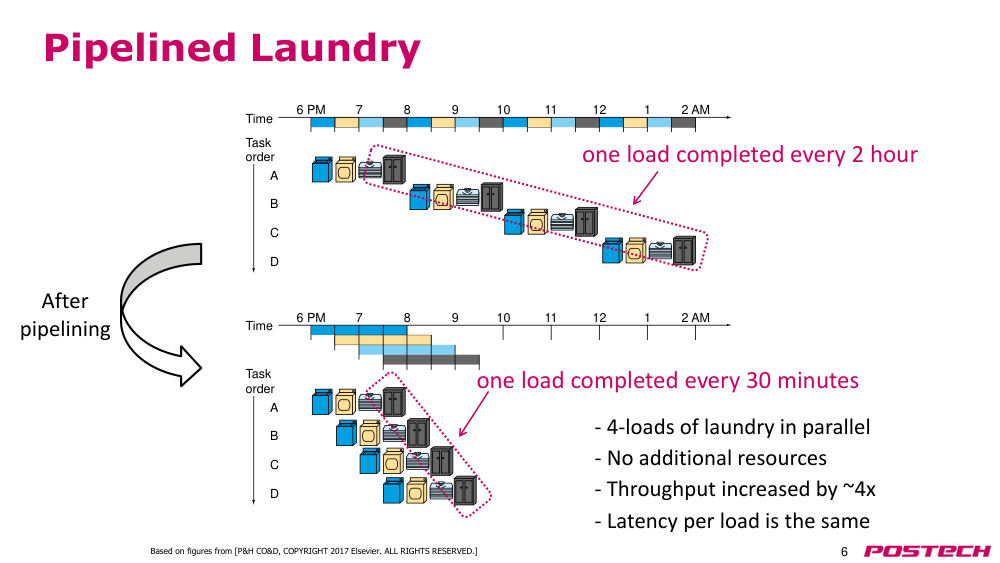
p.6파이프라인 세탁
- 한 뭉치당 latency(지연 시간)은 동일함
- throughput(처리량) 약 4배 증가
- 동시에 4개의 뭉치 세탁 중
- 추가 자원 없음
- 출처: [P&H CO&D, COPYRIGHT 2017 Elsevier. ALL RIGHTS RESERVED.]
- 파이프라인 적용 후
- 시간
- 작업 순서
- A
- B
- C
- D
- 6 PM
- 7
- 8
- 9
- 10
- 11
- 12
- 1
- 2 AM
- 2시간마다 한 뭉치 완료
- 30분마다 한 뭉치 완료
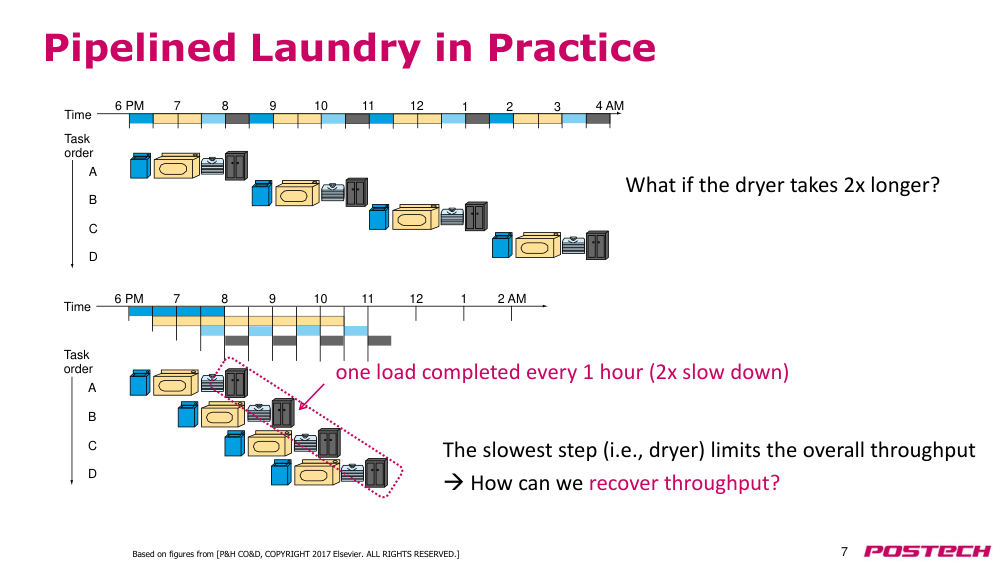
p.7실제 파이프라인 세탁소
- 가장 느린 단계(예: 건조기)가 전체 throughput(처리량)을 제한한다.
- 6 PM부터 4 AM까지, 1시간마다 한 번씩 세탁물 한 묶음 완료 (2배 느려짐)
- 건조기가 2배 더 오래 걸린다면? → throughput(처리량)을 회복할 수 있는 방법은?
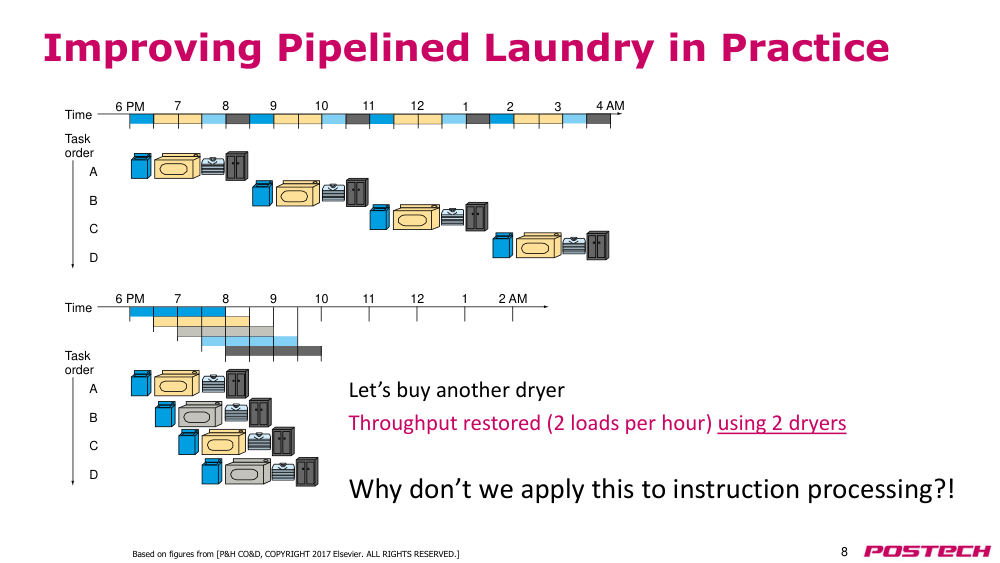
p.8실제 파이프라인 세탁소 개선
- 건조기 2대를 사용하여 throughput(처리량) 회복 (시간당 2번 세탁 완료)
- 왜 명령어 처리에도 이 방법을 적용하지 않을까?
p.9pipeline idealism(파이프라인 이상론)
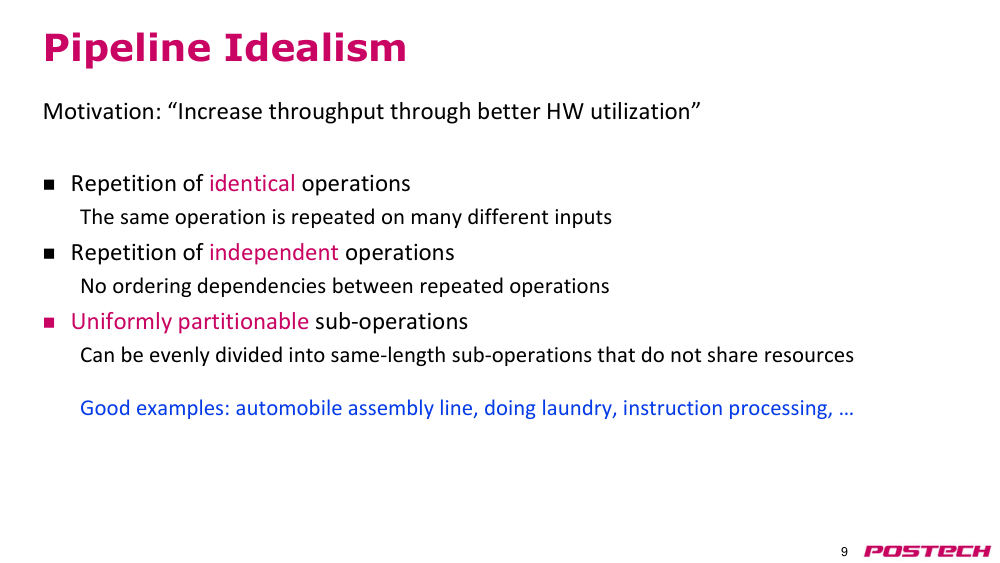
- 목표: 더 나은 하드웨어 활용을 통한 throughput(처리량) 증가
- 동일한 연산의 반복
- 동일한 연산이 여러 개의 서로 다른 입력에 대해 반복됨
- 독립적인 연산의 반복
- 반복되는 연산 간에 순서 의존성이 없음
- uniformly partitionable(균일하게 분할 가능한) 하위 연산
- 자원을 공유하지 않는 동일한 길이의 하위 연산으로 나눌 수 있음
- 좋은 예: 자동차 조립라인, 세탁, 명령어 처리 등
p.10이상적인 파이프라인
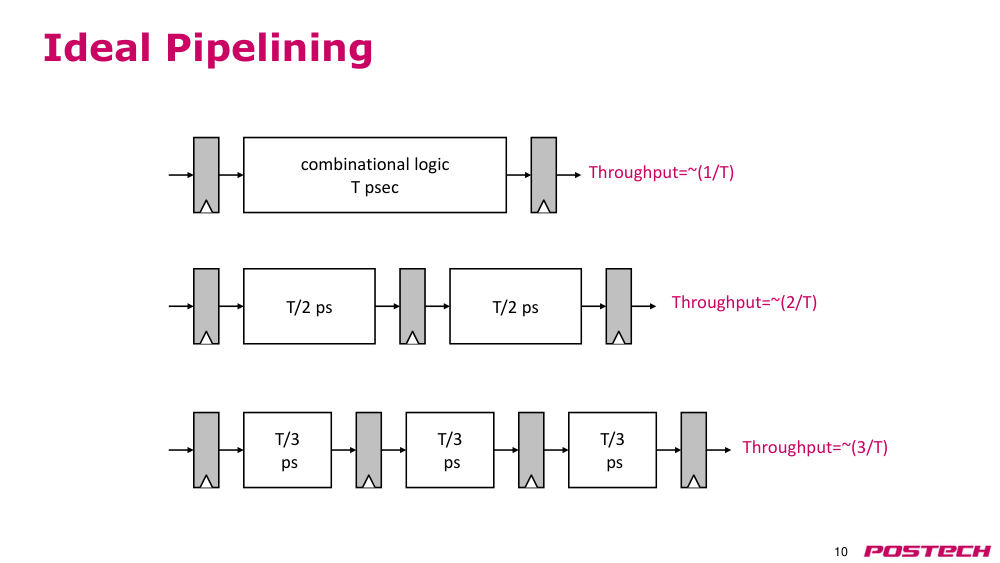
- combinational logic(조합 논리 회로) latency(지연 시간): T ps
- 비파이프라인 throughput(처리량): ~1/T
- 2단계 pipeline throughput(파이프라인 처리량): ~2/T
- 3단계 pipeline throughput(파이프라인 처리량): ~3/T
- 각 pipeline stages(파이프라인 스테이지) latency(지연 시간): T/2 ps, T/3 ps 등
p.11더 현실적인 성능 모델
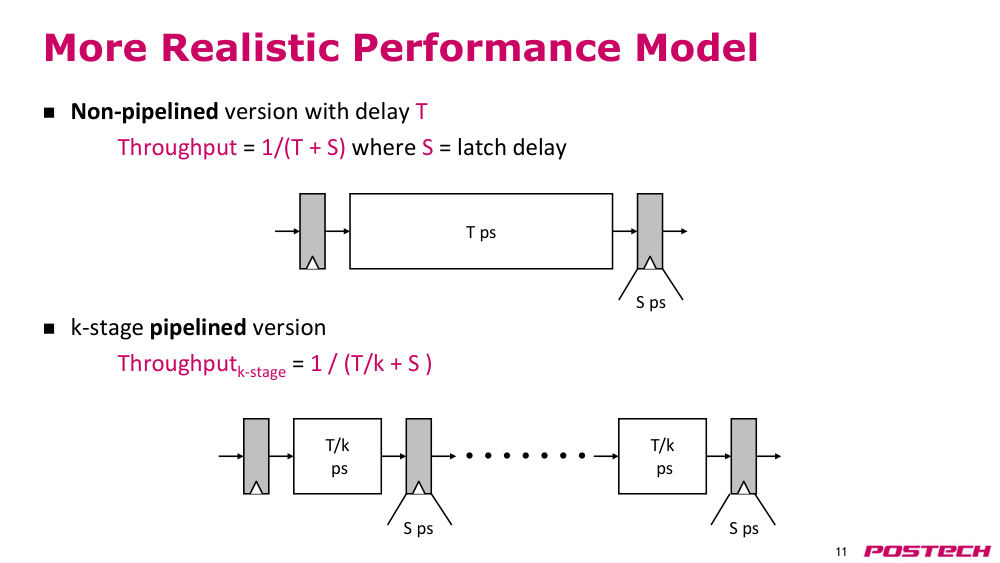
- 비파이프라인 버전 (지연 시간 T)
- throughput(처리량) = 1 / (T + S), 여기서 S = latch delay(래치 지연)
- k단계 파이프라인 버전
- throughput(처리량)k단계 = 1 / (T/k + S)
- 각 pipeline stages(파이프라인 스테이지) latency(지연 시간): T/k ps
- latch delay(래치 지연): S ps
p.12cost model(비용 모델)
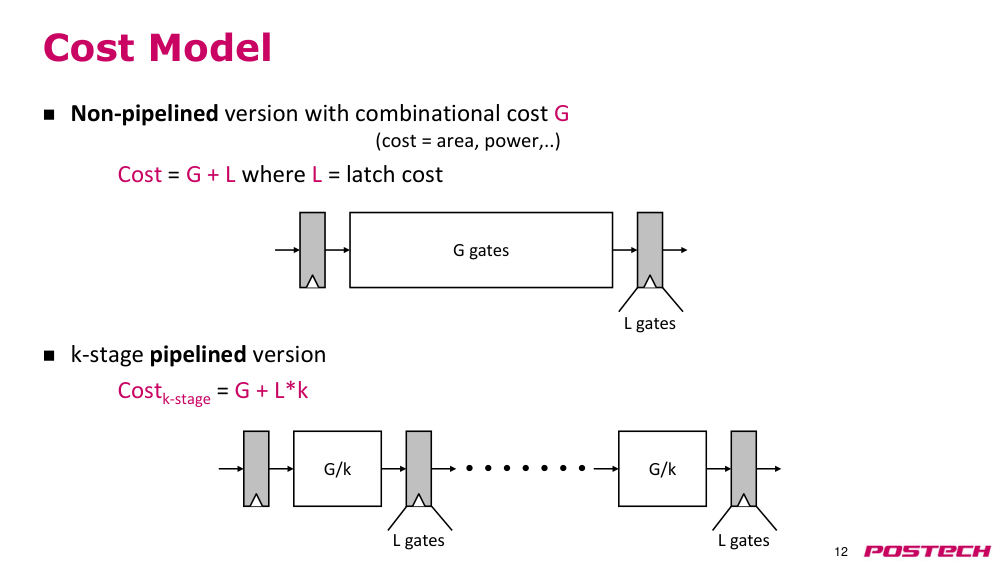
- 비파이프라인 버전 (조합 논리 비용 G)
- 비용 = G + L, 여기서 L = 래치 비용
- k단계 파이프라인 버전
- 비용k단계 = G + L*k
- 조합 논리 비용: G 게이트
- 래치 비용: L 게이트
- 각 pipeline stages(파이프라인 스테이지)의 조합 논리 비용: G/k 게이트
- 각 pipeline stages(파이프라인 스테이지)의 래치 비용: L 게이트
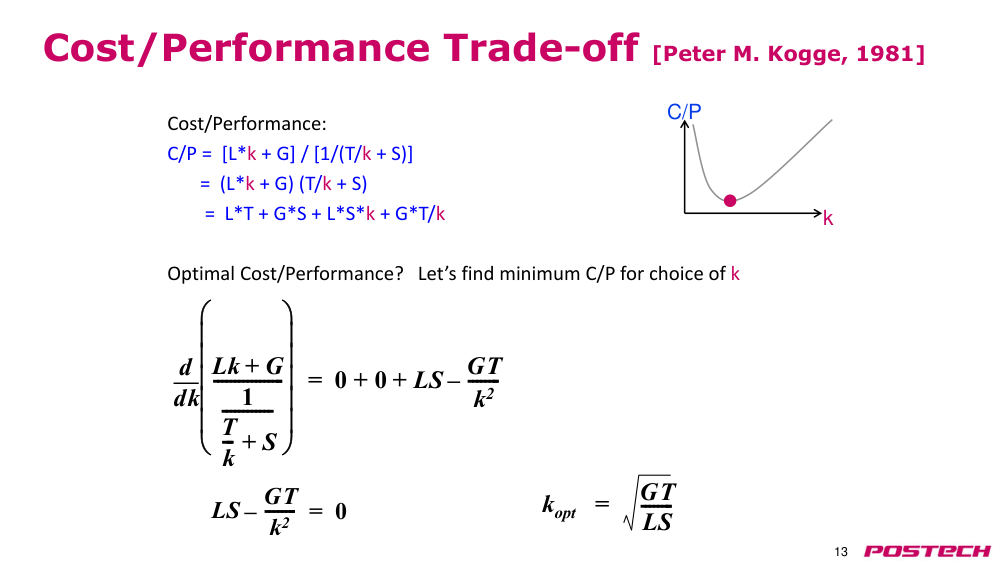
p.13비용/성능
- C/P = [L*k + G] / [1/(T/k + S)]
- = (L*k + G) (T/k + S)
- = L*T + G*S + L*S*k + G*T/k
- 비용/성능 최적화? k에 대한 C/P 최소값을 찾아보자.
- 비용/성능 트레이드오프 [Peter M. Kogge, 1981]
- d/dk (L*k + G) (T/k + S) = 0
- → LS - GT/k² = 0
- → k² = GT / LS
- → k<sub>opt</sub> = √(GT / LS)
p.14파이프라인 RISC-V CPU
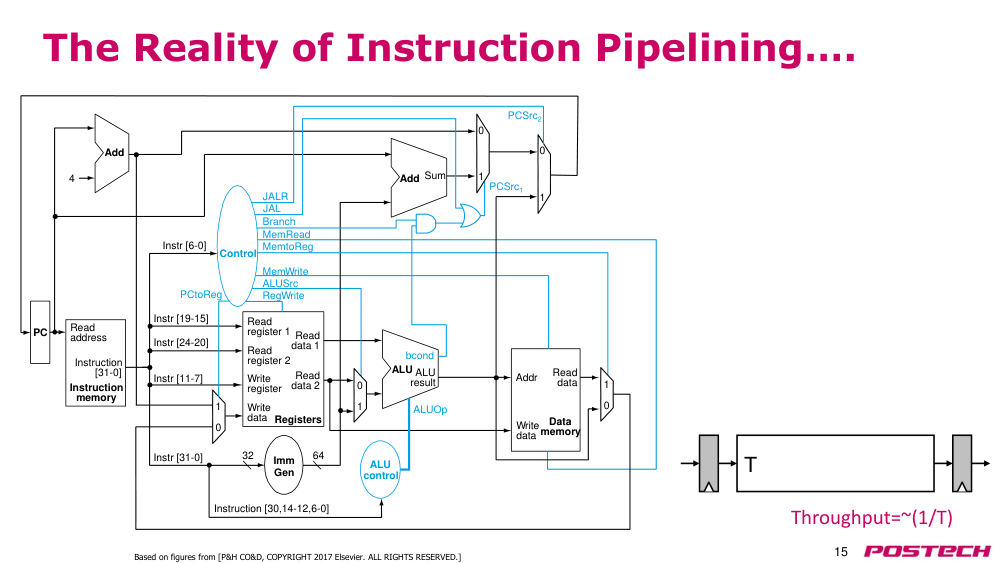
p.15명령어 파이프라인의 현실…
- 기반 자료: [P&H CO&D, COPYRIGHT 2017 Elsevier. ALL RIGHTS RESERVED.]
- Throughput ≈ 1/T
- 레지스터 1 읽기
- 데이터 쓰기
- 레지스터
- ALU
- 덧셈
- branch condition(브랜치 조건)
- 데이터 1 읽기
- 데이터 2 읽기
- 명령어 [31-0]
- ALU 결과
- 덧셈 합
- 주소
- data memory(데이터 메모리)
- 데이터 읽기
- 4
- 주소 읽기
- instruction memory(명령어 메모리)
- PC
- ALU control(ALU 제어)
- 브랜치
- MemRead
- MemtoReg
- ALUOp
- MemWrite
- ALUSrc
- RegWrite
- 제어
- 레지스터 2 읽기
- RegWrite(레지스터 쓰기)
- 데이터 쓰기
- ImmGen
- 32
- 64
- Instr [19-15]
- Instr [24-20]
- Instr [31-0]
- Instruction [30,14-12,6-0]
- Instr [6-0]
- Instr [11-7]
- 0
- 1
- 1
- 0
- 0
- 1
- 1
- 0
- JAL
- JALR
- 0
- 1
- PCtoReg
- PCSrc1
- PCSrc2
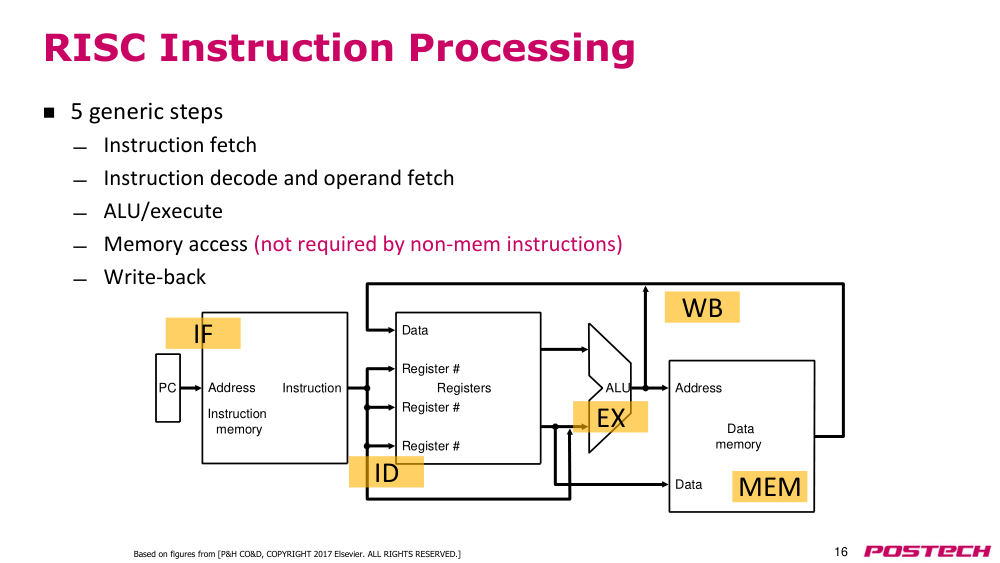
p.16RISC 명령어 처리
- 5개의 일반적인 단계:
- 명령어 가져오기 (IF)
- instruction decode(명령어 디코딩) 및 operand fetch(피연산자 가져오기) (ID)
- ALU/실행 (EX)
- 메모리 접근 (메모리 명령어에만 필요함)
- write-back(레지스터 쓰기) (WB)
- 레지스터
- 레지스터 번호
- 데이터
- 레지스터 번호
- 데이터
- data memory(데이터 메모리)
- 주소
- 데이터
- 레지스터 번호
- PC
- 명령어
- ALU
- instruction memory(명령어 메모리)
- 주소
- 기반 자료: [P&H CO&D, COPYRIGHT 2017 Elsevier. ALL RIGHTS RESERVED.]
- IF
- ID
- EX
- MEM
- WB
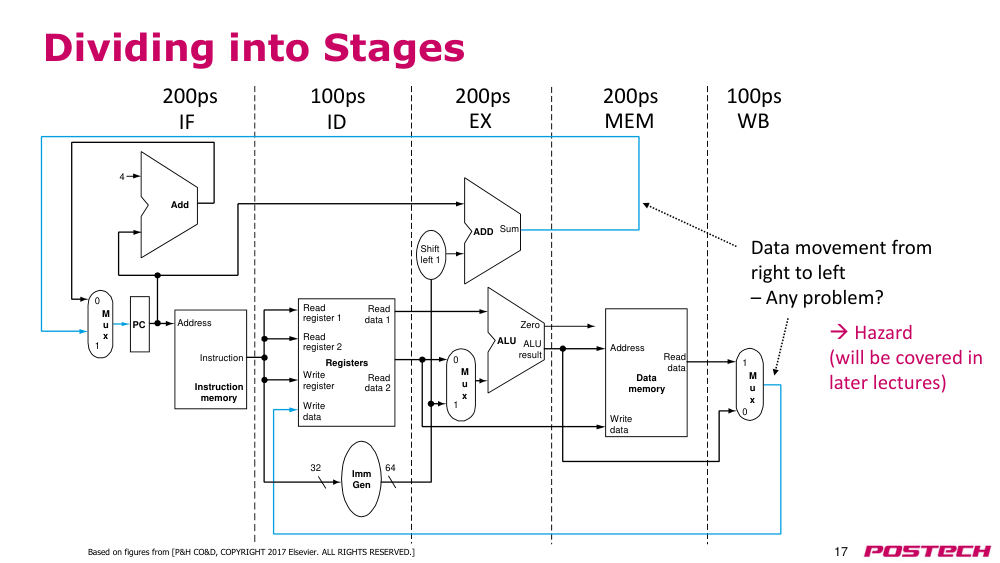
p.17스테이지로 나누기
- 기반 자료: [P&H CO&D, COPYRIGHT 2017 Elsevier. ALL RIGHTS RESERVED.]
- 200ps
- 100ps
- 200ps
- 200ps
- 100ps
- 오른쪽에서 왼쪽으로의 데이터 이동
- 문제가 있나요?
- EX
- 1
- Mux
- 0
- 0
- Mux
- 1
- 주소
- 데이터 쓰기
- 데이터 읽기
- data memory(데이터 메모리)
- 레지스터 1 읽기
- 레지스터 2 읽기
- RegWrite(레지스터 쓰기)
- 데이터 쓰기
- 레지스터
- 데이터 1 읽기
- 데이터 2 읽기
- ALU
- zero flag(제로 플래그)
- ALU 결과
- 덧셈 합
- shift left 1(왼쪽으로 1비트 시프트)
- 주소
- 명령어
- instruction memory(명령어 메모리)
- 덧셈 4
- PC
- ImmGen
- 0
- Mux
- 1
- 64
- ID
- 32
- MEM
- WB
- IF
- → hazard(해저드) (나중 강의에서 다룸)
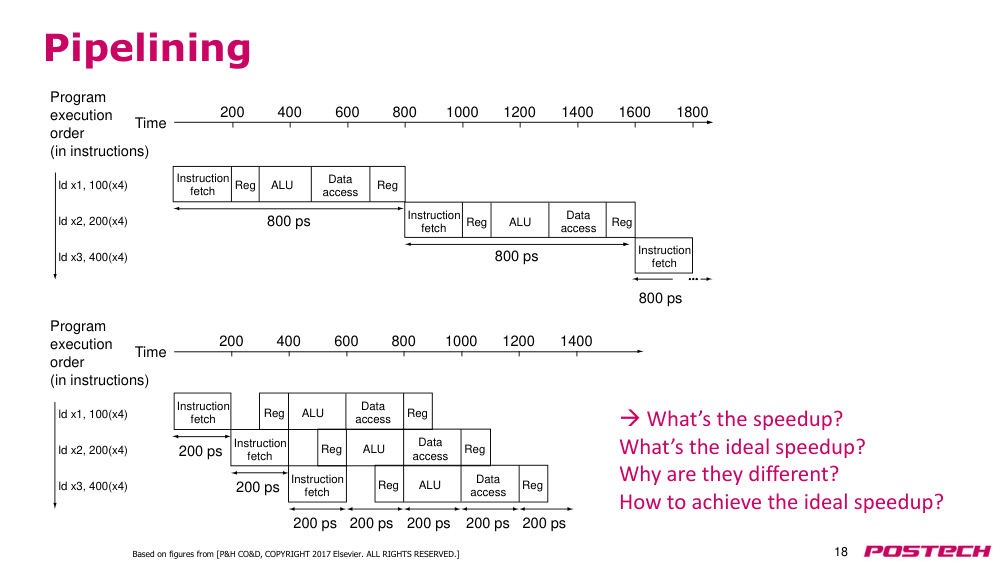
p.18파이프라인
- speedup(성능 향상)은 무엇인가?
- ideal speedup(이상적인 성능 향상)은 무엇인가?
- 왜 서로 다를까?
- ideal speedup(이상적인 성능 향상)을 달성하려면 어떻게 해야 할까?
- 기반 자료: [P&H CO&D, COPYRIGHT 2017 Elsevier. ALL RIGHTS RESERVED.]
- 프로그램 실행 순서 (명령어 기준)
- ld x1, 100(x4)
- ld x2, 200(x4)
- ld x3, 400(x4)
- 시간
- 1000
- 1200
- 1400
- 200
- 400
- 600
- 800
- 1600
- 1800
- instruction fetch(명령어 가져오기)
- 데이터 접근
- 레지스터
- instruction fetch(명령어 가져오기)
- 데이터 접근
- 레지스터
- instruction fetch(명령어 가져오기)
- 800 ps
- 800 ps
- 800 ps
- ALU
- 레지스터
- ALU
- 레지스터
- 1000
- 1200
- 1400
- 200
- 400
- 600
- 800
- 프로그램 실행 순서 (명령어 기준)
- ld x1, 100(x4)
- ld x2, 200(x4)
- ld x3, 400(x4)
- 시간
- instruction fetch(명령어 가져오기)
- 데이터 접근
- 레지스터
- instruction fetch(명령어 가져오기)
- instruction fetch(명령어 가져오기)
- 데이터 접근
- 레지스터
- 데이터 접근
- 레지스터
- 200 ps
- 200 ps
- 200 ps
- 200 ps
- 200 ps
- 200 ps
- 200 ps
- ALU
- ALU
- ALU
- 레지스터
- 레지스터
- 레지스터
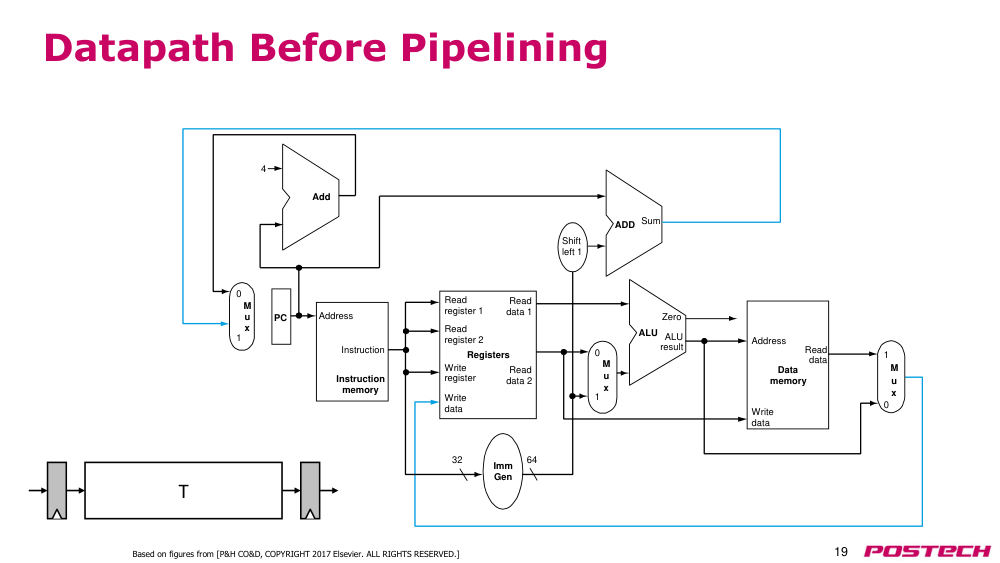
p.19파이프라인 전 datapath(데이터 경로)
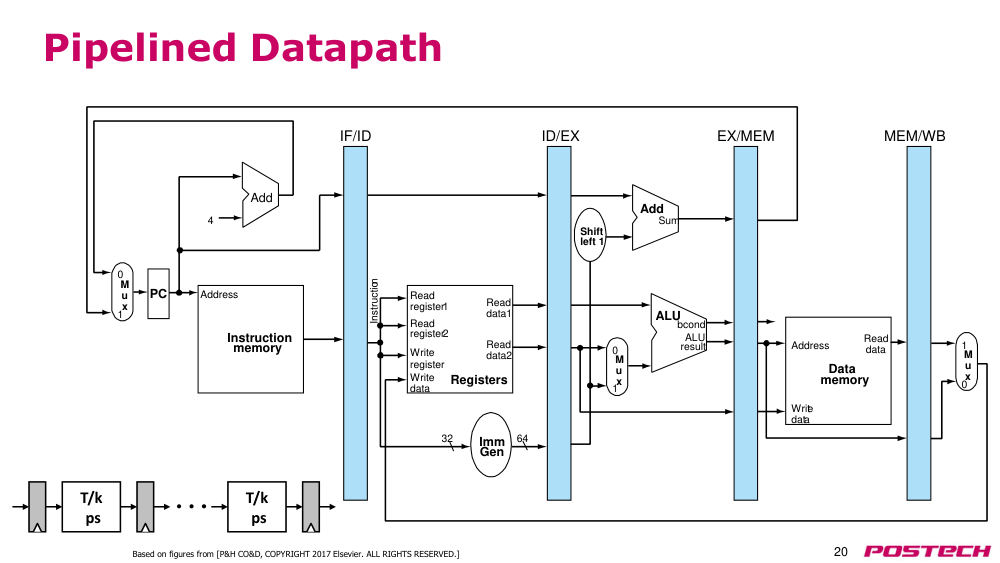
p.20파이프라인 datapath(데이터 경로)
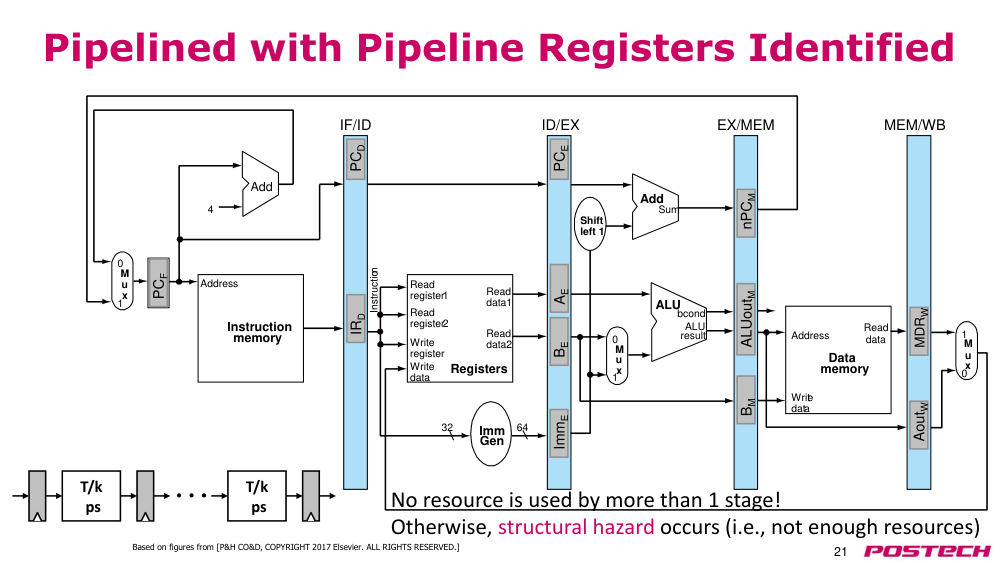
p.21pipeline register(파이프라인 레지스터)를 식별한 파이프라인 구조
- 둘 이상의 스테이지에 의해 사용되는 자원이 없음!
- 그렇지 않으면 structural hazard(구조적 해저드)가 발생함 (즉, 자원이 부족함)
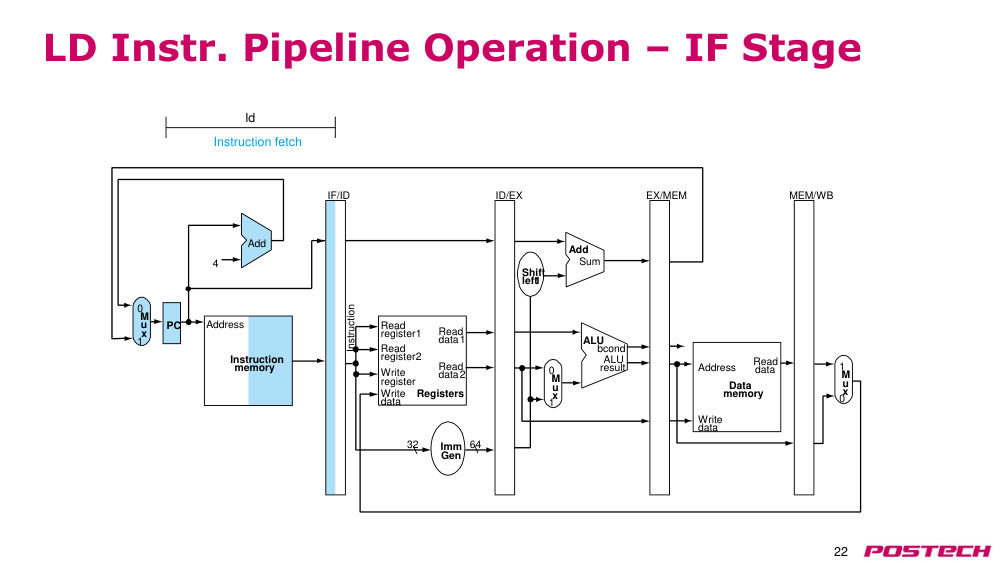
p.22LD 명령어 파이프라인 동작 – IF 스테이지
- instruction fetch(명령어 가져오기)
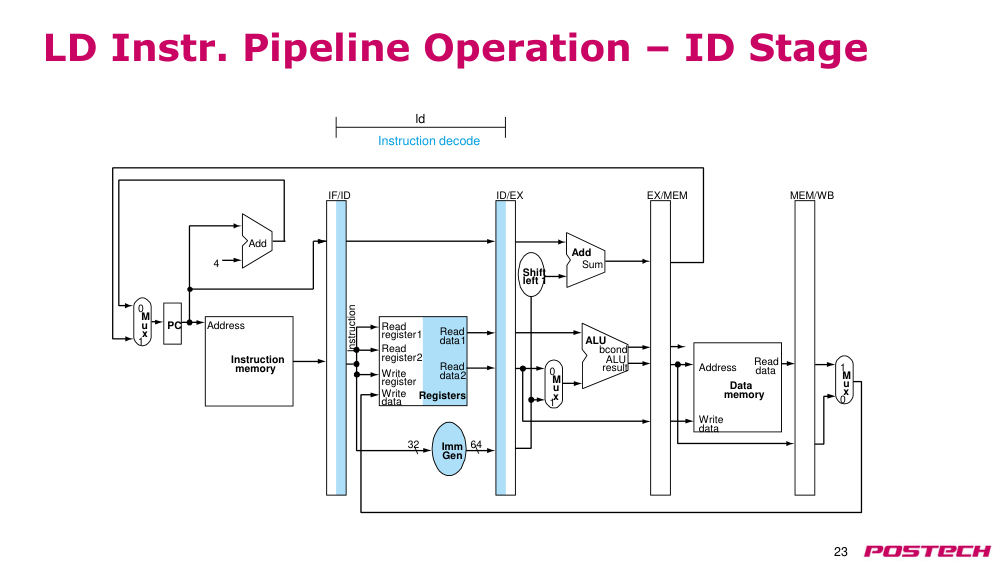
p.23LD 명령어 파이프라인 동작 – ID 스테이지
- instruction decode(명령어 디코딩)
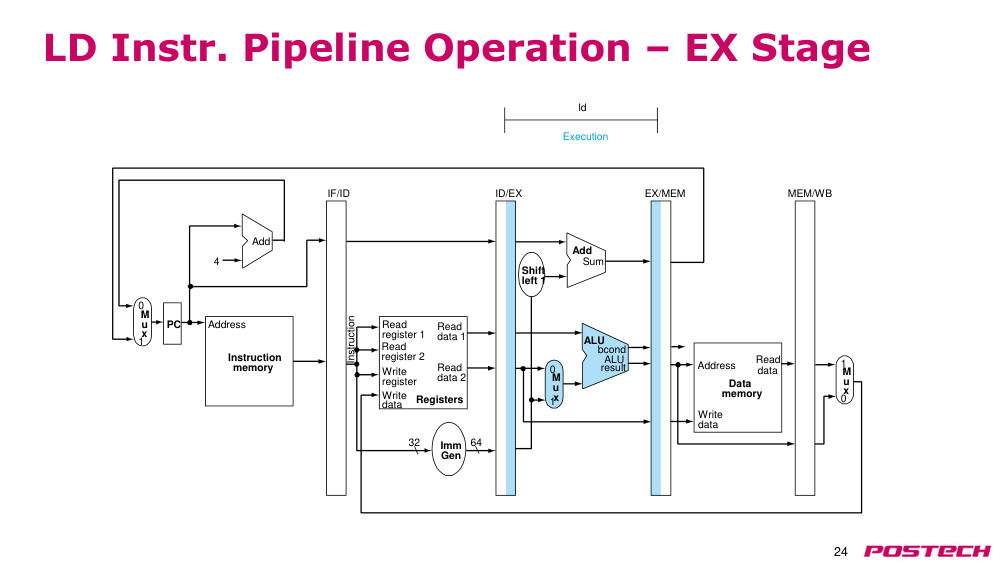
p.24LD 명령어 파이프라인 동작 – EX 스테이지
- 실행
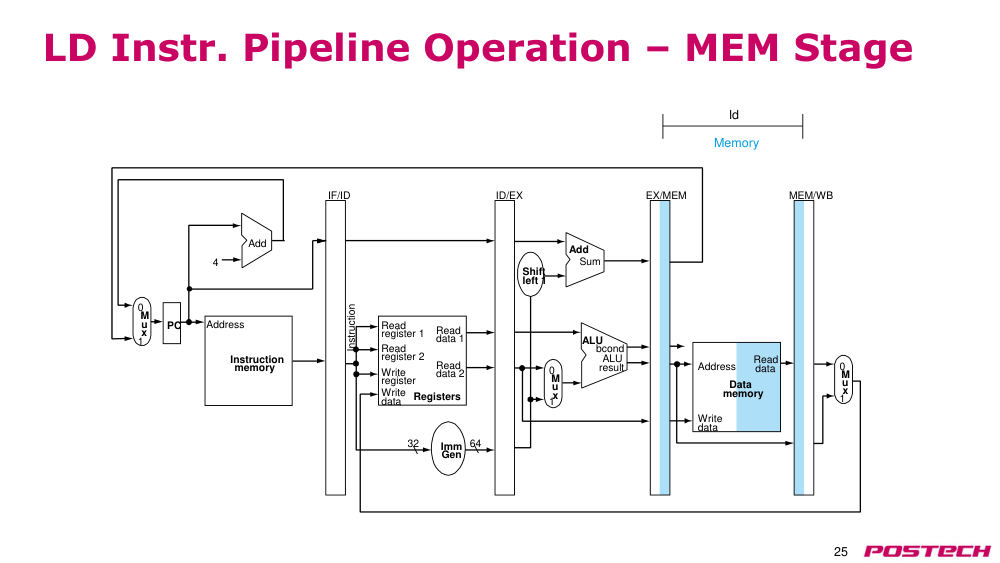
p.25LD 명령어 파이프라인 동작 – MEM 스테이지
- memory access(메모리 접근) 스테이지에서 명령어가 수행되는 과정을 보여줍니다.
- instruction memory(명령어 메모리)에서 명령어를 가져옵니다.
- register file(레지스터 파일)에서 두 개의 연산자(Read register 1, Read register 2)를 읽습니다.
- ALU에서 계산된 결과를 메모리 주소로 사용합니다.
- data memory(데이터 메모리)에서 데이터를 읽습니다.
- 파이프라인 레지스터(IF/ID, ID/EX, EX/MEM, MEM/WB)를 통해 데이터가 전달됩니다.
- Shift left 1과 ImmGen을 통해 상수를 생성합니다.
- PC는 4만큼 증가합니다.
- ALU 결과는 ALU 결과로 전달됩니다.
- bcond는 branch condition(브랜치 조건)을 나타냅니다.
- Add는 주소 계산을 위한 덧셈 연산을 수행합니다.
- Sum은 최종 주소를 나타냅니다.
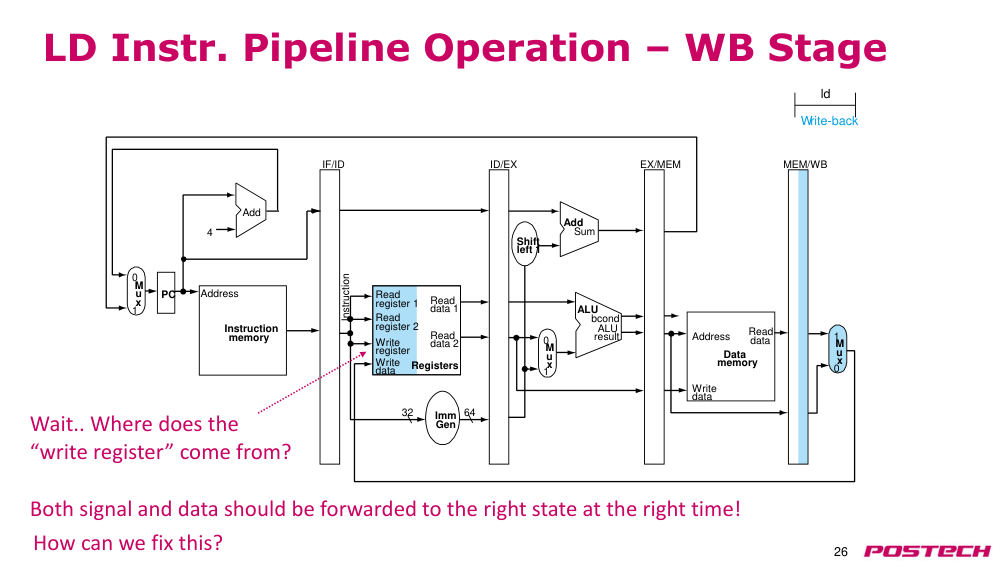
p.26LD 명령어 파이프라인 동작 – WB 스테이지
- write-back(레지스터 쓰기) 스테이지에서 데이터를 레지스터에 씁니다.
- 메모리에서 읽은 데이터를 register file(레지스터 파일)에 씁니다.
- write register(쓰기 레지스터) 필드는 쓸 레지스터 번호를 나타냅니다.
- 현재 상태에서 "쓰기 레지스터"는 어디에서 오는지 묻습니다.
- 이 문제를 해결하기 위해 신호와 데이터가 적절한 시점에 적절한 위치로 forwarding(포워딩)되어야 합니다.
- forwarding(포워딩)을 통해 data hazard(데이터 해저드)를 해결할 수 있습니다.
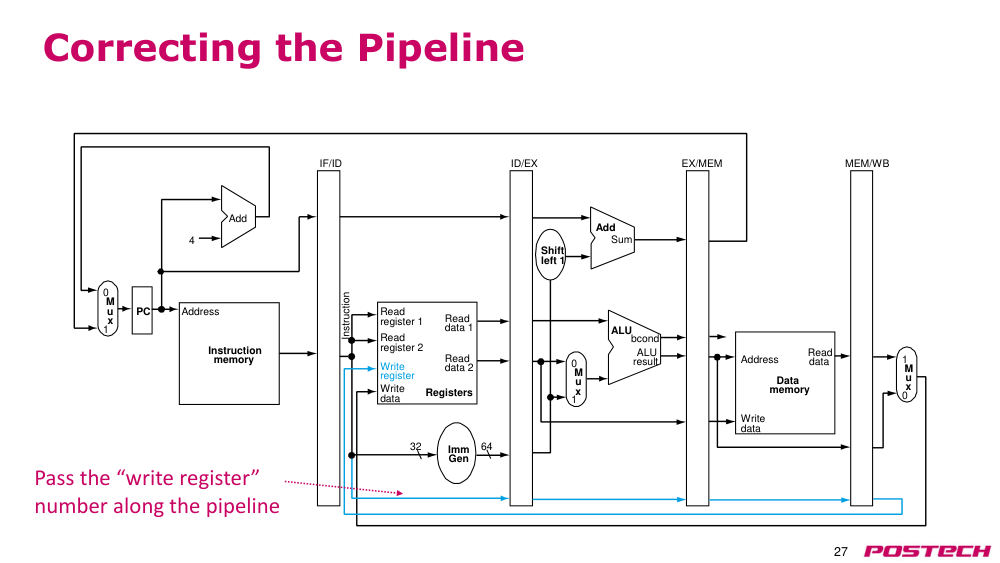
p.27파이프라인 수정
- 파이프라인 동작을 올바르게 하기 위해 쓰기 레지스터 번호를 파이프라인 전체를 따라 전달합니다.
- 각 파이프라인 레지스터(예: IF/ID, ID/EX, EX/MEM, MEM/WB)에 쓰기 레지스터 번호를 저장합니다.
- 이를 통해 write-back(기록 후 처리) 단계에서 올바른 레지스터에 데이터를 쓸 수 있습니다.
- 이 수정은 data hazard(데이터 해저드)를 방지하고 파이프라인의 정확성을 보장합니다.
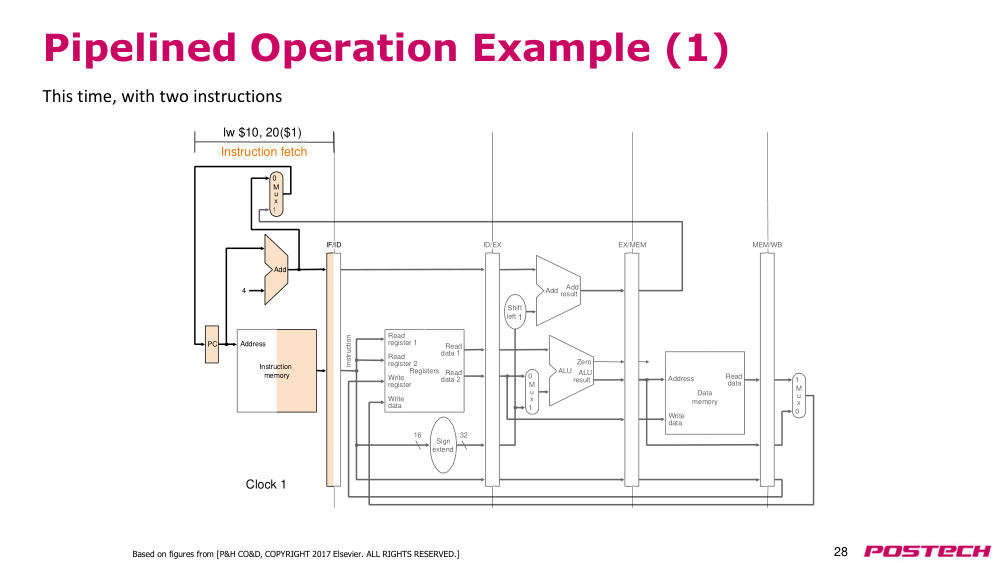
p.28파이프라인 동작 예제 (1)
- 클럭 1에서 instruction fetch(명령어 가져오기) 단계가 수행됩니다.
- lw $10, 20($1) 명령어가 instruction memory(명령어 메모리)에서 주소 4에서 읽힙니다.
- PC는 4만큼 증가하여 다음 명령어 주소를 계산합니다.
- IF/ID pipeline register(파이프라인 레지스터)에 명령어가 저장됩니다.
- IF/ID pipeline register(파이프라인 레지스터)는 instruction decode(명령어 디코딩) 및 레지스터 읽기를 수행합니다.
- sign extension(부호 확장)은 상수 20을 32비트로 확장합니다.
- Add는 PC와 상수를 더하여 주소를 계산합니다.
- EX/MEM pipeline register(파이프라인 레지스터)는 ALU 결과와 주소를 저장합니다.
- MEM/WB pipeline register(파이프라인 레지스터)는 memory access(메모리 접근) 결과와 쓰기 레지스터 번호를 저장합니다.
- 이 시점에서 memory access(메모리 접근)은 아직 수행되지 않았습니다.
p.29파이프라인 동작 예제 (2)
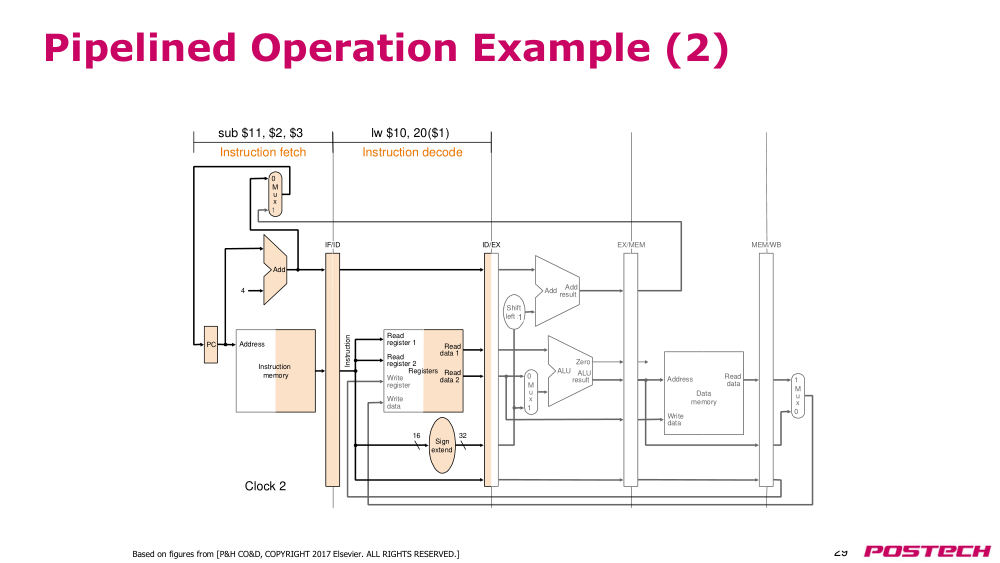
- 클럭 2에서 instruction decode(명령어 디코딩) 단계가 수행됩니다.
- lw $10, 20($1) 명령어가 IF/ID pipeline register(파이프라인 레지스터)에서 디코딩됩니다.
- sub $11, $2, $3 명령어가 instruction memory(명령어 메모리)에서 주소 4에서 읽혀 IF/ID pipeline register(파이프라인 레지스터)에 저장됩니다.
- IF/ID pipeline register(파이프라인 레지스터)는 두 번째 명령어의 레지스터 읽기를 수행합니다.
- ALU는 $2와 $3의 값을 빼어 결과를 계산합니다.
- EX/MEM pipeline register(파이프라인 레지스터)는 ALU 결과와 쓰기 레지스터 번호를 저장합니다.
- MEM/WB pipeline register(파이프라인 레지스터)는 memory access(메모리 접근) 결과와 쓰기 레지스터 번호를 저장합니다.
- 이 시점에서 두 명령어가 동시에 파이프라인에 존재합니다.
p.30파이프라인 동작 예제 (3)
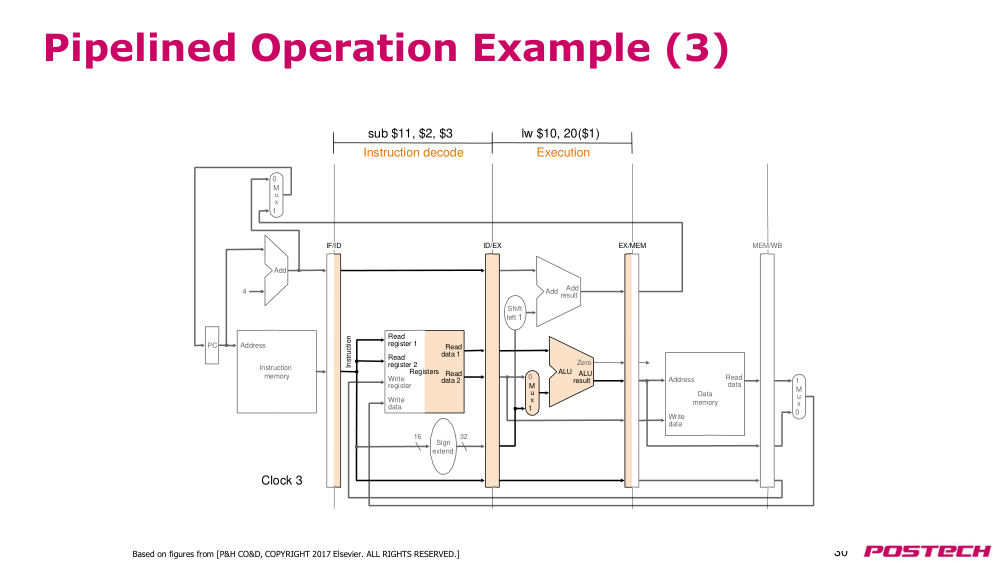
- 클럭 3에서 실행 단계가 수행됩니다.
- lw $10, 20($1) 명령어가 ID/EX pipeline register(파이프라인 레지스터)에서 실행됩니다.
- ALU는 $1과 20을 더하여 메모리 주소를 계산합니다.
- memory access(메모리 접근)은 data memory(데이터 메모리)에서 수행되며, 주소 32에서 데이터를 읽습니다.
- memory access(메모리 접근) 결과는 MEM/WB pipeline register(파이프라인 레지스터)에 저장됩니다.
- sub $11, $2, $3 명령어는 IF/ID pipeline register(파이프라인 레지스터)에서 디코딩됩니다.
- ALU는 $2와 $3의 값을 빼어 결과를 계산합니다.
- EX/MEM pipeline register(파이프라인 레지스터)는 ALU 결과와 쓰기 레지스터 번호를 저장합니다.
- 이 시점에서 두 명령어가 각각 다른 스테이지에서 처리되고 있습니다.
p.31파이프라인 동작 예제 (4)
- - 클럭 1: 명령어 가져오기 (Instruction fetch) - `lw $10, 20($1)` 명령어를 instruction memory(명령어 메모리)에서 가져옴 - 프로그램 카운터(PC)는 4에서 32로 증가 - PC increment(PC 증가) 값은 4이며, shift left 1(왼쪽으로 1비트 시프트)한 결과는 8이지만, 실제는 4로 고정됨 - 명령어는 IF/ID pipeline register(파이프라인 레지스터)로 전달됨
- - 클럭 2: 명령어 디코딩 (Instruction decode) - `lw $10, 20($1)` 명령어가 디코딩됨 - register file(레지스터 파일)에서 $1과 $10을 읽음 - sign extension(부호 확장)기에서 16비트 상수 20을 확장 - ALU 입력 소스(ALUSrc)는 1로 설정되어, 확장된 상수가 ALU에 입력됨 - PC 소스(PCSrc)는 0으로 설정되어, 다음 명령어 주소는 PC + 4로 계산됨 - 명령어는 ID/EX pipeline register(파이프라인 레지스터)로 전달됨
- - 클럭 3: ALU/실행 (ALU/execute) - ALU는 $1의 값과 확장된 상수 20을 더함 - 결과는 32비트 주소로 계산됨 - ALU 결과는 EX/MEM pipeline register(파이프라인 레지스터)로 전달됨 - memory access(메모리 접근) 주소는 ALU 결과로 결정됨 - `sub $11, $2, $3` 명령어는 이미 ID/EX 레지스터에 존재함
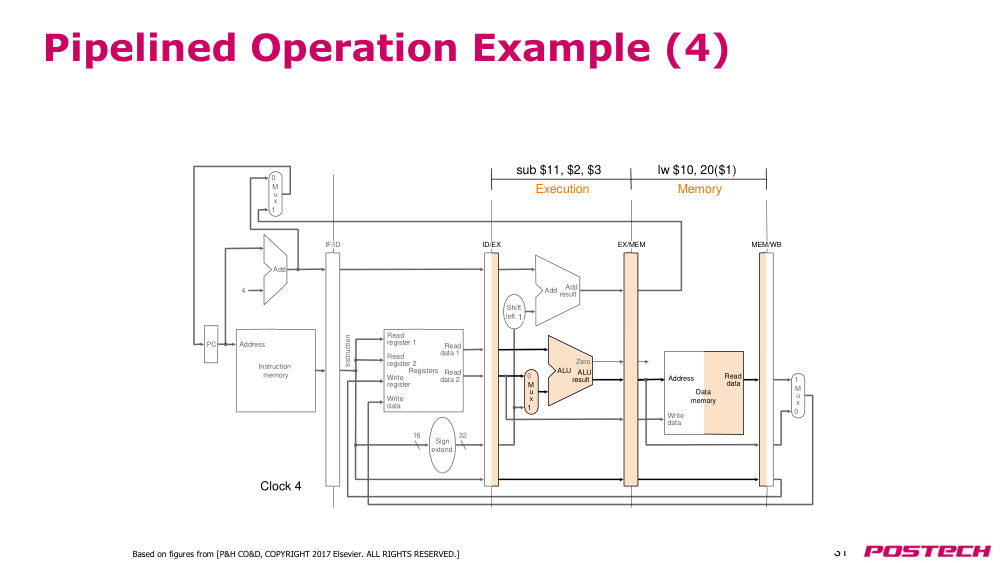
- - 클럭 4: 메모리 접근 (Memory access) - data memory(데이터 메모리)에서 `lw $10, 20($1)`의 주소에 해당하는 데이터를 읽음 - 읽은 데이터는 MEM/WB pipeline register(파이프라인 레지스터)로 전달됨 - `sub $11, $2, $3` 명령어는 EX/MEM 레지스터에서 메모리 접근 단계로 이동함
p.32파이프라인 동작 예제 (5)
- - 클럭 1: 명령어 가져오기 (Instruction fetch) - `lw $10, 20($1)` 명령어를 instruction memory(명령어 메모리)에서 가져옴 - PC는 4에서 32로 증가 - 명령어는 IF/ID pipeline register(파이프라인 레지스터)로 전달됨
- - 클럭 2: 명령어 디코딩 (Instruction decode) - `lw $10, 20($1)` 명령어가 디코딩됨 - register file(레지스터 파일)에서 $1과 $10을 읽음 - sign extension(부호 확장)기에서 16비트 상수 20을 확장 - ALU 입력 소스(ALUSrc)는 1로 설정되어, 확장된 상수가 ALU에 입력됨 - PC 소스(PCSrc)는 0으로 설정되어, 다음 명령어 주소는 PC + 4로 계산됨 - 명령어는 ID/EX pipeline register(파이프라인 레지스터)로 전달됨
- - 클럭 3: ALU/실행 (ALU/execute) - ALU는 $1의 값과 확장된 상수 20을 더함 - 결과는 32비트 주소로 계산됨 - ALU 결과는 EX/MEM pipeline register(파이프라인 레지스터)로 전달됨 - memory access(메모리 접근) 주소는 ALU 결과로 결정됨 - `sub $11, $2, $3` 명령어는 이미 ID/EX 레지스터에 존재함
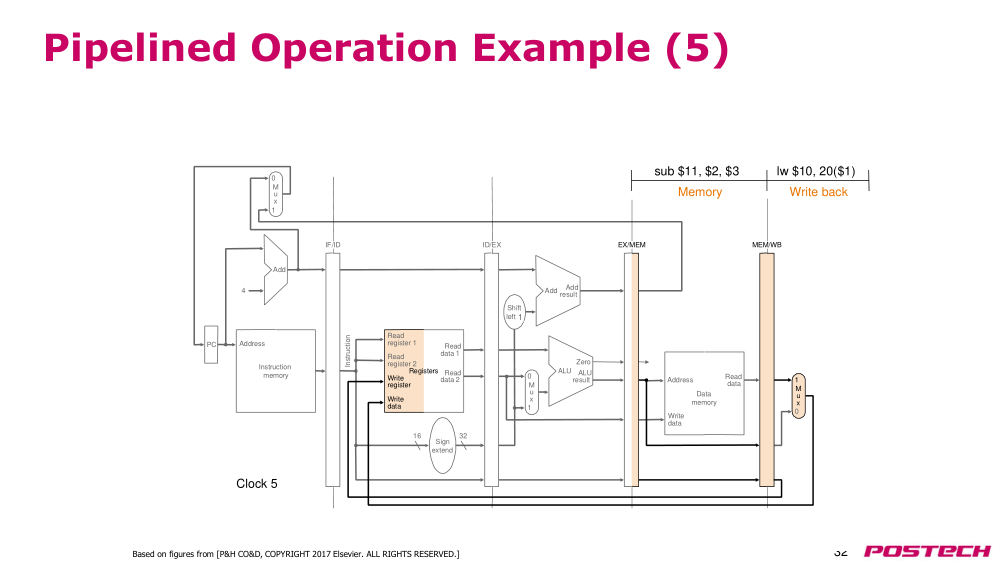
- - 클럭 4: 메모리 접근 (Memory access) - data memory(데이터 메모리)에서 `lw $10, 20($1)`의 주소에 해당하는 데이터를 읽음 - 읽은 데이터는 MEM/WB pipeline register(파이프라인 레지스터)로 전달됨 - `sub $11, $2, $3` 명령어는 EX/MEM 레지스터에서 메모리 접근 단계로 이동함
- - 클럭 5: write-back(레지스터 쓰기) - `lw $10, 20($1)` 명령어의 결과(읽은 데이터)가 레지스터 $10에 기록됨 - `sub $11, $2, $3` 명령어는 EX/MEM 레지스터에서 MEM/WB 레지스터로 이동함
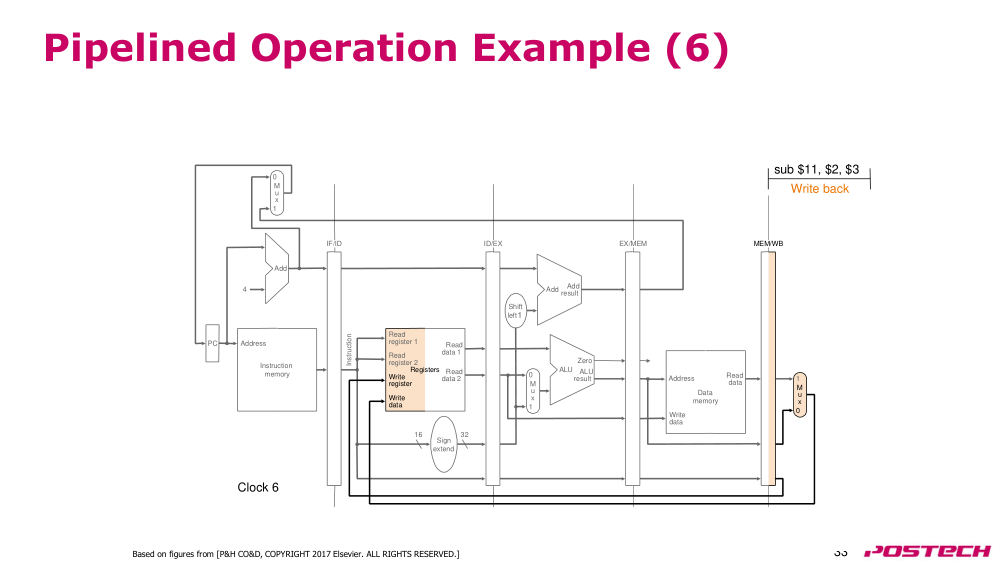
p.33파이프라인 동작 예제 (6)
- - 클럭 1: 명령어 가져오기 (Instruction fetch) - `lw $10, 20($1)` 명령어를 instruction memory(명령어 메모리)에서 가져옴 - PC는 4에서 32로 증가 - 명령어는 IF/ID pipeline register(파이프라인 레지스터)로 전달됨
- - 클럭 2: 명령어 디코딩 (Instruction decode) - `lw $10, 20($1)` 명령어가 디코딩됨 - register file(레지스터 파일)에서 $1과 $10을 읽음 - sign extension(부호 확장)기에서 16비트 상수 20을 확장 - ALU 입력 소스(ALUSrc)는 1로 설정되어, 확장된 상수가 ALU에 입력됨 - PC 소스(PCSrc)는 0으로 설정되어, 다음 명령어 주소는 PC + 4로 계산됨 - 명령어는 ID/EX pipeline register(파이프라인 레지스터)로 전달됨
- - 클럭 3: ALU/실행 (ALU/execute) - ALU는 $1의 값과 확장된 상수 20을 더함 - 결과는 32비트 주소로 계산됨 - ALU 결과는 EX/MEM pipeline register(파이프라인 레지스터)로 전달됨 - memory access(메모리 접근) 주소는 ALU 결과로 결정됨 - `sub $11, $2, $3` 명령어는 이미 ID/EX 레지스터에 존재함
- - 클럭 4: 메모리 접근 (Memory access) - data memory(데이터 메모리)에서 `lw $10, 20($1)`의 주소에 해당하는 데이터를 읽음 - 읽은 데이터는 MEM/WB pipeline register(파이프라인 레지스터)로 전달됨 - `sub $11, $2, $3` 명령어는 EX/MEM 레지스터에서 메모리 접근 단계로 이동함
- - 클럭 5: write-back(레지스터 쓰기) - `lw $10, 20($1)` 명령어의 결과(읽은 데이터)가 레지스터 $10에 기록됨 - `sub $11, $2, $3` 명령어는 EX/MEM 레지스터에서 MEM/WB 레지스터로 이동함
p.34파이프라인 동작 설명: 그래픽적 시각화
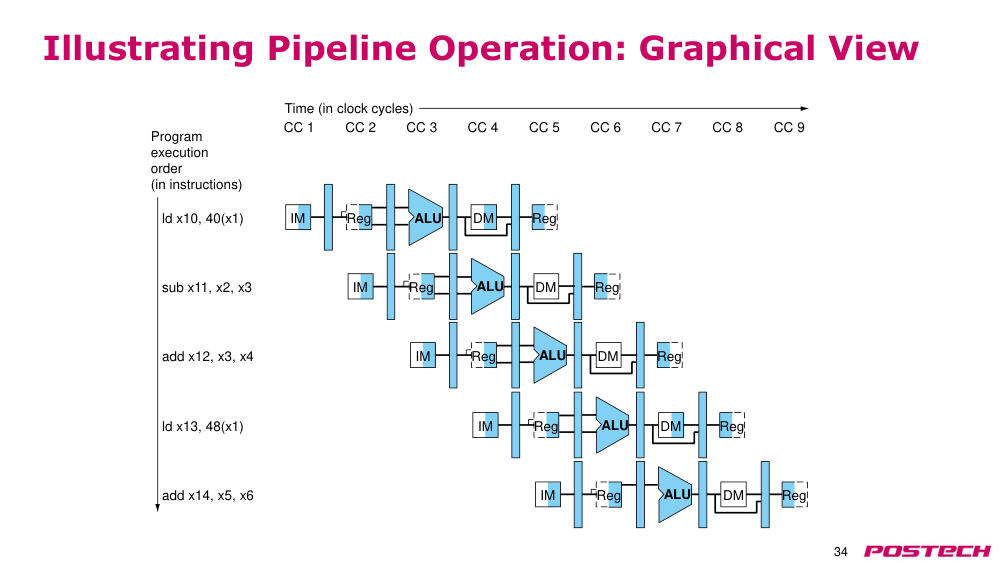
- - 프로그램 실행 순서 (명령어 기준) - `ld x10, 40(x1)` - `sub x11, x2, x3` - `add x12, x3, x4` - `ld x13, 48(x1)` - `add x14, x5, x6`
- - 시간 축 (클럭 주기 기준) - CC 1 ~ CC 9 까지의 클럭 주기에서 각 명령어가 각 파이프라인 스테이지(IF, ID, EX, MEM, WB)를 차례로 통과함 - 각 명령어는 5단계의 파이프라인 스테이지에서 동작함 - 명령어 메모리(IM), 레지스터 파일(Reg), ALU, 데이터 메모리(DM) 등 자원이 각 스테이지에서 사용됨
p.35파이프라인 동작 설명: 동작 시각화
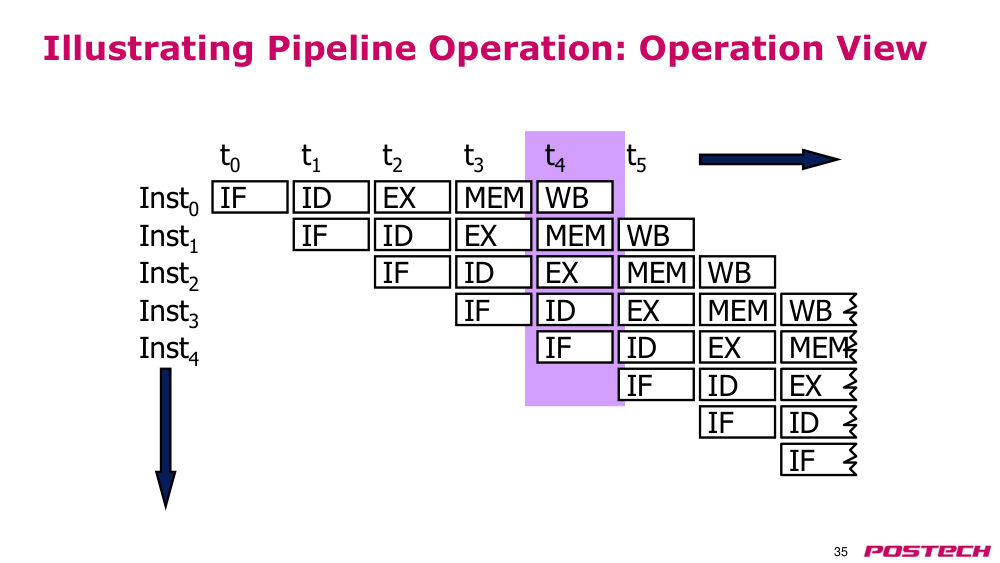
- - 시간 t0 ~ t5에 걸쳐 명령어의 각 스테이지 동작을 시각화 - Inst0: IF → ID → EX → MEM → WB - Inst1: IF → ID → EX → MEM → WB - Inst2: IF → ID → EX → MEM → WB - Inst3: IF → ID → EX → MEM → WB - Inst4: IF → ID → EX → MEM → WB - 각 명령어는 5단계의 pipeline stages(파이프라인 스테이지)에서 순차적으로 진행됨 - 파이프라인은 각 스테이지에서 동시에 여러 명령어를 처리함
p.36파이프라인 동작 설명: 자원 시각화
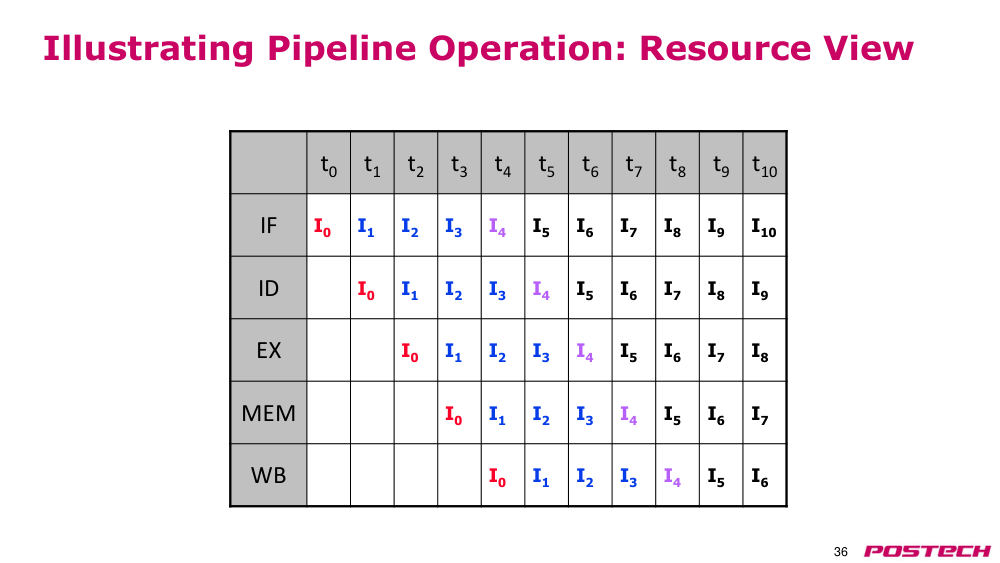
- - 시간 t0 ~ t10에 걸쳐 각 명령어가 각 파이프라인 스테이지(IF, ID, EX, MEM, WB)를 차례로 통과함 - I0: t0~t4 → IF, ID, EX, MEM, WB - I1: t1~t5 → IF, ID, EX, MEM, WB - I2: t2~t6 → IF, ID, EX, MEM, WB - I3: t3~t7 → IF, ID, EX, MEM, WB - I4: t4~t8 → IF, ID, EX, MEM, WB - I5: t5~t9 → IF, ID, EX, MEM, WB - I6: t6~t10 → IF, ID, EX, MEM, WB - 각 명령어는 5단계의 파이프라인 스테이지에서 동작하며, 자원이 중복 사용됨 - 파이프라인은 각 스테이지에서 동시에 여러 명령어를 처리함
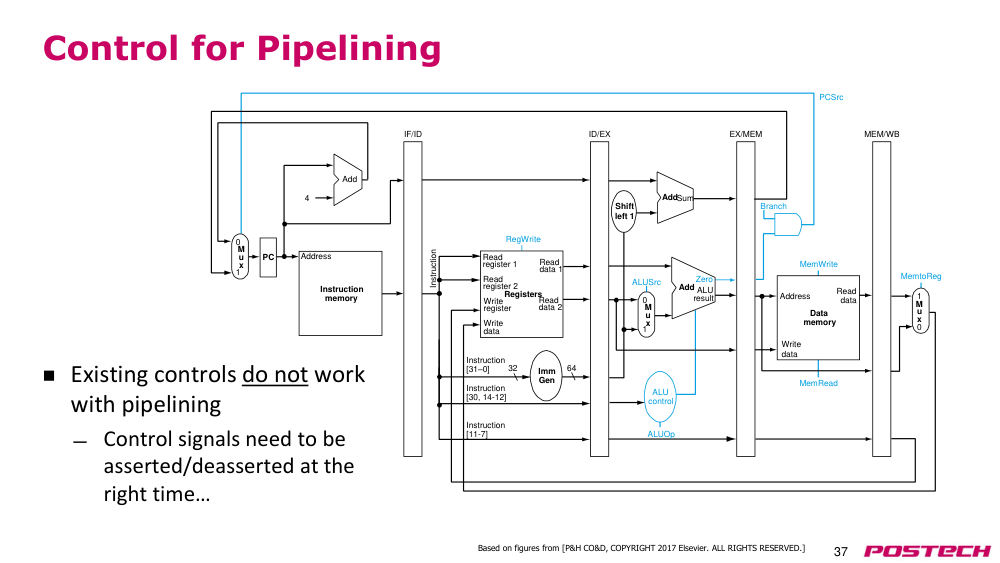
p.37파이프라인 제어
- 기존의 제어 회로는 파이프라인과 함께 작동하지 않는다.
- control signals(제어 신호)는 적절한 시점에 설정/해제되어야 한다…
- 출처: [P&H CO&D, COPYRIGHT 2017 Elsevier. ALL RIGHTS RESERVED.]
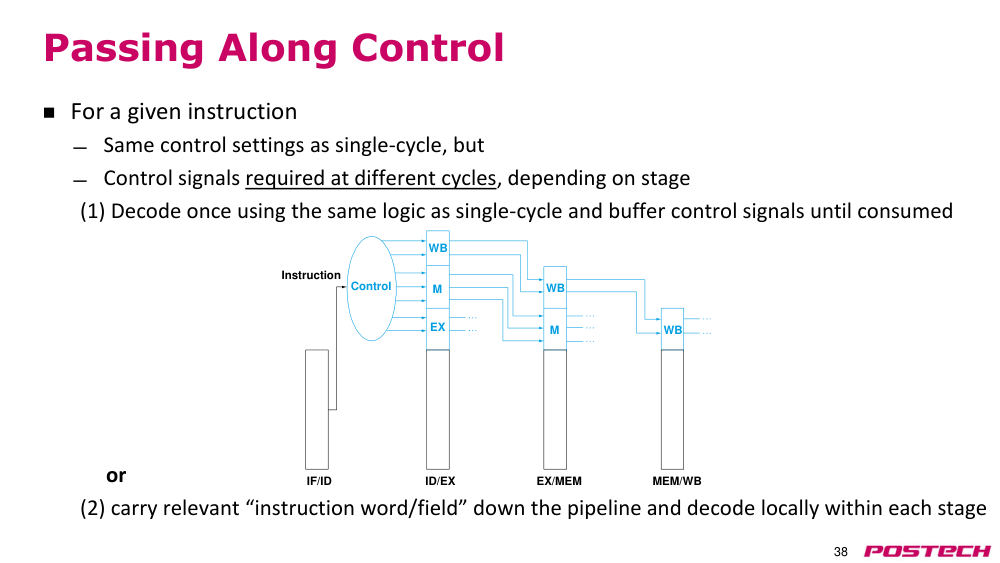
p.38control signals(제어 신호) 전달
- 주어진 명령어에 대해
- 싱글 사이클과 동일한 제어 설정을 사용하지만,
- 각 스테이지에 따라 다른 사이클에서 필요로 하는 control signals(제어 신호)
- (1) 싱글 사이클과 동일한 논리로 한 번 디코딩하고, 소비될 때까지 control signals(제어 신호)를 버퍼링하거나
- (2) 관련된 '명령어 워드/필드'를 파이프라인 내에서 전달하고, 각 스테이지 내에서 로컬로 디코딩함
- WB
- M
- EX
- WB
- M
- WB
- Control
- IF/ID
- ID/EX
- EX/MEM
- MEM/WB
- Instruction
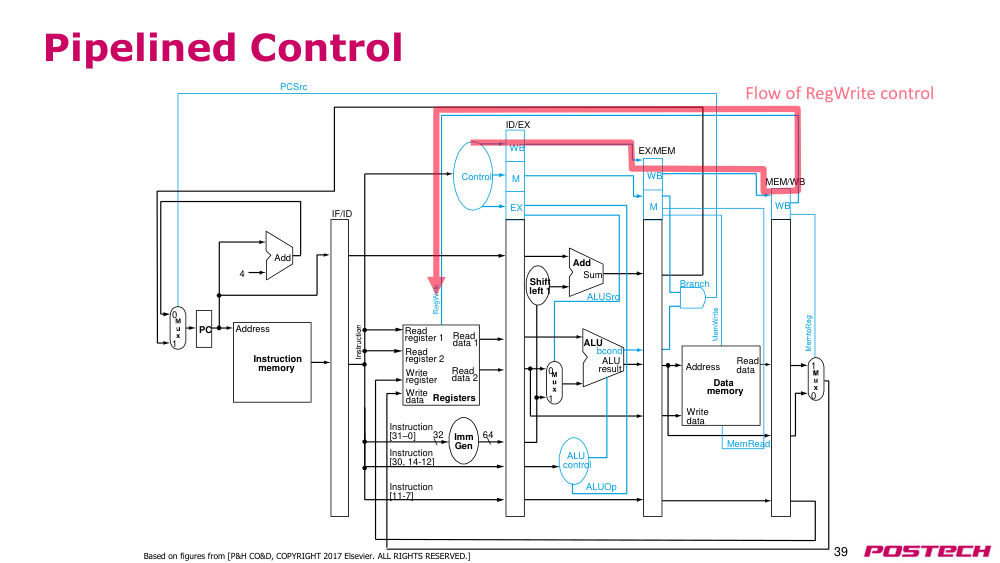
p.39파이프라인 제어
- 출처: [P&H CO&D, COPYRIGHT 2017 Elsevier. ALL RIGHTS RESERVED.]
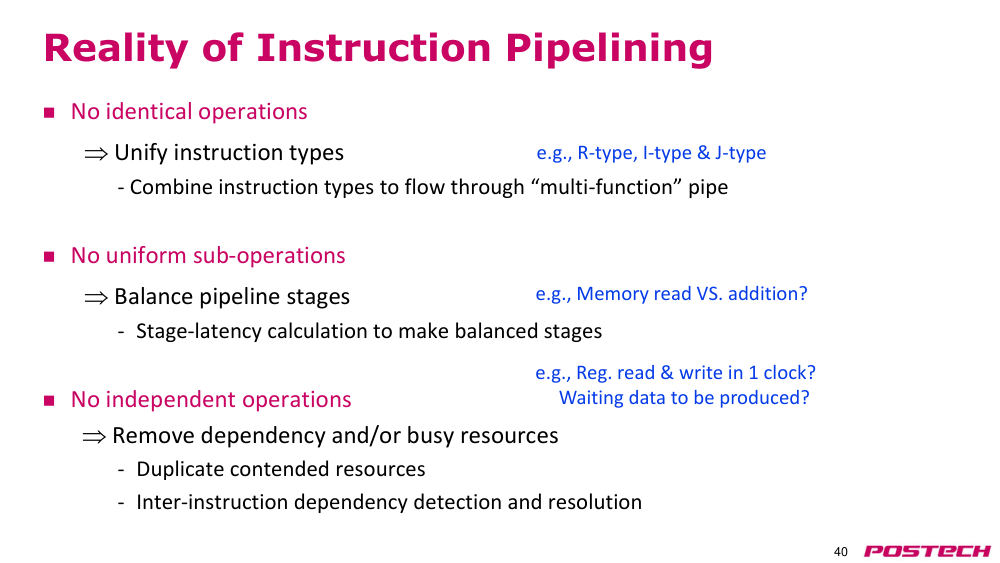
p.40명령어 파이프라인의 현실
- 동일한 연산이 없음
- → 명령어 유형을 통합하여 '다기능' 파이프를 통과시킴
- 균일한 하위 연산이 없음
- → pipeline stages(파이프라인 스테이지) 균형 조정
- 스테이지 latency(지연 시간) 계산을 통해 균형 잡힌 스테이지 구성
- 독립적인 연산이 없음
- → 의존성 제거 및/또는 사용 중인 자원 제거
- 경합하는 자원 중복
- 명령어 간 의존성 탐지 및 해결
- 예: R형, I형 및 J형
- 예: MemRead(메모리 읽기) vs. 덧셈?
- 예: 1 클럭 내에서 레지스터 읽기 및 쓰기?
- 생성된 데이터를 기다려야 하는가?
p.41질문?
- 공지사항
- -
- 읽기: P&H (RISC-V ed.) Ch 4.7