Lec 24 · LR/SC·Transactional memory 와 I/O·Warehouse-scale computing
정밀 정리 · 검증 2026-09-24 08:15
1개요
1.1Lec16 후반: CAS 의 한계(ABA) → LR/SC(MESI 구현, ABA 없음, livelock, RISC-V 진전 보장), AMO, transactional memory
1.2Lec17 I/O: memory-mapped I/O·polling/interrupt·bridge·DMA·serial link·crossbar·IOMMU·SoC 예
1.3Lec17 WSC: request-level parallelism, 전력·cooling·PUE, latency SLO·failure, Clos network, MapReduce
2섹션별 정리 상황·문제 → 원인 → 해결
2.10:16–2:16Recap: Compare-and-swap 과 그 한계
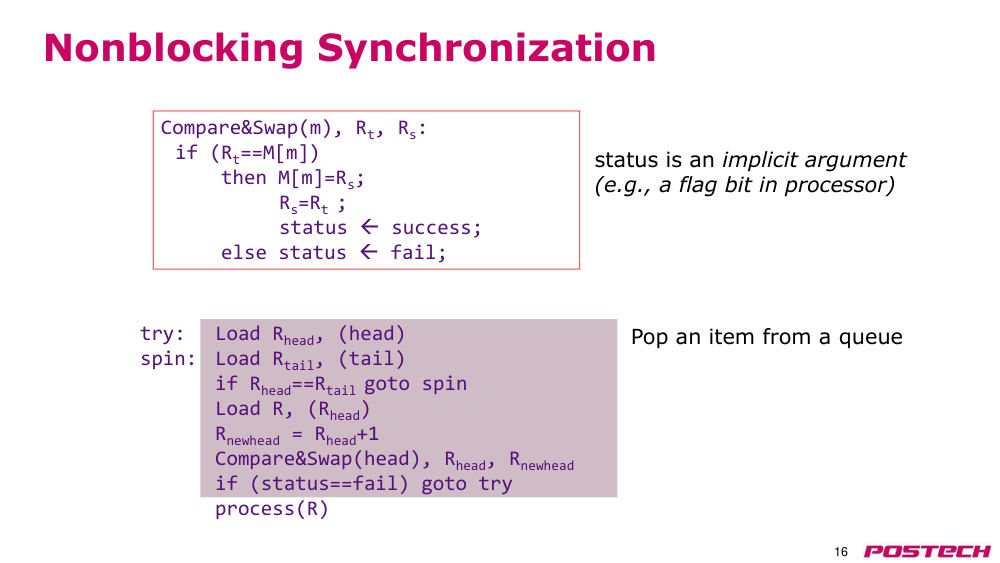
상황·문제non-blocking queue pop 을 CAS(Compare-and-swap) 로 구현: 값이 같으면 atomic 하게 교체
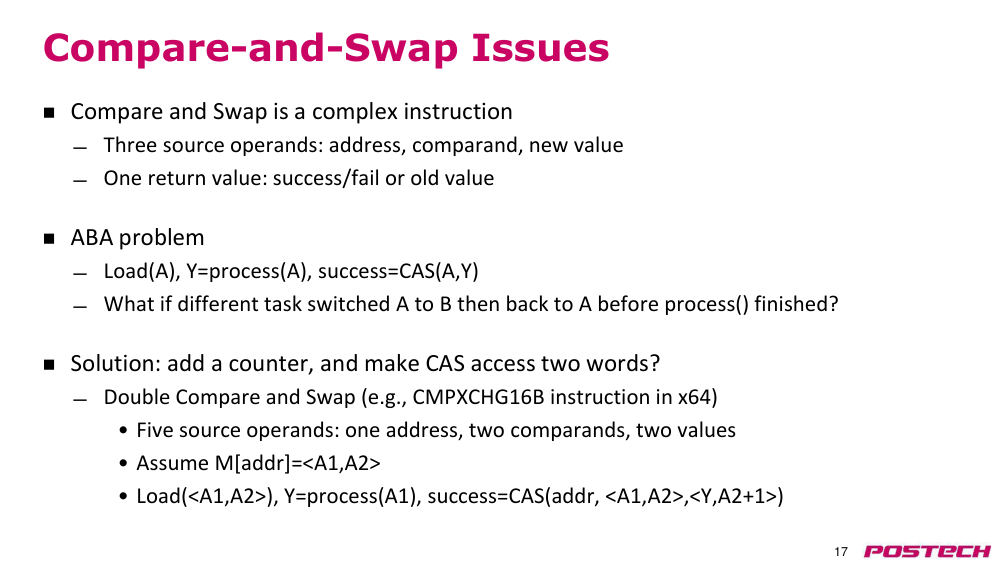
원인CAS 는 operand 가 많은 복잡 명령 → RISC 에 부적합, ABA problem(A→B→A 를 감지 못 함)
해결double CAS 로 ABA 회피 가능하나 구현이 더 복잡 → LR/SC 로 대안
- CAS 는 memory 값만 비교하므로 중간 변경을 모름
- double CAS 는 복잡도를 더 키움
2.22:16–5:11Load-reserve / Store-conditional (LR/SC)
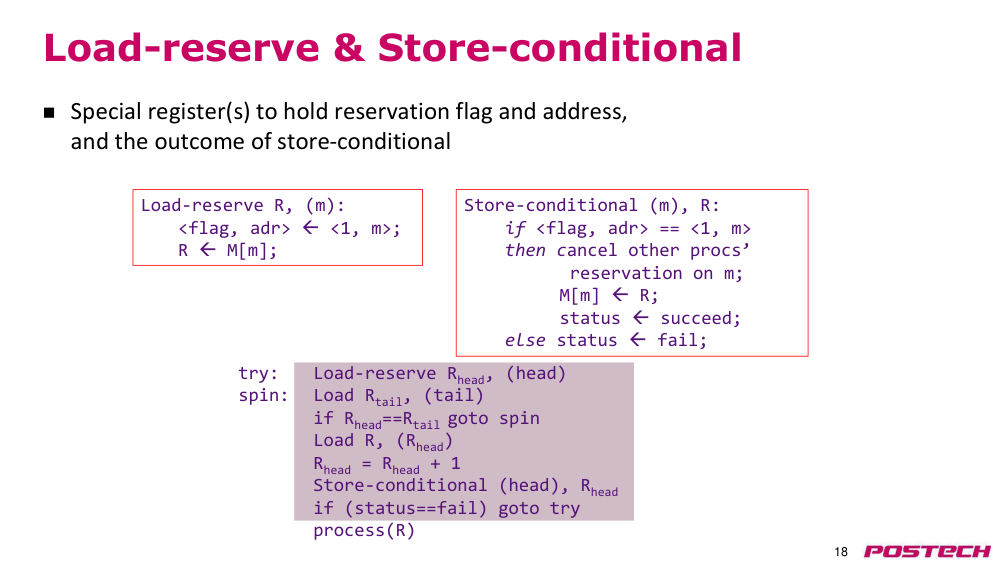
상황·문제CAS 대신 LR/SC pair 로 atomic update 를 구성
원인LR 이 <flag,addr> reservation 을 기록, 그 사이 다른 core 가 수정하면 reservation 취소
해결SC 는 reservation 이 살아 있을 때만 store·succeed, fail 이면 loop 처음으로 retry
- queue pop: head 를 LR 로 읽고 SC 로 갱신
- SC 의 status 로 성공/실패 판정
2.2.r.1Wikipedia: Load-link/store-conditional ↗ · LL/SC 의미, 값이 복원돼도 갱신 감지(ABA 없음), livelock·RISC-V 진전 보장
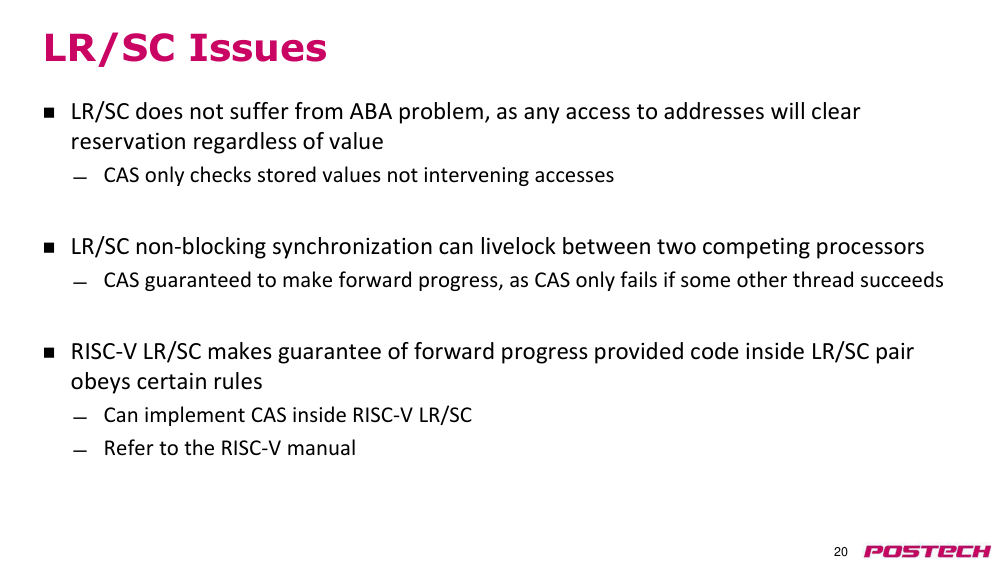
2.35:11–9:02LR/SC 구현(MESI)·ABA 없음·livelock·RISC-V AMO
상황·문제LR/SC 를 hardware 로 어떻게 만들고 CAS 대비 장단점은?
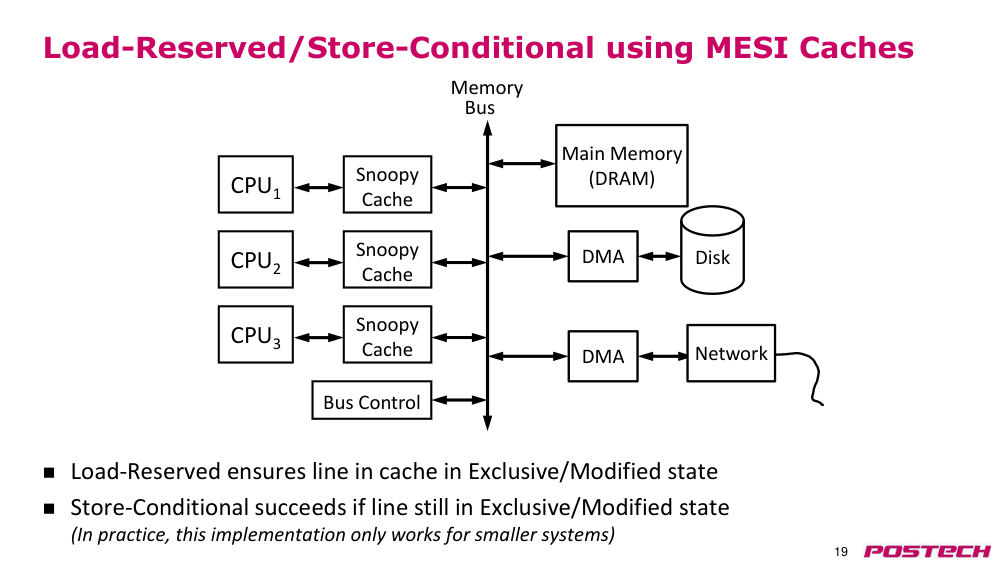
원인MESI: LR 이 line 을 E/M 으로 가져오고 SC 는 여전히 E/M 이면 성공. 여러 core 가 line 을 서로 뺏으면 모두 SC 실패 → livelock
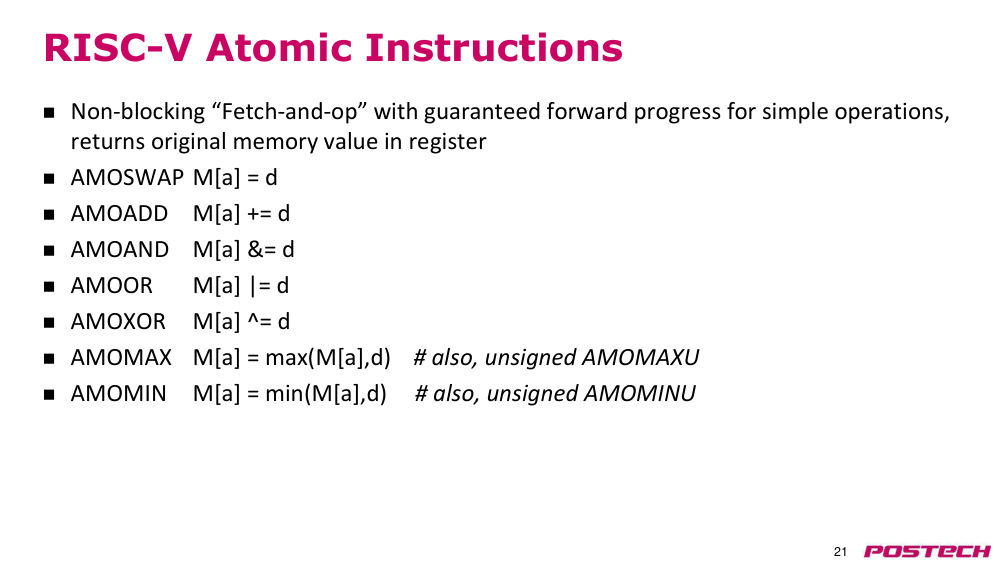
해결주소 접근 기반이라 ABA 없음. RISC-V 는 pair 안 코드 규칙 준수 시 forward progress 보장, CAS 도 LR/SC 로 구현 가능, 추가로 AMO 제공
- CAS 는 값만 보므로 ABA 취약, LR/SC 는 감지
- livelock 가능성은 LR/SC 의 단점
- 자세한 규칙은 RISC-V manual 참고
2.3.r.1Wikipedia: Load-link/store-conditional ↗ · LL/SC 의미, 값이 복원돼도 갱신 감지(ABA 없음), livelock·RISC-V 진전 보장
2.49:02–11:52Transactional memory 와 Lec16 마무리
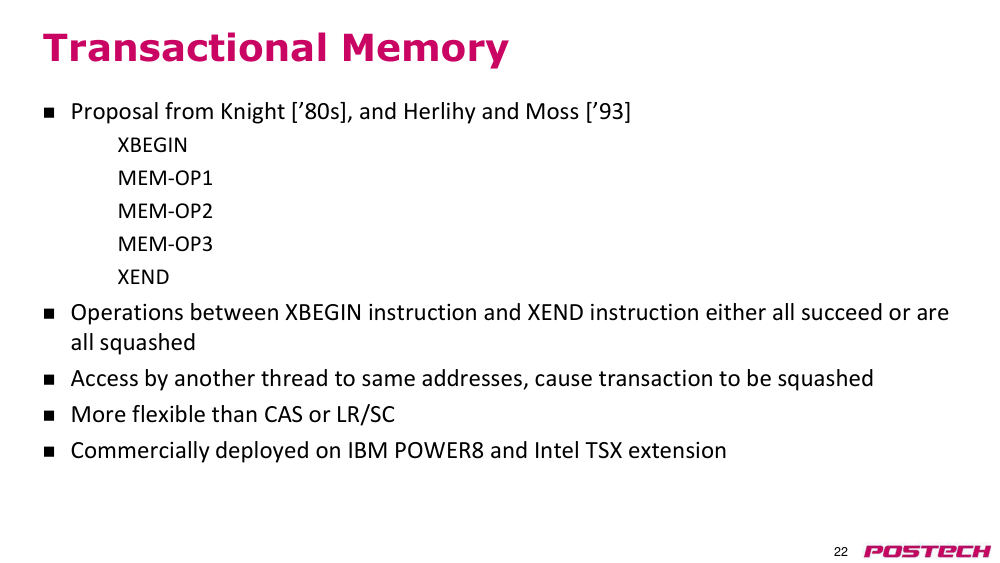
상황·문제begin~end 사이 memory 연산을 하나의 transaction 으로 묶는 방식
원인다른 thread 가 같은 위치를 수정·접근하면 transaction 전체가 squash (all-or-nothing)
해결programmer 는 시작·끝만 지정하면 돼 쉬움. IBM POWER·Intel TSX·AMD 구현 (지속 여부는 강의자도 모름), 자세히 다루지 않음
- 수십 년 연구된 주제
- 질문 시간에 질문 없음 → 23강 'CAS 가 starvation 을 일으키나' 질문에는 답하지 않음
2.4.r.2Wikipedia: Transactional Synchronization Extensions ↗ · Intel TSX(XBEGIN/XEND), 2021 microcode 로 비활성화된 이력
2.511:52–17:09Lec17 시작: I/O 개요와 접근 전략
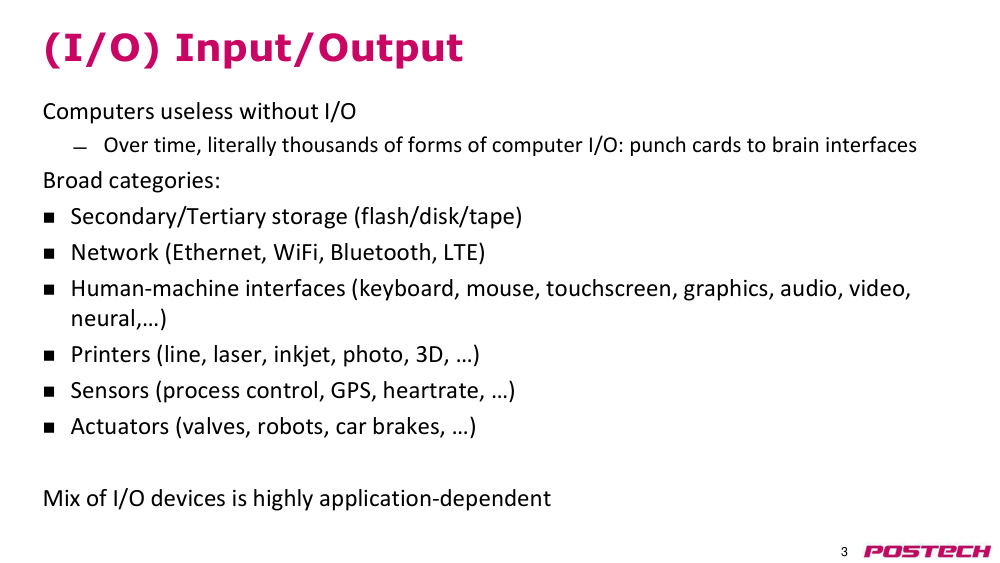
상황·문제I/O 없이는 computer 가 쓸모없음. storage·network·HID·printer·sensor·actuator 등 다양
원인CPU 가 장치와 대화하는 방법과 동기화 방법을 정해야 함
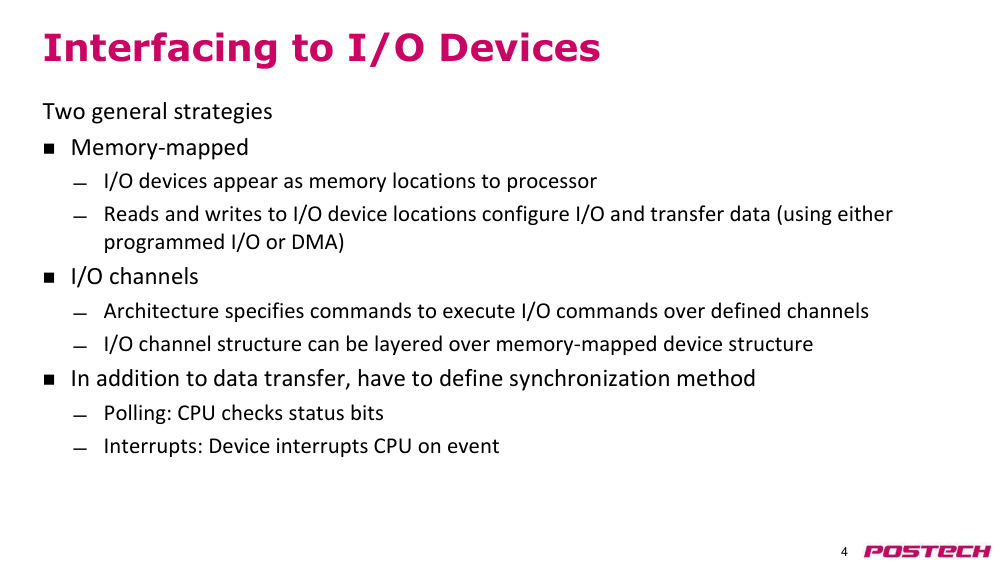
해결memory-mapped I/O(load/store 주소를 device register 로 매핑, privileged, uncached) 또는 I/O channel. 동기화는 polling 또는 interrupt
- I/O 는 대부분 이미 배웠다며 간단히 진행
- device 주소 영역은 cache 를 거치지 않음(uncached)
- 사용자 program 은 system call 로 I/O
2.5.r.1Wikipedia: Memory-mapped I/O and port-mapped I/O ↗ · memory-mapped I/O vs port-mapped(I/O-mapped) I/O
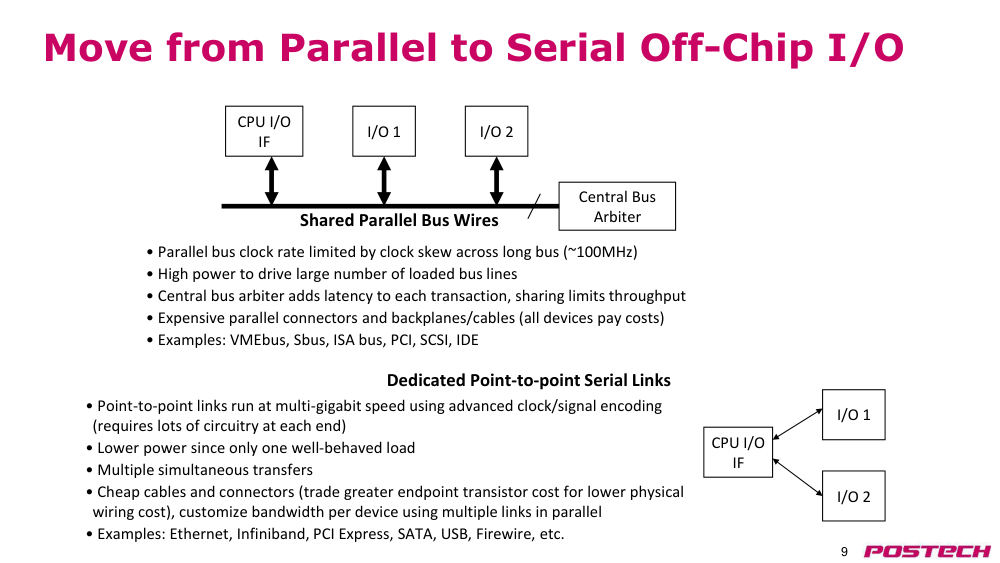
2.617:09–23:28Bus 구조: bridge·DMA·계층 bus·serial link
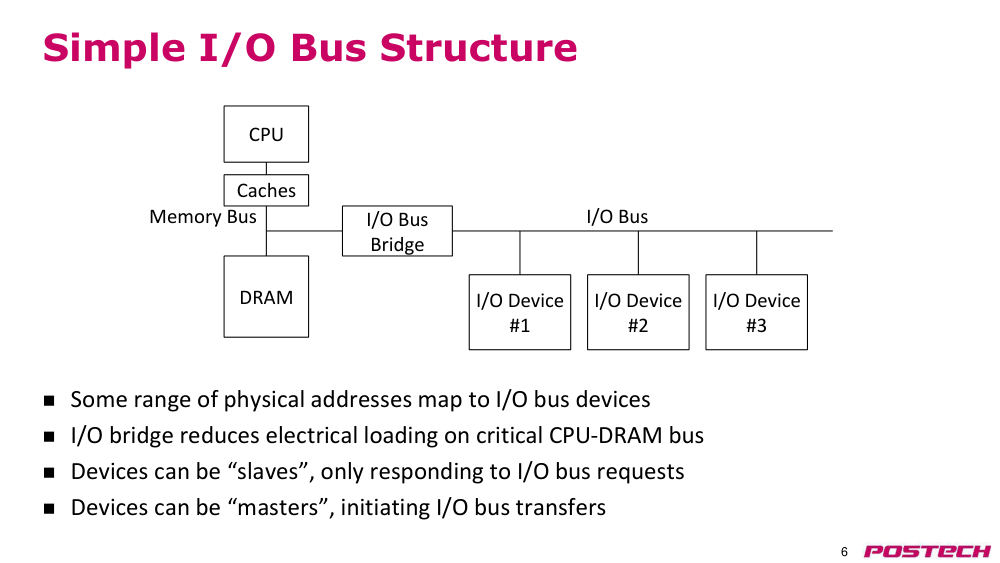
상황·문제장치가 많아지면 공유 bus 가 느려지고 memory 성능까지 떨어짐
원인한 bus 에 장치가 많으면 electrical loading 으로 고주파 동작 불가, parallel bus 는 clock skew·arbiter 한계
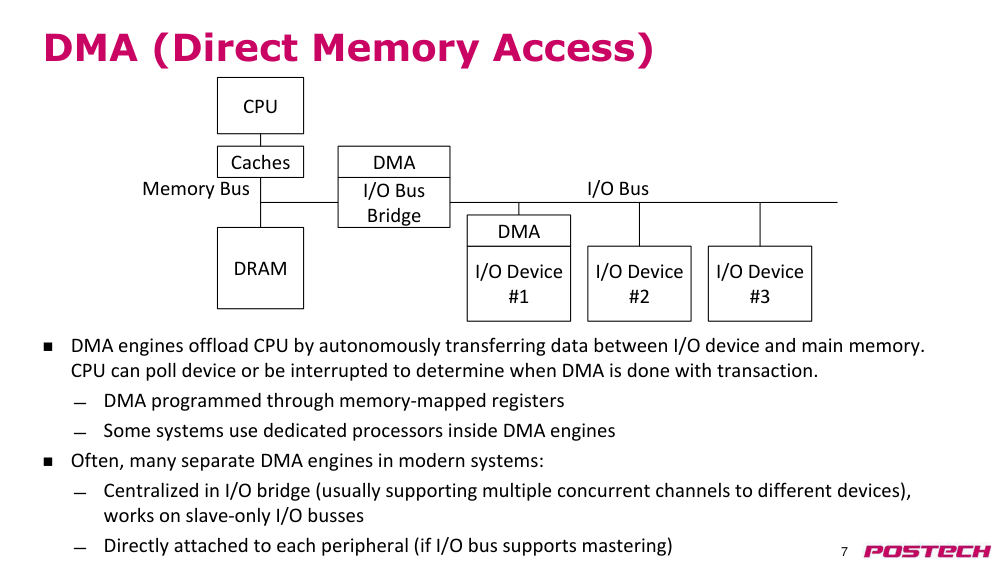
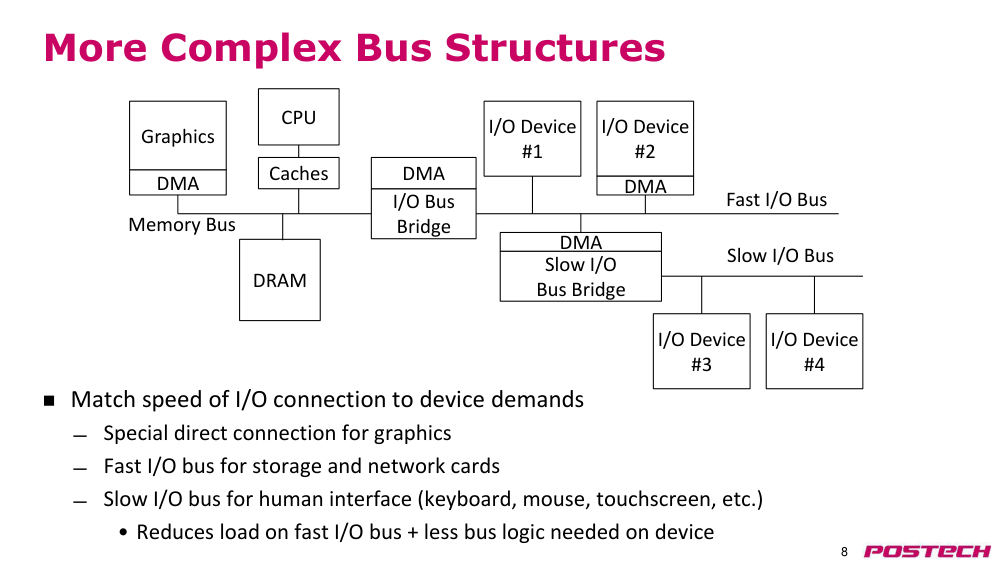
해결I/O bus bridge 로 CPU-DRAM bus 분리, DMA 로 CPU 개입 없이 대량 전송 후 interrupt, 속도별 bus 계층, PCIe 같은 point-to-point serial link
- DMA 중 CPU 는 다른 일 수행
- graphics 는 PCIe 같은 빠른 연결, keyboard·mouse 는 slow bus
- 옛 IDE 넓은 cable 대신 serial link
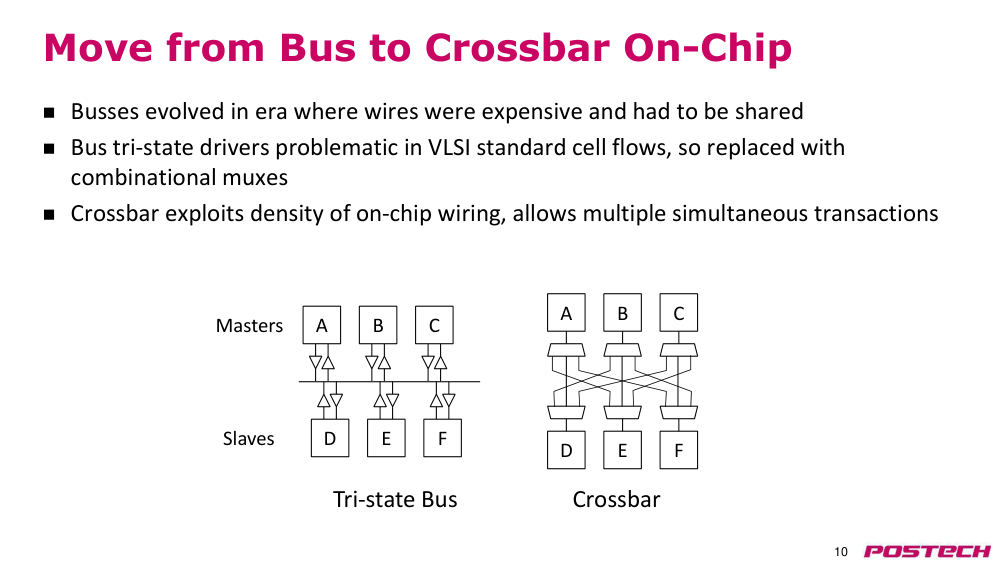
2.723:28–29:09On-chip crossbar, I/O coherence, IOMMU
상황·문제on-chip 에서도 bus 를 쓰면 확장성 부족, DMA 는 virtual address 연속성이 문제
원인tri-state driver 가 VLSI 에서 문제. virtual 로 연속인 buffer 가 physical 로는 흩어져 page 마다 DMA 필요
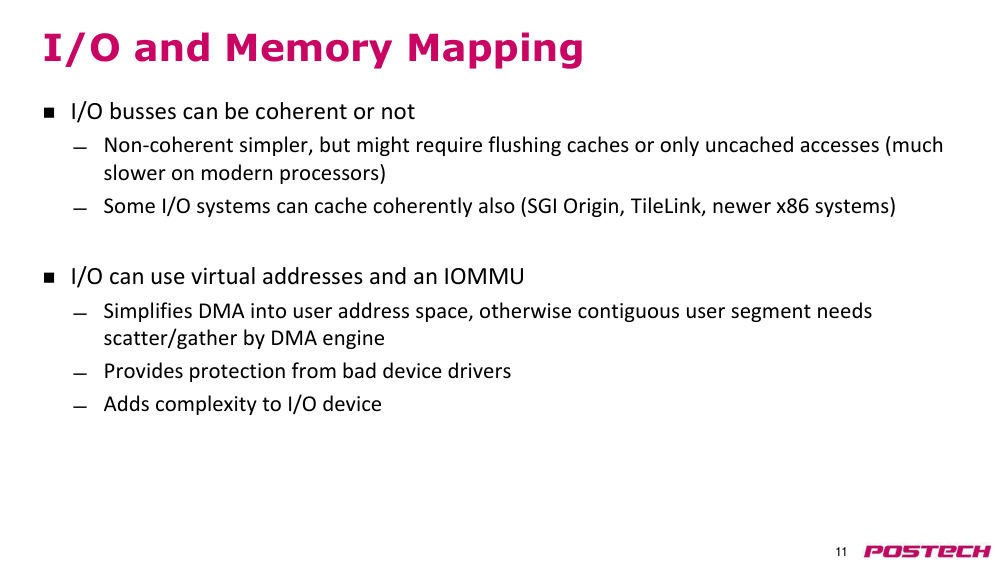
해결mux 기반 crossbar 로 동시 통신, CXL·CCIX·OpenCAPI 로 accelerator coherence, IOMMU 로 virtual address DMA
- crossbar: B-D, A-F, E-C 동시 통신
- I/O bus 는 보통 non-coherent(overhead 회피)
- IOMMU 없으면 page 당 DMA 1회
2.7.r.2Wikipedia: Compute Express Link ↗ · CPU-accelerator cache-coherent interconnect, CCIX·OpenCAPI 흡수
2.7.r.3Wikipedia: Input%E2%80%93output memory management unit ↗ · IOMMU: 연속 virtual address 를 흩어진 physical page 로 매핑
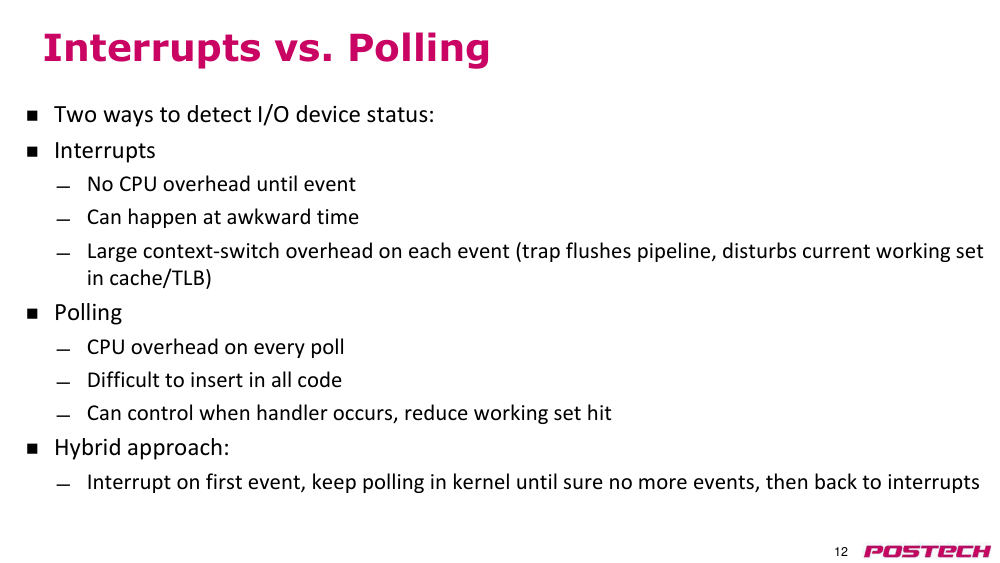
2.829:09–32:13Interrupts vs polling
상황·문제CPU-장치 동기화 방법 선택
원인interrupt 는 매번 context switch(pipeline flush, register 저장·복원) 비용
해결polling 전용 core 로 overhead 제거(DPDK), 또는 첫 event 만 interrupt 후 polling 하는 hybrid
- DPDK 는 polling 으로 interrupt 방식보다 높은 networking 성능
- hybrid: event 가 끊기면 다시 interrupt
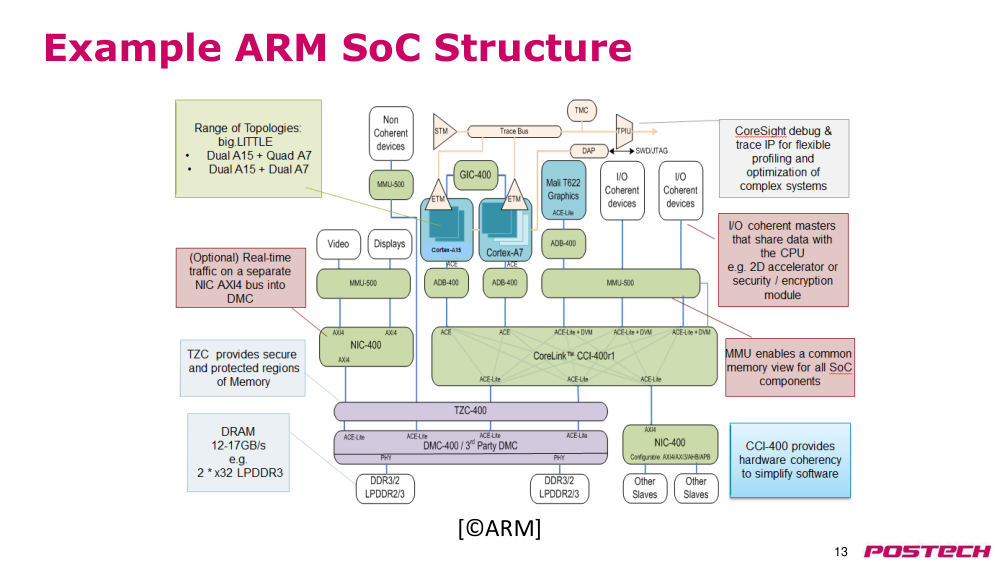
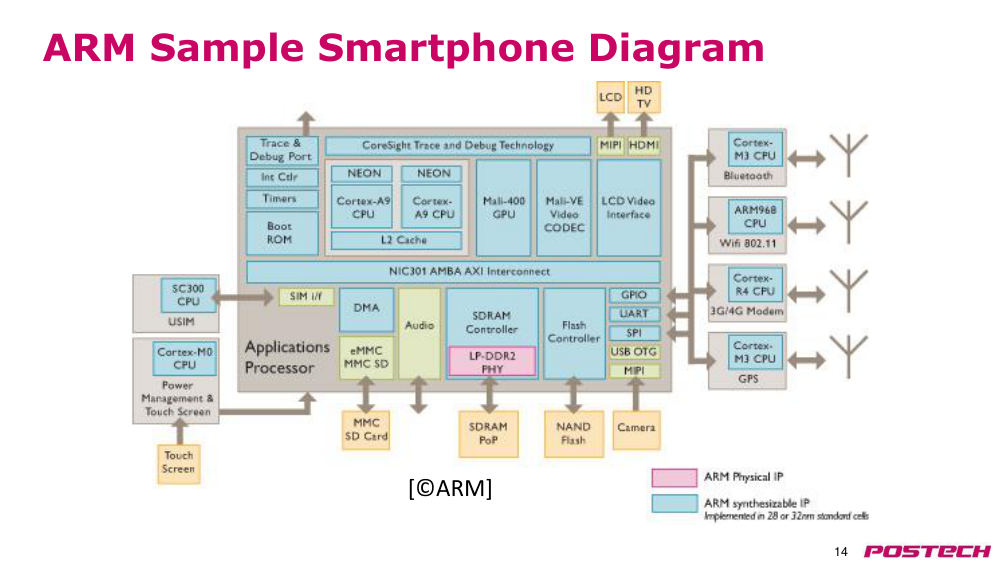
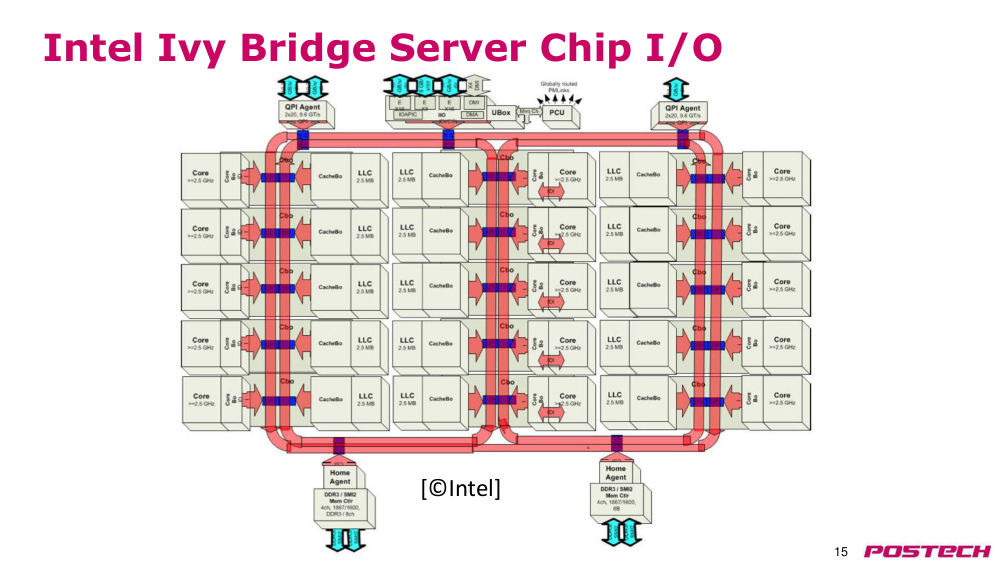
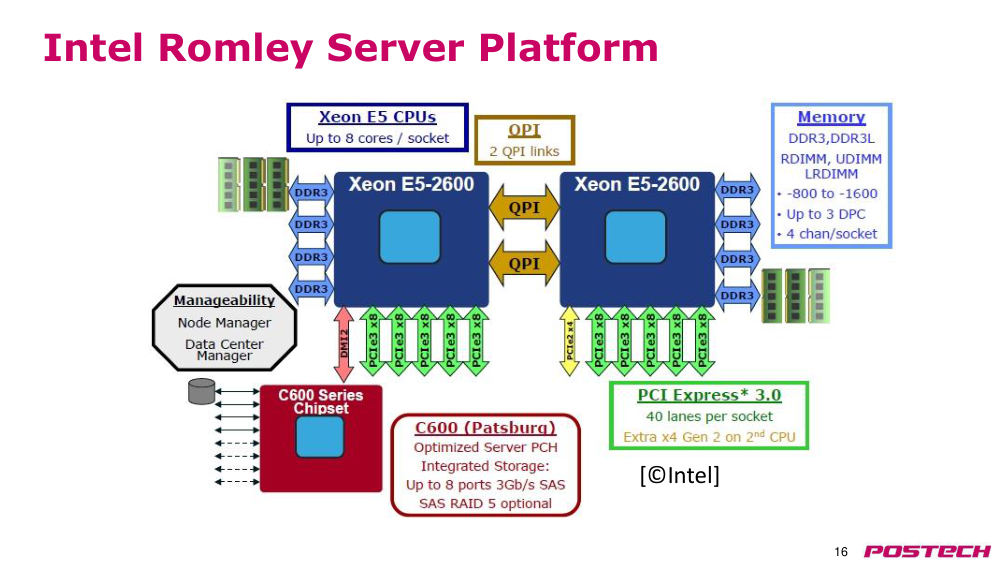
2.932:13–36:20실제 SoC·server 예: ARM, Intel ring, QPI
상황·문제실제 chip 의 on-chip/off-chip interconnect 구성
원인crossbar 는 core 수가 늘면 확장성 부족
해결ARM 은 crossbar·AMBA AXI, Intel server 는 ring NoC(더 크면 mesh·torus), socket 간 QPI 로 coherence, PCIe lane·memory channel 다수
- NoC 는 이후 강의에서
- I/O part 종료 후 질문 없음
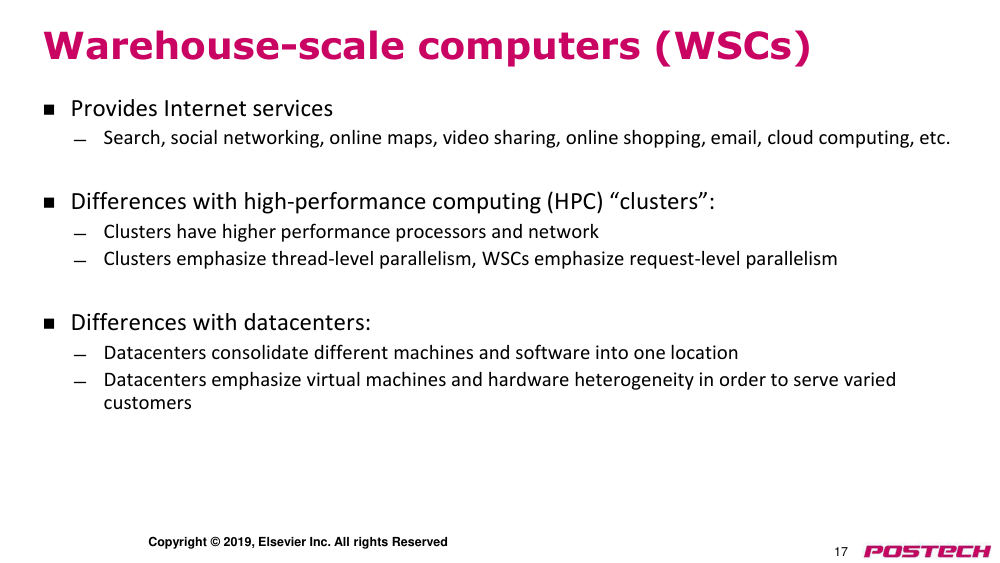
2.1036:20–45:37Warehouse-scale computer 정의와 특징
상황·문제대규모 internet service 를 위한 수많은 computer 의 통합 system
원인HPC cluster(thread-level parallelism)·datacenter(VM·이질 HW)와 달리 request-level parallelism
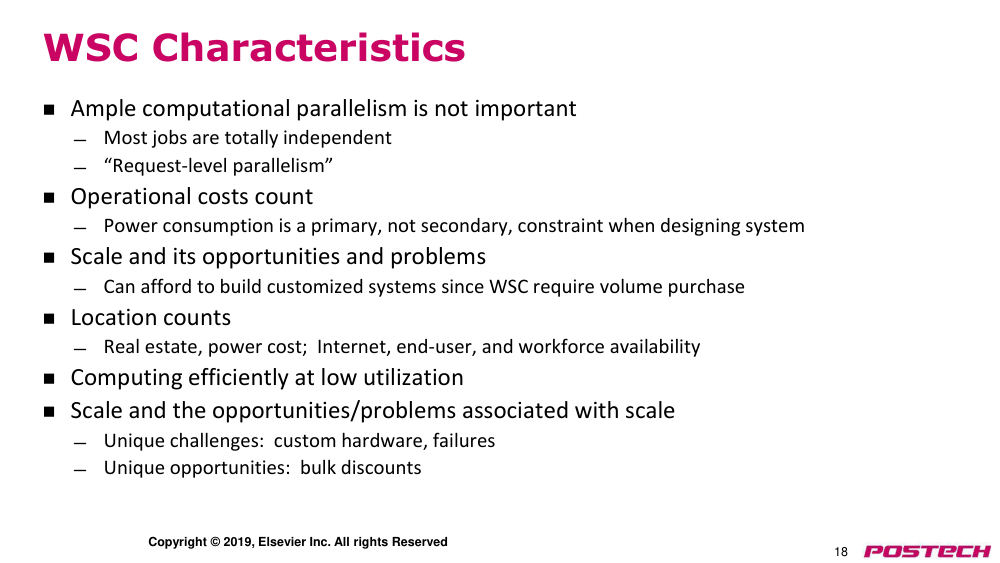
해결독립 요청 처리, 전력이 1차 제약, 대량 구매로 custom HW(Amazon CPU·ML 가속기, Microsoft FPGA)·bulk discount, 위치·저 utilization 효율 중요
- Google 은 한때 최상위 server 제조사(자체 사용)
- user 근처에 두어 latency 절감
2.1145:37–55:59위치·power distribution·cooling·PUE
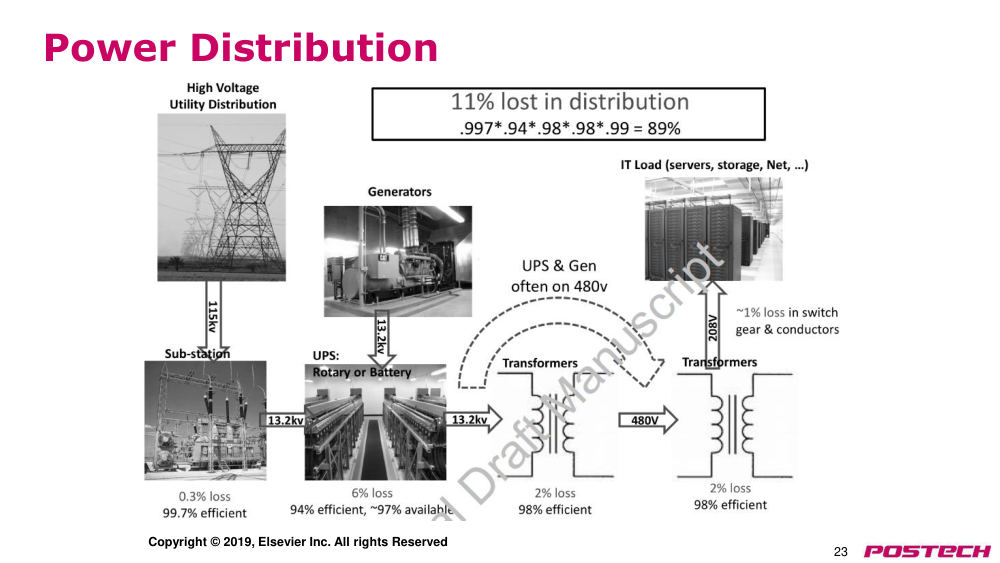
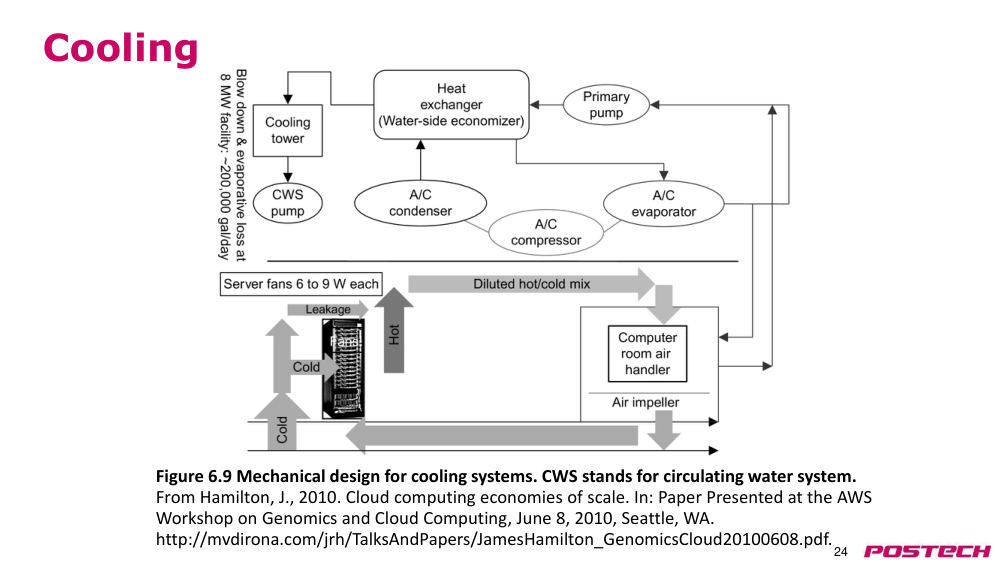
상황·문제WSC 는 막대한 전력·물을 쓰므로 위치와 효율이 비용을 좌우
원인변압 단계마다 손실이 누적(11%), cooling 은 전력·물을 대량 소비, nameplate 전력 기준 배치는 낭비
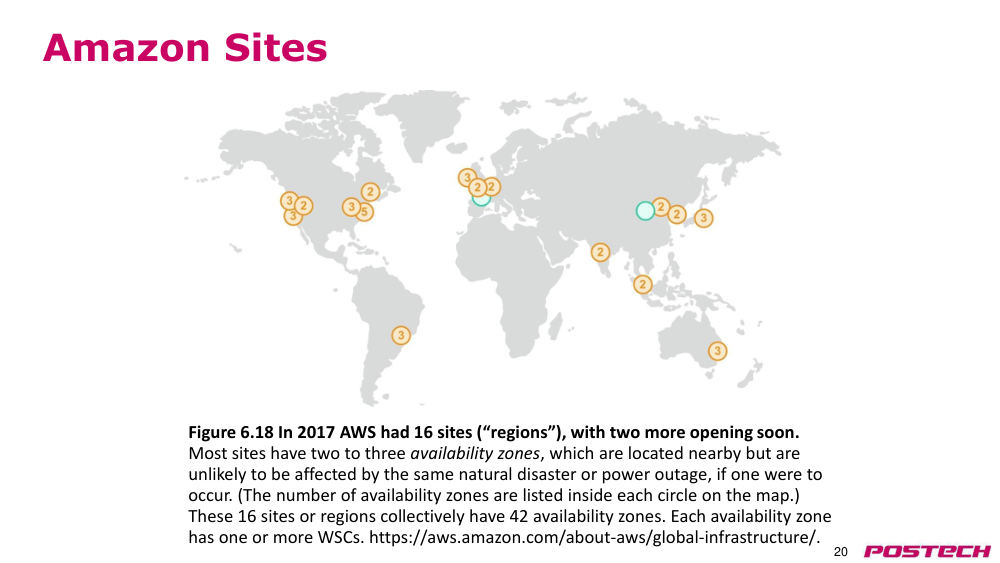
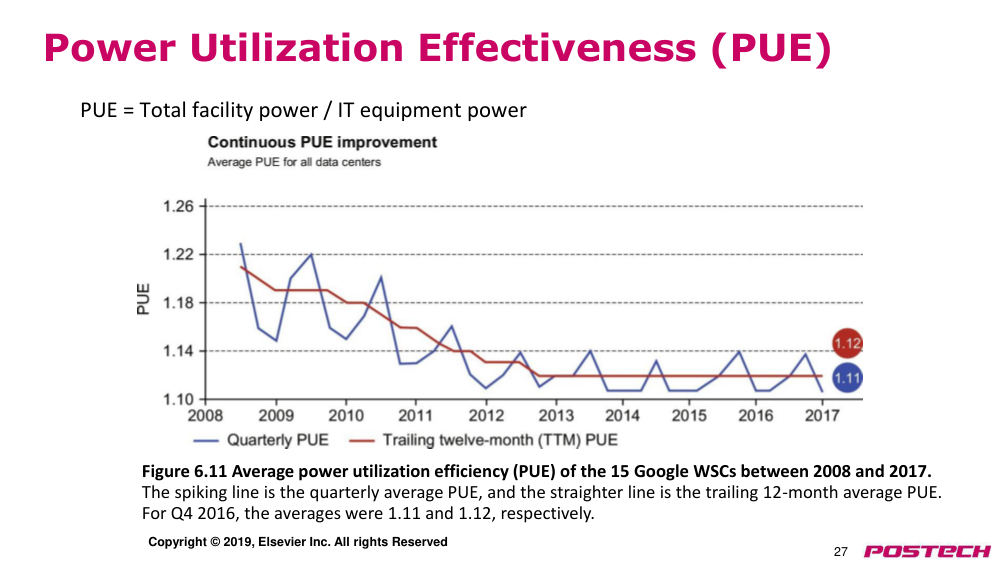
해결재해 위험 낮고 저렴한 위치·availability zone, 40% oversubscribe + 감시, PUE 를 지표로 지속 개선(Google ~1.22→~1.1)
- cooling tower 물 ~200,000 gal/day (8MW)
- CPU 42%, memory·I/O 합 30% 이상
- PUE 이상값 1.0
2.1255:59–1:03:36Latency·SLO 와 outages
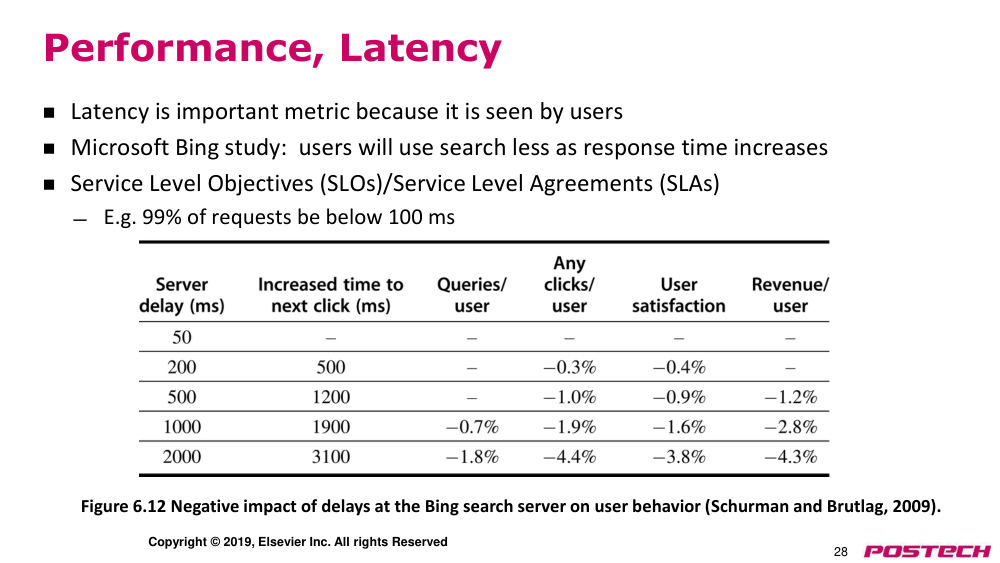
상황·문제성능 평가에서 throughput 만 보면 user 체감 latency 를 놓침
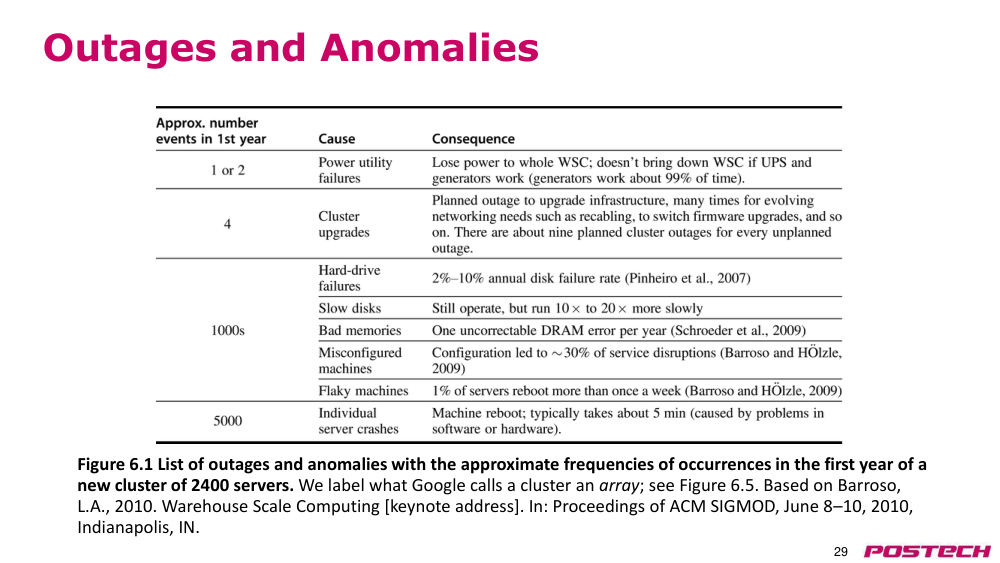
원인Bing 실험: delay 가 늘면 만족도·수익 감소. 대규모라 HW 고장이 상시 발생
해결SLO(예 99% 요청 100ms 이하)로 throughput(batching)과 균형, UPS·generator·replica 로 장애 흡수
- 2000ms delay 시 revenue/user -4.3%
- HDD 연 2~10% 고장, server crash 재부팅 ~5분
- memcached 는 더 엄격, DB 는 느슨한 SLO
2.131:03:36–1:10:18Utilization, rack, WSC network(Clos)
상황·문제server utilization 은 대개 낮고, network 는 비싼 array switch 에 의존
원인array switch 는 rack switch 10배 bisection bandwidth 필요, 비용 n^2, CAM·FPGA 사용
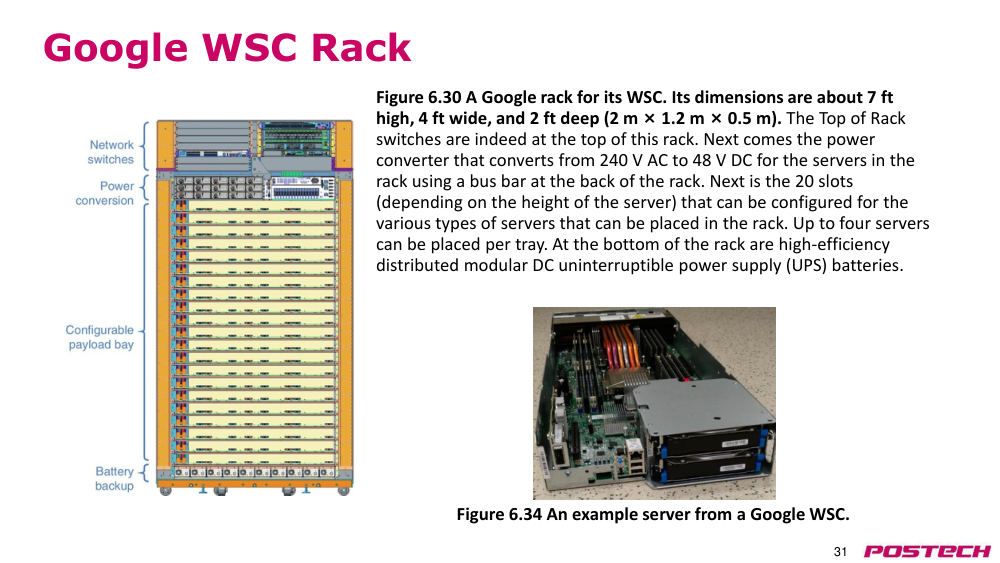
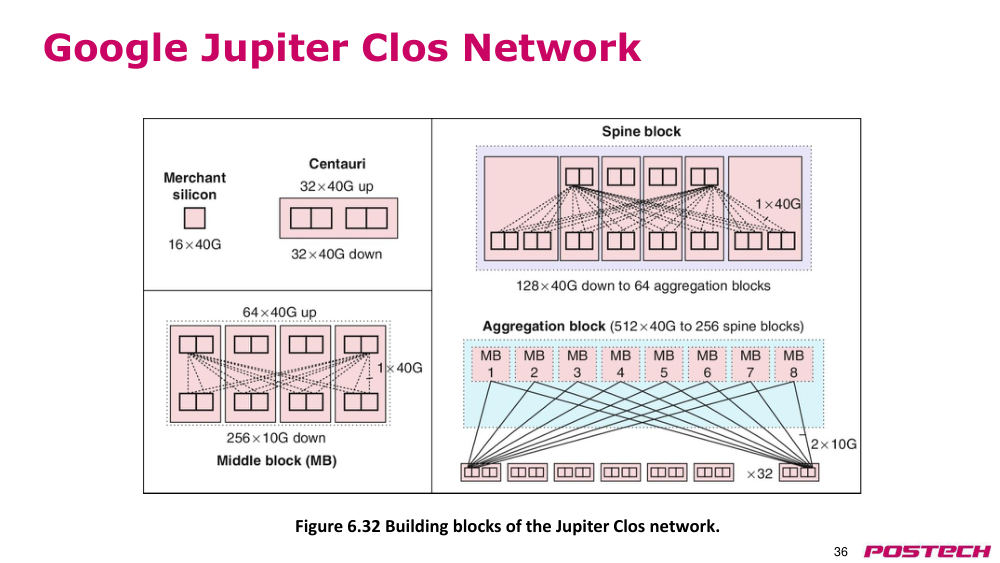
해결저 utilization 구간 효율 확보, rack 단 DC 전력·battery, merchant silicon 작은 switch 로 Clos(Jupiter) 구성
- utilization 대부분 10~50%
- Centauri 32×40G up/down → middle block → aggregation·spine block
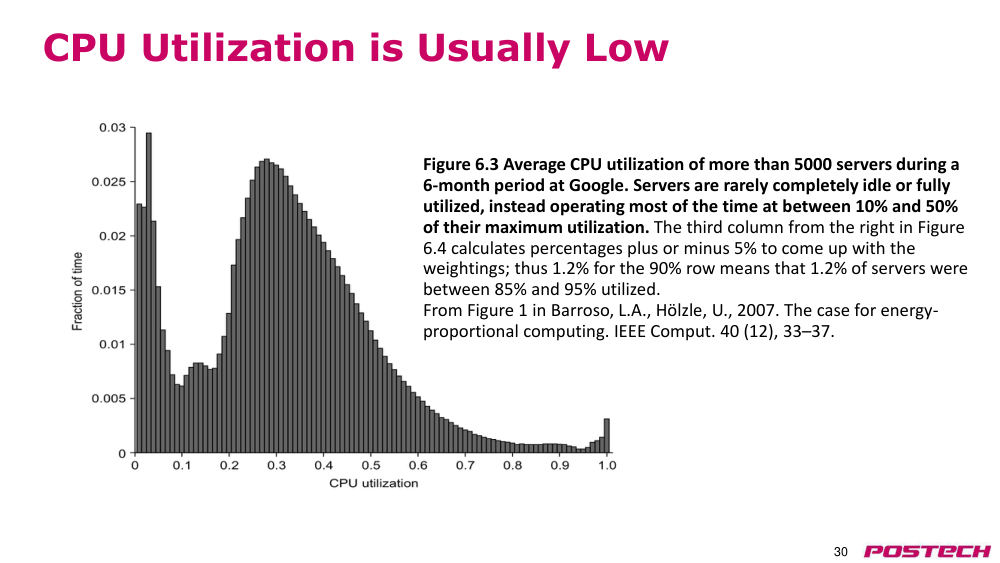
2.13.r.1Barroso & Hölzle, The Case for Energy-Proportional Computing (IEEE Computer 2007) ↗ · p30 CPU utilization 분포 그림의 출처
2.13.r.3Singh et al., Jupiter Rising (SIGCOMM 2015, Google Research) ↗ · 강의에서 '검색해 보라'고 한 Google 논문: merchant silicon 기반 Clos
2.141:10:18–1:13:30WSC memory hierarchy·storage·cost
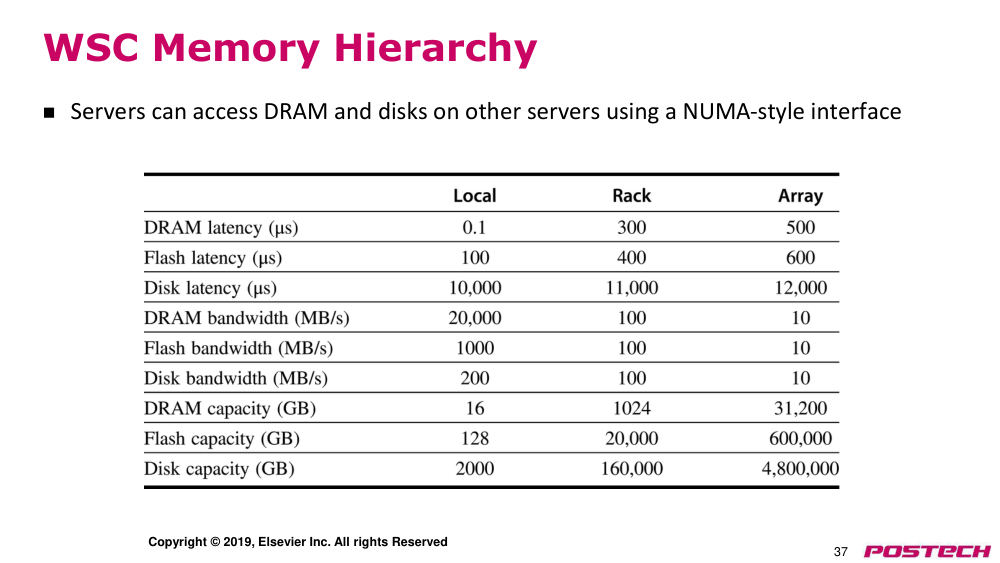
상황·문제data 가 여러 server 에 분산돼 원격 DRAM·disk 접근이 필요
원인거리(local→rack→array)가 멀수록 latency↑ bandwidth↓, capacity 는 증가
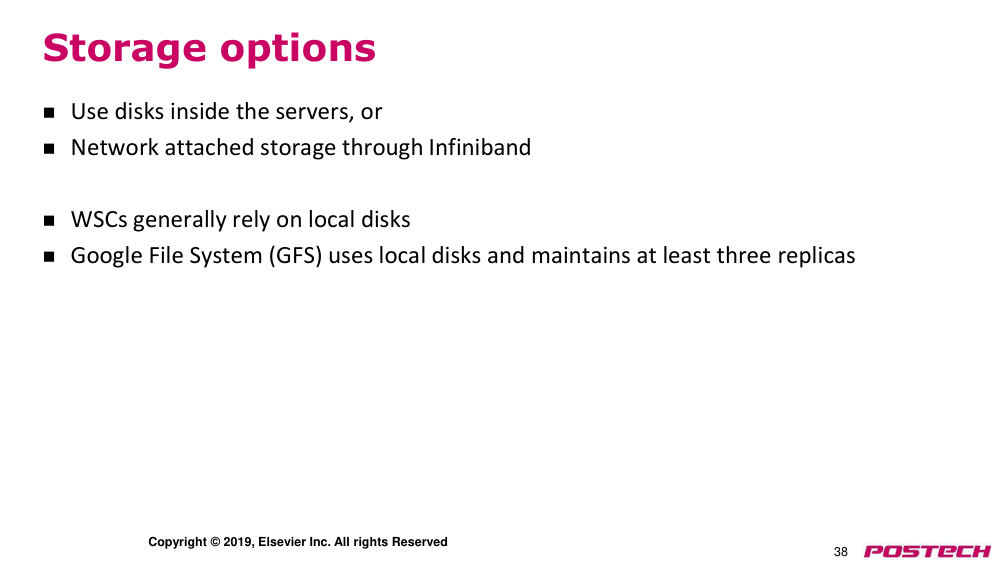
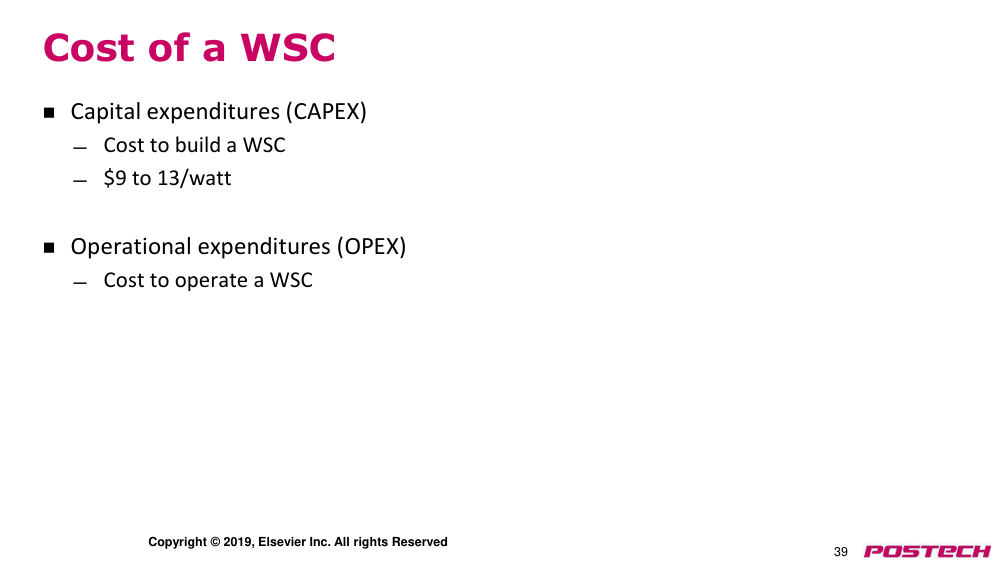
해결대개 local disk + GFS 복제, 비용은 CAPEX/OPEX 로 분석
- DRAM latency 0.1 / 300 / 500 µs
- GFS 는 최소 3 replica
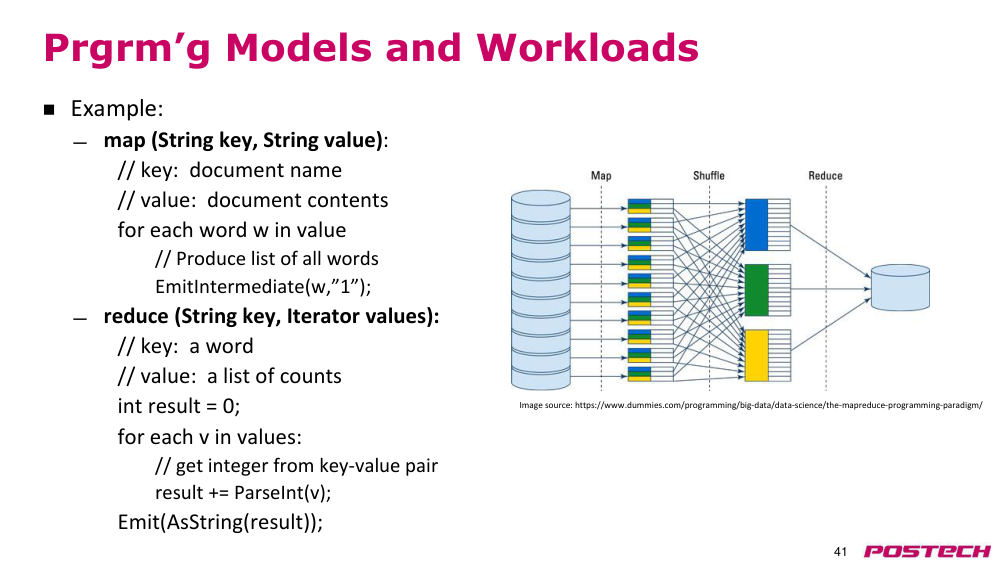
2.151:13:30–1:17:35Programming model: MapReduce
상황·문제여러 server 에 일을 나누고 결과를 모아야 함
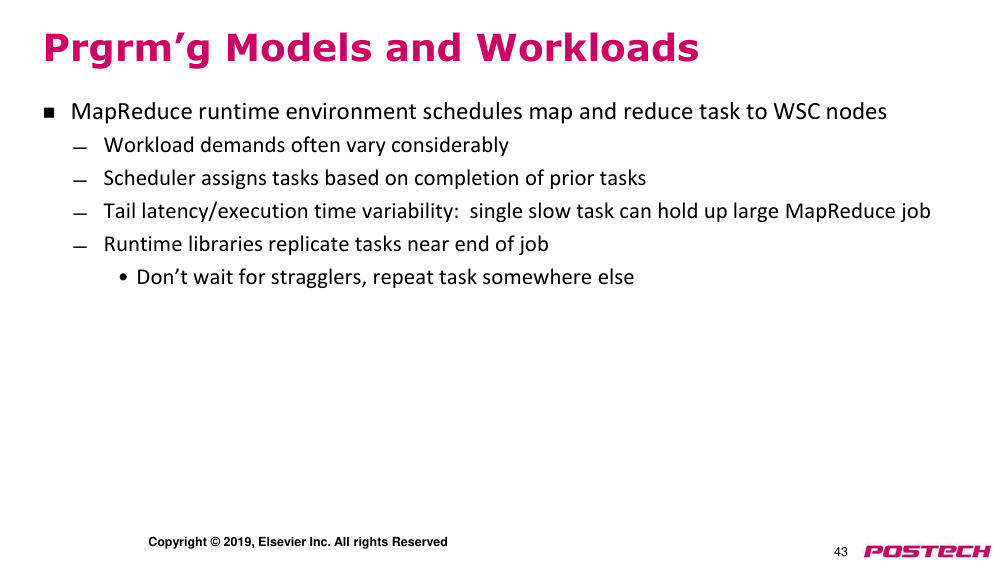
원인task 실행 시간 편차로 느린 task 하나가 전체 job 을 지연
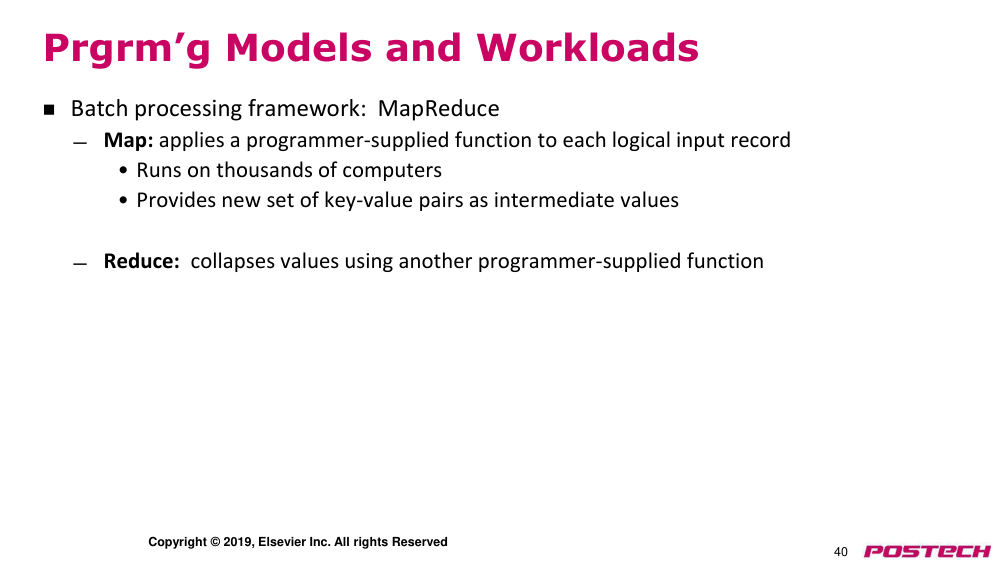
해결MapReduce(map→reduce), replica + relaxed consistency, 느린 task 는 다른 곳에서 복제 실행
- word count: 단어마다 (w,1) → 합산
- GFS·Colossus·Dynamo·BigTable
- 질문은 PLMS 로
2.15.r.2Dean & Ghemawat, MapReduce: Simplified Data Processing on Large Clusters (OSDI 2004) ↗ · MapReduce 원 논문
3핵심 개념
3.1Load-reserve/Store-conditional(LR/SC)
LR 이 reservation 기록, SC 는 reservation 이 살아 있을 때만 store. 주소 기반이라 ABA 없음, livelock 가능
3.1.r.1Wikipedia: Load-link/store-conditional ↗ · LL/SC 의미, 값이 복원돼도 갱신 감지(ABA 없음), livelock·RISC-V 진전 보장
3.2ABA problem(ABA 문제)
값이 A→B→A 로 바뀌어도 CAS 는 값만 비교해 성공
3.3Livelock(라이브락)
여러 core 가 서로 cache line 을 뺏어 SC 가 계속 실패, 진전 없음
3.3.r.1Wikipedia: Load-link/store-conditional ↗ · LL/SC 의미, 값이 복원돼도 갱신 감지(ABA 없음), livelock·RISC-V 진전 보장
3.4Transactional memory(트랜잭셔널 메모리)
begin~end 사이 memory 연산을 all-or-nothing 실행, 충돌 시 squash
3.5Memory-mapped I/O
device register 를 memory 주소에 매핑해 load/store 로 I/O, uncached·privileged
3.5.r.1Wikipedia: Memory-mapped I/O and port-mapped I/O ↗ · memory-mapped I/O vs port-mapped(I/O-mapped) I/O
3.6DMA(Direct Memory Access)
CPU 대신 DMA engine 이 memory↔device 전송, 완료 시 interrupt
3.7IOMMU
device 가 virtual address 로 DMA, 비연속 physical page 를 한 번에 전송
3.7.r.1Wikipedia: Input%E2%80%93output memory management unit ↗ · IOMMU: 연속 virtual address 를 흩어진 physical page 로 매핑
3.8Polling vs interrupt
interrupt 는 context switch 비용, polling 은 CPU 소모. DPDK 는 polling, hybrid 가능
3.9Request-level parallelism(요청 수준 병렬성)
독립된 user 요청을 대량 병렬 처리, WSC 의 특징 (HPC 는 thread-level)
3.10PUE(Power Utilization Effectiveness)
total facility power / IT equipment power, 이상값 1.0. Google ~1.22→~1.1
3.11SLO/SLA
latency 목표 예: 요청 99% 가 100ms 이하
3.12Clos network
작은 crossbar switch 3단(ingress·middle·egress)으로 대형 switch 대체, Google Jupiter
3.13MapReduce
map 이 key-value 중간값 생성, reduce 가 합침. 느린 task 는 복제 실행
4스스로 확인
4.1LR/SC 가 ABA 를 피하는 이유는?
답
reservation 이 값이 아니라 주소 접근으로 해제되므로 A→B→A 변경도 SC 실패로 드러남
4.2LR/SC 에서 livelock 은 어떻게 생기나?
답
여러 core 가 reserve 후 E/M line 을 서로 뺏어 모두 SC 실패를 반복
4.3memory-mapped I/O 영역을 uncached 로 두는 이유는?
답
load/store 가 cache 에 hit 하면 device 와 실제 통신이 일어나지 않기 때문
4.4IOMMU 가 없으면 DMA 는 어떻게 되나?
답
virtual 로 연속인 buffer 가 physical 로 흩어져 page 마다 별도 DMA 필요
4.5PUE 1.1 의 의미는?
답
IT 장비 전력 1 당 시설 전체가 1.1 사용, 즉 약 10% 가 cooling·전력 변환 overhead
4.6WSC 에서 throughput 만 최적화하면 안 되는 이유는?
답
batch 를 키우면 throughput 은 오르지만 user latency 가 SLO 를 넘을 수 있음
5참고 자료
5.1Hennessy & Patterson, Computer Architecture: A Quantitative Approach 6th ed. (Elsevier) ↗ · 추천 독서: ca_L16 5.5, ca_L17 Chapter 6
5.2Singh et al., Jupiter Rising (SIGCOMM 2015, Google Research) ↗ · 강의에서 '검색해 보라'고 한 Google 논문: merchant silicon 기반 Clos
5.3Dean & Ghemawat, MapReduce: Simplified Data Processing on Large Clusters (OSDI 2004) ↗ · MapReduce 원 논문
5.4Barroso & Hölzle, The Case for Energy-Proportional Computing (IEEE Computer 2007) ↗ · p30 CPU utilization 분포 그림의 출처