Lec17 - IO & WSC
한국어판 강의자료 · 44쪽
p.1CSED503 고급 컴퓨터 구조 – 강의 17
p.2강의 18에서 이전 내용
- - mutual exclusion(상호 배제) 동기화는 일반적인 로드와 스토어를 사용해 구현할 수 있지만, 복잡하고 비효율적이다.
- - 대부분의 아키텍처는 mutual exclusion(상호 배제)를 지원하기 위해 atomic Read-Modify-Write(원자적 읽기-수정-쓰기) 동기화 원시 명령어를 추가한다.
- - lock-based synchronization(잠금 기반 동기화)는 잠금을 보유한 스레드가 잠금을 보유한 채로 스케줄링 해제될 수 있어 취약하다.
- - non-blocking synchronization(비잠금 동기화)는 잠금을 보유하지 않고도 mutual exclusion(상호 배제)를 제공하려는 시도이다.
- - Compare-and-Swap(비교-스왑)은 forward progress guarantee(진행 보장)을 제공하지만, 복잡한 명령어이며 ABA problem(ABA 문제)에 취약하다.
- - double-wide Compare-and-Swap(이중 폭 비교-스왑)은 ABA problem(ABA 문제)를 방지하지만, 더 복잡한 명령어가 된다.
- - Load-Reserved/Store-Conditional(로드-예약/스토어-조건부) 쌍은 명령어 복잡성을 줄인다.
- - 주소 기반으로 보호하므로 값에 따라 취약하지 않아 ABA problem(ABA 문제)에 영향을 받지 않는다.
- - forward progress guarantee(진행 보장)이 추가되지 않으면 livelock(라이벨록)이 발생할 수 있다.
- - transactional memory(트랜잭션 메모리)는 점차 상용화되고 있다.
- - 복잡한 이식성/호환성 문제를 안고 있다.
p.3(I/O) 입출력
- - Input/Output (I/O)(입출력) 없이는 컴퓨터는 쓸모없다.
- - 시간이 지남에 따라 컴퓨터 Input/Output (I/O)(입출력)의 형태가 수천 가지에 이르렀다: 펀치 카드에서 뇌 인터페이스까지.
- - 주요 범주:
- - 보조/삼차 저장장치 (플래시/디스크/테이프)
- - 네트워크 (이더넷, 와이파이, 블루투스, LTE)
- - 사용자-기계 인터페이스 (키보드, 마우스, 터치스크린, 그래픽, 오디오, 비디오, 신경 등)
- - 프린터 (라인, 레이저, 잉크젯, 사진, 3D 등)
- - 센서 (공정 제어, GPS, 심박수 등)
- - 액추에이터 (밸브, 로봇, 자동차 브레이크 등)
- - Input/Output (I/O)(입출력) 장치의 조합은 매우 응용 프로그램에 따라 달라진다.
p.4I/O 장치와의 인터페이스
- - 두 가지 일반적인 전략:
- - Memory-Mapped I/O(메모리 매핑된 입출력):
- - I/O 장치가 프로세서에게 메모리 위치처럼 보인다.
- - I/O 장치 위치에 대한 읽기 및 쓰기는 I/O를 구성하고 데이터를 전송한다 (프로그램 기반 입출력 또는 DMA 사용).
- - Input/Output (I/O)(입출력) 채널:
- - 아키텍처가 정의된 채널을 통해 I/O 명령을 실행할 수 있는 명령을 지정한다.
- - Input/Output (I/O)(입출력) 채널 구조는 메모리 매핑된 장치 구조 위에 계층적으로 구성될 수 있다.
- - 데이터 전송 외에도 동기화 방법을 정의해야 한다.
- - polling(폴링): CPU가 상태 비트를 확인한다.
- - interrupts(인터럽트): 장치가 이벤트 발생 시 CPU에 인터럽트를 보낸다.
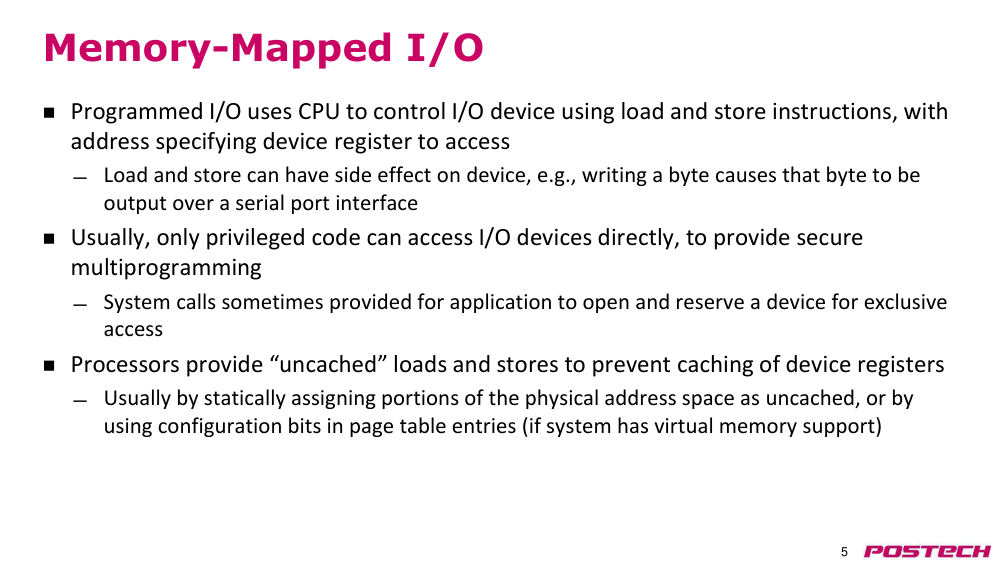
p.5Memory-Mapped I/O(메모리 매핑된 입출력)
- - programmed I/O(프로그램 기반 입출력)은 로드 및 스토어 명령어를 사용해 CPU가 I/O 장치를 제어하며, 주소는 접근할 장치 레지스터를 지정한다.
- - 로드 및 스토어는 장치에 부수적인 효과를 줄 수 있다. 예: 바이트를 쓰면 시리얼 포트 인터페이스를 통해 해당 바이트가 출력된다.
- - 일반적으로 I/O 장치에 직접 접근할 수 있는 것은 특권 코드뿐이며, 안전한 다중 프로그래밍을 보장하기 위해이다.
- - 애플리케이션에서 장치를 열고 독점적으로 예약하기 위해 system call(시스템 콜)이 제공될 수 있다.
- - 프로세서는 장치 레지스터의 캐시를 방지하기 위해 '캐시되지 않은' 로드 및 스토어를 제공한다.
- - 물리 주소 공간의 일부를 정적으로 캐시되지 않은 것으로 할당하거나,
- - 가상 메모리 지원 시 page table entry(페이지 테이블 항목)의 구성 비트를 사용한다.
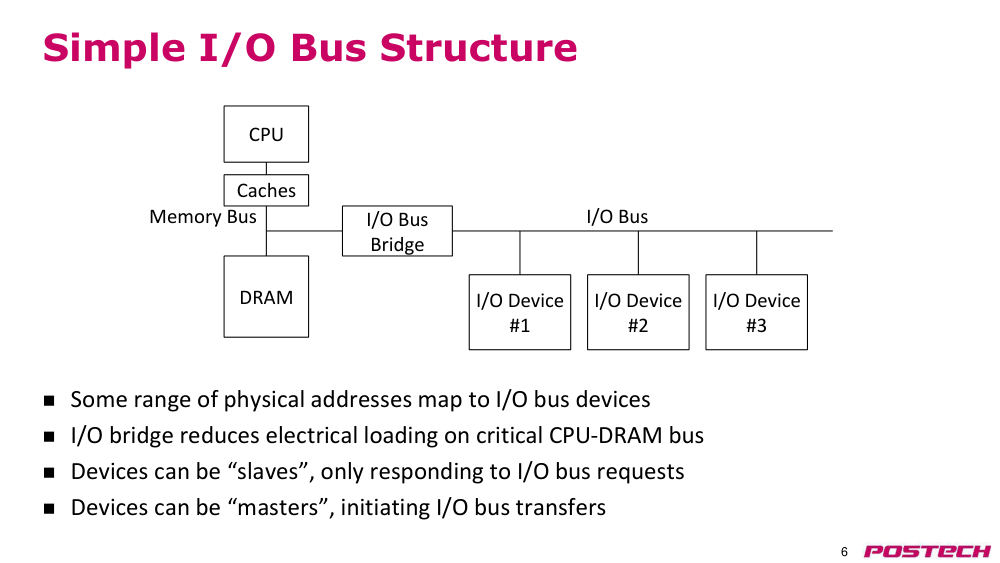
p.6간단한 I/O 버스 구조
- - 일부 물리 주소 범위가 I/O 버스 장치에 매핑된다.
- - I/O bridge(입출력 브리지)가 핵심 CPU-DRAM 버스에 대한 전기 부하를 줄인다.
- - 장치는 '슬레이브'가 될 수 있으며, I/O 버스 요청에만 응답한다.
- - 장치는 '마스터'가 될 수 있으며, I/O 버스 전송을 시작할 수 있다.
- CPU
- Caches
- DRAM
- I/O Bus
- Bridge
- Memory Bus
- I/O Bus
- I/O Device #1
- I/O Device #2
- I/O Device #3
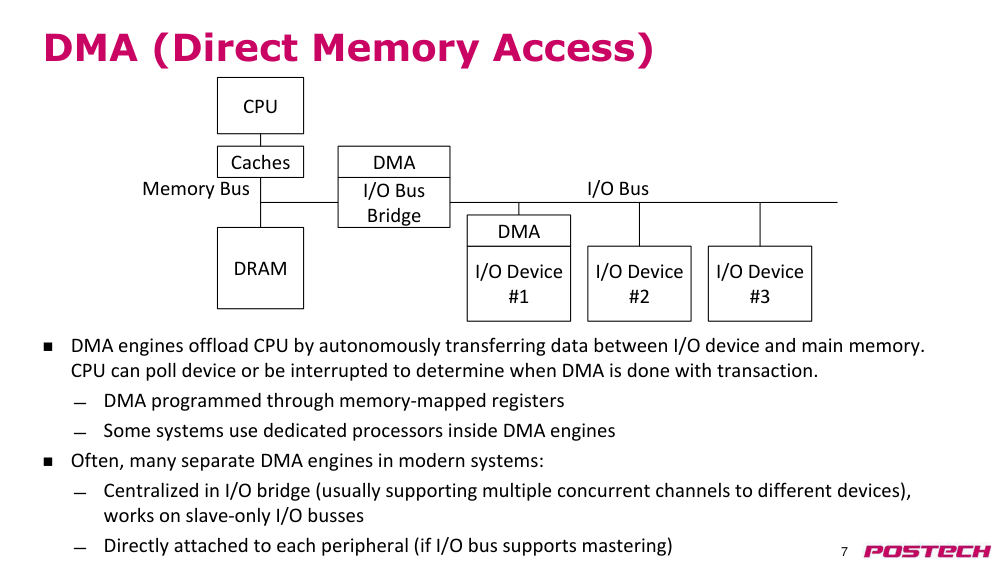
p.7DMA (직접 메모리 접근)
- DMA 엔진은 I/O 장치와 메인 메모리 사이의 데이터 전송을 자율적으로 수행함으로써 CPU의 부담을 줄임.
- CPU는 장치 상태를 polling(폴링)하거나 interrupts(인터럽트)를 받아 DMA 전송이 완료되었는지 확인할 수 있음.
- DMA는 메모리 매핑된 레지스터를 통해 프로그래밍됨.
- 일부 시스템은 DMA 엔진 내부에 전용 프로세서를 사용함.
- 현대 시스템에서는 일반적으로 여러 개의 별도 DMA 엔진이 존재함:
- I/O bridge(입출력 브리지)에 집중되어 있으며, 여러 장치에 대한 동시 채널을 지원함 (일반적으로 슬레이브 전용 I/O bus(입출력 버스)에서 작동함).
- 각 주변 장치에 직접 연결됨 (입출력 버스가 마스터링을 지원하는 경우).
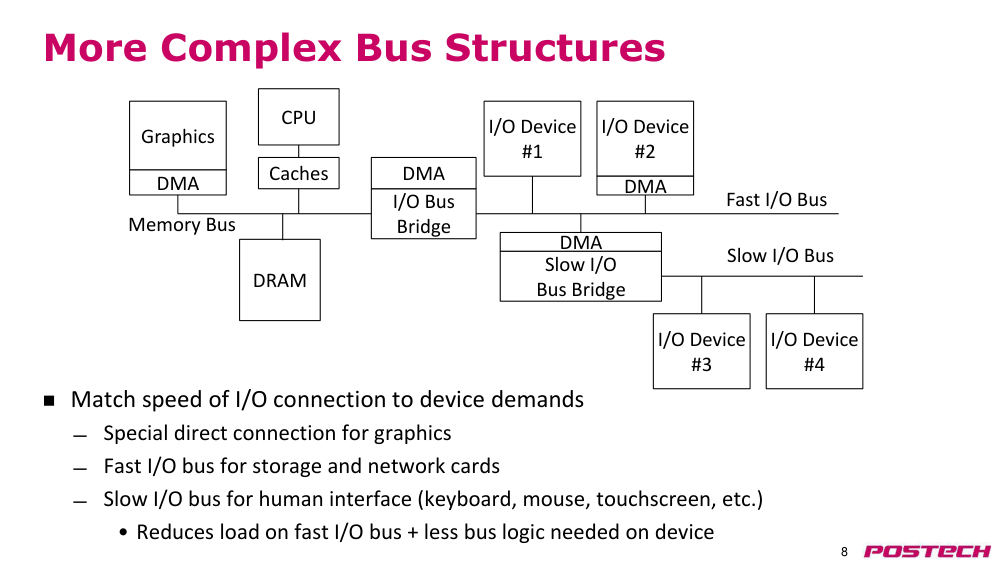
p.8더 복잡한 버스 구조
- I/O 연결의 속도를 장치의 요구에 맞춤.
- 그래픽용 특수 직접 연결.
- 저장장치 및 network(네트워크) 카드용 고속 I/O bus(입출력 버스).
- 사용자 인터페이스(키보드, 마우스, 터치스크린 등)용 저속 I/O bus(입출력 버스).
- 고속 I/O bus(입출력 버스) 부담 감소 + 장치에 필요한 버스 논리 회로 감소.
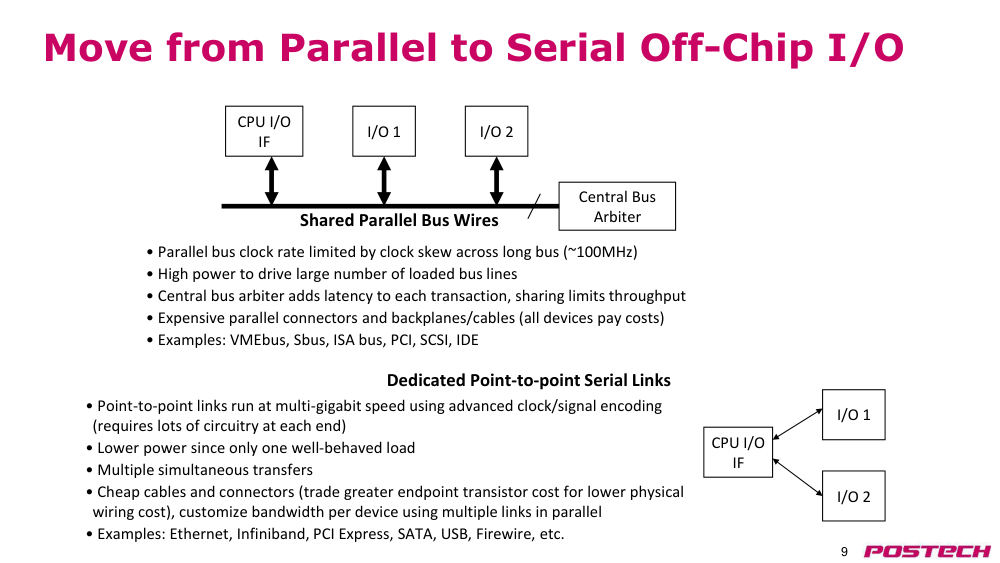
p.9병렬 외부 I/O에서 시리얼로의 전환
- parallel bus(병렬 버스)의 클록 주파수는 긴 버스에서의 clock skew(클록 스큐)로 인해 제한됨 (~100MHz).
- 많은 부하가 걸린 버스 라인을 구동하기 위해 높은 power consumption(전력 소비).
- 중앙 버스 아르비터는 각 트랜잭션에 latency(지연)을 추가하며, 공유로 인해 throughput(처리량)이 제한됨.
- 비용이 많이 드는 병렬 커넥터 및 백플레인/케이블 (모든 장치가 비용을 부담함).
- 예: VMEbus, Sbus, ISA bus, PCI, SCSI, IDE.
- 포인트투포인트 시리얼 링크는 고급 클록/신호 인코딩을 사용해 다기가비트 속도로 작동함 (각 끝단에 많은 회로 필요).
- 단일 잘 조절된 부하만 있으므로 power consumption(전력 소비)가 낮음.
- 다중 동시 전송 가능.
- 케이블 및 커넥터가 저렴함 (엔드포인트 트랜지스터 비용 증가를 물리적 배선 비용 감소로 교환), 병렬로 여러 링크를 사용해 각 장치에 맞춤형 bandwidth(대역폭) 제공 가능.
- 예: Ethernet, Infiniband, PCI Express, SATA, USB, Firewire 등.
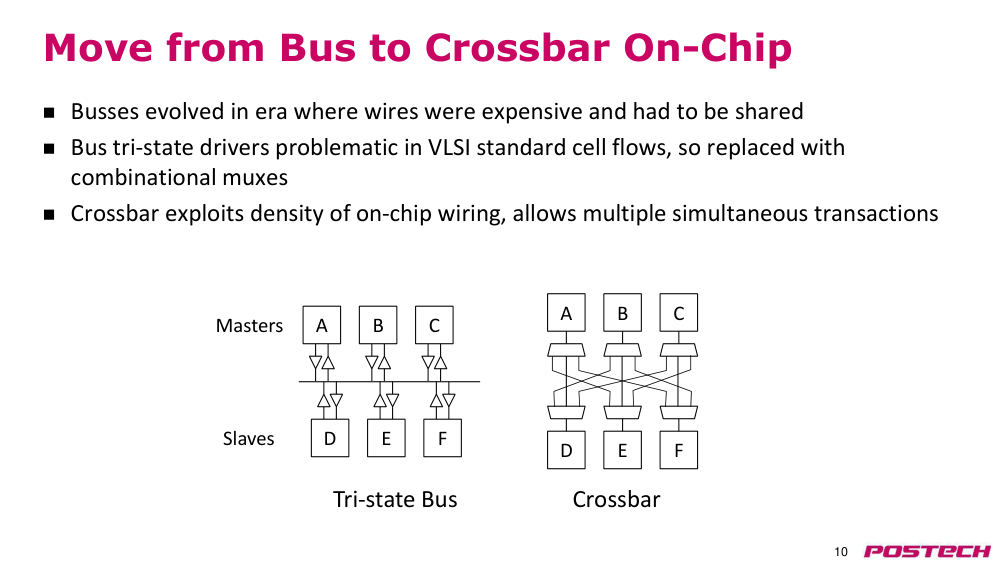
p.10버스에서 크로스바로의 전환 (온칩)
- 버스는 와이어가 비싸고 공유되어야 했던 시대에 발전함.
- VLSI standard cell flow(VLSI 표준 셀 흐름)에서는 트라이스테이트 드라이버가 문제를 일으키므로 combinational mux(조합형 멀티플렉서)로 대체됨.
- 크로스바는 On-Chip wiring(온칩 배선)의 밀도를 활용하여 다중 동시 트랜잭션을 허용함.
p.11Input/Output (I/O)(입출력) 및 메모리 매핑
- I/O bus(입출력 버스)는 coherent(코히어런트) 여부에 따라 다름.
- non-coherent(비코히어런트)은 단순하지만, cache flushing(캐시 플러싱) 또는 uncached access(캐시되지 않은 접근)만 허용해야 할 수 있음 (현대 프로세서에서는 훨씬 느림).
- 일부 Input/Output (I/O)(입출력) 시스템은 coherent(코히어런트) cache(캐시)도 가능함 (SGI Origin, TileLink, 최신 x86 시스템).
- Input/Output (I/O)(입출력)은 virtual address(가상 주소)를 사용하고 IOMMU를 활용할 수 있음.
- 사용자 주소 공간으로의 DMA를 단순화함, 그렇지 않으면 DMA 엔진이 scatter/gather(스캐터/개더)를 통해 연속된 사용자 세그먼트를 처리해야 함.
- 나쁜 장치 드라이버로부터 보호함.
- Input/Output (I/O)(입출력) 장치의 복잡성 증가.
p.12interrupts(인터럽트) vs. polling(폴링)
- I/O 장치 상태를 감지하는 두 가지 방법:
- interrupts(인터럽트):
- 이벤트 발생 전까지 CPU 오버헤드 없음.
- 부적절한 시점에 발생할 수 있음.
- 각 이벤트마다 큰 컨텍스트 전환 오버헤드 (트랩으로 파이프라인 정리, 캐시/TLB의 현재 작업 세트 방해).
- polling(폴링):
- 모든 polling(폴링)마다 CPU 오버헤드 발생.
- 모든 코드에 삽입하기 어려움.
- 핸들러 발생 시점을 제어 가능, working set(작업 세트) 간섭 감소 가능.
- hybrid approach(하이브리드 접근법):
- 첫 번째 이벤트에 interrupts(인터럽트) 발생, 커널에서 더 이상 이벤트가 없음을 확신할 때까지 polling(폴링) 유지, 이후 다시 인터럽트로 전환.
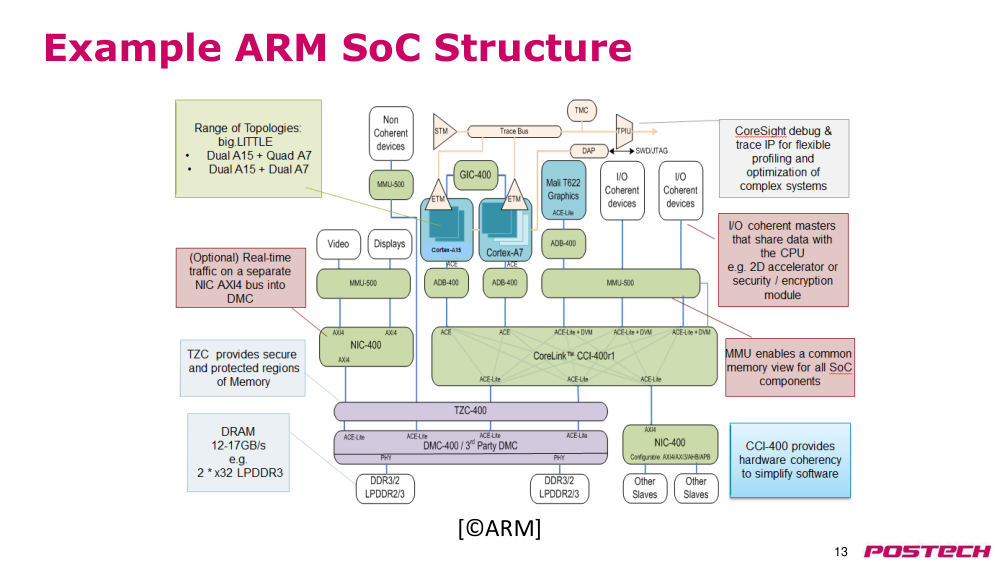
p.13ARM SoC 구조 예시
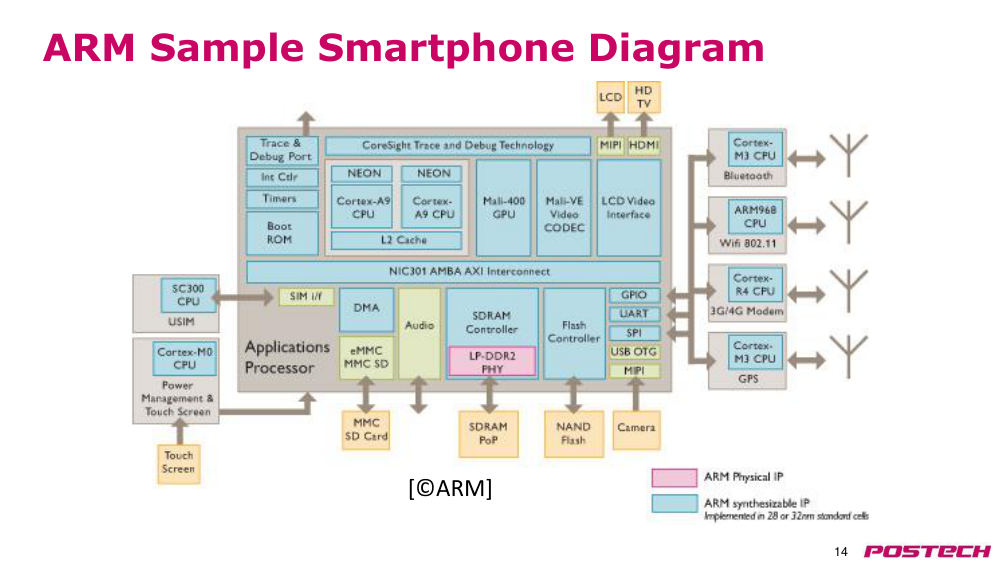
p.14ARM 스마트폰 예시 다이어그램
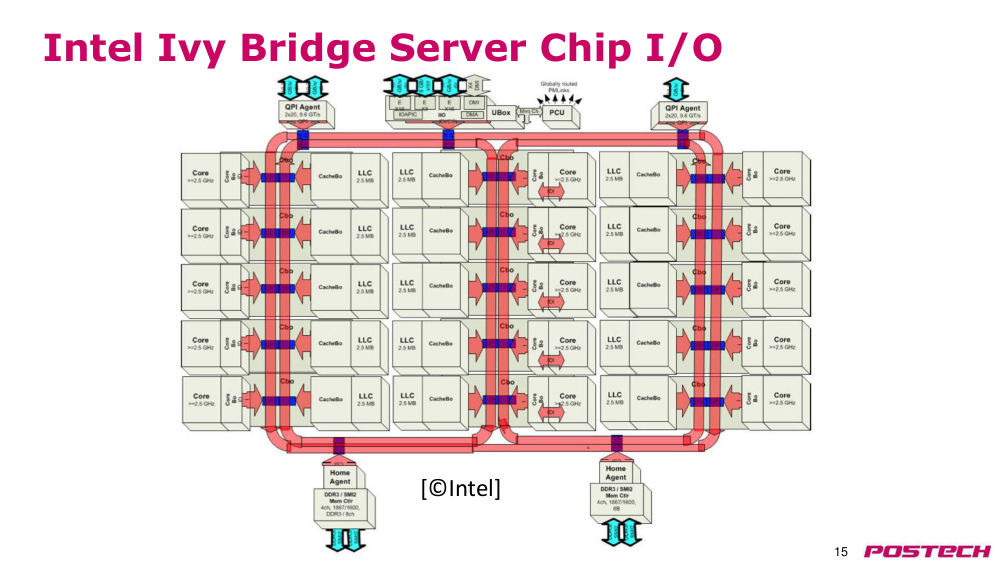
p.15Intel Ivy Bridge 서버 칩 Input/Output (I/O)(입출력)
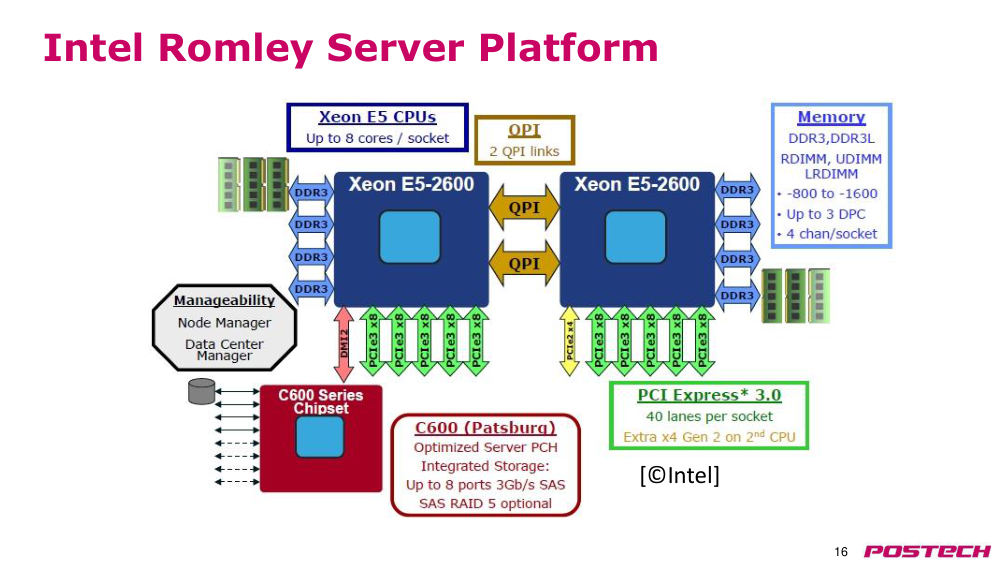
p.16Intel Romley 서버 플랫폼
p.17웨어하우스 규모 컴퓨터(WSCs)
- 인터넷 서비스 제공: 검색, 소셜 네트워킹, 온라인 지도, 동영상 공유, 온라인 쇼핑, 이메일, 클라우드 컴퓨팅 등
- 고성능 컴퓨팅(HPC) ‘클러스터’와의 차이점:
- - 클러스터는 더 높은 성능의 프로세서와 network(네트워크)를 갖춤
- - 클러스터는 Thread-Level parallelism(스레드 수준 병렬성)에 중점을 두며, WSC는 Request-Level parallelism(요청 수준 병렬성)에 중점을 둠
- 데이터센터와의 차이점:
- - 데이터센터는 다양한 머신과 소프트웨어를 하나의 장소에 통합함
- - 데이터센터는 다양한 고객을 서비스하기 위해 가상 머신과 하드웨어 이질성을 강조함
p.18WSC 특성
- 풍부한 계산 병렬성은 중요하지 않음
- - 대부분의 작업은 완전히 독립적임
- - ‘Request-Level parallelism(요청 수준 병렬성)’
- operational cost(운영 비용)이 중요함
- - 시스템 설계 시 power consumption(전력 소비)는 2차적 제약이 아니라 주요 제약이 됨
- 규모와 그로 인한 기회 및 문제점
- - WSC는 대량 구매를 통해 맞춤형 시스템을 구축할 수 있음
- 위치가 중요함
- - real estate(부동산), electricity cost(전기 비용); 인터넷, 최종 사용자, 인력 가용성
- 낮은 활용률에서도 효율적인 컴퓨팅
- 규모와 그로 인한 기회/문제점
- - 고유한 도전 과제: custom hardware(맞춤형 하드웨어), 고장
- - 고유한 기회: bulk discount(대량 할인)
p.19Warehouse-Scale computer (WSC)(웨어하우스 규모 컴퓨터)의 효율성과 비용
- WSC의 위치
- internet backbone(인터넷 백본)에 근접함, electricity cost(전기 비용), real estate(부동산) 세율, 지진, 홍수, 허리케인 등의 위험도 낮음
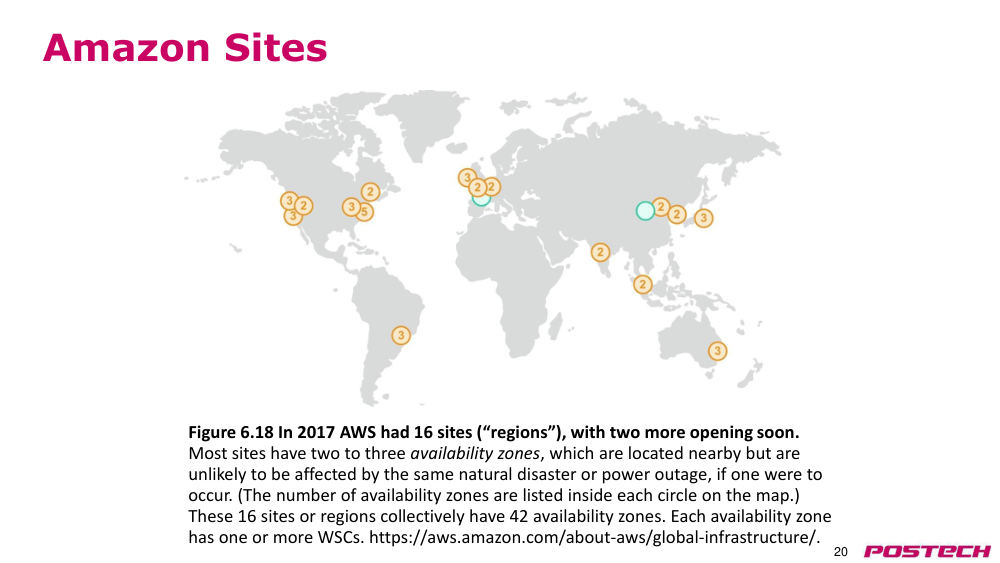
p.20그림 6.18 2017년 기준 AWS는 16개의 사이트('지역')를 운영 중이며, 추가로 2개가 곧 개설될 예정이다.
- 대부분의 사이트는 2~3개의 availability zone(가용성 영역)을 가지고 있으며, 이들은 서로 가까이 위치해 있지만, 자연재해나 전력 정전이 발생하더라도 동일한 영향을 받을 가능성은 낮다. (지도 내 원 안에 각 지역의 가용성 영역 수가 표시되어 있다.)
- 이 16개의 사이트 또는 지역은 총 42개의 availability zone(가용성 영역)을 포함한다.
- 각 availability zone(가용성 영역)에는 하나 이상의 WSC가 있다.
- https://aws.amazon.com/about-aws/global-infrastructure/
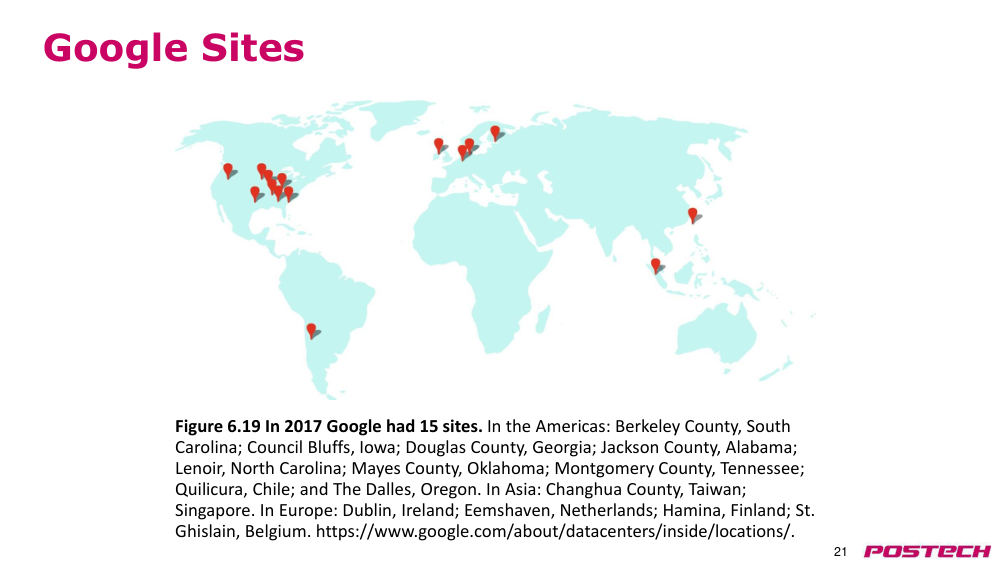
p.21그림 6.19 2017년 기준 Google은 15개의 사이트를 운영 중이다.
- Americas: Berkeley County, South Carolina; Council Bluffs, Iowa; Douglas County, Georgia; Jackson County, Alabama; Lenoir, North Carolina; Mayes County, Oklahoma; Montgomery County, Tennessee; Quilicura, Chile; The Dalles, Oregon
- Asia: Changhua County, Taiwan; Singapore
- Europe: Dublin, Ireland; Eemshaven, Netherlands; Hamina, Finland; St. Ghislain, Belgium
- https://www.google.com/about/datacenters/inside/locations/
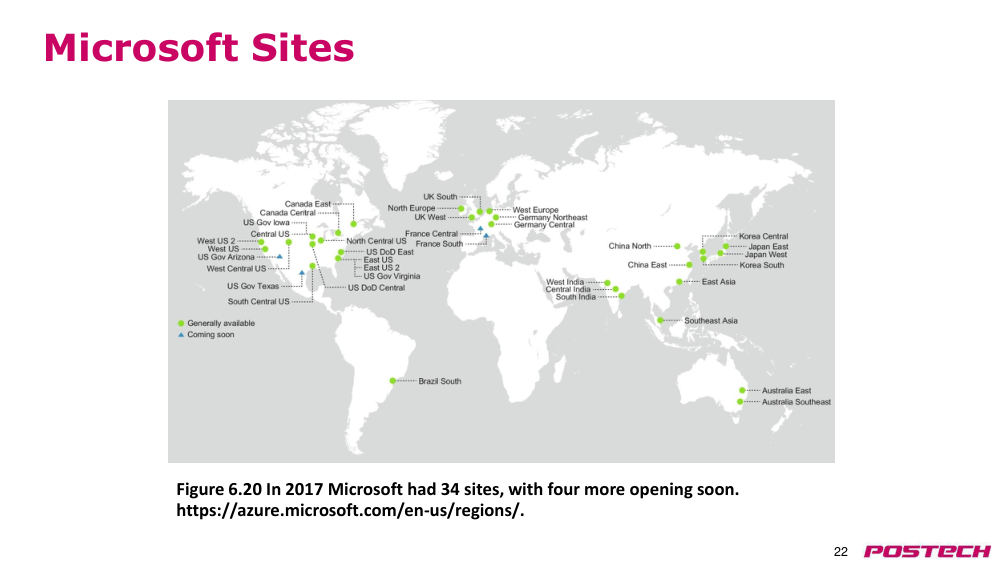
p.22그림 6.20 2017년 기준 Microsoft는 34개의 사이트를 운영 중이며, 추가로 4개가 곧 개설될 예정이다.
- https://azure.microsoft.com/en-us/regions/
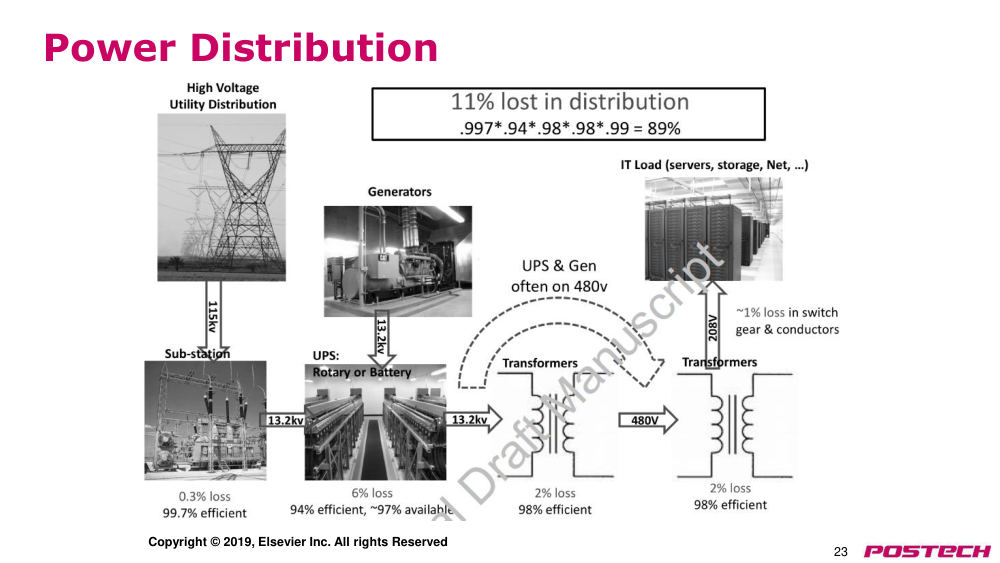
p.23전력 분배
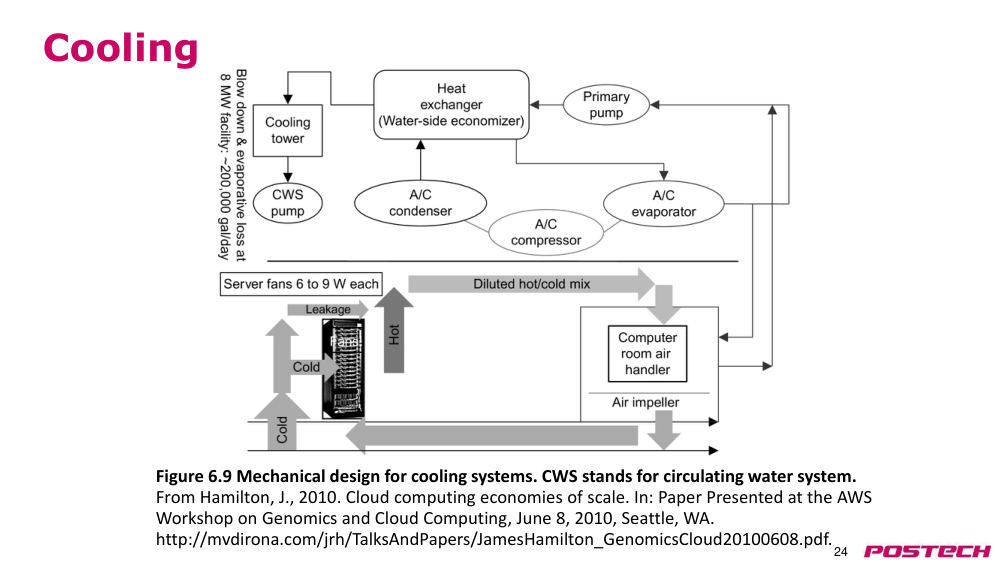
p.24그림 6.9 cooling system(냉각 시스템)의 기계적 설계. CWS는 순환수 시스템을 의미한다.
- Hamilton, J., 2010. Cloud computing economies of scale. In: Paper Presented at the AWS Workshop on Genomics and Cloud Computing, June 8, 2010, Seattle, WA.
- http://mvdirona.com/jrh/TalksAndPapers/JamesHamilton_GenomicsCloud20100608.pdf
p.25WSC의 인프라 및 비용
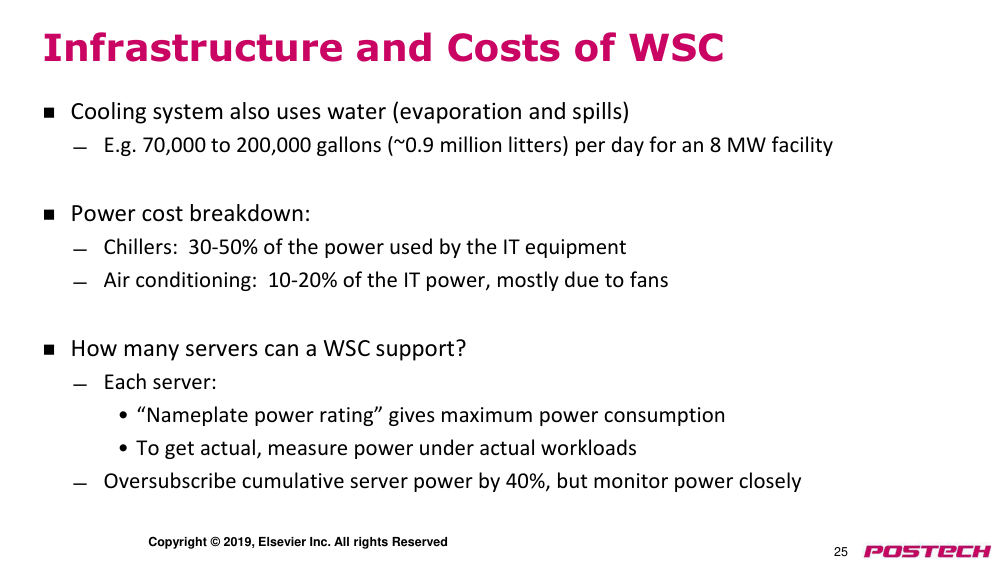
- cooling system(냉각 시스템)도 물을 사용한다 (증발 및 누수)
- 예: 8MW 시설에서 하루에 약 70,000~200,000 갤런 (~90만 리터)
- 전력 비용 구성:
- chiller(냉각기): IT 장비 사용 전력의 30~50%
- air conditioning(에어컨): IT 전력의 10~20%, 주로 팬 때문
- WSC는 몇 대의 서버를 지원할 수 있는가?
- 각 서버:
- • ‘nameplate power rating(명판 전력 정격)’은 최대 power consumption(전력 소비)를 제공한다
- • 실제 전력을 얻기 위해 실제 작업 부하에서 측정한다
- 서버 전력 합계를 40% 과잉 할당하되, 전력을 밀접하게 모니터링한다
p.26WSC의 인프라 및 비용
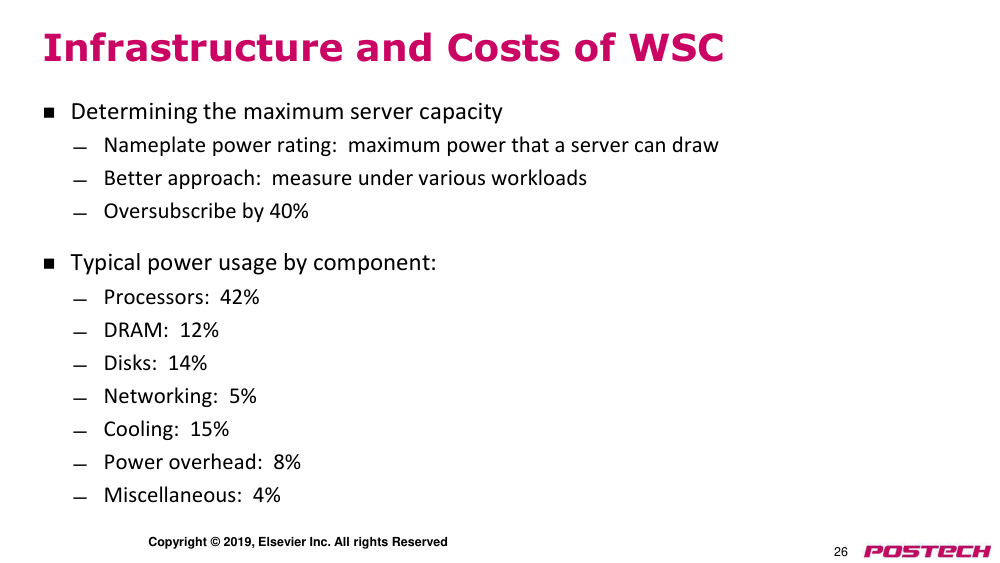
- 최대 서버 용량 결정하기:
- nameplate power rating(명판 전력 정격): 서버가 끌 수 있는 최대 전력
- 보다 나은 접근법: 다양한 작업 부하에서 측정하기
- 40% 과잉 할당
- 구성 요소별 일반적인 전력 사용:
- 프로세서: 42%
- DRAM: 12%
- 디스크: 14%
- 네트워킹: 5%
- 냉각: 15%
- power overhead(전력 오버헤드): 8%
- 기타: 4%
p.27전력 이용 효율성(PUE)
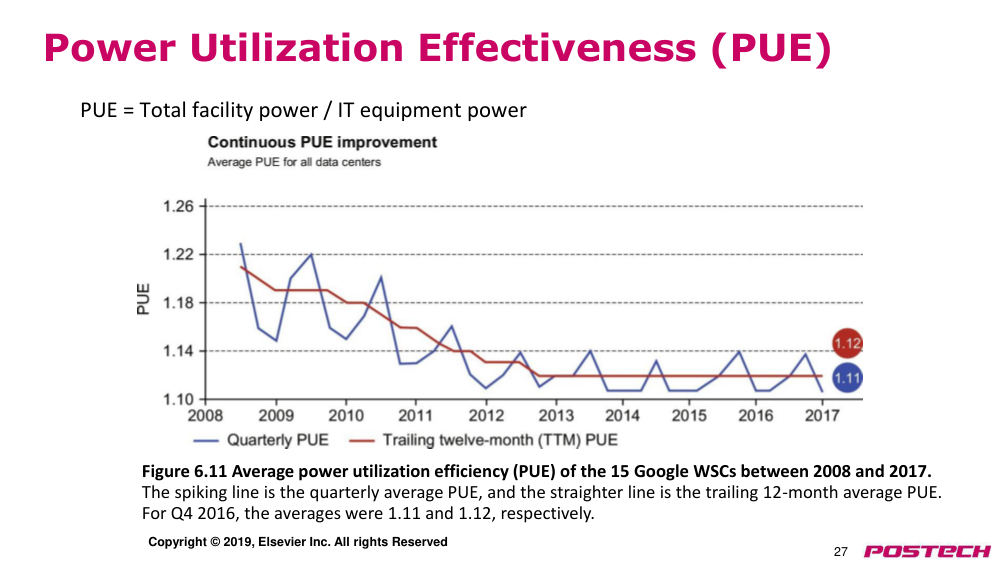
- PUE = 시설 전체 전력 / IT 장비 전력
- 그림 6.11 2008~2017년 사이 15개 구글 WSC의 평균 전력 이용 효율성(PUE).
- 파란색 점선은 분기별 평균 PUE, 검은색 직선은 이전 12개월 이동 평균 PUE이다.
- 2016년 4분기 평균은 각각 1.11과 1.12였다.
p.28성능 및 latency(지연)
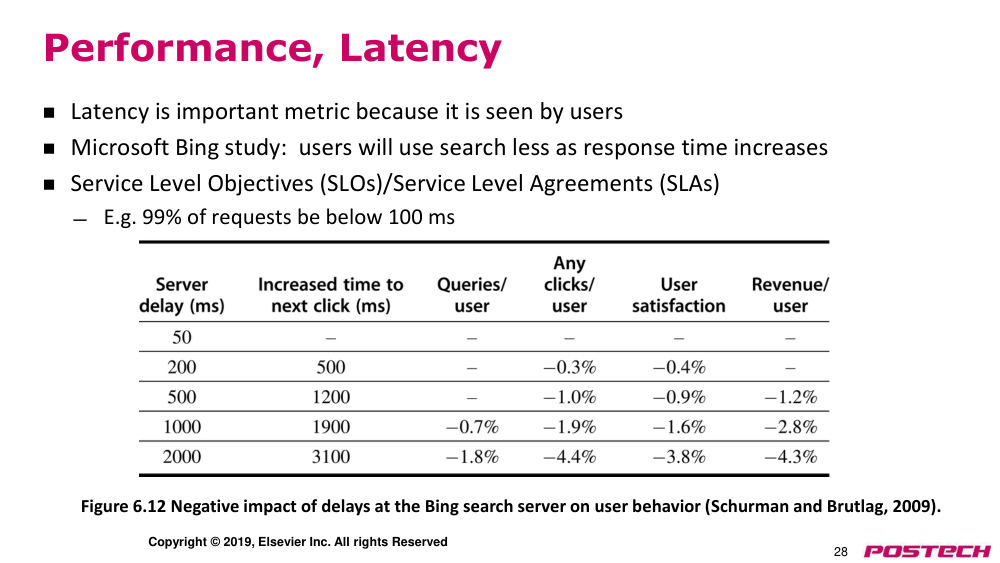
- latency(지연)은 사용자에게 직접적으로 느껴지므로 중요한 지표이다
- 마이크로소프트 빙 연구: response time(응답 시간)이 증가할수록 사용자가 검색을 덜 사용한다
- 서비스 수준 목표(SLO)/서비스 수준 계약(SLA):
- 예: 99%의 요청이 100ms 이하로 처리되어야 함
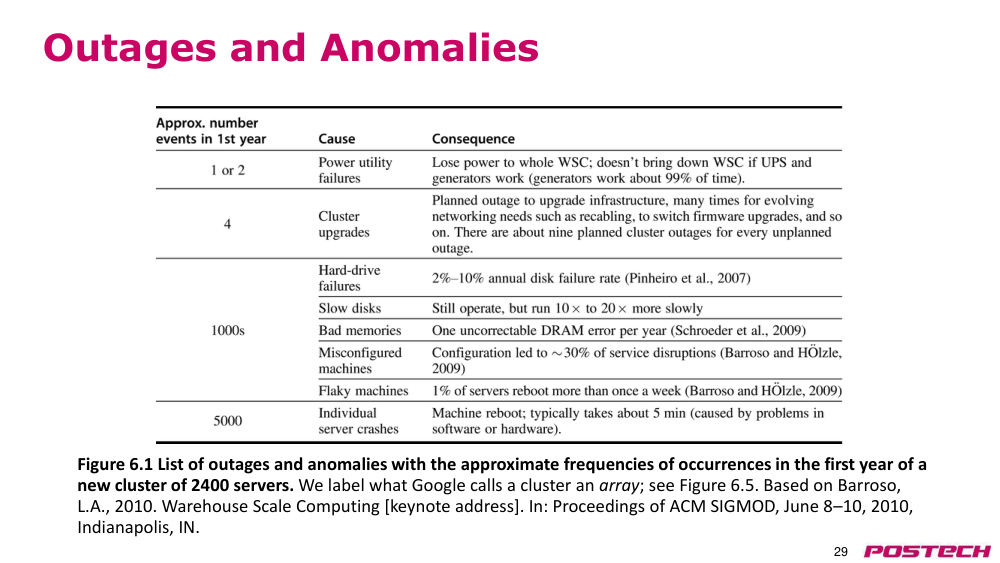
p.29장애 및 이상 현상
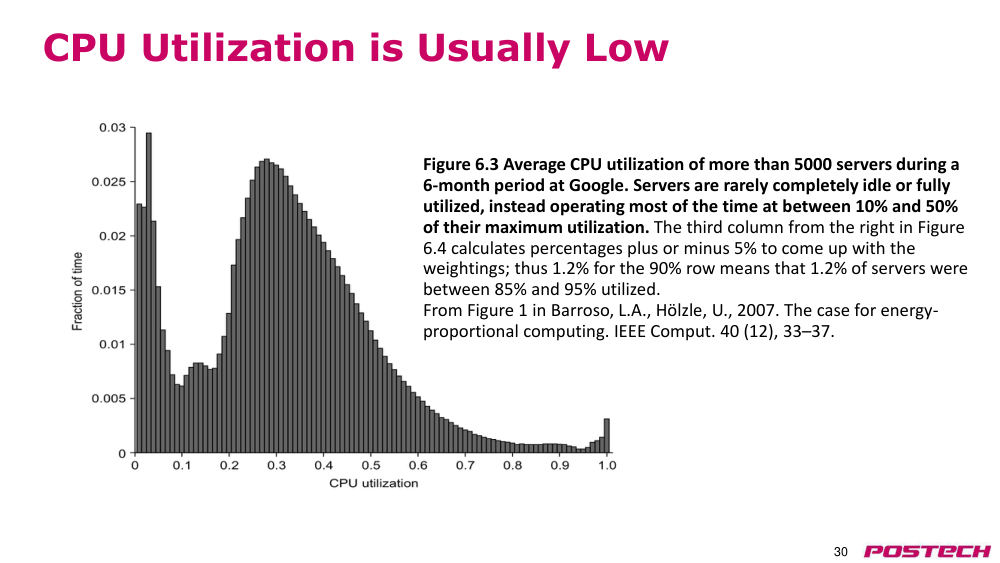
p.30CPU 활용률은 일반적으로 낮다
- 그림 6.3 구글에서 6개월 동안 5,000대 이상의 서버 평균 CPU 활용률.
- 서버는 거의 완전히 비어 있거나 완전히 사용되는 경우는 드물며, 대부분의 시간 동안 최대 활용률의 10%~50% 사이에서 운영된다.
- 그림 6.4에서 오른쪽에서 세 번째 열은 ±5% 범위 내의 백분율을 계산하여 가중치를 산출한다. 예를 들어 90% 행의 1.2%는 85%~95% 활용률을 가진 서버의 비율을 의미한다.
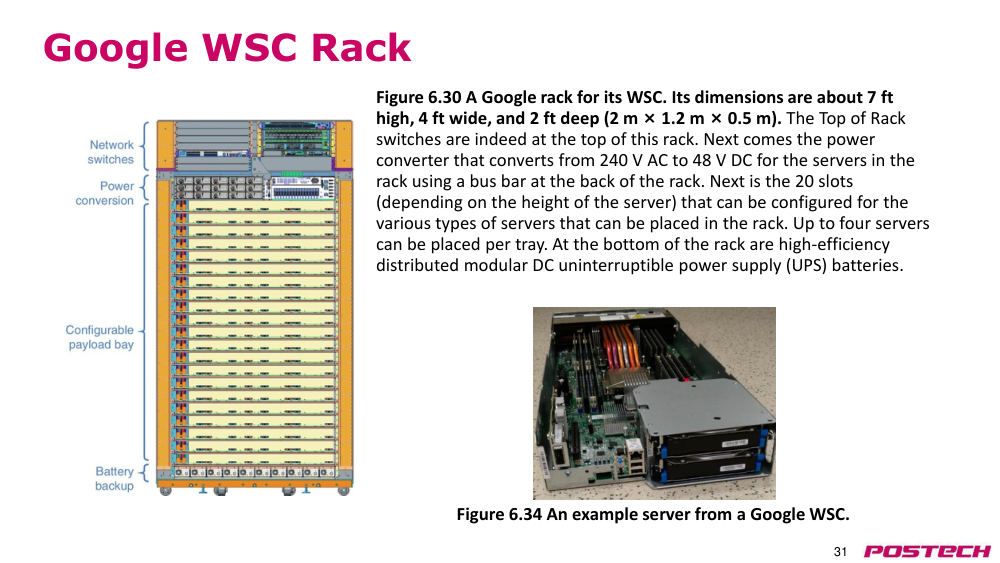
p.31Google WSC 랙
- 그림 6.30: Google의 웨어하우스 규모 컴퓨터(WSC)를 위한 랙. 크기는 약 7피트 높이, 4피트 너비, 2피트 깊이(2m × 1.2m × 0.5m)이다.
- 랙 상단에는 랙 상단 스위치가 위치해 있다.
- 다음은 랙 뒷면의 버스 바를 통해 240V AC를 48V DC로 변환하여 랙 내 서버에 공급하는 전원 변환기이다.
- 다음은 서버의 높이에 따라 달라지는 20개의 슬롯으로, 랙에 배치할 수 있는 다양한 유형의 서버에 대해 구성 가능하다.
- 트레이당 최대 4대의 서버를 설치할 수 있다.
- 랙 하단에는 고효율 분산 모듈형 DC 비정전 전원 공급 장치(UPS) 배터리가 위치해 있다.
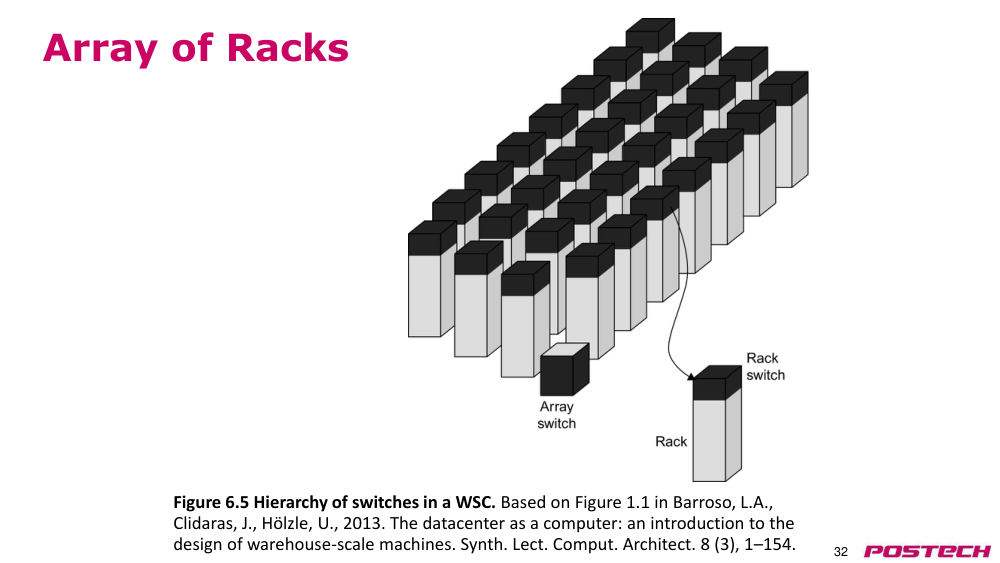
p.32WSC 내 스위치 계층 구조
- 그림 6.5: WSC 내 스위치의 계층 구조. Barroso, L.A., Clidaras, J., Hölzle, U., 2013. The datacenter as a computer: an introduction to the design of warehouse-scale machines. Synth. Lect. Comput. Architect. 8 (3), 1–154. 기반.
- 랙 배열
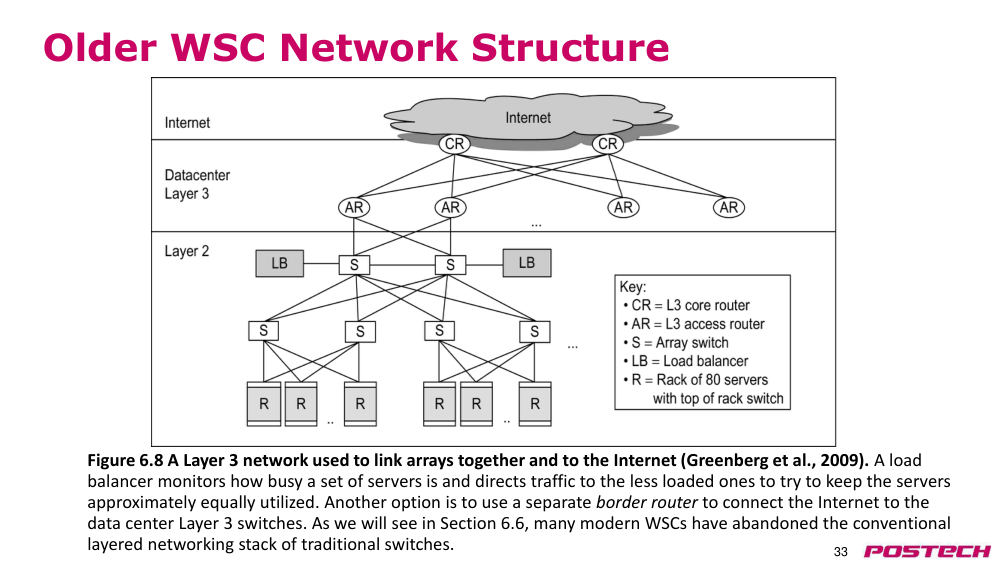
p.33오래된 WSC network(네트워크) 구조
- 그림 6.8: 랙 배열들을 연결하고 인터넷과 연결하기 위해 사용하는 레이어 3 네트워크(Greenberg et al., 2009).
- 로드 밸런서는 서버 집합의 부하를 모니터링하여, 서버들이 균일하게 활용되도록 덜 부하가 많은 서버로 트래픽을 전달한다.
- 다른 옵션으로는 인터넷과 데이터센터 레이어 3 스위치를 연결하기 위해 별도의 경계 라우터를 사용하는 것이다.
- 6.6절에서 살펴보겠지만, 많은 현대 WSC는 전통적인 스위치의 계층적 network(네트워크) 스택을 포기했다.
p.34랙 배열 스위치
- 랙 배열을 연결하는 스위치.
- 랙 스위치의 bisection bandwidth(양분 대역폭) 대비 10배 이상의 bisection bandwidth(양분 대역폭)을 가져야 한다.
- n포트 스위치의 비용은 n²에 비례하여 증가한다.
- 자주 content-addressable memory(내용 주소 지정 메모리) 칩과 FPGA를 활용한다.
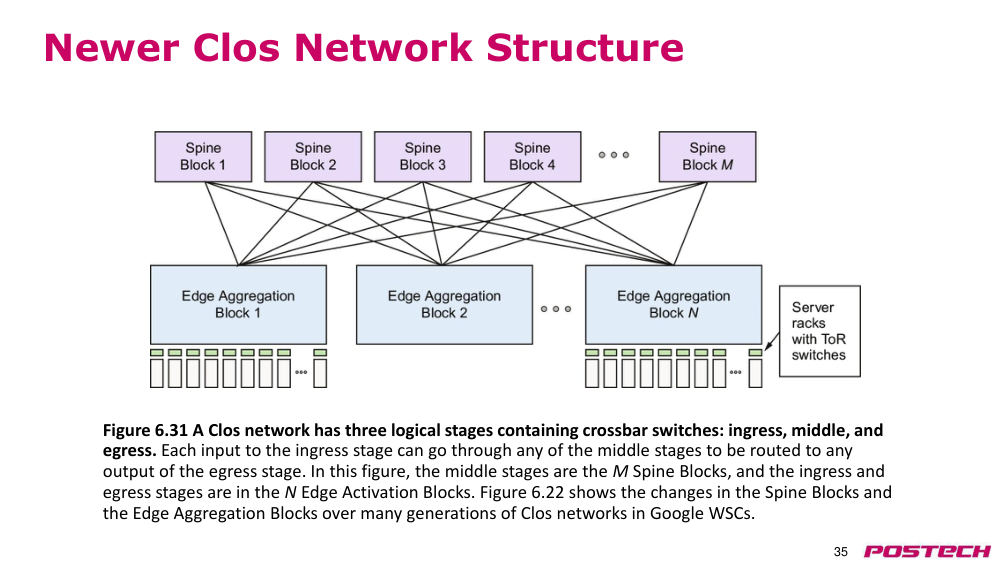
p.35새로운 Clos network(네트워크) 구조
- 그림 6.31: Clos network(네트워크)는 crossbar switch(크로스바 스위치)로 구성된 3개의 논리적 단계로 이루어져 있다: ingress(인그레스), middle(중간), egress(이그레스) 단계.
- ingress(인그레스) 단계의 각 입력은 middle(중간) 단계의 어느 하나를 통과하여 egress(이그레스) 단계의 어느 출력으로 라우팅될 수 있다.
- 이 그림에서 middle(중간) 단계는 M Spine Blocks이며, ingress(인그레스) 및 egress(이그레스) 단계는 N Edge Activation Blocks에 있다.
- 그림 6.22는 Google WSC의 여러 세대에 걸쳐 Spine Blocks와 Edge Aggregation Blocks의 변화를 보여준다.
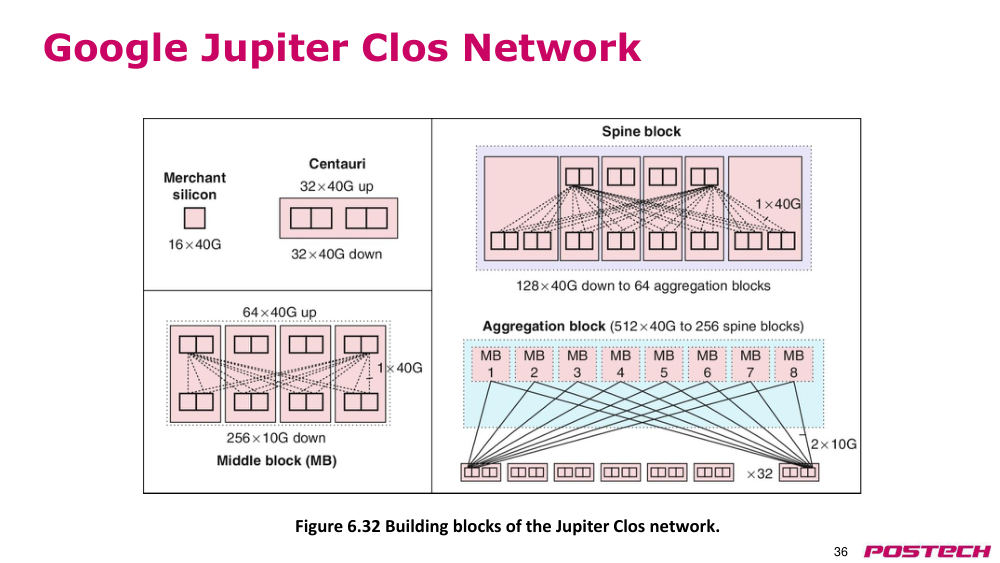
p.36Jupiter Clos network(네트워크)의 구성 요소
- 그림 6.32: Jupiter Clos network(네트워크)의 구성 블록.
- Google Jupiter Clos network(네트워크)
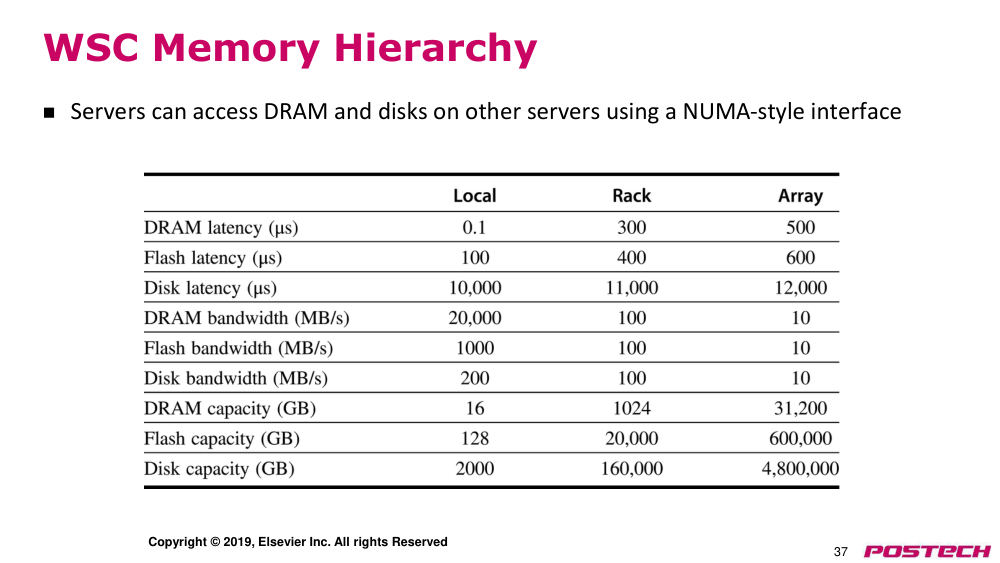
p.37Warehouse-Scale computer (WSC)(웨어하우스 규모 컴퓨터)의 메모리 계층
- 서버는 NUMA 스타일 인터페이스를 사용하여 다른 서버의 DRAM과 디스크에 접근할 수 있다.
p.38저장 옵션
- 서버 내부에 디스크를 사용하거나, Infiniband를 통한 network-attached storage(네트워크 연결 스토리지)를 사용한다.
- 웨어하우스 규모 컴퓨터(WSC)는 일반적으로 로컬 디스크에 의존한다.
- Google 파일 시스템(GFS)은 로컬 디스크를 사용하며, 최소한 세 개의 복제본을 유지한다.
p.39Warehouse-Scale computer (WSC)(웨어하우스 규모 컴퓨터)의 비용
- 자본 지출(CAPEX) – WSC를 구축하는 비용 – watt당 $9에서 $13
- 운영 지출(OPEX) – WSC를 운영하는 비용
p.40프로그래밍 모델과 워크로드
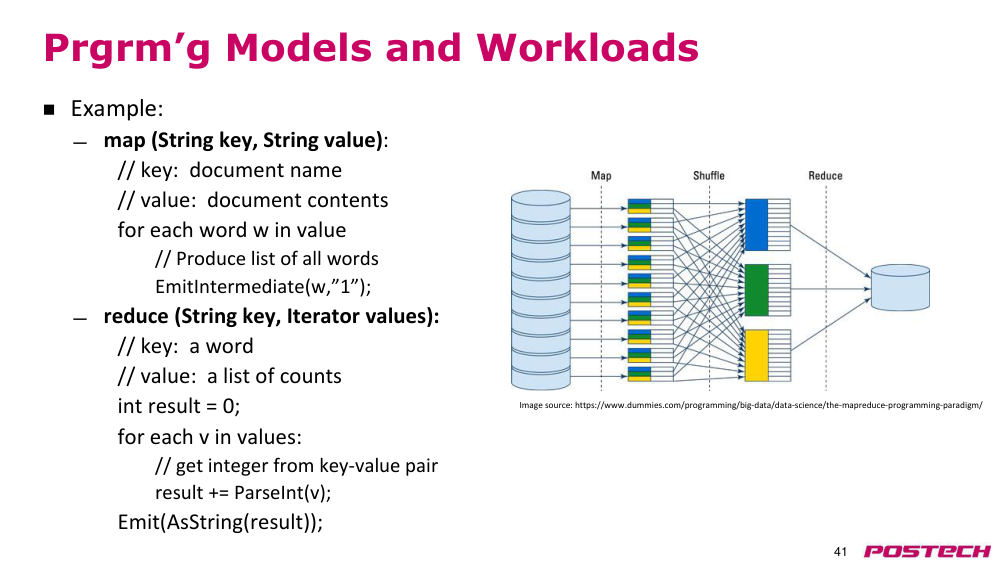
- 배치 처리 프레임워크: MapReduce
- Map: 프로그래머가 제공한 함수를 각 논리적 입력 레코드에 적용한다.
- • 수천 대의 컴퓨터에서 실행된다.
- • 중간 값으로 새로운 키-값 쌍의 집합을 제공한다.
- Reduce: 다른 프로그래머가 제공한 함수를 사용하여 값을 축소한다.
p.41프로그래밍 모델과 워크로드
- 예시:
- map (String key, String value):
- // key: 문서 이름
- // value: 문서 내용
- for each word w in value
- // 모든 단어의 목록을 생성
- EmitIntermediate(w, "1");
- reduce (String key, Iterator values):
- // key: 단어
- // value: 카운트 목록
- int result = 0;
- for each v in values:
- // 키-값 쌍에서 정수를 가져옴
- result += ParseInt(v);
- Emit(AsString(result));
p.42프로그래밍 모델과 워크로드
- 가용성:
- • 데이터의 복제본을 서로 다른 서버에 사용한다.
- • relaxed consistency(완화된 일관성) 사용:
- • 모든 복제본이 항상 일치할 필요는 없다.
- 파일 시스템: GFS 및 Colossus
- 데이터베이스: Dynamo 및 BigTable
p.43프로그래밍 모델과 워크로드
- MapReduce 런타임 환경은 맵 및 리듀스 작업을 WSC 노드에 스케줄링한다.
- 워크로드 요구사항은 종종 크게 달라진다.
- 스케줄러는 이전 작업의 완료 여부를 기반으로 작업을 할당한다.
- tail latency(꼬리 지연)/execution time variability(실행 시간 변동성): 단일로 느린 작업이 큰 MapReduce 작업을 막을 수 있다.
- 런타임 라이브러리는 작업의 마지막 근처에서 작업을 복제한다.
- straggler(지연 작업)을 기다리지 않고, 다른 곳에서 작업을 다시 실행한다.
p.44질문?
- 추천 독서:
- 교재의 6장