Lec 22 · VIPT·alias 방지·hashed page table·VM 역사, Memory Consistency(SC·TSO·fence)
정밀 정리 · 검증 2026-09-24 07:16
1개요
1.1전반(~31분): Lec14 마무리 — VIVT alias 복습, VIPT 와 associativity 한계, MIPS R10000 의 L2 기반 alias 방지
1.2Atlas PAR 의 scalability 문제 → hashed page table·PowerPC, VM 기능의 역사와 오늘날의 VM 사용
1.3후반: Lec15 memory consistency — producer-consumer 투표, coherence vs consistency, write serialization vs atomicity
1.4SC 와 그 최적화(non-binding prefetch, speculation), store buffer 가 SC 를 깨뜨림 → relaxed model, TSO, fence (RC 는 다음 강의)
2섹션별 정리 상황·문제 → 원인 → 해결
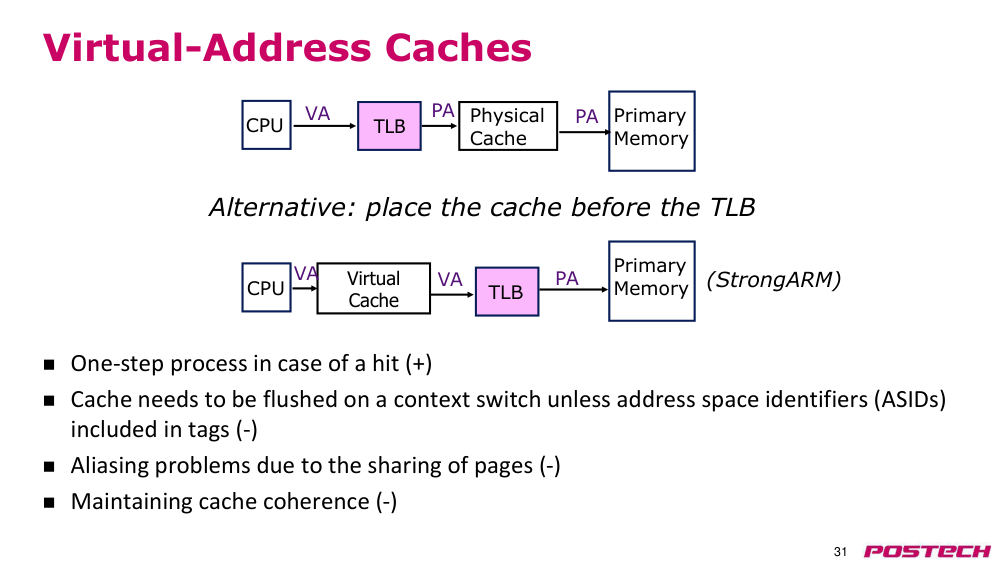
2.10:53–3:15복습: virtual cache(VIVT) 와 aliasing
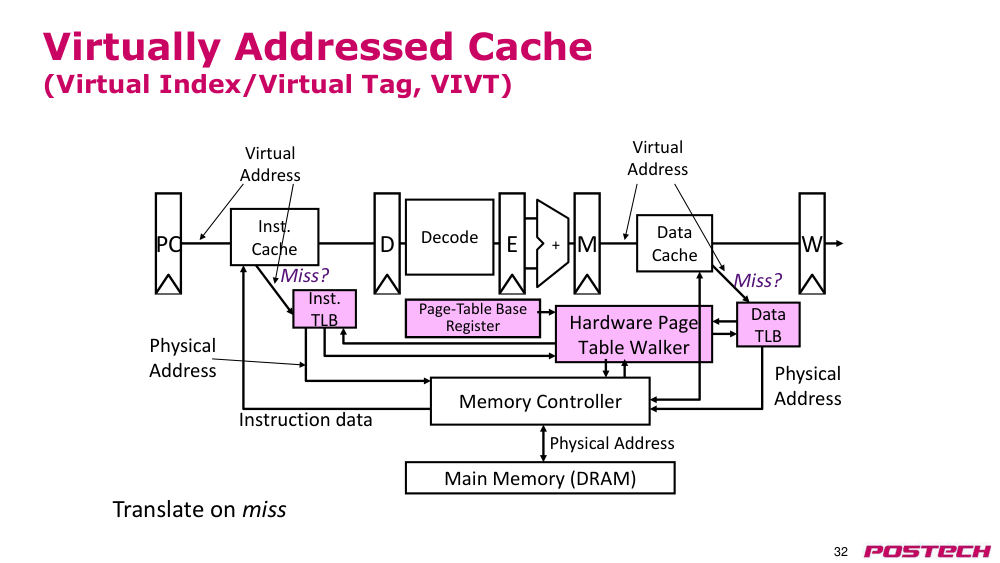
상황·문제translation 을 cache 접근 전에 하면 너무 비싸다 → virtual address 로 cache 를 접근하는 VIVT
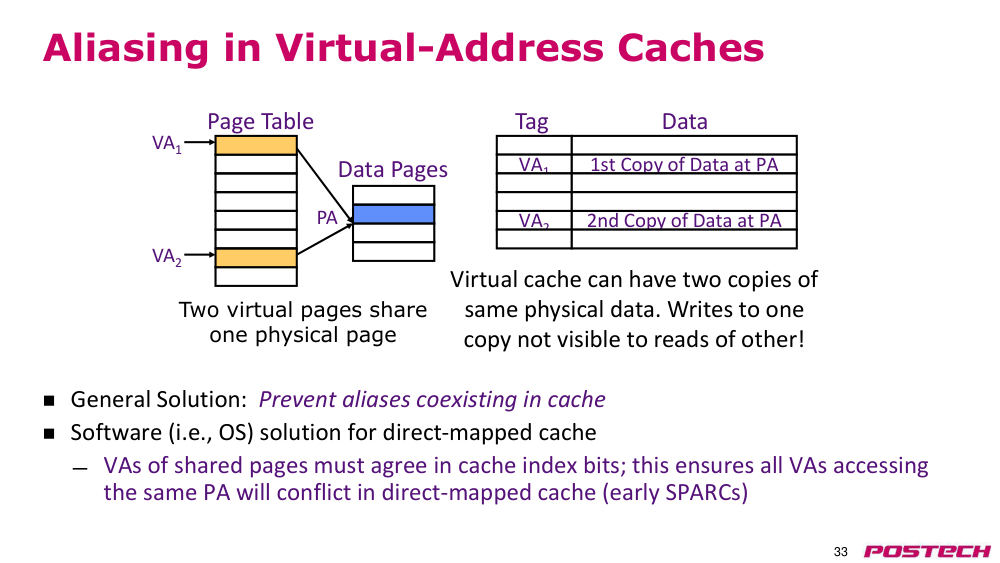
원인같은 physical address 를 가리키는 두 VA 가 cache line 두 개로 존재 → 한쪽 write 후 다른 쪽이 stale data
해결OS 가 page 할당 시 page number 를 골라 duplication 이 생기지 않게 함 (software 해법)
- VIVT: L1 은 VA 로 접근, L1 miss 때 translation 후 L2 접근
- alias 두 copy → correctness 유지 어려움
2.1.r.1Wikipedia: CPU cache ↗ · VIPT 는 index+offset 을 page offset 안에 두어 synonym 회피 → 크기 상한 = page size × associativity
2.23:16–5:54VIPT: TLB 와 cache 동시 접근
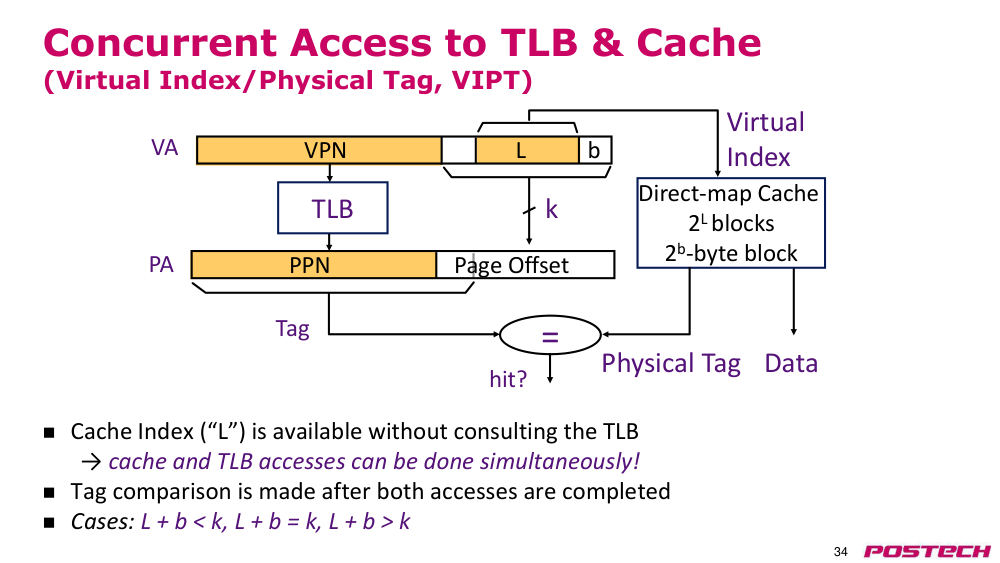
상황·문제두 번째 해법: translation 과 cache 접근을 동시에
원인cache 가 크지 않으면 index 를 page offset bit 만으로 만들 수 있다
해결index 로 tag 를 읽는 동안 TLB translation, 둘 다 끝나면 physical tag 비교 → TLB latency 완전히 숨김
- 세 경우 L+b<k, L+b=k, L+b>k
- index 가 VPN 으로 넘어가면(L+b>k) alias 가능성 발생
2.2.r.1Wikipedia: CPU cache ↗ · VIPT 는 index+offset 을 page offset 안에 두어 synonym 회피 → 크기 상한 = page size × associativity
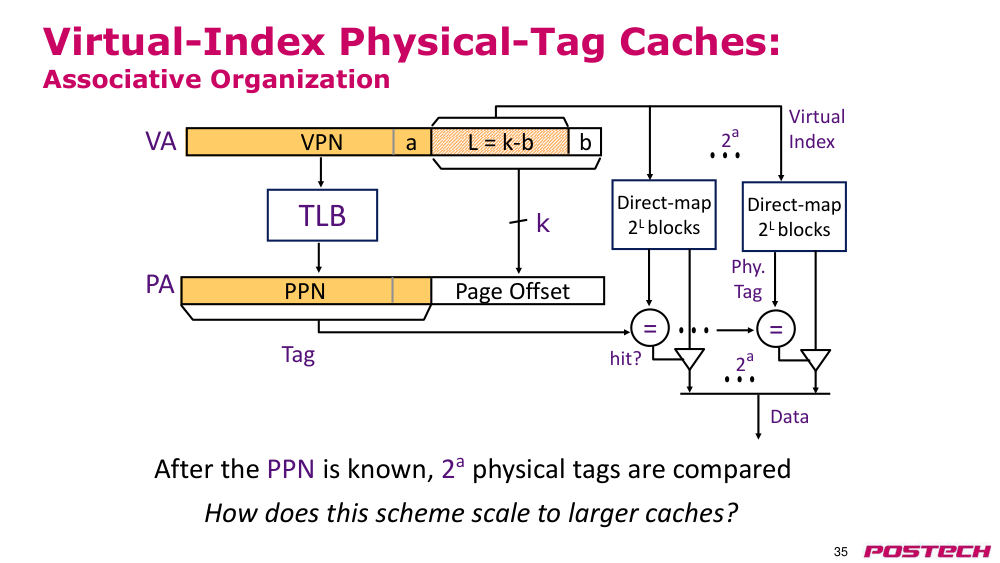
2.35:55–9:36associativity 로 VIPT 확장과 그 한계
상황·문제VPN bit 를 index 에 쓰지 않으면서 cache 를 키우고 싶다
원인direct-mapped 를 2-way 로 바꾸면 set 수가 절반 → index bit 1개 감소
해결용량 2배면 4-way 로 → 같은 offset bit 로 set 접근. 그러나 L1 에 64-way 같은 건 너무 비싸 확장성 없음
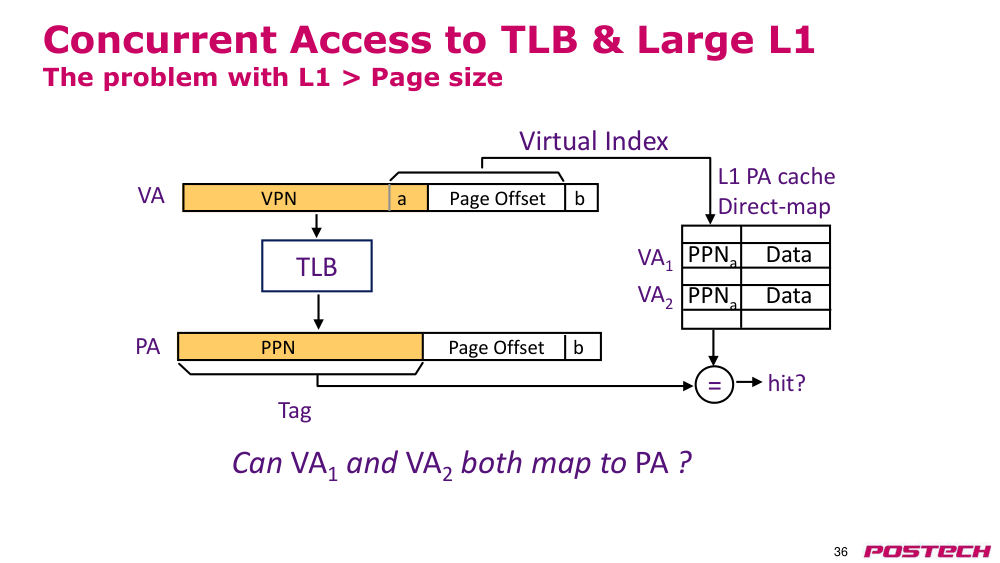
- L2 이하는 접근 시점에 translation 이 끝나 있으므로 L1 만 문제
- L1 > page size 면 VPN bit(a) 사용 → VA1·VA2 가 같은 PA 로 매핑될 수 있음
2.3.r.1Wikipedia: CPU cache ↗ · VIPT 는 index+offset 을 page offset 안에 두어 synonym 회피 → 크기 상한 = page size × associativity
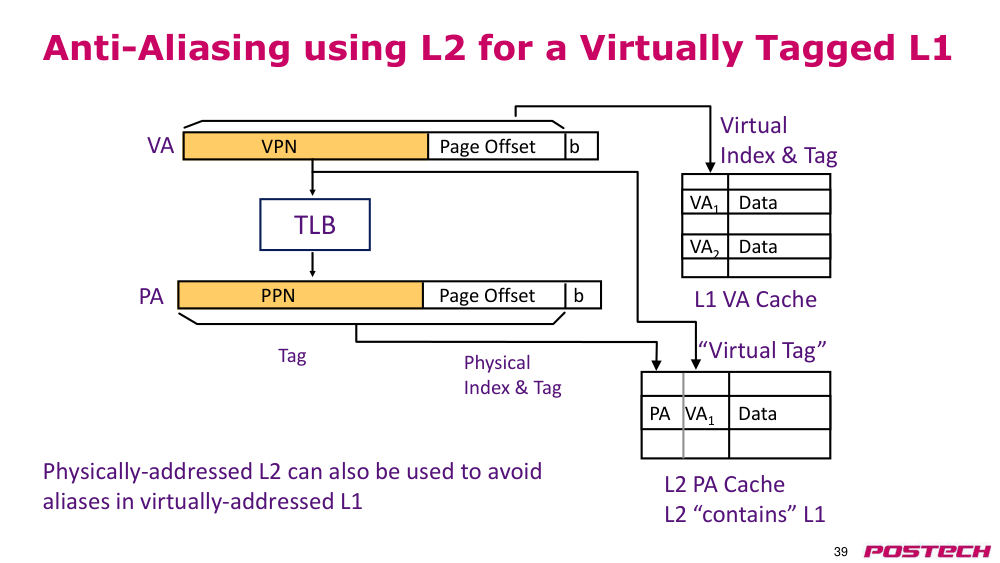
2.49:37–14:28L2 로 aliasing 방지: MIPS R10000
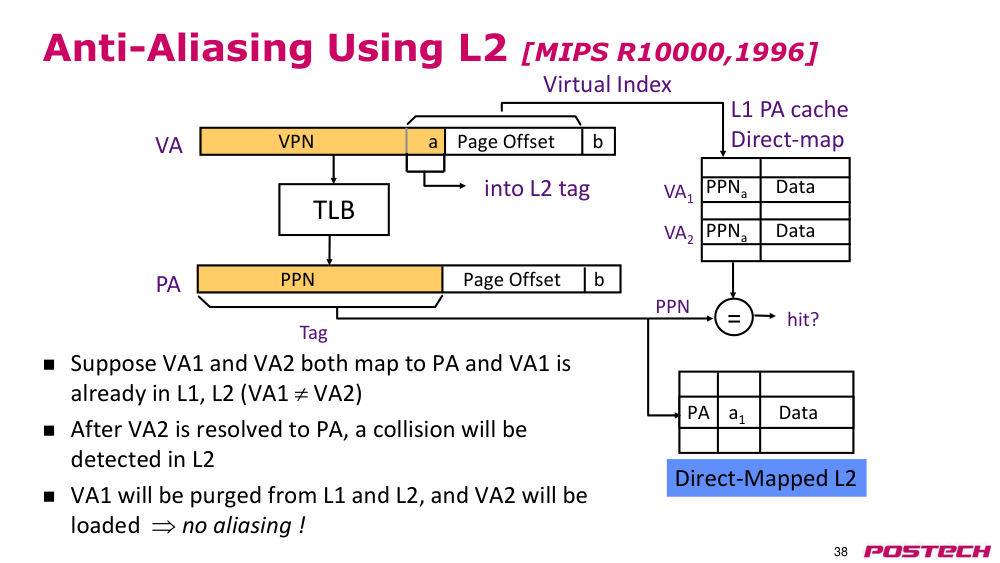
상황·문제큰 L1 이 VPN bit a 를 index 에 쓰면 alias 가 생길 수 있다
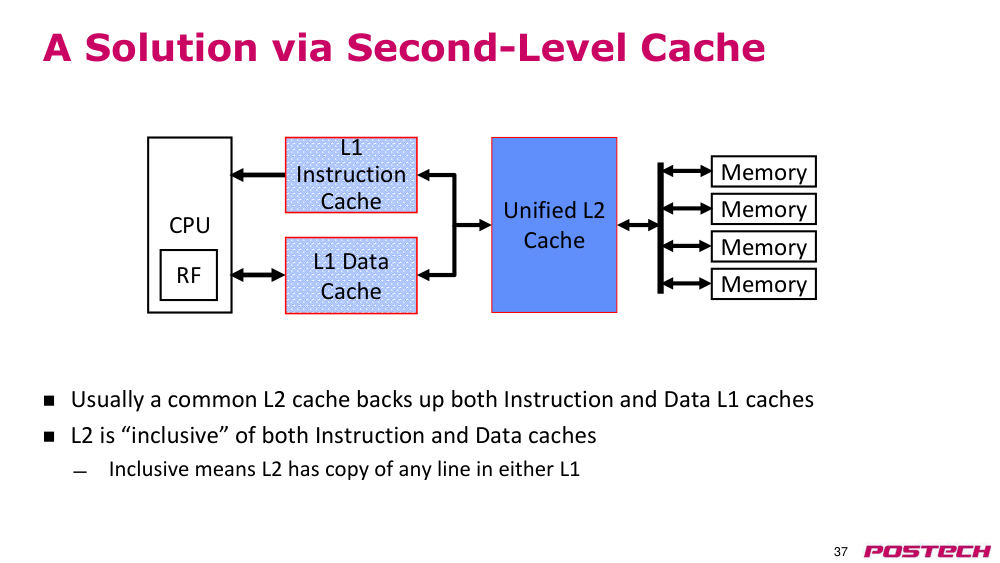
원인L1 은 inclusive L2 가 뒷받침 → L1 miss 때 L2 정보로 alias 여부를 판단할 수 있다
해결L2 tag 옆에 VA bit a 저장. L1 miss·L2 hit 인데 a 가 다르면 기존 line 을 L1 에서 purge 후 새 line 설치 → alias 없음
- L1 miss 시 a bit 를 L2 에 함께 전달해야 함
- 확장: L2 에 VA 를 저장하면 virtual L1(VIVT) 의 alias 도 제거
2.4.r.1Wikipedia: CPU cache ↗ · VIPT 는 index+offset 을 page offset 안에 두어 synonym 회피 → 크기 상한 = page size × associativity
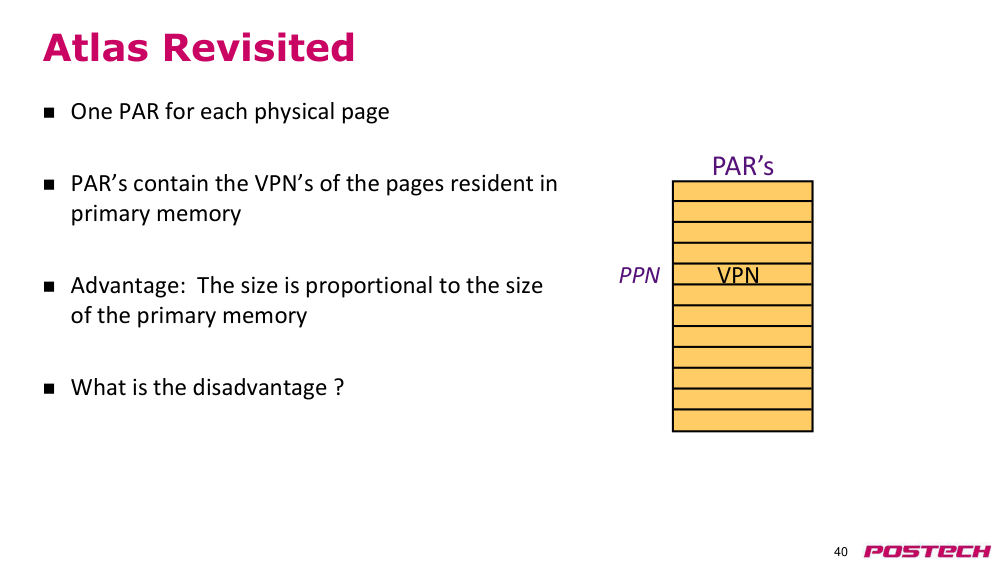
2.514:29–17:01Atlas 재조명: page address register
상황·문제Atlas 는 physical page 마다 PAR 1개(최대 32개), PAR 에 VPN 저장
원인모든 PAR 를 비교해야 match 를 안다 → main memory 가 크면 비교 비용이 prohibitive
해결장점은 구조 크기가 main memory 에 비례. 단점은 scalability → hashing 으로 해결(다음 섹션)
- match 면 해당 page frame 접근, 없으면 page fault 후 disk 에서 load
2.5.r.1Wikipedia: Atlas (computer) ↗ · page address register 의 associative memory 로 core 에 page 가 있는지 판정
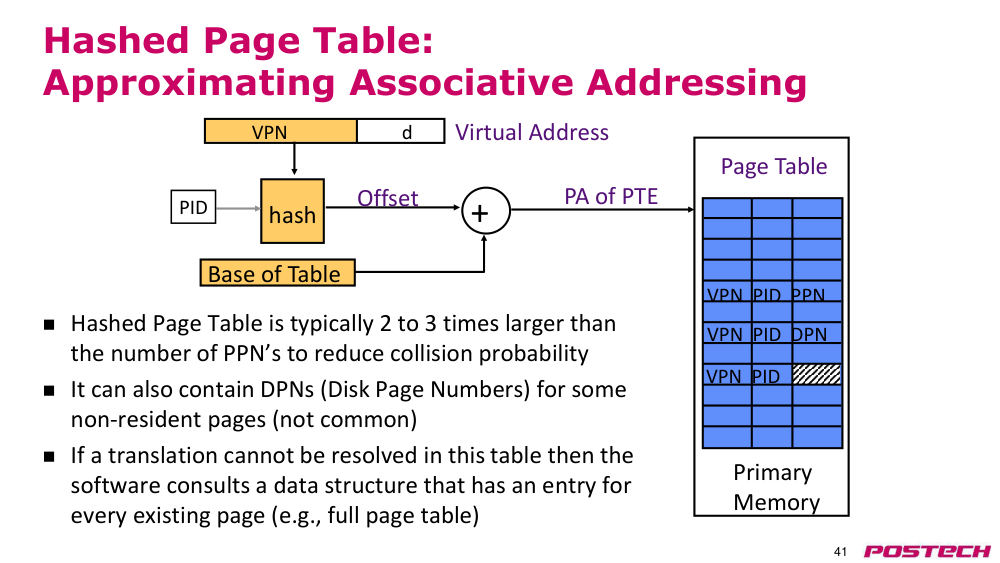
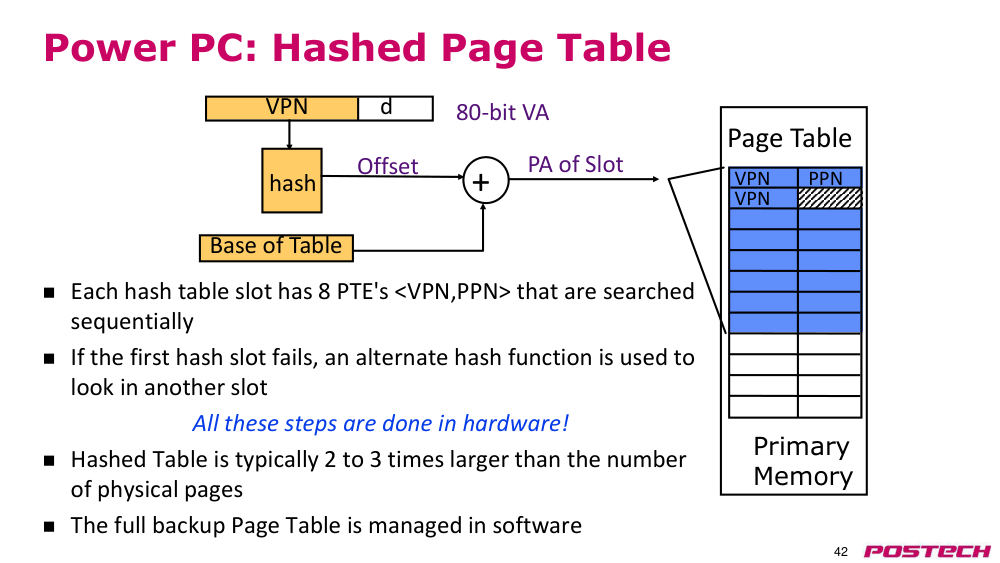
2.617:02–22:27hashed(inverted) page table 과 PowerPC
상황·문제모든 page frame 과 VPN 을 비교하는 비용을 없애고 싶다
원인VPN(+PID) 의 hash 로 한 entry 만 접근. hash collision 가능
해결table 을 physical page frame 수의 2~3배로 두어 collision 감소, 못 찾으면 OS 의 full page table 조회. PowerPC 는 slot 당 PTE 8개를 hardware walker 가 검색, 실패 시 두 번째 hash
- entry 는 VPN·PID 와 PPN(또는 non-resident page 의 DPN)
- hierarchical page table 과 다른 접근, 실제로는 multilevel 이 더 널리 쓰임
2.6.r.1Wikipedia: Page table ↗ · inverted page table: frame 수만큼 row, VPN(+PID) hash 와 collision chain
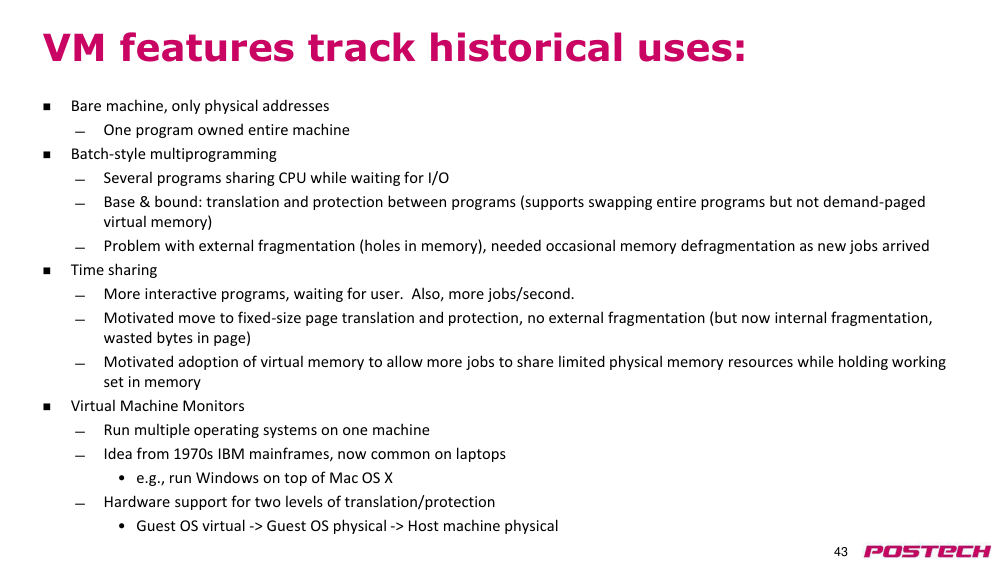
2.722:28–26:04VM 기능의 역사적 발전
상황·문제VM 관리 방식은 컴퓨터 사용 방식과 함께 바뀌었다
원인bare machine(한 program) → batch multiprogramming(base&bound, external fragmentation) → time sharing(fixed-size page)
해결virtual machine monitor 는 guest VA → guest PA → host machine PA 로 translation 한 단계 추가
- base&bound 는 demand paging 미지원
- paging 은 internal fragmentation 이 있지만 external 보다 낫다
2.7.r.2Wikipedia: Second Level Address Translation ↗ · guest PA 를 host VA 로 보고 host page table 을 hardware 가 walk (EPT/NPT)
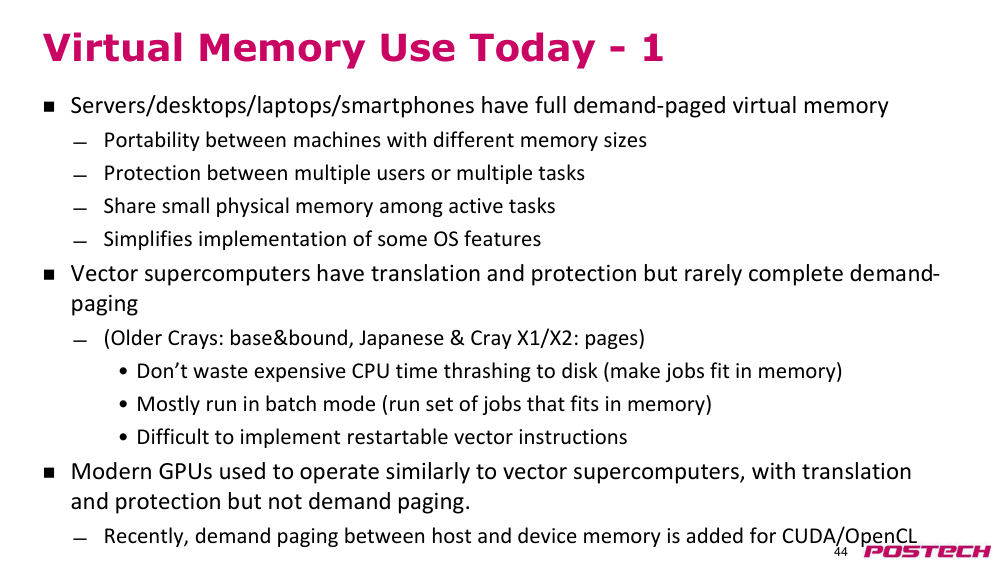
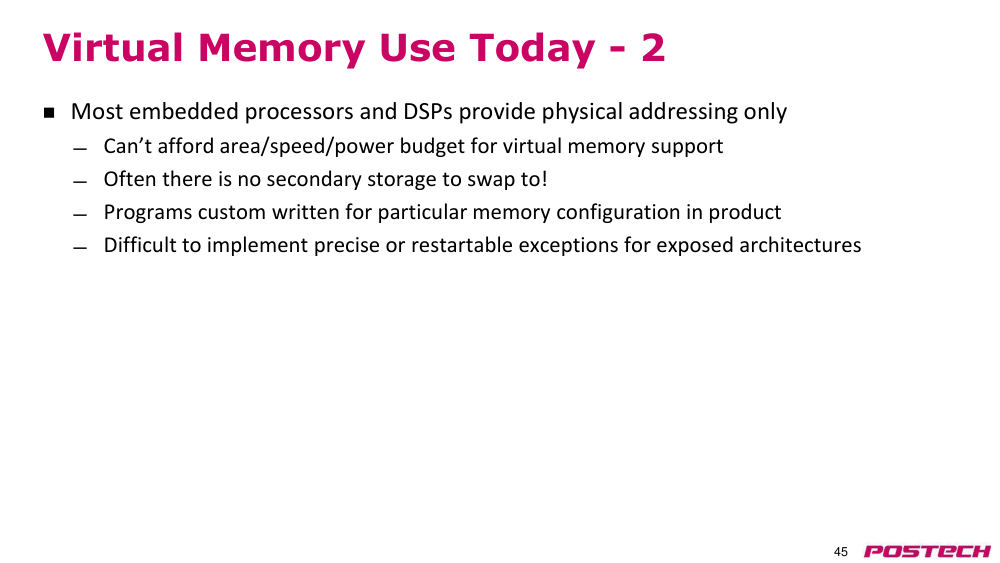
2.826:05–31:06오늘날의 VM 사용
상황·문제smartphone~server 는 full demand-paged VM: portability, protection, 작은 physical memory 공유
원인supercomputer(vector) 는 swap 중 CPU 가 놀면 낭비가 크고 restartable vector instruction 구현도 어려움
해결job 이 memory 에 맞도록 운용 (학과 cluster 도 swap 하면 성능 급락). GPU 는 원래 수동 copy, 이후 host-device demand paging 추가. embedded·DSP 는 VM 없이 필요한 용량을 맞춤
- embedded 는 무엇이 돌지 알기 때문에 sophisticated VM 불필요
2.8.r.2Hennessy & Patterson, Computer Architecture: A Quantitative Approach 6th ed. (Elsevier) ↗ · 추천 독서 교재 (ca_L14: 2.4-2.7, ca_L15: 5.6-5.7)
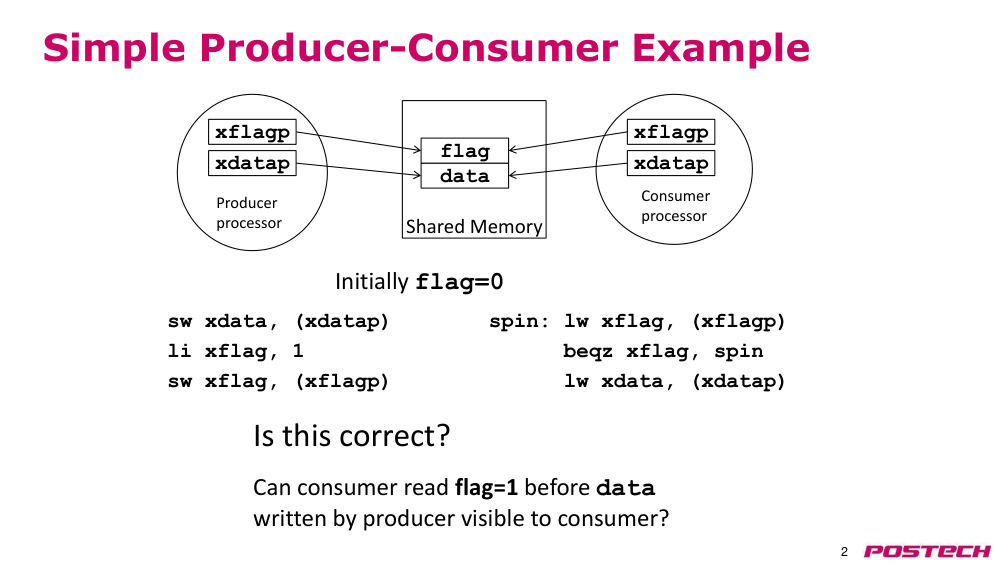
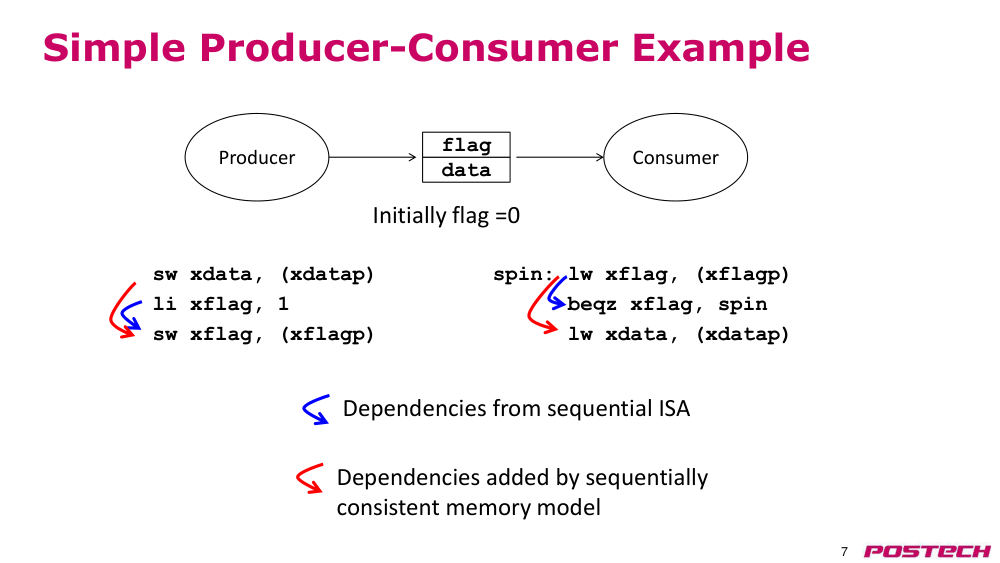
2.931:07–38:57memory consistency 도입: producer-consumer 예제
상황·문제producer 가 data 를 쓰고 flag=1, consumer 는 flag 가 0 이 아닐 때까지 spin 후 data load
원인각 instruction 이 atomic 이고 context switch 가 없어도 동작 보장 여부는 알 수 없다 (투표)
해결답: machine 의 memory consistency model 에 달려 있다
- consumer 가 flag=1 을 data 보다 먼저 볼 수 있는가가 핵심
2.1038:58–42:41cache coherence vs memory consistency
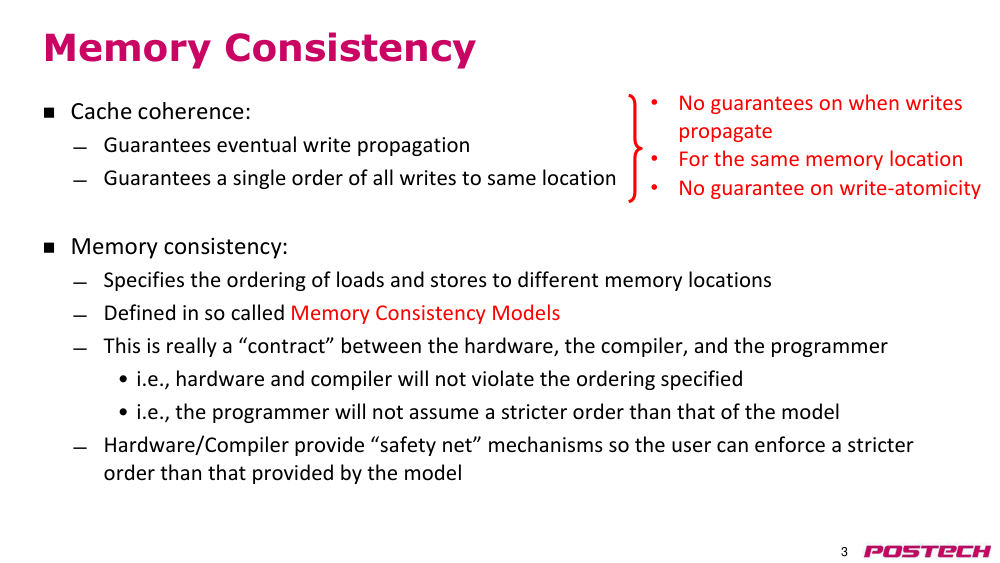
상황·문제consistency 를 coherence 와 혼동하기 쉽다
원인coherence 는 같은 위치에 대한 eventual write propagation 과 write 의 single order 만 보장. 다른 위치, 전파 시점, write atomicity 는 보장 안 함
해결consistency model 은 서로 다른 위치에 대한 load/store 순서를 정하는 hardware·compiler·programmer 사이의 contract. fence·barrier 가 safety net
- hardware 는 명시된 순서를 위반하지 않고, programmer 는 더 엄격한 순서를 가정하지 않는다
2.10.r.1Wikipedia: Consistency model ↗ · coherence(한 위치) vs consistency(여러 위치), SC·TSO·PSO·release consistency
2.10.r.2Sorin·Hill·Wood, A Primer on Memory Consistency and Cache Coherence (1st ed., UCLA 강의 사본) ↗ · Ch.3 SC(3.10 MIPS R10000), Ch.4 TSO/x86·fence, Ch.5 relaxed(XC)·release consistency — 목차 확인
2.1142:42–47:06write serialization vs write atomicity
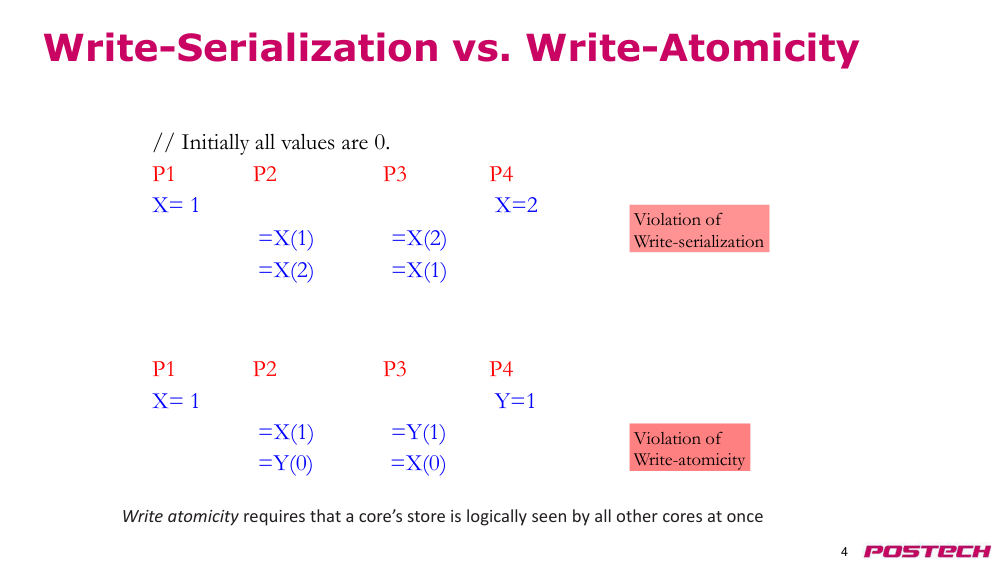
상황·문제P1 이 X=1, P4 가 X=2 를 쓸 때 P2 는 1→2, P3 은 2→1 로 관측
원인write 순서가 processor 마다 달라 write serialization 위반 (coherence protocol 이 막는 것)
해결write atomicity: store 가 모든 core 에 논리적으로 동시에 보여야 함. X·Y 예에서 P2 는 X 만, P3 는 Y 만 본 경우가 위반
- write serialization 은 같은 위치, write atomicity 는 서로 다른 위치까지의 문제
2.11.r.1Wikipedia: Consistency model ↗ · coherence(한 위치) vs consistency(여러 위치), SC·TSO·PSO·release consistency
2.1247:07–52:23sequential consistency(SC)
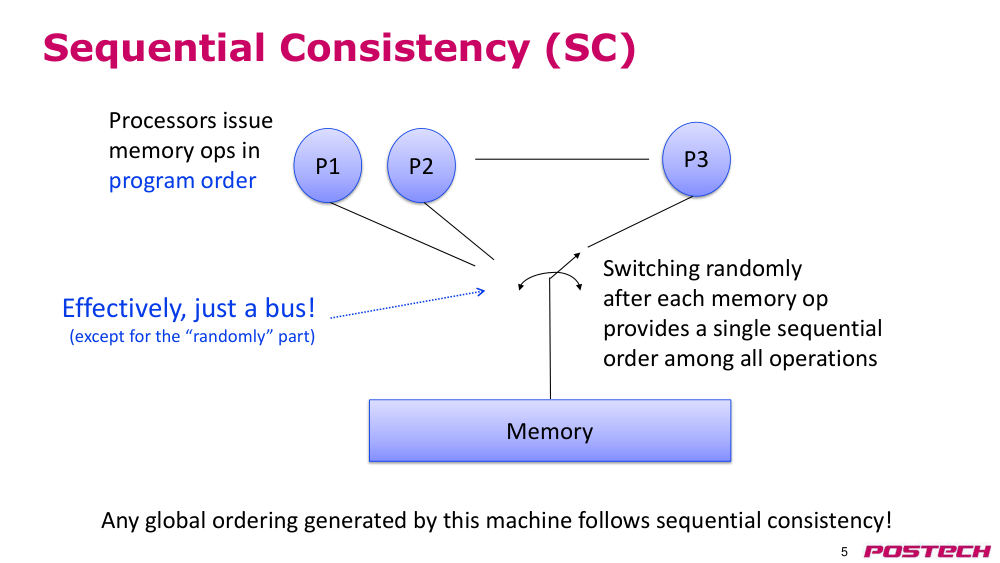
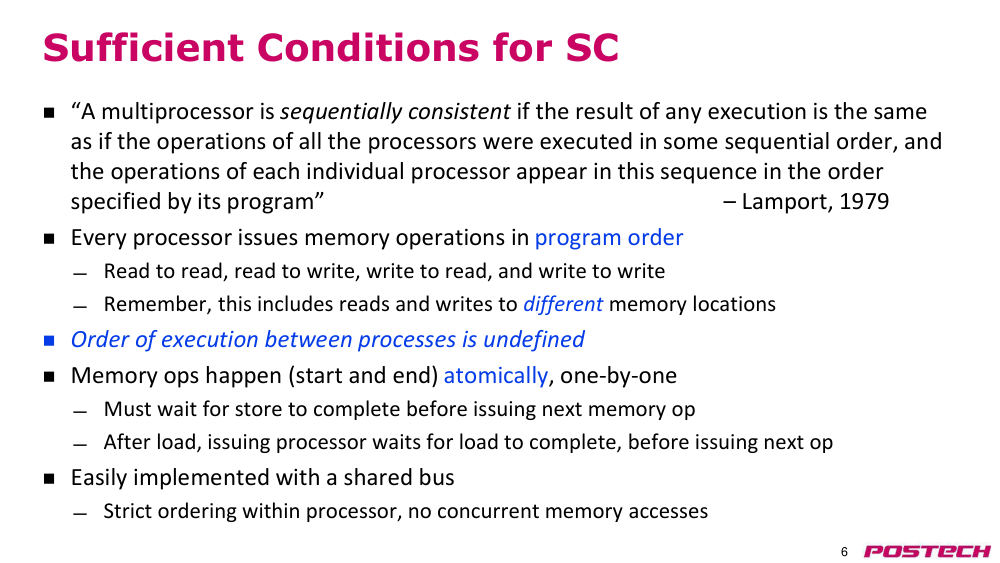
상황·문제가장 기본적인 model: 각 processor 가 program order 로 issue, 모든 processor 가 같은 single order 를 봄
원인switch 가 memory 를 한 번에 한 processor 에만 연결하는 모델 — 사실상 bus(random 제외)
해결producer-consumer 는 store-store, load-load 순서가 SC 로 보장되어 동작. 단점은 concurrent memory access 불가로 성능 제한
- Lamport 1979 정의
- ISA 가 주는 register dependency 와 memory model 이 추가하는 ordering 은 별개
2.12.r.1Wikipedia: Sequential consistency ↗ · Lamport 1979 정의: 어떤 sequential order + 각 processor 의 program order
2.12.r.2Sorin·Hill·Wood, A Primer on Memory Consistency and Cache Coherence (1st ed., UCLA 강의 사본) ↗ · Ch.3 SC(3.10 MIPS R10000), Ch.4 TSO/x86·fence, Ch.5 relaxed(XC)·release consistency — 목차 확인
2.1352:24–57:46SC 구현 최적화: non-binding prefetch 와 speculation
상황·문제program order 를 엄격히 지키면 성능 손해
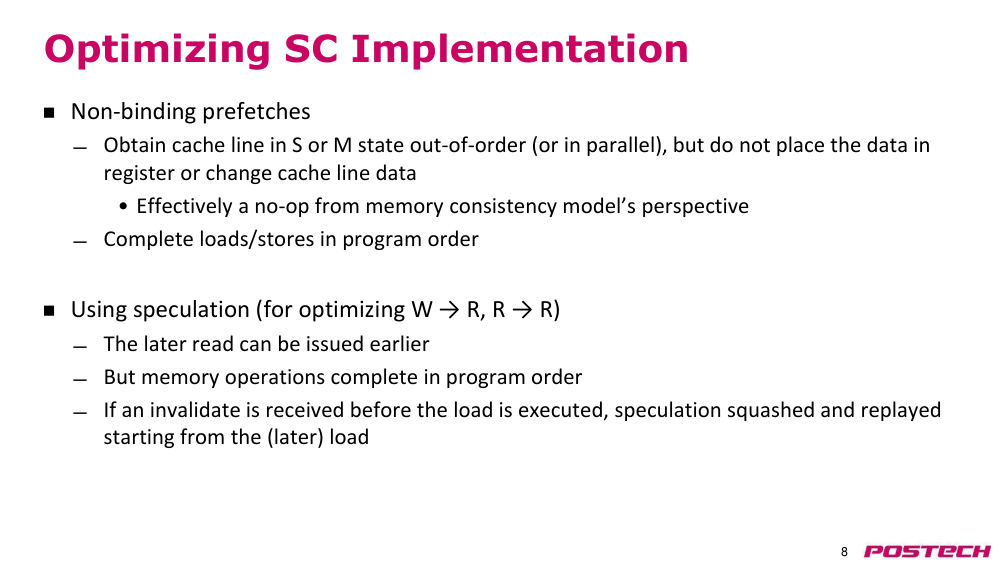
원인cache 내용 변경은 architectural state 를 바꾸지 않는다
해결non-binding prefetch 로 line 을 S(읽기)·M(쓰기) 상태로 미리 가져오되 register 에 넣지 않음. 뒤 load 를 먼저 수행하고 commit 전 invalidation 이 오면 squash·replay
- MSI protocol 가정
- prefetch 는 consistency 관점에서 no-op, load/store 는 program order 로 완료
2.13.r.1Sorin·Hill·Wood, A Primer on Memory Consistency and Cache Coherence (1st ed., UCLA 강의 사본) ↗ · Ch.3 SC(3.10 MIPS R10000), Ch.4 TSO/x86·fence, Ch.5 relaxed(XC)·release consistency — 목차 확인
2.1457:47–1:01:49store buffer 가 SC 를 깨뜨림, 실제 machine 은 SC 가 아님
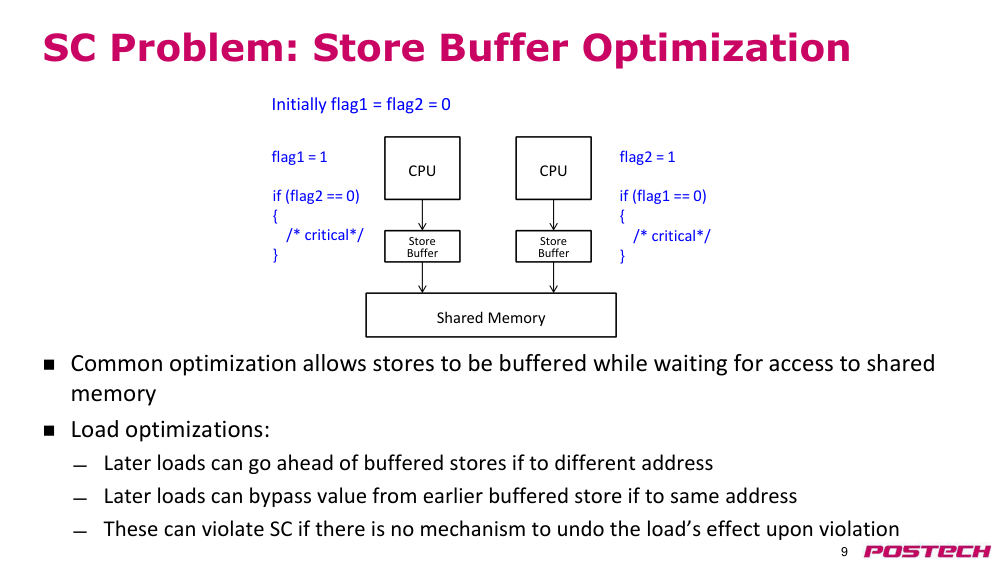
상황·문제flag1=1 후 flag2==0 이면 critical section 진입 (반대편도 대칭)
원인store 가 store buffer 에 머무는 사이 load 가 bypass → 두 CPU 모두 flag 0 을 읽고 동시 진입
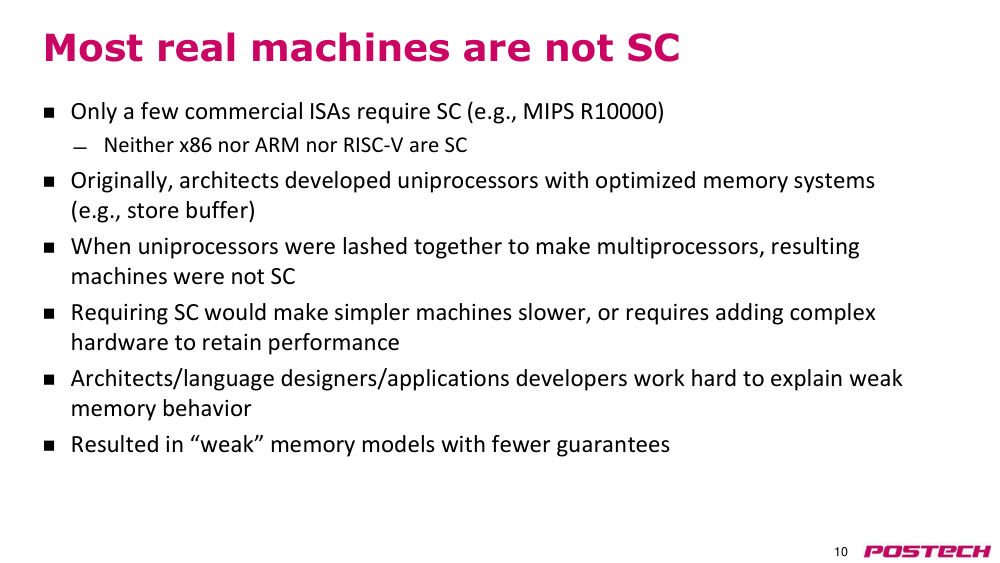
해결store buffer 없이는 성능 손해가 커서 대부분 machine 은 SC 를 포기. uniprocessor 최적화를 multiprocessor 로 묶으며 weaker model 이 생김
- SC 요구 ISA 는 MIPS R10000 등 소수, x86·ARM·RISC-V 는 SC 아님 (자막 3625 는 '따른다'로 잘못 말함, 슬라이드 기준)
2.14.r.2Sorin·Hill·Wood, A Primer on Memory Consistency and Cache Coherence (1st ed., UCLA 강의 사본) ↗ · Ch.3 SC(3.10 MIPS R10000), Ch.4 TSO/x86·fence, Ch.5 relaxed(XC)·release consistency — 목차 확인
2.151:01:50–1:07:16relaxed memory consistency models
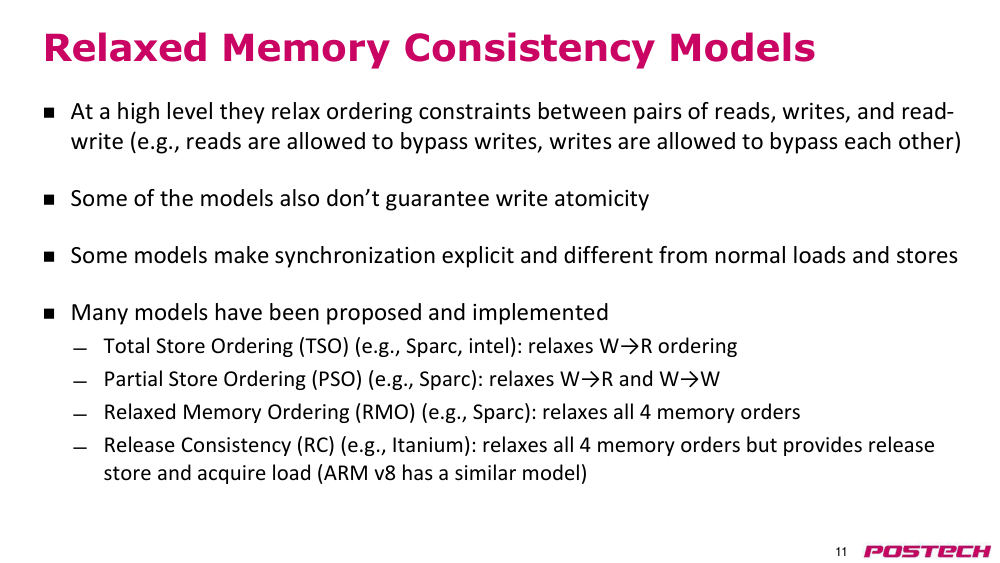
상황·문제read/write 쌍 사이 ordering 을 완화해 reordering 허용, 일부는 write atomicity 도 미보장
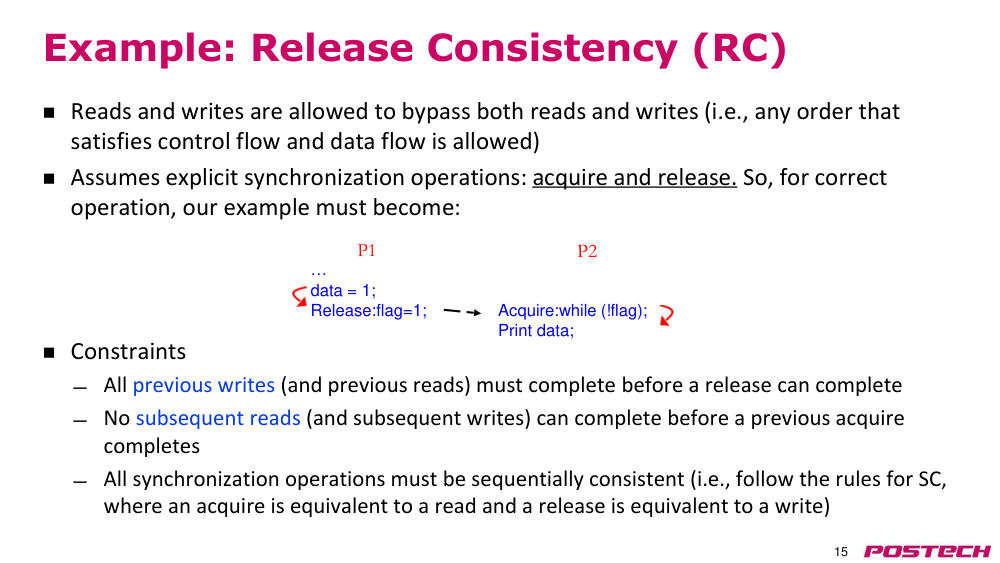
원인필요하면 fence·barrier, 또는 acquire/release 같은 명시적 synchronization
해결TSO(SPARC, x86): W→R 완화 / PSO: W→W 도 / RMO: 4가지 모두 / RC(Itanium): 4가지 모두 + release store·acquire load
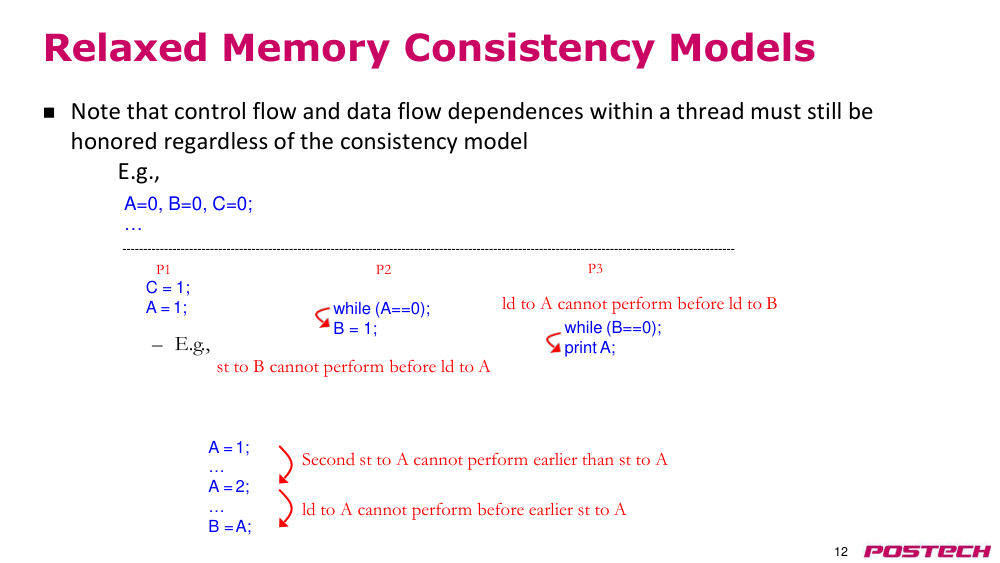
- 어떤 model 이든 thread 내 control·data dependency 는 지켜야 함
- 같은 위치 store 순서, store→load 는 유지
2.15.r.1Wikipedia: Memory ordering ↗ · architecture 별 허용 reordering 표 (x86 은 store 뒤 load 만, SPARC TSO/PSO/RMO)
2.15.r.2Wikipedia: Consistency model ↗ · coherence(한 위치) vs consistency(여러 위치), SC·TSO·PSO·release consistency
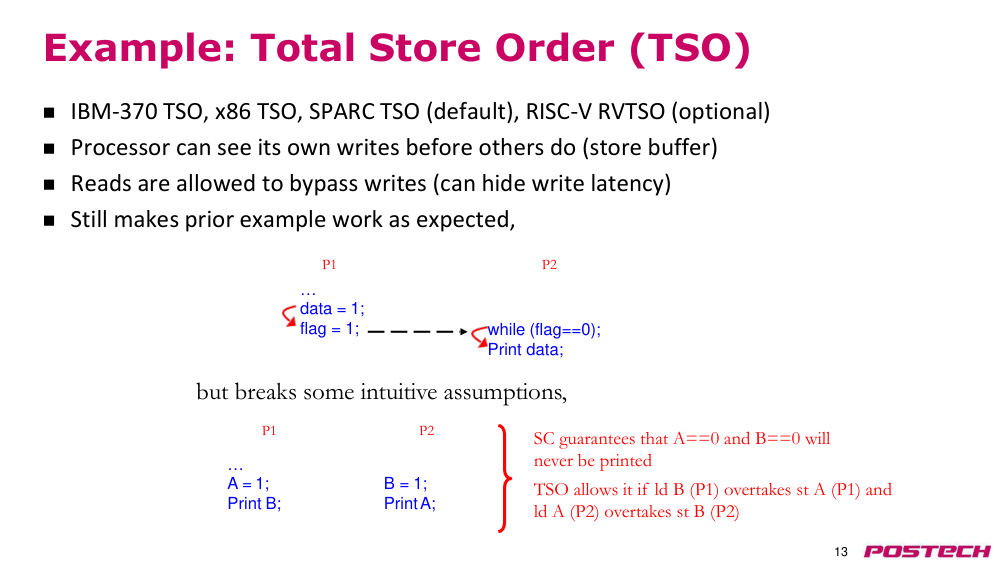
2.161:07:17–1:12:20total store order(TSO)
상황·문제IBM-370·x86·SPARC TSO, RISC-V RVTSO(선택)
원인processor 가 자기 write 를 다른 processor 보다 먼저 볼 수 있음(store buffer), read 가 write 를 bypass 해 write latency 를 숨김
해결producer-consumer 는 store 순서가 유지되어 여전히 동작. 하지만 A=1;print B / B=1;print A 에서 A==0·B==0 이 가능 (SC 는 불가)
- store buffer 는 write 를 순서대로 memory 에 반영
- RISC-V 는 여러 model 중 설계·boot 시 선택 가능
2.16.r.1Wikipedia: Memory ordering ↗ · architecture 별 허용 reordering 표 (x86 은 store 뒤 load 만, SPARC TSO/PSO/RMO)
2.16.r.2Sorin·Hill·Wood, A Primer on Memory Consistency and Cache Coherence (1st ed., UCLA 강의 사본) ↗ · Ch.3 SC(3.10 MIPS R10000), Ch.4 TSO/x86·fence, Ch.5 relaxed(XC)·release consistency — 목차 확인
2.171:12:21–1:17:00fence 로 순서 강제, Q&A
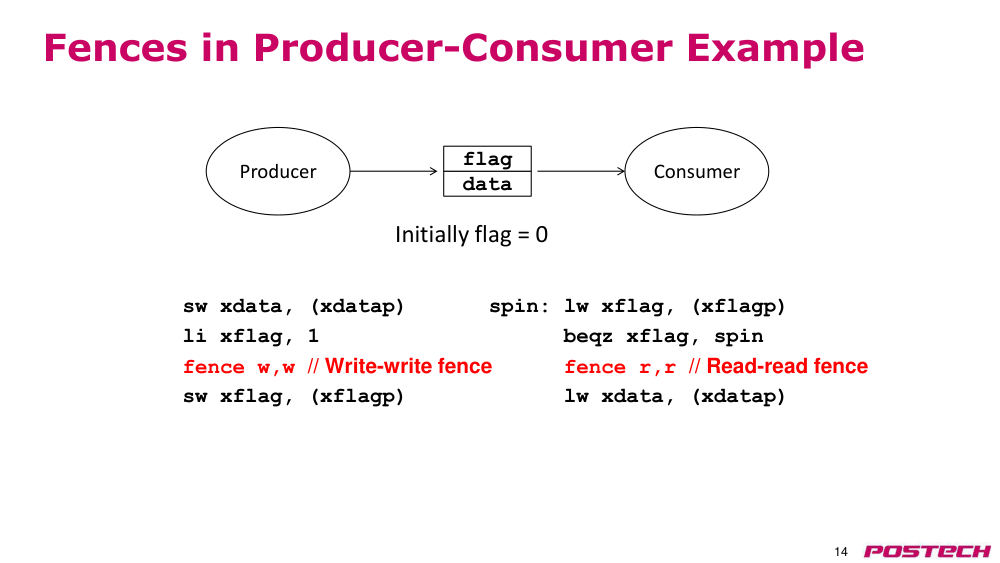
상황·문제relaxed model 에서 원하는 ordering 을 보장하고 싶다
원인hardware 가 아무 보장도 안 하면 결과를 예측할 수 없고 programmer 는 모든 연산 사이에 fence 를 넣어야 함
해결fence w,w 는 앞선 write 완료 후 다음 write, fence r,r 은 read 간 순서 강제. release consistency 는 다음 강의로
- 합리적 consistency model 이 correctness 와 성능 사이의 contract
2.17.r.2Wikipedia: Release consistency ↗ · acquire/release 로 critical section 경계 지정, eager vs lazy RC
3핵심 개념
3.1VIPT(virtually indexed physically tagged)
page offset bit 로 index 해 TLB 와 cache 를 동시 접근, physical tag 비교. 크기 ≤ page size × way
3.1.r.1Wikipedia: CPU cache ↗ · VIPT 는 index+offset 을 page offset 안에 두어 synonym 회피 → 크기 상한 = page size × associativity
3.2aliasing(synonym)
같은 PA 를 가리키는 두 VA 가 cache 에 두 copy → write 가 다른 copy 에 안 보임
3.2.r.1Wikipedia: CPU cache ↗ · VIPT 는 index+offset 을 page offset 안에 두어 synonym 회피 → 크기 상한 = page size × associativity
3.3inclusive L2
L1 의 모든 line 이 L2 에도 있음. R10000 은 여기에 VA bit 를 저장해 alias 감지
3.4hashed / inverted page table
physical frame 기준 table 을 VPN hash 로 접근, 2~3배 크기로 collision 감소
3.4.r.1Wikipedia: Page table ↗ · inverted page table: frame 수만큼 row, VPN(+PID) hash 와 collision chain
3.5memory consistency model
서로 다른 위치 load/store 의 순서 규약. hardware·compiler·programmer 사이의 contract
3.5.r.1Wikipedia: Consistency model ↗ · coherence(한 위치) vs consistency(여러 위치), SC·TSO·PSO·release consistency
3.6write serialization vs write atomicity
같은 위치 write 의 단일 순서(coherence) vs store 가 모든 core 에 동시에 보임
3.6.r.1Wikipedia: Consistency model ↗ · coherence(한 위치) vs consistency(여러 위치), SC·TSO·PSO·release consistency
3.7sequential consistency(SC)
program order + 모든 processor 가 보는 single global order (Lamport 1979)
3.7.r.1Wikipedia: Sequential consistency ↗ · Lamport 1979 정의: 어떤 sequential order + 각 processor 의 program order
3.8non-binding prefetch
line 을 S/M 으로 미리 가져오되 register·data 불변 → SC 를 깨지 않는 최적화
3.9store buffer
store 를 buffer 에 두고 load 가 bypass → W→R reordering, SC 위반의 주원인
3.10TSO(total store order)
W→R 만 완화(x86·SPARC). data/flag 는 동작, A=1;print B 류에서 0·0 허용
3.10.r.1Wikipedia: Memory ordering ↗ · architecture 별 허용 reordering 표 (x86 은 store 뒤 load 만, SPARC TSO/PSO/RMO)
3.11fence(memory barrier)
fence w,w / fence r,r 로 앞뒤 연산 순서를 강제
4스스로 확인
4.1VIPT 에서 alias 가 생기지 않는 cache 크기 조건은?
답
index+block offset bit 가 page offset 안(L+b≤k). 크기 ≤ page size × associativity
4.2MIPS R10000 은 L1 alias 를 어떻게 막는가?
답
inclusive L2 에 VA bit a 저장, L1 miss·L2 hit 때 a 가 다르면 기존 L1 line 을 purge 후 설치
4.3Atlas PAR 방식의 단점과 hashed page table 의 대응은?
답
모든 PAR 를 비교해야 해 memory 가 크면 비쌈 → VPN hash 로 한 entry(PowerPC 는 8 PTE slot)만 검사, 2~3배 크기
4.4cache coherence 가 보장하지 않는 것은?
답
다른 위치 간 순서, write 전파 시점, write atomicity
4.5store buffer 가 SC 를 깨는 예는?
답
flag1=1;if(flag2==0) 대칭 코드에서 load 가 buffered store 를 bypass 해 둘 다 critical section 진입
4.6TSO 에서 A=1;print B / B=1;print A 가 0,0 을 출력할 수 있는 이유는?
답
W→R 완화로 각 load 가 자기 store(store buffer 안)를 앞질러 실행
5참고 자료
5.1Hennessy & Patterson, Computer Architecture: A Quantitative Approach 6th ed. (Elsevier) ↗ · 추천 독서 교재 (ca_L14: 2.4-2.7, ca_L15: 5.6-5.7)
5.2Sorin·Hill·Wood, A Primer on Memory Consistency and Cache Coherence (1st ed., UCLA 강의 사본) ↗ · Ch.3 SC(3.10 MIPS R10000), Ch.4 TSO/x86·fence, Ch.5 relaxed(XC)·release consistency — 목차 확인
5.3Wikipedia: CPU cache ↗ · VIPT 는 index+offset 을 page offset 안에 두어 synonym 회피 → 크기 상한 = page size × associativity
5.5Wikipedia: Atlas (computer) ↗ · page address register 의 associative memory 로 core 에 page 가 있는지 판정
5.7Wikipedia: Second Level Address Translation ↗ · guest PA 를 host VA 로 보고 host page table 을 hardware 가 walk (EPT/NPT)
5.8Wikipedia: Consistency model ↗ · coherence(한 위치) vs consistency(여러 위치), SC·TSO·PSO·release consistency
5.9Wikipedia: Sequential consistency ↗ · Lamport 1979 정의: 어떤 sequential order + 각 processor 의 program order
5.10Wikipedia: Memory ordering ↗ · architecture 별 허용 reordering 표 (x86 은 store 뒤 load 만, SPARC TSO/PSO/RMO)