이 자료를 쓰는 강의: 21 Directory 마무리·Shared cache·NUCA, Virtual Memory(base&bound·paging·TLB·virtual cache) · 22 VIPT·alias 방지·hashed page table·VM 역사, Memory Consistency(SC·TSO·fence)
Lec14 - Virtual Memory
한국어판 강의자료 · 46쪽
p.1virtual memory(가상 메모리)
p.2bare machine(베어 머신)
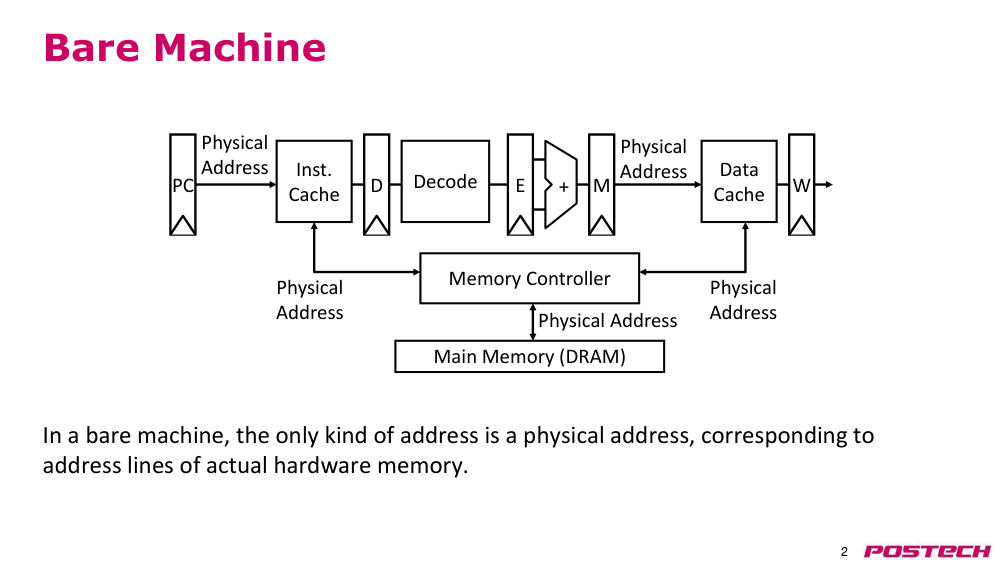
- bare machine(베어 머신)에서는 유일한 주소 유형은 실제 하드웨어 메모리의 주소 라인에 해당하는 physical address(물리 주소)이다.
- PC
- Inst. Cache
- D
- Decode
- E
- M
- Data Cache
- W
- +
- 메인 메모리 (DRAM)
- memory controller(메모리 컨트롤러)
- physical address(물리 주소)
- physical address(물리 주소)
- physical address(물리 주소)
- physical address(물리 주소)
- physical address(물리 주소)
p.3bare machine(베어 머신)에서의 메모리 관리
- 초기 기계는 한 번에 하나의 프로그램만 실행했으며, 이 프로그램은 모든 메모리와 모든 I/O 장치에 무제한 접근 권한을 가졌다.
- 서브루틴 라이브러리가 인기를 끌었고, 위치 독립 형식으로 작성되었다.
- 다른 프로그램들은 서로 다른 루틴 조합을 사용한다.
- bare machine(베어 머신)에서 프로그램을 실행하기 위해 linker(링커) 또는 loader(로더) 프로그램을 사용하여 라이브러리 모듈을 실제 physical memory(물리 메모리) 위치로 재배치한다.
p.4dynamic address translation(동적 주소 변환)
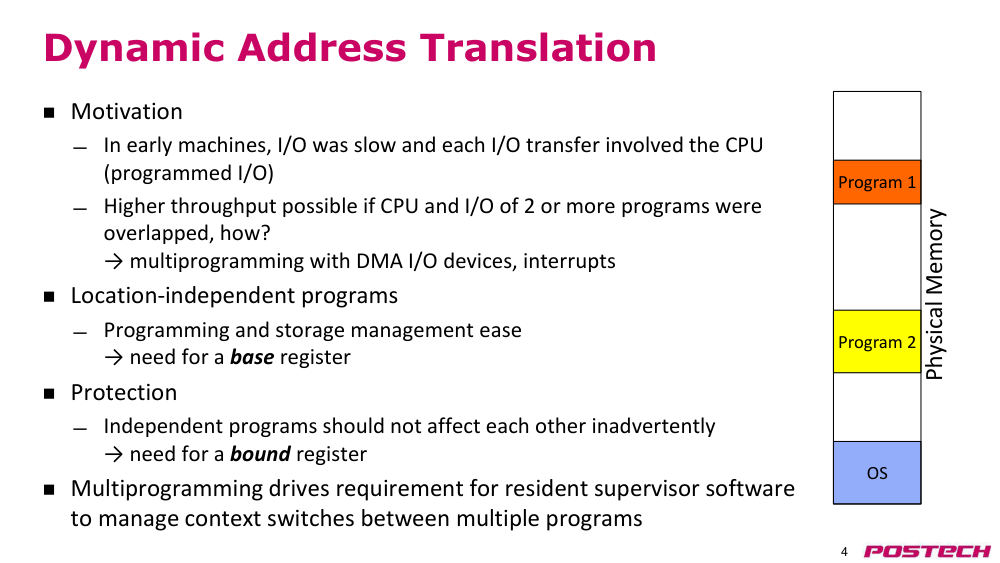
- motivation(동기):
- 초기 기계에서는 I/O가 느렸고, 각 I/O 전송은 CPU를 사용하여 수행되었다 (프로그램 I/O).
- CPU와 2개 이상의 프로그램의 I/O를 겹치게 하면 더 높은 처리량을 얻을 수 있다. 어떻게?
- → DMA I/O(DMA 입출력) 장치와 interrupts(인터럽트)를 사용한 multiprogramming(다중 프로그래밍)
- 위치 독립 프로그램:
- 프로그래밍 및 저장 관리의 용이성
- → base register(베이스 레지스터) 필요
- 보호:
- 독립된 프로그램은 의도치 않게 서로에게 영향을 주어서는 안 된다.
- → bound register(경계 레지스터) 필요
- multiprogramming(다중 프로그래밍)은 여러 프로그램 간 context switch(컨텍스트 전환)을 관리하는 resident supervisor software(상주 관리자 소프트웨어)의 필요성을 촉진한다.
- physical memory(물리 메모리)
- 프로그램 1
- 프로그램 2
- OS
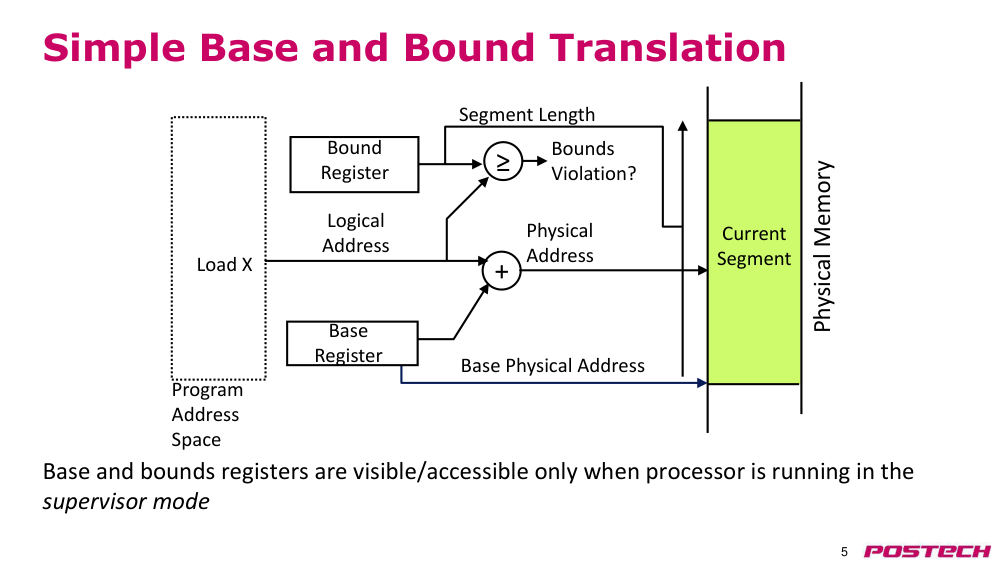
p.5간단한 베이스 및 경계 변환
- 베이스 및 bound register(경계 레지스터)는 프로세서가 supervisor mode(관리자 모드)에서 실행될 때만 가시적/접근 가능하다.
- Load X
- 프로그램 주소 공간
- bound register(경계 레지스터)
- 경계 위반?
- physical memory(물리 메모리)
- 현재 segment(세그먼트)
- base register(베이스 레지스터)
- +
- physical address(물리 주소)
- logical address(논리 주소)
- 베이스 physical address(물리 주소)
- segment(세그먼트) 길이
- ≥
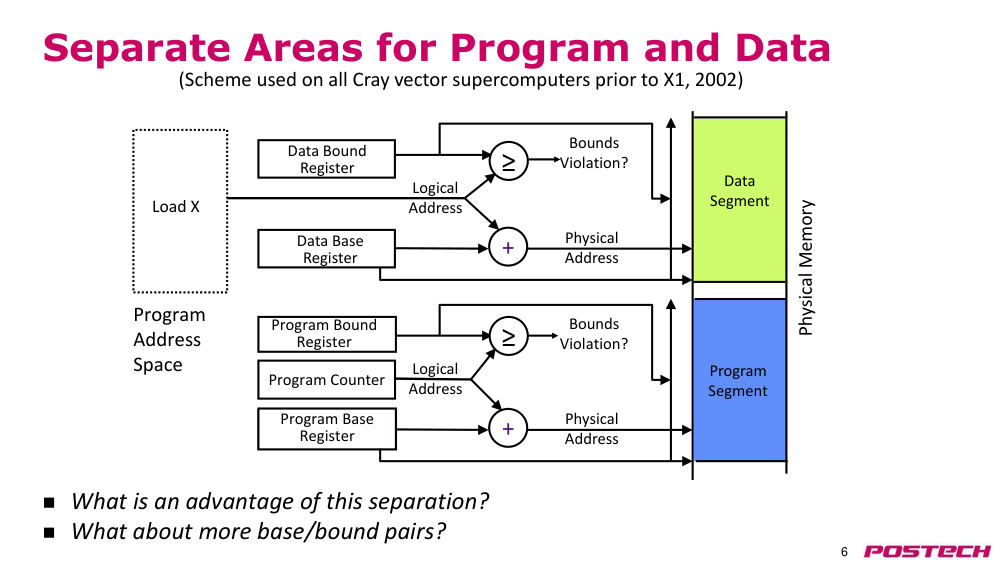
p.6프로그램과 데이터를 별도 영역으로 분리
- 이 분리의 장점은 무엇인가?
- 더 많은 베이스/경계 쌍은 어떻게 될까?
- (2002년 이전 Cray vector supercomputer(벡터 슈퍼컴퓨터)에서 사용된 방식)
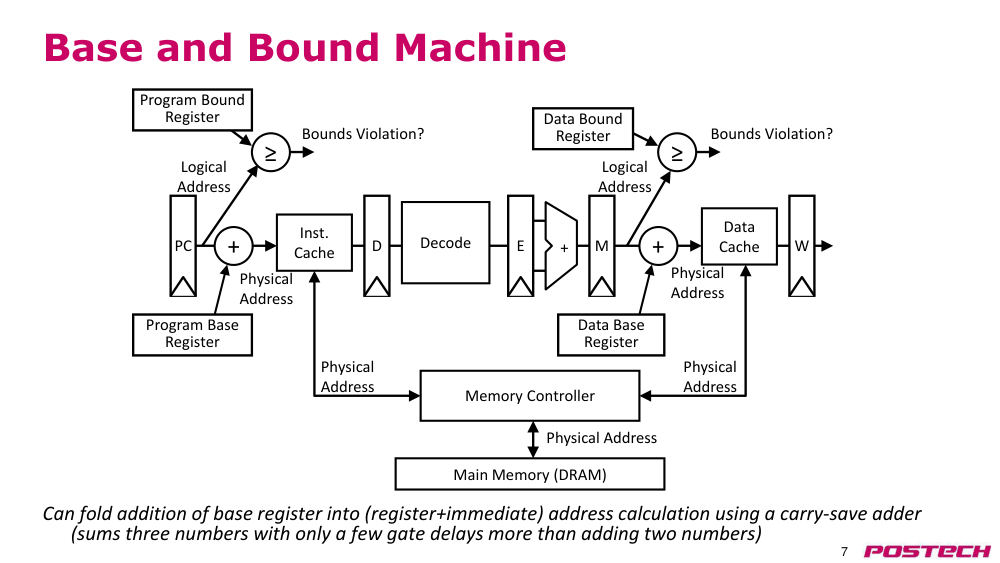
p.7베이스와 경계 머신
- base register(베이스 레지스터)의 덧셈을 (레지스터 + 즉시 값) 주소 계산에 통합할 수 있음
- 캐리 세이브 어드더(Carry-Save Adder)를 사용하여 세 개의 수를 두 개의 수를 더하는 것보다 몇 개의 게이트 지연만 추가하여 합산 가능
- 프로그램 카운터(PC)
- 명령어 cache(캐시)
- 디코딩
- 실행
- 메모리
- 데이터 cache(캐시)
- 쓰기
- 주기억장치(DRAM)
- memory controller(메모리 컨트롤러)
- physical address(물리 주소)
- physical address(물리 주소)
- physical address(물리 주소)
- physical address(물리 주소)
- 데이터 bound register(경계 레지스터)
- 데이터 base register(베이스 레지스터)
- logical address(논리 주소)
- 경계 위반 여부?
- physical address(물리 주소)
- 프로그램 base register(베이스 레지스터)
- logical address(논리 주소)
- 경계 위반 여부?
- ≥
- ≥
- 프로그램 bound register(경계 레지스터)
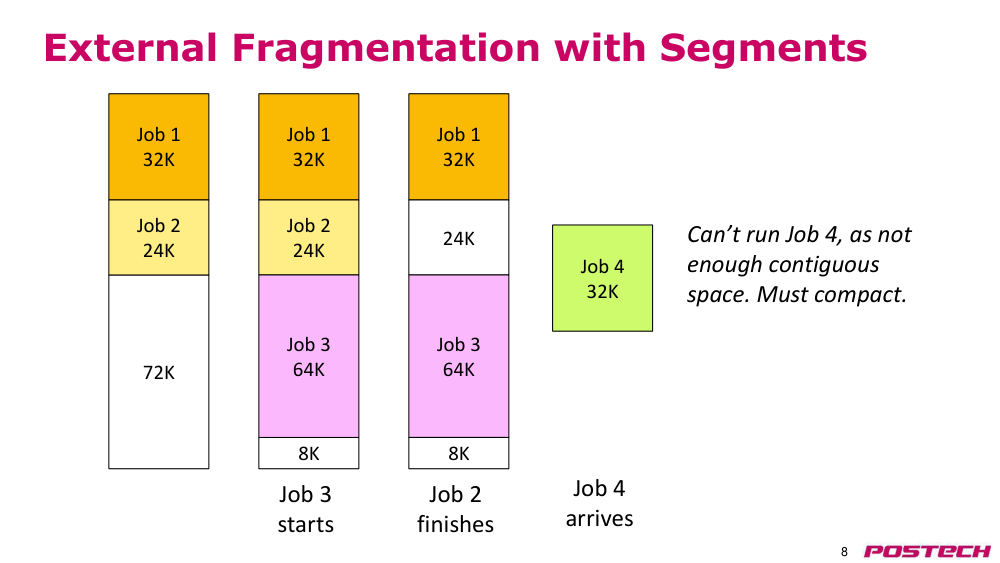
p.8segment(세그먼트)와 함께 발생하는 external fragmentation(외부 단편화)
- 72K
- 작업 1
- 32K
- 작업 2
- 24K
- 8K
- 작업 1
- 32K
- 작업 2
- 24K
- 작업 3
- 64K
- 작업 3 시작
- 작업 1
- 32K
- 24K
- 작업 3
- 64K
- 8K
- 작업 2 종료
- 작업 4
- 32K
- 작업 4 도착
- 연속된 공간이 충분하지 않아 작업 4를 실행할 수 없음
- compaction(압축)이 필요함
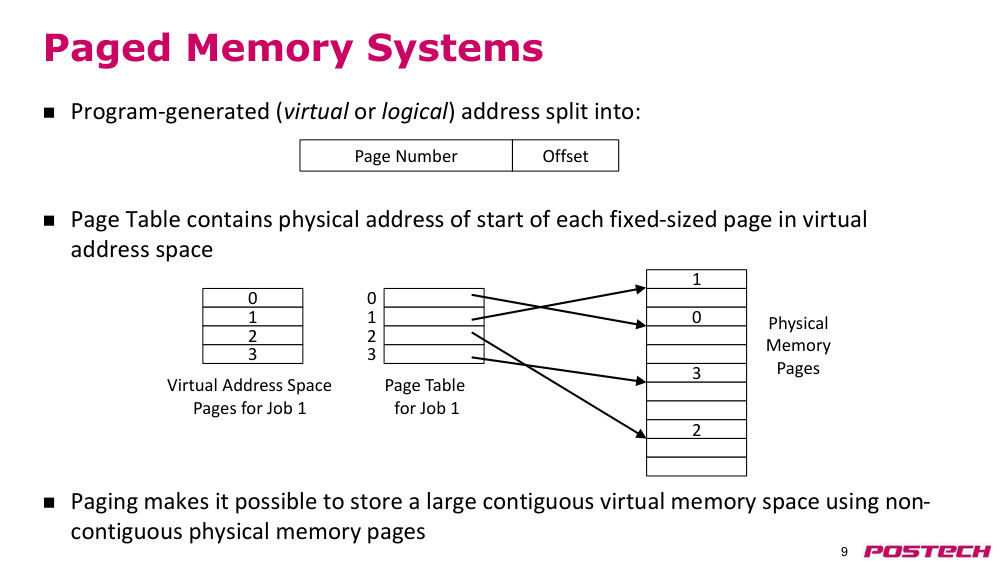
p.9paging(페이징) 메모리 시스템
- 프로그램이 생성한 (가상 또는 논리) 주소는 다음과 같이 분할됨:
- page table(페이지 테이블)은 virtual address(가상 주소) 공간 내 각 고정 크기 페이지의 시작 physical address(물리 주소)를 포함함
- paging(페이징)을 통해 비연속적인 physical memory(물리 메모리) 페이지를 사용하여 큰 연속적인 virtual memory(가상 메모리) 공간을 저장할 수 있음
- virtual address(가상 주소) 공간
- 작업 1의 페이지
- 작업 1의 page table(페이지 테이블)
- physical memory(물리 메모리)
- 페이지
- page number(페이지 번호)
- offset(오프셋)
- 0
- 1
- 2
- 3
- 0
- 1
- 2
- 3
- 1
- 0
- 3
- 2
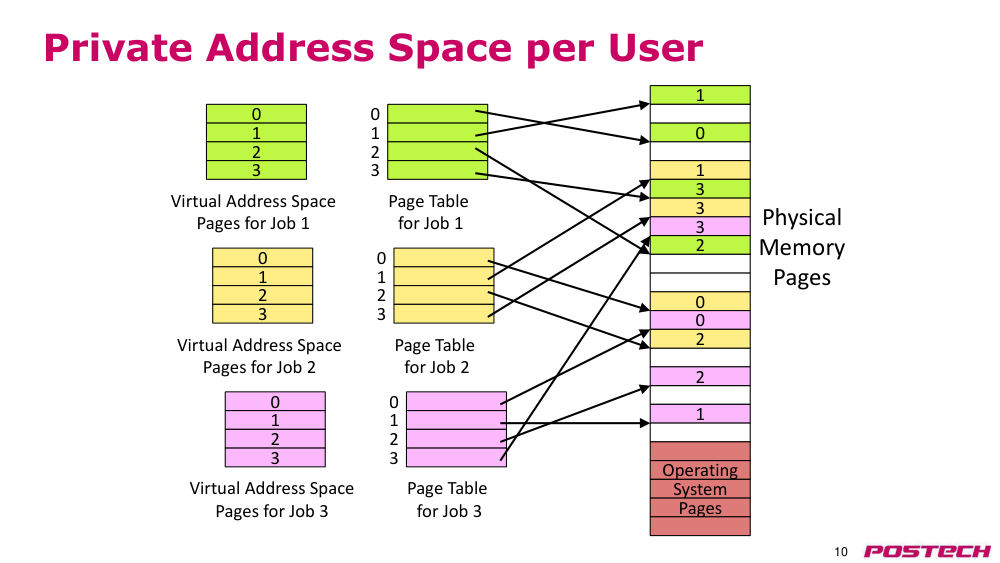
p.10사용자별 private address space(개별 주소 공간)
- virtual address(가상 주소) 공간
- 작업 1의 페이지
- 작업 1의 page table(페이지 테이블)
- physical memory(물리 메모리)
- 페이지
- 0
- 1
- 2
- 3
- 0
- 1
- 2
- 3
- 1
- 0
- 1
- 3
- 3
- 3
- 2
- 0
- 0
- 2
- 2
- 1
- operating system (OS)(운영체제)
- 페이지
- virtual address(가상 주소) 공간
- 작업 2의 페이지
- 작업 2의 page table(페이지 테이블)
- 0
- 1
- 2
- 3
- 0
- 1
- 2
- 3
- virtual address(가상 주소) 공간
- 작업 3의 페이지
- 작업 3의 page table(페이지 테이블)
- 0
- 1
- 2
- 3
- 0
- 1
- 2
- 3
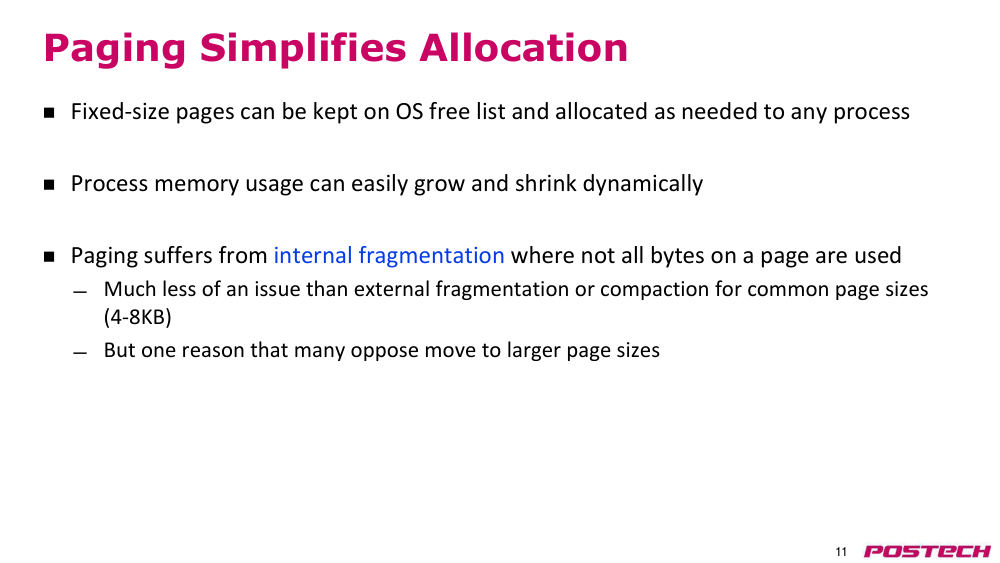
p.11paging(페이징)이 할당을 단순화함
- 고정 크기의 페이지는 operating system (OS)(운영체제)의 자유 목록에 보관되며, 필요 시 어떤 프로세스에도 할당 가능
- 프로세스 메모리 사용량은 쉽게 동적으로 증가하거나 감소할 수 있음
- paging(페이징)은 페이지의 일부 바이트만 사용될 때 발생하는 internal fragmentation(내부 단편화) 문제를 겪음
- 일반적인 페이지 크기(4-8KB)에서는 external fragmentation(외부 단편화)이나 compaction(압축)보다 훨씬 덜 심각한 문제
- 그러나 많은 이들이 page size(페이지 크기)를 더 크게 하기를 반대하는 이유 중 하나
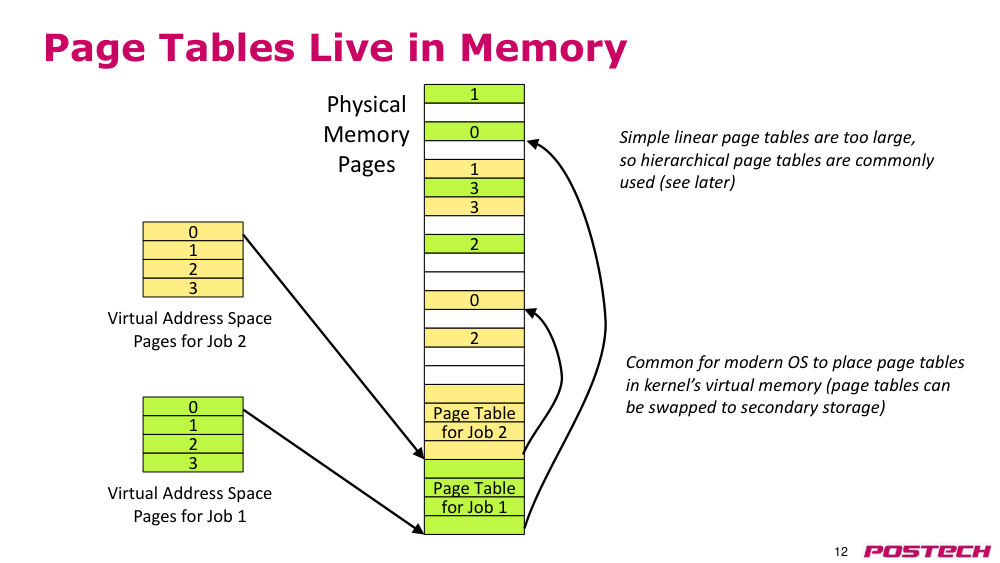
p.12page table(페이지 테이블)은 메모리에 존재함
- virtual address(가상 주소) 공간
- 작업 1의 페이지
- physical memory(물리 메모리)
- 페이지
- 0
- 1
- 2
- 3
- 작업 1의 page table(페이지 테이블)
- 1
- 0
- 1
- 3
- 3
- 2
- 0
- 2
- virtual address(가상 주소) 공간
- 작업 2의 페이지
- 0
- 1
- 2
- 3
- 작업 2의 page table(페이지 테이블)
- 간단한 linear page table(선형 페이지 테이블)은 너무 크므로, 일반적으로 hierarchical page table(계층적 페이지 테이블)이 사용됨 (나중에 설명)
- 현대 operating system (OS)(운영체제)에서는 page table(페이지 테이블)을 커널의 virtual memory(가상 메모리)에 배치하는 것이 일반적 (페이지 테이블은 secondary storage(보조 기억장치)로 스왑 가능)
p.13제한된 primary storage(주기억장치) 대응
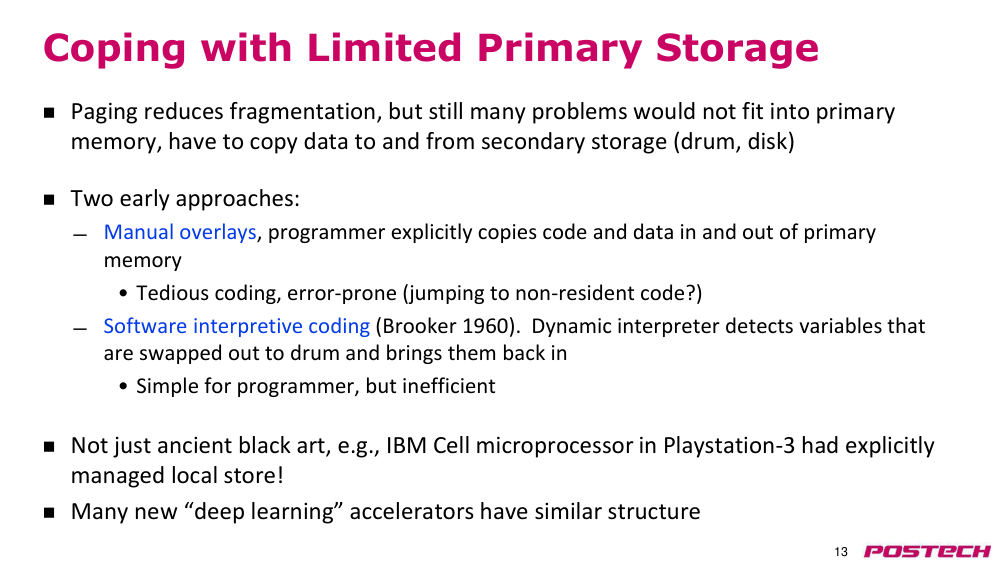
- paging(페이징)은 단편화를 줄이지만, 여전히 primary storage(주기억장치)에 맞지 않는 많은 문제들이 존재하며, 보조 기억장치(드럼, 디스크)와 데이터를 오가야 한다.
- 두 가지 초기 접근 방식:
- • 수동 overlay(오버레이): 프로그래머가 primary storage(주기억장치) 내외로 코드와 데이터를 명시적으로 복사
- - 번거로운 코딩, 실수하기 쉬움 (non-resident code(비상주 코드)로 점프하는 경우?)
- • 소프트웨어 해석적 코드 (Brooker 1960). 동적 인터프리터가 drum(드럼)으로 스왑된 변수를 감지하고 다시 불러옴
- - 프로그래머에게 간단하지만 비효율적이다.
- • 오래된 검은 예술이 아니라, 예를 들어 PS3의 IBM Cell 마이크로프로세서는 명시적으로 관리되는 로컬 스토어를 가짐!
- • 많은 새로운 '딥러닝' 가속기들도 유사한 구조를 가짐
p.14Atlas(1962)의 demand paging(요구 페이징)
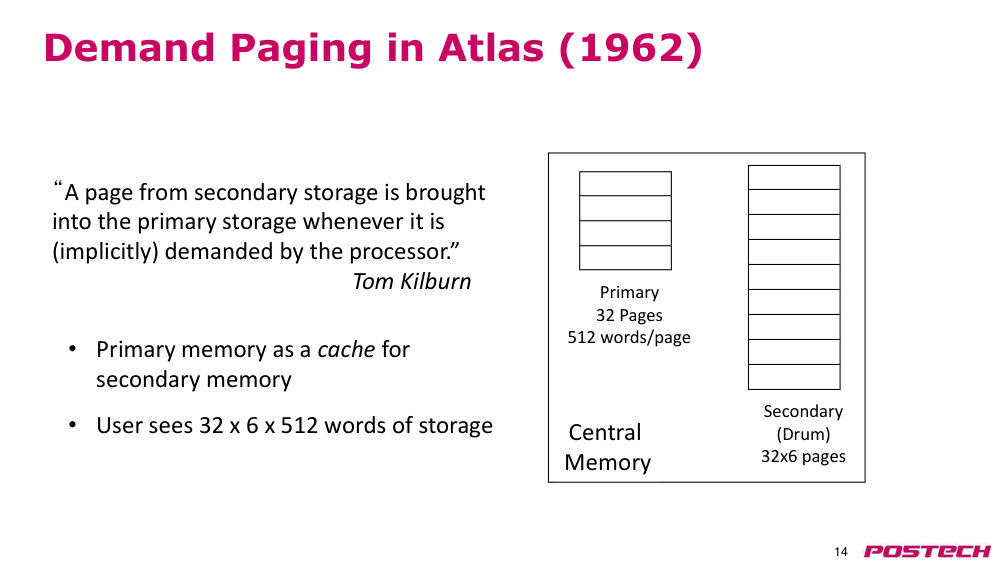
- 보조 기억장치 (드럼)
- 32x6 페이지
- primary storage(주기억장치)
- 32 페이지
- 512 단어/페이지
- 중앙 메모리
- • 사용자는 32 x 6 x 512 단어의 저장 공간을 인식한다.
- “프로세서에 의해 암시적으로 요구될 때마다 secondary storage(보조 기억장치)의 페이지가 primary storage(주기억장치)로 불러와진다.”
- Tom Kilburn
- • primary storage(주기억장치)는 secondary storage(보조 기억장치)에 대한 cache(캐시)로 작용한다
p.15Atlas의 하드웨어 구성
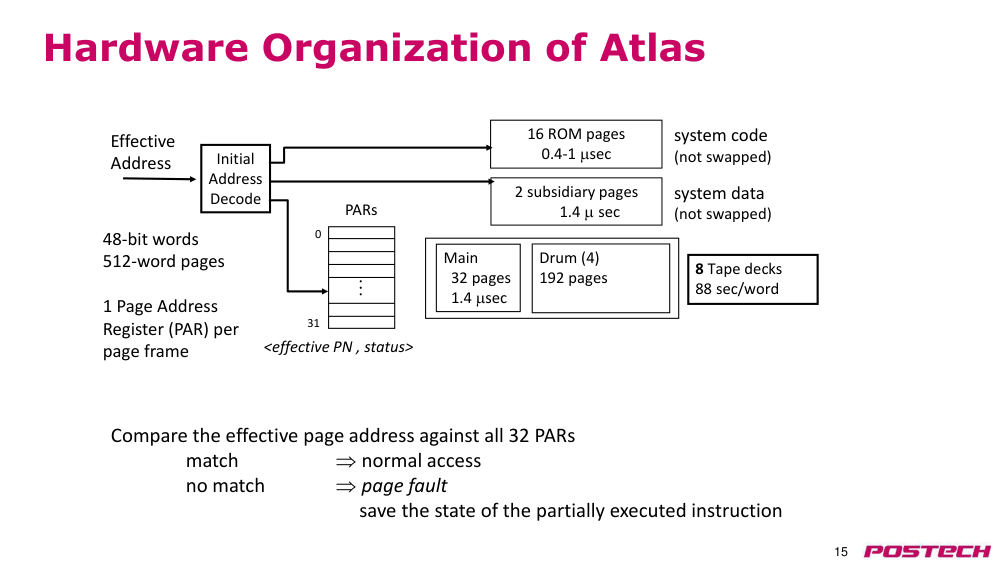
- 초기 주소
- 디코딩
- 16 ROM 페이지
- 0.4-1 sec
- 2 보조 페이지
- 1.4 sec
- 메인
- 32 페이지
- 1.4 sec
- 드럼 (4)
- 192 페이지
- 8 테이프 덱
- 88 sec/단어
- 48비트 단어
- 512단어 페이지
- 페이지 프레임당 1개의 페이지 주소 레지스터 (PAR)
- effective address(유효 주소)를 모든 32개의 PAR와 비교
- 일치 정상 접근
- 일치 없음 page fault(페이지 폴트)
- 부분적으로 실행된 명령어의 상태 저장
- effective address(유효 주소)
- 시스템 코드 (스왑되지 않음)
- 시스템 데이터 (스왑되지 않음)
- 0
- 31
- PARs
- <effective PN(유효 페이지 번호), 상태>
p.16Atlas의 demand paging(요구 페이징) 방식
- page fault(페이지 폴트) 발생 시:
- • 빈 페이지로의 입력 전송이 시작됨
- • 페이지 주소 레지스터 (PAR)가 갱신됨
- • 빈 페이지가 없을 경우, 사용량 기반으로 치환할 페이지 선택
- • 치환된 페이지는 drum(드럼)에 기록됨
- - drum(드럼) 지연 효과를 최소화하기 위해 드럼에서 처음 발견된 빈 페이지를 선택함
- • page table(페이지 테이블)이 페이지의 새로운 위치를 가리키도록 갱신됨
p.17linear page table(선형 페이지 테이블)의 크기
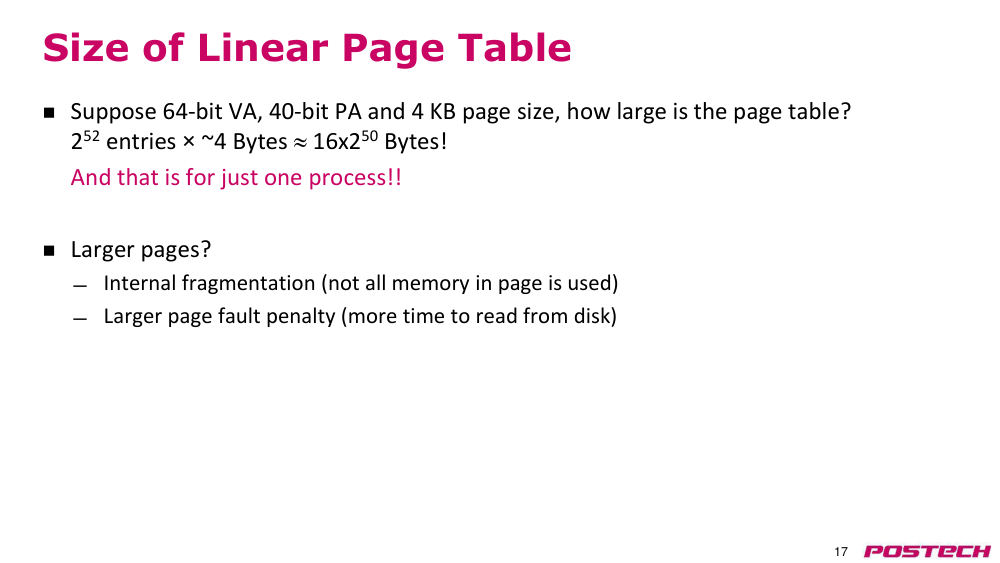
- 64비트 가상 주소(VA), 40비트 물리 주소(PA), 4 KB page size(페이지 크기)일 경우 page table(페이지 테이블) 크기는 얼마인가?
- 2⁵² 엔트리 × ~4 바이트 ≈ 16×2⁵⁰ 바이트!
- 그것도 단일 프로세스에 대한 것일 뿐이다!!
- 더 큰 페이지?
- • internal fragmentation(내부 단편화) (페이지 내 사용되지 않는 메모리 존재)
- • 더 큰 page fault(페이지 폴트) 페널티 (디스크에서 읽는 데 더 많은 시간 소요)
p.18hierarchical page table(계층적 페이지 테이블)
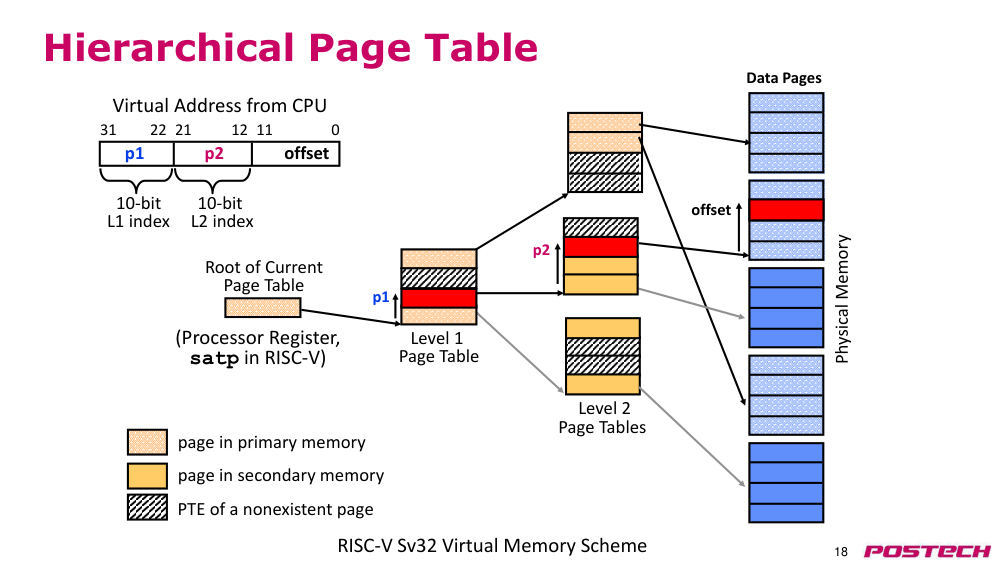
- 레벨 1 page table(페이지 테이블)
- 레벨 2 page table(페이지 테이블)
- 데이터 페이지
- 현재 page table(페이지 테이블)의 루트
- p1
- offset(오프셋)
- p2
- CPU로부터의 virtual address(가상 주소)
- (프로세서 레지스터, RISC-V의 satp)
- 존재하지 않는 페이지의 PTE
- p1
- p2
- offset(오프셋)
- 0
- 11
- 12
- 21
- 22
- 31
- 10비트
- L1 인덱스
- 10비트
- L2 인덱스
- physical memory(물리 메모리)
- RISC-V Sv32 virtual memory(가상 메모리) 체계
- primary storage(주기억장치)에 있는 페이지
- secondary storage(보조 기억장치)에 있는 페이지
p.19physical memory(물리 메모리) 내의 두 단계 page table(페이지 테이블)
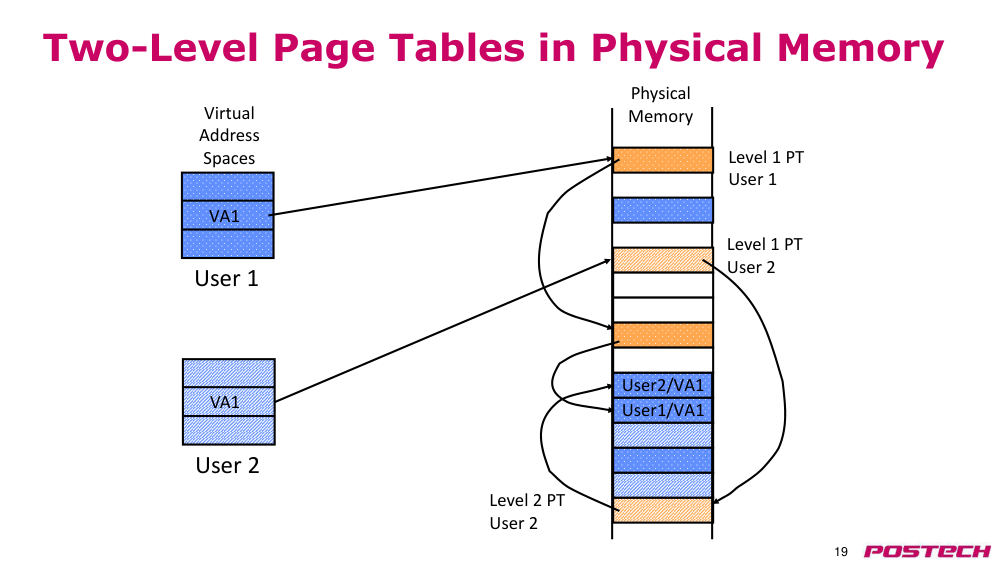
- VA1
- 사용자 1
- User1/VA1
- User2/VA1
- 레벨 1 PT
- 사용자 1
- 레벨 1 PT
- 사용자 2
- VA1
- 사용자 2
- 레벨 2 PT
- 사용자 2
- virtual address(가상 주소) 공간
- physical memory(물리 메모리)
p.20주소 변환 및 보호
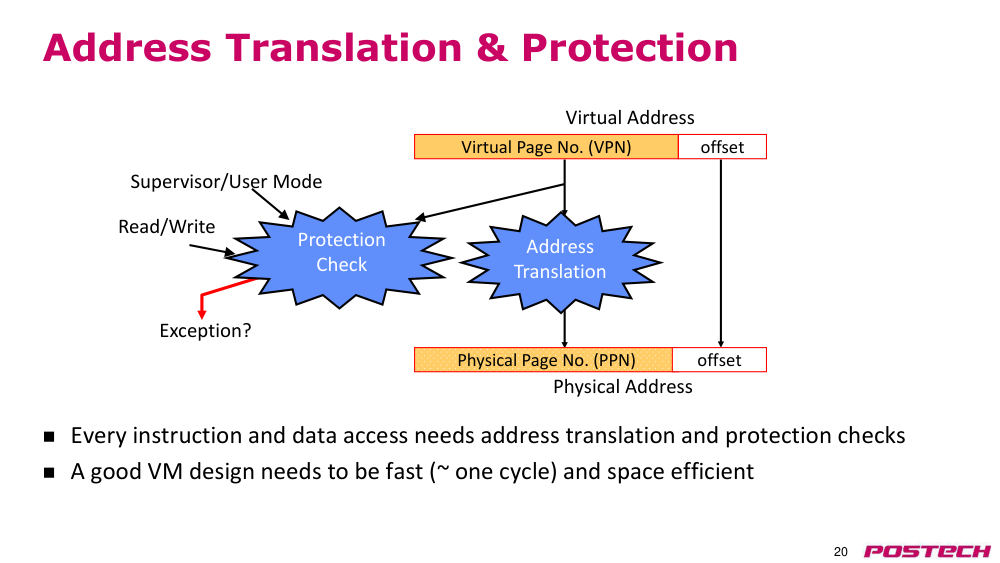
- 모든 명령어 및 데이터 접근은 주소 변환과 protection check(보호 검사)가 필요하다.
- 좋은 virtual memory(가상 메모리) 설계는 빠르고 (~1 사이클), 공간 효율적이어야 한다.
- physical address(물리 주소)
- virtual address(가상 주소)
- 주소 변환
- 가상 페이지 번호 (VPN)
- offset(오프셋)
- 물리 페이지 번호 (PPN)
- offset(오프셋)
- exception(예외)?
- 관리자/사용자 모드
- 읽기/쓰기
- protection check(보호 검사)
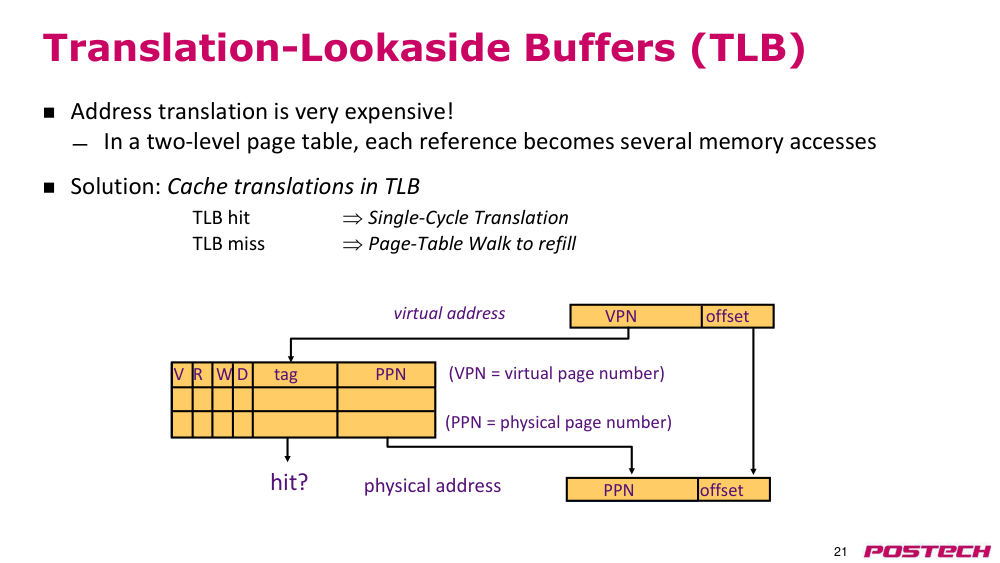
p.21변환 색인 버퍼 (TLB)
- 주소 변환은 매우 비용이 크다!
- 두 단계 page table(페이지 테이블)에서는 각 참조가 여러 메모리 접근을 유발한다.
- 해결책: TLB에 변환 결과를 cache(캐시)한다.
- TLB hit(TLB 히트)
- ⇒ 단일 사이클 변환
- TLB miss(TLB 미스)
- ⇒ page table walk(페이지 테이블 탐색)으로 재충전
- VPN
- offset(오프셋)
- V R W D 태그 PPN
- physical address(물리 주소)
- PPN
- offset(오프셋)
- virtual address(가상 주소)
- 히트?
- (VPN = 가상 페이지 번호)
- (PPN = 물리 페이지 번호)
p.22TLB 설계
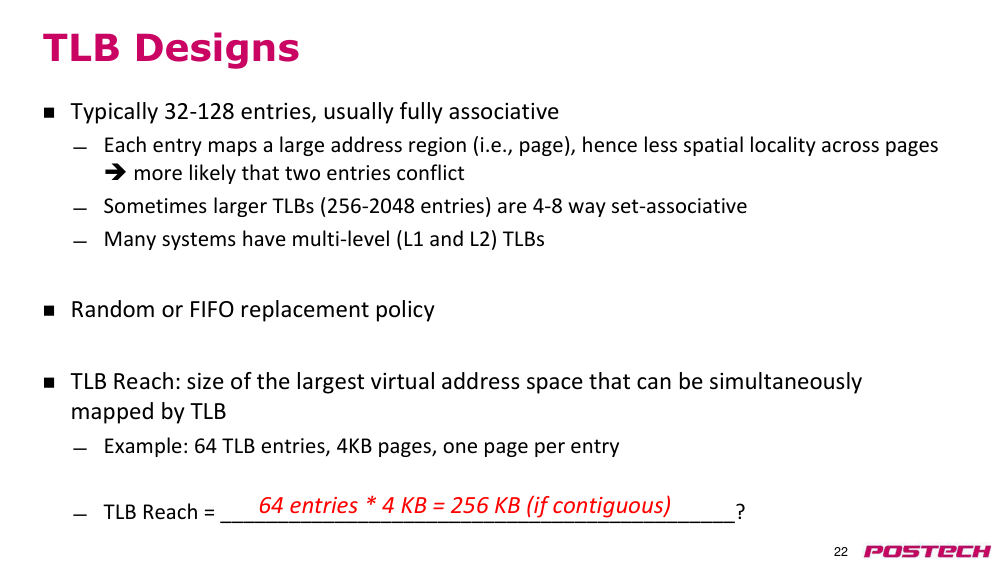
- 보통 32-128개의 엔트리, 일반적으로 fully associative(완전 연관)
- 각 엔트리는 큰 주소 영역(예: 페이지)을 매핑하므로 페이지 간 공간적 국소성이 낮다.
- ⇒ 두 엔트리가 충돌할 가능성이 높다.
- 때때로 더 큰 TLB(256-2048개 엔트리)는 4-8 way Set-Associative(세트 연관)
- 많은 시스템은 다중 레벨(L1 및 L2) TLB를 갖는다.
- 랜덤 또는 FIFO replacement policy(치환 정책)
- TLB reach(TLB 범위): TLB가 동시에 매핑할 수 있는 가장 큰 virtual address(가상 주소) 공간의 크기
- 예시: 64개 TLB 엔트리, 4KB 페이지, 엔트리당 1개 페이지
- TLB reach(TLB 범위) = _____________________________________________?
- 64 엔트리 × 4 KB = 256 KB (연속적인 경우)
p.23TLB miss(TLB 미스) 처리
- 소프트웨어 (MIPS, Alpha)
- TLB miss(TLB 미스)는 exception(예외)를 유발하고 operating system (OS)(운영체제)가 page table(페이지 테이블)을 탐색하여 TLB를 재로드한다.
- 탐색을 위해 특권 모드의 'untranslated addressing mode(비변환 주소 모드)' 사용.
- Out-of-Order superscalar(순서 없는 슈퍼스칼라) 프로세서에서는 소프트웨어 TLB miss(TLB 미스)가 매우 비용이 크다.
- pipeline flush(파이프라인 플러시)가 필요하여 트랩 핸들러로 전환해야 하기 때문이다.
- 하드웨어 (SPARC v8, x86, PowerPC, RISC-V)
- 메모리 관리 유닛(MMU)이 page table(페이지 테이블)을 탐색하고 TLB를 재로드한다.
- TLB 재로드 중 누락된(데이터 또는 PT) 페이지를 만나면 MMU는 포기하고 원래 명령어에 대한 page fault(페이지 폴트) exception(예외)를 신호한다.
- 참고: 특정 ISA는 TLB miss(TLB 미스) 전략 중 하나를 사용할 수 있다.
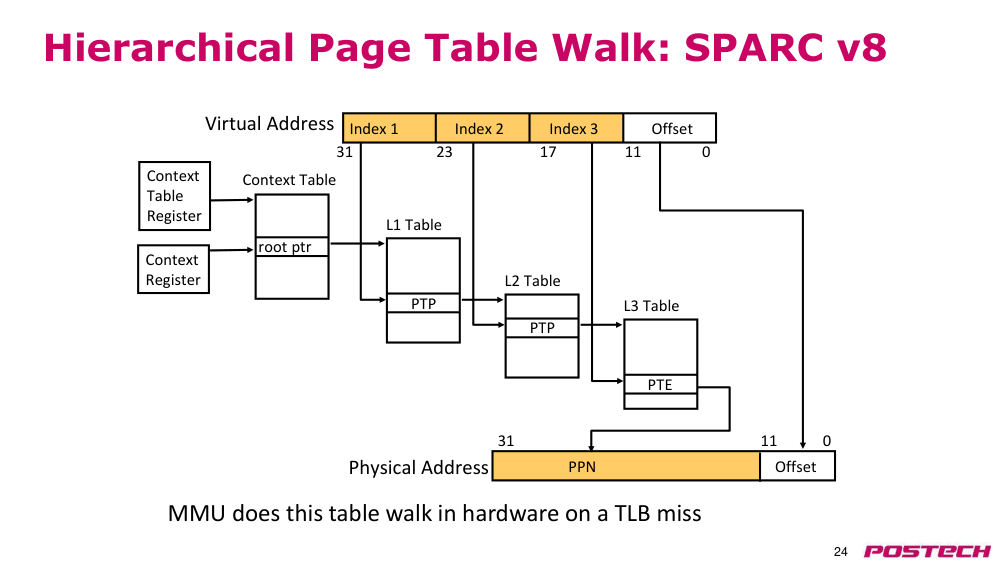
p.24hierarchical page table(계층적 페이지 테이블) 탐색: SPARC v8
- 31
- 11 0
- virtual address(가상 주소)
- 인덱스 1
- 인덱스 2 인덱스 3 offset(오프셋)
- 31 23 17 11 0
- context register(컨텍스트 레지스터)
- context register(컨텍스트 레지스터)
- root pointer(루트 포인터)
- PTP
- PTP
- PTE
- 컨텍스트 테이블
- L1 table(L1 테이블)
- L2 table(L2 테이블)
- L3 table(L3 테이블)
- physical address(물리 주소)
- PPN
- offset(오프셋)
- MMU는 TLB miss(TLB 미스) 시 하드웨어로 이 테이블 탐색을 수행한다.
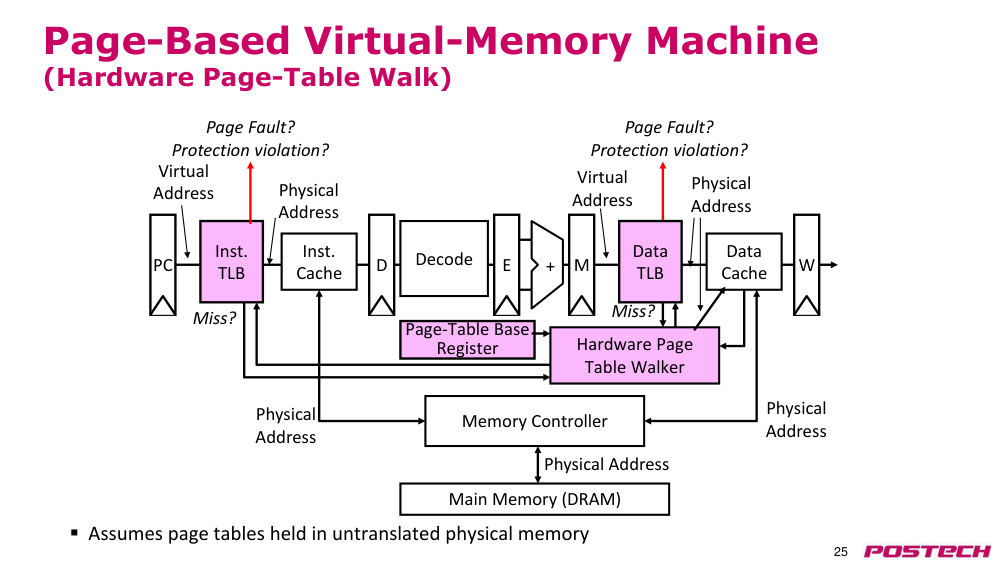
p.25페이지 기반 virtual memory(가상 메모리) 기계 (하드웨어 page table(페이지 테이블) 워커)
- page table(페이지 테이블)이 비변환 physical memory(물리 메모리)에 저장된다고 가정
- PC
- 명령어
- TLB
- 명령어 cache(캐시)
- D
- 디코딩
- E
- M
- 데이터 cache(캐시)
- W
- +
- page fault(페이지 폴트)?
- 보호 위반?
- 데이터 TLB
- 주기억장치 (DRAM)
- memory controller(메모리 컨트롤러)
- physical address(물리 주소)
- physical address(물리 주소)
- physical address(물리 주소)
- physical address(물리 주소)
- page table(페이지 테이블) base register(베이스 레지스터)
- virtual address(가상 주소)
- physical address(물리 주소)
- virtual address(가상 주소)
- hardware page table walker(하드웨어 페이지 테이블 워커)
- 미스?
- 미스?
- page fault(페이지 폴트)?
- 보호 위반?
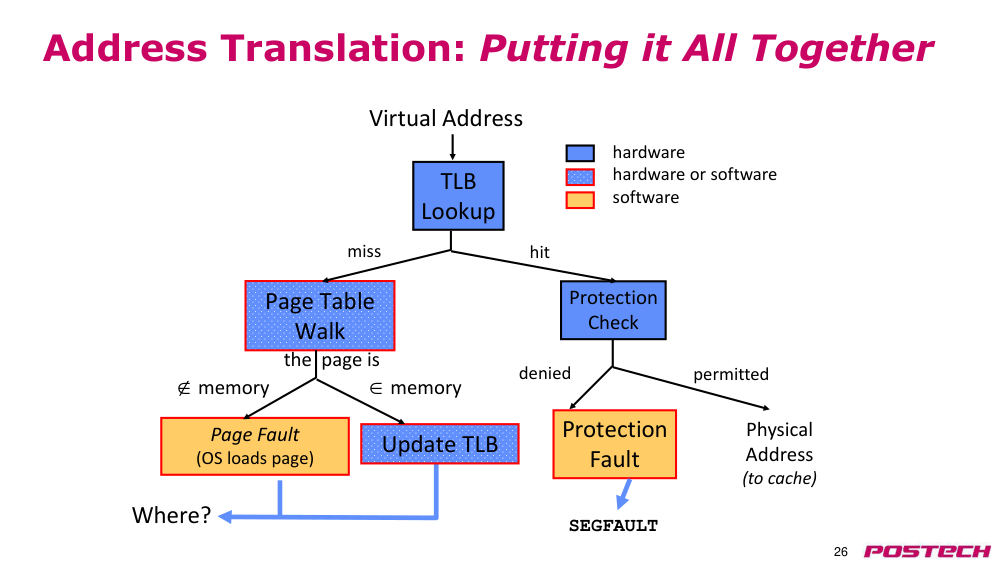
p.26주소 변환: 모두를 하나로 묶기
- virtual address(가상 주소)
- TLB 조회
- page table walk(페이지 테이블 탐색)
- TLB 업데이트
- page fault(페이지 폴트)
- (운영체제가 페이지를 로드)
- protection check(보호 검사)
- physical address(물리 주소)
- (캐시로)
- 미스
- 히트
- 해당 페이지는 메모리에 존재함
- 해당 페이지는 메모리에 없음
- 보호 위반
- 허용됨
- 거부됨
- 보호 결함
- 하드웨어
- 하드웨어 또는 소프트웨어
- 소프트웨어
- SEGFAULT
- 어디서?
p.27page-fault handler(페이지 폴트 핸들러)
- 참조된 페이지가 DRAM에 없을 때:
- 결측 페이지를 찾거나 생성
- 디스크에서 페이지를 가져와 page table(페이지 테이블)을 업데이트
- 첫 번째 작업이 디스크에서 요청된 페이지를 읽는 동안 CPU에서 다른 작업을 실행할 수 있음
- 사용 가능한 빈 페이지가 없을 경우, 페이지를 스왑 아웃
- pseudo-LRU(의사 LRU) replacement policy(치환 정책), 소프트웨어로 구현
- 페이지 전송에 오랜 시간(밀리초 단위)이 걸리므로, page fault(페이지 폴트)은 operating system (OS)(운영체제)에 의해 완전히 소프트웨어로 처리됨
- untranslated addressing mode(비변환 주소 모드)는 커널이 page table(페이지 테이블)에 접근할 수 있도록 필수적임
- TLB가 page table(페이지 테이블) 변경과 일관성을 유지하기 위해 비용이 큰 'TLB shootdown(TLB 쏘다운)'이 필요할 수 있음
- 다른 프로세서에 interrupts(인터럽트)를 보내서 오래된 TLB 항목을 무효화
- 일부 메인프레임은 하드웨어 TLB 일관성을 제공
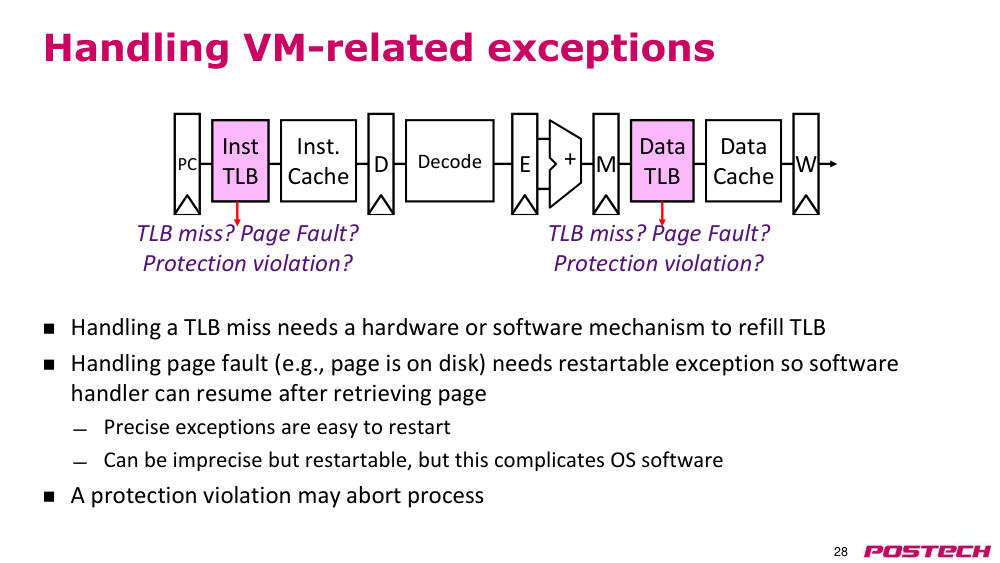
p.28VM 관련 exception(예외) 처리
- TLB miss(TLB 미스)를 처리하려면 TLB를 재충전할 수 있는 하드웨어 또는 소프트웨어 메커니즘이 필요
- page fault(페이지 폴트) 처리(예: 페이지가 디스크에 있음)는 restartable exception(재시작 가능한 예외)가 필요하여 소프트웨어 핸들러가 페이지를 가져온 후 재시작할 수 있음
- precise exception(정확한 예외)는 재시작하기 쉬움
- 정확하지 않지만 재시작 가능한 경우도 있지만, 이는 operating system (OS)(운영체제) 소프트웨어를 복잡하게 만듦
- 보호 위반은 프로세스를 종료시킬 수 있음
- PC
- 명령어
- TLB
- 명령어 cache(캐시)
- D
- 디코딩
- E
- M
- 데이터 TLB
- 데이터 cache(캐시)
- W
- +
- TLB miss(TLB 미스)?
- page fault(페이지 폴트)?
- 보호 위반?
- TLB miss(TLB 미스)?
- page fault(페이지 폴트)?
- 보호 위반?
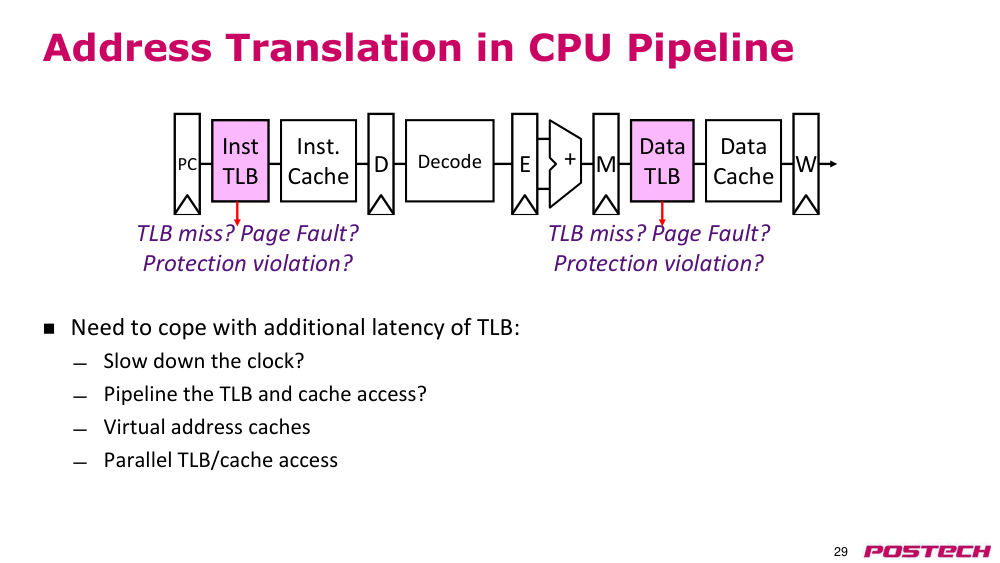
p.29CPU 파이프라인 내 주소 변환
- TLB의 추가 지연을 처리해야 함:
- 클럭 속도를 낮추기?
- TLB 및 cache(캐시) 접근을 파이프라인화하기?
- virtual address(가상 주소) cache(캐시)?
- 병렬 TLB/cache(캐시) 접근
- PC
- 명령어
- TLB
- 명령어 cache(캐시)
- D
- 디코딩
- E
- M
- 데이터 TLB
- 데이터 cache(캐시)
- W
- +
- TLB miss(TLB 미스)?
- page fault(페이지 폴트)?
- 보호 위반?
- TLB miss(TLB 미스)?
- page fault(페이지 폴트)?
- 보호 위반?
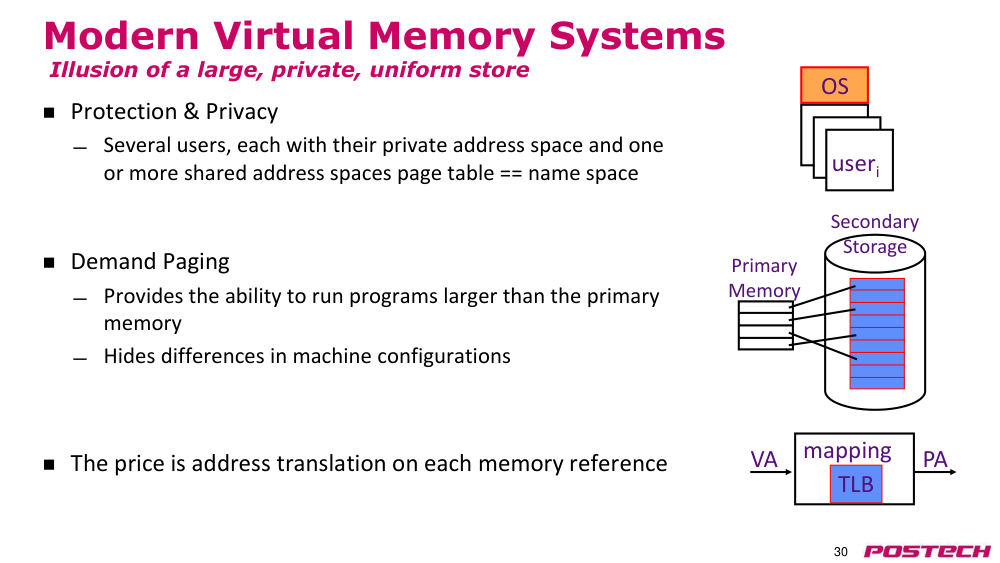
p.30현대의 virtual memory(가상 메모리) 시스템
- 큰, 개별적이고 균일한 저장소의 환상
- 보호 및 개인정보 보장:
- 여러 사용자 각각 private address space(개별 주소 공간)과 하나 이상의 공유 주소 공간을 가짐
- page table(페이지 테이블) == 이름 공간
- demand paging(요구 페이징):
- primary storage(주기억장치)보다 큰 프로그램을 실행할 수 있는 능력
- 기계 구성의 차이를 숨김
- 비용은 각 메모리 참조마다 주소 변환을 수행해야 한다는 것
- OS
- useri
- primary storage(주기억장치)
- secondary storage(보조 기억장치)
- VA
- PA
- 매핑
- TLB
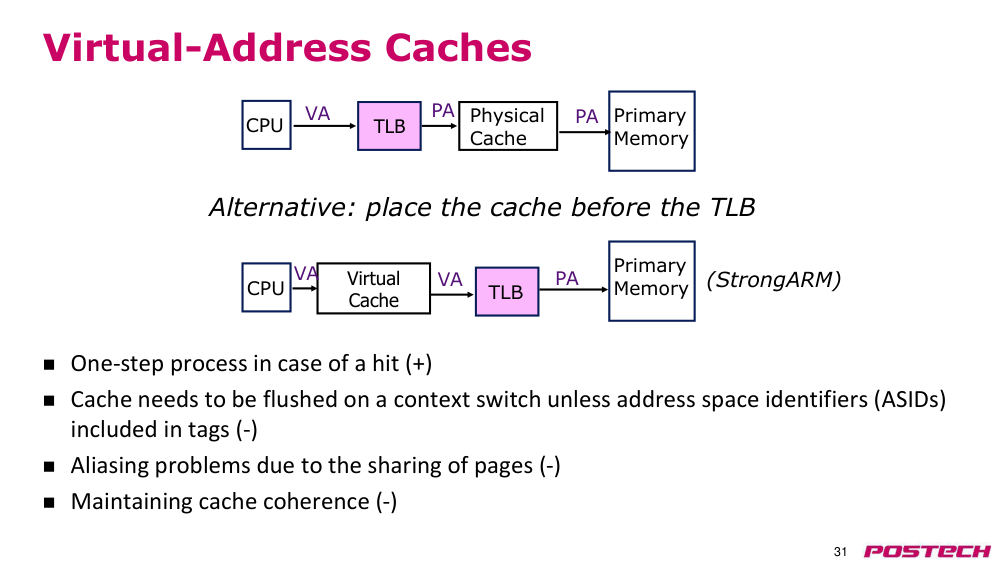
p.31virtual address(가상 주소) cache(캐시)
- 히트 경우 단일 단계 처리 (+)
- context switch(컨텍스트 전환) 시 주소 공간 식별자(ASIDs)가 태그에 포함되지 않으면 cache(캐시)를 플러시해야 함 (-)
- 페이지 공유로 인한 앨리어싱 문제 (-)
- cache(캐시) 일관성 유지 (-)
- CPU → 물리 cache(캐시) → TLB → primary storage(주기억장치)
- virtual address(가상 주소) → physical address(물리 주소) → 물리 주소
- 대안: TLB 전에 cache(캐시) 배치 (StrongARM)
- CPU → 가상 cache(캐시) → TLB → primary storage(주기억장치)
- virtual address(가상 주소) → physical address(물리 주소) → 물리 주소
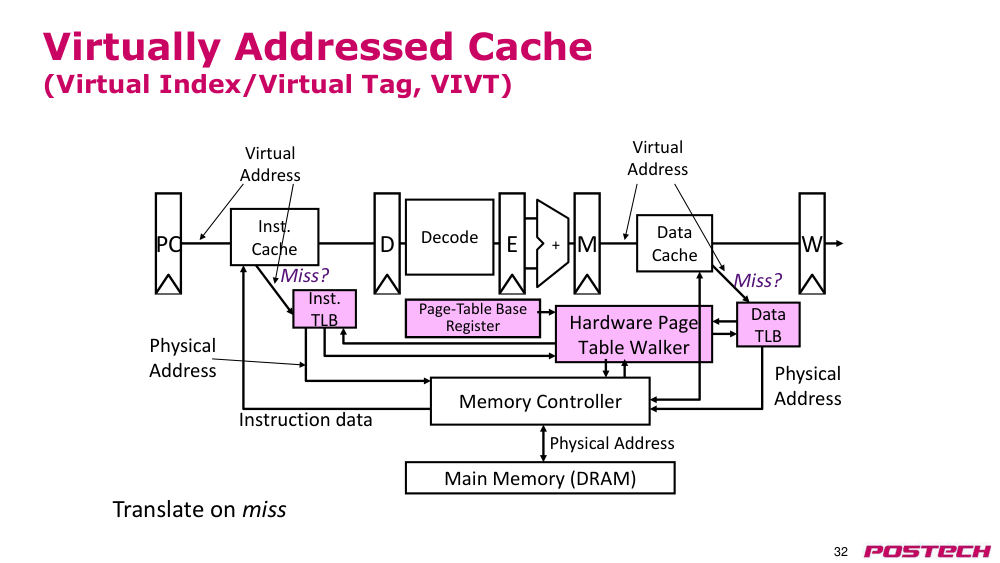
p.32virtual address(가상 주소) 기반 캐시 (가상 인덱스/가상 태그, VIVT)
- PC → 명령어 TLB → 명령어 cache(캐시) → 디코딩 → 실행 → 메모리 접근 → 데이터 캐시 → 쓰기
- 데이터 TLB → 주기억장치(DRAM) → memory controller(메모리 컨트롤러)
- physical address(물리 주소) → 명령어 데이터 → 물리 주소
- page table(페이지 테이블) base register(베이스 레지스터) → virtual address(가상 주소) → 가상 주소
- hardware page table walker(하드웨어 페이지 테이블 워커)
- cache(캐시) 미스 여부 확인 → 캐시 미스 시 번역 수행
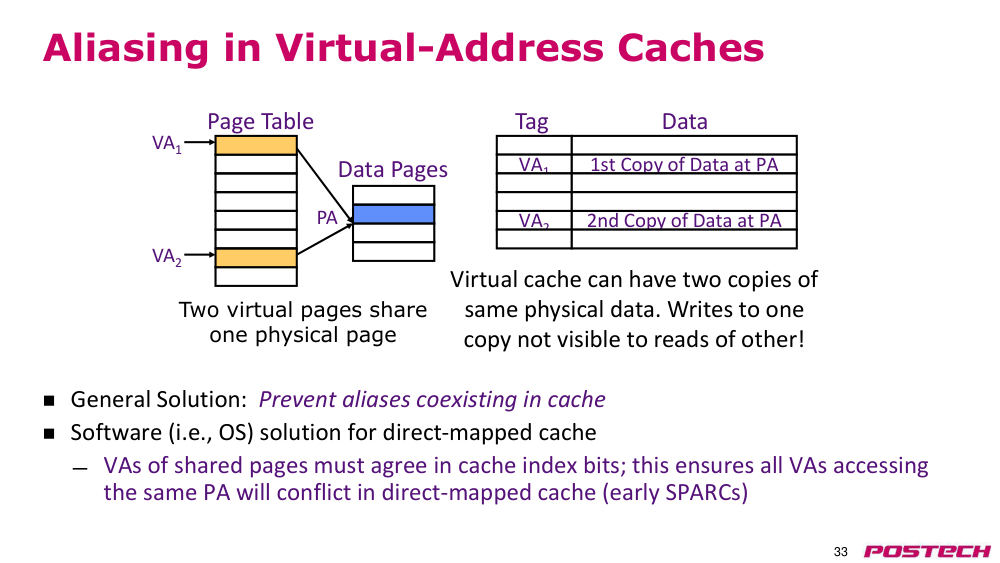
p.33virtual address(가상 주소) cache(캐시)의 앨리어싱
- 일반적 해결책: cache(캐시) 내에서 앨리어스가 공존하지 않도록 방지
- 직접 매핑 cache(캐시)의 경우 소프트웨어(운영체제) 해결책
- 공유 페이지의 가상 주소(VA)는 cache(캐시) 인덱스 비트에서 일치해야 함 → 동일한 물리 주소(PA)에 접근하는 모든 VA는 직접 매핑 캐시에서 충돌하게 됨 (초기 SPARC)
- VA1과 VA2가 동일한 물리 페이지(PA)를 가리킴
- 동일한 물리 데이터가 cache(캐시)에 두 번 존재할 수 있음
- 한 쪽의 쓰기 작업은 다른 쪽의 읽기에서 보이지 않음!
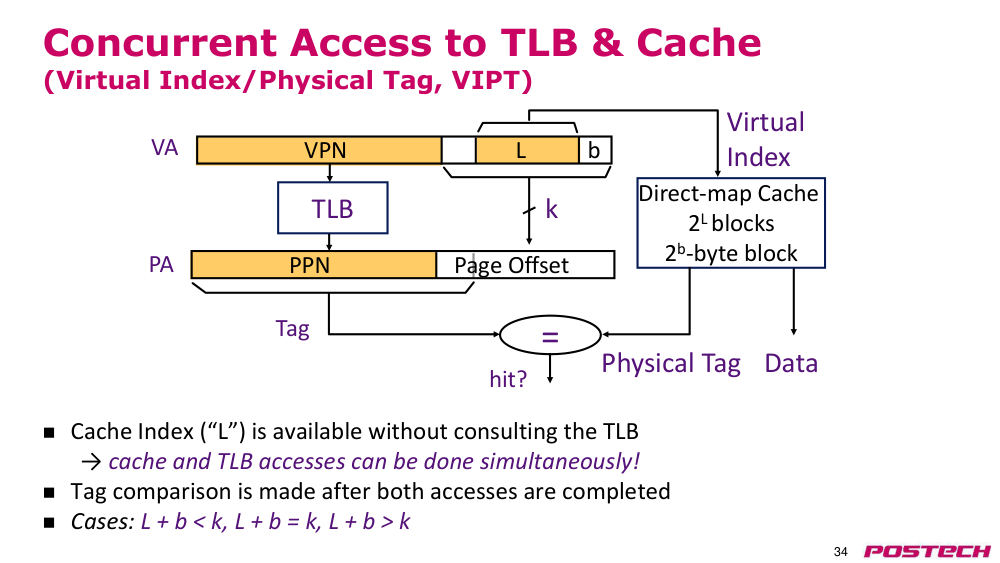
p.34TLB 및 cache(캐시) 동시 접근 (가상 인덱스/물리 태그, VIPT)
- cache(캐시) 인덱스(L)는 TLB를 참조하지 않고도 이용 가능 → 캐시와 TLB 접근을 동시에 수행 가능!
- 태그 비교는 두 접근이 완료된 후 수행됨
- 세 가지 경우: L + b < k, L + b = k, L + b > k
- 가상 페이지 번호(VPN) + L + b = k
- TLB → 직접 매핑 캐시 (2L 블록, 2b바이트 블록)
- 물리 페이지 번호(PPN) + 페이지 offset(오프셋)
- 물리 태그와 태그 비교 → 히트 여부 확인 → 데이터 반환
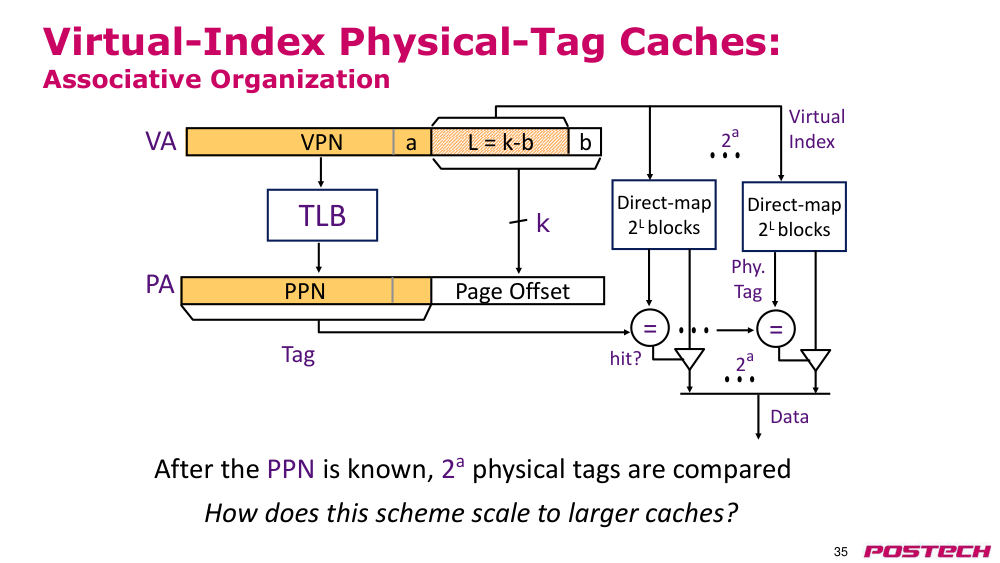
p.35가상 인덱스 물리 태그 cache(캐시): 연관 조직
- 이 방식은 더 큰 cache(캐시)에 어떻게 확장될 수 있는가?
- 가상 페이지 번호(VPN) + a + L = k - b + b = k
- TLB → 직접 매핑 캐시 (2L 블록)
- 물리 페이지 번호(PPN) + 페이지 offset(오프셋)
- PPN이 확인된 후, 2a개의 물리 태그를 비교함
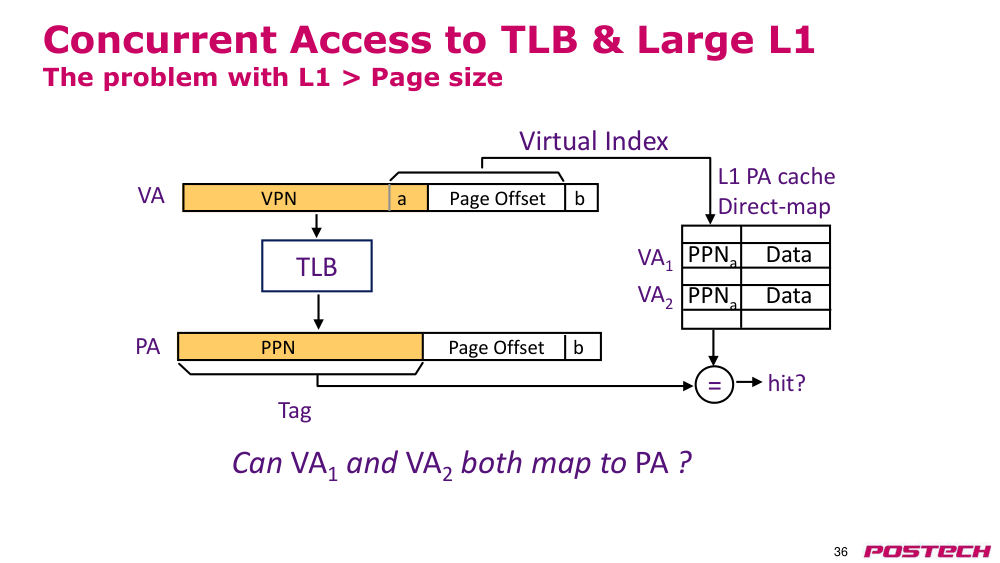
p.36TLB 및 대용량 L1 동시 접근
- L1 > page size(페이지 크기)인 경우의 문제
- VA1과 VA2가 동일한 PA로 매핑될 수 있는가?
- 가상 페이지 번호(VPN) + a + 페이지 오프셋(b)
- TLB → 물리 페이지 번호(PPN) + 페이지 오프셋(b)
- 태그 비교 → L1 physical address(물리 주소) 캐시 (직접 매핑)
- PPNa → 데이터 → PPNa → 데이터
- VA1과 VA2가 동일한 물리 주소(PA)로 매핑될 수 있음
p.37두 번째 수준 cache(캐시)를 통한 해결 방안
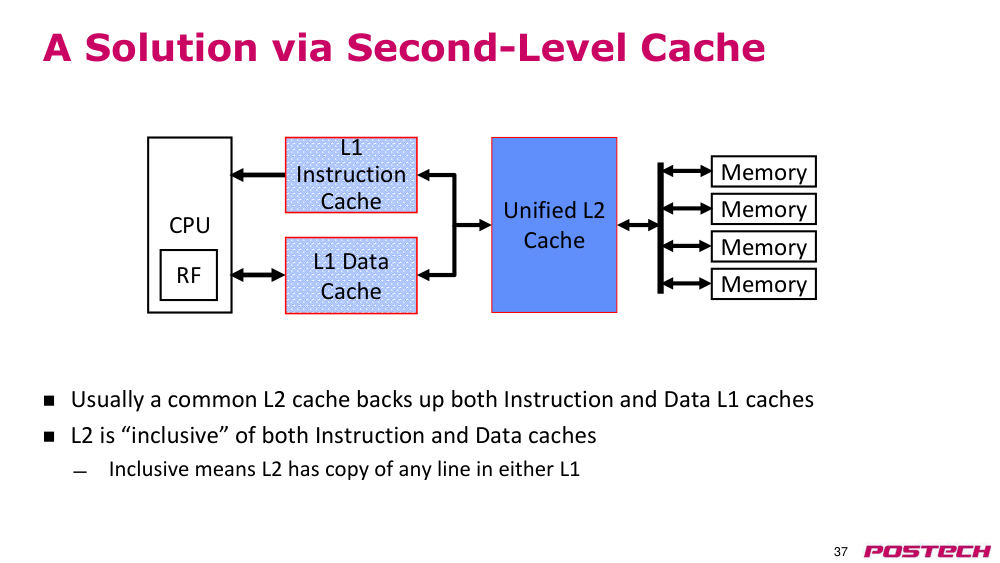
- 보통 공통의 L2 cache(캐시)가 명령어와 데이터 L1 캐시를 모두 지원한다.
- L2는 명령어 cache(캐시)와 데이터 캐시 둘 다에 대해 '포함적(Inclusive)'이다.
- 포함적이라는 것은 L1에 있는 어떤 라인도 L2에 복사본을 가지고 있다는 의미이다.
p.38L2를 이용한 앨리어싱 방지 [MIPS R10000, 1996]
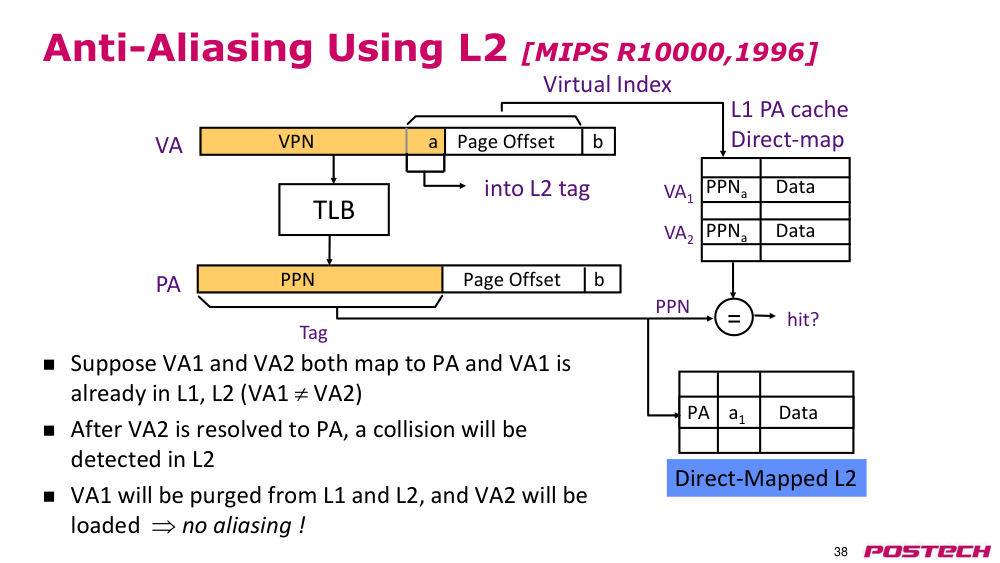
- virtual address(가상 주소) VA1과 VA2가 모두 동일한 physical address(물리 주소) PA로 매핑되며, VA1이 이미 L1과 L2에 존재한다고 가정한다. (VA1 ≠ VA2)
- VA2가 PA로 해석된 후, L2에서 충돌이 감지된다.
- VA1은 L1과 L2에서 제거되고, VA2가 로드된다. → 앨리어싱이 발생하지 않는다!
- VPN a | 페이지 offset(오프셋) b
- TLB
- PPN | 페이지 offset(오프셋) b
- 태그
- VA
- PA
- 가상 인덱스
- L1 PA cache(캐시)
- 직접 매핑
- 일치 여부?
- PPNa
- 데이터
- PPNa
- 데이터
- VA1
- VA2
- 직접 매핑 L2
- PA a1
- 데이터
- PPN
- L2 태그로
p.39가상 태그 L1을 위한 L2의 물리적 주소 사용을 통한 앨리어싱 방지
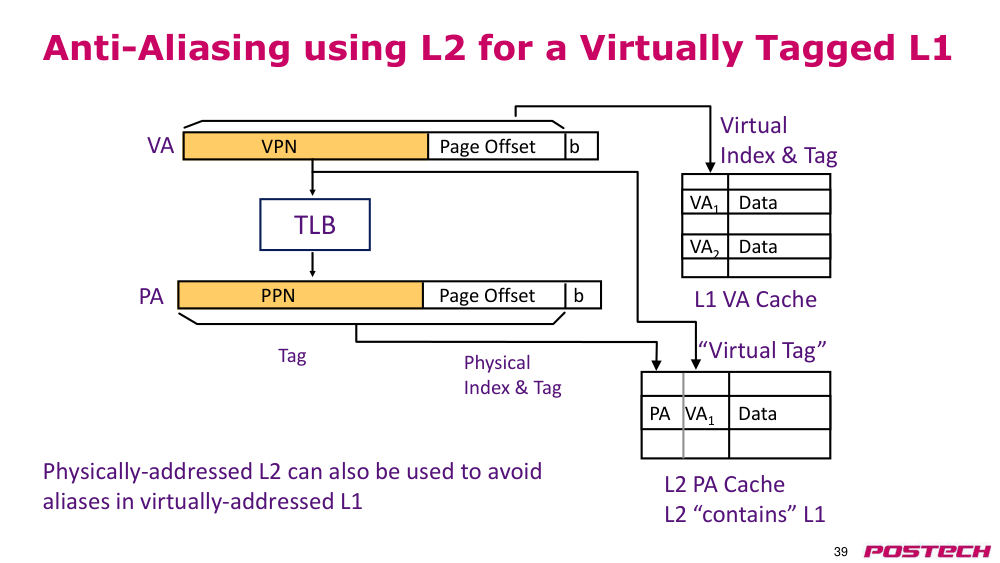
- 물리적 주소로 접근하는 L2는 virtual address(가상 주소)로 접근하는 L1에서의 앨리어싱을 방지하는 데 사용될 수 있다.
- VPN | 페이지 offset(오프셋) b
- TLB
- PPN | 페이지 offset(오프셋) b
- 태그
- VA
- PA
- 가상 인덱스 및 태그
- 물리적 인덱스 및 태그
- L1 VA cache(캐시)
- L2 PA cache(캐시)
- L2는 L1을 포함한다.
- PA VA1
- 데이터
- VA1
- 데이터
- VA2
- 데이터
- 가상 태그
p.40Atlas 재조명
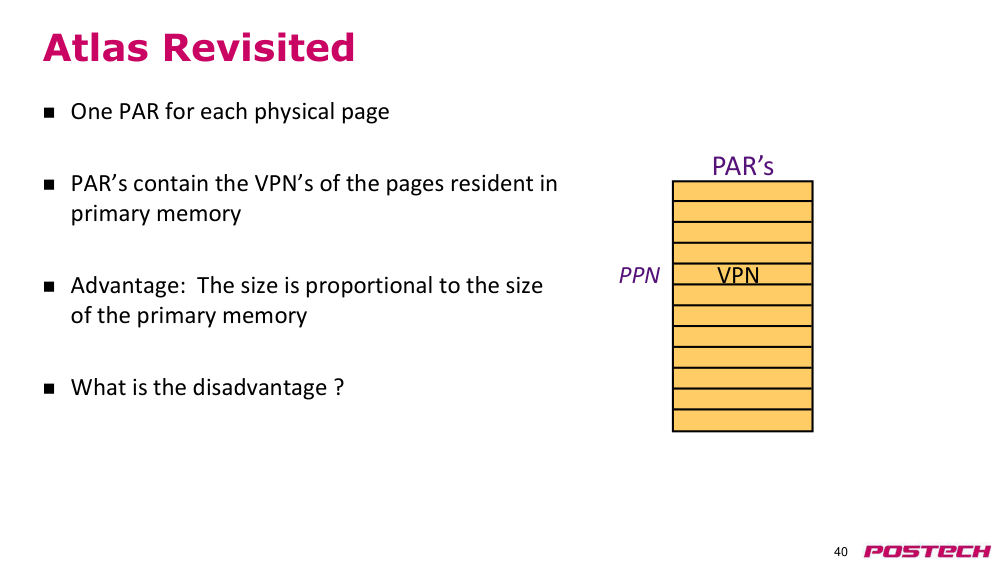
- 각 물리 페이지마다 하나의 페이지 주소 레지스터(PAR)가 있다.
- PAR는 primary storage(주기억장치)에 존재하는 페이지들의 가상 페이지 번호(VPN)를 포함한다.
- 장점: 크기가 primary storage(주기억장치) 크기에 비례한다.
- 단점은 무엇인가?
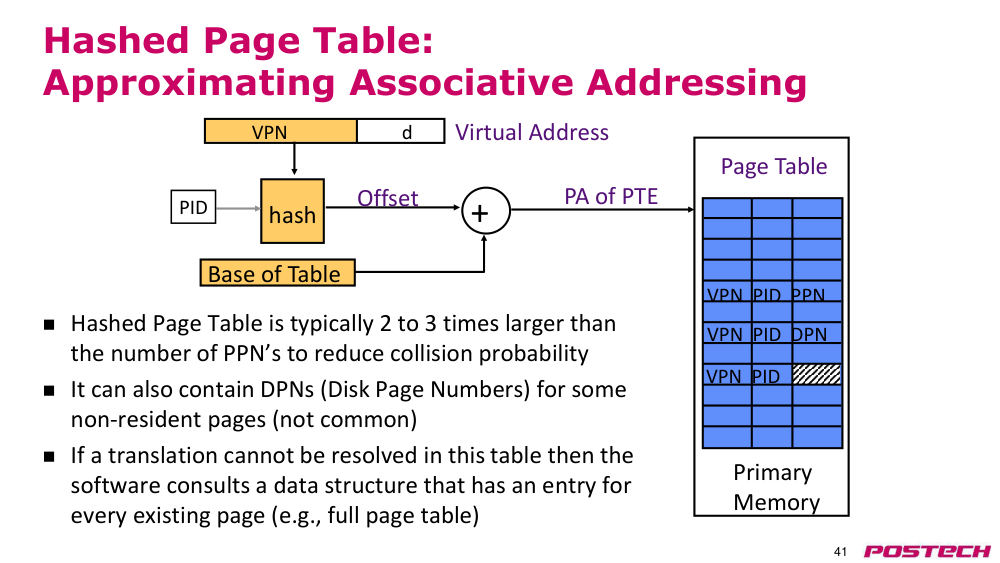
p.41해시 page table(페이지 테이블): 연관 주소 접근의 근사
- 해시 page table(페이지 테이블)은 충돌 확률을 줄이기 위해 일반적으로 물리 페이지 번호(PPN) 수의 2~3배 크기이다.
- 비거주 페이지를 위한 디스크 페이지 번호(DPN)도 포함할 수 있다 (보통은 아니다).
- 이 테이블에서 번역을 해결할 수 없으면, 소프트웨어가 모든 존재하는 페이지에 대한 항목이 있는 데이터 구조(예: 전체 페이지 테이블)를 참조한다.
- 해시
- offset(오프셋)
- 테이블 기준
- +
- PTE의 physical address(물리 주소)
- primary storage(주기억장치)
- VPN PID PPN
- page table(페이지 테이블)
- VPN
- d
- virtual address(가상 주소)
- VPN PID DPN
- VPN PID
- PID
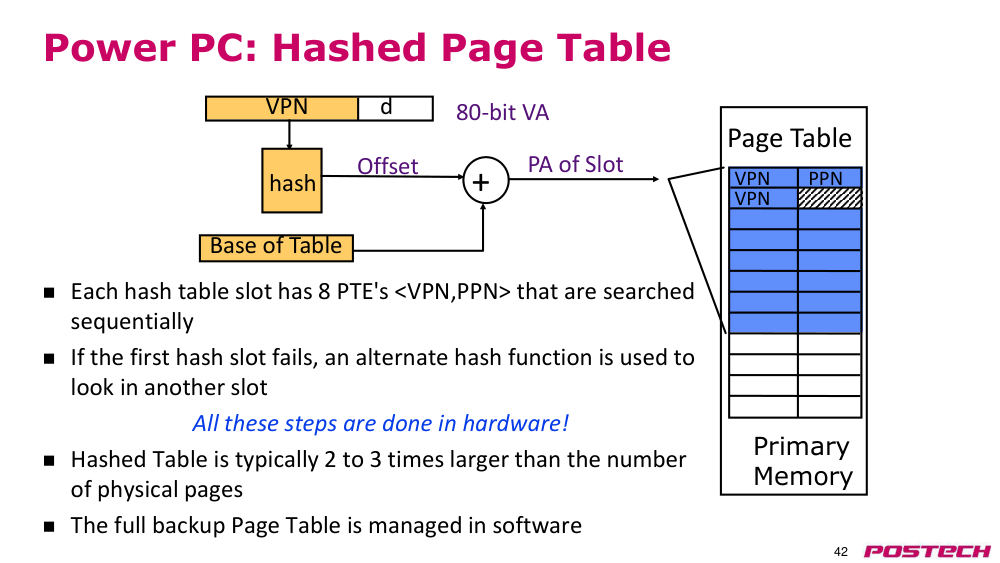
p.42Power PC: 해시 page table(페이지 테이블)
- 각 해시 테이블 슬롯은 8개의 PTE <VPN, PPN>을 포함하며, 순차적으로 검색된다.
- 첫 번째 해시 슬롯이 실패하면, 다른 해시 함수를 사용하여 다른 슬롯을 검색한다.
- 이 모든 단계는 하드웨어에서 수행된다!
- 해시 테이블은 일반적으로 물리 페이지 수의 2~3배 크기이다.
- 전체 백업 page table(페이지 테이블)은 소프트웨어에서 관리된다.
- 테이블 기준
- 해시
- offset(오프셋)
- +
- 슬롯의 physical address(물리 주소)
- primary storage(주기억장치)
- VPN PPN
- page table(페이지 테이블)
- VPN
- d
- 80비트 VA
- VPN
p.43virtual memory(가상 메모리) 기능의 역사적 발전
- bare machine(베어 머신): physical address(물리 주소)만 존재
- 하나의 프로그램이 전체 머신을 독점 사용
- 배치형 multiprogramming(다중 프로그래밍): I/O를 기다리는 동안 여러 프로그램이 CPU를 공유
- base register(베이스 레지스터) 및 bound register(경계 레지스터): 프로그램 간의 주소 변환 및 보호 제공 (전체 프로그램 스왑은 가능하지만, demand paging(요구 페이징) virtual memory(가상 메모리)는 지원하지 않음)
- external fragmentation(외부 단편화) 문제 발생 (메모리 내 구멍 발생), 새로운 작업이 도착할 때마다 주기적으로 compaction(압축) 필요
- 시간 공유: 더 많은 상호작용형 프로그램, 사용자 대기 시간 증가. 또한 초당 처리 가능한 작업 수 증가
- 고정 크기 페이지 기반의 주소 변환 및 보호로 전환 동기 부여 (external fragmentation(외부 단편화) 없음, 그러나 internal fragmentation(내부 단편화) 발생: 페이지 내 낭비되는 바이트 존재)
- 제한된 physical memory(물리 메모리) 자원을 공유하면서 작업 집합을 메모리에 유지할 수 있도록 virtual memory(가상 메모리) 도입 동기 부여
- 가상 머신 모니터: 하나의 머신에서 여러 operating system (OS)(운영체제)를 실행
- 1970년대 IBM 메인프레임에서 시작된 아이디어, 현재 노트북에서도 흔함
- 예: Mac OS X 위에 Windows 실행
- 두 수준의 주소 변환/보호를 위한 하드웨어 지원
- 게스트 OS virtual address(가상 주소) → 게스트 OS physical address(물리 주소) → 호스트 머신 물리 주소
p.44현재의 virtual memory(가상 메모리) 사용 - 1
- 서버/데스크톱/노트북/스마트폰: 완전한 demand paging(요구 페이징) virtual memory(가상 메모리) 사용
- 다른 메모리 크기를 가진 기기 간의 이식성 제공
- 다중 사용자 또는 다중 작업 간의 보호 제공
- 활성 작업들 간에 작은 physical memory(물리 메모리) 공유
- 일부 operating system (OS)(운영체제) 기능의 구현을 단순화
- vector supercomputer(벡터 슈퍼컴퓨터): 주소 변환 및 보호는 제공하지만 거의 완전한 demand paging(요구 페이징)은 사용하지 않음
- 오래된 Cray: 베이스&경계, 일본 및 Cray X1/X2: 페이지
- 비싼 CPU 시간을 디스크로 thrashing(스래싱)하는 것을 피하기 위해 작업이 메모리에 맞도록 구성
- 대부분 배치 모드로 실행 (메모리에 맞는 작업 집합 실행)
- 재시작 가능한 벡터 명령어 구현이 어려움
- 현대 GPU는 vector supercomputer(벡터 슈퍼컴퓨터)와 유사하게 동작, 주소 변환 및 보호는 제공하지만 demand paging(요구 페이징)은 없음
- 최근 CUDA/OpenCL에서 호스트 메모리와 장치 메모리 간의 demand paging(요구 페이징) 추가
p.45현재의 virtual memory(가상 메모리) 사용 - 2
- 대부분의 임베디드 프로세서 및 DSP: physical address(물리 주소)만 제공
- virtual memory(가상 메모리) 지원을 위한 면적/속도/전력 예산을 감당할 수 없음
- 스왑할 수 있는 secondary storage(보조 기억장치)가 없는 경우가 많음
- 제품의 특정 메모리 구성에 맞춰 맞춤형 프로그램 작성
- 노출된 아키텍처에서 정확한 또는 restartable exception(재시작 가능한 예외) 구현이 어려움
p.46질문?
- 추천 독서:
- 교재 2.4-2.7 장