Lec 20-2 · vector processor (벡터 프로세서) 구조와 memory
정밀 정리 · 검증 2026-09-24 23:59
1개요
1.1array vs vector processor 복습 후 vector processor 의 장단점과 구조(vector register, VLEN/VSTR/VMASK, deep pipeline functional unit, Cray-1, RISC-V V)를 다룸.
1.2memory: banking·interleaving 으로 1 element/cycle, stride 에 따른 bank conflict, irregular access 용 gather/scatter.
1.3성능 기법: vector chaining, stripmining(긴 vector), masked operation(조건문), data layout·randomized bank mapping, vector ILP, auto-vectorization.
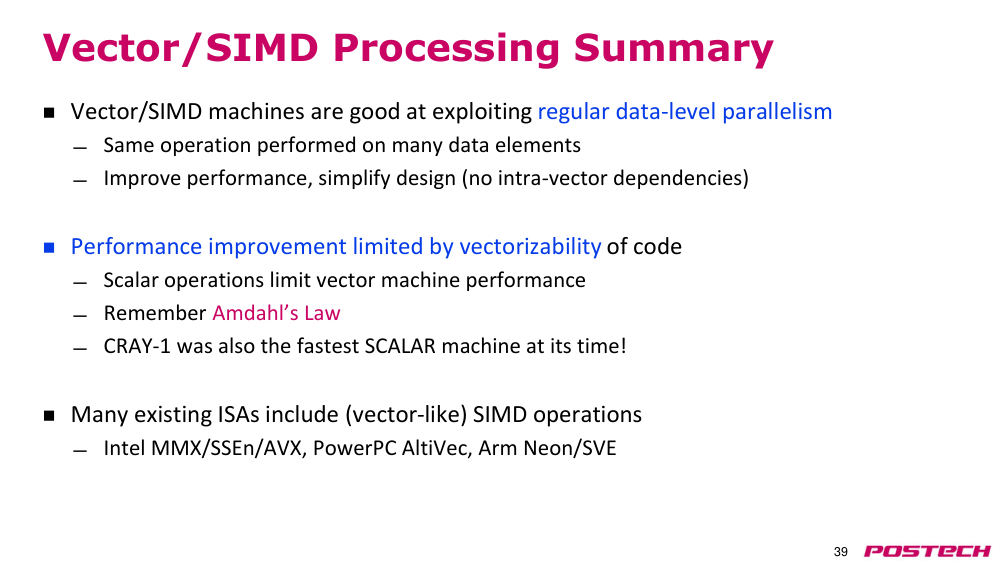
1.4요약: vector/SIMD 는 regular DLP 에 강하지만 Amdahl's law 로 제한. 교재 P&H Ch 6.1–6.5.
2섹션별 정리 상황·문제 → 원인 → 해결
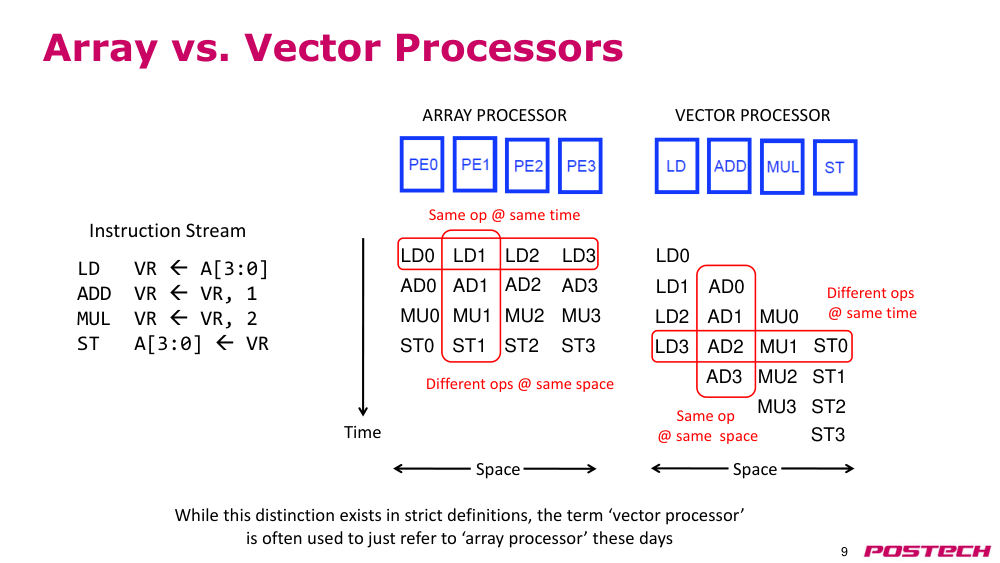
2.10:26–3:28복습: array vs vector processor, DLP
상황·문제지난 시간의 parallel processing 동기와 SIMD 두 방식을 이어서 정리.
원인array processor 는 space 축(같은 시각 여러 PE), vector processor 는 time 축(unit 별 전용 연산)으로 병렬 처리.
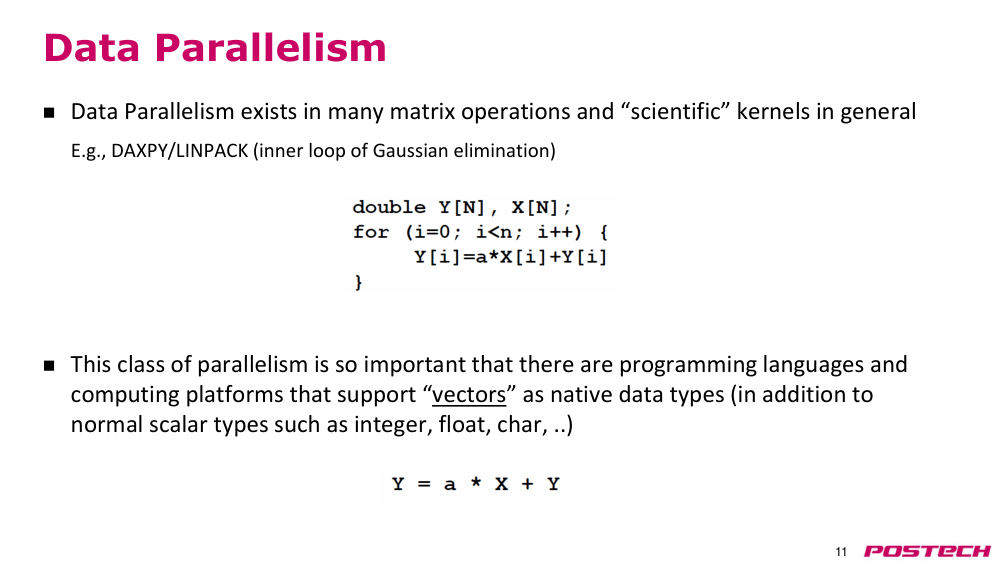
해결scientific kernel(많은 data 를 처리하는 계산 핵심) 에 DLP 가 풍부해 vector 를 native data type 으로 지원하는 언어도 있음.
- vector processor 의 각 PE 는 특정 연산 하나만 지원
- DAXPY 처럼 모든 element 에 같은 계산
2.23:28–6:22vector processor 의 장점
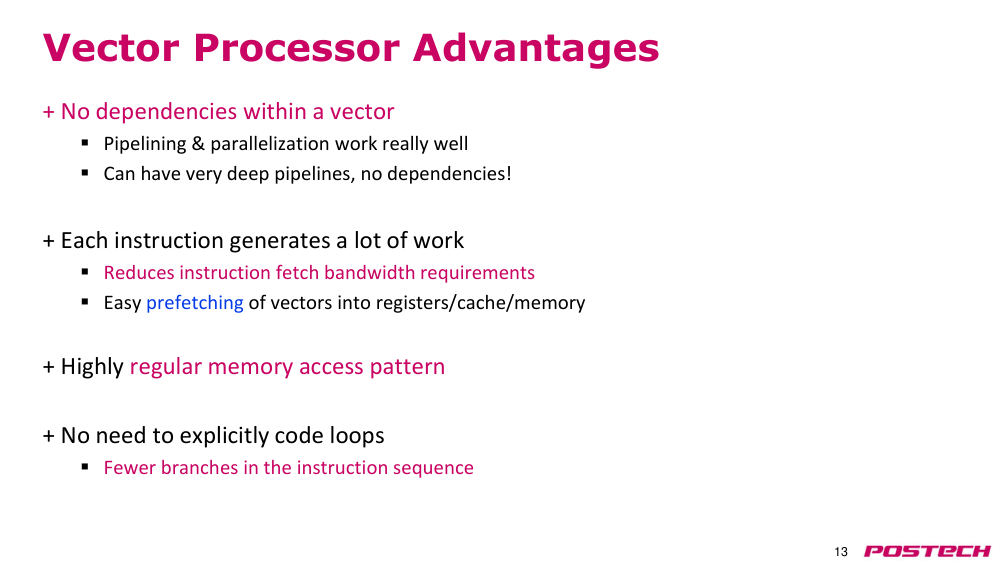
상황·문제vector processor 가 scalar 대비 무엇이 좋은가.
원인vector 내 element 간 dependency 가 없고, instruction 하나가 모든 element 를 처리.
해결deep pipeline 가능, instruction fetch bandwidth 감소, regular access 로 prefetch 쉬움, vector register 에 들어가면 loop 불필요.
- load instruction 하나로 vector 전체 load
- branch 수 감소
2.36:22–9:35vector processor 의 단점
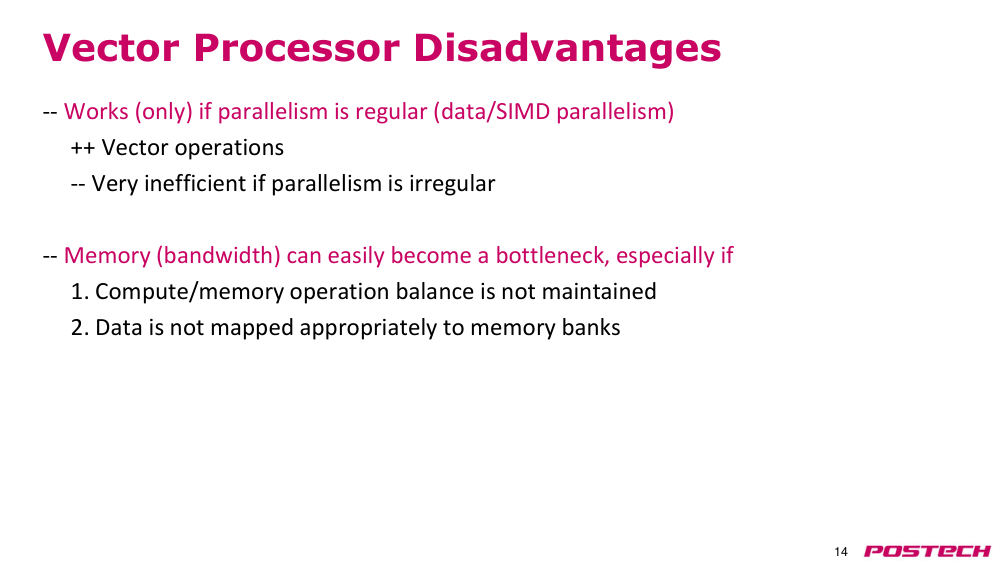
상황·문제vector 가 아닌 program·memory 가 받쳐주지 못하는 program 에서는 비효율.
원인scalar data 위주면 long vector 용 unit 이 놀고, compute 대비 memory 가 많거나 address 가 random 하면 memory bandwidth 가 병목.
해결compute intensity 와 memory access intensity 의 균형이 필요. 그래도 유용해서 laptop·smartphone CPU 도 작은 vector 기능을 가짐.
- irregular memory access → 낮은 memory throughput → 낮은 unit 활용률
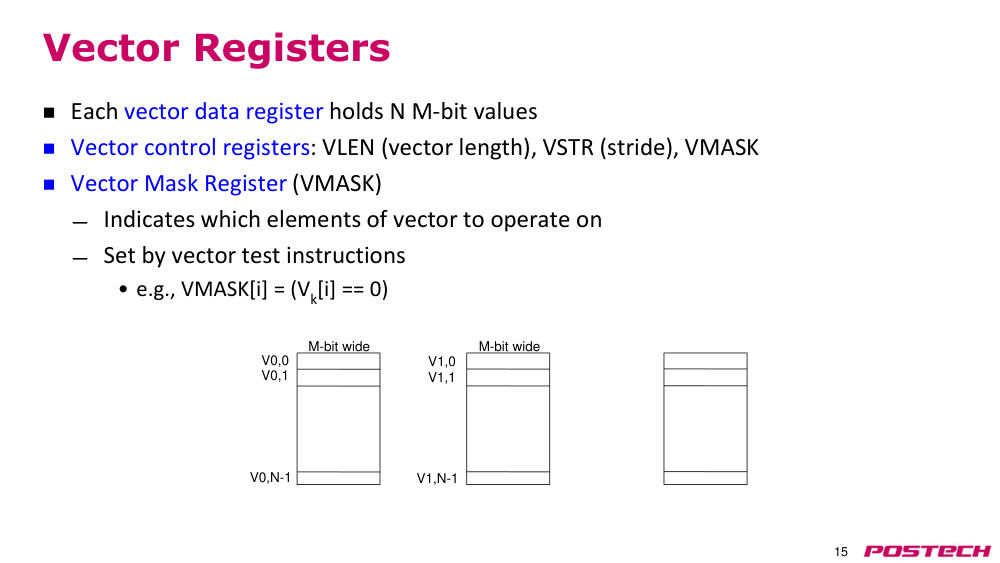
2.49:35–13:44vector register 와 제어 register (VLEN, VSTR, VMASK)
상황·문제CPU 안에 vector data 를 담을 공간과 그 처리를 제어할 수단이 필요.
원인element 가 모두 유효하지 않을 수 있고(64칸에 32개), 띄엄띄엄 load 하거나 일부 element 만 처리해야 할 때가 있음.
해결vector register(N × M-bit) + VLEN(길이), VSTR(stride, 예 2 = 짝수 element), VMASK(예 0,1,1,0 → 가운데 두 개만).
- vector register 를 여러 개 두면 비용이 큼
- VMASK 는 vector test instruction 으로 설정
2.513:44–19:07vector functional unit 과 Cray-1
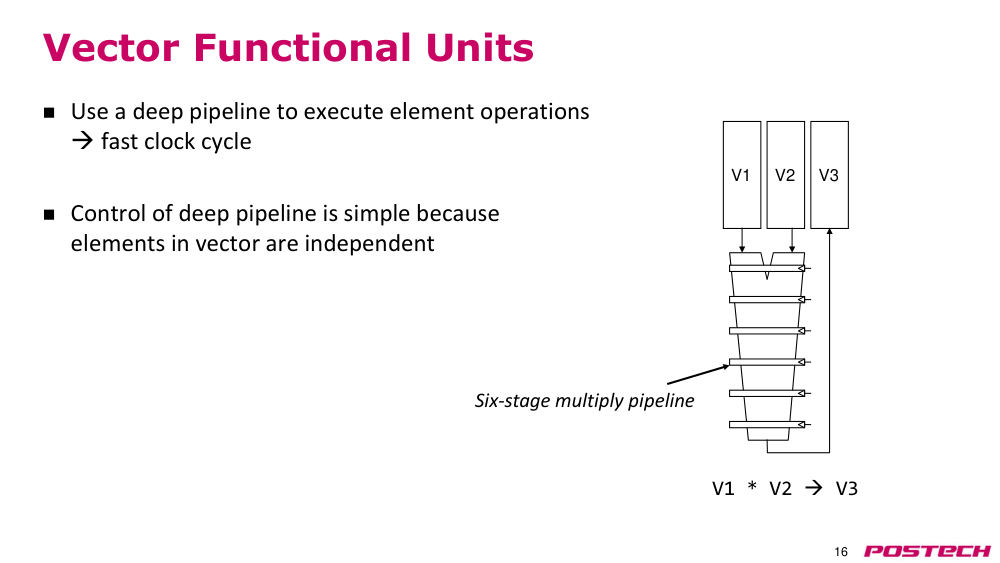
상황·문제vector 를 처리할 functional unit 은 scalar unit 과 어떻게 다른가.
원인매 cycle element 하나를 넣는 deep pipeline(예 6-stage multiply) 이고, element 간 dependency 가 없음.
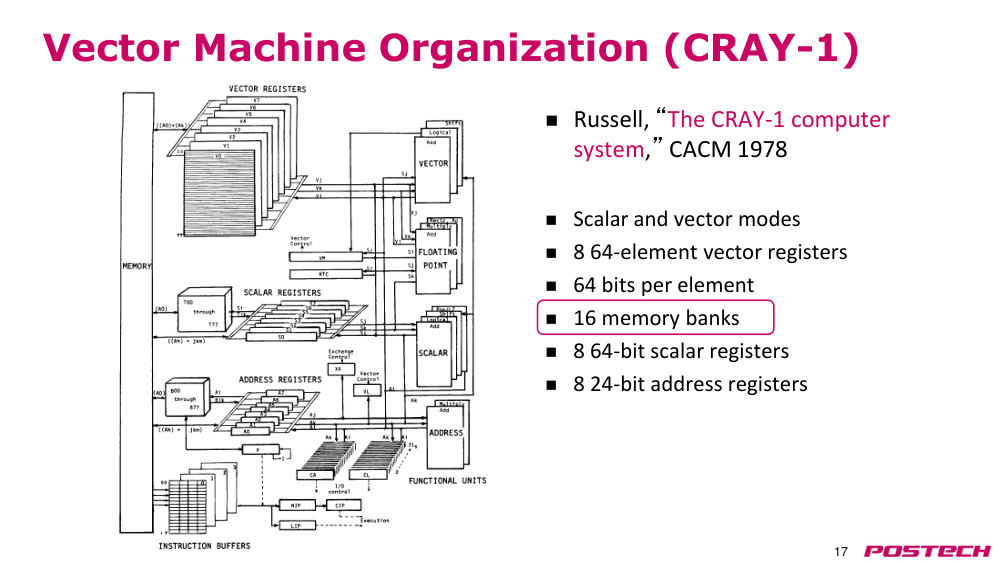
해결64 element 면 6 cycle latency 도 문제없음, 제어가 단순해 clock 을 높일 수 있음. 실제 예로 1970년대 후반 Cray-1 구조를 봄.
- Cray-1: 8개 64-element vector register(64-bit), 8개 64-bit scalar register
- vector·scalar functional unit, address register, instruction buffer, multi-bank memory
2.619:07–24:35RISC-V vector 확장과 DAXPY
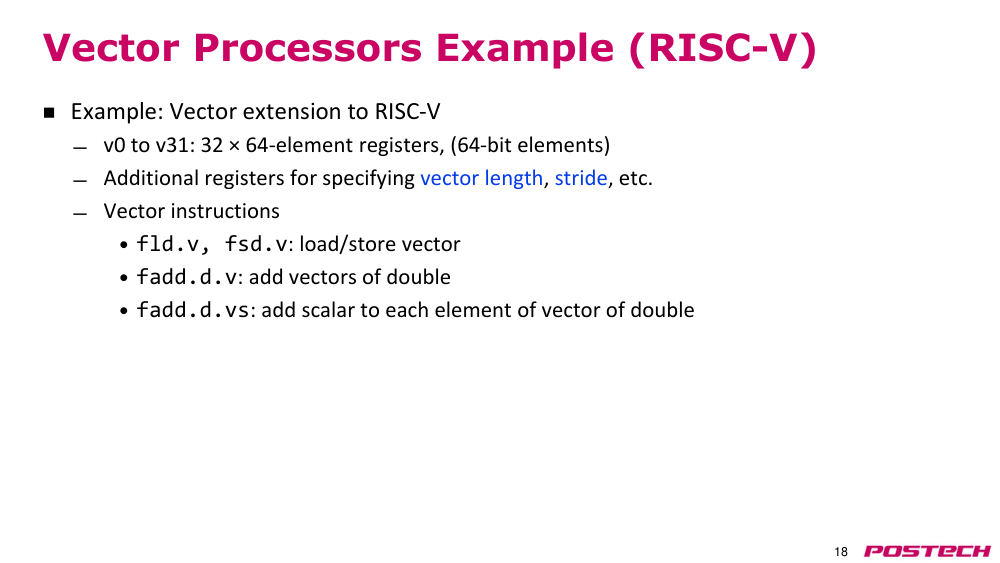
상황·문제vector ISA 는 어떤 instruction 을 제공하고 code 가 얼마나 달라지는가.
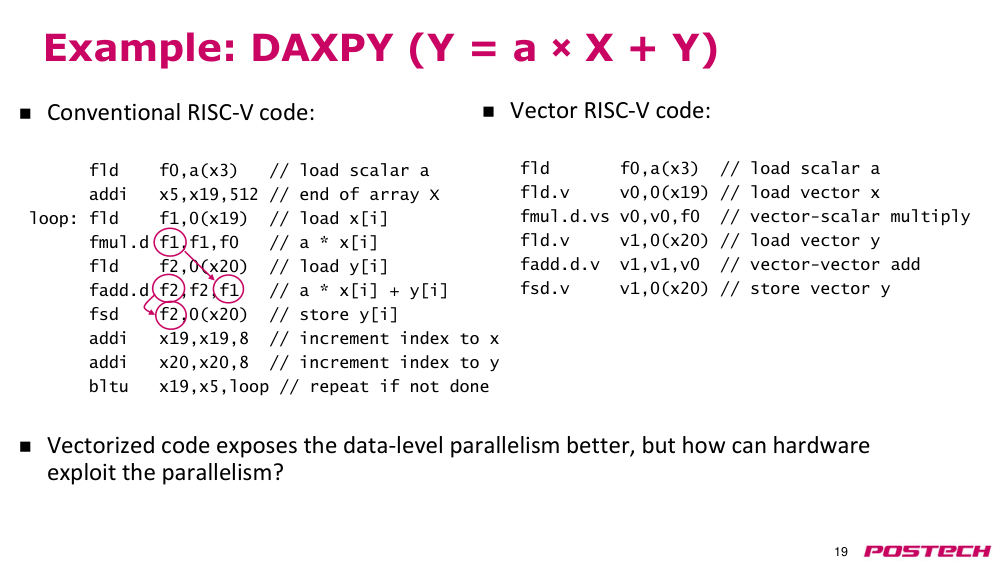
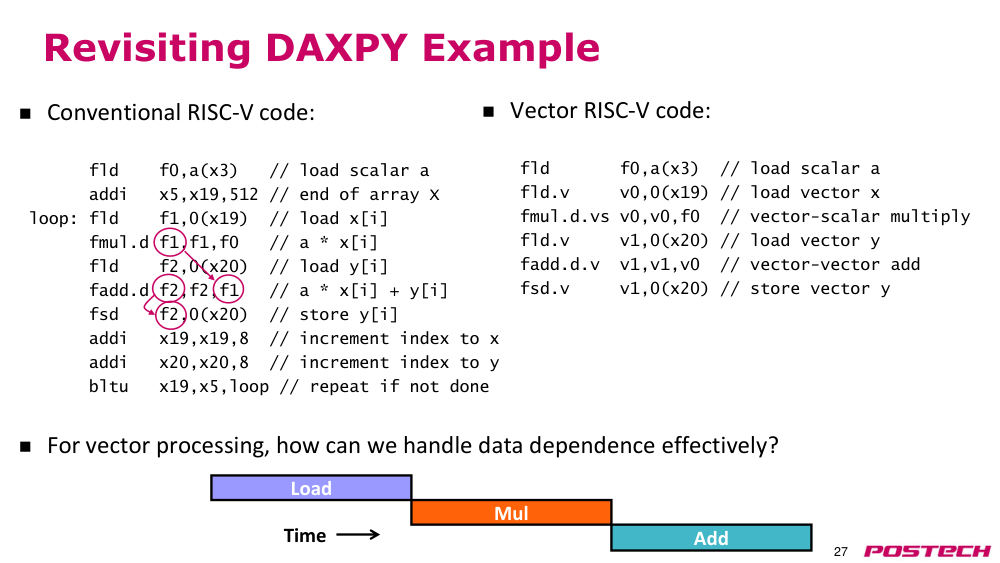
원인scalar RISC-V DAXPY 는 element 마다 load·mul·load·add·store 에 index 증가·branch 를 반복.
해결RISC-V V: 32개 64-element register, fld.v/fsd.v, fadd.d.v, fmul.d.vs 로 loop 없는 6 instruction code.
- fadd.d.v 는 vector+vector, fadd.d.vs 는 vector 각 element 에 scalar
- vector instruction 이 DLP 를 드러냄 → hardware 가 어떻게 활용할지가 다음 질문
2.724:35–31:58vector load/store 와 memory banking
상황·문제vector 는 한 번에 많은 element 를 memory 에서 가져와야 해 bandwidth 가 병목이 되기 쉬움.
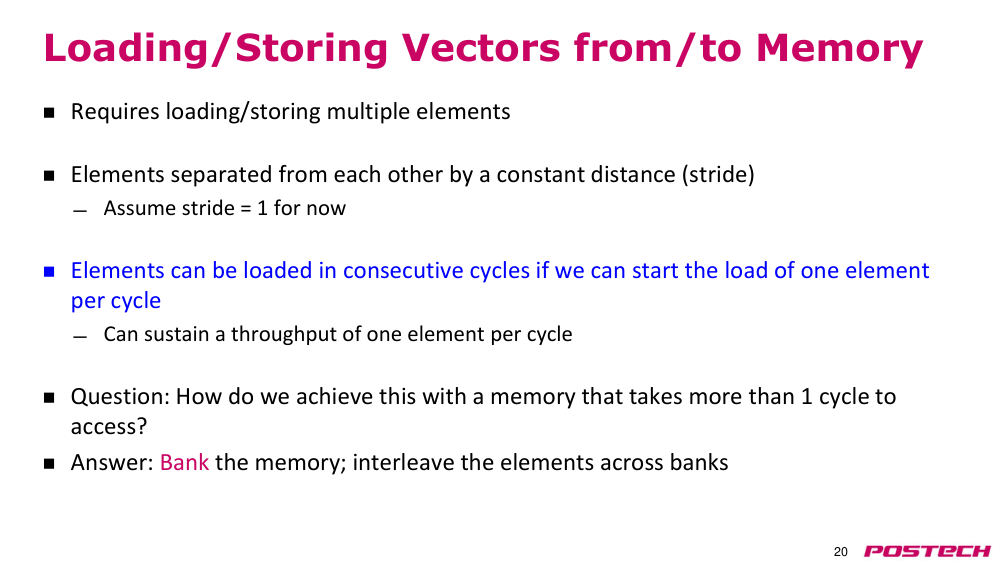
원인memory access 가 1 cycle 보다 길면 한 memory 로는 1 element/cycle 을 유지할 수 없음.
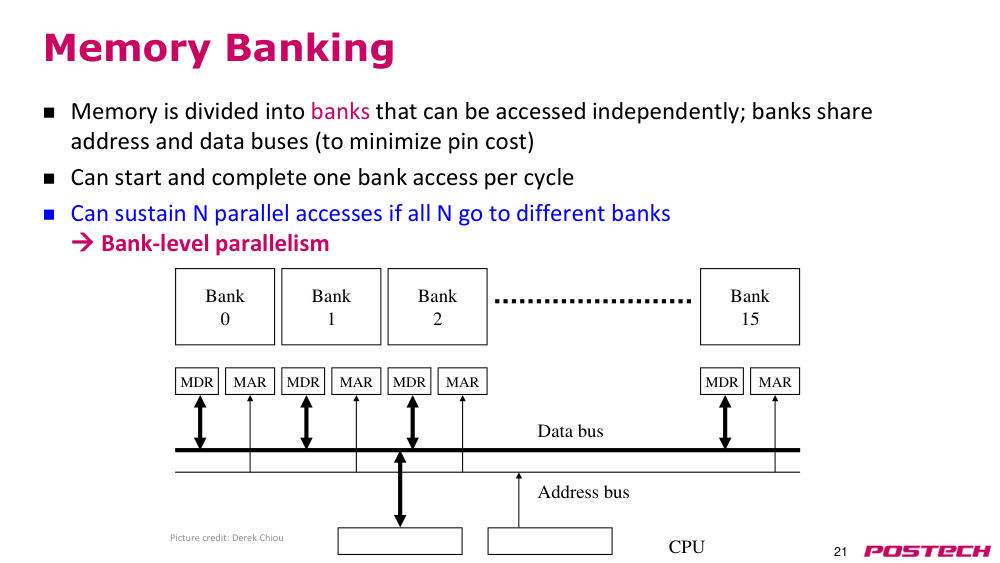
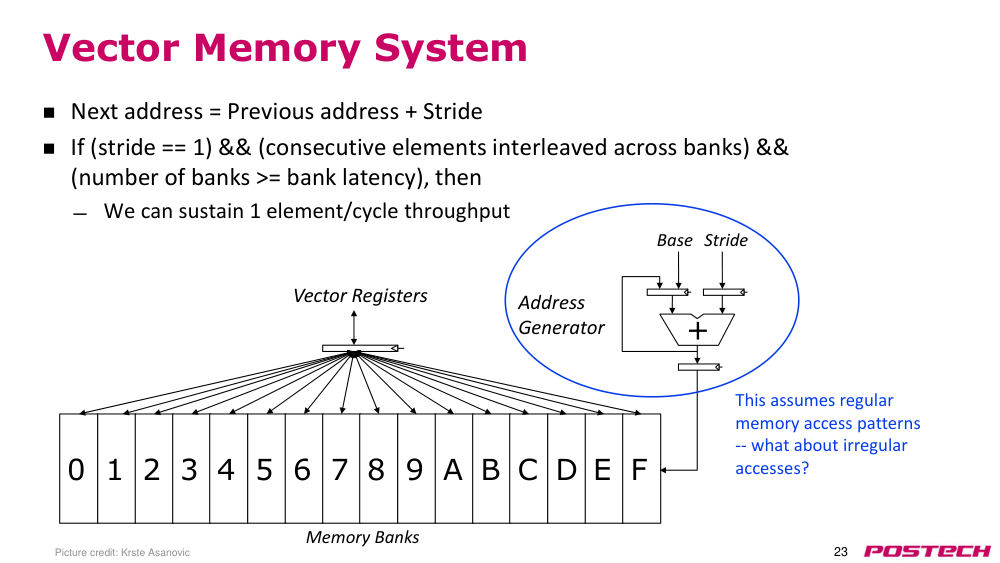
해결memory 를 독립 bank 로 나눠 element 를 interleave, cycle 마다 다른 bank 접근 시작 (bank-level parallelism).
- 예: 16 bank, address·data bus 공유
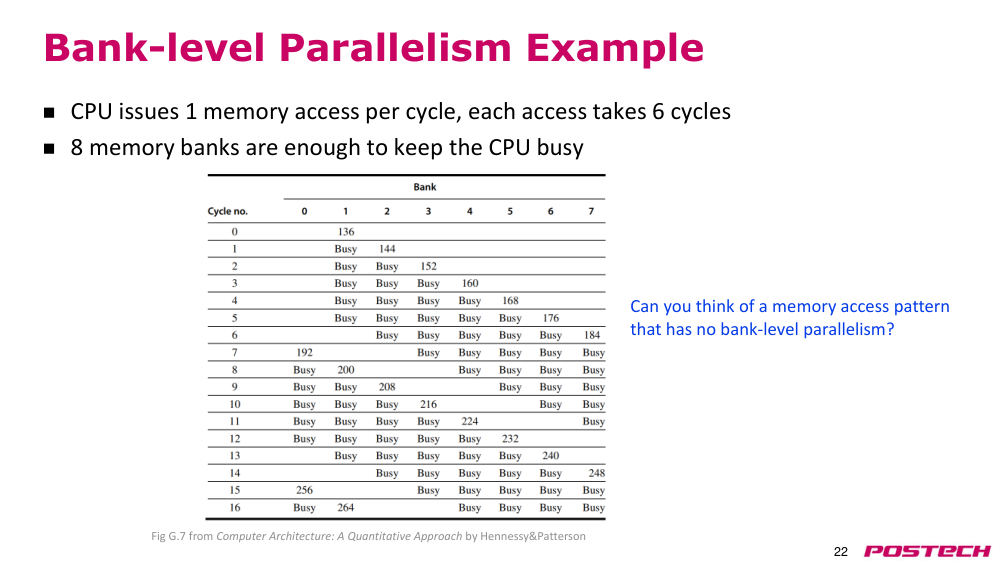
- 6 cycle access + 8 bank 면 매 cycle data 공급 (bank 수 > access cycle)
2.831:58–38:36bank conflict 와 vector memory system
상황·문제element 가 독립이고 access 가 regular 해도 bank-level parallelism 이 깨지는 경우가 있는가 (수업 중 질문).
원인stride 2 면 cycle 4 에 bank 1 이 아직 busy 라 cycle 6 까지 대기, stride 8 이면 bank 1 만 쓰고 나머지는 idle = bank conflict.
해결address generator = base + stride. stride 1, interleave, bank 수 ≥ bank latency 이면 1 element/cycle.
- regular pattern 도 stride 에 따라 functional unit 을 못 채움
- irregular access 는 별도 방법 필요
2.938:36–45:37gather/scatter (irregular access)
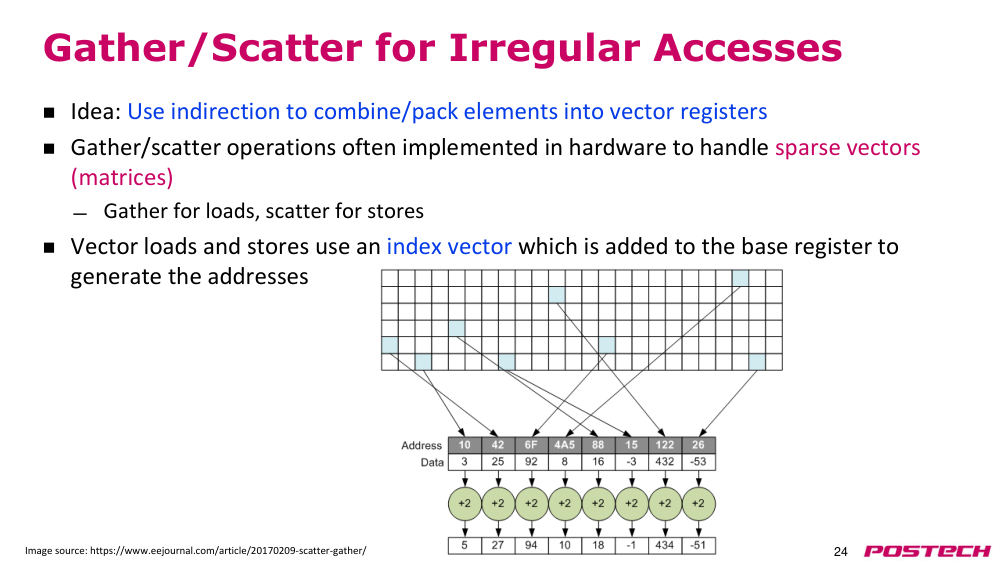
상황·문제sparse vector·matrix 처럼 non-zero 위치가 불규칙하면 stride 로 표현 불가.
원인element 위치에 pattern 이 없어 address 를 base + stride 로 생성할 수 없음.
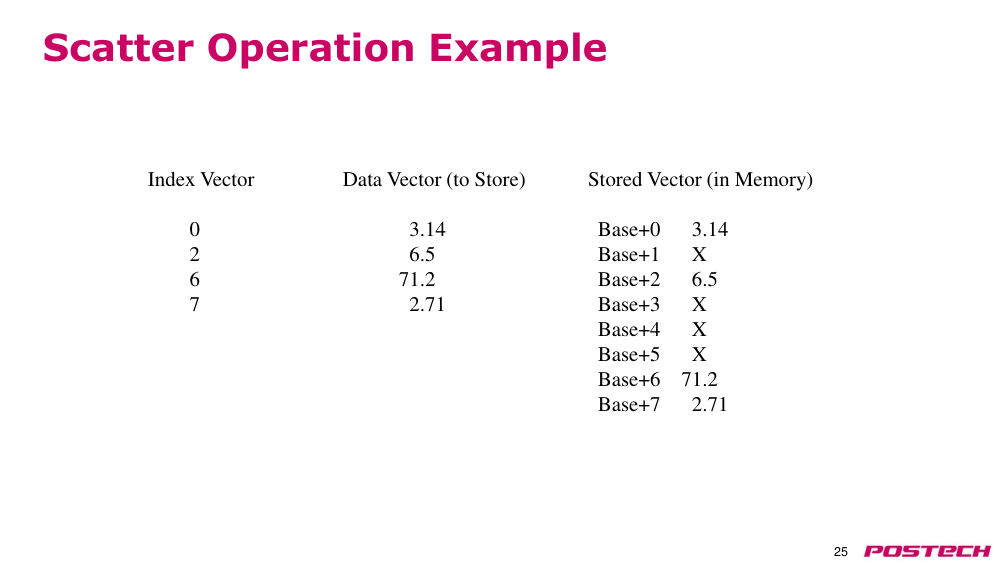
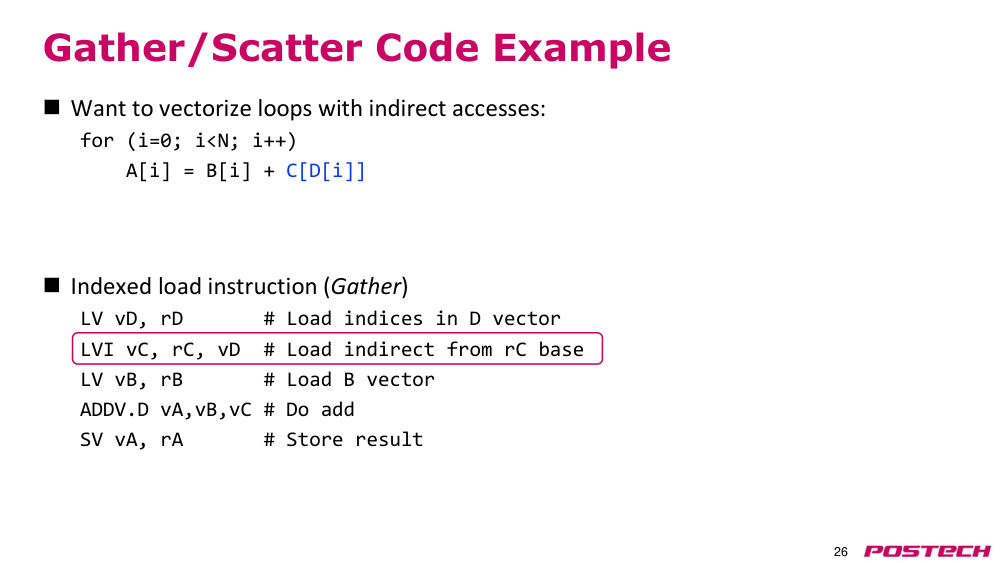
해결index vector 로 indirection: gather(load)/scatter(store), 주소 = base + index. A[i]=B[i]+C[D[i]] 는 LVI 로 vectorize.
- scatter 예: index (0,2,6,7) → Base+0/2/6/7 에만 저장
- 강의 중 PLMS 에 수정 slide 업로드, 영상 delay 확인(약 2348–2396초)
2.1045:37–51:00vector chaining
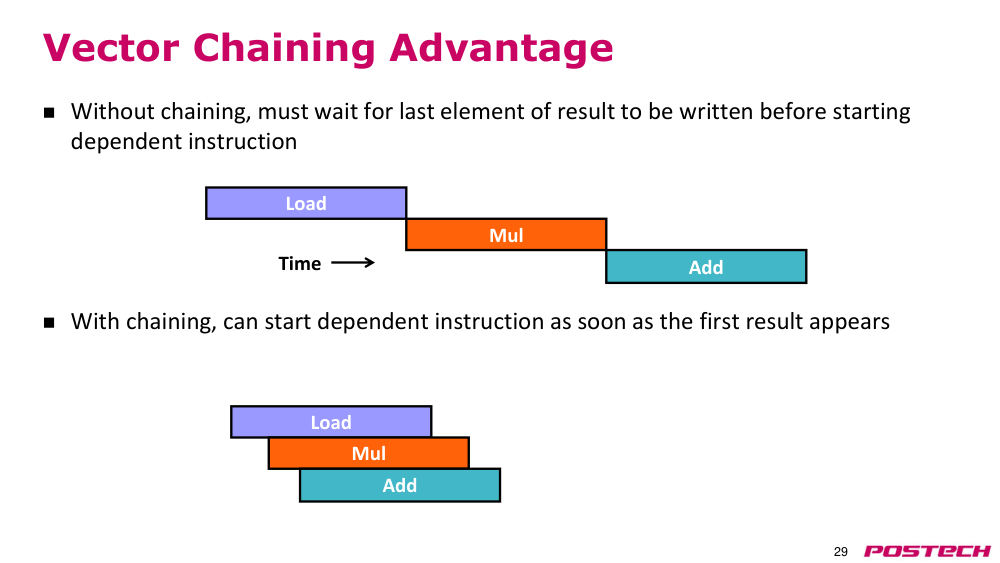
상황·문제DAXPY 의 load → mul → add 를 순서대로 하면 64 element 각각 64 cycle 이상씩 걸림.
원인앞 instruction 이 모든 element 를 register 에 쓸 때까지 dependent instruction 이 기다림.
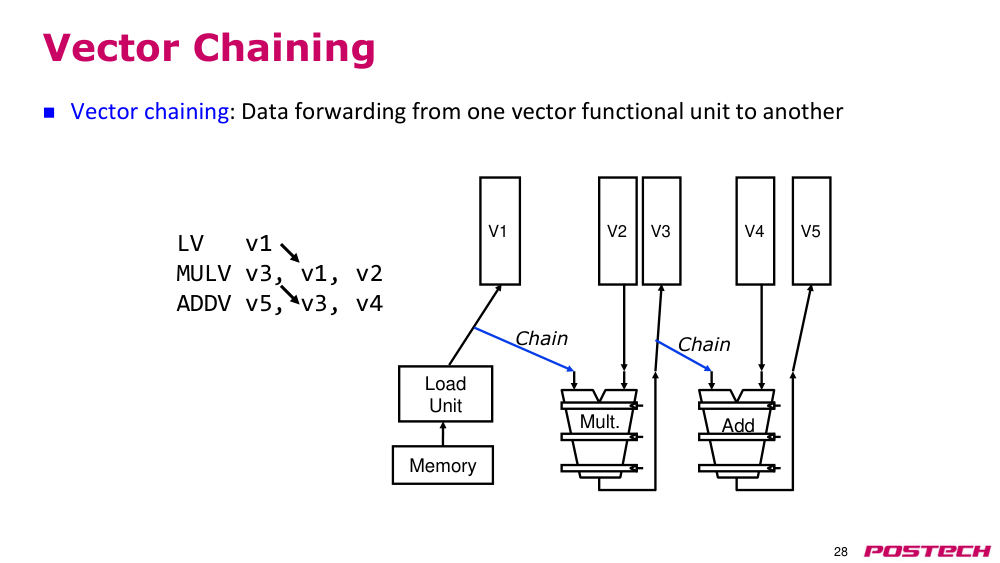
해결vector chaining: 5-stage pipeline 의 forwarding 처럼 functional unit 결과를 다음 unit 에 바로 전달해 실행을 겹침.
- load unit 이 register 에 쓰는 동시에 multiplier 에 공급
- 첫 결과가 나오자마자 dependent instruction 시작
2.1151:00–53:35vector stripmining (긴 vector)
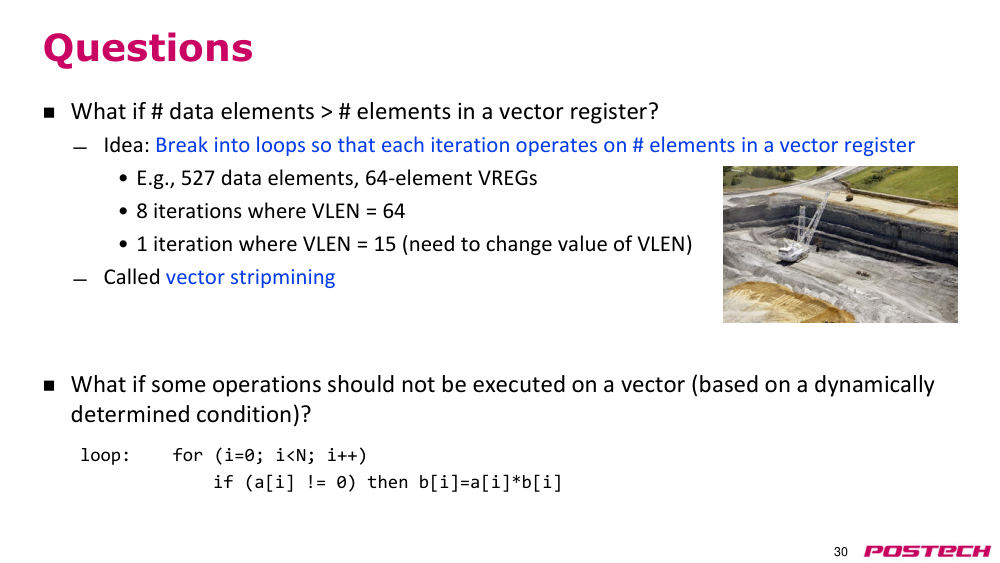
상황·문제logical vector 가 physical vector register(예 64 element) 보다 훨씬 길 수 있음.
원인register 에 한 번에 담을 수 없음.
해결register 크기 단위로 loop: 527 element → VLEN=64 로 8회 + VLEN=15 로 1회. 이름은 광산의 strip mining 에서 옴.
- VLEN register 를 마지막 iteration 에서 바꿈
2.1253:35–1:01:36조건부 연산: masked operation
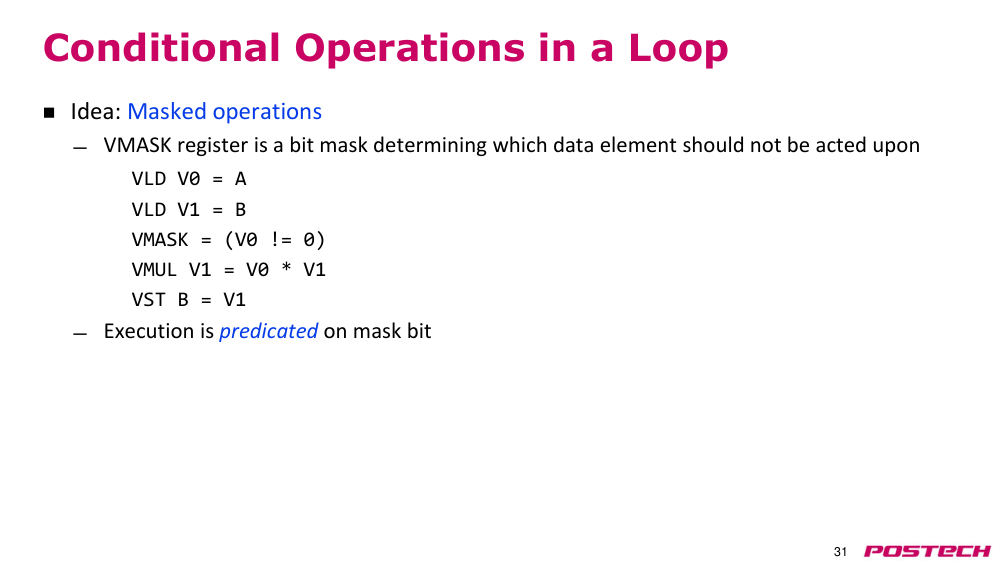
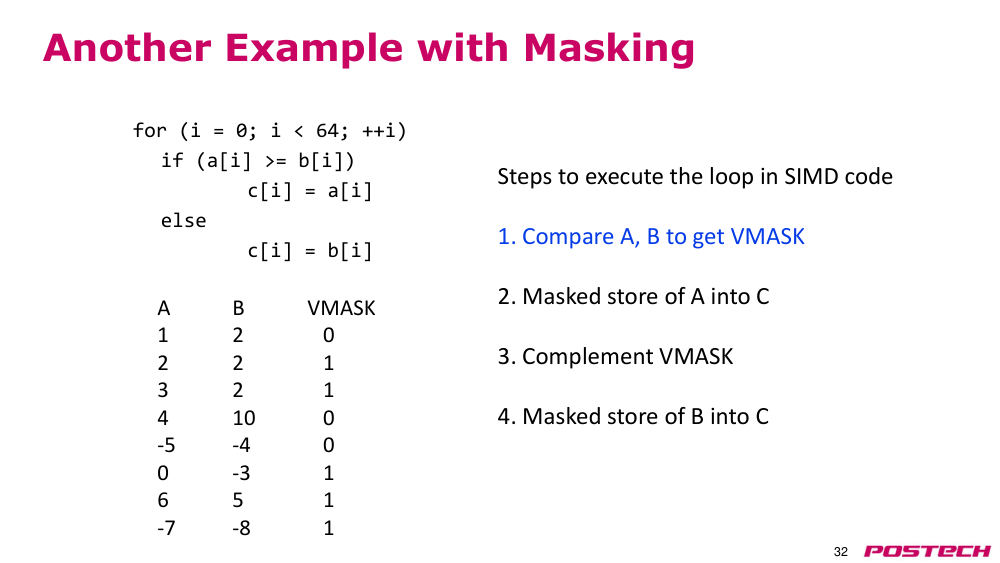
상황·문제if (a[i] != 0) 처럼 조건을 만족하는 element 만 계산해야 함 (control dependence).
원인vector instruction 은 기본적으로 모든 element 를 처리.
해결VMASK 에 조건 결과를 쓰고 이후 instruction 은 implicit 하게 mask 를 적용(predicated). max 예는 mask → store A → complement → store B.
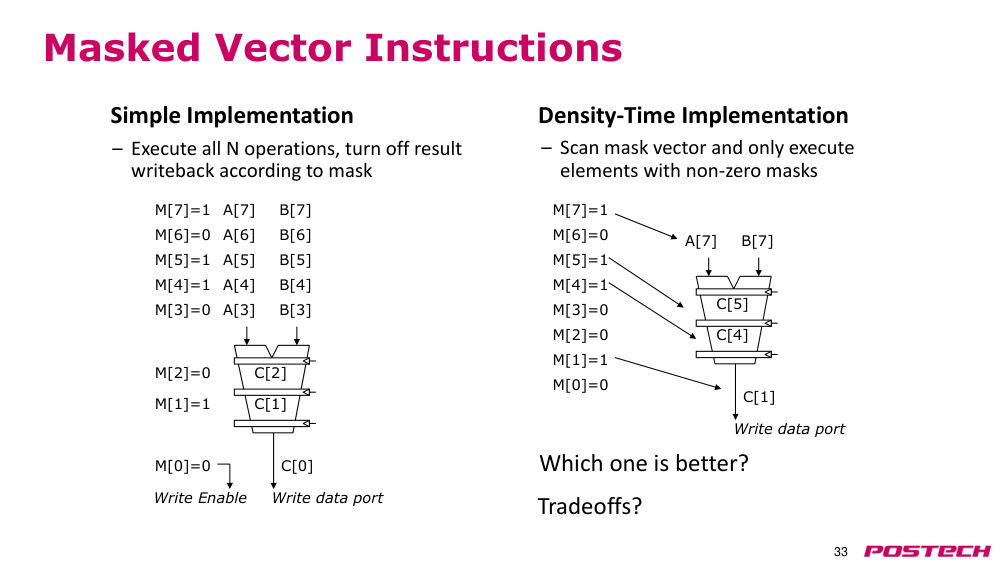
- simple: 모두 실행 후 write back 만 차단 (낭비)
- density-time: mask 1 인 element 만 실행 (빠르지만 제어 overhead)
2.12.r.1Wikipedia: Predication (computer architecture) ↗ · vector/SIMD 에서 mask bit 로 element 별 실행 여부 결정
2.131:01:36–1:11:38stride·data layout 과 bank conflict 최소화
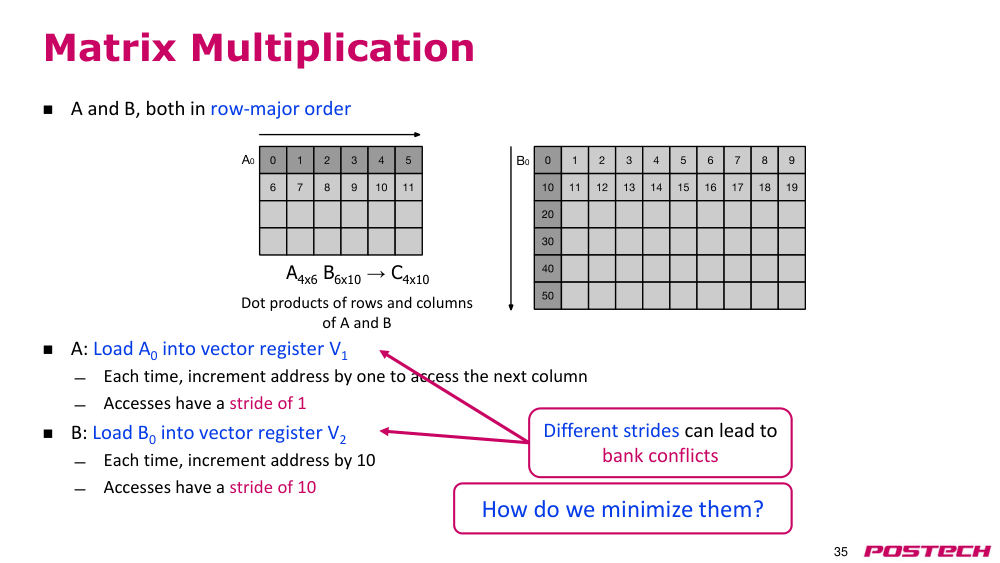
상황·문제stride 와 matrix 저장 방식에 따라 bank conflict 가 생김.
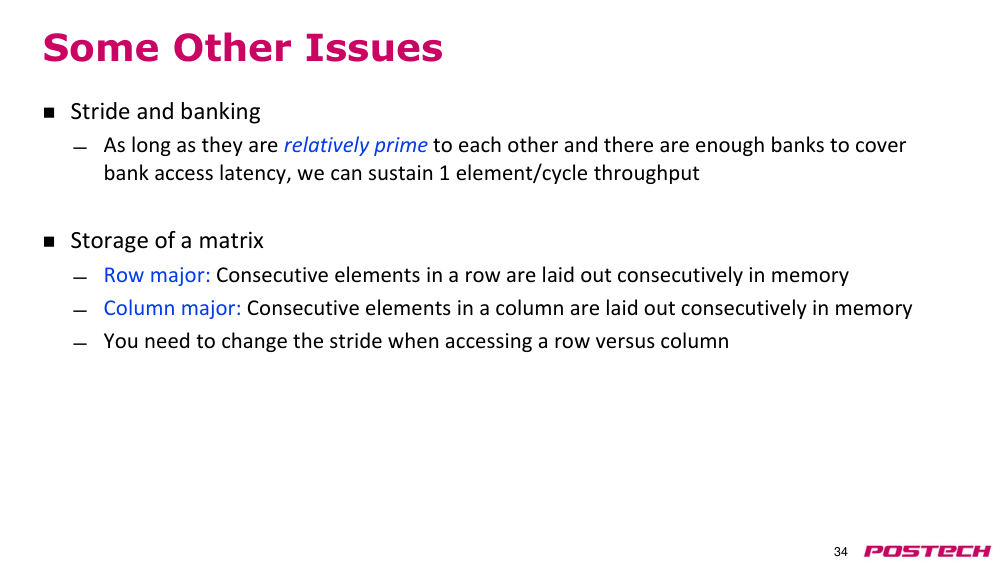
원인A·B 모두 row-major 면 A row 는 stride 1 이지만 B column 은 stride 10 → bank 에 고르게 퍼지지 않음.
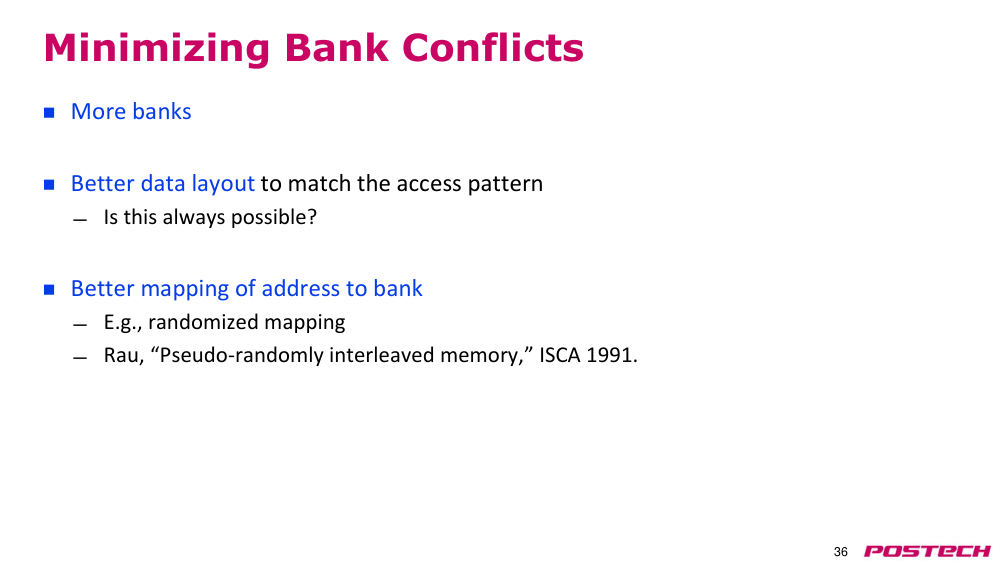
해결stride 와 bank 수를 서로소로, bank 증가, 접근에 맞는 layout(B 를 column-major, 단 다른 연산과 충돌 가능), address bit 를 XOR·hash 해 bank 를 randomize.
- B×D 처럼 row 접근이 또 필요하면 column-major 도 해결책이 아님
- randomized bank mapping 은 현대 processor 에 널리 쓰임 (Rau, ISCA 1991)
2.141:11:38–1:13:33vector ILP 와 자동 vectorization
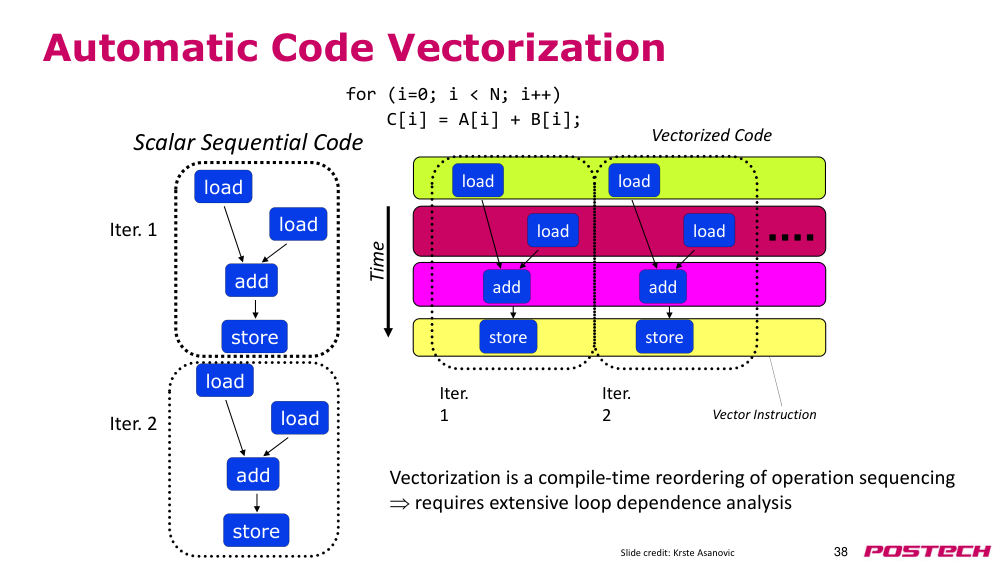
상황·문제vector code 에서도 더 많은 병렬성을 뽑고, assembly 를 직접 쓰지 않고 vector code 를 얻고 싶음.
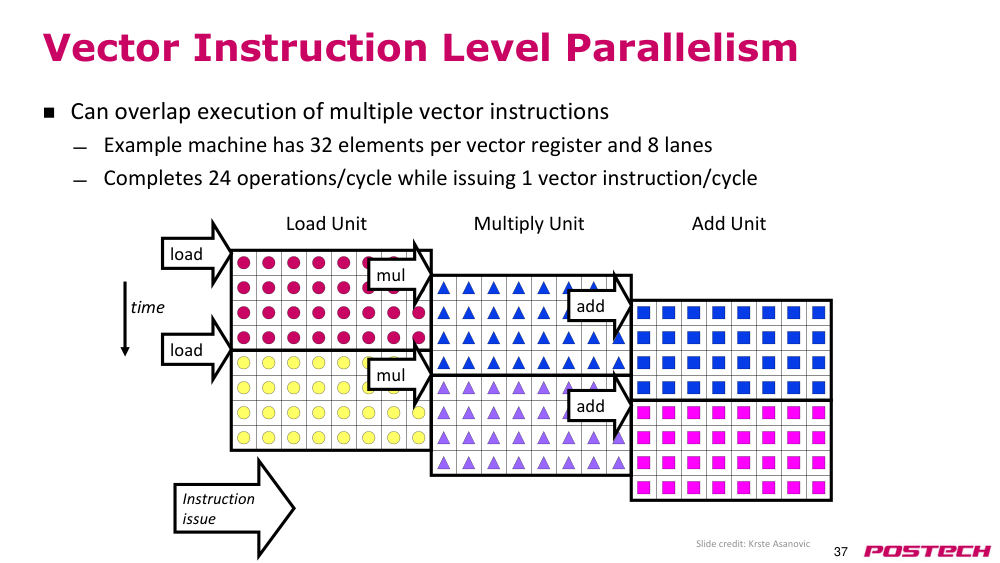
원인dependent instruction 은 chaining 으로 겹치지만 독립 instruction 도 동시에 실행 가능, 일반 code 는 scalar loop 로 작성됨.
해결독립 vector instruction 을 겹쳐 실행(예 8 lane, 24 op/cycle). compiler 가 loop 를 vectorize — 활발한 연구 분야.
- vectorization = compile-time operation 재배치, loop dependence analysis 필요
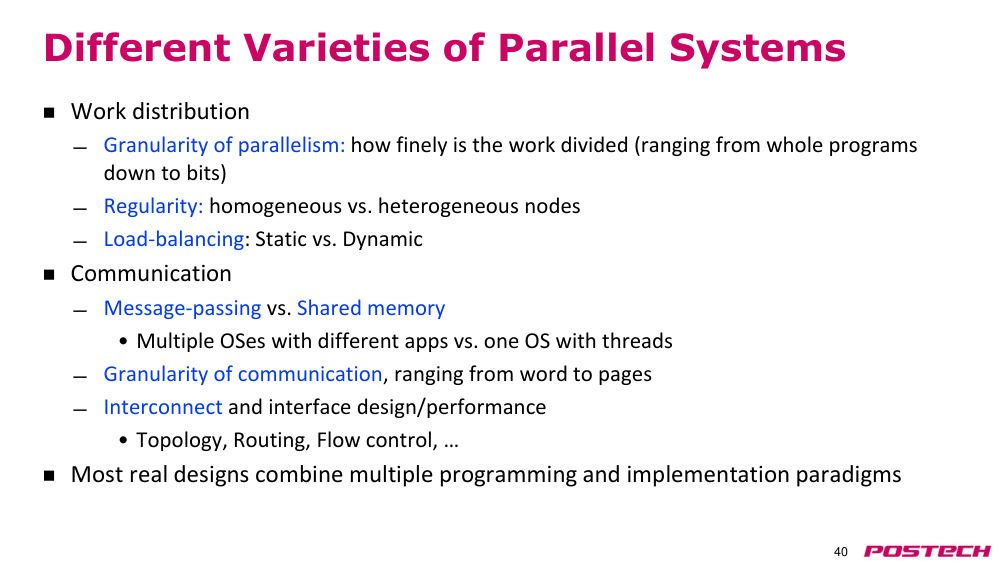
2.151:13:33–1:15:40요약과 병렬 시스템의 여러 형태
상황·문제vector/SIMD 의 장단점 정리와 이후 다룰 병렬 시스템의 큰 그림.
원인성능 향상은 vectorize 가능한 비율에 제한 (Amdahl's law), Cray-1 은 빠른 scalar machine 이기도 했음.
해결많은 ISA 가 SIMD 확장(MMX/SSE/AVX, AltiVec, Neon/SVE)을 포함. 병렬 시스템 분류는 훑어보기만 하고 종료.
- DLP: 같은 연산을 많은 element 에
- 교재 P&H Ch 6.1–6.5
3핵심 개념
3.1vector length register(VLEN, 벡터 길이 레지스터)
vector register 중 유효 element 수. stripmining 마지막 iteration 에서 15 처럼 바꿈.
3.2stride(스트라이드, VSTR)
연속 element 사이 memory 거리. 2 면 한 칸씩 건너뜀, bank conflict 원인이 될 수 있음.
3.3vector mask(VMASK, 벡터 마스크)
element 별 실행 여부 bit. 이후 instruction 이 implicit 하게 사용 (predicated execution).
3.3.r.1Wikipedia: Predication (computer architecture) ↗ · vector/SIMD 에서 mask bit 로 element 별 실행 여부 결정
3.4bank-level parallelism(뱅크 수준 병렬성)
독립 bank 에 element 를 interleave 해 cycle 마다 다른 bank 접근 시작. bank 수 ≥ bank latency 필요.
3.5bank conflict(뱅크 충돌)
같은 bank 가 busy 인데 다시 접근해야 해 대기. 예: 8 bank 에서 stride 8.
3.6gather/scatter(개더/스캐터)
index vector 로 불규칙 위치 load(gather)/store(scatter). 주소 = base + index.
3.7vector chaining(벡터 체이닝)
vector functional unit 간 data forwarding. 첫 결과가 나오면 dependent instruction 시작.
3.8vector stripmining(벡터 스트립마이닝)
긴 vector 를 register 크기 단위 loop 로 처리. 527 = 64×8 + 15.
3.9density-time implementation
mask 1 인 element 만 실행해 빠름. 대가는 functional unit 제어 overhead.
3.10row-major / column-major order(행 우선/열 우선)
matrix 를 row 또는 column 단위로 연속 배치. 접근 방향에 따라 stride 가 달라짐.
4스스로 확인
4.1access 가 6 cycle 걸리는 memory 로 1 element/cycle 을 유지하려면?
답
memory 를 6개 이상 bank 로 나누고 element 를 interleave 해 cycle 마다 다른 bank 접근을 시작.
4.28 bank 에서 stride 8 이면 어떤 일이 생기나?
답
모든 element 가 같은 bank 에 있어 한 bank 만 사용, 나머지 idle → bank conflict 로 throughput 저하.
4.3527 element 를 64-element register 로 처리할 때 VLEN 설정은?
답
VLEN=64 로 8회, 마지막 1회는 VLEN=15 (vector stripmining).
4.4vector chaining 은 scalar pipeline 의 어떤 기법에 해당하나?
답
data forwarding. 결과가 register 에 다 써지기 전에 다음 functional unit 으로 전달.
4.5masked operation 의 simple 구현과 density-time 구현의 tradeoff?
답
simple 은 모두 실행하고 write back 만 막아 resource 낭비, density-time 은 빠르지만 제어 overhead.
4.6A·B 가 row-major 일 때 A×B 에서 bank conflict 가 생기는 쪽과 이유는?
답
B 의 column 접근, stride 10 이라 element 가 bank 에 고르게 퍼지지 않음.