Lec 13 · memory hierarchy(메모리 계층 구조)와 cache(캐시) 기초
정밀 정리 · 검증 2026-09-24 19:15
1개요
1.1ideal memory(2⁶⁴ B, 1 cycle)는 불가능 → 작고 빠른 cache 와 크고 느린 main memory 의 hierarchy 로 근사.
1.2근거는 locality(temporal·spatial)와 cost amortization. 관리는 register↔L1 compiler, cache HW, DRAM↔SSD OS.
1.3성능식 Tᵢ = tᵢ + mᵢ·Tᵢ₊₁ (T₁ = AMAT), cache 는 request filter. capacity·replacement·prefetching·level 추가로 trade-off.
1.4Intel P4 예제로 T₁=7.6 계산 후 cache interface(valid/ready), basic issue 5개, basic operation flowchart 까지. p25 이후는 다음 강의.
2섹션별 정리 상황·문제 → 원인 → 해결
2.10:31–4:03도입: 'ideal' memory vs. 현실
상황·문제이상적으로는 program 이 2⁶⁴ B 전체 memory 를 보고, 어디든 1 processor cycle 에 접근하고 싶다.
원인그만큼의 memory 는 비싸고 필요하지도 않다. 큰 memory 는 물리적으로 빠를 수 없다 (큰 app 도 2⁴⁰ 정도).
해결작고 빠른 cache 와 크고 느린 main memory 의 hierarchy 로 '마법의' memory 를 만든다.
- 이번·다음 강의: memory hierarchy, 이후 virtual memory 와의 관계
- Burks, Goldstine, von Neumann (1946) 이 이미 제안
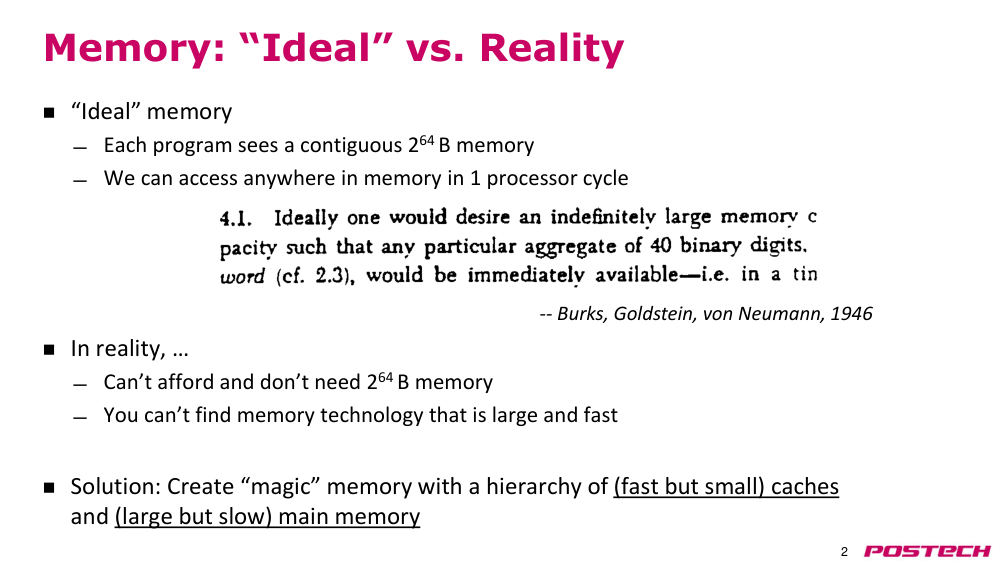
2.1.r.1Burks, Goldstine, von Neumann, Preliminary Discussion of the Logical Design ... (1946) ↗ · p2 인용문 4.1 'indefinitely large memory' 와 계층 memory 제안 원문
2.24:03–10:30memory hierarchy 비유와 storage 의 법칙
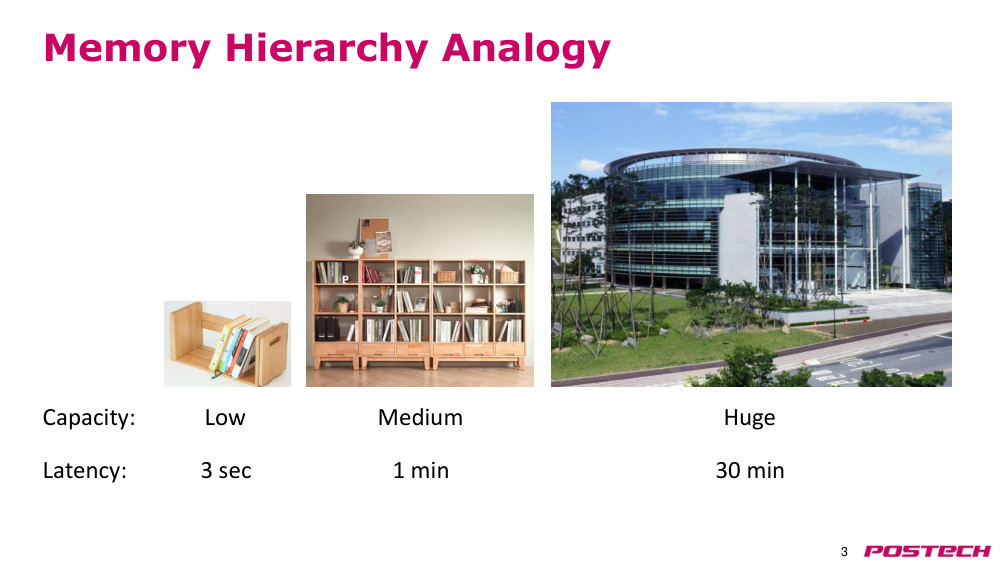
상황·문제책상(3초)·책장(1분)·도서관(30분)처럼 저장소는 capacity 와 latency 를 맞바꾼다.
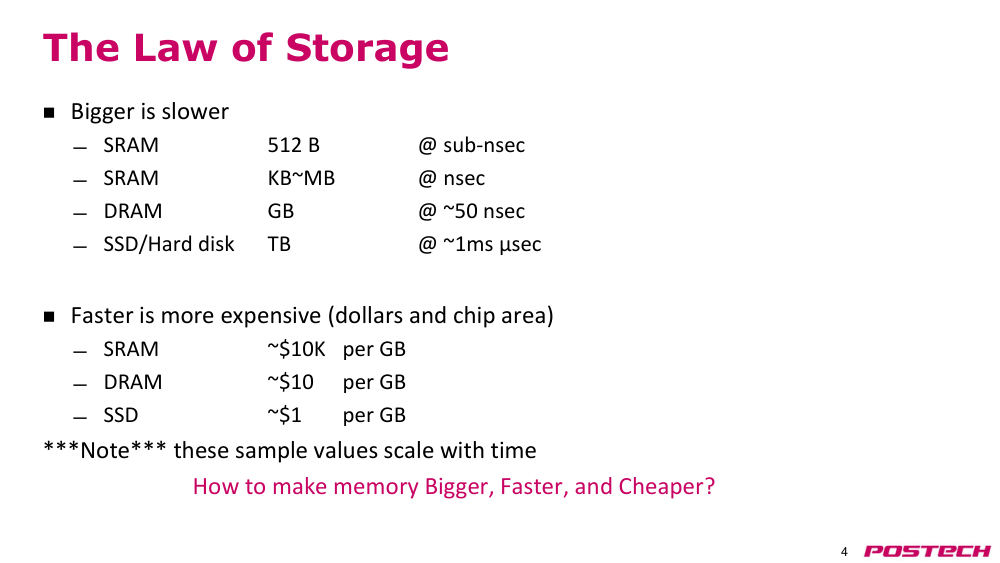
원인Bigger is slower (SRAM ns, DRAM ~50 ns, SSD/HDD μs~1 ms). Faster is more expensive (SRAM ~$10K/GB, DRAM ~$10, SSD ~$1).
해결SRAM 만으로 만들면 비용이 너무 크다 → 여러 device 를 섞어 SRAM 처럼 빠르고 크고 싸게 보이게 한다.
- 가격 값은 시간이 지나면 변한다 (같은 돈으로 더 큰 저장소)
- 목표: Bigger, Faster, Cheaper
2.2.r.3Dynamic random-access memory (Wikipedia) ↗ · DRAM 은 high density·low cost per bit, main memory
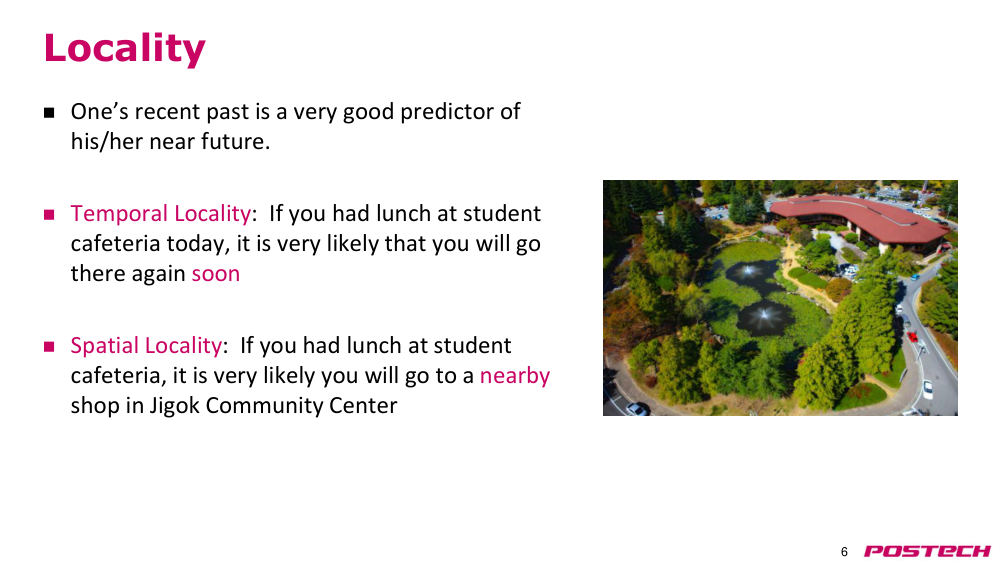
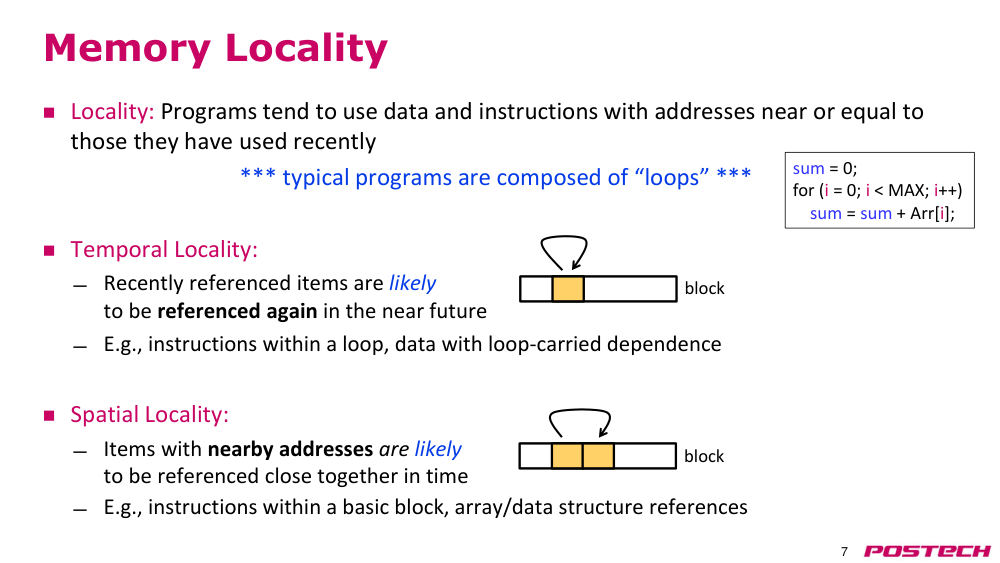
2.310:30–18:39locality(지역성): temporal·spatial
상황·문제memory hierarchy 가 통하려면 접근 pattern 에 규칙이 있어야 한다.
원인program 은 loop 로 구성 → 최근 쓴 주소(temporal)나 그 근처 주소(spatial)를 곧 다시 쓴다.
해결예: 지곡회관 점심 비유. loop 의 instruction·sum 변수는 temporal, 다음 instruction·Arr[i] 순차 접근은 spatial locality.
- sum = sum + Arr[i] 는 load·load·add·store·BLT 등 4~5개 instruction 이 반복 실행
- Arr 0,1,2,3… 순서 접근 = spatial locality
2.418:39–23:48cost amortization(비용 분산)
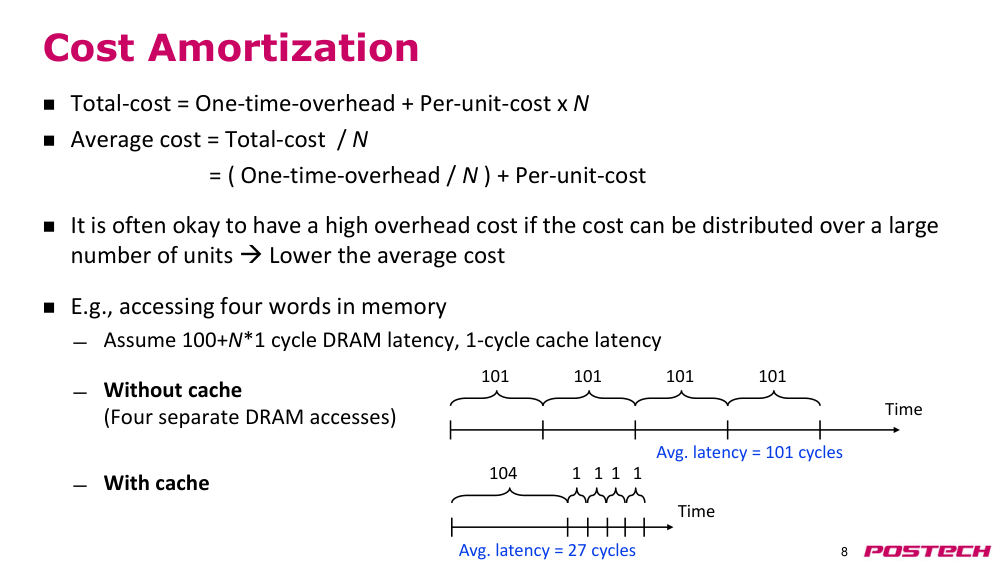
상황·문제같은 data 를 4번 읽을 때 매번 DRAM 에 가면 매번 101 cycle 이 든다.
원인평균 cost = 일회성 overhead / N + 단위당 cost. overhead 가 커도 N 이 크면 평균이 작아진다.
해결가져온 data 를 빠른 저장소에 두면 첫 접근 104 cycle 뒤 1 cycle 씩 → 평균 27 cycle (cache 없음 101).
- 도서관에서 책 4권을 한 번에 빌리면 30분 이 4권에 나뉜다
- 가정: DRAM 100+N×1 cycle, cache 1 cycle
2.523:48–28:23memory hierarchy 구조와 cache 의 정의
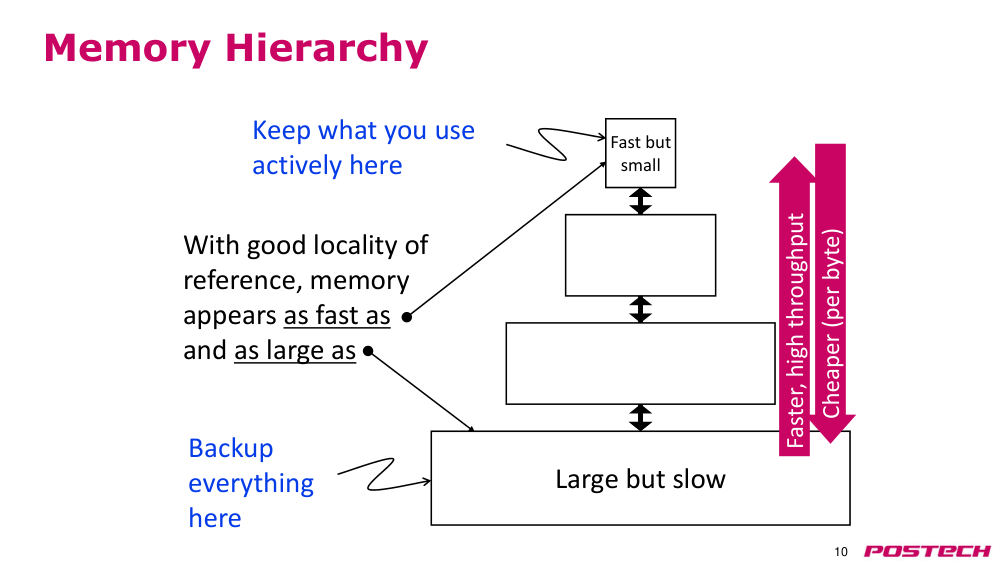
상황·문제하나의 device 로는 빠르면서 큰 memory 를 만들 수 없다.
원인작고 빠른 memory 는 CPU 가까이 두되 전부를 담지 못하고, 크고 느린 memory 가 모든 것을 backup 해야 한다.
해결locality 가 좋으면 hierarchy 전체가 맨 위처럼 빠르고 맨 아래처럼 크게 보인다. 위쪽은 high throughput, 아래쪽은 byte 당 저렴.
- 이 계층들을 computer architecture 에서 cache 라 부른다
- CSE 정의: 자주·최근 쓴 instruction/data 를 담는 짧은 access time memory (I-cache, D-cache)
- 일반적으로 YouTube 영상 cache server 같은 internet 서비스에도 쓰는 용어
2.628:23–34:03hierarchy 관리: manual vs. automatic
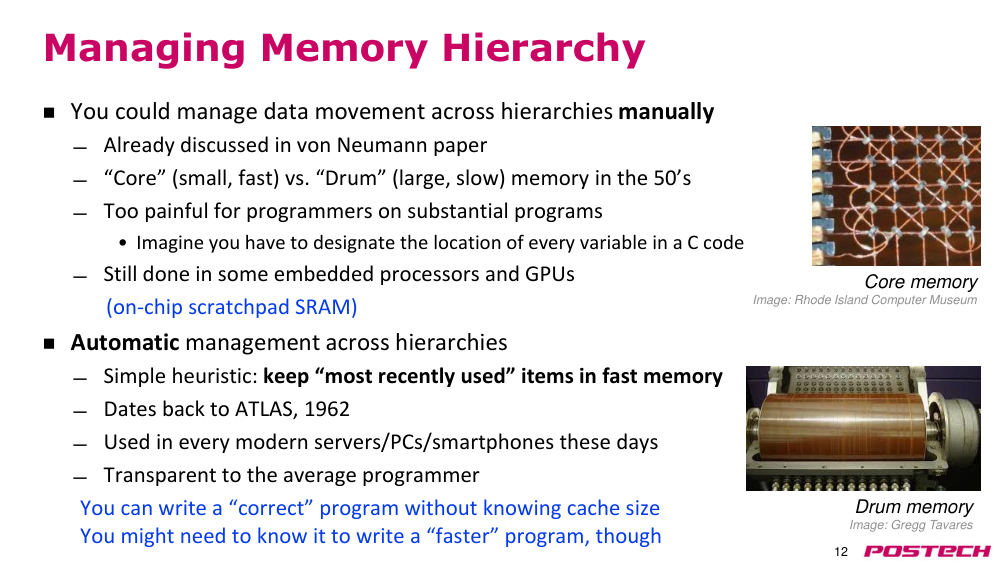
상황·문제어떤 data 를 어느 level 에 두고 level 사이를 어떻게 옮길지 정해야 한다.
원인manual 관리(1950년대 core vs. drum)는 C 변수마다 위치를 지정해야 해서 programmer 부담이 크다.
해결대부분은 hardware 가 '최근 사용 항목을 빠른 memory 에' 두는 automatic 관리 (ATLAS 1962~). manual 은 embedded·GPU scratchpad 에 남아 있다.
- automatic 은 programmer 에게 transparent → 정확한 program 은 cache 크기 몰라도 된다
- 대신 중요한 data 가 evict 될 수 있어 예측 가능성이 떨어진다
- 최고 성능을 원하면 cache 특성을 알아야 한다
2.734:03–38:05현대 memory hierarchy 와 level 별 관리 주체
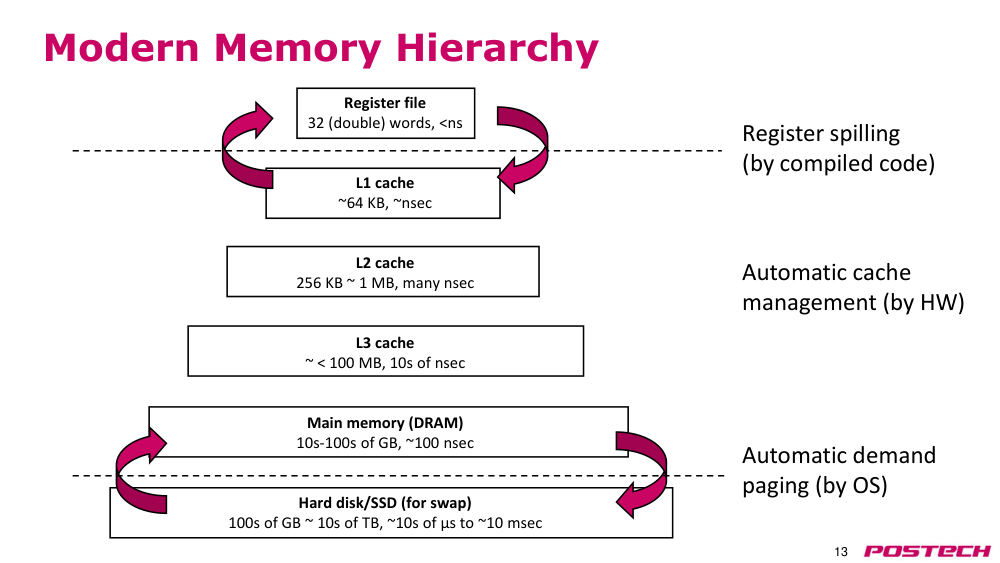
상황·문제register file → L1/L2/L3(SRAM) → DRAM → SSD/HDD, 아래로 갈수록 느리고 크다.
원인level 마다 data 를 옮기는 주체가 다르다.
해결register↔L1: compiler 가 load/store 삽입(register spilling). cache↔DRAM: HW 자동. DRAM↔SSD: OS 의 demand paging (DRAM 4 GB 로 8 GB 사용 가능).
- 일부 system 은 non-volatile memory(NVRAM) 를 main memory 에 섞는 연구가 진행 중
- 아래 level cache 일수록 느리지만 용량이 크다
2.838:05–39:345-stage pipeline 에 붙는 cache
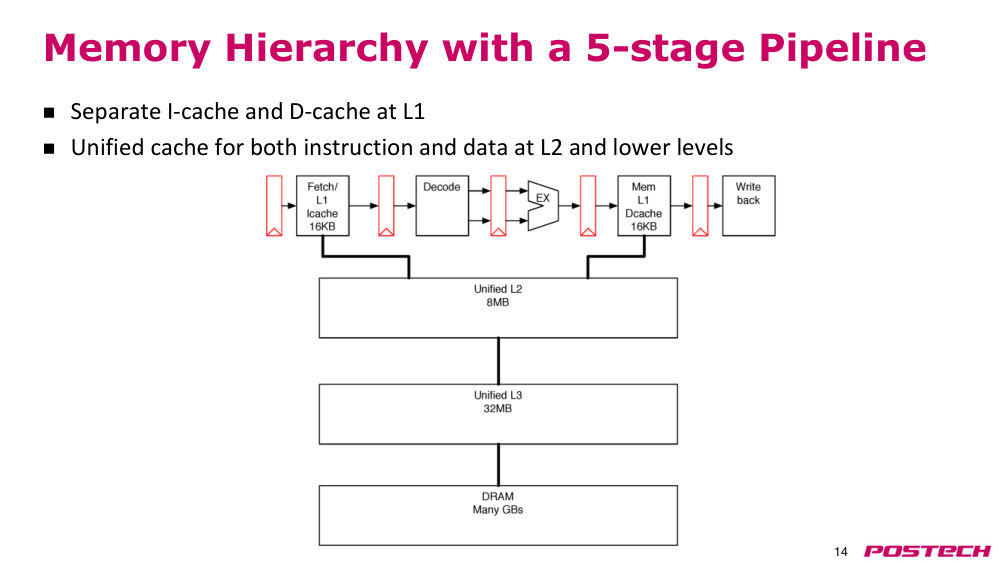
상황·문제지금까지 instruction/data memory 를 1 cycle 에 접근된다고 가정했다.
원인실제로는 small L1 cache 이며, 담지 못한 data 는 L2/L3/DRAM 에 있다.
해결L1 은 I-cache 와 D-cache 로 분리, L2 이하는 unified. L1 miss 면 하위 level 로 가며 pipeline 이 stall 된다.
- 그림 예: L1 I/D 각 16KB, unified L2 8MB, L3 32MB
2.8.r.1CPU cache (Wikipedia) ↗ · direct-mapped·set-associative·fully associative, tag/index/offset, split L1
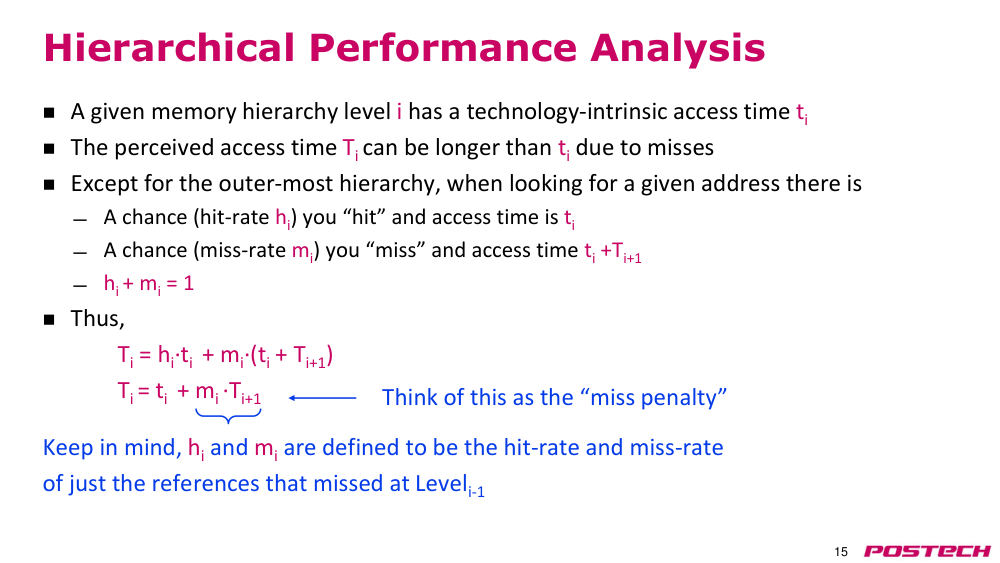
2.939:34–45:06hierarchical performance analysis: Tᵢ = tᵢ + mᵢ·Tᵢ₊₁
상황·문제level i 의 intrinsic access time tᵢ(공정 세대로 결정)와 miss 를 포함한 perceived access time Tᵢ 는 다르다.
원인hit(확률 hᵢ)면 tᵢ, miss(mᵢ)면 hit/miss 판단에 tᵢ 를 쓴 뒤 Tᵢ₊₁ 이 더해진다.
해결Tᵢ = hᵢ·tᵢ + mᵢ·(tᵢ + Tᵢ₊₁) = tᵢ + mᵢ·Tᵢ₊₁. mᵢ·Tᵢ₊₁ 을 miss penalty 로 본다.
- hᵢ, mᵢ 는 level i-1 에서 miss 한 참조 기준 (local rate)
- 예: 1,000 접근 → L1 hit 70% 면 300 miss → L2 hit 80% 면 240 hit, 60 miss
2.1045:06–49:42cache 를 request filter 로 보기
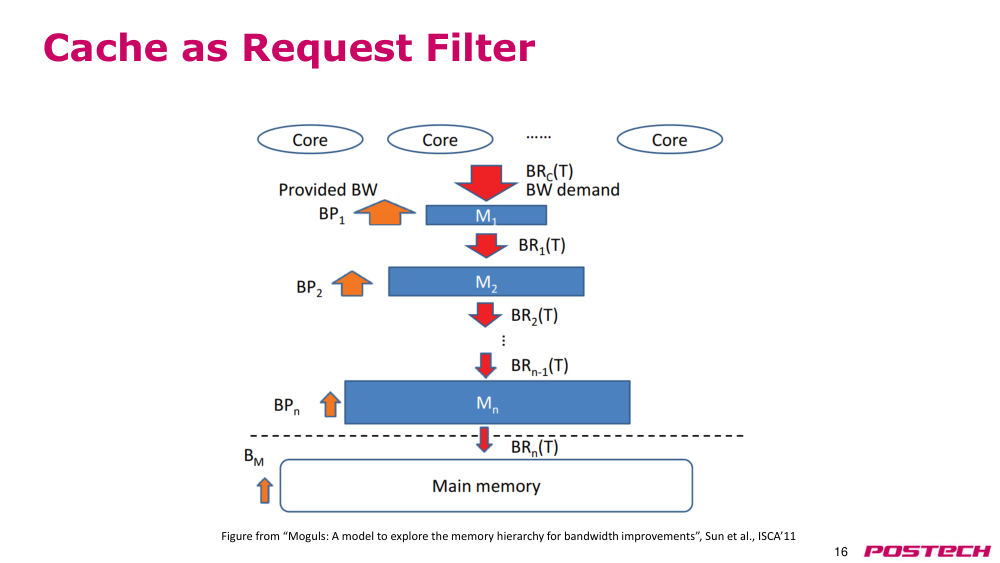
상황·문제아래 level memory 는 느려서 throughput(bandwidth) 도 낮다.
원인core 의 모든 요청이 그대로 내려오면 하위 level 이 감당하지 못한다.
해결L1 이 대부분(예: 700/1000)을 걸러 300 만 내려보내고, level 마다 걸러져 DRAM 에는 소수만 도달한다.
- 위 level 은 빠르고 high throughput, 아래는 low throughput 이지만 요청 수가 적어 괜찮다
2.10.r.1Sun et al., Moguls: a Model to Explore the Memory Hierarchy for Bandwidth Improvements (ISCA'11) ↗ · p16 request filter 그림의 출처 논문 (BW demand vs provided)
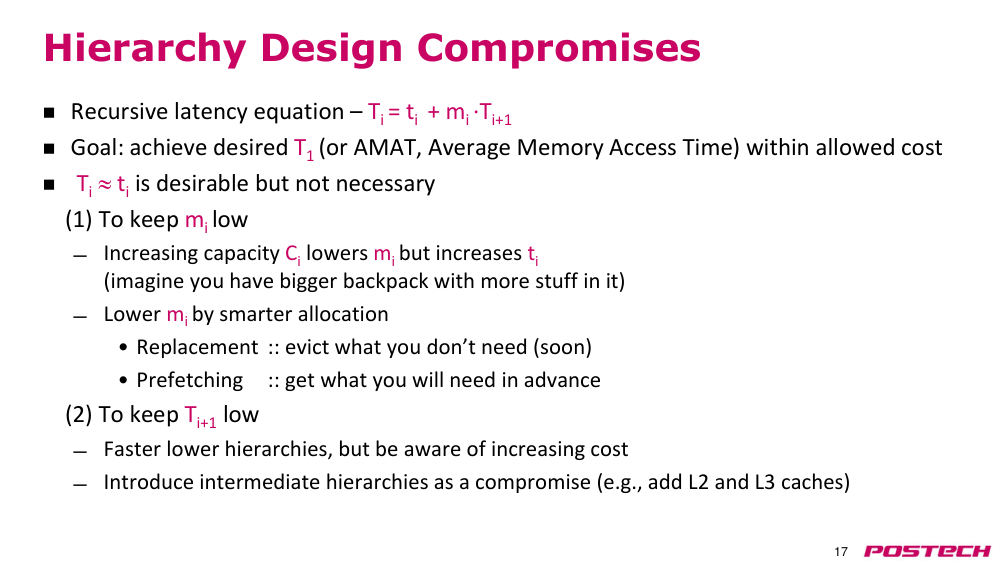
2.1149:42–55:21hierarchy design compromises: mᵢ 와 Tᵢ₊₁ 줄이기
상황·문제목표는 허용 cost 안에서 T₁(AMAT) 을 최소화. L1 hit latency 만으로는 불가능하다.
원인capacity Cᵢ 를 키우면 mᵢ 는 줄지만 tᵢ 가 늘어 모든 hit 가 느려진다. 하위 level 을 빠르게 하면 cost 가 는다.
해결mᵢ: 적정 capacity, 똑똑한 allocation (replacement, prefetching). Tᵢ₊₁: 더 빠른 하위 level 또는 중간 level(L2, L3, L4) 추가.
- 예: L2 10MB→40MB 면 T₂ 는 좋아지지만 cost·intrinsic latency 증가
- replacement: 곧 안 쓸 것을 evict, prefetching: 쓸 것을 미리 가져옴
2.1255:21–1:01:38hierarchy design considerations: DRAM, SRAM, working set
상황·문제level 마다 쓰는 device 와 최적화 목표가 다르다.
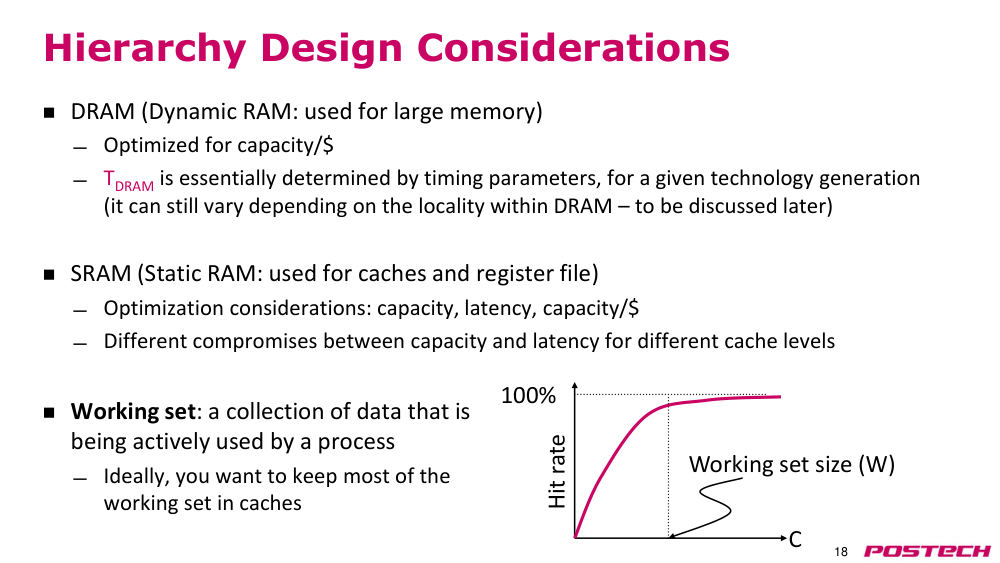
원인DRAM 은 capacity/$ 최적화 (Samsung·Hynix 는 latency 를 유지하며 용량을 키움), latency 는 timing parameter 로 거의 결정. SRAM 은 하위 level 은 capacity, 상위는 latency 가 중요.
해결level 별 capacity 는 working set(활발히 쓰는 data) 크기로 정한다. hit rate 는 working set 까지 급격히 오르고 그 뒤 포화.
- working set 5 MB 에 10 MB cache 를 줘도 hit rate 는 몇 % 만 오른다
- 곡선에 계단이 둘이면 L1·L2 두 level 로 각각 잡는다
2.12.r.3Dynamic random-access memory (Wikipedia) ↗ · DRAM 은 high density·low cost per bit, main memory
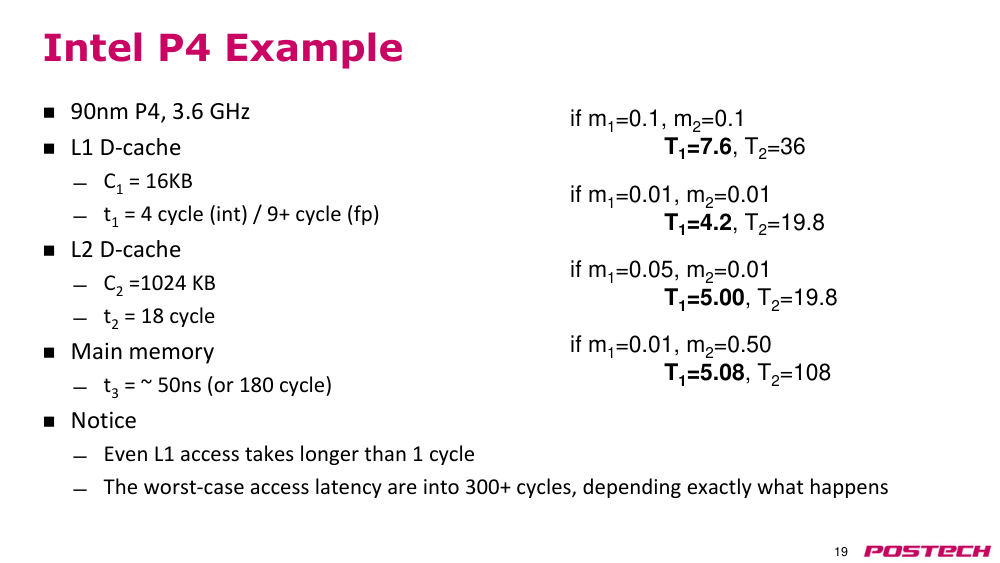
2.131:01:38–1:05:56Intel P4 예제로 T₁ 계산
상황·문제90nm P4 3.6 GHz: L1 D 16KB·t₁=4 cycle(int)/9+(fp), L2 1024KB·t₂=18, main memory ~50 ns(180 cycle).
원인L1 조차 1 cycle 보다 오래 걸리고, 최악의 경우 300+ cycle 까지 간다.
해결m₁=m₂=0.1: T₂ = 18 + 0.1×180 = 36, T₁ = 4 + 0.1×36 = 7.6. 나머지 경우도 같은 식으로.
- 지금도 L1 access 4 cycle 이 전형적
- 고성능 processor 는 이 memory latency 를 숨겨야 한다
2.141:05:56–1:09:33출석 확인·Q&A
상황·문제출석 확인 후 질문 2개: (1) tᵢ 는 hit·miss 에서 같은가 — 지금은 같다고 가정, 실제로는 miss 때 data 를 가져오느라 다를 수 있음. (2) I-cache vs D-cache — 용도 차이(instruction vs data), 구조는 거의 같다고 봐도 됨.
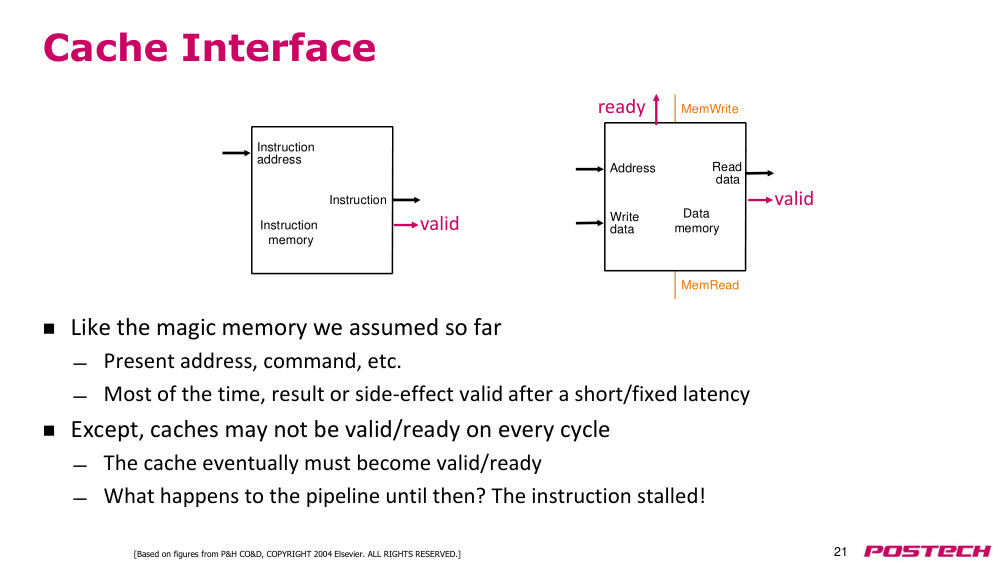
2.151:09:33–1:11:35cache interface
상황·문제지금까지 가정한 magic memory 처럼 address·command 를 받아 짧은 고정 latency 뒤 결과를 준다.
원인cache 는 miss 때문에 매 cycle valid/ready 가 아닐 수 있다.
해결I-cache 에 valid, D-cache 에 valid·ready 출력 추가. miss(valid=0)면 하위 level 에서 올 때까지 instruction 이 stall.
- hit → valid, miss → invalid
2.15.r.1CPU cache (Wikipedia) ↗ · direct-mapped·set-associative·fully associative, tag/index/offset, split L1
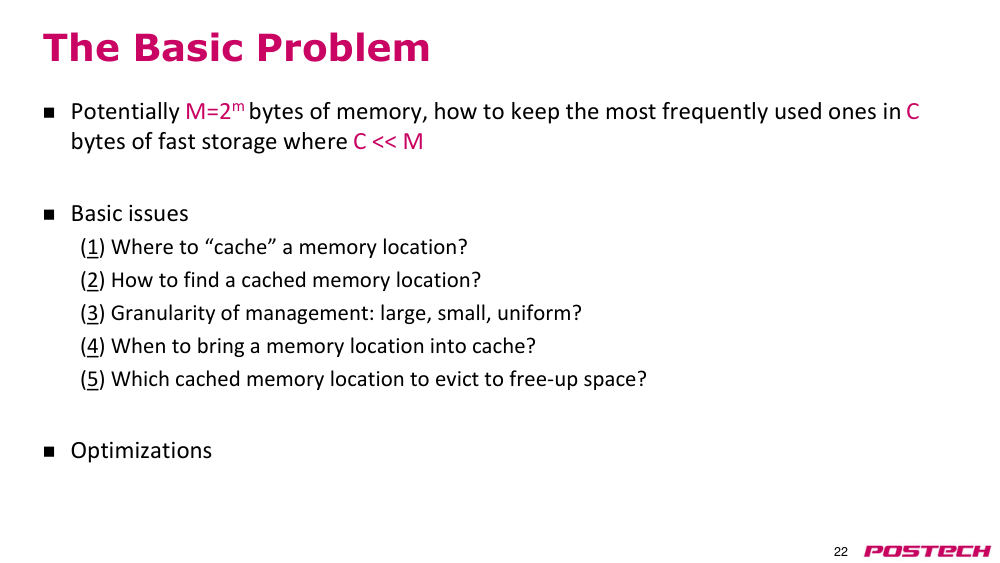
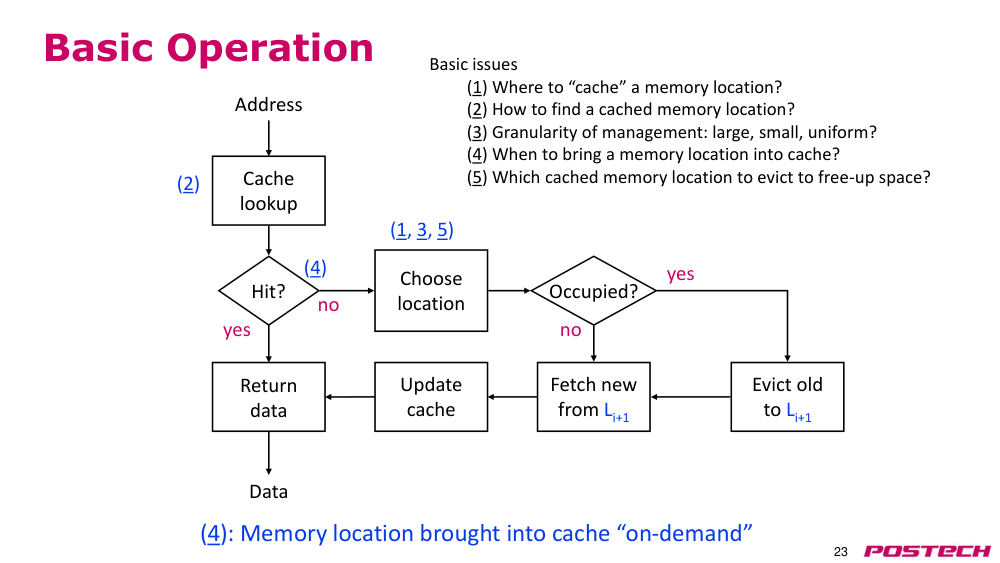
2.161:11:35–1:14:44cache 설계의 basic problem 과 basic operation
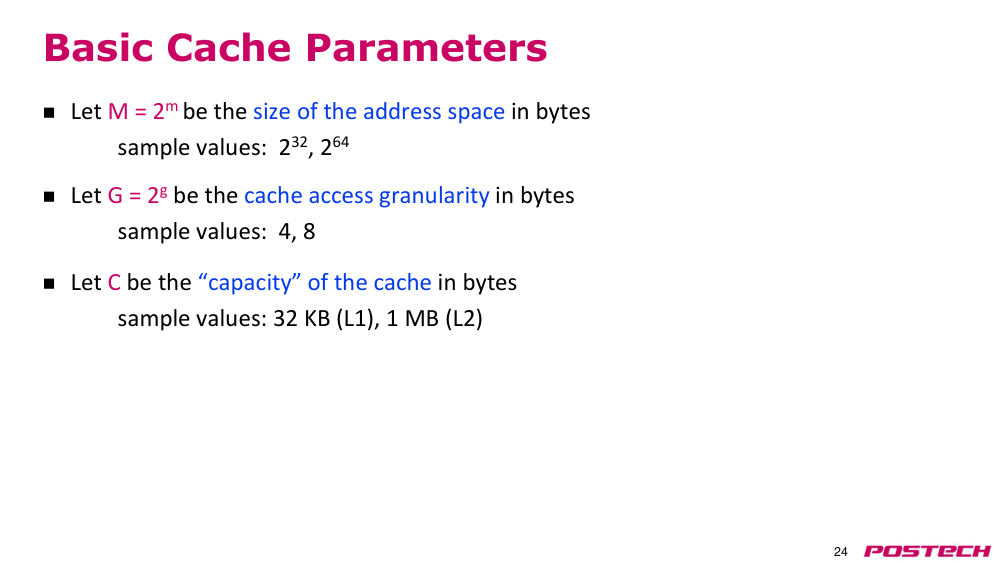
상황·문제M = 2ᵐ byte memory 중 자주 쓰는 것을 C byte (C ≪ M) 빠른 저장소에 둬야 한다.
원인basic issue 5개: (1) 어디에 둘까 (2) 어떻게 찾을까 (3) 관리 granularity (4) 언제 가져올까 (5) 무엇을 evict 할까.
해결flowchart: lookup → hit 면 data 반환, miss 면 위치 선택 → 차 있으면 old 를 Lᵢ₊₁ 로 evict → Lᵢ₊₁ 에서 fetch → update → 반환 (on-demand).
- (4) 의 답: 접근될 때 가져오는 on-demand loading (미리 가져오지 않음)
2.16.r.1CPU cache (Wikipedia) ↗ · direct-mapped·set-associative·fully associative, tag/index/offset, split L1
2.171:14:44–1:16:08마무리와 질문 (LSQ 는 cache 인가)
상황·문제cache 세부 설계는 다음(목요일) 강의로 넘김 (p24 basic cache parameter 만 화면에 띄움). 질문: LSQ 는 cache 가 아니라 core 안 별도 구조이며 L1 cache 와 interface 한다.
3핵심 개념
3.1temporal locality(시간적 지역성)
최근 참조한 같은 주소를 곧 다시 참조. loop instruction, sum 변수.
3.2spatial locality(공간적 지역성)
가까운 주소를 곧 참조. 다음 instruction, Arr[i] 순차 접근.
3.3cost amortization(비용 분산)
평균 cost = overhead/N + 단위 cost. 104+1+1+1 → 평균 27 cycle.
3.4register spilling(레지스터 스필링)
register 에 다 못 담는 변수를 compiler 가 load/store 로 memory 에 둠.
3.5demand paging(요구 페이징)
OS 가 DRAM↔SSD 사이 page 를 필요할 때 옮김.
3.6perceived access time Tᵢ
Tᵢ = tᵢ + mᵢ·Tᵢ₊₁. tᵢ 는 intrinsic hit latency, mᵢ·Tᵢ₊₁ 은 miss penalty.
3.7AMAT(average memory access time, 평균 메모리 접근 시간)
core 가 본 모든 접근 latency 의 평균 = T₁.
3.8request filter
상위 cache 가 요청 대부분을 처리해 low-throughput 하위 level 로 가는 요청을 줄임.
3.8.r.1Sun et al., Moguls: a Model to Explore the Memory Hierarchy for Bandwidth Improvements (ISCA'11) ↗ · p16 request filter 그림의 출처 논문 (BW demand vs provided)
3.9working set(작업 집합)
process 가 현재 활발히 쓰는 data 집합. cache capacity 결정 기준.
3.10on-demand loading(요청 시 로딩)
접근될 때 비로소 Lᵢ₊₁ 에서 cache 로 가져옴 (prefetch 아님).
3.10.r.1CPU cache (Wikipedia) ↗ · direct-mapped·set-associative·fully associative, tag/index/offset, split L1
4스스로 확인
4.1sum = sum + Arr[i] loop 에서 temporal·spatial locality 를 보이는 것은?
답
temporal: loop 의 instruction 들과 sum 변수. spatial: 연속 instruction 과 Arr[0],Arr[1],… 순차 접근.
4.2cache 없이 4번 101 cycle, cache 있으면 104,1,1,1 일 때 평균 latency 는?
답
없음 101 cycle, 있음 (104+1+1+1)/4 ≈ 27 cycle.
4.3P4 에서 m₁=0.1, m₂=0.1 일 때 T₁ 은?
답
T₂ = 18 + 0.1×180 = 36, T₁ = 4 + 0.1×36 = 7.6 cycle.
4.4L1 capacity 를 무작정 키우면 안 되는 이유는?
답
m₁ 은 줄지만 t₁ 이 늘어 모든 hit 가 느려진다. cost 도 증가.
4.51,000 요청, L1 hit 70%, L2 hit 80% 이면 DRAM 까지 가는 요청 수는?
답
L1 miss 300, 그중 L2 miss 20% = 60.
4.6cache 의 basic issue 5개는?
답
placement, lookup, granularity, 언제 가져올지(on-demand), 무엇을 evict 할지.
5참고 자료
5.2CPU cache (Wikipedia) ↗ · direct-mapped·set-associative·fully associative, tag/index/offset, split L1
5.6Burks, Goldstine, von Neumann, Preliminary Discussion of the Logical Design ... (1946) ↗ · p2 인용문 4.1 'indefinitely large memory' 와 계층 memory 제안 원문
5.7Sun et al., Moguls: a Model to Explore the Memory Hierarchy for Bandwidth Improvements (ISCA'11) ↗ · p16 request filter 그림의 출처 논문 (BW demand vs provided)
5.8Jouppi, Improving Direct-Mapped Cache Performance ... (ISCA'90) — UPenn CIS 501 사본 ↗ · p43 과제 논문: miss cache, victim cache, stream buffer