Lec 5 part2 · Lec 6 · control flow datapath 와 multi-cycle CPU(microcode)
정밀 정리 · 검증 2026-09-24 15:16
1개요
1.1전반부(Lec5 part2): single-cycle datapath 에 JAL·JALR·BEQ 를 추가하고 opcode 기반 control signal 생성, instruction 별 사용 경로 정리.
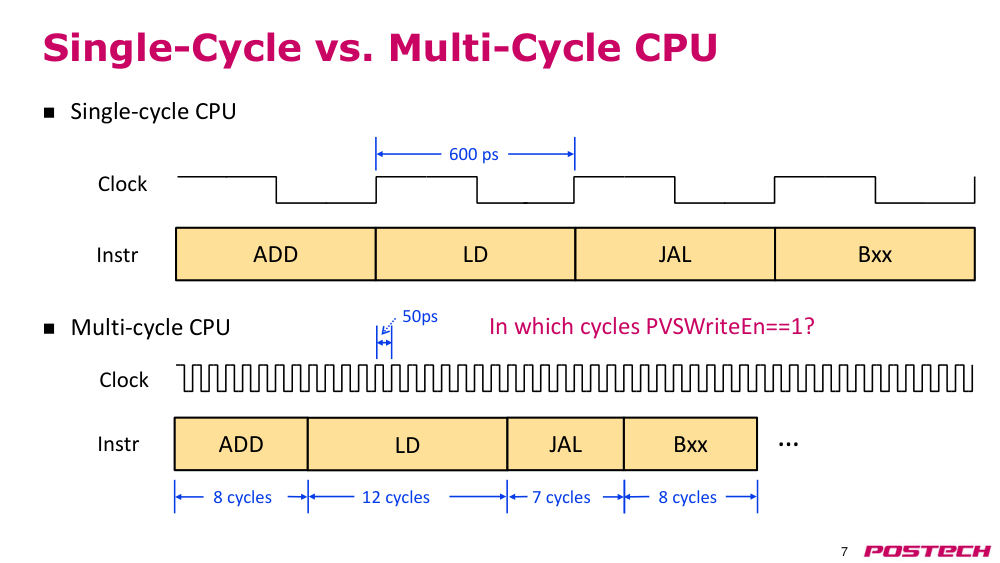
1.2후반부(Lec6): single-cycle 은 load(600 ps)가 clock 을 결정해 비효율 → 50 ps clock multi-cycle, PVSWriteEn 과 FSM.
1.3control 은 ROM microsequencer(O(2^n)) 대신 µPC 기반 microcode 로. 가정된 instruction mix 에서 2193 vs 1667 MIPS, 약 31.6% speedup.
1.4resource reuse(ALU·single memory, IR·MDR)와 새 control signal(ALUSrcA/B, IorD, IRWrite, PCSource 등)까지 진행.
2섹션별 정리 상황·문제 → 원인 → 해결
2.10:30–1:28control flow instruction datapath 시작
상황·문제R-type·I-type·load/store 까지 single-cycle datapath 구현 완료. 이제 control flow instruction(제어 흐름 명령어)을 추가한다.
2.21:28–4:52JAL(jump and link) datapath
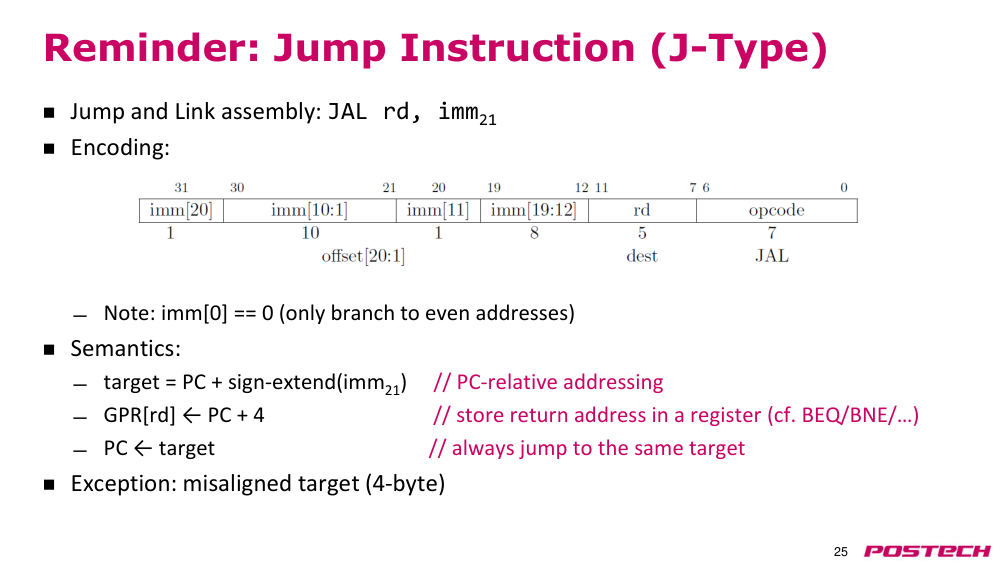
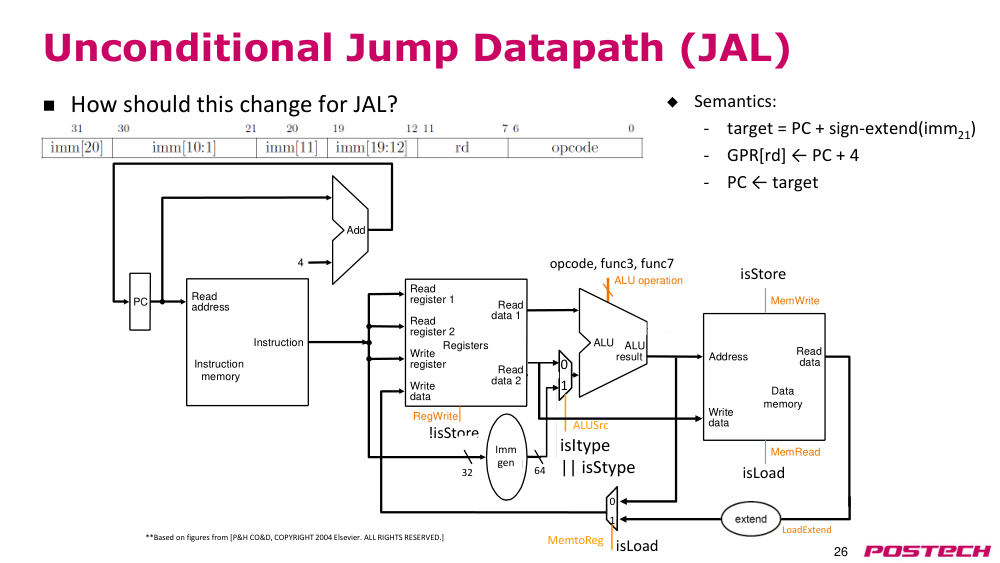
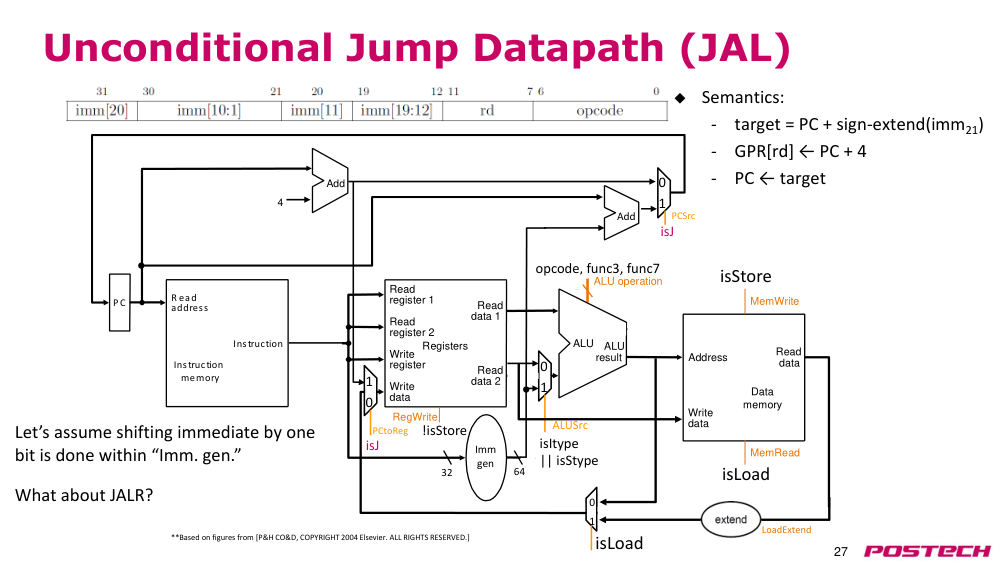
상황·문제지금 datapath 는 PC 를 +4 만 한다. JAL 은 target = PC + sign-extend(imm) 로 가고 rd ← PC+4 도 써야 한다.
원인datapath 에 target 을 계산하는 logic 이 없고, register file write port 로 PC+4 를 보낼 경로도 없다.
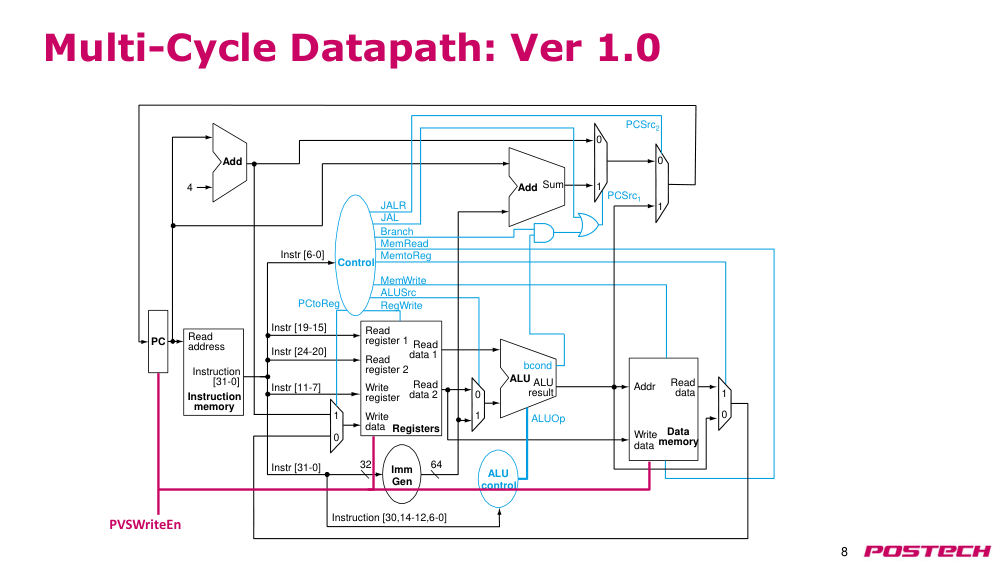
해결PC + imm 을 더하는 adder 추가, PC 앞 mux 로 PC+4 / target 선택. write data 앞 mux 로 PC+4 를 rd 에 기록.
- target 계산용 adder 를 별도로 둔다
- PC mux: PC+4 vs target
- write-back mux: ALU/memory 결과 vs PC+4
2.34:52–6:48JALR(jump and link register) datapath
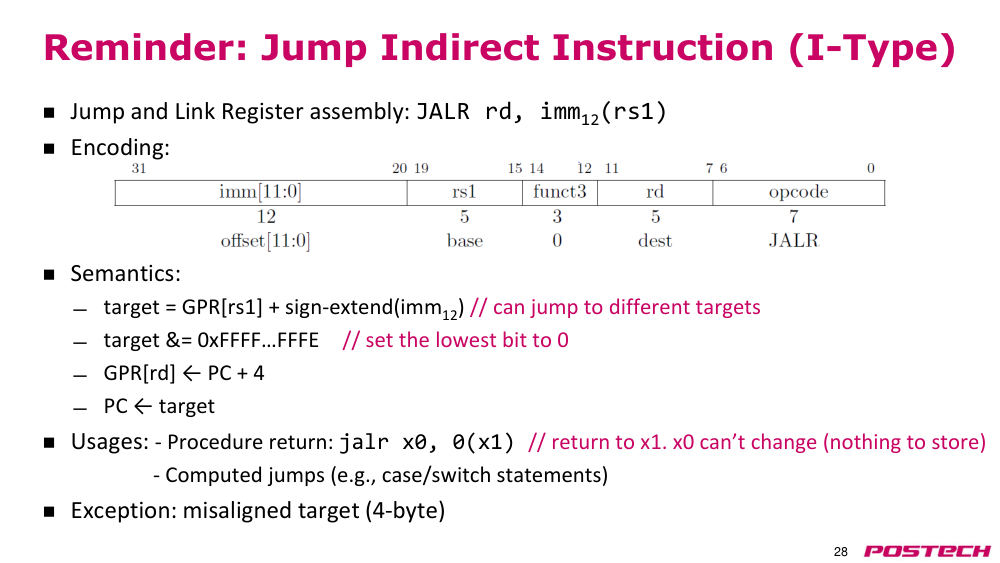
상황·문제JALR 은 target = GPR[rs1] + sign-extend(imm12) (최하위 bit 를 0 으로). PC 대신 register 값을 쓴다.
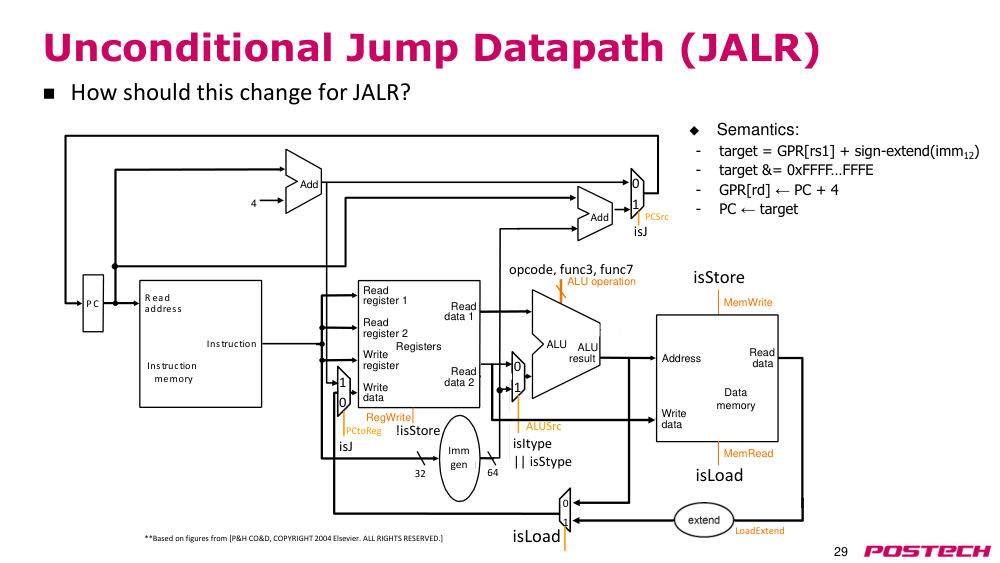
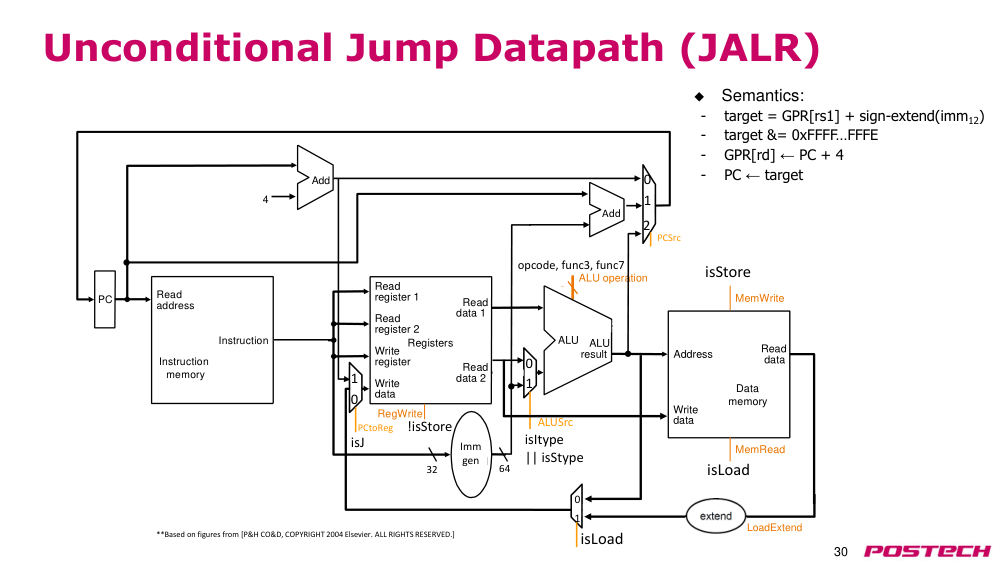
원인rs1 + imm 은 load/store 주소 계산과 같은 형태라 기존 ALU 가 이미 계산할 수 있다 (AND 도 ALU 안에서 처리한다고 가정).
해결ALU 출력을 PC 로 보내도록 PC mux 입력을 3개로 늘린다. rd ← PC+4 는 JAL 과 같다.
- JALR target 은 ALU 가 계산
- PC mux 3-input: PC+4 / PC+imm / ALU 결과
2.46:48–9:20conditional branch(BEQ 등) datapath
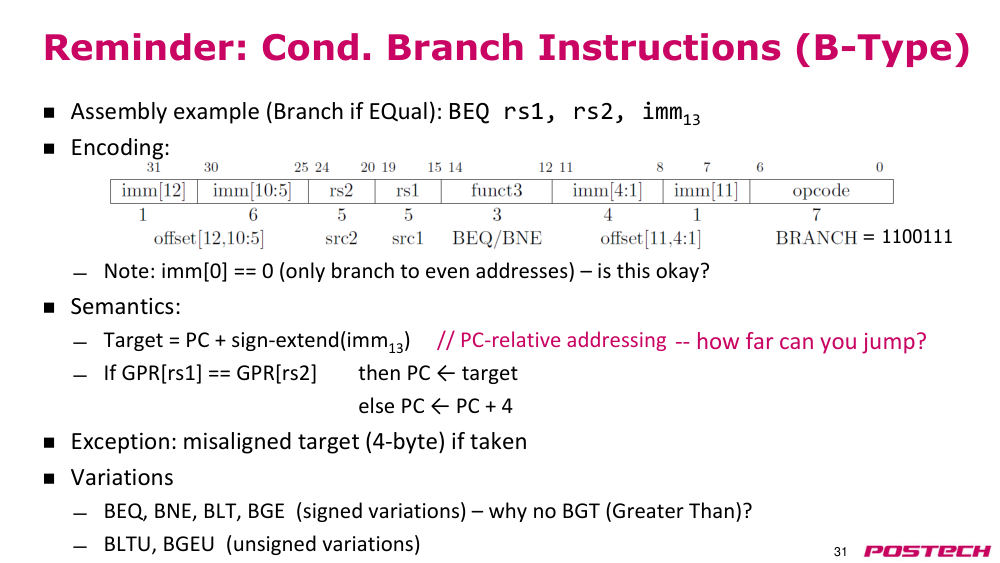
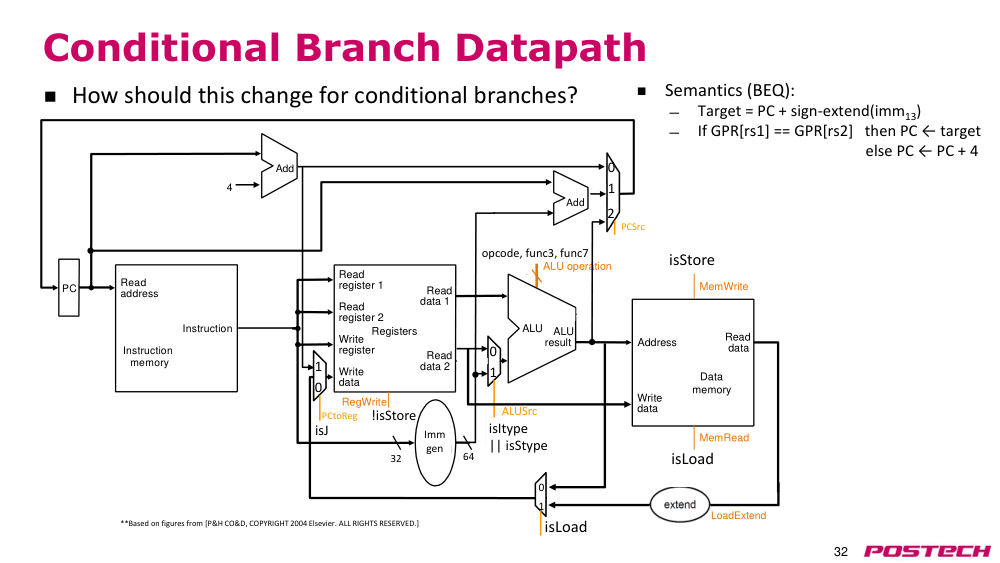
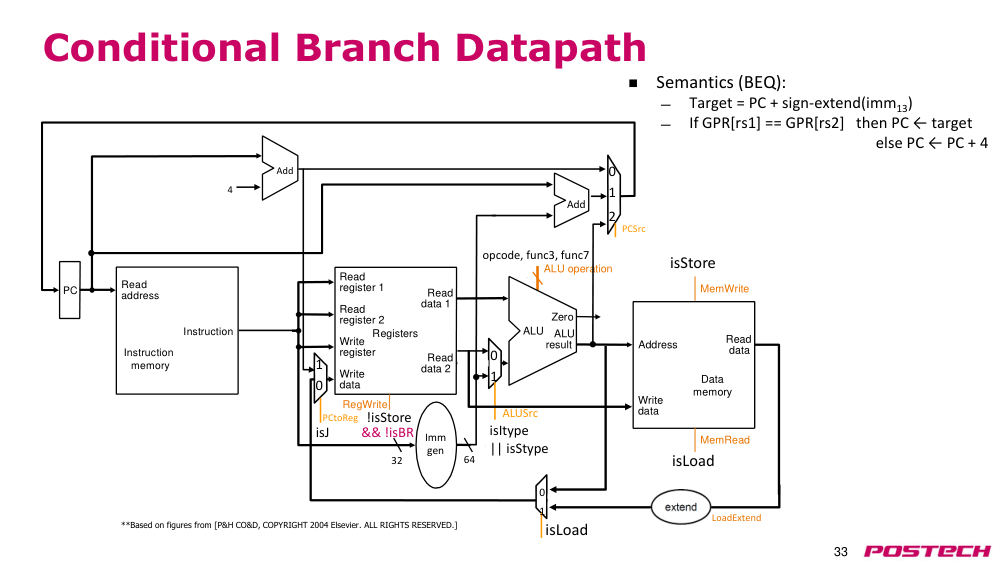
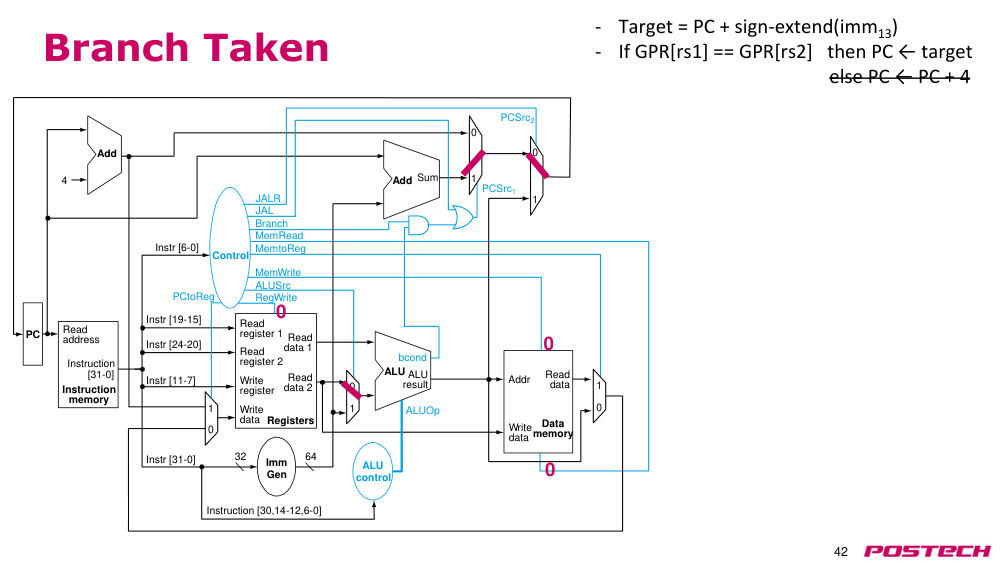
상황·문제BEQ 는 비교 결과에 따라 PC+4 와 target(PC + sign-extend(imm13)) 중 하나를 고른다.
원인target 은 JAL 용 adder 로 이미 계산된다. 비교는 ALU 에서 빼서 0 과 비교하면 된다 (BLT·BGE 등도 ALU 확장으로).
해결ALU 에서 비교 결과(bcond, 그림상 'zero') 출력을 하나 더 내어 PC mux 제어. branch 이면 RegWrite 를 끈다.
- 비교는 ALU subtract 로
- branch 는 register file write enable 을 disable
2.59:20–12:33control signal 생성
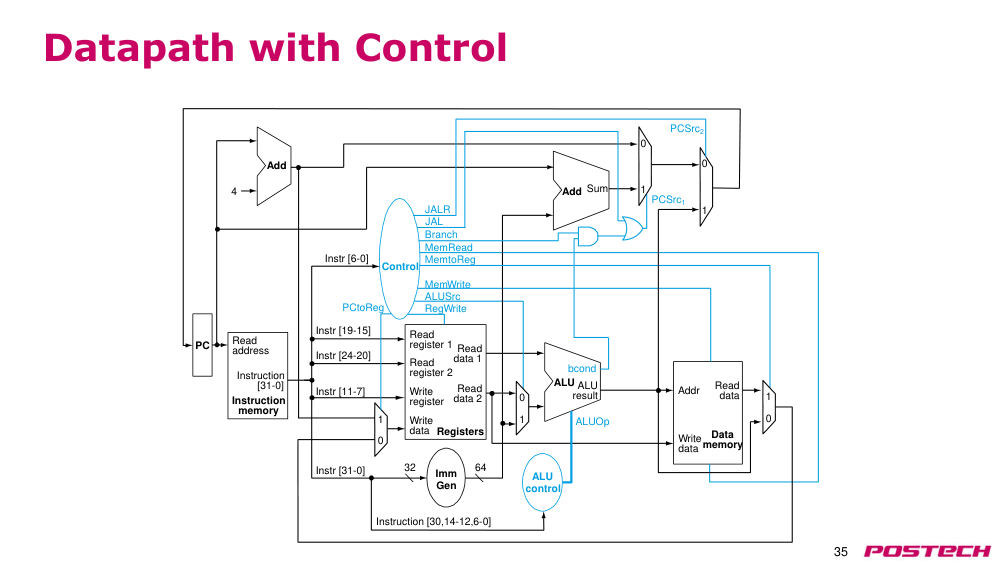
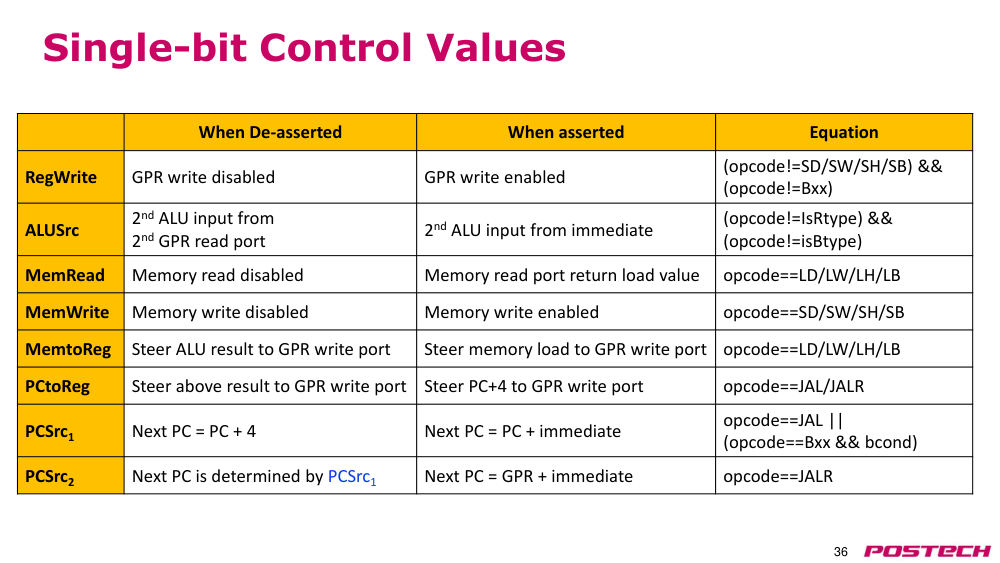
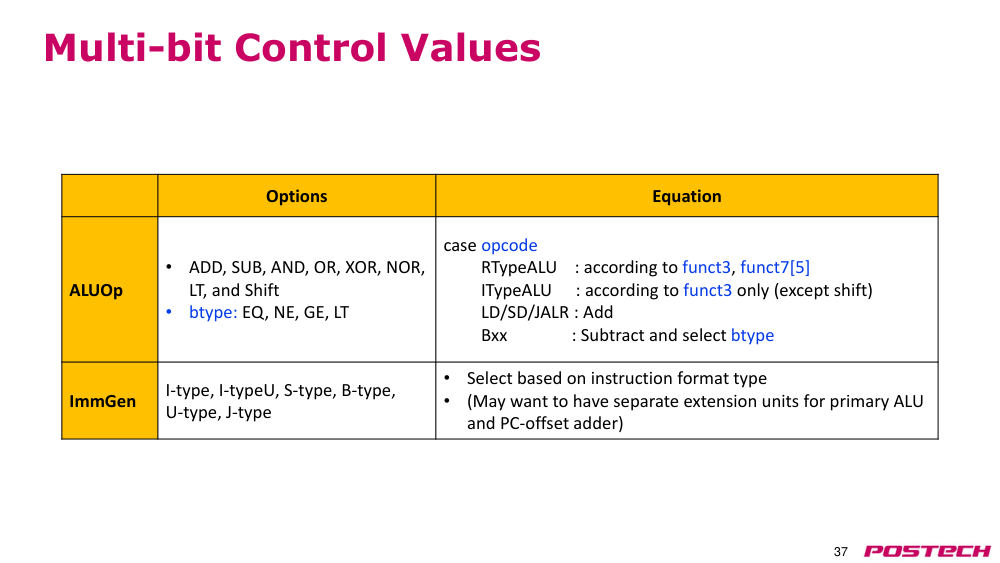
상황·문제datapath 가 완성됐으니 mux select, MemRead/MemWrite, RegWrite 등 control signal 을 만들어야 한다.
원인모두 instruction 의 opcode·funct bit 로 정해진다 (예: MemRead 는 load 인지만 보면 된다).
해결단일 bit signal 은 opcode 식, ALUOp 는 opcode+funct3/funct7, ImmGen 은 instruction format 에 따라 combinational logic 으로 만든다.
- MemtoReg: load 면 memory data, 아니면 ALU 결과
- ImmGen 은 다른 control 보다 조금 크지만 여전히 combinational
2.612:33–17:14instruction 별 datapath 사용 경로 정리
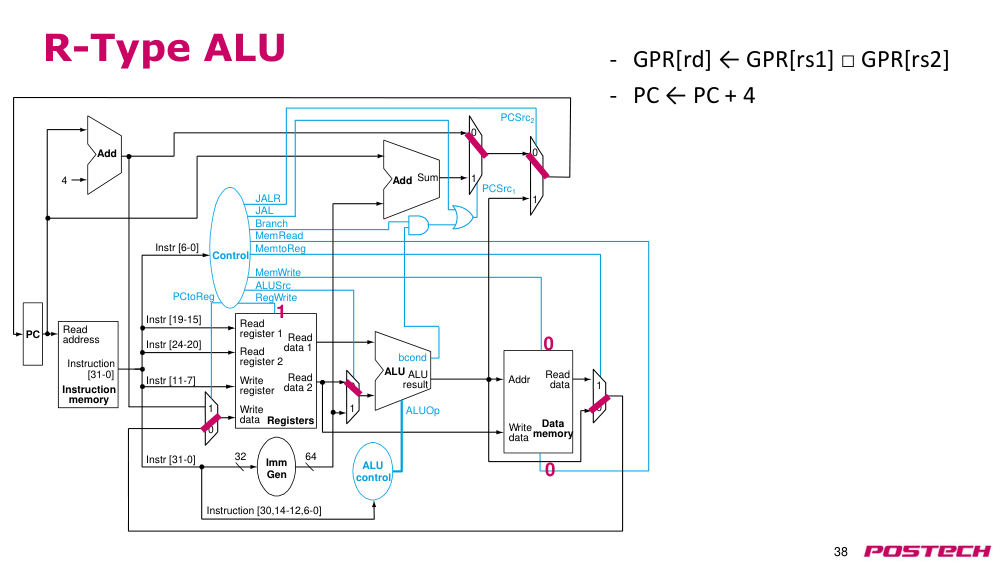
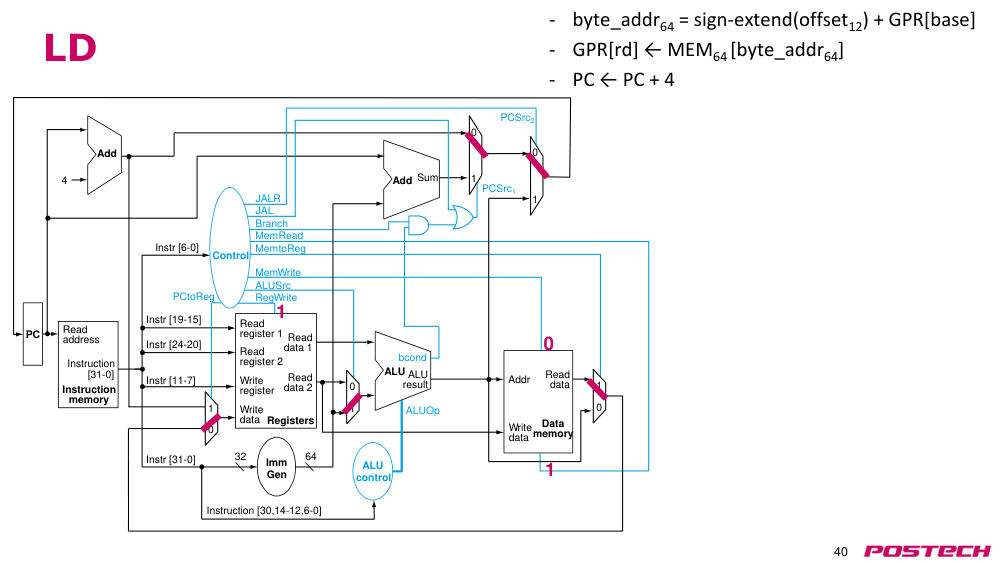
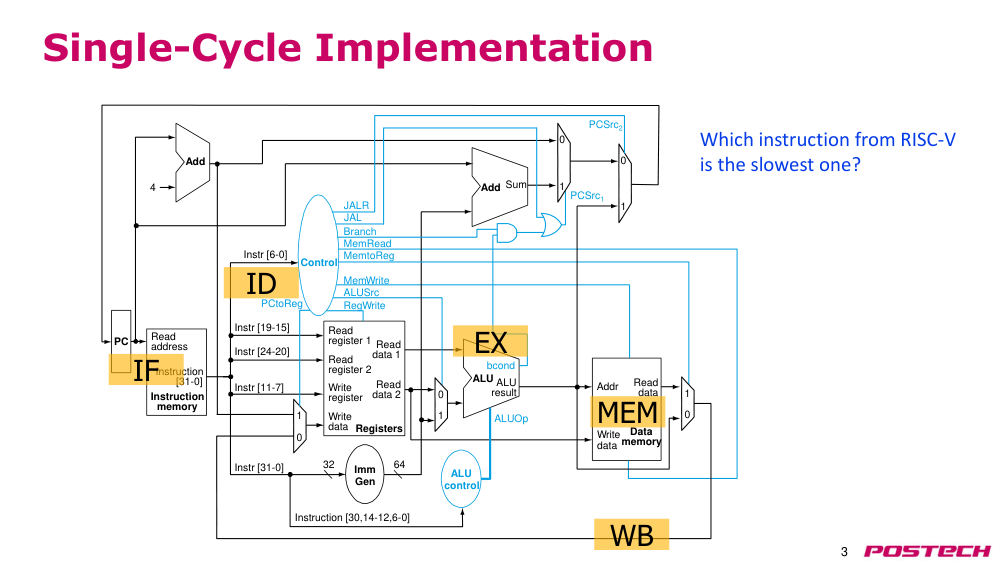
상황·문제single-cycle RISC-V CPU 완성. instruction 종류마다 datapath 의 어느 부분을 쓰는지 확인한다.
해결R-type: rs2 → ALU → RF write, PC+4 / I-type: rs2 대신 imm / LD: ALU 로 주소, MemRead, memory data → RF / SD: rs2 → memory write, MemWrite. branch taken/not taken 은 bcond 로 target vs PC+4, JAL: PC+imm, JALR: ALU 결과 → PC, 둘 다 PC+4 → rd.
- store 는 MemWrite assert, MemRead deassert
- JAL·JALR 모두 PC+4 를 rd 에 write-back
2.6.r.1Computer Organization and Design RISC-V Edition (Elsevier) ↗ · P&H 교재 (Ch 4, Appendix C 읽기 과제)
2.717:14–25:45single-cycle CPU 의 비효율
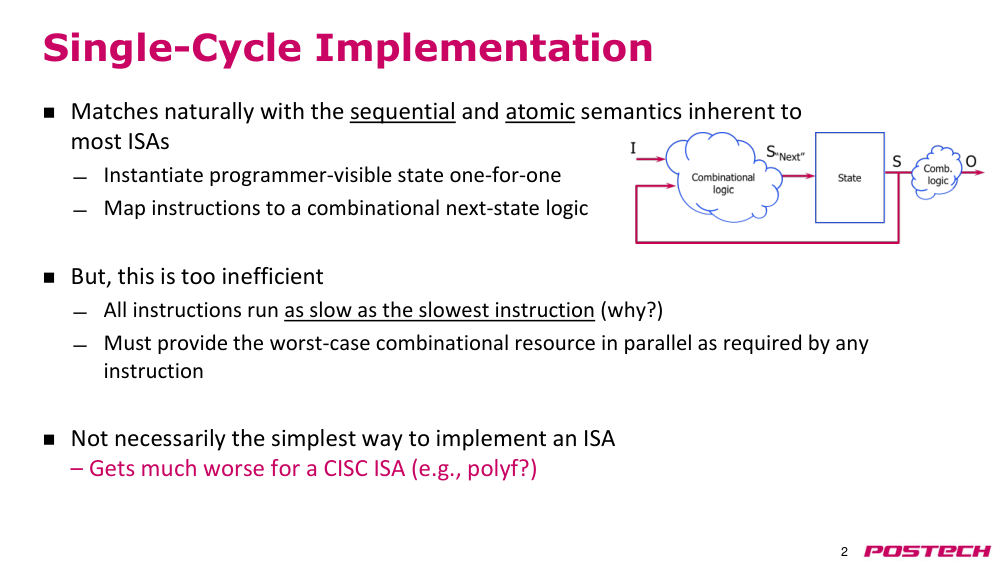
상황·문제single-cycle 은 ISA 의 sequential·atomic semantics 를 그대로 옮겨 직관적이다 (PVS → combinational next-state logic → PVS).
원인clock 이 고정이라 모든 instruction 이 가장 느린 instruction 만큼 걸린다. 또 한 instruction 이 병렬로 쓰는 자원(ALU + PC+4 adder)을 중복해 둬야 한다.
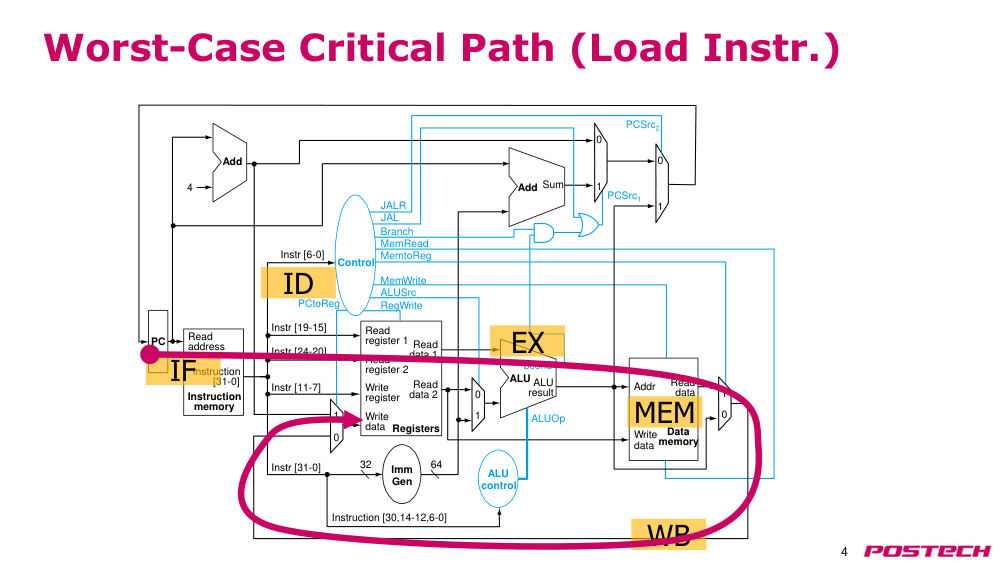
해결가장 느린 것은 data memory 를 접근하는 load (critical path). CISC(예: VAX polyf)라면 더 심해진다 → multi-cycle 로 해결.
- 모든 instruction = 가장 느린 instruction 의 시간
- worst-case 자원을 병렬로 복제
- load 가 critical path
2.825:45–28:55single-cycle datapath 지연 분석 (600 ps)
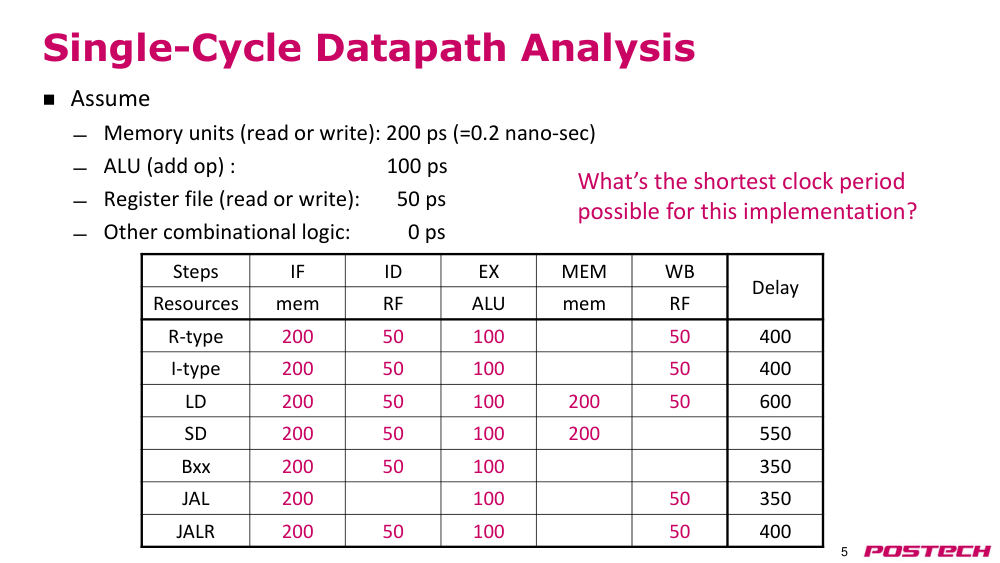
상황·문제가정: memory 200 ps, ALU 100 ps, register file 50 ps, 기타 logic 0 ps. 가장 짧은 clock period 는?
원인단계 합: R/I-type 400, LD 600, SD 550, Bxx 350, JAL 350, JALR 400 ps. LD 가 최대.
해결clock period ≥ 600 ps. clock 을 instruction 마다 바꿀 수는 없다 (OS 가 긴 시간 단위로 frequency 를 바꾸는 것은 가능, 수업에선 고정 clock 가정).
- LD 600 ps 가 clock period 를 결정
- fine-grained variable clock 은 불가
2.8.r.1Dynamic frequency scaling (Wikipedia) ↗ · 부하에 따라 clock frequency 를 on-the-fly 로 바꾸는 power 관리 (강의 Q&A)
2.928:55–38:20multi-cycle 구현 Ver 1.0 과 state machine
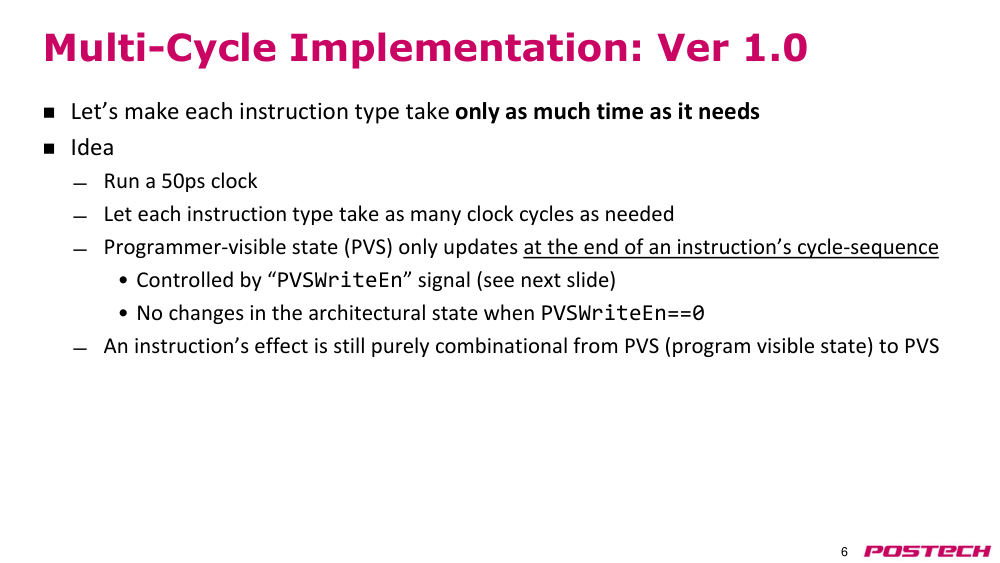
상황·문제instruction 마다 필요한 만큼만 시간을 쓰게 하자: 50 ps clock, instruction 별로 다른 cycle 수.
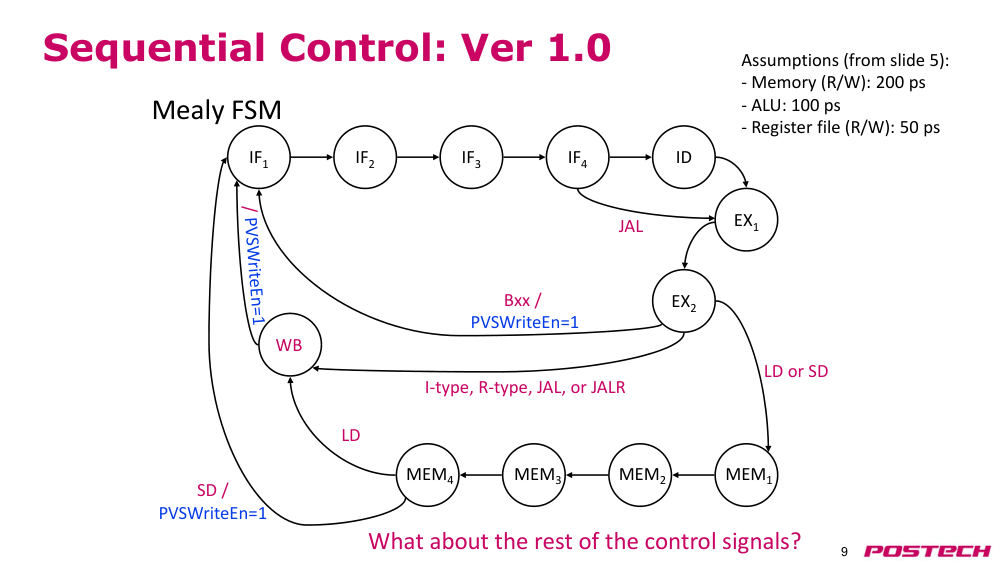
원인여러 cycle 에 걸쳐 실행해도 PVS 는 atomic 하게 한 번만 갱신돼야 한다.
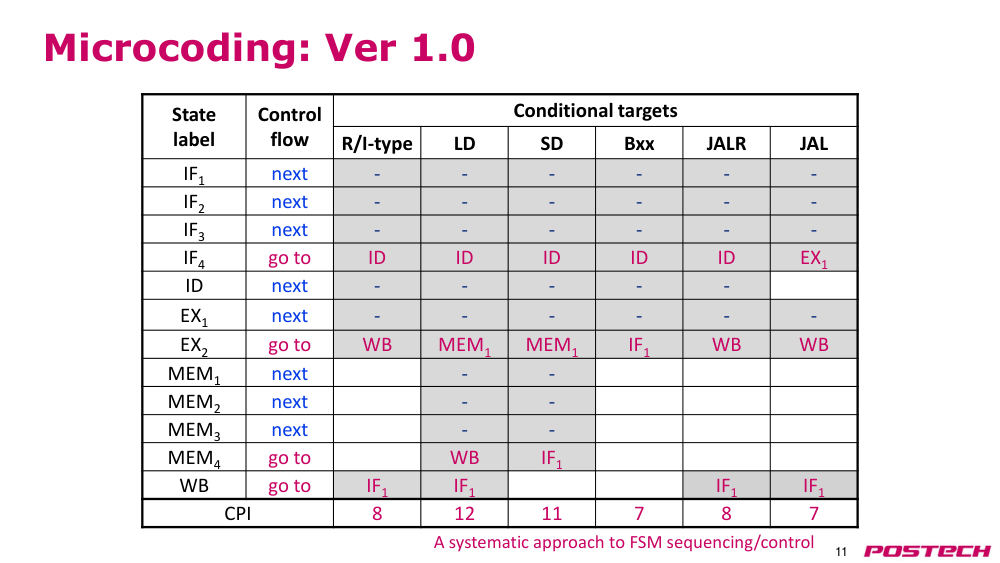
해결PVSWriteEn 을 마지막 cycle 에만 assert. IF 4개(200/50), ID 1개, EX 2개, MEM 4개, WB state 로 FSM 구성 → ADD 8, LD 12, JAL 7 cycle.
- PVSWriteEn == 0 이면 architectural state 불변
- JAL 은 ID 를 건너뛰고 EX 로
- store 는 WB 없음, 쓰기는 MEM4 마지막 rising edge 에 (Q&A)
2.1038:20–44:50MicroSequencer Ver 1.0: ROM lookup table
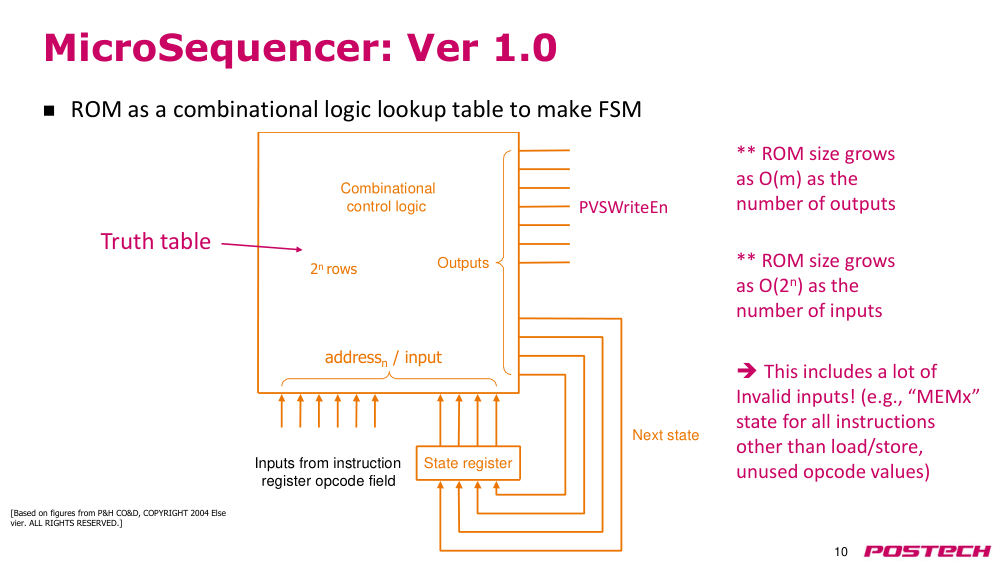
상황·문제각 state 마다 control signal 을 내야 한다. opcode + current state 를 address 로 하는 truth table(ROM)에서 control 과 next state 를 읽는다.
원인ROM 크기는 출력 수 m 에 O(m), address 폭 n 에 O(2^n). 10 bit 면 2^10 row. R-type × memory state 처럼 invalid 조합, 안 쓰는 opcode 값도 모두 row 를 차지한다.
해결state 는 10개 넘어 4 bit 필요, opcode 5 bit 중 실제로 쓰는 값은 10개 미만 → 이 방식은 비효율적이다.
- ROM = combinational lookup table
- size O(2^n)·O(m)
- 대부분 row 가 무효 조합
2.1144:50–50:25microcoding 과 microcode controller (µPC)
상황·문제table 은 state 간 flow control 도 구현한다: IF4 뒤 ID(JAL 은 EX1), EX2 뒤 instruction 별 분기. R-type 8 cycle, LD 12 cycle.
원인대부분의 transition 은 '다음 state 로 진행'이고 가끔만 jump 한다.
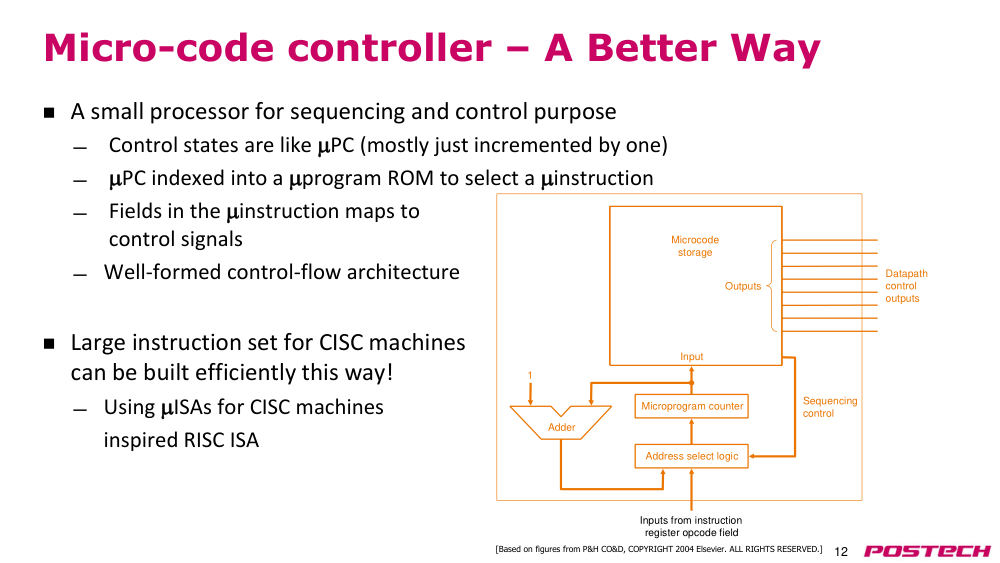
해결유효 row 만 담은 ROM 을 µPC 로 index. adder 로 µPC+1, 분기 때만 작은 lookup table 로 target 선택 → microprogramming. CISC 구현 방식이며 RISC ISA 의 영감이 됨.
- µPC 는 대부분 1씩 증가
- 읽기 과제: P&H Appendix C (multi-cycle lab 에 도움)
2.11.r.1Microcode (Wikipedia) ↗ · microsequencer, horizontal/vertical microcode, nanocode·millicode 설명
2.11.r.4Computer Organization and Design RISC-V Edition (Elsevier) ↗ · P&H 교재 (Ch 4, Appendix C 읽기 과제)
2.1250:25–56:50performance analysis: single vs multi-cycle
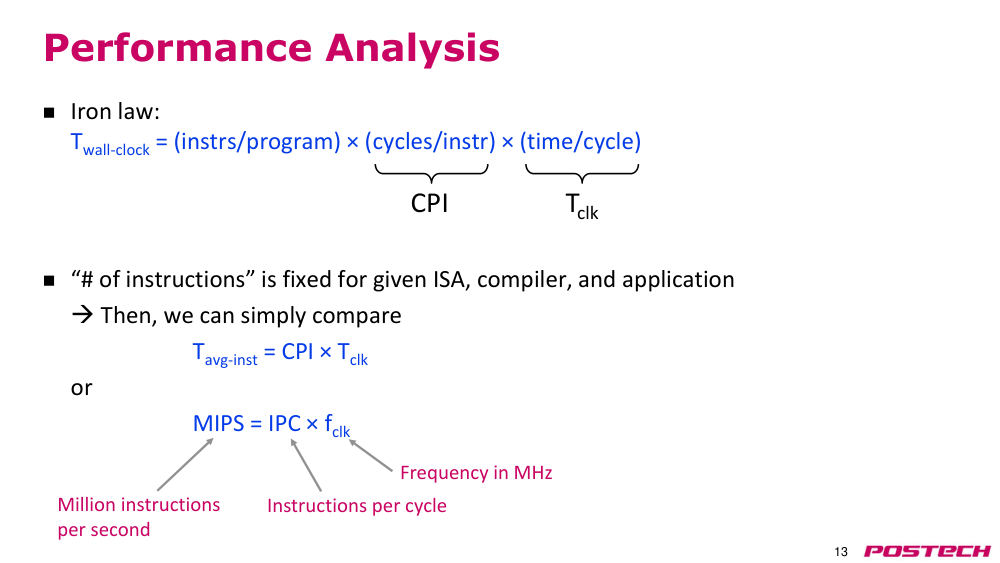
상황·문제multi-cycle 은 얼마나 빠른가? wall-clock time = instruction 수 × CPI × clock period (iron law).
원인같은 ISA·compiler·program 이면 instruction 수 고정. multi-cycle 은 clock 이 짧지만 CPI 가 커진다 → MIPS = IPC × f_clk 로 비교.
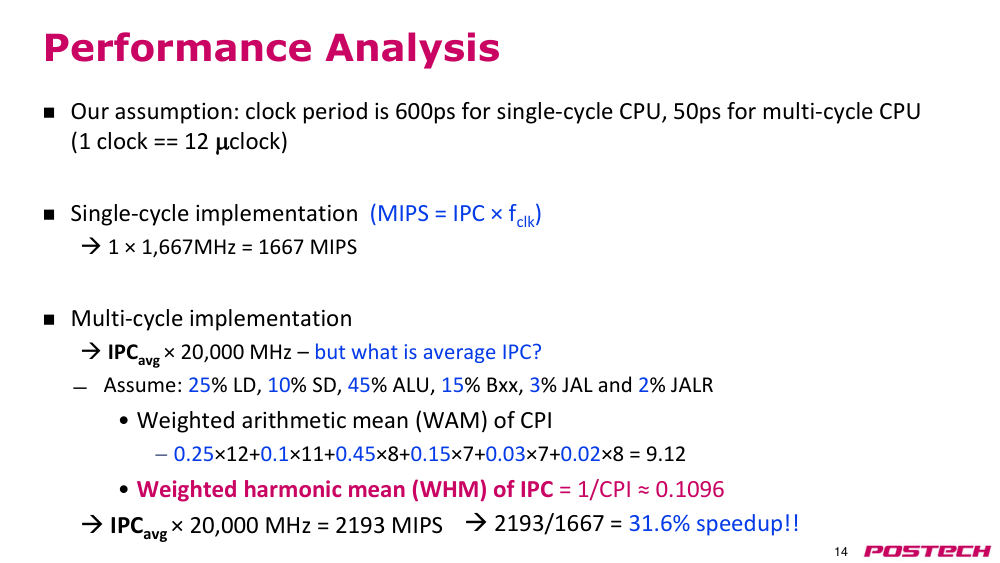
해결single: 1 × 1,667 MHz = 1667 MIPS. multi: mix 25% LD·10% SD·45% ALU·15% Bxx·3% JAL·2% JALR 로 CPI(WAM)=9.12, IPC≈0.1096, ×20,000 MHz = 2193 MIPS → 약 31.6% speedup.
- instruction mix 는 compiler 가 만든 assembly 에서 셀 수 있다
- 20 GHz 는 비현실적이지만 가정
2.12.r.1Iron law of processor performance (Wikipedia) ↗ · Time = Instructions/Program × Cycles/Instruction × Time/Cycle
2.1356:50–1:05:06Q&A: state 가 여러 개 필요한 이유, ROM·µPC 재설명
상황·문제질문: state 하나에 counter 를 두면 안 되나? instruction 별 소요 시간을 정확히 알아야 하나?
원인counter 값이 다르면 그것이 곧 다른 state. memory 접근 등 단계마다 해야 할 일이 달라 여러 state 가 필요하다.
해결(한국어) ROM 은 n-bit address 마다 row 가 있어 쓰지 않는 조합까지 담는다. 대부분 +1 진행이니 adder + mux + 작은 ROM 으로 필요한 row 만 둔다고 재설명.
- counter = state 의 다른 표현
- 각 instruction 의 소요 cycle 을 설계 시 알아야 한다
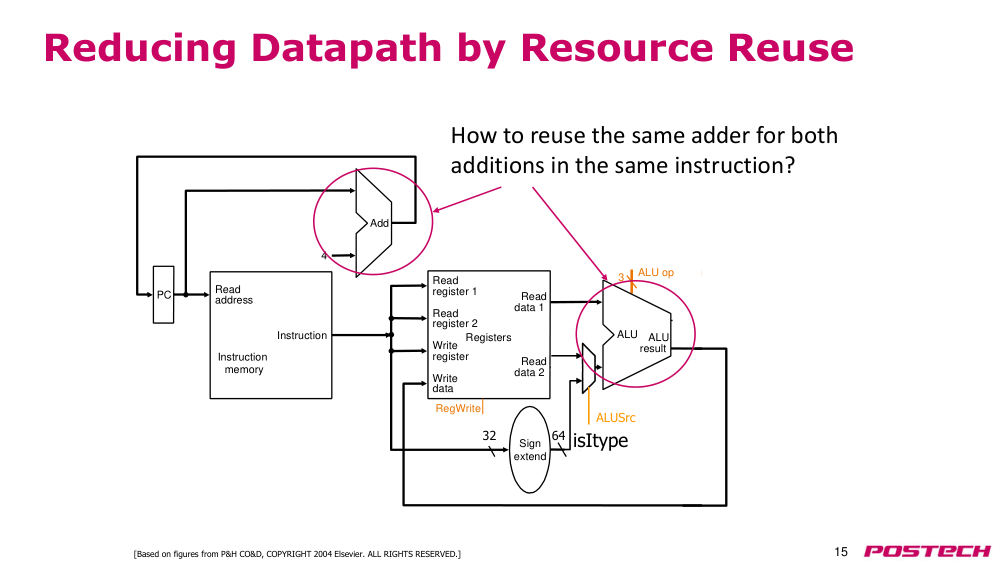
2.141:05:06–1:09:33resource reuse 로 datapath 축소
상황·문제multi-cycle 에선 자원을 cycle 별로 재사용해 중복을 없앨 수 있다.
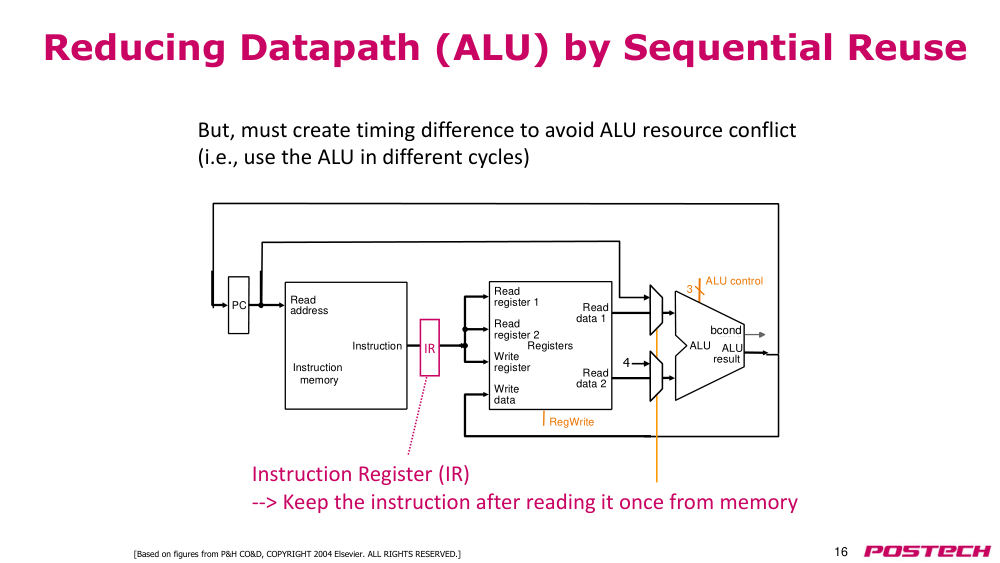
원인PC+4 adder 와 ALU 는 같은 cycle 에 쓰지 않으면 하나로 충분. 여러 cycle 동안 instruction 을 계속 fetch 하지 않으려면 보관할 곳이 필요.
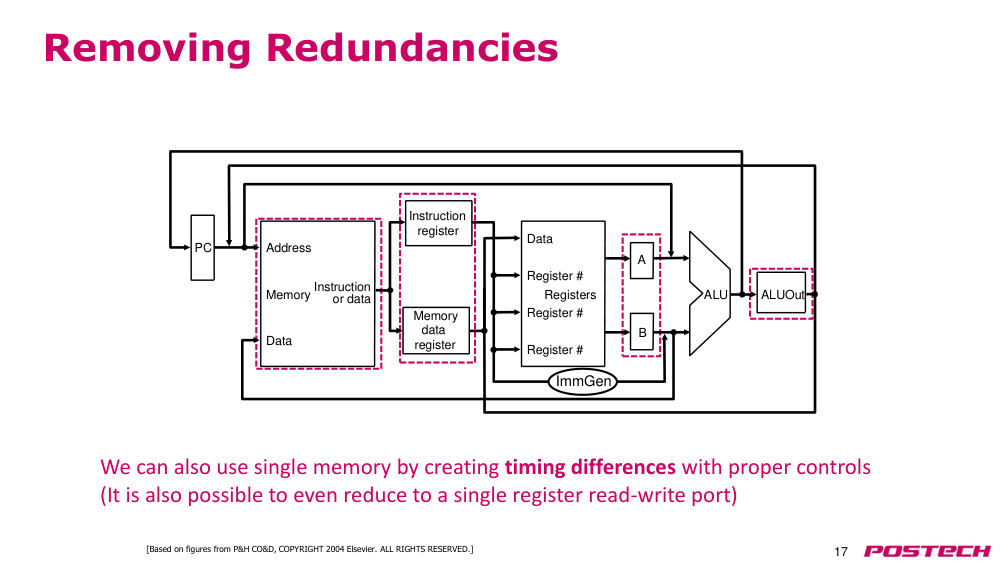
해결ALU 로 PC+4 계산(다른 cycle 에), 마지막 IF state 에서 IR 에 latch. instruction/data memory 를 하나로 합치고 data 는 MDR 에. read port 를 하나로 줄이는 것도 가능하나 cycle 증가라 채택 안 함.
- 같은 cycle 에 ALU 두 번 사용 불가
- IR·MDR 로 값을 다음 cycle 까지 유지
- single memory: IorD 로 instruction/data 선택
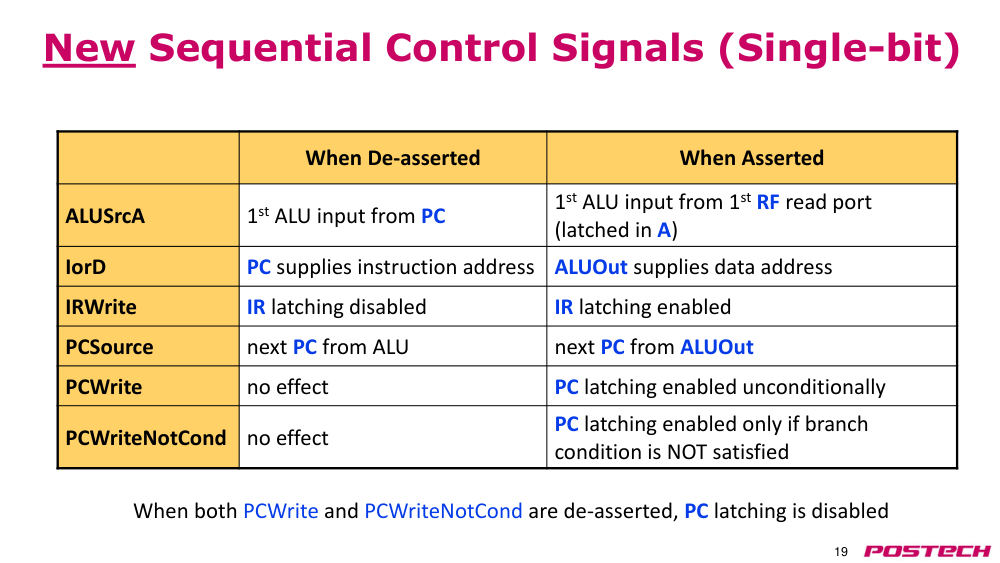
2.151:09:33–1:13:23multi-cycle control point 와 control signal
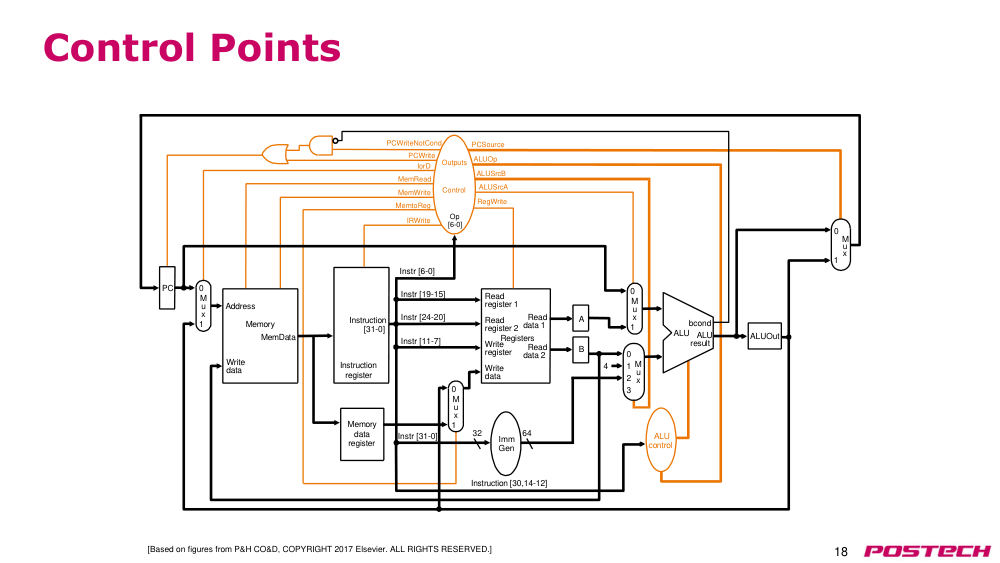
상황·문제자원을 cycle 마다 다르게 쓰려면 instruction type 과 state 에 따른 control signal 이 필요하다.
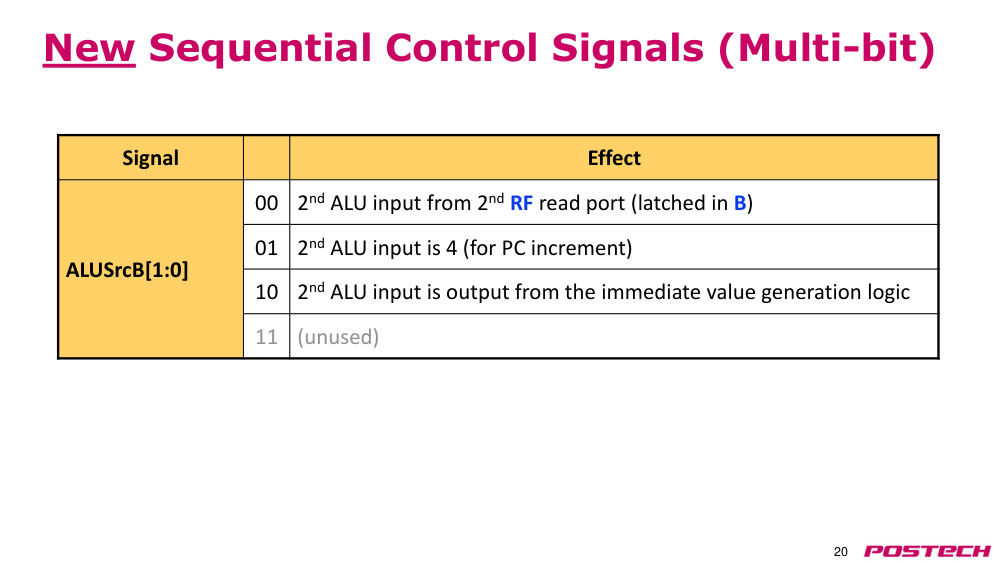
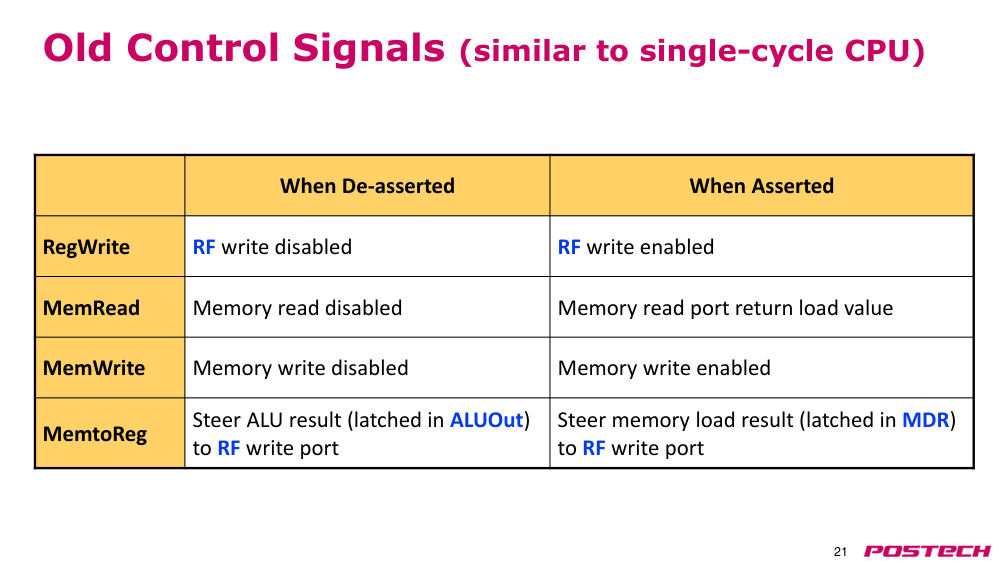
해결ALUSrcA(PC vs register A), IorD(PC vs ALUOut 주소), IRWrite(IF 마지막 cycle), PCSource, PCWrite/PCWriteCond(branch), ALUSrcB(B / 4 / imm). 기존 RegWrite·MemRead·MemWrite·MemtoReg 유지.
- ALUSrcB 는 3가지 선택 (11 미사용)
- PCWriteCond 로 branch 조건부 PC write
2.161:13:23–1:15:15마무리 (행정)
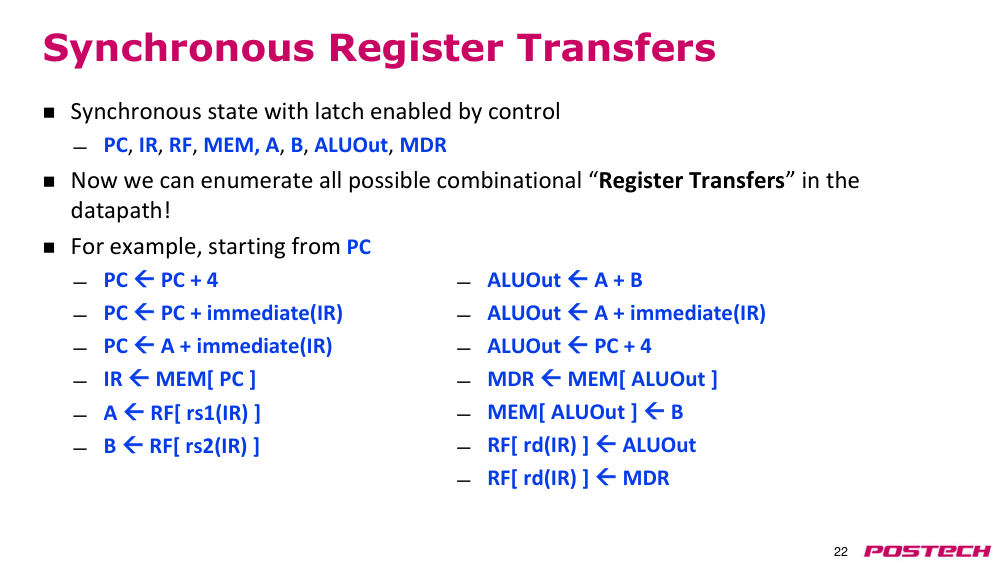
상황·문제질문 확인, Zoom 반응(손들기) 버튼 안내. 이해 못한 부분은 다음 시간 시작 때 복습. p22 synchronous register transfer 는 화면만 띄우고 종료.
3핵심 개념
3.1critical path(임계 경로)
single-cycle 에서 가장 긴 조합 경로 = load (IF→ID→EX→MEM→WB, 600 ps). clock period 를 결정.
3.2PVSWriteEn(프로그래머 가시 상태 쓰기 허용)
instruction 의 마지막 cycle 에만 assert 해 PC·RF·memory 를 atomic 하게 한 번 갱신.
3.3Mealy FSM(밀리 FSM)
output 이 current state 와 input(opcode) 둘 다에 의존. multi-cycle sequential control 이 이 형태.
3.4microsequencer(마이크로 시퀀서)
opcode + state 를 ROM address 로 control·next state 를 읽는 구조. ROM 크기 O(2^n).
3.4.r.2Microcode (Wikipedia) ↗ · microsequencer, horizontal/vertical microcode, nanocode·millicode 설명
3.5microprogram counter µPC(마이크로프로그램 카운터)
유효 microinstruction row 만 두고 µPC 를 대부분 +1, 분기 때만 작은 table 로 jump.
3.5.r.1Microcode (Wikipedia) ↗ · microsequencer, horizontal/vertical microcode, nanocode·millicode 설명
3.6iron law(철의 법칙)
T = instruction 수 × CPI × clock period. 같은 ISA·program 이면 CPI·T_clk 만 비교.
3.6.r.1Iron law of processor performance (Wikipedia) ↗ · Time = Instructions/Program × Cycles/Instruction × Time/Cycle
3.7weighted arithmetic mean of CPI(CPI 가중 산술 평균)
instruction mix 비율을 weight 로 한 평균 CPI (예 9.12). IPC 는 그 역수.
3.8IR / MDR(명령어 레지스터 / 메모리 데이터 레지스터)
여러 cycle 동안 instruction 과 memory data 를 보관해 memory 를 하나로 합칠 수 있게 함.
4스스로 확인
4.1JALR 의 target 계산에 새 adder 가 필요 없는 이유는?
답
rs1 + sign-extend(imm12) 는 load/store 주소 계산과 같은 형태라 기존 ALU 출력을 PC mux 로 보내면 된다.
4.2memory 200 ps, ALU 100 ps, RF 50 ps 일 때 single-cycle 최소 clock period 는?
답
LD = 200+50+100+200+50 = 600 ps.
4.350 ps clock multi-cycle 에서 LD 와 ADD 는 몇 cycle?
답
LD 12 (IF4+ID1+EX2+MEM4+WB1), ADD 8 (MEM 생략).
4.4microsequencer ROM 이 비효율적인 이유 두 가지는?
답
address 폭 n 에 O(2^n) 로 커지고, R-type × memory state 같은 invalid 조합과 안 쓰는 opcode 값도 row 를 차지한다.
4.5CPI 9.12, 20,000 MHz 일 때 MIPS 와 single-cycle(1667 MIPS) 대비 speedup 은?
답
20,000/9.12 ≈ 2193 MIPS, 2193/1667 ≈ 1.316 → 약 31.6% 빠름.
5참고 자료
5.4Iron law of processor performance (Wikipedia) ↗ · Time = Instructions/Program × Cycles/Instruction × Time/Cycle