Lec 1 part 3 · transistor·logic gate, 4개의 wall, 최근 동향
정밀 정리 · 검증 2026-09-24 12:55
1개요
1.1transistor(nMOS·pMOS)를 switch 로 보고 inverter·NAND·NOR 를 만든 뒤, 이것만으로 CPU·memory 까지 만들 수 있음을 보인다.
1.2Moore's law 와 scaling 한계(7nm→3nm GAA), 그리고 Power·Memory·Parallelism·Reliability wall.
1.3최근 동향: GPGPU·DGX-2, 3D-stacked memory, storage-class memory, Arm·RISC-V, domain-specific accelerator, carbon nanotube CPU.
1.4영상은 deck p52~p76 (약 33분). p1~p51 은 34·35강에서 다룸 (t=null).
2섹션별 정리 상황·문제 → 원인 → 해결
2.10:00–1:55Transistor 란: nMOS·pMOS switch
상황·문제앞에서 계속 "transistor 수" 를 말했는데 transistor 가 무엇인지 설명.
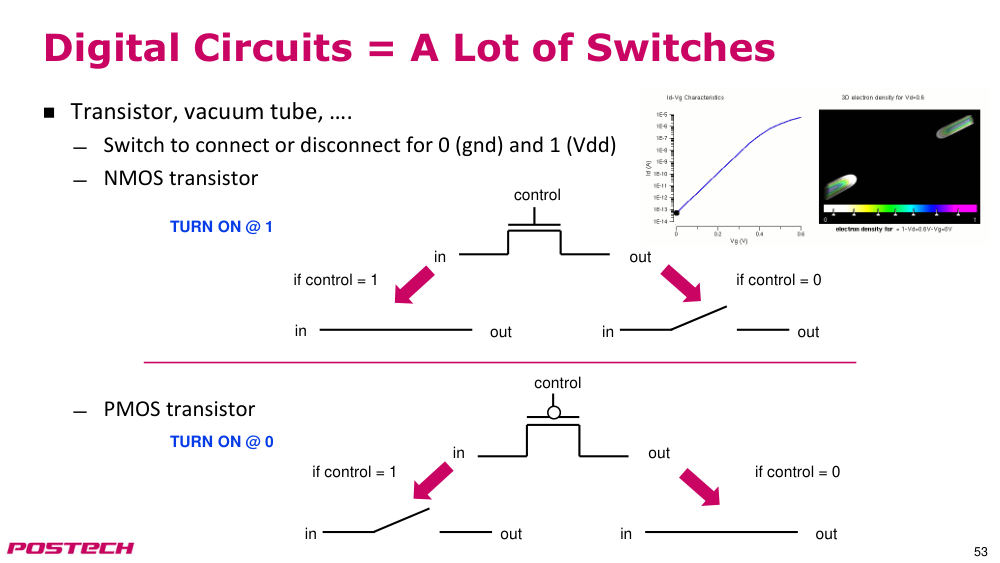
원인digital circuit 에서 transistor 는 input·output 을 연결/차단하는 switch. 세 단자: input, output, control.
해결nMOS 는 control=1 에서 연결, 0 에서 차단. pMOS 는 반대. gate voltage 를 올리면 연결되는 animation 으로 확인.
- nMOS: TURN ON @1
- pMOS: TURN ON @0
2.21:55–3:27Transistor 로 만든 inverter
상황·문제transistor 로 logic 을 어떻게 만드나. 가장 단순한 inverter 부터.
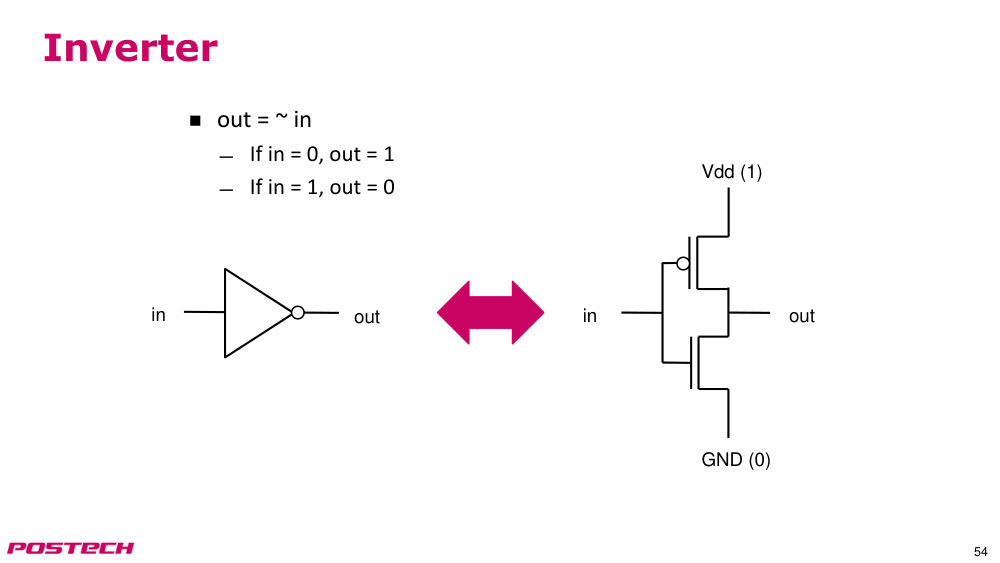
원인inverter 는 out = ~in. pMOS 는 out–VDD, nMOS 는 out–GND 사이에 둔다.
해결in=1: nMOS 연결·pMOS 차단 → out=GND=0. in=0: pMOS 연결 → out=VDD=1.
- out 은 VDD 또는 GND 중 하나에만 연결된다
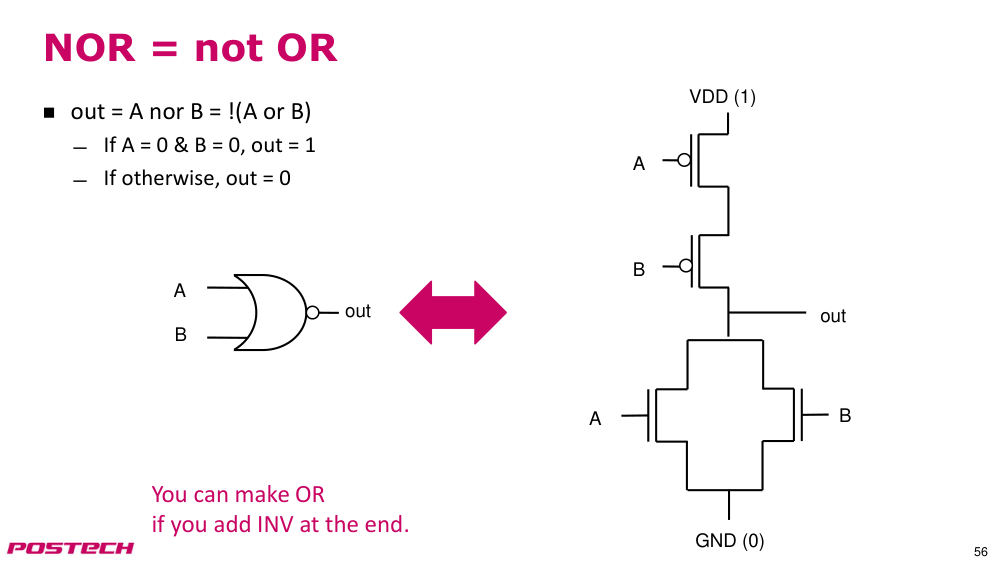
2.33:27–8:01NAND 와 NOR gate 의 transistor 구현
상황·문제더 복잡한 예: NAND(not AND), NOR(not OR). 학생에게 30초 동안 직접 값을 넣어 보게 함.
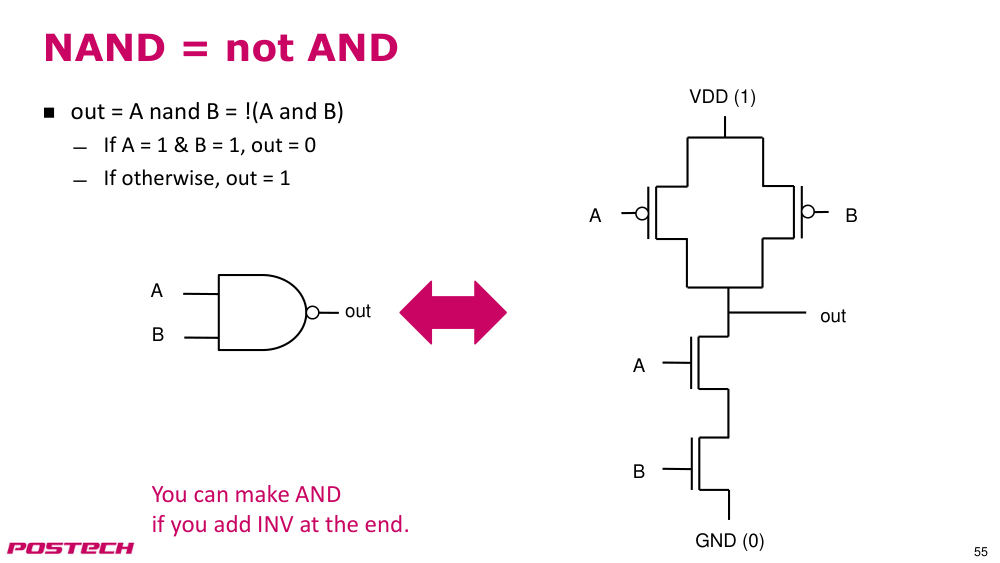
원인NAND: nMOS 2개 직렬(GND 쪽), pMOS 2개 병렬(VDD 쪽). NOR 는 그 반대 배치.
해결NAND: A=B=1 이면 nMOS 둘 다 연결 → 0, 하나라도 0 이면 pMOS 로 VDD → 1. NOR: 하나라도 1 이면 GND → 0.
- NAND/NOR 끝에 INV 를 붙이면 AND/OR
- NOR 의 나머지 경우는 직접 확인해 보라고 함
2.48:01–8:40INV·NAND·NOR 로 모든 것을
상황·문제기본 gate 가 갖춰졌을 때 무엇을 만들 수 있나.
원인CPU·memory 등 computer 구성 요소는 combinational circuit 과 sequential circuit 으로 이루어진다.
해결INV·NAND·NOR 로 모든 digital logic device 와 memory 를 만들 수 있고, 동작하는 computer 를 만들 수 있다.
2.58:40–11:49Moore's law 와 transistor scaling 의 한계
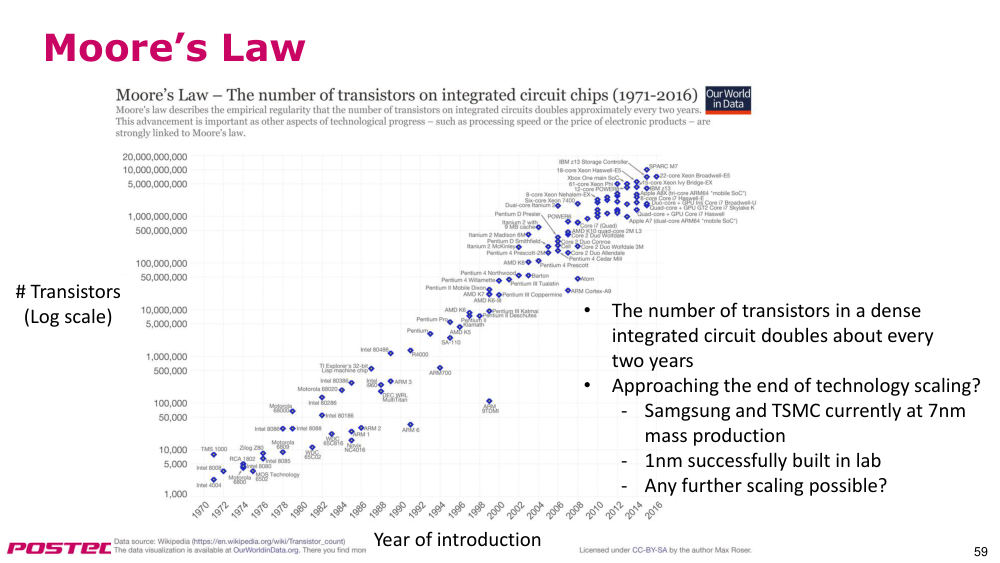
상황·문제computer 성능·energy efficiency 의 지수적 성장은 Moore's law 덕분.
원인transistor 수는 약 2년마다 2배(연 약 1.4배). 그러나 transistor 가 더 작아지면 원자 몇 개 수준이 된다.
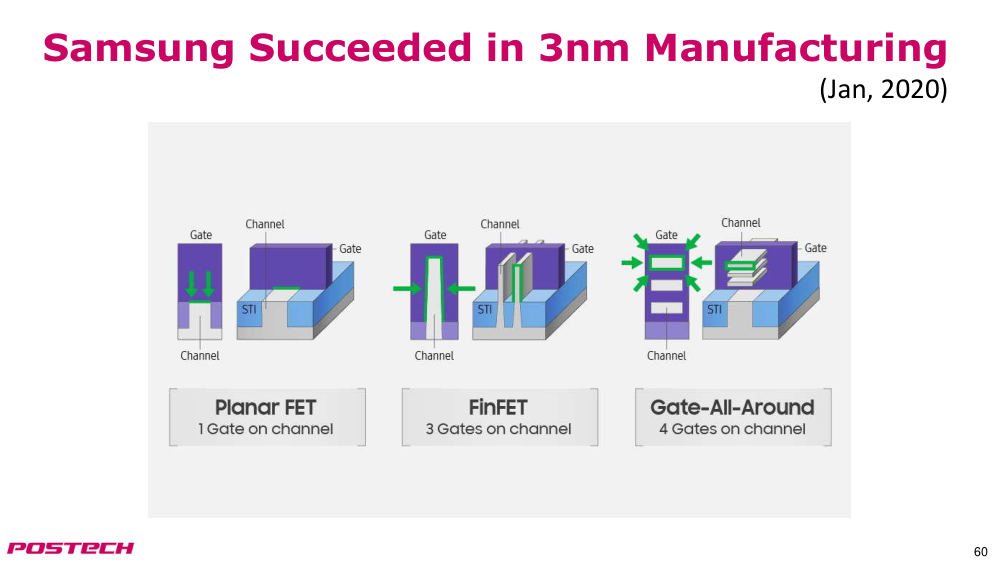
해결당시 Samsung·TSMC 7nm 양산, lab 에서 1nm. Samsung 3nm 는 Gate-All-Around(이전 FinFET ~20nm부터, 그 전 planar FET). 얼마나 계속될지는 불확실.
- log scale 에서 직선 = 지수 증가
- planar FET → FinFET → GAA
2.611:49–14:19Power Wall
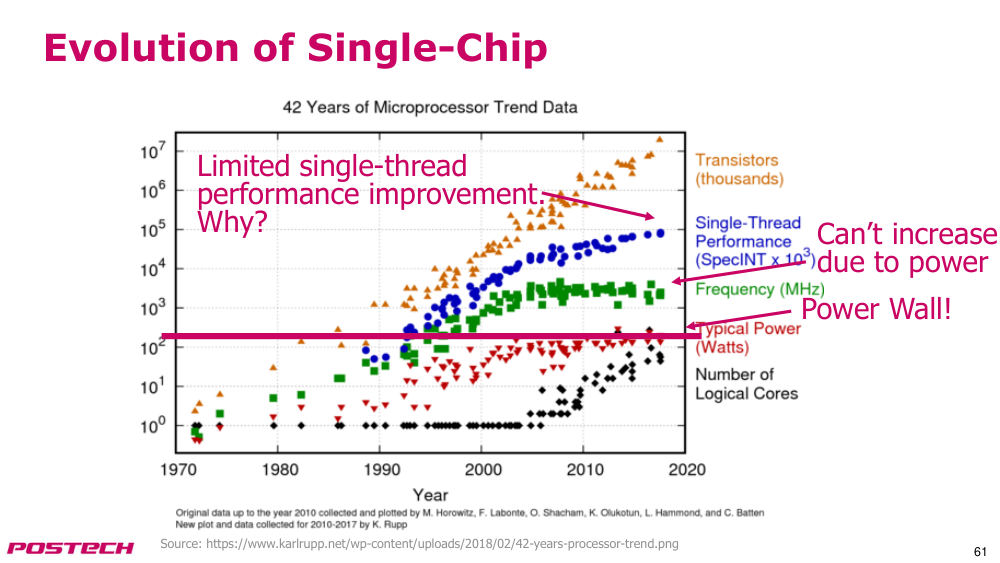
상황·문제transistor 수는 늘어도 single-thread performance 향상은 둔화, frequency 는 10~20년째 정체.
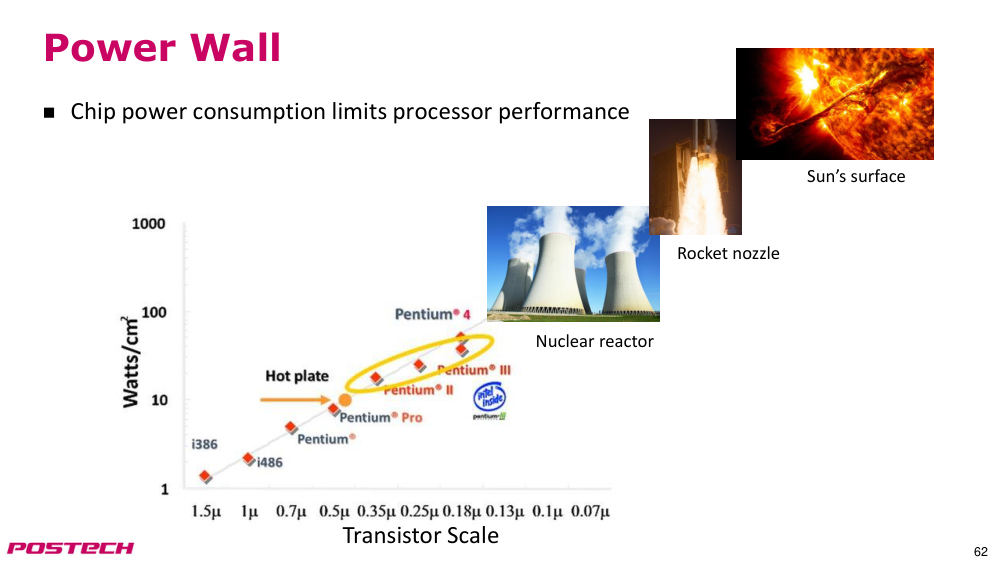
원인chip 하나가 쓸 수 있는 power 에 한계가 있고 이미 그 한계에 도달. heat density 가 지수적으로 증가해 왔다.
해결추세대로면 nuclear reactor → rocket nozzle → 태양 표면 수준 heat density. frequency 를 계속 올리는 것은 불가능.
- frequency 정체의 원인 = power limit
2.714:19–15:43Memory Wall
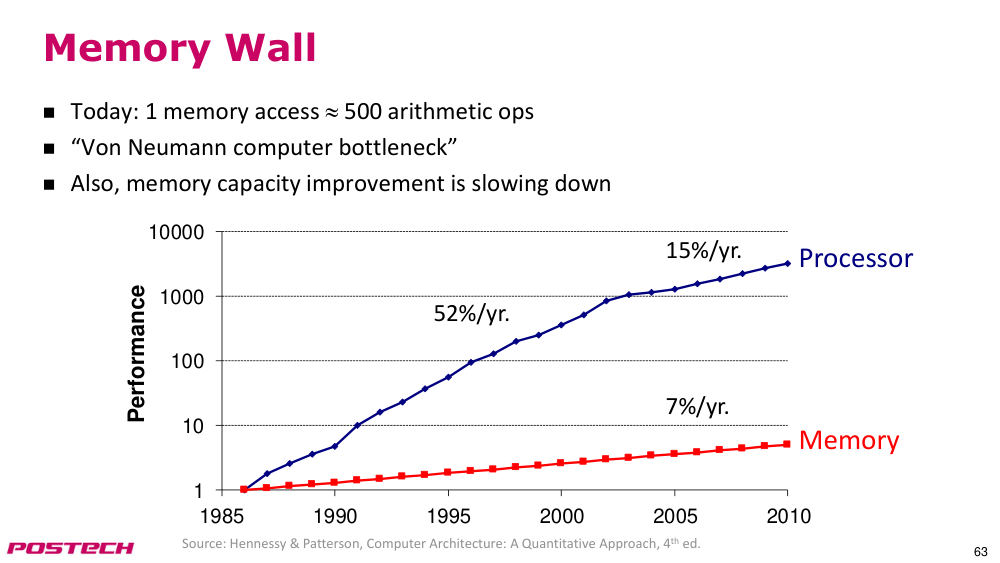
상황·문제processor 와 memory 사이 성능 격차가 계속 커진다.
원인processor 가 memory 보다 빠르게 개선되어 memory 가 상대적으로 점점 느려짐. program·data 가 모두 memory 에 있는 von Neumann 구조.
해결DRAM access 1번 동안 processor 는 약 500번 연산 가능. "von Neumann bottleneck" 이라고도 부른다.
- 1 memory access ≈ 500 arithmetic ops
2.815:43–18:42Parallelism Wall
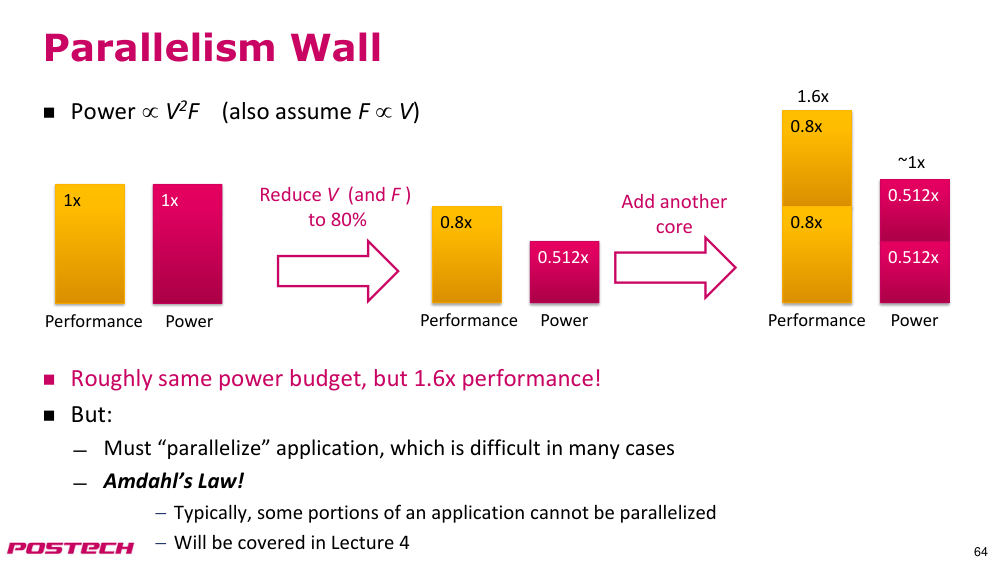
상황·문제power wall 을 피하는 방법 하나는 core 를 여러 개 두는 것.
원인Power ∝ V²F, F ∝ V → Power ∝ V³. V·F 를 80% 로 줄이면 성능 0.8x, power 0.8³ ≈ 0.5x.
해결core 2개면 성능 1.6x, power ~1x. 단, application 을 parallelize 해야 하고 어렵다. Amdahl's law 가 이득을 제한 (Lecture 4).
- 같은 power budget 으로 60% 성능 향상
- Amdahl's law 는 Lecture 4
2.918:42–19:32Reliability Wall
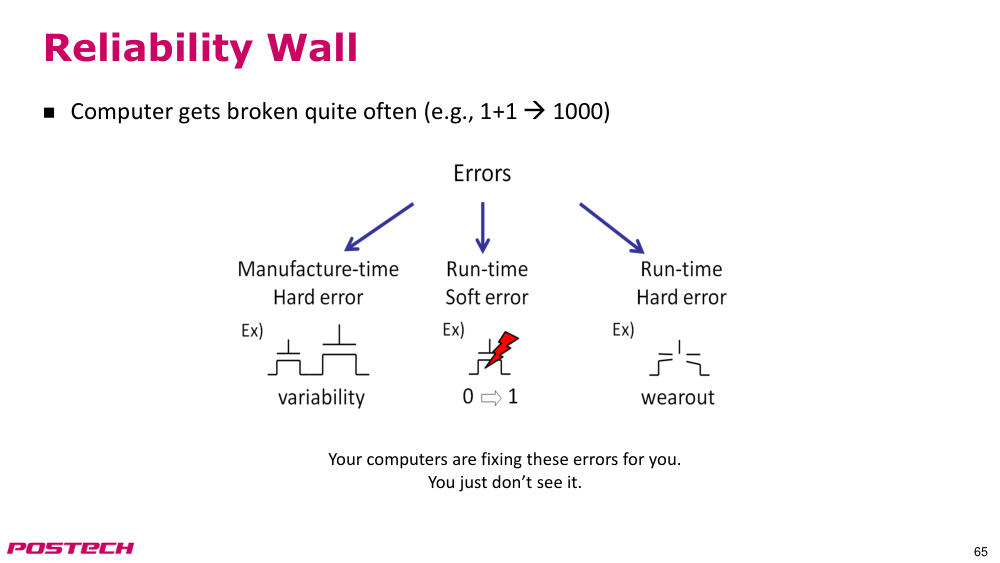
상황·문제transistor 가 작아질수록 error 를 내기 쉬워져 예상 밖 결과가 나온다.
원인manufacture-time hard error(variability), run-time soft error, run-time hard error(wearout).
해결지금은 error correction 기법으로 보이지 않게 고친다. 더 작아지면 제대로 고치기 어려워 transistor 축소의 또 다른 장벽.
2.1019:32–22:21GPGPU 와 deep learning, DGX-2
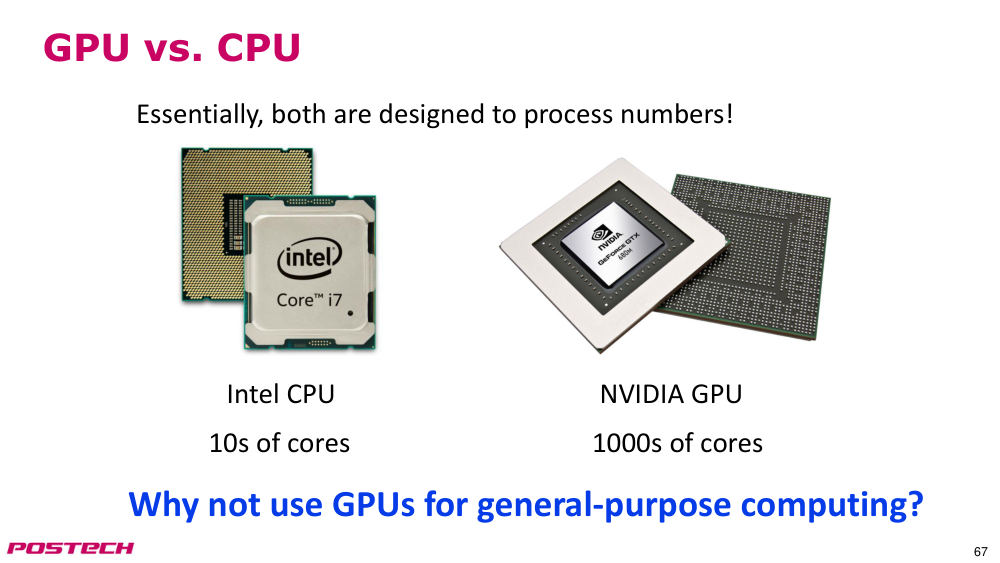
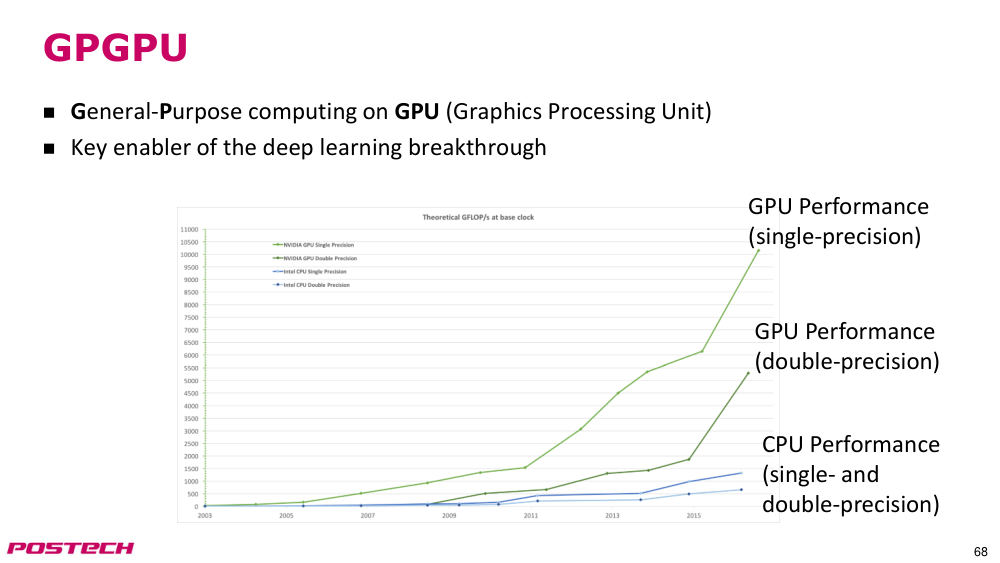
상황·문제최근 동향 1: GPU 를 범용 계산에 사용.
원인GPU 는 display 용으로 대량 data 를 처리하려고 core 가 매우 많다(CPU 는 많아야 수십 개).
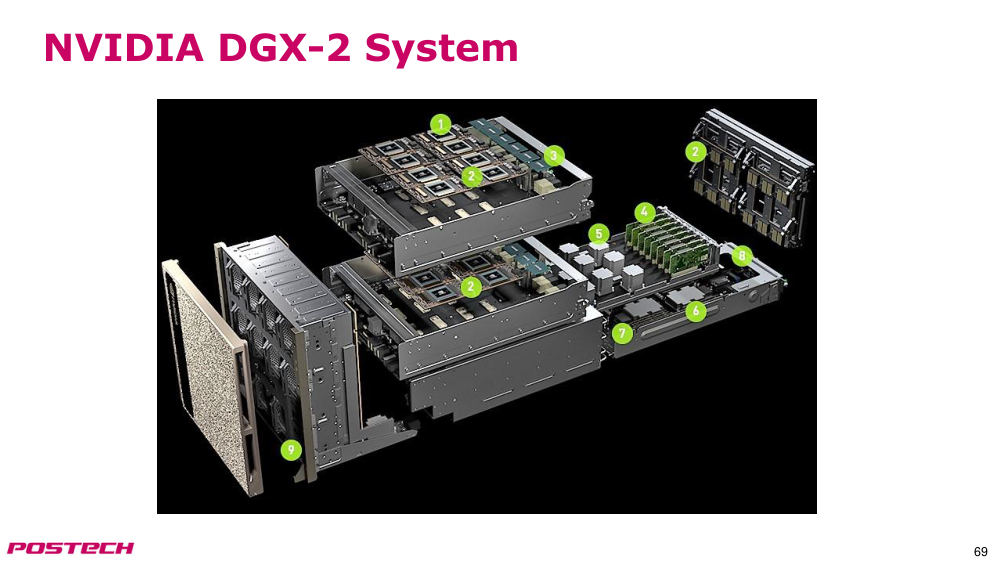
해결GPU 성능이 CPU 보다 빠르게 향상. deep learning 연구자들이 GPU 로 대량 계산 → deep learning breakthrough 의 key enabler. DGX-2 는 많은 GPU 를 한 system 에.
- deep learning 은 hardware 와 함께 진화 중
2.1122:21–23:383D-stacked memory
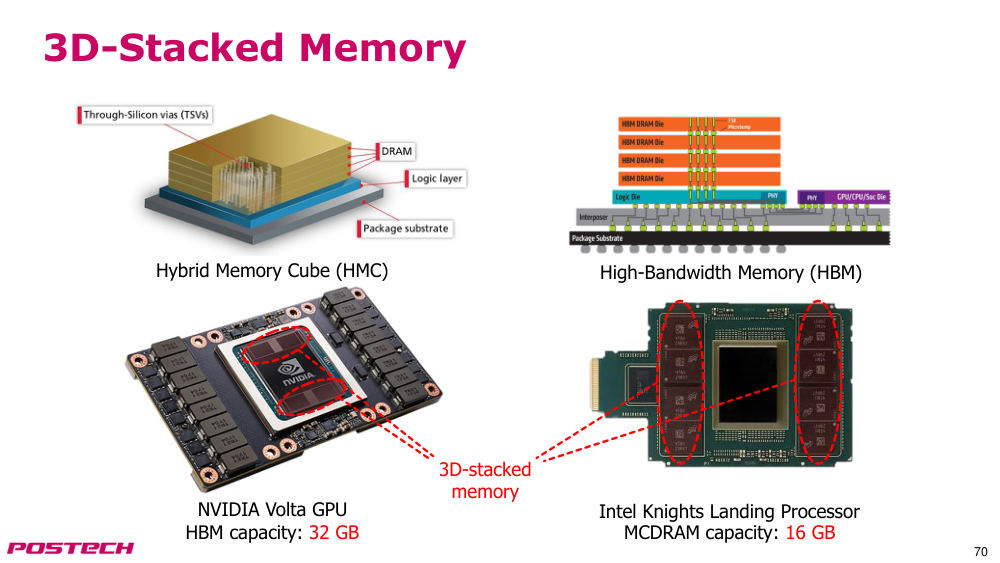
상황·문제memory wall 을 극복하기 위한 시도.
원인기존 memory device 는 planar 라 용량·bandwidth 에 한계.
해결memory die 여러 장을 적층해 한 package 로 큰 용량 + 높은 bandwidth. NVIDIA Volta GPU(HBM), Intel(Knights Landing, MCDRAM).
- HMC, HBM
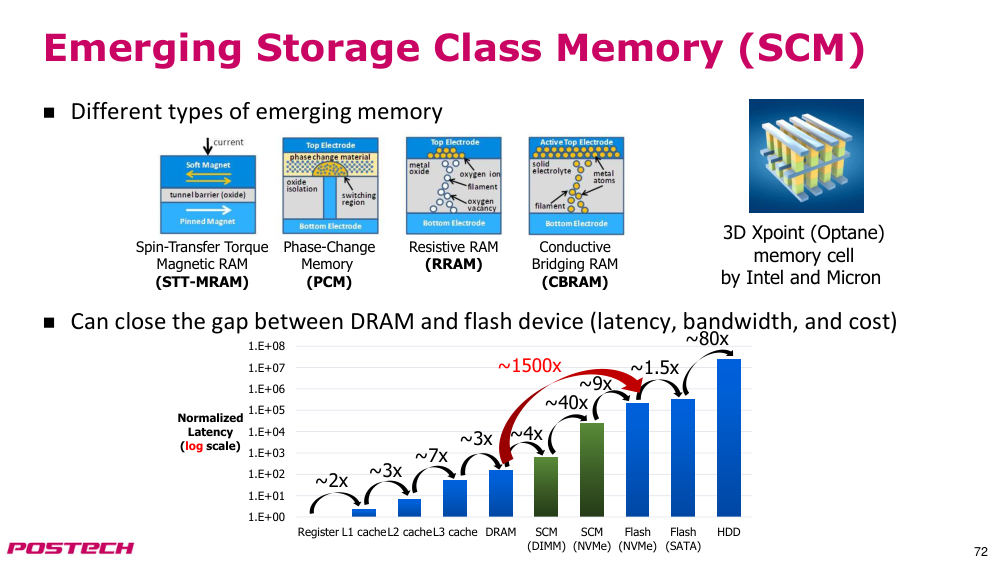
2.1223:38–26:08Storage-class memory(SCM)
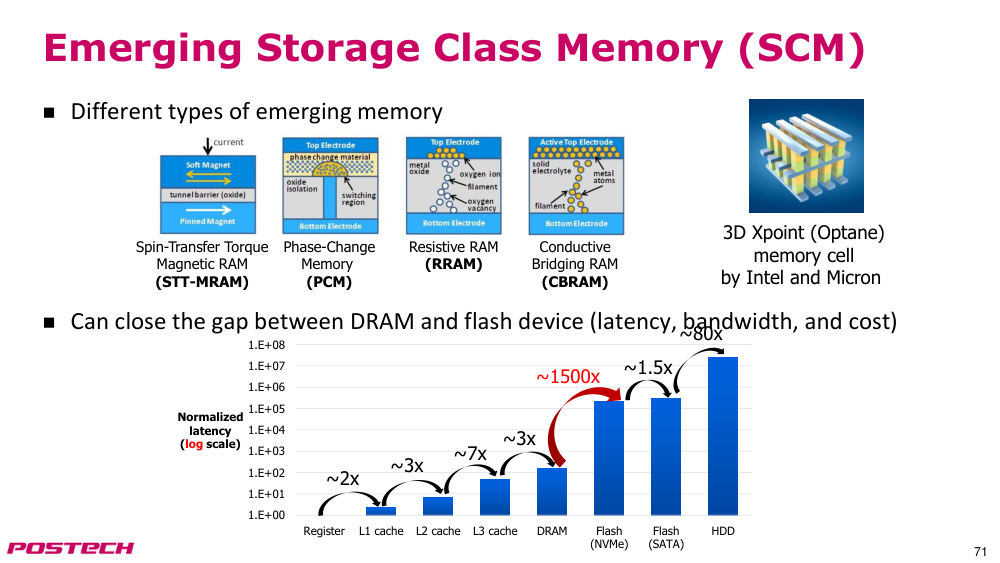
상황·문제main memory 는 DRAM 이지만 용량이 부족해 새 memory device 를 찾는다.
원인memory hierarchy 인접 계층은 1~7x 차이인데 DRAM 과 flash 사이는 약 1500x latency 차이.
해결3D XPoint(Intel·Micron) 등 SCM 이 DRAM 과 flash 사이 성능으로 gap 을 메울 것으로 기대. 아직 초기 단계.
- memory hierarchy 는 이후 강의에서
2.1326:08–30:16ISA disruption: Arm 과 RISC-V
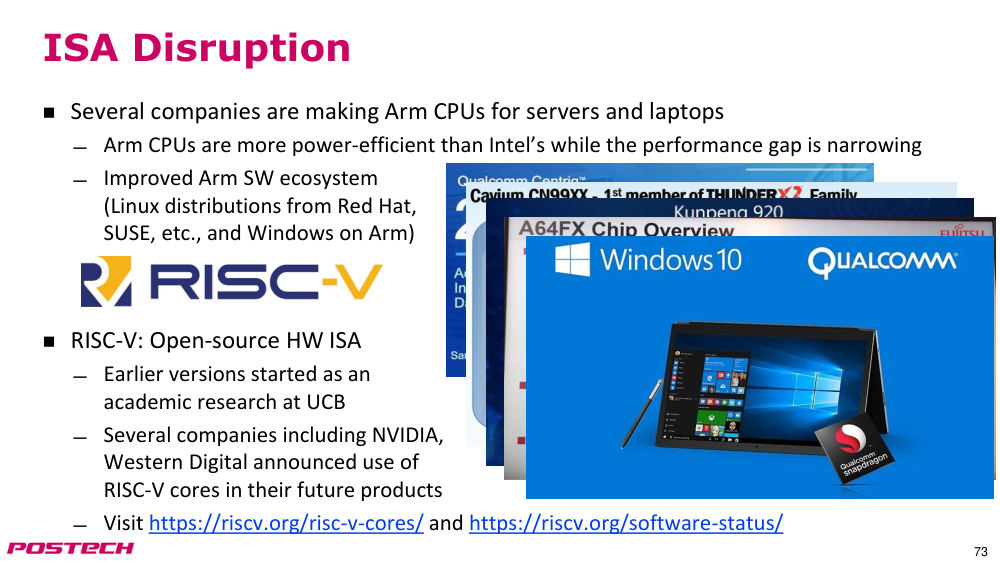
상황·문제instruction set architecture 쪽의 변화.
원인Arm CPU 는 mobile·microcontroller 용이었으나 Intel 보다 power-efficient 하면서 성능도 경쟁력을 갖췄다. Red Hat·SUSE Linux, Windows on Arm 등 SW ecosystem 개선.
해결Qualcomm(중단), Cavium ThunderX2, Huawei, Fujitsu A64FX(supercomputer). RISC-V 는 license fee 없는 open ISA, UC Berkeley 연구에서 출발, NVIDIA·Western Digital 채택 발표.
- A64FX supercomputer 가 상위권에 오를 것이라 예상(강의 당시)
- RISC-V core·software 목록 사이트 소개
2.1430:16–31:43Domain-specific accelerator
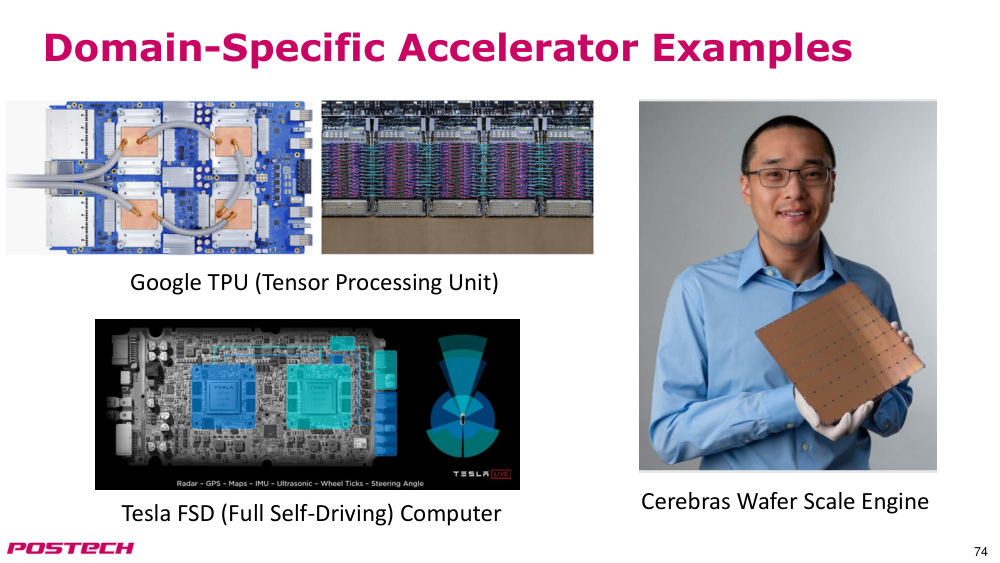
상황·문제특정 application(deep learning 등)에 쓰는 특화 processor.
원인범용 processor 로는 해당 workload 성능이 부족.
해결Google TPU(cloud ML), Tesla FSD chip(차량 deep learning), 초대형 chip(Cerebras). 많은 startup 이 뛰어든 활발한 분야.
2.1531:43–32:57Silicon 대체 기술
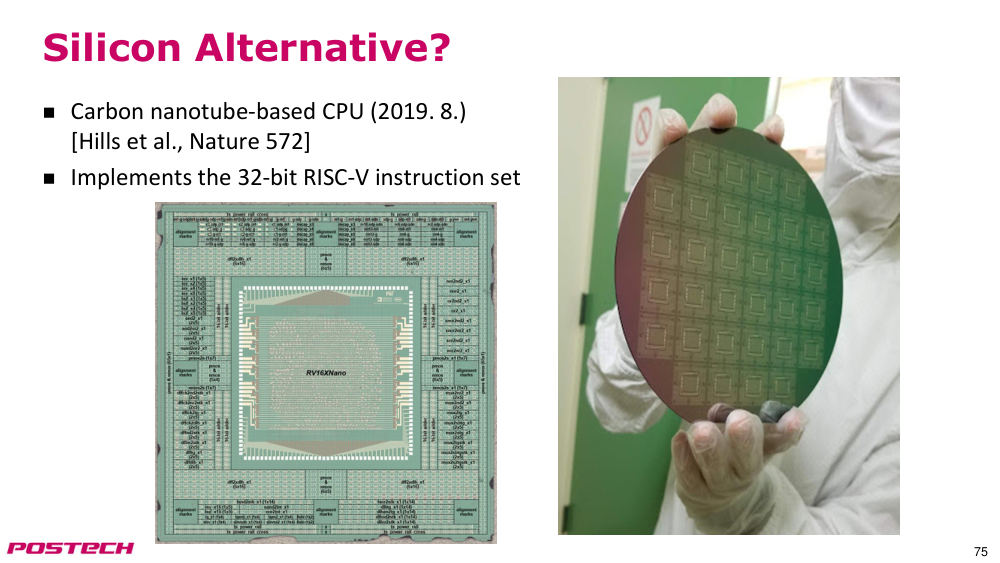
상황·문제Moore's law 가 느려져 silicon 을 대체할 기술을 시도.
원인carbon nanotube 기술로 RISC-V CPU 를 wafer 에 제작한 사례.
해결아직 초기 단계라 silicon processor 를 곧 대체하지는 않지만 지켜볼 만하다.
2.1632:57–33:28마무리 공지
상황·문제Lecture 1 종료. 질문은 Microsoft Teams 등으로(LMS 는 알림이 없어 느림). 다음 강의 전 P&H Ch.1–1.5 읽기.
2.16.r.1Computer Organization and Design RISC-V Edition, 2nd ed. (Elsevier) ↗ · 교재 P&H RISC-V판, 읽기 Ch.1–1.5
3핵심 개념
3.1nMOS / pMOS transistor
nMOS 는 control=1, pMOS 는 control=0 에서 input–output 연결.
3.2CMOS logic(상보형 논리)
pMOS 로 VDD, nMOS 로 GND 에 연결하는 상보 구조. out 은 둘 중 하나에만 연결.
3.3Moore's law(무어의 법칙)
dense IC 의 transistor 수가 약 2년마다 2배 (연 약 1.4배).
3.4Power wall(전력 장벽)
chip power 한계로 frequency·single-thread 성능 향상이 정체.
3.5Memory wall(메모리 장벽)
processor–memory 성능 격차. DRAM access 1번 ≈ 연산 500번. von Neumann bottleneck.
3.6Parallelism wall(병렬성 장벽)
multi-core 로 같은 power 에 1.6x 가능하나 병렬화 난이도와 Amdahl's law 가 제한.
3.7Storage-class memory(SCM)
DRAM 과 flash 사이(~1500x latency gap)를 메우는 새 memory. 예 3D XPoint.
3.8RISC-V
UC Berkeley 에서 시작한 license fee 없는 open ISA.
4스스로 확인
4.1pMOS 는 control 이 몇일 때 input 과 output 을 연결하나?
답
control=0. nMOS 는 control=1.
4.2CMOS NAND 에서 nMOS 2개는 직렬인가 병렬인가? 왜?
답
직렬. A·B 가 모두 1 일 때만 out 이 GND 에 연결돼 0 이 되어야 하므로.
4.3V·F 를 80% 로 낮추면 power 는 약 몇 배인가?
답
Power ∝ V²F, F ∝ V → V³. 0.8³ = 0.512, 약 절반.
4.4memory wall 을 한 줄로?
답
processor 가 memory 보다 빨리 개선돼 격차 확대. DRAM access 1번에 연산 약 500번.
4.5SCM 이 필요한 이유는?
답
인접 계층 차이는 1~7x 인데 DRAM–flash 는 약 1500x latency 차이라 그 사이를 메우려고.
5참고 자료
5.1Computer Organization and Design RISC-V Edition, 2nd ed. (Elsevier) ↗ · 교재 P&H RISC-V판, 읽기 Ch.1–1.5