이 자료를 쓰는 강의: 34 과목 안내 (CSED311 Computer Architecture) · 35 컴퓨터의 정의, ISA·microarchitecture, 컴퓨터 역사 · 36 transistor·logic gate, 4개의 wall, 최근 동향
Lec1-Intro
한국어판 강의자료 · 76쪽
p.1CSED311 computer architecture(컴퓨터 아키텍처) – 강의 1
- 소개
- Gwangsun Kim
- Department of Computer Science and Engineering
- POSTECH
p.2이 과목이 다루는 내용
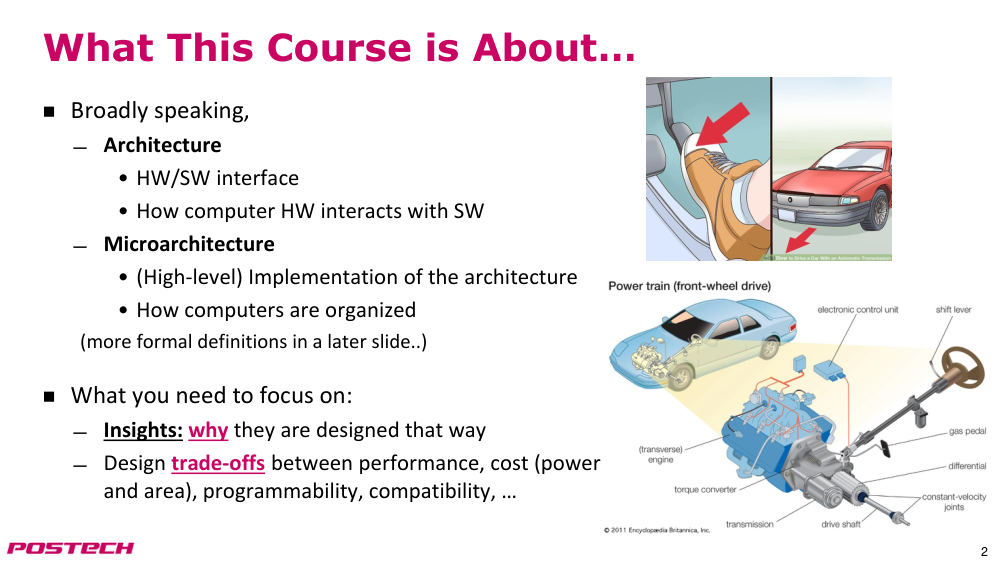
- 광범위하게 말하면, computer architecture(컴퓨터 아키텍처)는
- Hardware-Software interface(하드웨어-소프트웨어 인터페이스)
- 컴퓨터 하드웨어가 소프트웨어와 어떻게 상호작용하는지
- microarchitecture(마이크로아키텍처)는
- (고수준의) 아키텍처 구현
- 컴퓨터가 어떻게 구성되어 있는지
- 나중 슬라이드에서 더 공식적인 정의를 다룸
- 이 과목에서 집중해야 할 점은
- 왜 그렇게 설계되었는지에 대한 통찰
- 성능, 비용(전력 및 면적), programmability(프로그래머블성), compatibility(호환성) 사이의 design trade-offs(설계 트레이드오프)
p.3다루게 될 주제
- 입출력
- I/O mechanism(입출력 메커니즘)
- storage(저장 장치)
- parallel computing(병렬 계산)
- parallel architectures(병렬 아키텍처)
- synchronization(동기화)
- 고급 주제
- out-of-order execution(비순차 실행)
- GPGPU(일반 목적 GPU)
- Domain-Specific architecture(도메인 특화 아키텍처)
- instruction set architecture (ISA)(명령어 집합 아키텍처)
- 프로세서
- datapath(데이터 경로)
- control unit(제어 유닛)
- pipelining(파이프라인)
- 메모리
- memory hierarchy(메모리 계층 구조)
- cache(캐시)/TLB
- virtual memory(가상 메모리)
- memory devices(메모리 장치)
p.4왜 이 과목을 공부해야 할까?
- 하드웨어 엔지니어에게는, 하드웨어 개선 작업을 수행하려면 기존 하드웨어에 대한 철저한 이해가 필요함
- 소프트웨어 엔지니어에게는, 우수한 소프트웨어 구현을 위해서는 하드웨어에 대한 깊은 이해가 필요함
- 고성능
- 고전력 효율성 – 모바일 기기만이 아니라 모든 분야에서 중요함
- Hardware-Software co-design(하드웨어-소프트웨어 공동 설계)는 점점 더 중요해지고 있음
- computer architecture(컴퓨터 아키텍처)는 학계와 산업계에서 매우 활발하고 흥미로운 분야임
- “최근 프로세서의 피크 계산 성능과 메모리 대역폭은 증가하고 있지만, 이러한 플랫폼에서 성능을 효과적으로 추출하는 것은 점점 더 어려워지고 있다. 이로 인해 현대의 멀티/다중 코어 프로세서의 전체 성능을 활용할 수 있는 전문 프로그래머(‘ninja programmers(니나 프로그래머)’)는 극히 소수에 불과하며, 평균적인 프로그래머는 이 성능의 일부분도 얻지 못하고 있다.”
- [Can Traditional Programming Bridge the Ninja Performance Gap for Parallel Computing Applications?, Satish et al., ISCA’12]
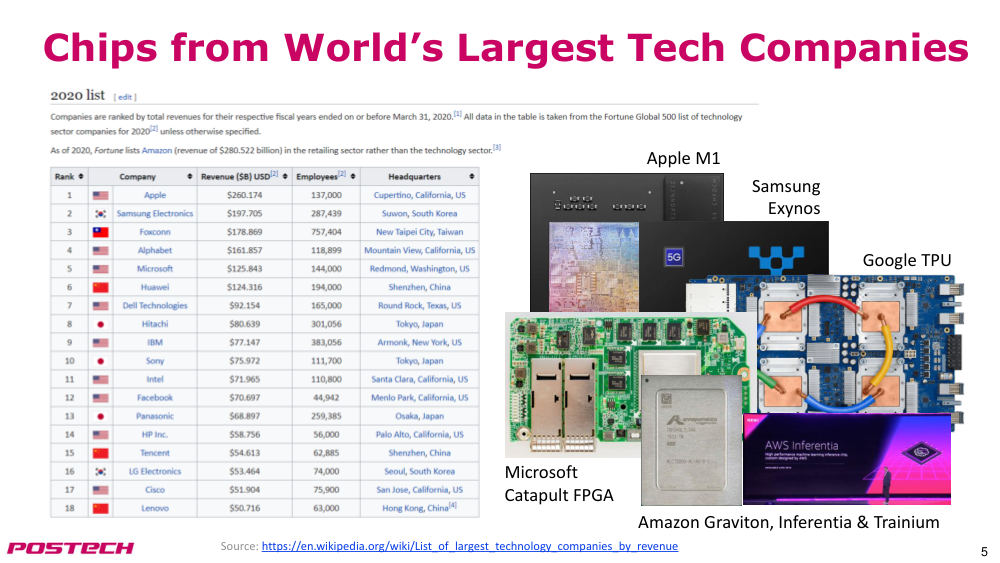
p.5세계 최대 기술 기업들의 칩
- 출처: https://en.wikipedia.org/wiki/List_of_largest_technology_companies_by_revenue
- Apple M1
- Samsung
- Exynos
- Google TPU
- Microsoft Catapult FPGA
- Amazon Graviton, Inferentia & Trainium
p.6오늘의 일정
- 이 과목이 다루는 내용
- 과목 정보 (성적 평가, 정책 등)
- 랩 소개
- computer architecture(컴퓨터 아키텍처)의 기초
- 역사적 관점
- 과제와 미래 방향
p.7강의 정보
- 강사: Prof. Gwangsun Kim (김광선)
- 연락처: g.kim@postech.ac.kr, 전화: 279-2260
- 사무실: PIAI(인공지능연구원, 구정보통신연구소) #433
- 오피스 아워: 사전 예약 (이메일로 연락 주세요!)
- 홈페이지: http://acp.postech.ac.kr
- 2018년 11월에 POSTECH에 입사. 그 전까지는 Austin, TX의 Arm에서 근무함.
- 연구 관심 분야
- • AI를 위한 시스템 및 시스템을 위한 AI
- • Hardware-Software co-design(하드웨어-소프트웨어 공동 설계)
- • 메모리 시스템
- • Processing-in-Memory(메모리 내 처리)
- • parallel architectures(병렬 아키텍처)
p.8조교
- 특정 조교와 상의할 필요가 없는 경우, 다음 그룹 이메일 별칭을 사용하세요: csed311-ta@postech.ac.kr
- 웹사이트/소통: plms.postech.ac.kr, MS Teams
- 공지사항, 강의 노트, 랩 자료 등
- 때때로 강의 노트가 LMS에 'Updated'라는 단어를 파일 이름 끝에 추가하여 조용히 업데이트될 수 있음 – 복습 등에 사용할 때는 최신 버전을 사용하세요.
- 질문은 (선호되는) MS Teams 또는 LMS의 Q&A 게시판에 올리세요.
- • 한국어로 작성해도 괜찮습니다. 누구나 답변할 수 있습니다.
- 이름
- 이메일
- 조성준(헤드 TA)
- allencho1222@postech.ac.kr
- 류재훈
- jaehunryu@postech.ac.kr
- 조현욱
- gusdnr9779@postech.ac.kr
- 함형규
- hhk971@postech.ac.kr
- 홍정민
- jmhhh@postech.ac.kr
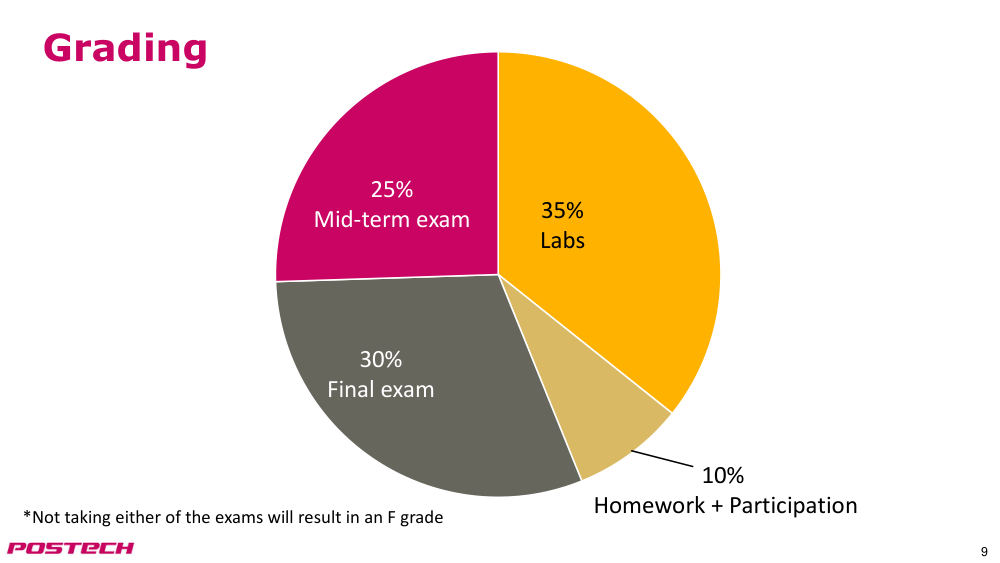
p.9성적 평가
- 25%
- 중간고사
- 25%
- 기말고사
- 35%
- 랩
- 10%
- 과제 + 참여도
- 25%
- 중간고사
- 30%
- 기말고사
- * 중간고사 또는 기말고사 중 하나라도 응시하지 않을 경우 F 등급 처리
p.10랩 (35%)
- 랩을 통해 간단한 CPU를 구현하는 방법을 배우게 됩니다!
- 각 랩 세션은 세 부분으로 구성됩니다.
- 튜토리얼 + 랩 과제 설명 – 온라인 제공
- 데모 (팀별) – 온라인으로 진행 (MS Teams)
- 랩 작업을 하기 위해 디지털 시스템 설계 (CSED273)에 대한 기본 지식이 필요합니다.
- 이 과목을 수강하지 않았거나 성적이 좋지 않았다면, 아래 두 유튜브 플레이리스트 중 적어도 하나를 시청하세요:
- • Derek Johnston의 'Introduction to Digital Design' – 링크
- • Neso Academy의 'Digital Electronics' (더 자세한 설명) – 링크
p.11과제 및 참여도 (10%)
- 과제
- 4개의 큰 과제 또는 8개의 작은 과제
- 교재의 연습 문제
- 모든 문제를 정확히 풀면 이 부분의 만점 획득
- 참여도
- 수업 중 좋은 질문을 하거나 교수의 질문에 답하면 1점 획득 가능
- 또한 MS Teams 또는 LMS Q&A 게시판에서 질문 가능
- • 100점이면 과제 및 참여도 부분의 만점 획득
- • 무의미한 질문/답변은 점수에 포함되지 않음 – 점수를 받을 수 있는지 여부는 제가 알려드립니다 (수업 후 이메일로 문의하거나 MS Teams 또는 Q&A 게시판에서 👍 이모지 확인)
- 과제에서 잃은 점수는 참여도를 통해 복구할 수 있습니다
p.12출석
- 온라인 또는 오프라인 여부와 상관없이 매번 출석이 체크됩니다.
- 4회 결석 → 전체 성적에 5% 감점
- 5회 결석 → 전체 성적에 6% 감점
- 6회 결석 → 전체 성적에 7% 감점
- 7회 결석 → 불합격 (F), 어떠한 exception(예외)도 없음
- 사전에 정당한 사유로 수업을 빠질 경우 미리 알려주세요
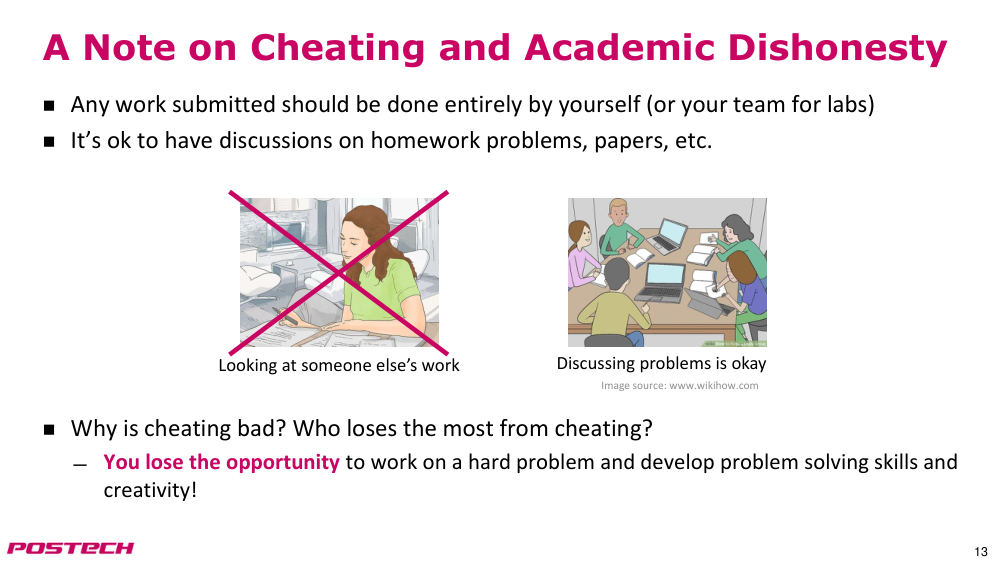
p.13 cheating 및 학술 부정에 대한 주의
- 제출하는 모든 작업은 자신(또는 실험실의 팀)이 완전히 독자적으로 수행해야 한다.
- 과제 문제, 논문 등에 대해 토론하는 것은 괜찮다.
- 왜 부정은 나쁜가? 부정으로 인해 가장 큰 피해를 입는 사람은 누구인가?
- 너는 어려운 문제를 해결하고 문제 해결 능력 및 창의성을 기르는 기회를 잃는다!
p.14부정 정책
- 실험실 및 과제에 대해
- 첫 번째 부정 행위가 적발되면 해당 실험실/과제에 대해 0점 처리된다 (즉, 과제 내 다른 문제도 포함).
- 두 번째 부정 행위가 적발되면 전체 실험실/과제에 대해 0점 처리된다.
- 이 규정은 사건에 관여한 모든 사람에게 적용된다.
- 중간고사 또는 기말고사에서의 부정 → 불합격 처리
- 부정 시도도 포함된다.
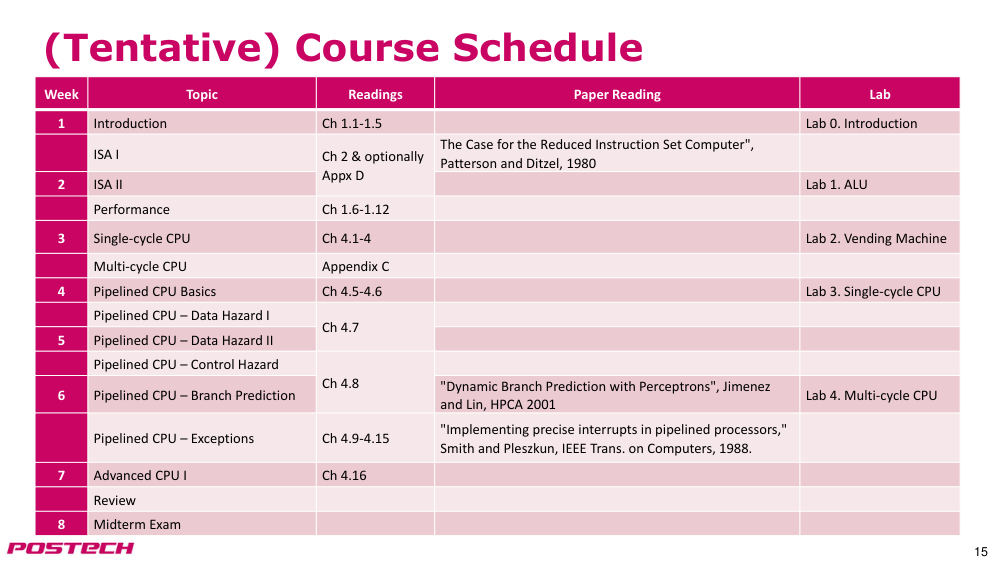
p.15(임시) 강의 일정
- 주차: 1, 주제: 소개, 읽기 자료: Ch 1.1-1.5, 논문 읽기: 없음, 실험실: Lab 0. 소개
- 주차: 2, 주제: instruction set architecture (ISA)(명령어 집합 아키텍처) I, 읽기 자료: Ch 2 & 선택적 Appx D, 논문 읽기: "Reduced Instruction Set Computer"에 대한 사례, Patterson and Ditzel, 1980, 실험실: Lab 1. ALU
- 주차: 3, 주제: 성능, 읽기 자료: Ch 1.6-1.12, 실험실: Lab 2. 자판기
- 주차: 4, 주제: single-cycle CPU(싱글 사이클 CPU), 읽기 자료: Ch 4.1-4, 실험실: Lab 3. 싱글 사이클 CPU, 주제: multi-cycle CPU(멀티 사이클 CPU), 읽기 자료: Appendix C
- 주차: 5, 주제: pipelined CPU(파이프라인 CPU) 기본, 읽기 자료: Ch 4.5-4.6, 실험실: Lab 4. multi-cycle CPU(멀티 사이클 CPU), 주제: pipelining(파이프라인) CPU – data hazard(데이터 해저드) I, 읽기 자료: Ch 4.7
- 주차: 6, 주제: pipelined CPU(파이프라인 CPU) – data hazard(데이터 해저드) II, pipelining(파이프라인) CPU – control hazard(제어 해저드), 읽기 자료: Ch 4.8, 논문 읽기: "Implementing precise interrupts in pipelined processors", Smith and Pleszkun, IEEE Trans. on Computers, 1988
- 주차: 7, 주제: 고급 CPU I, 읽기 자료: Ch 4.16, 복습
- 주차: 8, 주제: 중간고사
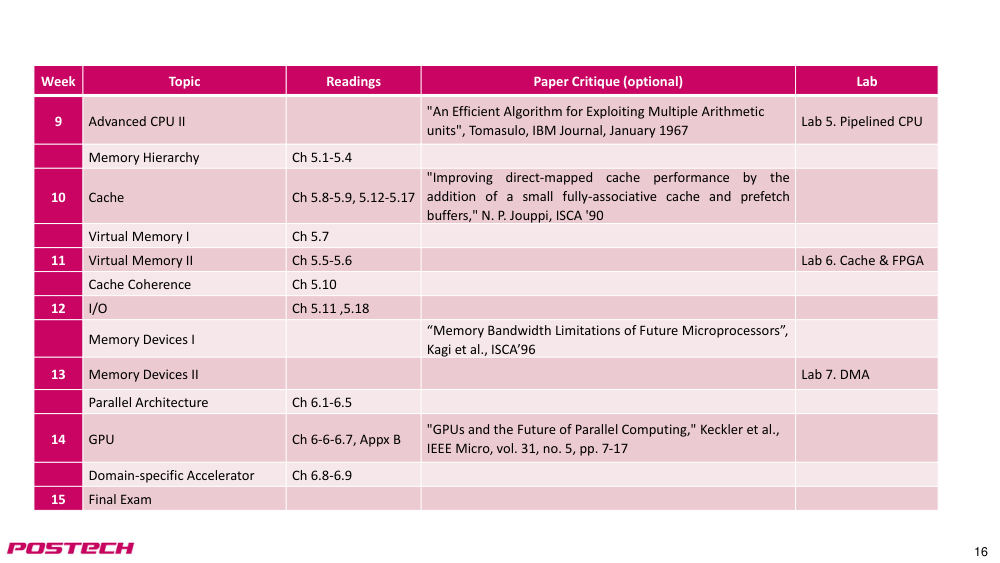
p.16(임시) 강의 일정 (계속)
- 주차: 9, 주제: 고급 CPU II, 읽기 자료: "An Efficient Algorithm for Exploiting Multiple Arithmetic units", Tomasulo, IBM Journal, January 1967, 실험실: Lab 5. pipelined CPU(파이프라인 CPU)
- 주차: 10, 주제: memory hierarchy(메모리 계층 구조), 읽기 자료: Ch 5.1-5.4, 논문 읽기: "Improving direct-mapped cache performance by the addition of a small fully-associative cache and prefetch buffers", N. P. Jouppi, ISCA '90, 주제: 캐시, 읽기 자료: Ch 5.8-5.9, 5.12-5.17, 주제: virtual memory(가상 메모리) I, 읽기 자료: Ch 5.7
- 주차: 11, 주제: virtual memory(가상 메모리) II, 읽기 자료: Ch 5.5-5.6, 실험실: Lab 6. cache(캐시) & FPGA, 주제: cache coherence(캐시 일관성), 읽기 자료: Ch 5.10
- 주차: 12, 주제: 입출력, 읽기 자료: Ch 5.11, 5.18, 주제: memory devices(메모리 장치) I, 논문 읽기: "Memory Bandwidth Limitations of Future Microprocessors", Kagi et al., ISCA’96
- 주차: 13, 주제: memory devices(메모리 장치) II, 실험실: Lab 7. DMA, 주제: parallel architectures(병렬 아키텍처), 읽기 자료: Ch 6.1-6.5
- 주차: 14, 주제: GPGPU(일반 목적 GPU), 읽기 자료: Ch 6-6-6.7, Appx B, 논문 읽기: "GPUs and the Future of Parallel Computing", Keckler et al., IEEE Micro, vol. 31, no. 5, pp. 7-17, 주제: 도메인 특화 가속기, 읽기 자료: Ch 6.8-6.9
- 주차: 15, 주제: 기말고사
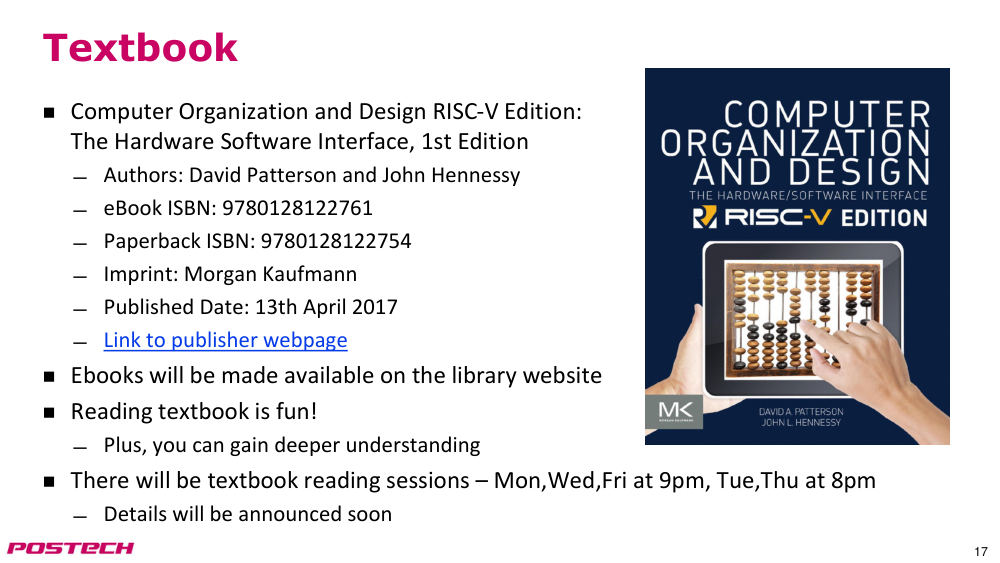
p.17교재
- Computer Organization and Design RISC-V Edition: The Hardware Software Interface, 1st Edition
- 저자: David Patterson and John Hennessy
- eBook ISBN: 9780128122761
- 종이책 ISBN: 9780128122754
- 출판사: Morgan Kaufmann
- 출간일: 2017년 4월 13일
- 출판사 웹사이트 링크
- eBook(전자책)은 도서관 웹사이트에서 제공될 예정이다.
- 교재를 읽는 것은 재미있다!
- 더 깊은 이해를 얻을 수 있다.
- 교재 읽기 세션은 월, 수, 금 오후 9시, 화, 목 오후 8시에 진행될 예정이다.
- 자세한 사항은 곧 공지될 예정이다.
p.18실험실 소개
- Verilog HDL (Lab 0 ~ Lab 2)
- HDL: 하드웨어 기술 언어
- ModelSim: 본 과정용 설계 및 시뮬레이션 도구
- 간단한 논리 회로의 기본 Verilog 구현
- Verilog를 이용한 CPU 설계 (Lab 3 ~ Lab 7)
- register(레지스터)
- datapath(데이터 경로)
- control unit(제어 유닛)
- pipelined CPU(파이프라인 CPU)
- cache(캐시)
- DMA
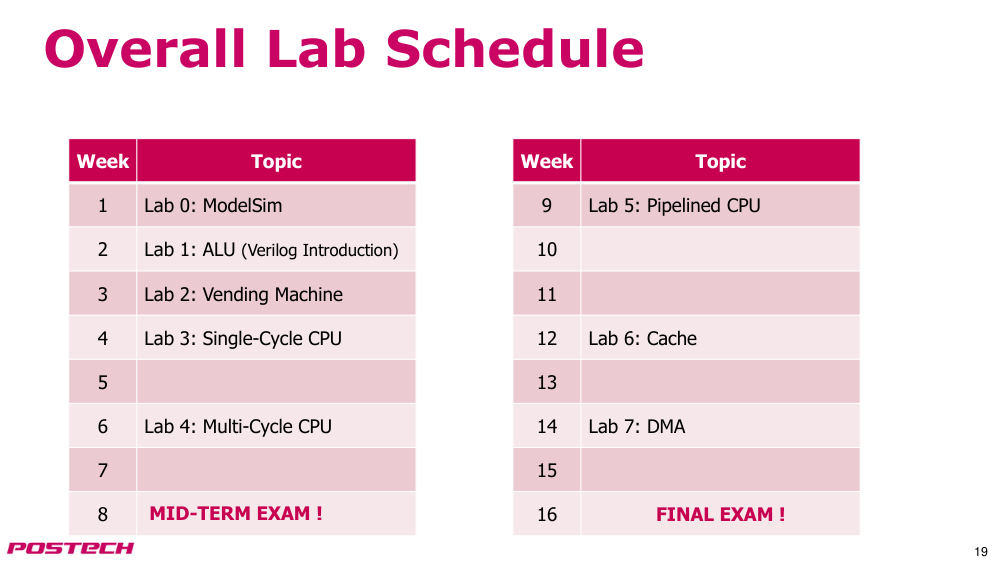
p.19전체 랩 일정
- 주차
- 주제
- 1
- 랩 0: ModelSim
- 2
- 랩 1: ALU (Verilog 소개)
- 3
- 랩 2: 자판기
- 4
- 랩 3: single-cycle CPU(싱글 사이클 CPU)
- 5
- 6
- 랩 4: multi-cycle CPU(멀티 사이클 CPU)
- 7
- 8
- 주차
- 주제
- 9
- 랩 5: pipelined CPU(파이프라인 CPU)
- 10
- 11
- 12
- 랩 6: cache(캐시)
- 13
- 14
- 랩 7: DMA
- 15
- 16
- 최종 시험 !
- 중간 시험 !
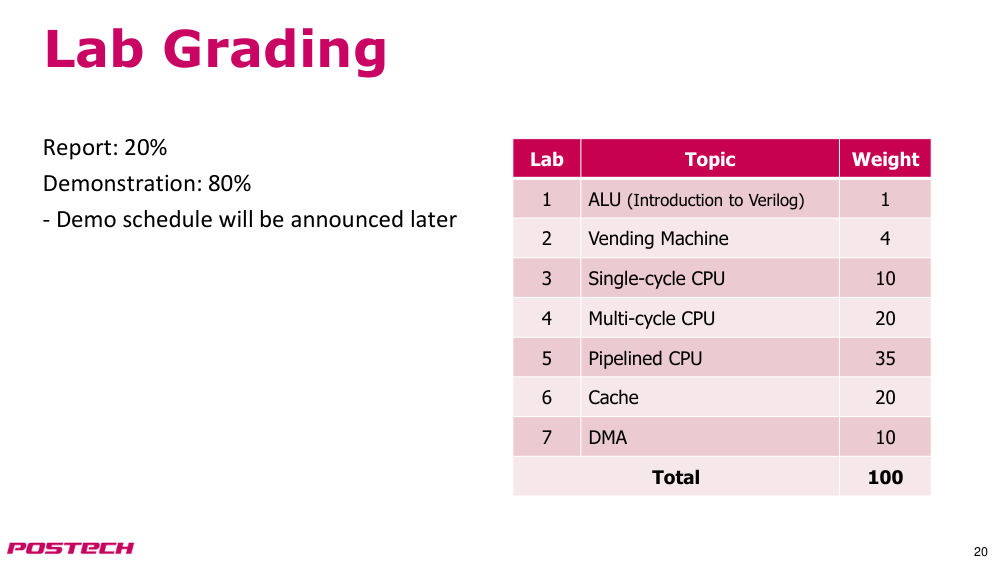
p.20랩 평가 기준
- 보고서: 20%
- 데모: 80%
- - 데모 일정은 나중에 공지될 예정
- 랩
- 주제
- 가중치
- 1
- ALU (Verilog 소개)
- 1
- 2
- 자판기
- 4
- 3
- single-cycle CPU(싱글 사이클 CPU)
- 10
- 4
- multi-cycle CPU(멀티 사이클 CPU)
- 20
- 5
- pipelined CPU(파이프라인 CPU)
- 35
- 6
- cache(캐시)
- 20
- 7
- DMA
- 10
- 합계
- 100
p.21규칙
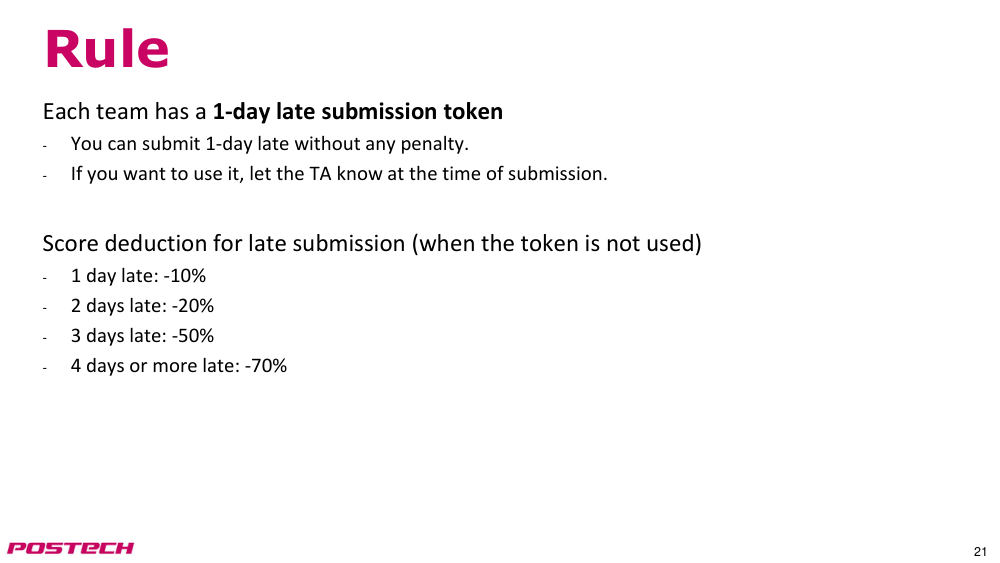
- 각 팀은 1일 연체 제출 토큰을 1개 보유
- - 1일 연체 제출 시 벌점 없이 제출 가능
- - 사용하고자 할 경우 제출 시 TA에게 알려야 함
- 연체 제출 시 감점 기준 (토큰 미사용 시)
- - 1일 연체: -10%
- - 2일 연체: -20%
- - 3일 연체: -50%
- - 4일 이상 연체: -70%
p.22팀 구성
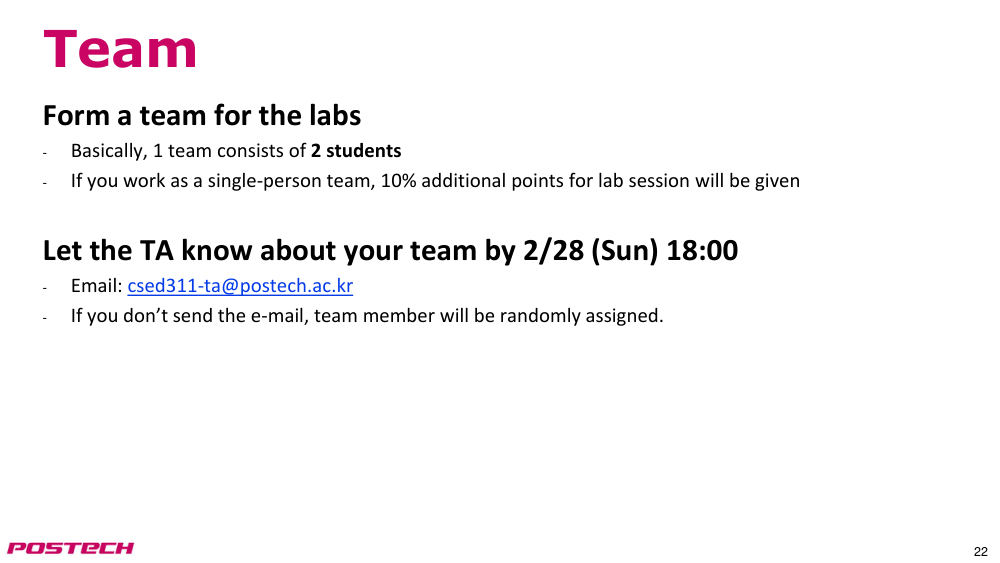
- 랩을 위한 팀 구성
- - 일반적으로 1팀은 2명으로 구성
- - 1인 팀으로 활동할 경우, 랩 수업에서 10% 추가 점수 제공
- 팀 구성은 2/28 (일) 18:00까지 TA에게 알리기
- - 이메일: csed311-ta@postech.ac.kr
- - 이메일 미발송 시, 팀원은 무작위로 배정됨
p.23면책 조항
- 슬라이드는 Carnegie Mellon University, University of Michigan, Purdue University, University of Pennsylvania, University of Wisconsin, and POSTECH의 Austin, Brehob, Falsafi, Hill, Hoe, Lipasti, Martin, Roth, Shen, Smith, Sohi, Tyson, Vijaykumar, Wenisch 교수진의 일부 자료를 바탕으로 개발됨.
- 시작해 봅시다!
p.24컴퓨터란 무엇인가?
- 컴퓨터: 계산 기계; 특히 수학적 또는 논리적 연산을 수행하는 자동 electronic device(전자 장치); 일반적으로 '아날로그', '디지털', '전자 컴퓨터'와 같은 정의어가 앞에 붙음.
- --- 옥스포드 영어 사전, 약 2000년
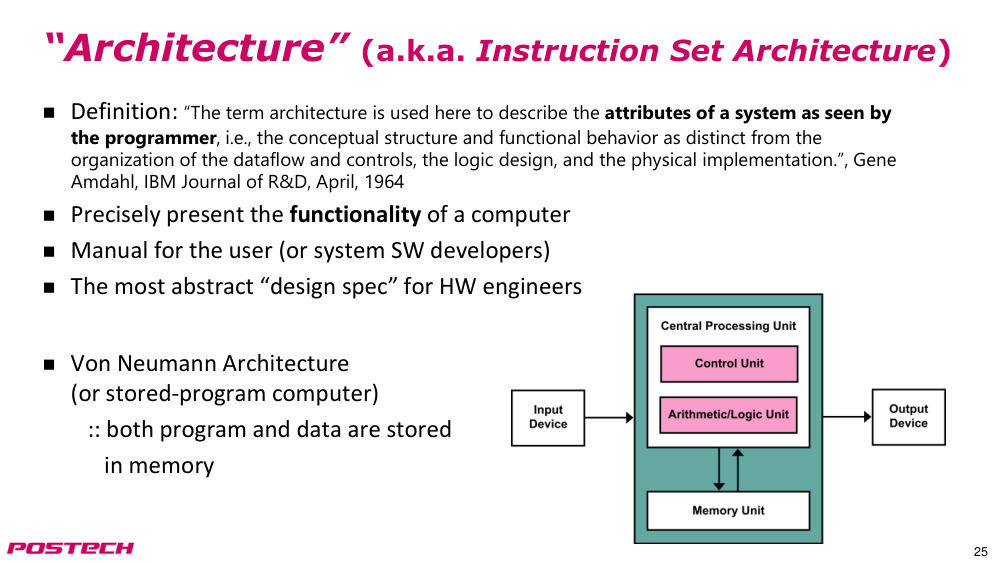
p.25컴퓨터 아키텍처 (명령어 집합 아키텍처)
- 정의: "아키텍처라는 용어는 여기서 프로그래머가 보는 시스템의 속성을 설명하기 위해 사용되며, 즉 데이터 흐름과 제어, 논리 설계, 물리적 구현과는 구분되는 개념적 구조와 기능적 동작을 의미한다." - Gene Amdahl, IBM Journal of R&D, 1964년 4월
- 컴퓨터의 기능을 정확히 표현한다
- 사용자(또는 시스템 소프트웨어 개발자)를 위한 매뉴얼
- 하드웨어 엔지니어를 위한 가장 추상적인 "설계 사양"
- Von Neumann 아키텍처 (또는 저장 프로그램 컴퓨터): 프로그램과 데이터가 모두 메모리에 저장된다
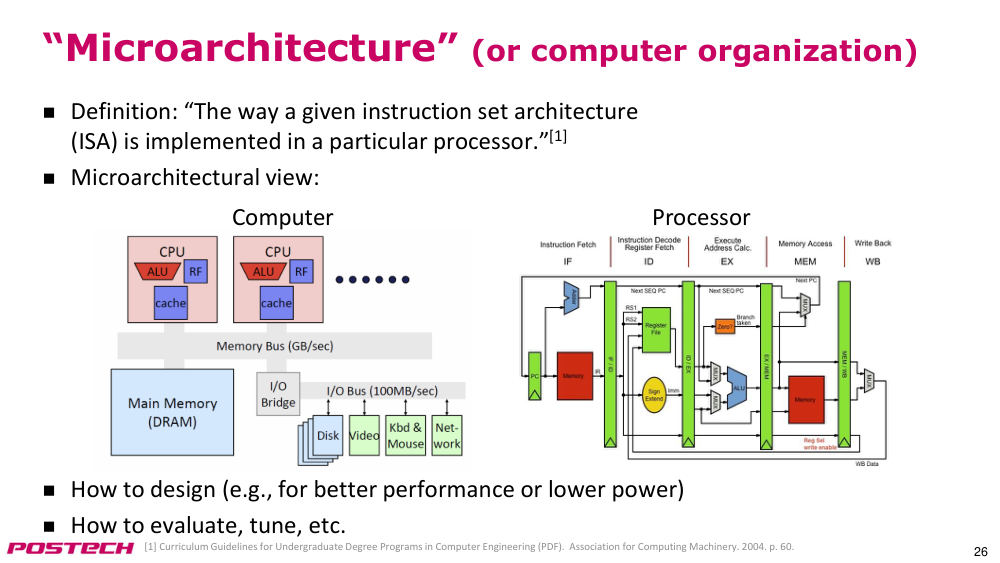
p.26마이크로아키텍처 (또는 컴퓨터 조직)
- 정의: "특정 프로세서에서 주어진 명령어 집합 아키텍처(ISA)가 어떻게 구현되는가." [1]
- microarchitecture(마이크로아키텍처)적 관점:
- 성능 향상 또는 전력 저하를 위해 설계하는 방법
- 평가, 튜닝 등의 방법
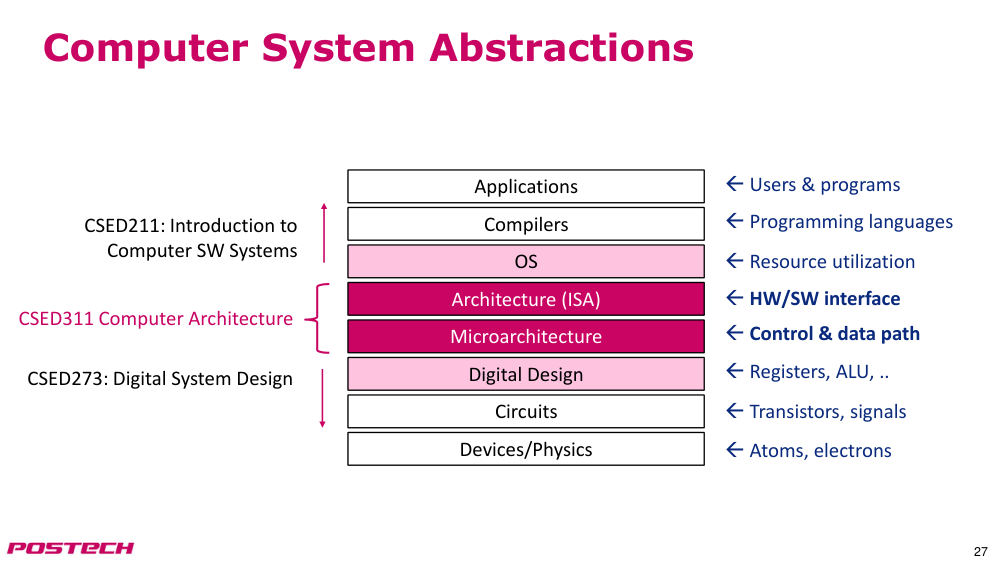
p.27컴퓨터 시스템 추상화
- 응용 프로그램
- 컴파일러
- 운영체제
- 컴퓨터 아키텍처 (ISA)
- microarchitecture(마이크로아키텍처)
- 디지털 설계
- 회로
- 장치/물리학
- CSED311 computer architecture(컴퓨터 아키텍처)
- 사용자 및 프로그램
- 프로그래밍 언어
- 자원 활용
- Hardware-Software interface(하드웨어-소프트웨어 인터페이스)
- 제어 및 datapath(데이터 경로)
- register(레지스터), ALU 등
- transistors(트랜지스터), signals(신호)
- atoms(원자), electrons(전자)
- CSED211: 컴퓨터 소프트웨어 시스템 개론
- CSED273: digital system design(디지털 시스템 설계)
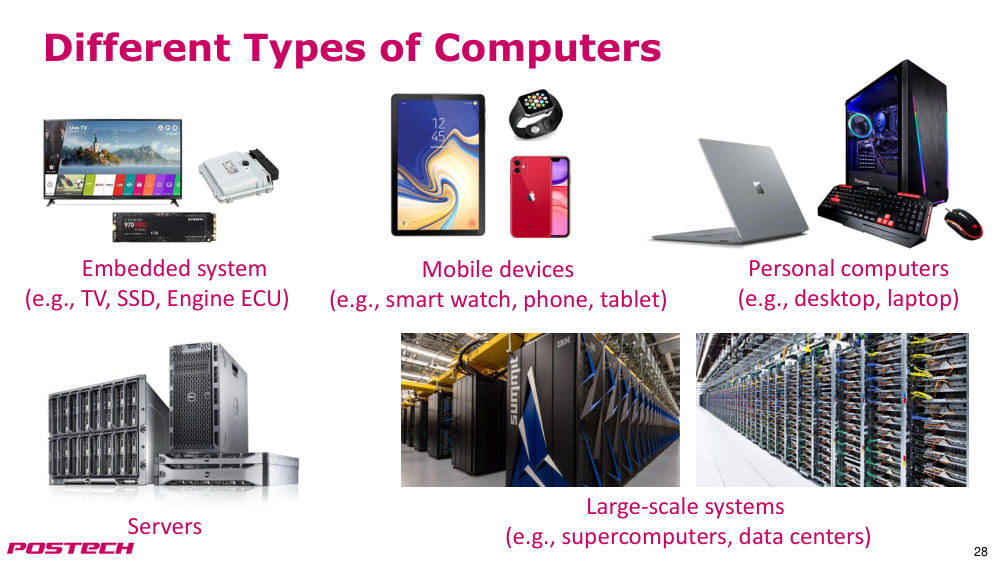
p.28컴퓨터의 다양한 유형
- 임베디드 시스템 (예: TV, SSD, 엔진 ECU)
- 모바일 장치 (예: 스마트워치, 스마트폰, 태블릿)
- 개인용 컴퓨터 (예: 데스크탑, 노트북)
- 서버
- 대규모 시스템 (예: supercomputer(슈퍼컴퓨터), 데이터 센터)
p.29역사적 관점: 현대 computer architecture(컴퓨터 아키텍처)의 전조
p.30컴퓨터 기술 전망의 함정
- "나는 아마도 다섯 대 정도의 컴퓨터가 전 세계 시장에 필요할 것이라고 생각한다." - Thomas Watson, IBM 회장, 1943년
- "집에 컴퓨터가 필요할 이유는 아무도 없을 것이다." - Ken Olsen, DEC 창립자, 1977년
- "DOS는 RAM을 1MB까지만 지원하는 이유는 더 많은 메모리가 필요한 애플리케이션이 상상할 수 없기 때문이다." - Microsoft, 1980년
- "640K는 누구에게나 충분할 것이다." - Bill Gates, 1981년
- "32비트 머신은 개인용 컴퓨터에 과잉이다." - Sol Libes, ByteLines
p.31디지털 컴퓨팅의 시작
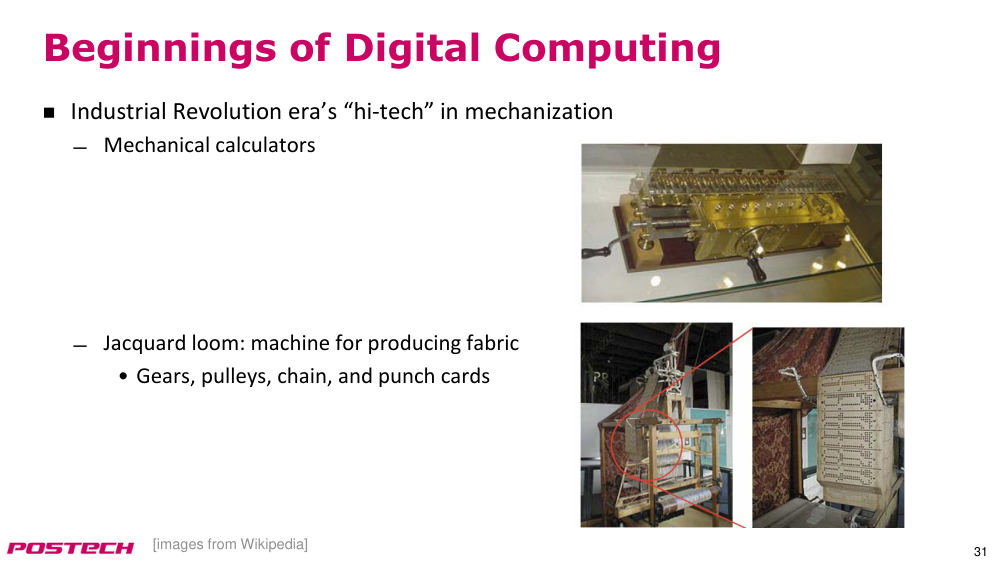
- 산업혁명 시대의 '최첨단 기술'은 기계화였다
- 기계식 계산기
- Jacquard 직물기: 직물을 생산하는 기계
- • 기어, 풀리, 체인, punch card(천공 카드)
p.32Charles Babbage (1791-1871)
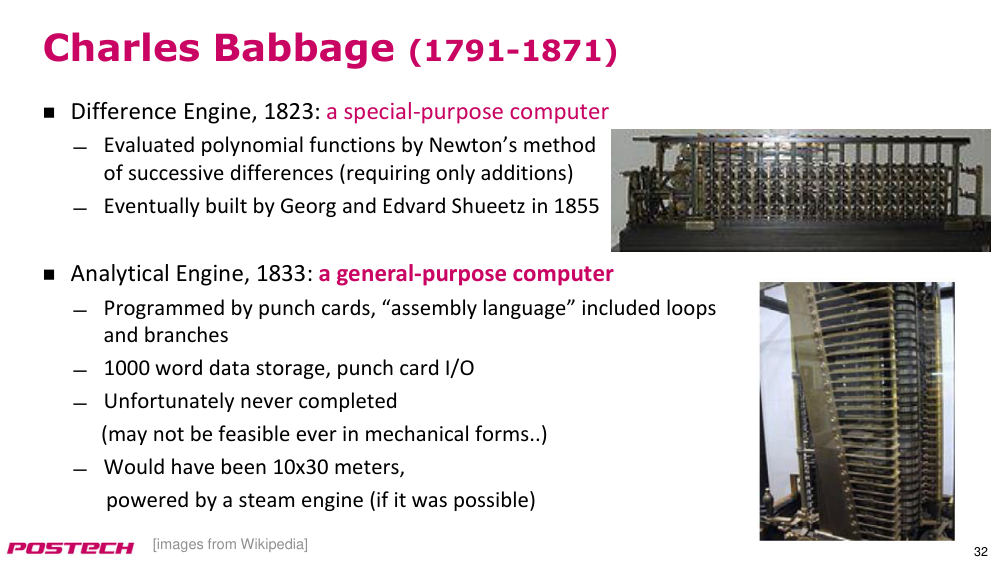
- 차이 기계(Difference Engine), 1823: 특수 목적 컴퓨터
- Newton의 차분법을 이용해 다항함수를 평가 (단지 덧셈만 필요)
- 최종적으로 Georg and Edvard Shueetz가 1855년에 완성
- 분석 기계(Analytical Engine), 1833: 일반 목적 컴퓨터
- punch card(천공 카드)로 프로그래밍, assembly language(어셈블리 언어)에 loop(루프)와 branch(분기) 포함
- 1000 word(워드) 데이터 저장, punch card(천공 카드) I/O(입출력)
- 안타깝게도 완성되지 못함 (기계적 형태로는 실현 가능하지 않을 수도 있음)
- 10m × 30m 크기, 증기기관으로 구동 (만약 가능했다면)
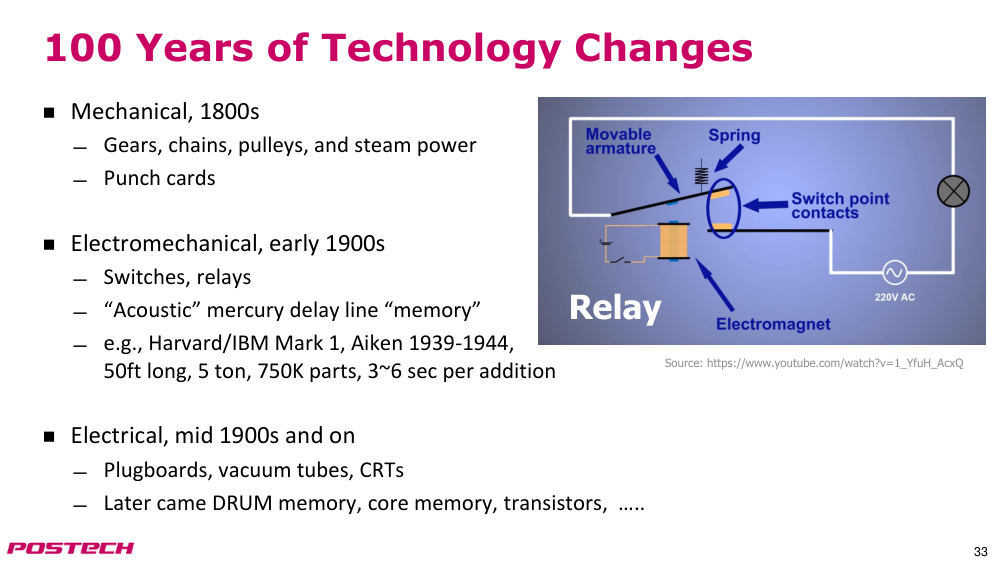
p.33100년간의 기술 변화
- 기계적, 1800년대
- 기어, 체인, 풀리, 증기력
- punch card(천공 카드)
- 전기기계적, 1900년대 초
- 스위치, relay(릴레이)
- ‘음향적’ 수은 지연선 ‘메모리’
- 예: Harvard/IBM Mark 1, Aiken 1939-1944, 50피트 길이, 5톤, 75만 개 부품, 덧셈당 3~6초
- 전기적, 1950년대 중반 이후
- 플러그보드, 진공관, CRT
- 이후 드럼 메모리, 코어 메모리, transistors(트랜지스터) 등 등장
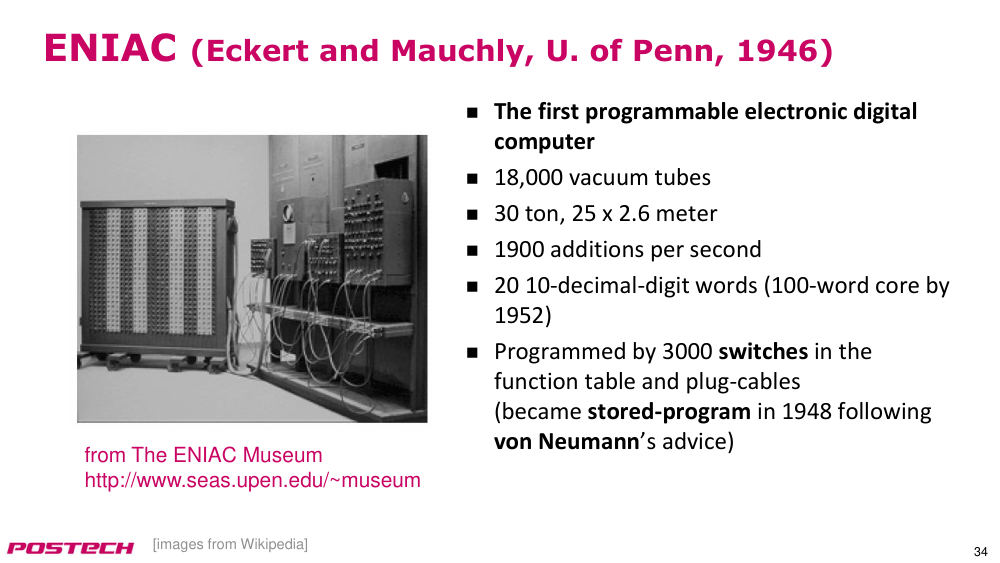
p.34ENIAC (Eckert and Mauchly, U. of Penn, 1946)
- 최초의 programmable electronic digital computer(프로그래밍 가능한 전자식 디지털 컴퓨터)
- 18,000개의 진공관
- 30톤, 25 × 2.6미터
- 초당 1900회 덧셈
- 20개의 10자리 십진수 단어 (1952년에는 100단어 코어)
- 기능 테이블과 플러그 케이블의 3000개 스위치로 프로그래밍
- (1948년 Von Neumann의 조언을 따르며 저장 프로그램 형태로 전환됨)
p.351940~1950년대의 확산
- U. of Penn Moore School of Engineering 출신
- ENIAC, Eckert & Mauchly, 1946
- EDVAC, Von Neumann, 1944~1952
- EDSAC, Wilkes, 1949 (최초의 저장 프로그램 컴퓨터)
- IAS, Bigelow, 1952
- ORDVAC, SEAC, MANICA, JOHNICA, ILLIAC 등
- 그들만이 아니다
- ABC, Atanasoff and Berry, 1939~1942
- Z3, Z4, Konrad Zuse, 1930년대 후반 ~ 1940년대 초
- Colossus, Alan Turing, 1943
- Harvard Mark I, Aiken
- 소프트웨어 발전도 잊지 말 것
- FORTRAN (1954), C (1973), C++ (1983), JAVA (1995)
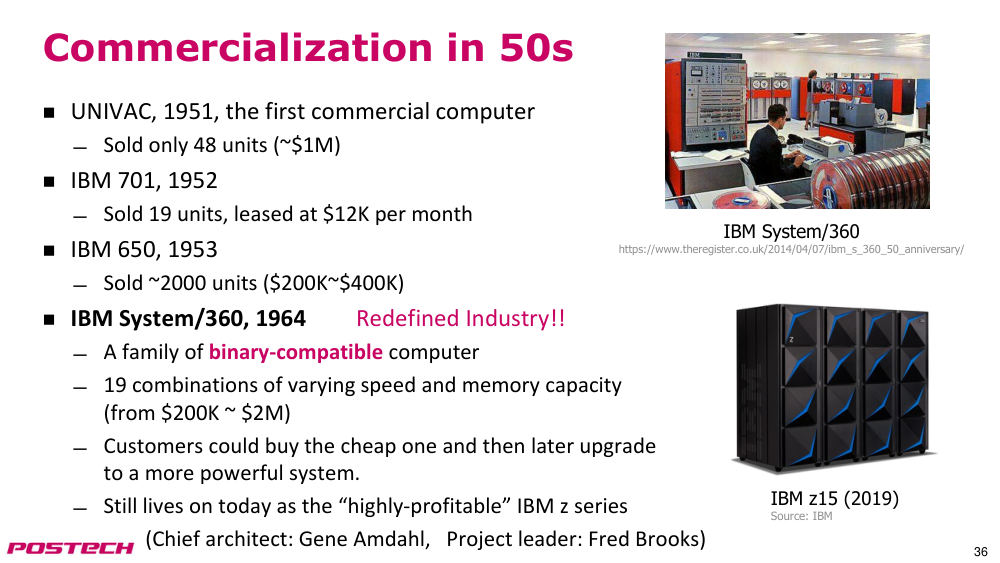
p.361950년대의 상용화
- UNIVAC, 1951, 최초의 상용 컴퓨터
- 전체 48대 판매 (~100만 달러)
- IBM 701, 1952
- 19대 판매, 월 12,000달러 렌탈
- IBM 650, 1953
- 약 2,000대 판매 (20만~40만 달러)
- IBM System/360, 1964
- 산업을 재정의했다!!
- 이진 compatibility(호환성) 있는 컴퓨터 패밀리
- 속도와 메모리 용량이 다른 19가지 조합 (20만~200만 달러)
- 고객은 저렴한 제품을 구매한 후 나중에 더 강력한 시스템으로 업그레이드 가능
- 오늘날까지도 ‘매우 수익성 높은’ IBM z 시리즈로 이어짐
- 주요 설계자: Gene Amdahl, 프로젝트 리더: Fred Brooks
p.371960~70년대의 저렴하거나 빠른 컴퓨터
- minicomputer(미니컴퓨터)
- DEC PDP-8, 1965, $20K, 대형 냉장고 크기
- mainframe(메인프레임)보다 성능은 낮지만 10배 저렴
- 부서용 컴퓨터, time-sharing(시분할)
- PDP-11과 VAX는 1970~80년대에 매우 인기 있음
- supercomputer(슈퍼컴퓨터)
- 성능을 최우선으로! (ECL, 액체 냉각, 수작업 제작 등)
- 주요 고객: 국가 안보, 핵무기, 암호학, 항공우주, 석유, 자동차, 제약 과학 등
- Seymour Cray, 1925~1996
- UNIVAC에서 일한 후 CDC6600 및 7600 개발
- 현재도 사용되는 고성능 기법의 선구자
- Cray Research Inc. → Cray Computer Corp → Cray Inc. (2019년 HP Enterprise에 인수)
p.38초기 사례
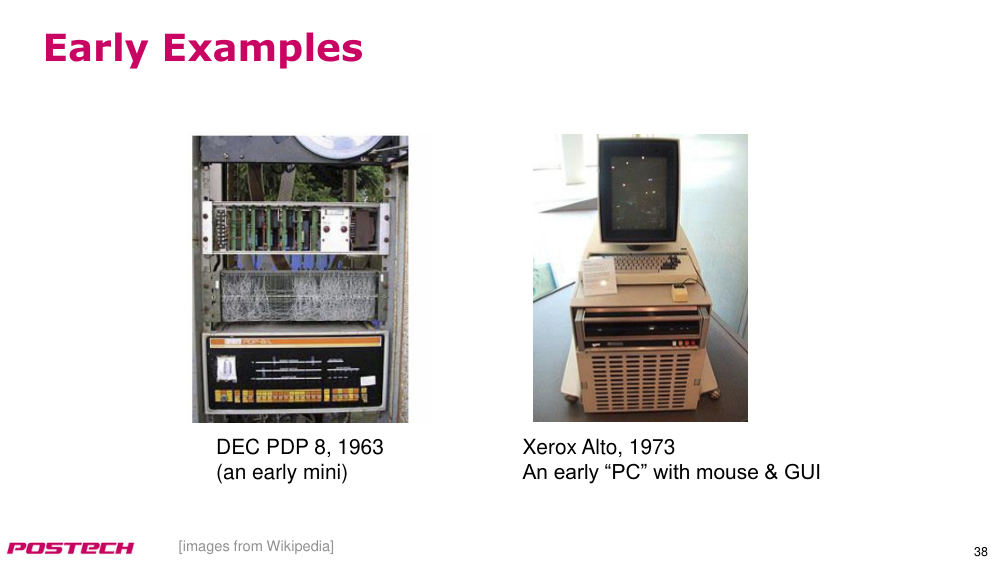
- DEC PDP 8, 1963
- (초기 minicomputer(미니컴퓨터))
- Xerox Alto, 1973
- 마우스와 GUI를 갖춘 초기 'PC'
p.39Cray 3, 1993
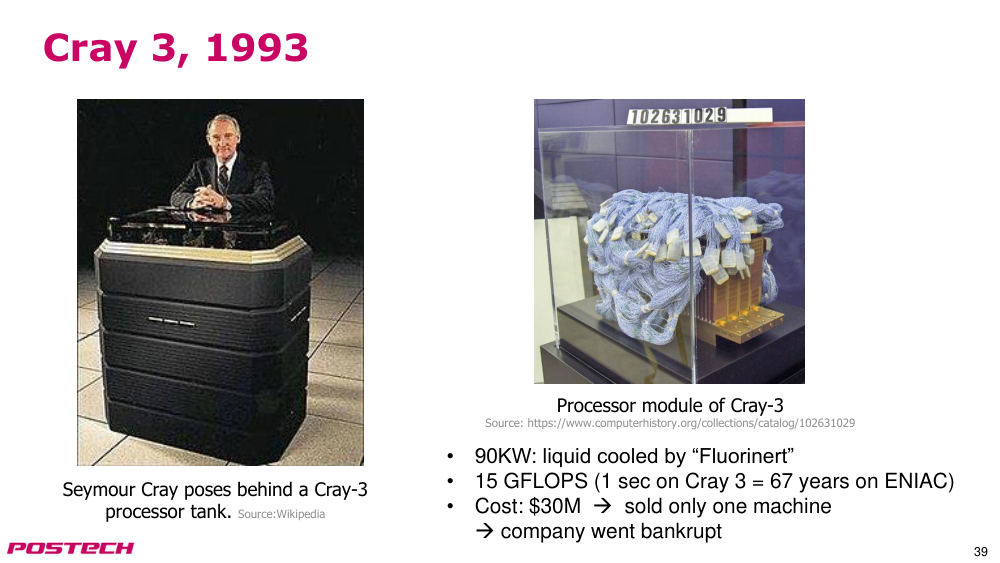
- 90KW: 'Fluorinert'로 액체 냉각
- 15 GFLOPS (Cray 3에서 1초 = ENIAC에서 67년)
- 비용: $30M → 단 1대만 판매
- 회사는 파산
p.401970년대 이후의 '킬러 마이크로'들
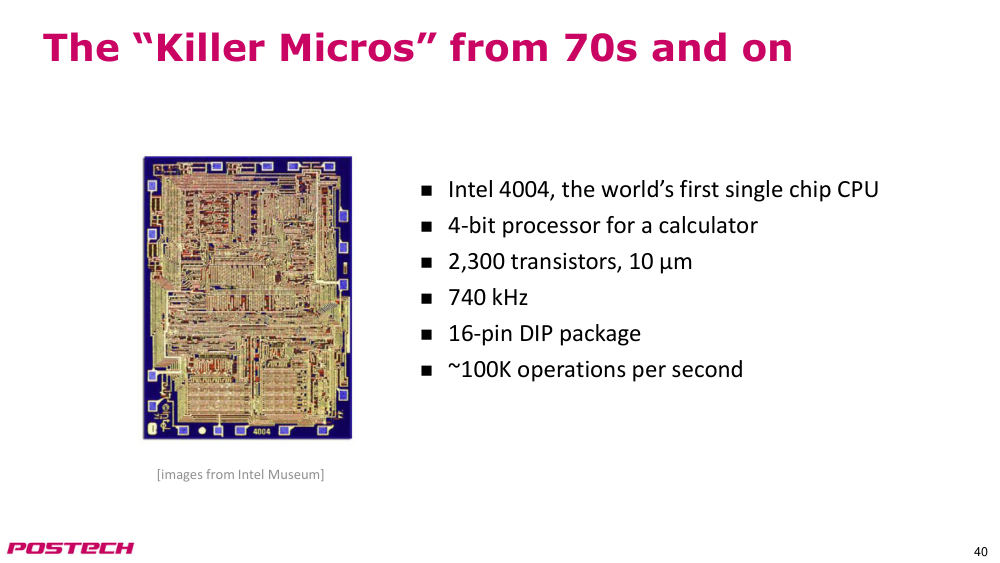
- Intel 4004, 세계 최초의 단일 칩 CPU
- 계산기용 4비트 프로세서
- 2,300개 transistors(트랜지스터), 10 μm
- 740 kHz
- 16핀 DIP 패키지
- ~10만 회의 연산 per 초
p.41Intel 8080, 80286, Pentium
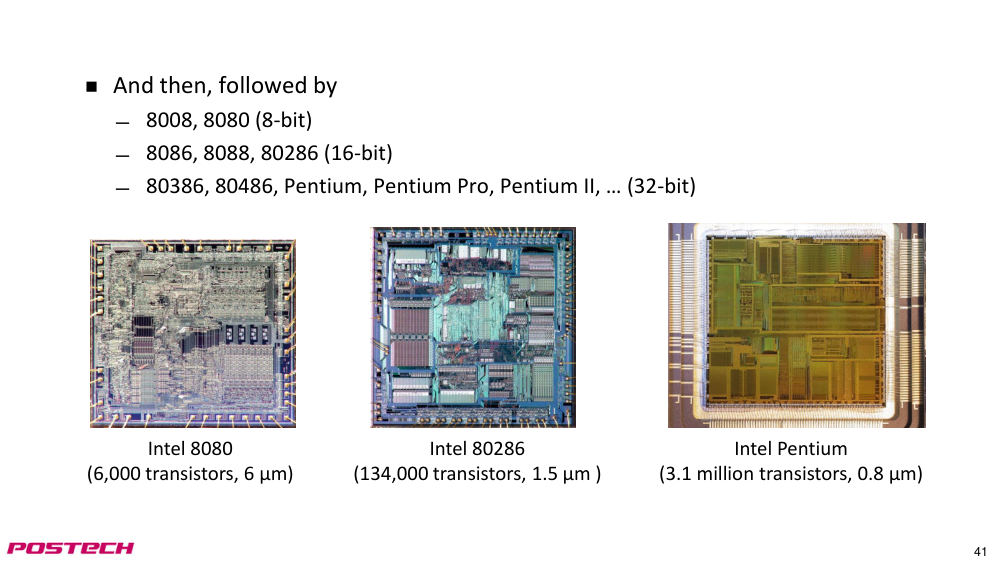
- Intel 8080 (6,000개 transistors(트랜지스터), 6 μm)
- Intel 80286 (134,000개 transistors(트랜지스터), 1.5 μm)
- Intel Pentium (310만 개 transistors(트랜지스터), 0.8 μm)
- 그 후 이어진 제품들
- 8008, 8080 (8비트)
- 8086, 8088, 80286 (16비트)
- 80386, 80486, Pentium, Pentium Pro, Pentium II, … (32비트)
p.42Intel Itanium 아키텍처 (IA-64), 1999-
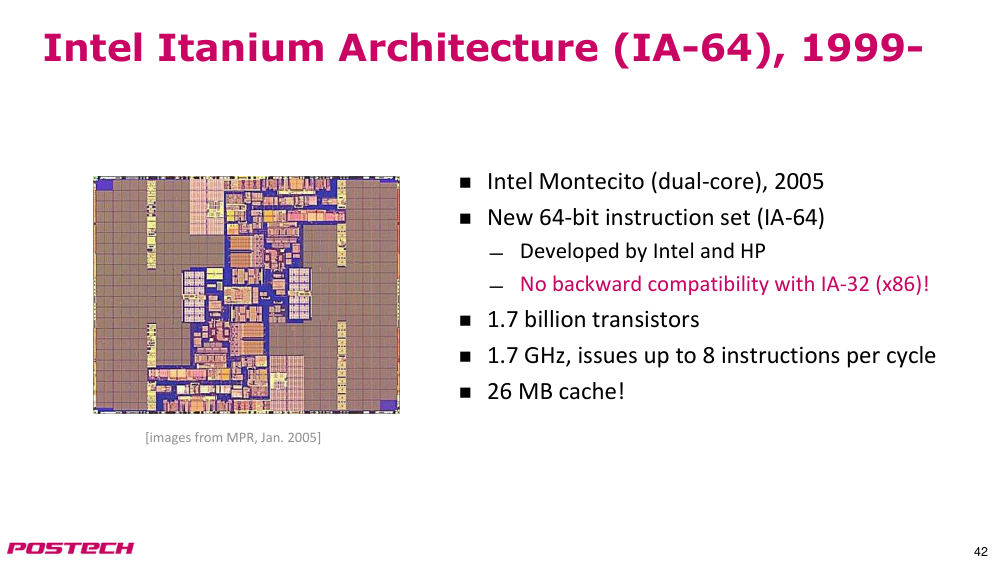
- Intel Montecito (이중 코어), 2005
- 새로운 64비트 명령어 집합 (IA-64)
- Intel과 HP 공동 개발
- IA-32 (x86)와의 역호환성 없음!
- 17억 개 transistors(트랜지스터)
- 1.7 GHz, 사이클당 최대 8개 명령어 처리
- 26MB cache(캐시)!
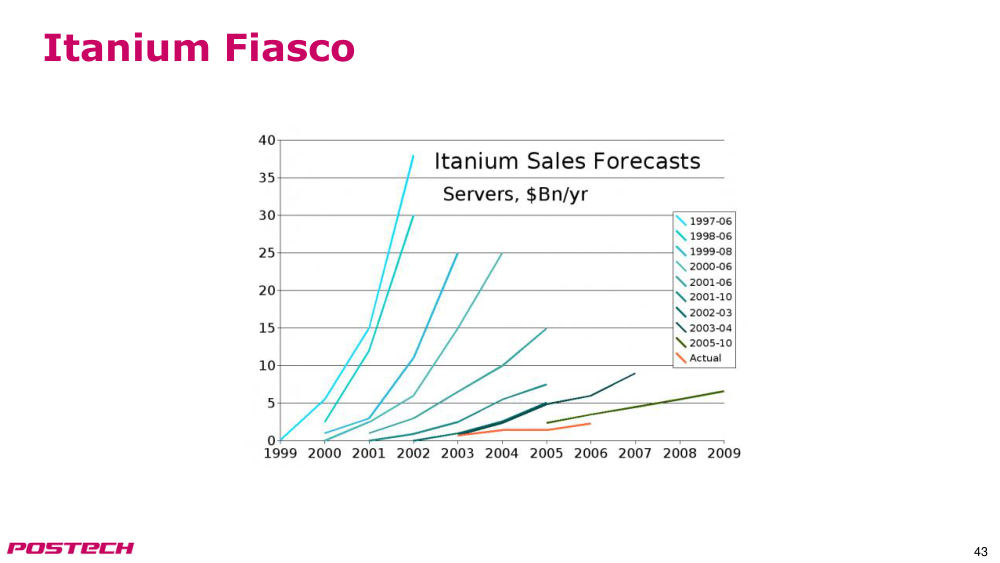
p.43Itanium 실패
p.44AMD64 아키텍처, 2000-
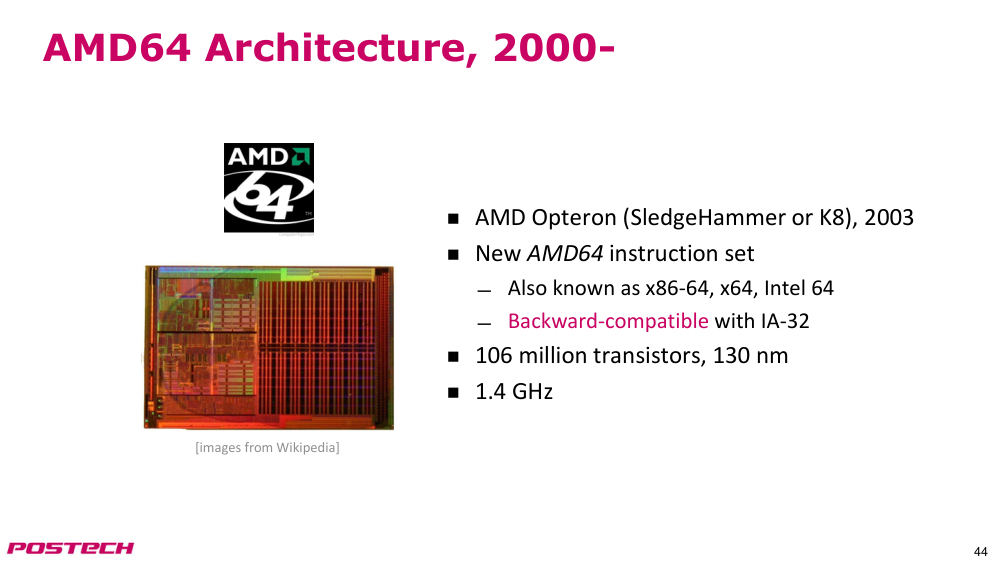
- AMD Opteron (SledgeHammer 또는 K8), 2003
- 새로운 AMD64 instruction set architecture (ISA)(명령어 집합 아키텍처) —
- 또는 x86-64, x64, Intel 64로도 알려짐 —
- IA-32와의 backward compatibility(하위 호환성) 보유
- 1억 600만 개 transistors(트랜지스터), 130 nm
- 1.4 GHz
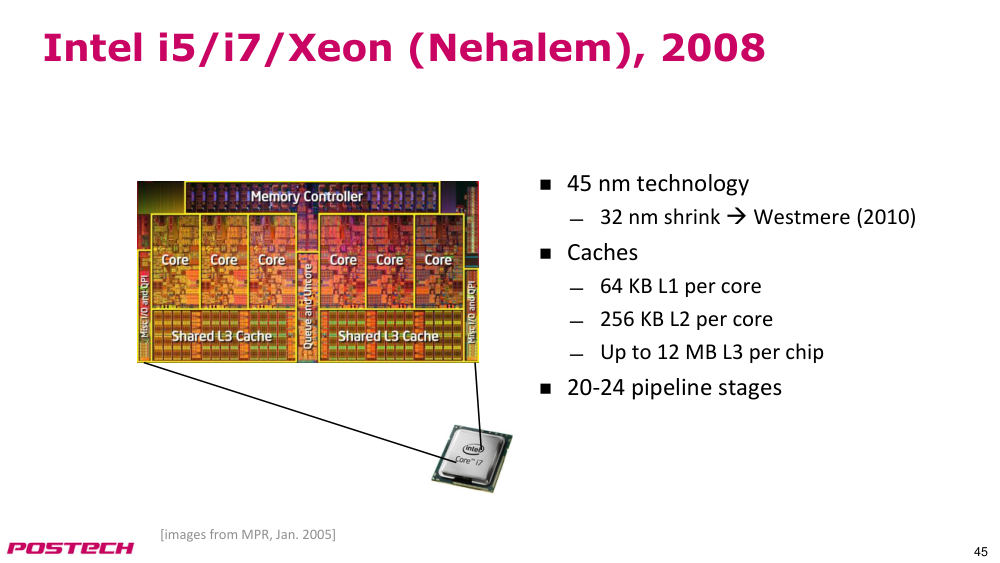
p.45Intel i5/i7/Xeon (Nehalem), 2008
- 45 nm 기술 —
- 32 nm 축소 → Westmere (2010)
- cache(캐시) —
- 코어당 64 KB L1 —
- 코어당 256 KB L2 —
- 칩당 최대 12 MB L3
- 20-24단계 pipelining(파이프라인)
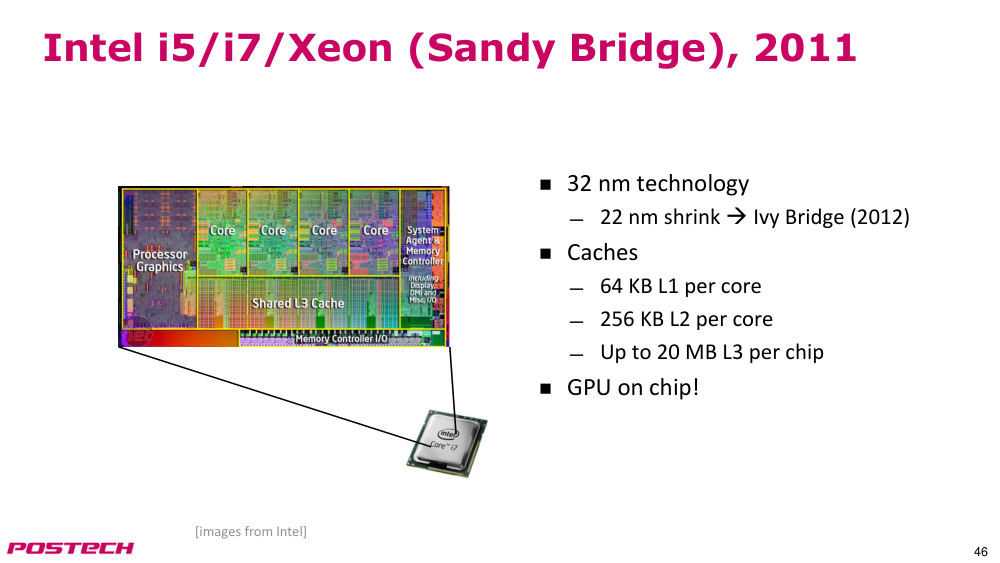
p.46Intel i5/i7/Xeon (Sandy Bridge), 2011
- 32 nm 기술 —
- 22 nm 축소 → Ivy Bridge (2012)
- cache(캐시) —
- 코어당 64 KB L1 —
- 코어당 256 KB L2 —
- 칩당 최대 20 MB L3
- 칩 내 GPU!
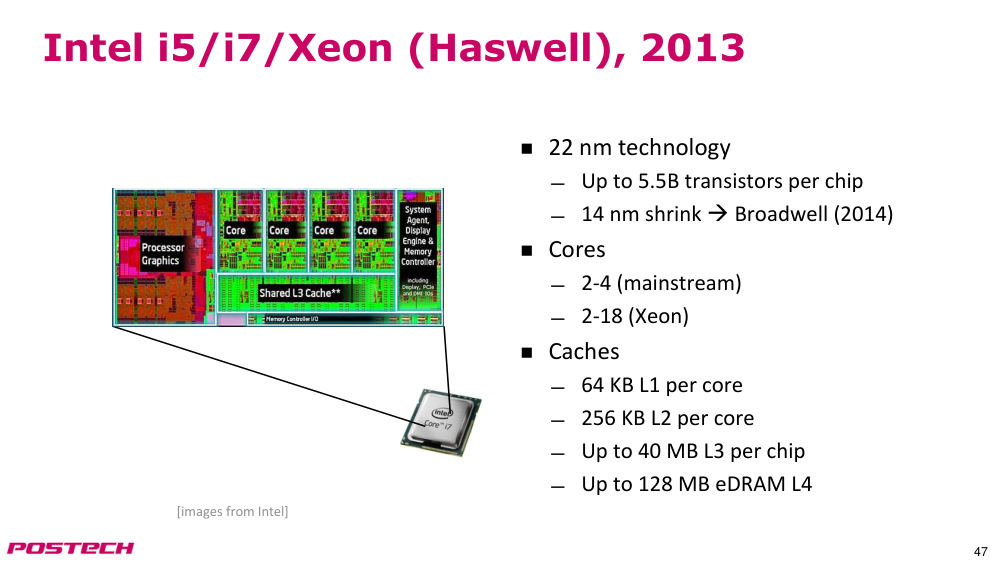
p.47Intel i5/i7/Xeon (Haswell), 2013
- 22 nm 기술 —
- 칩당 최대 55억 개 transistors(트랜지스터) —
- 14 nm 축소 → Broadwell (2014)
- 코어 —
- 2-4 (대중용) —
- 2-18 (Xeon)
- cache(캐시) —
- 코어당 64 KB L1 —
- 코어당 256 KB L2 —
- 칩당 최대 40 MB L3 —
- 칩당 최대 128 MB eDRAM L4
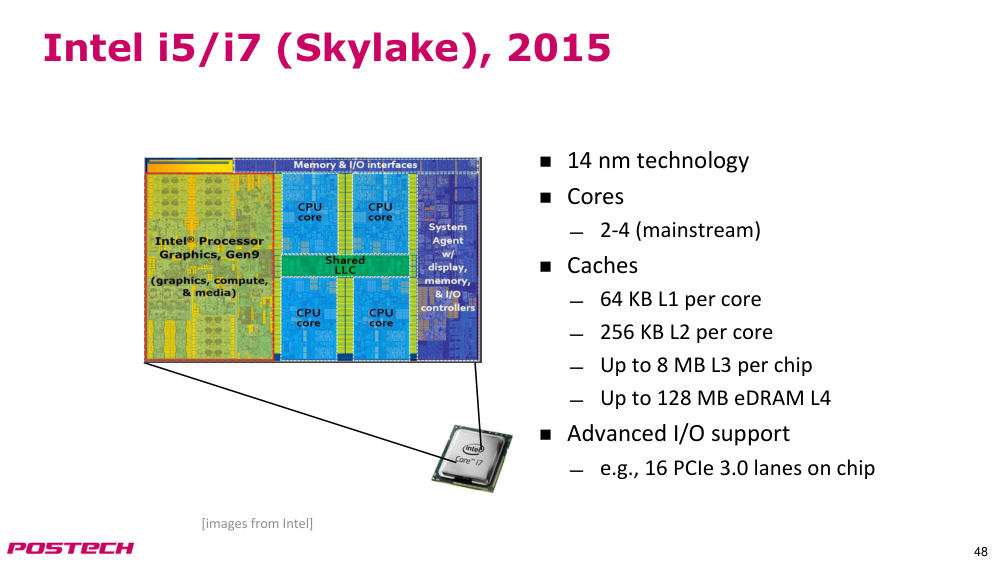
p.48Intel i5/i7 (Skylake), 2015
- 14 nm 기술
- 코어 —
- 2-4 (대중용)
- cache(캐시) —
- 코어당 64 KB L1 —
- 코어당 256 KB L2 —
- 칩당 최대 8 MB L3 —
- 칩당 최대 128 MB eDRAM L4 —
- 고급 입출력 지원 —
- 예: 칩 내 16개의 PCIe 3.0 레인
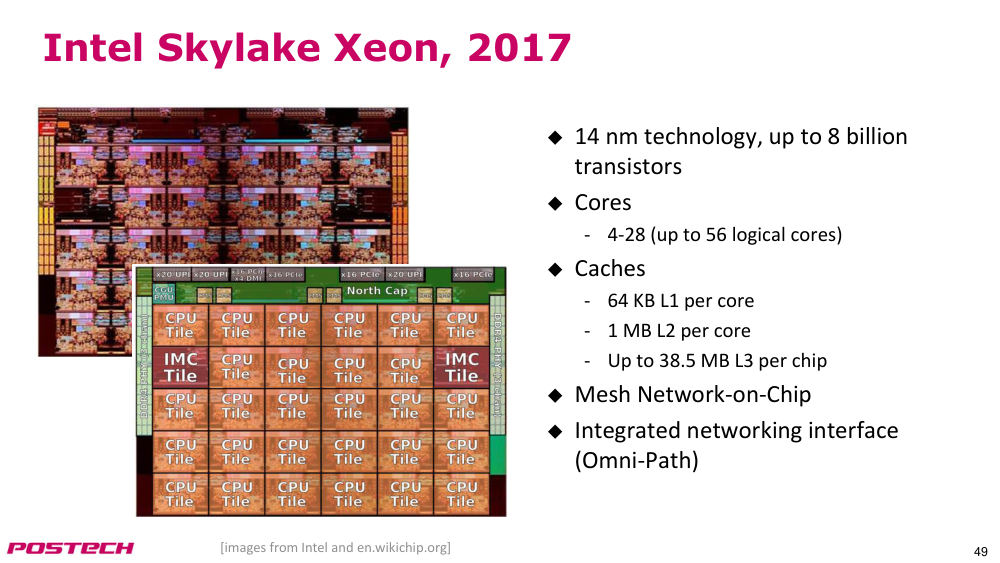
p.49Intel Skylake Xeon, 2017
- 14 nm 기술, 최대 80억 개의 transistors(트랜지스터)
- 코어
- - 4-28개 (최대 56개의 논리 코어)
- cache(캐시)
- - 코어당 64 KB L1
- - 코어당 1 MB L2
- - 칩당 최대 38.5 MB L3
- Mesh Network-on-Chip(메시 네트워크 온 칩)
- 통합 네트워킹 인터페이스 (Omni-Path)
- [이미지 출처: Intel 및 en.wikichip.org]
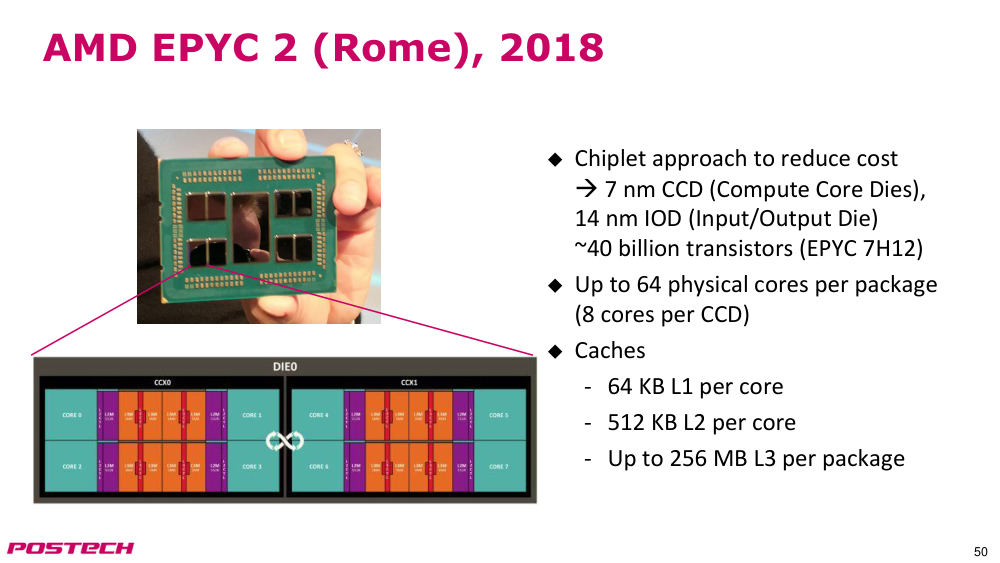
p.50AMD EPYC 2 (Rome), 2018
- 비용 절감을 위한 Chiplet(칩렛) 접근 방식
- → 7 nm CCD (Compute Core Dies), 14 nm IOD (Input/Output Die)
- 약 400억 개의 트랜지스터 (EPYC 7H12)
- 패키지당 최대 64개의 물리적 코어 (CCD당 8개 코어)
- cache(캐시)
- - 코어당 64 KB L1
- - 코어당 512 KB L2
- - 패키지당 최대 256 MB L3
p.51Amazon AWS Graviton 2, 2019
- 7 nm 기술, 약 300억 개의 transistors(트랜지스터)
- 64코어, monolithic chip(모놀리식 칩)
- cache(캐시)
- - 코어당 128 KB L1
- - 코어당 1 MB L2
- - 32 MB L3
- Mesh Network-on-Chip(메시 네트워크 온 칩)
- AWS EC2의 M6g 인스턴스로 제공
- “단일 다이라는 점에서 낮은 평탄한 지연 시간 덕분에, AMD나 인텔 제품보다 고스레드 스케일링 상황에서 훨씬 더 나은 시스템이라고 생각한다. 왜냐하면 NUMA 행동이 거의 없기 때문이다.” -- Linus Torvalds (2020년 3월 10일)
p.52우리는 계속해서 transistors(트랜지스터) 수를 말해왔다…
- 그런데 transistors(트랜지스터)란 과연 무엇인가요?
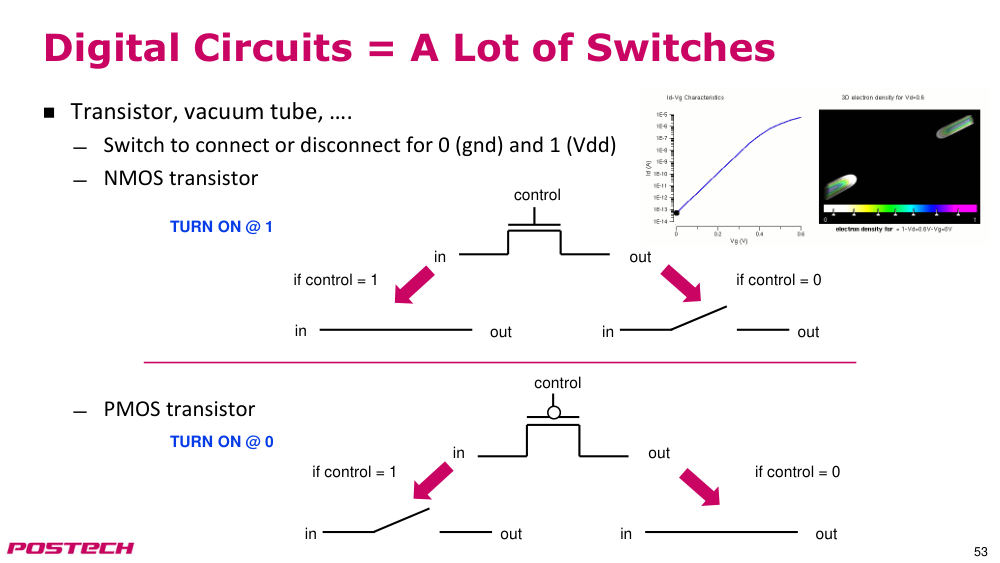
p.53디지털 회로 = 많은 스위치들
- transistors(트랜지스터), 진공관, …
- 0 (GND)과 1 (Vdd)을 연결하거나 차단하는 스위치
- NMOS transistors(트랜지스터)
- PMOS transistors(트랜지스터)
- 입력
- 출력
- 제어
- 입력
- 출력
- 입력
- 출력
- 제어 = 0일 경우
- 제어 = 1일 경우
- 1에서 ON
- 입력
- 출력
- 입력
- 출력
- 입력
- 출력
- 제어 = 0일 경우
- 제어 = 1일 경우
- 0에서 ON
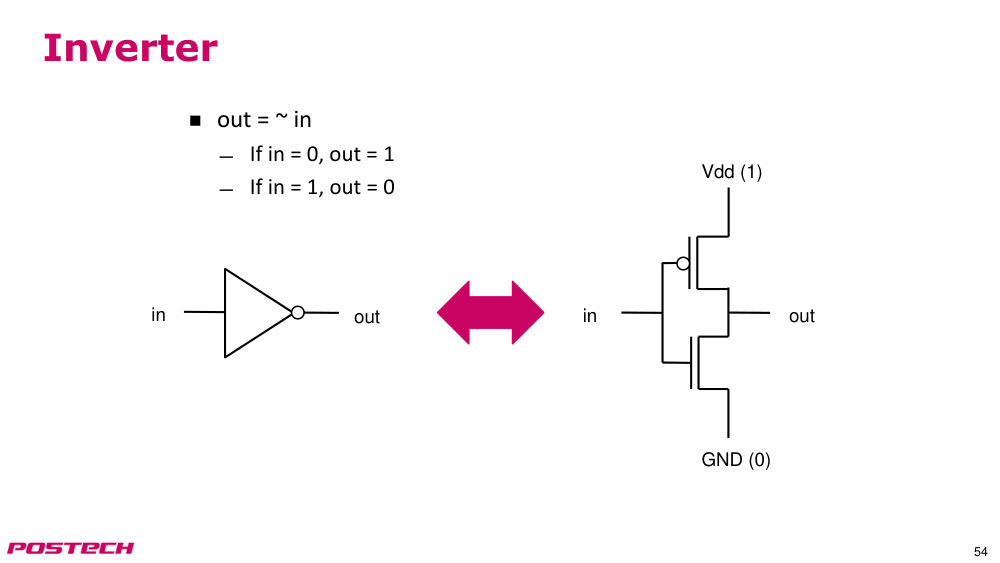
p.54inverter(인버터)
- out = ~in
- 입력 = 0이면 출력 = 1
- 입력 = 1이면 출력 = 0
- 입력
- Vdd (1)
- 출력
- GND (0)
- 입력
- 출력
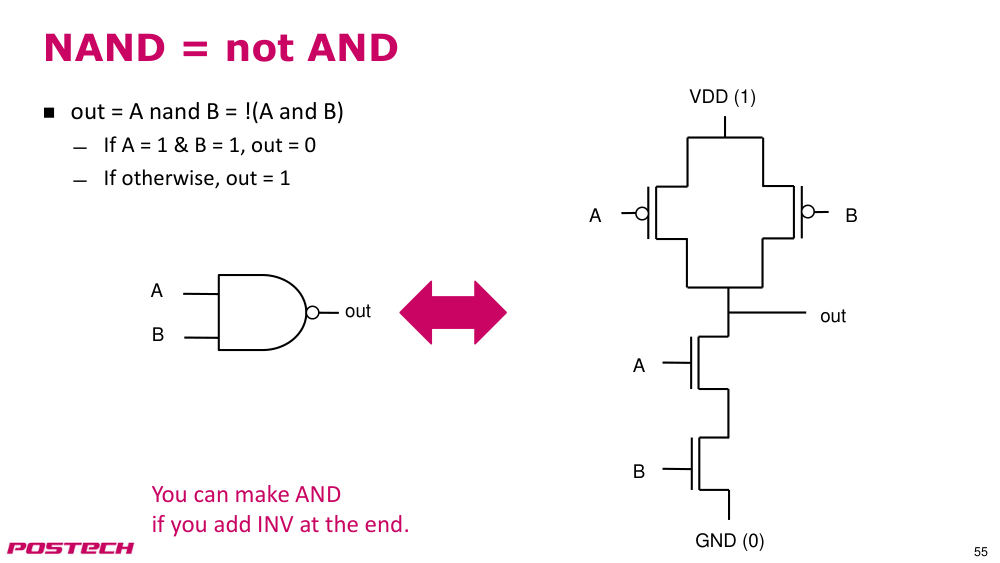
p.55NAND 게이트
- NAND = NOT AND
- out = A nand B = !(A and B)
- A = 1 및 B = 1이면, out = 0
- 그 외의 경우, out = 1
- AND 게이트를 만들려면 끝에 INV 게이트를 추가하면 된다.
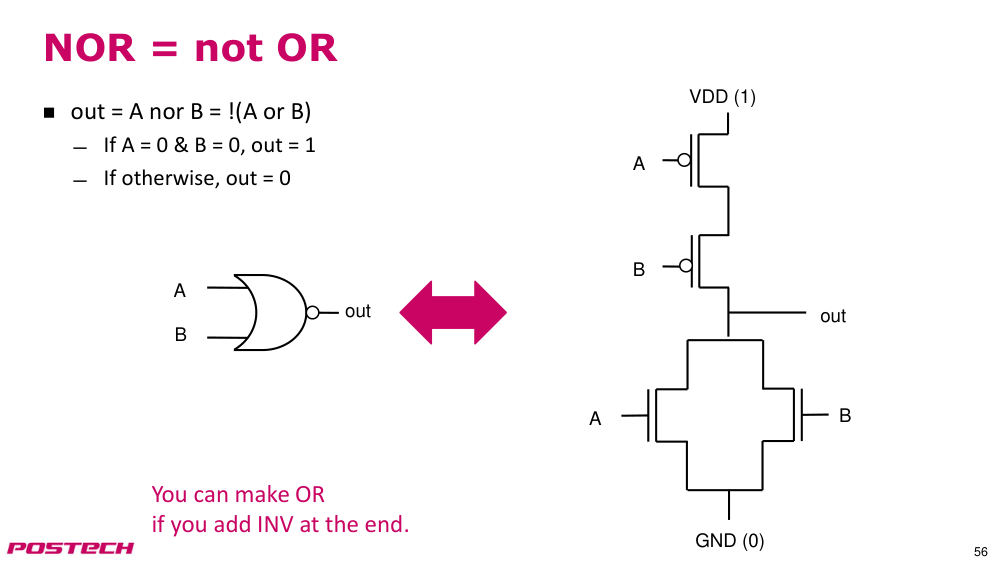
p.56NOR 게이트
- NOR = NOT OR
- out = A nor B = !(A or B)
- A = 0 및 B = 0이면, out = 1
- 그 외의 경우, out = 0
- OR 게이트를 만들려면 끝에 INV 게이트를 추가하면 된다.
p.57기본 게이트의 중요성
- INV, NAND, NOR 게이트를 갖는다면,
- 디지털 논리 장치와 메모리를 구축할 수 있는 모든 것을 갖춘 셈이다.
- → combinational circuits(조합 회로)
- → sequential circuits(순차 회로)
- CPU, 메모리 및 … 모든 것!
p.58computer architecture(컴퓨터 아키텍처)의 도전 과제
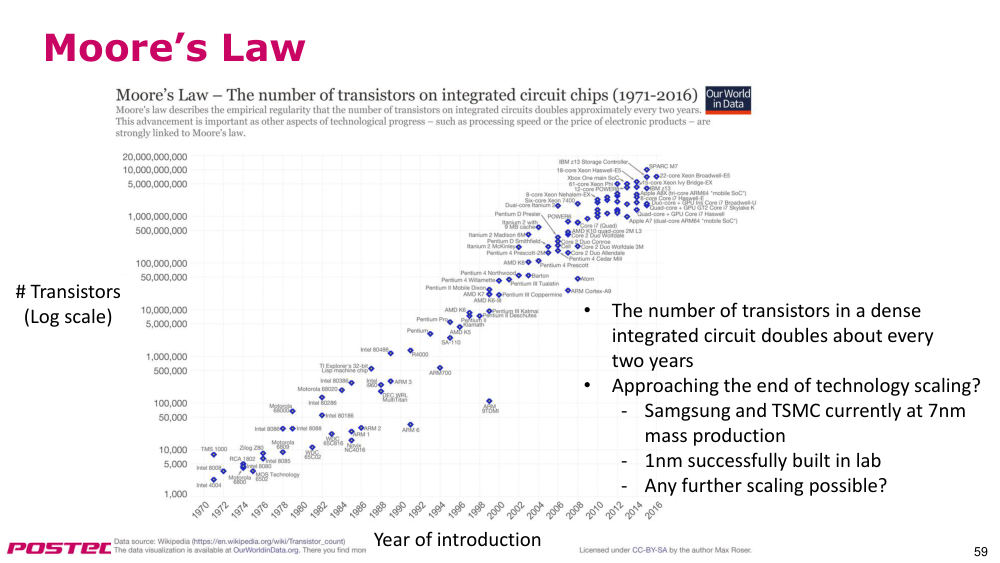
p.59무어의 법칙
- # 트랜지스터 (로그 스케일)
- 출시 연도
- 밀도 높은 집적 회로에 포함된 transistors(트랜지스터) 수는 약 2년마다 두 배로 증가한다.
- 기술 스케일링의 끝이 다가오고 있는가?
- - Samsung과 TSMC는 현재 7nm 대량 생산 중
- - 1nm는 실험실에서 성공적으로 구현됨
- - 더 이상의 스케일링이 가능한가?
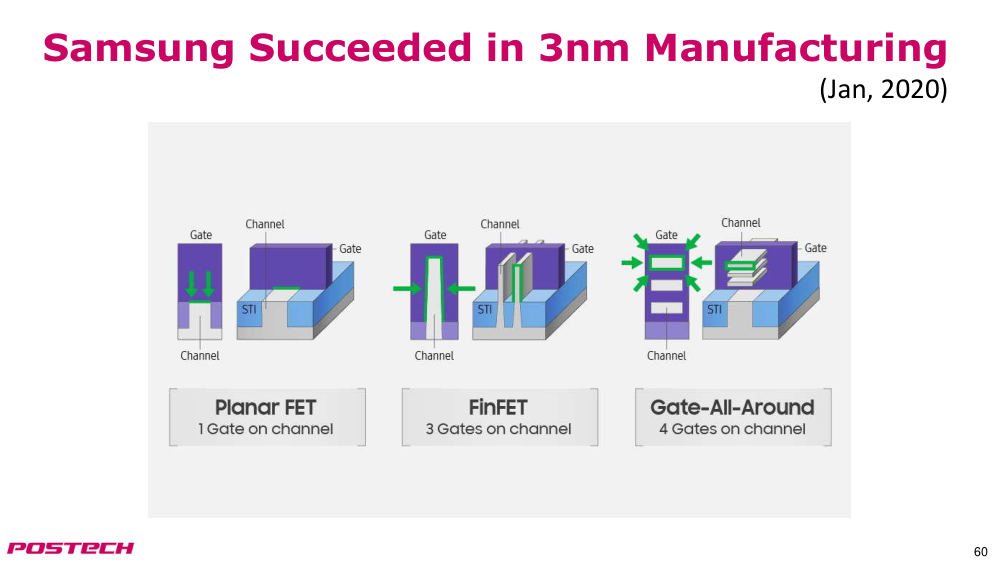
p.60Samsung, 3nm 제조 기술 성공
- (2020년 1월)
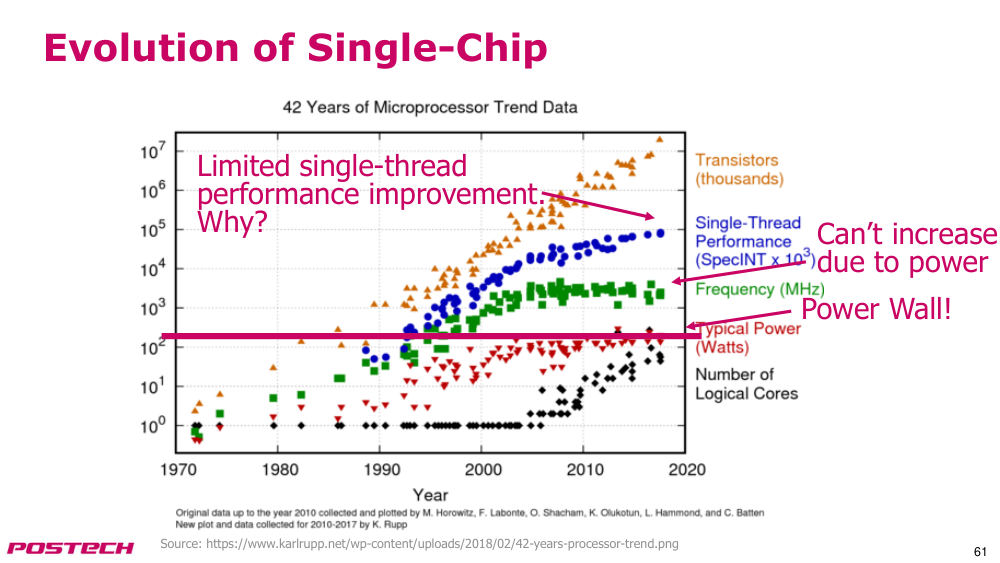
p.61단일 칩의 진화
- 싱글 스레드 성능 향상이 제한됨
- 왜? Power Wall(전력 장벽)!
- 전력 증가가 불가능함
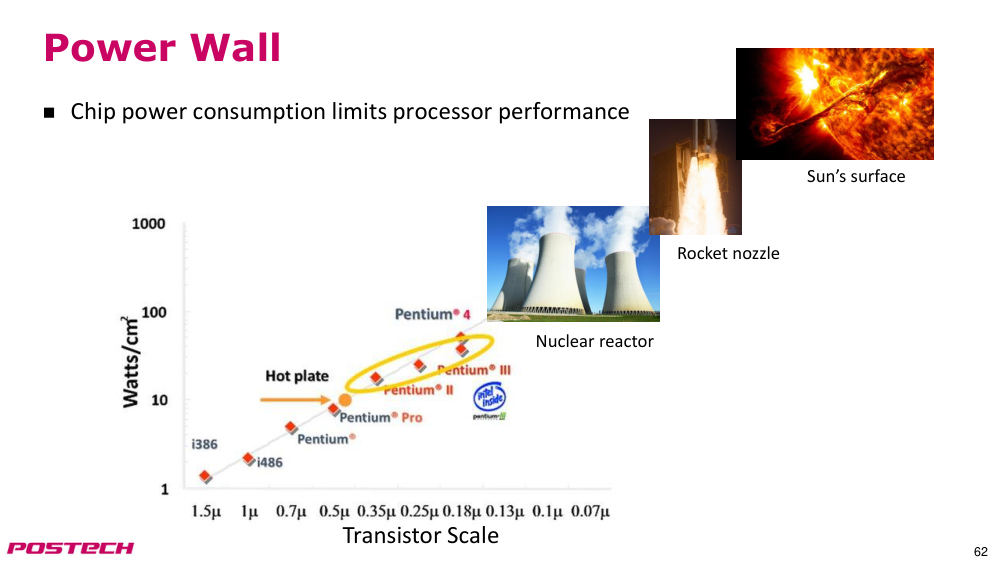
p.62Power Wall(전력 장벽)
- 핵 반응로
- 로켓 노즐
- 태양의 표면
- transistors(트랜지스터) 규모
- 칩의 전력 소비가 프로세서 성능을 제한함
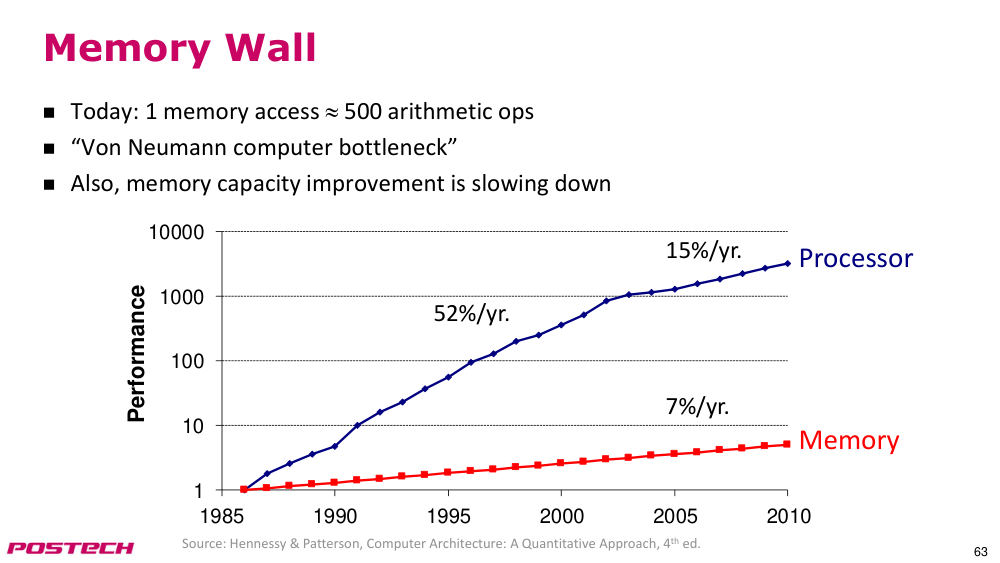
p.63Memory Wall(메모리 장벽)
- 오늘날: 1회의 메모리 접근 ≈ 500회의 산술 연산
- Von Neumann 컴퓨터의 병목 현상
- 또한 메모리 용량 향상 속도도 둔화되고 있음
- 프로세서 성능: 연간 52%
- 메모리 성능: 연간 15%
- 메모리 용량: 연간 7%
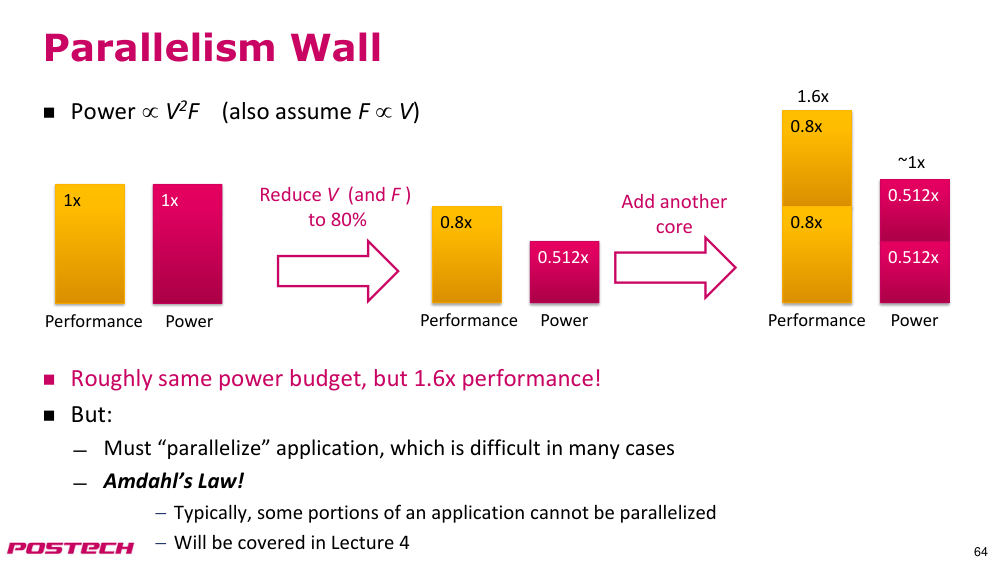
p.64Parallelism Wall(병렬성 장벽)
- 전력 ∝ V²F
- (또한 F ∝ V 라고 가정)
- 대략 동일한 전력 예산 내에서 성능 1.6배 향상!
- 그러나:
- 애플리케이션을 '병렬화'해야 하며, 많은 경우 어려움
- 암다울의 법칙(Amdahl’s Law)!
- - 일반적으로 애플리케이션의 일부는 병렬화할 수 없음
- - 강의 4에서 다룰 예정
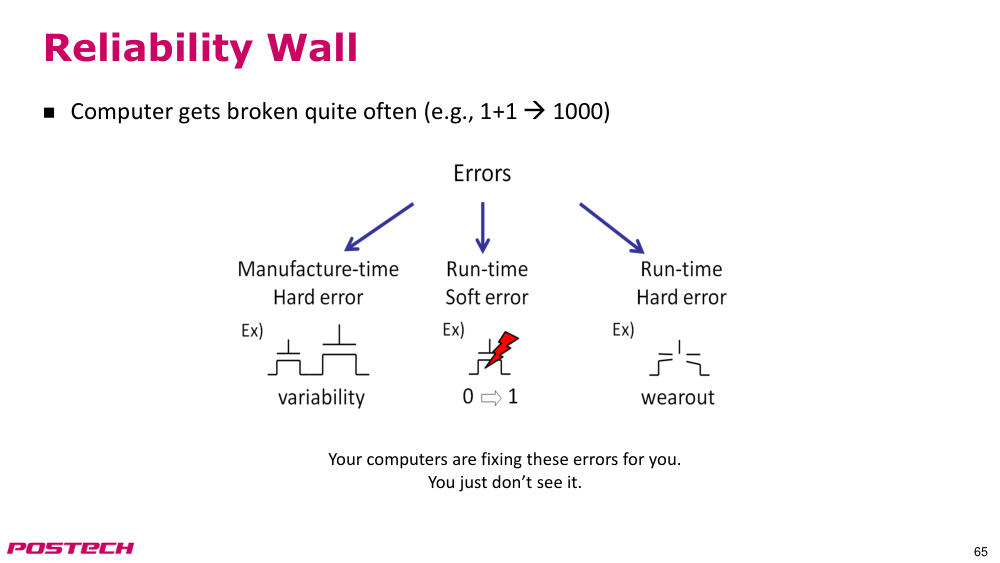
p.65Reliability Wall(신뢰성 장벽)
- 컴퓨터는 자주 고장남 (예: 1+1 → 1000)
- 당신의 컴퓨터는 이러한 오류를 자동으로 수정하고 있음
- 그러나 당신은 그것을 보지 못함
p.66computer architecture(컴퓨터 아키텍처)의 최신 발전
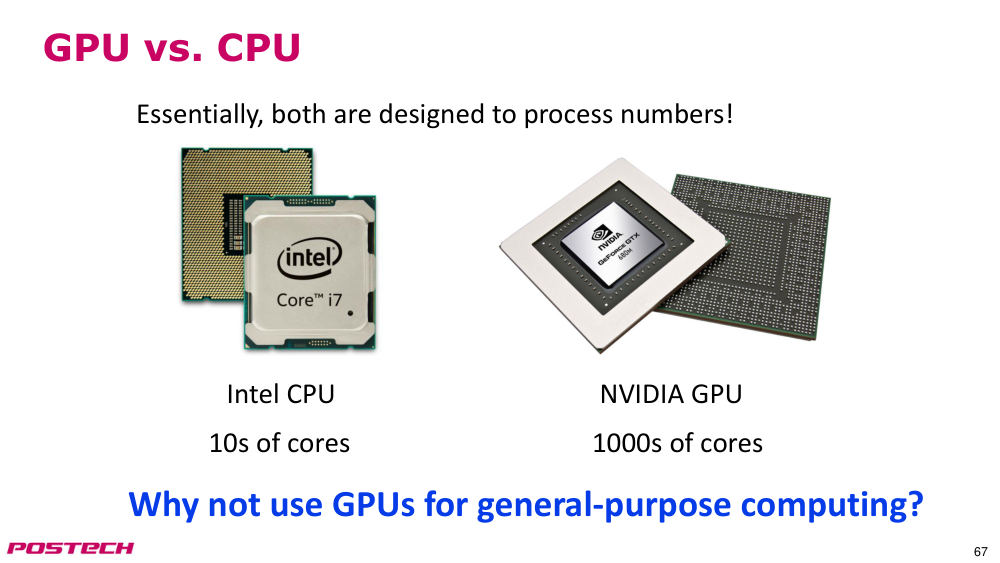
p.67GPU vs. CPU
- NVIDIA GPU
- Intel CPU
- 본질적으로 둘 다 숫자를 처리하도록 설계됨!
- 수천 개의 코어
- 수십 개의 코어
- 왜 일반 목적 계산에 GPU를 사용하지 않을까?
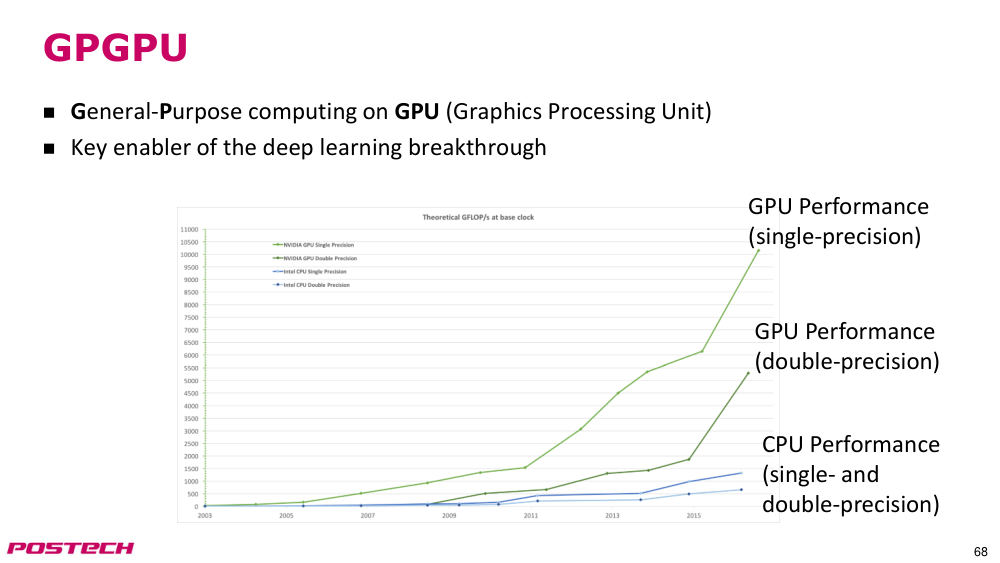
p.68GPGPU
- GPU(그래픽 처리 장치)에서의 일반 목적 계산(GPGPU)
- 심층 학습 혁신의 핵심 추진력
- GPU 성능 (단정밀도)
- GPU 성능 (이중 정밀도)
- CPU 성능 (단정밀도 및 이중 정밀도)
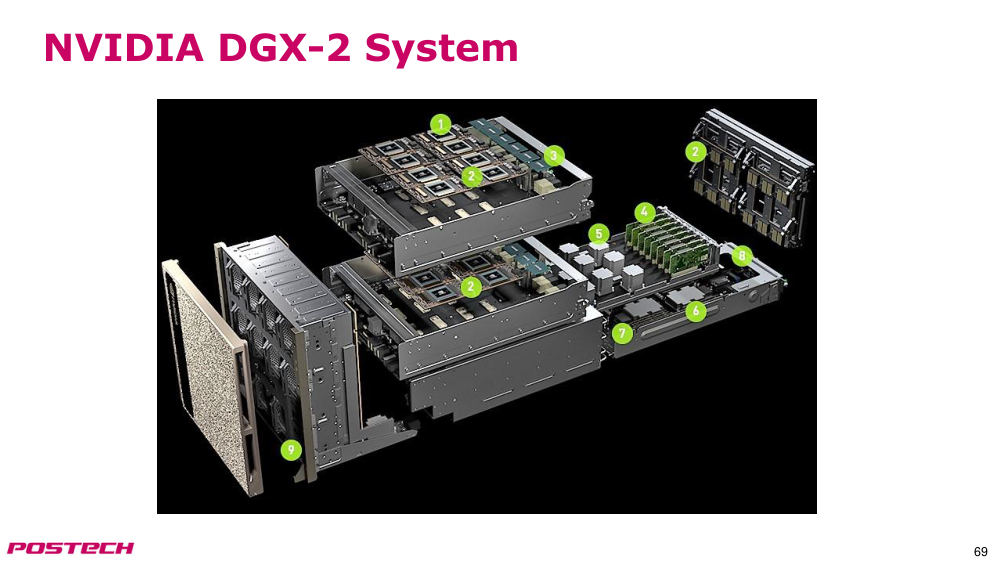
p.69NVIDIA DGX-2 System
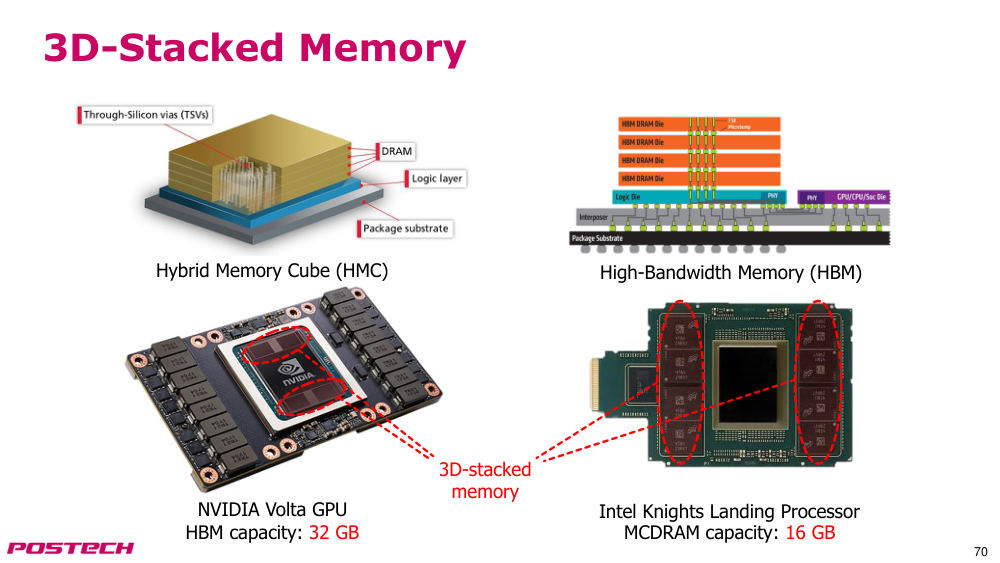
p.703D-Stacked Memory
- NVIDIA Volta GPU
- Intel Knights Landing 프로세서
- 3D-stacked memory(3D 적층 메모리)
- HBM 용량: 32 GB
- MCDRAM 용량: 16 GB
- 하이브리드 메모리 큐브(HMC)
- 고대역폭 메모리(HBM)
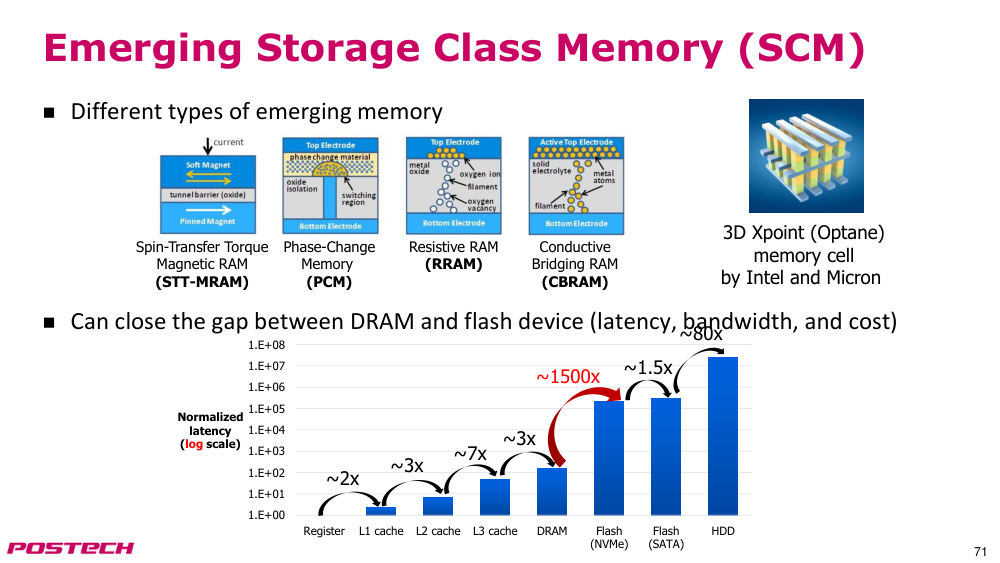
p.71Emerging Storage Class Memory (SCM)
- 다양한 유형의 새로운 메모리
- DRAM과 플래시 장치 사이의 격차를 좁힐 수 있음 (지연, 대역폭, 비용 측면)
- 스핀 전이 토르크 자기 RAM (STT-MRAM)
- phase-change memory(상변화 메모리, PCM)
- 저항성 RAM (RRAM)
- 도전성 브리징 RAM (CBRAM)
- 1.E+00
- 1.E+01
- 1.E+02
- 1.E+03
- 1.E+04
- 1.E+05
- 1.E+06
- 1.E+07
- 1.E+08
- register(레지스터)
- L1 cache(캐시)
- L2 cache(캐시)
- L3 cache(캐시)
- DRAM
- 플래시 (NVMe)
- 플래시 (SATA)
- HDD
- 정규화된 지연 (로그 스케일)
- ~2x
- ~3x
- ~7x
- ~3x
- ~1.5x
- ~80x
- ~1500x
- 3D Xpoint (Optane) 메모리 셀 (Intel과 Micron 공동 개발)
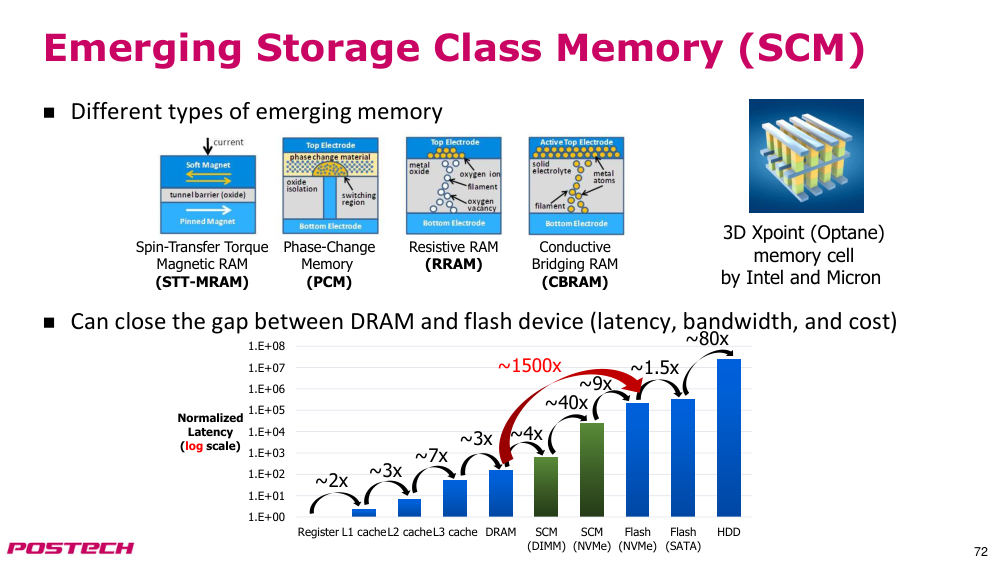
p.72Emerging Storage Class Memory (SCM)
- 다양한 유형의 새로운 메모리
- DRAM과 플래시 장치 사이의 격차를 좁힐 수 있음 (지연, 대역폭, 비용 측면)
- 스핀 전이 토르크 자기 RAM (STT-MRAM)
- phase-change memory(상변화 메모리, PCM)
- 저항성 RAM (RRAM)
- 도전성 브리징 RAM (CBRAM)
- 1.E+00
- 1.E+01
- 1.E+02
- 1.E+03
- 1.E+04
- 1.E+05
- 1.E+06
- 1.E+07
- 1.E+08
- register(레지스터)
- L1 cache(캐시)
- L2 cache(캐시)
- L3 cache(캐시)
- DRAM
- SCM (DIMM)
- SCM (NVMe)
- 플래시 (NVMe)
- 플래시 (SATA)
- HDD
- 정규화된 지연 (로그 스케일)
- ~2x
- ~3x
- ~7x
- ~3x
- ~1.5x
- ~80x
- ~1500x
- ~4x
- ~40x
- ~9x
- 3D Xpoint (Optane) 메모리 셀 (Intel과 Micron 공동 개발)
p.73instruction set architecture (ISA)(명령어 집합 아키텍처)의 혁신
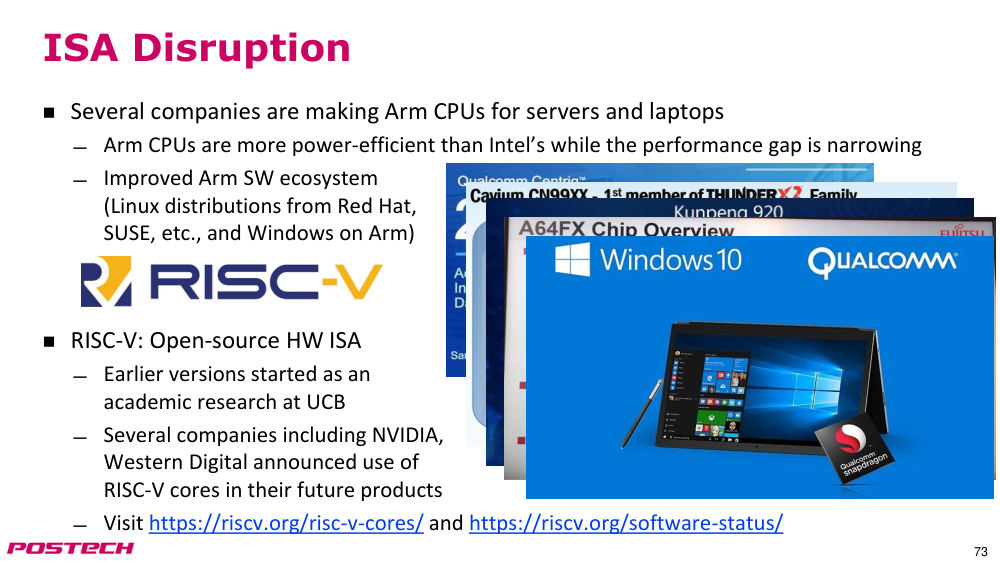
- 여러 회사들이 서버 및 노트북용 Arm CPU를 개발하고 있음
- Arm CPU는 Intel 제품보다 power efficiency(전력 효율성)이 뛰어나며 성능 차이는 점점 좁혀지고 있음
- 개선된 Arm 소프트웨어 생태계 (Red Hat, SUSE 등에서 제공하는 Linux 배포판, Arm용 Windows 포함)
- RISC-V: 오픈소스 하드웨어 instruction set architecture (ISA)(명령어 집합 아키텍처)
- 초기 버전은 UCB에서 학술 연구로 시작됨
- NVIDIA, Western Digital 등 여러 회사가 향후 제품에 RISC-V 코어를 사용할 예정임
- 자세한 정보는 https://riscv.org/risc-v-cores/ 및 https://riscv.org/software-status/ 참조
p.74도메인 특화 가속기 예시
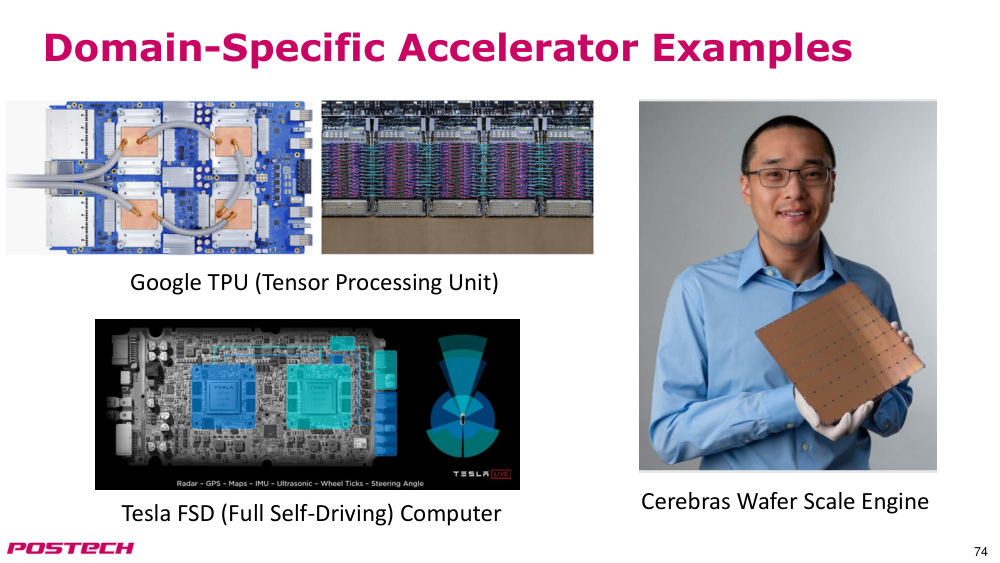
- Google TPU (텐서 프로세싱 유닛)
- Cerebras 웨이퍼 스케일 엔진
- Tesla FSD (풀 자율 주행) 컴퓨터
p.75반도체의 대안?
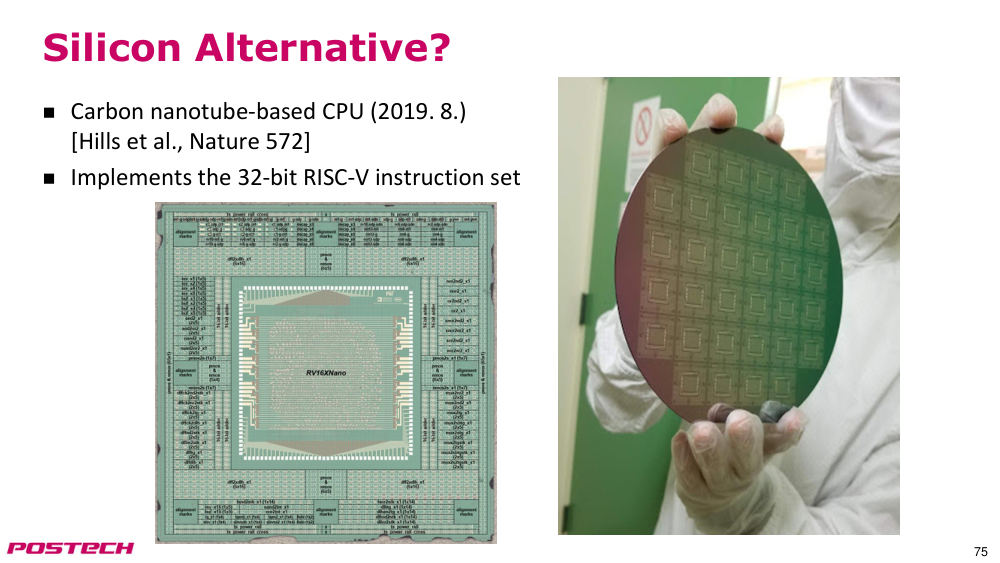
- 탄소 나노튜브 기반 CPU (2019. 8.) [Hills et al., Nature 572]
- 32비트 RISC-V 명령어 집합을 구현함
p.76질문?
- 공지사항
- - 읽기 자료: P&H Ch. 1 – 1.5 (RISC-V 버전)