Lec 11 · Cache(캐시) 설계와 최적화
정밀 정리 · 검증 2026-09-24 04:47
1개요
1.1memory system 파트의 첫 강의. AMAT·3C 복습 후 block size·sub-block, replacement policy(PLRU, SLRU, LIP/set dueling, Bélády OPT)를 다룬다.
1.2write policy 와 pipelined writes 로 write hit time 을 줄이는 법, multi-level cache 의 local/global miss rate·MPKI 를 설명.
1.3inclusive/exclusive/non-inclusive hierarchy 의 trade-off(back-invalidation, coherence)까지 진행하고 시간 부족으로 p26 에서 종료. p27~47(non-blocking cache, MSHR, 사례, compiler 최적화)은 미진행.
2섹션별 정리 상황·문제 → 원인 → 해결
2.12:45–5:58도입: memory system 과 cache 복습
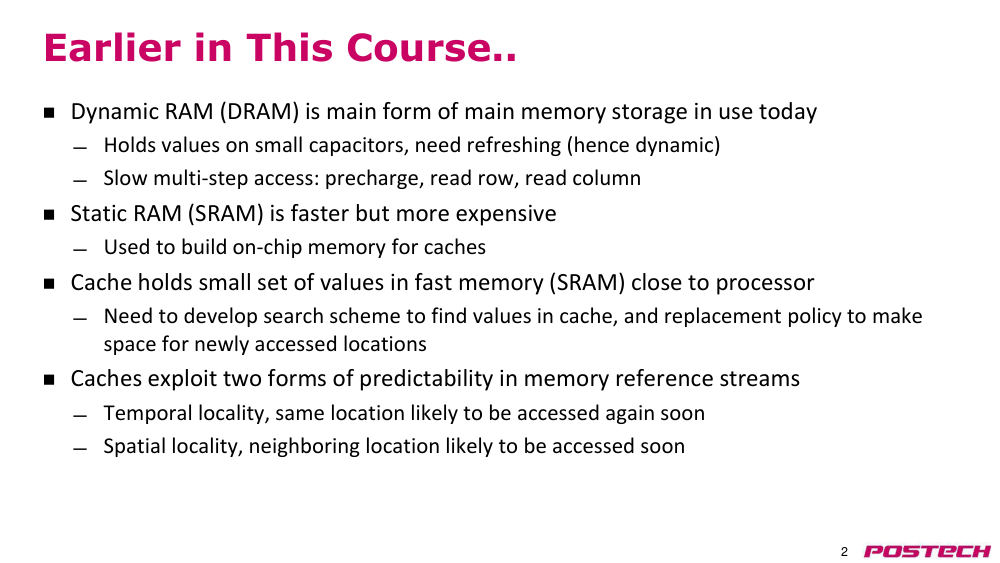
상황·문제이번 강의부터 memory system, 그 첫 주제로 cache 를 다룬다. 학부 지식을 전제로 짧게 복습.
원인DRAM 은 셀이 작아 대용량이지만 refresh 가 필요하고 다단계 접근이라 느리다. SRAM 은 빠르지만 비싸다.
해결SRAM 으로 processor 근처에 작은 cache 를 둬 temporal·spatial locality(시간·공간 지역성)를 이용한다.
- temporal: 같은 주소를 나중에 다시 접근
- spatial: 접근한 주소 근처가 곧 접근될 가능성이 큼
2.25:58–9:57CPU–cache 상호작용과 AMAT
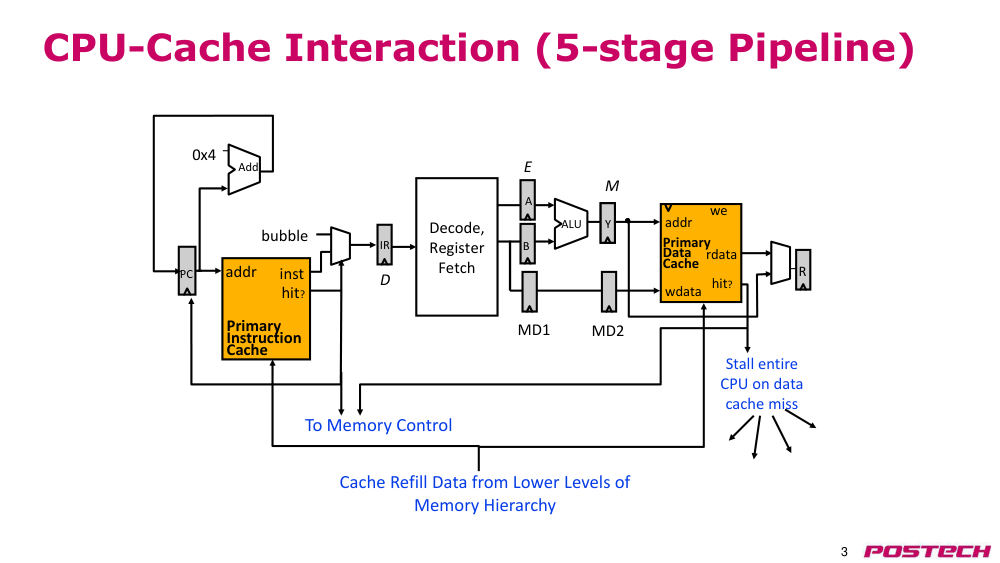
상황·문제5-stage pipeline 에서 I-cache·D-cache 가 miss 면 CPU 가 stall 한다.
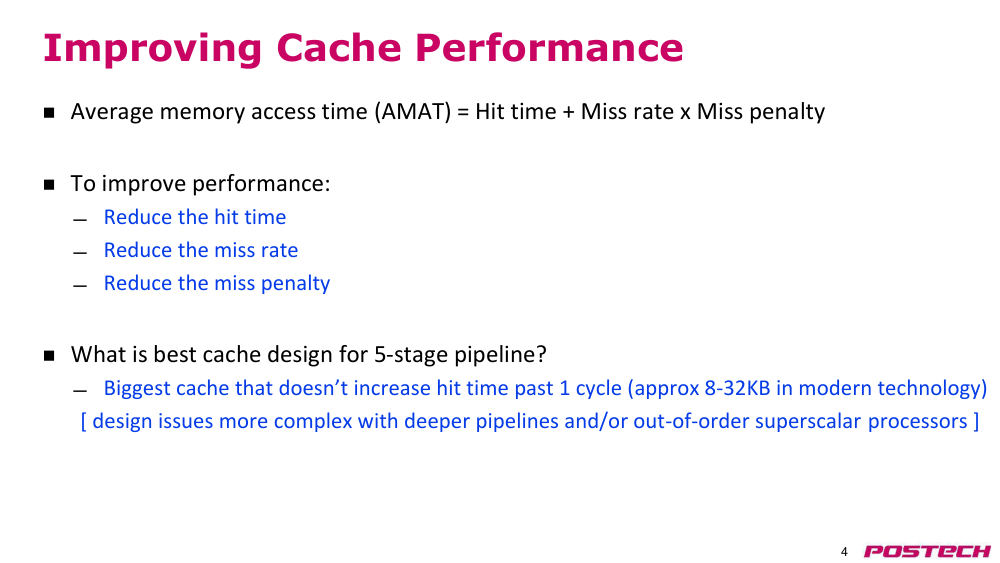
원인성능은 AMAT = hit time + miss rate × miss penalty 로 요약된다. hit time 을 2 cycle 로 늘리면 cache 를 안 쓰는 ALU 명령까지 모두 느려진다.
해결hit time 1 cycle 을 넘지 않는 가장 큰 cache (강의: 8~32KB). 깊은 pipeline 은 latency 를 늘려도 되며 다중 동시 접근 처리가 중요.
- AMAT 개선 = hit time·miss rate·miss penalty 중 하나를 줄이기
- 다중 memory access 동시 처리가 이 강의 후반의 초점
2.2.r.1Hennessy & Patterson, Computer Architecture: A Quantitative Approach 6th ed. (Elsevier) ↗ · 교재. 2장 Memory Hierarchy Design, 부록 B 가 이 강의 범위(슬라이드 p48 추천: 2.3절)
2.39:57–18:003C miss 와 cache parameter 의 영향
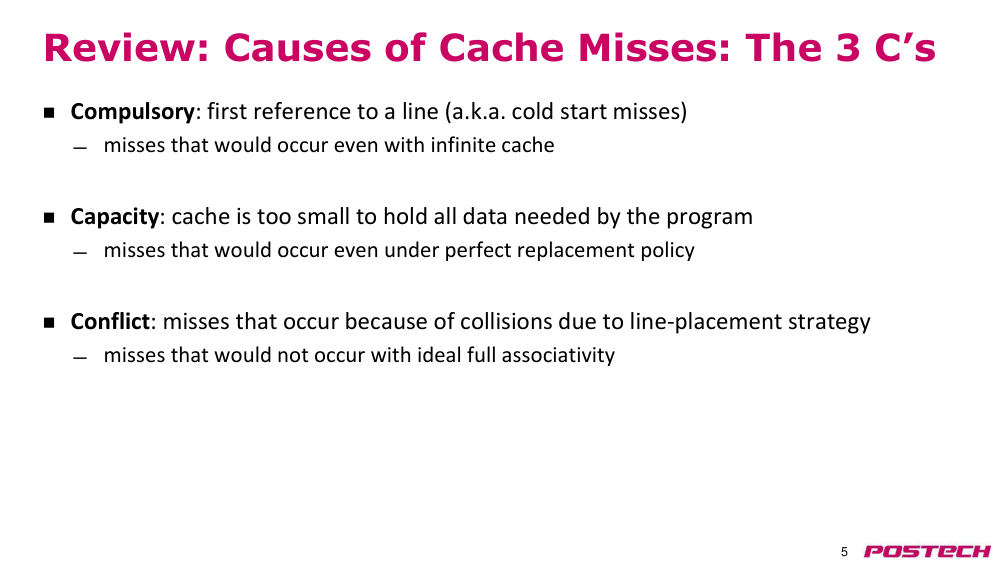
상황·문제cache miss 는 원인별로 compulsory·capacity·conflict 로 나뉜다.
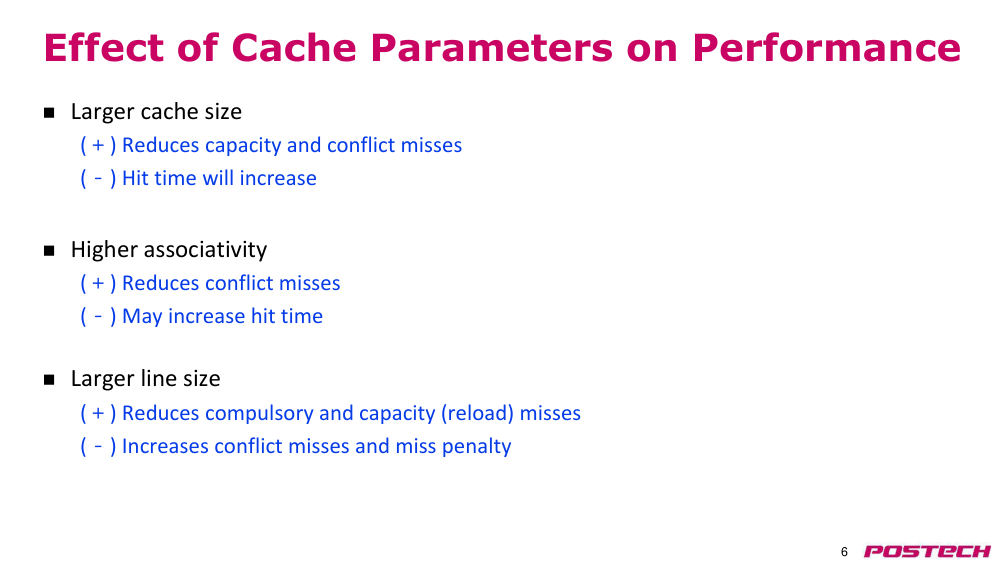
원인큰 cache·높은 associativity 는 miss 를 줄이지만 hit time 을 늘려 모든 접근에 영향. 큰 line 은 prefetch 효과가 있지만 line 수가 줄어 conflict ↑.
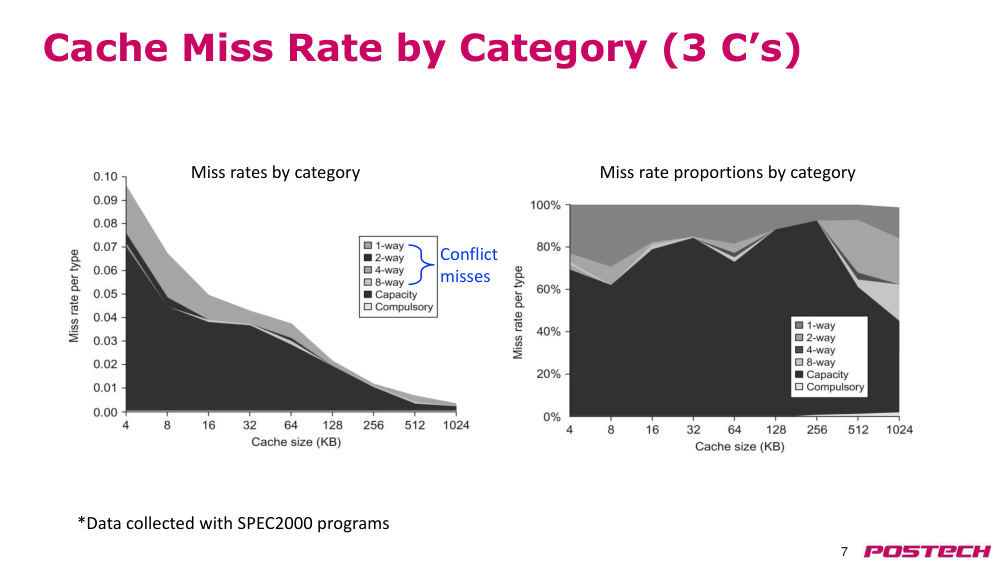
해결SPEC2000 data: capacity miss 가 대부분, compulsory 는 작음. 큰 cache 에선 conflict 비중이 커져 associativity 가 중요.
- compulsory 는 무한 cache 에서도, capacity 는 완벽한 replacement 에서도 발생
- conflict = fully associative 였으면 없었을 miss
- 강의: direct-mapped→4-way 로 miss rate 약 40% 감소
2.418:00–27:23block size 와 sub-block
상황·문제block size 는 tag overhead·DRAM bandwidth·miss rate 에 동시에 영향을 준다.
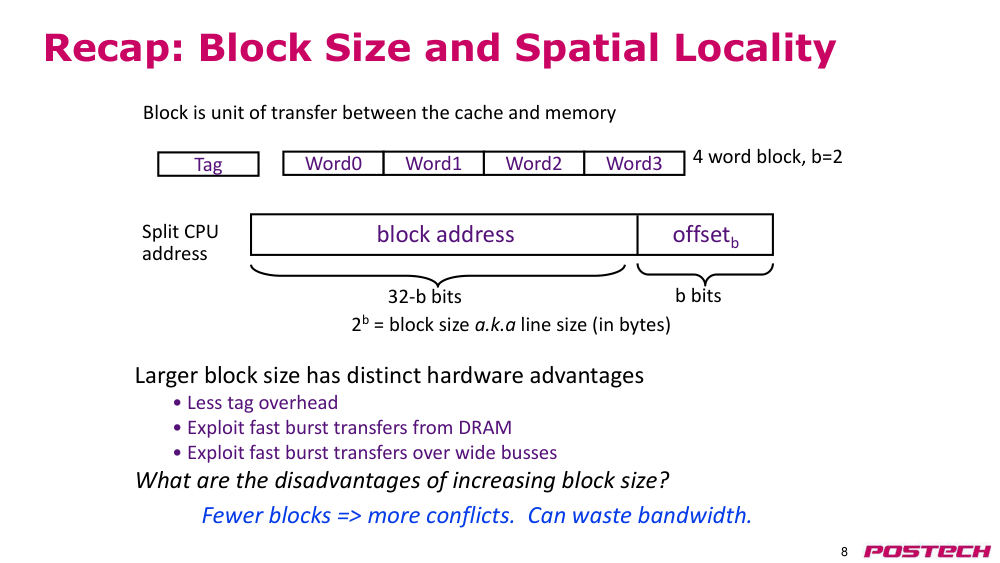
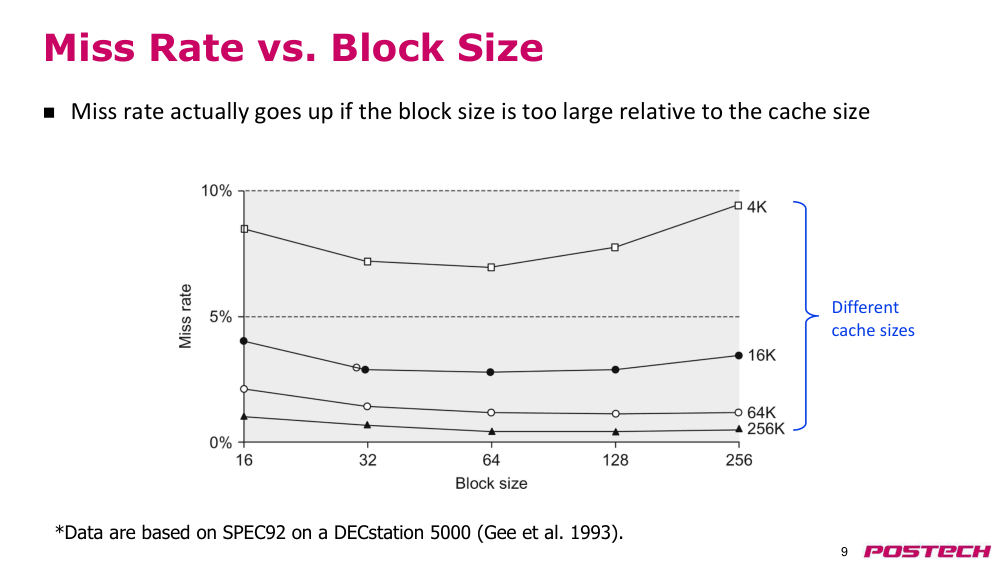
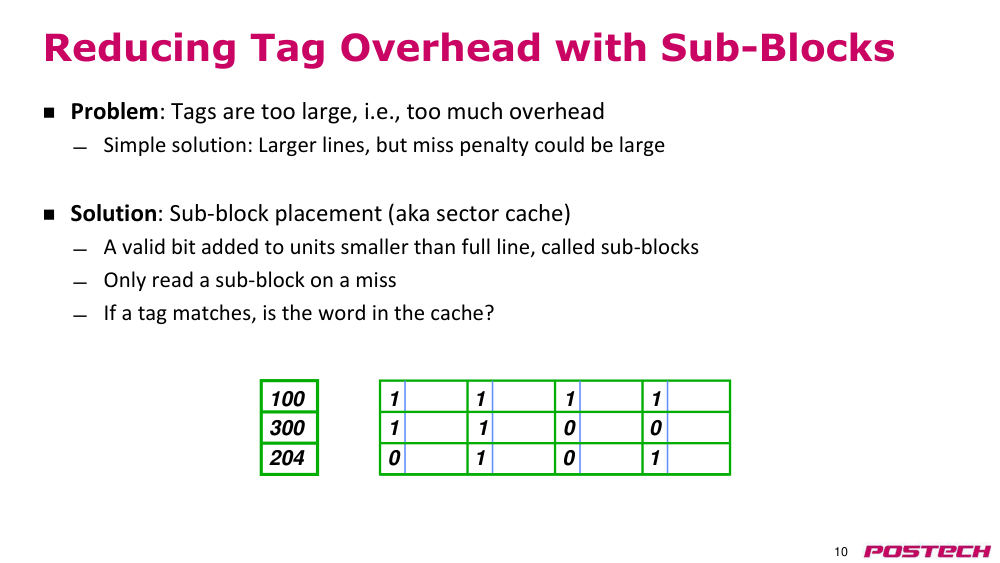
원인큰 block 은 tag overhead ↓(16KB cache: 4B→4K block, 16B→1K block), DRAM burst·넓은 bus 를 낭비 없이 활용. 너무 크면 conflict ↑·쓸모없는 fetch.
해결block 은 크게 두되 sub-block(sector) 단위 valid bit 로 miss 시 필요한 부분만 fetch.
- block size 는 DRAM 최소 access granularity(burst) 이상이 바람직
- 4KB cache: 16→64B 에선 miss ↓, 그 이상은 ↑ (DECstation 5000/SPEC92)
2.527:23–36:13replacement policy 와 Pseudo-LRU
상황·문제associative cache 에서 set 이 가득 차면 어떤 block 을 evict 할지 정해야 한다.
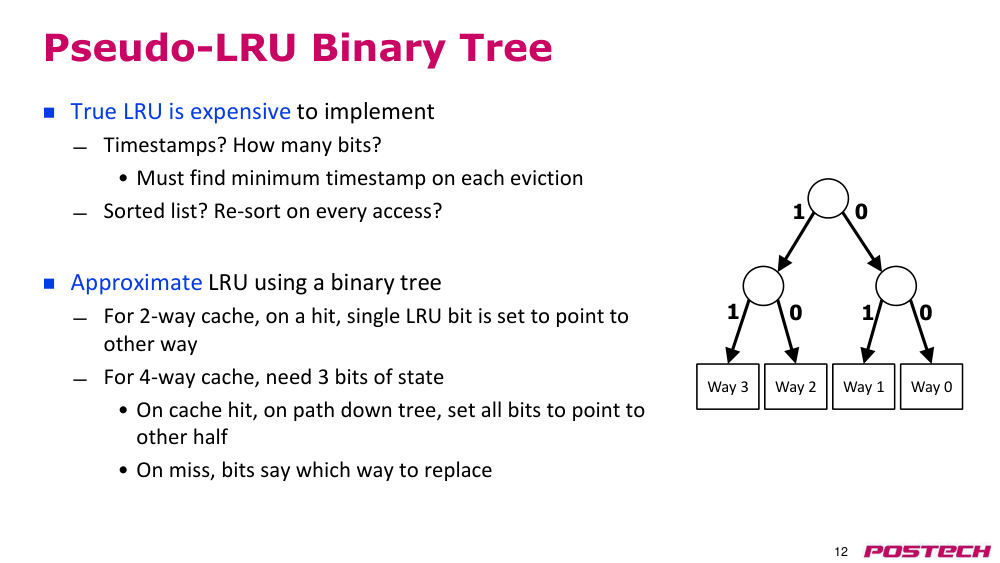
원인replacement 는 miss 때만 일어나는 second-order effect. true LRU 는 접근 순서 정보가 필요해 비싸다 (32bit timestamp 는 64B block 대비 큰 overhead, overflow, 전체 비교).
해결binary tree PLRU: 4-way 에 3 bit. hit 시 경로의 bit 를 반대쪽으로, miss 시 bit 를 따라 victim 선택. 실제로 true LRU 보다 PLRU 를 많이 쓴다.
- 후보: Random, LRU, PLRU, protected LRU, FIFO, NMRU, Bélády OPT
- footprint ≈ cache 크기일 때 policy 차이가 크다
2.5.r.1Wikipedia: Cache replacement policies ↗ · Bélády, PLRU, SLRU(probationary/protected segment), set dueling 정리
2.636:13–40:10true LRU 의 한계: scan 과 thrashing
상황·문제LRU 가 항상 좋은 policy 는 아니다.
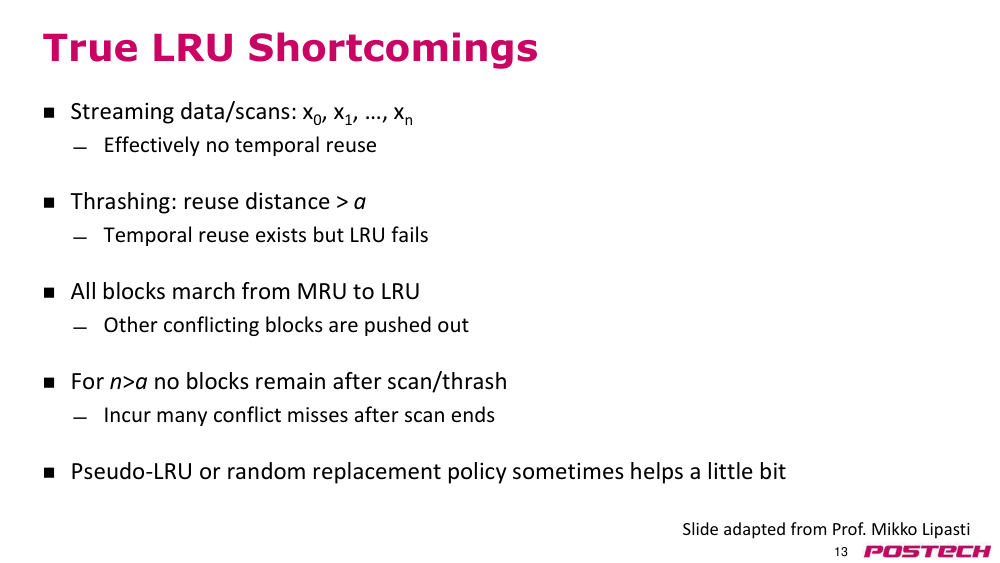
원인streaming/scan 은 reuse 가 없고, thrashing 은 reuse distance > associativity 라 reuse 전에 모든 block 이 MRU→LRU 로 밀려 evict 된다.
해결일부 block 만이라도 계속 남기면 hit 가 생긴다. PLRU·random 이 오히려 나을 수 있고, LRU 를 thrash 에 강하게 수정할 수 있다.
- 강의 예: 반복 scan 에서 앞부분 line 이 다음 순회 전에 이미 evict
2.6.r.1Wikipedia: Cache replacement policies ↗ · Bélády, PLRU, SLRU(probationary/protected segment), set dueling 정리
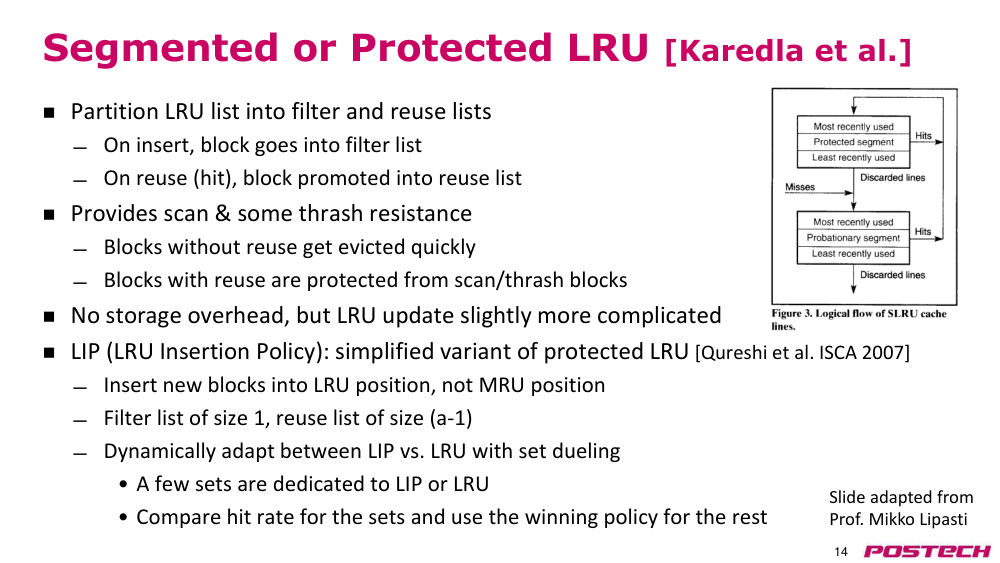
2.740:10–47:02protected LRU·LIP·set dueling
상황·문제thrash/scan block 이 reuse 가 있는 block 을 밀어내는 문제.
원인LRU 는 새 block 을 무조건 MRU 에 넣어 reuse 없는 block 도 오래 머문다.
해결SLRU: filter·reuse list 로 나누고 hit 시 reuse 로 승격(추가 storage 없음). LIP: 새 block 을 LRU 위치에 insert. set dueling 으로 LIP·LRU 중 hit rate 가 높은 쪽을 나머지 set 에 적용.
- LIP = filter 1 entry, reuse a-1 인 protected LRU
- set dueling 은 여러 replacement 제안에서 쓰는 동적 적응 기법
2.7.r.1Qureshi et al., Adaptive Insertion Policies for High Performance Caching (ISCA 2007) PDF ↗ · LIP·BIP·DIP 와 set dueling 원 논문 (슬라이드 p14 인용)
2.7.r.2Wikipedia: Cache replacement policies ↗ · Bélády, PLRU, SLRU(probationary/protected segment), set dueling 정리
2.847:02–51:04Bélády OPT 는 성능 최적인가
상황·문제Bélády OPT 는 다음 참조가 가장 먼 block 을 evict, 미래 정보가 필요해 구현 불가지만 headroom 분석에 쓴다.
원인miss rate 최소화엔 최적이지만 모든 miss 의 비용이 같지 않다.
해결DRAM 까지 가는 miss 와 LLC 에서 해결되는 miss, 다른 miss 와 overlap 되는 miss, prefetcher 가 예측 가능한 miss 가 다르므로 실행 시간 최적은 아니다.
- 수업 중 학생 질문으로 토론
2.8.r.1Wikipedia: Cache replacement policies ↗ · Bélády, PLRU, SLRU(probationary/protected segment), set dueling 정리
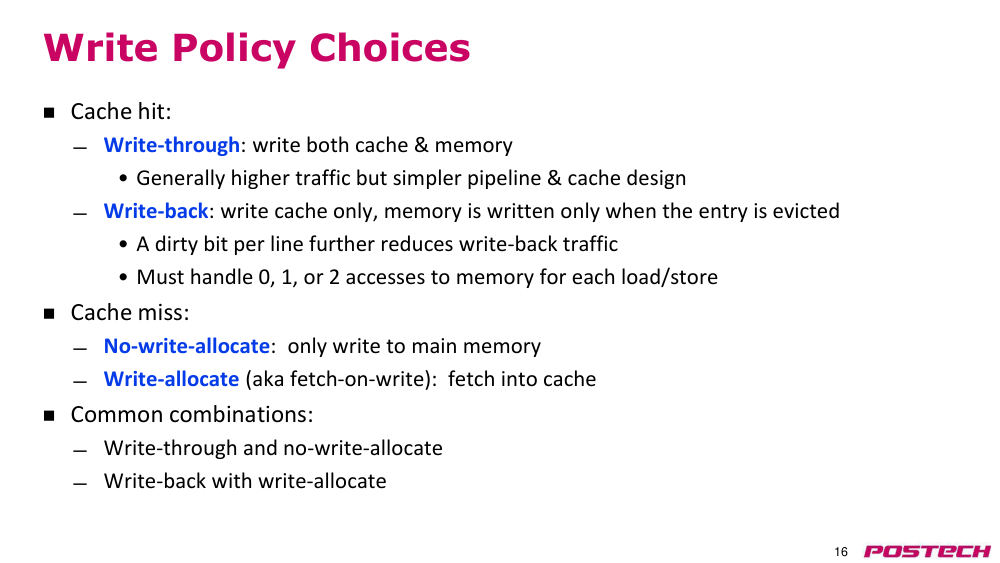
2.951:04–53:48write policy
상황·문제write hit·write miss 때 memory 를 언제 갱신할지 정해야 한다.
원인write-through 는 하위 level 까지 모두 갱신(traffic ↑, 단순), write-back 은 evict 때만 갱신(dirty bit, load 하나가 dirty evict 로 memory 접근 2회 유발 가능).
해결write miss: no-write-allocate(memory 로 바로) 또는 write-allocate(가져와서 update). 조합은 write-through+no-allocate, write-back+allocate.
- 같은 주소 다중 write 가 있으면 write-back 이 traffic 을 줄인다
2.9.r.1Wikipedia: Cache (computing) – Writing policies ↗ · write-through/write-back, dirty bit, write-allocate/no-write-allocate
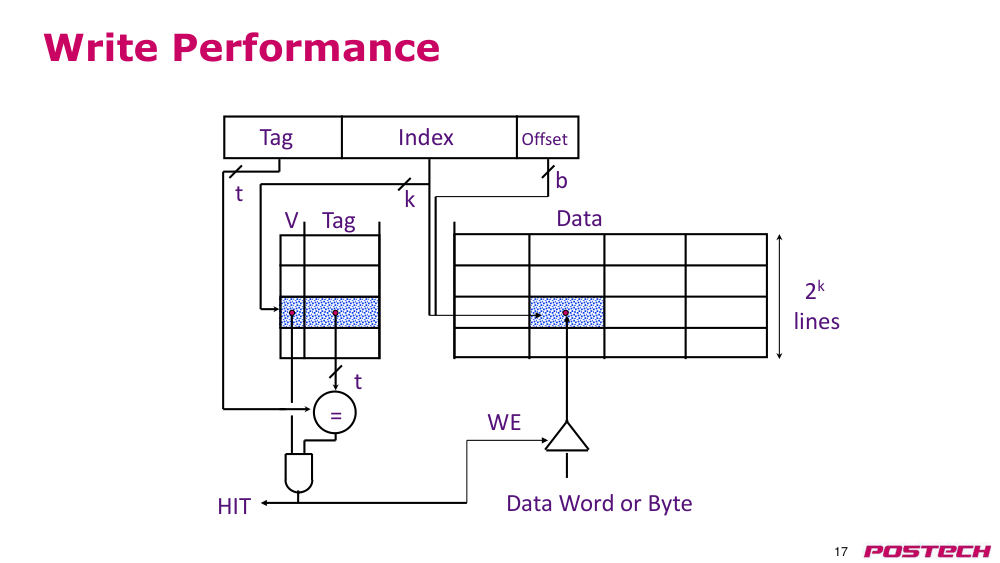
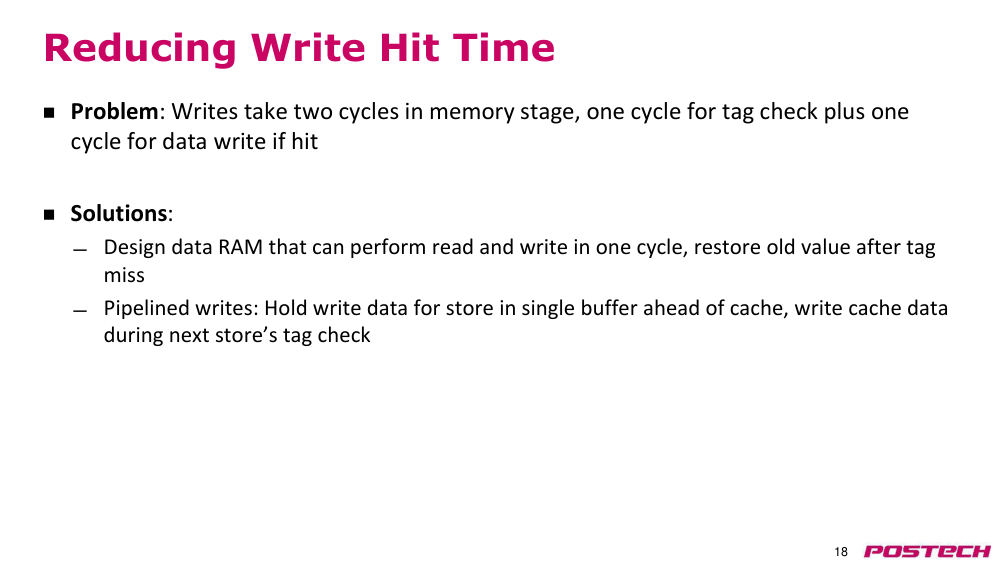
2.1053:48–59:15write hit time 줄이기: pipelined writes
상황·문제write 는 tag 로 hit 확인 후에만 data 를 쓸 수 있어 memory stage 에서 2 cycle, 뒤 접근이 queue 에서 대기.
원인tag check 와 data write 가 직렬.
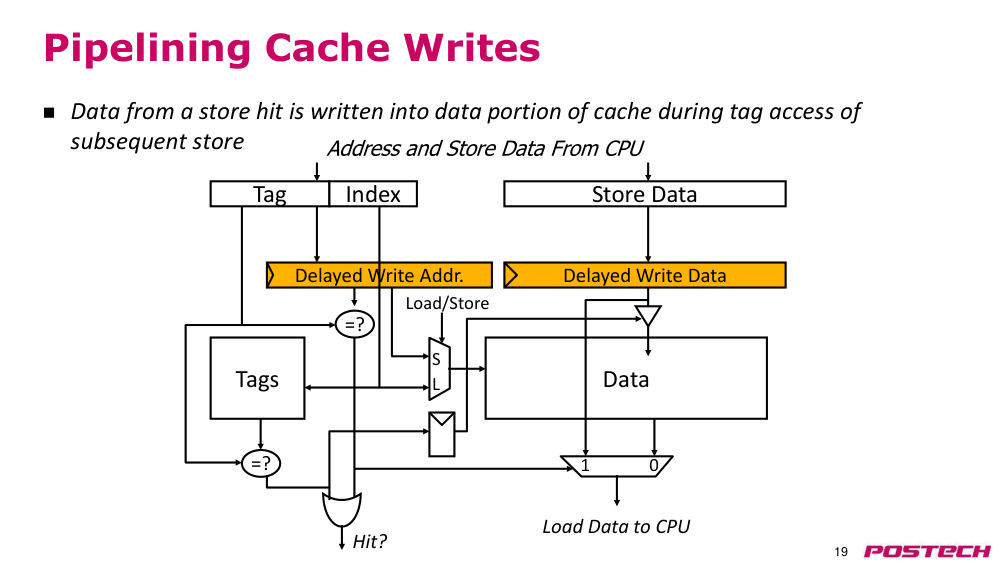
해결(1) read+write 1 cycle data RAM 에 먼저 쓰고 miss 면 old value 복원 — overhead 가 더 클 수 있음. (2) pipelined writes: cache 앞 delayed write buffer 에 두고 다음 store 의 tag check 때 write, load 는 buffer 주소도 비교.
- 대가: buffer, 추가 비교, buffer/data array 선택 mux
2.1159:15–1:06:02multi-level cache, local/global miss rate, MPKI
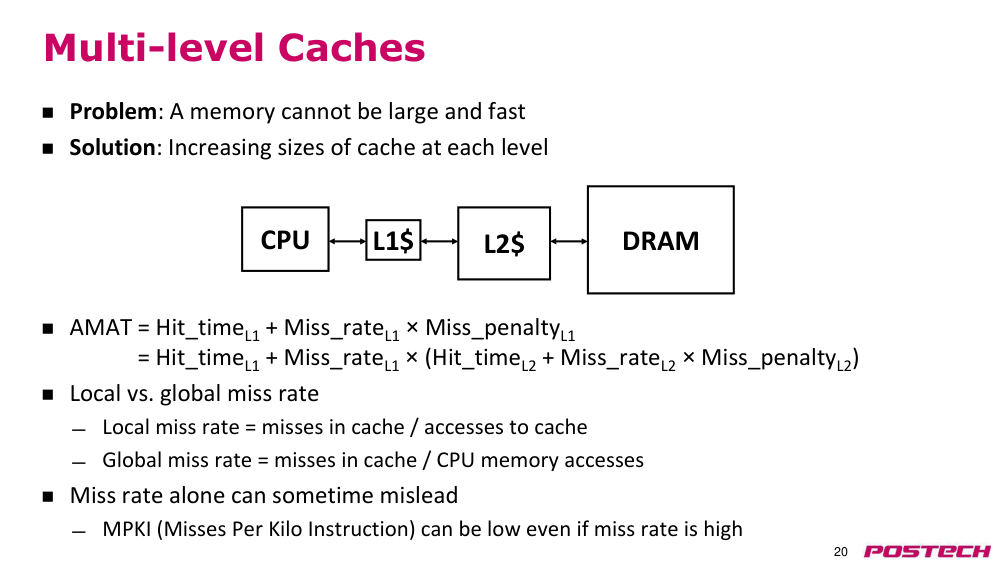
상황·문제크고 빠른 memory 는 만들 수 없다.
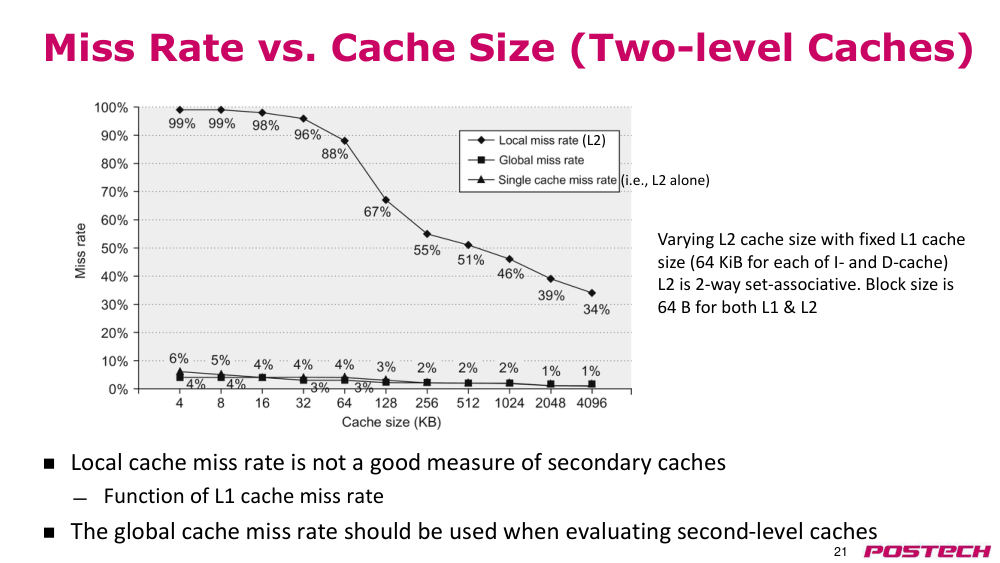
원인L1 이 대부분 접근을 걸러 주므로 하위 level 은 느려도 되고, 큰 L2 는 훨씬 느린 DRAM 접근을 줄인다. L2 는 L1 miss 만 보므로 local miss rate 는 오해를 부른다.
해결global miss rate 로 평가 (강의: L2 local 99% vs 34% 가 global 로는 4~6% vs 1%). miss rate 와 함께 MPKI 도 본다.
- AMAT 의 L1 miss penalty 를 L2 AMAT 로 전개
- 예: A MPKI 1·miss rate 0.9 → DRAM 0.9/KI, B MPKI 100·0.8 → 80/KI
2.121:06:02–1:09:52L2 가 L1 설계에 미치는 영향
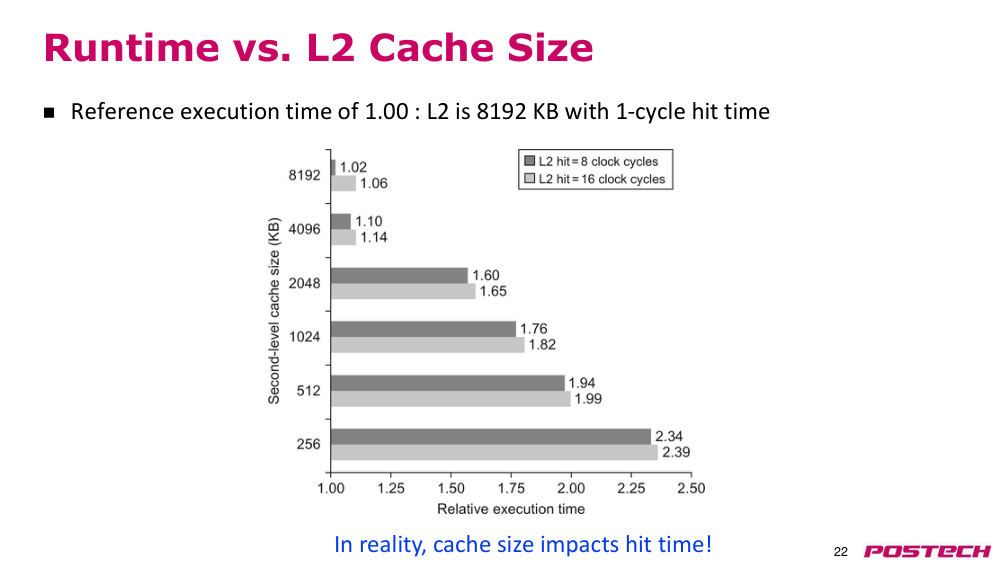
상황·문제L2 크기와 hit latency 는 실행 시간에 영향을 주고 둘은 trade-off.
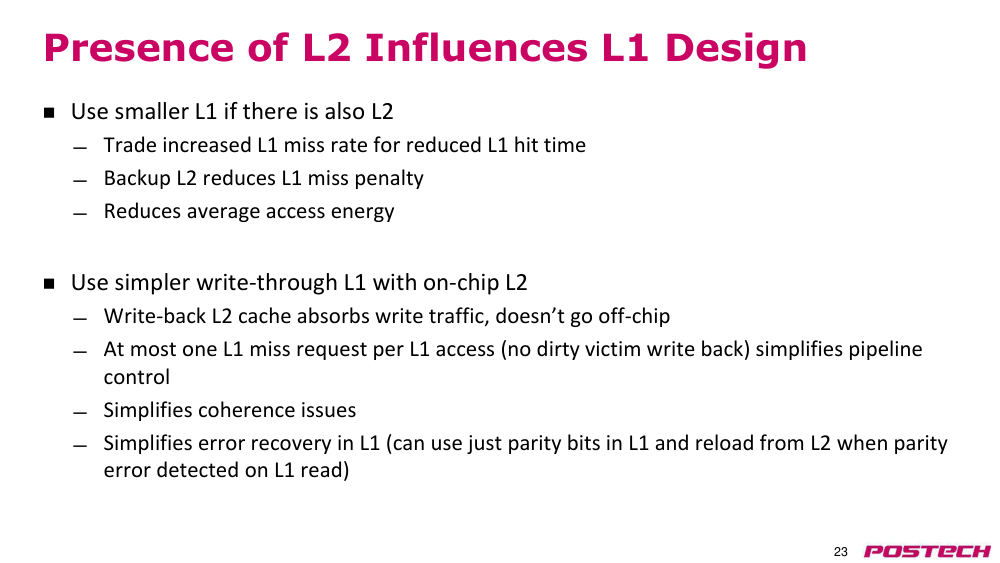
원인L2 가 L1 miss penalty 를 줄이므로 L1 은 hit time·energy 를 우선할 수 있다.
해결작은 L1, on-chip write-back L2 뒤의 write-through L1: write traffic 은 L2 가 흡수, L1 에 dirty 가 없어 coherence·error recovery(L2 에서 재로드) 단순.
- write-back L1 은 load/store 하나에 여러 memory 접근 가능
2.131:09:52–1:13:47inclusive vs exclusive vs non-inclusive
상황·문제multi-level 계층에서 level 간 data 복제를 허용할지 정해야 한다.
원인exclusive 는 복제 낭비가 없지만 LLC hit 시 LLC 에서 지우고 L2 victim 을 LLC 로 보내는 swap 이 필요해 controller 가 복잡.
해결inclusive 는 LLC→L2 복사만 하면 된다. non-inclusive 는 둘 다 보장하지 않아 유연하지만 복잡도가 추가된다.
- effective capacity 는 exclusive 가 유리
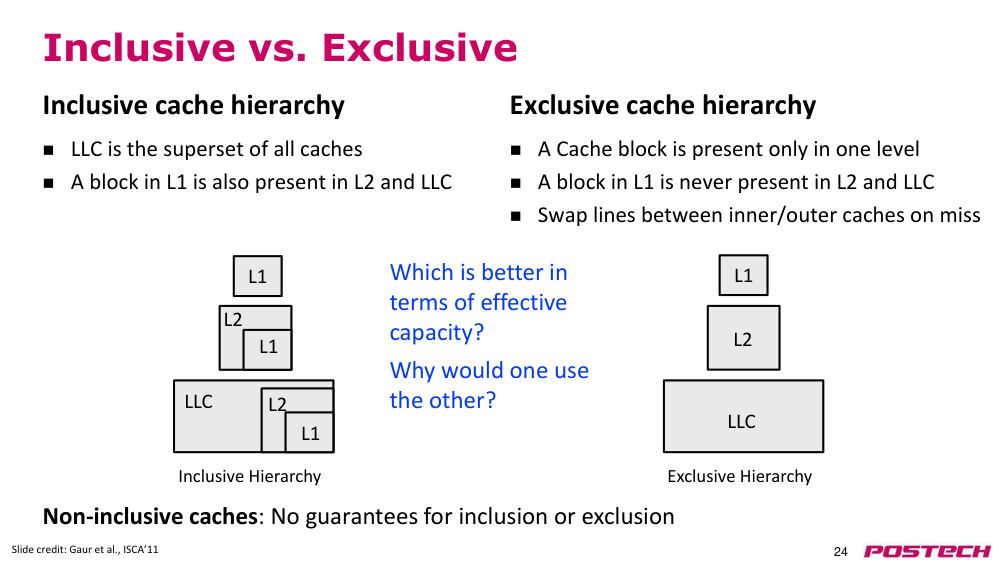
2.13.r.2Gaur, Chaudhuri, Subramoney, Bypass and Insertion Algorithms for Exclusive Last-level Caches (ISCA 2011) PDF ↗ · p24 그림 출처. inclusive LLC 의 복제 낭비 vs exclusive LLC
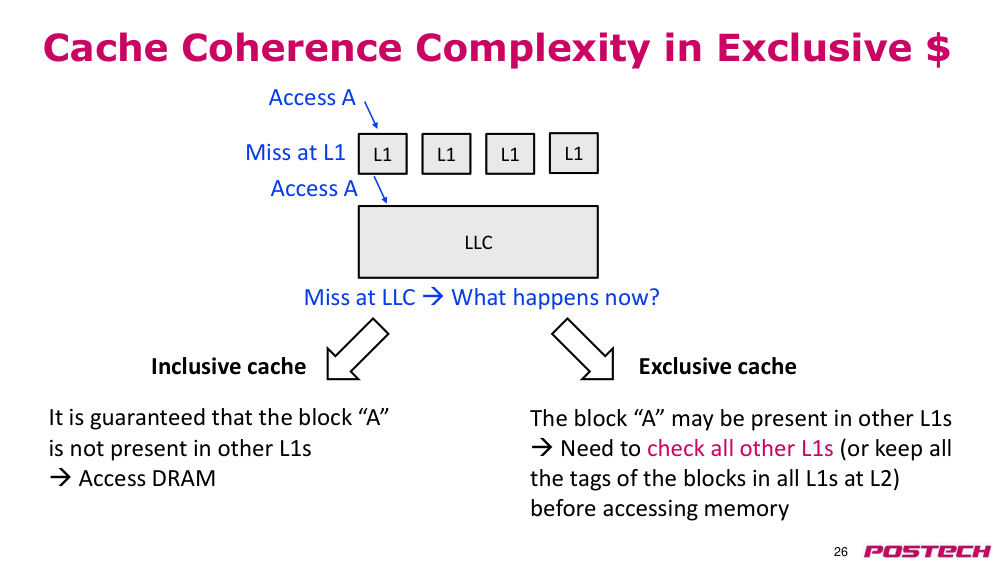
2.141:13:47–1:17:14inclusive 의 back-invalidation, exclusive 의 coherence 복잡도
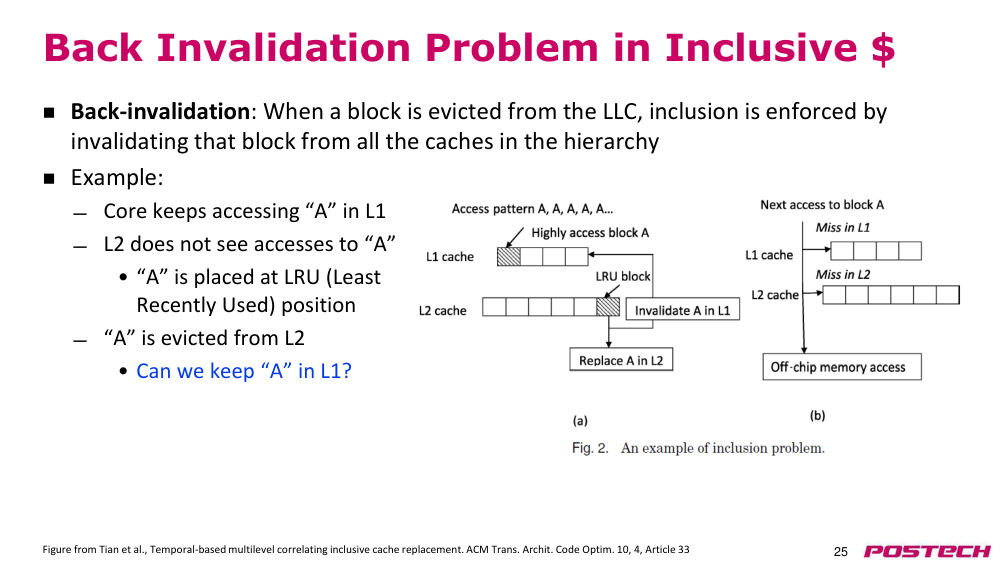
상황·문제각 inclusion policy 의 단점.
원인inclusive: L1 이 hot block A 의 접근을 걸러 L2 에선 A 가 LRU → evict 시 back-invalidation 으로 L1 의 MRU block 도 제거. exclusive: LLC miss 여도 다른 L1 에 A 가 있을 수 있다.
해결exclusive 는 모든 L1 probe 또는 L2 에 L1 tag 사본 유지가 필요. 강의는 시간 부족으로 p26 에서 종료, 다음 수요일 강의에서 이어감.
- inclusive LLC miss = 다른 L1 에도 없음 보장
3핵심 개념
3.1AMAT(평균 메모리 접근 시간)
hit time + miss rate × miss penalty. multi-level 에선 miss penalty 를 하위 level AMAT 로 전개.
3.23C (compulsory·capacity·conflict miss)
첫 참조, 용량 부족, associativity 부족에 의한 miss.
3.3sub-block(sector cache)
tag 는 큰 line 단위, valid bit·fetch 는 sub-block 단위.
3.4Pseudo-LRU(tree PLRU)
a-way 에 a-1 bit binary tree 로 LRU 근사. hit 시 경로 bit 반전, miss 시 bit 를 따라 victim.
3.5thrashing(쓰래싱)
reuse distance > associativity 라 reuse 전에 evict 되는 접근 패턴.
3.6LIP·set dueling
새 block 을 LRU 위치에 insert. 일부 set 으로 두 policy 를 겨뤄 이긴 쪽을 나머지에 적용.
3.6.r.1Qureshi et al., Adaptive Insertion Policies for High Performance Caching (ISCA 2007) PDF ↗ · LIP·BIP·DIP 와 set dueling 원 논문 (슬라이드 p14 인용)
3.7Bélády OPT
다음 참조가 가장 먼 block 을 evict. miss rate 최소지만 실행 시간 최적은 아님.
3.7.r.1Wikipedia: Cache replacement policies ↗ · Bélády, PLRU, SLRU(probationary/protected segment), set dueling 정리
3.8pipelined writes(delayed write buffer)
store hit data 를 buffer 에 두고 다음 store 의 tag check 중 data array 에 write.
3.9local vs global miss rate
local = 그 cache 접근 대비 miss, global = CPU memory 접근 대비 miss.
3.10MPKI(misses per kilo instruction)
1000 명령당 miss 수. miss rate 와 함께 봐야 DRAM 접근량을 알 수 있다.
3.11back-invalidation
inclusive 에서 하위 level evict 시 상위 level 사본도 무효화.
4스스로 확인
4.15-stage pipeline 에서 L1 hit time 을 1 cycle 로 유지하려는 이유는?
답
hit time 증가는 load/store 뿐 아니라 모든 명령의 pipeline 에 영향을 주기 때문.
4.2block size 를 계속 키우면 miss rate 가 다시 오르는 이유는?
답
block 수가 줄어 conflict miss 가 늘고, 쓰지 않는 data fetch 로 다른 line 을 evict.
4.34-way tree PLRU 에 필요한 bit 수와 hit 시 갱신 방법은?
답
3 bit. root→접근 line 경로의 bit 를 반대쪽(다른 subtree)을 가리키게 설정.
4.4LIP 가 thrashing 에 강한 이유는?
답
새 block 이 LRU 위치에 들어가 reuse 없으면 곧 evict, 기존 reuse block 은 보호된다.
4.5Bélády OPT 가 실행 시간 최적이 아닌 이유는?
답
miss 비용이 다르다: data 위치(LLC vs DRAM), miss overlap, prefetch 가능성.
4.6L2 평가에 local miss rate 대신 global miss rate 를 써야 하는 이유는?
답
L2 는 L1 miss 만 보므로 local 값이 과장된다 (99% vs 34% 가 global 로 4~6% vs 1%).
4.7exclusive LLC 에서 LLC miss 후 곧바로 DRAM 에 갈 수 없는 이유는?
답
다른 core 의 L1 에 block 이 있을 수 있어 L1 probe 나 tag 사본 확인이 필요.
5참고 자료
5.1Hennessy & Patterson, Computer Architecture: A Quantitative Approach 6th ed. (Elsevier) ↗ · 교재. 2장 Memory Hierarchy Design, 부록 B 가 이 강의 범위(슬라이드 p48 추천: 2.3절)
5.2Wikipedia: Cache replacement policies ↗ · Bélády, PLRU, SLRU(probationary/protected segment), set dueling 정리
5.3Qureshi et al., Adaptive Insertion Policies for High Performance Caching (ISCA 2007) PDF ↗ · LIP·BIP·DIP 와 set dueling 원 논문 (슬라이드 p14 인용)
5.5Gaur, Chaudhuri, Subramoney, Bypass and Insertion Algorithms for Exclusive Last-level Caches (ISCA 2011) PDF ↗ · p24 그림 출처. inclusive LLC 의 복제 낭비 vs exclusive LLC
5.6Wikipedia: Cache (computing) – Writing policies ↗ · write-through/write-back, dirty bit, write-allocate/no-write-allocate