이 자료를 쓰는 강의: 16 Cache(캐시) 설계와 최적화 · 17 Cache 최적화 후반(non-blocking cache·MSHR·victim·way prediction·compiler) 과 Prefetching 입문
Lec11 - Cache
한국어판 강의자료 · 48쪽
p.1CSED503 고급 컴퓨터 구조 – 강의 11
p.2이 강의에서 이전에 다룬 내용
- 동적 램(DRAM)은 오늘날 사용되는 주 메모리 저장의 주된 형태이다
- 작은 커패시터에 값을 저장하며, 재충전이 필요하다(따라서 '동적'이라 함)
- 느린 다단계 접근: 사전 충전, 행 읽기, 열 읽기
- 정적 램(SRAM)은 더 빠르지만 더 비싸다
- cache(캐시)를 위한 온칩 메모리로 사용된다
- cache(캐시)는 프로세서 근처의 빠른 메모리(SRAM)에 작은 값 집합을 보관한다
- cache(캐시)에서 값을 찾기 위한 검색 방식과 새로 접근한 위치를 위한 공간을 확보하기 위한 replacement policy(치환 정책)을 개발해야 한다
- cache(캐시)는 메모리 참조 스트림에서 두 가지 형태의 예측 가능성을 활용한다
- temporal locality(시간적 지역성): 같은 위치가 곧 다시 접근될 가능성이 높다
- spatial locality(공간적 지역성): 인접한 위치가 곧 접근될 가능성이 높다
p.3CPU-cache(캐시) 상호작용 (5단계 파이프라인)
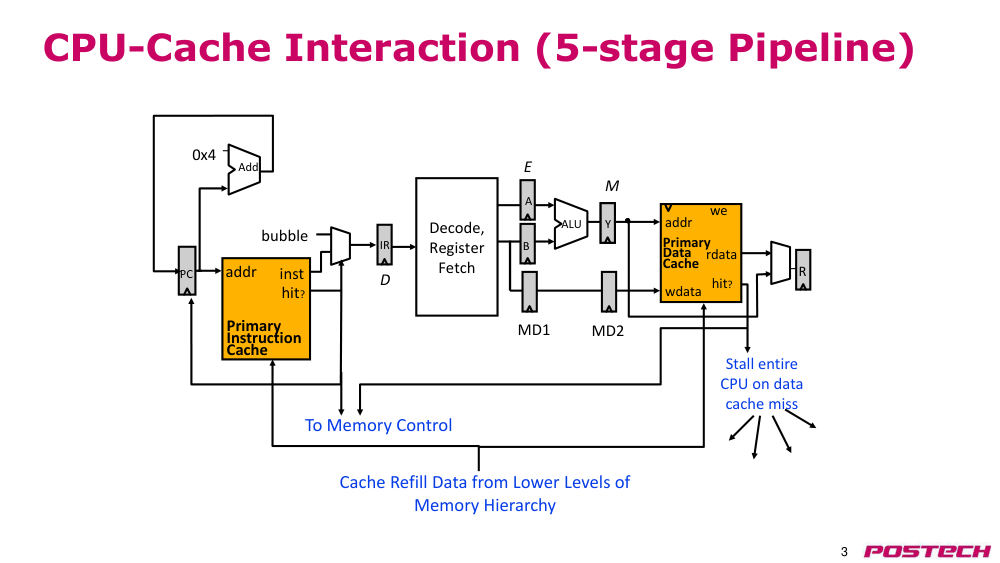
- PC
- addr
- inst
- Primary Instruction Cache
- 0x4
- Add
- IR
- D
- bubble
- hit?
- Decode, Register Fetch
- wdata
- R
- addr
- wdata
- rdata
- Primary Data Cache
- we
- A
- B
- Y
- ALU
- MD1
- MD2
- Cache Refill Data from Lower Levels of Memory Hierarchy
- hit?
- Stall entire CPU on data cache miss
- To Memory Control
- M
- E
p.4cache(캐시) 성능 향상
- 평균 메모리 접근 시간(AMAT) = hit time(히트 시간) + miss rate(미스 비율) × miss penalty(미스 패널티)
- 성능 향상을 위해:
- hit time(히트 시간) 감소
- miss rate(미스 비율) 감소
- miss penalty reduction(미스 패널티 감소)
- 5단계 파이프라인에 가장 적합한 cache(캐시) 설계는?
- hit time(히트 시간)이 1 사이클을 초과하지 않는 가장 큰 캐시(현대 기술 기준 약 8-32KB)
- [심층 파이프라인 및/또는 out-of-order superscalar(비순차 슈퍼스칼라) 프로세서에서는 설계 문제가 더 복잡하다]
p.5복습: cache miss(캐시 미스)의 원인: 3C
- compulsory miss(강제 미스): 라인에 대한 첫 번째 참조(또는 cold miss(콜드 미스)로도 알려짐)
- 무엇이든 무한한 cache(캐시)가 있더라도 발생하는 미스
- capacity miss(용량 미스): 프로그램이 필요로 하는 모든 데이터를 cache(캐시)가 담을 수 없을 정도로 cache size(캐시 크기)가 작다
- 완벽한 replacement policy(치환 정책)을 적용하더라도 발생하는 미스
- conflict miss(충돌 미스): 라인 배치 전략으로 인한 충돌로 인해 발생하는 미스
- 이상적인 완전 associativity(연관성)에서는 발생하지 않을 미스
p.6cache(캐시) 파라미터가 성능에 미치는 영향
- 더 큰 cache size(캐시 크기)
- (+) capacity miss(용량 미스)와 conflict miss(충돌 미스) 감소
- (-) hit time(히트 시간) 증가
- 더 높은 associativity(연관성)
- (+) conflict miss(충돌 미스) 감소
- (-) hit time(히트 시간) 증가 가능성
- 더 큰 line size(라인 크기)
- (+) compulsory miss(강제 미스)와 용량(재로드) 미스 감소
- (-) conflict miss(충돌 미스)와 miss penalty(미스 패널티) 증가
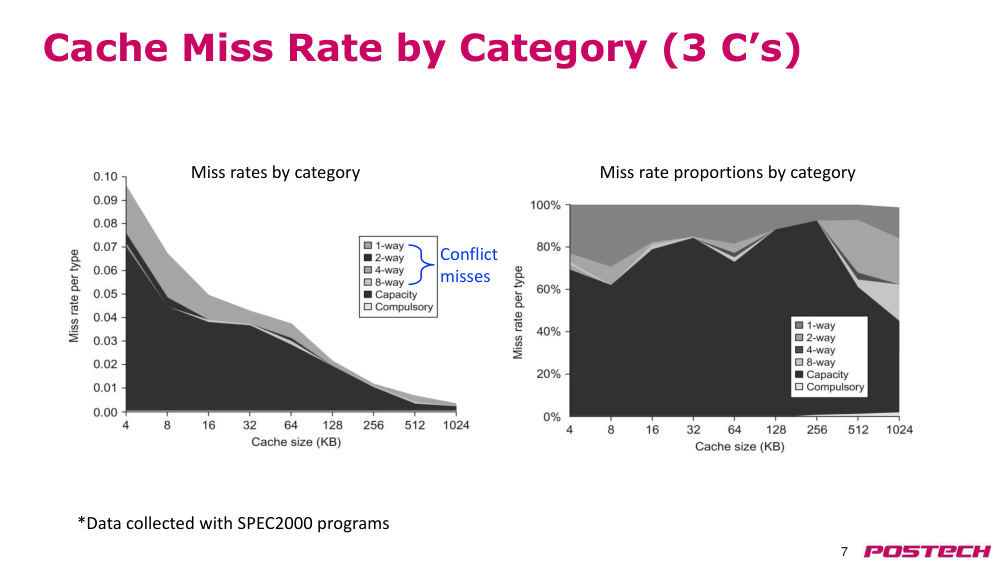
p.7카테고리별 miss rate(미스 비율)
- 카테고리별 miss rate(미스 비율) 비중
- ※ SPEC2000 프로그램을 이용해 수집한 데이터
- conflict miss(충돌 미스)
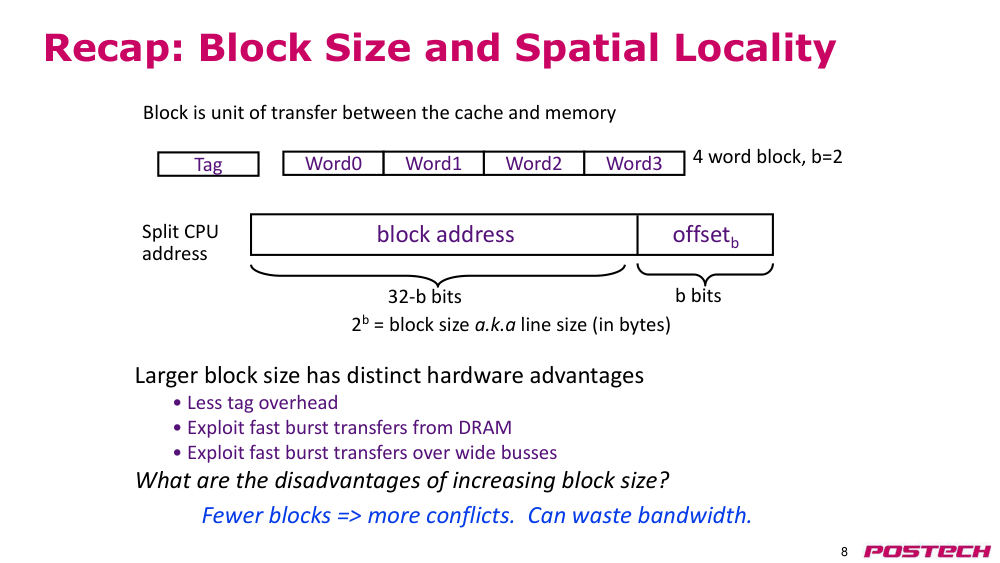
p.8block size(블록 크기)와 spatial locality(공간적 지역성) 요약
- Word3
- Word0
- Word1
- Word2
- 더 큰 block size(블록 크기)는 하드웨어 측면에서 명확한 이점이 있음
- • tag overhead(태그 오버헤드) 감소
- • DRAM에서 빠른 burst transfer(버스트 전송) 활용
- • 넓은 버스를 통한 빠른 burst transfer(버스트 전송) 활용
- block size(블록 크기)를 늘리는 단점은 무엇인가?
- 블록 주소
- offset(오프셋)b
- 2b = 블록 크기 (바이트 단위), 즉 line size(라인 크기)
- CPU 주소 분할
- b 비트
- 32-b 비트
- tag(태그)
- 블록은 cache(캐시)와 메모리 사이의 전송 단위
- 4워드 블록, b=2
- 블록 수 감소 → 더 많은 충돌 발생 가능. 대역폭 낭비 가능성 있음
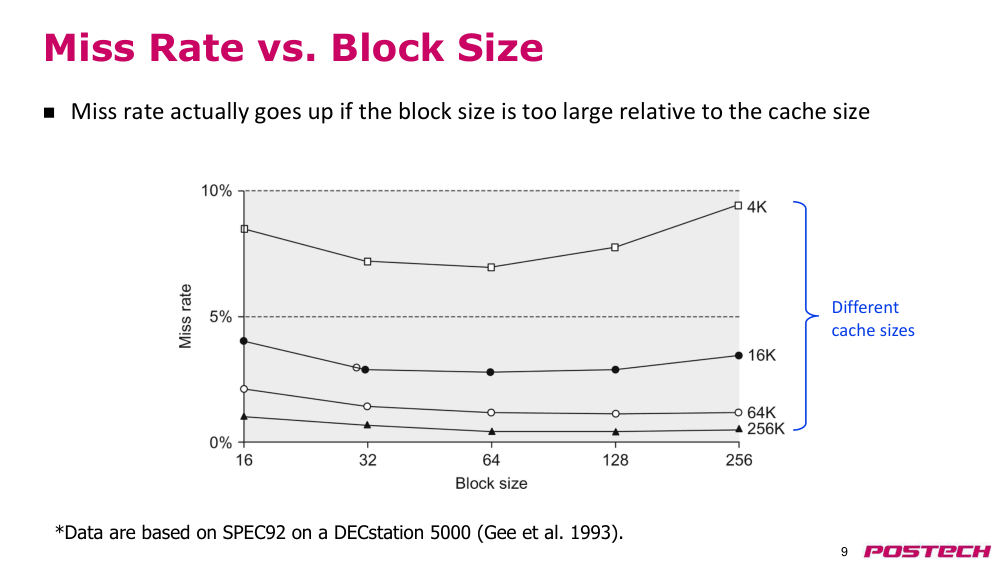
p.9miss rate(미스 비율) vs. block size(블록 크기)
- cache size(캐시 크기)에 비해 block size(블록 크기)가 너무 클 경우, 실제로 miss rate(미스 비율)이 증가함
- 다양한 cache size(캐시 크기)
- ※ 데이터는 DECstation 5000에서 SPEC92를 기반으로 함 (Gee 등, 1993)
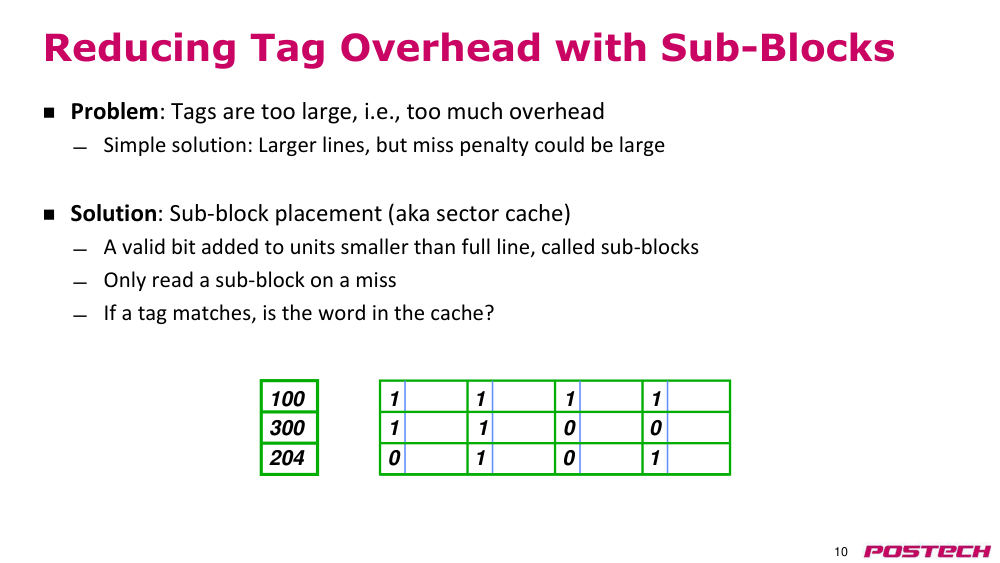
p.10sub-block(서브블록)을 통한 tag overhead(태그 오버헤드) 감소
- 문제: tag(태그)가 너무 크다 → 즉, 너무 많은 오버헤드
- 간단한 해결책: 더 큰 라인 사용, 그러나 miss penalty(미스 패널티)가 커질 수 있음
- 해결책: sub-block(서브블록) 배치 (또는 섹터 캐시)
- 전체 라인보다 작은 단위에 valid bit(유효 비트) 추가 → sub-block(서브블록)이라 부름
- 미스 발생 시에는 단지 sub-block(서브블록)만 읽음
- tag(태그)가 일치하면, 해당 워드는 cache(캐시)에 있는가?
- 100
- 300
- 204
- 1 1
- 1 1
- 1
- 1 0 0
- 0 1 0 1
p.11replacement policy(치환 정책)
- associativity(연관성) cache(캐시)에서, 세트가 가득 찼을 때 어떤 블록을 제거할 것인가?
- 랜덤
- 최근에 사용되지 않은 것 (LRU)
- Pseudo-LRU(가상 LRU)
- protected LRU(보호된 LRU)
- 선입선출 (FIFO), 즉 라운드로빈
- • 매우 associativity(연관성)이 높은 cache(캐시)에서 사용됨
- 가장 최근에 사용되지 않은 것 (NMRU)
- • 가장 최근에 사용된 블록 또는 블록들을 제외한 FIFO
- 벨라디의 최적 (Belady’s OPT)
- • 미래에 가장 멀리서 다시 사용되는 블록을 치환 (이상적)
- 이것은 2차 효과임. 치환은 오직 미스 발생 시에만 일어남
p.12Pseudo-LRU(가상 LRU) binary tree(이진 트리)
- 진짜 LRU는 구현하기 비쌈
- 타임스탬프? 몇 비트 필요?
- • 각 치환 시 최소 타임스탬프를 찾아야 함
- 정렬된 리스트? 모든 접근 시 재정렬?
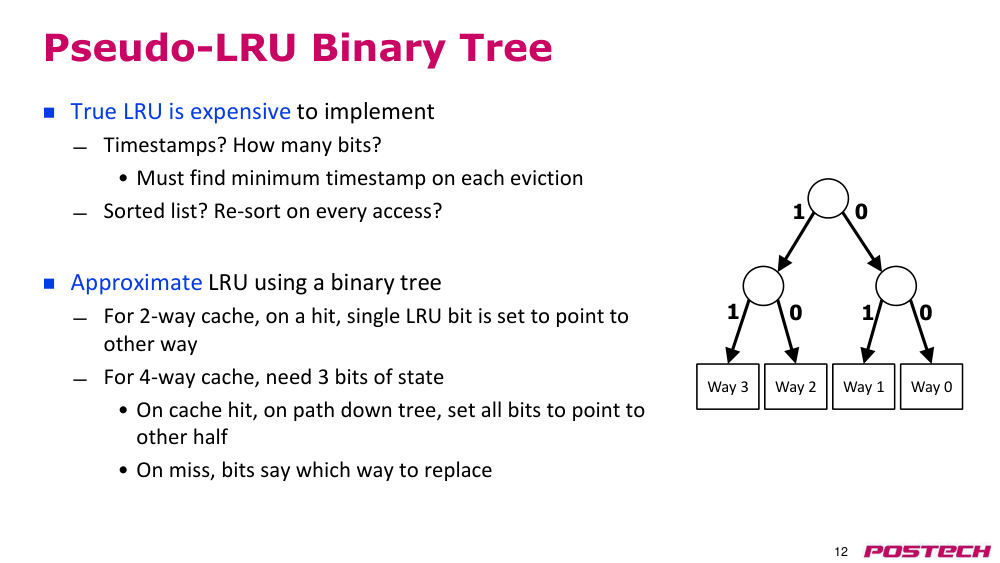
- binary tree(이진 트리)를 이용한 LRU 근사
- 2-way cache(캐시)의 경우, 히트 발생 시 단일 LRU 비트를 다른 방향을 가리키도록 설정
- 4-way cache(캐시)의 경우, 3비트의 상태 정보 필요
- • cache hit(캐시 히트) 시, 트리 내 내려가는 경로에서 모든 비트를 다른 반쪽을 가리키도록 설정
- • 미스 발생 시, 비트들이 어느 방향으로 치환할지 결정
p.13진정한 LRU의 한계
- streaming data(스트리밍 데이터)/스캔: x0, x1, …, xn
- 시간적 재사용이 거의 없음
- thrashing(쓰래싱): reuse distance(재사용 거리) > a
- 시간적 재사용은 존재하지만 LRU는 실패함
- 모든 블록이 MRU에서 LRU로 이동함
- 다른 충돌 블록들이 밀려나감
- n > a인 경우 스캔/thrashing(쓰래싱) 후 블록이 남지 않음
- 스캔 종료 후 많은 conflict miss(충돌 미스) 발생
- 가끔 Pseudo-LRU 또는 랜덤 replacement policy(치환 정책)이 약간 도움이 됨
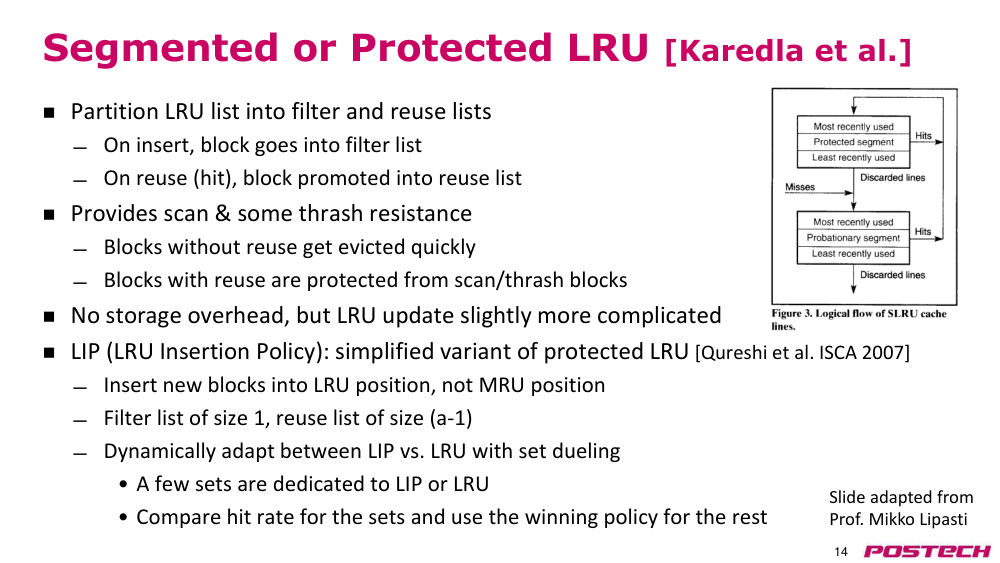
p.14세그먼트화 또는 protected LRU(보호된 LRU) [Karedla 등]
- LRU 리스트를 filter list(필터 리스트)와 reuse list(재사용 리스트)로 분할함
- 삽입 시 블록은 filter list(필터 리스트)에 삽입됨
- 재사용(히트) 시 블록은 reuse list(재사용 리스트)로 승격됨
- 스캔 및 일부 thrashing(쓰래싱)에 저항 가능함
- 재사용이 없는 블록은 빠르게 치환됨
- 재사용이 있는 블록은 스캔/thrashing(쓰래싱) 블록으로부터 보호됨
- 저장소 오버헤드 없음, 하지만 LRU 업데이트가 약간 더 복잡함
- LIP (LRU 삽입 정책): protected LRU(보호된 LRU)의 단순화된 변형 [Qureshi 등, ISCA 2007]
- 새 블록을 MRU 위치가 아닌 LRU 위치에 삽입함
- filter list(필터 리스트) 크기 1, reuse list(재사용 리스트) 크기 (a-1)
- set dueling(세트 대결)을 통해 LIP vs. LRU 동적으로 적응
- 일부 세트는 LIP 또는 LRU에 전용됨
- 세트별 hit rate(히트 비율)을 비교하고 승자 정책을 나머지 세트에 적용함
p.15최적 replacement policy(치환 정책)?
- 벨라디의 OPT – 가장 긴 reuse distance(재사용 거리)를 가진 블록을 치환함
- 즉, 블록의 다음 참조가 가장 먼 미래에 있음
- 미래를 알고 있어야 함! (현실 불가능)
- 구현할 수 없지만 트레이스를 통해 모델링 가능
- 유용한 이유: 기회를 드러냄
- 이 정책은 miss rate(미스 비율)을 최소화하는 데 최적인가?
- 이 정책은 실행 시간을 최소화하는 데 최적인가?
- 아님. cache miss(캐시 미스) 지연/비용은 블록마다 다름!
- 이유 두 가지: 데이터 위치(로컬 cache(캐시)/원격 캐시/DRAM)와 미스 겹침
p.16쓰기 정책 선택
- cache hit(캐시 히트):
- write-through(쓰기-통과): cache(캐시)와 메모리 모두 씀
- • 일반적으로 트래픽이 더 많지만 파이프라인 및 cache(캐시) 설계가 간단함
- write-back(쓰기-백): cache(캐시)만 씀, 메모리는 항목이 치환될 때만 씀
- • 각 라인에 dirty bit(더티 비트) 추가로 write-back(쓰기-백) 트래픽 감소
- • 각 로드/스토어에 대해 메모리 접근 0, 1, 또는 2회 필요
- cache miss(캐시 미스):
- no-write-allocate(쓰기-할당 없음): 메인 메모리에만 씀
- 쓰기-할당(=쓰기-읽기): cache(캐시)에 가져옴
- 흔한 조합:
- write-through(쓰기-통과)와 no-write-allocate(쓰기-할당 없음)
- write-back(쓰기-백)과 write-allocate(쓰기-할당)
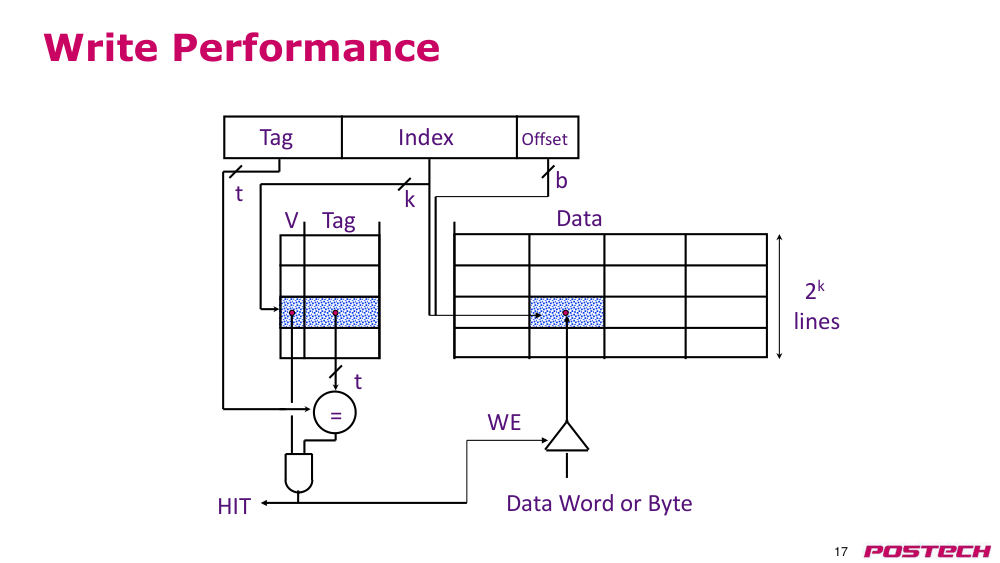
p.17쓰기 성능
- tag(태그)
- 데이터
- valid bit(유효 비트)
- =
- offset(오프셋)
- tag(태그)
- index(인덱스)
- t
- k
- b
- t
- 히트
- 데이터 워드 또는 바이트
- 2k 라인
- 쓰기 허용
p.18write hit time(쓰기 히트 시간) 감소
- 문제: 쓰기는 메모리 단계에서 두 사이클 소요, tag(태그) 검사 1 사이클 + 히트 시 데이터 쓰기 1 사이클
- 해결책:
- 읽기와 쓰기를 한 사이클 내에서 수행할 수 있는 데이터 RAM 설계, tag(태그) 미스 후 기존 값 복원
- pipelined writes(파이프라인화된 쓰기): 스토어의 쓰기 데이터를 cache(캐시) 앞의 단일 버퍼에 보관, 다음 스토어의 tag(태그) 검사 중 캐시 데이터 쓰기
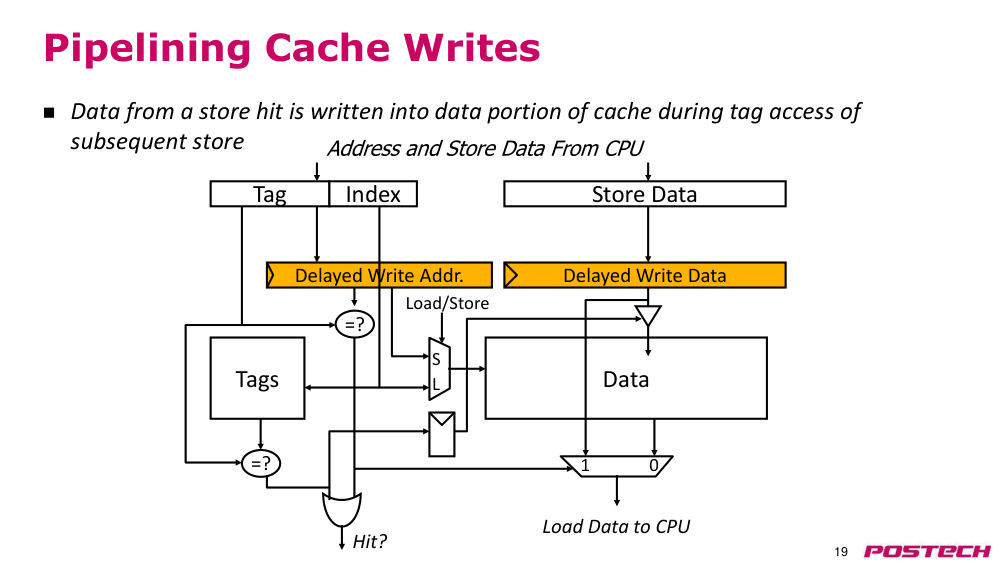
p.19cache(캐시) 쓰기의 파이프라인화
- 스토어 히트에서 데이터는 다음 스토어의 tag(태그) 접근 중 데이터 부분에 쓰임
- tag(태그)
- 데이터
- tag(태그)
- index(인덱스)
- 스토어 데이터
- CPU로부터 주소 및 스토어 데이터
- delayed write(지연 쓰기) 데이터
- delayed write(지연 쓰기) 주소
- CPU로 데이터 로드
- 로드/스토어
- L
- S
- 1
- 0
- 히트?
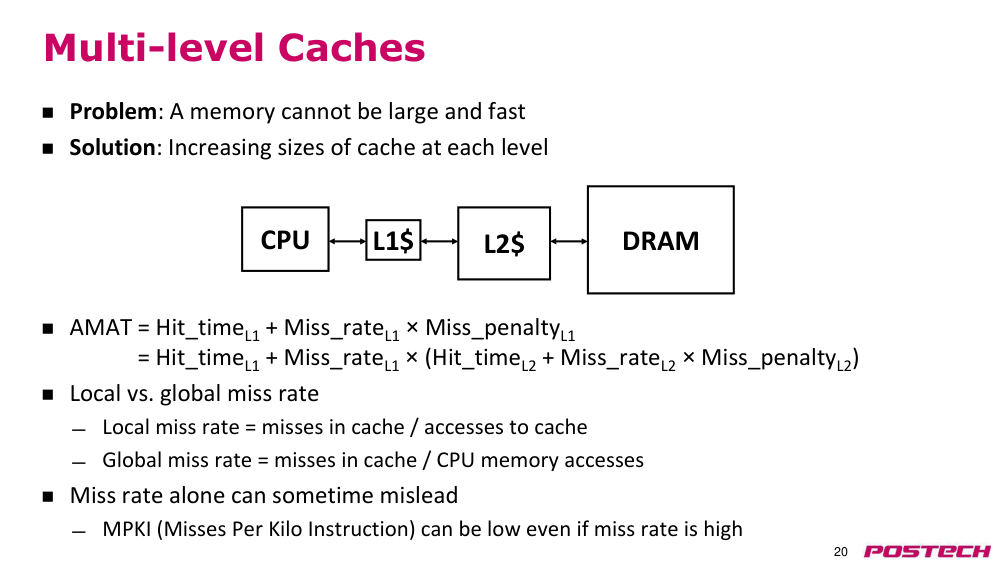
p.20multi-level caches(다수준 캐시)
- 문제: 메모리는 크고 빠르게 만들 수 없음
- 해결책: 각 레벨에서 cache size(캐시 크기)를 증가시킴
- 평균 메모리 접근 시간 (AMAT) = hit time(히트 시간)L1 + miss rate(미스 비율)L1 × miss penalty(미스 패널티)L1
- = hit time(히트 시간)L1 + miss rate(미스 비율)L1 × (히트 시간L2 + 미스 비율L2 × miss penalty(미스 패널티)L2)
- local miss rate(로컬 미스 비율) vs. global miss rate(글로벌 미스 비율)
- local miss rate(로컬 미스 비율) = cache(캐시) 내 미스 수 / 캐시 접근 수
- global miss rate(글로벌 미스 비율) = cache(캐시) 내 미스 수 / CPU 메모리 접근 수
- miss rate(미스 비율)만으로는 때때로 오해를 유발할 수 있음
- 천 명령어당 미스 수 (MPKI)는 miss rate(미스 비율)이 높아도 낮을 수 있음
- CPU
- L1$
- L2$
- DRAM
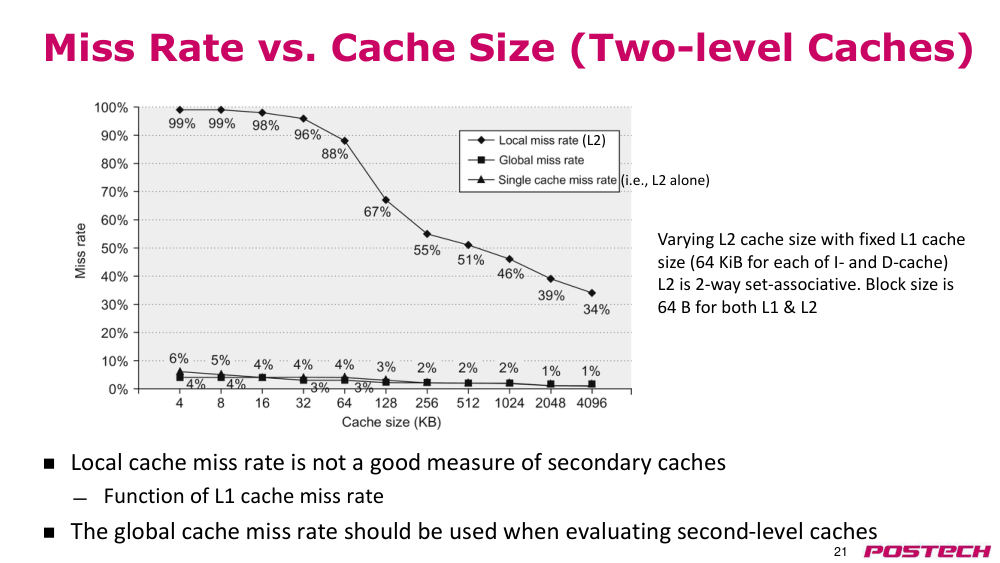
p.21miss rate(미스 비율) vs. cache(캐시) 크기 (이중 캐시)
- 로컬 cache(캐시) miss rate(미스 비율)은 2차 캐시 평가에 적합하지 않음
- L1 cache(캐시) miss rate(미스 비율)의 함수로서
- 2차 cache(캐시) 평가 시에는 글로벌 캐시 miss rate(미스 비율)을 사용해야 함
- 고정된 L1 cache(캐시) 크기(각각 I- 및 D-캐시 64 KiB)에서 L2 캐시 크기 변화
- L2는 2-way 세트 associativity(연관성). L1 및 L2 모두 block size(블록 크기)는 64 B
- (L2)
- (즉, L2만)
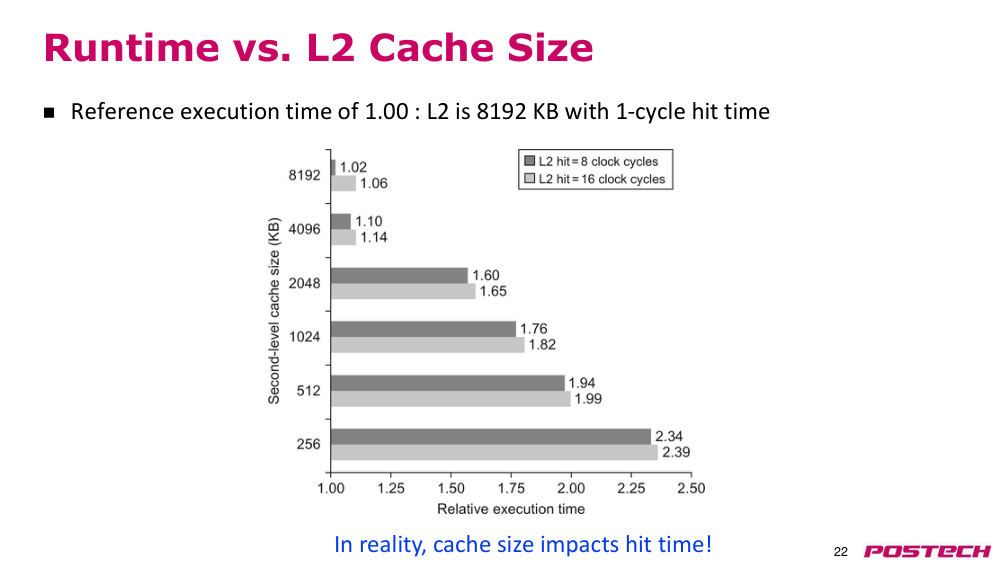
p.22L2 cache size(캐시 크기)와 실행 시간
- 참고 실행 시간: 1.00, L2 크기 8192 KB, hit time(히트 시간) 1 사이클
- 실제로 cache size(캐시 크기)는 hit time(히트 시간)에 영향을 미침!
p.23L2의 존재가 L1 설계에 미치는 영향
- L2가 존재하면 L1을 작게 사용함
- L1 miss rate(미스 비율) 증가를 허용하고 L1 hit time(히트 시간)을 감소시킴
- 백업 L2가 L1 miss penalty(미스 패널티)를 줄임
- 평균 접근 에너지를 감소시킴
- 온칩 L2와 함께 단순한 write-through(쓰기-통과) L1 사용
- write-back(쓰기-백) L2 cache(캐시)가 쓰기 트래픽을 흡수하여 외부 메모리로 가지 않음
- L1 접근당 최대 하나의 L1 미스 요청만 발생 (dirty victim write-back(더티 희생 라인 쓰기-백) 없음)으로 파이프라인 제어가 단순화됨
- 일관성 문제 단순화
- L1에서 오류 복구 단순화 (L1에서 패리티 비트만 사용하고, 패리티 오류 감지 시 L2에서 재로드)
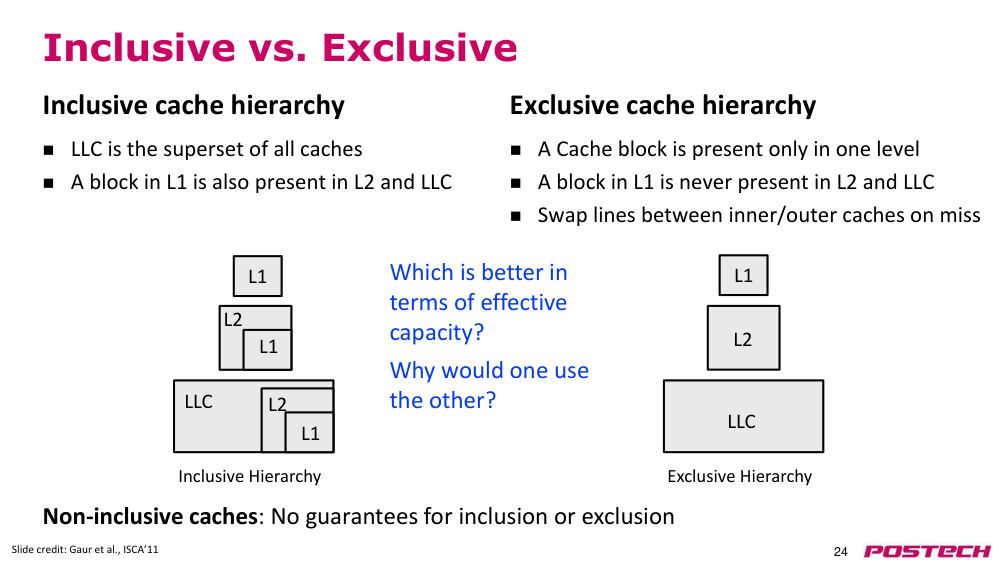
p.24inclusive cache hierarchy(포함 cache(캐시) 계층) vs. exclusive cache hierarchy(배제 캐시 계층)
- LLC는 모든 cache(캐시)의 초집합
- L1에 있는 블록은 L2 및 LLC에도 존재함
- cache(캐시) 블록은 오직 하나의 레벨에만 존재함
- L1에 있는 블록은 L2 및 LLC에 존재하지 않음
- 미스 발생 시 내부/외부 cache(캐시) 간 라인 교환
- LLC
- L1
- L2
- L1
- L1
- LLC
- L2
- 포함 계층
- 배제 계층
- L1
- L2
- L1
- 슬라이드 출처: Gaur 등, ISCA’11
- 어느 쪽이 효과적인 용량 측면에서 더 나은가?
- 왜 다른 쪽을 사용할까?
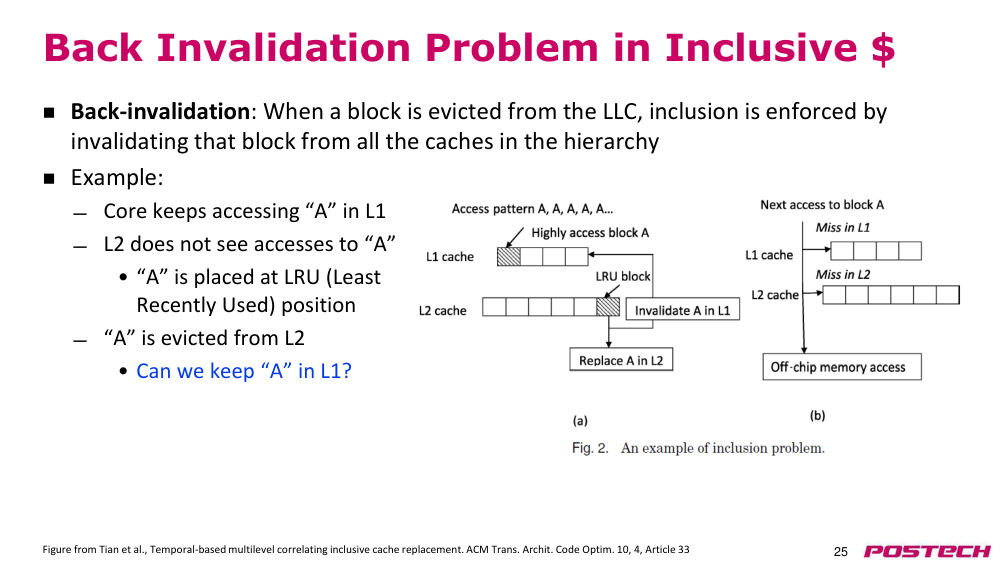
p.25포함 cache(캐시)에서의 back-invalidation(백인발리데이션) 문제
- back-invalidation(백인발리데이션): LLC에서 블록이 치환될 때, 계층 구조 내 모든 cache(캐시)에서 해당 블록을 무효화하여 포함성 유지
- 예시:
- 코어가 L1에서 "A"에 지속적으로 접근
- L2는 "A"에 대한 접근을 보지 못함
- • "A"는 LRU(최근에 사용되지 않은 것) 위치에 배치됨
- • "A"가 L2에서 치환됨
- • L1에 "A"를 유지할 수 있는가?
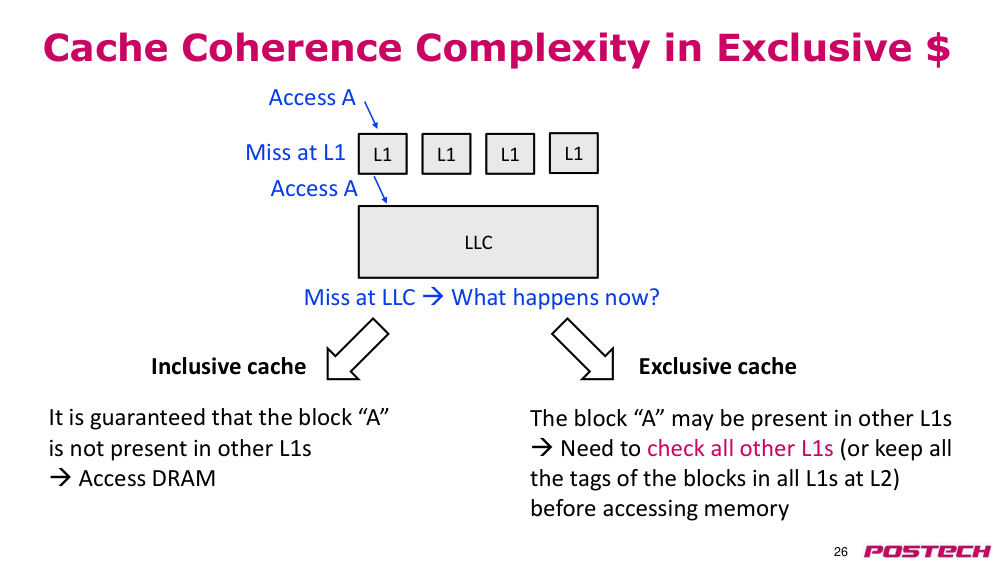
p.26배제 cache(캐시)에서의 cache coherence(캐시 일관성) 복잡성
- LLC
- L1
- L1
- L1
- A에 대한 접근
- L1에서 미스 발생
- LLC에서 미스 발생 → 이후 어떻게 되는가?
- A에 대한 접근
- L1
- 포함 cache(캐시)
- 블록 "A"가 다른 L1에 존재하지 않음을 보장
- → DRAM에 접근
- 배제 cache(캐시)
- 블록 "A"는 다른 L1에 존재할 수 있음
- → 메모리에 접근하기 전에 모든 다른 L1을 확인해야 함 (또는 L2에 모든 L1의 블록 tag(태그)를 유지)
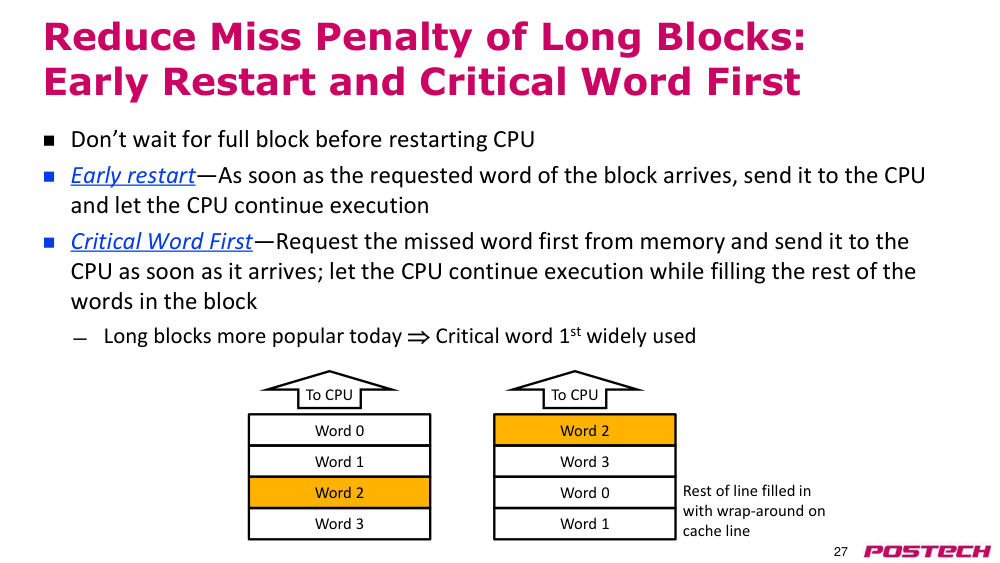
p.27긴 블록의 miss penalty reduction(미스 패널티 감소): early restart(조기 재시작)과 critical word first(크리티컬 워드 우선)
- 전체 블록 수신을 기다리지 않고 CPU 재시작
- early restart(조기 재시작): 블록의 요청된 단어가 도착하자마자 CPU에 전달하고 CPU가 실행을 계속하도록 함
- critical word first(크리티컬 워드 우선): 메모리에서 미스된 단어를 먼저 요청하고 도착하자마자 CPU에 전달; 블록의 나머지 단어가 채워지는 동안 CPU는 실행을 계속함
- 오늘날 긴 블록이 더 일반화됨 → critical word first(크리티컬 워드 우선)이 널리 사용됨
- Word 0
- Word 1
- Word 2
- Word 3
- CPU로 전달
- Word 2
- Word 3
- Word 0
- Word 1
- CPU로 전달
- cache line(캐시 라인)의 나머지 부분은 cache(캐시) 라인의 래핑 방식으로 채워짐
p.28non-blocking cache(비차단 캐시)를 통한 cache bandwidth(캐시 대역폭) 증가
- non-blocking cache(비차단 캐시) 또는 lockup-free cache(락업 프리 캐시)는 미스 발생 중에도 cache hit(캐시 히트)를 계속 제공할 수 있음
- • 레지스터에 전체/비어 있음 비트 또는 순서 외 실행이 필요
- • "hit under miss(미스 중 히트)"는 미스 중에 작업을 수행함으로써 효과적인 miss penalty(미스 패널티)를 감소시킴 (CPU 요청을 무시하는 것과 대비)
- • "hit under multiple miss(다중 미스 중 히트)" 또는 "미스 중 미스"는 여러 미스를 겹치게 하여 효과적인 miss penalty(미스 패널티)를 추가로 낮출 수 있음
- • MSHRs(미스 상태 보유 레지스터)가 필요 → 여러 개의 미완료 메모리 접근이 가능하므로 cache(캐시) 컨트롤러의 복잡도가 크게 증가하며, 미완료 미스가 있는 라인에 미스가 발생할 수 있음 (2차 미스)
- • 메모리 수준 병렬성 활용 가능
- • 파이프라인화되거나 banked memory system(뱅크드 메모리 시스템)이 필요 (다중 미스를 지원하지 않으면 불가능)
- • Cray X1E 벡터 슈퍼컴퓨터는 2,048개의 미완료 메모리 미스를 허용
p.29SPEC92에서의 hit under miss(미스 중 히트)의 가치
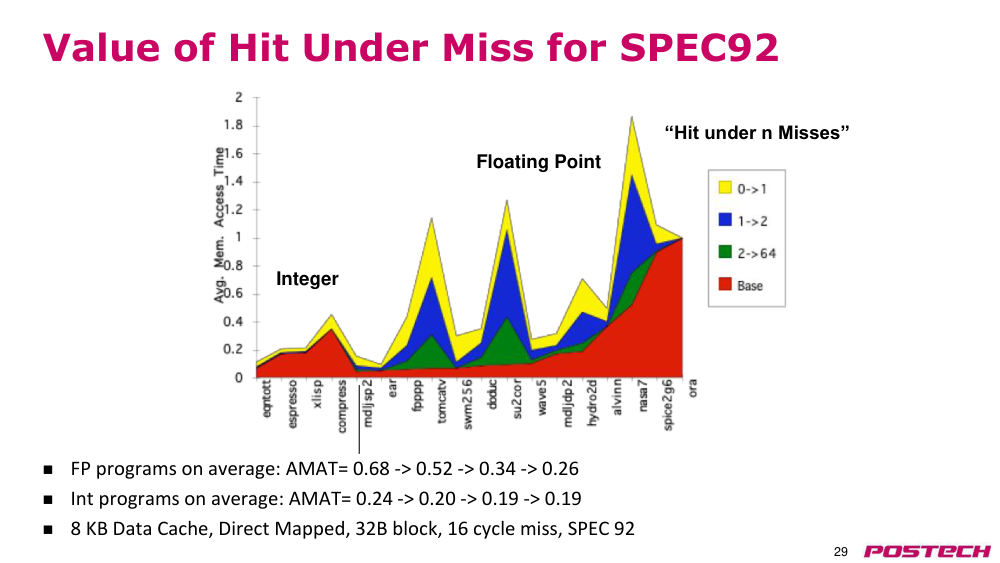
- FP 프로그램 평균: AMAT = 0.68 → 0.52 → 0.34 → 0.26
- Int 프로그램 평균: AMAT = 0.24 → 0.20 → 0.19 → 0.19
- 8 KB 데이터 cache(캐시), 직접 매핑, 32B 블록, 16 사이클 미스, SPEC 92
- 정수
- 부동소수점
- "미스 중 n번의 히트"
p.30MSHR(미스 상태 처리 레지스터)
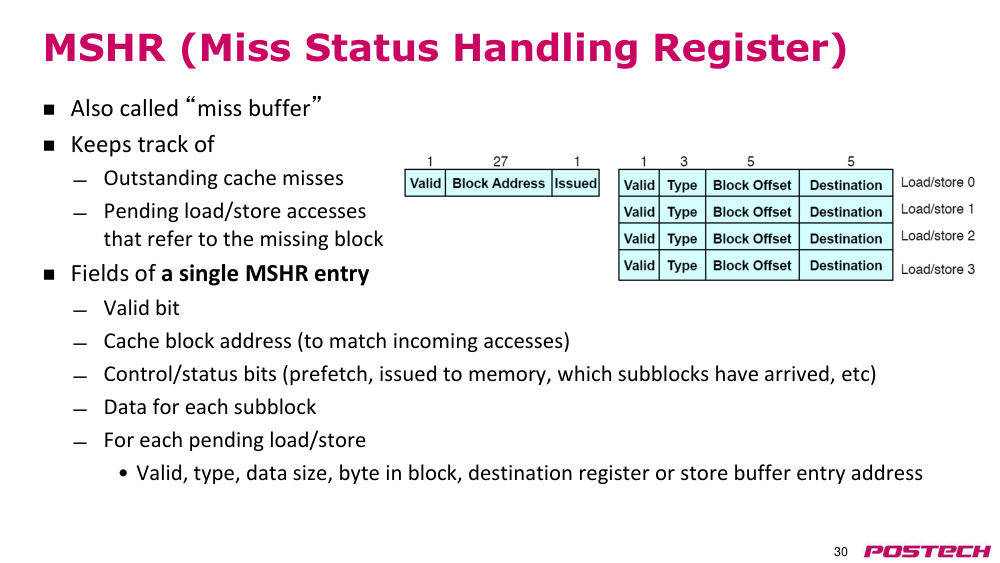
- 또는 "미스 버퍼"라고도 함
- • 미완료 cache miss(캐시 미스)를 추적
- • 미스 블록을 참조하는 보류 중인 로드/스토어 접근
- 단일 MSHR 항목의 필드:
- • valid bit(유효 비트)
- • cache(캐시) 블록 주소 (들어오는 접근과 매칭)
- • 제어/상태 비트 (프리패치, 메모리에 발행됨, 어떤 sub-block(서브블록)이 도착함 등)
- • 각 sub-block(서브블록)에 대한 데이터
- 각 보류 중인 로드/스토어에 대해:
- • 유효, 유형, 데이터 크기, 블록 내 바이트 위치, 목적 레지스터 또는 store buffer(스토어 버퍼) 항목 주소
p.31MSHR 동작
- cache miss(캐시 미스) 발생 시:
- • 동일한 블록에 대한 대기 중인 접근을 MSHR에서 검색
- • 발견된 경우: 동일한 MSHR 항목에 로드/스토어 항목 할당
- • 발견되지 않은 경우: 새로운 MSHR 할당
- • 사용 가능한 항목 없음: 정지(stall)
- 다음 레벨 메모리에서 sub-block(서브블록)이 반환될 때:
- • 해당 sub-block(서브블록)을 기다리는 로드/스토어 확인
- • 데이터를 로드/스토어 유닛으로 전달
- • MSHR 항목 내의 로드/스토어 항목 해제
- • cache(캐시) 또는 MSHR에 sub-block(서브블록) 쓰기
- • 마지막 sub-block(서브블록)인 경우, cache(캐시)에 블록 쓴 후 MSHR 해제
p.32Exponential X704 PowerPC 프로세서 (1997)
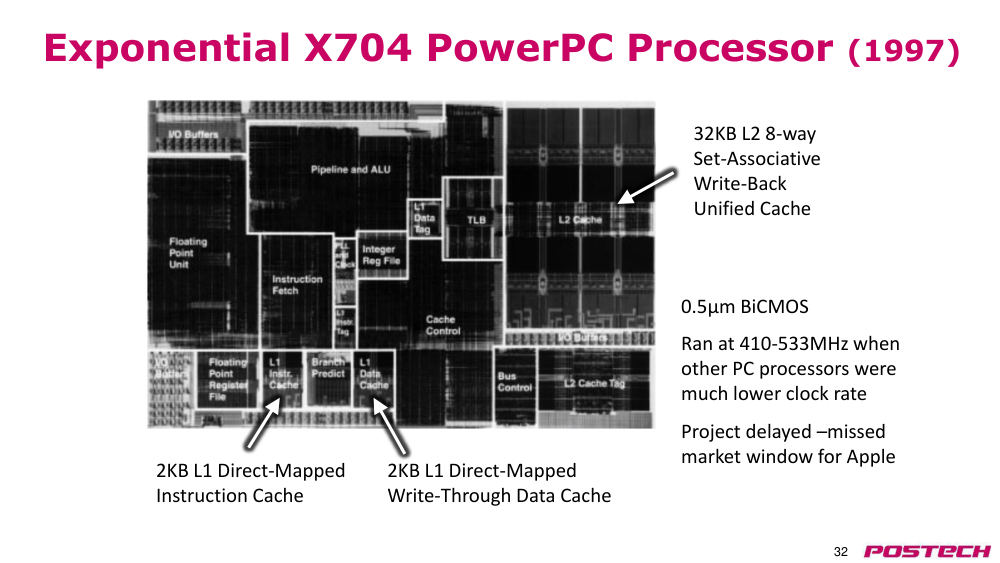
- 2KB L1 직접 매핑 명령어 cache(캐시)
- 2KB L1 직접 매핑 write-through(쓰기-통과) 데이터 cache(캐시)
- 32KB L2 8-way 세트 associativity(연관성) write-back(쓰기-백) 통합 cache(캐시)
- 0.5µm BiCMOS
- 기타 PC 프로세서보다 훨씬 낮은 클럭 속도에서 410-533MHz 작동
- 프로젝트 지연 – 애플의 시장 창문 놓침
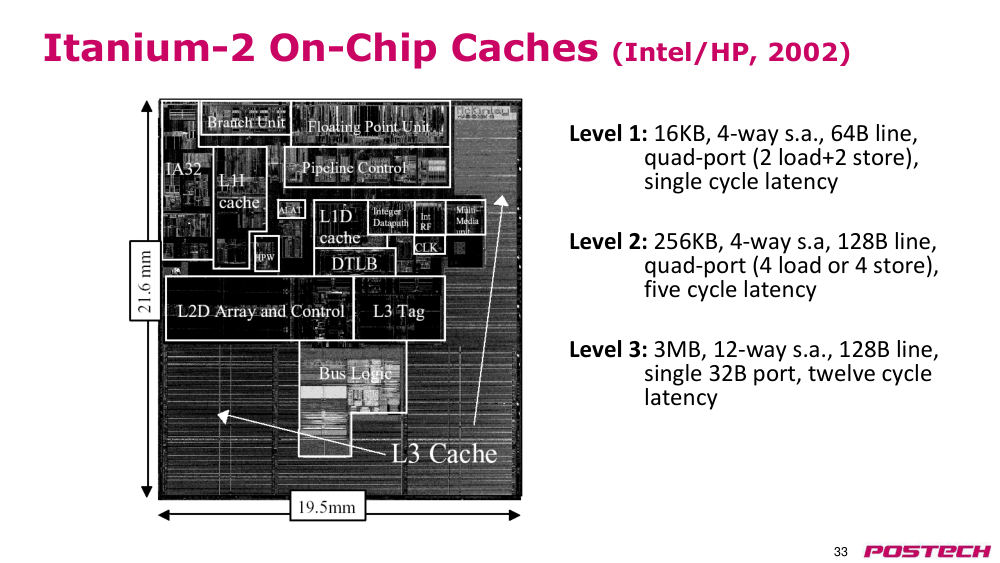
p.33Itanium-2 온칩 캐시 (Intel/HP, 2002)
- 레벨 1: 16KB, 4-way 세트 associativity(연관성), 64B 라인, 4포트 (로드 2개 + 스토어 2개), 단일 사이클 지연
- 레벨 2: 256KB, 4-way 세트 associativity(연관성), 128B 라인, 4포트 (로드 4개 또는 스토어 4개), 5사이클 지연
- 레벨 3: 3MB, 12-way 세트 associativity(연관성), 128B 라인, 단일 32B 포트, 12사이클 지연
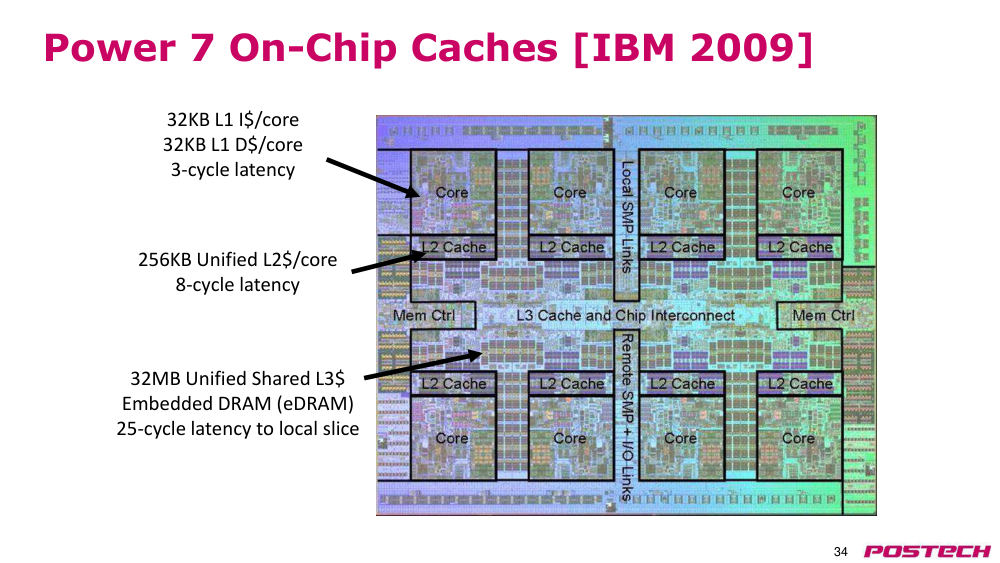
p.34Power 7 온칩 cache(캐시) [IBM 2009]
- 32KB L1 I$/코어
- 32KB L1 D$/코어
- 3사이클 지연
- 256KB 통합 L2$/코어
- 8사이클 지연
- 32MB 통합 공유 L3$
- 임베디드 DRAM (eDRAM)
- 로컬 슬라이스까지 25사이클 지연
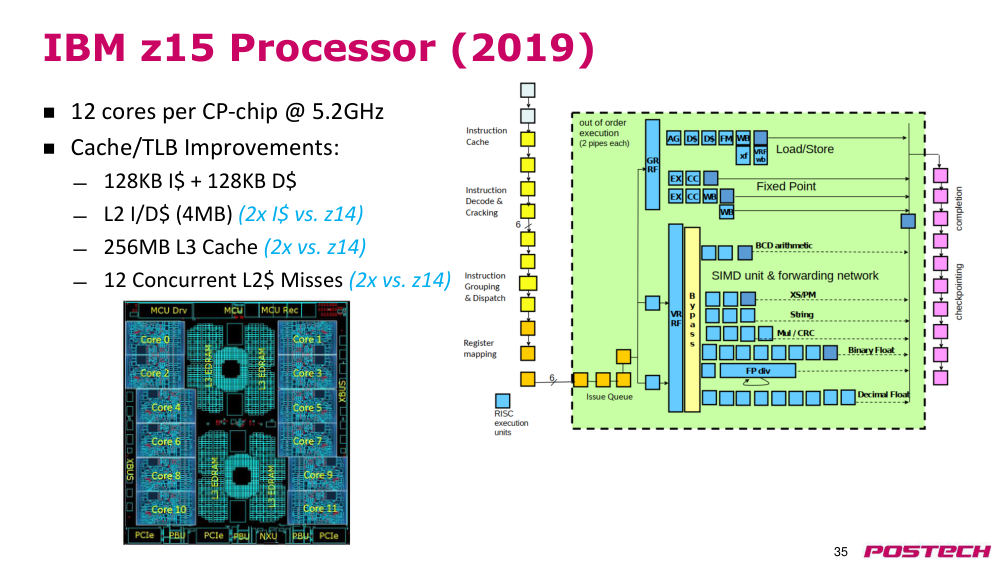
p.35IBM z15 프로세서 (2019)
- CP-칩당 12코어, 5.2GHz
- cache(캐시)/TLB 개선:
- • 128KB I$ + 128KB D$
- • L2 I/D$ (4MB) (z14 대비 2배)
- • 256MB L3 캐시 (z14 대비 2배)
- • 동시 12개의 L2$ 미스 처리 (z14 대비 2배)
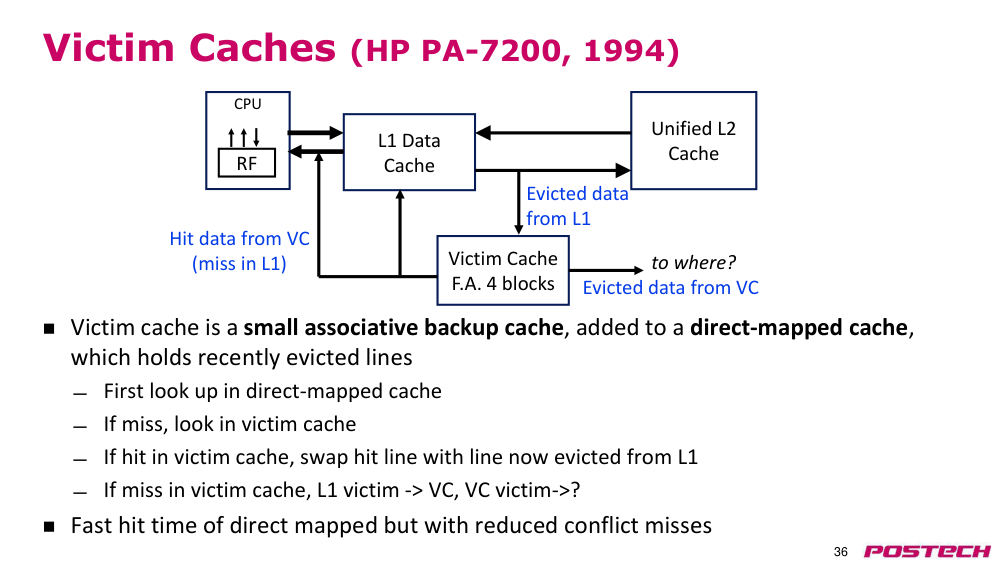
p.36victim cache(희생 캐시) (HP PA-7200, 1994)
- victim cache(희생 캐시)는 직접 매핑 캐시에 추가된 작은 associativity(연관성) 백업 캐시로, 최근에 치환된 라인을 보관
- • 먼저 직접 매핑 cache(캐시)에서 검색
- • 미스인 경우 victim cache(희생 캐시) 검색
- • victim cache(희생 캐시)에서 히트 시, 히트된 라인과 현재 L1에서 치환된 라인 교환
- • victim cache(희생 캐시)에서도 미스인 경우: L1 victim(희생 라인) → VC, VC victim(희생 라인) → ?
- • 직접 매핑 cache(캐시)의 빠른 hit time(히트 시간)과 함께 conflict miss(충돌 미스) 감소
p.37MIPS R10000 외부 L2 캐시 (Yeager, 1996)
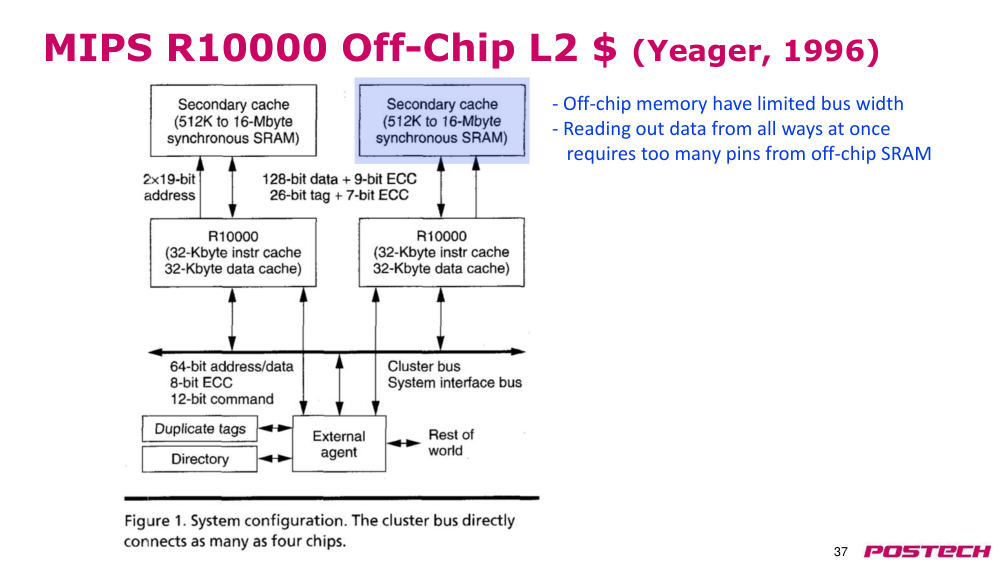
- 외부 메모리는 제한된 버스 폭을 가짐
- 모든 웨이에서 동시에 데이터를 읽는 것은 외부 SRAM에서 너무 많은 핀을 필요로 함
p.38웨이 예측 캐시 (MIPS R10000 L2 캐시)
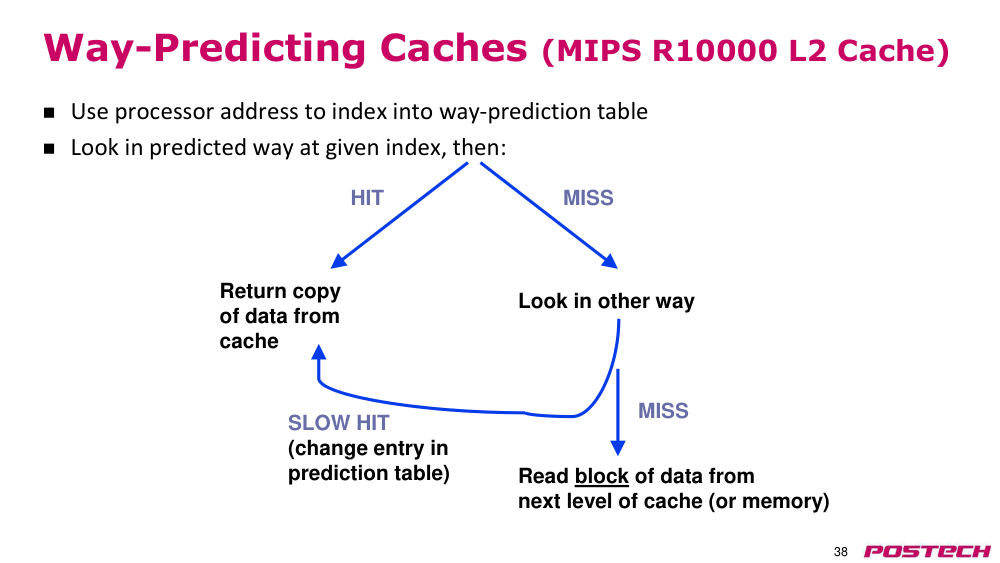
- 프로세서 주소를 사용하여 웨이 예측 테이블에 인덱싱
- 지정된 index(인덱스)에서 예측된 웨이를 확인하고, 다음 중 하나 수행:
- - 히트: cache(캐시)에서 데이터 복사본 반환
- - 미스: 다른 웨이를 확인하고, 다음 레벨 캐시(또는 메모리)에서 데이터 블록을 읽음
- - 느린 히트: 예측 테이블 항목 변경
p.39R10000 L2 cache(캐시) 타이밍 다이어그램
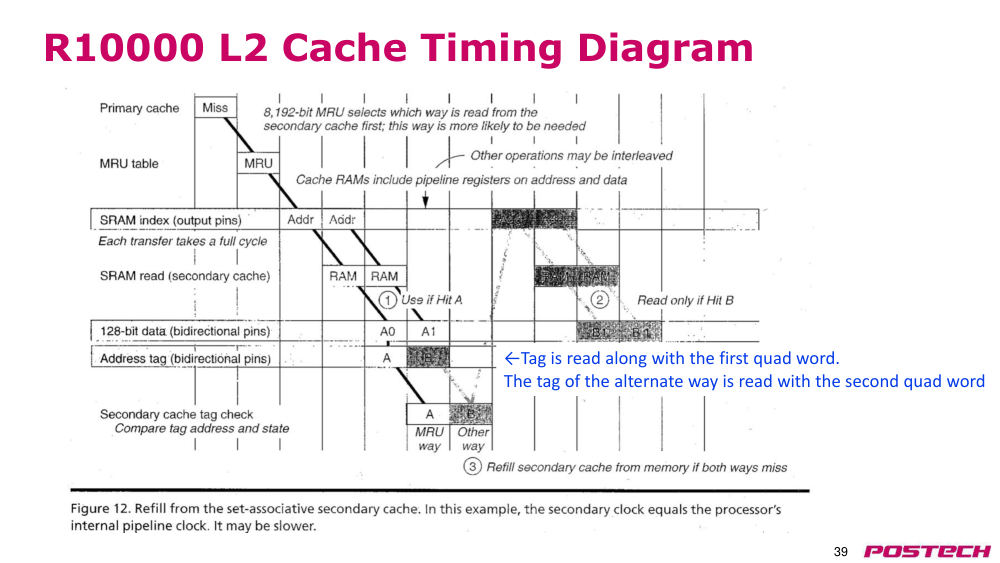
- tag(태그)는 첫 번째 quad word(쿼드 워드)와 함께 읽힘.
- 대체 웨이의 tag(태그)는 두 번째 quad word(쿼드 워드)와 함께 읽힘
p.40웨이 예측 명령어 캐시 (Alpha 21264 유사)
- PC addr
- inst
- 주 명령어 cache(캐시)
- 0x4
- Add
- 순차 웨이
- 브랜치 타겟 웨이
- way
- 점프 타겟
- 점프 컨트롤
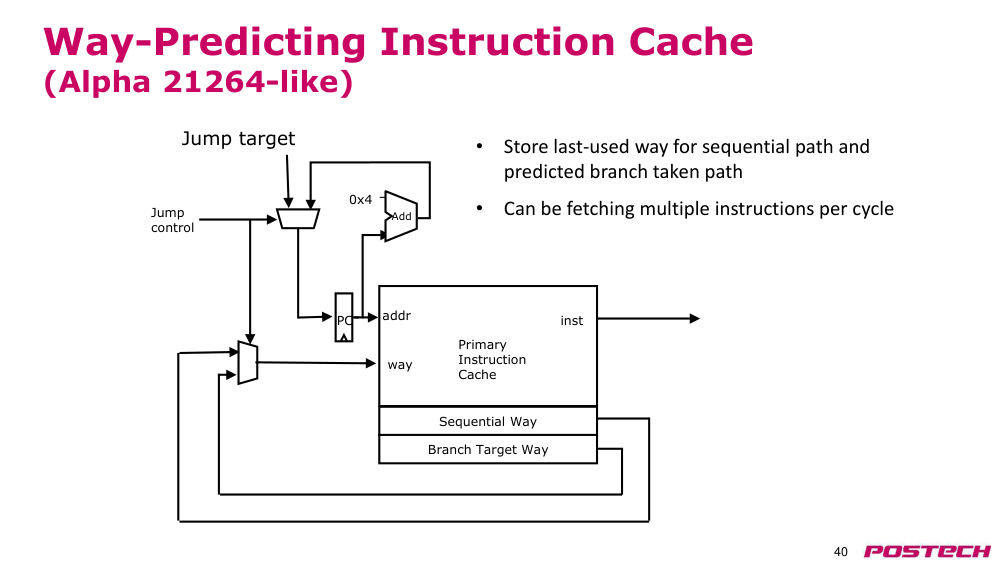
- • 순차 경로와 predicted branch taken path(예측된 분기 취함 경로)의 마지막 사용 웨이 저장
- • 사이클당 여러 명령어를 가져올 수 있음
p.41컴파일러 최적화
- 코드 재구성은 데이터 접근 순서에 영향을 줌 ̶
- - 데이터 접근을 그룹화하여 spatial locality(공간적 지역성) 향상
- - 데이터 접근 순서를 재정렬하여 temporal locality(시간적 지역성) 향상
- • cache(캐시)에 데이터가 들어가는 것을 방지 (cache bypassing(캐시 우회)) ̶
- - 한 번만 접근하고 다시 치환될 변수에 유용
- - 소프트웨어가 하드웨어에 cache(캐시)에 저장하지 말라고 알리는 메커니즘이 필요 ("no-allocate" 명령어 힌트 또는 페이지 테이블 비트)
- • 더 이상 사용되지 않을 데이터를 제거 ̶
- - streaming data(스트리밍 데이터)는 spatial locality(공간적 지역성)은 활용하지만 temporal locality(시간적 지역성)은 활용하지 않음
- - 죽은 cache(캐시) 위치에 치환
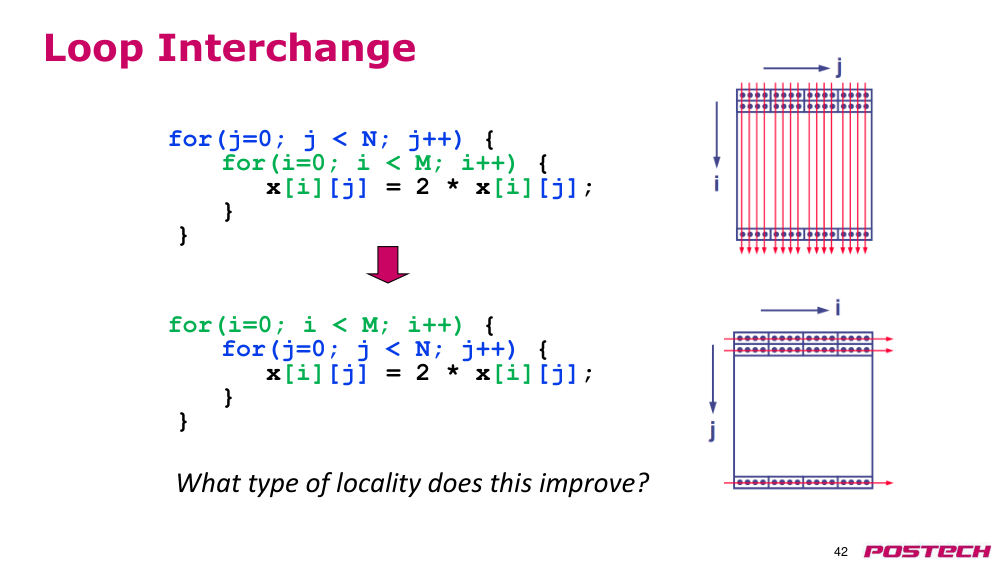
p.42루프 교환
- for(j=0; j < N; j++) {
- for(i=0; i < M; i++) {
- x[i][j] = 2 * x[i][j];
- }
- }
- for(i=0; i < M; i++) {
- for(j=0; j < N; j++) {
- x[i][j] = 2 * x[i][j];
- }
- }
- 이것이 개선하는 지역성의 유형은 무엇입니까?
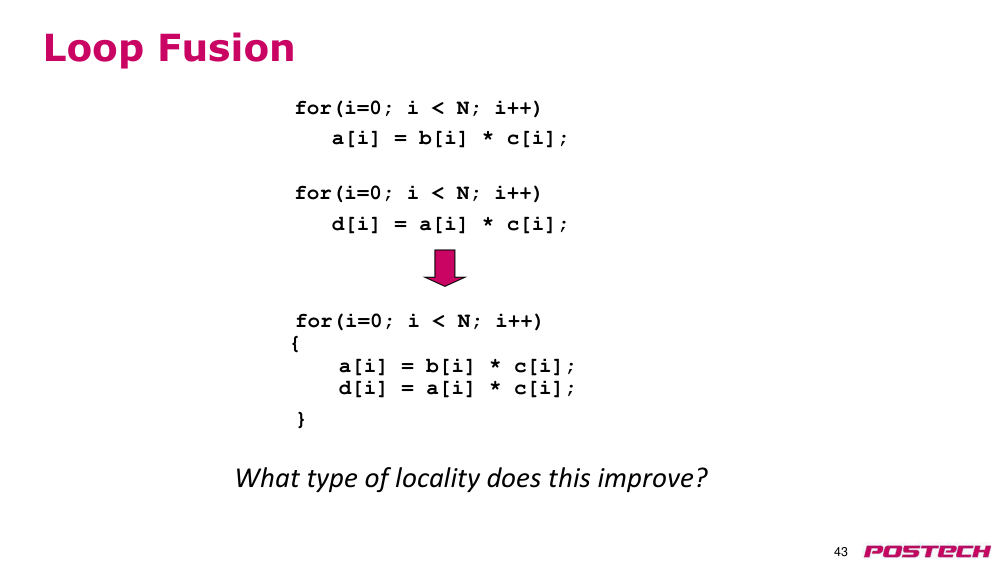
p.43루프 융합
- 루프 융합 전:
- for(i=0; i < N; i++)
- a[i] = b[i] * c[i];
- for(i=0; i < N; i++)
- d[i] = a[i] * c[i];
- 루프 융합 후:
- for(i=0; i < N; i++)
- {
- a[i] = b[i] * c[i];
- d[i] = a[i] * c[i];
- }
- 이 방법이 개선하는 지역성의 유형은 무엇인가요?
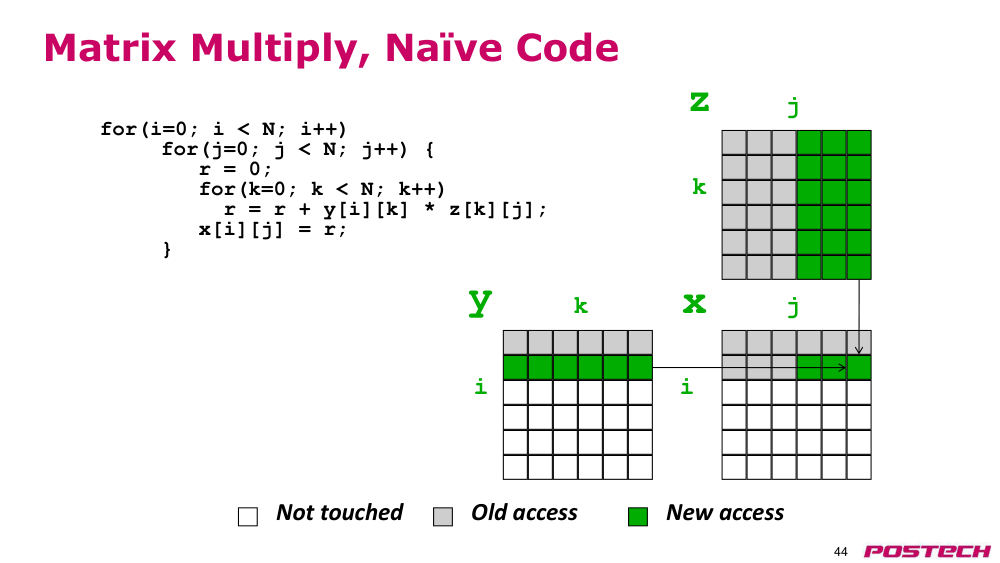
p.44행렬 곱셈, 단순 코드
- for(i=0; i < N; i++)
- for(j=0; j < N; j++) {
- r = 0;
- for(k=0; k < N; k++)
- r = r + y[i][k] * z[k][j];
- x[i][j] = r;
- }
- 접근되지 않음
- 이전 접근
- 새로운 접근
- x
- j
- i
- y
- k
- i
- z
- j
- k
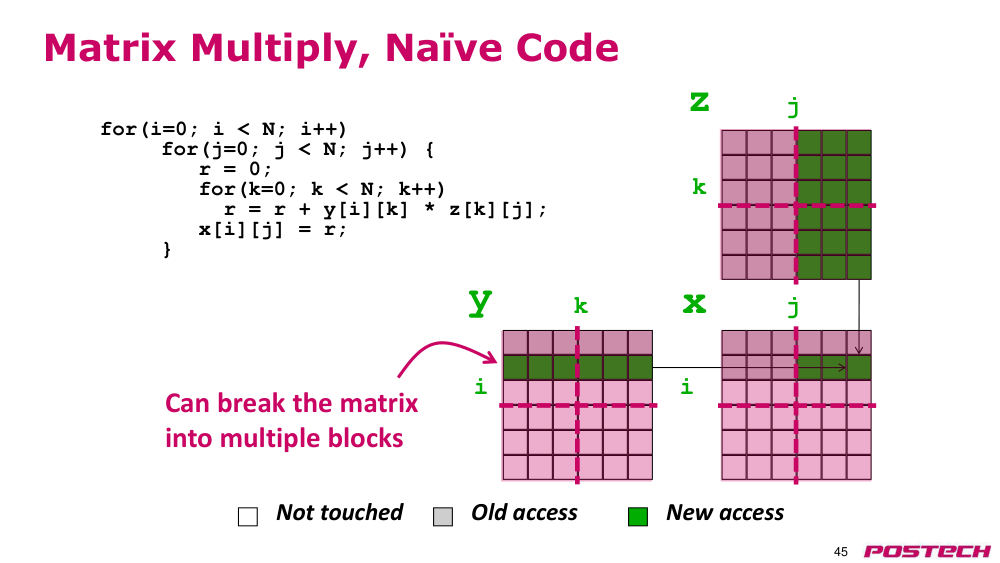
p.45행렬 곱셈, 단순 코드
- for(i=0; i < N; i++)
- for(j=0; j < N; j++) {
- r = 0;
- for(k=0; k < N; k++)
- r = r + y[i][k] * z[k][j];
- x[i][j] = r;
- }
- 접근되지 않음
- 이전 접근
- 새로운 접근
- x
- j
- i
- y
- k
- i
- z
- j
- k
- 행렬을 여러 블록으로 나눌 수 있음
p.46블록 행렬 곱셈
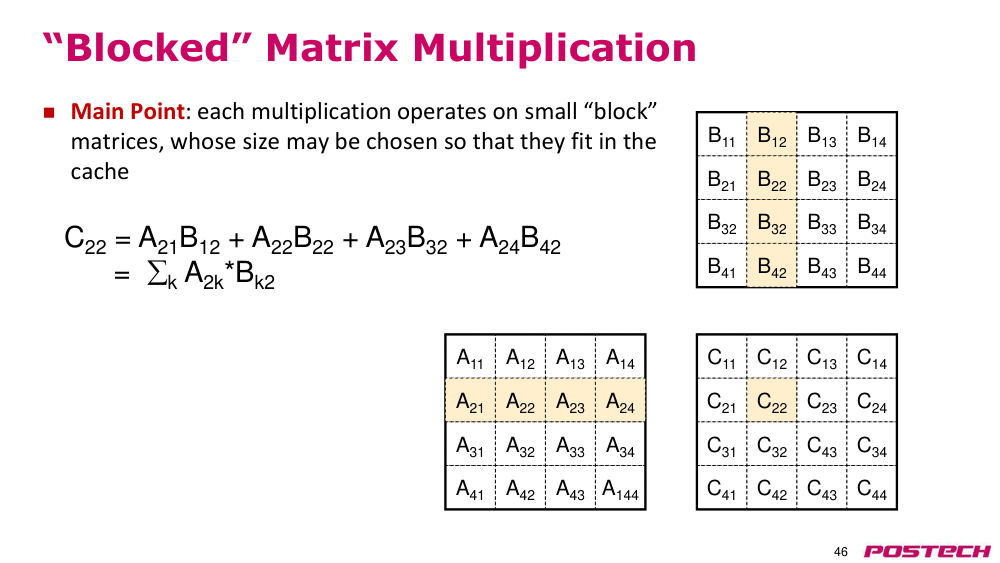
- 주요 포인트: 각 곱셈은 크기가 작아서 cache(캐시)에 맞는 작은 '블록' 행렬을 처리한다.
- 블록 행렬의 크기는 cache(캐시)에 맞게 선택될 수 있다.
p.47cache(캐시) 블로킹을 사용한 행렬 곱셈
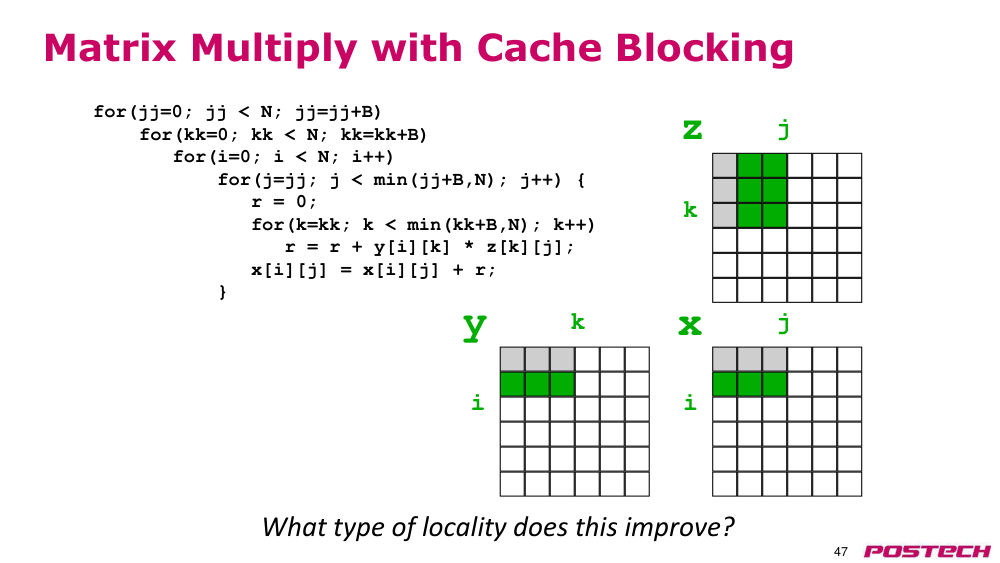
- 다음 코드는 cache(캐시) 블로킹을 사용한 행렬 곱셈이다.
- ```c
- for(jj=0; jj < N; jj=jj+B)
- for(kk=0; kk < N; kk=kk+B)
- for(i=0; i < N; i++)
- for(j=jj; j < min(jj+B,N); j++) {
- r = 0;
- for(k=kk; k < min(kk+B,N); k++)
- r = r + y[i][k] * z[k][j];
- x[i][j] = x[i][j] + r;
- }
- ```
- 이 코드가 개선하는 지역성의 유형은 무엇인가?
- y
- k
- i
- z
- j
- k
- x
- j
- i
p.48질문?
- 추천 독서: Chapter 2.3