Lec 12 · VLIW 컴파일 기법 (loop unrolling, software pipelining, trace scheduling)
정밀 정리 · 검증 2026-09-24 03:10
1개요
1.1Lec 9(VLIW) 후반부: VLIW 복습과 초기 VLIW machine(AP-120B, Multiflow Trace, Cydra-5).
1.2B[i]=A[i]+C loop 로 기본 schedule 0.125 → loop unrolling 0.36 → software pipelining 1 FLOP/cycle 비교.
1.3irregular code 의 짧은 basic block 문제와 trace scheduling. p16 부터는 Zoom 회의 이동으로 이 영상에 설명 없음.
2섹션별 정리 상황·문제 → 원인 → 해결
2.10:00–2:36행정: Zoom 40분 제한 안내
상황·문제Zoom 무료 계정 40분 제한으로 회의가 끊기면 미리 준 다른 Zoom 링크로 재접속하라는 안내(닉네임 변경 요청 포함).
2.22:36–5:16VLIW 복습: fixed slot 과 compiler 책임
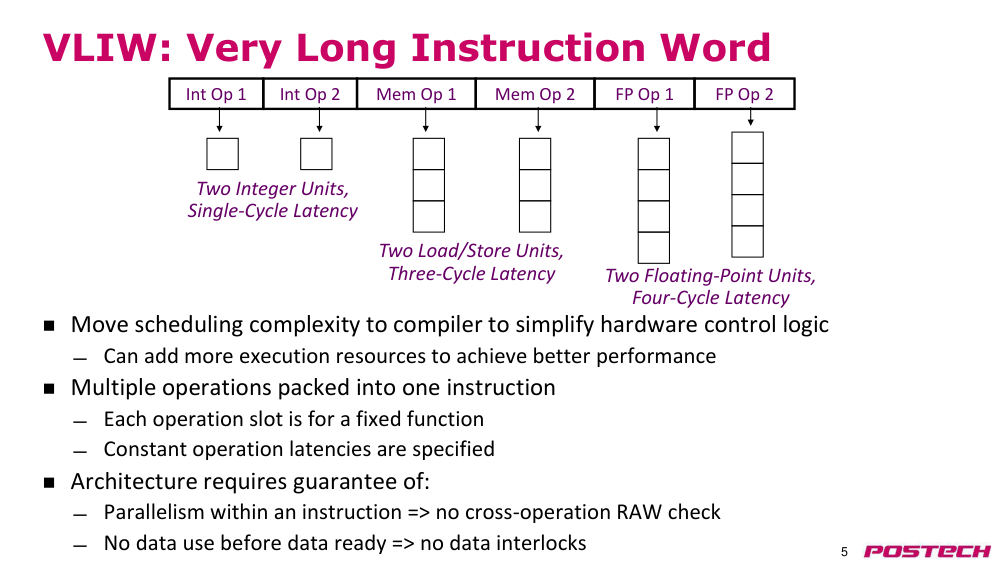
상황·문제VLIW = 한 very long instruction 에 여러 연산(Int·Mem·FP slot 각 2개)을 담는 구조.
원인연산 latency 가 다르고 hardware 가 dependence check·stall 을 하지 않으므로, instruction 내·instruction 간 독립성을 compiler 가 보장해야 한다.
해결복잡도를 hardware→software 로 이동. 성공하면 단순 HW 에 execution unit 을 더 붙일 수 있으나 많은 application 에선 잘 안 된다고 언급.
- instruction 내 연산 간 dependence check 없음
- 앞 instruction 과의 dependence 로 stall 하는 hardware 불필요
2.2.r.1Very long instruction word — Wikipedia ↗ · compiler 가 병렬 연산을 한 wide instruction 으로 묶는 개념, 역사, code size·호환성 문제
2.35:16–8:29초기 VLIW machine: AP-120B, Multiflow Trace, Cydra-5
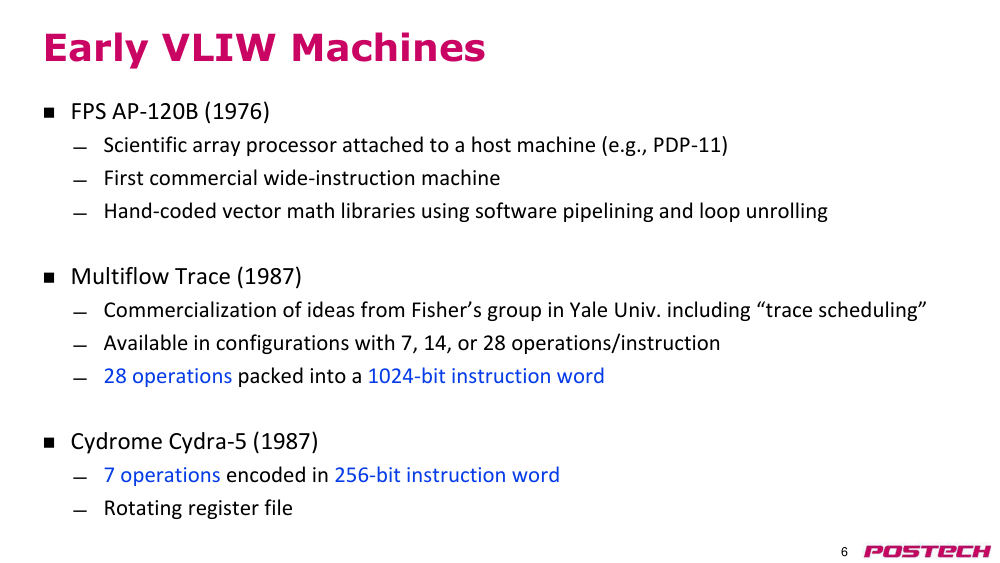
상황·문제초기 VLIW 는 compiler 가 미성숙해 활용이 어려웠다.
원인AP-120B(1976) 시절 compiler 가 이 구조를 위한 code 를 만들지 못함. 짧은 basic block 이 많으면 한 word 를 채울 연산을 찾기 어려움.
해결AP-120B: software pipelining·loop unrolling 을 쓴 hand-coded vector math library. Multiflow: trace scheduling 으로 basic block 묶음, 28 ops/1024-bit. Cydra-5: 7 ops/256-bit, rotating register file.
- AP-120B 는 PDP-11 같은 host 에 붙는 과학용 array processor, 최초 상용 wide-instruction machine
- Multiflow 의 이름 Trace 는 Yale 의 trace scheduling 에서 옴(강의에선 1980 이라 말했으나 slide 는 1987)
2.48:29–9:25VLIW compiler 의 책임
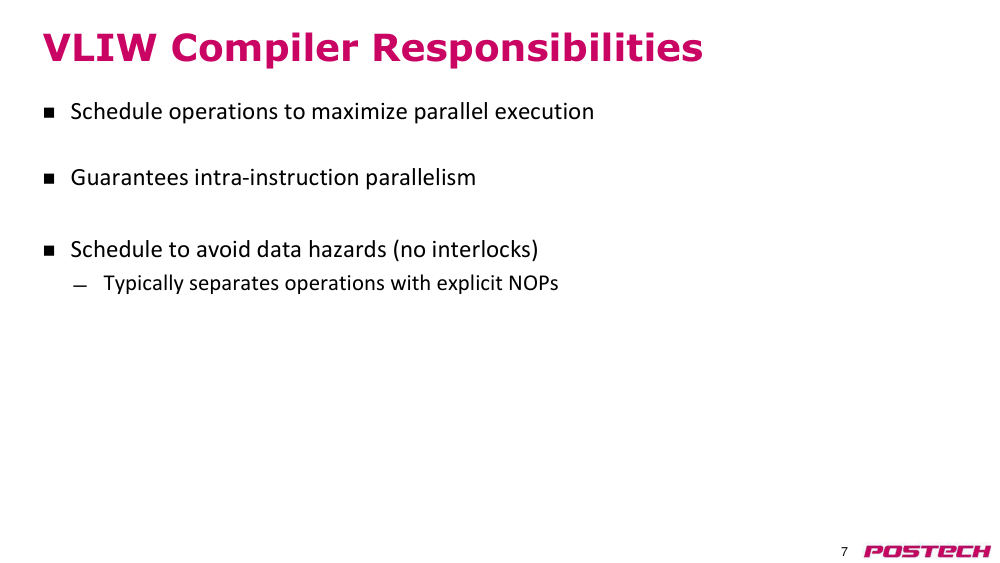
상황·문제compiler 가 여러 연산을 한 word 에 schedule 해 병렬 실행을 극대화해야 한다.
원인hardware interlock 이 없어 dependent 연산 사이 간격을 compiler 가 확보해야 한다.
해결사이에 넣을 유용한 일이 없으면 NOP 을 넣어 hazard 회피.
- intra-instruction parallelism 보장
- data hazard 를 hardware 지원 없이 회피
2.4.r.1Very long instruction word — Wikipedia ↗ · compiler 가 병렬 연산을 한 wide instruction 으로 묶는 개념, 역사, code size·호환성 문제
2.59:25–13:54Loop 예제: B[i]=A[i]+C 의 기본 schedule
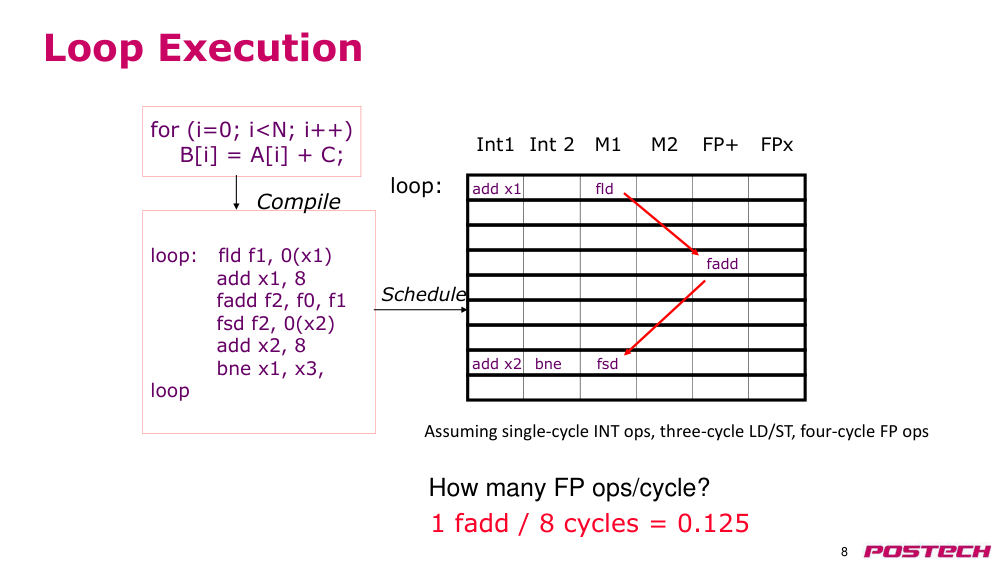
상황·문제vector 에 scalar 를 더하는 loop 를 VLIW 에 올리면 성능이 매우 낮다.
원인fld(3 cycle)→fadd(4 cycle)→fsd 의존 사슬만 있고 loop body 에 독립 연산이 부족.
해결1 FP op / 8 cycles = 0.125 ops/cycle(이상적 1 의 1/8) → loop unrolling 등으로 독립 연산을 늘려야 함.
- 가정 latency: Int 1, memory 3, FP 4 cycle
- add x1·add x2(pointer 증가)·bne 는 의존이 없어 빈 slot 에 배치
2.5.r.1Very long instruction word — Wikipedia ↗ · compiler 가 병렬 연산을 한 wide instruction 으로 묶는 개념, 역사, code size·호환성 문제
2.613:54–18:59Loop unrolling 과 그 schedule
상황·문제0.125 ops/cycle 은 loop body 내 독립 연산 부족 때문.
원인unroll 없이는 한 iteration 에 fld·fadd·fsd 한 쌍뿐.
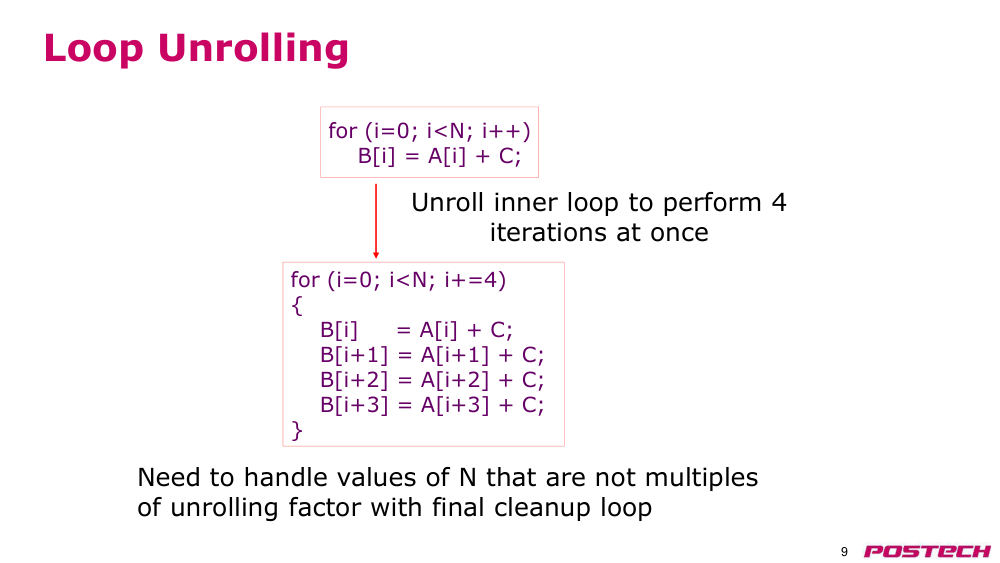
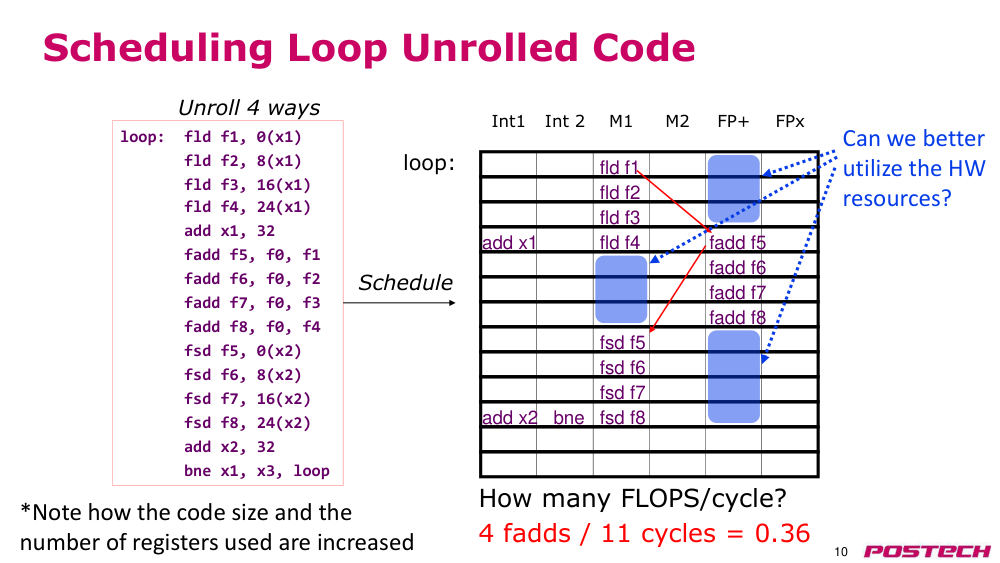
해결4-way unroll → 4 fadds / 11 cycles = 0.36(약 3배). 대가: code size 증가, FP register 2→8개. N 이 4의 배수가 아니면 cleanup loop.
- N=30 예: unroll loop 7회 + cleanup 2회
- FP unit 은 여전히 비는 cycle 이 있음
2.718:59–24:50Software pipelining
상황·문제unroll 후에도 FP unit 이 충분히 쓰이지 않는다.
원인한 iteration 안에서만 schedule 하면 load→add→store latency 동안 slot 이 빈다.
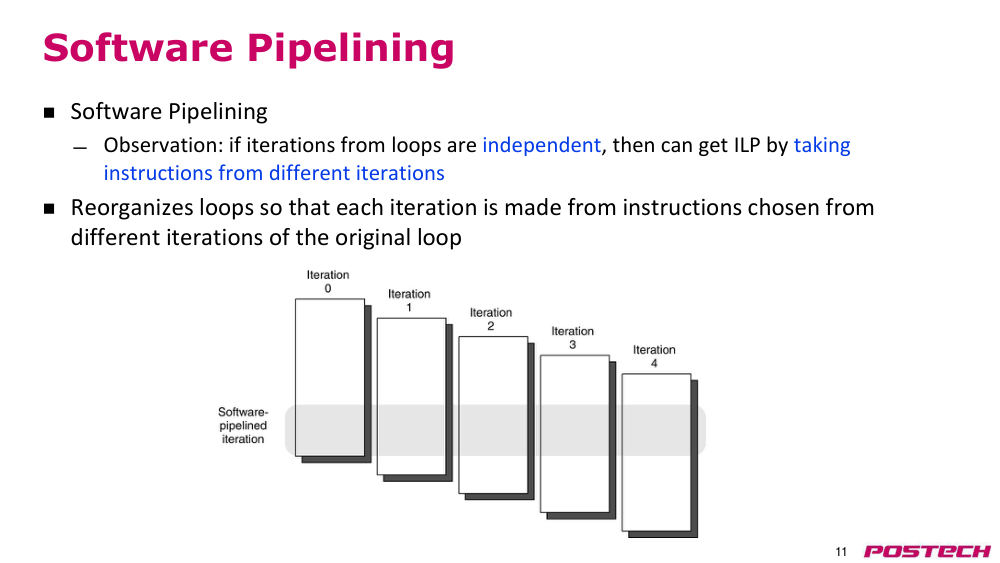
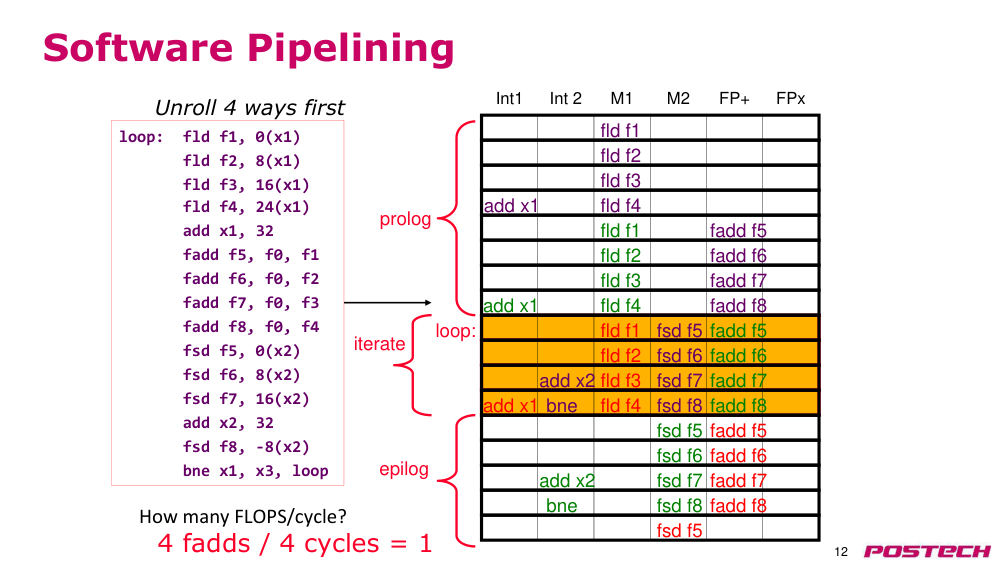
해결독립인 여러 iteration 의 연산을 겹쳐 schedule(다음 iteration fld 를 현재 fadd 와 동시에). prolog·iterate·epilog 구조로 4 fadds / 4 cycles = 1 FLOP/cycle.
- add x2 를 앞으로 옮기고 마지막 store 는 fsd f8,-8(x2) 로 offset 보정
- loop 앞 code = prologue, 뒤 = epilogue
2.7.r.1Software pipelining — Wikipedia ↗ · prologue/epilogue, loop unrolling 과의 결합, IA-64 rotating register
2.824:50–27:21Software pipelining vs loop unrolling
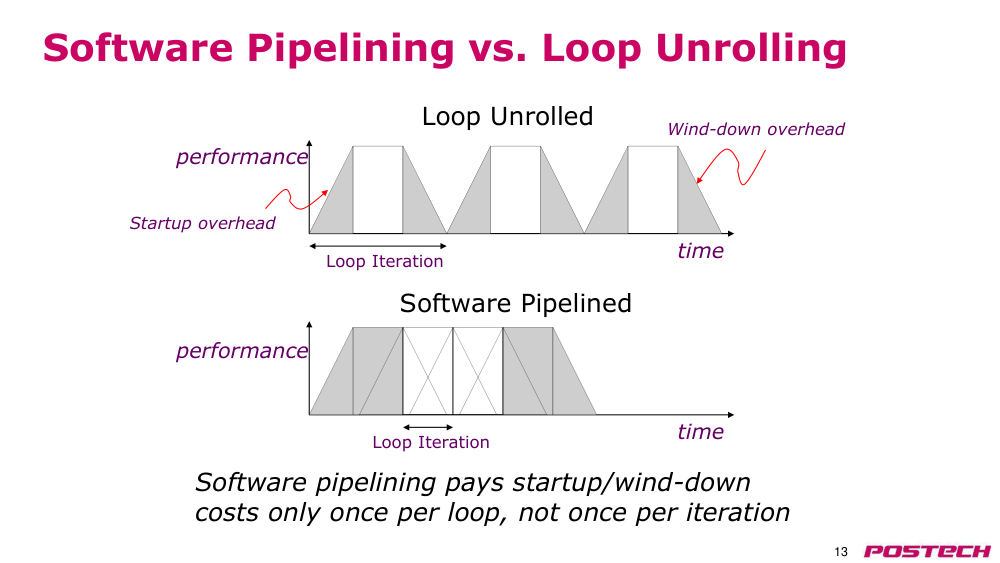
상황·문제두 기법의 overhead 차이를 그래프로 비교.
원인unrolling 은 iteration 마다 ramp-up(load)·wind-down(store) 을 반복해 main 부분 동안 HW 를 다 못 씀.
해결software pipelining 은 여러 iteration 을 압축해 main 부분을 계속 실행, 시작·끝 비용은 loop 당 한 번.
- startup/wind-down cost: unrolling 은 iteration 당, SWP 는 loop 당
2.8.r.1Software pipelining — Wikipedia ↗ · prologue/epilogue, loop unrolling 과의 결합, IA-64 rotating register
2.927:21–29:09Irregular code: 짧은 basic block 의 한계
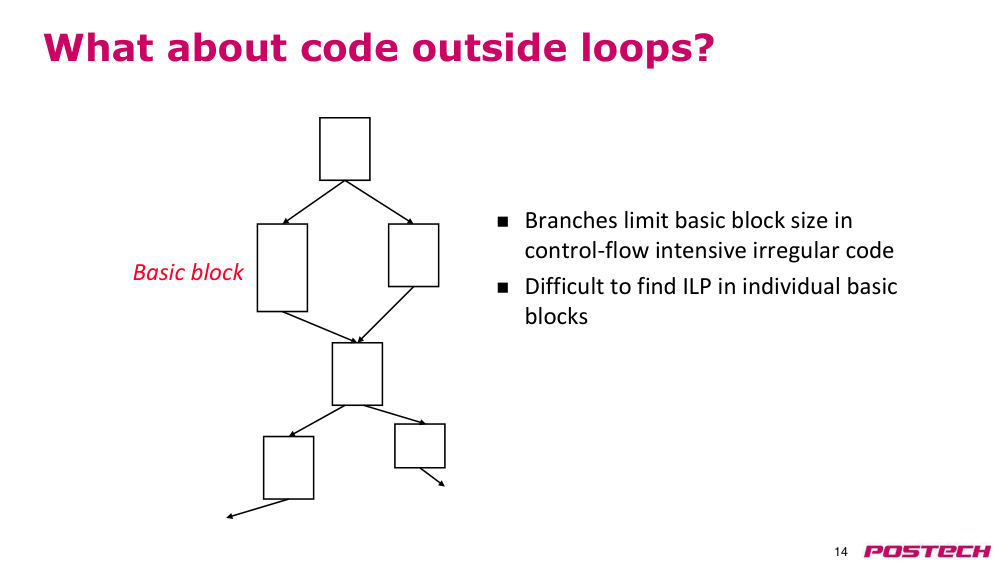
상황·문제control flow 가 복잡한 program 은 짧은 basic block 이 많다.
원인다음에 어느 basic block 이 실행될지 모르므로 block 경계를 넘어 연산을 모을 수 없다.
해결block 끝마다 덜 채워진 instruction 이 생겨 성능 저하 → trace scheduling 필요.
2.1029:09–32:18Trace scheduling [Fisher, Ellis]
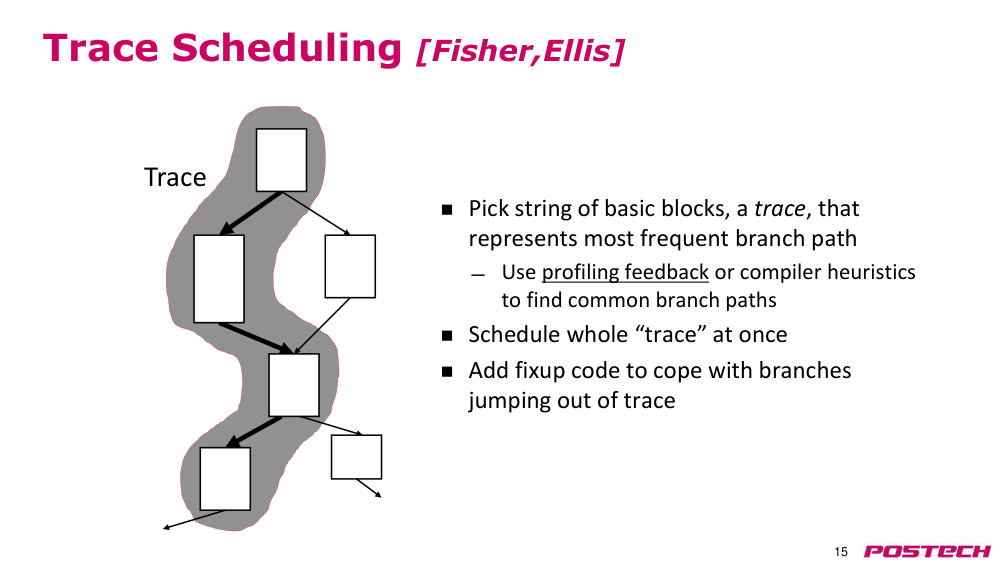
상황·문제여러 basic block 에 걸쳐 연산을 schedule 해야 한다.
원인가능한 trace 가 여러 개이고, 실행 중 trace 밖 경로로 나갈 수 있다.
해결profiling 으로 자주 실행되는 경로를 trace 로 골라 한 번에 schedule, trace 밖으로 나가면 fixup code 로 되돌리고 올바른 일을 수행. 흔한 경로가 대부분이면 평균 성능 향상.
- trace = 이전 강의 trace cache 처럼 basic block 묶음
- 드문 경로에선 undo·재실행으로 더 느려짐
2.1132:18–36:57마이크 꺼짐 → 다른 Zoom 회의로 이동
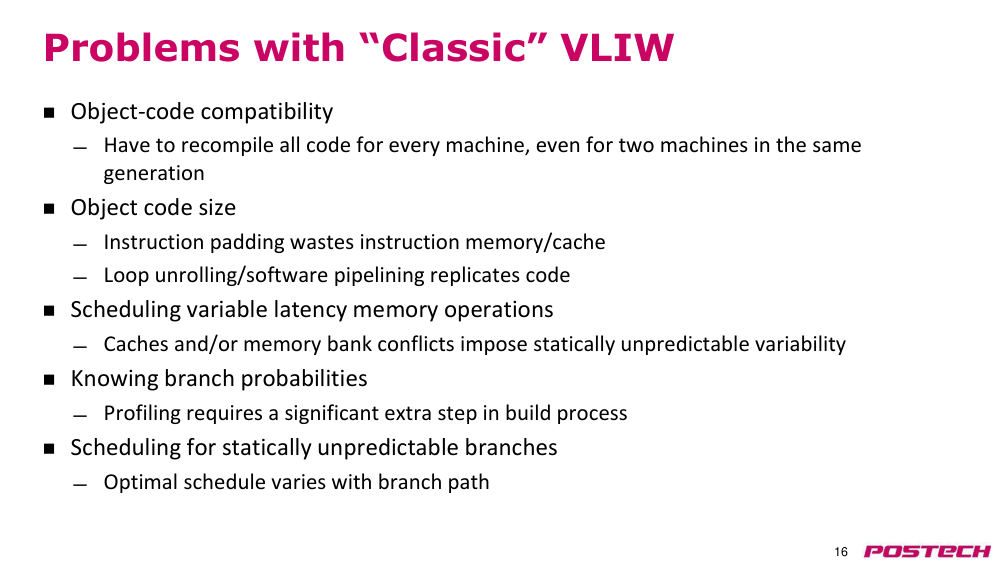
상황·문제p16(Problems with classic VLIW) 을 띄운 상태로 약 3.5분 음소거, 이후 40분 제한 때문에 다른 회의로 옮긴다고 안내하고 종료. p16 이후 내용은 이 영상에 없음.
3핵심 개념
3.1VLIW(Very Long Instruction Word)
고정 slot 에 여러 독립 연산을 담은 instruction. dependence check·interlock 을 compiler 가 대신.
3.1.r.1Very long instruction word — Wikipedia ↗ · compiler 가 병렬 연산을 한 wide instruction 으로 묶는 개념, 역사, code size·호환성 문제
3.2NOP insertion(NOP 삽입)
dependent 연산 사이에 넣을 일이 없을 때 hazard 회피용으로 compiler 가 넣는 빈 연산.
3.3loop unrolling(루프 펼치기)
loop body 를 여러 번 복제해 독립 연산을 늘림. code size·register 증가, cleanup loop 필요.
3.4software pipelining(소프트웨어 파이프라이닝)
서로 다른 iteration 의 연산을 겹쳐 schedule. prologue·epilogue 필요, overhead 는 loop 당 한 번.
3.4.r.1Software pipelining — Wikipedia ↗ · prologue/epilogue, loop unrolling 과의 결합, IA-64 rotating register
3.5prologue / epilogue(프롤로그/에필로그)
software pipelining 된 loop 앞의 시작 code 와 뒤의 마무리 code.
3.5.r.1Software pipelining — Wikipedia ↗ · prologue/epilogue, loop unrolling 과의 결합, IA-64 rotating register
3.6trace scheduling(트레이스 스케줄링)
profiling 으로 고른 빈번 경로의 basic block 열을 한 번에 schedule, 이탈 시 fixup code.
3.7rotating register file(회전 레지스터 파일)
Cydra-5 가 구현. 강의에서 뒤에 다룬다고만 언급(이 영상에선 설명 없음).
4스스로 확인
4.1B[i]=A[i]+C 기본 schedule 의 FP ops/cycle 과 그 원인은?
답
1/8 = 0.125. fld→fadd→fsd 의존 사슬뿐이라 loop body 에 독립 연산이 부족.
4.24-way unroll 후 성능과 대가는?
답
4 fadds / 11 cycles = 0.36. code size 증가, FP register 2→8개, cleanup loop 필요.
4.3software pipelining 이 unrolling 보다 나은 이유는?
답
startup/wind-down overhead 를 iteration 마다가 아니라 loop 당 한 번만 지불, steady state 에서 1 FLOP/cycle.
4.4trace scheduling 에서 trace 밖 경로가 실행되면?
답
fixup code 로 trace 에서 한 일을 되돌리고 올바른 일을 수행. 드물면 평균 성능은 이득.
5참고 자료
5.1Computer Architecture: A Quantitative Approach, 6th ed. — Elsevier ↗ · 교재. 3장 ILP, Appendix H VLIW/EPIC
5.2Very long instruction word — Wikipedia ↗ · compiler 가 병렬 연산을 한 wide instruction 으로 묶는 개념, 역사, code size·호환성 문제
5.4Software pipelining — Wikipedia ↗ · prologue/epilogue, loop unrolling 과의 결합, IA-64 rotating register