이 자료를 쓰는 강의: 11 Branch target·return stack·LSQ 와 VLIW 도입 · 12 VLIW 컴파일 기법 (loop unrolling, software pipelining, trace scheduling) · 13 Classic VLIW 의 한계와 EPIC/IA-64(Itanium)
Lec9 - VLIW
한국어판 강의자료 · 31쪽
p.1CSED503 고급 컴퓨터 구조 – 강의 9
VLIW
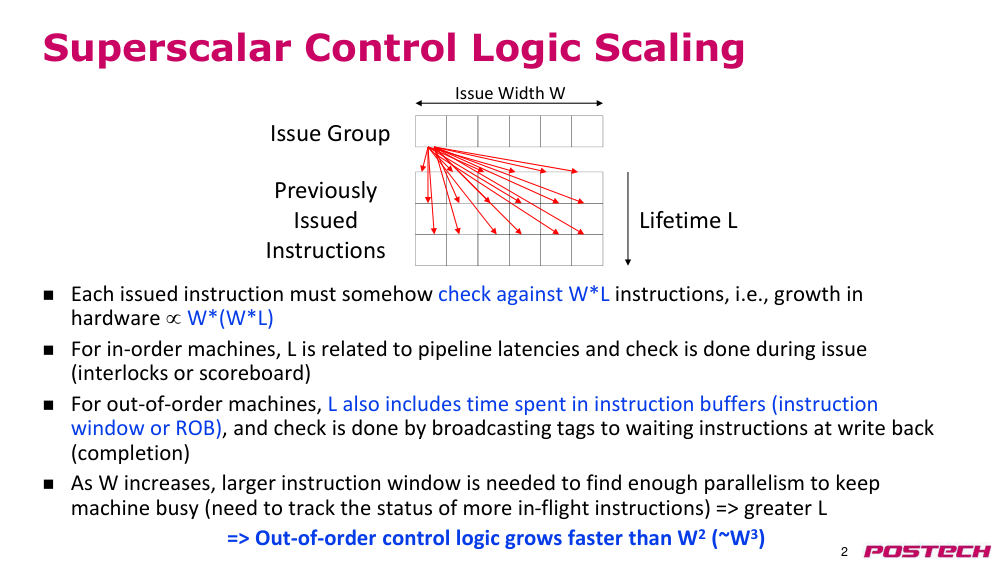
p.2superscalar(초순차 처리) control logic scaling(제어 논리 확장)
- 각 발행된 명령어는 W×L개의 명령어와 비교해야 하므로, 하드웨어 증가량은 W×(W×L) 비례한다.
- 순차적 머신의 경우, L은 파이프라인 지연과 관련 있으며, 발행 시점에 확인된다 (인터록 또는 scoreboard(스코어보드)를 통해).
- 비순차적 머신의 경우, L은 명령어 버퍼(명령어 창 또는 재정렬 버퍼)에 머무르는 시간도 포함되며, 쓰기 완료(완료) 시점에 태그를 방송하여 대기 중인 명령어에 확인한다.
- issue width w(발행 폭 W)가 증가함에 따라, 더 많은 병렬성을 찾기 위해 더 큰 instruction window(명령어 창)이 필요하다 (더 많은 비행 중 명령어 상태를 추적해야 함) → 더 큰 lifetime l(수명 L) → 비순차적 제어 논리는 W²보다 빠르게 증가 (~W³).
- lifetime l(수명 L)
- 발행 그룹
- 이전에 발행된 명령어
- issue width w(발행 폭 W)
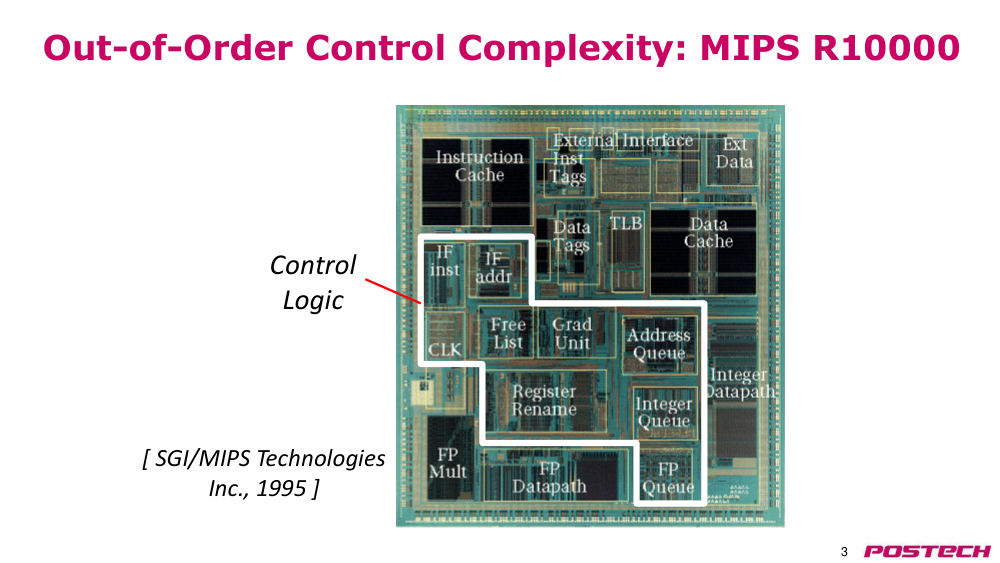
p.3비순차적 제어 복잡성: MIPS R10000
- 제어 논리
- [SGI/MIPS Technologies Inc., 1995]
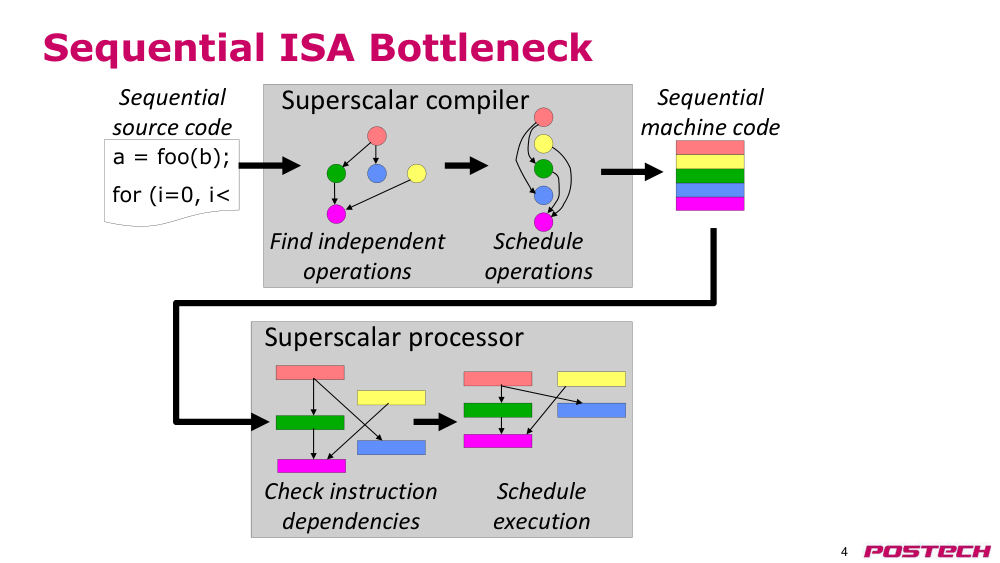
p.4순차적 ISA의 한계
- 명령어 의존성 확인
- superscalar(초순차 처리)기
- a = foo(b);
- for (i=0, i<
- 순차적 소스 코드
- 초순차 컴파일러
- 독립된 연산 찾기
- 연산 스케줄링
- 순차적 머신 코드
- 실행 스케줄링
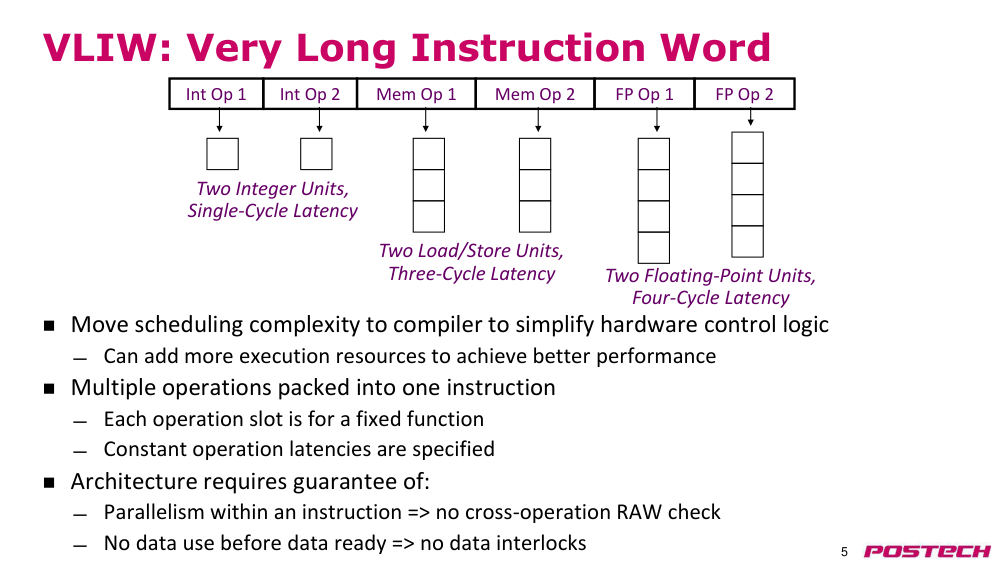
p.5VLIW: very long instruction word(매우 긴 명령어 단어)
- 스케줄링 복잡성을 컴파일러로 이동하여 하드웨어 제어 논리를 단순화한다.
- 더 많은 실행 자원을 추가해 성능을 향상시킬 수 있다.
- 여러 연산을 하나의 명령어에 패킹한다.
- 각 연산 슬롯은 고정된 기능을 위한 것이다.
- 고정된 연산 지연이 명시된다.
- 아키텍처는 다음을 보장해야 한다:
- intra-instruction parallelism(명령어 내 병렬성) → 명령어 간 RAW 확인 없음
- 데이터 준비 전에 데이터 사용 없음 → 데이터 No-Interlocks(인터록 없음)
- 정수 유닛 2개, 단일 사이클 지연
- 로드/스토어 유닛 2개, 세 사이클 지연
- 부동소수점 유닛 2개, 네 사이클 지연
- 정수 연산 2
- 메모리 연산 1
- 메모리 연산 2
- 부동소수점 연산 1
- 부동소수점 연산 2
- 정수 연산 1
p.6초기 VLIW 기계
- FPS AP-120B (1976)
- 호스트 머신(예: PDP-11)에 연결된 과학용 배열 처리기
- 상용화된 넓은 명령어 폭 기계의 첫 사례
- software pipelining(소프트웨어 파이프라인)과 loop unrolling(루프 전개)를 사용한 수동 벡터 수학 라이브러리 작성
- Multiflow Trace (1987)
- 예일 대학 Fisher 연구팀의 아이디어 상용화, ‘trace scheduling(트레이스 스케줄링)’ 포함
- 7, 14, 또는 28개의 연산/명령어 구성 가능
- 28개의 연산이 1024비트 명령어 단어에 패킹됨
- Cydrome Cydra-5 (1987)
- 256비트 명령어 단어에 7개의 연산 인코딩
- 회전식 레지스터 파일
p.7VLIW 컴파일러의 책임
- 병렬 실행을 극대화하기 위해 연산을 스케줄링한다
- intra-instruction parallelism(명령어 내 병렬성)을 보장한다
- data hazard(데이터 위험)을 피하기 위해 스케줄링한다 (인터록 없음)
- 일반적으로 명령어 사이에 명시적인 NOP을 삽입한다
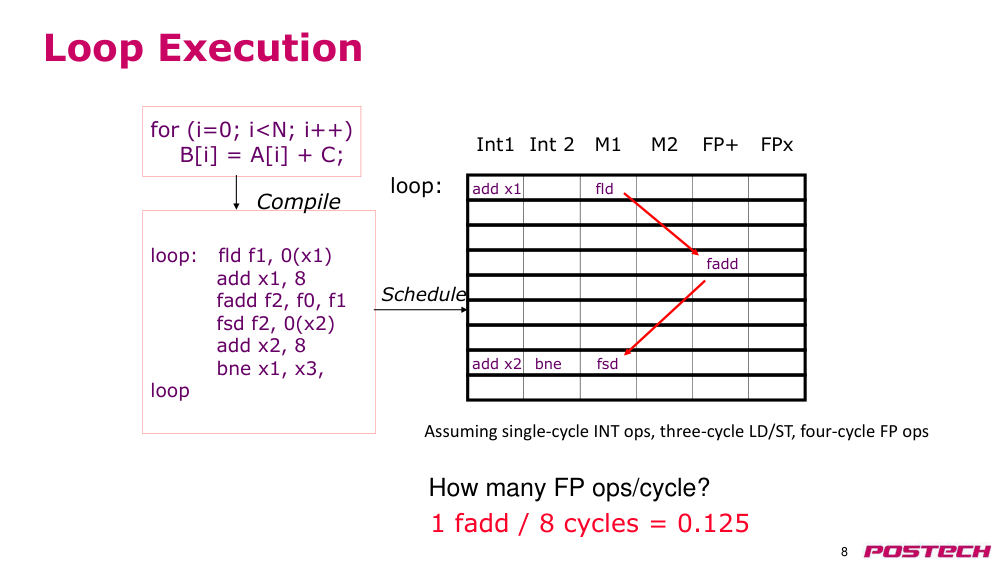
p.8루프 실행
- 1회 루프당 FP 연산 수는?
- for (i=0; i<N; i++)
- B[i] = A[i] + C;
- Int1 Int 2
- M1
- M2
- FP+
- FPx
- loop:
- fld
- add x1
- fadd
- fsd
- add x2
- bne
- 1 fadd / 8 cycles = 0.125
- loop: fld f1, 0(x1)
- add x1, 8
- fadd f2, f0, f1
- fsd f2, 0(x2)
- add x2, 8
- bne x1, x3, loop
- 컴파일
- 스케줄링
- 단일 사이클 INT 연산, 세 사이클 LD/ST, 네 사이클 FP 연산을 가정
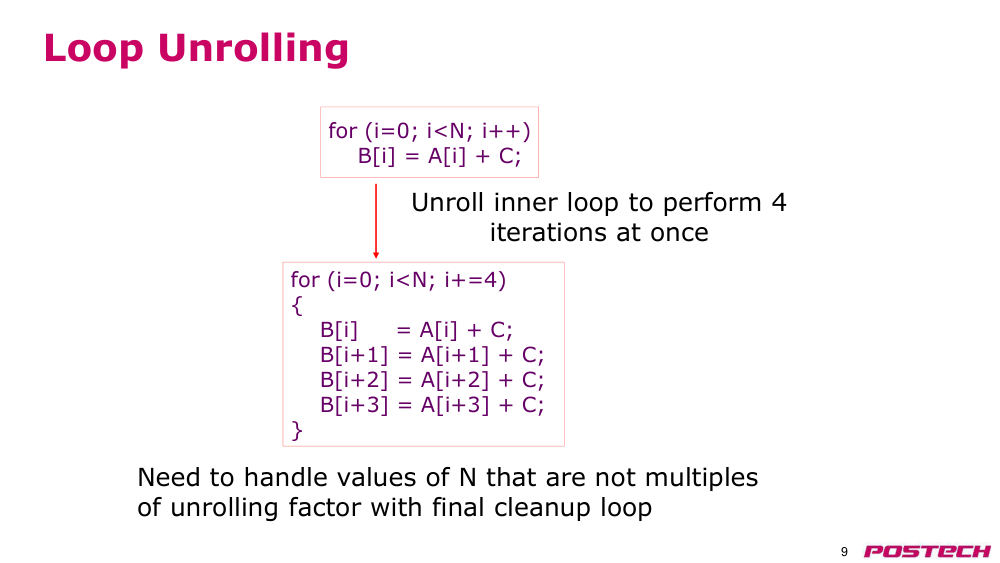
p.9loop unrolling(루프 전개)
- for (i=0; i<N; i++)
- B[i] = A[i] + C;
- for (i=0; i<N; i+=4)
- {
- B[i] = A[i] + C;
- B[i+1] = A[i+1] + C;
- B[i+2] = A[i+2] + C;
- B[i+3] = A[i+3] + C;
- }
- 전개 인자로 나누어지지 않는 N 값에 대해 최종 정리 루프를 처리해야 한다
- 내부 루프를 4회 반복을 동시에 수행하도록 전개한다
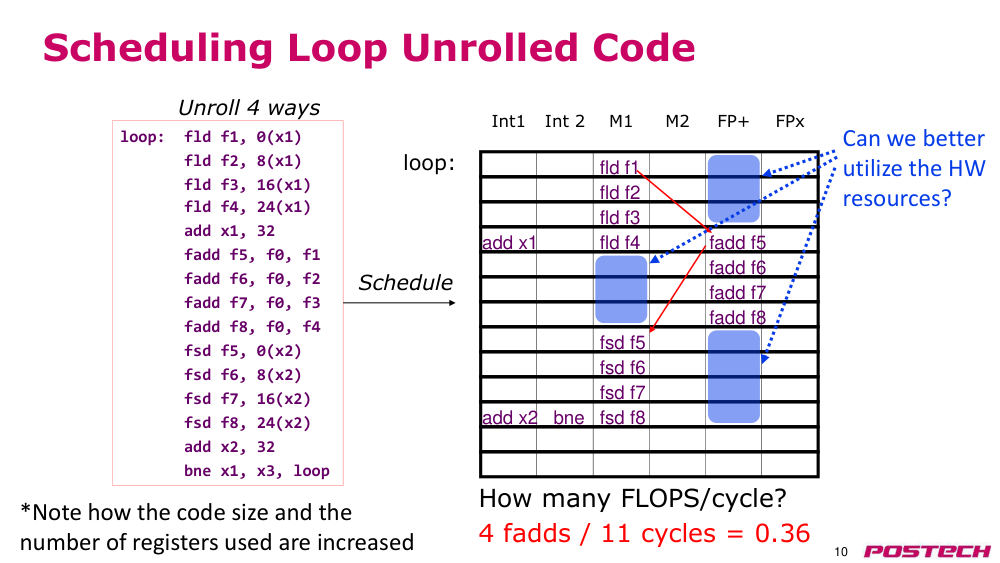
p.10loop unrolling(루프 전개)된 코드의 스케줄링
- loop: fld f1, 0(x1)
- fld f2, 8(x1)
- fld f3, 16(x1)
- fld f4, 24(x1)
- add x1, 32
- fadd f5, f0, f1
- fadd f6, f0, f2
- fadd f7, f0, f3
- fadd f8, f0, f4
- fsd f5, 0(x2)
- fsd f6, 8(x2)
- fsd f7, 16(x2)
- fsd f8, 24(x2)
- add x2, 32
- bne x1, x3, loop
- 스케줄링
- Int1
- Int 2
- M1
- M2
- FP+
- FPx
- loop:
- Unroll 4 ways
- fld f1
- fld f2
- fld f3
- fld f4
- add x1
- fadd f5
- fadd f6
- fadd f7
- fadd f8
- fsd f5
- fsd f6
- fsd f7
- fsd f8
- add x2
- bne
- 1회 루프당 FLOPS 수는?
- 4 fadds / 11 cycles = 0.36
- 하드웨어 자원을 더 잘 활용할 수 있을까?
- *코드 크기와 사용된 레지스터 수가 증가한 점을 주목
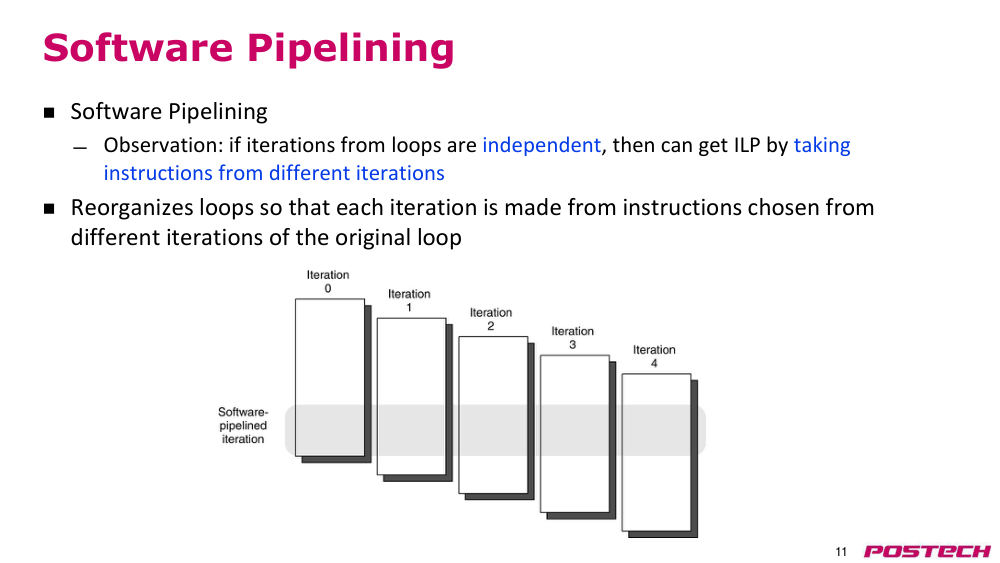
p.11software pipelining(소프트웨어 파이프라인)
- software pipelining(소프트웨어 파이프라인)
- 관찰: 루프의 반복이 독립적이라면, 서로 다른 반복에서 명령어를 가져와 ILP를 얻을 수 있다
- 루프를 재구성하여 각 반복이 원래 루프의 서로 다른 반복에서 선택된 명령어로 구성되도록 한다
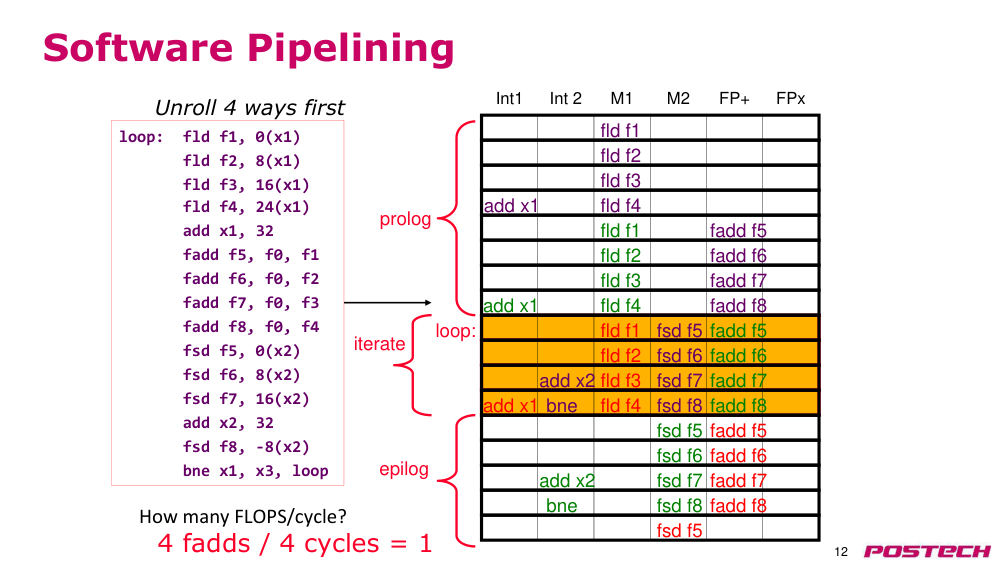
p.12software pipelining(소프트웨어 파이프라인)
- 1회 루프당 FLOPS 수는?
- loop: fld f1, 0(x1)
- fld f2, 8(x1)
- fld f3, 16(x1)
- fld f4, 24(x1)
- add x1, 32
- fadd f5, f0, f1
- fadd f6, f0, f2
- fadd f7, f0, f3
- fadd f8, f0, f4
- fsd f5, 0(x2)
- fsd f6, 8(x2)
- fsd f7, 16(x2)
- add x2, 32
- fsd f8, -8(x2)
- bne x1, x3, loop
- Int1
- Int 2
- M1
- M2
- FP+
- FPx
- 4회 전개 후
- fld f1
- fld f2
- fld f3
- fld f4
- fadd f5
- fadd f6
- fadd f7
- fadd f8
- fsd f5
- fsd f6
- fsd f7
- fsd f8
- add x1
- add x2
- bne
- fld f1
- fld f2
- fld f3
- fld f4
- fadd f5
- fadd f6
- fadd f7
- fadd f8
- fsd f5
- fsd f6
- fsd f7
- fsd f8
- add x1
- add x2
- bne
- fld f1
- fld f2
- fld f3
- fld f4
- fadd f5
- fadd f6
- fadd f7
- fadd f8
- fsd f5
- add x1
- loop:
- 반복
- 프롤로그
- 에필로그
- 4 fadds / 4 cycles = 1
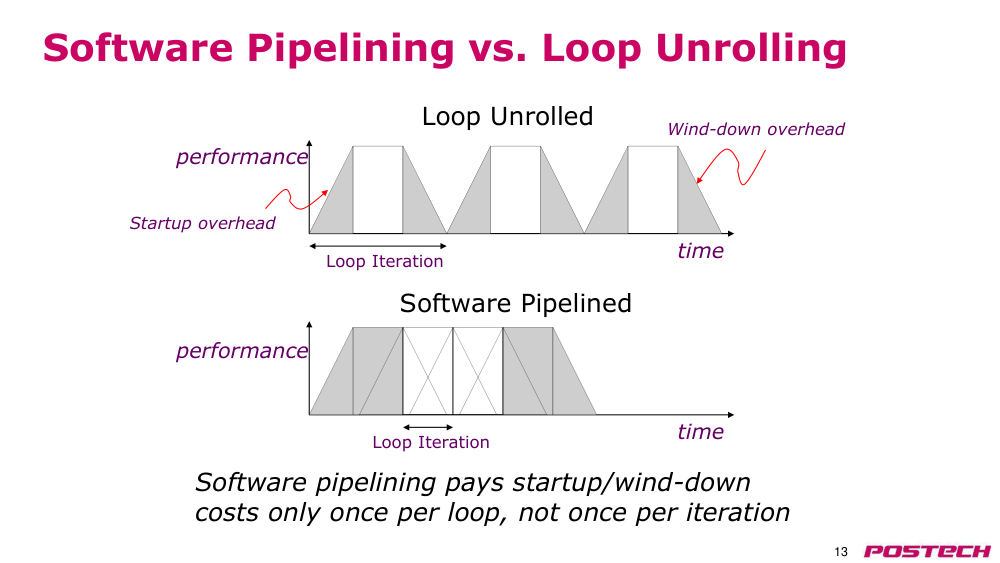
p.13software pipelining(소프트웨어 파이프라인) vs. loop unrolling(루프 전개)
- software pipelining(소프트웨어 파이프라인)은 루프당 한 번만 시작/종료 비용을 지불하지만, loop unrolling(루프 전개)는 반복마다 한 번씩 지불한다.
- 시간에 따른 성능: loop unrolling(루프 전개)는 반복마다 시작 오버헤드와 종료 오버헤드가 반복되지만, software pipelining(소프트웨어 파이프라인)은 루프당 한 번만 발생한다.
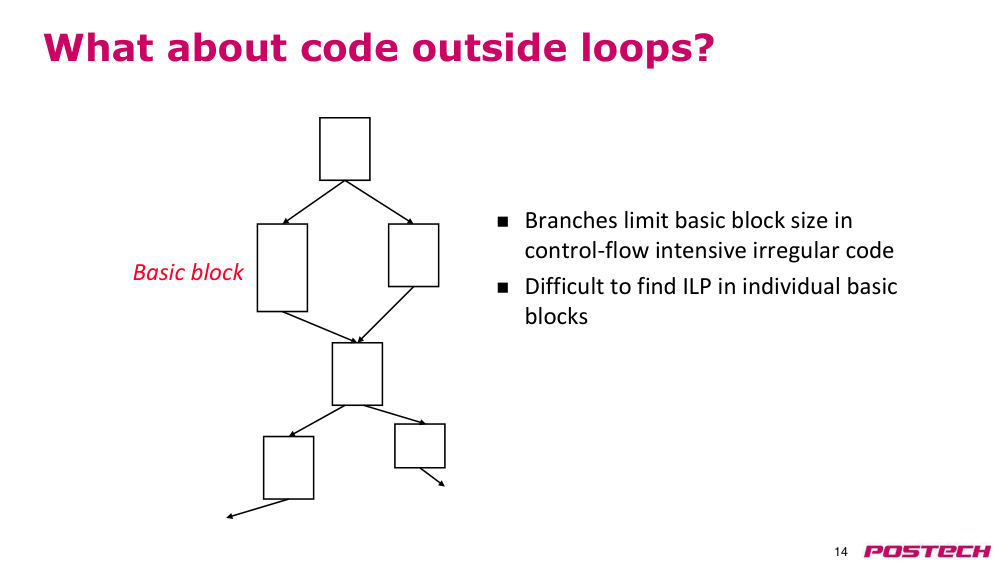
p.14루프 외부 코드는 어떻게 되나요?
- 브랜치는 제어 흐름이 많은 비정형 코드에서 basic block(기본 블록) 크기를 제한한다.
- 개별 basic block(기본 블록) 내에서 ILP(명령어 수준 병렬성)를 찾는 것이 어렵다.
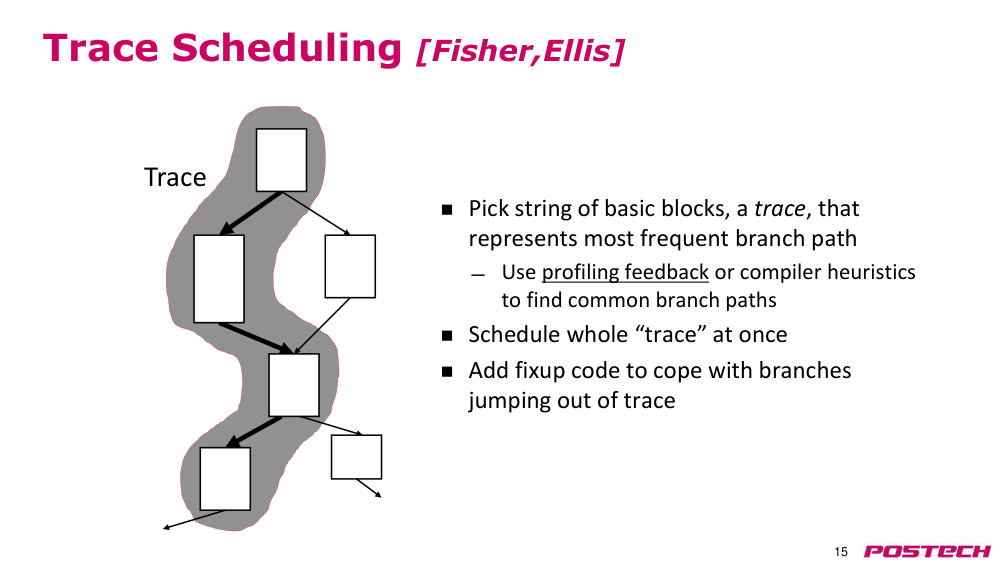
p.15trace scheduling(트레이스 스케줄링) [Fisher, Ellis]
- 가장 흔한 브랜치 경로를 나타내는 basic block(기본 블록)의 연속(트레이스)을 선택한다.
- profiling feedback(프로파일링 피드백) 또는 컴파일러 히우리스틱을 사용하여 흔한 브랜치 경로를 찾는다.
- 전체 '트레이스'를 한 번에 스케줄링한다.
- 트레이스를 벗어나는 브랜치를 처리하기 위해 fixup code(수정 코드)를 추가한다.
p.16"클래식" VLIW의 문제점
- Object-Code compatibility(객체 코드 호환성): 모든 기계마다 코드를 재컴파일해야 하며, 같은 세대의 두 기계 사이에서도 마찬가지다.
- 객체 코드 크기: instruction padding(명령어 패딩)이 명령어 메모리/캐시를 낭비한다. loop unrolling(루프 전개)/software pipelining(소프트웨어 파이프라인)은 코드를 복제한다.
- variable memory latency(변동 메모리 지연)을 위한 스케줄링: 캐시와/또는 메모리 벤드 충돌로 인해 정적 예측 불가 변수성이 발생한다.
- 브랜치 확률을 아는 것: 프로파일링은 빌드 프로세스에 추가적인 단계가 필요하다.
- statically unpredictable branches(정적 예측 불가 브랜치)를 위한 스케줄링: 최적의 스케줄은 브랜치 경로에 따라 달라진다.
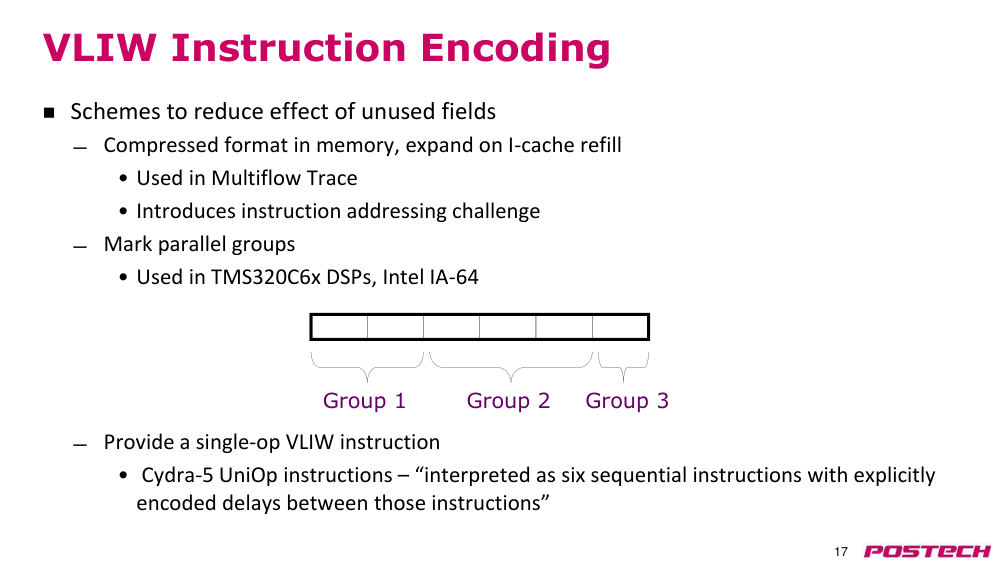
p.17VLIW 명령어 인코딩
- 사용되지 않는 필드의 영향을 줄이기 위한 기법:
- 메모리에서 compressed format(압축 형식) 사용, i-cache refill(I-캐시 리필) 시 전개
- • Multiflow Trace에서 사용
- • 명령어 주소 지정 문제를 유발함
- mark parallel groups(병렬 그룹 마킹)
- • TMS320C6x DSP 및 인텔 IA-64에서 사용
- single-op VLIW instruction(단일 연산 VLIW 명령어) 제공
- • Cydra-5 UniOp 명령어 – "다섯 개의 순차 명령어로 해석되며, 명시적으로 인코딩된 지연이 포함됨"
p.18인텔 이타니엄, EPIC IA-64
- EPIC은 아키텍처 스타일(예: CISC, RISC)이다.
- EPIC(명시적 병렬 명령어 계산)
- 기본적으로 VLIW와 유사하지만 더 큰 유연성을 가진다.
- IA-64는 인텔이 선택한 ISA(예: x86, MIPS)이다.
- IA-64 = intel architecture 64-bit(인텔 아키텍처 64비트)
- • 널리 사용되는 x86-64 ISA(또는 AMD64, 인텔 64)와는 다름
- RISC 스타일, 레지스터-레지스터 명령어 세트
- Object-Code compatibility(객체 코드 호환성) VLIW
- merced(머서드)는 첫 번째 이타니엄 구현체(예: 8086)
- 첫 번째 고객 출하 예정: 1997년(실제로는 2001년)
- McKinley(맥킨리)는 두 번째 구현체로 2002년 출시
- 최근 이타니엄 프로세서(킷슨)는 2017년에 출시됨
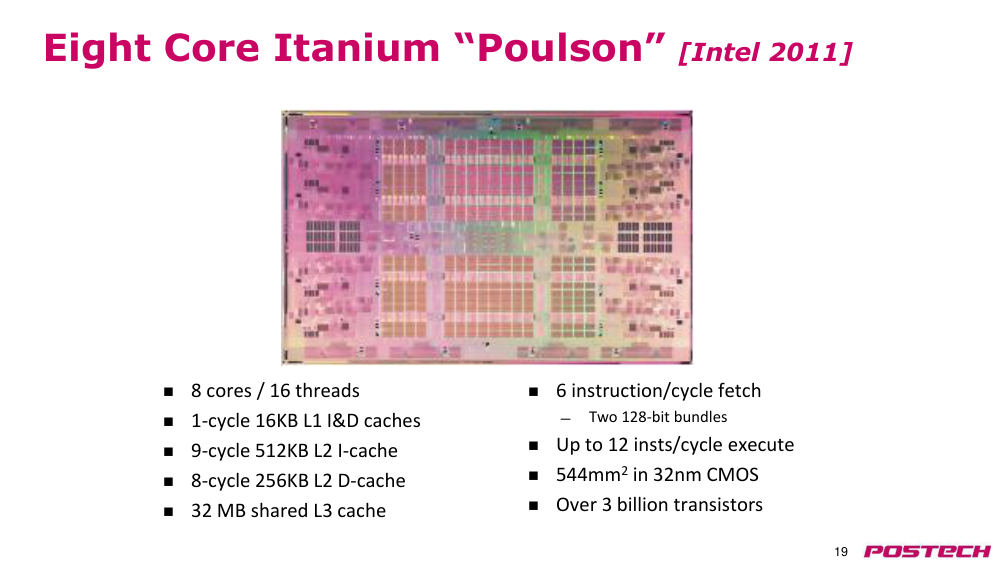
p.198코어 이타니움 ‘poulson(폴슨)’ [Intel 2011]
- 8코어 / 16스레드
- 1사이클 16KB L1 I&D 캐시
- 9사이클 512KB L2 I-캐시
- 8사이클 256KB L2 D-캐시
- 32MB 공유 L3 cache(L3 캐시)
- 초당 6명령어 가져오기 (두 개의 128비트 번들)
- 초당 최대 12명령어 실행
- 32nm CMOS 기술로 544mm²
- 30억 개 이상의 트랜지스터
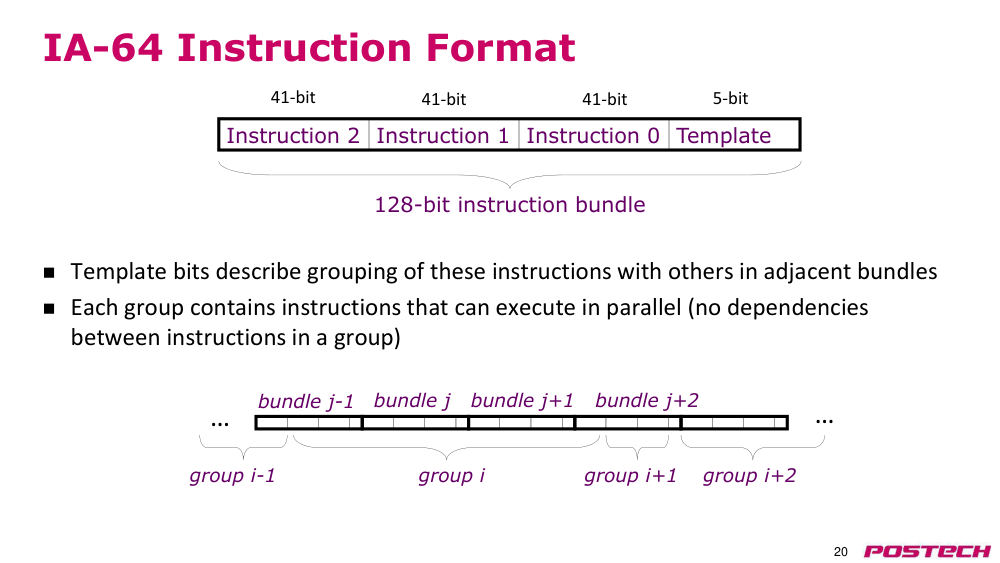
p.20IA-64 명령어 형식
- template bits(템플릿 비트)는 인접한 bundle(번들) 내 다른 명령어들과의 grouping(그룹화)를 설명한다
- 각 그룹은 병렬로 실행될 수 있는 명령어들을 포함한다 (그룹 내 명령어 간 의존성 없음)
- 128비트 명령어 bundle(번들)
- 그룹 i, i+1, i+2, i-1
- bundle(번들) j, j+1, j+2, j-1
- 41비트, 41비트, 41비트, 5비트
p.21IA-64 레지스터
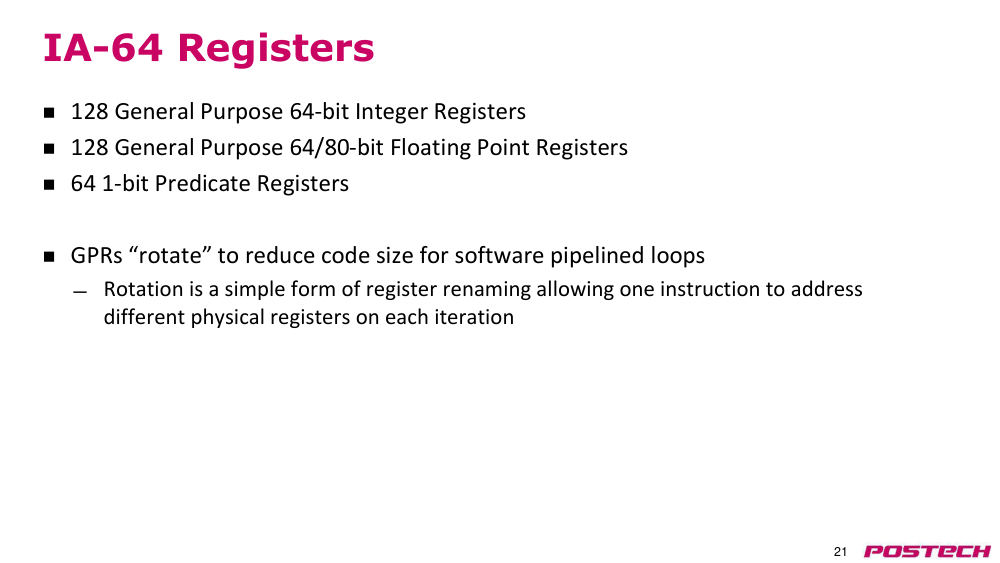
- 128개의 일반 목적 64비트 정수 레지스터
- 128개의 일반 목적 64/80비트 부동소수점 레지스터
- 64개의 1비트 predicate register(예측 레지스터)
- GPR은 software pipelining(소프트웨어 파이프라인) 루프를 위해 코드 크기를 줄이기 위해 '회전'된다
- 회전은 단순한 형태의 레지스터 이름 변경으로, 각 반복에서 한 명령어가 서로 다른 물리적 레지스터에 접근할 수 있게 한다
p.22회전 레지스터 파일
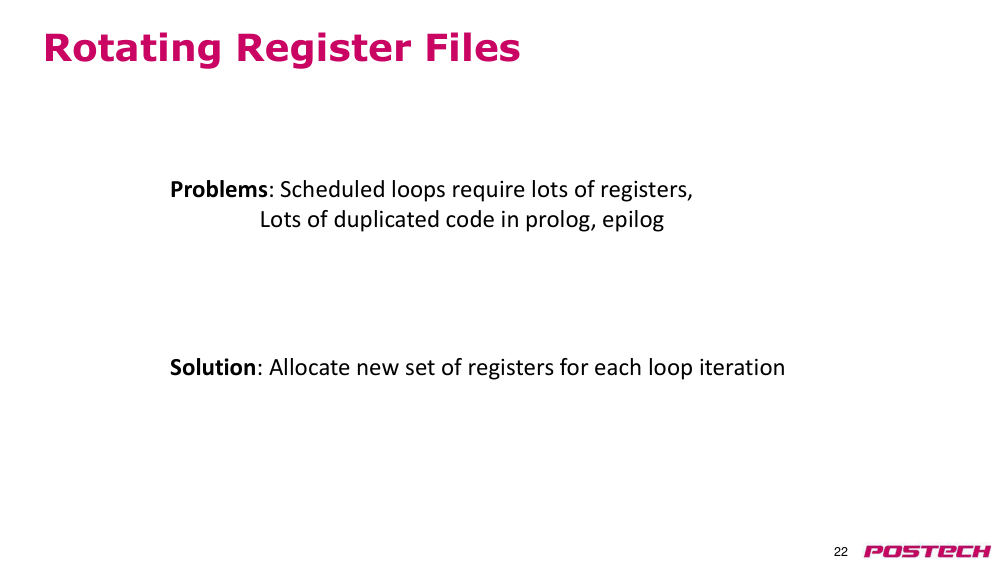
- 문제: 스케줄링된 루프는 많은 레지스터를 필요로 하며, 프롤로그 및 에필로그에 많은 중복 코드가 존재한다
- 해결책: 각 루프 반복에 대해 새로운 레지스터 세트를 할당한다
p.23회전 레지스터 파일
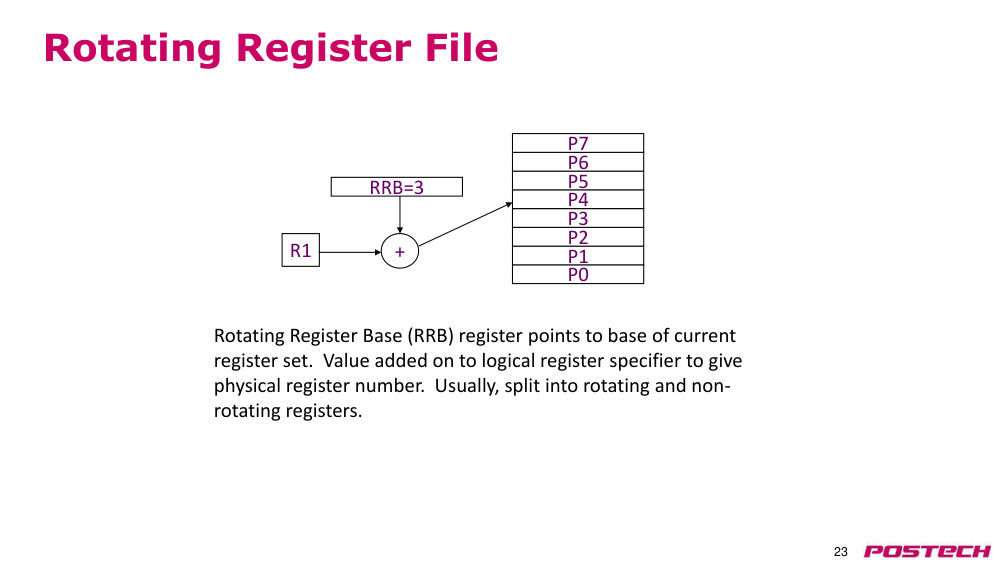
- RRB=3
- P0, P1, P2, P3, P4, P5, P6, P7
- 회전 레지스터 기준(RRB) 레지스터는 현재 레지스터 세트의 기준을 가리킨다
- 논리적 레지스터 식별자에 값이 더해져 물리적 레지스터 번호가 된다
- 일반적으로 회전 레지스터와 비회전 레지스터로 나뉜다
p.24회전 레지스터 파일
- bloop
- sd f9, ()
- fadd f5, f4, ...
- ld f1, ()
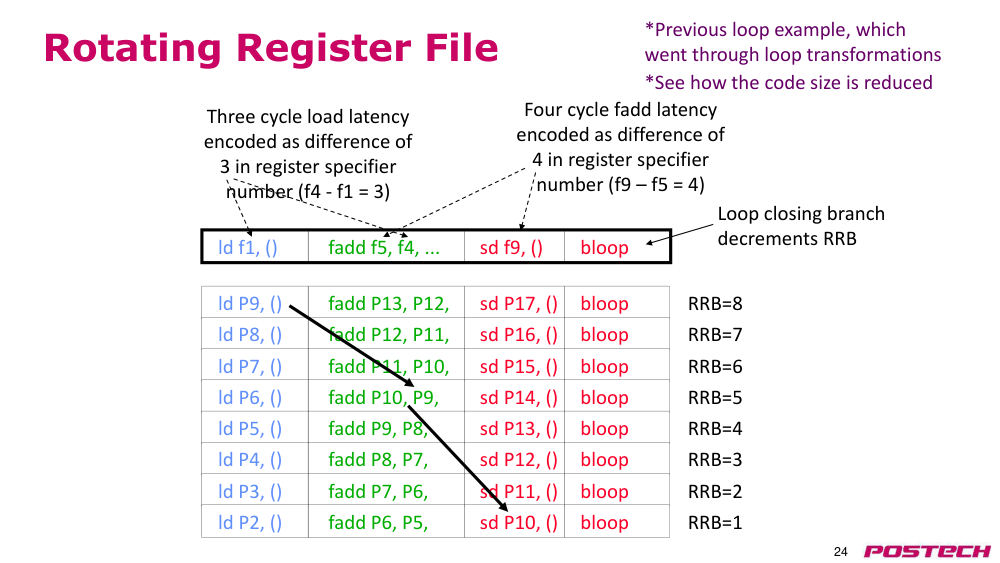
- 3사이클 로드 지연은 레지스터 식별자 번호의 차이(예: f4 - f1 = 3)로 인코딩됨
- 4사이클 fadd 지연은 레지스터 식별자 번호의 차이(예: f9 – f5 = 4)로 인코딩됨
- bloop
- sd P17, ()
- fadd P13, P12,
- ld P9, ()
- RRB=8
- bloop
- sd P16, ()
- fadd P12, P11,
- ld P8, ()
- RRB=7
- bloop
- sd P15, ()
- fadd P11, P10,
- ld P7, ()
- RRB=6
- bloop
- sd P14, ()
- fadd P10, P9,
- ld P6, ()
- RRB=5
- bloop
- sd P13, ()
- fadd P9, P8,
- ld P5, ()
- RRB=4
- bloop
- sd P12, ()
- fadd P8, P7,
- ld P4, ()
- RRB=3
- bloop
- sd P11, ()
- fadd P7, P6,
- ld P3, ()
- RRB=2
- bloop
- sd P10, ()
- fadd P6, P5,
- ld P2, ()
- RRB=1
- 루프 종료 브랜치는 RRB를 감소시킨다
- 이전 루프 예제 (루프 변환을 거친 경우)
- 코드 크기 감소가 어떻게 이루어지는지 확인할 수 있음
p.25IA-64 predicated execution(예측 실행)
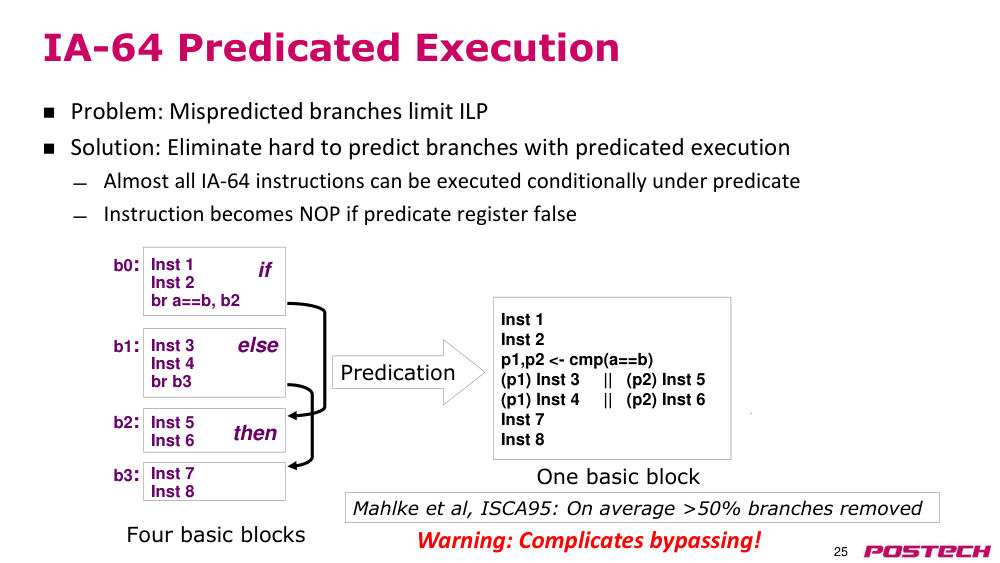
- 문제: 잘못 예측된 브랜치는 ILP를 제한한다
- 해결책: predicated execution(예측 실행)을 통해 예측하기 어려운 브랜치를 제거한다
- 거의 모든 IA-64 명령어는 predicate register(예측 레지스터)에 따라 조건부로 실행될 수 있다
- predicate register(예측 레지스터)가 false이면 명령어는 노-오퍼레이션(NOP)이 된다
- 네 개의 basic block(기본 블록)
- Inst 1
- Inst 2
- br a==b, b2
- Inst 3
- Inst 4
- br b3
- Inst 5
- Inst 6
- Inst 7
- Inst 8
- b0:
- b1:
- b2:
- b3:
- if
- else
- then
- predicated execution(예측 실행)
- 한 개의 basic block(기본 블록)
- Mahlke 등, ISCA95: 평균적으로 50% 이상의 브랜치 제거됨
- 경고: 버스패싱을 복잡하게 만든다!
p.26IA-64 speculative execution(추측 실행)
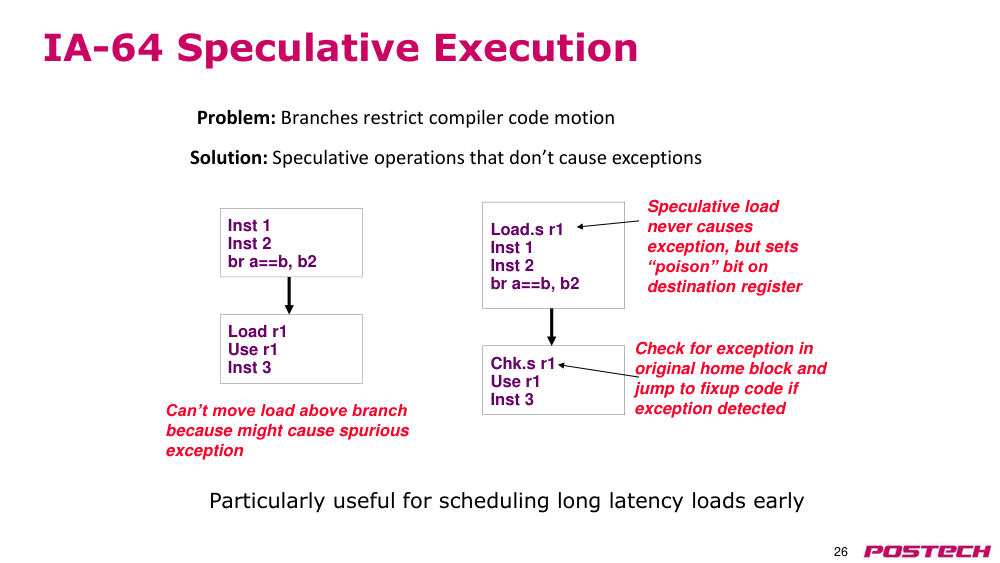
- 문제: 브랜치는 컴파일러의 코드 이동을 제한한다
- Inst 1
- Inst 2
- br a==b, b2
- Load r1
- Use r1
- Inst 3
- 브랜치 위로 로드를 이동할 수 없다
- 왜냐하면 비정상적인 예외를 유발할 수 있기 때문이다
- Load.s r1
- Inst 1
- Inst 2
- br a==b, b2
- Chk.s r1
- Use r1
- Inst 3
- speculative load(추측 로드)는 예외를 유발하지 않지만
- 목적 레지스터에 'poison bit(포이즌 비트)'를 설정한다
- 원래 홈 블록에서 예외를 확인하고
- 예외가 감지되면 수정 코드(fixup code)로 점프한다
- 특히 긴 지연을 가진 로드를 조기에 스케줄링하는 데 유용하다
- 해결책: 예외를 유발하지 않는 추측 연산
p.27IA-64 data speculation(데이터 추측)
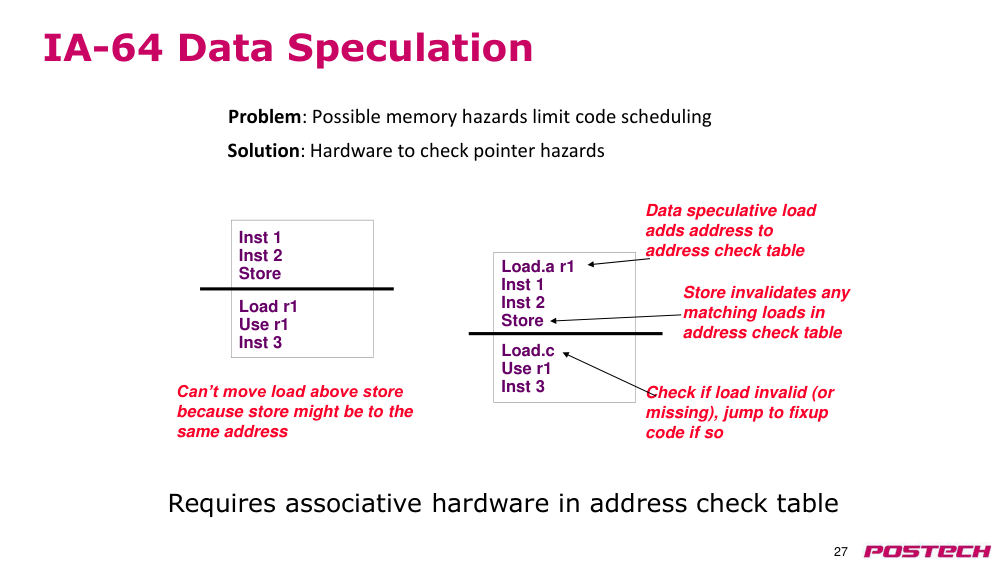
- 문제: 가능한 메모리 위험은 코드 스케줄링을 제한한다
- address check table(주소 체크 테이블)에 연관된 하드웨어가 필요하다
- Inst 1
- Inst 2
- Store
- Load r1
- Use r1
- Inst 3
- 스토어가 같은 주소에 쓸 수 있으므로
- 로드를 스토어 위로 이동할 수 없다
- Load.a r1
- Inst 1
- Inst 2
- Store
- Load.c
- Use r1
- Inst 3
- data speculation(데이터 추측) 로드는 주소를 address check table(주소 체크 테이블)에 추가한다
- 스토어는 address check table(주소 체크 테이블) 내 일치하는 로드를 무효화한다
- 로드가 무효화되었거나 누락되었는지 확인하고
- 그럴 경우 수정 코드(fixup code)로 점프한다
- 해결책: pointer hazard(포인터 위험)을 확인하는 하드웨어
p.28static scheduling(정적 스케줄링)의 한계
- statically unpredictable branches(정적 예측 불가 브랜치)
- 변동 메모리 지연(예측 불가한 캐시 미스)
- code size explosion(코드 크기 폭발)
- 컴파일러 복잡성
- 여러 시도에도 불구하고, VLIW는 일반 목적 컴퓨팅 분야에서 실패했다(지금까지)
- 더 복잡한 VLIW 아키텍처는 순차 처리 superscalar(초순차 처리)와 복잡도가 비슷하며, 대규모 복잡한 애플리케이션에서 실질적인 이점이 없다
- embedded DSP(임베디드 DSP) 시장에서는 성공했다
- 환경이 제한된 더 단순한 VLIW, 코드 친화적
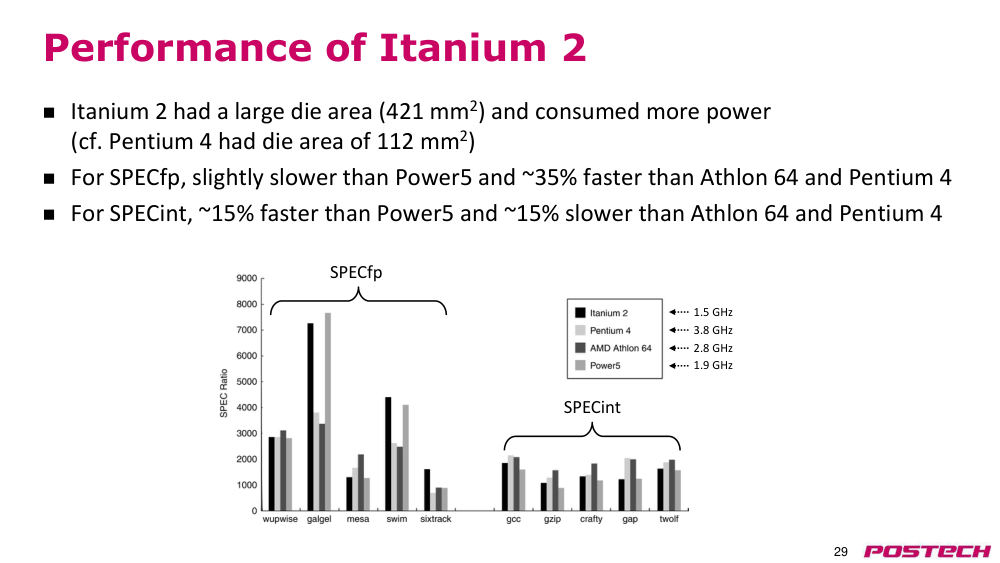
p.29아이테니엄 2의 성능
- 아이테니엄 2는 큰 다이 면적(421 mm²)을 가지며 더 많은 power consumption(전력 소비)를 한다
- (Pentium 4는 die area(다이 면적)이 112 mm²)
- SPECfp에서는 Power5보다 약간 느리고, Athlon 64 및 Pentium 4보다 약 35% 빠르다
- SPECint에서는 Power5보다 약 15% 빠르고, Athlon 64 및 Pentium 4보다 약 15% 느리다
- 1.5 GHz
- 3.8 GHz
- 2.8 GHz
- 1.9 GHz
- SPECfp
- SPECint
p.30아이테니엄의 종말
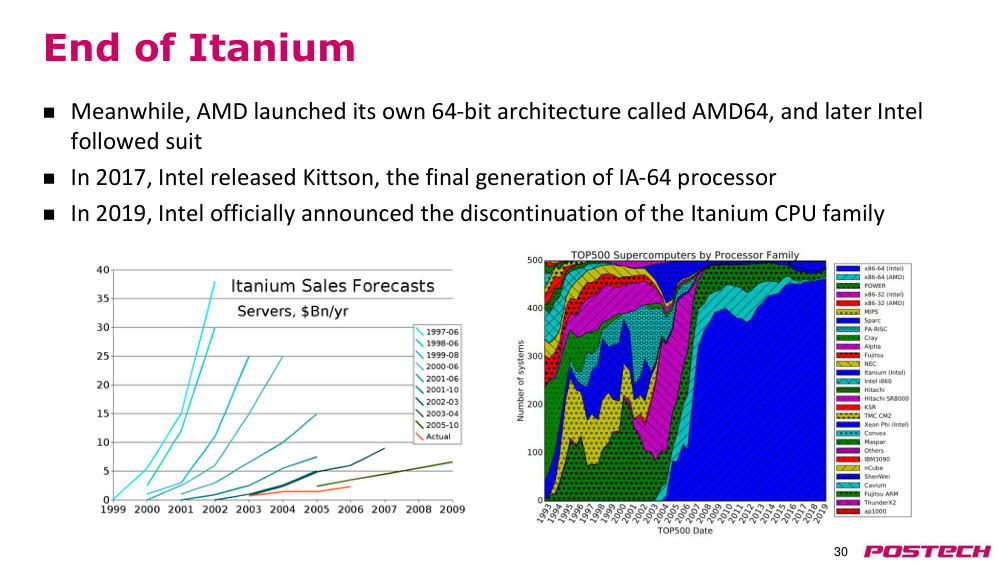
- 한편, AMD는 자체 64비트 아키텍처인 AMD64를 출시했고, 이후 인텔도 이를 따라했다
- 2017년, 인텔은 IA-64 프로세서의 최종 세대인 Kittson을 출시했다
- 2019년, 인텔은 공식적으로 아이테니엄 CPU 제품군의 중단을 발표했다
p.31