Lec 6 · complex pipeline, CDC 6600 scoreboard, out-of-order issue 의 한계
정밀 정리 · 검증 2026-09-24 01:00
1개요
1.105강 덱 p17~37: complex pipeline 의 문제(WB conflict, WAW, exception)와 latency 통일 in-order pipeline, in-order superscalar.
1.2CDC 6600 scoreboard: hazard 표 → 단순화(Busy·WP bit vector) → 동작 예제, out-of-order completion 으로 3 cycle 절약.
1.3out-of-order issue 는 WAR 때문에 이득이 없고 register 수가 한계 → 다음 강의 Tomasulo 예고 (06강 덱 p1~4).
2섹션별 정리 상황·문제 → 원인 → 해결
2.12:23–4:29공지: project proposal 마감, 휴일 강의
상황·문제오늘이 project proposal 마감(이메일 제출). 다음 월요일은 휴일이지만 수업을 그대로 진행하고 PLMS 영상으로 대체 시청 가능(수요일 강의 전 시청 권장).
2.24:29–5:51complex pipeline 의 동기 (복습)
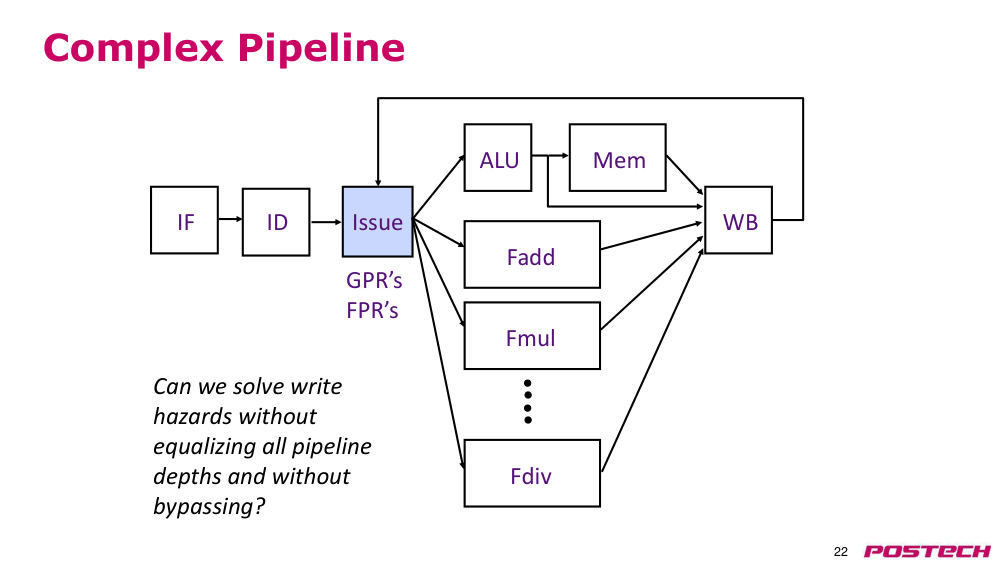
상황·문제long latency·부분 pipelined FP unit, 응답 시간이 가변인 memory system 이 있을 때 고성능을 내야 한다.
원인load/store 의 실제 latency 를 미리 알 수 없고, 여러 arithmetic·memory unit 을 동시에 활용해야 utilization 이 오른다.
해결여러 functional unit 을 둔 복잡한 pipeline 이 필요하지만, hazard 없이 설계하는 방법이 이번 강의 주제.
- 동기: FP unit latency, 가변 memory latency, 다중 unit 활용
2.35:51–11:21complex pipeline control 의 문제: structural conflict·WAW·exception
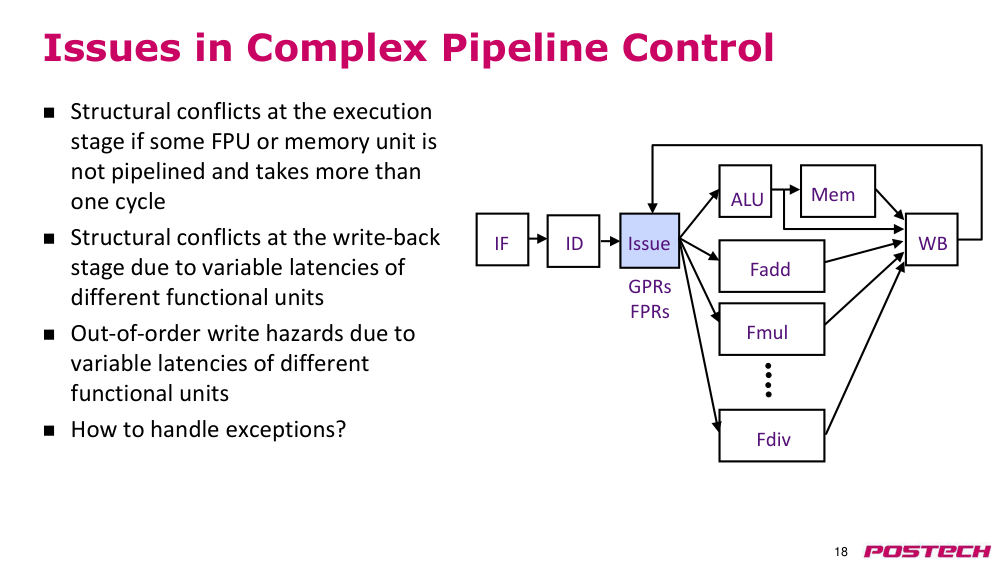
상황·문제unit 마다 latency 가 달라 execution 과 write-back stage 에서 structural conflict 가 생긴다. 예: add 3 cycle, multiply 7 cycle 이면 mul 을 cycle 0, add 를 cycle 4 에 issue 하면 같은 cycle 에 WB.
원인mul F2 를 먼저, add F2 를 다음 cycle 에 issue 하면 add 가 먼저 쓰고 mul 이 나중에 덮어써 F2 에 틀린 값(mul 결과)이 남는다 (out-of-order write hazard).
해결WB conflict, 쓰기 순서, precise exception(예외 시 architectural state 보존)을 모두 처리하는 설계가 필요.
- WB stage structural conflict: 여러 unit 이 같은 cycle 에 register file 에 쓰려 함
- WAW: 느린 앞 명령이 빠른 뒤 명령 결과를 덮어씀
- precise exception 을 지켜야 함
2.411:21–14:40더 복잡한 in-order pipeline: WB 지연으로 latency 통일
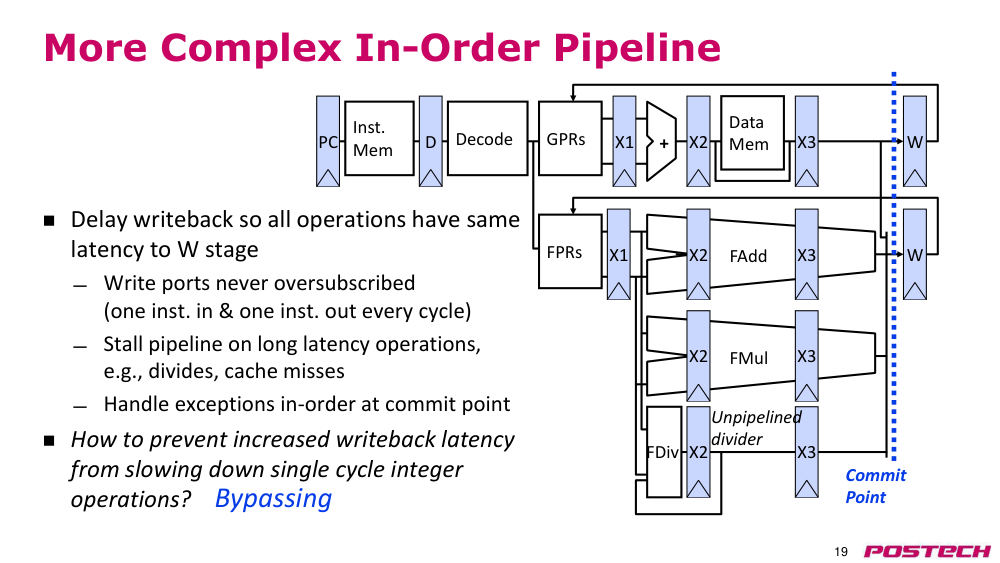
상황·문제WB conflict 와 WAW 를 가장 단순하게 막는 방법이 필요.
원인unit 마다 완료 시점이 달라 WB 가 겹치거나 순서가 뒤바뀐다.
해결빠른 unit 의 WB 를 늦춰 모든 연산이 같은 latency 로 W 에 도달(매 cycle 하나 들어가고 하나 나감). divide·cache miss 처럼 너무 긴 것은 stall, exception 은 commit point 에서 in-order 처리. 늦춘 결과는 bypass 로 전달(대신 설계 복잡도·면적·에너지 증가).
- divide 까지 늘리면 성능 손해가 커서 드문 divide 는 stall
- commit 을 in-order 로 하면 precise exception 가능
- bypass path 를 다 두면 성능 손해 없음, 비용은 증가
2.514:40–17:20in-order superscalar pipeline
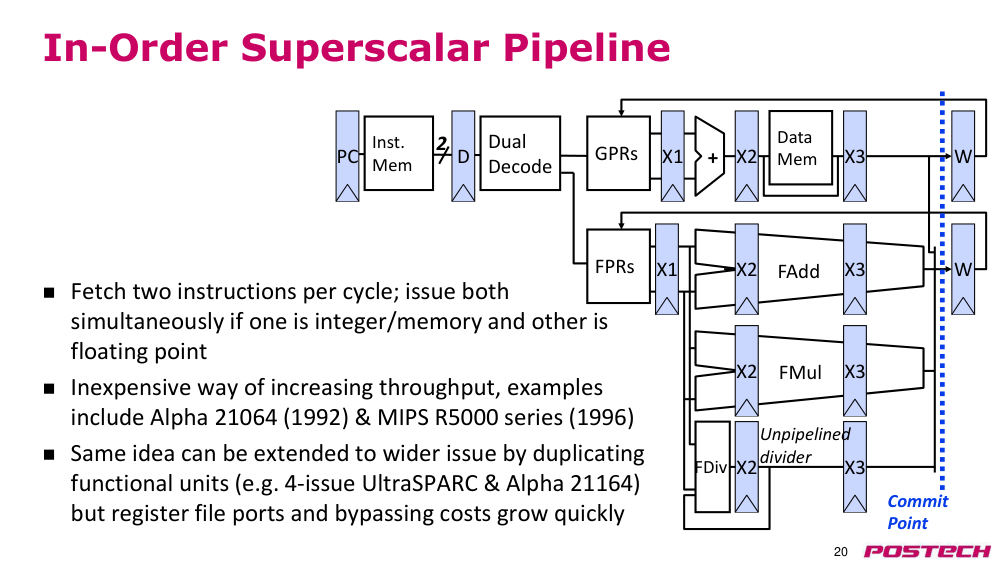
상황·문제single-issue pipeline 은 cycle 당 한 명령만 issue 한다.
원인dual-issue 로 fetch·decode 를 2개씩 하면 ideal IPC 는 2배지만, 두 명령이 같은 functional unit(예: 둘 다 fadd)을 쓰면 하나는 stall.
해결서로 다른 종류 명령은 병렬 실행. 4-issue 이상은 unit 을 복제해야 하고, unit 수에 따라 bypass 비용이 quadratic 으로 늘어 비용이 super-linear 증가.
- dual issue: ideal IPC 2배
- 같은 unit 경합 시 stall
- unit 증가 → bypass 비용 quadratic
2.617:20–21:13CDC 6600 scoreboard 개요
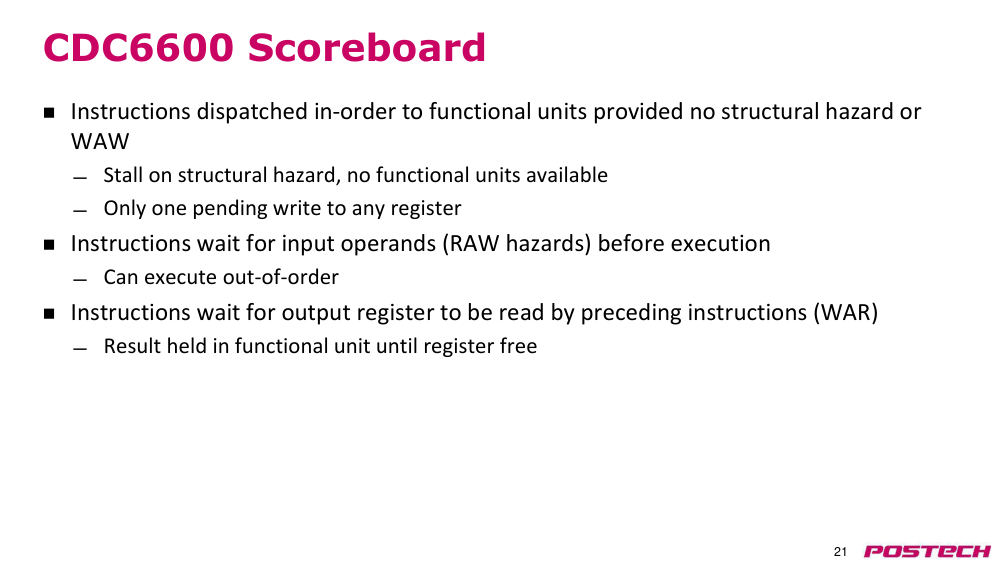
상황·문제latency 를 모두 같게 만들지 않고도 hazard 없이 실행하고 싶다.
원인structural hazard, WAW, RAW, WAR 를 issue 시점에 검출할 장치가 없다.
해결scoreboard: structural hazard·WAW 가 없을 때만 in-order issue (register 당 pending write 1개), RAW 는 operand 준비까지 대기, 실행·완료는 out-of-order. 앞 명령이 output register 를 읽을 때까지 기다려 WAR 방지.
- issue 는 in-order, completion 은 out-of-order
- 한 register 에 pending write 는 하나만
- 결과는 register 가 비기 전까지 functional unit 에 보관
2.721:13–24:18data hazard 종류 복습과 memory dependence
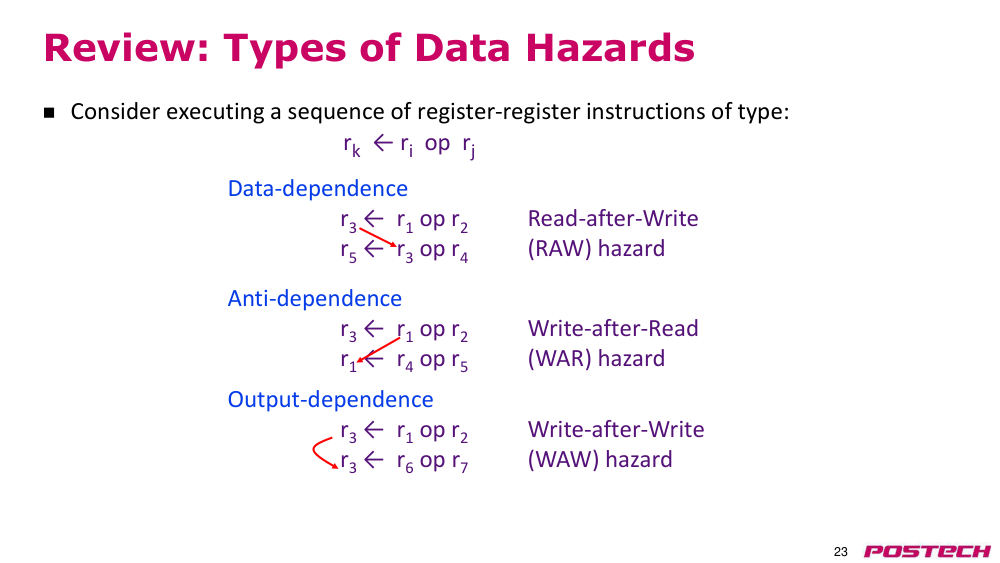
상황·문제complex pipeline 에서는 5-stage 에서 안 보이던 hazard 가 생긴다.
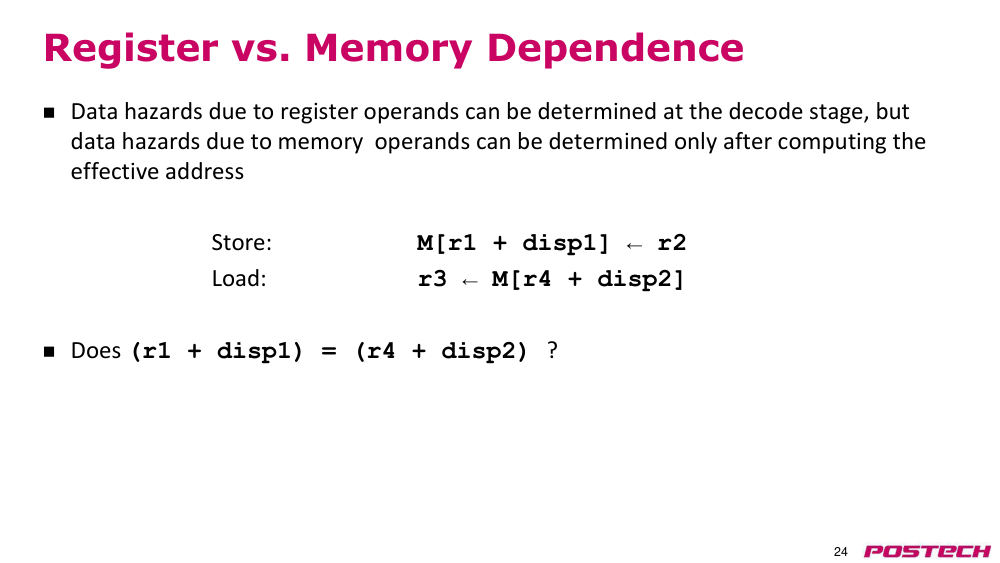
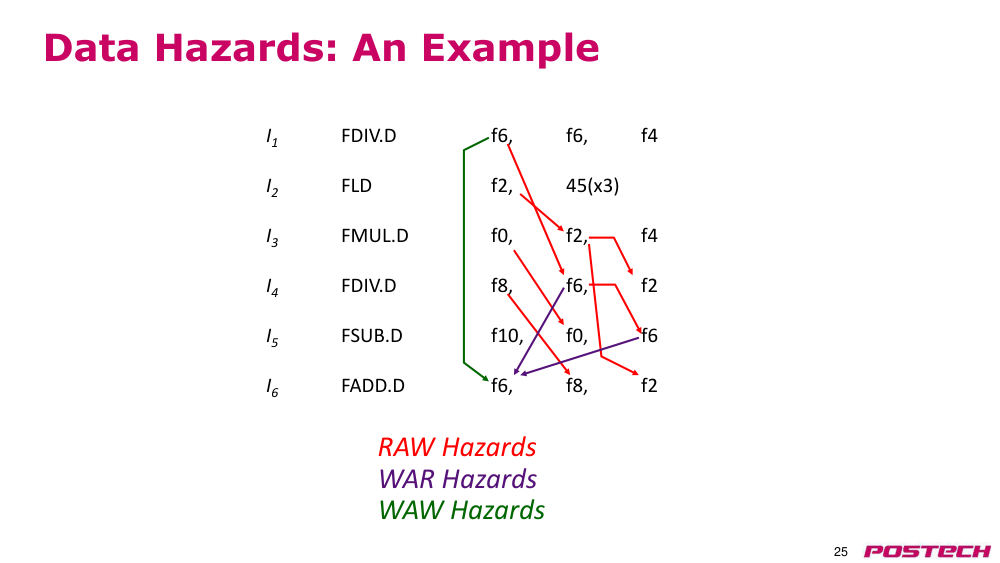
원인RAW(data dependence), WAR(anti-dependence: 뒤 명령이 앞 명령이 읽을 register 를 씀), WAW(output dependence: 같은 register 에 두 번 씀). store/load 의 주소는 execution 에서 계산되므로 decode 시점에는 의존 여부를 모른다.
해결register hazard 는 decode 에서 판단. memory 쪽은 r1+disp1 = r4+disp2 여부를 확인하는 memory disambiguation 이 필요(이후 강의).
- WAR·WAW 는 단순 5-stage 에선 안 생기고 complex pipeline 에서 문제
- memory dependence 는 주소 계산 후에만 판단 가능
2.824:18–31:02hazard 예제와 out-of-order completion
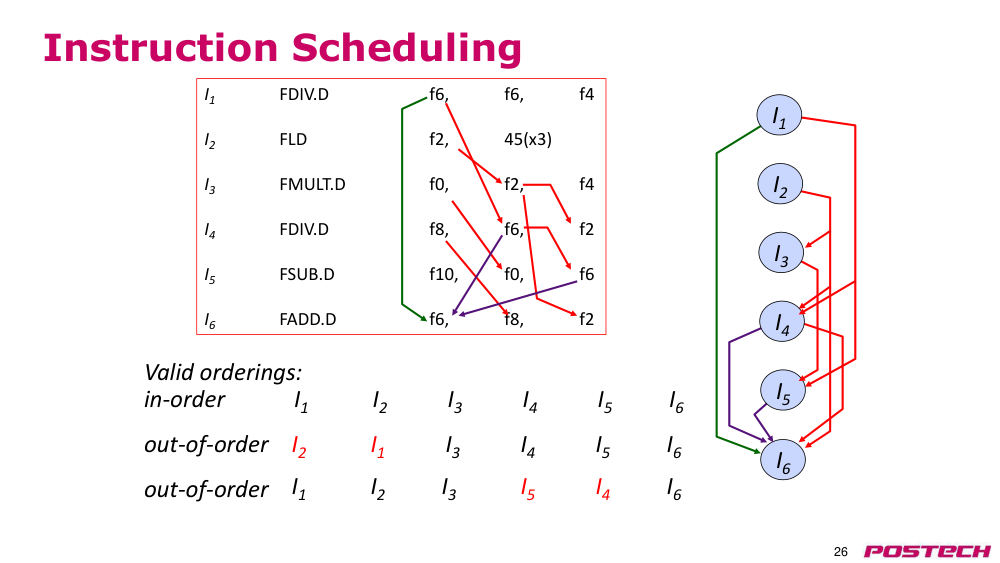
상황·문제6개 FP 명령(I1 FDIV.D f6 … I6 FADD.D f6)에 RAW·WAR·WAW 가 섞여 있다.
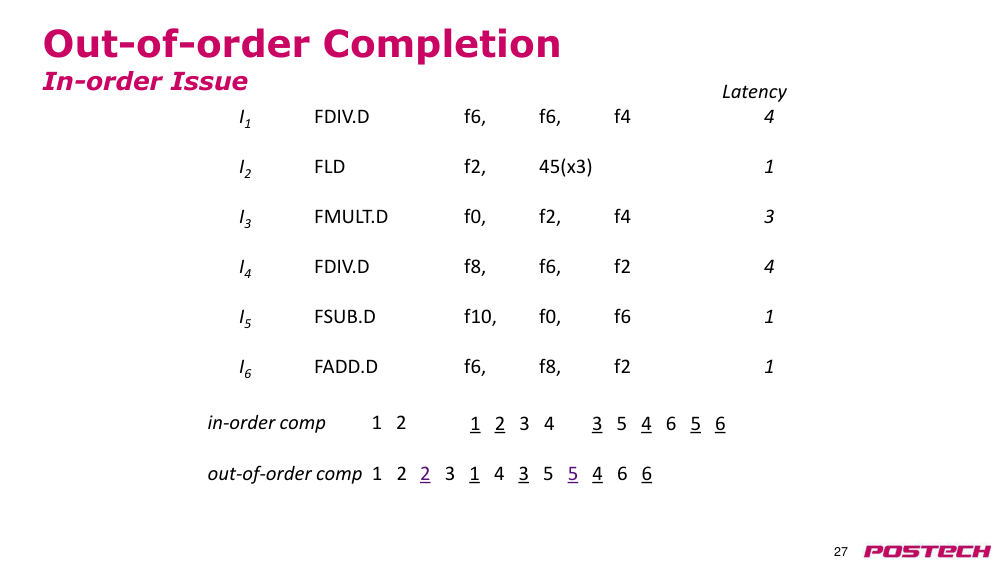
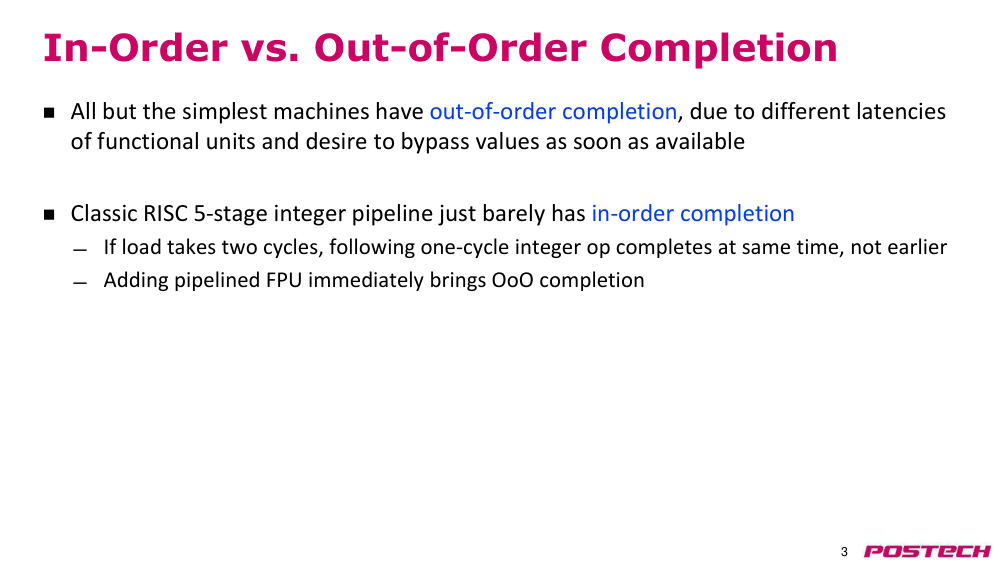
원인dependence graph 로 보면 독립 명령(I1, I2 등)은 순서를 바꿔도 결과가 같다 → ILP 존재. in-order completion 에서는 1-cycle 명령도 앞의 4-cycle FDIV 가 끝날 때까지 완료 못 함.
해결out-of-order completion 을 허용하면 I2 가 먼저 완료되고 I3 가 일찍 시작, I5 가 I4 보다 먼저 완료되어 예제에서 3 cycle 절약.
- latency: FDIV 4, FLD 1, FMUL 3, FSUB 1, FADD 1
- out-of-order completion 으로 3 cycle 절약
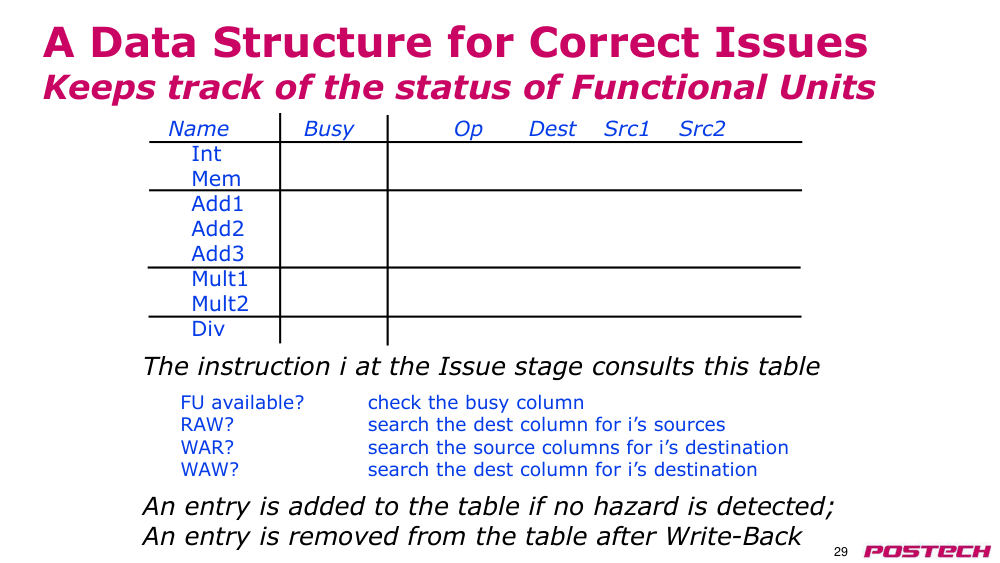
2.931:02–39:51안전한 issue 를 위한 data structure 와 단순화
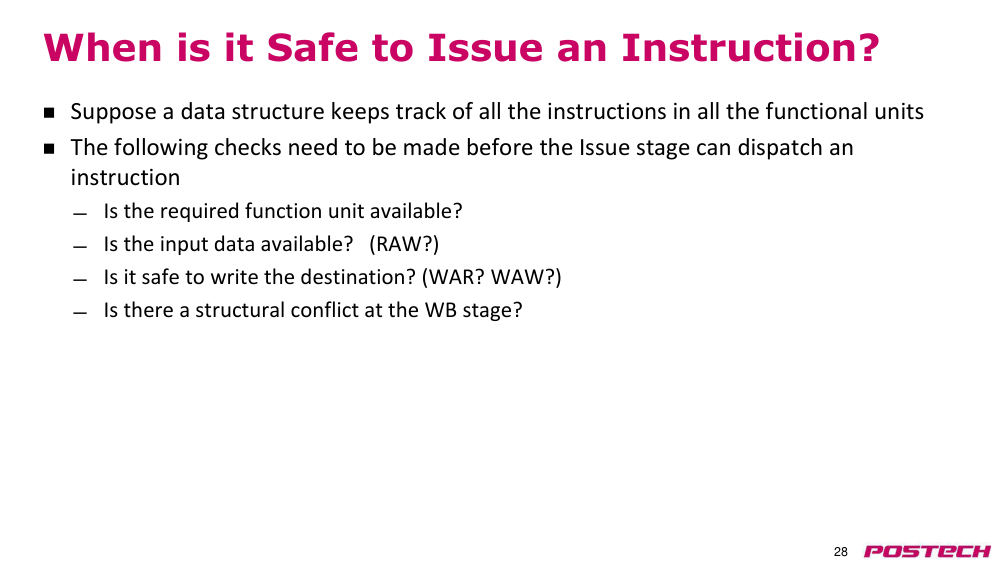
상황·문제issue 전에 FU 가용, RAW, WAR/WAW, WB conflict 를 검사해야 한다.
원인FU 별 busy·op·dest·src1·src2 표를 두면 RAW 는 dest 열에서 i 의 source, WAR 는 source 열에서 i 의 dest, WAW 는 dest 열에서 i 의 dest 를 찾는다.
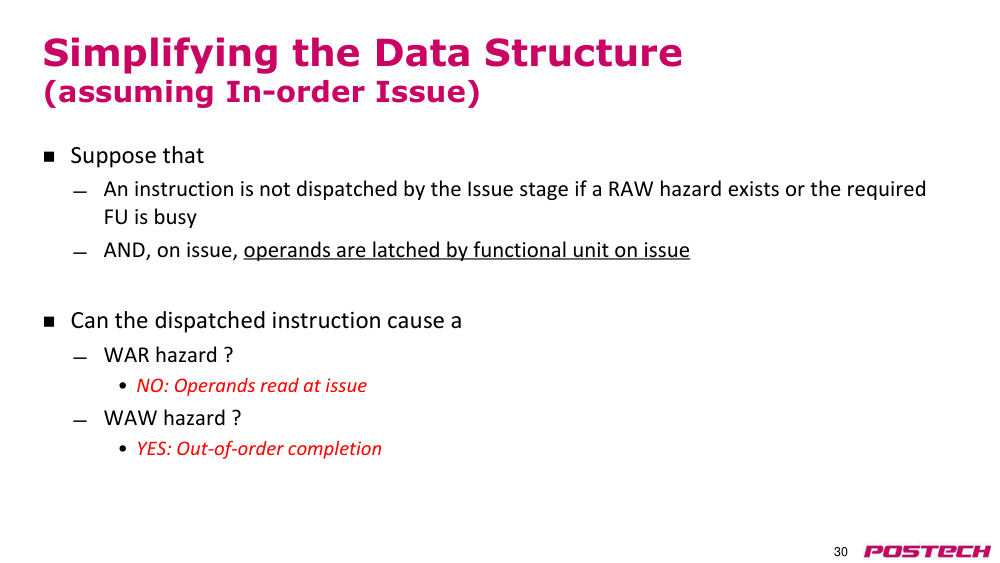
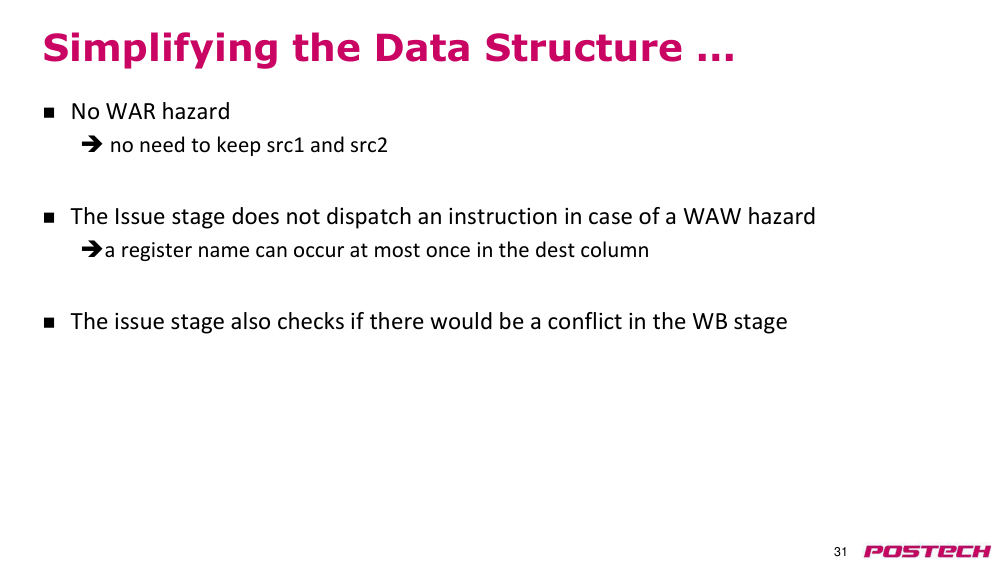
해결in-order issue + issue 시 operand latch 를 가정하면 WAR 는 불가능 → src 열 불필요. WAW 는 out-of-order completion 때문에 여전히 가능하므로 dest 가 겹치면 issue 하지 않음(dest 열에 register 는 최대 한 번).
- hazard 없을 때 표에 추가, WB 후 제거
- operand 를 issue 때 읽으므로 WAR 없음
- WAW 는 여전히 검사 필요, WB conflict 도 issue 단계가 검사
2.1039:51–49:40in-order issue scoreboard 구조와 동작 예제
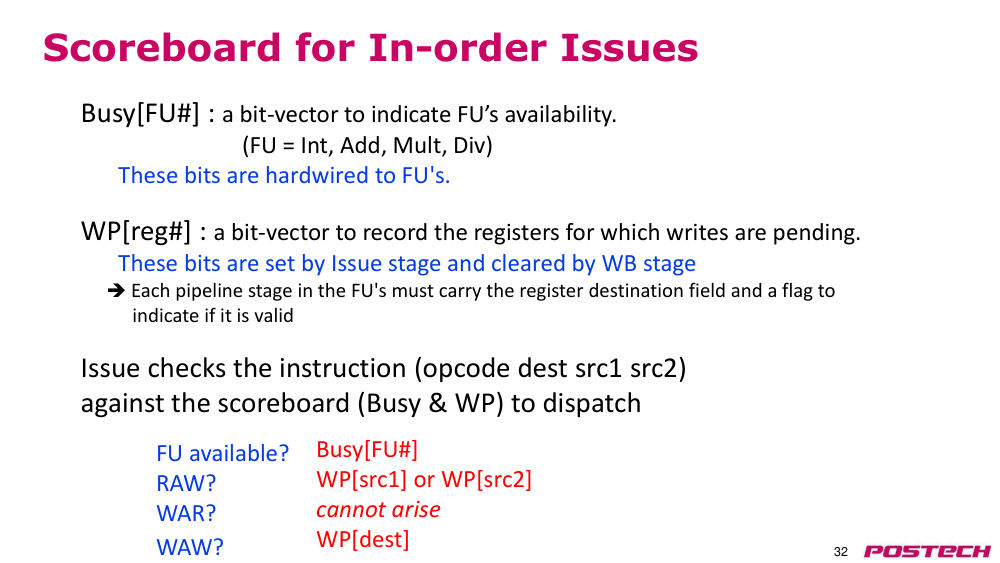
상황·문제단순화된 scoreboard 를 bit vector 로 구현한다.
원인Busy[FU#] (FU 가용, FU 에 hardwired), WP[reg#] (write pending, issue 때 set·WB 때 clear). 각 FU pipeline stage 는 dest register 와 valid flag(store 는 dest 없음)를 싣고 다닌다.
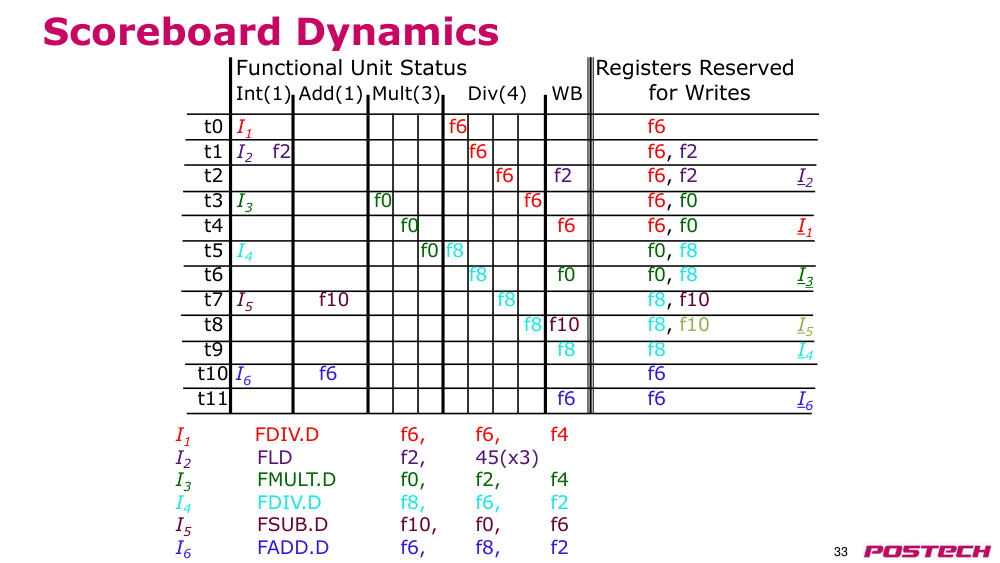
해결issue 조건: FU 가 비었고, source 에 WP 없음(RAW), dest 에 WP 없음(WAW). 예제: I1 FDIV f6 t0, I2 FLD t1, I3 FMUL 은 f2 대기 후 t3, I4 FDIV 는 f6·divider 대기 후 t5, I5 FSUB 는 f0 대기 후 t7, I6 FADD 는 f8 대기 후 t10 issue (slide p33).
- FU: int(1), add(1), mul(3), div(4) stage
- WP bit 는 register 수만큼
- WAR 검사는 불필요
2.1149:40–1:01:42in-order issue 의 한계와 out-of-order issue
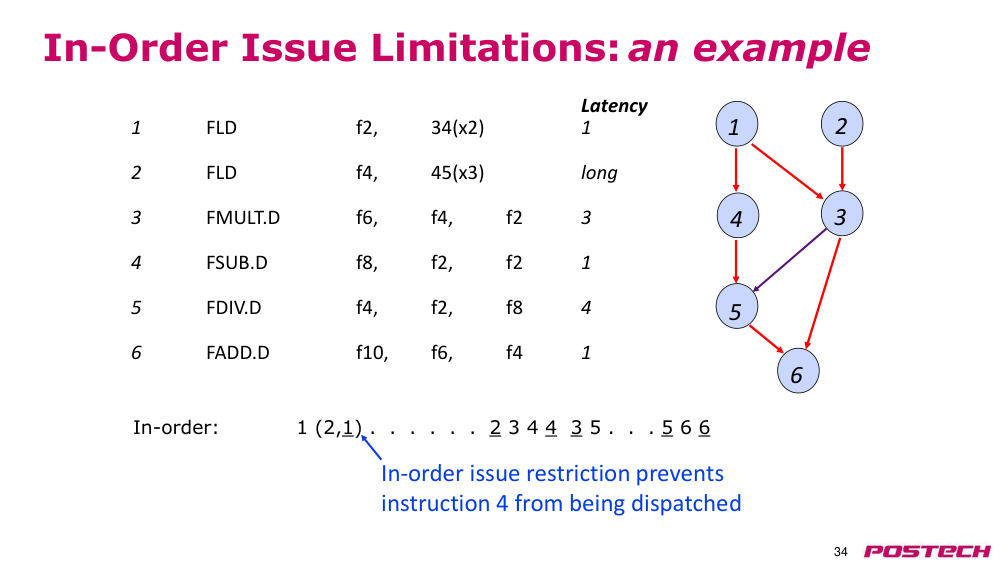
상황·문제in-order issue + out-of-order completion 에서, long-latency load(cache miss) 뒤의 RAW 명령이 막히면 독립 명령도 issue 못 한다.
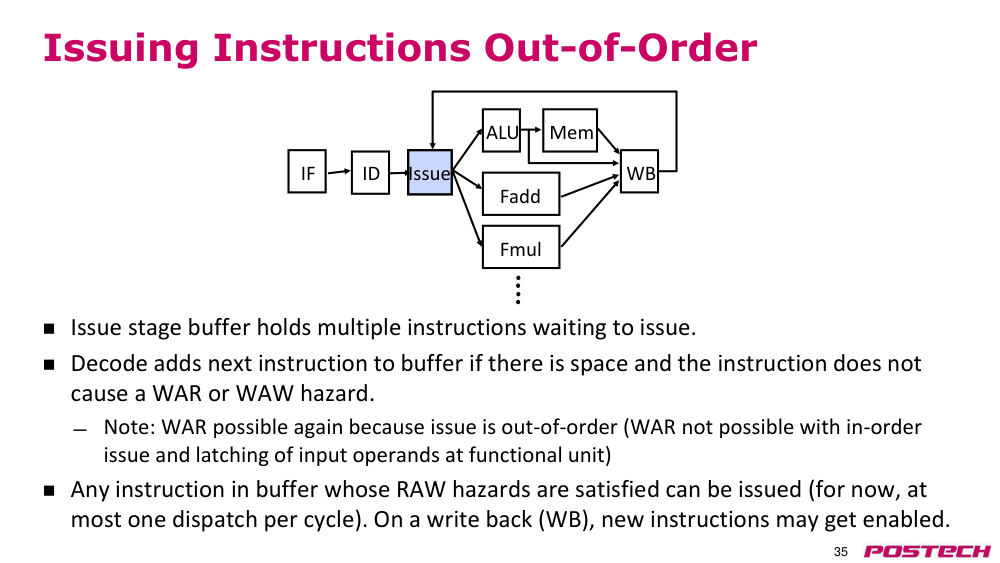
원인예제에서 I4 FSUB 는 I1 에만 의존해 준비됐지만 in-order issue 제한 때문에 I3 뒤에서 대기. out-of-order issue 를 하려면 decode 된 여러 명령을 담는 issue buffer 가 필요하고, 이때 WAR 가 다시 가능.
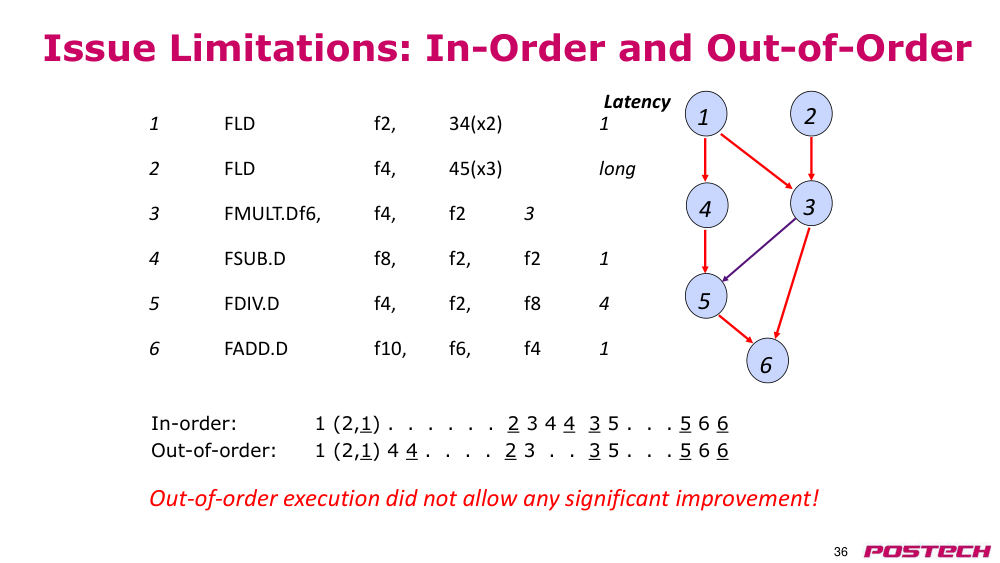
해결buffer 에 WAR/WAW 없는 명령만 넣고 RAW 가 풀린 명령은 아무거나 issue. 그러나 예제에서 I5 FDIV f4 가 I3 의 f4 read 와 WAR 로 막혀 총 cycle 이 줄지 않음 → out-of-order issue 만으로는 이득이 제한됨.
- issue buffer 필요, WB 때 새 명령이 enable
- out-of-order issue 에서 WAR 재등장
- WAR(false dependence) 때문에 이득 없음
2.121:01:42–1:10:37pipeline 에 들어갈 수 있는 명령 수와 Q&A (SMT)
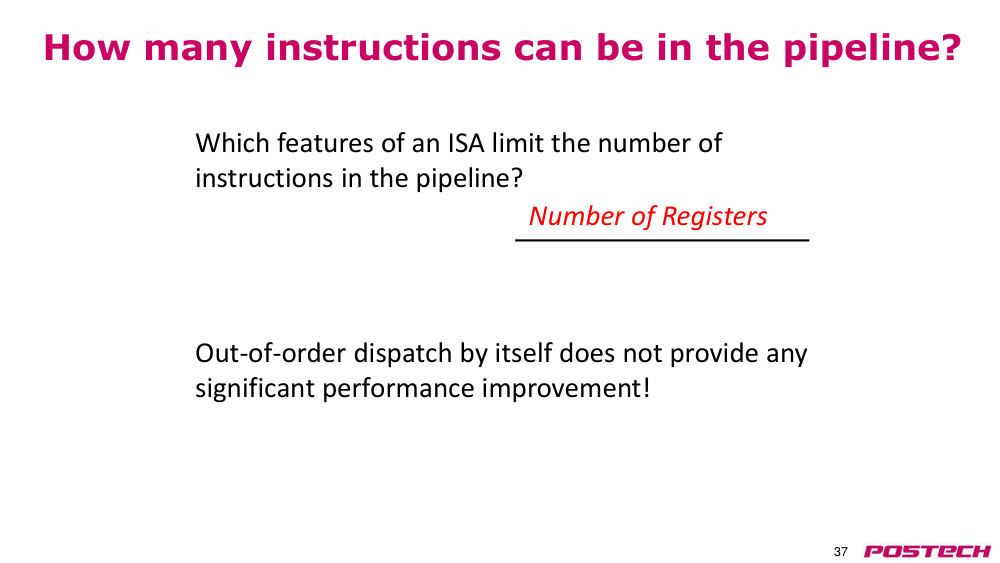
상황·문제어떤 ISA 특성이 pipeline 안 명령 수를 제한하는가?
원인답: number of registers. 같은 register 를 쓰는 명령들이 WAR/WAW 로 stall 하므로, register 수 제한을 넘지 못하면 out-of-order issue/execution 의 이득이 작다.
해결다음 강의에서 이 제한을 넘는 mechanism(Tomasulo)을 다룸. Q&A: 여러 register set 으로 thread 를 섞는 것은 SMT 로 가능하지만 single-thread 성능은 못 올림. register 2배의 효과는 ILP·FU 구성·workload 에 따라 다름.
- scoreboard 의 기여: out-of-order completion 으로 ILP 활용, register 수로 제한
- SMT: thread 별 architectural state 필요, pipeline 활용도 향상
- single-thread 성능은 thread 내 ILP 를 찾아야 함
2.131:10:37–1:18:24다음 강의 예고: Tomasulo 와 out-of-order issue
상황·문제IBM 이 CDC 와 경쟁하며 다른 구조적 제약 속에서 Tomasulo algorithm 을 만들었다.
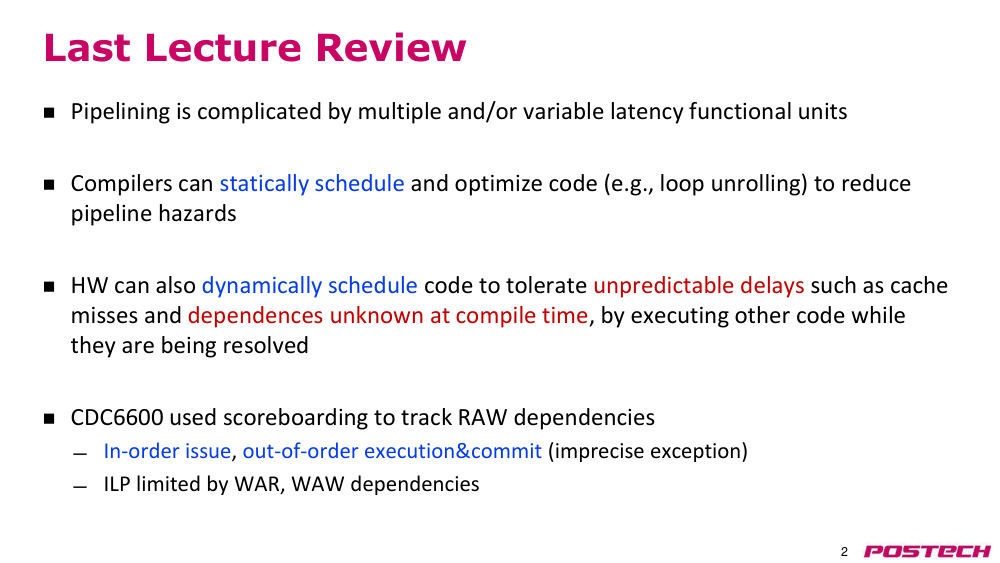
원인복습: compiler static scheduling(loop unrolling, software pipelining)은 runtime 동작을 몰라 한계. CDC 6600 scoreboard 는 in-order issue, out-of-order 실행·commit 이라 precise exception 불가, ILP 는 WAR·WAW 로 제한.
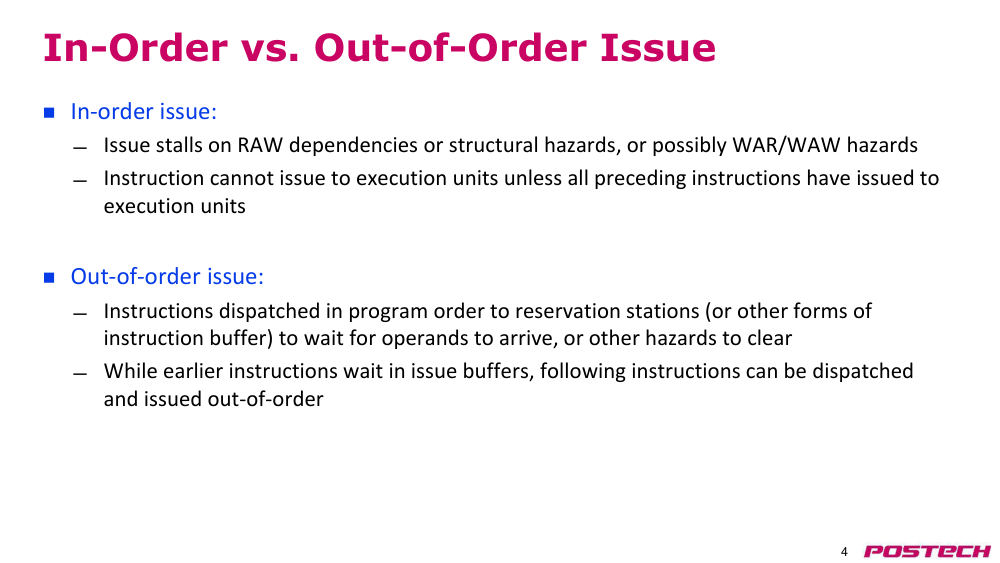
해결FP unit 이 있으면 out-of-order completion 이 사실상 필수. 다음은 out-of-order issue: 명령을 in-order 로 reservation station 에 dispatch 하고, RS 에서 RAW 가 풀리면 out-of-order 로 FU 에 issue.
- in-order issue: 앞 명령이 모두 issue 되어야 함
- reservation station 이 RAW 를 검사하고 out-of-order issue
3핵심 개념
3.1structural hazard at WB(WB 단계 구조적 경합)
latency 가 다른 unit 들이 같은 cycle 에 register file 에 쓰려는 충돌.
3.2out-of-order completion(비순서 완료)
issue 는 in-order, 완료는 latency 에 따라 순서 무관. WAW 검사 필요.
3.3scoreboard(스코어보드)
CDC 6600 의 issue 단계 hazard 검사 구조. Busy[FU#] 와 WP[reg#] bit vector.
3.4write pending bit(WP)
register 별로 pending write 표시. issue 때 set, WB 때 clear. RAW·WAW 검사에 사용.
3.5anti-dependence(WAR)·output dependence(WAW)
값이 아닌 register 이름 재사용 때문에 생기는 false dependence.
3.6memory disambiguation(메모리 모호성 해소)
store/load 주소가 같은지 execution 후에야 알 수 있어 따로 판별.
3.7out-of-order issue(비순서 발행)
issue buffer 에서 RAW 가 풀린 명령을 먼저 issue. WAR 가 다시 가능.
3.8SMT(simultaneous multithreading)
여러 thread 의 architectural state 를 두고 한 pipeline 을 공유. single-thread 성능은 그대로.
3.9reservation station(예약 스테이션)
Tomasulo 에서 in-order dispatch 받은 명령을 보관, RAW 가 풀리면 out-of-order issue.
4스스로 확인
4.1add 3 cycle, mul 7 cycle 일 때 mul 을 cycle 0 에 issue 하면 add 를 언제 issue 할 때 WB conflict 가 나는가?
답
cycle 4. 둘이 같은 cycle 에 WB 한다.
4.2in-order issue scoreboard 에서 WAR 검사가 필요 없는 이유는?
답
issue 시 operand 를 FU 에 latch 하므로 뒤 명령의 write 가 앞 명령의 read 에 영향 없음.
4.3scoreboard 에서 WAW 는 어떻게 막는가?
답
issue 할 명령의 dest register 의 WP bit 가 set 이면 issue 하지 않는다.
4.4out-of-order issue 만으로 예제 성능이 좋아지지 않은 이유는?
답
I5 FDIV f4 가 I3 의 f4 read 와 WAR 로 묶여 일찍 issue 할 수 없었다.
4.5pipeline 안 명령 수를 제한하는 ISA 특성은?
답
architectural register 수. register 재사용이 WAR/WAW stall 을 만든다.
5참고 자료
5.1Computer Architecture: A Quantitative Approach, 6th ed. — Elsevier ↗ · 교재. 05강 덱 권장 읽기 Chapter 3.2 & C.7, 06강 덱 Chapter 3.4–3.5