이 자료를 쓰는 강의: 05 Exception 처리, R4000, static scheduling 과 decoupled execution · 06 complex pipeline, CDC 6600 scoreboard, out-of-order issue 의 한계
Lec5 - Instruction Scheduling (updated)
한국어판 강의자료 · 38쪽
p.1CSED503 고급 컴퓨터 아키텍처 – 강의 5
p.2이전 강의 요약
- iron law of performance(성능의 철칙): 프로그램 시간 = 프로그램당 명령어 수 × 명령어당 사이클 수 × 사이클당 시간
- classic 5-stage RISC pipeline(클래식 5단계 RISC 파이프라인)
- structural hazard(구조적 경합), data hazard(데이터 경합), control hazard(제어 경합)
- structural hazard(구조적 경합)은 interlock(인터록) 또는 더 많은 하드웨어로 처리
- data hazard(데이터 경합)은 RAW, WAR, WAW 포함
- data hazard(데이터 경합)은 interlock(인터록), bypass(바이패스), 또는 speculation(추측 실행)으로 처리
- 제어 경합(브랜치, 인터럽트)은 다음 명령어가 무엇인지 변경되므로 가장 어려움
- 브랜치 예측이 일반적으로 사용됨
- precise trap(정확한 트랩): 한 명령어에서 깨끗하게 정지하며, 이전 모든 명령어는 완료되었고, 이후 명령어는 아키텍처 상태를 변경하지 않음
p.3간단한 vector addition(벡터 덧셈) 코드 예제
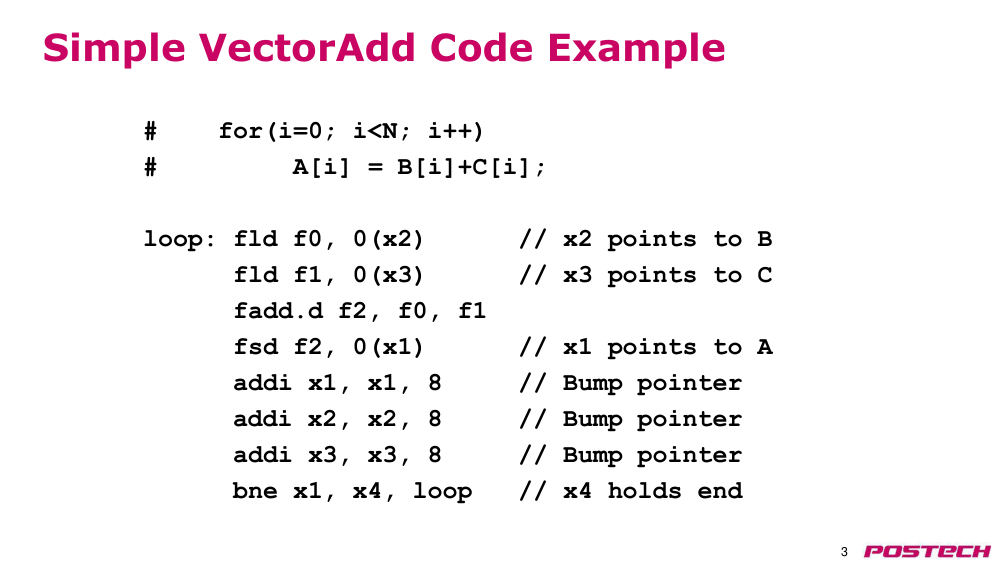
- #
- for(i=0; i<N; i++)
- #
- A[i] = B[i]+C[i];
- loop: fld f0, 0(x2) // x2는 B를 가리킴
- fld f1, 0(x3) // x3는 C를 가리킴
- fadd.d f2, f0, f1
- fsd f2, 0(x1) // x1는 A를 가리킴
- addi x1, x1, 8 // 포인터 증가
- addi x2, x2, 8 // 포인터 증가
- addi x3, x3, 8 // 포인터 증가
- bne x1, x4, loop // x4는 끝을 저장
p.4간단한 파이프라인 스케줄링
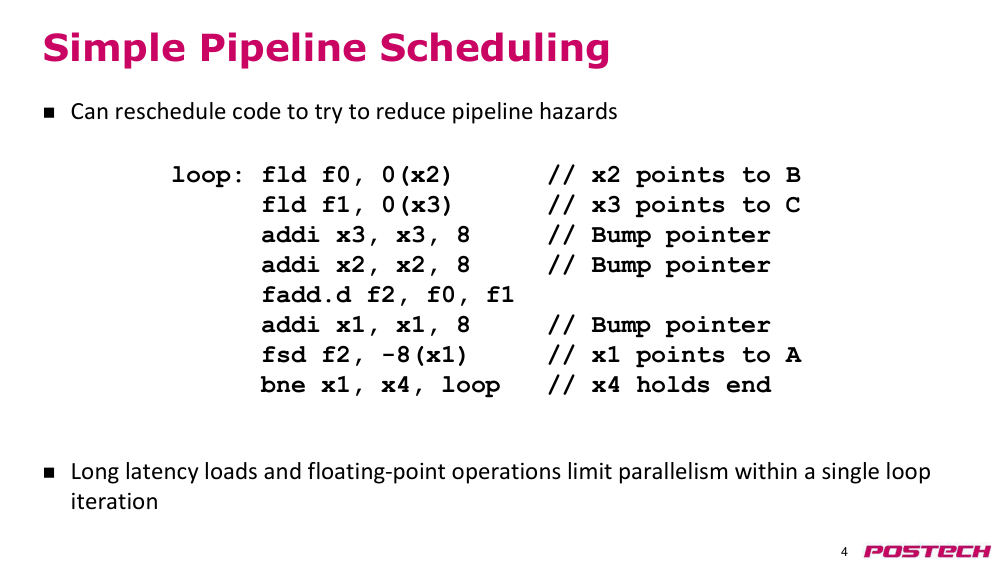
- 파이프라인 경합을 줄이기 위해 코드를 재스케줄링할 수 있음
- 긴 latency(지연 시간)을 가진 로드 및 부동소수점 연산은 단일 루프 반복 내에서 병렬성을 제한함
- loop: fld f0, 0(x2) // x2는 B를 가리킴
- fld f1, 0(x3) // x3는 C를 가리킴
- addi x3, x3, 8 // 포인터 증가
- addi x2, x2, 8 // 포인터 증가
- fadd.d f2, f0, f1
- addi x1, x1, 8 // 포인터 증가
- fsd f2, -8(x1) // x1는 A를 가리킴
- bne x1, x4, loop // x4는 끝을 저장
p.5경합을 줄이기 위한 loop unrolling(루프 전개)
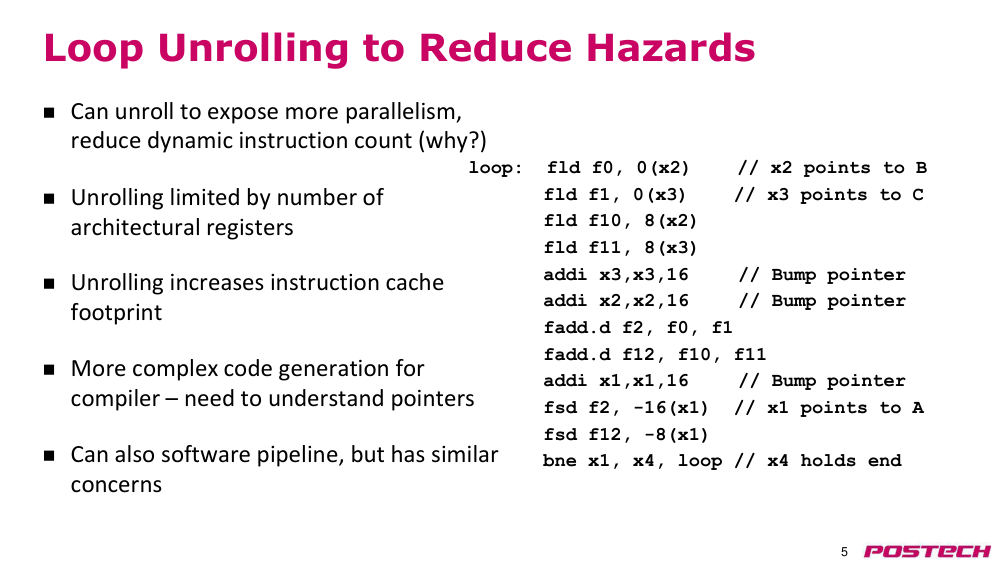
- 더 많은 병렬성을 드러내기 위해 loop unrolling(루프 전개)가 가능함 (왜 동적 명령어 수가 줄어드는가?)
- loop unrolling(루프 전개)는 아키텍처 레지스터 수에 의해 제한됨
- loop unrolling(루프 전개)는 instruction cache footprint(명령어 캐시 영역)을 증가시킴
- 컴파일러의 코드 생성이 더 복잡해짐 – 포인터 이해 필요
- software pipelining(소프트웨어 파이프라인화)도 가능하지만 유사한 문제 존재
- loop: fld f0, 0(x2) // x2는 B를 가리킴
- fld f1, 0(x3) // x3는 C를 가리킴
- fld f10, 8(x2)
- fld f11, 8(x3)
- addi x3,x3,16 // 포인터 증가
- addi x2,x2,16 // 포인터 증가
- fadd.d f2, f0, f1
- fadd.d f12, f10, f11
- addi x1,x1,16 // 포인터 증가
- fsd f2, -16(x1) // x1는 A를 가리킴
- fsd f12, -8(x1)
- bne x1, x4, loop // x4는 끝을 저장
p.6대안적 접근: µarchitecture(마이크로 아키텍처)에서의 decoupling(분리 실행) (lookahead(룩어헤드), runahead(런어헤드))
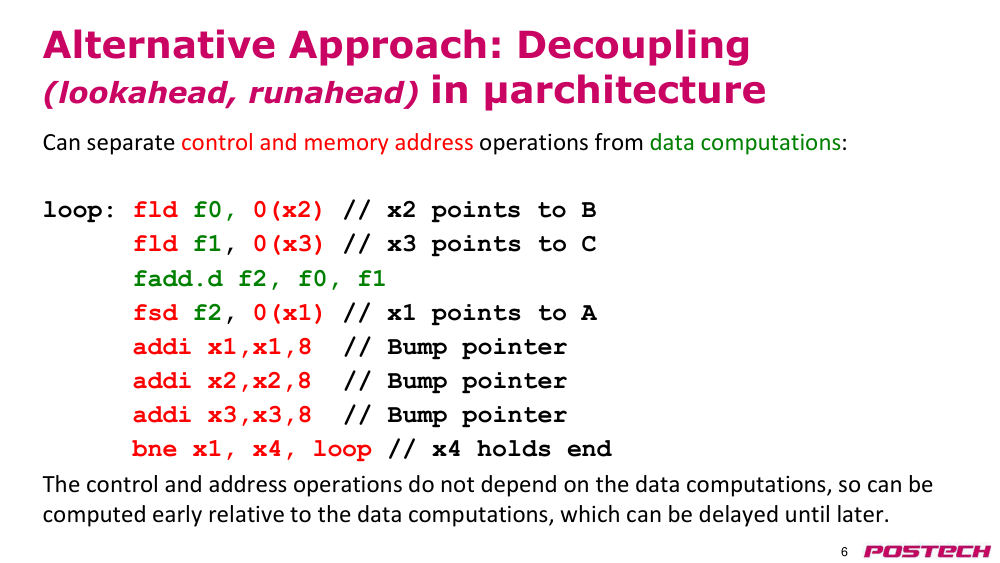
- 제어 및 메모리 주소 연산을 데이터 계산과 분리할 수 있음
- loop: fld f0, 0(x2) // x2는 B를 가리킴
- fld f1, 0(x3) // x3는 C를 가리킴
- fadd.d f2, f0, f1
- fsd f2, 0(x1) // x1는 A를 가리킴
- addi x1,x1,8 // 포인터 증가
- addi x2,x2,8 // 포인터 증가
- addi x3,x3,8 // 포인터 증가
- bne x1, x4, loop // x4는 끝을 저장
- 제어 및 주소 연산은 데이터 계산에 의존하지 않으므로, 데이터 계산보다 일찍 계산할 수 있으며, 데이터 계산은 나중에 지연될 수 있음
p.7간단한 decoupling(분리 실행) 기계
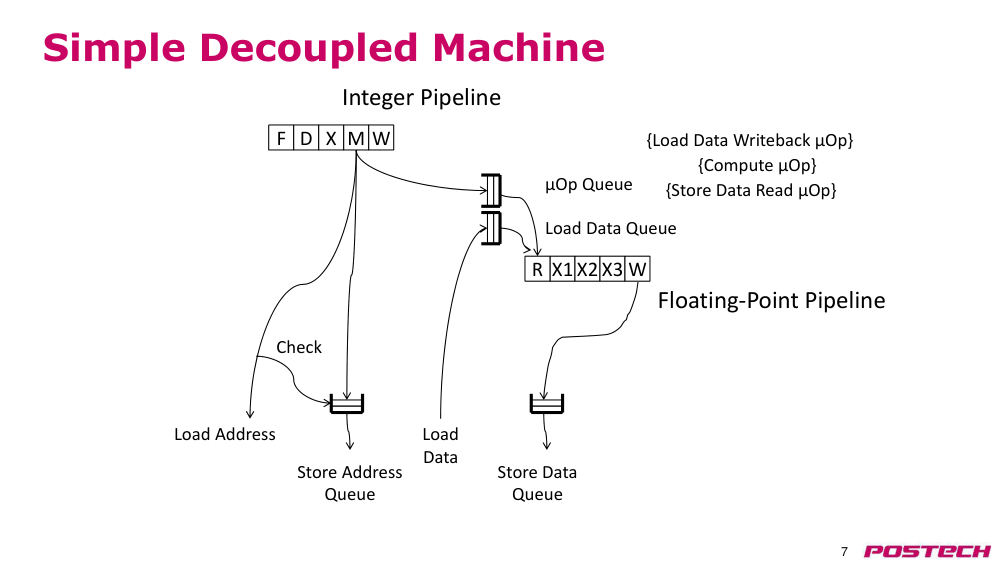
- F D X M W
- X1 X2 X3 W
- µop queue(마이크로 명령어 큐)
- R
- load data queue(로드 데이터 큐)
- store address queue(스토어 주소 큐)
- store data queue(스토어 데이터 큐)
- integer pipeline(정수 파이프라인)
- Floating-Point pipeline(부동소수점 파이프라인)
- load address check(로드 주소 확인)
- 로드 데이터
- {로드 데이터 쓰기-백 마이크로 명령어}
- {계산 마이크로 명령어}
- {스토어 데이터 읽기 마이크로 명령어}
p.8decoupling(분리 실행)
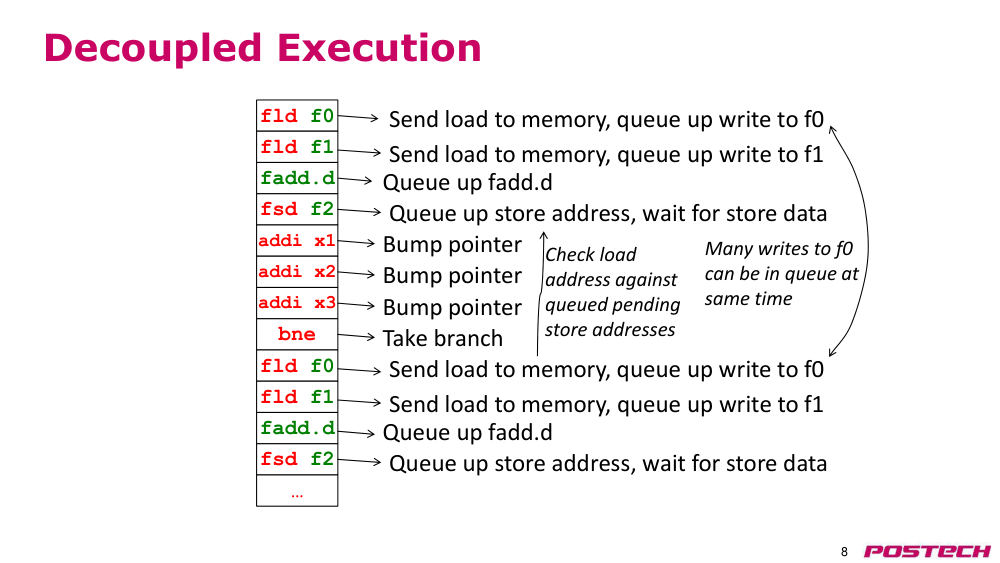
- fld f0
- fld f1
- 메모리로 로드 전송, f0에 쓰기 대기
- 메모리로 로드 전송, f1에 쓰기 대기
- fadd.d
- fadd.d 대기
- fsd f2
- 스토어 주소 대기, 스토어 데이터 대기
- addi x1
- 포인터 증가
- addi x2
- 포인터 증가
- addi x3
- 포인터 증가
- bne
- 분기 수행
- fld f0
- fld f1
- 메모리로 로드 전송, f0에 쓰기 대기
- 메모리로 로드 전송, f1에 쓰기 대기
- fadd.d
- fadd.d 대기
- fsd f2
- 스토어 주소 대기, 스토어 데이터 대기
- ...
- 로드 주소를 대기 중인 스토어 주소와 비교
- 동시에 f0에 여러 쓰기가 대기할 수 있음
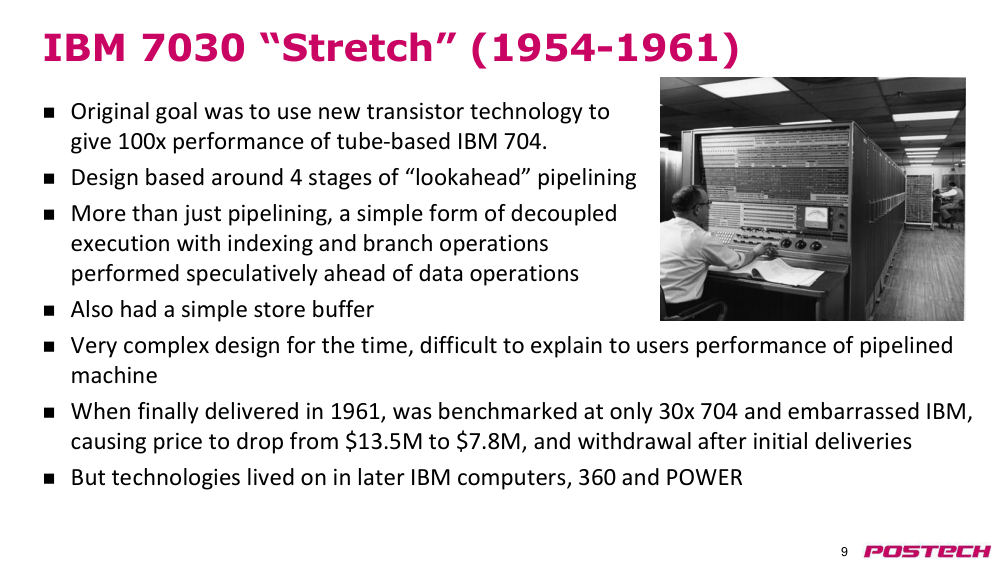
p.9IBM 7030 'Stretch' (1954-1961)
- 트랜지스터 기술을 사용해 IBM 704의 100배 성능을 달성하려는 원초적 목표
- 4단계의 lookahead pipelining(룩어헤드 파이프라이닝)을 기반으로 한 설계
- 단순한 파이프라인을 넘어서, 데이터 연산보다 앞서 인덱싱 및 분기 연산을 speculation(추측 실행)하는 단순한 decoupling(분리 실행) 형태
- 간단한 store buffer(스토어 버퍼)도 보유
- 당시로서는 매우 복잡한 설계로, 파이프라인 기계의 성능을 사용자에게 설명하기 어려웠음
- 1961년 최종 제공 시점에 벤치마크 성능은 704의 30배에 그쳐 IBM을 당황하게 만들었고, 가격은 1350만 달러에서 780만 달러로 하락하며 초기 출하 후 철수
- 그러나 기술은 후속 IBM 컴퓨터인 360과 POWER에 계승됨
- © IBM
p.10supercomputer(슈퍼컴퓨터)
- supercomputer(슈퍼컴퓨터)의 정의:
- 주어진 작업에서 세계에서 가장 빠른 기계
- 계산 중심 문제를 입출력 중심 문제로 전환하는 장치
- 가격이 3000만 달러 이상인 모든 기계
- Seymour Cray가 설계한 모든 기계
- CDC6600 (Seymour Cray, 1964)은 최초의 supercomputer(슈퍼컴퓨터)로 간주됨
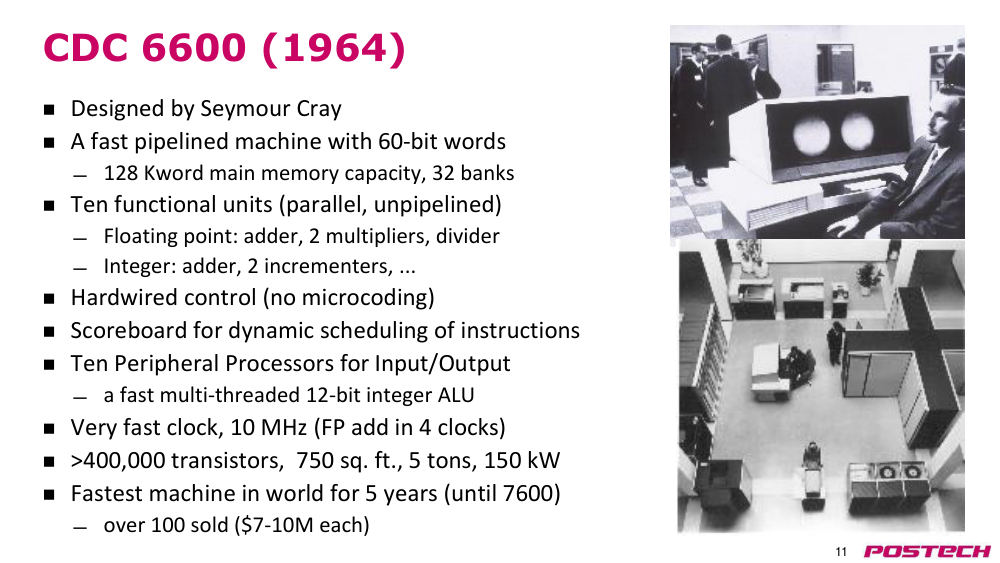
p.11CDC 6600 (1964)
- Seymour Cray가 설계
- 빠른 파이프라인 기계로, 60비트 단어, 128K워드 메인 메모리 용량, 32개의 메모리 뱅크
- 10개의 기능 유닛 (병렬, 비파이프라인)
- 부동소수점: 가산기, 2개의 승산기, 나눗셈기
- 정수: 가산기, 2개의 증가기 등
- 하드웨어 제어 (마이크로코딩 없음)
- 동적 instruction scheduling(명령어 스케줄링)을 위한 scoreboard(스코어보드)
- 입출력을 위한 10개의 peripheral processor(주변 프로세서)
- 빠른 멀티스레드 12비트 정수 ALU
- 매우 빠른 클럭, 10MHz (FP 가산 4클럭)
- 750제곱피트, 5톤, 150kW, 40만 개 이상의 트랜지스터
- 7600까지 5년간 세계에서 가장 빠른 기계
- 100대 이상 판매 ($7-10M 각각)
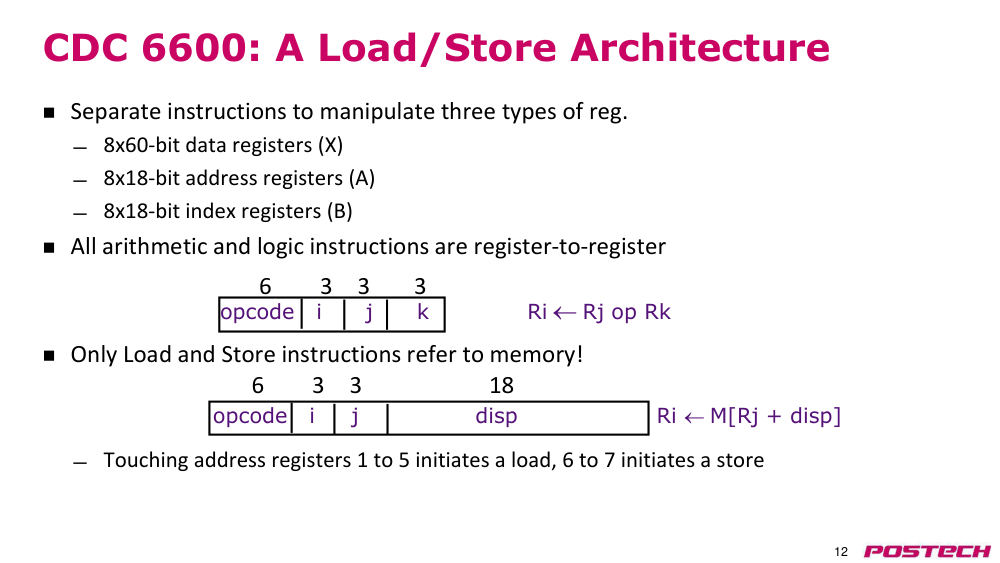
p.12CDC 6600: Load/Store architecture(로드/스토어 아키텍처)
- 세 가지 유형의 레지스터를 조작하는 별도의 명령어
- 8개의 60비트 데이터 레지스터 (X)
- 8개의 18비트 주소 레지스터 (A)
- 8개의 18비트 인덱스 레지스터 (B)
- 모든 산술 및 논리 명령어는 Register-to-Register instruction(레지스터 간 명령어)
- 메모리에 접근하는 것은 오직 로드 및 스토어 명령어만 가능!
- address register(주소 레지스터) 1~5를 접근하면 로드 시작, 6~7을 접근하면 스토어 시작
- opcode i
- j k
- Ri ← Rj op Rk
- opcode i
- j disp
- Ri ← M[Rj + disp]
- 6
- 3
- 3
- 3
- 6
- 3
- 3
- 18
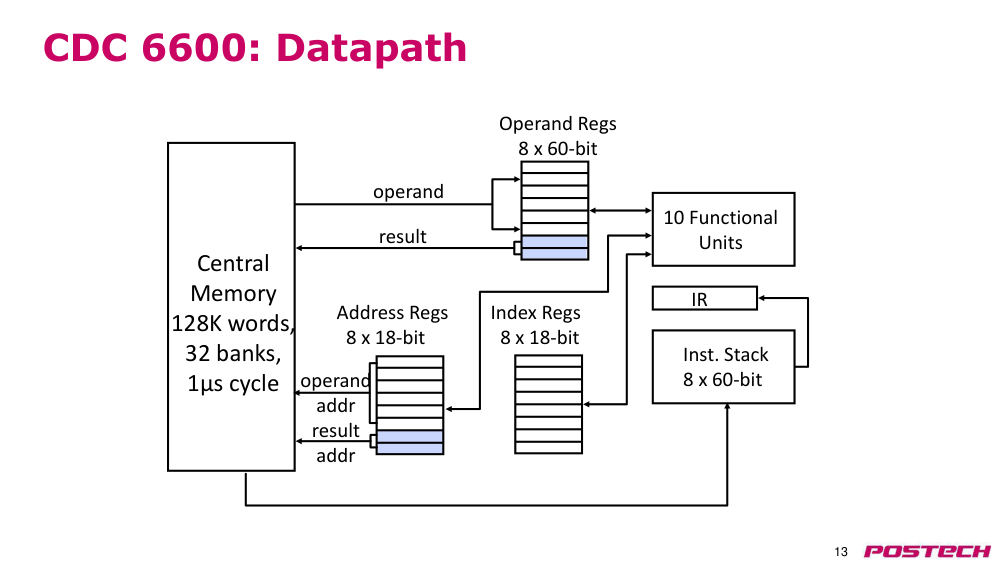
p.13CDC 6600: 데이터 경로
- 주소 레지스터 (Address Regs): 8개 × 18비트
- 인덱스 레지스터 (Index Regs): 8개 × 18비트
- 피연산자 레지스터 (Operand Regs): 8개 × 60비트
- 명령어 스택 (Inst. Stack): 8개 × 60비트
- 명령어 레지스터 (IR)
- 기능 유닛 (Functional Units): 10개
- 중앙 메모리 (Central Memory): 128K 단어, 32개의 bank(뱅크), 1µs 사이클
- 결과 (result)
- 주소 (addr)
- 결과 피연산자 (result operand)
- 입력 피연산자 (operand)
- 주소 (addr)
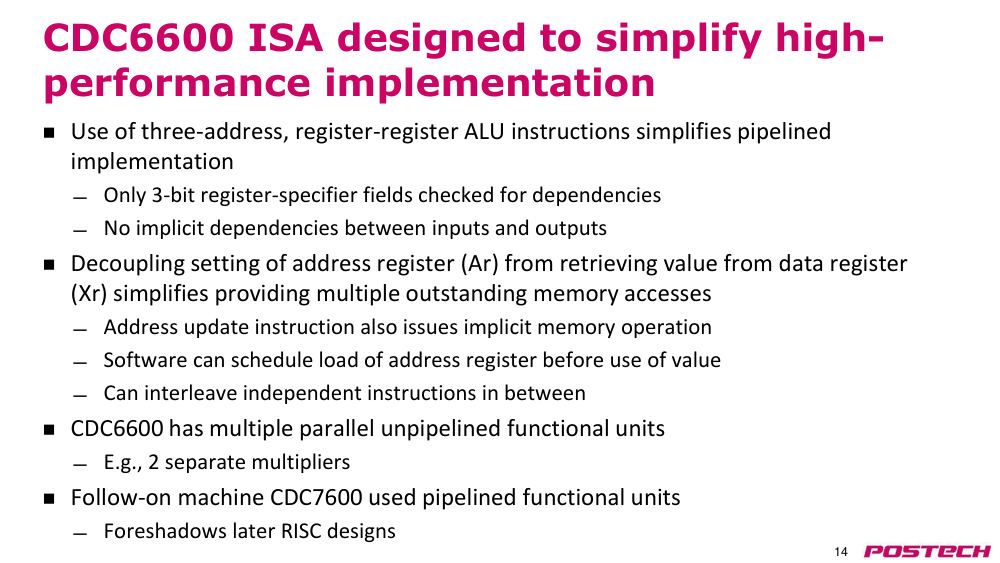
p.14CDC6600 instruction set architecture (ISA)(명령어 세트 아키텍처): 고성능 구현을 단순화하기 위해 설계됨
- 세 주소 형식의 레지스터 간 ALU 명령어 사용은 pipelined implementation(파이프라인 구현)을 단순화함
- 의존성 검사를 위해 단지 3비트의 레지스터 지정 필드만 확인됨
- 입력과 출력 사이에 implicit dependency(암묵적 의존성)이 없음
- 주소 레지스터 (Ar) 설정과 데이터 레지스터 (Xr) 값 가져오기 간의 decoupling(분리 실행)은 다수의 outstanding memory accesses(미완료 메모리 접근)을 제공하는 것을 단순화함
- 주소 업데이트 명령어는 암시적으로 메모리 작업을 발행함
- 소프트웨어는 값 사용 전에 address register(주소 레지스터) 로드를 스케줄링할 수 있음
- 독립적인 명령어들을 사이에 삽입하여 인터리빙 가능
- CDC6600은 다중 병렬 unpipelined functional unit(비파이프라인 기능 유닛)을 갖음
- 예: 별도의 2개의 곱셈기
- 후속 기계인 CDC7600은 pipelined functional unit(파이프라인 기능 유닛)을 사용함
- 후속 RISC 설계의 전조를 보여줌
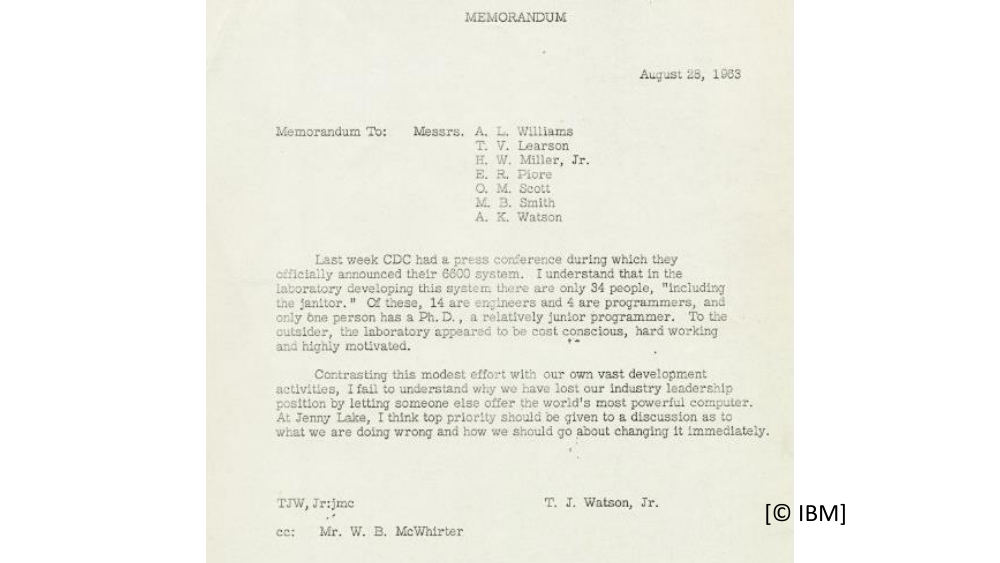
p.15[© IBM]
p.16IBM CDC6600 메모
- Thomas Watson Jr., IBM CEO, 1963년 8월:
- “지난 주, Control Data가 6600 시스템을 발표했다. 그 시스템 개발 실험실에는 청소부를 포함해 총 34명이 있으며, 그 중 14명은 엔지니어이고 4명은 프로그래머다... 이 소규모의 노력과 우리 대규모 개발 활동을 비교해보면, 왜 우리가 세계 최고 성능의 컴퓨터를 제공하는 기업이 되지 못했는지 이해할 수 없다.”
- 이에 대해 Cray는 이렇게 답했다: “Watson 씨가 스스로의 질문에 답한 것처럼 보인다.”
p.17복잡한 파이프라인화: 동기
- 파이프라인화는 다음과 같은 상황에서 복잡해진다:
- 긴 latency(지연 시간) 또는 부분적으로 파이프라인화된 부동소수점 유닛이 있는 경우
- 변동하는 접근 시간을 가진 메모리 시스템이 있는 경우
- 다중 산술 및 메모리 유닛이 있는 경우
p.18complex pipeline control(복잡한 파이프라인 제어)의 문제점
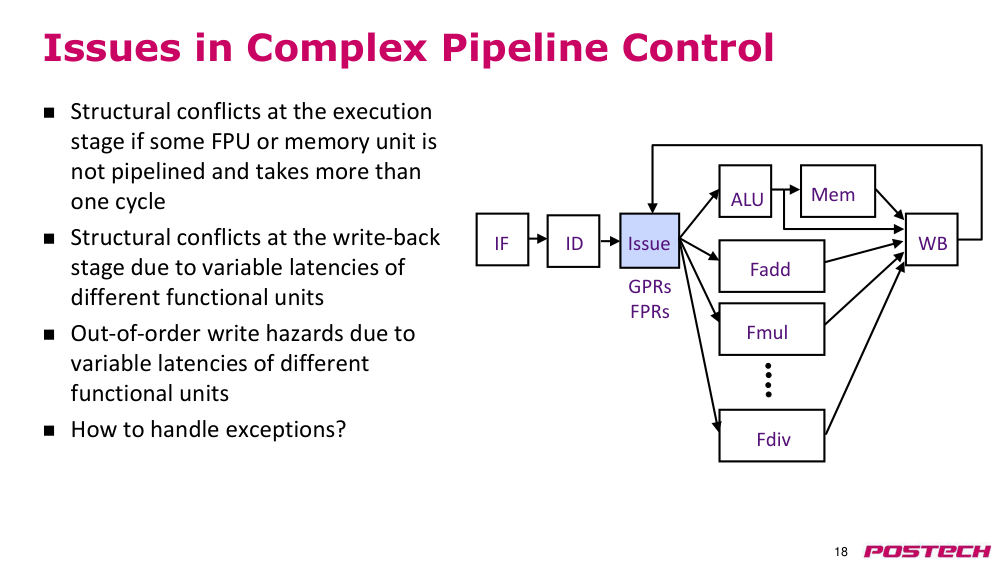
- 일부 FPU나 메모리 유닛이 파이프라인화되지 않고 1사이클 이상 소요되는 경우, 실행 단계에서 structural conflict(구조적 충돌) 발생
- 다양한 functional unit(기능 유닛)의 변동하는 latency(지연 시간)으로 인해 Write-Back stage(쓰기-백 단계)에서 structural conflict(구조적 충돌) 발생
- 다양한 functional unit(기능 유닛)의 변동하는 latency(지연 시간)으로 인해 Out-of-Order write hazard(비순서 쓰기 경합) 발생
- exception handling(예외 처리)는 어떻게 해야 하는가?
p.19보다 복잡한 In-Order pipeline(순서 유지 파이프라인)
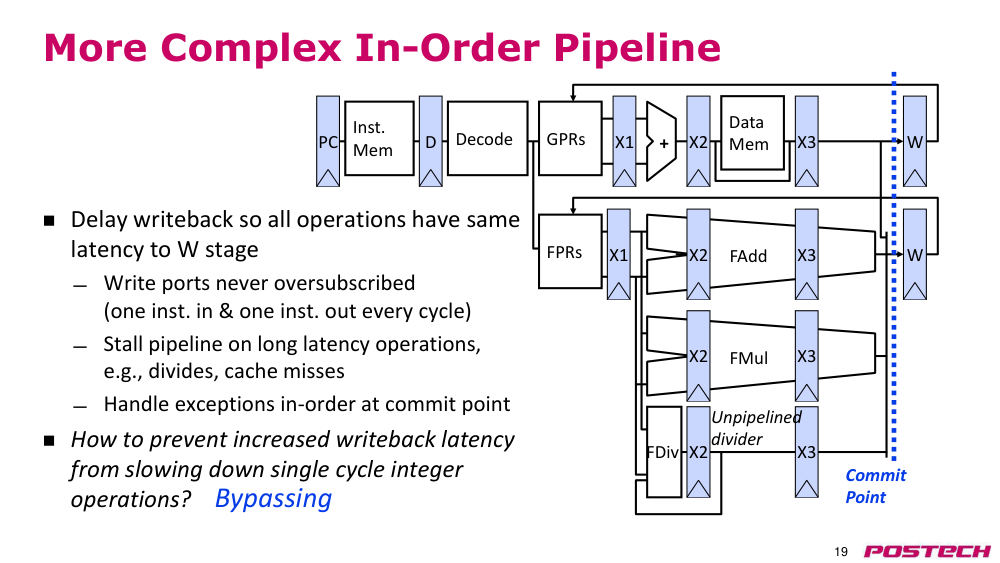
- 모든 연산이 W 단계까지 동일한 latency(지연 시간)을 가지도록 Write-Back stage(쓰기-백 단계)를 지연시킨다.
- 쓰기 포트는 항상 과도하게 사용되지 않도록 한다 (매 사이클마다 하나의 명령어가 입력되고 하나의 명령어가 출력된다).
- 장시간 지연 연산(예: 나눗셈, 캐시 미스)이 발생할 경우 파이프라인을 스톨한다.
- exception handling(예외 처리)는 commit point(커밋 포인트)에서 순서대로 처리한다.
- Write-Back stage(쓰기-백 단계)의 latency(지연 시간)이 증가하는 것을 방지하면서도 단일 사이클 정수 연산의 속도를 저하시키지 않으려면 어떻게 해야 하는가?
p.20순서 유지 superscalar pipeline(슈퍼스칼라 파이프라인)
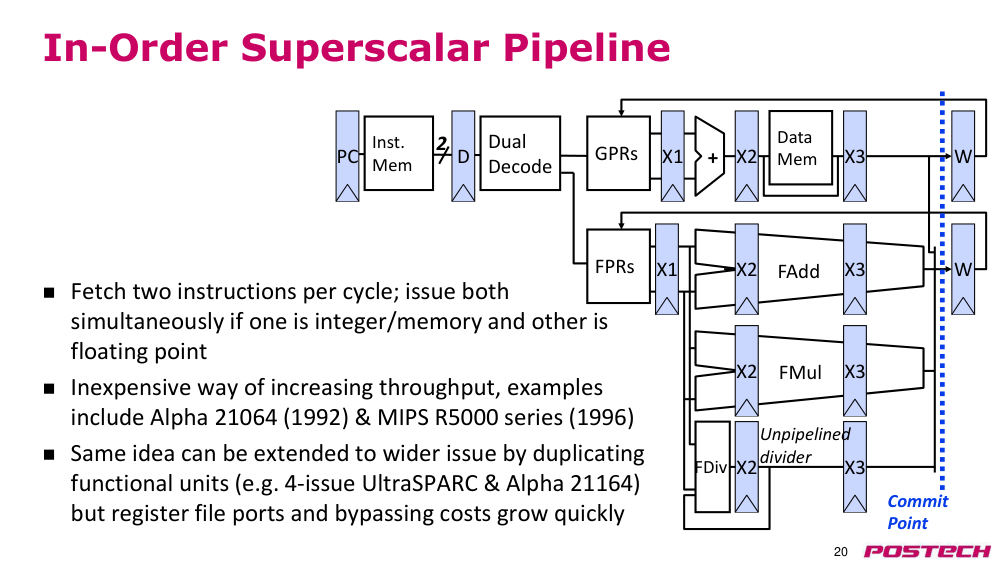
- 매 사이클에 두 개의 명령어를 가져오며, 하나는 정수/메모리 연산이고 다른 하나는 부동소수점 연산인 경우 동시에 발행한다.
- 처리량을 높이는 저비용 방법으로, 예를 들어 Alpha 21064(1992) 및 MIPS R5000 시리즈(1996)가 있다.
- functional unit(기능 유닛)을 복제함으로써 더 넓은 발행(예: 4-이슈 UltraSPARC 및 Alpha 21164)으로 확장할 수 있지만, register file ports(레지스터 파일 포트)와 bypass(바이패스) 비용이 급격히 증가한다.
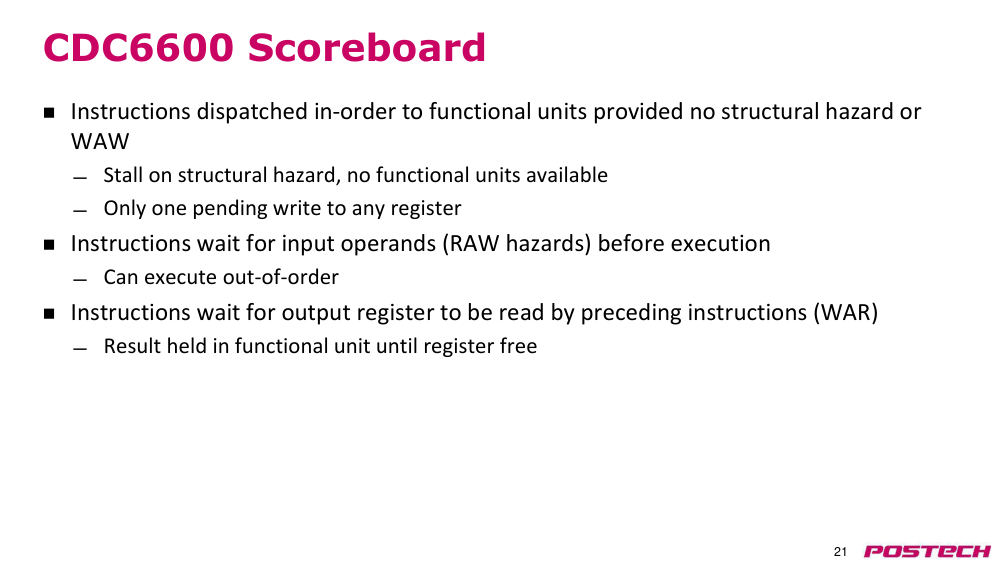
p.21CDC6600 scoreboard(스코어보드)
- structural hazard(구조적 경합)이나 WAW 경합이 없을 경우 명령어를 순서대로 functional unit(기능 유닛)에 발행한다.
- structural conflict(구조적 충돌) 발생 시 스톨하며, functional unit(기능 유닛)이 사용 가능하지 않을 경우 대기한다.
- 어떤 레지스터에도 동시에 하나의 기록만 허용된다.
- 입력 피연산자(RAW 경합)가 준비될 때까지 명령어는 실행을 기다린다.
- 비순서로 실행할 수 있다.
- 이전 명령어가 출력 레지스터를 읽을 때까지 기다린다(WAR 경합).
- 결과는 functional unit(기능 유닛)에 보관되어 레지스터가 비워질 때까지 기다린다.
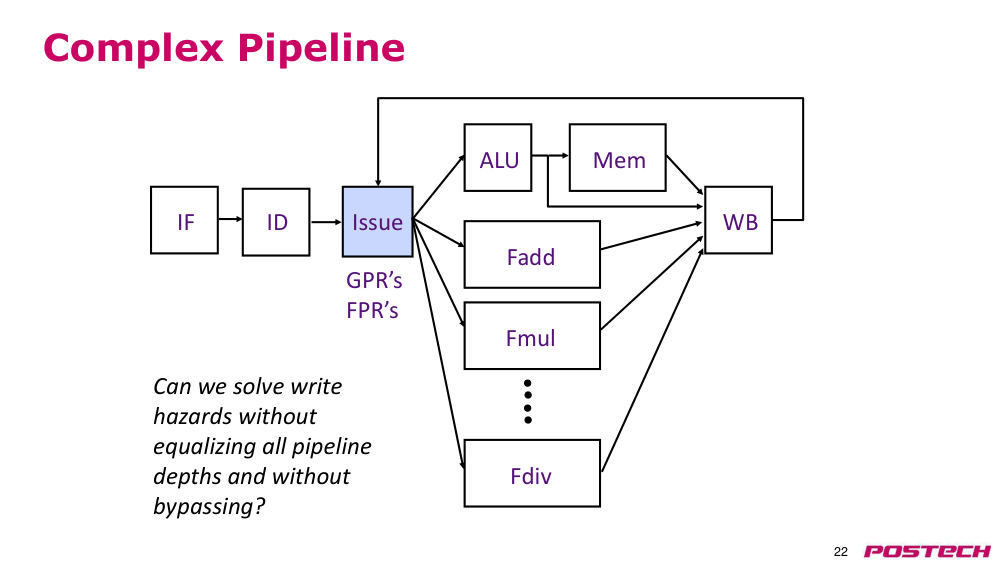
p.22복잡한 파이프라인
- IF
- ID
- WB
- ALU
- Mem
- Fadd
- Fmul
- Fdiv
- Issue
- GPR’s
- FPR’s
- 모든 파이프라인 깊이를 동일하게 하지 않고 bypass(바이패스) 없이 쓰기 경합을 해결할 수 있는가?
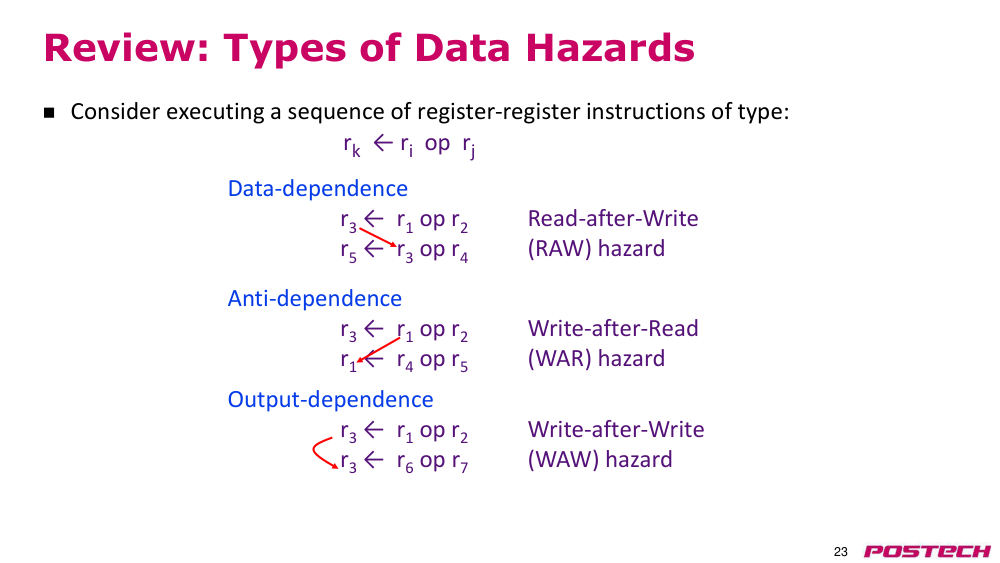
p.23리뷰: data hazard(데이터 경합)의 유형
- 다음과 같은 Register-to-Register instruction(레지스터 간 명령어) 시퀀스를 실행할 때를 고려한다: rk ← ri op rj
- 데이터 의존성
- r3 ← r1 op r2
- 쓰기 후 읽기 (RAW) 경합
- r5 ← r3 op r4
- 반대 의존성
- r3 ← r1 op r2
- 읽기 후 쓰기 (WAR) 경합
- r1 ← r4 op r5
- 출력 의존성
- r3 ← r1 op r2
- 쓰기 후 쓰기 (WAW) 경합
- r3 ← r6 op r7
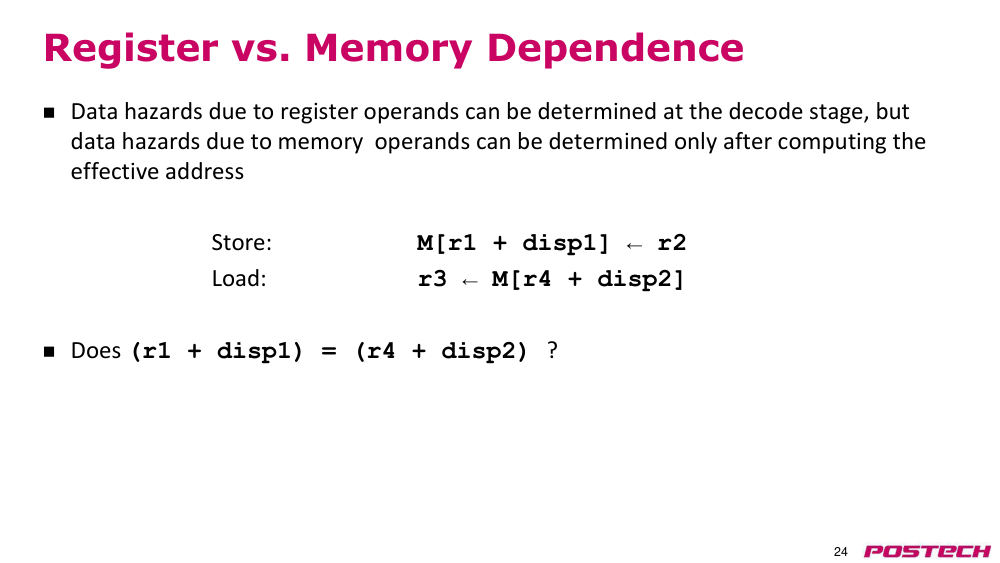
p.24레지스터 의존성 vs. 메모리 의존성
- 레지스터 피연산자에 의한 data hazard(데이터 경합)은 디코딩 단계에서 결정할 수 있지만, 메모리 피연산자에 의한 데이터 경합은 유효 주소를 계산한 후에야 결정할 수 있다.
- 스토어: M[r1 + disp1] ← r2
- 로드: r3 ← M[r4 + disp2]
- r1 + disp1 = r4 + disp2 인가?
p.25data hazard(데이터 경합): 예제
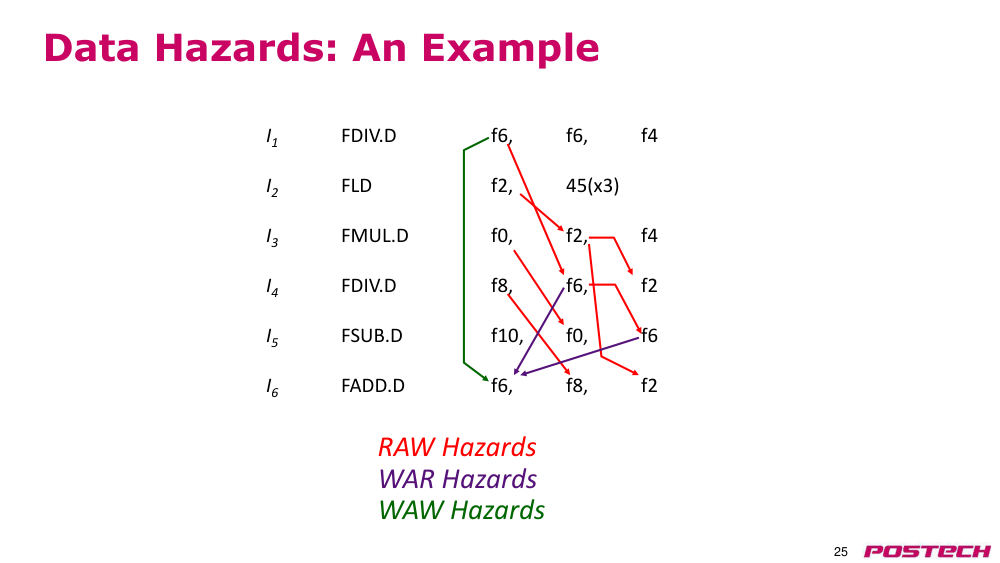
- I1 FDIV.D f6, f6, f4
- I2 FLD f2, 45(x3)
- I3 FMUL.D f0, f2, f4
- I4 FDIV.D f8, f6, f2
- I5 FSUB.D f10, f0, f6
- I6 FADD.D f6, f8, f2
- 읽기 후 쓰기 경합 (RAW Hazards)
- 쓰기 후 읽기 경합 (WAR Hazards)
- 쓰기 후 쓰기 경합 (WAW Hazards)
p.26instruction scheduling(명령어 스케줄링)
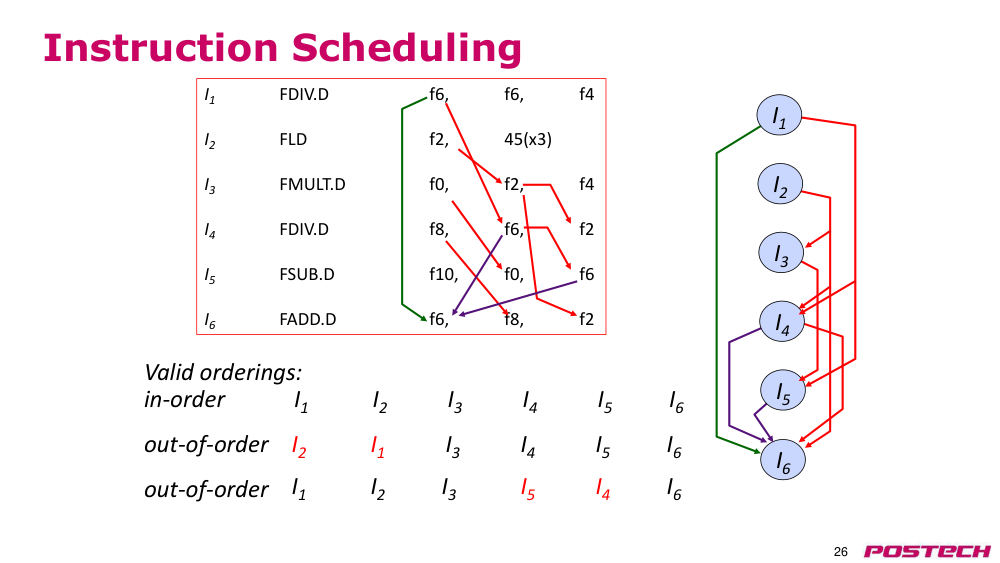
- I6
- I2
- I4
- I1
- I5
- I3
- 유효한 순서:
- 순서 유지 (in-order)
- I1 FDIV.D f6, f6, f4
- I2 FLD f2, 45(x3)
- I3 FMULT.D f0, f2, f4
- I4 FDIV.D f8, f6, f2
- I5 FSUB.D f10, f0, f6
- I6 FADD.D f6, f8, f2
- 비순서 (out-of-order)
- I1 FDIV.D f6, f6, f4
- I2 FLD f2, 45(x3)
- I3 FMULT.D f0, f2, f4
- I4 FDIV.D f8, f6, f2
- I5 FSUB.D f10, f0, f6
- I6 FADD.D f6, f8, f2
- I2
- I1
- I3
- I4
- I5
- I6
- I1
- I2
- I3
- I5
- I4
- I6
p.27Out-of-Order completion(비순서 완료)
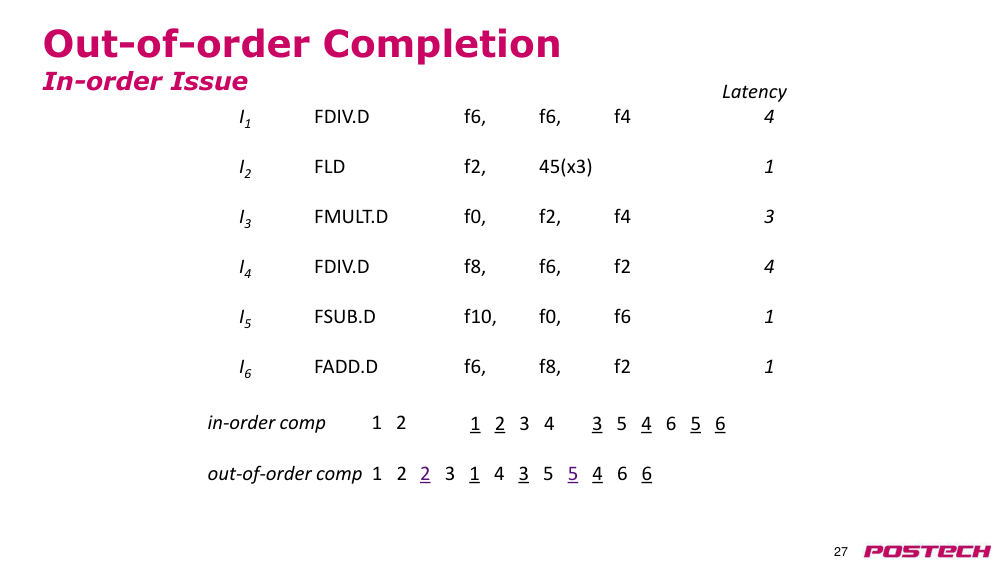
- 순서 유지 발행 (In-order Issue)
- 지연 시간 (Latency)
- I1 FDIV.D f6, f6, f4 4
- I2 FLD f2, 45(x3) 1
- I3 FMULT.D f0, f2, f4 3
- I4 FDIV.D f8, f6, f2 4
- I5 FSUB.D f10, f0, f6 1
- I6 FADD.D f6, f8, f2 1
- 순서 유지 완료 (in-order comp)
- 1 2
- 비순서 완료 (out-of-order comp)
- 1 2
- 1 2 3 4 3 5 4 6 5 6
- 2 3 1 4 3 5 5 4 6 6
p.28명령어를 발행하는 것이 안전한 경우
- functional unit(기능 유닛)에 있는 모든 명령어를 추적하는 데이터 구조가 있다고 가정하자
- 발행 단계에서 명령어를 발행하기 전에 다음 검사를 수행해야 한다:
- 필요한 functional unit(기능 유닛)이 가용한가?
- 입력 데이터가 가용한가? (RAW?)
- 목적지에 쓰는 것이 안전한가? (WAR? WAW?)
- Write-Back stage(쓰기-백 단계)에서 structural conflict(구조적 충돌)이 있는가?
p.29data structure for correct issues(정확한 발행을 위한 데이터 구조)
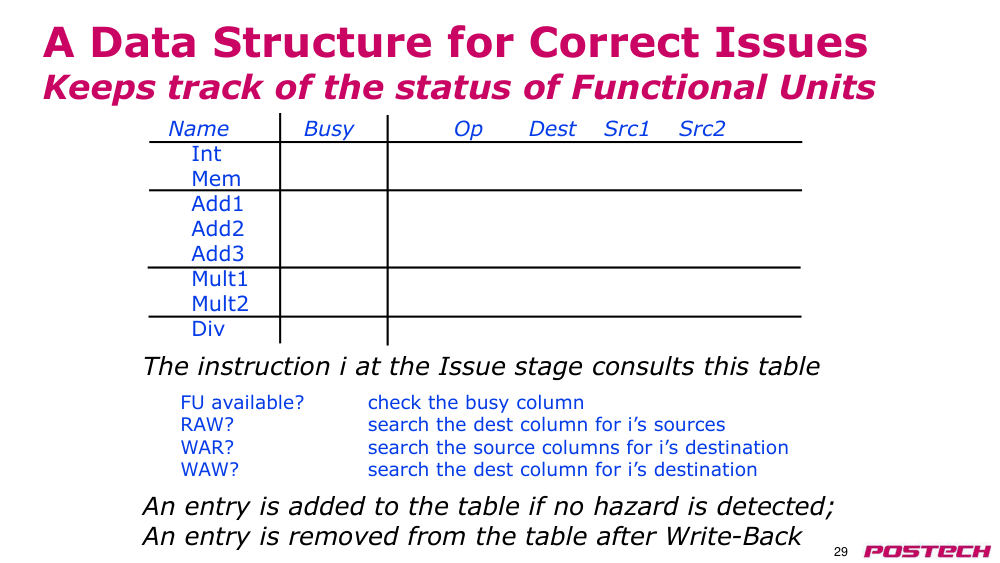
- functional unit(기능 유닛)의 상태를 추적하는 데이터 구조
- 발행 단계의 명령어 i는 이 테이블을 참조한다
- functional unit availability(기능 유닛 가용성)? → busy 열 확인
- RAW? → dest 열에서 i의 소스 검색
- WAR? → 소스 열에서 i의 목적지 검색
- WAW? → dest 열에서 i의 목적지 검색
- 경합이 감지되지 않으면 테이블에 항목 추가
- 쓰기-백 후 테이블에서 항목 제거
- 이름
- Busy
- Op
- Dest
- Src1
- Src2
- Int
- Mem
- Add1
- Add2
- Add3
- Mult1
- Mult2
- Div
p.30데이터 구조 간소화 (순서 유지 발행 가정)
- 다음 조건을 가정하자:
- RAW 경합이 존재하거나 필요한 functional unit(기능 유닛)이 바쁠 경우, 발행 단계에서 명령어가 발행되지 않음
- 발행 시, functional unit(기능 유닛)이 발행 시점에 피연산자들을 래치함
- 발행된 명령어가 다음을 유발할 수 있는가?
- WAR 경합? → 아니요: 피연산자는 발행 시 읽힘
- WAW 경합? → 예: Out-of-Order completion(비순서 완료) 시 발생
p.31데이터 구조 간소화
- WAR 경합 없음 → src1 및 src2를 유지할 필요 없음
- WAW 경합이 발생할 경우, 발행 단계는 명령어를 발행하지 않음 → 목적지 열에 레지스터 이름이 최대 한 번만 나타날 수 있음
- 발행 단계는 또한 WB 단계에서 충돌이 발생할지 확인함
p.32순서 유지 발행을 위한 scoreboard(스코어보드)
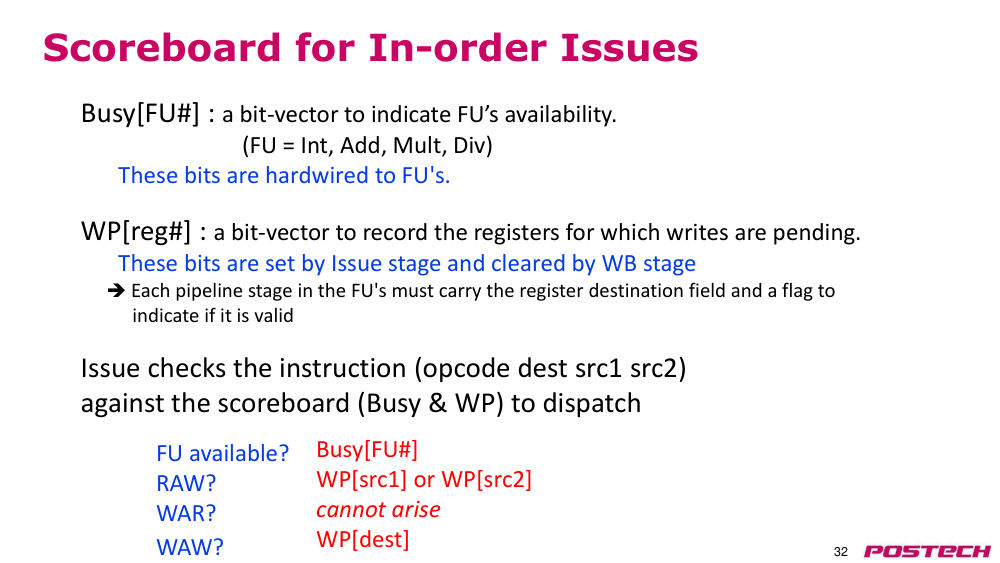
- Busy[FU#]: 기능 유닛(FU)의 가용성을 나타내는 비트 벡터. (FU = 정수, 덧셈, 곱셈, 나눗셈)
- 이 비트들은 하드웨어적으로 FU에 연결됨
- WP[reg#]: 쓰기 작업이 보류 중인 레지스터를 기록하는 비트 벡터
- 이 비트들은 발행 단계에서 설정되고, WB 단계에서 지워짐
- → 각 functional unit(기능 유닛)의 파이프라인 단계는 목적지 레지스터 필드와 유효성 여부를 나타내는 플래그를 가져야 함
- 발행 단계는 명령어(opcode dest src1 src2)를 스코어보드(Busy & WP)와 비교하여 발행 여부를 판단함
- functional unit availability(기능 유닛 가용성)?
- RAW?
- WAR?
- WAW?
- Busy[FU#]
- WP[src1] 또는 WP[src2]
- 발생할 수 없음
- WP[dest]
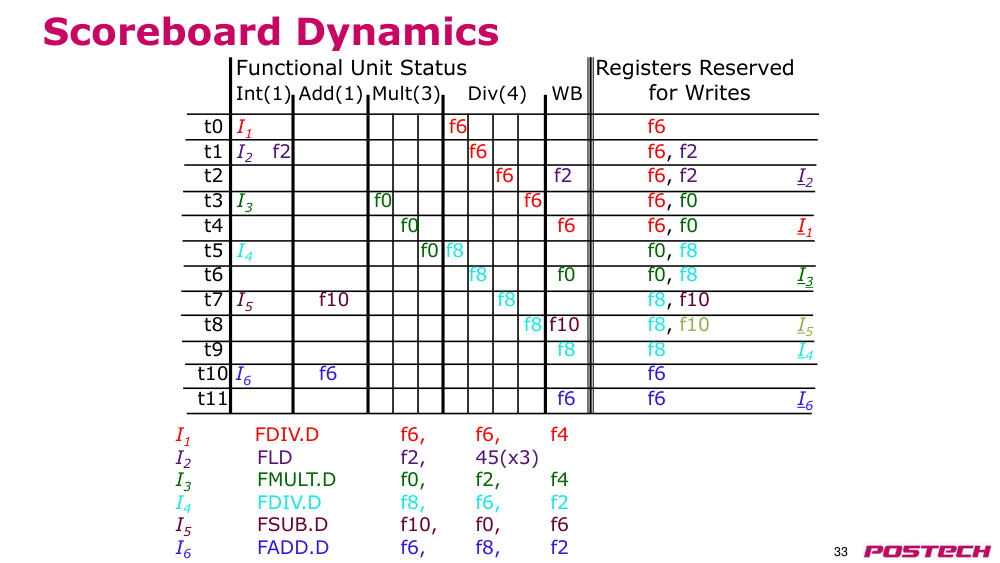
p.33scoreboard(스코어보드) 동작
- I1: FDIV.D f6, f6, f4
- I2: FLD f2, 45(x3)
- I3: FMULT.D f0, f2, f4
- I4: FDIV.D f8, f6, f2
- I5: FSUB.D f10, f0, f6
- I6: FADD.D f6, f8, f2
- functional unit(기능 유닛) 상태
- 쓰기 작업을 위해 예약된 레지스터
- 정수(1) 덧셈(1) 곱셈(3) 나눗셈(4) WB
- t0: I1 f6 f6
- t1: I2 f2 f6 f6, f2
- t2: f6 f2 f6, f2
- I2
- t3: I3 f0 f6 f6, f0
- t4: f0 f6 f6, f0
- I1
- t5: I4 f0 f8 f0, f8
- t6: f8 f0 f0, f8
- I3
- t7: I5 f10 f8 f8, f10
- t8: f8 f10 f8, f10
- I5
- t9: f8 f8
- I4
- t10: I6 f6 f6
- t11: f6 f6
- I6
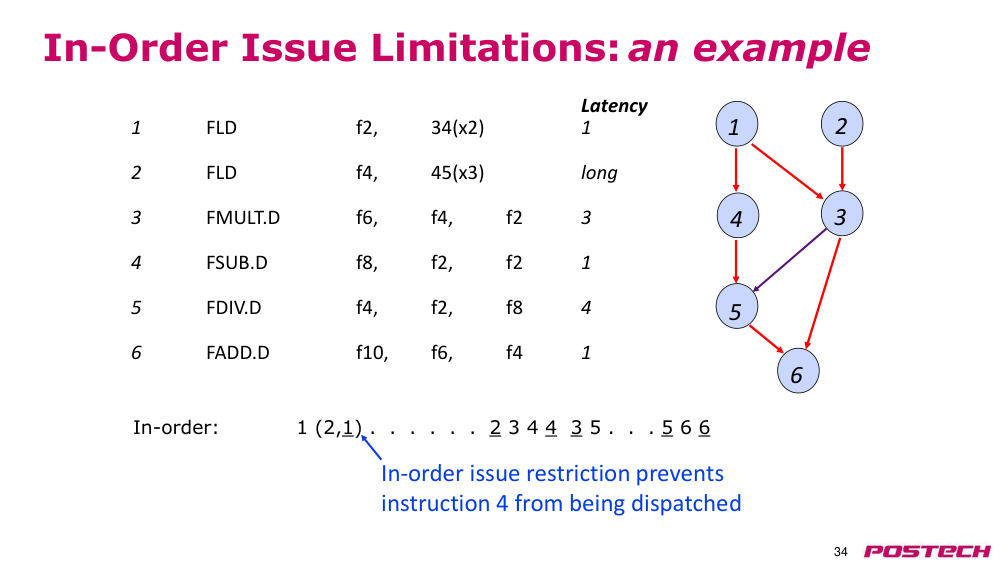
p.34순서 유지 발행의 한계: 예시
- latency(지연 시간)
- 1: FLD f2, 34(x2)
- 1: 2: FLD f4, 45(x3)
- 긴: 3: FMULT.D f6, f4, f2
- 3: 4: FSUB.D f8, f2, f2
- 1: 5: FDIV.D f4, f2, f8
- 4: 6: FADD.D f10, f6, f4
- 1: 1
- 2
- 3
- 4
- 5
- 6
- 순서 유지 발행 제한으로 인해 명령어 4가 발행되지 않음
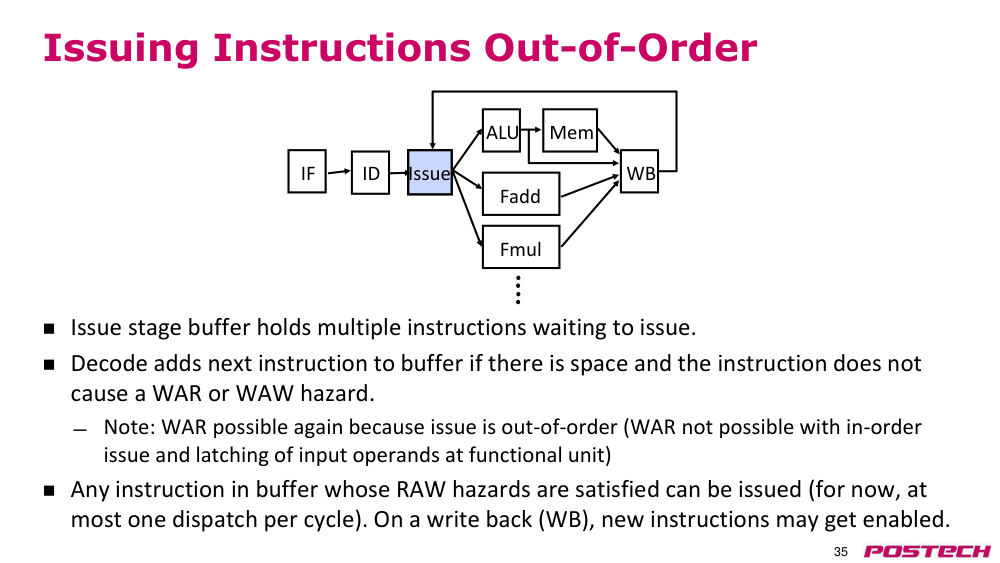
p.35비순서로 명령어 발행
- 발행 단계 버퍼는 여러 명령어를 발행을 기다리며 보관함
- 디코딩은 공간이 있고, WAR 또는 WAW 경합을 유발하지 않는 경우 다음 명령어를 버퍼에 추가함
- 참고: WAR가 다시 발생할 수 있음. 왜냐하면 발행이 비순서이기 때문 (순서 유지 발행과 functional unit(기능 유닛)의 입력 피연산자 래칭 시에는 WAR가 발생할 수 없음)
- RAW 경합이 해결된 버퍼 내의 어떤 명령어라도 발행될 수 있음 (지금은 최대 한 번의 발행만 허용). WB가 발생하면 새로운 명령어가 활성화될 수 있음
- IF
- ID
- WB
- ALU
- Mem
- Fadd
- Fmul
- Issue
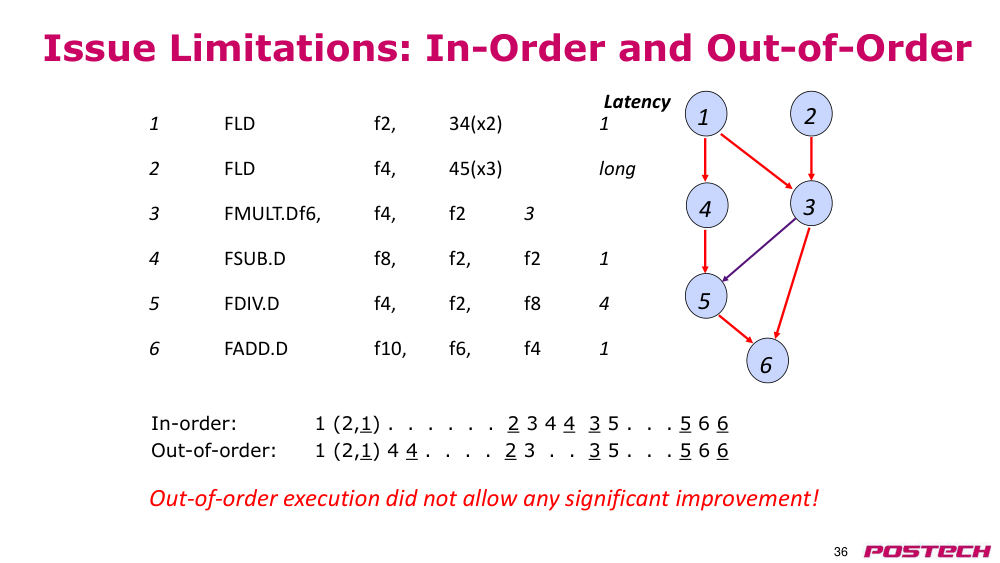
p.36발행 제한: 순서 유지 및 비순서
- latency(지연 시간)
- 1: FLD f2, 34(x2)
- 1: 2: FLD f4, 45(x3)
- 긴: 3: FMULT.D f6, f4, f2
- 3: 4: FSUB.D f8, f2, f2
- 1: 5: FDIV.D f4, f2, f8
- 4: 6: FADD.D f10, f6, f4
- 1: 1
- 2
- 3
- 4
- 5
- 6
- 순서 유지: 1 (2,1) . . . . . . 2 3 4 4 3 5 . . . 5 6 6
- 비순서: 1 (2,1) 4 4 . . . . 2 3 . . 3 5 . . . 5 6 6
- 비순서 실행은 의미 있는 개선을 제공하지 못함!
p.37파이프라인에 얼마나 많은 명령어가 있을 수 있는가?
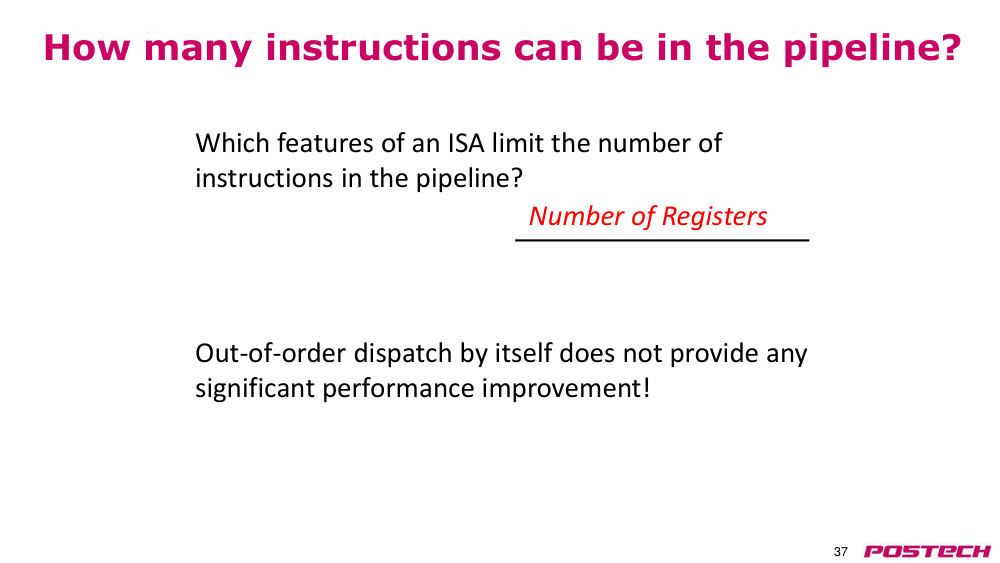
- 파이프라인에 얼마나 많은 명령어가 있을 수 있는가?
- 어떤 명령어 세트 아키텍처(ISA)의 특성이 파이프라인에 있는 명령어 수를 제한하는가?
- 비순서 발행(out-of-order dispatch)만으로는 의미 있는 성능 향상을 제공하지 않는다!
- 레지스터 수
p.38질문?
- 권장 독서: Chapter 3.2 & C.7 of the textbook