Lec 2 · 기술 동향, ISA, power·performance metric
정밀 정리 · 검증 2026-09-23 21:47
1개요
1.1technology trend: feature size·DRAM·flash·disk 용량 추세, wire delay 는 scaling 되지 않음.
1.2bandwidth 는 latency 보다 훨씬 빨리 개선됨(rule of thumb 1.2–1.4x per BW 2x)과 그 6가지 이유.
1.3ISA 는 SW/HW contract. microcoded CISC 의 비효율(IBM 801, VAX 분석)이 RISC 로 이어졌고, 수업 ISA 는 RISC-V.
1.4power·energy(TDP, ½CV²f, static power)와 절감 기법(clock gating, DVFS, power gating).
1.5performance 측정: SLA tail latency, benchmark 종류, AM/GM/HM 요약, SPEC CPU2017.
2섹션별 정리 상황·문제 → 원인 → 해결
2.11:24–3:38강의 시작·Lec 1 복습
상황·문제노트북 문제로 지연 후 시작. 오늘 주제는 technology trends, ISA, power·energy·performance metric.
원인지난 강의: Babbage 부터 IBM 360 까지 130년. calculator → fully programmable machine, 2차대전 이후 electromechanical → pure electronic.
해결software 비용이 커지면서 compatibility 가 중요해졌고, IBM 360 은 같은 ISA 로 성능·가격이 다른 여러 구현(family of machines)을 냄.
- software cost 증가 → compatibility 요구
- IBM 360: 하나의 ISA, 여러 implementation
2.23:38–7:52feature size 와 transistor scaling
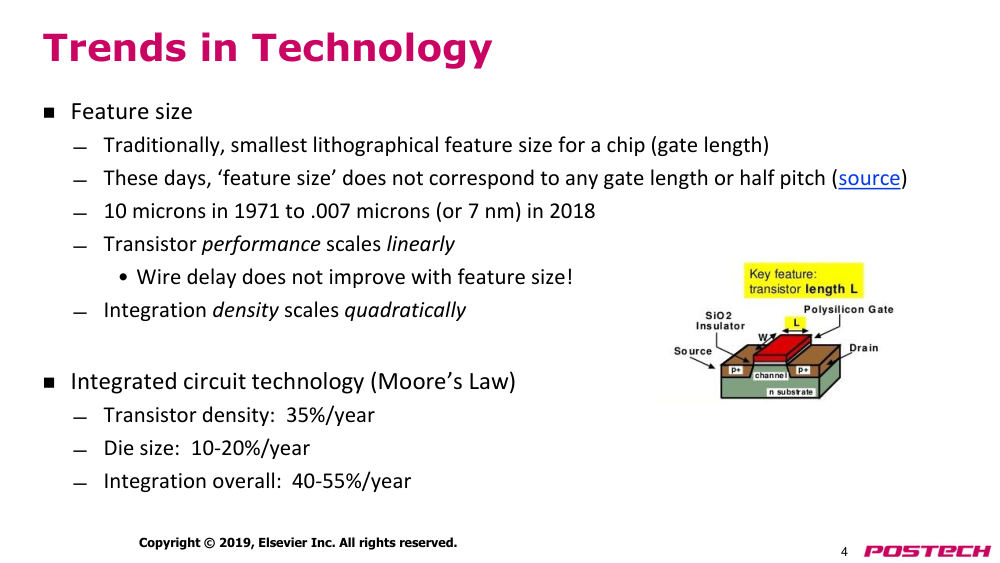
상황·문제feature size 는 전통적으로 gate length(최소 lithography 크기)를 뜻했음 (예: 90 nm → gate 길이 약 90 nm).
원인요즘 7 nm·5 nm 는 gate length 가 아니라 여러 차원 scaling 을 묶은 node 이름이고 foundry(Samsung, TSMC)가 정의를 공개하지 않음 → Intel 14 nm ≈ TSMC/Samsung 10 nm 같은 비교가 나옴.
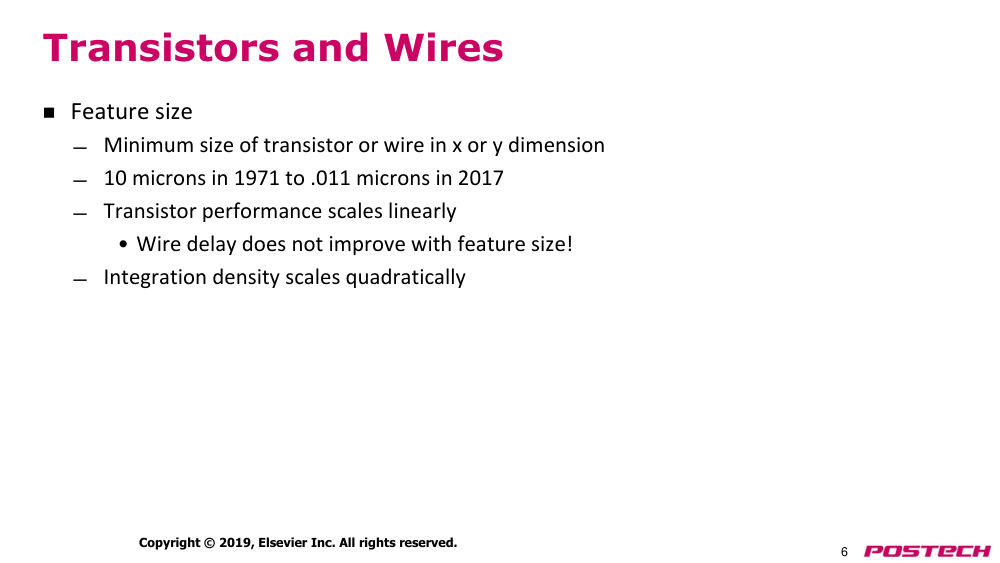
해결transistor performance 는 linear, integration density 는 quadratic(x·y 모두 축소)으로 좋아지지만 wire delay 는 개선되지 않아 회로 latency 를 지배할 수 있음.
- 10 µm(1971) → 7 nm(2018)
- transistor density 35%/year, die size 증가 포함 chip 당 transistor 40–55%/year
- wire delay does not improve with feature size
2.2.r.1Semiconductor device fabrication — Wikipedia ↗ · process node 이름(7 nm 등)이 실제 feature size 와 무관해진 배경
2.37:52–10:04DRAM·flash·magnetic disk 용량 추세
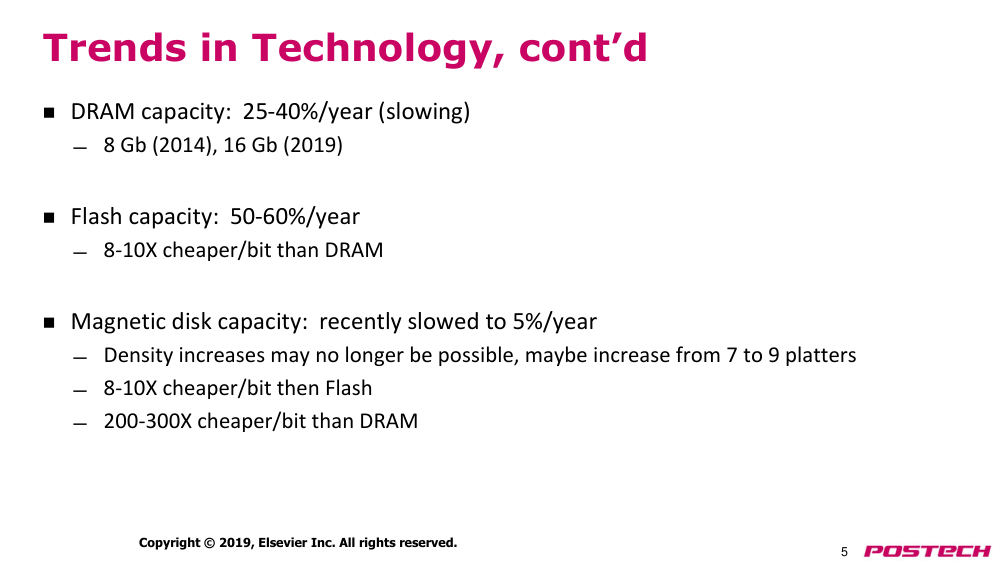
상황·문제logic 처럼 memory·storage 용량도 빠르게 늘었으나 둔화 중.
원인DRAM 은 chip 크기가 CPU/GPU 처럼 커지지 않아 density 가 곧 용량. 8 Gb(2014) → 16 Gb(2019), 5년에 2배.
해결flash 는 50–60%/year, DRAM 보다 bit 당 싸지만 느림 → storage 용. magnetic disk 는 5%/year 로 둔화됐지만 flash 보다 싸서 여전히 사용.
- DRAM 25–40%/year (slowing)
- flash 8–10X cheaper/bit than DRAM
- disk 200–300X cheaper/bit than DRAM
2.3.r.1Computer Architecture: A Quantitative Approach, 6th ed. — Elsevier ↗ · 교재 (1장 technology trend·power·performance, 부록 C)
2.410:04–13:55bandwidth vs latency: latency 가 뒤처진다
상황·문제작은 transistor 를 원하는 궁극적 이유는 performance 이고, performance 는 bandwidth(throughput)와 latency(response time)로 나뉨.
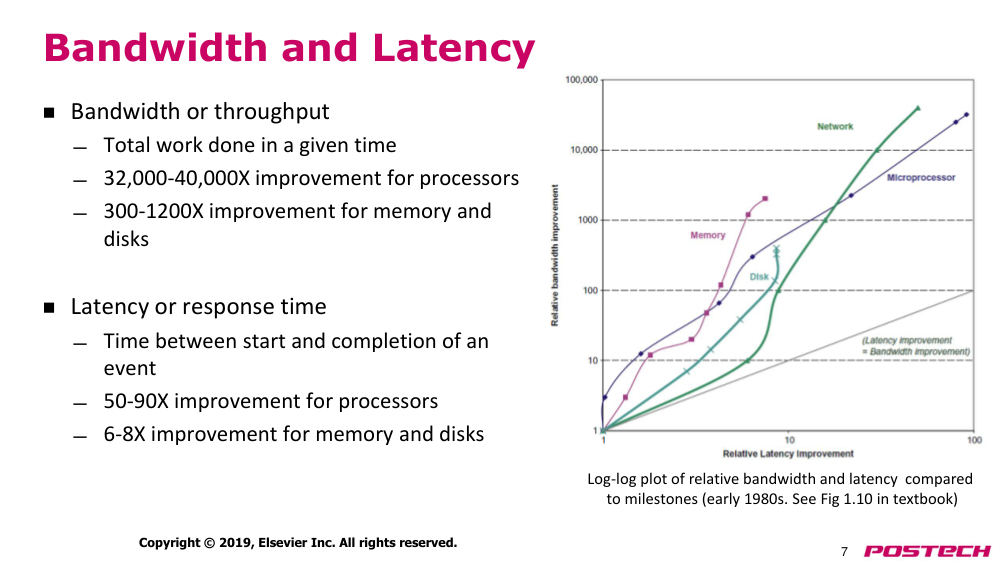
원인수십 년간 processor bandwidth 는 32,000–40,000X, memory·disk 300–1,200X 늘었지만 latency 는 processor 50–90X, memory·disk 6–8X 에 그침.
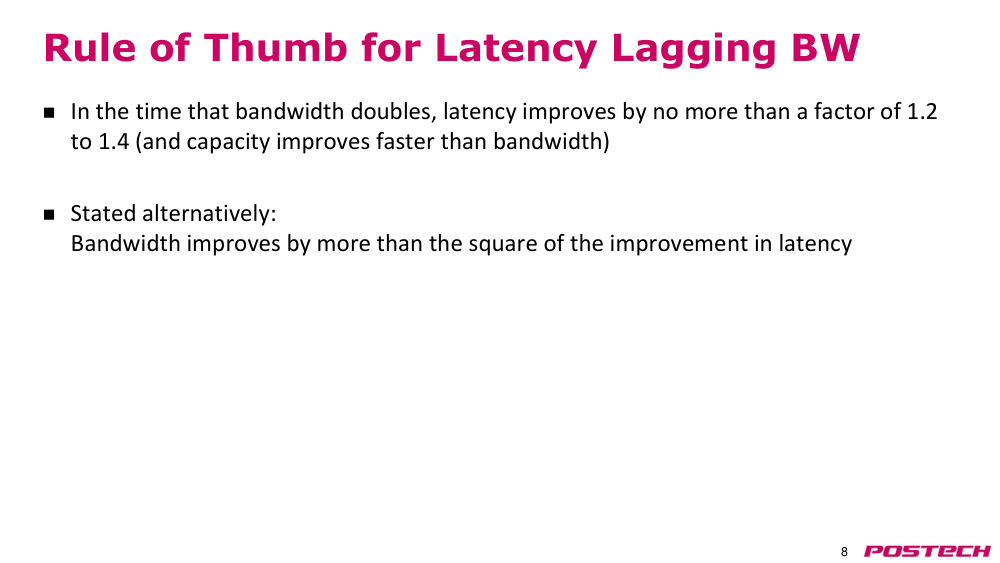
해결rule of thumb: bandwidth 가 2배 되는 동안 latency 는 1.2–1.4배만 개선 = bandwidth 개선이 latency 개선의 제곱보다 큼.
- bandwidth = 주어진 시간의 총 작업량, latency = 시작~완료 시간
- log-log plot (textbook Fig 1.10) 에서 microprocessor 곡선 예
2.4.r.1Computer Architecture: A Quantitative Approach, 6th ed. — Elsevier ↗ · 교재 (1장 technology trend·power·performance, 부록 C)
2.513:55–24:29latency 가 bandwidth 를 못 따라가는 6가지 이유
상황·문제bandwidth 만 빠르게 좋아지는 구조적 이유를 6가지로 정리.
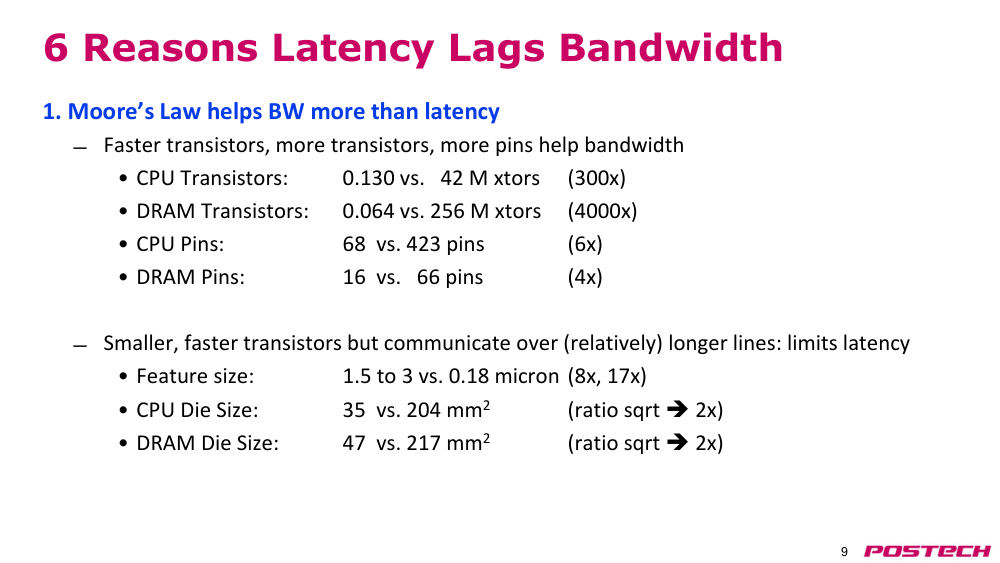
원인(1) Moore's law 의 더 많은 transistor·pin 은 bandwidth 에만 도움 (2) wire delay·die 크기·빛의 속도 → distance 가 latency 를 제한 (3) bandwidth 가 더 잘 팔려 자원이 몰림.
해결(4) latency 개선은 bandwidth 를 돕지만 역은 아님 (5) queue·memory module 확장(address fan-out)처럼 bandwidth 가 latency 를 해침 (6) OS·software overhead 는 짧은 message 의 latency 에 더 큼.
- pin 을 늘리면 DRAM 여러 개 연결로 bandwidth 는 늘지만 latency 는 그대로
- 10 Gbit Ethernet 은 팔리지만 20 ms → 10 ms 는 대부분 사용자가 체감 못 함 (HFT 는 예외)
- disk 회전 3600 → 15000 RPM: rotational latency 만 줄고 seek time 은 그대로
- DRAM chip 4개 → 8개: address line fan-out 증가로 bus 가 느려질 수 있음
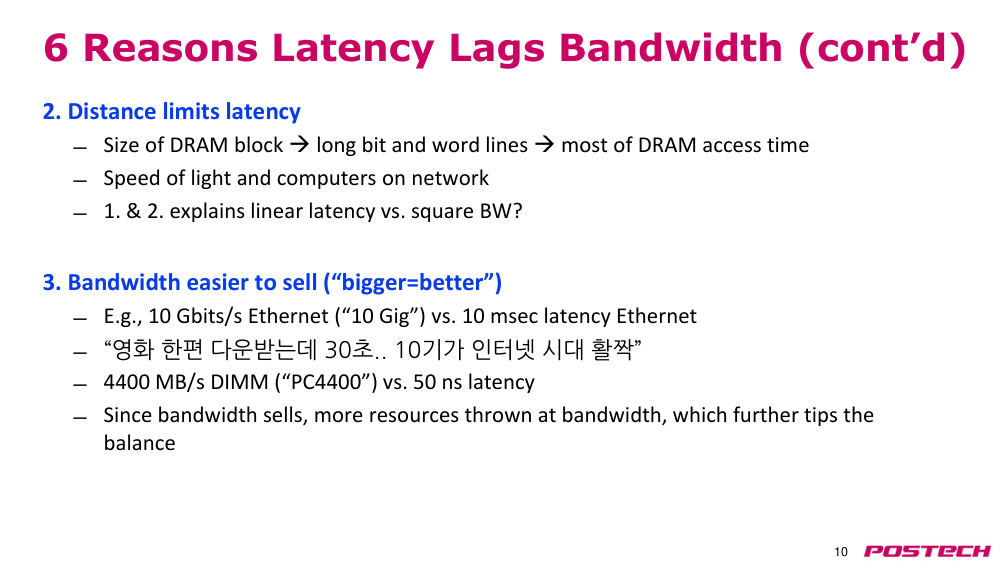
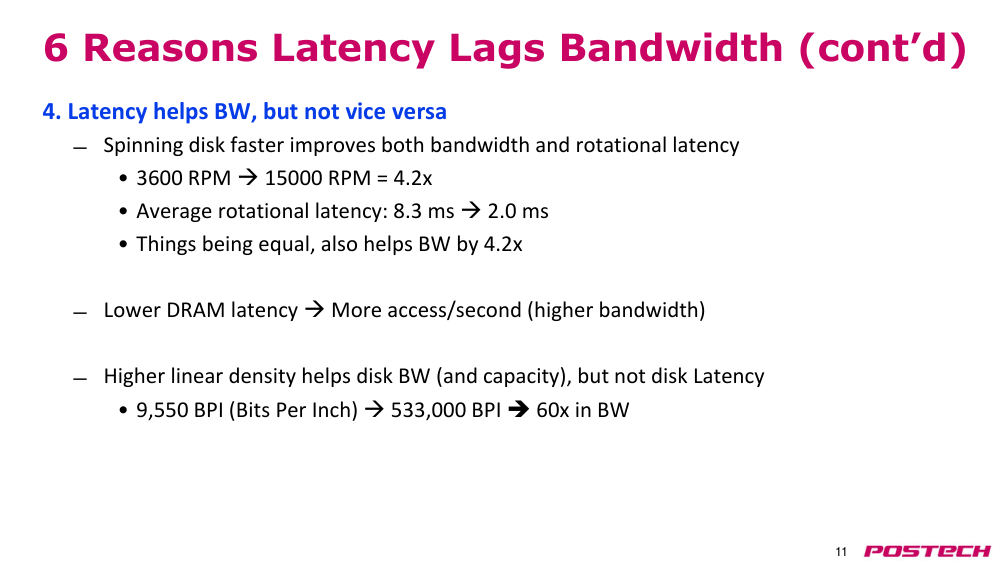
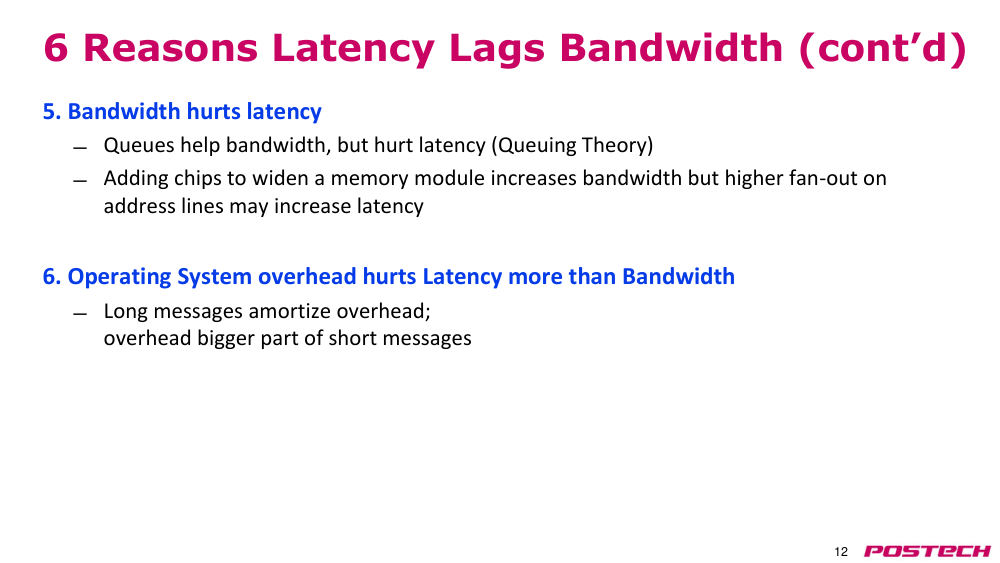
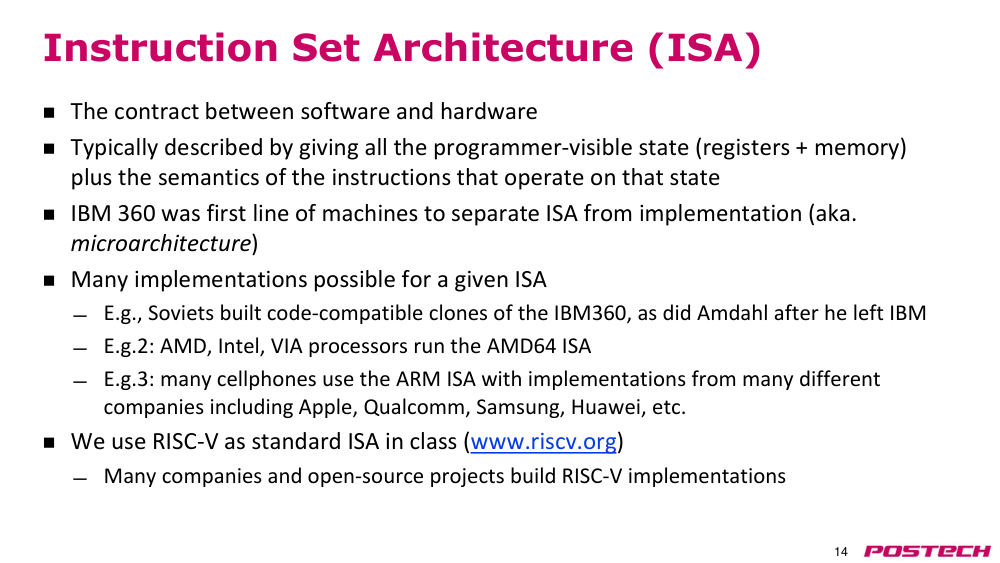
2.624:29–29:09ISA: software 와 hardware 의 contract
상황·문제대학원 과목이라 ISA 는 이미 안다고 가정(MIPS, ARM 등). 원칙 위주로 빠르게 진행.
원인ISA = programmer-visible state(register, memory, flag) + 그 state 를 다루는 instruction 의 semantics. privileged state·instruction 도 OS 개발자 관점에선 포함.
해결IBM 360 이 처음 ISA 를 implementation(microarchitecture)과 분리 → Soviet clone, AMD64 의 여러 구현, ARM 의 Apple·Qualcomm·Samsung 구현. 이 과목 표준 ISA 는 open ISA 인 RISC-V.
- 한 ISA 에 여러 implementation 가능
- RISC-V 는 누구나 자유롭게 사용·수정 가능한 open 표준
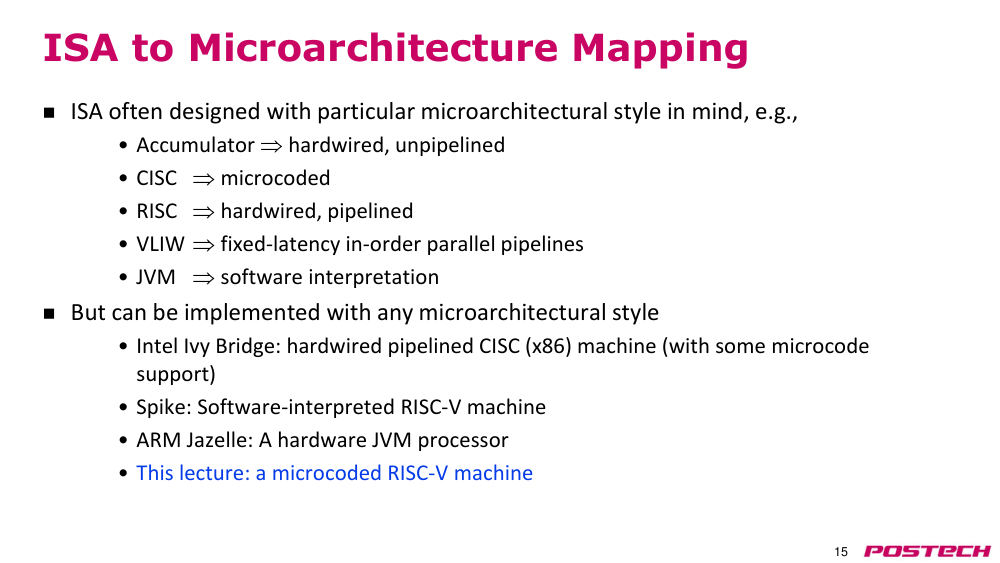
2.729:09–31:55ISA 와 microarchitecture 의 매핑
상황·문제ISA 는 보통 특정 microarchitecture 스타일을 염두에 두고 설계됨.
원인accumulator → hardwired·unpipelined, CISC → microcoded(복잡한 instruction 을 한정된 logic 으로 실행), RISC → hardwired·pipelined, VLIW → fixed-latency parallel pipeline(compiler 가 scheduling, 크게 성공 못 함), JVM → software interpretation.
해결그러나 어떤 스타일로도 구현 가능: Ivy Bridge(hardwired pipelined CISC), Spike(software 로 RISC-V 해석), ARM Jazelle(hardware JVM). 이번 강의 내용은 microcoded 구현.
- ISA 설계 의도 ≠ 실제 구현 제약
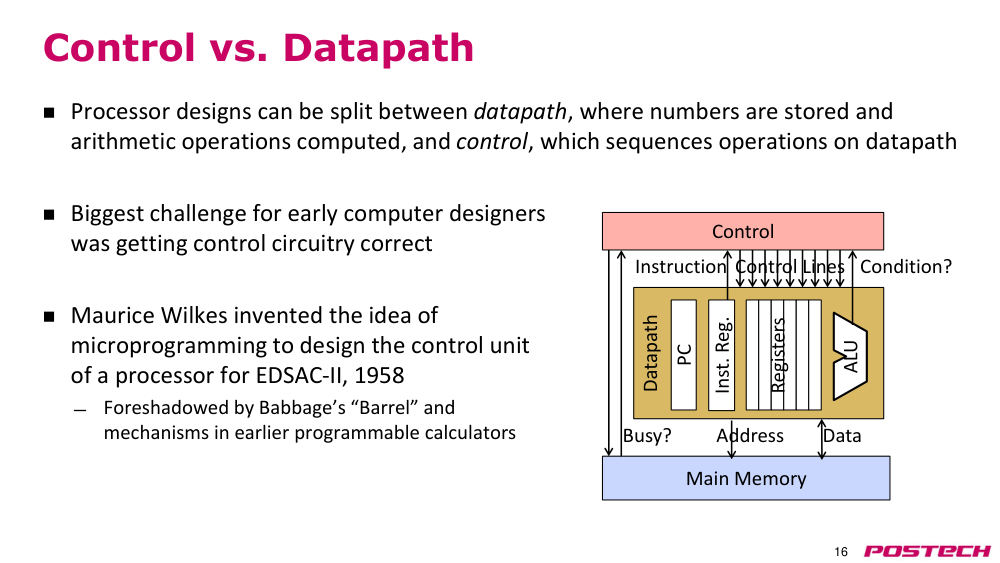
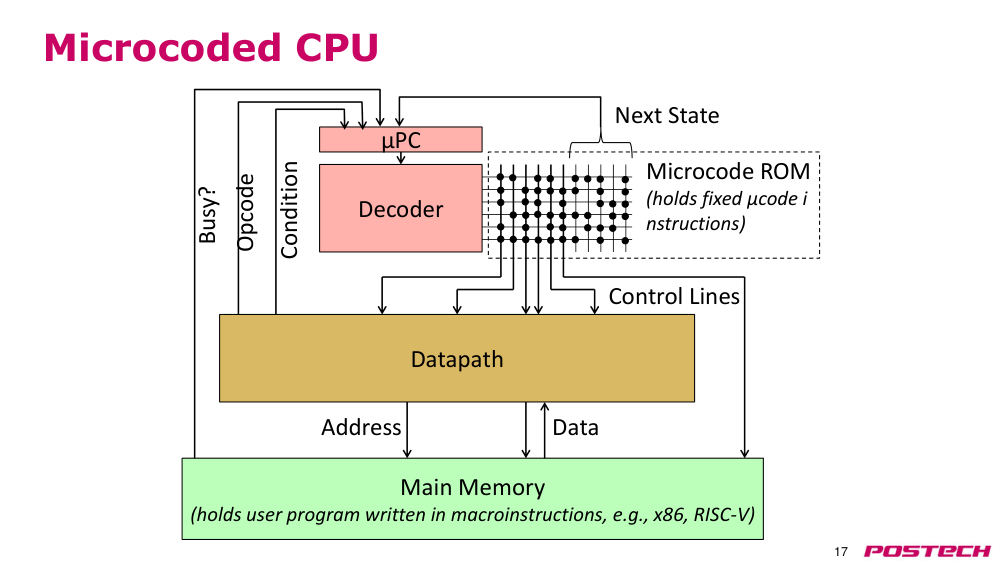
2.831:55–35:19control vs datapath 와 microcoded CPU
상황·문제processor = datapath(data 가 지나가며 저장·연산) + control(datapath 구성요소를 올바른 순서로 제어).
원인datapath 는 비교적 쉬웠지만 computer 가 복잡해질수록 control 을 맞게 설계하기 어려웠음.
해결Maurice Wilkes 가 microprogramming 고안(EDSAC-II, 1958): processor 안의 작은 program. decoder 가 opcode·condition·현재 state 로 microcode ROM row 를 찾아 control line 신호를 내고, next state 로 다음 row 를 접근.
- microcode ROM = 고정된 microinstruction 저장
- main memory 에는 macroinstruction(x86, RISC-V) program
2.935:19–41:10microcoded CISC 의 비효율과 nanocode
상황·문제CISC 는 programmer 편의·마케팅을 위해 instruction 을 계속 추가해 수백~수천 개가 됨.
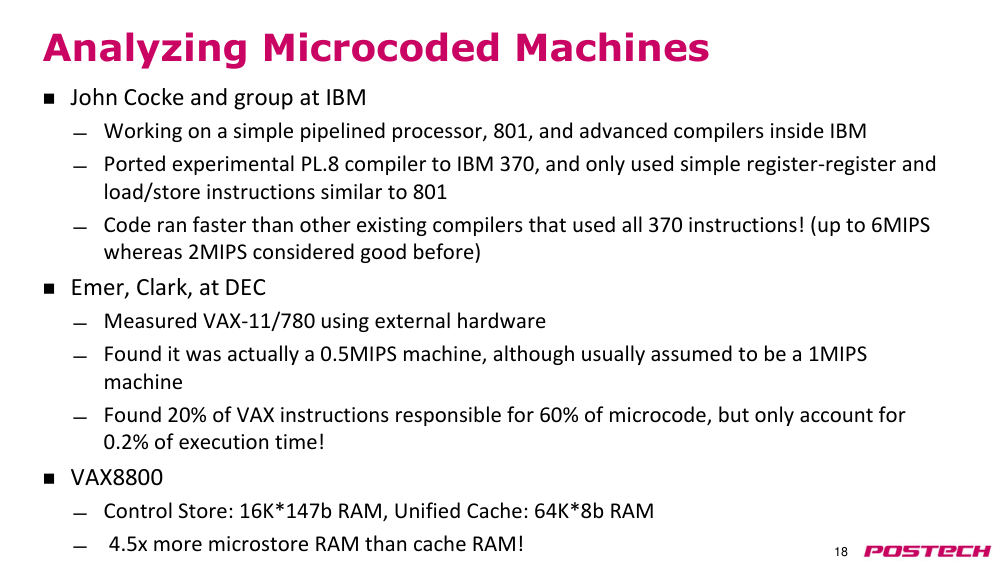
원인IBM(John Cocke): PL.8 compiler 를 370 에 port 해 단순 instruction 만 써도 전체 instruction 을 쓰는 compiler 보다 빠름. DEC: VAX instruction 20% 가 microcode 60% 를 차지하지만 실행 시간은 0.2%. VAX8800 은 control store 가 cache 보다 큼.
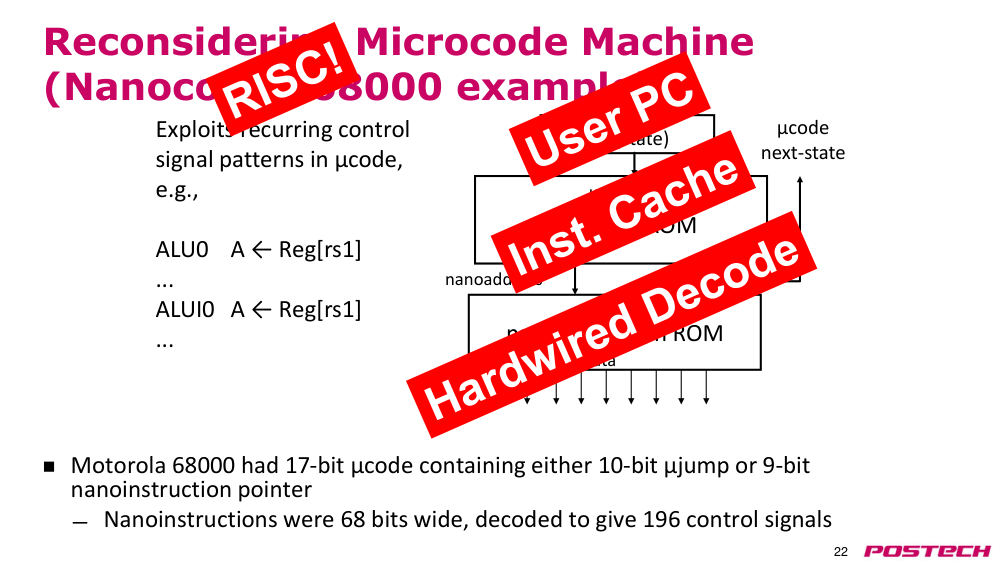
해결control store 를 줄여 data cache 에 투자하면 더 빠를 수 있음. Motorola 68000 은 microcode 아래 nanocode 계층을 두어 반복 control pattern 을 분리.
- 복잡성의 대부분은 드물게 쓰이는 complex instruction 에서 옴
- p19–21(Iron law, CPI, IC tradeoff) 은 Lec 1 에서 다뤘다며 건너뜀
- 68000: 17-bit µcode, 68-bit nanoinstruction → 196 control signal
2.1041:10–45:22CISC 에서 RISC 로
상황·문제microcode 안에 있던 것을 user-visible instruction 으로 꺼내자는 발상.
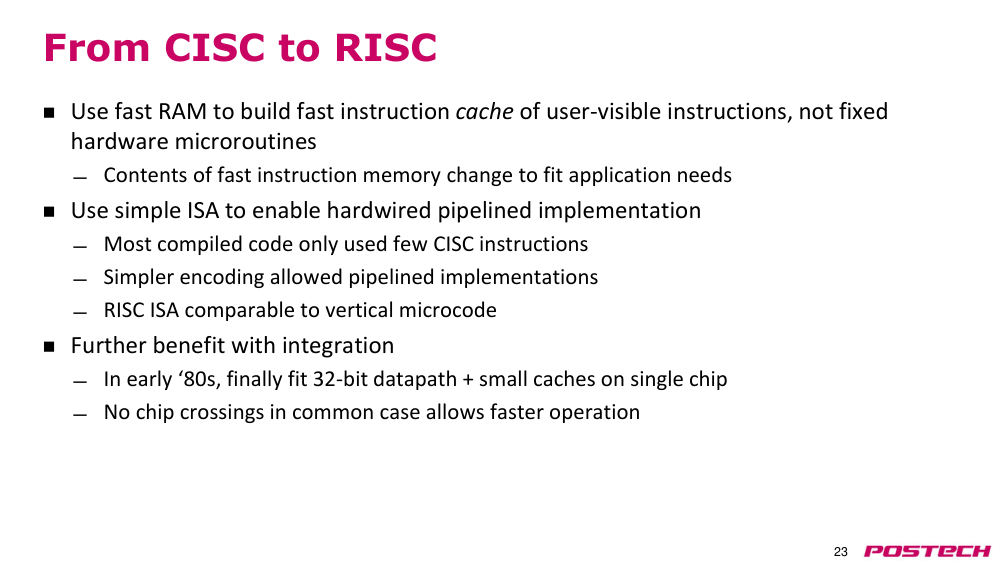
원인빠른 RAM(instruction cache)에 user instruction 을 두면 application 에 맞게 내용이 바뀜. compiler 가 high-level 문장을 단순 instruction 으로 번역하므로 complex instruction 이 필요 없음 (compiler 가 대부분 안 씀).
해결simple ISA → hardwired pipelined 구현이 쉬워짐. 80년대 초 32-bit datapath 와 small cache 를 한 chip 에 넣어 chip crossing 제거 → 추가 성능 이득.
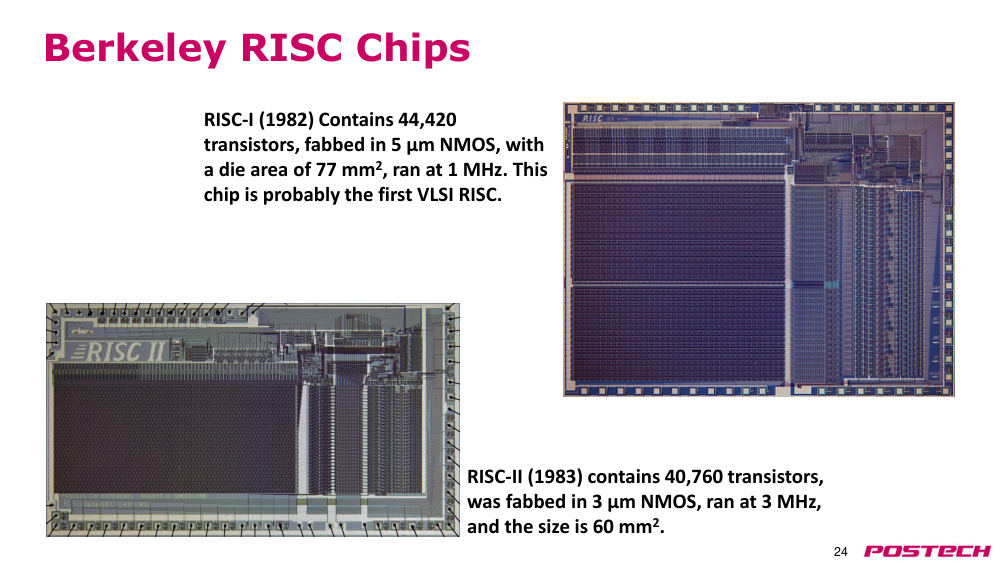
- Berkeley RISC-I(1982): 44,420 transistors, 5 µm NMOS, 77 mm², 1 MHz
- RISC-II(1983): 40,760 transistors, 3 µm, 60 mm², 3 MHz
2.1145:22–51:43RISC-V ISA 개요
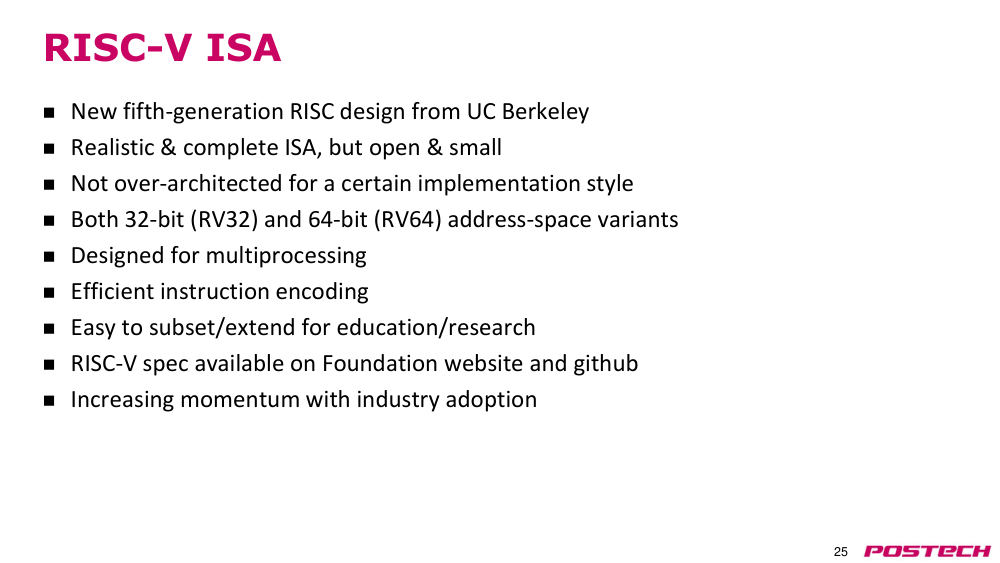
상황·문제RISC-V 는 Berkeley 의 5세대 RISC. realistic·complete 하면서 open·small (x86 대비).
원인RV32/RV64, multiprocessing 고려, 효율적 encoding, 교육·연구용 subset/extension 용이. simulator·emulator·open core 가 GitHub 에 공개. NVIDIA GPU 내부 관리용 core 도 RISC-V.
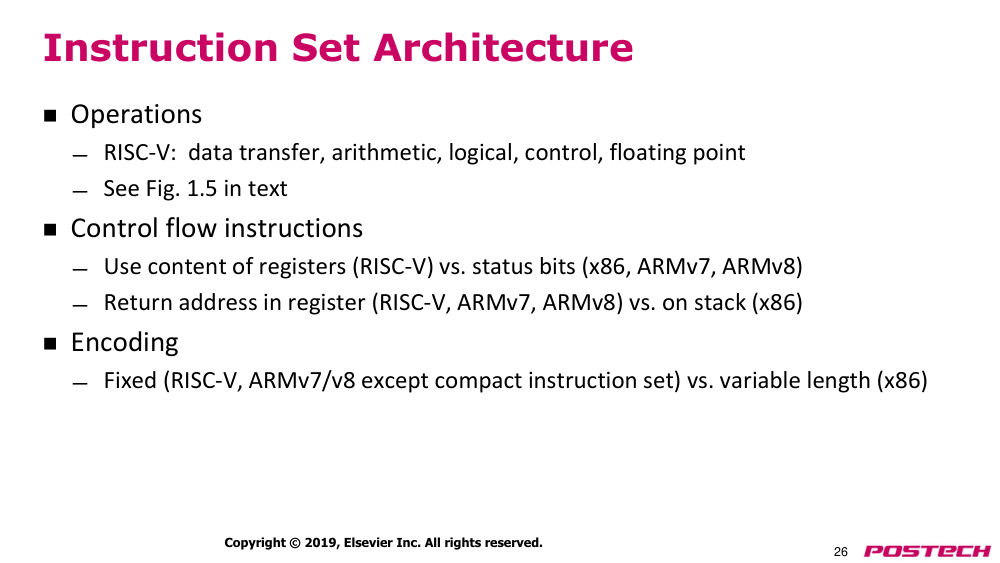
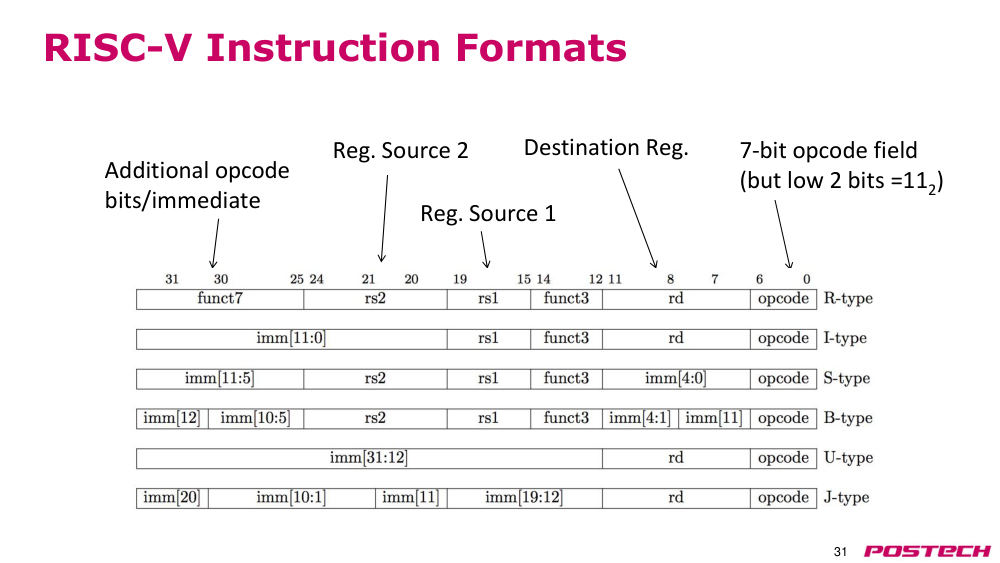
해결ISA 요소: control flow 는 register 내용 사용(x86·ARM 은 status bit), 고정 길이 encoding, byte addressed·aligned access 가 빠름, addressing mode 는 register·immediate·base+offset 만. format 은 6개, rs1·rs2 위치 고정 → hardware 단순화.
- x0 은 항상 0, 32 integer + 32 FP register, fcsr
- base RV32 instruction 은 32-bit, 하위 2 bit = 11₂ (variable-length 확장 가능)
- 3073초 부근 microphone 교체
2.11.r.3riscv/riscv-isa-manual — GitHub ↗ · unprivileged/privileged ISA manual 원본 (register state, instruction format)
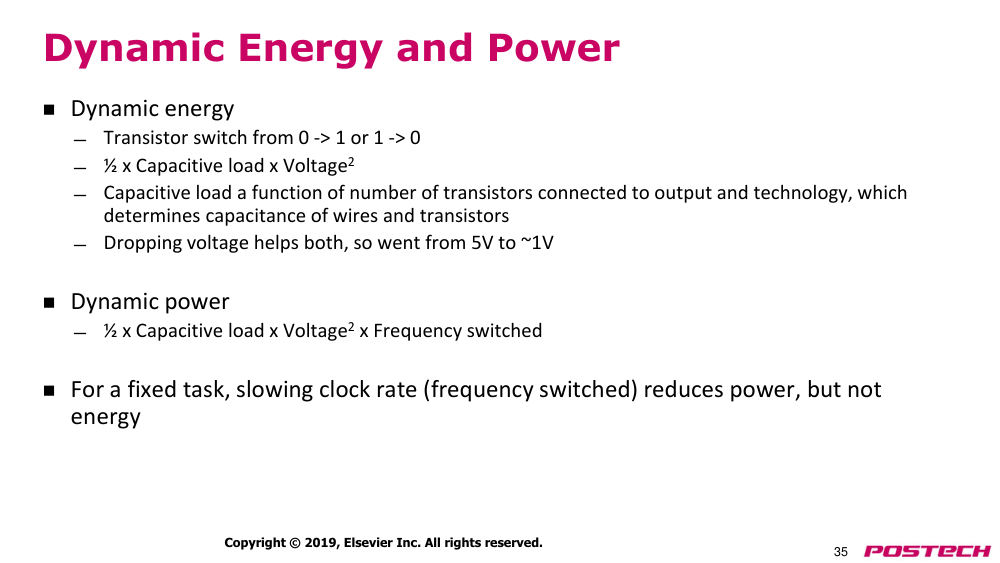
2.1251:43–59:17power 와 energy: TDP, dynamic energy
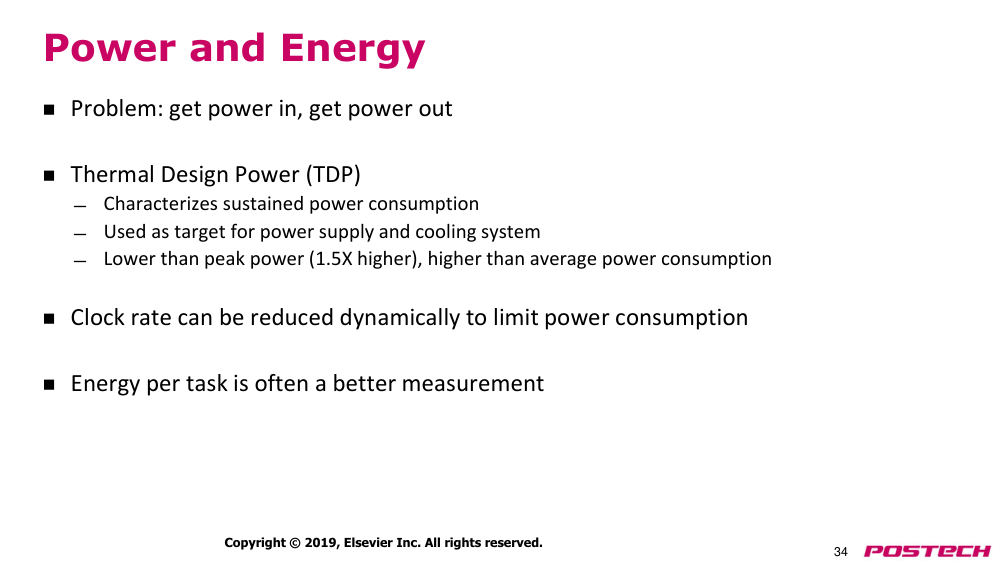
상황·문제power 를 넣고(get power in) 발생한 heat 를 빼야(get power out) 함.
원인TDP 는 sustained power 기준 cooling 요구치이며 순간 power 는 더 높을 수 있음. power 를 줄여도 network 예처럼 runtime 이 늘면 energy 가 오히려 증가할 수 있어 energy 가 더 나은 지표.
해결dynamic energy = ½·C·V² (0↔1 전환 시), dynamic power 는 × frequency. voltage 를 절반으로 → energy 1/4. 고정 task 에서 clock 만 낮추면 power 는 줄지만 energy 는 비슷.
- capacitive load = 연결된 transistor 수·technology 의 함수
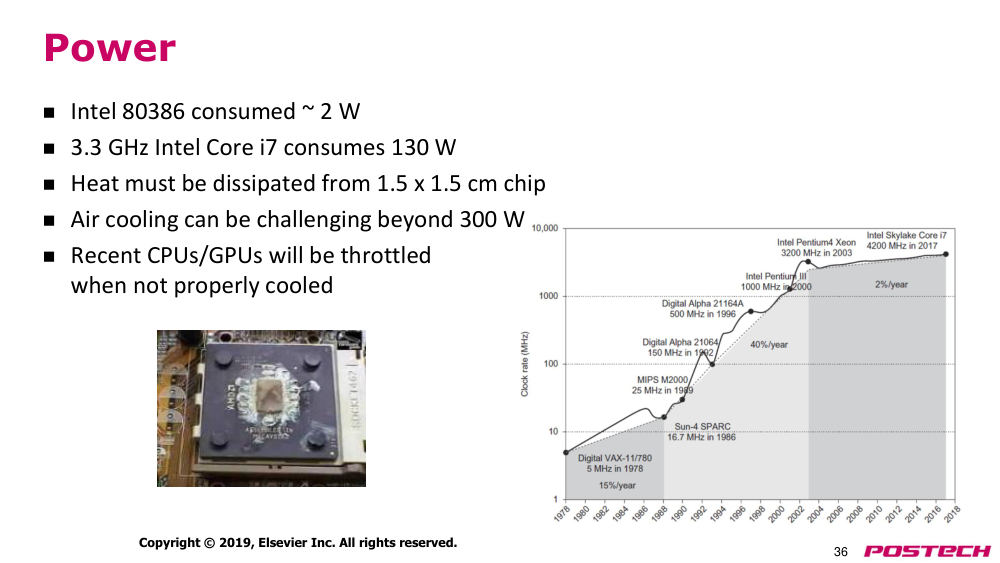
- CPU 가 수 W → 100 W 이상(300–400 W 까지)으로 증가, 300 W 넘으면 air cooling 어려움
- cooler 제거 video: 옛 CPU 는 타버림, 요즘은 throttling
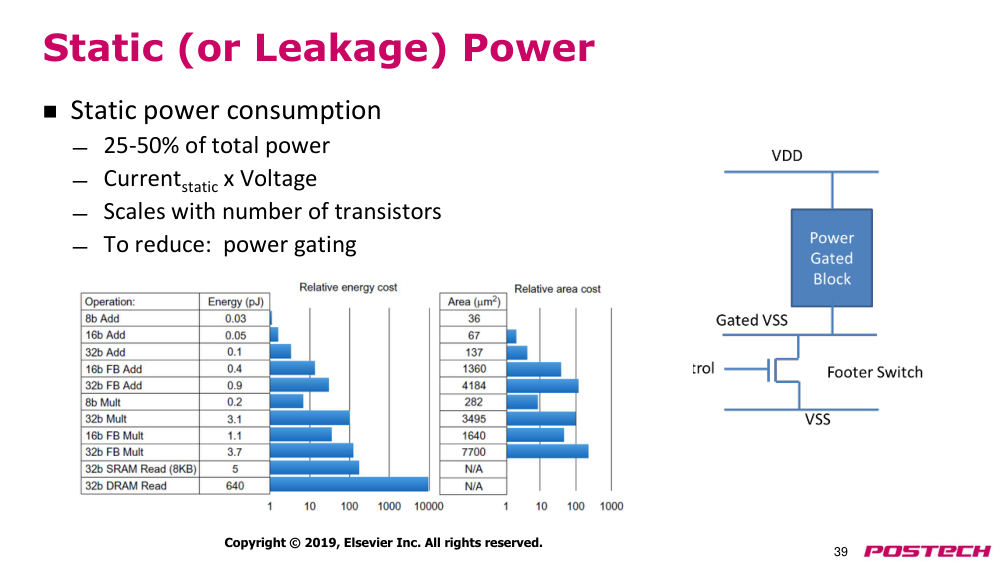
2.1359:17–1:05:25power 절감: clock gating, DVFS, power gating
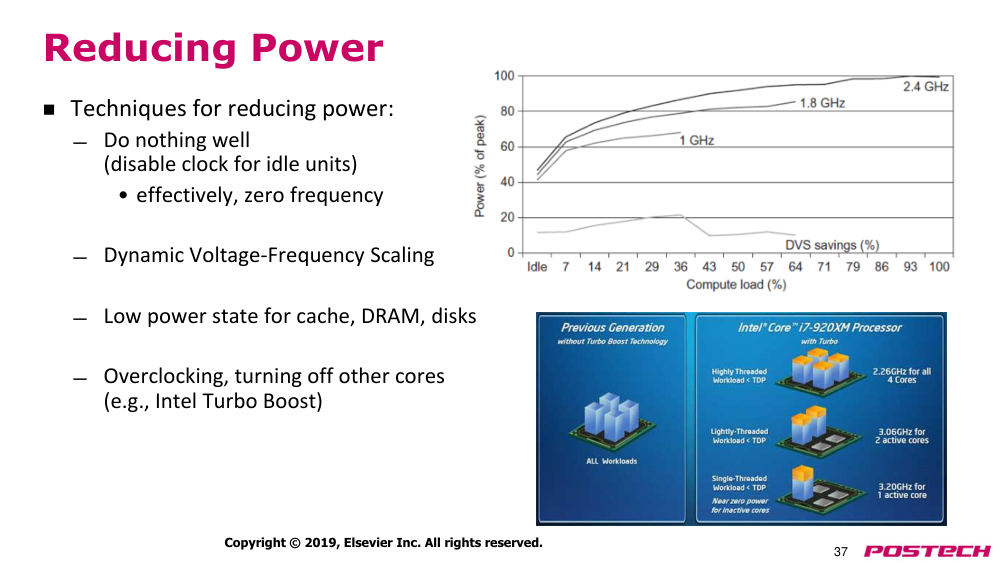
상황·문제power 를 줄이는 기법들.
원인dynamic power ∝ V²·f 이고 static(leakage) power 는 activity 와 무관하게 전체의 25–50%, transistor 수에 비례.
해결clock gating(idle unit clock 차단, 주파수 0 효과), DVFS(낮은 f 로 충분하면 V 도 낮춤; 2.4 GHz vs 1 GHz 예), cache·DRAM low-power state, idle core 끄고 나머지 overclock(Turbo Boost), power gating(ground 사이 switch 로 static power 제거).
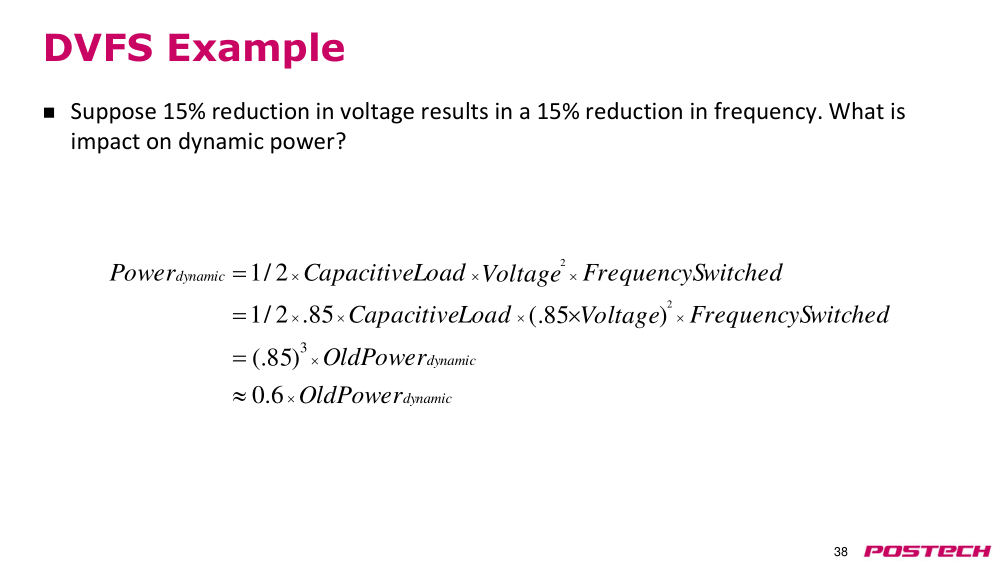
- DVFS 예: V·f 각 15% 감소 → 0.85³ ≈ 0.6, 약 40% 감소
- clock gating 도 static power 는 못 줄임
2.141:05:25–1:08:50performance 측정: SLA, tail latency, benchmark
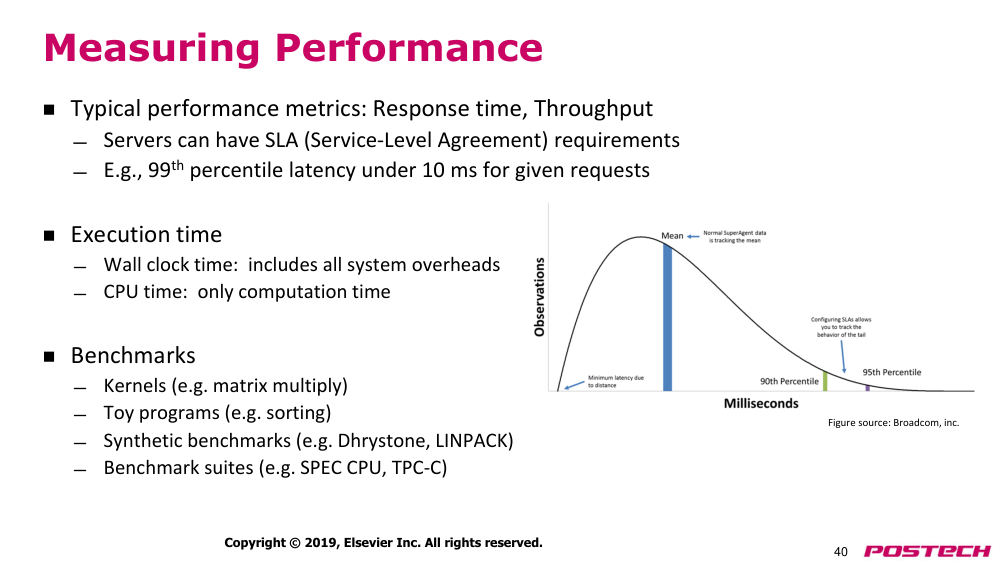
상황·문제주 metric 은 response time(latency) 과 throughput(bandwidth).
원인server application 은 SLA 가 있어 평균이 아니라 99th percentile latency 가 10 ms 이하 같은 요구를 가짐. 평균이 같아도 tail 이 길면 percentile latency 가 나빠짐.
해결execution time 은 wall clock(모든 overhead 포함) vs CPU time. benchmark: kernel(matrix multiply), toy(sorting), synthetic(Dhrystone, LINPACK), 최종적으로 real application suite(SPEC CPU, TPC-C).
- latency 분포 figure 에서 mean vs 90th/95th percentile 비교
2.151:08:50–1:11:30성능 요약 평균(AM·GM·HM)과 SPEC, 마무리
상황·문제p41–46 은 학부 과정 복습이라 빠르게 넘기며 스스로 보라고 함.
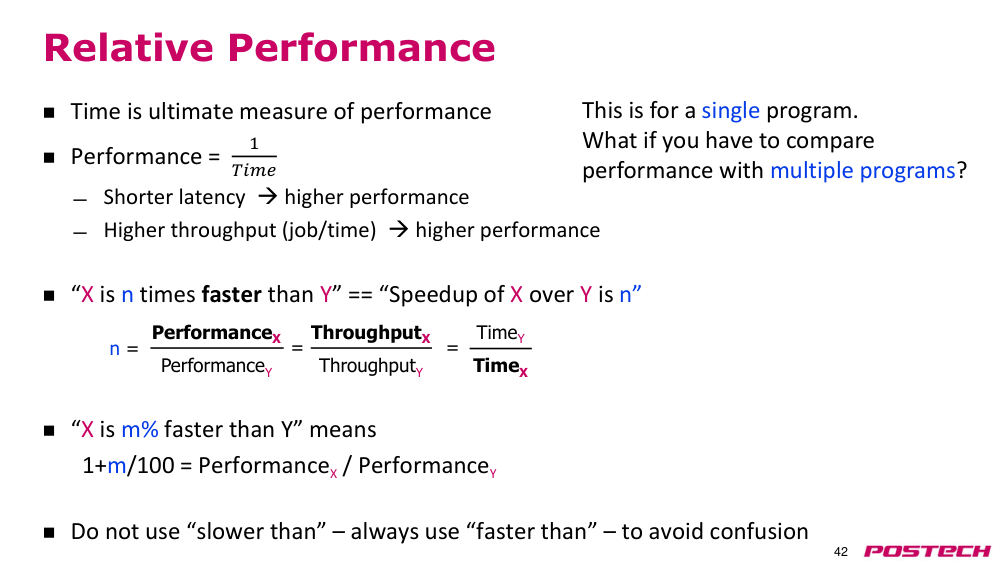
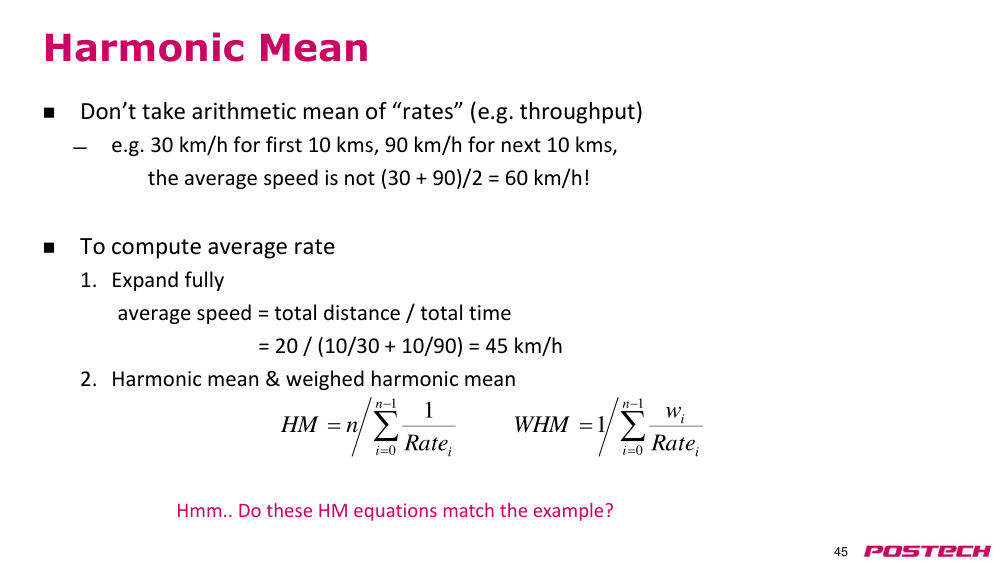
원인여러 application 결과를 하나로 요약할 때 측정량에 맞는 평균을 써야 함.
해결runtime → arithmetic mean, 정규화 speedup → geometric mean, IPC 같은 rate → harmonic mean. SPEC CPU2017 은 SPECspeed(single task 실행 시간) 와 SPECrate(throughput) 로 나뉨. 추천 읽기: 부록 C, RISC vs CISC 논쟁 논문.
- slide 48 의 SPECrate/SPECspeed 설명은 뒤바뀌어 있다고 강의자가 정정
- core 가 많으면 SPECrate 는 오르지만 SPECspeed 는 아닐 수 있음
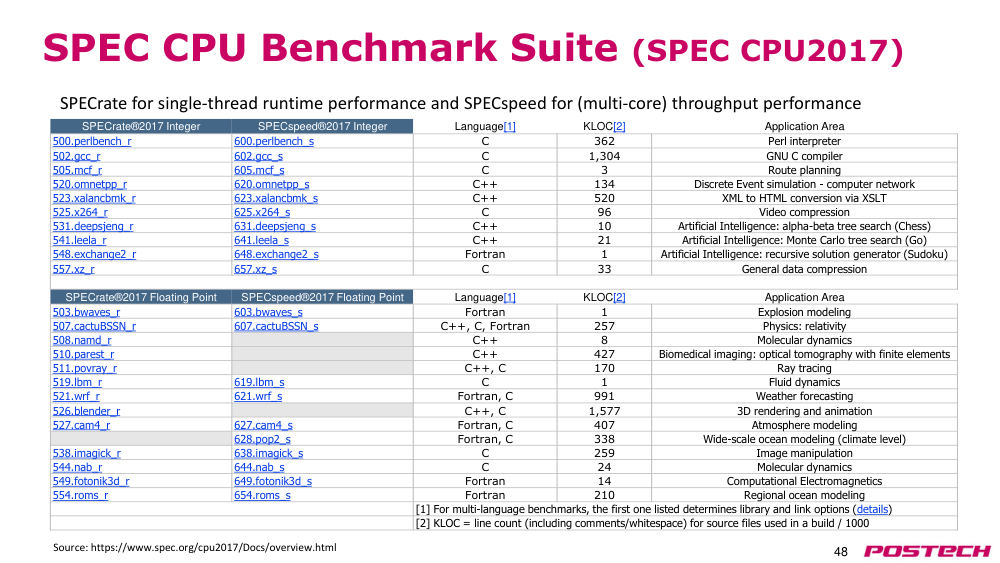
2.15.r.3SPEC CPU 2017 Overview ↗ · SPECspeed(time) vs SPECrate(throughput), benchmark 목록 (slide 48 출처)
3핵심 개념
3.1feature size(특징 크기)
원래 gate length. 요즘 7 nm 등은 node 이름일 뿐 실제 치수와 대응하지 않음.
3.1.r.1Semiconductor device fabrication — Wikipedia ↗ · process node 이름(7 nm 등)이 실제 feature size 와 무관해진 배경
3.3bandwidth vs latency
bandwidth = 단위 시간 총 작업량, latency = 시작~완료 시간. BW 2x 동안 latency 1.2–1.4x.
3.4ISA(instruction set architecture, 명령어 집합 구조)
programmer-visible state + instruction semantics. SW/HW contract.
3.5microprogramming(마이크로프로그래밍)
control 을 microcode ROM 의 작은 program 으로 구현. Wilkes 고안.
3.6nanocode(나노코드)
microcode 아래 한 단계 더 둔 control store (68000). 반복 control pattern 분리.
3.7RISC(reduced instruction set computer)
simple ISA + instruction cache + compiler 로 hardwired pipelined 구현.
3.8TDP(thermal design power)
sustained power 기준 cooling 설계 목표. 순간 peak 보다 낮음.
3.9dynamic power(동적 전력)
½·C·V²·f. voltage 절반 → energy 1/4.
3.10DVFS(dynamic voltage-frequency scaling)
낮은 f 로 충분하면 V 도 낮춤. V·f 15%↓ → power ≈ 0.6x.
3.11clock gating / power gating
clock gating 은 idle unit clock 차단(dynamic), power gating 은 switch 로 전원 차단(static).
3.12static(leakage) power(정적 전력)
activity 무관, 총 power 의 25–50%, transistor 수에 비례.
3.13SLA · tail latency
평균이 아니라 99th percentile latency 같은 요구. tail 이 길면 평균이 같아도 나쁨.
3.14AM · GM · HM
runtime 은 AM, 정규화 speedup 은 GM, rate(IPC) 는 HM.
3.15SPECspeed vs SPECrate
SPECspeed = single task 실행 시간, SPECrate = throughput.
3.15.r.1SPEC CPU 2017 Overview ↗ · SPECspeed(time) vs SPECrate(throughput), benchmark 목록 (slide 48 출처)
4스스로 확인
4.1요즘 '7 nm' 가 gate length 7 nm 를 뜻하지 않는 이유는?
답
node 이름이 여러 차원 scaling 을 묶은 명칭이고 foundry 가 정의를 공개하지 않기 때문.
4.2bandwidth 가 2배 될 때 latency 는 얼마나 개선되는가?
답
1.2–1.4배. bandwidth 개선이 latency 개선의 제곱보다 큼.
4.3DRAM chip 을 4개에서 8개로 늘릴 때 latency 가 나빠질 수 있는 이유는?
답
address line 을 모든 chip 이 공유해 fan-out 이 커지고 bus 가 느려짐.
4.4VAX 분석에서 microcode 복잡성과 실행 시간의 관계는?
답
instruction 20% 가 microcode 60% 를 차지하지만 실행 시간은 0.2%.
4.5고정 task 에서 clock frequency 만 낮추면 power 와 energy 는?
답
power 는 줄지만 runtime 이 늘어 energy 는 줄지 않음.
4.6V·f 를 각각 15% 낮추면 dynamic power 는?
답
0.85³ ≈ 0.6 배, 약 40% 감소.
4.7IPC 평균에 harmonic mean 을 쓰는 이유는?
답
같은 f·IC 면 평균 time ∝ A.M.(CPI) 이고 IPC=1/CPI 이므로 평균 IPC = H.M.(IPC).
5참고 자료
5.1Computer Architecture: A Quantitative Approach, 6th ed. — Elsevier ↗ · 교재 (1장 technology trend·power·performance, 부록 C)
5.4riscv/riscv-isa-manual — GitHub ↗ · unprivileged/privileged ISA manual 원본 (register state, instruction format)