이 자료를 쓰는 강의: 02 기술 동향, ISA, power·performance metric
Lec2 - Backgrounds
한국어판 강의자료 · 49쪽
p.1
p.2강의 1에서 이전 내용
- 컴퓨터 아키텍처 >> 명령어 집합 아키텍처 (ISA) 및 RTL
- CS152은 하드웨어와 소프트웨어의 상호작용, 적절한 추상화 계층의 설계에 관한 과목이다.
- 기술과 응용이 컴퓨터 아키텍처를 형성한다.
- 역사는 미래를 위한 교훈을 제공한다.
- 컴퓨터 아키텍처의 처음 130년(Babbage에서 IBM 360까지)
- 계산기(조건문 없음)에서 완전히 프로그래밍 가능한 기계로의 전환
- 제2차 세계대전(1940년대 중반)부터 급속한 변화 시작, 전기기계적 장치에서 순수 전자 처리 장치로의 전환
- 소프트웨어 개발 비용이 아키텍처 설계에 큰 제약이 되었음 (호환성 필요)
- IBM 360은 'family of machines(기계의 가족)' 개념을 도입, 동일한 명령어 집합 아키텍처 (ISA)를 실행하지만 매우 다른 구현 방식을 가짐
- 1964년 4월 7일에 여섯 대의 기계가 동시에 출시됨
- 후속 세대 기계에 대한 'future-proofing(미래 대비)' 전략을 수립함
p.3기술 트렌드
p.4기술 트렌드
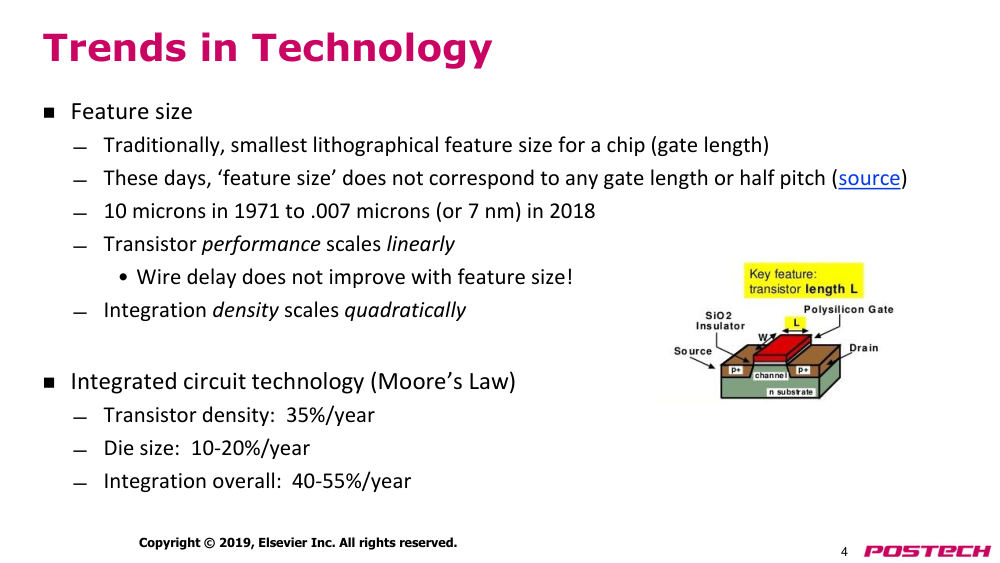
- feature size(특징 크기)
- 전통적으로, 칩의 최소 리소그래피 특징 크기(게이트 길이)
- 현재는 'feature size(특징 크기)'가 어떤 gate length(게이트 길이)나 반 피치와 대응하지 않음
- 1971년: 10 미크론 → 2018년: 0.007 미크론(또는 7 nm)
- transistor performance(트랜지스터 성능)은 선형적으로 증가
- • wire delay(선 지연)은 feature size(특징 크기)와 함께 개선되지 않음!
- integration density(통합 밀도)는 제곱으로 증가
- 집적 회로 기술(무어의 법칙)
- transistor density(트랜지스터 밀도): 연간 35%
- die size(다이 크기): 연간 10-20%
- integration density(통합 밀도) 전반: 연간 40-55%
p.5기술 트렌드, 계속
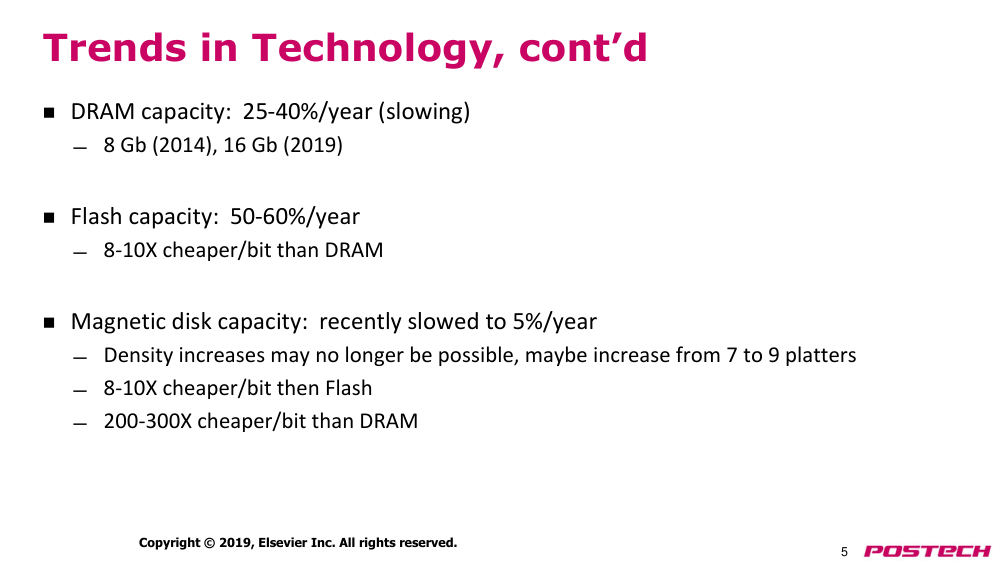
- DRAM capacity(DRAM 용량): 연간 25-40% (점차 둔화됨)
- 8 Gb (2014), 16 Gb (2019)
- flash capacity(플래시 용량): 연간 50-60%
- DRAM보다 비용당 8-10배 저렴
- magnetic disk capacity(자기 디스크 용량): 최근 5%로 둔화됨
- 밀도 증가가 더 이상 가능하지 않을 수 있음, 플래터 수를 7에서 9로 증가 가능성
- 플래시보다 비용당 8-10배 저렴
- DRAM보다 비용당 200-300배 저렴
p.6트랜지스터와 선
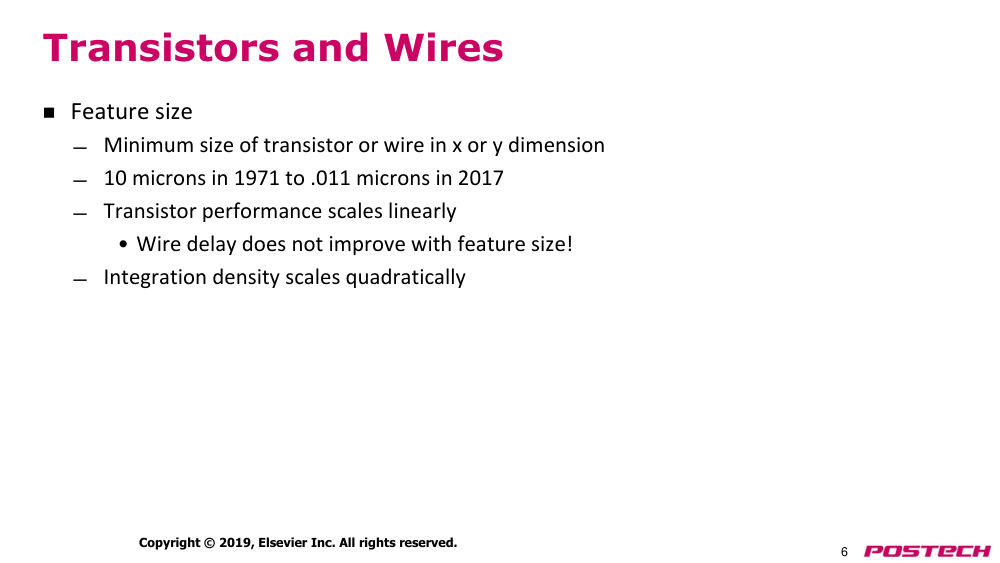
- feature size(특징 크기)
- 트랜지스터 또는 선의 x 또는 y 방향 최소 크기
- 1971년: 10 미크론 → 2017년: 0.011 미크론
- transistor performance(트랜지스터 성능)은 선형적으로 증가
- • wire delay(선 지연)은 feature size(특징 크기)와 함께 개선되지 않음!
- integration density(통합 밀도)는 제곱으로 증가
p.7bandwidth(대역폭)과 latency(지연)
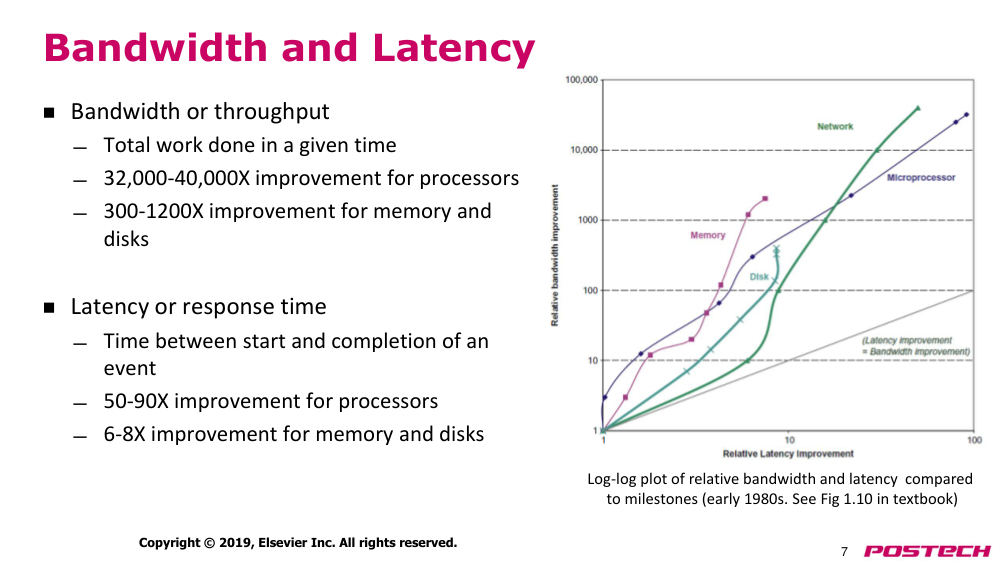
- bandwidth(대역폭) 또는 throughput(처리량): 주어진 시간 내에 수행되는 총 작업량
- 프로세서: 32,000~40,000배 향상
- 메모리 및 디스크: 300~1,200배 향상
- latency(지연) 또는 response time(응답 시간): 이벤트 시작과 완료 사이의 시간
- 프로세서: 50~90배 향상
- 메모리 및 디스크: 6~8배 향상
- 1980년대 초의 마일스톤과 비교한 상대적 bandwidth(대역폭) 및 latency(지연)의 로그-로그 플롯 (교재 Fig 1.10 참조)
p.8latency(지연)이 bandwidth(대역폭)을 따라잡지 못하는 rule of thumb(경험 법칙)
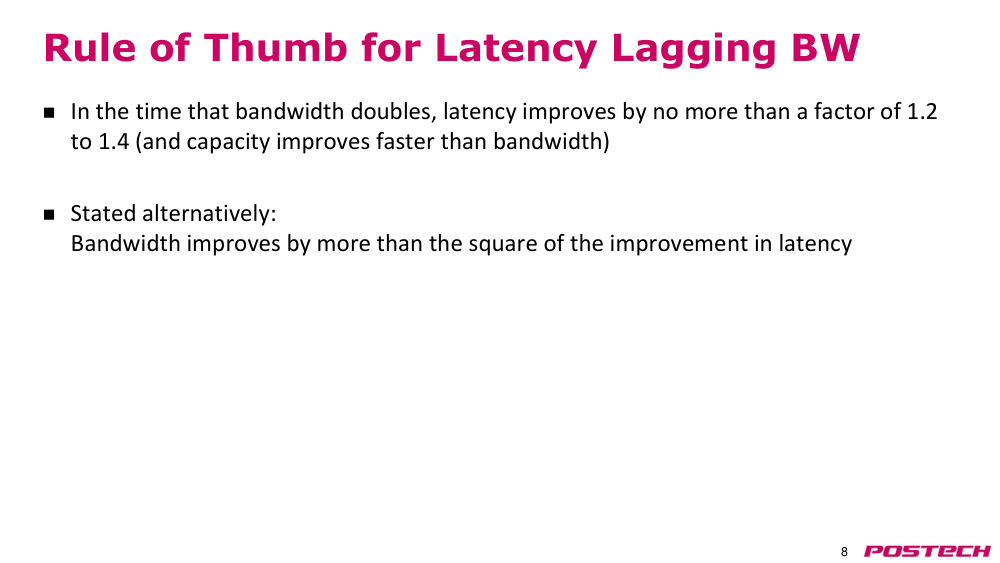
- bandwidth(대역폭)이 두 배로 증가하는 동안, latency(지연)은 1.2~1.4배 이내로만 향상됨 (용량은 대역폭보다 더 빠르게 향상됨)
- 다른 표현: latency(지연) 향상의 제곱보다 bandwidth(대역폭) 향상이 더 큼
p.9latency(지연)이 bandwidth(대역폭)을 따라잡지 못하는 6가지 이유 (1/2)
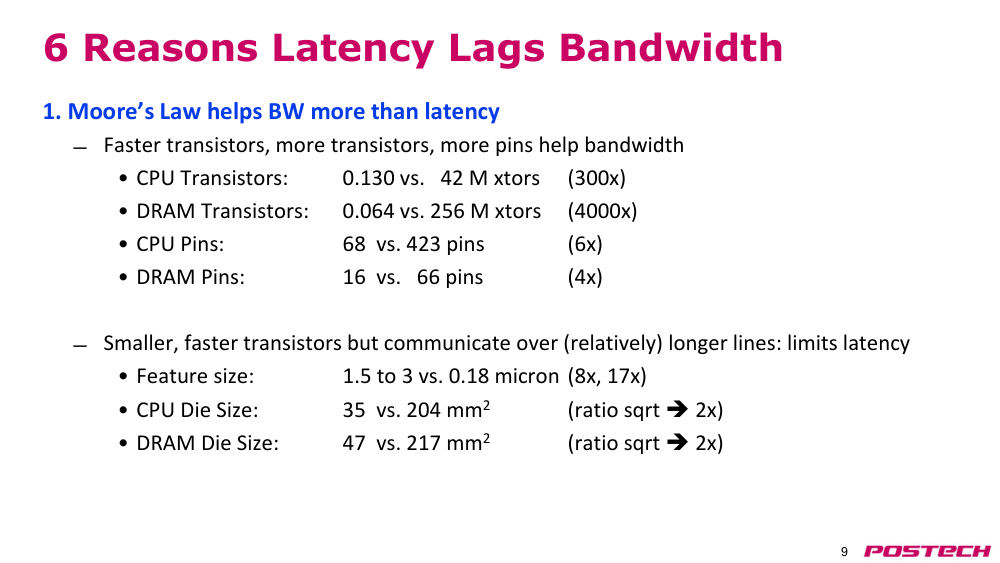
- Moore's law(무어의 법칙)은 bandwidth(대역폭)보다 latency(지연)에 더 큰 영향을 미침
- 더 빠른 트랜지스터, 더 많은 트랜지스터, 더 많은 핀은 bandwidth(대역폭)에 도움이 됨
- CPU 트랜지스터 수: 0.130 vs. 42M (300배)
- DRAM 트랜지스터 수: 0.064 vs. 256M (4,000배)
- CPU 핀 수: 68 vs. 423 (6배)
- DRAM 핀 수: 16 vs. 66 (4배)
- 더 작고 빠른 트랜지스터지만 (상대적으로) 긴 선을 통해 통신: latency(지연)을 제한함
- feature size(특징 크기): 1.5~3 vs. 0.18 마이크론 (8배, 17배)
- CPU die size(다이 크기): 35 vs. 204 mm² (비율 제곱근 계산 → 2배)
- DRAM die size(다이 크기): 47 vs. 217 mm² (비율 제곱근 계산 → 2배)
p.10latency(지연)이 bandwidth(대역폭)을 따라잡지 못하는 6가지 이유 (2/2)
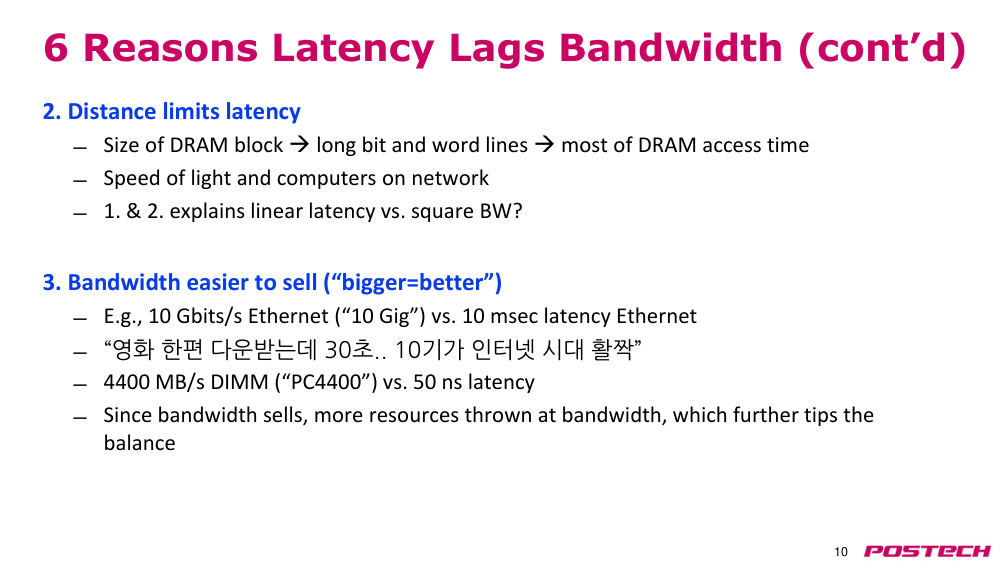
- 거리가 latency(지연)을 제한함
- DRAM 블록 크기 → 긴 비트선 및 워드선 → DRAM 접근 시간의 대부분을 차지함
- 빛의 속도와 네트워크 상의 컴퓨터
- 1번과 2번은 선형 latency(지연) 대 제곱 bandwidth(대역폭)을 설명함
- bandwidth(대역폭)은 더 쉽게 판매됨 ('크면 좋다')
- 예: 10 Gbits/s 이더넷 ('10기가') vs. 10ms latency(지연) 이더넷
- 영화 한 편 다운로드에 30초.. 10기가 인터넷 시대 활짝
- 4400 MB/s DIMM ('PC4400') vs. 50 ns latency(지연)
- bandwidth(대역폭)이 판매되기 때문에 더 많은 자원이 대역폭에 투입되며, 이는 균형을 더욱 기울임
p.11latency(지연)이 bandwidth(대역폭)을 도울 수 있지만, 그 반대는 아님
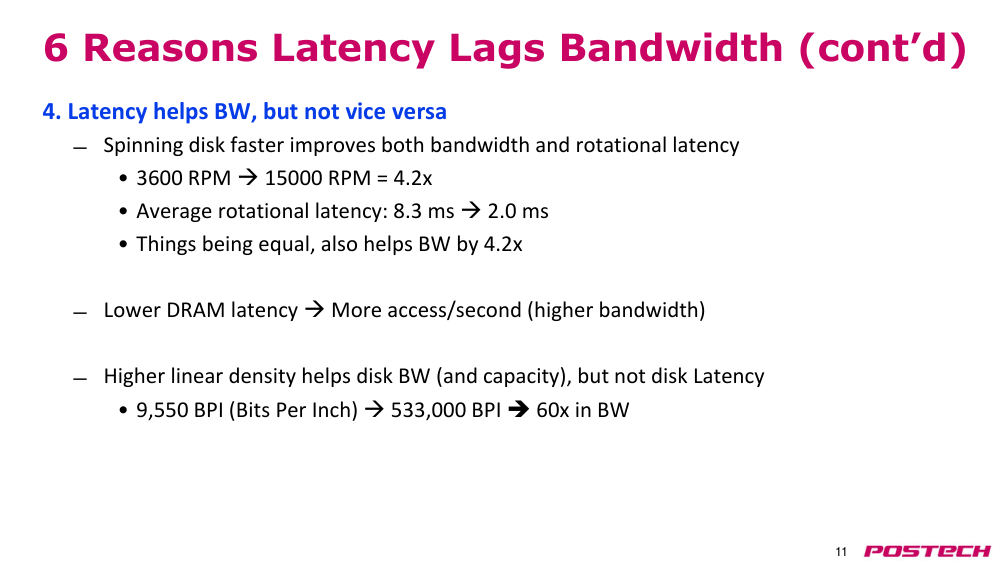
- 회전하는 디스크를 더 빠르게 하면 bandwidth(대역폭)과 회전 latency(지연) 모두 향상됨
- 3600 RPM → 15000 RPM = 4.2배
- 평균 회전 latency(지연): 8.3ms → 2.0ms
- 조건이 동일할 경우, bandwidth(대역폭)도 4.2배 향상됨
- 더 낮은 DRAM latency(지연) → 초당 더 많은 접근 (더 높은 대역폭)
- 더 높은 선형 밀도는 디스크 대역폭(용량)을 향상시키지만, 디스크 latency(지연)에는 영향 없음
- 9,550 BPI (비트/인치) → 533,000 BPI → bandwidth(대역폭) 60배 향상
p.12bandwidth(대역폭)이 latency(지연)을 악화시킴
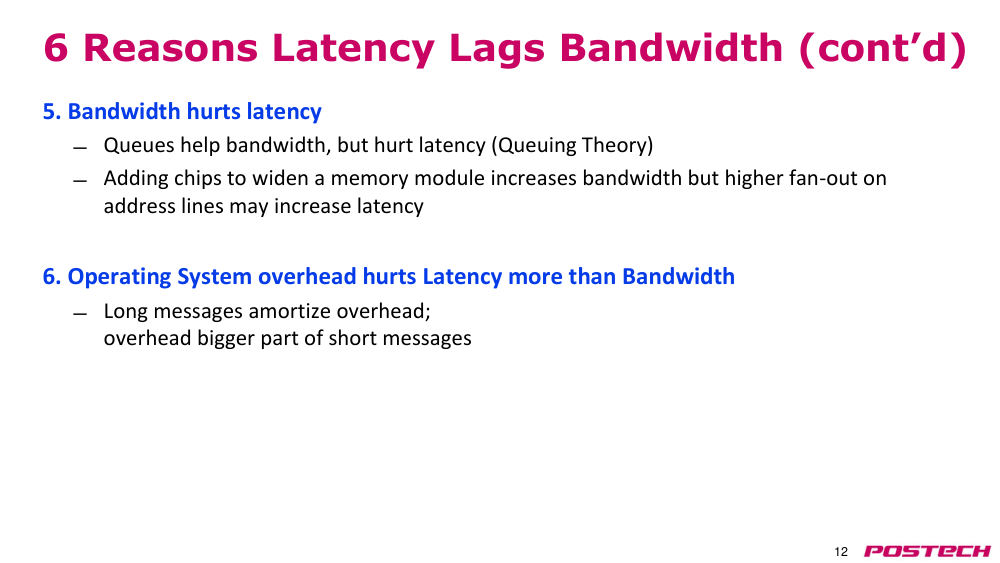
- 큐는 bandwidth(대역폭)을 도와주지만 latency(지연)을 악화시킴 (대기열 이론)
- 메모리 모듈을 넓히기 위해 칩을 추가하면 bandwidth(대역폭)은 증가하지만, address(주소) 라인의 더 높은 팬아웃으로 인해 latency(지연)이 증가할 수 있음
- operating system overhead(운영체제 오버헤드)는 latency(지연)에 더 큰 영향을 미치며, bandwidth(대역폭)에는 덜 영향을 미침
- 긴 메시지는 오버헤드를 분산시킴; 짧은 메시지에서는 오버헤드가 더 큰 비중을 차지함
p.13RISC-V instruction set architecture (ISA)(명령어 집합 아키텍처)
p.14명령어 집합 아키텍처 (ISA)
- 소프트웨어와 하드웨어 사이의 계약
- 일반적으로 프로그래머가 보는 상태(레지스터 + 메모리)를 모두 제시하고, 그 상태를 조작하는 명령어의 semantics(의미)를 설명함으로써 기술됨
- IBM 360은 하드웨어 구현(즉, 마이크로아키텍처)과 분리된 ISA를 처음으로 도입한 family of machines(기계의 가족)
- 동일한 ISA에 대해 여러 가지 구현이 가능함
- 예: 소련은 IBM360의 코드 호환 클론을 제작했으며, Amdahl은 IBM을 떠난 후에도 이를 수행함
- 예 2: AMD, Intel, VIA 프로세서는 AMD64 ISA를 실행함
- 예 3: 많은 스마트폰은 ARM ISA를 사용하며, Apple, Qualcomm, Samsung, Huawei 등 여러 회사의 구현을 사용함
- 본 수업에서는 표준 ISA로 RISC-V를 사용함 (www.riscv.org)
- 많은 회사와 오픈소스 프로젝트가 RISC-V 구현을 개발하고 있음
p.15ISA에서 microarchitecture(마이크로아키텍처)로의 매핑
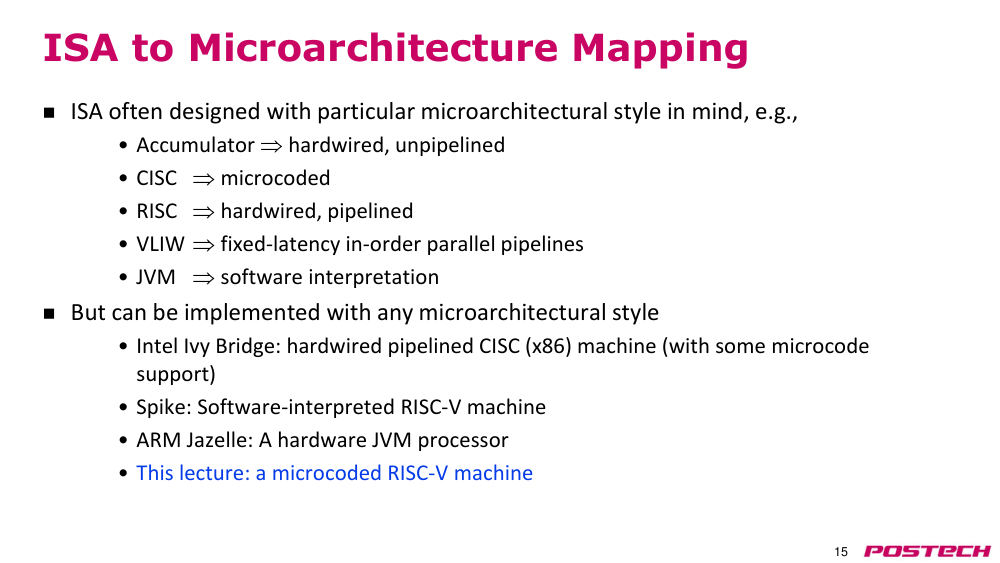
- ISA는 종종 특정 microarchitecture(마이크로아키텍처) 스타일을 고려하여 설계됨
- 예: 누산기 ⇒ hardwired(하드웨어로 구현된), 파이프라인화되지 않은
- 예: CISC ⇒ 마이크로코딩된
- 예: RISC ⇒ hardwired(하드웨어로 구현된), pipelined(파이프라인화된)
- 예: VLIW ⇒ 고정 latency(지연), 순서 유지 병렬 파이프라인
- 예: JVM ⇒ software interpretation(소프트웨어 해석)
- 하지만 어떤 microarchitecture(마이크로아키텍처) 스타일로도 구현 가능함
- 예: Intel Ivy Bridge: hardwired(하드웨어로 구현된) pipelined(파이프라인화된) CISC(x86) 기계(일부 마이크로코드 지원 포함)
- 예: Spike: software interpretation(소프트웨어 해석)된 RISC-V 기계
- 예: ARM Jazelle: 하드웨어 기반 JVM 프로세서
- 본 강의: 마이크로코딩된 RISC-V 기계
p.16제어와 datapath(데이터 경로)
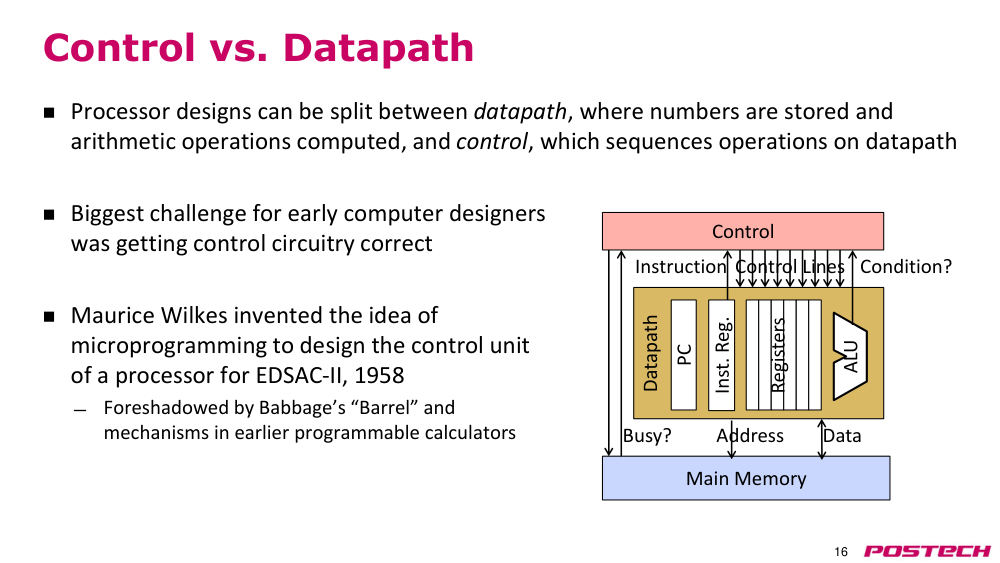
- 프로세서 설계는 숫자를 저장하고 산술 연산을 수행하는 datapath(데이터 경로)와 데이터 경로의 연산을 순서대로 수행하는 제어로 나눌 수 있음
- 초기 컴퓨터 설계자들에게 가장 큰 도전 과제는 제어 회로를 올바르게 설계하는 것이었음
- Maurice Wilkes는 1958년 EDSAC-II의 control unit(제어 유닛) 설계를 위해 microprogramming(마이크로프로그래밍)의 개념을 고안함
- Babbage의 'Barrel'과 이전 프로그래머블 계산기의 메커니즘에 의해 예고됨
- 조건?
- 제어
- 주요 메모리
- address(주소)
- 데이터
- control lines(제어 라인)
- datapath(데이터 경로)
- program counter (PC)(프로그램 카운터)
- instruction register(명령어 레지스터)
- register(레지스터)
- ALU(산술논리장치)
- 명령어
- busy?(사용 중?)
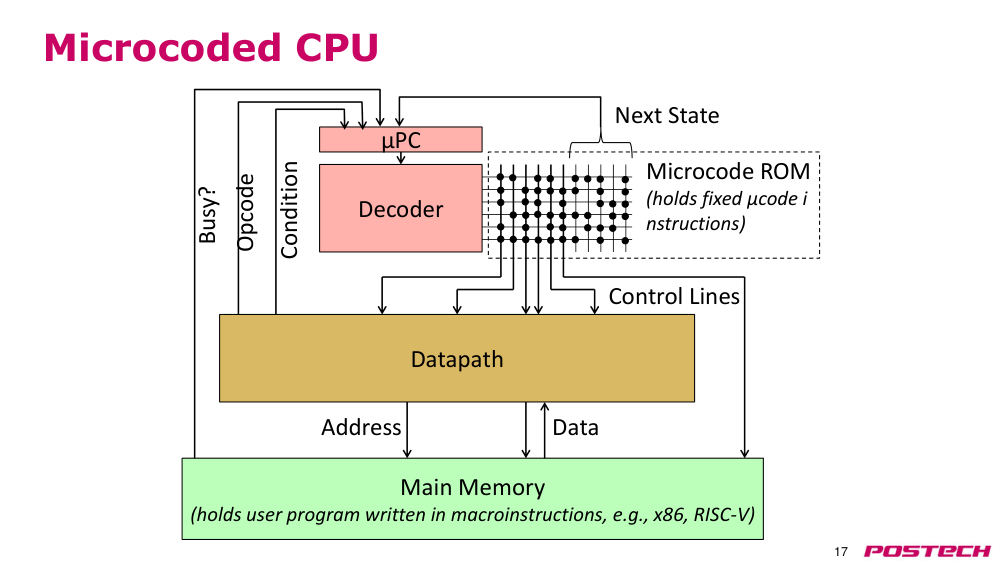
p.17microcoded CPU(마이크로코딩된 CPU)
- datapath(데이터 경로)
- 주요 메모리
- (사용자 프로그램을 매크로명령어로 저장, 예: x86, RISC-V)
- address(주소)
- 데이터
- decoder(디코더)
- µPC (microprogram counter)(마이크로프로그램 카운터)
- microcode ROM(마이크로코드 ROM)
- (고정된 µcode instruction(마이크로코드 명령어)을 저장)
- next state(다음 상태)
- control lines(제어 라인)
- Opcode
- 조건
- busy?(사용 중?)
p.18마이크로코딩된 기계 분석
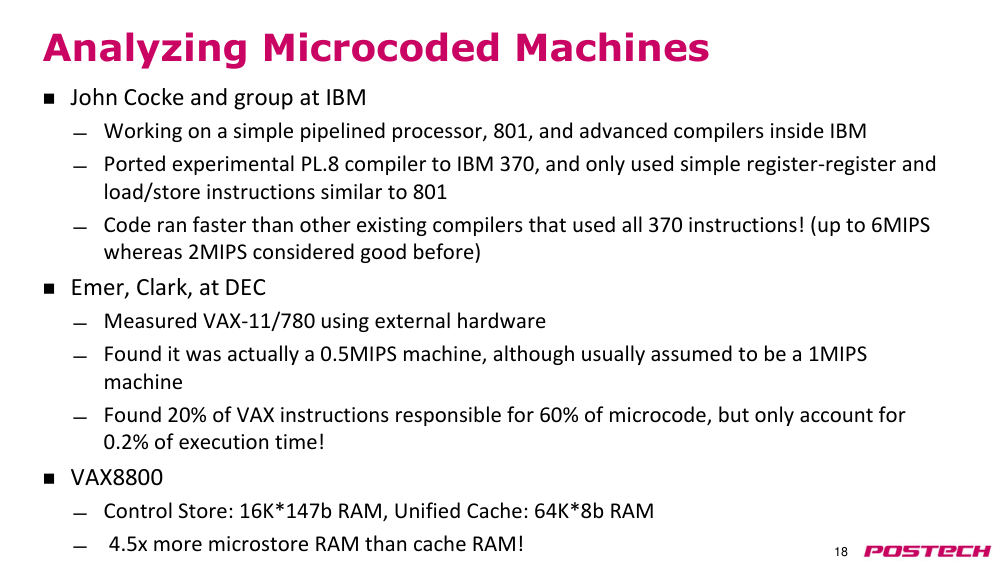
- John Cocke와 IBM 그룹
- 간단한 pipelined(파이프라인화된) 프로세서인 801과 IBM 내부의 고급 컴파일러 개발 중
- 실험용 PL.8 컴파일러를 IBM 370으로 이식하고, 801과 유사한 간단한 register(레지스터)-레지스터 및 load-store(로드-스토어) 명령어만 사용함
- 기존의 모든 370 명령어를 사용하는 컴파일러보다 코드 실행 속도가 빠름 (최대 6MIPS, 이전에 2MIPS가 우수한 수준으로 여겨짐)
- Emer, Clark, DEC
- 외부 하드웨어를 사용해 VAX-11/780 측정
- 실제로는 0.5MIPS 기계였음, 일반적으로 1MIPS로 간주됨
- VAX 명령어 중 20%가 마이크로코드의 60%를 차지하지만, 실행 시간의 0.2%만 차지함!
- VAX8800
- control store(제어 저장소): 16K*147b RAM, unified cache(통합 캐시): 64K*8b RAM
- cache(캐시) RAM보다 마이크로저장소 RAM이 4.5배 더 많음
p.19프로세서 성능의 '철칙'
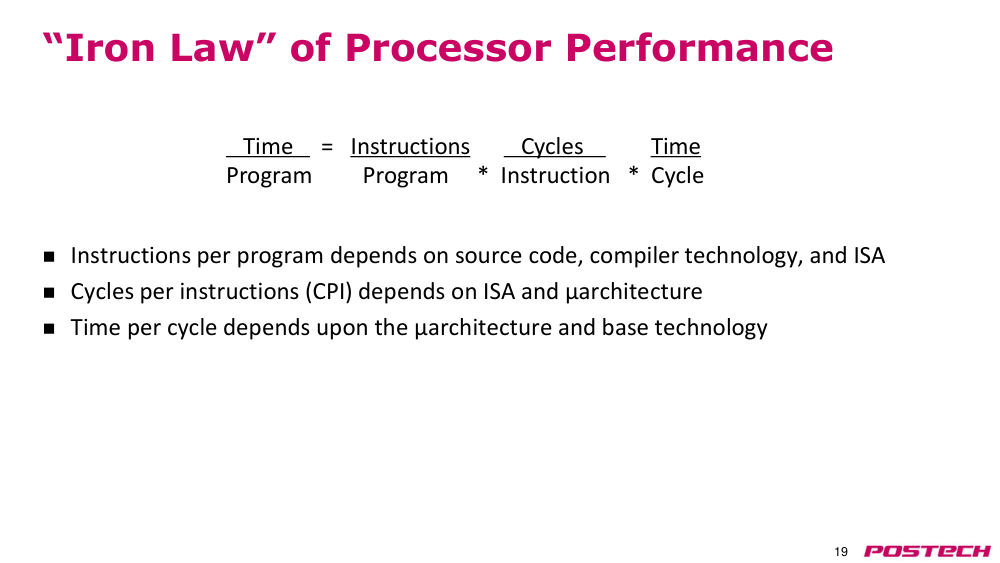
- instructions per program(프로그램당 지시어 수)는 source code(소스 코드), compiler technology(컴파일러 기술), instruction set architecture (ISA)(명령어 집합 아키텍처)에 따라 달라진다.
- 지시어당 사이클 수(CPI)는 instruction set architecture (ISA)(명령어 집합 아키텍처)와 microarchitecture(마이크로아키텍처)에 따라 달라진다.
- time per cycle(사이클당 시간)은 microarchitecture(마이크로아키텍처)와 base technology(기본 기술)에 따라 달라진다.
- time = instructions × CPI × cycle time(시간 = 지시어 수 × CPI × 사이클 시간)
p.20지시어당 사이클 수(CPI)
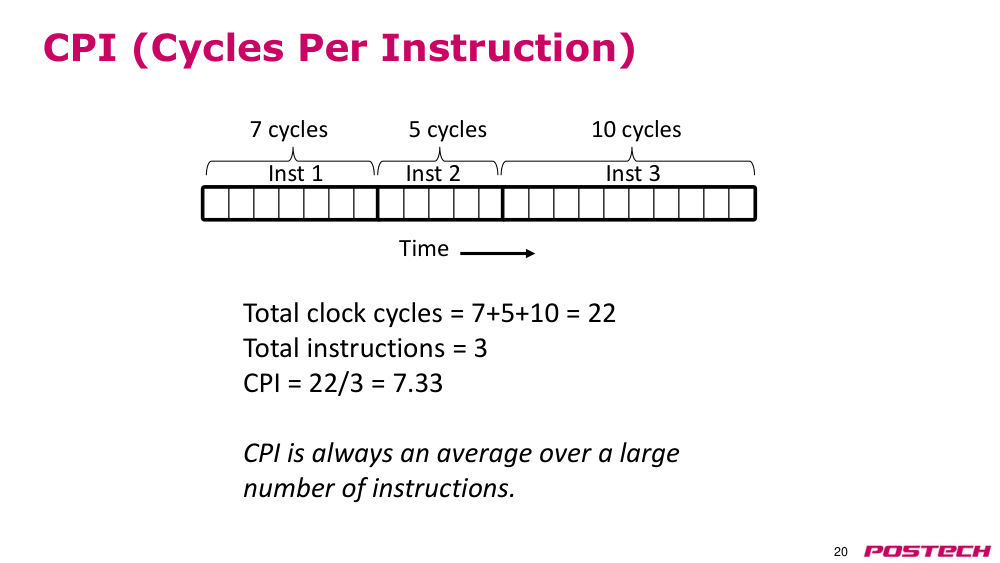
- 지시어 1: 10 사이클
- 지시어 2: 5 사이클
- 지시어 3: 7 사이클
- 총 사이클 수 = 7 + 5 + 10 = 22
- 총 지시어 수 = 3
- CPI = 22 / 3 = 7.33
- CPI는 대량의 지시어에 대한 평균값이다.
p.21IC 기술의 변화가 트레이드오프를 변화시킴
- 논리 회로, RAM, ROM 모두 MOS 트랜지스터를 사용하여 구현됨
- 반도체 RAM은 ROM과 거의 동일한 속도를 가짐
p.22마이크로코드 기계의 재고찰 (나노코딩된 68000 예시)
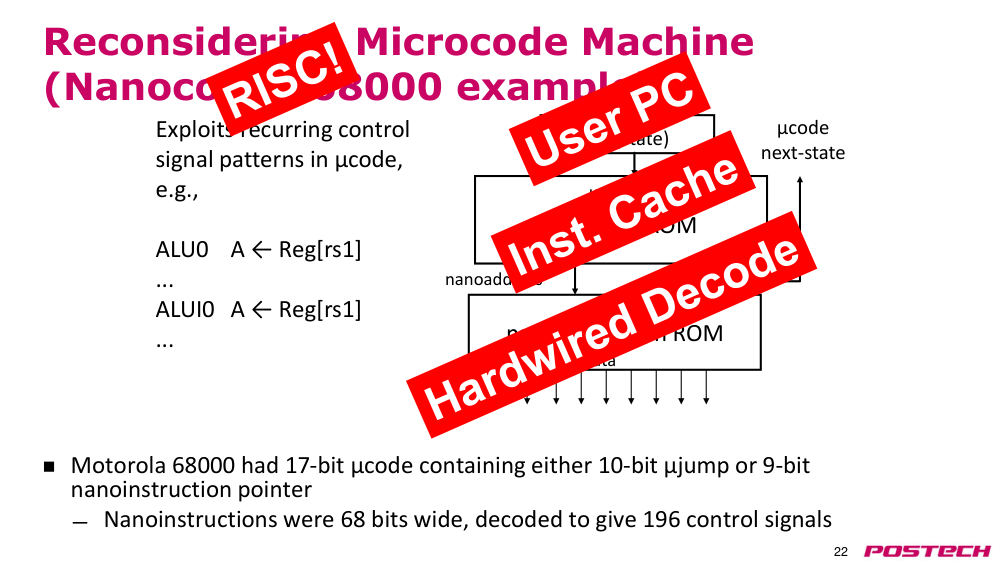
- Motorola 68000은 17비트 마이크로코드를 사용하며, 이는 10비트 마이크로점프 또는 9비트 nanoinstruction(나노명령어) 포인터를 포함함
- nanoinstruction(나노명령어)는 68비트 폭이며, 196개의 제어 신호로 디코딩됨
- microcode ROM(마이크로코드 ROM)은 반복적인 제어 신호 패턴을 활용함, 예: ALU0 → A ← Reg[rs1], ... → ALUI0 → A ← Reg[rs1]
p.23CISC에서 RISC로의 전환
- 빠른 RAM을 사용해 사용자에게 보이는 지시어의 빠른 instruction cache(명령어 캐시)를 구축하고, 고정된 하드웨어 마이크로루틴 대신 사용함
- 빠른 명령어 메모리의 내용은 애플리케이션 요구에 맞게 변경됨
- 간단한 instruction set architecture (ISA)(명령어 집합 아키텍처)를 사용해 hardwired(하드웨어로 구현된) pipelined(파이프라인화된) 구현을 가능하게 함
- 대부분의 컴파일된 코드는 CISC 지시어의 일부만 사용함
- 간단한 인코딩은 pipelined(파이프라인화된) 구현을 가능하게 함
- RISC instruction set architecture (ISA)(명령어 집합 아키텍처)는 수직 마이크로코드와 유사함
- 통합 기술의 추가적 이점
- 1980년대 초반, 드디어 32비트 datapath(데이터 경로)와 작은 cache(캐시)를 단일 칩에 맞출 수 있음
- 일반적인 경우 칩 간 전송이 없어 더 빠른 동작이 가능함
p.24Berkeley RISC 칩
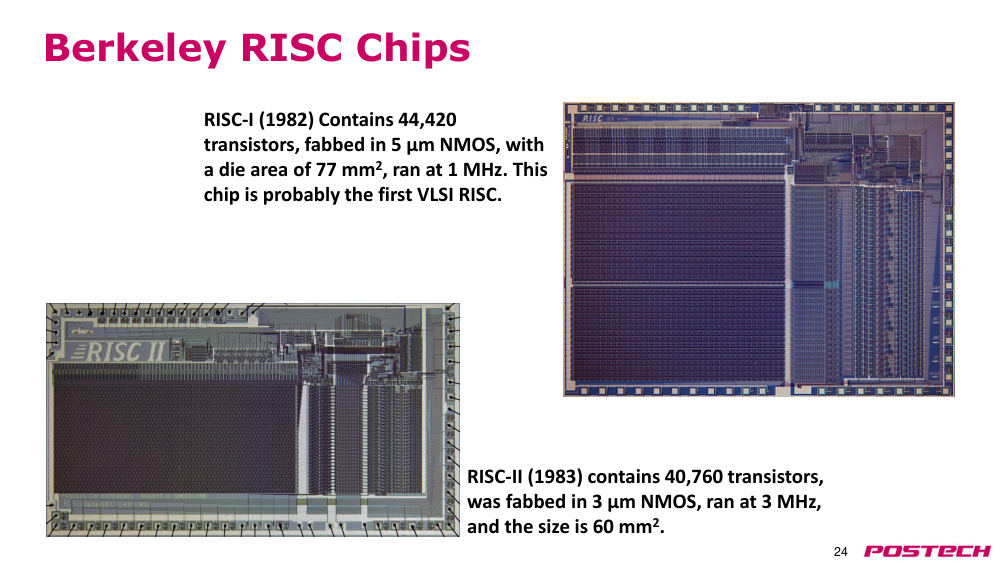
- RISC-I (1982): 트랜지스터 수 44,420개, 5 µm NMOS 공정, die area(다이 면적) 77 mm², 1 MHz에서 동작. 이 칩은 아마도 최초의 VLSI RISC일 가능성이 높음
- RISC-II (1983): 트랜지스터 수 40,760개, 3 µm NMOS 공정, 3 MHz에서 동작, 크기 60 mm²
p.25RISC-V instruction set architecture (ISA)(명령어 집합 아키텍처)
- UC Berkeley에서 개발한 새로운 다섯 번째 세대 RISC 설계
- 현실적이고 완전한 instruction set architecture (ISA)(명령어 집합 아키텍처)이지만, 오픈소스이면서도 작음
- 특정 구현 방식에 과도하게 설계되지 않음
- 32비트(RV32)와 64비트(RV64) address(주소) 공간 버전 모두 지원
- multiprocessing(다중 처리)를 위해 설계됨
- efficient instruction encoding(효율적인 명령어 인코딩)
- education/research(교육/연구)용으로 subset/extend(하위 집합/확장)을 쉽게 할 수 있음
- RISC-V 사양은 RISC-V Foundation 웹사이트 및 GitHub에서 제공됨
- industry adoption(산업적 채택) 증가로 점점 더 큰 추진력을 얻고 있음
p.26instruction set architecture (ISA)(명령어 집합 아키텍처)
- 연산
- RISC-V: 데이터 전송, 산술, 논리, 제어, 부동소수점
- 텍스트의 그림 1.5 참조
- control flow instructions(제어 흐름 명령어)
- register(레지스터) 내용 사용 (RISC-V) 대비 상태 비트 사용 (x86, ARMv7, ARMv8)
- return address(반환 주소) 저장 위치: 레지스터 (RISC-V, ARMv7, ARMv8) 대비 스택 (x86)
- 인코딩
- 고정 길이 (RISC-V, ARMv7/v8은 컴팩트 명령어 세트 제외) 대비 가변 길이 (x86)
p.27instruction set architecture (ISA)(명령어 집합 아키텍처)
- 메모리 address(주소) 지정
- RISC-V: byte addressed(바이트 address(주소) 지정), aligned accesses(정렬된 접근)이 더 빠름
- address(주소) 지정 모드
- RISC-V: register(레지스터), immediate(즉시), displacement addressing(변위 주소 지정) (베이스+오프셋)
- 기타 예: 자동 증가, 인덱스, PC 상대
- 피연산자 유형 및 크기
- RISC-V: 8비트, 32비트, 64비트
p.28RV32 프로세서 상태
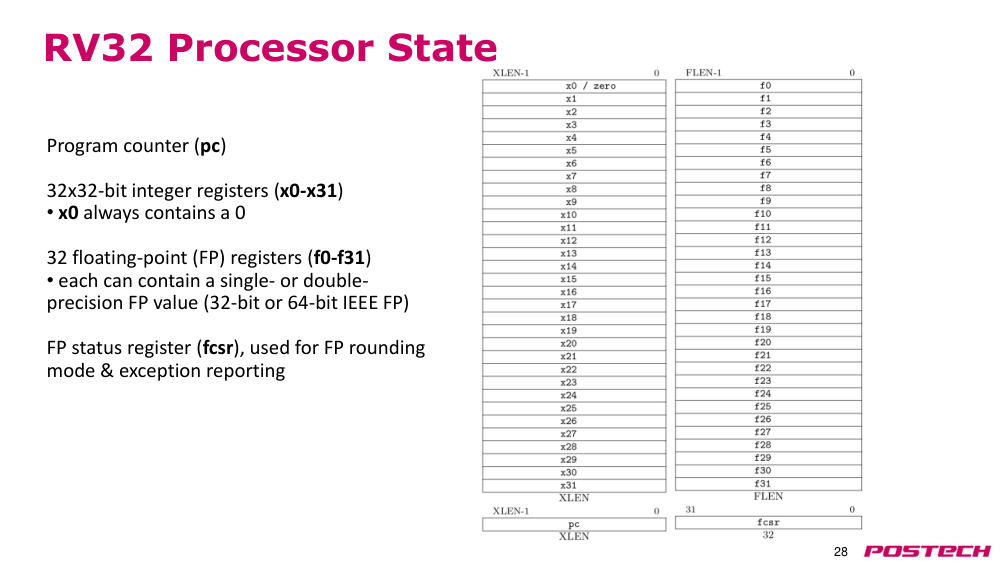
- 프로그램 카운터 (pc)
- 32개의 32비트 정수 레지스터 (x0-x31)
- • x0는 항상 0을 포함함
- 32개의 부동소수점 (FP) 레지스터 (f0-f31)
- • 각각은 단정밀도 또는 이중정밀도 FP 값 (32비트 또는 64비트 IEEE FP)을 포함할 수 있음
- 부동소수점 상태 레지스터 (fcsr), 부동소수점 rounding mode(반올림 모드) 및 exception reporting(예외 보고)에 사용
p.29instruction set architecture (ISA)(명령어 집합 아키텍처)
- instruction set architecture (ISA)(명령어 집합 아키텍처)의 종류
- general-purpose registers(일반 목적 레지스터)
- register-memory(레지스터-메모리) 대비 load-store(로드-스토어)
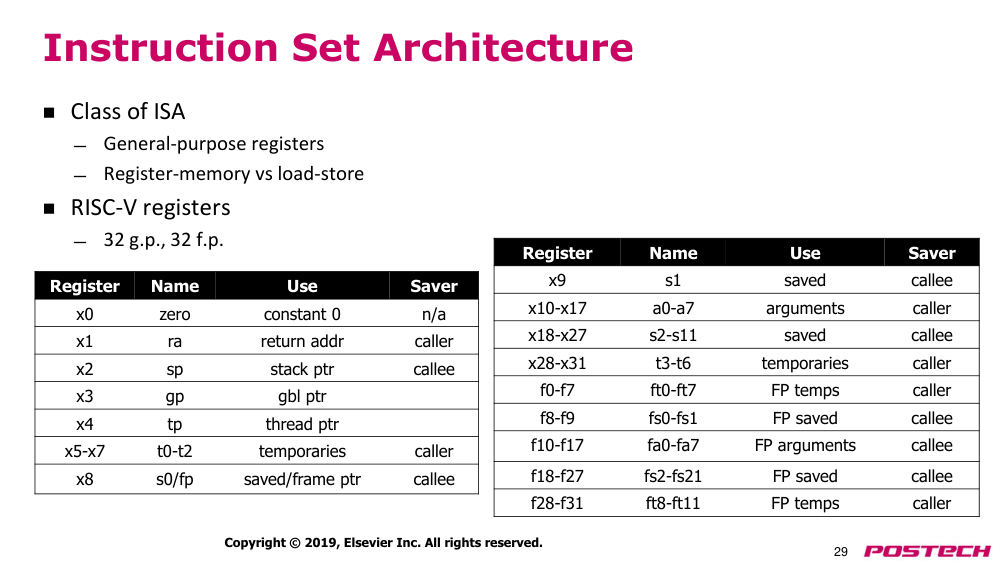
- RISC-V register(레지스터)
- 32개의 일반 목적, 32개의 부동소수점
- register(레지스터) 이름 및 사용
- x0: zero, constant 0(상수 0), 해당 없음
- x1: ra, return address(반환 주소), 호출자
- x2: sp, stack pointer(스택 포인터), 피호출자
- x3: gp, 전역 포인터
- x4: tp, thread pointer(스레드 포인터)
- x5-x7: t0-t2, 일시적 register(레지스터), 호출자
- x8: s0/fp, 저장된/frame pointer(프레임 포인터), 피호출자
- x9: s1, 저장된, 피호출자
- x10-x17: a0-a7, 인수, 호출자
- x18-x27: s2-s11, 저장된, 피호출자
- x28-x31: t3-t6, 일시적 register(레지스터), 호출자
- f0-f7: ft0-ft7, FP 일시적 register(레지스터), 호출자
- f8-f9: fs0-fs1, FP 저장된, 피호출자
- f10-f17: fa0-fa7, FP 인수, 피호출자
- f18-f27: fs2-fs21, FP 저장된, 피호출자
- f28-f31: ft8-ft11, FP 일시적 register(레지스터), 호출자
p.30RISC-V instruction encoding(명령어 인코딩)
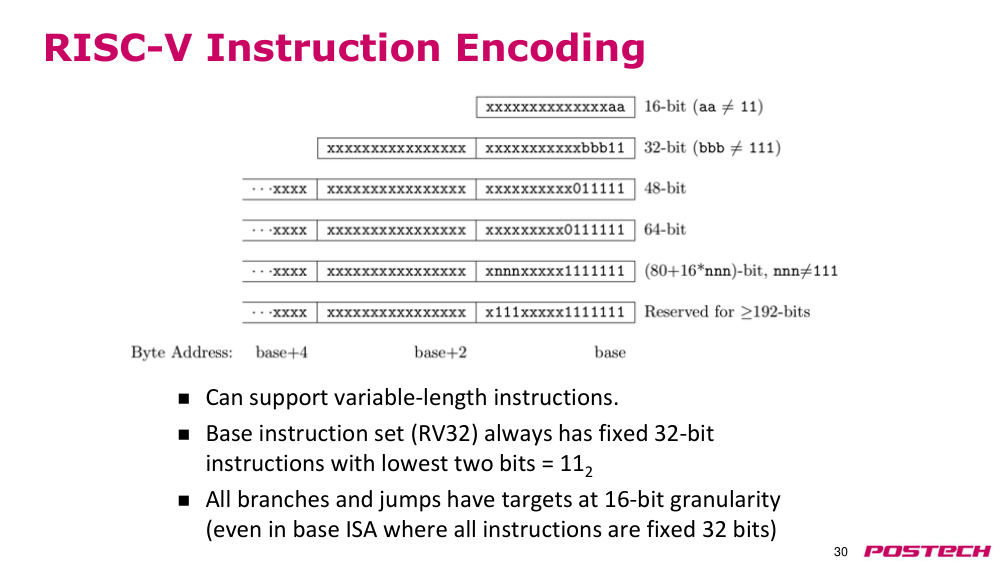
- 가변 길이 명령어를 지원할 수 있음
- 기본 명령어 세트 (RV32)는 항상 고정 32비트 명령어이며, 하위 두 비트 = 11₂
- 모든 브랜치와 점프는 16비트 단위의 타겟을 가짐 (기본 ISA에서 모든 명령어가 고정 32비트이더라도)
p.31RISC-V 명령어 형식
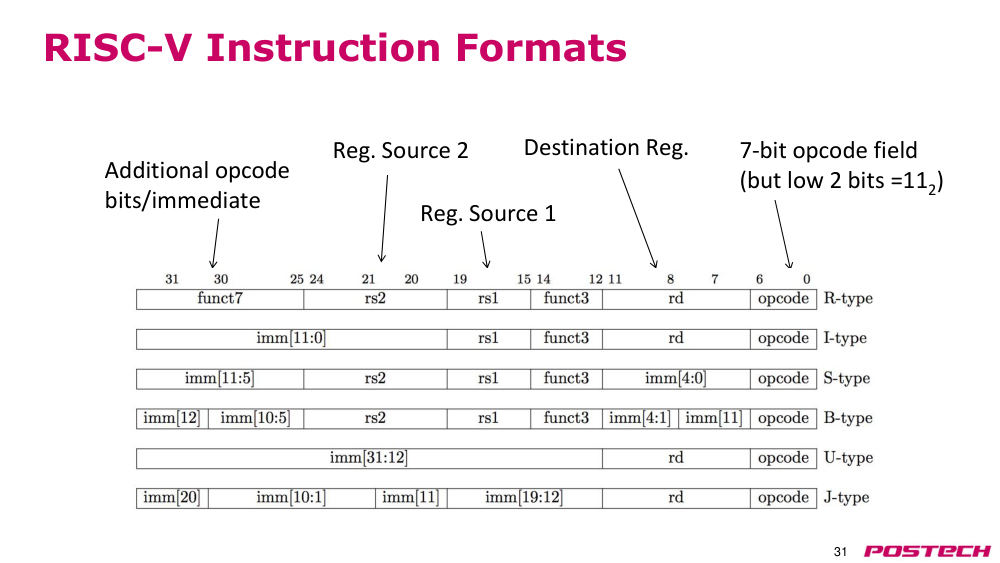
- 목적 register(레지스터)
- register(레지스터) 소스 1
- register(레지스터) 소스 2
- 7비트 오퍼코드 필드 (하지만 하위 2비트 = 11₂)
- 추가 오퍼코드 비트/즉시값
p.32RISC-V 어셈블리 예제
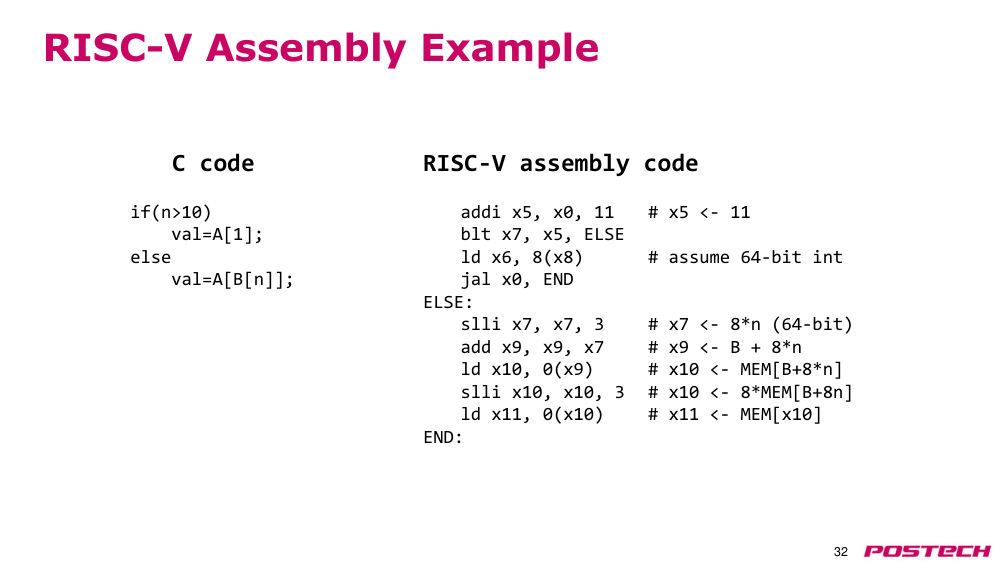
- C 코드
- if(n>10)
- val=A[1];
- else
- val=A[B[n]];
- RISC-V 어셈블리 코드
- addi x5, x0, 11 # x5 <- 11
- blt x7, x5, ELSE
- ld x6, 8(x8)
- # assume 64-bit int
- jal x0, END
- ELSE:
- slli x7, x7, 3 # x7 <- 8*n (64-bit)
- add x9, x9, x7
- # x9 <- B + 8*n
- ld x10, 0(x9)
- # x10 <- MEM[B+8*n]
- slli x10, x10, 3
- # x10 <- 8*MEM[B+8n]
- ld x11, 0(x10)
- # x11 <- MEM[x10]
- END:
p.33전력, 에너지, 성능 측정
p.34전력과 에너지
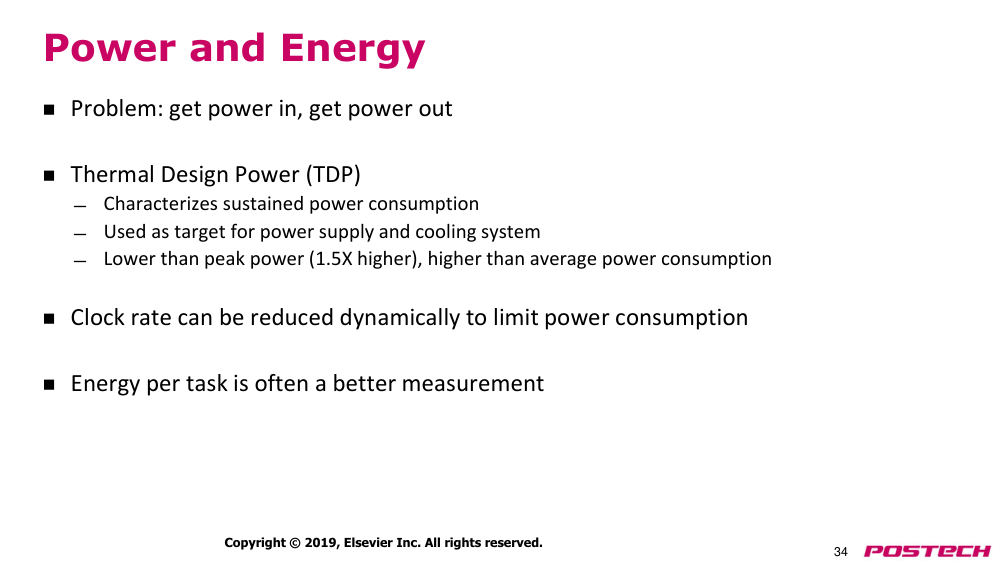
- 문제: 입력 전력과 출력 전력
- 열 설계 전력(TDP)̶
- 지속적인 전력 소비를 특성화함̶
- 전원 공급 장치 및 냉각 시스템의 목표로 사용됨̶
- 피크 전력보다 낮음 (1.5배 높음), 평균 전력 소비보다 높음
- 클럭 속도를 동적으로 감소시켜 전력 소비를 제한할 수 있음
- 작업당 에너지는 종종 더 나은 측정 기준
p.35동적 에너지와 전력
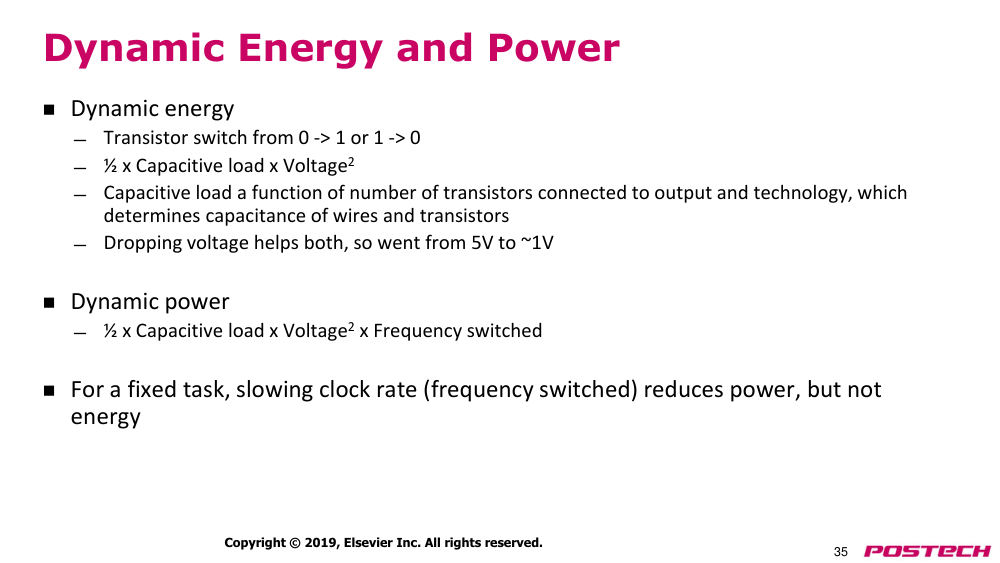
- 동적 에너지̶
- 트랜지스터가 0 -> 1 또는 1 -> 0로 전환될 때̶
- ½ x 용량 부하 x 전압²̶
- 용량 부하는 출력에 연결된 트랜지스터 수와 기술에 따라 결정되며, 이는 선과 트랜지스터의 용량을 결정함̶
- 전압을 낮추면 둘 다 개선되므로, 5V에서 ~1V로 전환됨
- 동적 전력̶
- ½ x 용량 부하 x 전압² x 스위칭 주파수
- 고정된 작업에 대해 클럭 속도(스위칭 주파수)를 낮추면 전력은 감소하지만, 에너지는 감소하지 않음
p.36전력
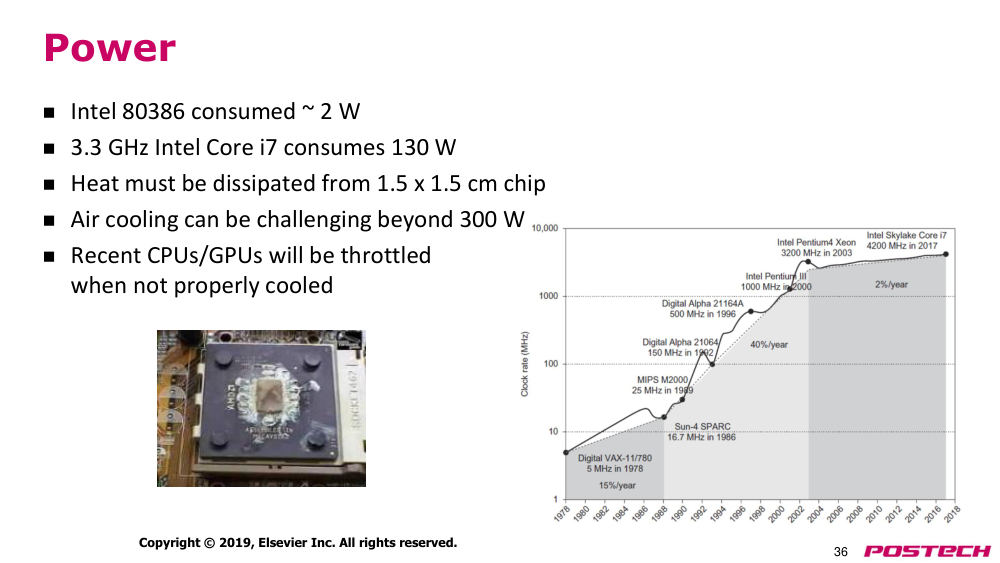
- Intel 80386은 약 2 W 소비
- 3.3 GHz Intel Core i7는 130 W 소비
- 1.5 x 1.5 cm 칩에서 열을 방출해야 함
- 300 W를 초과하면 공기 냉각이 어려움
- 최근 CPU/GPU는 적절히 냉각되지 않으면 throttled(스로틀링됨)
p.37전력 감소
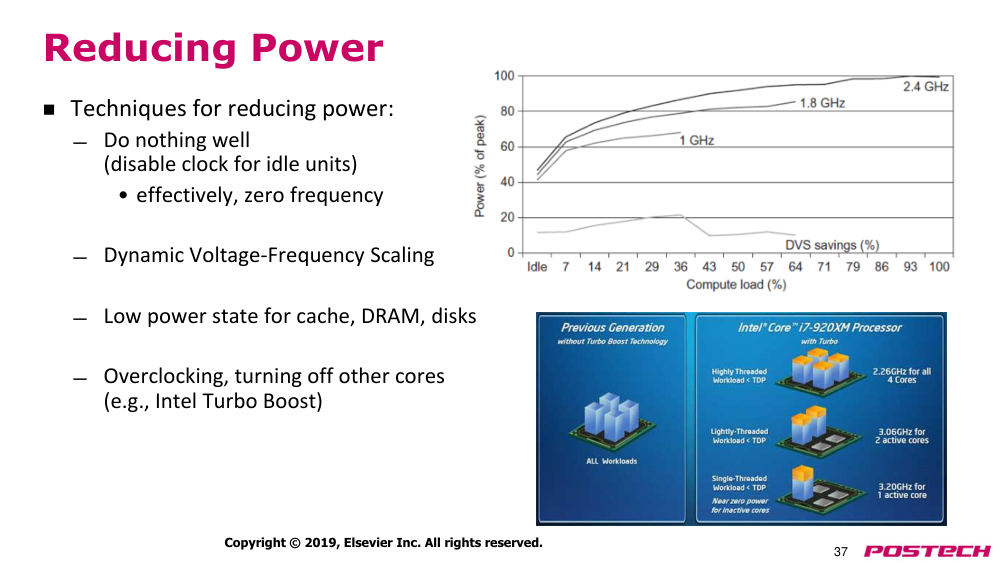
- 전력 감소를 위한 기술:
- • 아무것도 하지 않기 (공백 상태의 단위에 클럭 비활성화)
- → 실질적으로 주파수 0
- • 동적 전압-주파수 스케일링
- • cache(캐시), DRAM, 디스크용 저전력 상태
- • 오버클럭킹, 다른 코어 비활성화 (예: 인텔 터보 부스트)
p.38DVFS 예제
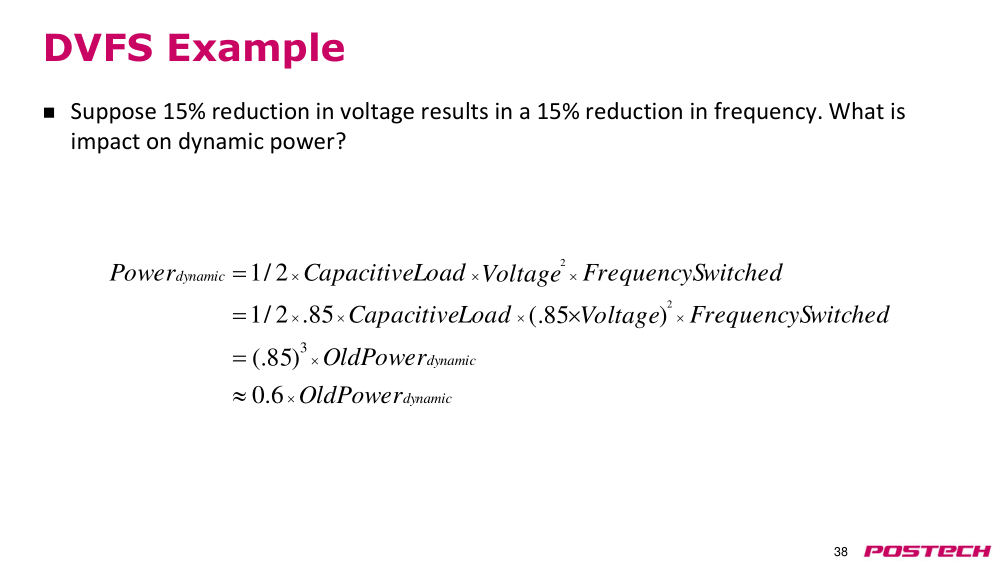
- 15% 전압 감소가 15% 주파수 감소를 초래한다고 가정할 때, 동적 전력에 미치는 영향은?
- dynamic power ∝ Voltage² × Frequency
- OldPower ≈ (0.85)² × (0.85) × DynamicPower = 0.614 × DynamicPower
- → 약 38.6% 감소
p.39정적(또는 누설) 전력
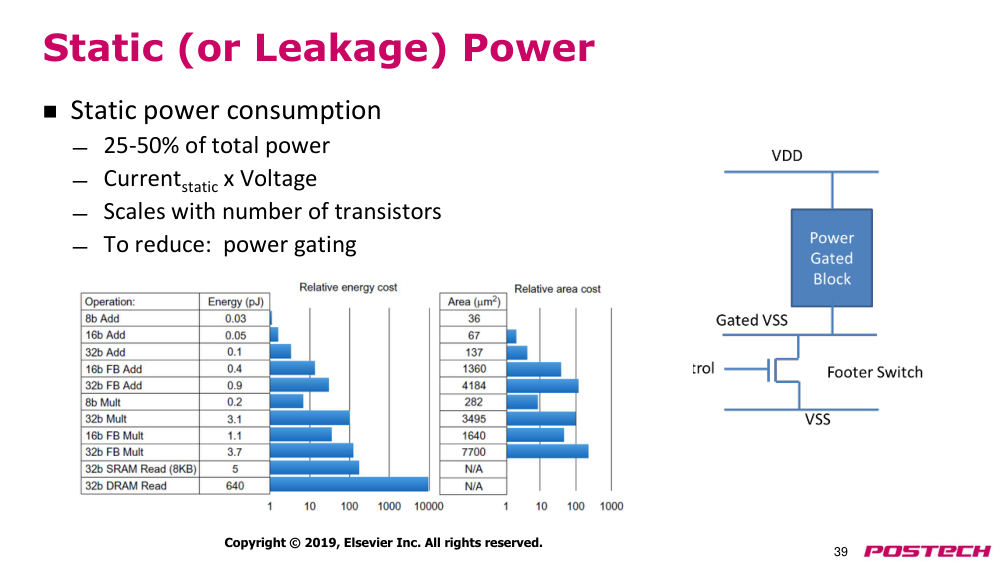
- 정적 전력 소비:
- • 총 전력의 25-50%
- • Current_static × Voltage
- • 트랜지스터 수에 비례
- • 감소를 위해: 전력 게이팅 사용
p.40성능 측정
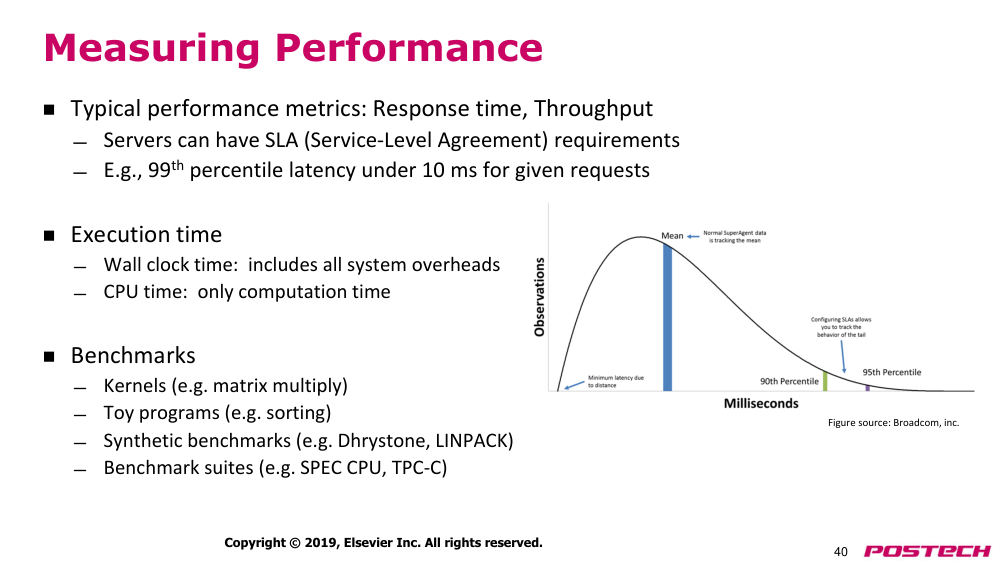
- 일반적인 성능 지표: response time(응답 시간), throughput(처리량)
- 서버는 SLA(Service-Level Agreement) 요구 사항을 가질 수 있음
- 예: 주어진 요청에 대해 99번째 백분위 latency(지연)이 10ms 이하
- 실행 시간:
- • 월클록 시간: 모든 시스템 오버헤드 포함
- • CPU 시간: 오직 계산 시간만 포함
- 벤치마크:
- • 커널 (예: 행렬 곱셈)
- • 토이 프로그램 (예: 정렬)
- • 합성 벤치마크 (예: Dhrystone, LINPACK)
- • 벤치마크 세트 (예: SPEC CPU, TPC-C)
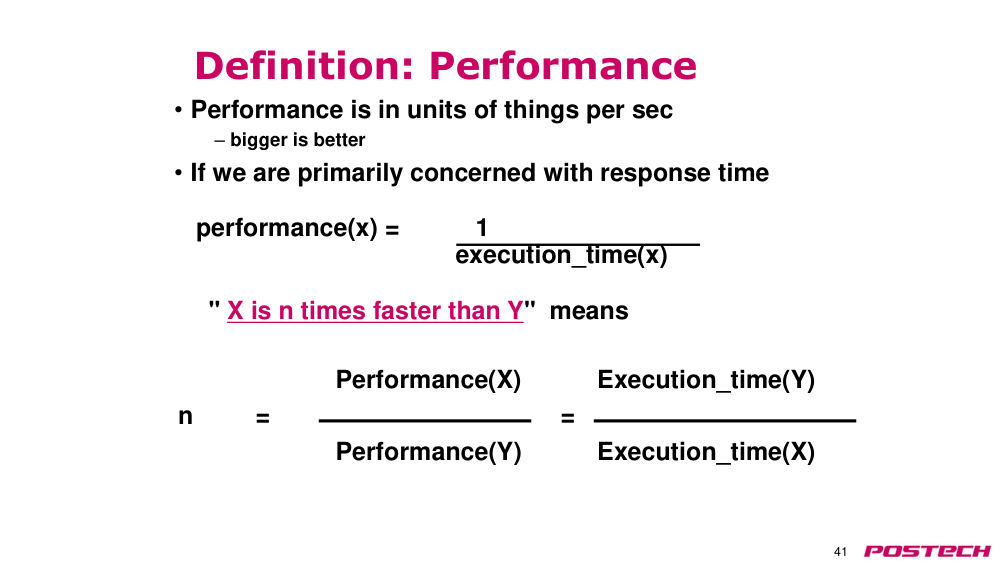
p.41성능 정의
- 성능 정의:
- Performance(X) = 1 / Execution_time(X)
- Performance(Y) = 1 / Execution_time(Y)
- • 성능은 초당 처리 가능한 작업 수 단위로 표현됨
- • 값이 클수록 좋음
- • response time(응답 시간)에 주로 관심이 있다면:
- Performance(X) = 1 / Execution_time(X)
- • X는 Y보다 n배 빠르다 → Performance(X) = n × Performance(Y)
p.42상대적 성능
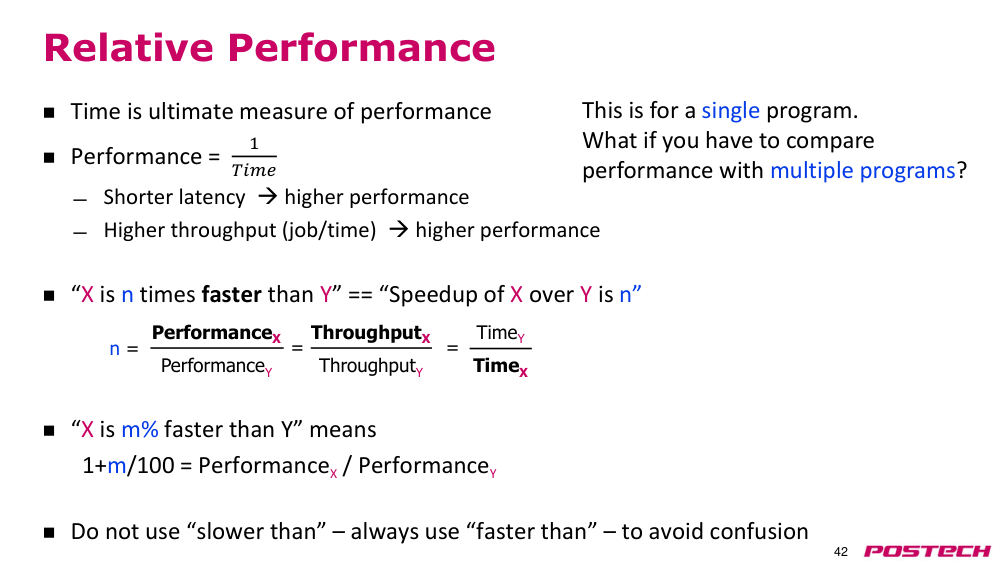
- 시간은 성능의 궁극적인 측정 기준
- 성능 = 1 / 시간
- • 짧은 latency(지연) → 높은 성능
- • 높은 처리량(job/시간) → 높은 성능
- • "X는 Y보다 n배 빠르다" = "X의 속도 향상은 n"
- • "X는 Y보다 m% 빠르다"는 semantics(의미): PerformanceX / PerformanceY = 1 + m/100
- • "보다 느리다"는 표현은 사용하지 말 것 → 항상 "보다 빠르다"로 표현하여 혼동 방지
- PerformanceX / PerformanceY = ThroughputX / ThroughputY = TimeY / TimeX = n
- → 이는 단일 프로그램에 대한 비교입니다.
- 다수의 프로그램을 비교해야 할 경우는 어떻게 할까요?
p.43산술 평균
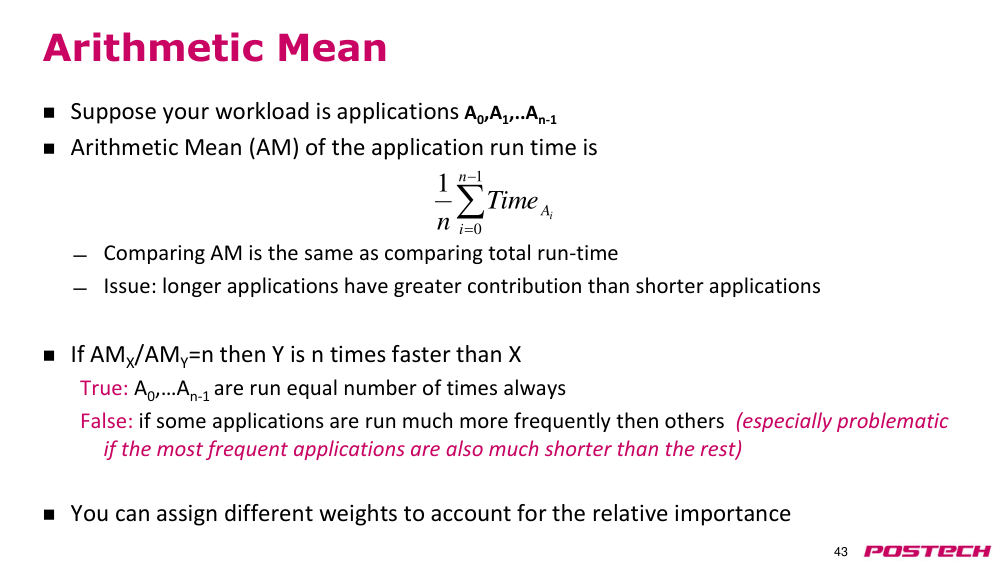
- 작업부하(workload)가 응용프로그램 A0, A1, ..., An-1로 구성된다고 가정하자.
- 응용프로그램 실행 시간의 산술 평균(AM)은 다음과 같다.
- 산술 평균을 비교하는 것은 총 실행 시간을 비교하는 것과 같다.
- 문제점: 더 긴 응용프로그램이 더 큰 기여를 한다.
- 만약 AMX / AMY = n이라면, Y는 X보다 n배 빠르다.
- 참: A0, ..., An-1는 항상 동일한 횟수로 실행된다.
- 거짓: 일부 응용프로그램이 다른 것보다 훨씬 더 자주 실행되는 경우 (특히 가장 자주 실행되는 응용프로그램이 나머지보다 훨씬 짧은 경우에 특히 문제가 된다).
- 상대적인 중요도를 반영하기 위해 가중치를 부여할 수 있다.
p.44기하 평균
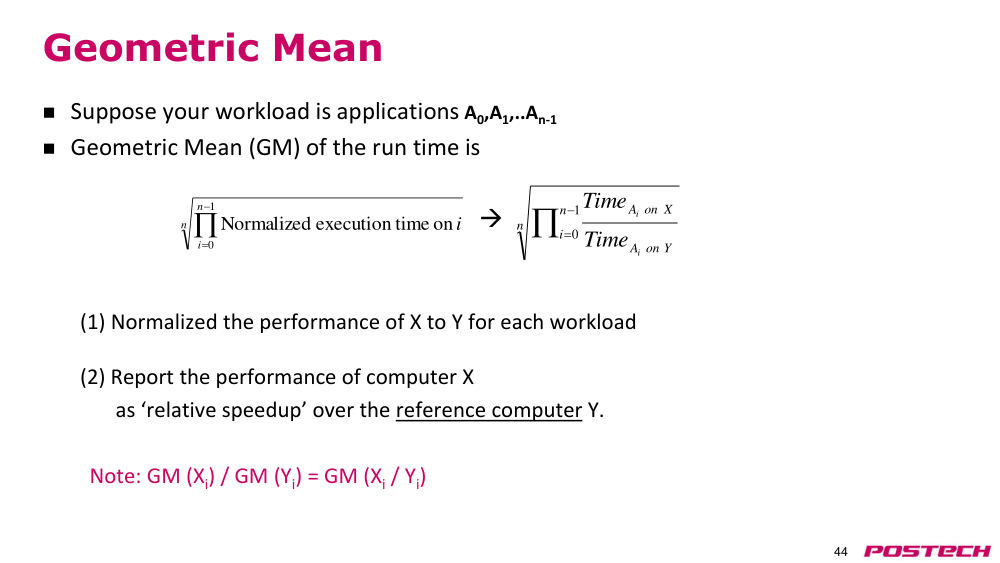
- 작업부하(workload)가 응용프로그램 A0, A1, ..., An-1로 구성된다고 가정하자.
- 실행 시간의 기하 평균(GM)은 다음과 같다.
- 1. 각 작업부하에 대해 컴퓨터 X의 성능을 Y에 대해 정규화한다.
- 2. 참조 컴퓨터 Y에 대한 상대적인 성능 향상(relative speedup)으로 컴퓨터 X의 성능을 보고한다.
- 참고: GM(Xi) / GM(Yi) = GM(Xi / Yi)
p.45조화 평균
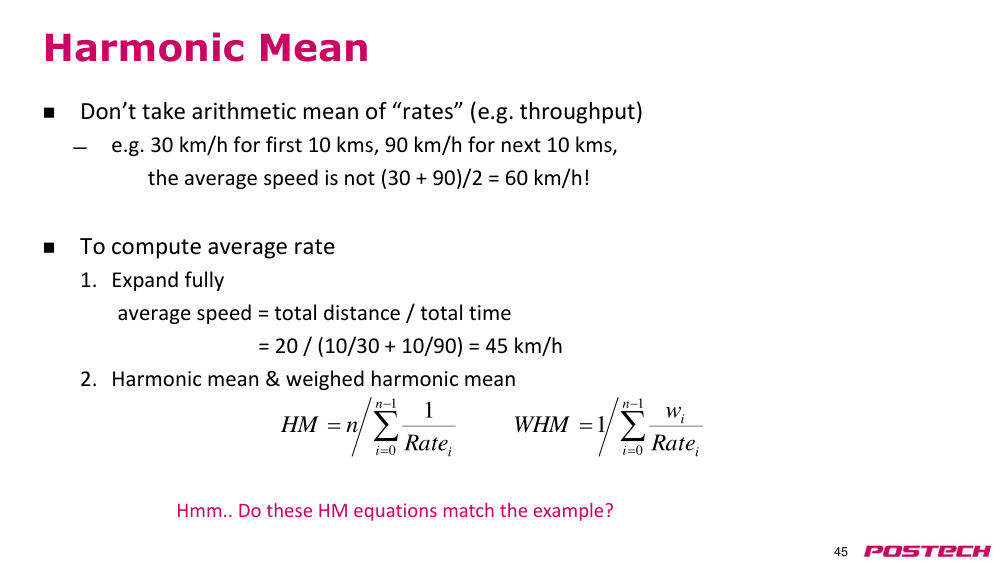
- "속도"(예: 처리량)의 산술 평균을 취하지 마라.
- 예: 처음 10km는 30km/h, 다음 10km는 90km/h일 때, 평균 속도는 (30 + 90)/2 = 60km/h가 아니다!
- 평균 속도를 계산하기 위해:
- 1. 전체적으로 전개한다.
- 평균 속도 = 총 거리 / 총 시간 = 20 / (10/30 + 10/90) = 45km/h
- 2. 조화 평균 및 가중 조화 평균
- 조화 평균(HM):
- 가중 조화 평균(WHM):
- 이 조화 평균 식이 예시와 일치하는가?
p.46IPC에 대해 조화 평균을 사용하는 이유
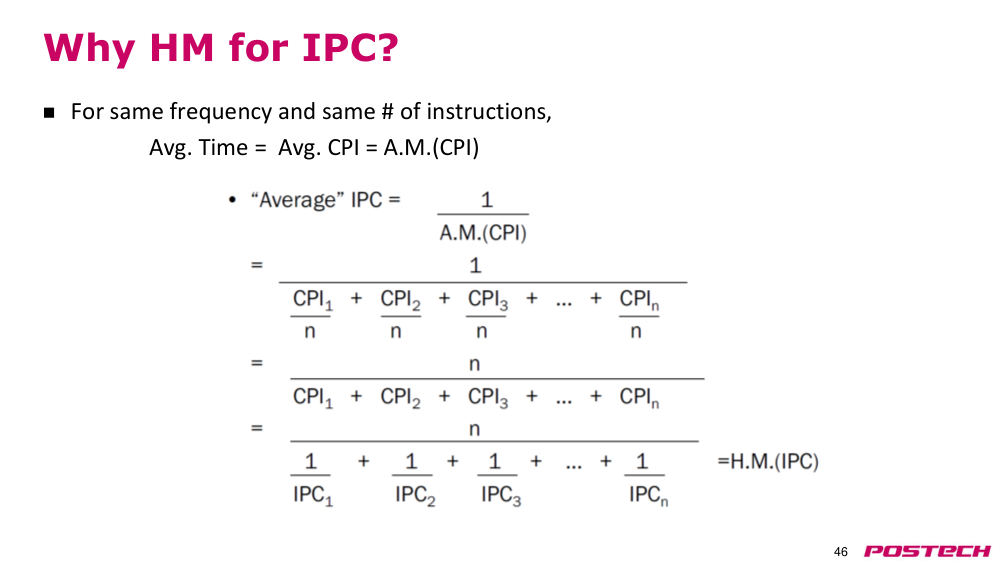
- 동일한 주파수와 동일한 지시어 수를 가진 경우,
- 평균 시간 = 평균 CPI = CPI의 산술 평균(A.M.)
p.47표준 벤치마크
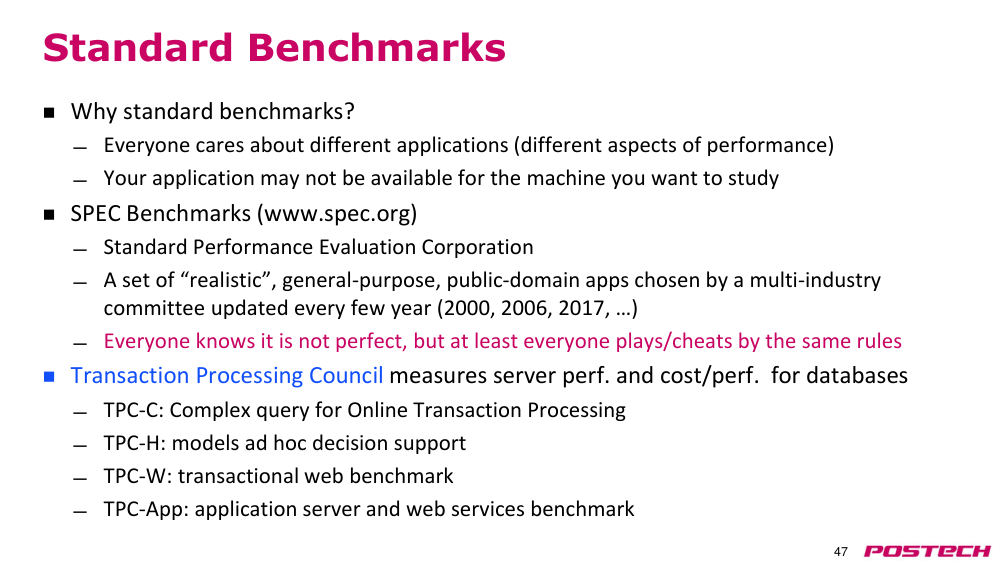
- 왜 표준 벤치마크가 필요한가?
- 모든 사람들은 다른 응용프로그램(성능의 다른 측면)에 관심이 있다.
- 연구하려는 기계에서 당신의 응용프로그램을 사용할 수 없을 수 있다.
- SPEC 벤치마크(www.spec.org)
- Standard Performance Evaluation Corporation(표준 성능 평가 기구)
- 다수 산업 위원회가 선정한 "현실적인", 일반 목적의, 공개 도메인 응용프로그램 모음으로, 몇 년마다 업데이트된다(2000, 2006, 2017, ...)
- 완벽하지 않다는 것은 모두 알고 있지만, 적어도 모두 같은 규칙으로 게임을 하거나 조작한다.
- 거래 처리 협회(Transaction Processing Council)는 데이터베이스의 서버 성능 및 비용-성능을 측정한다.
- TPC-C: 온라인 거래 처리를 위한 복잡한 쿼리
- TPC-H: 즉석 의사결정 지원을 모델링
- TPC-W: 거래형 웹 벤치마크
- TPC-App: 애플리케이션 서버 및 웹 서비스 벤치마크
p.48SPEC CPU 벤치마크 세트(SPEC CPU2017)
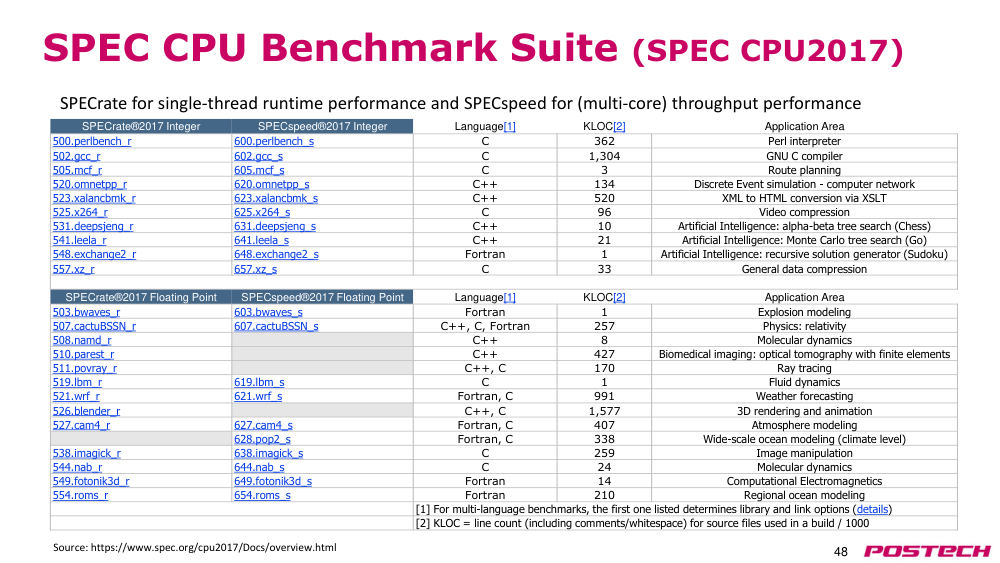
- SPECrate® 2017 정수
- SPECspeed® 2017 정수
- 언어[1]
- KLOC[2]
- 응용 분야
- 500.perlbench_r
- 600.perlbench_s
- C
- 362
- Perl 인터프리터
- 502.gcc_r
- 602.gcc_s
- C
- 1,304
- GNU C 컴파일러
- 505.mcf_r
- 605.mcf_s
- C
- 3
- 경로 계획
- 520.omnetpp_r
- 620.omnetpp_s
- C++
- 134
- 이산 사건 시뮬레이션 - 컴퓨터 네트워크
- 523.xalancbmk_r
- 623.xalancbmk_s
- C++
- 520
- XSLT를 통한 XML에서 HTML로 변환
- 525.x264_r
- 625.x264_s
- C
- 96
- 비디오 압축
- 531.deepsjeng_r
- 631.deepsjeng_s
- C++
- 10
- 인공지능: 알파-베타 트리 탐색(체스)
- 541.leela_r
- 641.leela_s
- C++
- 21
- 인공지능: 몬테카를로 트리 탐색(고)
- 548.exchange2_r
- 648.exchange2_s
- Fortran
- 1
- 인공지능: 재귀적 해 생성기(Sudoku)
- 557.xz_r
- 657.xz_s
- C
- 33
- 일반 데이터 압축
- SPECrate® 2017 부동소수점
- SPECspeed® 2017 부동소수점
- 언어[1]
- KLOC[2]
- 응용 분야
- 503.bwaves_r
- 603.bwaves_s
- Fortran
- 1
- 폭발 모델링
- 507.cactuBSSN_r
- 607.cactuBSSN_s
- C++, C, Fortran
- 257
- 물리학: 상대성 이론
- 508.namd_r
- C++
- 8
- 분자 역학
- 510.parest_r
- C++
- 427
- 생물의학 영상: 유한 요소를 통한 광학 토모그래피
- 511.povray_r
- C++, C
- 170
- 레이 트레이싱
- 519.lbm_r
- 619.lbm_s
- C
- 1
- 유체 역학
- 521.wrf_r
- 621.wrf_s
- Fortran, C
- 991
- 기상 예보
- 526.blender_r
- C++, C
- 1,577
- 3D 렌더링 및 애니메이션
- 527.cam4_r
- 627.cam4_s
- Fortran, C
- 407
- 대기 모델링
- 628.pop2_s
- Fortran, C
- 338
- 광범위한 해양 모델링(기후 수준)
- 538.imagick_r
- 638.imagick_s
- C
- 259
- 이미지 조작
- 544.nab_r
- 644.nab_s
- C
- 24
- 분자 역학
- 549.fotonik3d_r
- 649.fotonik3d_s
- Fortran
- 14
- 계산 전자기학
- 554.roms_r
- 654.roms_s
- Fortran
- 210
- 지역 해양 모델링
- [1] 다중 언어 벤치마크의 경우, 나열된 첫 번째 언어가 라이브러리 및 링크 옵션을 결정한다(세부 사항)
- [2] KLOC = 줄 수(줄 수)
p.49질문?
- 추천 독서:
- • 교재 부록 C.1 – C.6 (모든 부록은 온라인에서도 이용 가능)
- • "RISC(축소 명령어 집합)에 대한 근거", Patterson, Ditzel, 1980
- • "RISC(축소 명령어 집합)에 대한 근거"에 대한 의견, Clark, Strecker, 1980
- • "하드웨어 구성이 유사한 RISC와 CISC의 성능 비교", Bhandarkar, Clark, 1991